


Lyra 2.0: Explorable Generative 3D Worlds 요약 설명
14 Apr 2026 | Paper Review 3D Scene Generation Long-Horizon Video Generation Spatial Memory Self-Augmentation목차
이번 글에서는 Lyra 2.0: Explorable Generative 3D Worlds 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 14일(Arxiv)
- Shen, Tianchang, Bahmani, Sherwin, He, Kai, Srinivasan, Sangeetha Grama, Cao, Tianshi, Ren, Jiawei, Li, Ruilong, Wang, Zian, Sharp, Nicholas, Gojcic, Zan, et al.
- NVIDIA
- 논문 링크
요약
- Lyra 2.0: Explorable Generative 3D Worlds는 이미지 1장에서 카메라 궤적으로 제어하는 비디오를 생성하고, 이를 명시적인 3D 환경으로 재구성한다. 이전에 관측한 영역이 컨텍스트 윈도우를 벗어나면서 발생하는 공간적 망각과 자기회귀 생성 오류가 누적되면서 발생하는 시간적 드리프트를 다룬다.
- 이 방법은 프레임별 기하 정보를 독립적으로 저장한다. 융합한 전역 재구성 결과를 렌더링해 공간 메모리 조건으로 사용하는 대신, 관련된 과거 이미지를 검색하고 조밀한 기하 대응 관계로 어텐션을 유도한다. FramePack과 가벼운 자기 증강 학습으로 드리프트를 줄이며, 생성 비디오로 미세 조정한 재구성 모델을 통해 적은 수의 3D Gaussians와 표면 메시를 만든다.
- DL3DV와 Tanks and Temples에서 전체 모델은 비교한 기준 모델보다 외관 지표가 좋고, 제시된 재구성 장면 지표에서도 가장 좋은 성능을 보인다. 다만 카메라 제어와 재투영 오차는 GEN3C가 더 좋다. 4단계 증류 모델은 NVIDIA GB200 GPU 1대에서 80프레임 구간의 생성 시간을 약 194초에서 15초로 줄인다. 품질과 일관성의 상충 관계는 데이터셋에 따라 다르다. 이 프레임워크는 정적 환경을 대상으로 하며, 학습 데이터의 노출 불일치를 재현할 수 있다.
1. Introduction
생성 기반 재구성은 실제 환경을 조밀하게 촬영하는 대신 새로운 시점의 영상을 생성한 뒤, 이를 명시적인 기하 구조로 변환한다. 이 방식을 여러 방이나 거리를 따라 확장하려면 인접 프레임 사이의 일관성만으로는 부족하다. 시점이 크게 바뀌거나 이전 위치를 다시 방문해도 같은 장면을 유지해야 한다.
- 공간적 망각이 발생하면 컨텍스트가 제한된 모델은 이전에 관측한 구조를 다시 만들어야 한다. 시간적 드리프트는 자기회귀 오류가 누적되면서 색상, 텍스처, 기하 구조를 점차 바꾼다.
- 융합한 3D 메모리는 렌더링한 조건 입력을 통해 재구성 오류를 증폭할 수 있다. 반면 과거 이미지에 카메라 임베딩만 제공하면 여러 시점 사이의 대응 관계를 추론하는 일을 self-attention에 맡기게 된다.
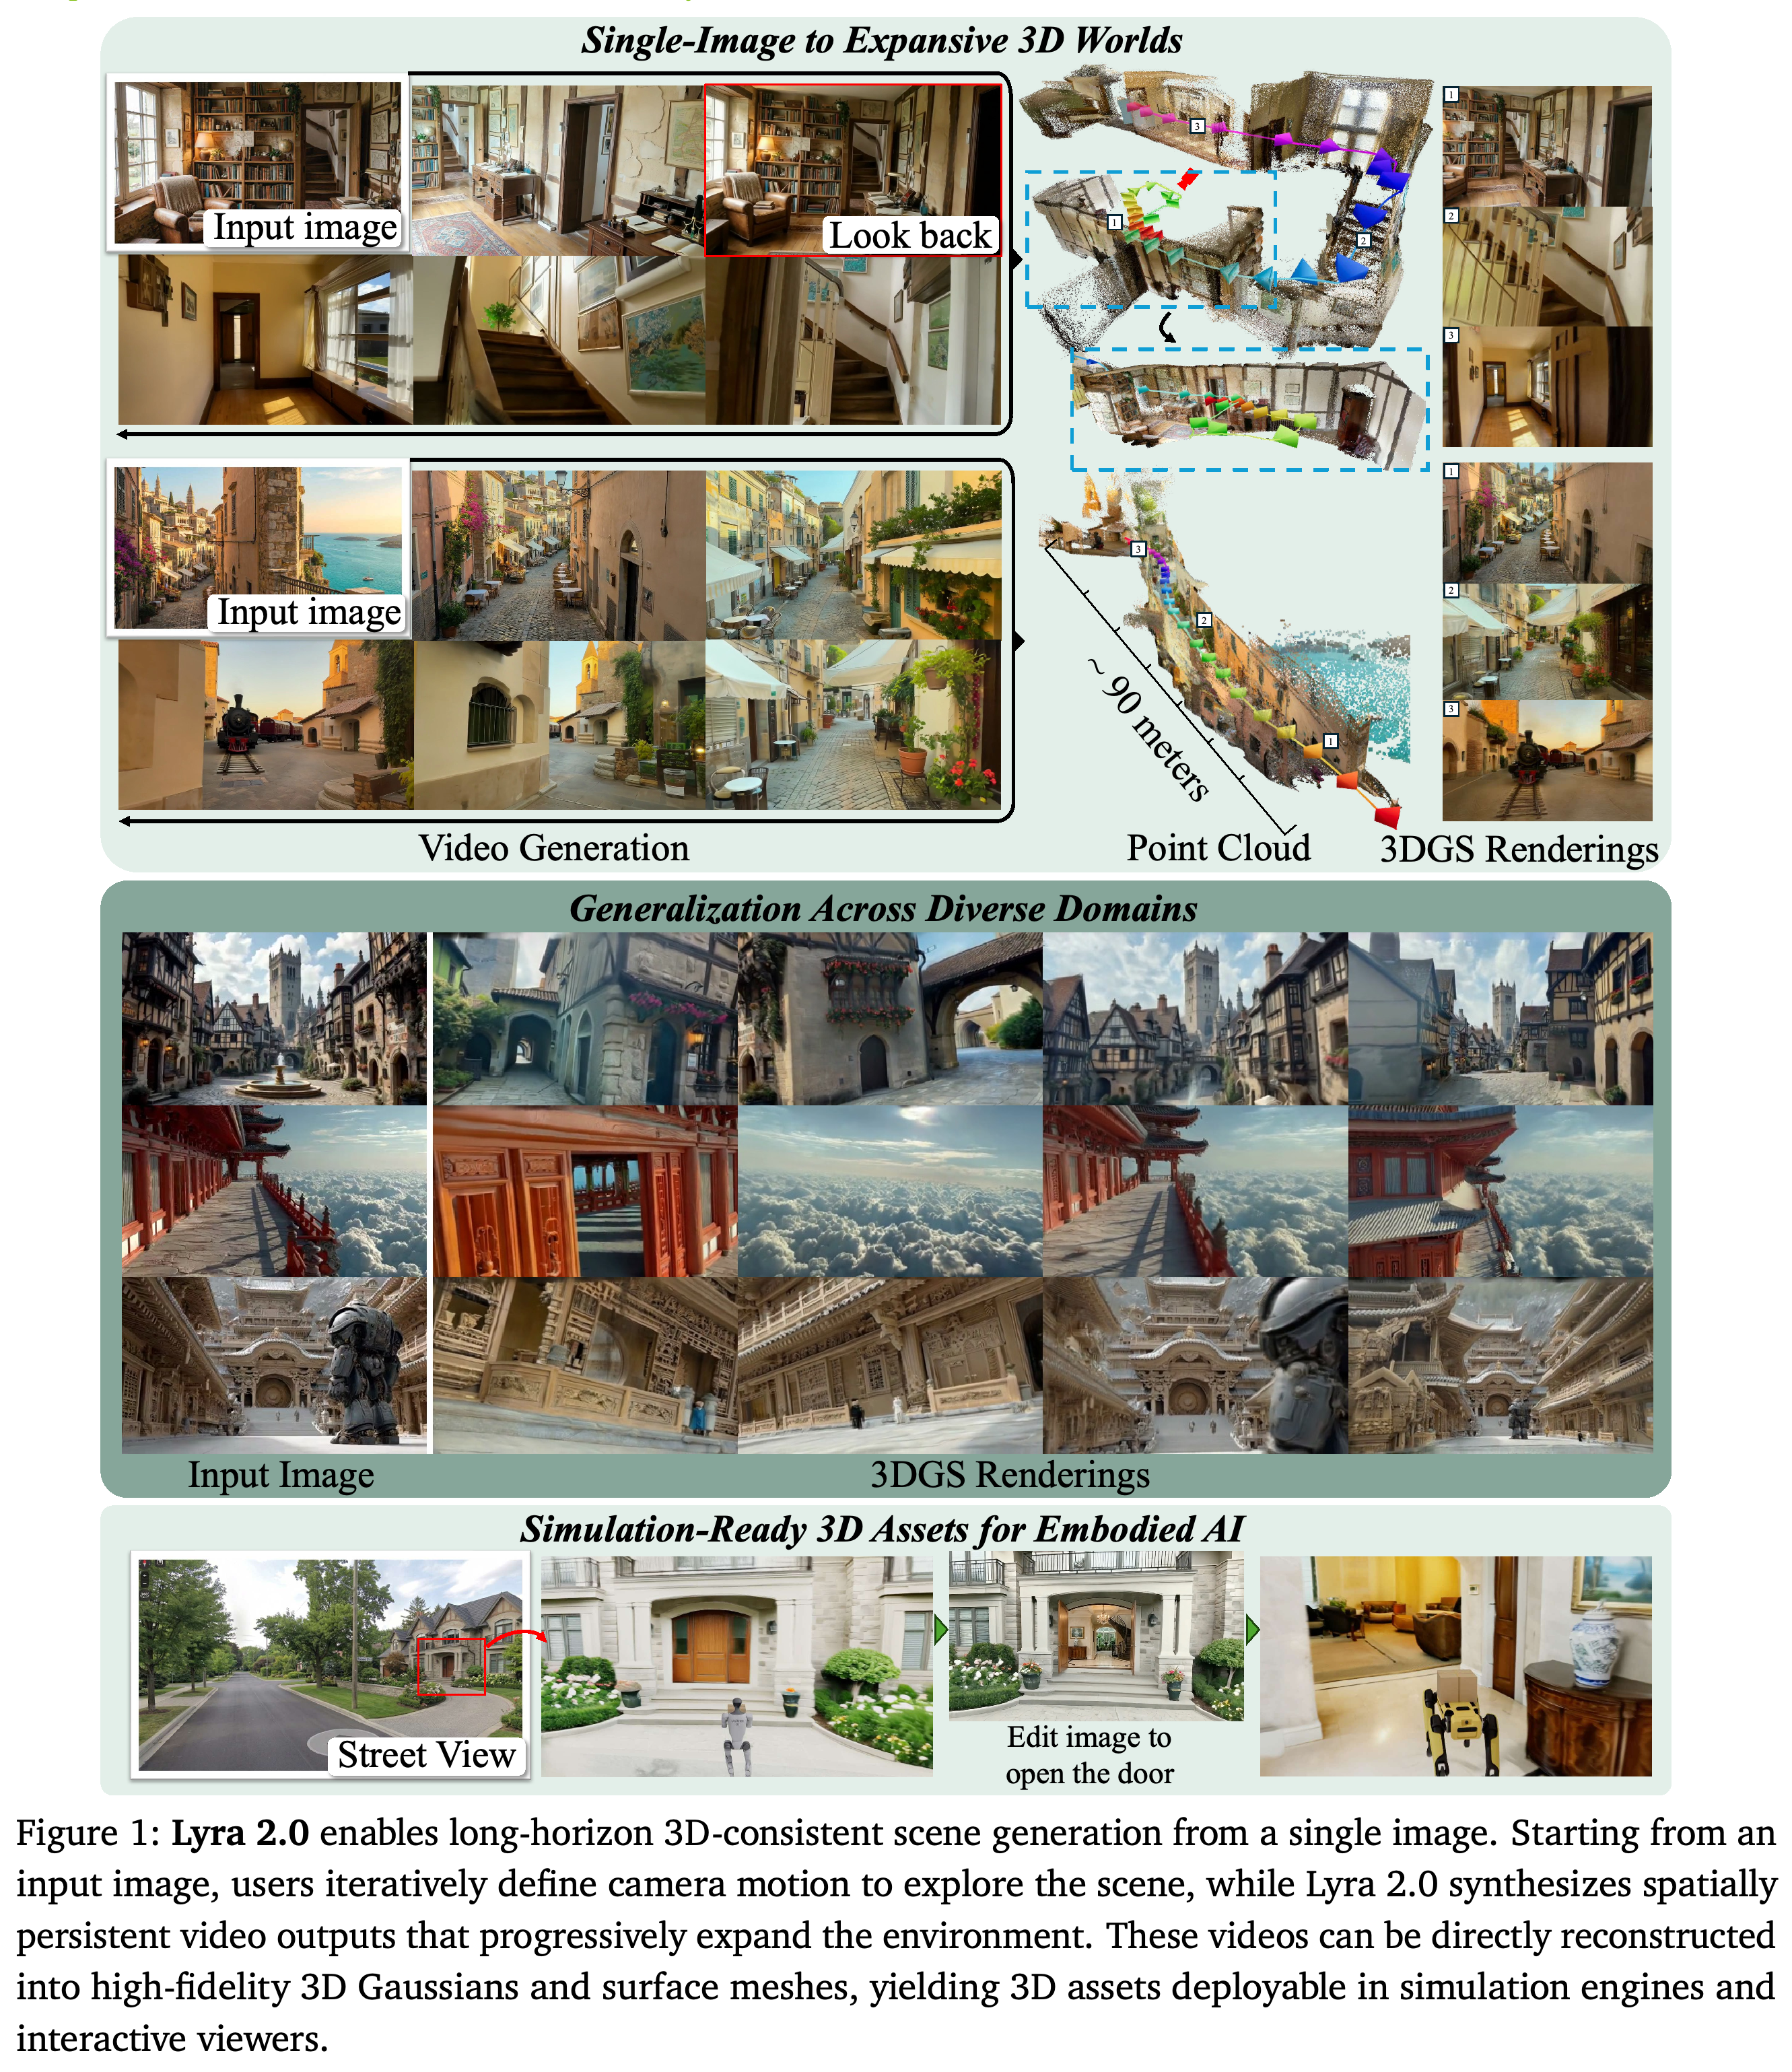
- Figure 1은 실내에서 이전 위치를 돌아보는 사례, 약 90미터에 걸친 실외 사례, 다양한 시각 도메인, 시뮬레이션용 자산을 보여준다. 프로젝트 URL은 https://research.nvidia.com/labs/sil/lyra2/이다.
실내 시퀀스에는 시작한 방을 돌아보는 장면이 포함되며, 실외 사례는 약 90미터로 표시된 궤적을 따라 확장된다. 함께 제시한 포인트 클라우드 뷰와 3DGS 렌더링은 비디오 탐색이 명시적인 장면 자산으로 이어지는 과정을 보여준다. 다양한 도메인과 시뮬레이션 사례는 활용 범위를 정성적으로 보여주지만, 일반화나 물리적 타당성을 측정하지는 않는다.
2. Related Work
관련 연구는 카메라 조건부 비디오 생성, 메모리를 활용한 장기 비디오 생성, 3D 장면 생성을 다룬다. Lyra 2.0은 이미지 검색과 기하 대응 관계에 기반한 조건 입력을 결합하면서, 공간 메모리에 단일 융합 기하 표현을 사용하지 않는다.
- 카메라 제어 방법은 포즈 벡터, Plücker rays, 이산 행동, 구조화된 3D 렌더링을 사용한다. GenWarp의 대응 관계 기반 조건 입력은 단일 이미지 diffusion에 한정된다.
- 장기 비디오용 메모리 방법은 과거 관측을 검색하거나, 명시적인 3D 장면 표현을 누적하거나, 내부 잠재 상태와 key–value 캐시를 유지한다. FramePack은 시간적 근접성에 따라 과거 정보를 컨텍스트 슬롯으로 압축한다.
- 기존 생성 기반 재구성 시스템은 합성한 시점 영상과 feed-forward 재구성을 결합하지만, 대체로 시점 범위가 제한된다. Lyra 2.0은 긴 카메라 궤적을 따라 장면을 점진적으로 확장한다.
3. Preliminaries
비디오 생성기는 Wan 2.1 causal VAE의 잠재 공간에서 DiT를 사용한다. 공간 다운샘플링은 8배, 시간 다운샘플링은 4배이며, 잠재 채널은 16개다. Flow matching은 (z_t=(1-t)z_0+t\epsilon)를 구성하고, 네트워크가 속도 (\epsilon-z_0)를 예측하도록 학습한다.
- 입력 프레임이 F개일 때 잠재 표현의 시간축 길이는 F′ = ⌊(F − 1)/4⌋ + 1이다. 첫 프레임은 독립적으로 인코딩하고, 이후 프레임은 시간축으로 압축한다.
- 가장 최근 프레임을 깊이로 워핑한 조건 입력은 카메라 제어에 사용된다. 그러나 시점이 크게 바뀌어 목표 시점에 투영되는 픽셀이 없으면 이 신호가 사라진다. 픽셀별 6D Plücker rays가 보완적인 카메라 정보를 제공한다.
- FramePack 배치는 초기 이미지 앵커인 f1k1, 시간 슬롯인 f16k4 f2k2 f1k1, 생성 목표인 g20으로 구성된다. 여기서 fnkm은 공간 서브샘플링 계수 m을 적용한 잠재 프레임 n개를 뜻한다. g20은 구현에서 사용하는 80프레임 비디오 구간에 해당한다.
4. Method
이 방법은 장기 비디오 생성과 명시적인 3D 재구성을 결합한다. 공간 메모리에서는 기하 정보로 유용한 관측을 찾고 정렬한다. 비디오 모델은 검색한 이미지와 학습한 사전 지식을 바탕으로 외관을 합성한다.
4.1. Overview
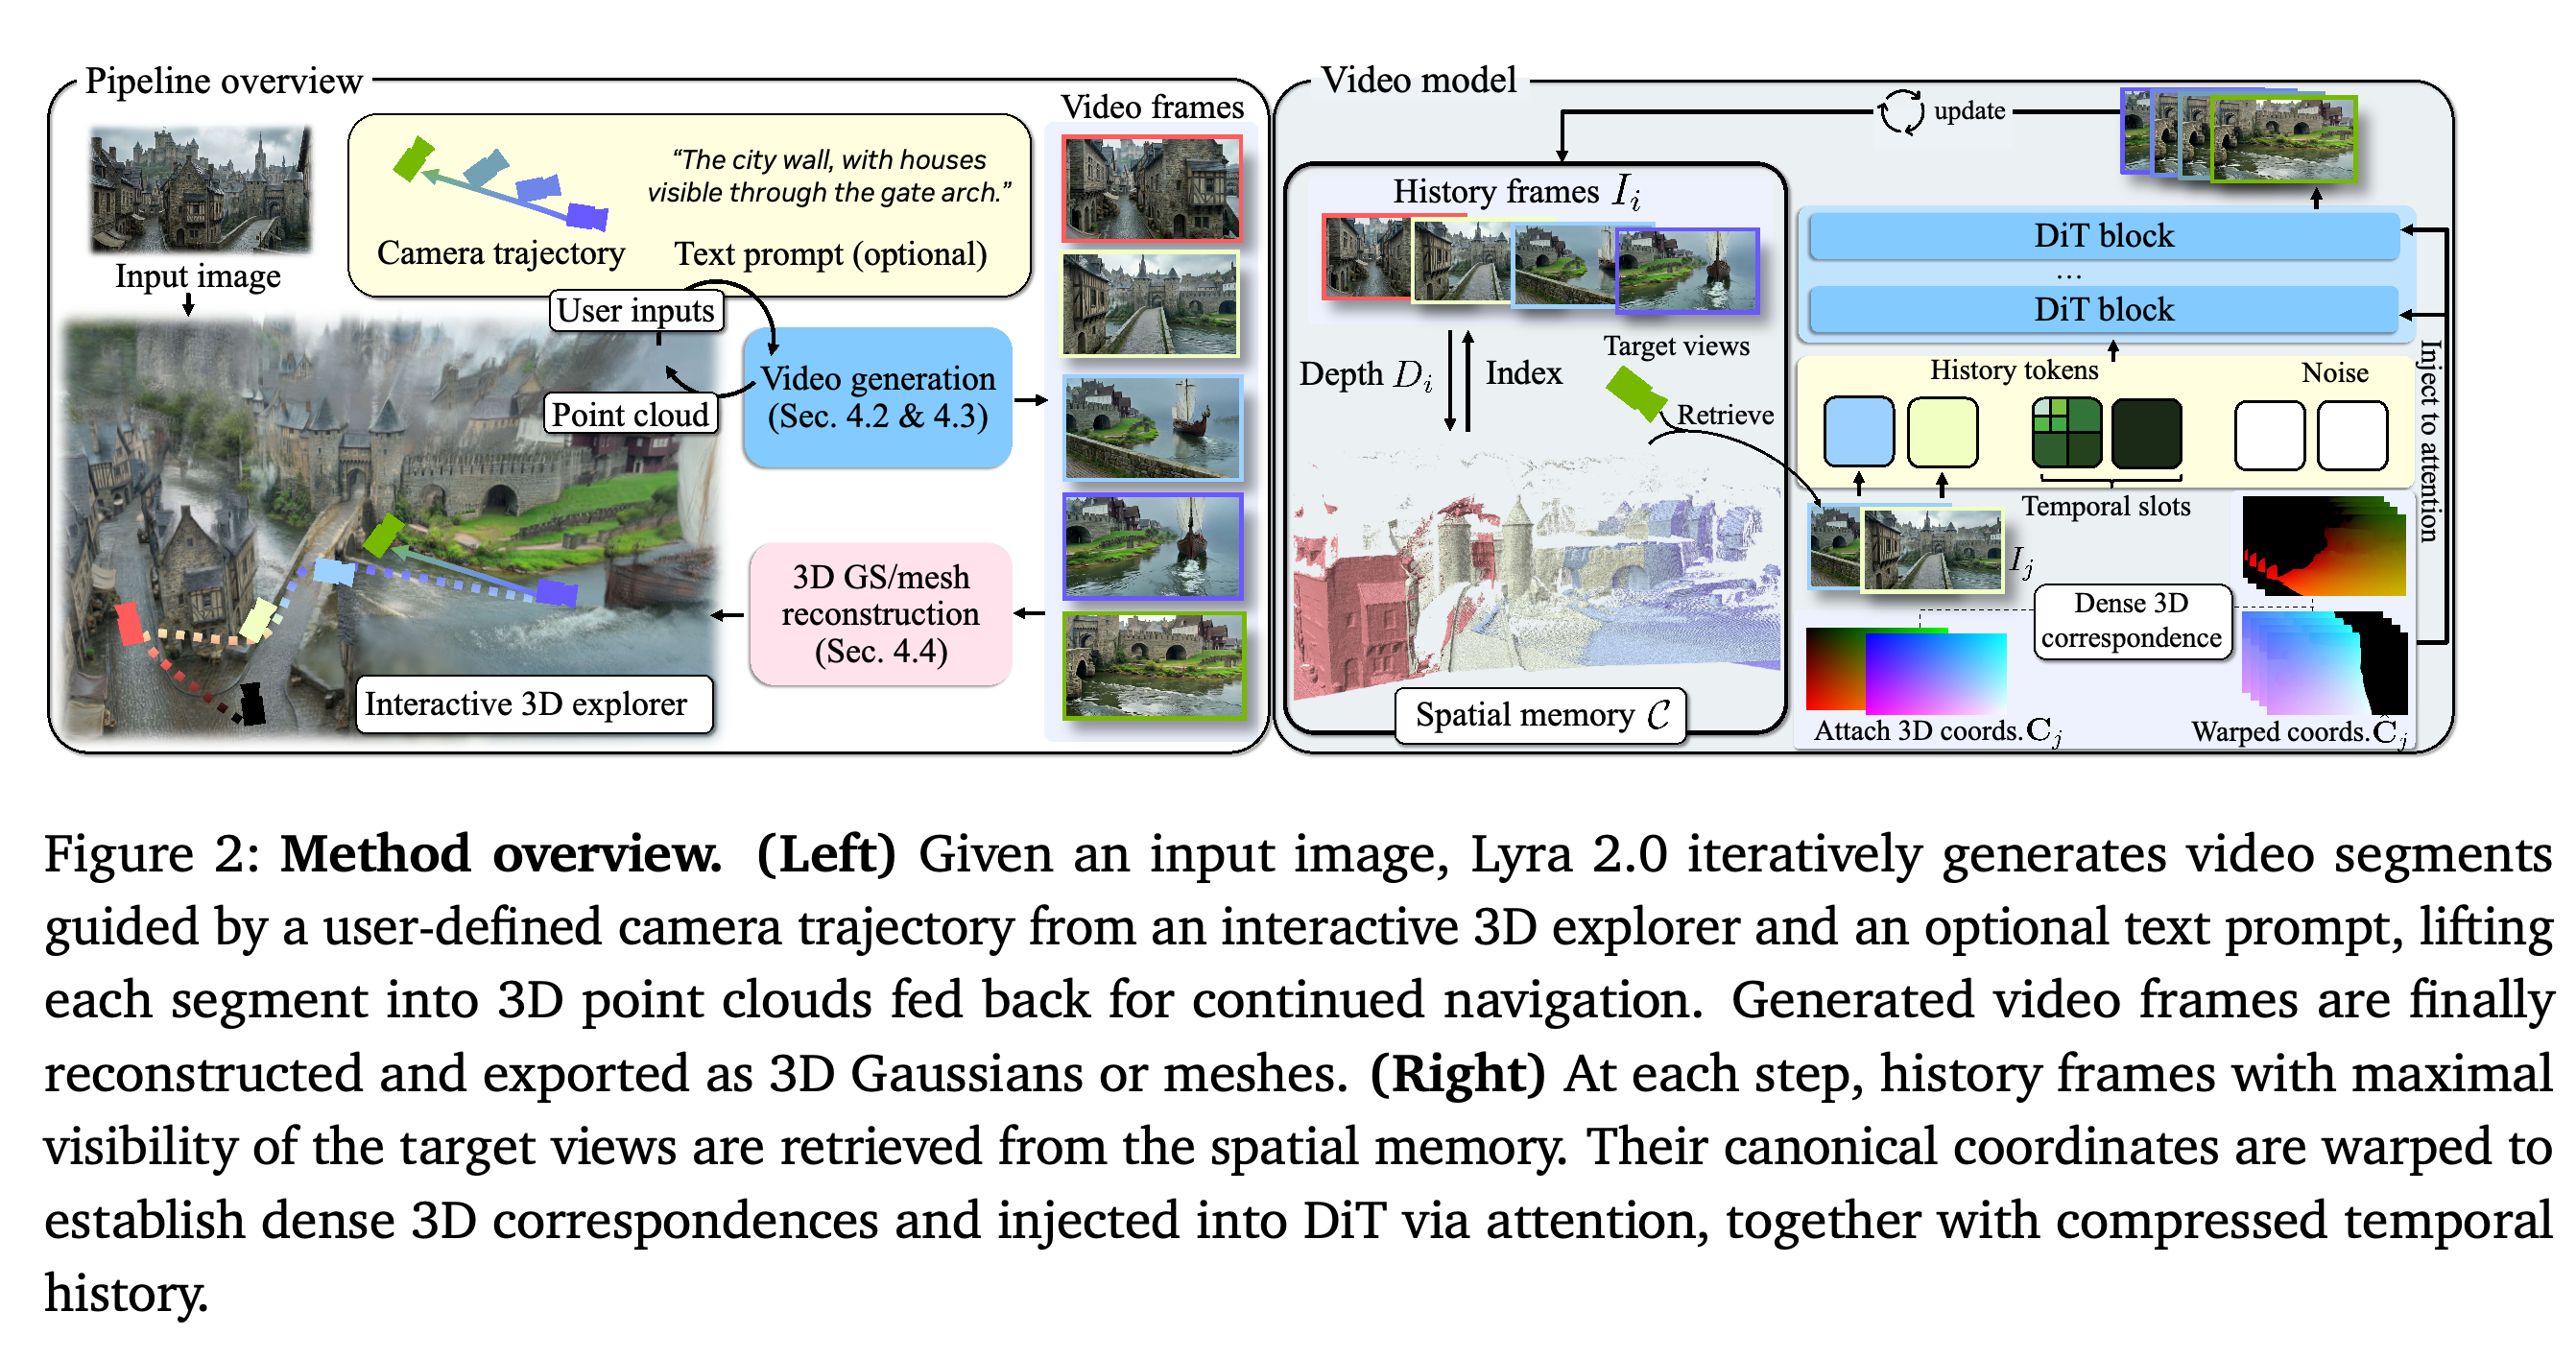
원문의 ‘Lyra 2.0 runs’는 입력 이미지와 사용자가 지정한 카메라 궤적에서 시작해 자기회귀 방식으로 검색–생성–갱신을 반복 실행하는 과정을 설명한다. Figure 2는 검색한 공간 컨텍스트와 압축한 시간 이력이 새 구간의 조건 입력으로 사용되는 과정을 보여준다. 이후 생성 프레임과 추정한 기하 정보로 메모리를 확장한다.
- 사용자는 선택적으로 텍스트 프롬프트를 제공해 outpainting을 유도하고, 대화형 3D 탐색기에서 다음 궤적을 계획할 수 있다.
- 점점 확장되는 메모리는 시간 컨텍스트 윈도우 밖의 영역을 다시 방문할 수 있게 한다. 생성 비디오는 3D Gaussians나 메시로 재구성한다.
- 이 구조에서는 구간이 이어질 때마다 메모리를 확장할 수 있다. 다만 유한한 길이의 실험만으로는 논문이 주장하는 임의로 긴 궤적의 일관성을 입증할 수 없다.
도식은 확장되는 공간 메모리, 비디오 생성기, 최종 재구성을 구분한다. 검색한 이미지는 외관을 전달하고, 워핑한 정준 좌표는 대응 관계 기반 어텐션을 유도하며, 시간 슬롯은 최근 이력을 제공한다. 이렇게 분리하면 융합한 전역 기하 구조를 공간 메모리 조건 입력으로 렌더링하지 않고도, 시간 윈도우 밖의 관측을 재방문에 활용할 수 있다.
4.2. Anti-Forgetting for 3D-Persistent Video Generation
Building the 3D Cache에서는 각 프레임의 원본 해상도 깊이와 카메라 매개변수를 다운샘플링한 월드 좌표계 포인트 클라우드와 함께 저장한다. 원본 해상도 깊이는 대응 관계 계산에, 작은 포인트 클라우드는 검색에 사용한다.
- 공간 메모리에서는 프레임별 포인트 클라우드를 단일 전역 포인트 클라우드로 융합하지 않는다. 이를 통해 공통 재구성 결과에 여러 시점 사이의 정렬 오차가 누적되는 문제를 피한다.
- 생성 이미지에서 얻은 불완전한 깊이 추정치를 각각 분리해 둔다. 따라서 그 오류를 향후 조건 입력에 사용하는 기하 정보에 통합하지 않는다.
Geometry-Aware Retrieval은 목표 시점에서 보이는 3D 내용을 기준으로 과거 관측의 순위를 정한다. 점을 목표 이미지 평면에 투영한 뒤, 프레임 전체에서 얻은 최소 투영 깊이와 비교한다. 깊이 차이가 가림 임계값보다 작을 때만 그 점을 보이는 점으로 판단한다.
- 학습에서는 보이는 점의 수에 비례해 과거 프레임을 샘플링한다. 이를 통해 생성기가 다양한 검색 결과를 접하게 한다.
- 추론에서는 아직 덮이지 않은 목표 픽셀을 가장 많이 덮는 프레임을 탐욕적으로 선택한다. 중복 시점을 줄이고 선택한 프레임 전체의 커버리지를 최대화한다.
- 시스템은 N_s = 5개의 프레임을 검색하며, 포인트 클라우드 서브샘플링 계수는 d = 8이다. δ = 0.1은 정규화된 깊이 단위로 설정한다.
Injecting Spatial Memory into the Video Model에서는 검색한 이미지를 각각 VAE로 인코딩하고, 시간 슬롯과 함께 공간 슬롯에 배치한다. 정준 좌표 맵은 정규화된 픽셀 위치와 검색 프레임의 식별 정보를 인코딩한다. 이후 깊이를 사용해 순방향 워핑함으로써 RGB 외관을 전달하지 않고 목표 시점과 과거 관측 사이의 대응 관계를 구성한다.
- 전체 배치는 앵커인 f1k1, 공간 슬롯인 f4k2 f1k1, 시간 슬롯인 f16k4 f2k2 f1k1, 생성 목표인 g20으로 구성된다. 검색 프레임이 부족하면 패딩한다.
- 각 정준 좌표 맵은 (u, v, 2j/N_s − 1) 채널을 가지며, 워핑한 깊이가 4번째 채널을 추가한다. 학습한 임베딩은 모든 DiT 블록의 query와 key에 주입되어 self-attention을 유도한다. value 투영은 바꾸지 않는다.
- 좌표 워핑은 RGB 워핑 아티팩트가 공간 메모리 조건 입력에 직접 들어가는 것을 피한다. 별도의 카메라 제어 모듈에서는 여전히 가장 최근 RGB 프레임을 깊이로 워핑한다.
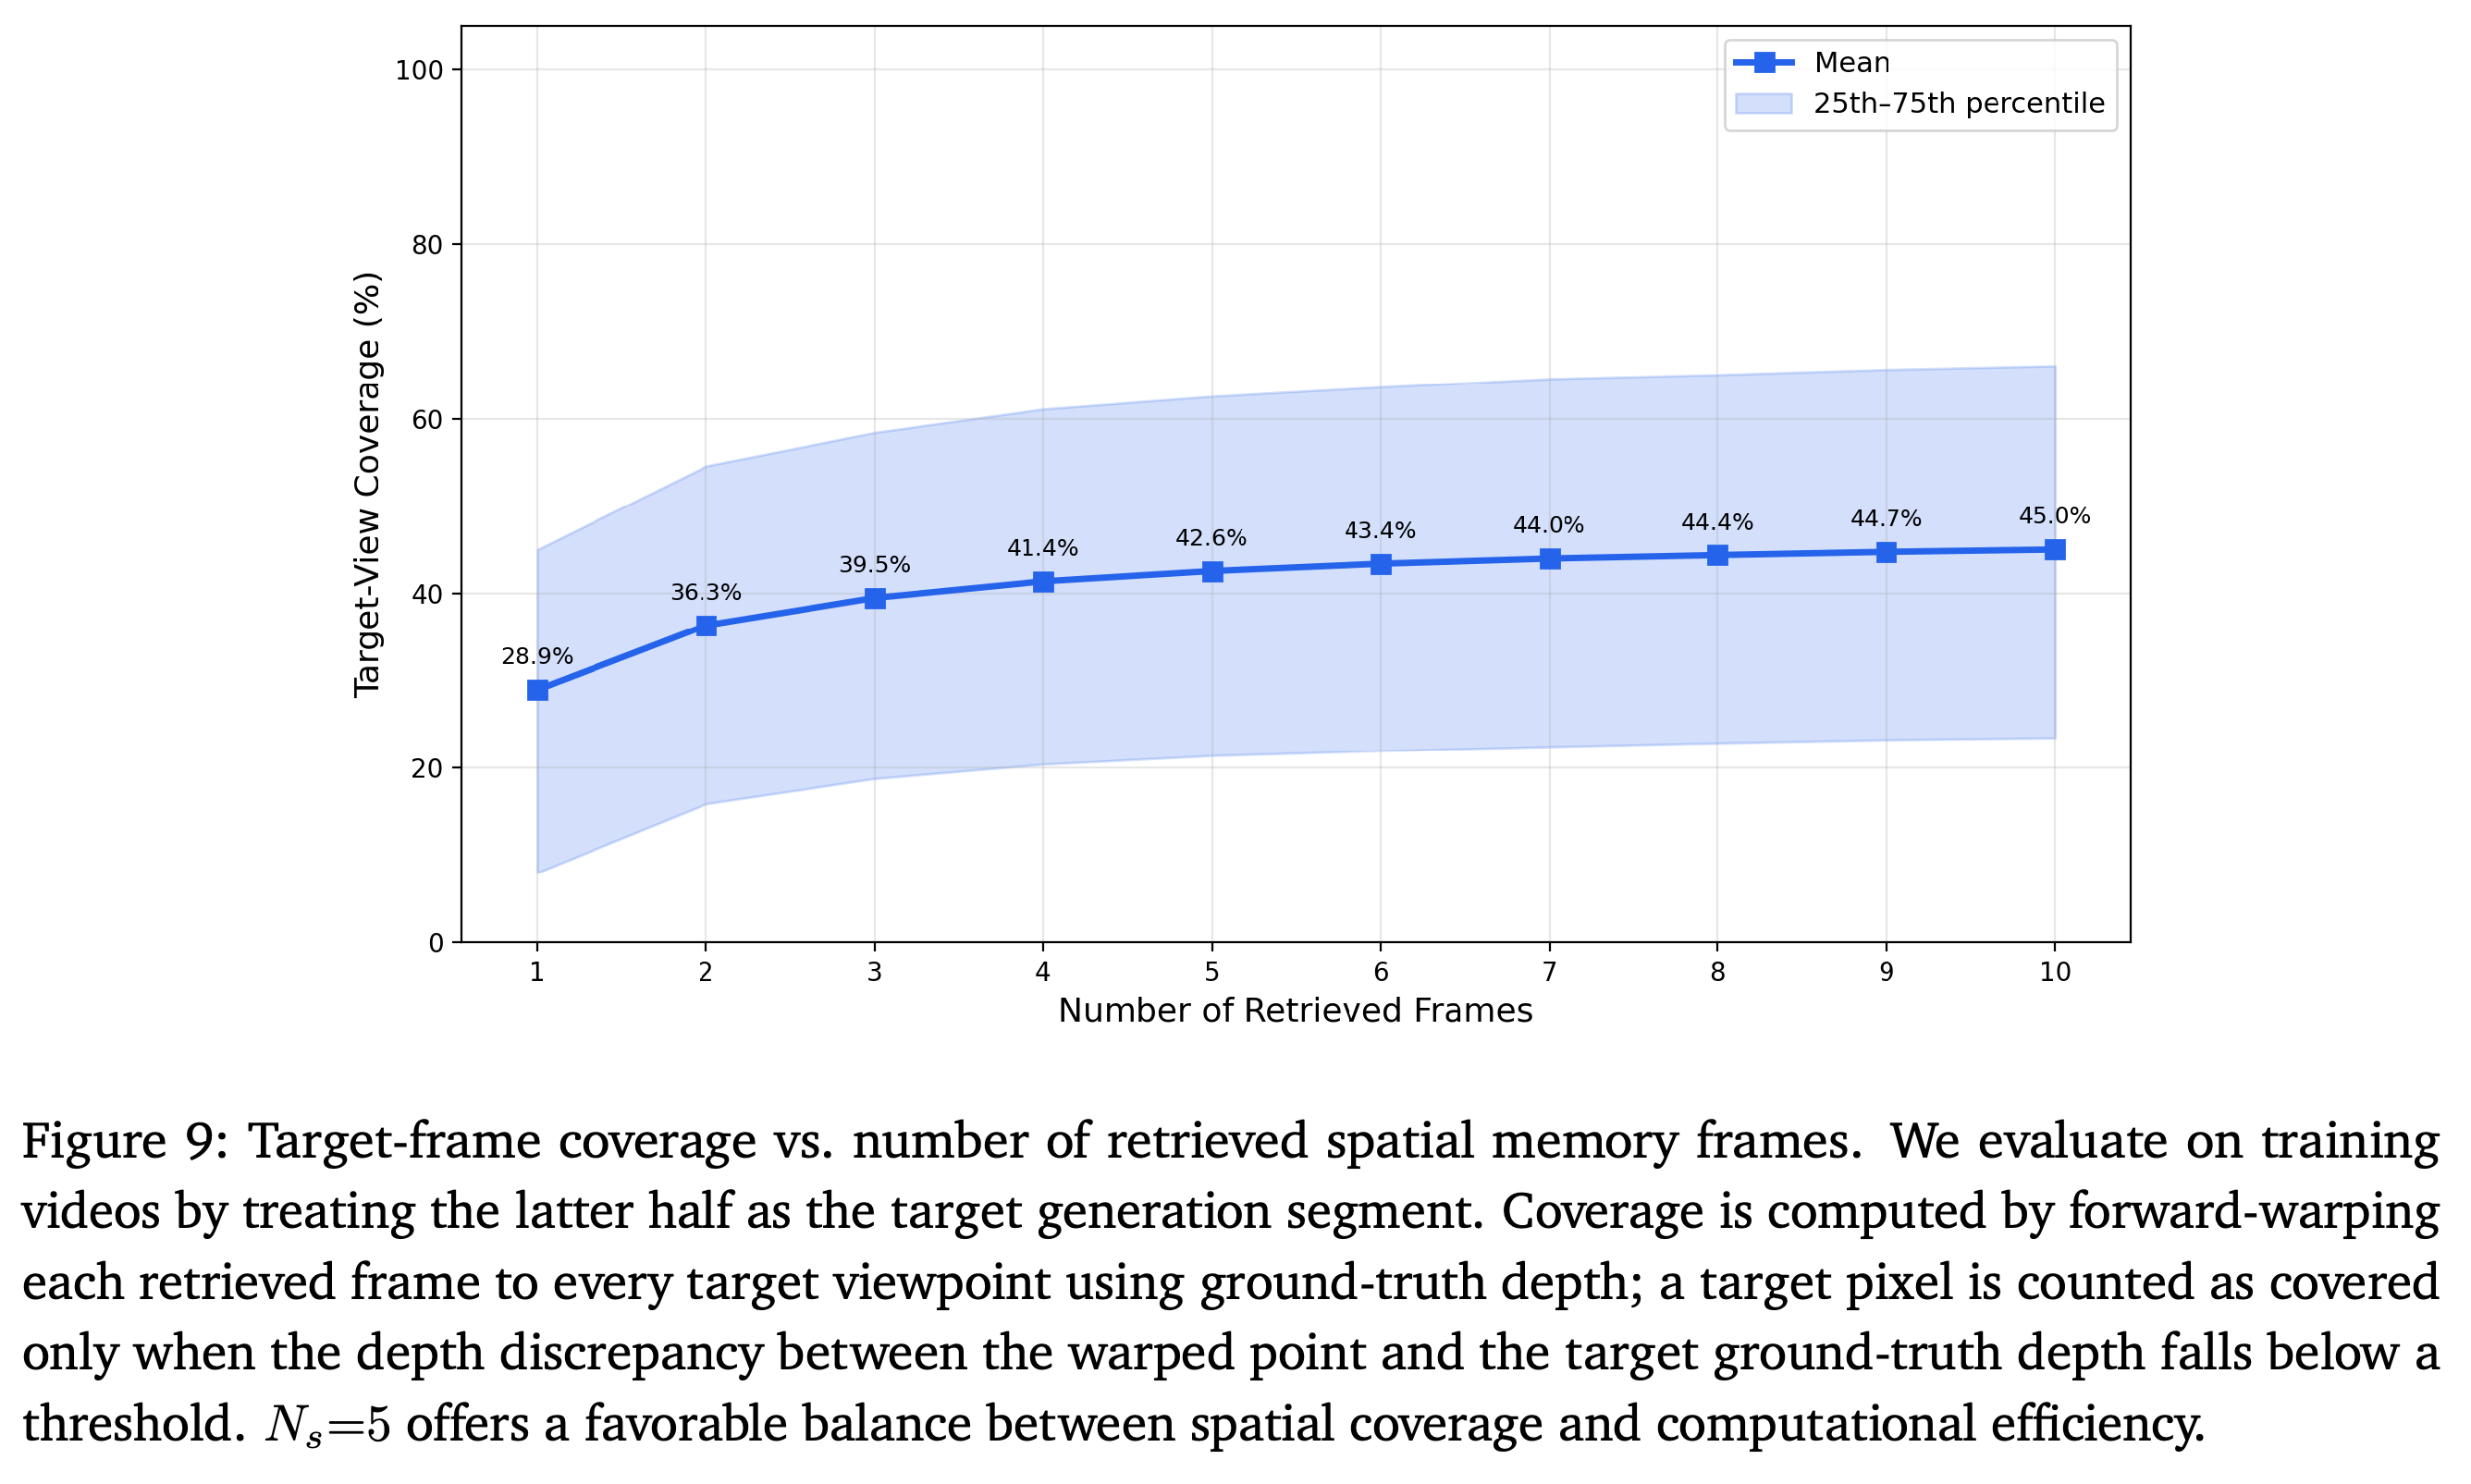
- Figure 9는 5개 슬롯을 선택한 근거를 보여준다. 검색 프레임이 5개일 때 평균 목표 시점 커버리지는 42.6%이며, 10개일 때는 45.0%다. 프레임 수를 늘릴수록 커버리지 증가 폭이 줄어든다.
평균 커버리지는 검색 프레임이 하나일 때 28.9%, 다섯일 때 42.6%, 열일 때 45.0%로 증가하며, 25th–75th 백분위 구간의 폭이 넓다. 정답 깊이를 사용한 이 테스트는 슬롯 다섯 개를 넘어가면 커버리지 증가 폭이 줄어든다는 근거를 제공한다. 다만 생성 비디오 품질이나 검색 실행 시간을 직접 측정하지는 않는다.
4.3. Anti-Drifting for Long-Horizon Video Generation
Self-Augmentation Training은 관측 편향을 다룬다. 일반적인 학습은 깨끗한 과거 관측을 조건으로 사용하지만, 추론은 불완전하게 생성한 과거 관측을 조건으로 사용한다. 이 방법은 p_aug = 0.7의 확률로 [0, 0.5]에서 t를 균등하게 샘플링하고 과거 잠재 표현을 손상시킨다. 이어서 1단계 디노이징을 수행해 모델 자체의 예측에서 불완전한 조건 입력을 얻는다.
- 손상된 과거 잠재 표현은 z_t^hist = (1 − t)z_0^hist + tε이며, 근사 복원 결과는 z̃_0^hist = z_t^hist − t·v_θ(z_t^hist, t, c)다.
- 현재 청크의 목표는 항상 깨끗한 과거 관측의 causal VAE 캐시를 사용해 인코딩한다. 따라서 모델은 손상된 DiT 조건 입력을 받더라도 깨끗한 목표를 복원해야 한다.
- 이 과정은 양방향 과거 구간마다 전체 다단계 생성을 수행하는 대신, 추가 DiT 순전파 1회만 요구한다. FramePack은 시간 컨텍스트를 확장하고, 자기 증강은 불완전한 과거 관측에서 복원하는 능력을 학습시킨다.
4.4. 3D Reconstruction
3D Reconstruction은 Depth Anything v3 (DAv3)를 생성 비디오의 해상도와 잔여 불일치에 맞게 조정한다. 고해상도 이미지 입력은 유지하면서 Gaussian DPT 헤드를 k × k로 다운샘플링해 예측 Gaussian 수를 k²배 줄인다. 생성 장면으로 미세 조정하면 생성 아티팩트에 더 잘 대응한다.
- 구현에서는 k = 2를 사용해 Gaussian 수를 4배 줄인다.
- Surface Mesh Extraction은 OpenVDB 기반 계층적 희소 격자를 사용한다. 생성 시점 근처에는 더 작은 셀을, 먼 영역에는 더 큰 셀을 배치한다.
- Gaussian 깊이의 중앙값과 깊이 기울기에서 구한 법선으로 방향 정보를 가진 점을 만들고, 이를 signed distance function 구성에 사용한다. Marching cubes로 표면을 추출한 뒤 계층 간 표면을 연결하고 폴리곤 수를 줄인다.
4.5. Distilled Model for Accelerated Inference
Distribution Matching Distillation은 학생 모델이 각 구간을 35단계 대신 4단계 디노이징으로 생성하도록 학습한다. Classifier-free guidance도 학생 모델에 증류해 조건부 및 무조건부 순전파를 따로 수행할 필요를 없앤다. 증류 중에도 자기 증강을 유지한다.
- 이 변경을 함께 적용하면 구간 생성 시간이 약 13배 줄어든다.
- 증류 모델은 구간 단위 탐색을 가속한다. 보고된 지연 시간과 품질의 상충 관계는 실험과 부록에서 자세히 다룬다.
5. Experiments
실험은 생성한 장기 비디오와 이를 재구성한 명시적 3D 장면을 평가한다. 제거 실험은 메모리와 드리프트 억제 구성 요소를 검증한다. 응용 사례는 대화형 탐색과 시뮬레이터 내보내기를 보여준다.
5.1. Training Details
학습에는 실제 환경의 긴 비디오 클립 10K개로 구성된 DL3DV를 사용한다. 카메라 포즈는 ViPE로 추정하고, 깊이는 Depth Anything V3로 예측하며, 캡션은 Qwen3-VL-8B-Instruct로 생성한다. 각 비디오에서 1,000프레임을 샘플링해 조건 입력과 목표를 구성한다.
- 30%의 확률로 수행하는 image-to-video 학습은 초기 이미지 1장에서 처음 L = 80개의 연속 프레임을 생성한다.
- 70%의 확률로 수행하는 자기회귀 학습은 s ∈ [0, S_max)를 샘플링하며, S_max = ⌊(T − 1)/L⌋ − 1이다. 과거 관측의 범위는 [0, s·L + 1)이며, 목표는 구간 s + 1에 속하는 다음 L개의 연속 프레임이다.
5.2. Evaluation on Long Video Generation
장기 비디오 평가는 도메인 내 테스트에 DL3DV-Evaluation을, 도메인 외 테스트에 Tanks and Temples를 사용한다. 기준 모델은 Yume-1.5, GEN3C, Context as Memory (CaM), VMem, SPMem, HY-WorldPlay다. CaM과 SPMem은 구현이 공개되지 않아 Wan2.1-14B로 재구현한다.
- SSIM, LPIPS, FID는 이미지 충실도와 외관 분포를 평가한다. WorldScore는 Subjective Quality, 첫 프레임과 마지막 프레임 사이의 Style Consistency, Camera Controllability를 제공한다.
- 재투영 오차는 기존 SLAM 시스템으로 추정한 프레임별 깊이를 사용해 기하 일관성을 평가한다.
- Yume-1.5와 HY-WorldPlay는 명시적인 카메라 궤적 조건 입력을 지원하지 않는다. Table 1에는 이 모델들의 Camera Controllability가 보고되지 않아 제어 정확도를 직접 비교하기 어렵다.
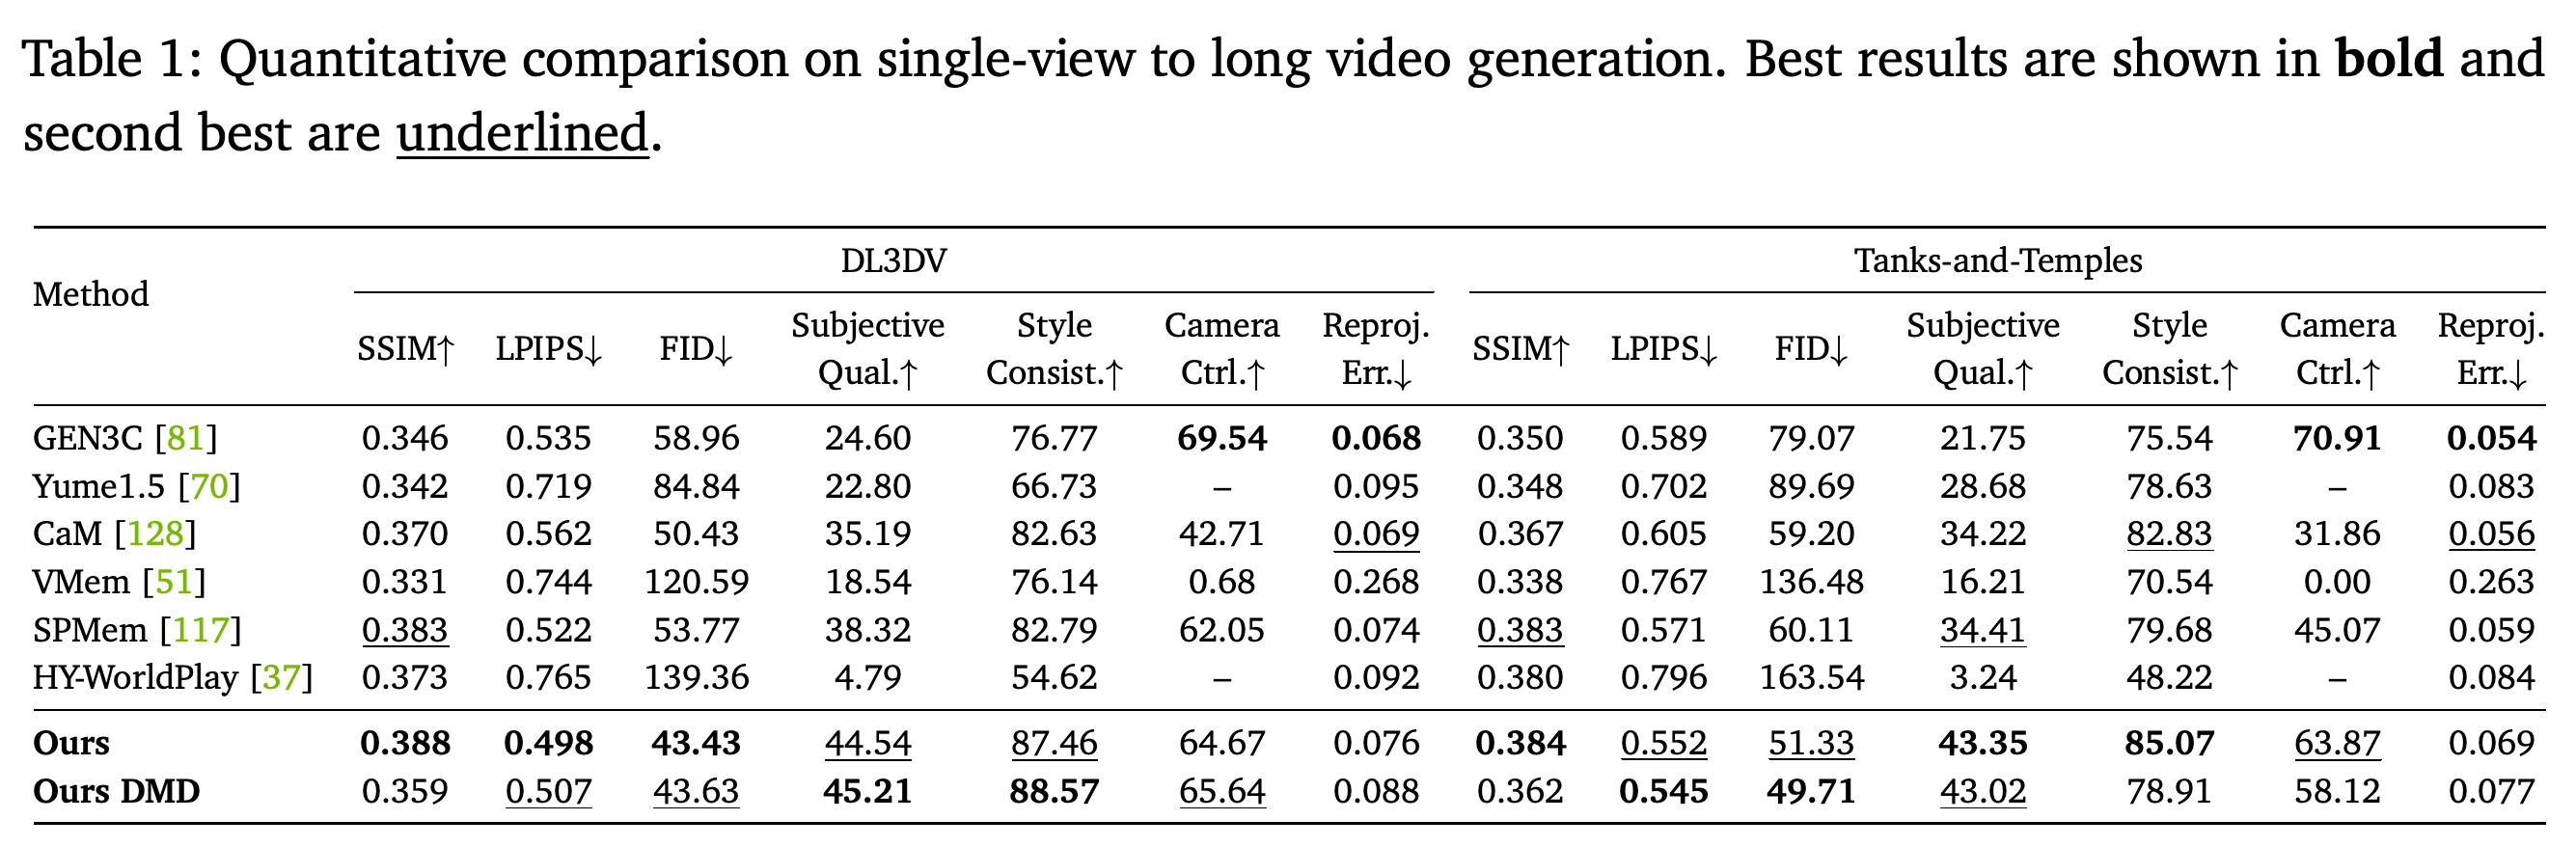
Table 1에서 전체 모델은 두 데이터셋 모두에서 비교한 기준 모델보다 주요 외관 지표가 좋다. DL3DV에서는 SSIM 0.388, LPIPS 0.498, FID 43.43, Subjective Quality 44.54, Style Consistency 87.46을 얻는다. Tanks and Temples에서는 같은 순서로 0.384, 0.552, 51.33, 43.35, 85.07을 얻는다.
- GEN3C는 카메라 제어와 재투영 오차에서 여전히 더 좋다. DL3DV에서 GEN3C의 점수는 69.54와 0.068이며, 전체 모델은 64.67과 0.076이다. Tanks and Temples에서는 GEN3C가 70.91과 0.054, 전체 모델이 63.87과 0.069다.
- CaM과 SPMem은 경쟁력 있는 외관 품질을 보이지만 카메라 제어가 더 약하다. 이 결과는 유용한 제어 능력을 유지하면서 외관을 개선했다는 근거이지, 모든 지표에서 우수하다는 근거는 아니다.
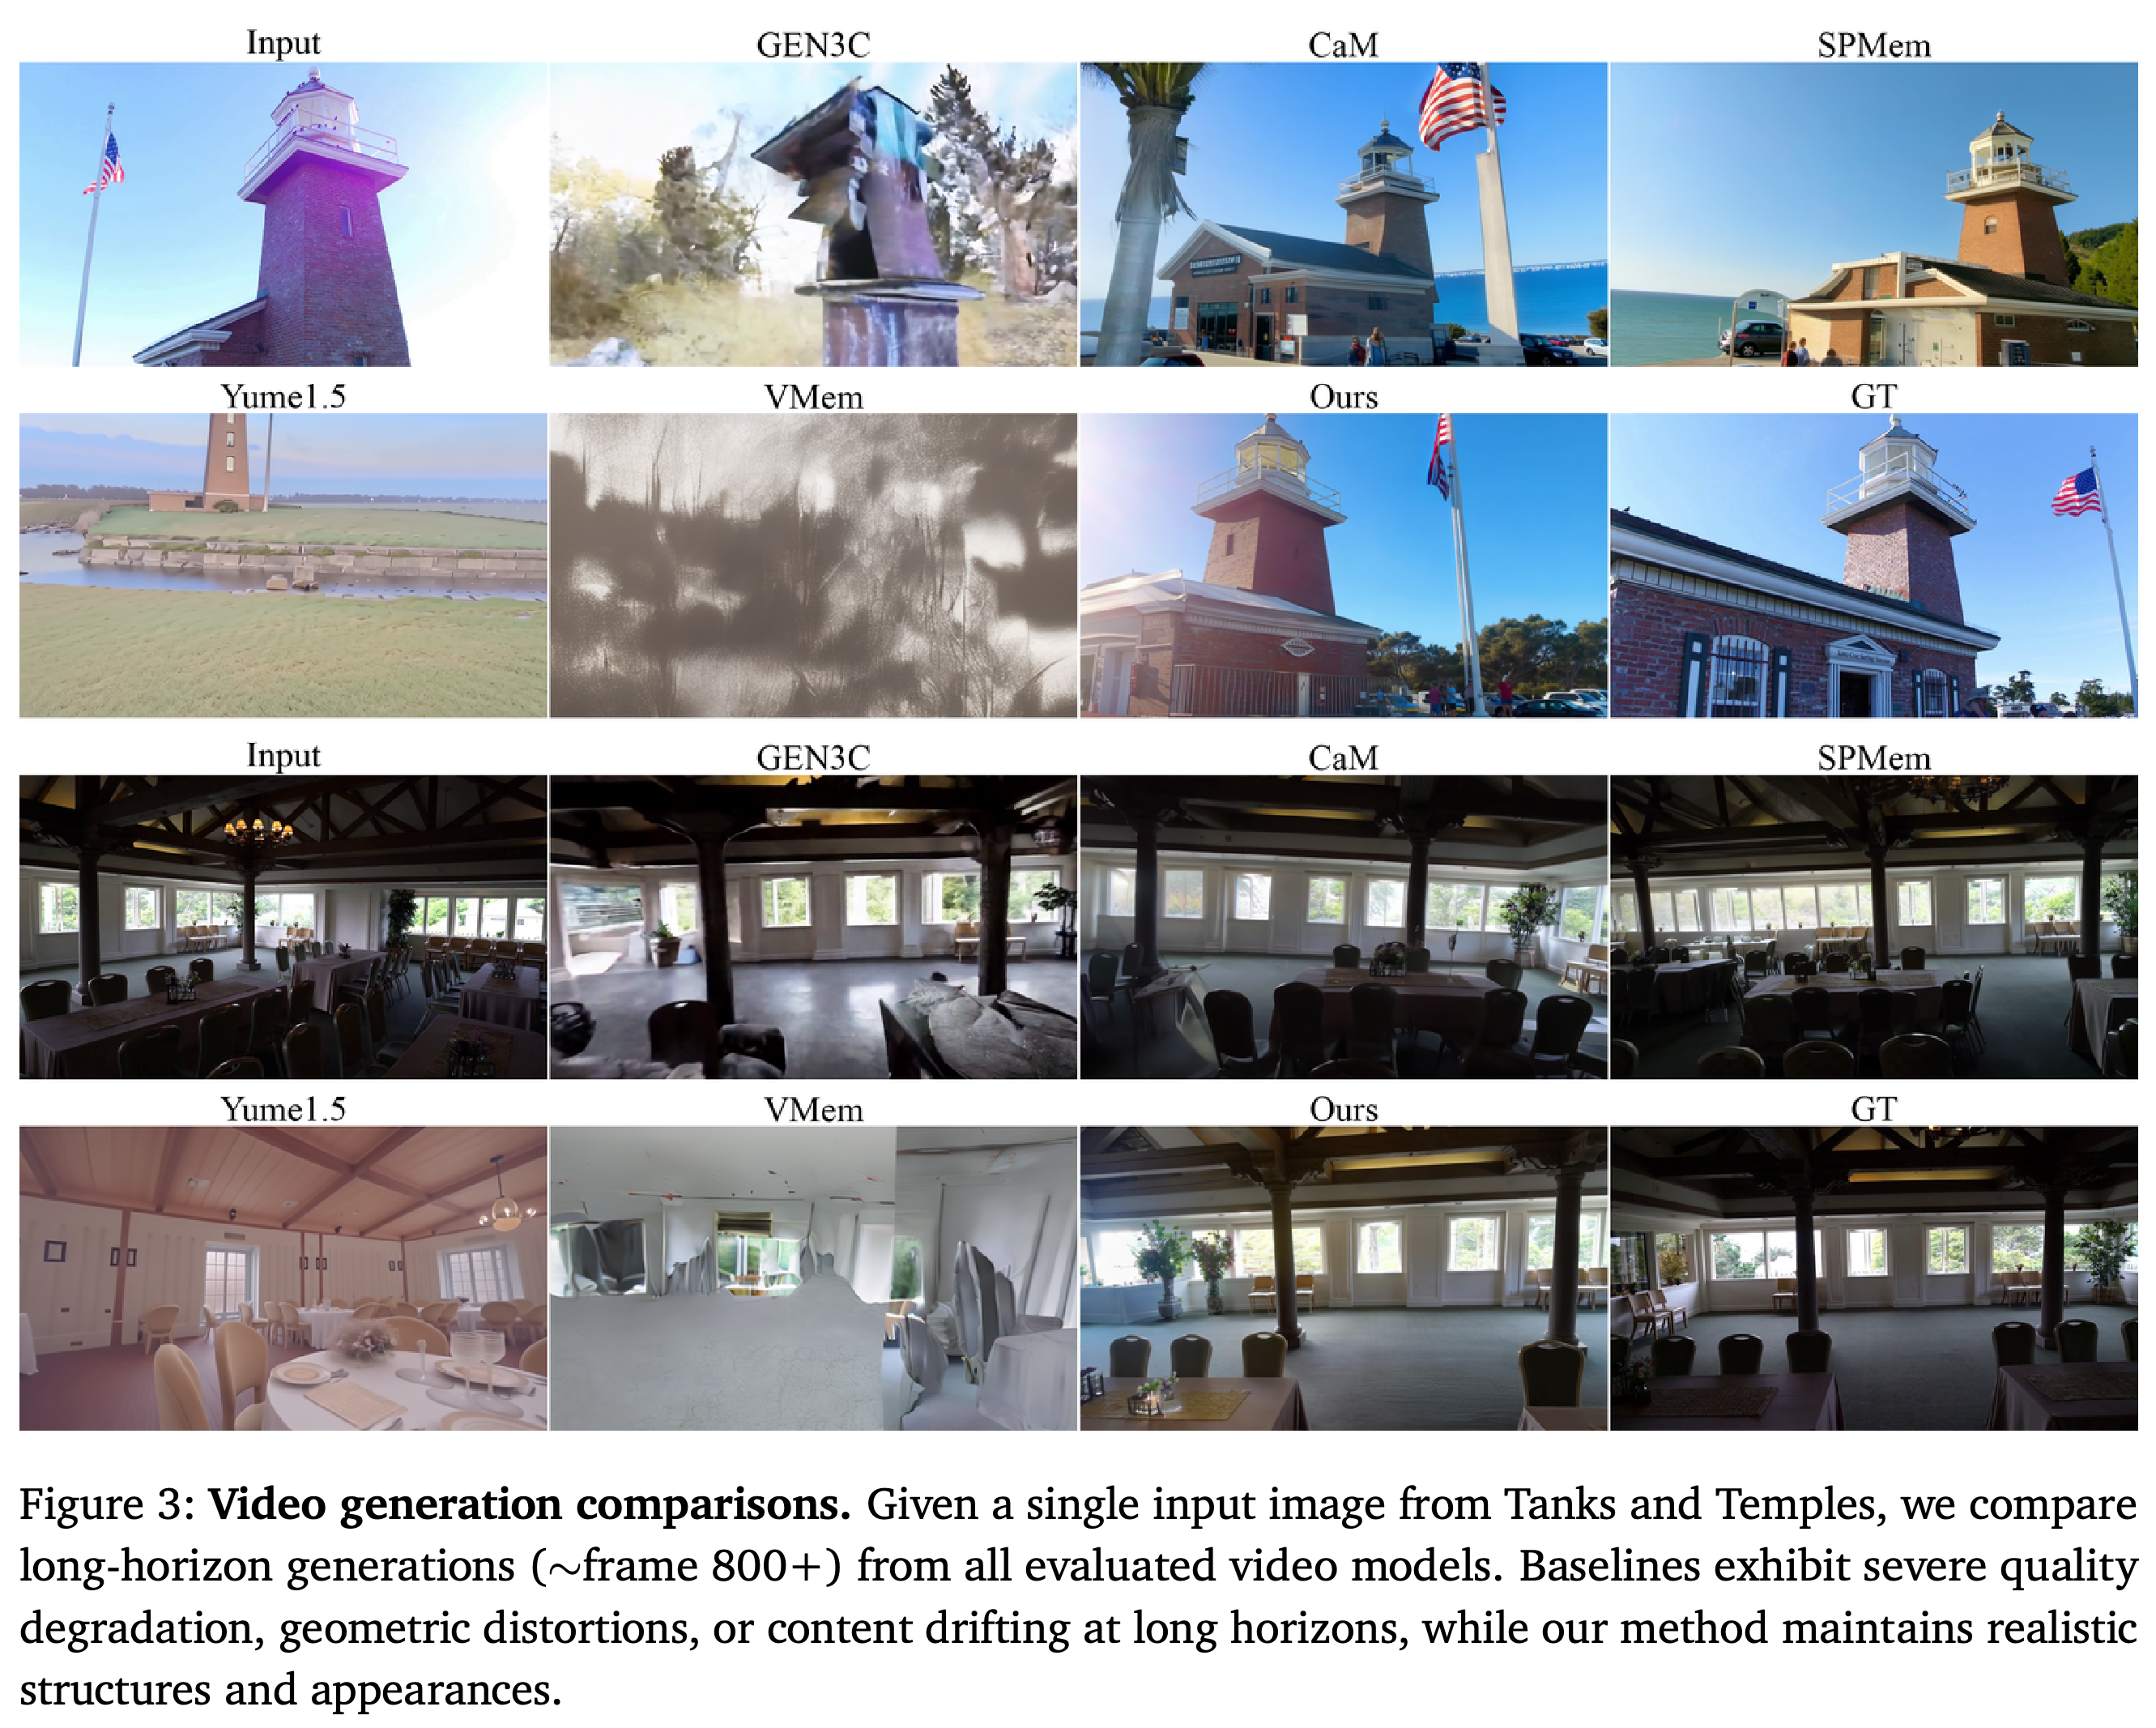
- Figure 3은 약 800+번째 프레임을 비교한다. 선택된 기준 모델 사례에서는 구조 왜곡, 붕괴, 외관 드리프트가 나타나지만, Lyra 2.0은 알아볼 수 있는 장면 구조를 유지한다.
DL3DV와 Tanks and Temples에서 전체 모델은 비교한 기준 모델보다 외관과 스타일 지표가 좋다. 그러나 GEN3C는 카메라 제어가 더 좋고 재투영 오차가 더 낮다. DMD 행은 데이터셋에 따라 효과가 달라짐을 보여준다. Tanks and Temples에서는 FID와 LPIPS가 소폭 개선되지만, Style Consistency는 85.07에서 78.91로 낮아진다.
선택된 등대와 실내 장면의 약 800+번째 프레임에서 기준 모델의 구조 왜곡, 외관 드리프트, 심각한 품질 저하가 드러난다. Lyra 2.0은 이 사례에서 알아볼 수 있는 건축 구조와 장면 외관을 유지한다. 다만 생성한 시점이 정답과 정확히 일치하지는 않는다.
증류 모델은 대체로 비슷한 외관 품질을 유지하지만, 효과는 데이터셋에 따라 다르다. Tanks and Temples에서는 FID가 51.33에서 49.71로, LPIPS가 0.552에서 0.545로 개선된다. 반면 Camera Controllability는 63.87에서 58.12로, Style Consistency는 85.07에서 78.91로 낮아진다.
- DL3DV에서 증류 모델의 FID는 43.63으로 전체 모델의 43.43보다 높고, LPIPS는 0.507로 0.498보다 높다. 반면 Subjective Quality는 44.54에서 45.21로, Style Consistency는 87.46에서 88.57로 개선된다.
- 증류는 두 데이터셋 모두에서 SSIM을 낮추고 재투영 오차를 높인다. 따라서 속도 향상에는 측정 가능한 상충 관계가 있으며, 전체 모델의 성능을 모든 지표에서 그대로 유지하는 것은 아니다.
5.3. Evaluation on 3D Scene Generation
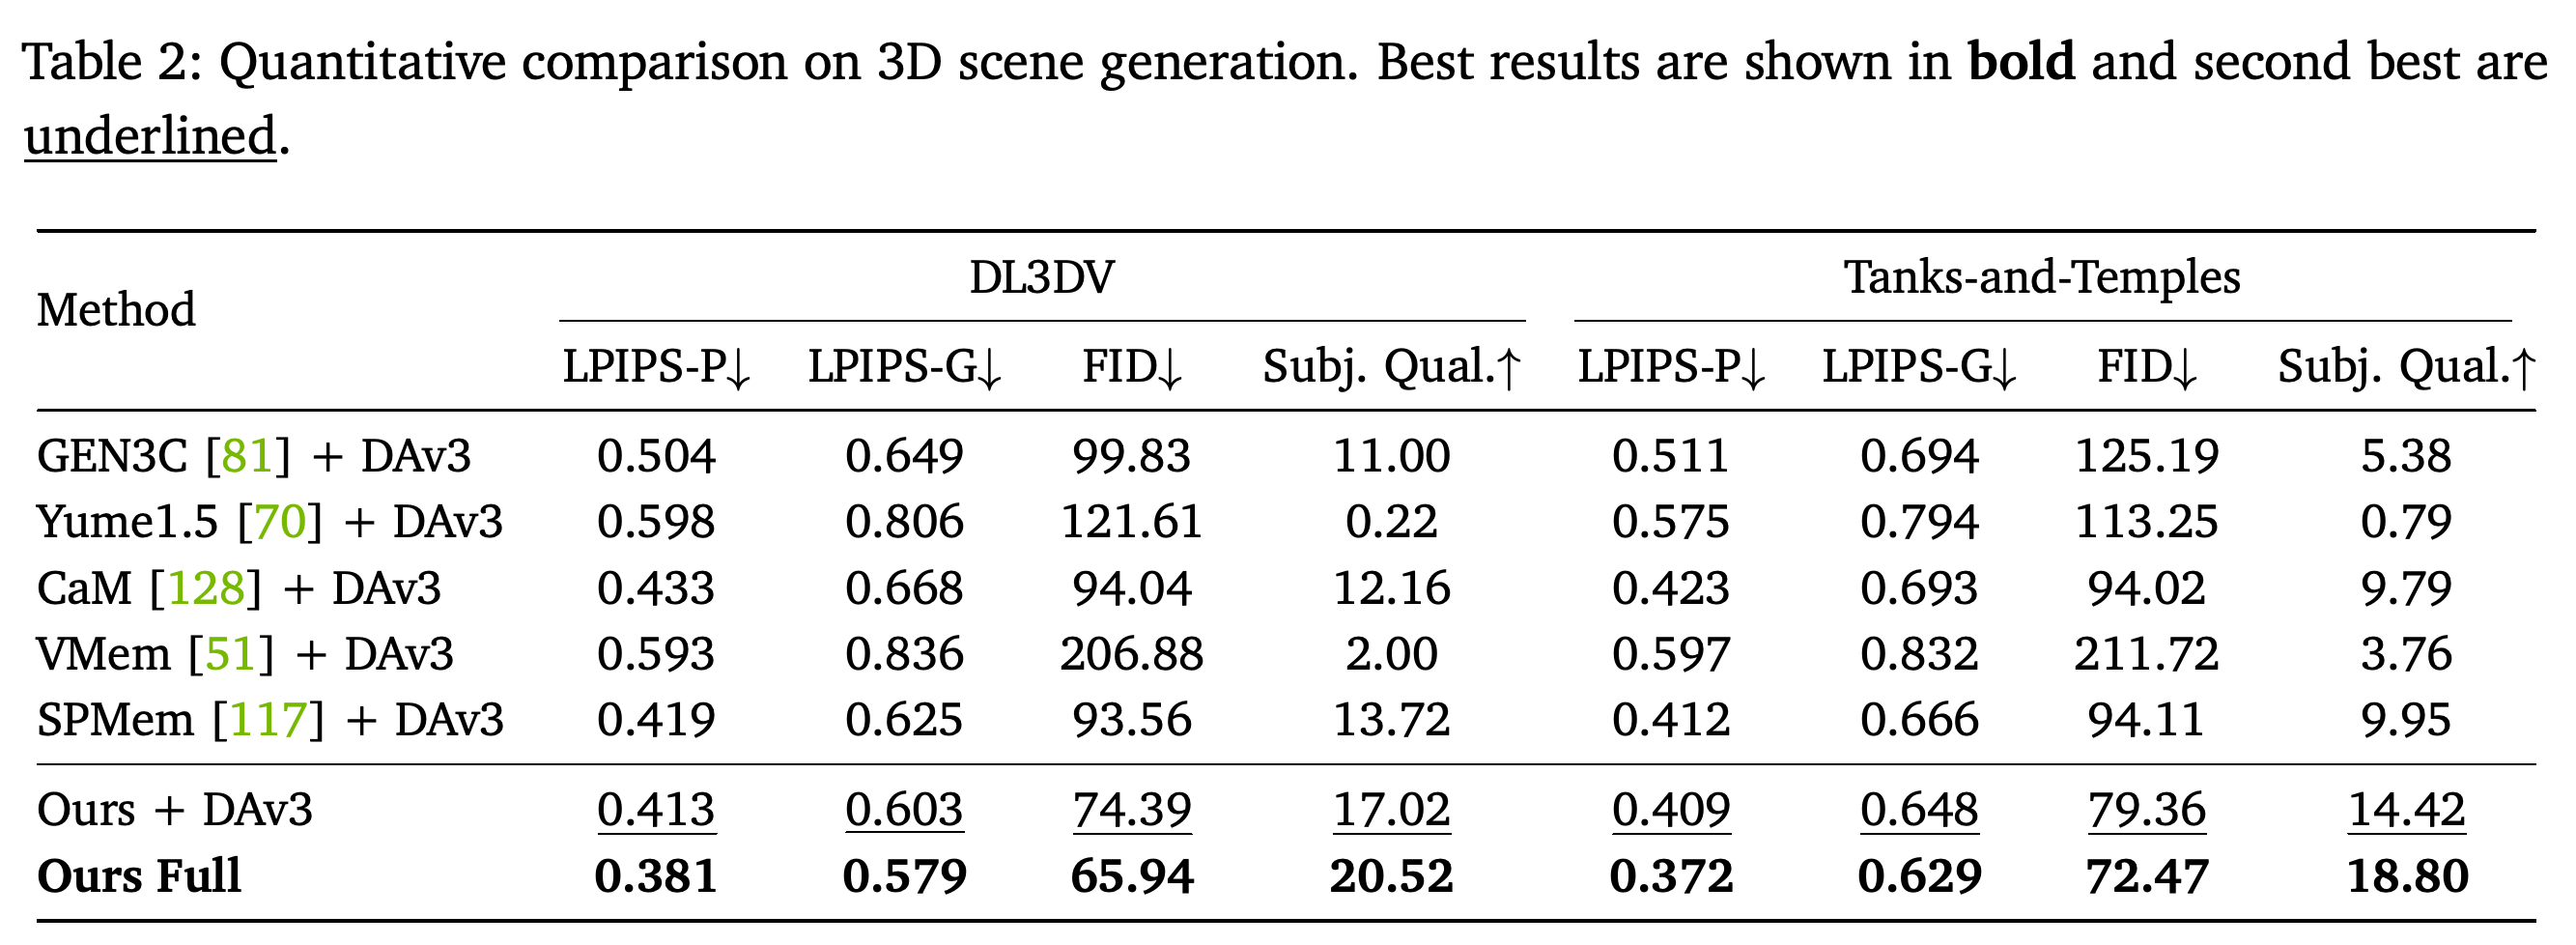
3D 장면 평가는 비디오 생성 기준 모델에 DAv3를 결합하고, 재구성한 3DGS에서 렌더링한 새로운 시점을 평가한다. LPIPS-G는 렌더링한 시점과 정답 프레임을 비교한다. LPIPS-P는 렌더링한 시점과 생성 비디오 프레임을 비교해 해당 관측을 얼마나 충실하게 재구성했는지 측정한다.
- FID와 Subjective Quality는 렌더링한 외관을 측정한다.
- LPIPS-P는 비디오 일관성을 재구성을 통해 간접적으로 평가하는 지표다. 정답 기하 구조를 직접 측정하지 않으며, 재구성 모델에도 영향을 받는다.
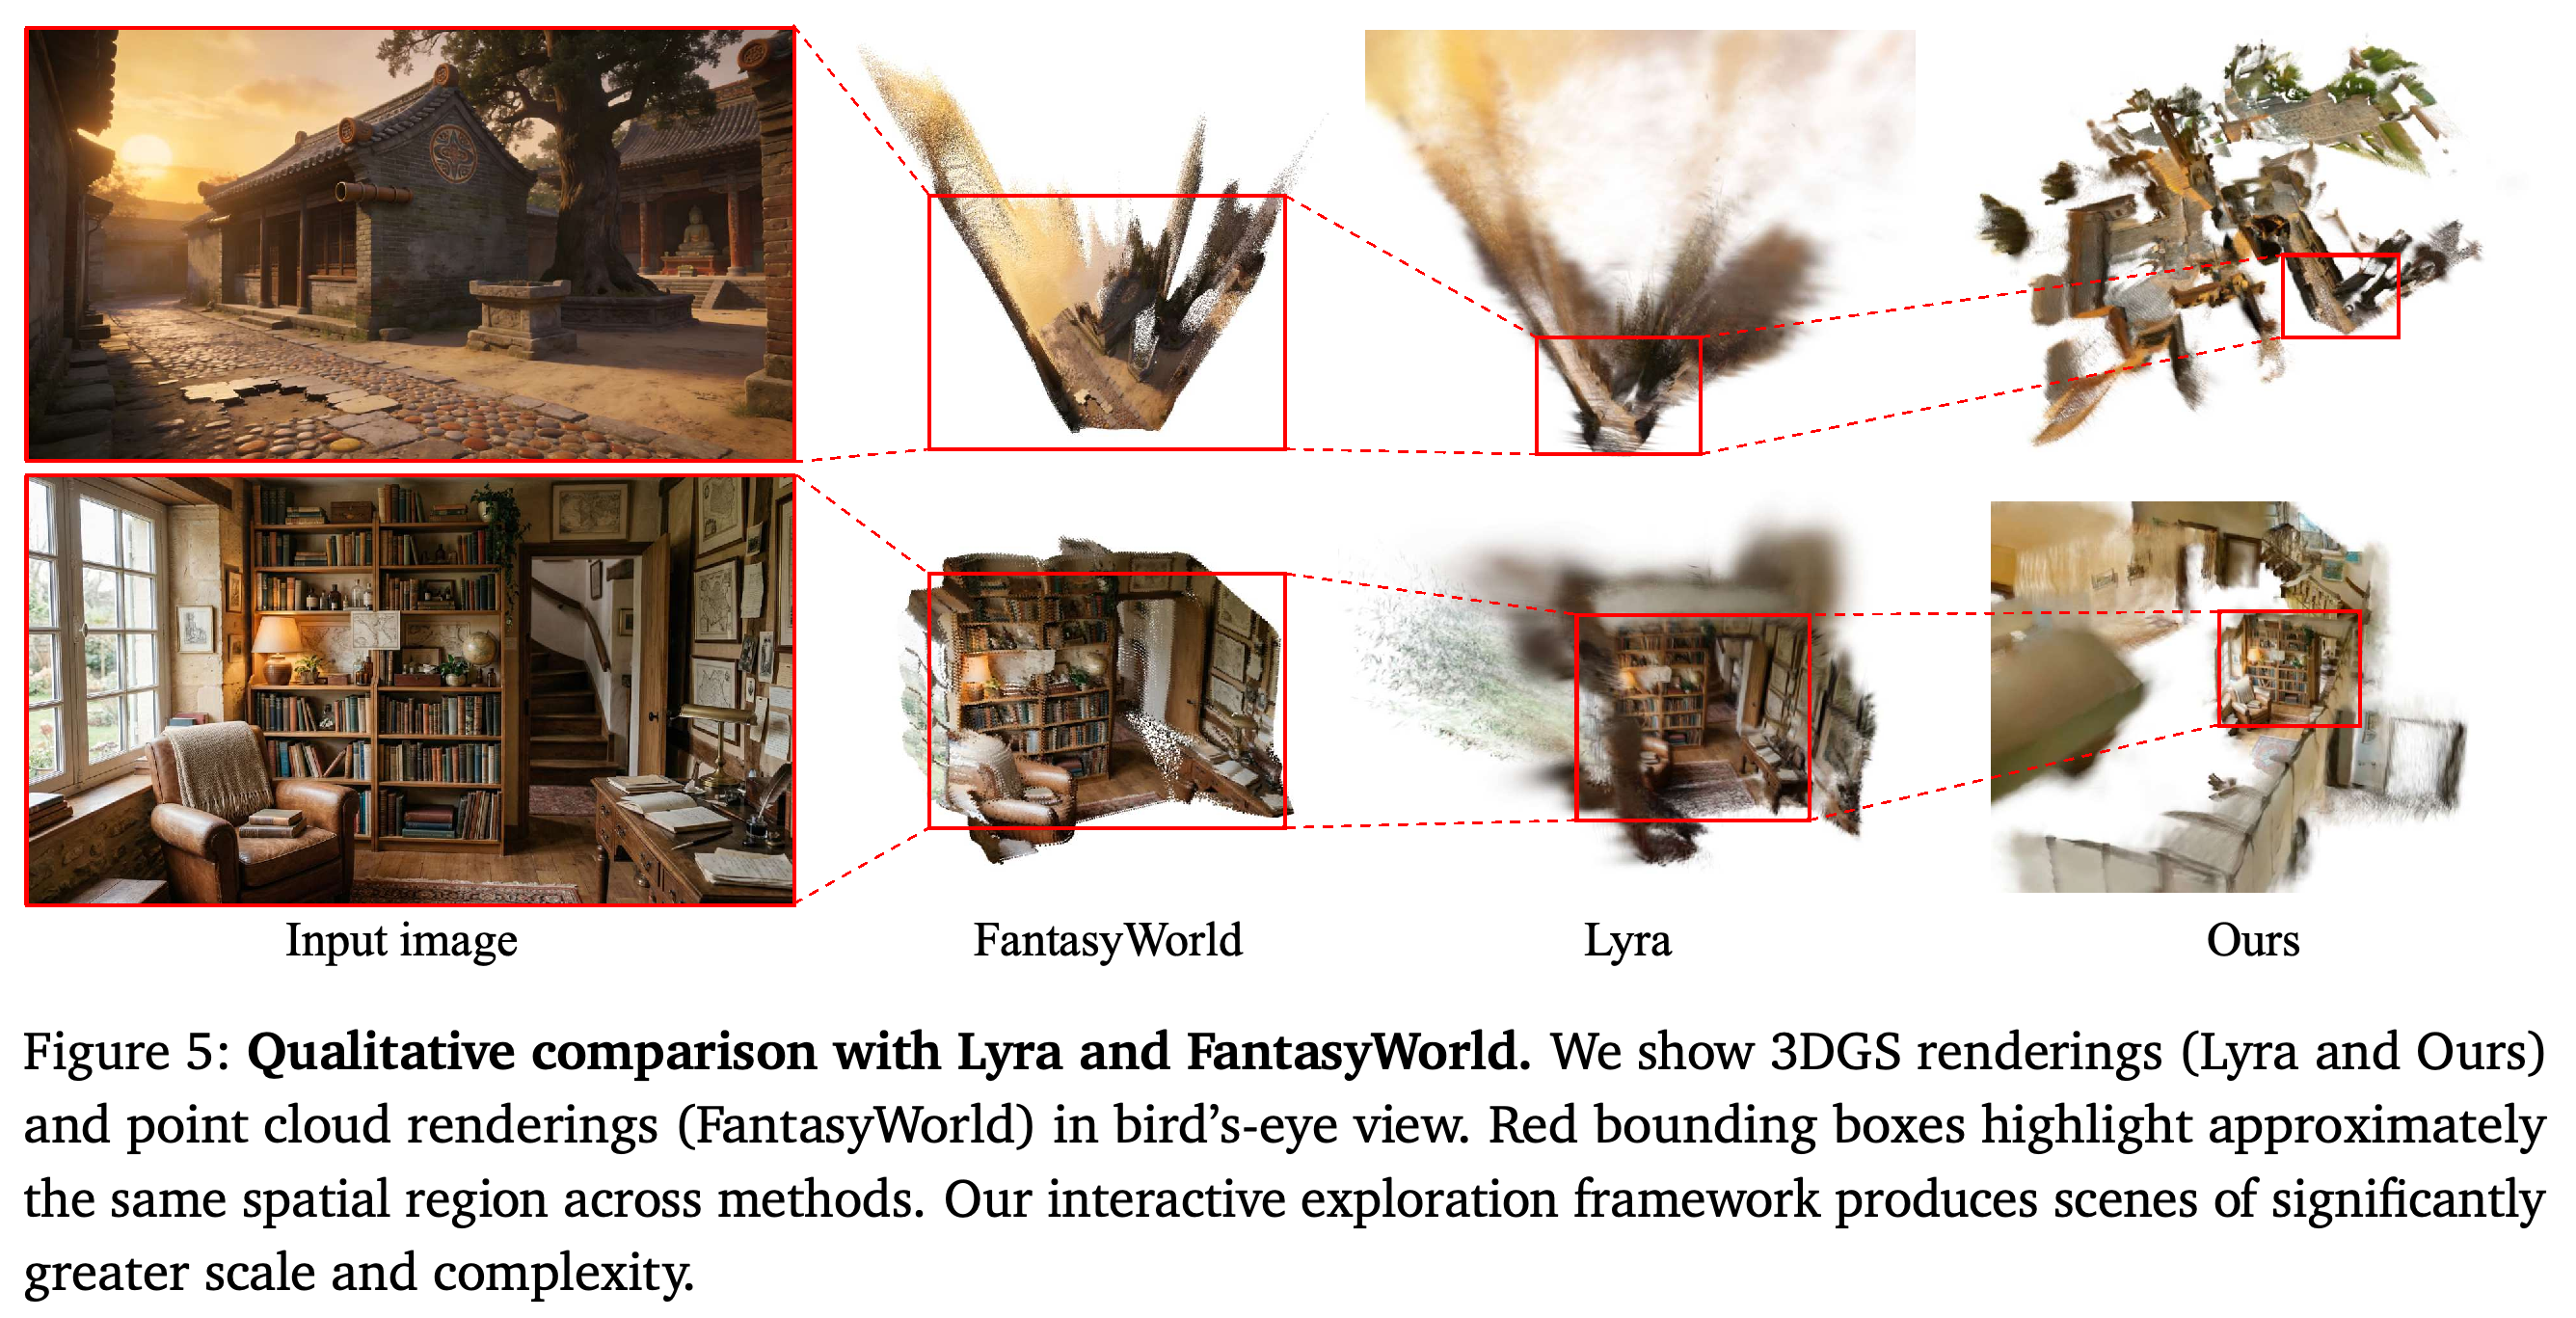
- Lyra와 FantasyWorld는 짧은 비디오 파이프라인 때문에 장면 규모가 제한되어 정성 비교도 수행한다.
Table 2에서 Ours Full은 두 데이터셋의 모든 재구성 지표에서 제시된 모델 중 가장 좋은 값을 얻는다. Ours + DAv3와 비교하면 미세 조정을 통해 DL3DV의 LPIPS-P가 0.413에서 0.381로, LPIPS-G가 0.603에서 0.579로, FID가 74.39에서 65.94로, Subjective Quality가 17.02에서 20.52로 개선된다.
- Tanks and Temples에서도 같은 비교에서 LPIPS-P가 0.409에서 0.372로, LPIPS-G가 0.648에서 0.629로, FID가 79.36에서 72.47로, Subjective Quality가 14.42에서 18.80으로 개선된다.
- Ours + DAv3도 다른 비디오 모델과 DAv3를 결합한 파이프라인보다 이미 좋은 성능을 보인다. 이를 통해 입력 비디오 개선의 효과와 추가적인 재구성 모델 조정의 효과를 구분할 수 있다.
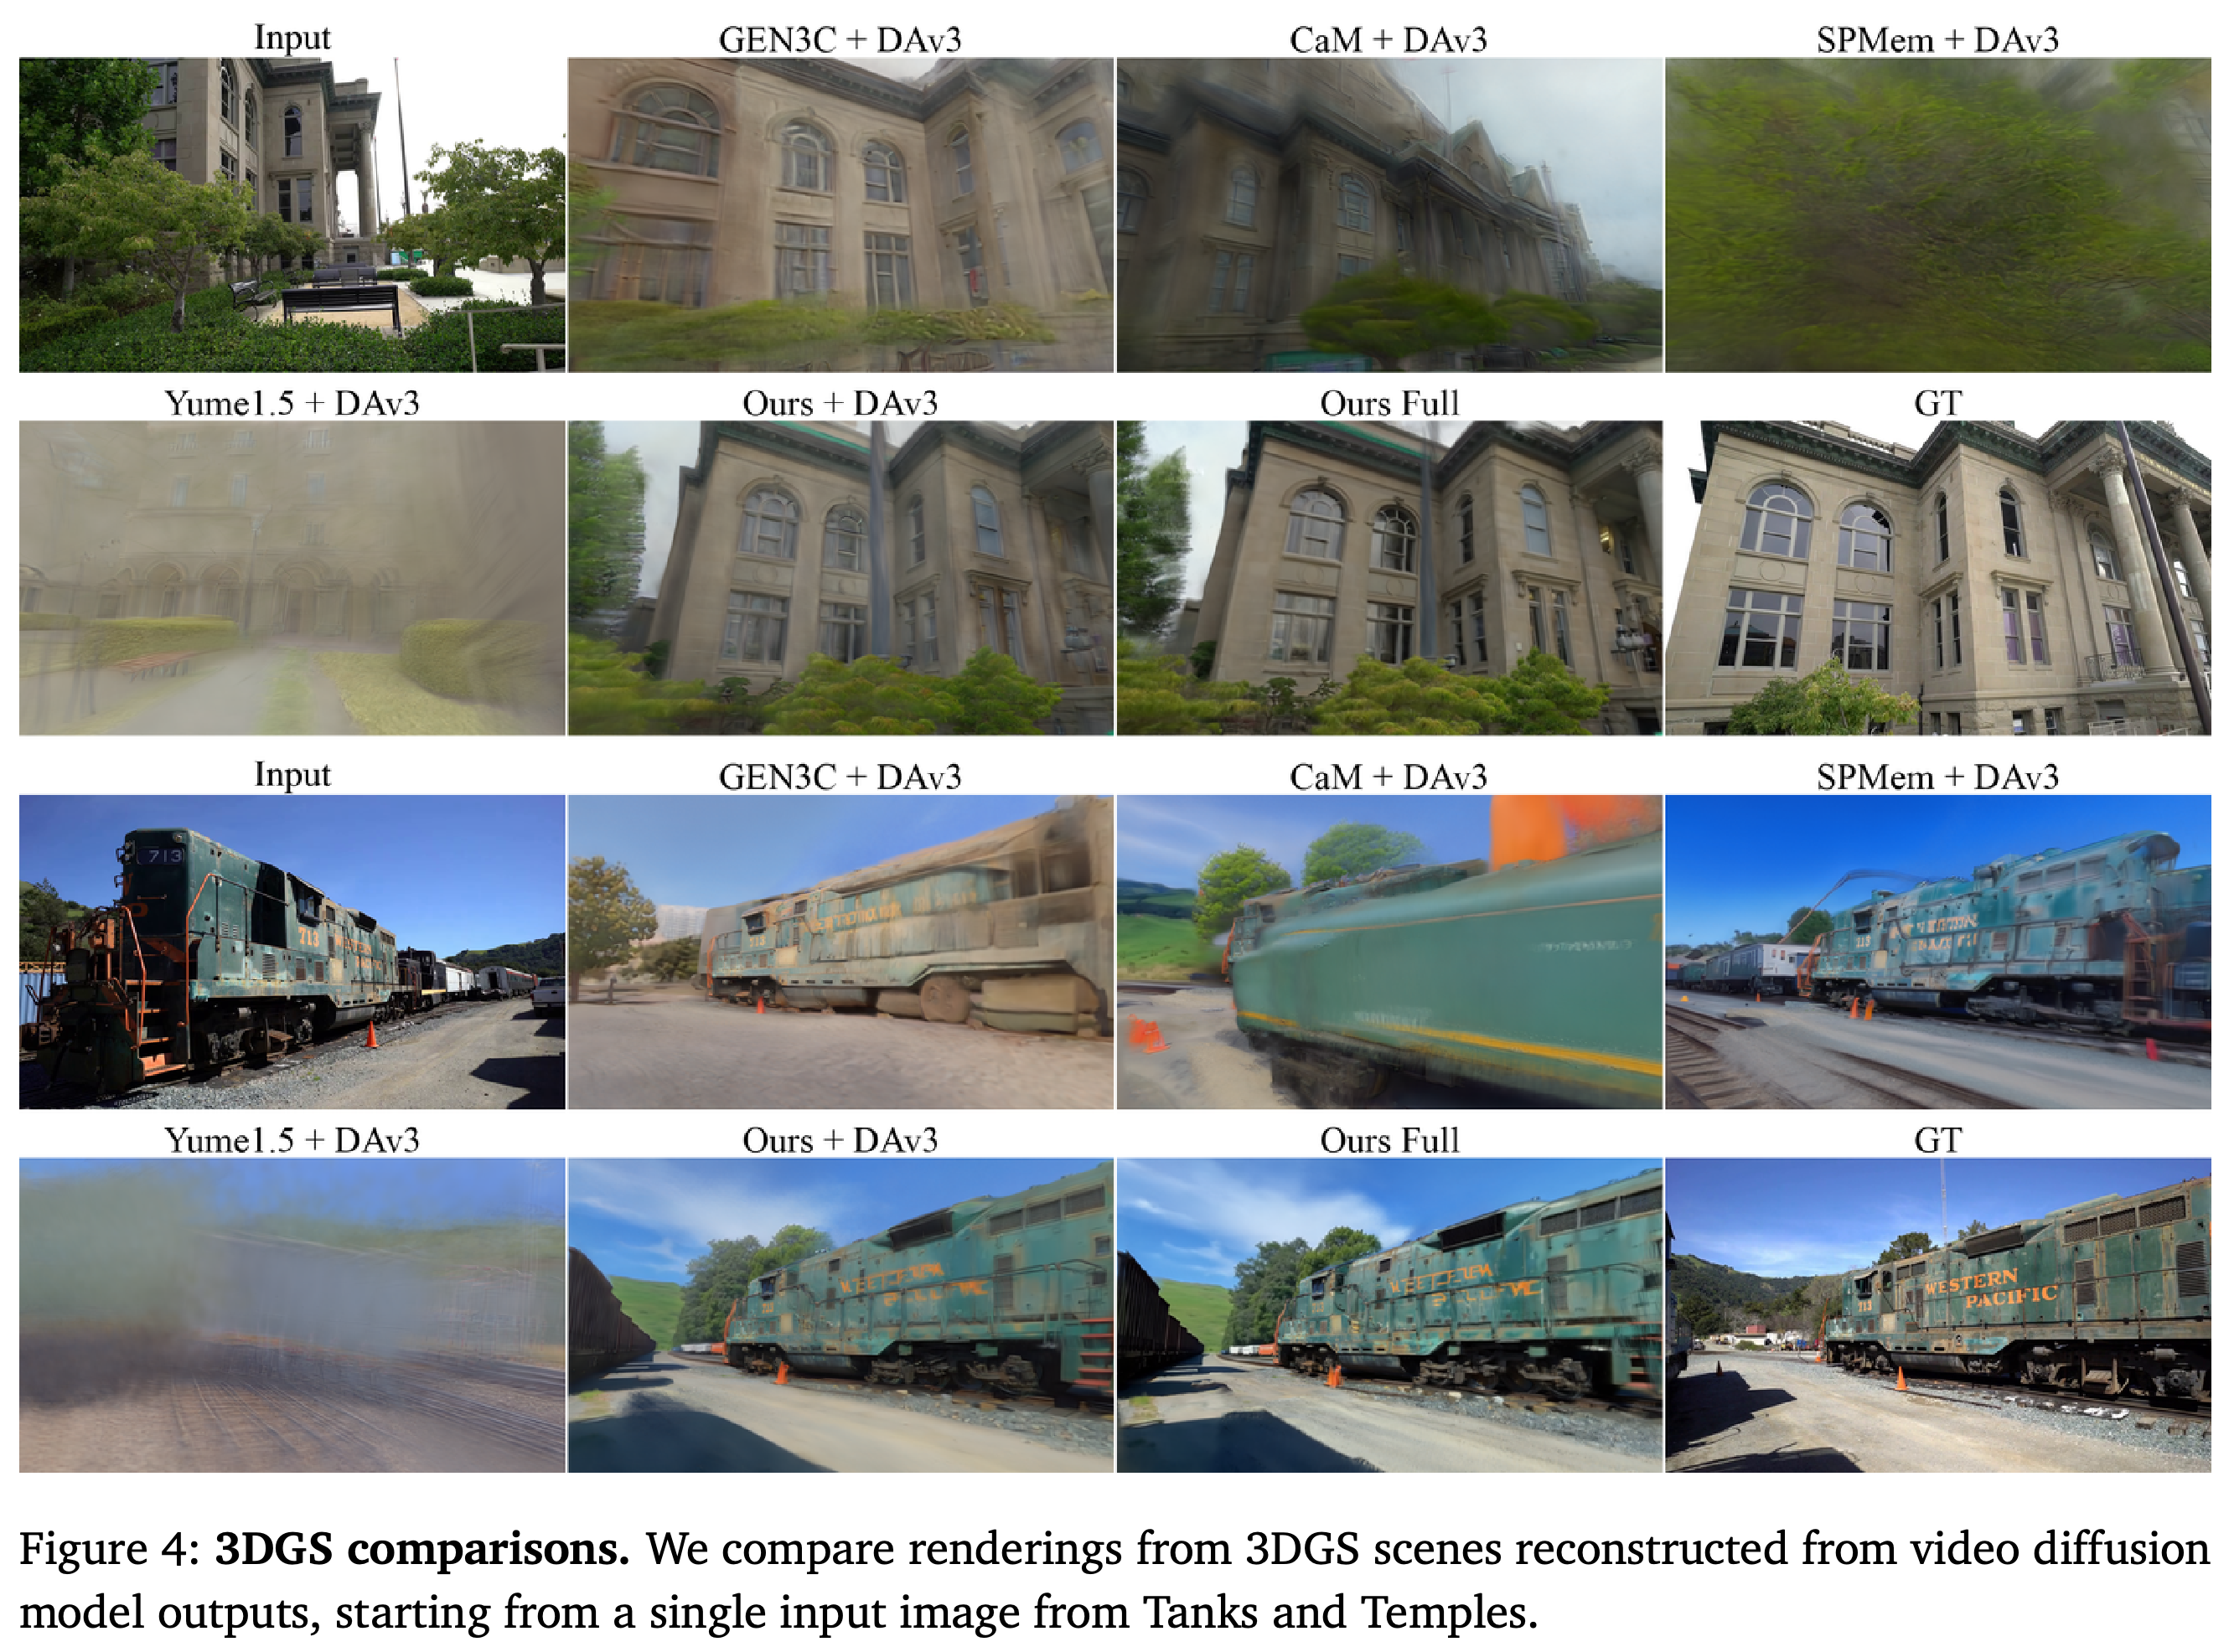
- Figure 4는 Ours Full이 건물과 기관차를 더 깔끔하게 렌더링하는 모습을 보여준다. Figure 5는 Lyra와 FantasyWorld보다 넓은 공간 범위를 보여주지만, 장면 규모를 정량적으로 평가하는 벤치마크는 제공하지 않는다.
동일한 사전 학습 DAv3 재구성 단계를 사용할 때 Lyra 2.0 비디오는 제시된 경쟁 비디오 파이프라인보다 좋은 점수를 얻는다. Ours Full은 두 데이터셋의 모든 지표를 추가로 개선한다. 이를 통해 비디오 생성의 개선 효과와 재구성 모델 조정의 효과를 구분할 수 있다.
공통 DAv3 파이프라인에서 Lyra 2.0 비디오를 입력하면 건물과 기관차의 구조가 더 깔끔하게 렌더링된다. 미세 조정한 Ours Full은 구조를 더 선명하게 만들고 눈에 보이는 아티팩트를 줄인다. 이는 Ours + DAv3와의 정량 비교를 보완한다.
빨간 상자는 각 방법에서 대략 같은 시작 영역을 표시해 Lyra 2.0이 추가로 확보한 공간 범위를 보여준다. FantasyWorld는 포인트 클라우드로, Lyra와 Lyra 2.0은 3DGS로 제시된다. 따라서 이 비교는 렌더링 품질을 통제해 비교하기보다 장면 범위를 보여주는 데 초점을 둔다.
5.4. Ablation Study
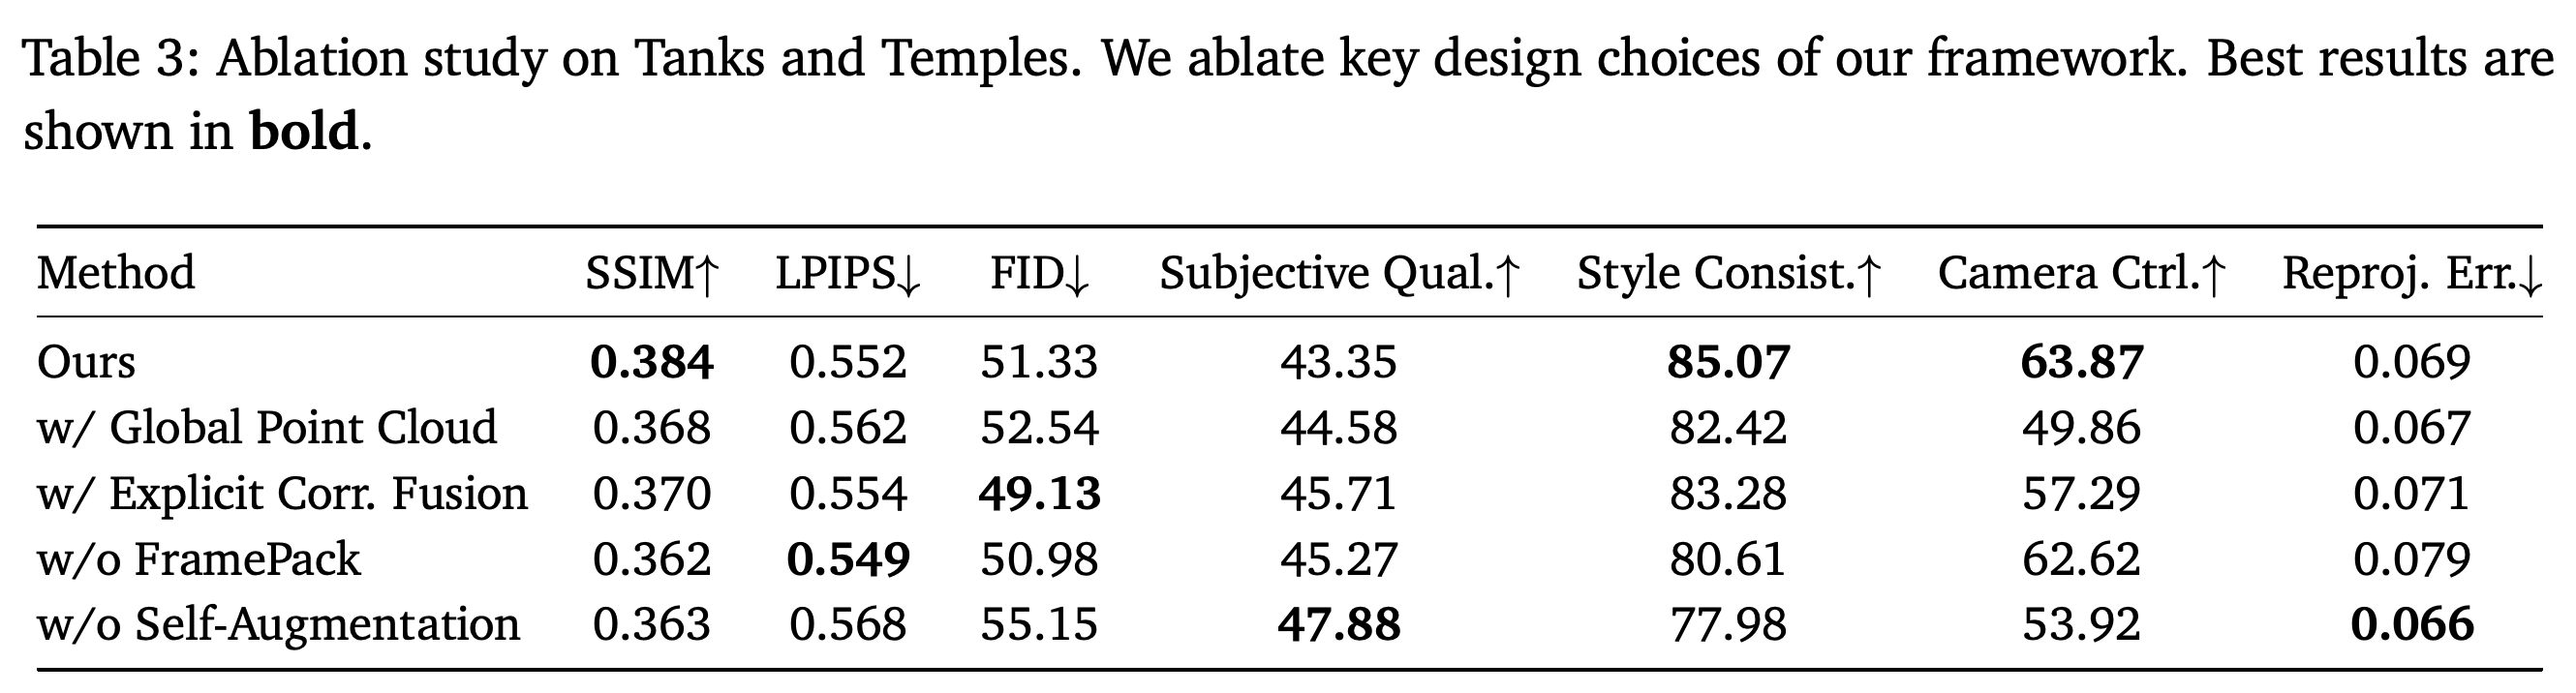
Tanks and Temples의 제거 실험은 프레임별 메모리, 학습한 대응 관계 집계, FramePack, 자기 증강을 함께 사용하는 설계를 뒷받침한다. Table 3에서 전체 모델은 SSIM, Style Consistency, Camera Controllability가 가장 좋지만, 다른 지표에서는 일부 구성 요소를 제거하거나 대체한 모델이 더 좋다.
- w/ Global Point Cloud는 프레임별 캐시와 대응 관계 조건 입력을 모두 융합 포인트 클라우드와 렌더링 이미지로 대체한다. Camera Controllability는 63.87에서 49.86으로, Style Consistency는 85.07에서 82.42로 낮아진다. 다만 재투영 오차는 0.069에서 0.067로 개선된다.
- w/ Explicit Corr. Fusion은 학습한 집계를 깊이에 기반한 고정 대응 관계 융합으로 대체한다. Camera Controllability는 57.29로 낮아지지만, FID는 51.33에서 49.13으로 개선된다.
- w/o FramePack은 Style Consistency를 80.61로 낮추고 재투영 오차를 0.079로 높인다.
- w/o Self-Augmentation은 Subjective Quality를 47.88로, 재투영 오차를 0.066으로 개선하지만, Style Consistency는 77.98로, Camera Controllability는 53.92로 낮춘다. Figure 6은 제거 실험 모델의 포즈 오류와 외관 드리프트를 보여준다.
전체 모델은 SSIM, Style Consistency, Camera Controllability가 가장 좋지만, 다른 지표에서는 제거 실험 모델이 더 좋다. 자기 증강을 제거하면 Subjective Quality가 47.88로 높아지고 재투영 오차가 0.066으로 낮아지는 반면, Style Consistency는 77.98로 낮아진다. 이는 개별 프레임 품질과 장기 안정성을 따로 평가해야 함을 보여준다.
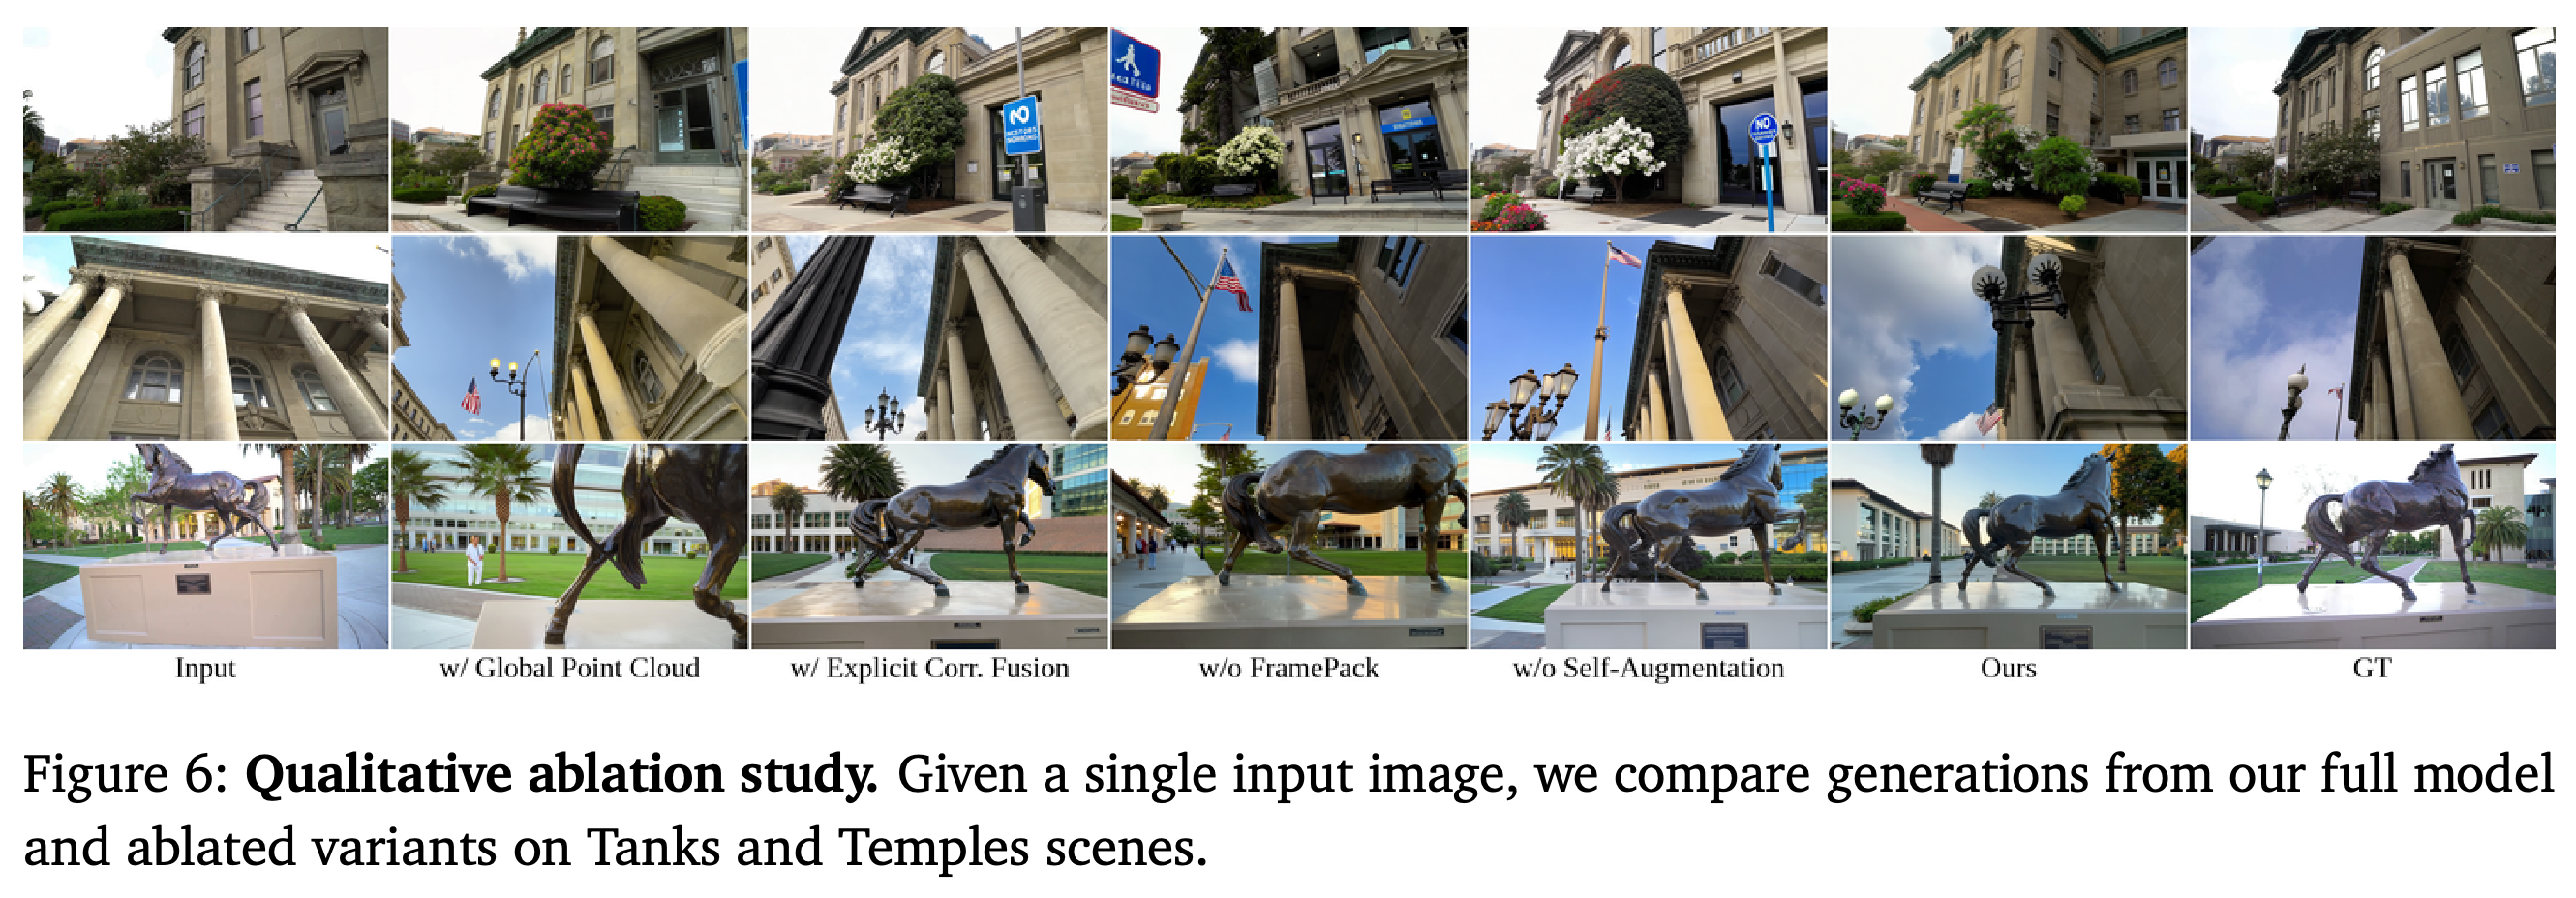
건물과 말 동상 사례는 제거 실험 설계에서 발생하는 시점 및 외관 편차를 보여준다. 카메라 제어와 스타일 일관성 점수가 낮아지는 현상을 정성적으로 설명하지만, 모든 제거 실험이 모든 지표에서 나쁘다는 근거는 아니다.
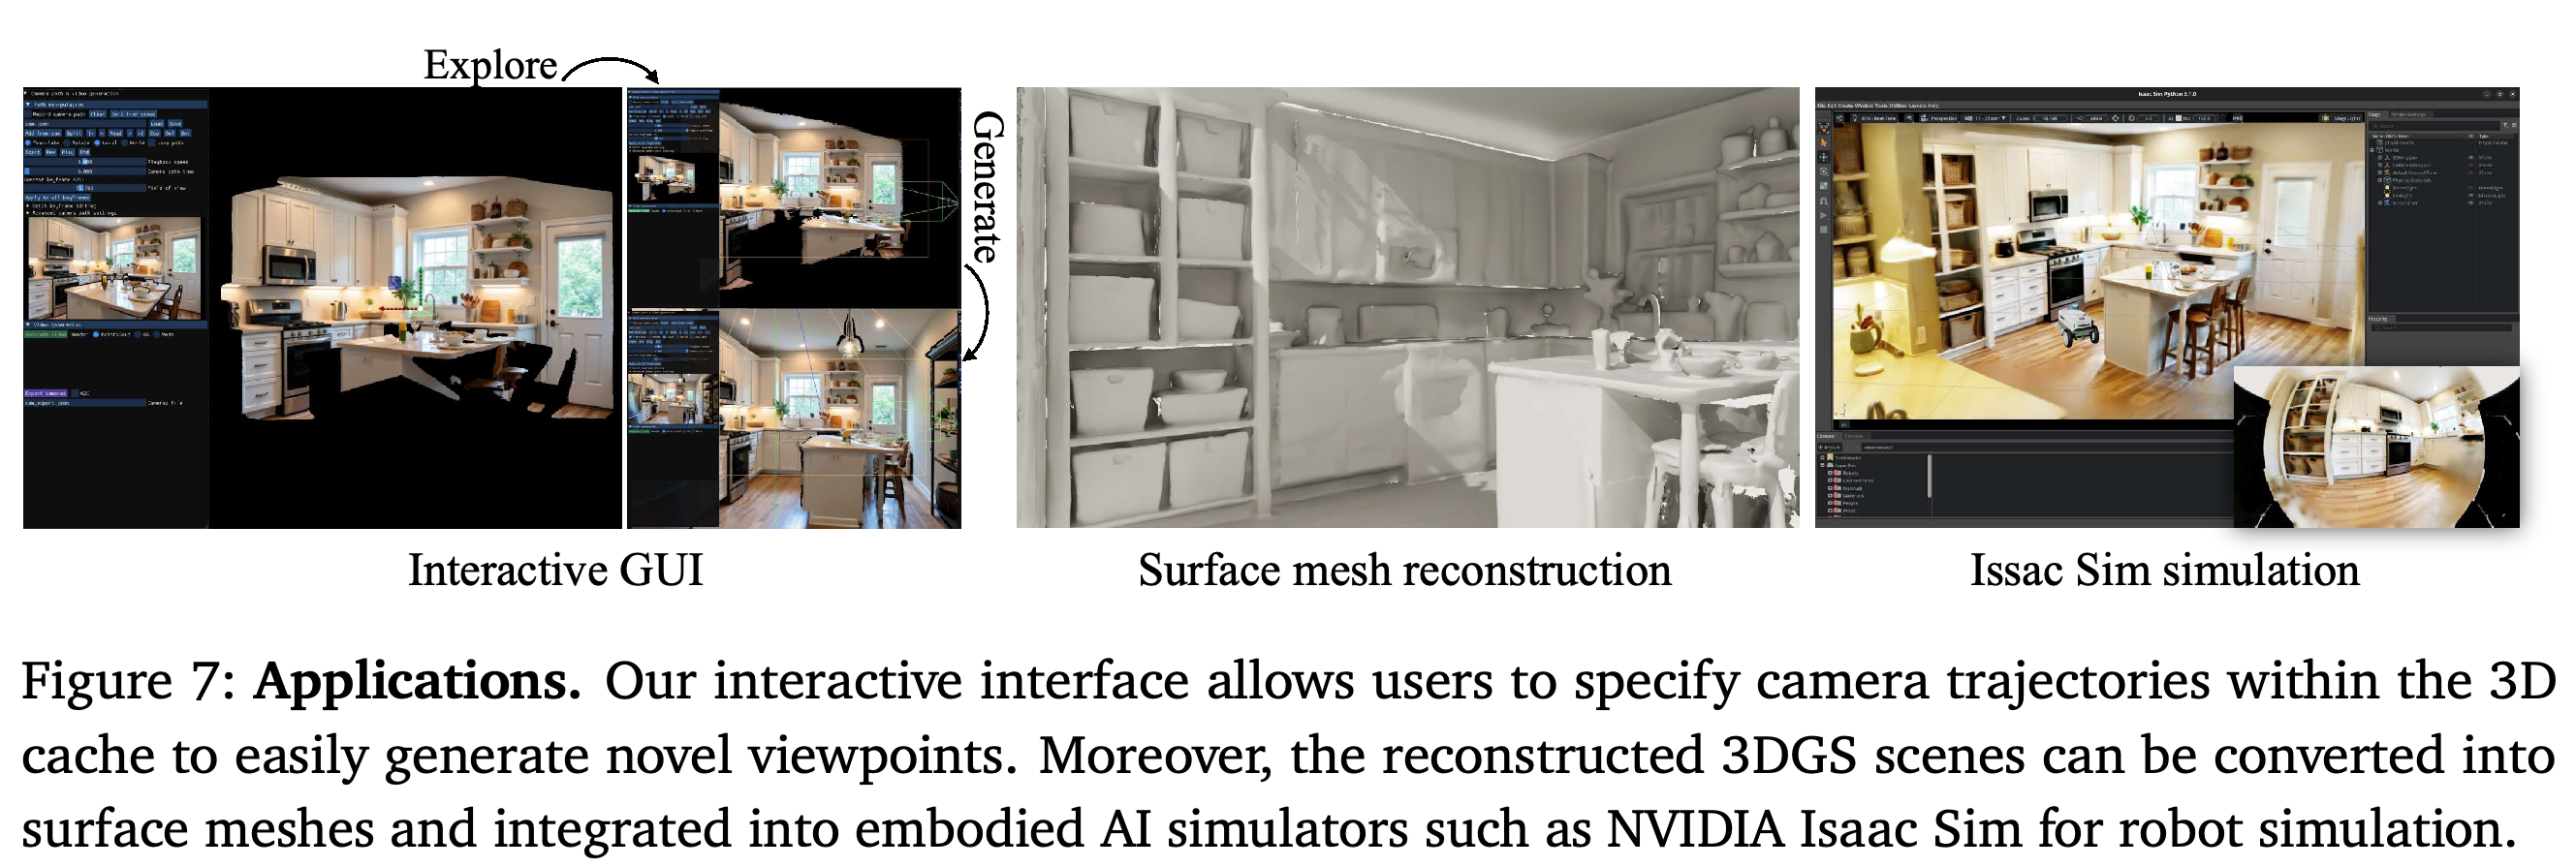
5.5. Applications
응용 시연은 궤적 계획, 점진적인 장면 확장, NVIDIA Isaac Sim으로의 내보내기를 결합한다. GUI는 누적된 포인트 클라우드를 시각화해 사용자가 이전 영역을 다시 방문하거나 탐색하지 않은 영역을 선택할 수 있게 한다. Figure 7은 대화형 생성에서 표면 메시 추출을 거쳐 시뮬레이션으로 이어지는 파이프라인을 보여준다.
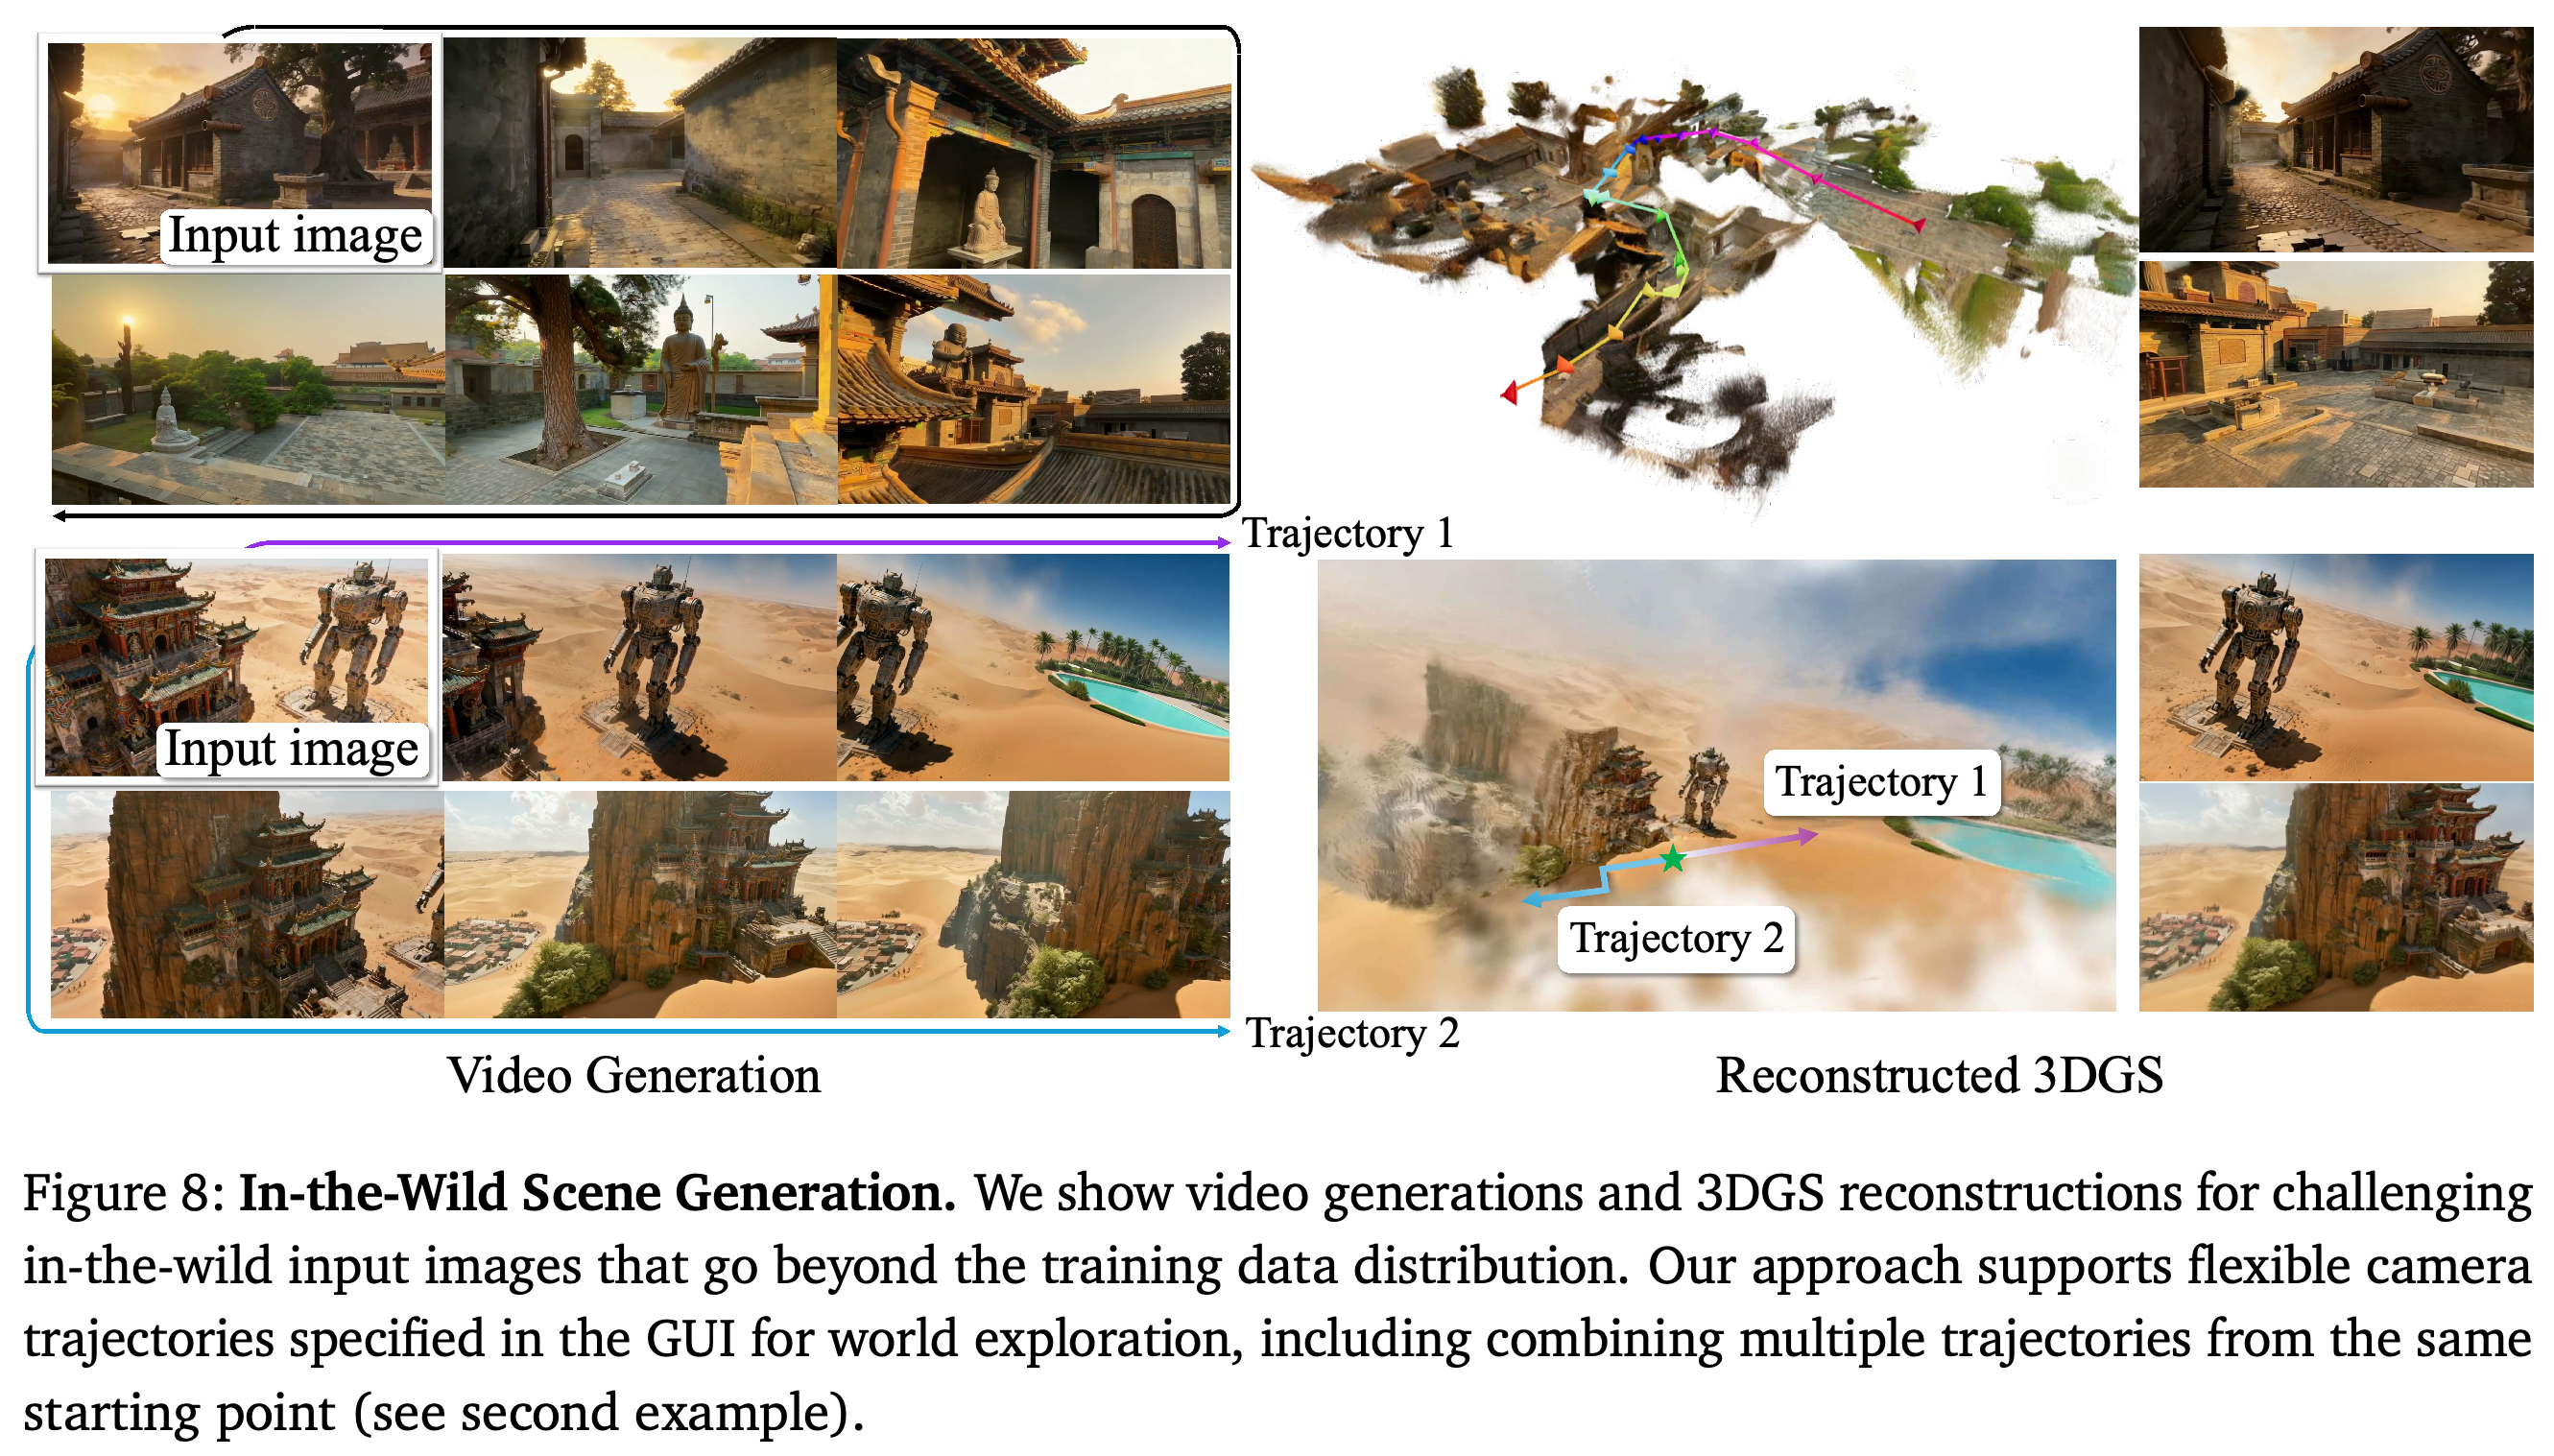
- Figures 1과 8은 평가 벤치마크를 넘어 실내, 실외, 상상 속 입력을 보여준다. 같은 초기 이미지에서 출발하는 여러 궤적도 포함한다.
- 내보낸 3DGS와 메시 자산은 시연한 로봇 시뮬레이션에 사용할 수 있다. 그러나 논문은 후속 정책 학습의 성능 향상이나 시뮬레이션 타당성에 대한 정량 평가를 보고하지 않는다.
- 대화형 탐색은 구간 단위로 이루어진다. 증류 모델은 보고된 GPU에서 80프레임 구간을 생성하는 데 약 15초가 걸린다.
주방 사례는 GUI에서 궤적을 선택한 뒤 표면 메시를 추출하고 Isaac Sim 장면으로 연결하는 과정을 보여준다. 체화 시뮬레이션용 자산을 내보내는 작업 과정을 시연하지만, 충돌 정확도, 물리 속성, 후속 로봇 정책의 성능은 정량적으로 평가하지 않는다.
제시된 환경은 실제 환경 벤치마크 장면의 범위를 넘어선다. 2번째 사례에는 같은 시작 이미지에서 출발한 궤적 2개가 포함된다. 이를 함께 재구성한 결과는 분기 탐색을 정성적으로 보여주지만, 분포 밖 일관성을 수치로 평가하지는 않는다.
6. Discussion
논의에서는 남은 한계 2가지를 짚는다. 프레임워크는 정적 환경을 대상으로 하며, DL3DV에 존재하는 노출 변화를 재현할 수 있다. 이러한 광도 불일치는 생성한 시점을 3DGS로 변환할 때 아티팩트를 만들 수 있다.
- 저자들은 가능한 대응 방법으로 네트워크 수준의 광도 안정화나 광도가 일관된 합성 학습 데이터를 제안한다. 다만 이를 평가한 해결책으로 제시하지는 않는다.
- 동적 장면은 향후 연구 과제로 남는다. 시연한 재구성과 시뮬레이터 내보내기는 동적 세계 모델링에 해당하지 않는다.
부록
- A. Implementation Details의 A.1. Model Architecture에서는 백본으로 Wan 2.1-14B를 사용하며, 모든 학습과 추론의 해상도는 832×480픽셀이다. 최근 프레임을 깊이로 워핑한 이미지는 VAE로 인코딩한 뒤 디노이징 잠재 표현과 연결한다. Plücker rays와 정준 좌표 맵은 pixel-shuffle과 선형 연산으로 임베딩하며, 좌표 맵 채널에는 sinusoidal positional encoding을 적용한다. 이 임베딩은 모든 transformer 블록의 attention query와 key에 들어가지만 value에는 들어가지 않는다. Figure 9는 학습 비디오의 후반부를 목표로 삼고 정답 깊이로 커버리지를 확인해 검색 커버리지를 평가한다. 이 결과는 N_s = 5가 커버리지와 효율성 사이의 절충점임을 뒷받침한다.
- A.2. Training에서 공간 메모리는 N_s = 5, d = 8을 사용하며, δ = 0.1은 정규화된 깊이 단위다. 자기 증강은 p_aug = 0.7을 사용한다. AdamW의 학습률은 3×10⁻⁵, weight decay는 0.1이다. NVIDIA GB200 GPU 64대에서 배치 크기 64로 7,000회 반복 학습한다. 새로 추가한 모듈은 0으로 초기화하며, bf16 혼합 정밀도로 학습한다. Rectified flow matching은 logit 공간의 평균이 0이고 표준편차가 1인 logit-normal 분포에서 시간 스텝을 샘플링하며, 시간 가중치는 균등하게 적용한다.
- A.3. Inference에서 전체 모델은 FlowUniPC를 35단계로 사용하며, 텍스트 classifier-free guidance scale은 5.0이다. 단일 NVIDIA GB200 GPU에서 80프레임 구간을 생성하는 데 약 194초가 걸린다. 이 시간에는 깊이 추정, 검색, 디노이징이 포함된다. Ours DMD는 별도 CFG 순전파 없이 4단계로 약 15초가 걸린다. 2가지 경우 모두 공간 메모리 검색은 구간당 1초 미만이 걸린다.
- A.4. 3D Reconstruction에서 Gaussian 헤드는 k = 2를 사용해 Gaussian 수를 4배 줄인다. DAv3 미세 조정에는 DL3DV 이미지와 카메라 궤적을 바탕으로 자기회귀 생성한 1분 길이 비디오 3,000개를 사용한다. 학습은 10,000회 반복하며, 학습률은 5×10⁻⁵, 배치 크기는 8이다. 메시 계층 수준과 복셀 크기는 장면 규모에 따라 정하며, marching-cubes 표면은 계층 수준이 바뀌는 경계에서 병합한다.
- A.5. Related Work의 확장된 문헌 검토는 범주별 GAN에서 CLIP 감독, Score Distillation Sampling, multi-view diffusion, 반복적 inpainting, 명시적 NeRF·Gaussian·메시 표현으로 이어지는 3D 생성 연구를 살펴본다. Feed-forward 3D 모델도 검토하며, 이 모델들이 흔히 정적 장면에 한정된다는 점을 짚는다. 또한 동적 재구성을 다양한 생성 콘텐츠와 큰 시점 변화에 일반화하기 어렵다고 설명한다.
짧은 생각
핵심 기여는 공간 메모리의 기하 정보와 외관 합성을 분리하고, 적은 비용으로 불완전한 과거 관측을 사용해 학습하는 것이다. 비디오 비교와 제거 실험은 외관과 장기적인 스타일 일관성의 개선을 뒷받침한다. 재구성 비교에서는 DAv3를 조정하는 효과가 일관되게 나타난다. 카메라 정확도, 재투영 오차, 개별 프레임 품질은 서로 다른 목표이며, 측정 가능한 상충 관계가 있다. 전역 포인트 클라우드 제거 실험은 메모리 표현과 조건 입력을 모두 바꾼다. 따라서 프레임별 저장만의 효과를 분리해 입증하기보다, 결합된 설계를 뒷받침한다. 시연한 결과는 정적 3D 자산을 대화형으로 구간 단위 생성하는 방식이다. 유한한 길이의 비교와 정성적인 시뮬레이터 시연만으로는 무제한적인 장면 유지나 물리 시뮬레이션의 충실도를 입증할 수 없다.