AIMO-2 Winning Solution: OpenMathReasoning 요약 설명
23 Apr 2025 | Paper Review Mathematical Reasoning Tool-Integrated Reasoning Dataset목차
이 글은 Ivan Moshkov와 공동 저자가 2025년 4월 23일 공개한 보존 원문 arXiv:2504.16891v1을 다룬다. 저자들은 AIMO-2 제출에 사용한 데이터와 학습 방식, 이후 공개한 OpenMath-Nemotron 모델을 설명한다. 프로젝트, 코드.
출처 및 라이선스. 이 글은 Ivan Moshkov, Darragh Hanley, Ivan Sorokin, Shubham Toshniwal, Christof Henkel, Benedikt Schifferer, Wei Du, Igor Gitman의 AIMO-2 Winning Solution: Building State-of-the-Art Mathematical Reasoning Models with OpenMathReasoning dataset, arXiv:2504.16891v1를 요약한다. arXiv 레코드에는 이 논문의 라이선스가 CC BY 4.0으로 표시되어 있다. 아래 이미지는 해당 버전 PDF에서 자른 그림과 표다: 그림 1 (PDF 1쪽), 표 1 (PDF 3쪽), 표 2 (PDF 3쪽), 그림 2 (PDF 6쪽), 그림 3 (PDF 7쪽), 표 7 (PDF 9쪽), 표 9 (PDF 10쪽) 및 표 10 (PDF 10쪽).
요약
- 저자들은 AIMO-2 비공개 시험 문제 50개 중 34개를 풀어 1위를 차지했다고 보고한다. 이 점수는 논문의 보고이며 여기서 대회 결과를 독립 재현하지 않았다. [PDF 1–2, 8쪽]
- OpenMathReasoning은 고유 문제 540K개, 긴 사고 연쇄(CoT) 풀이 3.2M개, 도구 통합 추론(TIR) 풀이 1.7M개로 보고된다. TIR은 추론 과정에 코드 실행을 섞는 방식이다. [PDF 1–2, 4–5쪽]
- 생성 기반 풀이 선택인 GenSelect는 여러 풀이를 비교해 답을 고르도록 모델을 학습한다. 다수결과 구별되는 방식이며 저자들의 Kaggle 제출에는 사용되지 않았다. [PDF 5–6, 8쪽]
- 대회 모델은 이전 단계의 14B 체크포인트였다. 이후 공개된 OpenMath-Nemotron 계열과 벤치마크 점수를 34/50을 얻은 동일한 시스템의 결과로 읽으면 안 된다. 또한 남은 GenSelect 예시 수는 4.2절에서 565K, 결론에서 566K로 다르게 제시된다. [PDF 6, 8, 12쪽]
1. Introduction
논문은 수학 추론에서 충분한 문제와 유용한 풀이 과정을 확보하는 일, 여러 답이 서로 다를 때 신뢰할 만한 답을 고르는 일을 다룬다. 핵심 기여는 OpenMathReasoning 데이터, 코드 실행을 포함한 추론 데이터를 생성하고 거르는 방법, 학습된 풀이 선택 절차다. 공개 모델 계열은 대회 제출 이후 평가됐으므로 결과를 해석할 때 이 시점 차이를 구분해야 한다. [PDF 1–2쪽]
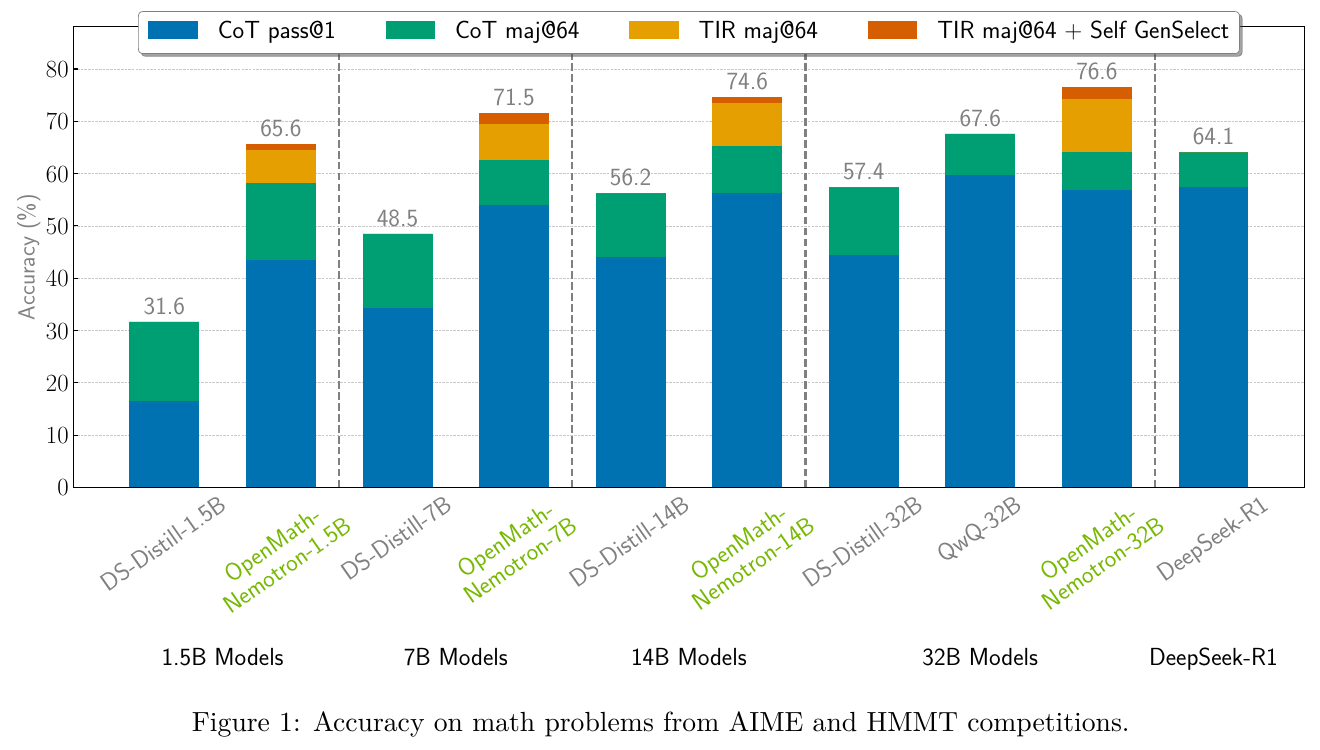
모델 크기와 추론 방식에 따른 AIME와 HMMT 정확도를 비교한다. 색은 CoT, TIR과 자체 GenSelect 결과를 구분한다.
2. Data Preparation
2.1 Problems preparation
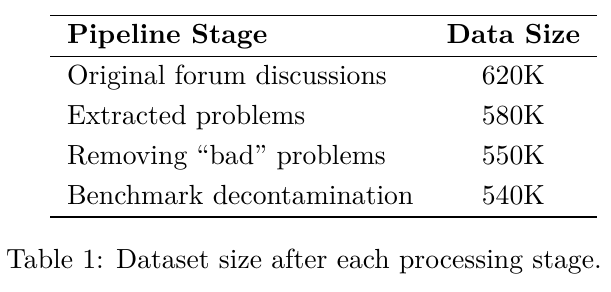
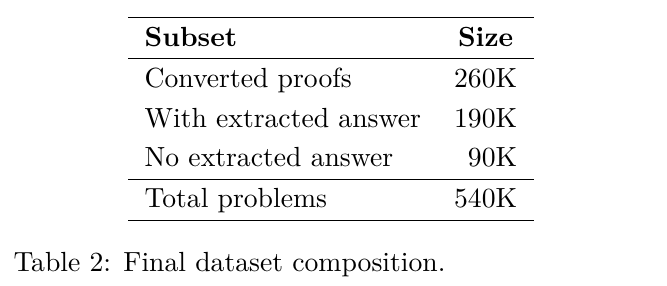
저자들은 포럼 토론을 출발점으로 삼아 문제 추출, 분류, 필터링, 답 추출, 평가 자료와의 중복 제거를 차례로 수행한다. 유효하지 않은 문제, 이진 선택 문제, 객관식 문제를 제거하고 일부 증명 문제는 답으로 검증할 수 있는 형태로 바꾼다. 표 1은 토론 620K건에서 문제 540K개까지 이어지는 과정을, 표 2는 최종 데이터 구성을 보여 준다. 이 과정은 생성되거나 추론된 판단에 의존하므로 데이터 수만으로 남은 모든 문제와 답의 정확성이 보장되지는 않는다. [PDF 2–3쪽]
저자들이 보고한 처리 과정에서는 포럼 토론 620K건을 추출, 필터링, 벤치마크 오염 제거를 거쳐 문제 540K개로 정리한다.
최종 데이터는 변환된 증명 260K개, 답이 추출된 문제 190K개, 답이 추출되지 않은 문제 90K개로 구성된다.
2.2 Comp-Math-24-25 Benchmark
저자들은 AIMO-2와 비슷한 평가를 위해 AIME 2024와 2025, HMMT 2024와 2025에서 문제 256개를 모았다. 증명 문제와 부분 점수를 주는 문제는 제외했다. 이 자료는 로컬 검증용이며 대회의 비공개 시험 자료와는 별개다. [PDF 3쪽]
2.3 Text-based Solution Synthesis
DeepSeek-R1과 QwQ-32B가 문제당 최대 32개의 CoT 풀이 후보를 생성한다. 추출된 정답이 있으면 그 답을 기준으로 후보를 거르고, 답을 추출하지 못한 경우에는 다수결로 얻은 답을 사용한다. 논문은 필터링 후 CoT 풀이 3.2M개를 보고한다. 다수결로 만든 정답에는 여러 후보가 공유하는 오류가 남을 수 있으므로 모든 답을 독립적으로 증명한 과정으로 볼 수는 없다. [PDF 3–4쪽]
3. Tool-Integrated Reasoning
TIR은 모델이 작성한 추론 문장 사이에 실행 가능한 코드와 그 결과를 포함한다. 저자들은 초기 추론 모델에 도구 사용을 지시하는 것만으로는 유용한 코드 사용이 일관되게 나타나지 않았다고 보고한다. 대안으로 TIR 예시 학습, 후보 생성, 필터링을 반복한다. [PDF 4–5쪽]
3.1 Instruction-following reasoning model
첫 단계에서는 지시 이행 모델을 소량의 추론 예시로 미세 조정한 뒤 초기 TIR 후보를 생성한다. 이는 반복 과정의 출발점이며, 이후 예시 전체가 한 번의 생성에서 나왔다는 뜻은 아니다. [PDF 4쪽]
3.2 Filtering TIR data
필터는 풀이의 정답 여부와 코드가 풀이에 실질적으로 기여하는지를 함께 평가한다. 단순한 계산 확인에만 쓰인 코드와 유용한 중간 계산을 수행한 코드는 같은 역할이 아니다. 이 품질 판단 역시 논문에서 사용한 필터 절차에 의존한다. [PDF 4–5쪽]
3.3 Iterative data generation
저자들은 생성, 필터링, 학습을 반복해 최종 TIR 풀이 1.7M개를 보고한다. 이 수치는 공개 데이터 전체를 가리키며, 대회용 학습 방식에 사용된 초기 단계(stage-0) TIR 예시 15K개와 구분해야 한다. [PDF 5, 8쪽]
3.4 Controlling code blocks
실행 예산을 조절하기 위해 학습 예시에 남은 호출 횟수를 표시하고 제한을 넘긴 생성을 걸러 낸다. 이는 모델이 주어진 제한 안에서 작업하도록 학습시키는 방법이며, 생성된 모든 코드의 안전성이나 정확성을 보장하지는 않는다. [PDF 5쪽]
4. Generative Solution Selection
다수결은 후보에서 가장 자주 나온 답을 선택한다. GenSelect는 학습된 모델이 후보 풀이들을 비교해 더 유망한 답을 고르게 한다. 성능은 후보 집합과 선택 모델 양쪽에 의존하며, 후보 중 정답이 하나도 없으면 선택 단계만으로 정답을 복구할 수 없다. [PDF 5–6쪽]
4.1 Creating New Summaries
일부 추론 모델의 답변은 마지막 부분이 지나치게 짧아 비교하기 어렵기 때문에 저자들은 후보 풀이의 요약을 다시 생성한다. 이 요약은 비교에 쓰는 입력이며, 원래 풀이가 타당하다는 독립적인 증거는 아니다. [PDF 5쪽]
4.2 Generating Selection Candidates
정답과 오답 후보가 섞인 그룹을 만들고, 선택 결과와 그 근거를 생성한 다음 잘못된 풀이를 선택한 기록을 걸러 낸다. 4.2절은 남은 기록을 565K개로 보고한다. 결론에는 566K개가 제시되며, 여기서 확인한 부분에서는 차이가 해소되지 않는다. [PDF 6, 12쪽]
4.3 Reducing computational cost
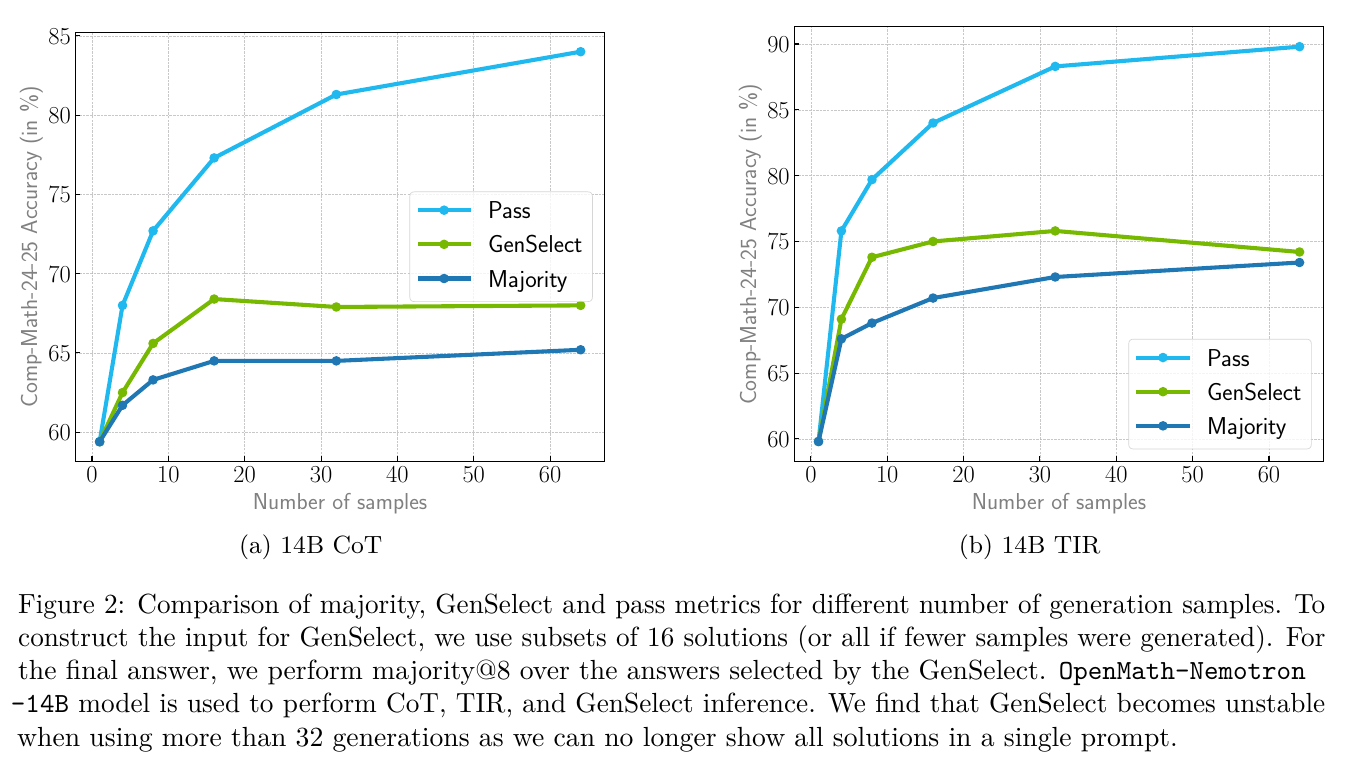
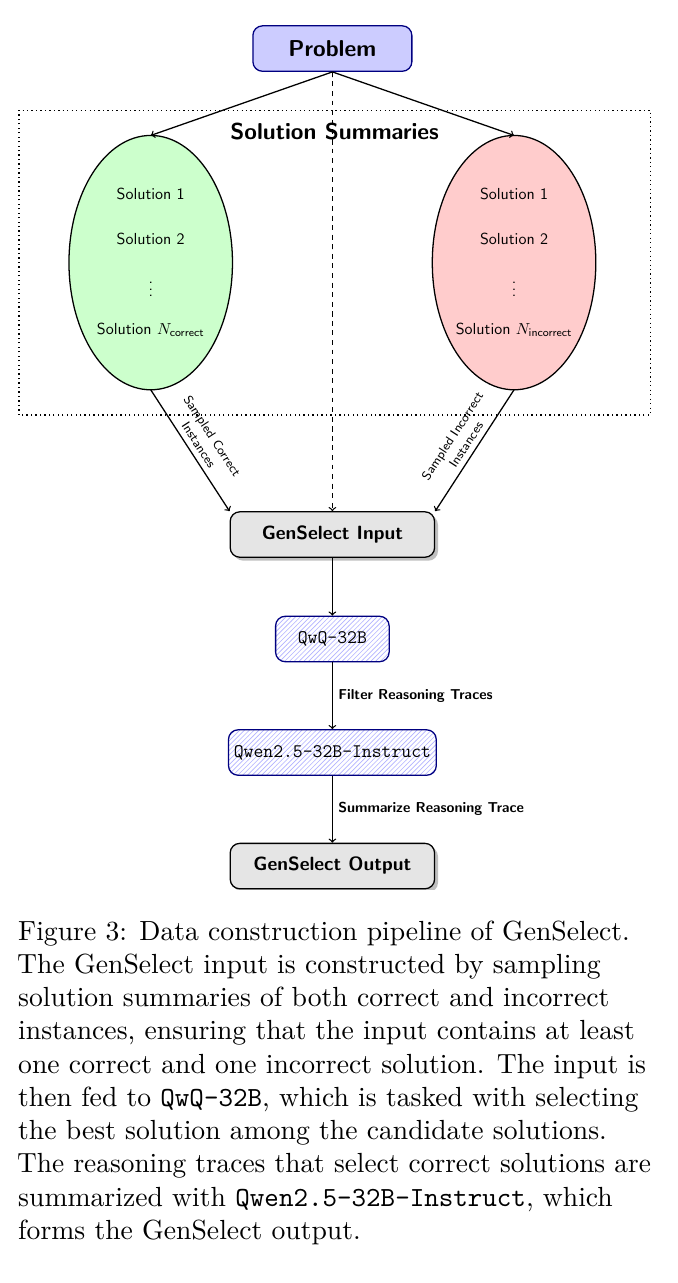
다시 생성한 요약을 사용하면 선택 모델이 비교해야 할 텍스트 양을 줄일 수 있다. 저자들은 프롬프트 길이 제한 때문에 후보 32개를 초과하면 비교가 불안정해졌다고 보고한다. 그림 2는 선택 방식과 다수결 및 통과 지표를 비교하고, 그림 3은 데이터 생성 과정을 보여 준다. [PDF 6–7쪽]
두 그래프는 14B CoT와 TIR 모델에서 생성 표본 수에 따른 pass, GenSelect, 다수결 정확도를 비교한다.
파이프라인은 정답과 오답 풀이 요약을 표본으로 뽑아 풀이를 선택하고, 추론 과정을 필터링한 뒤 남은 과정을 요약해 GenSelect 학습 데이터를 만든다.
5. OpenMath-Nemotron models
논문은 파라미터가 1.5B, 7B, 14B, 32B인 모델 계열과 CoT, TIR, 선택 작업에 맞춰 학습한 변형을 설명한다. 파라미터 수는 모델 크기를 나타내며 그 자체가 정확성이나 계산 비용을 측정하는 값은 아니다. [PDF 6–7쪽]
5.1 Training
저자들은 지도 미세 조정을 수행한 뒤 더 어렵고 긴 문제에 중점을 둔 두 번째 학습을 진행한다. 표 6은 첫 번째와 두 번째 학습 후 majority@64 결과를 제시한다. 이는 저자들의 설정 안에서 이뤄진 비교이며 데이터, 모델 크기, 학습 시간의 효과를 각각 완전히 분리한 결과는 아니다. [PDF 6–7쪽]
첫 번째 학습은 CoT, TIR, GenSelect 세 작업을 섞어 6 에폭 동안 진행하며 작업마다 다른 프롬프트를 사용한다. 논문이 밝힌 학습 데이터는 CoT 3.2M개, TIR 1.7M개, GenSelect 566K개로 총 5.5M개다. 두 번째 학습에는 더 어렵고 긴 2.2M개 표본을 사용해 4 에폭을 학습하며, 32B를 제외한 모델에 적용한다. 표 6에서 CoT 결과는 대체로 개선됐고 TIR 결과는 비슷하거나 조금 낮아졌다. 이는 보고된 실행에서 관찰된 결과다. 여기의 566K는 앞에서 설명한 4.2절의 565K와 다르다. [PDF 7쪽]
5.2 Results
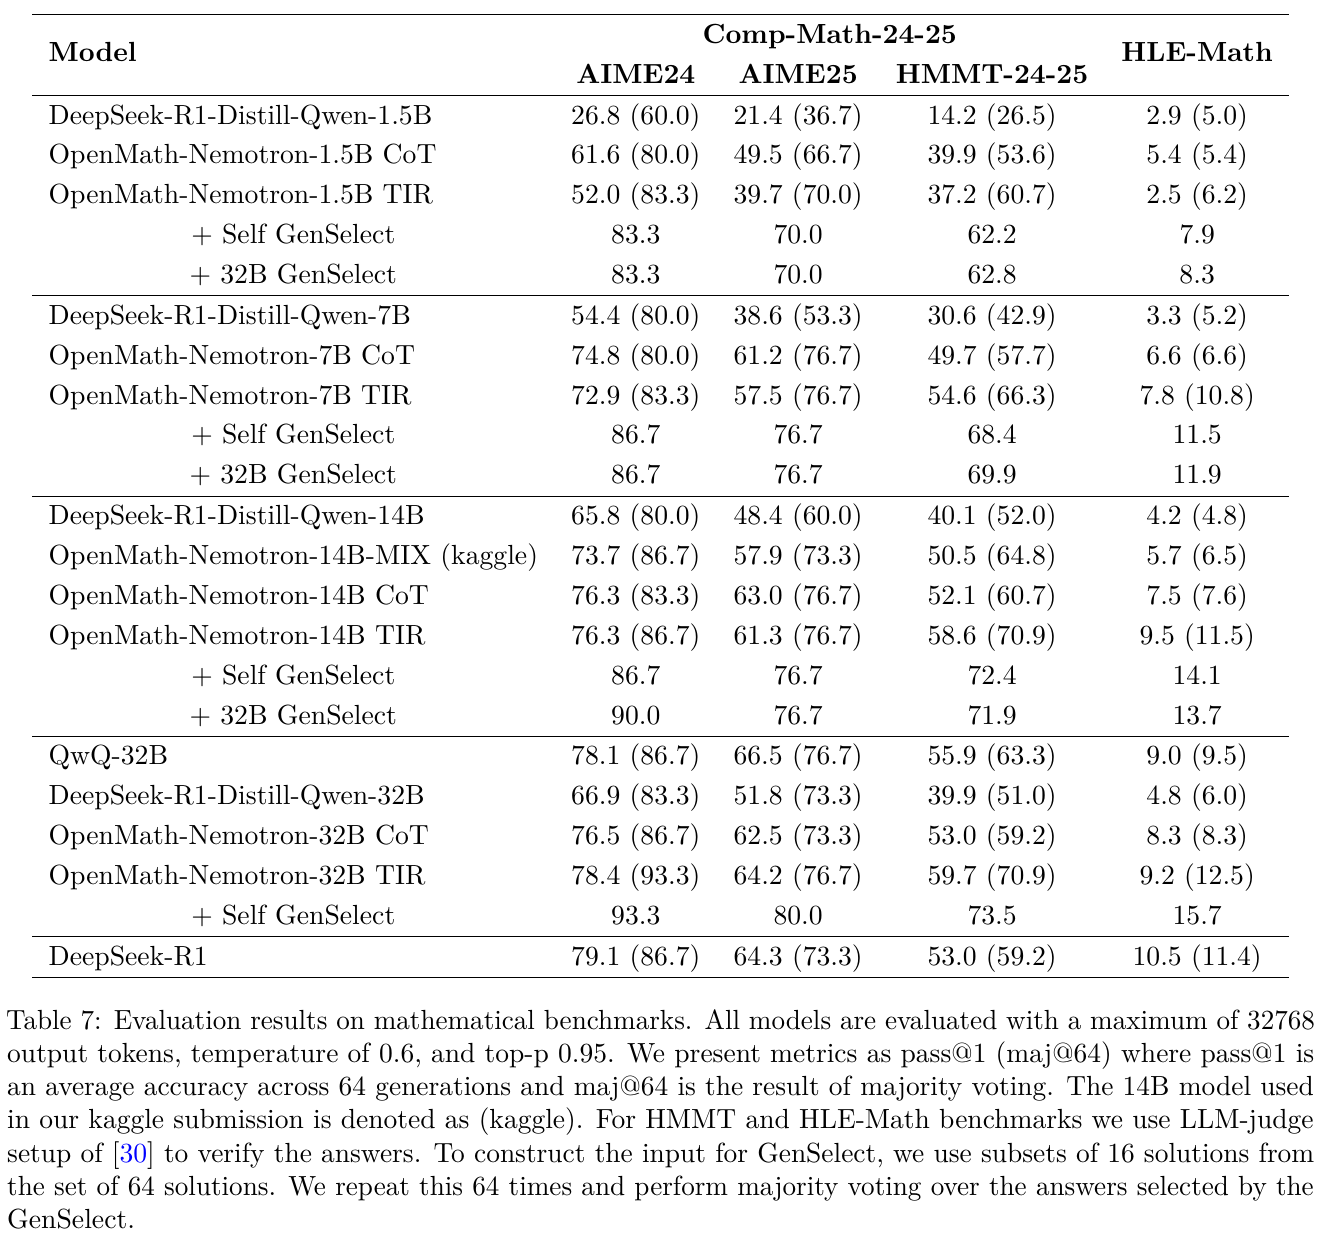
표 7은 pass@1 다음에 괄호로 majority@64를 표시한다. AIME24 열에서 OpenMath-Nemotron-14B CoT는 pass@1 76.3, majority@64 83.3으로 보고된다. 별도로 14B TIR 아래 행은 self GenSelect 86.7, 32B GenSelect 90.0을 제시한다. 이 선택 점수를 CoT 행의 결과로 돌리면 안 된다. 논문은 HLE-Math와 HMMT에 LLM 심사 방식을 사용했다고 설명하며, 이 글에서는 벤치마크 결과를 독립 재현하지 않았다. [PDF 7, 9쪽]
표 8은 32K 토큰을 생성한 결과에 \boxed 답이 없으면 미완성 풀이로 분류한다. 이 기준에서 1.5B의 미완성 비율은 CoT 2.23%, TIR 40.31%이고, 7B는 각각 0.98%와 6.45%, 14B는 1.13%와 4.06%다. 저자들은 작은 모델이 도구를 덜 일관되게 사용할 가능성을 제시하지만, 이를 가설로 설명한다. 미완성 비율은 pass@1과 다수결 결과를 비교할 때 참고할 수 있으나, 이 기준만으로 실패 원인을 각각 규명할 수는 없다. [PDF 8, 10쪽]
표는 모델과 추론 방식별 수학 벤치마크 결과를 제시한다. 캡션은 pass@1과 다수결@64를 구분하고 GenSelect와 LLM 판정 방식을 설명한다.
6. Kaggle submission
대회 제출에는 이전 Qwen2.5-14B 모델과 별도의 학습 및 서빙 방식이 사용됐다. 저자들은 CoT 예시 2.2M개와 초기 단계(stage-0) TIR 샘플 15K개로 학습한 뒤 CoT와 TIR 체크포인트를 합쳤다고 보고한다. Kaggle 제출에는 GenSelect를 사용하지 않았다고 명시한다. [PDF 8쪽]
6.1 Training recipe
대회용 방식은 앞에서 설명한 대회 전용 데이터 조합을 사용해 CoT와 TIR 모드를 학습한다. 이 데이터 구성과 체크포인트는 이후 모델 계열과 별개다. [PDF 8쪽]
저자들은 먼저 Qwen2.5-14B-Base를 CoT 풀이 2.2M개로 8 에폭 학습했다. 이때 DeepSeek-R1 풀이만 사용하고 증명에서 변환한 문제는 제외했다. 이어 초기 단계(stage-0) TIR 표본 15K개로 고정 학습률 1e-5에서 400 스텝 미세 조정하고, 평균화하지 않은 마지막 체크포인트를 사용했다. 이 방식은 이후 5.5M개 혼합 작업 학습과 구분해야 한다. [PDF 8쪽]
6.2 Model Merging
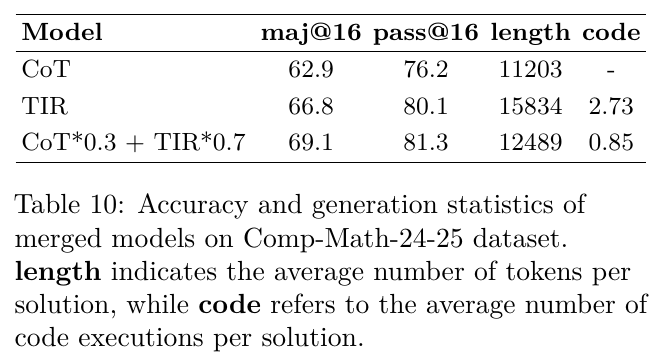
저자들은 CoT와 TIR 체크포인트를 합쳐 하나의 모델을 만든다. 이 모델이 이후 모델 계열처럼 프롬프트로 CoT와 TIR 모드를 전환하지 못했다고 설명한다. 따라서 대회 결과를 이후 GenSelect 시스템에 대한 직접 평가로 사용할 수 없다. [PDF 8쪽]
6.3 Inference Optimizations
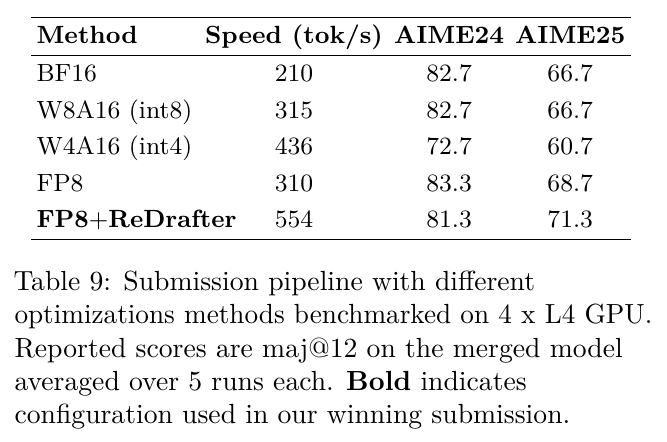
제출 시스템은 대회 운영 조건에 맞추기 위해 TensorRT-LLM, ReDrafter, 서빙과 시간 배분 방식, 격리된 코드 실행을 사용한다. 표 9와 10은 속도, 정확도와 병합 모델 비교를 제시한다. 특정 설정에서 측정한 속도가 다른 하드웨어에서도 같다는 뜻은 아니다. [PDF 8–10쪽]
6.3.1 TensorRT-LLM Optimization
TensorRT-LLM의 in-flight batching은 완료된 표본을 배치에서 개별적으로 내보내며 paged KV caching 같은 최적화도 사용한다. 저자들은 비교 실험에서 정확도 손실을 최소화하면서 추론 속도를 높이기 위해 W8A16 가중치 전용 방식과 FP8 양자화를 우선했다고 보고한다. 이는 속도와 정확도의 절충이며 다른 배포 환경에서 같은 결과를 보장하지 않는다. [PDF 9쪽]
6.3.2 Speculative Decoding
ReDrafter는 한 스텝에서 최대 3개 토큰을 제안하며, 논문은 약 65%의 스텝에서 3개가 모두 수용됐다고 보고한다. 학습에는 OpenMathReasoning 문제 100K개를 표본으로 뽑고 각 문제에 대한 대상 모델 풀이 하나를 사용했다. 최종 제출은 거의 greedy에 가까운 설정을 사용했다. 저자들은 동일 프롬프트 배치에서도 출력이 달라진 현상을 보고하며, 수치 오차의 누적을 가능한 원인으로만 제시한다. [PDF 9–10쪽]
6.3.3 Model Serving
FastAPI 백엔드와 Nemo-Skills의 비동기 생성은 시간 제한과 조기 종료를 지원했다. 저자들의 예에서는 생성 16개 중 먼저 완료된 4–5개가 같은 답에 동의하면 나머지를 취소할 수 있었고, 오래 걸리는 요청도 취소했다. 이 정책은 시간을 줄일 수 있지만 먼저 나온 답들의 일치만으로 정답이 보장되지는 않는다. [PDF 10쪽]
6.3.4 Time Management
문제마다 기본 350초를 배정했다. 일찍 끝나 남은 시간은 공유 버퍼에 넣고, 이후 문제는 여기서 최대 210초를 더 가져와 최대 560초를 사용할 수 있었다. 이는 대회 전용 제한이며 모델 지연 시간을 측정한 수치는 아니다. [PDF 10쪽]
6.3.5 Code Execution Integration
도구 래퍼는 Flask 샌드박스에서 Python 코드를 병렬 실행했다. 생성 주기당 코드 호출은 최대 6회, 각 실행 제한 시간은 2초였고 출력은 처음 200자만 모델에 돌려줬다. 실행 결과나 오류도 생성 과정에 전달했다. 이는 저자들의 구현에서 사용한 제한이며 임의의 생성 코드가 안전하다는 증거는 아니다. [PDF 10쪽]
4개 L4 GPU에서 최적화 방식별 속도와 AIME 점수를 비교한다. 캡션에 따르면 점수는 병합 모델의 다수결@12 결과를 다섯 번 실행해 평균한 값이다.
표는 Comp-Math-24-25에서 CoT, TIR과 병합 체크포인트의 정확도, 평균 출력 길이, 평균 코드 실행 횟수를 비교한다.
6.4 Discussion
저자들은 이후 모델이 대회 점수를 높이지 못한 이유로 순위표의 변동성, 로컬 평가와 대회 성능의 차이, 최종 모델에서 길어진 생성 등을 논의한다. 이는 저자들이 검토한 가능성이며 실험으로 확정된 원인은 아니다. [PDF 11쪽]
7. Related Work
관련 연구는 도구를 통합한 수학 추론, 생성 기반 보상 또는 선택 모델, 공개 수학 데이터셋을 다룬다. 각 구성 요소의 배경을 제공하지만, 한 요소만으로 최종 대회 결과가 발생했음을 입증하지는 않는다. [PDF 11–12쪽]
8. Conclusion
논문은 코드 실행과 후보 선택을 활용한 긴 수학 추론을 위한 데이터 파이프라인과 모델 계열을 제시한다. 대회에 관한 가장 직접적인 근거는 별도의 이전 제출에서 34/50을 얻었다는 저자들의 보고다. 이후 벤치마크 결과, 데이터 수와 후보 선택 실험은 더 넓은 연구 결과를 뒷받침하지만 독립 재현을 대신하지는 않는다. [PDF 8, 12쪽]
Appendix
부록 A부터 D까지는 문제 준비, TIR 생성 및 평가, 추론, GenSelect 데이터 생성에 사용한 프롬프트를 제시하며 부록 D는 PDF 37쪽까지 이어진다. 부록 E와 F에는 다시 생성한 요약과 TIR 출력 예시가 있다. 이 글의 쪽수는 보존된 PDF를 기준으로 한다. [PDF 16–39쪽]
간단한 생각
여러 그럴듯한 풀이를 생성하는 일과 코드 사용 및 답 선택이 신뢰성을 높이는지 확인하는 일은 구분해야 한다. 논문은 두 단계를 구체화하지만 데이터와 평가 과정에 모델 판단이 포함되며, 일부 결과는 여기서 독립적으로 감사하지 않았다. 더 강한 결론을 내리려면 원본 예시와 평가 절차, 해결되지 않은 565K와 566K의 차이를 확인해야 한다.