


Are We Ready For An Agent-Native Memory System? 요약 설명
23 Jun 2026 | Paper Review Agent's Memory LLM Evaluation Benchmark목차
이번 글에서는 Are We Ready For An Agent-Native Memory System? 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 23일(Arxiv)
- Zhou, Wei, Zhou, Xuanhe, Han, Shaokun, Xu, Hongming, Li, Guoliang, Li, Zhiyu, Xiong, Feiyu, Wu, Fan.
- Shanghai Jiao Tong University, Tsinghua University, MemTensor (Shanghai) Technology Co., Ltd
- 논문 링크
- Github
- Project Page
요약
- Are We Ready For An Agent-Native Memory System?은 에이전트 메모리를 지속적인 데이터 관리 인프라로 살펴본다. 핵심 문제는 최종 답변 품질을 측정하는 종단 간 지표만으로는 근거 보존, 시간에 따른 갱신, 검색, 운영 효율에서 발생하는 실패를 파악하기 어렵다는 점이다.
- 논문은 메모리 시스템을 표현과 저장, 추출, 검색과 라우팅, 유지관리로 분해한다. 11개 데이터셋을 포괄하는 5개 벤치마크 워크로드에서 대표 시스템 12개와 참조 베이스라인 2개를 비교하고, 구성요소를 통제한 변형 실험을 추가한다. 실험에 포함된 시스템 범위는 워크로드마다 다르다.
- 결과는 워크로드에 맞는 아키텍처 선택을 뒷받침한다. 연결형 또는 계층형 메모리는 분산된 근거를 검색하는 데 도움이 되지만, 과도한 추출과 요약은 나중에 필요한 세부 정보를 버릴 수 있다. 보고된 실행에서는 메모리 일부에 유지관리를 한정하는 시스템이 유용성과 지연 시간 사이에서 유리한 절충을 보인다. 다만 일부 그래프와 본문의 주장이 일치하지 않아 특정 순위의 신뢰도에는 한계가 있다.
3.1 Memory Representation and Storage
분석 프레임워크는 에이전트 메모리 시스템을 \(M_{sys}=\langle R,S,Q,U\rangle\)로 형식화하고, 메모리 수명주기를 4개 모듈로 나눈다. 표현과 저장에서는 검색과 추론에 제공하는 논리적 구성과 물리적 영속화 및 인덱싱을 구분한다.
- 기초 개념에서는 단기 메모리와 장기 메모리를 구분하고, 일화적 정보, 의미적 정보, 절차적 정보, 선호 정보를 정의한다. 논문은 기존 RAG를 정적 코퍼스에 대한 읽기 전용 검색으로 설명한다. 에이전트 메모리는 지속적으로 보존하고 수정할 수 있는 에이전트별 상태를 관리한다.
- 에이전트 워크로드는 의미 기반 접근, 불확실하거나 충돌하는 관측, 일화 회상과 시간 추론 및 절차 실행 같은 다양한 작업을 결합한다. 컨텍스트 엔지니어링은 추론에 사용할 윈도우를 구성하고, 메모리 인프라는 윈도우와 세션을 넘어 상태를 관리한다. 컨텍스트 엔지니어링에 대해서는 Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models 요약 설명 글을 참조하라.
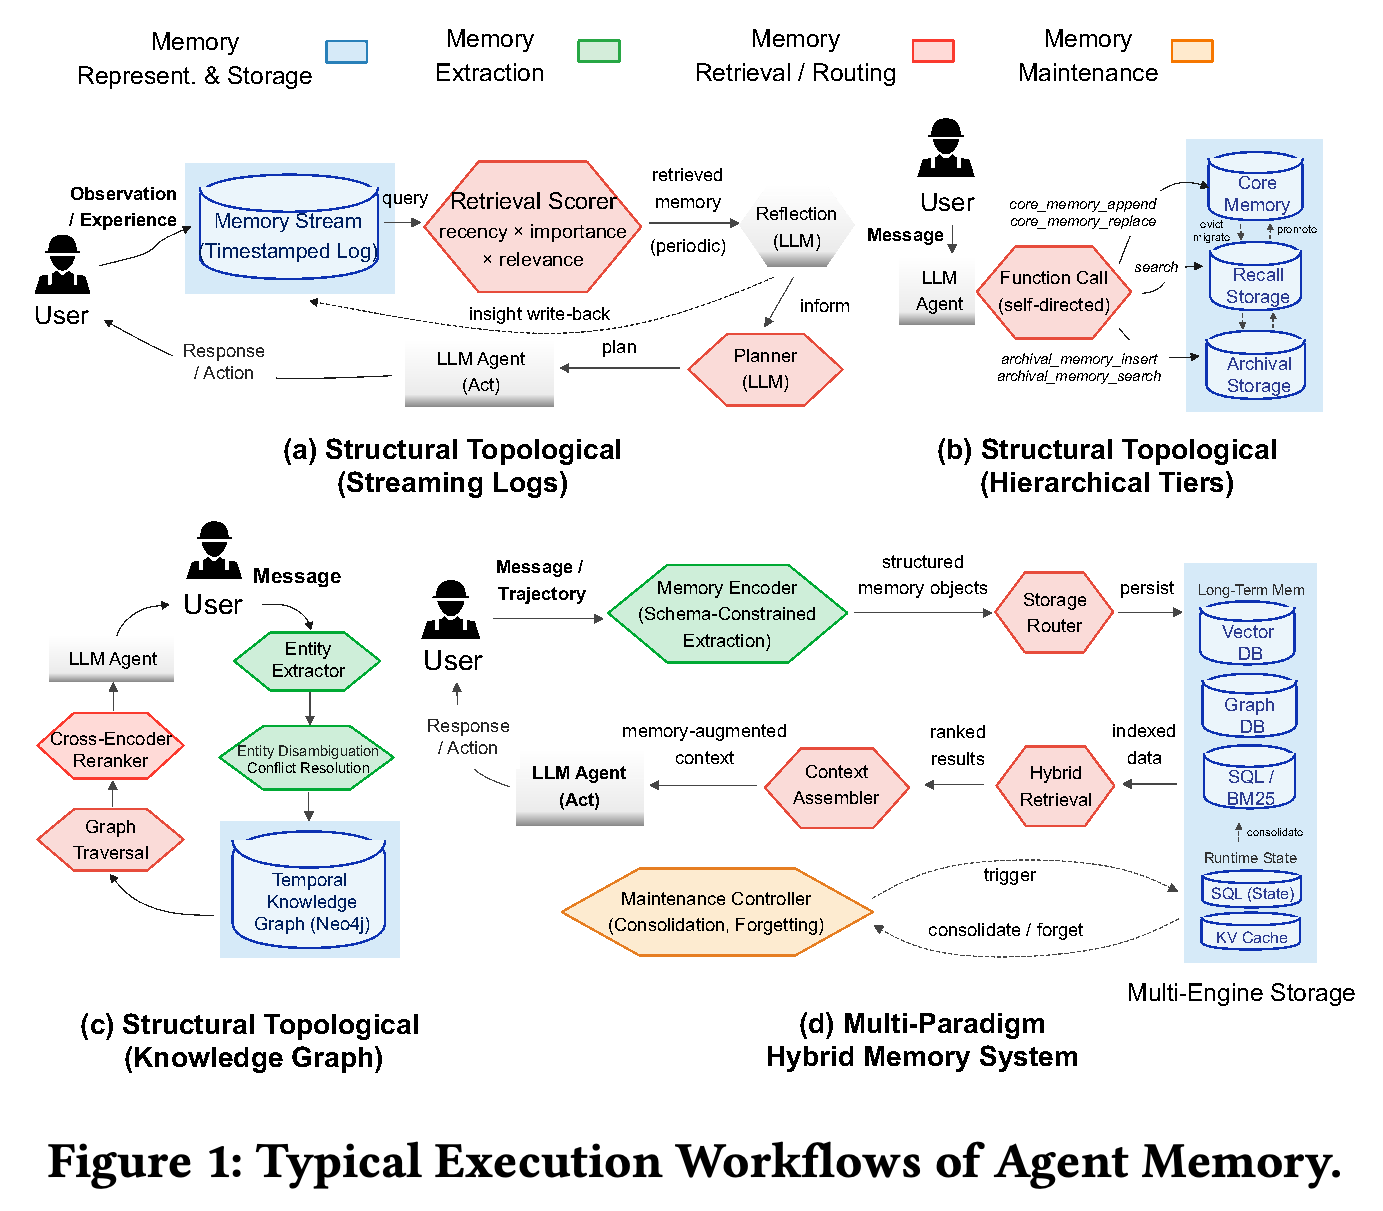
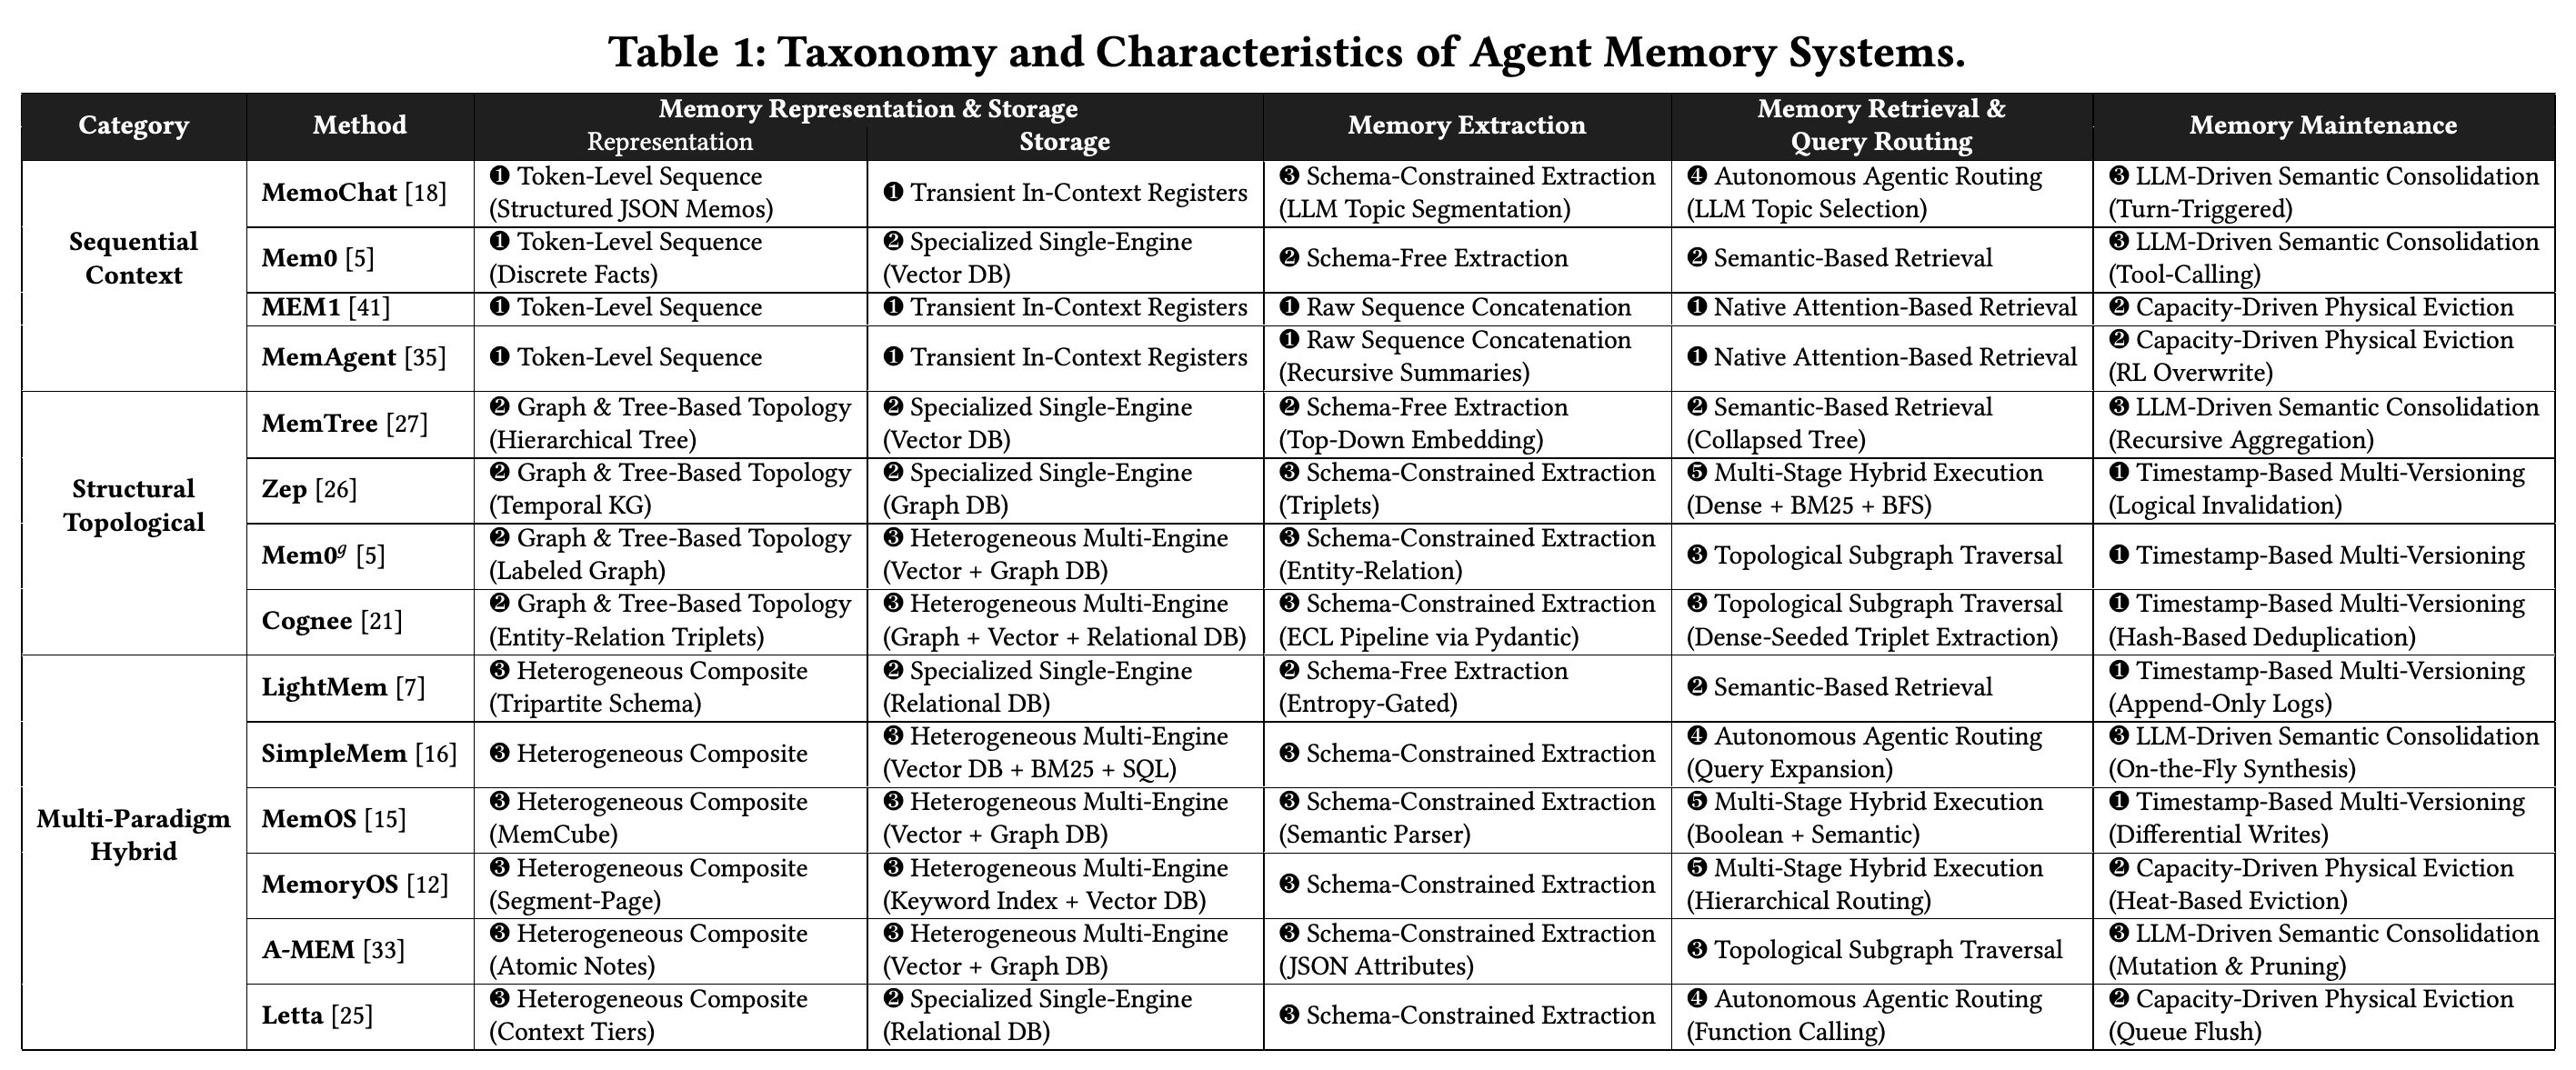
- Figure 1과 Figure 2는 실행 워크플로와 표현 방식을 소개한다. Table 1은 대표 시스템이 4개 모듈을 어떻게 조합하는지 정리한다.
워크플로는 시스템마다 메모리를 추출하고 검색하며 유지관리하는 단계가 다름을 드러낸다. 스트리밍 reflection, 계층 간 이동, 시간 그래프 처리, 하이브리드 저장소 라우팅을 보면 종단 간 답변 점수만으로 실패를 일으킨 모듈을 식별할 수 없는 이유를 알 수 있다.
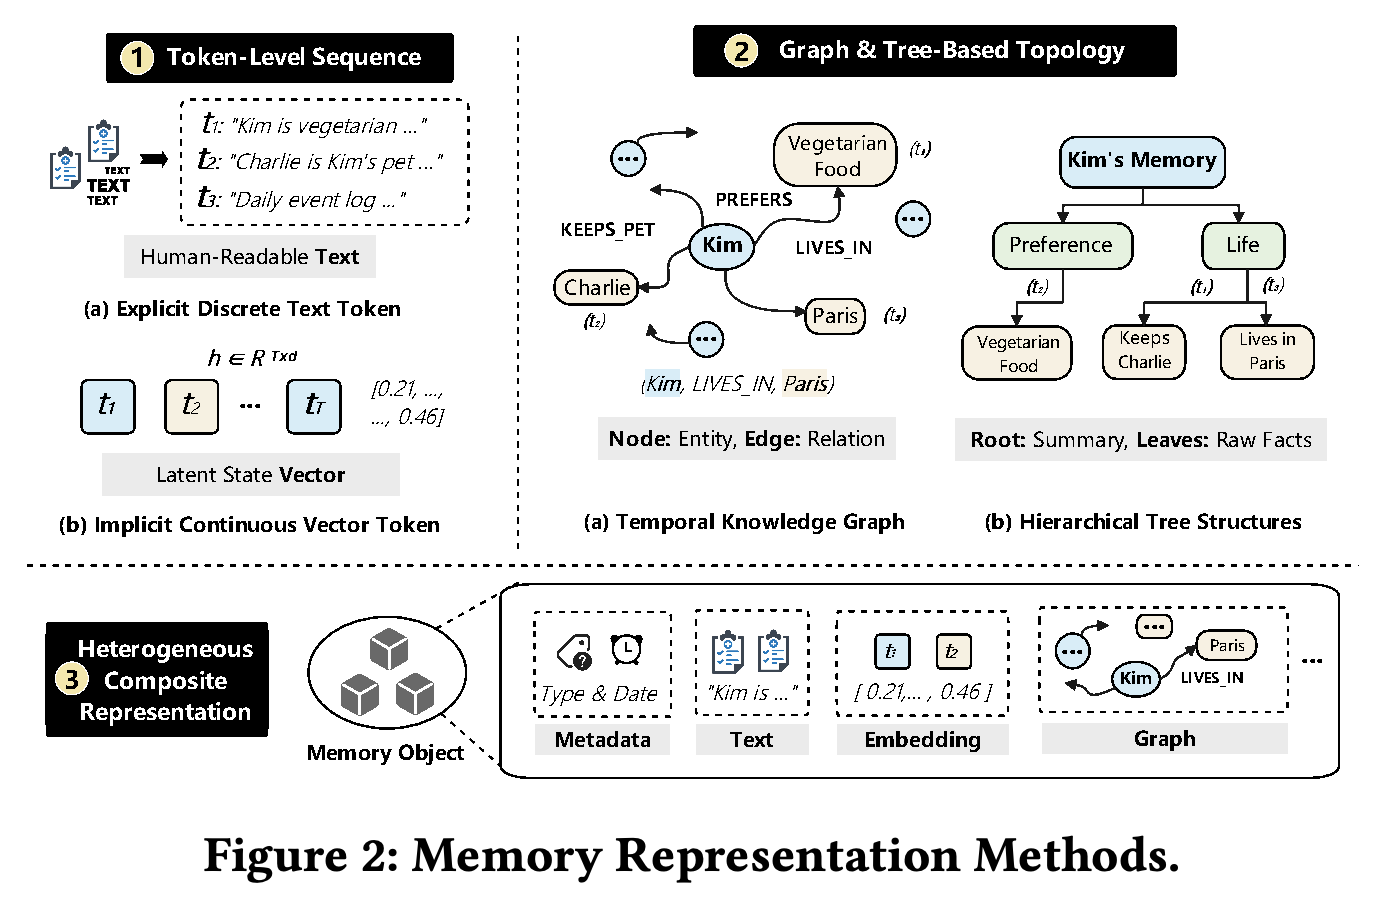
평면적 텍스트와 잠재 벡터는 명시적 관계 없이 내용을 인코딩하고, 그래프와 트리는 연결이나 추상화 수준을 드러낸다. 복합 메모리 객체는 메타데이터, 텍스트, 임베딩, 그래프 구조가 단일 표현에 한정되지 않고 공존할 수 있음을 보여준다.
3.1.1 Logical Representation.
논리적 표현은 토큰 수준 시퀀스, 그래프 및 트리 기반 위상 구조, 이질적인 복합 객체로 나뉜다. 이 선택에 따라 메모리가 읽을 수 있는 사실, 잠재 벡터, 명시적 관계, 계층적 요약, 동일한 정보에 대한 연계된 뷰 중 무엇을 제공하는지가 달라진다.
- 토큰 수준 메모리에는 개별 진술과 임베딩 또는 KV-cache 텐서 같은 연속 표현이 포함된다. 이들은 텍스트 처리나 의미 기반 접근을 지원하지만, 조건식 수준의 필터링과 특정 사실의 갱신에 필요한 명시적 관계를 자체적으로 드러내지는 않는다.
- Zep은 시간 지식 그래프를 모델링하고, MemTree는 세부 관측을 리프에 배치하고 더 넓은 범위의 요약을 상위 노드에 배치한다.
- 복합 객체는 텍스트, 메타데이터, 임베딩, 링크를 결합한다. MemOS의 MemCube는 일반 텍스트, 활성화, 파라미터 메모리 페이로드를 포함한다.
이 분류 체계는 개별 시스템을 모듈 조합으로 정리한다. 포괄적인 아키텍처 명칭만으로는 시스템의 동작을 충분히 설명하기 어렵다는 관점이다. 모든 벤치마크에 등장하지 않는 시스템도 포함하므로, 분류 체계에 속한다고 해서 전체 실험에 포함된 것은 아니다.
3.1.2 Physical Storage and Indexing.
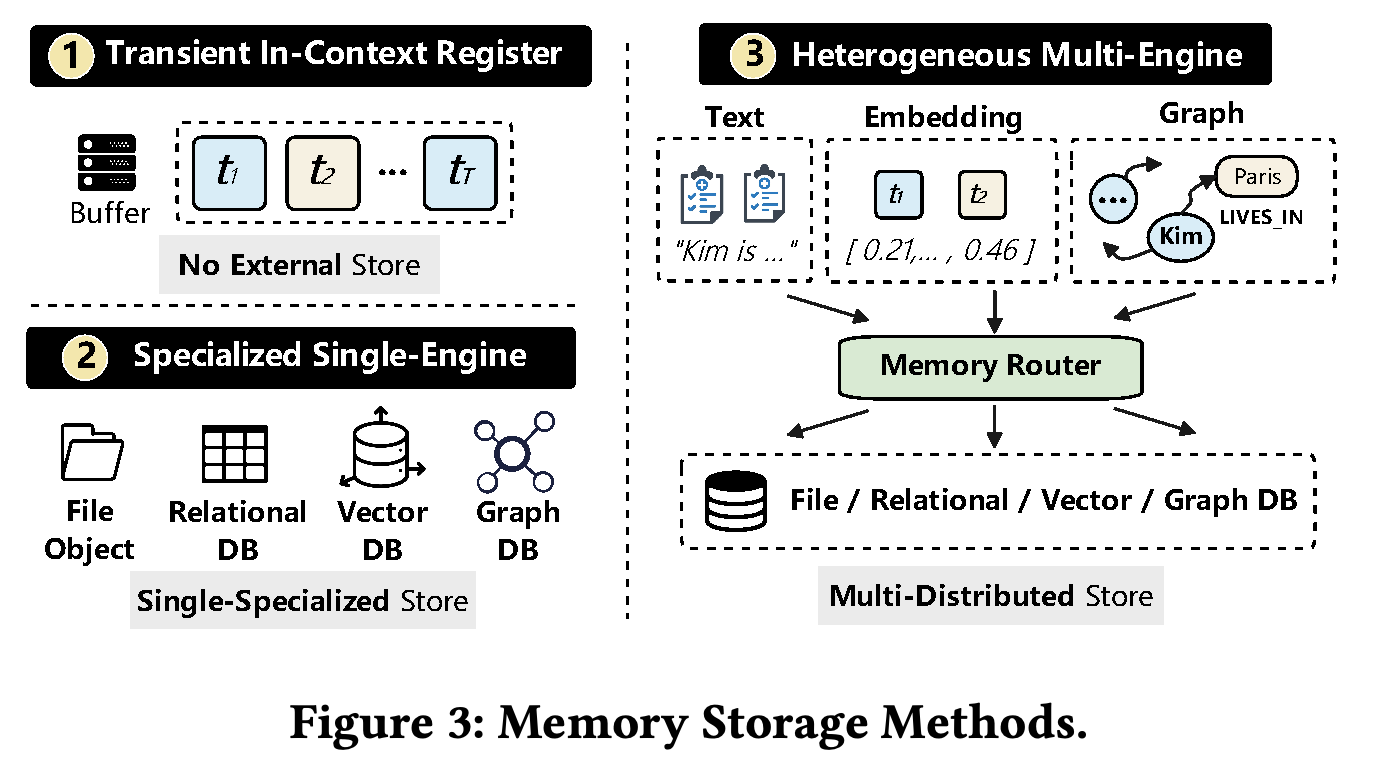
물리적 저장 방식에는 일시적인 컨텍스트 내부 레지스터, 특화된 단일 엔진 저장소, 이질적인 다중 엔진 백엔드가 있다. Figure 3은 이러한 배치 방식을 구분한다. 이들은 논리적 표현과 별개로 용량, 영속성, 접근 경로, 조정 오버헤드에 영향을 준다.
- MemoChat은 구조화된 메모를 LLM 입력 컨텍스트에 유지한다. 외부 저장소는 파일, 관계형 데이터베이스, 벡터 엔진, 그래프 데이터베이스를 사용할 수 있다.
- SimpleMem은 dense 임베딩, sparse BM25 인덱스, SQL 조건식을 갖춘 LanceDB를 사용한다. MemoryOS는 dense 코사인 유사도와 이산 Jaccard 유사도를 결합한다.
- 여러 인덱싱 뷰는 검색 선택지를 넓히지만, 동기화와 라우팅 작업도 추가하므로 그 비용을 측정해야 한다.
도식은 외부 저장소 없이 수행하는 연산, 특화된 단일 백엔드, 라우팅으로 연결한 이질적 저장소 집합을 구분한다. 이 구분을 통해 영속성과 저장소 간 조정이 실행 경로의 어느 지점에 들어가는지 파악할 수 있다.
3.2 Memory Extraction
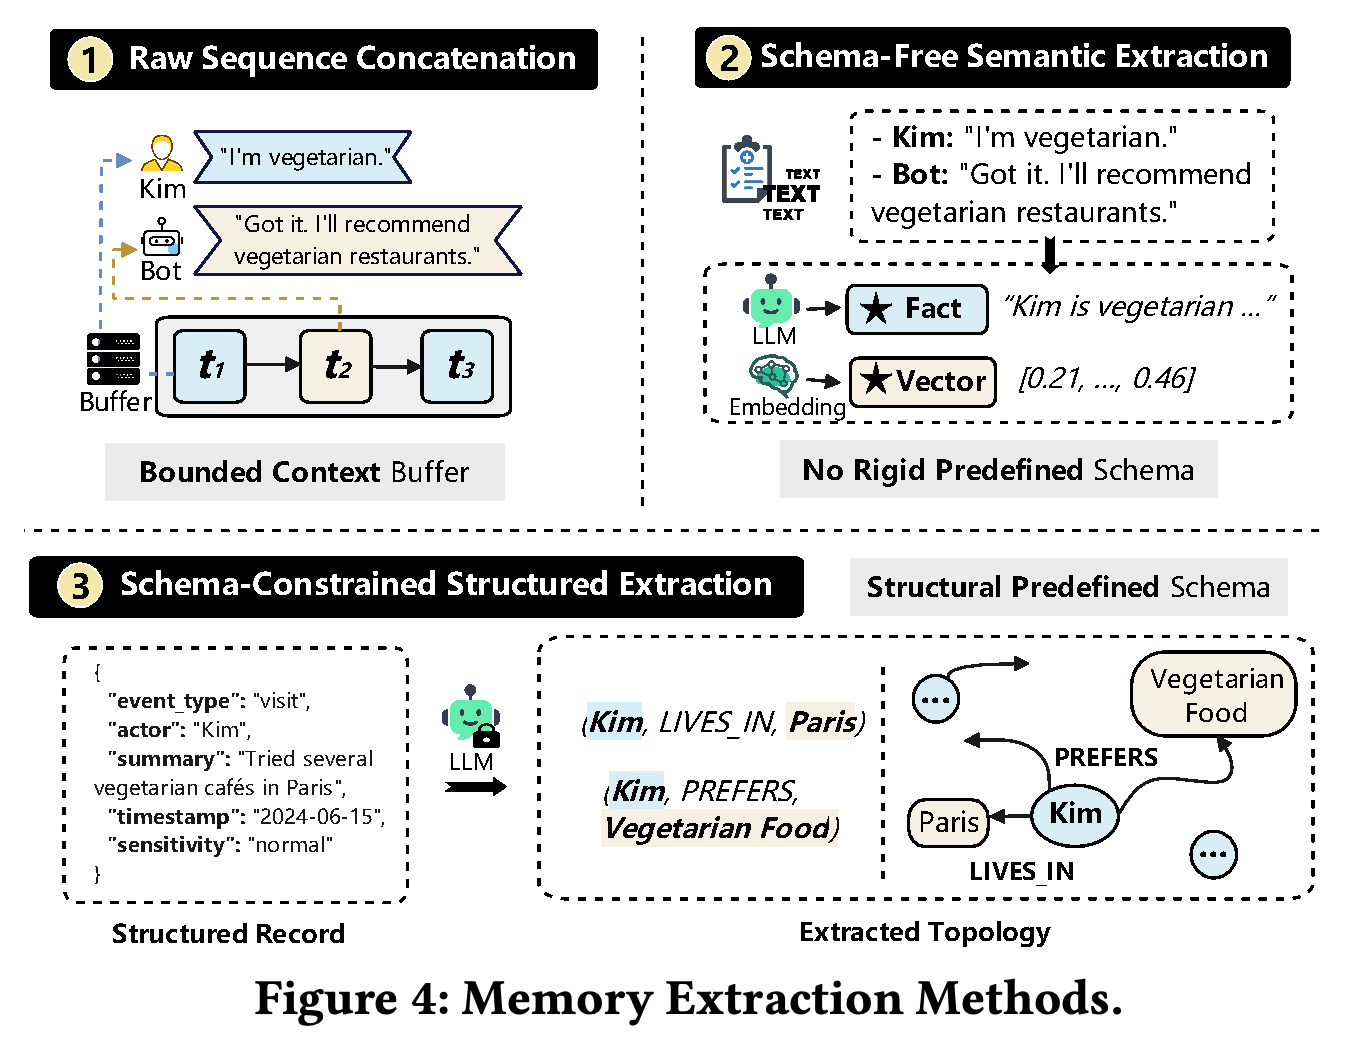
메모리 추출은 대화와 도구 실행 기록을 저장 단위로 변환한다. Figure 4는 원본 시퀀스 연결, 스키마 없는 의미 추출, 스키마 제약이 있는 구조화 추출을 구분한다.
- 원본 연결은 별도의 파싱 단계를 거치지 않고 상호작용 시퀀스나 일시적인 상태 요약을 유지한다.
- 스키마 없는 추출은 Mem0의 자연어 사실 진술처럼 독립적인 사실이나 잠재 표현을 추려낸다. 선택성을 높이면 나중의 질문에 필요한 맥락까지 제거할 수 있다.
- 스키마 제약 추출은 사전에 정의한 JSON 필드나 유형이 지정된 개체와 관계의 트리플을 생성한다. Zep은 환각으로 생성된 트리플을 억제하기 위한 검증도 적용한다.
동일한 대화 정보도 원본 발화로 남거나, 자유 형식의 사실 또는 벡터가 되거나, 구조화된 레코드와 위상 구조로 파싱될 수 있다. 각 변환은 이후 질의에서 사용할 수 있는 근거를 바꾼다.
3.3 Memory Retrieval and Query Routing
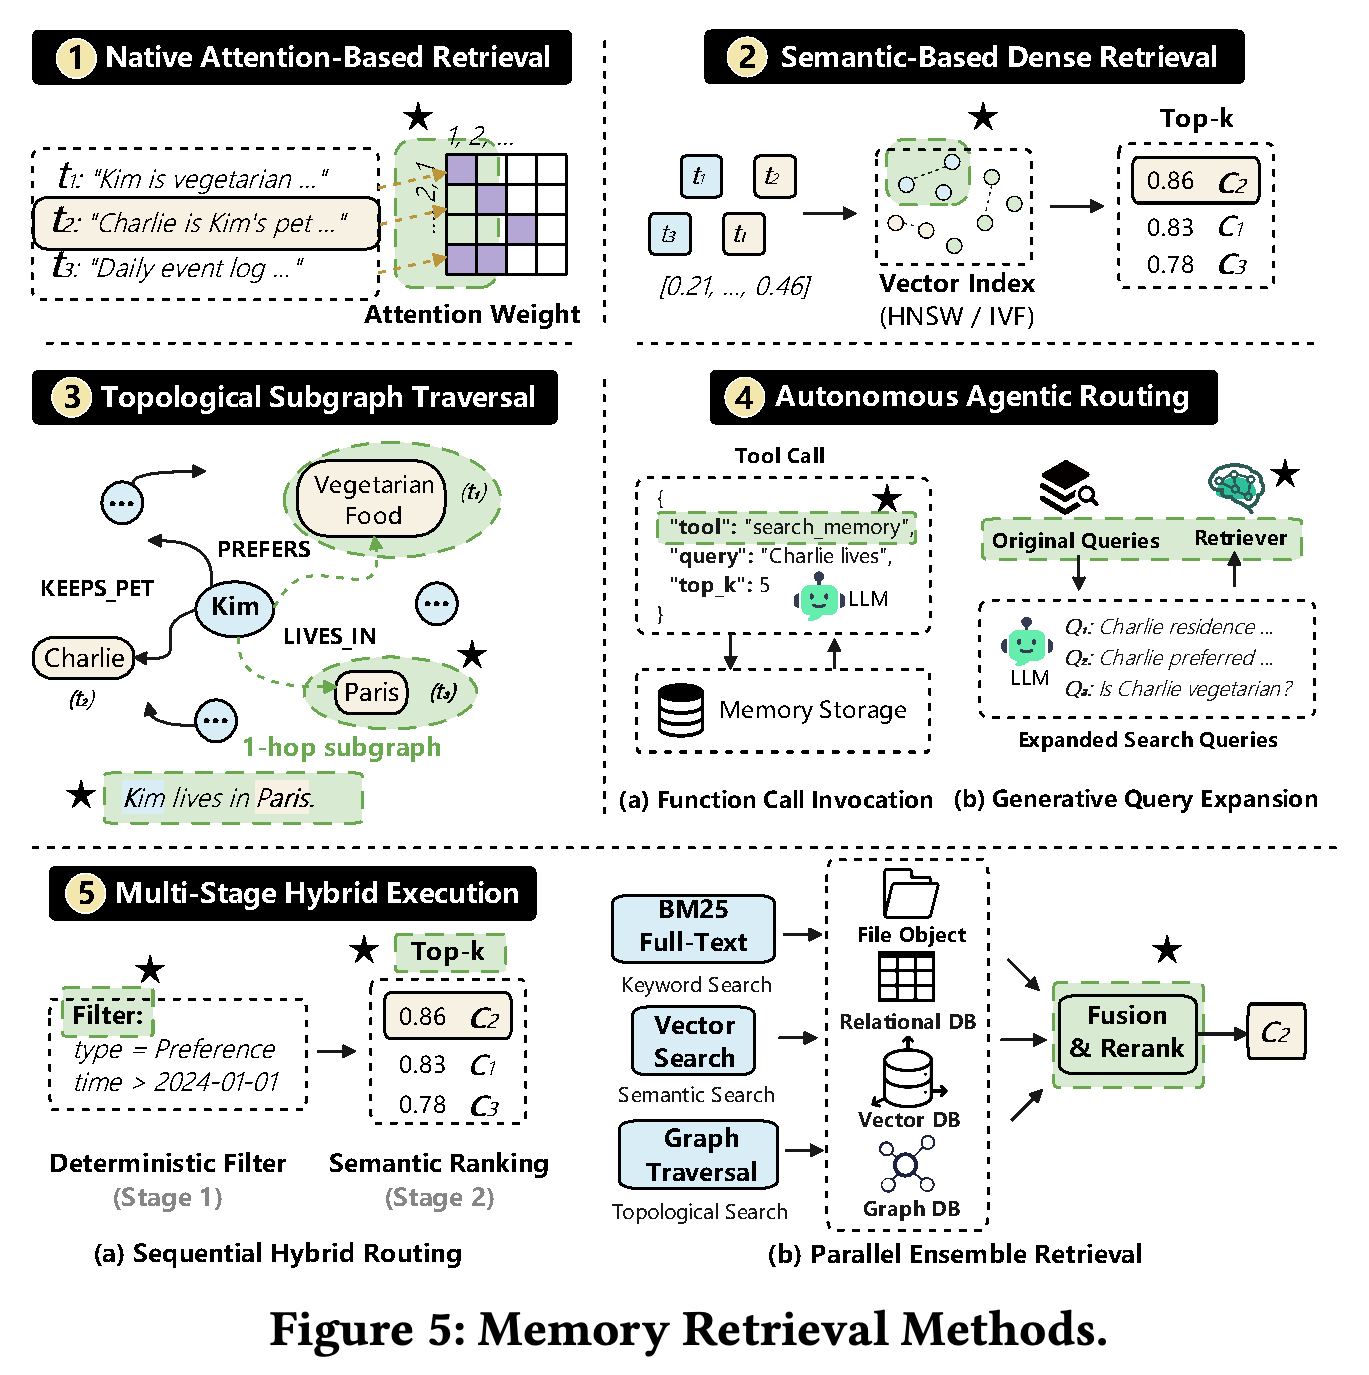
검색과 라우팅은 질의에서 과거 근거에 이르는 전체 경로를 다룬다. Figure 5는 그 방식을 모델 자체의 attention, dense 의미 검색, 위상 구조 탐색, 자율적인 에이전트 라우팅, 다단계 하이브리드 실행으로 정리한다.
- Dense 검색은 가까운 임베딩을 선택하고, 그래프 탐색은 연결된 사실을 수집한다. A-MEM은 dense 검색으로 기준점을 선택한 뒤 연결된 노트를 탐색한다.
- 에이전트 라우팅에는 archival_storage.search() 같은 명시적 함수 호출과 SimpleMem에서 사용하는 질의 확장 생성이 포함된다.
- 순차적 하이브리드 라우팅은 필터링 후 의미 기반 순위를 매긴다. 병렬 앙상블은 벡터 검색, BM25, 그래프 탐색의 후보 집합을 모은 뒤 융합하거나 재순위화한다.
검색 경로는 암묵적 attention부터 명시적 계획과 다중 엔진 실행까지 이어진다. 순차 파이프라인은 순위를 매기기 전에 후보를 필터링하고, 병렬 파이프라인은 상호 보완적인 후보를 모은 뒤 융합한다. 이는 근거 범위와 실행 비용을 관리하는 서로 다른 방식을 보여준다.
3.4 Memory Maintenance
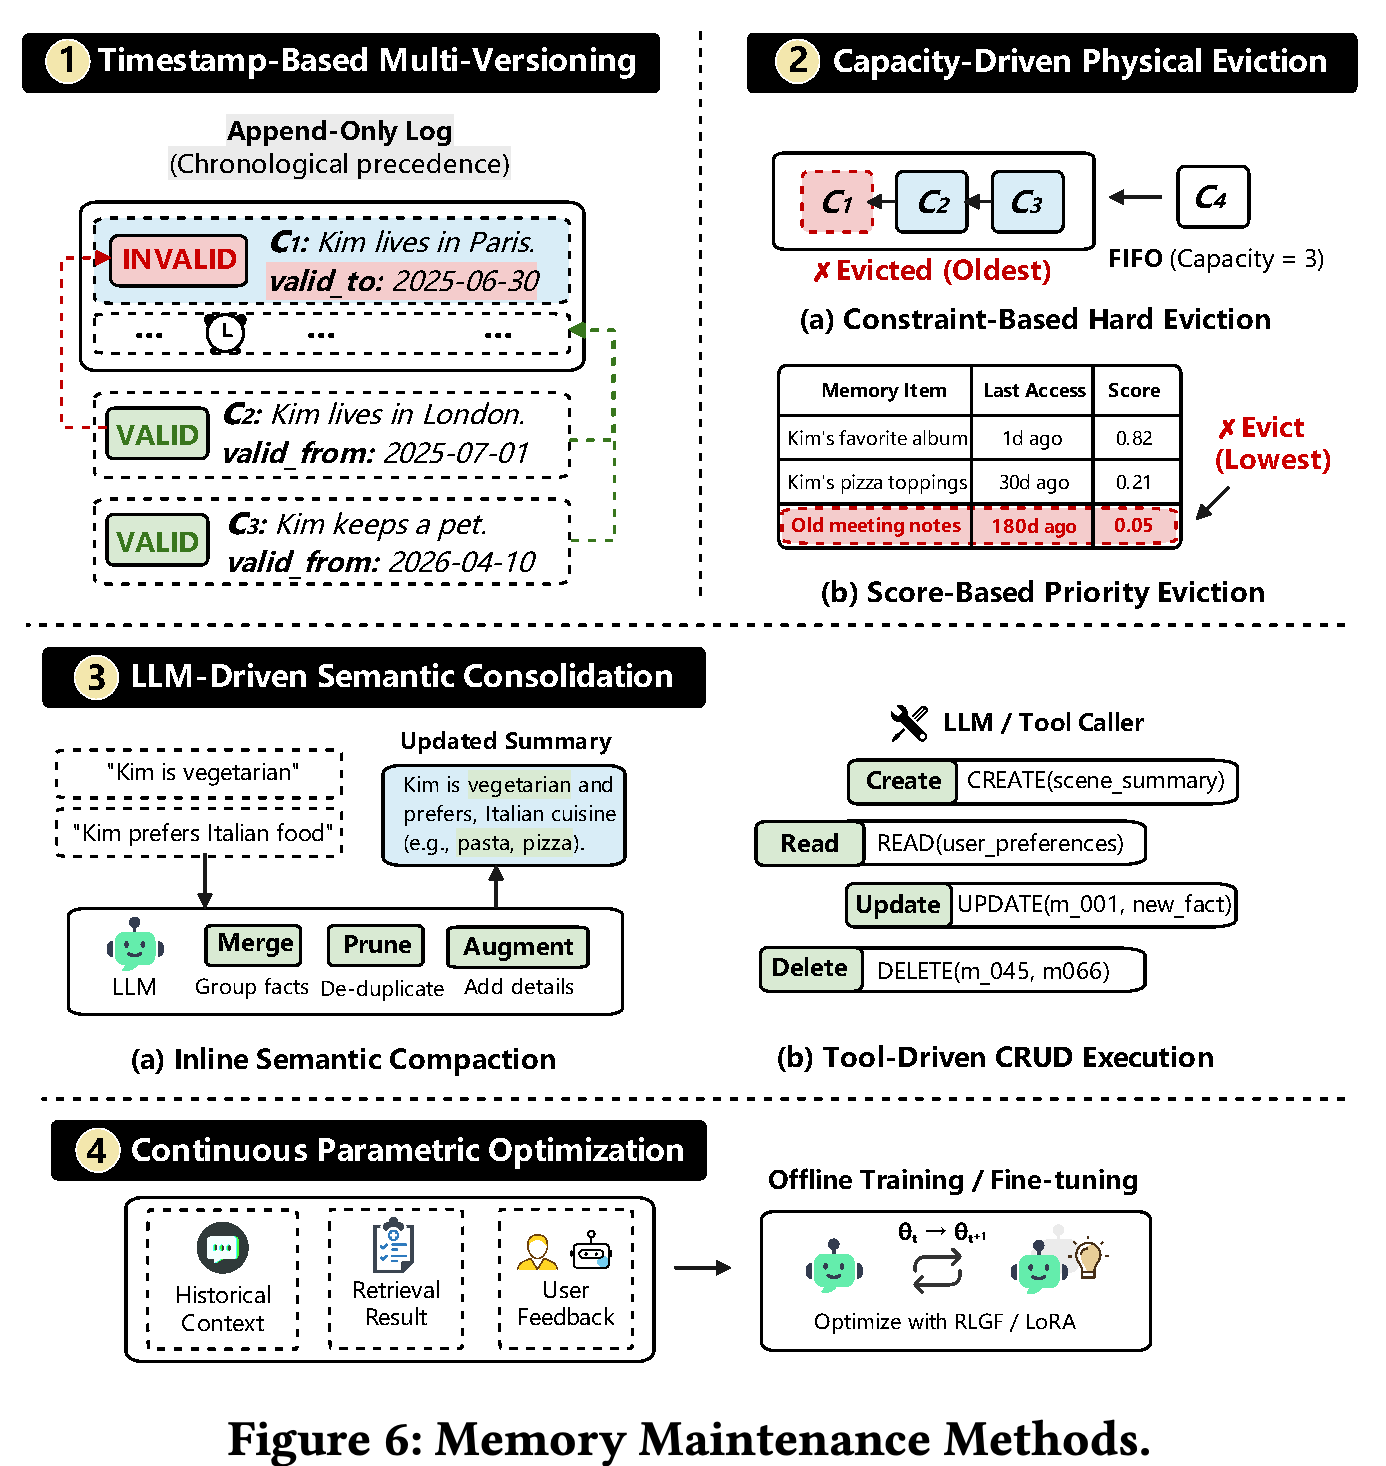
유지관리는 사실 수정, 용량 제한, 통합, 망각을 관리한다. Figure 6은 타임스탬프 기반 다중 버전 관리, 용량에 따른 물리적 제거, LLM 기반 의미 통합, 지속적인 파라미터 최적화를 구분한다.
- 버전 관리는 오래된 관계를 무효로 표시하거나 시간순 우선순위를 적용하면서 이력을 보존한다. 물리적 제거는 FIFO, 토큰 한도, 우선순위 정책에 따라 항목을 삭제하거나 덮어쓴다.
- 의미 통합은 중복 관측을 처리 중에 병합하거나 도구를 통해 명시적인 Create, Read, Update, Delete 연산을 수행할 수 있다. MemTree는 상위 요약을 재귀적으로 갱신하고, Mem0는 도구를 통해 데이터를 변경한다.
- 분류 체계에는 MemoRAG의 Reinforcement Learning with Generation Feedback (RLGF)으로 예시한 오프라인 파라미터 최적화도 포함된다. 다만 보고된 비교는 주로 컨텍스트 기반 및 외부 저장소 메모리 시스템을 다룬다.
오래된 사실을 무효화하면 과거 버전이 보존되지만, FIFO 또는 점수 기반 제거는 저장된 내용을 삭제한다. 통합과 CRUD 연산은 의미적 상태를 수정하고, 오프라인 최적화는 파라미터를 바꾼다. 이들은 서로 구별되는 유지관리 메커니즘이며, 같은 망각 방식으로 대체해서 다룰 수 없다.
4 End-to-End Assessment
종단 간 평가는 메모리가 작업 성능을 높이는지, 정답 근거를 검색하는지, 수정된 사실을 처리하는지, 장기간에도 안정성을 유지하는지, 운영 비용이 허용 가능한 수준인지라는 5개 질문을 다룬다. Long Context와 Embedding RAG를 참조 베이스라인으로 사용하지만, 실험마다 포함된 시스템이 다르다.
- LoCoMo는 장기 대화 질의응답을 평가하고, LongMemEval은 여러 세션에 걸친 회상과 추론을 평가한다. DB-Bench는 LifelongAgentBench의 데이터베이스 연산 작업을 사용한다.
- LongBench는 컨텍스트 길이에 대한 스트레스 테스트를 추가한다. 근거 거리 구간과 세션 이력 구간은 장기 메모리가 겪는 서로 다른 어려움을 드러낸다. 평가는 답변 품질, 근거 접근, 시간적 근거 확보, 운영 지연 시간을 단일 점수로 축약하지 않고 구분한다.
- 테스트베드 주소는 https://github.com/OpenDataBox/MemoryData 이고, 분류 체계 자료는 https://github.com/OpenDataBox/awesome-agent-memory 이다.
4.1 Overall Effectiveness (RQ1)
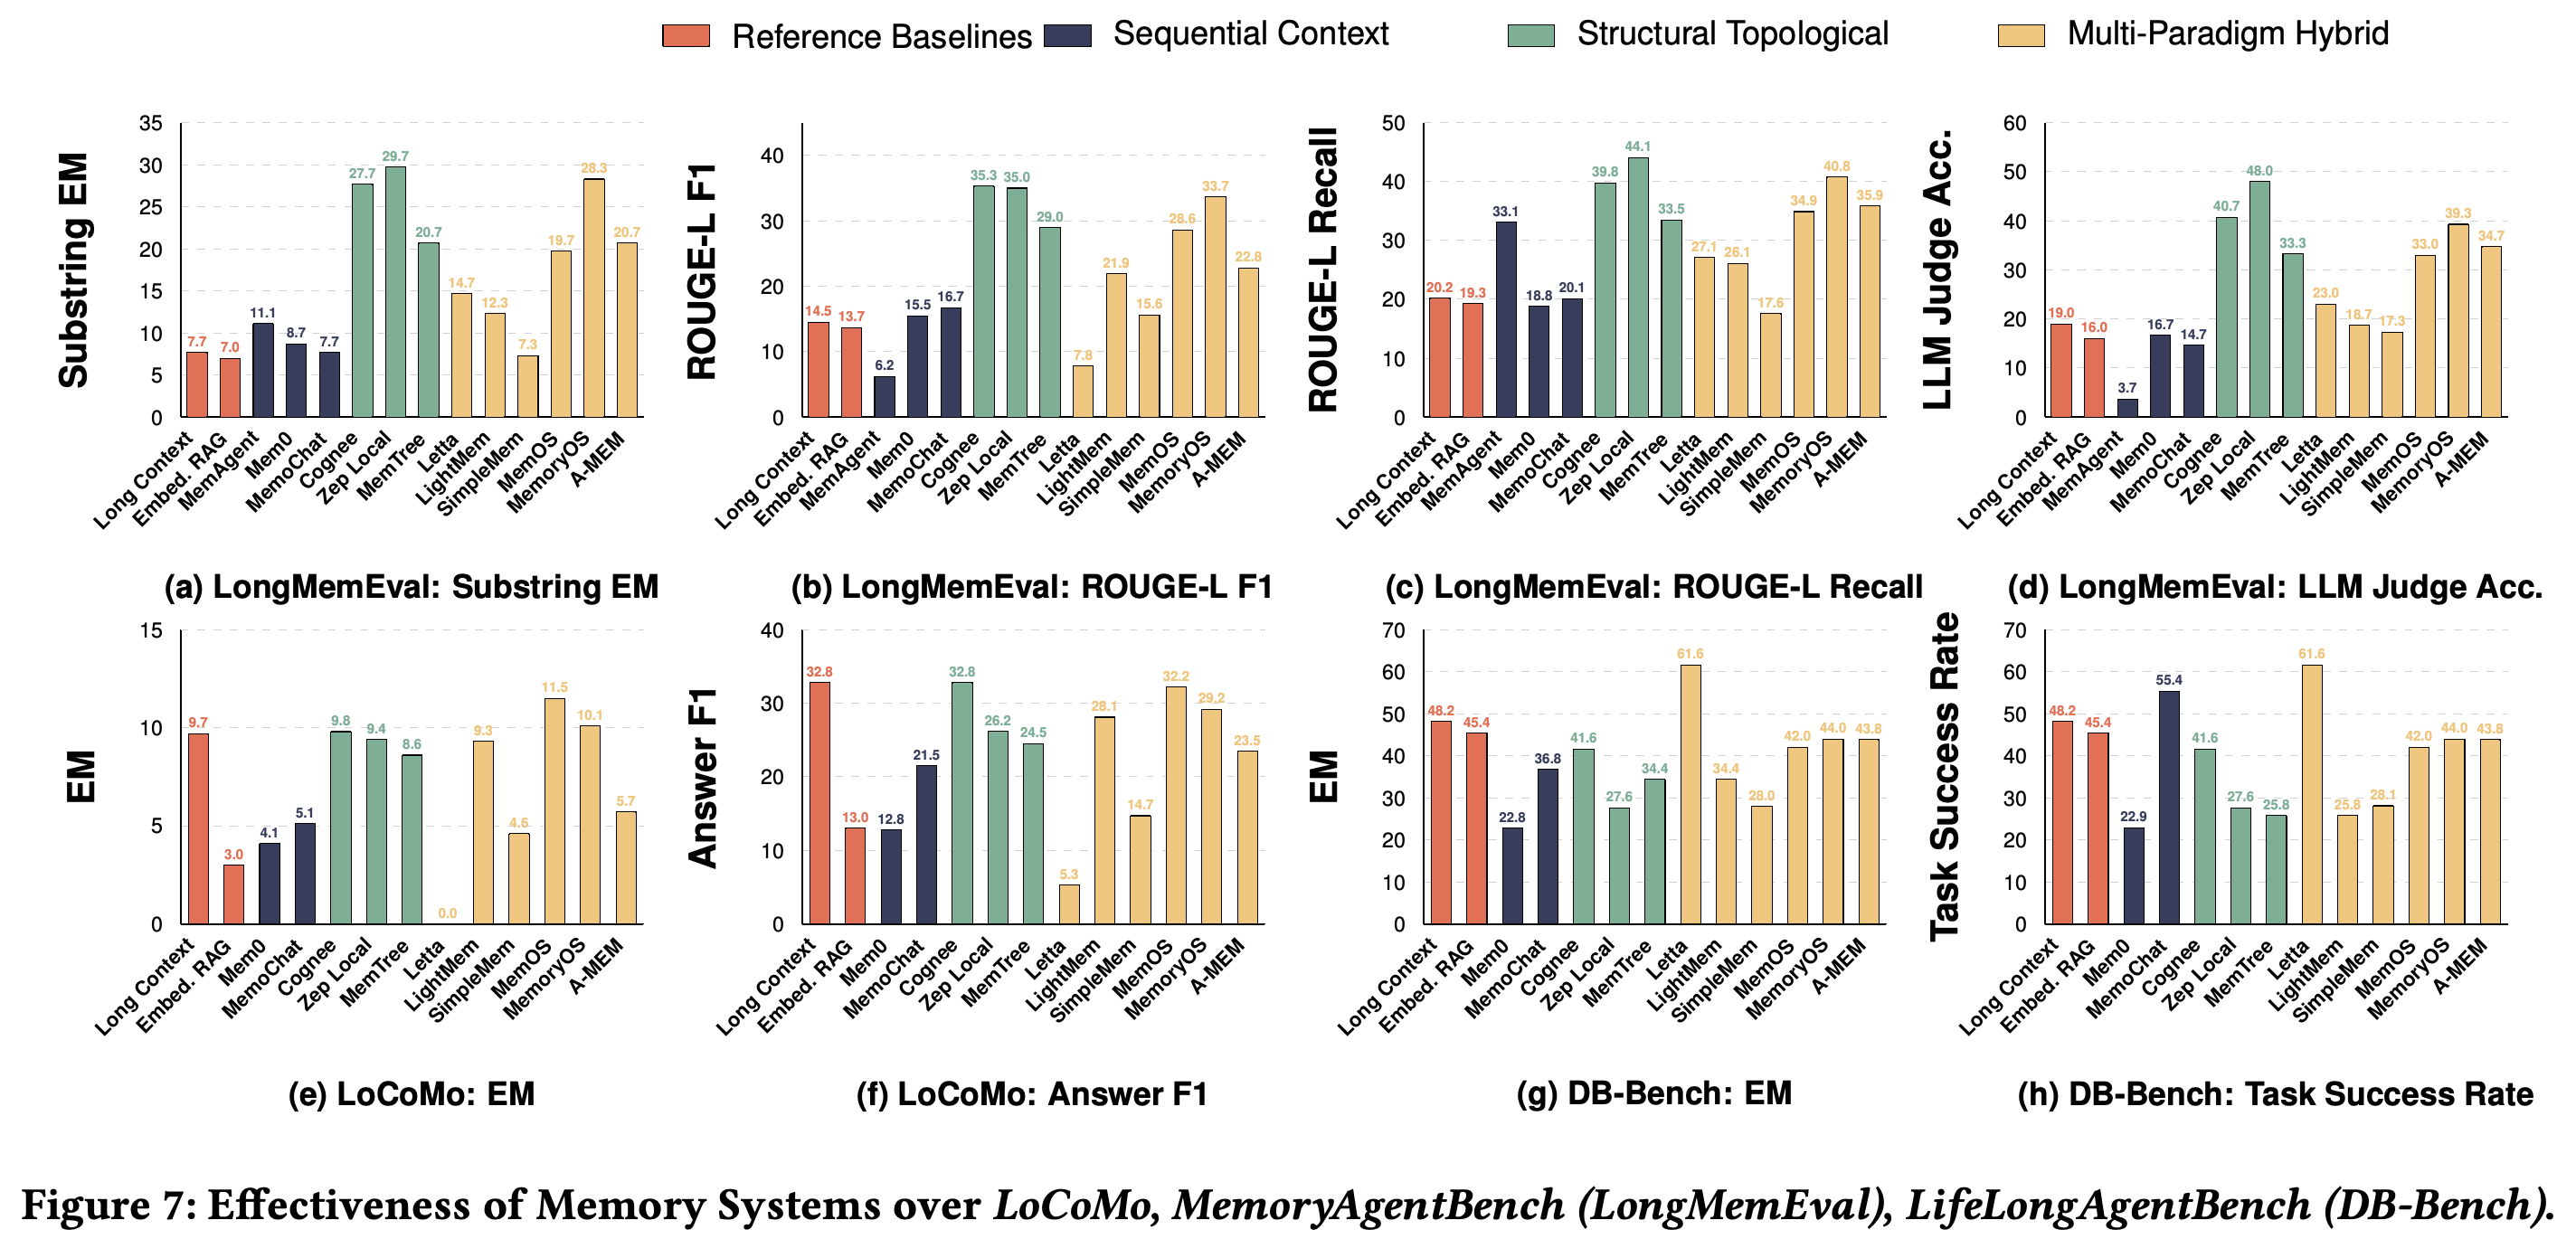
Figure 7은 워크로드와 지표에 따라 가장 우수한 구성이 달라짐을 보여준다. LongMemEval에서 Zep Local은 LLM Judge Accuracy 48.0, Cognee는 ROUGE-L F1 35.3을 기록한다. LoCoMo에서 MemOS는 EM 11.5를 기록한다.
- LoCoMo 점수는 질의 범주 4개의 범주별 EM과 Answer F1을 가중치 없이 평균한 값이다. LongMemEval은 Substring EM, ROUGE-L Recall, GPT-5.4 기반 판정 정확도도 보고한다.
- 그래프에서 Letta는 DB-Bench EM과 Task Success Rate 모두 61.6을 기록해 Long Context의 48.2와 MemoChat의 Task Success Rate 55.4를 웃돈다. 이는 Long Context가 DB-Bench EM에서 가장 높다는 본문의 설명과 충돌한다.
- MemoChat의 DB-Bench EM은 36.8이고 Task Success Rate는 55.4다. 이는 어휘 일치와 실제 실행 성공을 별도 지표로 측정해야 하는 이유를 보여준다. 저자들은 워크로드 적합성을 설명하면서 분산된 추론에는 관계 및 시간 기반 검색을, 대화에서 정확한 근거를 찾는 작업에는 거친 수준에서 세부 수준으로 진행하는 필터링을, 상태를 유지하는 실행에는 기록 보존을 연결한다. 이는 개별 요인의 인과관계를 분리해 검증한 결과가 아니라 설계에 대한 해석이다.
패널 8개는 워크로드와 지표에 따라 순위가 달라짐을 보여준다. 또한 본문과의 불일치를 드러낸다. 본문은 Long Context를 EM 선두로 설명하지만, 그래프에서 Letta는 DB-Bench EM과 Task Success Rate 모두 61.6으로 가장 높다.
4.2 Memory Retrieval Fidelity (RQ2)
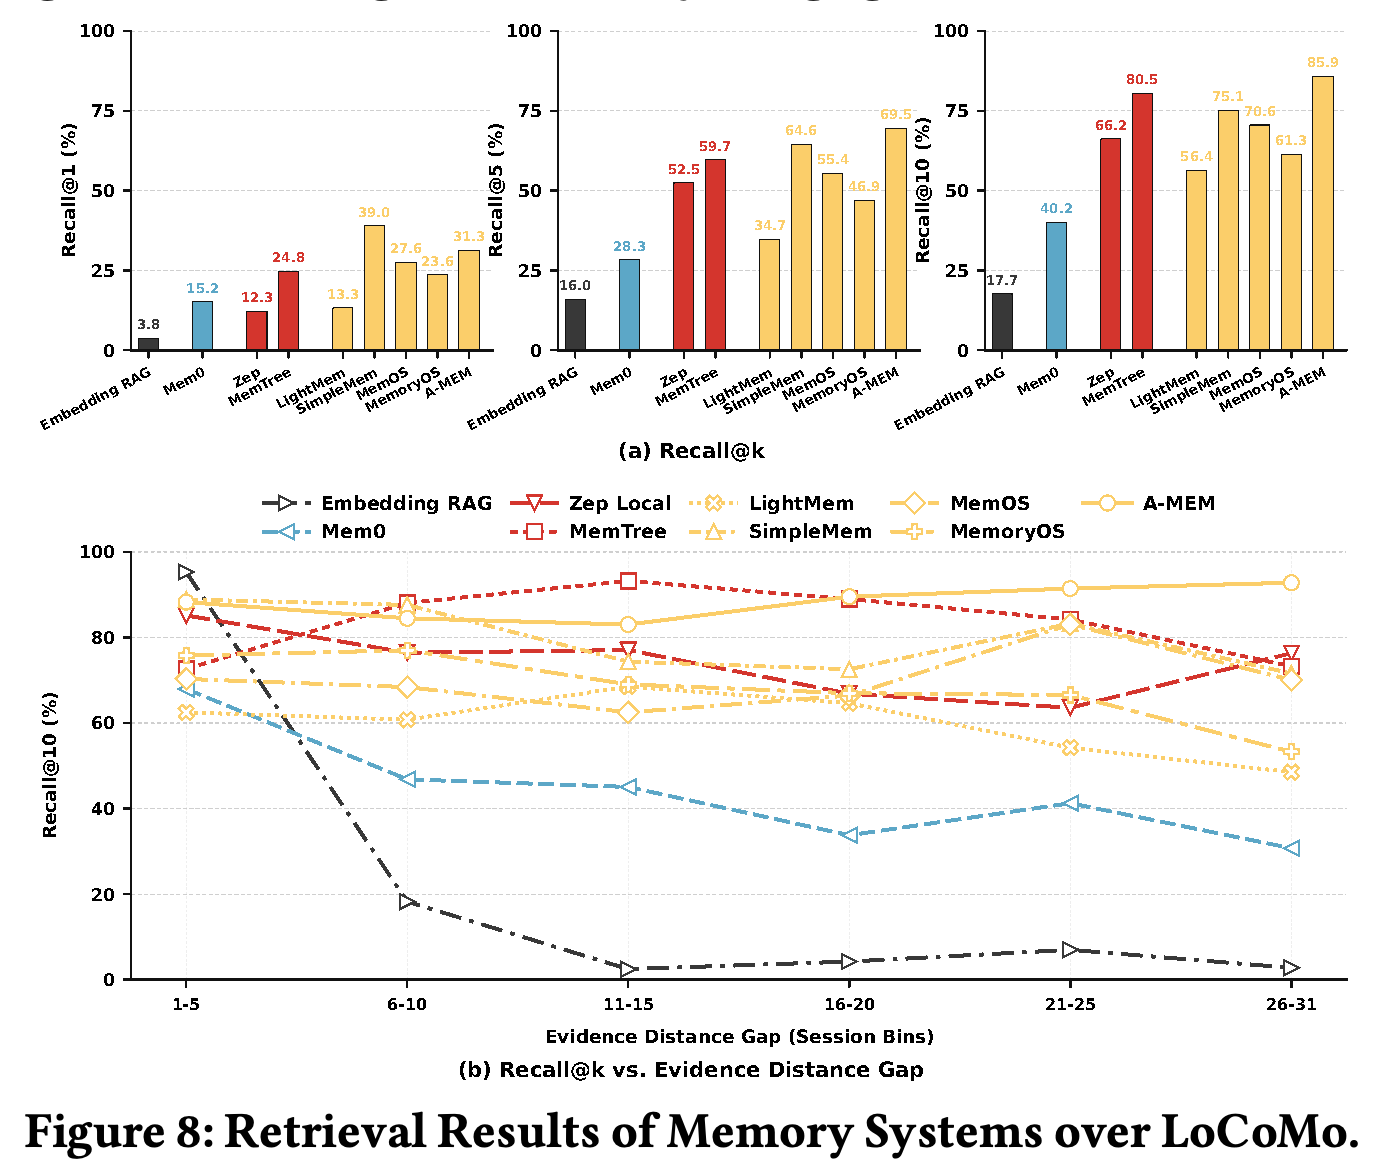
검색 충실도는 LoCoMo에 주석으로 표시된 원본 근거를 사용해 답변 생성과 독립적으로 평가한다. 검색된 top-k source-id 그룹이 정답 근거를 포함해야 적중으로 판정한다. Recall@10은 1–5부터 26–31회까지의 세션 거리 구간에서도 측정하며, 거리는 질의의 마지막 세션과 가장 이른 뒷받침 근거 사이의 간격으로 정의한다.
- SimpleMem은 Recall@1에서 39.0%로 가장 높다. A-MEM은 Recall@5와 Recall@10에서 각각 69.5%, 85.9%로 선두이며, MemTree는 59.7%, 80.5%를 기록한다.
- Figure 8은 연결형 또는 계층형 시스템이 Embedding RAG보다 먼 거리의 근거를 훨씬 잘 확보함을 보여준다. Embedding RAG의 전체 Recall@10은 17.7%에 그친다.
- 결과는 초기 근거 위치 파악과 더 넓은 근거 수집을 구분해야 함을 뒷받침한다. Recall@1은 재현율 지표이며 검색 정밀도를 직접 측정한 값은 아니다. 또한 전체 시스템 비교로는 구조의 효과를 다른 파이프라인 차이와 분리할 수 없다.
검색 예산이 가장 작을 때는 SimpleMem이 선두지만, 예산이 커지면 A-MEM과 MemTree가 더 넓은 근거 범위를 확보한다. 거리별 곡선은 연결형 또는 계층형 시스템이 평면적인 Embedding RAG 베이스라인보다 먼 거리의 뒷받침 근거를 훨씬 잘 유지함을 보여준다. 다만 이 비교는 표현 방식만의 효과를 분리하지는 않는다.
4.3 Memory Evolution Robustness (RQ3)
갱신 견고성은 LongMemEval의 Knowledge Update 및 Temporal Reasoning 하위 집합과 LoCoMo의 Temporal 하위 집합에서 평가한다. Table 2에서는 직접적인 수정, 시간에 걸쳐 분산된 근거, 정확한 시간적 근거 확보에서 각각 다른 시스템이 선두를 차지한다. 모든 갱신 작업에서 우세한 시스템은 나타나지 않는다.
- Zep은 Knowledge Update에서 Substring EM 44.4, ROUGE-L F1 36.8로 선두를 차지한다.
- Cognee는 Temporal Reasoning에서 Substring EM 18.7, ROUGE-L F1 35.8로 선두를 차지한다. LoCoMo Temporal에서는 MemOS가 EM 8.9로, Cognee가 Answer F1 28.1로 가장 높다.
- 이러한 하위 집합별 결과는 관계를 고려하고 시간 조건에 따라 선택하는 검색의 이점과 부합한다. 다만 개별 데이터베이스 갱신 연산의 정확성을 직접 측정한 결과는 아니다.
직접적인 지식 수정, 시간 추론, 시간 관련 질의응답에서는 각각 다른 시스템이 유리하다. Zep이 Knowledge Update에서, Cognee가 Temporal Reasoning에서 가장 높은 점수를 보인다는 결과는 수정된 사실에 대한 접근과 시간에 걸쳐 분산된 근거의 재구성을 구분해야 함을 뒷받침한다.
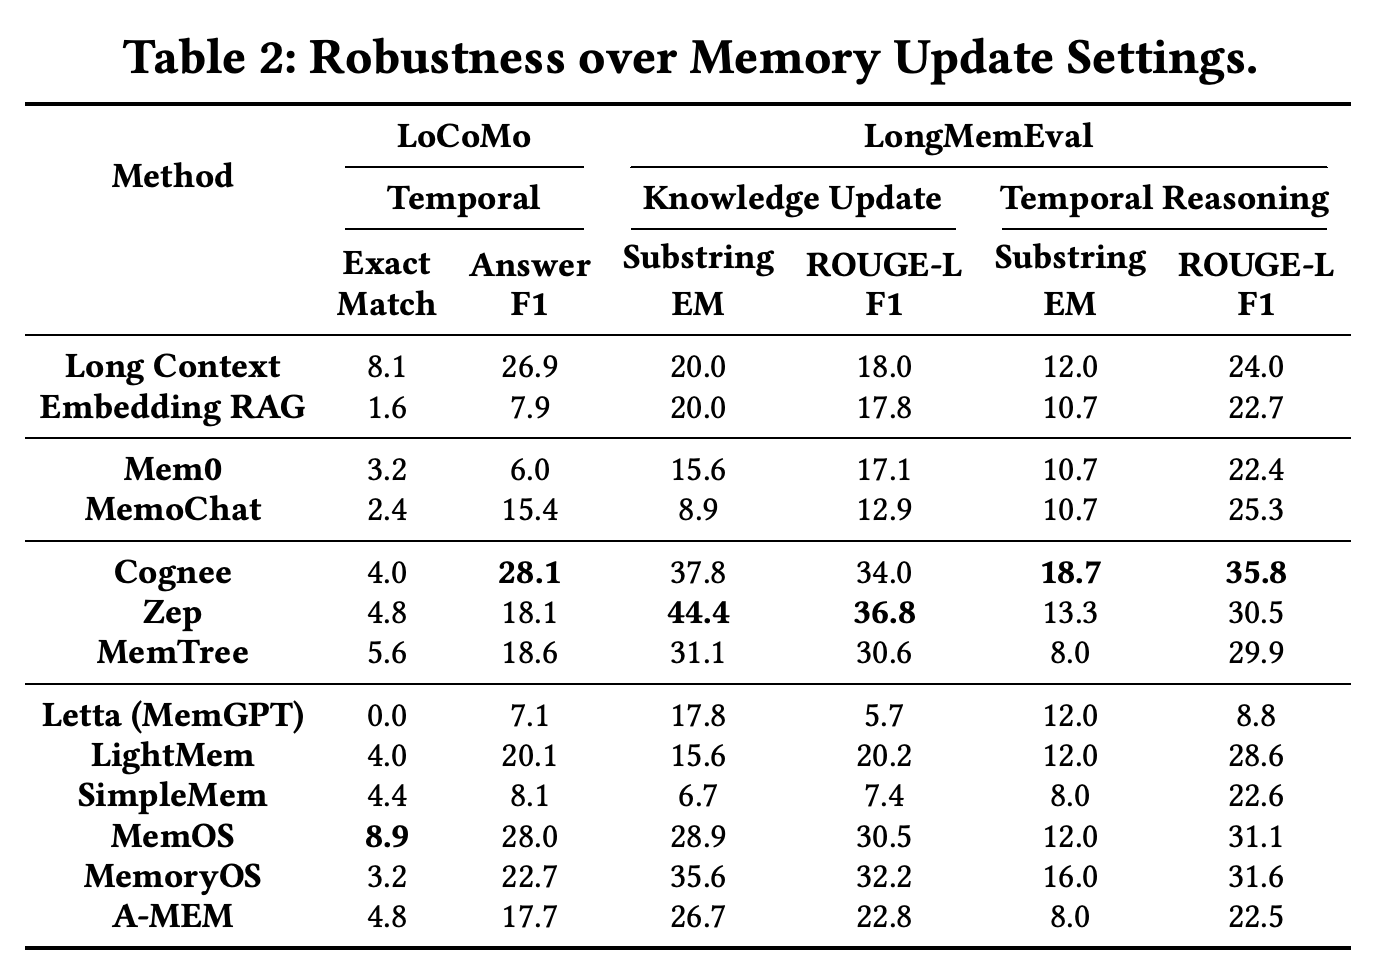
Figure 9는 LLM 백본을 Qwen3-8B, DeepSeek-Chat, GPT-5.4-mini, GPT-5.4로 바꿔 비교한다. MemOS는 각각 32.2, 41.2, 38.6, 41.2로 그래프에 표시된 구성 중 가장 높은 Answer F1을 유지한다. 다만 더 강한 생성기를 사용한다고 모든 시스템이 단조롭게 개선되지는 않는다.
- GPT-5.4-mini와 GPT-5.4에서는 A-MEM이 MemTree를 앞선다. 이는 상대 순위가 대체로 안정적이지만 불변하지는 않음을 보여준다. LightMem은 백본 4개 모두에서 MemTree와 A-MEM보다 높은 성능을 유지한다.
- Embedding RAG와 LightMem은 백본 4개에서 그래프의 Recall 값이 동일하지만, MemOS의 Recall은 크게 변한다. MemTree의 Recall은 38.2–39.6 범위에 머무르고, A-MEM은 45.7에서 56.8까지 변한다.
- 실험 설명에는 메모리 설정 6개가 언급되지만 그림에는 5개가 표시되어 있다. 이 그림의 Recall 값을 Figure 8의 Recall@10 결과와 동일하다고 가정할 수 없으며, 백본에 따라 최종 답변 생성만 달라진다고 볼 근거도 없다.
4.4 Long Horizon Memory Stability (RQ4)
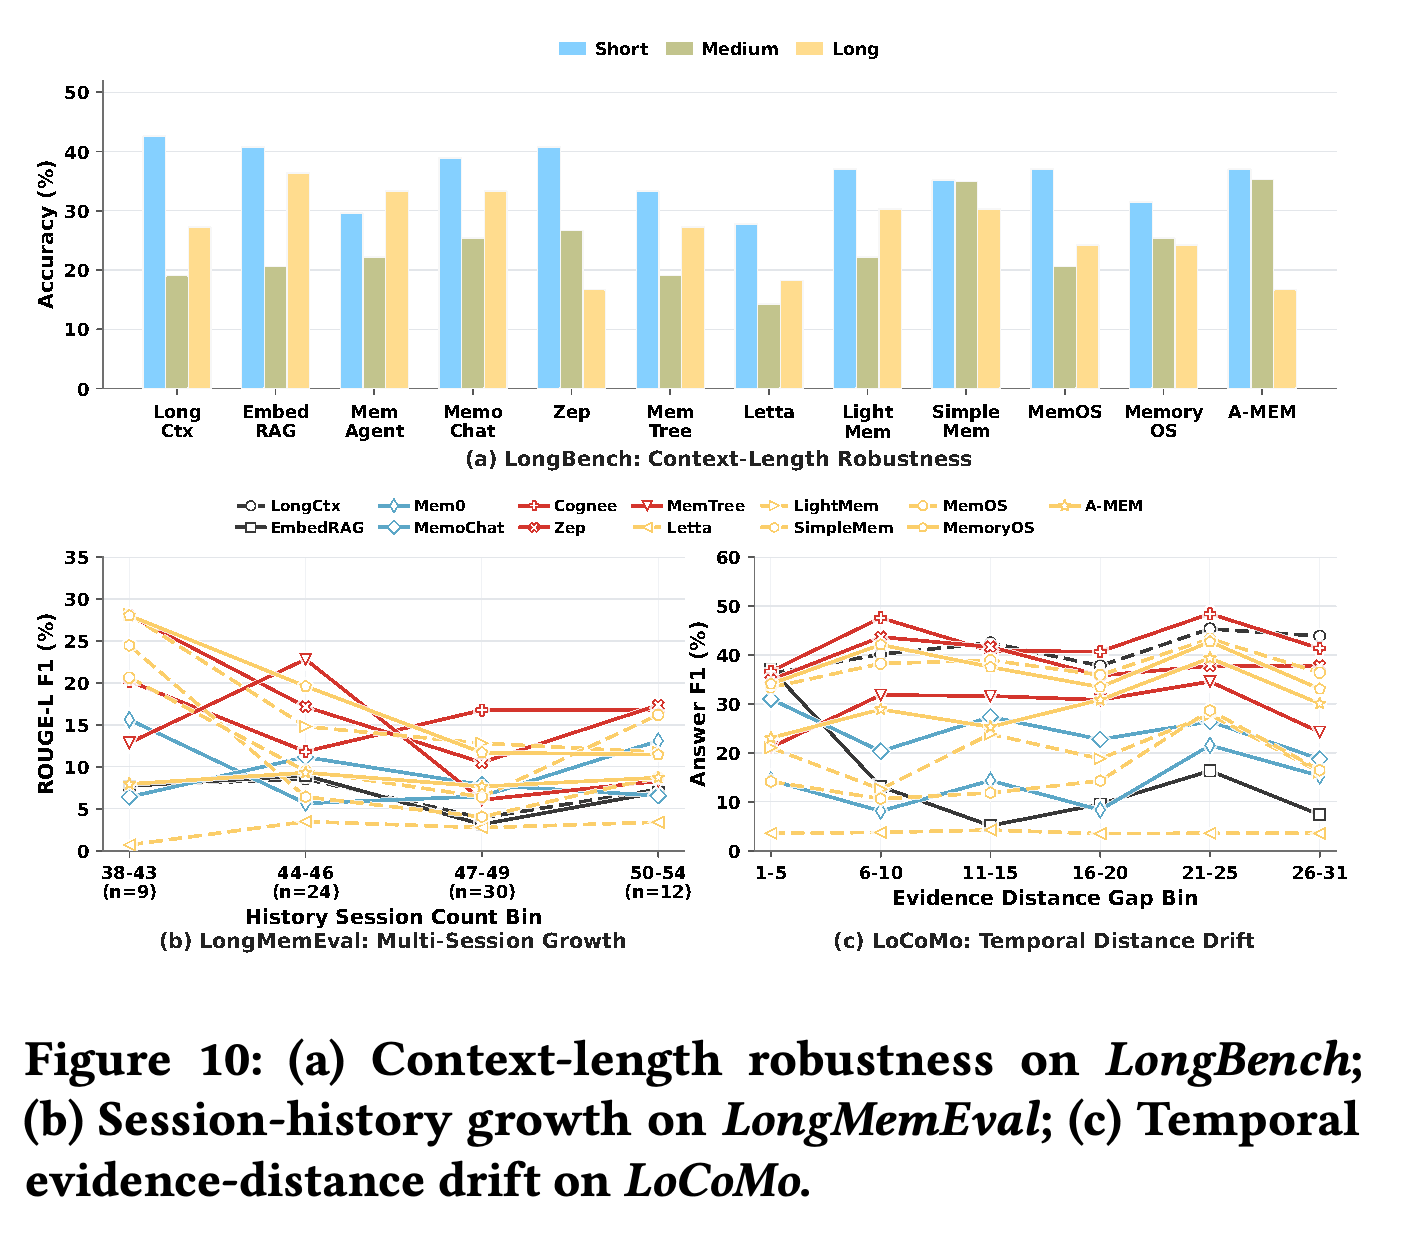
장기 안정성은 LongBench의 컨텍스트 길이 구간, LongMemEval의 과거 세션 수 구간, LoCoMo의 근거 거리 구간으로 시험한다. Figure 10에서는 뒷받침 근거가 멀어질 때 관계형 또는 계층형 구성이 대체로 평면적 매칭보다 유리하다. 다만 개별 성능 추이가 모두 단조로운 것은 아니다.
- LongBench의 Short에서 Medium으로 이동할 때 SimpleMem의 Accuracy는 35.2에서 34.9로 변하고, Long Context는 42.6에서 19.0으로 하락한다. 이 비교만으로 모든 컨텍스트 구간이나 시스템에서 안정성이 확보된다고 볼 수는 없다. LightMem과 MemTree의 성능도 워크로드에 따라 달라진다.
- Embedding RAG의 LoCoMo Answer F1은 근거 거리가 증가하면서 37.1에서 7.4로 떨어진다. 반면 Cognee, MemOS, MemoryOS는 먼 거리 구간에서도 훨씬 높은 성능을 유지한다. 이 결과는 먼 근거에 대한 접근을 전체 입력 길이와 별도로 평가해야 함을 뒷받침한다.
- LongMemEval의 세션 구간에는 각각 예제 9개, 24개, 30개, 12개가 포함된다. 표본 크기가 작고 불균등하며 불확실성 추정치도 없으므로, 세부 추이를 해석할 때 주의가 필요하다.
패널은 입력 컨텍스트의 길이 증가, 과거 세션 수 증가, 뒷받침 근거의 거리 증가를 구분한다. 구조화된 시스템은 대체로 먼 근거에서 더 우수하지만, 비단조적인 곡선과 불균등한 세션 구간별 표본 크기를 고려하면 모든 국소적 변화를 스케일링 법칙으로 해석하기는 어렵다.
4.5 Memory Operation Cost (RQ5)
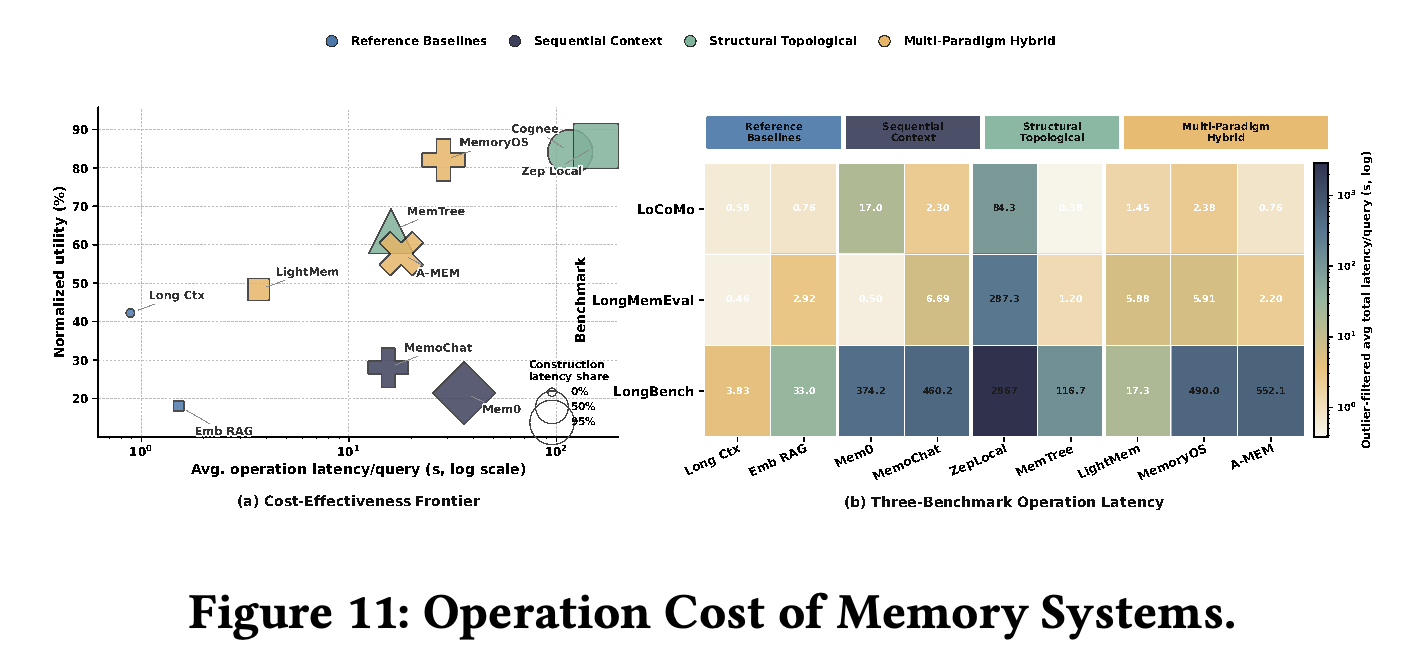
운영 비용에는 메모리 구축 시간과 질의 시간이 포함된다. 누적되거나 집중적으로 발생하는 쓰기의 비용은 질의당 평균 오버헤드로 나누어 해석한다. Normalized Utility는 LoCoMo와 LongMemEval의 답변 품질 지표 6개를 min–max 정규화한 뒤 평균한다. 워크로드 간 비교에서는 이상치를 제외한 질의당 평균 총 지연 시간을 보고한다.
- LightMem은 질의당 3.67초에 Normalized Utility 48.3을, MemTree는 15.9초에 63.5를 달성한다. MemoryOS는 28.6초에 82.0을 기록한다.
- Cognee와 Zep은 각각 116.5초와 155.1초에 유용성 84를 넘는다. 저자들은 더 넓은 범위의 재구성과 조정이 높은 오버헤드의 원인이라고 해석한다. 하지만 전체 시스템 비교로는 유지관리 범위를 유일한 원인으로 분리할 수 없다.
- LongBench에서 LightMem은 질의당 17.3초, MemTree는 116.7초, Zep Local은 2867초가 걸린다. 이 값들은 워크로드별로 이상치를 제외한 평균이며, 꼬리 지연 시간의 보장값이나 금전적 비용은 아니다.
유용성과 지연 시간 그래프에서 LightMem과 MemTree는 비교적 낮은 비용으로 유리한 절충을 제공한다. 반면 유용성이 더 높은 일부 구조화 시스템은 질의당 평균으로 나눈 연산 시간이 훨씬 길다. 히트맵에서는 LongBench에서 지연 시간 차이가 급격히 커지므로, 단일 집계 비용으로 모든 워크로드를 설명할 수 없다.
5 Fine-Grained Component Comparison
구성요소 연구는 선택한 시스템에서 모듈을 1개씩 바꿔 표현, 추출, 라우팅, 유지관리를 살펴본다. 이 실험은 전체 시스템 비교보다 특정 요소에 초점을 맞춘 근거를 제공한다. 다만 결론은 시험한 변형에 적용되며, 각 아키텍처 계열의 모든 구현으로 일반화할 수는 없다.
- 구성요소 비교 실험에는 LoCoMo와 LongMemEval을 사용하며, 유지관리는 LoCoMo에서 평가한다.
- 일부 구성요소 비교 실험 점수는 대응하는 종단 간 구성의 점수와 크게 다르다. 따라서 실험 조건이 일치하지 않는다면 표 사이의 차이를 단일 변경의 효과로 해석할 수 없다.
5.1 Memory Representation and Storage (M1)
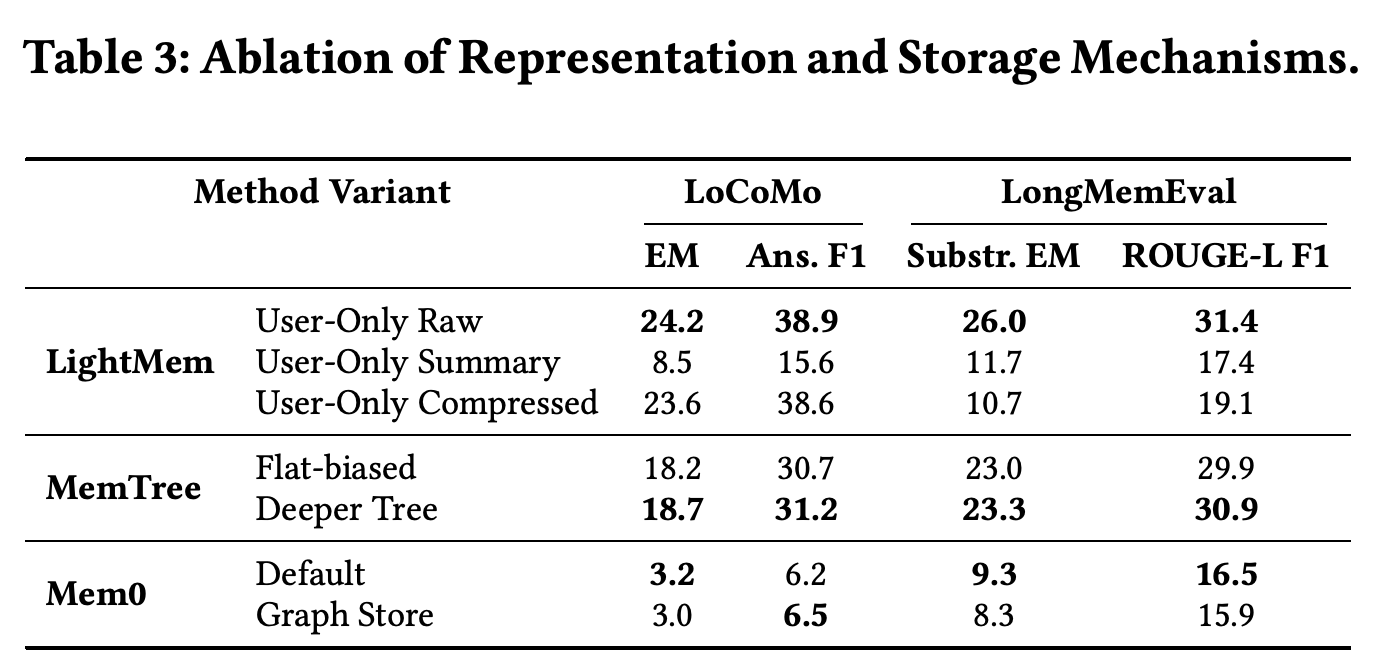
Table 3은 LightMem이 원본 내용을 요약으로 대체할 때 성능이 크게 떨어짐을 보여준다. User-Only Raw는 LoCoMo Answer F1 38.9와 LongMemEval Substring EM 26.0을 기록하지만, User-Only Summary는 각각 15.6과 11.7을 기록한다.
- User-Only Compressed는 LoCoMo Answer F1이 38.6으로 원본 저장과 비슷하지만, LongMemEval Substring EM은 10.7로 떨어진다.
- MemTree의 Deeper Tree는 Flat-biased 대비 LongMemEval ROUGE-L F1을 29.9에서 30.9로 높인다. 이는 LightMem의 표현 방식에 따른 차이보다 훨씬 작은 변화다.
- Mem0의 Graph Store는 Default보다 일관되게 우수하지는 않다. LoCoMo Answer F1은 6.2에서 6.5로 변하지만, LongMemEval ROUGE-L F1은 16.5에서 15.9로 변한다. 위상 구조를 추가하는 것만으로 일반적인 이점이 입증되지는 않는다.
LightMem의 원본 내용은 보고된 지표 4개 모두에서 요약보다 우수하다. 가벼운 압축은 LoCoMo 성능을 보존하지만 LongMemEval의 정확 일치를 크게 떨어뜨린다. 더 깊은 트리와 그래프 저장소가 만드는 변화는 더 작거나 지표에 따라 엇갈린다. 따라서 결과는 구조적 복잡성 자체의 이점보다 근거 보존의 이점을 더 분명하게 뒷받침한다.
5.2 Memory Extraction (M2)
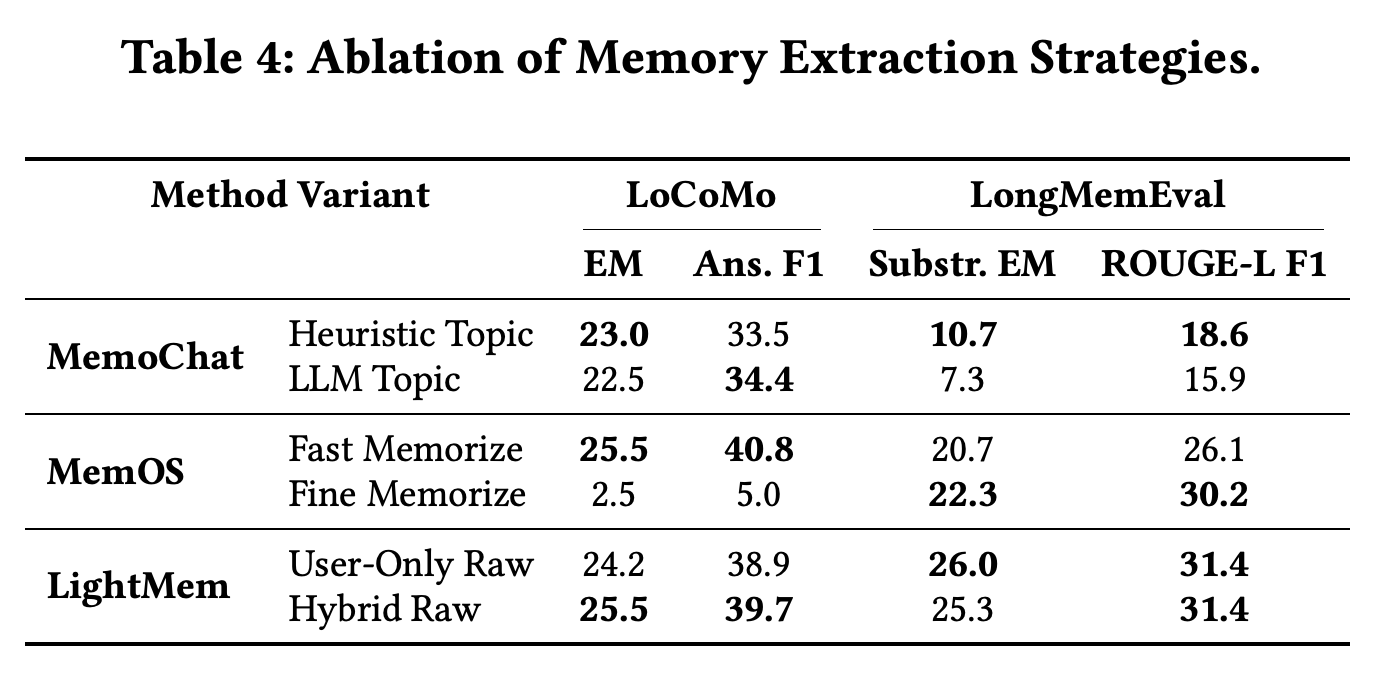
Table 4에서는 평가한 워크로드 2개 전반의 균형을 고려할 때 근거 범위를 보존하는 추출이 유리하다. 동시에 일부 사실 검색 지표에서는 더 세밀한 추출이 개선을 보인다. 가장 뚜렷한 절충은 Fast Memorize와 Fine Memorize가 동일한 tree_text 백엔드를 사용하는 MemOS에서 나타난다.
- Fine Memorize는 LongMemEval ROUGE-L F1을 26.1에서 30.2로 높이지만, LoCoMo Answer F1은 40.8에서 5.0으로 낮춘다.
- MemoChat Heuristic Topic은 LongMemEval Substring EM에서 LLM Topic보다 높은 10.7을 기록하며, LLM Topic은 7.3을 기록한다. 반면 LoCoMo Answer F1은 33.5로 LLM Topic의 34.4보다 약간 낮다.
- 사용자와 어시스턴트 발화를 포함하는 LightMem Hybrid Raw는 LoCoMo Answer F1을 38.9에서 39.7로 소폭 높이지만, LongMemEval ROUGE-L F1은 31.4로 유지한다. 이점은 작으며 워크로드에 따라 달라진다.
MemOS Fine Memorize는 LongMemEval의 중첩 지표를 높이는 반면 LoCoMo의 답변 품질을 크게 낮춰, 추출 방식의 절충이 워크로드에 따라 달라짐을 드러낸다. MemoChat과 LightMem 변형도 더 선택적이거나 정교한 추출이 더 넓은 근거 보존보다 일관되게 우수하지는 않음을 보여준다.
5.3 Memory Retrieval and Routing (M3)
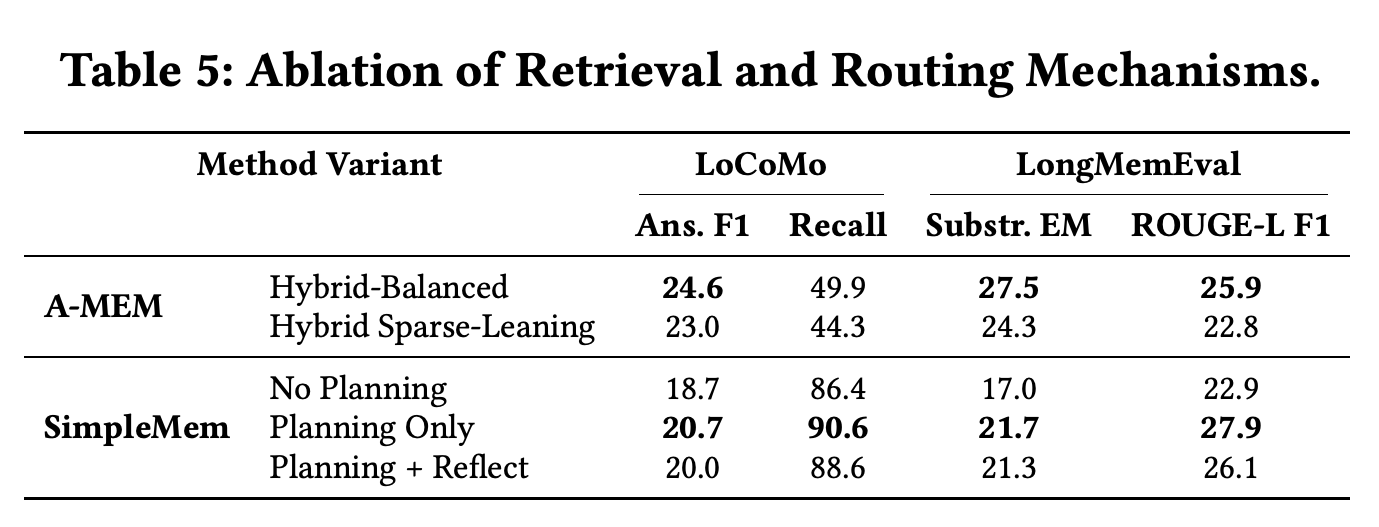
Table 5에서는 A-MEM의 경우 sparse에 치우친 융합보다 균형 잡힌 dense–sparse 융합이 유리하다. SimpleMem에서는 직접 검색이나 reflection을 결합한 계획보다 명시적 계획이 유리하다. 이 결과는 목적에 맞게 구성한 검색 구조의 이점을 보여주며, 추론 단계를 제한 없이 늘리는 방식까지 뒷받침하지는 않는다.
- A-MEM Hybrid-Balanced는 LoCoMo Answer F1 24.6과 LongMemEval Substring EM 27.5를 기록한다. Hybrid Sparse-Leaning은 각각 23.0과 24.3을 기록한다.
- SimpleMem Planning Only는 No Planning 대비 Answer F1을 18.7에서 20.7로, Recall을 86.4에서 90.6으로, LongMemEval ROUGE-L F1을 22.9에서 27.9로 높인다.
- Planning + Reflect는 해당 결과를 Answer F1 20.0, Recall 88.6, ROUGE-L F1 26.1로 낮춘다. 이 실행 결과에서는 reflection으로 인한 품질 개선이 확인되지 않으며, 표는 reflection의 지연 시간을 별도로 정량화하지 않는다.
A-MEM에서는 균형 잡힌 융합이 sparse에 치우친 융합보다 보고된 모든 지표에서 우수하다. SimpleMem은 계획을 사용하면 개선되지만 reflection을 추가하면 개선분 일부를 잃는다. 따라서 결과는 계획의 이점을 보여주며, 숙고를 전반적으로 늘리는 방식까지 뒷받침하지는 않는다.
5.4 Memory Maintenance (M4)
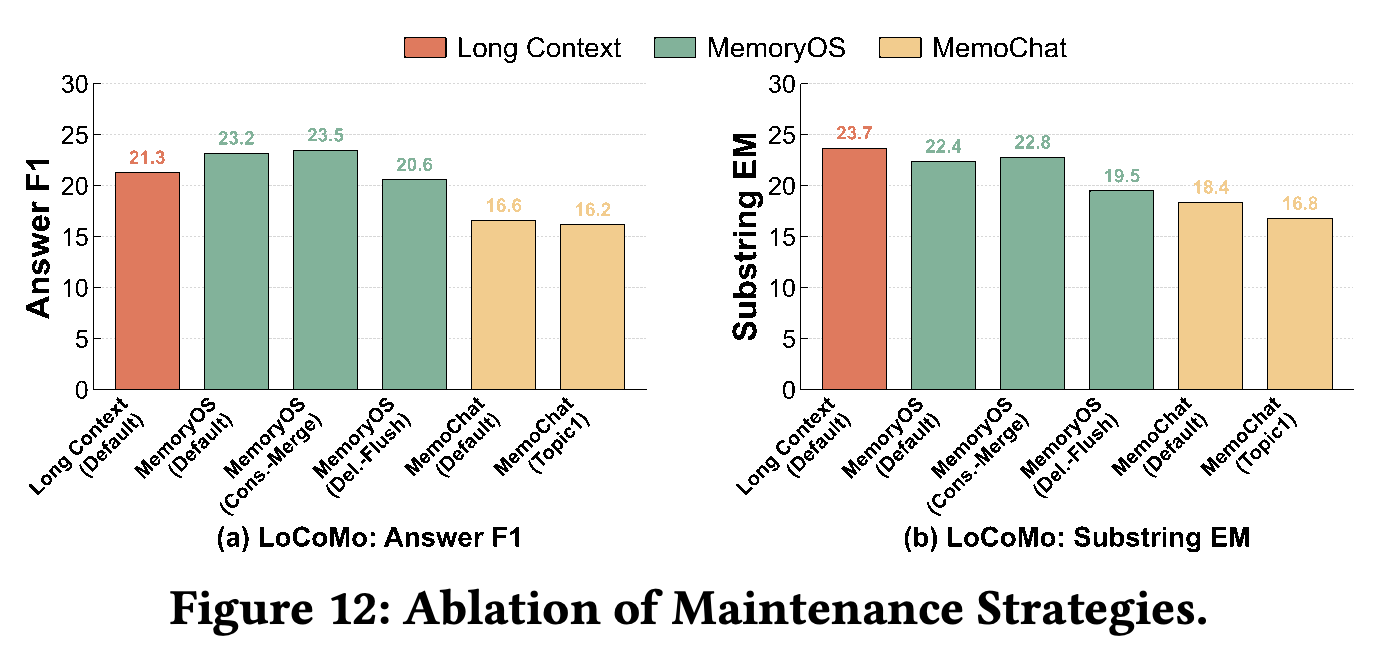
Figure 12는 LoCoMo에서 보수적 병합, 플러시 지연, 요약 세분성을 비교한다. MemoryOS Conservative-Merge는 Answer F1을 23.2에서 23.5로, Substring EM을 22.4에서 22.8로 소폭 높인다. 반면 Delayed-Flush는 각각 20.6과 19.5로 낮춘다.
- 윈도우마다 단일 주제 요약을 강제하는 MemoChat Topic1은 Default보다 낮은 성능을 보인다. Answer F1은 16.2 대 16.6, Substring EM은 16.8 대 18.4다.
- Long Context는 이 구성요소 비교 실험에서 Substring EM 23.7로 가장 높지만, Answer F1은 21.3으로 기본 MemoryOS와 보수적 병합 MemoryOS보다 낮다. 유지관리는 정확한 어휘 일치를 높이지 않더라도 답변 품질을 개선할 수 있다.
- 유지관리 결과는 정리를 지연하거나 지나치게 거칠게 요약하는 방식보다 선택적 통합을 지지한다. 다만 유의성 검정을 보고하지 않으므로 보수적 병합의 작은 개선은 관측 결과 수준으로 해석해야 한다. 결론은 분류 체계, 종단 간 평가, 구성요소 비교를 종합해 워크로드에 적합한 메모리 아키텍처를 선택하는 지침으로 제시한다.
보수적 병합은 기본 MemoryOS보다 소폭 개선되지만, 플러시 지연과 MemoChat의 단일 주제 요약은 그래프에 표시된 지표 2개 모두를 낮춘다. Long Context는 Substring EM에서 가장 높지만 Answer F1에서는 그렇지 않다. 이는 유지관리로 답변 품질이 개선되더라도 어휘 일치가 더 좋아지는 것은 아님을 보여준다.
부록
- 제공된 PDF에는 부록이 없으며, 6 Conclusion과 References로 끝난다. 본문에 없는 구현 세부사항을 가상의 보충 절에서 확인할 수는 없다.
짧은 생각
가장 유용한 기여는 메모리 품질을 복원 가능한 내용, 근거 접근, 시간적 유효성, 유지관리 비용으로 나눈 점이다. 표현과 추출의 구성요소 비교 실험은 기록 시점에 정보를 보존해야 한다는 구체적인 근거를 제공한다. 비용 비교는 풍부한 구조가 상당한 운영 오버헤드를 수반할 수 있음을 보여준다.
이 논문은 설계를 비교하는 근거로 읽는 편이 적절하며, 확정적인 시스템 순위표로 보기에는 한계가 있다. Figure 7은 DB-Bench의 최우수 시스템에 관한 본문 설명과 충돌하고, 명시된 구성 수가 그래프에 표시된 범위와 맞지 않는 경우도 있다. 또한 PDF는 하드웨어, 공통 기본 백본, 컨텍스트 구간 임계값, 이상치 필터링, 반복 실행의 불확실성을 충분히 명시하지 않는다. 이러한 공백은 재현성과 지연 시간 결과의 일반화를 제한한다.