


Captcha Attack: Turning Captchas Against Humanity 요약 설명
11 Jan 2022 | Paper Review Adversarial Learning Optical Character Recognition Out-of-Distribution Detection목차
이번 글에서는 Captcha Attack: Turning Captchas Against Humanity 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 11일(Arxiv)
- Conti, Mauro, Pajola, Luca, Tricomi, Pier Paolo.
- Department of Mathematics, University of Padua
- 논문 3판 (2022년 4월 4일 개정, 이 글은 개정판을 기준으로 작성했다)
요약
- 이 논문은 왜곡된 텍스트가 담긴 이미지가 온라인 게시물에서 유해 콘텐츠를 선별하는 자동 시스템을 어떻게 우회하는지 연구한다. 이미지에서 텍스트를 추출하는 광학 문자 인식(OCR)과 텍스트 모더레이터를 결합한 실험용 파이프라인에서 CAPtcha Attack (CAPA)은 Claptcha와 Multicolor 이미지에 대해 100%에 가까운 공격 성공률을 보였다. 왜곡하지 않은 이미지의 공격 성공률은 훨씬 낮았다.
- 사용자 연구에서 무해한 예제의 평균 전사 정확도는 94.53%였다. 일반 게시물과 다른 표본을 식별하는 Local Outlier Factor (LOF) 기반 방어는 3개 소셜 미디어 데이터셋에서 정밀도와 재현율을 결합한 지표인 F1-score가 평균 약 80%였지만, 정상 게시물의 약 9%를 탐지 대상으로 표시했다.
I. Introduction
온라인 플랫폼은 자동 콘텐츠 모더레이터(ACM)를 사용해 검토자가 잠재적으로 유해한 콘텐츠를 처리하도록 돕는다. 공격자가 조작한 입력은 전처리를 비롯한 모더레이션 파이프라인 전반의 취약점을 악용할 수 있다.
a) Contribution
저자들은 관찰한 난독화 기법을 분류하고 CAPA를 소개한 뒤 모더레이션 API와 지도학습 및 이상치 탐지 기반 방어를 평가한다. 예제에는 독자가 이해할 수 있는 텍스트 왜곡과 치환이 포함된다.
b) Paper organization
논문은 배경과 난독화 기법 분류를 설명한 뒤 공격, 데이터셋, 결과, 방어 및 결론을 다룬다.
II. Background & Related Works
배경에서는 머신러닝 애플리케이션의 보안, 콘텐츠 모더레이션, 텍스트 CAPTCHA 문제의 발전을 다룬다.
A. Security of Machine Learning Applications
회피 공격은 조작한 입력으로 시스템의 예측에 영향을 주고, 데이터 오염 공격은 학습 데이터를 변경한다. CAPA는 특정 분류기에 맞춰 최적화하지 않고 이미지에서 텍스트를 추출하는 단계를 공격한다.
B. Content Moderators
모더레이터는 텍스트, 이미지, 동영상, 음성을 처리하며, 혐오 밈 탐지에는 시각 정보와 텍스트 정보를 함께 사용할 수 있다. 논문은 이미지 변환과 텍스트 변경이 모더레이션 시스템에 영향을 준 선행 사례를 인용한다.
C. Captcha
CAPTCHA는 사람과 컴퓨터를 구별하기 위한 문제다. 텍스트 기반 CAPTCHA는 회전이나 왜곡과 같은 변환을 사용하며, 자동 인식 기술이 발전하면서 다른 유형의 문제도 등장했다.
III. The New Era of Textual Captcha
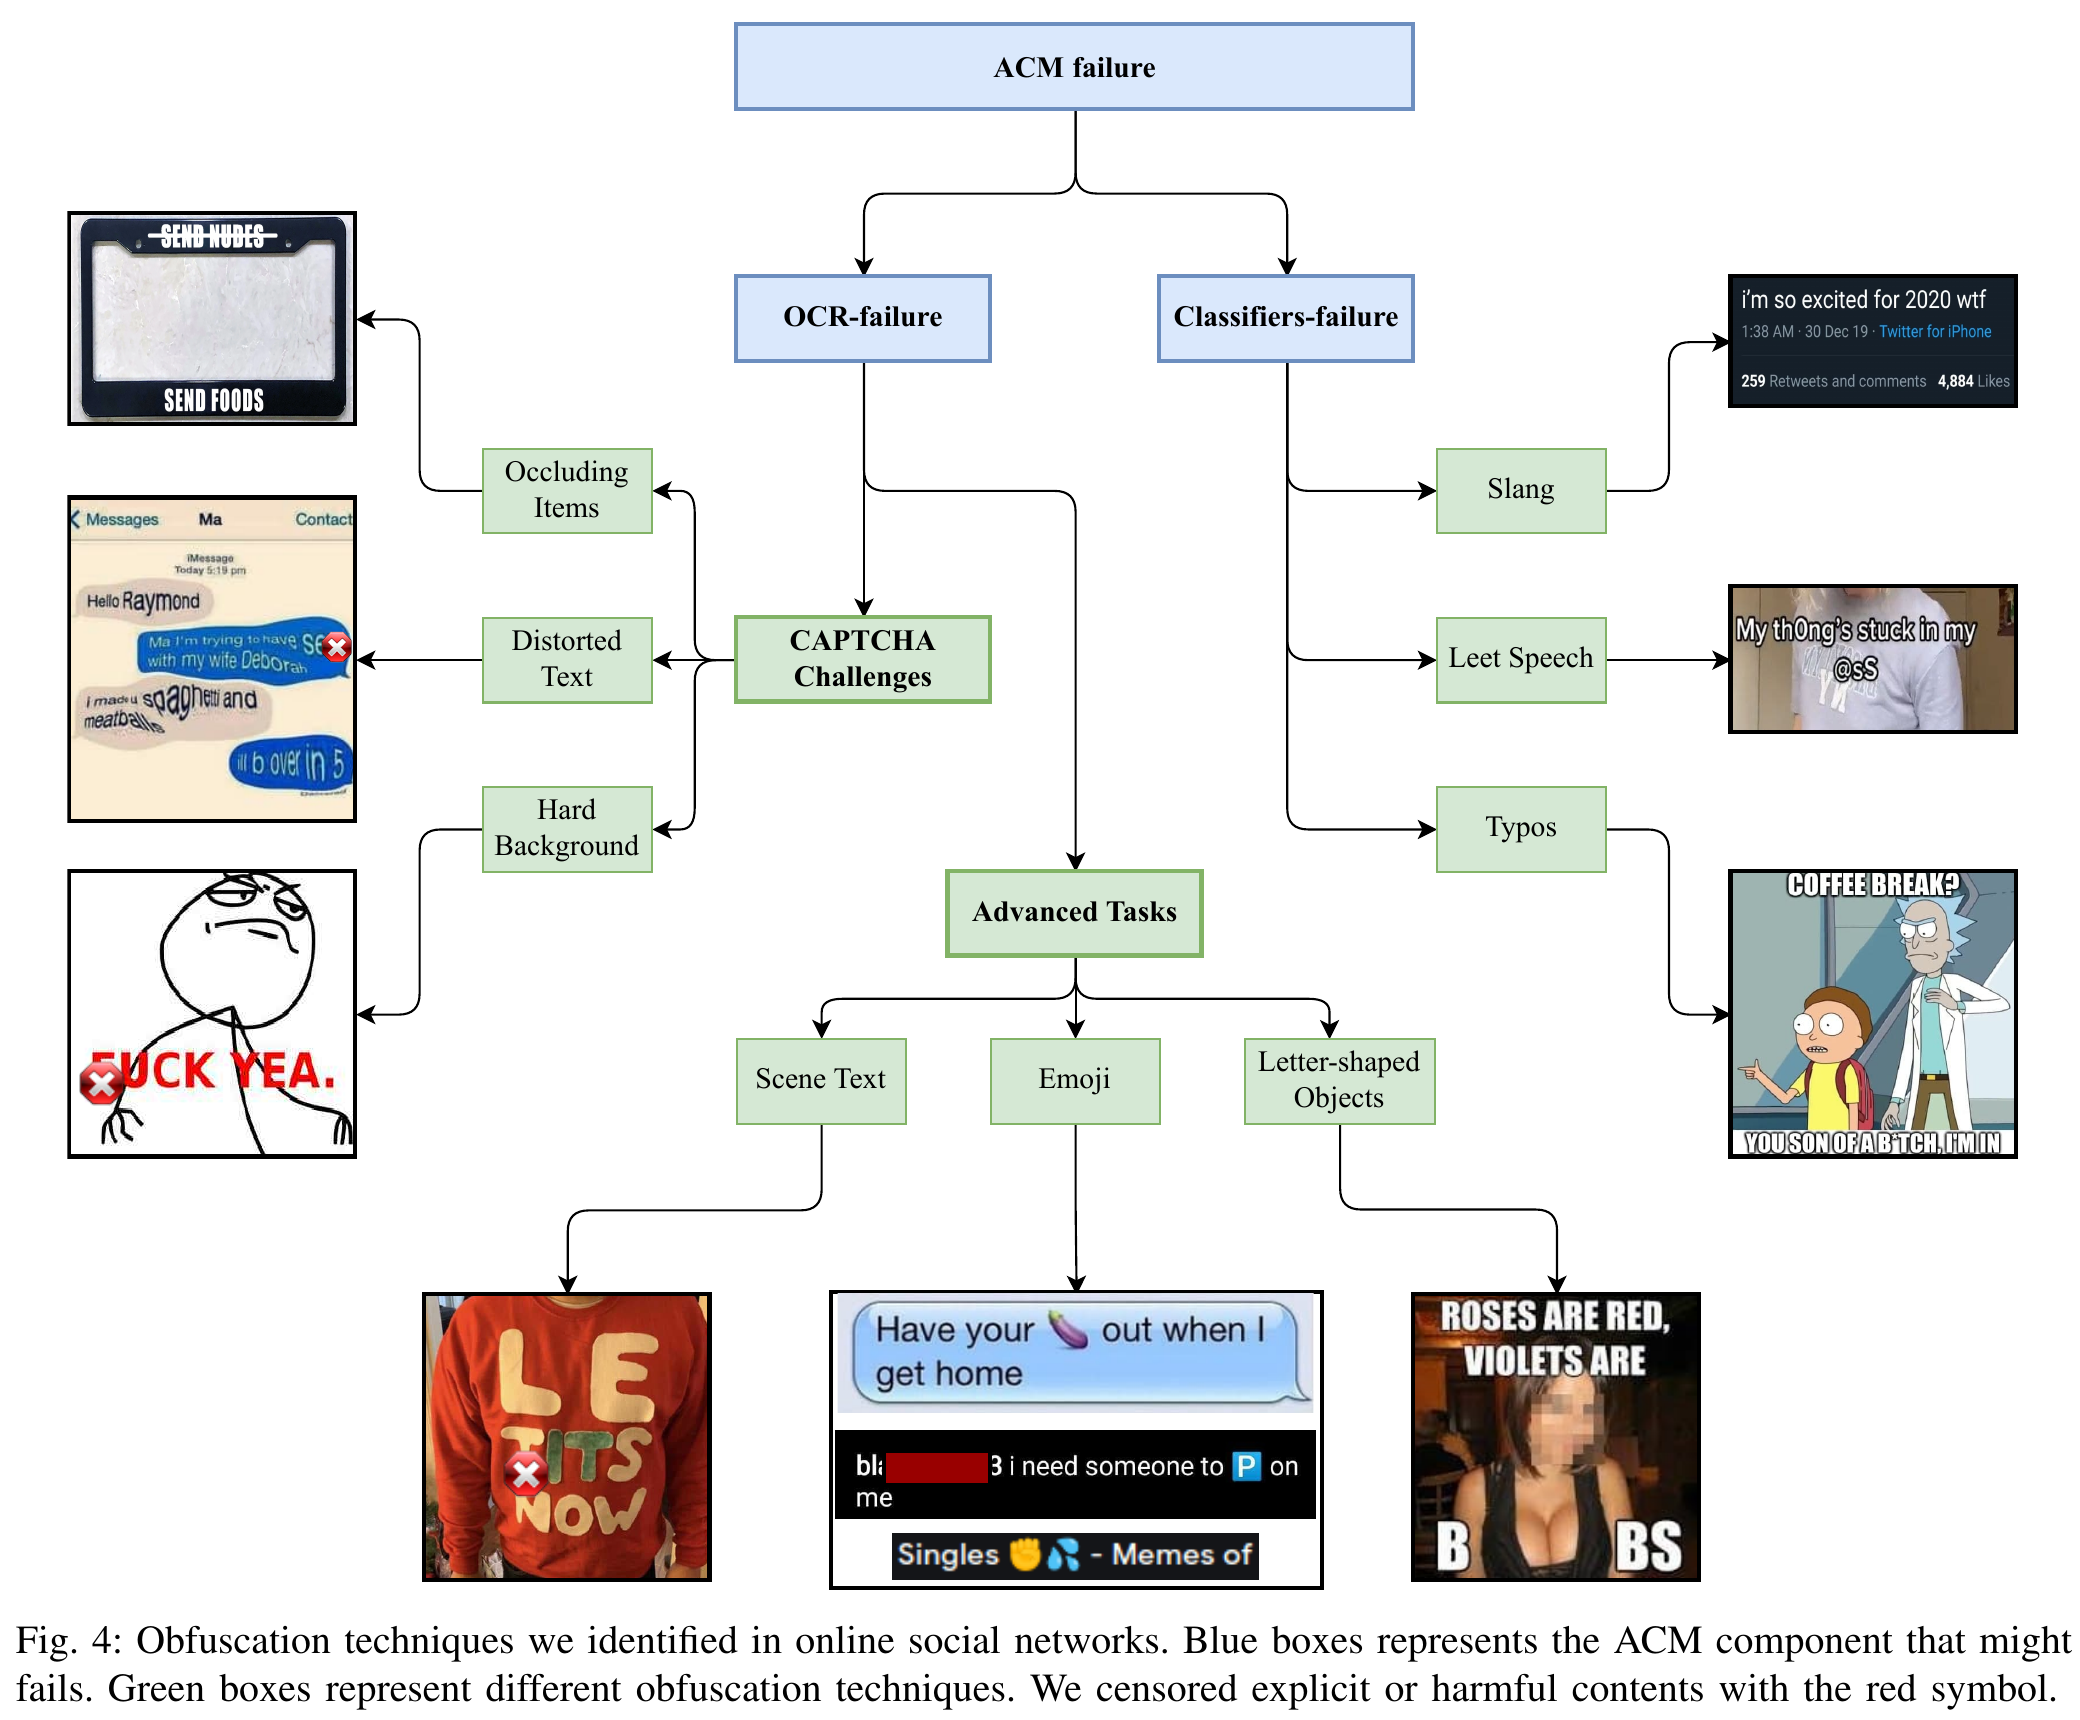
저자들은 관찰한 난독화 기법을 텍스트 추출을 방해하는지, 이후 분류기를 방해하는지에 따라 나눈다.
A. Challenges from OSN’s users: a Taxonomy
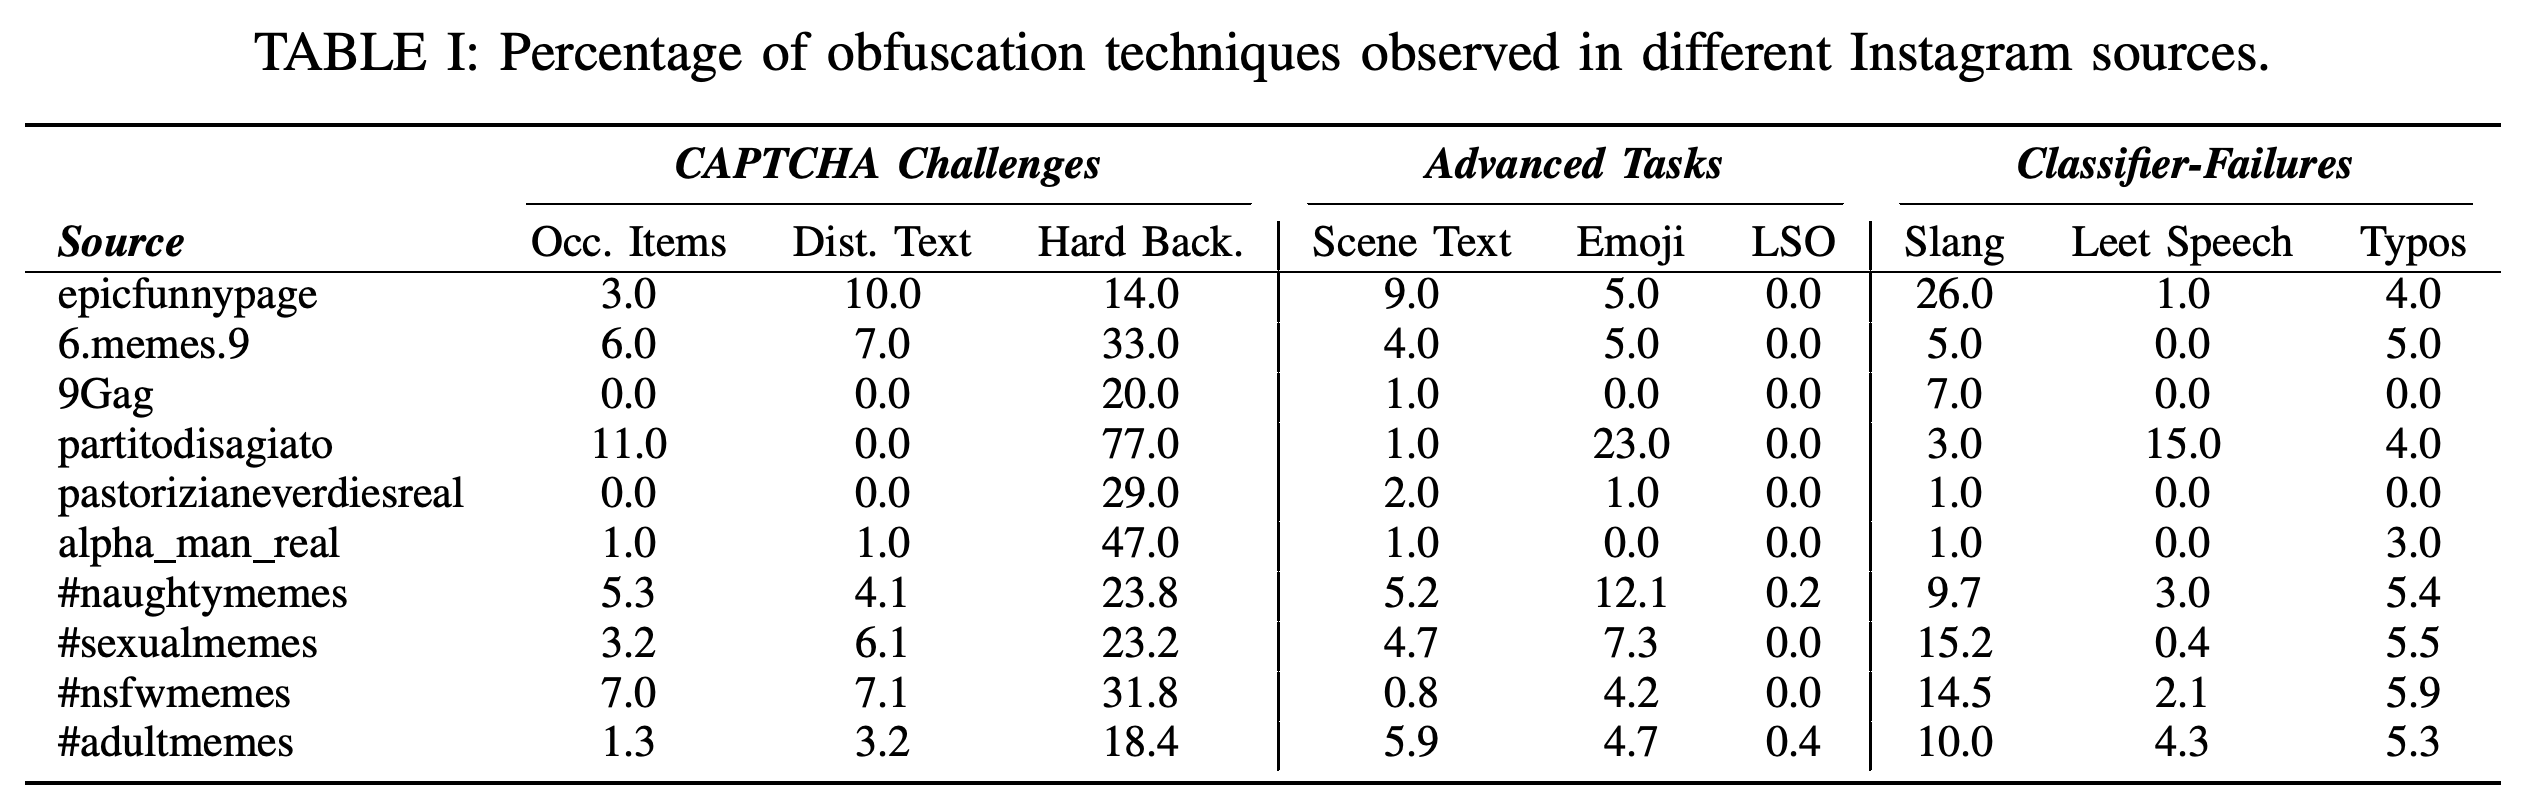
이 분류는 영어와 이탈리아어 Instagram 페이지 각각 3개에서 최신 게시물 100개씩, 해시태그 4개에서 최신 영어 게시물 1,000개를 직접 살펴본 결과다. 복잡한 배경은 나열된 모든 출처에서 나타났고 페이지 1개에서는 77%에 달했다. 선택한 출처만으로 플랫폼 전체의 출현 빈도를 판단할 수는 없다.
B. OCR-failure
OCR 실패를 유발하는 기법에는 실제 장면에 포함된 텍스트, 이모지, 글자 모양의 물체, 복잡한 배경, 왜곡된 텍스트, 텍스트를 가리는 물체가 있다. 이런 요소는 텍스트 추출을 어렵게 하거나 일반 문서 텍스트를 넘어서는 해석을 요구할 수 있다.
이 분류는 추출 실패와 분류기 실패를 구분해 변환이 파이프라인의 서로 다른 단계에 어떻게 영향을 주는지 보여준다.
나열된 출처에서 복잡한 배경의 비율은 14.0%에서 77.0%까지 분포하며, 글자 모양 물체는 이 표본에서 드물게 나타난다.
C. Classifier-failures
분류기 단계의 난독화에는 속어, 문자를 시각적으로 비슷한 기호로 바꾸는 leet speech, 오타가 있다. 텍스트를 추출하더라도 이런 표현은 분류에 영향을 줄 수 있다.
IV. Our Attack: CAPA
CAPA는 공격자가 선택한 텍스트를 맞춤형 텍스트 captcha로 변환해 사람이 읽을 수 있도록 유지하면서 모더레이션을 방해한다.
A. Target System
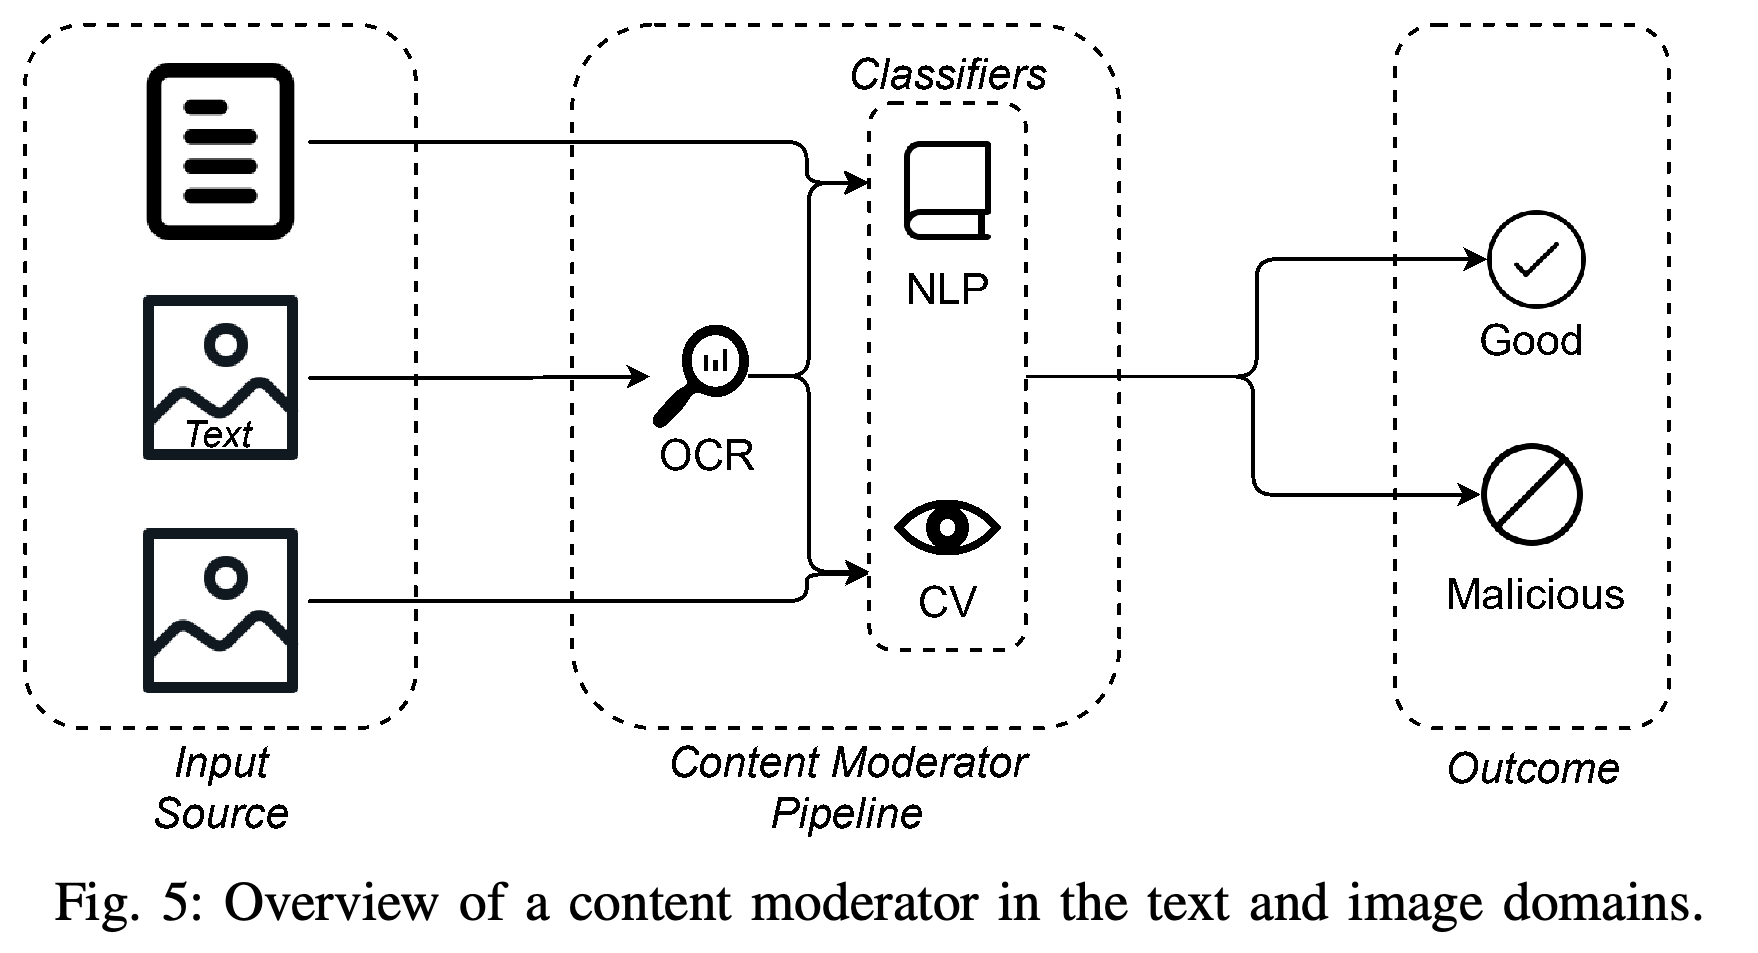
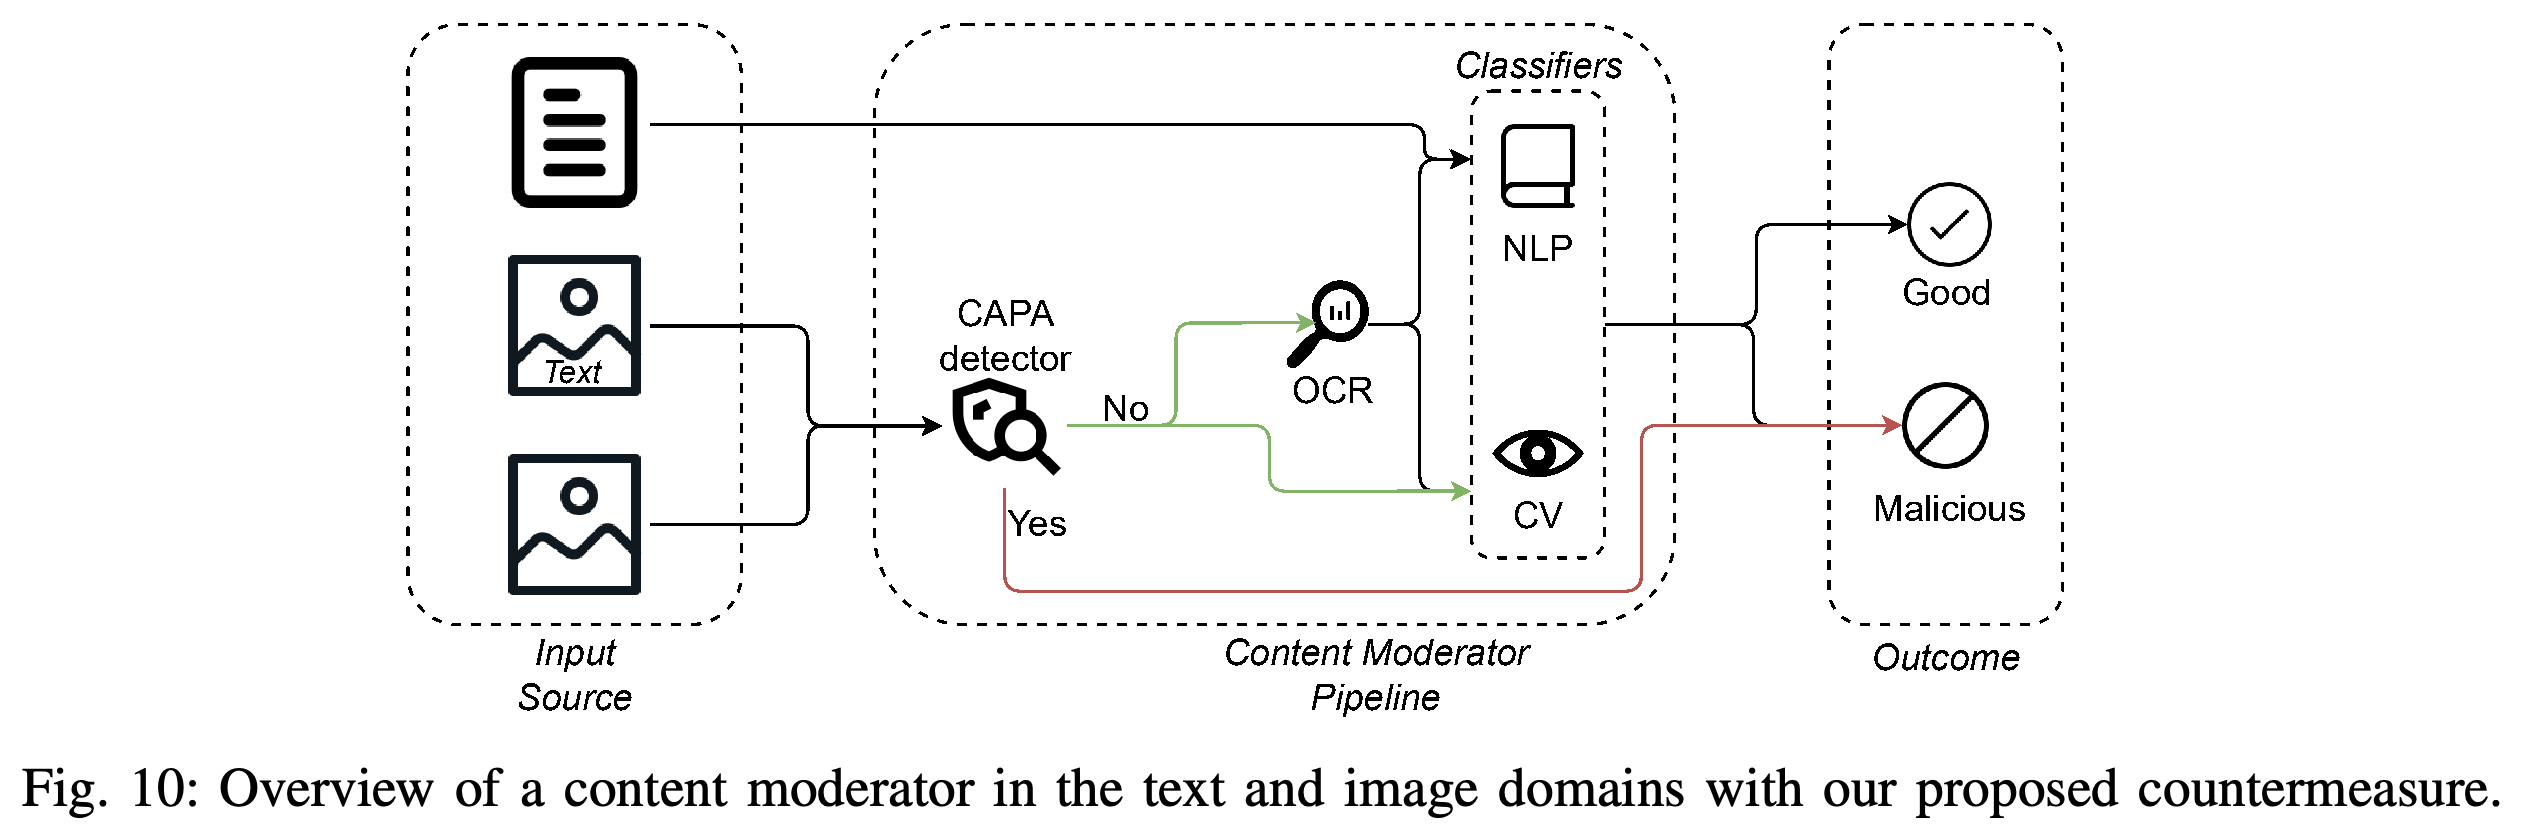
대상 시스템의 추상 모델은 일반 텍스트와 이미지를 언어 및 비전 분류기로 전달한다. 텍스트가 포함된 이미지에는 별도의 추출 단계가 필요하다. 저자들은 분류기들이 어떻게 협력해야 하는지는 명시하지 않는다.
B. Attack Motivation
실제 난독화 사례를 다양하고 대규모로 수집하기 어렵기 때문에 저자들은 관찰한 게시물을 확장하기 쉬운 형태로 단순화해 생성한 captcha를 사용한다. 생성된 이미지에는 텍스트 외에 유해한 시각 콘텐츠가 없다.
이미지에 포함된 텍스트는 언어 분류 전에 OCR을 거치므로 CAPA가 악용하는 추출 단계에 의존한다.
C. Attack Execution
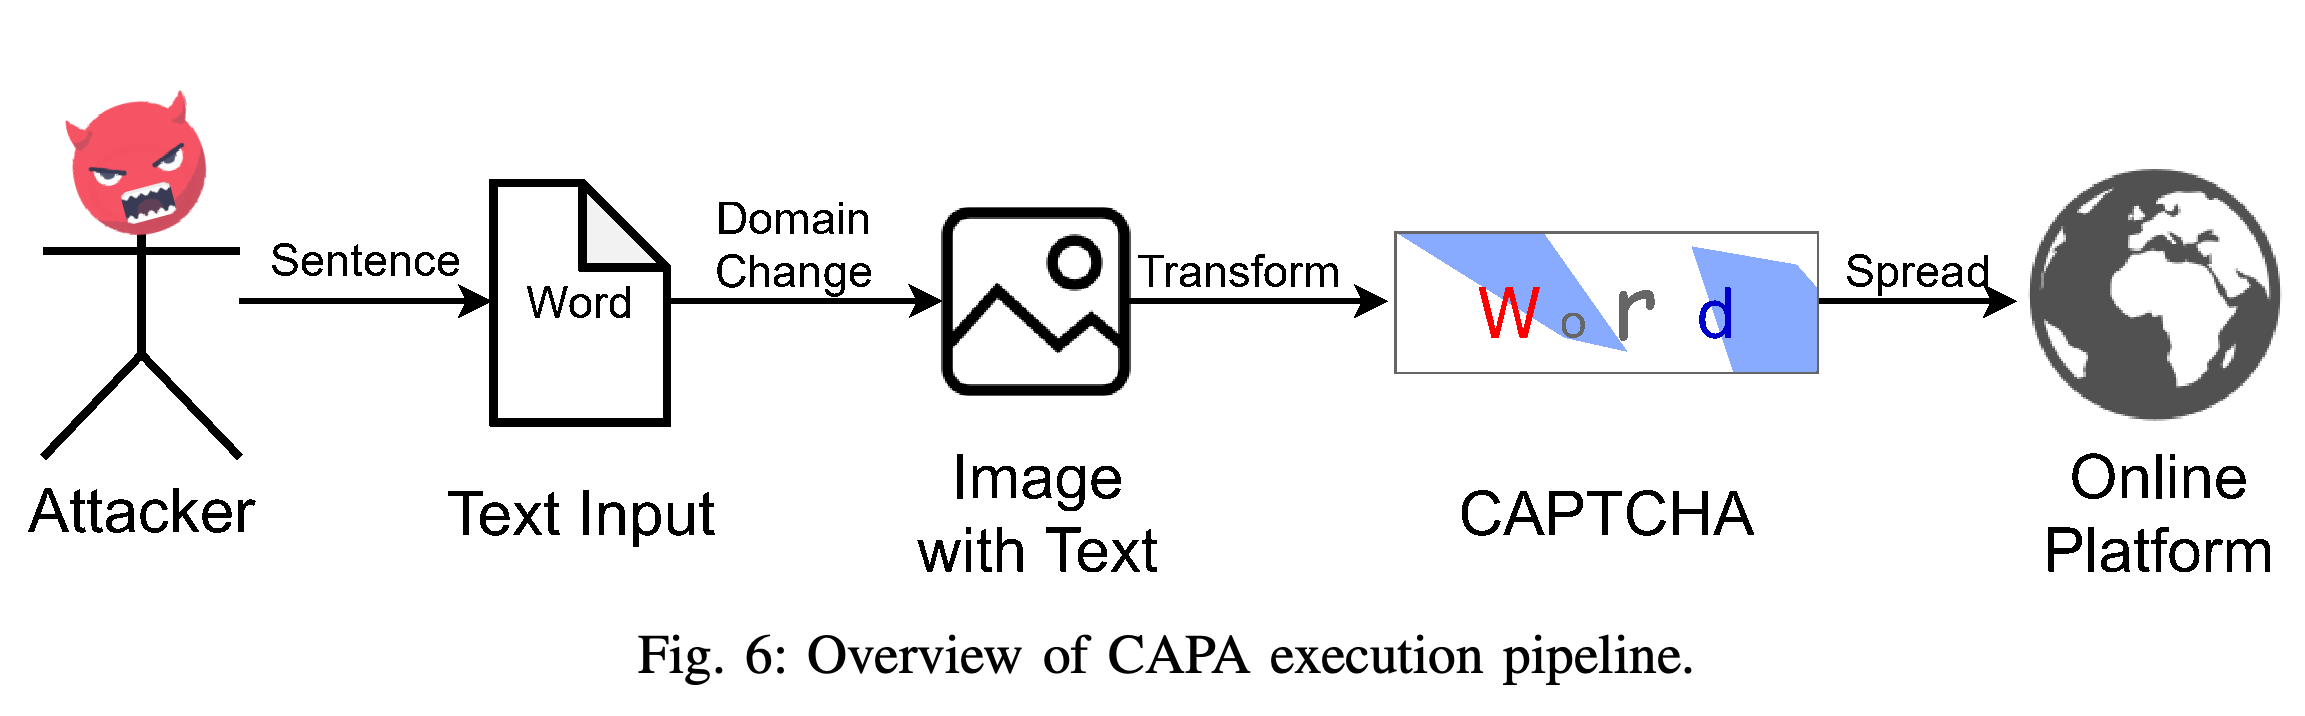
모더레이터 M과 공격적인 텍스트 x에 대해 공격은 M(x) = c_i이고 M(T(x)) = c_j인 변환 T를 찾는다. 여기서 c_i는 공격적, c_j는 비공격적 범주다. T는 먼저 텍스트를 이미지로 렌더링한 다음 이미지 변환을 적용하며, 대상 모델에 대한 지식이 필요하지 않도록 설계됐다.
그림은 공격자가 선택한 텍스트를 이미지로 만든 뒤 변환된 captcha를 온라인에 게시하는 순서를 보여준다.
V. CAPA Dataset
CAPA 데이터셋은 이미지 스타일 4개를 시험하며, 별도의 사용자 연구에서 가독성을 평가한다.
A. Dataset Generation
저자들은 혐오 문장과 관련된 영어 단어 1,383개 중 Microsoft Content Moderator가 부적절한 콘텐츠 범주 3개 가운데 적어도 1개에서 0.5를 넘는 점수를 부여한 단어 502개를 선별했다. 단어마다 Clean, Claptcha, Multicolor, Homemade 스타일 4개를 적용해 이미지 2,008개를 생성했다. 연구자는 요청을 통해 데이터셋을 받을 수 있다.
B. Captchas Readability
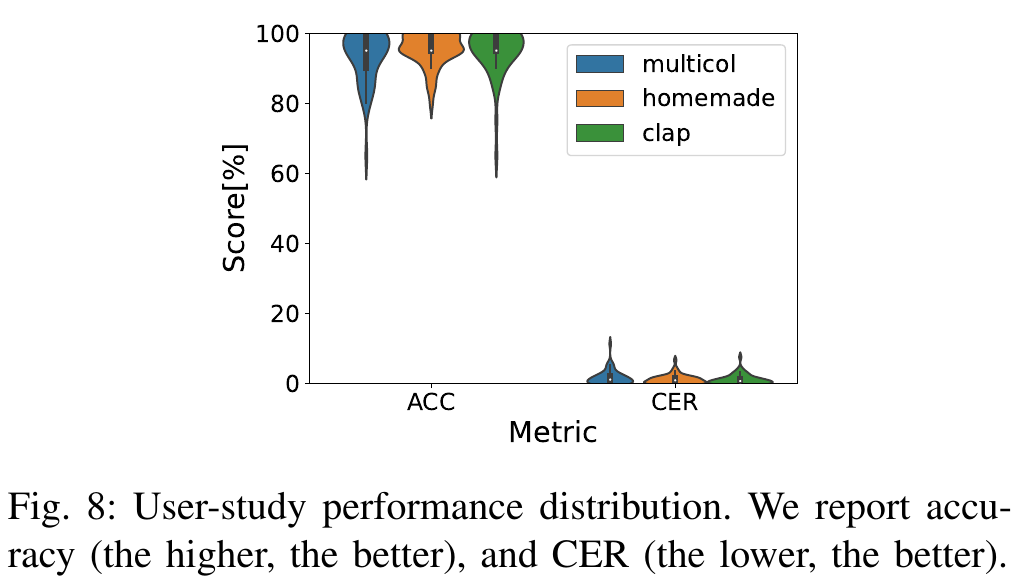
참가자 50명은 시간 제한 없이 생성된 이미지 600개에 담긴 무해한 영어 동사를 전사했다. 논문은 참가자마다 표본 50개를 주석 처리하고 참가자 5명이 각 표본을 처리했다고 서술하지만, 이 수치는 서로 일치하지 않는다. 평균 정확도는 94.53%, 정답과 문자 차이를 측정하는 문자 오류율은 1.31%였다. 평균 난이도 점수는 Claptcha 1.3, Multicolor 1.5, Homemade 1.3이었다.
Clean은 텍스트를 이미지로 옮기는 변환만 사용하고, 나머지 스타일은 회전, 배경, 글꼴, 색상, 가림 변환을 서로 다르게 조합한다.
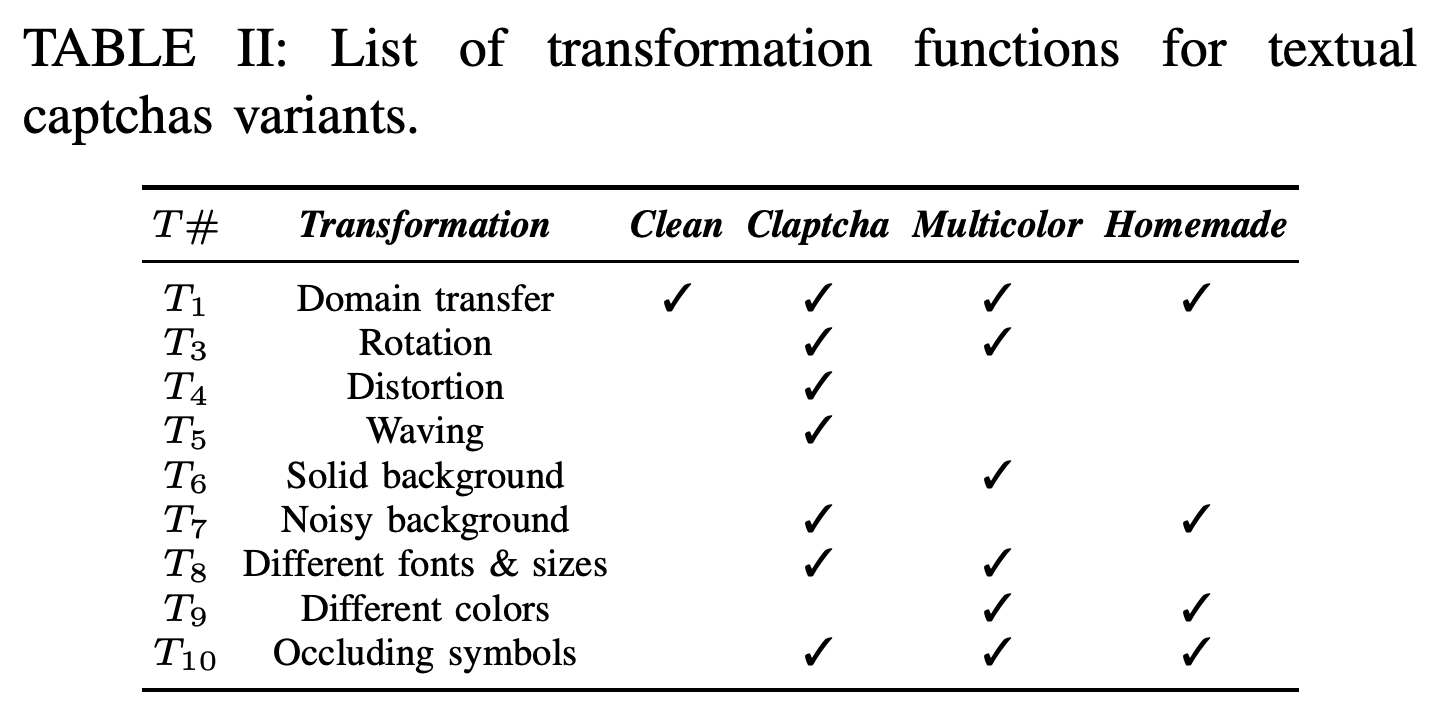
동일한 예시 단어를 통해 일반 텍스트부터 왜곡되거나 가려진 텍스트까지 4개 스타일의 시각적 차이를 보여준다.
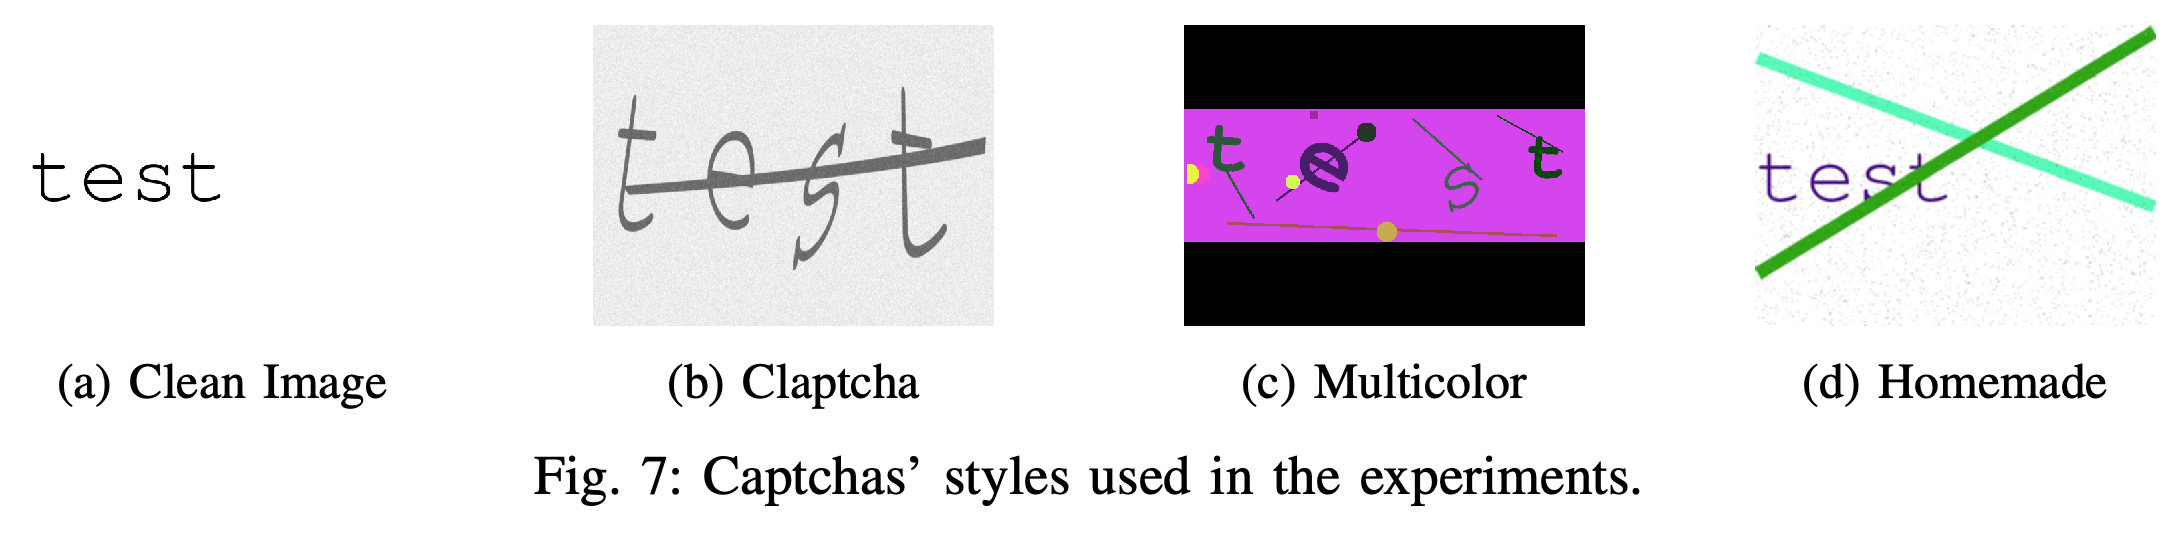
가독성 연구에서 변환된 스타일 3개 모두 전사 정확도는 높은 쪽에, 문자 오류는 낮은 쪽에 분포가 집중된다.
VI. Attack Results
실험은 배포된 이미지 모더레이션 API와 이미지에서 텍스트를 추출한 뒤 텍스트 모더레이션을 수행하는 실험용 파이프라인을 각각 평가한다.
A. Overview
저자들은 소셜 네트워크에 유해 자료를 게시하는 대신 API를 시험했다. Clean 이미지는 이미지 모더레이터가 이미지에 포함된 텍스트를 처리하는지 시험하고, 변환된 이미지는 OCR 기반 파이프라인을 시험한다.
B. Image Moderators
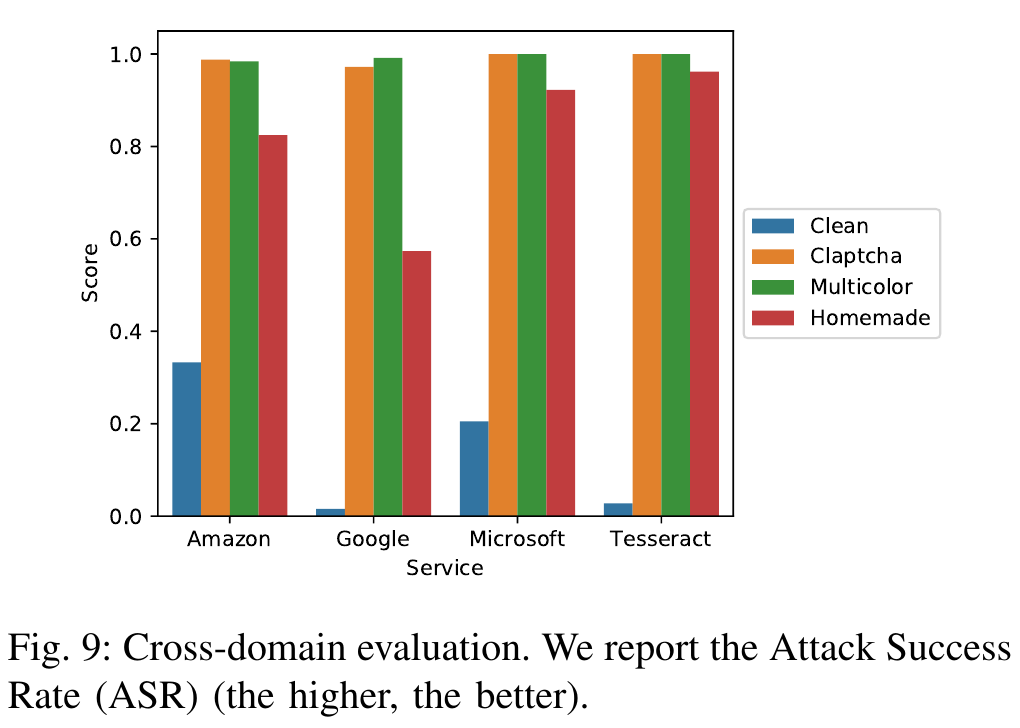
공격 성공률(ASR)은 안전하지 않은 표본 중 탐지되지 않은 비율이다. Clean 이미지의 ASR은 Amazon과 Microsoft 이미지 모더레이션에서 모두 1.0, Google SafeSearch에서 0.96이었다. Google이 표시한 4%는 spoofed로 분류됐다.
C. Cross-domain Moderators
실험용 파이프라인은 Amazon, Google, Microsoft 또는 Tesseract OCR을 텍스트용 Microsoft Content Moderator와 결합한다. Claptcha와 Multicolor의 ASR은 1.0에 가까웠고 Homemade의 평균은 0.8이었다. 추출한 텍스트와 실제 텍스트 사이의 문자 편집 거리를 길이로 정규화한 Levenshtein distance도 비슷한 경향을 보였다.
변환된 스타일은 Clean 이미지보다 실험용 파이프라인을 훨씬 자주 우회하지만, Homemade의 결과는 OCR 서비스에 따라 달라진다.
VII. Defense: Challenges & Possible Directions
논문은 가능한 방어 수단으로 지도학습 기반 captcha 분류와 비지도학습 기반 이상치 탐지를 모두 평가한다.
A. Overview
제안한 파이프라인은 이미지 분석 전에 CAPA 탐지기를 배치하고 탐지된 이미지를 차단하거나 사람이 검토하도록 보낸다. 이를 위해 의심스러운 captcha 형태의 이미지와 일반 게시물을 구별해야 한다.
B. A Supervised Approach: Classification
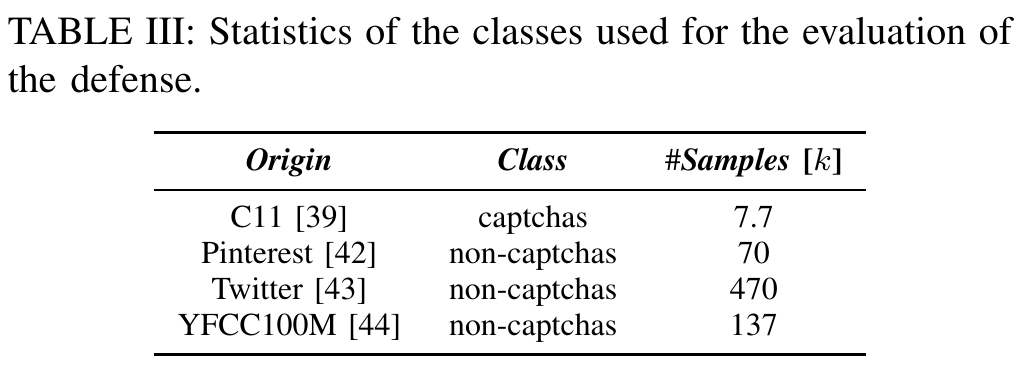
지도학습 실험은 알려진 captcha 방식 11개의 예제 7,700개를 Pinterest, Twitter 또는 YFCC100M 이미지와 결합하고 학습 70%, 검증 10%, 테스트 20%로 나눈다. 소형 합성곱 분류기와 미세 조정한 Alexnet, Resnet18, VGG는 알려진 방식에서 100%에 가까운 F1을 얻었지만, 모델, 데이터셋, 처음 보는 CAPA 스타일의 조합 36개 중 29개에서는 탐지율이 0이었다.
- 학습에는 학습률 0.001, 모멘텀 0.9의 확률적 경사 하강법과 교차 엔트로피 손실을 사용한다. 검증 손실이 5 에포크 동안 개선되지 않으면 조기 종료하며 최대 200 에포크까지 학습한다.
추가된 탐지기는 CAPA로 인식된 이미지를 일반적인 OCR 및 분류기 경로에서 다른 경로로 보낸다.
C. An Unsupervised Approach: Outlier Detection
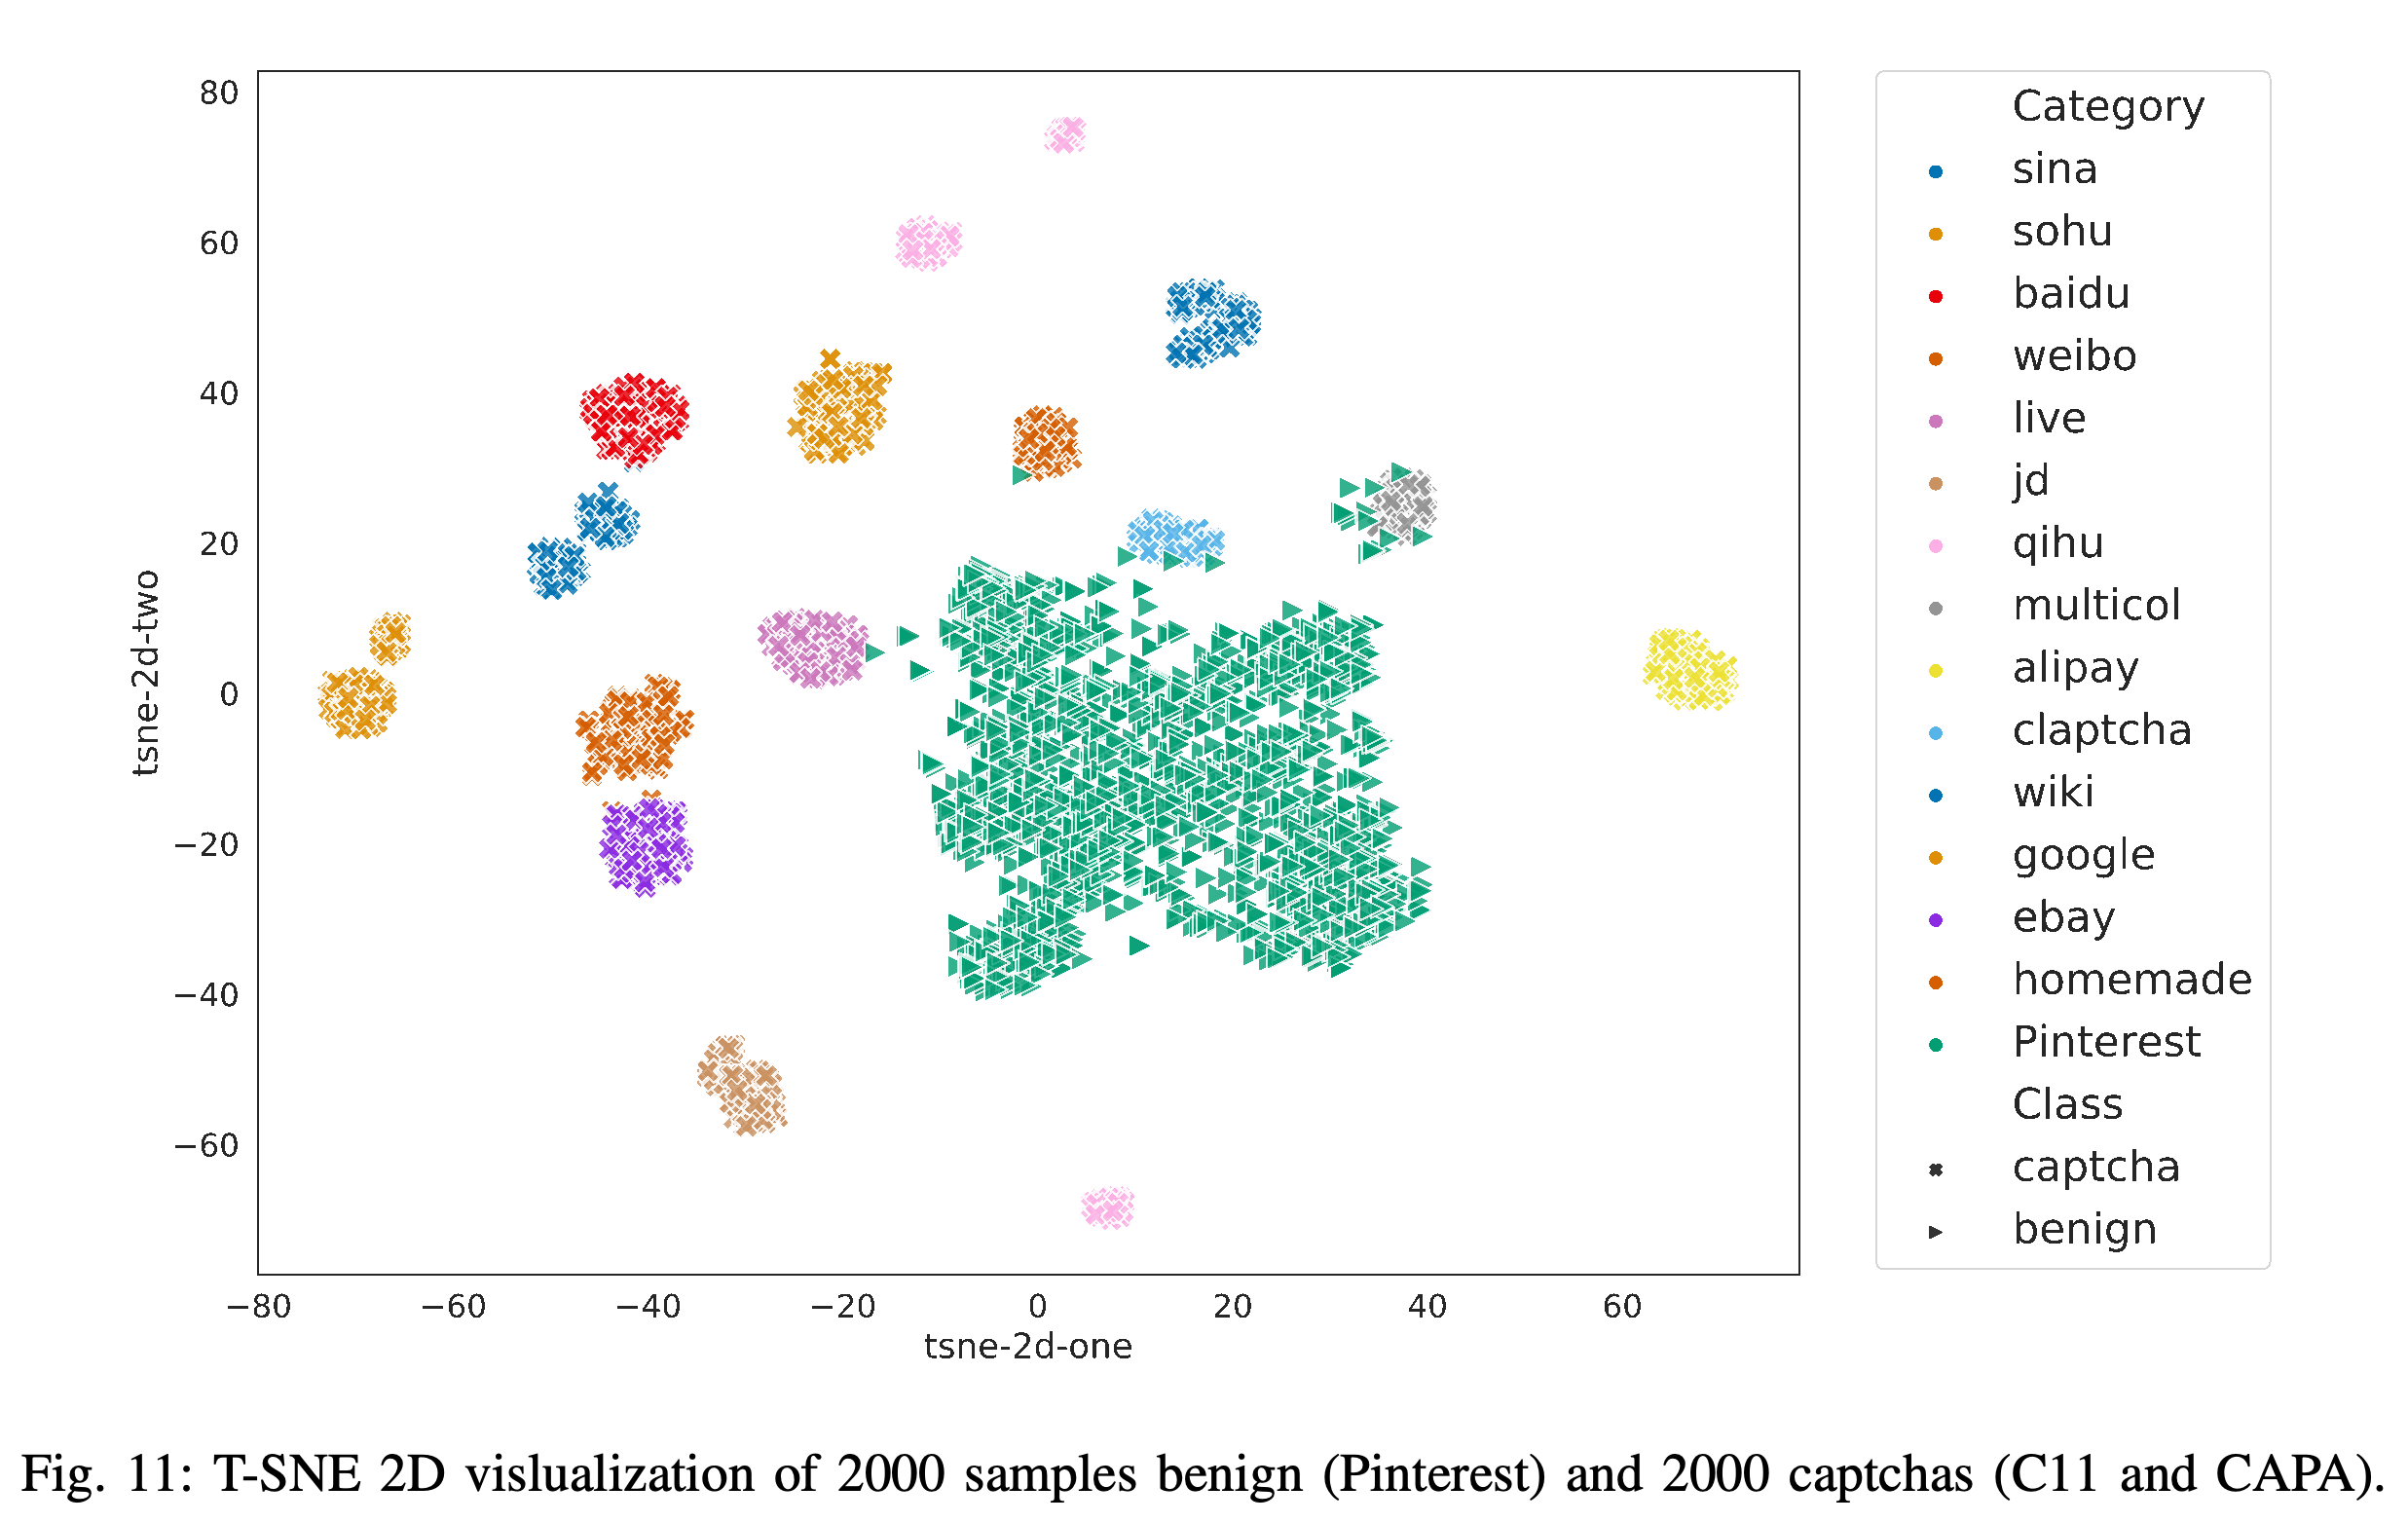
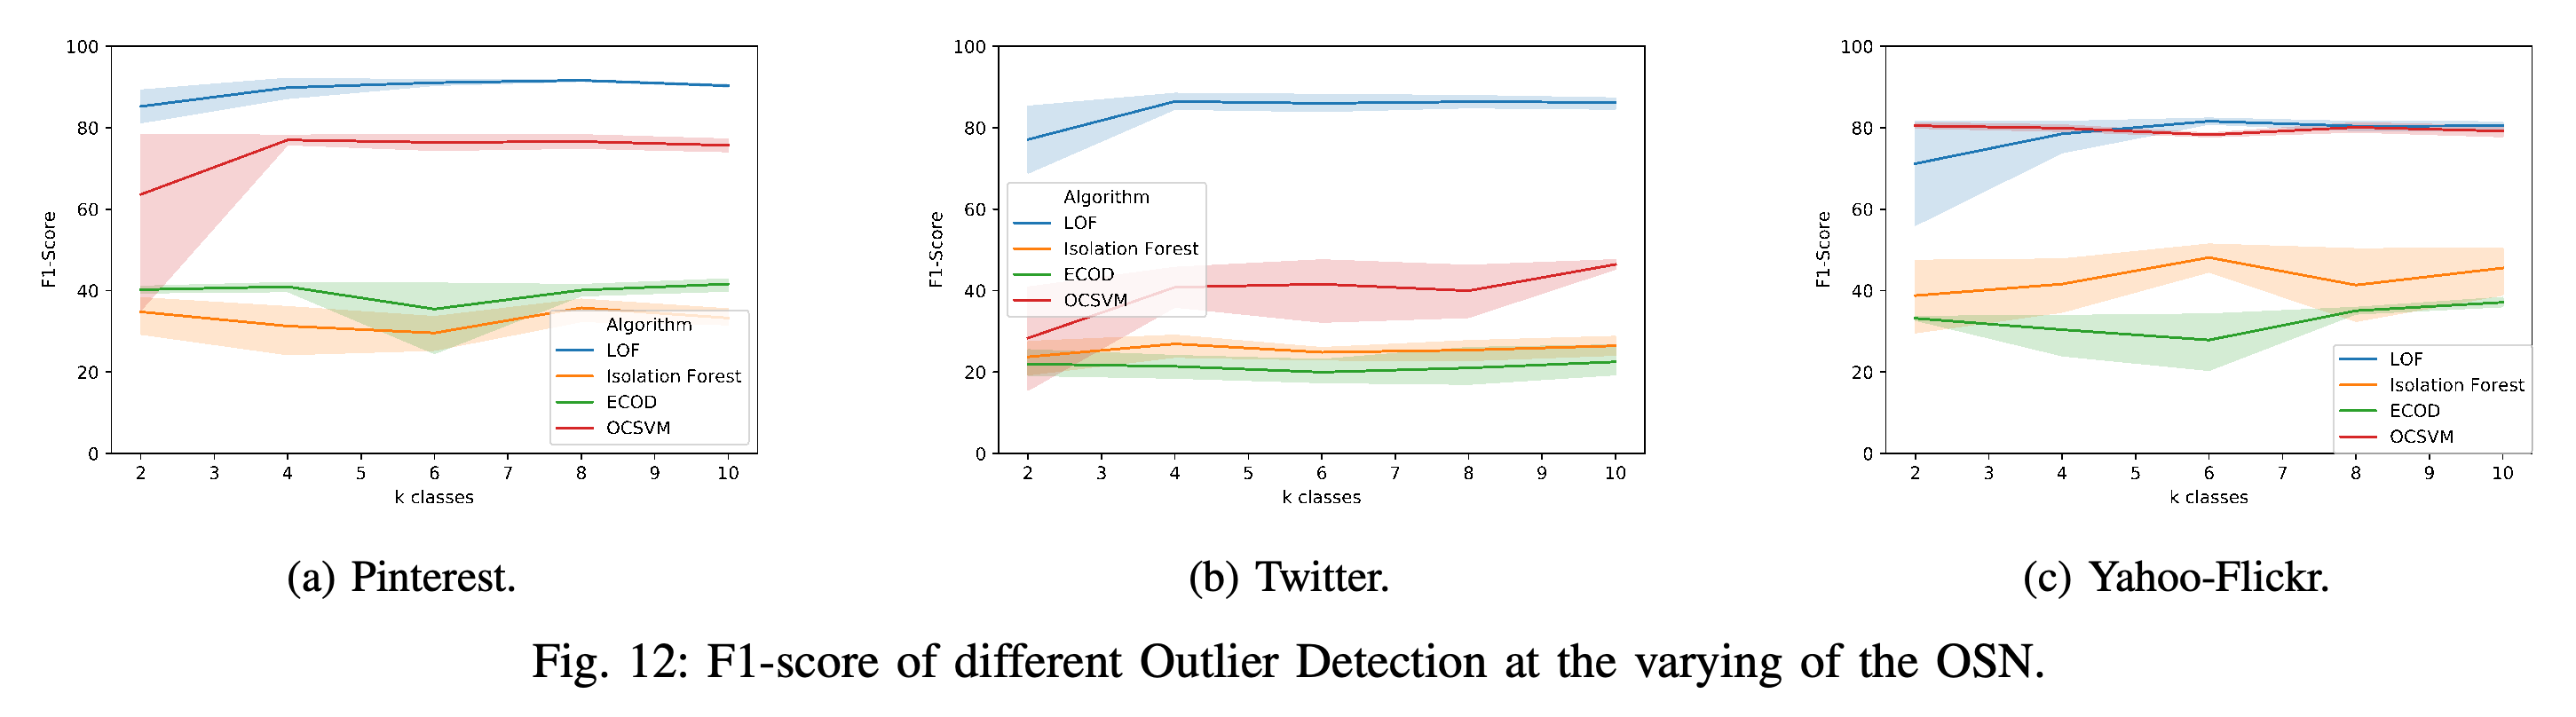
비지도학습 방식은 일반 게시물로 학습하며, 사전 학습된 ResNet-18 이미지 표현과 차원 축소를 위한 주성분 분석, 이상치 탐지기 4개를 사용한다. 데이터셋 3개에서 LOF의 평균 F1은 약 80%였고 알려진 검증 스타일 4개부터 성능이 안정됐지만, 정상 게시물의 약 9%가 오탐됐다.
- 플랫폼마다 일반 이미지 50,000개를 70%/10%/20%로 나눈다. 검증에는 k in {2, 4, 6, 8, 10}개의 알려진 captcha 스타일을 사용하며 각 설정에서 스타일 조합 5개를 사용한다.
- 그리드 탐색은 주성분 개수 2, 8, 64, 128과 가정한 이상치 비율 0.1, 0.05, 0.01을 대상으로 한다. 알려지지 않은 스타일은 테스트 세트에만 포함된다.
방어 데이터셋은 captcha 예제 7.7천 개를 훨씬 큰 비captcha 데이터셋과 결합해 의도한 클래스 불균형을 반영한다.
2차원 임베딩은 여러 captcha 스타일이 별도의 군집을 이루고 Pinterest 이미지가 넓은 군집을 형성함을 보여주며, 저자들이 이상치 탐지를 검토하는 근거가 된다.
LOF는 데이터셋 3개에서 대체로 가장 높은 F1 곡선을 보이며, 알려진 검증 스타일 4개 이후에는 성능 향상이 작아진다.
VIII. Conclusions and Future Works
저자들은 captcha와 일반 이미지의 경계 정의, 더 넓은 분류 체계를 위한 데이터 수집, 다양한 난독화 기법의 탐지를 미해결 문제로 제시한다.
부록
- Appendix A는 C11 captcha 방식 11개와 변환을 보여준다. Appendix B는 OCR 서비스별 공격 성공률과 정규화된 편집 거리를 그래프로 나타내며, Appendix C는 지도학습 결과와 알려진 스타일 및 알려지지 않은 스타일에 대한 이상치 탐지 정확도를 보고한다.
짧은 생각
이미지 전용 API 시험과 OCR 및 텍스트를 결합한 실험용 파이프라인 시험을 분리해 실패 원인을 해석하기 쉽다. 다만 어느 시험도 실제 소셜 네트워크에 배포된 모더레이션 시스템 전체를 직접 측정하지는 않는다. 방어 기법이 처음 보는 스타일에서 실패하고 정상 게시물을 오탐한다는 점은 일반화와 검토 업무량 측면의 실질적인 한계다.