


Contrastive Chain-of-Thought Prompting 요약 설명
15 Nov 2023 | Paper Review Reasoning Prompting Few-Shot Learning목차
이번 글에서는 Contrastive Chain-of-Thought Prompting 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 11월 15일(Arxiv)
- Chia, Yew Ken, Chen, Guizhen, Tuan, Luu Anh, Poria, Soujanya, Bing, Lidong.
- DAMO Academy, Alibaba Group, Singapore, Singapore University of Technology and Design, Nanyang Technological University, Singapore
- 논문 링크
- Github
요약
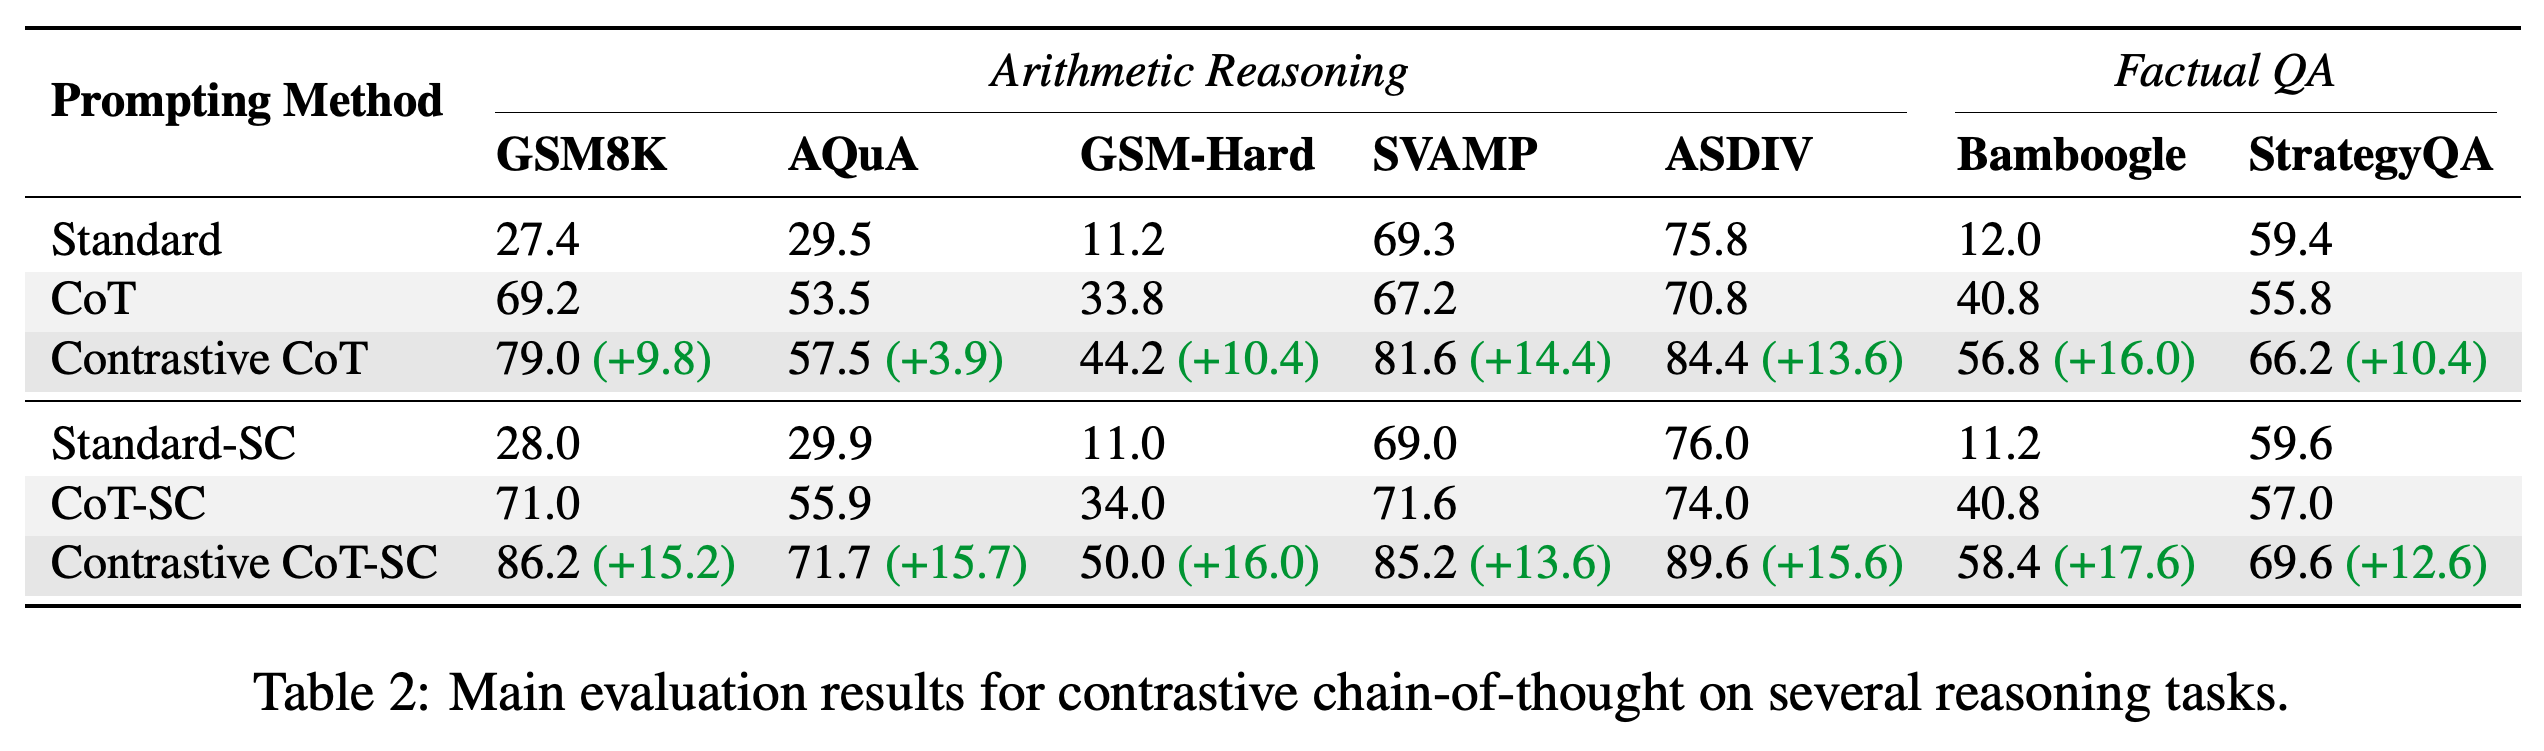
- 이 논문은 올바른 예시가 포함된 프롬프트에 잘못된 추론 예시를 추가해 언어 모델의 추론 오류를 줄이고자 한다. GPT-3.5-Turbo (0301)에 시연 예시 4개를 제공했을 때, contrastive prompting은 기존 chain-of-thought prompting보다 GSM8K에서 9.8점, Bamboogle에서 16.0점 높은 성능을 보였다.
- Chain-of-thought prompting은 예시 풀이에 중간 추론 단계를 제공한다. 제안하는 방법은 기존의 올바른 설명에서 숫자와 이름 같은 객체를 식별하고 순서를 섞어 잘못된 예시를 자동으로 생성한다.
- 이 방법은 여러 추론 경로를 결합하는 디코딩 전략인 self-consistency의 적용 여부와 관계없이 평가한 데이터셋 7개 모두에서 기존 chain-of-thought 베이스라인보다 높은 성능을 보였다. 다만 실험은 모델 버전 1개, 시연 예시 4개를 사용한 프롬프트, 데이터셋당 최대 500개의 테스트 예시로 제한된다.
1 Introduction
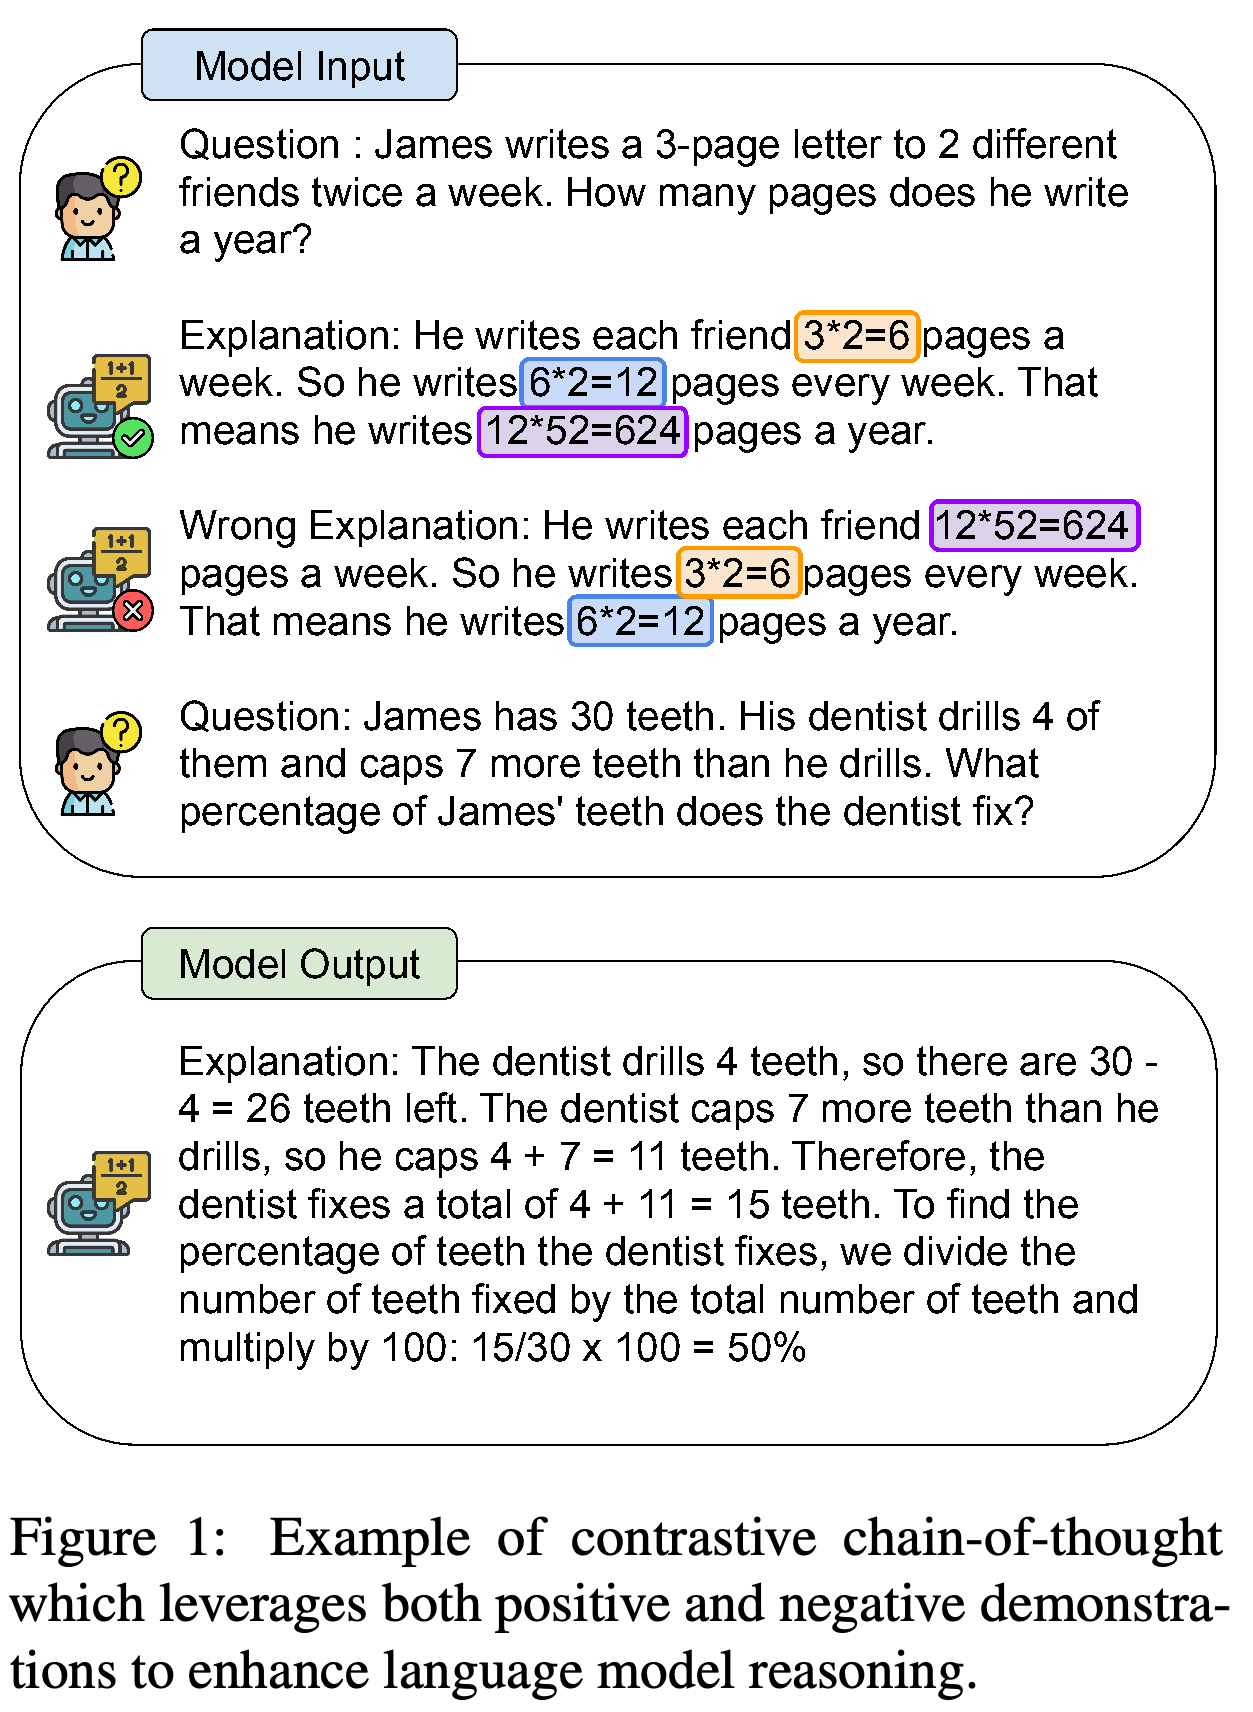
저자들은 중간 단계의 오류가 누적될 수 있지만, 기존 연구에서는 유효하지 않은 시연이 유효한 시연과 비슷한 성능을 보이는 경우도 있었다는 점에 주목한다 (Wang et al., 2023). 제안하는 방법은 긍정 예시와 부정 예시를 함께 제공해 유용한 단계와 피해야 할 오류를 모델에 보여준다.
시연은 올바른 산술 연산 순서와 그 연산의 순서를 바꾼 잘못된 설명을 함께 보여준다. 이어지는 모델 출력은 치아 30개 중 치료한 치아가 15개라고 계산해 50%를 도출한다.
2 Preliminary Study: Effect of Different Types of Contrastive Demonstrations
예비 연구에서는 유효하지 않은 추론 시연을 유효한 rationale, 즉 단계별 설명과 함께 제공할 때 chain-of-thought prompting의 성능을 높일 수 있는지 살펴본다.
2.1 Components of Chain of Thought
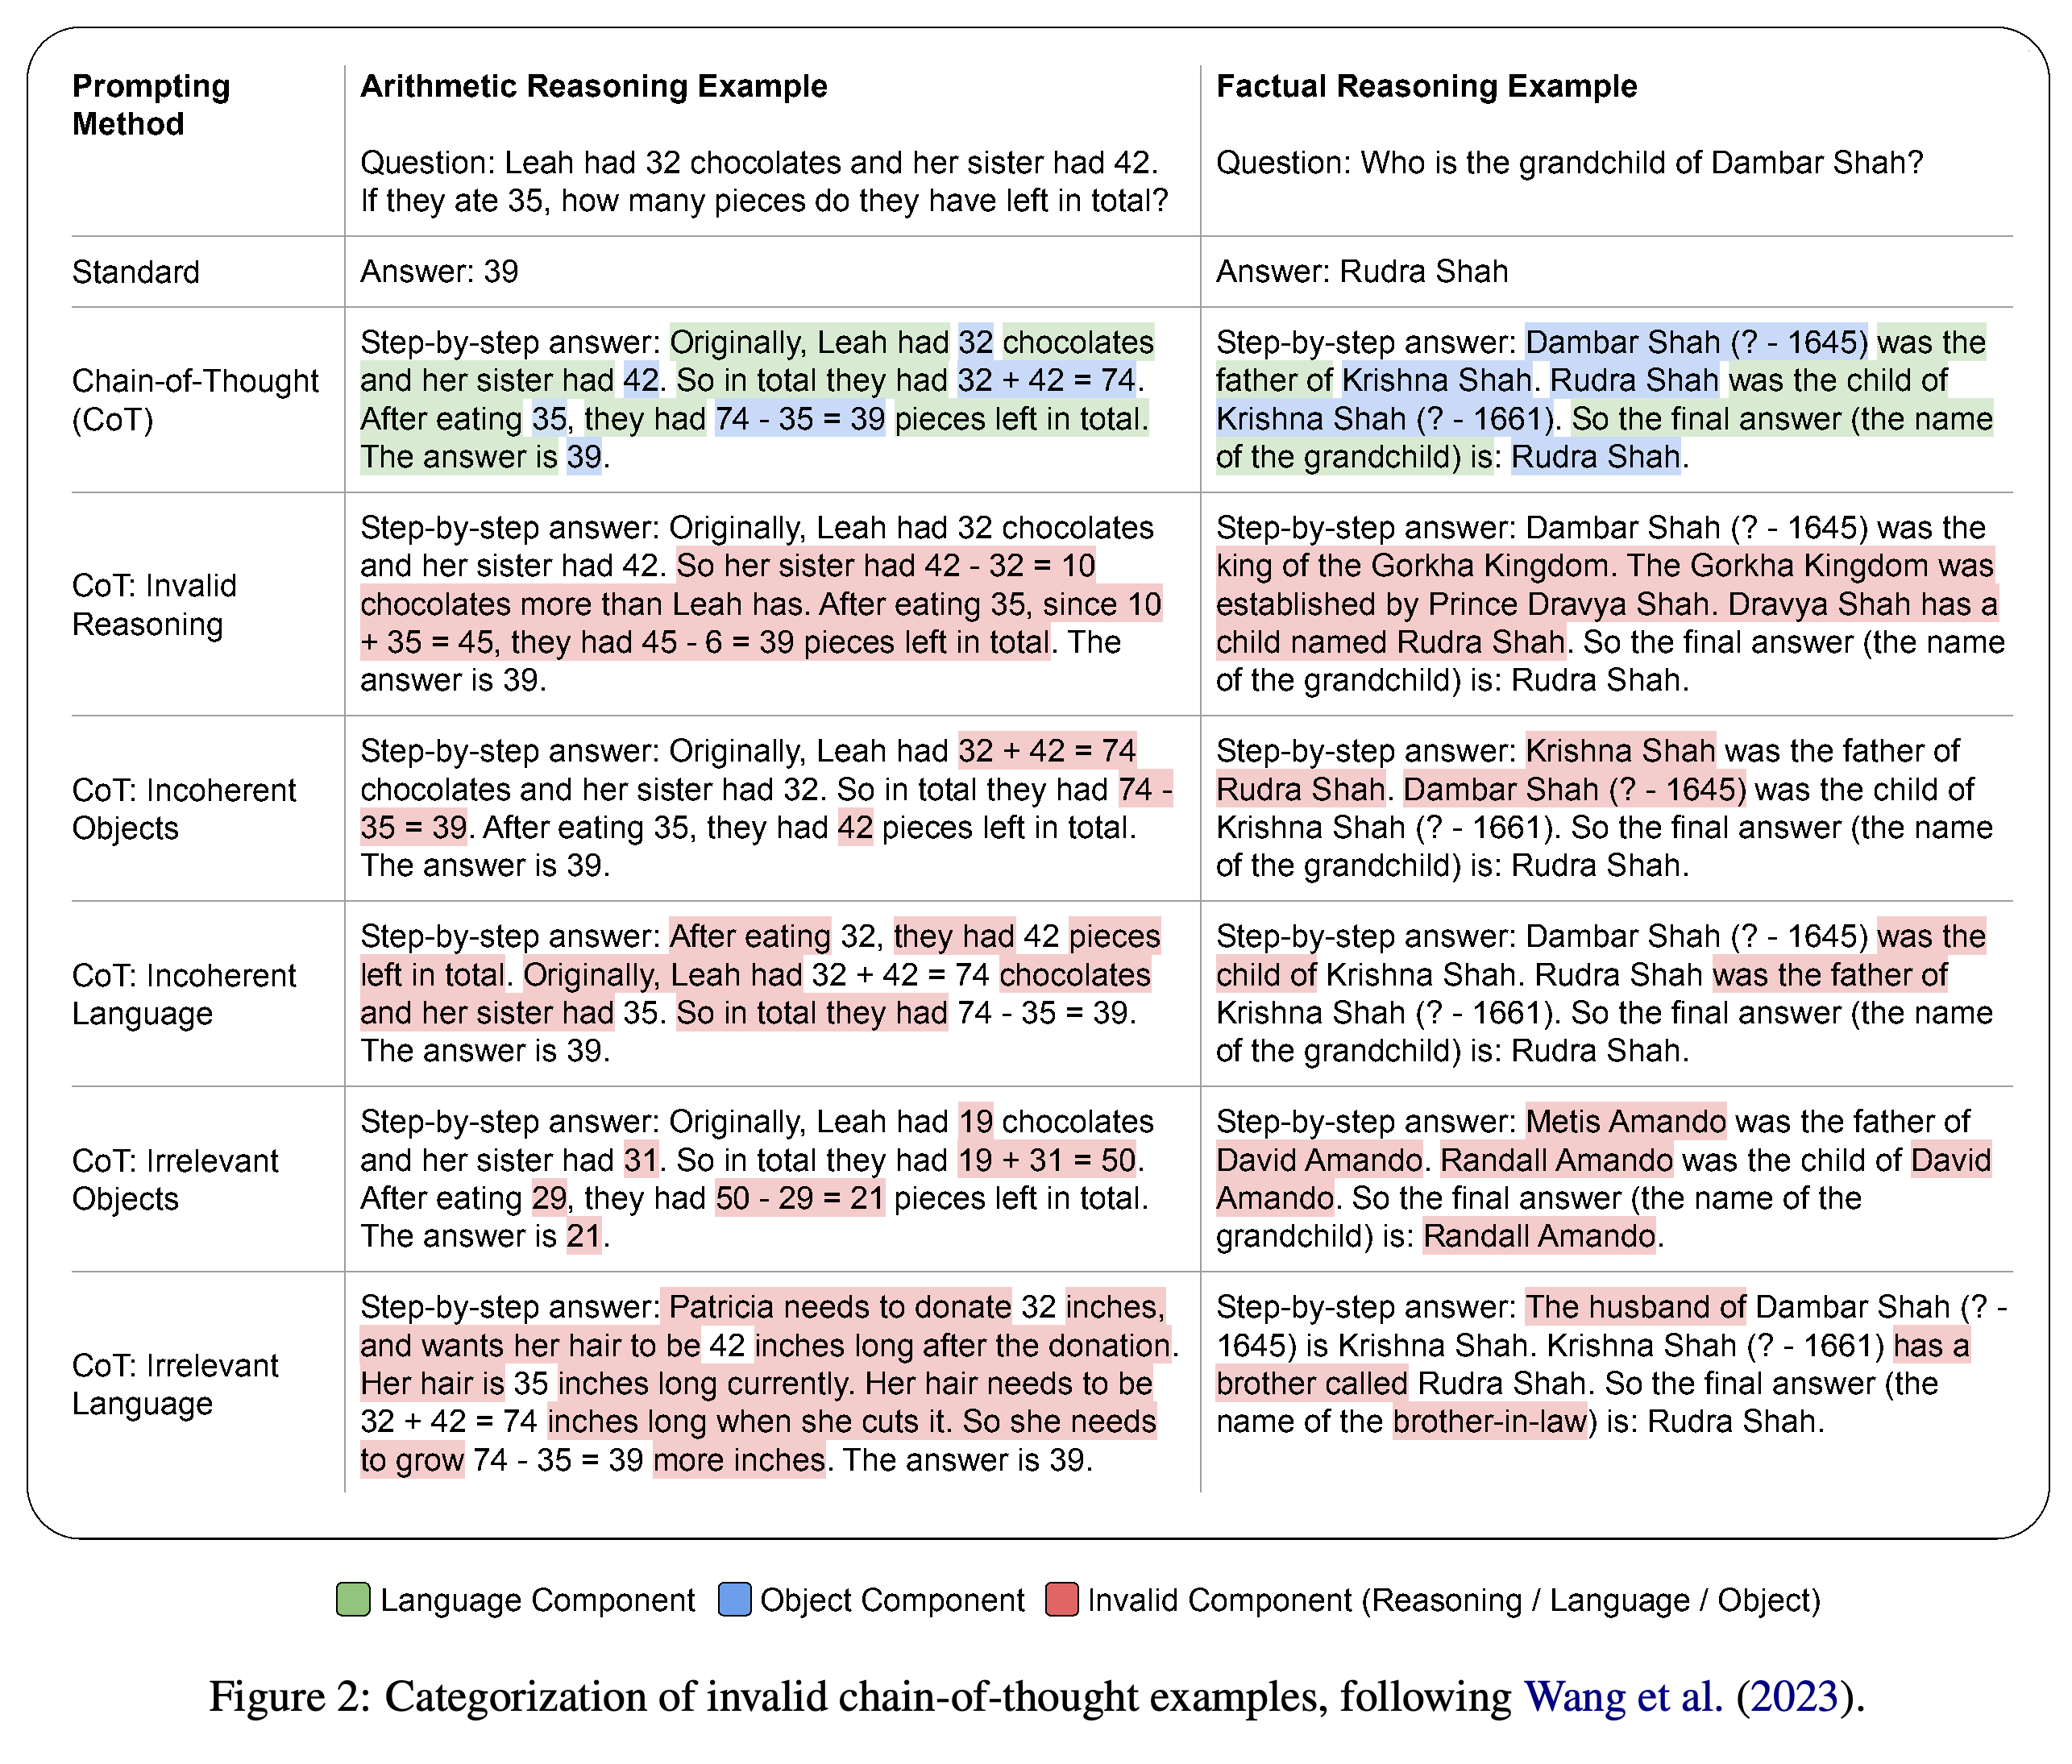
논문은 rationale을 추론 과정에서 거치는 기호 항목인 bridging objects와, 해당 객체를 도출하고 맥락을 제공하는 텍스트 단서인 language templates로 나눈다. 산술 문제에서는 숫자와 수식이 객체에 해당하며, 사실 기반 질문에서는 개체 이름이 같은 역할을 한다.
2.2 What is Invalid Chain of Thought?
유효하지 않은 rationale은 추론 단계의 순서를 나타내는 coherence와 rationale이 질문에 부합하는 정도를 나타내는 relevance에 따라 분류한다. 이 속성을 객체와 언어에 적용하면 범주 4개가 나오며, 5번째 범주인 invalid reasoning에는 비일관적이거나 무관하지 않더라도 논리적 오류가 있는 경우가 포함된다.
산술 문제와 사실 기반 질문의 예시를 통해 invalid reasoning, incoherent objects 또는 language, irrelevant objects 또는 language의 차이를 보여준다. 색상으로 언어, 객체, 유효하지 않은 구성 요소를 구분한다.
2.3 Experimental Setup
예비 실험에서는 산술 문제에 GSM8K를, 사실 기반 추론에 Bamboogle을 사용하고, GPT-3.5-Turbo (0301)와 데이터셋별로 수작업으로 만든 시연 예시 4개를 사용한다. 표준화된 프롬프트 형식에서 유효하지 않은 rationale의 범주 5개를 비교한다.
2.4 Preliminary Results
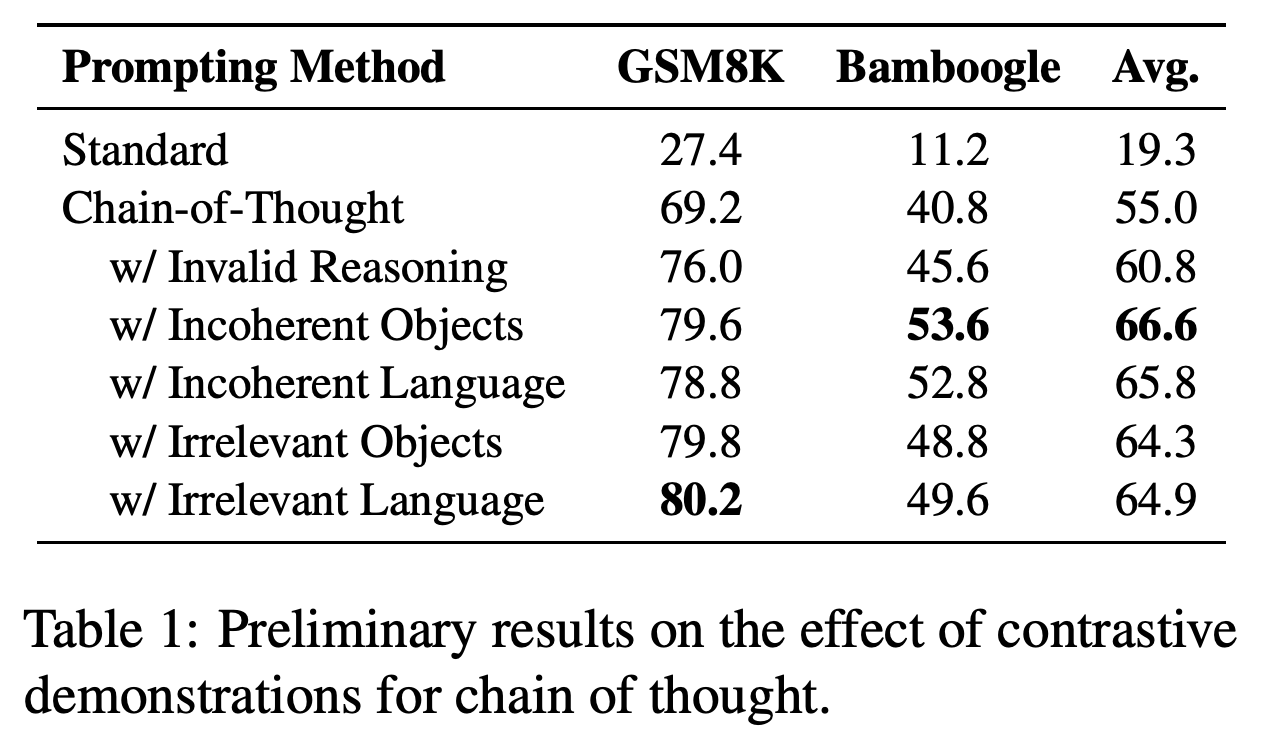
예비 비교에서는 contrastive 범주 5개 모두 기존 chain-of-thought보다 성능이 높았다. Incoherent objects는 GSM8K에서 79.6, Bamboogle에서 53.6을 기록해 데이터셋 2개의 평균이 66.6으로 가장 높았으며, 기존 chain-of-thought의 평균은 55.0이었다.
3 Contrastive Chain of Thought
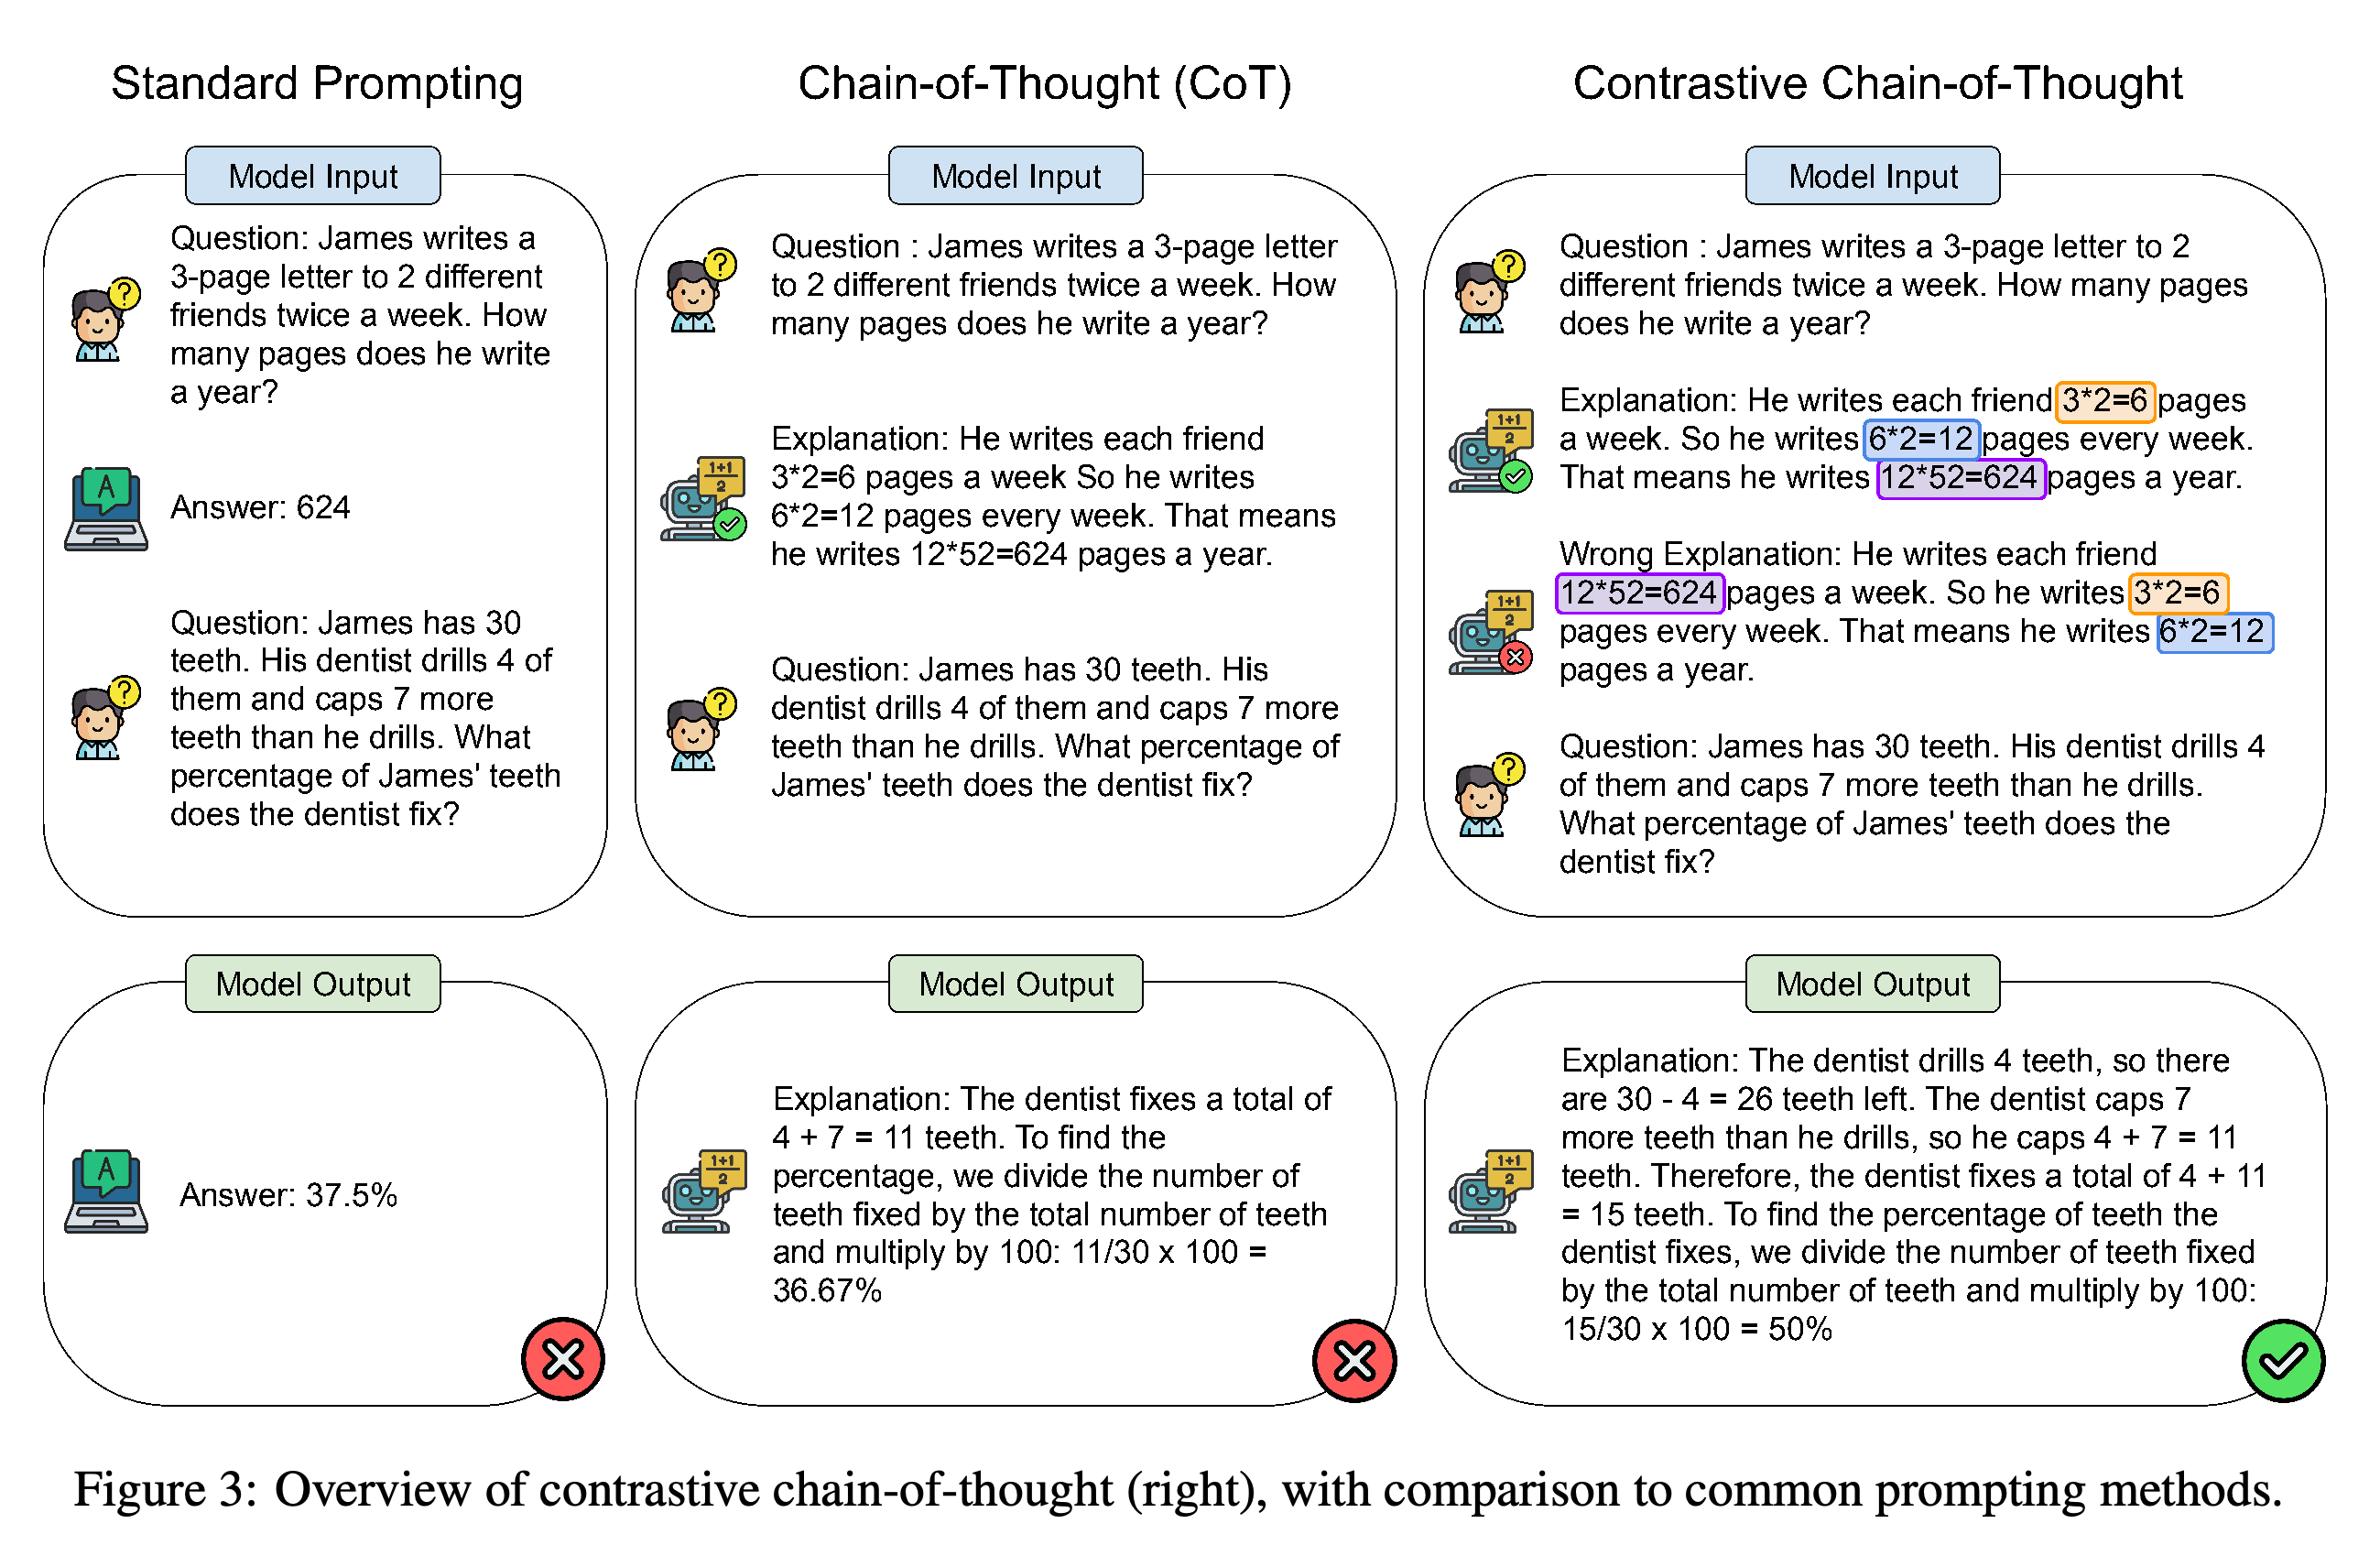
각 contrastive 시연은 질문, 올바른 추론과 답, 잘못된 추론과 답으로 구성된다. 잘못된 추론을 생성할 때는 개체 인식 모델로 유효한 rationale에서 객체의 텍스트 구간을 추출하고 그 위치를 무작위로 섞는다. 이후 모델은 시연을 참고해 새로운 질문에 답한다.
그림에 제시된 치아 문제에서 standard prompting은 37.5%, 기존 chain-of-thought는 36.67%, contrastive 예시는 정답인 50%를 출력한다. 이는 전체 성능을 비교한 결과가 아니라 설명을 위한 개별 예시다.
유효하지 않은 rationale의 범주 5개 모두 평균 점수를 기존 chain-of-thought의 55.0보다 높였으며, incoherent objects가 66.6으로 가장 높았다.
4 Experiments
주요 평가에서는 standard prompting, 기존 chain-of-thought, contrastive chain-of-thought를 비교하고 각각에 self-consistency를 적용한 경우도 평가한다.
4.1 Experimental Setup
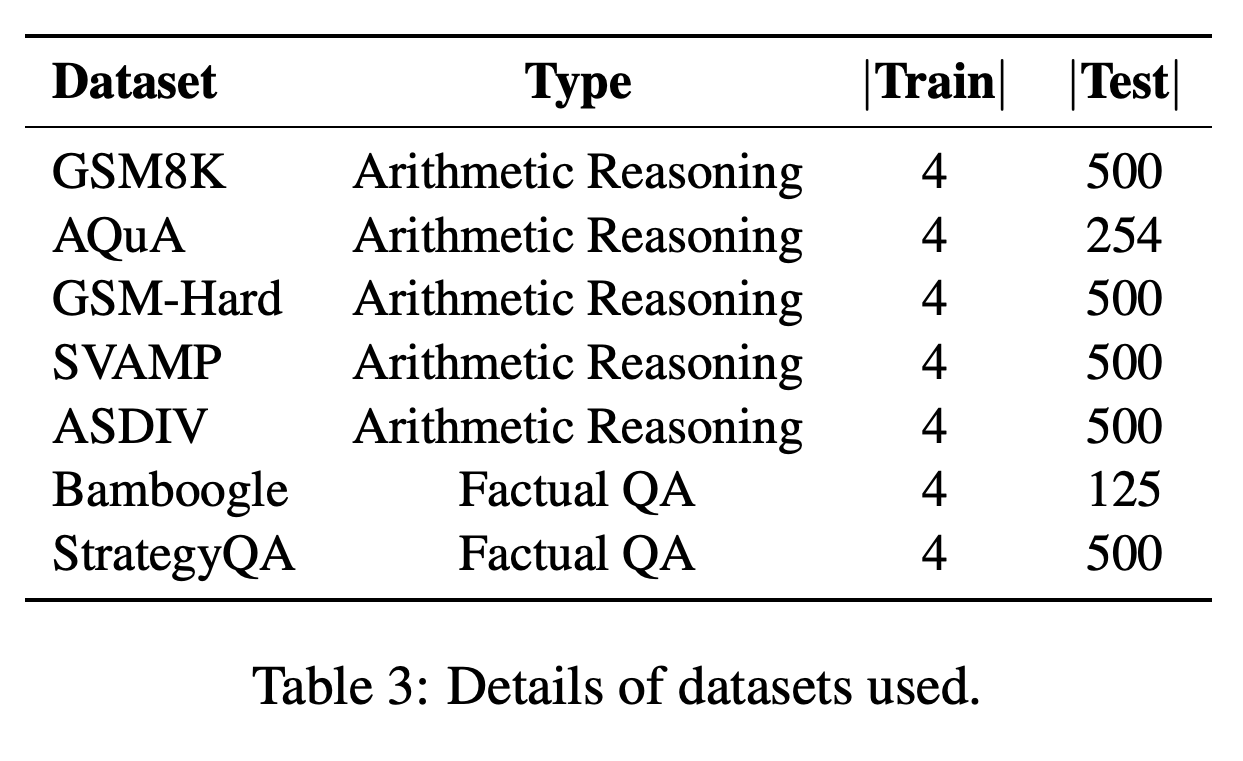
산술 데이터셋은 GSM8K, AQuA, GSM-Hard, SVAMP, ASDIV이며, 사실 기반 질의응답 데이터셋은 Bamboogle과 StrategyQA다. 각 데이터셋에 시연 예시 4개를 사용하며, 테스트 예시는 AQuA에서 254개, Bamboogle에서 125개, 나머지 각 데이터셋에서 무작위로 추출한 500개를 사용한다.
4.2 Main Results
Self-consistency를 적용하지 않았을 때 contrastive prompting과 기존 방법의 점수는 GSM8K에서 각각 79.0과 69.2, Bamboogle에서 각각 56.8과 40.8이었다. Table 2에 보고된 나머지 데이터셋 5개의 성능 향상 폭은 3.9점부터 14.4점까지다. Self-consistency를 적용했을 때는 GSM8K에서 각각 86.2와 71.0, Bamboogle에서 각각 58.4와 40.8을 기록했다. AQuA에 표시된 점수는 각각 71.7과 55.9다.
Contrastive chain-of-thought는 디코딩 설정 2개 모두에서 데이터셋 7개 전체에 걸쳐 해당하는 기존 베이스라인보다 높은 성능을 보였다. AQuA에 표시된 57.5와 53.5의 차이는 4.0점이지만 표에는 향상 폭이 +3.9로 표기되어 있다.
모든 데이터셋에 시연 예시 4개를 사용한다. AQuA와 Bamboogle의 테스트 예시는 각각 500개보다 적고, 나머지 데이터셋 5개는 각각 500개를 사용한다.
5 Related Work
저자들은 추가 모델 학습 없이 수행하는 prompting, 기존 chain-of-thought 방법, 부정 예시를 통한 학습과 이 연구의 관련성을 설명한다. 제안하는 방법은 프롬프트에 긍정과 부정 추론 시연을 사용하며, 논의된 관련 접근법에는 contrastive representation learning과 인간 선호도를 이용한 reward modeling이 포함된다. contrastive representation learning에 대해서는 Contrastive Learning, SimCLR 논문 설명(SimCLRv1, SimCLRv2) 글을 참조하라.
6 Conclusions
저자들은 실험에서 유효한 시연과 유효하지 않은 시연을 함께 사용하면 추론 성능이 향상되며, 자동 생성 방식으로 유효하지 않은 rationale을 수작업으로 주석 처리할 필요가 없어진다고 결론짓는다.
부록
- 제공된 논문에는 부록이 없다. 코드 링크는 https://github.com/DAMO-NLP-SG/contrastive-cot이다.
짧은 생각
유효하지 않은 rationale의 범주 5개를 비교한 결과는 객체의 순서를 섞는 방식을 선택한 근거가 되며, 데이터셋 7개에서 얻은 결과는 보고된 실험 조건에서 일관된 성능 향상을 보여준다. 다른 모델 버전, 시연 예시 선택, 더 큰 테스트 세트로 일반화할 수 있는지는 논문에서 검증하지 않았다. Contrastive 프롬프트는 길이가 더 길기 때문에 프롬프트 길이를 맞춘 비교가 유용하다.