


Data-to-Value: An Evaluation-First Methodology for Natural Language Projects 요약 설명
19 Jan 2022 | Paper Review Model Evaluation Data Curation Supervised Learning목차
이번 글에서는 Data-to-Value: An Evaluation-First Methodology for Natural Language Projects 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 19일(Arxiv)
- Leidner, Jochen L.
- Coburg University of Applied Sciences, University of Sheffield
- 논문 링크, arXiv v1
요약
- 자연어 프로젝트에는 성공 기준을 정하고 텍스트 데이터, 주석 작업, 윤리, 배포를 관리할 프로세스가 필요하다. 이 논문은 평가 우선 프로세스 모델인 Data to Value(D2V)를 제안한다. 저자가 기존 데이터 마이닝 방법론과 특성을 비교한 결과, D2V는 평가 설계를 더 이른 단계에 배치하고 비정형 텍스트를 명시적으로 다룬다. 프로젝트 성과가 개선되었다는 측정 결과는 보고하지 않는다.
- D2V는 프로젝트 초기에 평가 프로토콜을 정하고, 주석이 달린 참조 데이터를 만든 뒤, 시스템 변경 사항을 반복해서 평가한다. 지침은 프로젝트 계획부터 배포, 모니터링, 필요에 따른 모델 재학습까지 다룬다.
- 논문은 방법론 비교와 과거 사용 현황 설문을 제시하지만, D2V를 검증하는 통제 실험이나 사례 연구는 제시하지 않는다. 또한 D2V가 정형 데이터 마이닝에는 덜 적합하고 프로젝트 기간을 예측할 수 없다는 한계를 인정한다.
1 Introduction
저자는 실행 시간, 메모리, 출력 품질의 예측과 함께 프로젝트 완료 시점의 예측을 엔지니어링 목표로 제시한다. D2V는 세분화된 단계, 정량 평가, 단계별 질문을 통해 프로젝트를 더 일관되게 완료하고자 하지만, 논문은 그 결과를 예측하는 이론을 제시하지 않는다.
2 Related Work
논문은 데이터 선택부터 해석까지 반복하는 Knowledge Discovery in Databases(KDD) [5,6,4], Sample, Explore, Modify, Model, Assess로 구성된 SEMMA [10], Cross Industry Standard Process for Data Mining인 CRISP-DM [3,11,1]을 검토한다. 또한 비즈니스에 초점을 맞추고 지침 질문 6개를 제시하는 Marr’s Strategy Board를 설명한다 [8].
저자는 기존 접근법이 텍스트, 지도 학습, 윤리 문제, 대규모 처리에 관한 구체적인 지침이 부족하고 평가를 너무 늦게 배치한다고 주장한다. 따라서 D2V는 출력 평가를 명시하고 보통 프로젝트 초기에 테스트 하네스를 구현한다.
3 Data to Value (D2V)
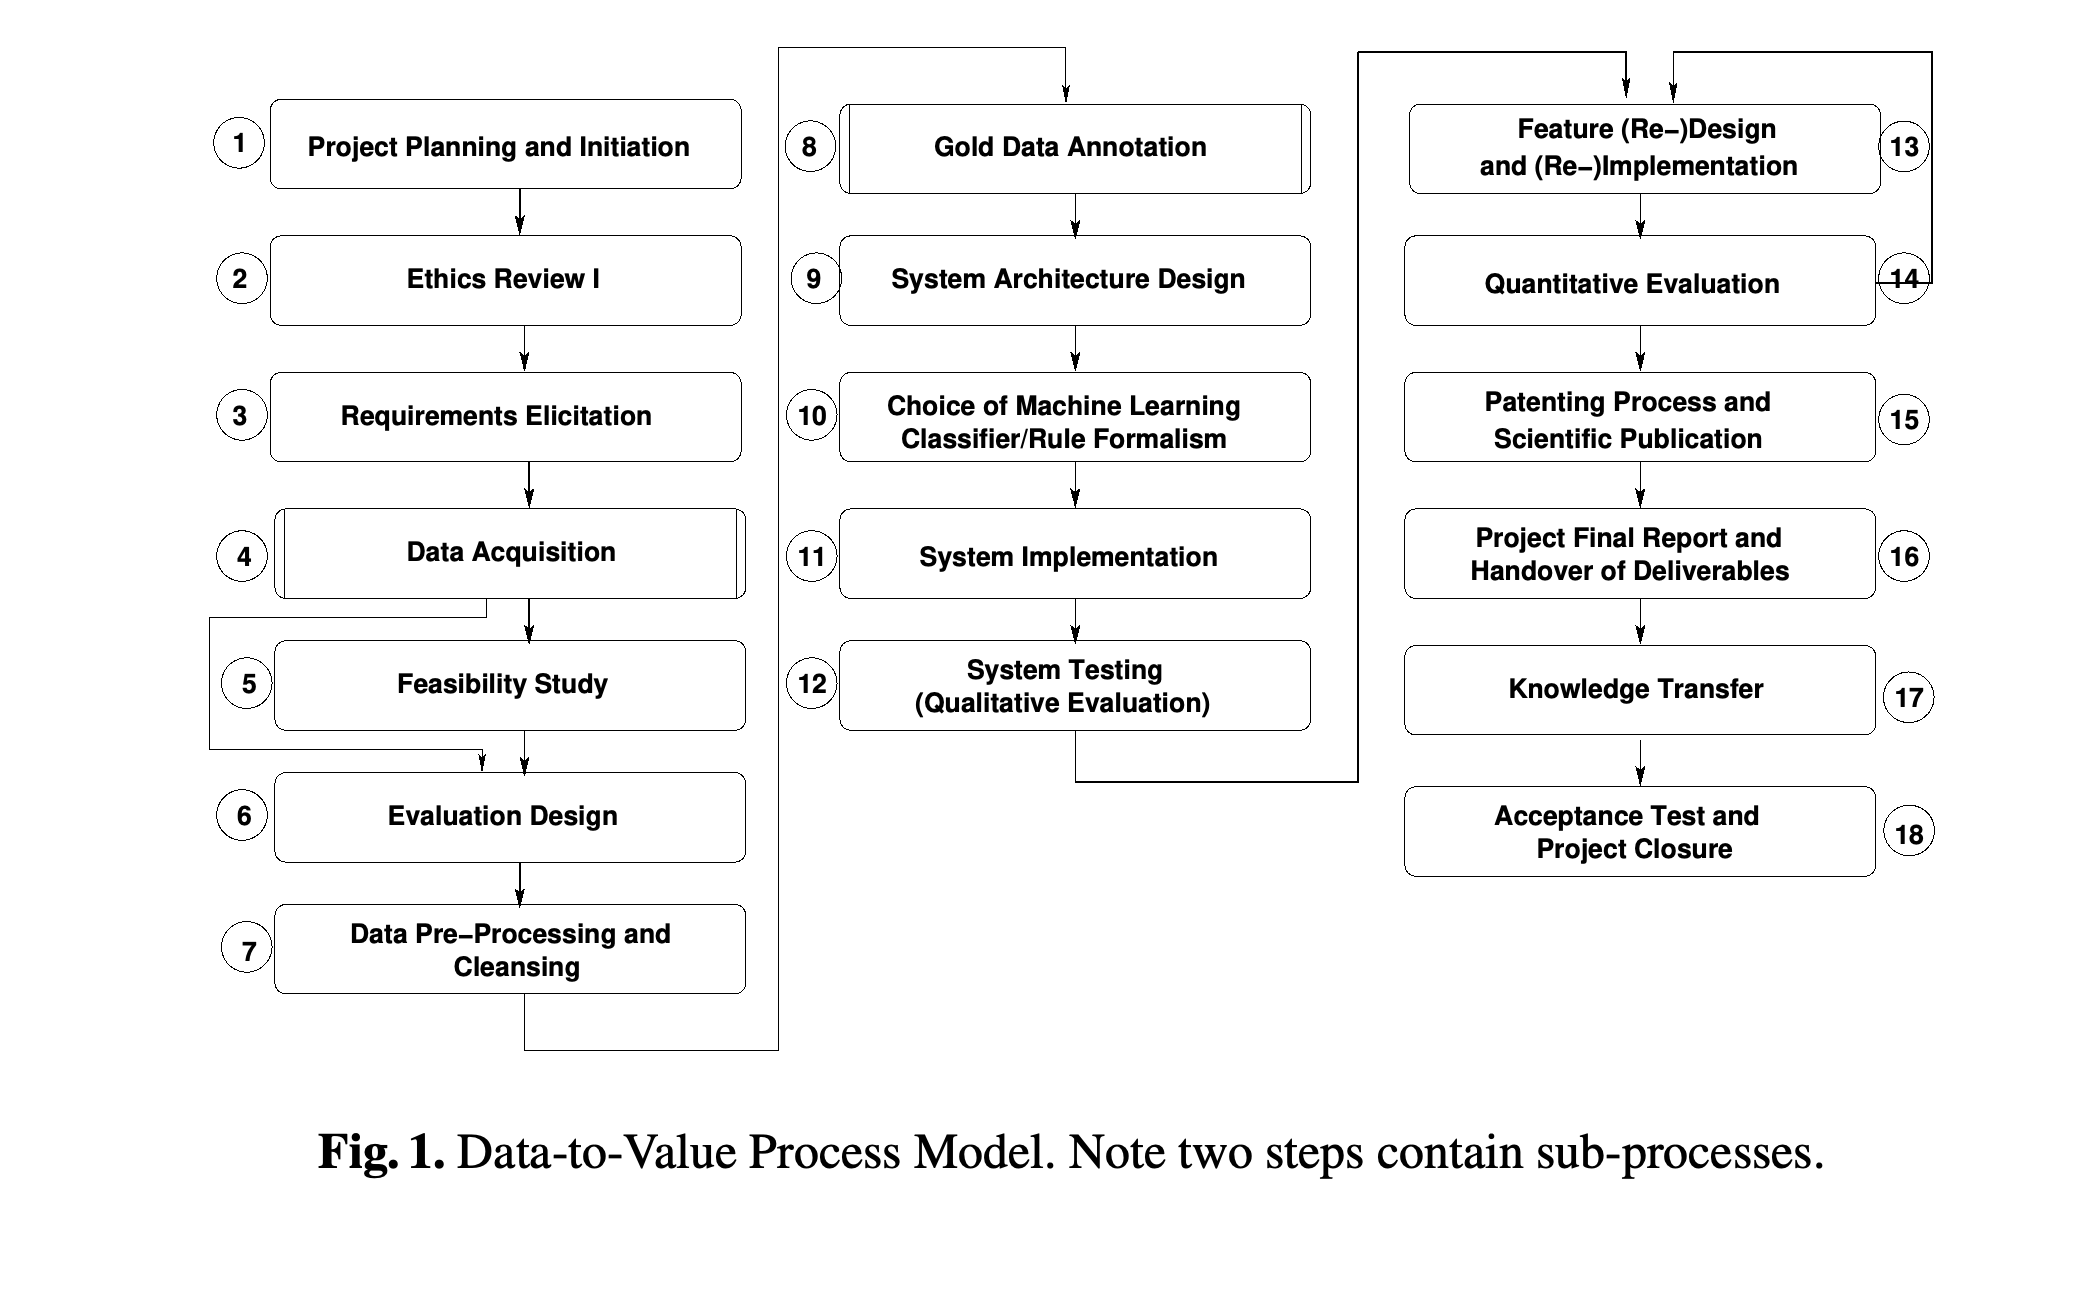
개발 모델은 계획, 윤리 검토, 요구사항 정의, 데이터 확보, 정적 샘플을 이용하는 선택적 타당성 조사로 시작한다. Evaluation Design 단계에서는 데이터 정제와 주석 작업에 앞서 실험 설계와 프로토콜을 정한다.
18개 단계로 구성된 개발 과정은 전처리와 주석 작업보다 앞에 Evaluation Design을 배치하고, 프로젝트 종료 전에 특성 구현과 정량 평가를 반복한다.
Gold data는 평가와 지도 학습을 사용할 때의 학습에 쓰이는 주석 참조 데이터다. 지침 작성, 중복 주석, 일치도 측정, 불일치 해소를 거쳐 생성한다. 논문은 최소 3명의 주석자가 더 큰 샘플에서 동일한 5–10%에 주석을 달도록 권장한다. 주석자 간 일관성을 나타내는 주석자 간 일치도가 부족하면 지침을 수정하고 다시 주석을 단다.
주석 작업 과정은 문서화된 지침과 여러 주석자의 작업을 일치도 측정, 불일치 판정, 지침 수정, 학습 세트와 개발 테스트 세트 및 테스트 세트로의 분할에 연결한다.
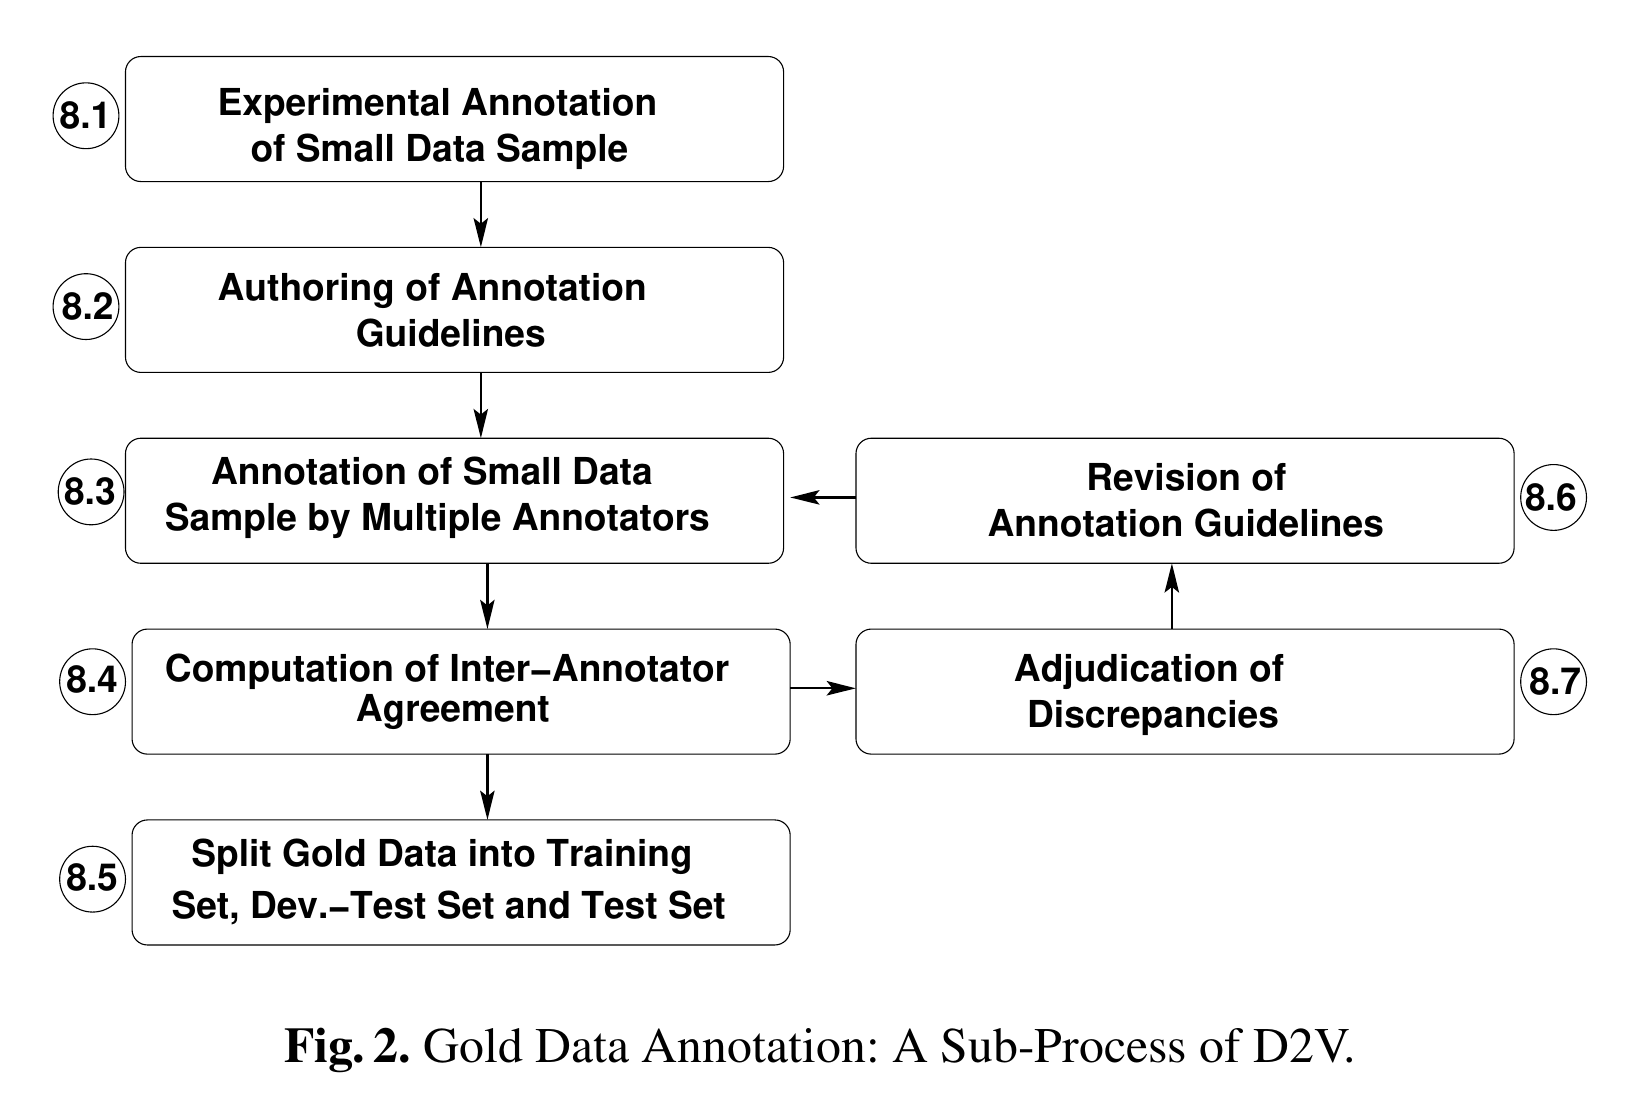
논문은 일반적인 데이터 분할 비율로 학습에 60% 또는 80%, 개발 테스트와 최종 테스트에 각각 10%–20%를 제시한다. 학습 세트는 지도 학습에만 필요하다. 개발 테스트 세트에서 데이터를 열람하지 않는 정기 평가와 테스트 세트에서 1회의 최종 평가를 제안한다. 품질 목표에 도달하거나, 시간 제한에 이르거나, 개선 효과가 감소하여 중단할 때까지 특성 설계와 정량 평가를 반복한다.
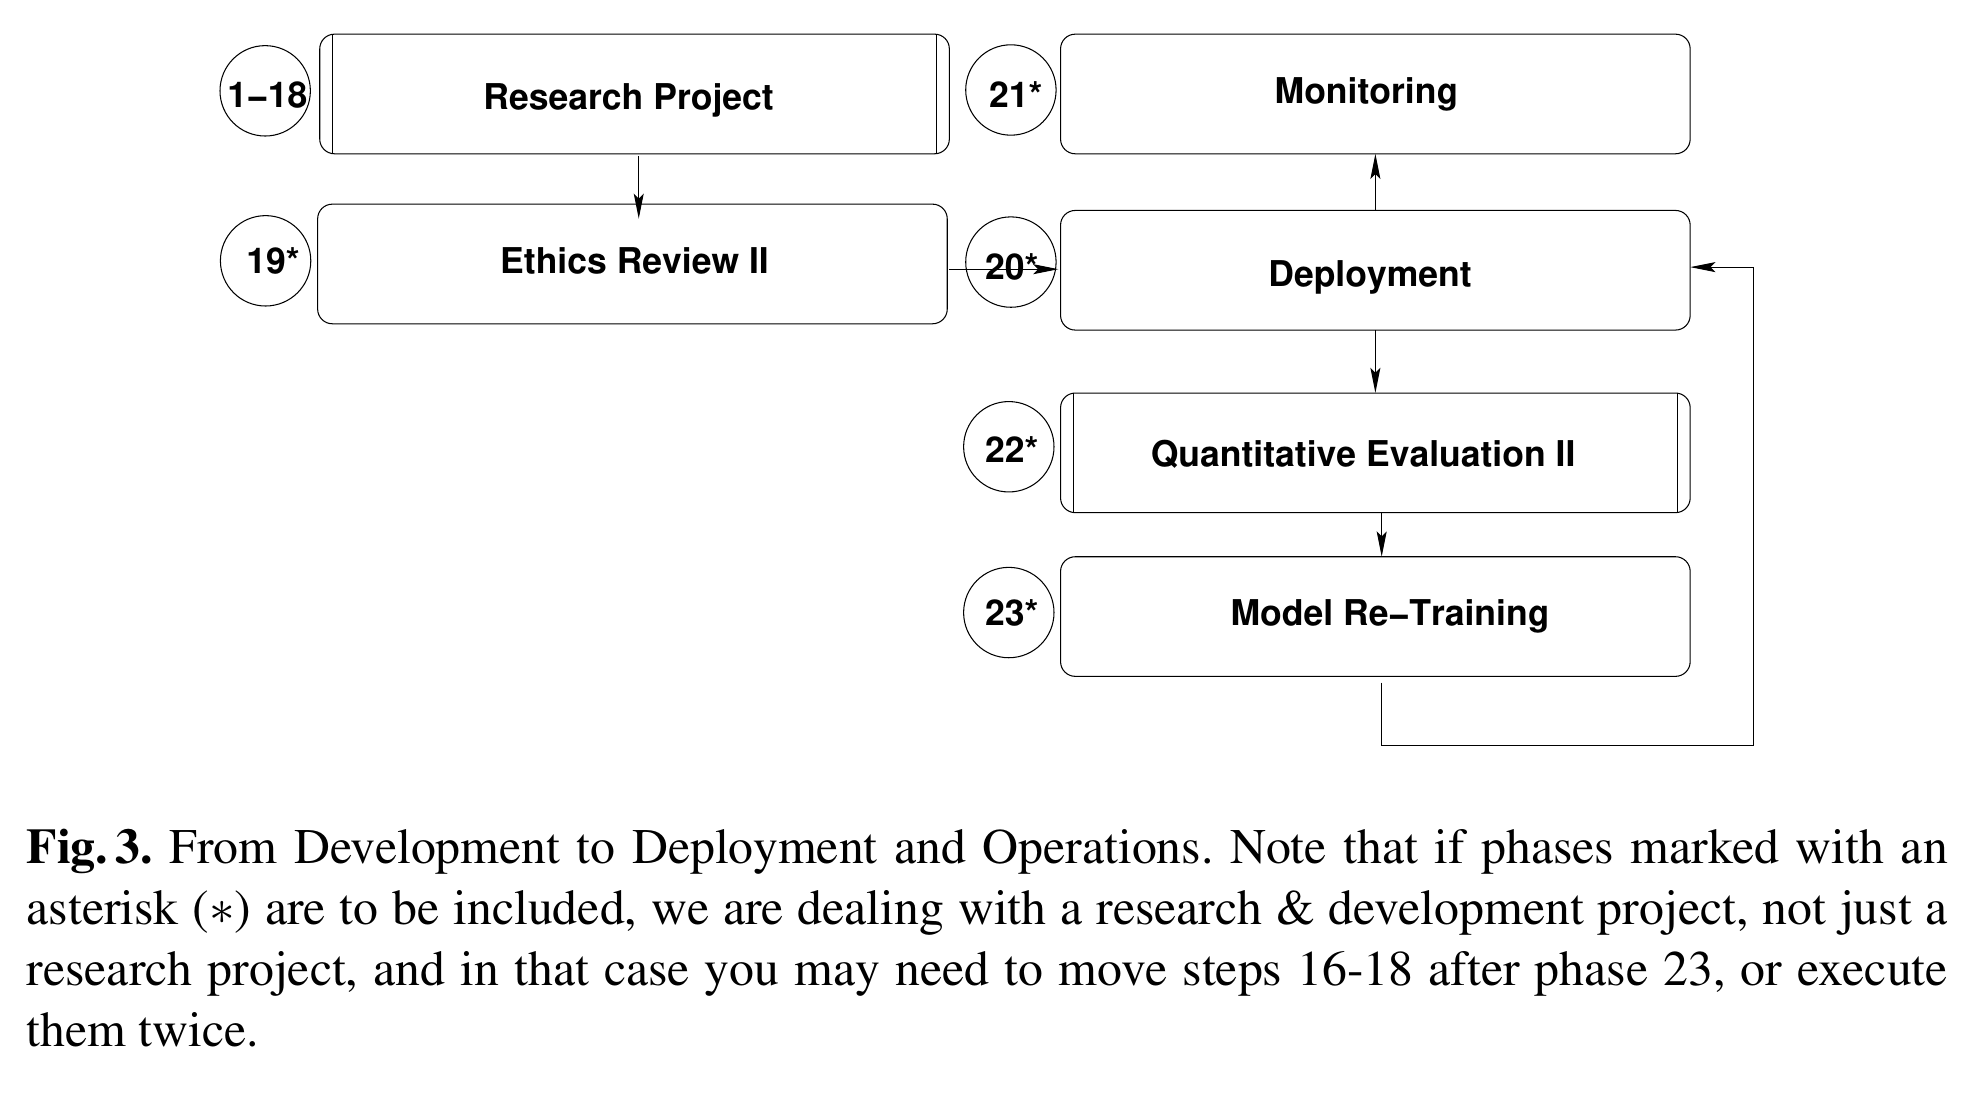
운영 단계로 확장할 때는 2번째 윤리 검토, 배포, 모니터링, 주기적인 정량 평가와 평가 결과에 따른 재학습을 추가한다. 저자는 유입 데이터가 크게 바뀌면 모델을 재평가하고 수명 종료까지 이 주기를 유지할 것을 제안한다.
운영 단계로 확장하면서 연구 프로젝트에 윤리 검토와 배포를 추가하고, 이후 모니터링과 평가 및 모델 재학습을 반복한다. 원본 캡션은 이 단계들을 포함할 때 프로젝트 인계와 종료 단계를 옮기거나 반복해야 할 수 있다고 설명한다.
4 Discussion
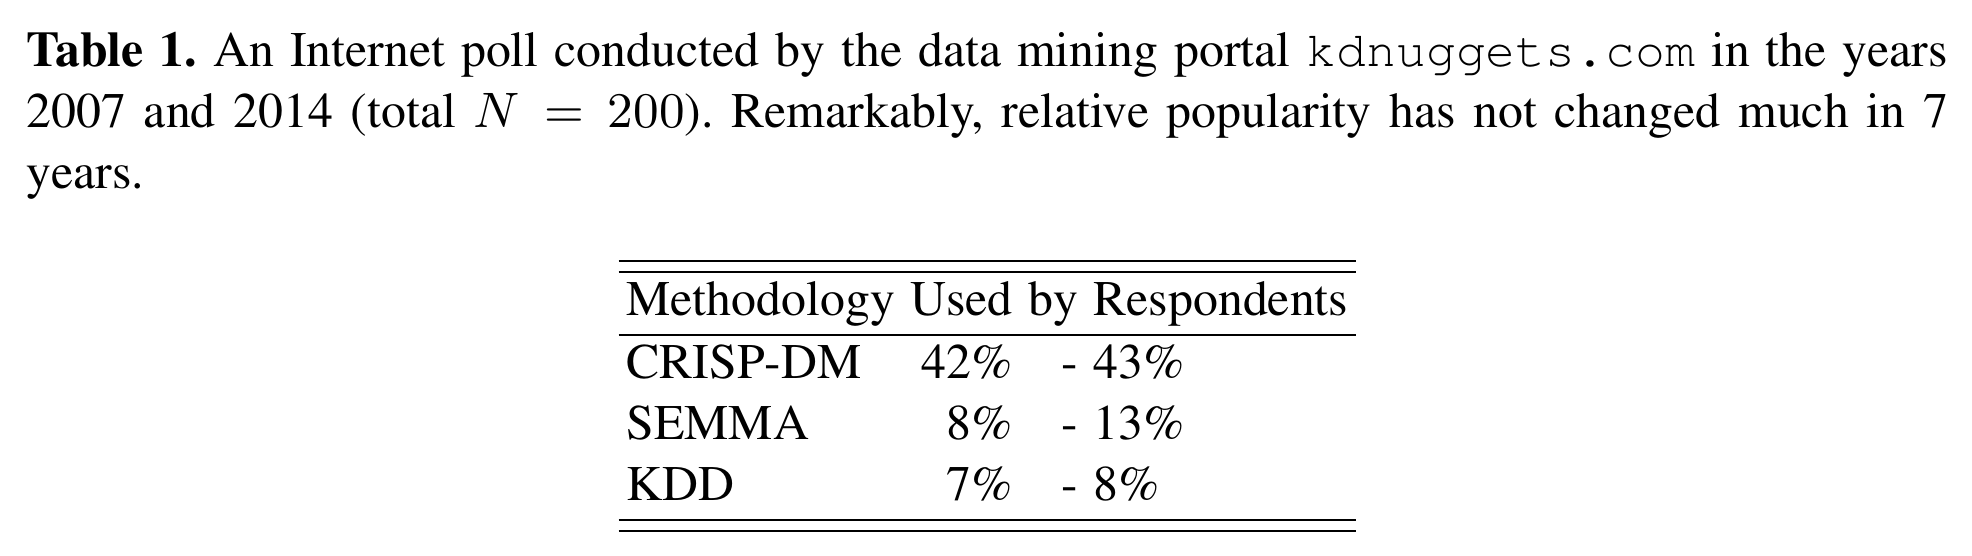
저자는 프로젝트 규모와 복잡도에 맞게 상세 프로세스를 조정할 것을 권장한다. 총 N = 200인 2007년과 2014년 kdnuggets.com 설문에서 CRISP-DM은 응답의 42%와 43%를 차지했다. 이 설문에는 텍스트나 빅데이터에 특화된 프로세스가 포함되지 않았으며 D2V를 평가하지도 않았다.
보고된 설문에서 CRISP-DM은 2년 모두 SEMMA와 KDD보다 훨씬 높은 비중을 차지하지만, D2V의 성과 비교는 포함되지 않는다.
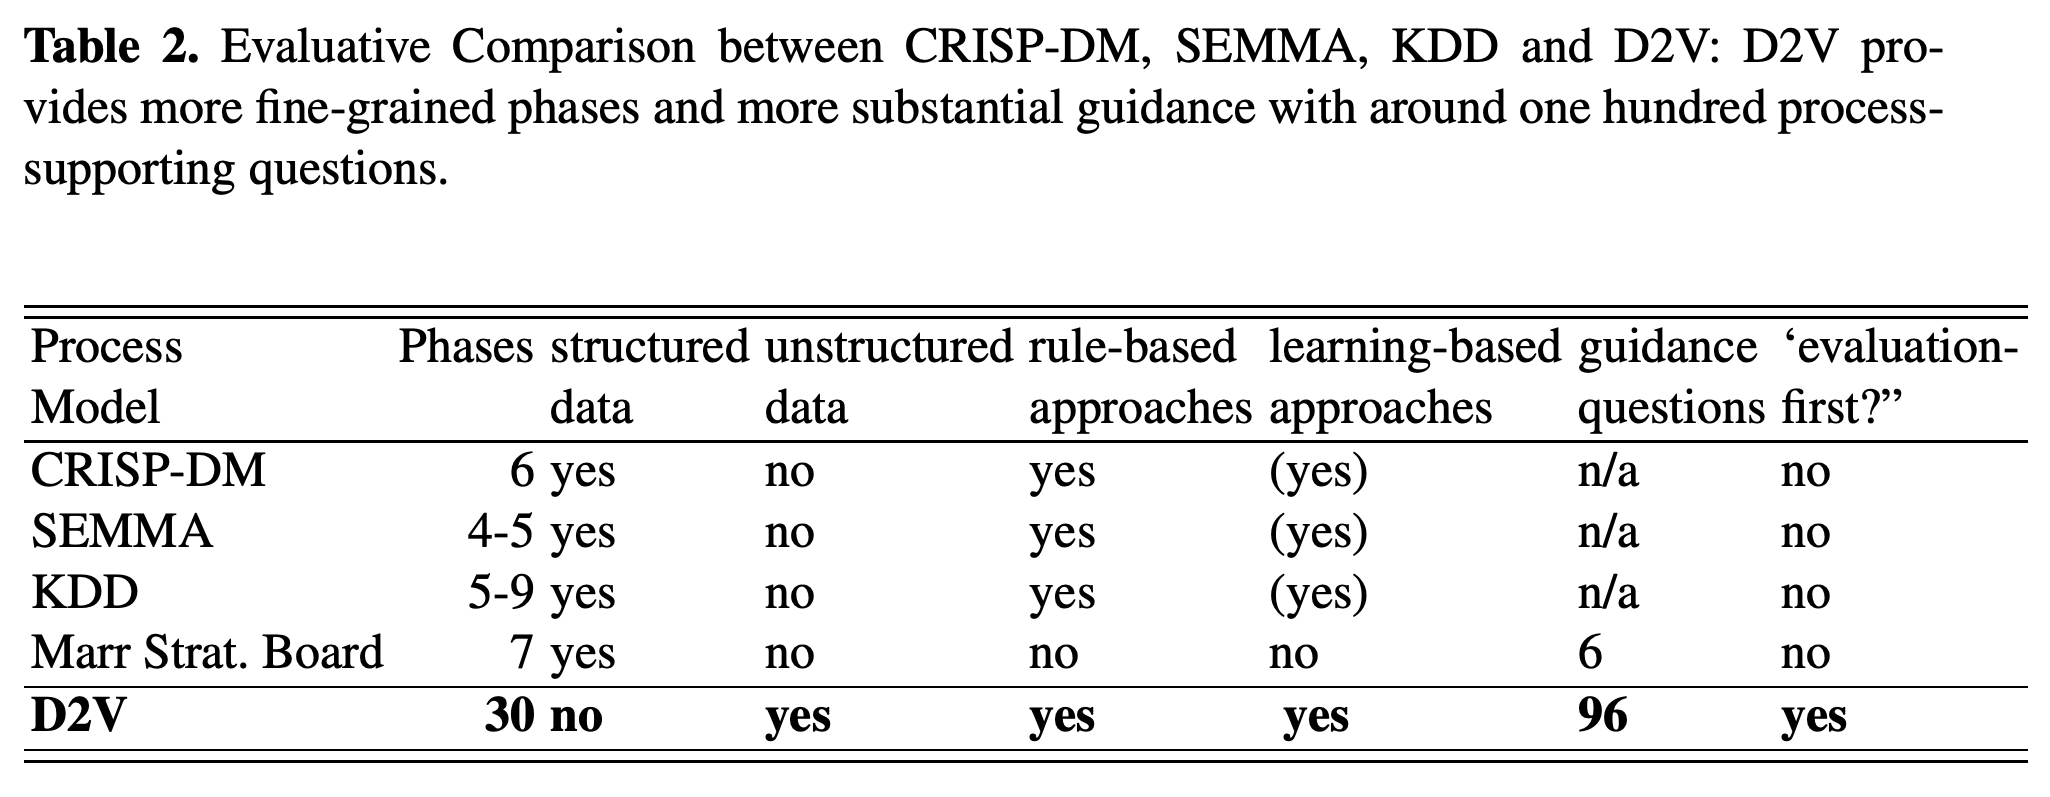
논문의 특성 비교에서 D2V는 30개 단계와 96개 지침 질문으로 구성된다. 이에 비해 CRISP-DM은 6개 단계, Marr’s Strategy Board는 6개 지침 질문으로 구성된다. 이 수치는 설계를 설명할 뿐, D2V가 프로젝트를 더 빠르거나 안정적으로 수행한다는 근거는 아니다.
저자의 비교에 따르면 D2V는 비정형 데이터, 규칙 기반과 학습 기반 접근법, 평가 우선 방식을 지원한다. 반면 다른 모델은 비정형 데이터를 명시적으로 지원하지 않는 것으로 표시된다.
5 Summary, Conclusion & Future Work
결론은 텍스트 프로젝트, 특히 지도 학습을 사용하는 프로젝트에서 평가 우선 계획, 주석이 달린 gold data, 반복 평가를 강조한다. 향후 연구로 단계별 자원 사용 데이터를 수집하고 시간 및 지출과 관련하여 비용과 품질을 모델링할 것을 제안한다.
부록
- D2V Question Catalog (Excerpt)는 약 100개 질문 중 데이터 신뢰성과 증가율, 라이선스, 윤리, 다국어 요구사항, 배포 후 재학습 책임에 관한 질문을 예시로 제시한다. 전체 질문 목록과 지원 소프트웨어 도구는 향후 연구 과제로 남겨 두었다.
짧은 생각
평가 프로토콜을 초기에 정하고 개발 테스트와 최종 테스트를 명확히 구분하는 방식은 텍스트 시스템을 만드는 팀에 구체적인 지침을 제공한다. 다만 이 논문은 실질적인 이점을 검증하지 않았다. 방법론 비교는 프로세스 특성을 설명하며, 과거 설문은 프로젝트 성과가 아닌 다른 방법론의 사용 현황을 측정한다.