


Deliberation in Latent Space via Differentiable Cache Augmentation 요약 설명
23 Dec 2024 | Paper Review Latent Reasoning KV Cache Self-Supervised Learning이번 글에서는 Deliberation in Latent Space via Differentiable Cache Augmentation 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 23일(Arxiv)
- Liu, Luyang, Pfeiffer, Jonas, Wu, Jiaxing, Xie, Jun, Szlam, Arthur.
- Google DeepMind
- 논문 링크
요약
- 대규모 언어 모델(LLM)이 답변 전에 중간 추론 텍스트를 생성하면 지연 시간이 늘어나고 추론 과정을 종단 간 최적화하기도 어려워진다. 모델의 문맥을 확장하는 연속 표현인 학습된 잠재 임베딩 64개를 추가하면, 과제별 학습 없이도 수학 추론 벤치마크 GSM8K에서 Gemma-2 2B의 정확도가 21.38%에서 31.43%로 높아진다. 이 결과는 프롬프트에 예시 8개를 제공하는 8-shot 평가에서 얻었으며, 원래 모델의 가중치는 고정해 변경하지 않는다.
- 별도로 학습하는 모델인 코프로세서는 디코더의 key-value(KV) 캐시를 읽고, 순전파 1회로 입력에 따라 달라지는 임베딩을 생성한다. KV 캐시는 앞선 텍스트의 어텐션 표현을 저장한다. 출력 텍스트를 생성하는 디코더는 목표 토큰의 예측 오차를 측정하는 언어 모델링 손실을 제공하며, 학습 과정에서는 코프로세서와 학습 가능한 입력 임베딩만 갱신한다.
- 성능 향상은 학습 시 예측 범위인 16토큰을 넘어서도 유지된다. 잠재 임베딩 64개를 사용하면 베이스라인 대비 perplexity가 증강 직후 첫 번째 토큰에서 3.94%, 32nd 토큰에서 1.20% 감소한다. Perplexity는 토큰 예측의 불확실성을 나타내며 낮을수록 좋다. 실험은 Gemma-2 2B의 예측 성능과 벤치마크 성능이 향상됨을 보이지만, 실제 지연 시간이나 처리량은 보고하지 않는다. 따라서 코프로세서 작업을 디코딩과 독립적으로 수행하는 비동기 실행의 실질적인 이점은 입증하지 못한다.
1. Introduction
이산적인 중간 추론 단계를 생성하면 추가 연산을 순차적으로 수행해야 하고 종단 간 최적화도 복잡해진다. 이 논문은 모델의 기존 캐시를 처리한 결과를 연속적인 문맥 표현으로 저장하고, 증강 이후 일반적인 디코딩을 재개하는 방식을 제안한다.
- 기본 모델을 고정하므로 코프로세서를 사용할 수 없을 때도 기본 모델은 정상적으로 텍스트를 생성할 수 있다.
- 후속 토큰에서도 이점이 유지된다는 점은 즉각적인 응답 생성과 독립적으로 증강을 수행할 근거가 된다.
2. Methodology
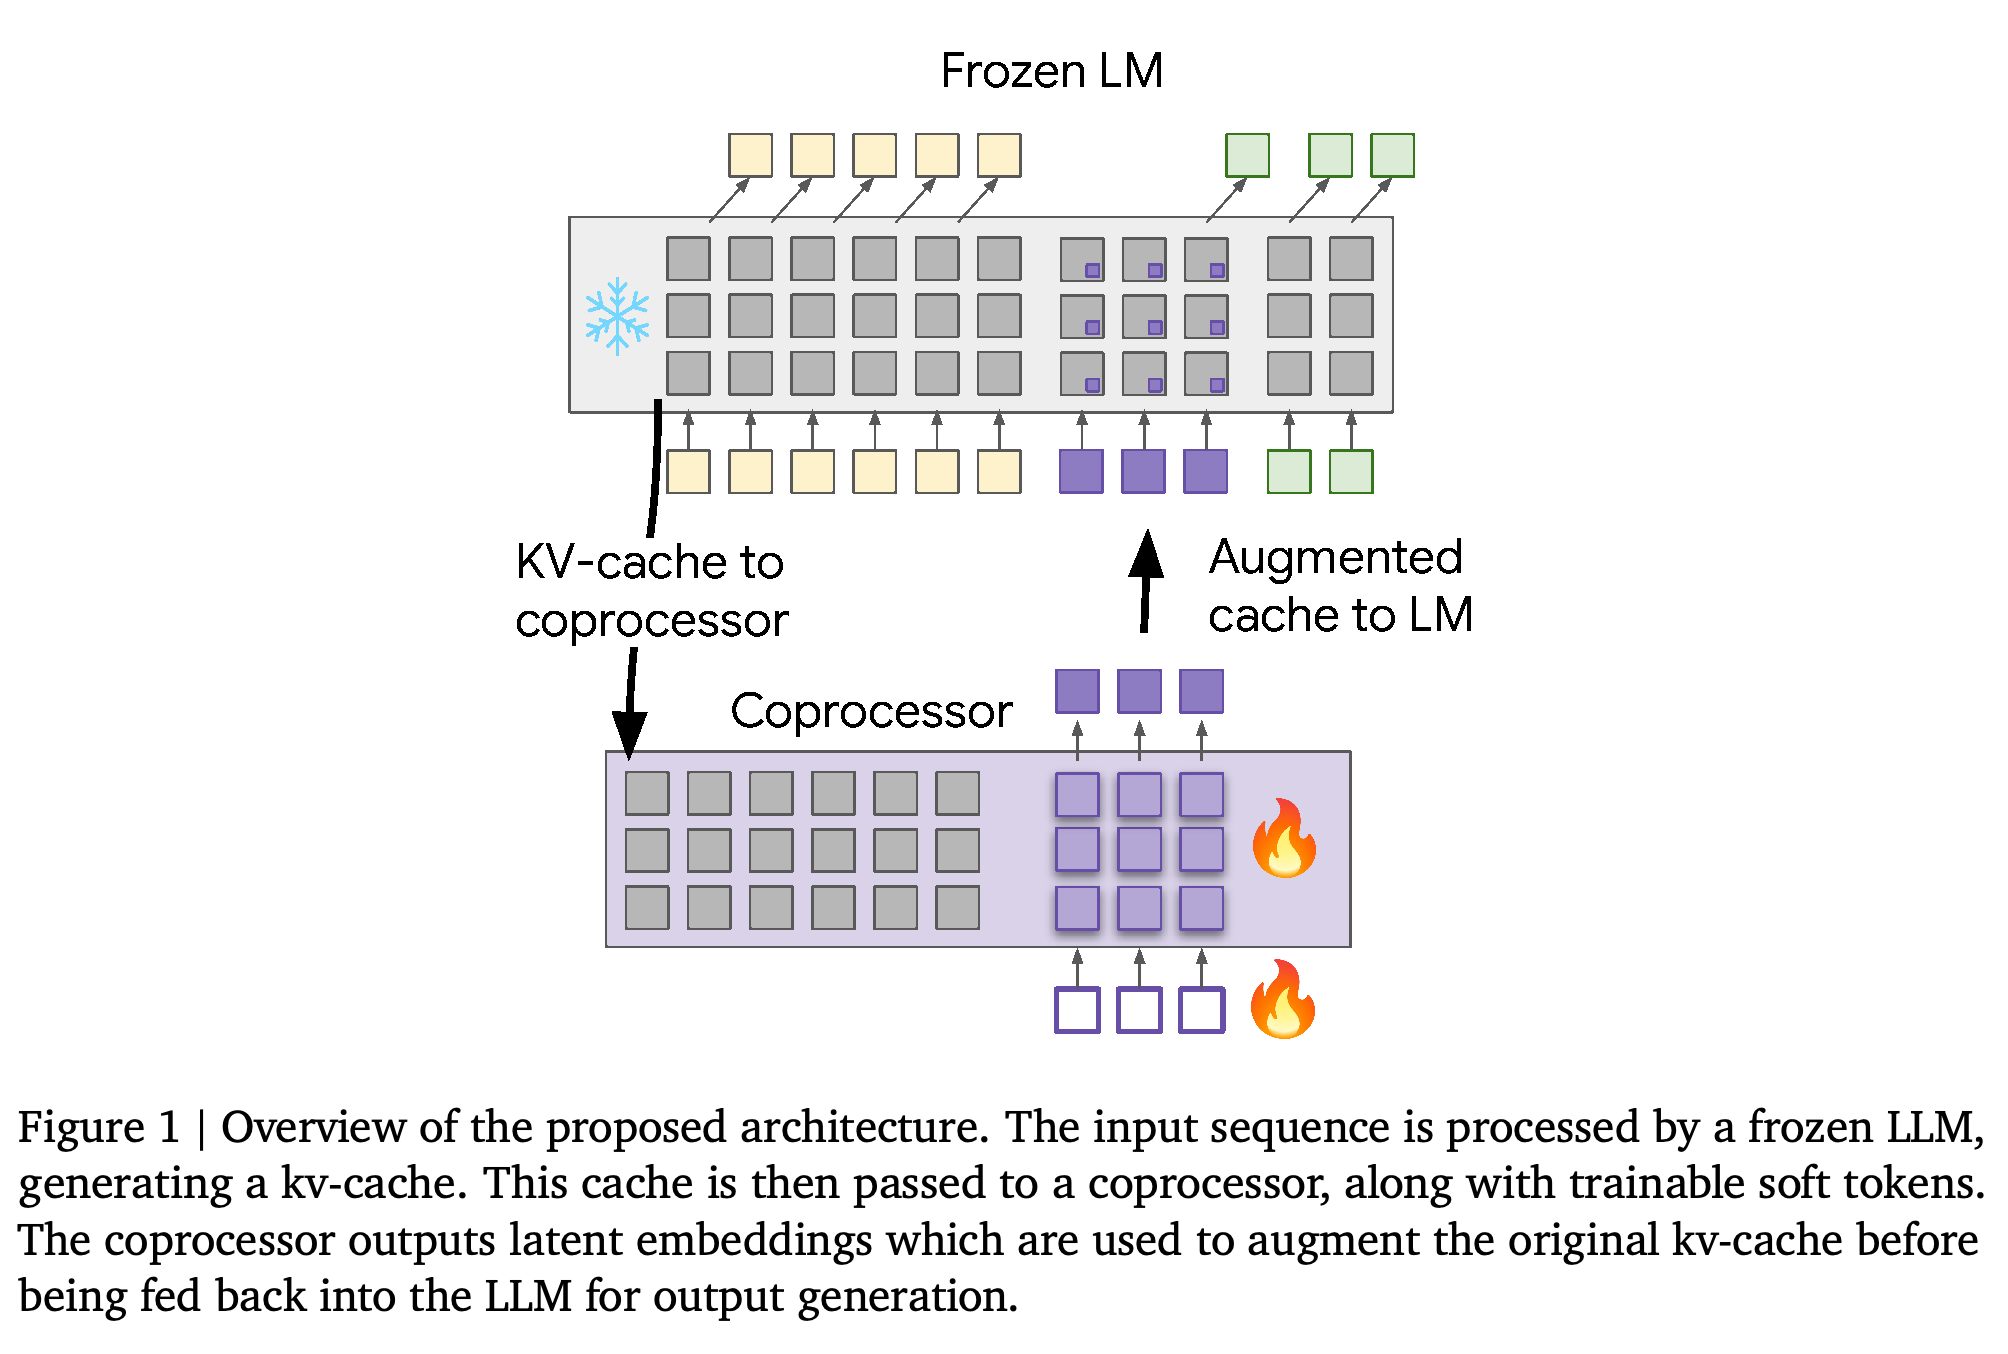
이 방법은 사전학습한 디코더를 고정하고, 디코더의 KV 캐시를 입력받아 소프트 토큰을 생성하는 코프로세서를 추가한다. 소프트 토큰은 대응하는 단어나 서브워드가 없는 연속 임베딩이다. 학습 과정에서는 출력 손실을 고정된 디코더를 통해 역전파하여, 디코더의 파라미터를 변경하지 않고 입력에 따라 달라지는 증강 표현을 학습한다.
2.1. Problem statement
입력 x와 목표 y에 대해, 고정된 모델은 파라미터 θ를 가지며 캐시 (k_{θ,x}, v_{θ,x})를 생성한다. 학습하는 코프로세서는 f(k_{θ,x}, v_{θ,x}) → z를 통해 이 캐시를 잠재 표현으로 변환한다. 명시된 목적함수는 max E_x[log p_θ(y | x, z)]이다. 따라서 θ를 고정한 상태에서 목표의 우도를 높이는 표현을 코프로세서가 학습한다.
2.2. Model architecture
먼저 고정된 디코더가 입력을 처리해 캐시를 생성한다. 디코더와 같은 아키텍처를 사용하고 디코더의 사전학습 가중치로 초기화한 코프로세서는 이 캐시와 서로 구분되는 학습 가능한 소프트 토큰을 함께 처리한다. 이후 코프로세서가 생성한 잠재 임베딩으로 원래 문맥을 증강한 뒤 출력을 생성한다.
- 출력 손실을 고정된 디코더를 통해 역전파하여 코프로세서와 소프트 토큰 임베딩을 학습한다.
- 모든 증강 임베딩은 텍스트를 순차적으로 생성하는 대신 순전파 호출 1회로 생성한다.
고정된 디코더와 학습 가능한 코프로세서는 캐시된 표현과 생성된 잠재 임베딩을 통해 정보를 주고받는다. 이 인터페이스를 통해 원래 디코더의 가중치를 유지하면서 출력 손실로 추가 연산을 학습할 수 있다.
2.3. Pretraining setup
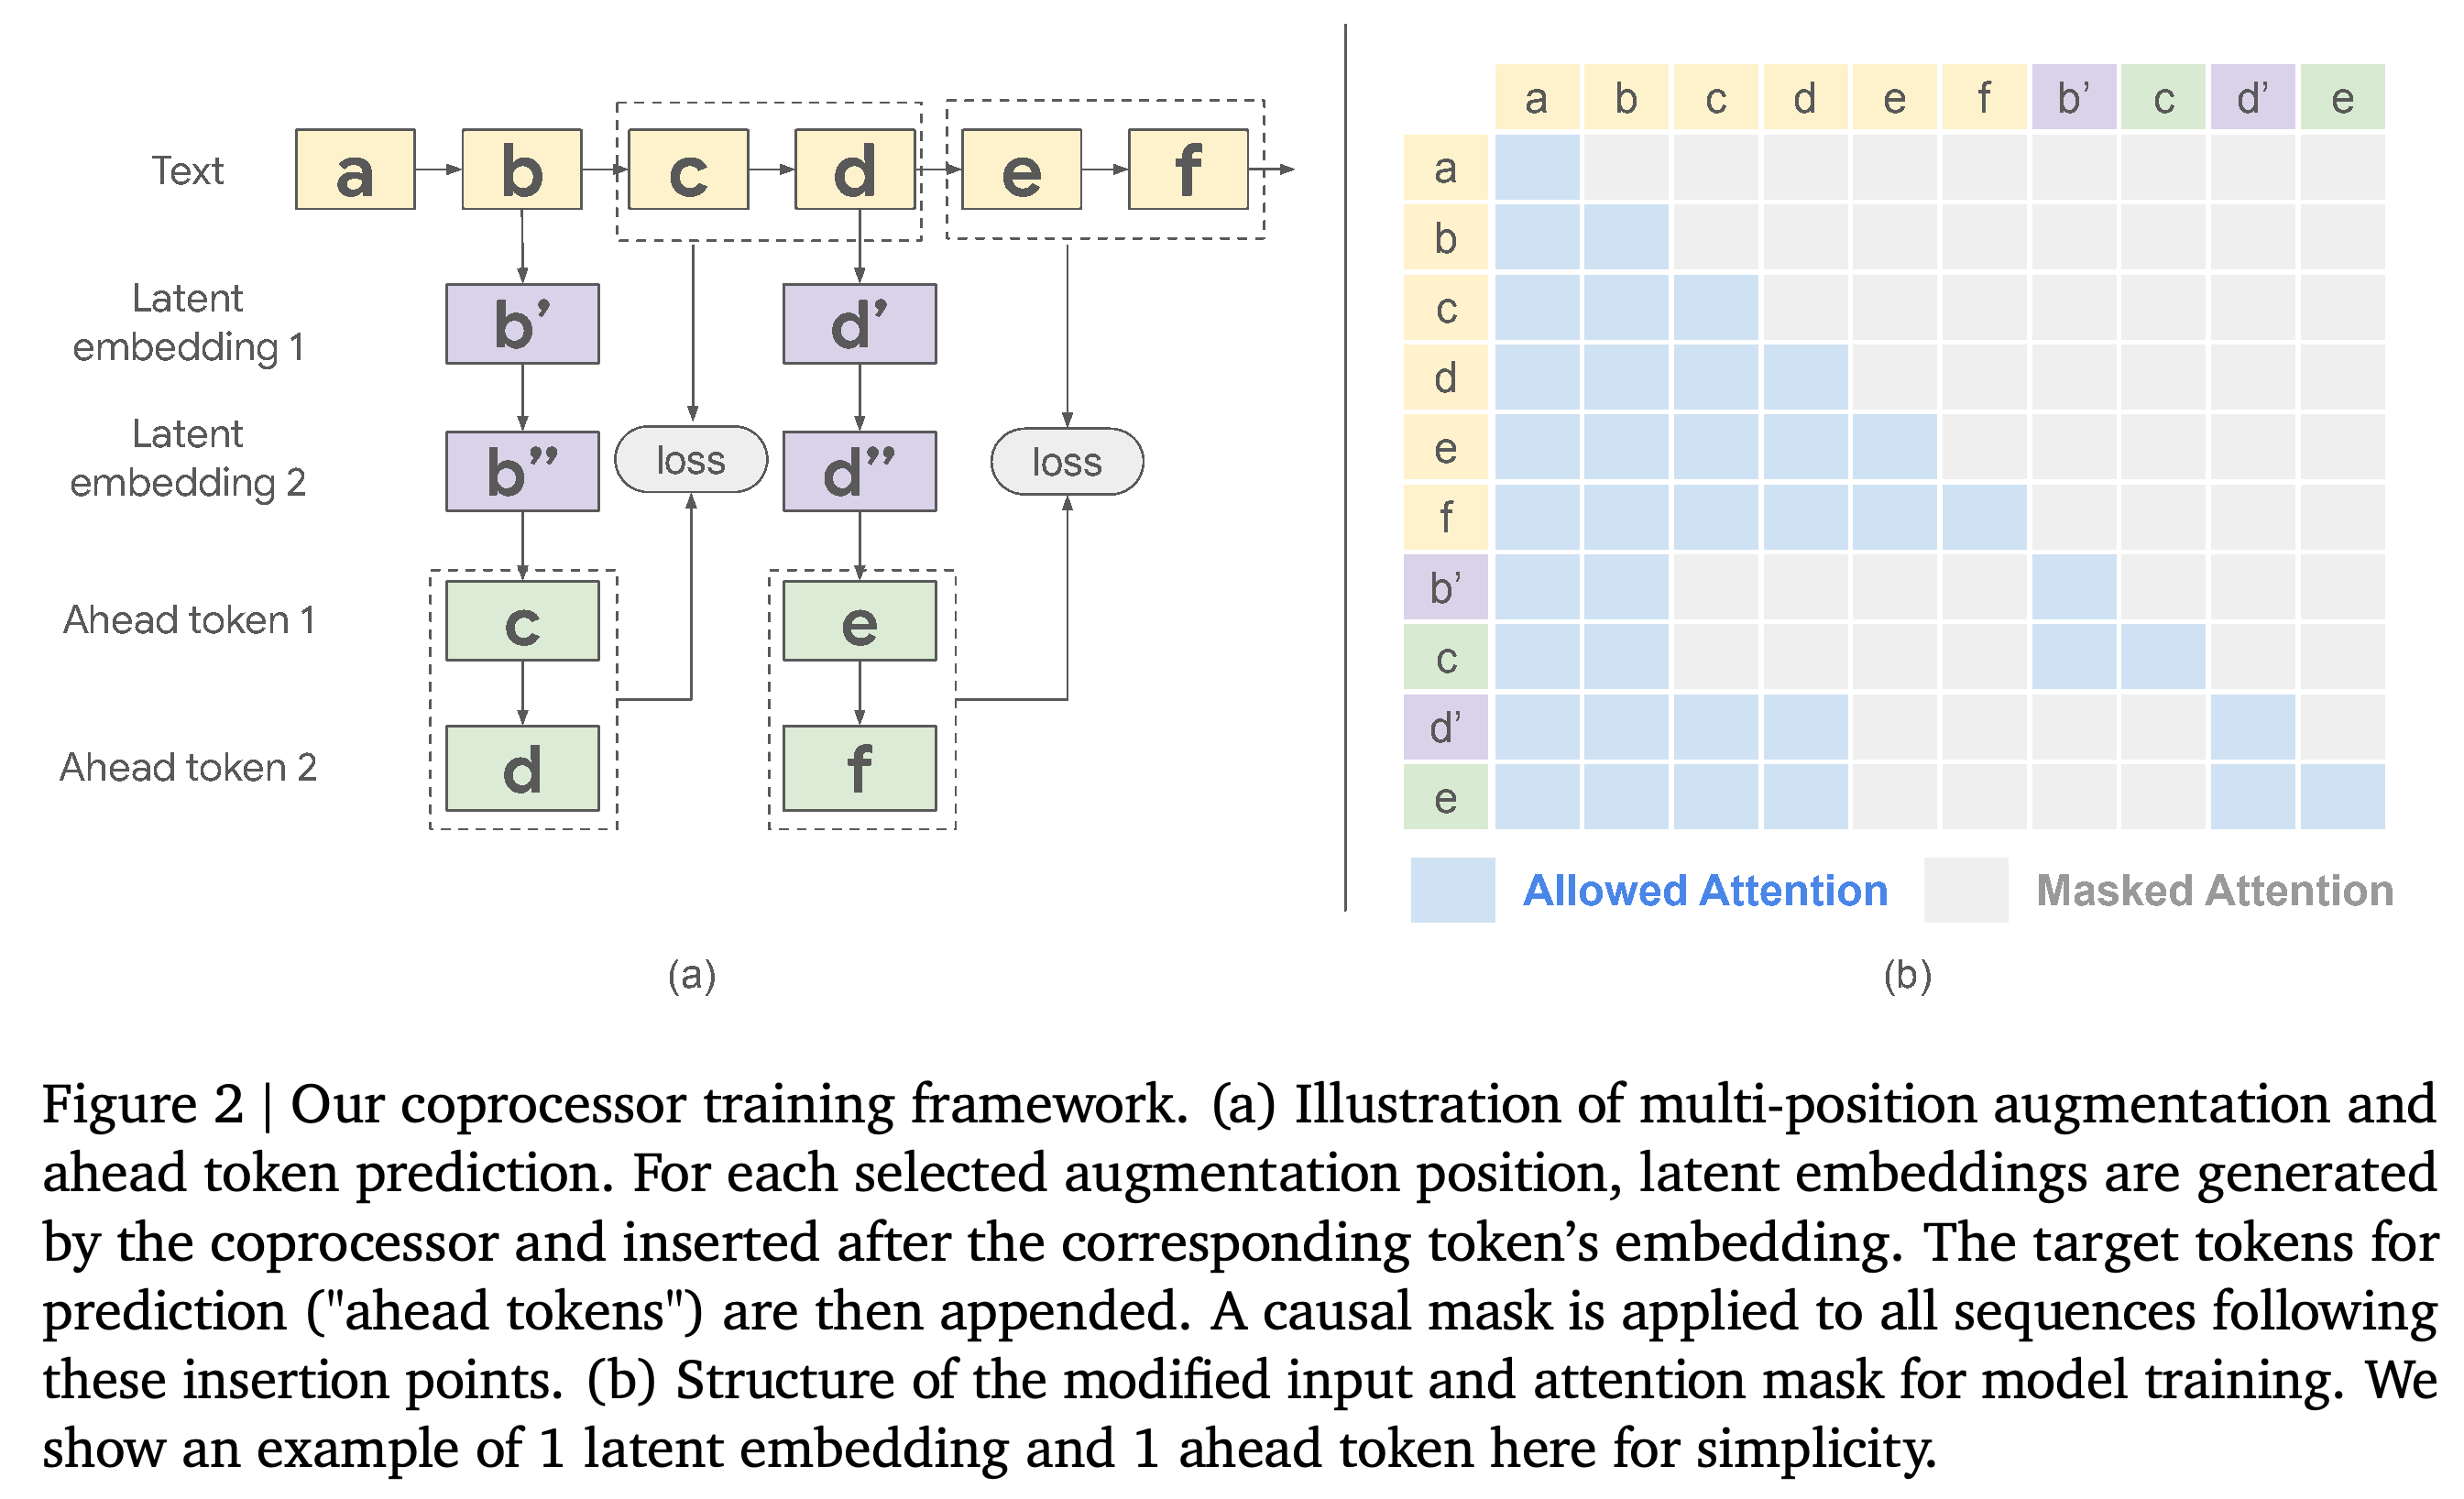
학습 시 각 시퀀스에서 여러 증강 위치를 표본 추출하고, 각 위치에서 후속 토큰 \(N_A\)개를 예측하는 데 잠재 임베딩 \(N_L\)개를 사용한다. 예측 과정에서 실제 이전 목표 토큰을 제공하는 teacher forcing을 사용하므로, 증강 지점 이후 구간에 손실을 적용할 수 있다.
- 예시 시퀀스 “a b c d e f”에서 “b” 뒤의 증강은 앞선 캐시를 사용해 “c”와 “d”의 예측을 돕고, “d” 뒤의 증강은 “e”와 “f”의 예측을 돕는다.
- 수정한 입력, 위치 인덱스, 목표, 어텐션 마스크를 사용해 여러 증강 분기를 디코더 순전파 1회로 함께 처리한다. 어텐션 마스크는 각 위치가 어떤 위치를 참조할 수 있는지 결정한다.
- 각 분기는 원래 접두 문맥과 허용된 이전 분기 위치를 사용할 수 있지만, 원래 시퀀스의 이후 토큰과 무관한 증강 분기는 마스킹한다.
“b”와 “d” 뒤의 분기는 원래 시퀀스를 공유하지만 각각 별도의 잠재 증강 표현을 받는다. 어텐션 행렬은 원래 텍스트의 이후 부분과 무관한 분기에 접근하지 못하게 하면서 분기별 손실을 함께 계산하는 방식을 보여준다.
3. Experiments
주요 실험은 고정된 Gemma-2 2B와 해당 모델의 사전학습에 사용한 동일한 2조 토큰 데이터셋을 사용한다. 데이터는 주로 영어이며 웹 문서, 코드, 과학 논문을 포함한다. 기본 설정은 100,000스텝, 배치 크기 1024, 패킹된 시퀀스 길이 2048, ahead token 16개, 무작위로 추출한 증강 위치 128개이다. Ahead token은 증강 이후의 미래 목표 토큰을 뜻하며, 증강 위치는 “traces”라고 부른다.
- 주요 공개 벤치마크 결과는 과제별 미세조정 없이 사전학습 데이터로 학습한 코프로세서를 사용한다.
- Ahead-token 절제 실험에서는 기본 예측 범위를 바꾸며, 부록에서는 과제별 학습 데이터를 사용한 적응을 별도로 평가한다.
3.1. Perplexity Evaluation
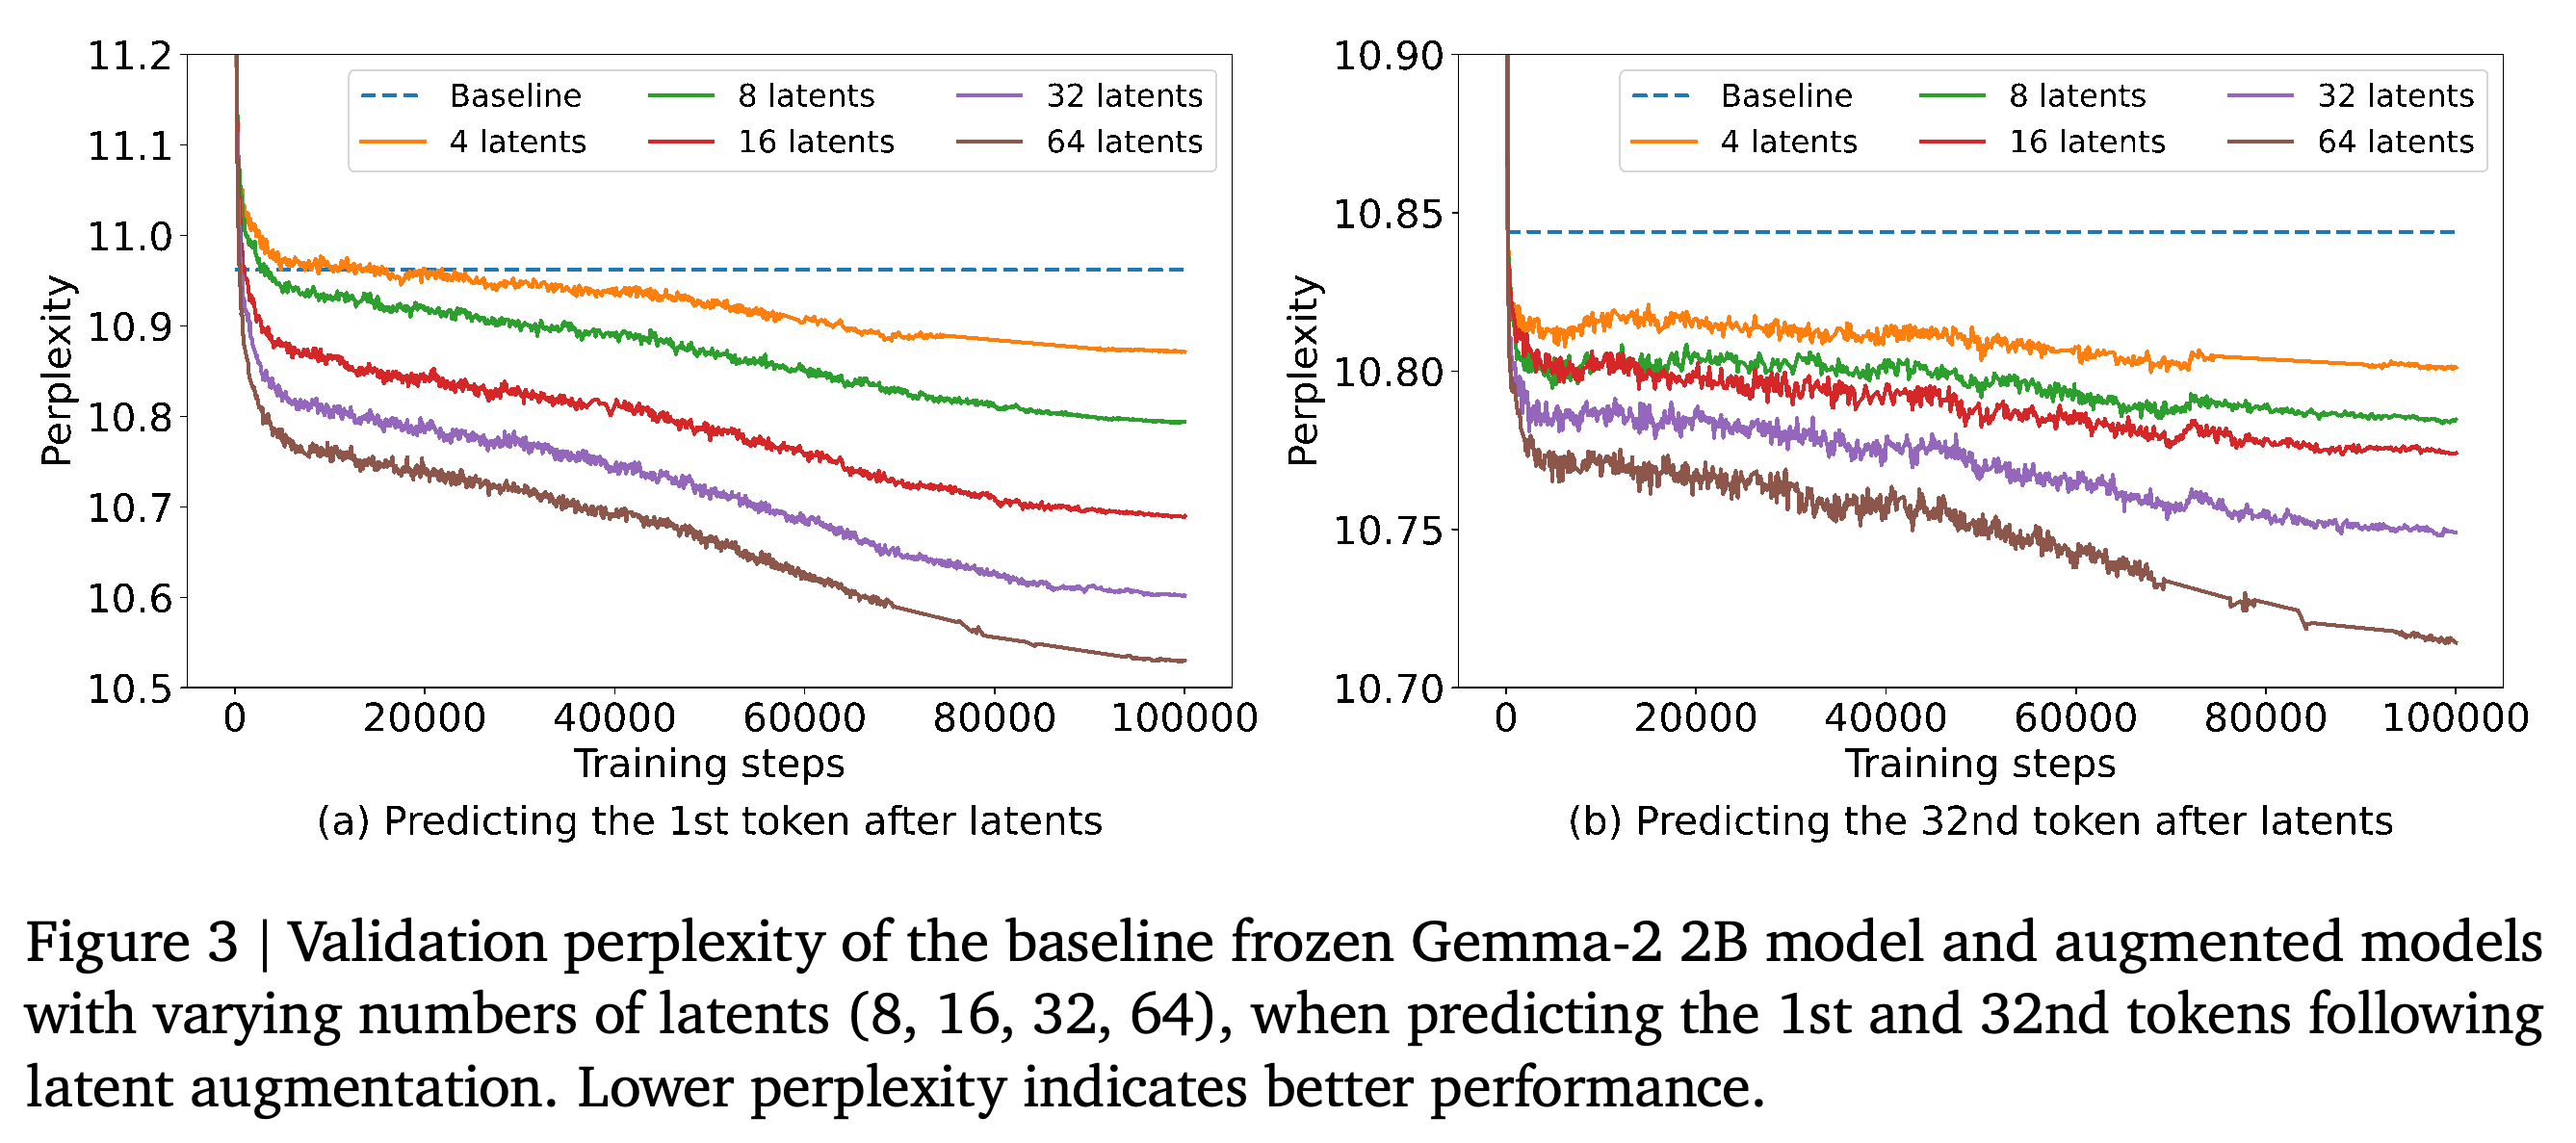
평가는 Gemma의 비공개 검증 데이터셋을 사용하며, 증강 이후 지정한 거리에서 예측 성능을 측정한다. 32nd-token 결과는 원래 접두 문맥, 잠재 임베딩, 그 뒤의 실제 토큰 31개를 조건으로 삼아, 조건부 예측의 이점이 얼마나 지속되는지 측정한다.
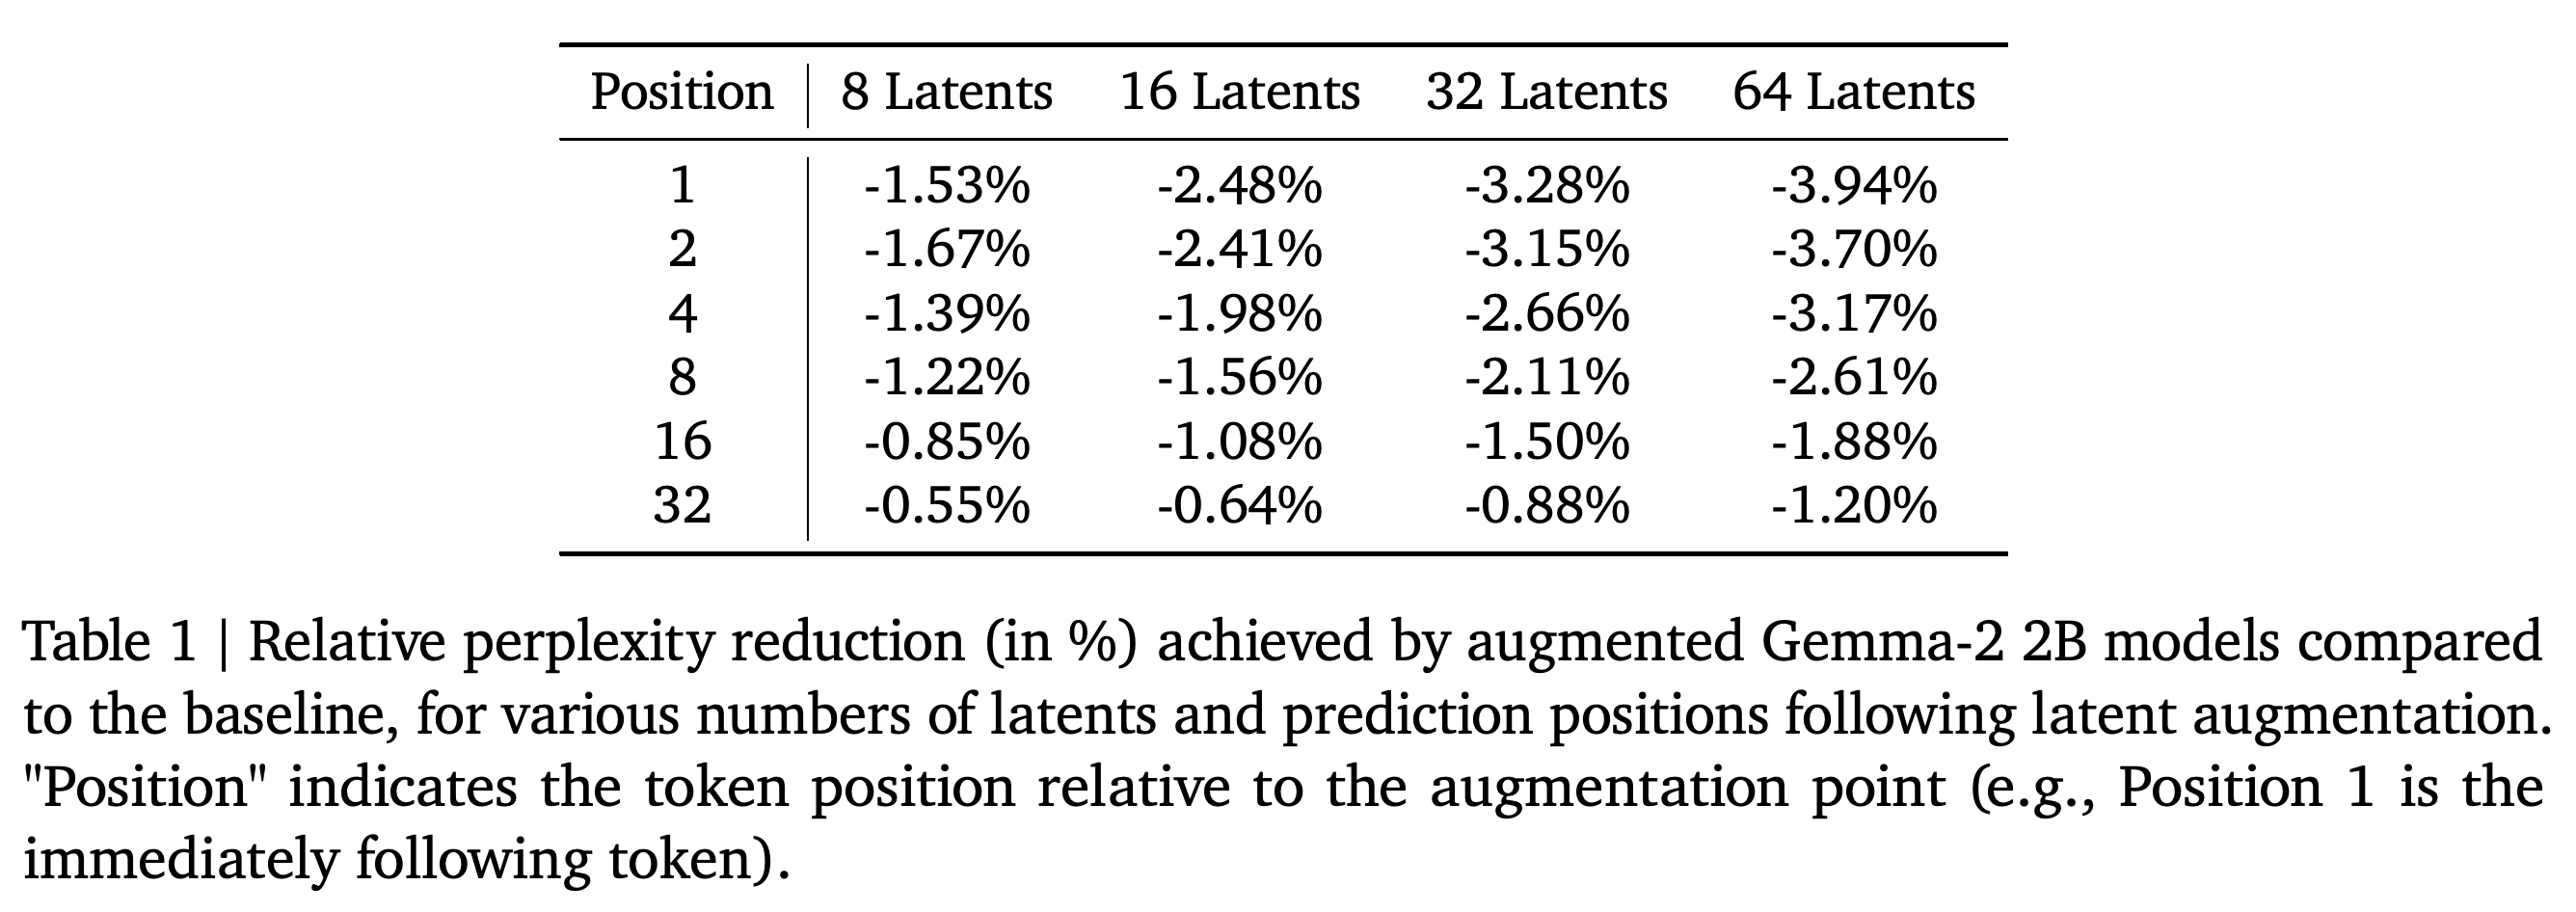
- 잠재 임베딩 8, 16, 32, 64개에서 첫 번째 토큰의 상대 perplexity 변화는 각각 −1.53%, −2.48%, −3.28%, −3.94%이다.
- 위치 32에서 같은 설정의 변화는 각각 −0.55%, −0.64%, −0.88%, −1.20%이며, 이는 ahead token 16개만으로 학습한 결과이다.
- Figure 3에는 잠재 임베딩 4개인 설정도 표시되어 있지만, 캡션에는 8, 16, 32, 64개만 나열되어 있다.
코프로세서를 학습하면서 증강 이후 첫 번째와 32nd 토큰 모두에서 perplexity가 낮아지며, 잠재 임베딩 수가 많을수록 대체로 감소 폭도 커진다. 두 번째 패널은 조건부 예측의 이점이 학습 범위인 16토큰을 넘어 유지됨을 보여준다.
증강 지점에서 멀어질수록 감소 폭은 대체로 작아지지만, 위치 32에서도 감소가 유지된다. 잠재 임베딩 64개에서 상대 perplexity 변화는 위치 1에서 −3.94%, 위치 32에서 −1.20%이다.
3.2. Public Benchmark Evaluation
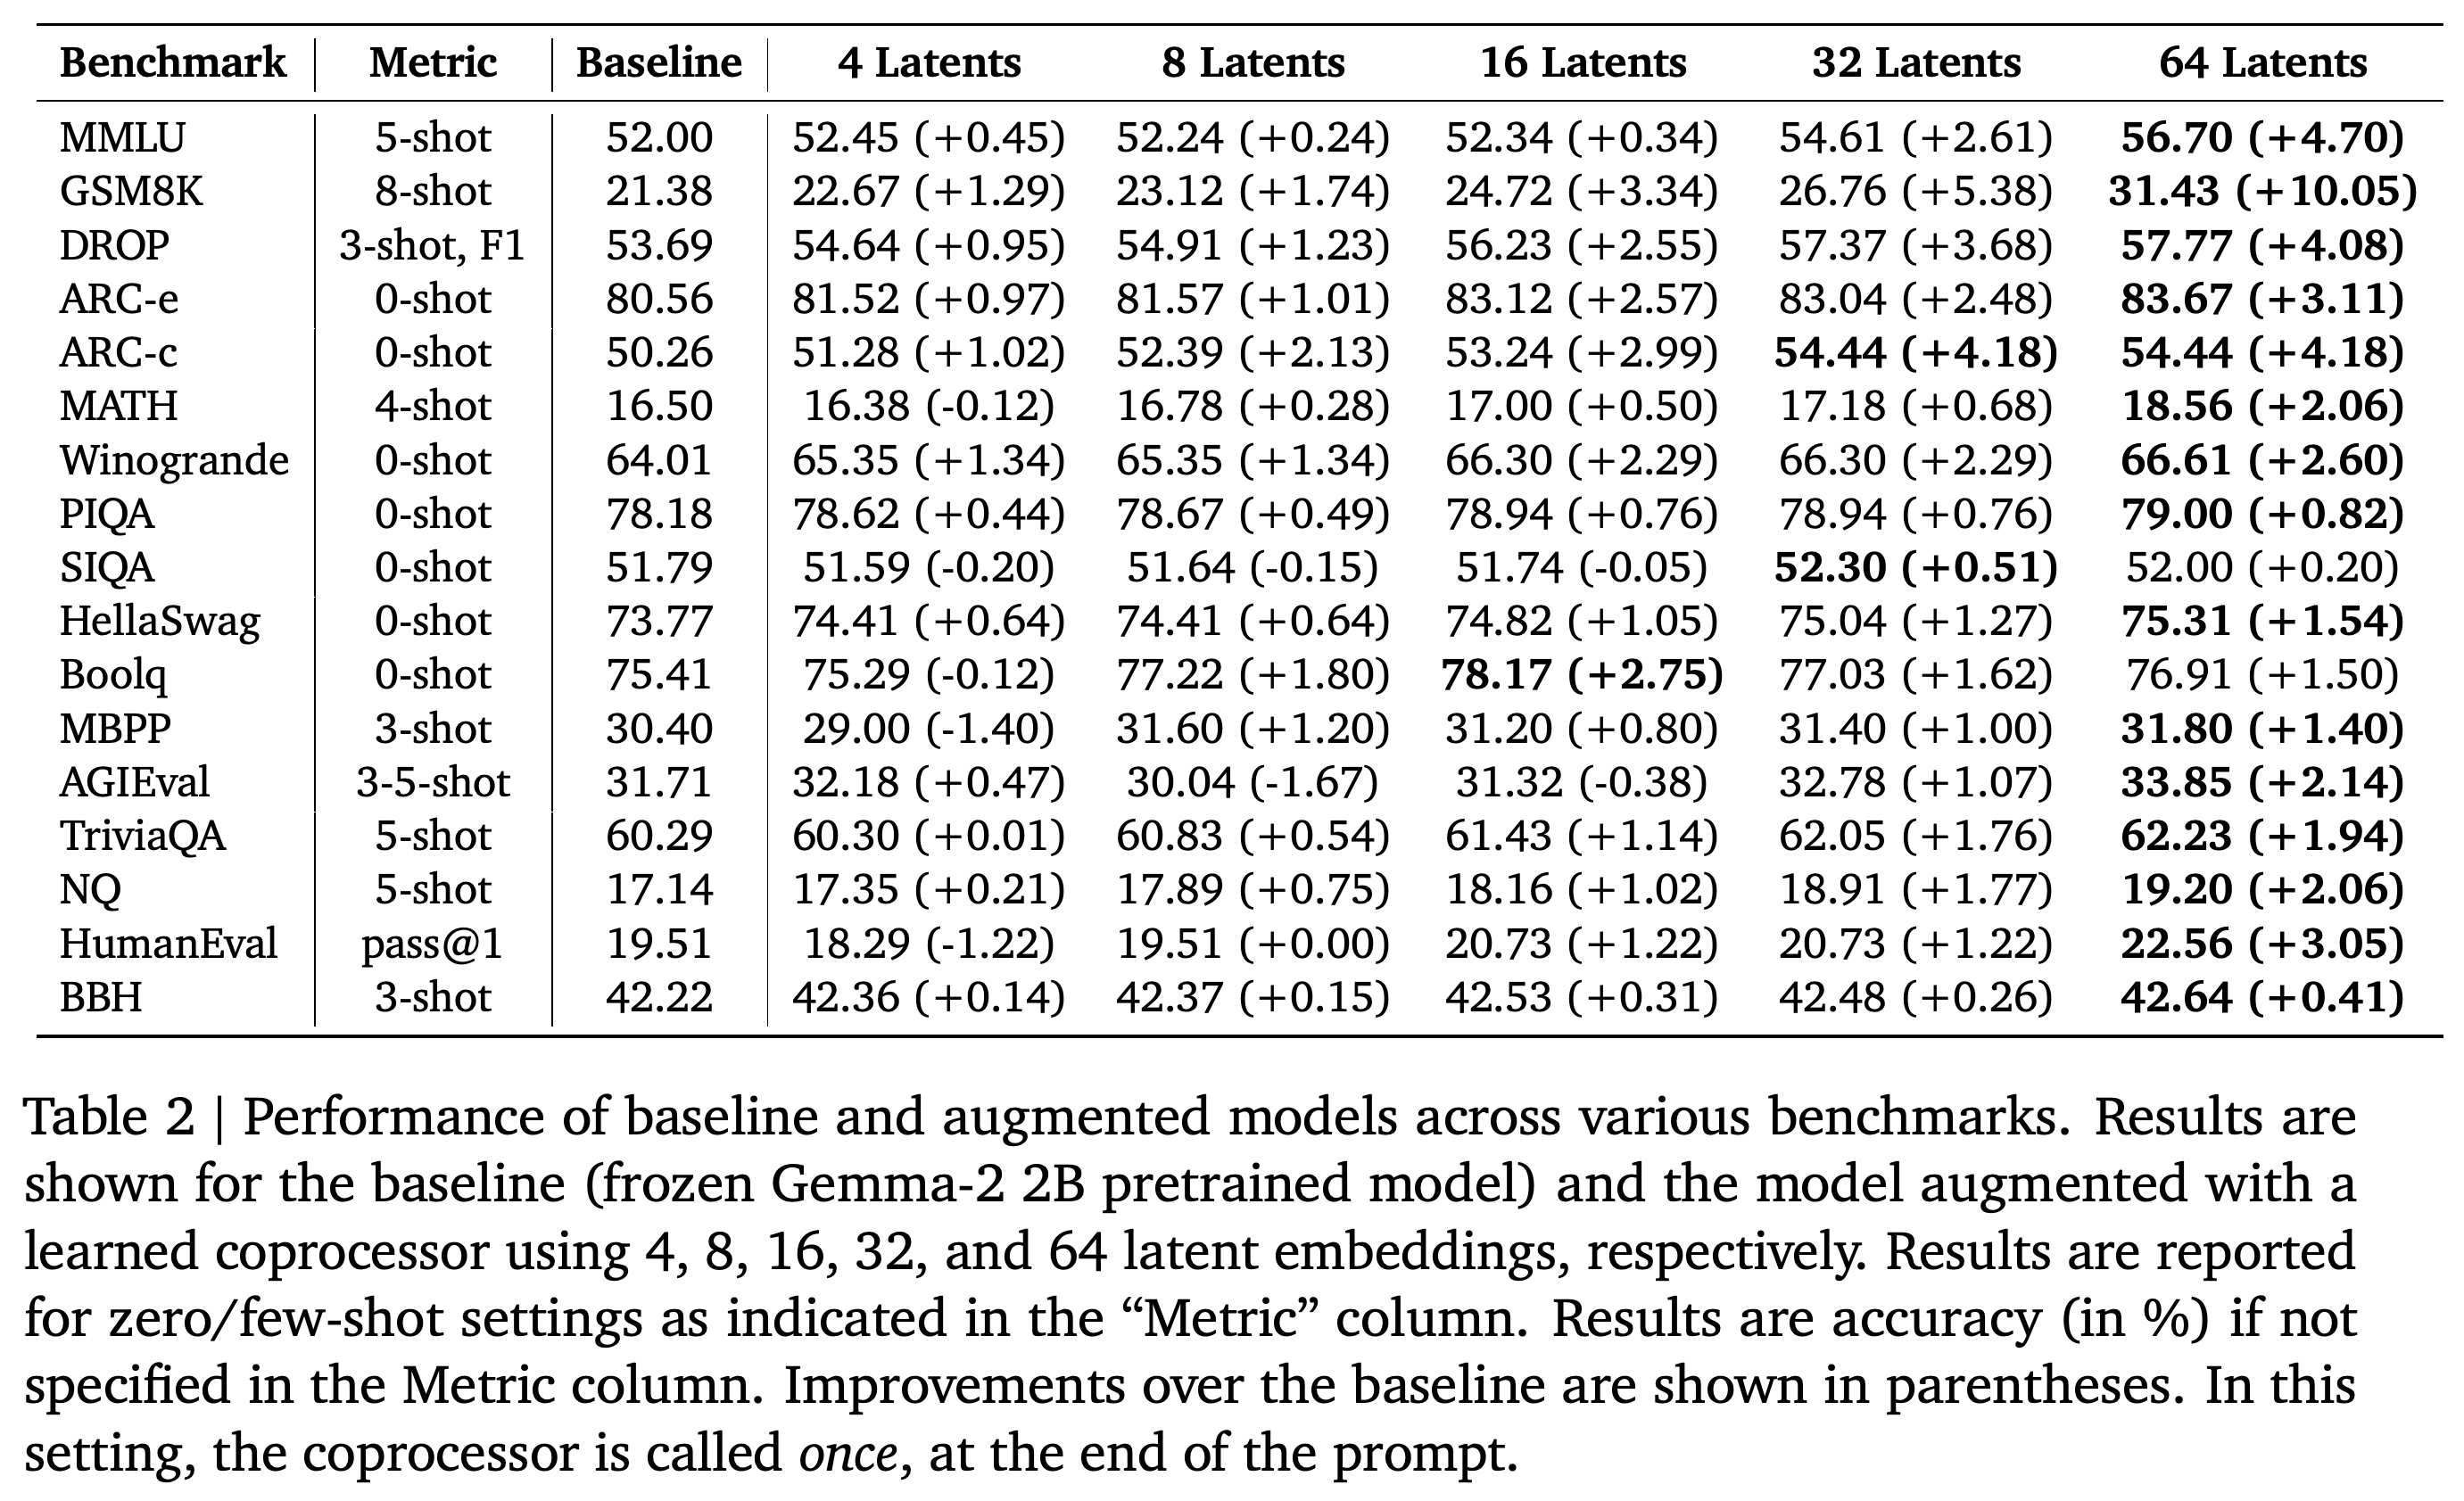
공개 벤치마크 평가에서는 잠재 임베딩 4, 8, 16, 32, 64개를 사용하고 프롬프트 끝에서 코프로세서를 1회 호출한다. 잠재 임베딩 64개를 사용하면 언어 이해 벤치마크 MMLU의 5-shot 점수는 52.00%에서 56.70%로, GSM8K의 8-shot 점수는 21.38%에서 31.43%로, 수학 문제 해결 데이터셋 MATH의 4-shot 점수는 16.50%에서 18.56%로 높아진다. 각 shot 수는 프롬프트에 제공하는 예시 수를 뜻한다.
- 각각의 향상 폭은 점수의 절대 차이로 계산하면 4.70, 10.05, 2.06 percentage points이다.
- 잠재 임베딩 64개 열의 벤치마크 점수 17개는 모두 베이스라인보다 높지만, 모든 잠재 임베딩 수에서 성능이 단조롭게 증가하지는 않는다.
- 예를 들어 평가한 추론 벤치마크 중 하나인 Boolq는 프롬프트 예시를 제공하지 않는 0-shot 평가에서 잠재 임베딩 16개일 때 78.17%로 가장 높고, 64개일 때는 76.91%로 낮아진다. 베이스라인은 75.41%이다.
프롬프트 끝에서 증강을 1회 수행하면 잠재 임베딩 64개에서 보고된 벤치마크 점수 17개가 모두 향상된다. 잠재 임베딩 수가 적을 때는 성능이 하락하는 경우도 있으며, 여러 벤치마크에서 잠재 임베딩 수 증가에 따른 점수 변화가 단조롭지 않다.
3.3. Comparison with other baselines and variations
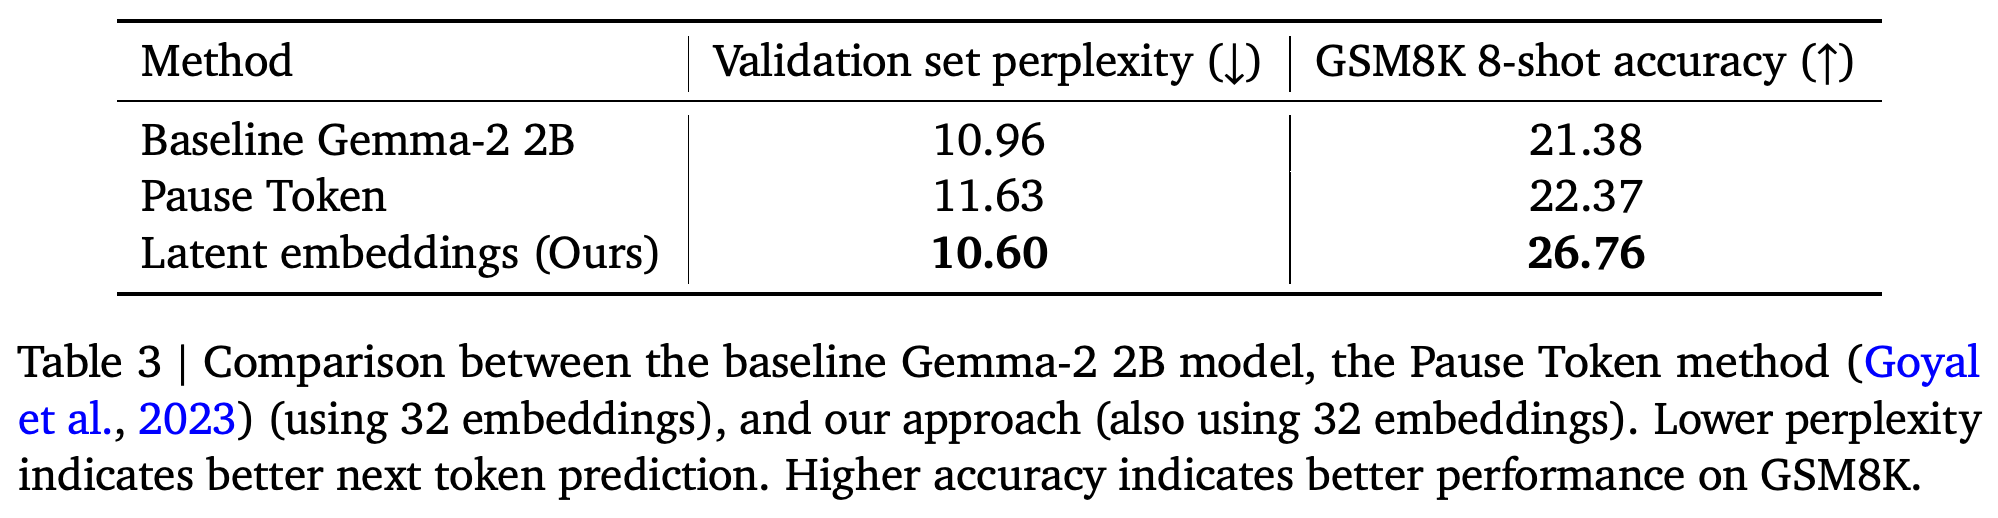
3.3.1. Pause Token에서는 입력과 출력 사이에 학습 가능한 임베딩을 배치하되, 임베딩 값을 입력에 조건부로 생성하지 않는 방법과 비교한다. 임베딩 32개와 동일한 학습 데이터 및 실험 설정을 사용했을 때, 캐시 증강의 검증 perplexity는 10.60, GSM8K 8-shot 정확도는 26.76%이다. Pause Token은 각각 11.63과 22.37%이며, 베이스라인은 10.96과 21.38%이다.
- 이 비교는 학습된 캐시 조건부 코프로세서의 효과를 뒷받침하지만, 추가 모델 연산량을 동일하게 맞추지는 않는다.
임베딩 32개에서 캐시 증강은 지표 2개를 모두 개선한다. 반면 Pause Token은 GSM8K 정확도를 높이지만 검증 perplexity는 10.96에서 11.63으로 높인다. 이 비교는 벤치마크 정확도와 언어 모델링 perplexity가 증강에 서로 다르게 반응할 수 있음을 보여준다.
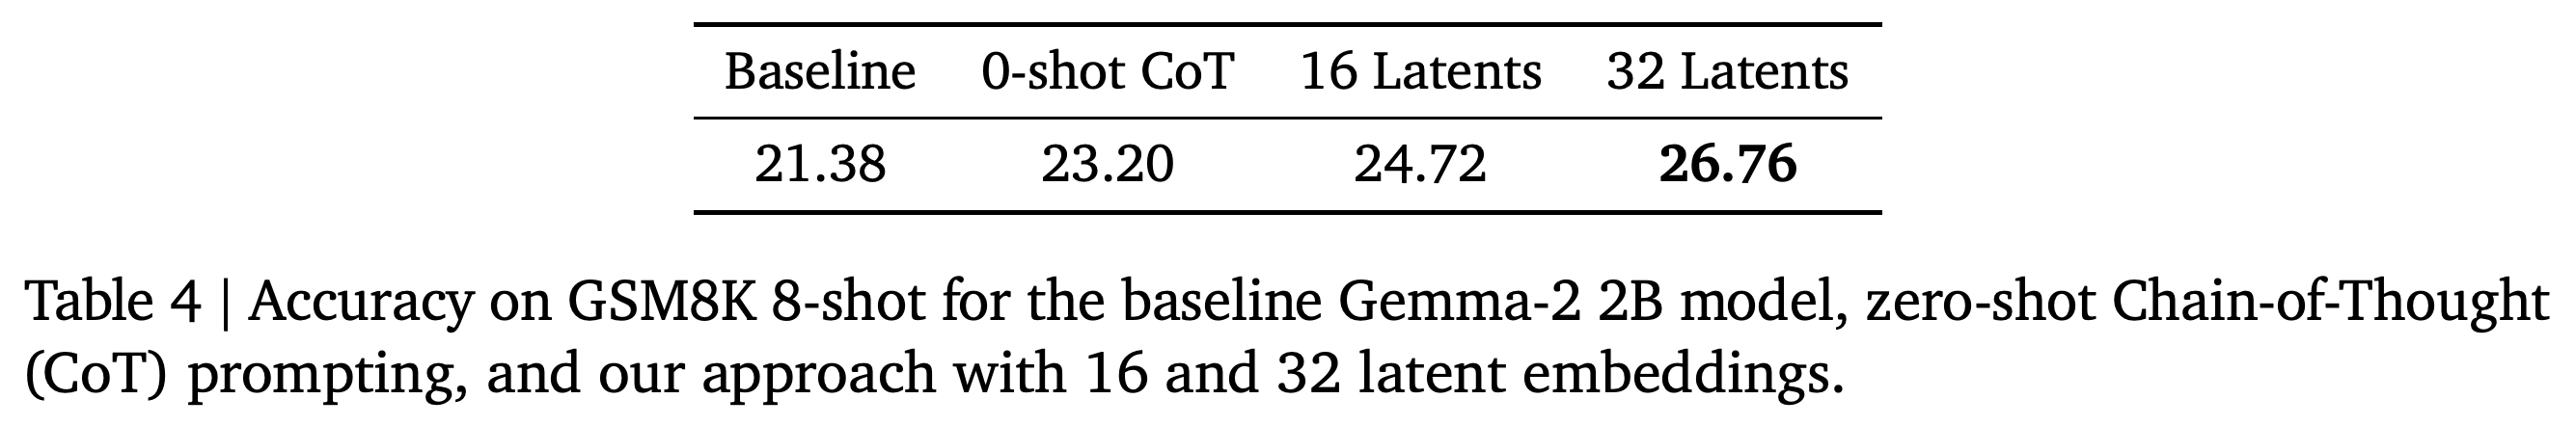
3.3.2. Zero-shot CoT에서는 프롬프트에 “Let’s think step by step”을 덧붙여, 모델이 중간 추론 단계를 생성하도록 유도하는 Chain-of-Thought(CoT)를 평가한다. Table 4에서 이 조건의 GSM8K 정확도는 23.20%이며, 잠재 임베딩 16개는 24.72%, 32개는 26.76%, 베이스라인은 21.38%이다. 캡션에는 벤치마크 설정이 GSM8K 8-shot으로 명시되어 있다.
- 논문은 캡션의 8-shot 벤치마크 표기를 유지하면서 이 방식을 “0-shot CoT”라고 부르며, 이 용어를 더 설명하지 않는다.
- 정확도 비교에는 시간 측정 결과가 포함되어 있지 않다.
보고된 “0-shot CoT” 조건의 정확도는 23.20%로, 잠재 임베딩 16개의 24.72%와 32개의 26.76%보다 낮다. 캡션에는 GSM8K 8-shot 평가라고 명시되어 있으며, 표에는 추론 비용 측정값이 없다.
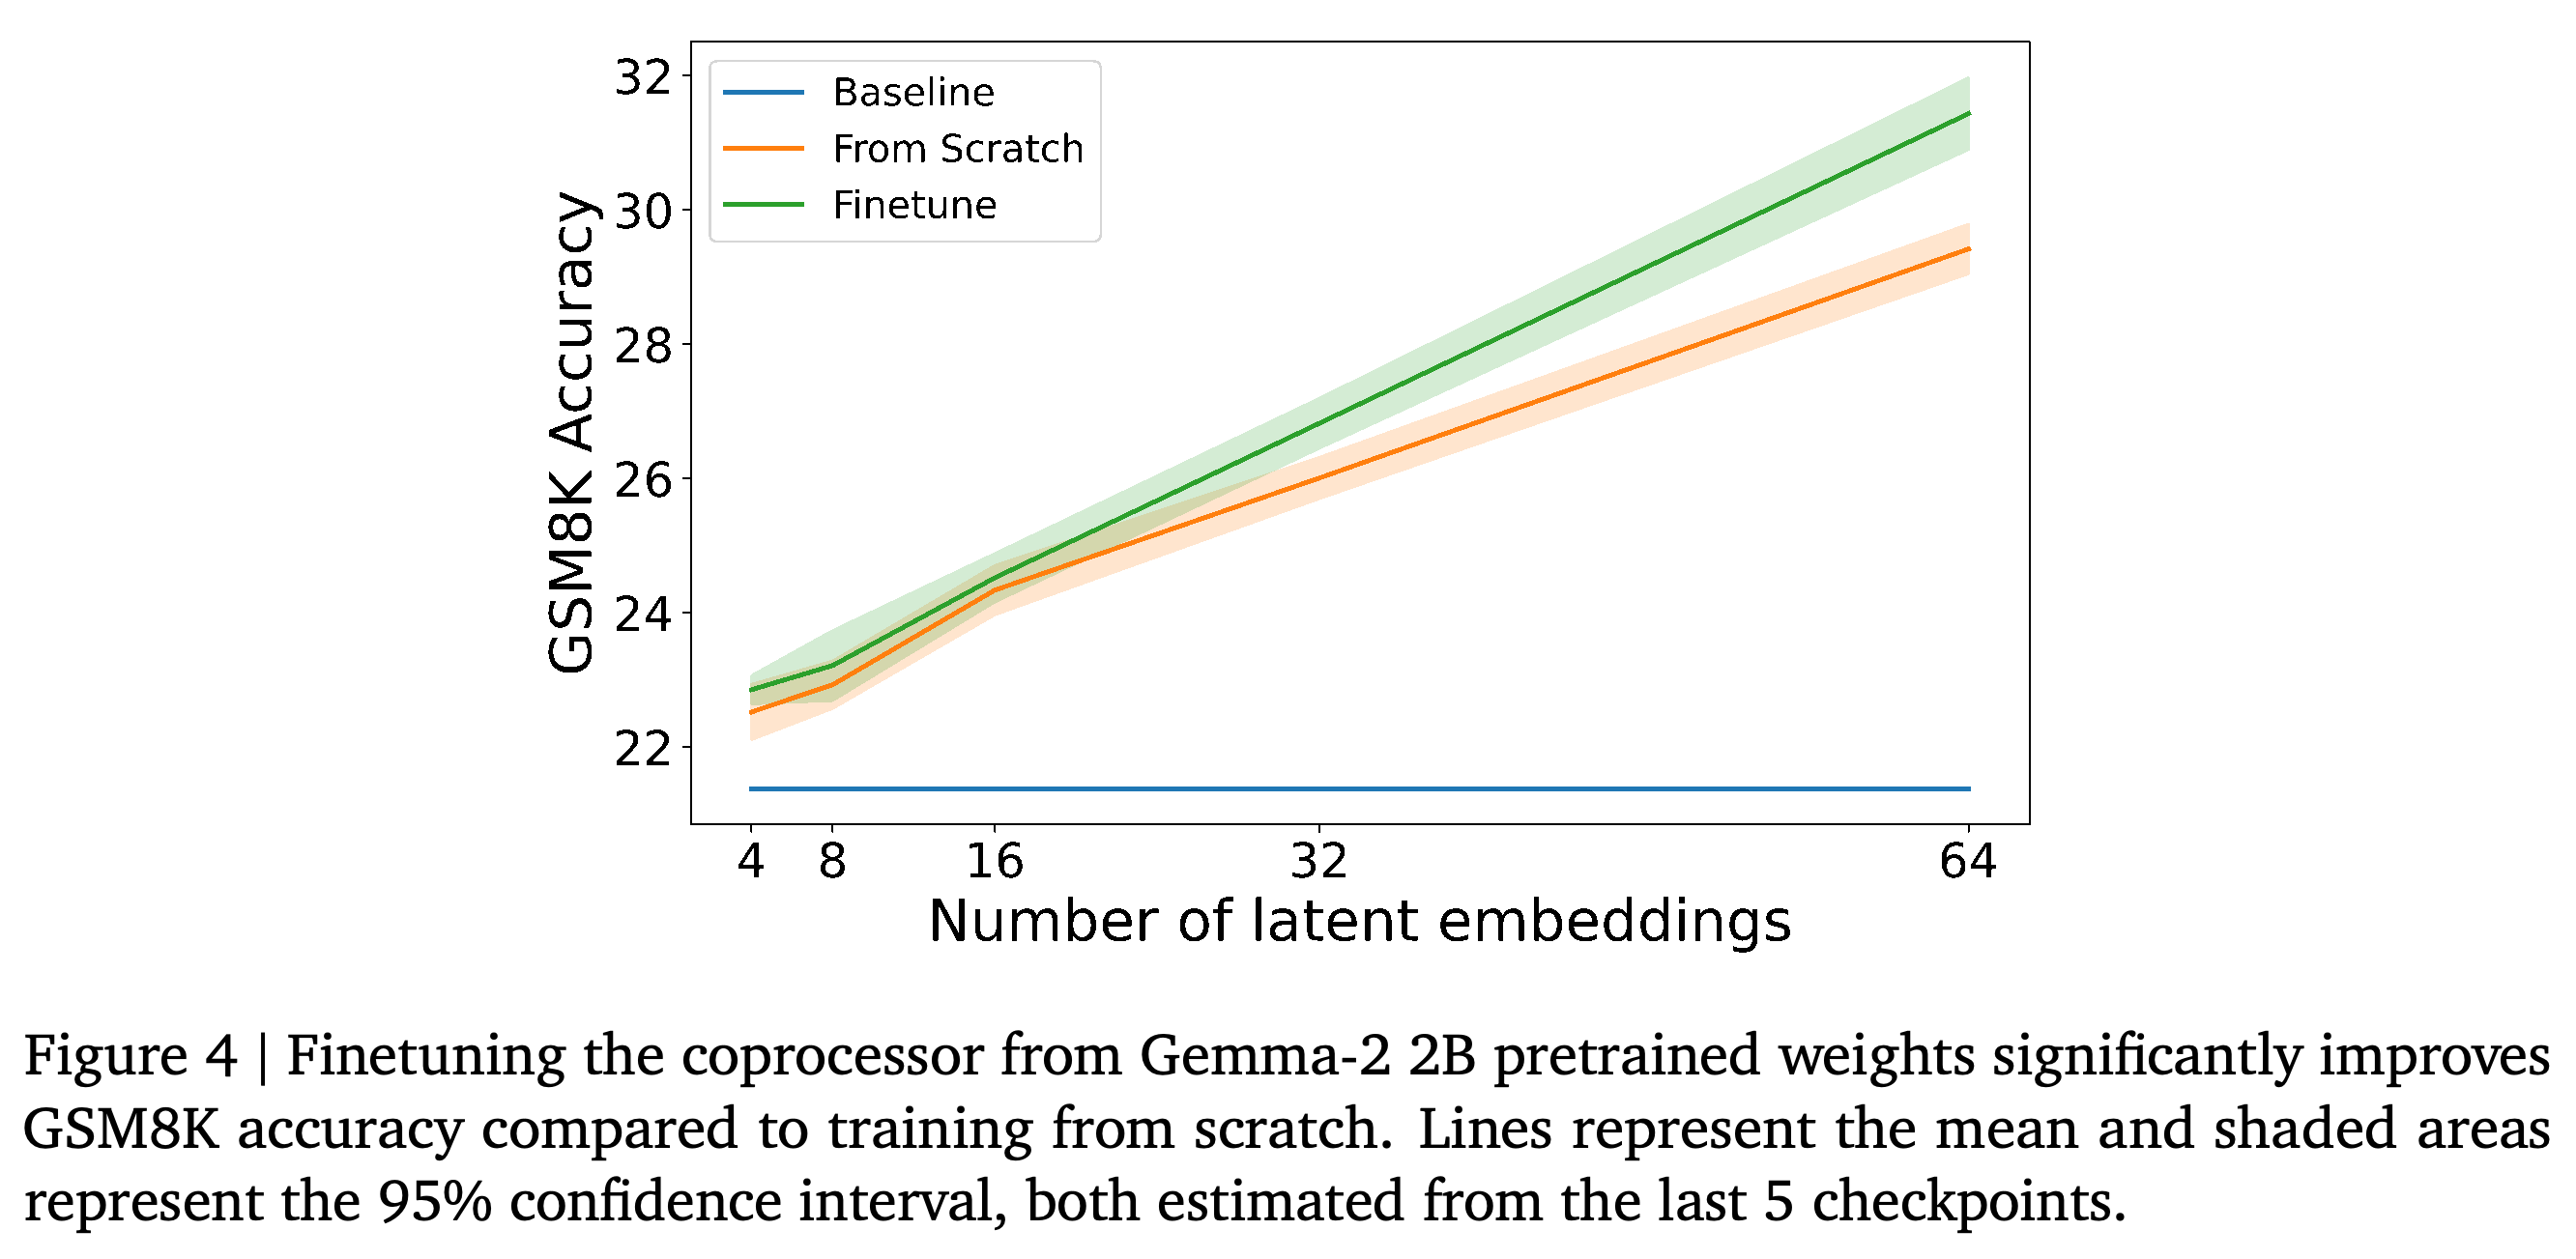
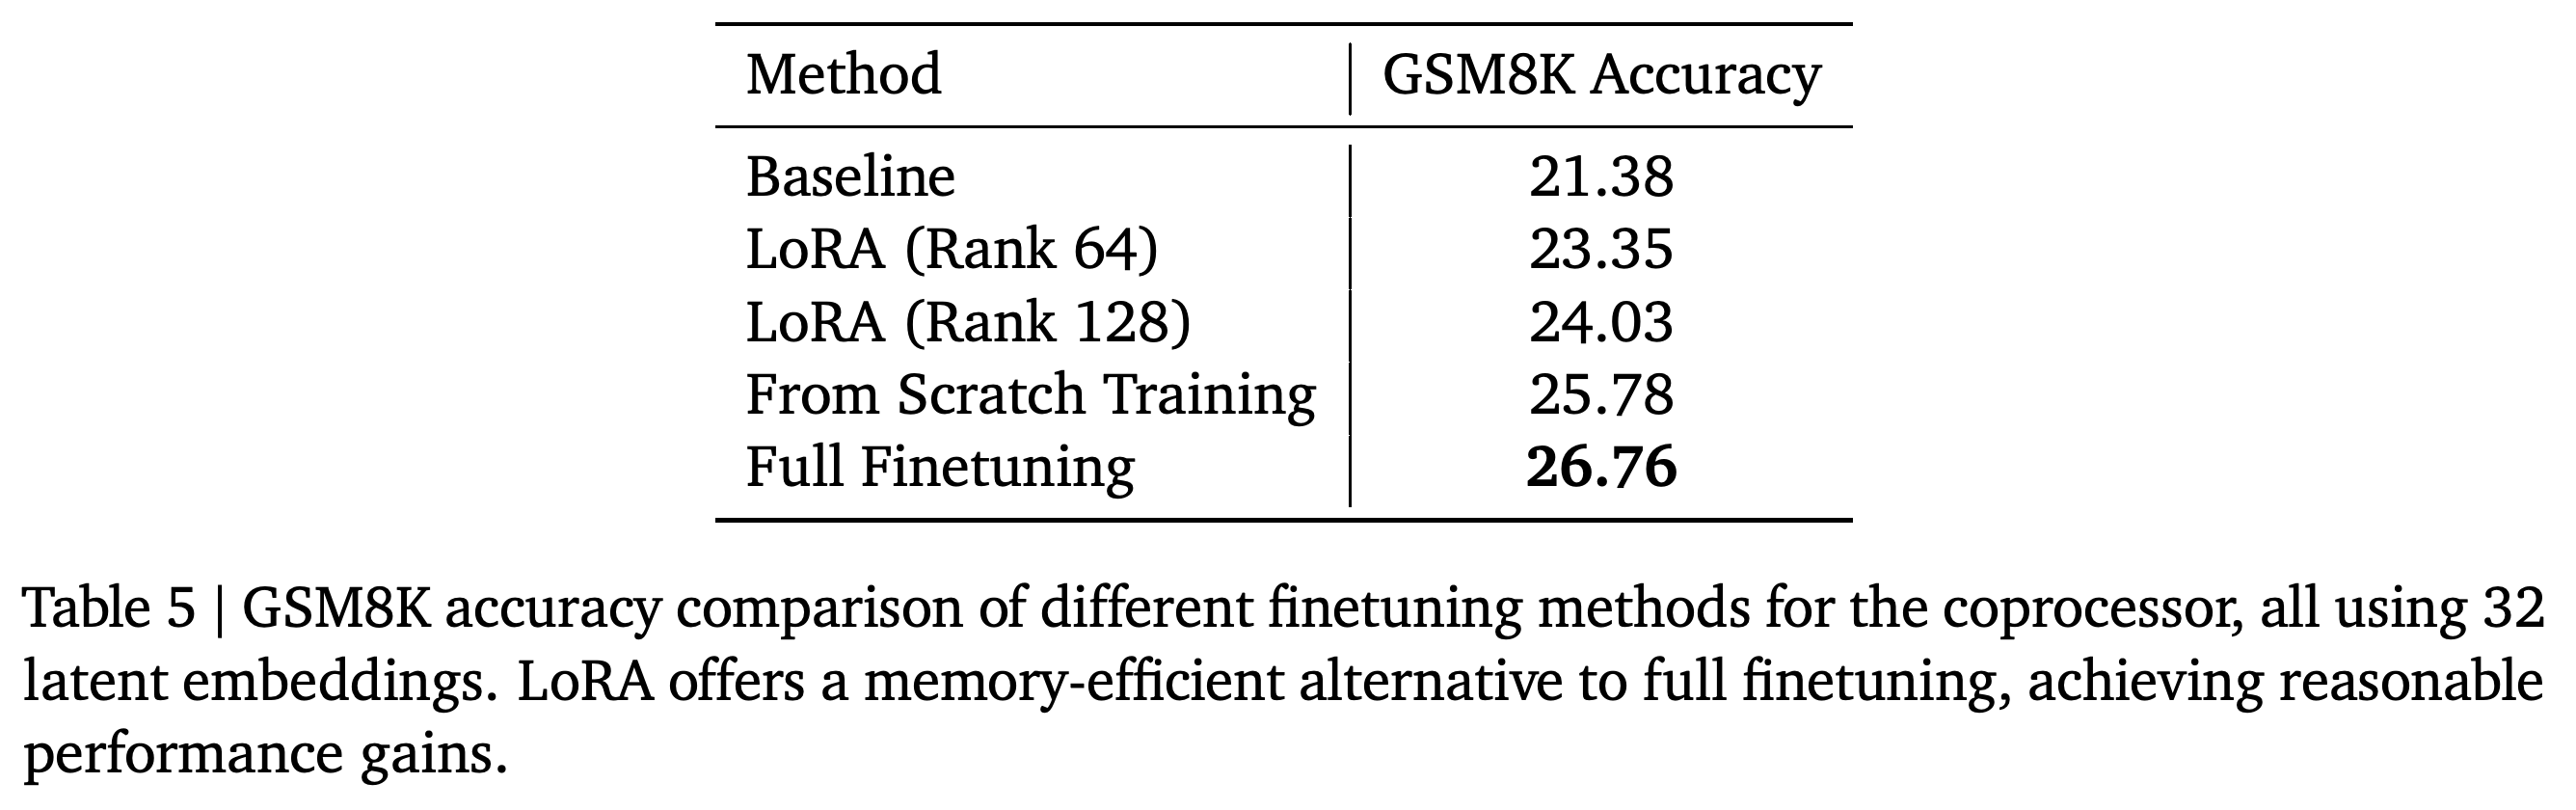
3.3.3. Alternative Coprocessor Configurations에서는 초기화, 제한된 파라미터 갱신, 입력 표현의 출처를 살펴본다. 그래프에 표시된 잠재 임베딩 수 전반에서 사전학습 초기화가 무작위 초기화보다 GSM8K 성능이 높다. 사전학습 가중치를 고정하고 저랭크 가중치 갱신을 학습하는 Low-Rank Adaptation(LoRA)은 코프로세서 전체 미세조정보다 향상 폭이 작다.
- 잠재 임베딩 32개에서 GSM8K 정확도는 LoRA rank 64가 23.35%, rank 128이 24.03%, 처음부터 학습한 경우가 25.78%, 전체 미세조정이 26.76%이며, 베이스라인은 21.38%이다. Rank는 저랭크 갱신의 크기를 정한다.
- 고정된 모델의 최종 계층 내부 표현인 마지막 계층 활성화만 사용하면 perplexity는 10.81, GSM8K 정확도는 23.20%이다. 이 문단에서 KV 캐시를 입력으로 사용한 결과는 각각 10.69와 26.76%이다.
- 이 절제 실험의 KV 캐시 perplexity 10.69는 Table 3에 보고된 잠재 임베딩 32개의 결과 10.60과 다르며, 논문은 이 차이를 해명하지 않는다.
- Figure 4의 평균과 95% 신뢰구간은 독립적인 학습 실행이 아니라, 저장된 학습 상태인 마지막 체크포인트 5개로 추정한다.
처음부터 학습한 코프로세서와 사전학습으로 초기화한 코프로세서 모두 잠재 임베딩 수가 늘수록 GSM8K 정확도가 높아지며, 그래프의 평균은 사전학습 초기화가 더 높다. 음영으로 표시한 95% 신뢰구간은 마지막 체크포인트 5개로 추정했으므로 독립적인 학습 실행 간 변동성을 측정하지 않는다.
LoRA rank 128은 rank 64보다 성능이 높지만, 잠재 임베딩 32개에서는 LoRA 설정 2개 모두 처음부터 학습한 경우와 전체 미세조정보다 낮다. 이 표는 파라미터 갱신을 제한했을 때의 정확도를 제시하며, 메모리 사용량이나 실행 시간은 측정하지 않는다.
3.4. Impact of the number of ahead token in training
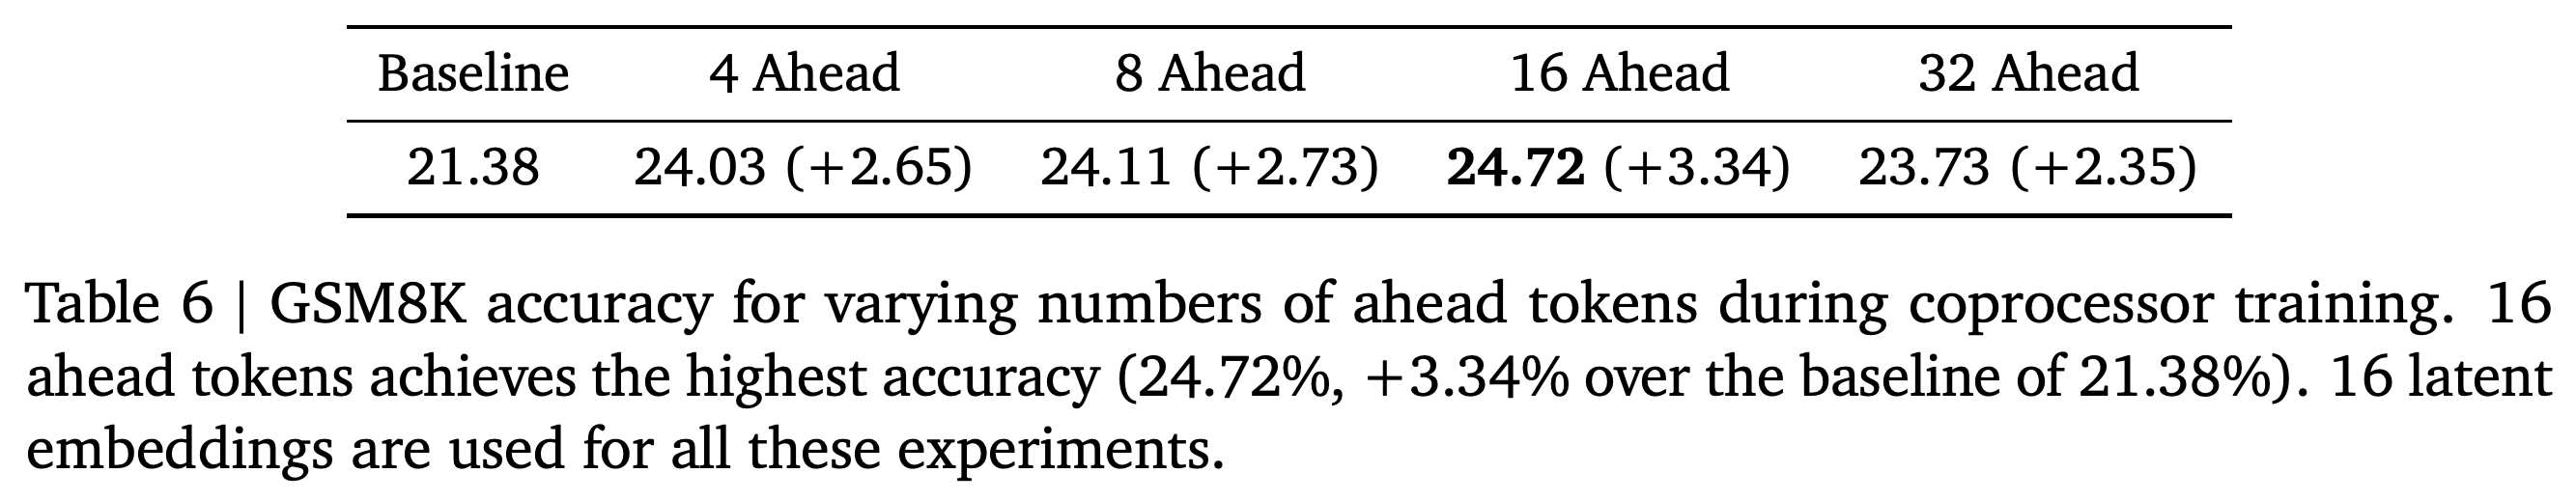
잠재 임베딩 16개를 사용하고 ahead token 4, 8, 16, 32개로 학습하면 GSM8K 정확도는 각각 24.03%, 24.11%, 24.72%, 23.73%이며, 베이스라인은 21.38%이다. 저자들은 이 비교에서 가장 좋은 결과를 낸 ahead token 16개를 선택한다. 또한 예측 범위를 늘리면 뒤쪽 토큰의 perplexity는 개선되지만 앞쪽 토큰의 perplexity는 악화되는 경우가 많다고 보고한다.
잠재 임베딩 수를 16개로 고정하면 학습 예측 범위가 16토큰일 때 정확도가 가장 높고, 범위를 32로 늘리면 낮아진다. 이는 시험한 설정 중에서 해당 예측 범위를 선택한 근거가 된다.
4. Related Work
관련 연구에서는 캐시 증강을 명시적 추론, 연속적인 내부 표현을 통한 연산, 문맥 압축, 외부 학습 모듈, 조건부 파라미터 생성과 연결한다. 이러한 연관성은 코프로세서가 캐시된 문맥을 통해 고정된 언어 모델을 확장하는 방식을 설명한다.
4.1. Chain-of-Thought Reasoning in LLMs
기존 CoT 방법은 중간 추론 텍스트를 생성하거나 종합, 검증, 탐색한다. 논문은 정답 여부나 목표 우도 같은 신호로 추론을 최적화하는 강화학습도 다루며, 추론 토큰의 순차적 생성을 학습 및 추론 비용의 원인으로 지목한다.
4.2. Latent Space Reasoning
기존 잠재 추론 연구는 Transformer의 중간 표현과 pause token 또는 filler token을 다룬다. 이 토큰들은 일반적인 텍스트 내용을 추가하지 않고 연산에 사용할 위치를 추가한다. 논문은 입력에 따라 달라지는 임베딩을 고정된 학습 토큰 임베딩과 구분한다. 또한 코프로세서만 학습하는 방식을 COCONUT과 비교한다. COCONUT은 은닉 상태를 잠재 입력 임베딩으로 사용하며 다단계 학습을 수행한다.
4.3. KV-Cache Compression
KV 캐시 압축은 학습된 압축 임베딩이나 문맥을 요약하도록 학습한 “gist tokens” 등을 통해 문맥을 더 간결하게 표현하여 메모리 요구량을 줄인다. 이 논문은 이러한 인터페이스에서 영감을 얻었지만, 예측과 추론을 돕는 문맥 표현을 추가한다. 실험은 캐시 크기의 감소를 입증하지 않는다.
4.4. Augmenting LLMs with External Modules
논문은 제안 방법을 연속 프롬프트를 학습하는 prompt tuning 및 prefix tuning, 사전학습 모델에 삽입하는 작은 학습 모듈인 adapter, 그리고 LoRA와 연결한다. 또한 서로 다른 구성요소의 표현 사이에 적용하는 어텐션인 cross-attention을 모델 결합 인터페이스로 다룬다. 여기에는 특화 언어 모델과 범용 언어 모델을 연결하는 시스템인 CALM도 포함된다.
4.5. Hypernetworks for Parameter Generation
Hypernetwork는 문맥 입력을 조건으로 다른 네트워크의 파라미터를 생성하는 네트워크이다. 저자들은 코프로세서가 고정된 모델의 캐시로부터 캐시 증강 표현을 동적으로 생성한다는 점에서 개념적인 유사성을 제시한다. 다만 코프로세서의 출력은 별도 모듈의 파라미터가 아니라 잠재 임베딩이다.
5. Conclusion
논문은 프롬프트 예시가 없거나 적은 설정에서 미분 가능한 캐시 증강이 고정된 디코더의 미래 토큰 예측과 벤치마크 성능을 개선함을 보인다. 더 큰 모델, 여러 모듈형 코프로세서, 다른 코프로세서 아키텍처, 더 다양한 과제에 대한 평가는 향후 연구로 제안한다.
부록
- A. Appendix에서는 코프로세서 학습을 더 오래 진행하면 GSM8K 정확도가 높아지고 검증 perplexity가 낮아짐을 보이지만, 데이터 노출량과 최적화 기간의 효과는 분리하지 않는다. 다운스트림 적응에서는 LoRA로 베이스라인 디코더를 갱신하고, 증강 모델은 디코더를 고정한 채 코프로세서만 갱신한다. 증강 모델은 개선되고 베이스라인은 초기에 개선된 뒤 악화되며, 이를 과적합 감소로 설명한 저자들의 가설은 직접 검증되지 않았다. 무작위 초기화로도 대부분의 벤치마크에서 성능이 향상된다. 사전학습 초기화는 GSM8K에서 더 좋은 결과를 보이며, 전반적인 우위에는 Winogrande의 예외가 있다.
짧은 생각
벤치마크 성능 향상과 위치 32에서의 조건부 예측 개선은 고정된 디코더가 자신의 예측 손실로 학습한 입력 의존적 캐시 추가 표현을 활용할 수 있음을 보여준다. 실용적인 효율성은 아직 확인되지 않았다. 기본 코프로세서는 디코더와 같은 아키텍처를 사용하고, 평가는 Gemma-2 2B에 집중하며, 검증 데이터는 비공개이다. 또한 종단 간 지연 시간, 처리량, 총연산량 비교를 보고하지 않는다. 부록은 학습 기간과 다운스트림 적응에 관한 근거를 더하지만, 체크포인트 기반 구간과 적응 곡선만으로는 독립 실행 간 변동성과 제안한 과적합 메커니즘을 검증할 수 없다.