


Demystifying Long Chain-of-Thought Reasoning in LLMs 요약 설명
05 Feb 2025 | Paper Review Reasoning Reinforcement Learning With Verifiable Rewards Reward Design Supervised Fine-Tuning목차
이번 글에서는 Demystifying Long Chain-of-Thought Reasoning in LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 5일(Arxiv)
- Yeo, Edward, Tong, Yuxuan, Niu, Morry, Neubig, Graham, Yue, Xiang.
- IN.AI, Tsinghua University, Carnegie Mellon University
- 논문 링크
- Github
요약
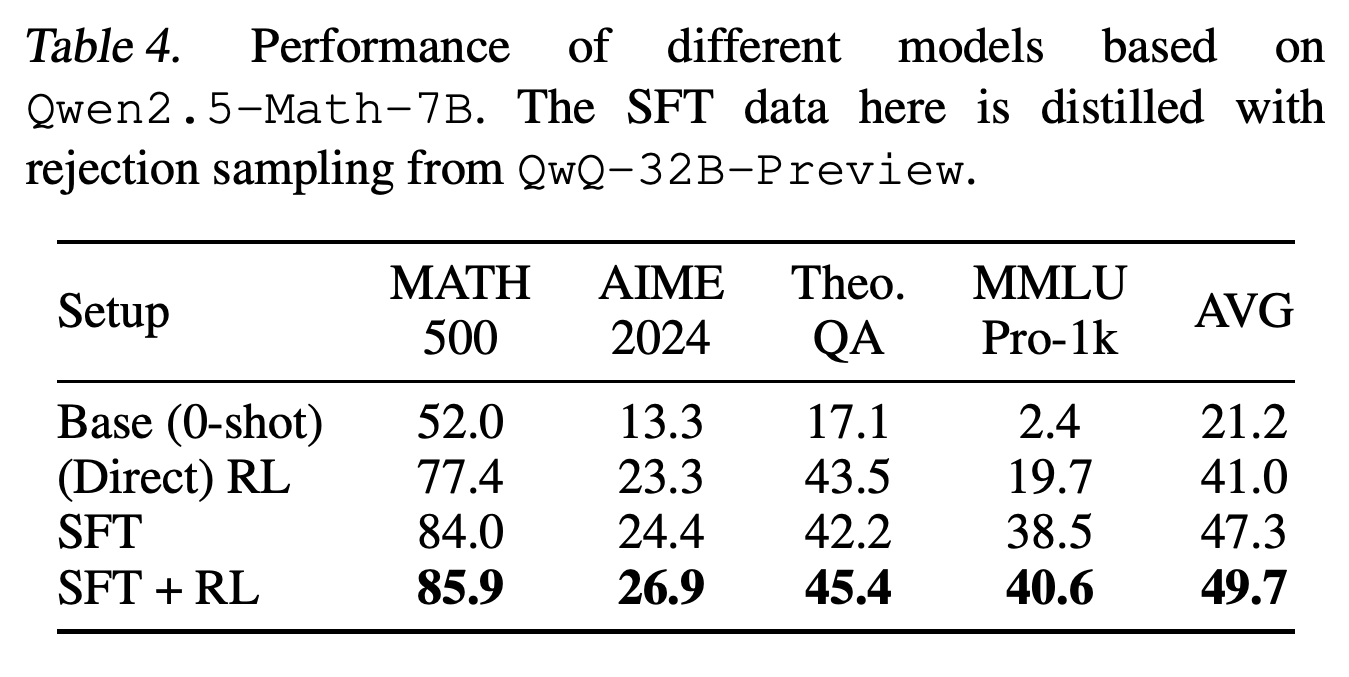
- 대규모 언어 모델(LLM)이 대안을 탐색하고 오류를 수정하는 긴 추론 과정인 long chains-of-thought(CoTs)를 생성하도록 학습하려면, 학습을 안정적으로 유지하면서 정답률을 높이는 방법을 선택해야 한다. 논문에서 학습과 디코딩 설정을 달리해 비교한 결과, Qwen2.5-Math-7B는 예시 응답으로 학습하는 지도 미세 조정(SFT) 후 보상으로 응답을 최적화하는 강화 학습(RL)을 적용했을 때 벤치마크 평균 정답률이 49.7%였다. 베이스 모델에 직접 RL을 적용했을 때는 41.0%였다.
- 기존 추론 모델이 생성한 응답을 학습 목표로 사용하는 증류 방식의 long CoT 데이터는, 실험에 사용한 short CoT 데이터나 인위적으로 구성한 행동 시퀀스보다 학습 규모 확대와 후속 RL에서 더 큰 성능 향상을 보였다. Llama-3.1-8B에 약 200k개의 SFT 샘플로 증류 패턴을 학습한 뒤 RL을 적용하면, 경시 수학 평가 부분집합인 MATH-500에서 59.4%, 일반 추론 문항 1,000개로 구성된 평가 부분집합인 MMLU-Pro-1k에서 34.6%를 달성한다. 인위적으로 구성한 패턴은 각각 52.4%, 19.2%를 기록한다.
- 정답 여부만으로 보상을 주면 응답이 사용 가능한 토큰 한도인 컨텍스트 윈도우를 소진하고 정답률이 급락할 수 있다. 응답 길이에 따라 정답 보상을 조정하는 Cosine Reward는 실험한 학습 실행을 안정화한다. 여기에 반복되는 토큰 시퀀스에 페널티를 주면 응답 길이가 더 줄어들고 여러 벤치마크 점수가 개선된다.
- 노이즈가 있는 웹 기반 지도 데이터도 적절한 데이터 혼합이나 검증 가능한 단답형 정답 필터링을 적용하면, 주된 수학 학습 분포를 벗어난 분포 외(OOD) 성능을 높인다. 직접 RL을 적용해도 성찰 키워드가 일관되게 늘어나거나 응답이 베이스 모델의 원래 길이를 넘어가지 않은 상태에서 정답률이 높아진다. 따라서 이 측정값만으로 새로운 추론 능력이 발현했다고 판단할 수는 없다.
1. Introduction
이 논문은 SFT가 long CoT 학습에 미치는 영향, 보상이 길이와 안정성을 제어하는 방식, 검증 가능한 지도 데이터의 규모를 늘리는 방법을 연구한다. 또한 관찰되는 추론 행동이 RL 과정에서 생기는지, 이미 베이스 모델에 존재하는지도 살펴본다. 긴 추론은 대안 경로 탐색, 이전 단계로의 복귀, 오류 수정을 도울 수 있지만, 이러한 행동을 안정적으로 이끌어 내는 학습 조건은 아직 명확하지 않다.
2. Problem Formulation
연구 목표는 비교 실험과 특정 구성 요소를 바꾸는 제거 실험을 통해 long CoT 추론의 성능과 안정성을 높이는 학습 방법을 찾는 데 있다. 문제 정식화에서는 생성된 추론 과정과 최종 답변을 구분하고, 지도 학습을 통한 초기화와 보상 기반 최적화를 함께 다룬다.
2.1. Notation
질의 x와 출력 시퀀스 y에 대해 매개변수 θ를 가진 모델은 조건부 토큰 분포 πθ(yt | x, y1:t−1)를 정의하며, \(\operatorname{CoT}(y)\subseteq y\)는 추론 토큰을 나타낸다. Long CoT는 긴 출력뿐 아니라 여러 풀이 경로를 탐색하는 분기, 경로가 실패하면 이전 지점으로 돌아가는 역추적, 중간 오류를 찾아 고치는 오류 검증과 수정 등의 행동도 뜻한다.
2.2. Supervised Fine-Tuning (SFT)
SFT는 데이터셋 DSFT = {(xi, yi)}i=1N으로 생성 토큰에 대한 모델의 분포인 정책을 초기화한다. 각 목표 응답에는 일반적인 추론 과정이나 긴 추론 과정이 포함될 수 있다. SFT는 이후 RL로 최적화할 응답 패턴을 가르친다.
2.3. Reinforcement Learning (RL)
RL은 필요에 따라 SFT 이후에 적용하며, 주석이 달린 중간 추론 단계 대신 최종 답변으로 결정하는 결과 기반 보상을 사용한다. 기본 최적화 알고리즘은 정책 최적화 알고리즘인 Proximal Policy Optimization(PPO)이다. 예측 답변과 참조 정답을 직접 비교하는 규칙 기반 검증기를 사용한다.
2.4. Training Setup
주요 베이스 모델은 범용 모델인 Llama-3.1-8B와 수학 특화 모델인 Qwen2.5-Math-7B다. 기본적으로 SFT와 RL은 모두 MATH 학습 프롬프트 7,500개를 사용한다. SFT 응답은 후보를 생성한 뒤 최종 답변이 맞는 응답만 남기는 거부 샘플링으로 얻는다. 학습에는 언어 모델 학습 프레임워크인 OpenRLHF를 사용한다. 후반 실험에서는 웹에서 추출한 다양한 질문과 풀이를 모았지만 지도 정보의 신뢰성은 낮은 WebInstruct를 도입한다.
2.5. Evaluation Setup
평가에는 도메인 내 수학을 위한 MATH-500, 도메인 외 경시 수학을 위한 American Invitational Mathematics Examination의 30문제로 구성된 AIME 2024, 수학과 관련 기술 분야의 정리 기반 추론을 위한 TheoremQA, 일반 추론을 위한 MMLU-Pro-1k를 사용한다. 기본 생성 설정은 샘플링의 무작위성을 조절하는 temperature 0.7, 누적 확률이 해당 값에 이르는 토큰으로 샘플링 범위를 제한하는 top-p 0.95, 최대 출력 길이 16,384토큰이다. 베이스 모델에서 직접 수행하는 RL에는 다음 토큰으로 확률이 가장 높은 토큰을 선택하는 별도의 탐욕적 디코딩 설정을 적용하며, Section 6에서 설명한다.
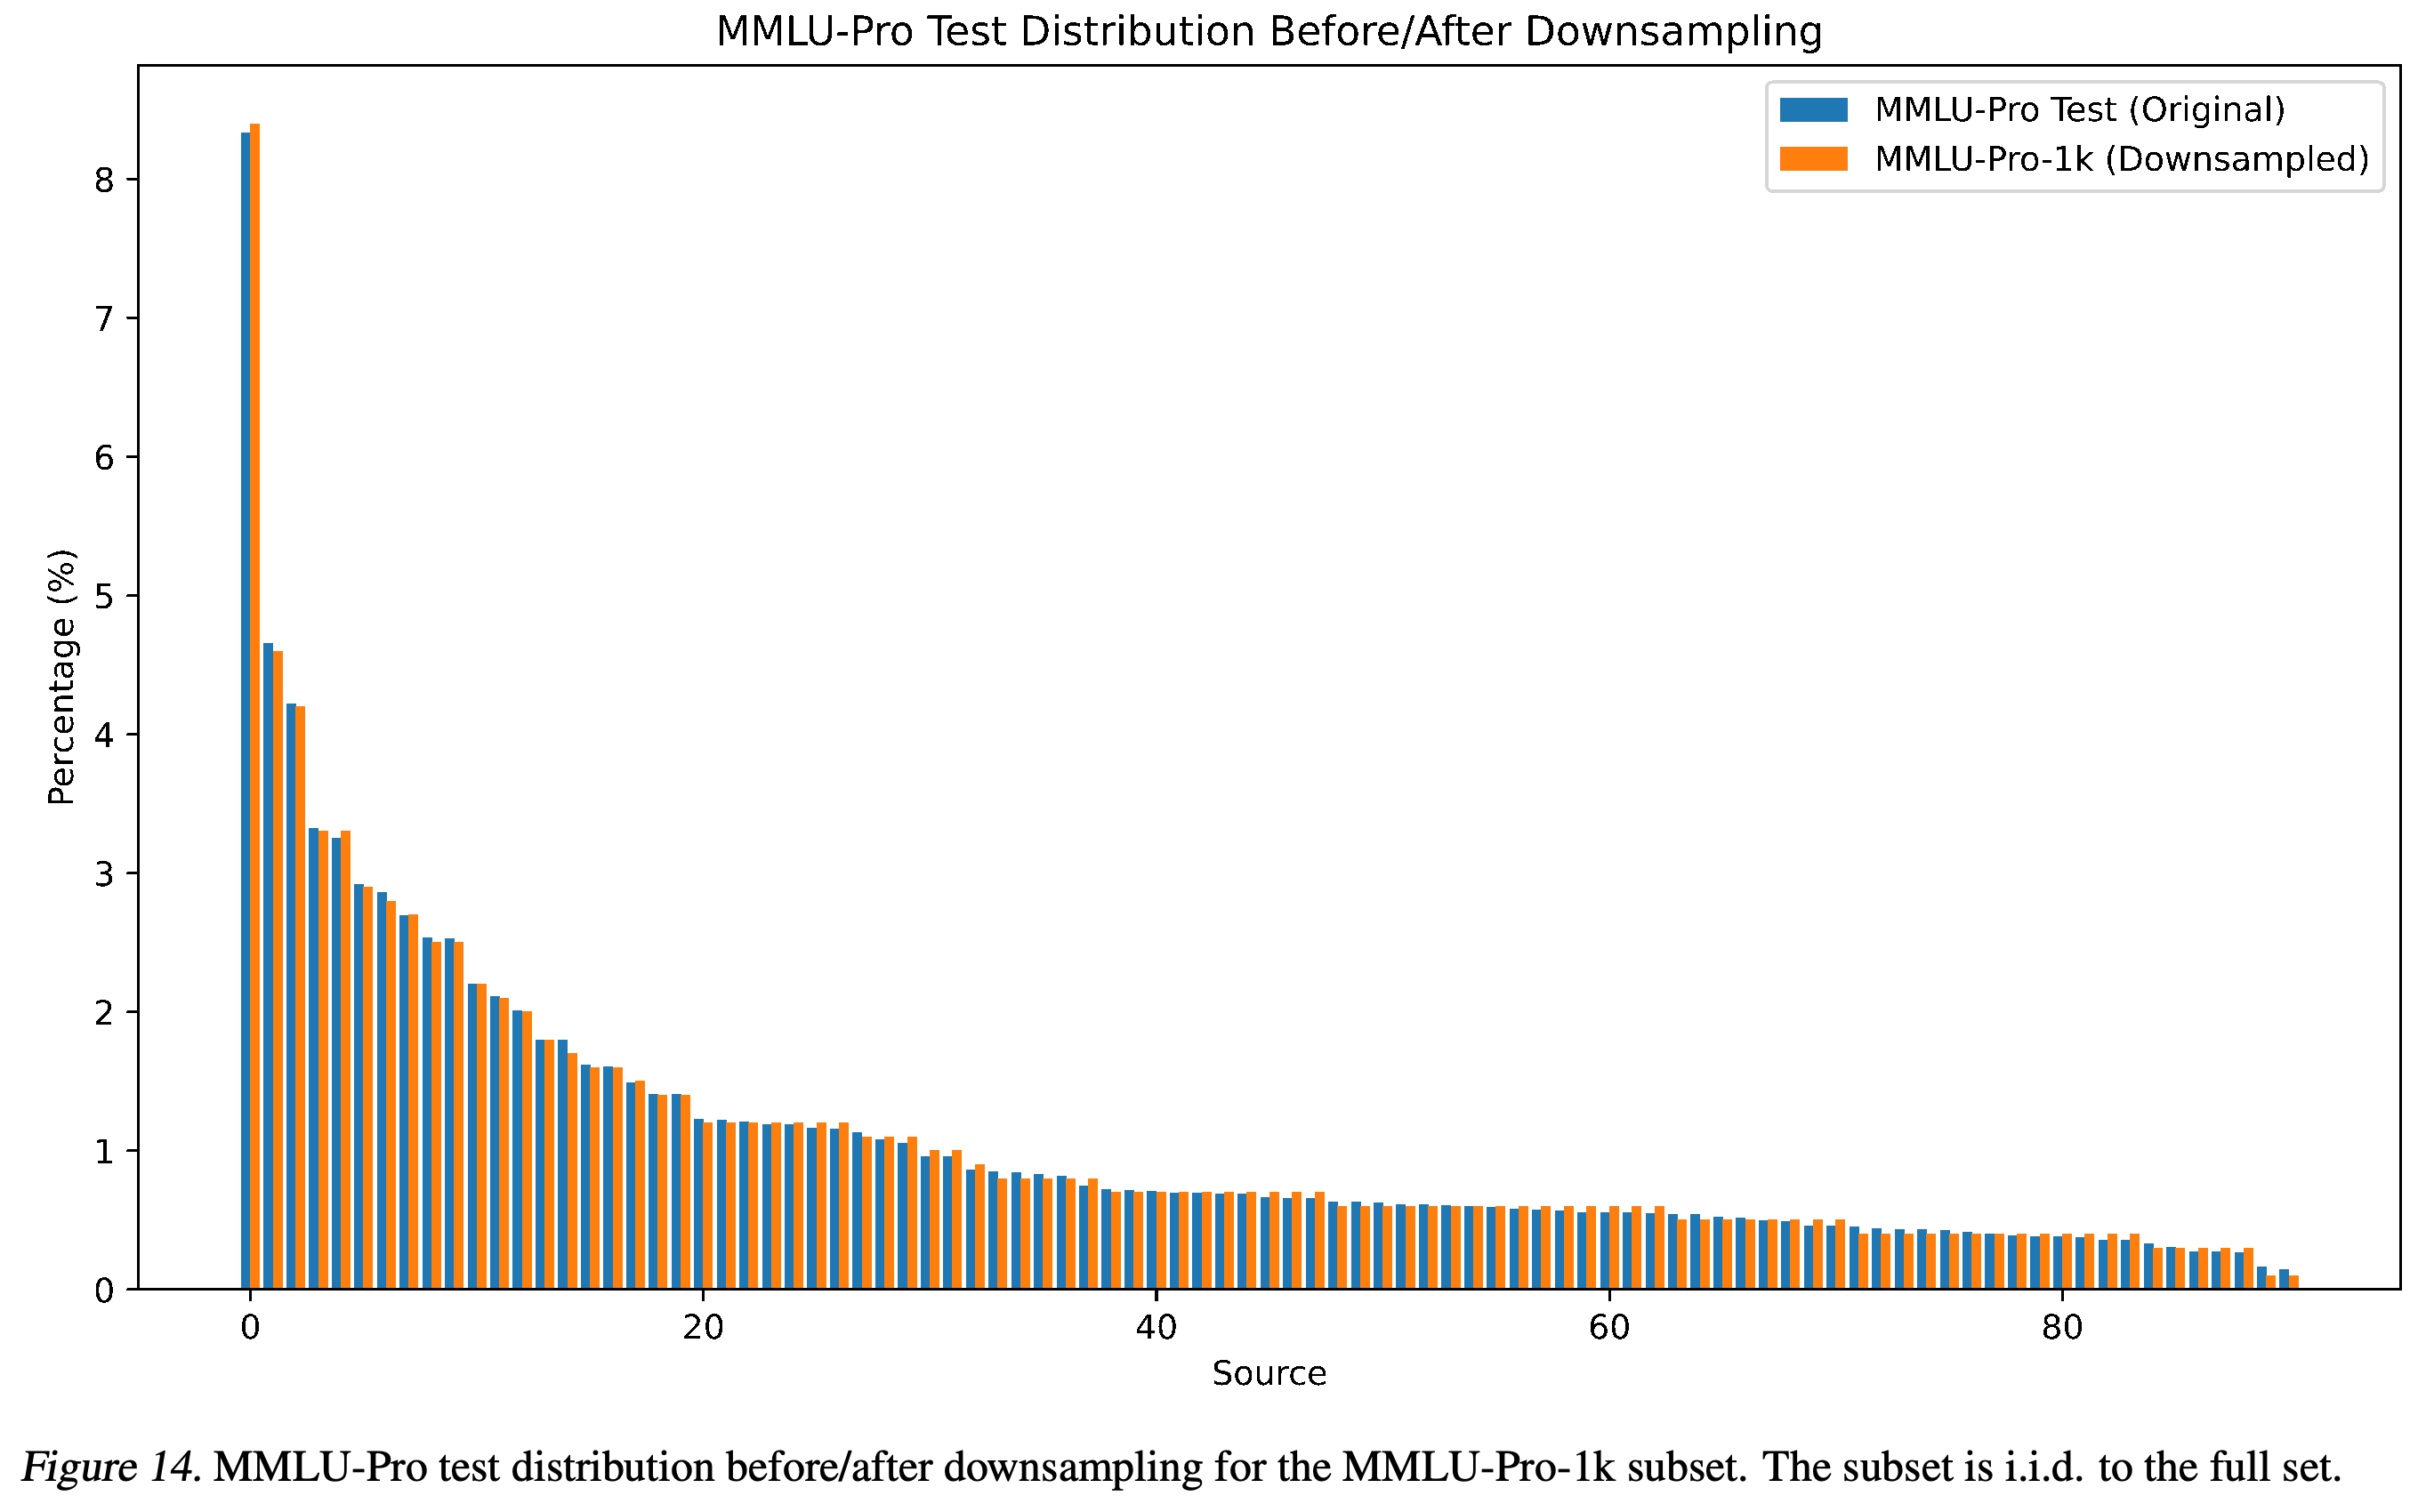
원본과 축소한 부분집합의 출처별 빈도 막대가 매우 비슷해, MMLU-Pro-1k의 분포를 유지하려던 의도를 뒷받침한다. 이 결과는 부분집합의 구성을 확인하며, 전체 벤치마크와 평가 불확실성까지 같다는 뜻은 아니다.
3. Impact of SFT on Long CoT
SFT 실험에서는 긴 추론 과정과 짧은 추론 과정을 독립적인 학습 목표와 RL 초기화에 각각 사용해 비교한다. 별도 실험에서는 수작업으로 순서를 구성한 추론 행동과 기존 long CoT 모델에서 증류한 추론 과정을 비교한다.
3.1. SFT Scaling
Llama-3.1-8B를 학습할 때 긴 추론 과정은 QwQ-32B-Preview에서, 짧은 추론 과정은 Qwen2.5-Math-72B-Instruct에서 얻는다. 거부 샘플링은 프롬프트마다 long CoT에 N ∈ {32, 64, 128, 192, 256}개의 후보를, short CoT에 N ∈ {32, 64, 128, 256}개의 후보를 사용해 SFT에 활용할 토큰 수를 늘린다.
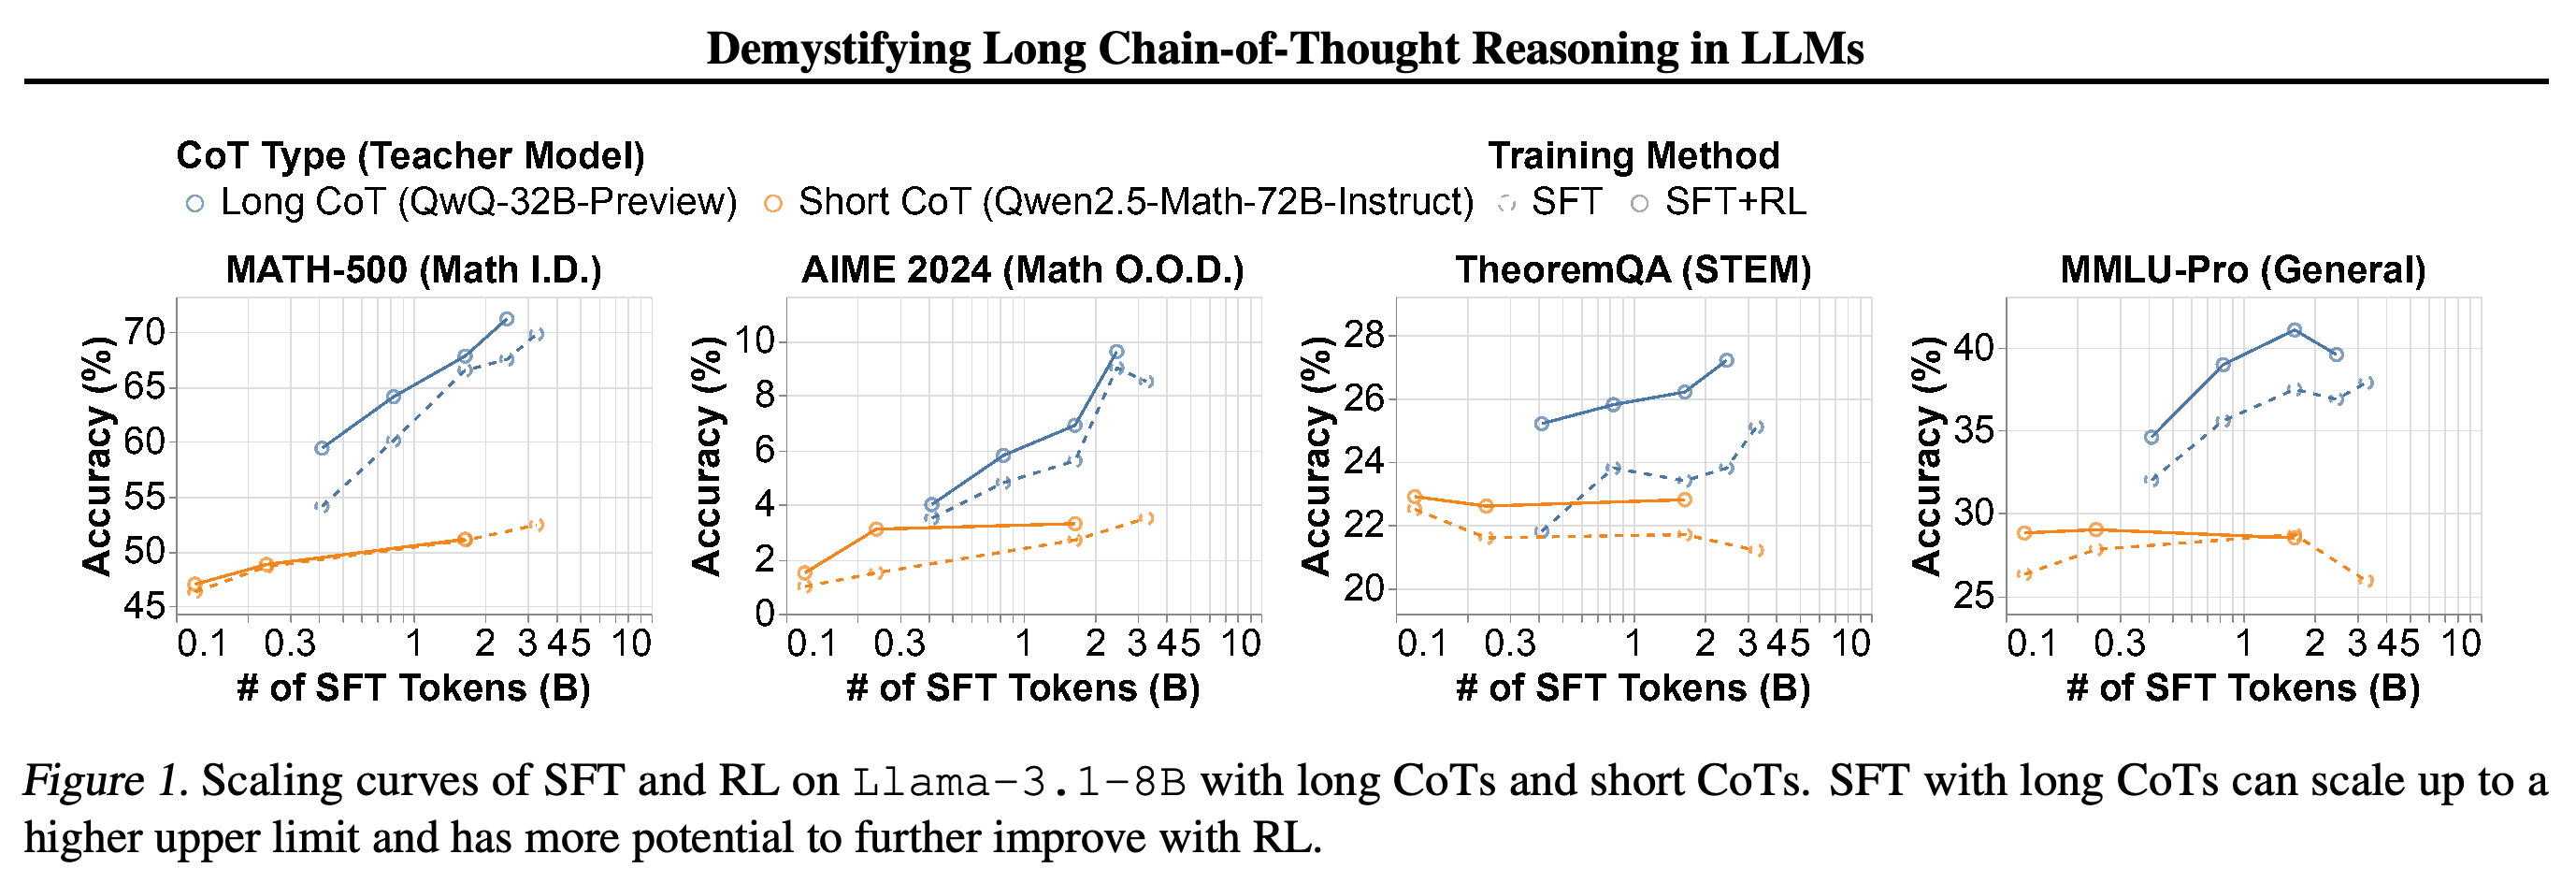
- Figure 1에서는 long CoT 학습의 성능이 계속 높아지고, short CoT 학습은 규모 확대에 따른 개선이 더 작다. Section 3.1은 3.5B토큰에서도 성능이 정체되지 않고 MATH-500 정답률이 70%를 넘는다고 서술한다. 다만 그래프의 SFT 단독 곡선은 70% 미만이며, SFT+RL 곡선이 이를 넘는다.
- 이 비교에서는 추론 길이와 함께 교사 모델도 달라지므로, 길이만을 원인으로 분리해 볼 수는 없다.
3.2. SFT Initialization for RL
저자들은 앞선 SFT 체크포인트로 PPO를 초기화한 뒤 MATH 프롬프트 집합을 4회 순회한다. 프롬프트마다 응답 4개를 샘플링하며 Cosine Reward와 반복 페널티를 사용한다. Figure 1에서 long CoT SFT 이후 RL을 적용하면 MATH-500 정답률이 대체로 3%포인트 넘게 높아지지만, short CoT로 초기화했을 때는 개선이 작다.
벤치마크 4개에서 long CoT 곡선은 대체로 SFT 토큰이 늘어날수록 더 크게 개선되며, 후속 RL의 이득도 더 크다. 긴 추론과 짧은 추론은 서로 다른 교사 모델에서 얻으므로, 곡선만으로 응답 길이의 효과를 분리할 수 없다. 그래프의 SFT 단독 MATH-500 곡선도 해당 절에서 서술한 70% 초과 결과에 미치지 못한다.
3.3. Sources of Long CoT SFT Data
Action Prompting은 clarify, decompose, solution_step, reflection, answer 행동으로 추론 과정을 구성한다. Short CoT 모델이 행동 순서를 정하고 o1-mini-0912가 reflection 단계를 생성한다. 다른 방식은 QwQ-32B-Preview에서 추론 과정을 증류한다. 어느 방식이든 MATH 프롬프트, 거부 샘플링, 약 200k개의 SFT 샘플을 사용하며, 베이스 모델은 동일한 8B 모델인 Llama-3.1-8B다.
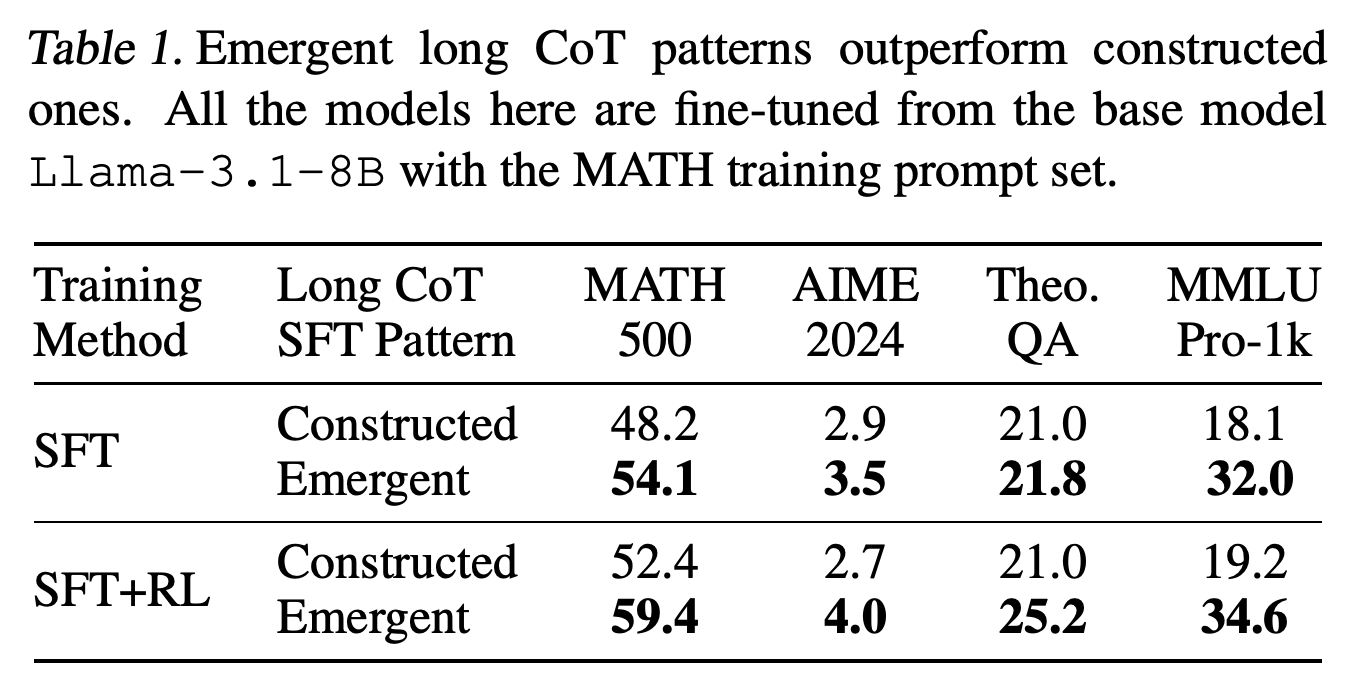
- Table 1에서는 증류 패턴이 더 우수하다. SFT 이후 MATH-500 정답률은 54.1%로, 인위적으로 구성한 추론 과정의 48.2%보다 높다. MMLU-Pro-1k 정답률도 32.0%로 18.1%보다 높다.
- RL 이후 증류한 추론 과정은 MATH-500, AIME 2024, TheoremQA, MMLU-Pro-1k에서 각각 59.4%, 4.0%, 25.2%, 34.6%를 달성한다. 인위적으로 구성한 추론 과정은 52.4%, 2.7%, 21.0%, 19.2%를 기록해, RL의 개선 폭이 더 작고 일관성도 낮다.
증류 패턴은 RL 전후 모두에서 인위적으로 구성한 행동 시퀀스보다 우수하다. 특히 RL 이후 MMLU-Pro-1k 점수는 34.6%와 19.2%로 차이가 크다. 다만 인위적으로 구성한 추론 과정도 MATH-500에서는 개선되므로, RL의 이득이 없는 것이 아니라 제한적이라고 볼 수 있다.
4. Impact of Reward Design on Long CoT
보상 설계 실험에서는 정답 여부, 응답 길이, 반복, 컨텍스트 한도, 이후 보상이 앞서 생성한 토큰에 영향을 주는 시간적 기여도 할당이 어떻게 상호작용하는지 살펴본다. 보상 조정으로 정답률을 유지하면서 응답 길이를 제어할 수 있는지 검증한다.
4.1. CoT Length Stability
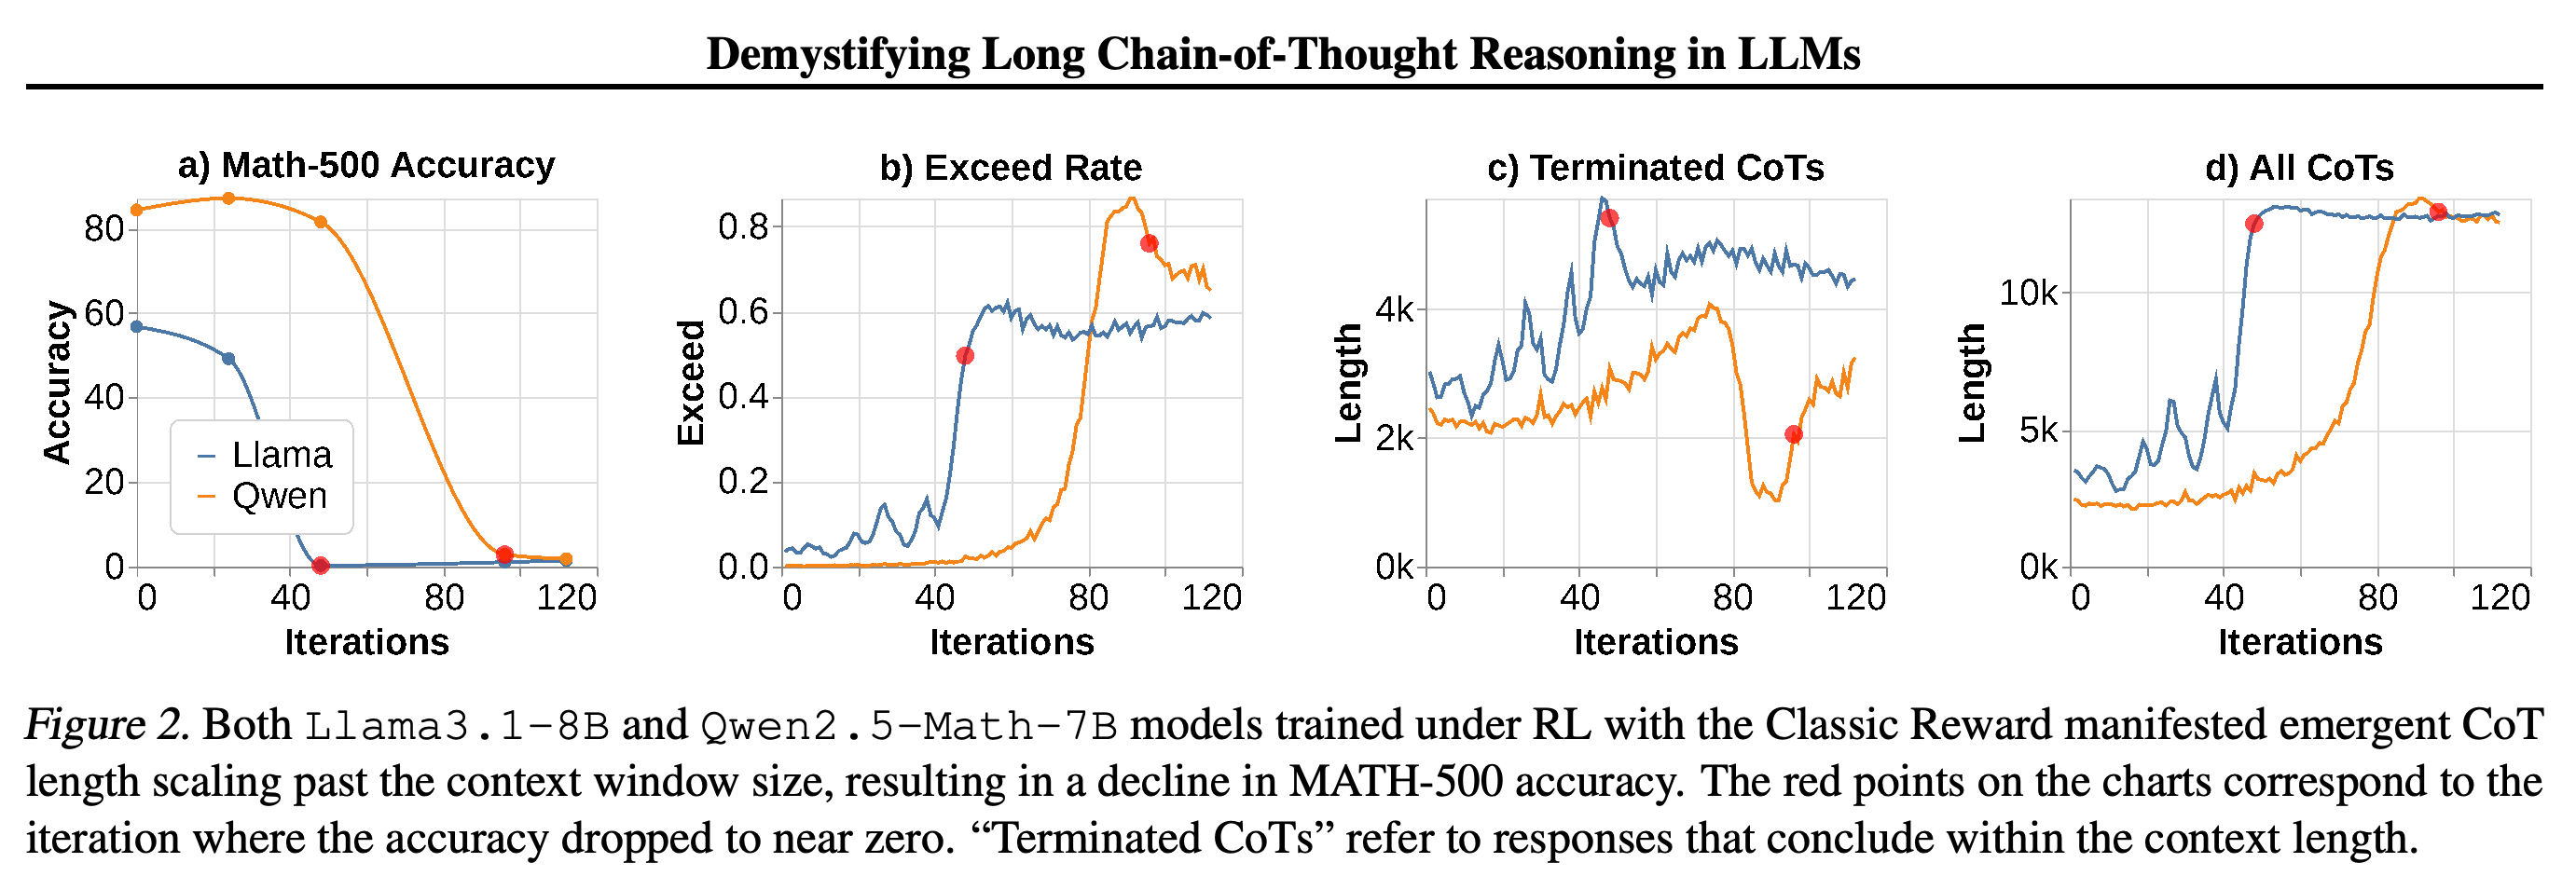
Long CoT SFT로 초기화하고 16K 컨텍스트 윈도우를 사용하면, Llama-3.1-8B와 Qwen2.5-Math-7B는 모두 정답에 1의 보상을 주는 Classic Reward에서 불안정해진다. Figure 2에서는 컨텍스트 한도 초과가 늘고 MATH-500 정답률이 거의 사라질 만큼 낮아진다. Llama-3.1-8B는 길이 변동이 더 크다.
- 컨텍스트 한도 초과 비율은 1 미만에서 안정된다. 저자들은 이를 과도한 길이를 억제하는 암묵적 압력으로 해석한다. 별도 페널티가 없어도 보상이나 어드밴티지를 정규화하면서 이러한 압력이 생길 수 있다는 설명이다. 어드밴티지는 행동이 기대 가치보다 얼마나 유리한지를 추정한 값이다.
초기화한 모델 2개 모두 Classic Reward에서 응답이 지나치게 길어지고, 컨텍스트 한도 초과가 늘며 MATH-500 정답률이 0에 가까워진다. 종료된 응답과 전체 응답을 나누어 보면, 완료된 출력만 집계하는 통계가 이러한 실패를 가릴 수 있는 이유가 드러난다.
4.2. Active Scaling of CoT Length
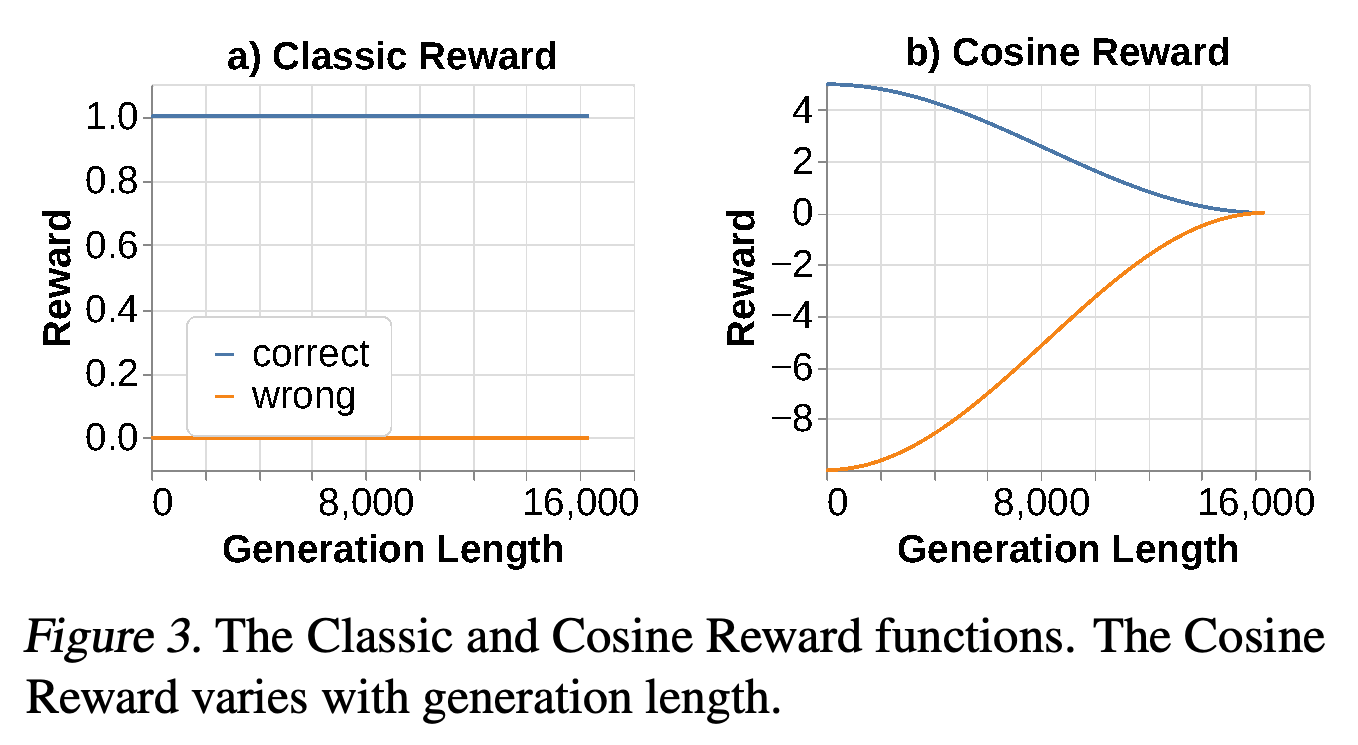
Cosine Reward는 오답보다 정답에 높은 보상을 주고, 짧은 정답 응답을 선호하며, 긴 오답 응답보다 짧은 오답 응답에 더 큰 페널티를 준다. 정답 여부와 생성 길이를 기준으로 종료 시점에 보상을 1개 부여하며, 생성이 최대 길이에 도달하면 별도 페널티를 준다.
- Figures 3과 4는 보상이 길이에 따라 어떻게 달라지고 Llama-3.1-8B를 어떻게 안정화하는지 보여 준다. Classic Reward에서는 학습이 붕괴하지만, Cosine Reward에서는 정답률과 응답 길이가 더 안정적으로 유지된다.
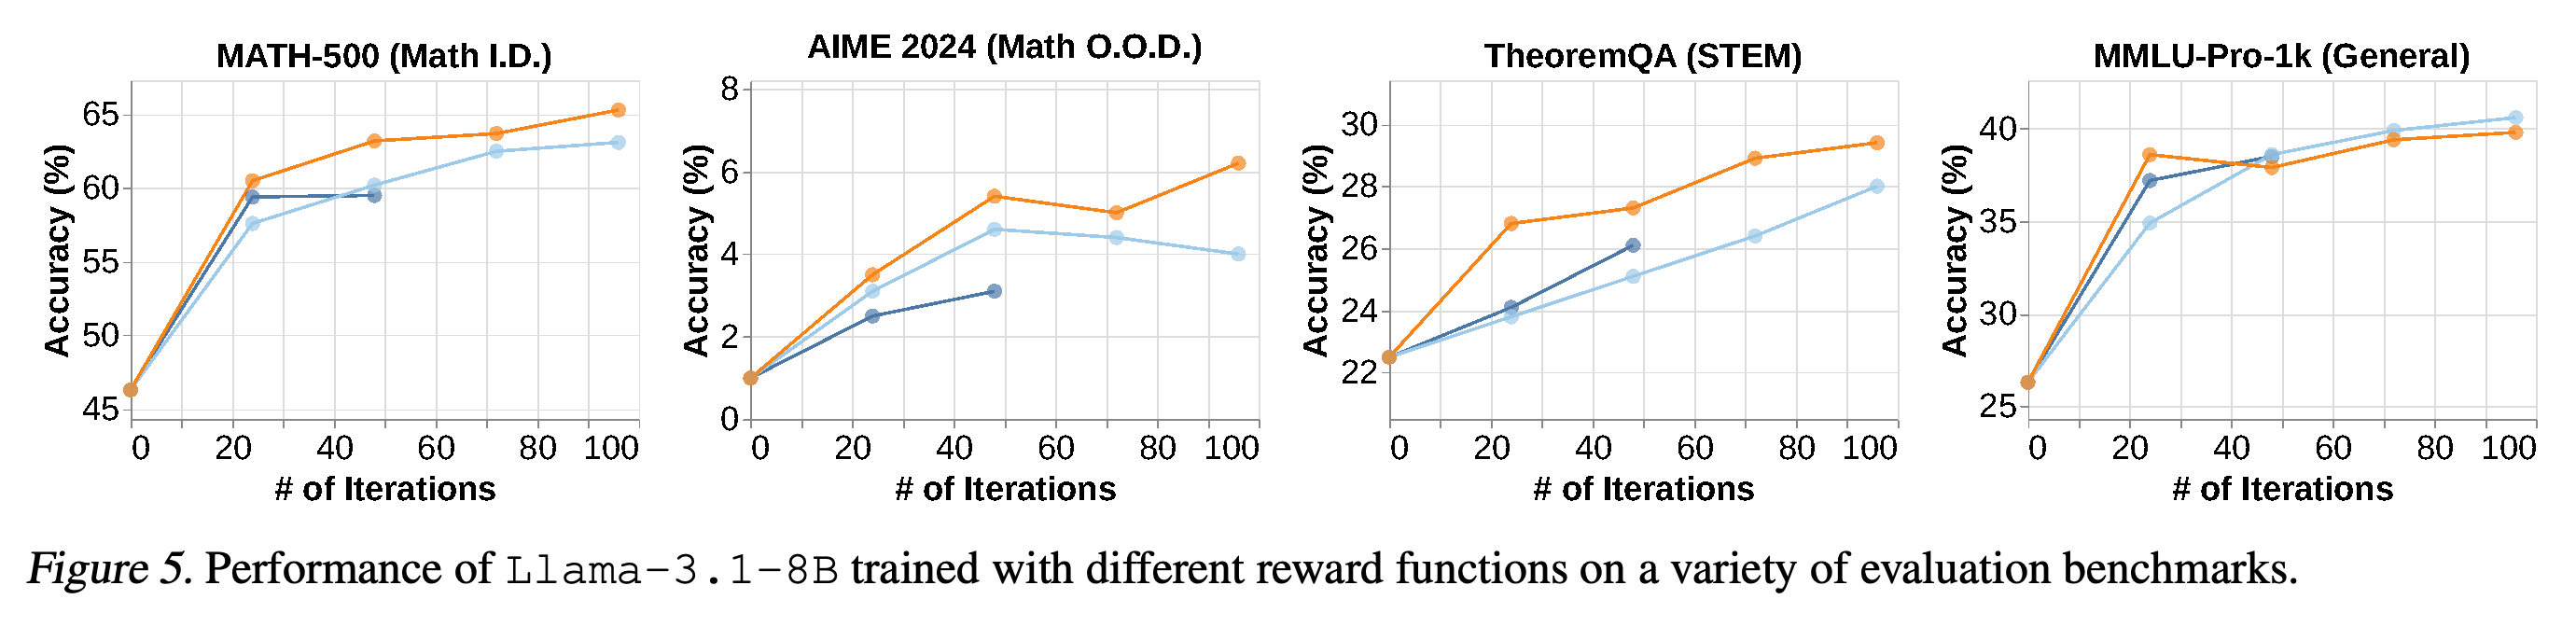
- Figure 5에서는 후속 평가 성능이 개선되며, Cosine Reward에 반복 페널티를 결합하면 여러 벤치마크에서 추가 이득을 얻는다.
Classic Reward는 응답 길이를 구분하지 않는다. 그래프의 Cosine Reward는 짧은 정답 응답을 선호하면서 짧은 오답 응답에 더 큰 비용을 부과한다. 중간 추론 단계에 대한 주석 없이도 길이에 따른 유인을 제공한다.
4.3. Cosine Reward Hyperparameters
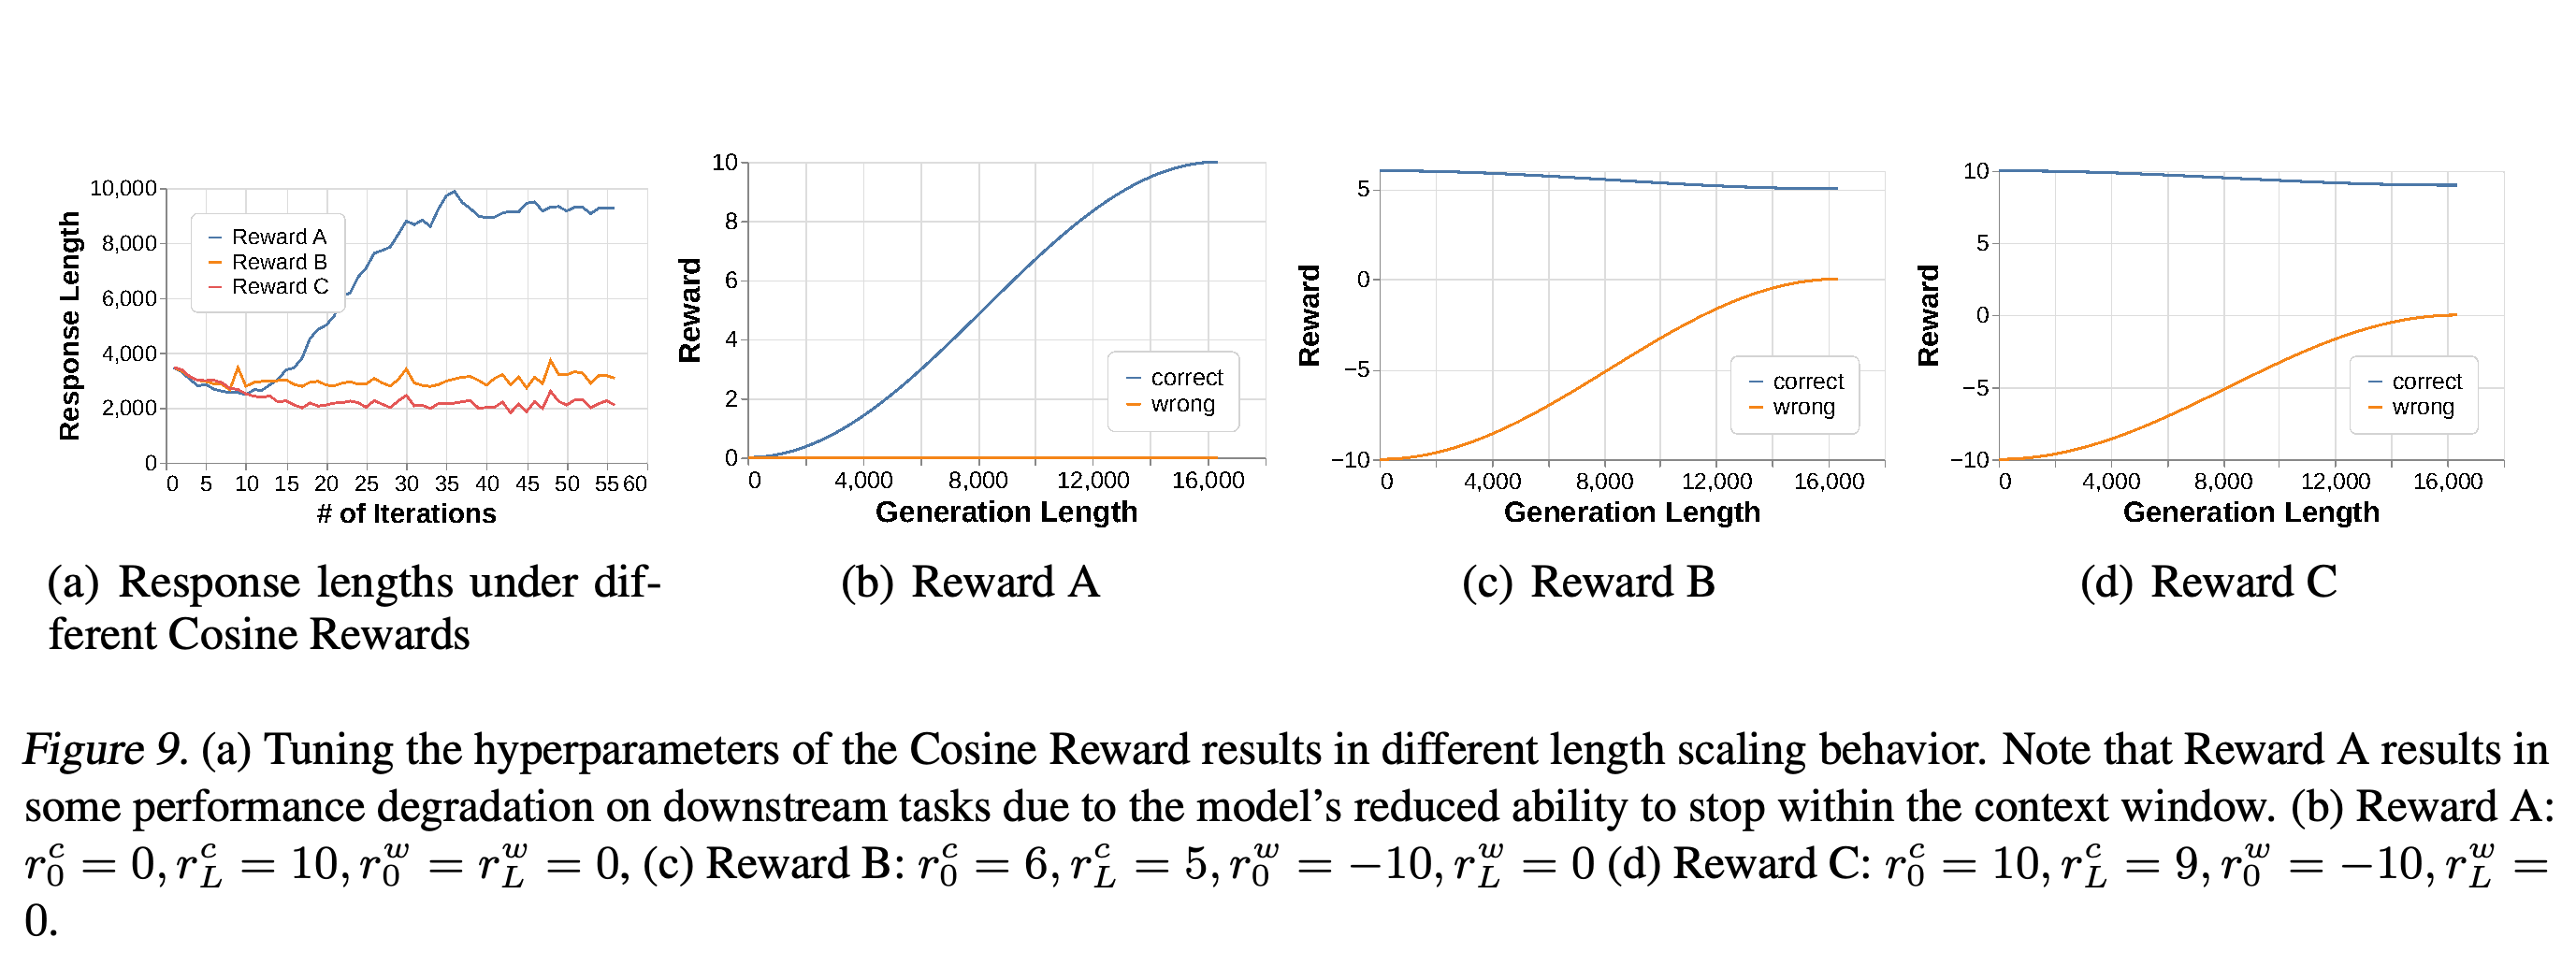
저자들은 생성 길이가 0일 때와 최대일 때의 정답 및 오답 보상을 바꾼다. Figure 9에서는 긴 정답 응답에 더 큰 보상을 주면 길이가 급격히 늘고 컨텍스트 윈도우 안에서 종료하기 어려워진다. 실험한 설정에서는 오답 페널티를 고정한 채 정답 보상을 높이면 추론 과정이 짧아진다.
- 이를 학습된 위험 회피로 해석하는 것은 가설로 남는다. 보상 비율은 모델이 추론을 마치고 답변하기 전에 어느 정도 확신을 가져야 하는지에 영향을 줄 수 있다.
Reward A는 길이에 따라 정답 보상을 높이며 응답 길이를 급격히 늘린다. Rewards B와 C는 짧은 정답을 선호하고 길이를 더 짧게 유지한다. 이는 보상 끝점이 종료 행동에 영향을 준다는 점을 보여 준다.
4.4. Context Window Size
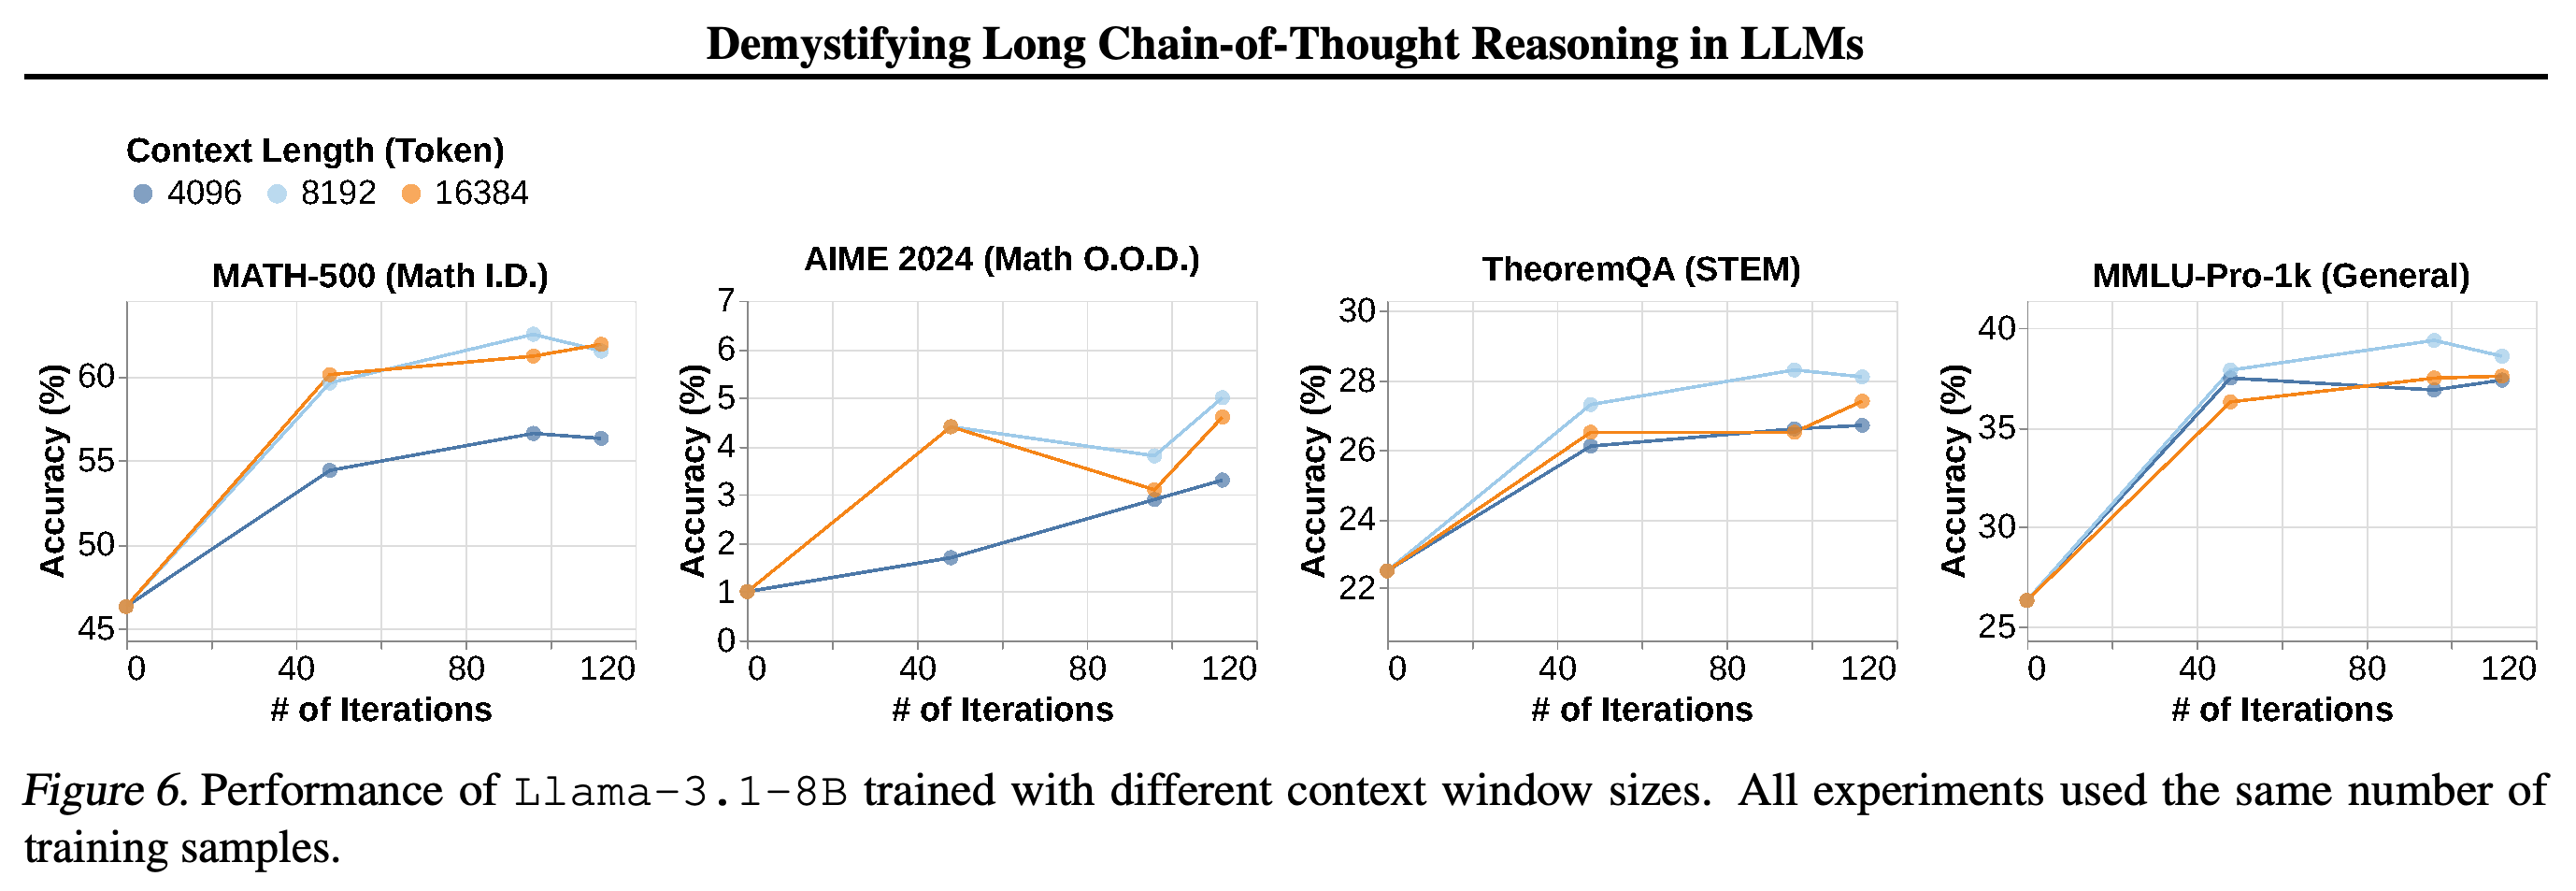
컨텍스트 윈도우 제거 실험에서는 동일한 8B 초기 모델인 Llama-3.1-8B, MATH 프롬프트, Cosine Reward, 반복 페널티, 학습 샘플 수를 유지하면서 4K, 8K, 16K 윈도우를 비교한다. Figure 6에서 8K는 4K보다 성능이 높고, 고정된 샘플 예산에서는 대체로 16K보다도 우수하다.
- 저자들은 큰 윈도우를 효과적으로 사용하려면 학습 샘플이 더 많이 필요할 수 있다고 제안한다. 이 실험으로는 16K가 더 유리해지려면 학습을 얼마나 추가해야 하는지 알 수 없다.
학습 샘플 수가 같을 때 8192토큰 설정은 대체로 4096토큰보다 우수하고, 16384토큰보다도 나은 경우가 많다. 따라서 이 샘플 예산에서는 컨텍스트 윈도우가 크다고 항상 정답률이 높아지는 것은 아니다.
4.5. Length Reward Hacking
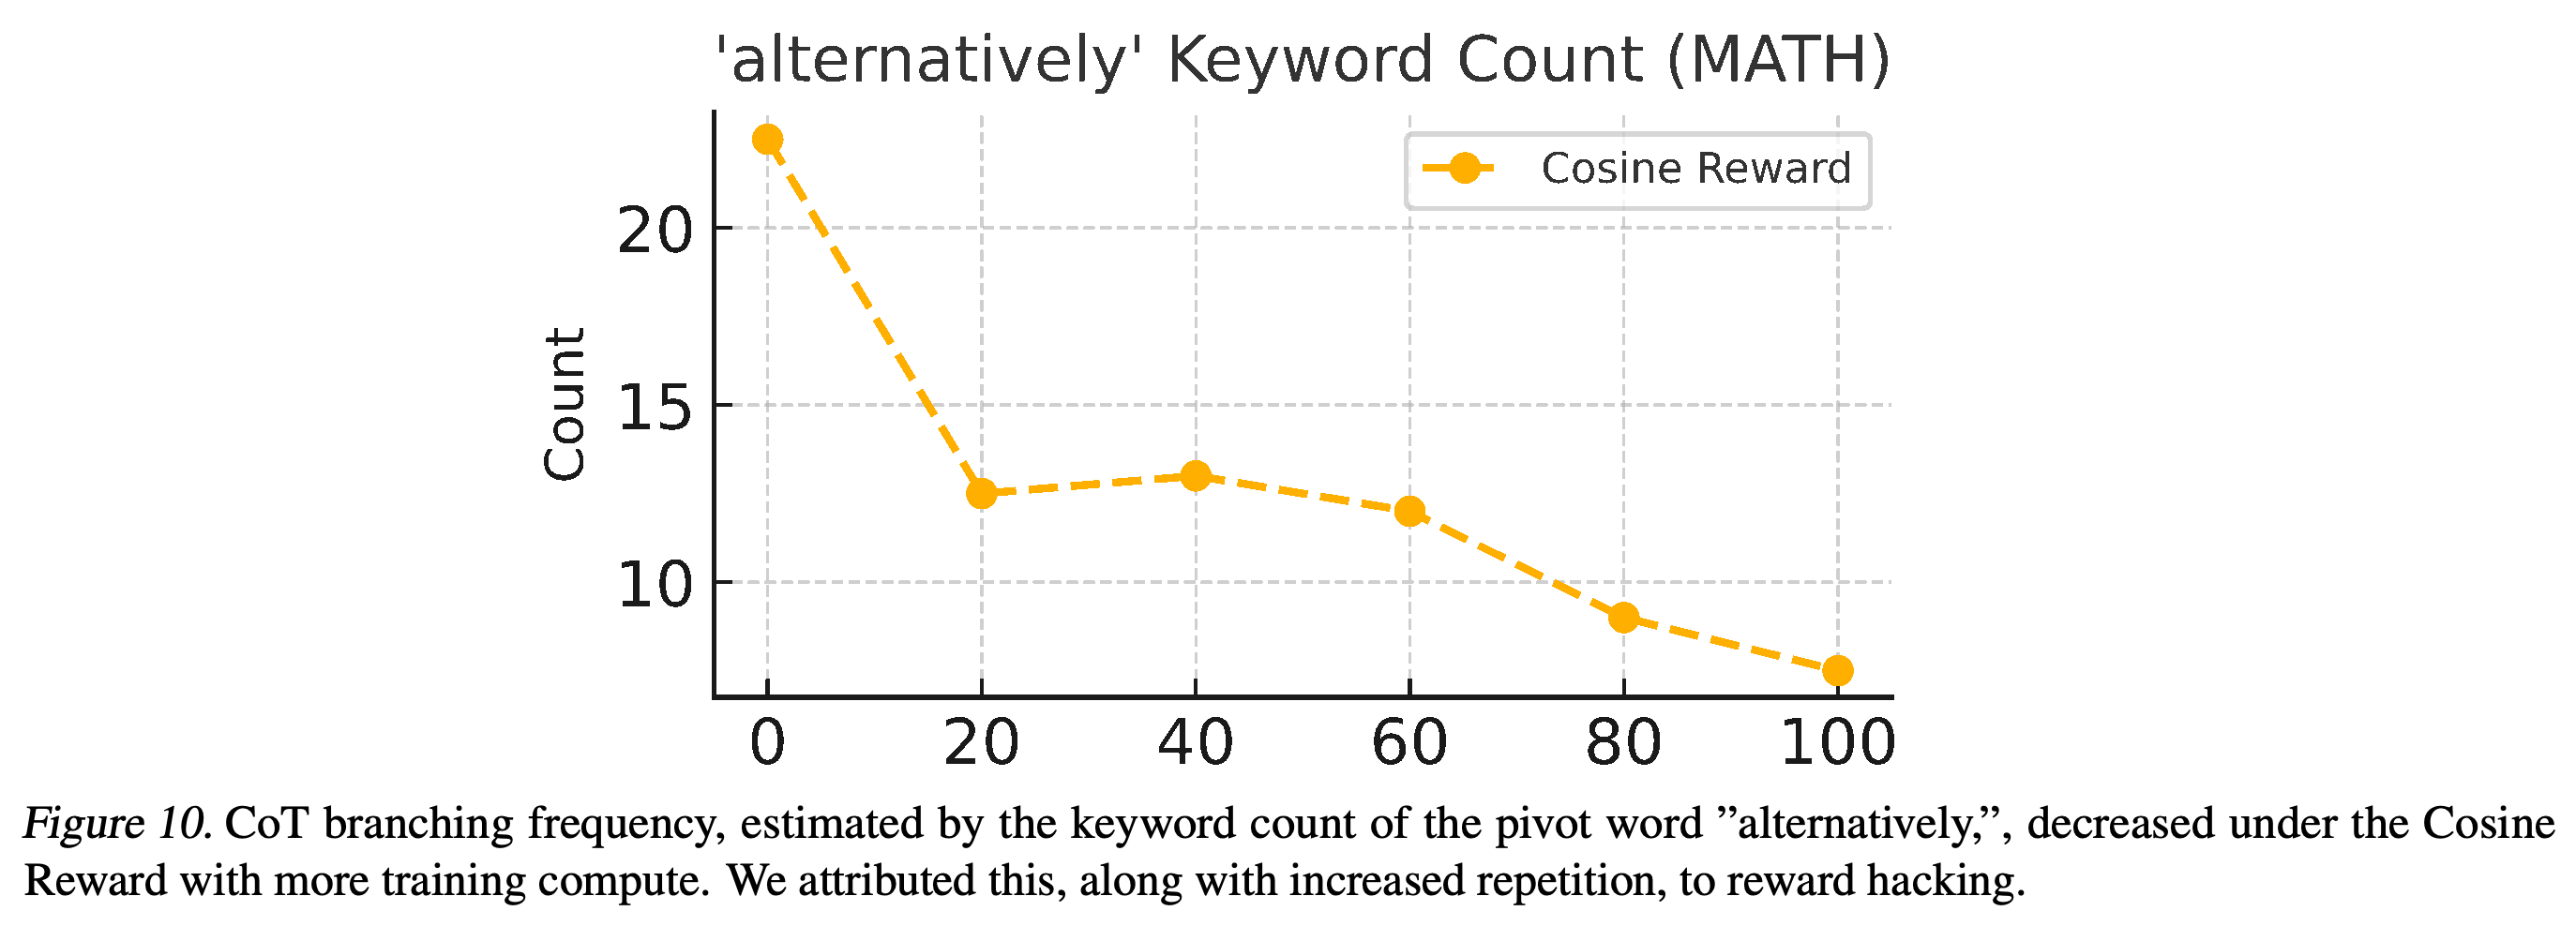
길이에 따라 조정한 보상으로 오래 학습하면, 모델이 어려운 응답에서 텍스트를 반복해 길이를 늘리는 경우가 있다. 이는 의도한 행동을 개선하지 않고 보상을 이용하는 보상 해킹에 해당한다. 저자들은 분기의 간접 지표로 사용한 “alternatively”의 출현도 줄어드는 현상을 관찰한다.
- N개의 토큰 시퀀스가 반복되면 페널티를 주는 N-gram 반복 페널티를 반복 토큰에 직접 적용한다. 페널티를 할인해 더 멀리 떨어진 이전 토큰에 미치는 영향을 줄이면 학습 신호를 해당 위치에 집중하는 데 도움이 된다.
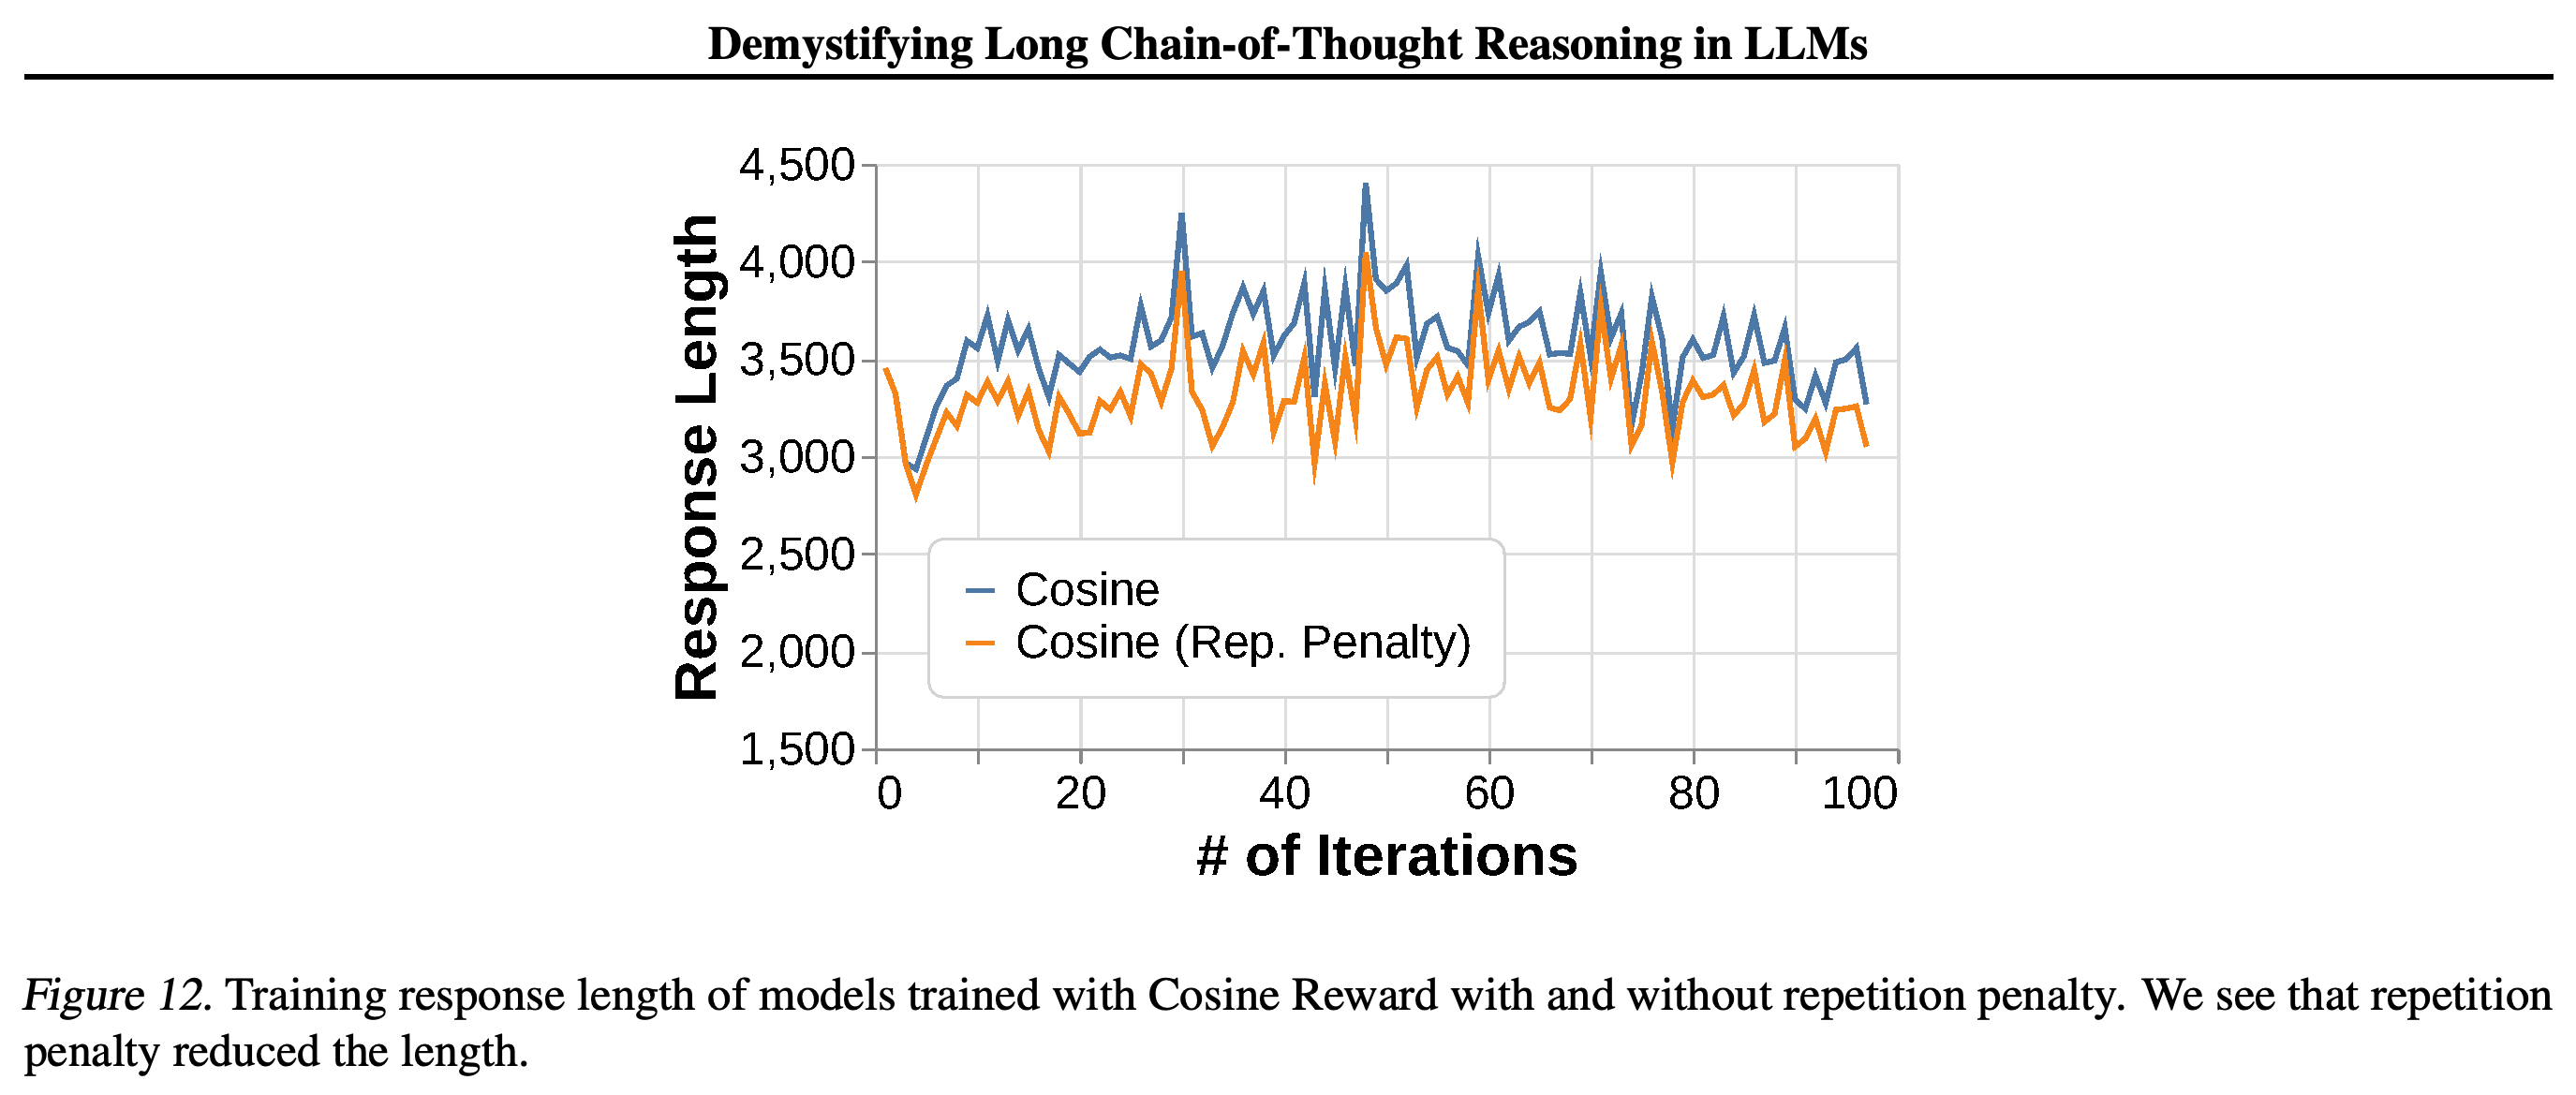
- Figures 5와 12에서는 여러 후속 과제의 점수가 높아지고 응답이 짧아진다. 저자들은 Cosine Reward에서 학습 정답률이 낮을수록 반복을 유도하는 압력이 커질 수 있다고 보고한다.
Cosine Reward는 Classic Reward 실행을 넘어 후속 평가 성능을 계속 높인다. 반복 페널티를 추가하면 MATH-500, AIME 2024, TheoremQA가 대체로 개선되지만, 최종 MMLU-Pro-1k 결과는 Cosine Reward만 사용한 곡선보다 조금 낮다.
Cosine Reward만 사용한 학습에서는 “alternatively,”의 출현 횟수가 줄어든다. 저자들은 관찰된 반복 현상과 함께 이를 보상 악용에 대한 우려의 근거로 삼는다. 다만 이 키워드는 분기의 간접 지표다.
반복 페널티를 적용한 응답 길이 곡선은 대체로 Cosine Reward만 사용한 곡선보다 낮다. 이는 실험한 페널티가 생성 길이를 줄인다는 점을 뒷받침하지만, 그 자체로 남은 추론의 품질을 측정하지는 않는다.
4.6. Optimal Discount Factors
저자들은 생성 행동에 대한 보상 기반 학습 신호를 계산하는 일반화 어드밴티지 추정(GAE)을 수정해, 보상 유형마다 별도 할인율을 적용한다. \(\lambda=1\)일 때 추정식은 \(\hat A_t=\sum_{l=0}^{L}\sum_{m=1}^{M}\gamma_m^l r_{m,t+l}-V(s_t)\)이다. 여기서 γm은 미래 단계에 걸쳐 보상 유형 m을 할인하며, V(st)는 현재 상태의 추정 가치다.
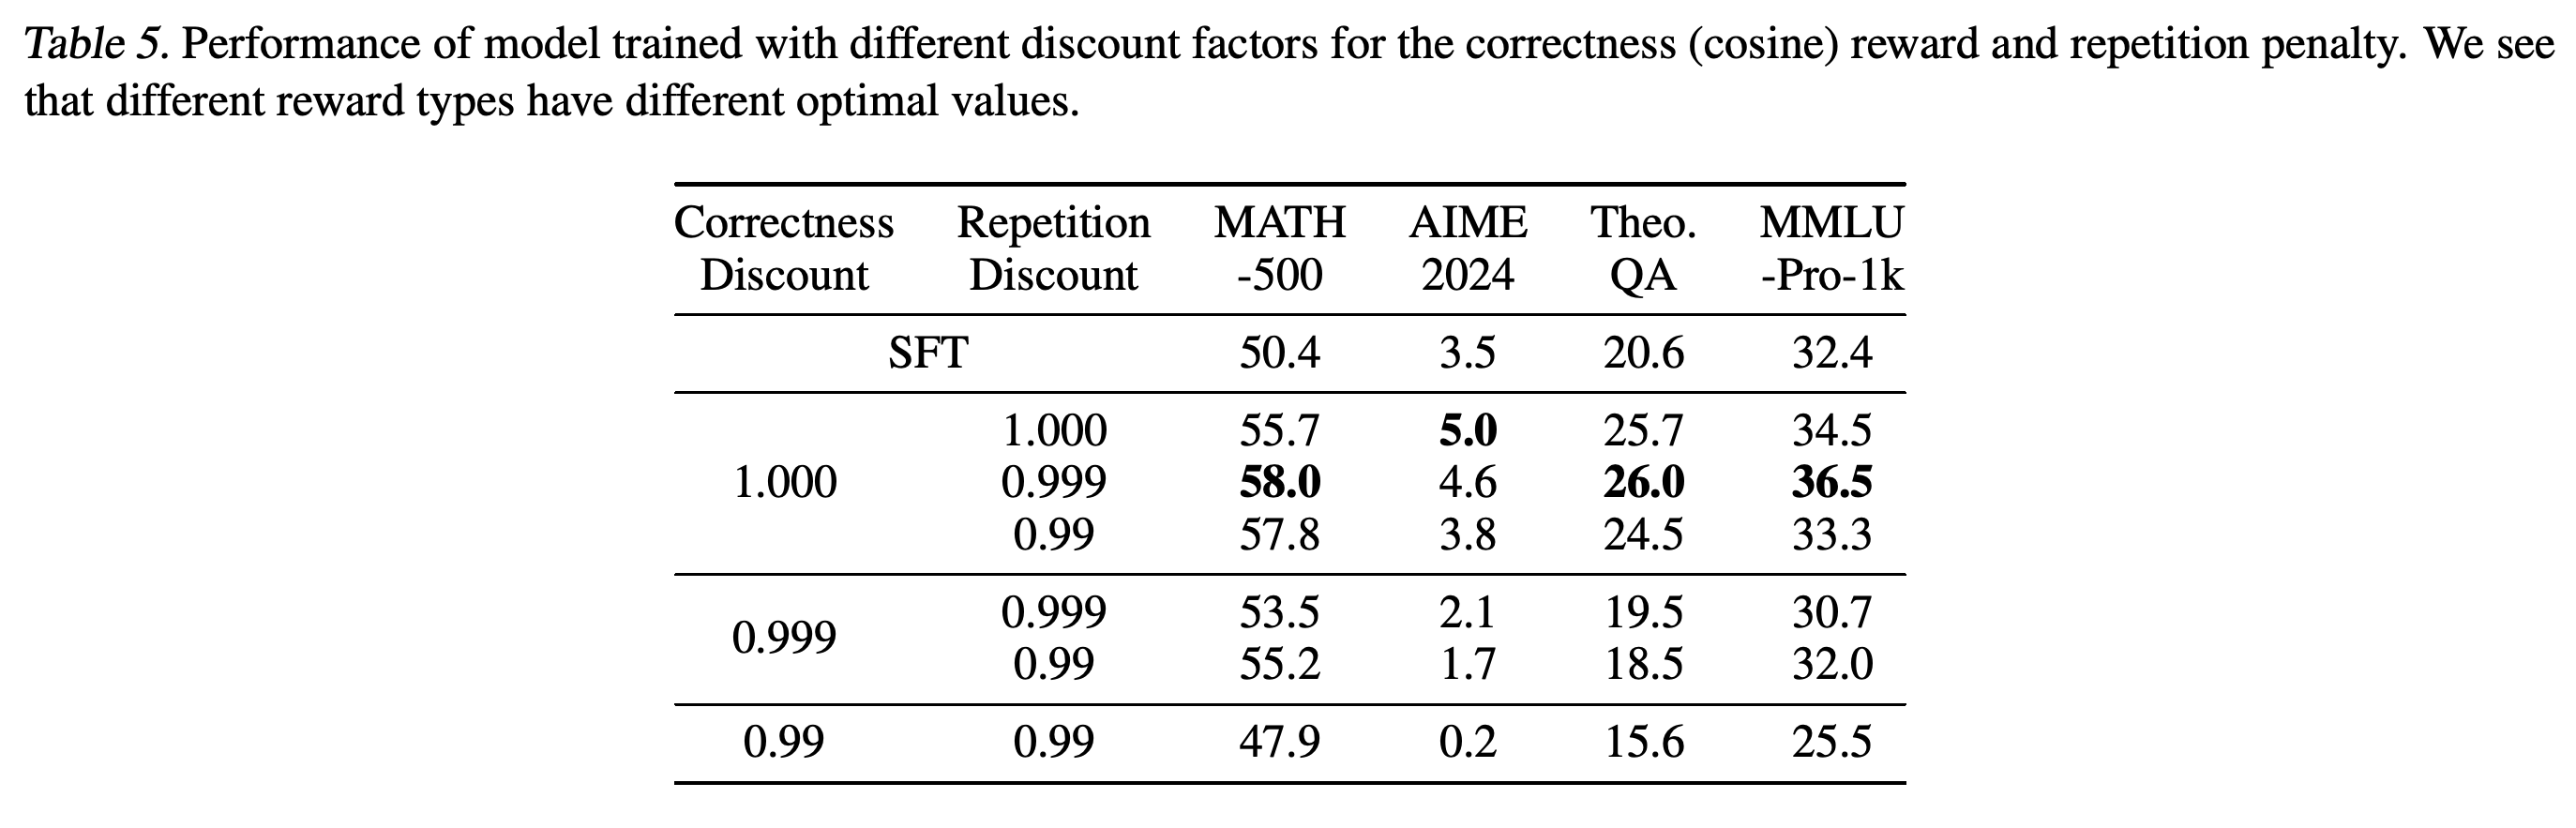
- Table 5에서는 정답 보상의 장기 기여도를 유지하면서 반복 페널티를 할인하는 설정이 유리하다. 정답 할인율 1.000과 반복 할인율 0.999를 사용하면 MATH-500에서 58.0%, TheoremQA에서 26.0%, MMLU-Pro-1k에서 36.5%를 달성한다.
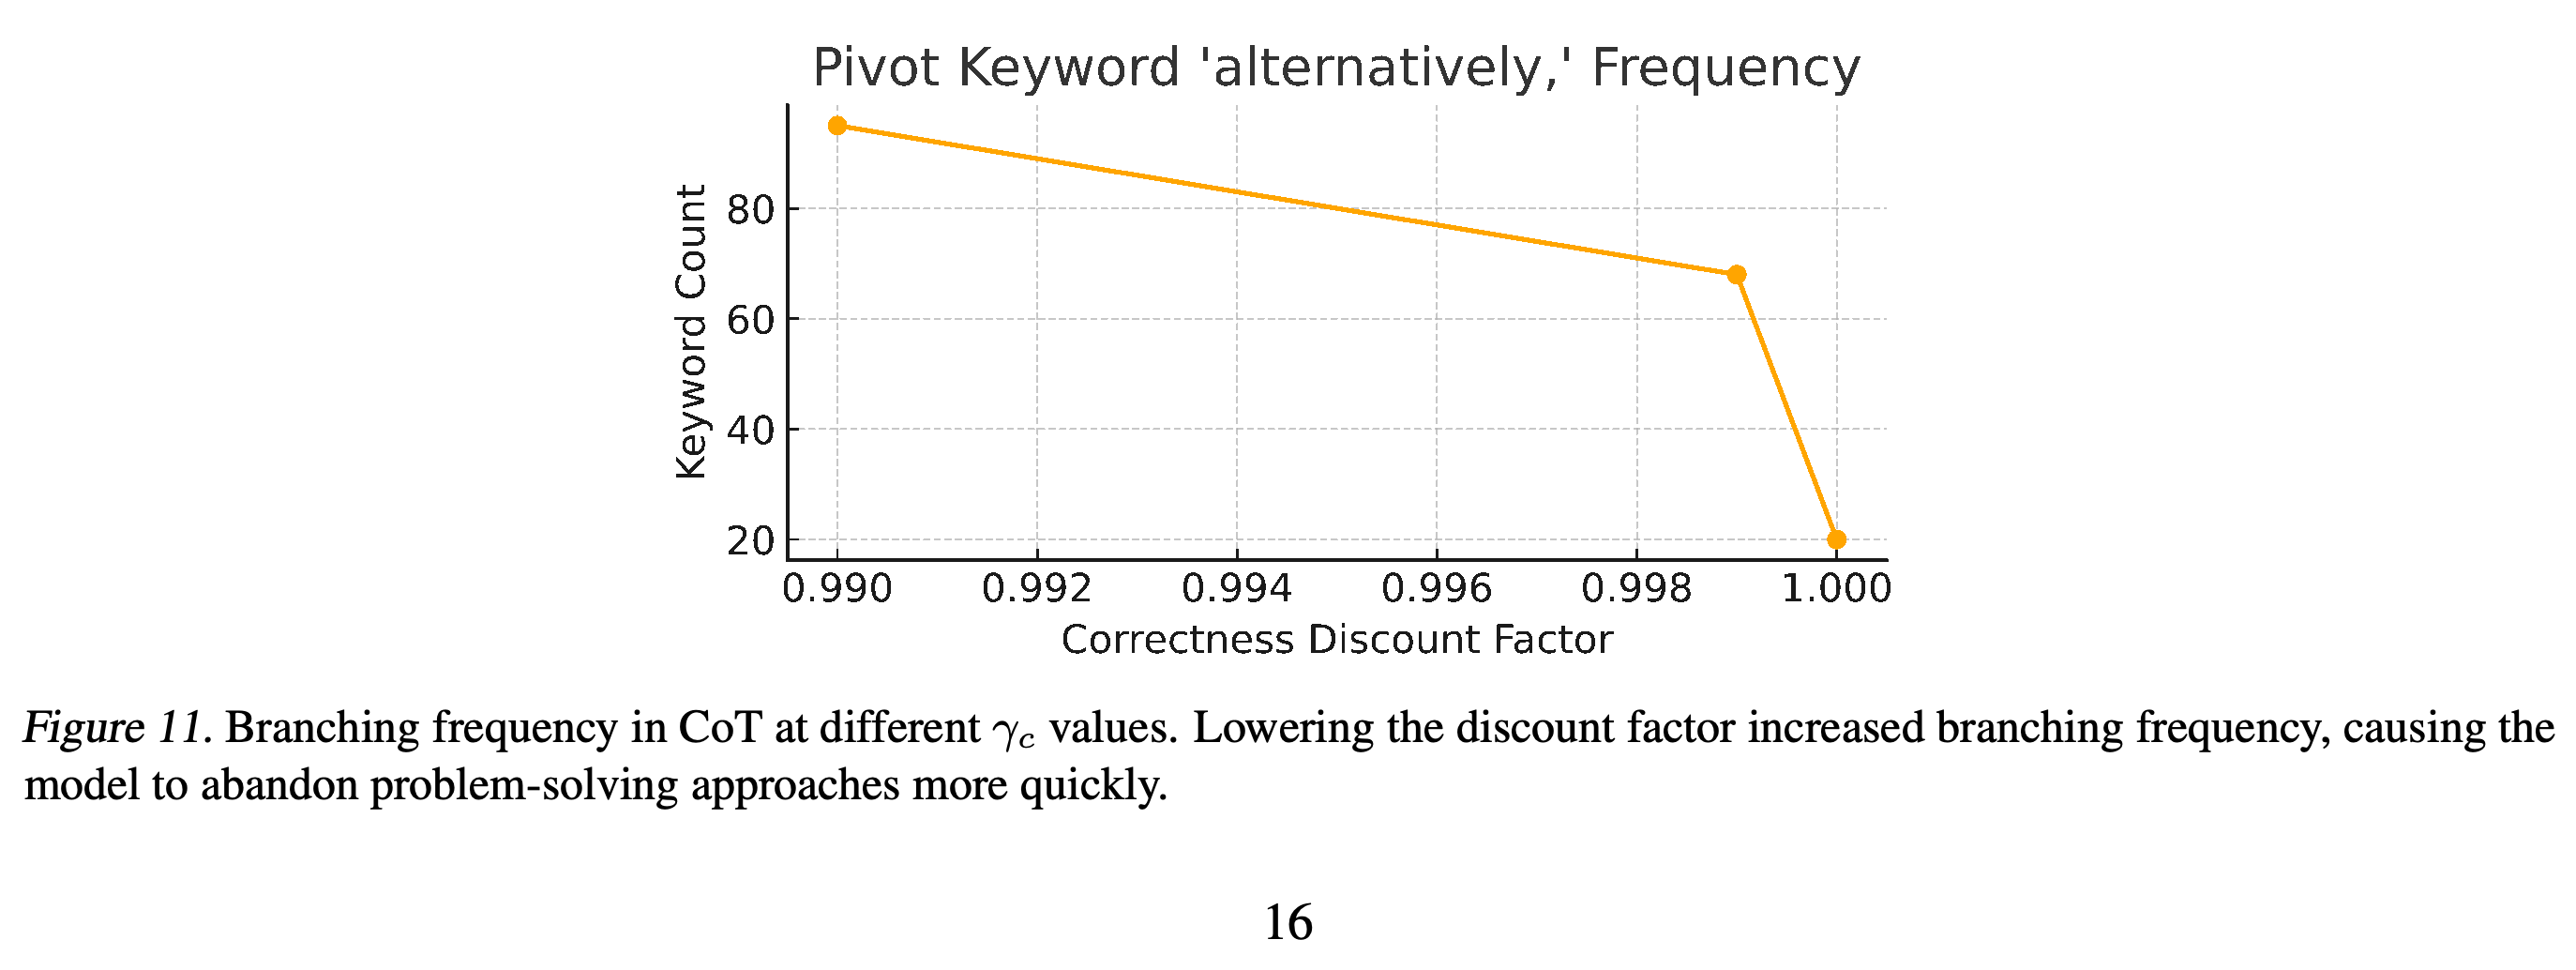
- 할인율 2개를 모두 0.99로 낮추면 해당 점수가 47.9%, 15.6%, 25.5%로 떨어진다. 정답 할인율을 낮췄을 때 “alternatively”가 더 자주 나타나지만 성능은 나빠지므로, 키워드 수만으로 탐색이 개선되었다고 볼 수는 없다.
정답 할인율이 낮을수록 분기 키워드가 더 자주 나타난다. Table 5의 낮은 정답률과 함께 보면, 명시한 접근법을 더 자주 전환하는 현상이 성능 저하와 함께 나타날 수 있음을 보여 준다.
정답 할인율 1.000과 반복 할인율 0.999의 조합은 벤치마크 3개에서 가장 좋은 결과를 보이며, 할인율 2개를 모두 1.000으로 설정하면 AIME 2024 결과가 가장 좋다. 정답 할인율을 낮추면 성능이 크게 떨어지므로, 이 실험은 보상 유형을 따로 다루는 방식을 뒷받침한다.
5. Scaling up Verifiable Reward
저자들은 부족한 사람 주석 참조 정답에 대한 의존도를 줄이기 위해, 웹에서 추출한 WebInstruct의 추론 질문과 답변 쌍을 조사한다. 여기서는 중복 제거에 사용하는 알고리즘인 MinHash로 WebInstruct-462k를 만들고, 노이즈가 더 많은 이 데이터를 SFT와 RL에서 시험한다.
5.1. SFT with Noisy Verifiable Data
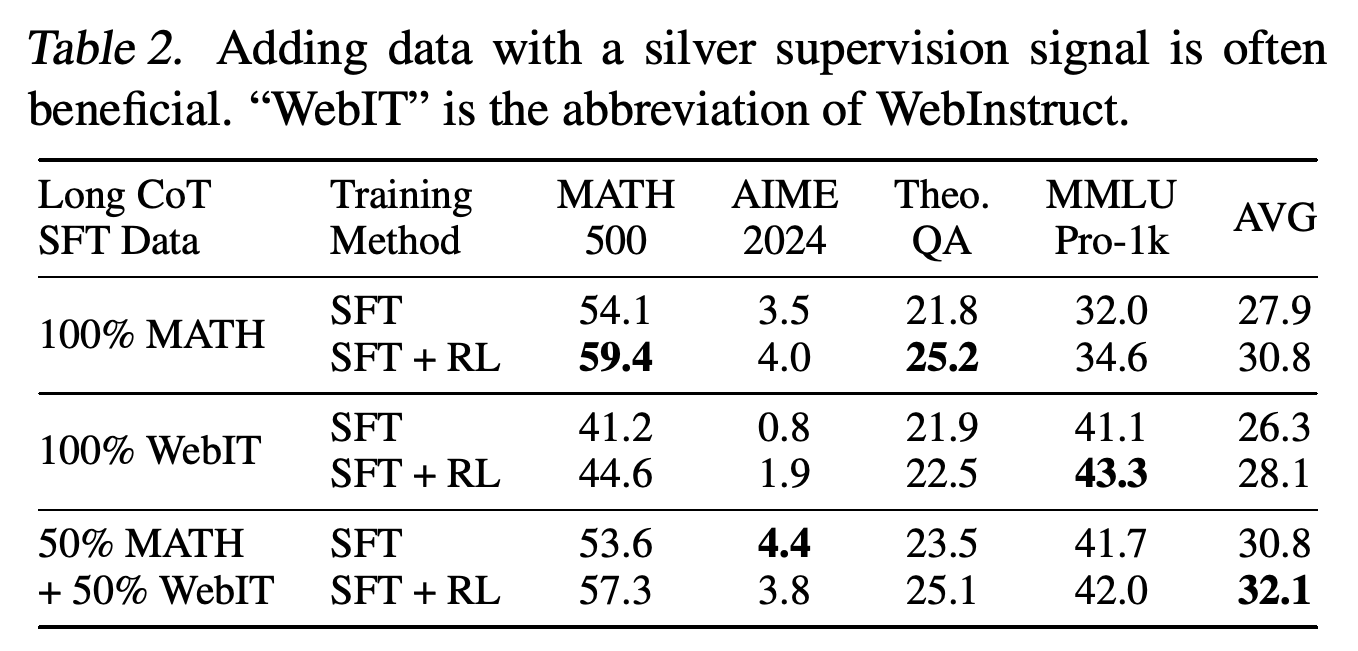
SFT에서는 MATH만 사용한 데이터, WebInstruct만 사용한 데이터, MATH 약 50%와 WebInstruct 약 50%를 혼합한 데이터를 비교하며, 응답은 QwQ-32B-Preview에서 증류한다. MATH 응답은 참조 정답으로 필터링하지만, WebInstruct는 프롬프트마다 필터링하지 않은 교사 응답 1개를 제공한다. 후속 RL에는 MATH를 사용한다.
- Table 2에서 혼합 데이터의 평균 정답률이 가장 높다. SFT 이후에는 30.8%, SFT+RL 이후에는 32.1%이며, MATH만 사용하면 각각 27.9%, 30.8%다. WebInstruct만 사용한 학습은 평균 점수가 MATH만 사용한 학습보다 낮으므로, 노이즈가 있는 데이터를 추가하는 것이 항상 유리하지는 않다.
- 혼합 데이터를 사용하면 SFT의 MMLU-Pro-1k 정답률이 32.0%에서 41.7%로 높아지고, MATH-500 정답률은 54.1%에서 53.6%로 바뀐다. 본문에는 “510% absolute”라고 적혀 있지만, 표에서 이 비교의 증가 폭은 9.7%포인트다.
MATH와 WebInstruct를 혼합하면 SFT 이후와 RL 이후 모두 벤치마크 4개 평균이 가장 높다. WebInstruct만 사용한 학습은 일반 추론 점수를 높이지만, MATH만 사용한 학습보다 수학 점수와 평균이 낮다.
5.2. Scaling up RL with Noisy Verifiable Data
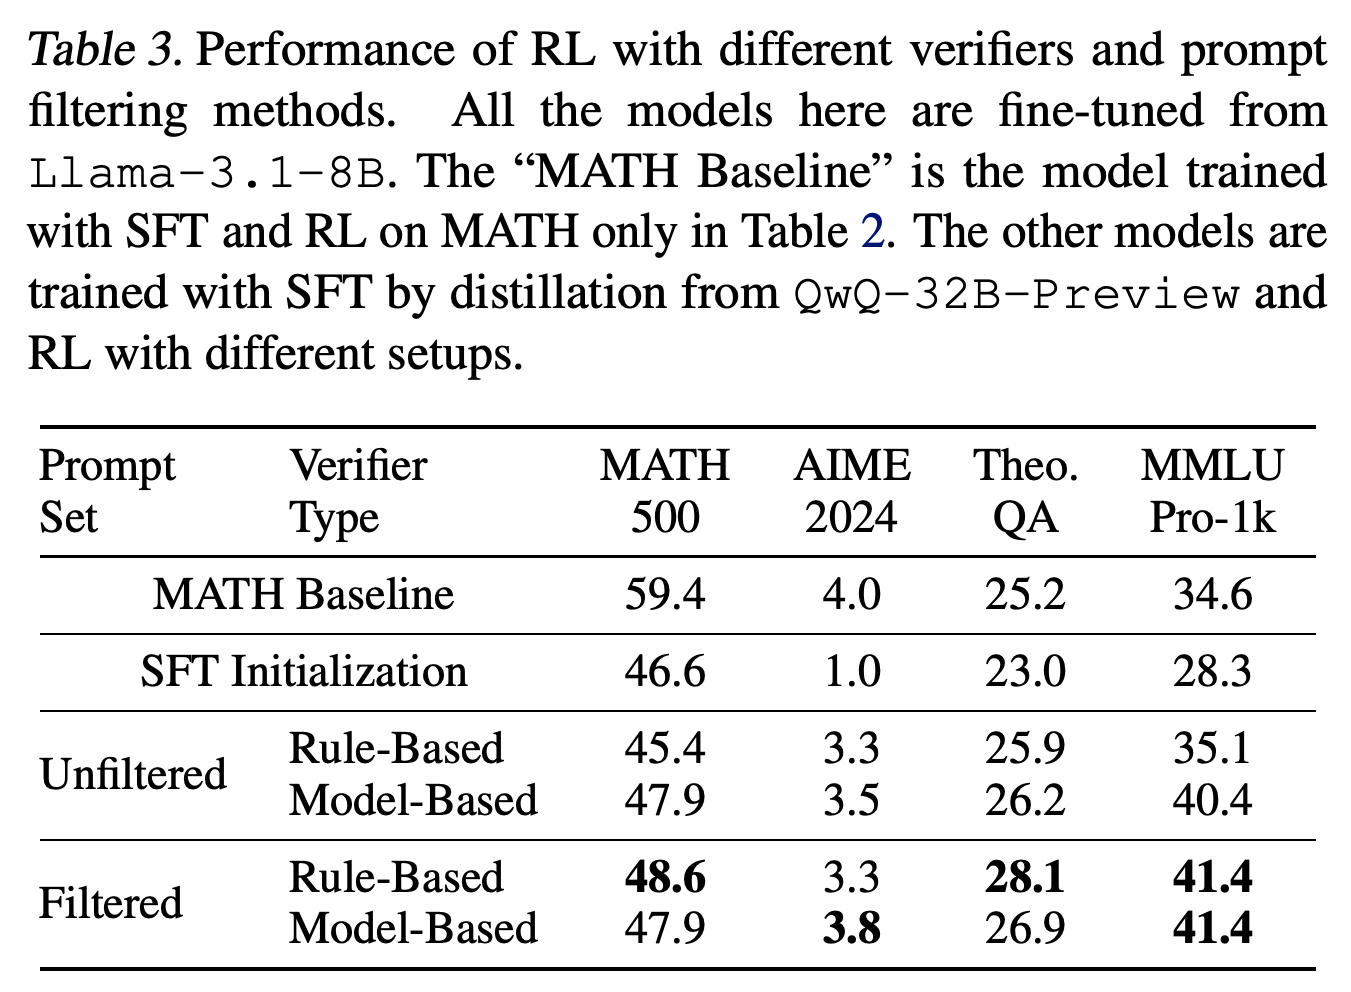
RL 비교에서는 WebInstruct 프롬프트의 필터링 여부와 규칙 기반 또는 다른 언어 모델로 정답 여부를 판단하는 모델 기반 검증 방식을 교차한다. Llama-3.1-8B-Instruct로 단답형 정답을 추출하고, 프롬프트마다 QwQ-32B-Preview 응답 2개를 정답과 대조해 약 115k개의 프롬프트에서 약 189k개의 응답을 확보한다. 각 RL 조건은 해당 데이터 풀에서 프롬프트 30k개를 샘플링하고, 프롬프트마다 응답 4개를 생성한다.
- Table 3에서 필터링한 프롬프트와 규칙 기반 검증기를 사용하면 MATH-500에서 48.6%, TheoremQA에서 28.1%, MMLU-Pro-1k에서 41.4%를 달성한다. 필터링한 모델 기반 검증은 WebInstruct RL 조건 중 AIME 2024 최고 점수인 3.8%를 기록하며, MMLU-Pro-1k에서는 41.4%로 공동 최고다.
- MATH만 사용한 SFT+RL 베이스라인과 비교하면, 필터링한 규칙 기반 학습은 TheoremQA를 2.9%포인트, MMLU-Pro-1k를 6.8점 높이지만 MATH-500은 59.4%에서 48.6%로 낮춘다. 필터링하지 않은 규칙 기반 검증은 벤치마크 4개 모두에서 필터링하지 않은 모델 기반 검증보다 성능이 낮다.
규칙 기반 검증에서는 필터링을 적용하면 적용하지 않았을 때보다 벤치마크 4개 모두에서 성능이 높아진다. WebInstruct RL 조건 중 필터링한 규칙 기반 검증은 MATH-500과 TheoremQA에서 최고이며, MMLU-Pro-1k에서는 공동 최고다. 필터링한 모델 기반 검증은 AIME 2024에서 가장 높다.
6. Exploration on RL from the Base Model
직접 RL 실험에서는 정답률 향상과 함께 새로운 성찰 패턴이 나타나는지, 응답 길이가 베이스 모델의 길이를 넘어서는지 살펴본다. 또한 직접 RL과 long CoT SFT 초기화를 비교하고, 비슷한 추론 패턴이 웹 데이터에도 존재하는지 조사한다.
6.1. Nuances in Analysis Based on Emergent Behaviors
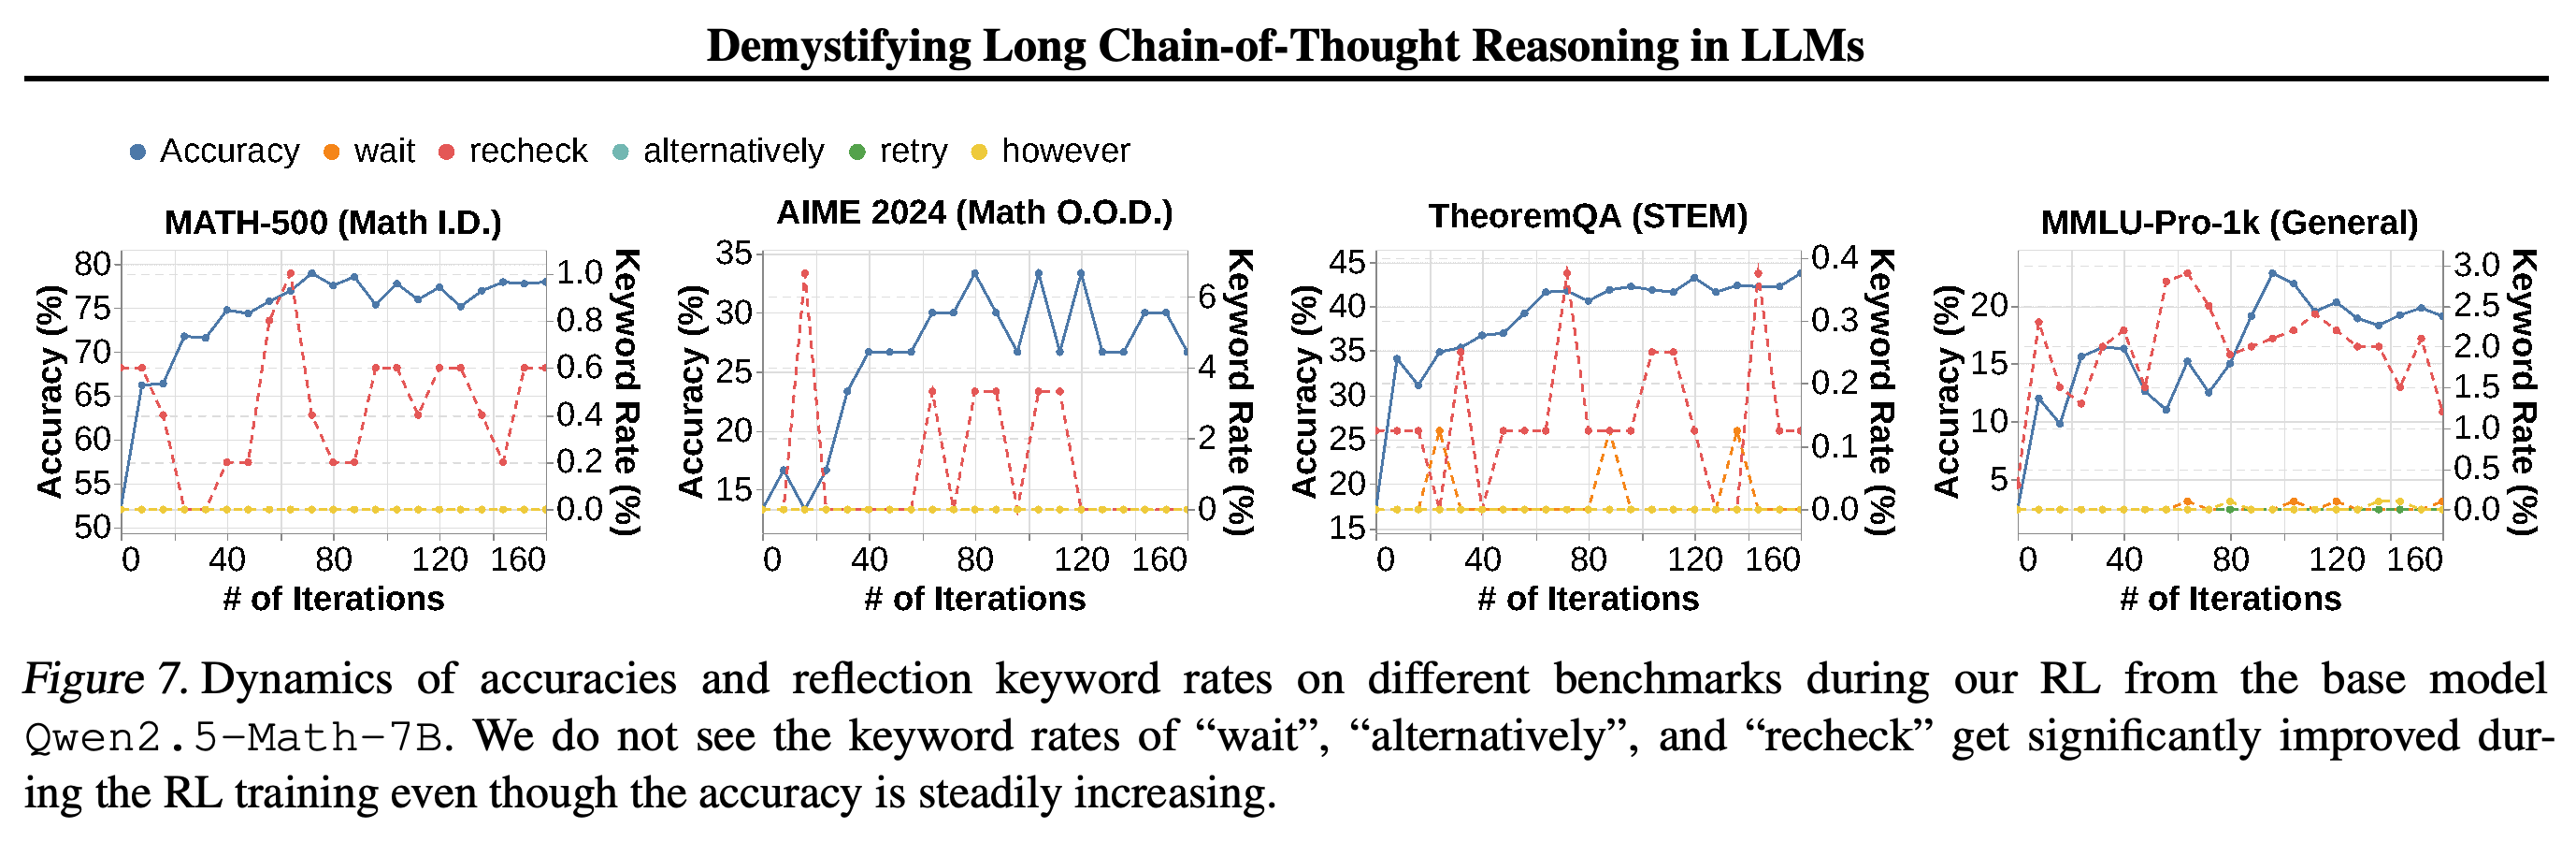
Qwen2.5-Math-7B를 약 8k개의 MATH level 3–5 문제로 학습하며 PPO와 규칙 기반 검증기를 사용한다. 평가에는 시연 예시를 주지 않는 zero-shot 프롬프팅, temperature 0의 탐욕적 디코딩, 최대 출력 길이 4096토큰을 적용한다. 학습 컨텍스트 길이도 4096토큰이다.
- Figure 7은 “wait”, “recheck”, “alternatively”, “retry”, “however”를 성찰의 간접 지표로 추적한다. 정답률은 크게 높아지지만 이 키워드의 빈도는 일관되게 늘지 않으며, “recheck”는 베이스 모델에서도 이미 나타난다.
- 이 결과는 정답률 향상에 이러한 표면적 지표가 반드시 동반되는 것은 아님을 보여 준다. 모든 형태의 자기 검증이 없다는 뜻은 아니다.
직접 RL에서 정답률은 높아지지만 선택한 성찰 키워드는 일관되게 늘지 않는다. 이 어휘 지표는 드물게 나타나거나 과제 성능 향상과 무관하게 변동하므로, 새롭게 발현하는 성찰의 근거로 사용하기에는 한계가 있다.
6.2. Nuances in Analysis Based on Length Scaling
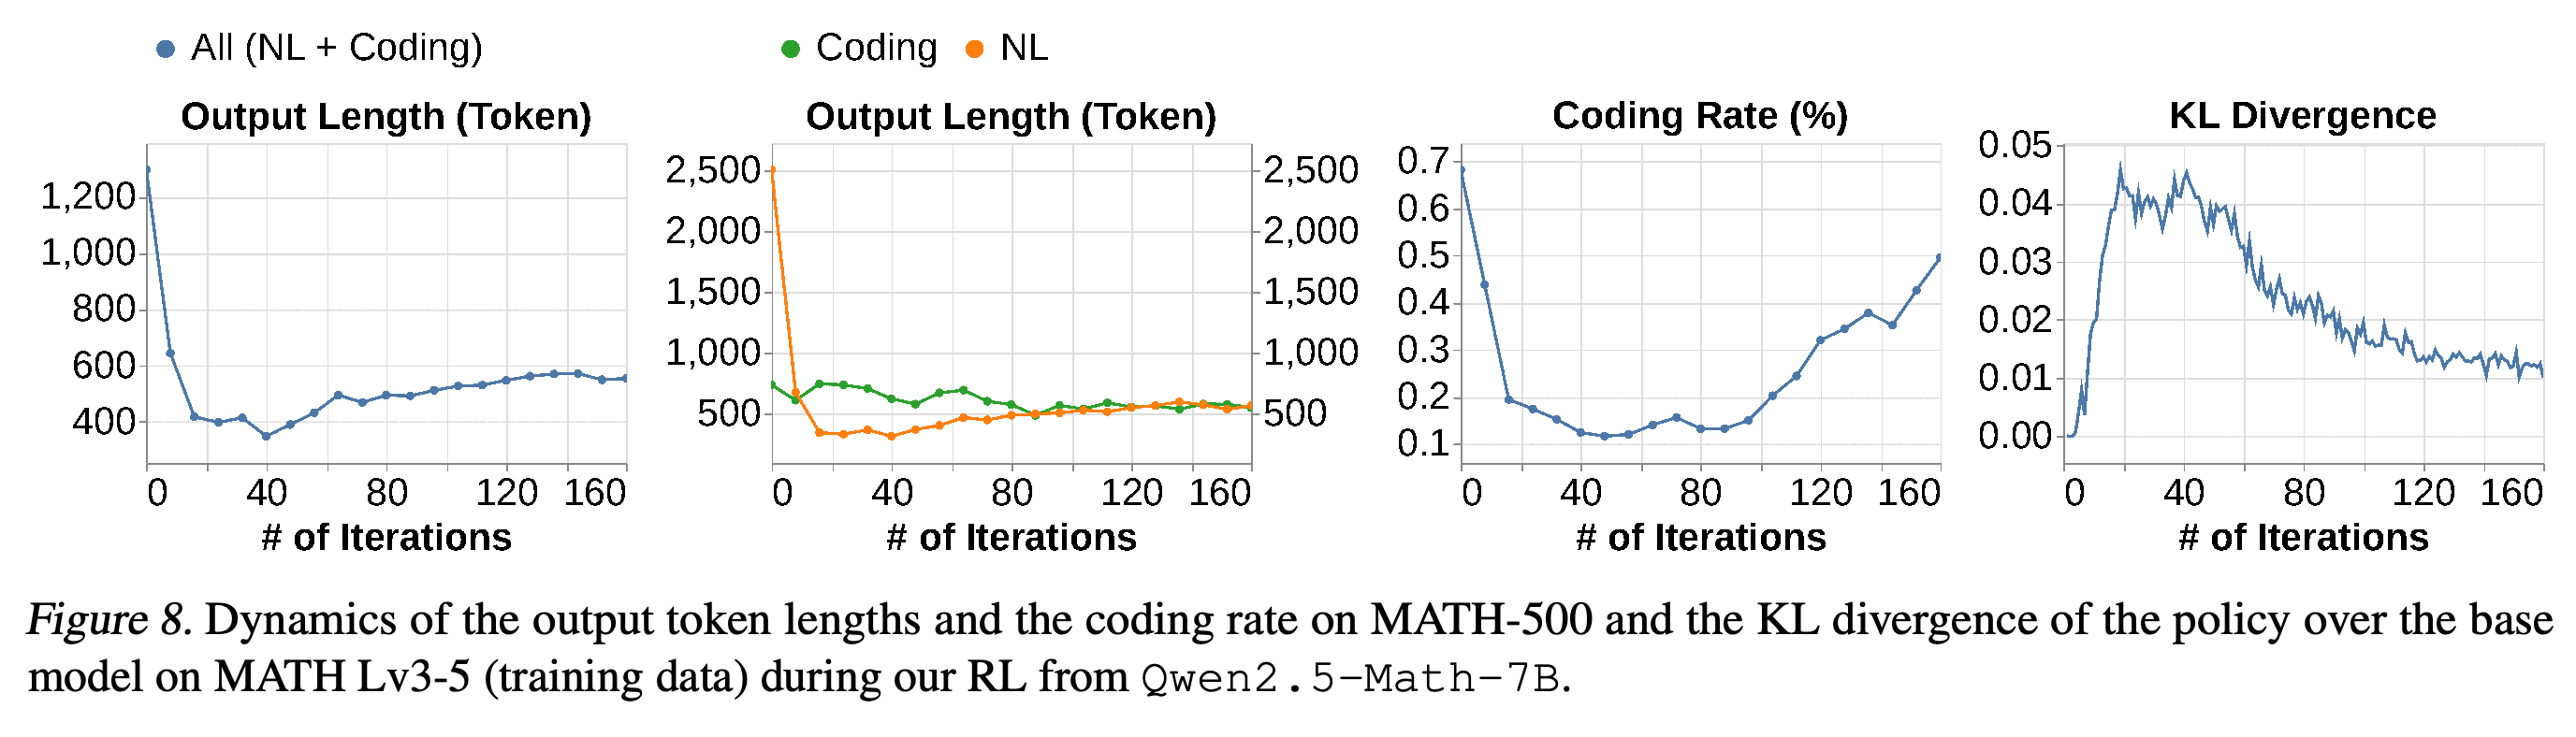
Figure 8에서 응답 길이는 초기에 줄어든 뒤 회복하지만, 베이스 모델의 원래 길이보다는 짧게 유지된다. `python을 포함한 출력은 코딩으로 분류하지만, 코드를 실행하지는 않는다. 모델이 코드의 실행 결과라고 제시하는 내용도 직접 생성한다.
- 코딩 출력과 자연어 출력 2가지 모두 초기에 짧아지며, 초기에는 자연어 출력이 더 길다. 이는 길이 감소가 단순히 코드에서 자연어로 전환되기 때문이라는 설명과 맞지 않는다.
- 이후 길이 회복은 학습된 정책이 베이스 모델과 얼마나 다른지를 나타내는 Kullback–Leibler(KL) 발산의 감소와 함께 나타난다. 저자들은 KL 페널티가 베이스 모델의 행동으로 돌아가도록 유도한다고 가정하지만, 실험에서 해당 페널티의 인과적 효과를 분리하지는 않는다.
응답 길이는 초기에 줄어든 뒤 일부 회복하지만, 시작 시점의 베이스 모델 길이보다 짧게 유지된다. 코드가 포함된 응답과 자연어 응답 2가지 모두 짧아지며, 이후 길이 회복은 KL 발산 감소와 함께 나타난다. 이는 제안된 정규화 설명의 근거가 되지만 입증하지는 않는다.
6.3. Potential Reasons Why Emergent Behavior is Not Observed with Qwen2.5-Math-7B
저자들은 Qwen2.5-Math-7B에서 DeepSeek-R1-like 발현 행동을 재현하지 못한 이유로, 7B 매개변수 규모의 제한된 용량과 지속 사전 학습 및 사전 학습의 마지막 단계인 어닐링 중 MATH와 유사한 짧은 지시 데이터에 지나치게 많이 노출되었을 가능성을 제시한다. 연구에서 모델 용량이나 사전 학습 노출량을 직접 바꾸지 않았으므로 어느 설명이든 가설로 남는다.
6.4. Comparison between RL from the Base Model and RL from Long CoT SFT
Qwen2.5-Math-7B의 long CoT 학습 경로는 MATH 학습 프롬프트 7.5k개, 거부 샘플링을 위한 프롬프트당 QwQ-32B-Preview 후보 32개, Cosine Reward와 반복 페널티를 적용한 PPO를 사용한다. 데이터를 8회 순회하며 프롬프트마다 응답 8개를 생성한다. 저자들은 원래 4096토큰인 컨텍스트를 더 긴 학습에 맞추기 위해 모델의 위치 표현 매개변수인 rotary position embedding(RoPE)의 θ에 10을 곱한다.
- Table 4에서 평균 정답률은 베이스 모델 21.2%, 직접 RL 41.0%, long CoT SFT 47.3%, SFT+RL 49.7%다. SFT+RL은 MATH-500에서 85.9%, AIME 2024에서 26.9%, TheoremQA에서 45.4%, MMLU-Pro-1k에서 40.6%를 달성한다.
- 보고된 평균에서 SFT+RL은 직접 RL보다 8.7%포인트 높다. 표의 반올림한 평균을 기준으로 SFT 대비 증가 폭은 2.4점이지만, 본문에는 2.6%라고 적혀 있다.
- 학습 설정과 디코딩이 다르다. 직접 RL은 탐욕적 디코딩으로 평가하고, long CoT 경로는 기본 temperature 샘플링을 사용한다. 따라서 이 결과는 전체 설정을 비교한 것이며 초기화의 효과만 분리하지 않는다. Long CoT SFT 이후 Classic Reward를 적용한 학습은 붕괴하므로 비교에서 제외한다.
보고된 평균에서 long CoT SFT는 직접 RL보다 우수하고, SFT+RL은 이를 49.7%로 높인다. 학습 경로마다 학습과 디코딩이 다르므로 이 표는 전체 설정을 비교한다. 반올림한 평균으로 계산하면 SFT 대비 개선 폭은 2.4점이지만, 본문에는 2.6%라고 적혀 있다.
6.5. Long CoT Patterns in Pre-training Data
저자들은 Perplexity.ai로 대안 풀이와 명시적 검증이 포함된 웹페이지를 찾은 뒤, MinHash와 GPT-4o가 생성한 구절을 사용해 수학 웹 텍스트 모음인 OpenWebMath를 검색한다. 검색된 포럼 토론에는 long CoT 추론 과정과 비슷한 분기, 역추적, 불확실성 표현, 수정이 포함되어 있다.
- 이 예시는 RL이 사전 학습에서 얻은 기술을 재조합한다는 가설의 근거가 된다. 다만 특정 문서가 평가한 모델의 학습에 사용되었거나 추론 행동을 일으켰음을 입증하지는 않는다. 저자들도 OpenWebMath에 포럼 자료가 흔하다고 인정한다.
7. Discussions and Future Work
논의에서는 모델 규모, RL 인프라, 최적화 알고리즘 튜닝, 검증, 추론 행동의 기원에 관한 미해결 문제를 제시한다. 제안한 연구 방향은 보고된 실험으로 확인한 범위를 넘어선다.
7.1. Scaling up Model Size
저자들은 더 큰 베이스 모델이라면 직접 RL 실험에서 나타나지 않은 행동을 더 쉽게 학습할 수 있다고 제안한다. 그러나 이 연구에는 모델 크기가 제약 요인임을 확인하는 규모 확대 실험이 없다.
7.2. RL Infrastructure Is Still in Its Infancy
32B 모델로 확장하려던 시도는 필요한 그래픽 처리 장치 수가 너무 많아 중단되었다. 저자들은 학습 시스템과 추론 시스템 간 모델 매개변수 중복, 동기식 PPO 작업, 응답 길이 차이로 느린 요청이 배치 전체를 지연시키는 현상을 인프라 제약으로 지적한다. 정량적인 시스템 벤치마크는 제시하지 않는다.
7.3. REINFORCE Is More Tricky to Tune than PPO
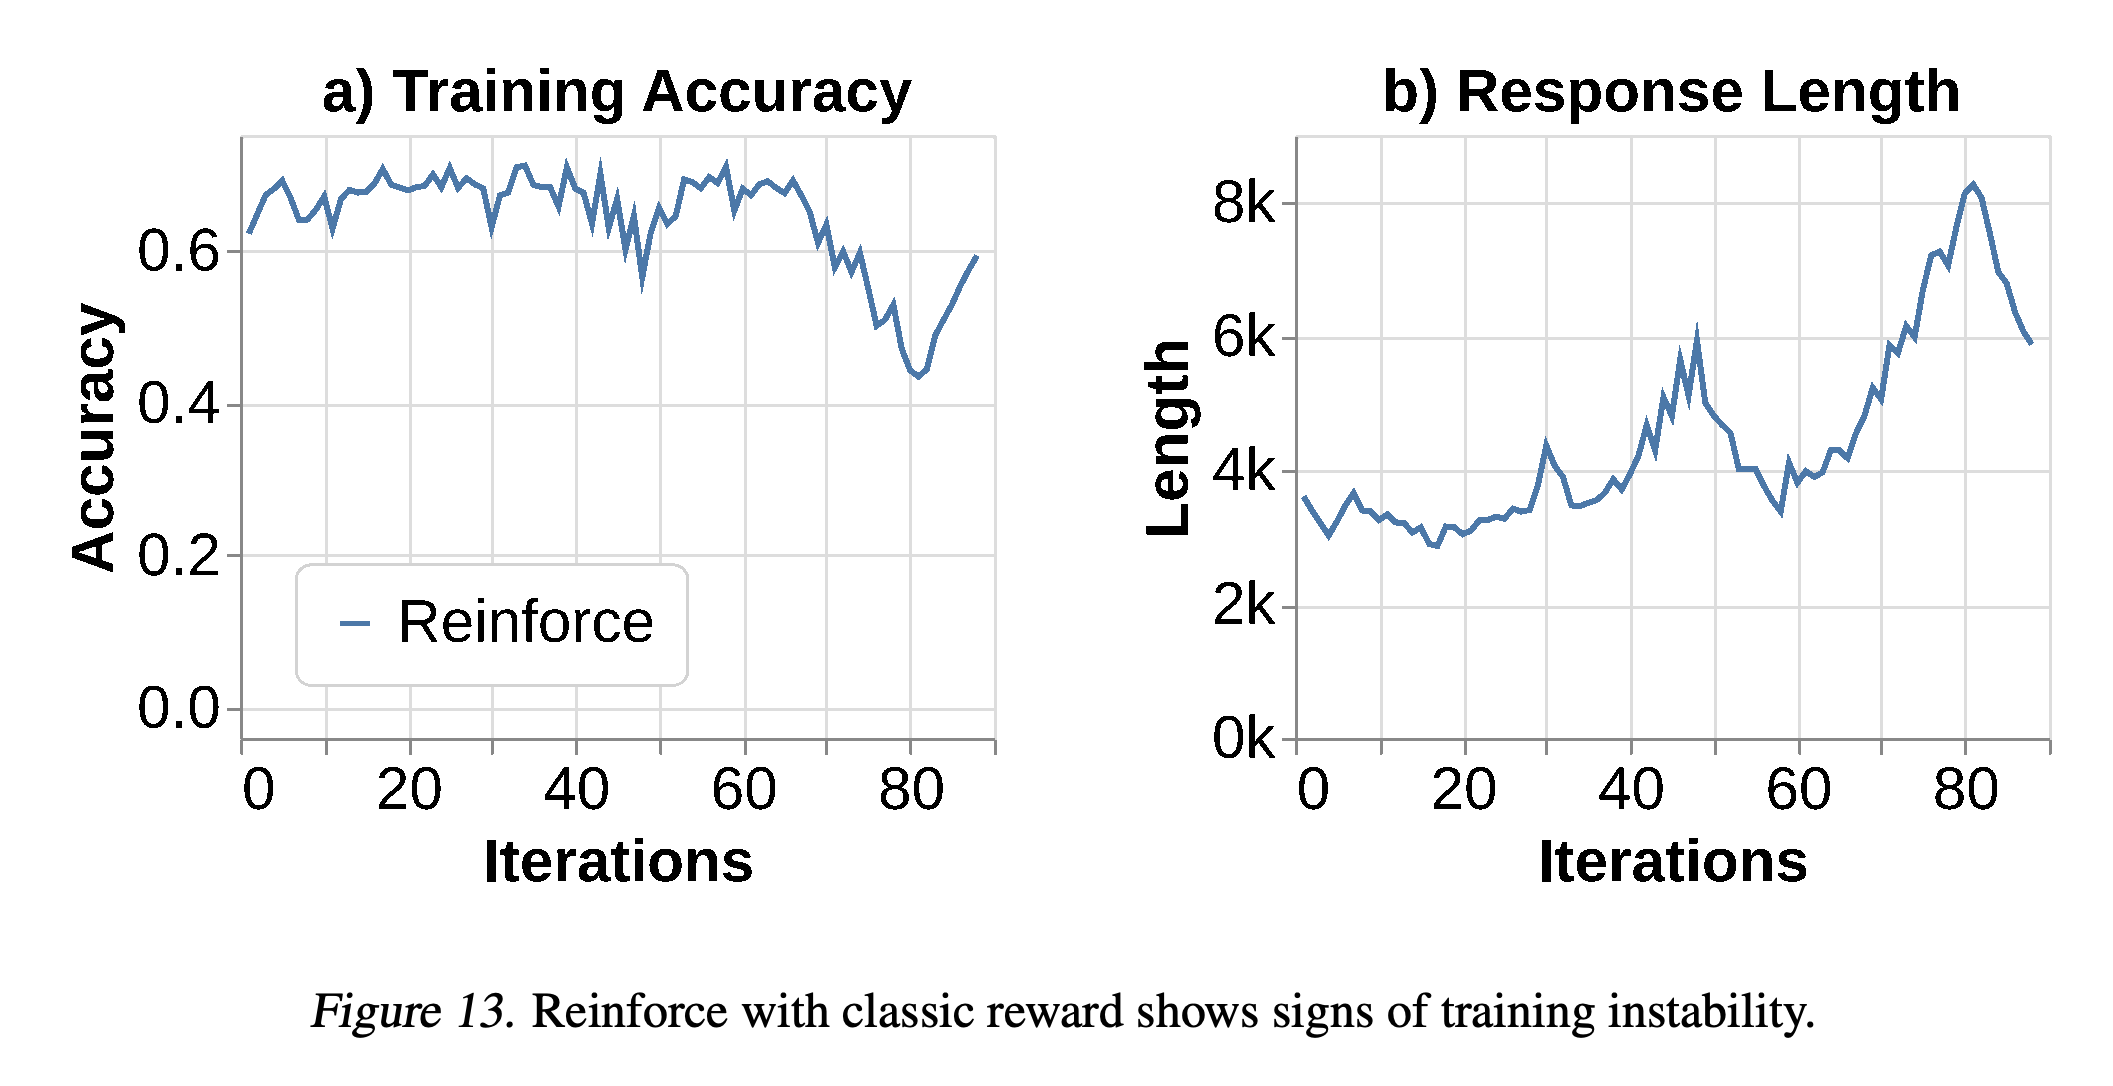
더 빠른 RL을 위해 시험한 정책 경사 기반 대안인 REINFORCE++는 저자들의 설정에서 PPO보다 학습 정답률이 낮고 불안정성이 크다. Figure 13은 정답률과 길이의 불안정성을 보여 준다. 다만 REINFORCE++ 설정이 충분히 튜닝되지 않았을 수 있으므로 저자들은 알고리즘 전반의 우열을 비교하지 않는다.
이 실행에서는 길이가 크게 변동하고 후반에 정답률이 떨어진다. 실험한 REINFORCE++ 설정의 불안정성을 보여 주지만, 설정이 충분히 튜닝되지 않았을 가능성이 있어 PPO와 일반적인 우열을 비교할 수는 없다.
7.4. Scaling up Verification
보고된 실험에서 프롬프트 필터링을 결합한 규칙 기반 검증은 좋은 성능을 보인다. 하지만 여러 도메인으로 규칙과 선별된 프롬프트 집합을 확장하려면 여전히 많은 수작업이 필요하다. 저자들은 검증 규모를 늘리기 위해, 사람이 완전히 검증하지 않은 목표를 사용하는 silver supervision과 수작업 주석 목표 없이 지도 신호를 얻는 자기 지도 접근법을 연구하자고 제안한다.
7.5. Latent Capabilities in Base Models
논문은 추론 행동이 베이스 모델에 잠재되어 있을 가능성을 제시하며, 사람들의 포럼 대화를 가능한 출처로 꼽는다. 제시한 텍스트 유사성만으로 기원을 밝힐 수 없으므로, 행동을 학습 데이터까지 추적하는 분석이 필요하다고 주장한다.
Impact Statement
영향 진술에서는 추론과 문제 해결 능력 향상에 따른 잠재적 이점을 설명하고, 신뢰할 수 있는 데이터 준비, 안정적인 학습, 검증 가능한 참조 정답을 강조한다. 의도하지 않은 결과를 줄이도록 보상과 학습을 신중하게 설계할 것을 권고하지만, 별도의 실증적 안전성 평가는 보고하지 않는다.
부록
- A. Related Work는 CoT 프롬프팅, 답변 생성 중 계산량을 늘리는 추론 시점 확장, DeepSeek-R1과 Kimi K1.5 같은 결과 보상 RL 시스템과 이 연구의 관계를 설명한다.
- B. Figures and Tables는 보상 형태 제거 실험, 성찰 키워드 수, 응답 길이 변화, 최적화 알고리즘의 불안정성, 할인율 비교로 주요 결과를 보충한다.
- C. Algorithms and Formulas의 C.1. Cosine Reward Formula는 CosFn(t, T, ηmin, ηmax) = ηmin + ½(ηmax − ηmin)(1 + cos(tπ/T))로 주어진다. C.2. N-gram Repetition Penalty는 앞서 관찰한 N-gram을 기록하고 이후 다시 등장하는 토큰에 페널티 P를 부여한다.
- D. Extracts는 정답 할인율 \(\gamma_c=0.99\)에서 잠정적인 접근법을 빠르게 전환하는 예시를 보여 준다.
- E. Experimental Setup과 E.1. Evaluation Setup은 AIME 2024 문제 30개, 350+개 정리를 다루는 TheoremQA 샘플 800개, 문항 1,000개로 구성된 MMLU-Pro-1k 부분집합을 명시한다. Figure 14에서 이 부분집합의 출처 분포는 원본과 매우 비슷하다. 정답률은 최소 4개의 무작위 시드에 걸쳐 평균을 내며, AIME에서는 샘플링 분산을 줄이기 위해 프롬프트마다 응답 16개를 생성한다. 추론에는 추론 라이브러리인 vLLM과 행렬, 함수 등의 수학 객체를 지원하는 정답 채점기인 SymEval을 사용한다. 일부 RL 실험은 이전 버전의 채점기를 사용해 성능 차이가 생길 수 있다. E.2. Details about Distillation은 QwQ-32B-Preview에 temperature 1.0, top-p 0.95, 출력 한도 8192토큰을 사용한다. Qwen2.5-Math-72B-Instruct에는 temperature 0.7, top-p 0.95, 4096토큰을 사용한다. E.3. Details abour SFT Setup은 배치 크기 256, 컨텍스트 길이 128K, 학습률 5e-6, 2에포크, 마이크로 배치 크기 1을 명시한다. OpenRLHF를 사용하며, DeepSpeed를 통해 효율적인 어텐션 구현인 Flash Attention 2와 메모리 최적화 방법인 ZeRO를 적용한다. E.4. Details about RL Setup은 OpenRLHF와 해당 프레임워크의 하이퍼파라미터 명명 규칙을 사용한다. E.5. Experiment Hyperparameters는 프롬프트 집합 순회 횟수와 최적화 에포크를 구분하고, Samples를 프롬프트당 응답 수로 정의한다. BS는 일반적으로 같은 값을 사용하는 rollout_batch_size와 train_batch_size를 뜻한다. E.5.1–E.5.4는 SFT 초기화, Classic Reward의 불안정성, 능동적인 길이 제어, 보상 끝점 제거 실험을 설명한다. E.5.5–E.5.7은 컨텍스트 한도, 반복 페널티, 별도 할인율을 명시한다. 공통 설정에는 배치 크기 512, 액터 학습률 5e-7, KL 계수 0.01이 포함된다. 많은 16K 실행에서는 프롬프트 2048토큰과 생성 14336토큰을 사용하며, 반복 페널티는 대체로 N = 40과 P = −0.05를 사용한다. E.5.8은 샘플링한 프롬프트 30k개와 프롬프트당 응답 4개로 노이즈 데이터 검증기를 비교한다. E.5.9는 정답, 오답, 답변 누락에 각각 +1, −0.5, −1의 보상을 주고 프롬프트 한도 1024토큰, 생성 한도 3072토큰을 사용하는 직접 베이스 모델 RL과 long CoT 초기화 설정을 설명한다. E.5.10은 학습률 5e-7과 클리핑 값 0.1을 사용한 REINFORCE++ 실행을 조기 종료했다고 보고한다. E.6. Implementation of the Model-Based Verifier는 응답의 마지막 20줄과 참조 풀이를 검증기에 제공한다. 이 절은 Qwen2.5-7B-Instruct를 명시하지만 Section 5.2는 Qwen2.5-Math-7B-Instruct를 명시하므로, PDF에 구현 설명의 불일치가 남아 있다. E.7. Implementation of Short-Form Answer Extraction은 Llama-3.1-8B-Instruct에 temperature 0과 512토큰 한도를 적용해 \boxed{…}에서 정답을 추출한다. E.8. Action Prompting Framework, E.8.1. CONTROL FLOW, E.8.2. ACTION PROMPTING TEMPLATES는 생성한 생각을 덧붙이고 모델이 행동과 분기를 선택하게 하며 answer 이후 종료하는 상태 기계를 설명한다. Reflection은 o1-mini가 생성한다.
- F. Long CoT Patterns in Pre-training Data는 F.1. Snapshot of webpages에서 검증과 대안 산술 풀이가 담긴 웹페이지를 제시한다. 이어 F.2. OpenWebMath, F.2.1. QUERIES, F.2.2. MATCHES에서는 생성한 검색 구절과 MC Stan, Physics Forums, StackExchange의 예시를 제시한다. 코드는 https://github.com/eddycmu/demystify-long-cot 에, 채점기는 https://github.com/tongyx361/symeval 에 공개되어 있다.
짧은 생각
가장 명확한 공학적 근거는 보상 설계, 컨텍스트 한도 초과 실패, 후속 평가 정답률의 관계에서 나온다. Figures 2–5는 long CoT 초기화 이후 정답에만 보상을 주는 방식이 왜 실패할 수 있는지 보여 준다. Table 3도 검증기가 확인할 수 있는 정답으로 필터링하면 여러 일반화 점수가 높아지지만, 수학 정답률은 MATH만 사용한 베이스라인보다 낮음을 보여 준다.
특정 학습 설정에 대한 근거는 추론의 기원에 대한 근거보다 강하다. 키워드 수, 함께 변하는 길이와 KL 추이, 서로 다른 교사 모델과 디코딩 조건, 웹 문서와의 정성적 유사성만으로는 인과적 설명을 확정할 수 없다.