


End-to-End Vision Tokenizer Tuning 요약 설명
15 May 2025 | Paper Review Semantic Tokenization Multimodal Learning Autoregressive Language Models목차
이번 글에서는 End-to-End Vision Tokenizer Tuning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 5월 15일(Arxiv)
- Wang, Wenxuan, Zhang, Fan, Cui, Yufeng, Diao, Haiwen, Luo, Zhuoyan, Lu, Huchuan, Liu, Jing, Wang, Xinlong.
- Institute of Automation, Chinese Academy of Sciences, School of Artificial Intelligence, University of Chinese Academy of Sciences, Beijing Academy of Artificial Intelligence, Dalian University of Technology, Tsinghua University
- 논문 링크
요약
- 시각 토크나이저는 이미지를 이산 표현으로 압축하지만, 이미지 복원만 학습하면 이미지 이해와 생성에 필요한 정보가 사라질 수 있다. 통제된 절제 실험에서 end-to-end vision tokenizer tuning(ETT)은 동결된 이산 인덱스 베이스라인보다 성능을 높인다. 이미지 이해 벤치마크인 SEEDBench-Img는 54.8에서 60.0으로, 이미지 속 텍스트를 읽어야 하는 TextVQA는 40.1에서 46.9로, 텍스트와 생성 이미지의 일치도를 평가하는 GenEval은 0.40에서 0.43으로 오른다.
- ETT는 이산 시각 코드에 대응하는 학습된 벡터인 코드북 임베딩을 프로젝터에 통과시켜 대규모 언어 모델(LLM)의 입력 공간으로 변환한다. 의미 학습 단계에서는 캡션 예측과 이미지 복원을 함께 학습하여 토크나이저와 LLM을 갱신한다. 이후 후속 학습에서는 토크나이저를 동결하고, 이해와 생성을 각각 담당하는 ETT-Chat과 ETT-Gen을 별도로 학습한다.
- 전체 시스템은 1.5B-parameter 언어 백본을 사용하며 GenEval에서 0.63을 기록한다. 확산 기반 이미지 생성 모델인 SDXL은 0.55, 이산 멀티모달 토큰을 예측하는 Emu3는 0.66을 기록한다. 선별된 복원 예시는 튜닝 전후에 비슷해 보이지만, 통제된 절제 실험에서 기본 손실 가중치를 적용하면 reconstruction Fréchet Inception Distance(rFID)는 1.033에서 1.648로 나빠진다. rFID는 낮을수록 복원 품질이 좋은 지표다.
1 Introduction
자기회귀 모델링은 앞선 토큰으로 다음 토큰을 예측하므로 이미지와 텍스트 시퀀스를 같은 다음 토큰 예측 체계로 다룰 수 있다. 논문은 토크나이저를 픽셀 복원만으로 별도 학습하면 다운스트림 작업에 필요한 의미 정보, 특히 텍스트 인식과 렌더링에 필요한 정보가 사라질 수 있다고 주장한다. 기존 파이프라인은 토크나이저를 동결한 채 이산 인덱스로부터 새로운 시각 임베딩을 학습하므로, 다운스트림 피드백이 시각 표현 학습에 전달되지 않는다.
- 벡터 양자화(VQ)는 연속적인 이미지 특징을 유한한 코드북의 항목에 대응시키며, 이 과정에서 표현 병목이 생길 수 있다. 벡터 양자화(VQ)에 대해서는 VQ-VAE 논문 설명(Neural Discrete Representation Learning) 글을 참조하라.
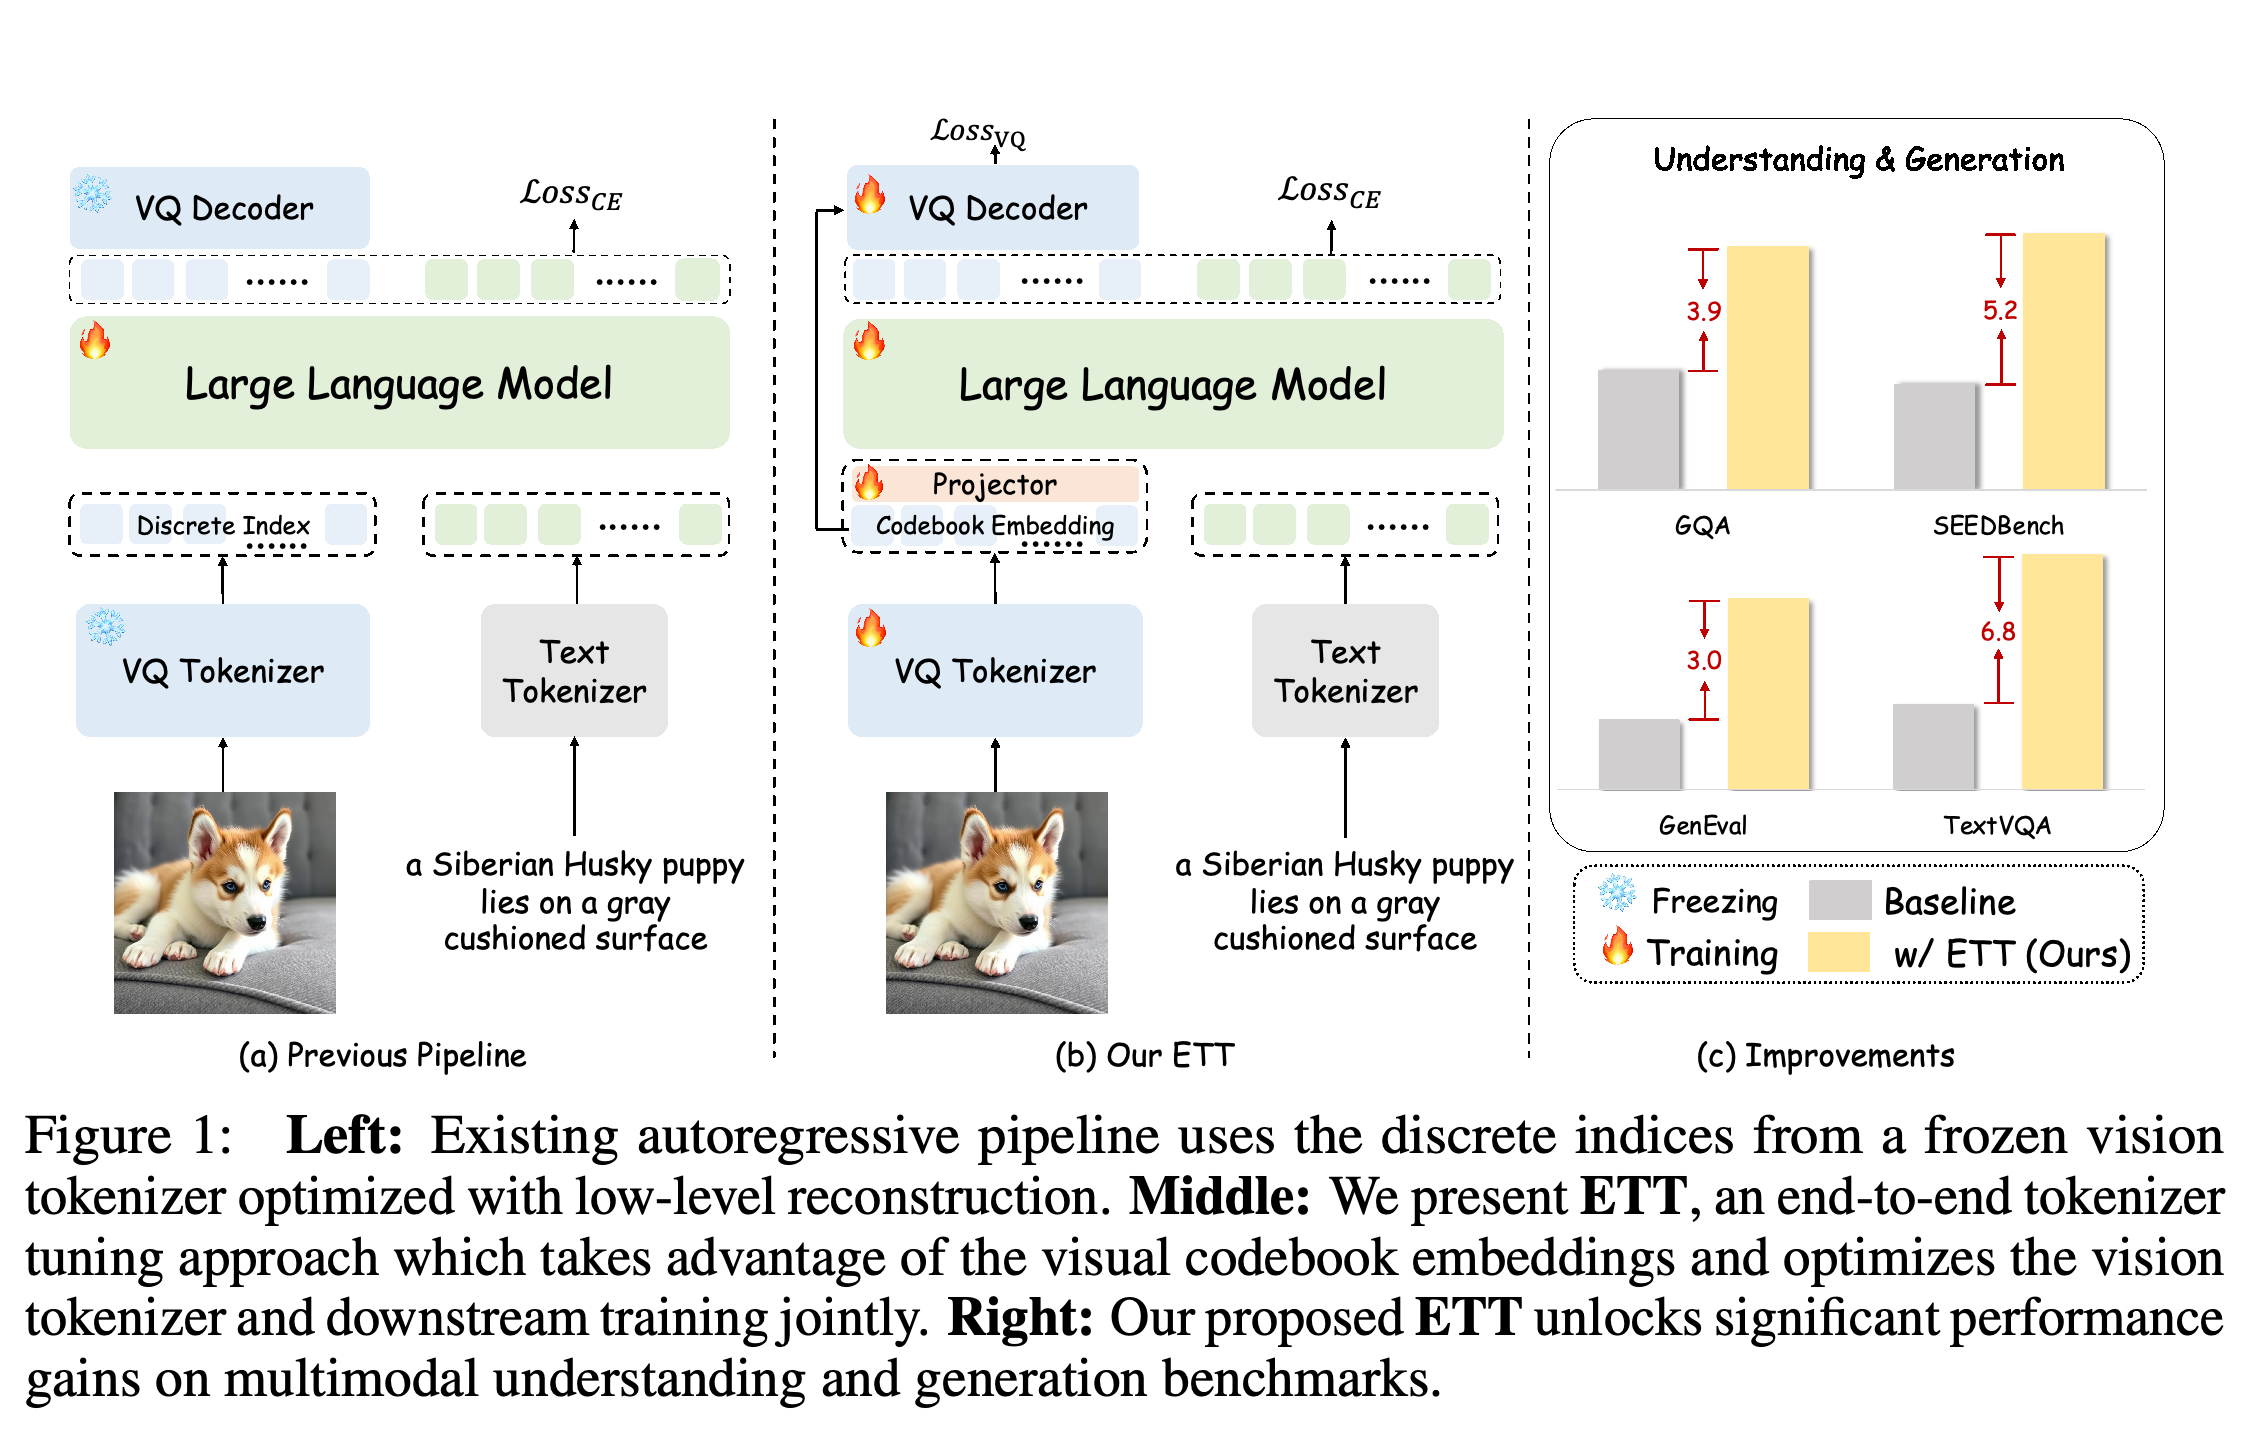
- ETT는 토크나이저의 기존 코드북 벡터와 캡션 감독 신호를 사용하여 LLM의 원래 텍스트 어휘를 바꾸지 않고 다운스트림 학습을 토크나이저에 연결한다.
이 도식은 ETT가 바꾸는 지점을 보여준다. 코드북 벡터가 학습 가능한 프로젝터를 통과하고, 토크나이저와 디코더도 동결되지 않은 채 공동 학습에 참여한다. 표시된 향상 폭은 통제된 절제 실험에 해당한다. SEEDBench는 5.2점 오르고, GenEval의 절대 증가량은 0.03이며 그림에는 3.0으로 표시되어 있다.
2 Related Work
관련 연구에서는 이미지 복원과 양자화를 개선하는 방법과 시각 토큰에 의미 정보를 더하는 방법을 구분한다. 양자화기를 갖춘 이미지 오토인코더인 VQ-VAE는 연속 특징을 이산 표현으로 변환한다. VQGAN은 시각 특징을 비교하는 지각 손실과 판별기를 상대로 학습하는 적대적 목적함수를 추가한다. ETT는 매 학습 단계에서 코드북 전체를 갱신하여 큰 코드북을 지원하는 IBQ 토크나이저 프레임워크를 채택한다.
- 기존 시각 생성 시스템은 순차적 토큰 예측이나, 가려진 시각 토큰을 예측하는 마스크 토큰 모델링을 사용한다.
- Emu3를 비롯한 통합 시스템은 동결된 이산 토크나이저를 사용한다. 이해와 생성을 모두 수행하는 Janus는 2개 작업에 서로 다른 시각 인코딩을 사용한다. ETT는 기존 토크나이저와 자기회귀 모델을 공동 최적화하는 방법을 연구한다.
3 Methodology
제안 방법은 IBQ 기반 이미지 토크나이저, 경량 시각 프로젝터, 사전 학습된 LLM을 결합한다. 양자화된 코드북 임베딩을 LLM에 입력하고, 캡션 예측과 복원을 공동 최적화한 뒤 작업별 후속 학습을 수행한다.
3.1 Vision Tokenizer
토크나이저는 이미지를 공간 특징 맵으로 인코딩하고, 각 특징을 가장 가까운 코드북 벡터에 할당한 뒤, 양자화된 임베딩을 다시 이미지로 디코딩한다. ETT는 다운샘플링 비율 s = 16, 임베딩 차원 D = 256, 코드북 크기 131,072를 사용한다. 코드북 크기는 인용한 IBQ 설정의 262,144개 항목에서 줄인 값이다.
- 토크나이저의 목적함수는 \(\mathcal{L}_{vq}=\mathcal{L}_{rec}+\mathcal{L}_{quant}+\mathcal{L}_{lpips}+\lambda_G\cdot\mathcal{L}_{GAN}+\lambda_E\cdot\mathcal{L}_{entropy}\)이다.
- 각 항은 순서대로 픽셀 복원, 인코딩된 특징과 양자화된 특징의 일치도, 특징 기반 이미지 비교 지표인 LPIPS를 이용한 지각적 유사도, 이미지 패치 판별기인 PatchGAN을 이용한 적대적 사실성, 코드북 엔트로피를 측정한다.
3.2 End-to-End Vision Tokenizer Tuning
ETT는 기존에 LLM 입력으로 사용하던 이산 시각 인덱스를 해당 토크나이저의 코드북 임베딩으로 대체한다. GeLU 활성화 함수를 사용하는 작은 투영 신경망인 다층 퍼셉트론이 각 256차원 시각 임베딩을 LLM의 은닉 차원으로 변환한다. 텍스트는 사전 학습된 텍스트 토크나이저와 텍스트 임베딩 계층이 계속 처리한다.
- 이 연결을 통해 캡션 감독 신호가 논문에서 설명한 학습 계산 그래프를 따라 시각 토크나이저를 갱신할 수 있다.
- 프로젝터를 사용하면 이산 인덱스에 대응하는 무작위 초기화 임베딩만으로 LLM의 시각 입력 표현을 학습할 필요가 없다.
캡션 감독에는 이미지와 앞선 텍스트를 조건으로 각 정답 텍스트 토큰의 음의 로그 확률을 계산하는 교차 엔트로피를 사용한다. 공동 목적함수는 \(\mathcal{L}=\mathcal{L}_{cap}+\alpha\cdot\mathcal{L}_{vq}\)이며, α는 의미 감독과 복원 사이의 균형을 조절한다. 토크나이저의 인코더와 디코더를 LLM과 함께 갱신하여 복원 품질 저하를 제한하면서 이해 성능을 높이고자 한다.
- 캡션 목적함수는 L_cap = −Σ_{t=1}^{N} log P(x_t^T | x^I, x_<t^T)이며, N은 텍스트 시퀀스 길이, x^I는 이미지 임베딩, x_<t^T는 앞선 텍스트 임베딩을 나타낸다.
- 기본 복원 가중치는 복원과 이해 성능을 비교한 절제 실험에서 선택한 α = 0.25다.
3.3 Training Recipe for Multimodal Generation and Understanding
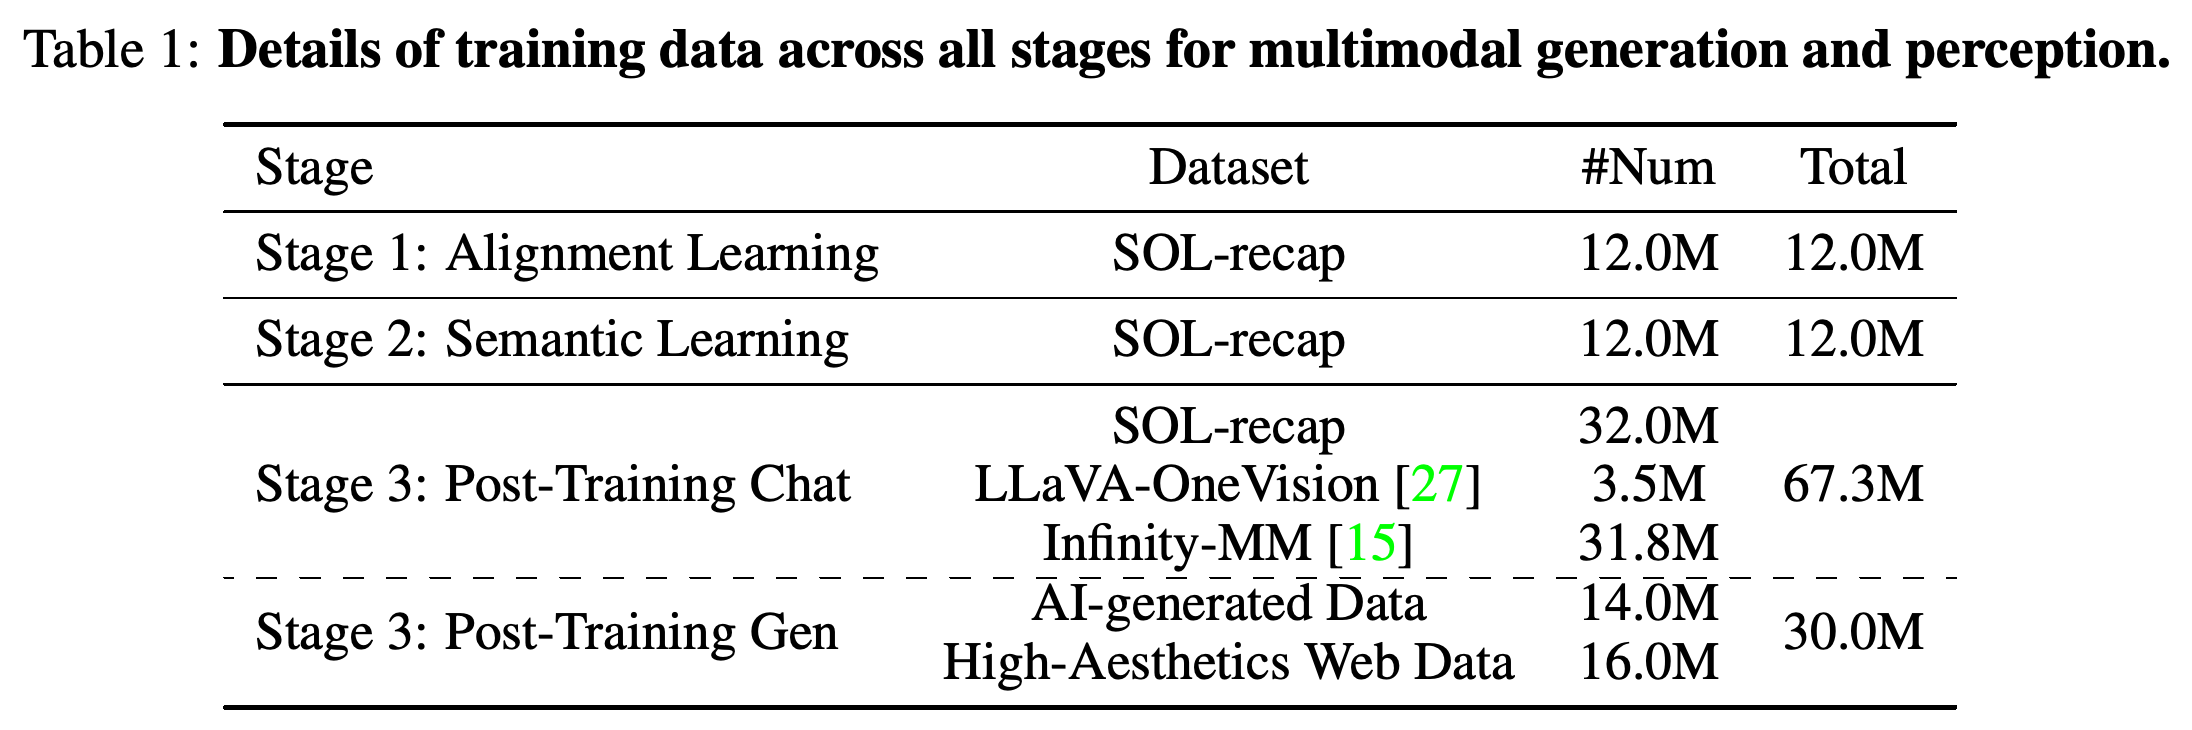
Stage 1인 정렬 학습에서는 사전 학습된 토크나이저와 LLM을 동결하고 캡션 손실로 시각 프로젝터만 학습한다. SOL-recap의 12M-image 부분집합을 사용한다. SOL-recap은 저자들이 공개 이미지 데이터셋 SA-1B, OpenImages, LAION에서 수집하고 캡션을 다시 작성한 이미지-텍스트 쌍 32M개로 구성된다.
Stage 2인 의미 학습에서는 토크나이저, 프로젝터, LLM의 동결을 해제한다. SOL-recap 쌍 12M개로 캡션과 복원을 함께 학습하여 토크나이저를 종단간 튜닝한다.
Stage 3인 후속 학습에서는 튜닝한 토크나이저를 동결하고, ETT-Chat과 ETT-Gen용 프로젝터와 LLM을 각각 학습한다. Chat 학습은 SOL-recap 쌍 32.0M개와 지시 데이터셋인 LLaVA-OneVision의 예시 3.5M개, Infinity-MM의 예시 31.8M개를 합쳐 총 67.3M개를 사용한다. 생성 학습은 Flux 이미지 모델로 생성한 샘플 14.0M개와 심미성이 높은 웹 이미지-텍스트 쌍 16.0M개를 합쳐 총 30.0M개를 사용한다.
데이터 배분은 공통 정렬 및 의미 학습 단계와 전문 모델을 위한 2개 후속 학습 분기를 구분한다. Chat의 총 67.3M개에는 SOL-recap과 지시 데이터가 포함되며, 생성의 총 30.0M개는 합성 이미지와 필터링한 웹 이미지-텍스트 쌍을 합친 값이다.
4 Experimental Results
실험은 멀티모달 이해, 텍스트 기반 이미지 생성, 통제된 절제 실험에서 토크나이저 튜닝이 기여하는 정도를 평가한다. 전체 시스템 간 비교에서는 모델 크기와 학습 데이터셋이 서로 다르다. 임베딩 입력 방식과 공동 목적함수의 효과는 절제 실험에서 더 직접적으로 확인할 수 있다.
4.1 Training Settings
모든 실험은 Qwen2.5-1.5B를 언어 백본으로 사용한다. 논문은 8-A100 노드에서 Adam 옵티마이저로 학습했다고 보고한다. 각 단계의 배치 크기는 1024이며, 최대 학습률은 순서대로 4 × 10⁻⁵, 4 × 10⁻⁵, 2 × 10⁻⁵다. 워밍업 비율은 0.03이며 코사인 학습률 감소를 사용한다. 별도 언급이 없으면 이미지는 512 × 512로 처리한다. 이해 절제 실험에서는 3단계에 시각 지시 데이터셋인 LLaVA-mix-665K를 사용한다.
- 캡션을 다시 작성한 32M-image 모음은 SA-1B의 이미지 11M장, OpenImages의 이미지 7M장, LAION의 이미지 14M장으로 구성된다.
- 생성 데이터는 이미지 해상도와 심미성 점수로 필터링하지만, 구체적인 필터링 임곗값은 보고하지 않는다.
토크나이저는 고정 학습률 1 × 10⁻⁴, 옵티마이저 계수 β₁ = 0.5와 β₂ = 0.9를 적용한 Adam으로 500,000단계 동안 학습한다. 전역 배치 크기는 256이고 입력 크기는 256 × 256이다. 적대적 손실과 엔트로피 손실의 가중치는 λ_G = 0.1과 λ_E = 0.05다. 학습 안정성을 높이기 위해 판별기 정규화 방법인 LeCAM을 사용한다.
4.2 Multimodal Understanding Evaluation
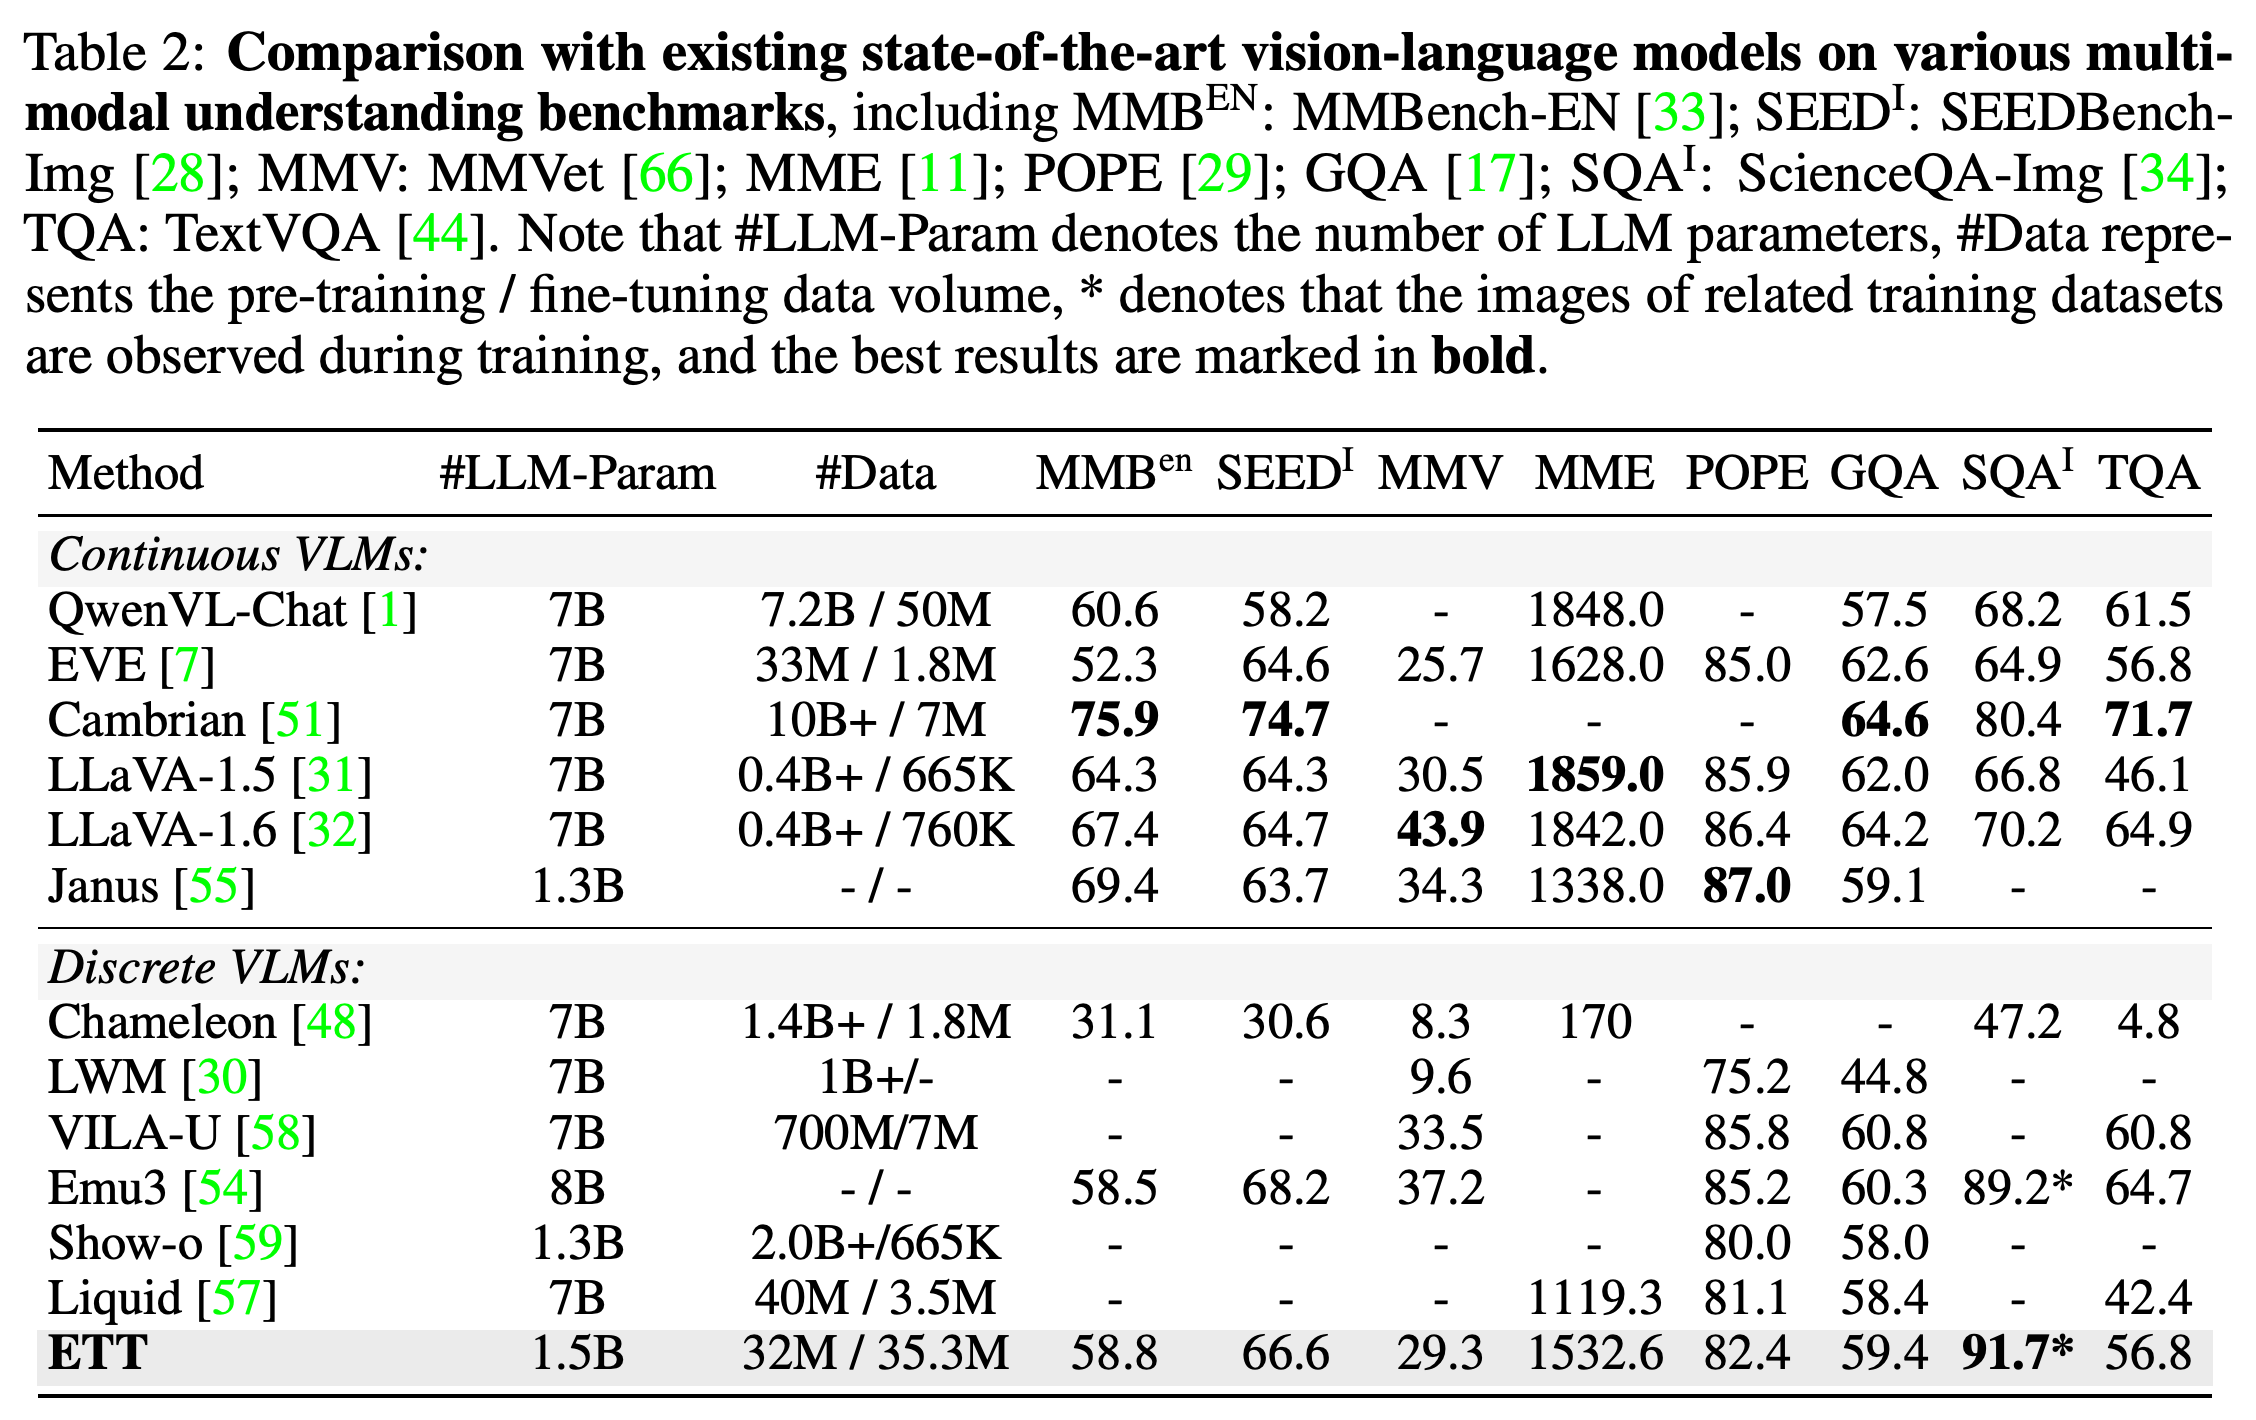
이해 평가는 조합적 시각 질의응답을 평가하는 GQA, 이미지에 없는 객체를 언급하는 객체 환각을 탐지하는 POPE, 이미지 기반 과학 추론을 평가하는 ScienceQA-IMG, 일반 멀티모달 벤치마크를 포함한다. ETT는 MMBench의 영어 평가인 MMBench-EN에서 58.8, SEEDBench-Img에서 66.6, 통합 멀티모달 능력 벤치마크인 MMVet에서 29.3, 멀티모달 평가 벤치마크인 MME에서 1532.6을 기록한다. POPE에서는 82.4, GQA에서는 59.4, ScienceQA-IMG에서는 91.7, TextVQA에서는 56.8을 기록한다.
- ETT는 이산 토큰 멀티모달 모델인 Liquid와 공통으로 보고한 4개 지표 MME, POPE, GQA, TextVQA에서 모두 앞선다. Emu3보다 MMBench-EN은 조금 높지만 SEEDBench-Img, MMVet, POPE, GQA, TextVQA는 낮다.
- ScienceQA-IMG의 91.7에는 관련 학습 데이터셋의 이미지를 학습 중 보았다는 의미로 별표가 붙어 있다. Emu3의 89.2에도 같은 조건이 표시되어 있다.
- Table 2는 ETT의 데이터를 사전 학습 예시 32M개와 미세 조정 예시 35.3M개로 보고한다. Table 1은 SOL-recap 쌍 32M개를 포함한 Stage 3 Chat 혼합 데이터를 67.3M개로 보고한다. 이 합계들은 SOL-recap을 서로 다르게 집계한다.
ETT는 공통 지표에서 더 큰 이산 토큰 시스템 여러 개를 앞서지만, 모든 이해 벤치마크에서 최고 성능을 보이지는 않는다. 누락된 항목 때문에 비교에 한계가 있고 모델 및 데이터 규모도 다르다. ScienceQA-IMG의 별표는 관련 학습 데이터셋의 이미지를 학습 중 보았다는 조건을 나타낸다.
4.3 Visual Generation Evaluation
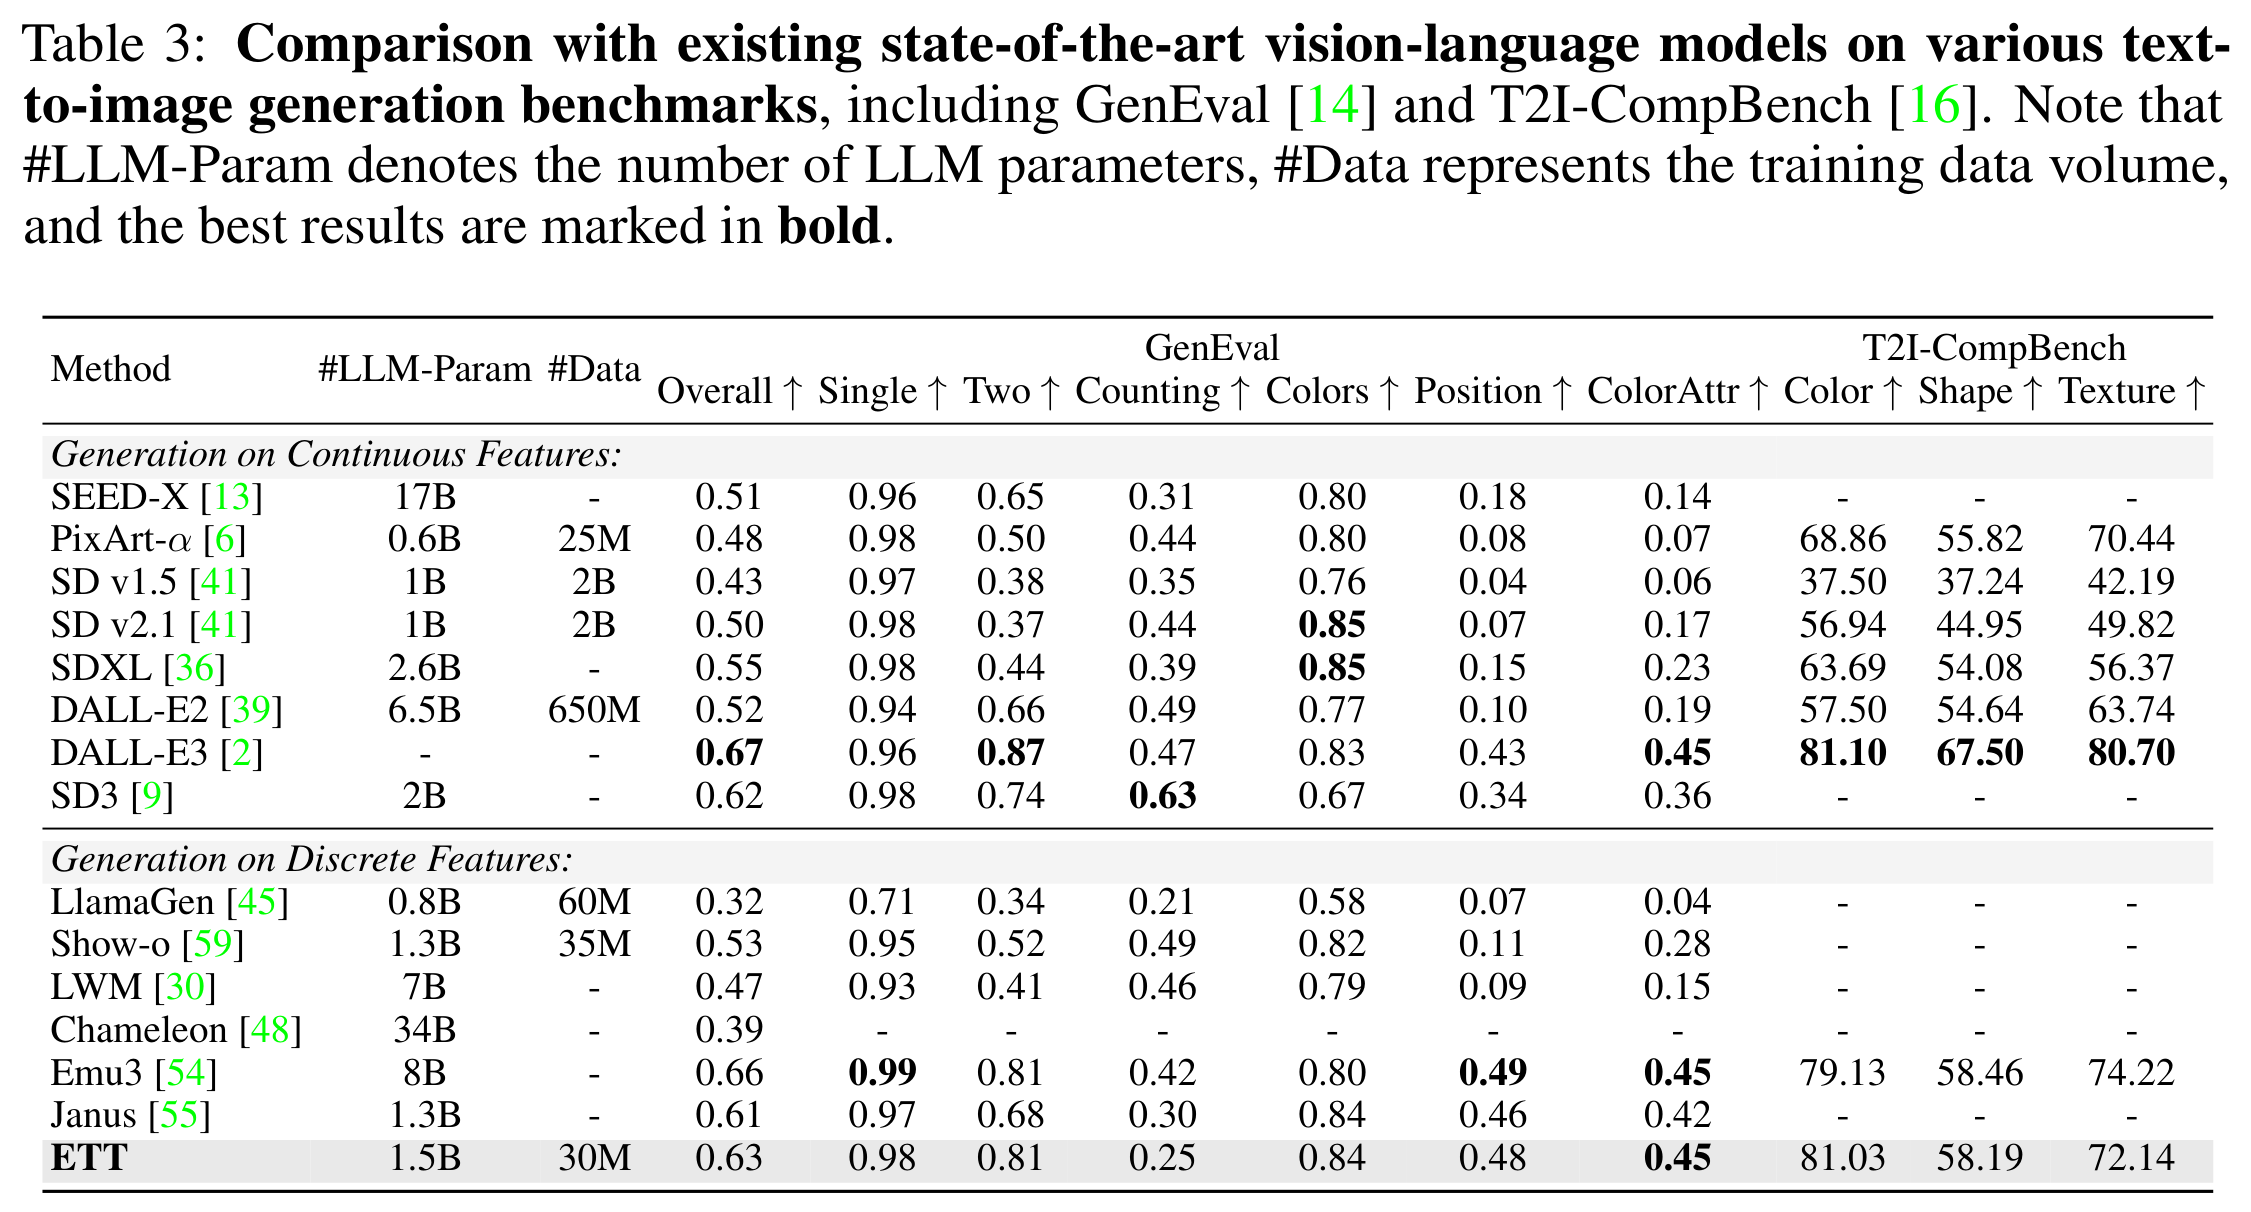
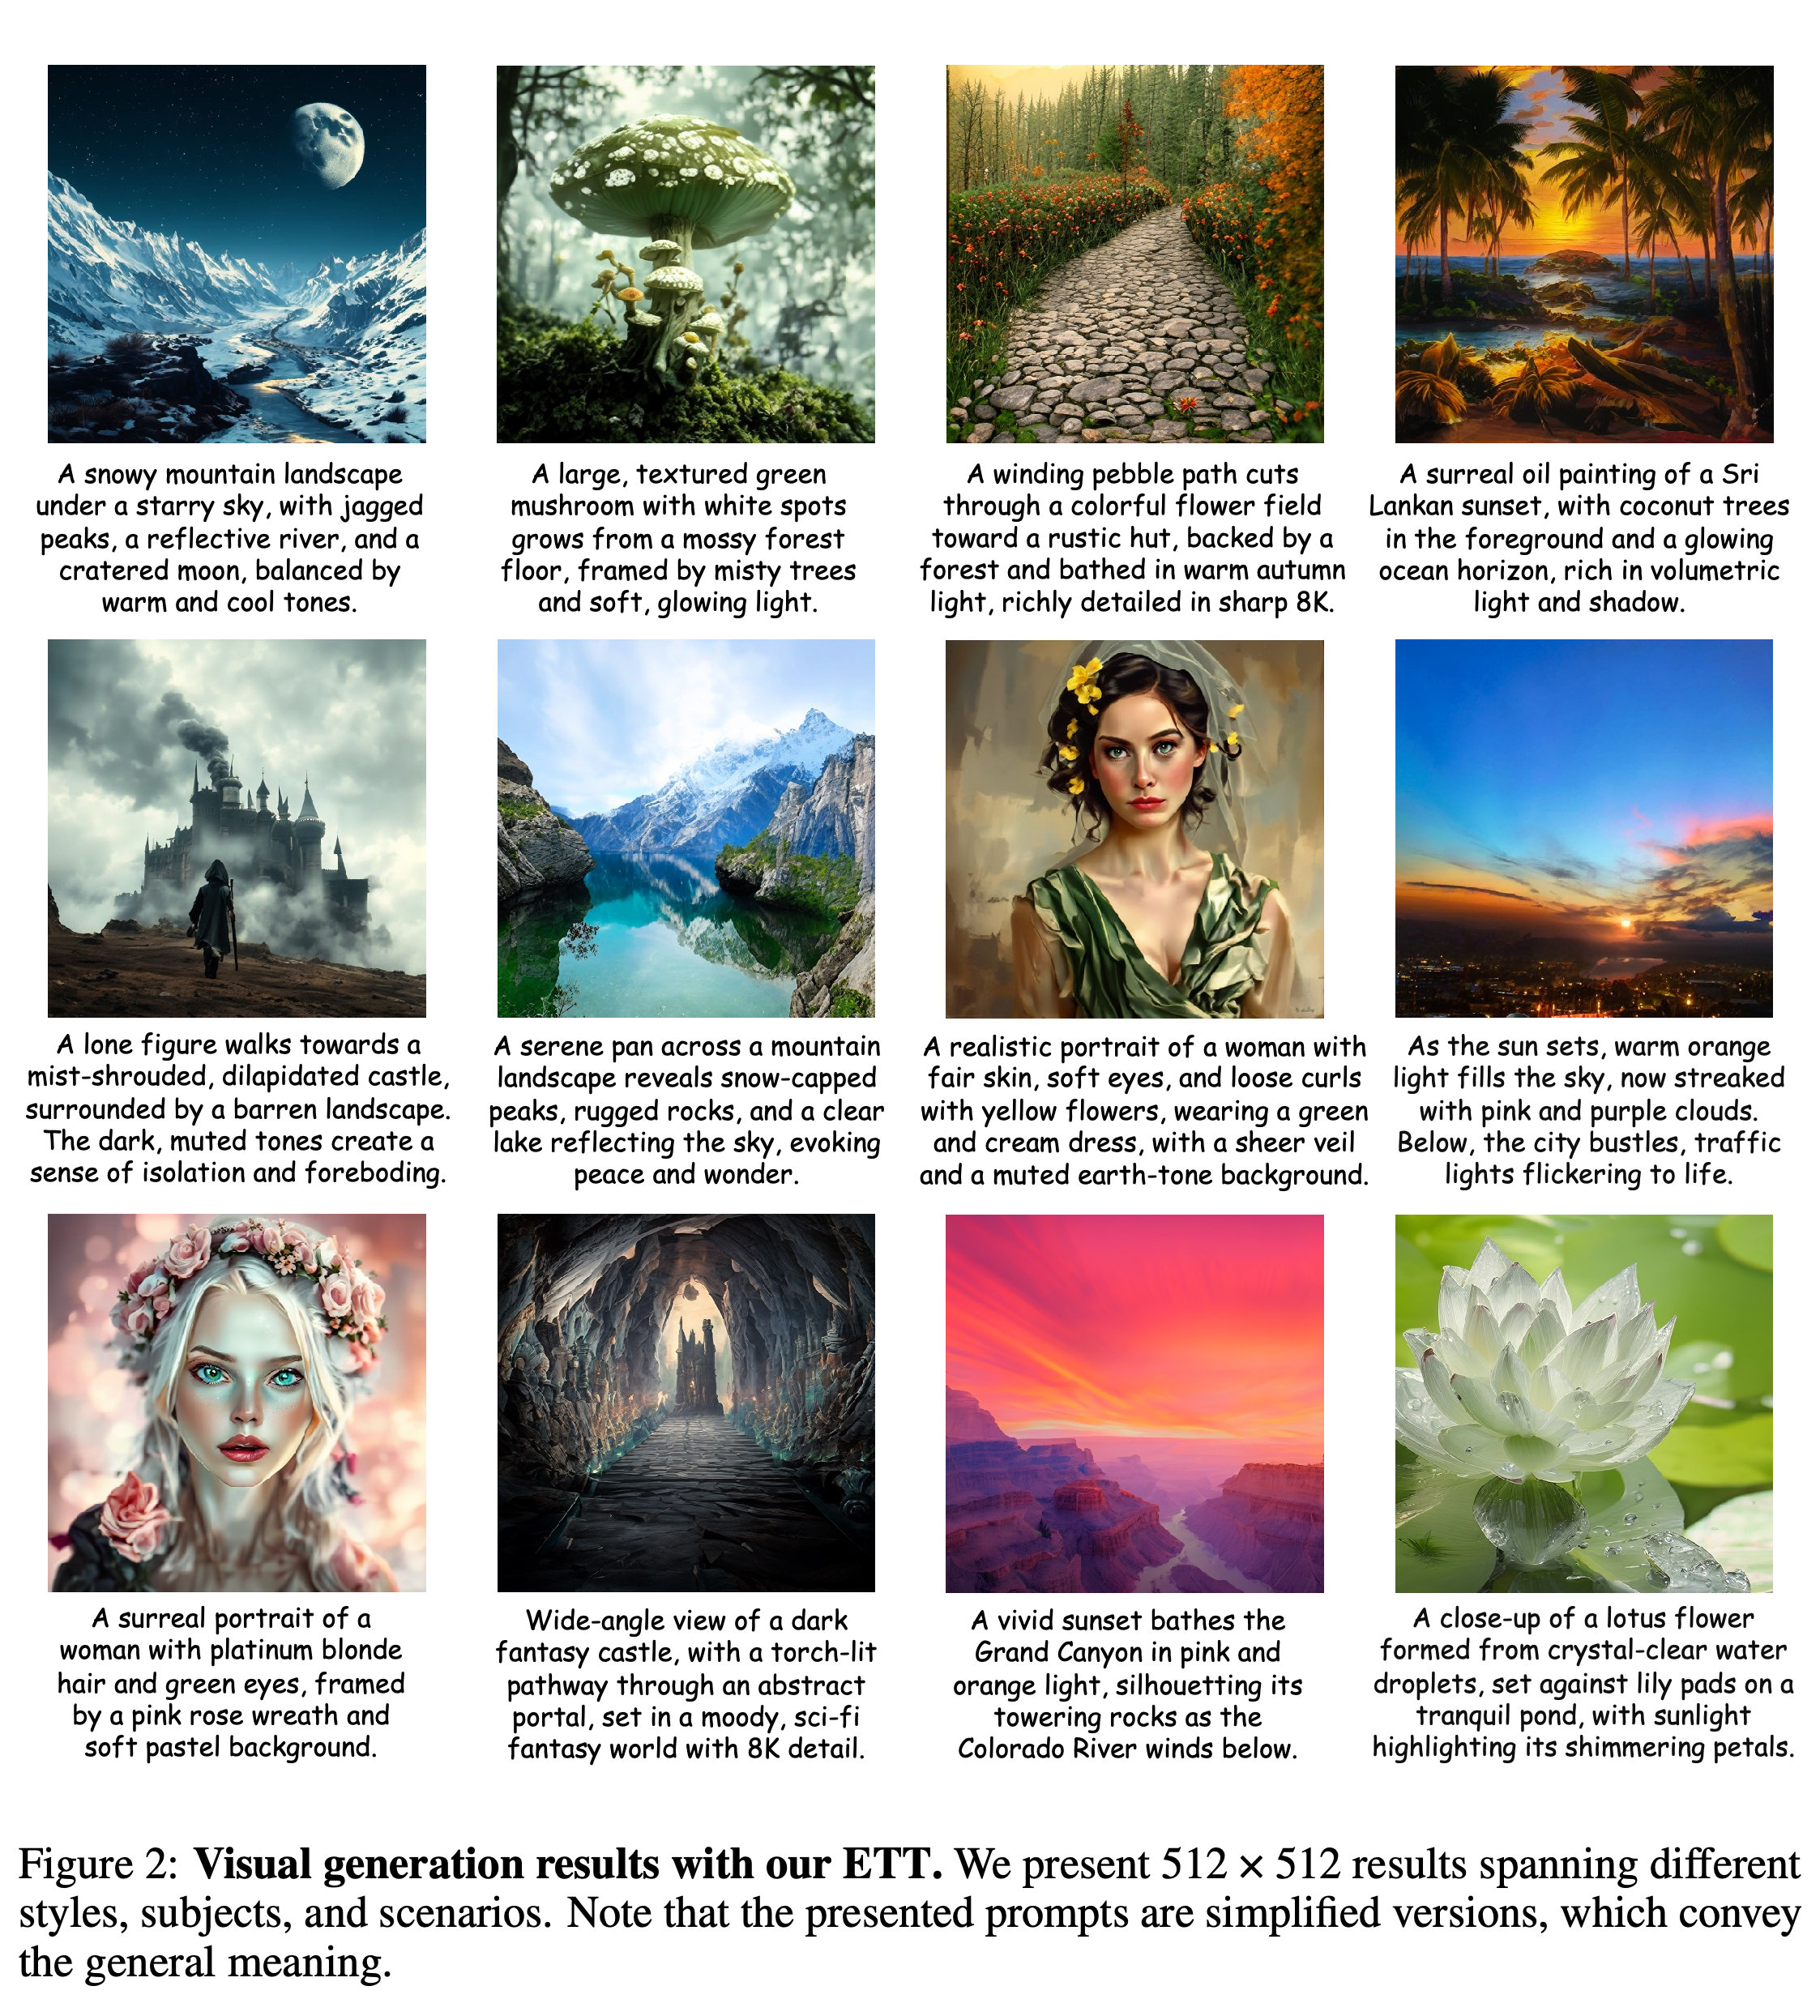
전체 시각 어휘를 유지하는 샘플링 설정인 top-k = 131,072와 top-p = 1.0에서 ETT-Gen은 1.5B language backbone과 생성 예시 30M개를 사용하여 GenEval 종합 점수 0.63을 기록한다. Table 3에서 SDXL은 0.55, 또 다른 확산 기반 생성 모델인 SD3는 0.62, Emu3는 0.66, 텍스트 기반 이미지 생성 모델인 DALL-E3는 0.67을 기록한다. 이 비교에서는 모델과 데이터 조건이 서로 다르다.
- ETT의 GenEval 점수는 단일 객체에서 0.98, 2개 객체에서 0.81, 개수 세기에서 0.25, 색상에서 0.84, 위치에서 0.48, 색상 속성에서 0.45다. 비교 대상인 여러 시스템에 비해 개수 세기 성능이 약하다.
- 조합적 텍스트 기반 이미지 생성을 평가하는 T2I-CompBench에서 ETT는 색상 81.03, 형태 58.19, 질감 72.14를 기록한다. DALL-E3는 각각 81.10, 67.50, 80.70을 기록한다.
- 본문은 생성 전에 입력 설명을 수정하는 프롬프트 재작성을 논의하지만, 그 효과만 분리한 수치 절제 실험은 제시하지 않는다. 정성적 예시는 512 × 512 출력과 간략하게 표시한 프롬프트를 보여준다.
범주별 결과는 생성 성능이 고르지 않음을 보여준다. ETT는 위치에서 0.48, 색상 속성에서 0.45를 기록하지만 개수 세기는 0.25에 그친다. GenEval 종합 점수 0.63은 표에 나열된 여러 시스템보다 높지만 Emu3와 DALL-E3보다는 낮다. DALL-E3는 보고된 T2I-CompBench의 3개 차원에서도 모두 ETT를 앞선다.
선별된 출력은 풍경, 인물, 판타지 장면, 양식화된 사물을 포함하며 모델이 512 × 512로 생성하는 이미지의 다양성을 보여준다. 표시된 프롬프트가 간략하고 같은 조건의 베이스라인 패널이 없어, 다른 모델보다 프롬프트를 얼마나 잘 따르는지 판단하기에는 한계가 있다.
4.4 Ablation Study
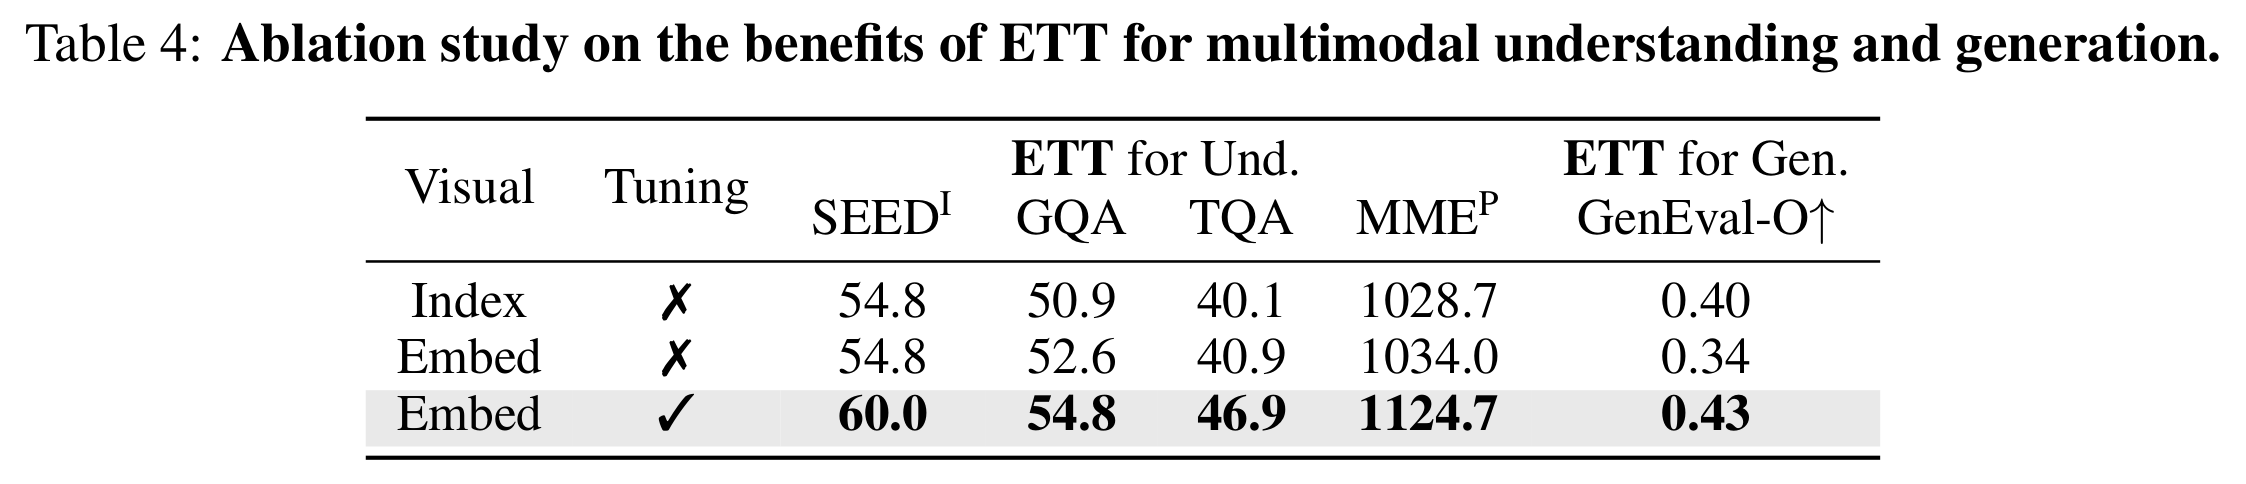
통제된 비교에서는 SOL-recap으로 이해 모델과 생성 모델을 학습하고, 이해 모델에는 LLaVA-mix-665K 지도 미세 조정을 추가한다. 동결된 이산 인덱스를 동결된 코드북 임베딩으로 바꾸면 GQA는 50.9에서 52.6으로, TextVQA는 40.1에서 40.9로 오르지만 GenEval은 0.40에서 0.34로 낮아진다. 종단간 튜닝을 추가하면 SEEDBench-Img는 60.0, GQA는 54.8, TextVQA는 46.9, MME의 지각 하위 집합인 MME-Perception은 1124.7, GenEval은 0.43으로 오른다.
- 이산 인덱스 베이스라인 대비 향상 폭은 SEEDBench-Img에서 5.2점, GQA에서 3.9점, TextVQA에서 6.8점, GenEval에서 0.03이다.
- 동결된 임베딩의 결과는 입력 방식만으로 생성 성능 향상을 설명할 수 없음을 보여준다. 이 실험에서는 공동 튜닝을 통해 성능이 회복되고 베이스라인을 넘어선다.
3개 행은 임베딩 입력 방식과 토크나이저 튜닝의 효과를 분리한다. 동결된 임베딩은 일부 이해 지표를 높이지만 GenEval을 0.40에서 0.34로 낮춘다. 튜닝을 적용하면 나열된 모든 점수가 이산 인덱스 베이스라인보다 높아진다.
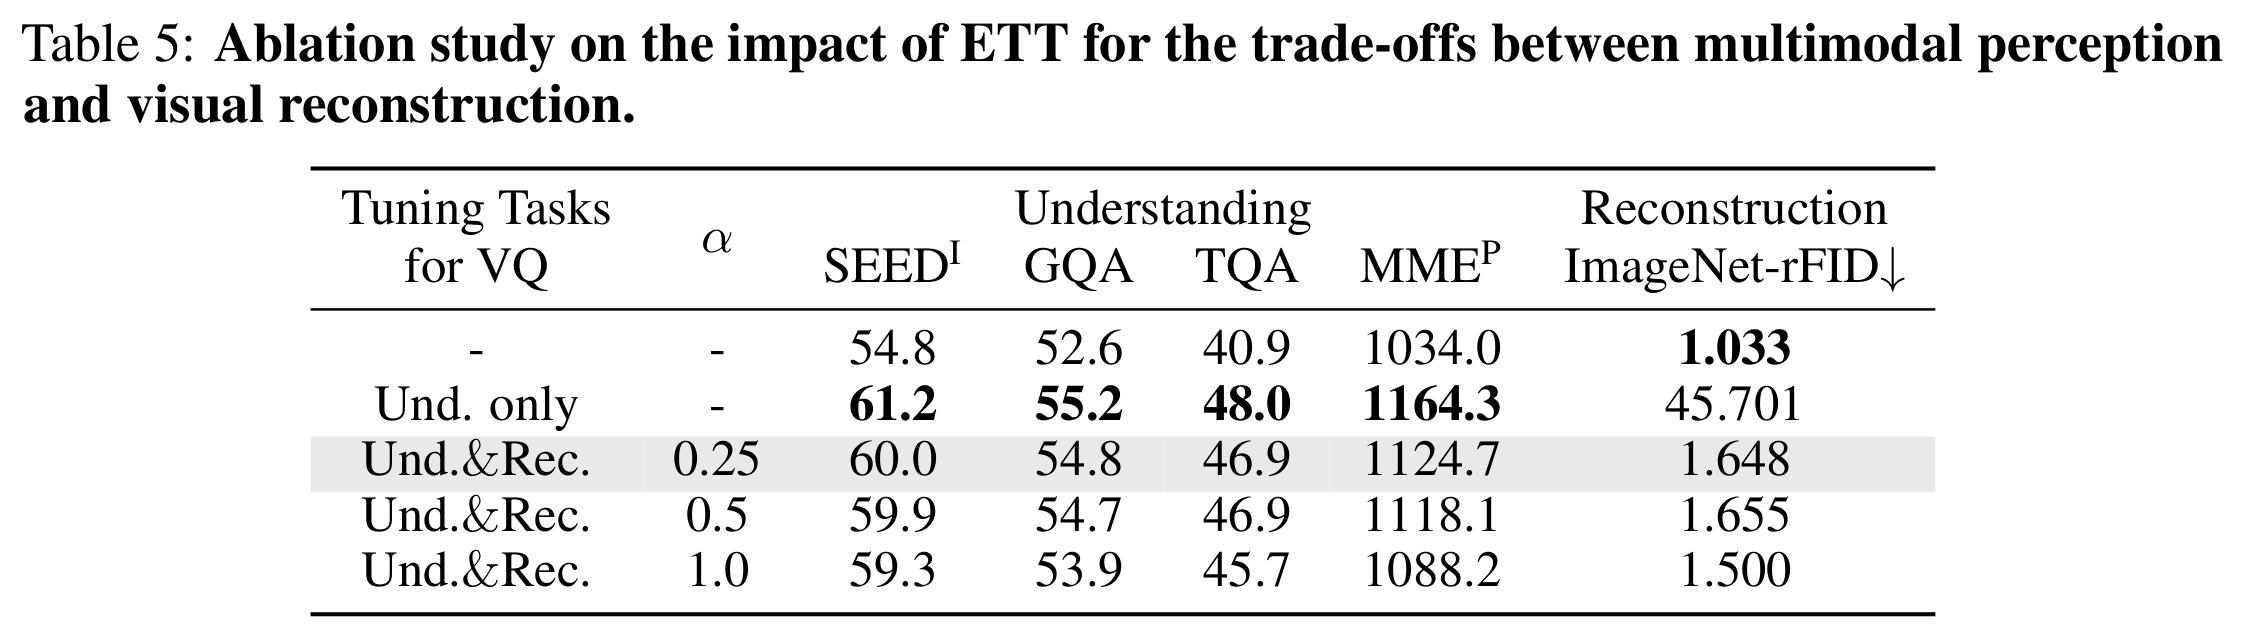
복원 절제 실험은 이미지 데이터셋인 ImageNet을 256 × 256 크기로 사용하고 rFID를 보고한다. 이해 작업만으로 튜닝하면 이해 점수는 가장 높지만 rFID가 1.033에서 45.701로 나빠진다. 복원 손실을 α = 0.25의 가중치로 추가하면 이해 성능 향상을 대부분 유지하면서 rFID를 1.648로 개선한다. α를 1.0으로 높이면 rFID는 1.500이 되지만 SEEDBench-Img는 59.3, TextVQA는 45.7로 낮아진다.
- α = 0.25에서 SEEDBench-Img는 60.0, TextVQA는 46.9이며, 이해 작업만으로 튜닝하면 각각 61.2와 48.0이다.
- 중간 설정인 α = 0.5의 rFID는 1.655이므로, 시험한 가중치 범위에서 복원 품질이 단조롭게 개선되지는 않는다.
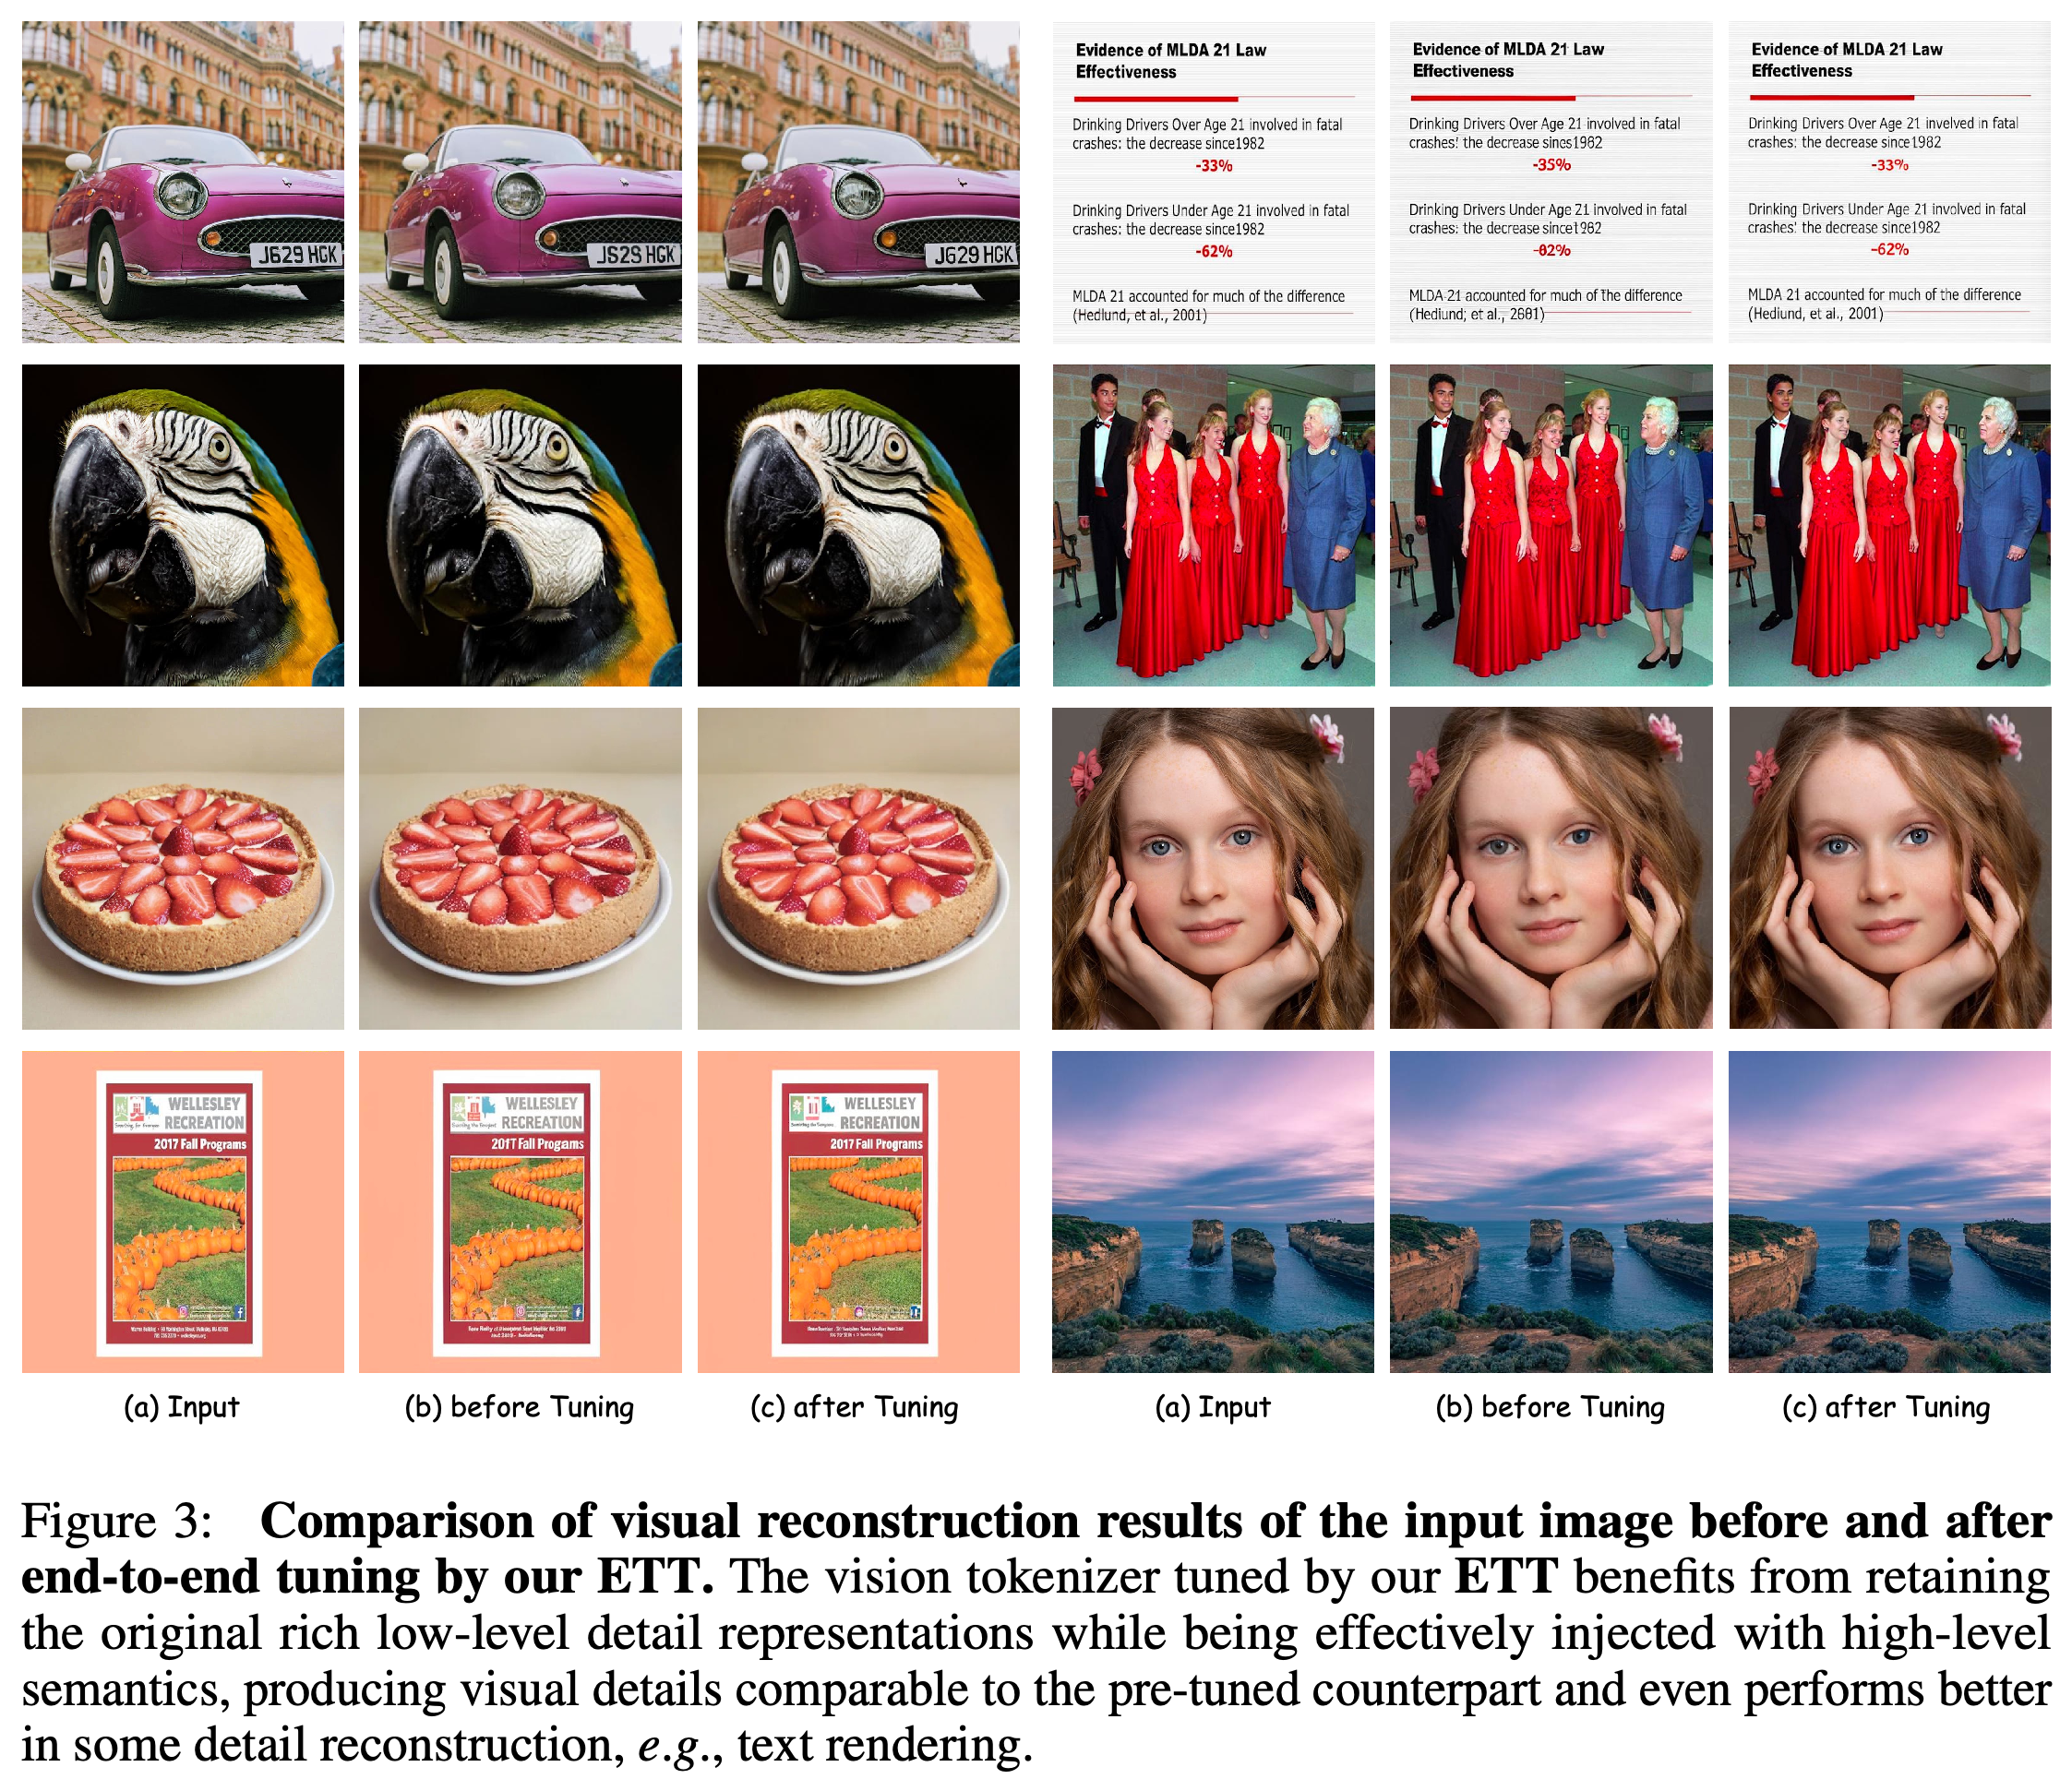
- Figure 3은 튜닝 전후에 비슷한 복원 결과를 보여주며, 일부 텍스트 세부 표현은 개선된다. 이 예시들은 지표를 보완하지만 복원 품질이 그대로 유지되었다는 근거는 되지 않는다.
이해 작업만 학습하면 이해 점수는 가장 높지만 복원 품질이 크게 나빠진다. 기본값 α = 0.25는 이러한 저하를 크게 줄인다. α = 1.0은 공동 튜닝 설정 중 복원 성능이 가장 좋지만 이해 성능은 더 낮아진다. 어느 설정도 튜닝 전 rFID인 1.033에는 도달하지 못한다.
입력, 튜닝 전 복원, 튜닝 후 복원을 나란히 비교하면 자연 이미지, 얼굴, 문서, 포스터의 모습이 비슷하다. 일부 텍스트 세부 표현은 튜닝 후 더 잘 보존된 것으로 보이지만, 이 예시만으로 전체 복원 품질이 그대로 유지되었다고 판단할 수는 없다.
5 Conclusion
결론에서는 토크나이저 코드북 임베딩과 토큰 수준 캡션 감독을 사용하여 시각 표현을 다운스트림 학습과 공동 최적화한 점을 ETT의 성능 향상 요인으로 제시한다. 실험은 토크나이저를 동결한 절제 실험 대비 이해와 생성 모두에서 성능 향상을 뒷받침한다. 보조 복원 목적함수는 품질 저하를 제한하지만, rFID는 튜닝하지 않은 베이스라인보다 여전히 나쁘다.
6 Limitations and Future Topics
저자들은 모델 용량과 종단간 학습 데이터 규모를 추가 연구 과제로 제시한다. ETT는 이해와 생성에 특화된 토크나이저를 처음부터 학습하지 않고 기존 토크나이저를 미세 조정한다. 향후 방향으로 더 큰 규모의 학습, 토크나이저를 처음부터 학습하는 방법, 비디오와 오디오로의 확장을 제안하지만, 이 논문에는 해당 설정의 결과가 없다.
부록
- 제공된 13페이지 논문에는 부록이 없다. 10–13페이지는 References이며, 그 뒤에 추가 실험 세부 사항이나 보충 결과는 없다.
짧은 생각
가장 강한 근거는 통제된 절제 실험이다. 튜닝 없이 임베딩만 사용하면 생성 성능이 낮아지지만, 공동 튜닝은 생성과 이해 성능을 모두 높인다. 이 결과는 데이터셋과 파라미터 수가 다른 시스템 간 비교보다, 다운스트림 감독 신호를 토크나이저에 전달하는 방식의 실용적 이점을 더 직접적으로 뒷받침한다. 품질 보존 주장은 조건을 명확히 해야 한다. α = 0.25는 이해 작업만으로 튜닝할 때 발생하는 심각한 복원 품질 저하를 막지만, rFID는 여전히 1.033에서 1.648로 증가한다. 보고된 Qwen2.5-1.5B 백본과 IBQ 기반 토크나이저 이외의 설정에서는 일반성이 검증되지 않았다. 논문은 반복 실행에 따른 불확실성 추정치를 보고하지 않는다. 또한 Stage 3에서는 2개 작업을 모두 수행하는 최종 체크포인트 1개를 보여주는 대신 작업별 전문 모델을 별도로 학습한다.