


Group Sequence Policy Optimization 요약 설명
24 Jul 2025 | Paper Review Reinforcement Learning Mixture-of-Experts Loss Functions목차
이번 글에서는 Group Sequence Policy Optimization 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 7월 24일(Arxiv)
- Zheng, Chujie, Liu, Shixuan, Li, Mingze, Chen, Xiong-Hui, Yu, Bowen, Gao, Chang, Dang, Kai, Liu, Yuqiong, Men, Rui, Yang, An, et al.
- Qwen Team, Alibaba Inc.
- 논문 링크
요약
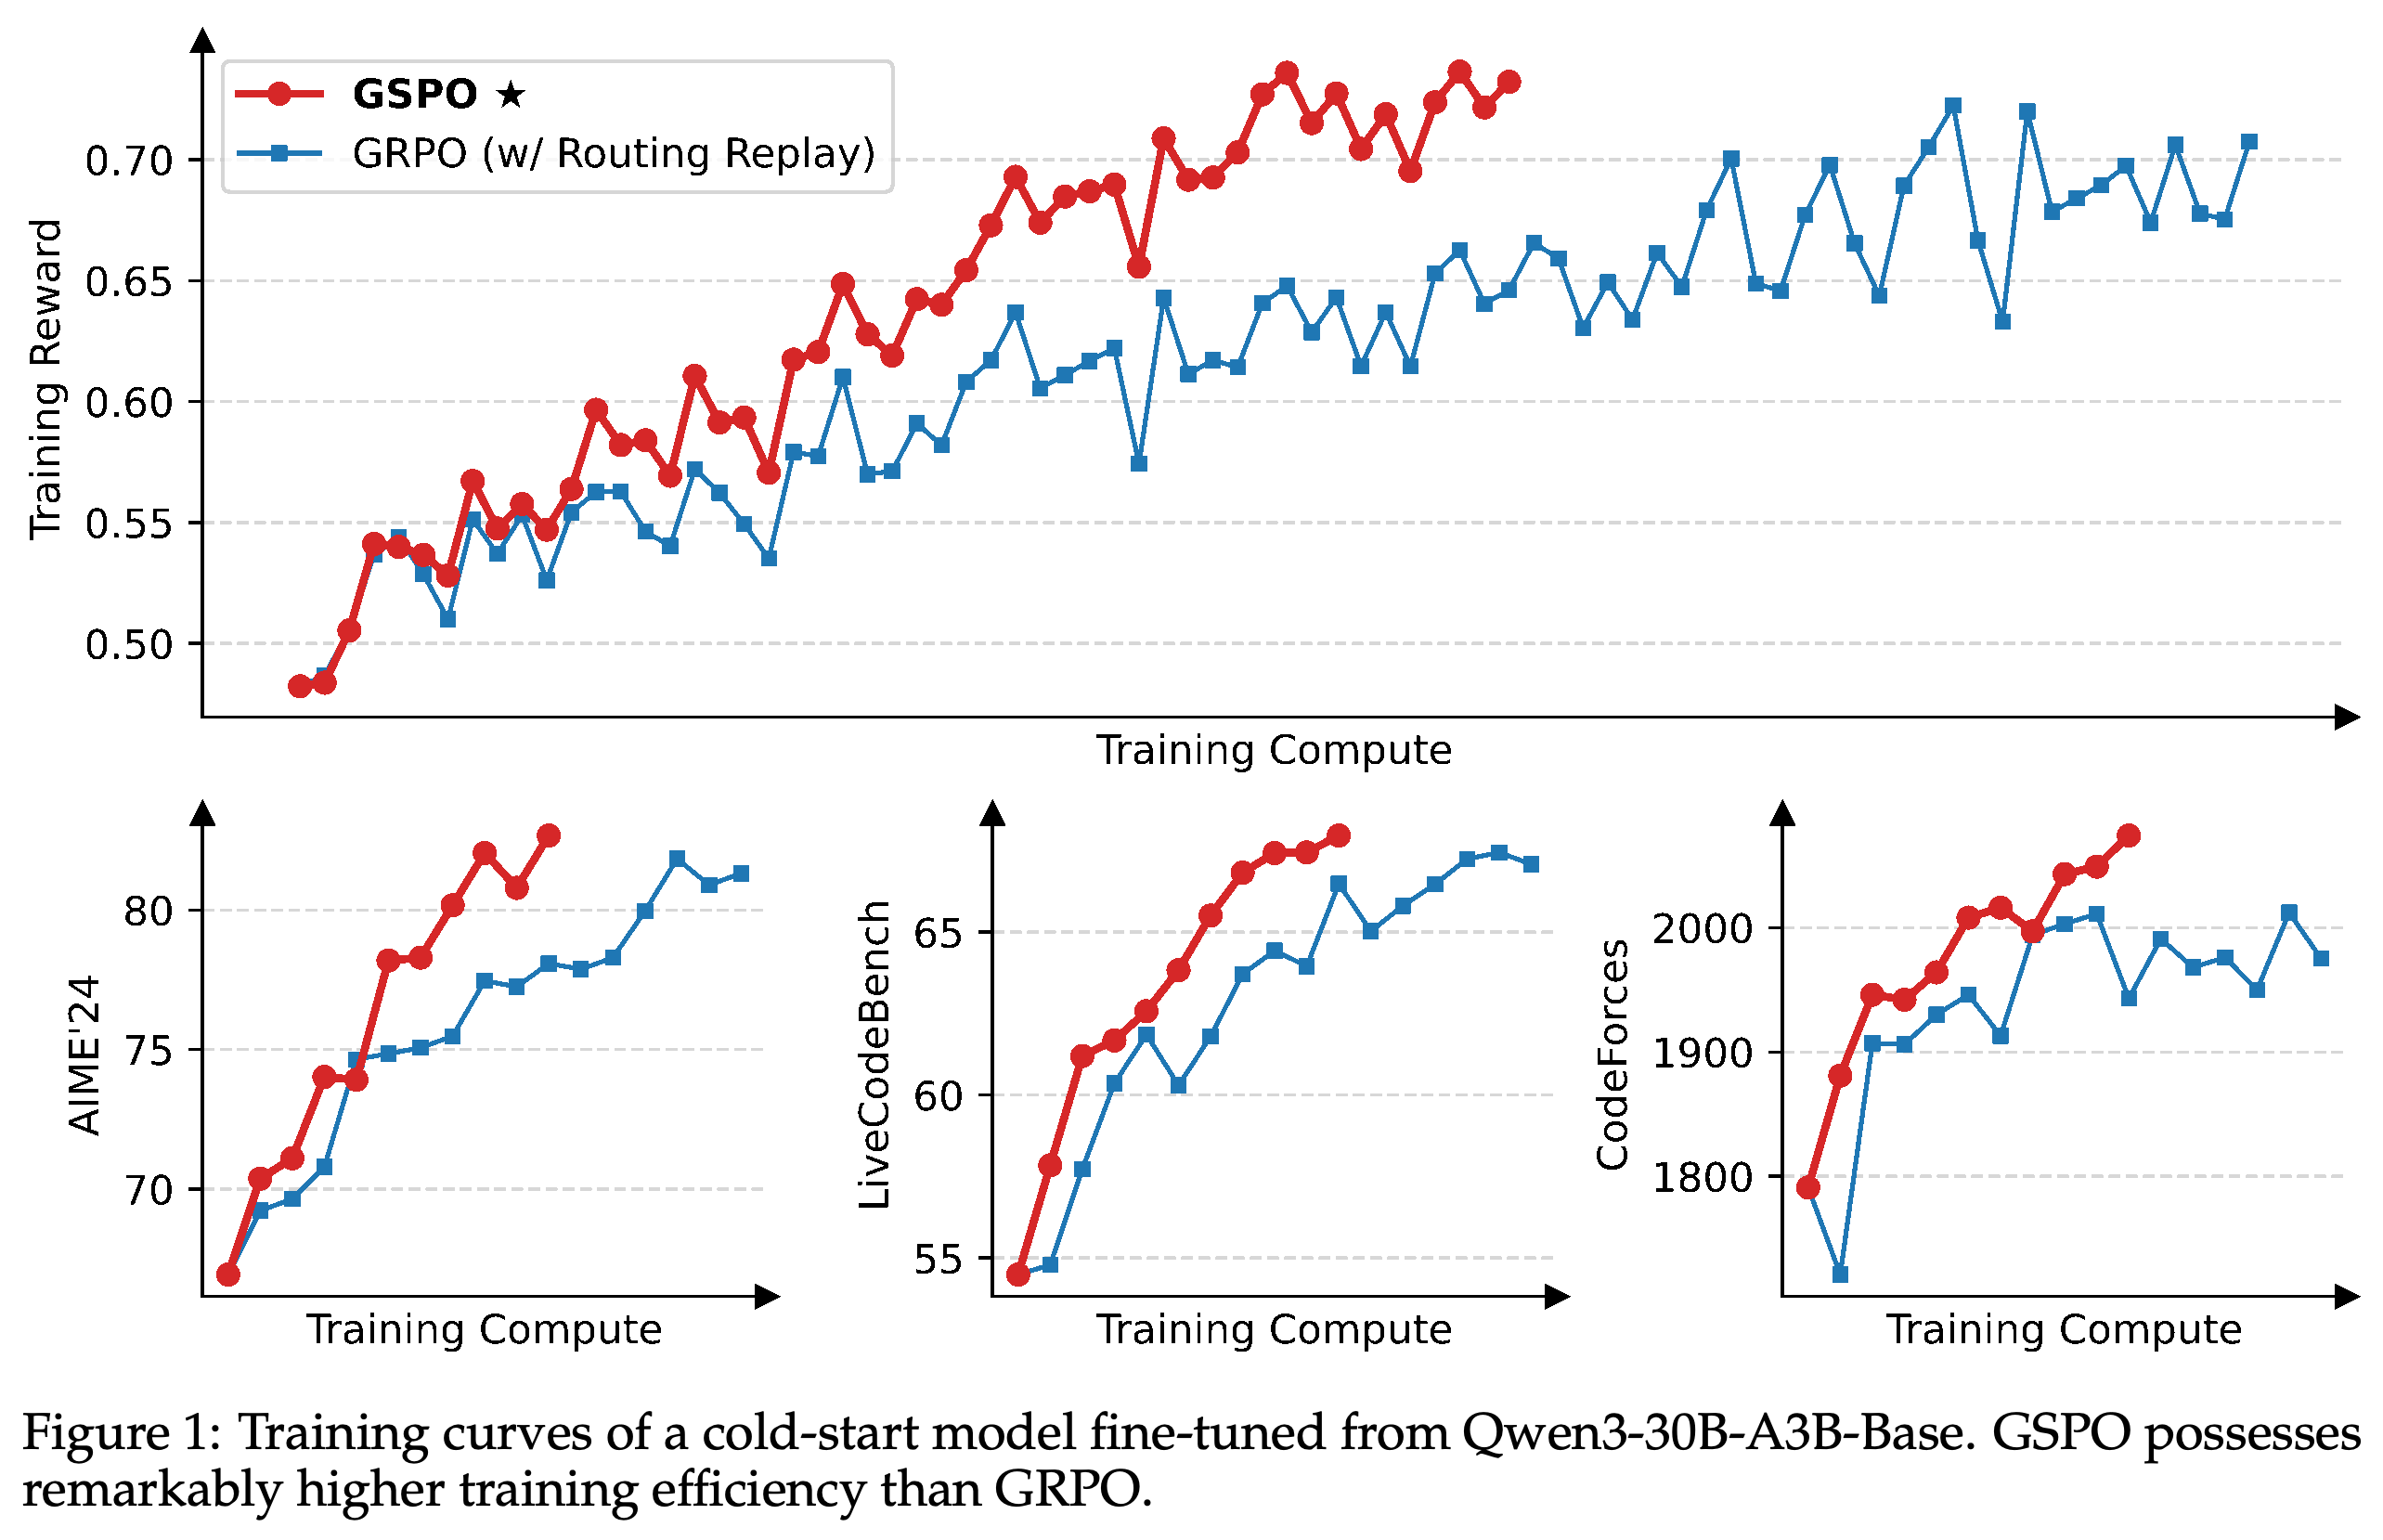
- 언어 모델을 보상으로 학습할 때 응답이 길어지면 학습이 불안정해질 수 있다. Qwen3-30B-A3B-Base를 미세 조정한 모델에서 학습을 시작했을 때, 응답 전체의 확률로 업데이트 가중치를 정하는 Group Sequence Policy Optimization(GSPO)은 토큰별 확률 비율을 사용하는 Group Relative Policy Optimization(GRPO)보다 같은 학습 연산량과 사용한 쿼리 수에서 더 높은 보상과 벤치마크 성능을 달성한다. GRPO가 Routing Replay를 통해 데이터를 생성한 모델의 전문가 선택을 업데이트 과정에서 재사용하는 조건에서도 이 결과가 나타난다.
- GSPO는 같은 쿼리에 대한 응답 그룹 안에서 정규화한 보상과, 현재 모델과 데이터 생성 모델의 응답 확률 비율을 길이로 정규화한 값을 결합한다. 이 비율이 임계값을 넘으면 일부 업데이트를 억제하는 clipping을 응답 전체에 적용한다. 평가에 사용한 Mixture-of-Experts(MoE) 모델은 토큰마다 전문가 네트워크 일부만 활성화하며, GSPO를 사용하면 Routing Replay 없이도 안정적으로 학습한다.
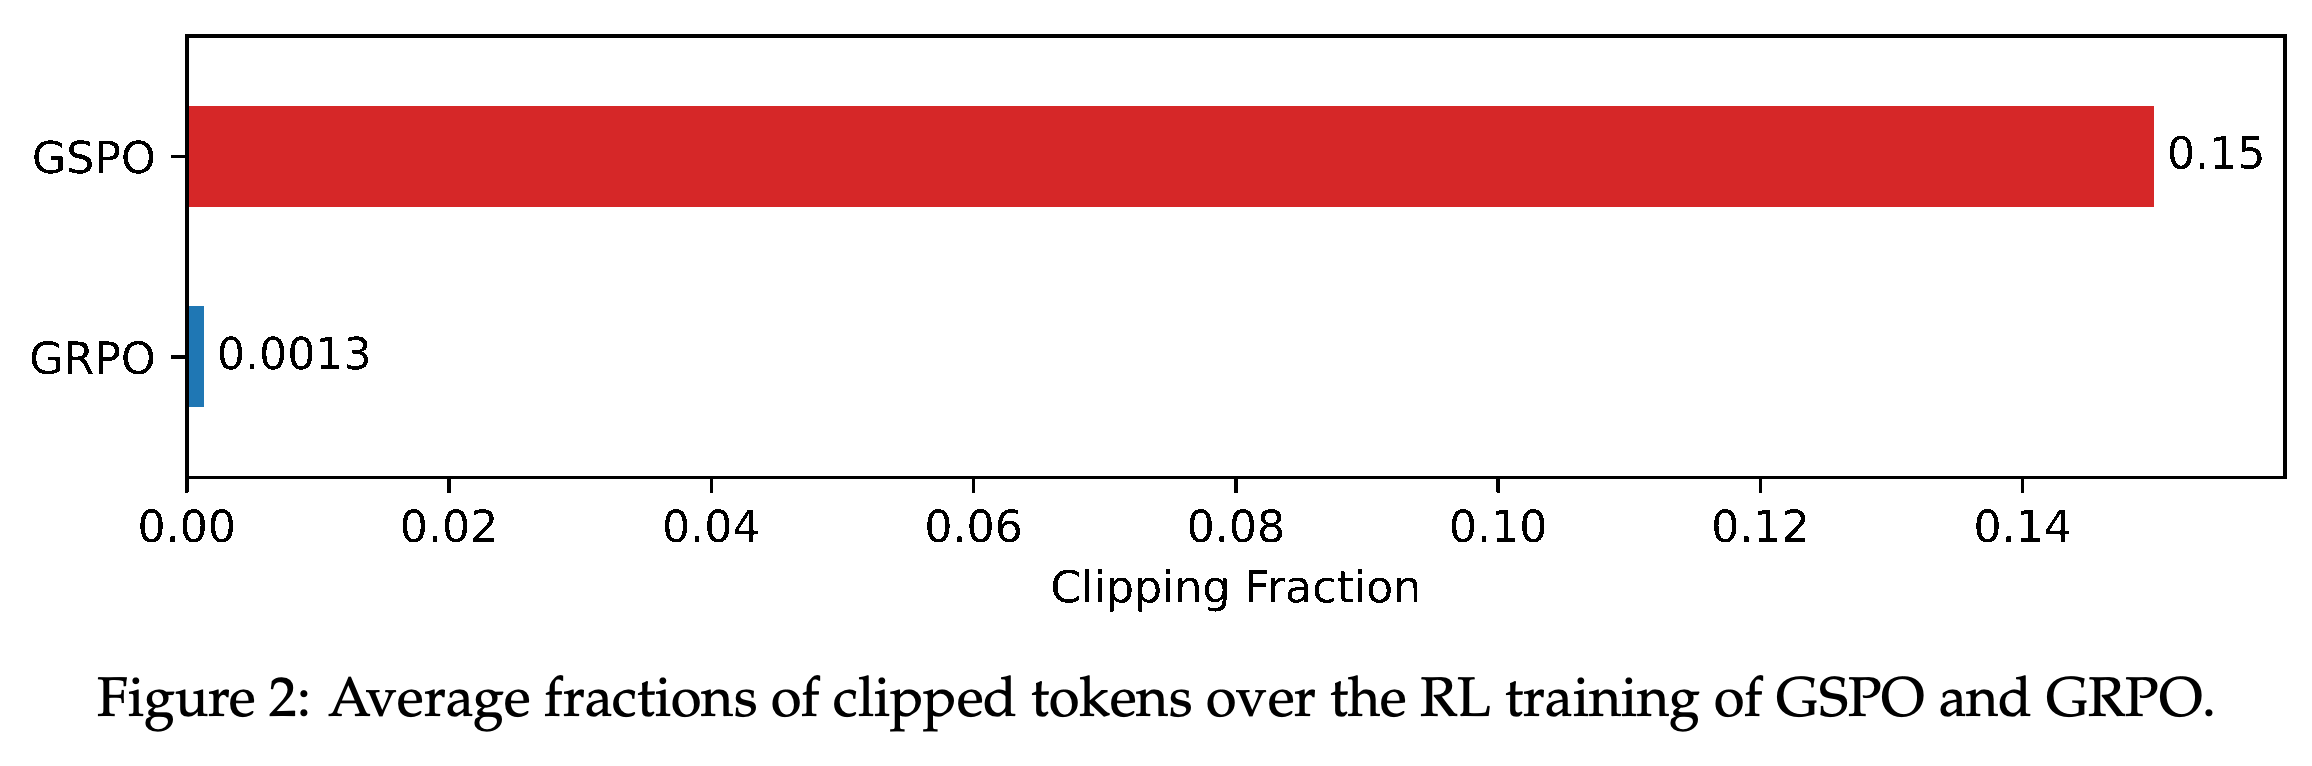
- 보고된 평균 clipping 토큰 비율은 GSPO가 0.15, GRPO가 0.0013이지만, 학습 효율은 GSPO가 더 높다. 실험 근거는 주로 이름이 명시된 초기 모델 1개의 학습 곡선이다. 논문은 구체적인 연산 예산, 반복 실행에 따른 불확실성, 실측한 인프라 절감량을 제공하지 않는다.
1 Introduction
서론은 강화학습(RL)을 확장하려면 학습 안정성이 필요하다고 설명한다. RL은 보상을 사용해 정책, 즉 응답을 생성하는 모델을 개선하는 학습 방식이다. 저자들은 GRPO의 학습 붕괴 원인으로 잡음이 큰 토큰 단위 중요도 가중치를 지목한다. 이는 현재 정책과 이전 정책의 토큰 확률 비율이며, 긴 응답에서 그 영향이 누적되고 clipping과 상호작용한다는 설명이다. 저자들은 최적화 단위를 보상을 받는 응답 전체에 맞추자고 제안한다.
2 Preliminaries
정책 πθ는 자기회귀 언어 모델로, 각 토큰의 확률은 쿼리와 앞선 토큰들을 조건으로 계산한다. 쿼리 x와 응답 y에 대한 우도는 πθ(y|x) = ∏ₜ₌₁^|y| πθ(yₜ|x,y<ₜ)이며, 검증기는 보상 \(r(x,y)\in[0,1]\)을 부여한다. Proximal Policy Optimization(PPO)은 clipping한 확률 비율로 업데이트를 제한하는 알고리즘이다. 기대 보상을 예측하는 별도의 가치 모델로 토큰의 상대적 선호도를 나타내는 advantage를 추정한다. GRPO는 응답의 모든 토큰에 같은 그룹 정규화 보상을 부여해 가치 모델을 제거한다.
- GRPO는 응답 보상에서 그룹 평균을 뺀 뒤 그룹 표준편차로 나누어 응답 advantage를 계산한다. G는 쿼리마다 생성하는 응답 수를 나타낸다.
- 논문은 가치 모델의 메모리 사용량, 연산량, 추정 신뢰도를 PPO의 실용적 한계로 지적한다. 제시된 목적함수에서는 정책 간 차이에 페널티를 부여하는 Kullback–Leibler(KL) 정규화 항을 생략한다. 이 항은 논문의 논의 범위 밖에 있기 때문이다.
3 Motivation
생성한 응답의 큰 배치를 경사 업데이트용 미니배치 여러 개로 나누면 off-policy 상황이 생긴다. 이후 업데이트에서는 데이터를 생성한 정책과 다른 정책을 최적화하기 때문이다. 중요도 샘플링은 표본을 생성하는 분포의 변화를 반영하도록 표본에 가중치를 다시 부여하는 방법이며, 이러한 업데이트에서 확률 비율을 사용하는 근거가 된다. 저자들은 GRPO가 각 접두부에서 샘플링한 토큰 1개로 수행하는 보정에 잡음이 크다고 주장한다. 또한 체크포인트 롤백, clipping 조정, 생성 길이 확대, 쿼리 변경 이후에도 학습 붕괴가 지속되었다고 보고한다.
- 이는 관찰된 불안정성에 대해 저자들이 제시한 설명이다. 이 절은 시퀀스 단위 최적화의 동기를 설명하지만, 토큰 단위 중요도 샘플링이 일반적으로 불가능하다는 결과를 입증하지는 않는다.
4 Algorithm
알고리즘 절에서는 GSPO의 시퀀스 단위 목적함수를 정의하고, 경사 가중치를 GRPO와 비교하며, 토큰별 advantage를 조정할 수 있는 GSPO-token을 소개한다. GSPO와 GSPO-token 모두 길이로 정규화한 시퀀스 우도 비율 1개로 응답의 중요도 가중치 값을 정한다.
4.1 GSPO: Group Sequence Policy Optimization
응답 i에 대해 GSPO는 sᵢ(θ) = (πθ(yᵢ|x)/πθold(yᵢ|x))^(1/|yᵢ|)를 정의한다. 이는 토큰별 확률 비율의 기하평균이다. 목적함수는 응답과 쿼리에 걸쳐 min(sᵢ(θ)Âᵢ, clip(sᵢ(θ),1−ε,1+ε)Âᵢ)의 평균을 구한다. 여기서 Âᵢ는 그룹 정규화 보상이고, ε는 clipping 범위를 정한다. Clipping은 응답 전체에 적용한다. 저자들은 비율의 분산을 줄이고 길이가 다른 응답들의 비율을 비교 가능한 수치 범위에 유지하기 위해 길이 정규화를 사용한다.
- 식 (7)은 현재 정책과 이전 정책 사이의 토큰 로그 확률 차이를 평균한 뒤 지수함수를 적용해 같은 비율을 계산한다.
- 길이 정규화를 하지 않으면 일부 토큰의 확률 변화만으로도 시퀀스 비율이 크게 변동할 수 있다. 비율의 정의가 다르기 때문에 GSPO와 GRPO는 일반적으로 자릿수 규모가 다른 clipping 범위를 사용한다.
4.2 Gradient Analysis
Clipping을 제외하고 유도하면, GSPO는 토큰 로그 우도 경사의 평균에 응답 전체에 공통인 계수 sᵢ(θ)Âᵢ를 곱한다. 반면 GRPO는 모든 토큰이 같은 응답 advantage를 공유하더라도 각 토큰의 경사에 해당 토큰의 확률 비율을 가중치로 적용한다. 따라서 GSPO는 응답 안의 모든 토큰에 같은 중요도 가중치를 부여한다. 저자들은 GRPO의 서로 다른 가중치가 불안정성을 누적시키는 원인이라고 지적한다.
- 논문에 따르면 GRPO에서 경사에 기여하는 토큰 가중치의 범위는 advantage가 양수일 때 (0,1+ε], 음수일 때 [1−ε,+∞)이다. Clipping을 적용해도 남은 토큰 가중치가 모두 거의 같아지는 것은 아니다.
4.3 GSPO-token: A Token-level Objective Variant
GSPO-token은 여러 차례 주고받는 상호작용으로 학습하는 multi-turn RL을 고려해 토큰마다 advantage를 다르게 설정할 수 있게 한다. sᵢ,ₜ(θ) = sg[sᵢ(θ)]πθ(yᵢ,ₜ|x,yᵢ,<ₜ)/sg[πθ(yᵢ,ₜ|x,yᵢ,<ₜ)]로 정의하며, sg는 수치는 유지하면서 경사 전파를 중단한다. 이는 머신러닝 프레임워크 PyTorch의 detach 연산에 해당한다. 이 비율의 값은 응답 비율과 같지만, 경사는 개별 토큰 확률을 통해 전달된다.
- 모든 토큰 advantage가 응답 advantage와 같으면 GSPO-token과 GSPO의 목적함수 값, clipping 조건, 이론적 경사가 동일하다. 논문은 이러한 동등성을 유도하지만, 토큰 advantage를 별도로 조정한 실험은 보고하지 않는다.
5 Experiments and Discussion
실험에서는 학습 보상과 수학 및 프로그래밍 성능을 비교한 뒤, clipping 토큰 비율과 전문가 선택의 변화를 살펴본다. 인프라 논의에서는 이전 정책의 우도 재계산을 생략하는 방안을 제안하지만, 시스템 벤치마크는 보고하지 않는다.
5.1 Empirical Results
Qwen3-30B-A3B-Base를 미세 조정한 cold-start 모델에서 학습을 시작하며, 생성한 응답의 각 배치를 경사 업데이트용 미니배치 4개로 나눈다. 수학 벤치마크 AIME’24는 32회 샘플링한 평균 Pass@1, 즉 단일 시도 성공률로 평가한다. 프로그래밍 벤치마크 LiveCodeBench는 202410–202502 구간에서 8회 샘플링한 평균 Pass@1로 평가한다. 프로그래밍 벤치마크 CodeForces는 경쟁 성과를 나타내는 Elo Rating으로 평가한다. GSPO의 왼쪽과 오른쪽 clipping 범위는 각각 3e-4와 4e-4이다. 조정된 GRPO 기준 모델은 각각 0.2와 0.27을 사용하며 Routing Replay를 포함한다.
- Figure 1에서 GSPO는 비슷한 학습 연산량으로 더 높은 보상과 벤치마크 성능을 보인다. 본문은 사용한 쿼리 수도 맞췄다고 설명하며, 연산량 증가, 쿼리 갱신, 생성 길이 확대에 따라 GSPO의 성능이 계속 개선된다고 서술한다.
- 연산량 축에는 수치 눈금이 없으며, 논문은 최종 점수를 정리한 표나 불확실성 추정치를 제공하지 않는다. 곡선은 정성적인 효율 우위를 뒷받침하지만, 정확한 연산량 절감 수준을 제시하지는 않는다.
빨간색 GSPO 곡선은 대체로 학습 연산량 축의 비슷한 위치에서 더 높은 학습 보상과 AIME’24, LiveCodeBench, CodeForces 성능에 도달한다. GRPO에는 Routing Replay가 포함되므로 안정화한 기준 모델과의 비교이다. 축에 수치로 된 연산량 척도가 없어 정확한 연산량 절감 수준을 추정할 수는 없다.
5.2 Curious Observation on Clipping Fractions
Figure 2에서 보고한 평균 clipping 토큰 비율은 GSPO가 0.15, GRPO가 0.0013으로, 약 2자릿수 규모의 차이가 난다. GSPO는 응답 단위 clipping으로 훨씬 더 많은 토큰을 경사 추정에서 제외하면서도 더 높은 학습 효율을 달성한다. 저자들은 이를 학습 신호의 잡음이 더 적다는 근거로 해석한다. 다만 clipping 토큰 비율만으로 경사 분산을 직접 측정할 수는 없다.
평균적으로 clipping되는 토큰 비율은 GSPO가 0.15, GRPO가 0.0013이다. Figure 1과 함께 보면, 보고된 비교에서는 경사 추정에 더 많은 토큰을 남기는 것만으로 더 높은 학습 효율이 보장되지는 않는다는 점을 보여준다.
5.3 Benefit of GSPO for MoE Training
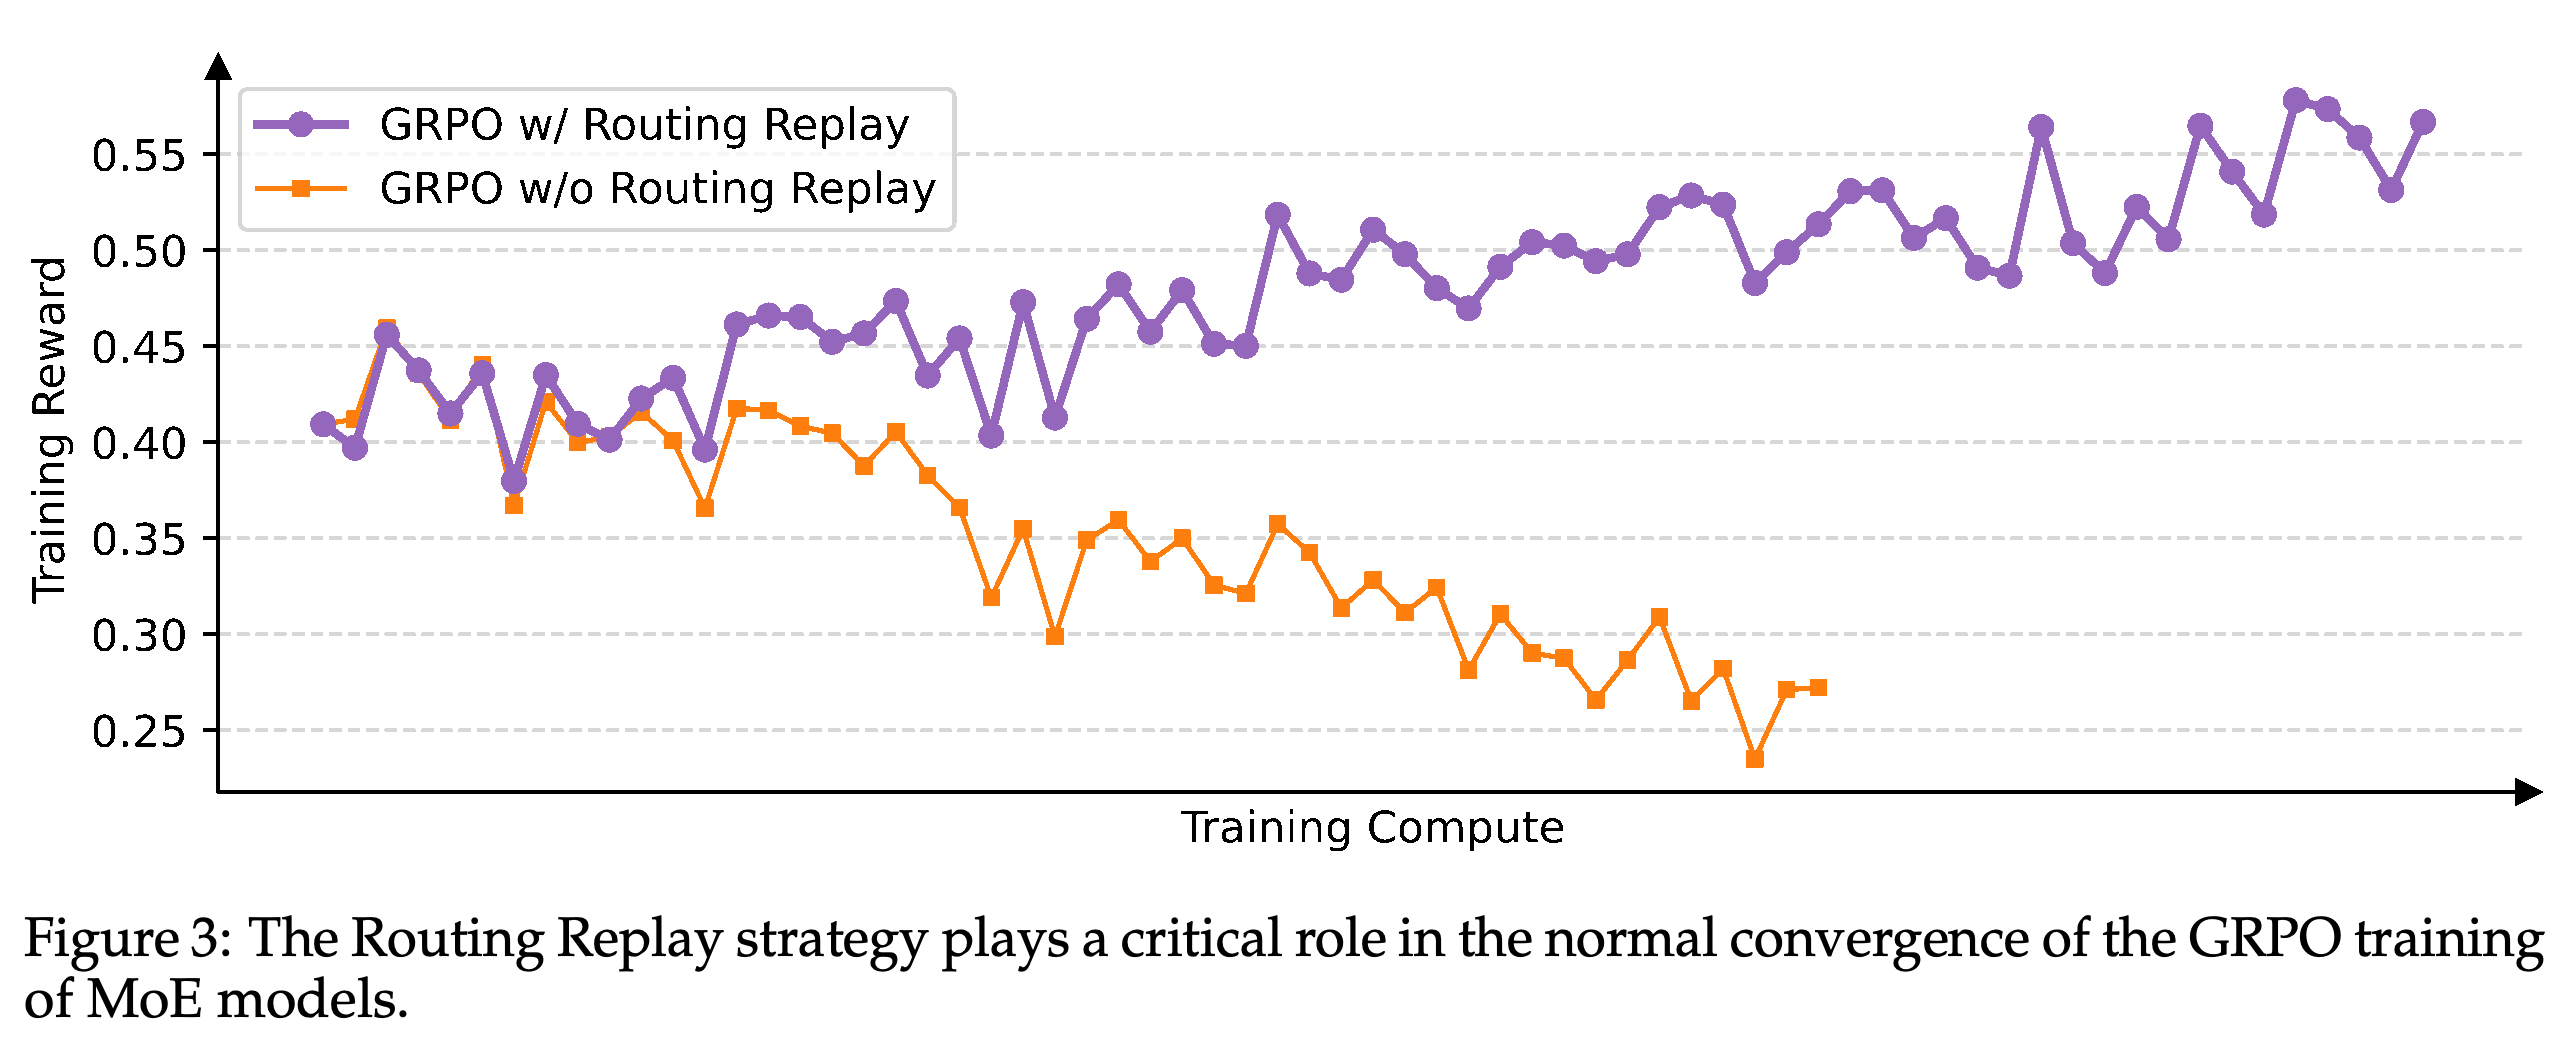
저자들은 정책 업데이트 후 같은 응답에 대해 선택되는 전문가가 바뀌는 전문가 활성화 변동성을 보고한다. 48개 레이어로 구성된 Qwen3-30B-A3B-Base 모델에서는 RL 경사 업데이트마다 동일한 생성 표본에 대해 활성화되는 전문가 중 약 10%가 이전 정책과 새 정책 사이에서 달라진다. Routing Replay는 이전 정책의 전문가 선택을 캐싱하고 현재 정책의 토큰 비율을 계산할 때 재사용해 GRPO를 안정화한다. Figure 3에서는 이 전략을 사용하면 보상이 증가하고, 사용하지 않으면 감소한다.
- 저자들에 따르면 라우팅 결정을 재사용하면 메모리와 통신 오버헤드가 발생하며, 모델이 활용할 수 있는 전문가 용량이 제한될 수 있다.
- Figure 1에서 GSPO는 Routing Replay 없이도 안정적으로 학습한다. 저자들은 시퀀스 단위 비율이 개별 토큰의 우도 변동에 덜 민감하기 때문이라고 설명한다.
이전 전문가 라우팅 결정을 재사용하면 GRPO 보상이 상승하는 추세를 보이고, 재사용하지 않으면 하락한다. 이는 제시된 MoE 실험에서 Routing Replay가 학습을 안정화한다는 근거가 된다. 이 그림에는 GSPO 곡선이 없으며, Routing Replay 없이 학습하는 GSPO의 안정성은 Figure 1에 별도로 제시된다.
5.4 Benefit of GSPO for RL Infrastructure
모델 학습을 실행하는 Megatron 같은 학습 엔진과, 생성을 실행하는 SGLang 및 vLLM 같은 추론 엔진은 서로 다른 우도 값을 산출할 수 있다. 저자들은 GSPO의 시퀀스 단위 비율이 이러한 수치 차이를 충분히 허용하므로 추론 엔진의 우도를 직접 사용하고 학습 엔진에서의 재계산을 생략할 수 있다고 주장한다. 생성을 나누어 수행하는 partial rollout, multi-turn RL, 학습과 추론 구성요소가 분리된 프레임워크가 이점을 얻을 수 있다고 제안하지만, 지연 시간, 메모리, 처리량 측정치는 보고하지 않는다.
6 Conclusion
결론은 시퀀스 단위 우도 비율, clipping, 보상, 최적화를 GSPO의 핵심 설계로 제시한다. 저자들은 최신 Qwen3 모델의 학습에 GSPO를 사용했다고 밝히지만, 이 논문은 해당 모델들의 전체 성능 향상에서 GSPO가 기여한 정도를 정량적으로 분리해 평가하지 않는다.
부록
- 제공된 7페이지 논문에는 부록이 없으며, 결론과 참고문헌으로 끝난다.
짧은 생각
가장 강한 실용적 근거는 Routing Replay를 적용한 GRPO보다 나은 학습 곡선과, Routing Replay 없이도 안정적인 GSPO 학습이 함께 나타난다는 점이다. 길이 정규화는 원래의 시퀀스 우도 비율을 바꾸므로, 중요도 샘플링을 동기로 제시한 것만으로 결과 업데이트가 분포 변화를 편향 없이 보정한다고 입증되지는 않는다. 실험에서 초기 모델 1개만 명시하고 구체적인 연산 예산, 상세한 학습 데이터, 반복 실행에 따른 불확실성, 인프라 절감량이나 별도로 조정한 GSPO-token advantage의 개별 평가를 제공하지 않아 더 넓은 적용 가능성은 불확실하다.