


Hymba: A Hybrid-head Architecture for Small Language Models 요약 설명
20 Nov 2024 | Paper Review State Space Models Transformer Architectures Efficient Inference목차
이번 글에서는 Hymba: A Hybrid-head Architecture for Small Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 11월 20일(Arxiv)
- Dong, Xin, Fu, Yonggan, Diao, Shizhe, Byeon, Wonmin, Chen, Zijia, Mahabaleshwarkar, Ameya Sunil, Liu, Shih-Yang, Van Keirsbilck, Matthijs, Chen, Min-Hung, Suhara, Yoshi, et al.
- NVIDIA, Georgia Institute of Technology, USA, HKUST
- 논문 링크
- Github
요약
- 소형 언어 모델은 이전 입력을 정확하게 검색하면서도 이를 보존하는 데 필요한 메모리와 연산을 줄여야 한다. 논문의 7개 과제 평균에서 Hymba-1.5B-Base는 61.06%, Llama-3.2-3B는 59.74%를 기록한다. NVIDIA A100에서 시퀀스 길이를 8k로 설정하고 배치 크기를 128부터 시작해 메모리가 부족한 모델의 배치 크기를 절반씩 줄이는 조건에서, 논문은 Hymba의 캐시가 11.67배 작고 처리량은 3.49배 높다고 보고한다.
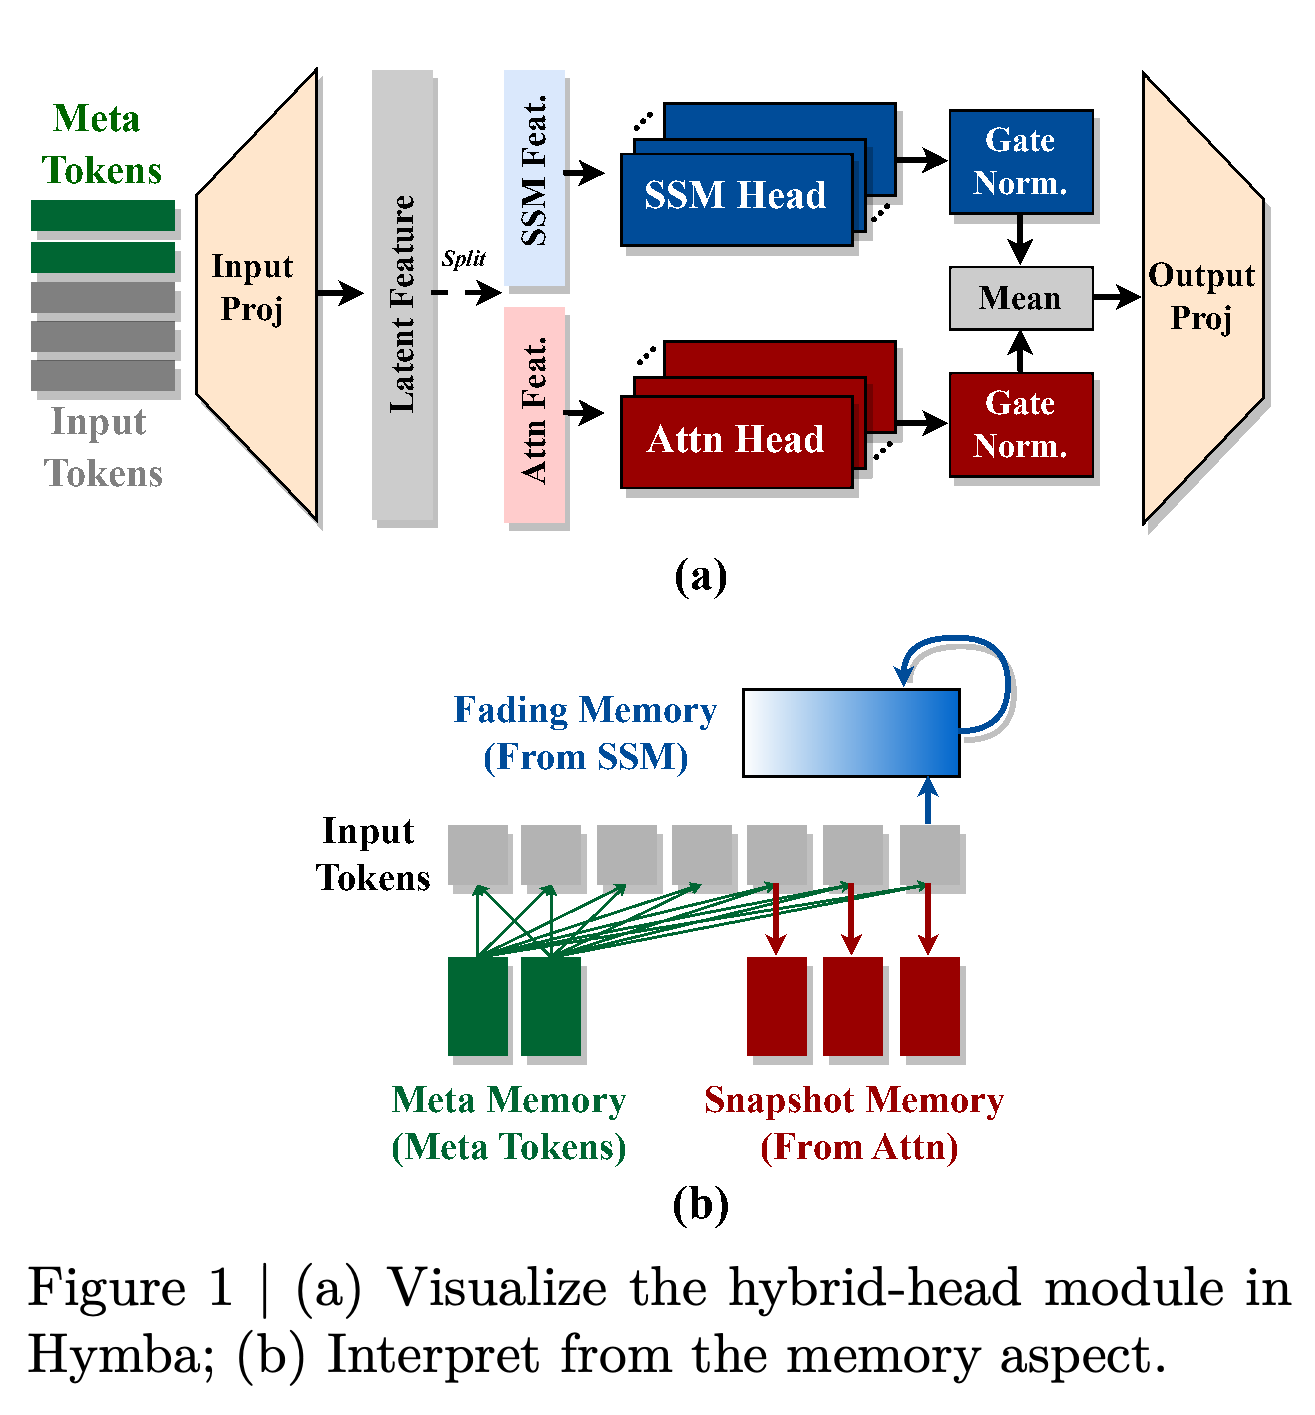
- Hymba는 각 레이어의 입력을 attention head와 state space model (SSM) head에서 처리한다. Attention head는 이전 토큰의 세부 정보를 검색하고, SSM head는 고정 크기 상태에 문맥을 순환적으로 요약한다. 이러한 병렬 분기에 meta token이라는 학습된 접두 임베딩 128개, 대부분의 레이어에서 최근 토큰 윈도우만 참조하는 local attention, 연속된 레이어가 캐시된 attention key와 value를 재사용하는 레이어 간 key-value (KV) 공유를 결합한다.
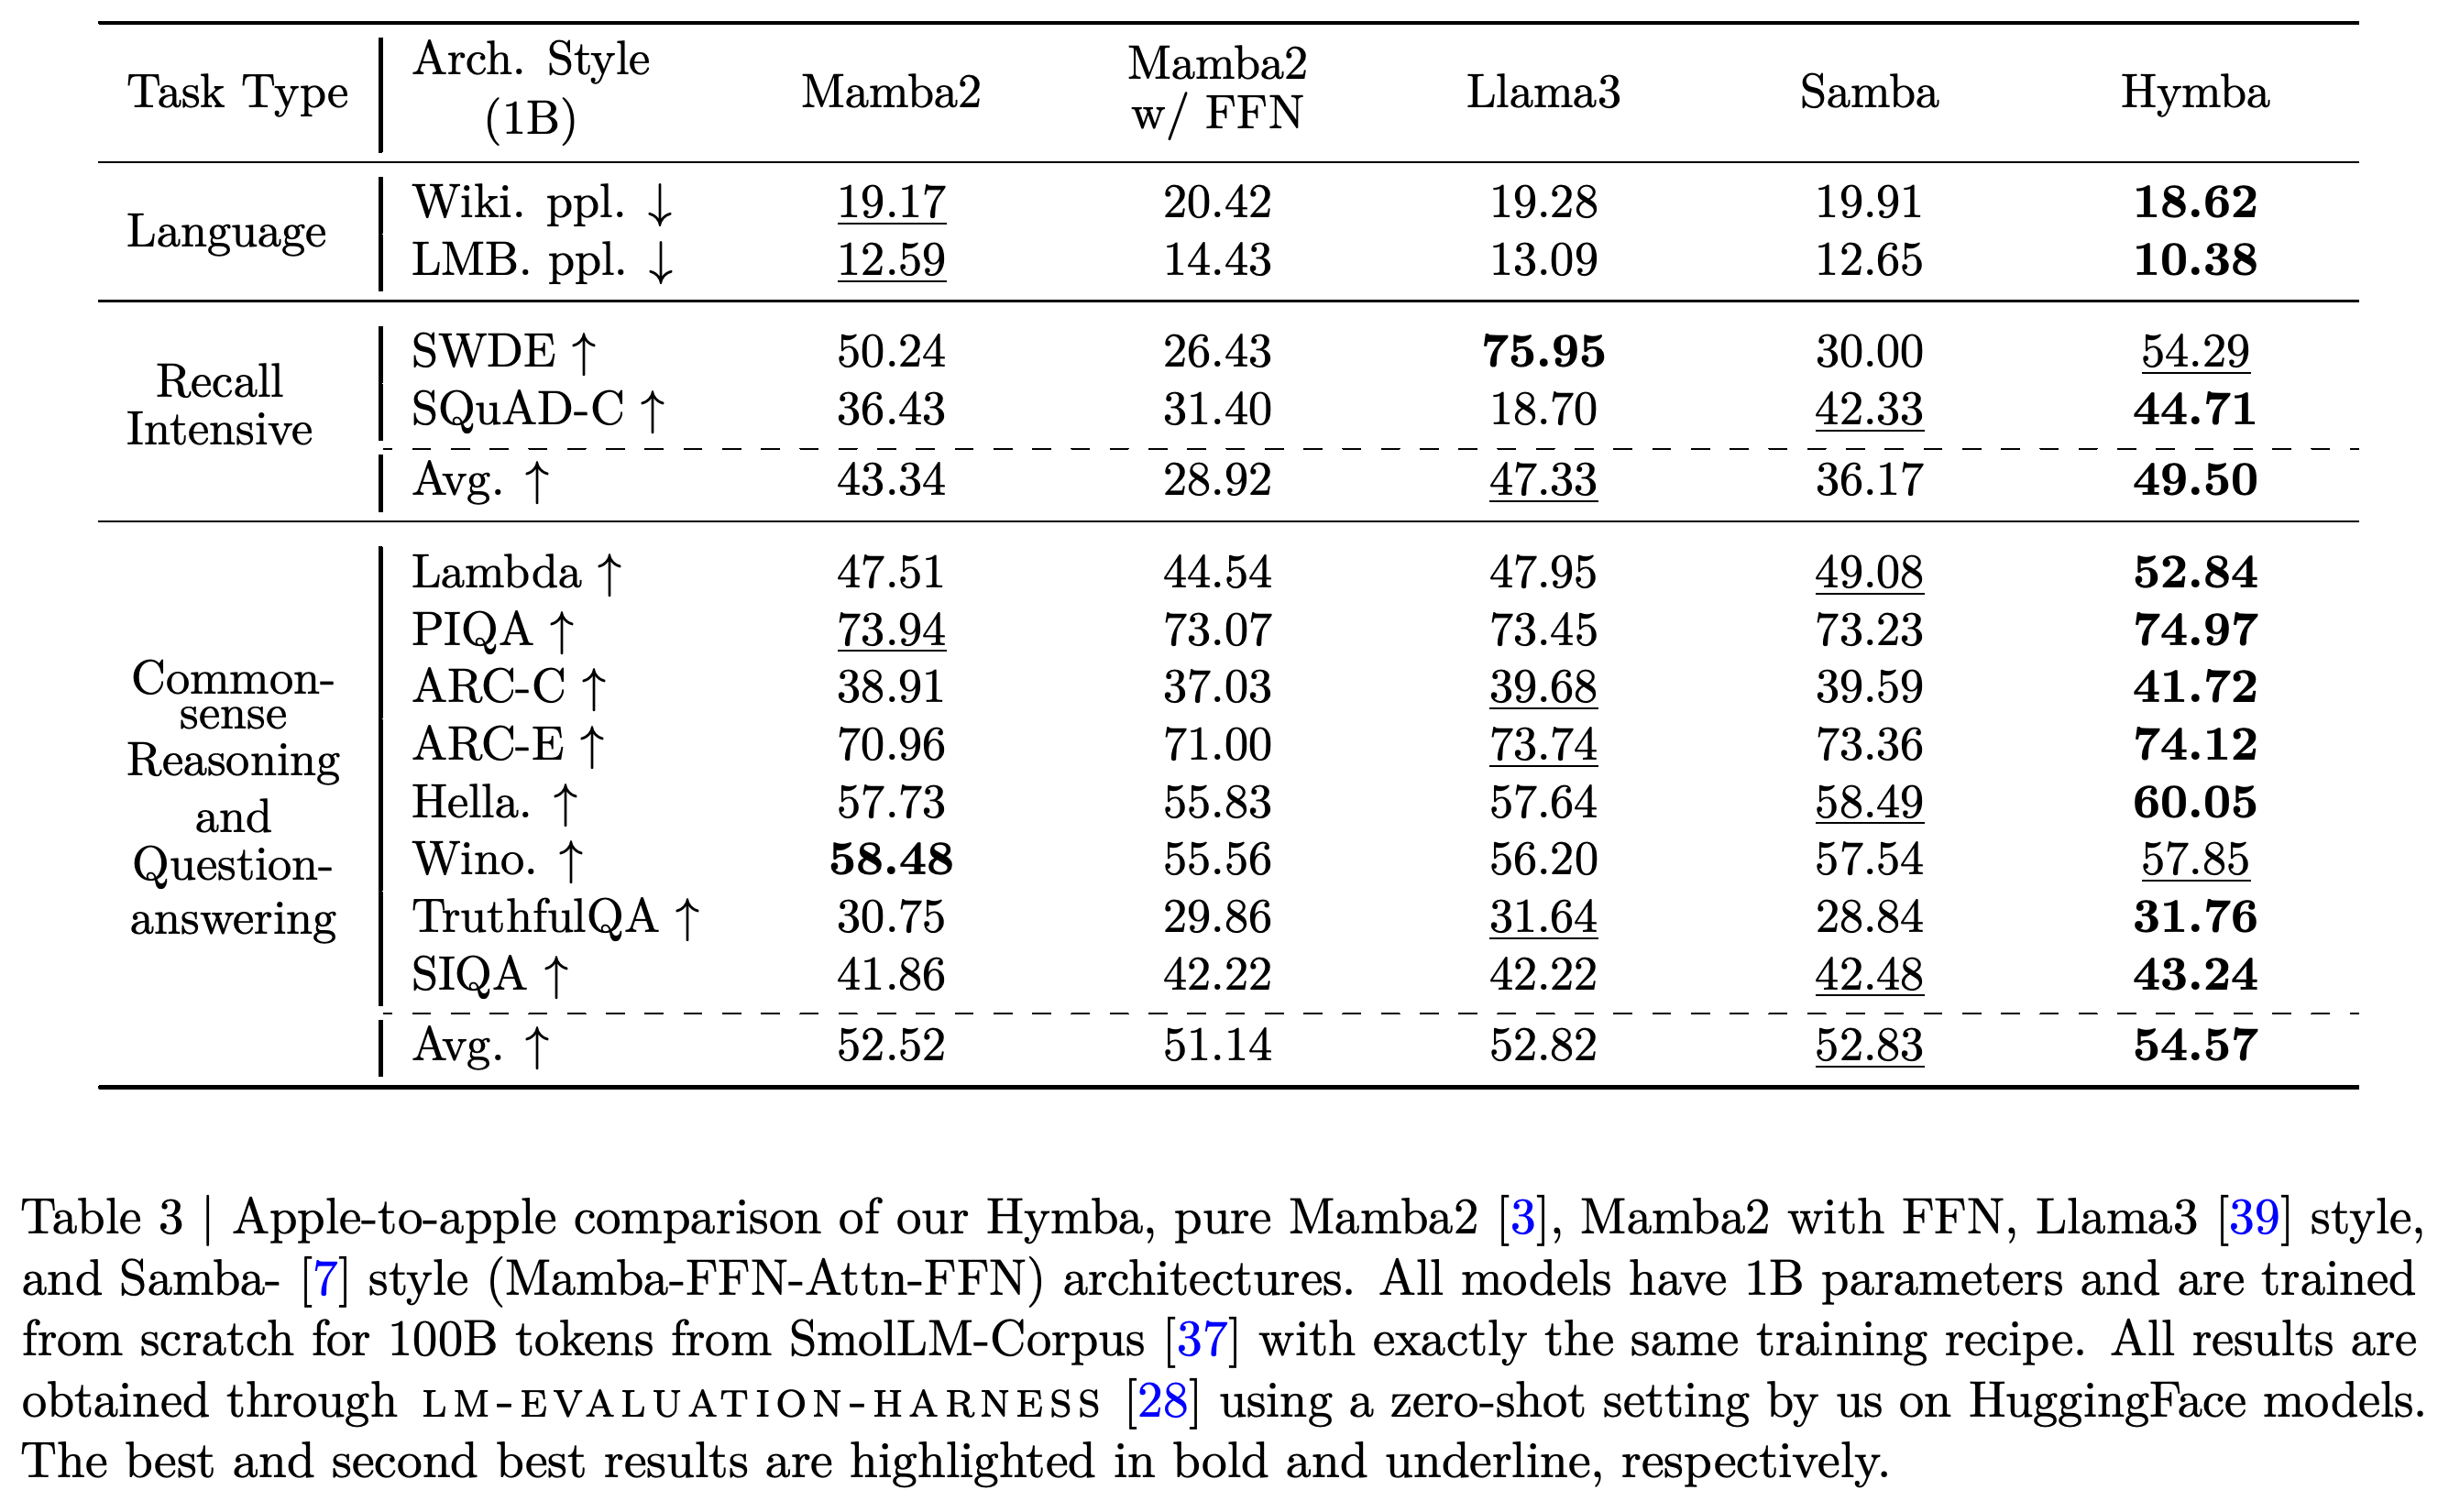
- 파라미터 수를 1B로 맞추고 동일한 학습 토큰 100B를 사용한 통제 실험에서 Hymba는 일반 과제 8개 평균으로 54.57%를 기록한다. Attention과 SSM 연산자를 순차적으로 쌓는 Samba는 52.83%를 기록한다. 여기서 B는 1000000000을 뜻한다. Hymba가 모든 개별 과제에서 앞서는 것은 아니며, PDF에 서로 다른 학습 사양이 기재되어 있어 재현에 필요한 일부 세부 사항은 확인되지 않은 상태다.
1. Introduction
Transformer는 attention cache에 토큰의 세부 정보를 보존하지만, full attention의 시퀀스 처리 비용은 길이의 제곱에 비례하고 캐시 요구량도 입력 길이에 따라 증가한다. Mamba 계열 SSM은 고정 크기 메모리로 이전 정보를 순환적으로 요약하는 대신 세부 정보 회상 능력이 제한된다. 논문은 이 연산자들을 순차적으로 교대 배치하면, 특정 레이어가 나중에 필요한 정보를 보존하지 못할 때 병목이 생길 수 있다고 주장한다.
- Hymba는 연산자 2개를 같은 레이어에 배치해 동일한 입력을 처리하고 상호 보완적인 표현을 제공하도록 한다.
- 공개된 모델 식별자는 Hymba-1.5B-Base와 Hymba-1.5B-Instruct이며, 각각 https://huggingface.co/nvidia/Hymba-1.5B-Base 와 https://huggingface.co/nvidia/Hymba-1.5B-Instruct 에서 제공한다.
2. Hymba: The Proposed Hybrid-Head Architecture
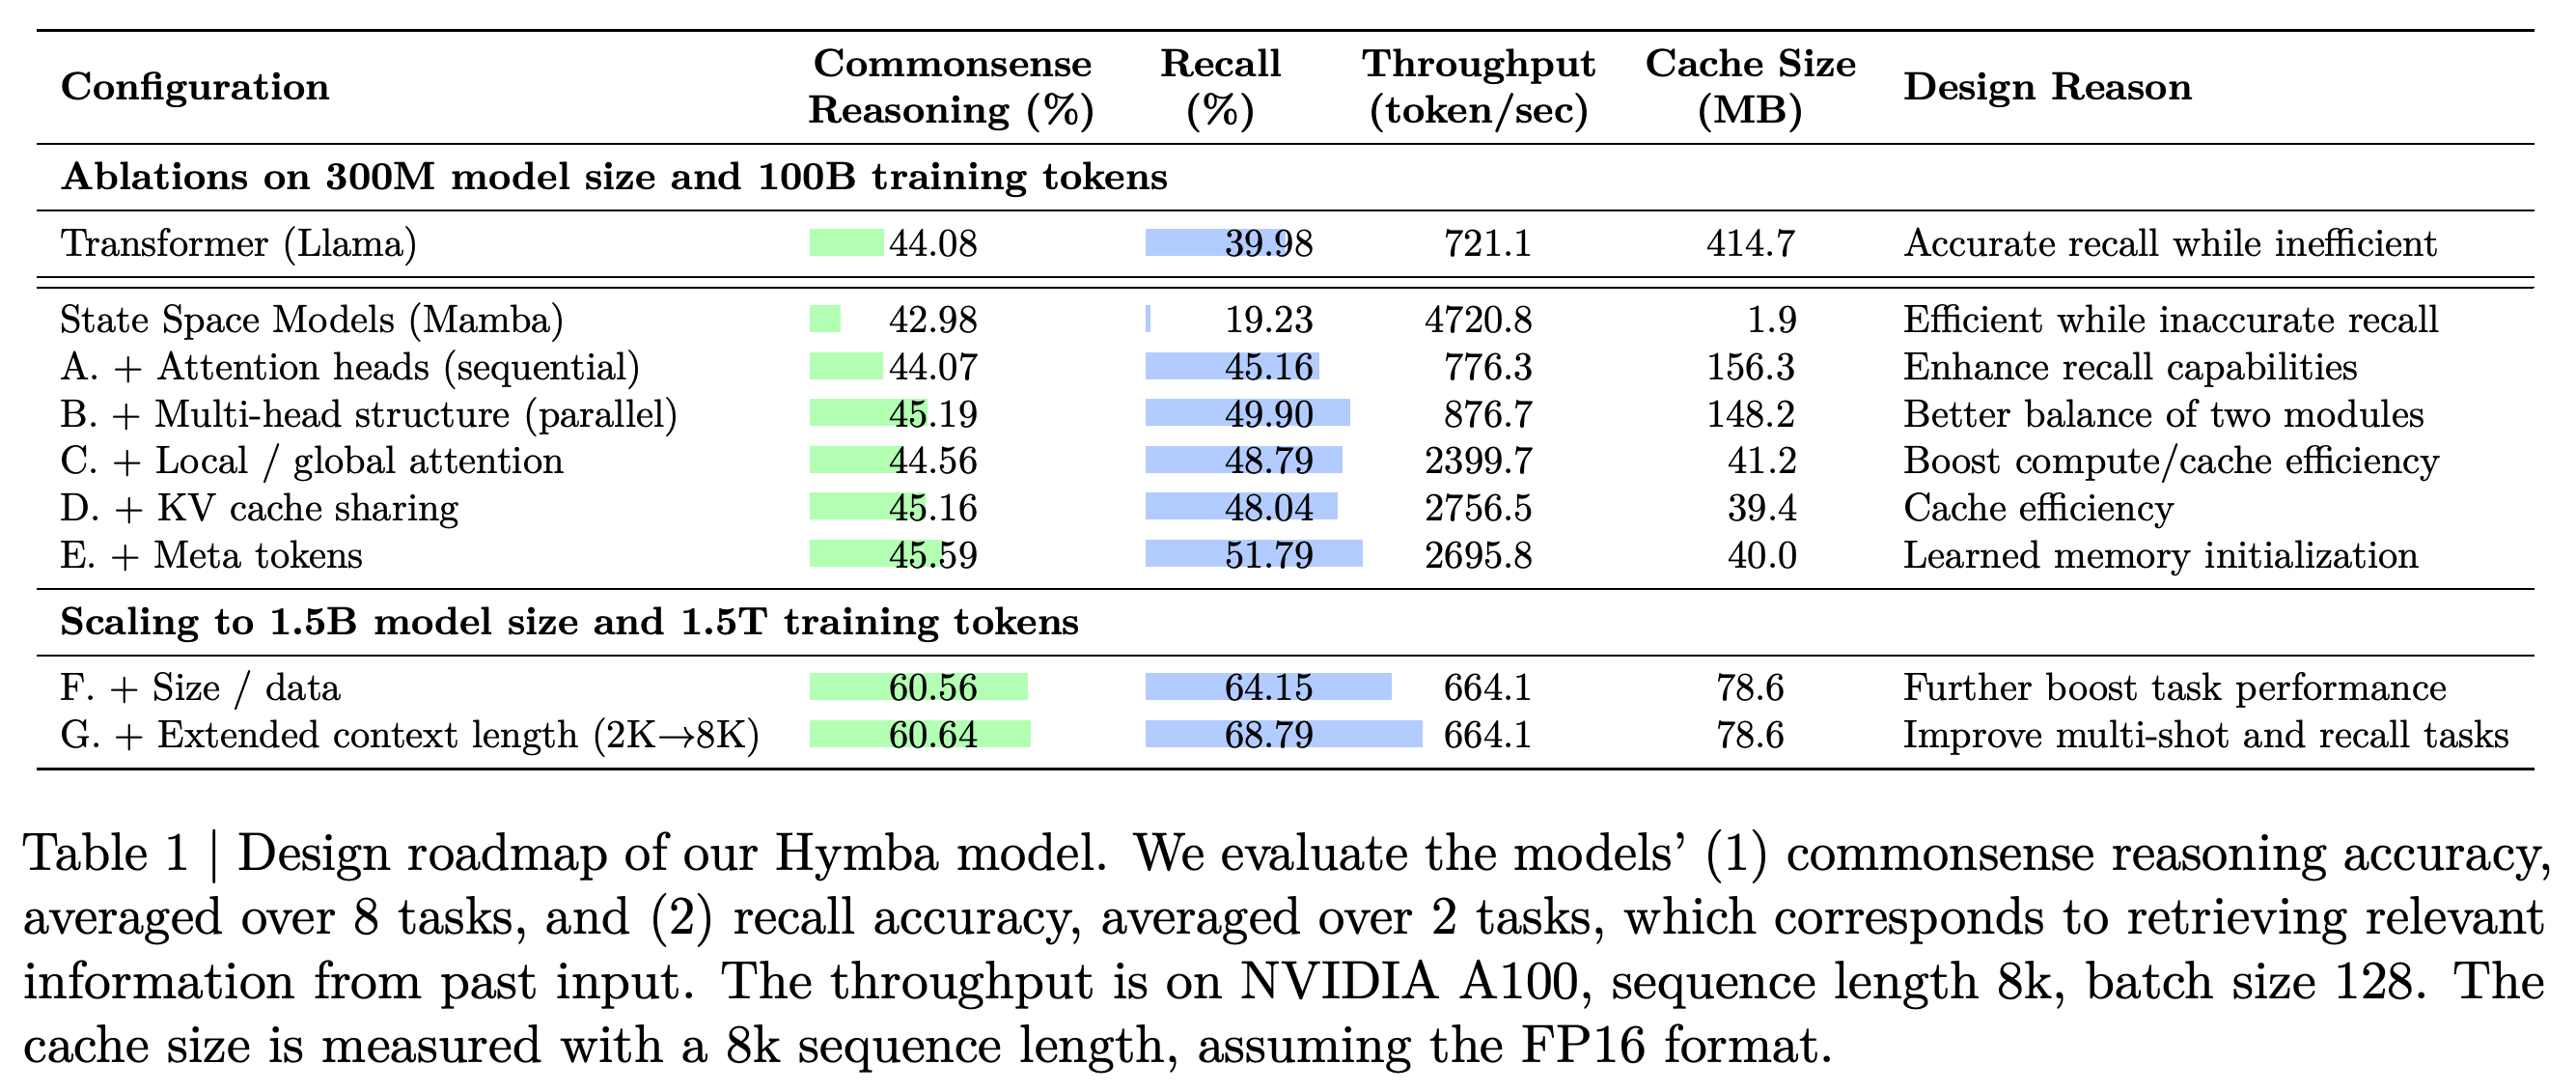
설계 로드맵은 아키텍처 개발과 규모 확장을 구분한다. 개별 설계 요소를 바꾸는 초기 ablation 실험에서는 파라미터 300M과 학습 토큰 100B를 사용해 병렬 융합, 캐시 최적화, meta token을 검증한다. 여기서 M은 1000000을 뜻한다. 이후 실험에서는 모델과 학습 데이터 규모를 늘리고 문맥 길이를 2K에서 8K 토큰으로 확장한다.
- Table 1에서 병렬 융합의 일반 정확도는 45.19%, 회상 정확도는 49.90%이며, 순차 융합은 각각 44.07%, 45.16%를 기록한다.
- 로드맵의 최종 구성은 일반 정확도 60.64%, 회상 정확도 68.79%를 기록한다. 이 평균에 사용한 과제 구성은 Table 2의 공개 모델 비교에 사용한 7개 과제 구성과 다르다.
2.1. A Fused Hybrid-Head Module
공유 입력 projection은 attention의 query, key, value와 함께 SSM 특징과 출력 gate를 생성한다. 출력 gate는 SSM의 기여를 조절한다. 측정한 SSM 출력의 크기가 일관되게 더 크므로, Hymba는 학습 가능한 채널별 벡터로 분기 2개를 정규화하고 크기를 조정한 뒤 융합과 최종 출력 projection을 수행한다.
- 식 (3)은 융합을 Y = W_out_proj(β₁ norm(M_attn X̃) + β₂ norm(M_ssm X̃))로 표현한다. M_attn과 M_ssm은 접두 토큰이 추가된 입력 X̃에 적용하는 attention 및 SSM 연산자를 뜻한다.
- 논문은 선택한 융합 방식을 평균이라고 설명하지만, 제시한 식은 명시적인 평균 계수 없이 가중합으로 작성되어 있다.
- 개별 레이어에서 분기를 제거했을 때의 영향은 과제마다 다르다. 문장 완성 과제인 HellaSwag의 샘플 1000개에서 attention 제거 시 평균 정확도 감소는 0.24%, SSM 제거 시에는 1.1%로 보고한다. 첫 레이어의 SSM 분기를 제거했을 때 특히 크게 저하된다.
분기 2개는 접두 토큰이 추가된 동일한 입력에서 도출한 특징을 받고, 융합 전에 정규화된다. 메모리 비유는 attention의 세부 정보 검색, 순환적인 문맥 요약, 학습된 접두 정보를 구분한다. 이는 연산자에 대한 개념적 해석이다.
병렬 융합은 순차 융합보다 일반 및 회상 평균을 개선하며, local attention과 캐시 공유가 처리량 증가와 캐시 감소의 대부분을 이룬다. 표는 일반 과제 8개와 회상 과제 2개의 평균을 사용하며, 공개 모델 비교의 7개 과제와는 구성이 다르다.
2.2. KV Cache Optimization
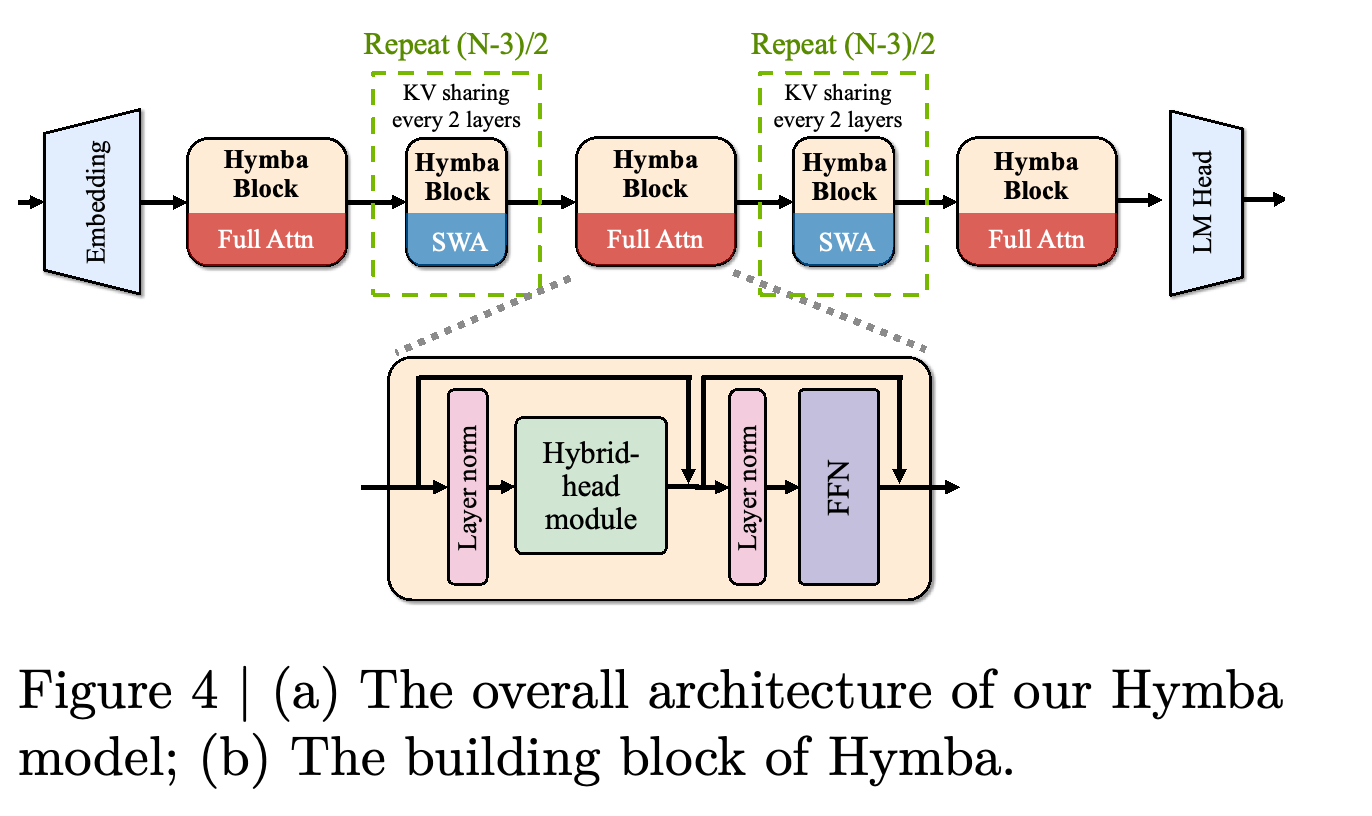
최근 토큰 윈도우만 참조하는 Sliding Window Attention (SWA)이 대부분의 레이어에서 full attention을 대체한다. Hymba는 첫 번째, 중간, 마지막 레이어에 global attention을 유지하고, 연속된 레이어 사이에서 key와 value를 공유해 캐시 저장량과 중복 projection을 줄인다.
- Table 10에서 모든 attention 레이어를 SWA로 바꾸면 회상 정확도가 49.90%에서 29.78%로 감소한다. Global attention 레이어 3개를 복원하면 48.79%까지 회복하며, 처리량은 876.7 tokens/s에서 2399.7 tokens/s로 증가하고 캐시는 148.24 MB에서 41.19 MB로 감소한다.
- 레이어 간 공유를 추가하면 처리량은 2756.5 tokens/s, 캐시는 39.42 MB가 된다. 일반 정확도는 44.56%에서 45.16%로 증가하고, 회상 정확도는 48.79%에서 48.04%로 변한다.
- SSM 분기는 캐시를 크게 줄일 수 있게 하지만, 모든 attention을 local로 바꾼 구성의 결과는 이 실험에서 global attention이 여전히 필요함을 보여준다.
전체 구조는 3개 위치에서 global attention을 유지하고 나머지에서는 local attention 블록을 반복한다. 연속된 local 블록 사이에서 캐시된 key와 value를 공유해 저장량을 줄이면서 병렬 SSM 경로를 유지한다.
2.3. Meta Tokens
Meta token은 입력과 무관하며 모델과 함께 학습되는 임베딩 128개로, 모든 시퀀스 앞에 추가된다. 고정된 접두 부분이므로 추론 시 오프라인으로 미리 계산할 수 있으며, attention cache와 SSM 상태의 학습된 초기값 역할을 한다. 모든 과제에서 동일한 집합 1개를 공유한다.
- 저자들은 이 토큰들이 의미적 관련성이 낮아도 많은 attention을 받는 위치인 attention sink를 흡수한다고 가정한다. 또한 softmax attention이 사용 가능한 위치에 확률 질량을 분배해야 하므로, meta token이 그 질량을 받아 줄 위치를 제공한다고 가정한다.
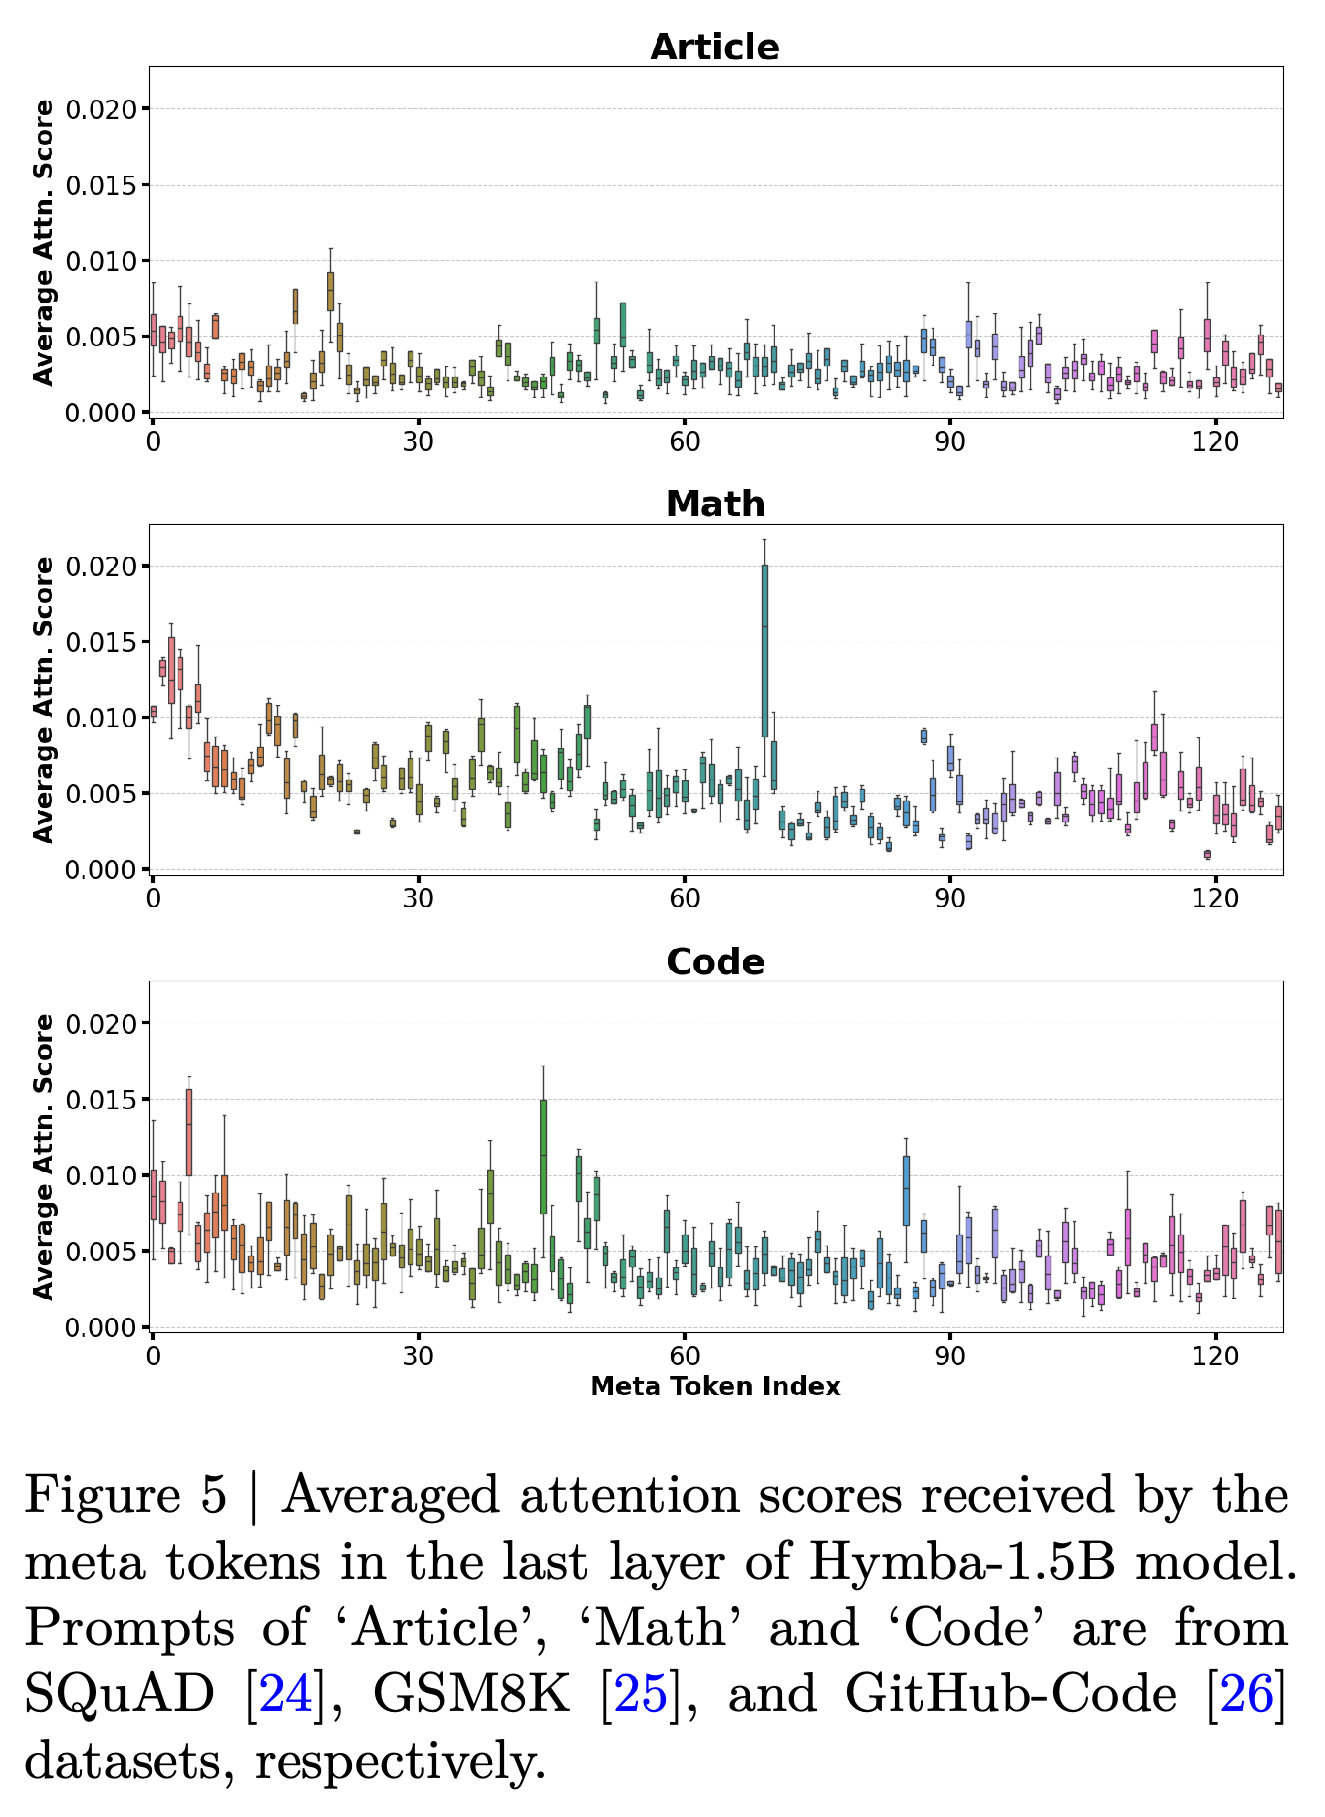
- 마지막 레이어의 attention 분포는 기사, 수학, 코드 프롬프트에 따라 달라진다. 이는 표본으로 사용한 도메인마다 학습된 접두 부분을 다르게 활용함을 보여준다. 개별 토큰이 특정 세계 지식을 담는다는 해석은 여전히 가설이다.
- Table 10에서 캐시를 줄인 hybrid에 meta token을 추가하면 일반 정확도는 45.16%에서 45.53%로, 회상 정확도는 48.04%에서 51.79%로 증가한다. 처리량은 2756.5 tokens/s에서 2695.8 tokens/s로, 캐시는 39.42 MB에서 40.01 MB로 변한다. Table 1은 이에 해당하는 일반 정확도를 45.59%로 기재한다.
기사, 수학, 코드 프롬프트는 학습된 접두 위치 128개에 걸쳐 서로 다른 attention 분포를 만든다. 이는 표본으로 사용한 도메인마다 meta token을 다르게 활용함을 보여주지만, 각 토큰에 담긴 정확한 의미를 식별하지는 못한다.
2.4. Hymba Attention Map
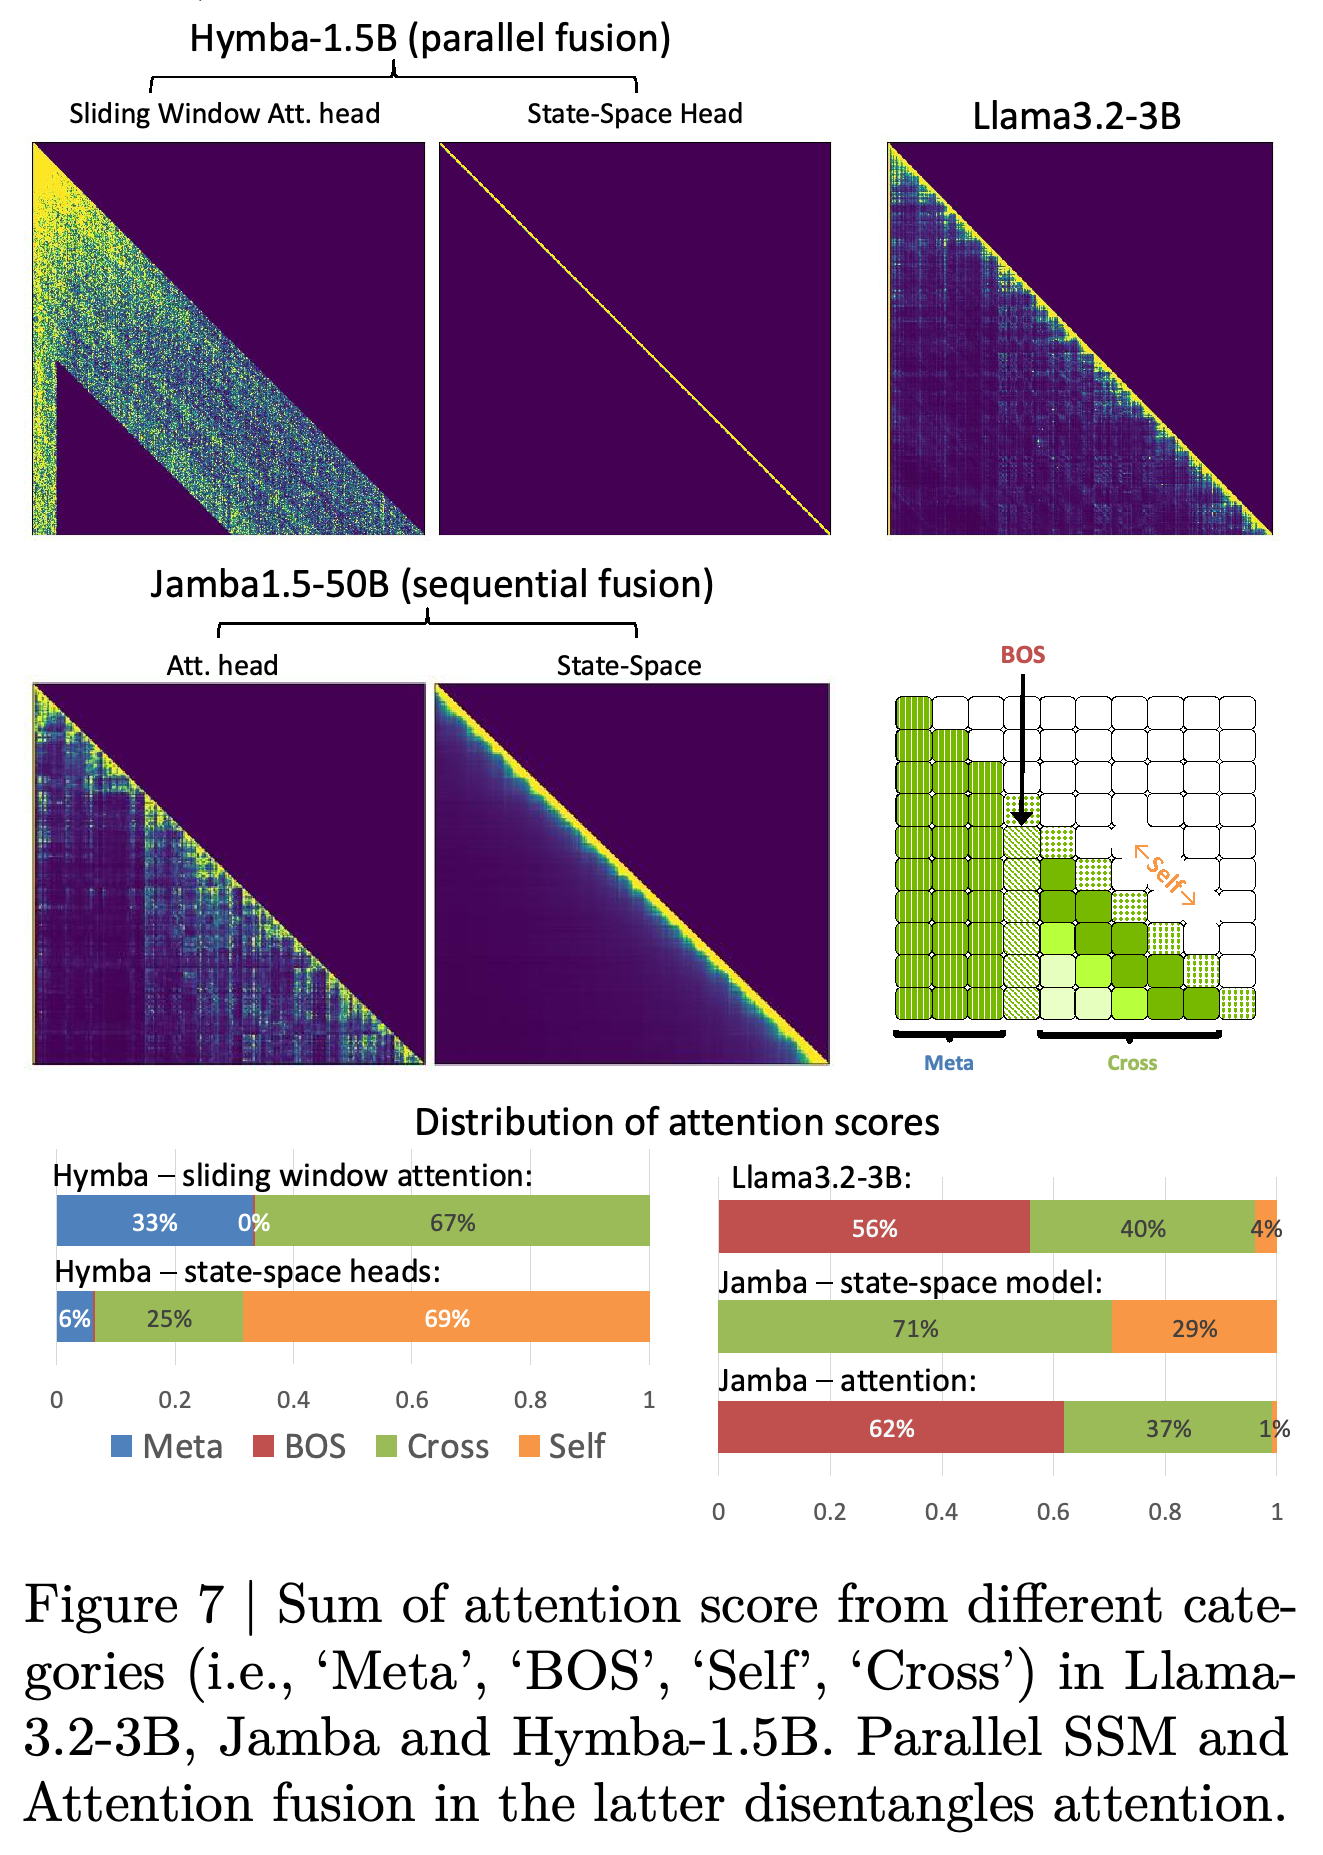
Attention map 분석은 토큰의 기여를 Meta, BOS, Self, Cross로 구분한다. Meta는 학습된 접두 토큰, BOS는 시퀀스 시작 토큰, Self는 현재 토큰, Cross는 다른 실제 토큰에 대한 attention을 뜻한다. SSM에는 순환 연산자에서 토큰 간 기여를 도출한 implicit attention map을 계산하고, 각 행의 합이 1이 되도록 정규화한다.
- Oliver Twist의 Chapter 29 텍스트에서 Hymba의 local attention은 약 33%를 Meta에, 67%를 Cross에 할당한다. SSM 분기는 약 6%를 Meta에, 25%를 Cross에, 69%를 Self에 할당한다.
- 제시된 비교에서 Llama-3.2-3B는 약 56%를 BOS에, 40%를 Cross에, 4%를 Self에 할당한다. 이 패턴은 분석한 텍스트에서 분기들이 상호 보완적으로 작동함을 보여주지만, 논문은 이 비율이 다른 과제에서도 유지됨을 입증하지 않는다.
제시된 예시에서 Hymba의 attention 분기는 주로 meta token과 다른 실제 토큰에 기여를 분배하고, SSM 분기는 현재 토큰에 집중한다. Llama-3.2-3B 및 Jamba와의 비교는 분석한 예시에서 분기들이 상호 보완적으로 작동함을 보여준다. SSM의 기여는 정규화된 implicit attention map으로 표현한다.
2.5. Hymba Model Family
Hymba 계열은 파라미터 규모가 125M, 350M, 명목상 1.5B 모델로 구성된다. Section 2.5는 DCLM-Baseline-1.0 토큰 1T, SmolLM-Corpus 토큰 250B, 독점 고품질 데이터의 토큰 50B를 혼합한다고 설명한다. 여기서 T는 1000000000000을 뜻한다. 학습률을 3e-3과 1e-5 사이에서 증가, 유지, 감소시키는 Warmup-Stable-Decay 스케줄을 사용한다.
- 본문은 2M-token 배치를 사용하고, 마지막 100000000000 tokens 구간 전까지 시퀀스 길이를 2k로 설정한다고 명시한다. 마지막 구간에서는 길이를 8k로 늘리고, 위치 인코딩을 제어하는 파라미터인 rotary positional encoding (RoPE)의 base를 변경한다.
- Figure 8은 일반 사전학습 토큰 1T 이후 학습률 annealing에 500000000000 tokens를 사용한다고 제시하며, 이는 주요 결과에 기재한 총량 1.5T와 일치한다. 나열된 데이터 혼합량의 합은 1.3T여서 불일치가 해소되지 않은 상태다.
- Table 11에서 모델 크기 3종의 블록 수는 각각 24, 32, 32이고 hidden size는 각각 512, 768, 1600이다. 모두 full attention 레이어 3개, 토큰 1024개의 local window, SSM 상태 크기 16을 사용한다.
3. Model Evaluations
평가는 공개된 base 모델, 통제된 아키텍처 비교, 요청을 따르도록 추가 학습한 instruction-tuned 모델을 다룬다. 과제군은 언어 모델링, 상식 추론, 질의응답, 주어진 문맥에서의 검색, 수학 추론, function calling, 역할 수행 능력을 평가한다.
3.1. Experiment Settings
공개 모델 벤치마크는 학습 데이터와 토큰 예산이 서로 다른 기존 소형 Transformer 및 hybrid 모델을 Hymba와 비교한다. 통제 벤치마크는 아키텍처의 영향을 더 직접적으로 평가하기 위해 파라미터 수, 레이어 수, 데이터, 하이퍼파라미터, 코드베이스를 맞추고 모델을 처음부터 학습한다.
- 공개 base 모델 평가는 언어 모델 벤치마크 실행 도구인 lm-evaluation-harness를 사용한다. Table 2에서 지식 벤치마크인 MMLU에는 예시 5개, 질의응답 완성 변형인 SQuAD-C에는 예시 1개, 나머지 나열된 과제에는 예시 0개를 사용한다.
- 처리량은 NVIDIA A100에서 PyTorch를 사용해 길이 8k의 시퀀스와 초기 배치 크기 128로 측정한다. 메모리가 부족하면 측정에 성공할 때까지 배치 크기를 반복해서 절반으로 줄인다. 캐시 비교는 16비트 부동소수점 형식인 FP16을 가정한다.
- 따라서 처리량 비교에는 이 절차에서 실행 가능한 배치 크기가 반영된다. 논문은 모바일 기기에서 이에 대응하는 측정 결과를 보고하지 않는다.
3.2. Benchmark with SOTA Small LMs
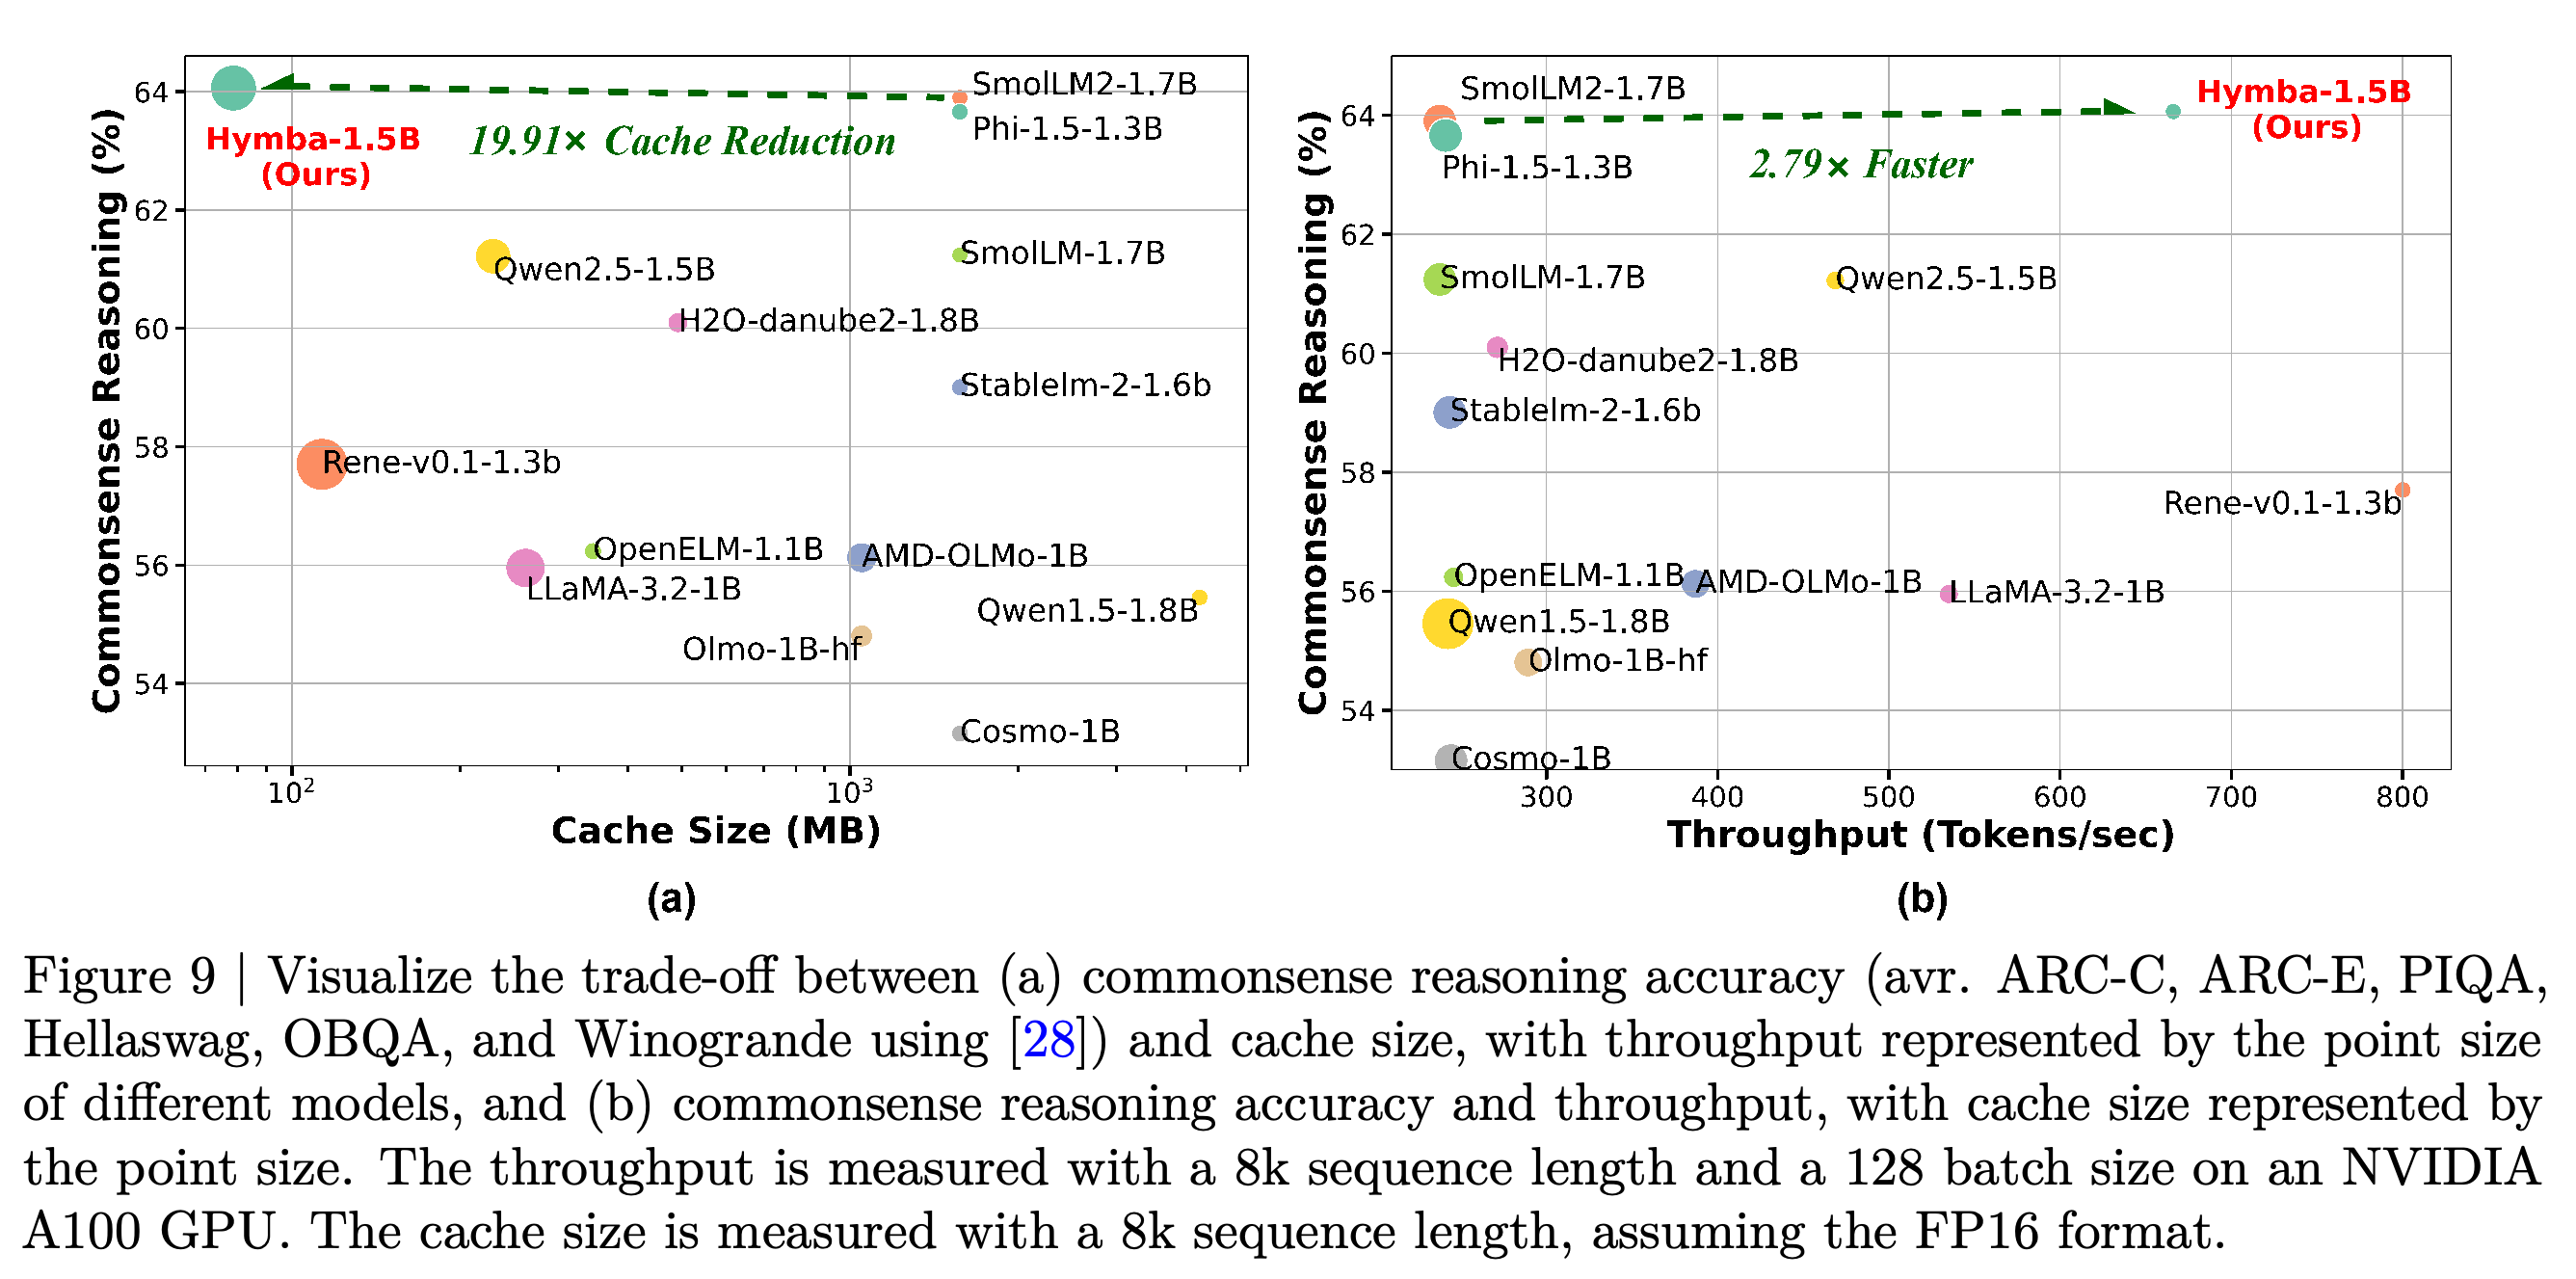
Hymba-1.5B는 Table 2에서 평가한 sub-2B 모델 중 가장 높은 평균인 61.06%를 기록한다. SmolLM2-1.7B는 60.04%, Llama-3.2-3B는 59.74%를 기록한다. 논문은 SmolLM2 대비 캐시가 19.91배 작고 처리량은 2.79배 높으며, Llama-3.2-3B 대비 캐시가 11.67배 작고 처리량은 3.49배 높다고 보고한다.
- Table 2는 Hymba의 처리량을 664 tokens/s, 반올림한 캐시를 79 MB로 기재한다. SmolLM2는 238 tokens/s와 1573 MB, Llama-3.2-3B는 191 tokens/s와 918 MB로 기재한다. 이 반올림된 값으로는 보고된 모든 비율을 정확하게 재현할 수 없다.
- 평균 정확도의 차이인 1.02와 1.32의 단위는 퍼센트포인트다. Hymba의 보고된 학습 토큰 1.5T는 SmolLM2의 11T와 Llama-3.2-3B의 9T보다 적다. 그러나 데이터와 학습 절차가 달라 공개 모델 간 격차를 아키텍처만의 영향으로 볼 수 없다.
- 이 순위는 평균에 관한 결과다. 2B 미만 모델 중 MMLU는 Qwen2.5, Easy로 구분된 과학 질문 하위 집합인 ARC-E는 SmolLM2, 대명사 지시 대상 판별 과제인 Winogrande는 Phi-1.5, HellaSwag는 h2o-danube2가 앞선다. Hymba는 Challenge로 구분된 과학 질문 하위 집합인 ARC-C, 물리적 상식 과제인 PIQA, SQuAD-C에서 앞선다.
Hymba는 과제 7개 평균에서 61.06%로 앞서며, 처리량 664 tokens/s와 반올림한 캐시 79 MB를 함께 달성한다. 개별 열에서는 Qwen2.5의 더 높은 MMLU 점수와 Llama-3.2-3B의 더 높은 Winogrande 및 HellaSwag 점수 등 평균 순위만으로는 드러나지 않는 차이를 확인할 수 있다.
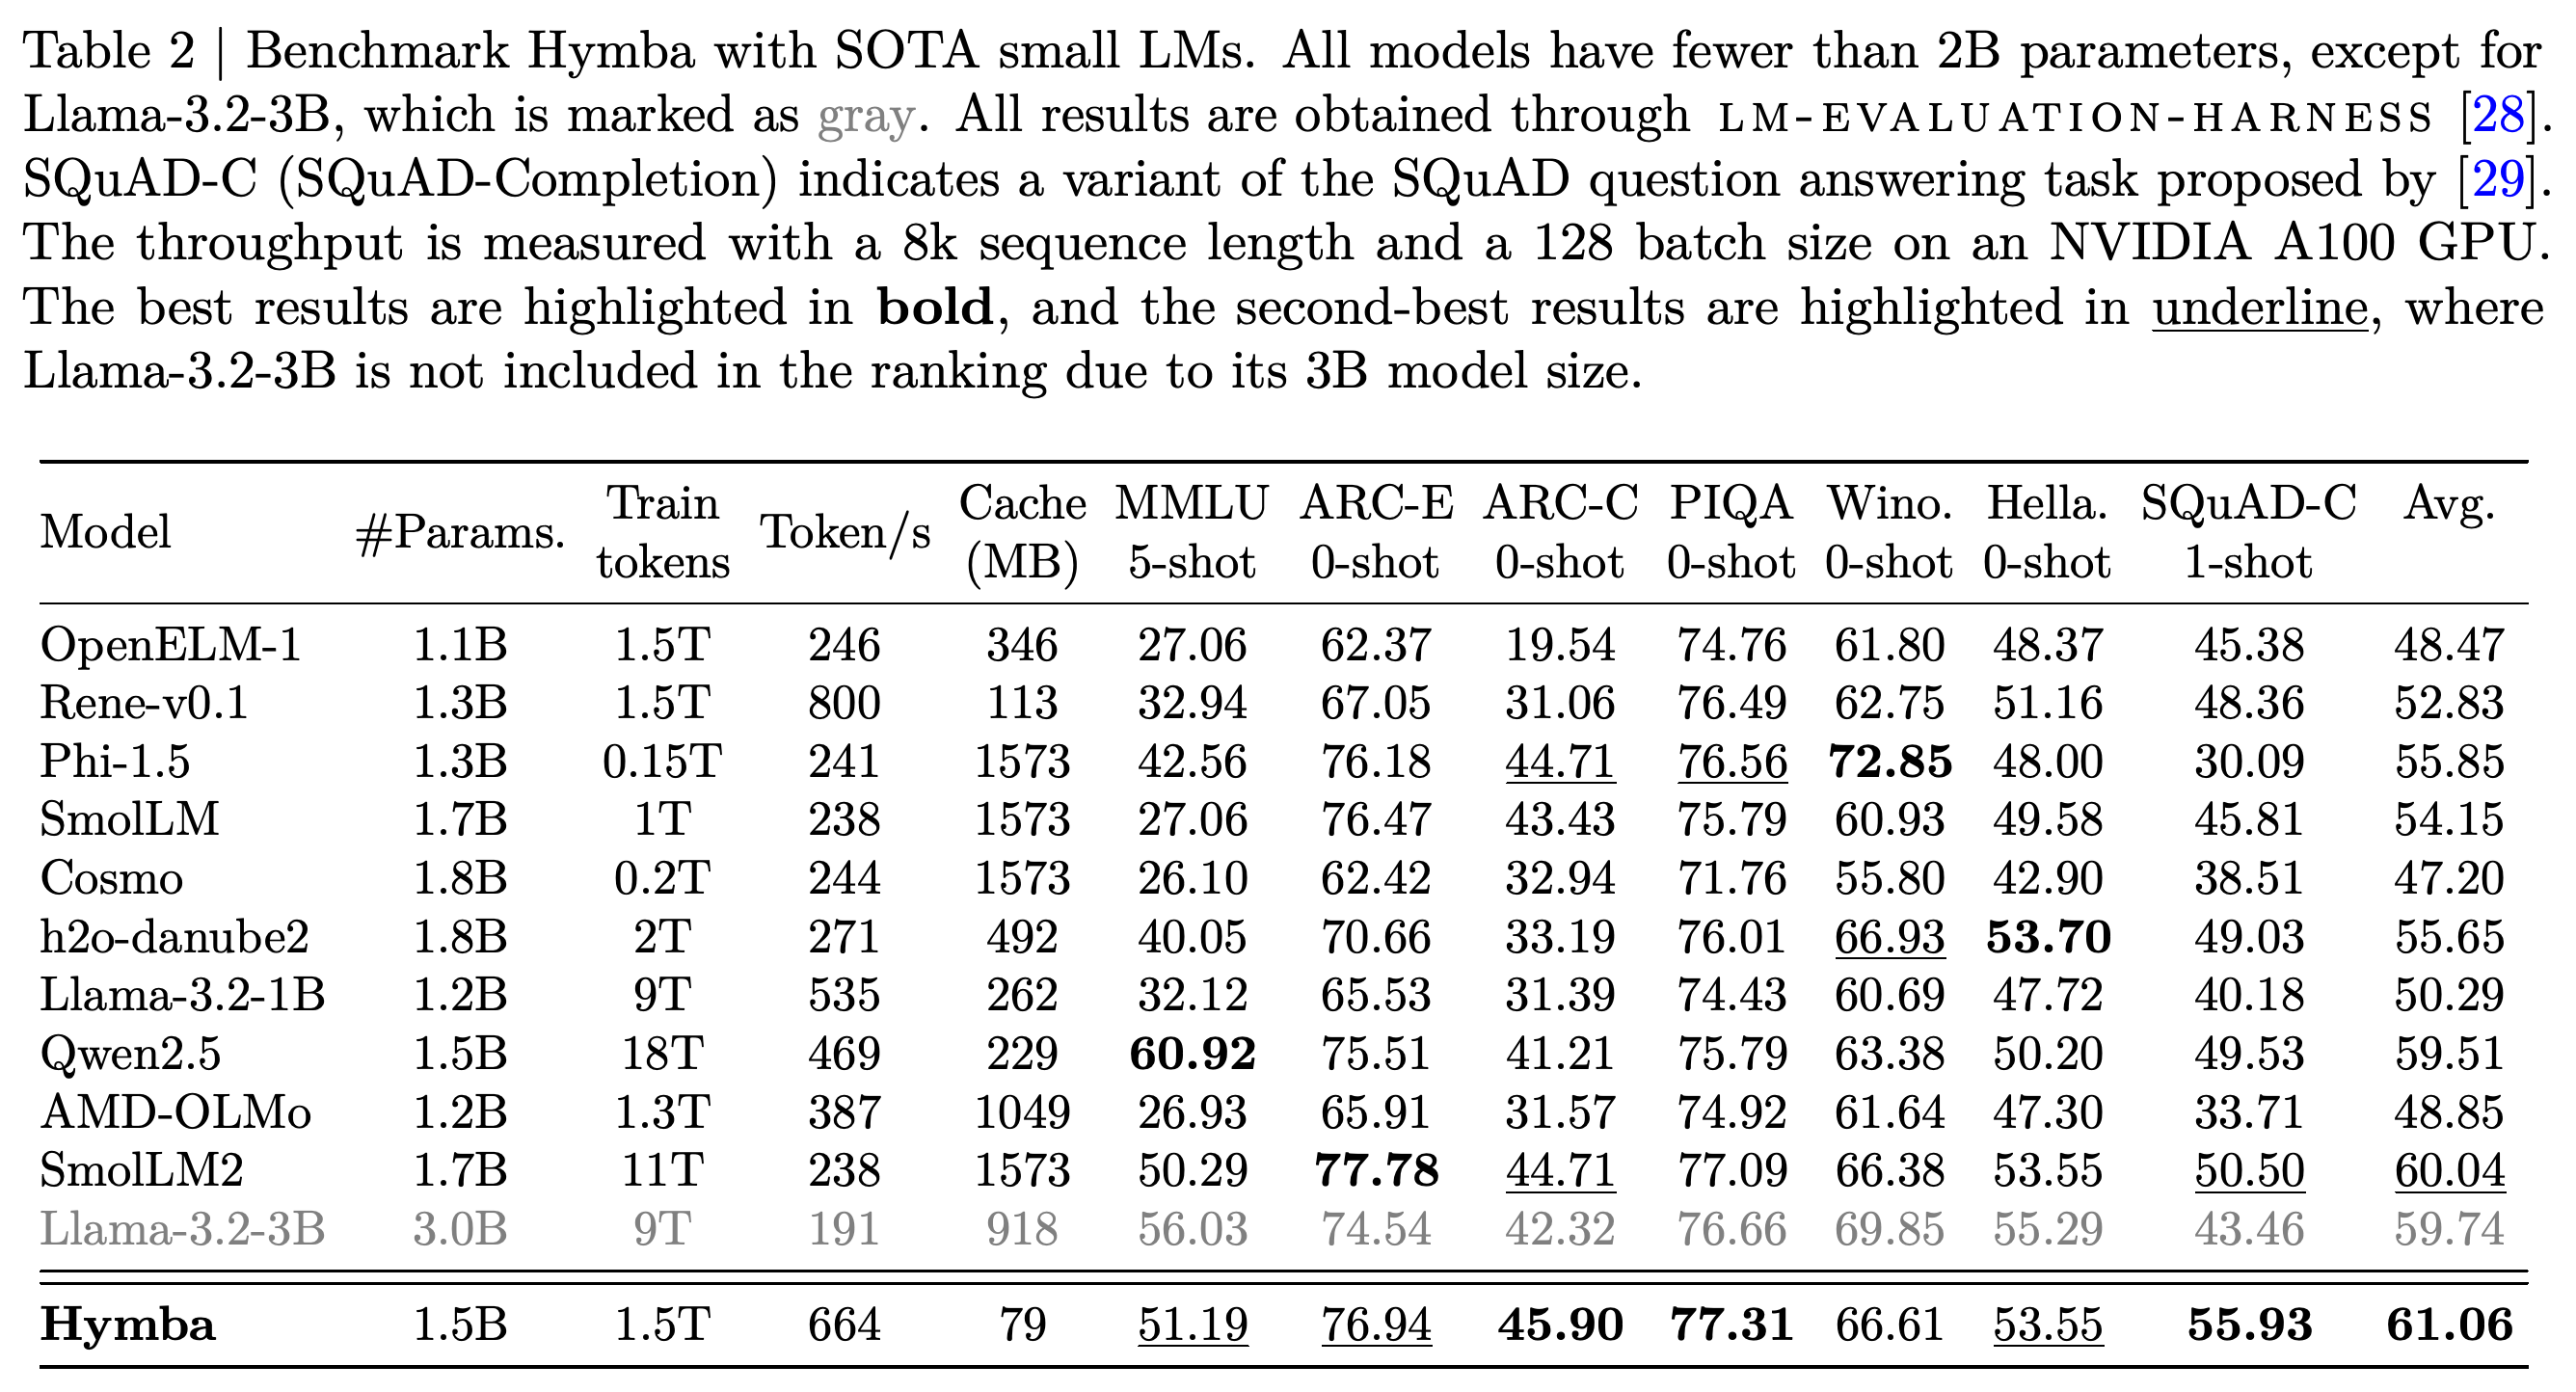
파이프라인은 base 사전학습과 학습률 annealing을 지도학습을 통한 적응 및 선호 최적화와 구분한다. 1T-plus-500B 사전학습 일정은 보고된 총량 1.5T와 일치하지만, 다른 곳에 기재된 데이터 혼합량 합계 1.3T와는 다르다.
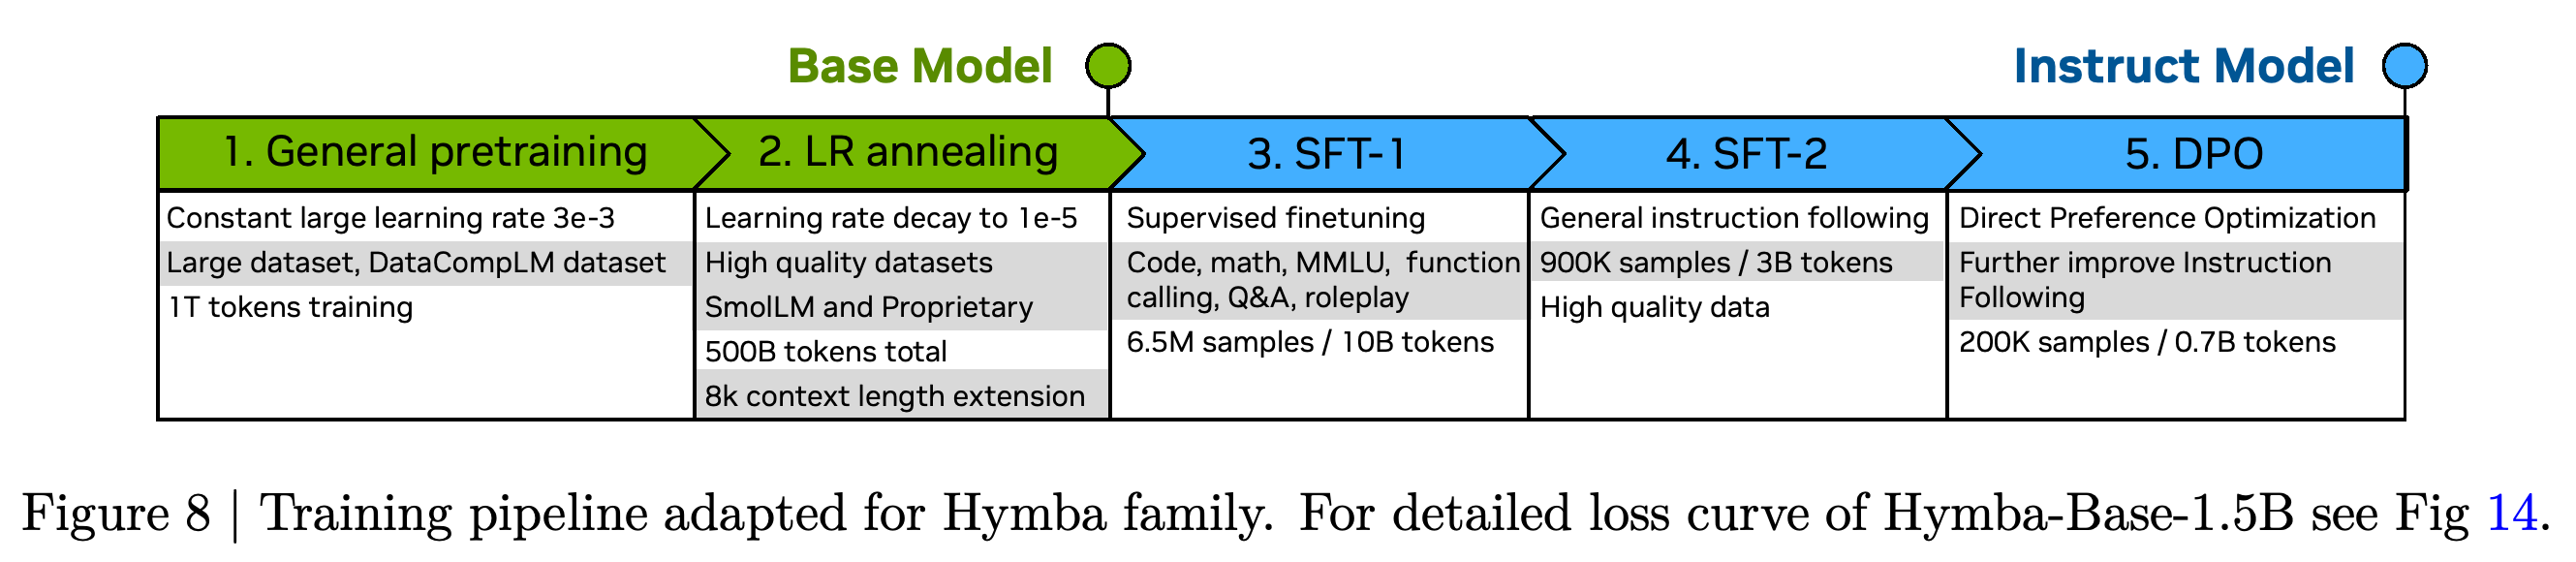
그래프에서 Hymba는 제시된 상식 정확도 중 최상위에 가까우면서 SmolLM2보다 적은 캐시를 사용하고 더 높은 처리량을 달성한다. 상식 과제 6개 평균은 Table 2의 과제 7개 평균과 다르며, 측정은 명시된 A100, 8k-sequence 조건을 사용한다.
3.3. Benchmark Different Architectures Under The Same Setting
통제 실험의 모든 모델은 파라미터 규모를 1B로 맞추고 동일한 학습 절차로 SmolLM-Corpus 토큰 100B를 학습하며, 예시 없이 평가한다. 일반 과제 8개의 평균에서 Hymba는 54.57%, Samba는 52.83%를 기록한다. 회상 과제 2개의 평균에서는 Hymba가 49.50%, Llama3가 47.33%를 기록한다.
- 회상 과제는 원시 HTML 웹사이트에서 반정형 관계를 추출하는 SWDE와 주어진 문맥으로 답변을 완성하는 SQuAD-C다. Hymba는 각각 54.29%, 44.71%를 기록하고, Llama3는 75.95%, 18.70%를 기록한다. 평균에 포함된 개별 과제 사이에 상당한 차이가 있음을 보여준다.
- 텍스트 예측의 불확실성을 나타내는 perplexity에서도 Hymba는 Wiki.와 LMB.로 표기된 언어 모델링 평가 2개 모두에서 가장 낮은 보고값을 기록하며, 각각 18.62와 10.38이다.
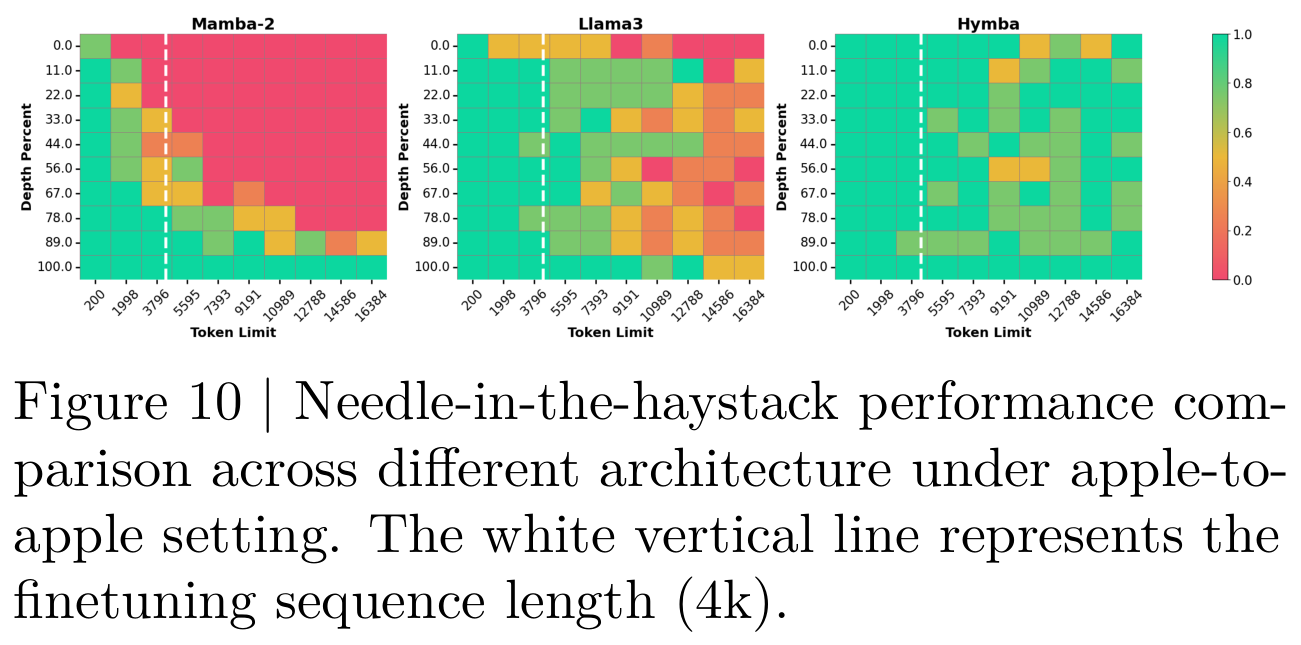
- Needle-in-the-haystack 평가는 긴 문서에 정보가 담긴 문장을 삽입하고 모델에 해당 정보를 검색하도록 요청한다. 조건을 맞춘 1B 모델은 시퀀스 길이 1k에서 사전학습하고 4k에서 fine-tuning한 뒤 최대 16k까지 평가한다. Hymba의 heatmap은 Mamba2와 Llama3보다 더 넓은 위치 및 길이 범위에서 검색 성공을 보여주지만, 그림은 단일 종합 점수를 제공하지 않는다.
동일한 100000000000 tokens로 학습하고 조건을 맞춘 1B 모델은 공개 모델 비교보다 아키텍처의 우위에 대해 더 강한 근거를 제공한다. Hymba는 종합 정확도 그룹 모두에서 앞선다. 그러나 SWDE에서는 Llama3의 75.95%가 Hymba의 54.29%보다 높아, 회상 평균 안에서도 상당한 차이가 있음을 보여준다.
Heatmap은 4k에서 fine-tuning한 뒤 문서 길이와 삽입 위치에 따른 검색 성능을 비교한다. Hymba는 더 넓은 범위에서 검색에 성공한다. Mamba2는 앞쪽에 삽입된 정보 검색에 어려움을 보이며, Llama3는 fine-tuning 범위를 넘어서면 위치에 따라 실패한다.
3.4. Instruction-tuned Model
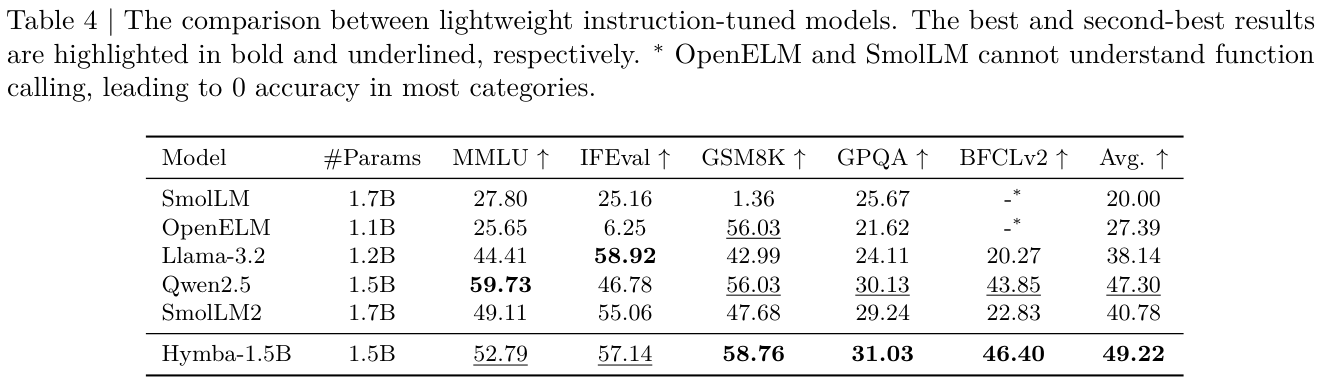
사후학습은 응답 예시로 모델을 갱신하는 supervised full fine-tuning과 선호 응답 및 비선호 응답으로 학습하는 Direct Preference Optimization (DPO)을 결합한다. 명시된 학습률은 각각 5e-5와 3e-6이다. Hymba-1.5B-Instruct는 벤치마크 5개 평균에서 49.22%를 기록하며, Qwen2.5는 47.30%를 기록한다.
- Hymba는 수학 문장제 벤치마크인 GSM8K에서 58.76%, 질의응답 벤치마크인 GPQA에서 31.03%, 함수 호출 생성을 평가하는 Berkeley Function-Calling Leaderboard v2 (BFCLv2)에서 46.40%를 기록한다. MMLU에서는 Qwen2.5보다, 지시 이행 평가인 IFEval에서는 Llama-3.2보다 낮다.
- BFCLv2는 live_simple, live_multiple, live_parallel, live_parallel_multiple, live_relevance를 사용하며, 함수 호출이 필요 없는 범주인 live_irrelevance는 제외한다. 보고된 점수는 이 범주 선택에 한정된다.
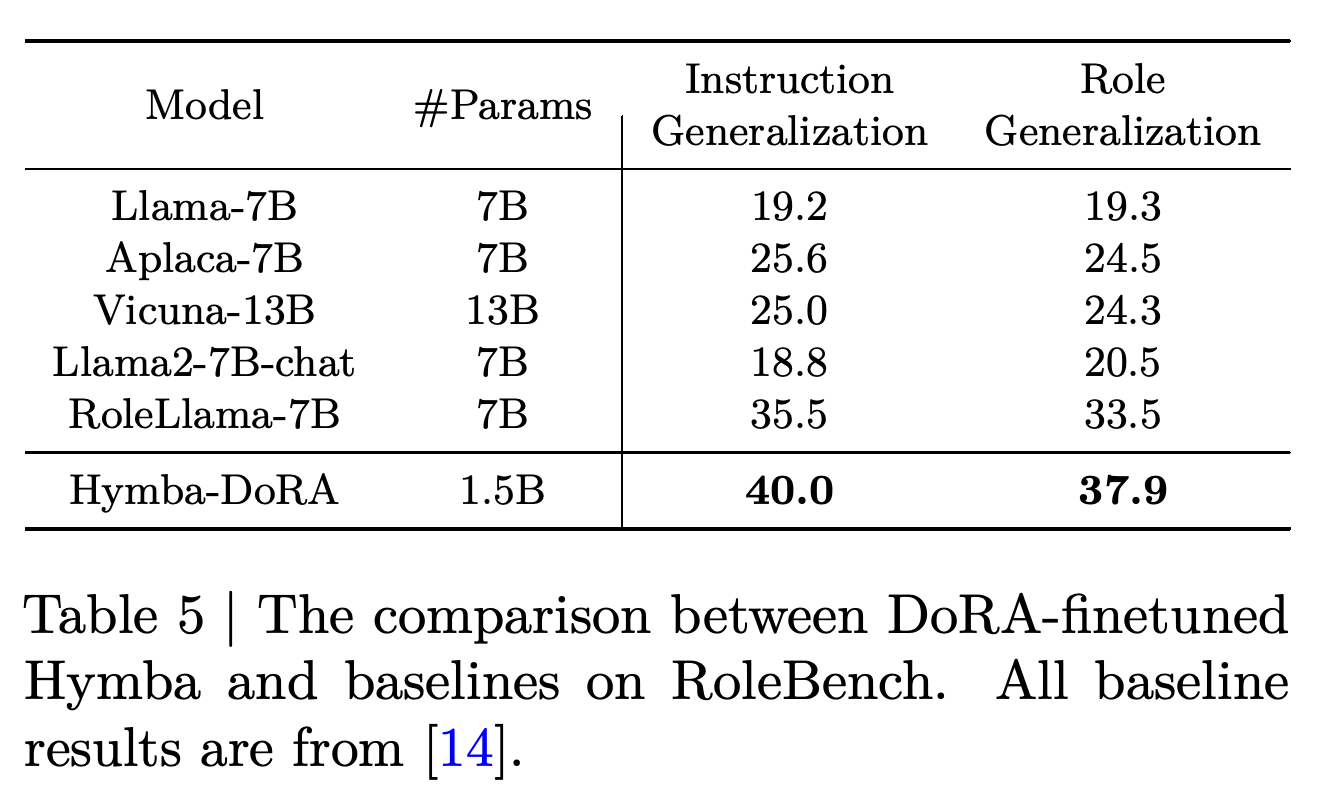
- 소량의 추가 파라미터를 학습하고 저장하는 파라미터 효율적 적응 방법인 DoRA를 적용하면, Hymba는 역할 수행 평가인 RoleBench에서 지시 일반화 40.0%, 역할 일반화 37.9%를 기록한다. Table 5에 기재된 RoleLlama-7B의 결과는 각각 35.5%, 33.5%이며, 베이스라인 결과는 선행 연구에서 가져온다.
Hymba의 평균 49.22%는 Qwen2.5의 47.30%보다 높으며, 수학, GPQA, 선택된 function-calling 평가에서 더 높은 점수를 기록한다. MMLU 점수는 Qwen2.5보다 낮고 IFEval 점수는 Llama-3.2보다 낮아, 평균의 우위가 모든 능력으로 이어지지는 않음을 보여준다.
Hymba-DoRA는 지시 일반화에서 40.0%, 역할 일반화에서 37.9%를 기록해, 기재된 RoleLlama-7B 결과보다 각각 4.5와 4.4 %p 높다. 베이스라인 결과는 선행 연구에서 가져왔으므로, 이 비교의 실험 통제 수준은 Table 3보다 낮다.
4. Related Works
관련 연구에서는 Hymba를 Transformer 언어 모델, 효율적인 순환 아키텍처, attention과 SSM을 결합하는 hybrid 모델과 연결한다. Jamba, Zamba, Samba는 이 연산자들을 순차 구조로 결합하며, Hymba는 동일한 융합 모듈 안에서 병렬로 처리한다.
- 학습된 접두 부분은 학습 가능한 프롬프트 임베딩으로 모델을 적응시키는 prompt tuning 및 기존의 학습 가능한 memory token과도 연결된다. Hymba는 사전학습 중 접두 부분을 함께 학습하고, 고정된 접두 부분의 기여를 추론 시 초기값으로 변환한다.
5. Conclusion
논문은 attention과 SSM의 병렬 처리, 학습된 meta token, 캐시 최적화가 보고된 평가에서 함께 정확도와 효율을 개선한다고 결론짓는다. 통제 비교는 아키텍처의 기여를 뒷받침하며, 캐시 ablation은 회상 정확도를 상당 부분 보존하는 구성과 크게 저하시키는 구성을 구분해 보여준다.
부록
- A. Extensive Benchmark for More Hymba Model Variants와 A.1. Comparison with SOTA Tiny LMs at 350M and 125M Scales는 벤치마크 실행 도구인 LightEval의 평균을 보고한다. Hymba-125M은 49.35%, Hymba-350M은 55.34%를 기록하며, 대응하는 SmolLM 베이스라인은 각각 48.44%, 53.56%를 기록한다. 이 결과는 더 작은 모델에서도 보고된 평균 성능 우위가 이어짐을 보여주며, 평가 설정은 Table 2와 다르다.
- A.2. Evaluating Hymba-1.5B Trained on Public Data Only는 DCLM-Baseline-1.0 토큰 1T 이후 SmolLM-Corpus 토큰 500B를 사용한다. 공개 데이터 모델의 평균은 60.81%이며, 주요 모델은 61.06%, SmolLM2는 60.04%다. MMLU 점수는 51.19%에서 44.31%로 떨어지지만, 다른 여러 과제의 점수는 개선된다.
- A.3. Apple-to-Apple Comparison with Other Architectures at 300M Scale에서는 FineWeb 토큰 100B, 최대 학습률 5e-4, warmup과 cosine decay, 길이 1K의 시퀀스를 사용해 모델을 학습한다. Local attention을 적용하는 곳에서는 토큰 256개의 윈도우를 사용한다. 일반 정확도는 Hymba가 45.53%, Llama3가 44.08%이며, 회상 정확도는 Hymba가 51.79%, Llama3가 39.98%다.
- B. Ablation Studies of Our Hymba Architecture에서는 Parallel vs. Sequential fusion을 비롯한 분석을 수행한다. 토큰 간 정보가 전달되는 거리를 경험적으로 측정하는 effective receptive field를 캐시 크기와 비교한다. 병렬 설계는 비슷한 캐시 크기에서 순차 설계보다 측정된 receptive field가 크다. Table 10은 attention 용량을 늘리면 회상 성능과 메모리 비용이 함께 증가하며, concatenation은 선택된 평균 융합보다 일반 과제 평균을 개선하지 못함을 추가로 보여준다.
- C. Head Importance Analysis는 레이어별로 attention 또는 SSM 분기를 제거하고 과제당 샘플 1000개를 예시 없이 평가한다. 레이어와 과제 전체에서 평균한 정확도 감소는 attention 제거 시 0.46%, SSM 제거 시 1.2%로 보고하며, 첫 레이어의 SSM이 특히 중요하다. 이 개입 실험은 평가한 모델과 과제에서 각 분기가 중요함을 입증한다.
- D. Meta Tokens: More Analysis and Visualization은 학습된 접두 부분을 prompt tuning, memory token, 전역 정보를 유지하도록 학습하는 vision-transformer register와 연결한다. Figure 15에서 meta token을 추가하면 제시된 모든 attention 레이어와 SSM 레이어 12개 중 10개에서 attention map의 entropy가 낮아진다. 이는 토큰의 기여가 더 집중됨을 뜻한다. 이러한 집중이 검색 성능 개선과 연결된다는 설명은 여전히 해석에 해당한다.
- E. Pretraining and Post-training Implementation Details는 NVIDIA A100 GPU 128개, warmup 1%, 학습률 감소 구간 20%, 2M-token 학습 배치를 명시한다. 또한 full fine-tuning과 DPO를 각각 1 epoch 수행하고, 전역 배치 크기 1024와 fine-tuning 도구인 LMFlow를 사용한다고 명시한다. 재현하려면 부록과 본문의 차이를 해소해야 한다. 사전학습 토큰 수는 1.3T와 1.5T로 다르고, 부록의 시퀀스 길이 설명은 2K인 반면 본문은 마지막에 8k로 확장한다고 설명하며, 사후학습 block size도 2048과 8192로 다르다.
짧은 생각
통제 비교는 병렬 융합이 아키텍처 측면에서 기여함을 뒷받침한다. 모델 크기, 데이터, 학습 절차를 맞춰도 우위가 유지되며, 캐시 ablation은 global attention을 제거할 때의 비용을 보여준다. 메모리에 대한 비유와 attention 시각화는 설계를 해석하는 데 도움이 되지만, 특정 meta token에 저장된 세계 지식을 식별하지는 못한다. 배포 가능성을 평가하려면 목표 하드웨어와 워크로드에서 측정해야 하며, 재현하려면 서로 다른 학습 사양을 명확히 해야 한다.