MedGemma Technical Report 요약 설명
07 Jul 2025 | Paper Review Medical AI Vision-Language Models Foundation Models목차
이번 글은 Google Research와 Google DeepMind의 MedGemma Technical Report를 살펴본다.
- 최초 arXiv 공개: 2025년 7월 7일
- 논문, arXiv v4
- MedGemma 프로젝트
이미지 출처. Google Research와 Google DeepMind, MedGemma Technical Report, arXiv:2507.05201v4, © 2026 Google. All rights reserved. arXiv 기록에는 논문 라이선스가 CC BY 4.0으로 표시되어 있다. 이미지는 원문 PDF의 Figure 1(2쪽), Tables 4, 7, 13(각각 9, 14, 17쪽)에서 잘라냈다.
원문 버전과 작성 경위. 이 글은 2026년 4월 6일에 공개된 arXiv v4를 수동으로 분석한 회고 글이다. 보고서에는 2026년 4월 8일이 표기되어 있다. 아래 결과는 이후 개정판의 내용이며 2025년 7월 당시에 확인된 성능을 뜻하지 않는다.
요약
- MedGemma는 Gemma 3를 의료 텍스트와 영상에 맞게 조정한 모델 모음이다. 본문은 4B 멀티모달 모델과 27B 텍스트 전용 모델을 주로 평가하며, 별도의 27B 멀티모달 모델에 대해서는 부록 F에 예비 결과가 실려 있다. 본문의 두 모델은 모두 텍스트를 출력한다.
- 학습 분포 밖의 CheXpert 흉부 X선 벤치마크에서 제로샷 MedGemma 4B의 macro F1은 48.1, Gemma 3 4B는 32.6이다. 텍스트 전용 MedXpertQA 정확도는 두 27B 모델이 각각 25.7%와 15.7%다. 이는 보고서의 평가 조건에서 얻은 점수이며 임상 성능을 직접 측정한 수치가 아니다.
- 추가 미세 조정은 합성 전자의무기록 질의응답을 포함한 일부 과제의 점수를 개선했다. 저자들은 벤치마크 평가를 첫 단계로 설명하며, 이 보고서는 임상 현장에서의 안전성과 효과를 확립하지 않는다.
1 Introduction
의료 데이터에는 영상과 텍스트가 함께 포함된다. 개별 과제에 특화된 모델은 많은 레이블 데이터를 필요로 할 수 있다. MedGemma는 개발자가 의료 응용에 맞게 조정할 수 있는 공개 기반 모델을 목표로 한다. 모델 모음에는 의료 영상 인코더인 MedSigLIP도 포함된다. 논문 2쪽의 Figure 1은 4B 멀티모달 모델, 27B 텍스트 모델과 인코더의 관계를 정리한다.
그림은 네 의료 영상 분야와 의료 텍스트를 모델 모음에 연결한다. MedSigLIP은 4B 멀티모달 모델의 영상 인코더이며, 여기에 표시된 27B 모델은 텍스트 전용이다.
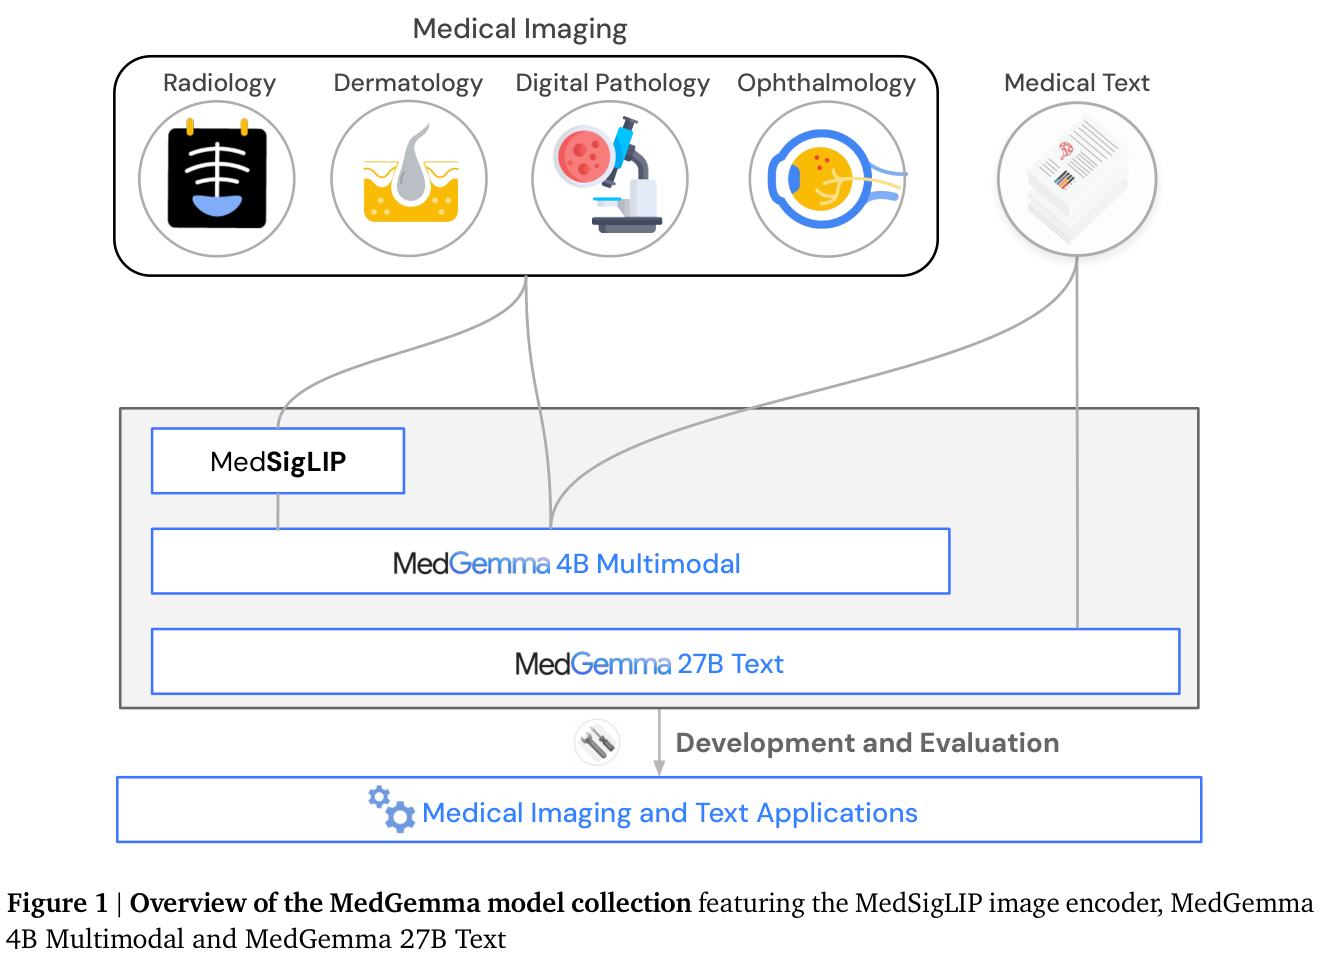
4B 모델은 영상, 텍스트 또는 둘을 함께 입력받는다. 본문에서 별도 표시가 없는 “MedGemma 27B”는 텍스트 전용 모델이다. 27B 멀티모달 모델은 별도로 존재하며 부록 F의 평가는 예비 결과다.
2 Methods
2.1 데이터와 전처리
학습에는 범용 데이터와 의료 텍스트, 의료 영상이 함께 쓰인다. 의료 텍스트 후속 학습에는 여러 질의응답 데이터셋에서 얻은 교사 모델의 응답과 로짓, 약 20만 개의 합성 질문이 포함된다. 영상 데이터는 영상의학, 조직병리, 피부과, 안과와 의학 문헌의 이미지를 다룬다. 4쪽 Table 1은 데이터셋과 각 학습 단계를 정리한다.
영상 입력은 2차원에 초점을 맞춘다. X선과 선택된 CT, MRI 2차원 단면은 포함하지만 3차원 볼륨과 유전체 데이터는 제외한다. 이미지는 896 × 896 픽셀로 조정한다. CT 단면은 뼈와 폐, 연조직, 뇌를 강조하는 세 가지 윈도 설정을 RGB 채널에 대응시킨다.
2.2 구조와 학습
MedGemma는 Gemma 3 구조와 400M 파라미터 SigLIP 영상 인코더를 사용한다. 4B 모델의 인코더는 3,300만 쌍이 넘는 의료 영상과 텍스트로 추가 학습한다. 대부분은 조직병리 패치이며 범용 데이터도 유지한다. 이 단계에서 의료 데이터의 혼합 가중치는 2%다. 별도로 공개된 MedSigLIP은 같은 가중치를 사용하되 위치 임베딩을 축소해 448 × 448 해상도로 동작한다.
이후 4B 멀티모달 디코더를 사전 학습할 때 의료 영상과 텍스트의 혼합 가중치는 10%다. 증류 단계에는 의료 텍스트를 추가하고, 강화학습 후속 단계에는 의료 영상과 짝을 이룬 텍스트를 사용한다. 27B 텍스트 전용 모델은 전체 멀티모달 학습 과정 대신 후속 학습 단계를 사용한다. 자세한 방법은 4–5쪽에 나온다.
3 Evaluation design
보고서는 의료 텍스트 질의응답, 영상 분류, 시각 질의응답, 흉부 X선 보고서 생성, 모의 에이전트 행동과 범용 벤치마크를 평가한다. 6쪽 Table 2는 데이터셋과 학습 분포 밖의 과제를 구분한다. 별도 설명이 없는 한 의료 벤치마크에서 MedGemma는 사례마다 한 번 추론하고 temperature 0을 사용한다. 비교 모델의 기본 샘플링 설정은 다를 수 있다.
영상의학 데이터셋마다 레이블 처리와 대상 질환이 다르다. MIMIC-CXR의 두 시험 집합은 누락과 불확실 레이블을 다르게 처리하며 CheXpert와 ChestX-ray14는 평가하는 질환의 수도 다르다. 피부과와 병리 평가 일부에는 내부 데이터셋을 사용하므로 결과를 일반적인 임상 검증으로 확대할 수 없다.
보고서 생성 평가에서는 흉부 영상 전문의 한 명이 306건을 검토했다. 검토자는 보고서의 출처를 알고 있었다. AgentClinic은 모델이 환자와 평가자 역할을 맡는 모의 진료 환경이며 실제 환자를 대상으로 한 전향적 연구가 아니다.
4 Results
4.1 의료 지식과 영상 이해
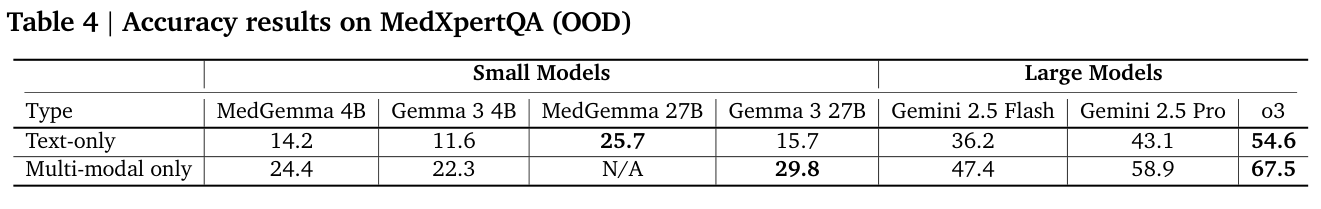
9쪽 Table 4의 분포 밖 MedXpertQA 텍스트 문제에서 MedGemma 4B와 Gemma 3 4B의 정확도는 각각 14.2%와 11.6%다. 27B 텍스트 모델은 각각 25.7%와 15.7%다. 멀티모달 전용 문제에서 두 4B 모델은 24.4%와 22.3%를 기록했다. 차이는 각각 2.6, 10.0, 2.1%포인트다.
텍스트 전용 행과 멀티모달 전용 행은 서로 다른 MedXpertQA 문제 집합을 비교한다. 텍스트 전용 MedGemma 27B는 멀티모달 전용 행에서 평가할 수 없다.
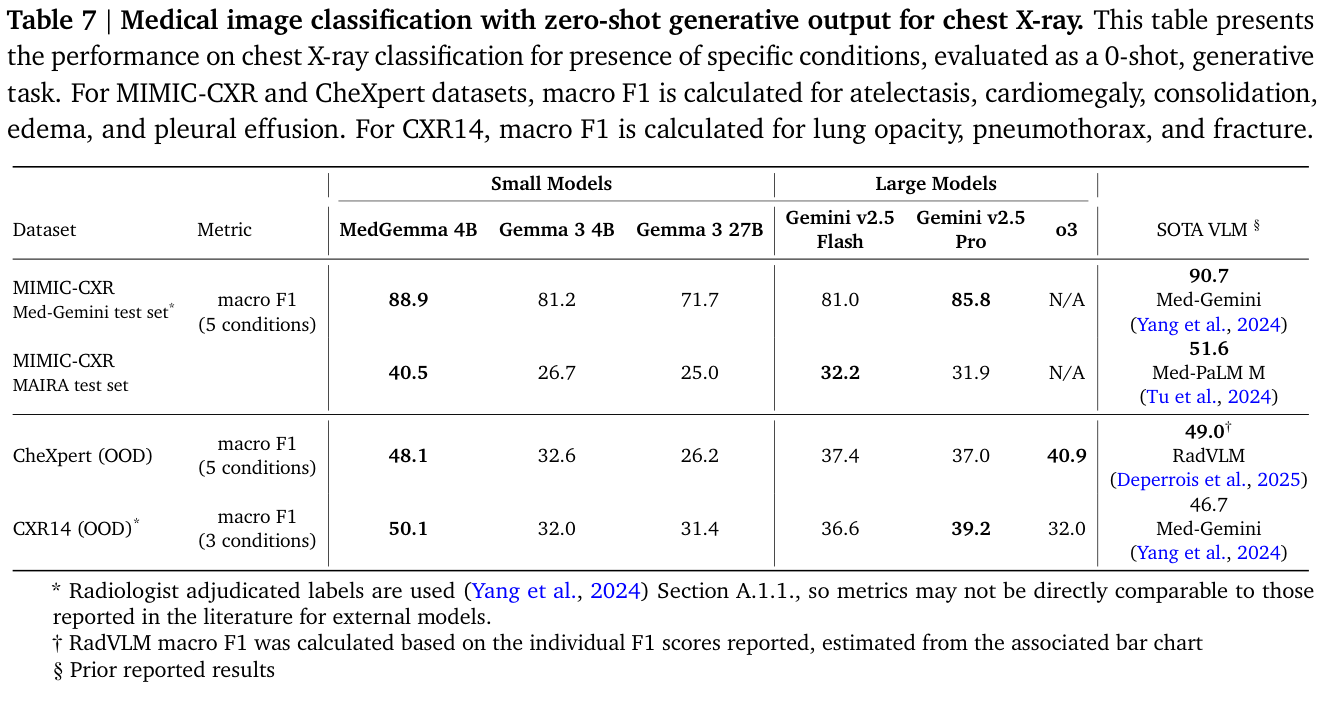
14쪽 Table 7은 제로샷 생성 방식의 흉부 X선 분류를 보고한다. CheXpert에서 MedGemma 4B와 Gemma 3 4B의 macro F1은 각각 48.1과 32.6이고, ChestX-ray14에서는 50.1과 32.0이다. CheXpert는 다섯 질환의 평균이며 ChestX-ray14는 영상의학과 전문의가 판정한 세 질환의 평균이다. 15.5점과 18.1점의 차이는 상대 증가율이나 환자 치료 효과를 뜻하지 않는다.
MIMIC-CXR과 CheXpert는 다섯 소견을 평균하고 CXR14는 폐 음영, 기흉, 골절 세 소견을 평균한다. 별표가 붙은 행에는 영상의학과 전문의가 판정한 레이블을 사용하며 RadVLM 비교치는 공개 막대그래프에서 추정했다.
자유 형식의 시각 질의응답은 SLAKE와 VQA-RAD에서 평가한다. 저자들은 VQA-RAD의 학습과 시험 이미지 중복을 피하도록 나눈 데이터셋을 사용했으므로 원래 분할로 보고된 수치와 직접 비교하기 어렵다고 설명한다. Figure 2와 3은 개별 응답의 예시이며 전체 성능을 나타내지 않는다.
15쪽 Table 9에서 영어 SLAKE 전체 token F1은 MedGemma 4B가 72.3, Gemma 3 4B가 40.2다. 저자들이 사용한 VQA-RAD 분할에서는 각각 49.9와 33.6이다. 14쪽 Table 8은 내부 영상 분류를 제로샷 객관식 문제로 평가한다. MedGemma 4B의 정확도는 병리 69.8, 피부과 71.8, 망막 영상 64.9이며 해당 데이터셋과 문제 형식에 한정된 결과다.
4.2 보고서와 모의 에이전트
흉부 X선 보고서 생성에는 사전 학습 체크포인트를 사용했다. 평가 지표가 보고서 문체에 민감하기 때문이다. MIMIC-CXR 보고서는 학습에 사용됐으며 저자들은 사전 학습 체크포인트가 후속 학습 모델보다 해당 보고서의 문체를 더 잘 따른다고 설명한다. 이는 비교에 영향을 줄 수 있는 조건이며 시험 이미지의 중복을 입증하지는 않는다. 전문가가 검토한 306건에서 생성 보고서의 81%는 원래 보고서와 같거나 더 나은 임상 결정을 이끈다고 평가됐다. 이는 눈가림 없이 검토한 전문의 한 명의 판단이며 해당 표본과 평가 방식에 한정된다. 원문 8쪽과 13쪽 Figure 4에 조건이 나온다.
16쪽 Table 11의 분포 밖 AgentClinic-MIMIC 모의 실험에서 MedGemma 27B의 정확도는 46.0%, Gemma 3 27B는 35.2%로 차이는 10.8%포인트다. 표에 인용된 의사 점수는 GPT-4 환자 에이전트를 사용한 기존 결과이고, 다시 계산한 모델 평가는 GPT-4o를 사용한다. 이 수치를 의사와 모델의 통제된 직접 비교로 해석할 수는 없다.
일반 텍스트 벤치마크인 MMLU Pro의 16쪽 Table 12에서는 MedGemma 4B가 39.1%, Gemma 3 4B가 43.6%다. 27B 모델은 각각 60.2%와 67.5%다. 이 비교에서는 의료 분야에 맞춘 모델의 MMLU Pro 정확도가 낮다. 저자들은 14쪽에서 기존 벤치마크가 공개되어 널리 사용되므로 시험 데이터가 학습에 섞였을 가능성도 제기한다. 특정 시험 문항이 이 모델들의 학습 데이터에 들어갔다고 확인한 것은 아니다.
5 Task-specific adaptation
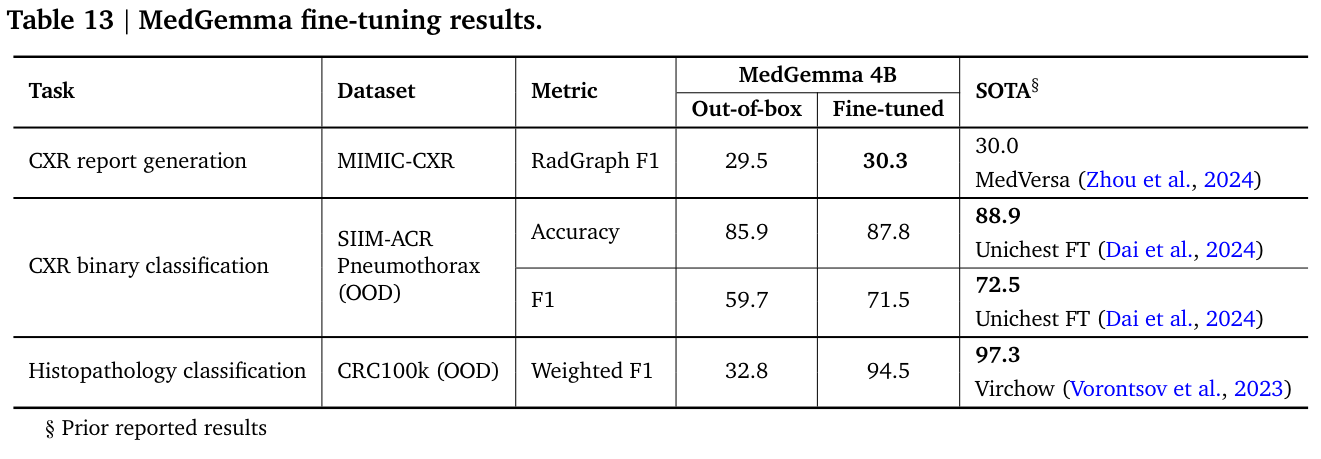
저자들은 영상 과제에 지도 학습으로 MedGemma 4B를 미세 조정했다. 17쪽 Table 13에서 SIIM-ACR 기흉 분류의 정확도는 85.9에서 87.8로, F1은 59.7에서 71.5로 높아졌다. CRC100k 조직병리 패치 분류의 weighted F1은 32.8에서 94.5로 높아졌다. 이 수치는 해당 데이터셋과 미세 조정 조건의 결과이며 기본 모델의 점수가 아니다.
같은 표에서 MIMIC-CXR 보고서 생성의 RadGraph F1은 사전 학습 체크포인트가 29.5, instruction-tuned MedGemma 4B 체크포인트에서 출발해 미세 조정한 모델이 30.3이다. 두 점수는 동일한 체크포인트의 미세 조정 전후를 비교한 결과가 아니다. 이 지표는 생성된 텍스트를 참조 보고서와 비교하며 보고서 문체의 영향을 받는다.
세 과제에서 기본 모델과 조정된 모델의 결과를 비교한다. MIMIC-CXR 보고서 생성의 29.5는 사전 학습 체크포인트, 30.3은 instruction-tuned 체크포인트에서 출발해 미세 조정한 모델의 점수다.
전자의무기록 검색과 추론을 위해서는 MedGemma 27B에 강화학습을 적용했다. 18쪽 Table 14의 EHRQA 정확도는 86.3%에서 93.6%로 높아졌다. 이 벤치마크는 합성 FHIR 기록을 사용한다. 문맥 길이 제한에 맞는 기록 81건을 학습 42건, 검증 20건, 시험 19건으로 나눴으며 임상 메모는 포함하지 않았다. 이 결과는 실제 환자 기록의 성능이나 임상 신뢰성을 입증하지 않는다.
6 MedSigLIP and the preliminary multimodal 27B model
MedSigLIP은 제로샷 분류와 선형 프로브로 평가한다. 선형 프로브는 고정된 표현 위에 단순한 분류기를 학습하는 방식이다. 20쪽 Table 15와 16은 의료 분야와 흉부 X선 소견별 AUC를 보고한다. 결과는 소견과 비교 모델에 따라 다르므로 선택된 소견의 평균을 모든 임상 상황의 정확도로 해석해서는 안 된다.
19쪽 Figure 5는 CheXpert와 ChestX-ray14의 흉부 X선 소견 일곱 개를 대상으로 학습 표본 수에 따른 선형 프로브 평균 AUC를 나타낸다. 저자들은 학습 사례가 512개 이상일 때 MedSigLIP이 높은 성능을 보였다고 설명한다. 이 곡선은 해당 평가의 결과이므로 모든 영상 과제에 일반화할 수 없다.
60쪽 부록 F는 별도의 27B 멀티모달 모델을 설명한다. 이 모델은 멀티모달 학습에 EHRQA와 Chest ImaGenome 데이터를 추가한다. Table A14는 예비 결과임을 명시한다. 예를 들어 CheXpert 점수는 27B가 49.9, 4B가 48.1이지만 ChestX-ray14에서는 각각 45.3과 50.1이다. 어느 모델도 표의 모든 과제에서 우세하지는 않다.
7 Limitations and interpretation
벤치마크는 모델의 특정 조건에서의 동작을 보여주지만, 완성된 응용이 실제로 안전하고 효과적인지 입증하지는 않는다. 데이터 구성과 레이블 방식, 제한된 전문가 검토, 모의 에이전트 환경과 합성 기록은 해석 범위를 제한한다. 저자들은 더 어려운 벤치마크와 실제 응용의 요구사항을 추가로 평가해야 한다고 설명한다. 의료 현장에 적용하려면 대상 집단과 업무 흐름에 맞는 별도 검증이 필요하다.