


MiniMax-01: Scaling Foundation Models with Lightning Attention 요약 설명
14 Jan 2025 | Paper Review Linear Attention Long-Context Language Models Mixture-of-Experts Vision-Language Models목차
이번 글에서는 MiniMax-01: Scaling Foundation Models with Lightning Attention 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 14일(Arxiv)
- MiniMax, Li, Aonian, Gong, Bangwei, Yang, Bo, Shan, Boji, Liu, Chang, Zhu, Cheng, Zhang, Chunhao, Guo, Congchao, Chen, Da, et al.
- MiniMax
- 논문 링크
- Github
요약
- 수백만 개의 입력 토큰을 처리하려면 많은 계산이 필요하다. MiniMax-01은 일반적인 언어 모델 성능을 유지하면서 이 비용을 줄인다. 13개 긴 문맥 과제로 구성된 RULER에서 입력 길이를 모두 1M 토큰으로 설정했을 때, MiniMax-Text-01의 평균 정확도는 0.910으로 Gemini-1.5-Pro (002)의 0.850보다 높다.
- 이 모델은 lightning attention 계층 7개마다 softmax attention 계층 1개를 배치한다. Lightning attention은 메모리 전송을 고려해 구현한 linear attention으로, 특징 차원과 블록 크기가 고정되어 있으면 계산량이 시퀀스 길이에 비례해 증가한다. Softmax attention은 앞선 토큰에 대한 정규화된 가중치를 계산한다. Mixture of Experts (MoE)는 각 토큰을 선택된 피드포워드 네트워크로 보내며, 총 파라미터 456 billion개 중 토큰마다 45.9 billion개를 활성화한다.
- 학습을 통해 모델이 입력으로 사용할 수 있는 길이인 문맥 창을 1M 토큰까지 확장하고, 합성 검색 테스트에서 4M 토큰까지 외삽할 수 있음을 보인다. 통신 스케줄링과 모델 연산을 실행하는 전용 추론 커널이 이 규모를 지원한다. MiniMax-VL-01은 이미지 처리 기능을 추가해 이미지와 텍스트를 함께 이해한다.
- 긴 문맥 질의응답 벤치마크인 LongBench v2에서 MiniMax-Text-01은 추론 과정을 명시적으로 생성하는 chain-of-thought를 사용할 때 56.5를 기록한다. 같은 평가 방식에서 GPT-4o (11-20)는 51.4다. 성능은 과제에 따라 다르다. 코딩은 여러 경쟁 모델보다 약하고, 4M-token 결과는 단순화된 검색 과제에 해당하며, 남겨 둔 softmax 계층은 매우 긴 입력에서 여전히 큰 비용을 요구한다.
1. Introduction
이 보고서는 당시 일반적이라고 설명한 32K–256K 문맥 창을 넘어서는 응용을 목표로 한다. 책 전체나 프로그래밍 프로젝트를 처리하고, 입력에 제공된 예시로 학습하는 경우가 이에 해당한다. 배포 조건은 graphics processing unit (GPU) 최대 8개, 메모리 640GB를 갖춘 장비 1대와 8-bit 양자화다. 양자화는 모델 가중치를 저장하는 수치 정밀도를 낮춘다.
- 기여는 아키텍처, 학습 데이터, 분산 실행, 추론 구현을 아우른다. 보고서는 최종 모델 성능의 원인을 attention 하나로 분리해 입증하지 않는다.
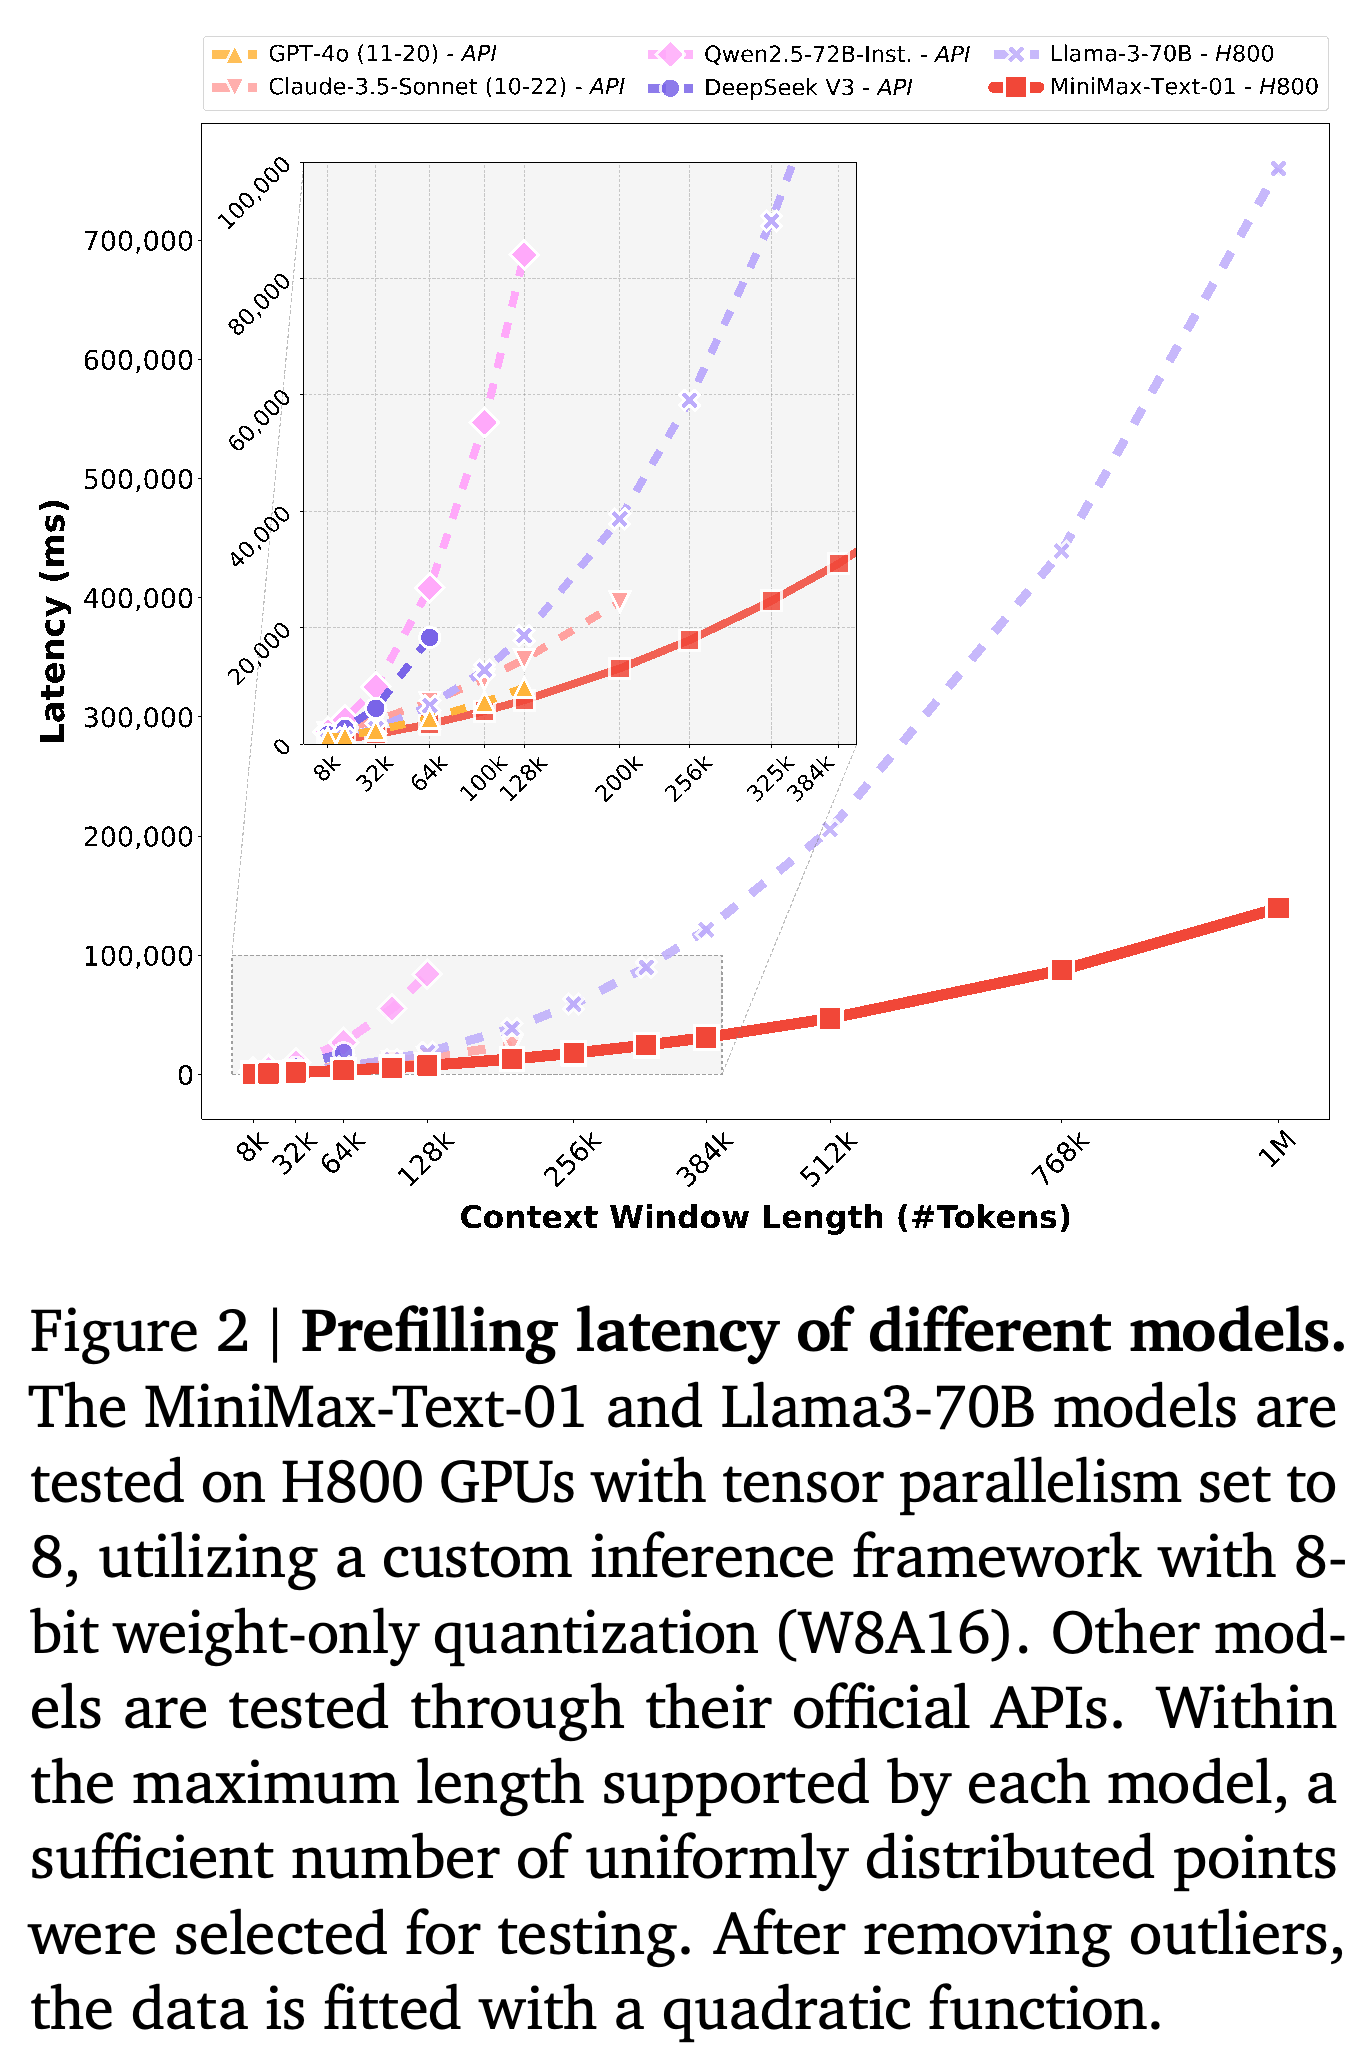
- Prefilling은 후속 토큰을 생성하기 전에 입력을 처리하는 단계다. 지연 시간 비교에서는 MiniMax-Text-01과 Llama3-70B를 H800 GPU에서 실행하고, 모델 계산을 장치 8개에 나누는 tensor parallelism 8과 W8A16을 적용한다. W8A16은 가중치 8-bit, 활성값 16-bit를 뜻한다. 다른 모델은 공식 application programming interface (API)를 사용한다.
곡선은 입력이 길어질수록 MiniMax-Text-01의 prefilling 지연 시간 우위가 커짐을 보여 준다. Llama3-70B와의 로컬 비교는 H800 하드웨어, tensor parallelism 8, W8A16 조건을 공유한다. API 비교에는 서로 다른 서빙 시스템이 포함되며, 이상치 제거와 이차함수 적합도 해석에 영향을 준다.
2. Model Architecture
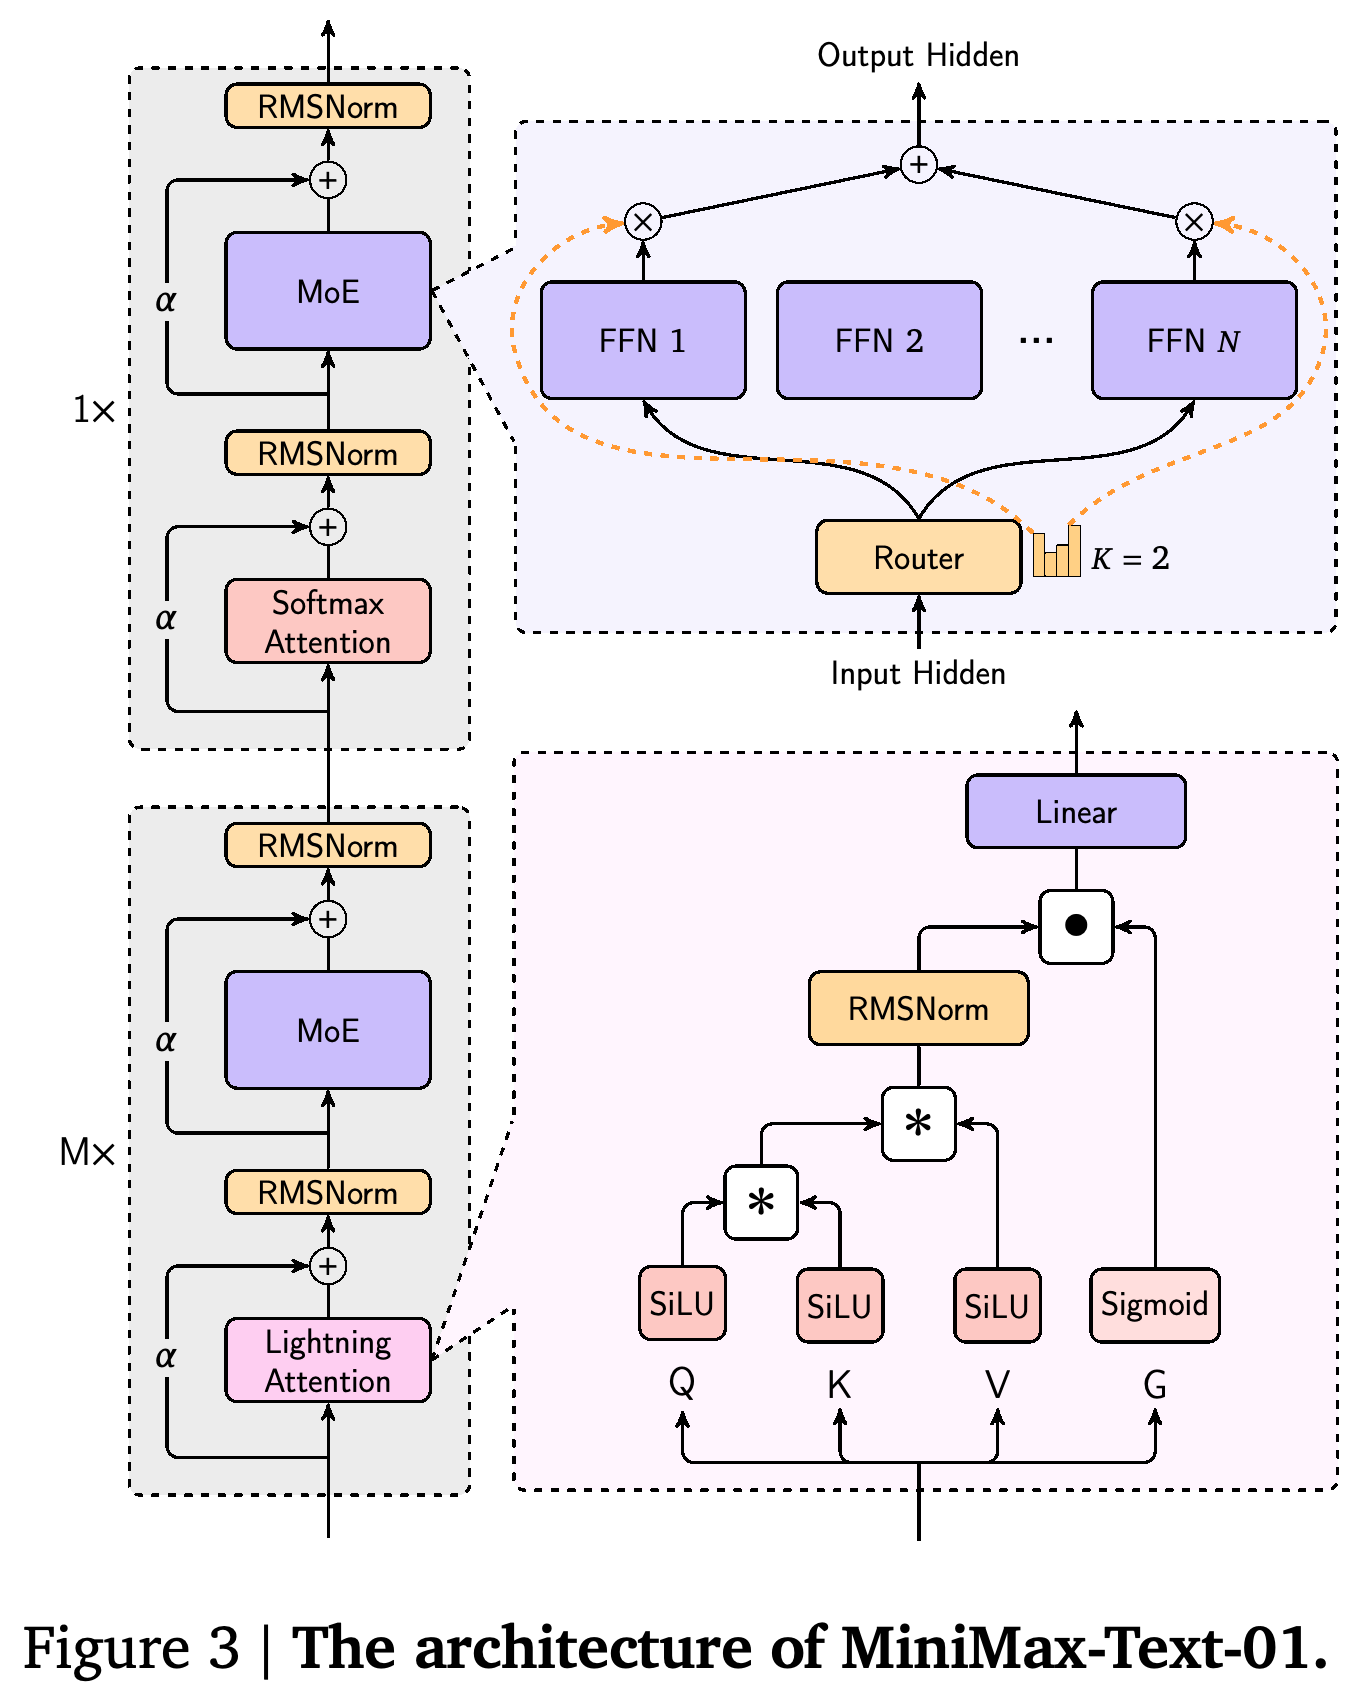
MiniMax-Text-01은 80개 계층으로 구성되며, lightning attention 블록 7개 뒤에 softmax attention 블록 1개가 오는 구성을 반복한다. 각 계층에는 전문가 32개가 있고, 토큰마다 전문가 2개를 선택하는 top-2 routing을 사용한다. 깊은 네트워크의 학습을 안정화하기 위해 정규화와 잔차 스케일링 방식인 DeepNorm을 적용한다.
- 은닉 차원은 6144이고, 각 전문가의 피드포워드 은닉 차원은 9216이다. Attention은 병렬 구성 요소인 head 64개를 사용하며, head 차원은 128이다.
- Softmax 계층은 query head 그룹이 key와 value를 공유하는 Group Query Attention (GQA)을 사용하며, 그룹 크기는 8이다. Attention 내부의 회전으로 위치를 표현하는 Rotary Position Embedding (RoPE)은 head 차원의 절반에 적용하고, 초기 기준 주파수는 10,000으로 설정한다.
이 도식은 반복되는 attention 혼합과 희소 전문가 계산의 연결을 보여 준다. Lightning 블록 7개 뒤에 softmax 블록이 오고, router는 피드포워드 전문가 2개를 선택한다. 따라서 최종 아키텍처는 누적된 linear attention 상태와 이전 입력에 대한 직접적인 softmax 접근을 모두 유지한다.
2.1. Mixture of Experts
MoE는 학습된 router가 부여한 가중치로 전문가 출력을 결합한다. 학습 중에는 전문가마다 처리 용량을 제한하고, 이를 초과해 전달된 토큰을 버린다. Global router는 전문가를 장치에 분산하는 expert parallel (EP) 그룹 사이에서 전문가별 토큰 수를 동기화해 부하 불균형과 토큰 누락을 줄인다.
- 비교 실험에서는 토큰마다 피드포워드 네트워크 전체를 사용하는 7B dense 모델과, 총 파라미터 24B 중 2 billion개를 활성화하는 MoE를 1 trillion 토큰으로 학습한다. 그래프에 제시된 다섯 벤치마크에서 MoE는 더 적은 계산량으로 비슷한 성능에 도달한다.
- Global router는 부하 균형을 위한 보조 손실에 allgather 연산을 추가한다. 이 연산은 토큰을 전달하기 전에 참여 그룹의 토큰 수 정보를 모은다.
2.2. Linear Attention
Linear attention은 곱셈 순서를 Norm((QKᵀ)V)에서 Norm(Q(KᵀV))로 바꾼다. Q, K, V는 각각 query, key, value 행렬이고, Norm은 정규화를 뜻한다. 이 방식은 시퀀스 길이의 제곱 크기인 행렬을 만들지 않는다. 다만 현재와 이전 토큰에만 접근하는 인과적 예측에서는 누적 계산에 대한 의존성이 생긴다.
- Lightning Attention은 시퀀스를 타일로 나눈다. 타일 내부의 상호작용은 마스킹된 attention으로 처리하고, 앞선 타일은 누적 key-value 상태로 요약한다. Algorithm 1은 이 기여분 2개를 계산하고 상태를 갱신한 뒤, 각 출력 타일을 기록한다.
- 순전파 유도에서는 분석을 단순화하기 위해 정규화, 원소별 비선형 변환인 sigmoid linear unit 활성화, 특징별 기여를 조절하는 gating을 생략한다. 제시한 시간 복잡도는 \(O(nd^2+nBd)\)이며, n은 시퀀스 길이, d는 특징 차원, B는 타일 크기다.
효과 검증 실험은 정확한 attention을 최적화해 구현한 FlashAttention-2 기반 softmax attention, 순수 lightning attention, 여덟 번째 계층마다 softmax를 넣는 Hybrid-lightning을 비교한다. 모델 파라미터 수는 70 million, 160 million, 410 million, 1 billion, 3 billion, 7B다. 학습 토큰은 최대 300 billion, 문맥 길이는 8192, 전역 배치는 4 million 토큰이다. 적응형 옵티마이저 Adam을 사용하며 학습률은 3e-4, 가중치 감쇠는 0.1이다.
- 자원 제약으로 고정된 학습률 스케줄러를 사용한다. 계산량, 모델 크기, 데이터 크기, 손실 사이의 경험적 관계인 scaling law를 적합할 때는 학습 손실을 테스트 손실의 대용 지표로 사용한다.
- 연구한 범위에서 적합한 계산량 대비 손실 곡선은 순수 softmax보다 lightning과 hybrid attention에 유리하다. Hybrid-lightning의 적합 관계는 \(L(C)=3.4797C^{-0.0763}\)이고, softmax는 \(3.7087C^{-0.0798}\)이다. L은 손실, C는 계산 예산을 뜻한다. 이 적합 결과가 임의의 규모에서 성능을 보장하지는 않는다.
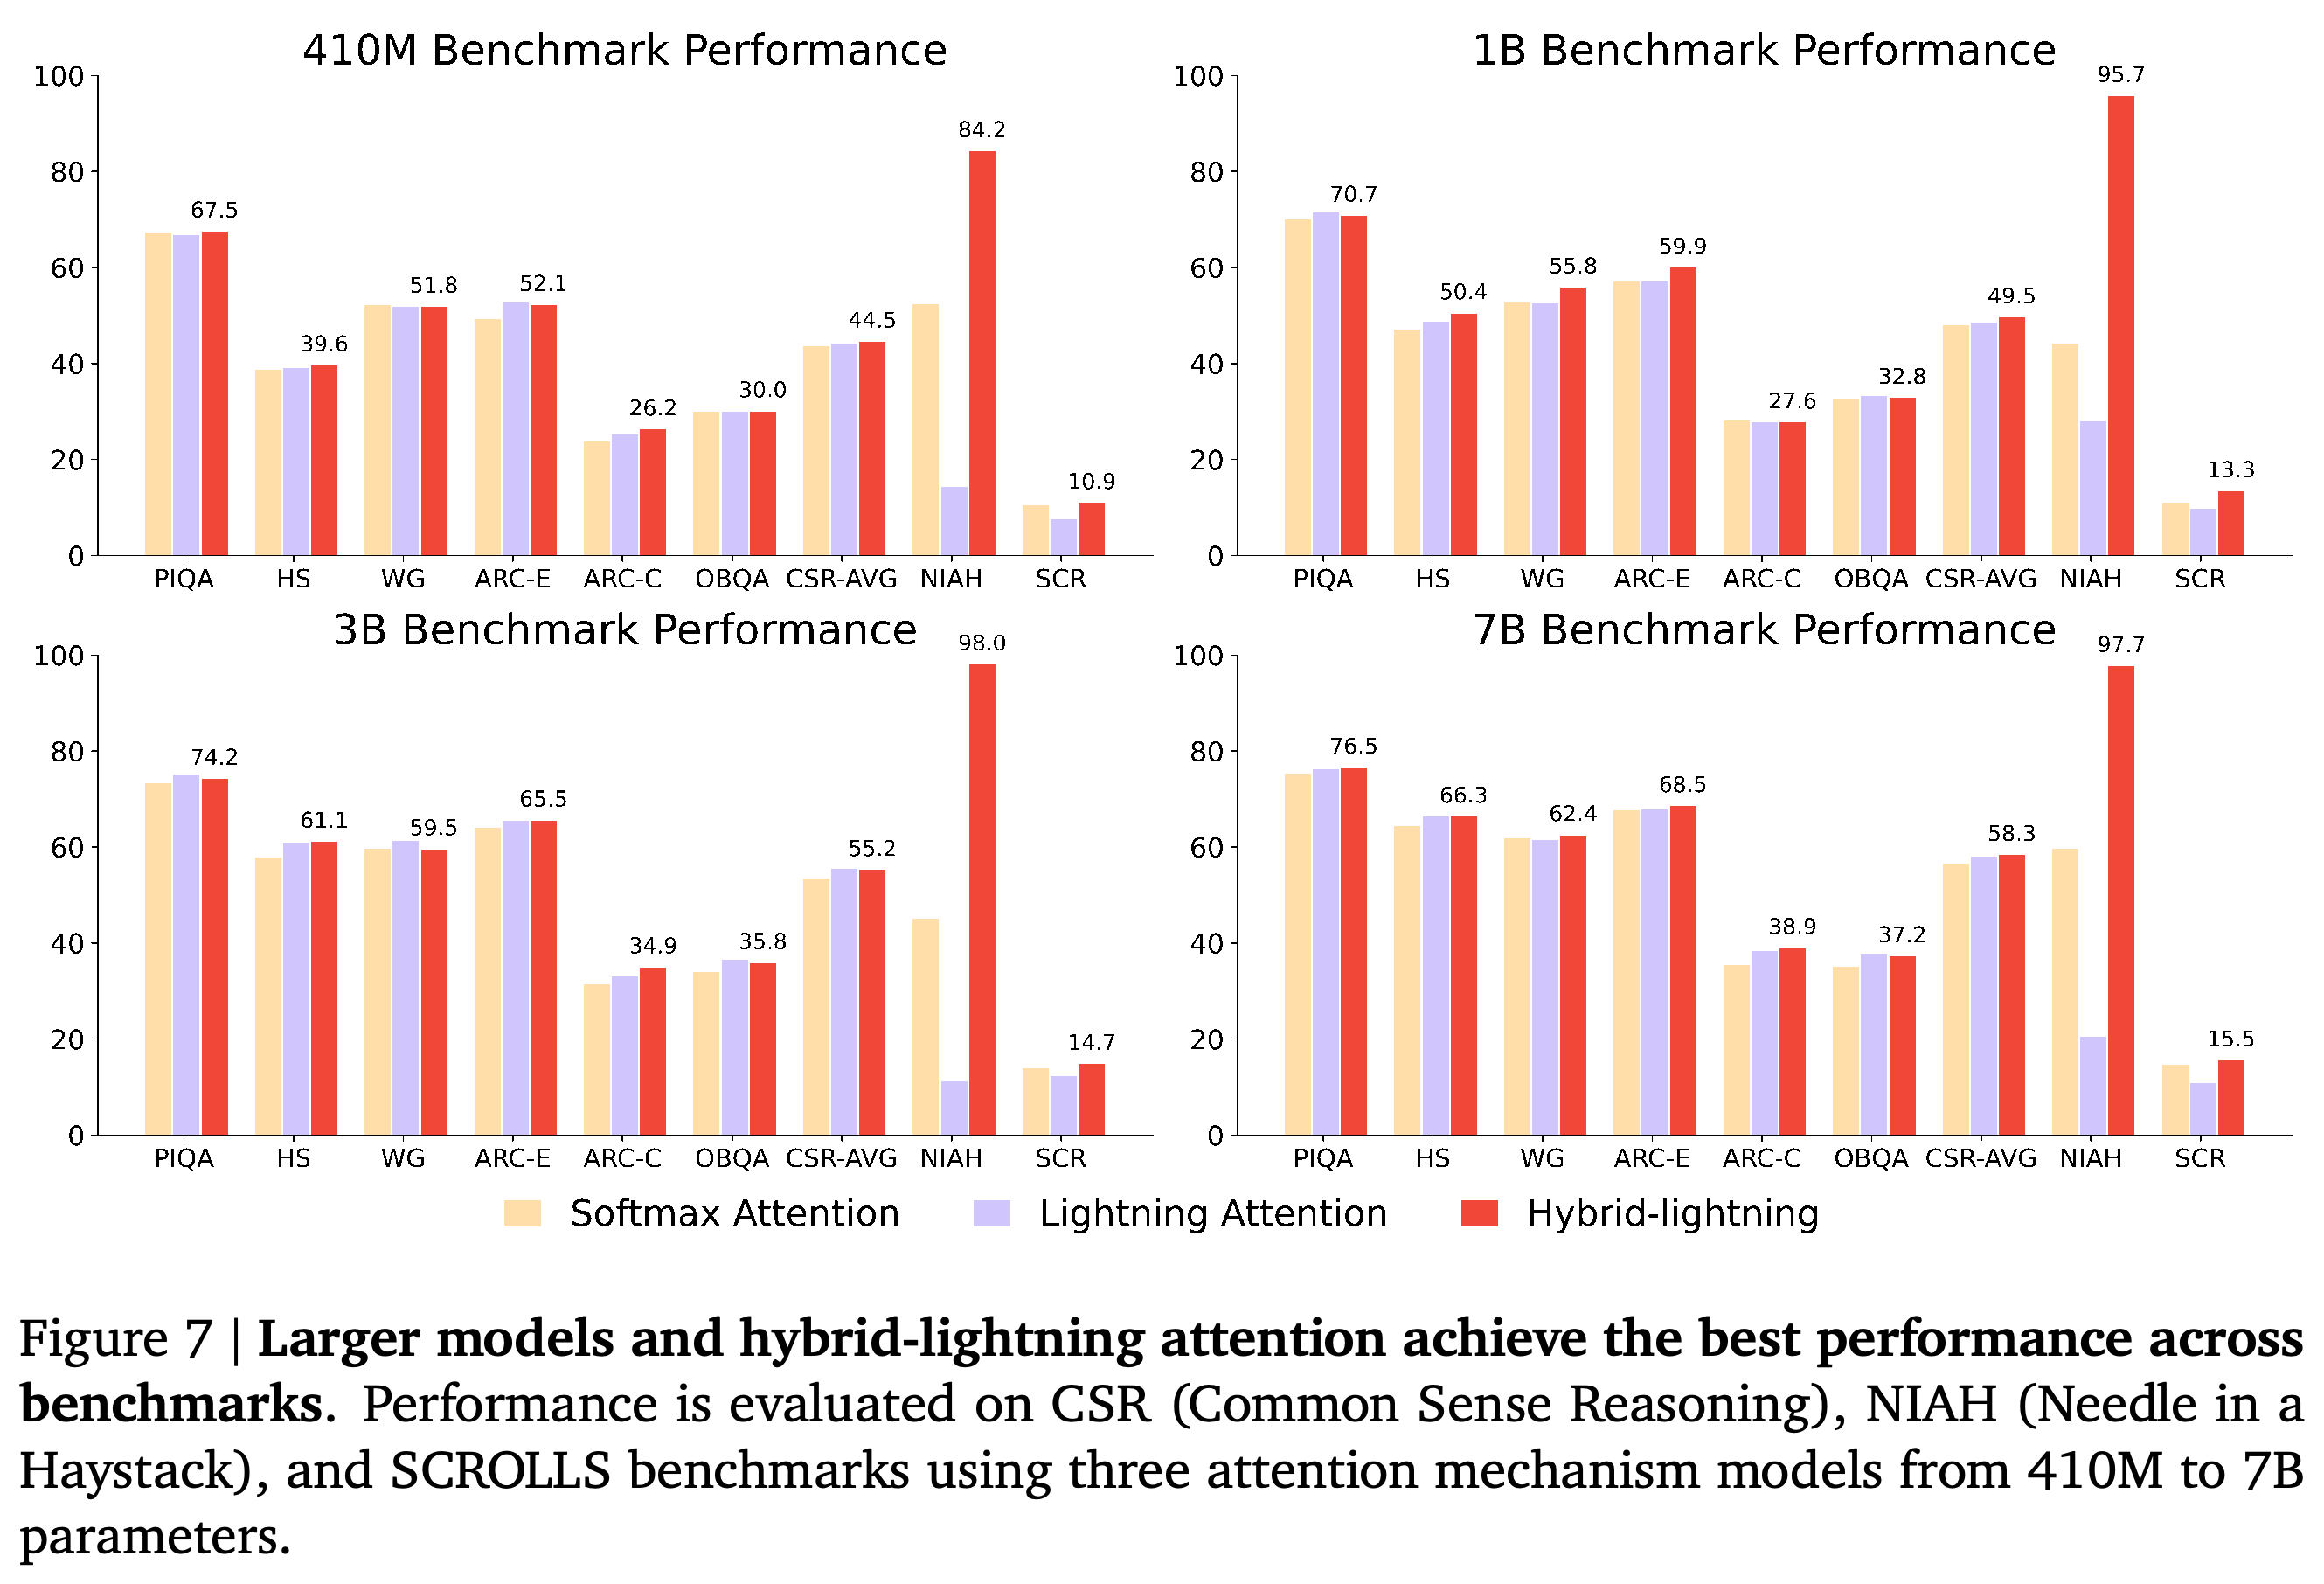
다운스트림 실험에서 순수 lightning attention의 주요 약점은 검색으로 나타난다. 일반 과제 점수는 softmax와 비슷한 경우가 많지만, 삽입한 정보를 찾는 Needle in a Haystack (NIAH) 성능은 상당히 낮다. Hybrid-lightning의 NIAH 점수는 파라미터 1B, 3B, 7B에서 각각 95.7, 98.0, 97.7이다.
- 속도 실험은 H800 노드 1대에서 3B 모델의 시퀀스 길이를 메모리 한계까지 늘려 평가한다. 순수 lightning attention은 GPU당 초당 처리 토큰 수가 대체로 일정하지만, softmax 처리량은 시퀀스가 길어질수록 감소한다.
- Hybrid-lightning도 softmax 계층이 남아 있어 길이가 늘어나면 처리량이 감소한다. 처리량이 대체로 일정하다는 관찰은 실험 범위 내의 순수 lightning attention에 해당한다.
410M–7B 모델에서 가장 큰 차이는 NIAH에 나타난다. 순수 lightning attention은 성능이 낮지만, Hybrid-lightning은 84.2, 95.7, 98.0, 97.7을 기록한다. 일반 과제의 차이가 더 작다는 점에서, 검색은 주기적인 softmax 계층을 유지하는 가장 뚜렷한 실험적 근거다.
Hybrid 비교에는 주기적으로 softmax 계층을 넣는 대안적 시퀀스 모델인 hybrid-cosformer2와 hybrid-hgrn2, 그리고 국소 sliding-window attention에 8번째 계층마다 전체 softmax를 결합하는 hybrid-window 모델이 포함된다. 파라미터 1B에서 Hybrid-lightning은 GPU당 초당 33.4K 토큰과 NIAH 95.7을 기록하며, hybrid-hgrn2는 29.5K와 91.8을 기록한다. 평균 상식 추론 점수는 hybrid-hgrn2가 49.87로 Hybrid-lightning의 49.55보다 높다.
- 파라미터 3B에서 Hybrid-lightning의 NIAH는 98.0이다. 윈도 크기 256, 512, 1024를 쓰는 hybrid-window 구성은 40.9–57.9다. Hybrid-lightning은 상식과 긴 시퀀스의 종합 점수에서 앞서지만, 모든 지표에서 우세하다는 주변 본문의 주장을 표가 뒷받침하지는 않는다.
- 논의에서는 토큰 사이에 전달하는 요약의 크기인 순환 상태 용량과, 이전 입력에 반복 접근하는 softmax attention의 특성으로 결과를 해석한다. 이는 실험에 대한 설명 가설이며, 모든 순수 linear attention 모델에 본질적으로 검색 능력이 부족하다는 증명은 아니다.
2.3. Module Ablations in MoE
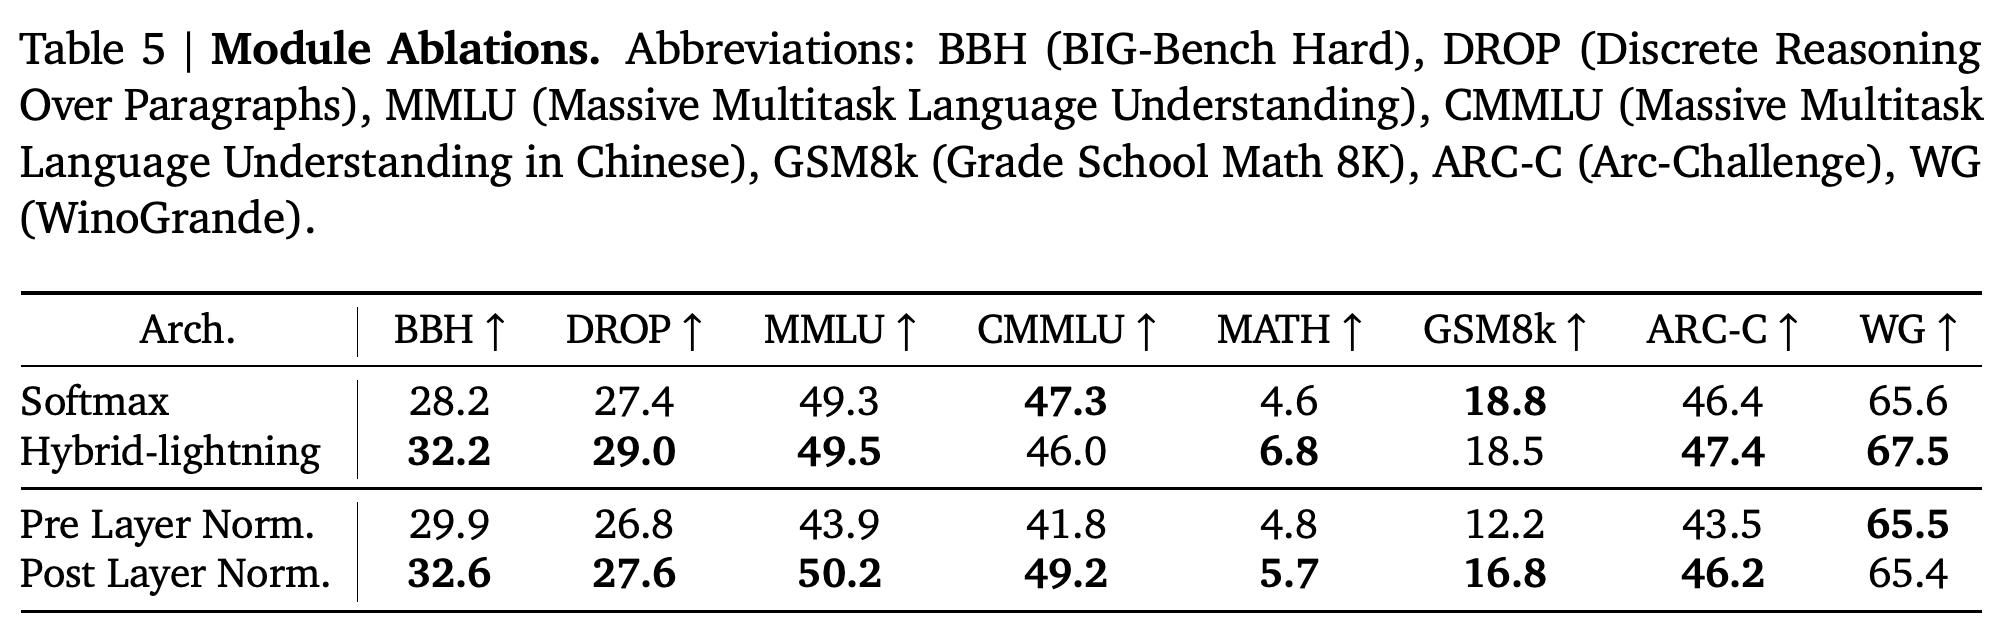
Attention 제거 실험은 총 파라미터 28B개 중 5B개를 활성화하는 MoE 모델을 1 trillion 토큰으로 학습한다. Hybrid-lightning은 softmax보다 보고된 지표 8개 중 6개를 개선한다. 어려운 추론 벤치마크인 BIG-Bench Hard (BBH)는 28.2에서 32.2로, 수학 문제 풀이 벤치마크인 MATH는 4.6에서 6.8로 높아진다. 중국어 지식과 초등 수학 점수는 낮아진다.
- 정규화 제거 실험은 총 파라미터 60B개 중 9.3B개를 활성화하는 48개 계층 모델을 500B 토큰으로 학습한다. 잔차 연산 뒤에 정규화하는 Post Layer Normalization은 DeepNorm을 사용하며, 하위 계층 앞에서 정규화하는 Pre Layer Normalization보다 지표 8개 중 7개를 개선한다.
- 표의 결과는 모든 지표가 개선된다는 주변 본문의 주장에 예외가 있음을 보여 준다. 상식 벤치마크 WinoGrande는 post-normalization에서 65.4, pre-normalization에서 65.5다.
표의 값은 대부분의 지표에서 개선을 뒷받침한다. Hybrid-lightning은 중국어 지식 벤치마크 CMMLU와 초등 수학 벤치마크 GSM8k에서 softmax보다 낮다. WinoGrande에서는 post-normalization이 65.4, pre-normalization이 65.5다. 따라서 모든 지표가 개선된다는 주변 본문의 주장에는 예외가 있다.
2.4. Model Spec
모델 선택은 학습 계산 예산과 총 파라미터 500B개 미만이라는 제약 아래 예측 손실을 최소화한다. 이 파라미터 제한은 8-bit 양자화 상태에서 8×80G 노드로 1M-token 추론을 지원하려는 조건이다. 소형 모델 실험에서는 attention 혼합, 너비 대비 깊이, linear attention 메모리, attention 대비 활성 피드포워드 용량, RoPE 적용 차원의 비율을 살핀다.
- 저자들은 더 깊은 모델, 더 큰 linear attention 메모리, softmax 차원 절반에 RoPE를 적용하는 구성이 유리하다고 보고한다.
- 규모 확장 실험은 활성 파라미터 44 million–1.2 billion개, 전문가 16개, 32개, 64개, 학습 토큰 500 billion을 다룬다. 기존 규모 확장 식이 활성 파라미터 9.3B개로 잘 외삽되지 않아, 활성 파라미터와 학습 토큰 사이의 상호작용 항을 추가한 뒤 456B-total, 활성 45.9B개 구성을 선택한다.
3. Computation Optimization
학습에는 H800 GPU 1500–2500개로 규모가 달라지는 클러스터를 사용한다. 계산 최적화는 전문가 통신과 가중치 저장, 백만 토큰 시퀀스의 분산 처리, 입력 길이와 캐시된 접두부가 서로 다른 추론 배치를 다룬다. 캐시된 접두부는 이전 입력 구간에서 수행한 계산을 재사용한다.
3.1. MoE Optimization
구현에서는 전문가 가중치를 분할하는 Expert Tensor Parallel (ETP)과 데이터 분할마다 동일한 전문가를 복제하는 Expert Data Parallel (EDP)을 분리한다. 이에 따라 전문가 구성 요소는 나머지 네트워크와 독립적인 병렬 구성을 사용할 수 있고, 전문가 통신을 토큰 그룹 계산과 겹쳐 실행할 수 있다.
- EP-ETP 스케줄은 전문가 가중치 메모리, 계산 집약도, 통신 사이의 균형을 맞춘다. 계산 구간이 길면 더 많은 통신을 숨길 수 있지만, 토큰 그룹이 너무 적으면 유휴 구간이 생기고 너무 많으면 스케줄링 오버헤드가 커진다.
- 저자들은 최적화 전 구현 대비 순수 MoE 통신 오버헤드가 50% 감소했다고 보고한다. 이 비율은 전체 학습 시간의 감소율을 뜻하지 않는다.
3.2. Long Context Optimization
Data-packing은 길이가 다른 샘플을 이어 붙여 패딩을 줄인다. 패딩은 계산에 필요한 형태를 맞추기 위해 추가하는 위치다. Varlen Ring Attention은 패킹한 가변 길이 softmax attention을 장치에 분산하고, 각 샘플의 마스크 오프셋을 추적한다. 이를 통해 샘플마다 많은 패딩을 추가하지 않고도 샘플 경계를 지켜 계산한다.
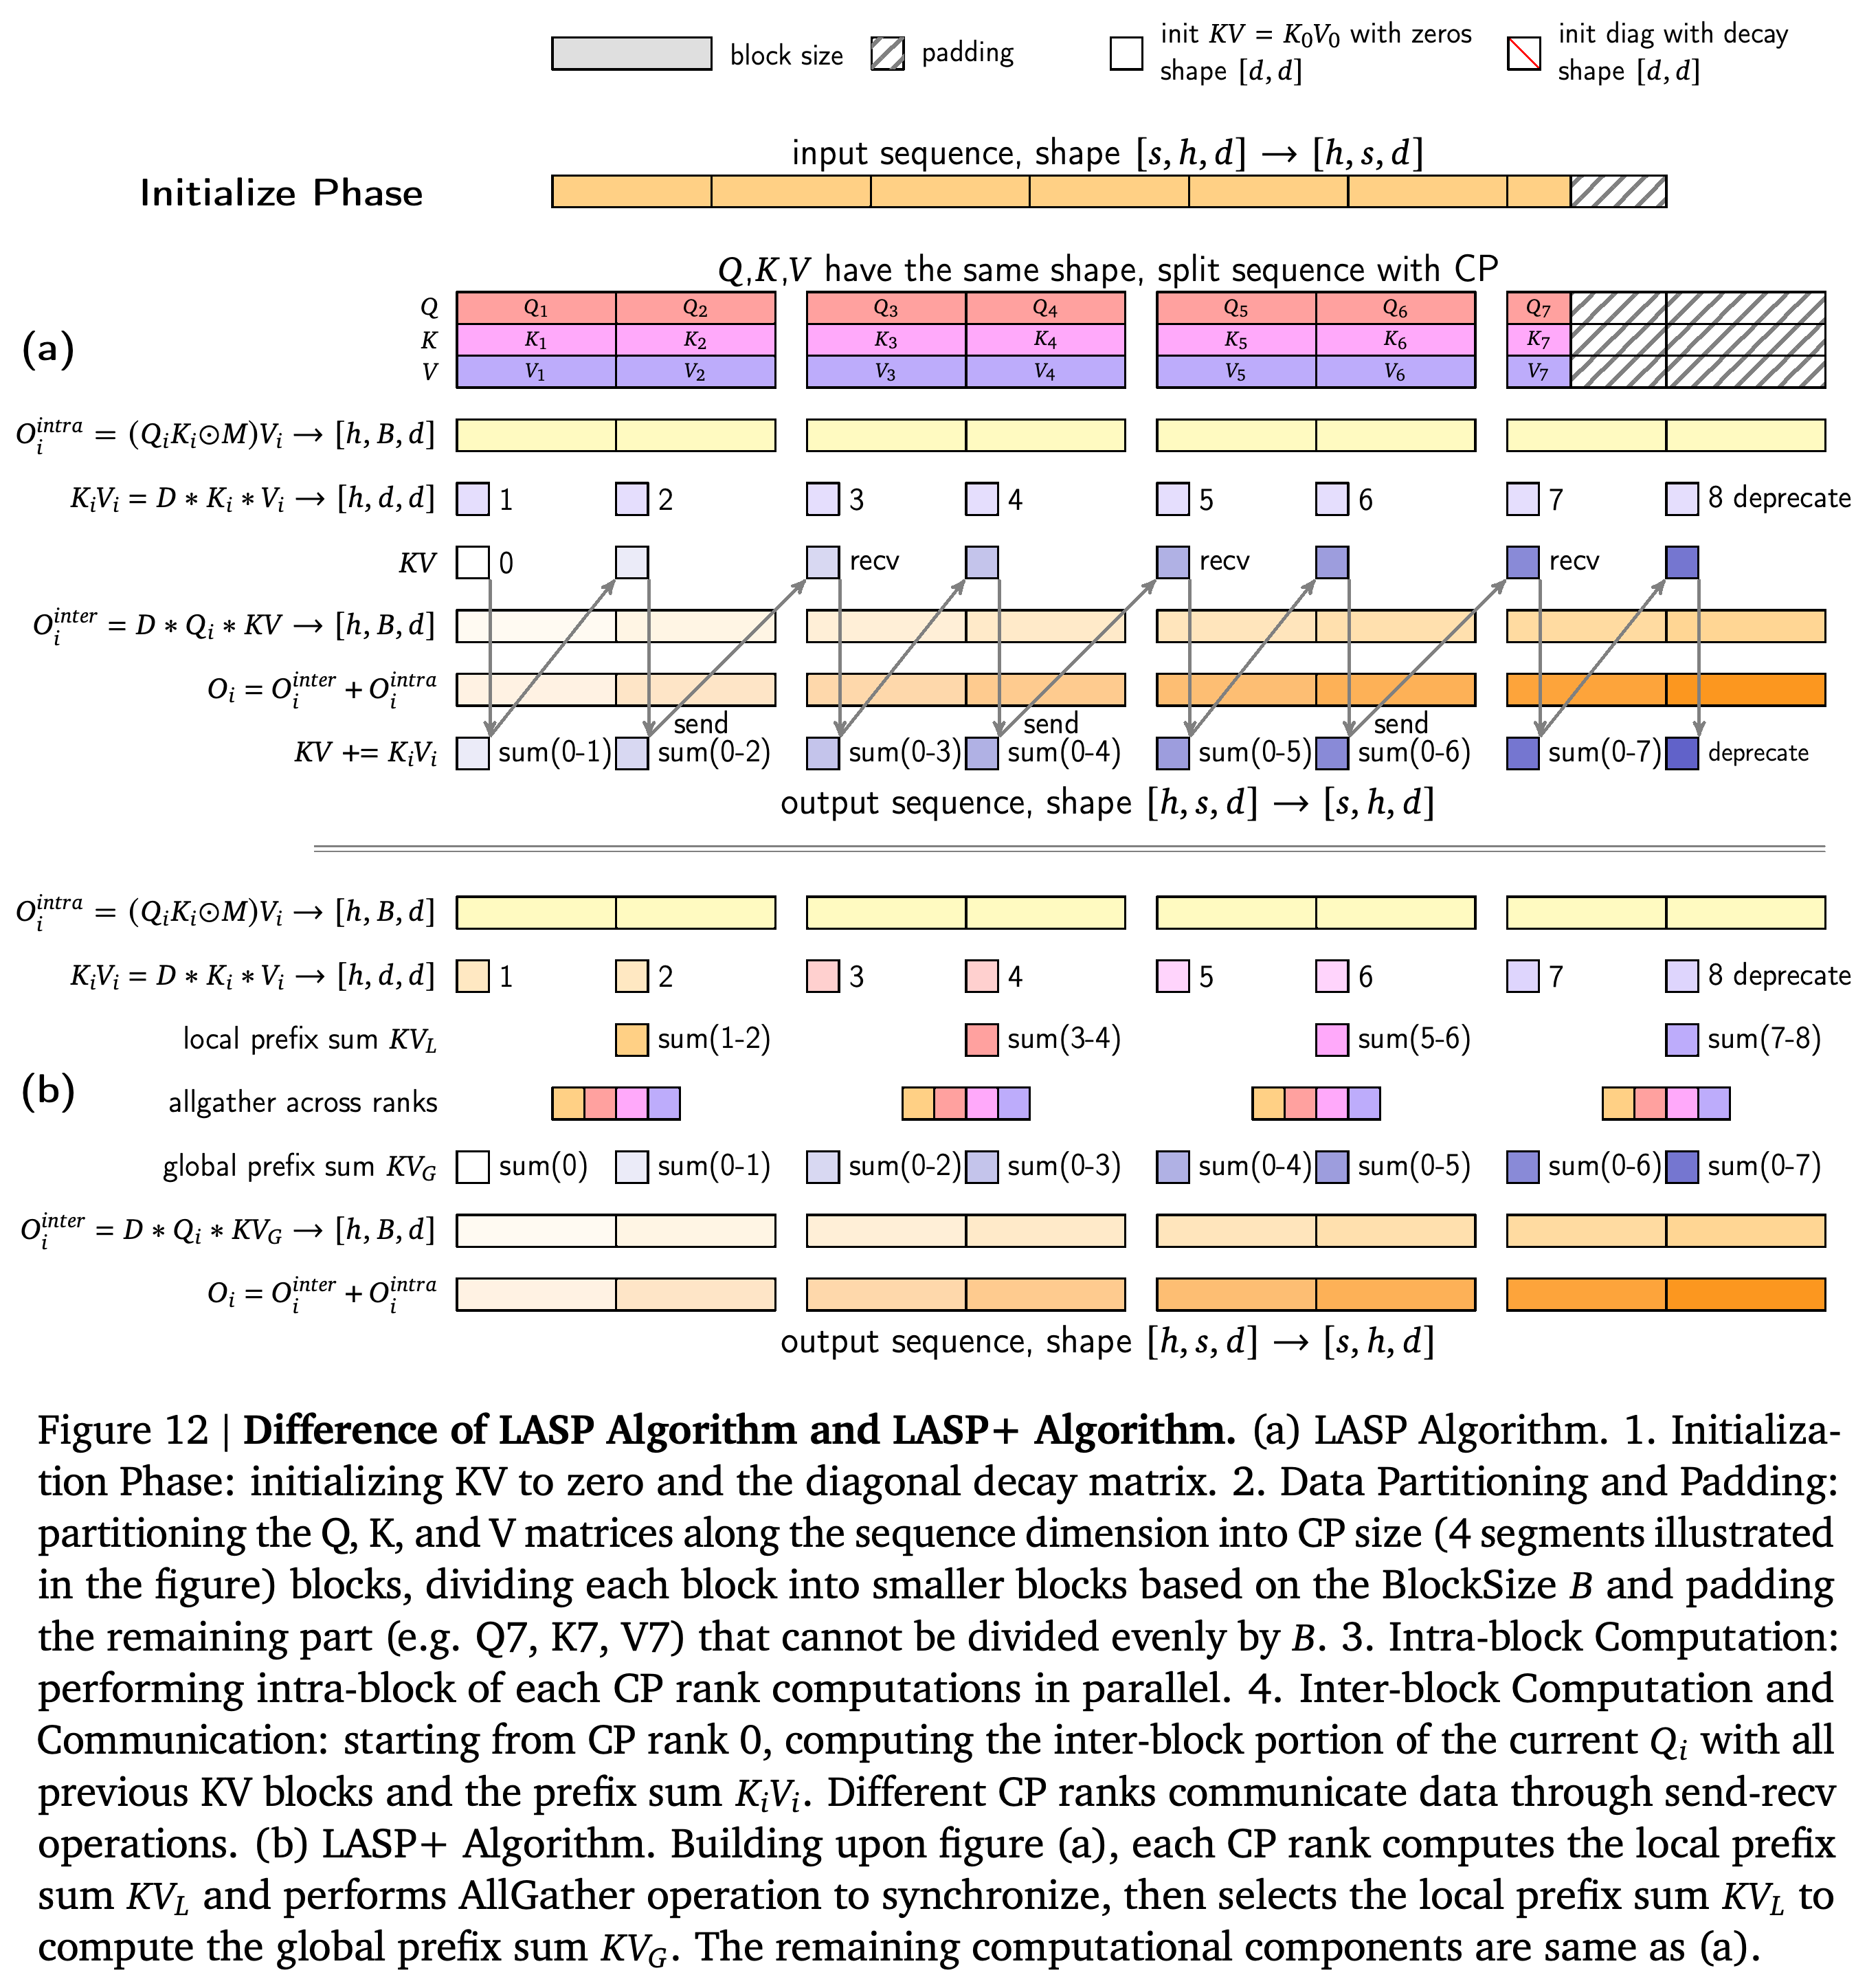
- 기존 Linear Attention Sequence Parallelism (LASP)은 서로 다른 시퀀스 구간을 맡은 context-parallel rank 사이에서 중간 key-value 상태를 순차적으로 전달한다. LASP+는 로컬 접두부 요약을 계산하고 AllGather로 동기화한 뒤, 필요한 전역 접두부를 구성한다.
- LASP+는 통신량과 임시 메모리를 늘리는 대신 rank 사이의 직렬 의존성을 없앤다. 가변 길이 구현에서는 각 샘플을 256의 배수 길이로 패딩한 뒤 이어 붙인다. 계산 속도가 LASP의 1/Npcn에 도달한다는 문구는 의미가 모호해, 명확한 실측 가속 배수를 입증하지 않는다.
기존 LASP는 연속된 시퀀스 구간 사이에서 누적 상태를 전달한다. LASP+는 로컬 요약을 모은 뒤 전역 접두부를 구성해 병렬성을 높인다. 다만 동기화와 임시 저장 공간은 여전히 필요하다.
3.3. Lightning Attention Inference Optimization
Batched Kernel Fusion은 메모리 접근에 제약받는 연산을 결합한다. 후속 토큰을 생성하는 decoding과 짧은 텍스트 입력에서 종단 간 지연 시간이 10% 감소했다고 보고한다. Separated Prefill and Decoding Execution은 단일 토큰 생성과 더 긴 입력 처리를 별도 커널에 배정하고, 서로 다른 CUDA stream에서 실행한다. CUDA stream은 GPU 작업을 동시에 스케줄링할 수 있는 큐다.
- 제시한 예시에서 캐시된 입력 20개로 구성된 배치에는 50토큰 입력이 1개 또는 2개 있고, 나머지는 단일 토큰 입력이다. 실행을 분리하면 지연 시간이 100밀리초에서 약 50밀리초로 줄어든다.
- Multi-level Padding은 256에 더해 블록 크기 32, 64, 128을 추가해 짧은 입력의 중복 계산을 줄인다. StridedBatchedMatmul Extension은 배치 행렬 곱셈에 cublasGemmStridedBatchedEx를 사용한다. 추가적인 Hopper 전용 융합은 일부가 진행 중인 작업으로 설명된다.
- 저자들은 H20 종단 간 추론에서 하드웨어 최대 성능 대비 모델 부동소수점 연산의 비율인 Model Flops Utilization (MFU)이 75%를 넘는다고 보고한다. 1,024,000토큰에서 attention과 피드포워드의 지연 시간을 비교한 집계에서는 softmax attention의 비중이 95%이고, 대응하는 비교에서 lightning attention은 12% 미만이다.
4. Pre-Training
MiniMax-Text-01의 사전학습은 코퍼스 구축, 통제된 데이터 실험, 단계별 학습 스케줄을 결합한다. 문맥 확장에서는 최대 1M 토큰 길이로 학습한다. 보고한 4M-token 능력은 추론 시 외삽한 결과다.
4.1. Data
코퍼스는 학술 문헌, 책, 웹 콘텐츠, 프로그래밍 코드를 결합한다. 규칙 기반 정제와 중복 제거를 수행하고, 총 파라미터 60B개 중 5B개를 활성화하는 이전 모델로 문서 점수를 매긴다. 샘플링은 지식의 깊이와 실용적 유용성을 중시하면서도 범주의 다양성을 유지한다. 저자들의 실험에서는 낮은 점수의 데이터를 모두 제거하면 다운스트림 성능이 나빠지기 때문이다.
- 대화와 질의응답 데이터는 다양한 템플릿을 갖춘 중첩 문서 형식을 사용해 경직된 형식 패턴을 줄인다. 토큰화에는 바이트 시퀀스를 병합해 토큰을 만드는 byte-level Byte Pair Encoding (BPE)을 사용하며, 200K-token 어휘와 다국어 업샘플링을 적용한다.
- 통제된 데이터 실험은 총 파라미터 8B개 중 1B개를 활성화하는 MoE 모델을 40B 토큰으로 학습한다. 이 중 20B는 웹 데이터 토큰이고, 후보 구성에서 가져온 데이터는 20 billion 토큰이다. 바이트 수로 정규화한 답변 우도를 사용해 신뢰 수준 95%, 검정력 80%를 목표로 설계한 가설 검정을 수행한다. 검정력은 지정한 효과가 실제로 존재할 때 이를 탐지할 확률이다.
- 반복을 고려한 실험에서는 전역 중복 제거 후 반복률을 최종 학습 스케줄에 맞춘다. Epoch는 전체 데이터를 통과하는 학습 단위다. 저자들은 저품질 데이터는 2 epoch를 넘으면 성능을 떨어뜨리지만, 고품질 데이터는 최대 4 epoch까지 유용하다고 보고한다.
4.2. Training Strategy
초기 사전학습은 시퀀스 길이 8192를 사용한다. 초기 가중치의 크기를 설정하는 Xavier 초기화와, 가중치 감쇠를 분리한 적응형 옵티마이저 AdamW를 적용하며, β₁ = 0.9, β₂ = 0.95, 가중치 감쇠는 0.1이다. 배치 크기는 16M 토큰에서 시작해 학습 토큰 69B에서 32M, 790B에서 64M, 4.7T에서 128M으로 늘린다. 이는 손실과 임계 배치 크기 사이에 적합한 관계를 따른다. 임계 배치 크기는 학습 시간과 데이터 효율의 균형을 맞추기 위한 배치 규모다.
- 학습률은 500 iteration 동안 2×10⁻⁴까지 높인 뒤 7.2T 토큰 동안 유지한다. 이후 비정상적인 gradient norm이 나타나자 1.3×10⁻⁴로 낮춰 3.2T 토큰을 학습한다. 마지막 1T-token 구간에서는 3×10⁻⁵까지 지수적으로 감쇠한다. MoE 보조 손실 계수는 0.01이다.
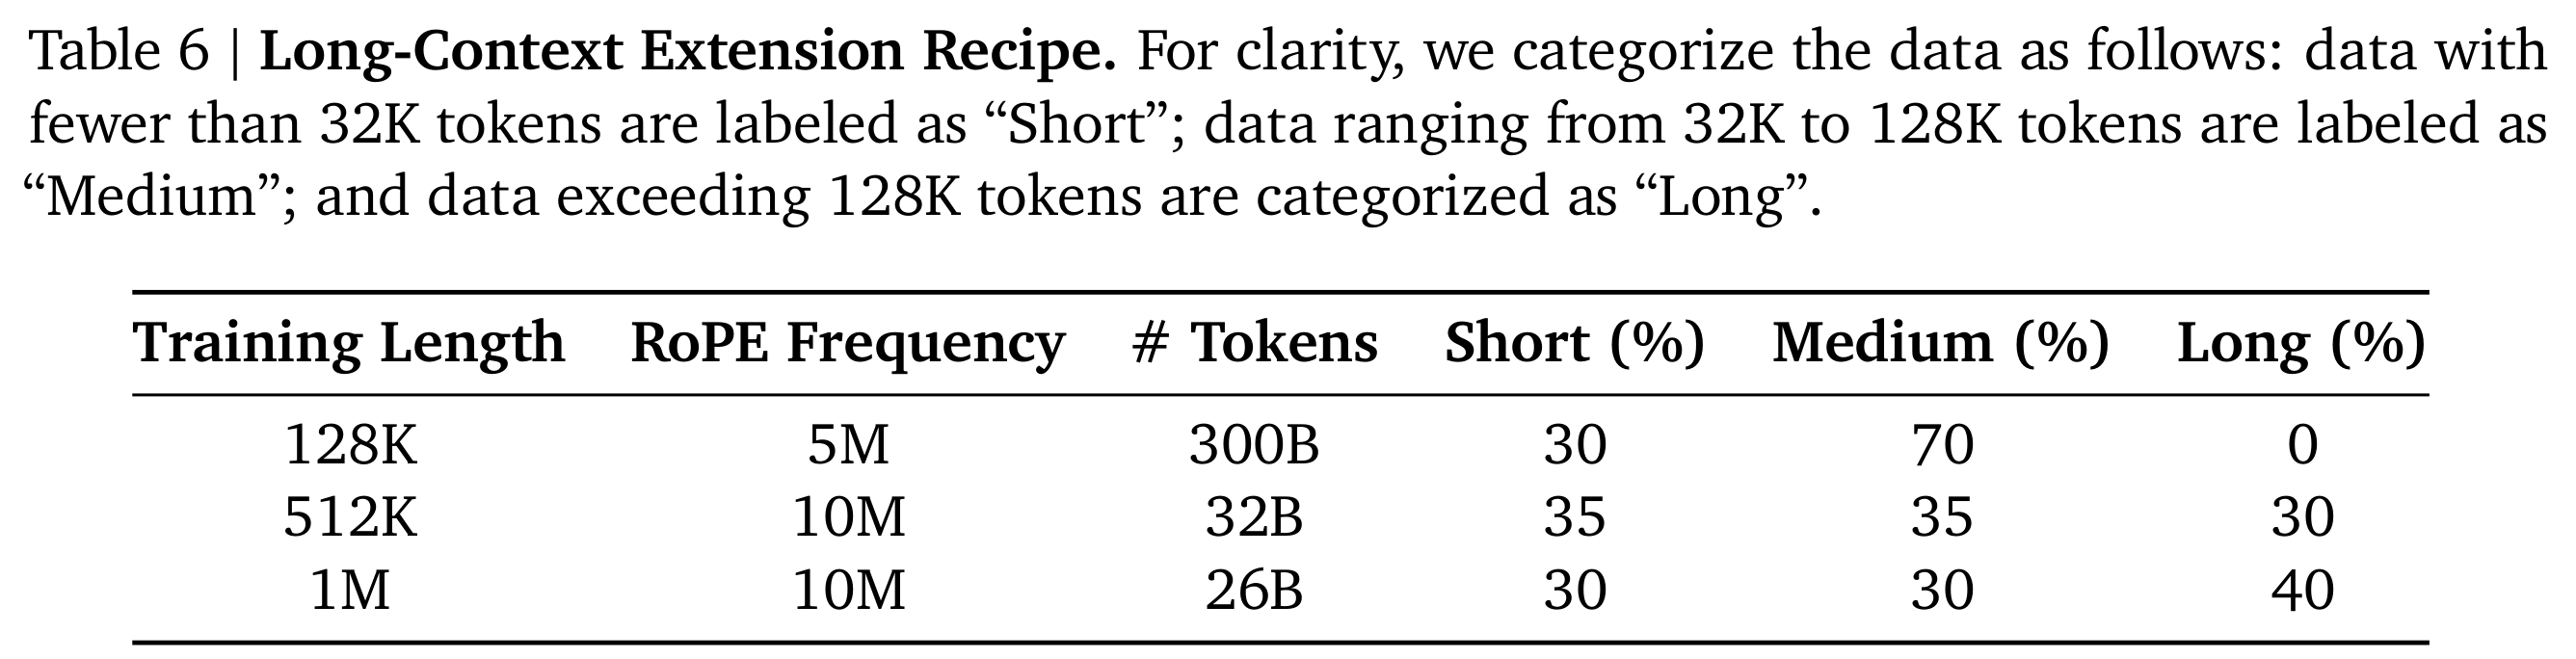
- 긴 문맥 확장은 학습 길이 128K, 512K, 1M에서 각각 300B, 32B, 26B 토큰을 사용한다. RoPE 주파수는 5M, 10M, 10M이고, 짧은/중간/긴 데이터 비율은 30/70/0, 35/35/30, 30/30/40이다. 짧은 데이터는 32K 토큰 미만, 중간 데이터는 32K–128K, 긴 데이터는 128K 초과다.
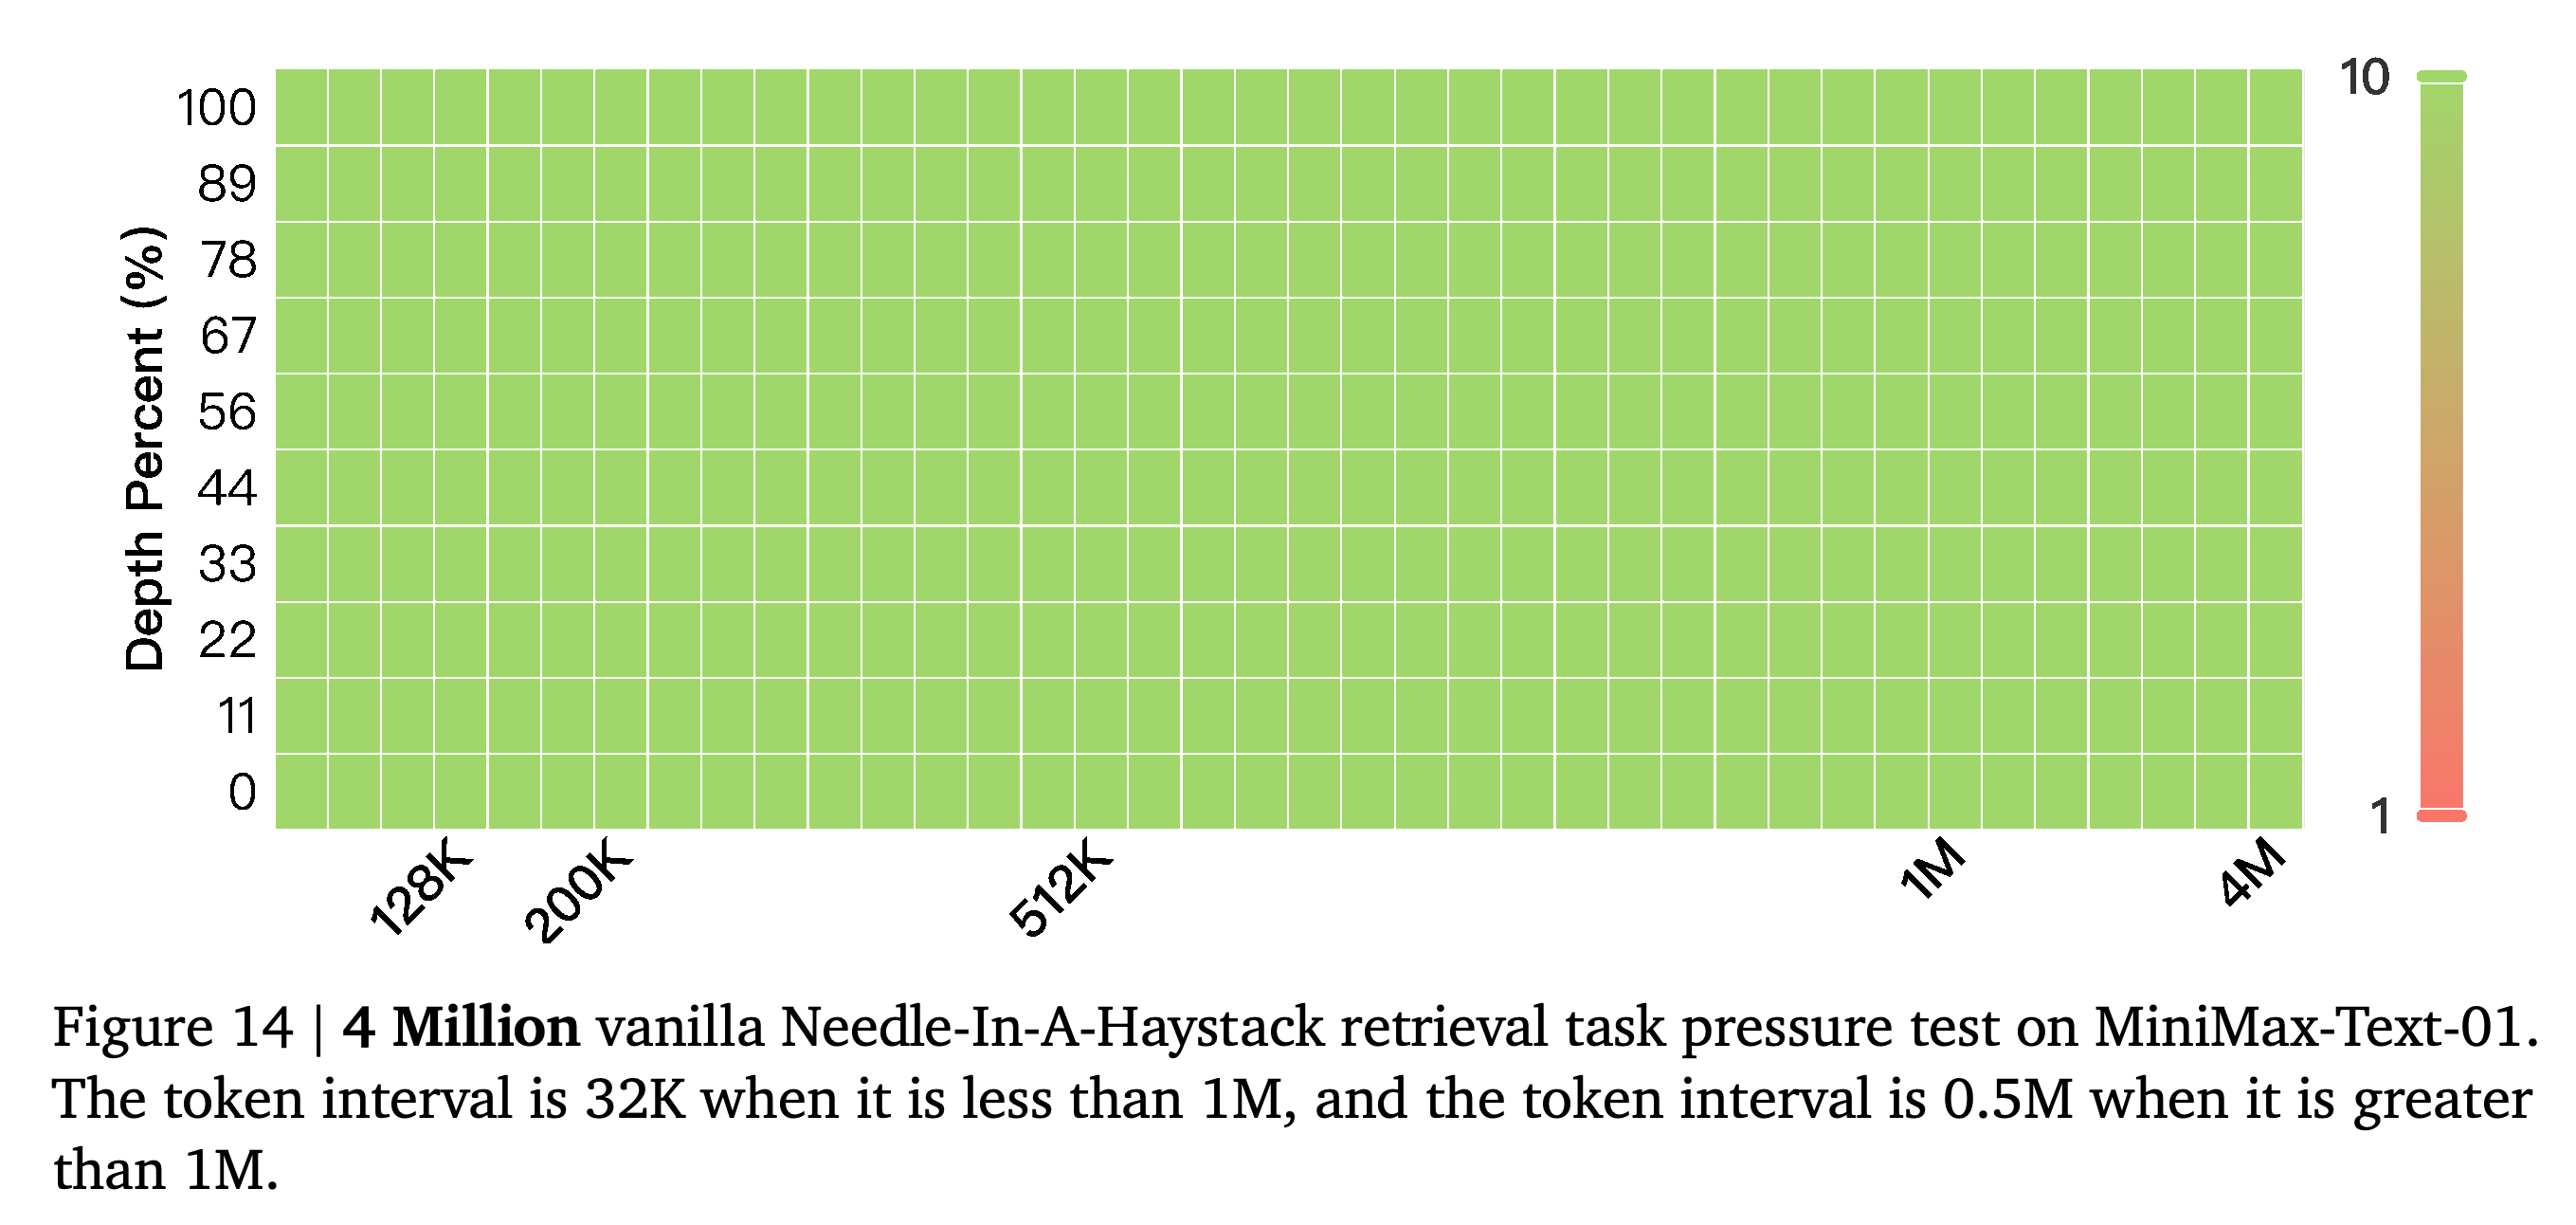
- 각 확장 단계의 마지막 20%에서는 고품질 긴 문맥 질의응답 데이터를 10% 섞고, 출처별 샘플링 가중치를 선형 보간으로 전환한다. 4M-token NIAH 테스트는 Paul Graham의 에세이를 배경으로 쓰고, 특정 숫자가 담긴 문장을 삽입한다. 저자들은 이 테스트가 너무 일찍 포화되어 더 폭넓은 긴 문맥 학습을 추적하기 어렵다고 인정한다.
삽입 깊이 전반에서 거의 균일하게 높은 점수는 제시한 합성 조건에서 4M 토큰까지 검색을 외삽할 수 있음을 뒷받침한다. 이 테스트가 복잡한 문서 추론에서도 비슷한 정확도를 입증하지는 않는다. 논문도 기본 NIAH가 너무 일찍 포화되어 지속적인 개선을 추적하기 어렵다고 지적한다.
학습 절차는 1M-token 학습 한도와 4M-token 추론 외삽을 구분한다. 또한 문맥 확장에 길이 분포의 변화와 상당한 추가 학습이 필요함을 보여 준다. 128K에서 300 billion 토큰을 학습한 뒤, 512K와 1M에서 각각 32 billion 토큰과 26 billion 토큰을 학습한다.
5. Post-training
후속 학습은 선택한 응답 예시로 학습하는 Supervised Fine-Tuning (SFT), 오프라인 선호도 최적화, 샘플링한 응답의 보상으로 모델을 갱신하는 온라인 Reinforcement Learning (RL)을 결합한다. 정확성, 진실성, 유용성, 무해성의 우선순위에 따라 응답을 선택하고 최적화하며, 짧은 문맥과 긴 문맥 단계를 번갈아 진행한다.
5.1. Prompt Collection
프롬프트 모음에는 과제, 지식 분야, 난이도 태그가 붙은 수백만 개의 질의가 포함된다. 필터링으로 중복을 제거하면서 긴 문맥 과제, 프로그래밍, 수학, 논리 추론, 창작, 외부 함수 호출을 요청하는 function calling, 일반 지식, 안전성 전반에서 다양한 난이도를 유지한다.
5.2. Reward Model
보상 체계는 응답의 속성 4개를 평가한다. 정확성은 수학과 추론에서는 답변의 일관성으로, 프로그램에서는 테스트 케이스 통과 여부로 평가한다. 진실성은 진술 분해, 군집화, 사람의 검증, 모델 비교로 평가한다.
- 유용성은 자동 제약 검사와 일관성, 깊이, 관련성, 문체에 대한 사람의 평가를 결합한다.
- 무해성은 안전 규칙과 사람의 주석에 맞춰 보정한 모델 평가를 사용한다. 명시한 원칙에 따라 응답을 평가하는 Constitutional AI를 참고한다.
5.3. Supervised Fine-Tuning
분야별 전문가 모델은 지도학습과 강화학습을 반복한 뒤 SFT 후보 응답을 생성한다. Rejection sampling은 응답의 변동성을 조절하는 여러 sampling temperature에서 생성한 후보를 평가 품질에 따라 선별한다. 반복 토큰 시퀀스를 탐지하는 n-gram 필터와 의미 유사도 필터는 중복을 줄인다.
5.4. Reinforcement Learning
오프라인 Reinforcement Learning은 선호 응답과 비선호 응답의 쌍으로 학습하는 Direct Preference Optimization (DPO)을 사용한다. 보상 우선순위에 따라 샘플링한 응답 중 최선과 최악을 선택한다. 저자들은 비슷한 분포에서 가져온 미사용 프롬프트와 차이가 미미하다고 확인한 뒤 SFT 프롬프트를 재사용한다.
- 온라인 Reinforcement Learning은 SFT에 없는 프롬프트를 사용하며, 성공률이 중간 수준인 다양한 프롬프트를 선호한다. 이전 프롬프트를 재사용하면 포화가 발생한다고 보고한다. 이는 예측 텍스트의 불확실성을 나타내는 응답 perplexity의 감소로 확인한다.
- 상대적인 응답 보상으로 정책을 갱신하는 Group Relative Policy Optimization (GRPO)을 수정한다. 정책 갱신에 가중치를 부여하는 비율인 importance weight가 크고, 추정 advantage가 음수인 토큰에 clipping을 추가한다. 음수 advantage는 기준보다 나쁜 결과를 뜻한다. 또한 기준 정책에서 벗어난 정도를 나타내는 Kullback–Leibler divergence 항을 재구성하고, 양의 보상과 음의 보상의 기여를 조정한다.
- 이 변경은 학습 안정성을 목표로 하지만, 해당 절에는 각 수정의 기여를 입증하는 별도의 수치 제거 실험이 없다.
5.5. Safety Alignment
Safety Alignment는 범주별 프롬프트를 만들고, 웹 문서에서 안전 관련 질문을 수집하며, 이전 MiniMax-Text-01 모델로 적대적 프롬프트를 보강한다. 무해성 보상 모델은 상세한 안전 규칙과 유용성 기준을 결합해 부적절한 응답과 불필요한 거절을 줄인다.
- 이 절은 학습 절차와 의도한 동작을 설명한다. 모든 형태의 악용을 막을 수 있음을 입증하지는 않는다.
5.6. Training Methodology with Long-Context Adaptation
5단계 긴 문맥 적응 스케줄은 시퀀스 길이 8,192와 1,032,192에서 SFT와 DPO를 번갈아 수행한 뒤, 8,192에서 온라인 RL로 마무리한다. 후속 학습 내내 RoPE 기준 주파수는 10 million으로 유지한다.
- Stage I은 짧은 문맥 SFT를 수행한다. Stage II는 긴 문맥 프롬프트를 50% 포함해 SFT를 확장한다. Stage III은 짧은 문맥 DPO, Stage IV는 전부 긴 문맥 데이터로 DPO를 수행하고, Stage V는 짧은 문맥 온라인 RL을 수행한다.
- 각 단계는 순서대로 2, 2, 1, 1, 1 epoch를 학습하며, 배치 크기는 128, 80, 64, 64, 512다. 최대 학습률은 1e-5, 3e-6, 5e-7, 5e-7, 1e-6이다.
5.7. Academic Benchmarks
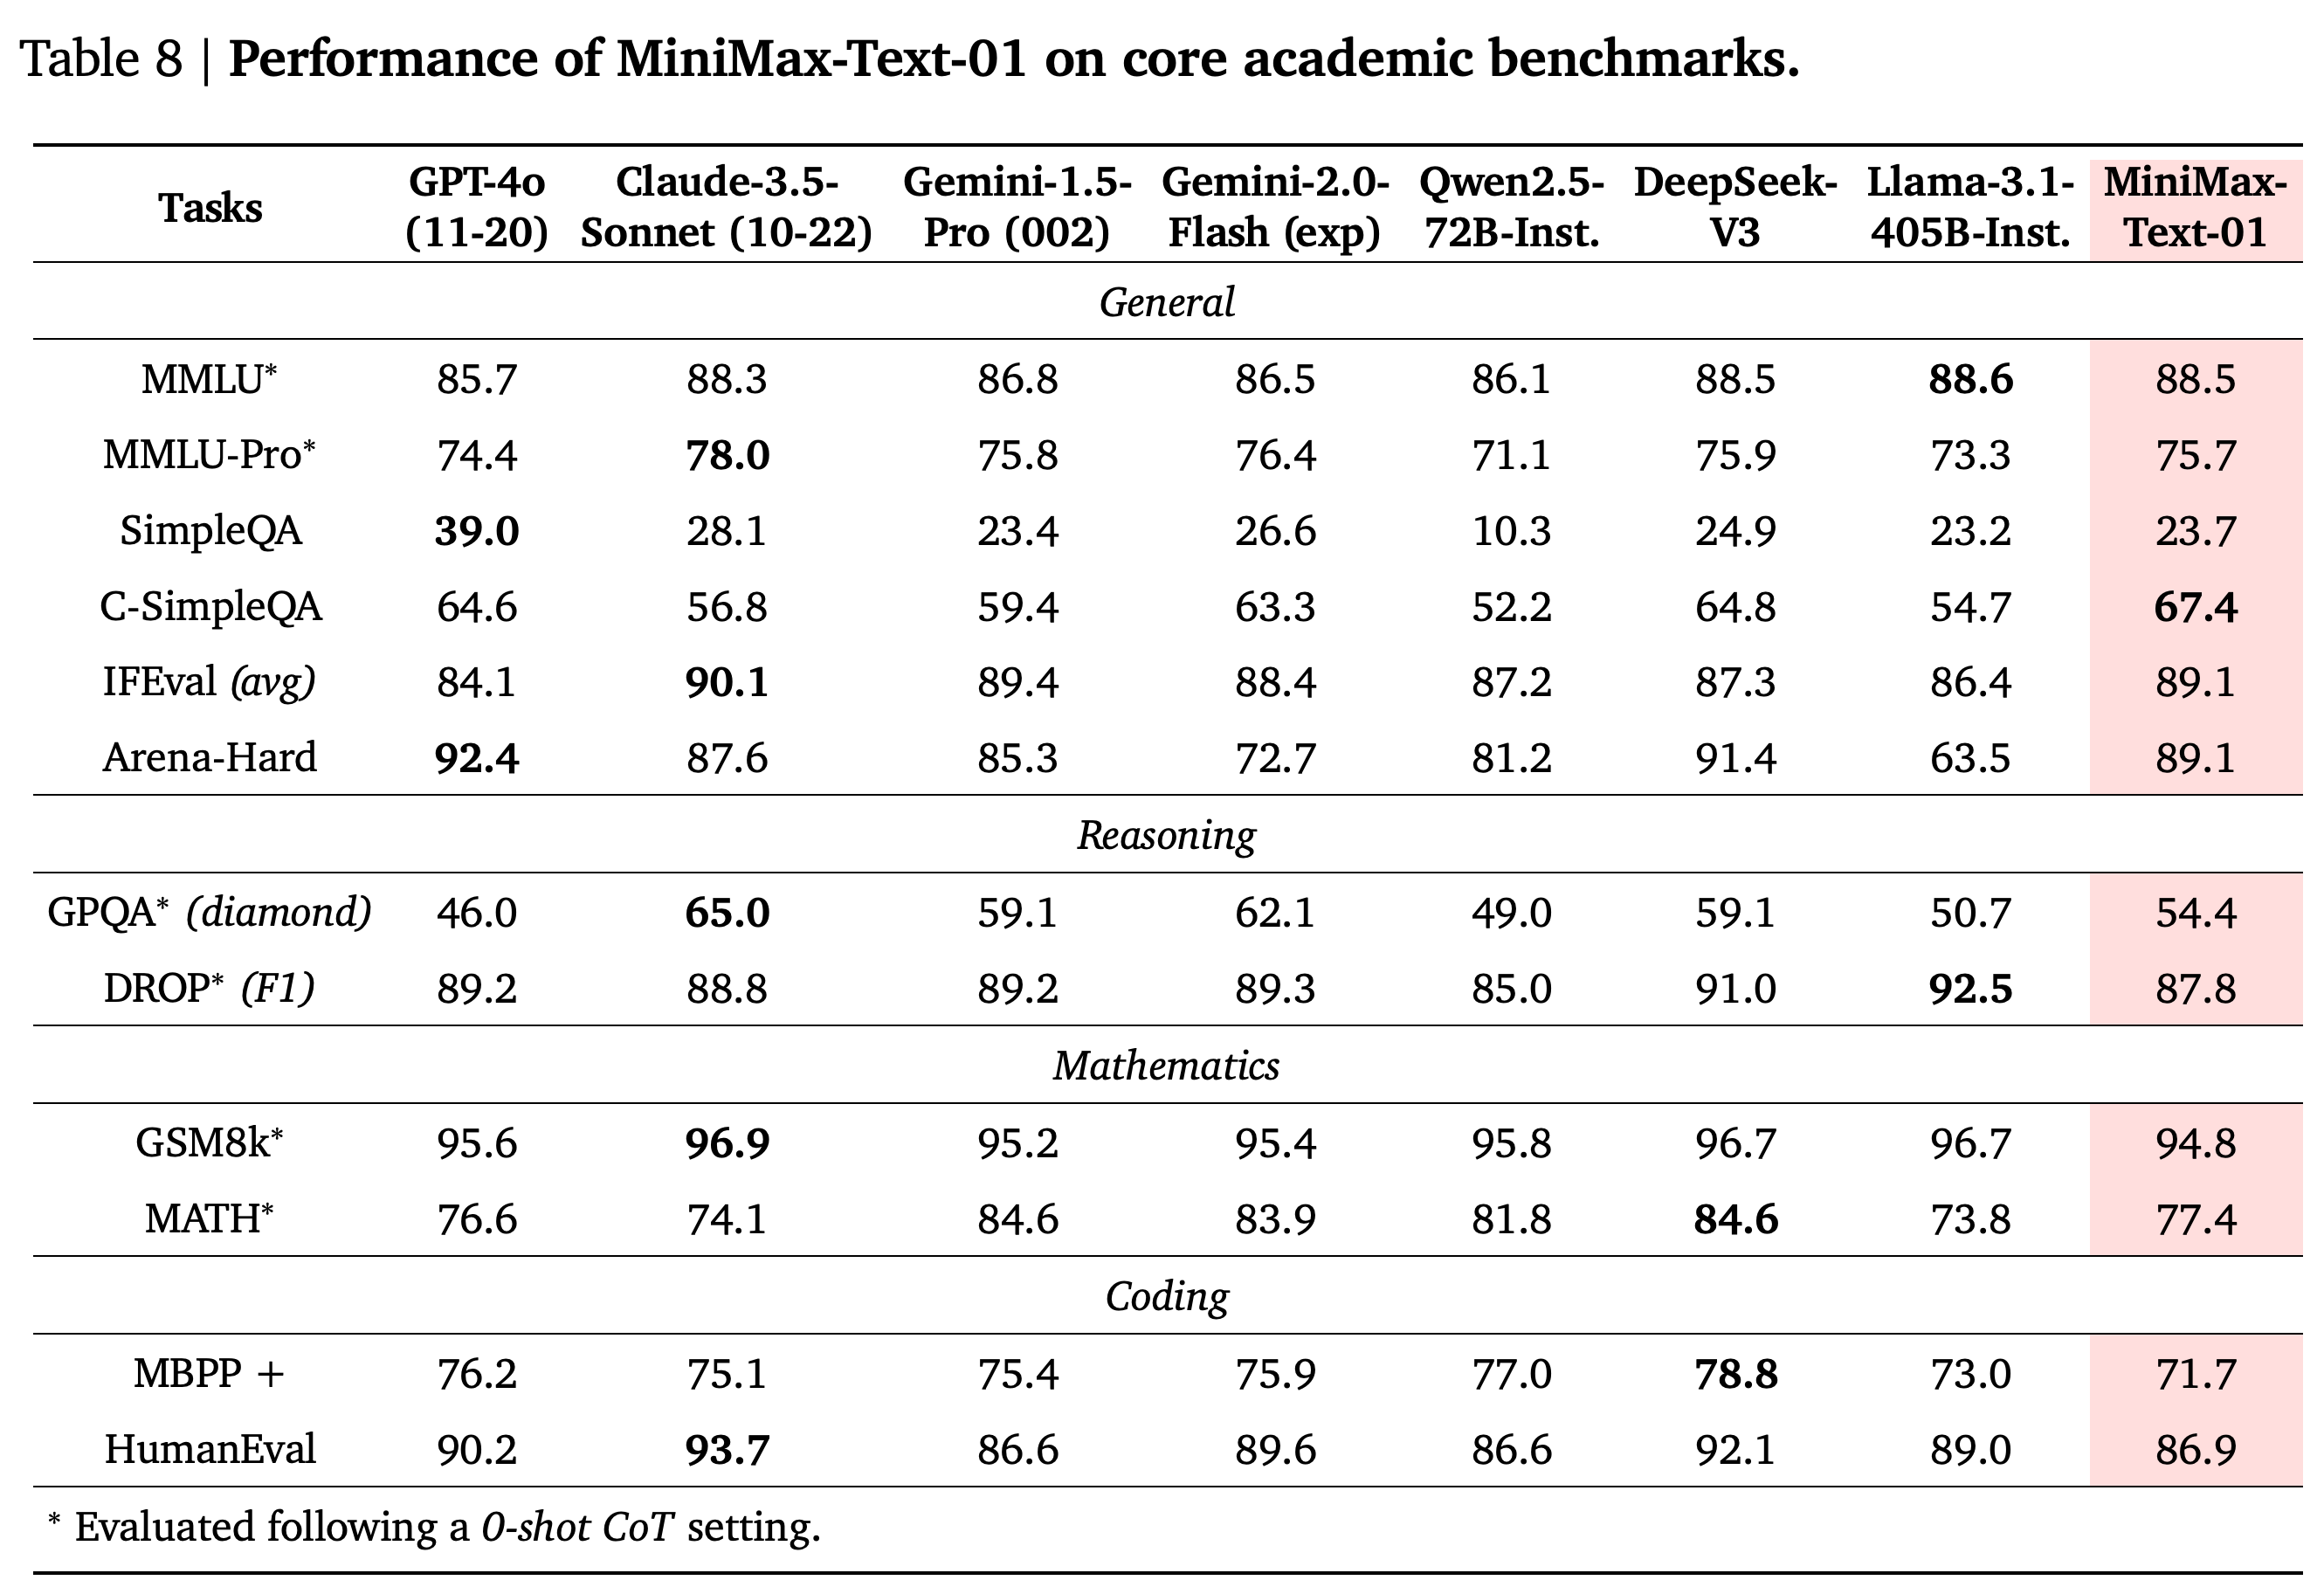
핵심 벤치마크 평가는 다음 토큰 중 확률이 가장 높은 것을 고르는 greedy decoding을 사용한다. 지정된 과제에는 풀이 예시 없이 추론을 요청하는 zero-shot chain-of-thought를 적용한다. MiniMax-Text-01은 폭넓은 지식을 평가하는 Massive Multitask Language Understanding (MMLU)에서 88.5를 기록하고, 중국어 사실성 벤치마크 C-SimpleQA에서는 67.4로 나열된 모델 중 가장 높다.
- 성능은 고르지 않다. MATH는 77.4로 GPT-4o (11-20)의 76.6보다 높지만, 프로그램 생성 벤치마크 MBPP+는 71.7로 DeepSeek-V3의 78.8보다 낮다. 또 다른 코드 생성 벤치마크 HumanEval은 86.9로 Claude-3.5-Sonnet (10-22)의 93.7보다 낮다.
- 상세 표는 지시 이행 벤치마크 IFEval을 89.1로 보고하지만, 도입부 그림에는 89.0으로 표시한다. 여기서는 상세 표의 값을 사용한다.
결과는 폭넓은 지식과 중국어 사실성의 강점, 코딩과 일부 추론 및 수학 과제의 약점을 함께 보여 준다. 전반적인 성능은 경쟁력이 있지만, 과제와 비교 모델에 따라 차이가 크다.
긴 문맥 평가는 검색, 이해, 제공된 문맥을 통한 학습을 구분한다. Long-Context Retrieval은 Multi-Round Needles-In-A-Haystack (MR-NIAH)을 도입한다. 이 과제는 2K–1M 토큰의 합성 대화에서 특정한 이전 응답을 반복하도록 요청한다.
- 목표 상호작용은 대화의 25%, 50%, 75% 지점에 배치한다. 각 목표 응답은 핵심 구성 요소 3개를 포함하며, 조정된 재현율은 올바르게 복원한 구성 요소 수를 3으로 나눈 값이다.
- 영어와 중국어 곡선은 긴 입력에서 비교 모델보다 성능 저하가 작지만, 1M 토큰에 가까워질수록 재현율이 여전히 낮아진다. 이처럼 더 어려운 대화 검색 과제는 거의 포화된 기본 NIAH 테스트가 놓치는 오류를 드러낸다.
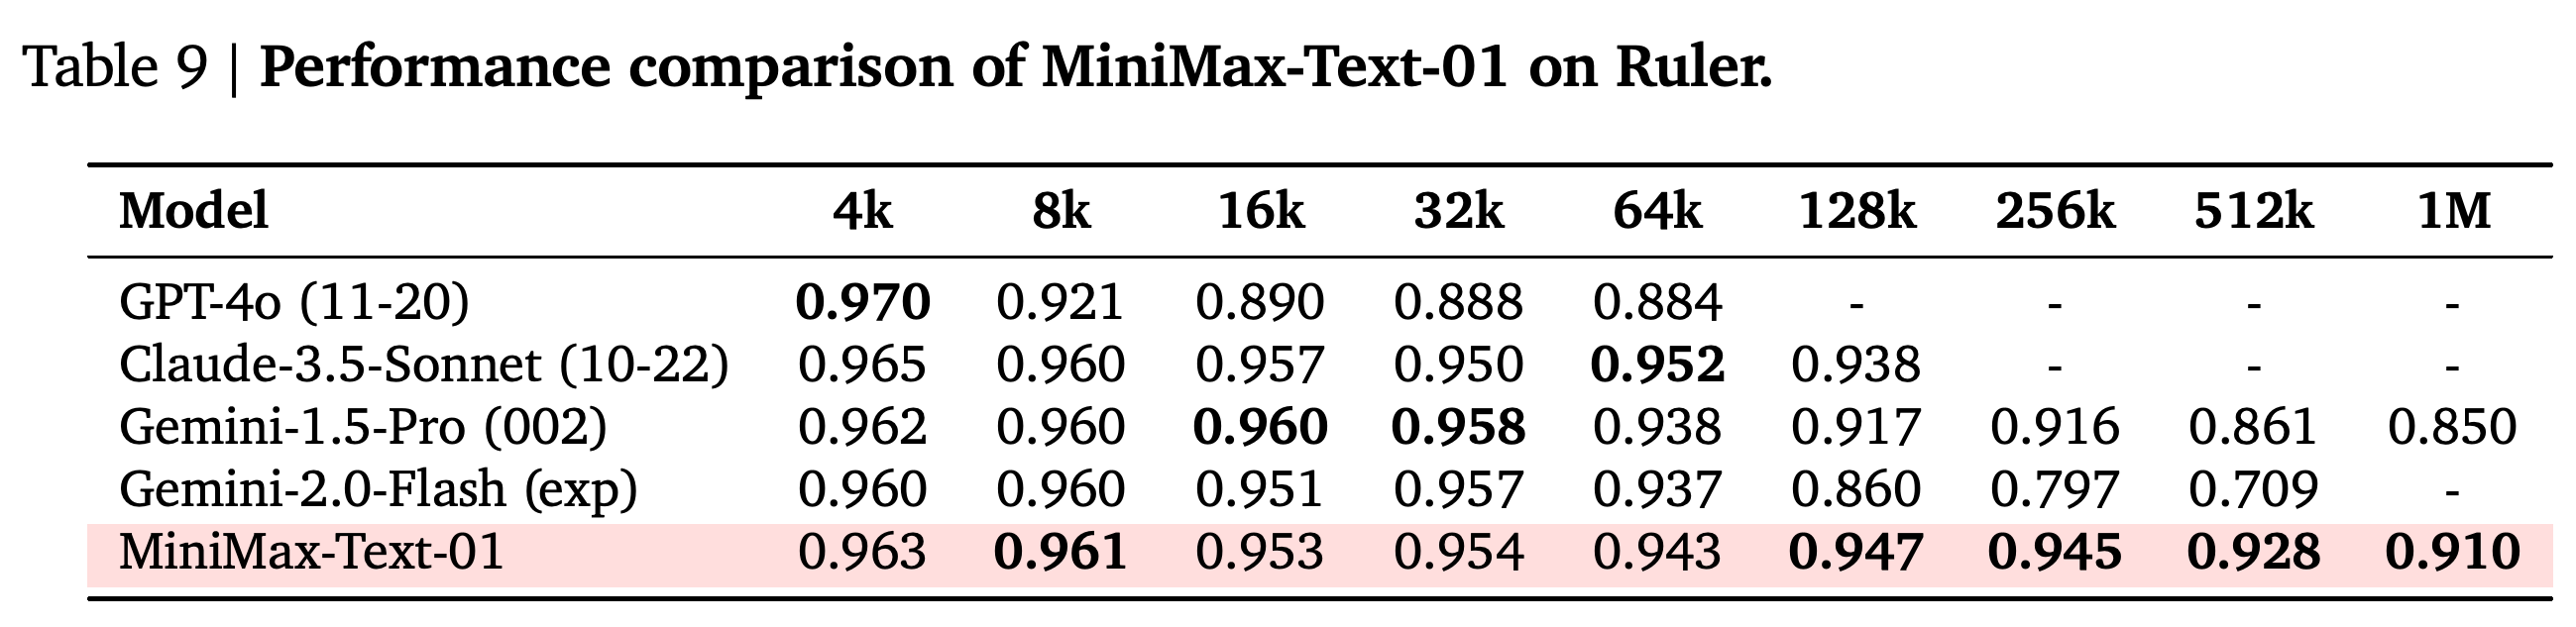
Long-Context Understanding은 문서, 대화, 코드 저장소, 구조화된 데이터에 관한 질문을 포함하는 RULER와 LongBench v2를 평가한다. MiniMax-Text-01은 RULER에서 128K부터 나열된 모델 중 가장 높으며, 128K에서 0.947, 512K에서 0.928, 1M에서 0.910을 기록한다.
- 1M에서 Gemini-1.5-Pro (002)의 점수는 0.850이다. 다른 모델의 빈 항목은 해당 길이의 결과가 없음을 뜻한다.
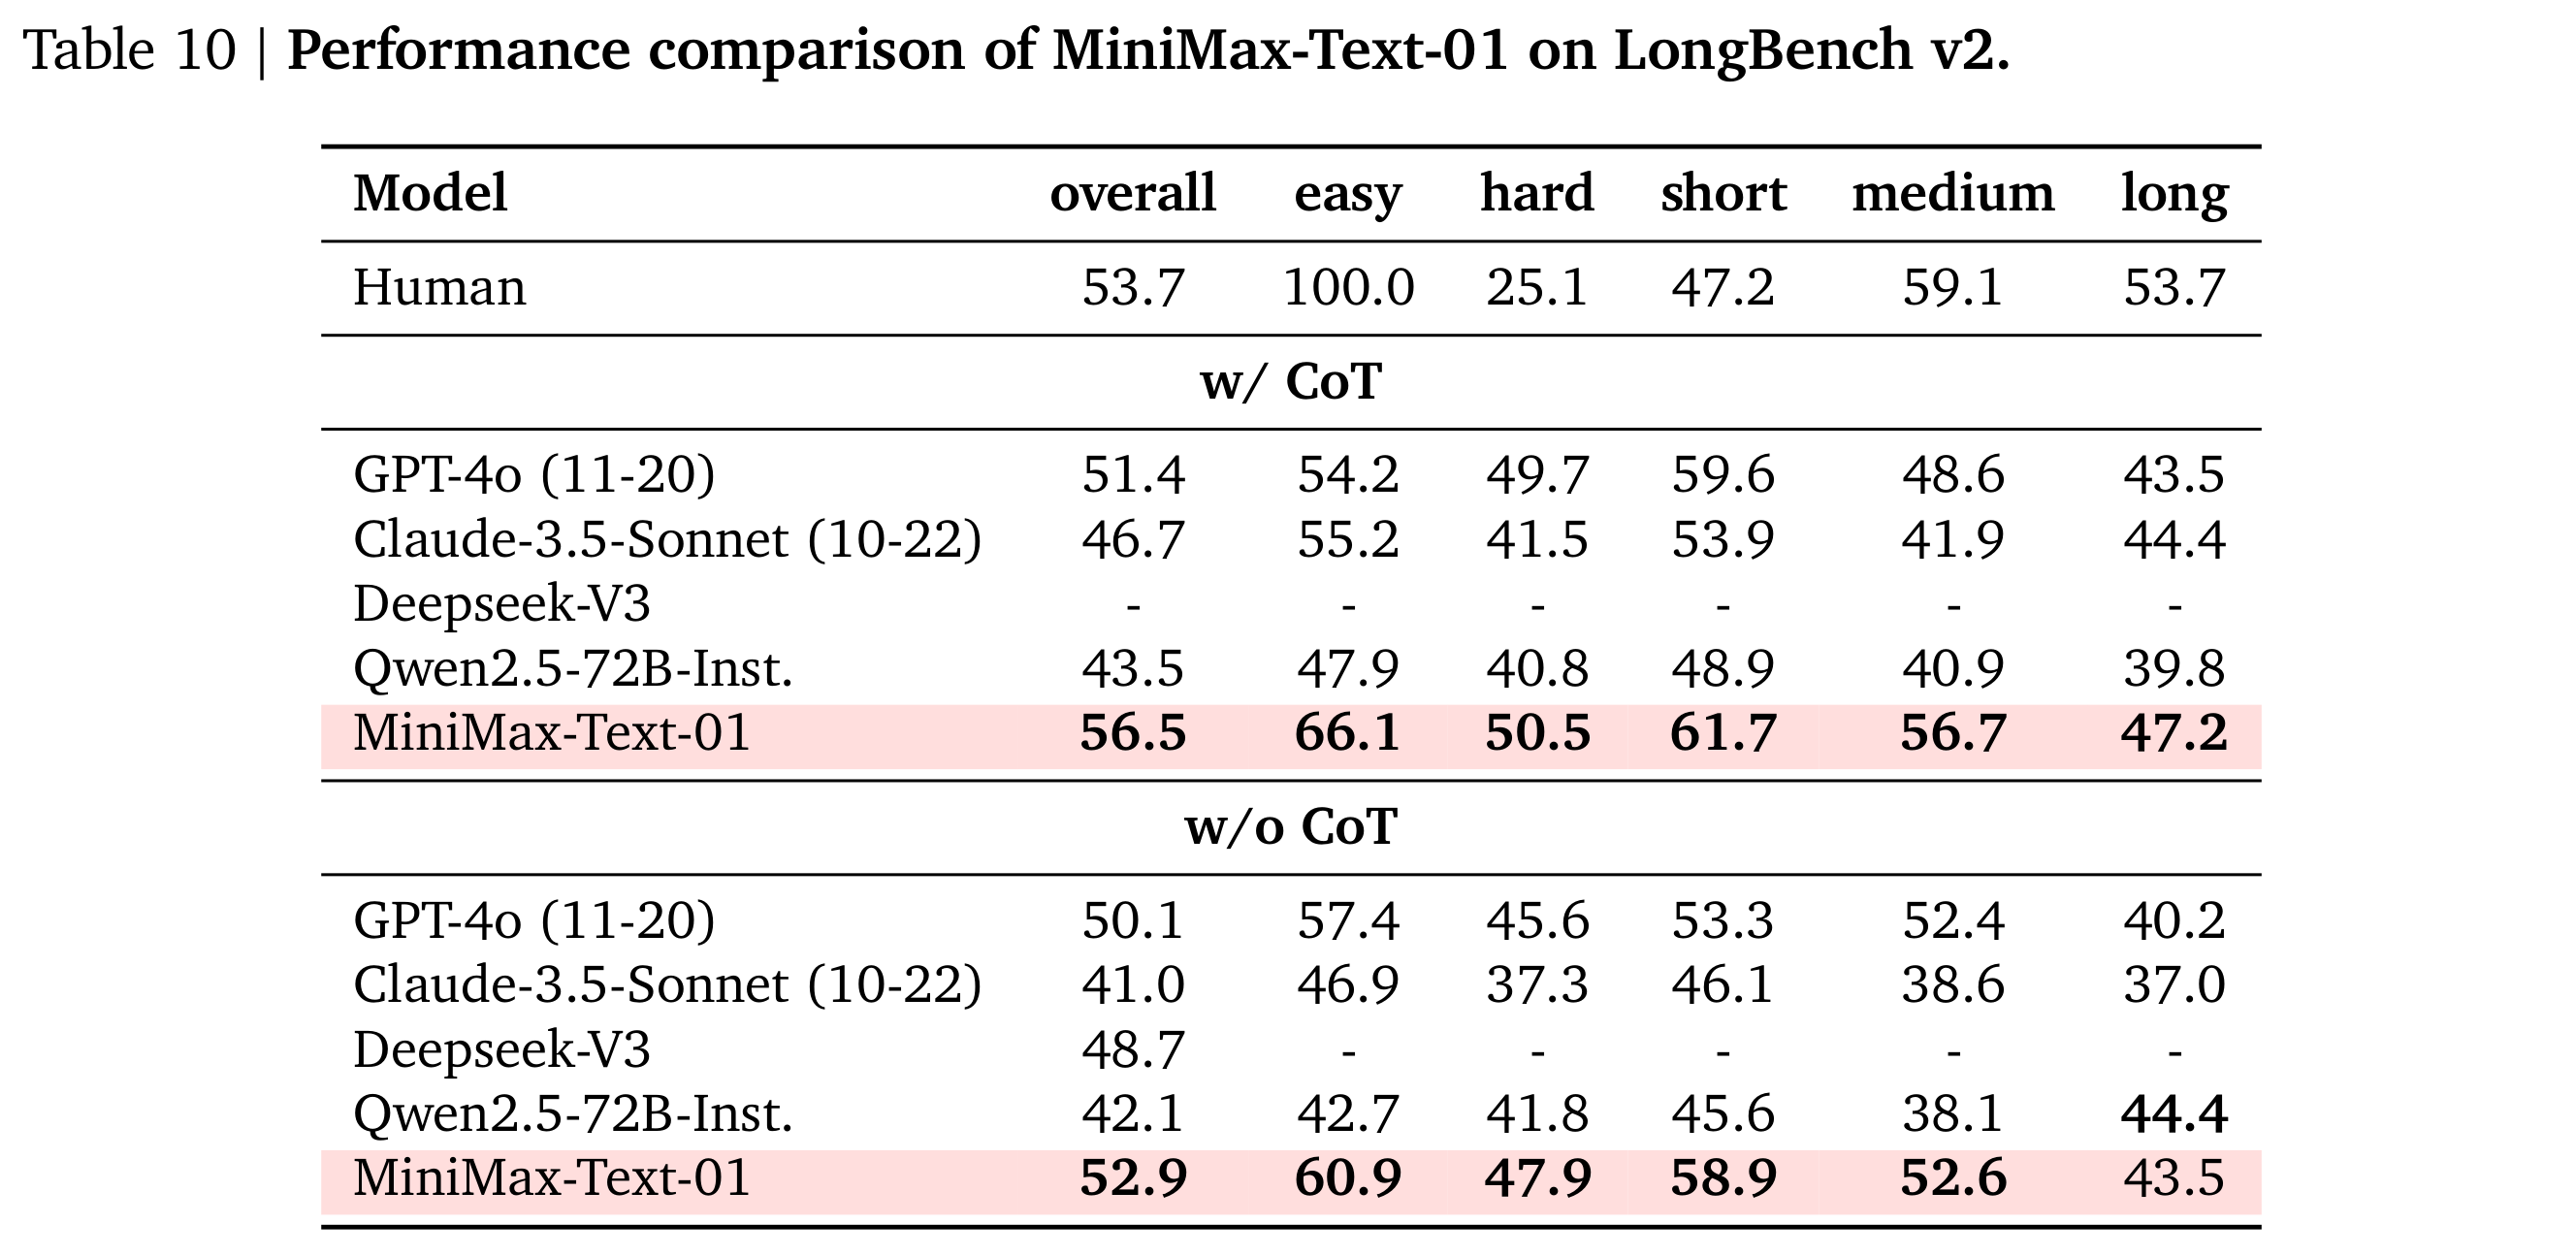
- LongBench v2 전체 점수는 chain-of-thought를 사용하면 56.5, 사용하지 않으면 52.9다. GPT-4o (11-20)는 각각 51.4와 50.1이다. MiniMax가 모든 하위 집합에서 앞서지는 않는다. Chain-of-thought를 사용하지 않는 long 하위 집합에서는 Qwen2.5-72B-Inst.가 44.4로 MiniMax의 43.5보다 높다. 비교 모델 결과는 벤치마크에서 보고한 결과를 가져온다.
- LongBench v2의 길이 범주는 토큰이 아닌 단어 수를 사용한다. Short는 0–32K 단어, medium은 32K–128K, long은 128K–2M이다.
MiniMax-Text-01은 128K부터 나열된 모델 중 가장 높고, 1M에서도 0.910을 유지해 Gemini-1.5-Pro (002)의 0.850보다 높다. 더 짧은 길이에서는 항상 앞서지 않으며, 긴 입력의 빈 항목은 직접 비교를 제한한다.
MiniMax는 chain-of-thought 사용 여부와 관계없이 보고된 모델의 전체 결과에서 가장 높으며, 각각 56.5와 52.9를 기록한다. Chain-of-thought를 사용하지 않는 long 하위 집합은 예외다. Qwen2.5-72B-Inst.는 44.4로 MiniMax의 43.5보다 높다.
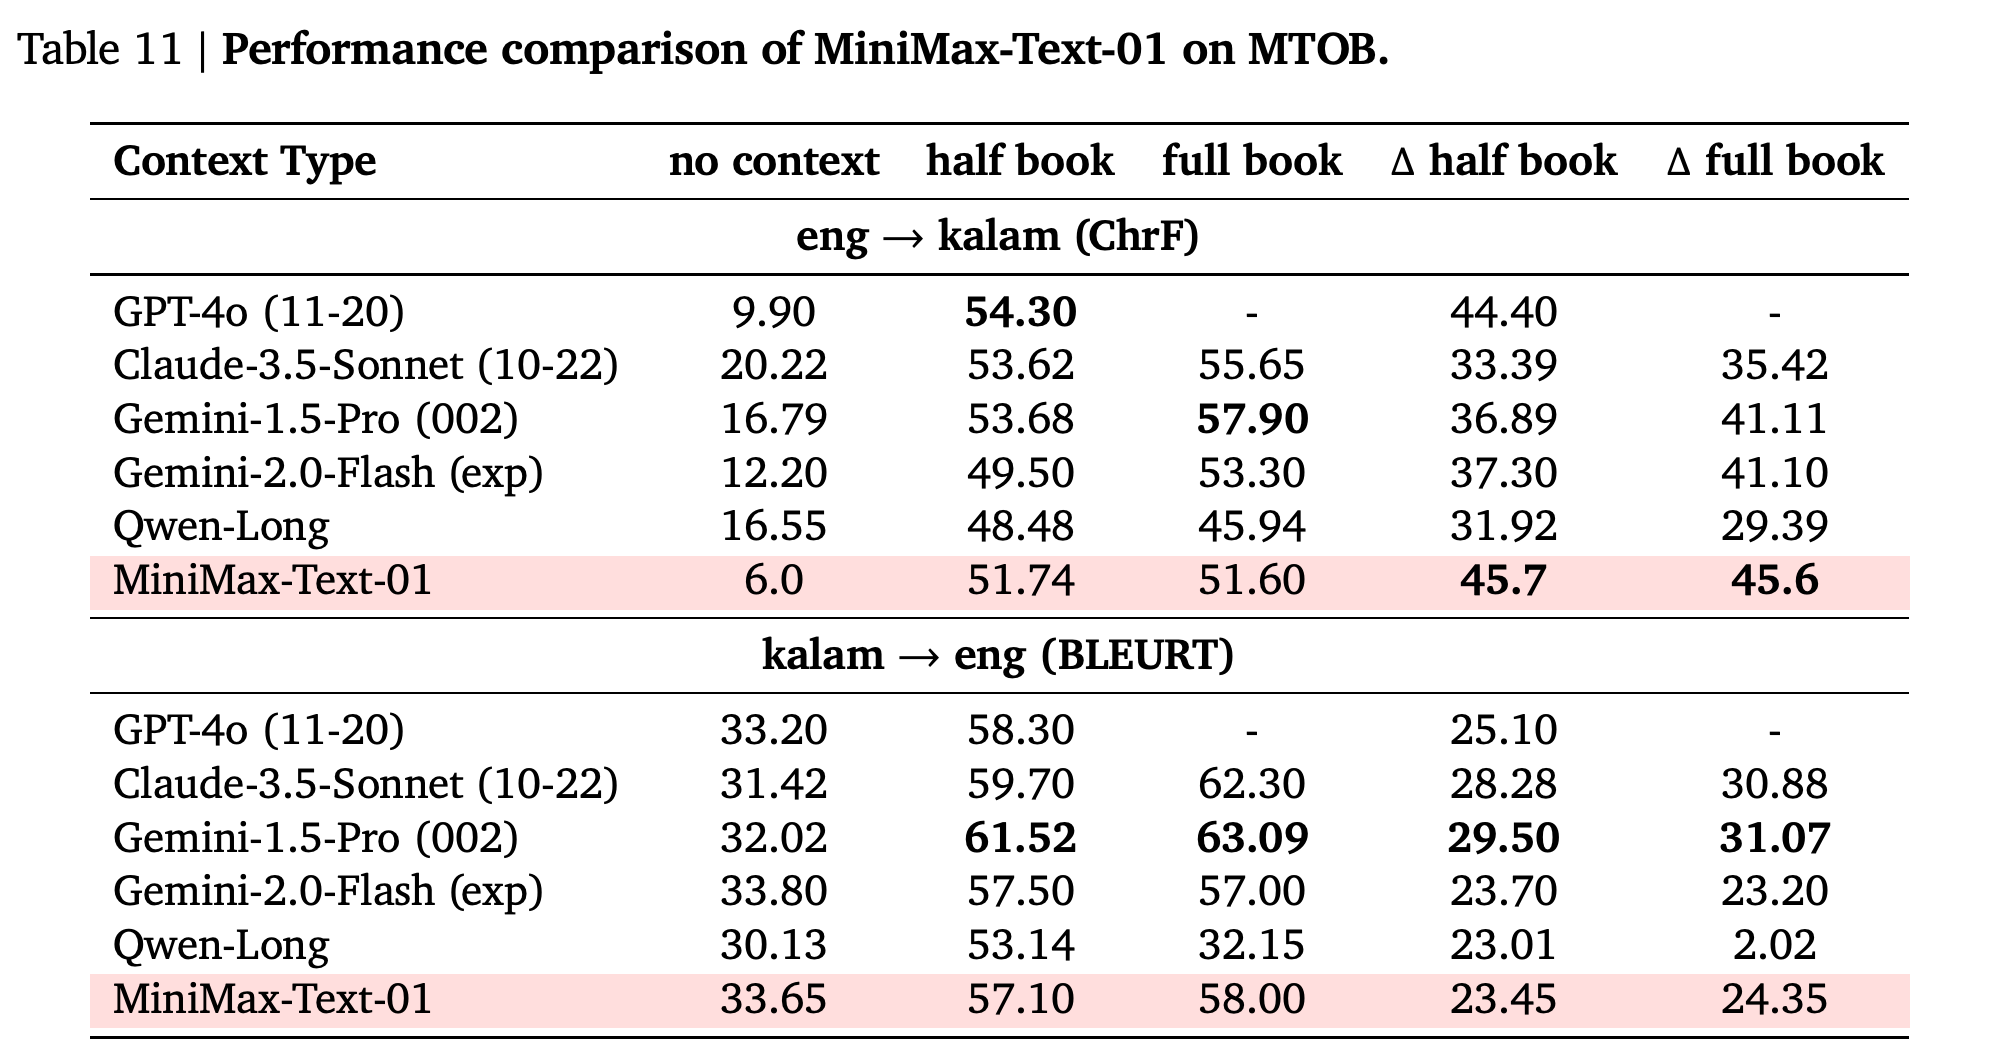
입력에 제공된 정보로 과제를 학습하는 Long In-Context Learning은 Machine Translation from One Book (MTOB)을 사용한다. 모델은 문법책, 단어 목록, 예시 375개를 이용해 영어와 Kalamang을 번역한다. 책 절반을 제공하는 문맥은 약 81K 토큰이고, 책 전체를 제공하는 문맥은 133K 토큰이다.
- 영어에서 Kalamang으로 번역할 때 보고된 ChrF 번역 품질 점수는 문맥이 없으면 6.0, 책 절반을 제공하면 51.74, 책 전체를 제공하면 51.60이다. 보고된 향상 폭 45.7과 45.6은 표에서 가장 크지만, 절대 점수가 가장 높지는 않다. Gemini-1.5-Pro (002)는 책 전체에서 57.90을 기록한다.
- Kalamang에서 영어로 번역할 때 책 전체를 제공한 BLEURT 번역 평가 점수는 58.00으로, Gemini-1.5-Pro (002)의 63.09보다 낮다. Figure 16은 긴 문맥 확장 과정의 개선을 보여 준다. 경쟁 모델이 학습 중 Kalamang에 더 많이 노출되었을 것이라는 논문의 추측은 이 비교로 입증되지 않는다.
이 표는 향상 폭과 절대적인 번역 품질을 구분한다. MiniMax는 문맥 없는 기준 점수가 낮아 영어에서 Kalamang으로의 번역 향상 폭이 보고된 값 중 가장 크다. 그러나 책 전체를 제공했을 때의 점수 51.60은 Gemini-1.5-Pro (002)의 57.90보다 낮다.
5.8. User-in-the-loop
자체 평가는 자동 평가와 전문가의 사람 평가를 결합한다. 질의는 주로 저자들의 챗봇 서비스 Hailuo AI에서 가져오며, 표준 중국어와 중국 문화 관련 내용이 상당 부분을 차지한다. MiniMax-Text-01은 일반 비서 성능 73.9, 창작 81.3, 지식 질의응답 78.6, 긴 문맥 93.8로 나열된 모델 중 가장 높다. 반면 지시 이행 점수는 46.3으로 여러 경쟁 모델보다 낮다.
- Hailuo AI의 Search는 특수 토큰으로 직접 검색 여부를 결정하도록 학습한다. 적용 시나리오는 사용자 질의의 약 30–40%를 차지할 것으로 추정한다. 사람 평가에서는 도메인 외 종단 간 평가 점수가 58%에서 71.5%로 높아졌다고 보고한다.
- 검색 결과는 동일 시스템 내부의 비교다. 저자들은 검색 도구의 제공 조건이 비슷한지 불확실해 다른 비서와의 비교를 피한다. 내부 벤치마크의 언어 분포도 다른 사용자 집단으로 일반화하는 데 제약이 된다.
6. Vision-language Model
MiniMax-VL-01은 MiniMax-Text-01에 이미지 인코더와 어댑터를 추가한 vision-language model로, 이미지와 텍스트를 함께 처리한다. 인코더는 이미지를 표현으로 변환하고, 어댑터는 그 표현을 언어 모델에 연결한다. 학습에서는 먼저 시각 구성 요소를 정렬한 뒤 전체 파이프라인을 갱신한다.
6.1. Multimodal Data
Caption Data는 고유한 이미지-캡션 쌍 694 million개를 포함하며, 이 중 이미지 180 million개에는 개선한 캡션이 있다. 개선한 캡션이 있으면 원본과 개선본을 동일한 확률 p = 0.5로 샘플링한다. Description Data는 모델이 생성하고 사람이 다듬은 설명이 붙은 이미지 100 million개를 포함하며, 이미지당 설명 길이는 평균 약 300개 텍스트 토큰이다.
- Instruction Data는 텍스트 추출, 객체의 위치를 찾는 object localization, 기하 등을 위한 시각 질의응답 쌍을 합성하고, 프롬프트 유형별로 균형 있게 샘플링한다.
- Data Distribution은 샘플링한 이미지-지시 쌍 1 million개를 다른 vision-language model로 분석한다. 약 50,000개의 고유 태그가 생성되며, 그중 10회를 초과해 나타난 2,817개를 주요 범주 14개로 묶는다. 이는 샘플링한 과제에 모델이 부여한 설명이다.
6.2. Architecture
아키텍처는 이미지를 패치 표현으로 처리하는 303-million-parameter Vision Transformer (ViT), 시각 특징을 언어 모델에 맞게 매핑하는 두 계층의 multilayer perceptron (MLP) projector, MiniMax-Text-01을 결합한다. 동적 이미지 해상도는 336×336–2016×2016이다. 겹치지 않는 336×336 크롭과 별도의 336×336 썸네일을 각각 인코딩하고, 특징 다운샘플링 없이 이어 붙인다.
- 시각 인코더는 CoCa로 ViT-L/14를 처음부터 학습한다. CoCa는 일치하는 이미지-텍스트 쌍과 불일치하는 쌍을 구별하는 대조학습에 캡션 생성 학습을 결합한다.
- 인코더는 224×224에서 이미지-캡션 쌍 37 billion개를 처리한 뒤, 336×336에서 1.2 billion개를 처리하며 캡션은 76토큰으로 잘라낸다. 과제별 지도 적응 없이, 이미지 클래스 1,000개로 구성된 ImageNet-1K에서 zero-shot 분류 정확도 80.55%를 기록한다.
6.3. Training Recipes
4단계 시각 학습 절차는 Modality alignment로 시작한다. 336×336 해상도에서 설명 토큰 80 billion개를 사용해 인코더와 어댑터를 갱신한다. Enhancement of Vision Understanding은 이미지와 텍스트 입력을 나타내는 멀티모달 토큰 420 billion개를 텍스트 후속 학습 데이터와 20:1 비율로 결합해 모든 파라미터를 갱신한다.
- Enhancement of User Experience는 응용 중심의 사람 주석 대화에서 가져온 멀티모달 토큰 44.8 billion개로 1 epoch를 학습한다.
- Enhancement of Preference는 이미지-텍스트 쌍 40,000개와 텍스트 전용 쌍에 DPO를 적용하고, 평가 점수 차이가 큰 응답을 선택한다. 후보를 구성할 때 sampling temperature를 바꾸고, 이미지 정보를 약화하며, 응답에 의도적으로 오류를 넣는다. 과적합을 줄이기 위해 1 epoch를 모두 마치기 전에 학습을 중단한다.
- 초록은 vision-language 토큰 512 billion개를 보고하지만, 앞선 3개 단계에 명시된 수량을 합하면 544.8 billion개다. 보고서는 이 수치 차이를 해명하지 않는다.
6.4. Benchmarks
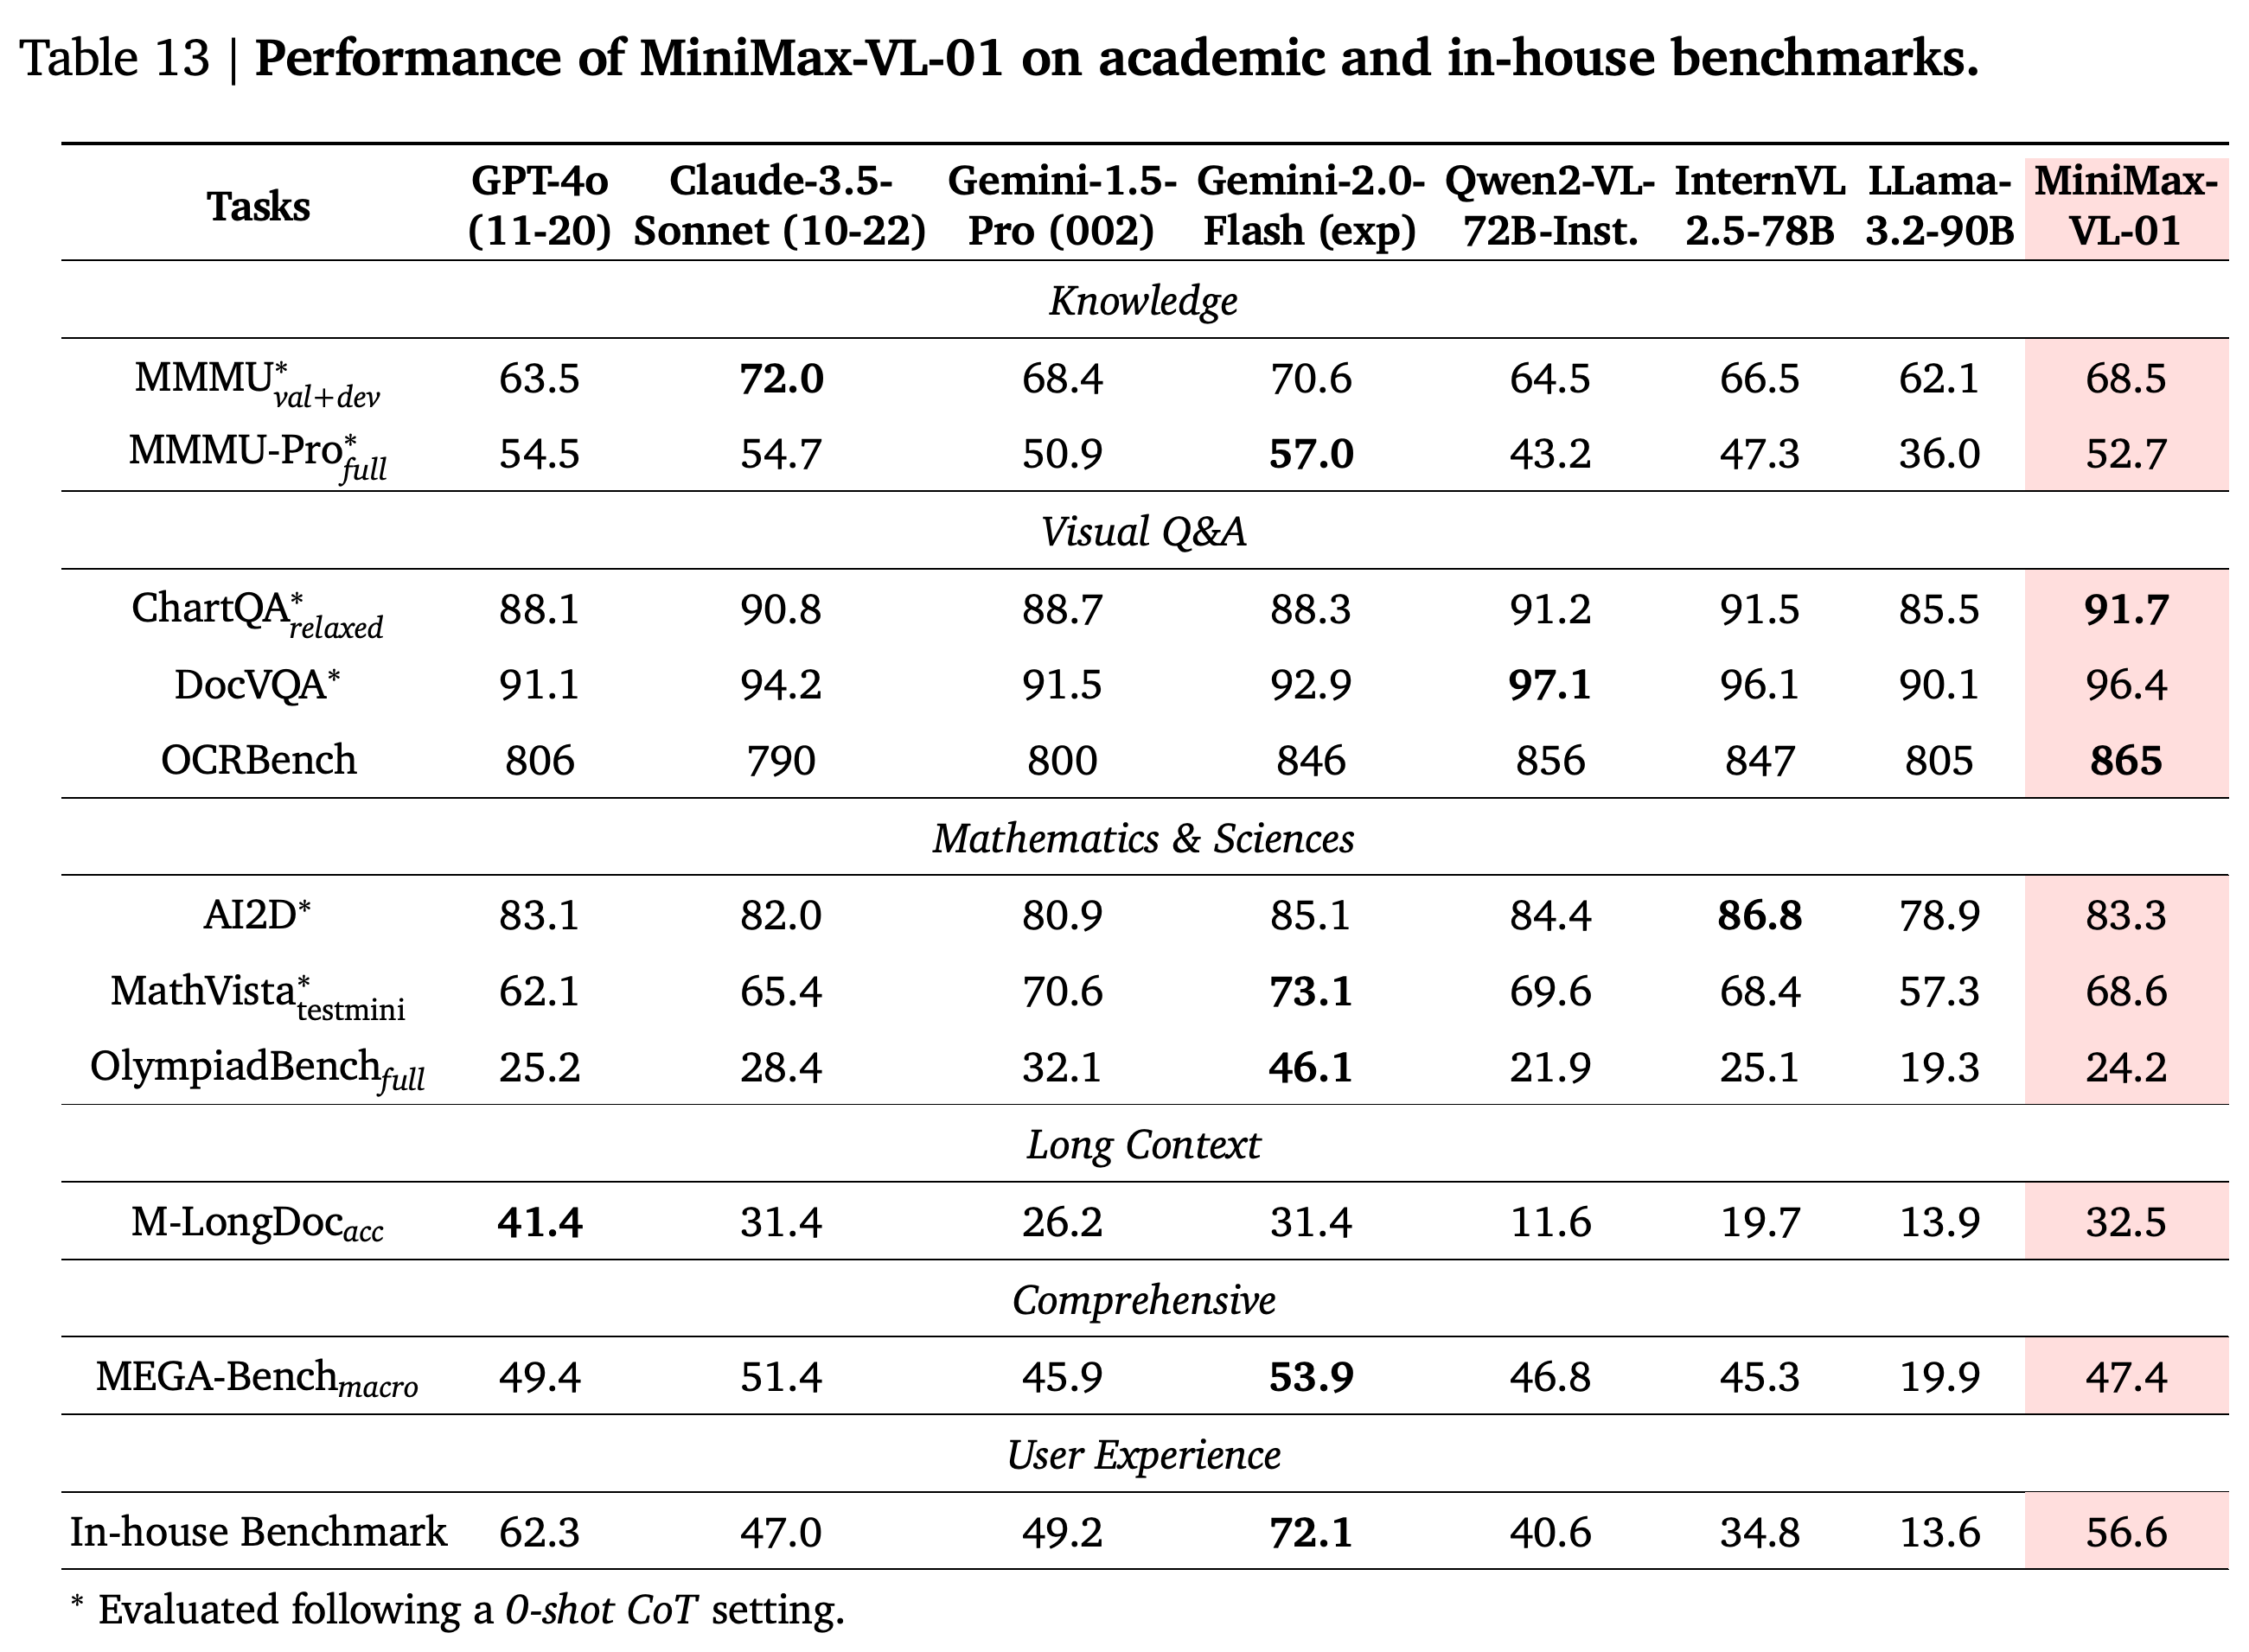
MiniMax-VL-01은 차트 질의응답 벤치마크 ChartQA에서 91.7, 이미지의 글자를 읽는 광학 문자 인식을 평가하는 OCRBench에서 865로 나열된 모델 중 가장 높다. 문서 이미지에 관해 질문하는 DocVQA에서는 96.4를 기록한다. 반면 고급 수학과 과학 문제를 다루는 OlympiadBench는 24.2로 Gemini-2.0-Flash (exp)의 46.1보다 낮다.
- 긴 문서 이해 벤치마크 MMLongBench-Doc에서 MiniMax는 32.5로 GPT-4o (11-20)의 41.4보다 낮다. 단일 페이지와 여러 페이지 하위 집합의 정확도는 각각 47.3%와 28.4%다.
- 폭넓은 멀티모달 평가 모음인 MEGA-Bench에서 MiniMax는 평가 과제별 평균인 macro 점수 47.4를 기록한다. 나열된 오픈소스 대안보다 높지만 여러 상용 모델보다 낮다. 논문은 계획 수립과 지표 평가를 약점으로 지적한다.
- 내부 시각 벤치마크는 과제 90개와 주석을 단 중국어 및 영어 샘플 524개를 포함하며, 주로 중국어로 구성된다. 학습 데이터와의 중복을 제거하고 샘플별 체크리스트를 사용한다. MiniMax는 56.6으로 GPT-4o (11-20)의 62.3, Gemini-2.0-Flash (exp)의 72.1보다 낮다.
MiniMax-VL-01은 나열된 시스템 중 ChartQA와 OCRBench에서 가장 높다. 반면 고급 수학, 긴 문서 이해, 내부 사용자 경험 벤치마크에서는 선두 상용 모델보다 낮다. 이러한 과제별 차이를 고려하면 전반적인 멀티모달 능력이 비슷하다는 주장은 제한적으로 해석해야 한다.
7. Conclusion and Future work
이 보고서는 일반 평가에서 경쟁력 있는 대규모 hybrid attention 모델을 제시하며, 가장 뚜렷한 강점은 긴 문맥 텍스트 처리에서 나타난다. 모델은 https://github.com/MiniMax-AI 에 공개한다. 검색 기능을 갖춘 챗봇 주소는 https://www.hailuo.ai/ 이고, API 주소는 https://intl.minimaxi.com 이다.
- 저자들은 긴 문맥 평가가 여전히 인위적이거나 단순화되어 있고, 계층의 1/8이 softmax attention을 사용하며, 복잡한 프로그래밍 성능을 개선해야 한다고 인정한다.
- Softmax를 완전히 제거하고 현실적인 긴 문맥 추론을 개선하는 방안을 연구 방향으로 제안한다. 무제한 문맥이나 남은 attention 오버헤드의 제거를 입증하지는 않는다.
부록
- A. Contributors는 보고서 기여자를 알파벳순으로 나열한다.
- B. MiniMax-Text-01 Case Demonstrations는 벤치마크 예시와 평가자가 작성한 요청을 제시한다. 이 요청은 사용자 개인정보를 보호하면서 실제 사용자 상호작용과 비슷하도록 작성했다. B.1. Learning A ‘New’ Language From Long Context는 문법책, 단어 목록, 병렬 문장을 통한 Kalamang 번역을 보여 준다. B.2. Memorizing Long History Dialogues는 최대 영어 1889개 또는 중국어 2053개의 과거 상호작용에서 정보를 검색하는 과정을 설명한다. B.3. Summarizing Long Papers with Figures와 B.4. Translating Long Papers는 문서 처리 예시를 보여 준다. B.5. Lyrics Writing, B.6. Story Writing, B.7. Poetry Composition은 창작 결과와 사람의 논평을 제시한다. B.8. Safety는 제한 해제를 요구하는 프롬프트에 무해하게 응답하는 사례를 보여 주고, B.9. Search는 잘못된 전제를 받아들이는 경우와 검색으로 바로잡는 경우를 비교한다. 선택된 사례는 동작을 보여 주지만 전반적인 신뢰성을 입증하지는 않는다.
- C. Vision In-house User Experience Benchmark Examples는 이미지, 요청, 체크리스트, 응답을 제공한다. C.1. Nature는 태양계의 일부 위성을 그린 삽화의 해석을 평가한다. C.2. Daily Life는 길 찾기와 의류 수 세기를, C.3. Digital Scenarios는 작업 과정의 병목과 이메일 기반 일정 조정을, C.4. Special Imaging은 날짜가 다른 위성 이미지 비교를 다룬다. 의류 예시의 마지막 체크리스트 항목에는 “second row”가 반복되지만, 제시된 응답은 3번째 줄을 설명한다.
- D. Evaluation Details for Selected Benchmarks는 서로 다른 입력 구성을 기록한다. D.1. MMLongBench-Doc는 평가 대상 오픈소스 모델에는 문서 페이지를 이미지 5개로, Claude-3.5-Sonnet-1022에는 10개로 이어 붙인다. 한편 다른 상용 모델과 MiniMax-Text-01에는 기본 최대 120페이지, 해상도 144를 사용한다고 설명한다. 시각 평가 설명에 이 텍스트 모델 식별자가 등장하는 것은 불일치로 보인다. D.2. MEGA-Bench는 MiniMax-VL-01에 이미지 128개와 시연 동영상 프레임 16개를 허용하며, GPT-4o-2024-1120은 64/8, Qwen2-VL-72B-Instruct는 10/1이다. D.3. MMMU & DocVQA는 규칙 기반 평가가 다른 형태의 유효한 답변을 인식하지 못할 때 GPT-4o-2024-05-13을 판정자로 사용한다. MMMU는 여러 학문 분야의 멀티모달 이해를 평가한다.
짧은 생각
가장 큰 기여는 검색 능력을 유지하는 hybrid 아키텍처와, 이를 파라미터 456B 규모로 학습하고 서비스하는 데 필요한 시스템 작업을 결합한 점이다. Attention 제거 실험, RULER 결과, LongBench v2 비교는 4M-token 창 자체보다 이 평가를 더 직접적으로 뒷받침한다. 백만 토큰 규모에서 신뢰할 수 있는 추론을 한다는 근거는 여전히 제한적이다. 기본 검색은 일찍 포화되고, 더 어려운 대화 재현율은 감소하며, 저자들도 현실적인 평가의 부족을 인정한다. 배포를 예상할 때는 남아 있는 softmax 비용과 비교에 사용된 서로 다른 멀티모달 입력 한도를 고려해야 한다. 결과는 특정 긴 문맥 과제의 개선을 입증하지만, 코딩, 여러 페이지에 걸친 이해, 고급 시각 수학에서는 약점을 보인다.