


MLGym: A New Framework and Benchmark for Advancing AI Research Agents 요약 설명
20 Feb 2025 | Paper Review AI Research Agents LLM Evaluation Tool Use목차
이번 글에서는 MLGym: A New Framework and Benchmark for Advancing AI Research Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 20일(Arxiv)
- Nathani, Deepak, Madaan, Lovish, Roberts, Nicholas, Bashlykov, Nikolay, Menon, Ajay, Moens, Vincent, Budhiraja, Amar, Magka, Despoina, Vorotilov, Vladislav, Chaurasia, Gaurav, et al.
- University of California, Santa Barbara, University College London, University of Wisconsin–Madison, University of Oxford, PyTorch Core Libraries at Meta, FAIR at Meta, GenAI at Meta
- 논문 링크
- Github
요약
- MLGym은 다양한 머신러닝 연구 과제에서 대규모 언어 모델(LLM) 에이전트를 평가할 공통 환경이 부족하다는 문제를 다룬다. 여기서 에이전트는 명령을 실행하고 피드백을 활용해 해법을 개선하는 시스템이다. 동일한 SWE-Agent 명령 실행 프레임워크에서 13개 과제마다 독립적으로 실행한 4회 중 최고 결과를 비교하면, OpenAI O1-preview가 평가 모델 5개 중 가장 높은 종합 점수를 기록한다. 저자들은 개선이 대체로 기존 방법을 조정하는 데서 나온다고 보고한다.
- 이 프레임워크는 Gymnasium 인터페이스를 통해 에이전트, 환경, 데이터셋, 과제를 분리한다. Gymnasium은 정책이 상호작용과 보상을 통해 학습하는 강화학습의 표준 인터페이스다. 모델 가중치, 알고리즘, 게임 전략을 실행해 평가할 수 있으므로, 출력 형식과 성능 지표가 다른 과제도 공통 평가 플랫폼을 사용할 수 있다.
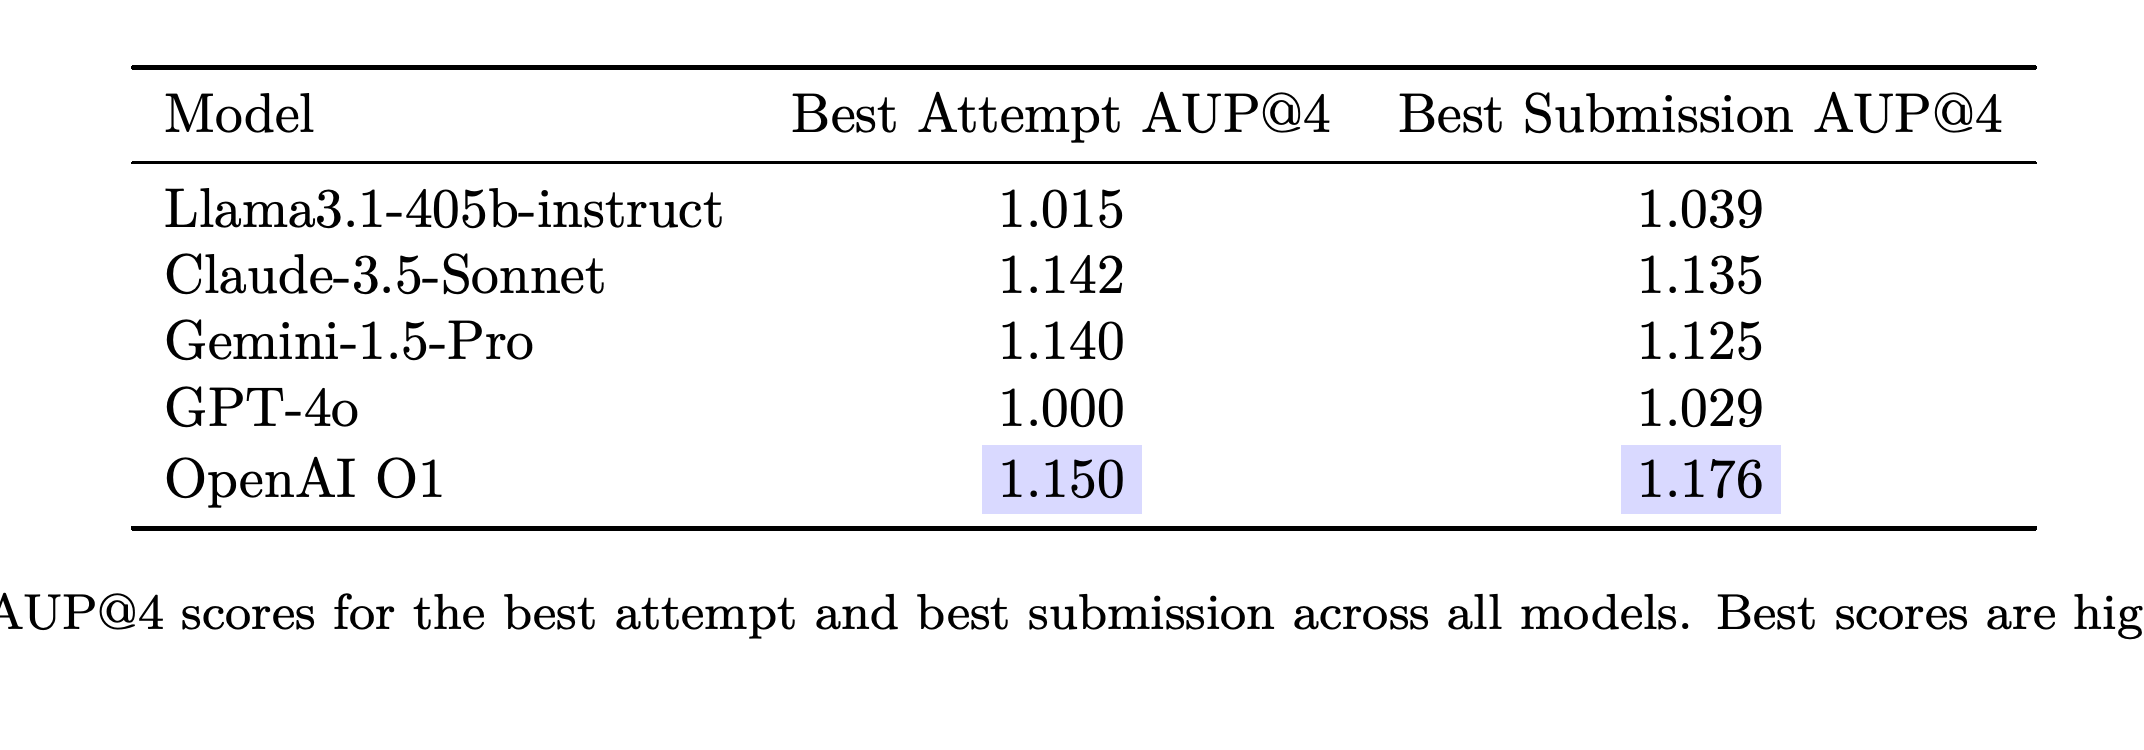
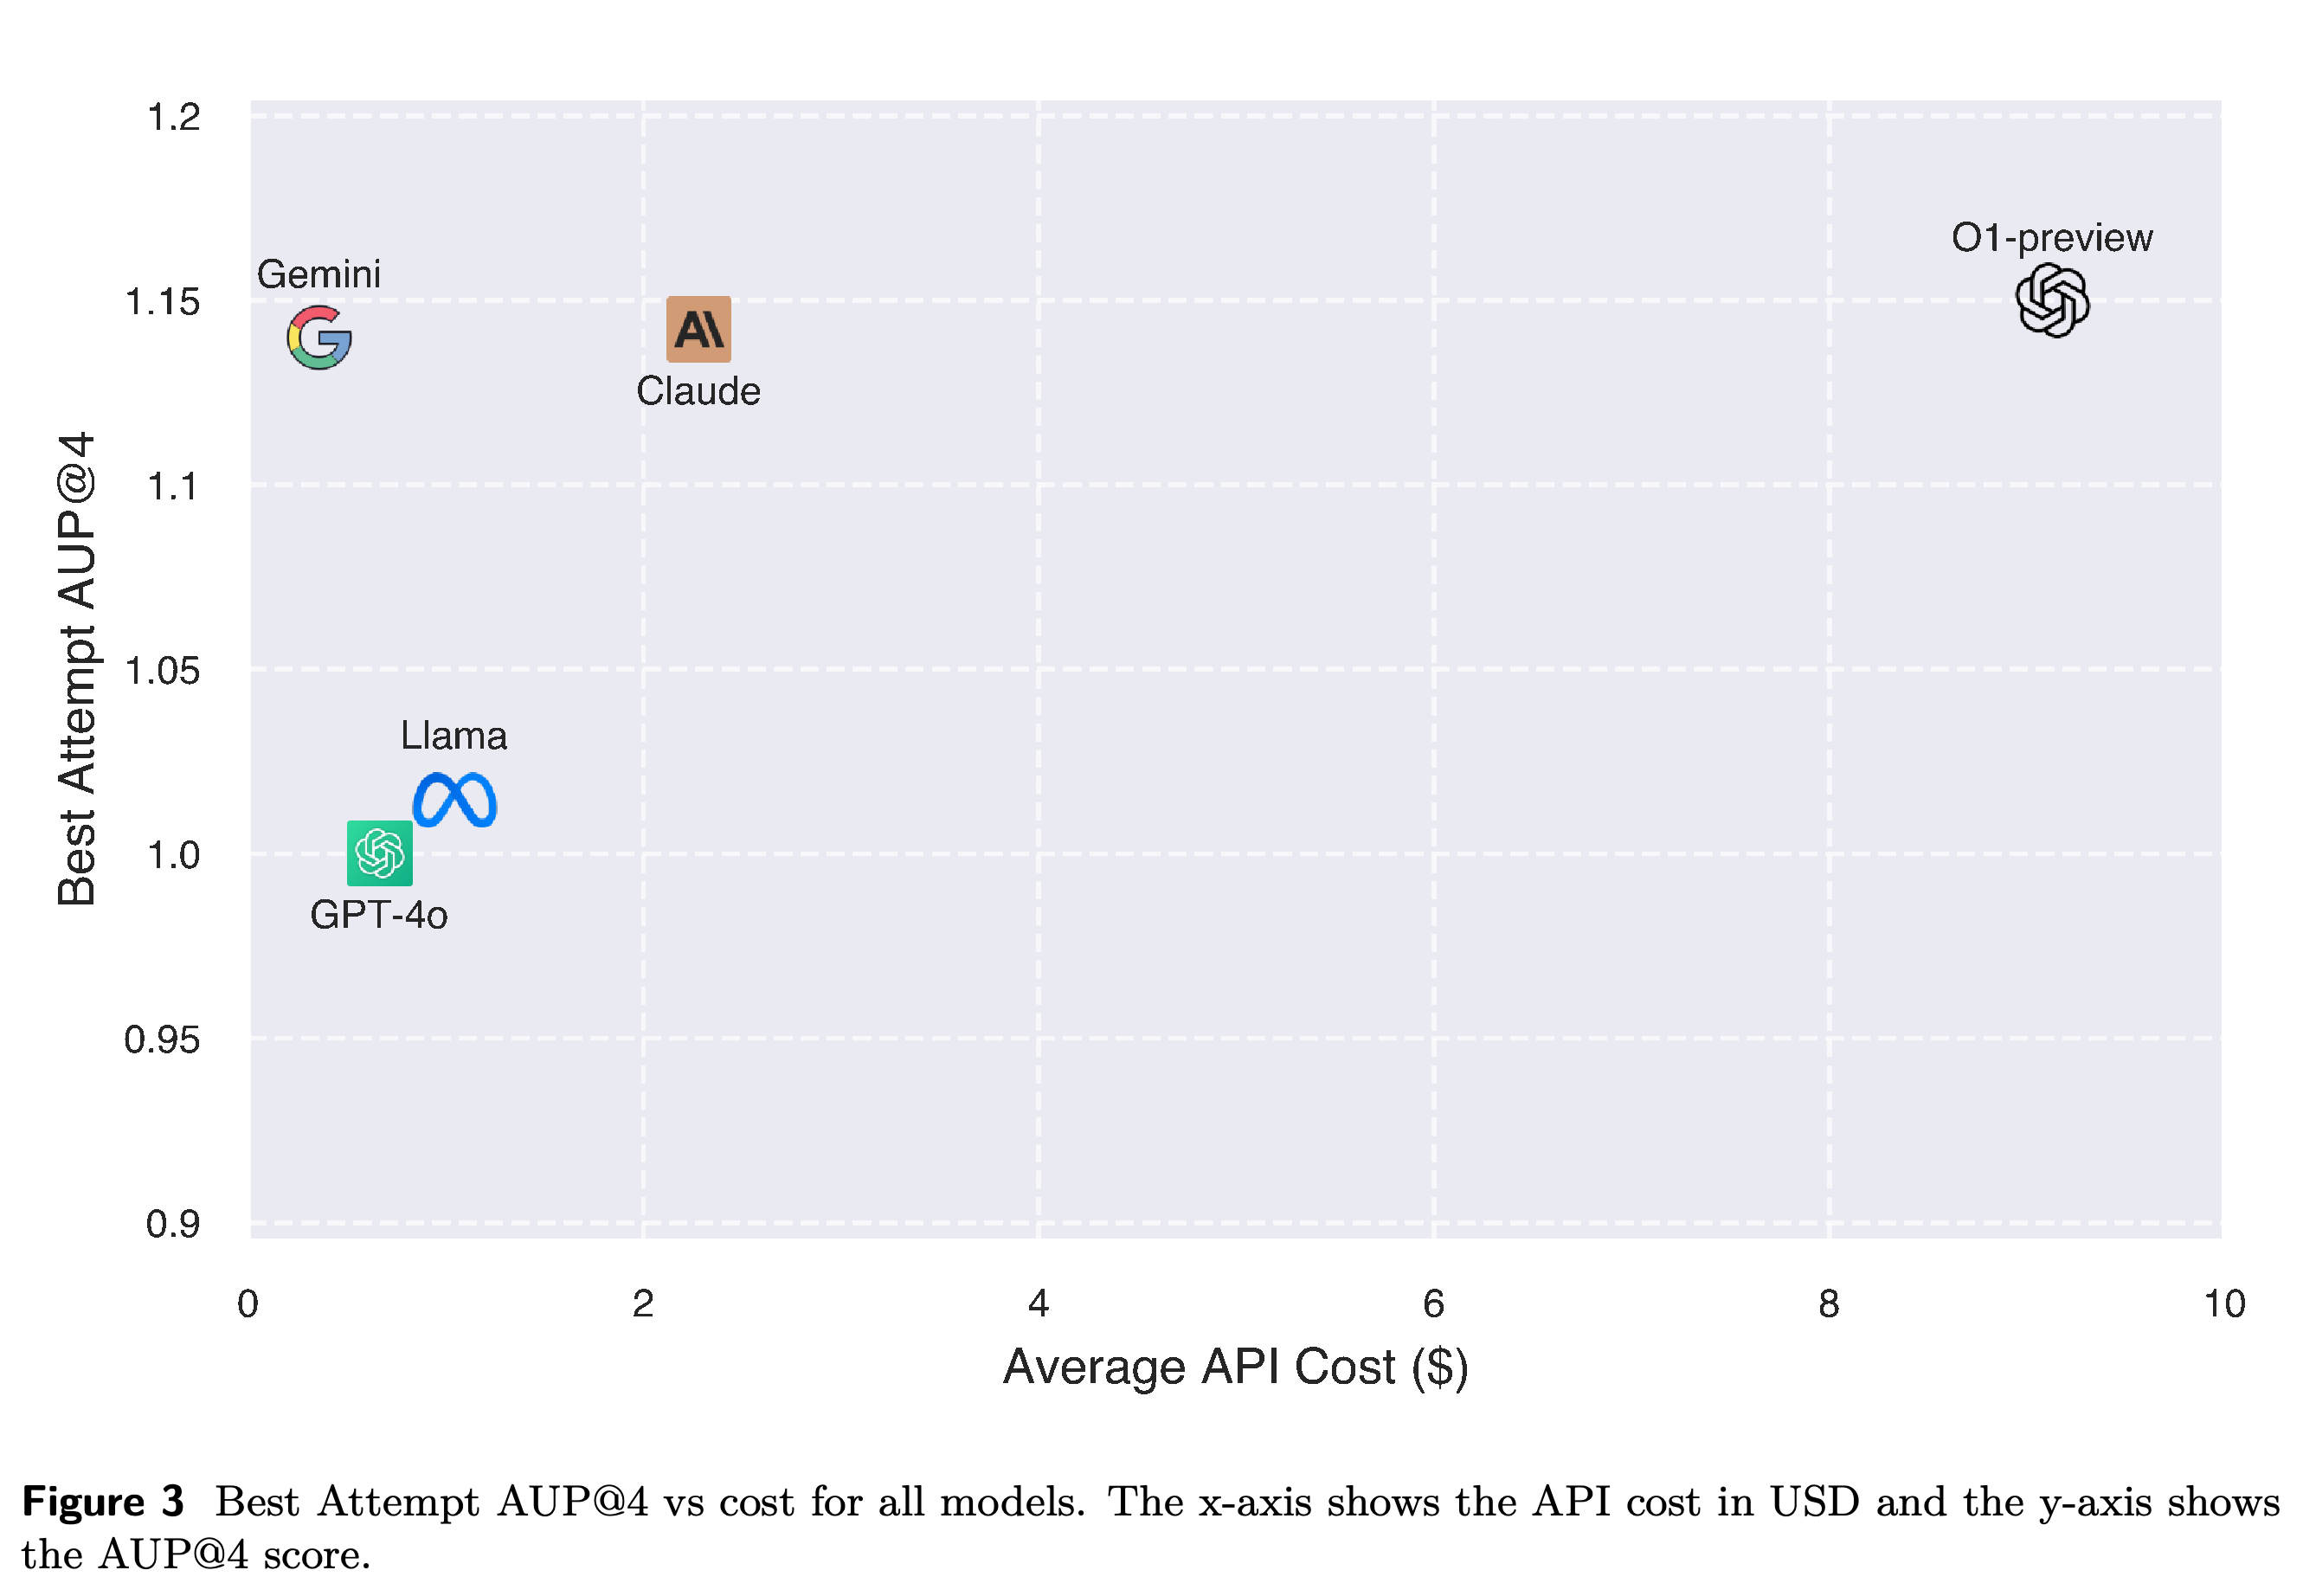
- OpenAI O1-preview의 Best Attempt AUP@4는 1.150이며, Claude-3.5-Sonnet은 1.142, Gemini-1.5-Pro는 1.140을 기록한다. Best Attempt@4는 4회 실행에서 가장 좋은 중간 평가 결과를 선택하며, AUP는 과제 전반의 상대 성능을 요약한 성능 프로파일 아래 면적이다. 논문은 Gemini-1.5-Pro가 O1-preview의 Best Attempt AUP 약 99%에 도달하면서 모델 호출 비용은 약 9배 낮다고 보고한다. 다만 부록 A.1의 토큰 수와 가격을 적용해 계산하면 O1-preview는 약 9.18달러, Gemini-1.5-Pro는 약 0.36달러로 약 25.4배 차이가 나며, 논문은 이 수치 불일치를 설명하지 않는다. 이 벤치마크는 제공된 베이스라인 대비 개선을 측정하며, 자율적인 과학적 발견을 입증하지는 않는다.
1 Introduction
MLGym: A New Framework and Benchmark for Advancing AI Research Agents는 구현, 학습, 평가, 분석을 반복하는 작업을 위한 공통 환경을 제안한다. 저자들은 기존 벤치마크에서 다루는 분야의 범위, 연구 에이전트 학습 지원, 평가 산출물의 유연성이 부족하다고 지적한다. 여기서 산출물은 학습된 모델, 알고리즘, 예측 결과 등을 뜻한다. 프레임워크와 벤치마크는 https://github.com/facebookresearch/MLGym 에 공개되어 있다.
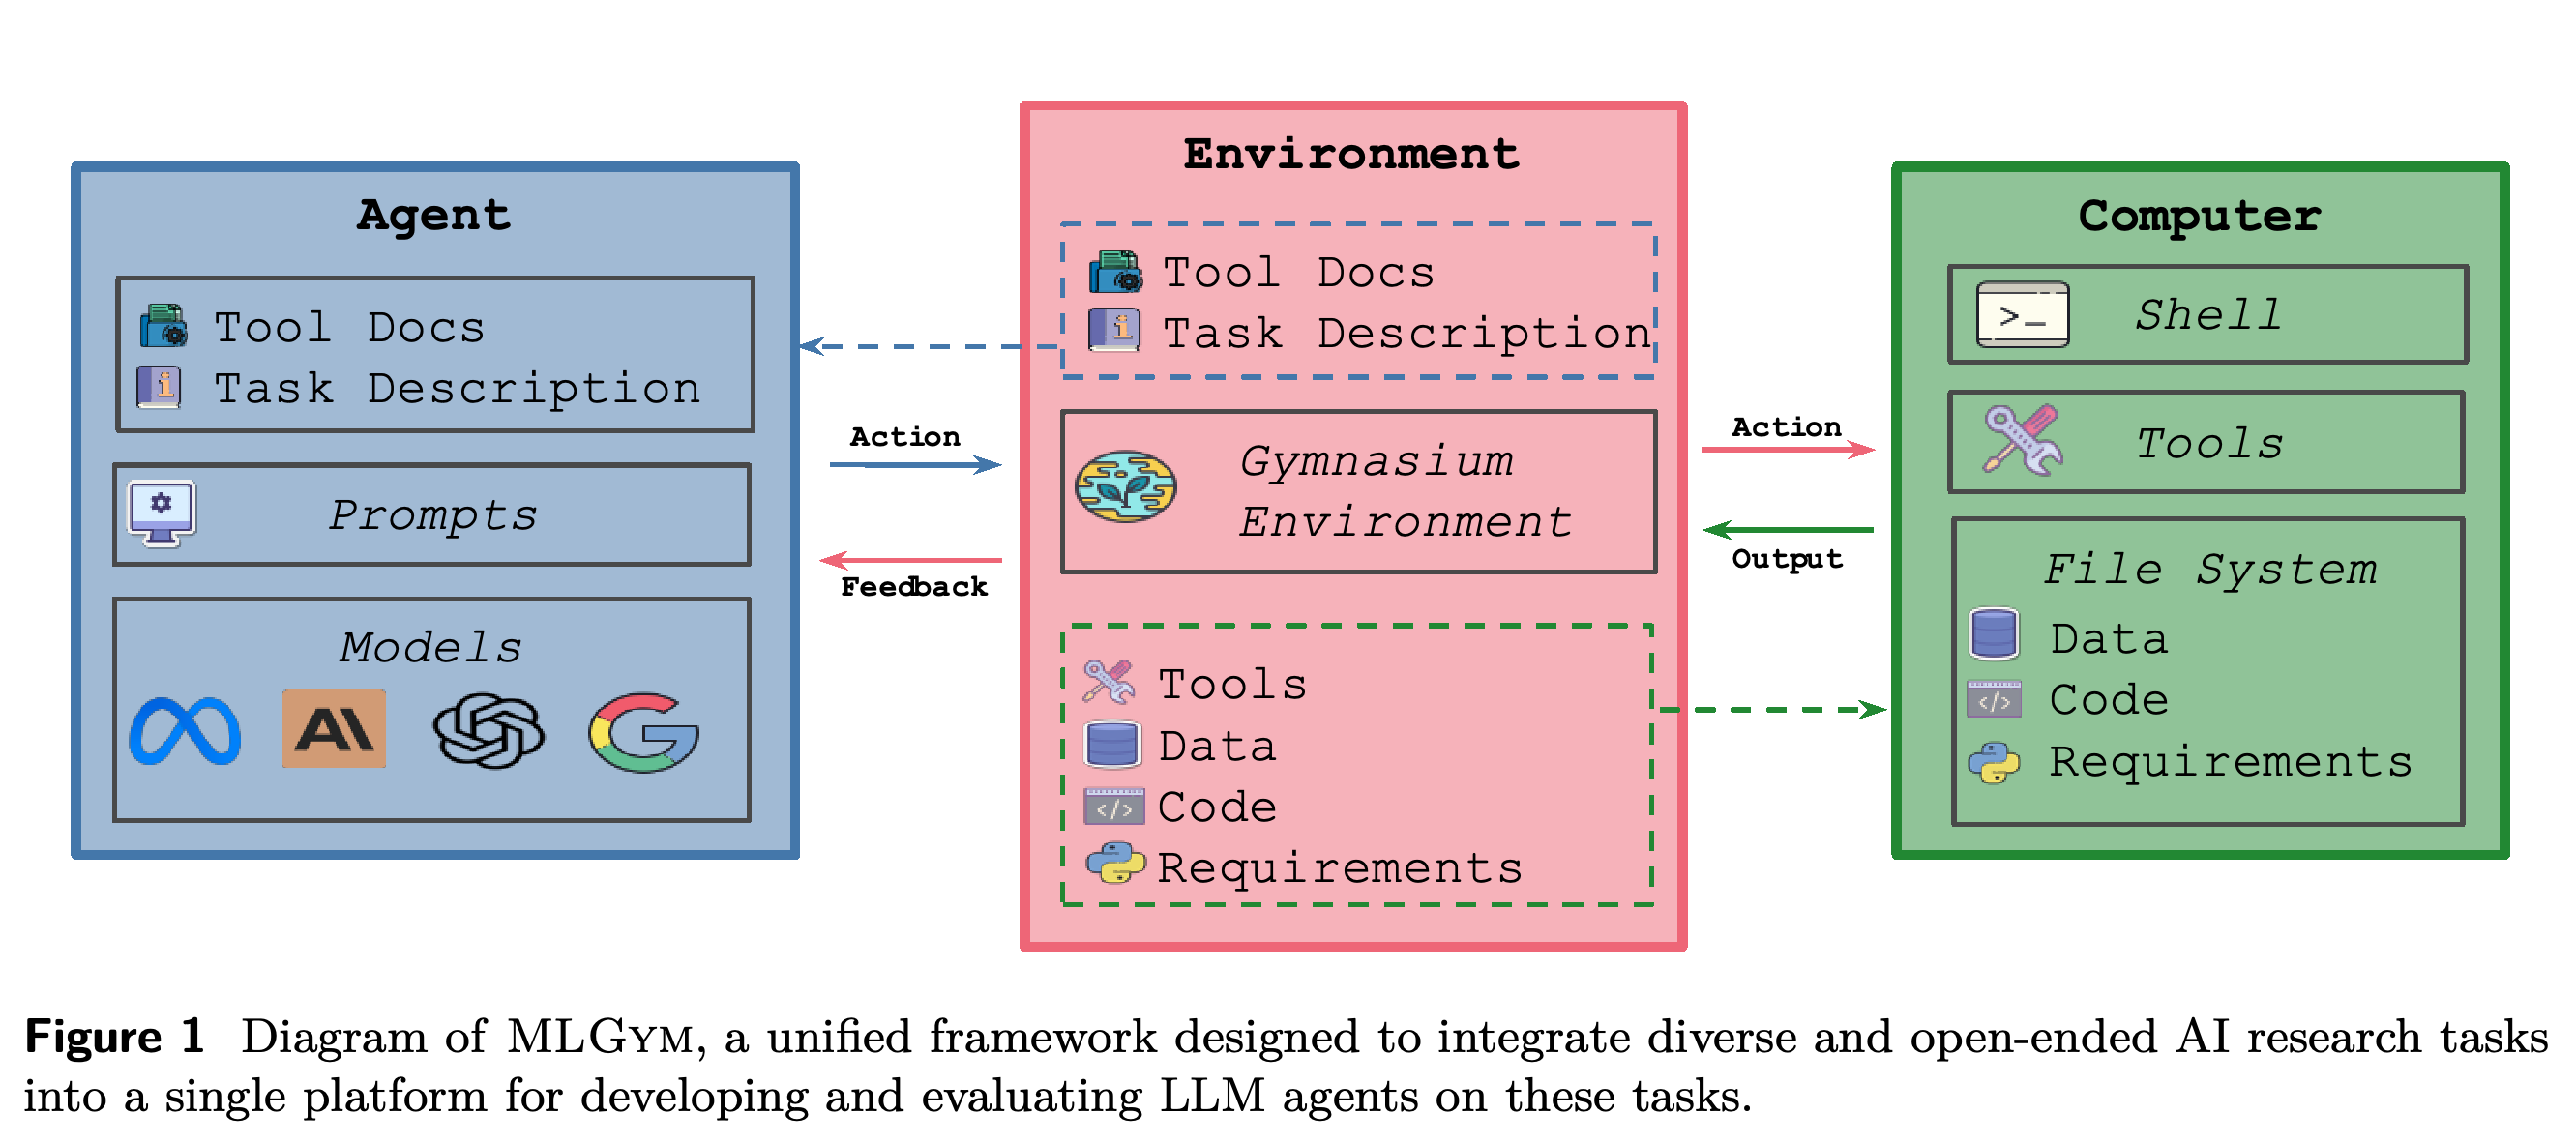
환경은 도구, 코드, 데이터, 의존성을 제공하면서 에이전트와 컴퓨터 사이의 명령과 피드백을 중개한다. 이러한 분리 덕분에 서로 다른 에이전트가 같은 과제 기반 시설을 사용할 수 있다.
1.1 Capability Levels for AI Research Agents
제안한 역량 체계는 Level 0: Reproduction, Level 1: Baseline Improvement, Level 2: SOTA Achievement, Level 3: Novel Scientific Contribution, Level 4: Groundbreaking Scientific Contribution, Level 5: Long-Term Research Agenda로 구성된다. SOTA는 최고 수준의 성능을 뜻한다. Level 2에서는 과제 설명과 SOTA 방법이 나오기 전의 문헌만 제공하며, 해당 방법의 논문과 코드는 제외한다. 상위 단계로 갈수록 더 크고 지속적인 과학적 기여를 요구한다. MLGym-Bench는 최고 수준에 미치지 못하는 제공 코드를 개선하는 Level 1을 목표로 한다.
2 Related Work
관련 연구는 연구 프레임워크와 벤치마크, 범용 도구 사용 에이전트, 소프트웨어 공학 및 데이터 과학 에이전트, 과학 연구 시스템을 다룬다. 이러한 비교를 바탕으로, 에이전트가 방법을 바꾸고 다양한 산출물을 만들 수 있도록 하면서도 측정 가능한 연구 성과를 평가하고자 한다.
2.1 AI Research Frameworks and Benchmarks
저자들은 MLGym을 머신러닝 공학 벤치마크인 MLE-Bench, 소프트웨어 공학 벤치마크와 에이전트인 SWE-Bench/Agent, 연구 벤치마크인 MLAgentBench, RE-Bench, ScienceAgentBench와 비교한다. 비교 항목은 Gym 인터페이스, 알고리즘 과제, 개방형 연구, 유연한 산출물, 기본 에이전트 실행 프레임워크다. MLGym은 이러한 기능을 결합한다. 다만 논문은 다른 연구 벤치마크 중에서도 이미 스크립트 기반 평가를 사용하는 사례가 있음을 인정한다.
2.2 LLM Agents
범용 에이전트 벤치마크는 도구, 웹사이트, 운영체제, 게임, 시뮬레이션 환경 또는 물리적 환경과의 상호작용을 평가한다. AssistantBench는 현실적인 웹 과제를, AgentBench는 8개 상호작용 환경을, GAIA는 도구와 멀티모달 추론이 필요한 실제 질문을, AppWorld는 애플리케이션과의 반복적인 상호작용을 평가한다. 저자들은 이러한 설정을 개방형 AI 연구와 구분하며, 성능과 비용을 모두 보고하는 평가 프로토콜을 강조한다.
2.3 Agents for Software Engineering and Data Science
SWE-agent와 OpenHands 같은 소프트웨어 공학 시스템은 통제된 실행 환경을 제공한다. AutoKaggle과 AgentK v1.0은 데이터 과학 경진대회의 작업 과정을 자동화하며, Spider 시스템들은 데이터베이스 질의와 기업 업무를 다룬다. 탐색 기반 방법은 대안적인 실행 경로를 살펴보지만, 인용된 Agentless 결과에서는 간단한 3단계 절차가 SWE-bench Lite에서 더 복잡한 에이전트를 능가하기도 한다. 이러한 연구는 기반 모델뿐 아니라 에이전트의 실행 절차도 서로 다르다.
2.4 Agents for Scientific Research
과학 연구를 평가하려면 작동하는 코드를 만드는 것을 넘어 신규성, 반증 가능성, 일반화를 검토해야 한다. 반증 가능성은 시험을 통해 주장이 틀렸음을 보일 수 있는지를 뜻한다.
- Data Science: ML-Bench는 저장소 내 과제에 중점을 두고, Data Interpreter는 더 폭넓은 응용을 다룬다. SUPER는 에이전트가 연구 저장소 안에서 과제를 구성하고 실행하도록 요구한다.
- AI Research: 자동화된 머신러닝과 신경망 구조 탐색은 지정된 탐색 공간 안에서 방법과 구조의 선택을 자동화하지만, 연구 에이전트는 제약이 더 적은 해법을 제안할 수 있다. MLAgentBench, RE-Bench, MLE-bench는 과제 범위와 에이전트 실행 프레임워크가 서로 다른 관련 실험 환경을 제공한다.
- Scientific Discovery: DiscoveryWorld는 시뮬레이션 환경에서 발견을 평가하고, ScienceAgentBench는 출판된 연구에서 도출한 과제를 평가하며, ResearchAgent는 문헌을 바탕으로 아이디어를 반복적으로 발전시킨다. 저자들은 주관적인 선호 판단을 객관적인 성과 지표로 뒷받침해야 한다고 주장한다.
3 MLGym
에이전트는 과제 설명, 시작 코드, 실행 이력을 받은 뒤 셸 명령을 반복적으로 실행하고 출력을 관찰한다. MLGym은 격리된 소프트웨어 작업 공간인 로컬 Docker 컨테이너에서 이 상호작용을 구현한다. 구성 요소는 Agents, Environment, Datasets, Tasks의 4개 모듈이다. 연구자는 에이전트 실행 프레임워크 교체, 도구 추가, 데이터셋 재사용, 과제 도입을 각각 독립적으로 수행할 수 있다.
3.1 Agents
Agent 클래스는 기반 LLM을 감싸고 모델 연동, 이력 처리, 비용을 관리한다. 이전 관찰과 행동을 바탕으로 다음 행동을 반환하면, 환경이 이를 실행하고 다음 관찰을 제공한다. 기본 에이전트는 SWE-Agent를 수정한 것으로, 동일한 실행 절차 안에서 기반 모델을 비교할 수 있게 한다.
3.2 Environment
Environment는 별도의 Docker 작업 공간에 과제에 필요한 의존성, 도구, 코드, 데이터를 준비하고 명령 실행을 관리한다. 루트 권한이 없는 “agent” 사용자와 파일 권한을 통해 보호된 자원에 대한 접근을 제한한다. 도구는 에이전트와 별도로 초기화하며, 도구 문서를 에이전트 프롬프트에 넣을 수 있다. 각주에서는 최신 SWE-Agent 릴리스도 도구와 에이전트를 분리한다고 설명한다.
3.3 Datasets
데이터셋 설정은 과제 설정과 독립적이며, 로컬 저장 파일과 Hugging Face 호스팅 데이터셋이라는 2가지 제공 방식을 모두 지원한다. 데이터셋 하나를 여러 과제에서 사용할 수 있고, 과제 하나에 여러 데이터셋을 포함해 방법의 일반화 여부를 평가할 수 있다. 로컬 데이터셋 파일은 읽기 전용 권한으로 복사한다. 원격 데이터셋은 프롬프트나 시작 코드에 제공된 URL로 식별한다.
3.4 Tasks
과제 설정은 데이터셋, 읽기 전용 평가 스크립트, 의존성, 선택적인 시작 코드, 학습 시간 제한, 메모리 설정을 지정한다. 평가 산출물은 과제에 따라 예측 파일, 학습된 모델, 실행 가능한 전략 함수가 될 수 있다. 시작 코드의 제공 여부를 바꾸거나 버그를 넣어 난도를 달리할 수 있지만, 보고된 벤치마크에서는 베이스라인을 제공한다.
3.5 Tools and ACI
ACI는 agent-computer interface의 약자로, 파일 검색, 탐색, 편집, 검증, 제출 기능을 셸에서 사용할 수 있는 도구로 제공한다. 권한 때문에 작업이 차단되면 텍스트 피드백을 반환한다. validate 명령은 실행을 끝내지 않고 현재 산출물을 테스트 세트에서 평가한다. submit은 산출물을 평가한 뒤 행동과 관찰의 연속인 궤적을 종료한다.
- 확장 도구에는 논문을 찾고 내용을 추출하는 literature_search와 parse_pdf_url, 연구 기록을 저장하고 텍스트의 수치 표현 간 유사도로 기록을 검색하는 memory_write와 memory_read가 있다.
- 메모리 예시는 앞선 실험 이후 성공했던 설정으로 돌아가는 과정을 보여준다. 다만 논문은 보고된 실험에서 SWE-Agent 도구와 검증 기능만 사용했다고 명시한다. 따라서 주요 모델 비교는 문헌 검색이나 메모리의 효과를 입증하지 않는다.
4 MLGym-Bench
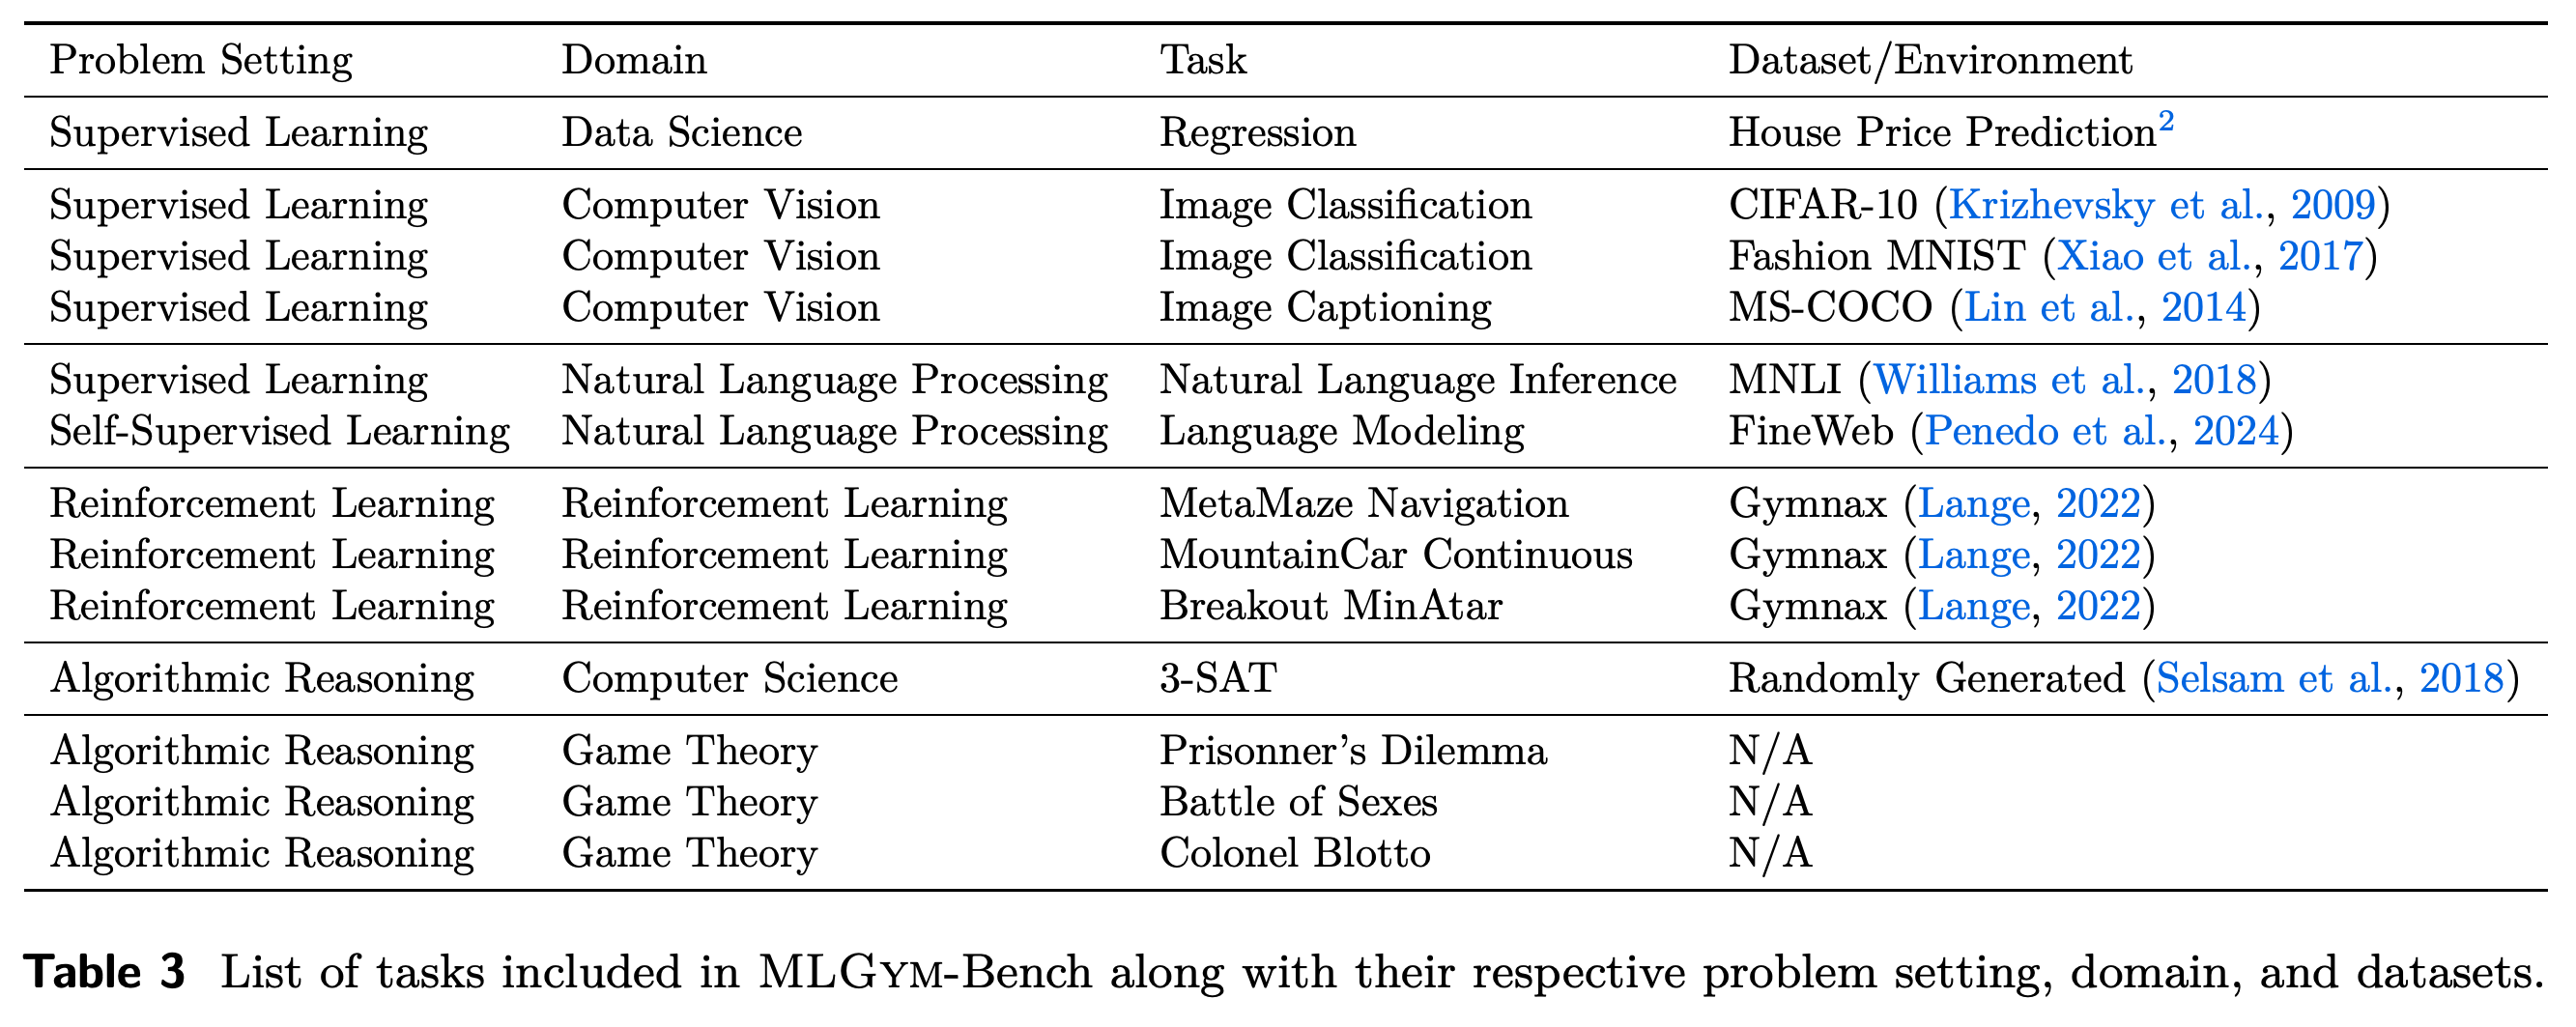
MLGym-Bench는 회귀, 이미지 분류, 이미지 캡셔닝, 언어 추론, 언어 모델링, 강화학습, 충족 가능성 문제 풀이, 반복 게임에 걸친 13개 과제로 구성된다. 각 과제는 베이스라인 구현과 표준화된 평가기를 포함한다. 이 과제들은 하나의 환경에서 데이터 처리, 학습 관련 의사결정, 코드 수정, 전략적 추론을 평가한다.
4.1 Data Science
House Price Prediction은 표 형식의 특성으로 주택 가격을 예측하는 과제다. 에이전트는 특성 공학을 최소한으로 적용한 회귀 모델인 Ridge Regression에서 시작한다. 과제 설명은 예측 오차 지표인 평균제곱근오차와 회귀 적합도 점수인 R²를 명시하며, 결과 표는 R²를 보고한다. 논문에 제공된 데이터셋 URL은 https://www.kaggle.com/datasets/yasserh/housing-prices-dataset 이다.
4.2 3-SAT
불리언 충족 가능성 문제인 3-SAT task는 제공된 DPLL 솔버 코드의 변수 선택을 개선하도록 요구한다. 솔버 자체는 읽기 전용이지만, 다음 변수를 고르는 규칙인 변수 선택 휴리스틱은 무작위 선택 베이스라인에서 변경할 수 있다. 성능은 생성된 100개 인스턴스를 푸는 데 걸린 전체 경과 시간을 초 단위로 측정한다.
4.3 Game Theory
게임 과제는 Prisoner’s Dilemma, Battle of Sexes, Colonel Blotto에서 고정된 상대에 대한 최적 반응, 즉 기대 보상을 최대화하는 전략을 작성하도록 요구한다. Prisoner’s Dilemma에서는 협력과 배신을 선택하고, Battle of Sexes에서는 선호가 다른 상황에서도 선택을 조율하며, Colonel Blotto에서는 한정된 자원을 경쟁 전장에 배분한다. 앞의 2개 게임은 k = 20라운드를 사용한다. 에이전트가 상대 코드를 살펴볼 수 있으므로, 이 과제들은 알려진 전략을 이해하고 활용하는 능력을 평가한다.
과제 목록은 지도 및 자기지도 모델 학습, 강화학습, 충족 가능성 문제 풀이, 게임 전략을 함께 다룬다. 각 과제에는 서로 다른 제출 산출물과 성능 지표가 필요하다.
4.4 Computer Vision
CIFAR-10은 베이스라인 정확도 49.71%에서 시작해 10개 클래스의 이미지 분류를 평가한다. Fashion MNIST는 이미지에 공간 필터를 적용하는 모델인 2층 합성곱 신경망을 베이스라인으로 사용해 의류 이미지를 분류한다. 에이전트는 모델 구조와 학습을 제어하는 설정인 학습 하이퍼파라미터를 수정할 수 있다. MS-COCO는 학습 및 검증 세트에서 사람이 포함된 이미지를 모두 제거한 뒤 이미지 캡셔닝을 평가한다. 평가 지표인 BLEU는 생성한 캡션을 참조 캡션과 비교한다.
4.5 Natural Language Processing
Natural Language Inference는 사전 학습된 언어 이해 모델 BERT와 텍스트 쌍 간 추론 벤치마크인 MNLI의 베이스라인 미세조정 코드에서 시작한다. Language Modeling은 https://github.com/KellerJordan/modded-nanogpt 의 modded-nanogpt 버전 #8에서 시작해 다음 토큰 예측을 학습한다. 데이터는 학습 토큰 1.773B와 검증 토큰 100M을 포함하는 FineWeb 텍스트 부분집합을 사용한다. 과제 설명은 예측 불확실성을 나타내는 perplexity를 명시하지만, 결과 표에서는 보고된 값을 Validation Loss로 표기한다.
4.6 Reinforcement Learning
강화학습 과제는 MetaMaze Navigation, Mountain Car Continuous, Breakout MinAtar다. 각 과제는 국소 관찰을 바탕으로 길을 찾고, 연속 제어로 자동차를 언덕 위로 움직이며, 단순화된 아케이드 게임을 플레이하도록 요구한다. 모두 강화학습 환경 라이브러리인 Gymnax와 https://github.com/RobertTLange/gymnax-blines 에서 제공하는 정책 학습 알고리즘 PPO를 사용한다.
5 Experimental Setup
실험에서는 SWE-Agent-derived 실행 프레임워크를 고정하고, 에이전트의 행동을 생성하는 LLM인 백본 모델을 바꾼다. 과제별 학습 시간 제한으로 학습을 제약하고, 공통 상호작용 제한으로 에이전트가 실행할 수 있는 명령 수를 제한한다. 모델과 과제마다 독립적으로 4회 실행해 그중 최고 결과를 비교한다.
5.1 Agent and Models
에이전트는 추론과 행동을 번갈아 수행하는 ReAct 방식의 루프를 사용하며, 단계마다 명령 1개를 실행한다. 대화형 인터프리터인 Python REPL이나 vim 같은 대화형 세션은 사용하지 않는다. 평가 모델은 OpenAI O1-preview, Gemini 1.5 Pro, Claude-3.5-sonnet-20241022, 결과에 표기된 Llama-3.1-405b-Instruct, GPT-4o다. 디코딩에는 출력 샘플링을 제어하는 temperature=0.0과 top-p=0.95를 사용한다. 예외적으로 O1-preview는 고정된 기본값인 temperature=1.0을 사용한다.
5.2 Environment Configuration
파일은 1000줄 단위로 표시하며 인접 구간 사이에 2줄을 겹친다. 이력 처리에서는 가장 최근의 행동과 관찰 상호작용 5개를 유지한다. 실행은 50단계 후 종료하며, 이때 마지막 코드 상태를 자동으로 제출한다. 과제별 학습 시간 제한은 개별 학습 명령의 실행 시간을 제한해 모델 크기만 늘려 개선하는 방식을 억제한다.
6 Evaluation
정확도, 보상, 손실, 실행 시간의 원점수를 평균하면 지표의 척도에 따라 과제별 가중치가 달라진다. Dolan and Moré (2002)를 따라, 성능 프로파일은 각 과제에서 최고 방법과 비교한 상대적 거리를 요약한다. 각 프로파일 아래 면적을 종합 AUP 점수로 사용하며, 선택한 구성 방식에서 값이 클수록 성능이 좋다.
6.1 Performance Profiles and the AUP Score
식 (1)은 ρ_m(τ) = |{t ∈ T : log₁₀ r_t,m ≤ τ}| / |T|로 정의한다. 낮을수록 좋은 지표에서는 r_t,m = ℓ_t,m / min{ℓ_t,m : m ∈ M}을 사용한다. T는 과제 집합, M은 방법 집합, ℓ_t,m은 과제 점수다. 식 (2)에 인쇄된 정의는 AUP_m = ∫₁^τmax ρ_m(τ)dτ이며, τmax는 모든 방법의 프로파일이 1에 도달하는 최소 임곗값이다. 프로파일은 로그 비율을 사용하고 그래프의 임곗값은 0에서 시작하므로, 인쇄된 적분 하한 1은 추가 설명이 필요하다.
6.2 Usage in MLGym
높을수록 좋은 지표에서는 식 (3)의 r_t,m = max{ℓ_t,m : m ∈ M} / ℓ_t,m을 사용한다. 베이스라인을 능가하는 유효한 해법이 없는 방법은 실행 불가능한 것으로 처리하고, ε = 0.05인 (1 + ε) × r_t,m_baseline을 비율로 부여한다.
- Best Submission@4는 4회 실행에서 가장 좋은 최종 산출물을 선택하며, 종료 후 자동 제출된 산출물도 포함한다.
- Best Attempt@4는 4회 실행에서 가장 좋은 유효 중간 평가 결과를 선택한다. 이 2개 지표를 구분하면 성공한 실험 결과가 최종 제출까지 유지되는지 확인할 수 있다. 어느 지표도 4회 중 최고 결과로 평균적인 실행 신뢰도를 추정하지는 않는다.
7 Results
결과는 종합 프로파일, 개별 과제 점수, 모델 호출 비용, 실행 실패 및 행동 분석을 함께 제시한다. 에이전트는 여러 분야에서 제공된 베이스라인을 개선하지만, 결과의 품질, 신뢰도, 비용에는 차이가 있다.
7.1 AUP Scores and Performance Profiles
OpenAI O1-preview는 종합 지표 2개 모두에서 선두를 기록한다. Best Attempt AUP@4는 1.150, Best Submission AUP@4는 1.176이다. Claude-3.5-Sonnet은 각각 1.142와 1.135, Gemini-1.5-Pro는 각각 1.140과 1.125를 기록하며, Llama3.1-405b-instruct와 GPT-4o의 점수는 더 낮다. Attempt와 Submission 프로파일은 별도로 구성하므로, 종합 값의 차이가 중간 산출물에서 최종 산출물로의 개선을 직접 측정하지는 않는다.
O1-preview는 Best Attempt AUP@4에서 1.150, Best Submission AUP@4에서 1.176으로 선두를 기록한다. Claude와 Gemini의 Best Attempt 점수는 각각 1.142와 1.140으로 서로 가깝다. 이러한 종합 점수 차이는 개별 과제 성능의 개선율을 뜻하지 않는다.
7.2 Raw Performance Scores
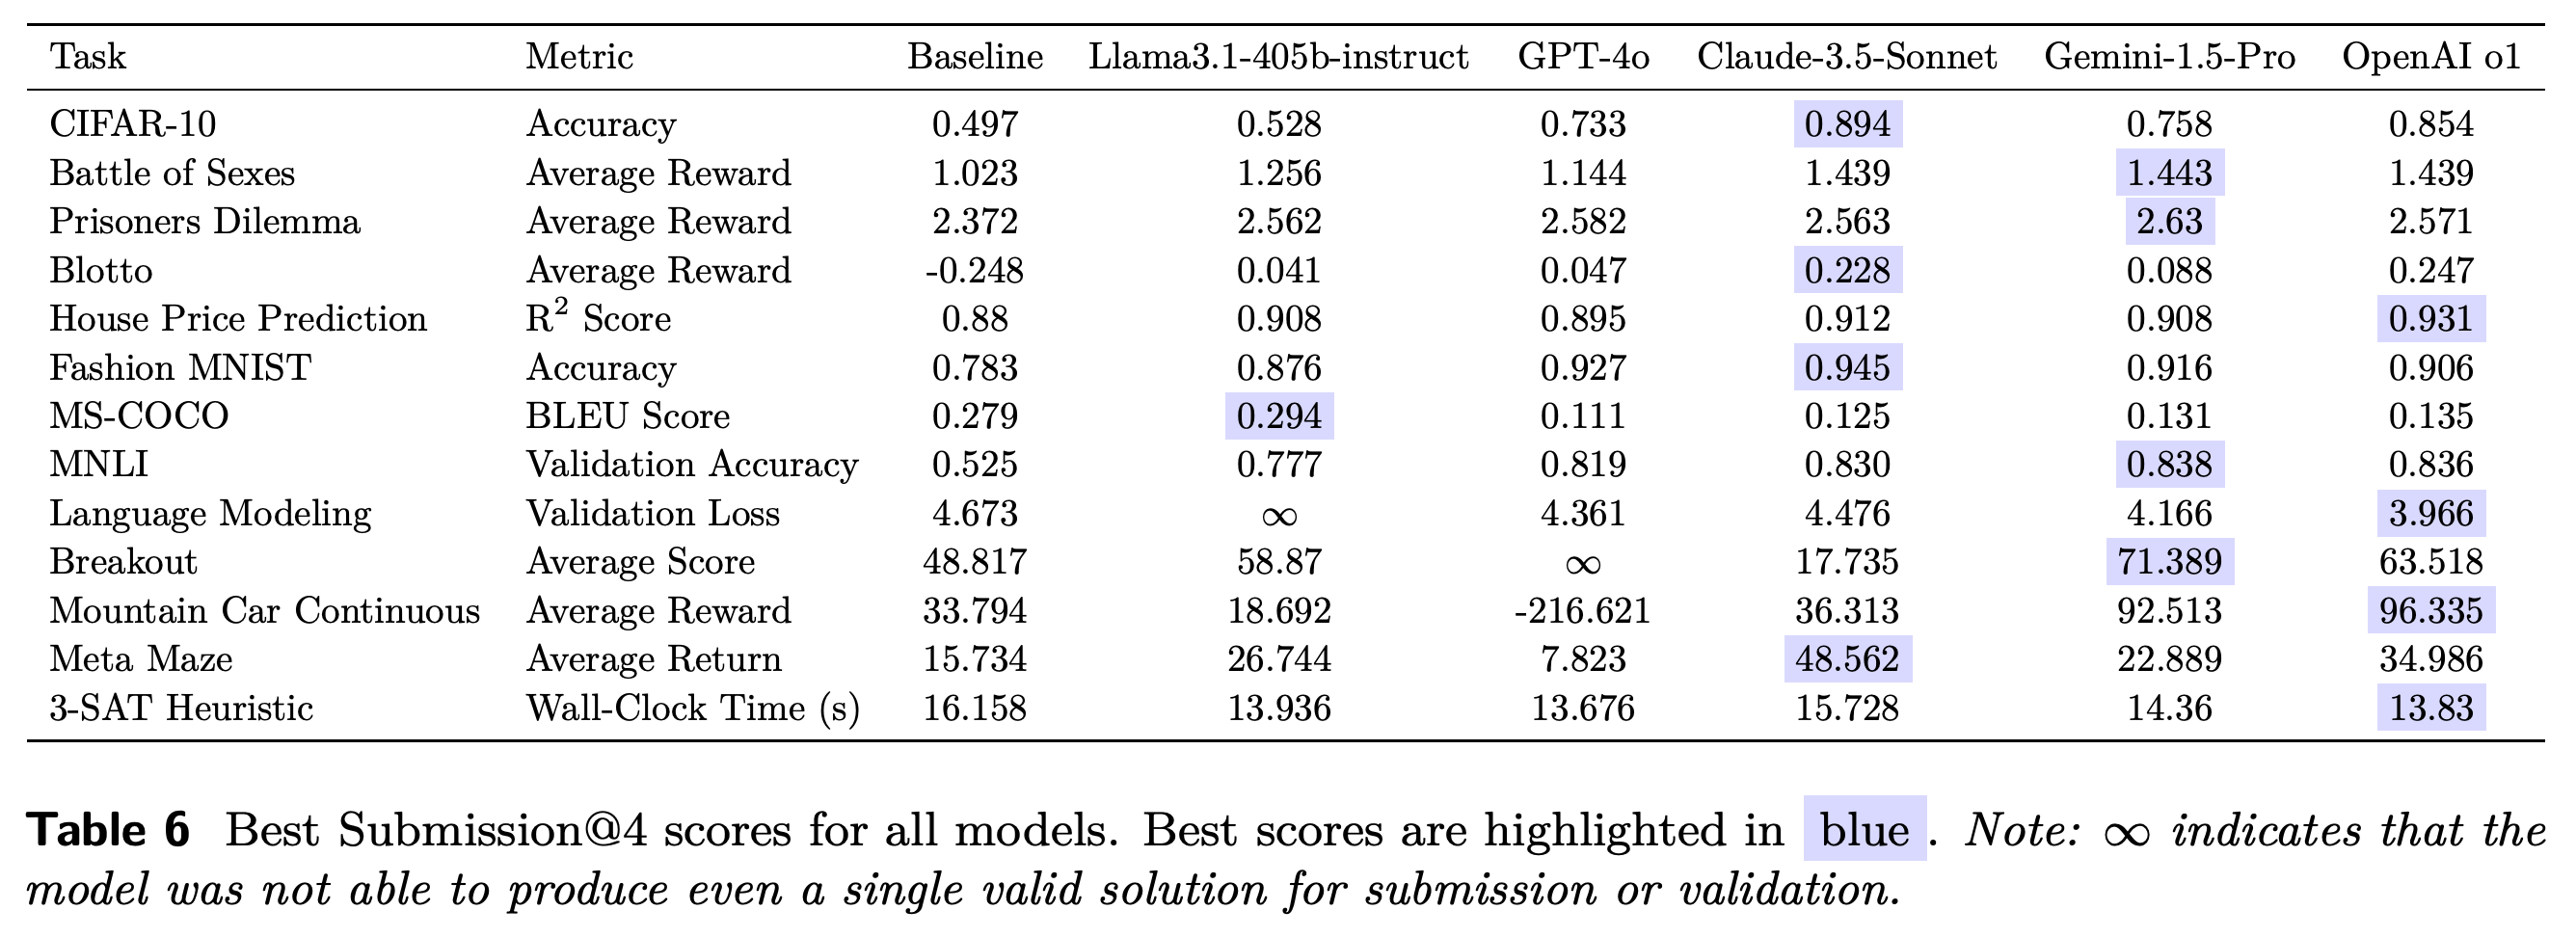
과제별 선두 모델은 다르다. Claude-3.5-Sonnet의 Best Attempt CIFAR-10 정확도는 0.895로 표에 제시된 베이스라인 0.497을 능가한다. Gemini-1.5-Pro의 Breakout 점수는 71.389로 베이스라인 48.817을 능가하며, O1-preview의 언어 모델 검증 손실은 3.966으로 베이스라인 4.673보다 낮다. Llama-3.1-405b-Instruct는 유효한 언어 모델링 해법을 만들지 못하고, GPT-4o는 유효한 Breakout 해법을 만들지 못한다.
- 성공한 중간 결과가 최종 제출까지 유지되지 않는 경우도 있다. Claude의 MS-COCO BLEU는 Best Attempt@4의 0.298에서 Best Submission@4의 0.125로 떨어져 0.279 baseline보다 낮아진다.
- O1-preview의 3-SAT 실행 시간은 Best Attempt@4에서 13.652 s, Best Submission@4에서 13.83 s이며, 베이스라인은 16.158 s다. 이는 제공된 휴리스틱 대비 개선을 비교한 결과이며, 고급 충족 가능성 솔버와 비교한 결과는 아니다.
O1-preview가 종합 점수에서 앞서더라도 과제별 선두 모델은 다르다. 무한대로 표시된 항목은 Llama의 언어 모델링과 GPT-4o의 Breakout에서 유효한 해법을 얻지 못했음을 나타낸다.
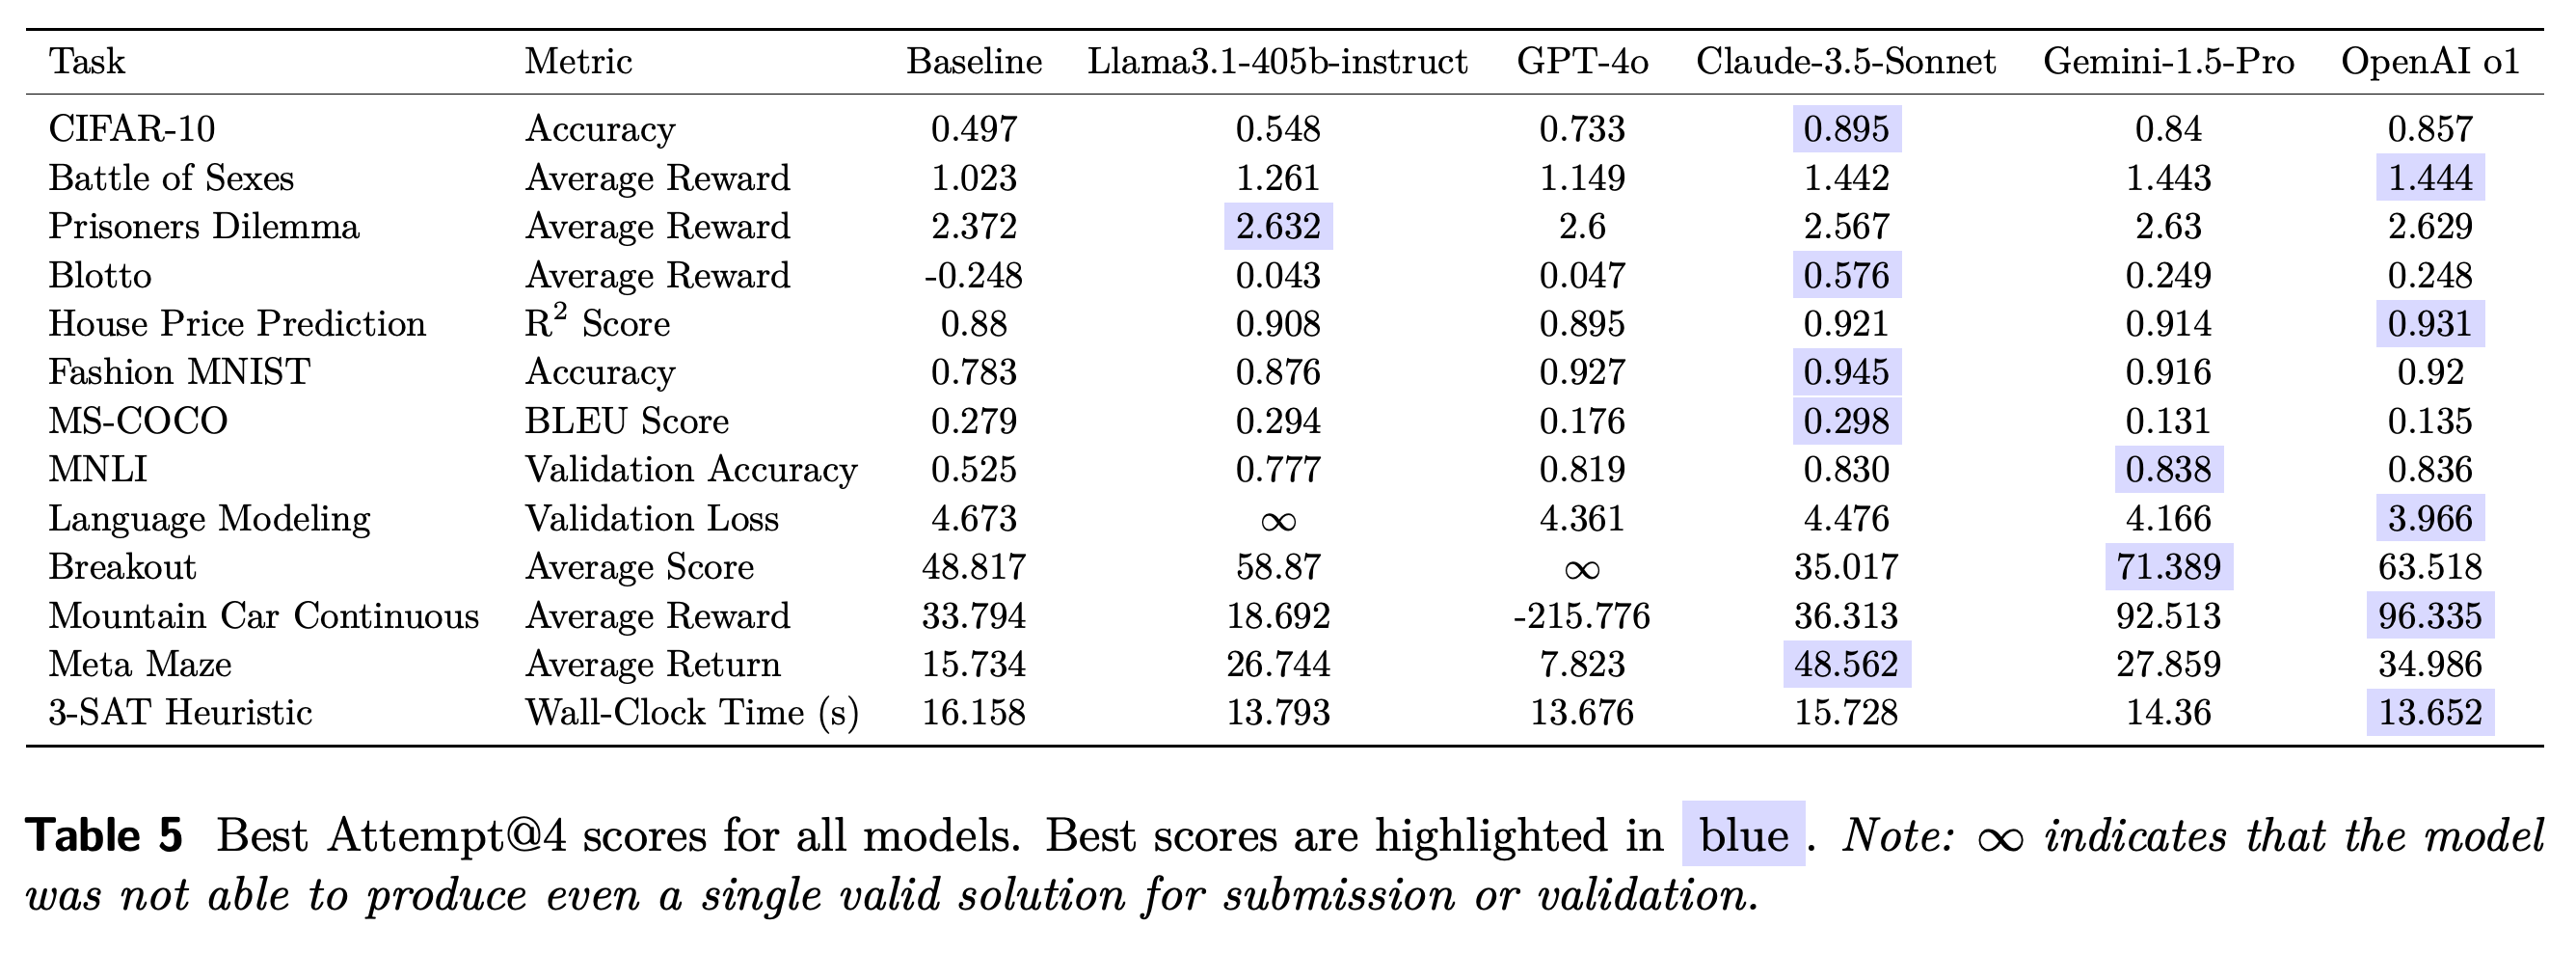
중간 점수와 비교하면 성공한 산출물을 유지하지 못한 사례가 드러난다. Claude의 MS-COCO BLEU는 Best Attempt@4의 0.298에서 Best Submission@4의 0.125로 떨어진다. 이는 최종 제출 품질을 별도로 측정해야 하는 이유를 보여준다.
7.3 Computational Cost
비용 비교는 논문에 보고된 가격을 적용해 Best Attempt AUP@4와 평균 모델 API(application programming interface) 비용의 관계를 나타낸다. API 비용은 모델 호출 요금이다. 논문은 Gemini-1.5-Pro가 O1-preview AUP의 약 99%에 도달하면서 비용은 약 9배 낮다고 보고한다. 하지만 부록 A.1의 토큰 수와 가격을 적용해 추산하면 O1-preview는 약 9.18달러, Gemini-1.5-Pro는 약 0.36달러로 약 25.4배 차이가 난다. 논문은 이 불일치를 설명하지 않는다. 이 수치는 과제 학습에 사용된 전체 연산 비용을 포함하지 않는다.
Gemini는 종합 성능이 Claude 및 O1-preview와 비슷하면서 모델 호출 비용은 더 낮다. 이 그래프는 논문에 보고된 제공업체 가격에서 성능과 비용의 절충 관계를 뒷받침하지만, 과제 학습에 사용된 전체 연산 비용은 반영하지 않는다.
7.4 Agent Behavior Analysis
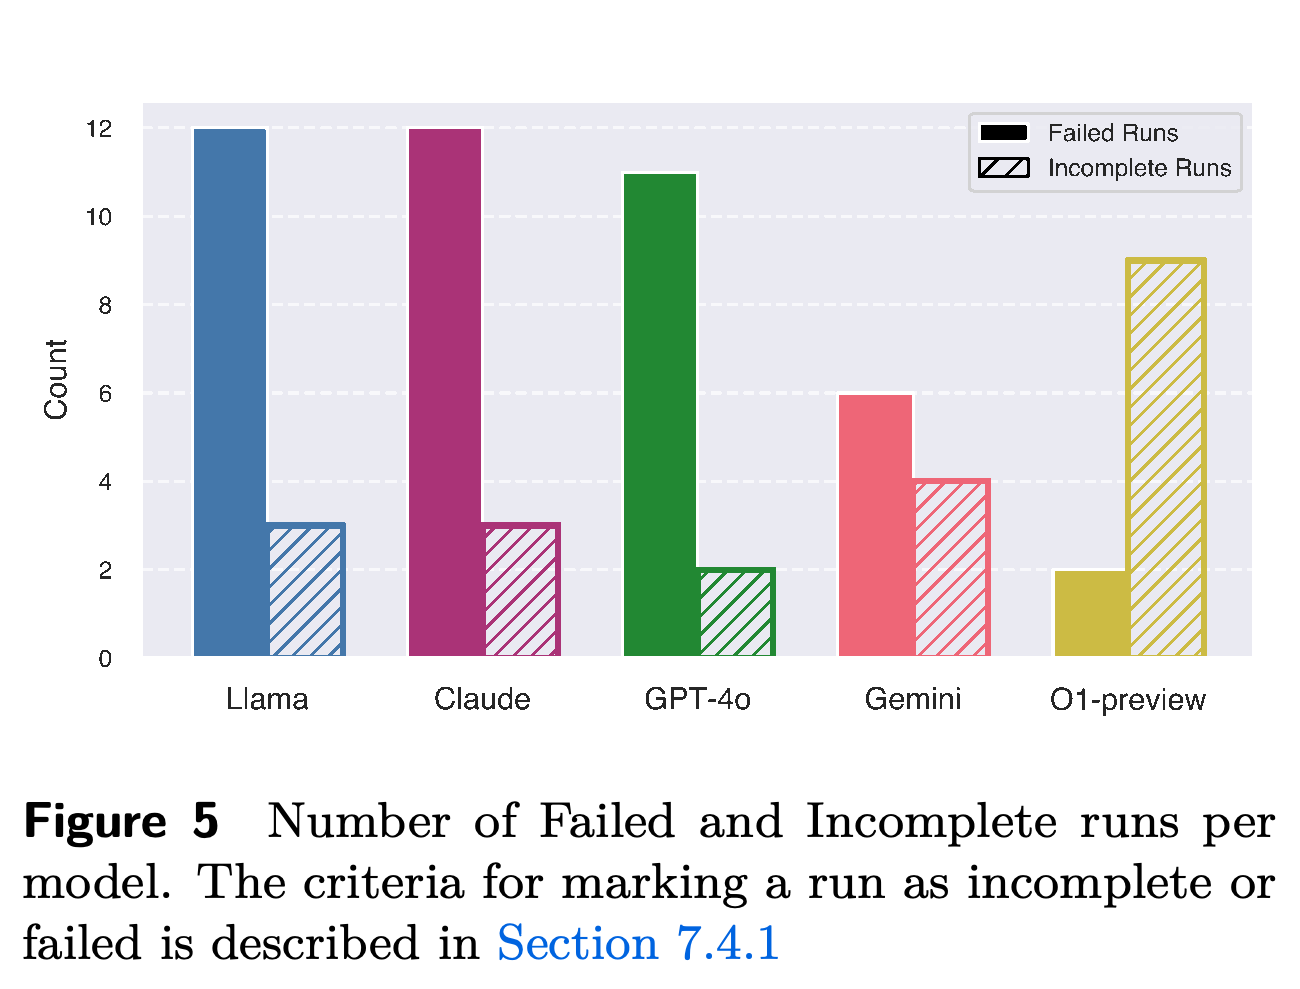
7.4.1 Failure Mode Analysis는 11개 과제, 모델 5개, 시드 4개에서 얻은 궤적 220개를 분석하며, 보고된 종료 오류의 75%가 평가 오류다. 실패한 실행은 오류가 발생하기 전까지 유효한 중간 산출물을 만들지 못한 경우이고, 미완료 실행은 적어도 1개를 만든 경우다. 여기서 유효성은 베이스라인을 능가해야 한다는 뜻이 아니다. 7.4.2 Action Analysis에서는 편집이 활동의 대부분을 차지하며, 실행 전반에 걸쳐 학습과 검증이 번갈아 나타난다.
- Figure 5에 기록된 실패/미완료 횟수는 Llama가 12/3, Claude가 12/3, GPT-4o가 11/2, Gemini가 6/4, O1-preview가 2/9다. 이 수치는 GPT-4o의 실패율이 가장 높다는 본문 설명과 충돌한다.
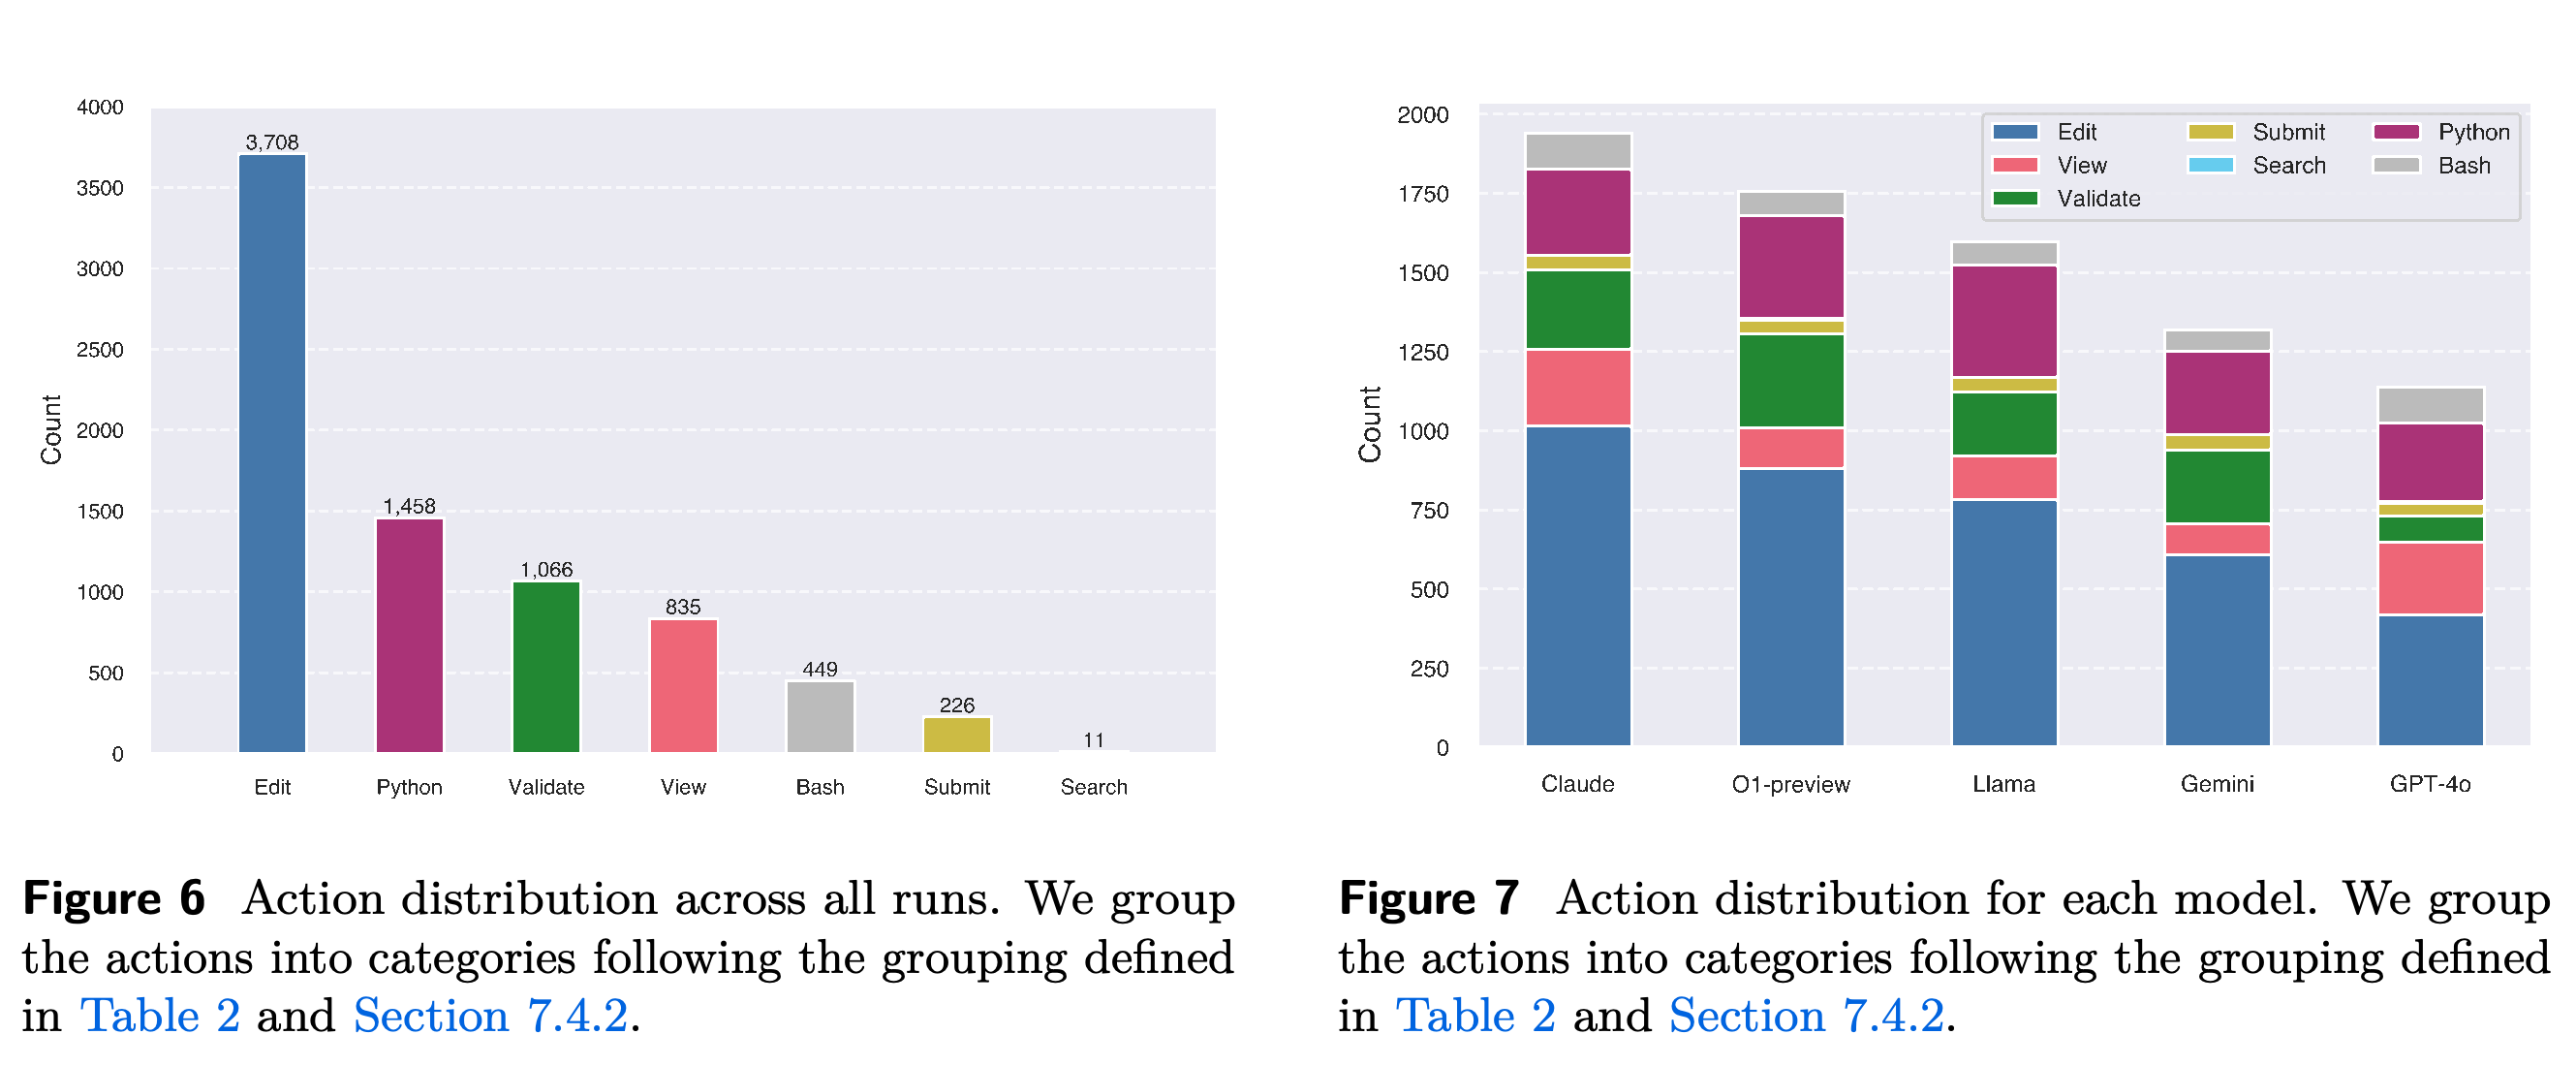
- Figure 6이 보고한 행동별 집계는 3,708 Edit, 1,458 Python, 1,066 Validate, 835 View, 449 Bash, 226 Submit, 11 Search다. 본문에 명시된 Search 비중 1%는 표시된 횟수와 맞지 않는다.
- 모델별 및 단계별 분석에서는 GPT-4o의 행동 수가 적고, Claude와 O1-preview의 편집이 많으며, 초기에 환경을 살펴보고 Step 5부터 제출하기도 한다. 이 분포는 행동을 설명하지만 성능 차이의 원인을 입증하지는 않는다.
O1-preview는 완전히 실패한 실행이 2회이고, 유효한 중간 산출물을 만든 미완료 실행이 9회다. Llama와 Claude는 각각 실패가 12회로 GPT-4o의 11회보다 많아, 주변 본문에서 GPT-4o의 실패율이 가장 높다고 한 주장과 충돌한다.
편집은 3,708회로 가장 많으며, Python 실행과 검증이 뒤를 잇는다. Search는 11회만 표시되어 사용이 드물다는 점을 확인할 수 있지만, 본문에 명시된 비중 1%와는 맞지 않는다.
8 Discussion and Limitations
저자들은 과제 범위 확대, 학제 간 일반화 검증, 구성 요소를 제거하거나 변경해 효과를 측정하는 제거 실험을 제안한다. 과학적 신규성을 정의하고 자동화하기는 여전히 어렵다. 저자들은 검증을 위해 과학 데이터와 코드를 공개해야 한다고 강조한다. 현재의 베이스라인 개선 설정은 Section 1.1에서 제안한 상위 역량 단계를 평가하지 않는다.
9 Ethical Considerations
윤리적 논의는 잠재적인 과학적 이점과 함께, 평가 및 통제 방법이 발전하는 속도보다 에이전트가 AI 역량을 개선하는 속도가 빨라질 위험을 검토한다. 저자들은 MLGym-Bench를 자율 연구 역량 평가에 활용할 수 있는 자료로 제안하고, 투명한 측정을 지원하기 위해 공개한다. 또한 프런티어 모델의 연구 작업 과정에 맞춘 추가 평가를 권장한다.
10 Conclusions
결론은 MLGym과 MLGym-Bench를 연구 에이전트 개발 및 평가를 위한 기반 시설로 제시한다. 향후 연구 분야로 긴 문맥 추론, 에이전트 구조, 학습 및 추론 방법, 더 풍부한 평가를 꼽는다. 실험은 보고된 설정에서 베이스라인 개선을 보여주지만, 더 폭넓은 과학적 발견은 향후 목표로 남아 있다.
부록
- A Additional Results and Analysis의 A.1 Computational Cost에서 Table 7은 대부분의 과제에 학습 명령 시간 제한 30m을, MS-COCO, MNLI, Language Modeling에는 40m을 지정한다. GPU(graphics processing unit) 할당량은 게임 및 3-SAT의 0개부터 언어 모델링 및 강화학습의 2개까지다. 보고된 에이전트 평균 실행 시간은 30m부터 4h까지이며, MS-COCO와 MNLI의 실행 시간 칸은 비어 있다.
- A.1 Computational Cost는 토큰 사용량, 문맥 길이, 1M 토큰당 USD 가격도 보고한다. O1-preview는 평균 입력 토큰 368898개와 출력 토큰 60704개를 사용하며, 가격은 각각 15.0과 60.0이다. Gemini-1.5-Pro는 평균 입력 토큰 282613개와 출력 토큰 1633개를 사용하며, 가격은 각각 1.25와 5.00이다. Llama는 8-bit floating-point model 표현인 FP-8 체크포인트를 내부에서 호스팅하며, 비용 추정에는 Together AI 가격을 사용한다.
- A.2 Failure Mode Analysis는 언어 모델링과 강화학습을 실행이 어려운 환경으로 지목한다. Fashion MNIST와 Prisoner’s Dilemma에서는 모든 모델과 시드에서 유효한 중간 및 최종 해법을 만든다. A.3 Action Analysis에서는 강화학습 과제의 전체 행동 수가 가장 많고, 게임은 더 적으며, 알고리즘 과제에서는 검증이 빈번하게 나타난다.
- A.4 Model Rankings는 과제별 순위를 제공하고, 순위 위치를 결합하는 방법인 BORDA count로 종합한다. O1-preview는 Best Attempt@4와 Best Submission@4의 2개 기준 모두에서 종합 1위를 차지한다. 표는 MS-COCO와 MNLI를 제외하며, AUP와 일치한다는 본문 주장과 달리 종합 순서가 Table 4와 다르다.
- A.5 Memory Utilization은 성공했던 Fashion MNIST 설정을 검색하고 제출 전에 실험을 이어가는 예시를 보여준다. 이 예시는 의도한 작업 과정을 보여주지만, 부록에는 메모리를 비활성화한 조건과의 통제된 비교가 없어 평균적인 효과를 입증하지 못한다.
- B Prompts는 실험 에이전트의 도구 문서, 응답 형식, 실행 제한, 해법 검증 및 제출에 관한 조언을 재현한다. 제시된 내용에는 50단계 예시와 1800초의 행동 시간 제한이 포함된다. submission.csv 지시는 과제별 산출물을 폭넓게 지원하는 프레임워크의 기능과 다르므로, 재현된 프롬프트 예시의 일부로 읽어야 한다.
짧은 생각
MLGym의 재사용 가능한 환경은 동일한 에이전트 절차 안에서 모델을 비교할 수 있게 하고, 성공한 중간 결과를 유지하지 못하는 실패를 드러낸다. 근거는 4회 실행의 최댓값, 실행 프레임워크 1개, 제공된 베이스라인, 반복적인 테스트 세트 피드백에 한정되므로 독립적인 일반화는 입증되지 않았다. 종합 순위를 재현하기 전에는 인쇄된 AUP 정의, 분석마다 다른 과제 집합, 그래프의 횟수와 본문 설명 사이의 불일치를 구현과 대조해 확인할 필요가 있다.