


MMFactory: A Universal Solution Search Engine for Vision-Language Tasks 요약 설명
24 Dec 2024 | Paper Review Multi-Agent Coordination Tool Use Program Synthesis목차
이번 글에서는 MMFactory: A Universal Solution Search Engine for Vision-Language Tasks 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 24일(Arxiv)
- Fan, Wan-Cyuan, Rahman, Tanzila, Sigal, Leonid.
- University of British Columbia, Vector Institute for AI, CIFAR AI Chair
- 논문 링크
- Project Page
요약
- MMFactory는 이미지와 텍스트를 처리하는 시각 언어 모델과 전문 시각 도구를 결합해 재사용 가능한 프로그램을 만들고, 사용자가 요구하는 정확도와 연산 제약에 따라 선택하는 문제를 다룬다. GPT-4o와 Visual Sketchpad가 사용하는 것과 동일한 시각 도구를 사용했을 때, 시각 지각 벤치마크 BLINK에서 jigsaw 점수는 75.3으로 Visual Sketchpad의 70.7보다 높고, function correspondence 점수는 55.4로 42.1보다 높다. Visual Sketchpad는 중간 시각 결과에 따라 도구 사용을 조정하는 시스템이다. 해당 과제는 각각 이미지 조각 맞추기와 기능에 따른 객체 대응을 평가하며, 다른 여러 과제에서는 MMFactory 점수가 더 낮다.
- Solution Router는 언어를 생성하고 언어로 추론하는 대규모 언어 모델(LLM)에 제안과 검토 역할을 맡긴다. 이러한 에이전트는 과제 설명과 정답이 있는 예시를 바탕으로 실행 가능한 Python 해법을 여러 개 만든다. Metric Router는 평가 지표를 선택하고 각 해법의 성능과 연산 비용을 추정해 사용자가 대안을 선택할 수 있도록 한다.
- 과제 전반에서 프로그램을 재사용하면 계획을 반복해서 세우는 작업이 줄어든다. 보고된 샘플당 평균 실행 시간은 9.74초로 Visual Sketchpad의 19.96초보다 짧다. 해법을 생성한 뒤 도구를 조율하는 온라인 라우팅 시간은 약 0초다. 해법 1개를 생성하는 데는 약 8분이 걸리며, 정확도 향상 폭은 벤치마크에 따라 다르다. 지각과 공간 이해를 다루는 이미지 질문 벤치마크 SeedBench에서는 GPT-4o 대비 평균 정확도가 75.6에서 75.8로 높아진다.
1. Introduction
서론은 시각 도구를 호출하는 프로그램을 만드는 visual programming과 도구를 통합한 멀티모달 시스템에서 3가지 한계를 짚는다. 하위 과제별 도구 선택의 폭이 좁고, 사용자 자원 제약을 충분히 고려하지 않으며, 개별 샘플에 맞춘 프로그램을 만든다는 점이다. MMFactory는 시각 모델, 언어 모델, 시각 언어 모델을 탐색해 성능과 비용을 측정한 프로그램 집합을 만든다.
- 사용자는 과제 설명, 소수의 입출력 예시 쌍, 선택적 제약을 제공한다. 생성된 각 프로그램은 고정된 실행 코드 경로를 통해 같은 과제의 후속 입력을 처리하도록 설계된다.
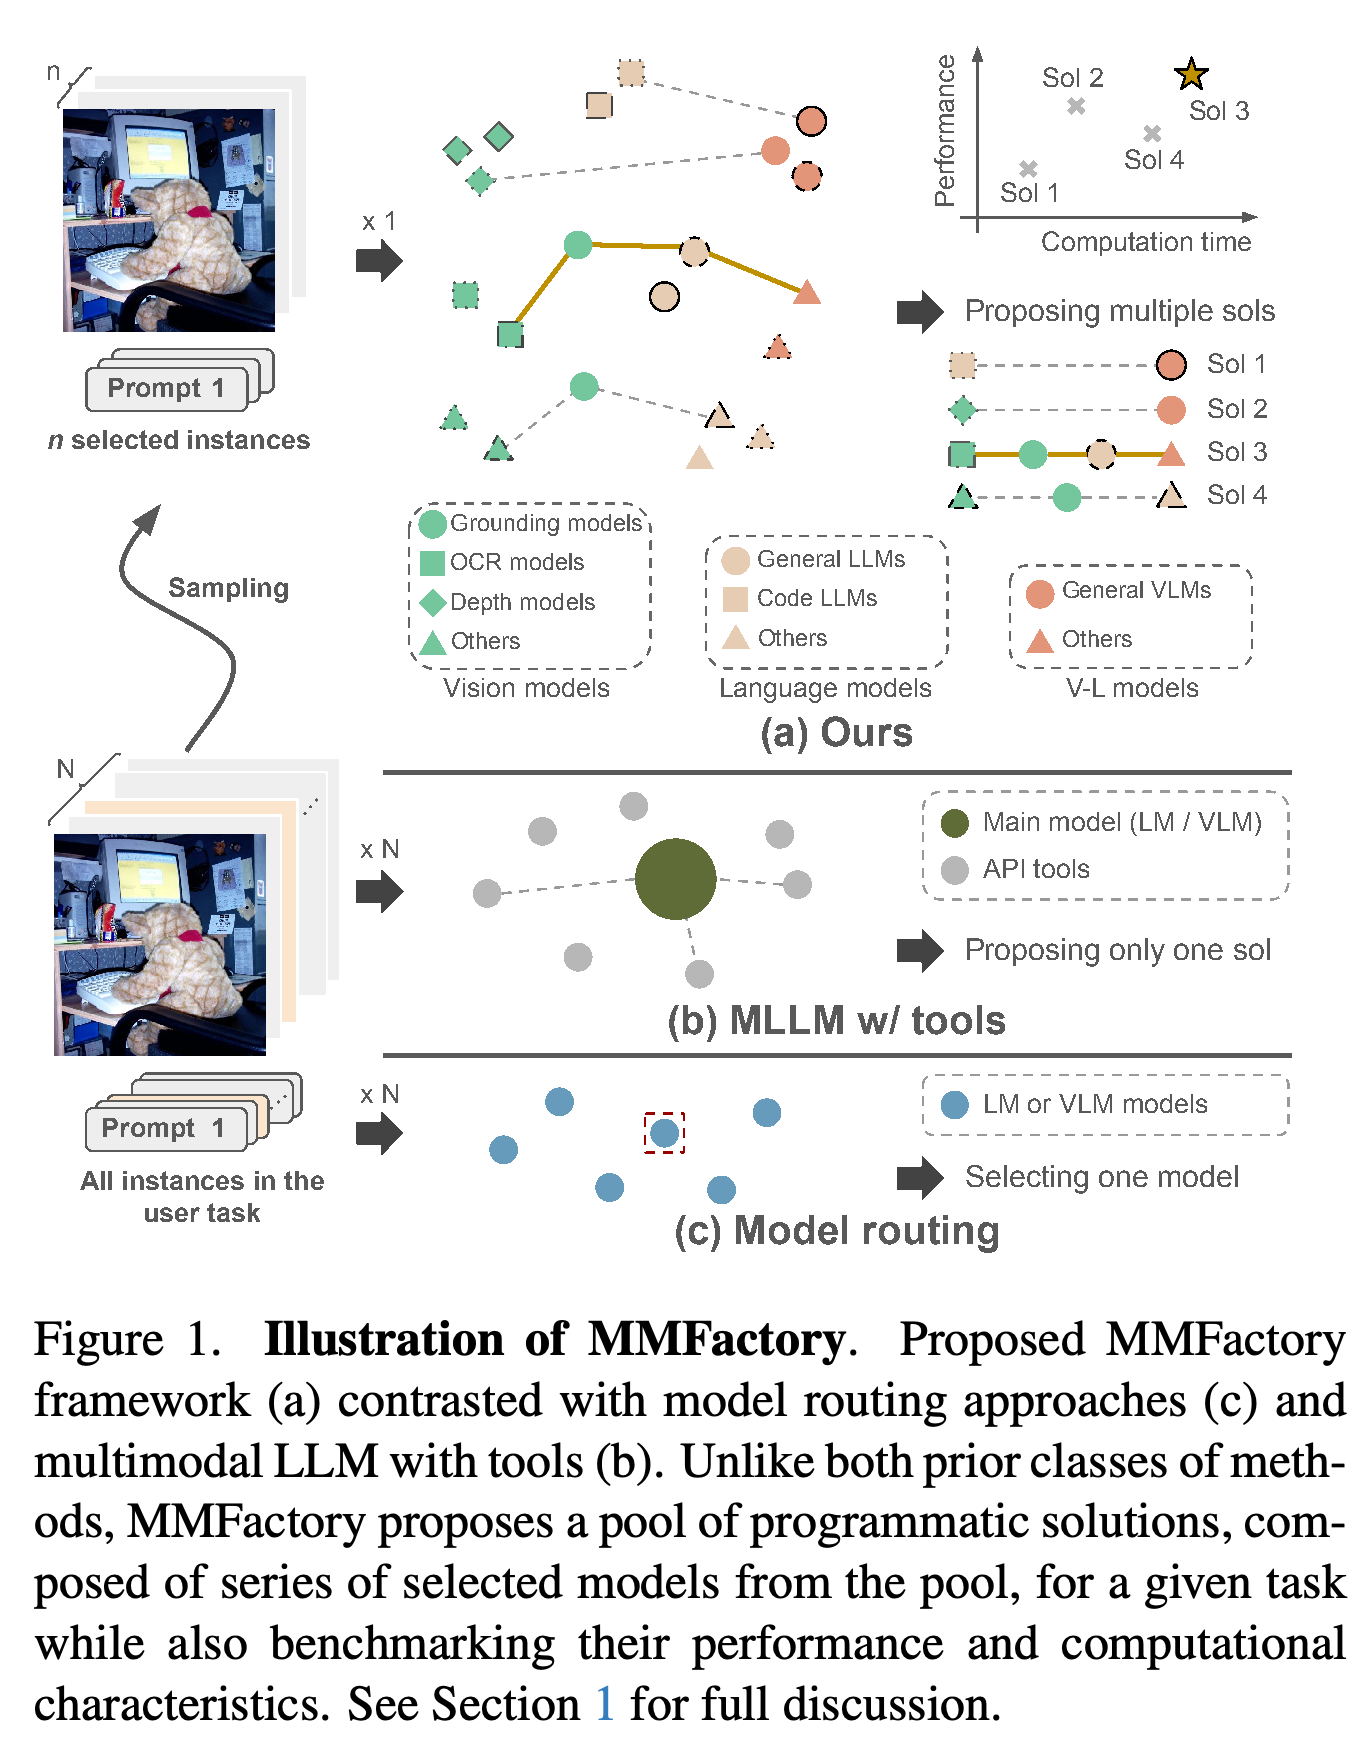
- Figure 1은 과제 단위 해법 탐색과 모델 1개를 선택하거나 입력마다 도구 사용 계획을 반복해서 세우는 방식을 구분한다.
도식은 무엇을 재사용하는지 명확히 보여준다. MMFactory는 과제 예시를 샘플링하고 모델을 조합한 여러 프로그램을 만든다. 비교 시스템은 입력마다 계획을 세우거나 모델 1개를 선택한다. 성능과 시간을 나타낸 그래프는 출력이 선택 가능한 해법 집합인 이유를 설명한다.
2. Related works
관련 연구에서는 텍스트와 이미지 같은 여러 모달리티의 정보를 처리하는 멀티모달 모델을 visual programming, 모델 라우팅, 다중 에이전트 프레임워크와 연결한다. 모델 라우팅은 성능과 비용의 균형을 맞추기 위해 모델을 선택한다. MMFactory는 모델을 조합해 여러 후보 프로그램을 제공한다.
- 논문은 입력별로 도구 호출을 따로 계획하는 시스템, 단일 모델을 선택하는 라우팅 방법과 제안 방식을 비교한다.
- 에이전트를 자동으로 만드는 프레임워크 AutoAgents와 비교하면, MMFactory는 시각 모델 조합, Python 실행, 성능과 비용 추정치를 함께 제공하는 복수의 해법을 강조한다.
3. Methodology
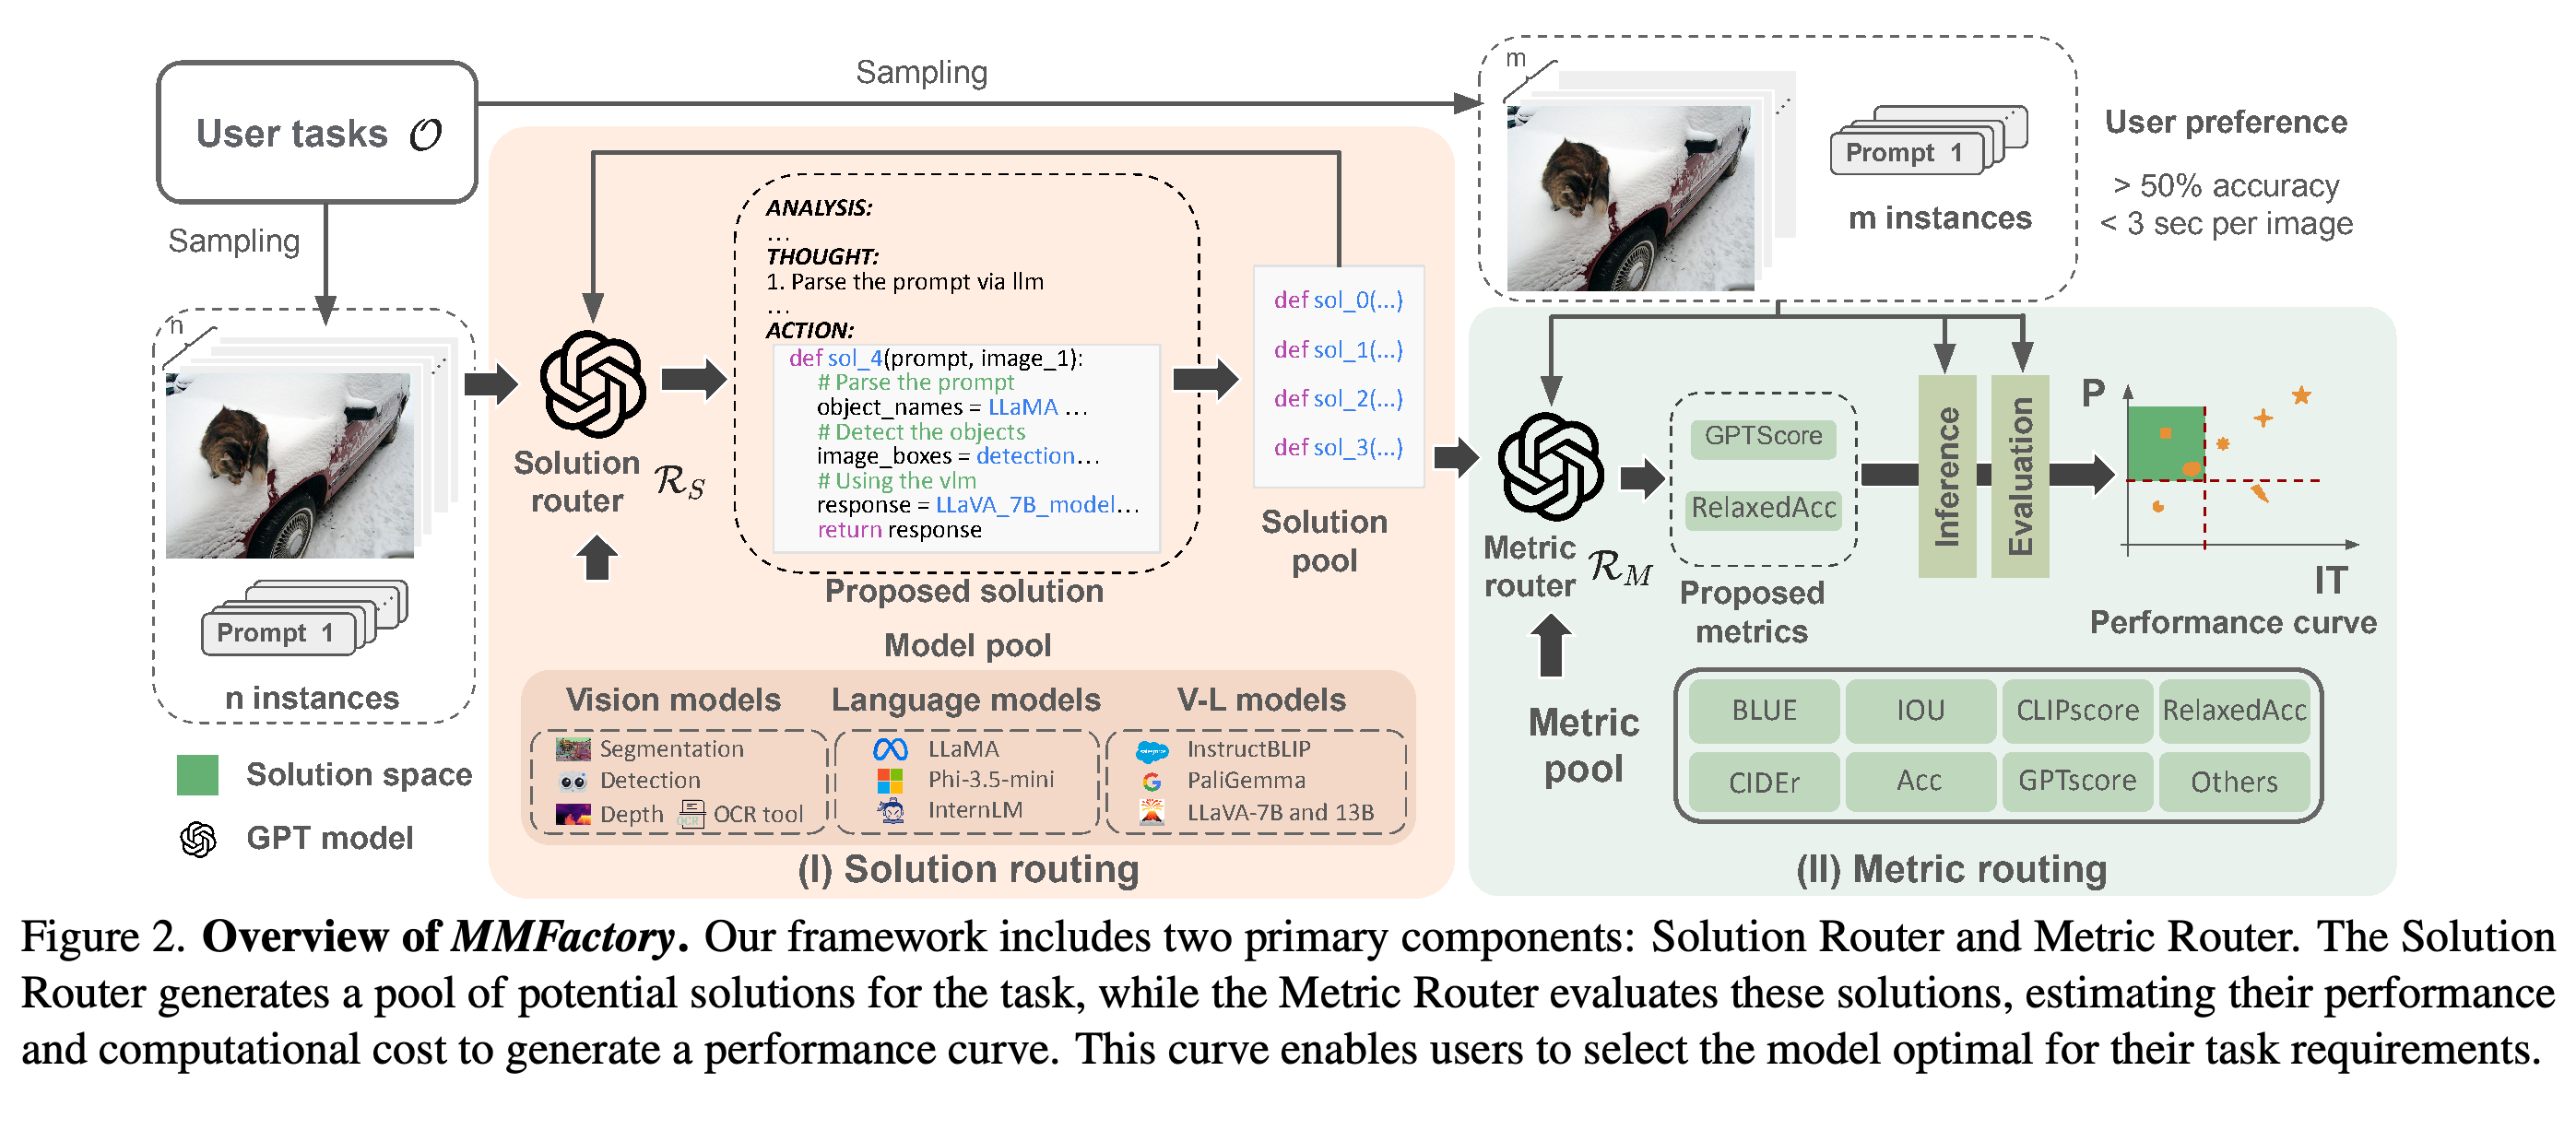
방법론은 프로그램 구성과 평가를 분리한다. Solution Router는 후보 풀을 만들고, Metric Router는 사용자 선호에 따라 선택할 수 있도록 후보 풀을 평가한다. Figure 2는 샘플링한 예시, 모델 정의, 지표 정의, 제약이 각 단계에 어떻게 입력되는지 보여준다.
3.1. Overview of MMFactory
입력 N개로 구성된 과제에서 정답이 있는 예시는 n개뿐이며, n은 N보다 훨씬 작다. Solution Router는 이 예시를 사용해 과제 전체를 처리할 프로그램을 생성한다. Metric Router는 샘플링한 입력 m개로 프로그램을 평가한다.
- 각 후보에는 성능과 연산 비용을 짝지은 측정값이 부여되며, 다른 측정값도 기록할 수 있다.
- 구현에는 에이전트 간 소통과 Python 실행을 지원하는 프레임워크 Autogen을 사용하며, 고성능 멀티모달 언어 모델을 라우터로 사용한다.
2단계 흐름은 후보 프로그램 생성과 성능 및 시간 평가를 분리한다. 사용자 선호에 따라 평가된 풀에서 해법을 선택하며, 이를 통해 모델 저장소가 배포할 해법의 선택으로 이어진다.
3.2. Inputs Structure for Solution Router
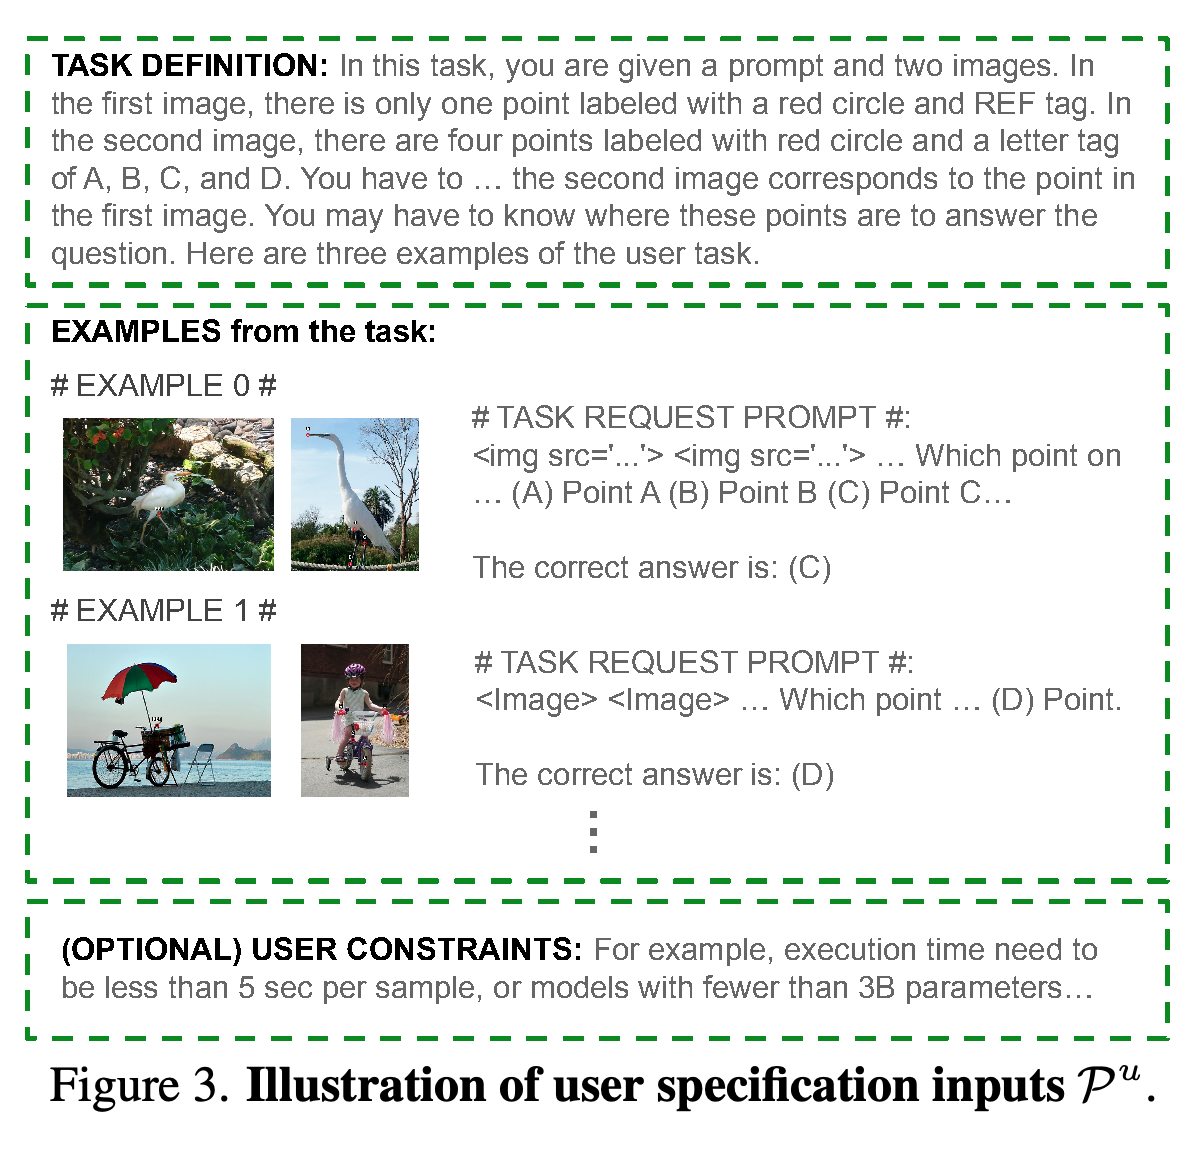
Solution Router는 기능, 인자, 반환값, 사용 예시를 기술한 모델 정의와 사전 정의된 요구사항, 출력 참고 예시 4개, 이전에 생성한 해법의 Python 코드를 입력받는다. 출력을 유도하기 위해 프롬프트에 포함하는 이러한 in-context example은 사용자의 대상 과제에서 샘플링한 예시와 별개다.
- 과제별 입력에는 과제 정의, 이미지를 포함한 정답 예시, 선택적 사용자 제약이 들어간다. 이전 해법이 없으면 해법 풀 필드에는 “EMPTY”가 들어간다.
- Figure 3은 샘플당 실행 시간 5초 미만이나 파라미터 수가 3B 미만인 모델 사용과 같은 제약을 예로 든다. 여기서 모델 규모의 기준은 3 billion parameters를 뜻한다. 이는 입력 예시이며, 벤치마크 전체에 적용한 실험 설정은 아니다.
예시는 과제 명세에 자연어 지시사항뿐 아니라 이미지와 정답도 포함됨을 보여준다. 선택적인 실행 시간 및 파라미터 수 제한은 제약이 프롬프트에 어떻게 들어가는지 설명한다. 다만 생성된 모든 프로그램이 제약을 충족한다는 점을 입증하지는 않는다.
3.3. Multi-agent solution router
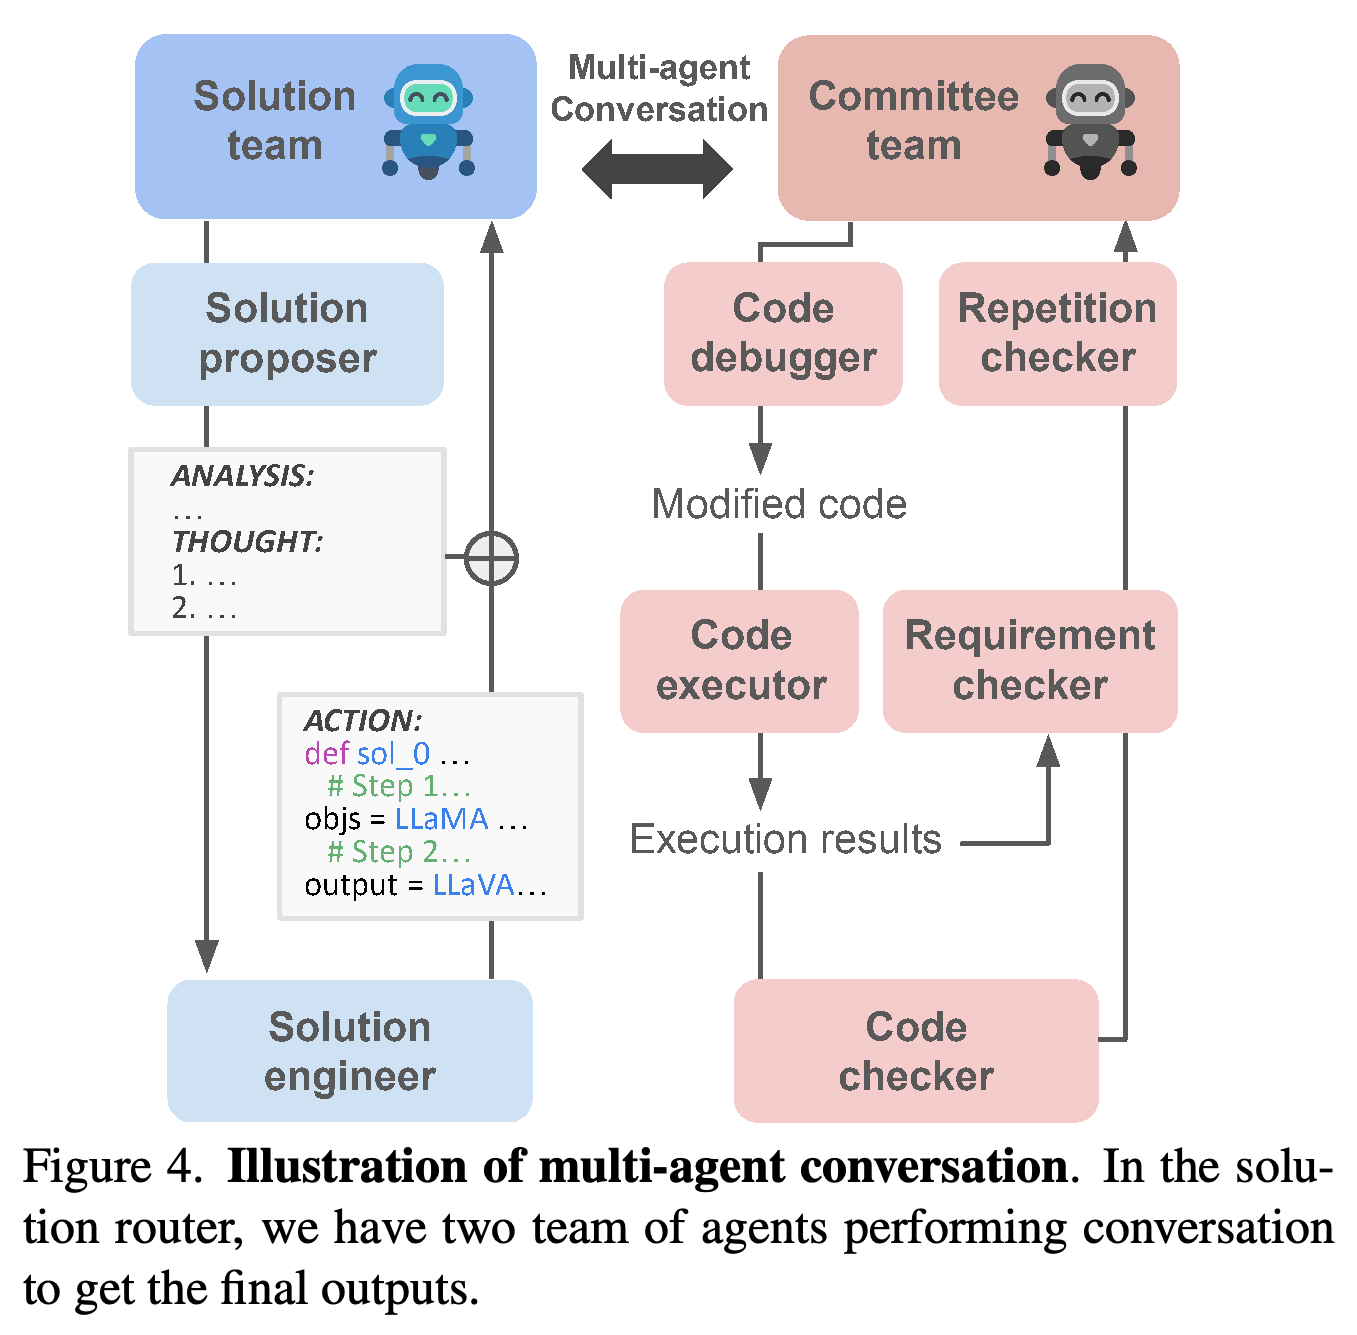
Solution proposer는 기존 프로그램과 피드백을 분석해 접근법을 제시하고, solution engineer는 이를 실행 가능한 Python으로 변환한다. 출력에서는 분석, 지시사항, 코드에 각각 ANALYSIS, THOUGHT, ACTION 식별자를 사용한다.
- 검토 위원회는 중간 결과를 얻기 위한 code debugger와 code executor, 제약 충족 여부를 평가하는 requirement checker, 실행 결과와 논리를 평가하는 code checker, 중복된 해법 논리를 감지하는 repetition checker를 사용한다.
- 팀 리더들은 위원회 구성원 전원이 수락하거나 반복 한도에 도달할 때까지 제안과 피드백을 주고받는다. 종료 시 repetition checker가 중복이 없다고 판단하면 최신 해법을 보존한다. 따라서 반복 한도에 도달했다고 해서 만장일치 수락이 보장되지는 않는다.
에이전트 간 연결은 실행 근거가 검토자에게 전달되는 방식을 설명한다. 코드를 수정하고 실행한 뒤 중간 결과와 최종 결과를 정확성 검토에 활용한다. Debugger와 code checker ablation은 이 메커니즘을 검토한다.
3.4. Metric Router
Metric Router는 GPT-4를 사용해 지표를 선택한다. 입력으로는 사용 사례, 인자, 출력, 예시를 기술한 지표 정의를 받는다. 과제 지시사항, 정답 예시, 후보 해법의 예측도 입력받으므로 과제와 답변 형식을 모두 반영해 지표를 선택할 수 있다.
- 사용자는 사용자 정의 지표를 제공해 자동 지표 선택을 건너뛸 수 있다.
- 지표를 선택한 뒤 시스템은 더 큰 샘플로 후보를 평가하고 연산 비용 대비 성능을 그래프로 표시한다. 제공된 PDF는 자동 지표 선택의 신뢰성을 별도로 정량화하지 않는다.
4. Experiments
실험에는 시각 지각 과제 14개와 객관식 질문 3,807개를 포함하는 BLINK, 과제 9개에 걸쳐 이미지-질문-답변 쌍 14k개를 포함하는 SeedBench를 사용한다. BLINK는 사람이 한눈에 풀 수 있는 지각 문제를 강조한다. SeedBench는 공간 이해, 작은 객체, 복잡하고 상세한 프롬프트를 포함한다.
- 이러한 단일 선택형 과제에서는 GPT가 자유 형식 예측을 주어진 선택지에 대응시키고, 문자열 일치로 정확도를 계산한다.
- 정량 비교에서는 멀티모달 모델을 해당 베이스라인과 동일하게 고정하고, Visual Sketchpad와 동일한 시각 모델을 사용한다.
4.1. Quantitative Analysis
Table 1은 일부 BLINK 과제에서 GPT-4o 단독 사용 대비 성능 향상을 보여준다. Jigsaw 정확도는 55.3에서 75.3으로, 이미지 간 점을 대응시키는 visual correspondence는 75.0에서 85.5로, function correspondence는 39.2에서 55.4로 높아진다. 모든 과제에서 개선되지는 않는다. Reflection은 38.8에서 35.1로 낮아지고, 시각 추론을 평가하는 IQ 범주는 30.0에서 28.7로 낮아진다.
- 7 billion parameters 규모의 시각 언어 모델 LLaVA-7B에서는 spatial 정확도가 61.5에서 78.8로 높아진다. 이에 대응하는 13-billion-parameter 모델인 LLaVA-13B에서는 jigsaw 정확도가 58.0에서 64.0으로 높아진다. 이는 서로 다른 기본 모델을 고정한 조건에서도 성능이 향상됨을 보여준다.
- GPT-4o와 Visual Sketchpad를 함께 사용한 경우와 비교하면, MMFactory는 jigsaw를 70.7에서 75.3으로, function correspondence를 42.1에서 55.4로 높인다. 그러나 depth, counting, localization, similarity 점수는 더 낮다. Table 1에는 기존에 보고된 Visual Sketchpad 결과와 공식 코드로 수집한 결과가 함께 들어 있다.
GPT-4o를 사용하는 MMFactory는 jigsaw와 function correspondence에서 Visual Sketchpad보다 점수가 높고, depth와 similarity에서는 Visual Sketchpad 점수가 더 높다. 주석은 기존에 보고된 결과와 공식 코드로 실행한 결과를 구분하며, 이는 비교를 해석할 때 고려해야 할 조건이다.
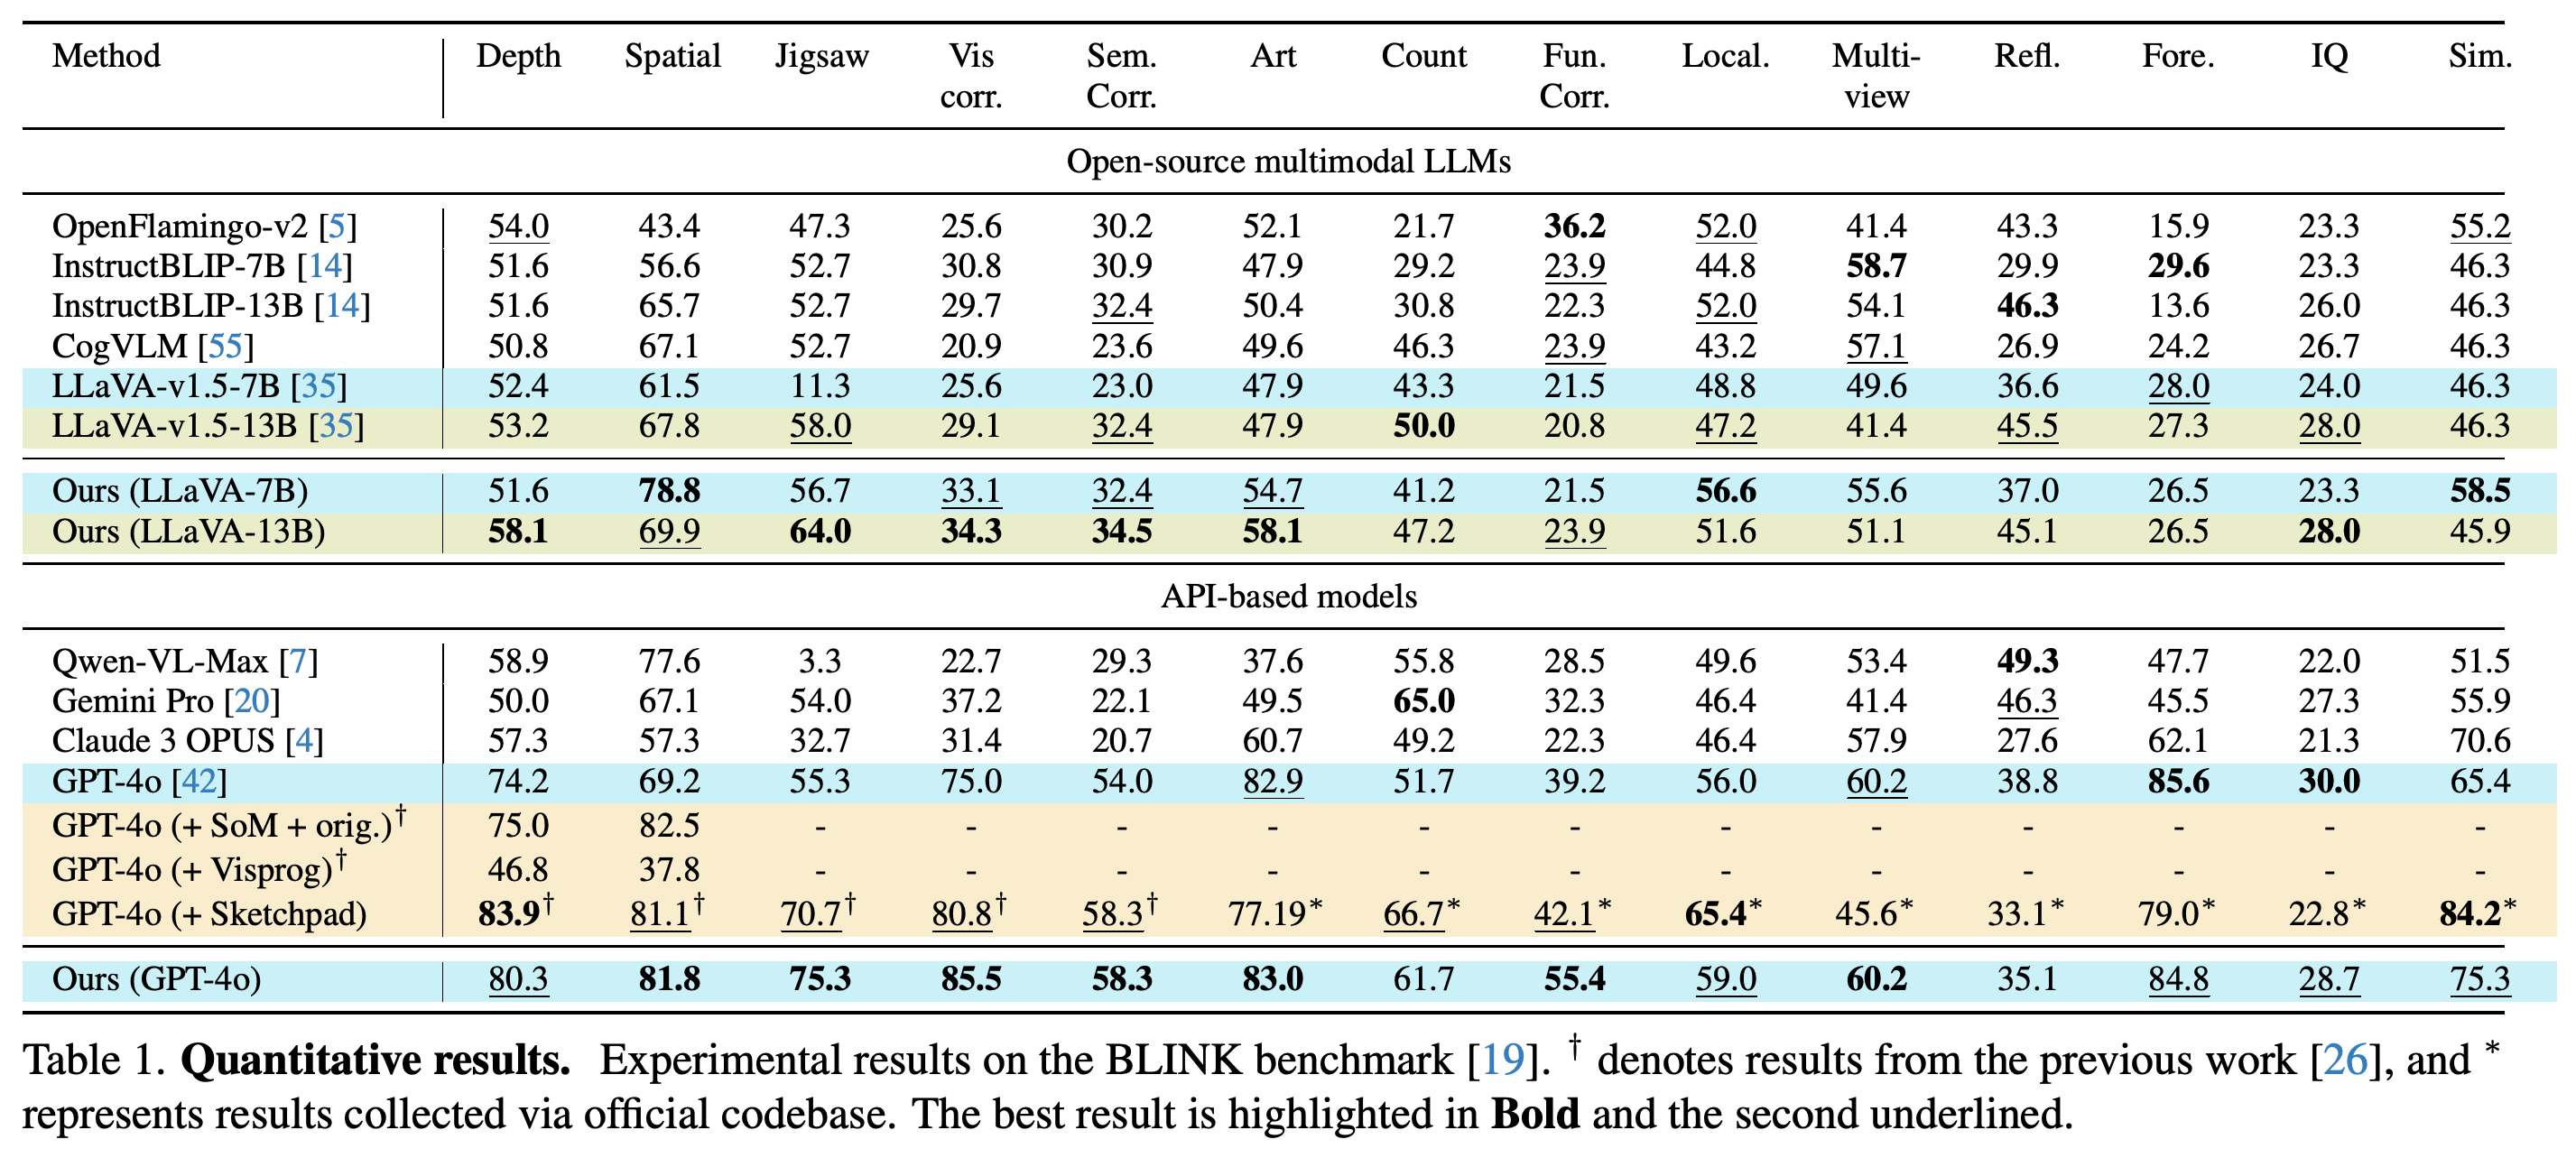
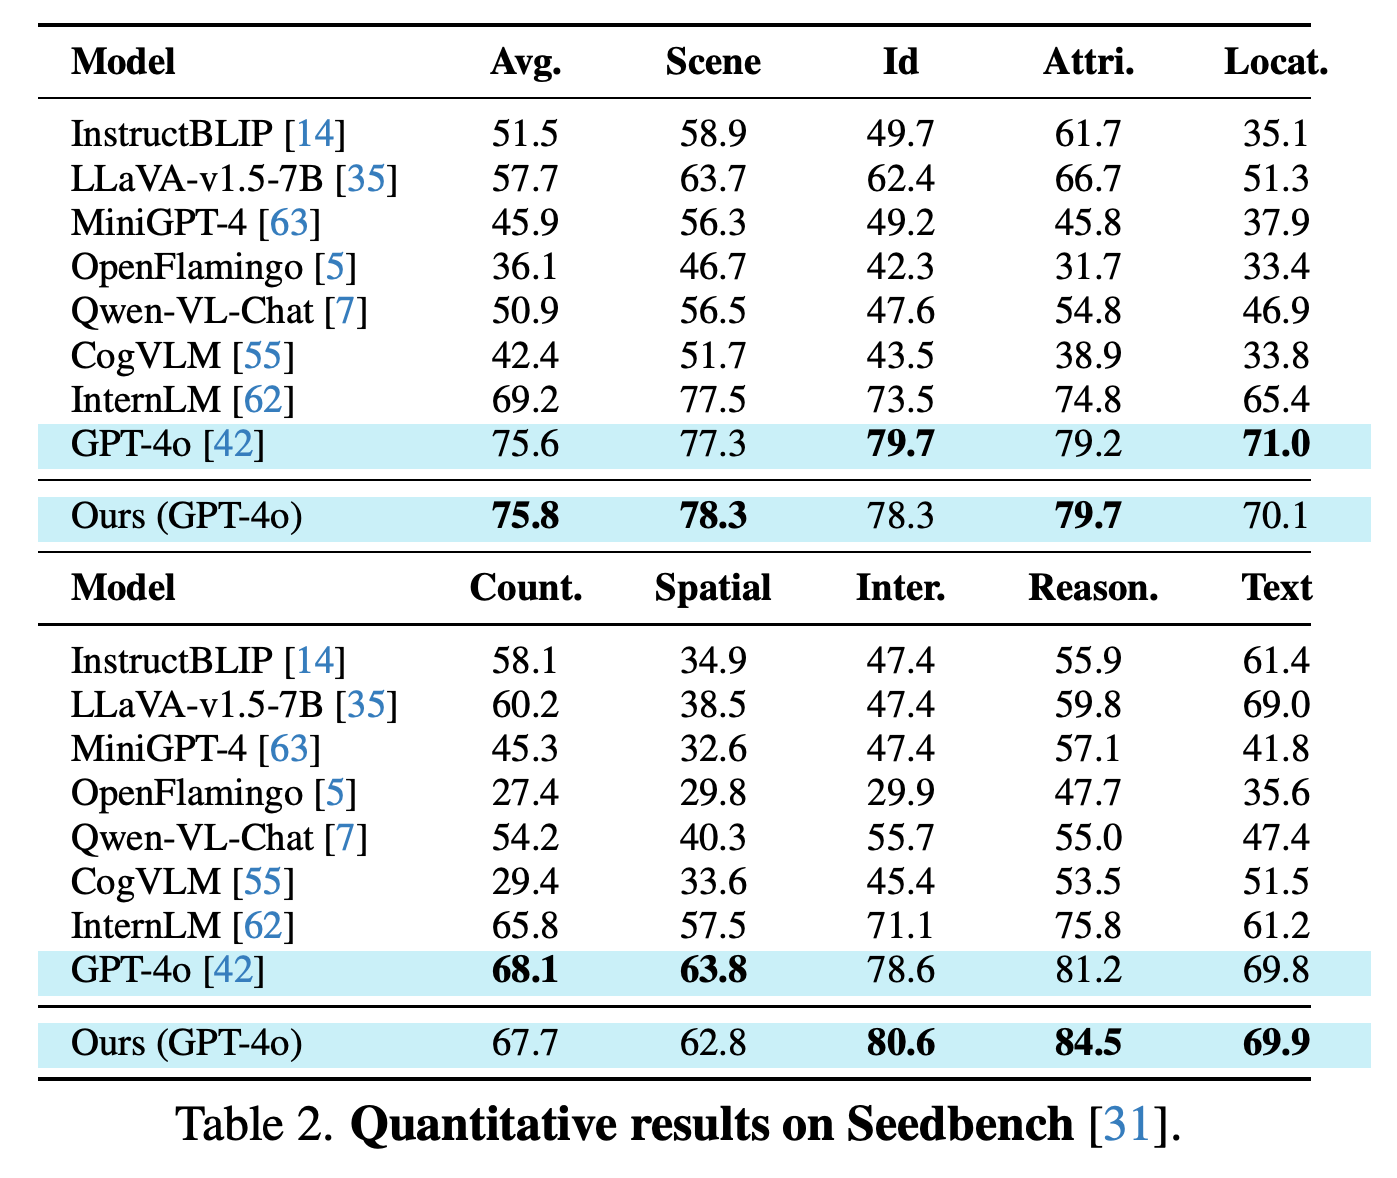
Table 2에서 SeedBench 평균 정확도는 GPT-4o의 75.6에서 MMFactory의 75.8로 소폭 높아진다. Interaction은 78.6에서 80.6으로, reasoning은 81.2에서 84.5로 높아지지만, instance identity, location, counting, spatial 점수는 낮아진다.
- 결과는 일부 범주에서 이점을 보여준다. 보고된 평균 차이에는 신뢰구간이나 유의성 검정이 제시되지 않는다.
Interaction과 reasoning은 향상되지만 다른 여러 범주에서는 성능이 낮아진다. 따라서 평균이 75.6에서 75.8로 높아진 폭은 개별 범주에서 나타난 최대 향상 폭보다 훨씬 작다.
4.2. Qualitative Analysis
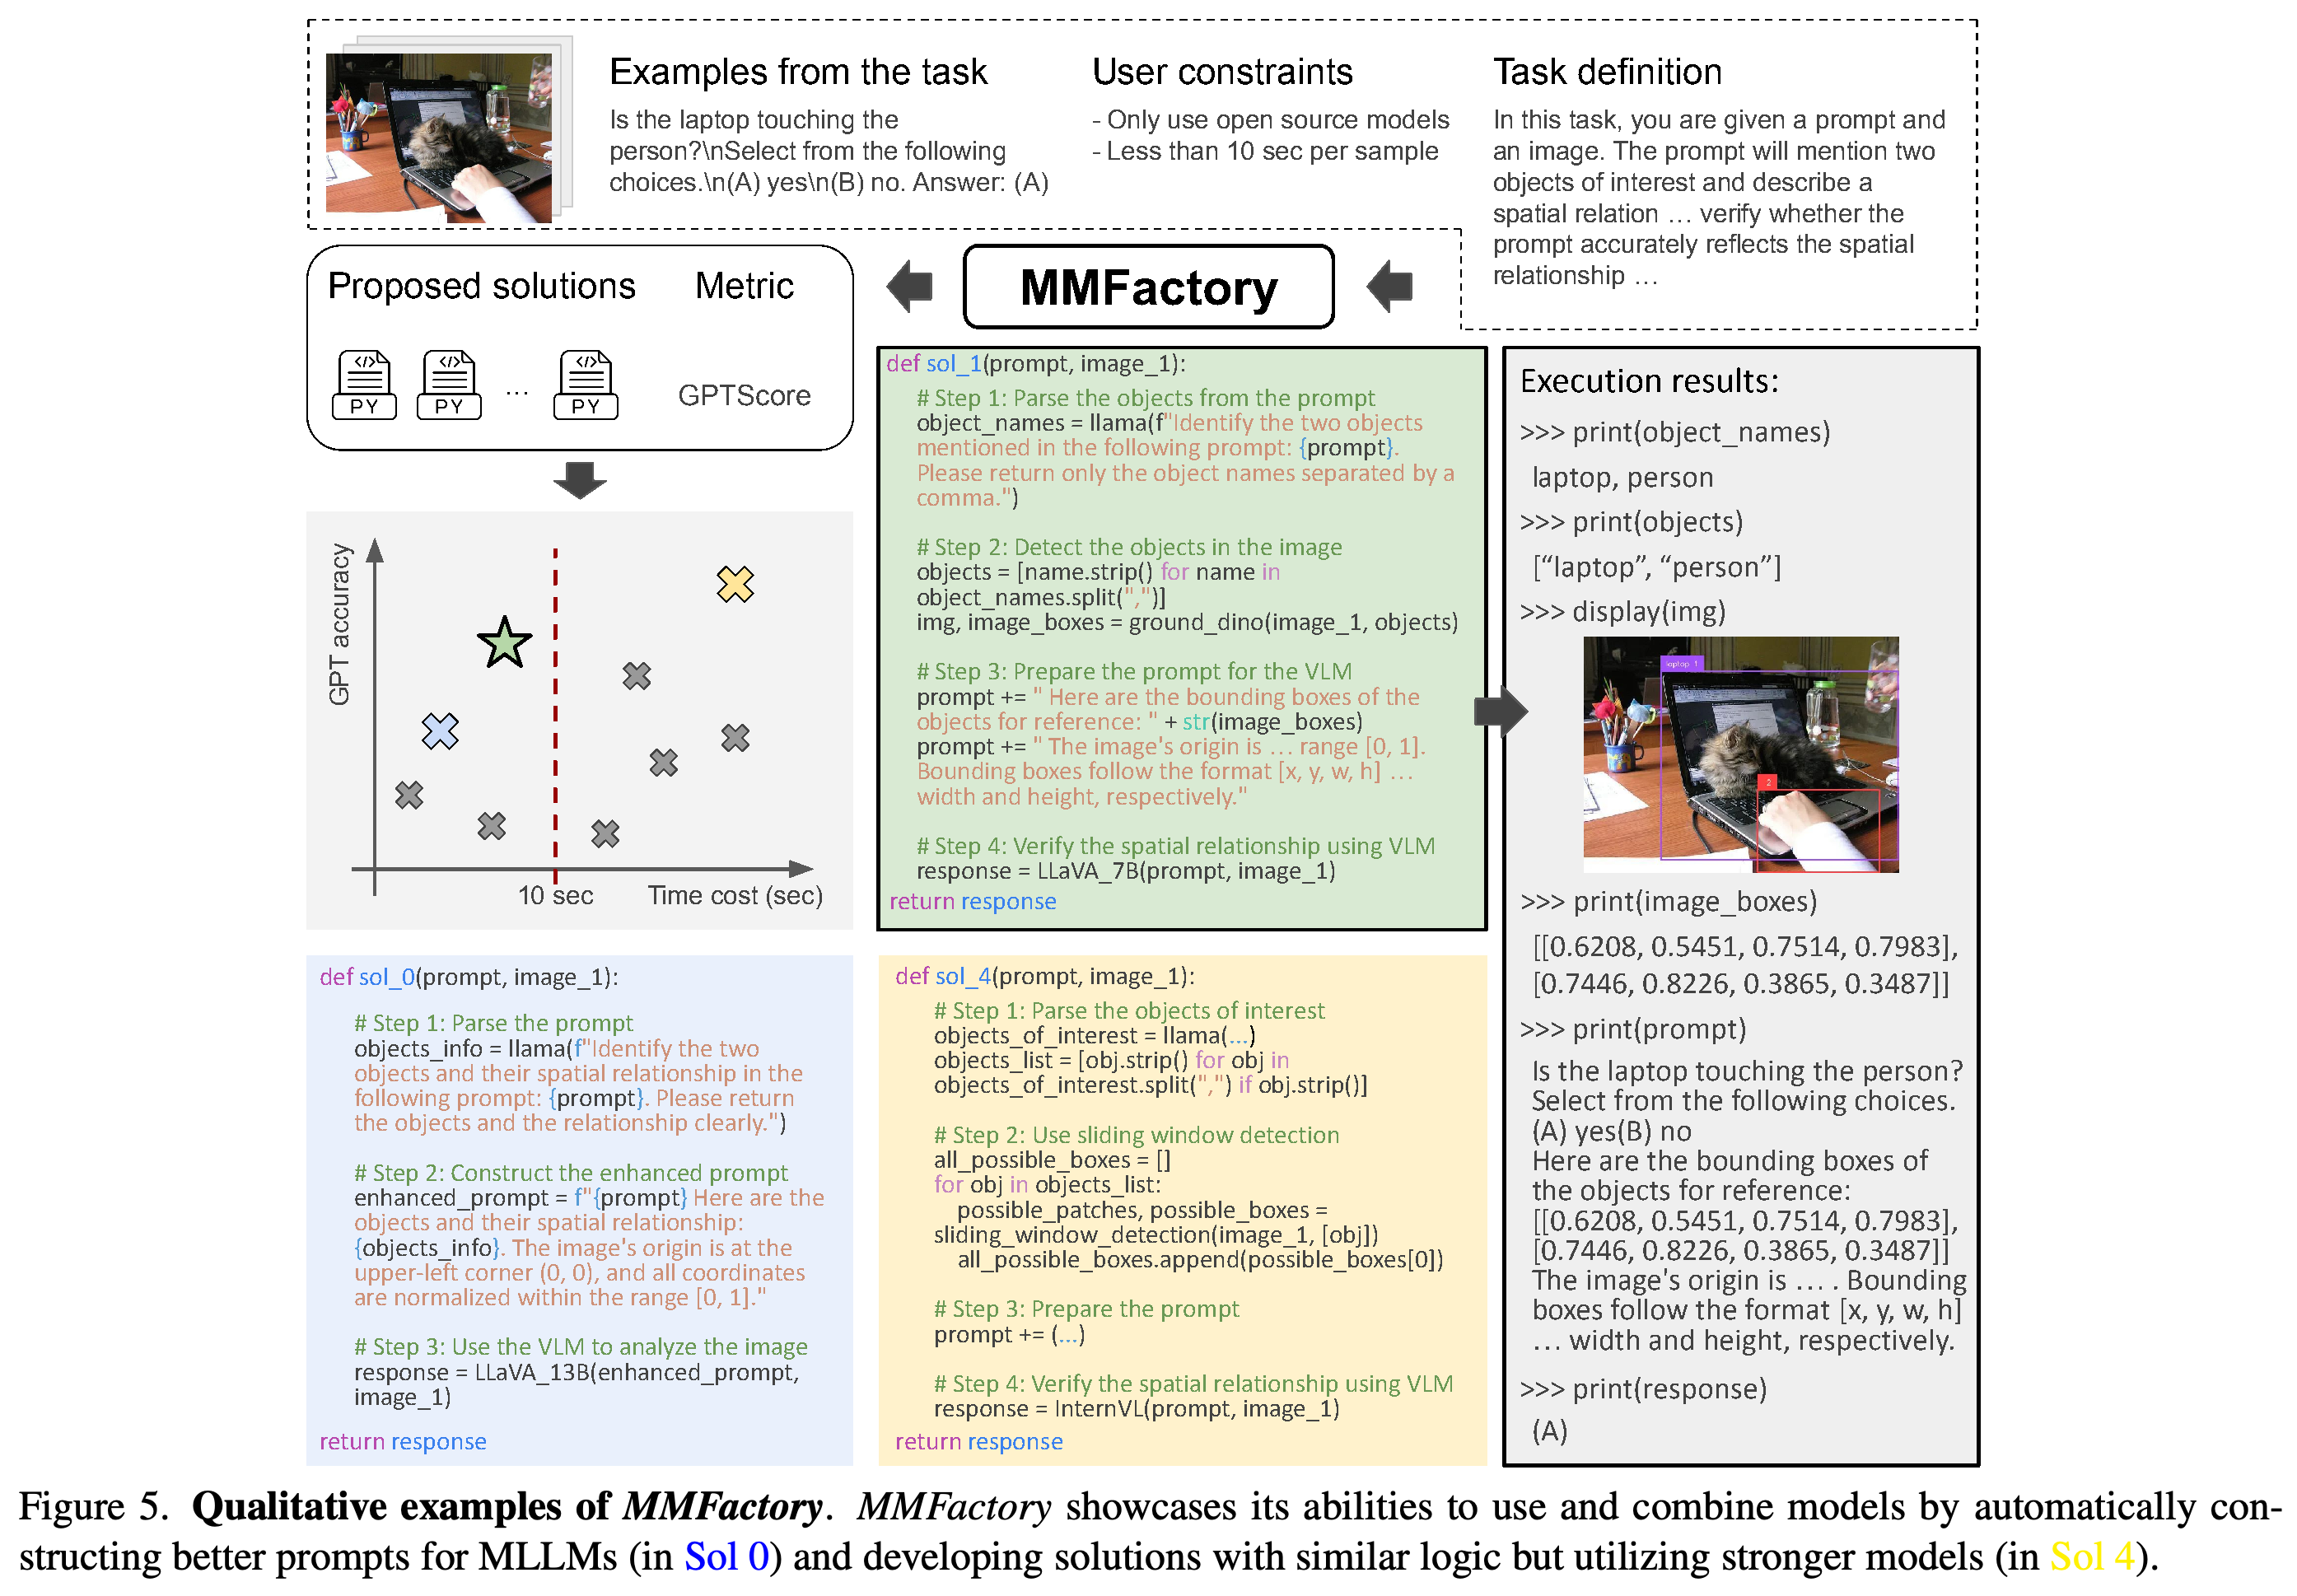
Figure 5는 오픈소스 모델만 사용하고 샘플당 실행 시간을 10초 미만으로 제한한 공간 관계 과제를 보여준다. 후보 프로그램은 프롬프트 보강부터 객체 탐지 후 시각 언어 추론까지 다양하다. 측정된 정확도와 시간에 따라 실행 시간 제약에 맞는 프로그램을 선택할 수 있다.
- 후보 1개는 객체 이름을 추출하고 객체 탐지 도구 Grounding DINO로 객체를 탐지한다. 이어서 객체 위치를 좌표로 나타내는 bounding box를 프롬프트에 추가한 뒤 LLaVA-7B에 질의한다.
- 중간 출력에는 추출한 이름, 탐지한 박스, 보강된 프롬프트, 최종 답변이 나타난다. 이 예시는 프로그램을 검토할 수 있음을 보여주지만, 제약 충족의 일반적인 성공률을 입증하지는 않는다.
공간 관계 예시는 생성된 코드, 중간 출력, 실행 시간 10초 제한에 따른 선택을 연결한다. 후보마다 프롬프트, 객체 탐지, 시각 언어 모델을 달리하며, 이를 통해 풀에 있는 프로그램의 차이를 보여준다.
4.3. Model Analysis
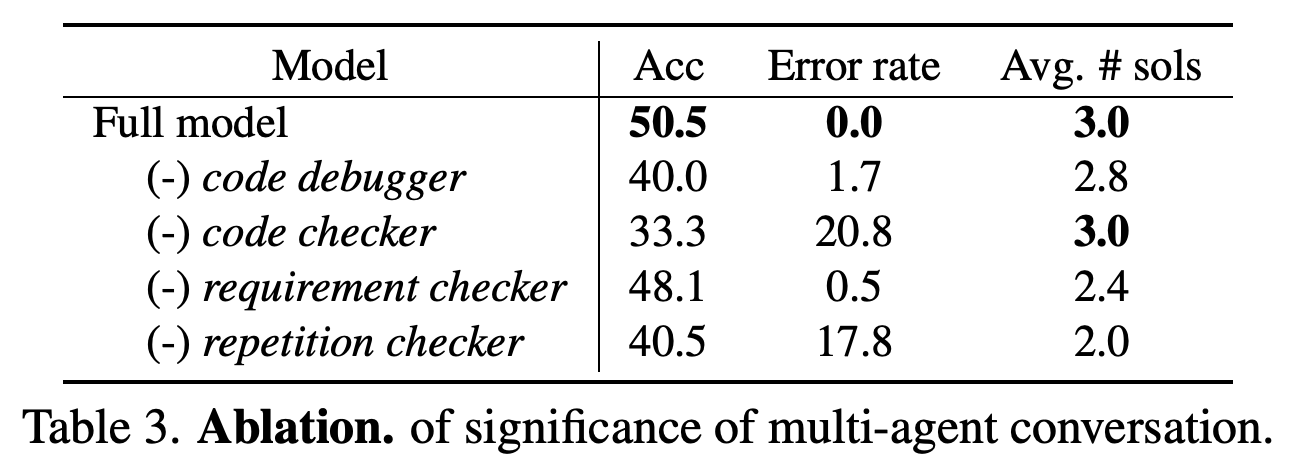
구성 요소를 개별적으로 제거해 기여도를 측정하는 위원회 ablation은 Table 1의 첫 5개 BLINK 과제에서 과제당 3회 실행하며, 대화는 최대 6회 반복한다. Table 3에서 전체 시스템의 정확도는 50.5, 실행 오류율은 0.0이다. Code debugger를 제거하면 정확도가 40.0으로 낮아지고, code checker를 제거하면 정확도가 33.3으로 낮아지며 오류율은 20.8로 높아진다.
- Requirement checker를 제거하면 정확도는 48.1, 오류율은 0.5, 평균 해법 수는 2.4개다. Repetition checker를 제거하면 정확도는 40.5, 오류율은 17.8이며, 평균 해법 수는 전체 시스템의 3.0개에서 2.0개로 줄어든다.
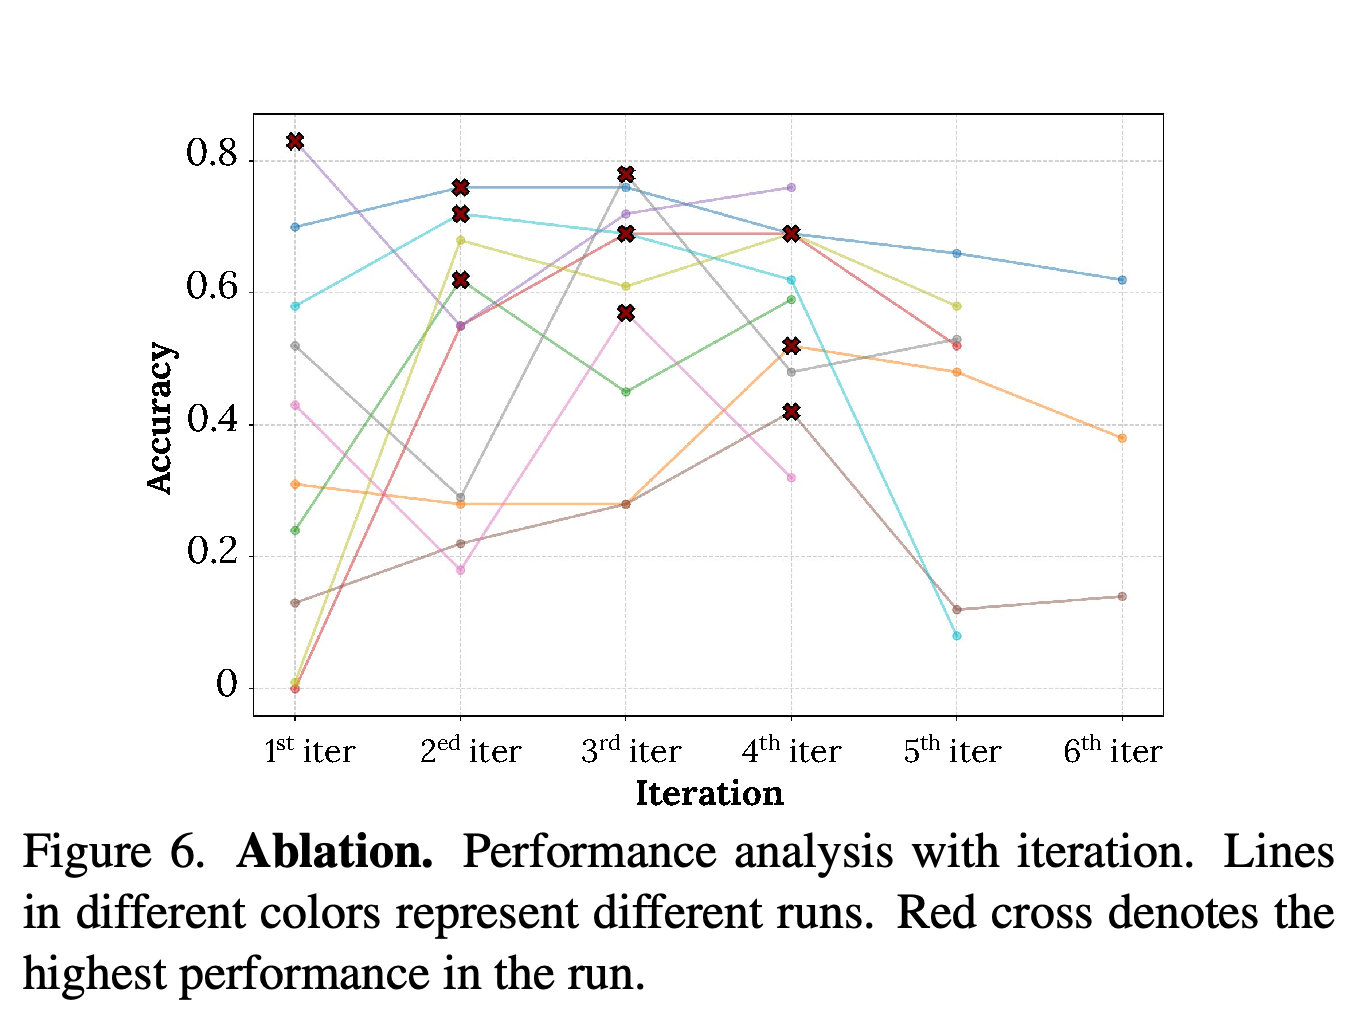
- BLINK 과제 10개를 무작위로 선택해 최대 6회 반복한 별도 분석에서 저자들은 최적 해법이 대체로 반복 2–4회 부근에 나타난다고 보고한다. Figure 6은 추가 수정 과정에서 정확도가 낮아질 수도 있음을 보여준다.
Code checker를 제거하면 표에 제시된 구성 중 정확도 하락 폭이 가장 크고, 실행 오류율은 전체 시스템의 0.0에서 20.8로 높아진다. Repetition checker를 제거하면 평균 해법 수가 3.0개에서 2.0개로 줄어들어 후보 다양성을 유지하는 역할을 뒷받침한다.
변화 곡선은 후속 대화 단계에서 앞서 얻은 성능 향상이 사라질 수 있음을 보여준다. 저자들은 최적 해법이 대체로 반복 2–4회 부근에 나타난다고 보고한다. 이는 논의를 추가해도 정확도가 안정적으로 높아지지는 않음을 시사한다.
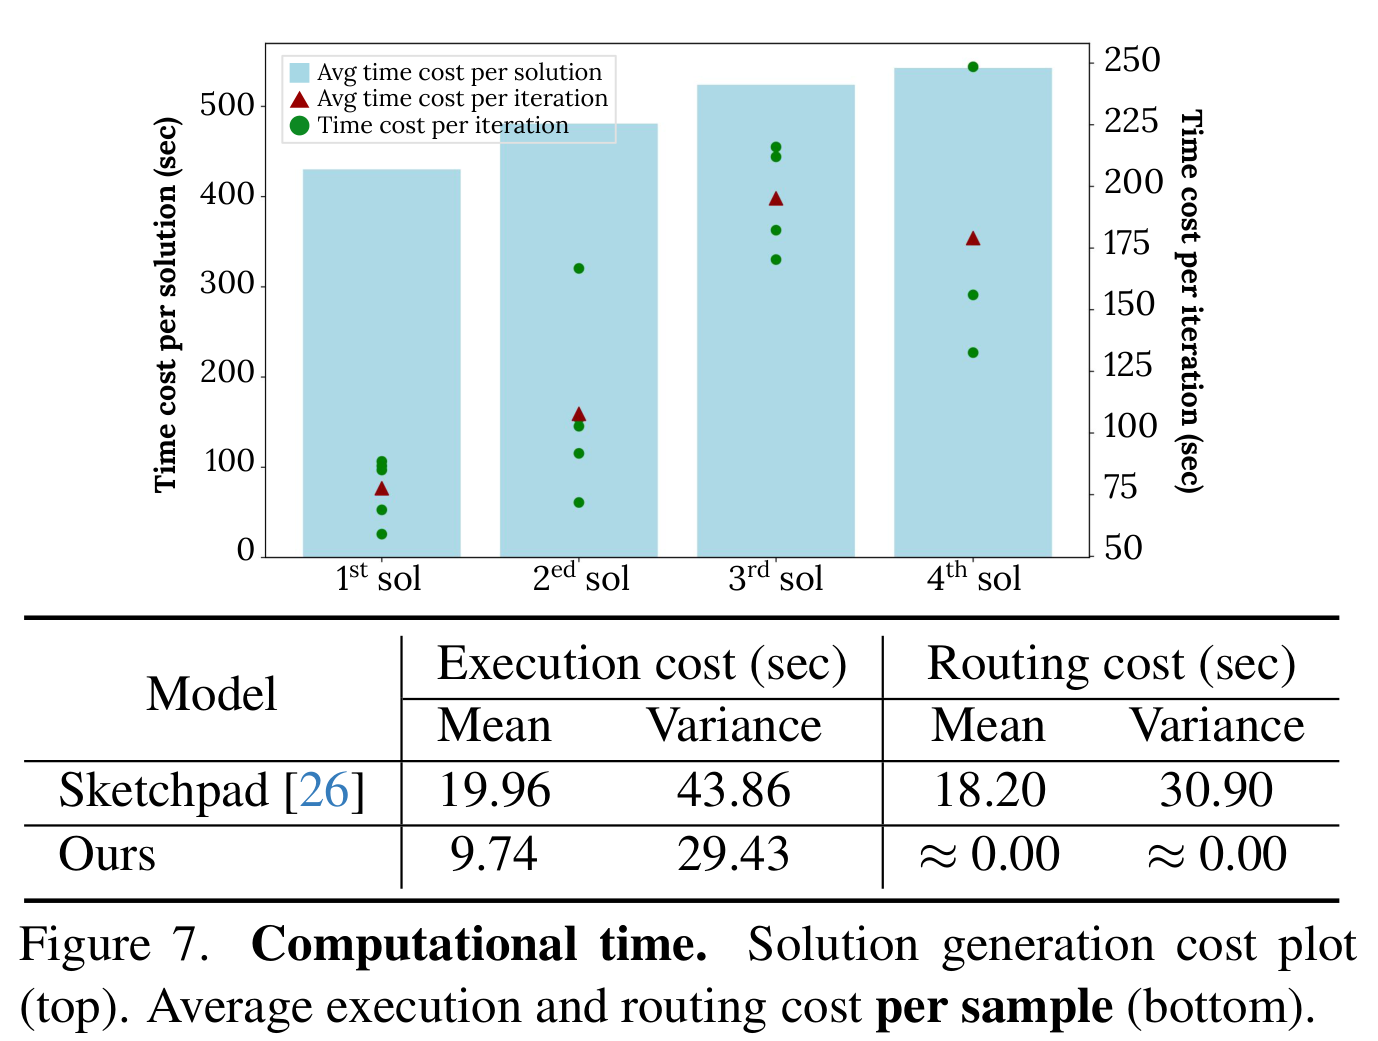
해법 생성에는 평균 약 8분이 걸리며, 후보 풀이 커질수록 해법당 측정 시간이 늘어난다. Figure 7에서 평균 실행 시간은 MMFactory가 9.74초, Visual Sketchpad가 19.96초다. 샘플당 라우팅 시간은 각각 약 0.00초와 18.20초다. 이 라우팅 시간은 재사용 가능한 프로그램을 생성한 뒤의 온라인 조율 시간을 가리킨다.
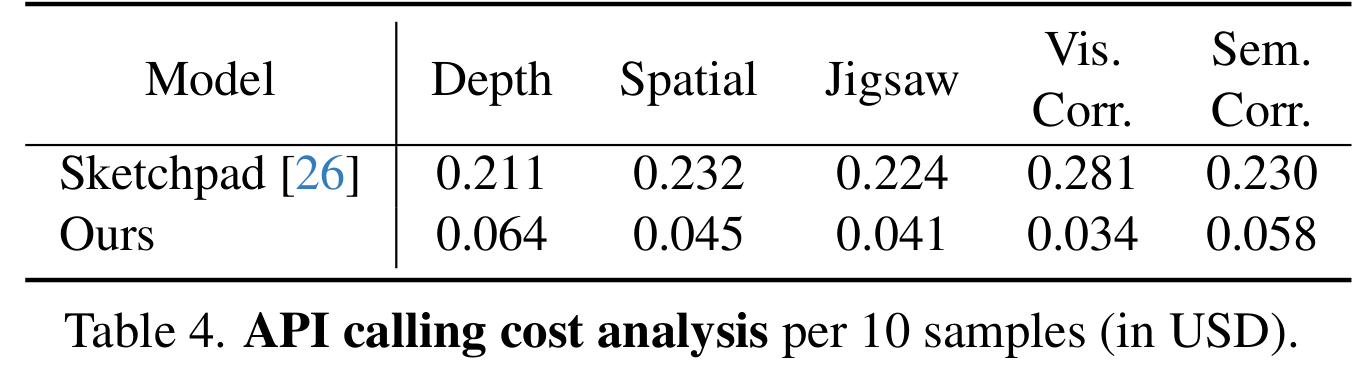
- Table 4는 샘플 10개당 응용 프로그램 인터페이스(API) 호출 비용을 미국 달러인 USD로 보고한다. MMFactory와 Visual Sketchpad의 비용은 각각 depth에서 0.064와 0.211, spatial에서 0.045와 0.232, jigsaw에서 0.041과 0.224, visual correspondence에서 0.034와 0.281, 이미지 내용을 의미에 따라 대응시키는 semantic correspondence에서 0.058과 0.230이다.
- 이 측정값은 평가한 비교 조건에서 비용이 더 낮음을 보여준다. 재사용의 이점을 평가하려면 별도로 드는 초기 생성 시간도 고려해야 한다. 논문은 손익분기점에 도달하는 작업량을 보고하지 않는다.
위쪽 그래프는 초기 탐색 시간과 해법이 추가로 생성될수록 시간이 늘어나는 양상을 보여준다. 아래쪽 비교에서는 MMFactory의 샘플당 실행 시간이 더 짧고 온라인 라우팅 시간이 약 0초다. 전체 시간 절감 효과를 평가하려면 생성과 재사용을 모두 고려해야 한다.
평가한 과제 5개 모두에서 MMFactory의 API 호출 비용이 더 낮지만, 감소 폭은 과제마다 다르다. 이 수치는 해당 비교에서 비용이 절감됨을 뒷받침하며, 보편적인 감소 배율을 입증하지는 않는다.
5. Conclusion
결론은 MMFactory를 사용자 제약에 따라 풀에서 재사용 가능한 과제 해법을 선택하는 방법으로 제시한다. 보고된 실험에서는 여러 지각 및 추론 과제의 성능이 높아지고 반복 라우팅 비용이 줄어든다. 정확도상의 이점은 과제와 비교 방법에 따라 달라진다.
짧은 생각
프로그램 탐색과 반복적인 과제 실행을 분리하는 것은 유용한 공학적 선택이다. 고정된 프로그램은 도구 조합을 검토할 수 있게 하고 반복적인 조율을 줄인다. 시간 비교와 위원회 ablation은 이 설계를 뒷받침한다. 다만 생성에 약 8분이 걸리므로 실제 이점은 이후 재사용 여부에 달려 있다.
SeedBench 평균 차이가 작고 여러 BLINK 과제에서 성능이 낮아지므로 전반적인 정확도 향상을 주장하는 데는 한계가 있다. 위원회 ablation은 과제 5개만 다루며, 제공된 PDF에는 지표 선택에 대한 별도 평가가 없다. 더 넓은 과제 범위에서의 성능과 평가 신뢰성은 여전히 확인이 필요하다.
본문은 보충 프롬프트, 에이전트 응답, 추가 예시, 지표 라우팅 논의를 언급하지만, 제공된 PDF에서는 해당 자료를 확인할 수 없다.