Multi-Token Attention 요약 설명
01 Apr 2025 | Paper Review Attention Mechanisms Long-Context Language Models LLM Pretraining목차
이번 글에서는 Multi-Token Attention 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 1일(Arxiv), COLM 2025
- Golovneva, Olga, Wang, Tianlu, Weston, Jason, Sukhbaatar, Sainbayar.
- FAIR at Meta
- 논문 링크
요약
- 언어 모델은 여러 정보를 동시에 만족하는 구절을 찾는 데 어려움을 겪을 수 있다. 다양한 출처의 텍스트를 모은 SlimPajama의 동일한 105B 토큰으로 학습한 880M-parameter 모델을 비교하면, Multi-Token Attention(MTA)은 평균 검증 perplexity를 표준 Transformer의 11.25에서 10.91로 낮춘다. Perplexity는 다음 토큰 예측의 불확실성을 측정하는 지표다.
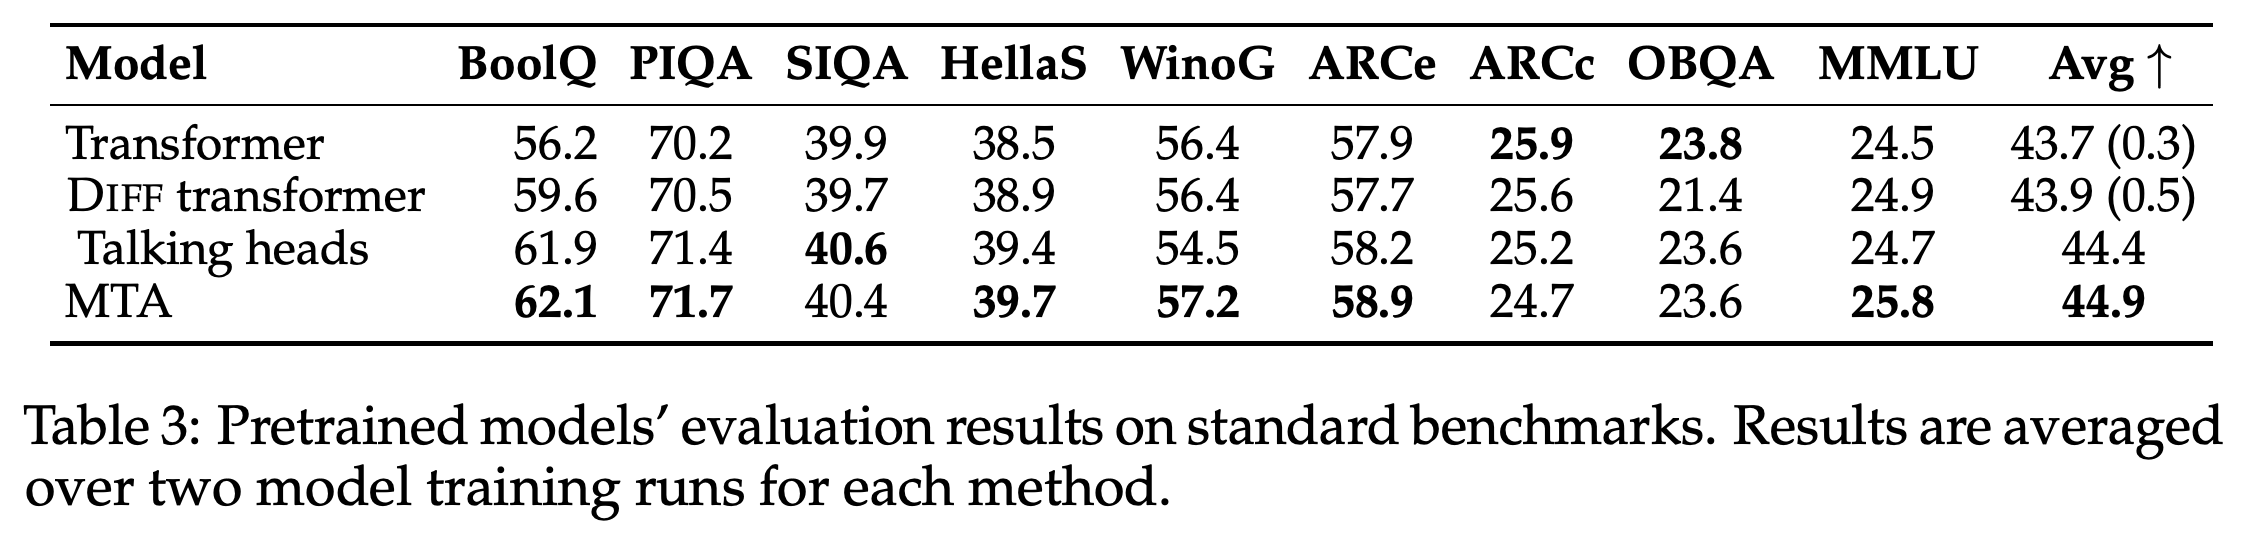
- MTA는 query 위치, key 위치, attention head에 걸쳐 학습 가능한 convolution을 적용하여 인접한 값들을 가중 결합한다. Query는 검색 요청을, key는 문맥에서 검색 후보가 되는 토큰을 나타내며, head는 한 층 안에서 병렬로 수행되는 attention 연산이다. MTA는 표준 벤치마크 평균 점수를 43.7에서 44.9로 높이고, 여러 대상을 검색하거나 방해 문맥을 처리할 때 더 큰 이점을 보인다. 다만 모든 과제에서 가장 좋은 성능을 내지는 않는다.
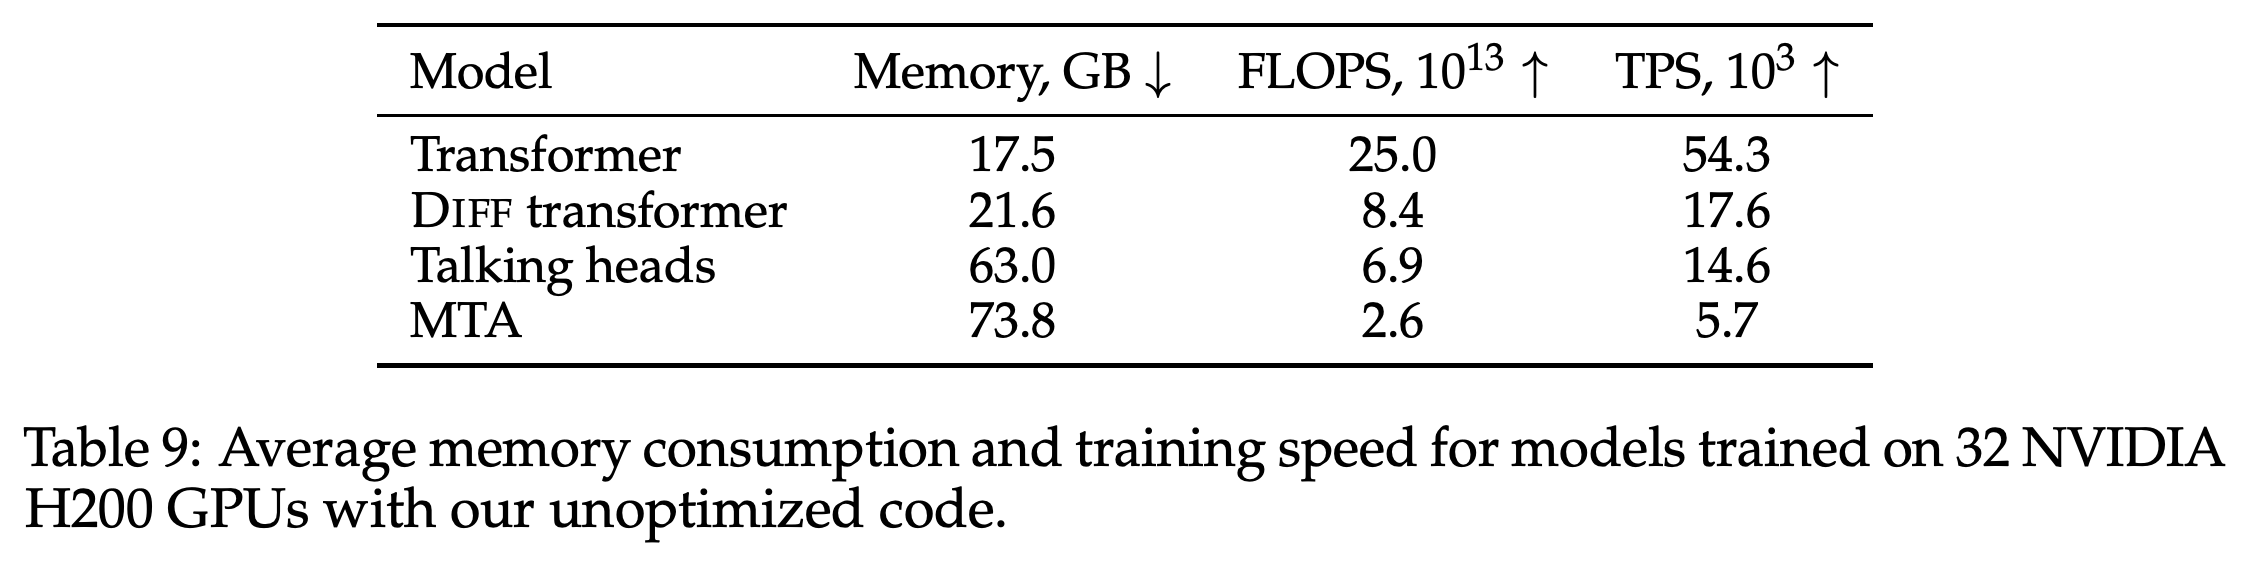
- 파라미터 수는 거의 변하지 않지만, 구현에는 상당한 실행 시간과 메모리 부담이 따른다. 32대의 NVIDIA H200 GPU에서 학습할 때 보고된 MTA 구현은 초당 5.7 × 10³ 토큰을 처리하고 73.8 GB를 사용한다. 표준 Transformer는 초당 54.3 × 10³ 토큰을 처리하고 17.5 GB를 사용한다. 저자들은 이 격차의 상당 부분이 MTA에서 최적화된 attention kernel을 사용할 수 없기 때문이라고 설명한다. Attention kernel은 GPU에서 attention을 실행하는 연산 루틴이다.
1 Introduction
표준 attention은 query 벡터 1개와 key 벡터 1개로 정규화 전 관련성 점수를 각각 계산한다. 저자들은 “Alice”와 “rabbit”이 모두 포함된 문장을 찾으려면 단일 벡터가 두 조건을 모두 인코딩해야 한다고 주장한다. 각 단어를 독립적으로 검색하는 것만으로는 두 단어가 함께 등장하는 위치를 직접 식별할 수 없다는 설명이다.
- MTA는 query와 key 사이의 관련성 가중치를 배열로 나타낸 attention map들이 인접한 key, 이전 query, head에 걸쳐 상호작용하도록 한다. 이를 통해 따로 감지한 근거를 공통 점수에 반영할 수 있다.
- 논문은 통제된 문자 블록 과제, 조건을 맞춘 언어 모델 사전 학습, 장거리 의존성 평가, 모델 크기 비교를 통해 이러한 동기를 검증한다.
- 코드 주소는 https://github.com/facebookresearch/RAM/tree/main/projects/mta 이다.
2 Background on multi-head attention
한 층 안의 토큰 표현인 은닉 상태 H에 대해 각 attention head는 key K = HW_k, value V = HW_v, query Q = HW_q를 구성한다. Value는 출력에 모을 정보를 담는다. 은닉 차원이 D이고 head 수가 M이면 각 head의 차원은 d = D/M이며, 확률로 정규화하기 전 점수인 attention logit은 Â = QKᵀ/√d다.
- Softmax는 logit을 key 전체에 대한 합이 1인 가중치로 변환한다. Causal mask는 미래 위치에 −∞를 부여하여 예측에 이후 토큰을 사용할 수 없게 한다.
- 각 head는 AV를 출력하며, 이 출력들을 이어 붙인 뒤 출력 projection을 곱한다.
3 Multi-Token Attention
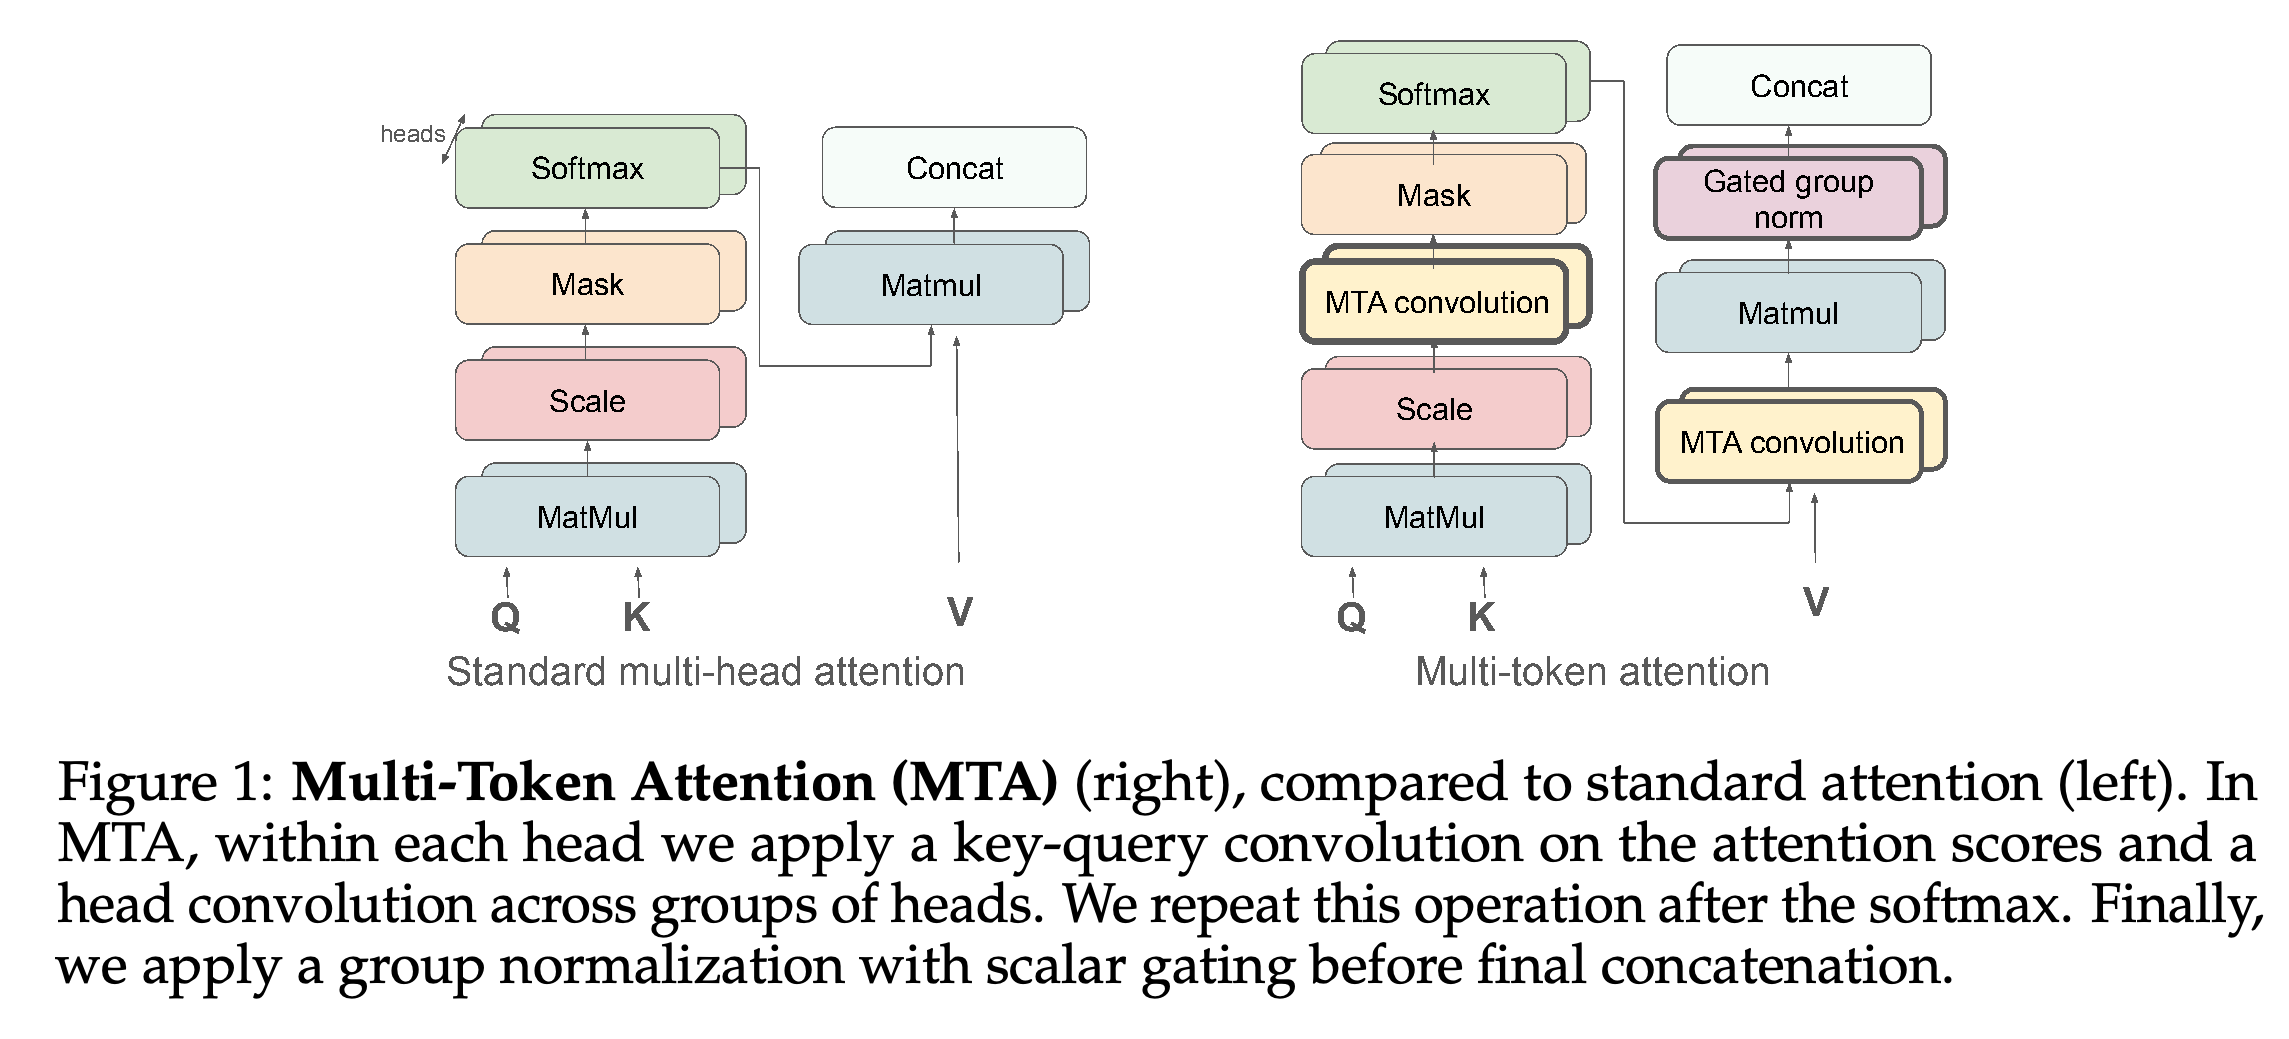
MTA는 multi-head attention에 key-query convolution, head mixing convolution, scalar gating을 결합한 group normalization이라는 3가지 구성 요소를 추가한다. 이들은 인접한 토큰의 일치를 결합하고, head 사이에서 attention 정보를 교환하며, 각 head의 기여도를 학습하면서 출력의 크기를 재조정한다.
- “Alice”와 “rabbit” 예시는 query 하나가 모든 검색 조건을 인코딩하도록 요구하는 대신, 문맥의 인접한 위치에서 나타나는 attention peak들을 결합하는 방식을 보여준다.
- Figure 1과 Figure 2는 각 연산이 attention 처리 과정의 어디에 들어가며 어떤 차원을 혼합하는지 보여준다.
MTA는 softmax 이전의 attention 점수와 이후의 attention 가중치를 혼합한 뒤 value를 집계한다. 이어서 gated normalization으로 head 출력의 크기를 재조정한 뒤 출력들을 이어 붙인다.
3.1 Key-query convolution
Key-query convolution은 각 head의 attention map에서 query와 key 위치에 걸쳐 별도로 학습한 2차원 kernel을 적용한다. Kernel은 필터 가중치를 배열로 나타낸 것이다. Softmax 전에 적용하면 logit을 결합하므로 지수 연산 후에는 곱셈 형태의 상호작용이 생긴다. Softmax 후에 적용하면 attention 가중치를 덧셈 형태로 결합한다.
- 실제 softmax 이전 구현은 \(A=\operatorname{Softmax}\!\left(\operatorname{Mask}_{-\infty}\!\left(\operatorname{Conv2d}_{\theta}\!\left(\operatorname{Mask}_{0}(\hat A)\right)\right)\right)\)다. Convolution 전에 0으로 마스킹하여 미래 점수가 기여하지 못하게 하고, 두 번째 마스크로 정규화 전에 미래 key를 제외한다.
- 현재와 과거의 query 위치만 사용한다. 간단한 마스킹 구현은 필요한 것보다 정보를 조금 더 제거하지만, convolution kernel을 수정할 필요가 없다.
- Kernel 크기는 토큰이 상호작용하는 범위를 결정한다. 논문의 단어 단위 토큰화 예시는 관련 query 단어를 포함하도록 c_q = 4를, 관련 문맥 단어를 결합하도록 c_k = 5를 사용한다.
3.2 Head mixing convolution
Head mixing convolution은 M개의 head를 서로 겹치지 않는 M/c_h개 그룹으로 나눈다. 각 그룹에는 c_h개의 head가 있으며, 그룹 안에서 선형 결합을 학습한다. Head가 2개라면 새로운 map은 A¹_new = w₁₁A¹ + w₁₂A²와 A²_new = w₂₁A¹ + w₂₂A²다.
- 이 연산은 softmax 이전의 logit이나 softmax 이후의 attention 가중치를 혼합할 수 있다.
- Kernel이 head 그룹 전체에 걸쳐 있으므로, 그룹 내부의 완전 연결 변환으로도 볼 수 있다.
3.3 Putting everything together
Key-query mixing과 head mixing을 모두 softmax 이전이나 이후에 적용한다면, query, key, head 그룹에 걸친 3차원 convolution으로 함께 구현할 수 있다. 논문은 key-query convolution을 softmax 전에 적용하고 head mixing을 그 뒤에 적용하는 구성도 검토한다.
- Group normalization은 attention 출력의 크기를 재조정한다. 이어 붙이기 전에는 학습 가능한 sigmoid scalar gate가 각 출력의 기여도를 조절한다. 이 gate는 값의 범위가 제한된 승수다.
- 저자들은 softmax attention map 2개를 빼는 attention 변형인 Differential Transformer의 층별 scaling을 scalar gating으로 대체하고, 정규화와 scaling 선택을 실험으로 비교한다.
4 Experiments
실험은 합성 검색 과제, 언어 모델 사전 학습, 문맥 길이 확장, 장거리 의존성 과제, 학습된 kernel 분석, ablation을 다룬다. Ablation은 개별 설계 선택을 바꾸어 비교하는 통제 실험이다. 별도 명시가 없으면 MTA convolution을 softmax 전후에 모두 적용한다.
4.1 Motivating toy task
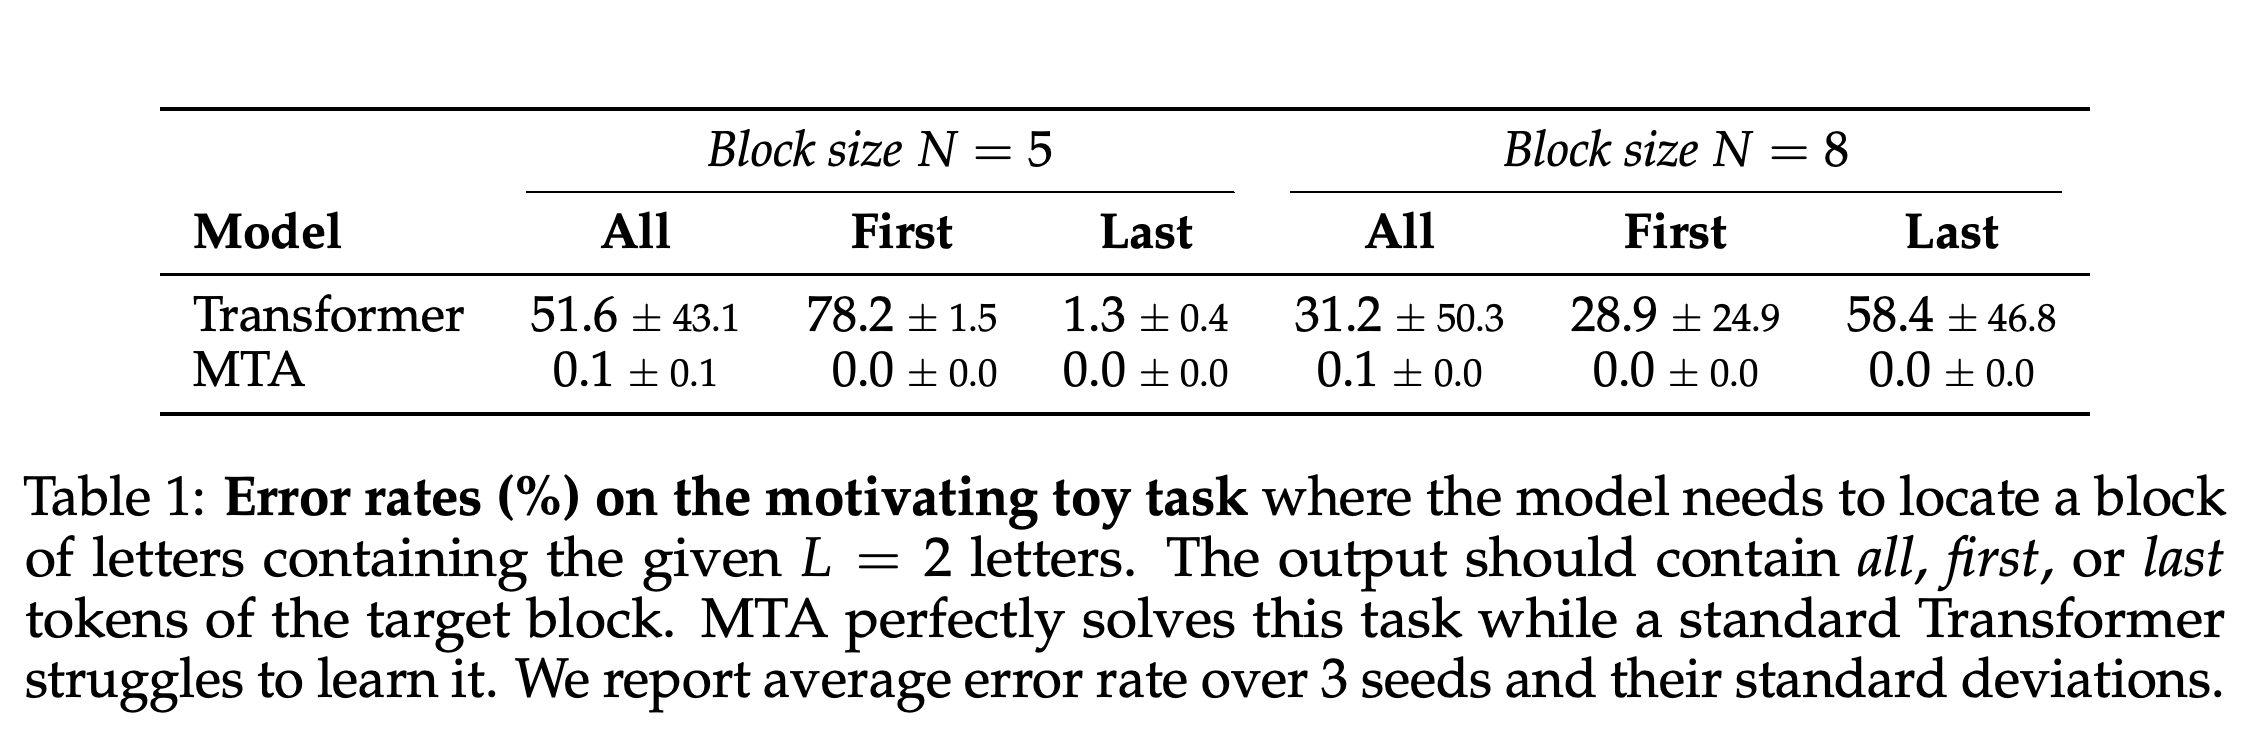
단순화한 과제에서는 N개의 무작위 문자로 구성된 블록들 사이에서 L = 2개의 질문 문자를 포함하는 유일한 블록을 찾고, 해당 블록의 모든 문자, 첫 문자, 마지막 문자 중 하나를 출력한다. 이전 토큰으로 다음 토큰을 예측하는 decoder-only Transformer는 4개 층, 2개 head, 256차원 은닉 상태를 사용한다. MTA 변형은 softmax 이전의 key-query convolution만 사용하며, c_q = 2와 c_k = 2N − 1로 설정한다.
- 블록 크기 N = 5와 N = 8에서 MTA는 모든 출력 방식에 걸쳐 3개 seed의 평균 오류율 0.0–0.1%를 달성한다.
- 표준 Transformer의 평균 오류율은 1.3%부터 78.2%까지이며, 여러 조건에서 seed에 따른 편차가 크다. 이는 실험한 조건에서의 이점을 입증하지만, 표준 attention이 일반적으로 논리곱 조건을 해결할 수 없다는 뜻은 아니다.
MTA는 각 블록 크기와 3가지 출력 방식 모두에서 평균 오류율을 최대 0.1%로 낮춘다. 표준 Transformer의 여러 조건에서는 표준편차가 커서, 학습 seed 3개 사이의 상당한 변동을 보여준다.
4.2 Large language modeling
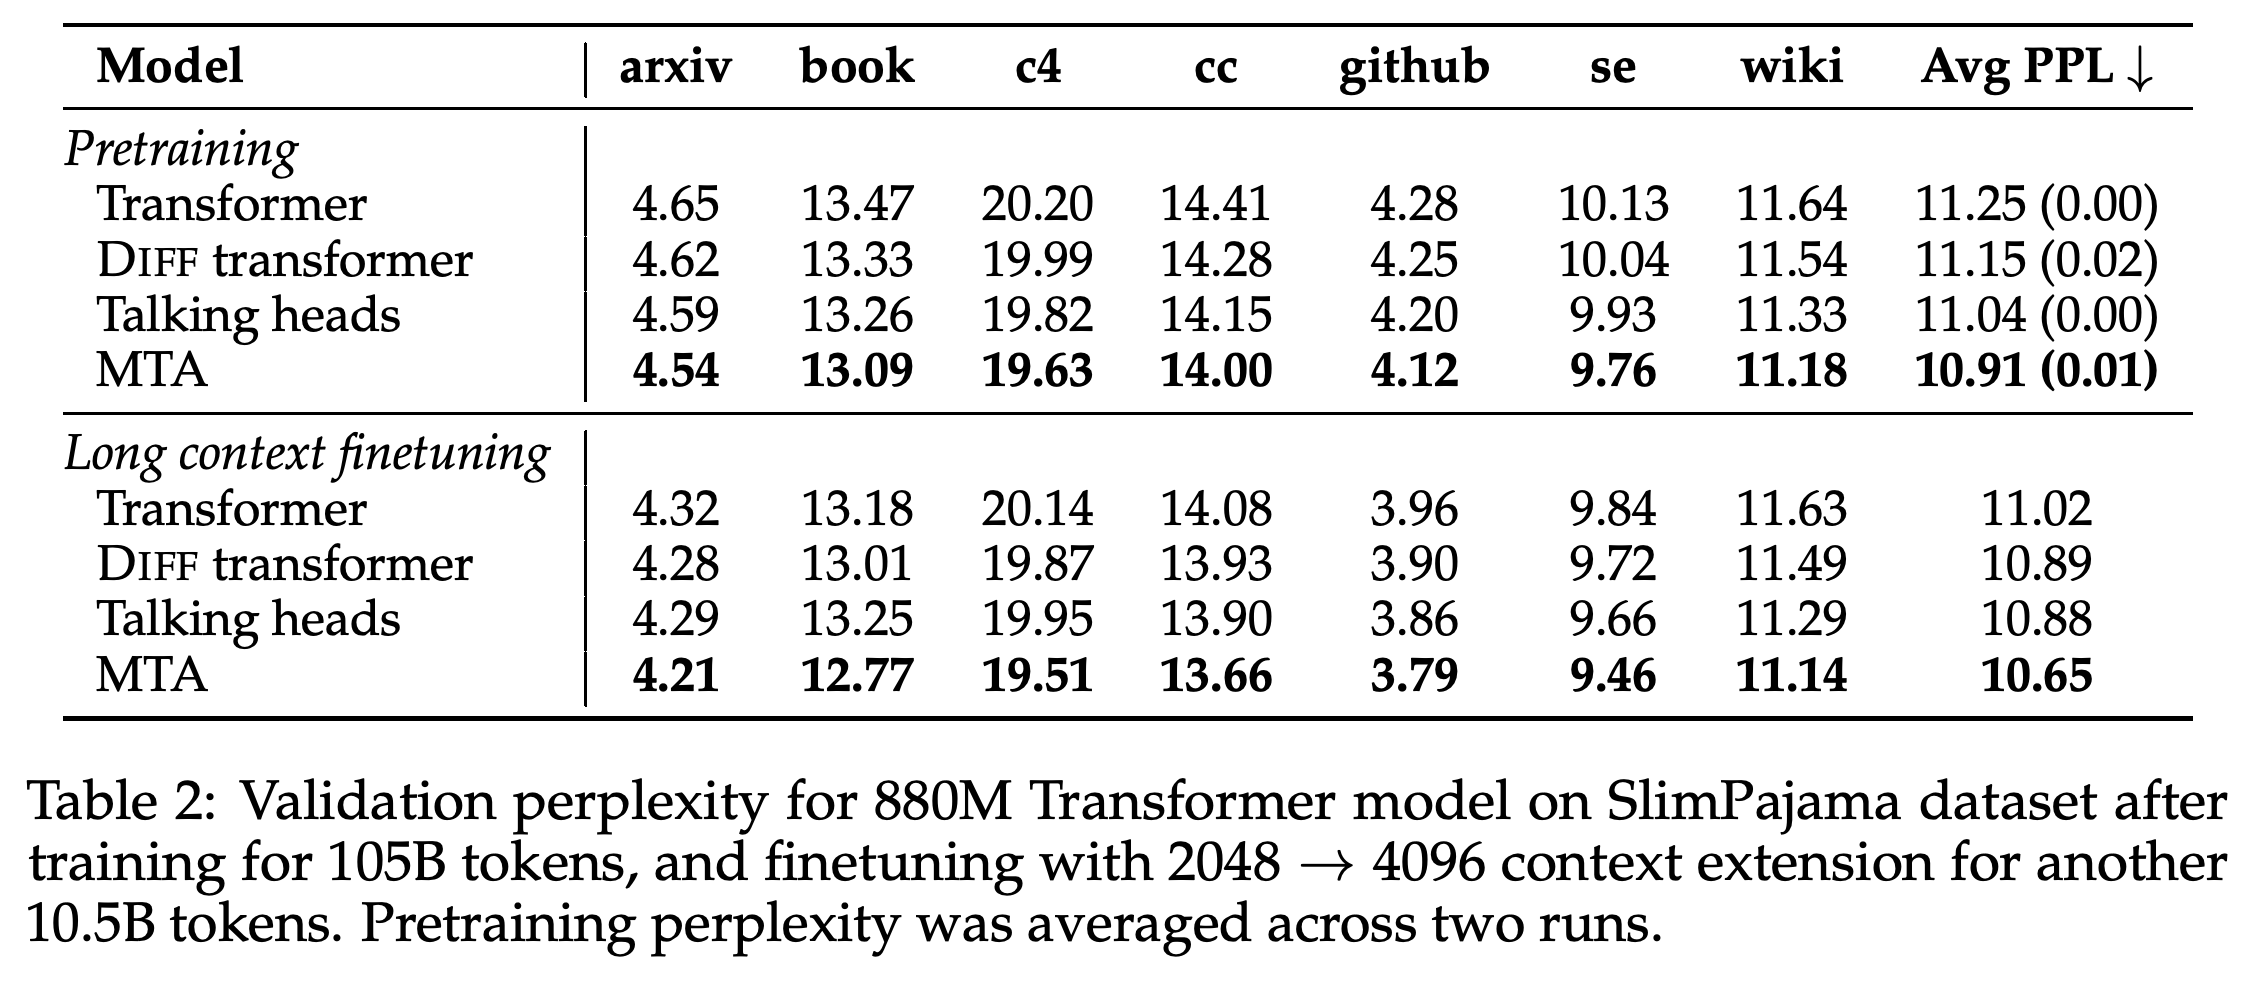
주요 비교에서는 학습 프레임워크 Lingua를 사용하여 105B SlimPajama 토큰으로 880M 규모 모델을 학습한다. 비교 대상은 표준 Transformer, Differential Transformer, softmax 전후에 head 간 projection을 학습하는 Talking heads attention이다.
- MTA는 c_q = 6, c_k = 11, c_h = 16을 사용한다. Key-query convolution은 4개 층마다 적용하고, head mixing은 모든 층에 적용한다.
- 2회 학습 실행에서 평균 검증 perplexity는 Transformer가 11.25, Differential Transformer가 11.15, Talking heads가 11.04, MTA가 10.91이다. MTA는 보고된 모든 검증 도메인에서 가장 낮은 perplexity를 보인다.
- 표준 벤치마크 평균 점수는 MTA가 44.9이며, 비교 모델 3개는 각각 43.7, 43.9, 44.4다. MTA는 사회적 상식을 평가하는 SIQA, 과학 질의응답 벤치마크 ARC challenge, 기초 사실을 활용하는 질의응답 벤치마크 OpenBookQA에서는 가장 좋은 성능을 내지 못한다. Appendix D에 따르면 다중 과제 언어 이해 벤치마크 MMLU에서는 예시 5개를 사용한다. 따라서 과제 예시 없이 평가한다는 본문의 전반적인 0-shot 설명에는 예외가 있다.
4.3 Long context finetuning
긴 문맥 finetuning에서는 문맥 길이를 2048에서 4096으로 늘리면서 동일한 데이터 혼합으로 10.5B 토큰을 추가 학습한다. 저자들은 모델의 위치 표현인 Rotary Position Embeddings(RoPE)의 theta를 500000으로 높이고, weight decay를 0으로 설정하며, warmup을 50 steps로 줄인다.
- MTA의 평균 검증 perplexity는 10.65이며, Transformer는 11.02, Differential Transformer는 10.89, Talking heads는 10.88이다.
- 문맥 길이를 확장한 뒤에도 MTA의 언어 모델링 이점이 유지된다.
MTA는 사전 학습과 문맥 확장 이후 모두에서 제시된 모든 도메인의 검증 perplexity가 가장 낮다. 10.5B 토큰을 추가 학습한 뒤에도 평균 성능 이점이 유지된다.
MTA는 가장 높은 평균 점수인 44.9를 달성하지만, 개선 폭은 과제마다 다르다. ARC challenge와 OpenBookQA에서는 표준 attention이, SIQA에서는 Talking heads가 가장 좋은 성능을 낸다.
4.4 Long-range dependency tasks
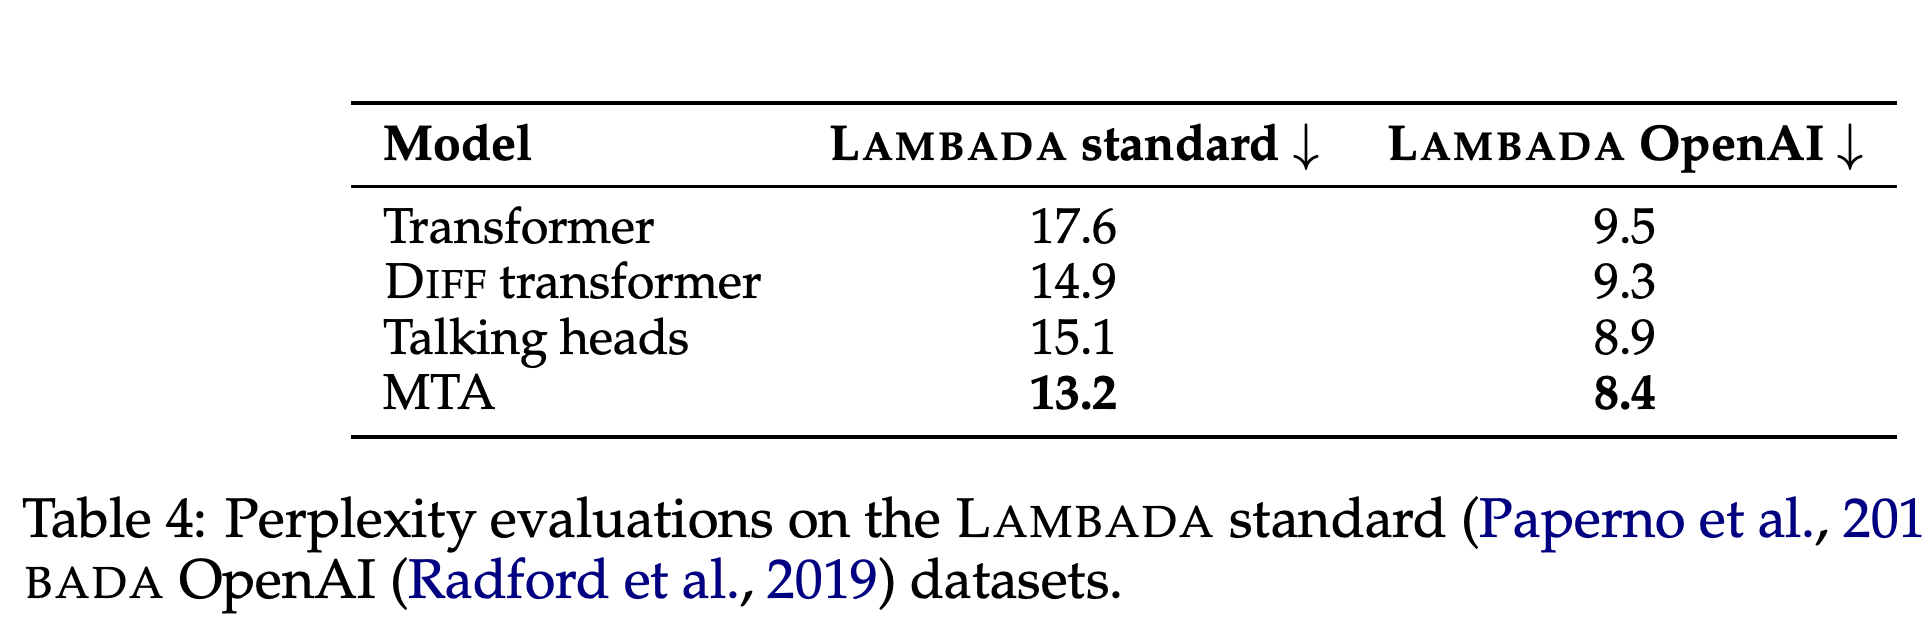
장거리 평가는 넓은 담화 문맥이 필요한 다음 단어 예측 데이터셋 LAMBADA, needle이라 부르는 삽입된 목표 사실을 검색하는 Needle-In-A-Haystack, 방해 문서에 포함된 사실을 바탕으로 추론하는 BabiLong을 사용한다. MTA는 LAMBADA standard/OpenAI perplexity를 표준 Transformer의 17.6/9.5에서 13.2/8.4로 낮춘다.
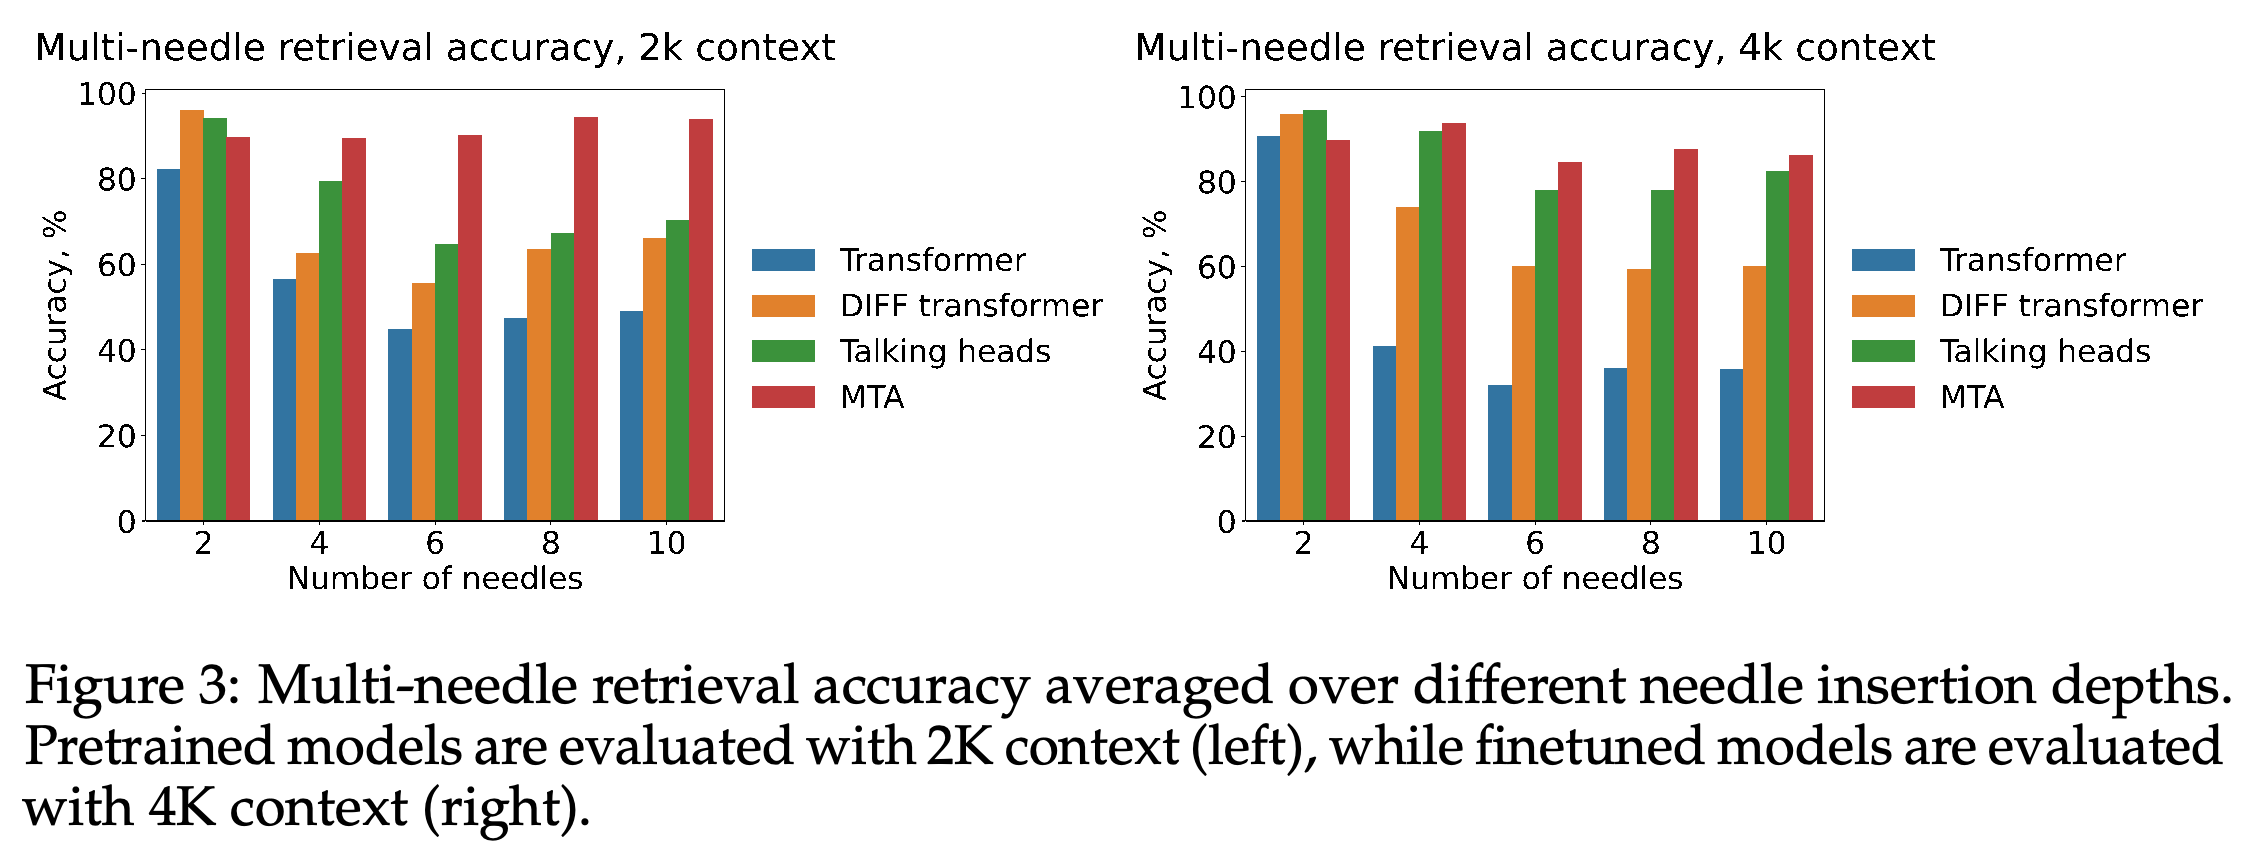
- Needle 검색은 사전 학습 모델의 2K 문맥과 finetuning 모델의 4K 문맥을 사용한다. 목표 항목 순서를 섞고, 설정마다 500개 샘플을 평가하며, 삽입 깊이별 정확도를 평균한다. 본문은 처음에 needle 수를 2, 4, 6개만 나열하지만, Figure 3은 2, 4, 6, 8, 10개 결과를 보고한다.
- Figure 3은 여러 needle을 검색해야 할 때 MTA의 뚜렷한 이점을 보여준다. Needle이 2개일 때는 다른 비교 모델의 성능이 더 좋다.
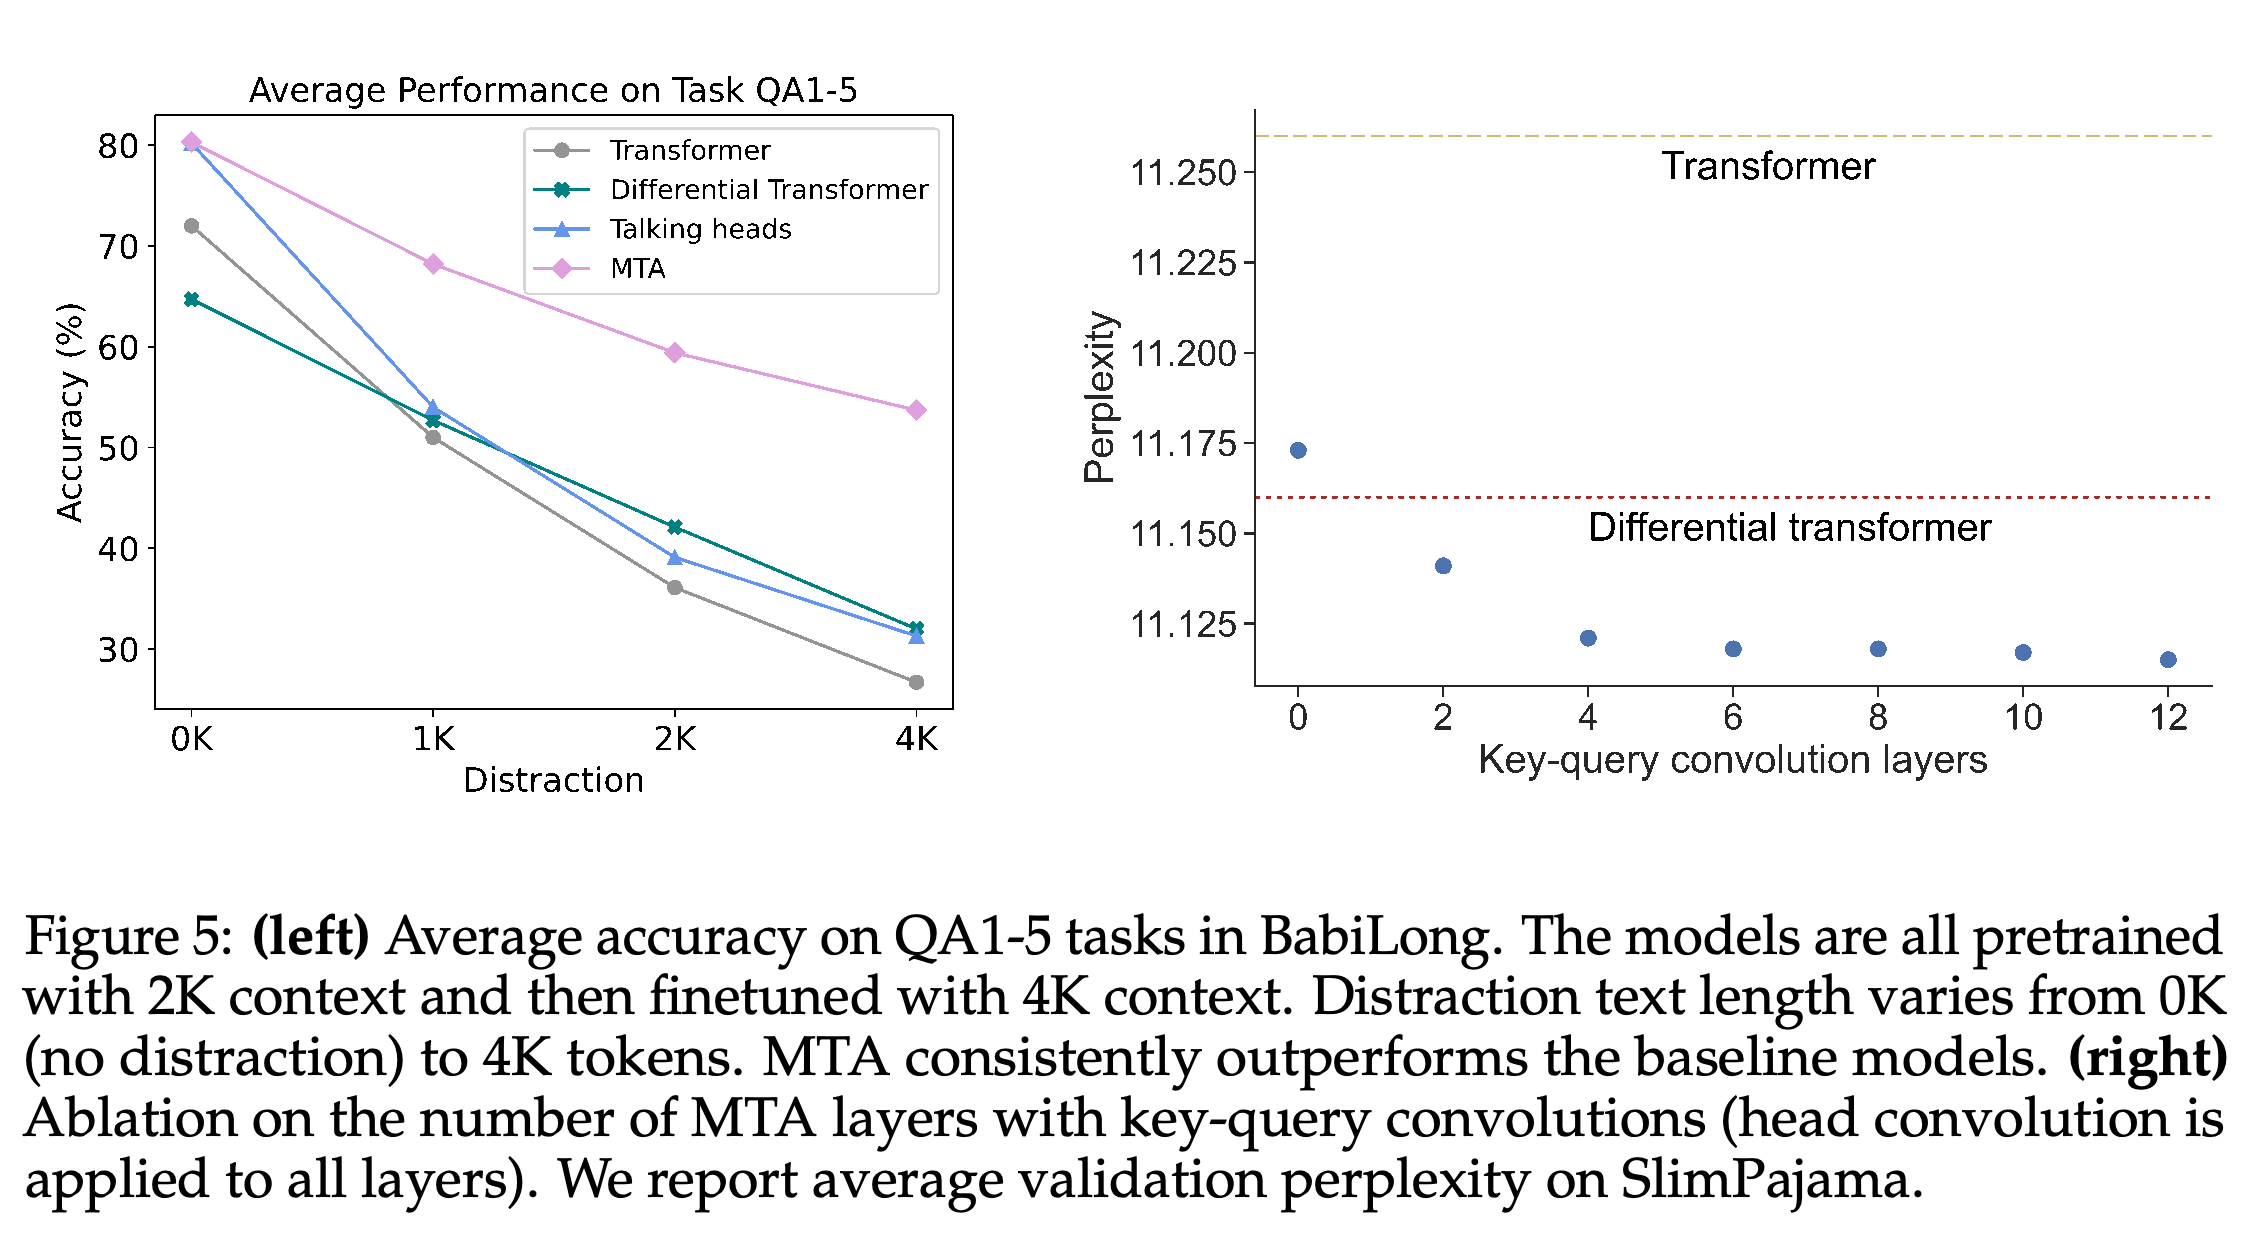
- 근거 사실이나 논항 관계를 다루는 5개 과제인 BabiLong QA1-5에서는 방해 문맥이 4K 토큰까지 늘어날수록 MTA의 전체 성능 이점이 커진다. Appendix E의 과제별 결과는 남아 있는 추론상의 약점을 보여준다.
MTA는 LAMBADA의 각 버전에서 표준 Transformer와 attention 비교 모델 2개보다 낮은 perplexity를 달성한다. 이는 담화 문맥이 필요한 다음 단어 예측에서도 MTA의 효과를 뒷받침한다.
각 문맥 설정에서 목표가 4개 이상일 때 MTA의 이점이 뚜렷하다. Needle이 2개일 때는 다른 방법이 더 좋은 성능을 내므로, 모든 개수에서 개선된다는 본문의 주장에는 예외가 있다.
4.5 Kernel patterns
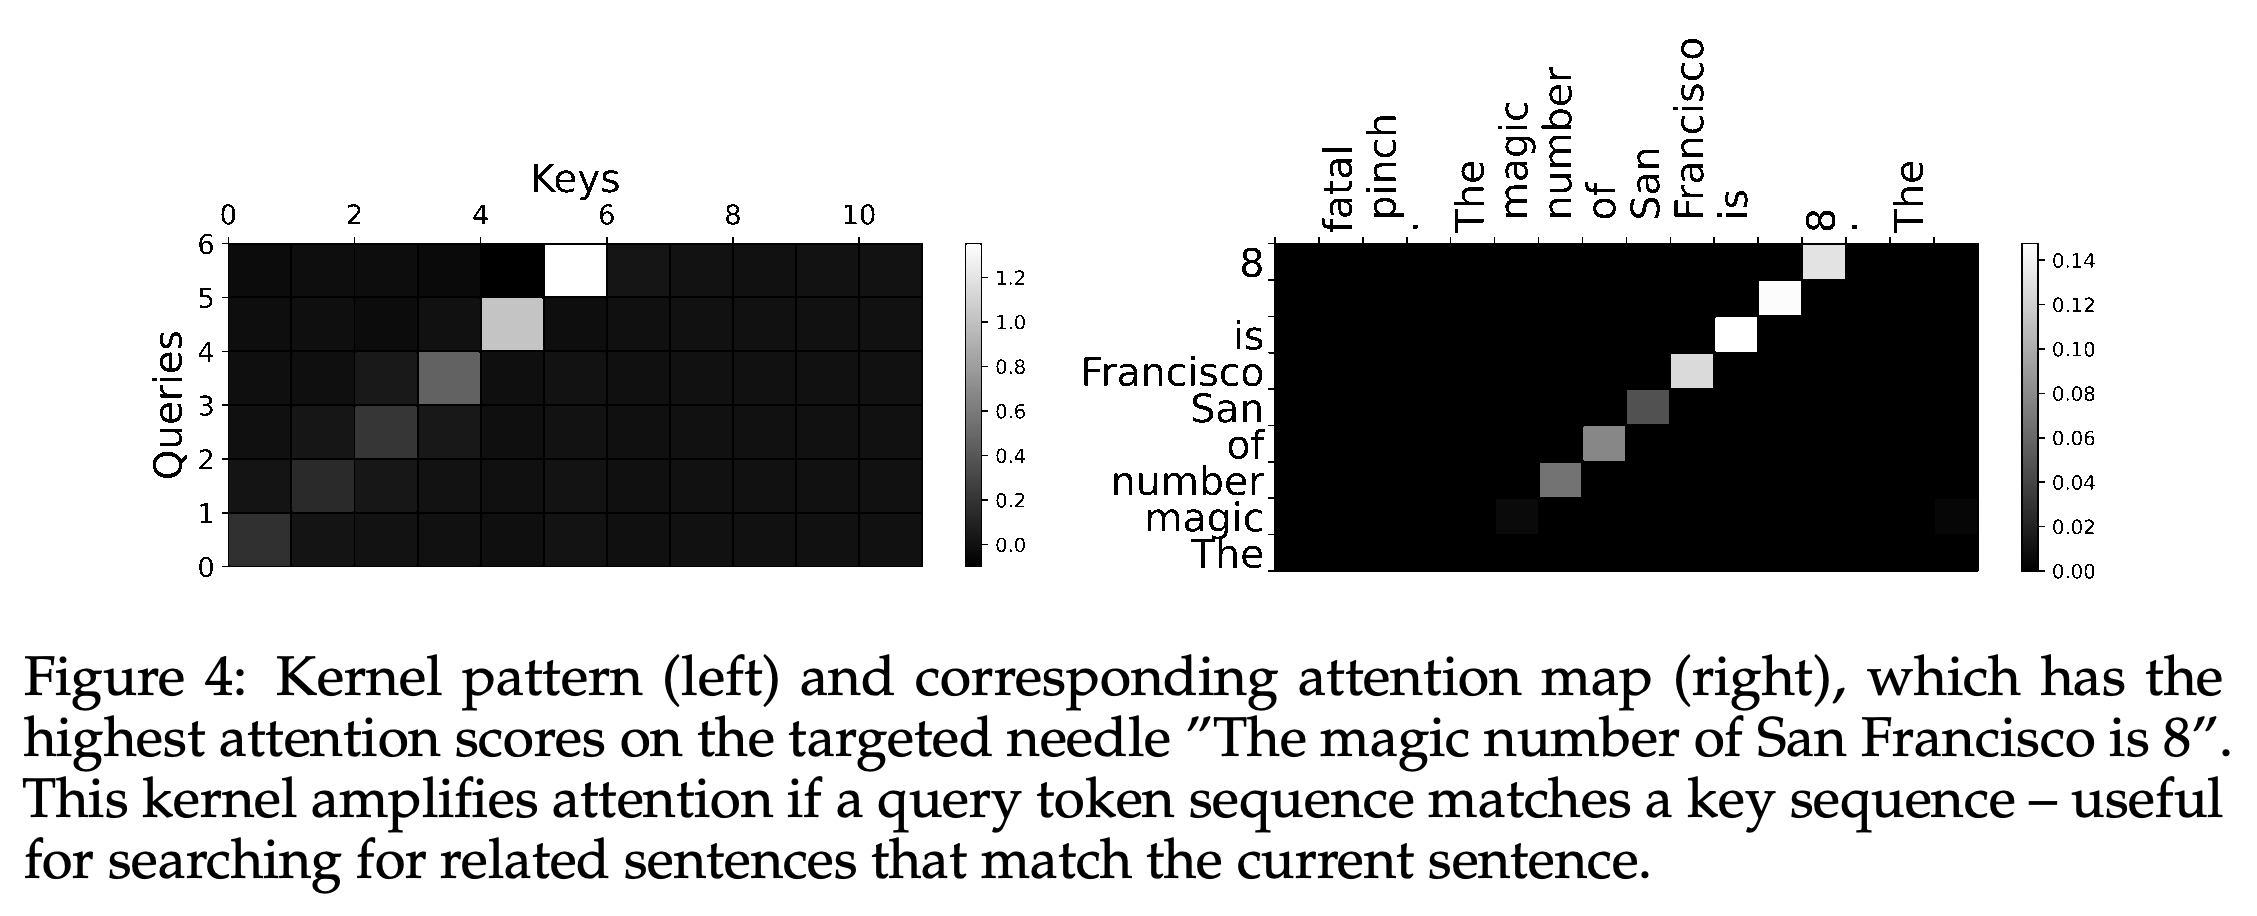
학습된 key-query kernel에는 원래 점수를 대부분 유지하는 항등 변환에 가까운 패턴과 인접한 일치를 결합하는 구조적 패턴이 나타난다. Figure 4는 대각선 kernel과 “The magic number of San Francisco is 8”에 집중하는 해당 attention map을 보여준다. 이는 이 kernel이 일치하는 토큰 시퀀스를 강화한다는 해석을 뒷받침한다.
- 저자들은 다른 예시를 이전에 주목한 key에 대한 반응을 강화하거나, attention이 연속으로 높은 영역의 경계를 감지하는 패턴으로 해석한다. 이는 정성적 해석이다.
- 작은 head-mixing kernel은 뺄셈으로 attention map 사이의 차이를 드러내는 경우가 많다. Group normalization이 없으면 층이 깊어질수록 kernel 가중치의 규모가 커진다. 이것이 skip connection을 통해 전달되는 표현인 residual stream에 대응하기 위한 것이라는 설명은 가설로 남아 있다.
대각선 kernel은 정렬된 인접 query-key 일치를 결합하며, 해당 attention map은 목표 도시와 숫자가 포함된 문장을 강조한다. 이는 점수 convolution으로 시퀀스의 일치를 감지한다는 저자들의 해석을 보여준다.
4.6 Ablations
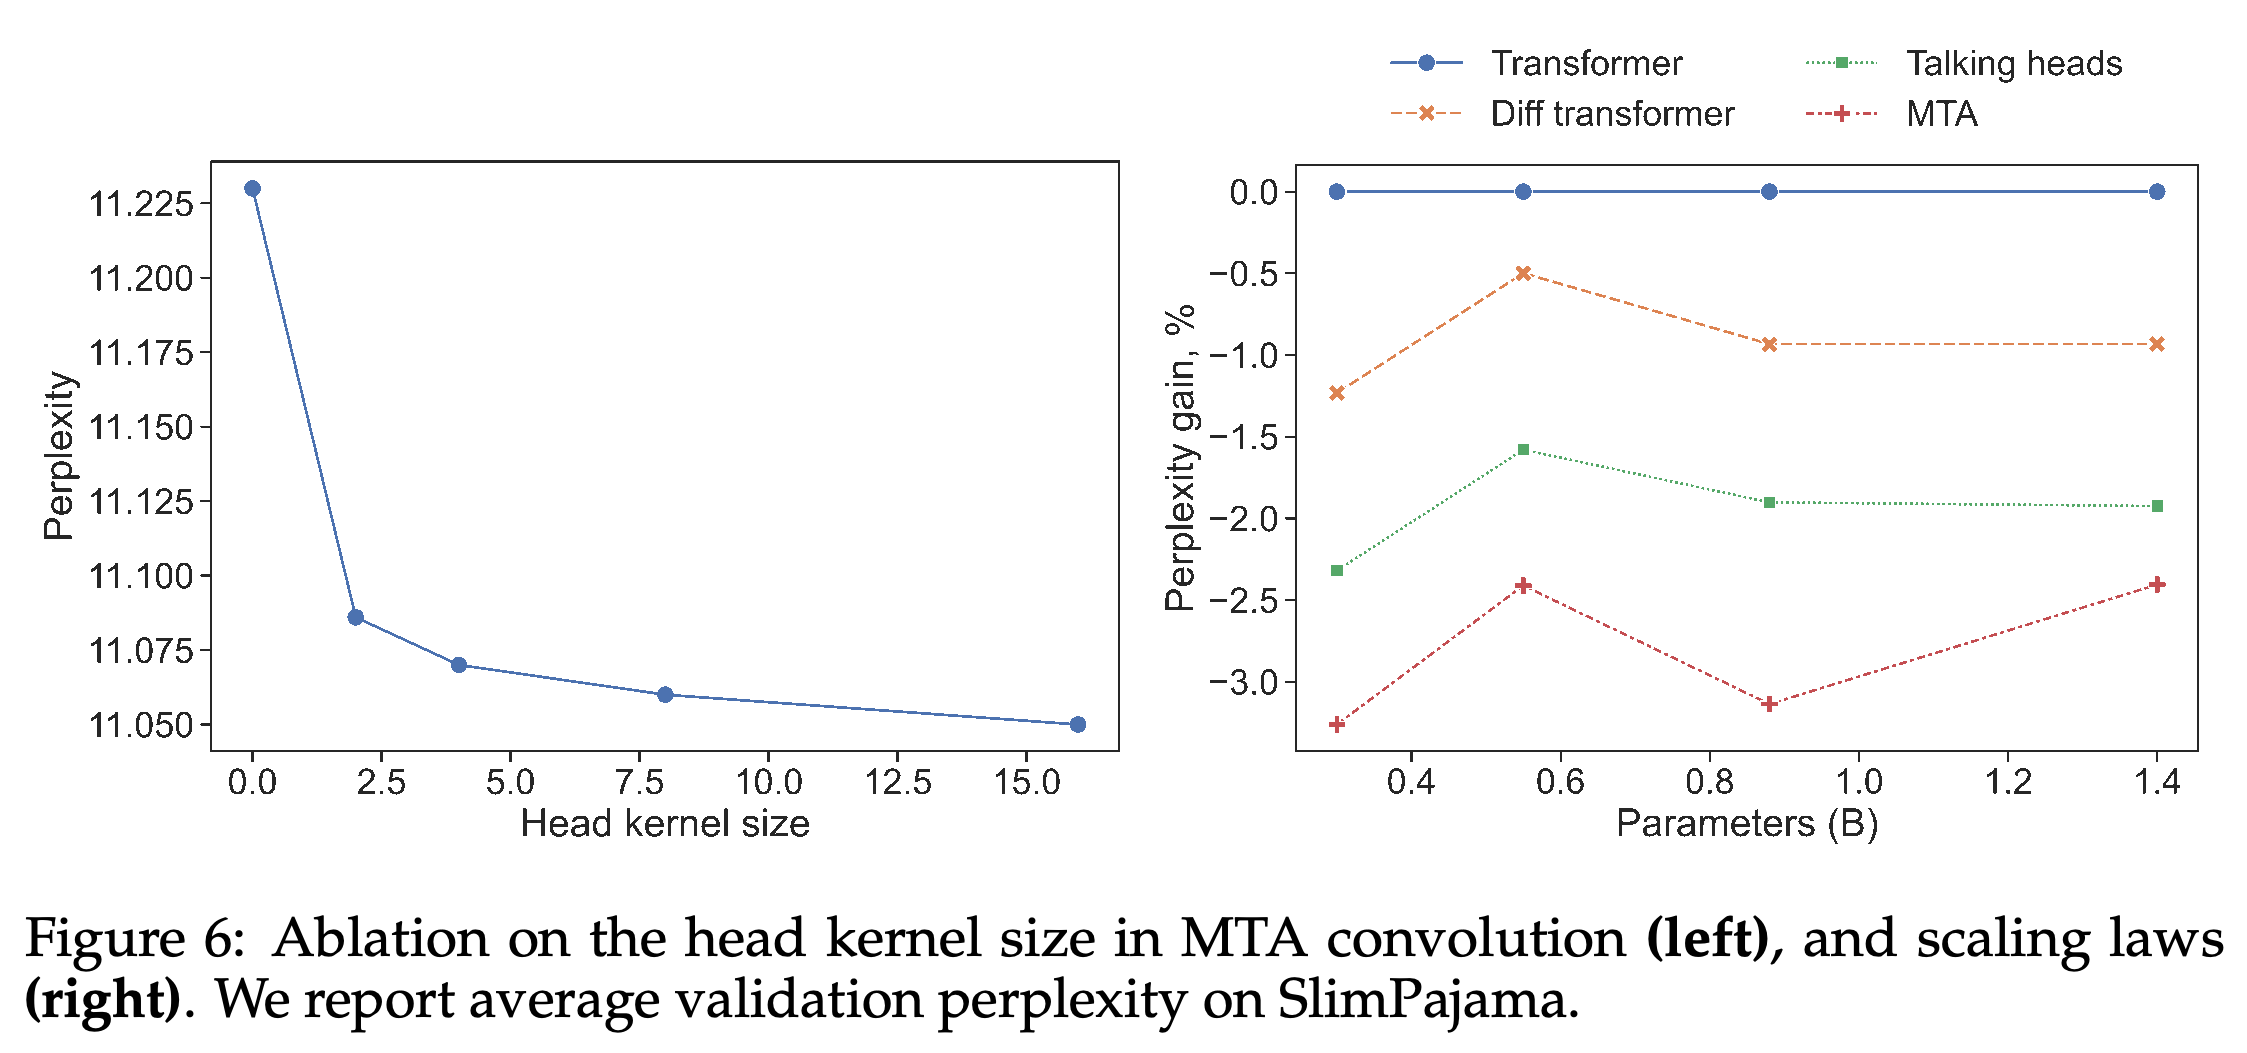
Ablation에서는 2개 층에만 key-query convolution을 추가해도 그래프에 제시된 Transformer와 Differential Transformer보다 검증 perplexity가 개선된다. 성능과 복잡성 사이의 절충안으로는 6개 층을 선택한다. Head 그룹이 클수록 perplexity가 개선되며, 저자들은 실험한 0 초기화와 상수 0.3 초기화보다 항등 초기화에서 수렴과 최종 성능이 더 좋다고 보고한다.
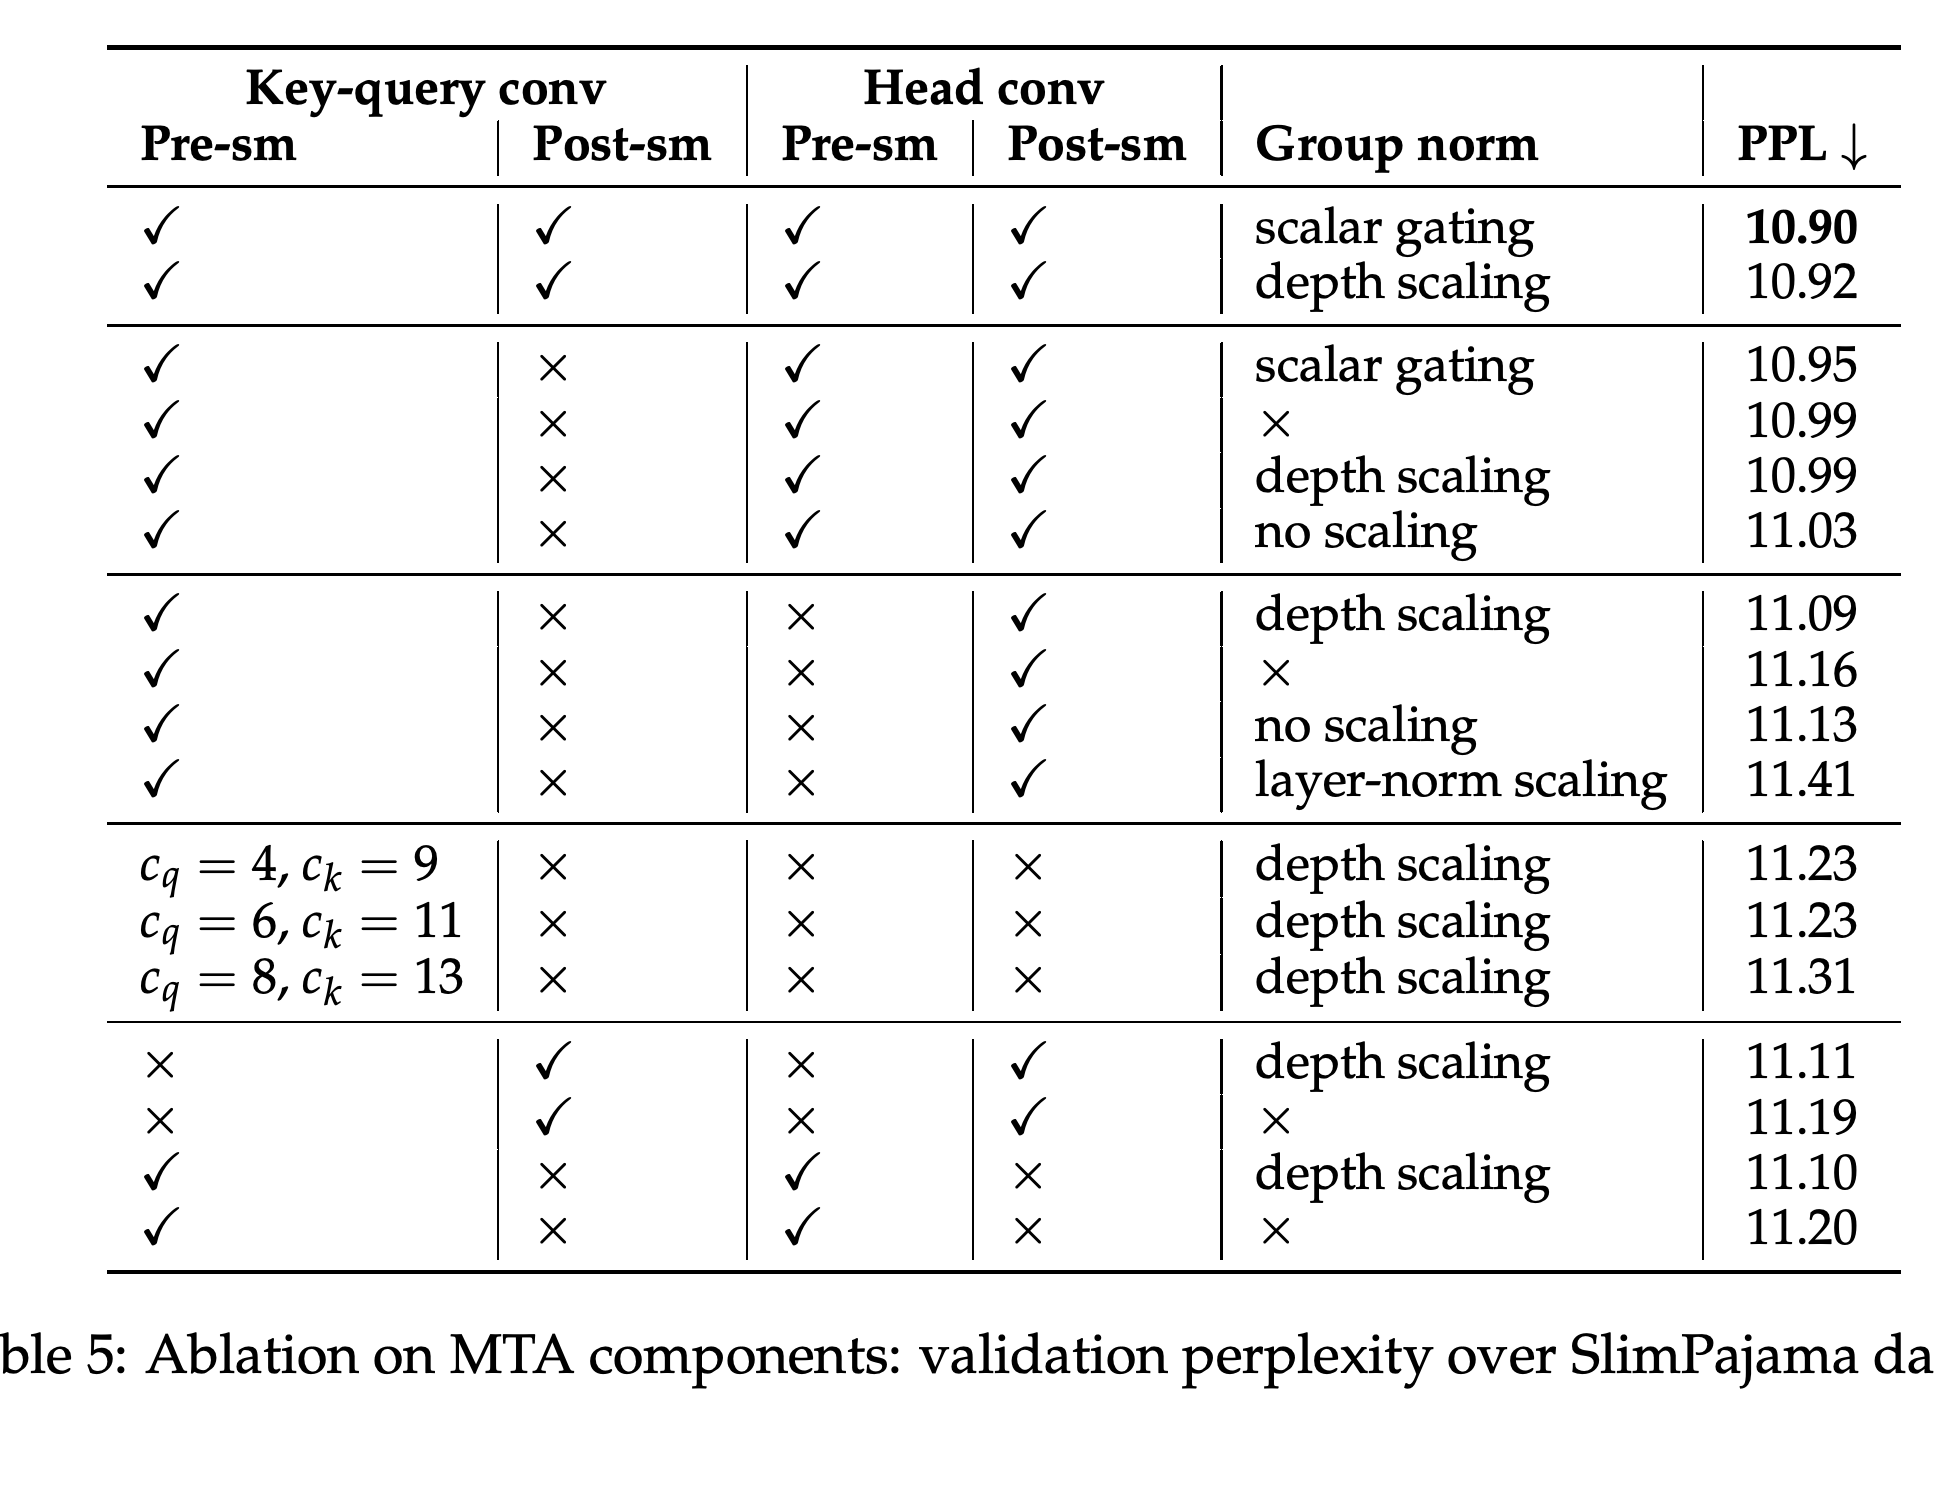
- Table 5에서 scalar gating과 함께 convolution 2종을 softmax 전후에 모두 적용하면 perplexity가 10.90이며, depth scaling을 사용하면 10.92다.
- 정규화와 scaling은 결과에 영향을 준다. 실험한 layer-norm scaling 구성 1개는 11.41을 기록하지만, 비교한 구성들에서 convolution 위치를 바꿀 때의 차이는 더 작다.
- Figure 6은 표시된 모델 크기 전반에서 MTA의 상대적 perplexity 이점을 보여준다. 본문은 추가 구성을 300M, 550M, 1B로 명시하지만, 그래프의 가장 큰 점은 약 1.4B에 있고 Appendix I도 1.4B 모델을 설명한다. 논문은 이 표기 차이를 해명하지 않는다.
왼쪽 패널은 방해 텍스트가 늘어날 때 MTA가 전체 정확도를 더 잘 유지함을 보여준다. 오른쪽 패널에서는 key-query convolution을 적용하는 층이 많아질수록 perplexity의 추가 개선 폭이 줄어든다. 이는 일부 층에만 적용하는 선택을 뒷받침한다.
Head 그룹 크기를 늘리면 perplexity가 낮아지지만 추가 개선 폭은 줄어든다. MTA는 그래프에 표시된 각 파라미터 규모에서 비교한 attention 변형보다 더 큰 상대적 perplexity 감소를 달성한다.
제시된 구성 중 가장 좋은 결과는 scalar gating과 함께 각 convolution을 softmax 전후에 모두 적용한 경우다. 정규화와 scaling에 따라 결과가 달라지므로, 성능 개선은 convolution뿐 아니라 주변 attention 출력 설계에도 좌우된다.
5 Related work
논문은 MTA를 attention 분포를 더 뚜렷하게 만드는 정규화, 무관한 메모리 제거, 문맥을 반영한 위치 인코딩, head mixing, 잡음 제거 attention과 연결한다. Talking heads attention은 MTA의 head-mixing 구성 요소와 밀접하며, Differential Transformer는 뺄셈으로 무관한 attention을 억제한다.
- 기존 convolution-attention 결합 방식은 key와 value를 압축하거나, convolution과 Transformer 층을 번갈아 배치하거나, key 차원을 따라 attention에 convolution을 적용한다.
- 저자들은 여러 query 위치, key 위치, head에 걸쳐 attention 점수에 convolution을 함께 적용한다는 점으로 MTA를 구별한다.
6 Conclusion
저자들은 여러 query, key, head의 attention 근거를 결합하면 관련 문맥의 위치를 더 잘 찾을 수 있다고 결론짓는다. 실험에서는 합성 논리곱 과제에서 0에 가까운 오류율, 더 낮은 언어 모델 perplexity, 여러 목표와 방해 텍스트가 있는 조건에서 더 좋은 검색 성능을 보인다.
부록
- A Limitations: 저자들은 현재 MTA가 널리 쓰이는 최적화된 attention kernel과 호환되지 않는다고 밝힌다. 실행 시간 최적화는 향후 과제로 남긴다. 따라서 보고된 품질 개선은 상당한 학습 부담이 따르는 구현에서 얻은 결과다.
- B MTA Architecture: Softmax 이후에 head 2개를 혼합하는 연산은 rank가 2배인 value/output projection으로 표현할 수 있다. Rank는 해당 행렬 변환의 표현 용량을 나타내는 차원 수다. 부록은 softmax 이전의 query/key projection에도 유사한 유도를 제시한다. 다만 파라미터를 공유하므로 독립적인 파라미터를 갖는 2배 rank의 head와 동등하지는 않다고 설명한다.
- C Toy task details: 시퀀스에는 N ∈ {5, 8}개의 소문자로 구성되고 마침표로 구분된 블록이 최대 50개 들어간다. 뒤에는 “#”와 L = 2개의 질문 문자가 이어지며, 목표 블록은 정확히 1개다. 학습에는 시퀀스 1M개, 별도로 분리한 평가 시퀀스 1K개, 배치 크기 64, 100K스텝, 무작위 seed 3개를 사용한다.
- D Language model training details: 학습은 하위 층 앞에 root mean square normalization(RMSNorm)을 적용하고, SwiGLU gated activation과 Rotary Embeddings를 사용하는 LLaMa 구조를 따른다. 880M 구성은 차원 1536, 24개 층, 16개 head, 배치당 262144 토큰, 문맥 길이 2048, 학습률 1.5e−4, weight decay 0.05, warmup 375스텝, RoPE theta 100000을 사용한다. Differential Transformer는 2배인 head 차원에 맞추어 head 수를 절반으로 줄이며, MMLU는 5-shot으로 평가한다.
- E BabiLong details: Table 6은 근거 사실 1개, 2개, 3개 또는 논항 2개, 3개의 관계를 다루는 QA1-5 과제를 예시로 보여준다. Figure 7은 전체 성능이 개선되어도 추론상의 약점이 남는다는 점을 보여준다. QA3 정확도는 무작위 기준선인 16.67% 근처에 머물며, QA4에서는 Differential Transformer가 MTA보다 좋은 성능을 낸다.
- F Complexity evaluation: Table 8의 파라미터 수는 Transformer가 876553728개, MTA가 876583320개다. 증가량은 29592개로 약 0.0034%이며, 서론에서 제시한 0.001%와 다르다. Table 9에 따르면 32대의 NVIDIA H200 GPU에서 학습할 때 MTA는 73.8 GB를 사용하고 초당 5.7 × 10³ 토큰을 처리한다. Transformer는 17.5 GB를 사용하고 초당 54.3 × 10³ 토큰을 처리한다. 표준 Transformer는 이 MTA 구현에서 사용할 수 없는 최적화된 attention kernel의 이점을 얻는다.
- G Multi-needle evaluation results: Figure 8은 2K-context 검색 결과를 needle 수 2, 4, 6, 8개와 삽입 깊이 0%, 25%, 50%, 75%, 100%로 나누어 보여준다. MTA는 needle 수가 많은 조건에서 삽입 깊이 전반에 걸쳐 높은 정확도를 유지한다. Needle이 두 개와 네 개인 일부 조건에서는 다른 방법이 더 좋은 성능을 낸다.
- H MTA kernel patterns.: Figure 9–14는 3, 7, 11, 15, 19, 23번 층의 head별 key-query kernel을 보여준다. Figure 15는 처음 3개 층에서 c_h = 2인 head kernel을 보여준다. Figure 16과 Figure 17은 group normalization 유무에 따른 대각 성분의 kernel 가중치 크기와 비대각/대각 비율을 비교하여, 깊이에 따른 scaling과 head 사이의 차이를 강조하는 상호작용을 보여준다.
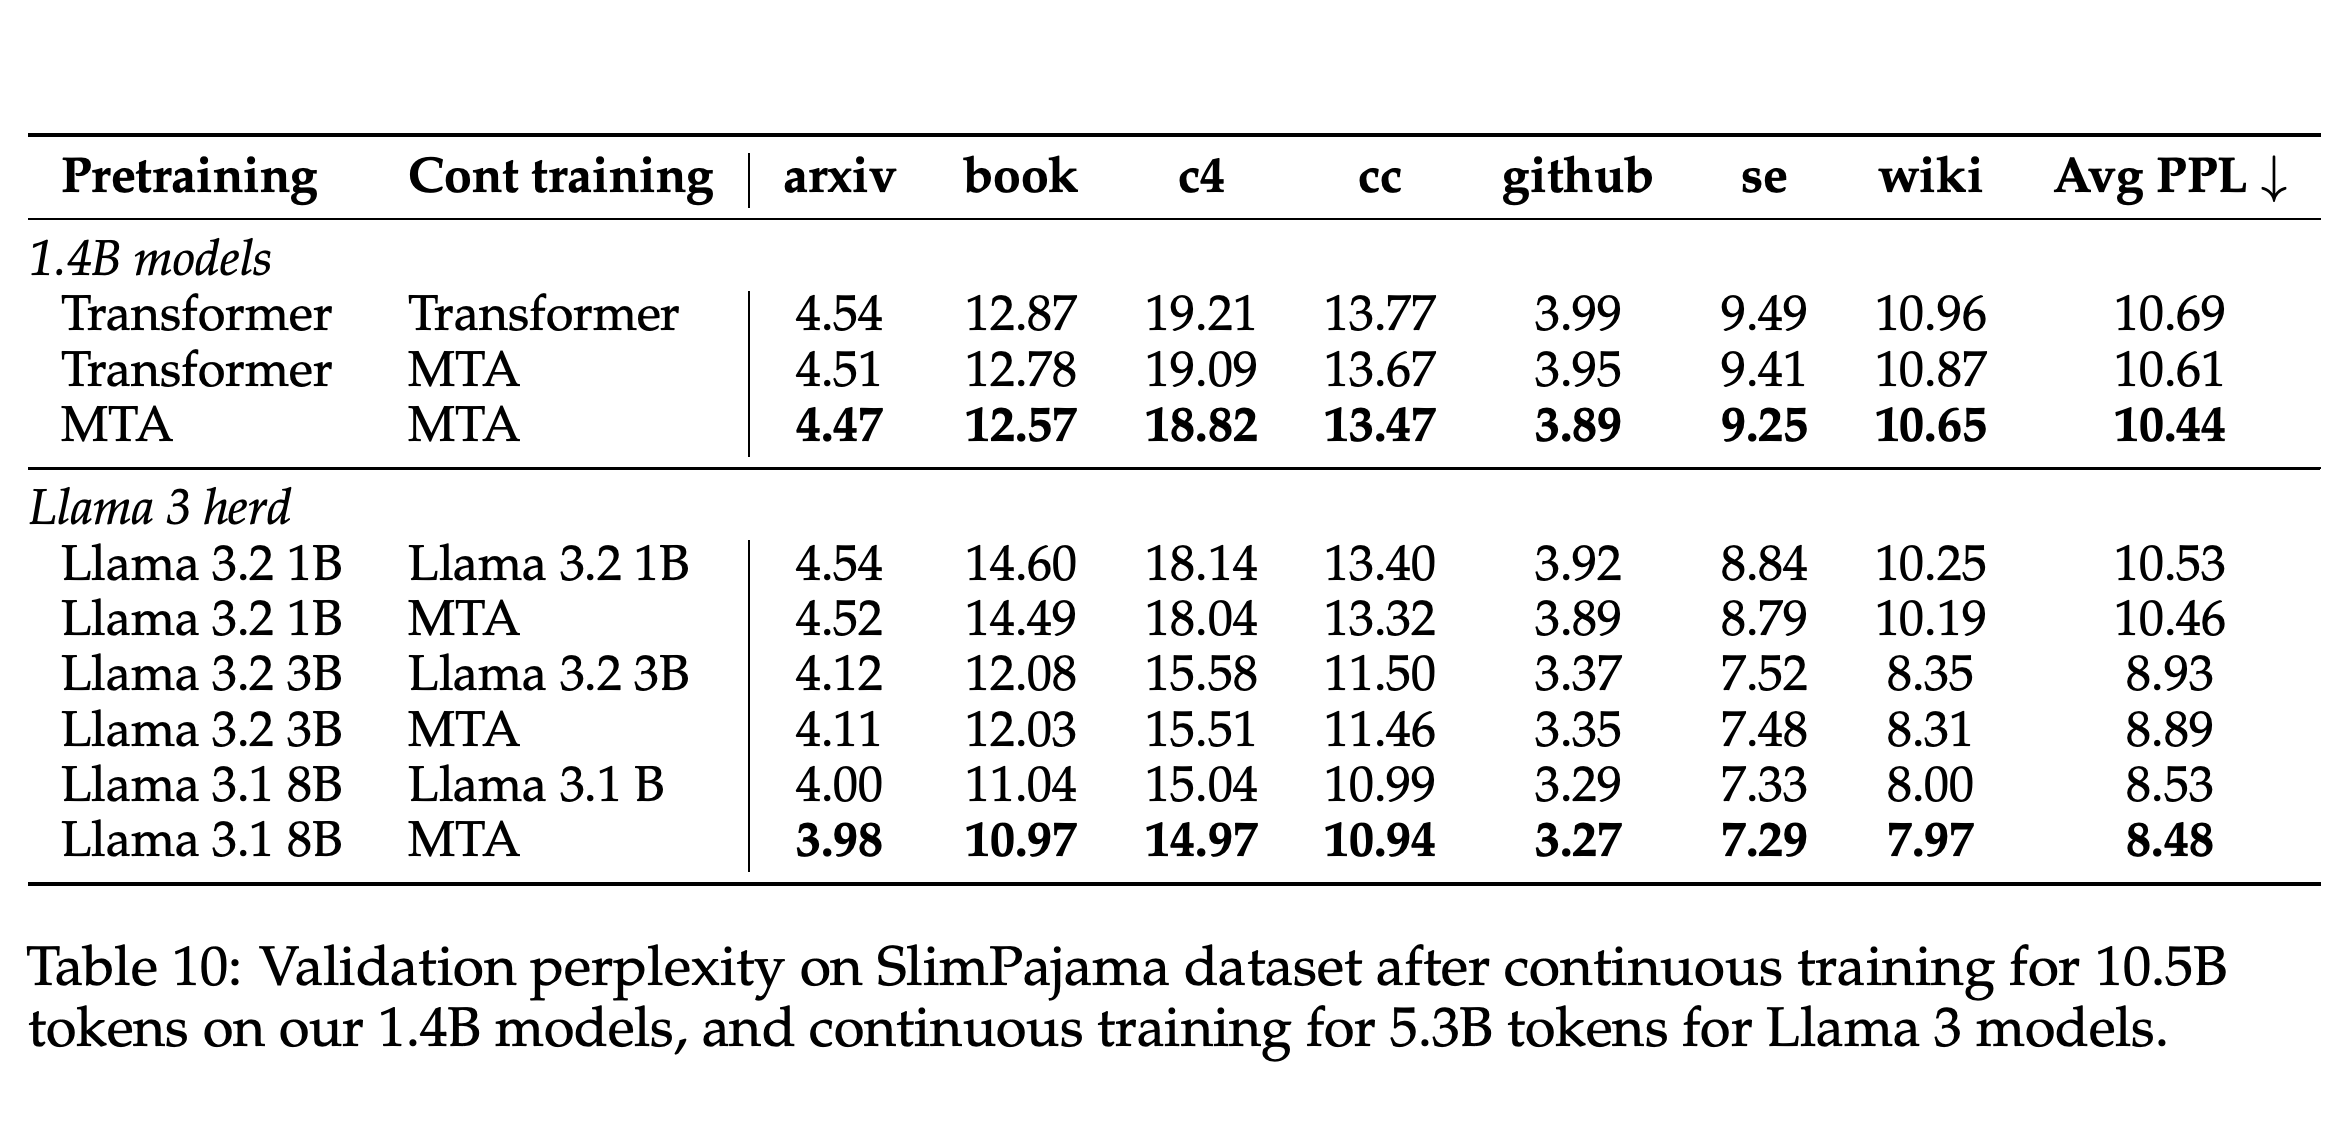
- I Finetuning with MTA: 항등 초기화한 convolution을 사전 학습된 Transformer 층에 삽입하고 계속 학습하여 갱신할 수 있다. 문맥 길이 2048에서 저자들의 1.4B 모델을 10.5B 토큰으로 추가 학습하면, MTA를 도입했을 때 평균 perplexity는 10.61이며 표준 Transformer를 계속 학습했을 때는 10.69다. Llama 3.2 1B, Llama 3.2 3B, Llama 3.1 8B를 5.3B 토큰으로 추가 학습한 경우에는 각각 10.46 대 10.53, 8.89 대 8.93, 8.48 대 8.53이다.
짧은 생각
이 연구의 기여는 attention map 사이에 명시적인 상호작용을 도입한 데 있다. 이를 검증하도록 설계한 합성 과제와 표준 attention 및 head-mixing 비교 모델 대비 성능 개선이 근거를 제공한다. 파라미터 증가량이 작다고 계산 비용까지 낮은 것은 아니다. Table 9는 상당한 메모리 증가와 처리량 감소를 보여주며, 구현마다 최적화된 kernel을 사용할 수 있는지가 비교에 영향을 준다.
메모리와 처리량 측정은 파라미터 수만으로 드러나지 않는 구현 비용을 보여준다. 표준 Transformer는 최적화된 attention kernel을 사용하지만 MTA는 사용하지 않는다. 따라서 이 결과는 현재 이용 가능한 구현을 비교한 것이며, 각 기법을 동등하게 최적화한 상태의 비교는 아니다.
실험 결과는 평가한 조건에서 검색과 언어 모델링이 개선됨을 뒷받침하지만, 일반적인 추론이나 훨씬 긴 문맥에 대한 근거는 더 제한적이다. 주요 검색 평가는 2K와 4K 문맥을 사용하며, BabiLong에는 과제별 실패가 남아 있다. Table 10은 도입 후 perplexity가 소폭 개선됨을 보여주지만, 이에 따른 검색 성능 개선은 평가하지 않는다.
추가 학습 중 MTA를 도입하면 평가한 모든 사전 학습 모델의 평균 perplexity가 낮아진다. 처음부터 MTA로 사전 학습한 저자들의 모델은 표준 Transformer에 MTA를 도입한 모델보다 여전히 성능이 좋다. 도입 이후의 검색 성능은 평가하지 않는다.