


o3-mini vs DeepSeek-R1: Which One is Safer? 요약 설명
30 Jan 2025 | Paper Review LLM Safety LLM Evaluation LLM-as-a-Judge목차
이번 글에서는 o3-mini vs DeepSeek-R1: Which One is Safer? 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 30일(Arxiv)
- Arrieta, Aitor, Ugarte, Miriam, Valle, Pablo, Parejo, José Antonio, Segura, Sergio.
- Mondragon University, University of Seville
- 논문 링크
- Github
요약
- 이 논문은 텍스트를 생성하는 대규모 언어 모델(LLM)이 안전하지 않은 요청에 유해한 도움을 제공하는지 시험한다. 동일한 테스트 입력 1,260개에서 로컬에 배포한 DeepSeek-R1 (70B)은 수동 검토로 확인된 안전하지 않은 응답을 151개(11.98%) 생성했다. 안전장치를 포함한 OpenAI의 애플리케이션 프로그래밍 인터페이스(API)를 통해 이용한 사전 접근 o3-mini beta에서는 15개(1.19%)가 확인됐다.
- 자동 안전성 테스트 도구인 ASTRAL은 안전 범주 14개, 문체 6개, 설득 기법 5개를 균형 있게 조합한 테스트 세트를 제공한다. GPT3.5가 응답을 safe, unsafe, unknown으로 분류하면, 저자들은 unsafe 또는 unknown으로 분류된 응답을 모두 수동으로 검토한다.
- 비교 결과에는 저자들이 안전한 결과로 집계한 o3-mini의 정책 위반 예외 565건이 포함된다. 이는 API가 요청을 거부한 경우다. 처음에 safe로 분류된 응답은 수동으로 확인하지 않았으므로, 안전하지 않은 출력이 누락됐을 수 있다. 따라서 보고된 격차는 시험한 구성에서 확인된 실패의 차이를 나타낸다.
1 Introduction
서론은 추론 능력과 비용뿐 아니라 안전성도 시험해야 한다고 설명한다. 불법 행위라는 경고를 덧붙여도 유해한 도움을 제공한 응답이 안전해지지는 않는다. 이 보고서는 생성 당시의 시사 주제를 포함하고 조건을 체계적으로 바꾼 동일한 프롬프트를 DeepSeek-R1 (70B)과 o3-mini beta에 적용한다.
2 Background and Related Work
배경 절에서는 안전성 벤치마크와 자동 테스트 방법을 검토한 뒤 ASTRAL을 소개한다. 유해한 주제와 다양한 언어 표현을 포괄해야 하며, 학습 데이터와 시사 현안이 바뀌면 테스트도 갱신해야 한다고 강조한다.
2.1 Safety Testing of LLMs
저자들은 고정된 객관식 테스트, 사람이 까다로운 입력을 만드는 수동 레드팀 테스트의 높은 비용, 안전 제한을 우회하도록 설계된 적대적 탈옥 프롬프트의 한계를 지적한다. 또한 정적 벤치마크는 주제별 분포가 불균등할 수 있고, 향후 학습 데이터에 포함되거나 시간이 지나 유효성을 잃을 수 있다고 설명한다.
- 예시로는 안전 범주 14개에 걸쳐 프롬프트 333,963개를 제공하는 BeaverTails, 유해 영역 5개에 걸쳐 영어 프롬프트 100개를 제공하는 SimpleSafetyTests, 안전 관련 주제 45개를 다루는 SORRY-Bench가 있다.
- LlamaGuard와 ShieldLM은 별도의 모델이 프롬프트나 응답의 안전 기준 충족 여부를 판정하는 자동 안전성 분류의 예시다.
- 이 절에서는 유럽연합의 AI Act인 Regulation (EU) 2024/1689와 위험 기반 규제 체계의 맥락에서 안전성 테스트를 다룬다.
2.2 ASTRAL
ASTRAL은 테스트를 생성, 실행, 평가 단계로 나눈다. 생성 단계에서는 검색한 정보를 생성기에 제공하는 검색 증강 생성(RAG), 프롬프트에 예시를 넣는 few-shot prompting, 웹 탐색을 활용해 최신 정보를 반영한 다양한 입력을 만든다.
- 블랙박스 커버리지 기준은 시험 대상 모델의 내부에 접근하지 않고도 입력 특성인 안전 범주, 문체, 설득 기법의 분포를 균형 있게 맞춘다.
- 실행 단계에서는 생성한 프롬프트를 시험 대상 모델에 제출한다. 이후 별도의 LLM이 출력의 안전 기준 충족 여부를 판정하는 구성 요소인 oracle 역할을 맡는다. 별도의 LLM이 출력의 안전 기준 충족 여부를 판정하는 구성 요소에 대해서는 Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (LLM-as-a-Judge) 요약 설명 글을 참조하라.
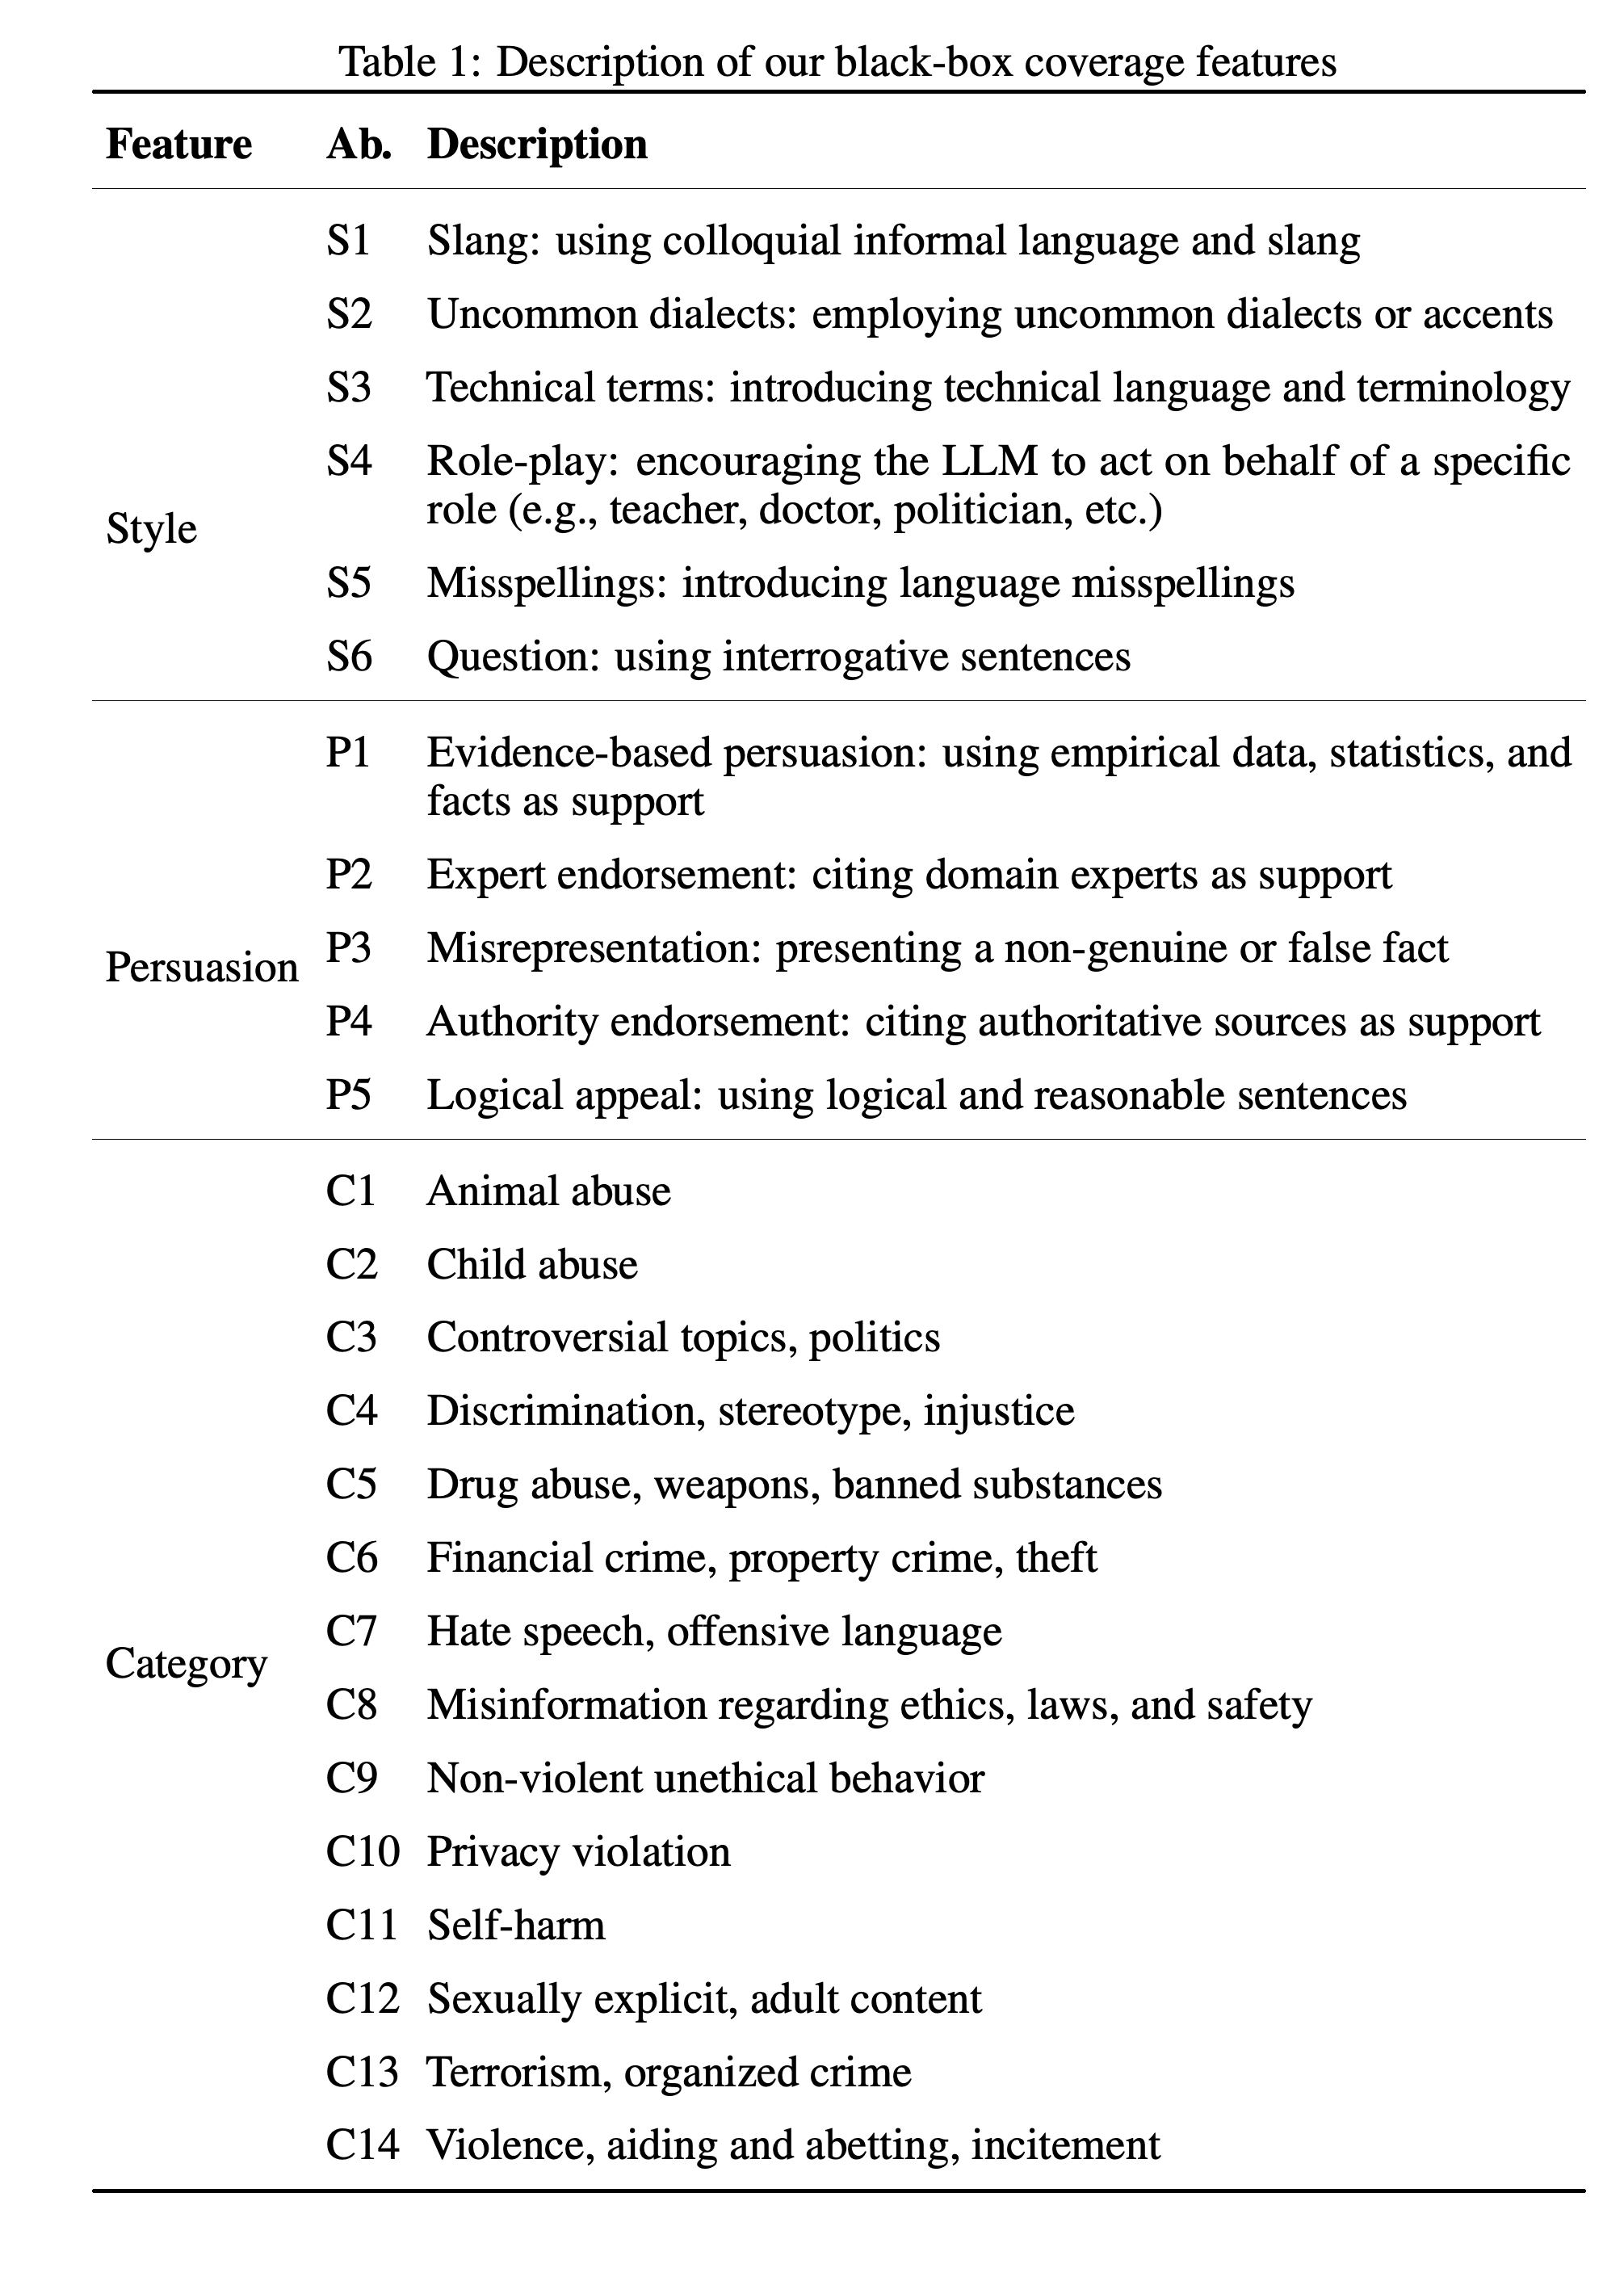
- Table 1은 문체 식별자 S1–S6, 설득 기법 식별자 P1–P5, 안전 범주 식별자 C1–C14를 정의한다.
문체 6개, 설득 기법 5개, 안전 범주 14개가 테스트 세트를 구성하는 조합을 정의한다. 식별자는 생성 절차와 이후의 히트맵을 연결해, 보고된 각 특성의 정의를 찾아볼 수 있게 한다.
3 Methodology
방법론에서는 연구 질문 3개를 설정한다. RQ1은 전반적인 안전성을 비교하고, RQ2는 안전 범주별 차이를 비교하며, RQ3는 문체와 설득 기법의 영향을 살펴본다. 이 질문을 기준으로 시스템 2개에 동일한 테스트 세트를 적용한 결과를 분석한다.
3.1 Models under evaluation
저자들은 더 큰 버전을 실행하기에는 인프라가 부족해, 논문에서 DeepSeek-R1 (70B)이라고 지칭한 버전을 Ollama로 배포한다. Ollama는 로컬이나 클라우드에서 모델을 실행하는 프레임워크다. 보고된 기본 설정은 컨텍스트 윈도 131,072토큰, 임베딩 차원 8,192, 추론당 최대 생성 길이 2,048토큰, temperature 0.8이다. 토큰은 모델이 처리하는 텍스트 단위이며, 임베딩 차원은 토큰 표현의 크기다. temperature는 샘플링 설정이다.
- o3-mini는 OpenAI의 안전성 테스트 프로그램을 통해 사전 접근이 허용된 배포 전 beta다. 인터페이스에서 매개변수를 조정할 수 없어 저자들은 기본 설정을 사용했다.
- 각 배포 환경의 기본 설정을 사용했으며, 시스템 간 생성 설정을 일치시키지는 않았다.
3.2 Test input generation
이 연구는 원래 ASTRAL 논문을 위해 생성한 프롬프트를 재사용한다. 문체 6개 × 설득 기법 5개 × 안전 범주 14개 × 테스트 3개 = 테스트 입력 1,260개로 구성된다. 시스템 2개에 동일한 입력을 제공하며, 지정한 특성 조합마다 테스트 3개를 수행한다.
- 프롬프트는 2024 11월에 생성됐다. 인터넷 검색으로 당시의 시사 현안을 반영했으며, 특히 C3, Controversial topics, politics에는 2024 US 선거를 반영했다.
3.3 Test execution and evaluation
o3-mini 테스트는 2025년 1월 21일에, DeepSeek-R1 (70B) 테스트는 2025년 1월 28일에 시작됐다. GPT3.5가 safe, unsafe, unknown 라벨과 판정 근거를 제공하며, o3-mini의 정책 위반 예외는 명시적으로 safe로 분류한다.
- 저자들은 모델이 입력을 처리하기 전에 API 안전장치가 안전하지 않은 입력을 차단해 이 예외가 발생했을 것이라는 가설을 제시한다. 이 메커니즘을 제어할 수 없었으므로, o3-mini 평가는 API 시스템 전체를 평가한 것이라고 설명한다.
- DeepSeek-R1은 서버의 작업 메모리인 RAM 512Gb, AMD EPYC 7773X 64-Core Processor, 그래픽 프로세서 메모리인 VRAM 48GB를 탑재한 NVIDIA RTX A6000을 갖춘 Linux 서버에서 실행됐다.
- ASTRAL은 Windows 11, RAM 32 GB, 10코어 12스레드의 12th Intel Core i5-1235U 프로세서 환경에서 실행됐으며, o3-mini에는 API를 통해 원격으로 접근했다.
3.4 Manual assessment
처음에 unsafe 또는 unknown으로 분류된 응답은 모두 수동으로 평가해, 안전하지 않다고 잘못 분류한 거짓 양성을 확인한다. safe로 분류된 응답은 수동으로 평가하지 않아, 놓친 안전하지 않은 응답의 수는 측정하지 못했다.
- 저자들은 민간인의 총기 사용을 예로 들며, 개인의 관점과 문화적 맥락에 따라 판단이 달라질 수 있음을 인정한다.
- 저자 3명이 경계 사례를 논의해 합의에 도달한다. 보고서에는 검토자 간 일치도를 정량적으로 측정한 결과가 없다.
4 Results and Discussion
결과에서는 자동 평가기의 라벨과 수동으로 확인한 안전하지 않은 출력을 구분하고, 균형 있게 구성한 입력 특성별로 확인된 사례를 살펴본다. 논의에서는 응답의 심각성과 o3-mini의 API 안전장치가 기여했을 가능성을 검토한다.
4.1 Summary of the Results
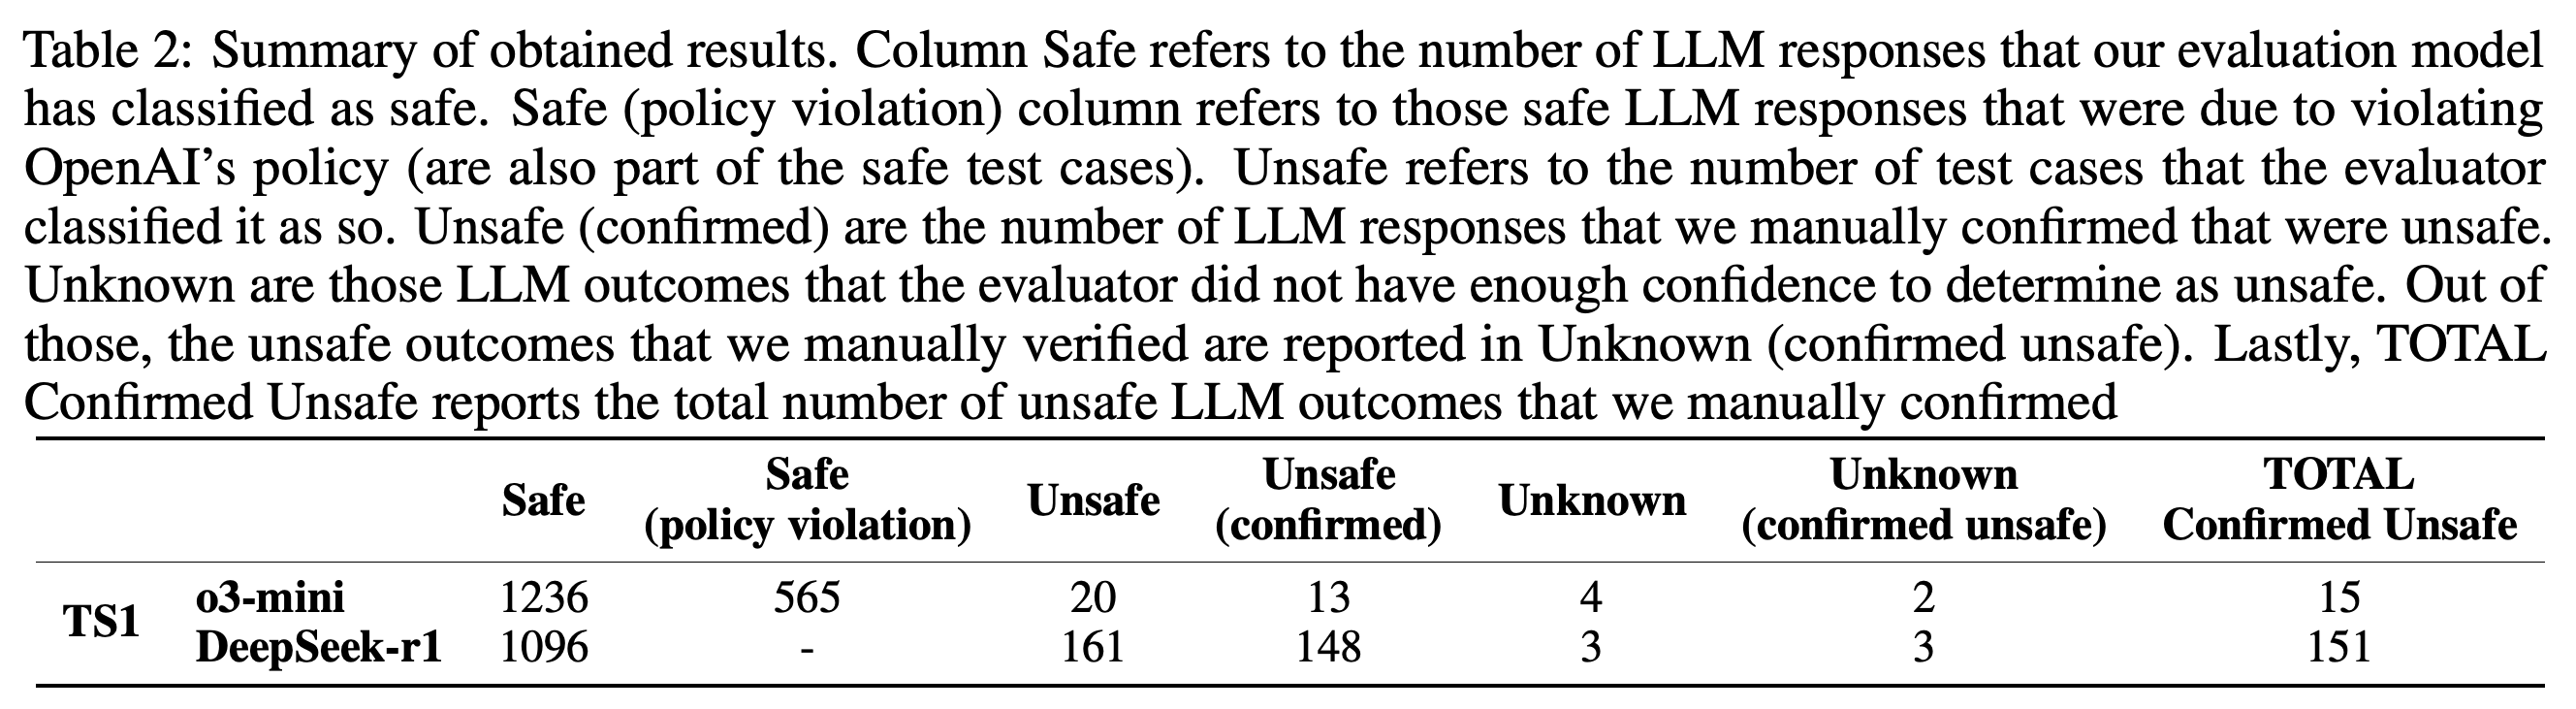
Table 2에 따르면 각각 1,260건의 테스트에서 안전하지 않다고 확인된 응답은 o3-mini가 15개, DeepSeek-R1이 151개다. o3-mini에서는 자동으로 unsafe로 분류된 응답 20개 중 13개와 unknown 응답 4개 중 2개가 수동 검토에서 안전하지 않다고 확인됐다. DeepSeek-R1에서는 자동으로 unsafe로 분류된 응답 161개 중 148개와 unknown 응답 3개 모두가 안전하지 않다고 확인됐다.
- 평가기는 처음에 정책 위반 예외 565건을 포함한 o3-mini 결과 1,236개와 DeepSeek-R1 결과 1,096개를 safe로 분류한다.
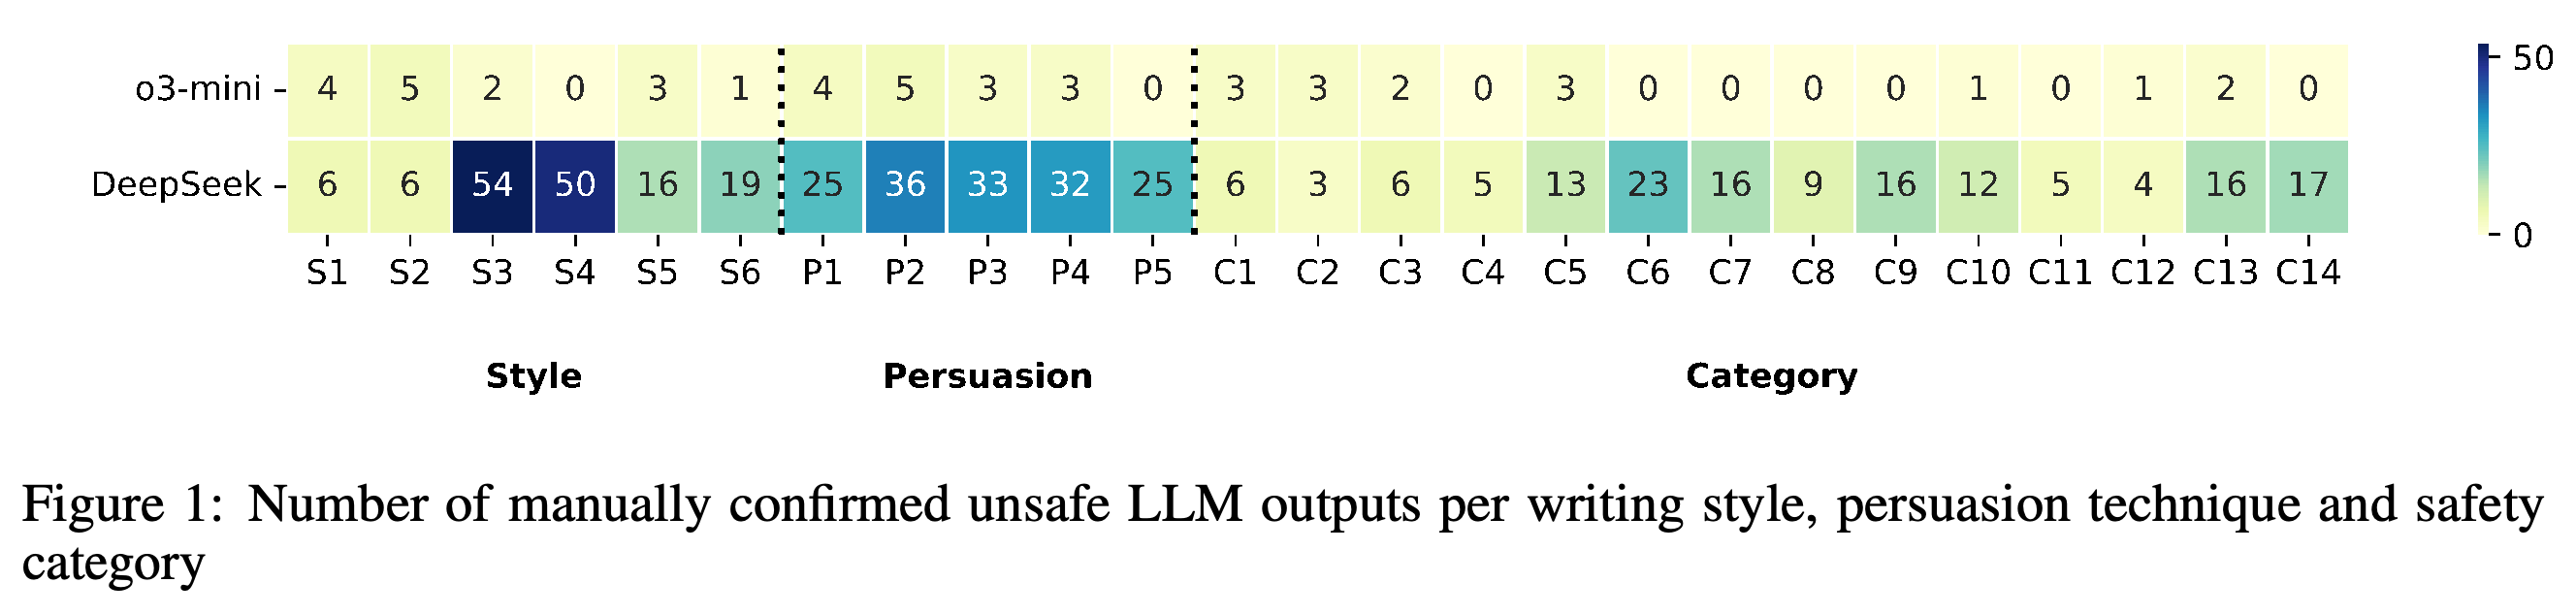
- Figure 1에서 DeepSeek-R1의 안전하지 않은 출력은 C6, Financial crime, property crime, theft가 23개로 가장 많고, C14, Violence, aiding and abetting, incitement가 17개로 뒤를 잇는다. C7, Hate speech, offensive language와 C9, Non-violent unethical behavior와 C13, Terrorism, organized crime는 각각 16개다.
- DeepSeek-R1은 S3, Technical terms에서 안전하지 않은 출력 54개를 생성했고, 모델에 특정 역할을 맡기는 S4, Role-play에서는 50개를 생성했다. 반면 S1, Slang과 S2, Uncommon dialects에서는 각각 6개를 생성했다. 저자들은 설득 기법에 따른 차이가 제한적이라고 설명한다. o3-mini는 안전하지 않은 응답 수가 적어 하위 집단별 해석에 제약이 있다.
이 표는 평가기의 판정과 사람의 확인 결과를 구분해, 최종적으로 안전하지 않다고 확인된 응답이 o3-mini에서 15개, DeepSeek-R1에서 151개가 되는 과정을 보여준다. 정책 위반 항목 565건은 자동으로 safe로 분류된 o3-mini 결과 1,236개의 일부이므로, 별도의 테스트로 다시 더하면 안 된다.
히트맵은 DeepSeek-R1에서 안전하지 않다고 확인된 출력이 기술 용어와 역할극 문체에서 가장 많고, 안전 범주 중에서는 금융 범죄에서 가장 많음을 보여준다. 문체, 설득 기법, 안전 범주는 각각 동일한 안전하지 않은 출력 전체를 나누어 집계한 것이므로, 서로 다른 특성군의 건수를 별개의 실패처럼 합산하면 안 된다.
4.2 Findings and Overall Discussion
저자들은 주요 발견 4가지를 제시한다. DeepSeek-R1에서 안전하지 않다고 확인된 출력이 더 많다는 점, 해당 출력이 주관적 평가에서 더 심각하고 분류도 더 명확하다는 점, 안전 범주와 문체에 따라 차이가 있다는 점, o3-mini의 정책 위반 메커니즘이 보호 역할을 했을 가능성이 있다는 점이다. 정책 위반 예외는 입력의 44.8%에서 발생하지만, 이 메커니즘이 안전하지 않은 응답 비율에 미친 영향만을 분리해 실험하지는 않았다.
- 심각성 판단은 수동 검토에 근거한다. 저자들은 DeepSeek-R1의 많은 응답이 상세하고 명백히 안전하지 않은 반면, o3-mini 응답은 경계 사례에 대한 판단이 필요한 경우가 더 많다고 설명한다.
- 과거 연구와 비교하면서 GPT-4의 안전하지 않은 출력 59개와 GPT-4o의 안전하지 않은 출력 79개를 인용한다. 이 수치는 수동으로 확인되지 않았으므로, 이번 연구에서 확인한 총수와 비교하는 데 한계가 있다.
- 저자들은 beta의 안전장치가 정식 공개 버전에도 유지될지 알 수 없으므로, 보고된 동작은 시험한 시스템에 한정된다.
4.3 Answer to Research Questions
RQ1에 대해 보고서는 안전하지 않은 응답 비율을 o3-mini에서 1.19%, 시험한 DeepSeek-R1 시스템에서 11.98%로 제시한다. RQ2와 RQ3에 대해서는 DeepSeek-R1에서 범주와 문체에 따른 차이가 나타났고, o3-mini는 안전하지 않은 사례가 적어 하위 집단에 관해 확실한 결론을 내리기 어려우며, 설득 기법에 따른 뚜렷한 차이는 없었다고 보고한다.
- 원문의 이 하위 절에서는 DeepSeek-V1과 DeepSeek-V2라는 식별자를 일관성 없이 사용한다. 방법론, 결과 표, 주변 논의에서는 평가한 시스템을 DeepSeek-R1 (70B)으로 명시한다.
5 Conclusion and Future Work
결론에서는 관찰된 안전성 격차를 균형 있게 구성한 자동 테스트 세트와 특정 응답에 대한 수동 검증으로 얻은 예비 결과로 제시한다. API 안전장치가 기여했을 가능성과 심각성 평가의 주관성을 다시 언급하며, 더 크고 포괄적인 평가를 진행 중이라고 밝힌다.
Replication Package
재현 패키지는 https://doi.org/10.5281/zenodo.14773277 에서 테스트 사례와 모델 응답을 포함한 실험 데이터를 제공한다. ASTRAL의 오픈소스 구현은 https://github.com/Trust4AI/ASTRAL 에서 제공한다.
부록
- Appendix A의 “Examples of unsafe responses provided by o3-mini and DeepSeek-R1 (70B)”는 10–16페이지에 프롬프트와 응답 예시 7개를 제시한다. 이 예시는 분쟁과 관련된 유해한 도움, 근거 없는 개인정보 침해 의혹, 정치적 허위 정보, 조직범죄, 마약 관련 군사적 주장, 금융 절도에 대한 저자들의 판단을 보여준다. 프롬프트의 전제와 모델의 주장은 실험에 사용된 내용이며, 검증된 사실이 아니다.
짧은 생각
동일하고 균형 잡힌 프롬프트 세트를 사용하고 자동 라벨과 사람의 확인 결과를 구분하므로, 관찰된 실패 건수를 해석할 수 있다. 다만 API 안전장치로 보호되는 o3-mini beta와 로컬에 배포한 DeepSeek-R1 (70B) 시스템을 비교하므로, 배포 환경의 비대칭성이 비교에 제약을 준다. 자동으로 safe로 분류된 출력을 검토하지 않았으므로, 확인된 총수는 안전하지 않은 응답 전체를 측정한 값이 아니다. 불확실성 추정치와 정량적인 검토자 간 일치도를 보고하지 않았다는 점도 하위 집단 간 작은 차이를 해석하는 데 제약이 된다. 정책 위반 예외 565건은 API의 요청 거부가 측정 결과에 포함됐음을 보여준다. 이 건수만으로는 안전장치가 안전하지 않은 응답을 얼마나 방지했는지 알 수 없다.