


ReVision: Refining Video Diffusion with Explicit 3D Motion Modeling 요약 설명
30 Apr 2025 | Paper Review Video Diffusion Models Motion Control 3D Motion Modeling목차
이번 글에서는 ReVision: Refining Video Diffusion with Explicit 3D Motion Modeling 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 30일(Arxiv), Transactions on Machine Learning Research (01/2026)
- Liu, Qihao, He, Ju, Yu, Qihang, Chen, Liang-Chieh, Yuille, Alan.
- Johns Hopkins University, Independent Researcher
- 논문 링크
- Project Page
원문 버전. 이 W18 회고 글은 2026년 1월 8일자 arXiv 2504.21855v2, TMLR (01/2026) 게재본을 검토했다. 2025년 4월 30일은 최초 arXiv 공개일이며, 벤치마크와 표에는 이후 v2의 개정 내용이 포함되어 있다.
요약
- 비디오 생성 모델은 그럴듯한 이미지를 만들지만, 복잡한 움직임과 객체 간 상호작용을 일관되게 유지하지 못하는 경우가 많다. ReVision을 사전 학습된 비디오 생성 모델인 Stable Video Diffusion (SVD)에 적용하면, VBench++ 비디오 생성 벤치마크에서 움직임의 활발한 정도를 나타내는 Dynamic Degree가 SVD-XT-1.1 기준 43.17%에서 83.15%로 높아진다. 논문에 보고된 일관성, 움직임의 부드러움, 이미지 품질 점수도 함께 개선된다.
- ReVision은 먼저 초기 비디오를 생성하고, 명시적인 3차원 모션 표현을 추출해 보정한 다음, 보정한 모션으로 비디오를 다시 생성한다. 모션 시퀀스를 복원하도록 학습한 네트워크인 Parameterized Motion Prior model (PMP)은 범주에 맞는 표현을 사용해 사람, 동물, 일반 객체를 지원한다.
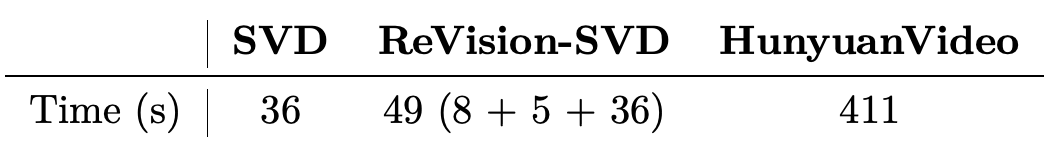
- 원하는 최종 상태를 지정하는 목표 포즈를 입력하지 않은 사용자 연구에서도, 논문에 보고된 1.5B-parameter ReVision-SVD는 또 다른 비디오 생성 모델인 13B-parameter HunyuanVideo보다 모션 선호도가 높다. 이러한 결과를 얻으려면 생성 모델의 일부를 미세 조정하고, 주석이 달린 20K-video 데이터셋과 외부 복원 모델을 사용해야 한다. 논문의 실행 시간 비교에서 32프레임 생성에는 ReVision이 49초, SVD가 36초 걸린다.
1 Introduction
ReVision: Refining Video Diffusion with Explicit 3D Motion Modeling은 일반적인 비디오 생성에서 신뢰할 만한 모션 가이드가 부족하다는 문제를 다룬다. 제공된 포즈 시퀀스로 이미지 속 사람에게 움직임을 부여하는 human image animation은 명시적인 가이드가 복잡한 움직임을 개선할 수 있음을 보여준다. 하지만 일반적인 생성 상황에서는 완전한 시퀀스를 구하기 어렵다.
- 제안한 Extract–Optimize–Reinforce 파이프라인은 생성 모델 자체에서 초기 모션을 얻고, 2번째 생성 단계에 앞서 해당 모션을 보정한다.
- 사용자는 완전한 궤적을 제공하는 대신, 간단한 스케치나 드래그로 객체 또는 신체 부위의 최종 위치를 선택적으로 지정할 수 있다.
2 Related Work
관련 연구는 텍스트나 초기 이미지에서 시작하는 비디오 생성, 텍스트와 optical flow를 통한 모션 제어, human image animation을 다룬다. Optical flow는 프레임 사이에서 이미지 평면상의 움직임을 나타낸다. ReVision은 객체별 모션을 추출하고, 이를 파라미터로 표현한 3차원 공간에서 보정한다.
- 기존 애니메이션 방법은 선택한 신체 위치를 나타내는 keypoint, flow, 각 부위가 차지하는 픽셀을 표시하는 신체 부위 마스크처럼 조밀한 가이드를 사용한다.
- ReVision은 참조 모션이 없을 때 초기 생성 비디오에서 가이드를 구성하고 보정한다.
3 Preliminary
Latent diffusion은 인코더와 디코더로 구성된 Variational Autoencoder가 만든 압축 표현에서 노이즈를 제거하는 역과정을 통해 데이터를 생성한다. SVD는 이미지 diffusion 모델에 시간축 convolution과 attention 계층을 추가해 비디오 프레임 간 관계를 처리한다.
- SMPL-X와 SMAL은 각각 사람과 동물을 위한 파라미터 기반 메시 모델이다. 포즈와 형상 파라미터가 3차원 표면을 결정하며, 미리 정의된 정점 레이블로 신체 부위 마스크를 만든다.
- SMPL-X는 정점 10,475개를 생성하며 포즈 파라미터 165개, 형상 파라미터 10개, 표정 파라미터 10개를 사용한다. SMAL은 정점 3,889개를 생성하며 포즈 파라미터 105개와 형상 파라미터 41개를 사용한다.
- 일반 객체에는 완전한 범주별 표면 모델 대신 2.5D 표현을 사용한다. 객체를 둘러싸는 2차원 bounding box와 segmentation mask에 추정 깊이를 추가한 표현이다.
4 Method
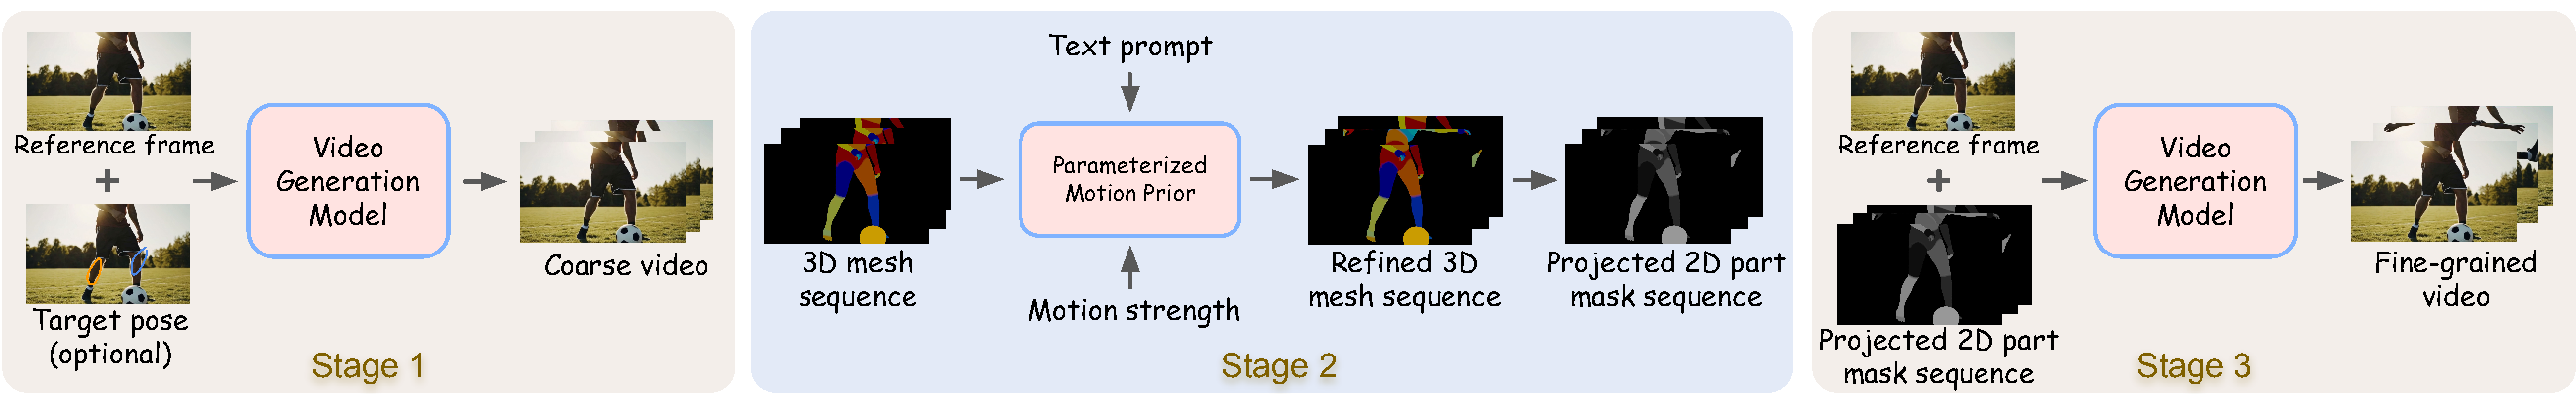
먼저 SVD가 모션 가이드를 입력받도록 조정한 다음, 이 생성 모델을 초기 비디오 생성과 최종 비디오 생성에 재사용한다. 생성 단계 사이에서 PMP가 추출된 모션을 보정하고, 이미지 좌표에 맞춘 조건 입력으로 변환한다. 조건 입력은 생성 과정을 유도하는 추가 입력을 뜻한다.
이 도식은 비디오 생성 모델을 2회 사용하는 사이에 모션 보정을 배치한다. 추출된 모션을 보정한 뒤 조밀한 가이드로 사용하는 구조다. 이를 통해 ReVision에 모션 복원과 2번째 합성 단계가 필요한 이유를 설명한다.
4.1 Motion-Conditioned Video Generation
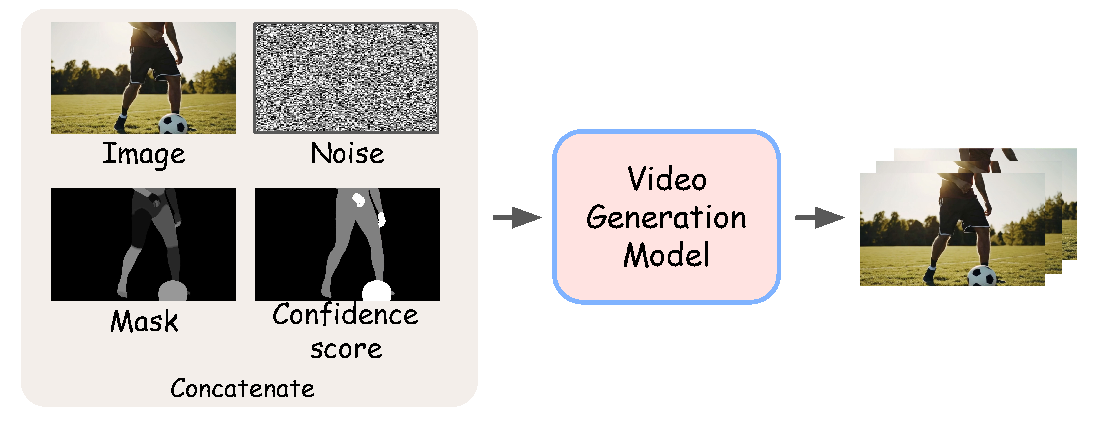
모션 조건 입력에는 2개 채널을 추가한다. 하나는 부위별 segmentation mask이며, 다른 하나는 가이드가 제공된 위치를 표시하는 confidence map이다. 초기 convolution 블록과 시간축 계층만 미세 조정하므로, 전체 생성 모델을 다시 학습하지 않고도 서로 다른 수준의 가이드를 입력받을 수 있다.
- 학습 예시의 40%에는 전체 모션 시퀀스를 제공하고 confidence를 1로 지정한다.
- 30%에는 마지막 프레임의 다각형 목표 마스크를 제공하고 confidence를 0.5로 지정한다. 다각형은 추론 시 제공되는 간단한 스케치를 근사한다.
- 나머지 30%에는 confidence가 0인 빈 마스크를 사용해, 명시적인 모션 입력 없이도 생성할 수 있도록 한다.
추가된 마스크와 confidence 입력 덕분에 조정된 생성 모델 1개가 완전한 궤적, 대략적인 최종 포즈, 모션 가이드가 없는 입력을 모두 처리한다. Confidence 채널은 별도의 신뢰도 모델이 예측하는 값이 아니라 학습 중 제공하는 표지다.
4.2 Proposed Method: ReVision
S1: Coarse Video Generation은 첫 프레임과 선택적으로 제공되는 마지막 프레임의 목표 포즈를 사용해 모션과 장면 구조를 제안한다. 모션 특징만 남기므로 원래 해상도의 1/4, 프레임 수의 1/2을 사용하고, denoising 단계도 50회 대신 32회로 줄일 수 있다. 이에 따라 논문에 보고된 실행 시간은 36초에서 8초로 줄어든다.
S2: Object-Centric 3D Optimization은 사람과 동물에는 메시를 피팅하고, 일반 객체에는 간결한 표현을 구성한다. 일반 객체마다 마스크 윤곽의 정점 16개, bounding box의 모서리 4개, 상자 중심을 합쳐 21개 점을 만들고, 추정 깊이를 이용해 이 점들을 3차원 공간으로 옮긴다.
- PMP는 추출된 모션, 사전 학습된 CLIP text encoder의 텍스트 특징, motion strength를 입력받는다. CLIP text encoder는 설명을 특징 벡터로 변환하며, motion strength는 인접 프레임의 파라미터 변화로 계산한 속도 척도다.
- Transformer 블록은 self-attention으로 모션 시퀀스 내부의 관계를 결합하고, cross-attention으로 텍스트와 motion strength 조건을 반영한다.
- 학습 시 주석이 달린 모션에 노이즈를 추가하거나, 시간 순서를 섞거나, 구간을 누락하고 반복해 손상시킨 다음 PMP가 원래 시퀀스를 복원하도록 학습한다.
S3: Fine-grained Video Generation은 보정된 3차원 모션을 2차원 부위 마스크와 해당 confidence map으로 투영한다. 같은 조정된 SVD가 전체 모션 시퀀스를 가이드로 사용해 비디오를 다시 생성한다. 이는 S1에서 사용한 희소한 가이드나 가이드가 없는 입력을 대체한다.
5 Experimental Results
실험에서는 제공된 이미지에서 시작하는 image-to-video 생성, 참조 움직임을 재현하는 모션 전이, 사용자 선호도, 가림 처리, 실행 시간, 춤 생성, PMP의 기여를 평가한다. 또한 다른 기반 비디오 생성 모델에도 프레임워크를 적용할 수 있는지, PMP가 별도의 사람 모션 생성 모델을 개선하는지 확인한다.
5.1 Image-to-Video Generation
학습에는 캡션이 있는 비디오 데이터셋 Panda-70M에서 가져와 자동으로 주석을 단 비디오 20K개를 사용한다. 주석에는 프레임별 box, semantic mask, depth map, 복원된 사람 또는 동물 메시가 포함된다. SVD는 batch size 64, 고정 learning rate 2 × 10⁻⁵로 300K회 미세 조정한다. 클립은 stride 4로 샘플링한 16프레임이며, 해상도는 1024 × 576이다.
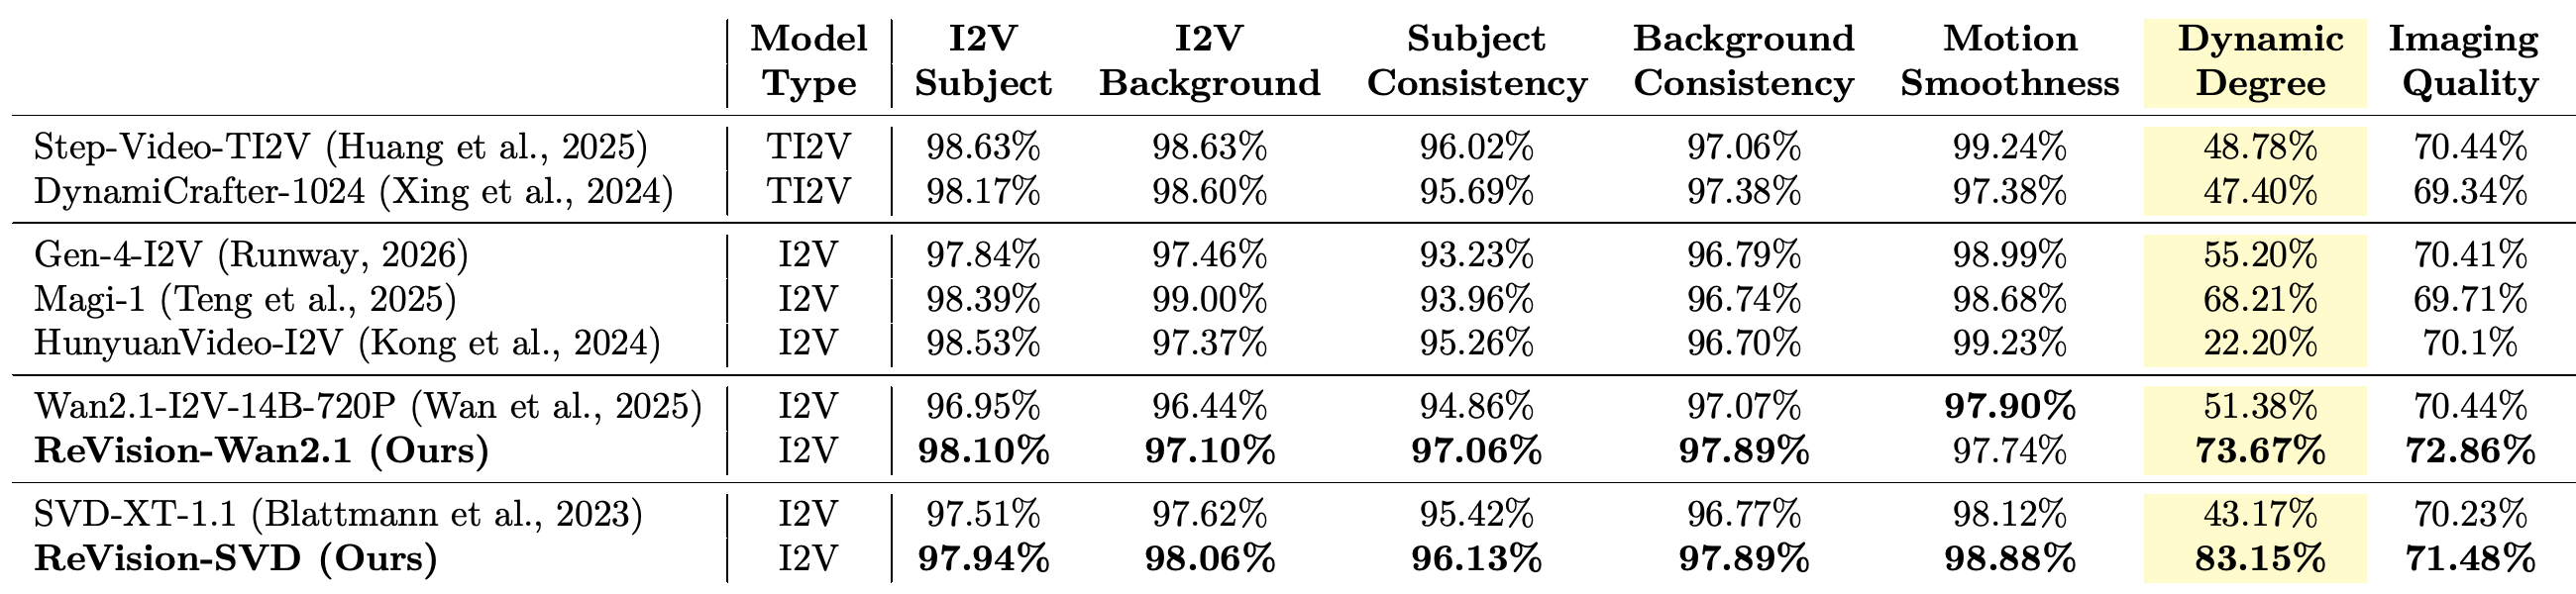
VBench++에서 ReVision-SVD는 Dynamic Degree를 43.17%에서 83.15%로, 피사체 일관성을 95.42%에서 96.13%로, 이미지 품질을 70.23%에서 71.48%로 높인다. 같은 데이터셋과 설정으로 학습한 ReVision-Wan2.1은 기반 생성 모델 Wan2.1-I2V-14B-720P의 Dynamic Degree를 51.38%에서 73.67%로 높인다. 다만 움직임의 부드러움은 97.90%에서 97.74%로 소폭 낮아진다.
- 2번째 기반 생성 모델과의 비교는 SVD 외 모델에도 적용할 수 있음을 뒷받침하며, 움직임의 부드러움에서는 소폭 손해가 있다.
- Dynamic Degree는 일관성, 품질, 사용자 평가와 함께 해석해야 한다. 움직임이 늘었다는 사실만으로 모션의 정확성을 입증할 수는 없다.
기반 생성 모델과의 비교 모두에서 Dynamic Degree가 크게 높아지고, 보존 및 품질 점수도 대부분 개선된다. Wan2.1의 움직임 부드러움 점수는 97.90%에서 97.74%로 낮아지므로 모든 지표에서 개선되는 것은 아니다.
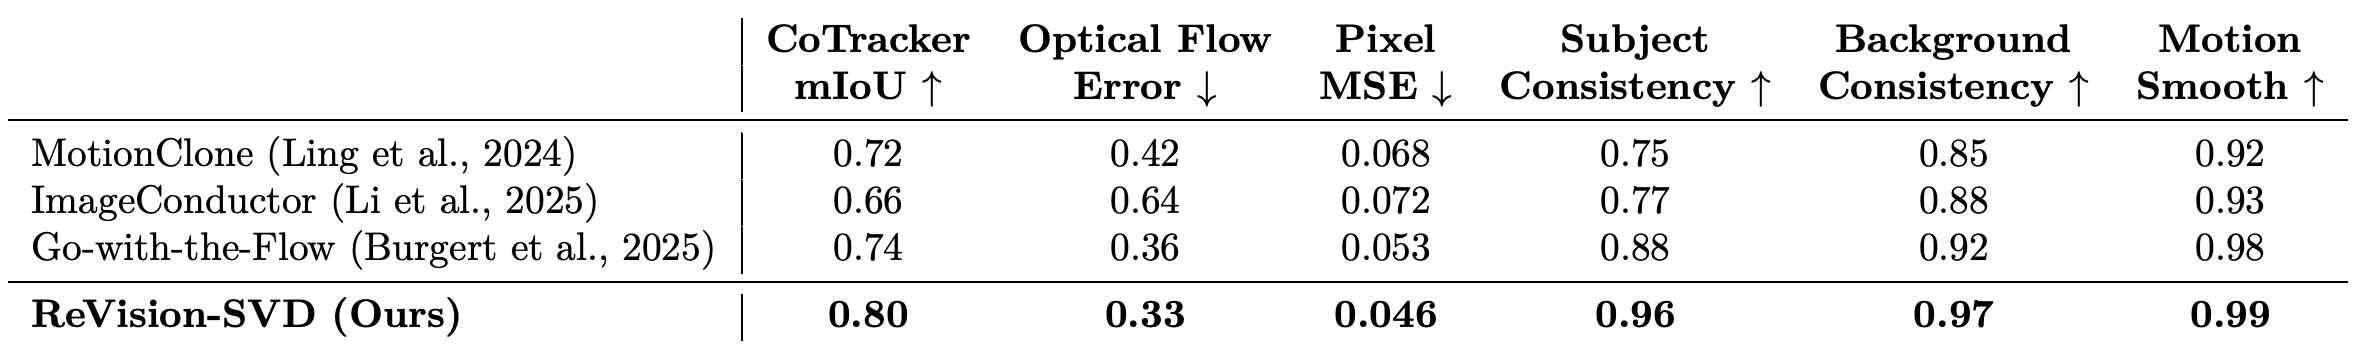
비디오 객체 분할 벤치마크인 DAVIS를 모션 전이 평가에 사용한 결과, ReVision-SVD는 모션 조건부 생성 방법인 MotionClone, ImageConductor, Go-with-the-Flow보다 보고된 6개 지표 모두에서 우수하다. 추적된 모션의 평균 intersection-over-union 중첩 점수인 CoTracker mIoU는 0.80으로, Go-with-the-Flow의 0.74보다 높다. Optical-flow 오차는 0.36에서 0.33으로, 픽셀 차이의 제곱을 평균한 pixel mean squared error는 0.053에서 0.046으로 낮아진다.
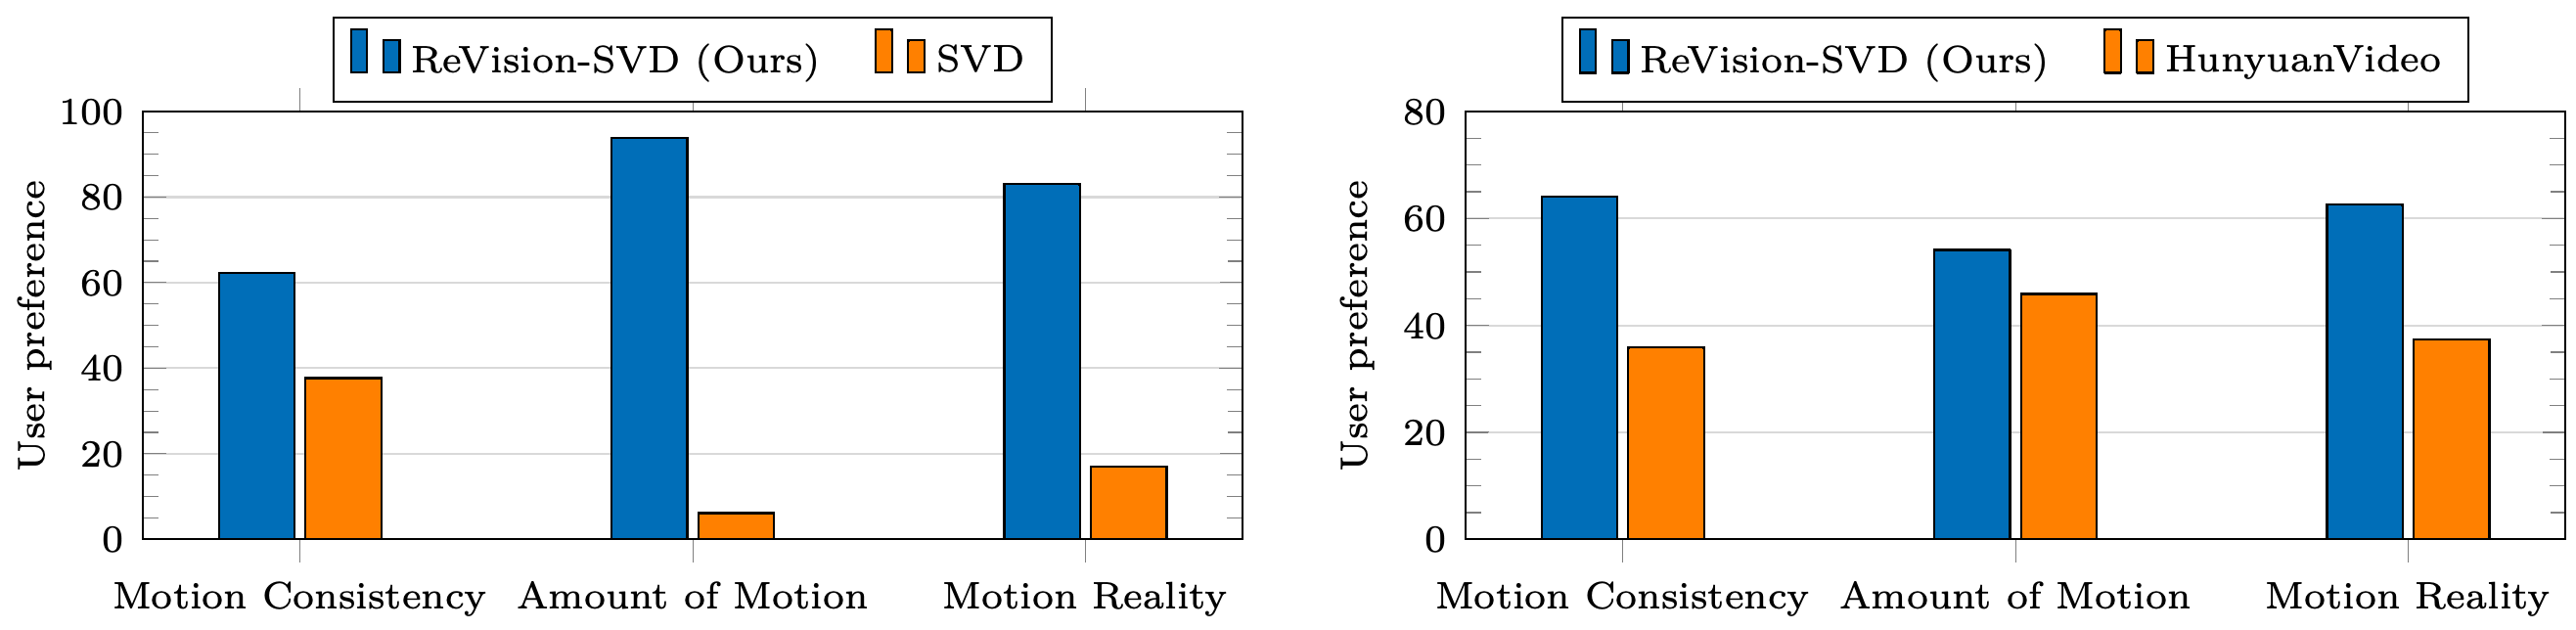
- 주요 선호도 연구에서는 프롬프트와 입력 이미지 생성에 사용한 모델인 GPT-4o로 활동 설명 500개를 만들었다. 각 baseline 비교에서 설명마다 입력 5개를 사용해 총 5,000쌍의 비디오를 구성한다.
- 어떤 모델에도 목표 포즈를 제공하지 않는다. 각 쌍에는 seed 42를 사용하고, 크라우드소싱 플랫폼 Amazon Mechanical Turk (MTurk)에서 무작위로 선정한 평가자 3명이 표시 순서를 무작위로 바꾼 비디오를 평가한다. 총 비교 횟수는 15,000회다.
- SVD 비교에는 생성한 이미지를 1024 × 576으로 조정해 입력한다. HunyuanVideo 비교에서는 1280 × 720으로 생성한 HunyuanVideo 출력의 첫 프레임을 ReVision에 입력한다. 비교마다 입력 프로토콜이 다르다.
ReVision은 두 baseline 모두와의 비교에서 모션 일관성, 움직임의 양, 모션의 사실성에 대한 선호도가 더 높으며, HunyuanVideo에 대한 우위는 상대적으로 작다. 이 비교에서는 어떤 모델에도 목표 포즈를 제공하지 않는다.
ReVision-SVD는 추적 모션의 중첩, flow 오차, 픽셀 오차, 피사체 일관성, 배경 일관성, 움직임의 부드러움에서 표에 제시된 방법보다 우수하다. 이 표는 모션뿐 아니라 전이 정확도와 외형 보존도 평가한다.
ReVision-SVD가 32프레임 비디오를 생성하는 데 걸리는 시간은 49초다. 초기 생성에 8초, 검출과 모션 보정에 5초, 최종 생성에 36초가 걸린다. 논문은 추가된 검출 및 보정 단계에 A100 GPU 1개를 사용했다고 보고한다. 실행 시간 표에서 SVD는 36초, HunyuanVideo는 411초가 걸린다. ReVision은 SVD보다 13초 더 걸리지만 HunyuanVideo보다 약 8.4배 빠르다.
- 객체가 다른 객체를 가리는 상황과 상호작용에 대한 선호도 평가에도 같은 5,000쌍을 사용한다. 상호작용이나 가림이 없다고 표시된 응답 4,793건을 제외하면 평가 10,207건이 남는다.
- 유효한 비교에서 ReVision의 선호도는 SVD 대비 97.63%, HunyuanVideo 대비 63.99%다.
- 깊이를 고려한 투영은 겹치는 객체의 앞뒤 순서를 정하는 수단이지만, 이러한 선호도 결과가 일반적인 물리적 정확성을 입증하지는 않는다.
보고된 비교에서 ReVision은 SVD보다 13초 더 걸리며, HunyuanVideo보다는 약 8.4배 빠르다. 원문 캡션은 SVD와 속도가 같다고 주장하지만, 표의 수치는 49초와 36초로 차이가 있다.
더 긴 비디오를 생성할 때 PMP는 중간 모션 상태를 삽입하는 보간으로 32프레임 모션 시퀀스를 64프레임으로 늘린다. 이후 원래 시퀀스 밖으로 모션을 확장하는 외삽과 보정을 통해 128프레임으로 늘린다. 비디오 합성에는 stride 24, 중첩 8의 32프레임 윈도우를 사용한다. 중첩 구간의 모션 조건을 정렬하고 겹치는 프레임을 혼합하며, 외형과 정체성 조건을 공유한다.
- 이 시연은 파라미터 공간의 재샘플링과 클립 연결을 통한 모션 확장을 뒷받침한다. 논문은 긴 비디오를 위한 별도의 정량 벤치마크를 보고하지 않는다.
5.2 Complex Motion Generation
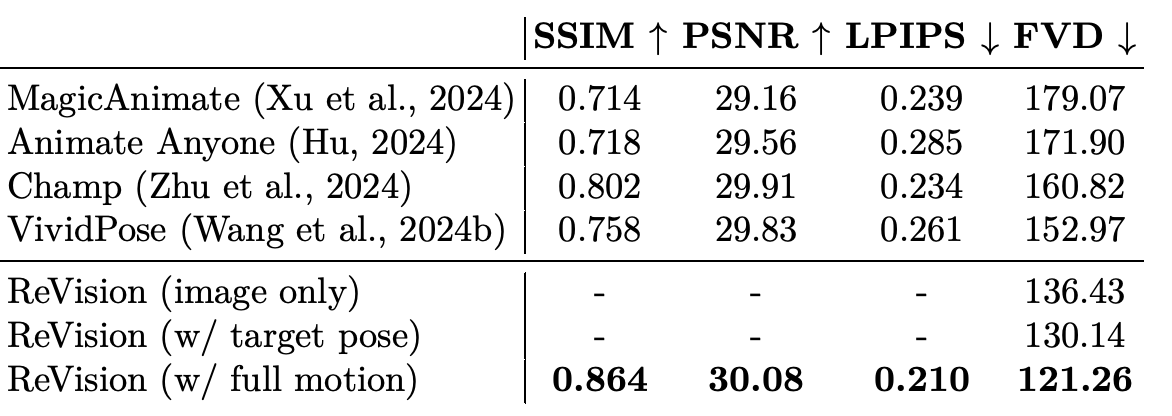
춤 실험에는 Disco 춤 생성 방법에서 사용한 학습 및 테스트 분할에 따라 TikTok Dancing 데이터셋을 사용한다. 비디오를 576 × 1024로 자르고, 학습 분할에서 batch size 8, learning rate 1 × 10⁻⁵로 SVD를 30K회 미세 조정한다. 전체 모션 가이드를 제공하면 ReVision은 이미지 구조의 유사도를 나타내는 Structural Similarity Index (SSIM) 0.864, 이미지 복원 품질 척도인 Peak Signal-to-Noise Ratio (PSNR) 30.08, 학습된 지각적 이미지 차이 척도인 Learned Perceptual Image Patch Similarity (LPIPS) 0.210, 비디오 분포의 충실도 지표인 Fréchet Video Distance (FVD) 121.26을 달성한다.
- 보고된 평가에서는 SSIM과 PSNR이 높고 LPIPS와 FVD가 낮을수록 결과가 좋다. 전체 모션 가이드를 사용하는 변형은 이 지표들에서 표에 제시된 모든 baseline보다 우수하다.
- 이미지만 입력한 변형과 목표 포즈를 입력한 변형의 FVD는 각각 136.43과 130.14로, human image animation baseline인 VividPose의 152.97보다 낮다. 이 변형들의 대응 프레임 SSIM, PSNR, LPIPS는 보고되지 않았다.
- 전체 모션 비교에는 애니메이션 baseline에 제공되는 가이드를 사용한다. 희소 입력 변형은 더 적은 모션 가이드로 생성할 수 있다는 별도의 주장을 뒷받침한다.
이 표는 전체 모션 조건 입력을 이미지만 입력한 생성 및 목표 포즈를 입력한 생성과 구분한다. ReVision의 3개 설정 모두 표에 제시된 baseline보다 FVD가 개선되지만, 대응 프레임의 품질 지표는 전체 모션 설정에 대해서만 보고한다.
5.3 Parameterized Motion Prior Model (PMP)
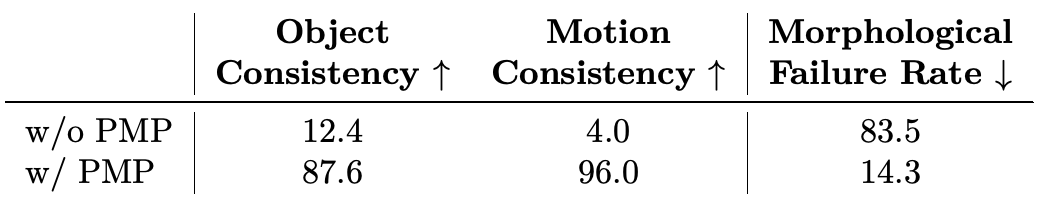
모션 보정을 적용한 파이프라인과 적용하지 않은 파이프라인을 비교하는 PMP ablation에서는 비디오 500쌍을 평가자 3명씩 평가해 총 1,500건의 평가를 수집한다. PMP를 추가하면 보고된 객체 일관성 선호도는 12.4에서 87.6으로, 모션 일관성 선호도는 4.0에서 96.0으로 높아진다. 사람이나 동물의 구조가 잘못된 비디오의 비율인 형태 오류율은 83.5에서 14.3으로 낮아진다.
- 정성적 춤 비교는 정답 첫 프레임과 목표 포즈를 사용해 잘못된 모션을 보정하는 모습을 보여준다. 이 근거는 해당 복원 조건에 한정된다.
- PMP는 별도의 모션 denoiser로서 사람 모션 생성 모델 MoMask도 개선하며, MoMask와 같은 학습 데이터셋을 사용한다.
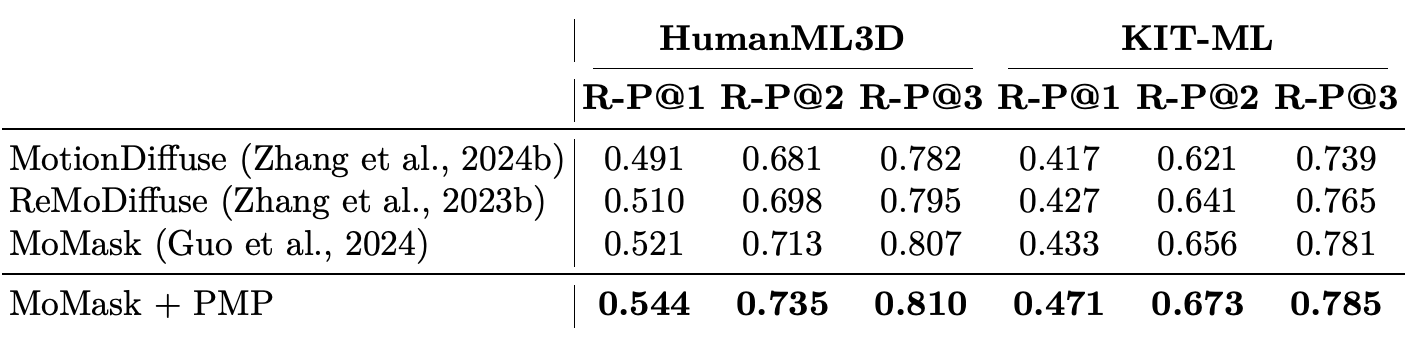
- 사람 모션과 언어를 연결하는 벤치마크 HumanML3D와 KIT-ML에서, 텍스트와 모션의 순위 기반 일치 점수인 Top-1 R-Precision은 각각 0.521에서 0.544로, 0.433에서 0.471로 높아진다. Top-2와 Top-3 점수도 높아진다.
MoMask에 PMP를 추가하면 HumanML3D와 KIT-ML에서 보고된 텍스트와 모션의 순위 기반 일치 점수 6개가 모두 개선된다. 이는 비디오 재생성 외에도 보정 네트워크를 사용할 수 있음을 뒷받침하지만, 이 점수들은 비디오의 외형을 평가하지 않는다.
사용자는 객체 일관성과 모션 일관성에서 PMP를 적용한 출력을 선호하며, 보고된 구조 오류율은 83.5에서 14.3으로 낮아진다. 이 비교는 실험 조건에서 PMP의 기여를 뒷받침하지만, 각 복원 구성 요소의 효과를 따로 분리하지는 않는다.
6 Conclusion
논문은 비디오를 다시 생성하기 전에 명시적인 3차원 모션을 보정하면 모션의 충실도와 일관성이 개선된다고 결론짓는다. 벤치마크 향상, 사용자 선호도, PMP ablation은 실험한 데이터셋, 기반 생성 모델, 조건 입력 프로토콜의 범위에서 이 결론을 뒷받침한다.
부록
- 부록은 아키텍처, 데이터셋, ablation, 한계, 사회적 영향에 관한 세부 내용을 제공한다. 본문의 예시와 추가 모션 제어 시연이 담긴 보충 비디오도 안내한다. A Architectural details for PMP는 객체 범주 전반에서 공유하는 1개 모델을 설명한다. 모델은 self-attention, cross-attention, feedforward 계층으로 구성되며, 교란된 입력에서 보정된 포즈를 직접 예측한다. 예측 포즈와 참조 포즈 사이의 mean squared error로 학습한다.
- B Dataset에 따르면 20K-video 부분집합은 사람 약 55%, 동물 15%, 일반 객체 30%로 구성된다. 캡션 기반 모션 필터링과 segmentation으로 적합한 클립을 선정한다. 사람 주석은 몸, 손, 얼굴 추정 결과를 SMPL-X로 통합하며, 동물 주석은 segmentation, 카메라 추정, SMAL 피팅을 결합한다. 투영 결과의 중첩과 복원 품질을 검사해 신뢰하기 어려운 주석을 걸러낸다.
- C Ablation Study는 비디오 500쌍에서 전체 설정과 효율적인 초기 생성 설정을 비교한다. 전체 모델의 선호도는 종합 평가 52.60%, 시각적 품질 50.27%, 모션 일관성 51.87%, 움직임의 양 54.27%다. 시각적 품질과 모션 일관성의 선호도는 거의 비슷하며, 움직임의 양에서는 전체 설정의 선호도 우위가 더 크다. 추가 예시는 파라미터 기반 메시가 신체 구조 prior를 제공하고, 텍스트가 모션 유형을 선택하며, motion strength 0.3과 0.7이 같은 목표 포즈에서도 서로 다른 궤적을 만드는 모습을 보여준다.
- C Ablation Study는 전체 모션, 다각형 목표 포즈, 빈 가이드의 confidence 값을 (1, 0.5, 0), (0.8, 0.5, 0.2), (3, 2, 1)로 설정한 실험도 수행한다. 이 설정들에서 SSIM은 0.851~0.873, PSNR은 30.07~30.10, LPIPS는 0.210~0.217 범위다. 이 결과는 confidence 채널을 보정된 예측 신뢰도 추정치가 아니라 조건 입력 유형을 표시하는 용도로 사용한다는 논문의 설명을 뒷받침한다.
- D Limitations는 여러 범주별 복원 모델에 대한 의존성, 손가락과 손을 처리할 때 남아 있는 어려움, vanilla-SVD 구현에서 80GB RAM으로 명시한 메모리 제약을 제시한다. 128프레임 시연은 중단 없는 1회 생성 대신 윈도우를 연결한다. E Statement of Broader Impact는 창작과 합성 데이터에 활용할 가능성을 deepfake와 악성 콘텐츠 위험과 함께 논의한다. 다만 후속 활용의 이점을 측정한 결과나 검증된 안전장치 시스템은 보고하지 않는다.
짧은 생각
핵심적인 공학적 기여는 2회의 생성 단계 사이에 보정하고 재사용할 수 있는 명시적 모션 표현을 둔다는 점이다. PMP ablation과 SVD, Wan2.1 모두에서 나타난 개선은 모델 크기 비교만으로 얻는 근거보다 이 설계를 더 직접적으로 뒷받침한다.
실제로 활용하려면 주석 구축 과정, 범주별 복원 모델에 대한 의존성, 측정된 실행 시간 49초를 고려해야 한다. 결과는 보고된 평가에서 모션이 개선됨을 보여준다. 일반적인 물리적 정확성과 정량적으로 검증된 긴 비디오의 일관성은 아직 입증되지 않았으며, 저자들은 손의 세부 표현을 한계로 제시한다. 프로젝트 자료는 https://revision-video.github.io/ 에서 제공한다.