


Scalable Chain of Thoughts via Elastic Reasoning 요약 설명
08 May 2025 | Paper Review Length-Controlled Generation Reasoning Reinforcement Learning이번 글에서는 Scalable Chain of Thoughts via Elastic Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 5월 8일(Arxiv)
- Xu, Yuhui, Dong, Hanze, Wang, Lei, Sahoo, Doyen, Li, Junnan, Xiong, Caiming.
- Salesforce AI Research
- 논문 링크
- Github
- Project Page
요약
- Scalable Chain of Thoughts via Elastic Reasoning은 엄격한 출력 제한으로 중간 추론이 중단될 때 언어 모델이 답변 품질을 유지하는 방법을 다룬다. 수학 문제 풀이 벤치마크인 MATH500에서 이 논문이 추가 학습한 E1-Math-1.5B 모델은 문항당 평균 1619토큰으로 단일 시도 정확도(Pass@1) 83.6%를 달성한다. 토큰은 생성된 텍스트를 세는 단위다. 다양한 생성 예산에서 평가한 길이 제어 베이스라인 2개인 L1-Max와 L1-Exact는 각각 1796토큰으로 83.6%, 1959토큰으로 79.9%를 기록한다.
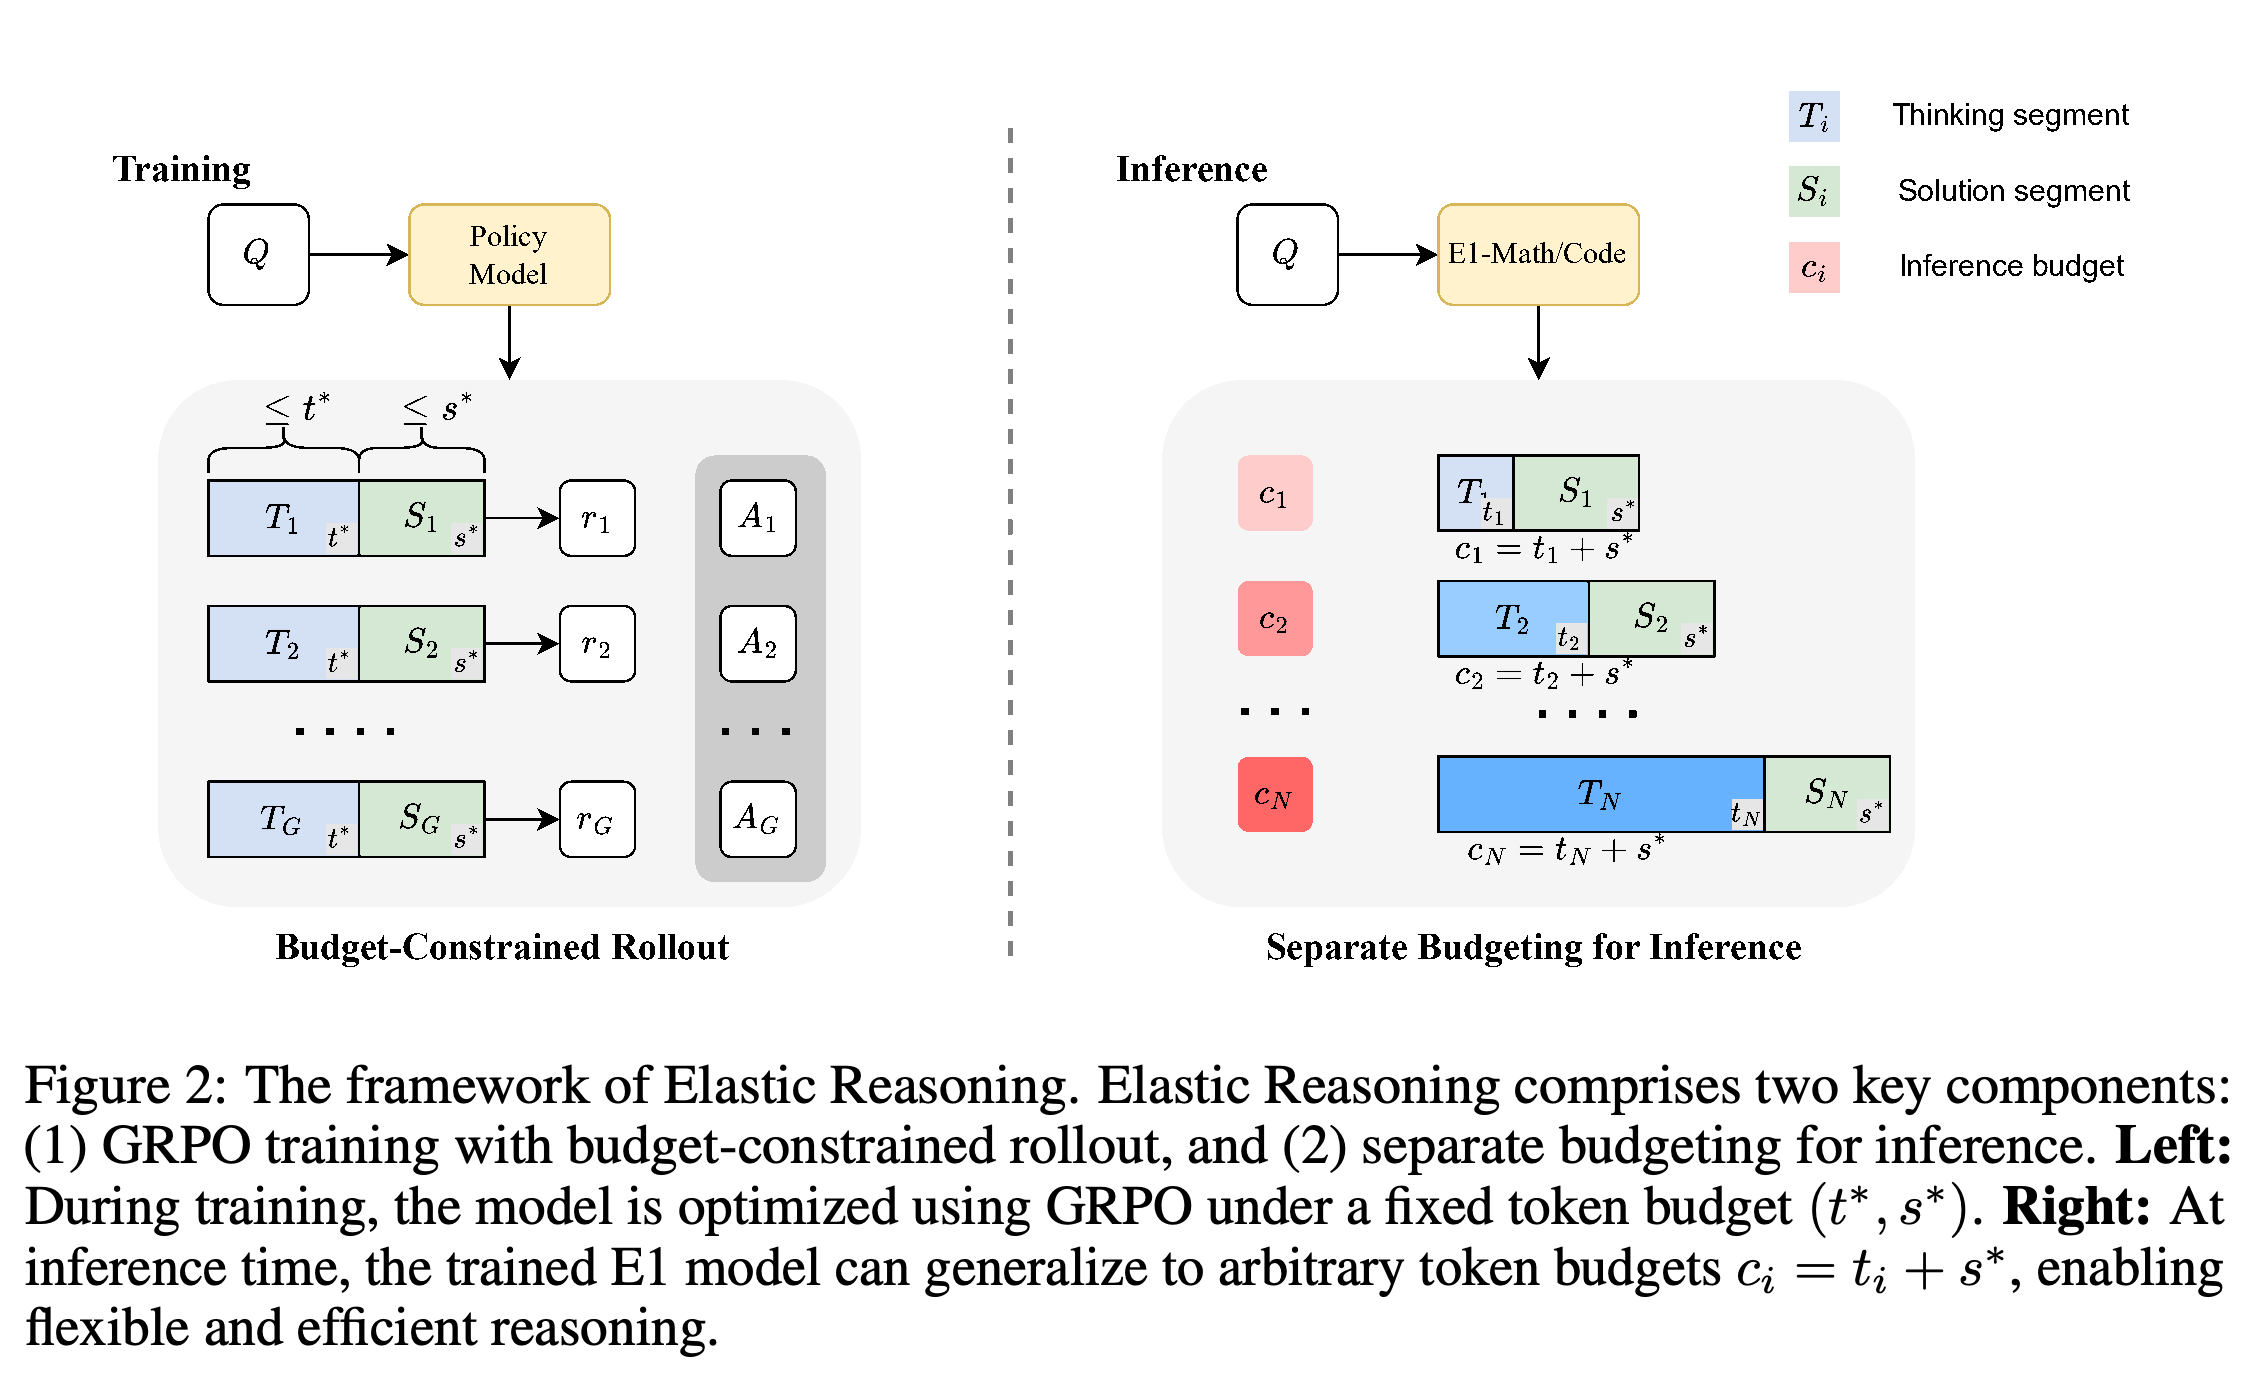
- Elastic Reasoning은 생성을 사고 단계와 풀이 단계로 나누고 각 단계에 독립적인 예산을 배정한다. 사고 단계에는 답변에 앞서 수행하는 중간 추론인 chain-of-thought가, 풀이 단계에는 최종 응답이 포함된다. Budget-constrained rollout은 사고를 강제로 중단할 수 있는 조건에서 응답을 생성하고 이를 학습에 사용한다. 이를 통해 모델은 불완전한 추론에서도 풀이를 생성하는 방법을 학습하며, 추가 학습 없이도 실험에서 사용한 다른 추론 예산에 적응한다.
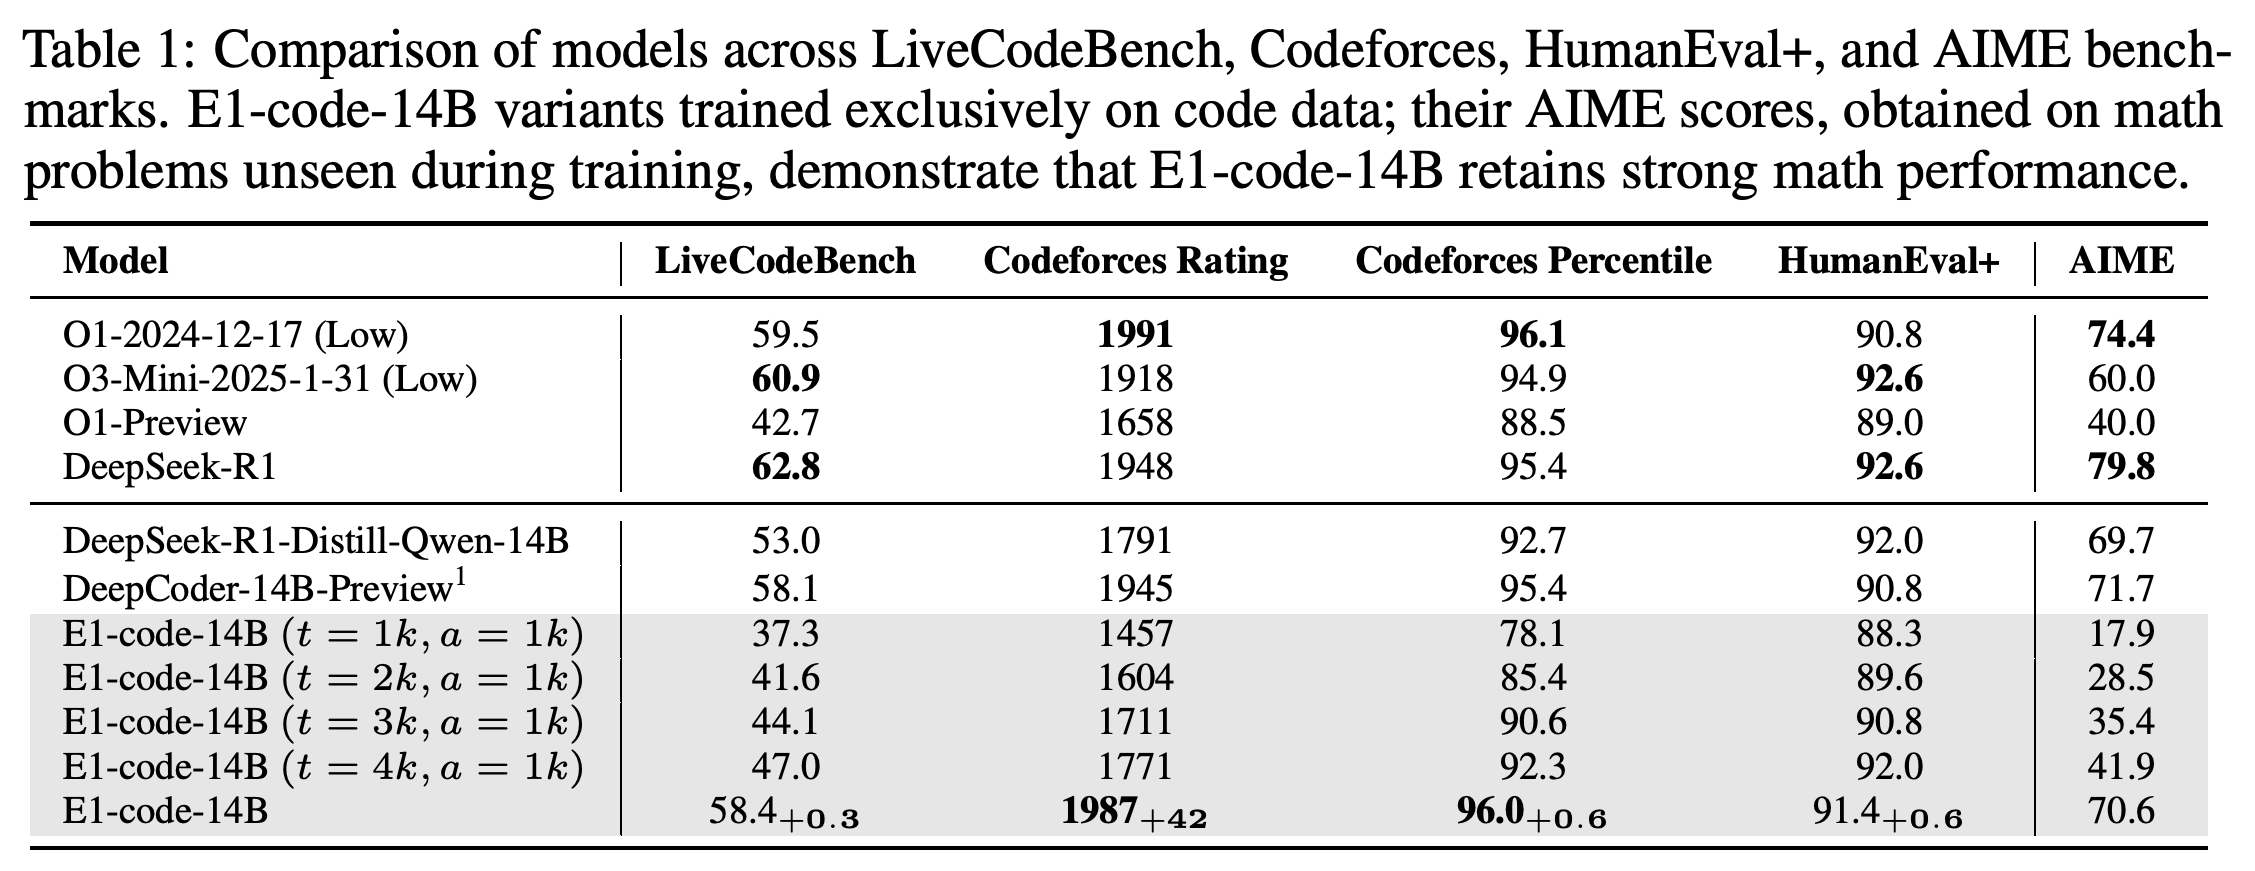
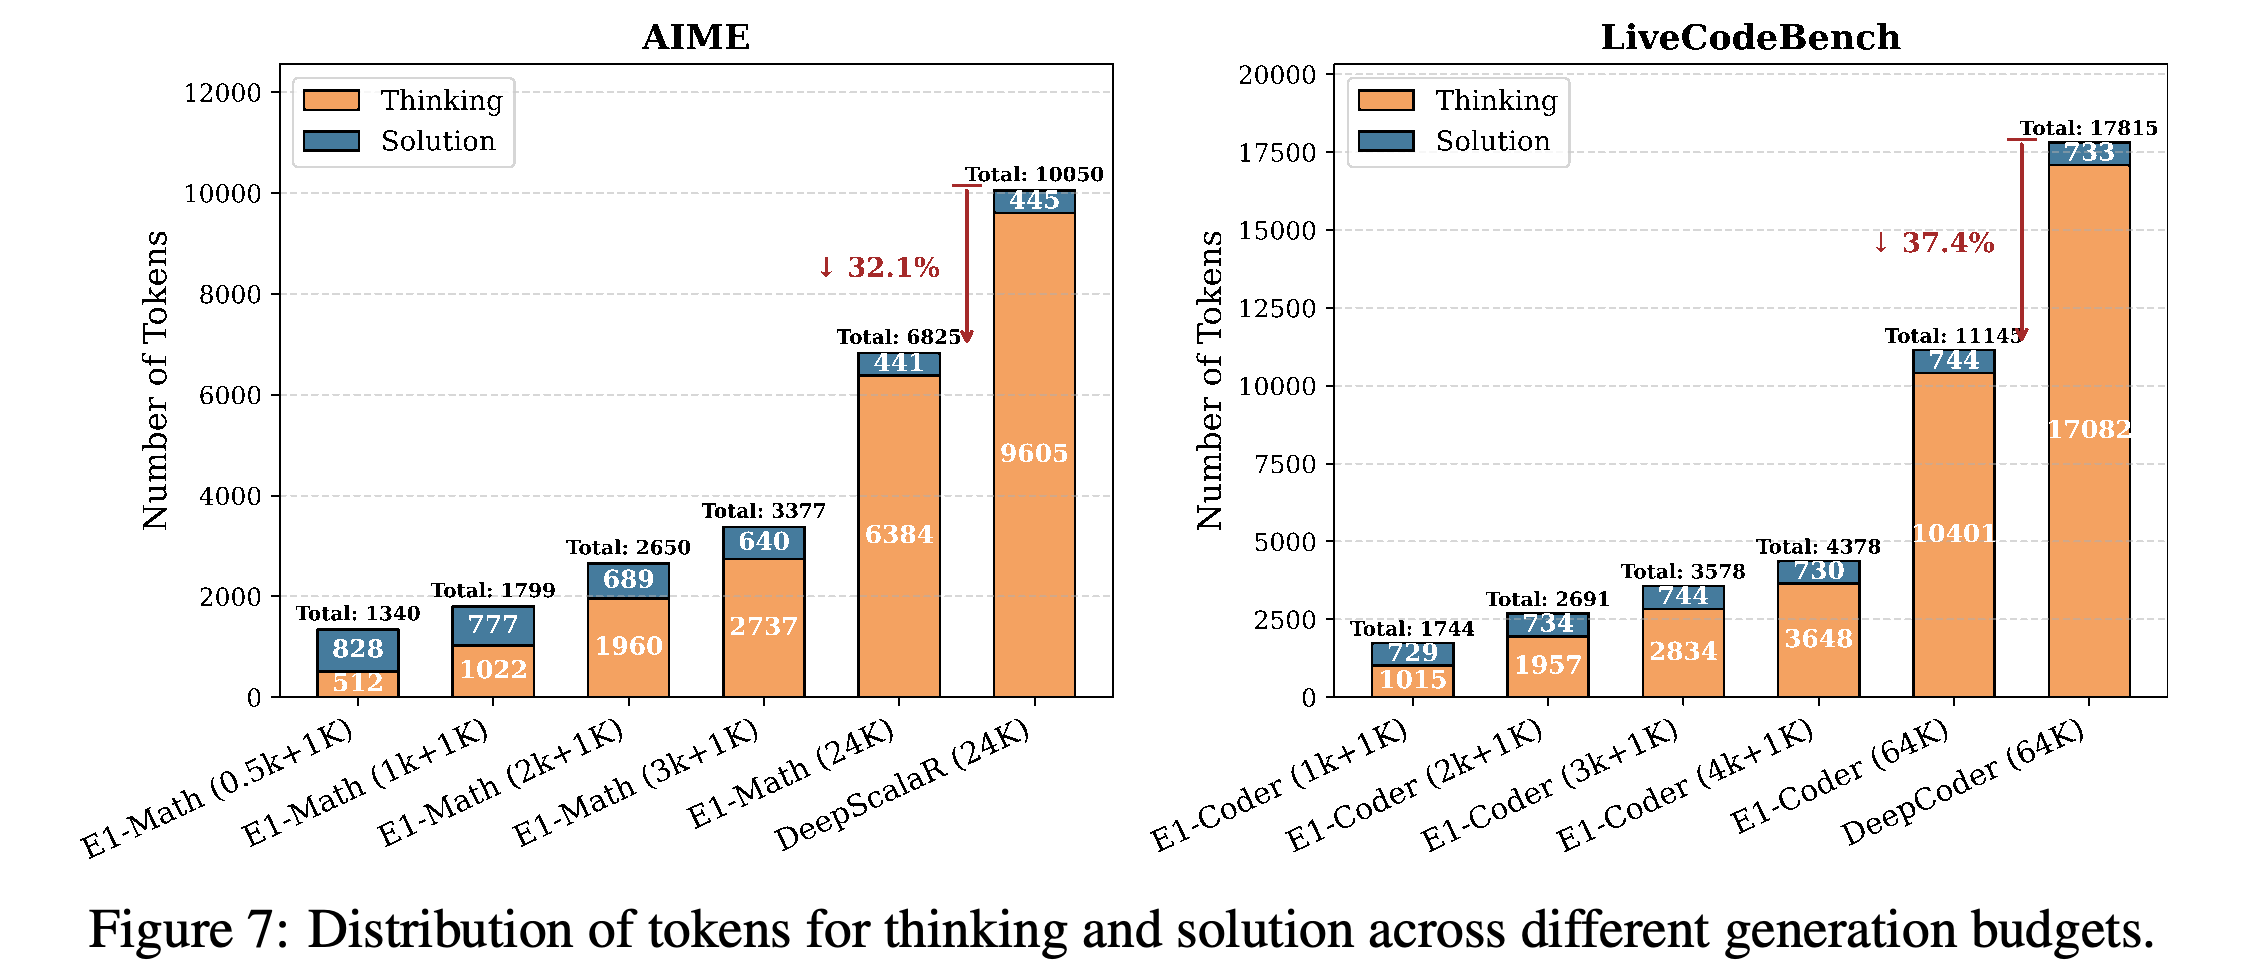
- 논문에서 제약 없는 코드 성능 비교에 사용한 생성 한도는 64K다. 이 조건에서 추가 학습한 E1-Code-14B 모델은 코드 생성 벤치마크인 LiveCodeBench의 평균 출력 길이를 DeepCoder-14B-Preview의 17,815에서 11,145토큰으로 줄이면서 정확도를 58.1%에서 58.4%로 높인다. 실험 근거는 수학과 프로그래밍 과제에 한정되며, 이 방법은 사고 생성과 풀이 생성을 의미 있게 분리할 수 있다고 가정한다.
1 Introduction
대규모 추론 모델은 긴 중간 추론을 생성한다. 이는 문제 풀이에 도움이 되지만 추론 비용을 제어하기 어렵게 만든다. Long2Short 계열 방법은 짧은 추론 시퀀스를 학습시키고, S1은 특수 토큰으로 생성을 조절한다. L1은 과제 보상으로 최적화하는 강화학습을 통해 명시적인 길이 제약을 학습한다. Elastic Reasoning은 풀이를 위한 출력 용량을 확보하고, 사고가 중단되어도 답변할 수 있도록 모델을 학습한다. 코드는 https://github.com/SalesforceAIResearch/Elastic-Reasoning 에 공개되어 있다.
- 수학 모델은 최대 응답 길이 2K토큰으로 200스텝을 학습한다. 비교 대상인 L1-Exact와 L1-Max는 응답 길이 4K에서 각각 700 steps와 820스텝을 학습했다고 보고되어 있다.
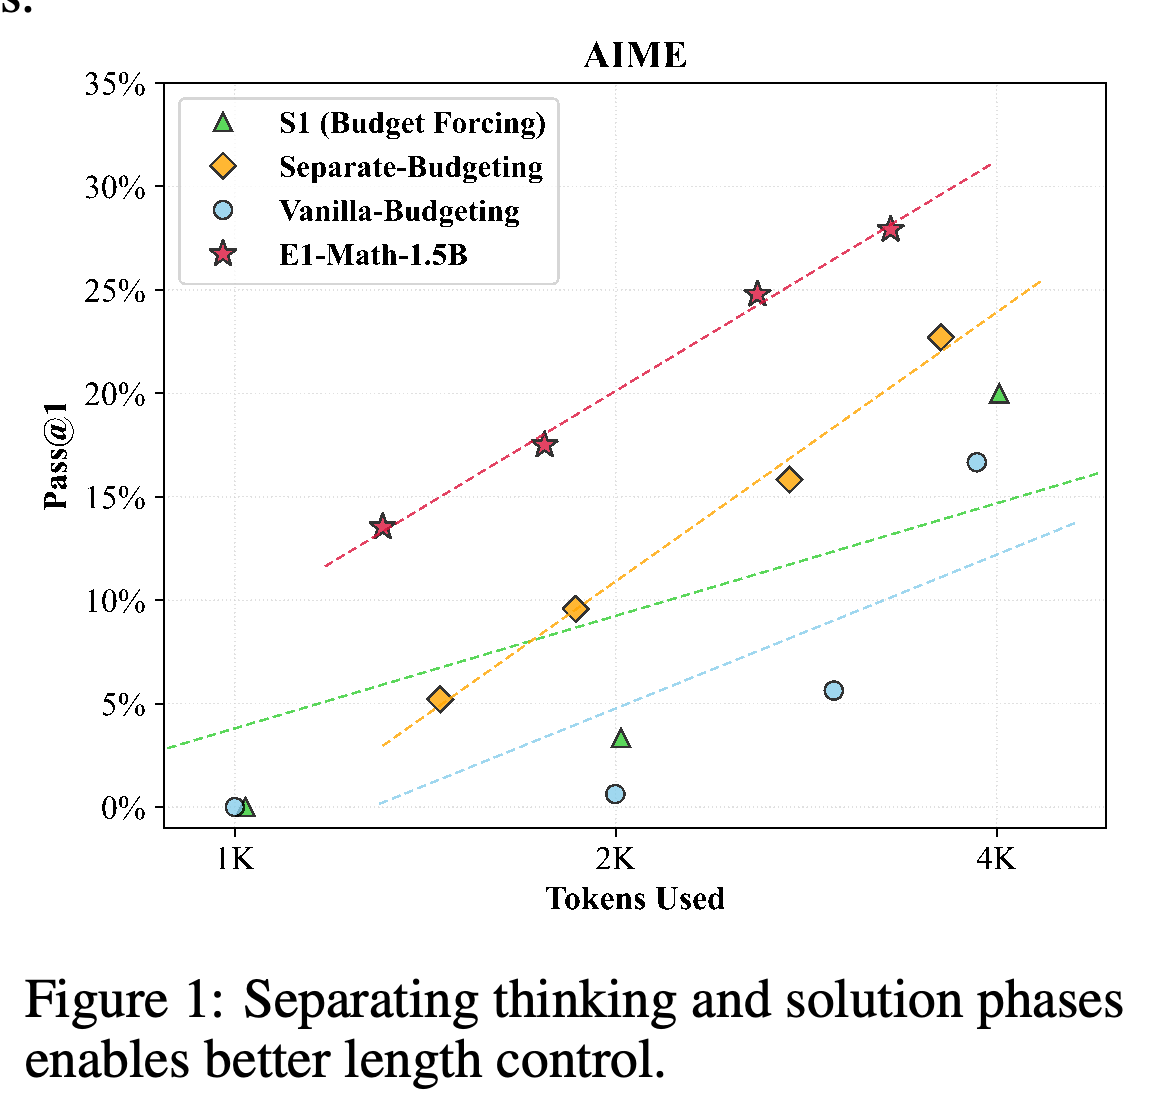
- 수학 경시대회 평가인 AIME2024의 24K-limit 비교에서 E1-Math-1.5B의 정확도는 35.0%다. L1-Max는 27.1%, L1-Exact는 24.2%, 원본 모델은 41.0%를 기록한다.
AIME 비교는 추론 제어와 학습의 효과를 구분한다. 풀이 용량을 확보하면 전체 출력 잘라내기와 S1보다 성능이 좋아지며, E1-Math-1.5B는 그래프에 표시된 토큰 범위 전반에서 정확도를 더 높인다. 이 성능 순서는 Elastic Reasoning의 구성 요소 2개를 결합한 근거를 보여 준다.
2 Related works
관련 연구는 3가지 질문을 다룬다. 추론 시 계산량을 늘리면 추론 능력이 어떻게 개선되는지, 생성 길이를 어떻게 제어하는지, 추론 효율을 어떻게 높이는지 살펴본다. Elastic Reasoning은 명시적인 추론 한도와 해당 한도 아래에서의 학습을 결합한다.
2.1 Test-time scaling in large language models
Test-time scaling은 성능을 높이기 위해 추론 시 계산량을 늘리는 방법이다. 기존 접근법에는 중간 추론 생성과 self-consistency가 있다. Self-consistency는 여러 추론 경로를 샘플링하고 이들이 가장 일관되게 제시하는 답을 선택한다. 다른 연구들은 모델 크기와 추론 계산량 사이의 절충 관계를 살펴본다. 이 논문은 엄격한 출력 제한 아래에서도 유용한 추론을 유지하는 데 초점을 맞춘다.
2.2 Length control in large language models
기존 길이 제어 방법은 시퀀스 위치를 나타내는 positional encoding을 수정하거나, 목표 길이에서 벗어나면 페널티를 부여하거나, 출력 길이를 지정하는 지시문으로 학습한다. 저자들은 이러한 방법이 추론 중단의 결과를 직접 다루지 않는다고 주장한다. 특수 토큰으로 출력을 잘라내거나 채우는 budget forcing 역시 불완전한 출력을 만들 수 있다. Elastic Reasoning은 프롬프트에 길이 지시문을 넣지 않고 생성 제어와 학습을 통해 한도를 적용한다.
2.3 Efficient reasoning in large language models
기존 효율화 방법은 짧은 추론에 보상을 주거나, 제공된 예제로 학습하는 지도 미세조정을 통해 간결한 추론을 가르친다. 중간 단계를 명시적인 텍스트 대신 잠재 내부 표현으로 압축하거나, 재학습 없이 추론 방식을 조정하는 방법도 있다. Elastic Reasoning은 고정된 사고 한도와 풀이 한도 아래에서 강화학습을 수행하여 답변 품질과 출력 비용 사이의 균형을 맞춘다.
3 Methodology
이 방법은 2가지 요소로 구성된다. Separate Budgeting은 사고 생성과 풀이 생성에 독립적인 용량을 확보하고, budget-constrained rollout은 학습 중에도 같은 중단 절차를 적용한다. 이들을 결합하여 전체 출력을 잘라낼 때 답변이 누락되는 문제와 불완전한 사고로 답변 품질이 떨어지는 문제를 다룬다.
3.1 Preliminaries: Reasoning Language Models
입력 x에 대한 출력은 y = (y^think, y^solution)이다. y^think는 <think>와 </think>로 둘러싸인 중간 추론이며, y^solution은 최종 풀이를 담는다. 논문에 따르면 사고는 일반적으로 생성 토큰의 90%를 넘게 차지하므로 예산 제어의 주요 대상이 된다.
3.2 Elastic reasoning
3.2.1 Budget-constrained inference: 일반적인 토큰 상한은 |y| ≤ c를 적용한다. 여기서 |y|는 출력 길이이고 c는 생성 예산이다. 이 한도에서 전체 출력을 잘라내면 풀이가 불완전하거나 아예 없을 수 있다. 상당한 추론을 생성하고도 사용할 수 없는 예측이 나올 수 있다.
3.2.2 Separate budgeting for thinking and solution: 전체 예산을 c = t + s로 나누어 사고에 t토큰, 풀이에 s토큰을 배정한다. 모델이 </think>를 일찍 출력하면 즉시 풀이 생성을 시작한다. 그렇지 않으면 t를 모두 소진했을 때 </think>를 덧붙이고 최대 s토큰까지 풀이를 생성한다. 이 절차는 풀이 용량을 확보하지만, 풀이 예산에도 한도가 있으므로 모든 답변이 완전하거나 정확하다고 보장하지는 않는다.
3.2.3 Budget-constrained rollout: 학습 중에는 t*까지 사고를 생성하고 필요하면 </think>를 삽입한 뒤, s* 안에서 풀이를 생성한다. 여기에 사용하는 강화학습 알고리즘 GRPO는 다른 샘플 응답과 비교하여 정규화한 보상으로 모델의 응답 생성 정책을 갱신한다. 목적함수 J(θ) = E[r(y)]는 제약이 적용된 생성 정책에서 과제 보상의 기댓값을 나타낸다. 기본 학습 예산은 (t*, s*) = (1K, 1K)이며, 학습된 모델은 추가 미세조정 없이 다른 사고 예산에서 평가한다.
- 보상은 과제별로 정한다고 설명하지만, 논문은 각 과제의 보상을 상세히 명세하지 않는다.
- Separate Budgeting만 적용하면 중단된 사고가 답변을 충분히 뒷받침하지 못해 여전히 실패할 수 있다. 이는 같은 제약을 적용한 학습을 도입한 이유다.
학습에서는 고정된 사고 한도와 풀이 한도로 샘플을 생성하고 보상을 부여한다. 추론에서는 풀이 용량을 유지하면서 사고 허용량을 바꾼다. 도식은 학습과 추론이 사고를 중단하고 풀이를 이어서 생성하는 같은 절차를 사용함을 보여 준다.
4 Experiment results
실험은 수학과 프로그래밍 과제에서 단일 시도 정확도와 생성 토큰 사용량을 비교한다. 추가 분석에서는 각 출력 단계에 사용하는 모델을 서로 교체하고 학습 예산을 바꾼다. 이를 통해 어떤 요소가 개선되는지, 개선 효과가 다른 추론 한도에서도 유지되는지 살펴본다.
4.1 Models and datasets
시작 모델은 DeepScaleR-1.5B-Preview와 DeepCoder-14B-Preview다. 이들은 DeepSeekR1-Distill-Qwen-1.5B와 14B에서 생성 한도를 점차 늘리는 iterative context lengthening으로 학습한 모델이다. 수학 학습에는 수학 추론 데이터셋인 AIME (1984–2023), AMC, Omni-Math, STILL을 사용한다. 코드 학습에는 프로그래밍 데이터셋인 TACO, SYNTHETIC-1, LiveCodeBench (2023/05/01–2024/07/31)를 사용한다.
- 수학 평가는 수학 문제 풀이 벤치마크인 AIME2024, MATH500, AMC, Olympiad-Bench, Minerva Math를 사용한다.
- 프로그래밍 평가는 LiveCodeBench (2024/08/01–2025/02/01), 경쟁 프로그래밍 성능을 레이팅과 백분위로 보고하는 Codeforces, 코드 생성 벤치마크인 HumanEval+를 사용한다.
4.2 Mathematical reasoning results
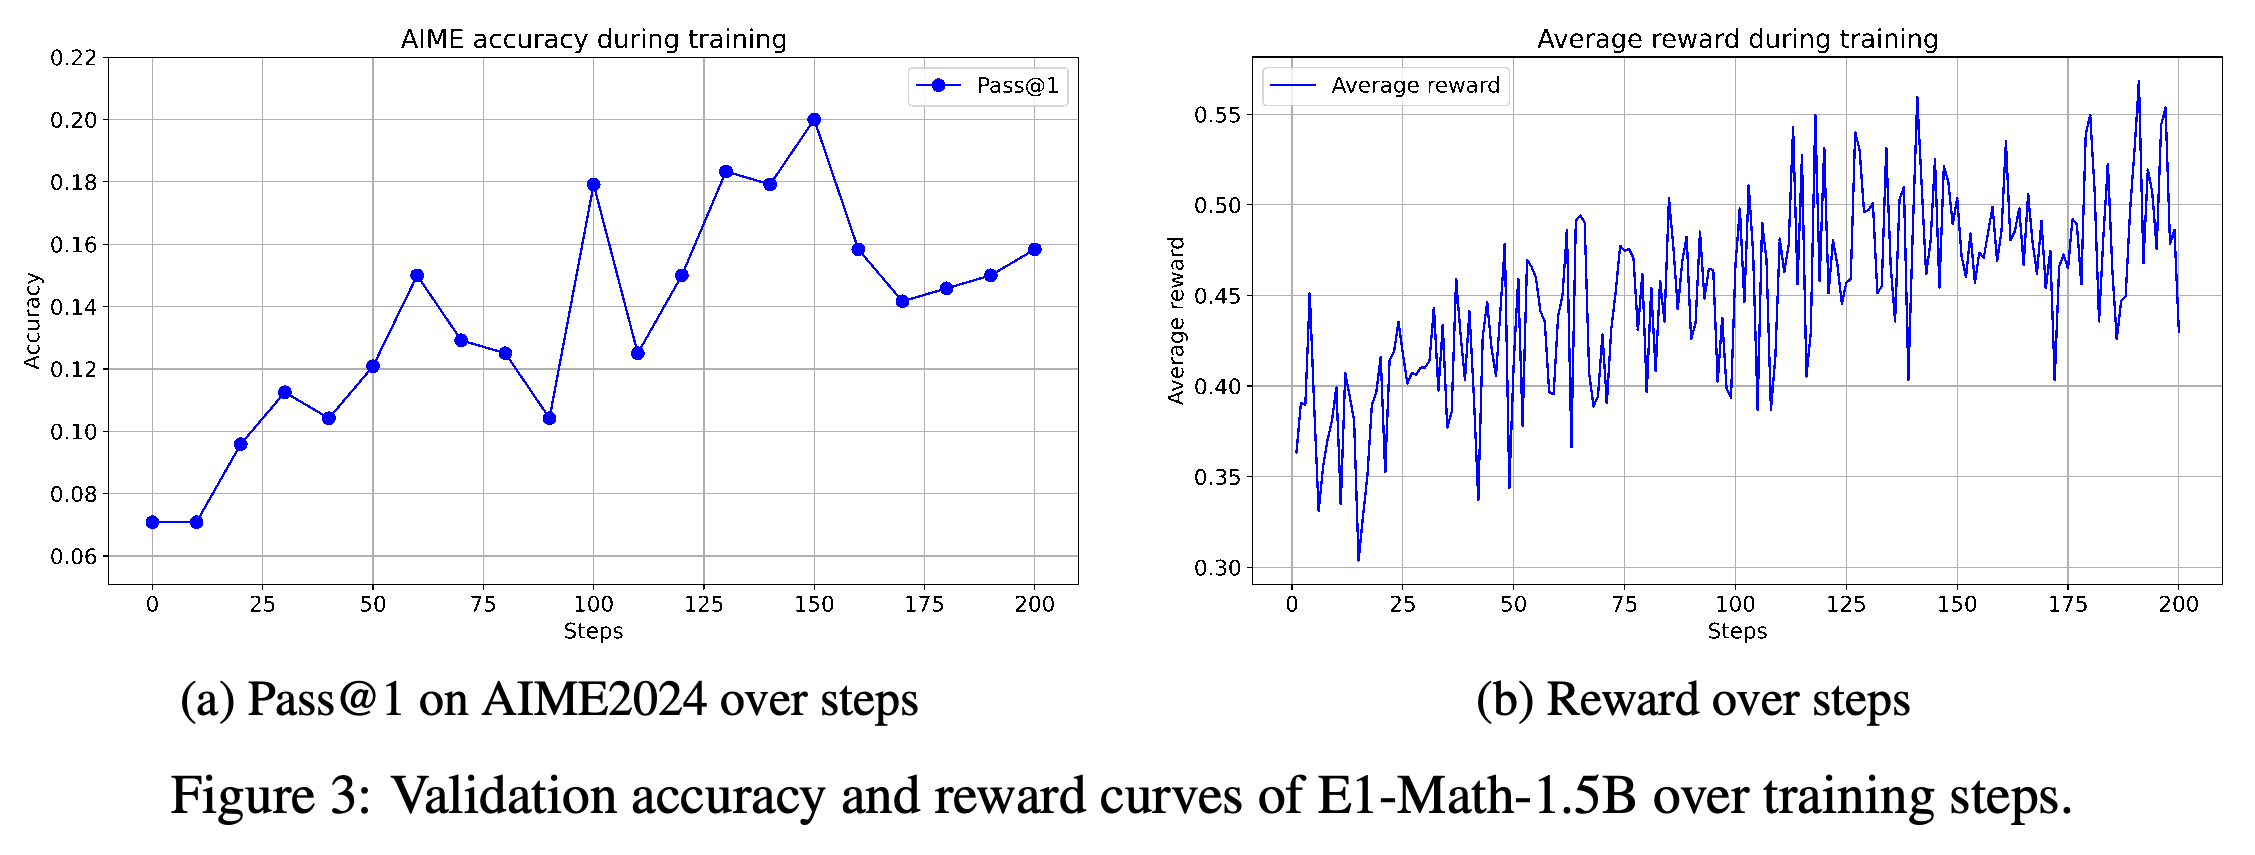
AIME2024 검증 성능은 학습 10스텝마다 측정한다. 정확도는 약 0.07에서 시작하여 150스텝 부근에서 약 0.20으로 정점에 도달하며, 그래프에서 200스텝의 최종 값은 약 0.16이다. 평균 학습 보상은 크게 변동하면서 상승한다. 곡선은 학습 중 성능이 개선됨을 보여 주지만 검증 정확도가 단조롭게 증가하지는 않는다.
보상은 대체로 증가하지만 검증 정확도는 변동한다. 정확도는 150스텝 부근에서 약 0.20으로 정점에 도달하고, 200스텝에서는 약 0.16으로 끝난다. 그래프는 학습 중 성능이 개선되더라도 검증 성능이 계속 향상되지는 않음을 보여 준다.
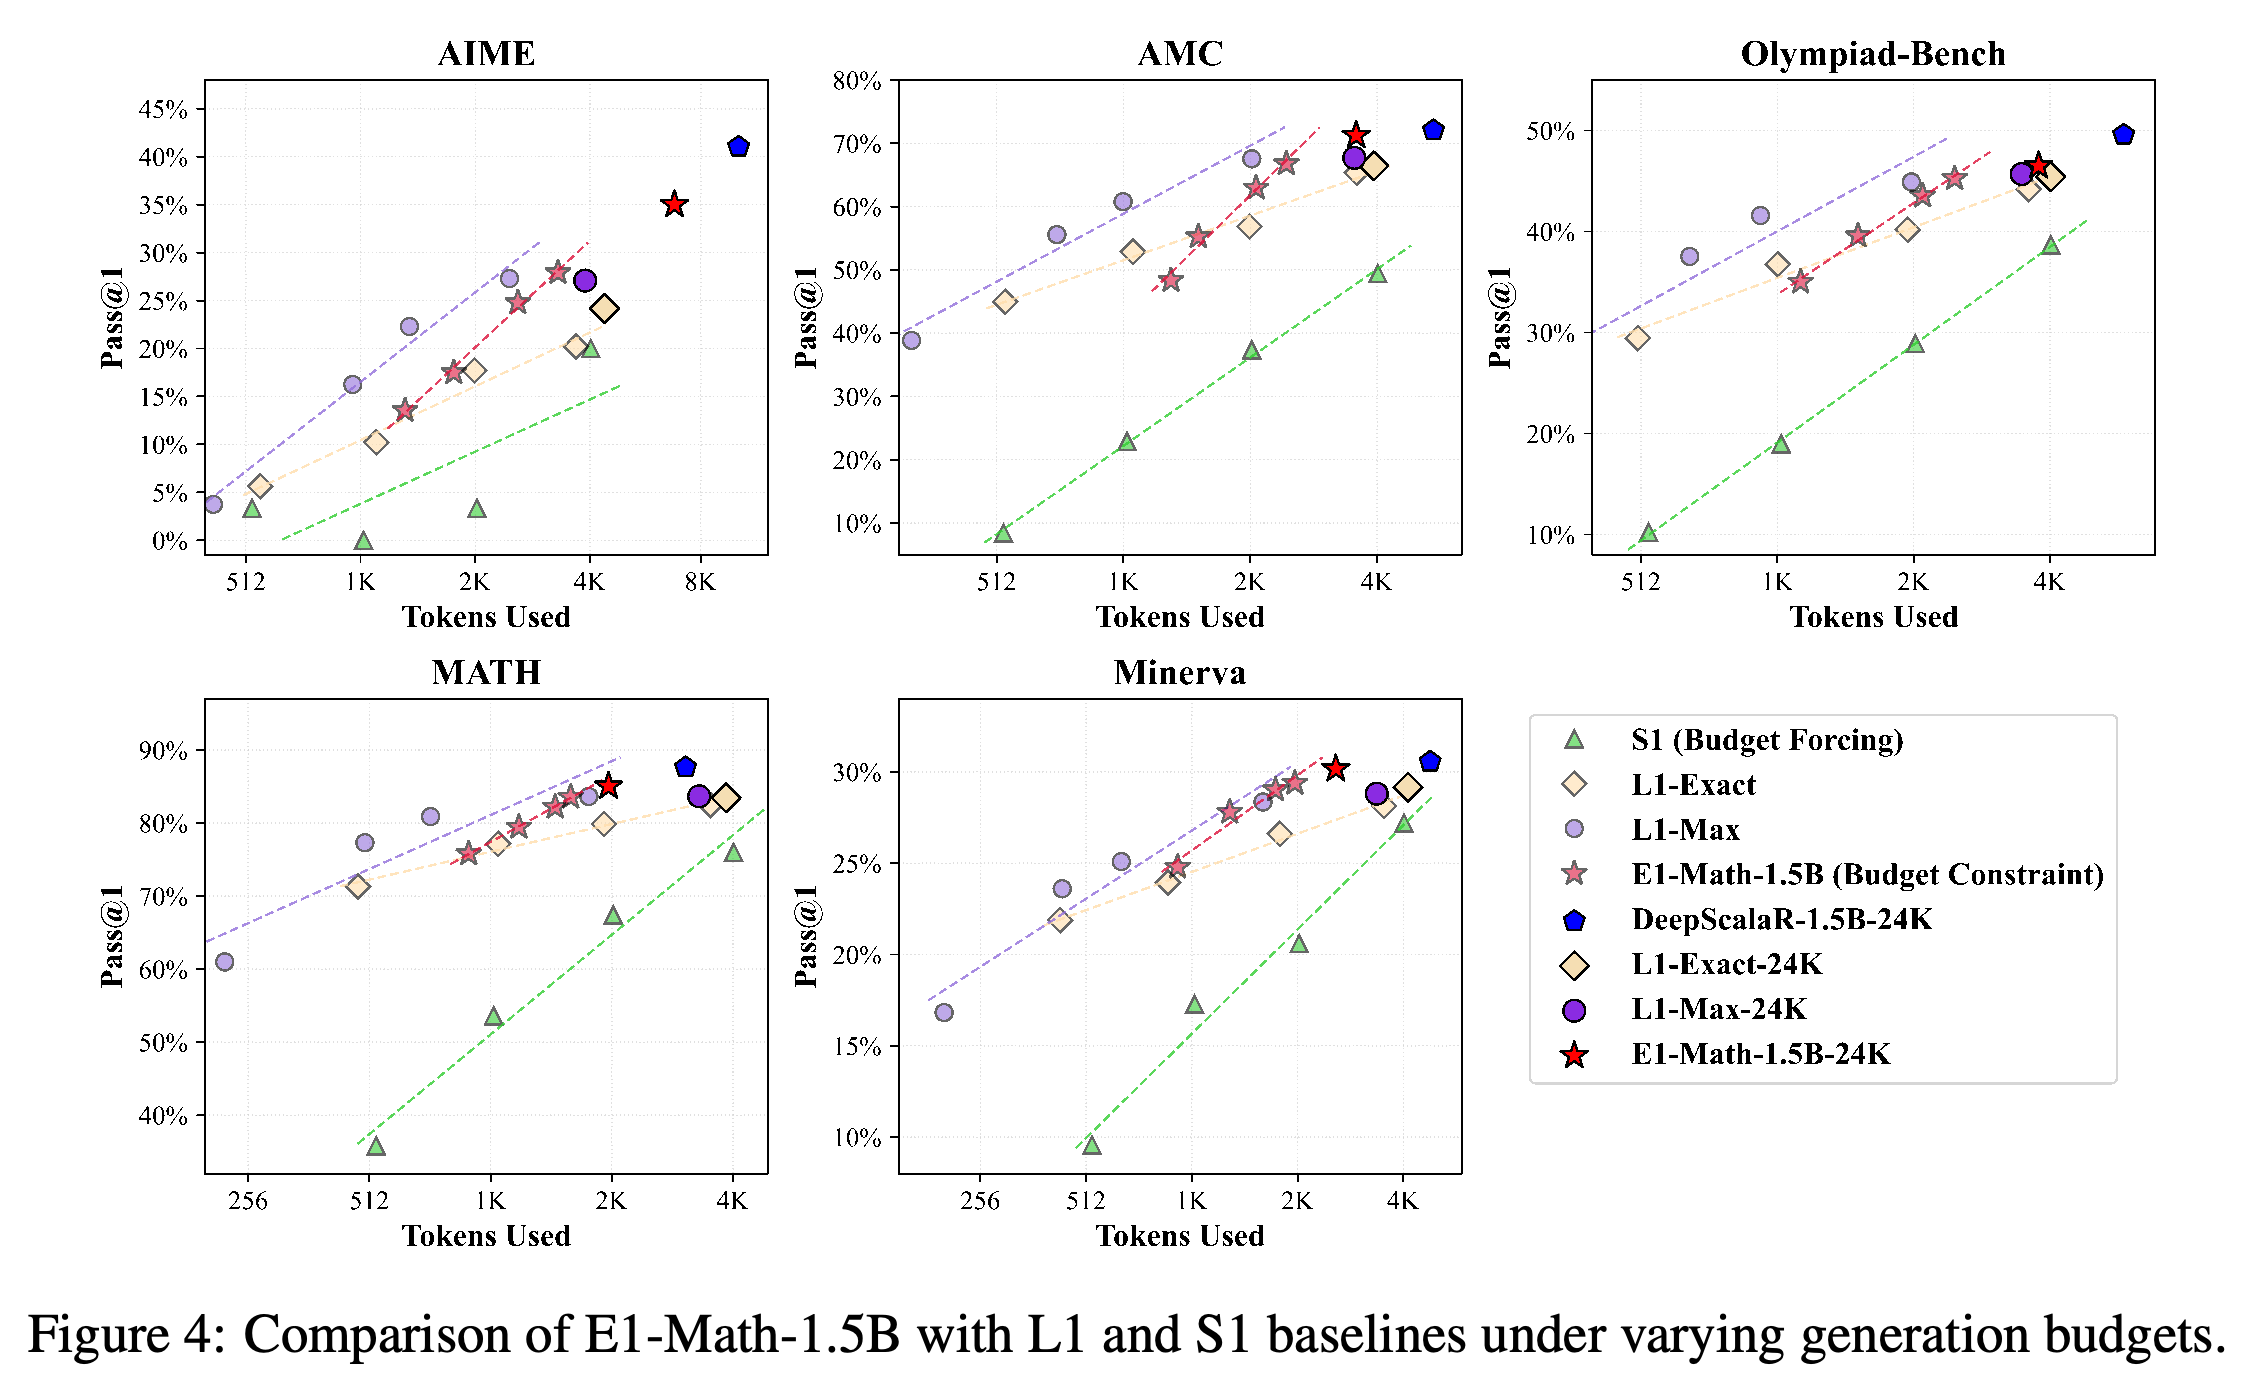
E1-Math-1.5B는 수학 벤치마크 5개 전반에서 대체로 S1과 L1-Exact보다 정확도와 토큰 사용량 사이의 절충 관계가 좋으며 L1-Max와도 경쟁력 있는 성능을 보인다. MATH500에서는 평균 1619토큰으로 Pass@1 83.6%를 달성한다. 이는 1796토큰을 사용하는 L1-Max의 83.6%와 같고, 1959토큰을 사용하는 L1-Exact의 79.9%보다 높다.
- 생성 한도 24K에서 E1-Math-1.5B의 AIME2024 정확도는 35.0%로, 원본 모델의 41.0%보다 6.0%p 낮다. 서론의 L1-Max 수치 27.1%와 원본 41.0%의 차이는 13.9%p다. 하지만 Results 본문은 L1-Max의 성능 저하를 12.9%로 따로 서술해 논문 안에서 수치가 일치하지 않는다.
- AIME2024 평균 출력 길이는 원본 모델 대비 32.1% 감소한다. 실험한 범위에서 정확도는 대체로 생성 토큰 사용량의 로그에 대해 거의 선형으로 증가한다.
수학 벤치마크 다섯 개 전반에서 E1은 대체로 S1과 L1-Exact보다 정확도와 토큰 사용량 사이의 절충 관계가 좋으며 L1-Max와도 경쟁력 있는 성능을 보인다. 24K-limit 결과에서는 E1의 정확도가 여전히 원본 모델보다 낮아 효율과 정확도 사이의 절충 관계를 확인할 수 있다.
4.3 Code reasoning results
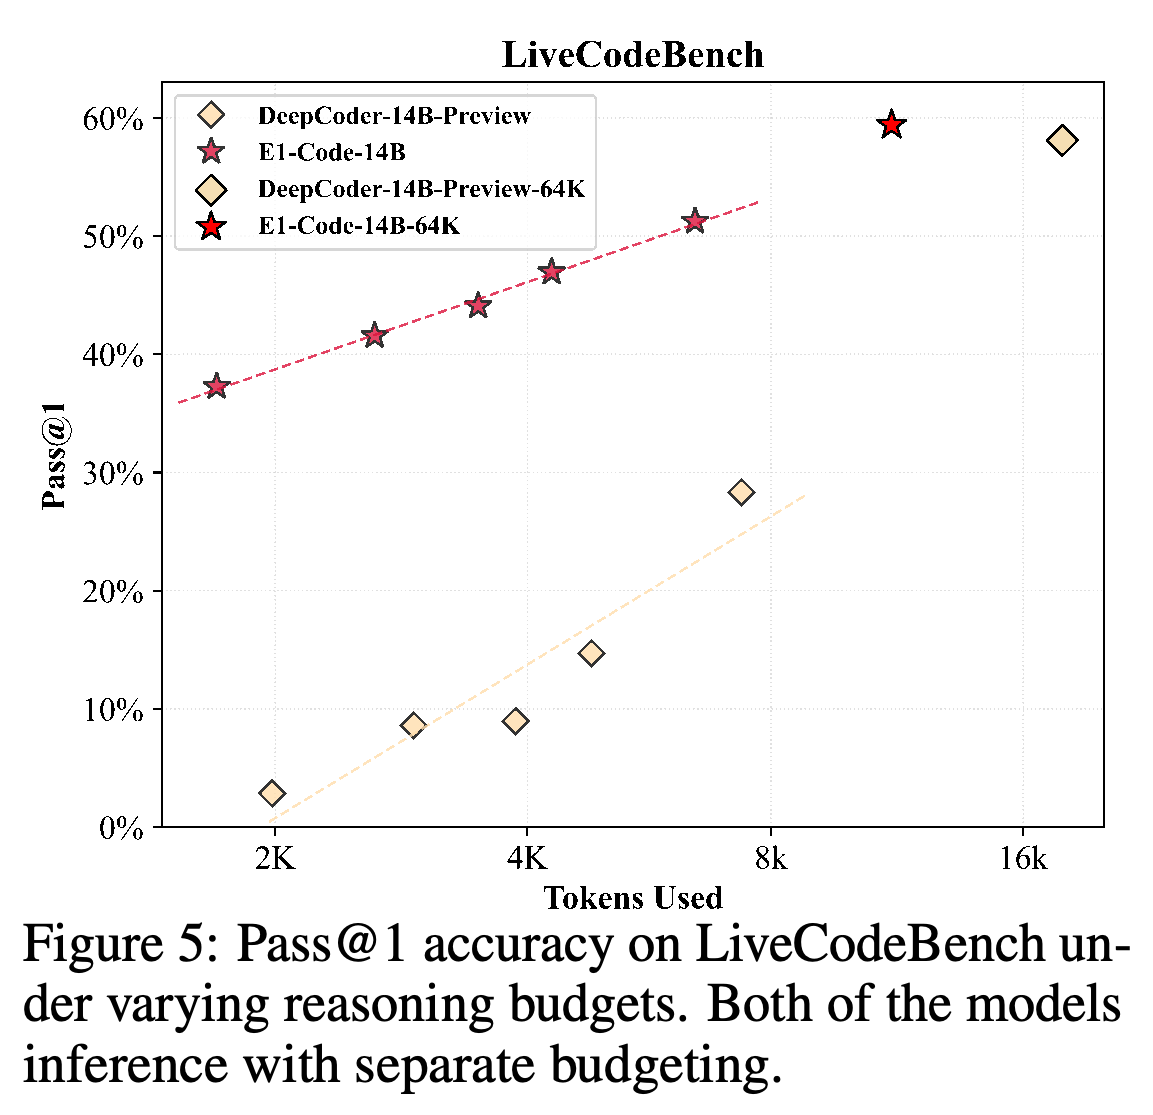
LiveCodeBench에서 DeepCoder-14B-Preview는 Separate Budgeting을 적용해도 추론 예산이 4K 미만이면 정확도가 10%에 미치지 못한다. E1-Code-14B는 사고 예산이 각각 1K, 2K, 3K, 4K일 때 37.3%, 41.6%, 44.1%, 47.0%를 기록한다. 각 조건의 풀이 예산은 1K다. 모델 2개 모두 Separate Budgeting을 사용하므로, 엄격한 한도에서 나타난 성능 향상을 답변 용량 확보만으로 설명할 수는 없다.
생성 한도 64K에서 E1-Code-14B는 LiveCodeBench 58.4%, Codeforces 레이팅 1987과 96.0 percentile, HumanEval+ 91.4%, AIME2024 70.6%를 기록한다. DeepCoder-14B-Preview는 각각 58.1%, 레이팅 1945와 95.4 percentile, 90.8%, 71.7%를 기록한다. LiveCodeBench 평균 출력 길이는 17,815에서 11,145토큰으로 37.4% 감소한다.
- Codeforces 결과는 레이팅 1991과 96.1 percentile로 보고된 O1-2024-12-17 (Low)에 가깝다. 이 비교는 Codeforces에 한정되며 모든 벤치마크에서 동등하다는 뜻은 아니다.
- E1 코드 모델은 이 추가 학습 과정에서 코드 데이터만 사용한다. AIME2024 결과는 시작 모델보다 1.1%p 낮다.
E1-Code-14B의 사고 예산을 늘리면 평가 4개 모두에서 보고된 결과가 개선된다. 더 큰 한도에서는 DeepCoder보다 LiveCodeBench가 0.3%p, Codeforces 레이팅이 42점, HumanEval+가 0.6%p 높아지지만, AIME 정확도는 1.1%p 낮아진다. 아래첨자로 표시한 향상 값은 베이스라인 대비 변화량이며 불확실성 추정치가 아니다.
모델 2개 모두 Separate Budgeting을 사용하지만, 출력이 짧을 때 E1-Code-14B의 성능이 훨씬 좋다. 추론 절차를 동일하게 유지한 이 비교는 풀이용 출력 용량을 확보하는 효과에 더해 추가 학습한 모델이 기여함을 뒷받침한다.
4.4 Analysis and discussions
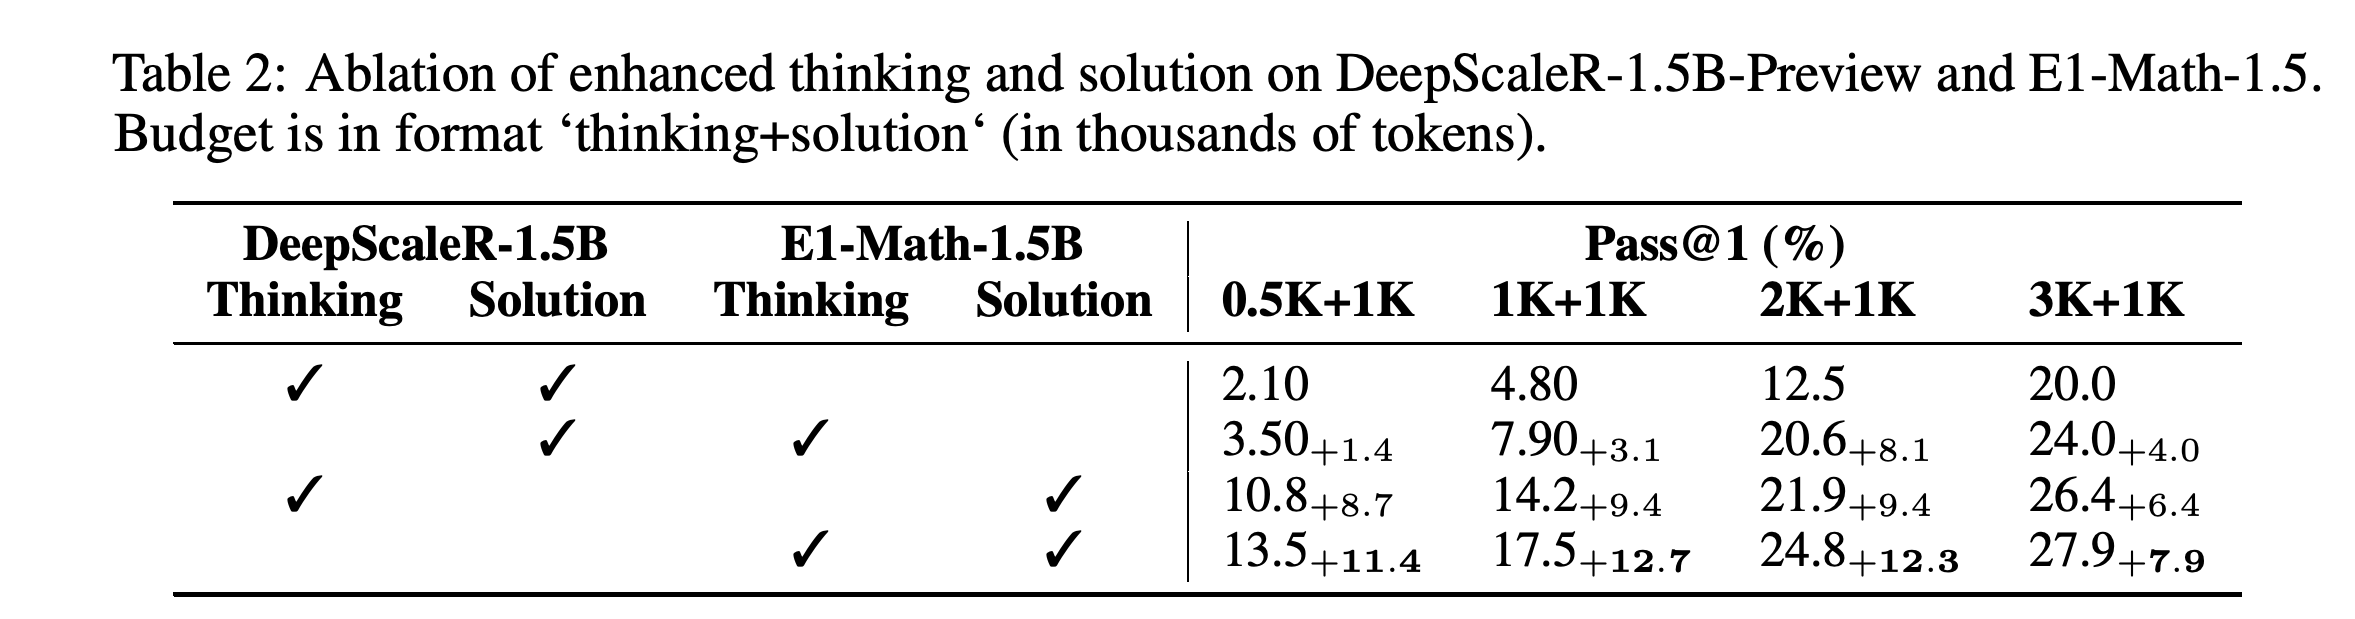
4.4.1 Which part is enhanced after training? 저자들은 AIME2024에서 DeepScaleR-1.5B-Preview와 E1-Math-1.5B의 사고 생성과 풀이 생성을 서로 교체한다. 사고와 풀이 예산을 0.5K+1K로 설정하면 원본 모델의 정확도는 2.10%다. 사고만 교체하면 3.50%, 풀이만 교체하면 10.8%로 높아지며, 단계 2개 모두 E1을 사용하면 13.5%를 기록한다.
- 풀이 단계를 교체할 때 성능 향상이 더 크다는 결과는 불완전한 추론에서 답변하는 능력의 개선이 주요 기여 요인임을 뒷받침한다.
- 저자들은 풀이 생성의 개선이 다른 예산에서도 성능이 유지되는 이유라고 가설을 제시한다. 다만 구성 요소 교체 실험만으로 인과관계 전체를 확정할 수는 없다.
생성 단계를 교체한 결과는 E1이 사고 생성과 풀이 생성을 모두 개선함을 보여 준다. 0.5K+1K에서 풀이만 교체하면 정확도가 8.7%p 높아지고, 사고만 교체하면 1.4점 높아진다. 사고와 풀이에 모두 E1을 사용하면 표에 제시된 모든 예산에서 가장 높은 정확도를 기록한다.
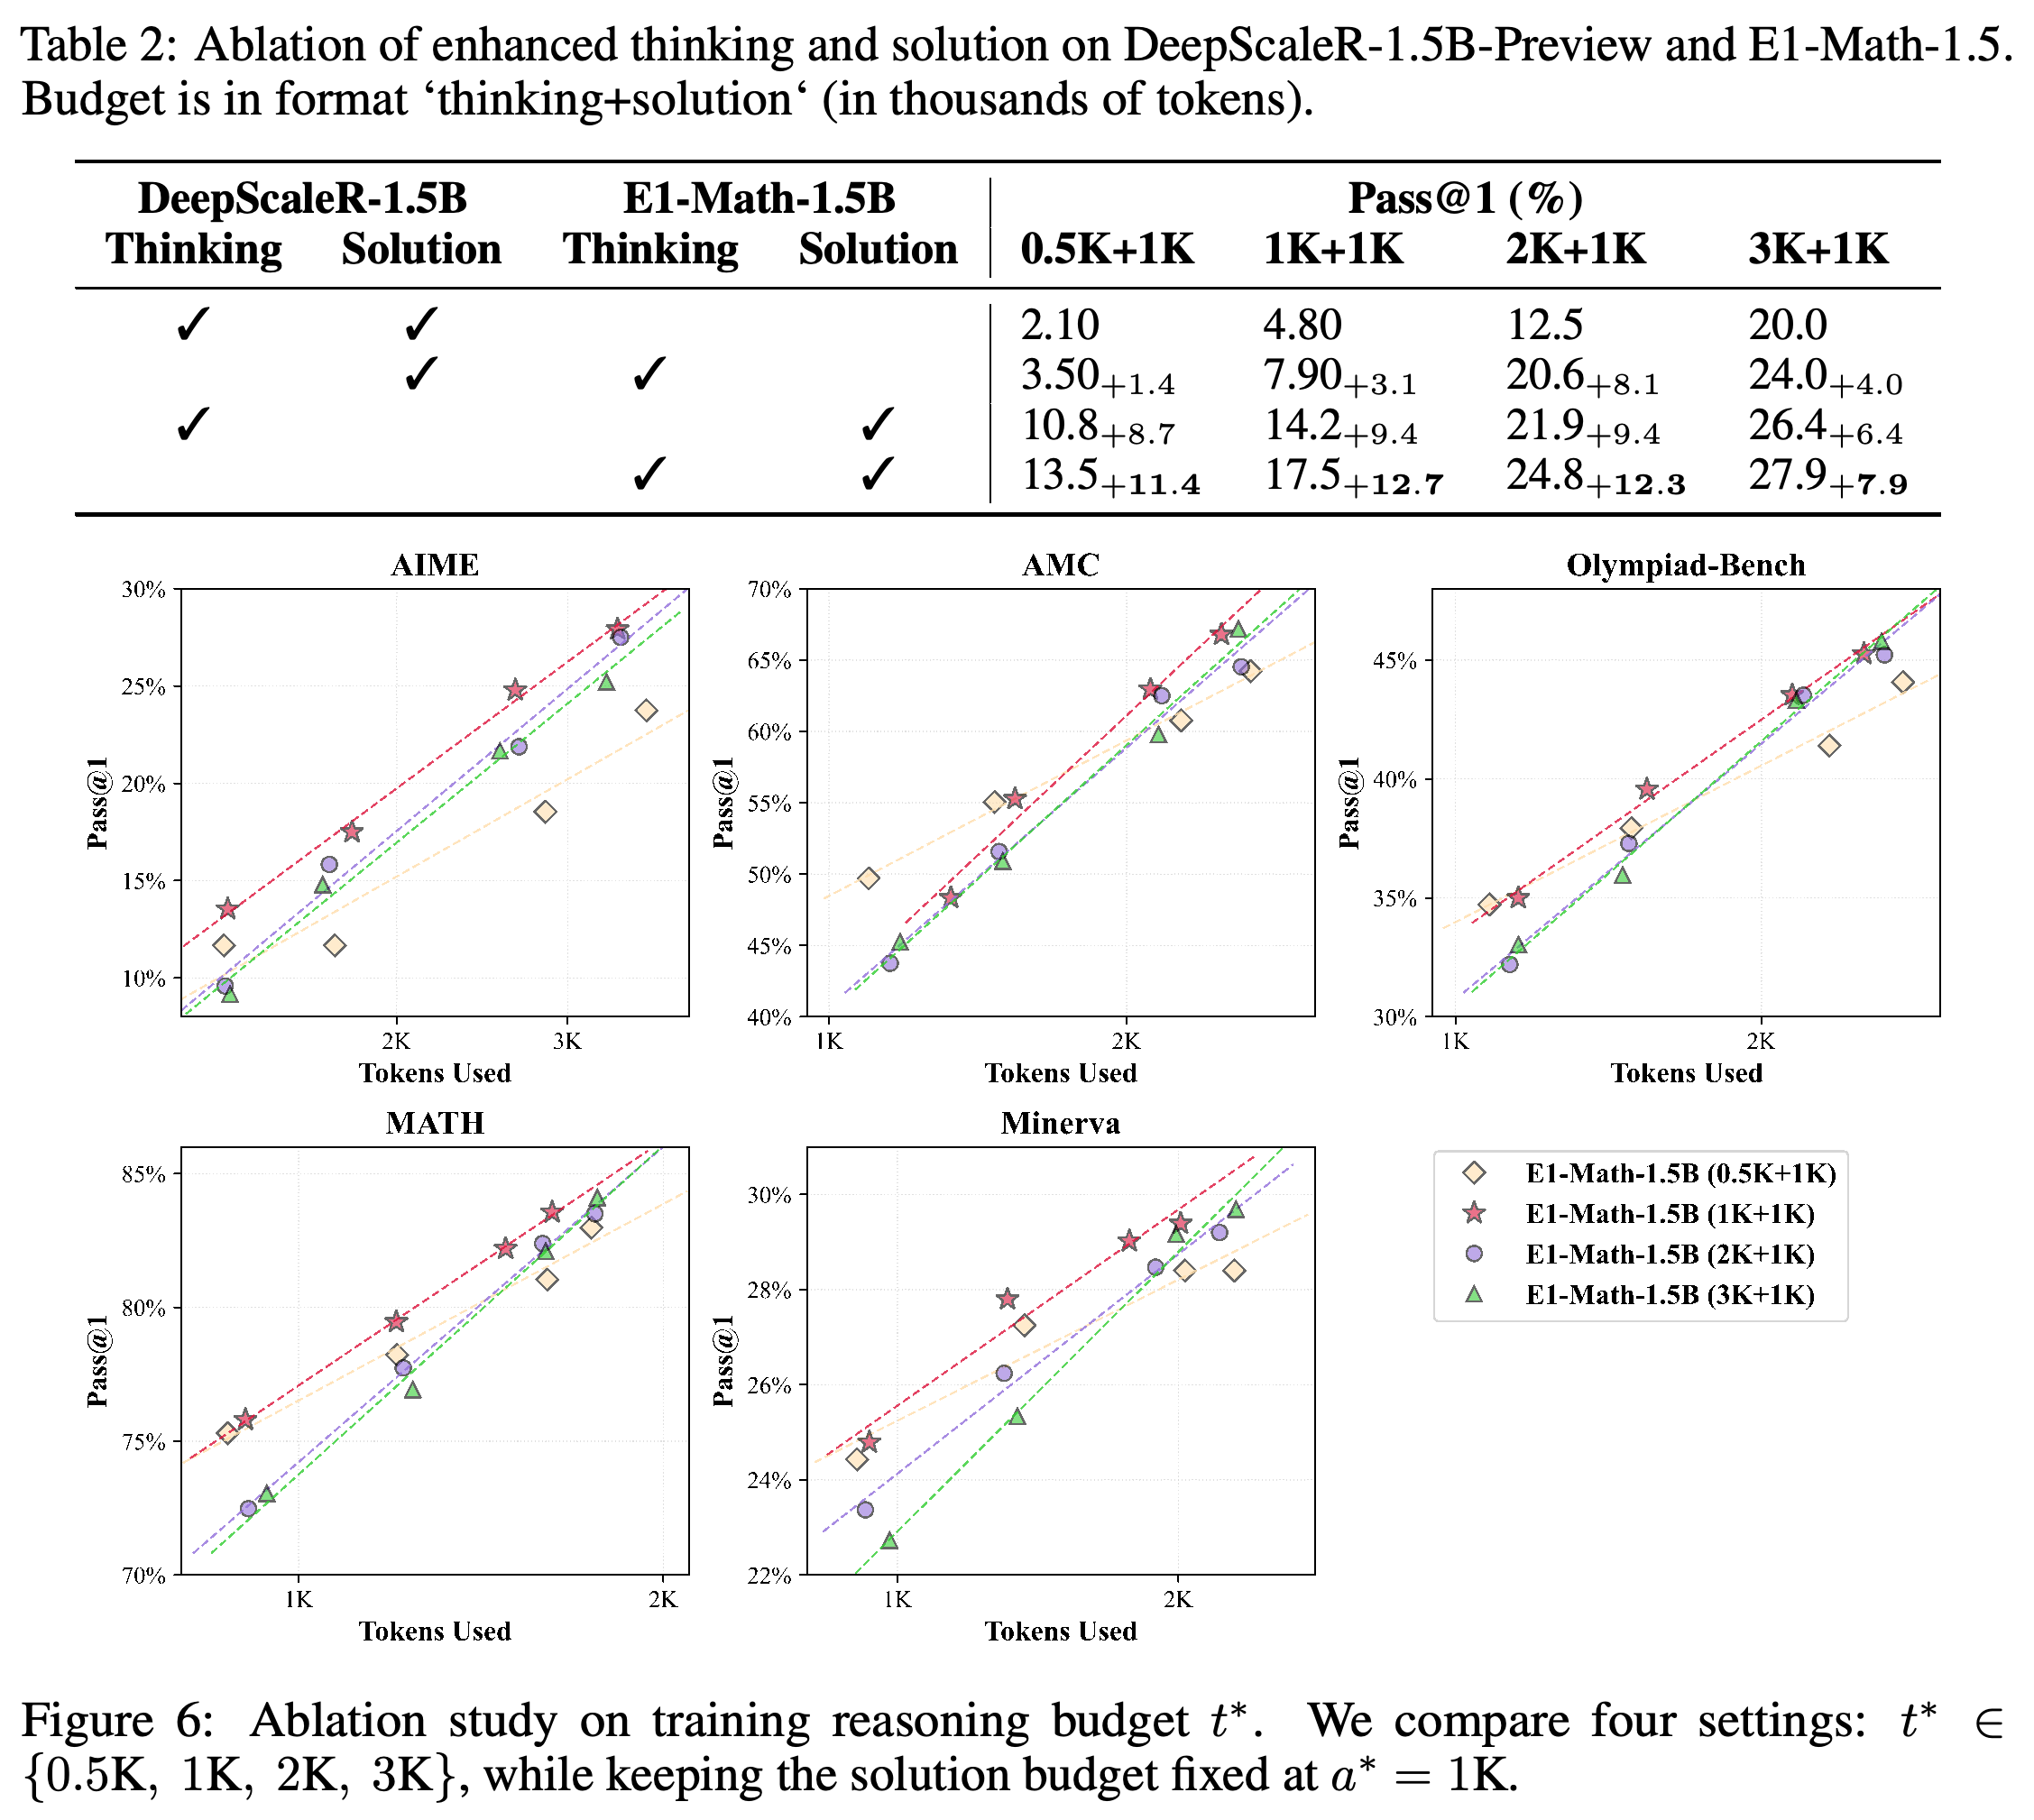
4.4.2 Ablation of training budget t*: 풀이 예산을 1K로 고정하고 학습 시 사고 예산을 {0.5K, 1K, 2K, 3K}로 바꾼다. 모든 설정이 실험한 추론 예산들에 적응한다. 저자들은 수학 벤치마크 5개 전반에서 정확도와 토큰 사용량 사이의 절충 관계가 좋은 1K+1K를 기본값으로 선택한다.
서로 다른 사고 한도로 학습한 모델은 여러 평가 예산에서도 유용한 성능을 유지한다. 사고 예산 1K 설정은 전반적으로 정확도와 토큰 사용량 사이의 절충 관계가 좋아 기본값 선택을 뒷받침한다. 학습 허용량을 늘린다고 결과가 일관되게 좋아지지는 않는다.
4.4.3 Token allocation between thinking and solution: 추론 한도를 줄이면 주로 사고 토큰이 감소한다. 풀이 길이는 AIME2024에서 다소 늘어나고 LiveCodeBench에서는 비교적 일정하게 유지된다. 더 큰 평가 한도에서는 AIME2024 출력 길이가 10,050에서 6825토큰으로, LiveCodeBench 출력 길이가 17,815에서 11,145토큰으로 감소한다. 따라서 학습된 모델은 학습 예산을 넘어 생성을 계속할 수 있는 조건에서도 더 짧은 출력을 생성한다.
누적 막대는 출력 절감의 대부분이 사고 구간에서 발생함을 보여 준다. 더 큰 한도에서는 풀이 길이가 원본 모델과 비슷하게 유지되면서 전체 사용량이 AIME2024에서 32.1%, LiveCodeBench에서 37.4% 감소한다.
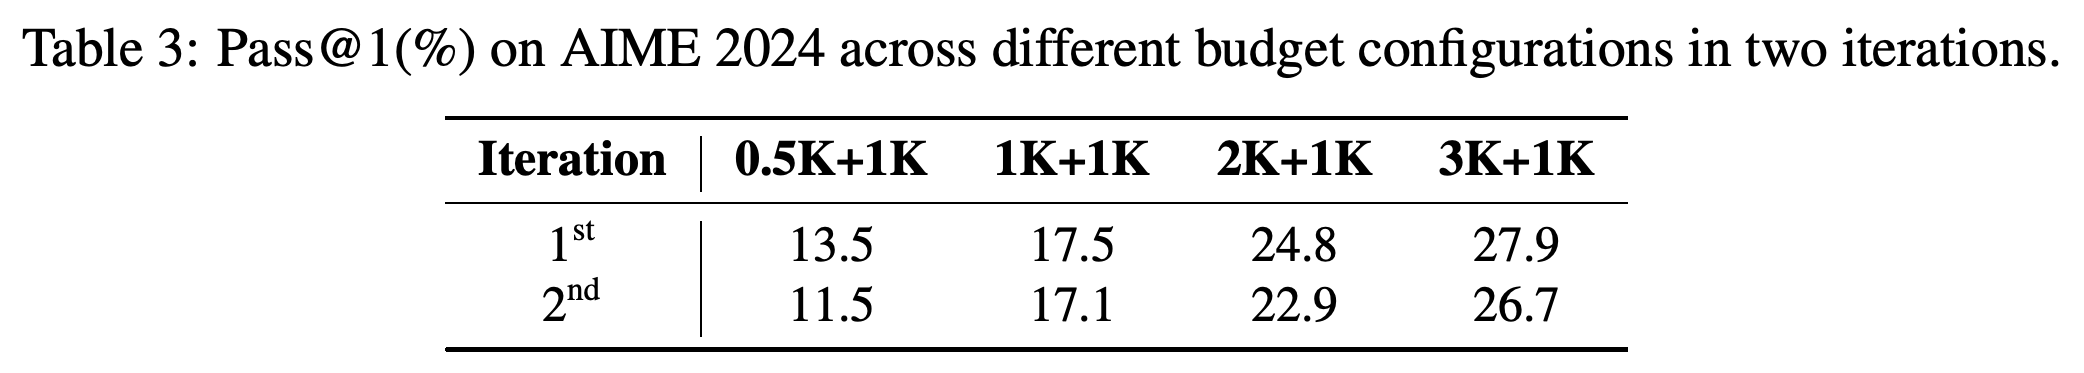
4.4.4 Iterative training: 2차 학습에서는 풀이 예산을 1K로 유지하고 사고 예산을 1K에서 3K로 늘린다. 평가 예산이 각각 0.5K+1K, 1K+1K, 2K+1K, 3K+1K일 때 AIME2024 정확도는 13.5%, 17.5%, 24.8%, 27.9%에서 11.5%, 17.1%, 22.9%, 26.7%로 감소한다. 실험한 이 추가 학습은 성능을 개선하지 못한다.
사고 용량을 늘린 2차 학습 후에는 표에 제시된 모든 AIME2024 평가 예산에서 점수가 낮아진다. 이 결과는 실험한 추가 학습 설정에 부정적인 근거를 제공하지만, 모든 형태의 반복 학습이 실패한다는 것을 입증하지는 않는다.
5 Conclusion
논문은 사고 생성과 풀이 생성에 별도 예산을 배정하고 중단된 사고로 학습하는 방법이 실험한 수학과 프로그래밍 과제 전반에서 길이 제어와 강건성을 개선한다고 결론짓는다. 더 큰 생성 한도에서도 출력이 짧아지는 결과를 보인다. 다만 원본 모델의 정확도를 유지하는지는 과제와 평가 조건에 따라 달라진다.
부록
- A Limitations and broader impacts: 이 방법은 사고와 풀이 단계가 구분된다고 가정하므로, 추론과 답변이 섞여 있는 대화나 상식 과제에는 적합하지 않을 수 있다. 평가가 수학과 프로그래밍에 집중되어 있어 과학 질의응답과 여러 단계를 연결해야 하는 multi-hop retrieval은 검증하지 않았다. 저자들은 효율 개선 가능성과 중요한 근거를 생략할 위험을 제시하지만, 에너지 절감량이나 사용자 신뢰, 판단의 파급력이 큰 응용 분야에 미치는 영향은 측정하지 않는다.
- B Training details: 모델 2개 모두 학습률 1 × 10⁻⁶, 배치 크기 128을 사용하며 사고와 풀이에 각각 별도의 1K-token 한도를 둔다. E1-Math-1.5B는 학습 프레임워크 VeRL로 200 steps 동안 학습하고, E1-Code-14B는 30 steps 동안 학습한다. 부록에 따르면 나머지 학습 설정은 시작 모델을 따른다.
짧은 생각
코드 성능 비교와 구성 요소 교체 실험은 추론 시 예산 제어에 더해 학습이 기여한다는 가장 명확한 근거를 제공한다. 코드 모델 2개 모두 Separate Budgeting을 사용하지만, 추가 학습한 모델이 엄격한 한도에서 더 좋은 성능을 보인다. 수학 모델의 생성 단계를 교체한 실험에서도 사고만 교체할 때보다 풀이 생성을 교체할 때 성능 향상이 더 크다.
측정된 효율 개선은 토큰 사용량과 정확도에 관한 것이다. 논문은 실제 경과 시간 기준 지연 시간, 하드웨어 차이를 보정한 학습 비용, 반복 실행 간 불확실성을 보고하지 않는다. 학습 스텝과 응답 한도가 줄었다는 점은 학습 작업량이 작아졌음을 뒷받침하지만, 전체 과정의 비용 절감량을 정량화하지는 못한다. 24K 한도에서 AIME2024 정확도가 6.0%p 낮아진다는 결과는 원본 수학 모델과의 절충 관계를 명확히 보여 준다.