


Search-o1: Agentic Search-Enhanced Large Reasoning Models 요약 설명
09 Jan 2025 | Paper Review Retrieval-Augmented Generation Search Agents Reasoning이번 글에서는 Search-o1: Agentic Search-Enhanced Large Reasoning Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 9일(Arxiv)
- Li, Xiaoxi, Dong, Guanting, Jin, Jiajie, Zhang, Yuyao, Zhou, Yujia, Zhu, Yutao, Zhang, Peitian, Dou, Zhicheng.
- Renmin University of China, Tsinghua University
- 논문 링크
요약
- Search-o1은 답변 전에 긴 단계별 추론을 생성하는 대규모 추론 모델의 지식 부족을 다룬다. 부족한 지식은 추론을 잘못된 방향으로 이끌 수 있다. QwQ-32B-Preview에 검색과 문서 정제를 적용하면, 대학원 수준의 과학 질의응답 벤치마크인 198문항의 GPQA diamond에서 Pass@1이 검색을 사용하지 않았을 때의 58.1에서 63.6으로 높아진다. Pass@1은 답변을 1개 생성했을 때의 성공률이다.
- 이 프레임워크는 모델이 외부 정보를 언제, 무엇을 검색할지 결정하는 agentic retrieval-augmented generation(RAG)과 Reason-in-Documents를 결합한다. Reason-in-Documents는 현재 쿼리와 이전 추론을 바탕으로 검색한 페이지를 분석하는 별도의 생성 과정이다. 정제된 정보만 주 추론 시퀀스로 돌아간다. 논문은 추론 시점의 처리 절차를 설명하며, 추가 모델 학습은 보고하지 않는다.
- 가장 뚜렷한 개선은 과학 문제와 여러 추론 단계의 정보를 결합해야 하는 multi-hop 질의응답에서 나타난다. 논문에 따르면 Search-o1은 multi-hop 데이터셋 4개에서 정답과 일치하는 답변의 비율인 exact match의 평균을 같은 모델을 사용하는 standard RAG보다 상대적으로 29.6% 높인다. 효과는 과제마다 다르다. 프로그래밍 벤치마크인 LiveCodeBench에서는 직접 추론과 같은 33.0에 머무르며, 부록 사례에서는 정제된 정보의 오류와 불필요하게 반복된 검색이 드러난다.
1 Introduction
서론은 추론 시퀀스가 길어질수록 부족한 사실 지식이 후속 단계에 영향을 줄 기회도 늘어난다고 설명한다. 원래 질문으로 문서를 1번만 검색하면 나중에 필요한 지식을 놓칠 수 있다. 추론 도중 긴 페이지를 삽입하면 무관한 정보가 유입되고 추론의 연속성이 끊길 수 있다.
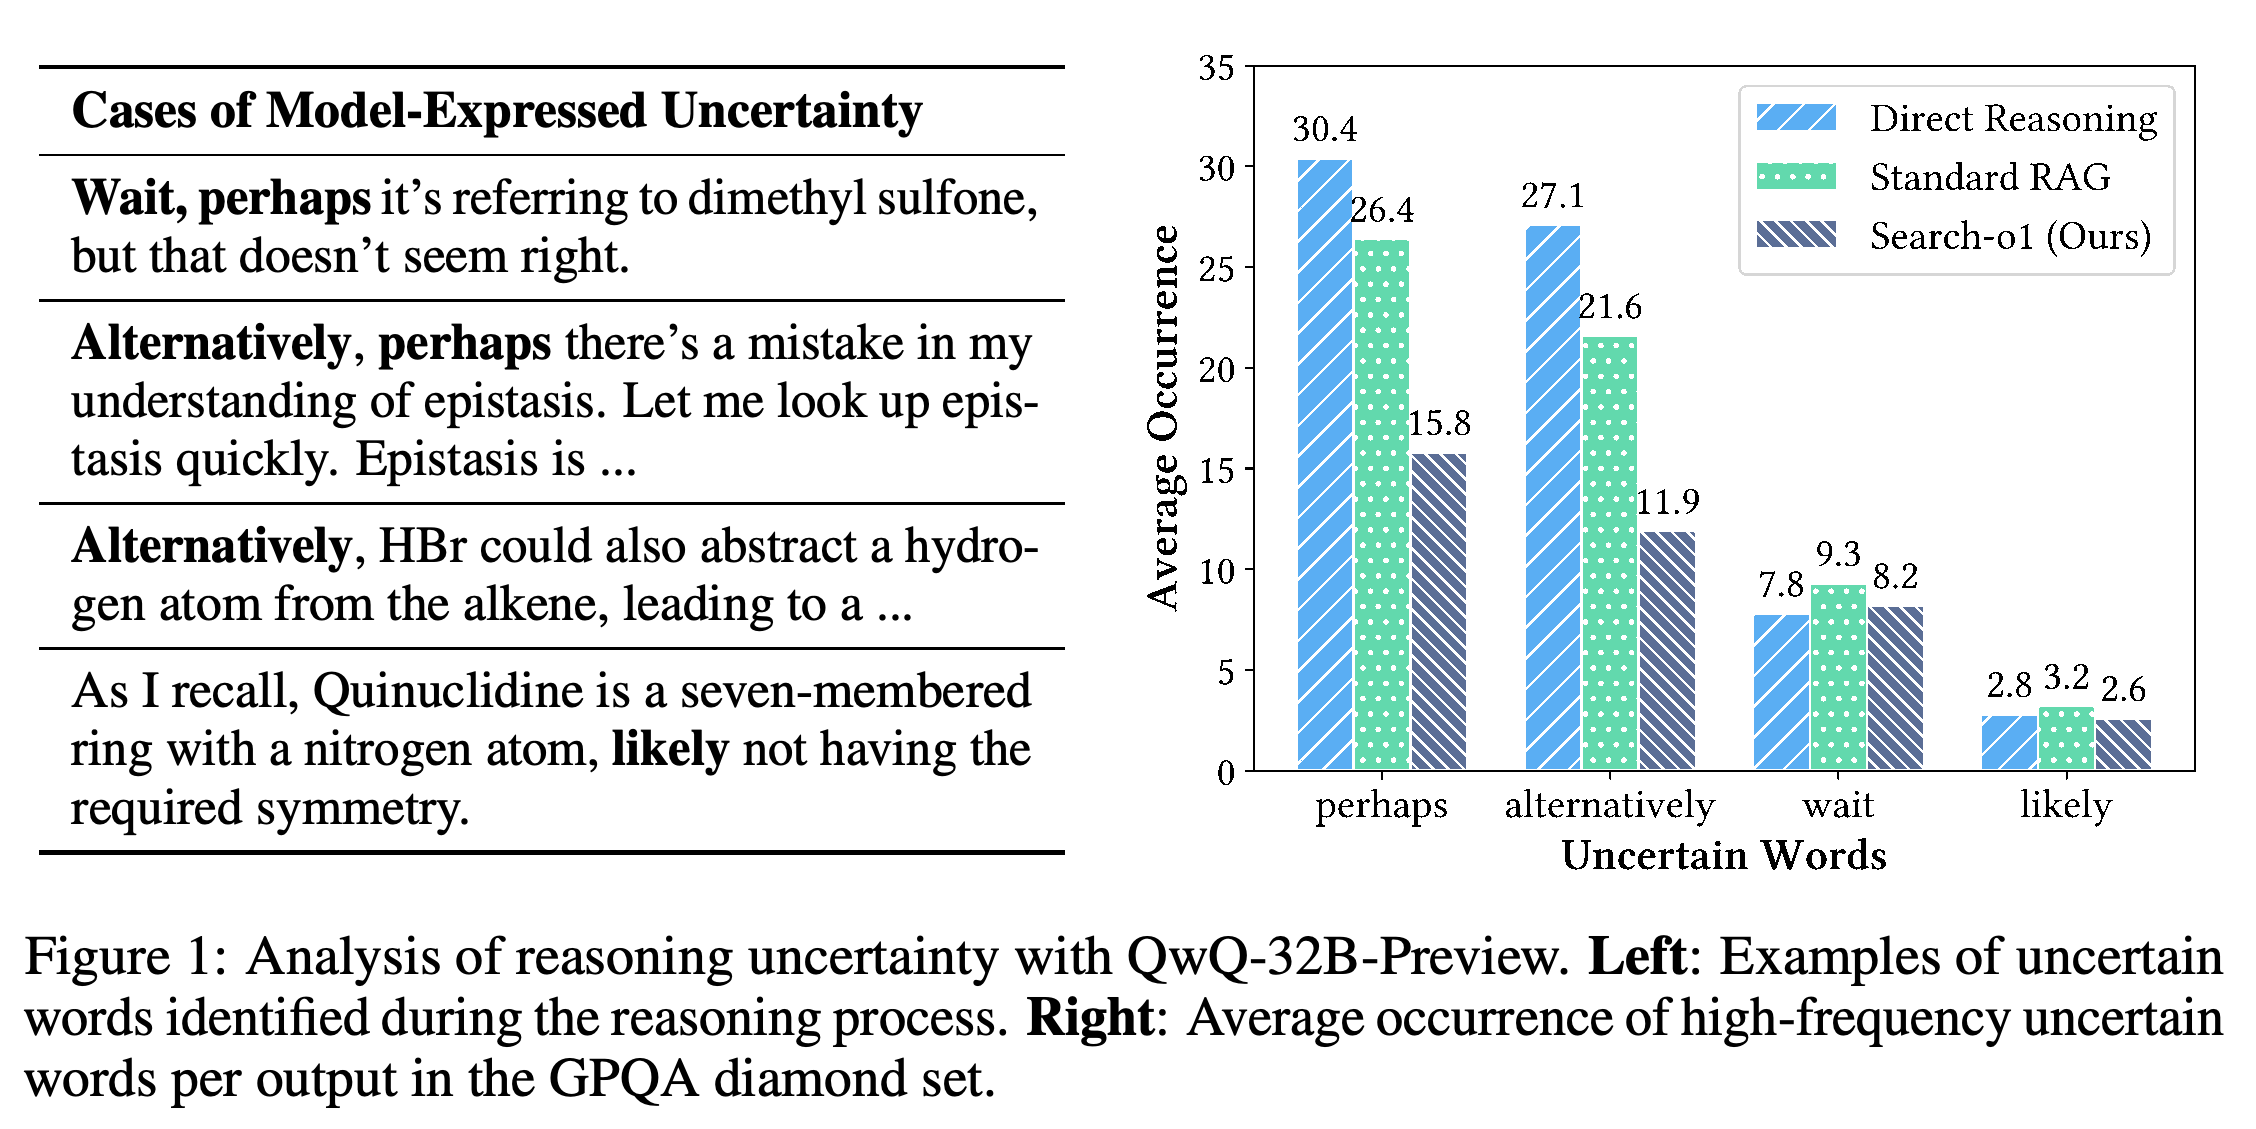
- Figure 1은 GPQA diamond에 대한 QwQ-32B-Preview 출력에서 불확실성 표현을 측정한다. Search-o1은 직접 추론에 비해 “perhaps”의 평균 출현 횟수를 30.4에서 15.8로, “alternatively”의 평균 출현 횟수를 27.1에서 11.9로 줄인다.
- 이 횟수는 생성된 언어의 특성을 나타낸다. 이 수치만으로 사실적 정확성이나 표현된 불확실성이 실제 오류를 반영하는지는 확인할 수 없다.
- 제안한 방법은 모델이 주도하는 반복 검색과 현재 추론 단계에 필요한 정보를 선별하는 별도 과정을 결합한다.
Search-o1은 직접 추론과 standard RAG보다 “perhaps”와 “alternatively”의 사용을 줄이지만, “wait”는 8.2로 직접 추론의 7.8보다 약간 높다. 이 차트는 불확실성 표현의 사용을 측정하며, 사실적 신뢰성을 측정하지는 않는다.
2 Related Work
관련 연구에서는 추론 시점의 연산을 늘려 추론 능력을 개선하는 접근과 RAG로 외부 지식을 제공하는 접근을 연결한다. 기존 검색 연구는 쿼리 처리, 문서 압축, 잡음 제거, 정제, 검색 여부 결정 등을 다룬다. Search-o1은 필요할 때 수행하는 검색을 기존 모델의 긴 추론과 결합한다.
3 Methodology
Search-o1은 추론 생성, 필요할 때 검색 쿼리 요청, 검색 문서의 별도 분석, 정제된 정보 삽입, 추론 재개를 반복한다. 이어지는 절에서는 생성 시퀀스를 수식으로 정의하고 단일 질문 처리와 배치 실행을 설명한다.
3.1 Problem Formulation
이 과제는 지시문 I, 질문 q, 동적으로 검색한 문서 D를 받아 추론 시퀀스 R과 최종 답변 a를 생성한다. Equation (1)은 이전 추론과 검색 문서를 조건으로 토큰을 차례로 생성하는 추론 과정과, 완성된 추론 시퀀스를 조건으로 답변을 생성하는 과정을 구분한다.
- 추론 도중에도 검색을 사용할 수 있으므로, 후속 단계는 생성 시작 시점에 없었던 정보를 활용할 수 있다.
- 이 정식화는 생성 확률을 설명한다. 새로운 학습 목적함수나 올바른 추론에 대한 보장은 제시하지 않는다.
3.2 Overview of the Search-o1 Framework
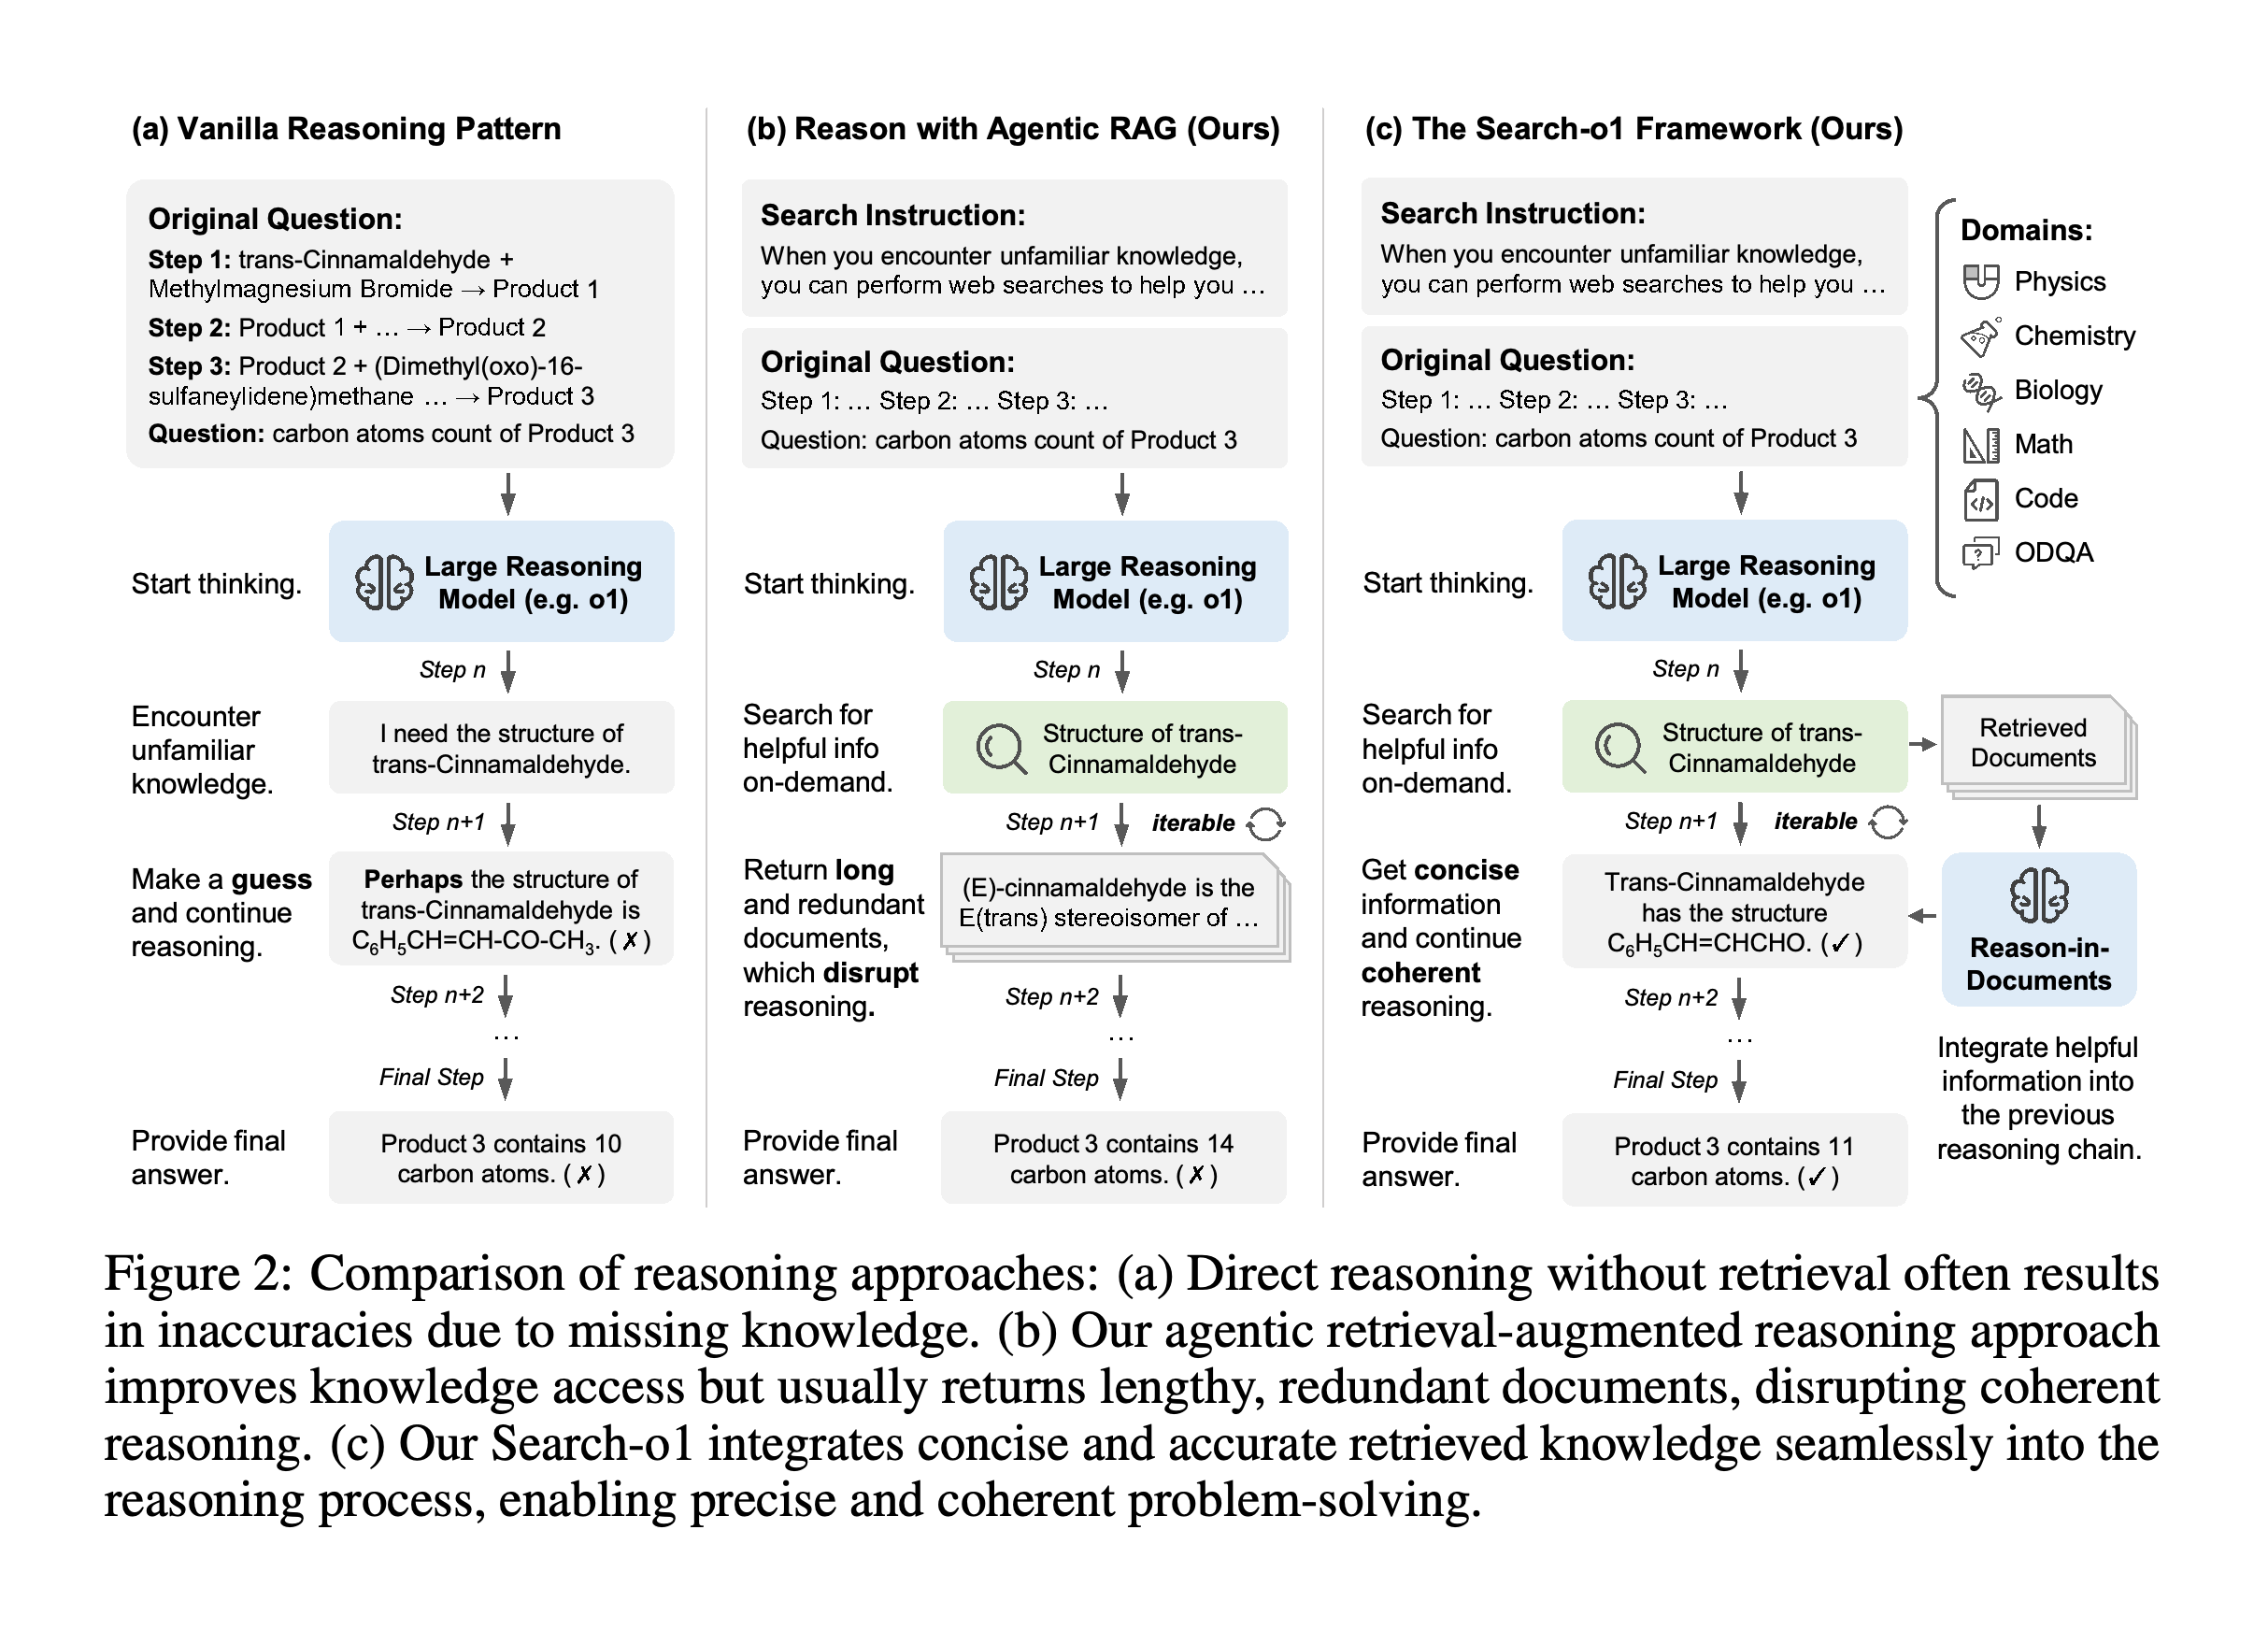
프레임워크는 직접 추론, 검색 자료를 추론 시퀀스에 삽입하는 agentic retrieval, Reason-in-Documents를 사용하는 Search-o1을 비교한다. Figure 2의 화학 예시에서 3개 경로는 각각 탄소 원자 수를 10, 14, 11로 답하며, 11이 정답으로 표시되어 있다.
- 직접 추론은 잘못된 사실적 가정을 바탕으로 계속 진행될 수 있다.
- Agentic retrieval은 외부 정보를 제공하지만, 길거나 중복된 자료를 반환할 수 있다.
- Search-o1은 현재 쿼리, 검색한 페이지, 이전 추론을 조건으로 문서를 정제한 뒤 필요한 정보를 주 시퀀스로 돌려보낸다.
검색 문서는 Reason-in-Documents를 거친 뒤 주 추론 시퀀스로 정보가 반환된다. 이 화학 예시에서는 Search-o1 경로에서만 올바른 개수인 11이 나타나 의도한 효과를 보여주지만, 여러 사례를 종합한 평가는 아니다.
3.3 Agentic Retrieval-Augmented Generation Mechanism
모델은 <|begin_search_query|>와 <|end_search_query|> 사이에 쿼리를 생성하여 검색을 요청한다. 종료 마커가 감지되면 생성을 일시 중단하고 쿼리를 추출한 뒤 Search를 호출하여 검색 순위가 가장 높은 문서들을 가져온다. 검색 결과에는 <|begin_search_result|>와 <|end_search_result|>를 사용한다.
- 각 쿼리는 지시문, 원래 질문, 이전 쿼리와 결과를 포함해 누적된 추론에 따라 결정된다.
- 답변 1개를 생성하는 동안 검색을 반복할 수 있으므로, 각 추론 단계에서 서로 다른 사실을 요청할 수 있다.
- 검색 여부는 모델의 생성 결과로 결정된다. 논문은 별도의 수치적 불확실성 임계값을 정의하지 않는다.
3.4 Knowledge Refinement via Reason-in-Documents
Reason-in-Documents는 원래 추론 모델을 별도의 생성 과정에서 사용하여 검색한 페이지를 분석한다. 먼저 중간 문서 분석 시퀀스를 생성하고, 그 분석과 현재 쿼리, 이전 추론을 조건으로 정제된 정보를 생성한다.
- 정제된 출력만 주 추론 시퀀스에 삽입하므로 이후 단계로 전달되는 검색 자료를 제한한다.
- Equations (4)–(6)은 문서 분석, 정제된 정보 생성, 이전에 정제한 정보를 사용하는 후속 추론을 구분한다.
- 이 모듈은 정확하고 관련성 높은 정보를 선별하는 것을 목표로 하지만, 부록에서는 출력에 잘못된 결론이 포함될 수 있음을 보여준다.
3.5 Search-o1 Inference Process
단일 질문에서는 답변을 완성할 때까지 추론과 검색 요청에 따른 정제를 번갈아 수행한다. Algorithm 1은 미완료 시퀀스 집합과 완료 시퀀스 집합을 유지하여 생성과 정제를 배치로 수행할 수 있게 한다.
- 생성은 완료를 나타내는 end-of-sequence 토큰이나 <|end_search_query|>가 나올 때까지 진행된다.
- 검색을 요청한 시퀀스는 정제된 정보를 받은 뒤 생성을 재개한다. 완료된 시퀀스는 완료 집합으로 이동한다.
- 본문은 처리량을 높이기 위한 병렬 처리를 설명하지만, 실험에서는 처리량, 지연 시간, 정제에 필요한 추가 생성 비용을 정량적으로 측정하지 않는다.
4 Experiments
실험은 검색과 정제가 고난도 추론과 일반 지식을 다루는 open-domain 질의응답(QA)을 개선하는지 평가한다. 직접 추론, 추론 전 1번의 검색, 추론 중 모델이 주도하는 검색을 비교한다.
4.1 Tasks and Datasets
고난도 추론 평가에는 198문항의 GPQA diamond, 수학 문제 500개로 구성된 MATH500, 수학 경시대회 문제 40개로 구성된 AMC2023, 수학 경시대회 문제 30개로 구성된 AIME2024, 2024년 8월부터 11월까지의 LiveCodeBench 프로그래밍 문제 112개가 포함된다. 인간 전문가와의 별도 비교에는 546문항의 GPQA extended를 사용한다.
- 과학 문제는 물리학, 화학, 생물학을 다룬다. LiveCodeBench에는 쉬움, 중간, 어려움 난도의 프로그래밍 문제가 포함된다.
- 지식 항목 1개에서 얻은 정보가 필요한 single-hop QA에는 Google 쿼리와 Wikipedia 답변으로 구성된 Natural Questions(NQ), 퀴즈 웹사이트와 대회에서 수집한 TriviaQA를 사용한다.
- Multi-hop 평가에는 Wikipedia 문단을 연결해 추론하는 HotpotQA, 명시적 추론 경로를 제공하는 2WikiMultihopQA(2WIKI), 2–4홉이 필요한 질문으로 구성된 MuSiQue, Google이 잘못 답하는 조합형 질문을 담은 Bamboogle을 사용한다.
4.2 Baselines
직접 추론 베이스라인에는 Qwen2.5-32B-Instruct, Qwen2.5-Coder-32B-Instruct, QwQ-32B-Preview, Qwen2.5-72B-Instruct, Llama3.3-70B-Instruct가 포함된다. DeepSeek-R1-Lite-Preview, GPT-4o, o1-preview의 참고 결과는 각 모델의 공식 발표에서 가져오며, 저자들이 구현한 결과가 아니다.
- Standard RAG는 원래 질문에 대한 상위 10개 문서를 검색하여 추론 전에 제공한다.
- 모델 주도 검색 베이스라인인 RAG Agent(RAgent)는 처음에 상위 10개 검색 스니펫을 반환하며, 모델이 선택한 URL의 전체 페이지를 요청할 수 있게 한다.
- RAgent와 Search-o1은 스니펫 선택과 별도 문서 정제 등 검색 정보가 추론 모델에 전달되는 방식이 다르다. 따라서 이 비교는 동일한 문서 제시 조건에서 정제의 효과만 분리해 측정하지 않는다.
4.3 Implementation Details
Search-o1은 QwQ-32B-Preview를 사용하며, 최대 생성 토큰 수는 32,768, temperature는 0.7, top_p는 0.8, top_k는 20, repetition penalty는 1.05로 설정한다. 검색에는 지역을 US-EN으로, top-k를 10으로 설정한 Bing Web Search API를 사용하며, Jina Reader API로 페이지 내용을 가져온다. 실험은 NVIDIA A800-80GB 그래픽 처리 장치(GPU) 8개에서 수행한다.
- Temperature는 샘플링의 무작위성을 조절한다. top_p와 top_k는 각각 누적 확률과 개수를 기준으로 후보 토큰을 제한하며, repetition penalty는 토큰 반복을 억제한다. 논문은 이러한 생성 설정을 모델 전반에 적용한다고 명시한다.
- 추론에 특화된 학습을 받지 않은 베이스라인에는 답변 전에 단계별로 추론하도록 지시하는 Chain-of-Thought(CoT) 프롬프팅을 적용한다.
- 모든 검색 기반 방법은 최종 답변을 내놓지 못하면 직접 추론 결과를 대신 사용하므로, 보고된 점수에는 이 대체 처리 결과가 포함된다.
4.4 Results on Challenging Reasoning Tasks
Table 1에서 GPQA diamond의 전체 Pass@1은 직접 추론을 수행한 QwQ-32B의 58.1, RAgent-QwQ-32B의 61.6에서 Search-o1의 63.6으로 높아진다. MATH500 점수는 Search-o1이 86.4이며, 직접 추론과 RAgent는 각각 83.2, 85.0이다. AMC2023과 AIME2024에서는 각각 85.0, 56.7로 RAgent와 같다.
- LiveCodeBench 전체 점수는 Search-o1이 33.0, 직접 추론 QwQ-32B가 33.0, standard RAG가 24.1, RAgent가 26.8이다.
- Section 4.4는 평균 개선율을 RAgent 대비 4.7%, 직접 추론 QwQ-32B 대비 3.1%로 보고한다. 이 비교 대상 표기는 뒤바뀐 것으로 보인다. 표시된 벤치마크 5개의 점수 평균으로 상대 개선율을 계산하면 RAgent 대비 약 3.05%, 직접 추론 대비 약 4.7%다.
- 이 표는 과제에 따라 개선 효과가 다르며, 전체 코딩 성능에서는 직접 추론 QwQ-32B보다 향상되지 않음을 보여준다.
같은 QwQ-32B 모델을 사용할 때 GPQA 전체 점수는 직접 추론의 58.1에서 Search-o1의 63.6으로 높아진다. 수학 결과는 agentic 베이스라인보다 높거나 같지만, LiveCodeBench 전체 점수는 직접 추론과 같은 33.0에 머무른다.
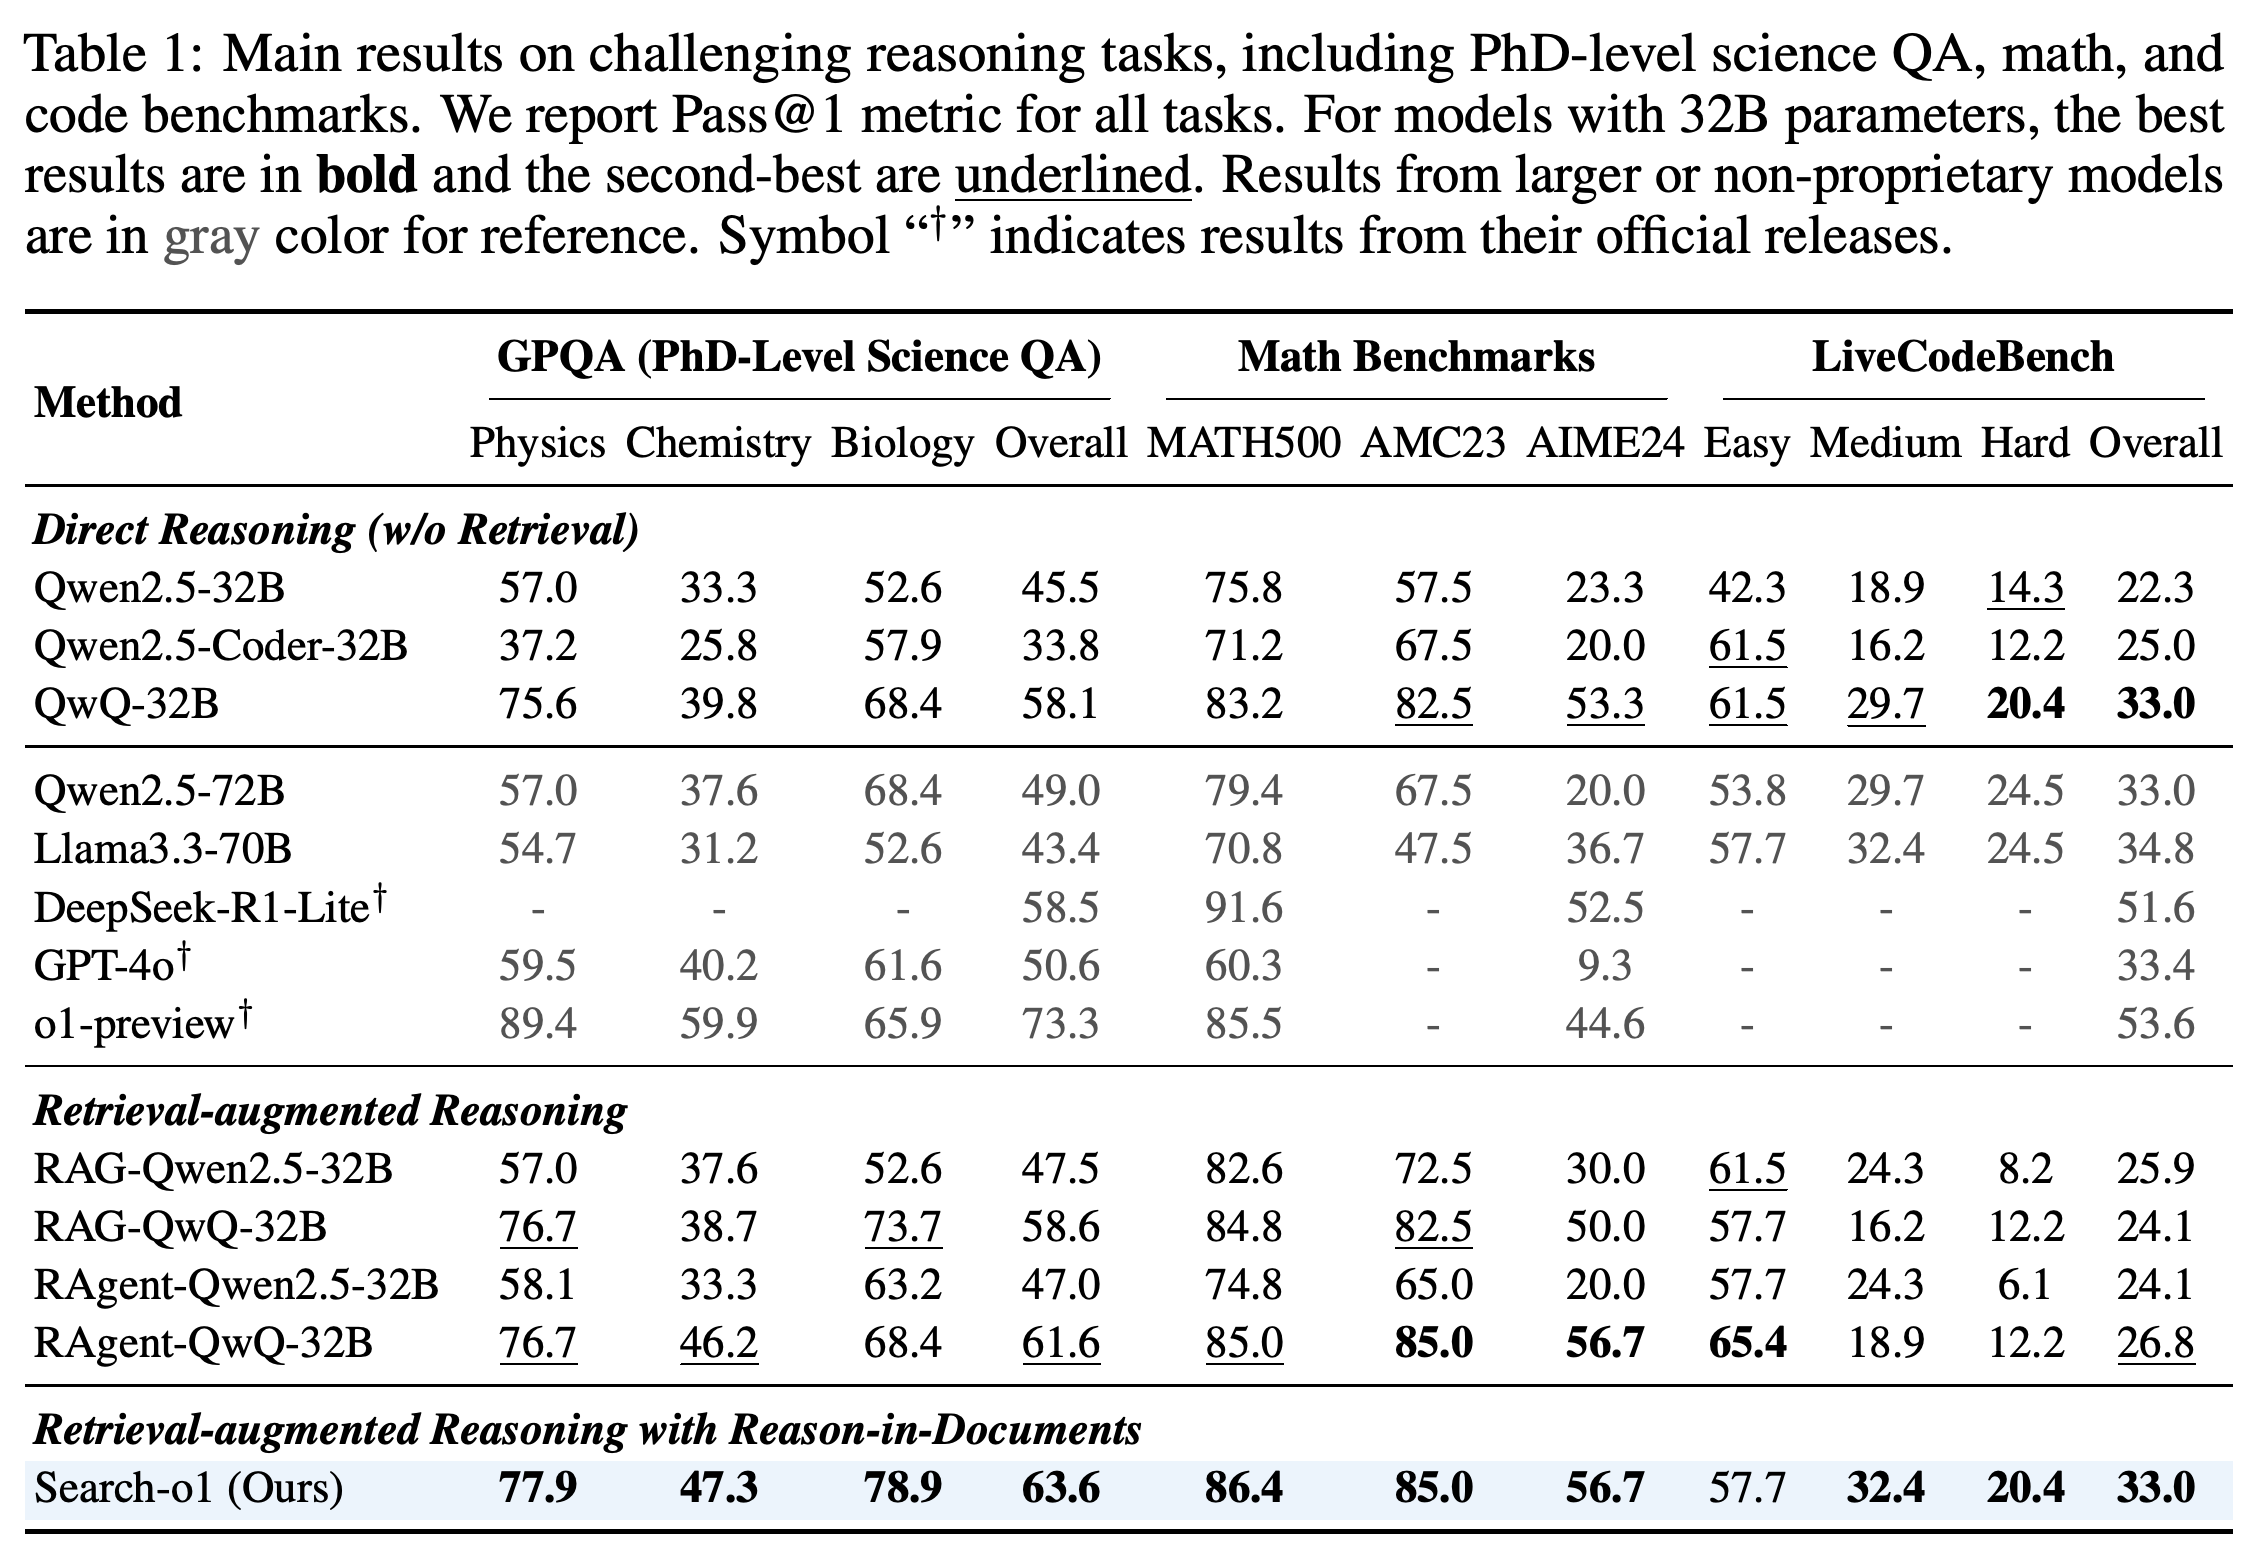
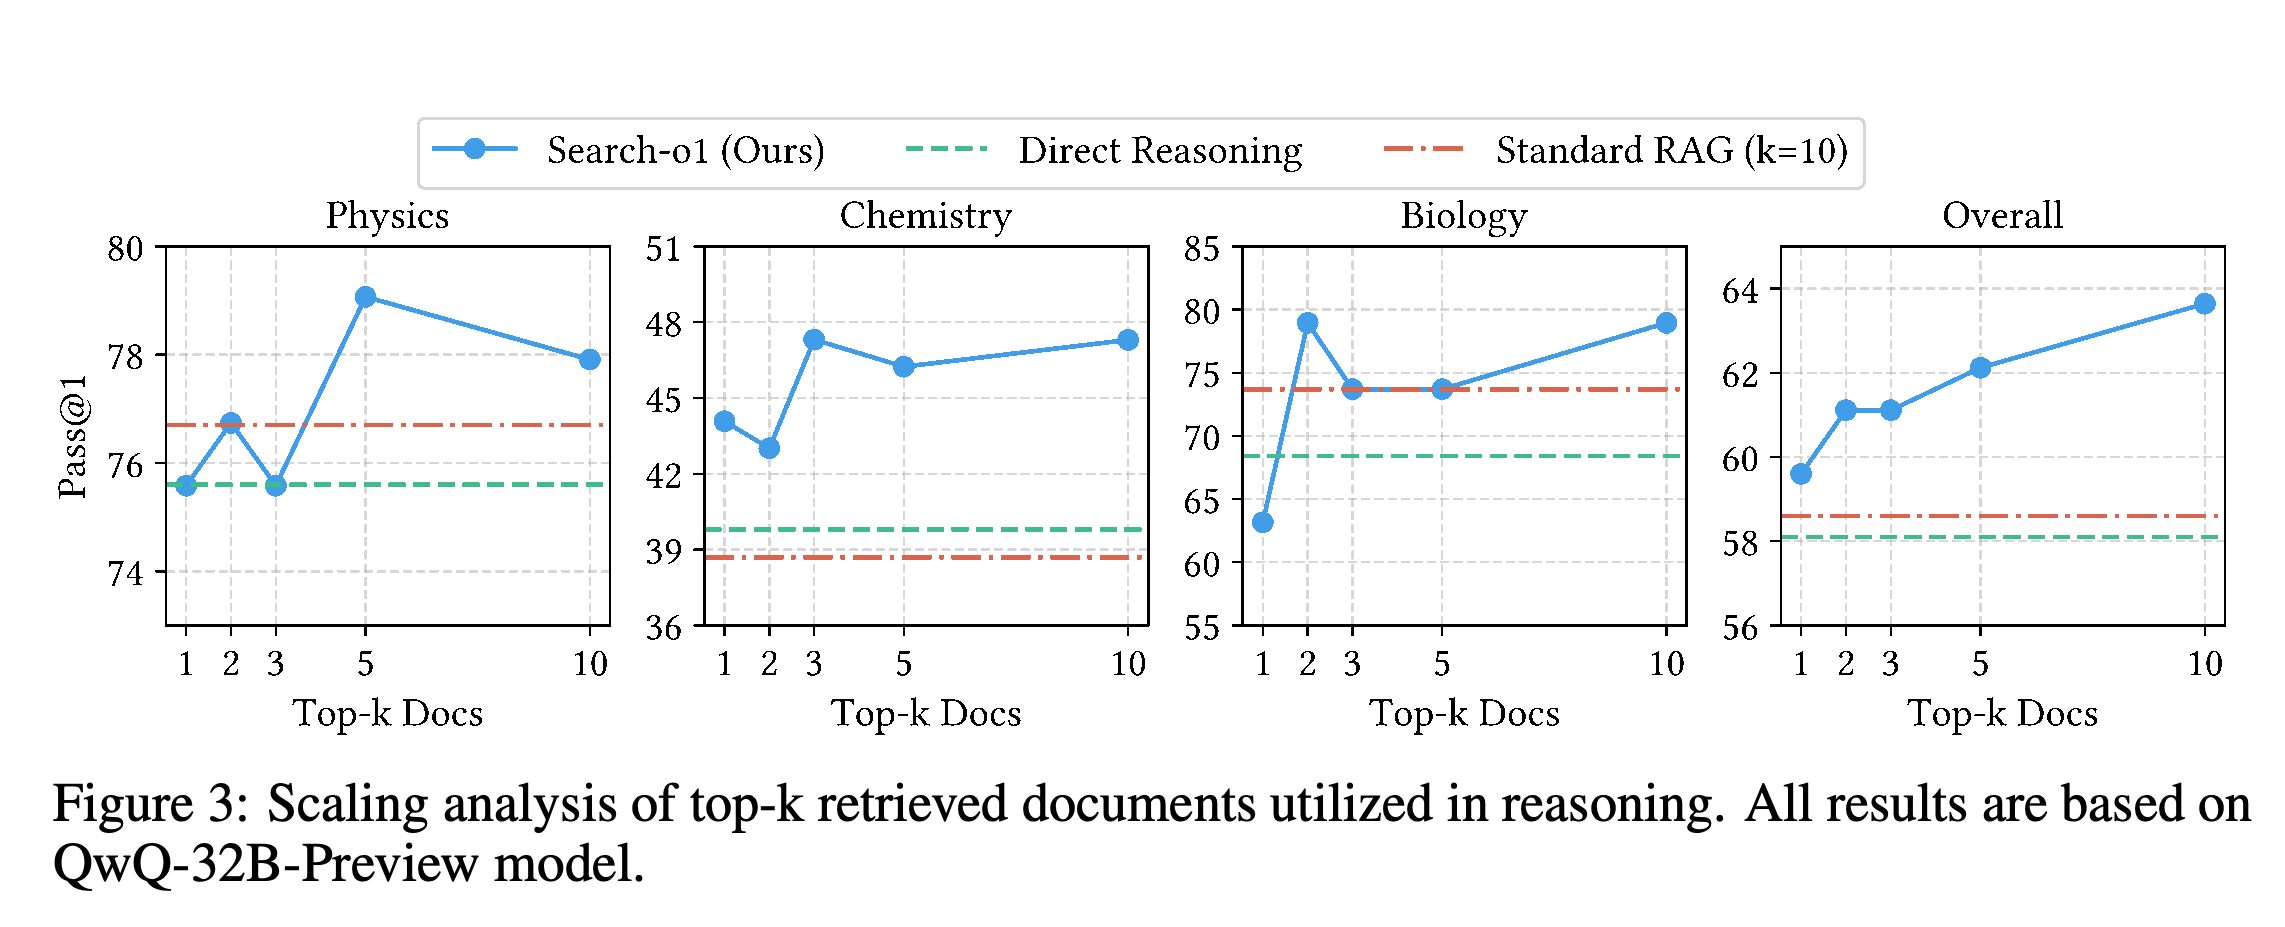
Figure 3은 QwQ-32B-Preview를 사용하여 검색 문서 수를 1, 2, 3, 5, 10개로 바꾼다. 이 설정들에서 GPQA 전체 성능은 감소하지 않는 추세를 보이며, 문서 1개만 사용하는 설정도 직접 추론과 문서 10개를 사용하는 standard RAG를 능가한다.
- 개별 과학 분야의 결과는 변동한다. 물리학은 문서 5개에서 최고 성능을 보이며, 생물학은 문서 2개를 사용한 결과 이후 하락했다가 10개에서 회복한다.
- 이 전체 추세만으로 각 분야에서 성능이 단조 증가한다거나 문서 처리 비용을 고려해도 효율성이 더 높다고 판단할 수는 없다.
실험한 문서 수가 늘어남에 따라 GPQA 전체 성능은 감소하지 않는 추세를 보이며, 문서 1개 설정도 문서 10개를 사용하는 standard RAG를 능가한다. 다만 물리학이 문서 5개에서 최고 성능을 보이는 등 분야별로는 변동이 있어, 이 전체 추세를 모든 분야에 적용할 수는 없다.
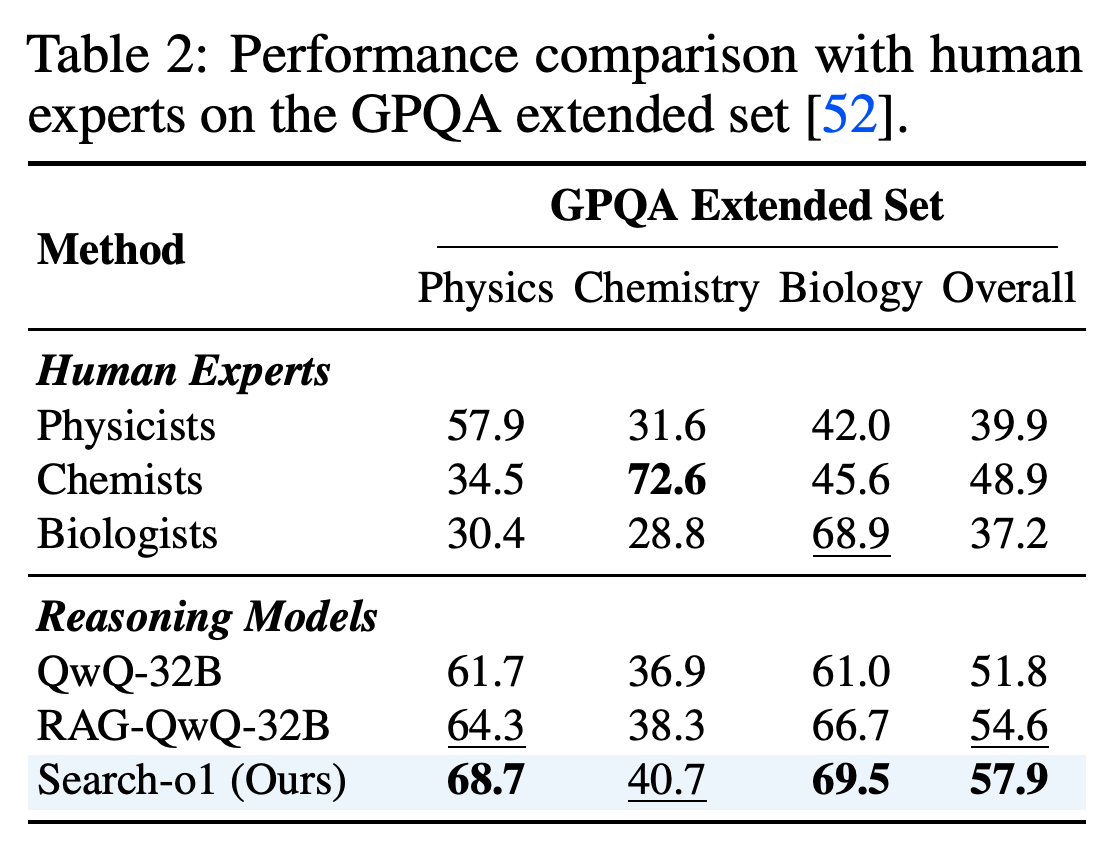
GPQA extended에서 Search-o1의 전체 점수는 57.9이며, 직접 추론 QwQ-32B는 51.8, standard RAG는 54.6이다. Search-o1의 물리학과 생물학 점수는 각각 68.7, 69.5로 해당 분야 전문가의 57.9, 68.9보다 높다. 반면 화학 점수는 40.7로 화학 전문가의 72.6보다 크게 낮다.
- 전체 분야가 섞인 문제에서 표시된 인간 전문가의 전체 점수는 물리학 전문가 39.9, 화학 전문가 48.9, 생물학 전문가 37.2다.
- 이 비교는 해당 벤치마크와 분야별 결과에 적용된다. 인간 전문가보다 일반적으로 우수함을 입증하지는 않는다.
Search-o1은 표시된 전체 점수 중 가장 높은 57.9를 기록하며, 물리학과 생물학에서는 표시된 해당 분야 전문가 점수를 넘어선다. 화학에서는 Search-o1이 40.7, 화학 전문가가 72.6으로 뚜렷한 약점이 남는다.
4.5 Results on Open-Domain QA Tasks
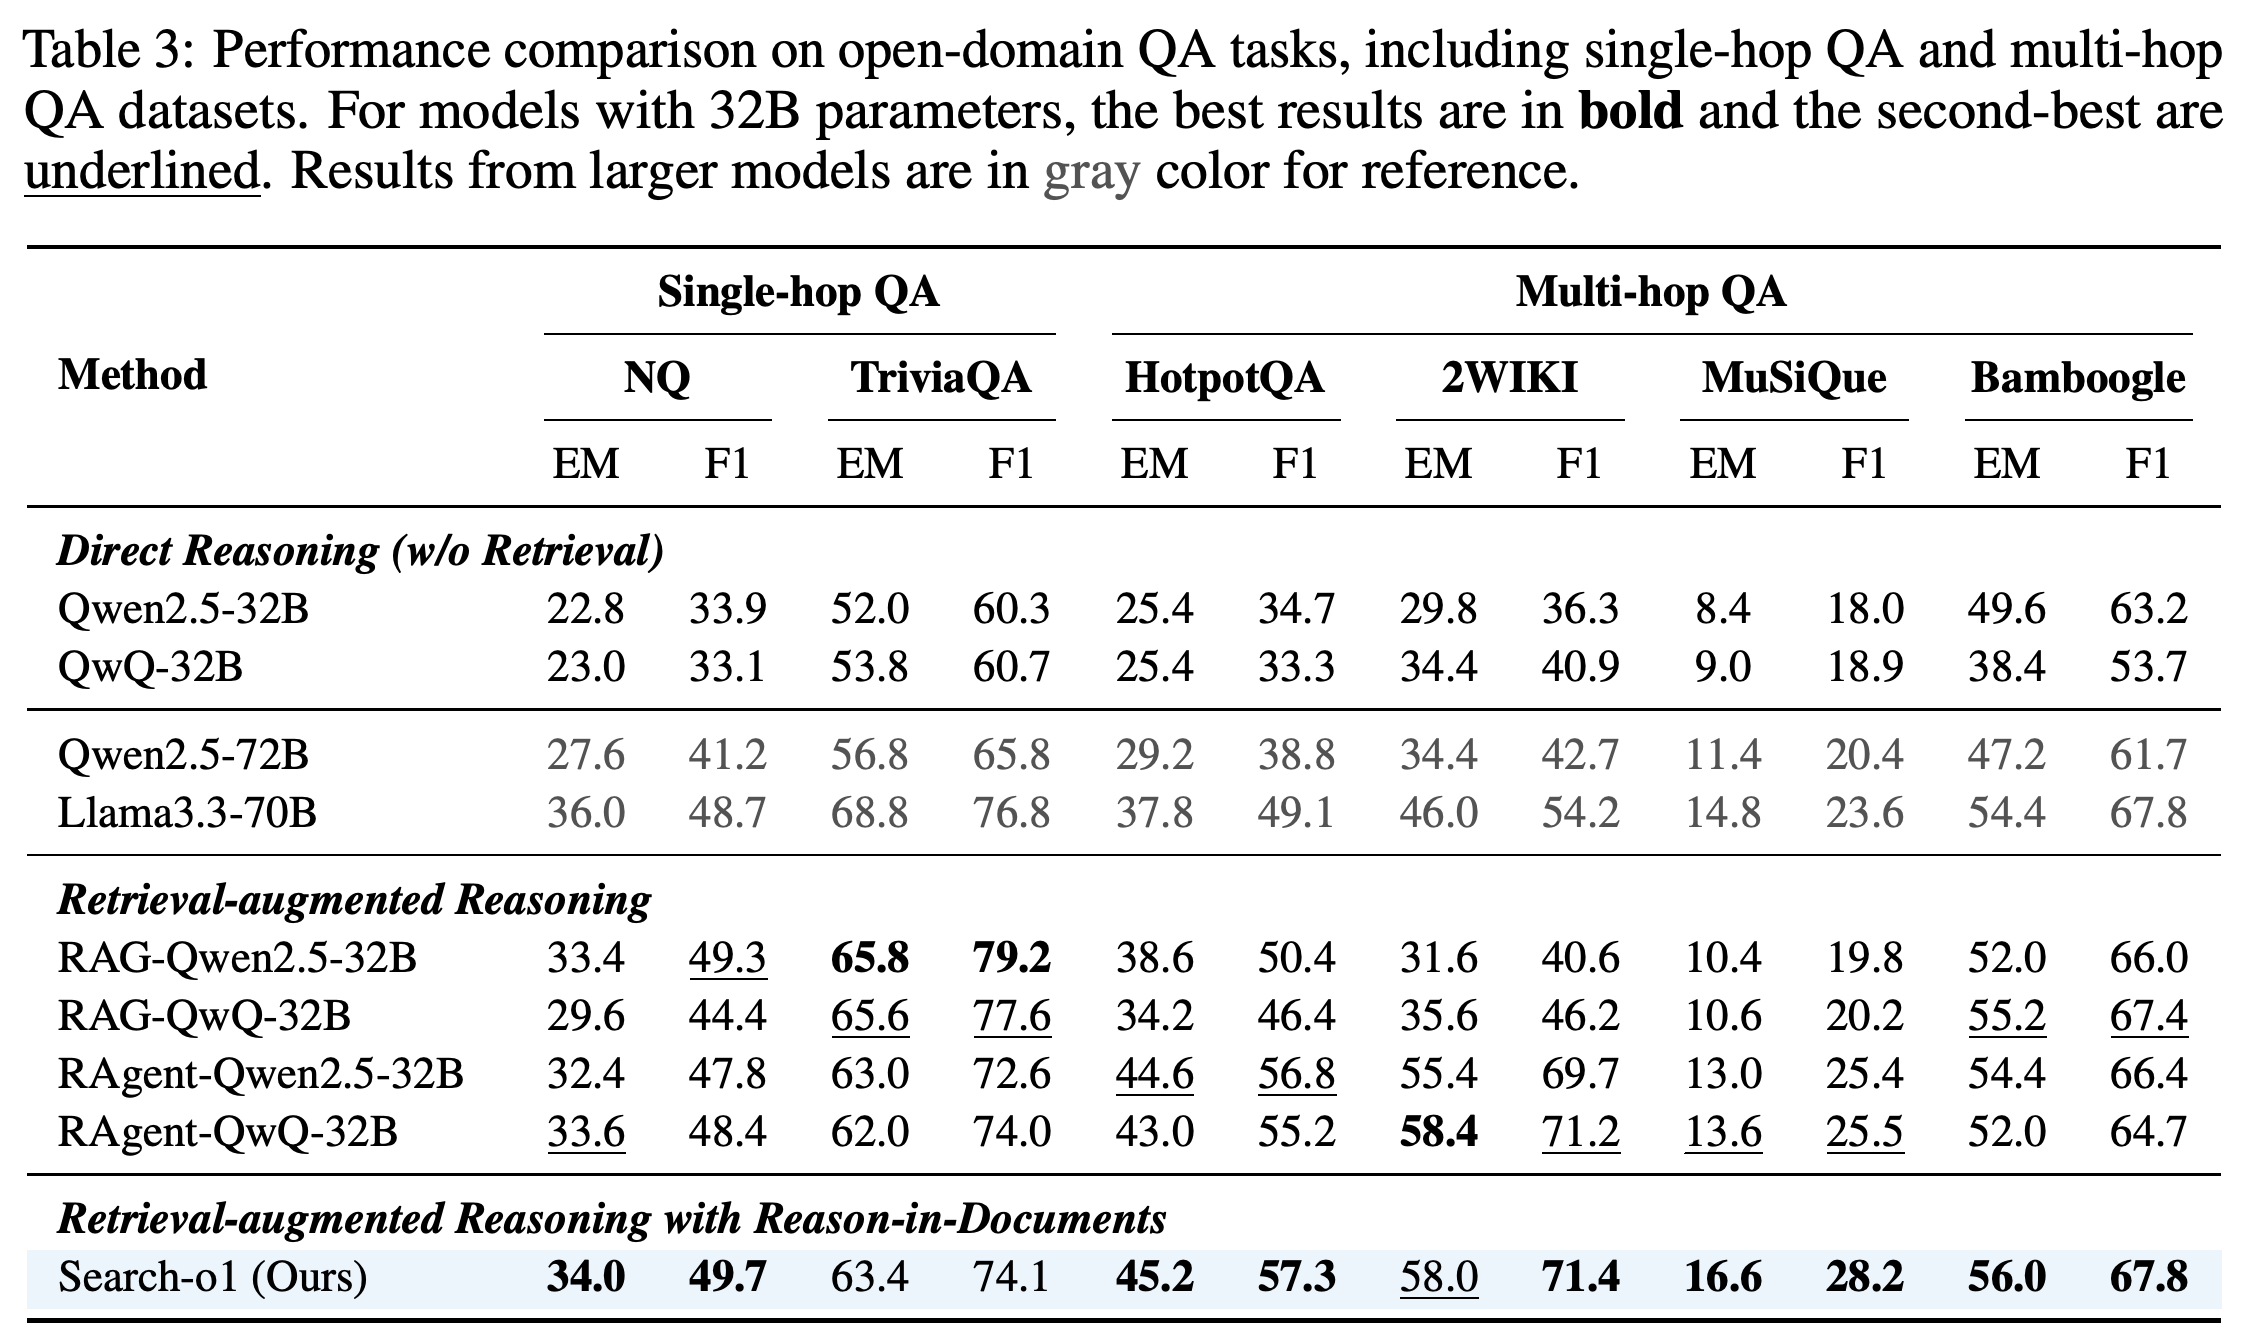
Table 3은 exact match(EM)와 답변 간 중첩을 측정하는 F1을 보고한다. 논문에 따르면 multi-hop 데이터셋 4개에서 Search-o1의 평균 EM은 RAG-QwQ-32B 대비 상대적으로 29.6%, RAgent-QwQ-32B 대비 5.3% 높다.
- Search-o1의 EM은 HotpotQA에서 45.2, 2WIKI에서 58.0, MuSiQue에서 16.6, Bamboogle에서 56.0이다.
- 2WIKI EM은 RAgent-QwQ-32B가 58.4로 약간 더 높다. TriviaQA EM은 standard RAG-QwQ-32B가 65.6으로 Search-o1의 63.4보다 높다.
- QwQ-32B의 평균 single-hop EM은 standard RAG의 47.6에서 RAgent의 47.8로 소폭만 변한다. Multi-hop에서 더 큰 개선이 나타난다는 점은 여러 정보 수집 단계가 필요한 과제에 대한 논문의 강조를 뒷받침한다.
Search-o1은 검색 베이스라인 2개보다 평균 multi-hop exact match를 높인다. 예외적으로 2WIKI exact match는 RAgent-QwQ-32B가 더 높고 TriviaQA 점수는 standard RAG가 더 높아, 반복 검색과 정제의 효과가 과제마다 다름을 보여준다.
5 Conclusion
결론은 동적 검색과 Reason-in-Documents를 긴 추론 중 지식 부족을 해결하는 상호 보완적 방법으로 제시한다. 벤치마크 결과는 과학과 multi-hop QA에서의 개선을 뒷받침하지만, 일부 수학 및 코딩 비교에서는 개선 폭이 작거나 없다. Tables 4–6의 사례 연구는 올바른 최종 답변과 함께 정제된 정보의 오류, 불완전한 풀이 근거, 불필요하게 반복된 검색을 보여준다.
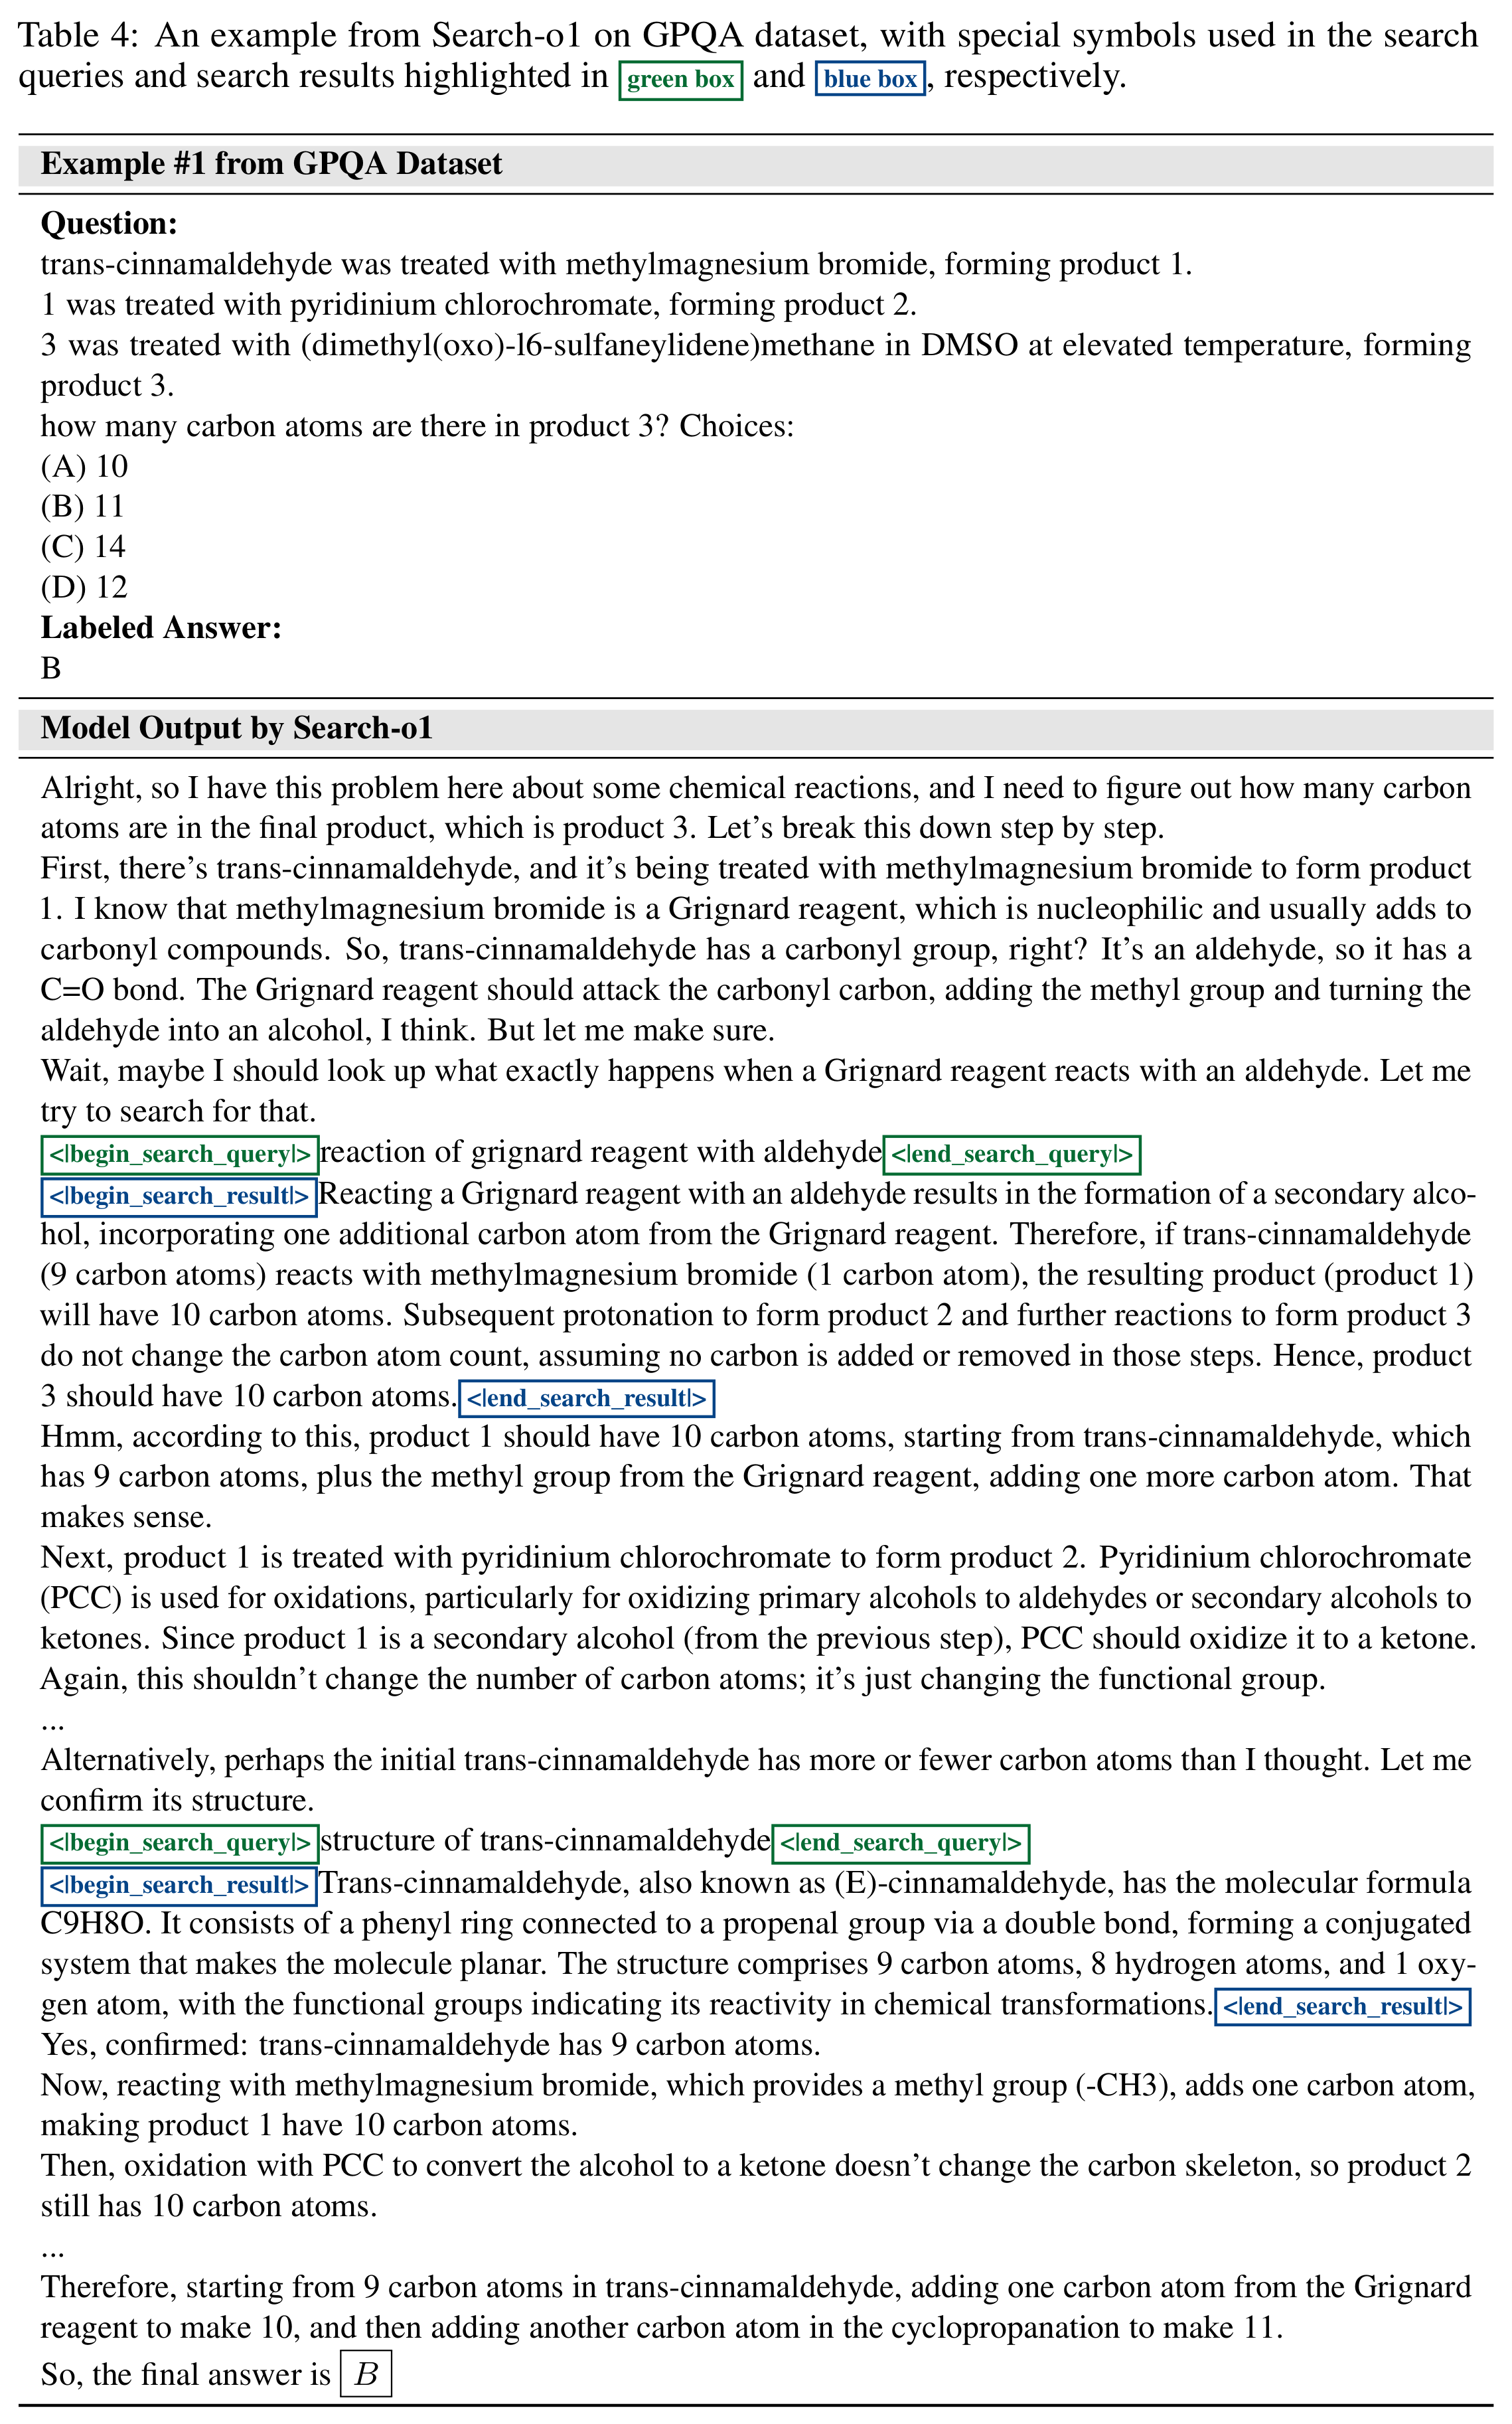
실행 기록은 탄소 원자 11개에 해당하는 정답 B로 끝나지만, 처음 정제한 검색 결과는 최종 생성물에 탄소가 10개 있어야 한다고 잘못 예측한다. 이 사례는 최종 답변에서 오류를 바로잡는 모습과 정제 과정 내부의 오류를 함께 보여준다.
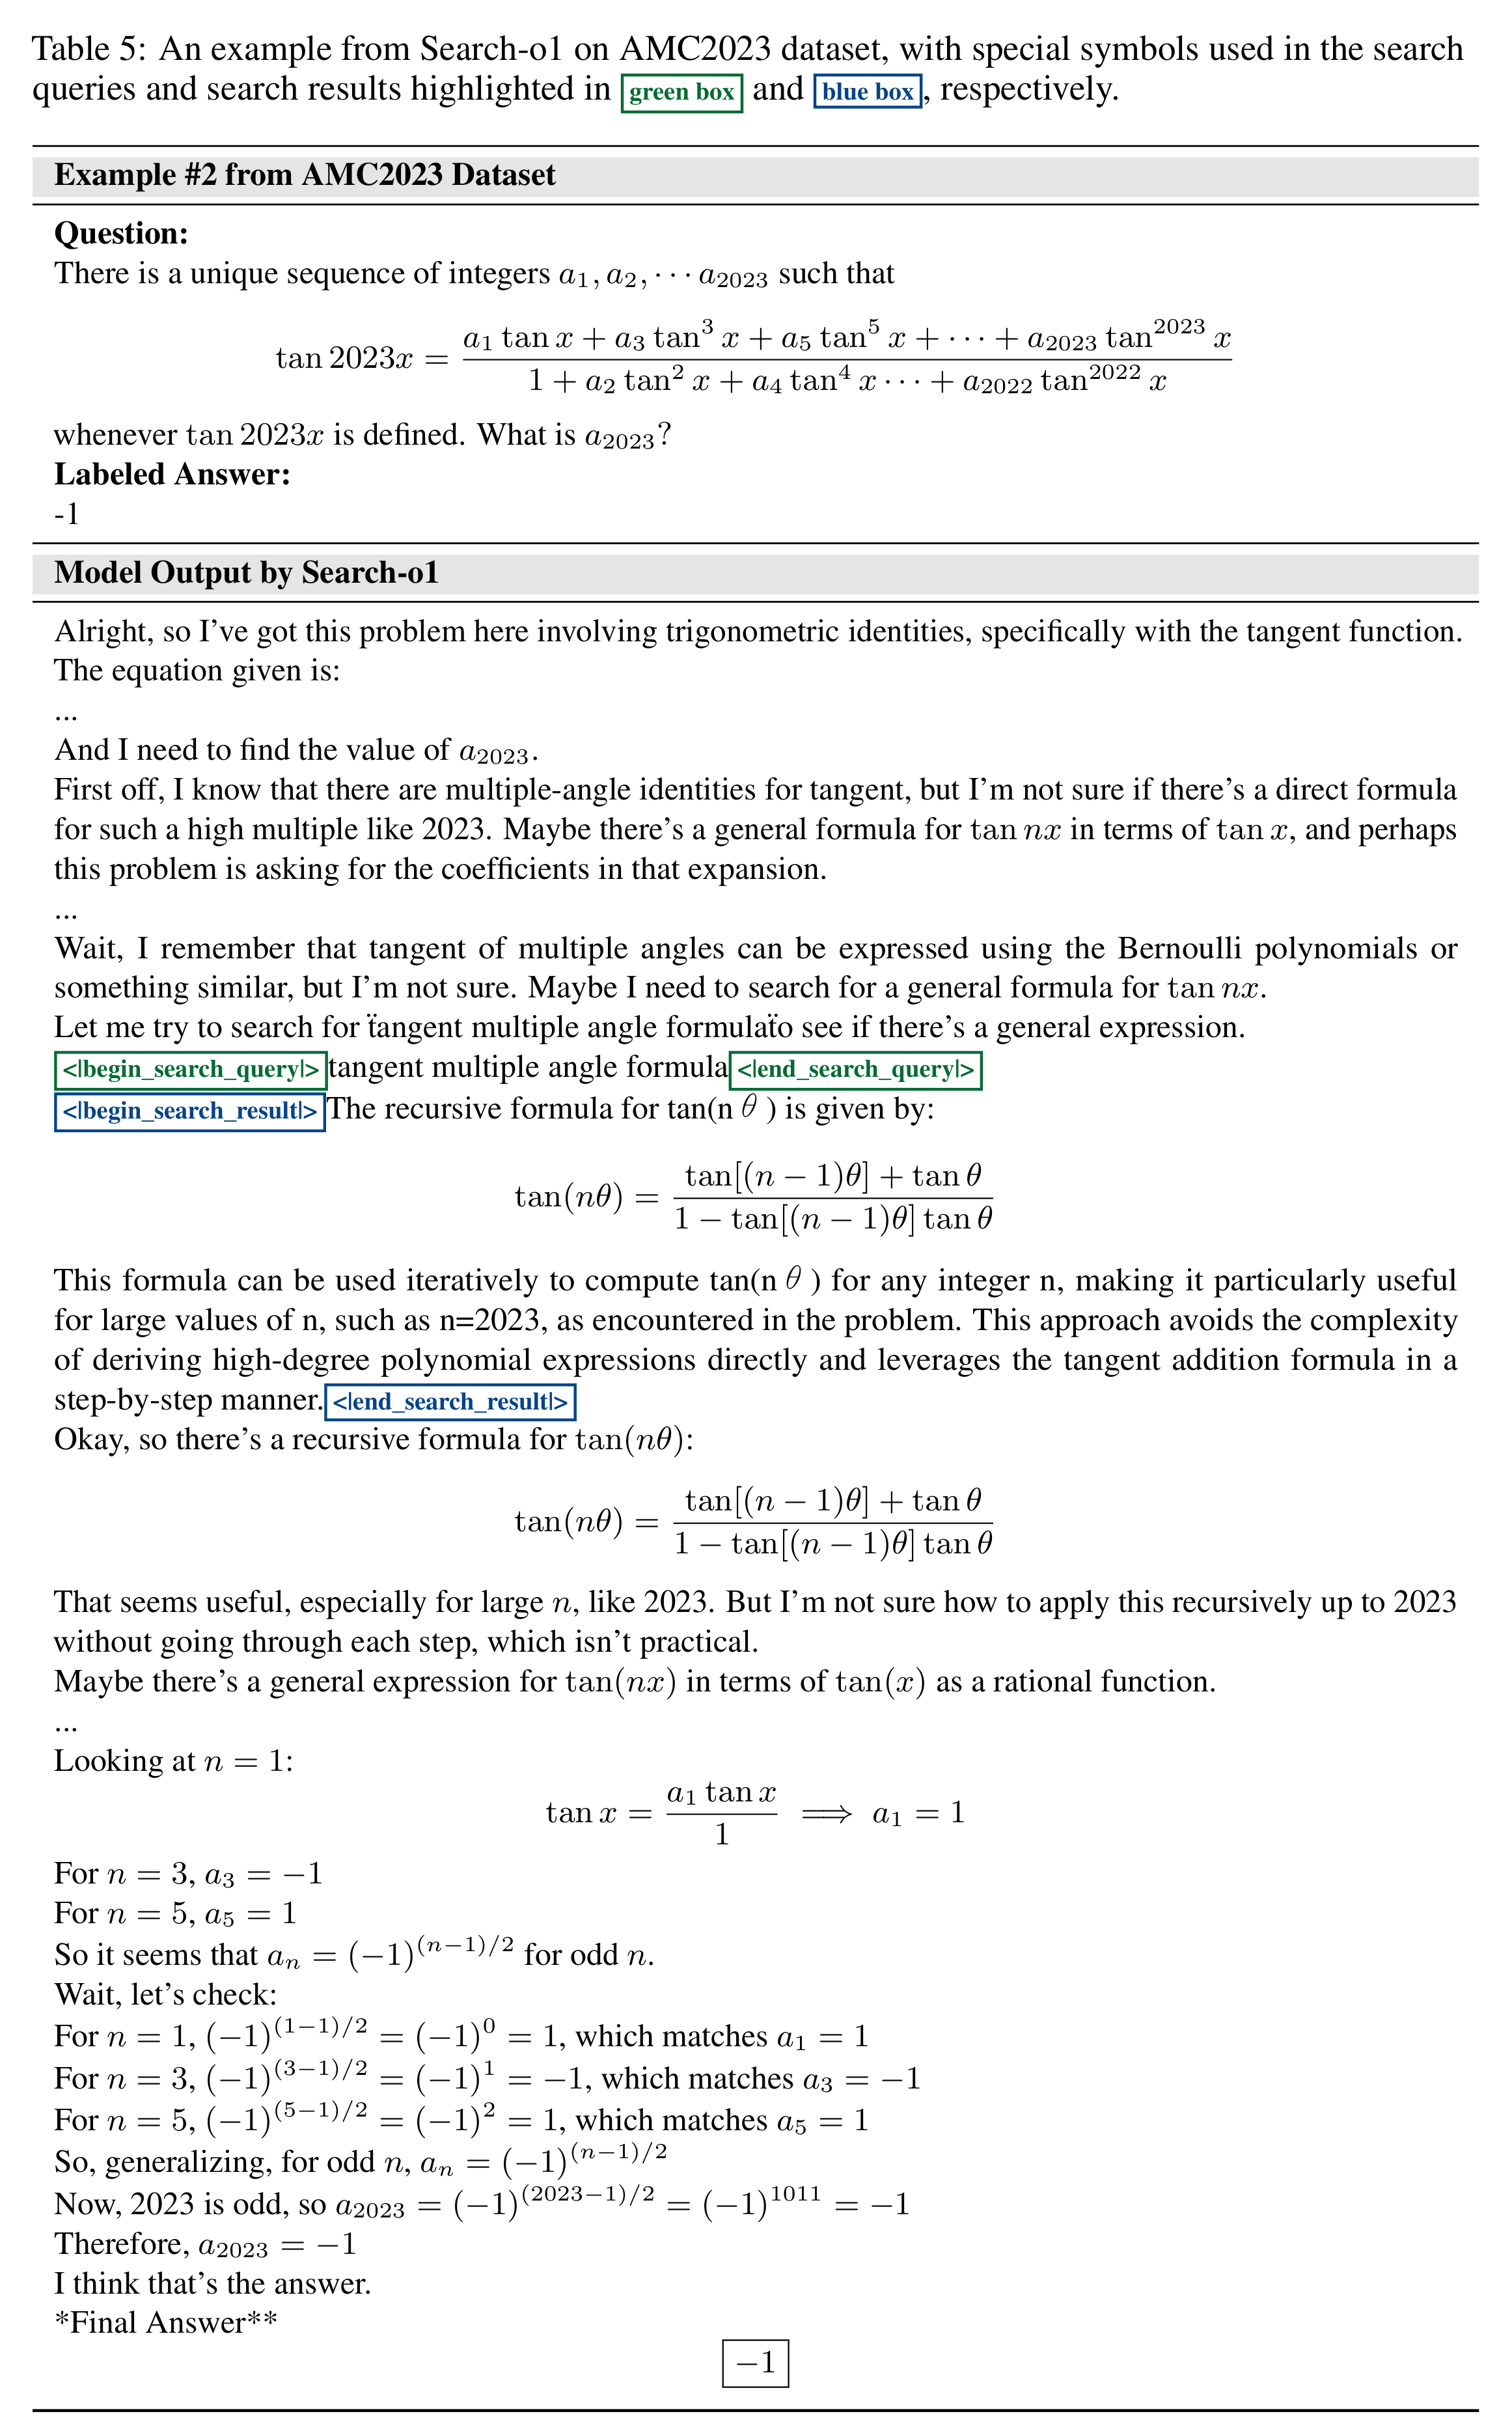
모델은 탄젠트 다중각 점화식을 검색하고 이후 정답으로 표시된 계수값 −1에 도달한다. 제시된 후속 추론은 더 작은 홀숫값에서 일반화하므로, 최종 답변이 맞더라도 검색이 필요했다거나 제시된 풀이 근거가 완전하다고 입증되지는 않는다.
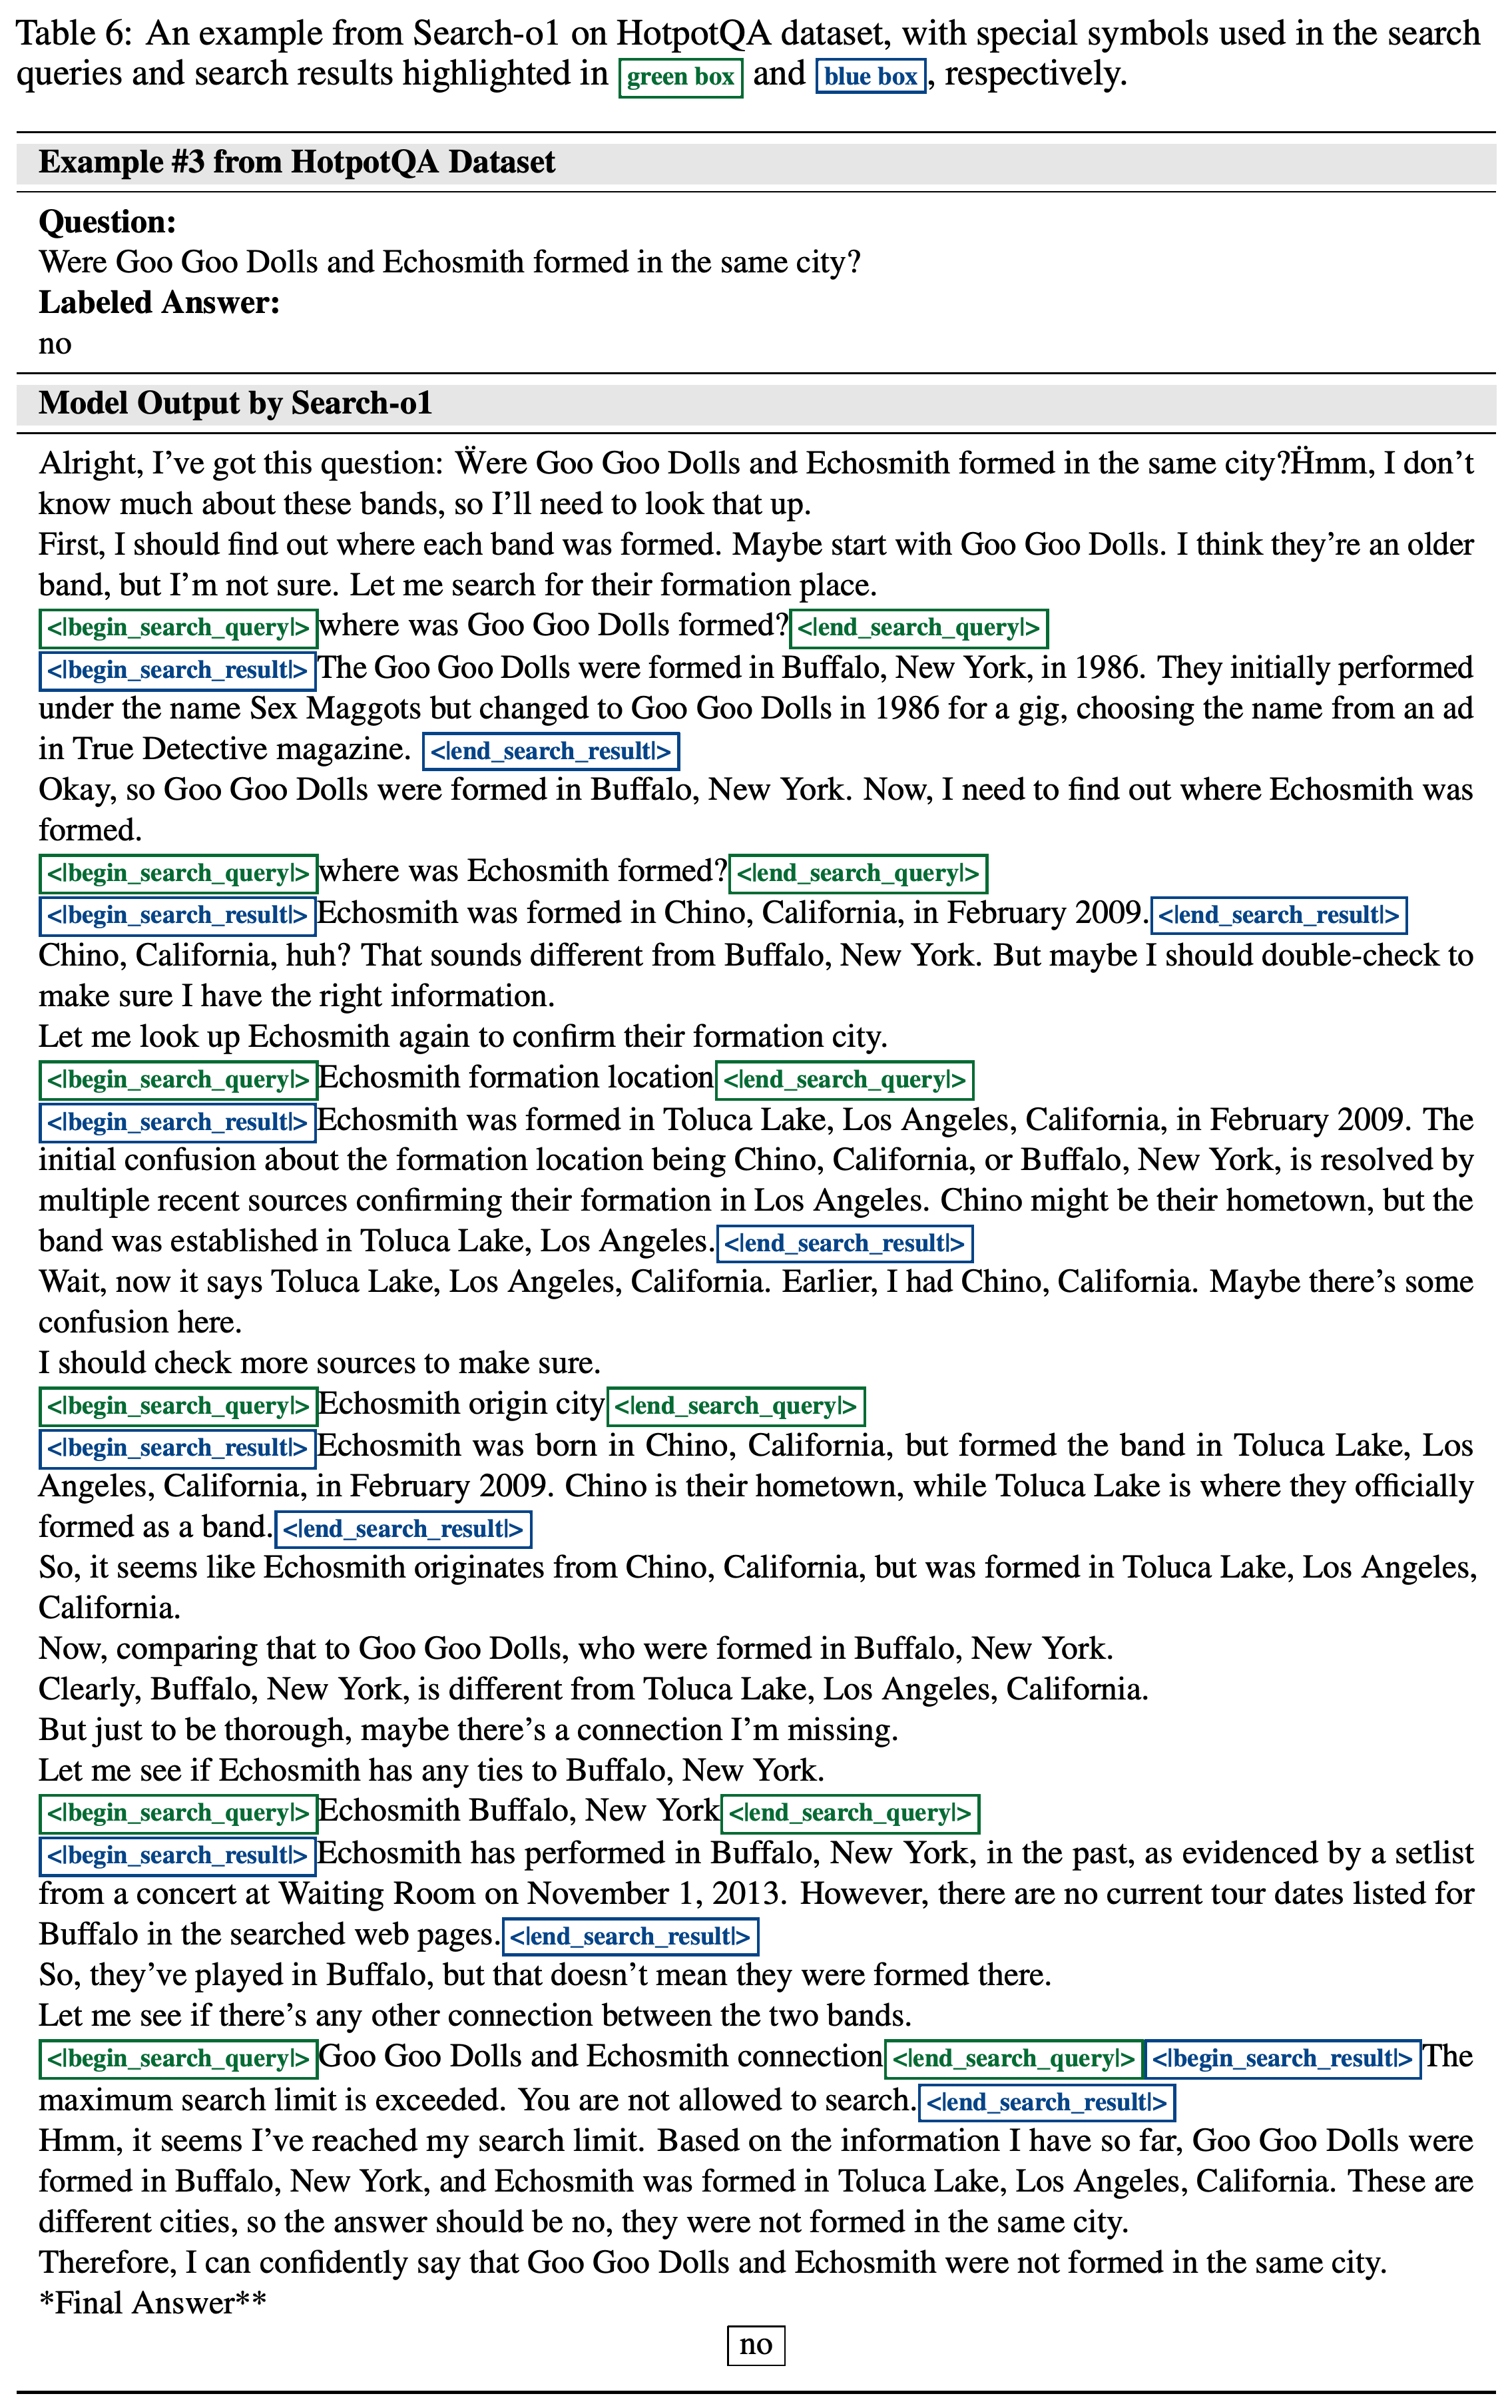
실행 기록은 밴드들이 서로 다른 도시에서 결성되었다는 근거를 찾고도 쿼리를 계속 생성한다. Echosmith의 위치에 관해 서로 충돌하는 설명을 받고 검색 한도를 소진한 뒤 “no”라고 올바르게 답한다. 이 사례는 불필요한 반복 검색과 일관되지 않은 중간 정보를 보여준다.
부록
- A Instruction Templates에는 Instruction for Search-o1과 Instruction for Reason-in-Documents로 구성된 A.1 Instructions for Search-o1이 포함된다. 검색 템플릿은 쿼리 및 결과 마커와 자리표시자 {MAX_SEARCH_LIMIT}를 정의한다. 정제 템플릿은 {prev_reasoning}, {search_query}, {document}를 제공하며, 출력이 “Final Information”으로 시작하고 적절한 경우 “No helpful information found.”를 포함하도록 명시한다. A.2 Instructions for Standard RAG와 그 안의 Instruction for Standard RAG 상자는 질문과 문서를 제공한다. A.3 Instructions for RAG Agent와 그 안의 Instruction for RAG Agent 상자는 추가로 <|begin_url|>, <|end_url|>, <|begin_full_page|>, <|end_full_page|>를 정의하며, 제한값은 {MAX_SEARCH_LIMIT}와 {MAX_URL_FETCH}로 표현한다. A.4 Task-Specific Instructions에는 A.4.1 Open-Domain QA Tasks Instruction, A.4.2 Math Tasks Instruction, A.4.3 Multi-choice Tasks Instruction, A.4.4 Code Tasks Instruction과 각각에 대응하는 지시문 상자가 포함된다. Open-domain 및 수학 답변은 \boxed{YOUR_ANSWER}를 사용하고, 객관식 답변은 A, B, C, D 중 하나를 넣은 \boxed{YOUR_CHOICE}를 사용하며, 코드는 Python 코드 블록을 사용한다. A.5 Additional Notes는 이 템플릿들을 사용자 프롬프트로 제공하고, 추론 특화 모델이 아닌 모델에는 “You should think step by step to solve it.”을 추가로 제공한다고 명시한다.
- B Case Study는 Tables 4–6에서 GPQA, AMC2023, HotpotQA 사례를 제시한다. GPQA 실행 기록은 앞선 정제 결과에서 탄소 원자 수를 10으로 예측했음에도, 탄소 원자 11개에 해당하는 정답 B에 도달한다. AMC2023 실행 기록은 연속된 각도 배수 사이의 관계를 나타내는 탄젠트 점화식을 검색하여 정답 −1에 도달한다. HotpotQA 실행 기록은 “no”라고 올바르게 답하지만, 서로 충돌하는 위치 정보를 접하고 서로 다른 도시를 확인한 뒤에도 검색을 계속하다가 결국 검색 한도에 도달한다.
짧은 생각
문서 분석을 주 추론 시퀀스에서 분리한 점이 이 논문의 가장 뚜렷한 설계상 기여다. GPQA와 평균 multi-hop EM에서 RAgent보다 개선된 결과는 전체 처리 절차의 효과를 뒷받침한다. 다만 문서 제시 방식이 다르고 총 연산량을 맞춘 비교가 없어, 개선을 정제만의 효과로 설명하기는 어렵다.
신뢰성과 효율성은 충분히 측정되지 않았다. 불확실성 표현이 줄었다고 추론의 정확성이 검증되지는 않으며, GPQA 사례에는 정제된 결론의 오류가 나타나고 HotpotQA 사례에는 불필요한 반복 검색이 나타난다. 평가는 Search-o1 모델 1개에 집중하며, 각각 40문항과 30문항에 불과한 경시대회 문제 집합을 포함한다. 반복 실행에 따른 변동성이나 전체 처리 비용 측정값도 보고하지 않는다.