


The Router Within: Eliciting Native Skill Routing from a Frozen LLM 요약 설명
14 Sep 2026 | Paper Review Agentic Skills Information Retrieval Contrastive Learning목차
이번 글에서는 The Router Within: Eliciting Native Skill Routing from a Frozen LLM 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 14일(Arxiv), arXiv preprint
- Chen, Ruishuo, Wang, Xun, Chen, Yu, Li, Zhuoran, Huang, Longbo.
- Institute for Interdisciplinary Information Sciences, Tsinghua University
- 논문 링크
요약
- 대규모 언어 모델(LLM) 에이전트가 작업 컨텍스트에 후보 설명을 채워 넣지 않고 수천 개의 후보를 검색해야 할 때 스킬 선택은 어려워진다. 스킬은 지침, 스크립트, 참고 자료를 담은 문서다. Gavel은 Qwen3-32B의 가중치를 고정한 상태에서 실험에 사용한 가장 강력한 대안보다 서면 과제의 스킬 선택 정확도를 최대 13.4%p, 시뮬레이션한 에이전트 실행에서는 최대 21.9점 높인다. 비교 대상은 프롬프트에 담긴 스킬 메타데이터로 선택하는 progressive disclosure와 후보를 검색한 뒤 순위를 다시 매기는 외부 파이프라인이다.
- Gavel은 Glance And Verdict from a frozen LLM의 약자다. 먼저 중간 토큰 표현에 학습된 선형 투영 2개를 적용해 라이브러리의 순위를 매긴다. 이어서 같은 모델의 과제 우도와 yes/no 관련성 판단으로 후보 목록을 검토한다. 7.9M 투영 파라미터는 과제와 스킬의 쌍으로 구성된 SkillRet에서 학습한다. 새 스킬은 인덱싱을 위한 순전파 1회만 필요하며, 다른 라이브러리를 평가할 때는 투영과 보정값을 고정한다.
- 평가 근거는 공개 서면 과제 벤치마크 3개, 시뮬레이션한 다중 턴 궤적 372개로 구성된 SkillTraj, Skill-Use 배포 실험이다. Skill-Use에서 Gavel을 적용한 Qwen3-32B는 과제의 90.9%에서 올바른 스킬을 로드하며, 같은 에이전트 하네스의 progressive disclosure는 1.1%를 기록한다. 하네스는 모델 호출과 도구 상호작용을 관리하는 소프트웨어다. 이 결과는 최종 과제 완수가 아니라 스킬 선택과 로드를 측정한다. 배포하려면 모델 내부 정보에 접근할 수 있어야 하며, 라우팅 시점을 결정하는 별도의 게이트도 학습해야 한다.
1. Introduction
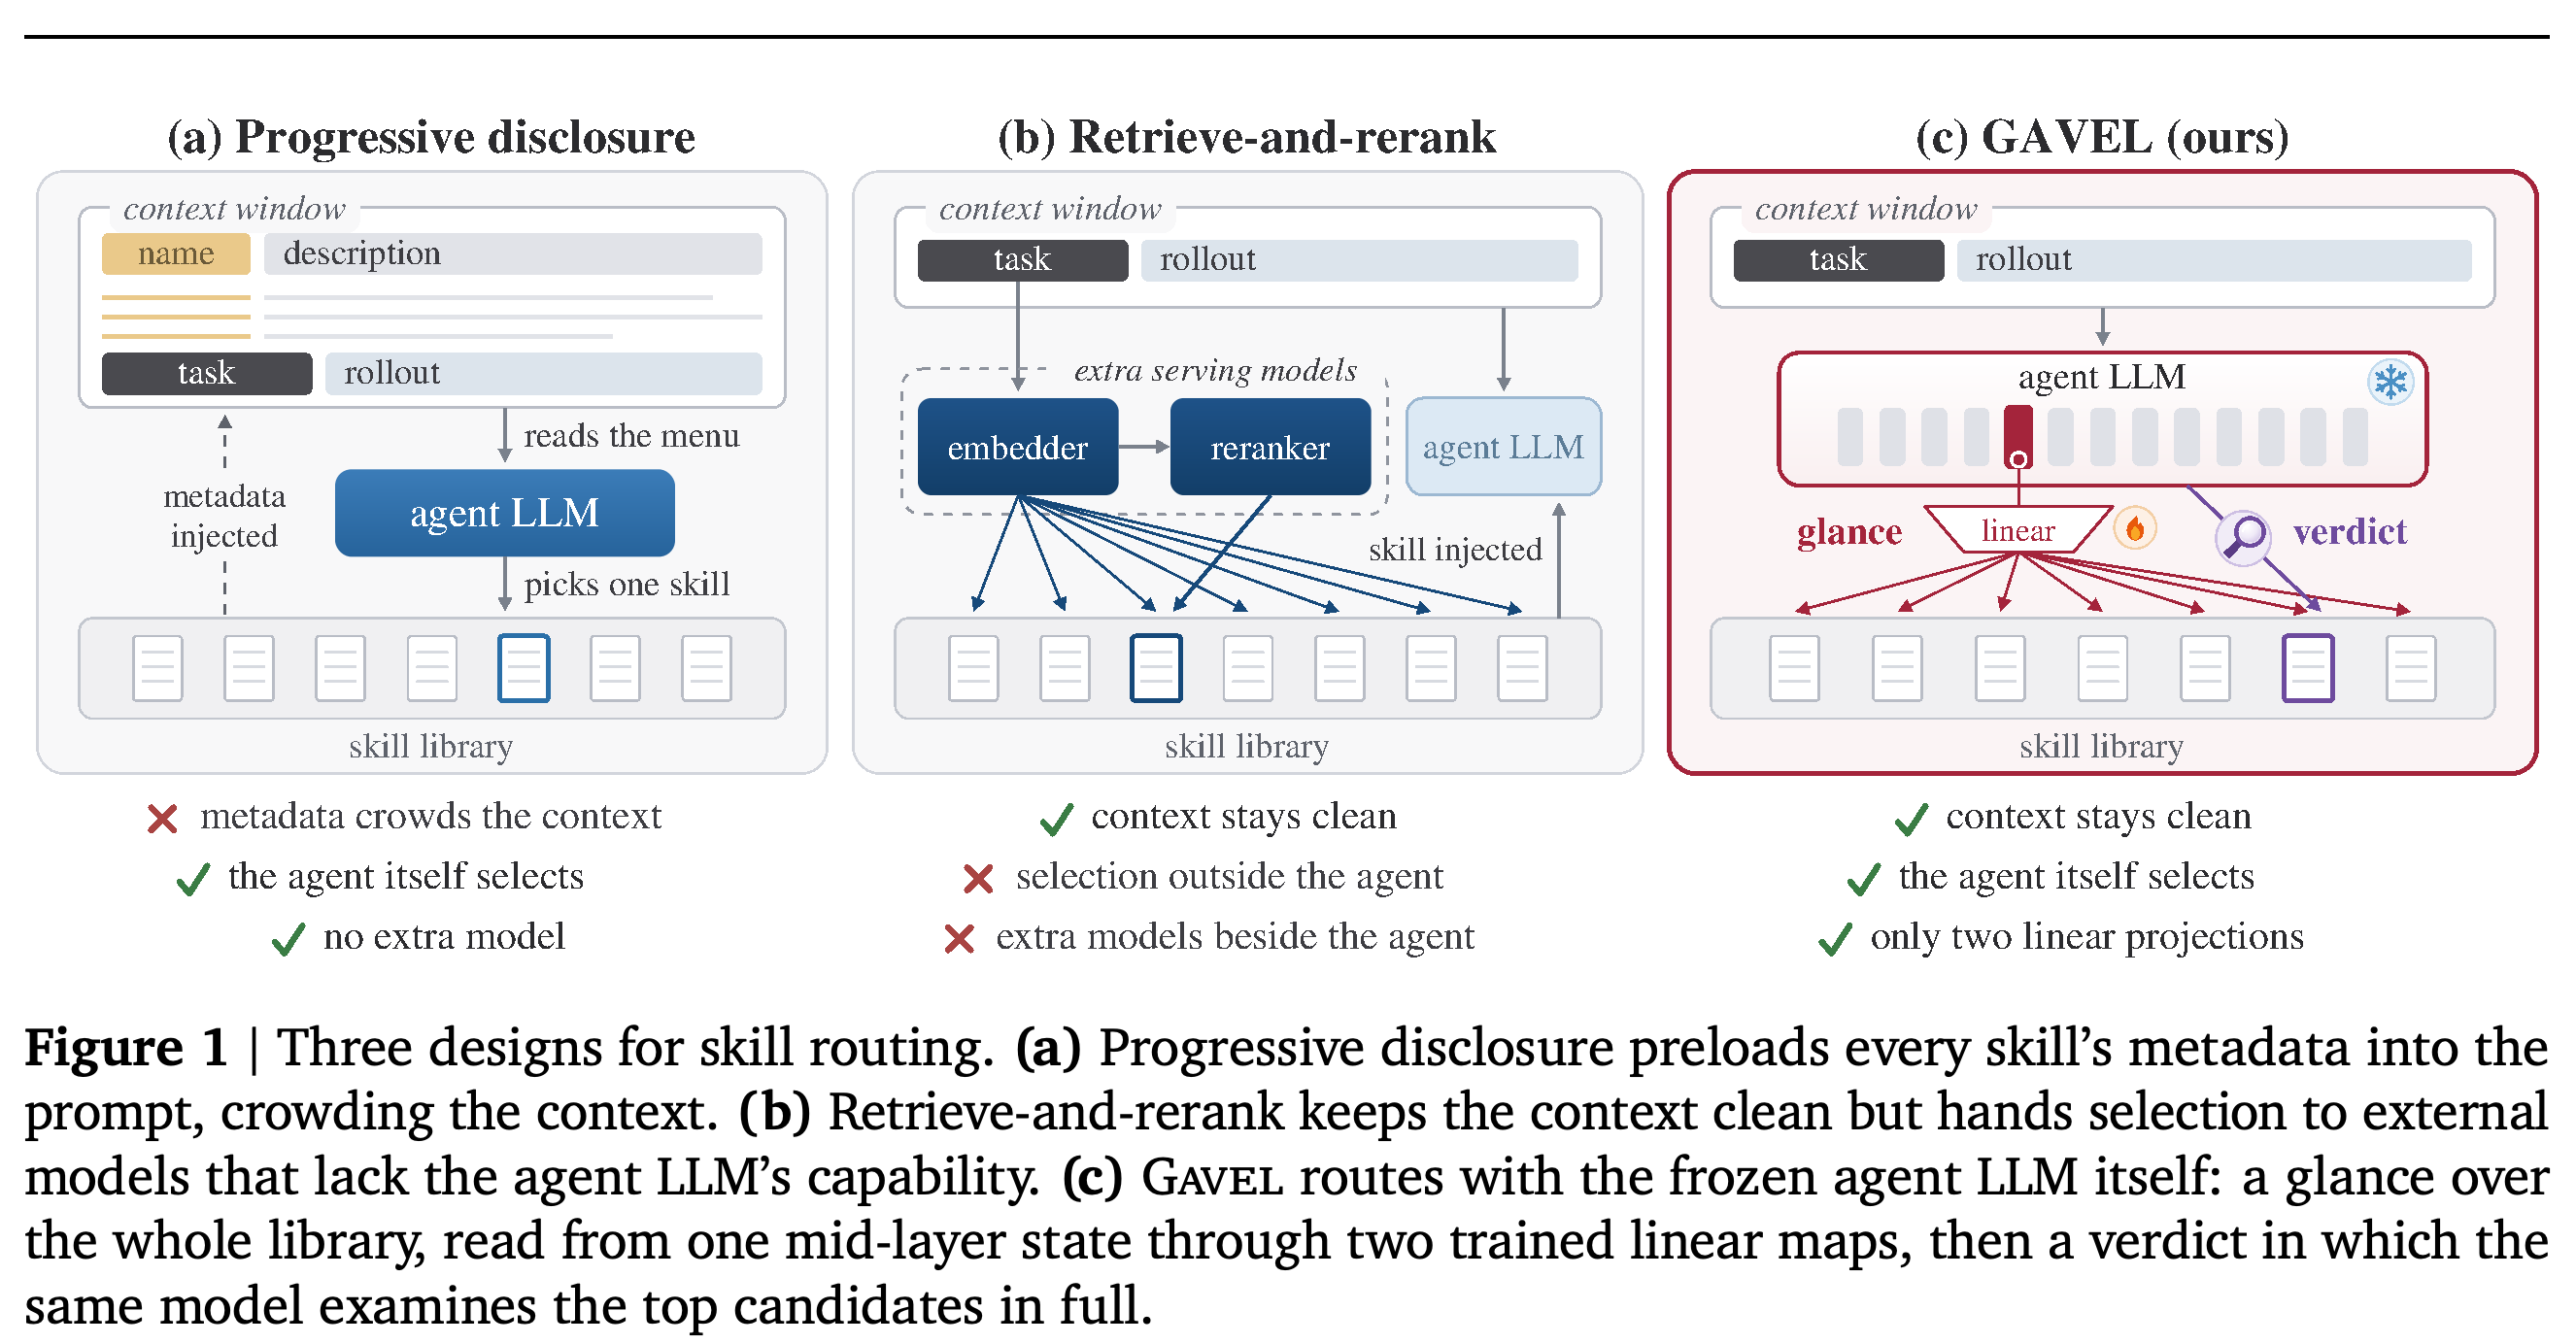
The Router Within: Eliciting Native Skill Routing from a Frozen LLM은 라이브러리를 작업 컨텍스트 밖에 두면서도 스킬 선택에 에이전트의 역량을 활용할 수 있는지 묻는다. 스킬은 SKILL.md 문서로 제공된다. 부적절한 스킬을 로드하면 성능이 저하될 수 있다. 이름과 설명으로 선택하면 컨텍스트 비용이 발생하고 후보를 구별하는 데 필요한 세부 정보가 빠진다.
- Progressive disclosure는 설치된 스킬의 메타데이터를 미리 로드하고, 에이전트가 읽을 문서를 결정하게 한다. 논문은 라이브러리가 커질수록 메타데이터도 늘어나며, Codex는 이를 컨텍스트 윈도우의 2%로 제한한다고 보고한다.
- 외부 검색은 이러한 컨텍스트 부담을 피하지만, 텍스트를 벡터로 표현하는 임베딩 모델과 검색된 후보를 재평가하는 reranker에 선택을 맡긴다. Gavel은 고정된 에이전트 자체의 순전파에서 선택 신호를 추출한다. 임베딩 모델에 대해서는 Llama-Embed-Nemotron-8B: A Universal Text Embedding Model for Multilingual and Cross-Lingual Tasks 요약 설명 글을 참조하라.
이 비교는 선택하지 않은 스킬 문서를 작업 컨텍스트 밖에 두면서 에이전트 자체의 역량으로 선택할 수 있는지 묻는다. Gavel은 내부 read-out과 별도의 후보 평가로 이러한 특성을 결합한다.
2. Related Work
관련 연구는 스킬 선택을 도구 검색, LLM 표현이나 예측에서 정보를 추출하는 방법과 연결한다. Gavel은 기반 언어 모델인 백본을 고정한 채 이러한 접근을 결합한다.
- ToolkenGPT는 도구를 출력 토큰으로 표현하지만 도구마다 임베딩을 학습하므로, 도구를 추가할 때 학습이 필요하다. Gavel은 투영을 갱신하지 않고 순전파로 새 스킬을 인덱싱한다.
- 기존 임베딩 방법은 학습이나 프롬프팅으로 디코더 모델을 조정한다. 임베딩과 생성을 함께 지원하는 GRIT는 백본 전체를 미세 조정한다. 기존 reranker는 쿼리 우도나 yes/no 관련성 예측을 사용하며, Gavel은 이 신호 2개를 학습된 표현 read-out과 결합한다.
3. Gavel: Routing on the Agent’s Own Forward Passes
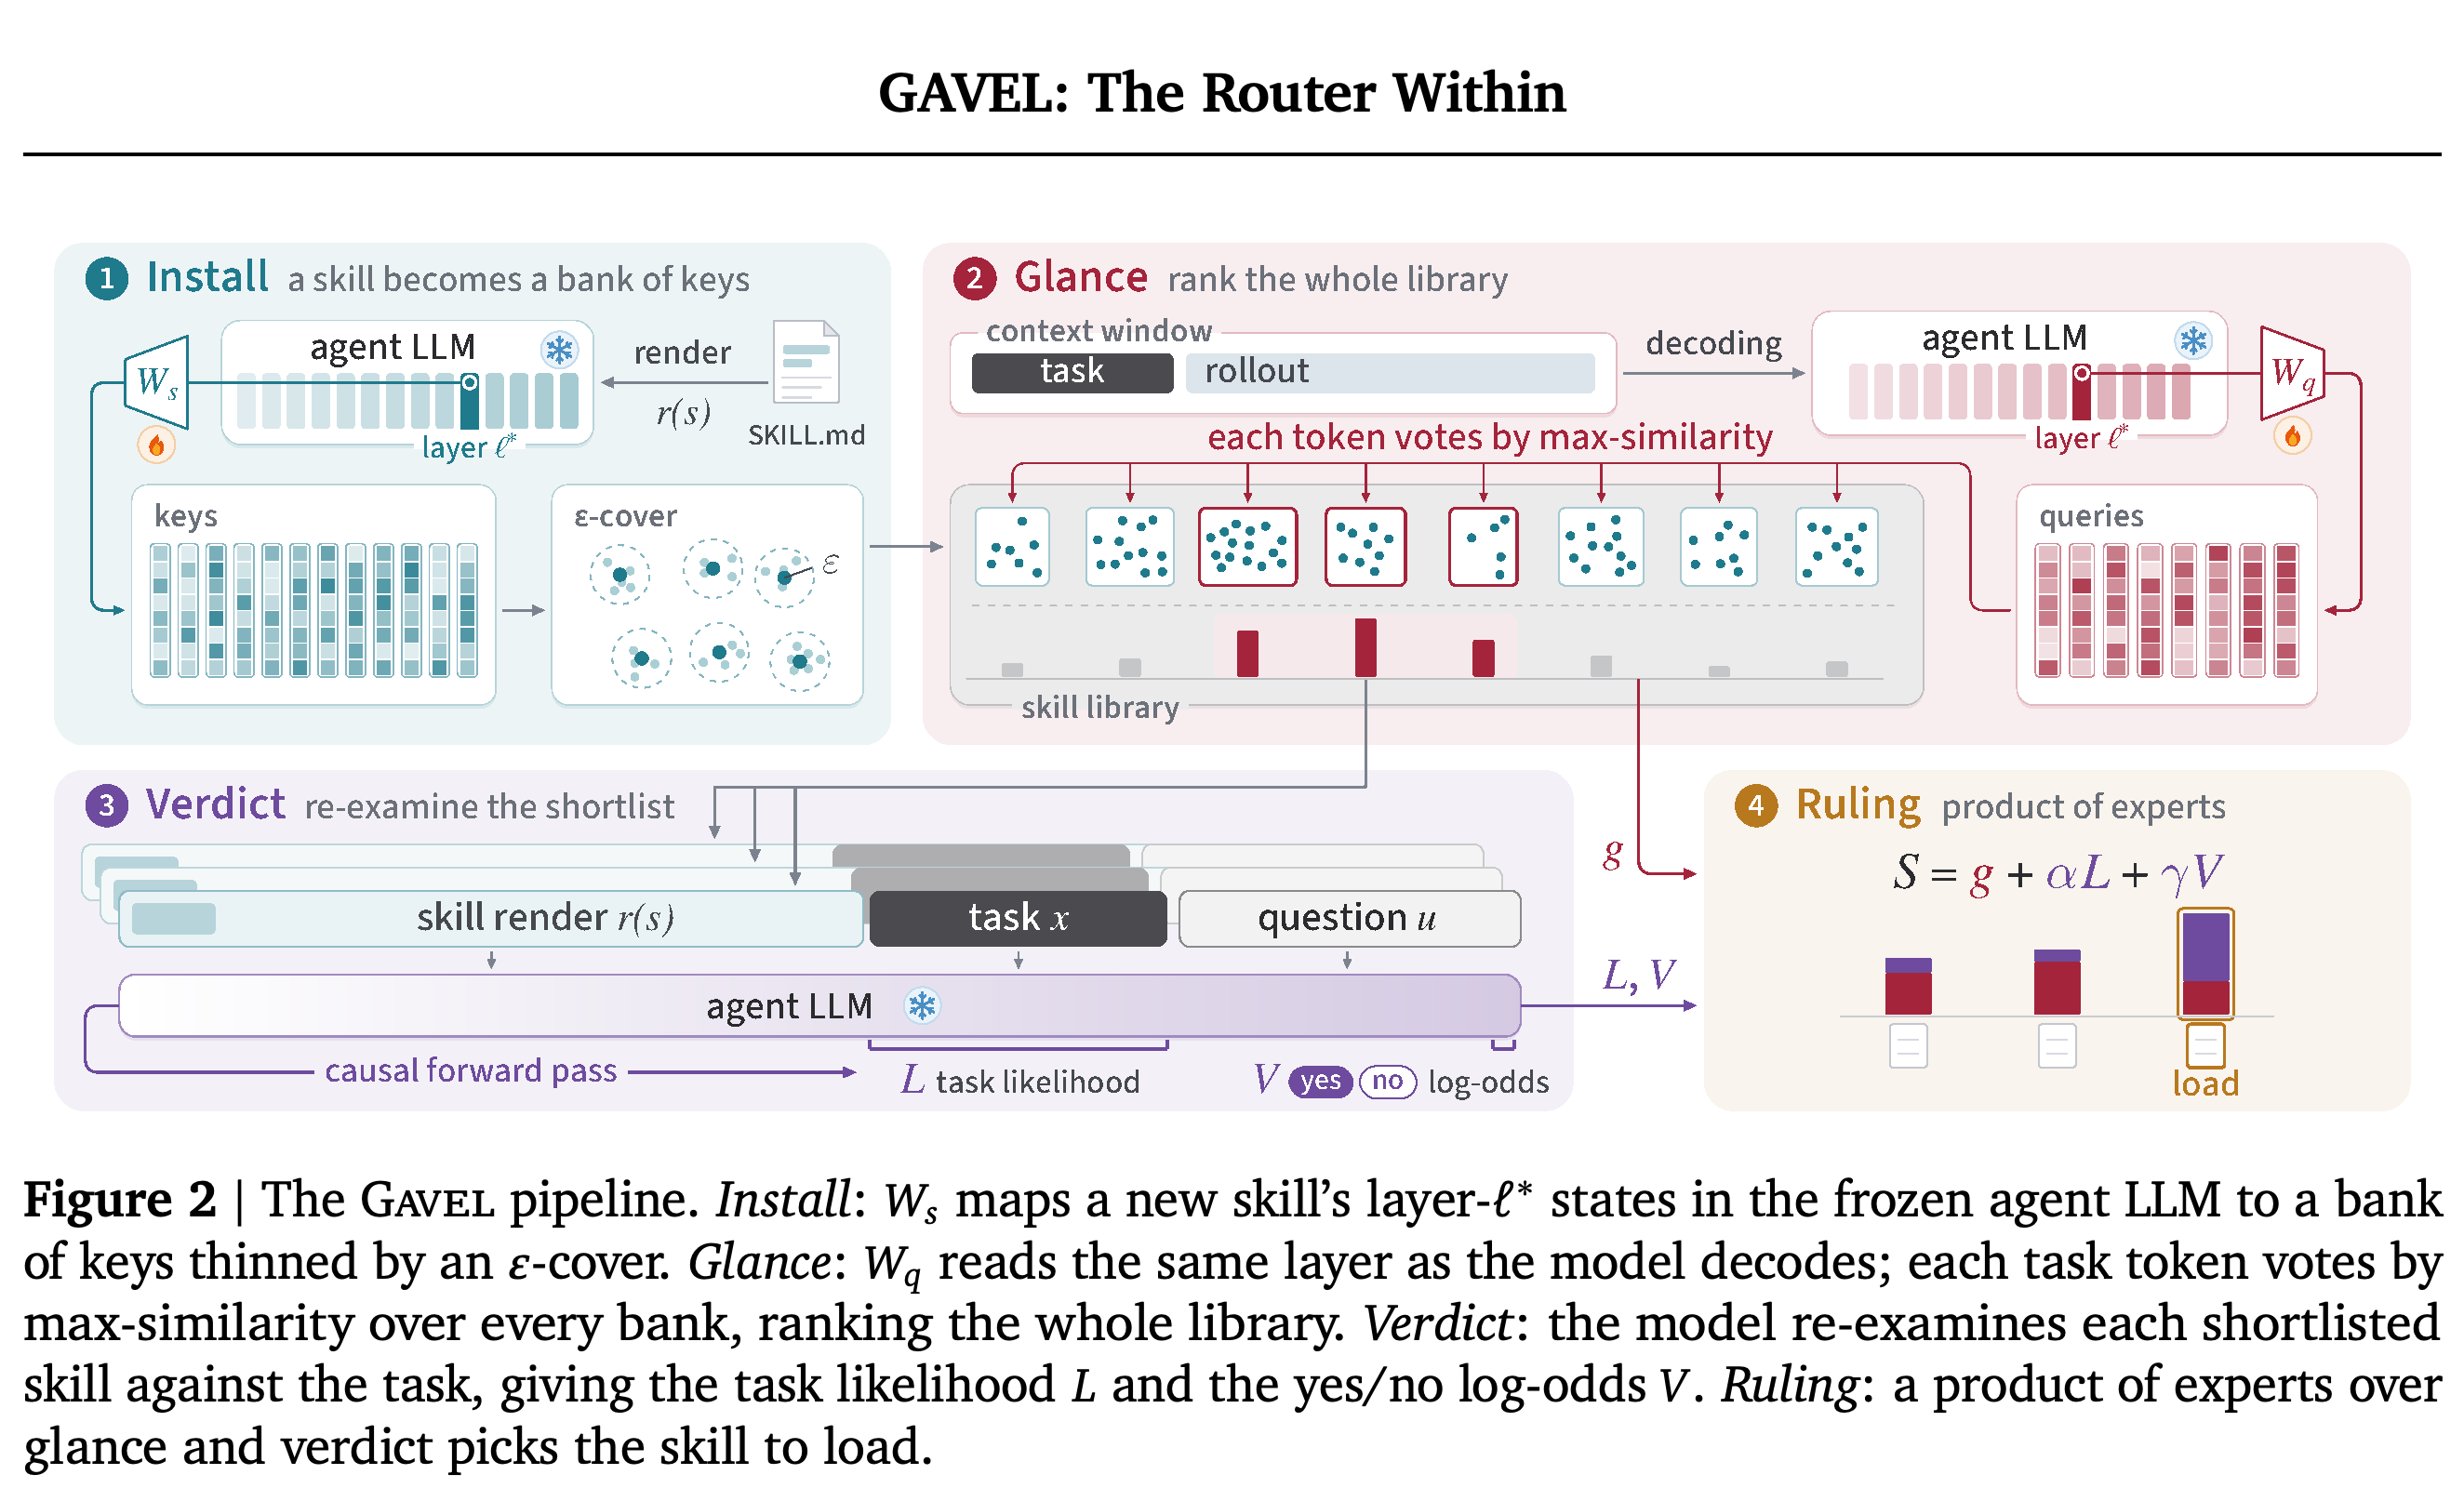
Gavel은 라이브러리 전체를 선별하는 과정과 개별 후보를 상세히 평가하는 과정을 나눈다. 설치 단계에서 재사용할 스킬 표현을 만들고, glance가 라이브러리의 순위를 매기며, verdict가 후보 목록을 평가한다. 마지막으로 ruling이 점수 3개를 결합해 로드할 문서를 선택한다.
파이프라인은 재사용 가능한 설치 작업과 쿼리에 따라 달라지는 라우팅을 분리한다. 스킬 키는 1회 인코딩하고 압축하며, 과제 표현으로 라이브러리를 선별한다. 비용이 더 큰 우도와 관련성 평가는 후보 목록에 남은 스킬에만 적용한다.
3.1. Problem setup and design principles
라이브러리는 메타데이터 헤더와 지침 본문을 갖춘 문서로 구성된다. 라우팅 시점에 라우터는 과제 컨텍스트를 관찰한다. 이 컨텍스트는 사용자 요청일 수도 있고, rollout 중에 도달한 실행 상태일 수도 있다. Rollout은 에이전트의 메시지와 도구 상호작용이 이어지는 실행 과정이다.
- 설계 요건은 선택 전까지 작업 컨텍스트에 과제만 유지하고, 독립적인 선택 모델을 사용하지 않으며, 새 스킬마다 학습하지 않고 설치 시점에 인덱싱하는 것이다.
- 라우터는 스킬 문서를 별도의 순전파로 처리한다. 따라서 스킬을 선택하기 전까지 후보 텍스트가 에이전트의 진행 중인 작업 컨텍스트에 들어가지 않는다.
3.2. The glance: token-level read-out of the frozen forward pass
Glance는 중간 계층 하나에서 과제 토큰의 은닉 상태에 쿼리 투영 Wq를, 스킬 토큰의 은닉 상태에 키 투영 Ws를 적용한다. 은닉 상태는 모델 내부의 토큰 표현이다. 결과 벡터는 단위 노름을 갖는다. 각 과제 토큰은 스킬 뱅크에 있는 키와의 내적 중 최댓값을 해당 스킬의 점수로 사용한다. 이는 토큰 표현을 비교한 뒤 집계하는 late interaction 연산이다.
- Read-out 계층은 노름이 가장 큰 토큰을 제거한 뒤 행렬 엔트로피가 최솟값에 도달하는 compression valley에서 선택한다. 행렬 엔트로피는 은닉 상태가 얼마나 다양한 방향을 차지하는지 나타낸다. Qwen3-32B에서는 계층 44이며, 전체 64개 블록 중 블록 45의 출력이다.
- 투영 2개는 모두 multi-positive contrastive loss로 학습한다. 이 손실은 적합하다고 주석이 달린 스킬의 상대 점수를 샘플링한 부적합 후보보다 높인다. 그래디언트는 백본의 은닉 상태에서 차단한다.
- 학습에는 평균 토큰 매칭 점수를 사용한다. 추론에서는 관련 없는 컨텍스트가 소수의 유익한 토큰을 압도하지 않도록 각 토큰이 자신의 상위 k개 스킬에만 기여하게 한다. 규칙은 k = min(10, max(3, round(0.1N)))이며, N은 라이브러리 크기다. 토큰 가중치로 최근 컨텍스트를 더 중시할 수 있다.
3.3. Compressing the skill bank to an 𝜀-cover
ε-cover는 버린 모든 키가 남겨 둔 키 중 하나와 유클리드 거리 ε 이내에 있도록 키의 부분집합을 유지해 스킬 뱅크를 압축한다. Farthest-first traversal은 이 조건이 충족될 때까지 현재 집합에서 가장 먼 키를 반복해서 추가한다.
- 쿼리와 키가 단위 노름을 가지면 전체 뱅크를 cover로 대체해도 최대 내적은 ε보다 많이 감소하지 않으며 증가하지도 않는다. 스킬이 모든 토큰의 top-k 경계에서 ε보다 멀리 떨어져 있으면 집계된 투표에도 같은 단방향 오차 한계가 적용된다.
- 남겨 둔 뱅크는 키 사이의 거리가 각각 ε 이상인 ε-separated 집합이기도 하다. 따라서 뱅크 크기는 가능한 최소 cover 크기인 covering number와 가능한 최대 분리 부분집합 크기인 packing number 사이에 놓인다.
- 압축 후에는 Ws와 저장된 키를 고정한 채, 압축된 학습 뱅크를 대상으로 Wq만 짧게 추가 미세 조정한다.
3.4. The verdict: native signals under the model’s full attention
Verdict에서는 고정된 모델이 후보 목록의 각 스킬과 과제 전체에 어텐션을 적용한다. 설치 시점에 만든 스킬 포함 고정 프롬프트 뒤에 과제를 붙여 재사용 가능한 접두부를 유지하고, 이어지는 순전파 1회에서 점수 2개를 추출한다.
- L은 스킬이 주어졌을 때 과제의 평균 조건부 로그 우도다. 스킬이 모델의 과제 문구 예측을 얼마나 잘 유도하는지 측정한다.
- V는 스킬이 과제에 필요한 내용을 제공하는지 묻는 고정 질문에 대한 yes 대 no의 로그 오즈다. 이는 응답 확률의 비율에 로그를 취한 값이다. 점수에는 yes와 no의 대소문자 변형과 앞쪽 공백 유무를 반영한다.
- 관련성 질문은 과제 뒤에 놓인다. 각 위치가 앞선 토큰만 보게 하는 인과적 어텐션 때문에 이 질문은 과제 토큰의 우도를 바꾸지 못한다. 따라서 점수 2개를 같은 순전파에서 얻는다.
3.5. The ruling: a product of experts
Ruling은 후보 목록에서 결합 점수 S(s|x) = g(s|x) + αL(s|x) + γV(s|x)가 가장 높은 스킬을 선택한다. 여기서 g는 glance 점수다. 이는 각 구성 요소의 근거를 지수화한 뒤 곱하는 product of experts 방식이다.
- 모든 스킬에 같은 초기 확률을 부여하는 균등 사전분포 아래에서, 논문은 대조 학습으로 얻은 glance와 생성적 과제 우도를 스킬의 사후확률과 관련된 추정치로 해석한다. 사후확률은 과제가 주어졌을 때 해당 스킬의 확률이다. Yes/no 판단은 관련성에 대한 판별적 추정치로 취급하며, 이 해석은 유도 과정 없이 제시한다. 대조 학습에 대해서는 Contrastive Learning, SimCLR 논문 설명(SimCLRv1, SimCLRv2) 글을 참조하라.
- 검증 데이터에 맞춘 α와 γ는 점수 척도를 조정하고 지나치게 확신하는 구성 요소의 영향을 완화한다. 긴 과제가 다른 근거를 압도하지 않도록 우도는 과제 길이에 따라 평균을 낸다.
4. Experiments
실험은 서면 요청에서의 선택, 시뮬레이션 실행 중 지정된 시점에서의 선택, 실제 하네스에서의 자율 호출, 백본 역량에 따른 변화를 평가한다. 외부 검색 파이프라인, 메타데이터 기반 선택, Gavel의 개별 구성 요소를 대체한 방식과 비교한다.
4.1. Setup
주 모델은 고정된 Qwen3-32B이며, 학습 가능한 투영 파라미터는 7.9M이다. Qwen3.5가 스킬 9,084개에 대해 생성한 SkillRet 쿼리 51,104개로 학습한다. 대조 학습 온도 τ = 40은 학습 손실에서 매칭 점수의 크기를 조절하는 계수다.
- Cover 반경 ε = 0.83은 스킬 뱅크를 약 8.5배 압축하며, 평가한 벤치마크에서 보고된 성능 손실은 최대 1.6%p다.
- SkillRet 검증 데이터로 (α, γ) = (1.0, 0.025)와 가지치기 마진 Δ = 0.133을 정한다. 최고 glance 점수와의 차이가 Δ 이내인 후보만 verdict를 받으며, 쿼리당 평균 약 9개다.
- 다른 라이브러리에서도 투영과 스칼라 설정값 4개를 고정한다. 이 zero-shot 전이는 대상 라이브러리에서 학습하거나 보정하지 않고 학습된 라우터를 평가한다.
4.2. Routing from written tasks
서면 과제 평가에는 SkillRet v1의 쿼리 4,997개와 학습에서 제외한 스킬 6,660개, 스킬 26,262개에 대한 SRA-Bench 과제의 층화 표본 861개, 문서 풀 2개에 대한 Eval-Core의 task.md 쿼리 75개를 사용한다. Adjudicated Hit@1은 선택한 스킬 1개가 과제에 적합한지 측정한다. 주석에는 유효한 대안이 빠져 있으므로, GPT-5.6 Sol (high)이 정답으로 주석되지 않은 선택을 주석에 명시된 모든 정답 스킬과 2가지 제시 순서로 비교하고, 승리 횟수가 패배 횟수 이상이면 정답으로 인정한다.
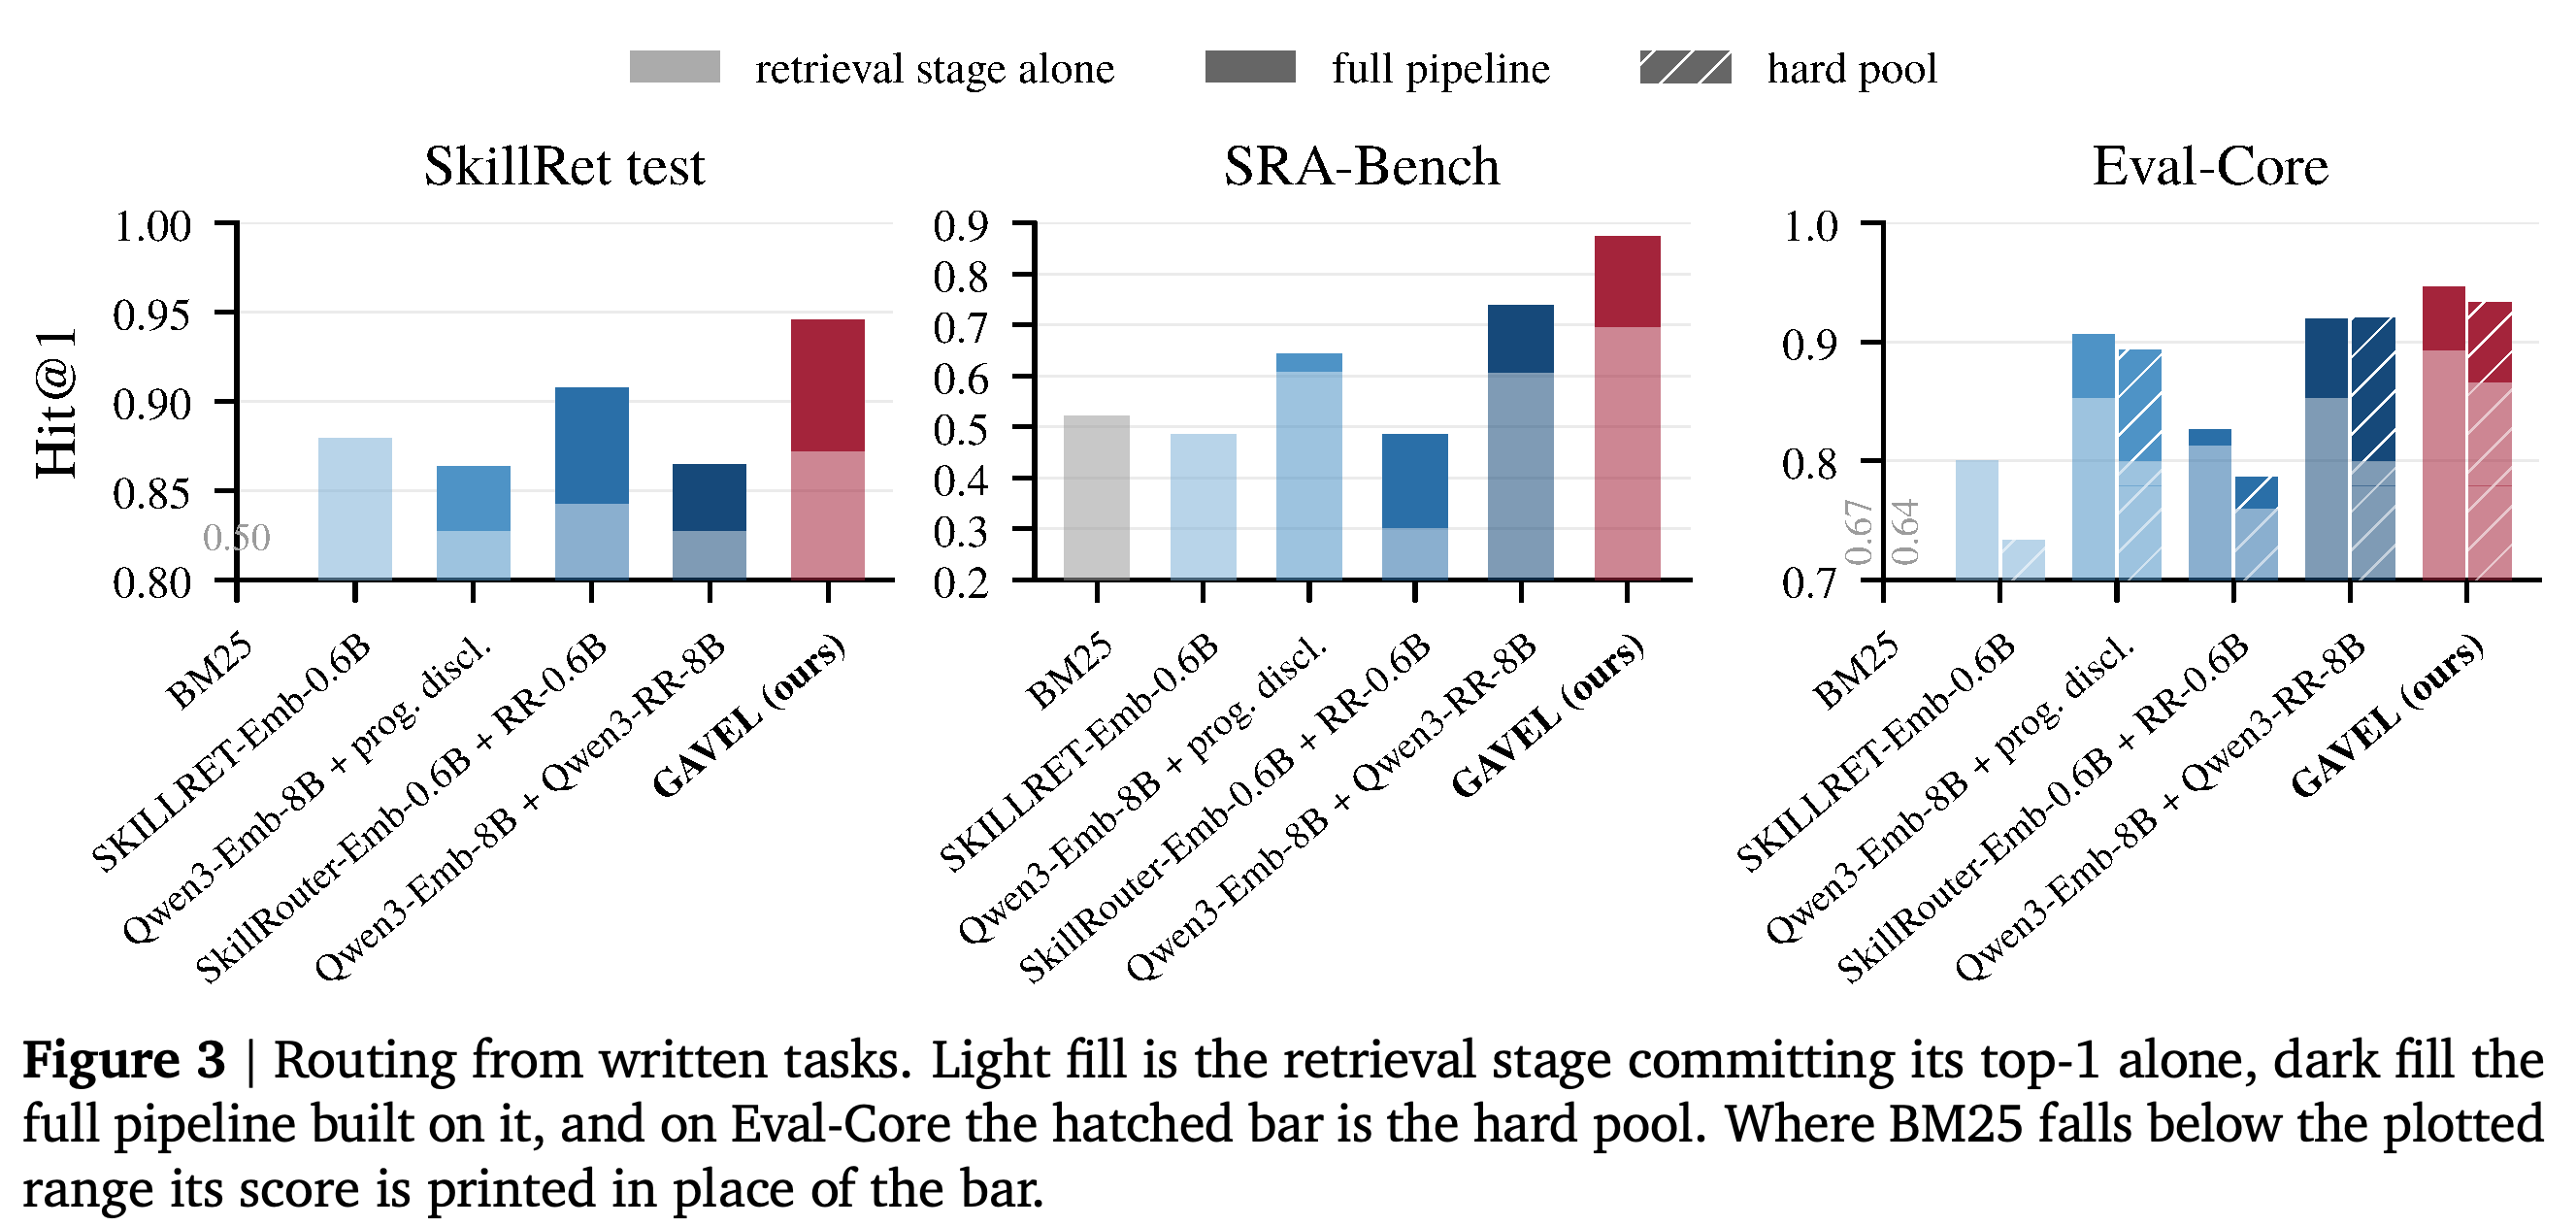
- 4.2.1 기존 실무 방식과의 비교: progressive disclosure에는 Qwen3-Embedding-8B가 검색한 후보 20개를 제공한다. 다른 파이프라인은 SkillRouter의 0.6B embedder와 0.6B reranker 또는 Qwen3-Embedding-8B와 Qwen3-Reranker-8B를 결합한다. 어휘 기반 검색 베이스라인인 BM25와 SKILLRET-Emb-0.6B도 비교 기준으로 사용한다.
- Gavel의 adjudicated Hit@1은 SkillRet에서 0.9460, SRA-Bench에서 0.8734, Eval-Core easy에서 0.9467, Eval-Core hard에서 0.9333이다. 가장 강력한 베이스라인 대비 향상 폭은 각각 3.8, 13.4, 1.3–2.7%p다.
- Glance만 사용해도 SRA-Bench와 Eval-Core의 검색 단계에서 가장 높은 성능을 보이지만, SkillRet에서는 SKILLRET-Emb-0.6B가 약간 앞선다. 따라서 상세 결과를 보면 Gavel이 2개 단계 모두에서 앞선다는 논문의 포괄적인 서술에는 예외가 있다.
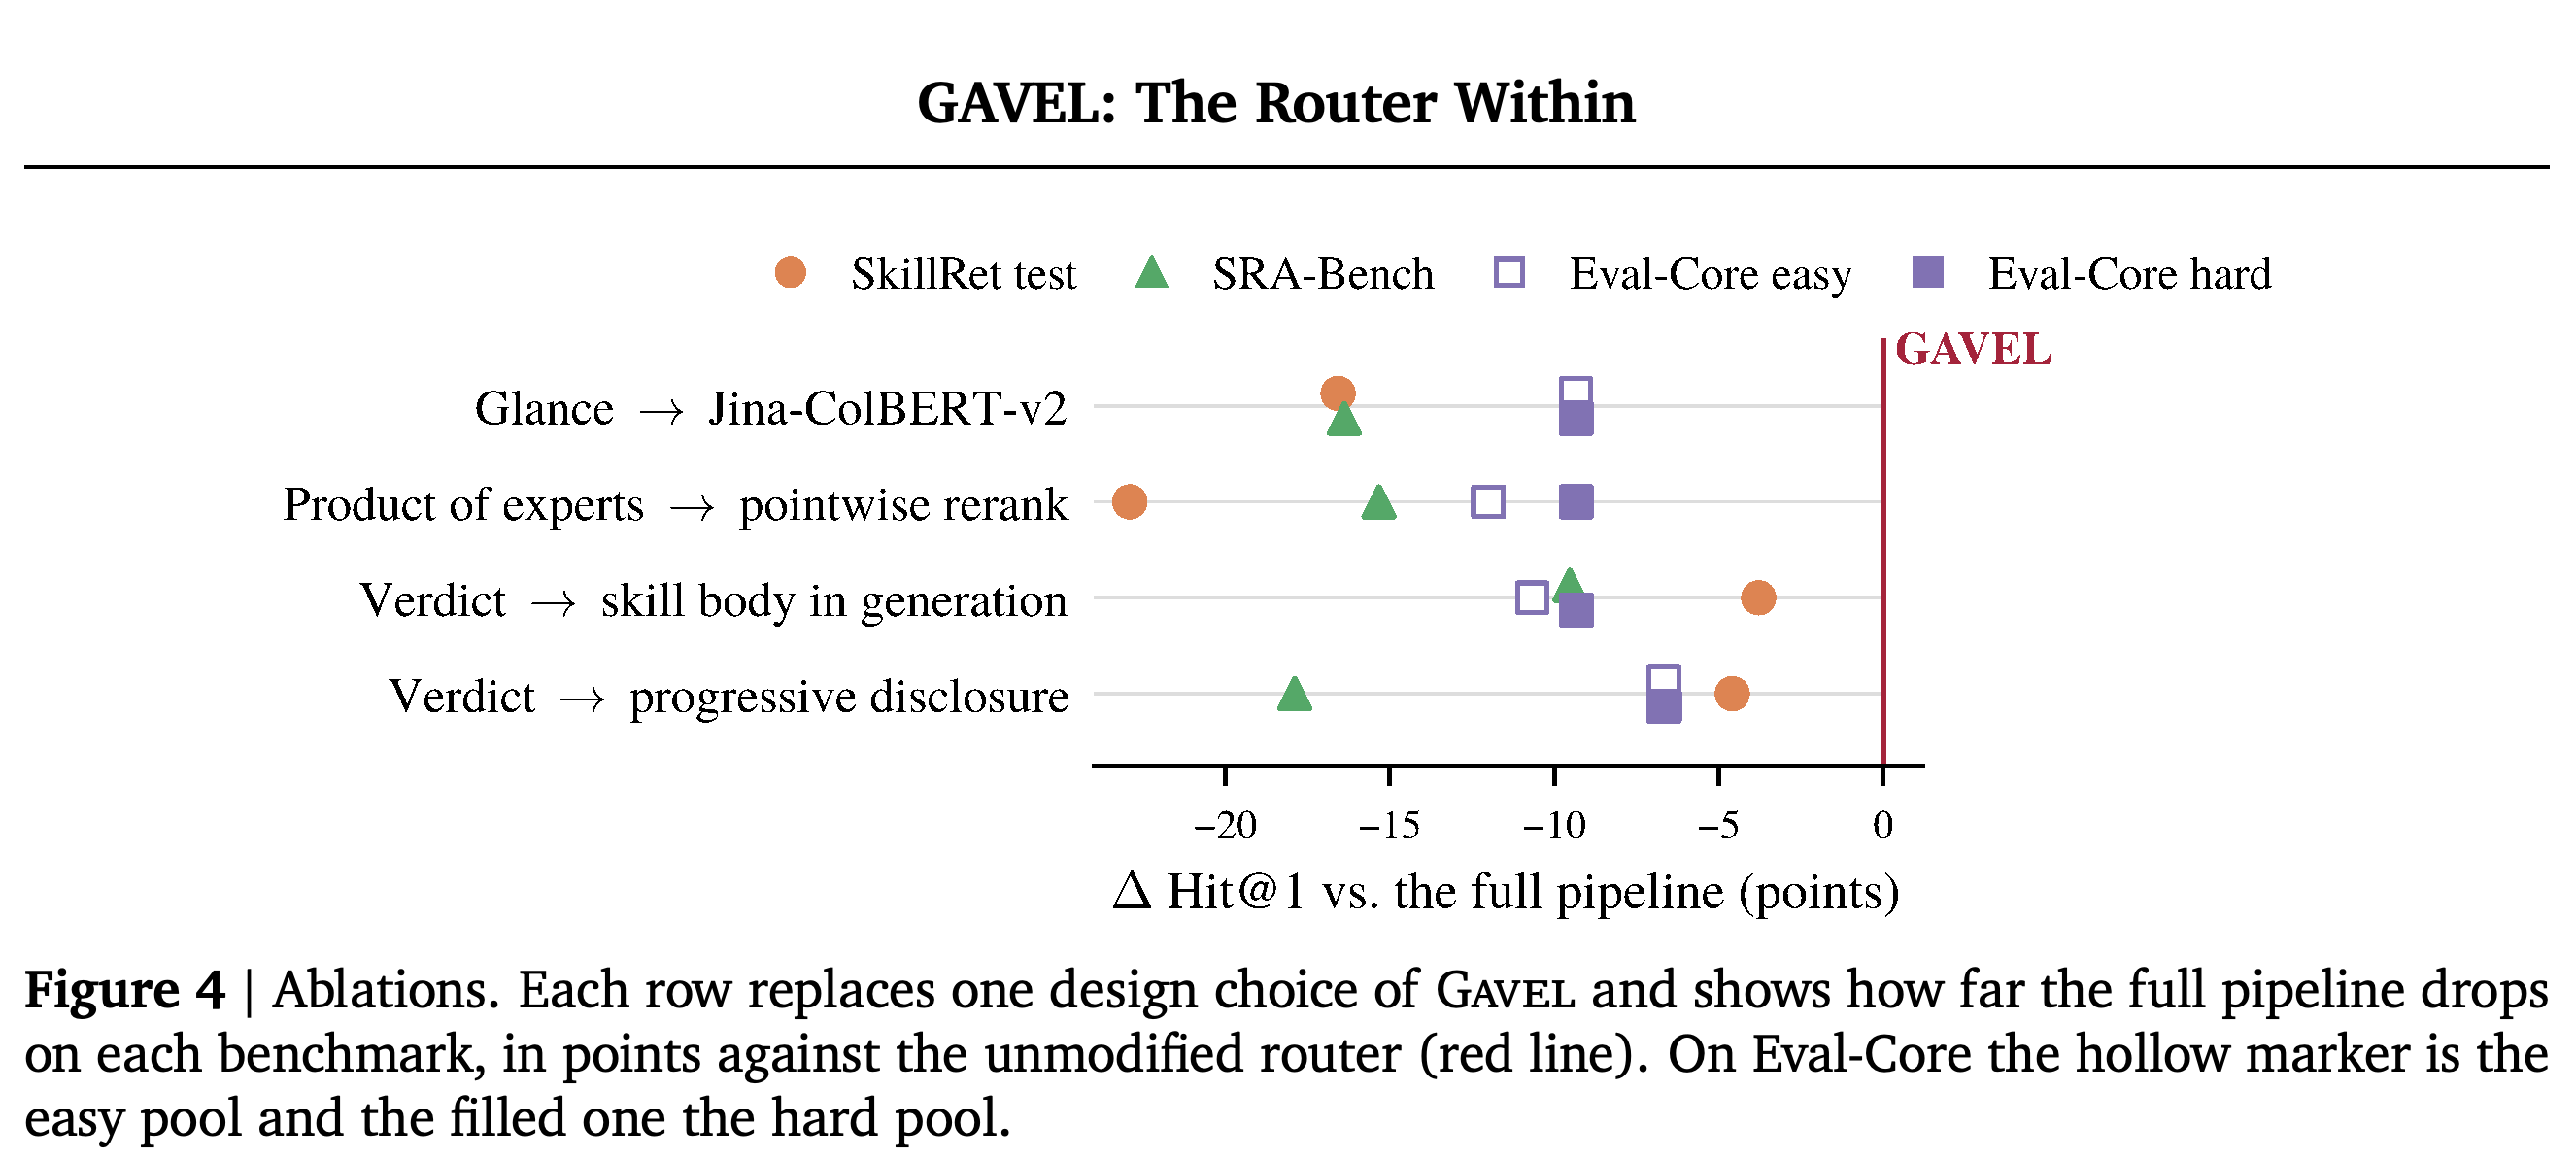
- 4.2.2 설계 선택을 하나씩 대체하는 ablation 실험: glance를 Jina-ColBERT-v2로 대체하거나, V만으로 선택하거나, 과제 대신 스킬 본문을 예측하거나, verdict를 progressive disclosure로 대체하면 모든 벤치마크에서 adjudicated 정확도가 낮아진다. 이 비교는 에이전트에서 추출한 표현, 점수 결합, 우도 계산 방향이 각각 기여함을 뒷받침한다.
전체 파이프라인은 모든 서면 과제 평가에서 앞서며, SRA-Bench에서 차이가 가장 크다. 검색 단계만 보면 이러한 양상에 예외가 있다. Glance는 SRA-Bench와 Eval-Core에서 앞서지만, SkillRet에서는 SKILLRET-Emb-0.6B가 약간 높다.
실험한 모든 구성 요소 대체 방식에서 adjudicated 정확도가 낮아진다. Yes/no 판단만으로 선택하면 SkillRet의 하락 폭이 가장 크다. 이는 해당 판단을 glance 및 과제 우도 근거와 결합하는 방식을 뒷받침한다.
4.3. Routing mid-rollout
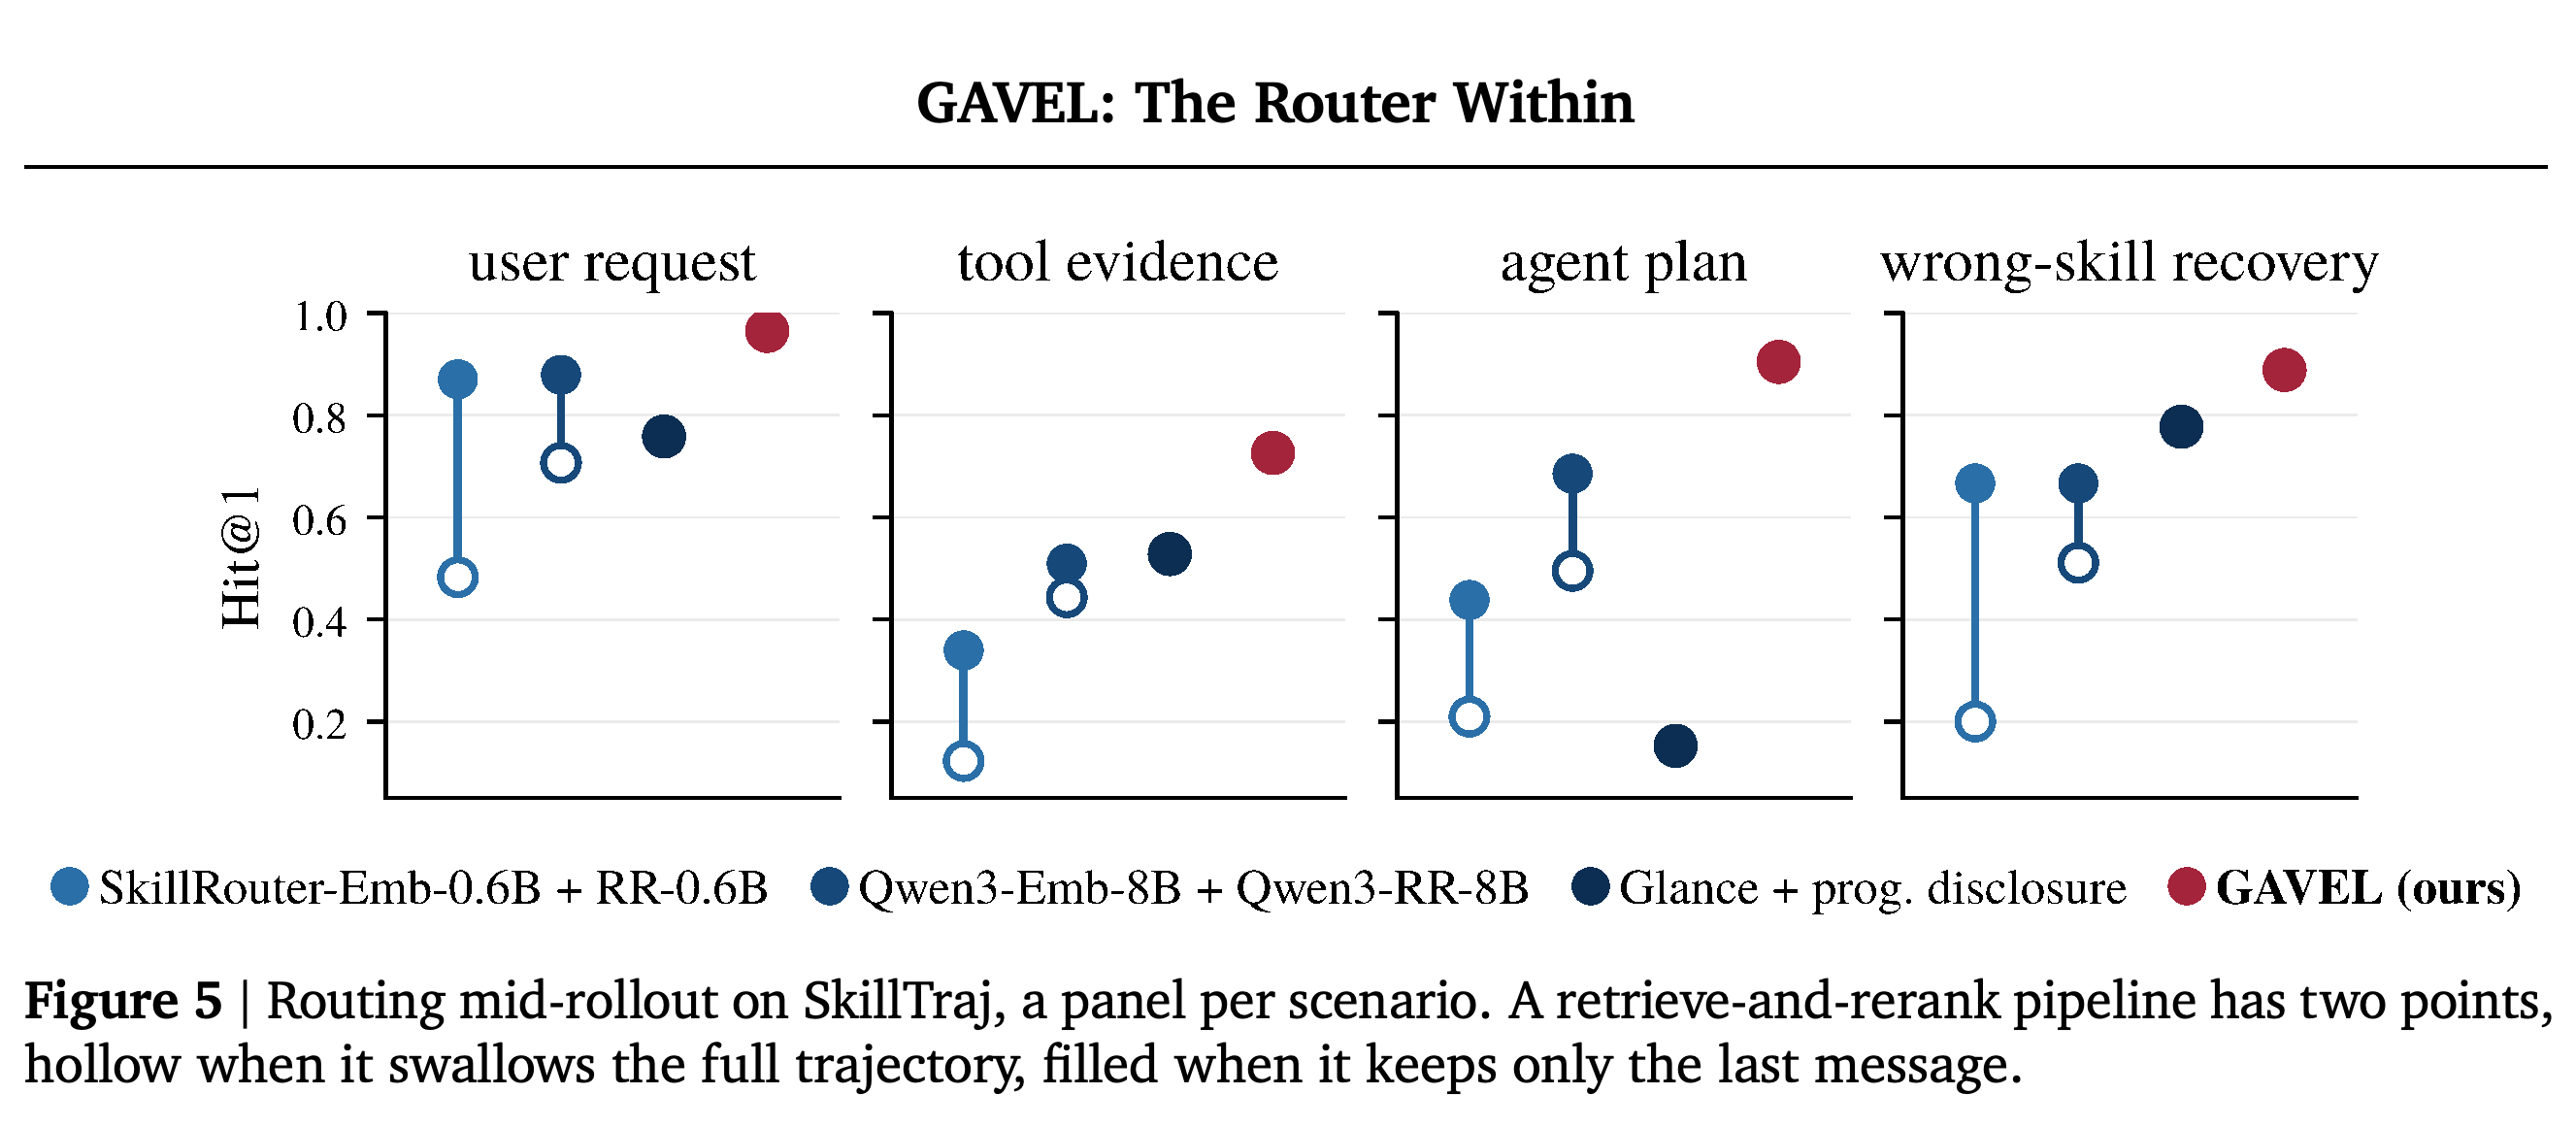
SkillTraj는 스킬이 필요해지는 시점을 표시한 시뮬레이션 궤적 372개로 구성된다. 시나리오는 사용자 요청(116개), 도구 근거(106개), 에이전트 계획(105개), 잘못된 스킬 선택 후 복구(45개)다. GPT-5.6 Sol이 대화를 생성하고, Claude 심사 모델은 표시 시점 전에는 스킬이 필요하지 않고 이후에는 필요하며 정답 스킬이 그 필요를 충족하는지 확인한다.
- Glance는 현재 렌더링된 컨텍스트를 읽고 최신성 가중치 wi = 2^(−ai/64)를 사용한다. ai는 해당 위치와 결정 시점 사이의 토큰 수다. Verdict는 가장 최근 메시지를 과제의 후속 입력으로 사용한다.
- Gavel의 adjudicated Hit@1은 시나리오 4개에서 각각 0.9655, 0.7264, 0.9048, 0.8889이며, 가장 강력한 대안보다 8.6–21.9%p 높다.
- 외부 검색 파이프라인 2개는 모두 전체 궤적 대신 마지막 메시지만 받으면 성능이 향상된다. Glance 후보 목록에 progressive disclosure를 적용하면 에이전트 계획에서 0.1524까지 떨어진다. 이 시나리오에서는 스킬을 선택하려면 메타데이터 이상의 세부 정보가 필요하다.
- 이 평가에서는 모든 시스템에 라우팅 시점을 알려 준다. 실험은 해당 시점의 스킬 선택을 측정하며, 자율적인 시점 결정은 배포 실험에서 별도로 평가한다.
외부 파이프라인은 마지막 메시지만 받으면 일관되게 성능이 향상된다. 이는 이 실험에서 누적된 대화를 처리하기 어렵다는 점을 보여 준다. Gavel은 시나리오 4개 모두에서 앞서며, 에이전트 계획 안에서 스킬의 필요성이 드러날 때 메타데이터 기반 선택은 특히 약하다.
4.4. End-to-end deployment
최소한의 bash 에이전트 하네스인 mini-swe-agent에 배포하기 위해, 저자들은 라우팅 호출 시점을 결정하는 선형 게이트를 추가로 학습한다. 이 게이트는 누적 glance 점수와 현재 최종 계층의 은닉 상태를 읽는다. 연속된 토큰 2개에서 양성 판단을 내리면 작동하며, 선택된 스킬의 verdict가 V < 0이면 아무것도 로드하지 않는다.
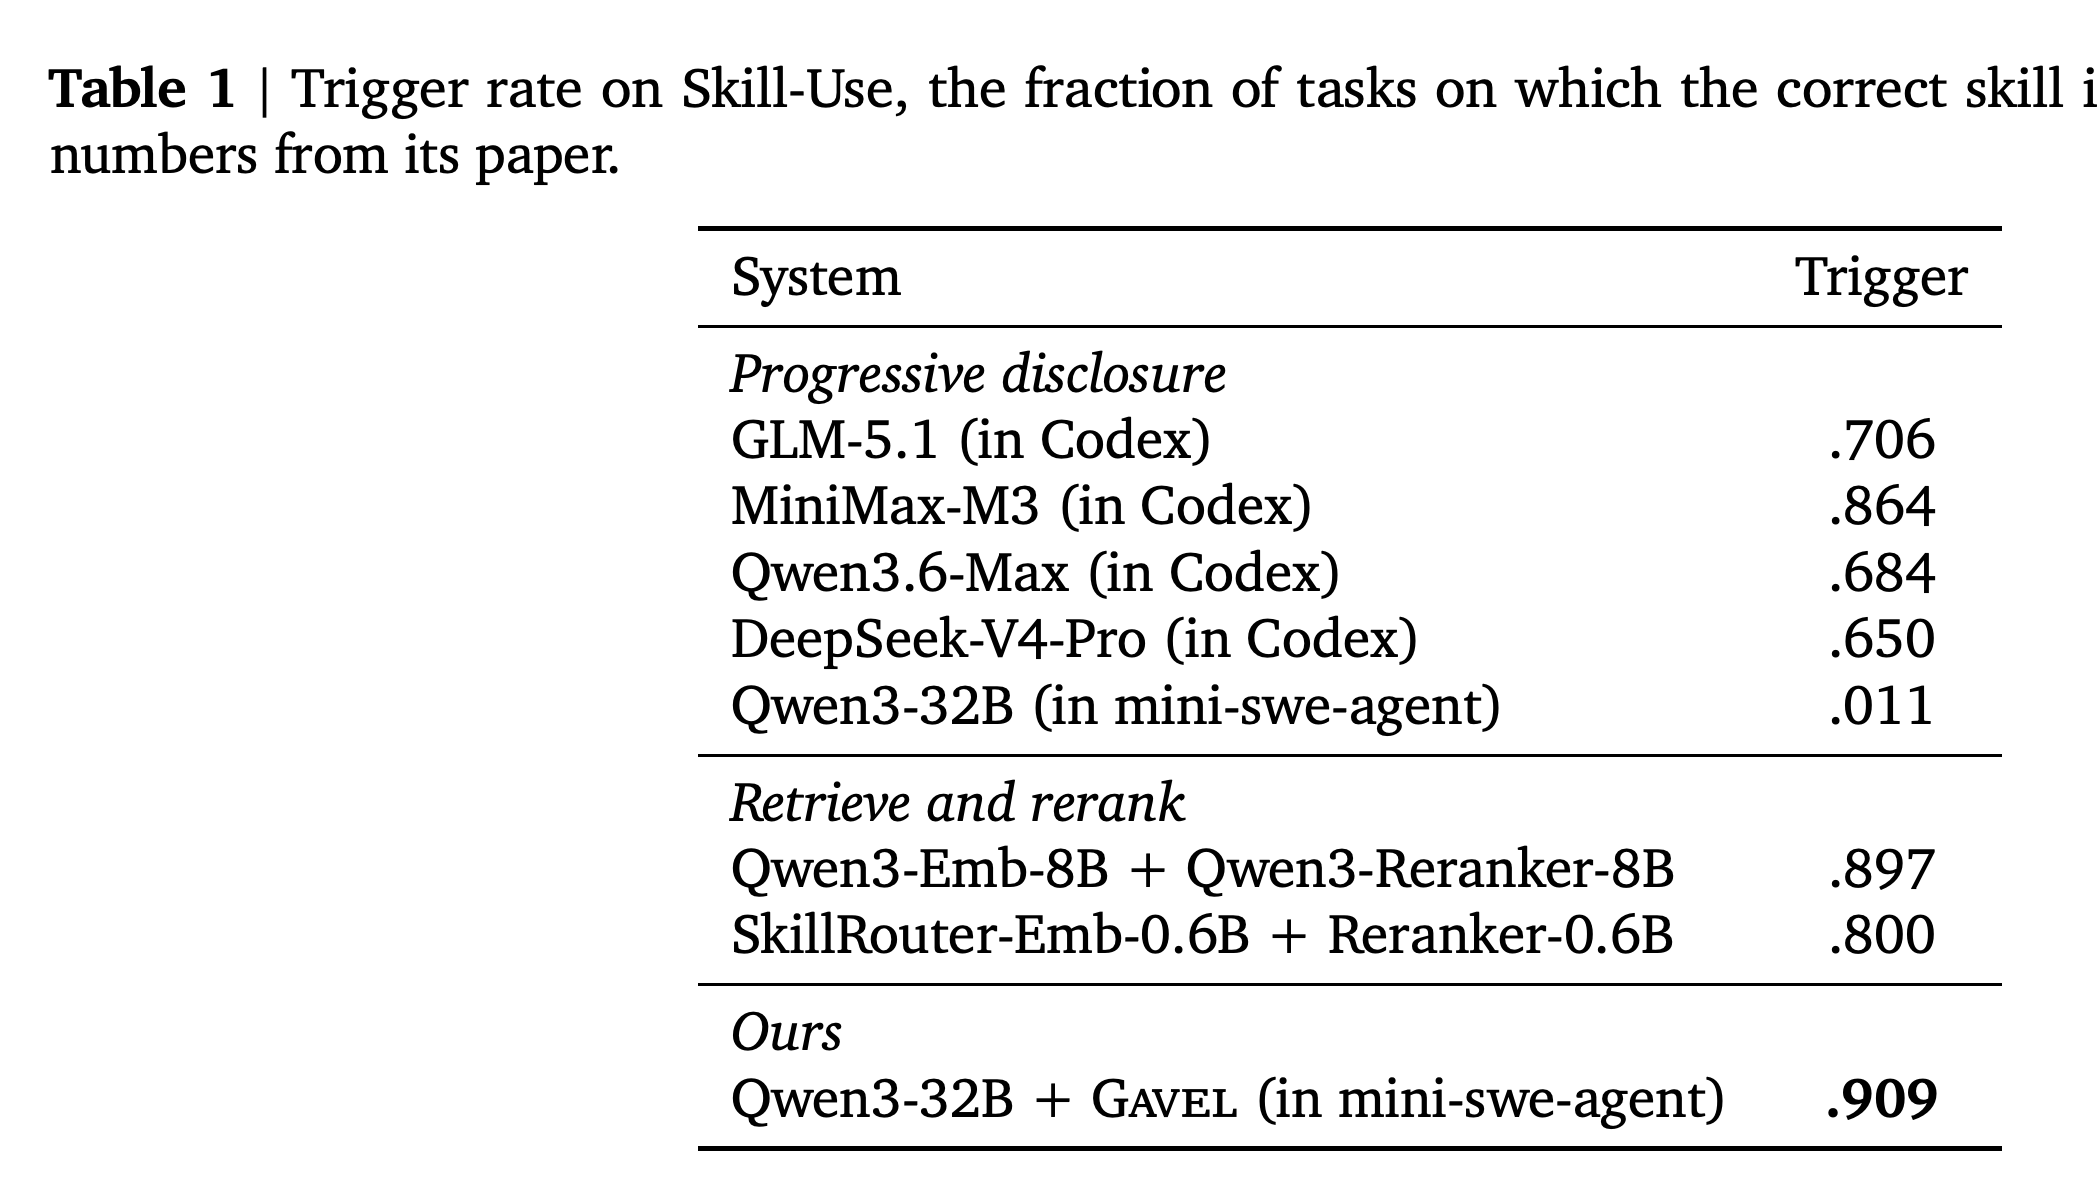
- Skill-Use는 실행 가능한 과제 177개와 스킬 79개로 구성된다. Qwen3-32B에 Gavel을 적용하면 올바른 스킬 호출률이 0.909에 도달한다. 같은 하네스의 progressive disclosure는 0.011, 8B-plus-8B 검색 파이프라인은 0.897, SkillRouter는 0.800이다.
- 인용된 Codex의 프런티어 모델 결과 중 가장 높은 호출률은 MiniMax-M3의 0.864다. 이 프런티어 모델 결과는 Skill-Use 논문에서 가져왔으며 다른 하네스를 사용하므로, 비교에는 모델과 하네스라는 2개 요소의 차이가 모두 포함된다.
- 논문은 다른 약 5%의 과제에서 Gavel이 아무것도 로드하지 않는다고 보고한다. 배포에는 스킬 순위 계산에 사용하는 투영 2개 외에 게이트 학습도 필요하다.
같은 백본을 비교하면 mini-swe-agent에 Gavel을 추가할 때 올바른 스킬 호출률이 0.011에서 0.909로 바뀐다. Gavel의 0.909는 보고된 검색 파이프라인과 프런티어 시스템보다도 높다. 다만 프런티어 시스템 행은 Codex를 사용하므로 하네스 차이도 포함한다.
4.5. Scaling with backbone capability
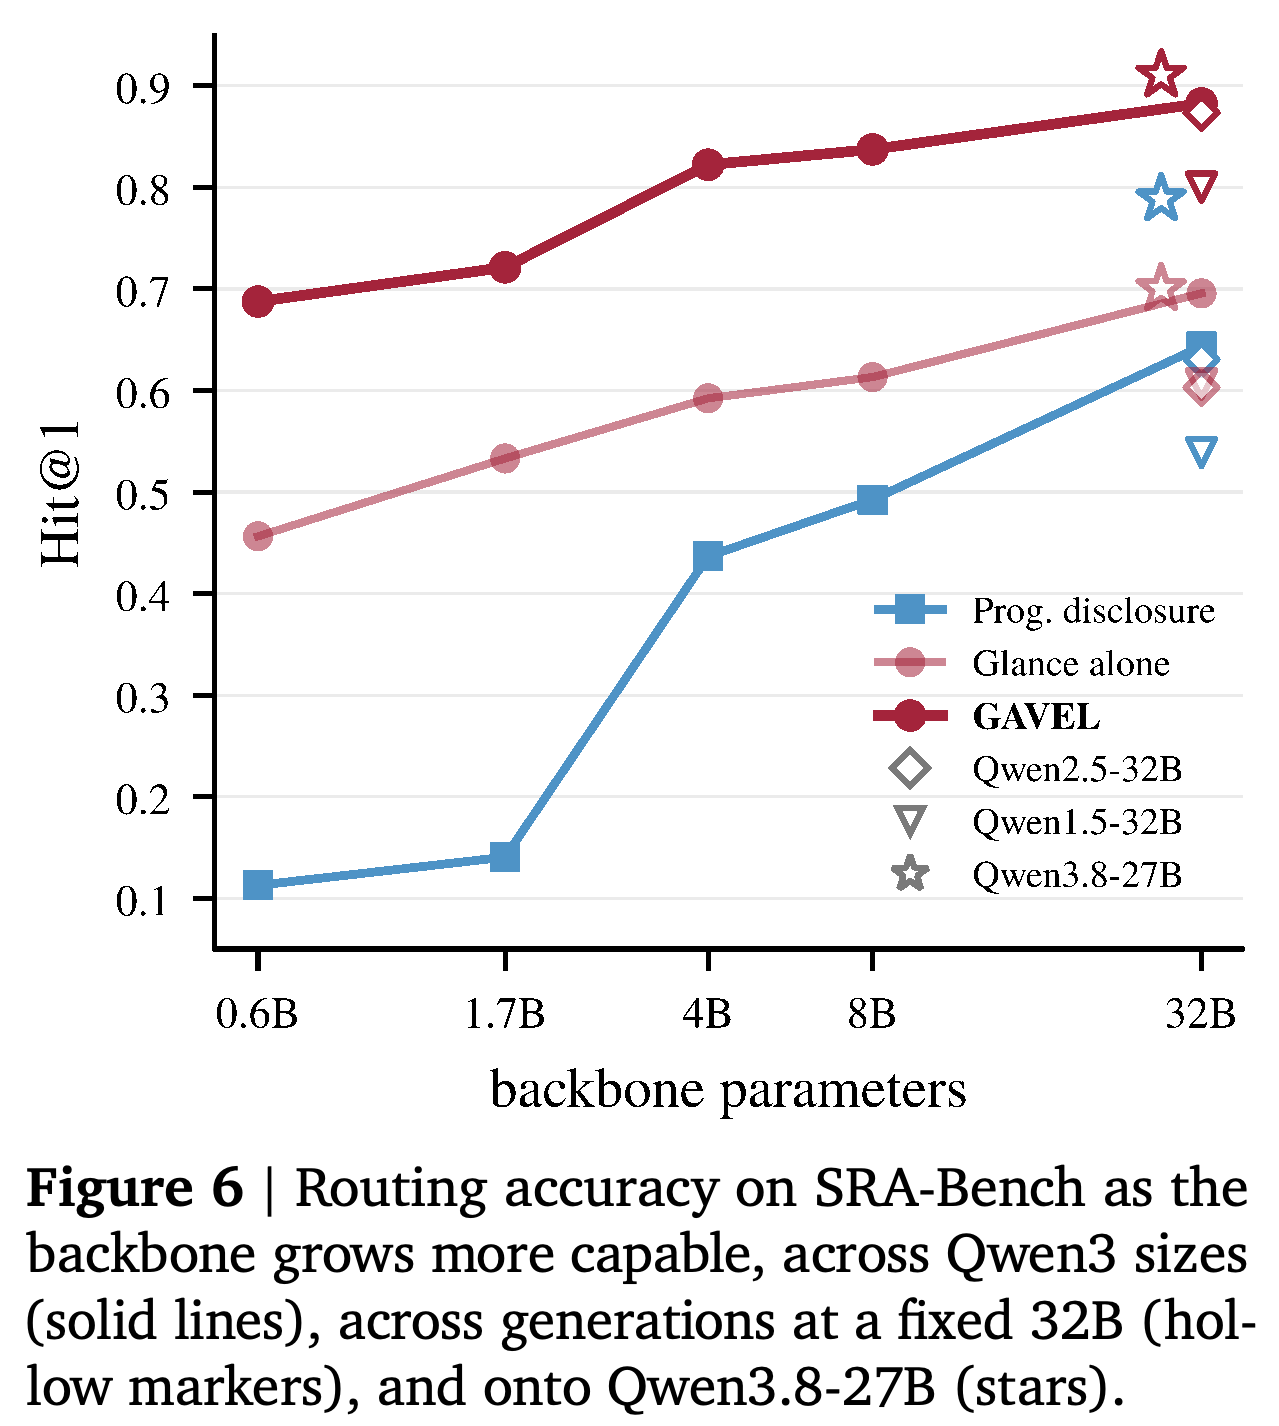
SRA-Bench에서 glance와 전체 Gavel의 2개 방식은 모두 Qwen3의 크기가 0.6B에서 32B로 커지고 모델 세대가 발전할수록 성능이 향상된다. 후보 20개를 검색하는 실험 설정에서는 0.6B 백본의 Gavel도 32B 백본의 progressive disclosure보다 높은 성능을 보인다.
- Qwen3.8-27B에서도 Gavel은 같은 백본을 사용하는 메타데이터 기반 선택보다 12.2%p 앞선다.
- 스케일링 실험은 더 유능한 백본에서 더 나은 라우팅 신호를 추출할 수 있음을 뒷받침한다. 서로 다른 백본 사이에서 학습된 투영을 전이하는 방식은 아직 평가하지 않았다.
Gavel의 단계 2개는 모두 실험한 백본 크기와 세대에 따라 성능이 향상된다. 이는 더 강력한 내부 표현이 라우팅에 도움이 될 수 있다는 주장을 뒷받침한다. 메타데이터 선택과의 격차도 유지되며, Qwen3.8-27B에서는 12.2점 앞선다.
5. Conclusion
논문은 고정된 에이전트 안에 유용한 스킬 선택 정보가 있으며, 학습된 투영과 모델 자체의 예측 점수로 이를 활용하면 작업 컨텍스트에 라이브러리 메타데이터를 추가하지 않아도 된다고 결론짓는다. 실험은 스킬 문서를 평가한다. Read-out을 도구, 메모리, 에이전트에 외부 기능을 제공하는 Model Context Protocol (MCP) 서버로 확장할 수 있는지는 아직 열린 문제다.
부록
- A. 실패하는 native read-out: 모델 자체의 어텐션 쿼리와 키를 직접 사용하면 독립적으로 인코딩한 문서 사이에서 성능이 낮다. 학습하지 않은 설정 24개 중 최고 SkillRet 검증 Hit@1은 0.001이며, 학습된 glance는 0.918이다. 모델 자체의 헤드를 사용한 초기화와 6개 헤드 구조도 채택한 무작위 초기화 단일 광폭 헤드보다 성능이 낮다. 학습된 검색 토큰 64개를 덧붙이면 오래된 근거에 선택적으로 주목하는 대신 최근 정보에 집중하는 집계를 학습한다.
- B. 계층 선택: 노름이 가장 큰 토큰을 제거하면 스킬 500개에서 측정한 행렬 엔트로피 중앙값이 블록 1개를 거치며 4.01에서 1.83으로 떨어지고, 계층 44에서 최솟값에 도달한다. 후보 깊이 6곳에서 read-out을 학습한 결과, 계층 44의 recall at 20이 가장 높다. 이 지표는 후보 20개 안에 주석에 명시된 정답이 포함된 쿼리의 비율이다. 반면 각 텍스트 구간의 토큰 상태를 평균 낸 뒤 단순 코사인 유사도를 계산하면 이 깊이에서 성능이 낮다.
- C. 학습 세부 사항: Wq와 Ws는 편향이 없는 768 × 5120 행렬이다. 32비트 부동소수점 정밀도인 fp32와 AdamW 옵티마이저로 24,000 steps 동안 학습하며, 학습률은 10^−3, 가중치 감쇠는 0.01이다. 각 스텝에는 스킬 토큰 예산 200K 안에서 과제 256개까지 넣는다. 학습에서는 스킬당 최대 8,192개 키를 허용하고, 평가에서는 30,720토큰 서빙 예산을 사용한다. 압축 후에는 Wq만 3,000스텝 학습하며 학습률은 10^−4다. 서면 과제 투표에는 균일한 토큰 가중치를 사용한다.
- D. 압축 보장: 부록은 Cauchy–Schwarz 부등식으로 최대 내적의 왜곡 한계를 증명하고, top-k 경계 근처의 토큰을 위한 추가 항을 포함해 투표 안정성을 유도한다. 또한 farthest-first traversal이 ε-separated인 ε-cover를 생성함을 증명한다. 이 한계는 표현 점수에 적용되며, 후보 점수가 서로 가까우면 스킬 순위는 여전히 바뀔 수 있다.
- E. Qwen 이외의 백본: gemma-4-31b-it에서 투영을 새로 학습해 파이프라인을 다시 구축한다. 전체 60개 블록 중 블록 34에서 read-out하며, ε = 0.77과 재보정한 (α, γ) = (0.15, 0.003)을 사용한다. Gavel은 서면 과제 벤치마크 3개에서 다시 가장 높은 adjudicated 점수를 얻는다. 이는 모델별 학습과 보정을 거치면 2번째 모델 계열에도 적용할 수 있음을 뒷받침한다.
- F. 추가 ablation: F.1. 전체 스킬 본문을 사용하는 progressive disclosure는 스무 항목의 메뉴에 문서 전체를 제공한다. 131K-token 윈도우를 사용하며 가장 긴 프롬프트는 124K토큰이다. SRA-Bench 성능은 향상되지만 adjudicated 점수 차이는 여전히 약 16으로 Gavel보다 낮고, 프롬프트 중앙값은 1.3K토큰에서 28K–52K토큰으로 늘어난다. F.2. Verdict 신호를 하나씩 제거하는 실험에서는 전체 조합의 adjudicated 정확도가 어느 단일 신호 변형보다도 높다. 전체 궤적을 합산한 SkillTraj에서는 차이가 4.6점이다. F.3. Glance를 기성 embedder로 대체하면 Gavel의 verdict가 Qwen3-Embedding-8B 후보의 성능을 크게 개선하지만, 이 파이프라인도 SkillTraj에서 전체 Gavel보다 9.1점 낮다.
- G. 프롬프트 템플릿: 부록은 설치, 과제, verdict, progressive disclosure, 순서 반전 ablation, adjudication 프롬프트를 제시한다. 모두 제시된 빈 thinking 블록을 사용하는 non-thinking 모드다. Verdict의 후속 입력은 설치 시점의 렌더링을 그대로 이어 가므로 접두부를 재사용할 수 있다. Yes/no 점수는 대소문자 변형과 앞쪽 공백 유무를 반영한다. 판정 모델은 과제와 스킬 문서 2개를 보며, 비교할 때 문서의 역할을 서로 바꾼다.
- H. 벤치마크 세부 사항과 공개 정보: H.1. 불완전한 정답 주석에서는 벤치마크 3개 모두의 사례를 통해 중복 스킬이나 적합한 대안 스킬을 보여 준다. 주석에 명시된 정답만 인정하는 raw Hit@1은 이러한 선택을 오류로 처리한다. Eval-Core의 easy 풀에는 문서 78,361개가 있고, hard 풀에는 적대적 방해 문서 780개가 추가된다. H.2. Adjudication의 raw 점수와 사람의 일치도에서는 Gavel의 주요 비교 결과가 raw Hit@1에서도 유지된다고 보고한다. 저자 주석은 쌍 200개 중 171개에서 심사 모델의 정답 인정 판단과 일치하며, 이를 86%로 보고한다. 심사 모델이 정답으로 인정한 수는 저자 주석보다 순증 기준으로 9개 많다. H.3. 검색 단계의 후보 풀 재현율에서는 glance의 R@20, 즉 recall at 20이 SkillRet에서 0.9706, SRA-Bench에서 0.9675라고 보고한다. H.4. SkillTraj의 구성과 사례에서는 사용자 턴 2–8개, 최대 도구 호출 5회, Claude Sonnet 4.6의 블라인드 전후 검사, 정답 이름과 본문 원문 유출을 막기 위한 검사를 설명한다.
- I. 배포 과정 사례: Gavel은 과제 177개에서 181회 로드하며, 이 중 17회는 명령 출력이 나타난 이후의 후속 턴에서 발생한다. 사례는 양식 편집, 새로운 소프트웨어 개발 키트로의 마이그레이션, 서로 다른 스킬 2개가 필요한 과제를 보여 준다. Qwen3-32B의 첫 행동을 메타데이터 메뉴에서 선택한 스킬 읽기로 강제하면 베이스라인 호출 점수가 0.834로 높아진다. 이는 자율 실행 결과 0.011이 주로 스킬 참조를 시작하지 못하는 데서 비롯됨을 시사한다.
- J. 라우팅 비용: 논문의 August 2026 요금 가정에서 100 메타데이터 토큰, 본문 1,895토큰, 쿼리 239토큰에 대한 아홉 번의 verdict 순전파 비용은 게이트 작동당 약 $0.080이다. 캐시된 progressive-disclosure 메뉴는 스킬 n개와 호출 T회에 대해 약 $4 × 10^−5 nT의 비용이 들며, 작동 m회에 대한 비용 역전 기준은 n > 2,000m/T 부근이라고 제시한다. 약 반 초의 verdict 지연 시간은 현대적인 서빙 스택에 대한 추정치다. 계산에는 오프라인 인덱싱과 두 접근에 공통으로 드는 선택된 본문의 비용이 빠져 있다.
- K. 논의: 선형 게이트는 초기 단계의 시점 결정 장치이며, 시퀀스를 고려한 게이팅과 전용 스킬 호출 토큰은 향후 과제로 남는다. 실험은 백본을 로컬에서 실행한다. 제안한 클라우드 응용 프로그램 인터페이스(API) 배포에서는 제공자가 투영, 인덱싱, verdict 순전파, 게이트를 내부에서 실행해야 한다. 라우터에는 텍스트 전용 인터페이스로 얻을 수 없는 은닉 상태가 필요하기 때문이다.
짧은 생각
보정값을 고정한 평가, 구성 요소 대체 실험, raw 점수 검사는 서로 보완하는 근거를 제공한다. 쿼리 형식과 문서 장르가 달라져도 향상 효과가 유지되며, adjudication 없이도 효과가 나타난다. 2번째 모델 계열 실험도 이 아키텍처를 뒷받침하지만, 새 파라미터로 라우터를 다시 구축한 결과다.
이 근거는 특정 평가 조건에서의 스킬 선택과 로드에 관한 것이다. SkillTraj는 시뮬레이션 데이터이고, Eval-Core의 쿼리는 75개뿐이며, 사람의 검증에는 저자 주석을 사용한다. Skill-Use는 최종 실행 성공 대신 올바른 스킬 로드를 측정한다. 순위 계산 파라미터 수가 적더라도 은닉 상태와 토큰 확률에 대한 접근, 모델별 투영 학습, 뱅크 저장 공간, verdict 계산은 여전히 주요 배포 요건이다.