


Transformers without Normalization 요약 설명
13 Mar 2025 | Paper Review Normalization-Free Training Transformer Architectures목차
이번 글에서는 Transformers without Normalization 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 13일(Arxiv)
- Zhu, Jiachen, Chen, Xinlei, He, Kaiming, LeCun, Yann, Liu, Zhuang.
- FAIR, Meta, New York University, MIT, Princeton University
- 논문 링크
- Github
- Project Page
요약
- Transformers without Normalization은 입력 통계로 내부 활성값을 재조정하는 정규화 층 없이도 Transformer를 효과적으로 학습할 수 있는지 검증한다. 학습 가능한 스케일링과 출력 범위가 제한된 쌍곡탄젠트를 원소별로 적용하는 Dynamic Tanh(DyT)는 동일한 학습 하이퍼파라미터에서 Large Vision Transformer의 ImageNet-1K 분류 정확도를 정규화 사용 시 83.1%에서 83.6%로 높인다.
- 전체 대체 연산은 DyT(x) = γ * tanh(αx) + β다. tanh는 쌍곡탄젠트이고, α는 층마다 학습하는 스칼라 1개이며, γ와 β는 각 채널, 즉 특징 차원의 스케일과 이동량을 조절한다. 이 설계는 정규화가 0 부근에서는 대체로 선형인 입출력 관계를 만들고 극단적인 활성값은 압축한다는 관찰에서 출발한다.
- 지도 및 자기지도 비전 학습, 이미지 생성, 언어, 음성, 유전체 서열 모델링 실험에서 정규화를 사용하는 베이스라인과 전반적으로 비슷한 성능을 보인다. 언어 모델에는 초기화 조정과 추가 임베딩 스칼라가 필요하다. 컴파일한 구현에서는 측정된 속도 이점이 없으며, 샘플 간 통계를 계산하는 batch normalization을 대체하면 전통적인 합성곱 신경망의 정확도가 낮아진다.
1 Introduction
정규화 층은 최적화와 학습 안정성을 개선하므로, 다른 아키텍처 구성 요소가 바뀌어도 계속 사용되어 왔다. 이 논문은 활성값 통계를 계산하지 않고도 학습 가능한 활성값 스케일링과 극단값 압축으로 이러한 이점을 유지할 수 있는지 검증한다.
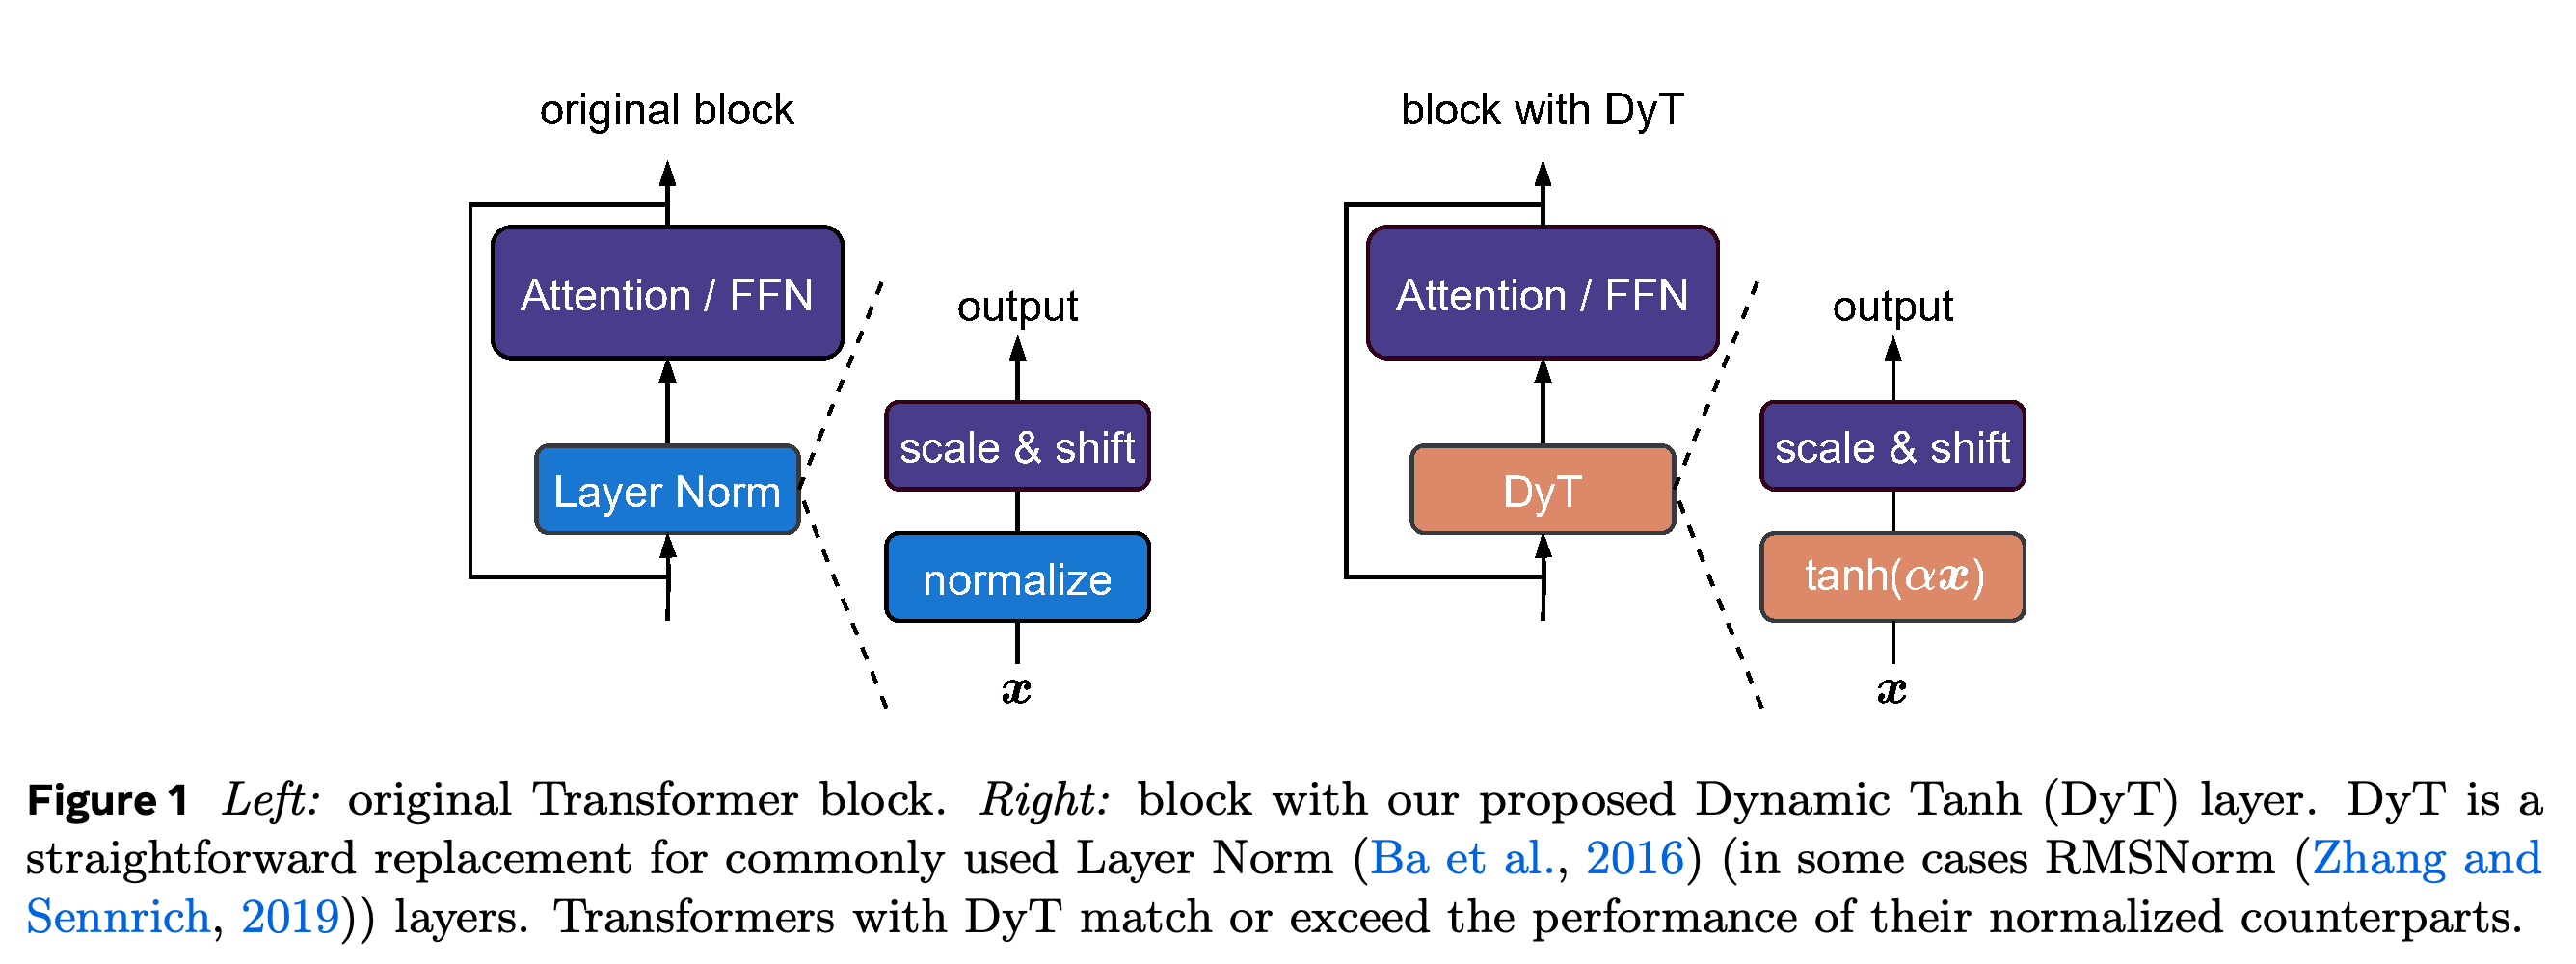
잔차 블록 구조를 유지하면서 활성값 통계 기반 정규화를 학습 가능한 입력 스케일링을 적용한 tanh로 대체한다. 스케일과 이동을 조절하는 단계가 유지된다는 점은 DyT가 학습 가능한 출력 스케일 조정을 보존하면서 정규화 연산을 바꾼다는 것을 보여준다.
2 Background: Normalization Layers
배치 크기, 토큰 수, 임베딩 차원을 나타내는 (B, T, C) 형태의 입력에 대해 정규화는 일반적으로 normalization(x) = γ * ((x − μ) / √(σ² + ϵ)) + β를 계산한다. μ와 σ²는 입력의 평균과 분산이고, ϵ는 작은 상수이며, γ와 β는 학습 가능한 채널 벡터다.
- Batch normalization(BN)은 각 채널에서 배치와 토큰 차원에 걸쳐 통계를 계산한다.
- Layer normalization(LN)은 각 토큰에서 독립적으로 채널 간 평균과 분산을 계산한다.
- Root mean square normalization(RMSNorm)은 평균을 빼지 않고 활성값 제곱의 평균을 사용해 스케일을 조정한다. 평가한 Transformer는 RMSNorm을 사용하는 LLaMA를 제외하면 LN을 사용한다.
3 What Do Normalization Layers Do?
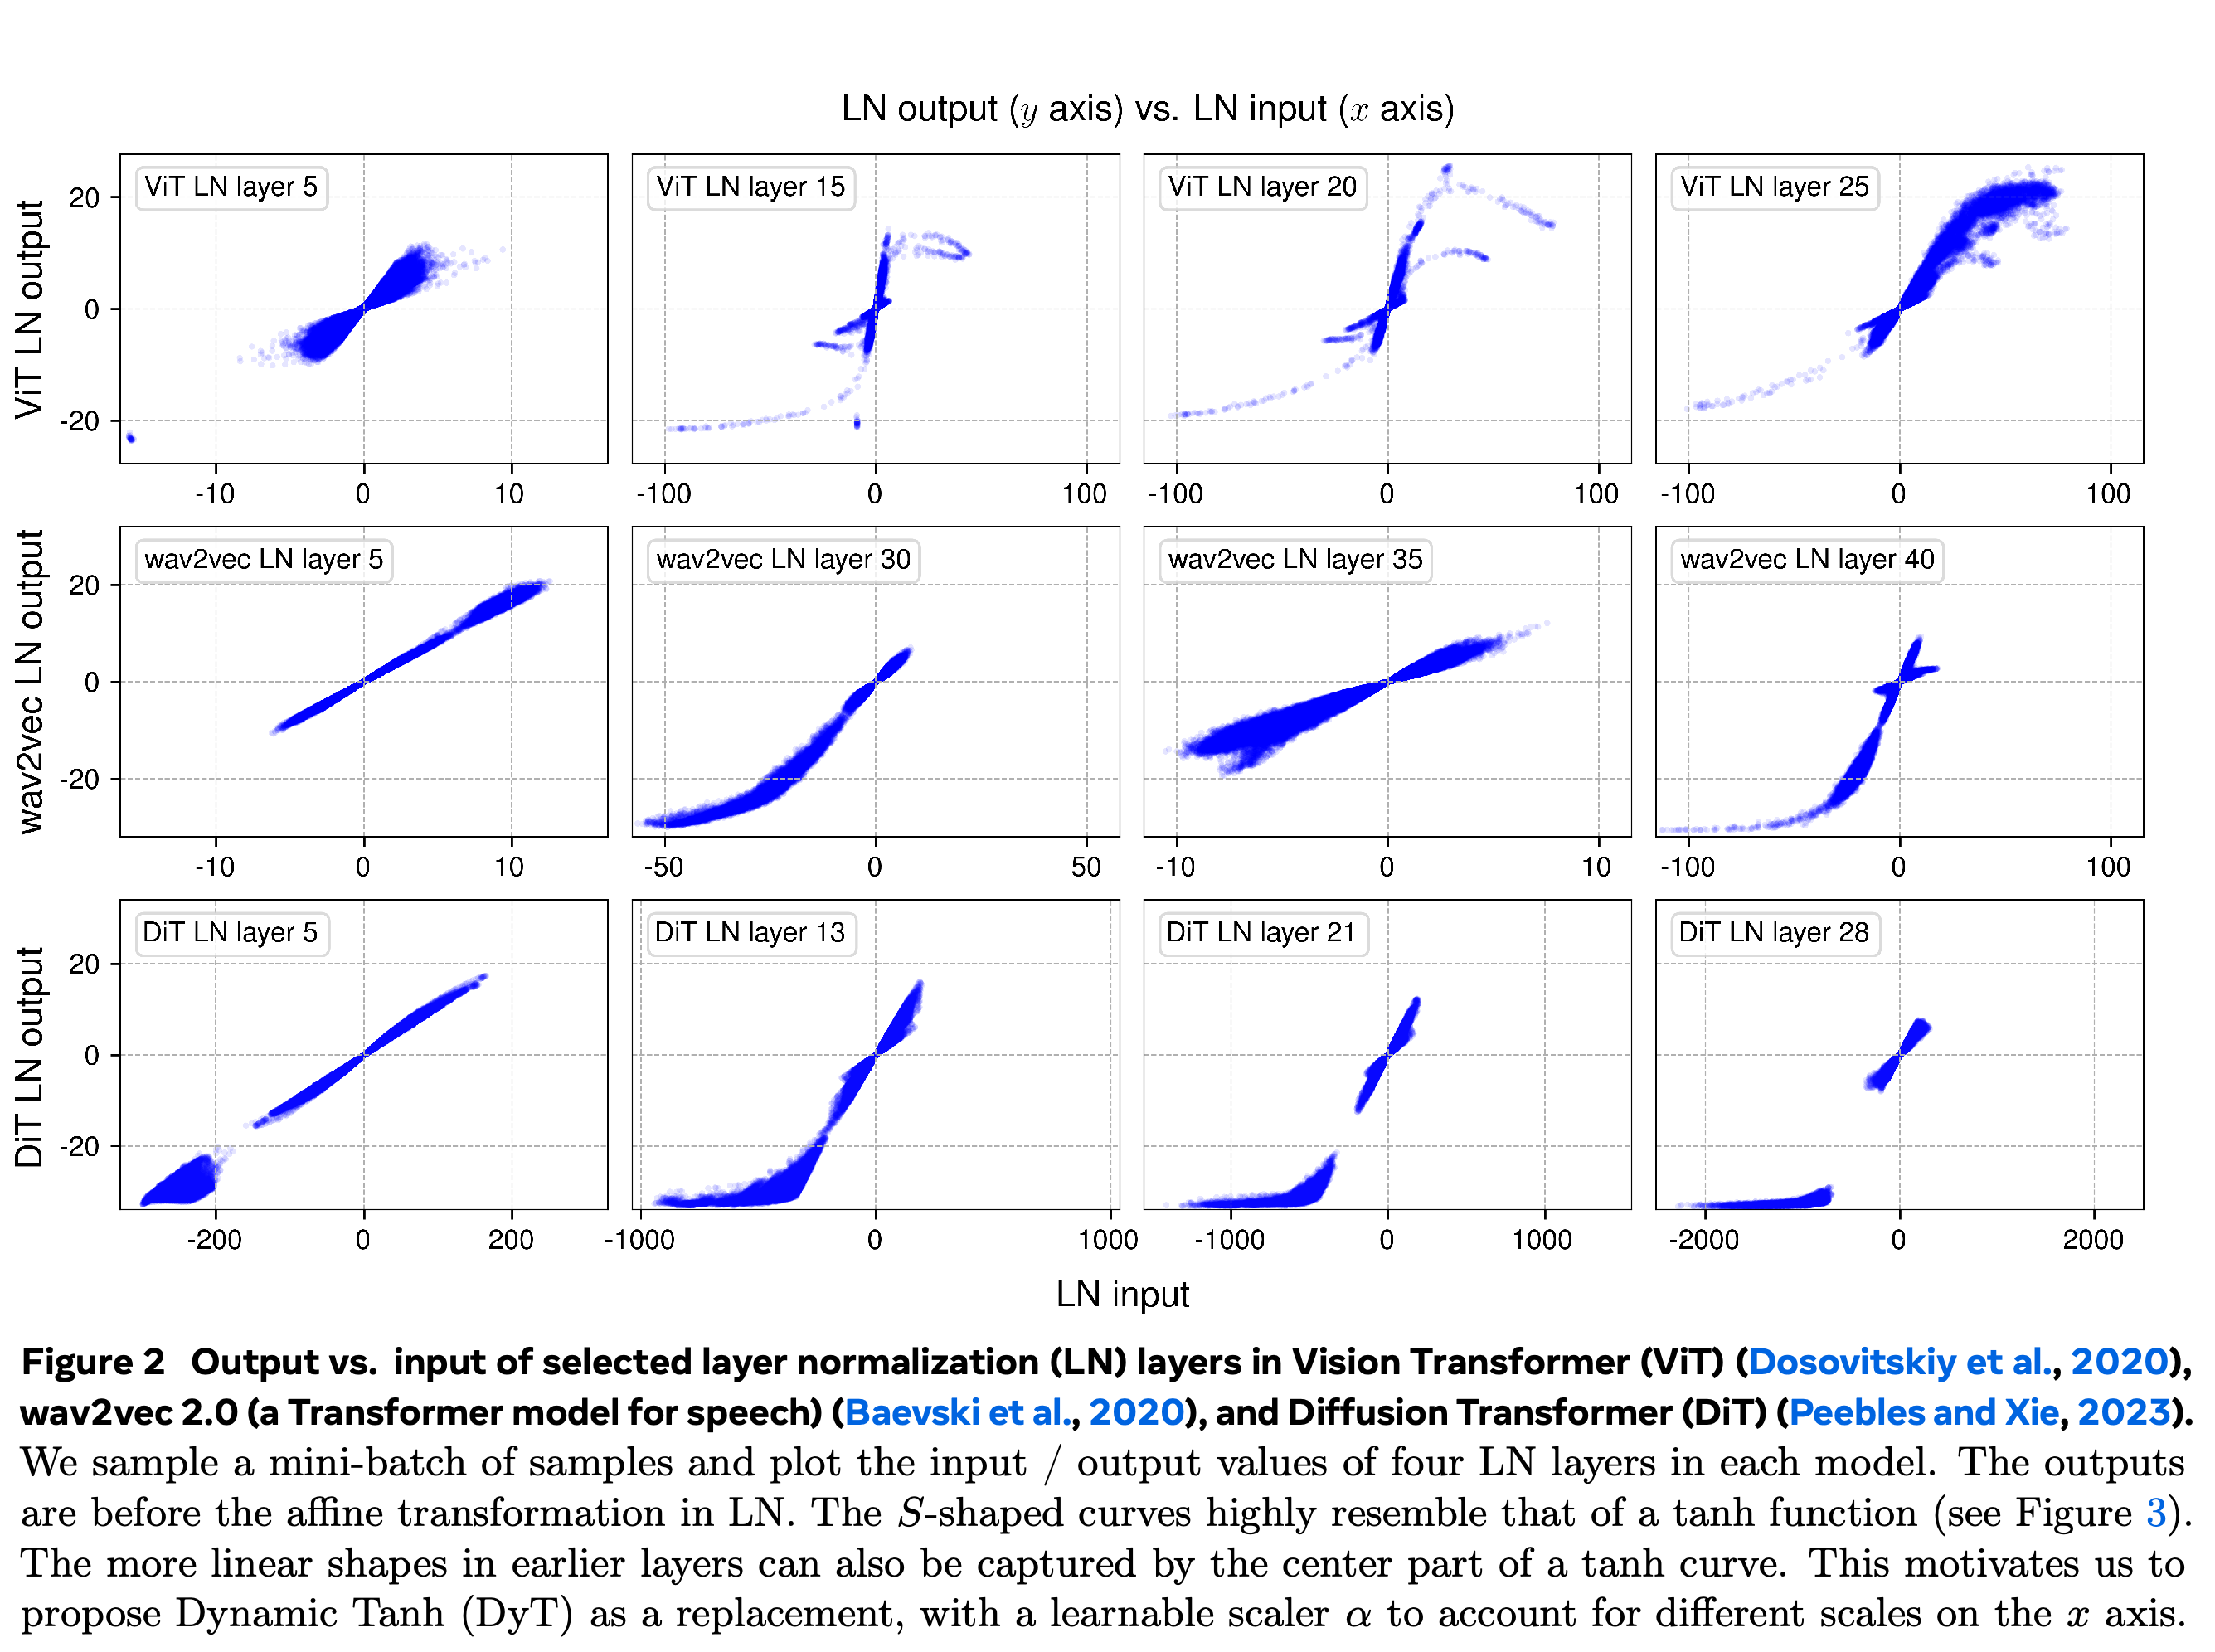
저자들은 학습된 이미지 인식 모델 ViT-B(Base Vision Transformer), 음성 표현 모델 wav2vec 2.0 Large, 이미지 생성 모델 DiT-XL(Extra Large Diffusion Transformer)에서 학습 가능한 스케일링과 이동을 적용하기 전 정규화의 입력과 출력을 살펴본다. 앞쪽 층에서는 대부분 선형 관계가 나타나지만, 깊은 층에서는 완전하거나 부분적인 S자 곡선이 자주 나타난다.
- 표시된 점의 약 99%는 대체로 선형인 중앙 영역에 위치한다. 조사한 ViT에서 50보다 크거나 −50보다 작은 입력과 같은 극단값은 더 강하게 압축된다.
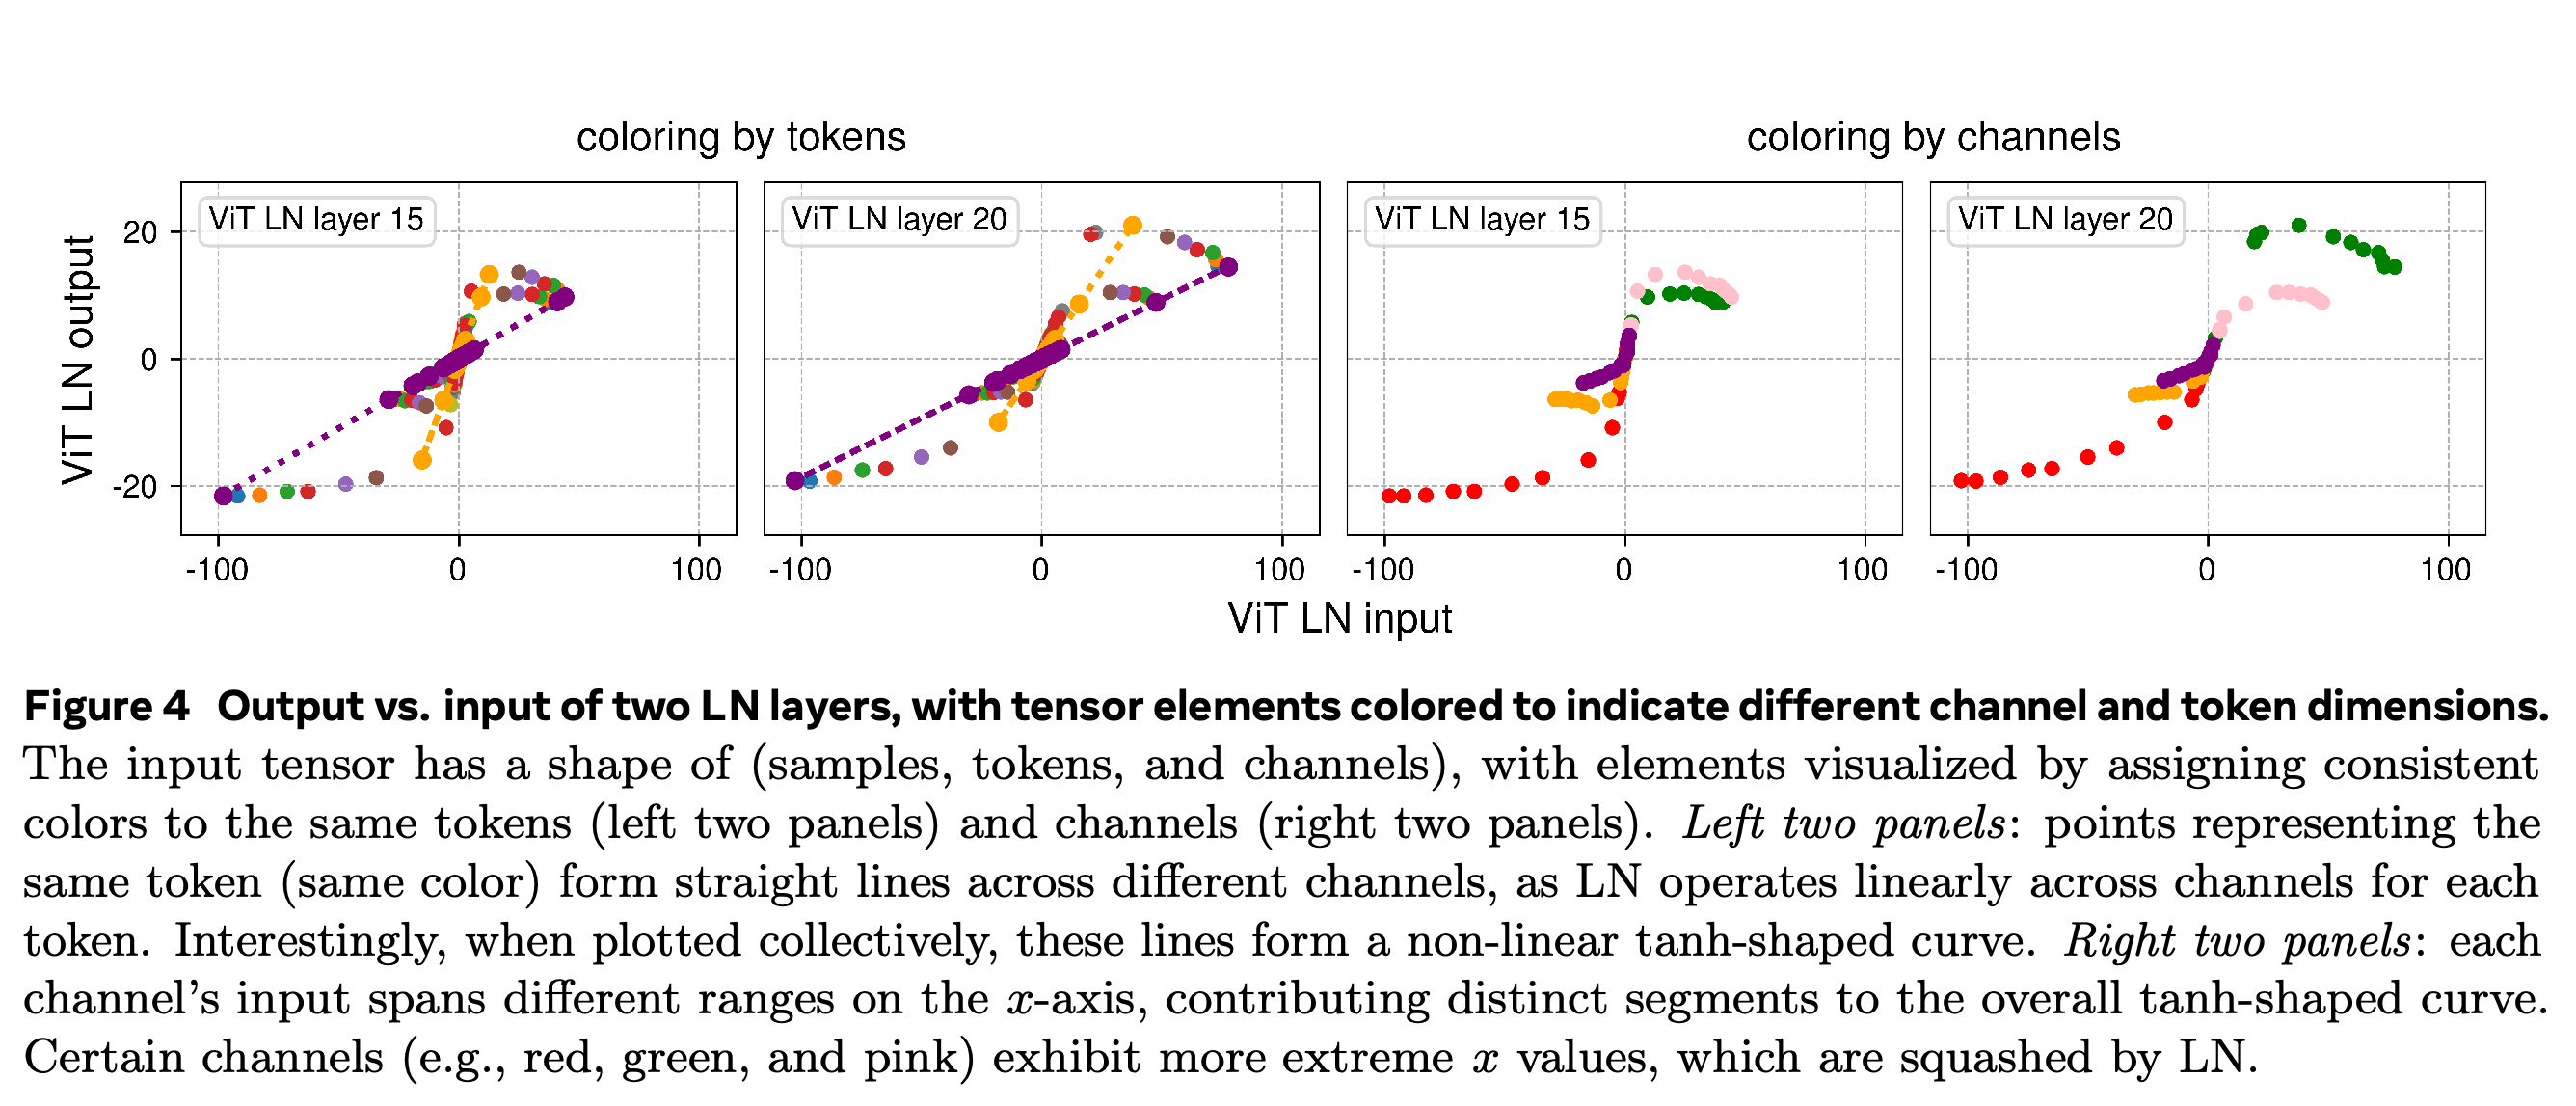
- 활성값을 토큰별로 색칠하면 토큰마다 통계가 달라 기울기가 다른 직선들이 나타난다. 채널별로 색칠하면 소수의 채널에서 극단값이 많이 발생함을 확인할 수 있다.
- 이 관찰은 극단값을 비선형적으로 억제하는 것이 학습에 도움이 된다는 가설로 이어진다. 다만 LN과 tanh가 보편적으로 동등하다는 점을 입증하지는 않는다.
이미지 인식, 음성, 이미지 생성 모델에서 선택한 층들은 대체로 선형인 중앙 영역과 압축된 양 끝 영역을 보인다. 이 표본들의 입출력 관계는 스케일을 조절한 tanh를 사용할 근거를 제공하지만, 모든 정규화 층이 같은 함수를 구현한다는 점을 입증하지는 않는다.
점을 토큰별로 묶으면 기울기가 다른 직선들이 나타나고, 채널별로 묶으면 극단값을 만드는 채널을 구분할 수 있다. 각 패널은 토큰마다 자체 통계로 스케일을 조정할 때 전체 산점도가 S자 형태로 나타날 수 있는 이유를 설명한다.
4 Dynamic Tanh (DyT)
완전한 DyT 층은 DyT(x) = γ * tanh(αx) + β를 계산한다. 아키텍처의 기존 활성화 함수는 유지하면서, attention 블록, 각 토큰의 특징을 변환하는 feed-forward network(FFN) 블록, 마지막 정규화 층에서 정규화 연산을 대체한다.
- 각 층은 스칼라 α 1개와 채널별 벡터 γ, β를 학습한다. 기본 초기값은 α = 0.5, γ = 1, β = 0이며, 언어 모델에는 예외를 적용한다.
- 순전파에서는 평균, 분산이나 다른 집계 연산 없이 각 원소를 독립적으로 처리한다. α는 현재 입력에서 계산하는 값이 아니라 학습 과정에서 변하는 매개변수다.
- 프로젝트 페이지와 코드는 https://jiachenzhu.github.io/DyT 에서 확인할 수 있다.
5 Experiments
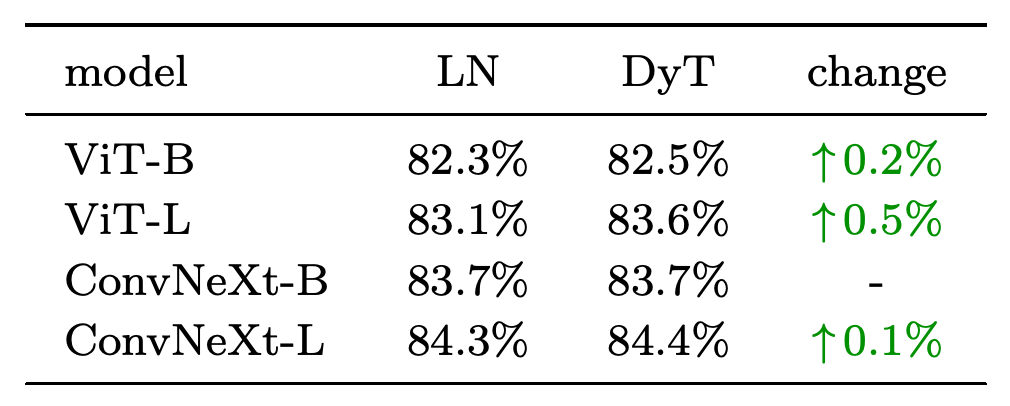
ImageNet-1K 지도 분류에서 DyT와 LN은 동일한 학습 하이퍼파라미터를 사용한다. Top-1 정확도는 가장 높은 점수를 받은 예측이 정답인 샘플의 비율이다. ViT-B에서는 82.3%에서 82.5%, ViT-L에서는 83.1%에서 83.6%, ConvNeXt-B에서는 83.7%에서 83.7%, ConvNeXt-L에서는 84.3%에서 84.4%로 변한다. B와 L은 Base와 Large를 뜻하며, ConvNeXt는 Transformer와 함께 평가한 합성곱 아키텍처다.
- ViT-B와 ConvNeXt-B의 학습 손실 곡선은 300 epochs 동안 비슷한 양상을 보인다. 이는 해당 실험에서 수렴 양상이 비슷하다는 근거다.
동일한 학습 하이퍼파라미터에서 DyT에 따른 지도학습 정확도 변화는 아키텍처와 크기 조합 4개에 걸쳐 0.0에서 0.5%포인트다. 보고된 개선 폭은 ViT-L에서 가장 크다.
자기지도 비전 실험에서는 레이블 없이 사전학습한 뒤 레이블을 사용해 분류를 미세조정한다. 가려진 이미지 내용을 복원하도록 학습하는 masked autoencoder(MAE)의 LN/DyT 정확도는 ViT-B에서 83.2%/83.2%, ViT-L에서 85.5%/85.4%다. 학습된 이미지 표현에 대한 목적함수로 학습하는 DINO는 패치 크기 16에서 83.2%/83.4%, 패치 크기 8에서 84.1%/84.5%를 달성한다.
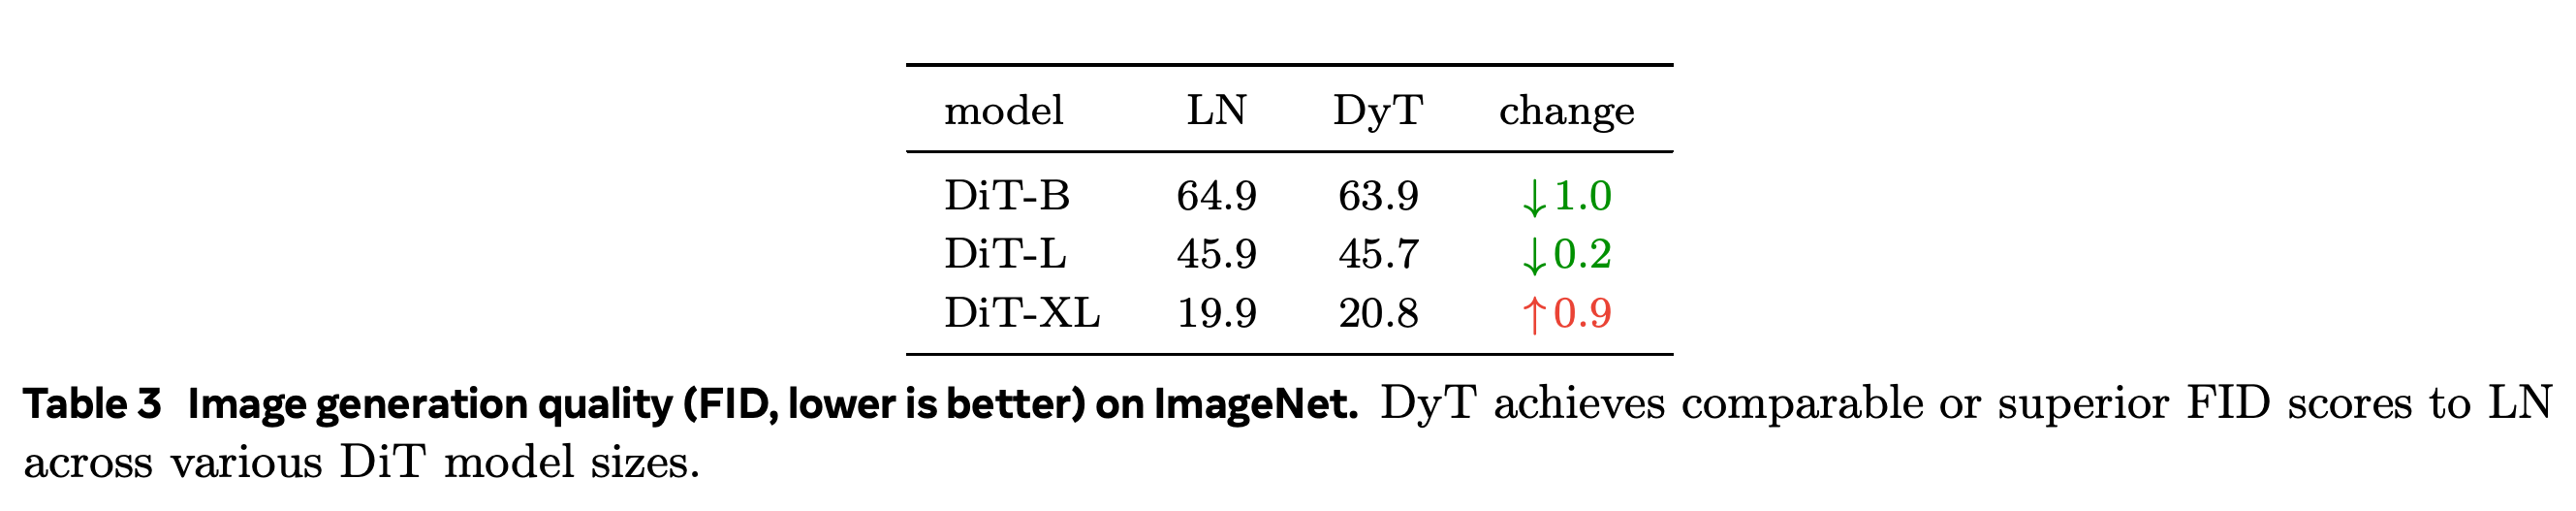
- 이미지 생성에서는 DiT-B, DiT-L, DiT-XL이 각각 패치 크기 4, 4, 2를 사용한다. 이미지 생성 품질 지표인 Fréchet Inception Distance(FID)는 낮을수록 좋으며, 각각 64.9에서 63.9, 45.9에서 45.7, 19.9에서 20.8로 변한다.
- DiT 실험은 클래스 레이블을 생성 조건으로 제공하는 데 쓰는 아핀 매개변수를 유지한다. Appendix A에 따르면 LN 베이스라인에 유지한 0 초기화를 DyT에서는 제거하므로, 이 비교에는 초기화 변경도 포함된다.
DyT는 DiT-B와 DiT-L의 FID를 낮추지만, DiT-XL에서는 19.9에서 20.8로 높인다. 따라서 평가한 생성 모델 중 가장 큰 모델은 이 지표에서 성능이 나빠진다.
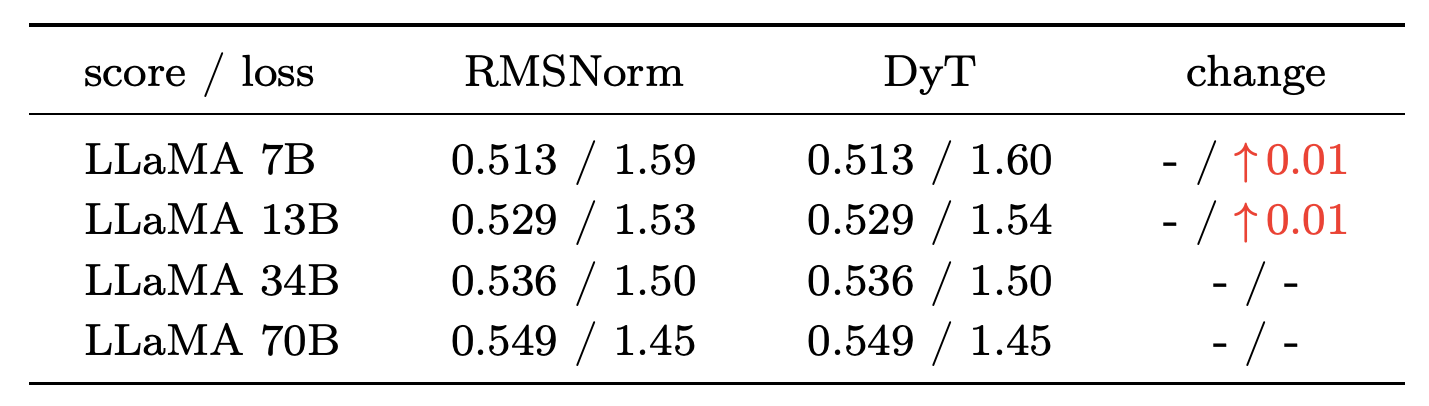
매개변수가 7B, 13B, 34B, 70B인 LLaMA 대규모 언어 모델(LLM)을 The Pile 텍스트 데이터셋의 200B 토큰으로 사전학습한다. B는 1000000000을 뜻한다. lm-eval 평가 프레임워크를 사용해 과제별 예시 없이 zero-shot 과제 15개를 평가하며, RMSNorm과 DyT의 평균 점수는 각각 0.513, 0.529, 0.536, 0.549로 동일하다. 최종 RMSNorm/DyT 학습 손실은 각각 1.59/1.60, 1.53/1.54, 1.50/1.50, 1.45/1.45다.
- DyT 언어 모델은 임베딩 층 뒤에 학습 가능한 스칼라를 추가하고 α 초기값을 조정한다. 손실 곡선은 RMSNorm 베이스라인과 매우 비슷하다.
- LibriSpeech 음성 데이터셋에서 사전학습한 wav2vec 2.0 Base의 검증 손실은 어느 방법에서나 1.95이며, Large에서는 1.92에서 1.91로 변한다. 채널 그룹 내 통계를 계산하며 여기서는 원시 입력 데이터를 처리하는 첫 group normalization 층은 음성 모델 2개 모두에 유지한다.
- 유전체 서열 모델링에서는 HyenaDNA와 Caduceus를 GRCh38 인간 참조 유전체 데이터로 사전학습하고, 유전체 서열 분류 데이터셋 모음인 GenomicBenchmarks로 평가한다. LN과 DyT의 방법 2개 모두 HyenaDNA에서 평균 정확도 85.2%, Caduceus에서 86.9%를 달성한다.
보고된 평균 zero-shot 점수는 모든 모델 크기에서 동일하다. DyT의 학습 손실은 7B와 13B에서 0.01 높고, 34B와 70B에서는 같다. DyT에는 추가 임베딩 스칼라와 조정한 초기값을 사용한다.
6 Analysis
분석에서는 출력 범위를 제한하는 함수와 학습 가능한 스칼라의 기여를 검증하고, α와 활성값 스케일의 관계를 살펴본다. 또한 정규화 없이 학습하는 기존 방법과 DyT를 비교한다.
6.1 Ablations of tanh and α
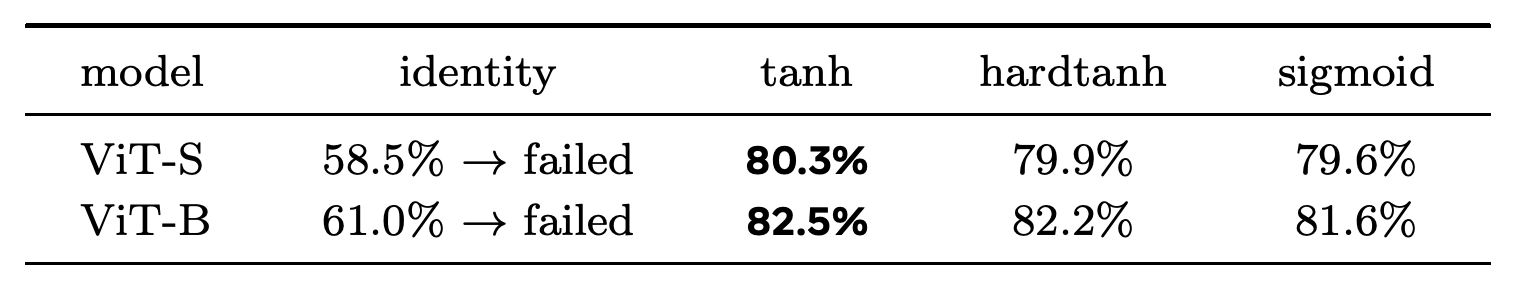
tanh를 입력을 그대로 출력하는 항등함수로 바꾸면 ViT-S와 ViT-B가 각각 최고 정확도 58.5%, 61.0%에 도달한 뒤 학습이 발산한다. S는 Small을 뜻한다. 출력 범위가 제한된 대안들은 학습에 성공하지만, tanh의 ViT-S/ViT-B 정확도가 80.3%/82.5%로 가장 높다. 구간 밖 값을 잘라내는 선형 함수 hardtanh는 79.9%/82.2%, 출력 범위가 0과 1 사이로 제한된 sigmoid는 79.6%/81.6%를 기록한다.
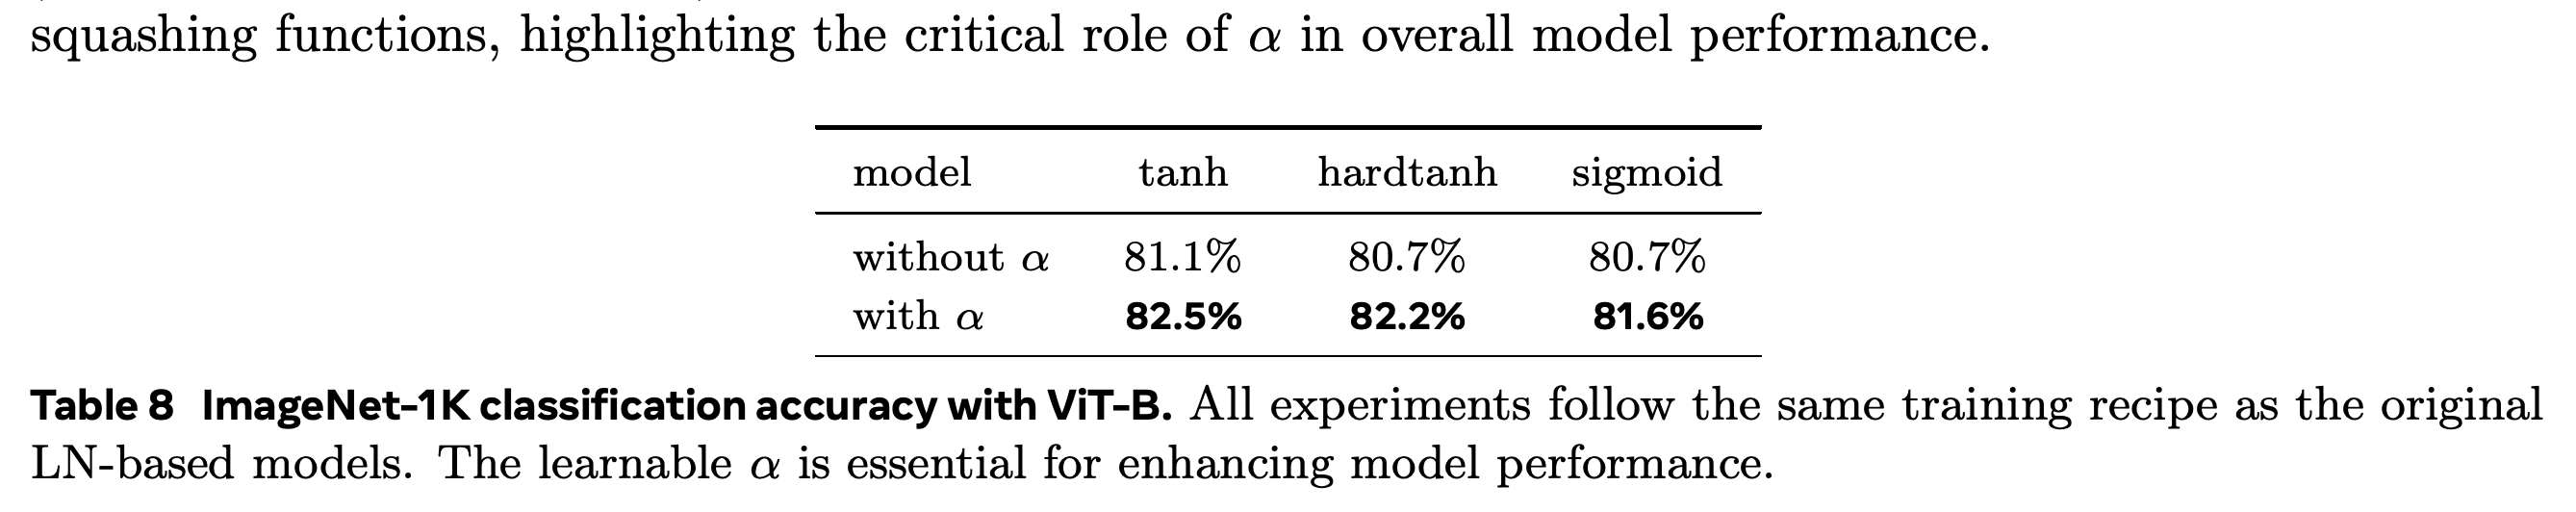
- 학습 가능한 α를 제거하면 ViT-B 정확도가 tanh에서 82.5%에서 81.1%, hardtanh에서 82.2%에서 80.7%, sigmoid에서 81.6%에서 80.7%로 낮아진다.
- 이 결과는 평가한 학습 설정에서 출력 범위를 제한하는 압축과 학습 가능한 스케일링이 유효하다는 근거다. tanh의 이점이 매끄러움과 0을 중심으로 한 출력에서 비롯된다는 저자들의 설명은 가설로 남는다.
항등함수로 대체하면 평가한 모델 크기 2개 모두에서 학습이 발산하지만, 출력 범위가 제한된 대안 3개는 모두 학습을 완료한다. tanh의 정확도가 가장 높지만, 이 실험은 다른 유계 함수보다 유리한 이유가 어떤 특성에 있는지 분리해 검증하지 않는다.
α를 학습하면 평가한 모든 출력 범위 제한 함수에서 ViT-B 정확도가 높아진다. tanh에서는 81.1%에서 82.5%로 높아진다. 이 학습 설정에서는 출력 범위를 제한하는 압축만으로 완전한 DyT의 결과를 얻지 못한다.
6.2 Values of α
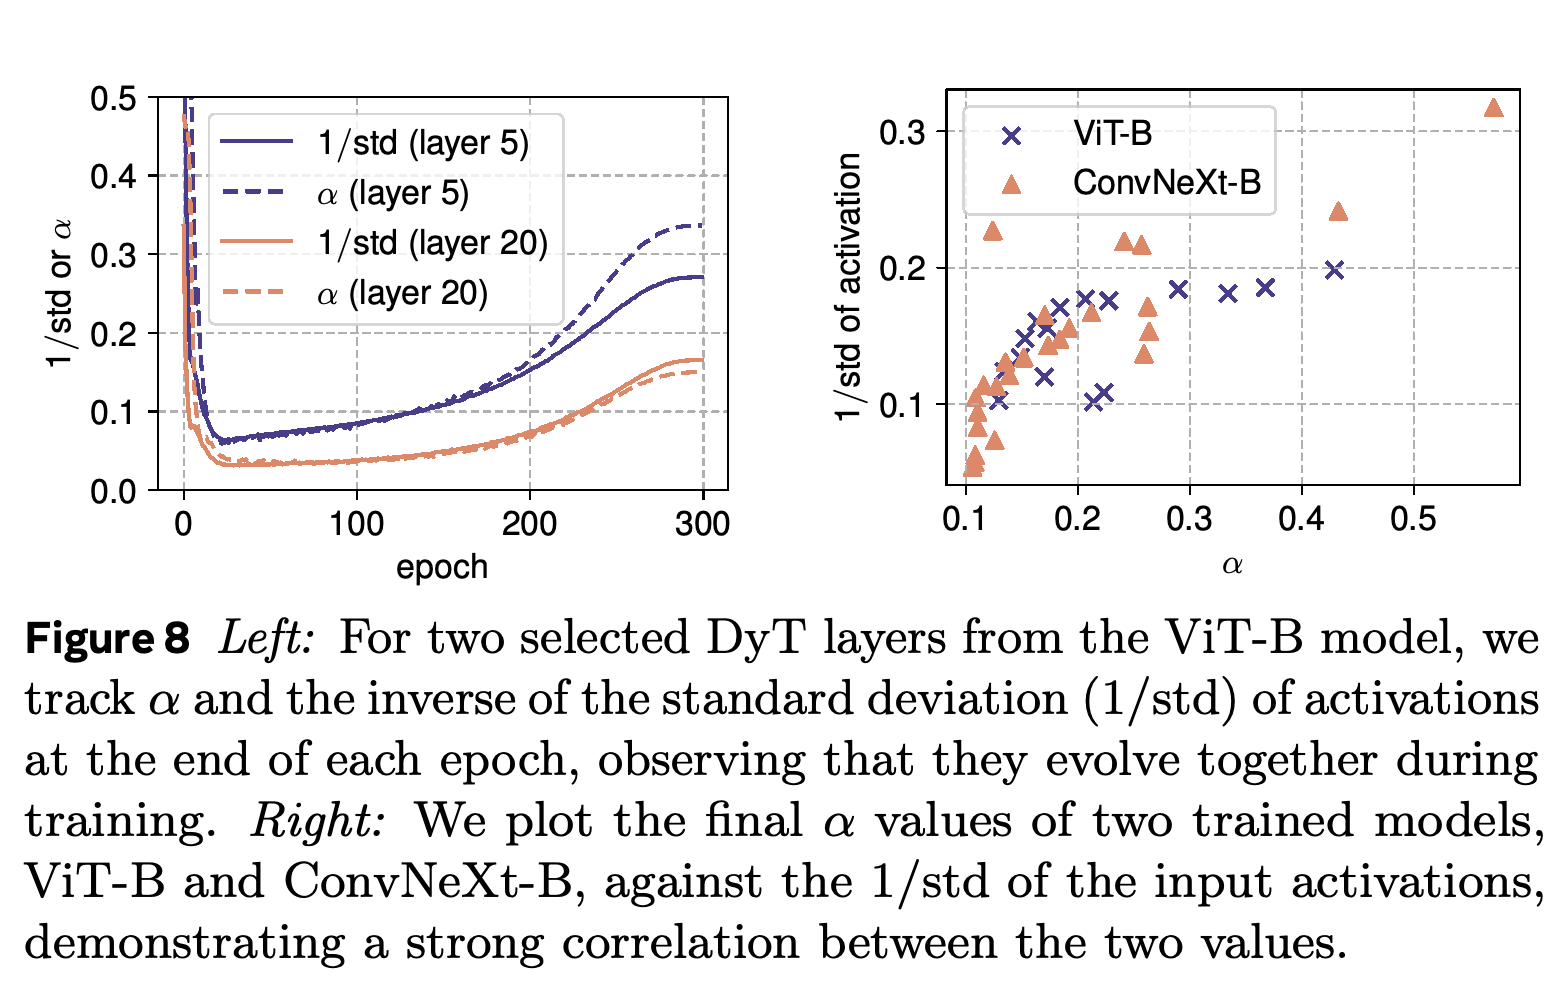
조사한 층에서 학습 중 α는 입력 활성값의 표준편차 역수인 1/std와 전반적으로 비슷하게 변한다. ViT-B와 ConvNeXt-B에서는 층별 최종 α 값도 1/std와 상관관계를 보인다. 이는 학습 가능한 스케일링이 활성값 크기에 적응함을 시사한다.
- 깊은 층일수록 활성값의 표준편차가 큰 경향이 있다. 토큰별로 통계를 계산하는 LN과 달리 α는 층 전체에 학습된 스케일 1개를 제공하므로, tanh가 수행하는 비선형 억제를 단독으로 수행할 수는 없다.
학습 중 변화와 층별 최종값에서 α가 클수록 활성값 표준편차의 역수도 큰 관계가 나타난다. 이 관계는 α가 활성값 스케일에 맞춰 학습된다는 해석을 뒷받침하지만, 통계적 정규화를 정확히 수행한다는 점을 입증하지는 않는다.
6.3 Comparison with Other Methods
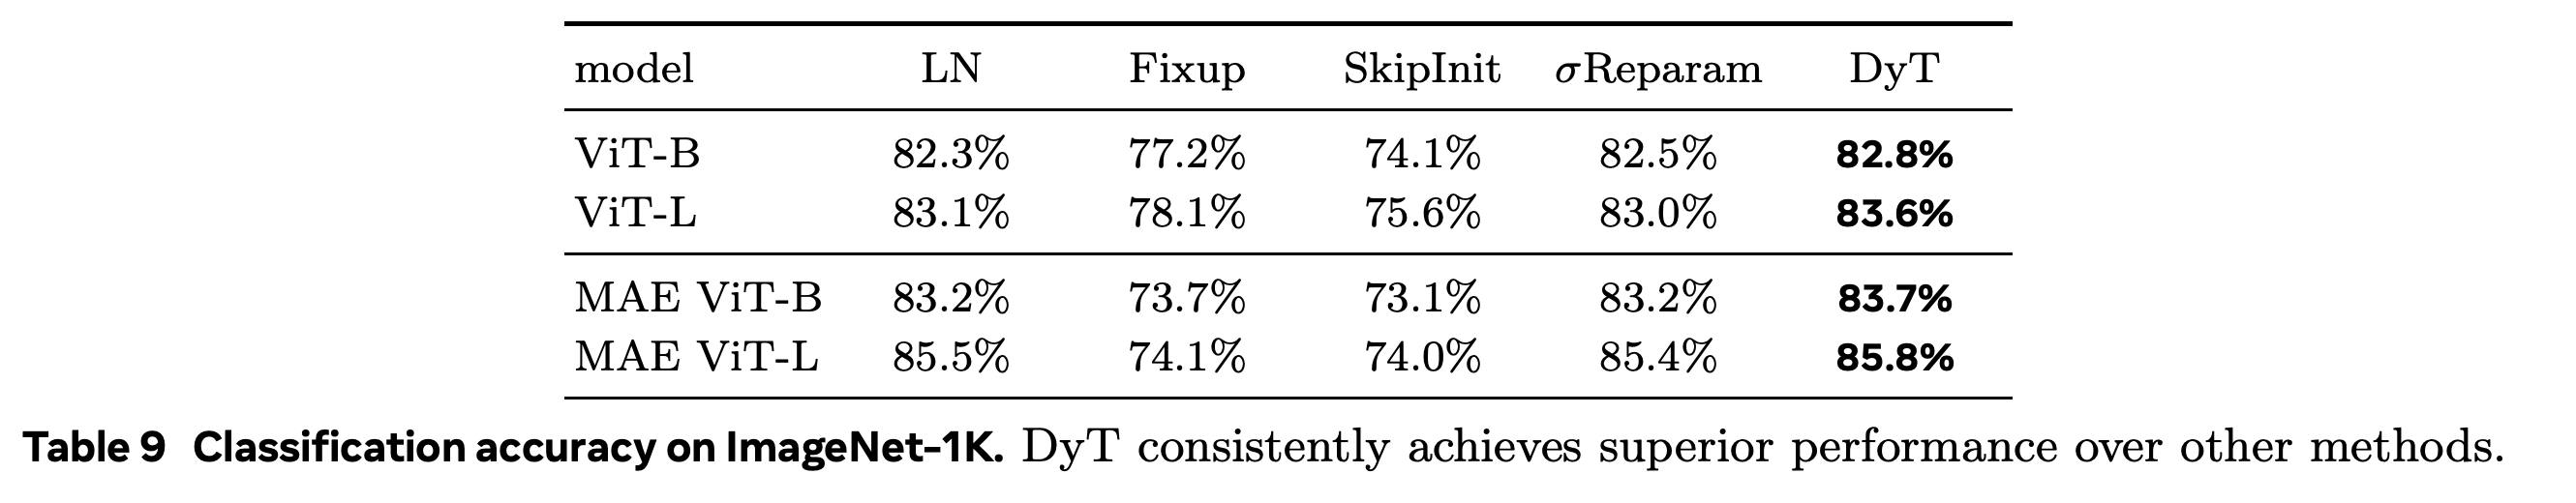
비교 대상은 초기 활성값과 기울기가 커지는 것을 방지하려는 초기화 기법 Fixup과 SkipInit, 가중치 행렬의 spectral norm, 즉 최대 특잇값을 제한하는 σReparam이다. Fixup과 SkipInit은 발산을 피하려면 더 낮은 학습률이 필요하므로, 저자들은 DyT를 포함한 모든 비교 방법의 학습률을 탐색한다.
- ViT-B, ViT-L, MAE ViT-B, MAE ViT-L에서 DyT는 각각 82.8%, 83.6%, 83.7%, 85.8%를 달성한다. 이에 대응하는 σReparam 결과는 82.5%, 83.0%, 83.2%, 85.4%이며, Fixup은 77.2%, 78.1%, 73.7%, 74.1%, SkipInit은 74.1%, 75.6%, 73.1%, 74.0%다.
- 이처럼 조정한 DyT 결과는 Section 5에서 원래 하이퍼파라미터를 사용한 결과와 비교 조건이 다르다.
모든 방법의 학습률을 탐색한 뒤 DyT는 설정 4개 전체에서 가장 높은 정확도를 기록한다. 이 탐색 조건 때문에 일부 DyT 수치가 원래 학습 설정의 결과와 다르다.
7 Initialization of α
논문은 α의 초기값을 α₀로 표기하고, 언어 모델과 비언어 모델에서 초기값에 대한 민감도를 따로 조사한다. 언어 모델링 외에서는 초기값 조정으로 얻는 개선이 대체로 작지만, 언어 모델은 모델 크기와 층의 위치에 맞춰 초기값을 선택하면 성능이 좋아진다.
7.1 Initialization of α for Non-LLM Models
대부분의 비언어 실험은 넓은 α₀ 범위에서 일관된 성능을 보이며, 대체로 0.5에서 1.2 사이의 값에서 좋은 결과를 얻는다. 지도학습 ViT-L은 예외로, 원래 학습 설정에서는 α₀가 0.6을 넘으면 발산한다.
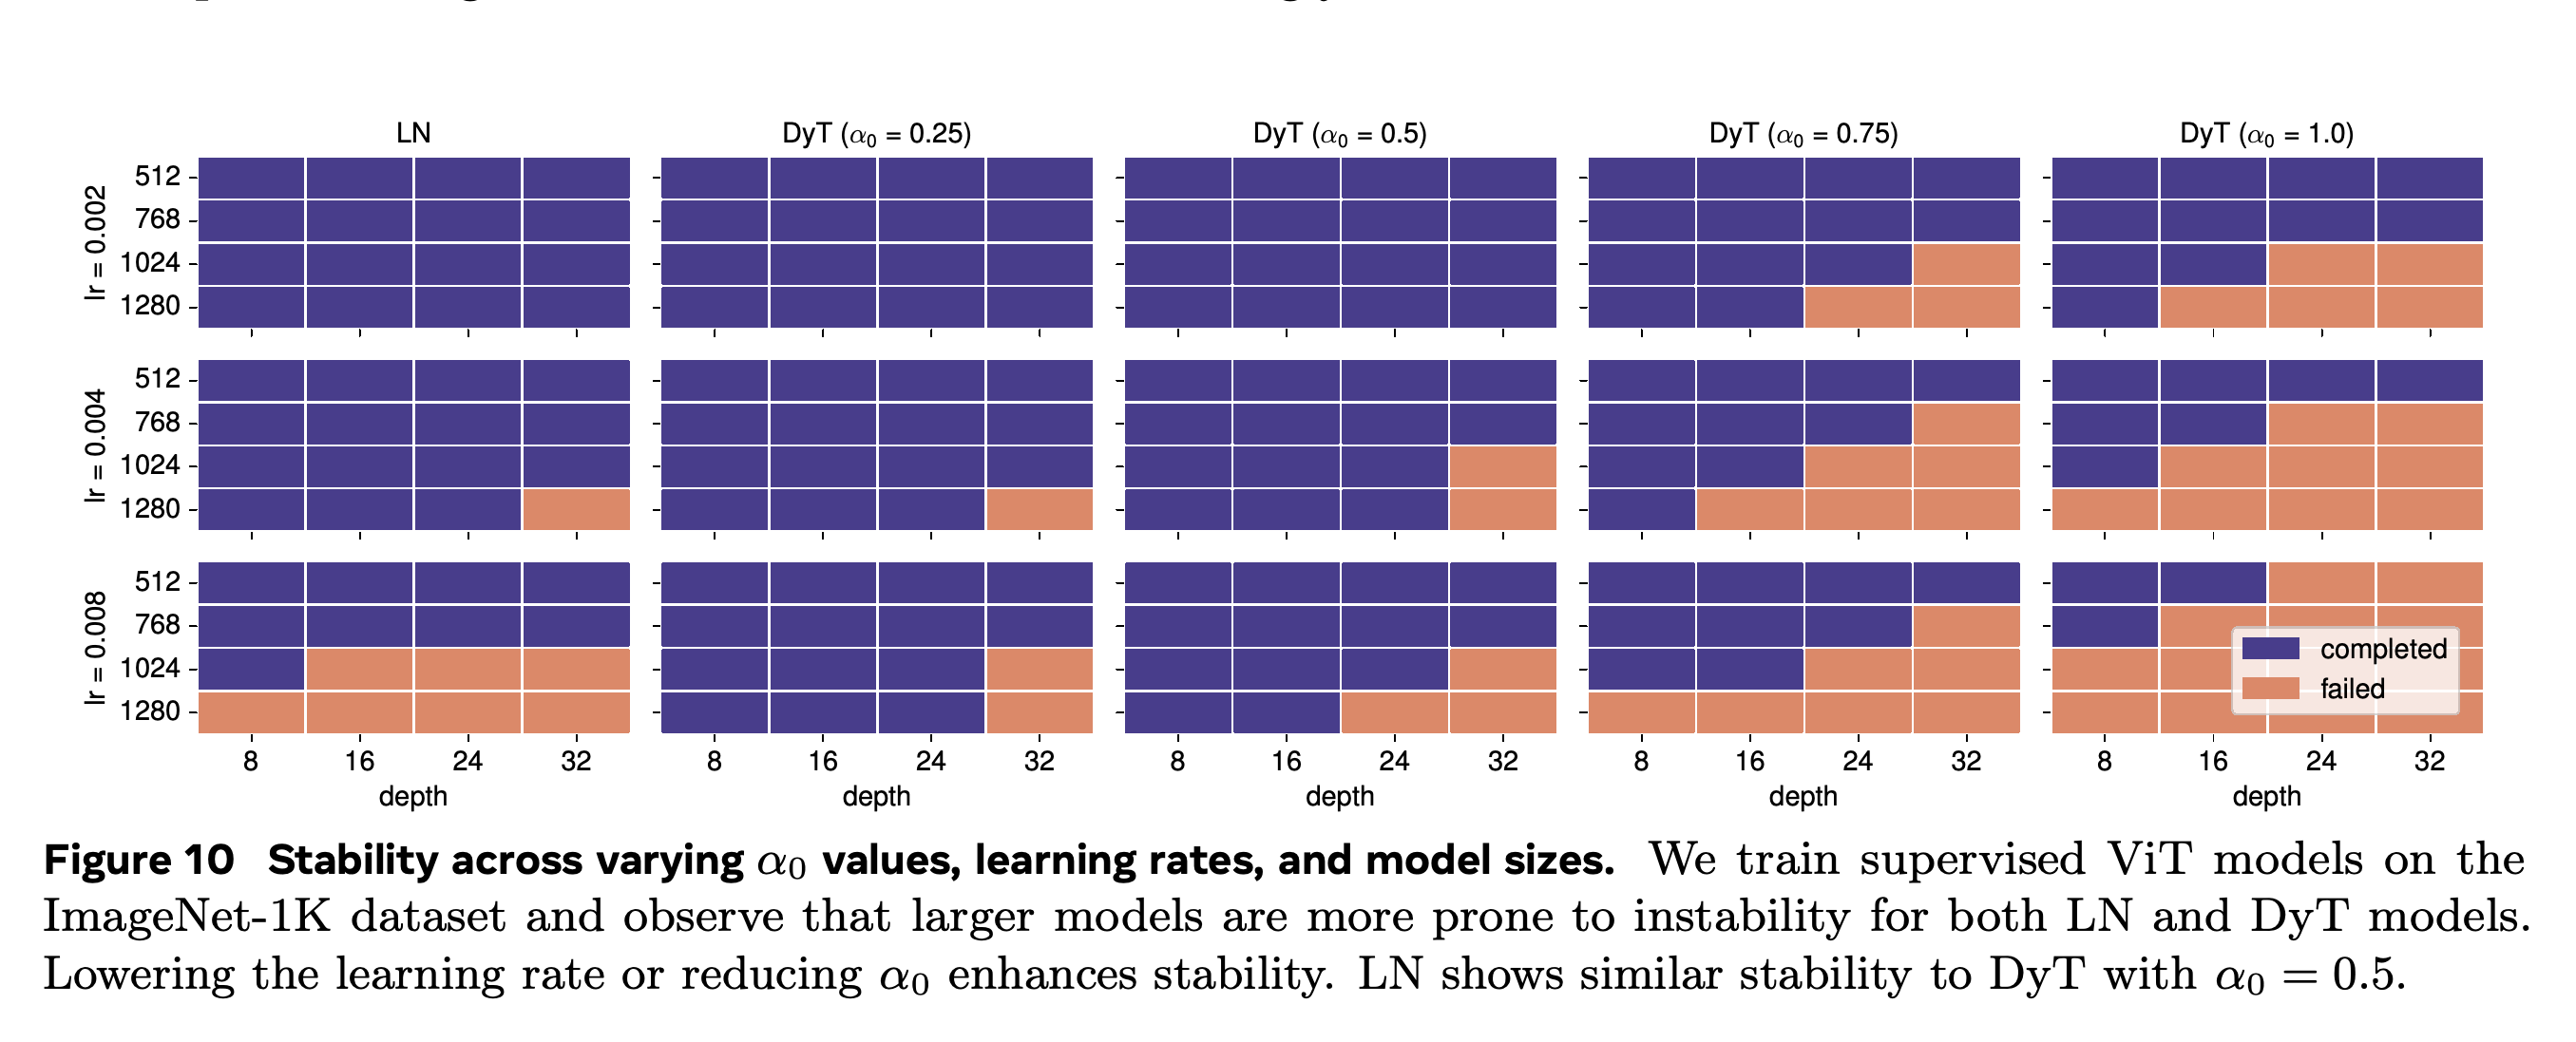
- 안정성 탐색에서는 너비를 512에서 1280, 깊이를 8에서 32로 바꾸고 학습률 0.002, 0.004, 0.008을 사용한다. 모델이 크거나 학습률이 높으면 실패 위험이 커지며, α₀나 학습률을 낮추면 안정성이 좋아진다.
- 이 탐색에서 기본값 α₀ = 0.5는 LN과 비슷한 안정성 양상을 보인다.
모델 크기, 학습률, DyT 초기값이 커질수록 실패 영역이 대체로 넓어진다. α₀ = 0.5는 LN과 비슷한 안정성 양상을 보이며, α₀를 낮추면 더 많은 설정에서 학습을 완료한다.
7.2 Initialization of α for LLMs
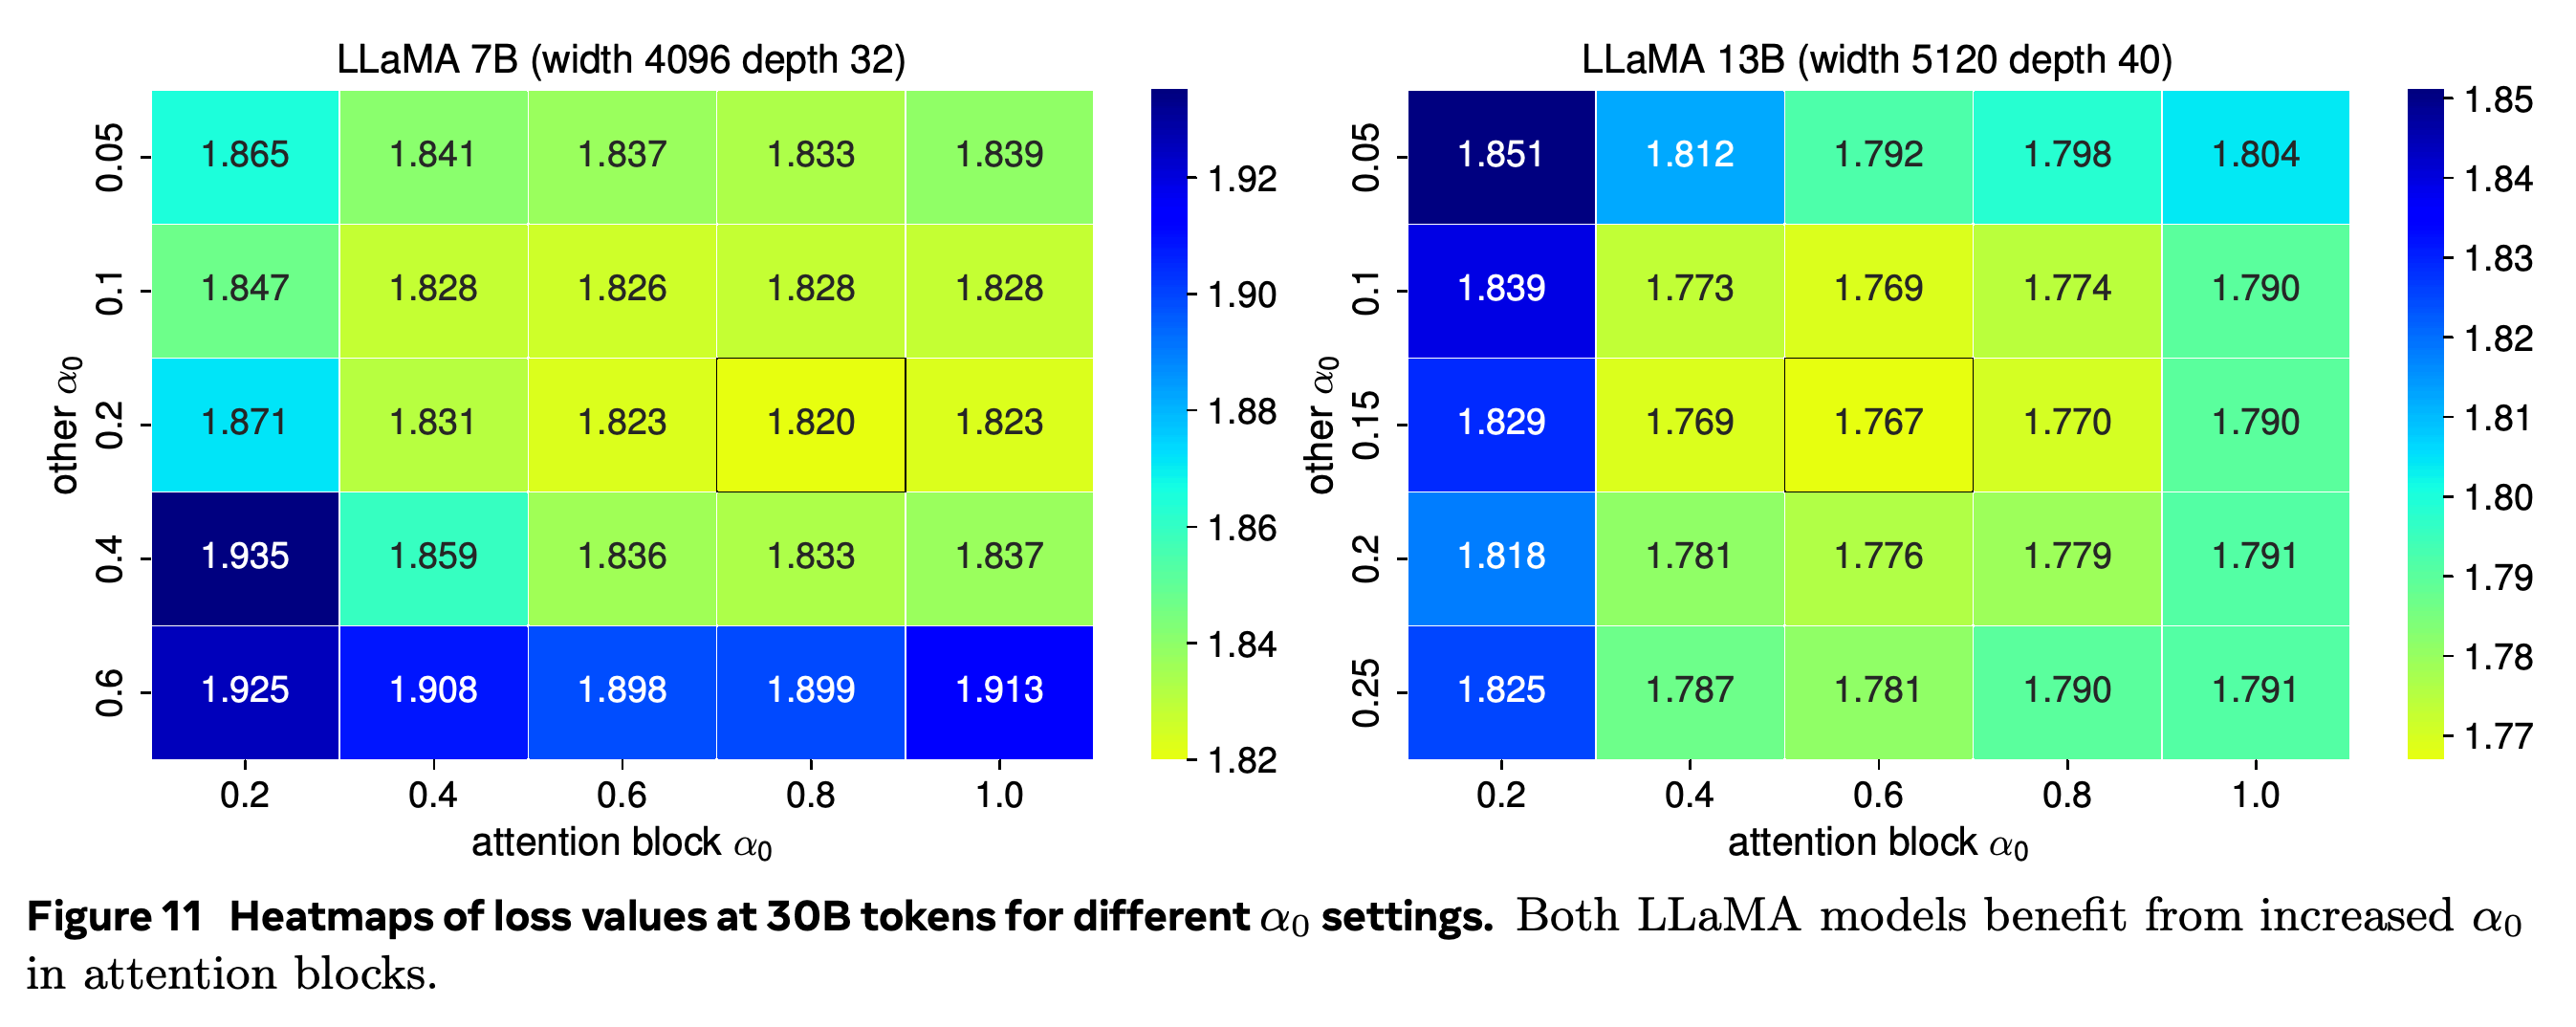
언어 모델의 초기값은 30B 토큰을 학습한 뒤 손실을 비교해 선택한다. 보고된 attention/기타 위치의 α₀ 조합은 LLaMA 7B에서 0.8/0.2, 13B에서 0.6/0.15이며, 34B와 70B 모델 2개 모두에서는 0.2/0.05다. 여기서 기타 위치는 FFN 위치와 마지막 DyT 층을 포함한다.
- 7B 히트맵은 0.8/0.2에서 손실 1.820, 13B 히트맵은 0.6/0.15에서 1.767에 도달한다. 모델 2개 모두 다른 위치보다 attention 블록에서 높은 초기값이 유리하다.
- 너비 1024, 2048, 4096, 8192와 깊이 8, 16, 32, 64를 별도로 탐색하면, 너비에 따라 각각 1.0/1.0, 1.0/0.5, 0.8/0.2, 0.2/0.05 조합이 선택된다. 선택된 조합은 평가한 깊이에 따라 바뀌지 않는다. 따라서 이 탐색에서는 너비가 초기값 선택을 결정한다.
- Table 10은 34B와 70B 모델의 너비를 8196으로 표기하지만, Table 11의 통제된 너비 탐색에서는 8192를 사용한다.
표시된 최저 손실은 attention과 기타 위치에 서로 다른 초기값을 사용했을 때 나타난다. 7B에서는 0.8/0.2, 13B에서는 0.6/0.15다. 이 30B토큰 탐색은 언어 실험에서 위치별로 다른 초기값을 사용할 근거를 제공한다.
8 Related Work
관련 연구는 정규화를 기울기 안정성, 초기화 민감도, 더 매끄러운 최적화, 일반화와 연결한다. 논문은 Transformer 내 정규화 위치, 특수한 초기화, 가중치 제약, 미세조정을 통한 점진적인 정규화 제거도 검토한다.
- DyT는 아키텍처와 학습 설정 대부분을 유지하면서 활성값 정규화를 원소별 변환으로 대체한다. 다른 정규화 제거 방법과의 실증 비교는 평가한 비전 설정을 대상으로 한다.
9 Limitations
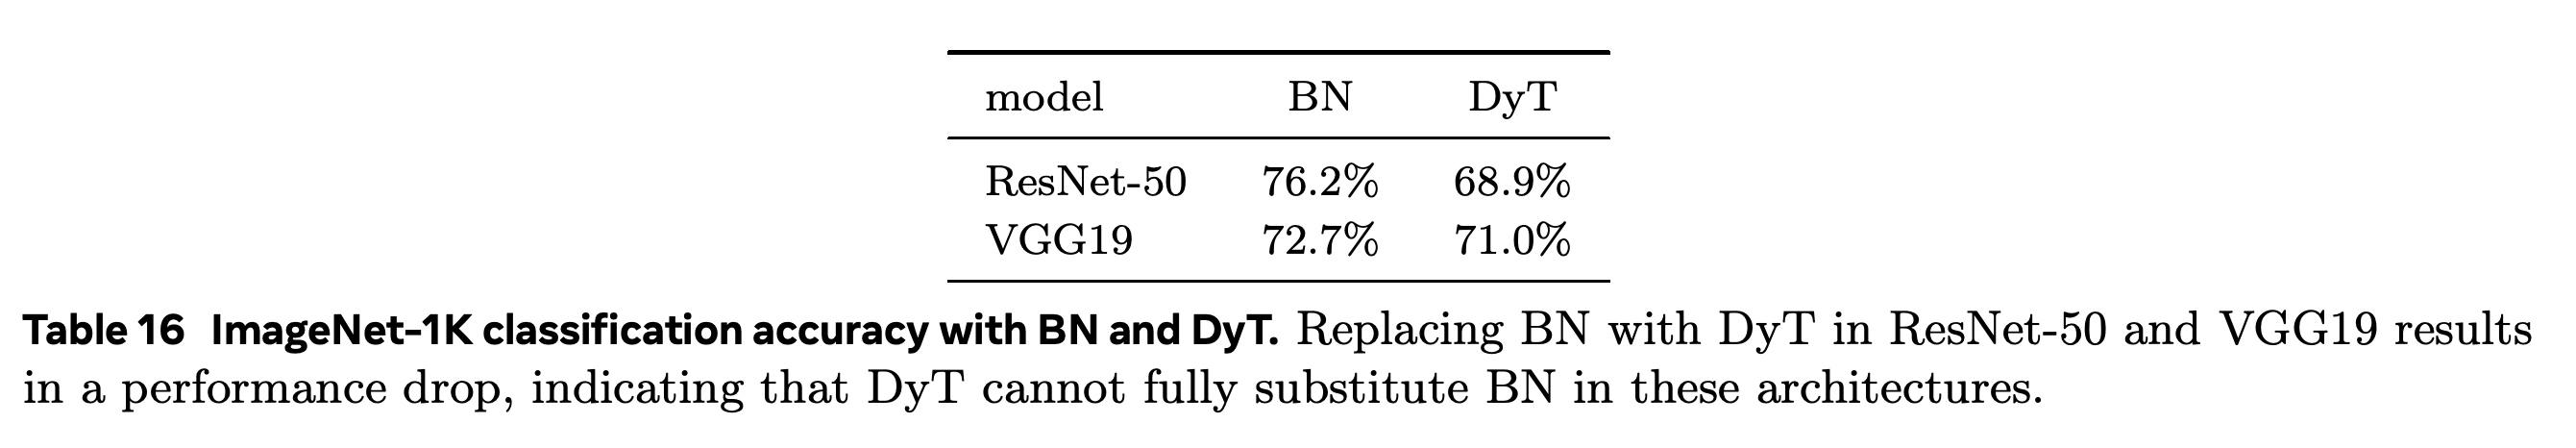
검증된 대체 범위는 주로 LN과 RMSNorm이다. 동일한 하이퍼파라미터에서 BN을 직접 대체하면 전통적인 합성곱 신경망 2개인 ResNet-50과 VGG19의 ImageNet-1K 정확도가 각각 76.2%에서 68.9%, 72.7%에서 71.0%로 낮아진다.
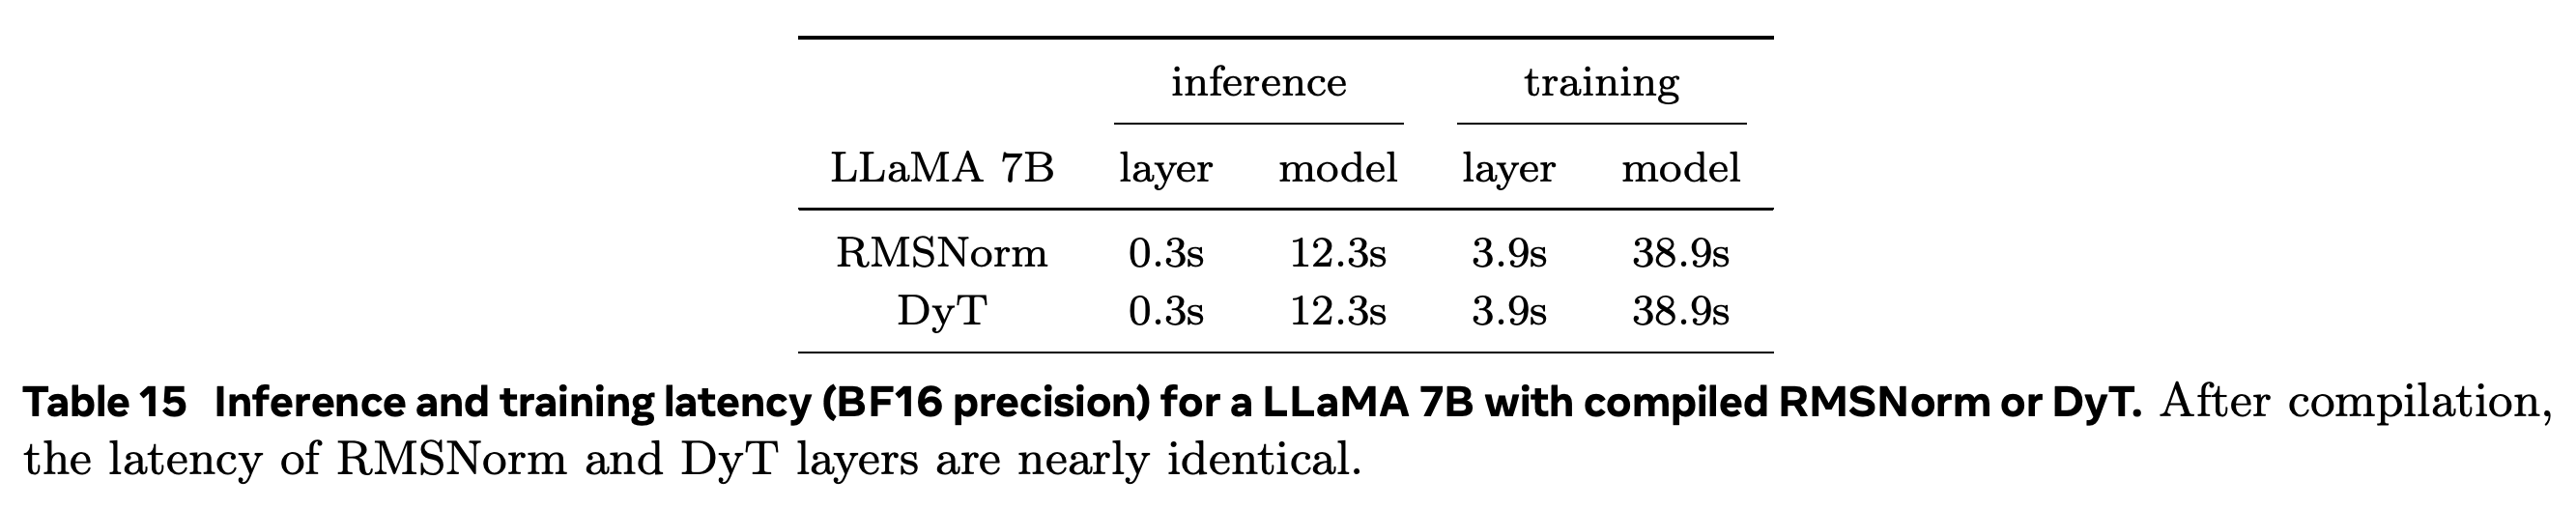
- 효율 벤치마크는 Nvidia H100 그래픽 처리 장치 1개에서 수치 정밀도 형식인 BF16으로 LLaMA 7B를 실행한다. 4096토큰 시퀀스 1개에 대해 순전파 100회 또는 순전파와 역전파 100회의 총시간을 측정한다. 추가 최적화가 없으면 전체 모델의 추론 시간은 14.1s에서 13.0s, 학습 시간은 42.6s에서 39.1s로 줄어든다.
- PyTorch의 컴파일 기능인 torch.compile로 RMSNorm 또는 DyT 층만 컴파일하면 모델 2개 모두 추론에 12.3s, 학습에 38.9s가 걸린다. 이 측정에서는 컴파일한 설정의 속도 이점이 나타나지 않는다.
- 결과 표에는 작은 성능 차이에 대한 불확실성 추정치가 없어 통계적 신뢰성을 판단하기 어렵다.
층을 컴파일한 뒤 RMSNorm과 DyT의 전체 모델 총시간은 추론 12.3s, 학습 38.9s로 동일하다. 따라서 최적화하지 않았을 때의 실행 시간 이점은 이 컴파일 벤치마크에서 유지되지 않는다.
동일한 학습 설정에서 BN을 직접 대체하면 ResNet-50의 정확도는 7.3%포인트, VGG19의 정확도는 1.7%포인트 낮아진다. 이 결과는 LN과 RMSNorm을 넘어선 DyT의 적용 가능성이 아직 제한적으로 검증되었음을 보여준다.
10 Conclusion
실험 결과, 평가한 Transformer 설정에서는 학습 가능한 스케일링과 출력 범위를 제한하는 압축으로 활성값 통계 기반 정규화를 대체하면서도 경쟁력 있는 성능을 유지할 수 있다. BN 기반 네트워크에 대한 적용 가능성과 다양한 하드웨어 및 배포 설정에서의 효율은 아직 확인되지 않았다.
부록
- A Experimental Settings: 지도 비전 학습은 ConvNeXt 학습 설정을 따른다. ViT-L의 AdamW 옵티마이저 beta 매개변수는 (0.9, 0.95)이며, 학습 중 잔차 분기를 무작위로 생략하는 stochastic depth 비율은 ViT-B에서 0.1, ViT-L에서 0.4다. DiT 학습률은 LN 모델에서 선택해 DyT에 그대로 적용하며, 0 초기화는 DyT에서만 제거한다. LLaMA에는 √d로 초기화한 임베딩 스칼라를 추가하며, d는 임베딩 차원이다. 배치 크기는 4M 토큰, 학습률은 7B/13B에서 3e-4, 34B/70B에서 1.5e-4이고, 학습 토큰 수는 200B다. M은 1000000을 뜻한다.
- A Experimental Settings: lm-eval 식별자 15개는 anli_r1, anli_r2, anli_r3, arc_challenge, arc_easy, boolq, hellaswag, openbookqa, piqa, record, rte, truthfulqa_mc1, truthfulqa_mc2, wic, winogrande다. 음성 실험은 첫 group normalization 층을 유지하고 나머지는 공식 하이퍼파라미터를 사용한다. 주요 비교에서 MAE, DINO, HyenaDNA, Caduceus는 하이퍼파라미터 조정 없이 공개 구현을 사용한다.
- B Hyperparameters: 학습률을 조정하면 DyT ViT-B는 4e-3에서 82.5%이던 정확도가 6e-3에서 82.8%로 높아진다. MAE ViT-B는 2.4e-3에서 83.2%이던 정확도가 3.2e-3에서 83.7%, MAE ViT-L은 2.4e-3에서 85.4%이던 정확도가 3.2e-3에서 85.8%로 높아진다. 별도로 α₀를 1.0으로 조정하면 ViT-B는 82.6%, MAE ViT-B는 83.4%로 높아지고, wav2vec 2.0 Large의 검증 손실은 1.91에서 1.90으로 낮아진다. 표에서는 개선이 없는 경우를 “-”로 표시한다.
- C Efficiency of DyT: 최적화하지 않은 측정에서 전체 모델 실행 시간은 추론에서 7.8%, 학습에서 8.2% 줄어들지만, 대체 층을 컴파일하면 측정된 이점이 사라진다. D Replacing Batch Normalization with DyT: ResNet-50과 VGG19 모델 2개 모두 원래 torchvision 학습 설정에서 정확도가 낮아진다. 저자들은 이 아키텍처들에서 BN 층이 더 자주 사용되는 점이 대체를 어렵게 하는 원인일 수 있다고 추측하지만, 이 설명을 직접 검증하지는 않는다.
짧은 생각
DyT는 여러 분야의 실험으로 뒷받침되는 간단한 아키텍처 대안을 제시한다. 구성 요소 제거 실험도 근거를 보강한다. 평가한 비전 학습 설정에서는 출력 범위를 제한하는 압축을 제거하면 학습이 발산하고, 학습 가능한 스케일링을 제거하면 정확도가 낮아진다.
실용적인 이점은 설정에 따라 달라진다. 언어 모델에는 추가 스케일링과 초기값 조정이 필요하고, DiT-XL에서는 FID가 나빠지며, 컴파일한 경우 실행 시간은 동일하다. 이 결과는 DyT를 아키텍처 선택지로 평가할 근거를 제공하지만, 일반적인 정확도나 실행 시간 개선을 입증하지는 않는다.