


Video-R1: Reinforcing Video Reasoning in MLLMs 요약 설명
27 Mar 2025 | Paper Review Video Understanding Reinforcement Learning Reward Design이번 글에서는 Video-R1: Reinforcing Video Reasoning in MLLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 27일(Arxiv), 39th Conference on Neural Information Processing Systems (NeurIPS 2025)
- Feng, Kaituo, Gong, Kaixiong, Li, Bohao, Guo, Zonghao, Wang, Yibing, Peng, Tianshuo, Wu, Junfei, Zhang, Xiaoying, Wang, Benyou, Yue, Xiangyu.
- CUHK MMLab, CUHK (SZ), Tsinghua University, UCAS, CUHK HCCL
- 논문 링크
- Github
- Project Page
요약
- Video-R1은 시각 정보와 언어를 함께 처리하는 멀티모달 대규모 언어 모델(MLLM)이 개별 이미지에 의존하는 대신 비디오의 여러 프레임을 종합해 추론하도록 학습하는 방법을 다룬다. 보상을 통해 응답을 학습하는 강화학습(RL)을 1k 스텝 진행한 Video-R1-7B는 비디오 공간 추론 벤치마크인 VSI-Bench에서 정확도 37.1%를 달성한다. Qwen2.5-VL-7B 기반 모델은 31.4%를 기록하며, 모두 64개 프레임과 추론 단계를 명시하는 chain-of-thought(CoT)를 사용한 결과다.
- 이 방법은 이미지와 비디오를 혼합한 학습 데이터에 Temporal Group Relative Policy Optimization(T-GRPO)을 결합한다. T-GRPO는 프레임을 시간순으로 제시했을 때와 순서를 섞었을 때의 성능을 비교해 정답 응답에 보상을 부여한다. 먼저 Video-R1-CoT-165k의 주석 응답을 학습하는 지도 미세조정(SFT)을 진행하고, 이어서 Video-R1-260k로 RL을 수행한다. 이미지 데이터, 시간적 보상, SFT 초기화 중 하나를 제거하면 평가한 6개 벤치마크 모두에서 성능이 떨어진다.
- 64개 프레임을 사용한 Video-R1-7B는 VSI-Bench에서 37.1%를 기록해 GPT-4o의 보고된 결과인 34.0%를 넘는다. 그러나 다른 비디오 평가 데이터셋 3개인 VideoMMMU, MMVU, VideoMME에서는 GPT-4o보다 낮은 성능을 보이며, GPT-4o가 사용한 프레임 수는 명시되지 않았다. 이 결과는 실험한 학습 절차에서 성능이 향상됐음을 뒷받침한다. 다만 학습 입력을 16개 프레임으로 제한한 점, 순서를 섞은 프레임을 처리하는 추가 연산이 필요한 점, 모델로 시간적 추론을 평가한 점은 결과를 더 넓게 일반화하는 데 한계가 된다.
1 Introduction
서론은 사전에 정한 채점 규칙으로 보상을 계산하는 규칙 기반 RL을 텍스트와 이미지에서 비디오로 확장할 때 생기는 장애물 2개를 제시한다. 시간 순서를 활용할 유인이 부족하고, 고품질 비디오 추론 데이터도 부족하다는 점이다. 표본 추출한 응답 그룹에서 상대적 어드밴티지를 계산하는 Group Relative Policy Optimization(GRPO)은 시간적 추론과 1개 프레임에 의존한 지름길을 구분하지 않은 채 정답에 보상을 줄 수 있다.
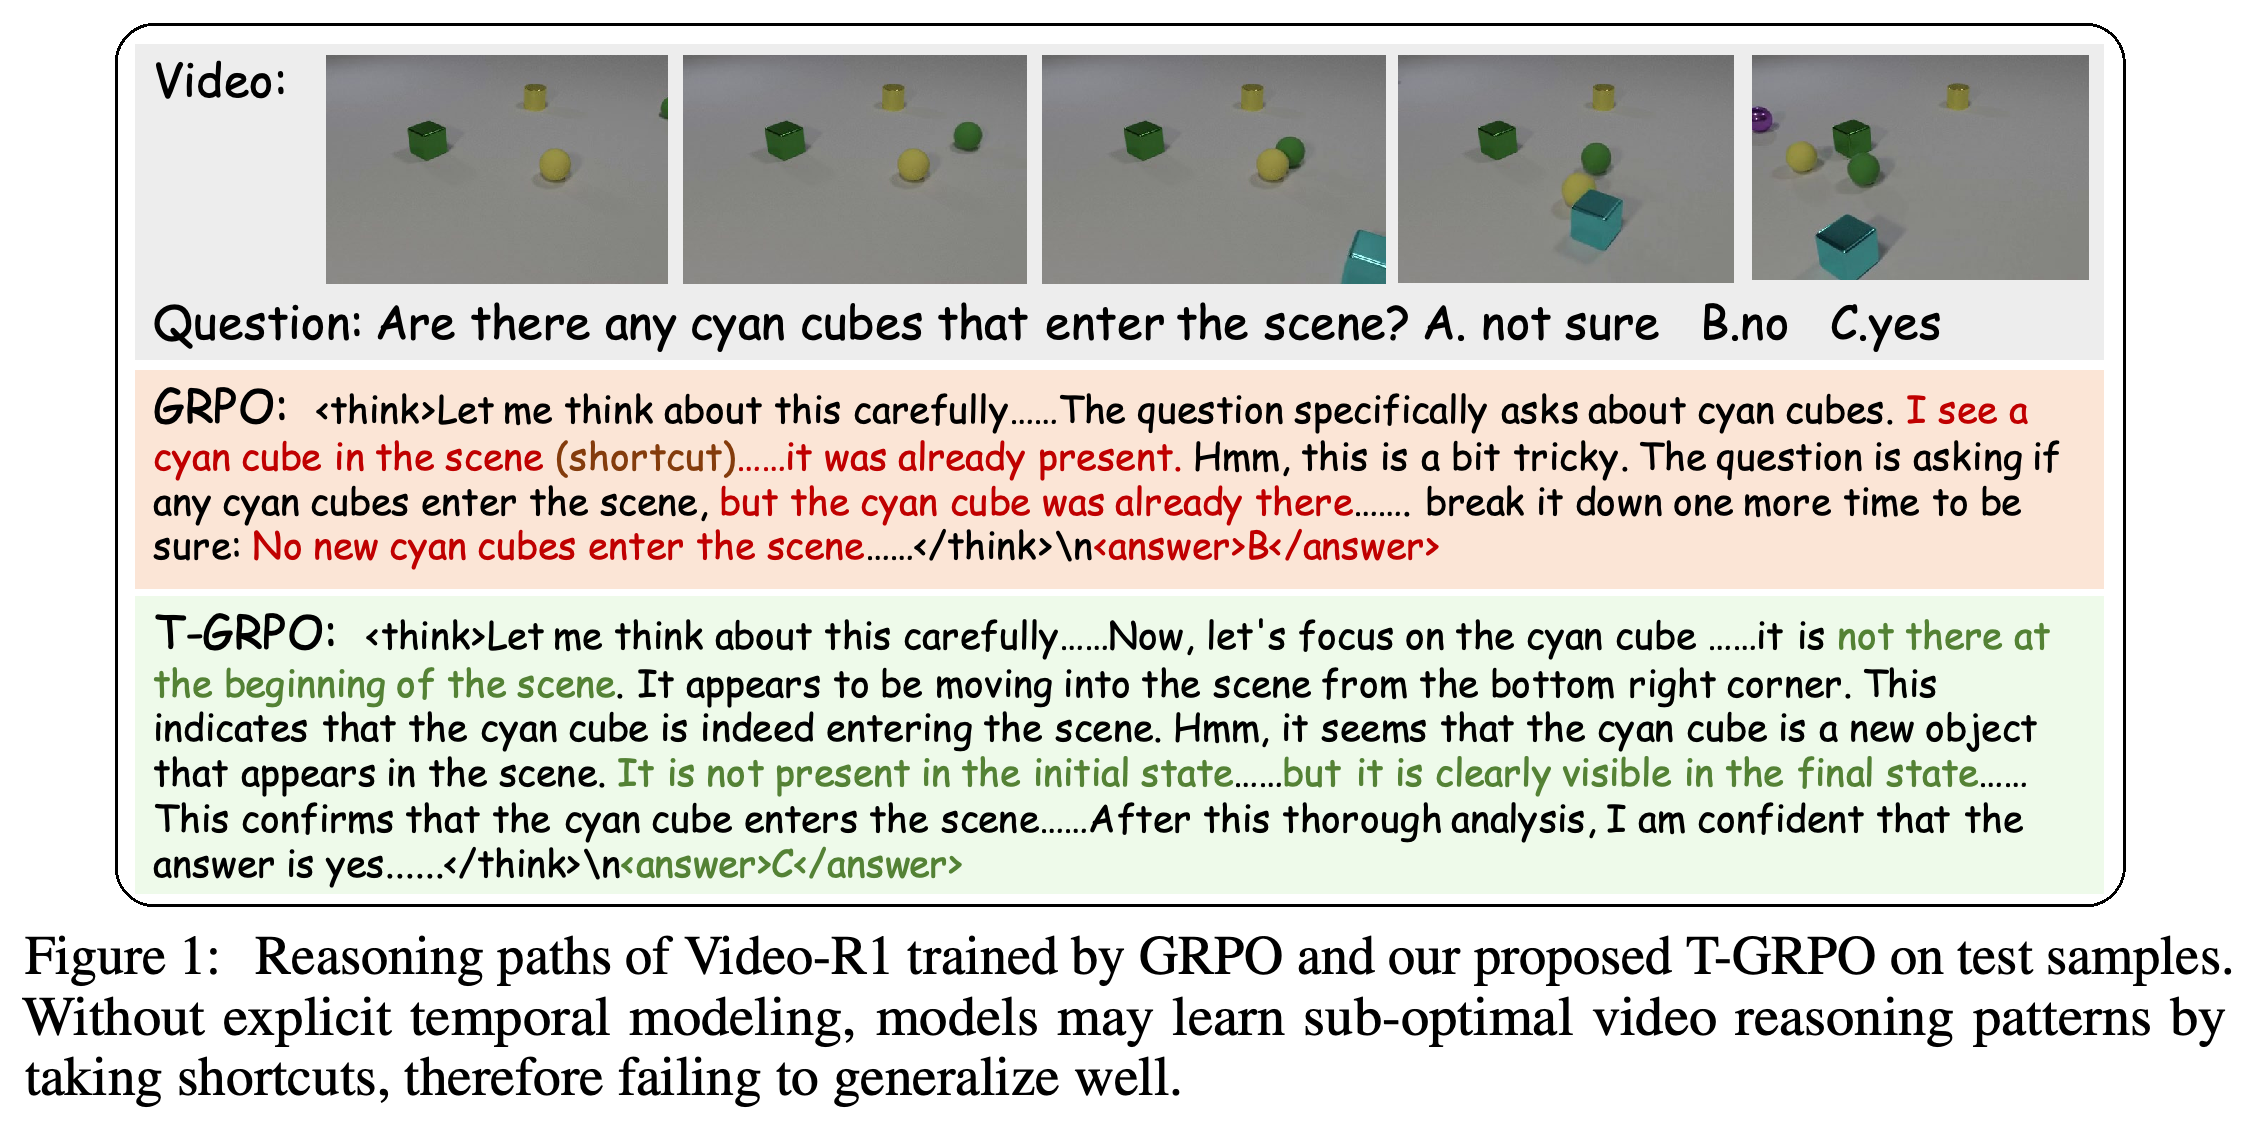
- Figure 1은 이러한 실패 사례를 보여준다. GRPO로 학습한 모델은 청록색 큐브가 처음부터 있었다고 잘못 판단하지만, T-GRPO 모델은 시퀀스의 시작과 끝을 비교해 큐브가 들어오는 것을 식별한다.
- Video-R1은 이미지 추론 과제와 비디오 과제를 혼합해 데이터 부족에 대응한다. 이미지로 추론 과제의 범위를 넓히고, 비디오로 시간에 따른 의존 관계를 학습하게 한다.
GRPO 출력은 청록색 큐브가 처음부터 있었다고 가정해 B로 답한다. T-GRPO 출력은 처음에는 없었다가 나중에 나타나는 모습을 비교해 C로 답하며, 보상 설계에서 학습시키려는 시간적 구분을 보여준다.
2 Related Works
관련 연구에서는 비디오를 처리하는 멀티모달 모델과 언어 모델의 추론을 위한 규칙 기반 학습을 연결한다. Video-R1은 학습 데이터와 시간적 보상 설계를 통해 이러한 접근법을 확장한다.
2.1 Multimodal Large Language Models for Video
LLaMA-VID는 문맥 토큰과 콘텐츠 토큰으로 비디오 표현을 압축한다. VideoLLaMA2는 공간과 시간에 걸친 국소 패턴을 처리하는 시공간 합성곱과 오디오 분기를 추가한다. LongVA는 언어 백본이 처리할 수 있는 입력 범위인 문맥 창을 확장해 더 긴 비디오를 처리한다. VISA는 세계 지식과 객체 추적을 결합해, 질의한 객체를 여러 프레임에서 식별하는 추론 기반 비디오 객체 분할을 수행한다.
- 저자들은 이 분야의 많은 연구가 지각과 입력 처리에 집중하며, 비디오 추론을 명시적으로 학습하는 연구는 상대적으로 부족하다고 설명한다.
2.2 Large Language Model Reasoning
이 논문은 모든 중간 단계를 지도하지 않고도 최종 결과에 따라 규칙으로 계산한 보상으로 추론을 학습하는 DeepSeek-R1의 접근법을 참고한다. Open Reasoner Zero와 Kimi k1.5는 각각 텍스트와 이미지 환경의 관련 사례다. 이러한 연구를 바탕으로 비디오에서 추가로 요구되는 시간적 추론을 탐구한다.
3 Methods
제안 방법은 이미지와 비디오를 혼합한 데이터셋 구축, 비디오 입력의 GRPO에 추가하는 시간적 보상, 응답 길이 보상을 더한 2단계 학습을 결합한다. 기반 모델은 Qwen2.5-VL-7B-Instruct다.
3.1 Dataset Construction
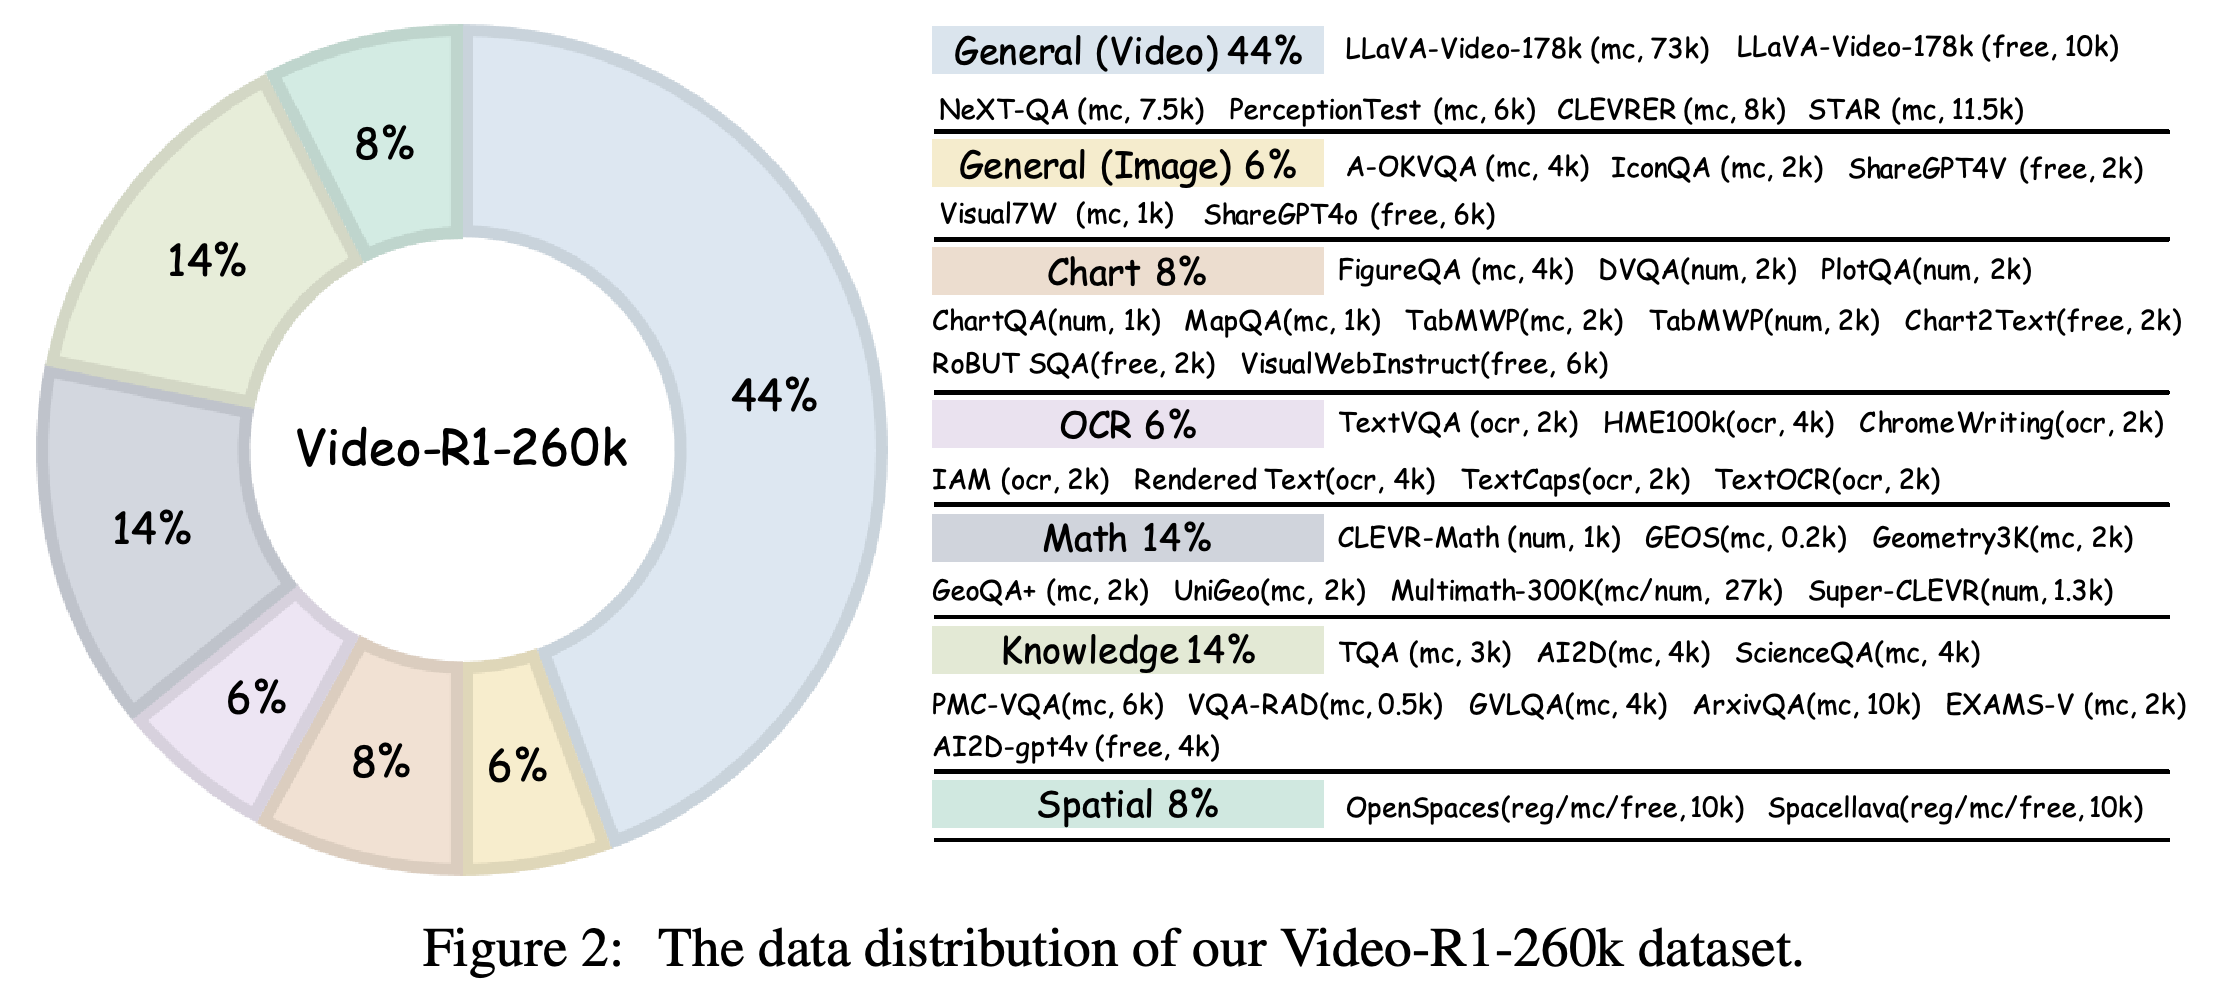
Video-R1-260k는 일반 비디오 예제 약 116k와 일반 이해, 차트, 이미지에서 텍스트를 읽는 광학 문자 인식(OCR), 수학, 지식, 공간 추론을 다루는 이미지 예제를 결합한다. 이미지 범주별 예제 수는 같은 순서로 15k, 21k, 16k, 37k, 37k, 20k이며, 논문은 이 수치를 근삿값으로 제시한다.
- Qwen2.5-VL-72B-Instruct가 수집된 예제의 CoT 주석을 생성한다. 기본적인 규칙 기반 필터링으로 품질이 낮거나 일관성이 없는 출력을 제거해 SFT 초기화에 사용할 Video-R1-CoT-165k를 구축한다.
- 이미지 예제는 다양한 추론 능력을 가르치고, 비디오 예제는 사건의 진행, 프레임 간 의존 관계, 움직임, 시간에 따른 인과적 변화를 가르치도록 구성한다.
표시된 분포에서 일반 비디오 예제는 44%를 차지한다. 나머지는 이미지 과제로, 일반 이해 6%, 차트 8%, OCR 6%, 수학 14%, 지식 14%, 공간 추론 8%다. 따라서 혼합 데이터에서는 이미지가 과반을 차지한다.
정답 보상은 답변 형식에 따라 달라진다. 객관식 답변은 기준 정답과 대조하고, 수치 답변은 기준값과 정확히 일치해야 한다. 수량을 예측하는 회귀 과제는 1에서 상대 오차를 뺀 값을 사용한다. OCR 보상은 예측 텍스트와 기준 텍스트 사이의 편집 거리를 측정하는 Word Error Rate를 사용한다. 자유 형식 질의응답은 기준 답변과의 중복을 측정하는 ROUGE-1, ROUGE-2, ROUGE-L의 평균을 사용한다.
- 대부분의 예제는 정답을 쉽게 검증할 수 있는 객관식이나 수치 답변을 사용한다. 자유 형식, OCR, 회귀 과제는 더 작은 비중으로 포함해 지원하는 출력 형식을 넓힌다.
3.2 Temporal Group Relative Policy Optimization (T-GRPO)
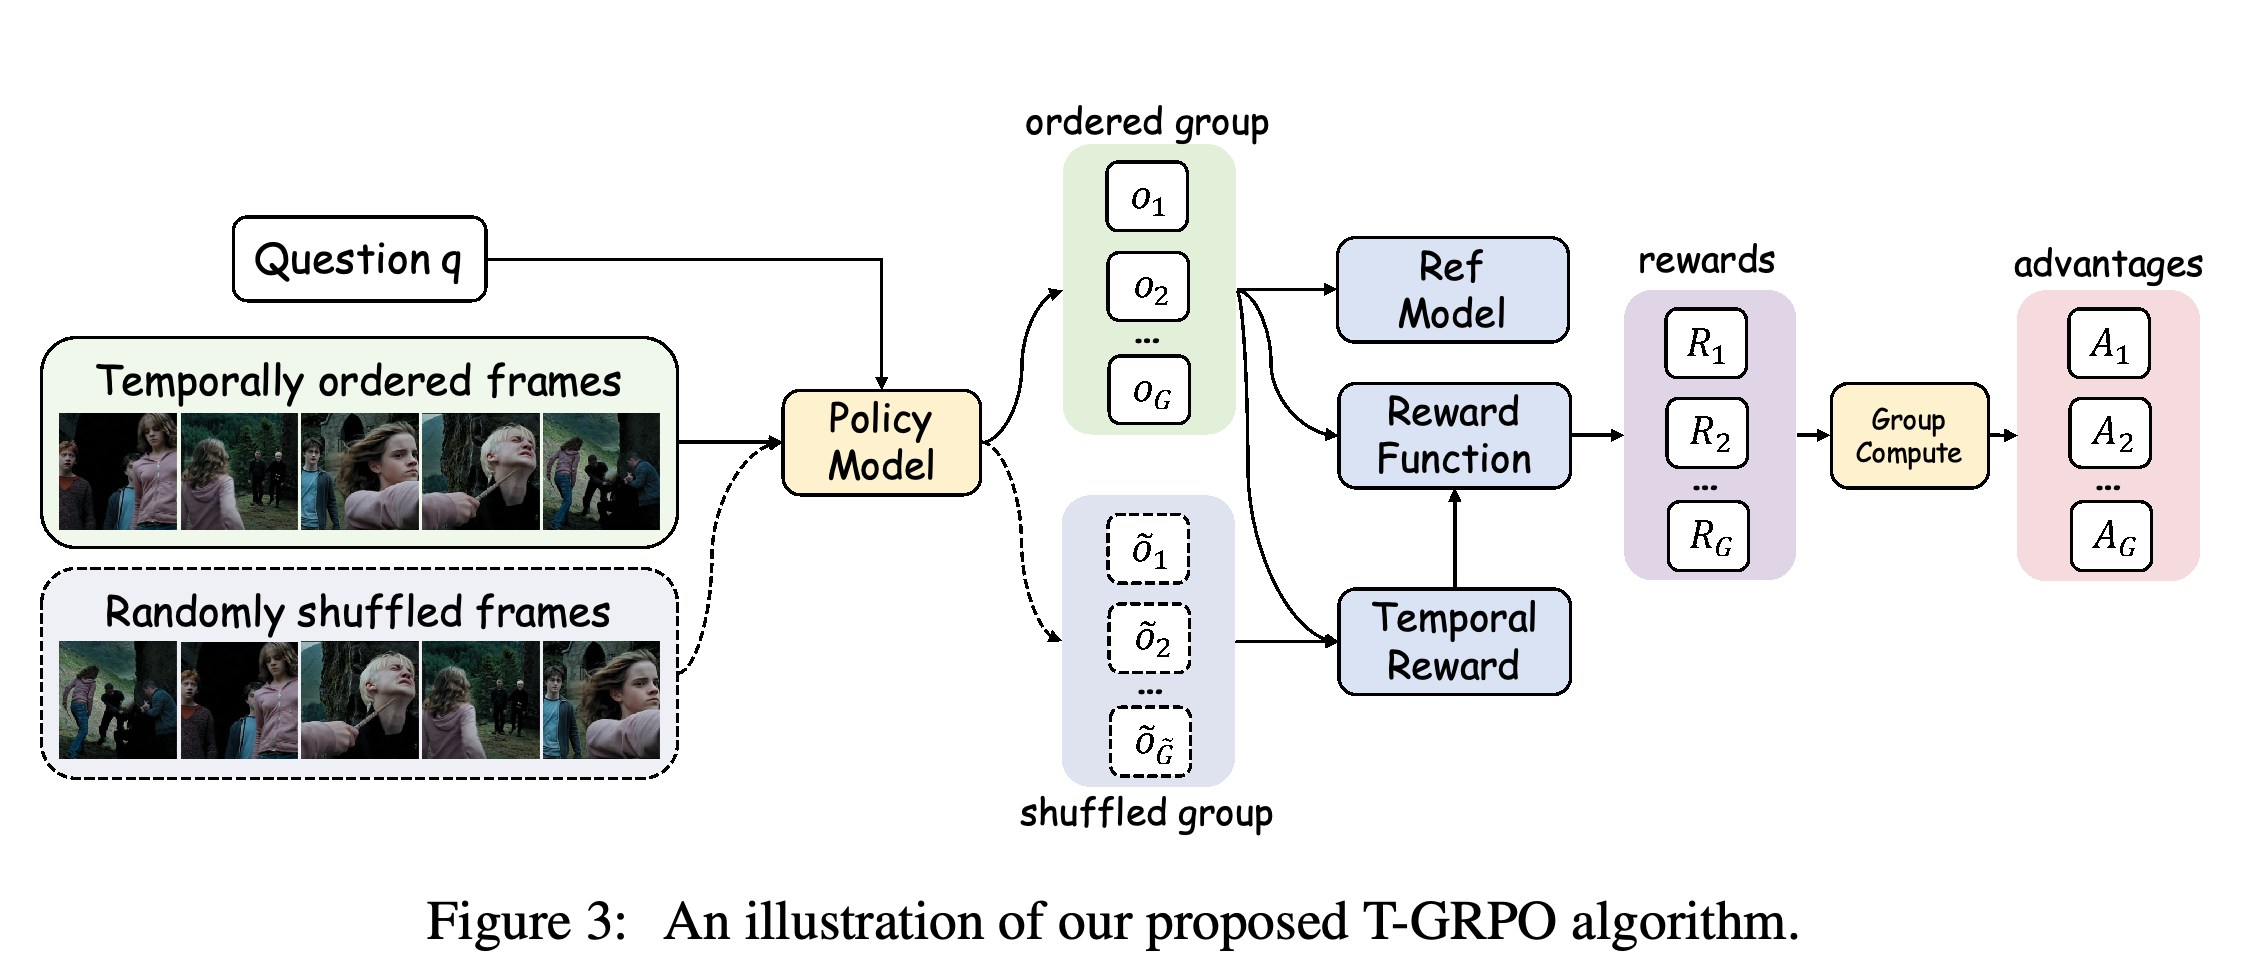
T-GRPO는 같은 질문에 시간순 프레임과 무작위로 순서를 섞은 프레임을 각각 입력해 응답을 표본 추출하고, 정답 비율 p와 p̃를 비교한다. Equation (1)은 시간적 보상을 p ≥ p̃이면 r_t = α, 그 외에는 0으로 정의하며, α = 0.3을 사용한다. 이 식은 동률을 포함하지만, 주변 본문은 시간순 그룹이 순서를 섞은 그룹보다 더 높은 성능을 보여야 한다고 설명한다.
- 시간적 추가 보상은 시간순 입력에서 나온 정답 응답에만 더한다. o_i가 정답이면 R_i = r_i + r_t이고, 그 외에는 R_i = r_i다. 기본 보상 r_i는 정답 보상과 형식 보상을 포함한다. 연속값 보상을 받는 출력은 0.5와 같은 임곗값으로 정답 여부를 분류할 수 있다.
- 최적화에 사용하는 상대적 보상 신호인 어드밴티지는 응답 그룹 안에서 정규화한다. 계산식은 \(A_i=\frac{R_i-\operatorname{mean}(\{R_j\})}{\operatorname{std}(\{R_j\})}\)다. 정책 목적함수는 갱신을 유도하는 신호의 범위를 제한하는 클리핑된 확률 비율과 기준 모델에서 벗어나는 정도를 제한하는 Kullback–Leibler 발산 페널티를 사용한다.
- 시간적 보상을 위한 처리는 비디오 입력에만 적용한다. 순서를 섞은 프레임에서 생성한 응답은 시간적 추가 보상을 결정할 비교 기준으로 사용한다.
같은 프레임을 시간순으로 제시한 입력과 순서를 섞은 입력에서 별도의 응답 그룹을 생성한다. 그룹 간 비교로 시간적 보상을 결정하고, 이를 다른 보상과 합친 뒤 학습에 사용할 그룹 상대적 어드밴티지를 계산한다.
3.3 Training Strategies
Qwen2.5-VL-7B-Instruct를 먼저 Video-R1-CoT-165k로 SFT해 Qwen2.5-VL-7B-SFT를 만들고, 이어서 Video-R1-260k로 RL을 수행해 Video-R1-7B를 만든다. 모든 단계에서 이미지와 비디오 예제를 혼합한다.
- 정답 응답이 320 ≤ len(o_i) ≤ 512를 만족하면 길이 보상 ω = 0.2를 추가로 받는다. 이 고정 구간은 과도한 출력을 제한하면서 충분한 추론을 유도하기 위한 것이다.
- 길이 보상은 시간적 추가 보상과 별개이며, 답변이 정답일 때만 부여한다.
3.4 Aha Moment in Video Reasoning
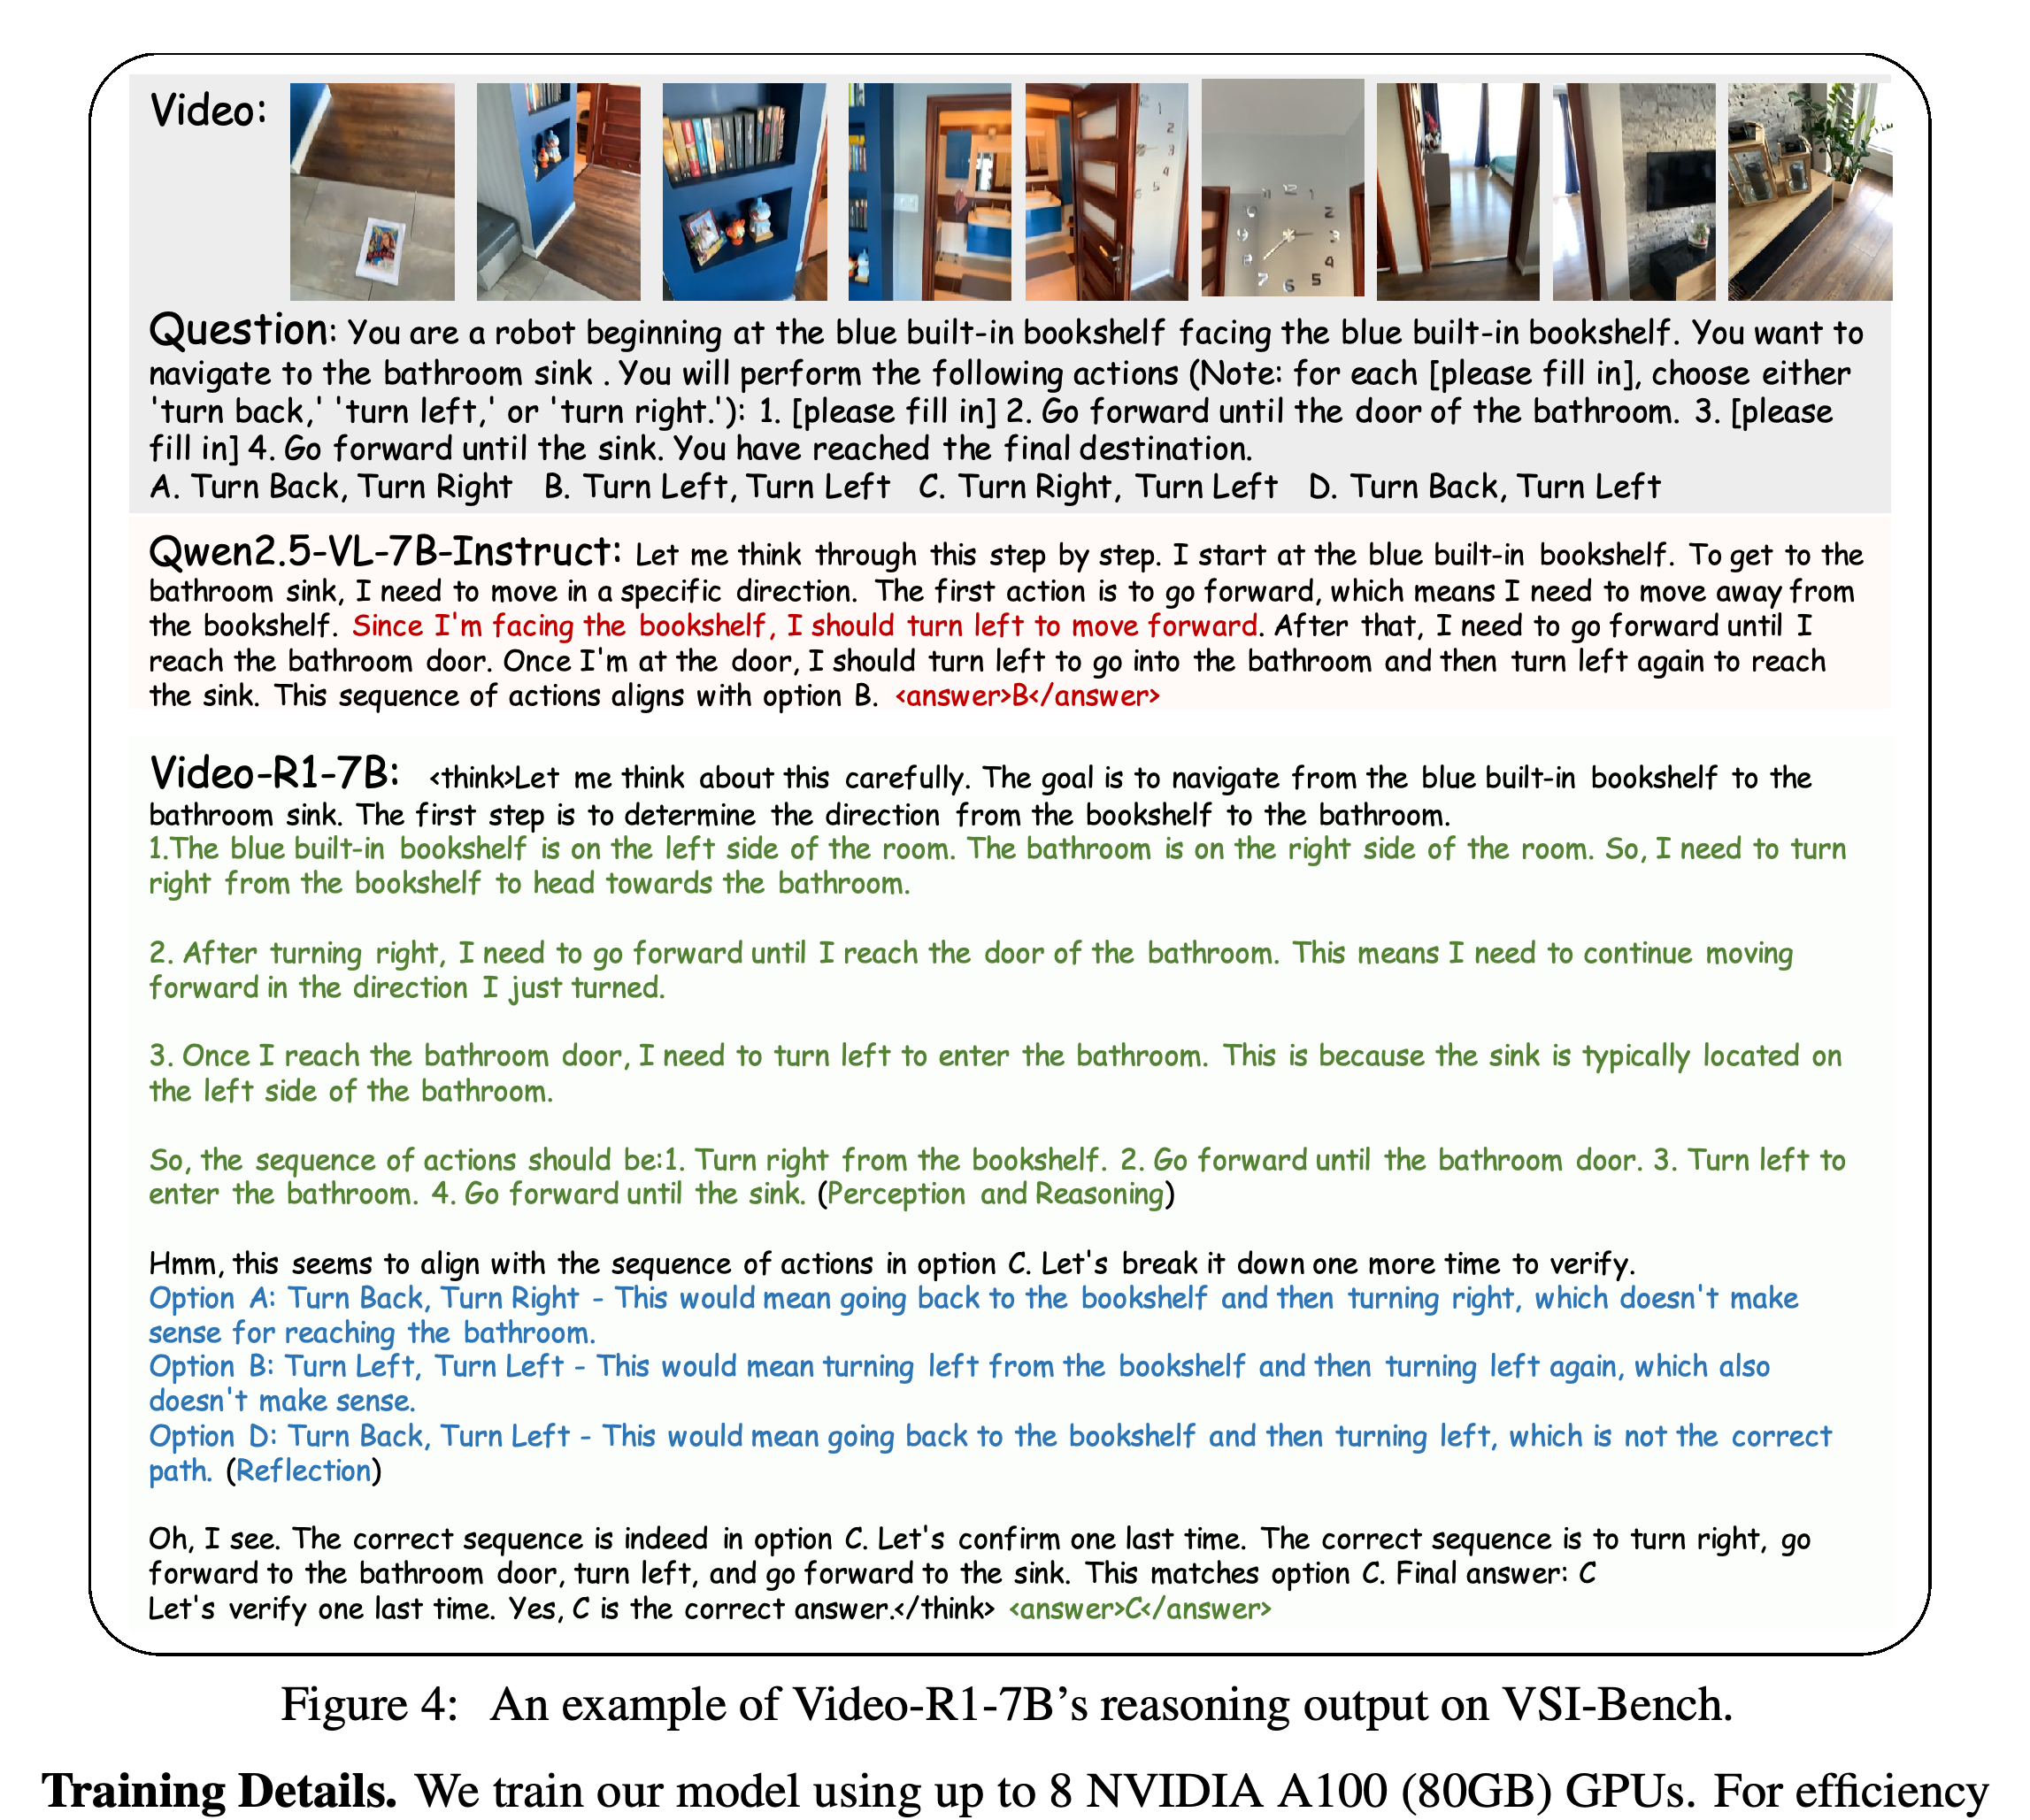
저자들은 해석을 재검토하고 대안을 확인하는 출력을 비디오 추론의 “aha moment”라고 설명한다. Figure 4에서 Video-R1-7B는 경로를 검토하고 대안을 배제한 뒤 내비게이션 문제의 정답 C를 선택하지만, 기반 모델은 B를 선택한다.
- 이 사례는 생성된 설명에 언어로 표현한 자기 점검이 포함돼 있음을 보여준다. 다만 이 설명이 모델의 내부 계산을 충실히 반영한다는 사실을 독립적으로 입증하지는 않는다.
내비게이션 질문에 기반 모델은 B를 선택하고, Video-R1-7B는 C를 선택하며 대안 경로를 검토한다. 이 사례는 명시적인 점검을 포함한 정답 응답을 보여준다. 다만 설명에는 세면대 위치를 비디오에서 식별하는 대신 일반적인 세면대 위치를 근거로 삼는 내용도 포함된다.
4 Experiments
실험은 기반 모델, SFT 모델, RL 모델의 벤치마크 점수를 비교하고, 개별 학습 구성 요소를 제거한 변형을 평가한다. 추가 분석에서는 학습 중 변화, 응답에 시간적 내용이 나타나는 빈도, 시간적 보상 크기에 대한 민감도를 살펴본다.
4.1 Setup
평가에는 비디오 추론 벤치마크인 VSI-Bench, VideoMMMU, MMVU와 일반 비디오 이해 벤치마크인 MVBench, TempCompass, VideoMME를 사용한다. MMVU는 객관식 하위 집합을 사용하고, VideoMME는 자막 없이 평가한 결과를 보고한다. 평가 설정은 표본 추출의 확률 기준인 top_p = 0.001과 표본 추출의 무작위성을 조절하는 temperature = 0.01이다.
- 학습에는 최대 8개의 NVIDIA A100 (80GB) 그래픽 처리 장치를 사용한다. 주요 결과는 학습 데이터셋을 순회하는 SFT 1에포크와 RL 1k 스텝으로 얻는다. 학습용 비디오 입력은 최대 16개 프레임을 포함하고, 평가에는 16, 32, 64개 프레임을 사용한다.
- 보고된 프레임당 최대 픽셀 수는 학습 시 128 × 28 × 28, 추론 시 256 × 28 × 28이다. 시간순 응답 그룹의 크기는 G = 8이고, 순서를 섞은 응답 그룹의 크기는 G̃ = 4다.
4.2 Main Results
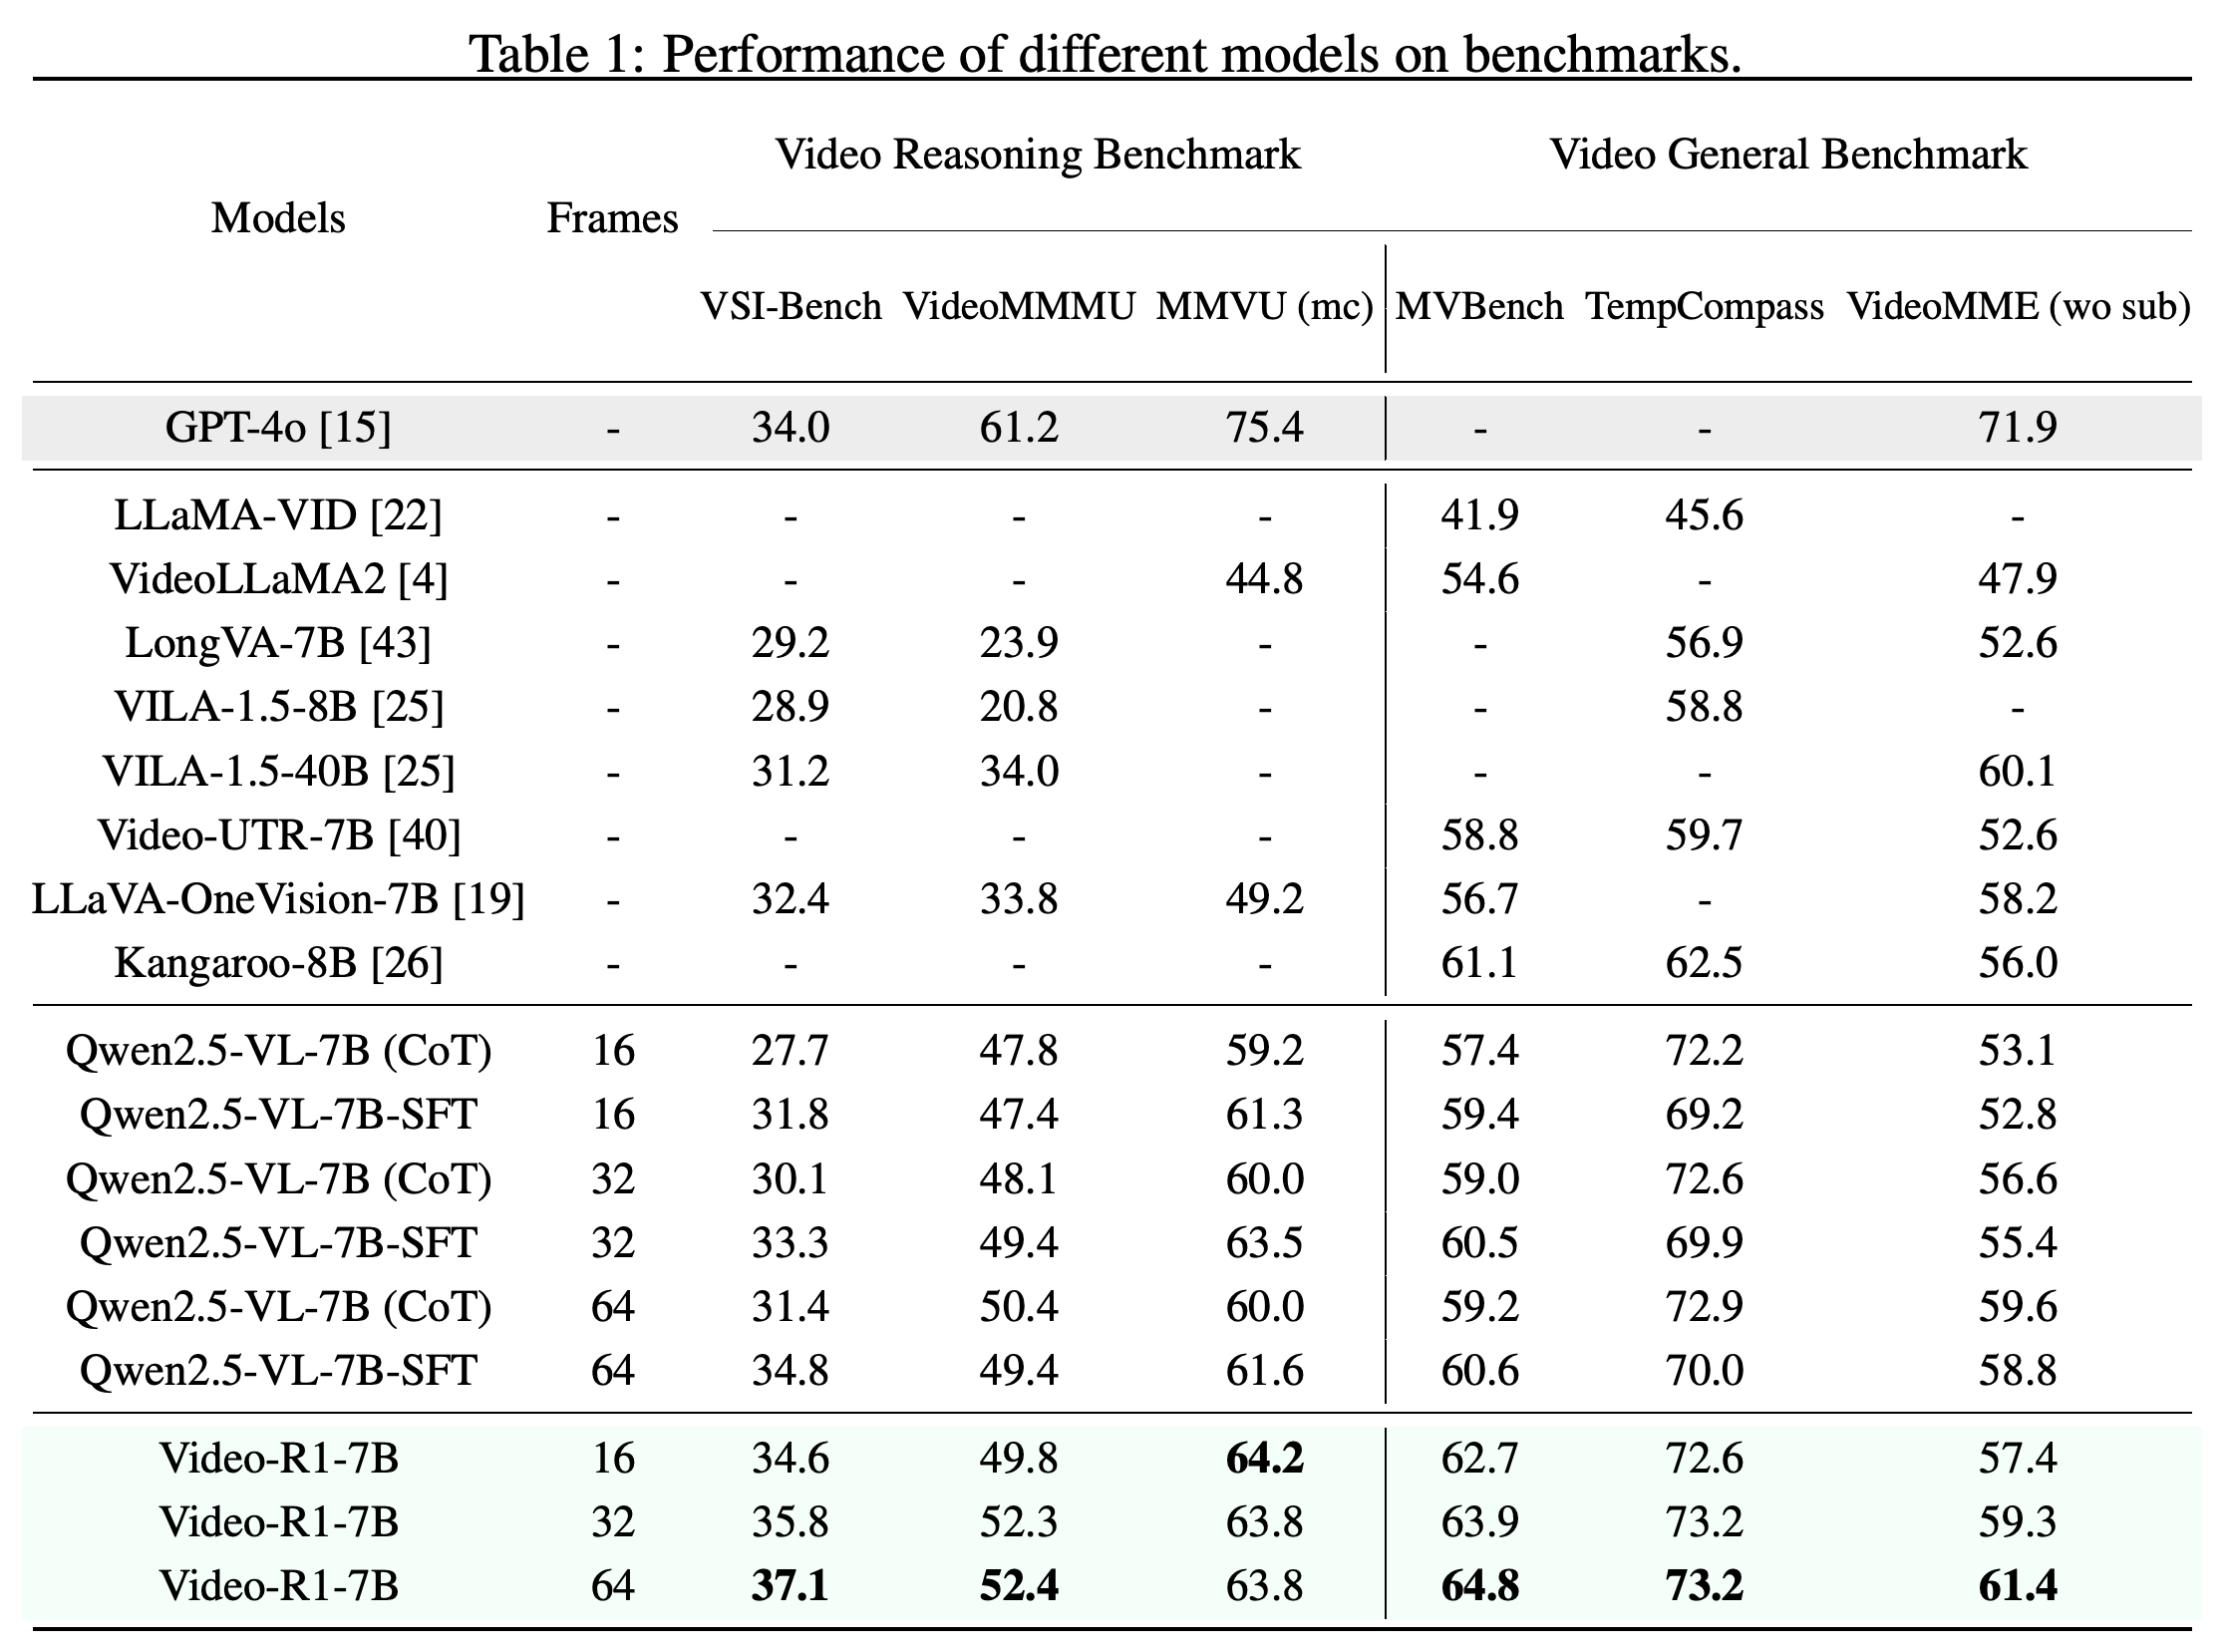
64개 프레임에서 Video-R1-7B는 VSI-Bench 37.1, VideoMMMU 52.4, MMVU 63.8, MVBench 64.8, TempCompass 73.2, VideoMME 61.4를 기록한다. 프레임 수를 동일하게 맞춘 각 비교에서 모든 벤치마크에 걸쳐 기반 CoT 모델과 SFT 모델을 앞선다.
- 64개 프레임에서 기반 CoT 모델은 같은 벤치마크 순서로 31.4, 50.4, 60.0, 59.2, 72.9, 59.6을 기록하고, SFT 모델은 34.8, 49.4, 61.6, 60.6, 70.0, 58.8을 기록한다. 따라서 SFT가 기반 모델의 성능을 일관되게 개선하지는 않는다.
- GPT-4o는 VSI-Bench에서 34.0으로 Video-R1-7B보다 낮지만, VideoMMMU 61.2, MMVU 75.4, VideoMME 71.9로 Video-R1-7B보다 높다. 표에는 GPT-4o의 프레임 수가 명시되지 않았다.
- Video-R1-7B의 입력을 16개에서 64개 프레임으로 늘리면 대부분의 결과가 개선된다. VSI-Bench는 34.6에서 37.1로, VideoMME는 57.4에서 61.4로 오른다. 반면 MMVU는 64.2에서 63.8로 떨어진다.
16, 32, 64개 프레임으로 조건을 맞춘 비교에서 Video-R1-7B는 모든 벤치마크에서 기반 CoT 모델과 SFT 모델을 앞선다. 비교 대상 2개 모델의 결과가 모두 보고된 벤치마크 중 GPT-4o보다 높은 성능을 보인 것은 VSI-Bench뿐이다.
4.3 Ablation Study
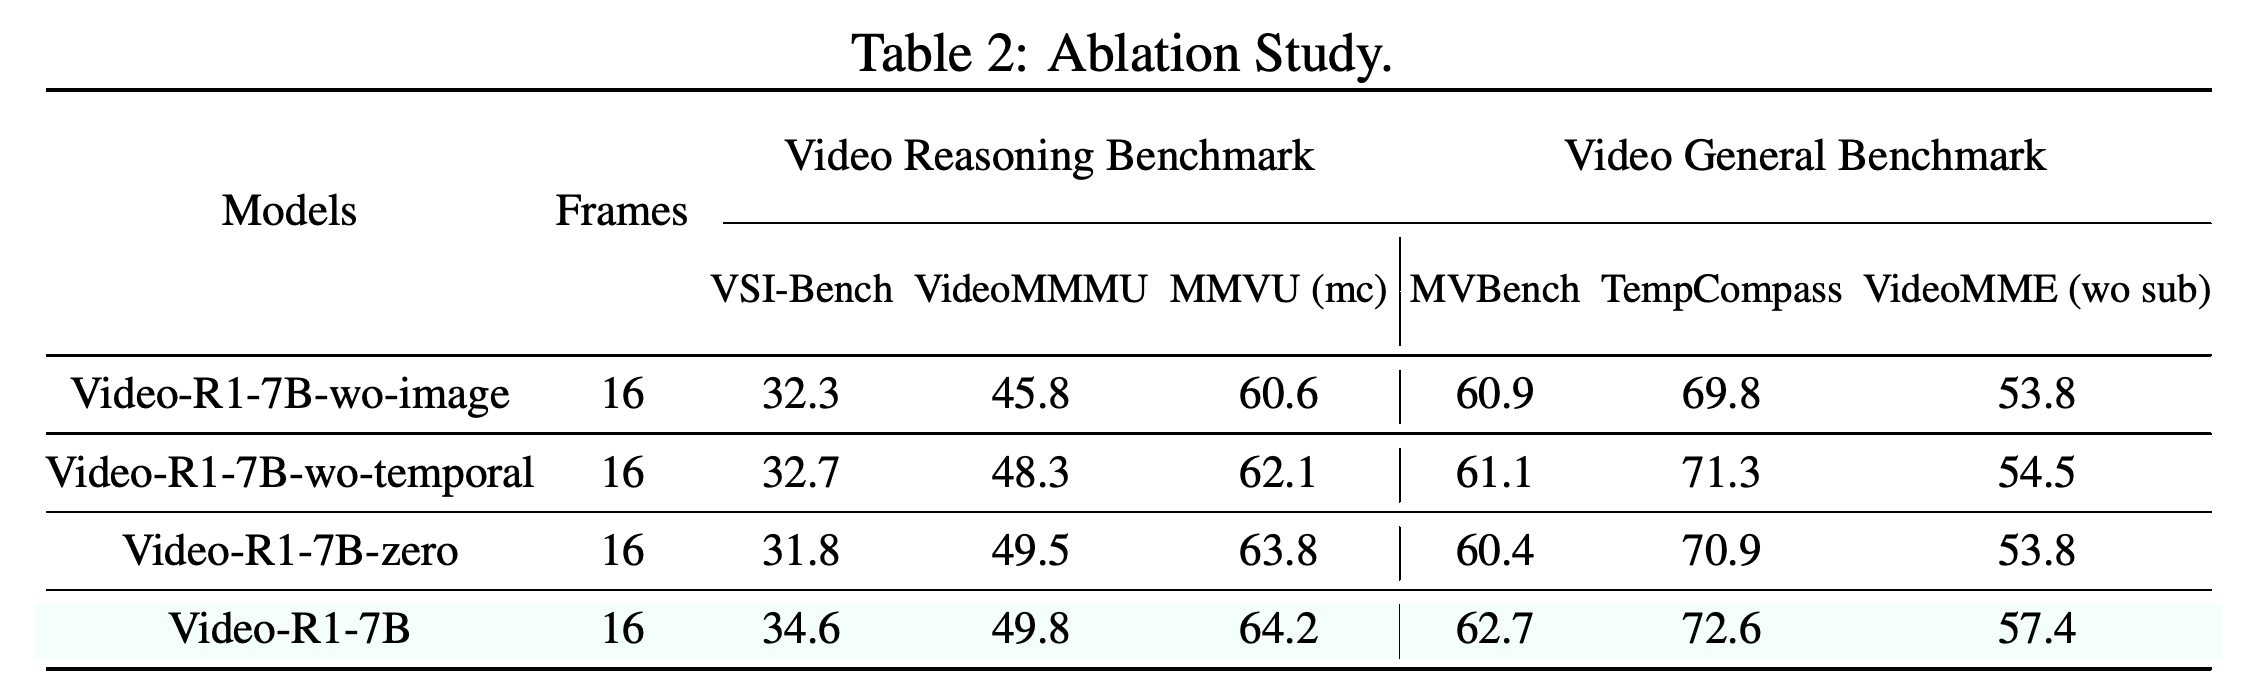
구성 요소를 제거해 효과를 확인하는 실험에서는 16개 프레임으로 변형 3개를 평가한다. 이미지 데이터를 제거하거나, T-GRPO를 원래 GRPO로 대체하거나, SFT 초기화를 생략한다. 각 변형은 전체 모델보다 6개 벤치마크 모두에서 점수가 낮다. VSI-Bench 점수는 각각 32.3, 32.7, 31.8이며, Video-R1-7B는 34.6을 기록한다.
- 이미지 데이터를 제거하면 VideoMMMU가 49.8에서 45.8로 떨어지고, 시간적 모델링을 제거하면 VideoMME가 57.4에서 54.5로 떨어진다. 이 비교는 해당 학습 절차에서 각 구성 요소가 유용함을 뒷받침한다.
- 표는 반복 실행에 따른 변동이나 신뢰구간 없이 점 추정값만 보고하므로, 작은 차이의 신뢰성을 입증하지는 않는다.
16개 프레임을 사용하는 변형 3개 모두 6개 벤치마크에서 전체 모델보다 낮은 점수를 기록한다. 이미지 데이터를 제거하면 VideoMMMU가 49.8에서 45.8로 떨어져 변형 중 가장 크게 하락하고, SFT를 생략하면 VSI-Bench가 34.6에서 31.8로 떨어진다.
4.4 Training Curves
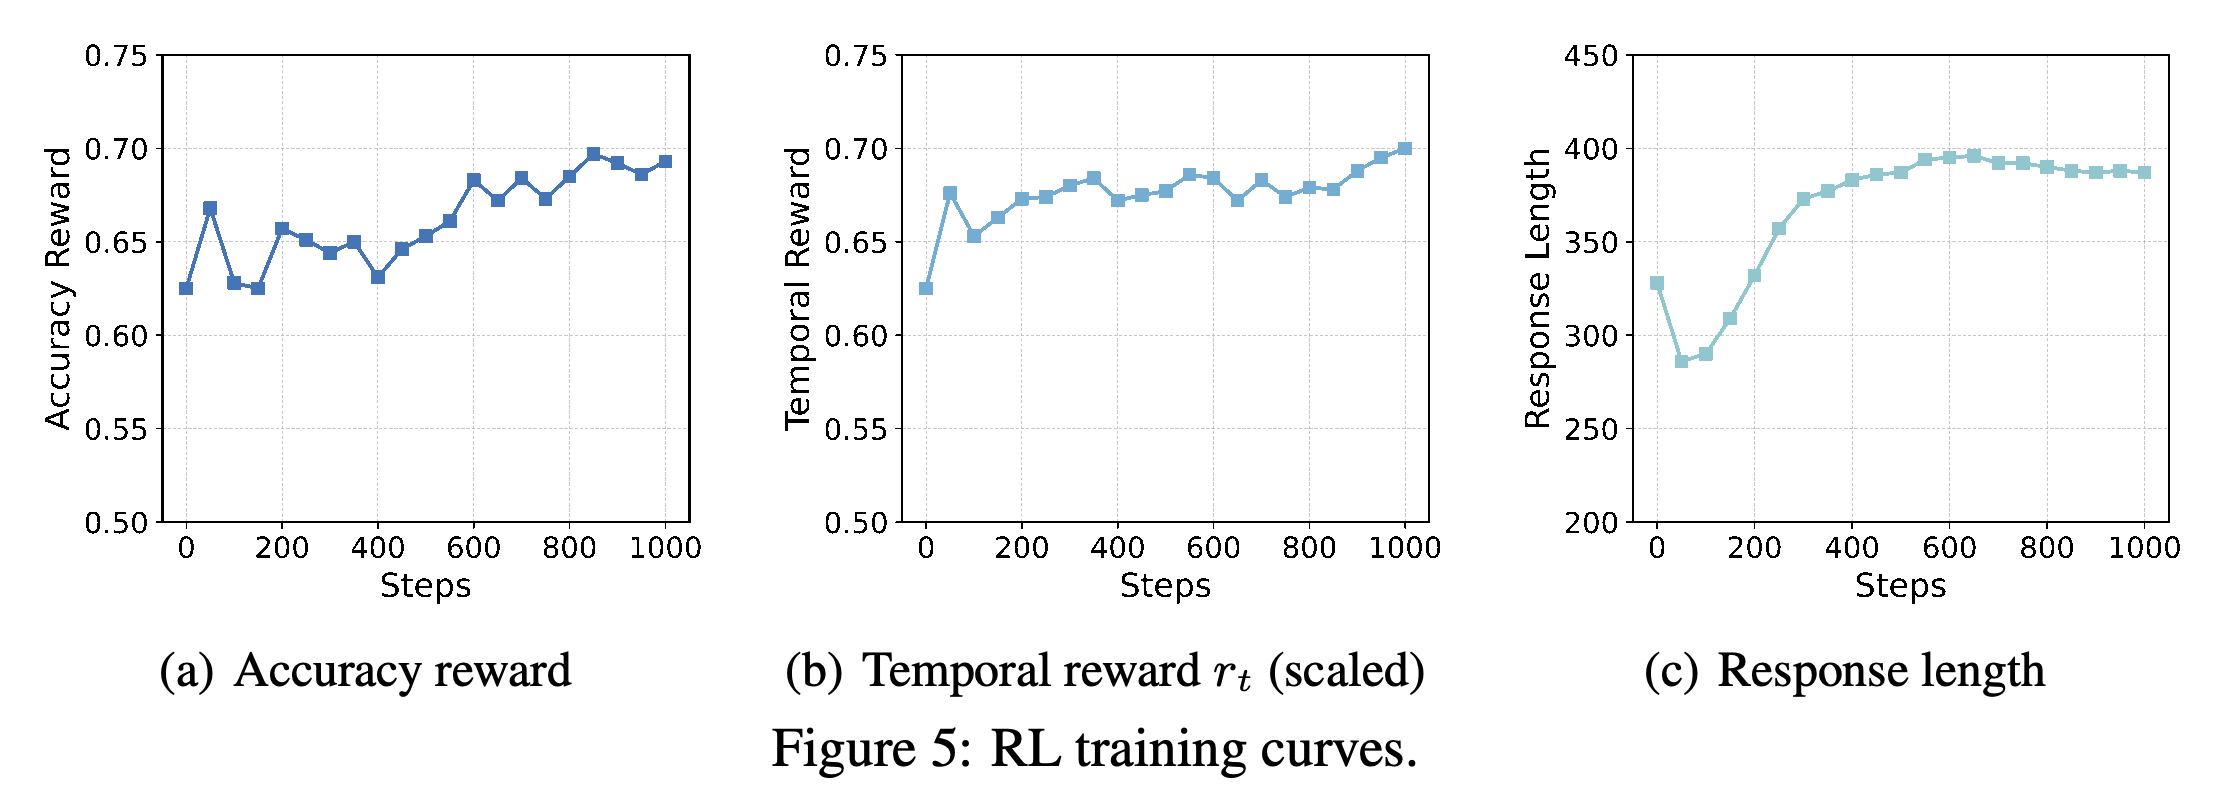
RL 1k 스텝 동안 정답 보상과 0–1로 조정한 시간적 보상은 전반적으로 증가한다. 응답 길이는 초기에 감소한 뒤 증가하고 안정화된다.
- 저자들은 이러한 길이 변화가 SFT의 추론 방식에서 벗어나는 전환을 반영할 수 있다고 추측한다. 곡선은 변화 양상을 보여주지만, 이 설명을 직접 검증하지는 않는다.
학습 중 정답 보상과 조정된 시간적 보상은 전반적으로 증가한다. 응답 길이는 초기에 감소한 뒤 증가하고 안정화된다. 이 곡선은 출력 행동의 변화를 보여주지만, 그 원인은 밝히지 못한다.
4.5 Effect of Temporal Reward Analysis
Qwen2.5-VL-72B는 먼저 벤치마크 전반에서 시간적 추론이 필요한 질문을 식별하고, 생성된 응답이 시간적 추론을 포함하는지 판정한다. Video-R1 응답의 75.0%가 시간적 추론을 포함한다고 분류하며, Video-R1-wo-temporal의 60.2%보다 14.8%p 높다.
- 이 평가는 모델 판정자를 사용해 생성된 설명에 시간적 내용이 있는지를 측정한다. 프레임 순서가 각 답변을 인과적으로 결정하는지를 직접 측정하지는 않는다.
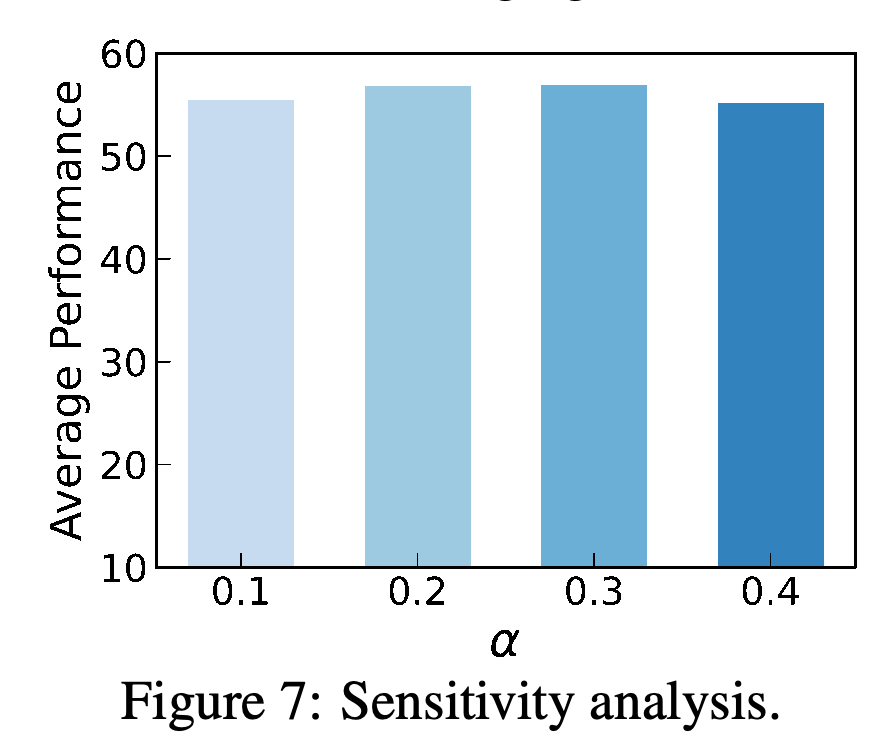
- 민감도 실험은 6개 벤치마크의 평균 성능으로 α = 0.1, 0.2, 0.3, 0.4를 비교한다. 논문은 0.2와 0.3의 결과가 비슷하고, 0.1과 0.4에서는 약간 낮다고 보고한다.
시간적 보상 크기가 0.2와 0.3일 때 평균 벤치마크 성능이 비슷하고, 0.1과 0.4일 때는 약간 낮다. 표시된 결과는 이 4개 설정에 대한 민감도를 평가한다.
5 Conclusions
결론은 학습 보상에 추가 보상을 더하는 시간적 보상 설계와 이미지, 비디오 혼합 추론 데이터를 통해 Video-R1이 규칙 기반 RL을 확장했다고 요약한다. 코드, 모델, 데이터셋은 https://github.com/tulerfeng/Video-R1 에 공개했다고 보고한다.
부록
- A Additional Experiments는 A.1 Scaling Up RL Training과 A.2 Effect of Length Reward Analysis를 포함한다. RL을 1k에서 10k 스텝으로 늘리면 여러 결과가 개선된다. 64개 프레임에서 VSI-Bench는 37.1에서 37.8로, MMVU는 63.8에서 65.0으로, MVBench는 64.8에서 65.5로, TempCompass는 73.2에서 74.2로, VideoMME는 61.4에서 61.8로 오른다. 반면 VideoMMMU는 52.4에서 51.4로 떨어진다. 길이 보상을 제거하면 응답이 짧아지고 평균 벤치마크 성능이 낮아진다. 이것이 얕아진 추론을 반영한다는 저자들의 설명은 가설로 남는다.
- B Reasoning Examples는 운동에너지 손실에 관한 MMVU 사례와 등장인물의 동기에 관한 MVBench 사례를 제시한다. 출력은 후보 해석을 비교하고 언어로 검증하는 과정을 포함하며, 저자들이 설명하는 성찰적 응답의 예를 보여준다.
- C Prompt Template은 C.1 Prompt Template for Training and Inference와 C.2 Prompt Template for Temporal Reasoning Evaluation을 포함한다. 학습, 추론, CoT 주석에 공통으로 쓰는 템플릿은 자기 성찰과 검증을 명시적으로 권장하며, 추론을 <think>…</think> 안에, 최종 답변을 <answer>…</answer> 안에 작성하도록 한다. 평가 템플릿은 시간적 내용을 폭넓게 해석해, 응답이 시간, 순서, 진행, 지속 시간, 속도, 방향을 다루는지 묻는다.
- D Additional Implementation Details는 모델 매개변수를 갱신하는 옵티마이저로 Adam을 명시한다. 학습률은 1e-6, 가중치 감쇠는 0.01, 최대 그래디언트 노름은 5, 최대 응답 길이는 768 토큰이다. 기준 정책과의 발산 계수는 β = 0.04다. 보고된 소요 시간은 SFT 에포크당 약 40시간, RL 1k 스텝당 약 15시간이다.
- E Limitations and Future Works는 학습 입력의 16개 프레임 제한, 시간순 입력과 순서를 섞은 입력을 비교하는 추가 연산, 질문 난도를 고려하지 않는 고정 길이 보상 구간, 이미지 데이터를 단순하게 혼합하는 방식, 과제별 보상 규칙을 한계로 제시한다. 향후 방향으로 더 긴 비디오를 활용한 학습, 더 효율적인 시간적 모델링, 적응적 응답 길이, 이미지에서 비디오로 추론 능력을 더 체계적으로 전이하는 방법, 범용 비디오 보상 모델을 제안한다.
짧은 생각
가장 강한 근거는 같은 기반 모델과 프레임 수를 맞춘 비교에서 나타난 성능 향상과 개별 구성 요소를 제거할 때 일관되게 나타난 성능 하락이다. 시간순 입력과 순서를 섞은 입력의 비교는 구체적인 학습 개입 방법을 제공한다. 다만 Equation (1)의 p ≥ p̃와 본문의 엄격한 성능 우위 조건이 달라 동률을 어떻게 처리하는지는 불분명하다. 공통 프롬프트는 성찰과 검증을 명시적으로 요청한다. 따라서 보고된 “aha moment” 사례만으로는 학습을 통해 획득한 자기 교정 능력을 분리해 확인할 수 없다. 시간적 내용 평가는 생성된 설명의 변화를 뒷받침한다. 모델을 통한 판정, 불확실성 추정의 부재, 외부 비교 모델의 불명확한 프레임 수는 시간적 추론이나 모델 간 우위에 관한 더 강한 주장을 제약한다.