


Random Attention: Rethinking KV Cache Eviction for Efficient Reasoning 요약 설명
03 Sep 2026 | Paper Review KV Cache Long-Context Inference Reasoning목차
- 요약
- 3 Random Attention
- 4 Experiments
- 5 Why the Selection Signal Buys So Little
- 6 Efficiency Evaluation
- 부록
- 짧은 생각
- 관련 글
이번 글에서는 Random Attention: Rethinking KV Cache Eviction for Efficient Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 3일(Arxiv), arXiv preprint
- Wang, Heng, Qiu, Jielin, Zhao, Wenting, Qian, Cheng, Yang, Liangwei, Han, Jiawei, Ji, Heng, Savarese, Silvio, Heinecke, Shelby, Wang, Huan.
- Salesforce AI Research, University of Illinois Urbana-Champaign
- 논문 링크
요약
- 긴 chain of thought를 생성하는 reasoning model에서는 decode에 따라 KV cache가 선형으로 커져 메모리 병목이 된다. 논문은 미래 중요도를 추정하는 selection signal로 KV pair를 순위화하는 기존 eviction의 전제를 검증하고, 전체 prefill을 보존한 뒤 나머지를 KV head별로 균등 무작위 선택하는 Random Attention을 제안한다. 저자들은 네 모델과 여섯 reasoning task에서 이 정책이 가장 강한 기존 evictor와 비슷한 성능을 보이며, selection signal의 추가 기여가 작다고 주장한다.
- Eviction은 고정 예산의 KV pair만 유지하고 폐기한 pair를 복구하지 않는 decode-time 메모리 제한 방식이며, 모든 pair를 저장한 채 일부만 attend하는 sparse-attention selection과 구별된다. 실험은 Qwen3-4B, Qwen3-14B, Qwen3-32B, Phi-4-reasoning을 MATH500 500문제, GPQA-D 198문제, AIME 2025와 2026의 합산 열, HMMT 60문제, LiveCodeBench-v6 medium 383문제에서 평가했고, 주 지표는 boxed answer 정확도와 실제 test execution으로 측정한 LiveCodeBench pass@1이다. Qwen3 계열은 temperature 0.6, Phi-4-reasoning은 0.8, 모든 모델은 nucleus $p=0.95$를 사용하며, main grid는 task별 전형적인 trace에 약 4× compression, LiveCodeBench에는 약 3× compression을 적용한다.
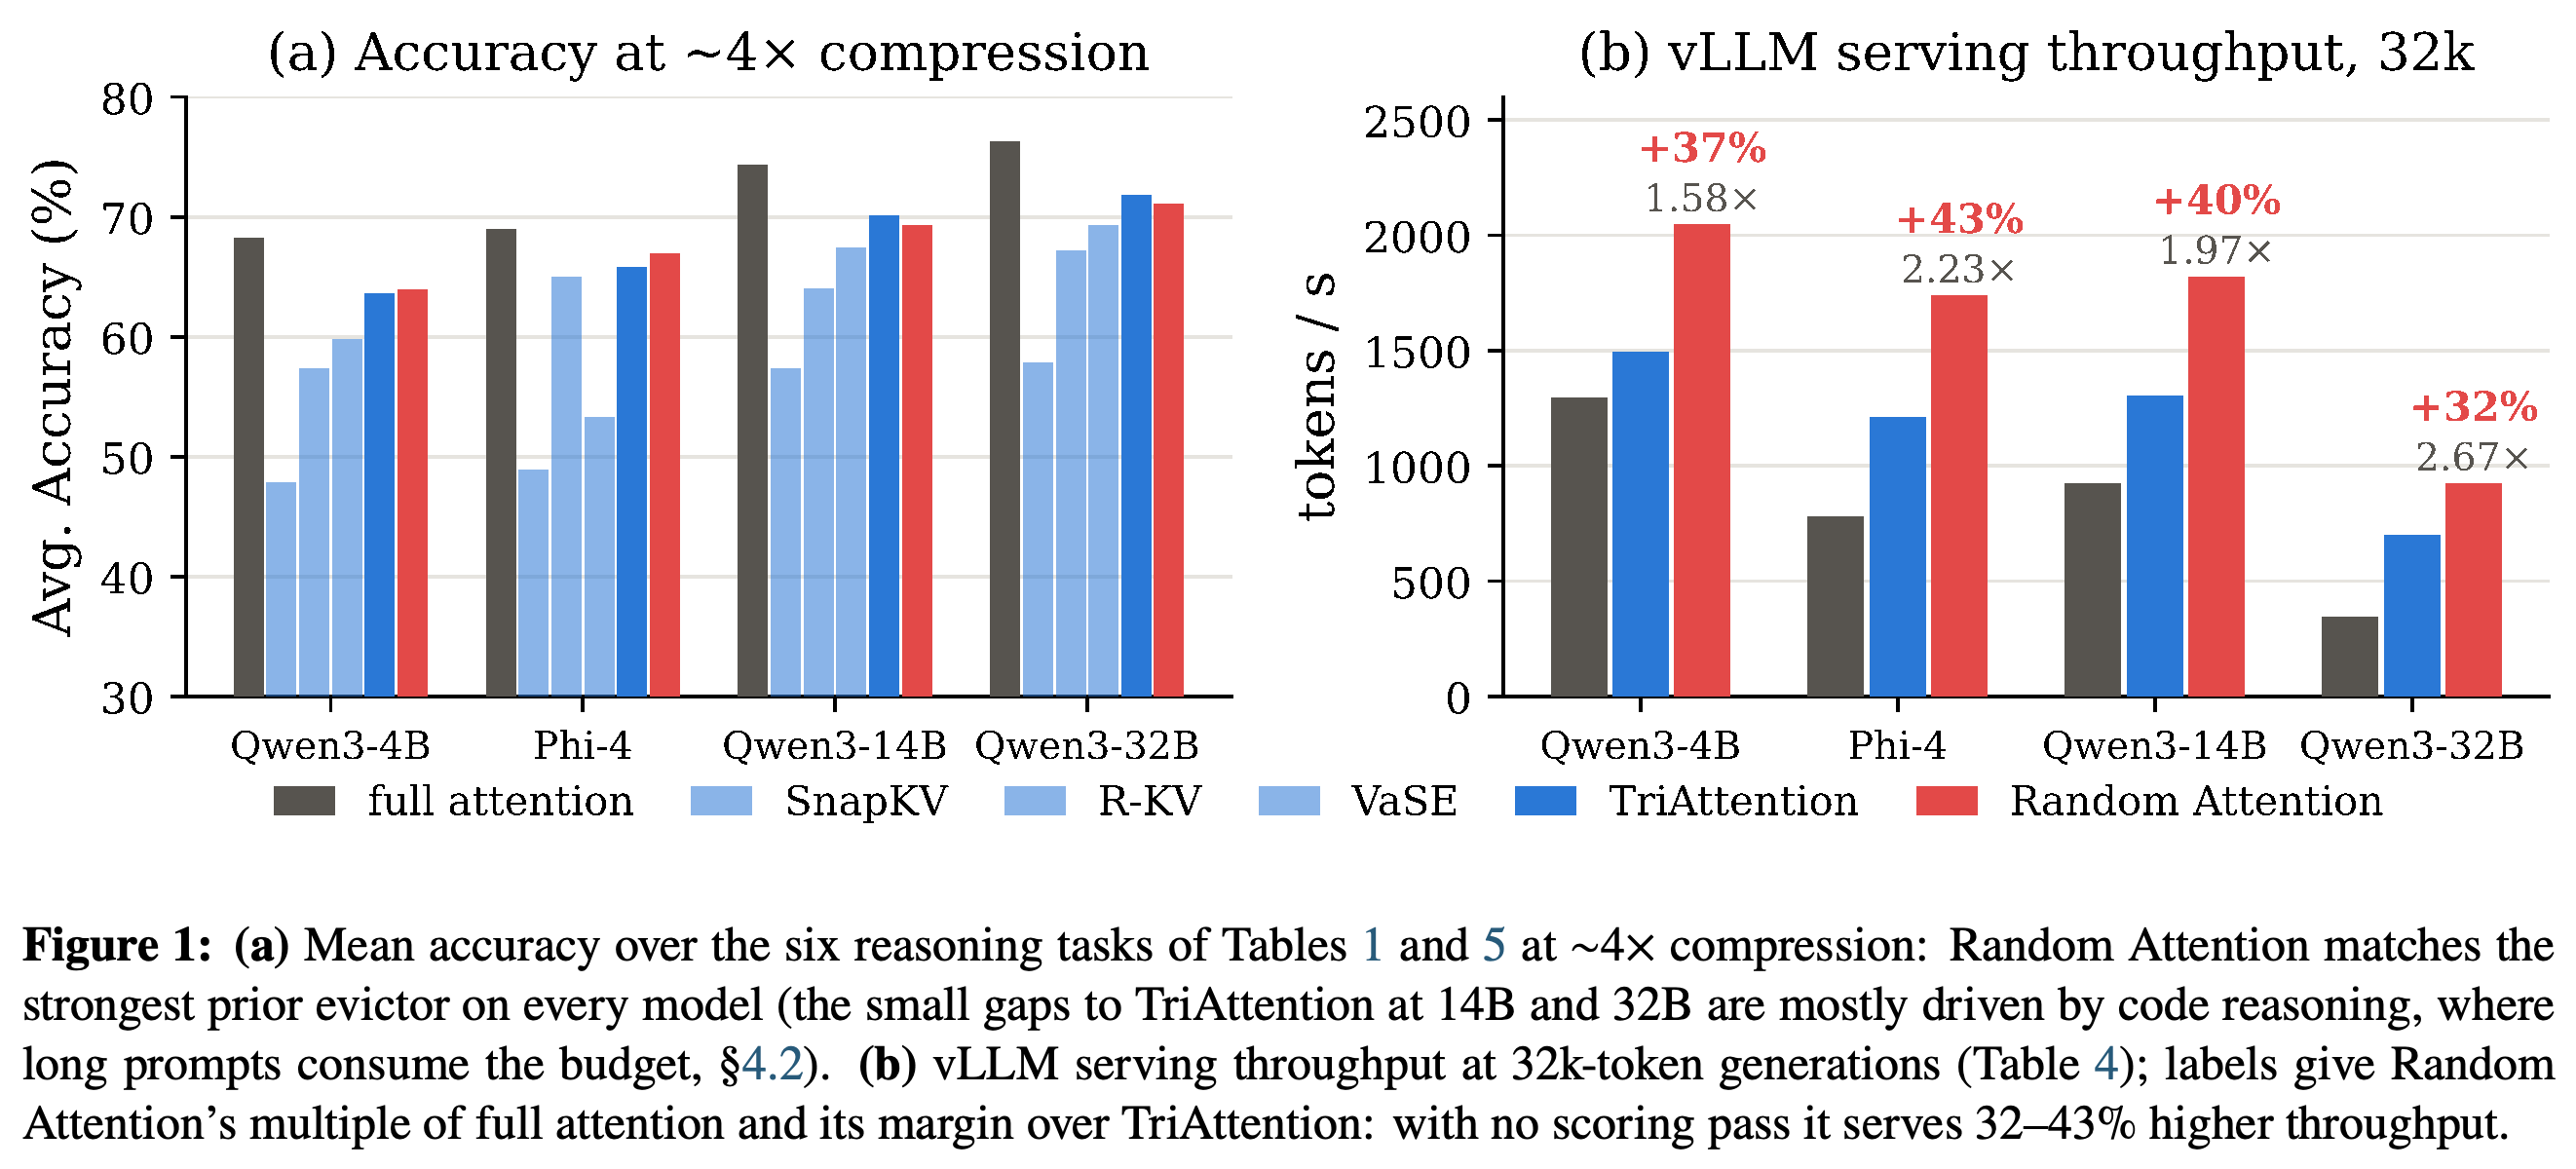
왼쪽 패널은 Tables 1과 5의 여섯 reasoning task 평균 정확도를 약 4× compression에서 모델별로 비교한다. 오른쪽 패널은 32k-token generation의 vLLM throughput을 비교하며, Random Attention의 full attention 대비 배수와 TriAttention 대비 상대 증가율을 표시한다.
3 Random Attention
Random Attention은 system prompt, chat template, 질문을 포함한 위치 $1$부터 $\ell_p$까지의 prefill 전체를 항상 유지한다. 그 밖의 cached position에는 eviction event마다 KV head별 독립 Uniform(0, 1) score를 부여하고 각 head에서 top-$K$를 유지하므로, 난수 생성과 top-$K$ 이외의 calibration, tuning, content-dependent scoring pass가 필요 없다. 오래된 position은 반복적인 무작위 추첨을 거치며 생존 확률이 낮아져, 정책은 head마다 서로 다른 오래된 tail을 남기는 soft recency window로 작동한다.
4 Experiments
비교 대상은 SnapKV, R-KV, VaSE, TriAttention이며, 모두 같은 budget, eviction trigger, 최근 buffer에서 실행했고 full attention을 상한으로 둔다. 각 결과는 독립 표본 생성의 평균이며 MATH500은 2회, GPQA-D와 LiveCodeBench는 4회, AIME와 HMMT는 16회 반복한다. 모든 성능 차이는 paired problem-clustered percentile bootstrap 95% CI와 exact sign test로 판정하고, 최대 생성 길이는 32,768 tokens이다.
4.2 Main Results
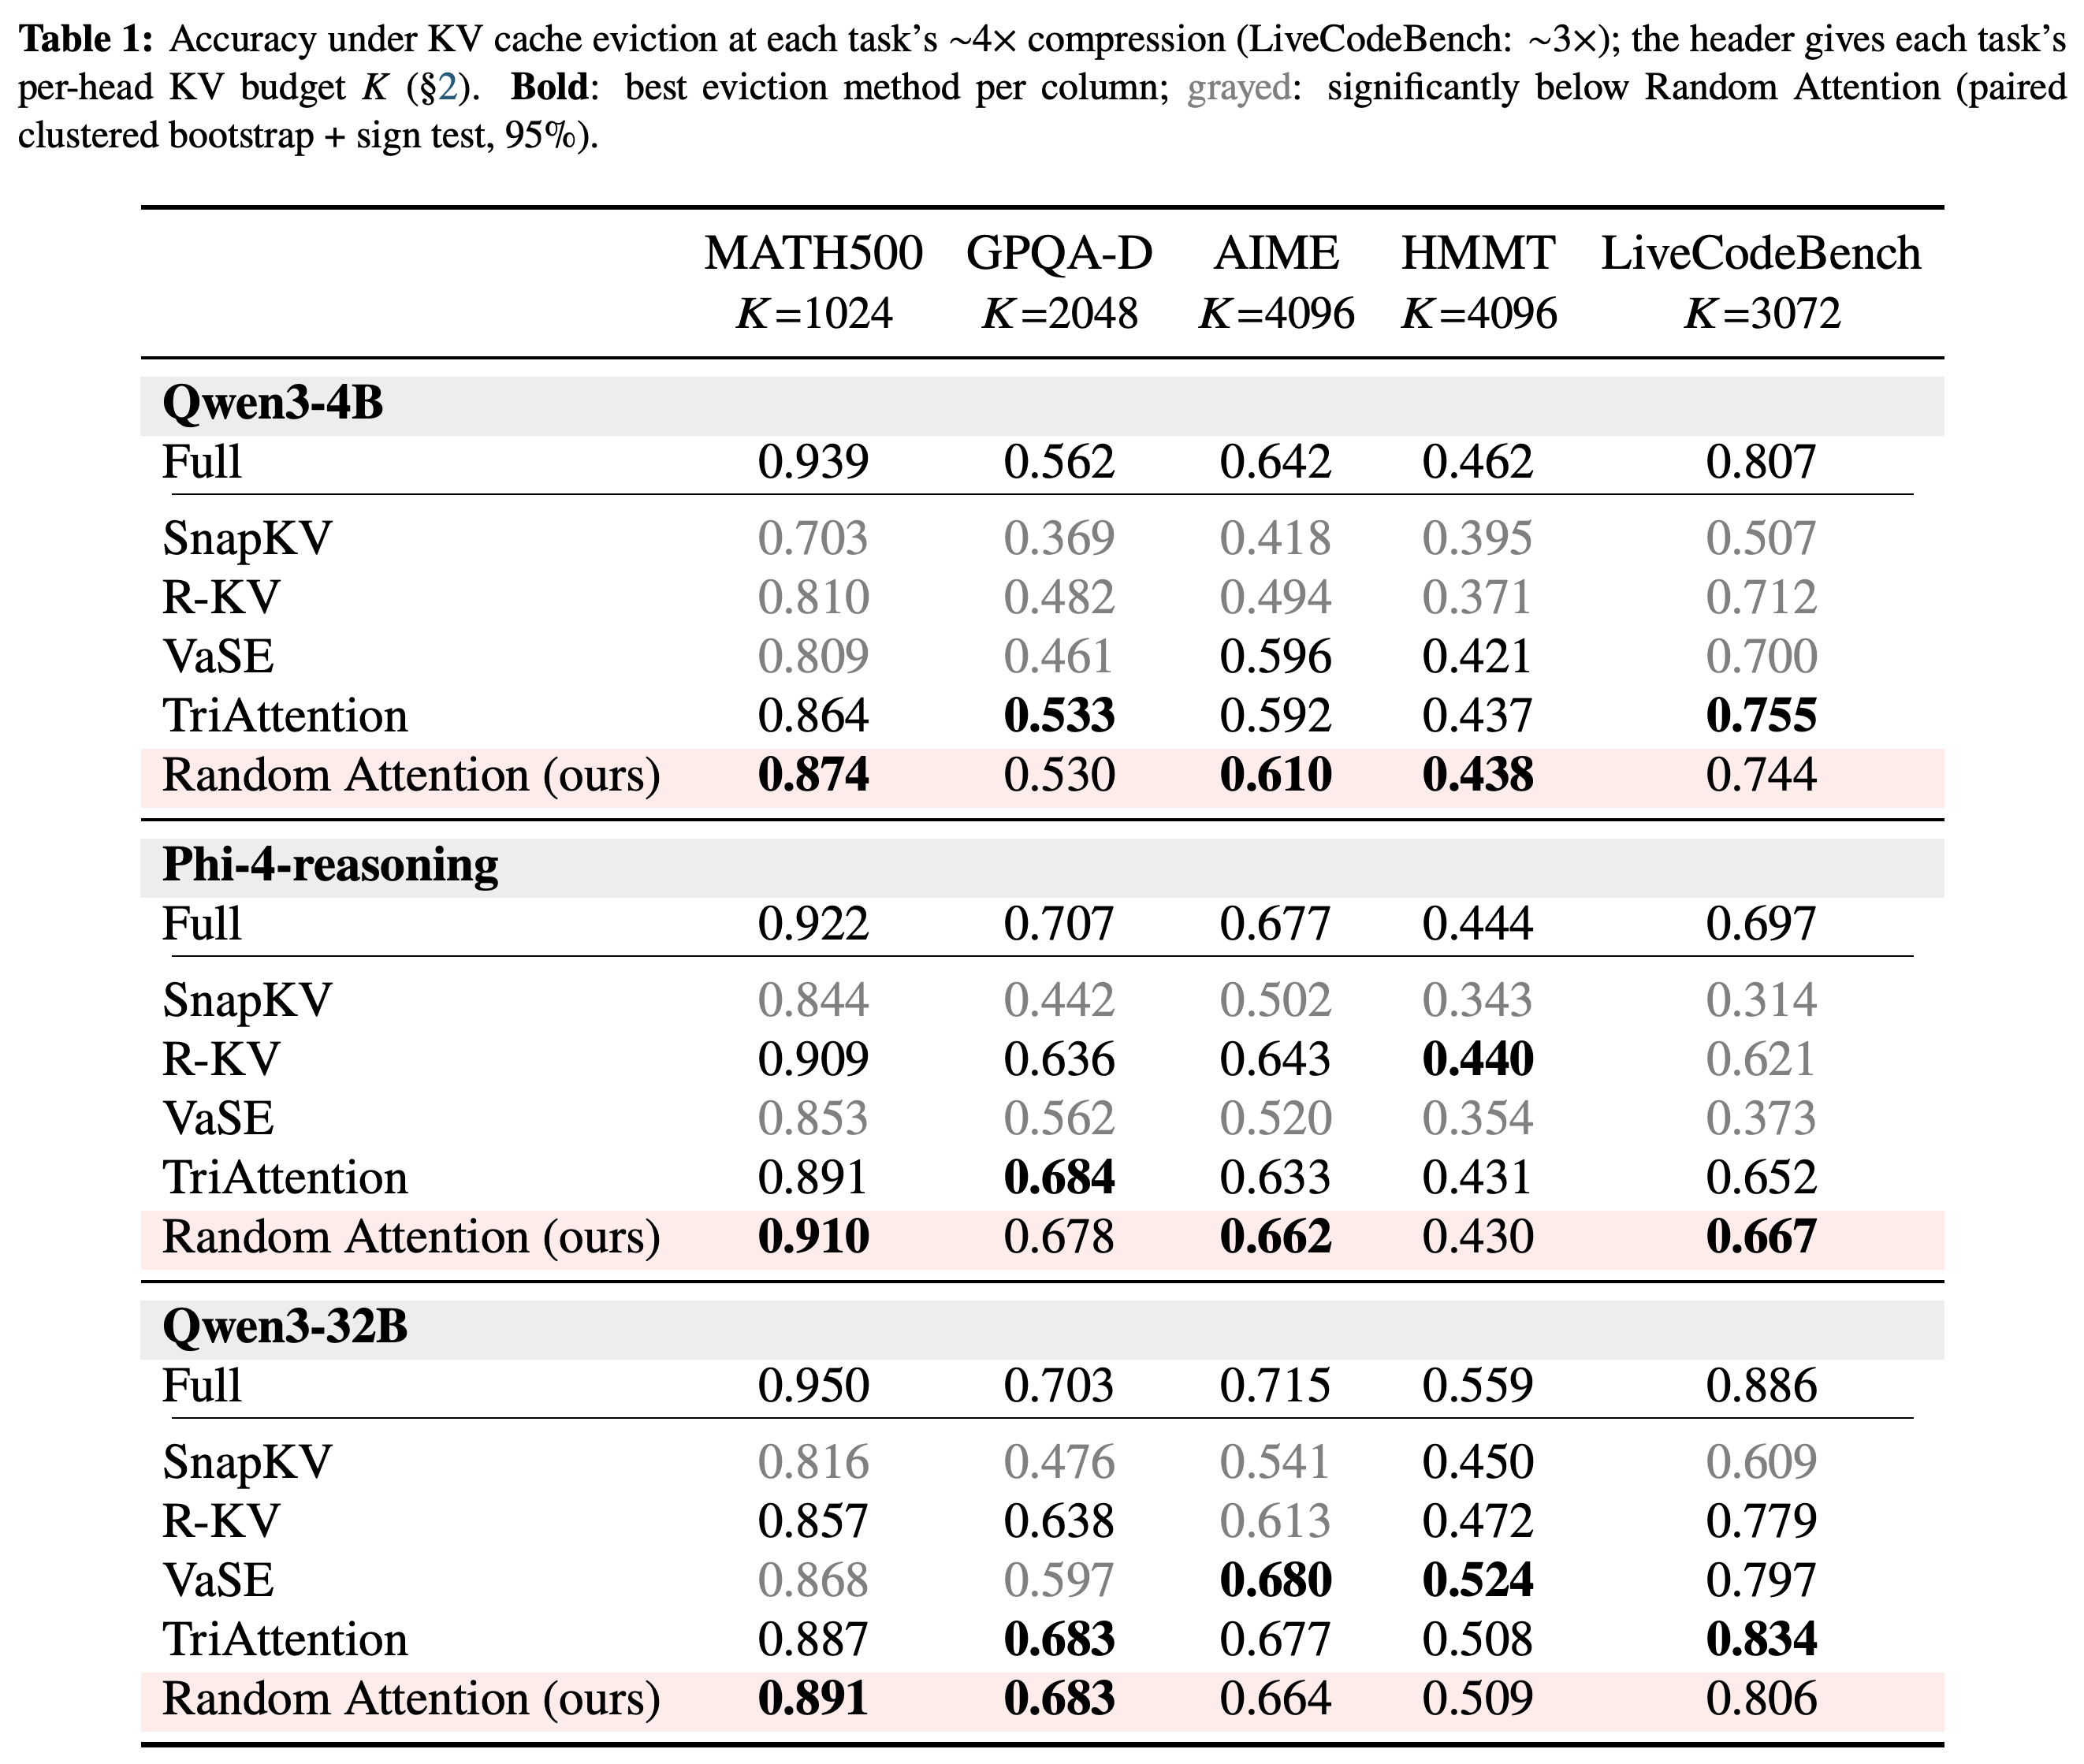
§4.2의 원문 서술과 Table 1을 대조하면, 약 4× compression 조건의 60개 baseline cell에서 Random Attention은 31개 cell에서 유의하게 앞서고 1개 cell에서 유의하게 뒤졌다. MATH500과 GPQA-D에서는 어떤 selector도 Random Attention을 유의하게 앞서지 않았으며, Qwen3-32B LiveCodeBench에서만 TriAttention이 0.834, Random Attention이 0.806으로 2.8%p 앞서 유일한 유의 baseline 승리가 된다. 저자들은 평균 557-token인 LiveCodeBench prompt와 $K=3072$ budget을 이 차이의 맥락으로 제시하며, 가장 긴 prompt는 budget의 최대 절반을 차지할 수 있다고 설명한다.
표는 task별 KV head budget $K$가 서로 다른 약 4× compression 조건에서 Qwen3-4B, Phi-4-reasoning, Qwen3-32B의 정확도를 제시한다. LiveCodeBench의 compression은 약 3×이며, 회색 cell은 paired clustered bootstrap과 sign test에서 Random Attention보다 유의하게 낮은 결과다.
4.3 Compression Pressure Widens the Gap, in Every Family
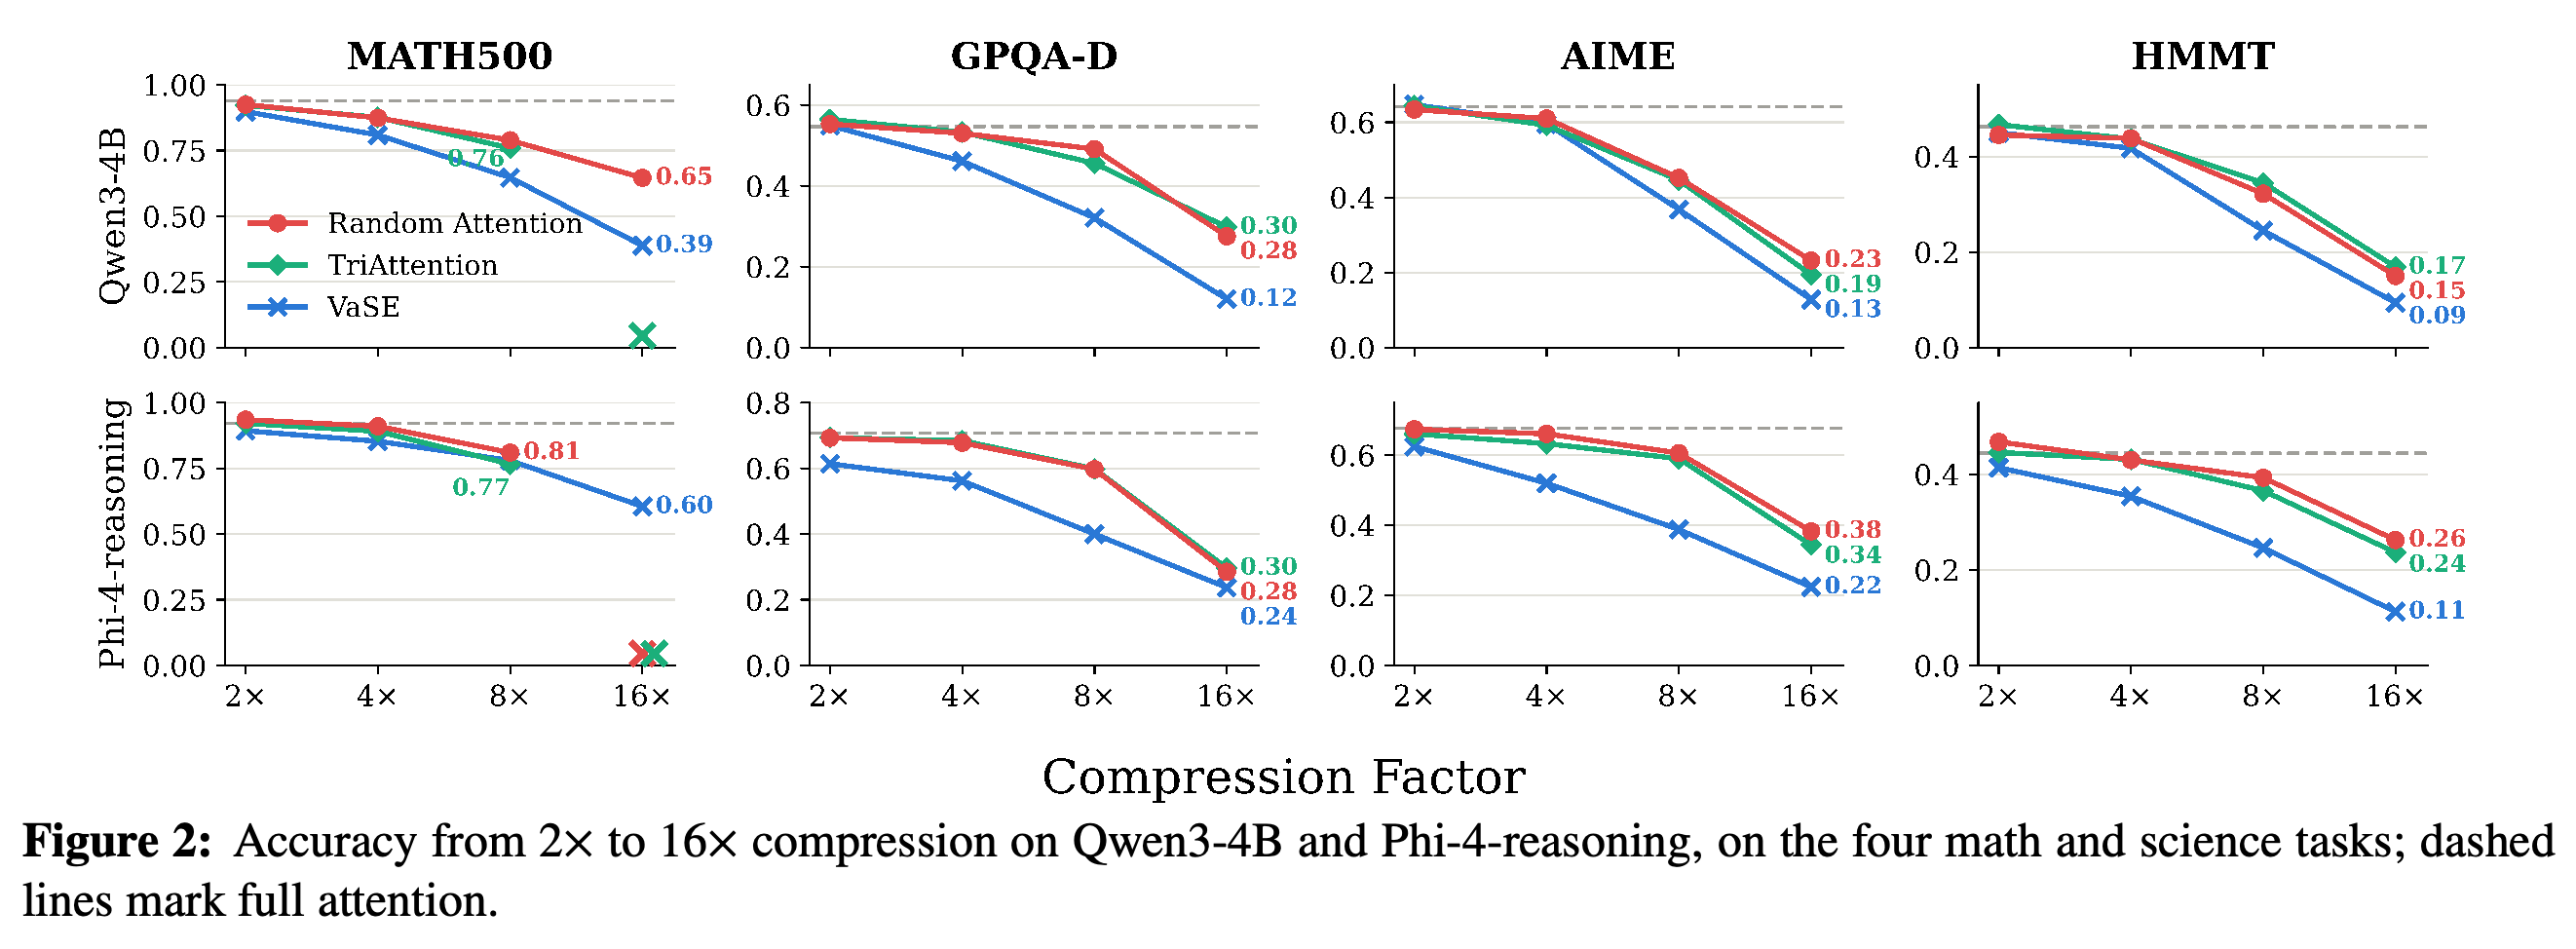
Figure 2는 Qwen3-4B와 Phi-4-reasoning의 MATH500, GPQA-D, AIME, HMMT에서 2×부터 16× compression까지를 비교한다. 원문은 2×에서 모든 방법이 full attention에 가깝고, 예산이 줄어들수록 Random Attention과 TriAttention은 비슷하게 유지되는 반면 두 방법과 VaSE의 격차가 커진다고 서술한다. 작은 budget에 prompt만으로도 들어가지 않을 수 있는 LiveCodeBench는 이 sweep에서 제외했다.
Qwen3-4B와 Phi-4-reasoning에서 MATH500, GPQA-D, AIME, HMMT의 정확도를 2×, 4×, 8×, 16× compression에 따라 표시한다. 점선은 각 모델과 task의 full-attention 수준이며, LiveCodeBench는 작은 budget에 prompt가 들어가지 않을 수 있어 포함하지 않는다.
5 Why the Selection Signal Buys So Little
저자들은 reasoning cache를 한 번만 제시되는 prompt와 생성 중 반복적으로 작성되는 working state로 구분한다. prompt는 evict되면 복구할 수 있는 다른 사본이 없지만, working state는 텍스트 재서술과 KV head 간 사본으로 중복될 수 있으므로 무작위 보존에서도 필요한 사본이 남는다는 가설을 제시한다. 이에 따라 selection signal은 먼 뒤에 필요하지만 한 번만 언급되고 재서술되지 않는 사실을 보존하는 경우에 주로 역할을 한다고 해석한다.
5.1 The Prompt Is the Fragile Part
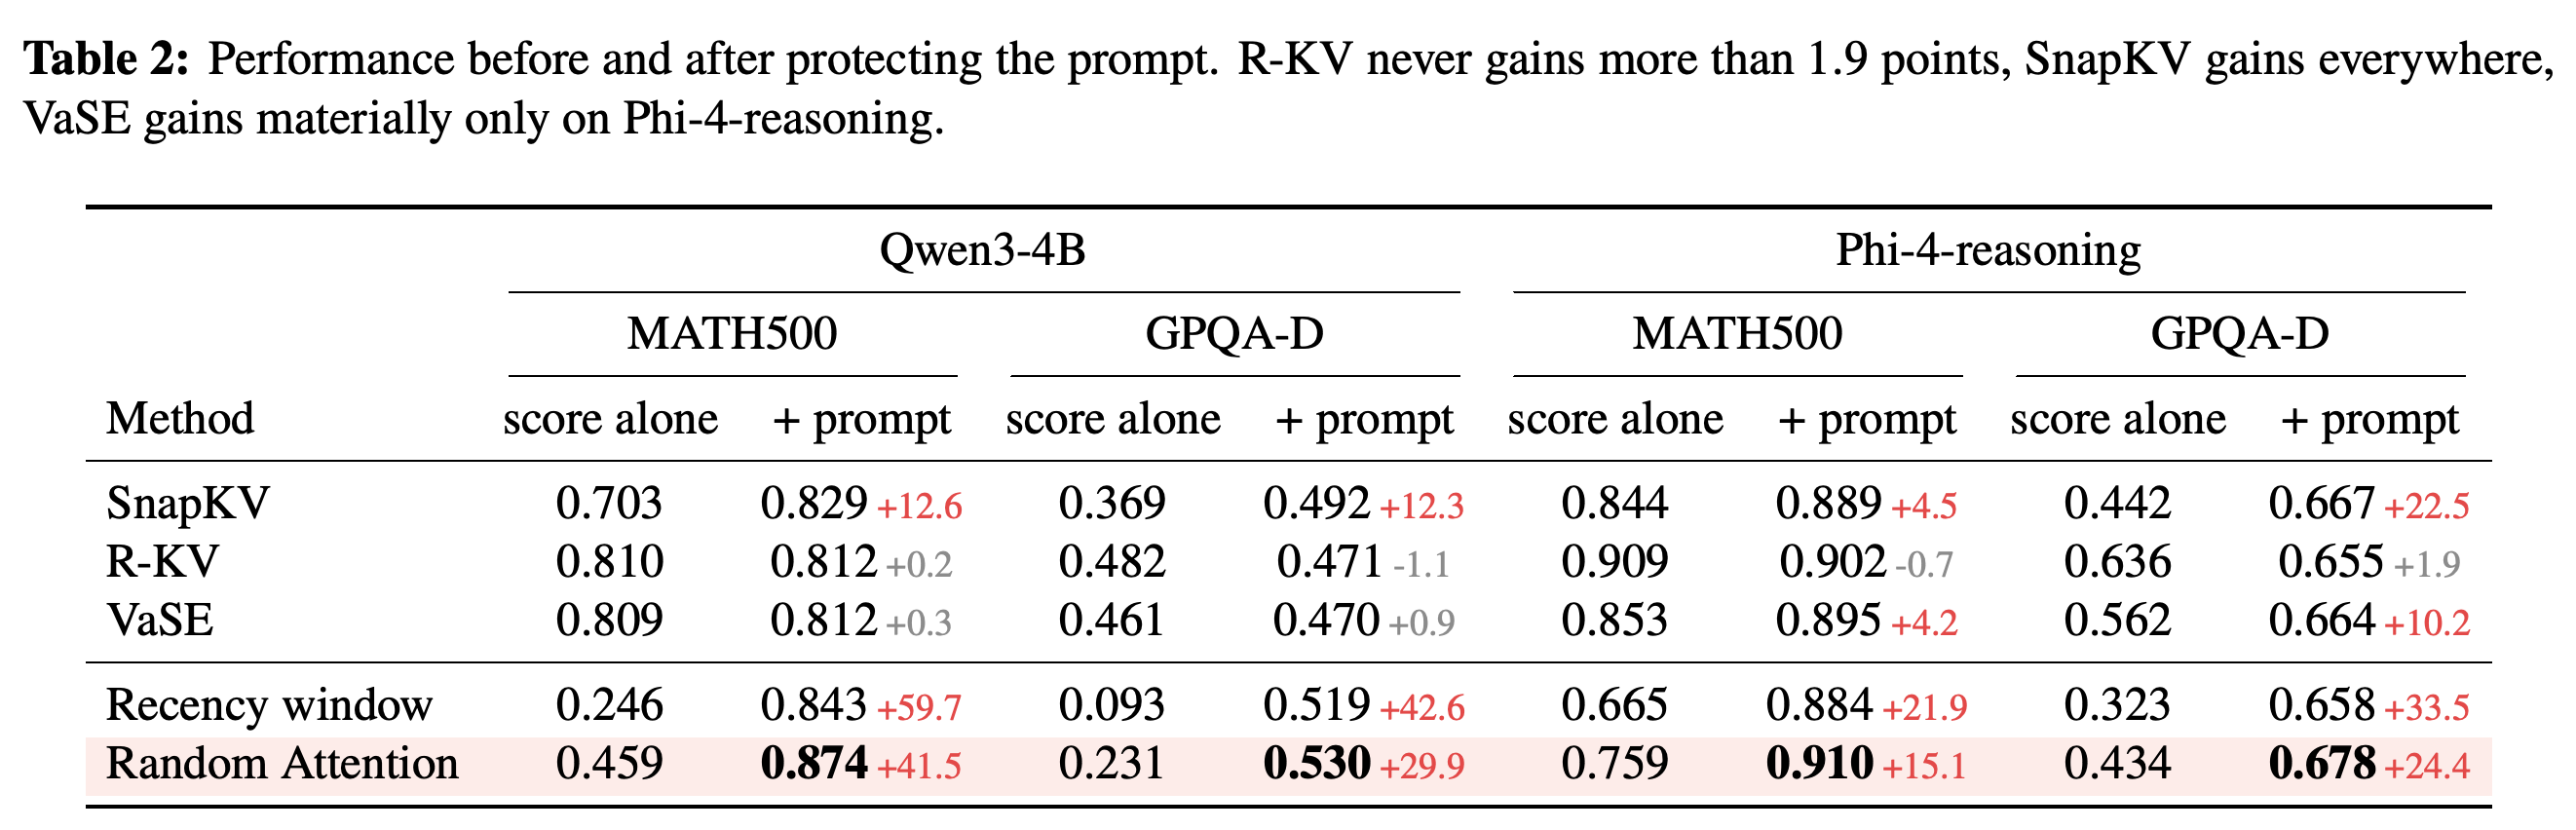
Table 2는 Qwen3-4B와 Phi-4-reasoning의 MATH500, GPQA-D에서 모든 정책에 동일한 prompt 보호 규칙을 적용해 score와 보호 방식을 분리한다. Phi-4-reasoning GPQA-D에서 SnapKV는 score alone 0.442에서 prompt 보호 후 0.667로 22.5%p 상승했고, R-KV의 보호 전후 변화는 모든 해당 설정에서 최대 1.9%p였다. 보호 뒤 세 baseline은 각 설정에서 서로 2.2%p 이내였으며, Qwen3-4B에서는 이 baseline들이 Random Attention보다 4–6%p 낮은 잔차가 남았다고 원문은 보고한다.
표는 SnapKV, R-KV, VaSE, recency window, Random Attention에 대해 score alone 조건과 prompt를 보호한 조건의 성능을 비교한다. 대상은 Qwen3-4B와 Phi-4-reasoning의 MATH500 및 GPQA-D이며, 증감값은 prompt protection rule 적용 전후의 절대 정확도 차이인 points다.
5.2 The Working State Protects Itself
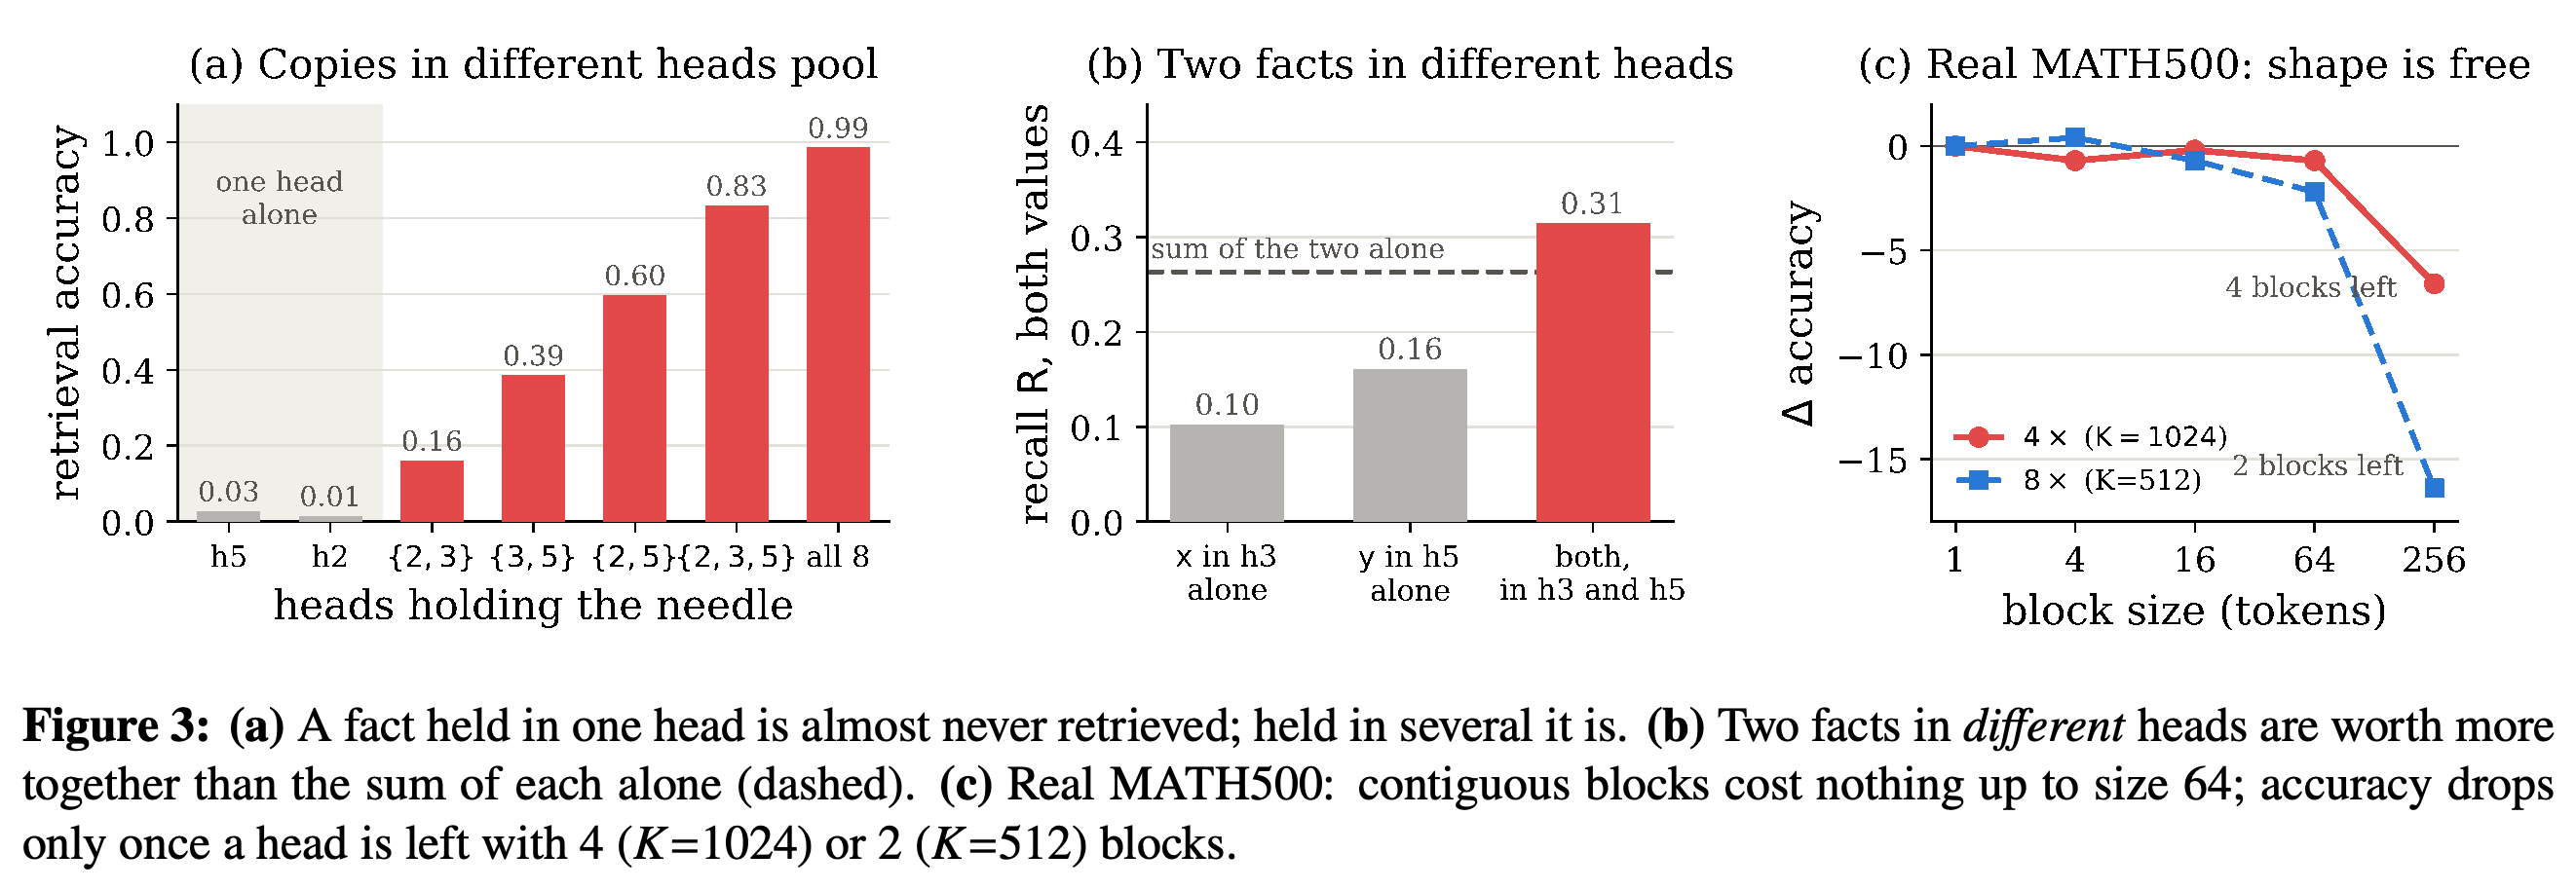
Planted-fact probe는 실제 모델 생성 MATH500 reasoning trace에 합성 사실을 넣고, 질문 1,536 tokens 전의 사실을 지정한 KV head에서만 pinning해 cross-head redundancy를 시험한다. Qwen3-4B에서 단일 head의 retrieval은 최고 0.03이지만 두 head는 0.60, 세 head는 0.83, 여덟 head는 0.99였고, 서로 다른 head에 둔 두 사실의 결합 recall $R=0.31$은 각각만 유지한 조건의 0.10과 0.16보다 높았다. Figure 3은 실제 MATH500에서 contiguous block과 scattered token의 형태 차이가 block size 64까지 작고, $K=1024$에서 head당 4개 block, $K=512$에서 2개 block만 남는 256-token block에서 정확도가 하락함을 보여 준다.
첫 패널은 planted fact를 유지하는 KV head 수와 retrieval accuracy의 관계를, 둘째 패널은 서로 다른 head에 둔 두 사실을 함께 보존할 때의 recall $R$을 보여 준다. 셋째 패널은 실제 MATH500에서 retained history의 block size를 바꾸며 4×와 8× compression의 정확도 변화를 비교한다.
5.3 What Is Left for a Selection Signal
질문 57 compression rounds 전에 한 번만 제시한 passcode 조건에서 Table 3의 Random Attention retrieval은 0.000, 정답 passcode의 평균 log $p$는 −18.35이고, R-KV는 각각 0.836과 −0.71이다. 이 조건에서 selection signal은 비중복 장거리 사실을 보존하는 데 기여하며, 저자들은 needle-finding 능력과 aggregate reasoning 성능을 같은 지표로 취급하지 않는다. Table 1의 main grid에서는 R-KV가 한 열에서만 앞선다는 원문 관찰을 근거로, 실제 reasoning trace에는 필요한 정보를 재서술하는 경우가 많다고 해석한다.
6 Efficiency Evaluation
vLLM PagedAttention의 H200 serving 비교는 $K=2048$, 1k-token prompt, 32k-token generation에서 Random Attention과 TriAttention에 같은 kernel, paging, scheduler, compression trigger를 적용한다. Table 4에서 Random Attention의 throughput은 Qwen3-4B, Phi-4-reasoning, Qwen3-14B, Qwen3-32B에서 각각 2046, 1737, 1819, 923 tok/s이고, TriAttention의 1494, 1212, 1303, 700 tok/s 대비 상대 증가율은 각각 37%, 43%, 40%, 32%다. 이 비교는 해당 vLLM serving 조건에서 TriAttention을 대상으로 하며, 저자들은 paged cache를 읽는 scoring pass와 batch 동기화 지점의 누적 대기를 원인으로 든다.
표는 한 H200에서 PagedAttention을 사용하는 vLLM의 output tok/s를 $K=2048$, 1k-token prompt, 32k-token generation 조건에서 비교한다. Random Attention과 TriAttention은 동일 serving integration에서 비교되며, 마지막 행은 Random Attention의 TriAttention 대비 throughput 증가율이다.
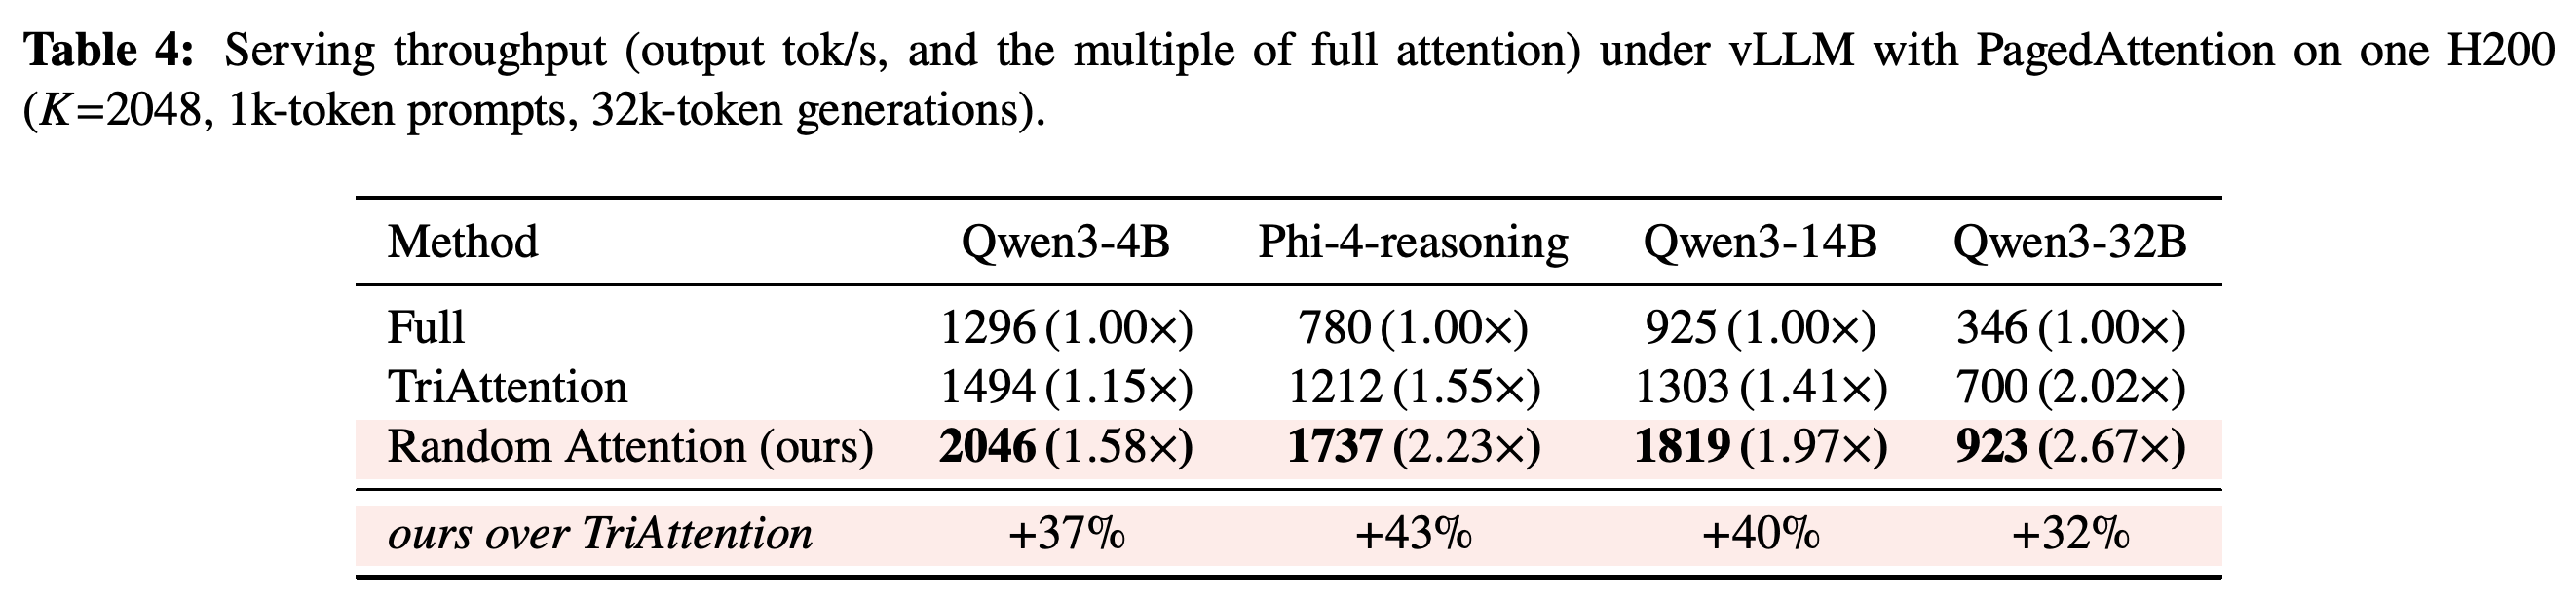
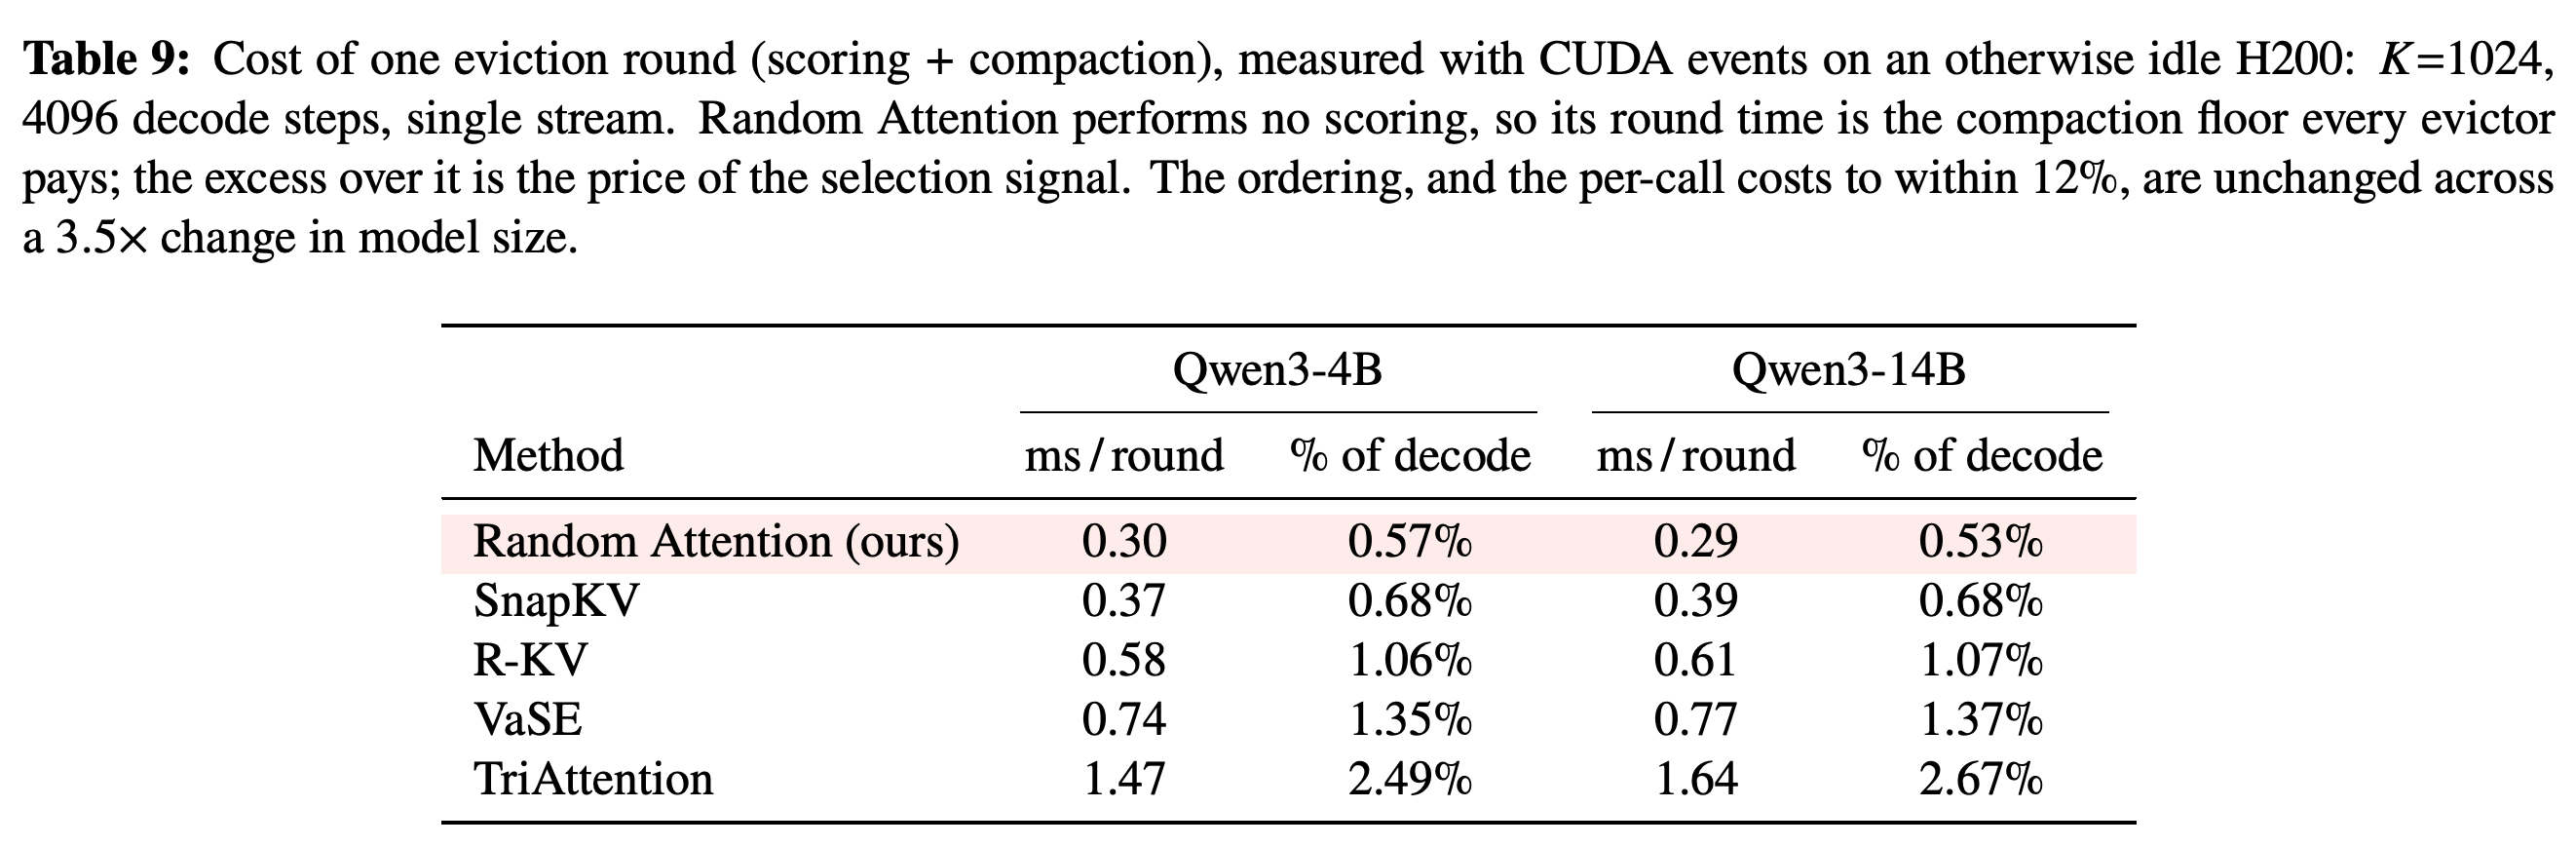
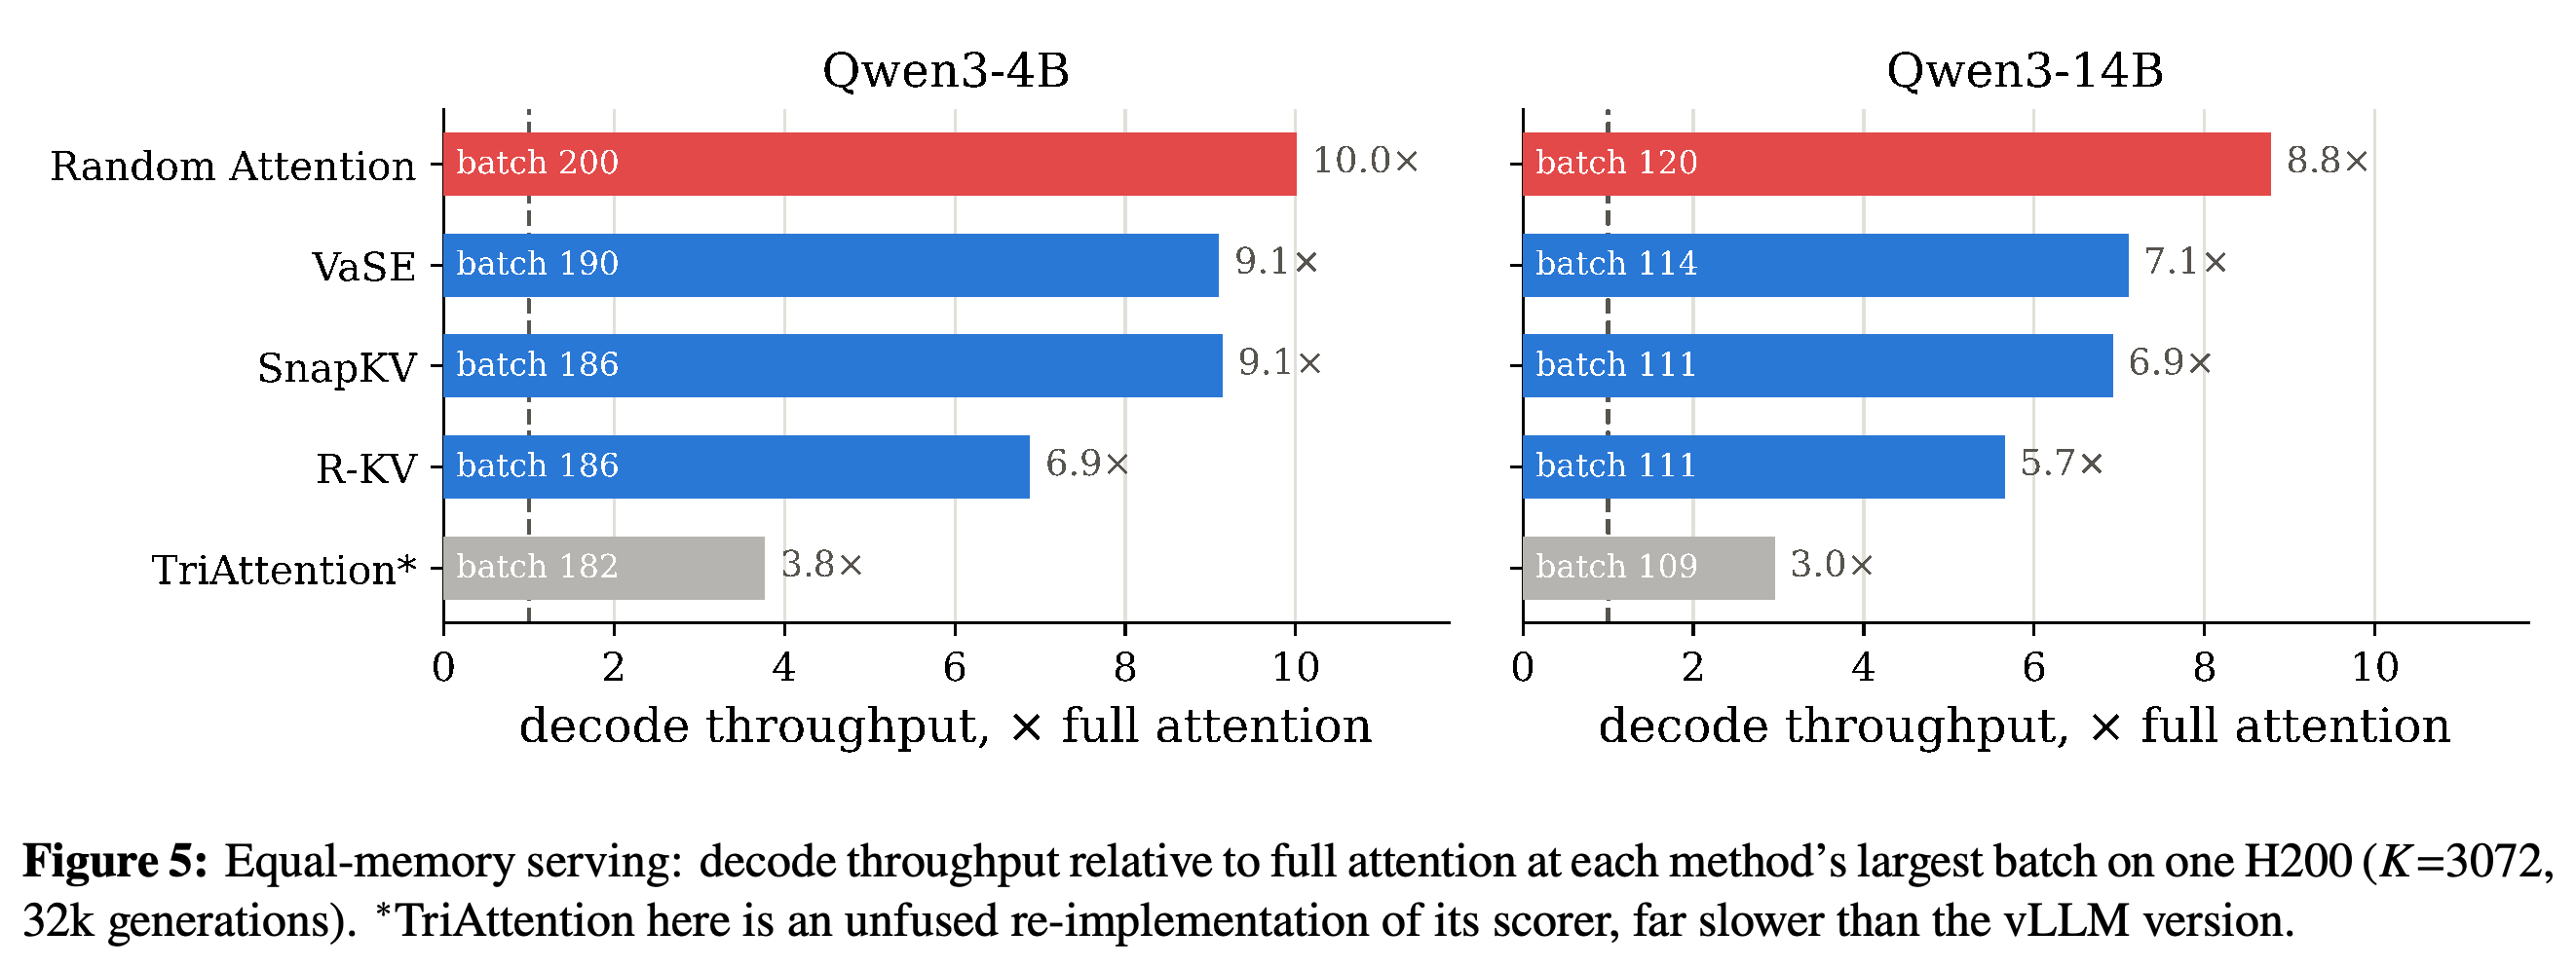
Table 9의 idle H200 single-stream 측정에서는 $K=1024$, 4096 decode steps에서 Random Attention의 eviction round 시간이 Qwen3-4B 0.30 ms, Qwen3-14B 0.29 ms이고 TriAttention은 각각 1.47 ms, 1.64 ms다. 143 GB H200의 equal-memory unpaged 조건에서 Table 10은 Random Attention이 Qwen3-4B에서 1779 tok/s, full attention의 10.01×, Qwen3-14B에서 1436 tok/s, 8.78×를 기록했음을 보이지만, TriAttention scorer가 unfused 재구현이므로 저자들은 Figure 5와 Table 10을 method-level serving 속도 비교의 근거로 채택하지 않는다. 결론적으로 논문은 prompt 보호와 head별 무작위 보존이 reasoning eviction의 실용적 기준선이 될 수 있으며, 긴 code prompt의 예산 배분과 희소한 once-stated fact 보존을 후속 과제로 제시한다.
표는 idle H200의 single stream에서 $K=1024$, 4096 decode steps로 측정한 eviction round당 scoring과 compaction 시간을 제시한다. Random Attention의 시간은 scoring 없이 공통 compaction만 수행한 값이며, 다른 정책과의 시간 차이는 selection signal 계산 비용을 포함한다.
그림은 $K=3072$, 32k generation에서 한 H200에 수용되는 최대 batch를 방법별로 찾은 뒤 full attention 대비 decode throughput을 표시한다. TriAttention은 unfused scorer 재구현 결과이므로, 원문은 이 그림의 TriAttention 대비 격차를 vLLM kernel 기반 method-level serving 비교에 사용하지 않는다.
부록
- 부록은 Qwen3-14B의 추가 일반화 결과, planted-fact probe의 도구와 recall metric, 나머지 설정의 matched prompt protection, keep-log 측정, 생성 길이와 run-to-run variability, eviction engine 세부 사항, 효율 측정 protocol과 추가 측정을 다룬다.
짧은 생각
이 논문의 핵심 통제는 prompt 보호 규칙과 selection signal을 분리했다는 점이다. 같은 보호 규칙 아래에서도 일부 설정의 잔차와 한 번만 제시된 passcode의 명확한 실패가 남으므로, 무작위 보존의 적합성은 재서술과 중복이 있는 reasoning workload라는 조건과 함께 판단해야 한다. 특히 긴 code prompt에서 prompt 전체를 고정하는 비용을 내용 단위 압축과 비교하면, Qwen3-32B LiveCodeBench의 TriAttention 우위가 어떤 정보 보존에서 나오는지 더 분명해질 것이다.
관련 글
효율적 자기어텐션에 대해서는 이 글을 참조하라. 어텐션 연산 최적화에 대해서는 이 글을 참조하라. 언어 모델 추론에 대해서는 이 글을 참조하라.