


Program-as-Weights: A Programming Paradigm for Fuzzy Functions 요약 설명
02 Jul 2026 | Paper Review Parameter-Efficient Fine-Tuning Hypernetworks On-Device Inference Synthetic Data목차
- 요약
- 1 Introduction
- 2 Programs as Weights
- 3 The Compiler–Interpreter System
- 4 Training
- 5 FuzzyBench: A 10M-Example Dataset of Fuzzy Functions
- 6 Main Results
- 7 Ablations
- 8 Robustness to Noisy Specifications
- 9 Local Execution
- 10 Related Work
- 11 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Program-as-Weights: A Programming Paradigm for Fuzzy Functions 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 2일(Arxiv), Preprint
- Zhang, Wentao, Hotsko, Liliana, Kim, Woojeong, Nie, Pengyu, Shieber, Stuart, Deng, Yuntian.
- University of Waterloo, Cornell University, Harvard University
- 논문 링크
- Github
- Project Page
요약
- Program-as-Weights (PAW)는 로그 분류, 형식이 잘못된 JSON 복구, 의도 기반 순위 결정처럼 정확한 기호 규칙으로 표현하기 어려운 퍼지 함수를 다룬다. 자연어 명세를 재사용 가능한 신경 프로그램으로 컴파일하고, 작고 고정된 인터프리터가 이를 로컬에서 실행하도록 한다.
- 프로그램은 텍스트 의사 프로그램과 컴파일러가 생성한 LoRA 어댑터를 결합한다. 학습된 4B LoRA 컴파일러는 공개된 10M-example 합성 데이터셋 FuzzyBench로 학습한다. 기존 모델을 그대로 사용하는 의사 프로그램 컴파일러와 기본 Qwen3 0.6B 인터프리터의 가중치는 고정된다. LoRA에 대해서는 이 글을 참조하라.
- FuzzyBench의 모델 검증 테스트 세트에서 Qwen3 0.6B 인터프리터를 사용하는 PAW는 정확 일치율 73.78%를 기록한다. Qwen3-32B를 직접 프롬프팅한 결과는 68.70%이며, PAW의 추론 메모리 사용량은 약 50배 적다. 컴파일한 프로그램은 오프라인에서 실행할 수 있지만, 평가는 단일 단계 함수에 한정되며 인터프리터 계열을 바꾸려면 컴파일러를 재학습해야 한다.
1 Introduction
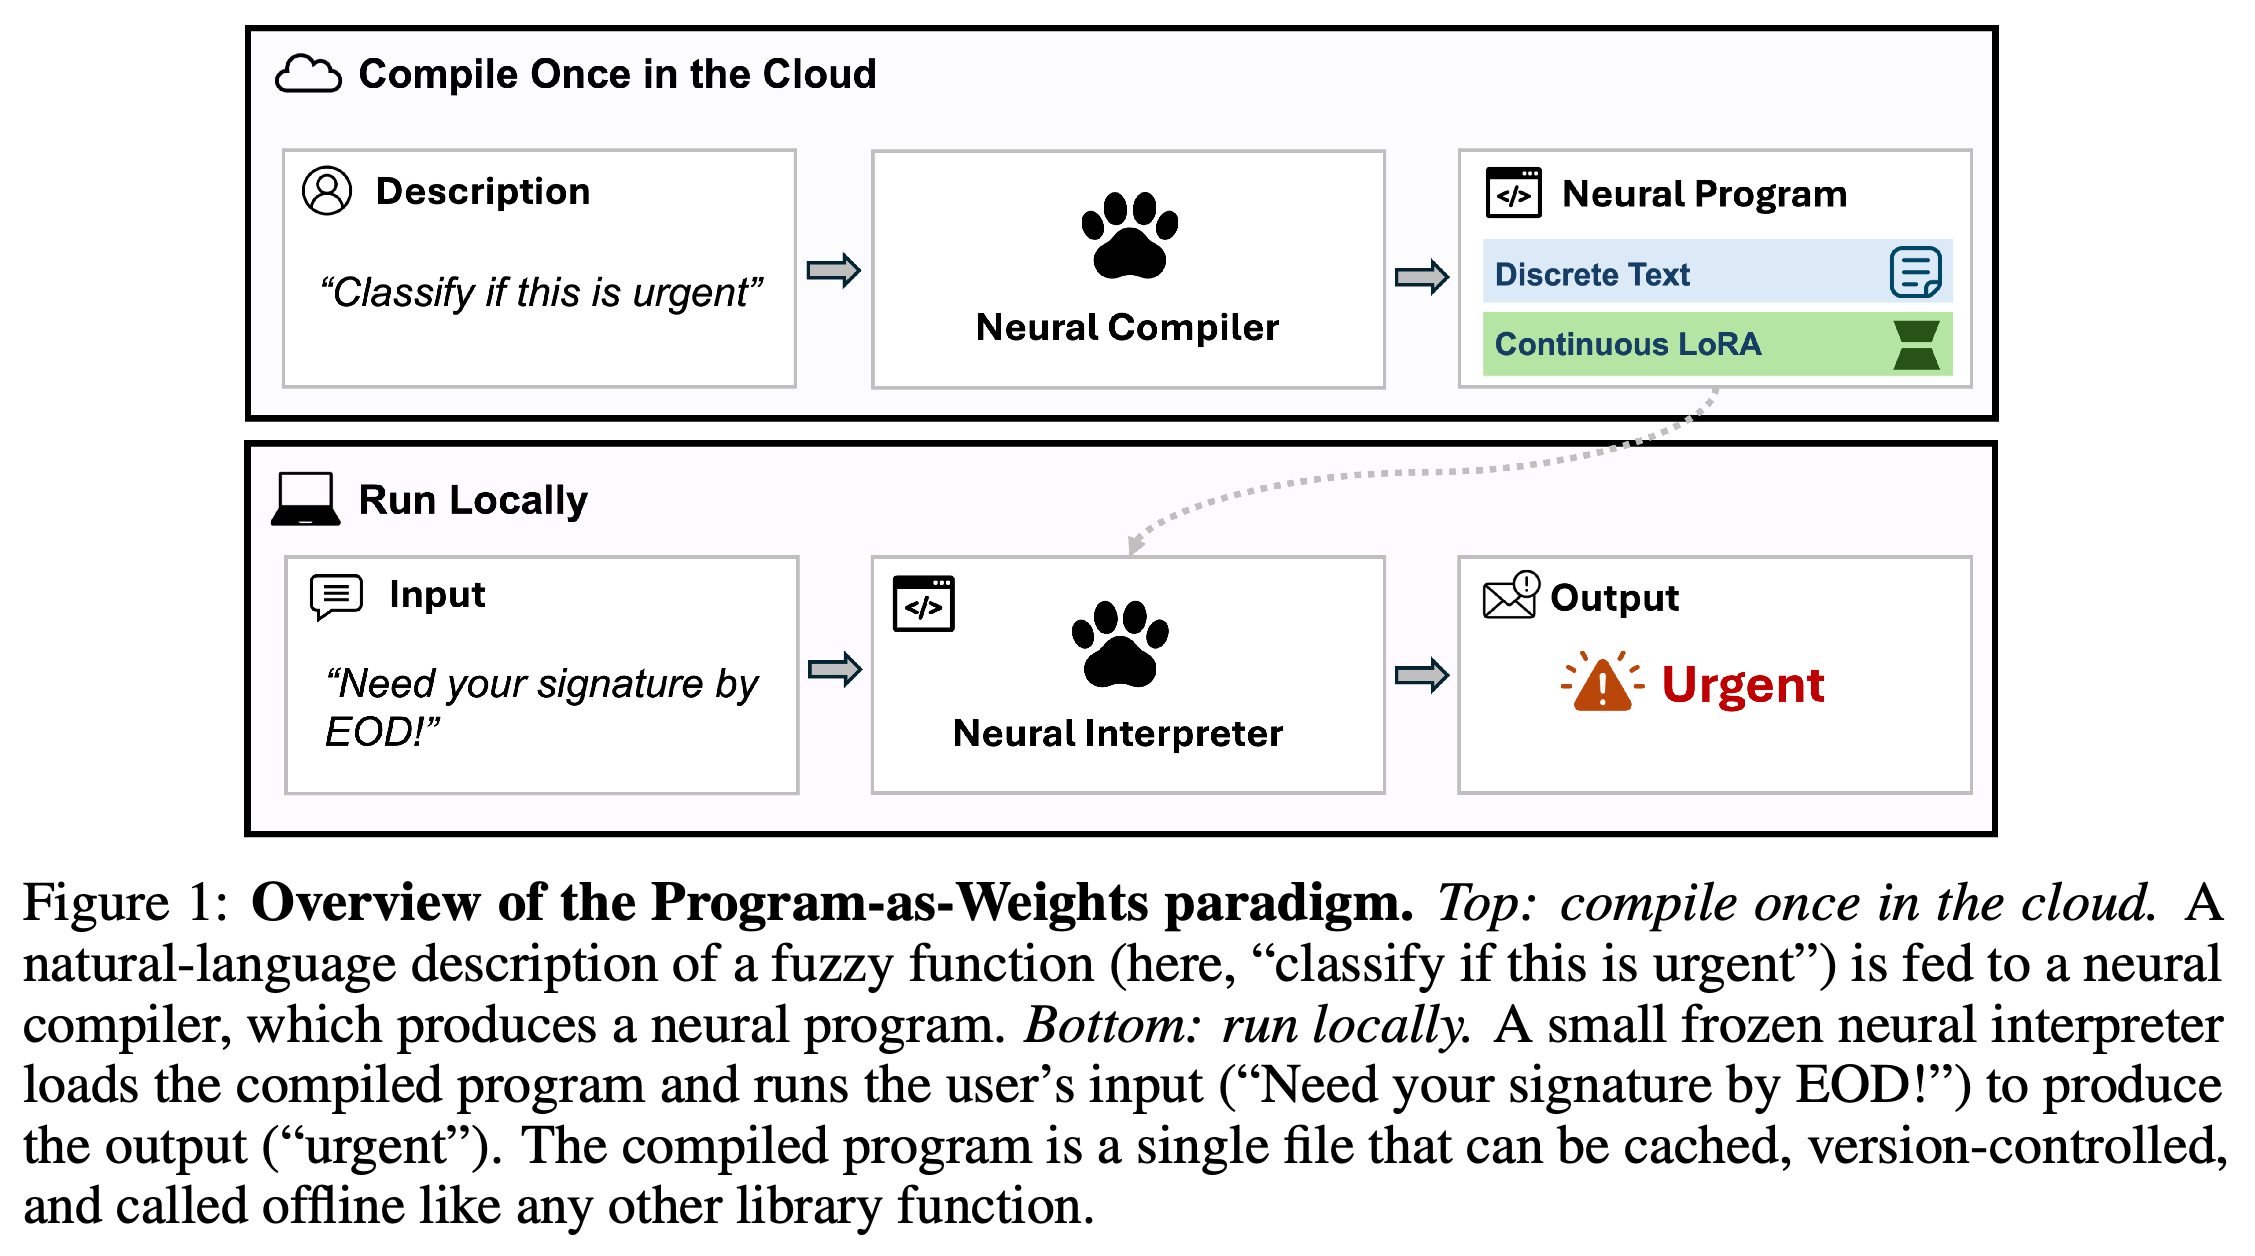
원격 LLM 호출을 사용하면 퍼지 함수를 쉽게 구현할 수 있지만, 입력마다 비용이 들고 네트워크에 의존하며 제공업체가 모델을 바꾸면 재현성이 떨어질 수 있다. PAW는 큰 모델이 맡는 작업을 컴파일 단계로 옮긴다. 개발자는 함수를 기술해 이식 가능한 프로그램을 얻고, 이후 입력은 기기에 상주하는 인터프리터로 처리한다. 코드는 https://github.com/programasweights 에, 데모는 https://programasweights.com 에 공개되어 있다.
위쪽 경로에서는 긴급도 분류 설명을 컴파일러에 1번 전달한다. 아래쪽 경로에서는 생성된 이산 텍스트와 연속 어댑터를 로컬 인터프리터에 적용해 새 메시지를 처리한다. 이 도식은 컴파일과 입력마다 반복하는 작업을 구분한다.
2 Programs as Weights
명세 s와 입력 x에 대한 추상화는 p = Compiler(s) 및 ŷ = Interpreter(p, x) ≈ f(x)이다. 이 구현에서 p는 이산적인 의사 프로그램과 연속적인 파라미터 효율 구성요소로 이루어진다. 전자는 예시와 함께 작업을 기술하고, 후자는 고정된 인터프리터를 조정한다. 0.6B 인터프리터용 Q4_0 어댑터는 공유 기본 모델과 별도로 약 23 MB를 차지한다.
3 The Compiler–Interpreter System
파이프라인은 명세 재작성, PEFT 생성, 실행을 분리한다. 저자들은 컴파일러–인터프리터 추상화를 유지하면서 연속적인 구성요소를 생성된 LoRA 가중치 또는 prefix-tuning KV 캐시로 구현한다.
3.1 Compiler–interpreter abstraction
기존 Qwen3-4B-Instruct-2507 모델을 그대로 사용하는 의사 프로그램 컴파일러는 명세를 대표적인 입출력 예시가 포함된 독립적인 작업 설명으로 다시 쓴다. 별도로 학습한 4B PEFT 컴파일러는 명세와 의사 프로그램을 입력받는다. 실행 시에는 고정된 인터프리터가 의사 프로그램과 생성된 PEFT 모듈을 받는다.
3.2 Text-to-LoRA: our current best
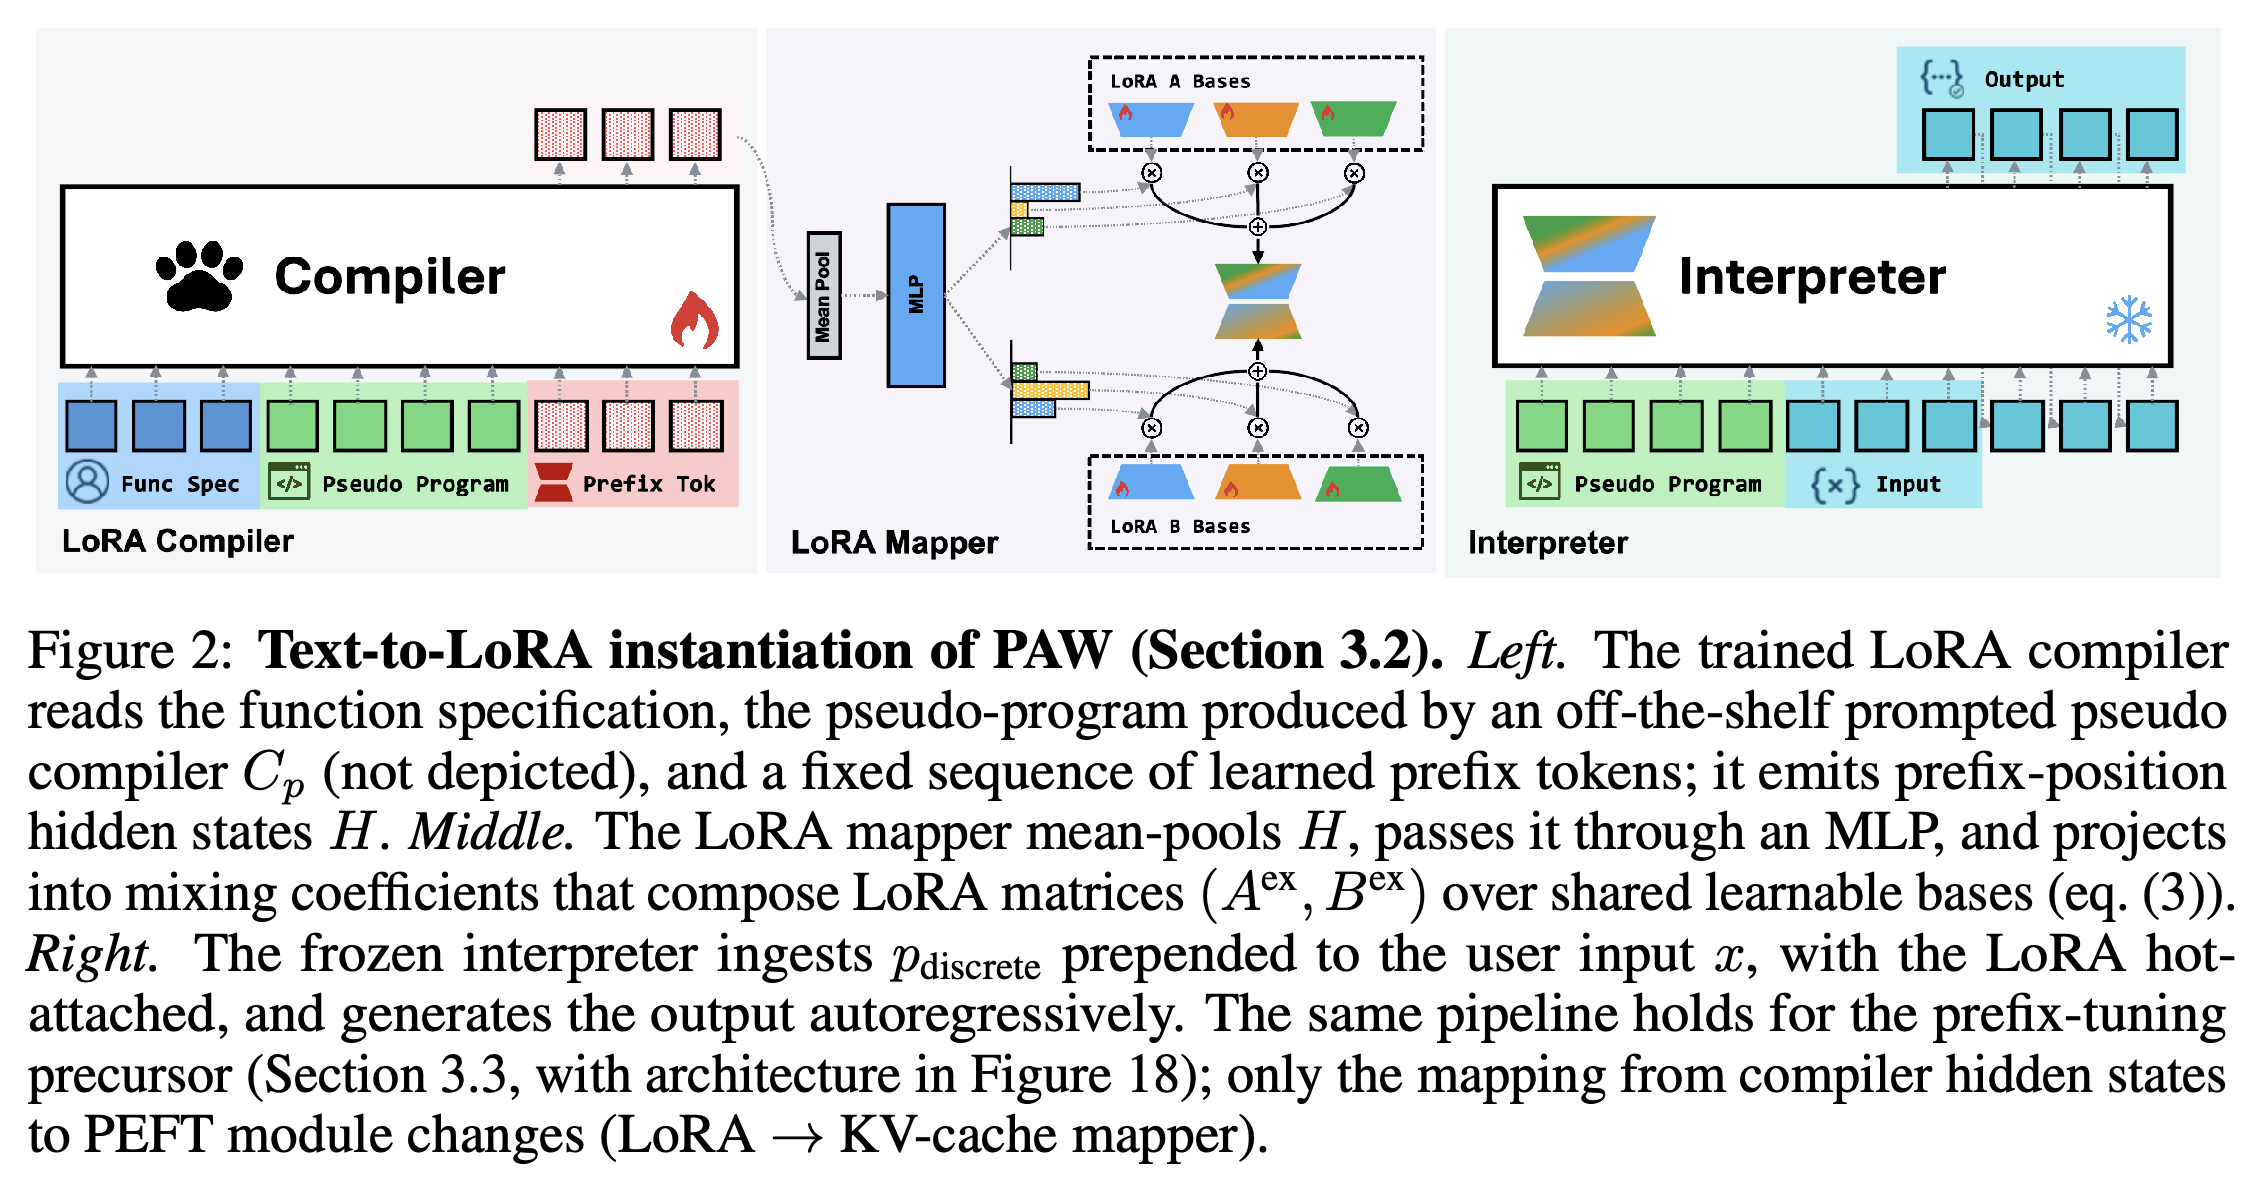
LoRA 컴파일러는 명세, 의사 프로그램, EOS, 학습된 접두 토큰 T = 64개를 1번의 순전파로 처리한다. 깊이가 대응하는 컴파일러 층 L개의 접두 위치 은닉 상태를 평균 풀링한 뒤, 이를 계수로 변환해 공유 기저 N = 64개를 층별 LoRA A·B 행렬로 조합한다. attention의 q/k/v/o와 MLP의 gate/up/down 모듈에 rank r = 64를 적용하면 함수마다 고정된 인터프리터용 LoRA 파라미터 약 38.5M개가 생성된다.
각 패널은 컴파일러의 은닉 상태가 매퍼를 거쳐 공유 LoRA 기저에 연결되는 과정과, 생성된 어댑터가 고정된 인터프리터에 부착되는 과정을 보여준다. 학습 대상인 컴파일러·매퍼와 실행에 사용하는 인터프리터를 구분한다.
3.3 Prefix-tuning: a precursor instantiation
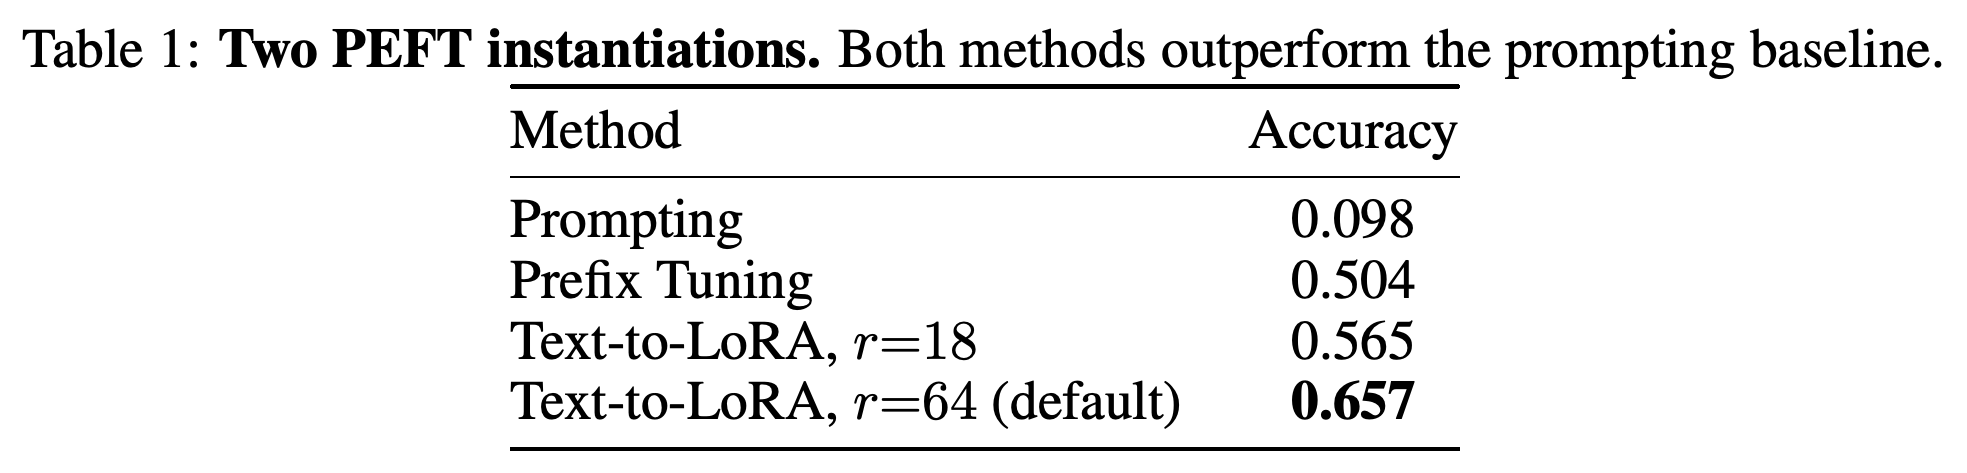
이전 방식은 컴파일러의 은닉 상태를 위치별 key–value 쌍으로 변환해 인터프리터의 attention 캐시 앞에 붙인다. 논문에서 학습 연산량을 동일하게 맞춰 비교한 규모에서 prefix-tuning의 FuzzyBench 정확 일치율은 50.4%이고, text-to-LoRA는 크기를 맞춘 r = 18에서 56.5%, r = 64에서 65.7%를 기록한다. 직접 프롬프팅은 9.8%다. 따라서 본문의 주요 실험에는 LoRA 방식을 사용한다.
이 통제된 비교에서는 컴파일된 PEFT 형태가 모두 0.098 prompting baseline보다 높은 점수를 기록한다. LoRA 점수는 r = 18에서 0.565, r = 64에서 0.657로 높아지며, prefix-tuning은 0.504를 기록한다.
4 Training
PEFT 컴파일러와 매퍼만 학습한다. 각 (s, x, y)에 대해 미리 생성한 의사 프로그램과 컴파일러가 생성한 어댑터를 고정된 인터프리터에 제공하고, y의 토큰별 로그 가능도 평균에 음수를 취한 값을 목적함수로 사용한다. 기울기는 인터프리터를 통과하지만 인터프리터 가중치는 갱신하지 않는다. Appendix G에는 예제 10M개에 대해 3 epoch를 학습하고 유효 배치 크기 48을 사용했으며, GPU 3개에서 수행한 Qwen3 0.6B run에 약 72시간이 걸렸다고 명시되어 있다.
5 FuzzyBench: A 10M-Example Dataset of Fuzzy Functions
FuzzyBench는 gpt-5.2로 생성한 합성 (명세, 입력, 출력) 예제 10M개로 구성되며, 주제별 버전 29개와 하위 범주 800개 이상을 포함한다. 먼저 명세를 생성한 다음 입출력 쌍을 만든다. 명세를 기준으로 80/10/10으로 분할해 테스트 명세가 학습 중 등장하지 않도록 한다. 검증된 평가 세트에는 gpt-5.2와 gpt-5-mini가 동의한 사례만 남겨 모호한 정답 일부를 걸러내지만, 독립적인 인간 검증을 제공하지는 않는다.
6 Main Results
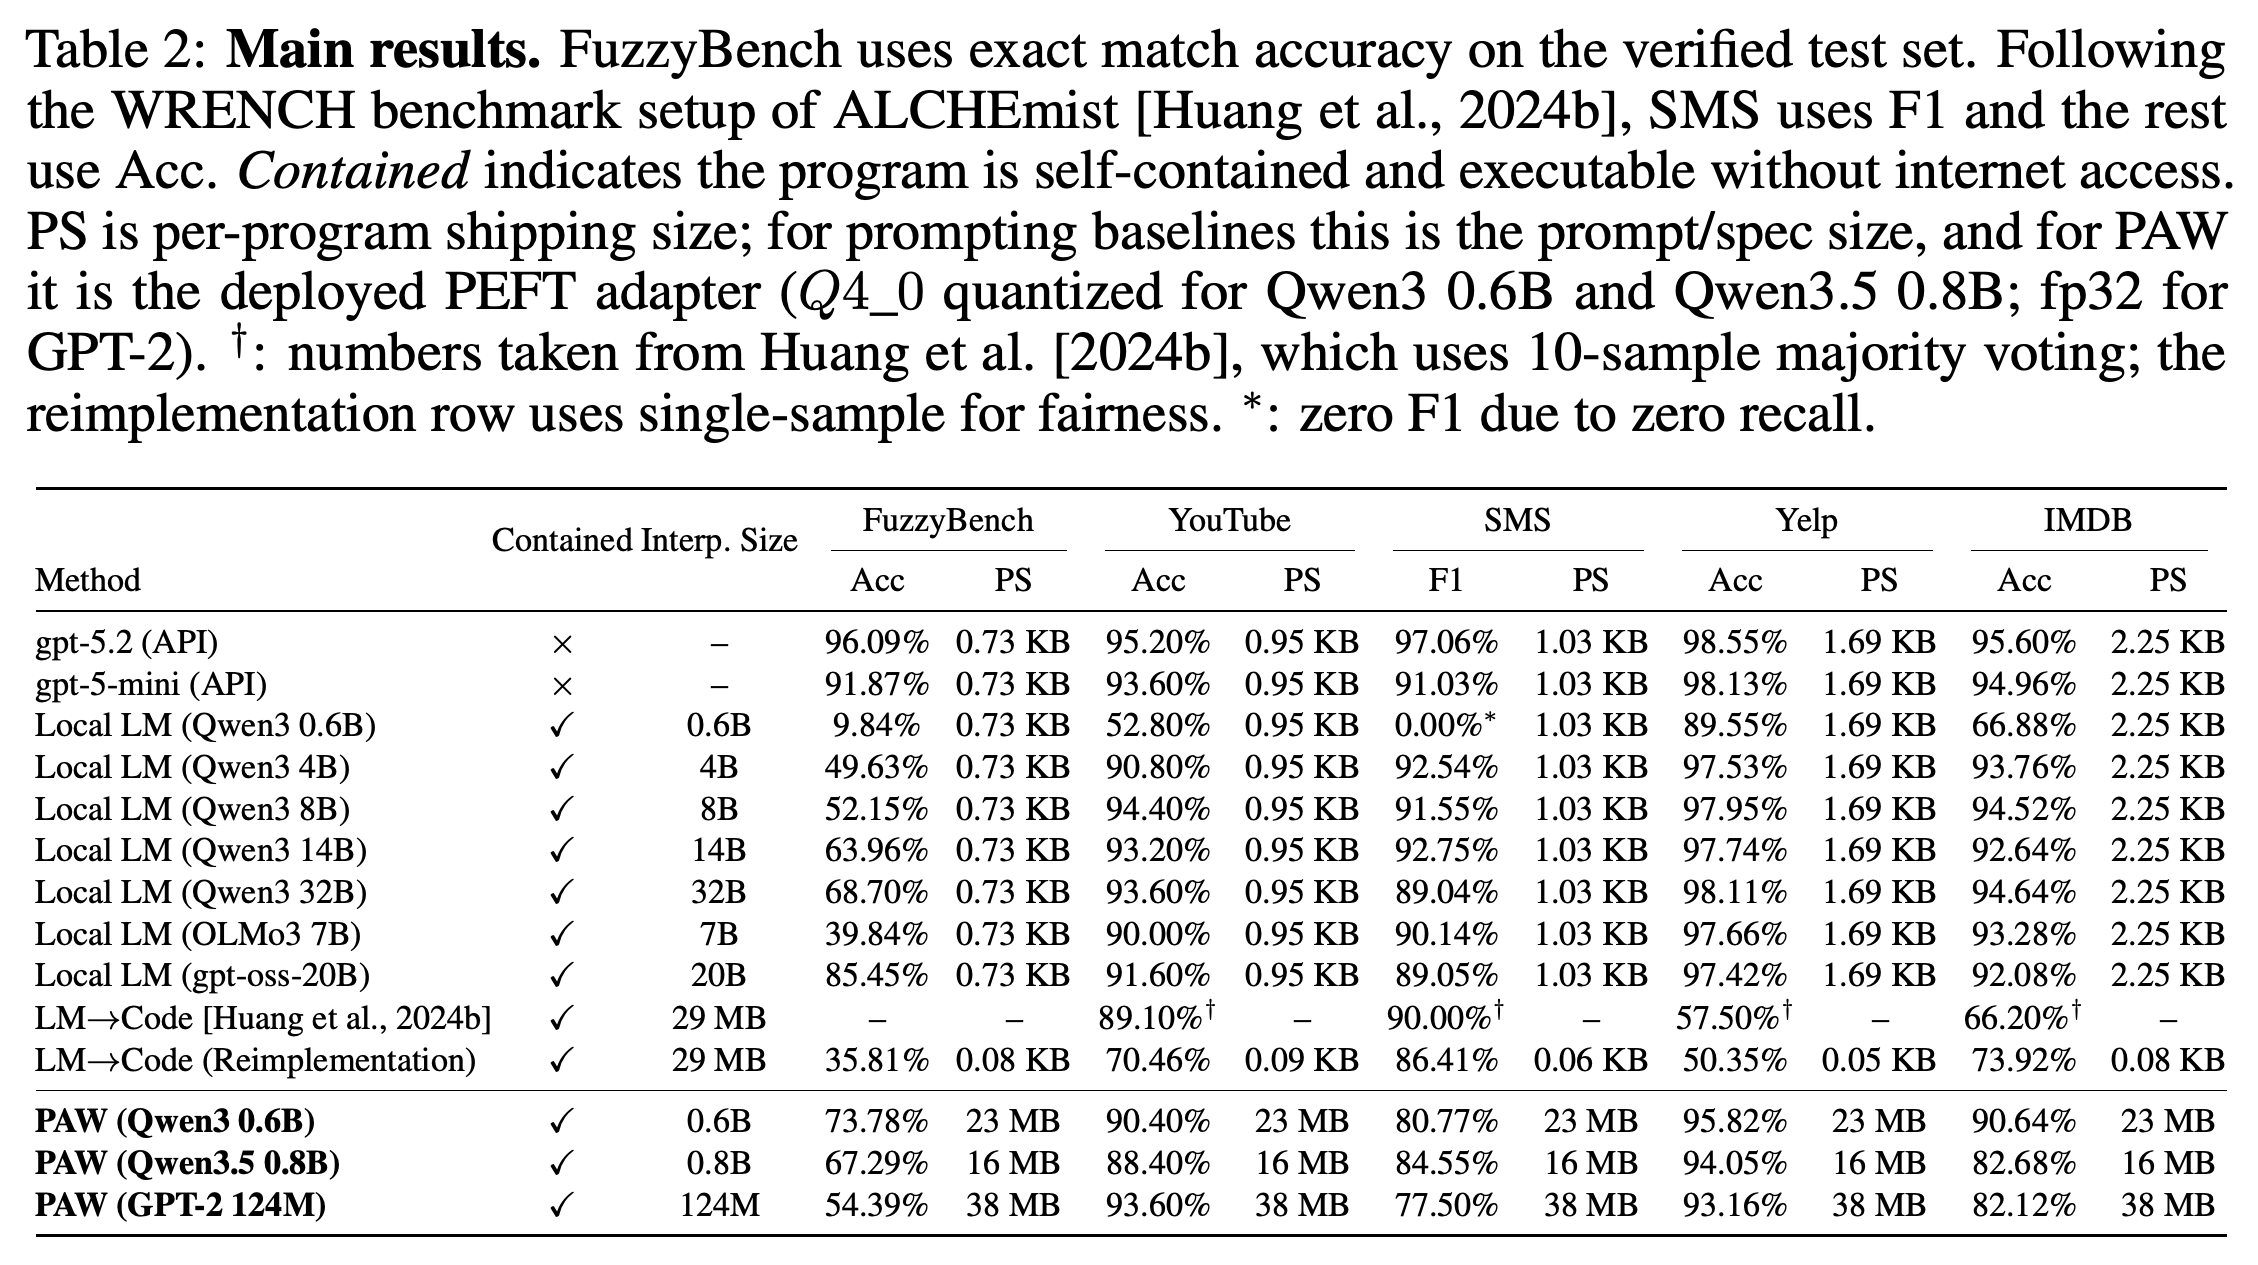
검증된 FuzzyBench 테스트 세트에서 Qwen3 0.6B를 사용하는 PAW의 정확 일치율은 73.78%다. Qwen3-32B 직접 프롬프팅은 68.70%, gpt-oss-20B 직접 프롬프팅은 85.45%, 데이터를 생성한 gpt-5.2 API model은 96.09%다. PAW는 명시된 Qwen3 프롬프팅 기준선보다 높지만, 모든 대형 모델이나 API 모델보다 높은 것은 아니다. 외부 텍스트 데이터셋에서는 FuzzyBench의 정확 일치율 대신 작업별 정확도 또는 F1을 사용한다.
PAW Qwen3 0.6B 행은 FuzzyBench 73.78%와 프로그램당 배포 크기 23 MB를 제시한다. Qwen3-32B 직접 프롬프팅의 점수는 68.70%다. 외부 데이터셋 열은 서로 다른 지표를 사용한다. SMS에는 F1을, 나머지에는 정확도를 사용하며, 상대적 성능도 데이터셋에 따라 달라진다.
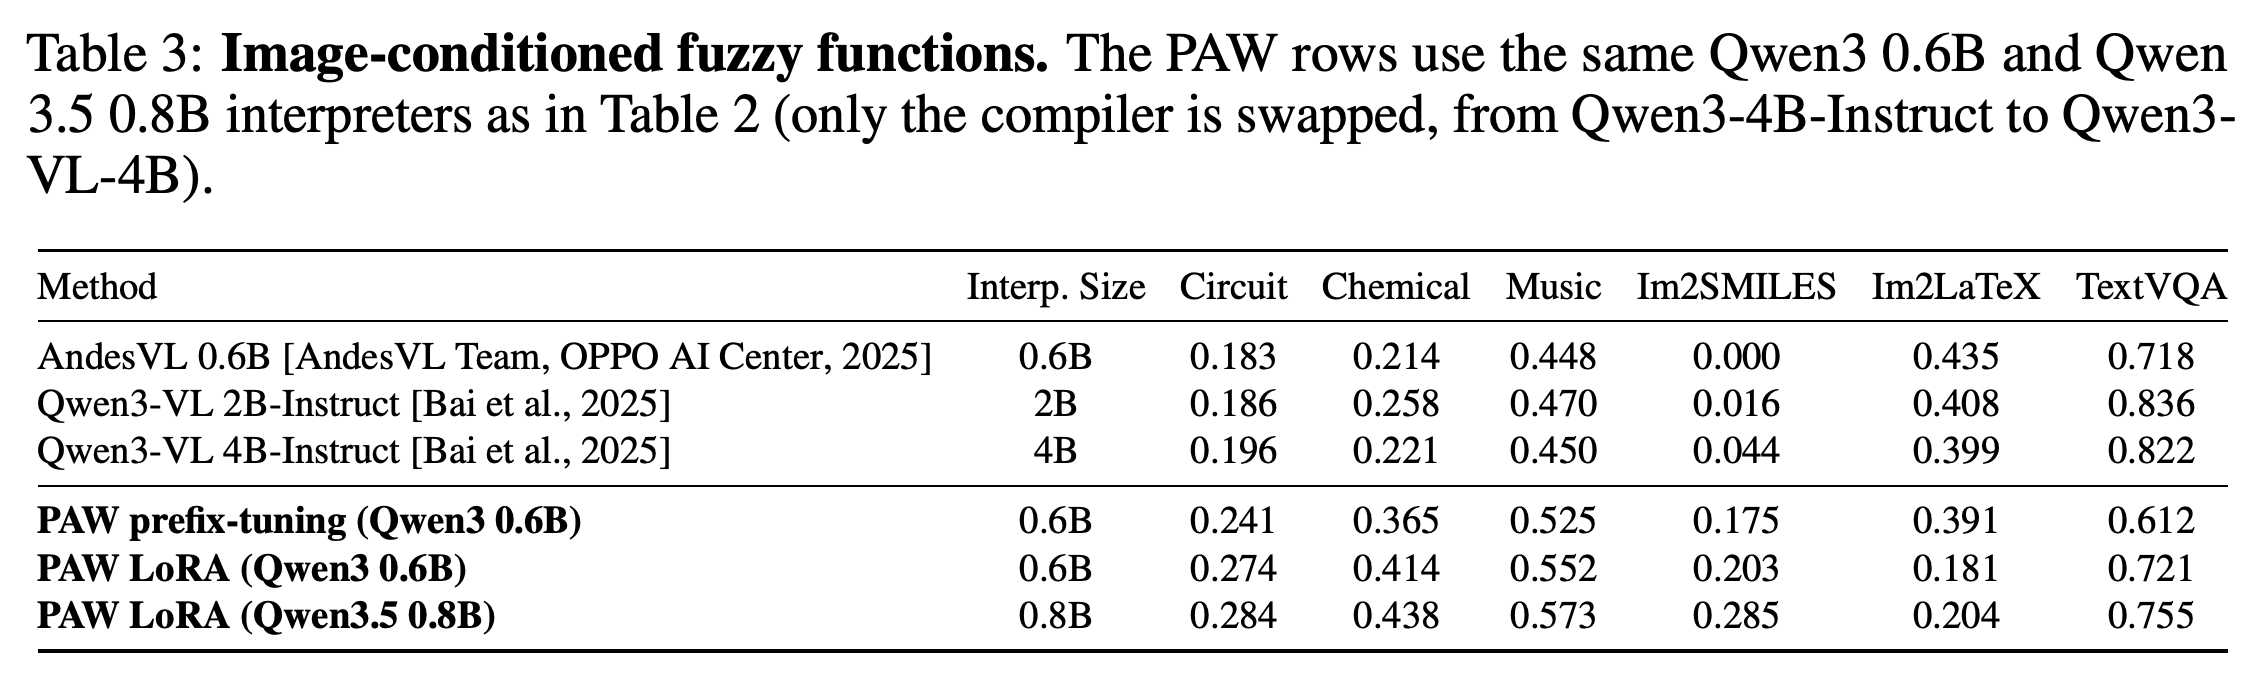
이미지 조건부 함수에서는 텍스트 컴파일러를 Qwen3-VL-4B로 교체하고 작은 텍스트 인터프리터와 LoRA 매퍼는 유지한다. Qwen3 0.6B PAW LoRA 결과는 Circuit, Chemical, Music에서 표에 제시된 VLM 기준선을 넘지만, Im2LaTeX 점수는 0.181로 PAW prefix-tuning의 0.391보다 낮다. 부록의 prefix-tuning 구성요소 실험은 긴 이미지-마크업 작업에서 의사 프로그램의 예시가 인터프리터의 문맥 공간을 잠식할 수 있음을 시사한다.
컴파일러를 Qwen3-VL-4B로 교체했을 때, Qwen3 0.6B 인터프리터를 사용하는 PAW LoRA는 Circuit, Chemical, Music에서 표의 VLM 기준선보다 높지만 Im2LaTeX에서는 prefix-tuning보다 낮다. 작업 6개는 교차 모달 적용 가능성과 작업별 성능 차이를 함께 보여준다.
7 Ablations
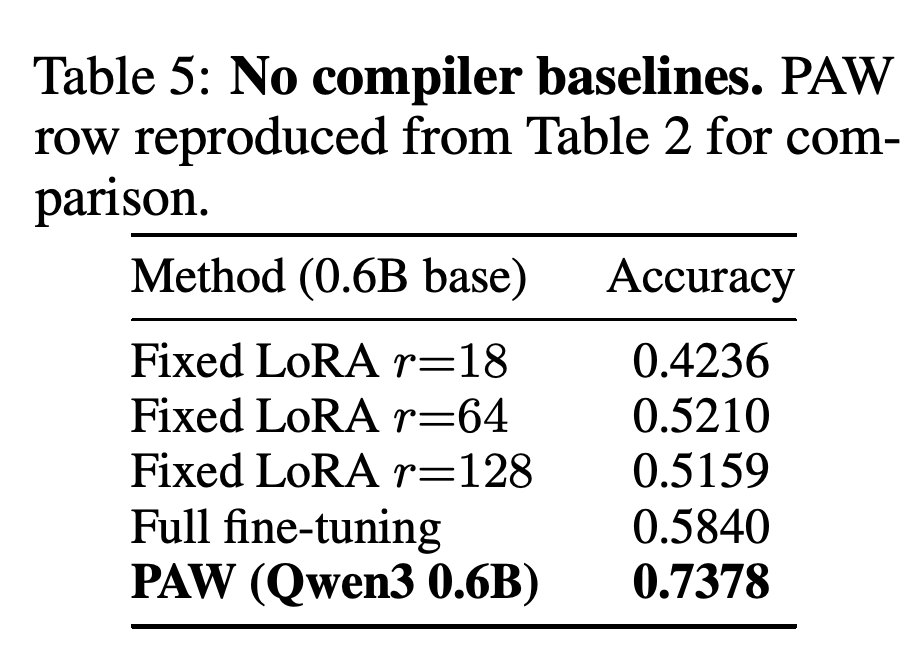
매퍼 비교에서 기본 공유 기저 설계의 점수는 0.6223으로, 위치별 집계 0.5598, 층별 기저 0.6028, LoRA와 prefix 경로의 결합 0.6033보다 높다. 저자들은 이 차이에 대한 이론적 설명은 제시하지 않는다. 동일한 기본 모델, 데이터, 학습 예산을 사용했다고 보고한 비교에서 PAW는 0.7378, 전체 파인튜닝은 0.5840, 가장 성능이 높은 고정 LoRA는 0.5210을 기록한다.
PAW는 0.7378, 전체 파인튜닝은 0.5840, 가장 성능이 높은 고정 LoRA는 0.5210을 기록한다. 논문은 이 비교에 동일한 기본 모델, 데이터, 학습 예산을 사용했다고 보고한다.
8 Robustness to Noisy Specifications
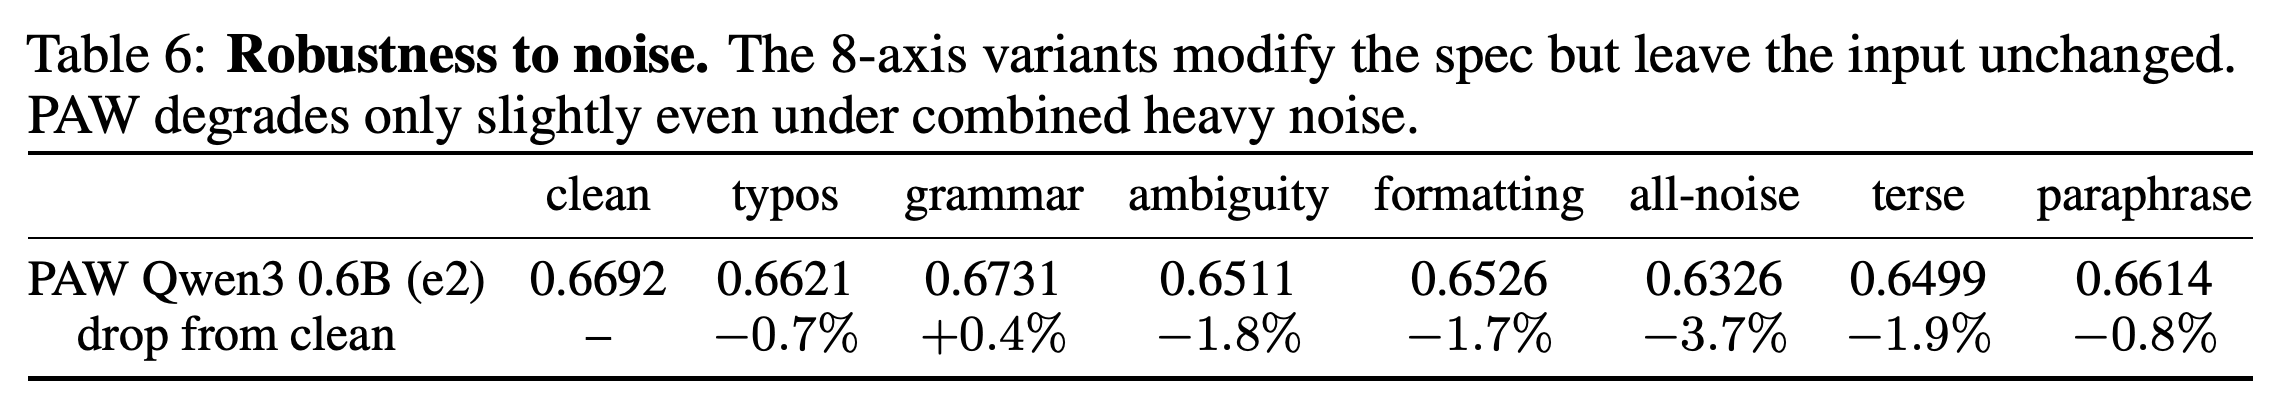
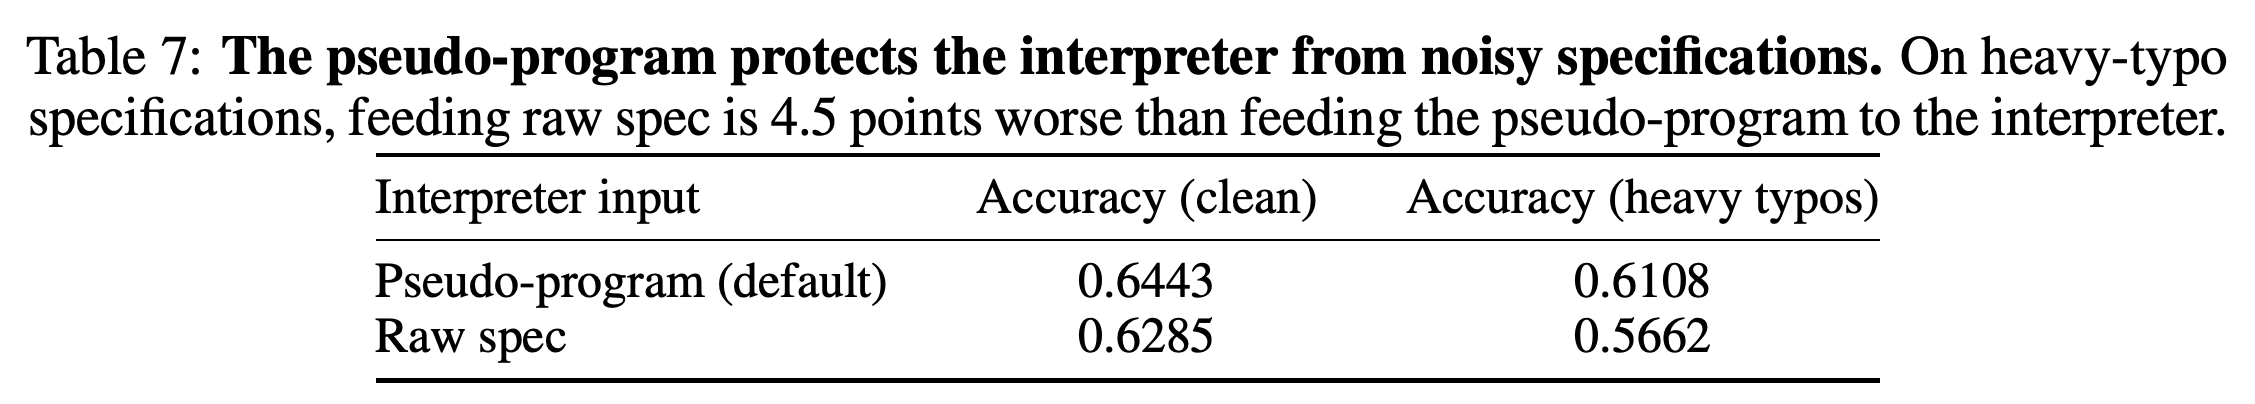
노이즈 변형 실험은 작업 입력을 유지한 채 명세를 변경한다. epoch 2에서 깨끗한 명세의 정확 일치율은 0.6692이고, 여러 종류의 강한 노이즈를 결합하면 0.6326이다. 모든 변형이 정확도를 낮추지는 않는다. 별도의 심한 오타 실험에서는 인터프리터 입력으로 재작성된 의사 프로그램을 사용할 때 0.6108, 원래 명세를 사용할 때 0.5662를 기록해 이산 구성요소가 노이즈를 완화하는 역할을 뒷받침한다.
여러 종류의 강한 노이즈를 결합하면 깨끗한 명세의 정확도 0.6692가 0.6326으로 바뀐다. 이 실험에서 문법 노이즈의 점수는 깨끗한 명세보다 약간 높으므로, 모든 변형이 정확도를 낮추지는 않는다.
심한 오타가 있을 때 재작성된 의사 프로그램의 점수는 0.6108이고, 인터프리터가 원래 명세를 받으면 0.5662다. 깨끗한 명세에서는 각각 0.6443과 0.6285로, 오타가 있을 때 관찰된 차이가 더 크다.
9 Local Execution
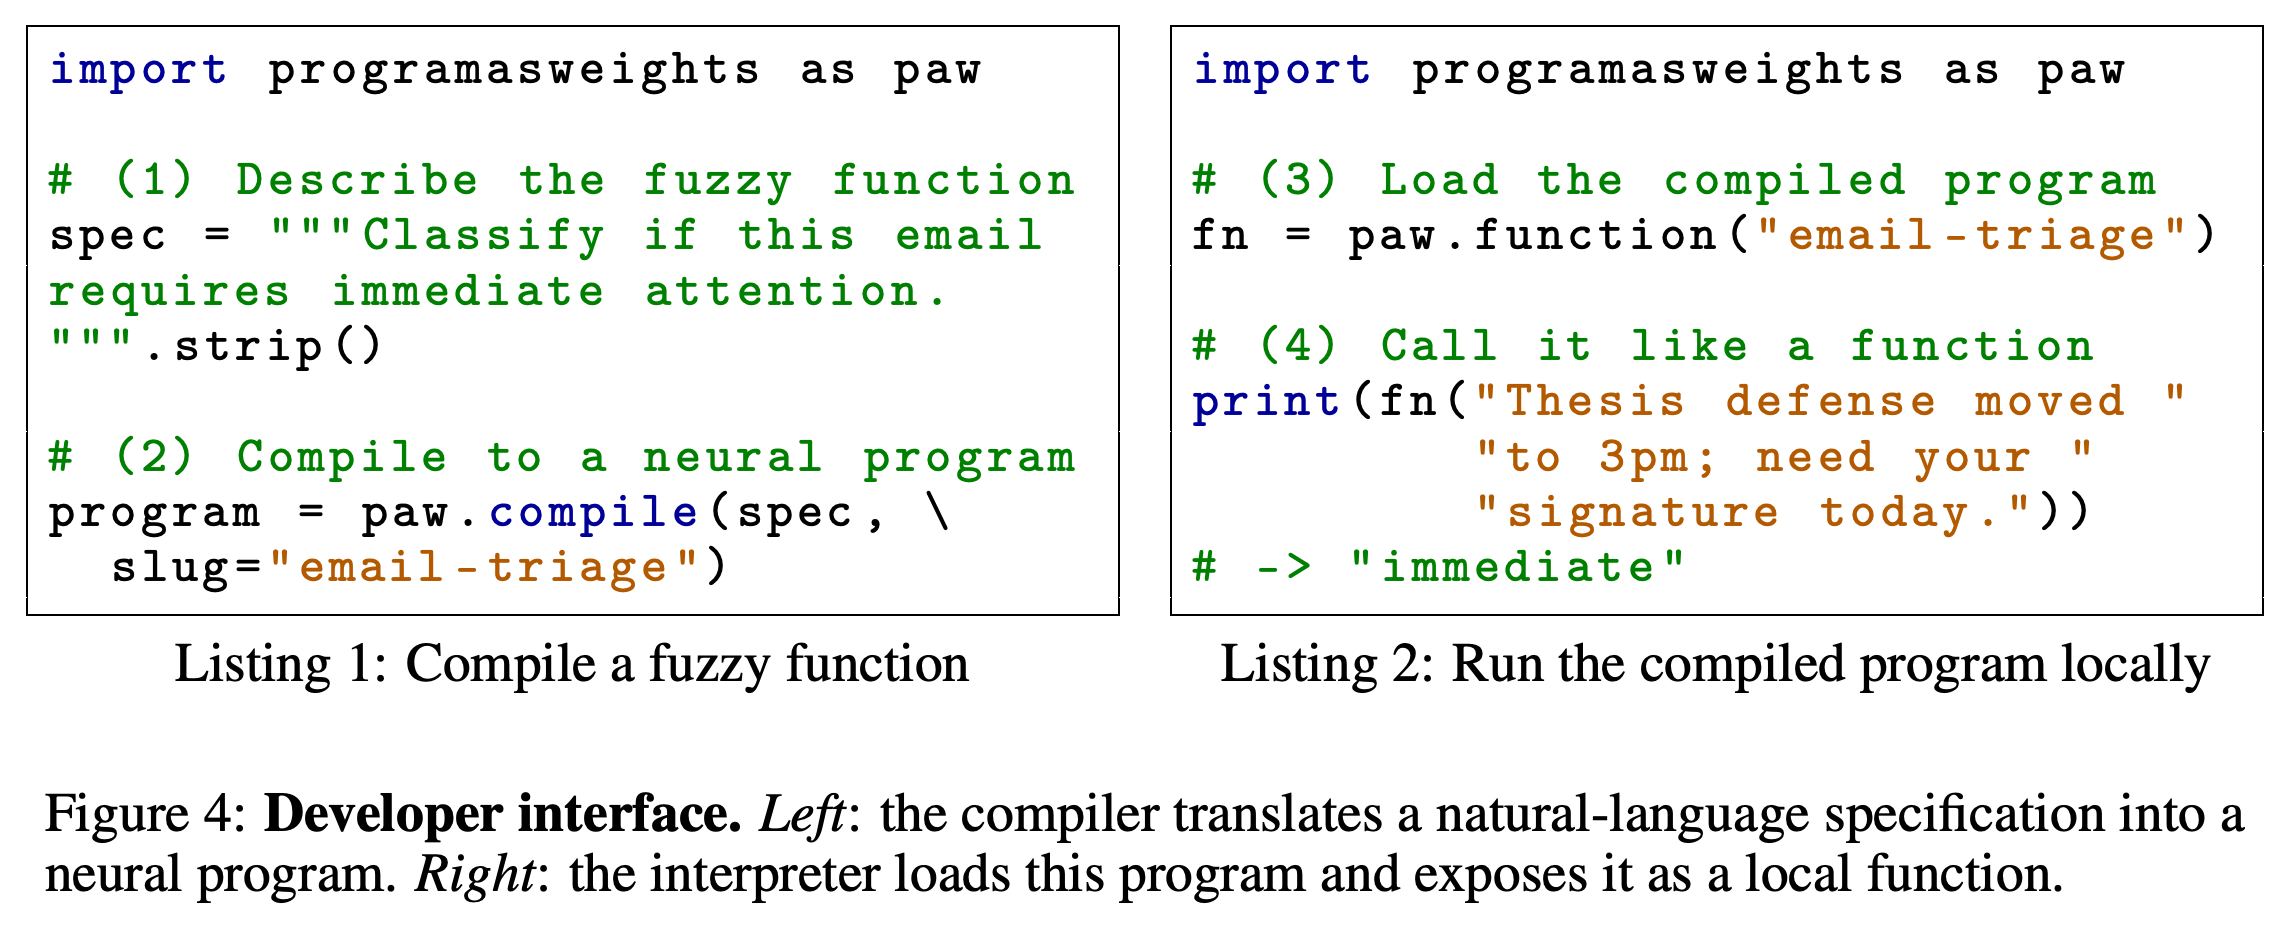
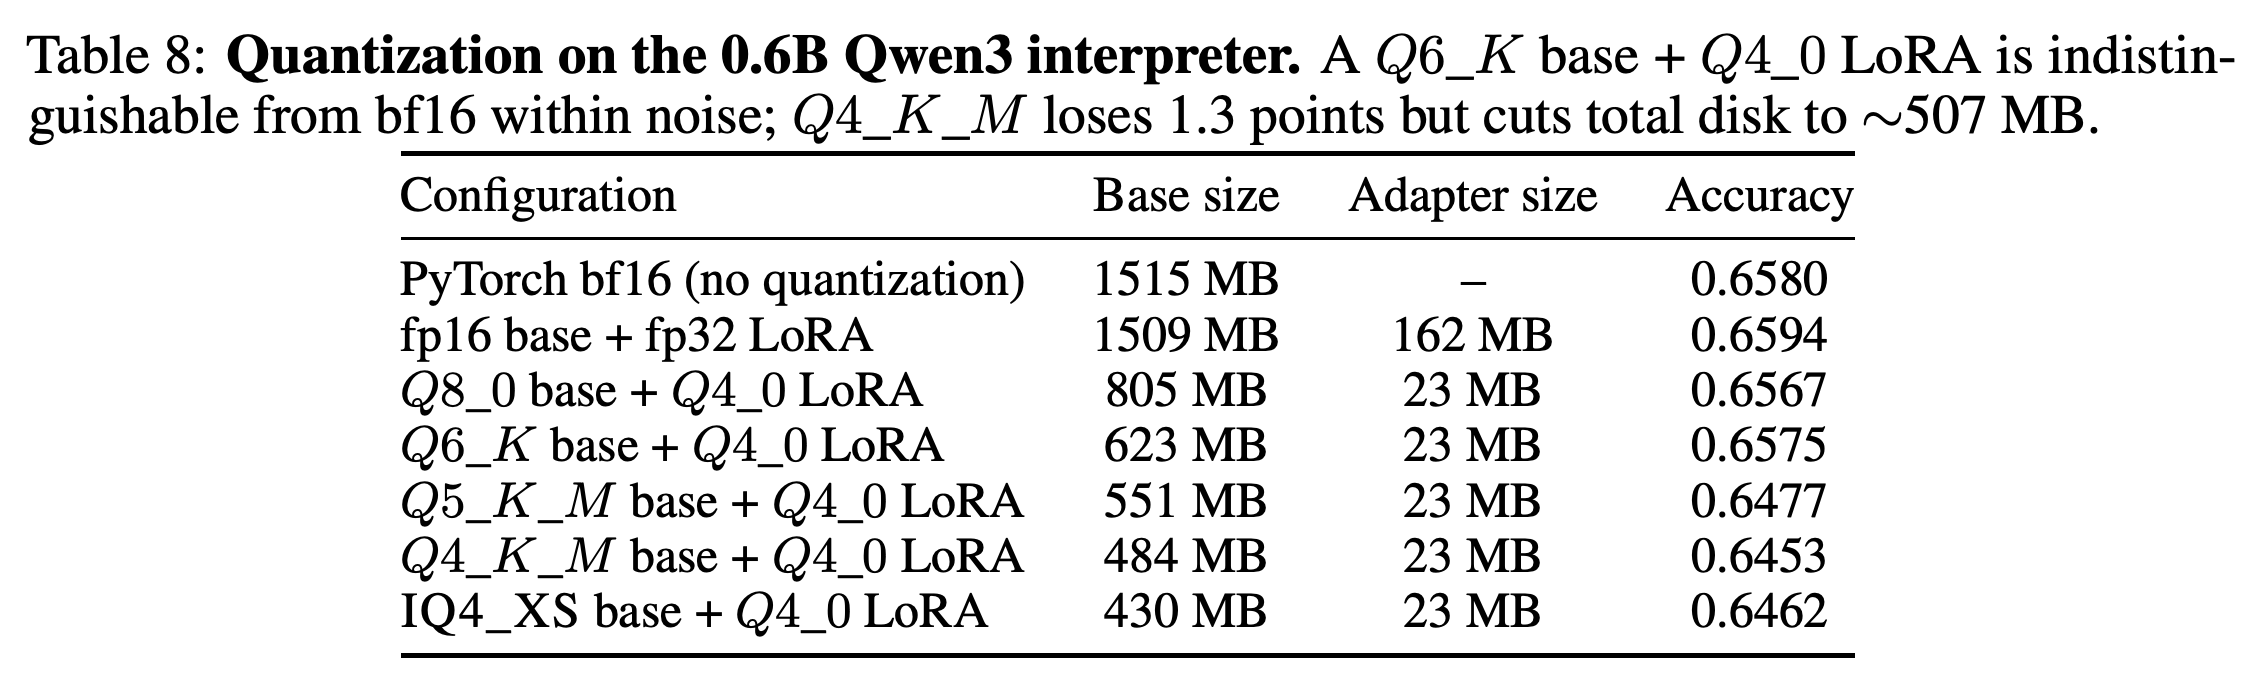
인터페이스에서는 paw.compile(prompt)로 직렬화 가능한 프로그램을 얻고, paw.function(id_or_path)로 불러와 로컬 호출 함수로 사용한다. 컴파일에는 컴파일러 서비스가 필요하지만, 다운로드한 뒤 실행할 때는 외부 API 호출이 필요하지 않다. 양자화 평가용 예제 4096개에서 Q6_K 기본 모델과 Q4_0 어댑터는 0.6575를 기록해 PyTorch bf16의 0.6580과 비슷하다. Q4_K_M 기본 모델과 Q4_0 어댑터의 총크기는 약 507 MB이고 점수는 0.6453이다. 별도의 IQ4_XS 구성은 약 430 MB의 기본 모델과 23 MB의 어댑터를 사용한다.
나란히 놓인 Python 코드 예시는 paw.compile을 사용한 컴파일과, 함수 호출에 앞서 paw.function으로 프로그램을 불러오는 과정을 보여준다. 정확도나 지연 시간의 결과가 아니라 개발자 인터페이스를 설명한다.
예제 4096개의 부분집합에서 Q6_K와 Q4_0 조합은 bf16에 가까운 정확도를 유지하며, 표에 제시된 기본 모델과 어댑터 크기는 각각 623 MB와 23 MB다. Q4_K_M과 Q4_0 조합의 총크기는 약 507 MB이고 점수는 0.6453으로, bf16의 0.6580과 비교된다.
Metal 가속을 사용하는 MacBook M3에서 Q5_K_M 기본 모델과 Q4_0 어댑터는 31.6 tokens/s로 실행되며, 처음 불러오는 데 0.48 s가 걸린다. 사례 연구 5개는 로그 모니터링, 사이트 탐색, 검색 결과 재정렬, 도구 호출, 다국어 단어 맞히기 게임을 다룬다. 함수 10개로 구성된 도구 호출 파이프라인은 TOOLCALL-15에서 93%를 기록한다. 이 시연에는 주변 애플리케이션 코드가 포함되어 있으므로 일반적인 장기 추론 능력에 대한 통제된 평가로 볼 수 없다.
10 Related Work
PAW는 배포 시 작업별 경사하강 없이 어댑터나 접두 표현을 생성하는 텍스트 조건부 하이퍼네트워크와 PEFT 방법을 바탕으로 한다. 저자들이 강조하는 차별점은 의사 프로그램과 PEFT를 결합한 산출물, 프로그래머가 작성할 법한 퍼지 함수 명세를 활용한 학습, 버전 관리가 가능한 개발자용 프로그램 인터페이스다. 반면 ALCHEmist [Huang et al., 2024b]는 실행 가능한 Python 라벨링 코드를 출력하며, 작업을 코드로 안정적으로 표현할 수 있을 때 사용할 수 있는 기호적 대안이다.
11 Conclusion
이 논문은 컴파일을 마친 뒤 고정된 경량 런타임에서 로컬로 실행할 수 있는 퍼지 함수를 보여준다. 컴파일러를 교체해 이 추상화를 이미지 조건부 작업으로도 확장한다. 텍스트 작업에서 가장 강한 정량적 결과는 검증된 합성 FuzzyBench 테스트 세트에서 얻은 것이며, 독립적으로 작성된 임의의 명세나 장기 프로그램에서의 성능은 입증되지 않았다.
부록
- Appendix A는 호스팅 환경에서 컴파일, 테스트, 내보내기를 수행하는 절차를 설명한다. B와 C는 데이터 구축 및 컴파일러·인터프리터 프롬프트를 제공하며, 여기에는 기존 의사 프로그램 컴파일러가 예시 3-6개를 요청하는 내용도 포함된다. D와 D.1은 이미지 작업 프롬프트와 prefix-tuning 구성요소 실험을 제시한다. 이산적인 의사 프로그램을 추가하면 일부 단답형 작업에는 도움이 되지만, Im2SMILES와 Im2LaTeX에서는 연속 구성요소만 사용한 방식보다 성능이 낮다. E는 이전 prefix-tuning 방식을 도식화하고, F는 데이터셋 버전 29개를 기록한다. 여기에는 예제 8.25M개를 포함하는 spaCy-superset/custom-NLP-pipeline 주제의 version 23도 있다.
- Appendices G와 H는 학습과 추가 ablation을 자세히 설명한다. I의 컴파일러 크기 및 가중치 고정 비교는 결과가 비단조적이어서 결론을 내리기 어렵고, J는 노이즈 유형별 결과를 제공한다. K에는 전체 양자화 표가 있으며, L은 인터프리터마다 rollout 20개를 살펴 관찰된 강점과 실패를 서술하지만 모집단 수준의 비율을 입증하지는 않는다. M은 사례 연구 5개를 설명한다. 로그 모니터링에는 별도의 정체 감지 타이머가 필요하고, 도구 호출 파이프라인은 JSON 생성에 결정적 Python 코드를 사용한다. N은 인터프리터 결합, 해석하기 어려운 어댑터, 단일 단계 평가, 합성 데이터 의존성, 작업에 따라 달라지는 PEFT 선택을 한계로 꼽는다. O는 오프라인 실행의 이점과 오용 위험에 대한 저자들의 평가를 논의한다.
짧은 생각
동일한 기본 모델을 사용한 ablation과 양자화 기기에서 측정한 결과는 여러 차례 로컬로 호출할 때 컴파일 비용을 분산할 수 있음을 뒷받침한다. 주요 한계는 평가 범위다. 학습에 사용하지 않은 합성 명세와 사례 연구 5개만으로는 독립적으로 작성된 실제 운영 작업 전반의 신뢰성을 측정할 수 없다. 이미지 결과도 적합한 PEFT 형태가 작업에 따라 달라짐을 보여준다.