


Meta-Harness: End-to-End Optimization of Model Harnesses 요약 설명
30 Mar 2026 | Paper Review Harness Optimization AI Coding Agents목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Meta-Harness: A Harness for Optimizing Harnesses
- 4 Experiments
- 5 Discussion
- 부록
- 짧은 생각
이번 글에서는 Meta-Harness: End-to-End Optimization of Model Harnesses 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 30일(Arxiv)
- Lee, Yoonho, Nair, Roshen, Zhang, Qizheng, Lee, Kangwook, Khattab, Omar, Finn, Chelsea.
- Stanford, KRAFTON, MIT
- 논문 링크
요약
- Meta-Harness: End-to-End Optimization of Model Harnesses는 가중치가 고정된 언어 모델을 둘러싼 실행 코드를 탐색한다. 후보를 제안하는 코딩 에이전트는 스칼라 보상이나 미리 정한 요약만 받는 대신, 모든 이전 후보의 소스 코드, 평가 점수, 실행 추적이 담긴 파일시스템을 선택적으로 읽는다.
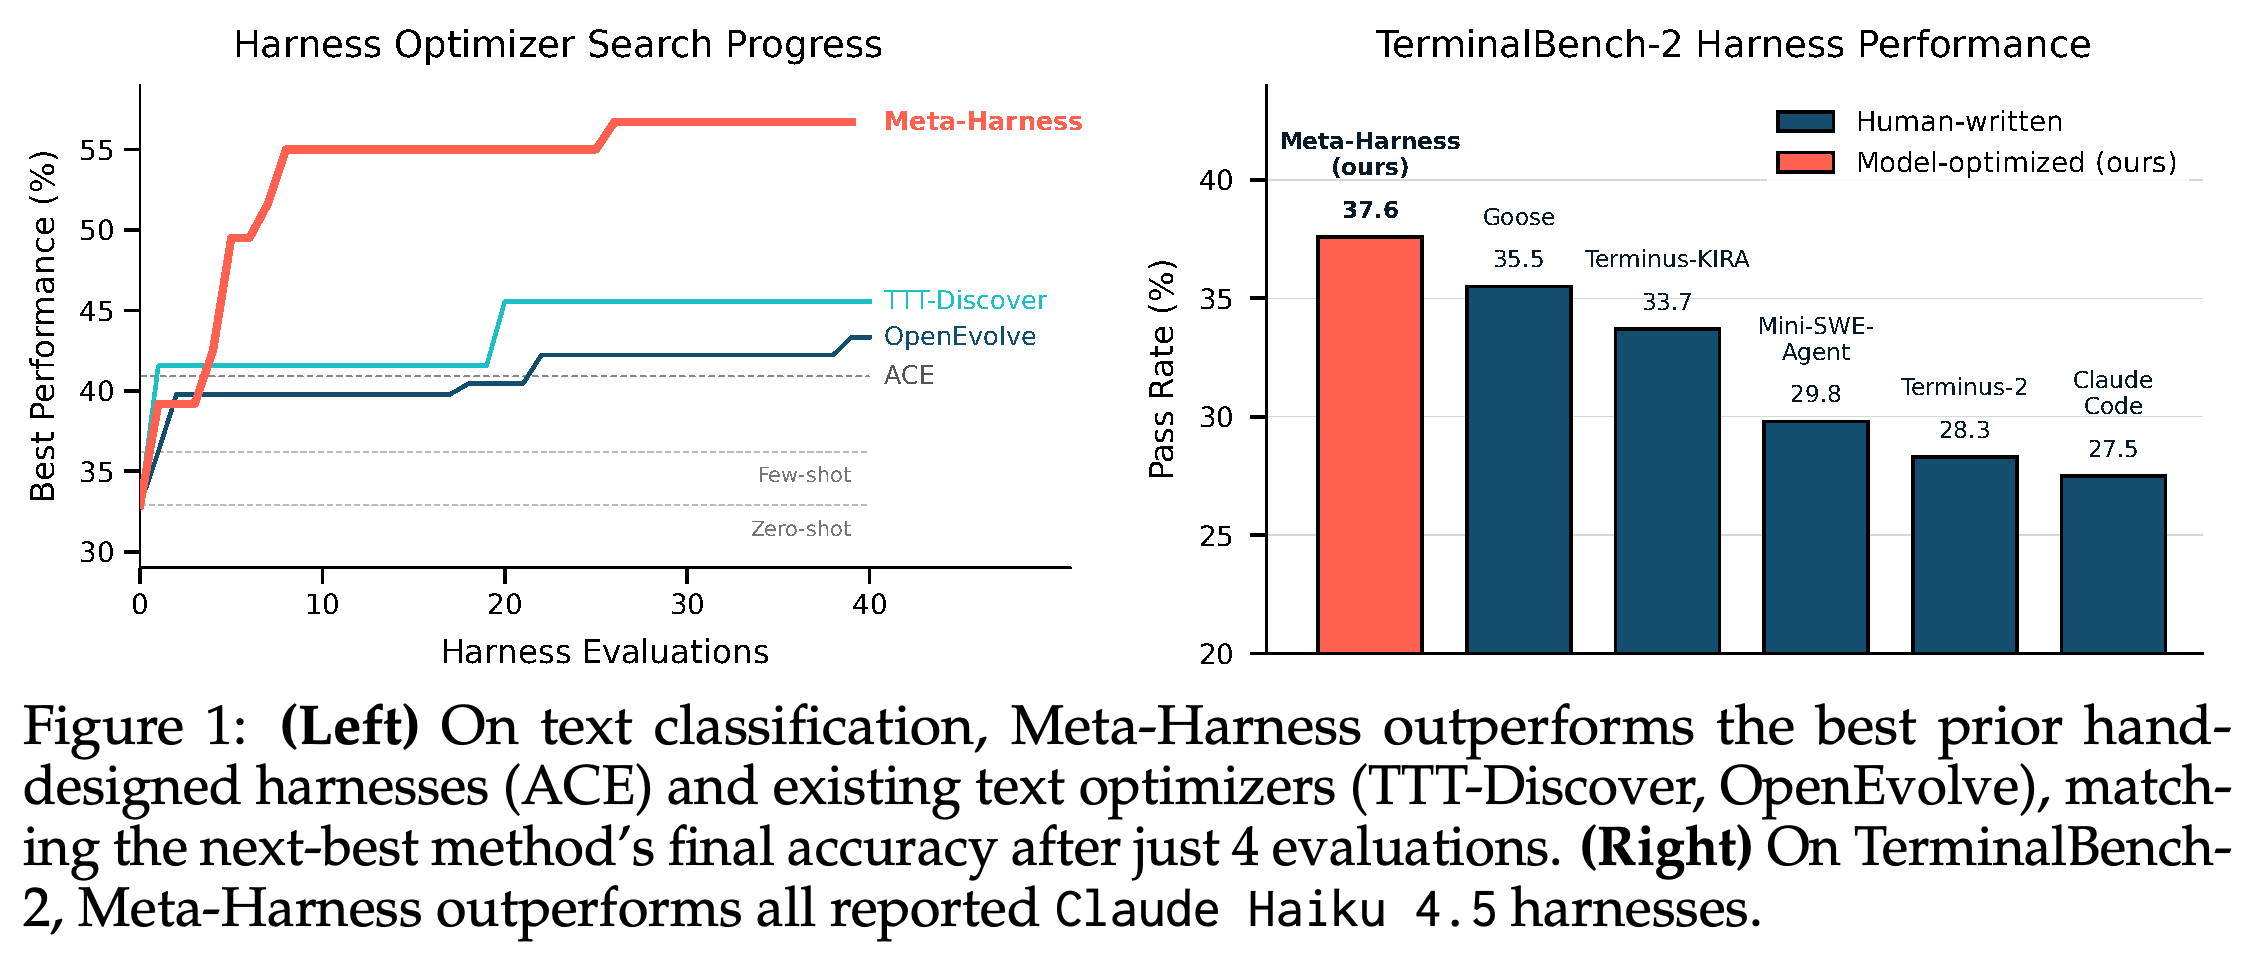
- 온라인 텍스트 분류에서 선택된 하네스는 테스트 정확도 48.6%를 달성한다. ACE의 정확도는 40.9%이며, 추가 컨텍스트 토큰은 각각 11.4K와 50.8K다. 탐색으로 발견한 수학 검색 하네스는 IMO 수준 문제 200개에서 평가한 모델 5개의 평균 정확도를 34.1%에서 38.8%로 높인다. TerminalBench-2 하네스는 Claude Opus 4.6에서 76.4%, Claude Haiku 4.5에서 37.6%를 달성한다.
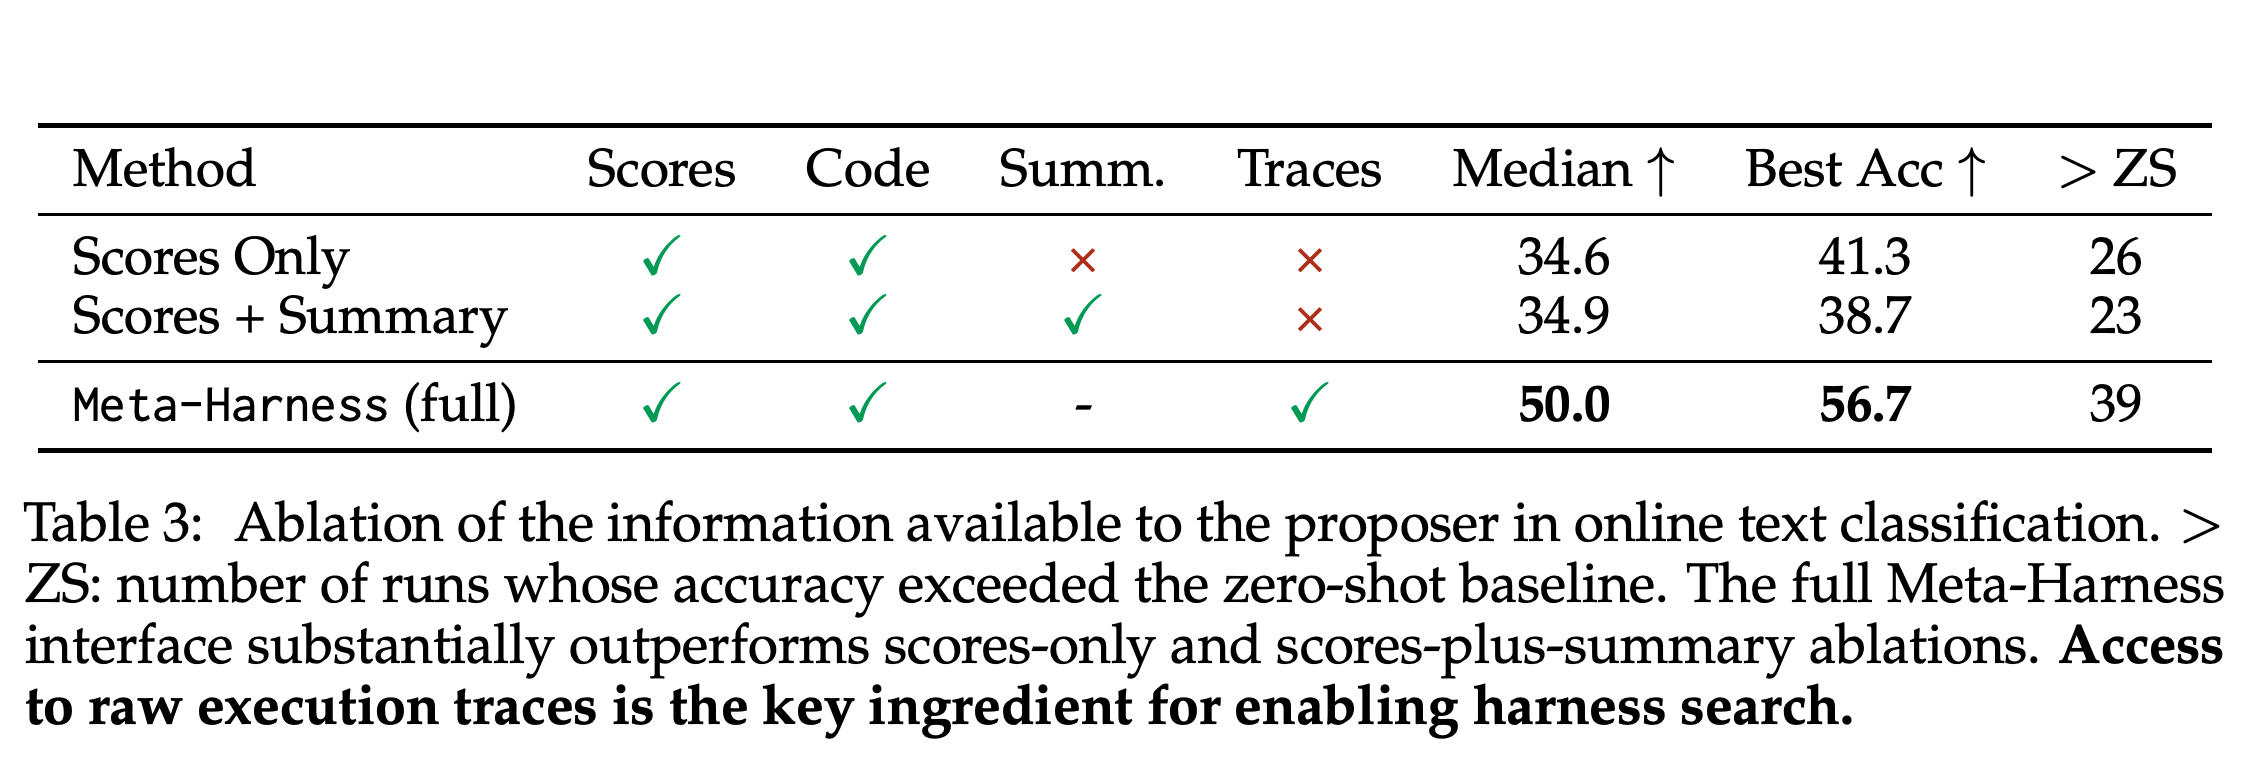
- 원시 실행 추적에 접근하는 효과를 가장 명확하게 보여 주는 결과는 분류 인터페이스 절제 실험이다. 전체 인터페이스에서 후보의 탐색 정확도 중앙값은 50.0%이며, 점수와 코드만 제공하면 34.6%, 요약까지 추가하면 34.9%다. 탐색에 사용하지 않은 분류 데이터셋과 수학 모델 4개는 전이 가능성을 뒷받침한다. 다만 TerminalBench-2는 탐색과 최종 평가에 같은 과제를 사용하며, 다른 제안 에이전트는 시험하지 않았다.
왼쪽 패널은 분류에서 평가 횟수 기준의 효율성을 요약하고, 오른쪽은 Haiku 4.5 하네스의 통과율을 비교한다. 분류 곡선은 탐색셋에서의 진행 상황을 측정한다. TerminalBench-2 막대는 같은 벤치마크에서 탐색한 뒤 얻은 벤치마크 성능을 보고한다.
1 Introduction
모델 하네스는 어떤 정보를 저장하고 검색하여 LLM에 제시할지, 상호작용과 상태 갱신을 어떻게 조율할지 결정한다. 논문은 모델 가중치를 바꾸지 않고도 실패를 살펴보고 코드를 수정하는 수작업을 자동화할 수 있는지 묻는다.
- 장기 작업의 실패는 앞선 검색, 메모리, 프롬프트 구성 결정에서 비롯될 수 있다. 집계 점수만으로는 이러한 의존 관계를 파악하기 어렵다.
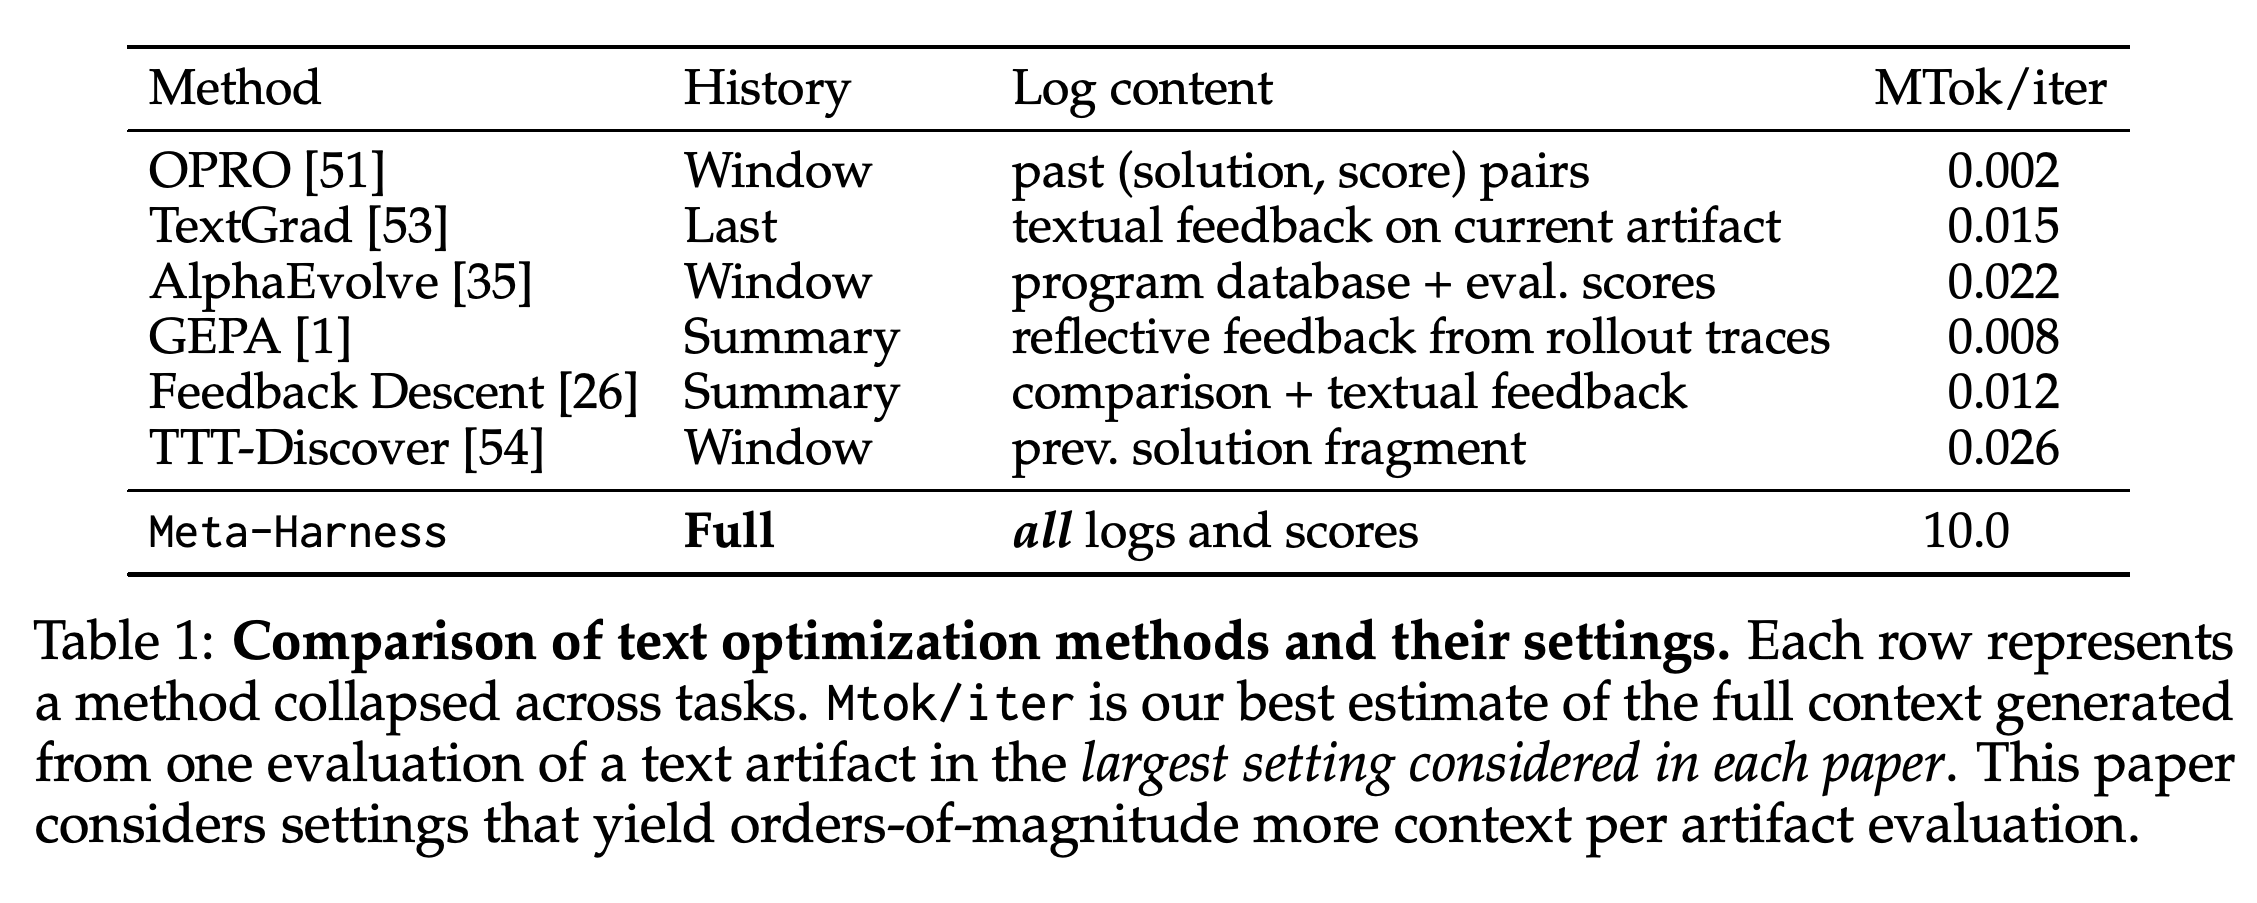
- Table 1은 산출물 평가당 생성되는 진단용 컨텍스트의 추정량을 비교한다. 이 수치가 반드시 제안 에이전트가 실제로 소비한 토큰 수를 뜻하지는 않는다. 가장 큰 Meta-Harness 설정은 최대 10,000,000토큰을 생성하므로 파일시스템에 선택적으로 접근할 필요가 있다.
- 프로젝트 페이지는 https://yoonholee.com/meta-harness/ 이다. 최적화한 TerminalBench-2 산출물은 https://github.com/stanford-iris-lab/meta-harness-tbench2-artifact 에서 제공한다.
평가당 생성되는 컨텍스트 추정량은 나열된 기존 설정의 0.002–0.026백만 토큰에서 Meta-Harness의 10.0백만 토큰까지 분포한다. 이 표는 이용 가능한 진단 정보의 규모를 설명한다. 제안 에이전트의 실제 소비량이나 공통 과제에서의 계산 효율성을 나타내지는 않는다.
2 Related Work
Meta-Harness는 하네스 수준의 기여도 할당을 적응적 외부 컨텍스트 접근, 실행 가능한 프로그램 탐색, 텍스트 최적화와 연결한다. 모델 가중치를 갱신하는 대신, 과거 실행을 바탕으로 실패를 진단하고 이후 행동을 제어하는 외부 절차를 다시 작성한다.
External memory and adaptive access.
검색 증강 생성, 검색과 추론을 번갈아 수행하는 방법, 메모리 기반 에이전트, recursive language models는 대규모 정보원을 필요에 따라 질의할 수 있는 자원으로 취급한다. Meta-Harness는 코드, 점수, 실행 추적이 담긴 최적화 이력에 이러한 접근 방식을 적용한다. 이를 통해 제안 에이전트는 컨텍스트 관리 절차 자체를 수정할 수 있다.
Executable code search.
기존 실행 코드 탐색 방법은 함수, 에이전트, 워크플로 그래프, 메모리 설계를 진화시킨다. Meta-Harness는 고정된 부모 선택 규칙이나 미리 정의한 변이 연산자 없이, 프롬프트 구성, 검색, 상태 갱신을 포함한 도메인별 하네스 구현 전체를 수정할 수 있게 한다.
- 논문이 구분한 설정에서는 외부 루프의 탐색 이력이 후보 간에 유지되지만, 과제별 하네스 상태는 과제가 바뀔 때 초기화된다.
- 제안 에이전트는 경험 파일시스템에 접근하여 어떤 이전 산출물과 실패를 살펴볼지 선택한다. 탐색 절차가 특정 부모 1개의 피드백만 지정하지는 않는다.
Text optimization methods.
ProTeGi, TextGrad, OPRO, GEPA, AlphaEvolve/OpenEvolve, Feedback Descent는 이전 시도의 피드백으로 텍스트나 코드를 최적화한다. 논문은 이들의 일반적인 피드백 인터페이스가 어떤 정보가 진단에 중요한지 알기 전에 정보를 압축하거나 구조화한다고 지적한다. 반면 하네스 개발에서는 여러 예제와 후보의 원시 실행 추적을 비교해야 할 수 있다.
- Table 1은 인용한 논문에서 연구한 설정을 정리한 것이며, 조건을 통제한 성능 비교가 아니다.
- 분류 실험은 Meta-Harness를 GEPA, Best-of-N, OpenEvolve, TTT-Discover의 텍스트 최적화 구성 요소와 직접 비교한다.
3 Meta-Harness: A Harness for Optimizing Harnesses
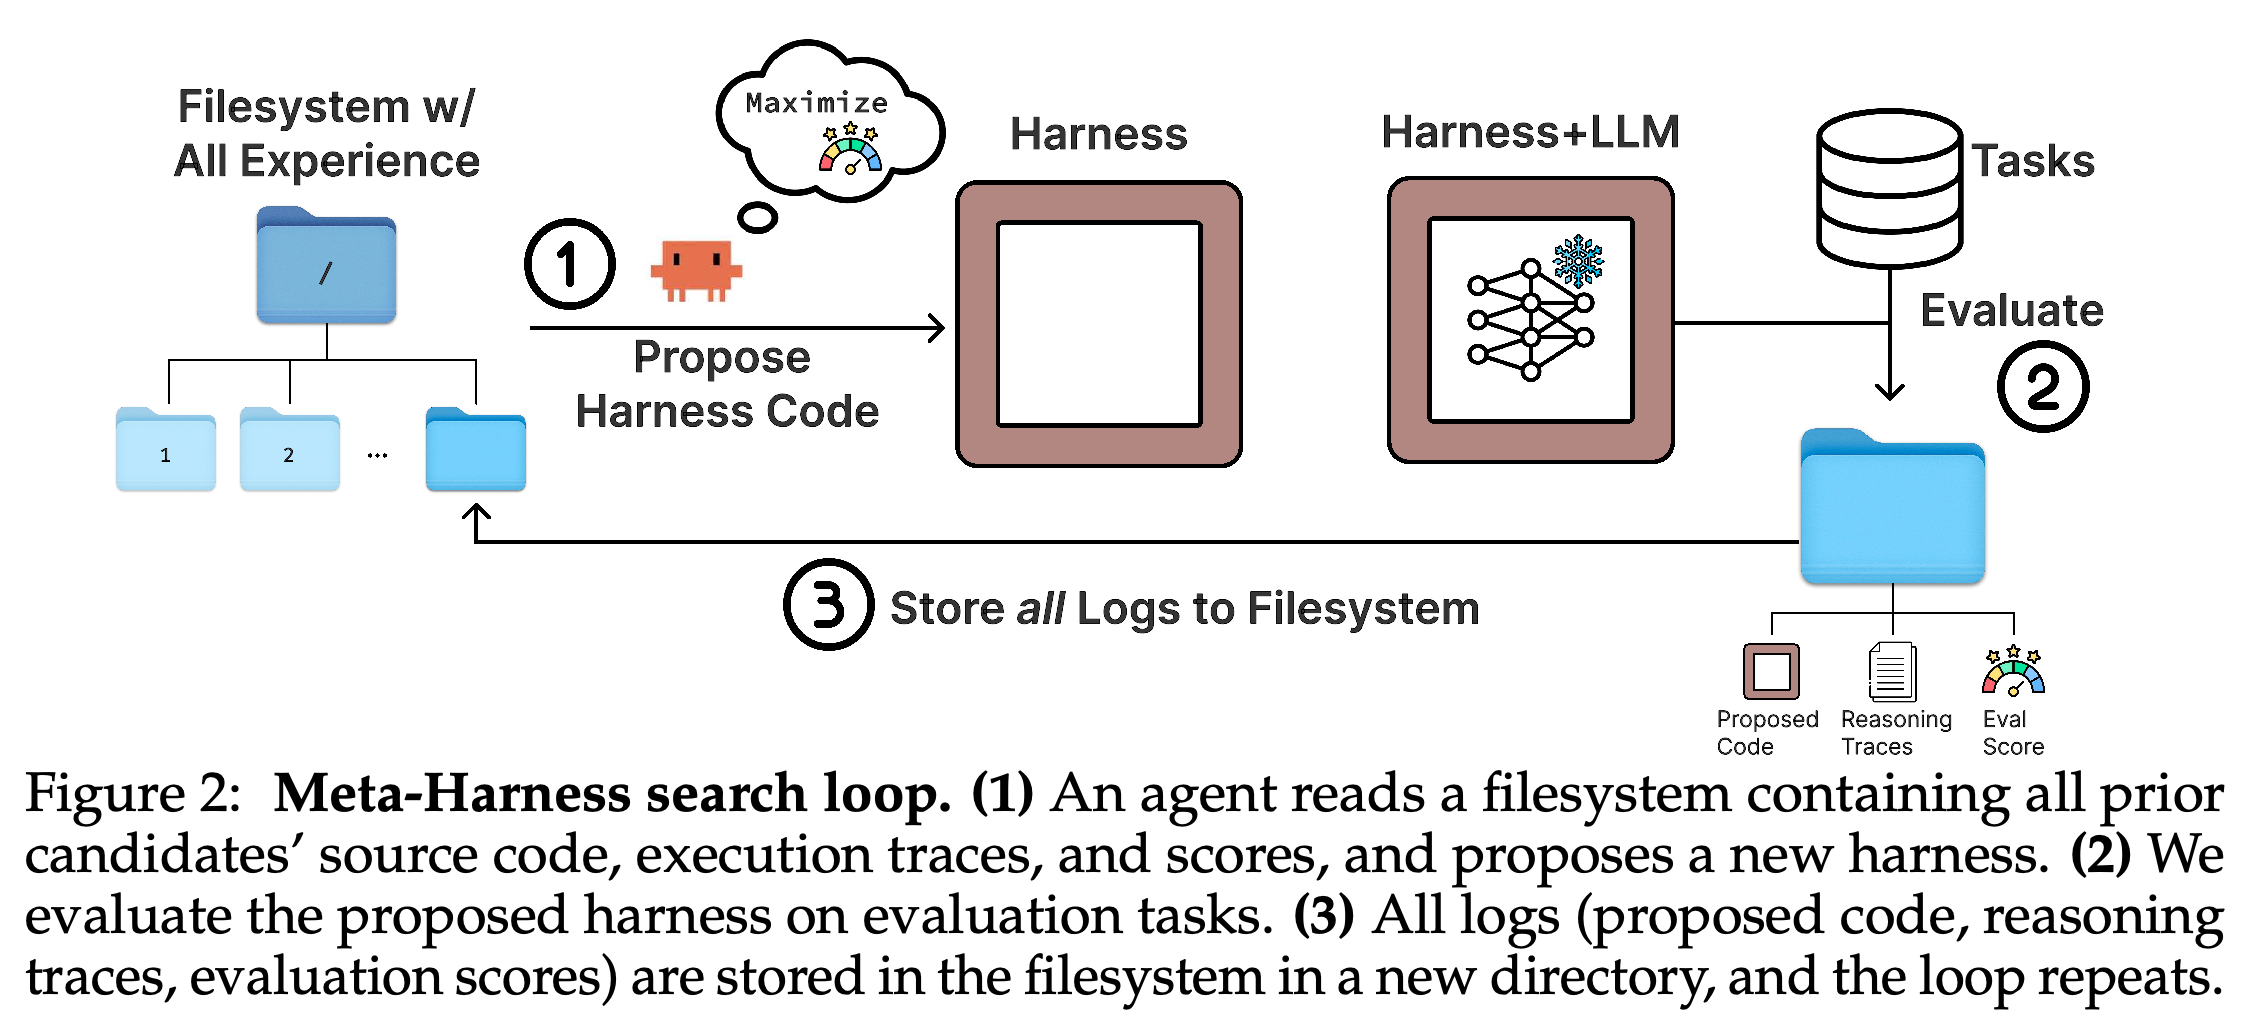
Meta-Harness는 과제별 하네스를 반복해서 제안하고 평가하고 기록하는 외부 루프 하네스다. 이전 경험을 질의 가능한 파일시스템에 보관하고, 진단과 프로그램 수정을 코딩 에이전트에 맡긴다.
Objective.
가중치가 고정된 모델 M, 과제 분포 X, 상태를 유지하는 하네스 H가 주어지면, 실행은 하네스의 프롬프트 구성 규칙과 상태 갱신 규칙을 따른다. 최적화 목적은 H* = arg max_H E_{x∼X, τ∼p_M(H,x)} r(τ,x)이며, r은 결과 궤적을 평가한다. 정확도와 컨텍스트 비용이 모두 중요할 때는 Pareto dominance로 후보를 비교한다.
Meta-Harness search loop.
평가한 각 후보는 소스 코드, 점수, 실행 추적을 담은 디렉터리를 남긴다. 실행 추적에는 프롬프트, 도구 호출, 모델 출력, 상태 갱신이 포함된다. 제안 에이전트는 grep, cat 같은 도구로 누적된 이력을 조회하고, 가능한 실패 원인을 진단하여 새 하네스를 만든다.
- Algorithm 1은 초기 후보군을 평가한 뒤, 제안된 각 하네스가 인터페이스를 준수하는지 검증한다. 이후 비용이 큰 평가를 실행하고 산출물을 파일시스템에 추가한다.
- 탐색은 평가한 후보를 보존하고 Pareto frontier를 반환한다. 다만 제안 에이전트는 부모를 배정받는 대신 이전 후보 중 어느 것이든 살펴볼 수 있다.
- 분류와 수학 후보는 제안 에이전트에 테스트셋 결과를 공개하지 않고 탐색셋 피드백으로 선택한다. TerminalBench-2는 탐색과 최종 평가에 같은 벤치마크를 쓰는 예외이며, 논문도 이를 명시한다.
피드백 경로는 제안된 코드, 추론 추적, 점수를 파일시스템 산출물로 보존한다. 제안 에이전트는 이를 선택적으로 다시 살펴볼 수 있다. 따라서 이전 경험의 검색이 고정된 프롬프트 구성 단계가 아니라 최적화의 일부가 된다.
Advantages of code-space search.
코드 공간 탐색은 템플릿 채우기나 국소적인 프롬프트 변이에 그치지 않고, 검색과 메모리 규칙부터 전체 재작성까지 알고리즘 구조를 바꿀 수 있게 한다. 정성적 실행 추적에서는 제안 에이전트가 실패한 수정을 비교하고 공통된 프롬프트 변경을 찾아낸다. 제어 흐름을 바꿀 때 성능이 반복해서 하락하자, 결국 기존 구조에 기능을 추가하는 수정을 선택한다.
- 코딩 모델이 일관되고 재사용 가능한 알고리즘을 생성하는 경향이 정규화 효과를 준다는 설명은 별도로 측정한 효과가 아니라 해석이다.
- TerminalBench-2 사례는 가설에 따른 진단 과정을 보여 주지만, 제안 에이전트가 제시한 인과적 설명이 각각 옳다는 사실을 실험으로 입증하지는 않는다.
Practical implementation.
실험 하네스는 도메인별 프롬프트 구성, 검색, 메모리, 오케스트레이션을 수정하는 단일 파일 Python 프로그램이다. 제안 에이전트는 Opus-4.6을 사용하는 Claude Code다. 산출물 위치, 허용된 수정, 이전 실행을 살펴보는 방법을 명시한 최소한의 스킬을 따르며, 실제 과제를 수행하는 모델의 가중치는 고정된다.
- 논문은 일반적인 실행을 20회 반복에서 약 60개 하네스를 평가하는 과정으로 설명하며, 도메인별 예산은 별도로 보고한다.
- 인터페이스 검증은 전체 벤치마크 평가 전에 제안된 프로그램을 점검하며, 후보 채점은 제안 에이전트 외부에서 수행한다.
4 Experiments
실험은 온라인 텍스트 분류, 검색 증강 수학 추론, 자율적인 터미널 과제를 다룬다. 수작업으로 설계한 도메인 하네스와 프로그램 탐색 방법을 비교하며, 설정에 따라 정확도, 컨텍스트 비용, 통과율을 보고한다.
4.1 Online Text Classification
온라인 분류에는 GPT-OSS-120B를 사용한다. 모델은 레이블이 있는 예제를 순차적으로 받고 메모리를 갱신한 뒤, 별도로 남겨 둔 예제를 예측한다. 탐색은 클래스 215개의 LawBench, 클래스 22개의 Symptom2Disease, 클래스 180개의 USPTO-50k를 대상으로 한다. zero-shot, few-shot, ACE, MCE 하네스에서 시작해, 반복당 후보 2개씩 20회 반복하여 후보 40개를 생성한다.
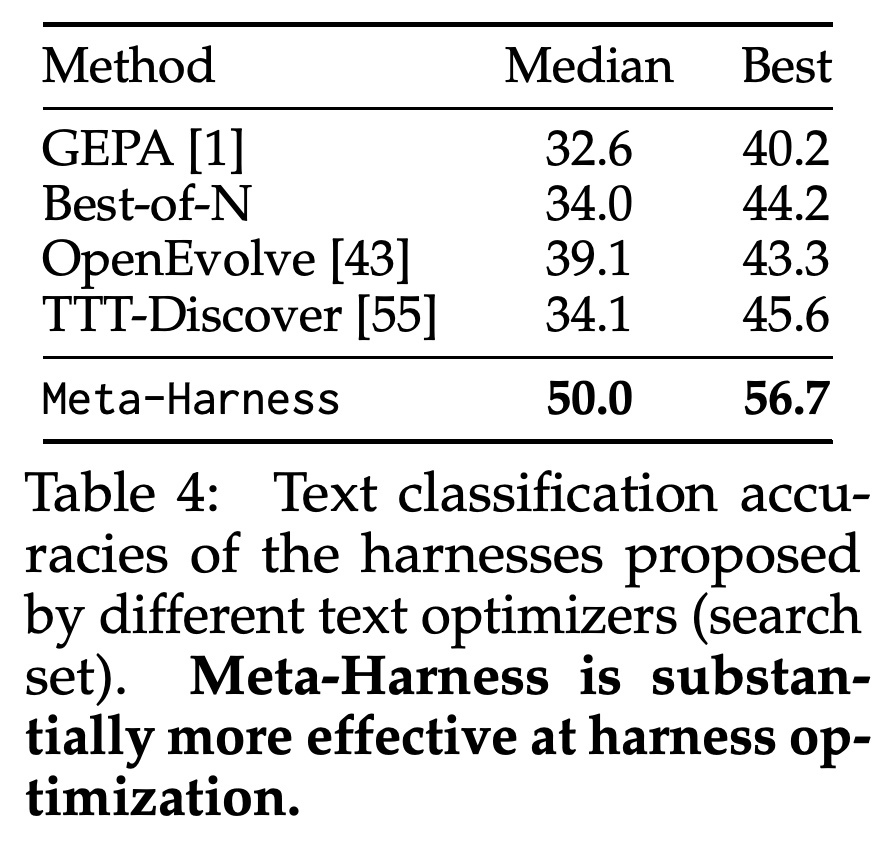
텍스트 최적화 방법과 비교할 때는 max reasoning을 적용한 동일한 Opus-4.6 제안 에이전트 설정, 같은 후보 하네스 평가 예산, 탐색셋만을 이용한 선택을 사용한다. Table 4의 후보 탐색 정확도 중앙값/최댓값은 GEPA 32.6/40.2, Best-of-N 34.0/44.2, OpenEvolve 39.1/43.3, TTT-Discover 34.1/45.6, Meta-Harness 50.0/56.7이다.
- Best-of-N은 초기 하네스에서 독립적으로 표본을 생성한다. TTT-Discover 비교에는 전체 방법이 아니라 PUCT 재사용 규칙을 적용한 텍스트 최적화 구성 요소를 사용한다.
- Figure 1과 Figure 4에 따르면 Meta-Harness는 평가 4회 이내에 OpenEvolve와 TTT-Discover의 최종 정확도에 도달하며, 최종적으로 10포인트 넘게 앞선다.
- “Meta-Harness is 10× Faster and Converges to a Better Harness”는 전체 평가 횟수를 가리킨다. 실제 경과 시간이나 제안 에이전트의 총 토큰 비용이 10배 줄었다는 결과는 아니다.
Meta-Harness의 후보 탐색 정확도 중앙값과 최댓값이 가장 높다. 중앙값 50.0%가 모든 비교 방법의 최고 점수를 넘으므로, 보고된 우위는 유난히 뛰어난 후보 1개에만 한정되지 않는다. 이 표는 독립적인 탐색 실행 간 변동성을 정량화하지 않는다.
후보를 나타내는 점과 현재까지의 최고값을 나타내는 선이 제안의 품질과 보존한 최고 결과를 구분한다. Meta-Harness는 56.7%에 도달하며, 가장 강한 비교 방법은 45.6%로 끝난다. 이는 탐색셋 결과이지 별도 테스트셋 정확도가 아니다.
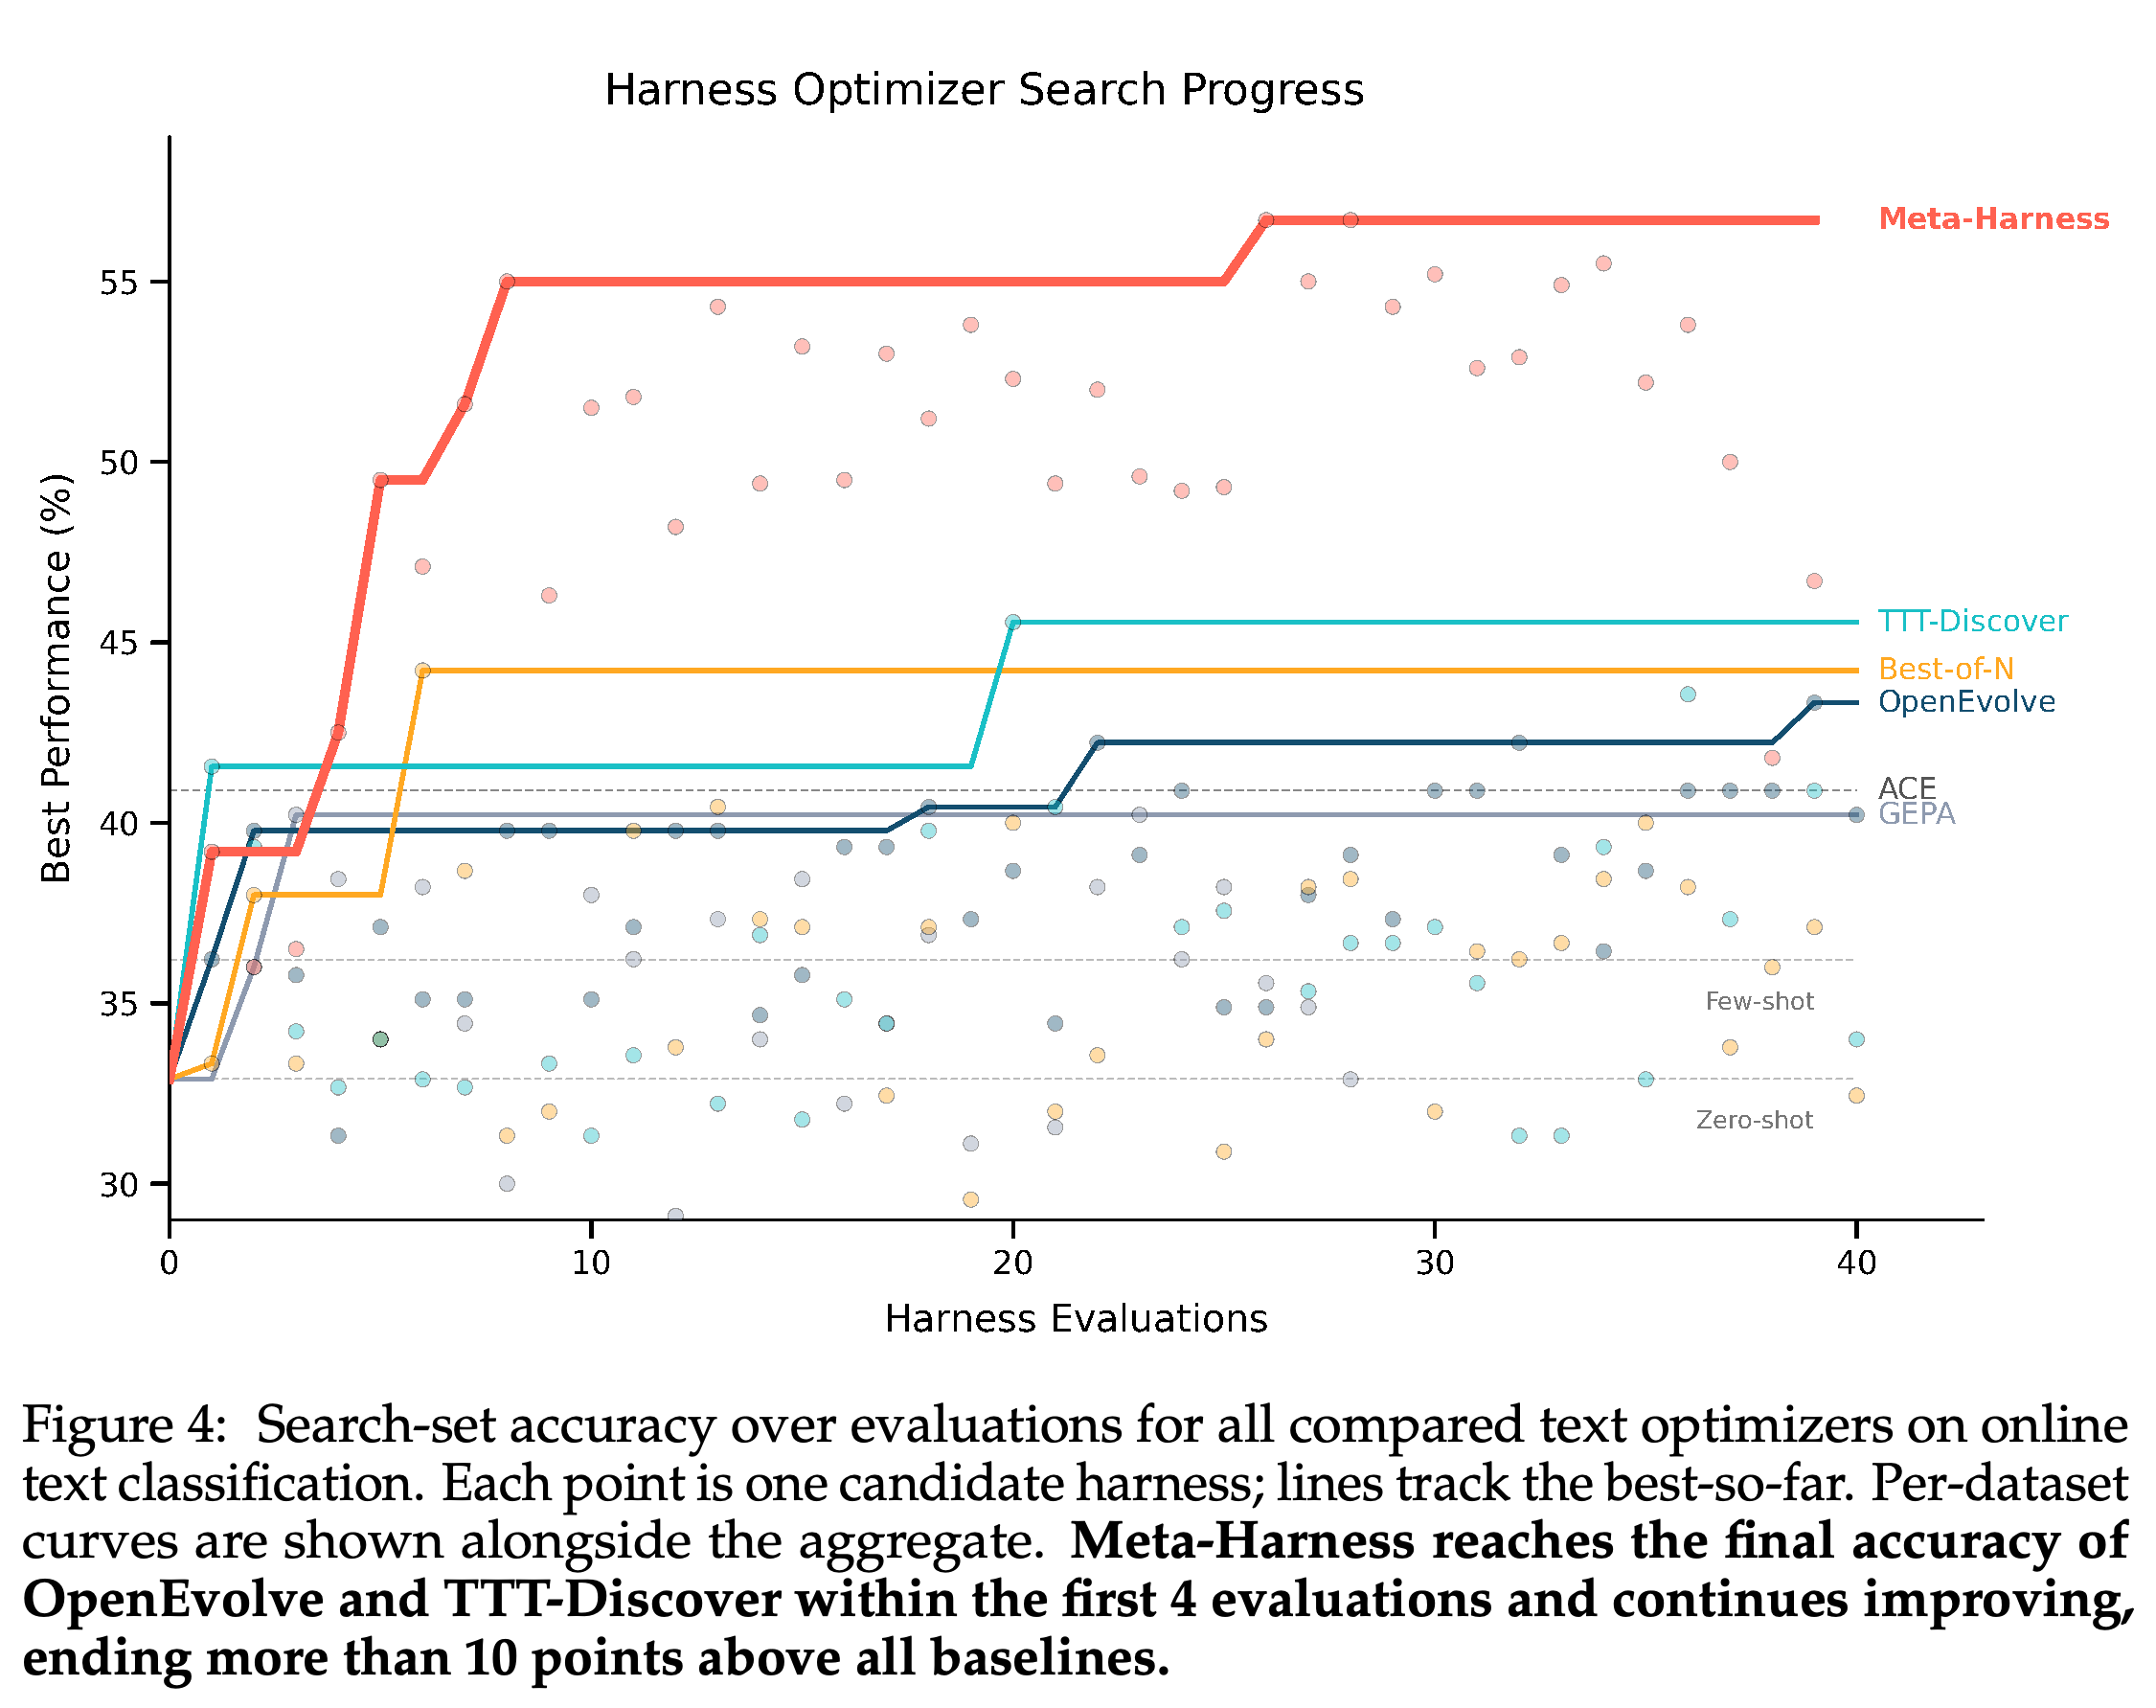
Table 3의 인터페이스 절제 실험은 모든 조건에서 코드와 점수를 유지한다. Scores Only의 후보 정확도는 중앙값 34.6%, 최댓값 41.3%다. Scores + Summary는 중앙값 34.9%, 최댓값 38.7%이며, 원시 실행 추적을 제공하는 전체 인터페이스는 중앙값 50.0%, 최댓값 56.7%다.
- 예제 0개를 사용하는 기준선보다 높은 성능을 보인 평가 후보 수는 각각 26개, 23개, 39개다.
- 전체 인터페이스의 중앙값은 제한된 각 조건의 최댓값보다 높다. 이는 이 분류 설정에서 원시 실행 추적에 접근하는 효과를 뒷받침한다.
- 요약 조건은 손실된 진단 정보를 복구하지 못한다. 다만 최댓값이 낮다는 사실만으로 요약이 일반적으로 해롭다고 결론 내릴 수는 없다. 이 중앙값은 후보들의 통계이며, 독립적으로 반복한 탐색 간 변동성을 나타내지 않는다.
모든 조건에서 코드와 점수를 제공하며, 전체 인터페이스는 원시 실행 추적 접근을 추가한다. 전체 인터페이스의 후보 정확도 중앙값은 제한된 각 인터페이스의 최고 결과보다 높다. 생성된 요약은 이 격차를 줄이지 못한다.
최첨단 하네스와 비교하면, 선택된 하네스의 평균 테스트 정확도는 48.6%이며 ACE는 40.9%, MCE는 40.0%다. 추가 컨텍스트 토큰은 각각 11.4K, 50.8K, 28.5K다. 개선 폭은 고르지 않다. Meta-Harness는 USPTO에서 14.0%, Symptom2Disease에서 86.8%, LawBench에서 45.0%를 기록하며, USPTO에서는 ACE보다 낮다.
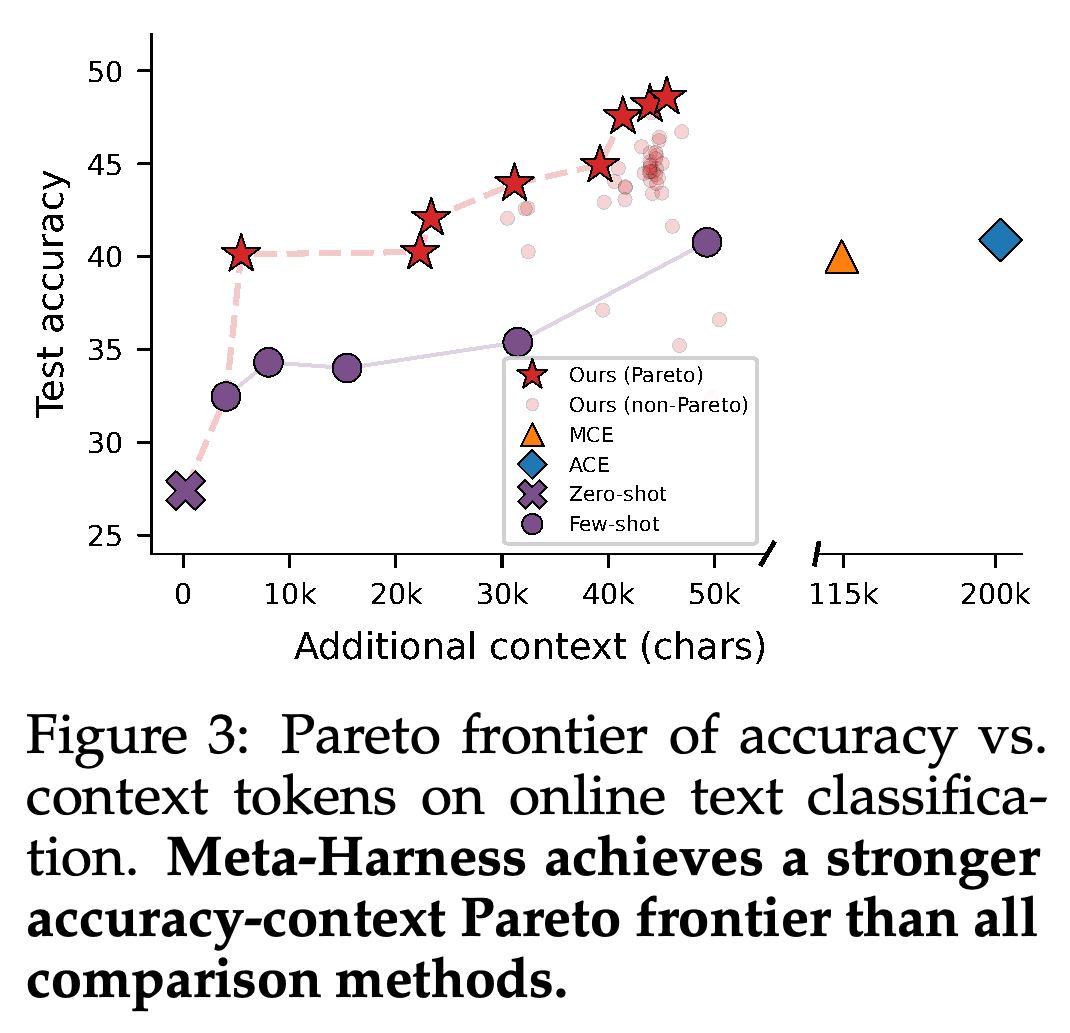
- Figure 3은 정확도와 컨텍스트의 절충 관계를 보여 준다. 고정된 컨텍스트 예산 1개가 아니라 탐색으로 발견한 여러 운용 지점을 제시한다. 가로축은 추가 컨텍스트를 문자 수로 측정하지만 캡션은 토큰으로 설명한다. Table 2는 별도로 토큰 수를 보고한다.
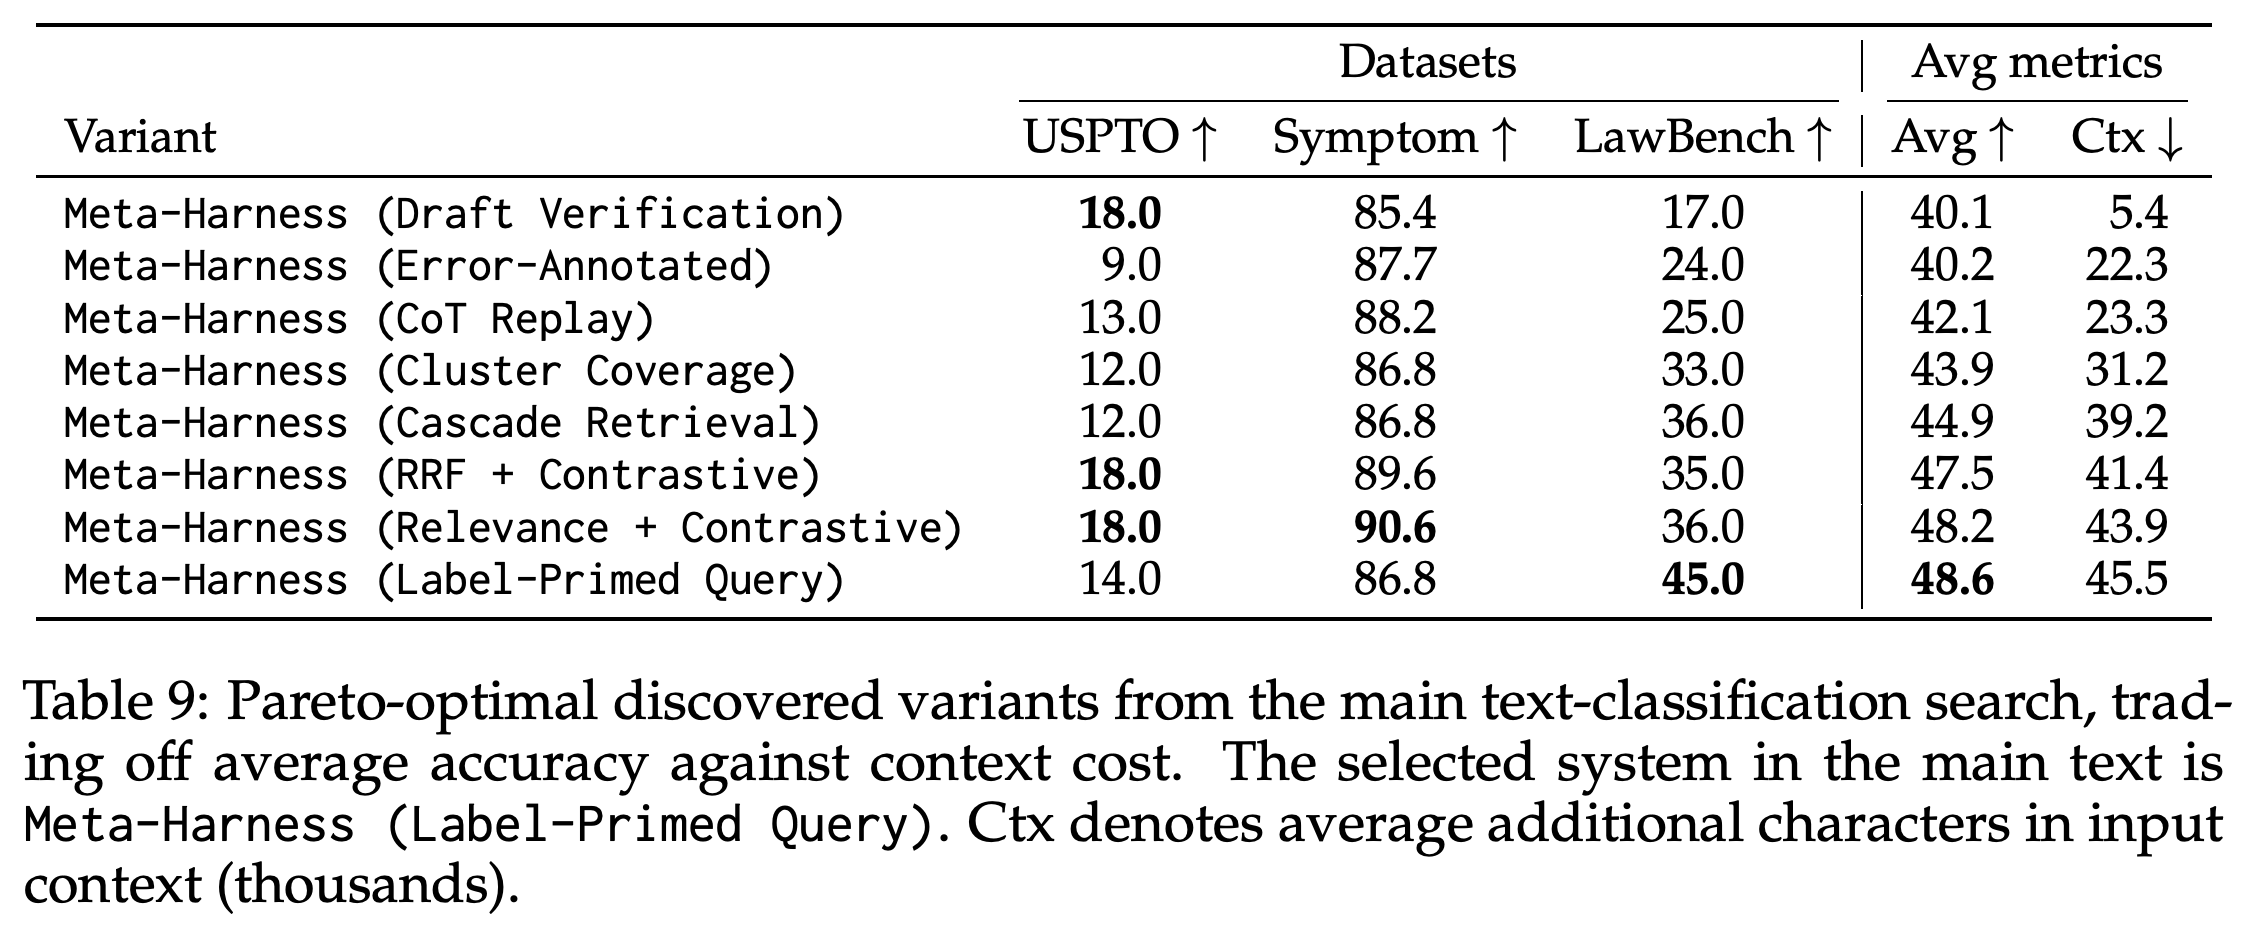
- Table 9는 추가 문자 수를 천 단위로 표시한 frontier 변형 8개를 보고한다. Draft Verification의 정확도 40.1%, 문자 수 5.4K부터 Label-Primed Query의 정확도 48.6%, 문자 수 45.5K까지 분포한다.
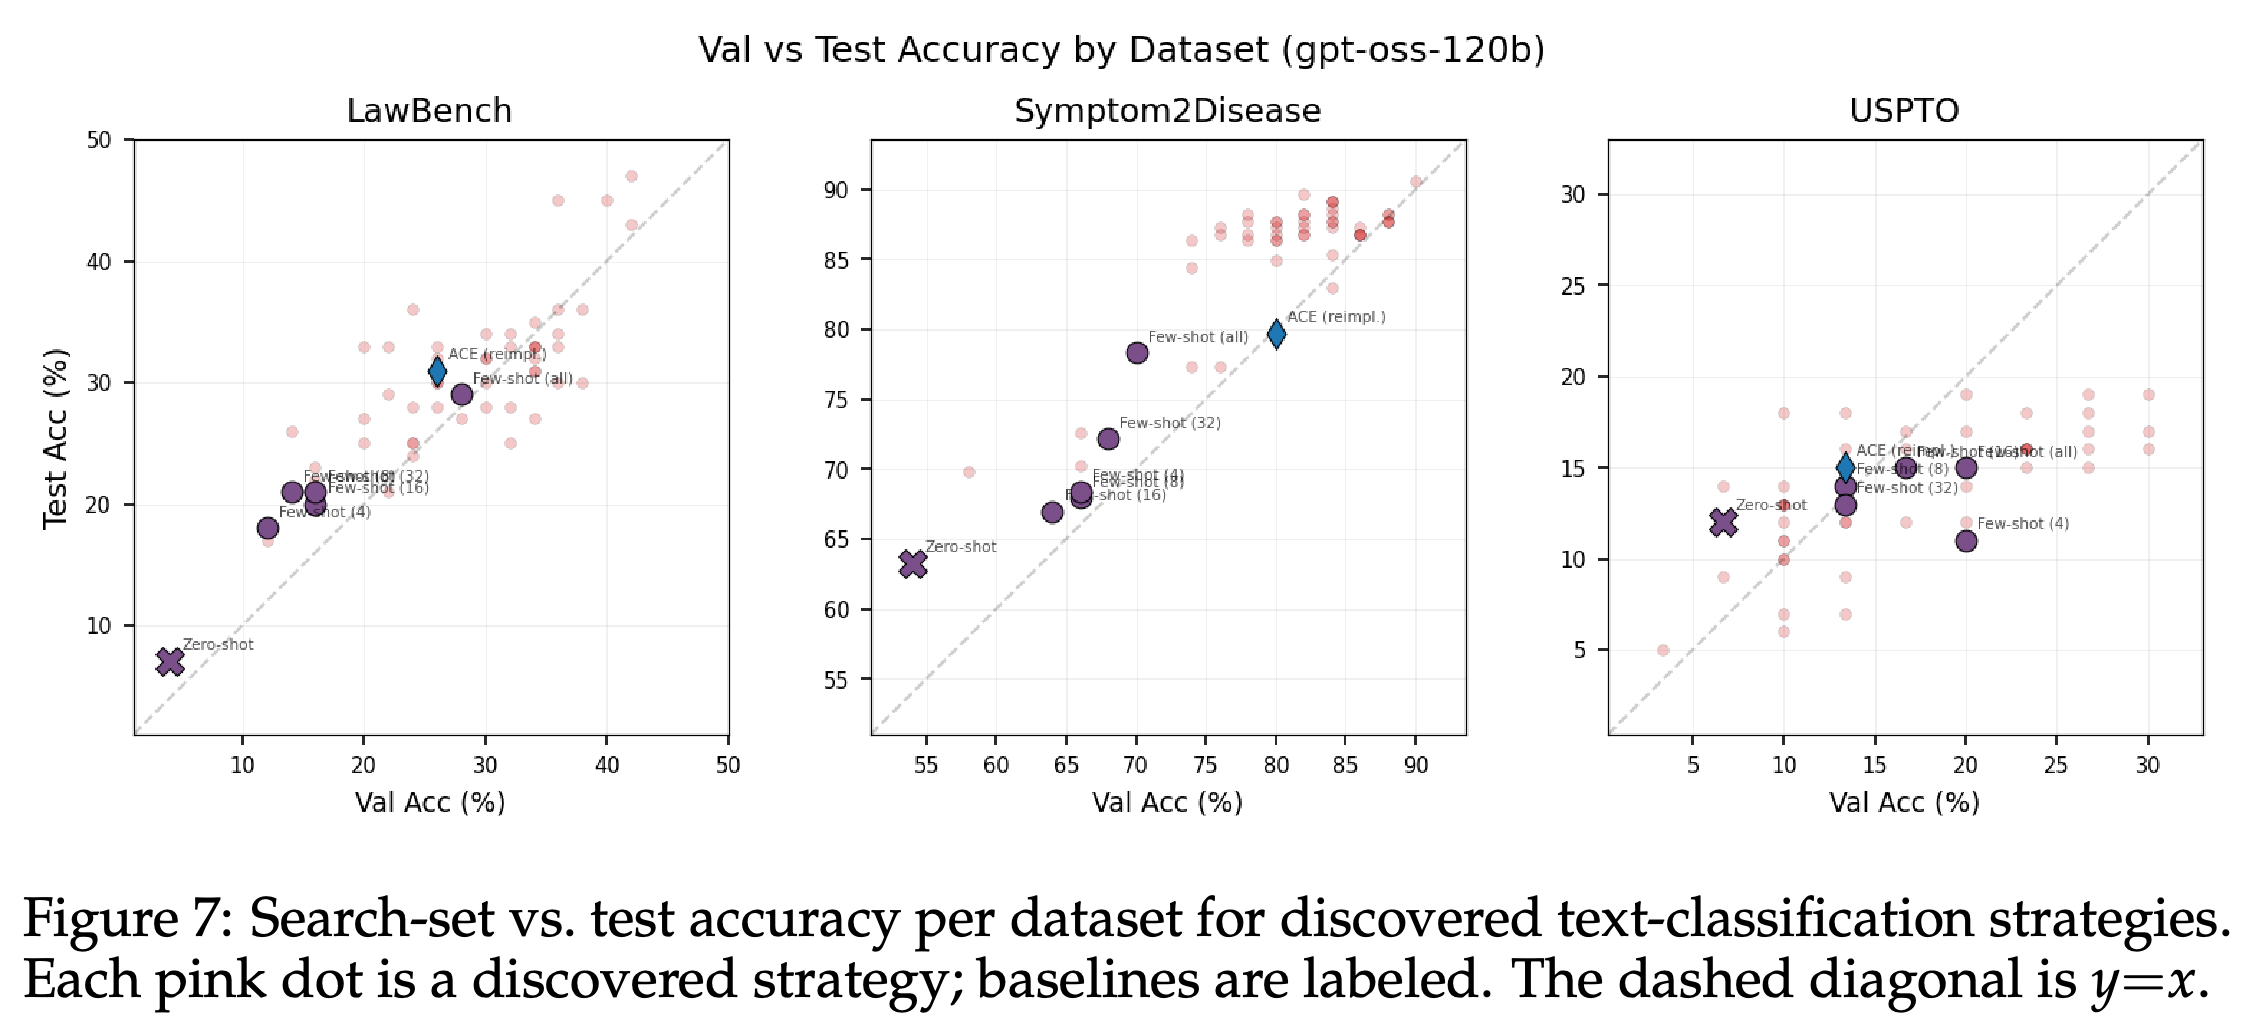
- Figure 7은 데이터셋별 탐색 정확도와 테스트 정확도를 비교한다. 특히 USPTO에서 점들이 대각선으로부터 벗어나는 양상을 보면, 탐색셋 성능 향상이 테스트 성능 향상으로 일관되게 이어지지는 않는다.
선택된 하네스는 Symptom2Disease와 LawBench에서 얻은 개선으로 평균 정확도를 높이지만, USPTO에서는 ACE보다 낮다. 추가 토큰 11.4K는 ACE의 50.8K보다 훨씬 적으므로, 평균 성능 향상에 더 큰 입력 컨텍스트가 필요한 것은 아니다.
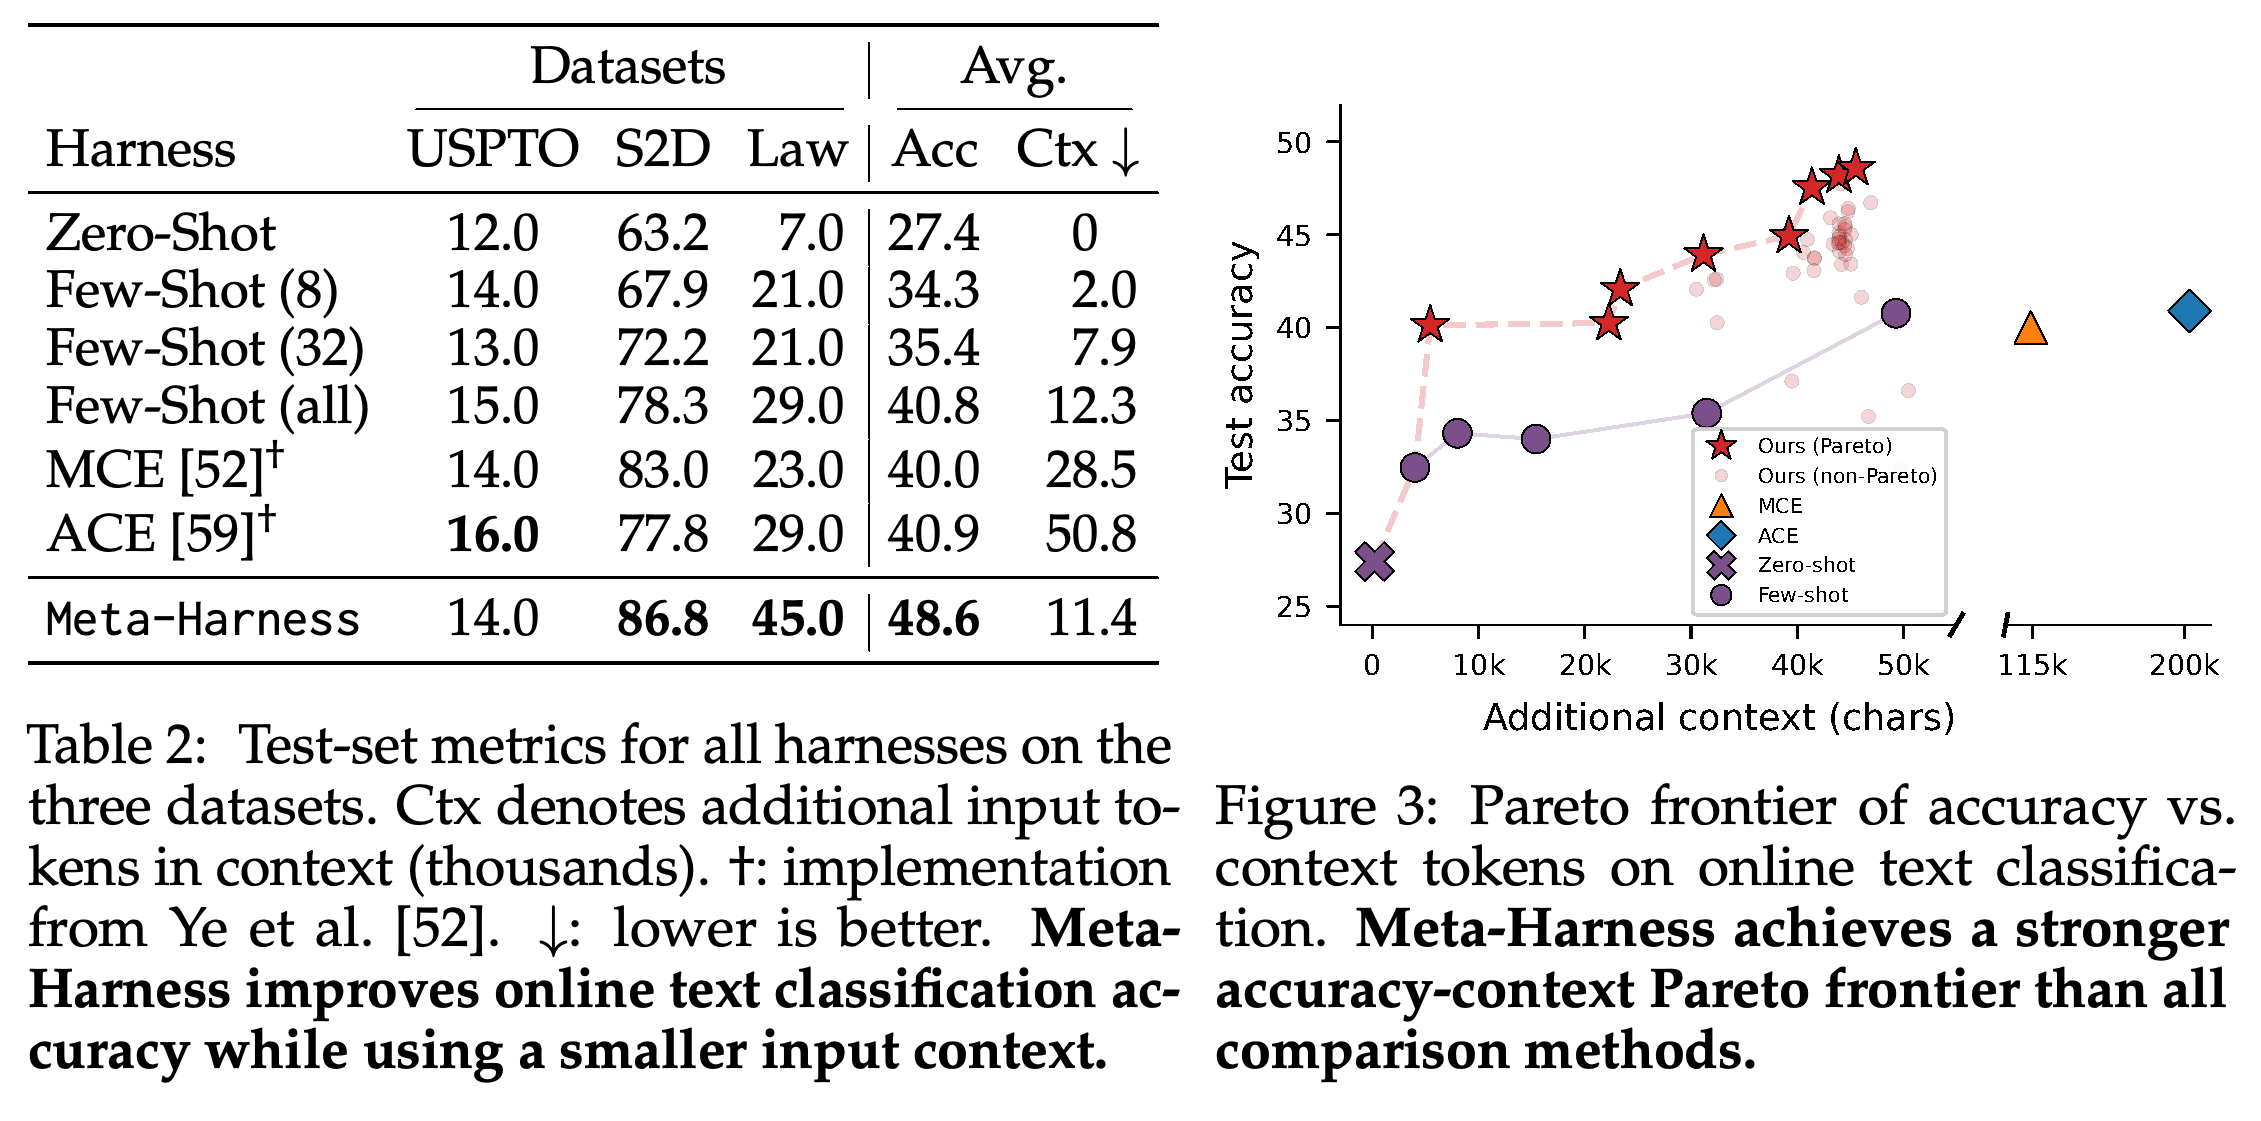
발견한 운용 지점은 고정된 설계 1개가 아니라 다양한 컨텍스트 예산에서 더 높은 정확도를 제공한다. 가로축은 명시적으로 문자 수를 사용한다. 이는 Table 2의 토큰 단위 및 캡션의 토큰 표현과 구분해야 한다.
변형 8개는 서로 다른 정확도–컨텍스트 운용 지점에 분포한다. Draft Verification의 컨텍스트 비용이 가장 낮고, Label-Primed Query의 평균 정확도가 가장 높다. 컨텍스트는 천 문자 단위로 측정하며, Table 2의 천 토큰 단위와 다르다.
데이터셋별 그래프는 탐색 성능과 테스트 성능이 관련되지만 서로 대체할 수는 없음을 보여 준다. USPTO 후보 다수가 대각선 아래에 위치하므로, 집계된 탐색 성능 향상을 일관된 일반화로 해석하지 않도록 주의해야 한다.
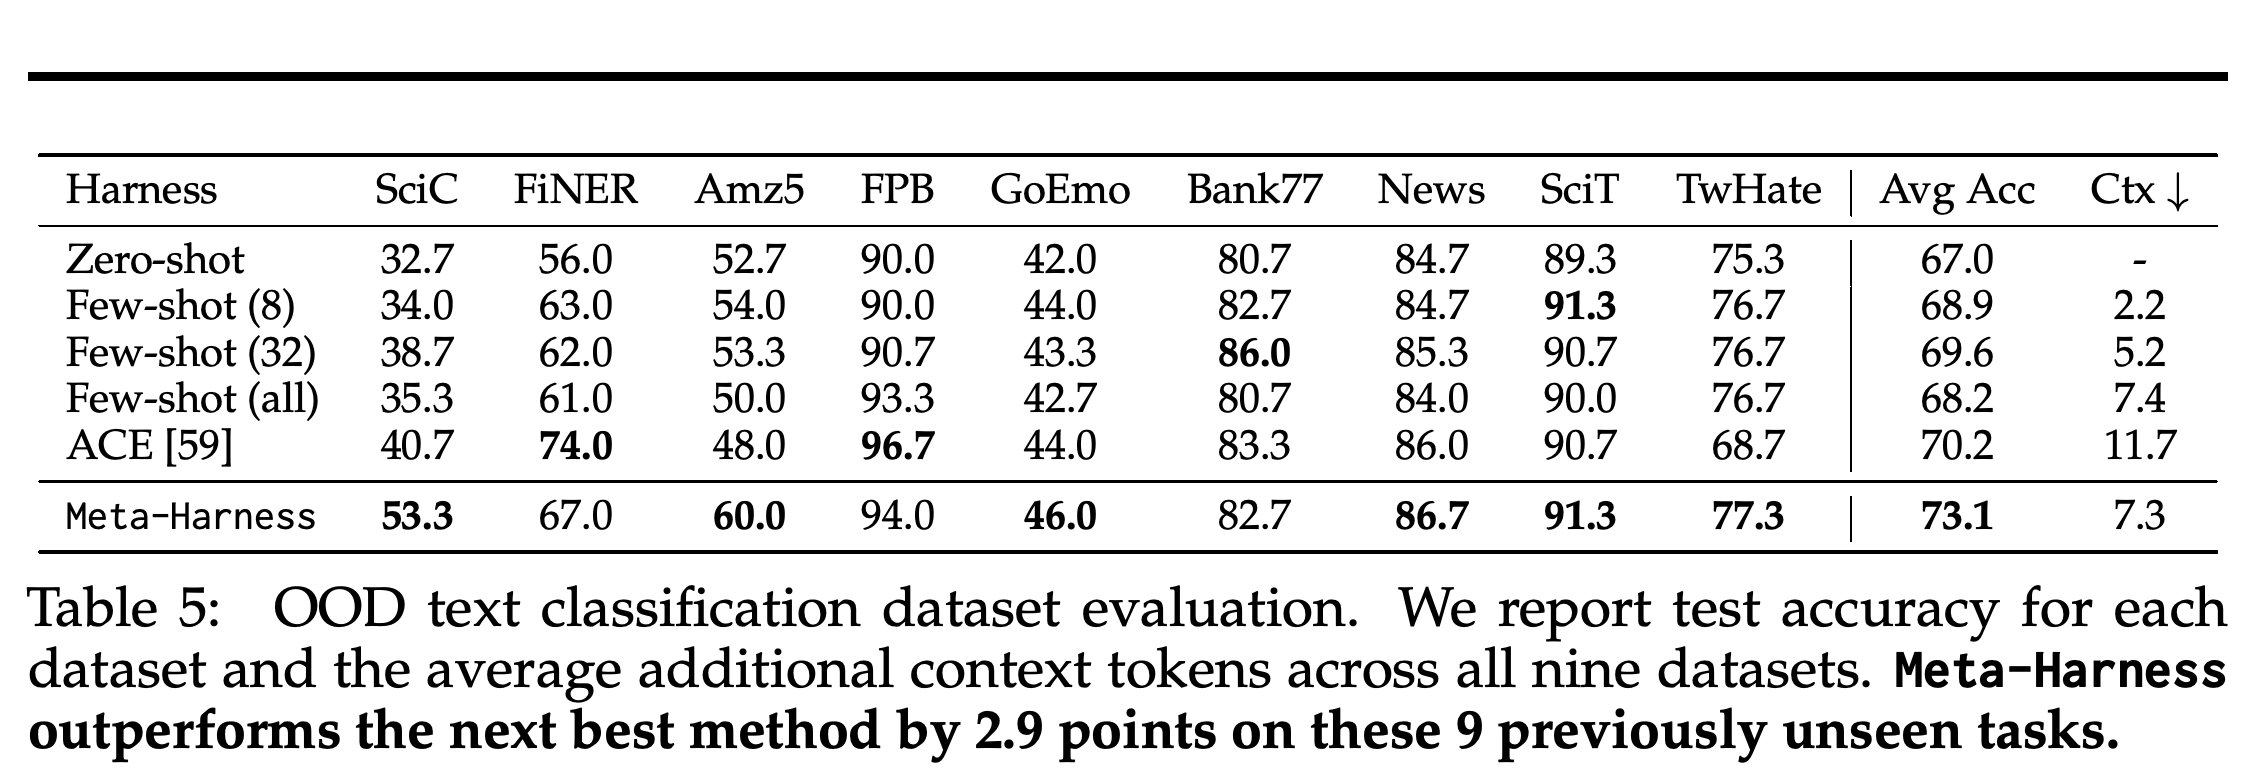
분포 밖(OOD) 과제 평가에서는 탐색에 사용하지 않은 데이터셋 9개에서 선택된 하네스의 평균 정확도가 73.1%다. ACE는 70.2%이며, 보고된 few-shot 평균 중 최고값은 69.6%다. 동률을 포함해 데이터셋 6/9개에서 최고 성능을 달성한다. 평균 추가 컨텍스트 토큰은 7.3K로, ACE의 11.7K보다 적다.
- Table 5는 인용 의도, 금융 개체, 리뷰 평점, 금융 감성, 감정, 은행 업무 의도, 뉴스 주제, 과학적 함의, 트윗 혐오 발언을 다룬다.
- FiNER와 Financial PhraseBank에서는 ACE의 성능이 더 높고, Banking77에서는 Few-shot (32)의 성능이 더 높다.
- few-shot 예제 32개 대신 이용 가능한 예제를 모두 사용하면 과제 7/9개에서 정확도가 낮아진다. 이 평가에서 컨텍스트가 많다고 항상 더 좋은 것은 아니다.
평균 73.1%는 탐색에 사용하지 않은 데이터셋으로의 전이를 뒷받침하며, 평균 컨텍스트 비용도 ACE보다 낮다. 개별 열은 한계도 보여 준다. FiNER와 Financial PhraseBank에서는 ACE가 앞서고, Banking77에서는 Few-shot (32)가 앞선다.
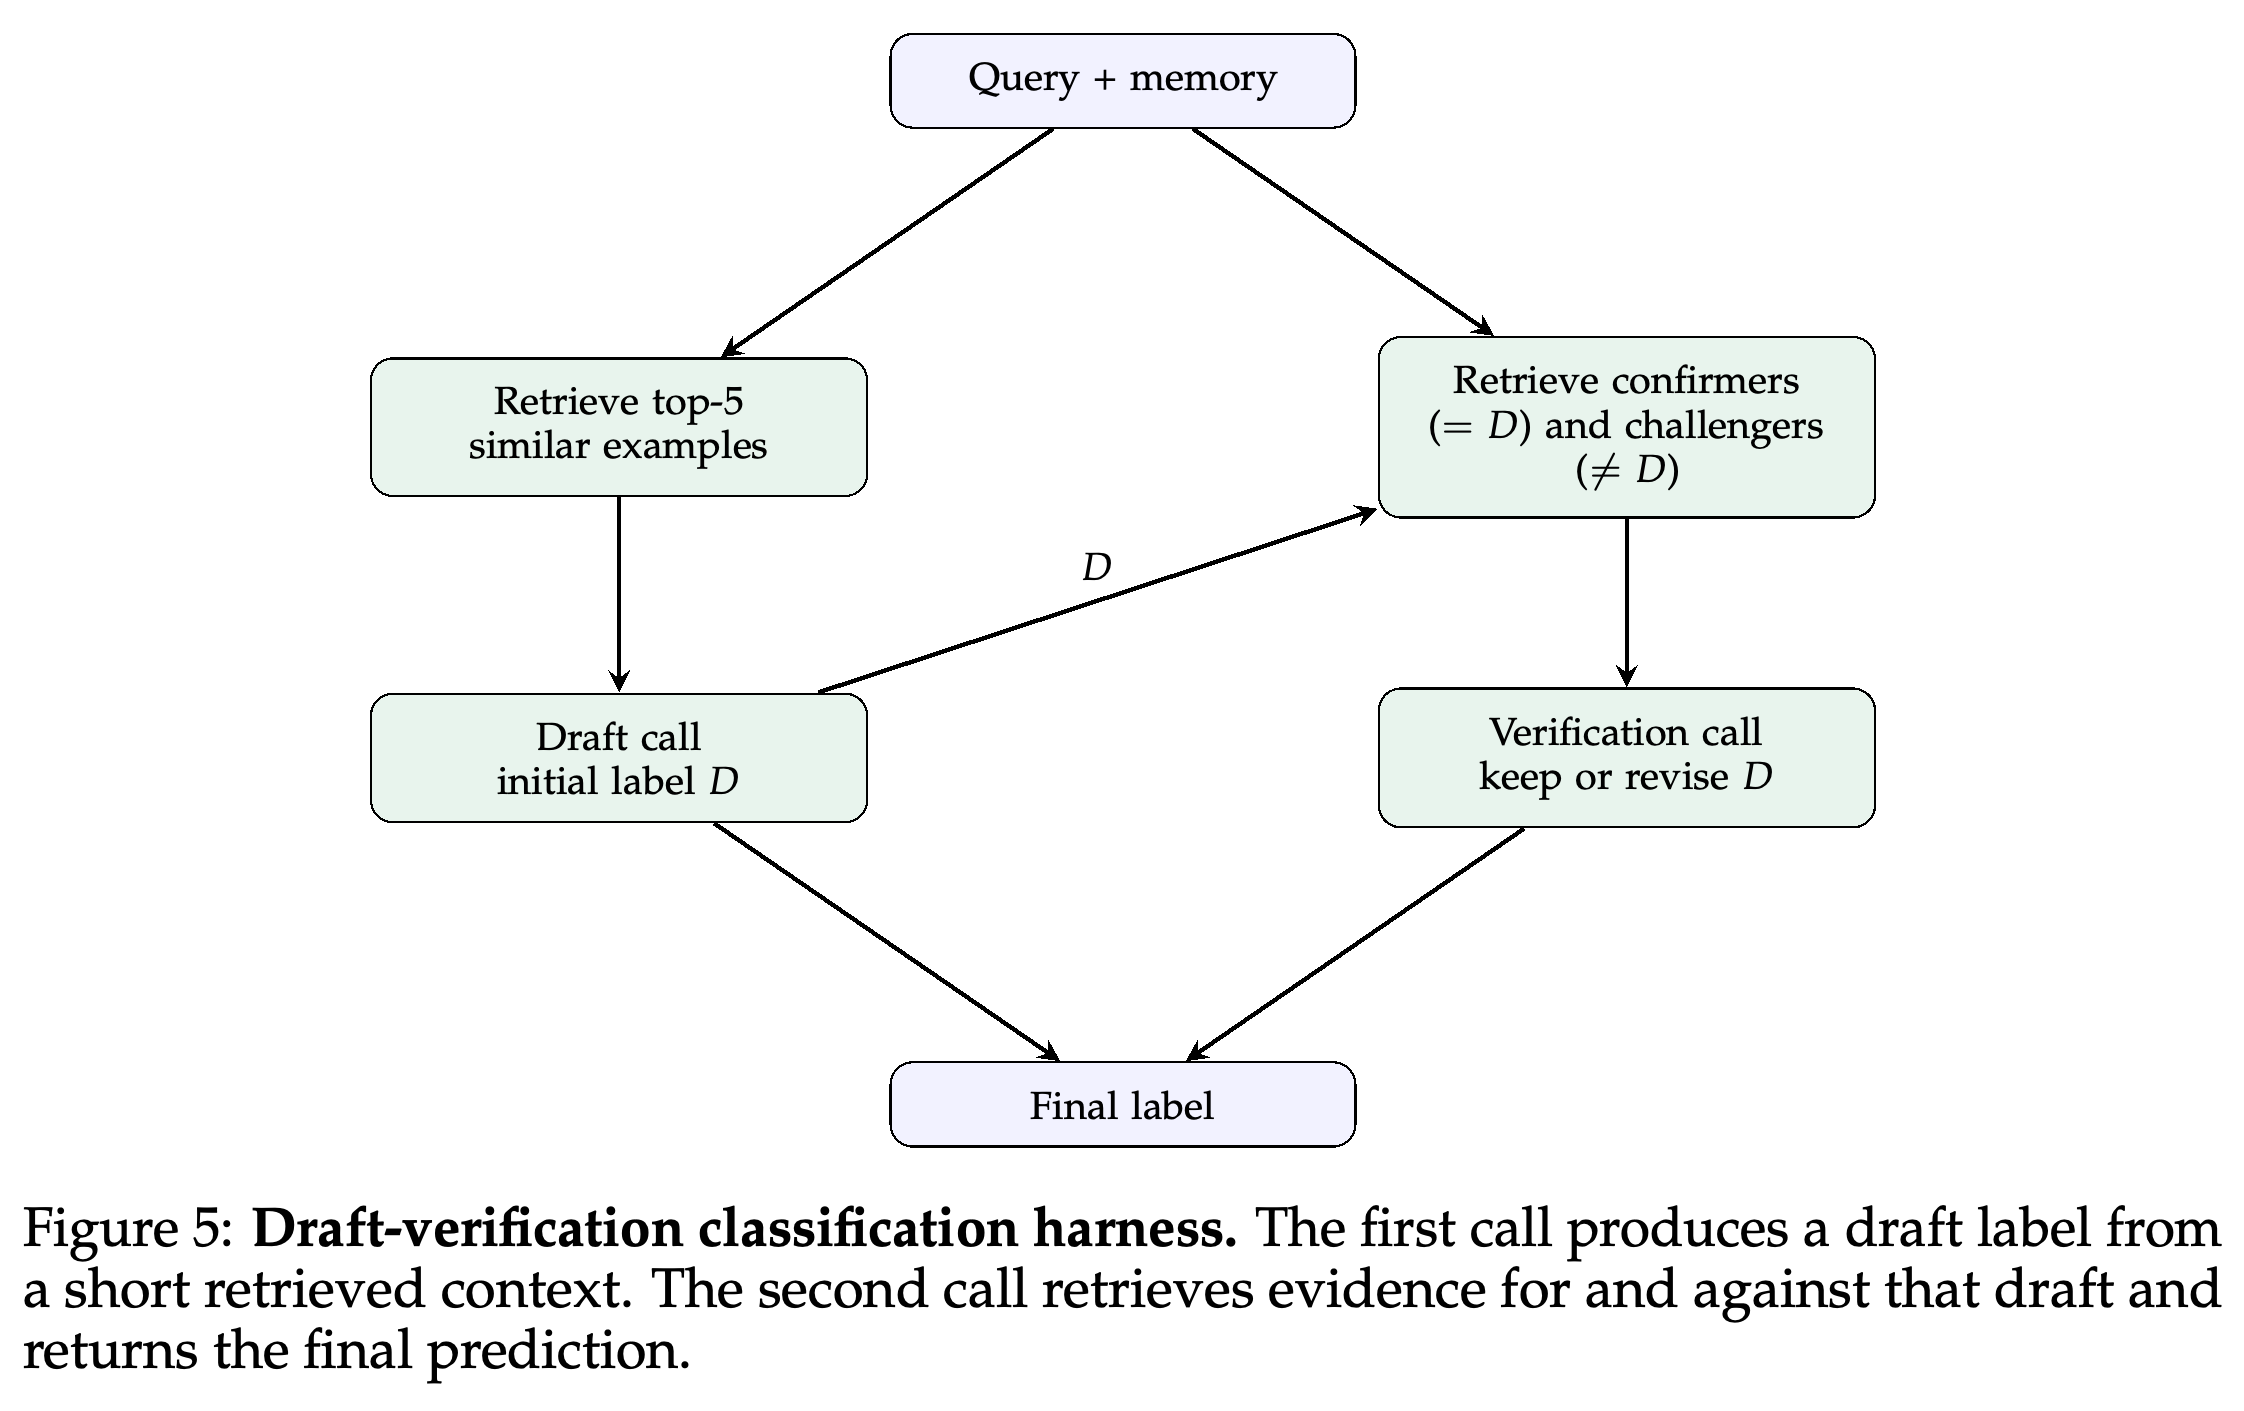
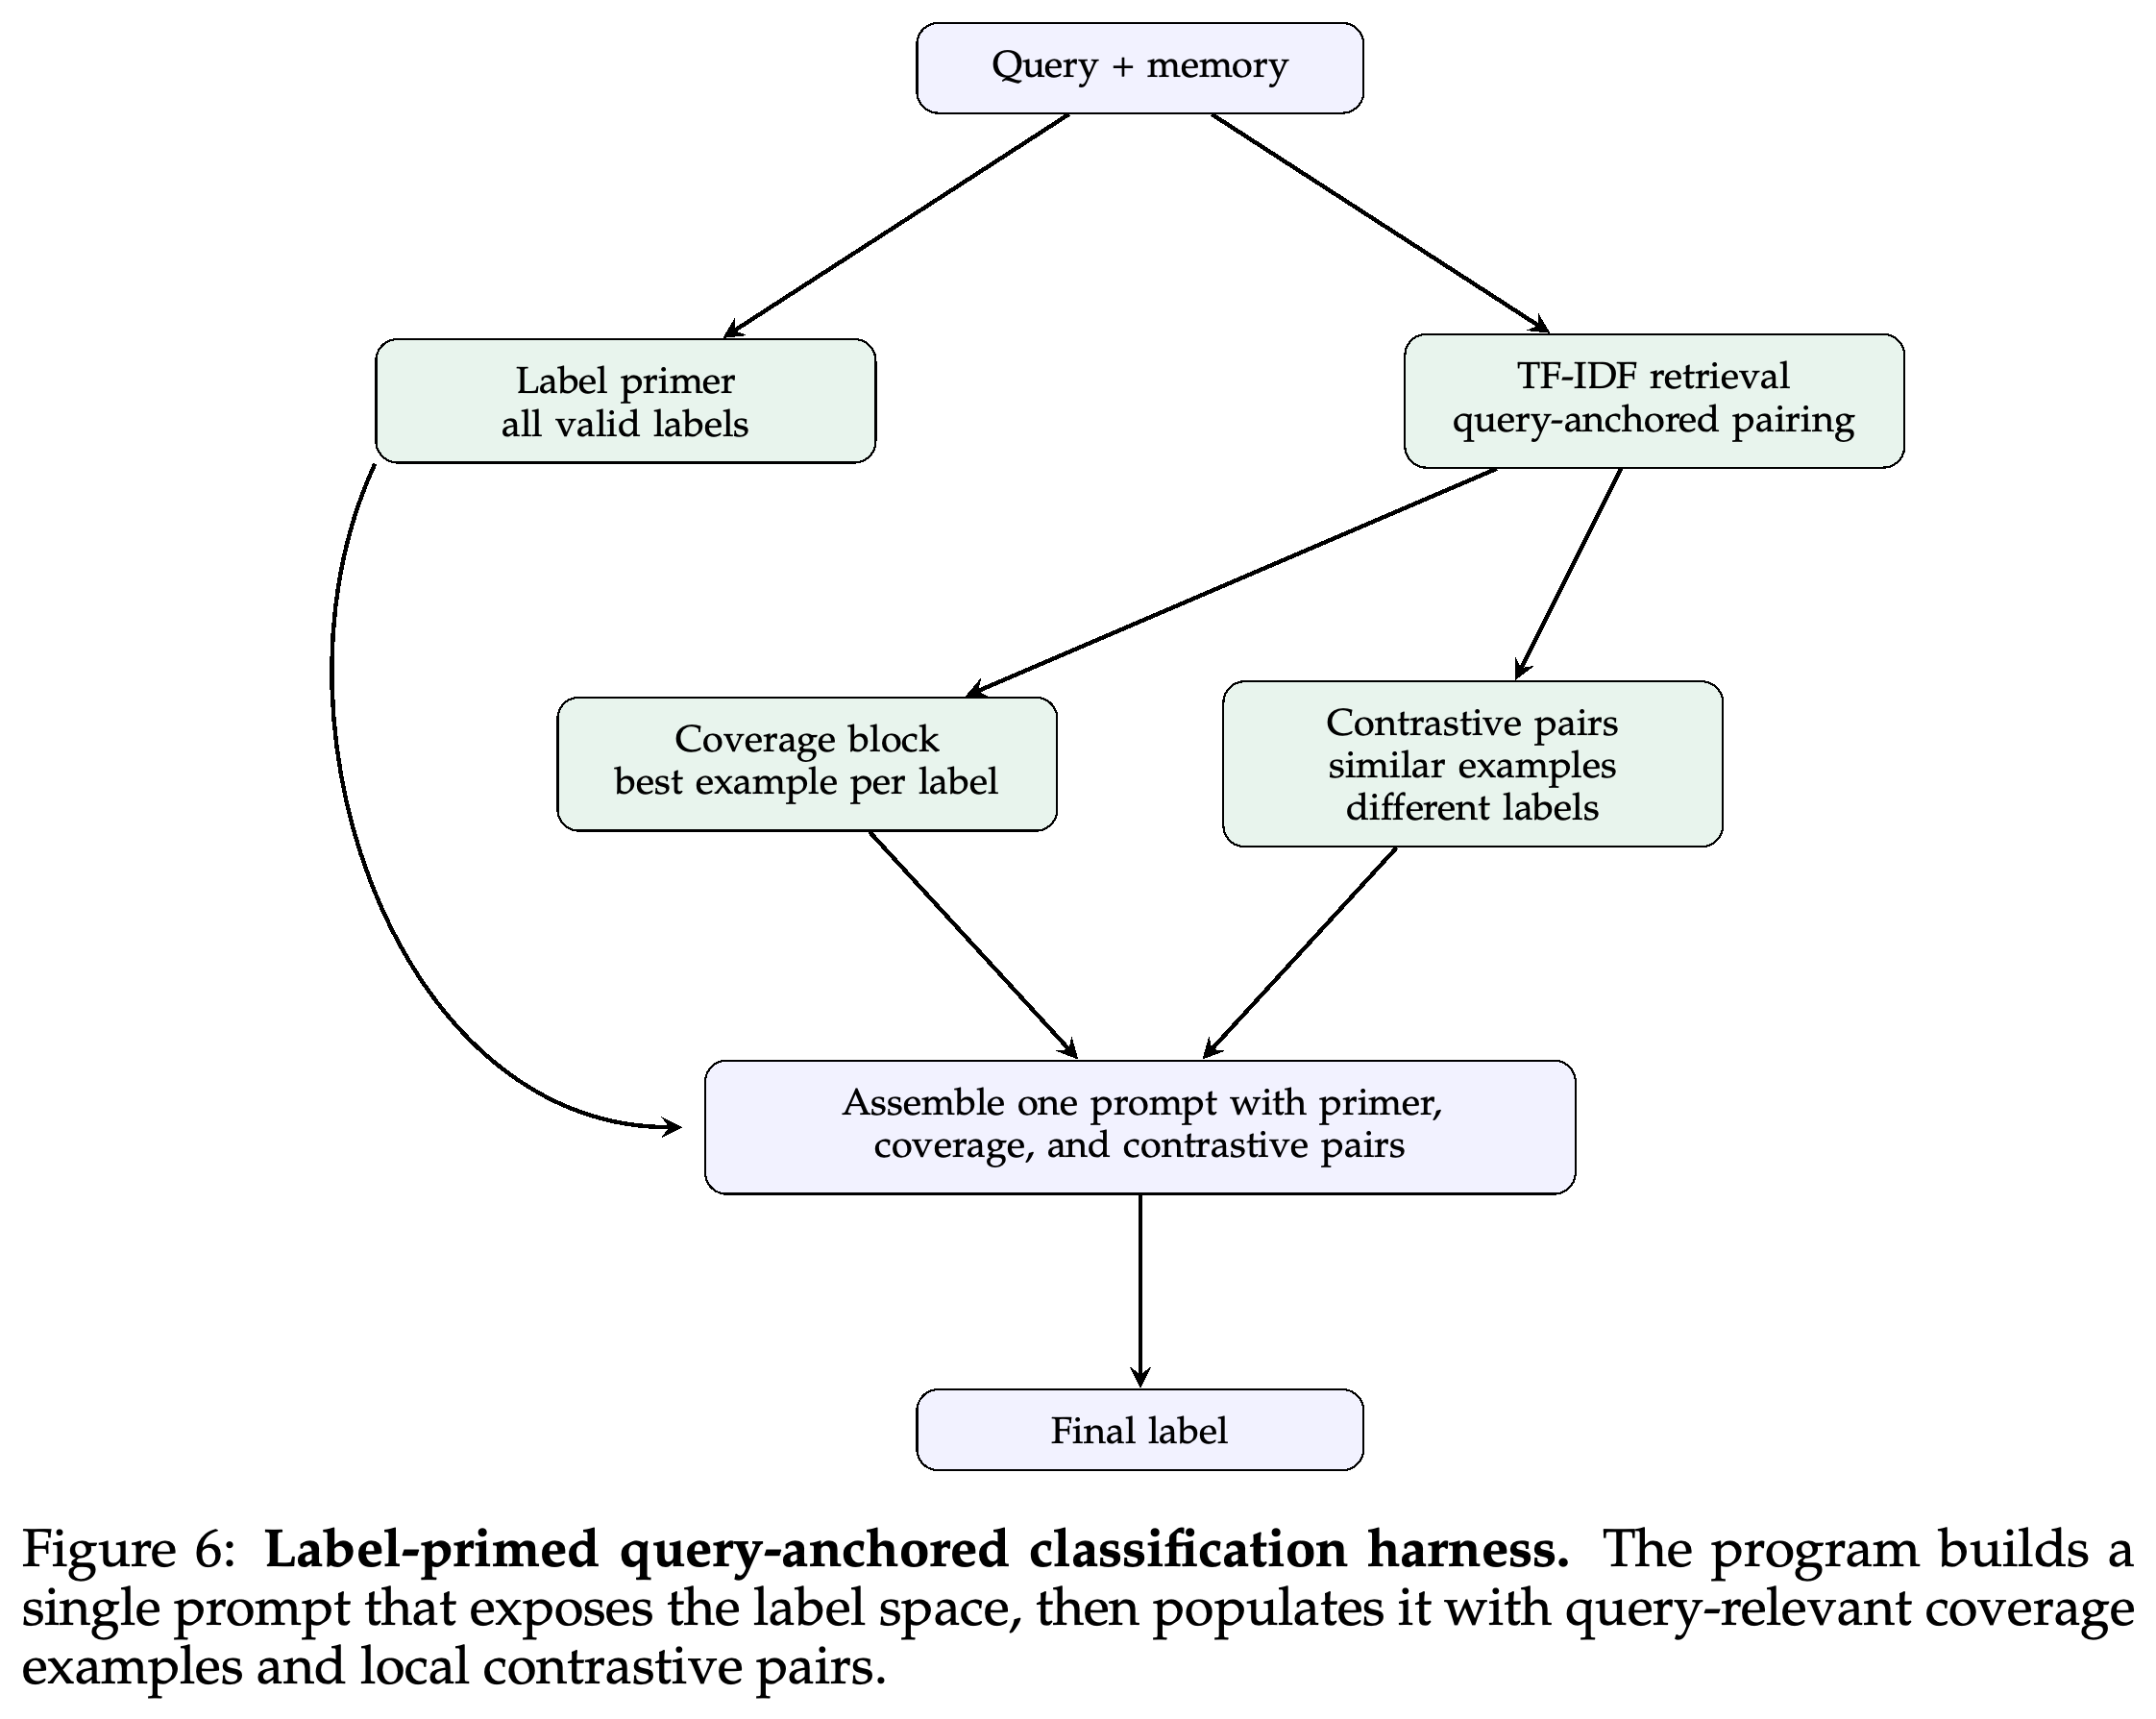
탐색으로 발견한 분류 프로그램은 레이블이 있는 메모리를 조회하는 2가지 방법을 구현한다. Draft Verification은 초기 예측을 위해 이웃 예제 5개를 검색한 뒤, 같은 레이블의 확인 예제 5개와 다른 레이블의 반박 예제 5개를 검색한다. Label-Primed Query는 유효한 레이블, 알려진 레이블마다 질의와 관련된 예제 1개, TF-IDF로 선택한 국소적 대조 쌍을 포함하는 프롬프트 1개를 구성한다.
- Figure 5는 예측에 따라 달라지는 2단계 검색을 보여 준다. 저장된 예제가 5개 미만이면 단일 호출 few-shot 방식으로 대체한다.
- Figure 6은 정확도가 더 높은 단일 호출 정책을 보여 준다. 클래스별 예제는 레이블 공간을 드러내고, 서로 다른 레이블을 가진 유사 예제는 국소적 결정 경계를 명확히 한다.
- 이 절차들은 탐색으로 발견한 frontier의 대표적인 결과이며, 사람이 미리 지정한 탐색 템플릿이 아니다.
후속 검색은 초안 레이블에 따라 달라지므로, 확인 및 반박 예제로 현재 결정을 검증할 수 있다. 이는 일반적인 최근접 이웃을 더 많이 검색하는 것과 다르다.
단일 호출 프롬프트는 전체 레이블 공간을 포괄하는 예제와 국소적으로 대비되는 예제를 결합한다. 별도의 검증 호출 없이 가능한 답과 질의별 결정 경계를 모두 드러낸다.
4.2 Harnesses for Retrieval-Augmented Reasoning
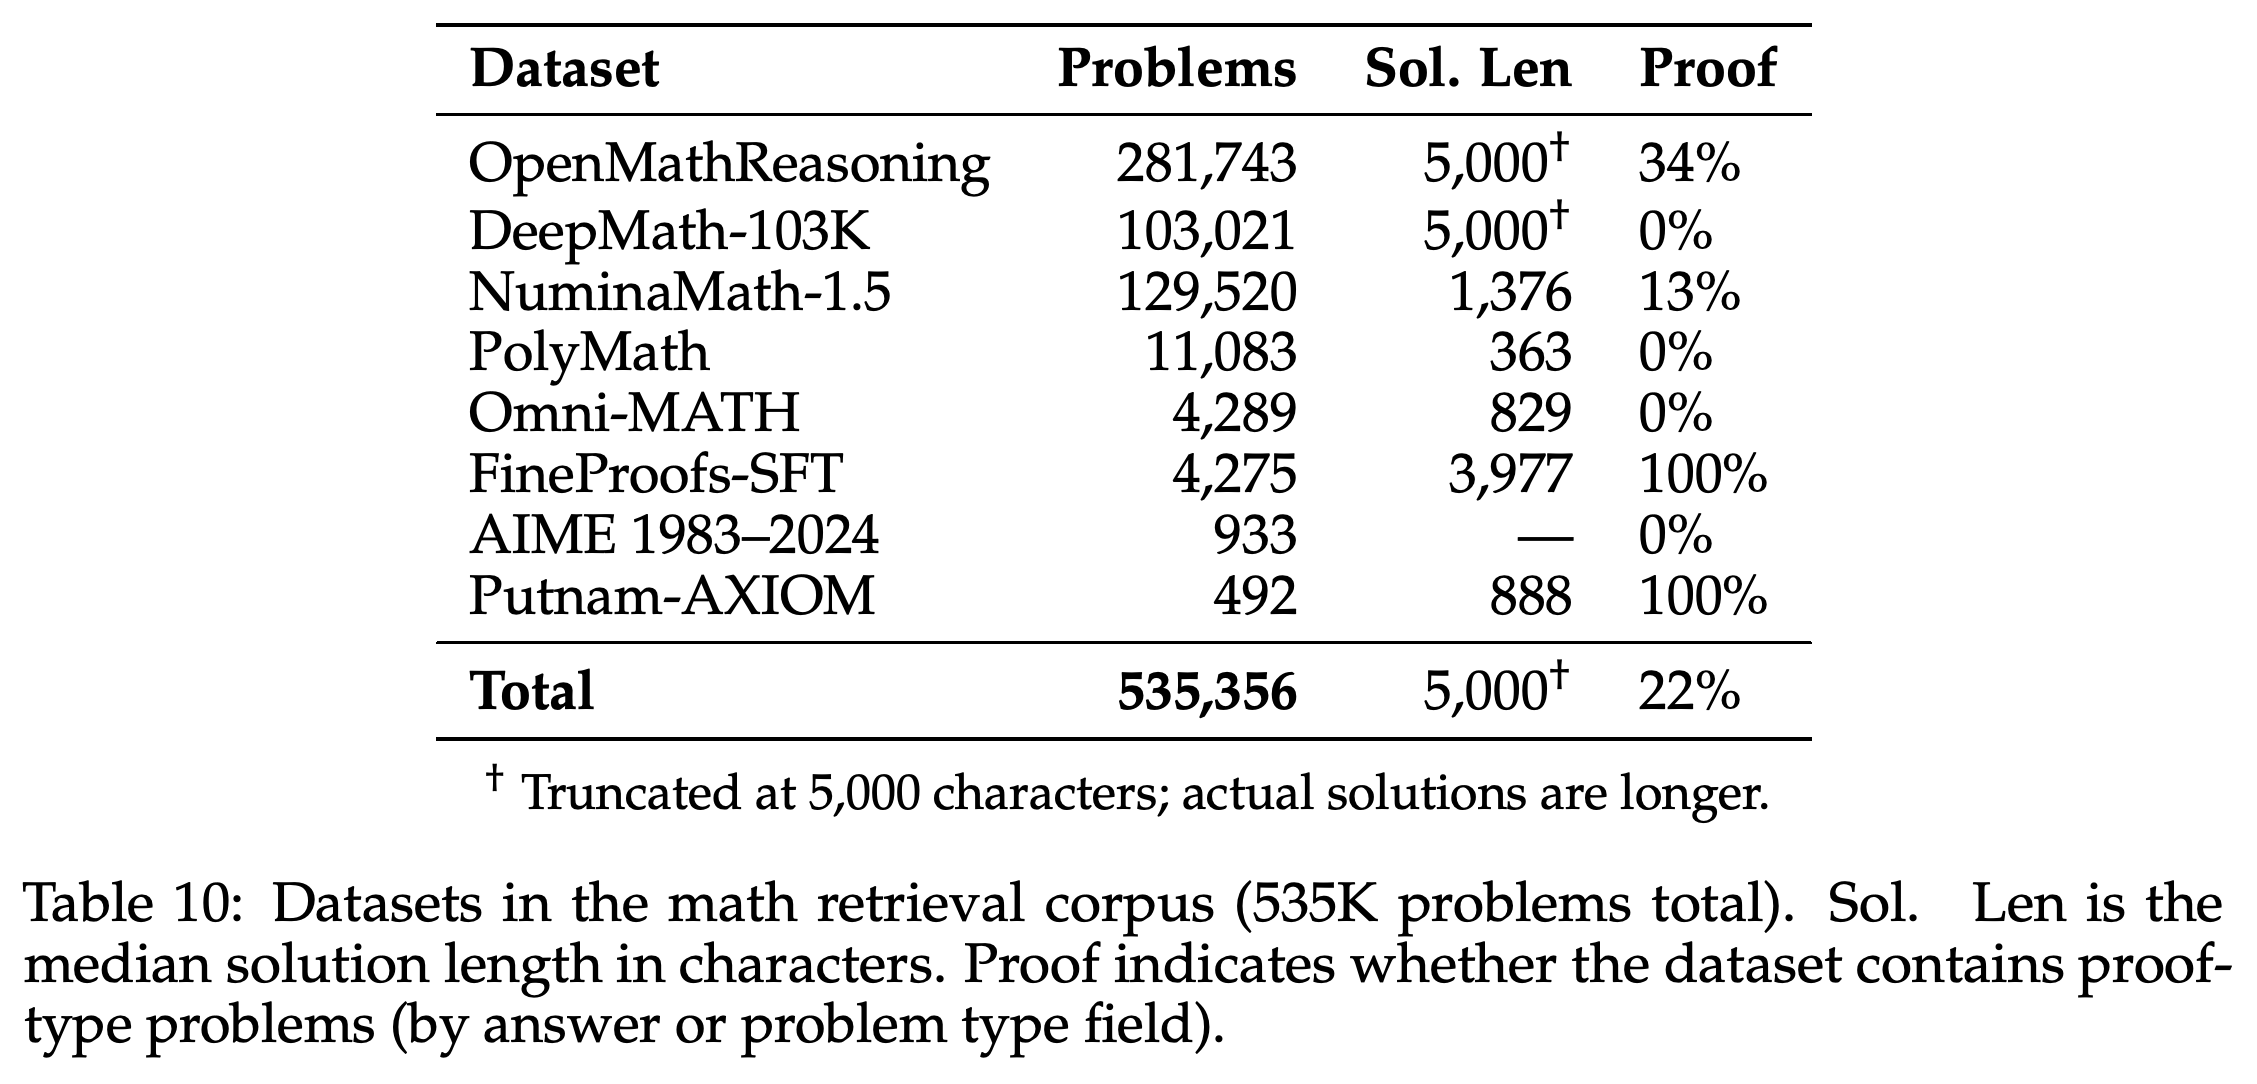
수학 탐색은 데이터셋 8개의 풀이가 있는 문제 535,356개로 구성된 코퍼스에서 검색 동작을 최적화한다. 주 실험은 40회 반복, 후보 하네스 109개, OlympiadBench와 Omni-MATH hard에서 가져온 문제 250개의 탐색셋을 사용한다. GPT-OSS-20B로 하네스 1개를 선택하며, 초기 하네스는 zero-shot, few-shot, ACE다.
- 최종 평가는 탐색에 사용하지 않은 IMO 수준 문제 200개로 구성된다. Table 11에 따르면 IMO-AnswerBench 100개, IMO-ProofBench 60개, ArXivMath December 2025 17개, ArXivMath January 2026 23개다.
- 평가에는 GPT-OSS-20B와 탐색에 사용하지 않은 모델 4개인 GPT-5.4-nano, GPT-5.4-mini, Gemini-3.1-Flash-Lite, Gemini-3-Flash를 사용한다.
- Table 10은 코퍼스를 설명한다. 정확한 접두사 일치와 임계값 0.8의 fuzzy Jaccard 필터링으로 평가 및 탐색 문제와 일치하는 항목을 제거한다. 저자들은 BM25 상위 검색 결과도 수동으로 점검한다.
코퍼스는 풀이 길이와 증명 내용이 서로 다른 문제 535,356개를 결합하며, 보고된 전체 증명 비율은 22%다. 출처 통계는 검색 자원을 설명한다. 오염 제거와 실행 시 풀이 길이 필터는 실제로 사용할 수 있는 항목을 추가로 제한한다.
평가셋의 절반은 표본 추출한 IMO-AnswerBench 부분집합이며, 나머지는 증명형과 연구형 벤치마크를 결합한다. 이 표는 구성을 제시할 뿐 별도의 성능 추정치를 제공하지 않는다. 따라서 어떤 벤치마크가 전체 개선에 가장 많이 기여했는지는 알 수 없다.
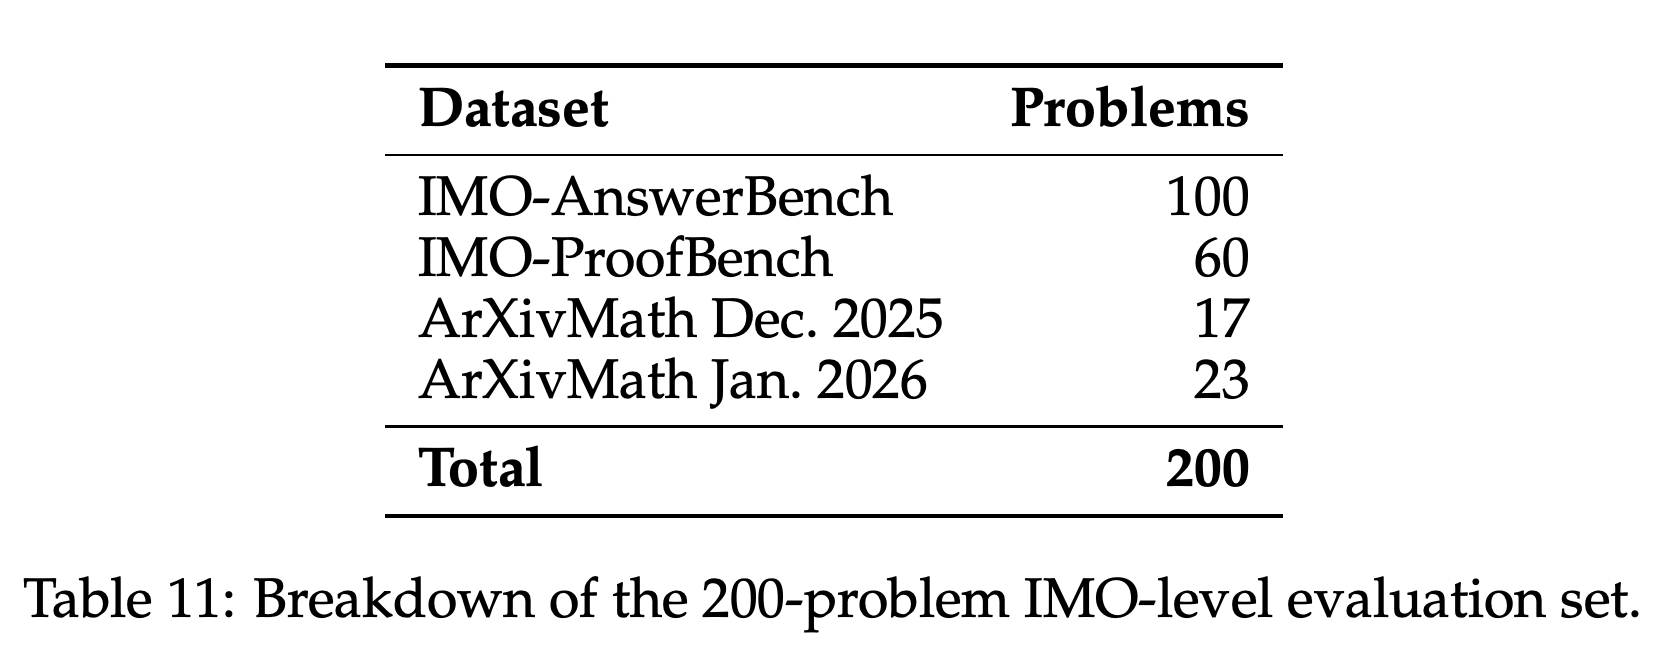
Table 6은 문제당 표본 3개의 pass@1 평균을 보고한다. Meta-Harness는 평가 모델 5개에서 평균 38.8%를 달성한다. 검색 없음은 34.1%, k=1인 dense retrieval은 34.4%, k=5는 38.1%, 무작위 few-shot 프롬프트는 32.2%, BM25 검색은 37.5%다. 검색 없음 대비 개선 폭은 표의 모델 순서대로 +8.7, +1.6, +6.3, +3.7, +3.0포인트다.
- 발견한 하네스는 sparse 기준선과 같은 BM25 기반 어휘 검색 구성을 사용하며, dense retrieval은 text-embedding-3-small을 사용한다.
- 검색 없음 대비 평균 개선 폭은 4.7포인트이며, 평가 모델 5개 모두에서 향상된다. BM25 대비 평균 우위는 1.3포인트다.
- 평균이 가장 높다고 모델별로 모두 우세한 것은 아니다. k=5인 dense retrieval은 Gemini-3.1-Flash-Lite와 Gemini-3-Flash에서 더 높으며, 고정 BM25도 Gemini-3-Flash에서 약간 더 높다.
- 이 결과는 “Meta-Harness Improves Reasoning on IMO-Level Math Problems”를 뒷받침한다. 다만 PDF의 “five held-out models”라는 표현은 실제 프로토콜보다 범위가 넓다. GPT-OSS-20B는 탐색에 사용하며, 나머지 모델 4개만 탐색에 사용하지 않는다.
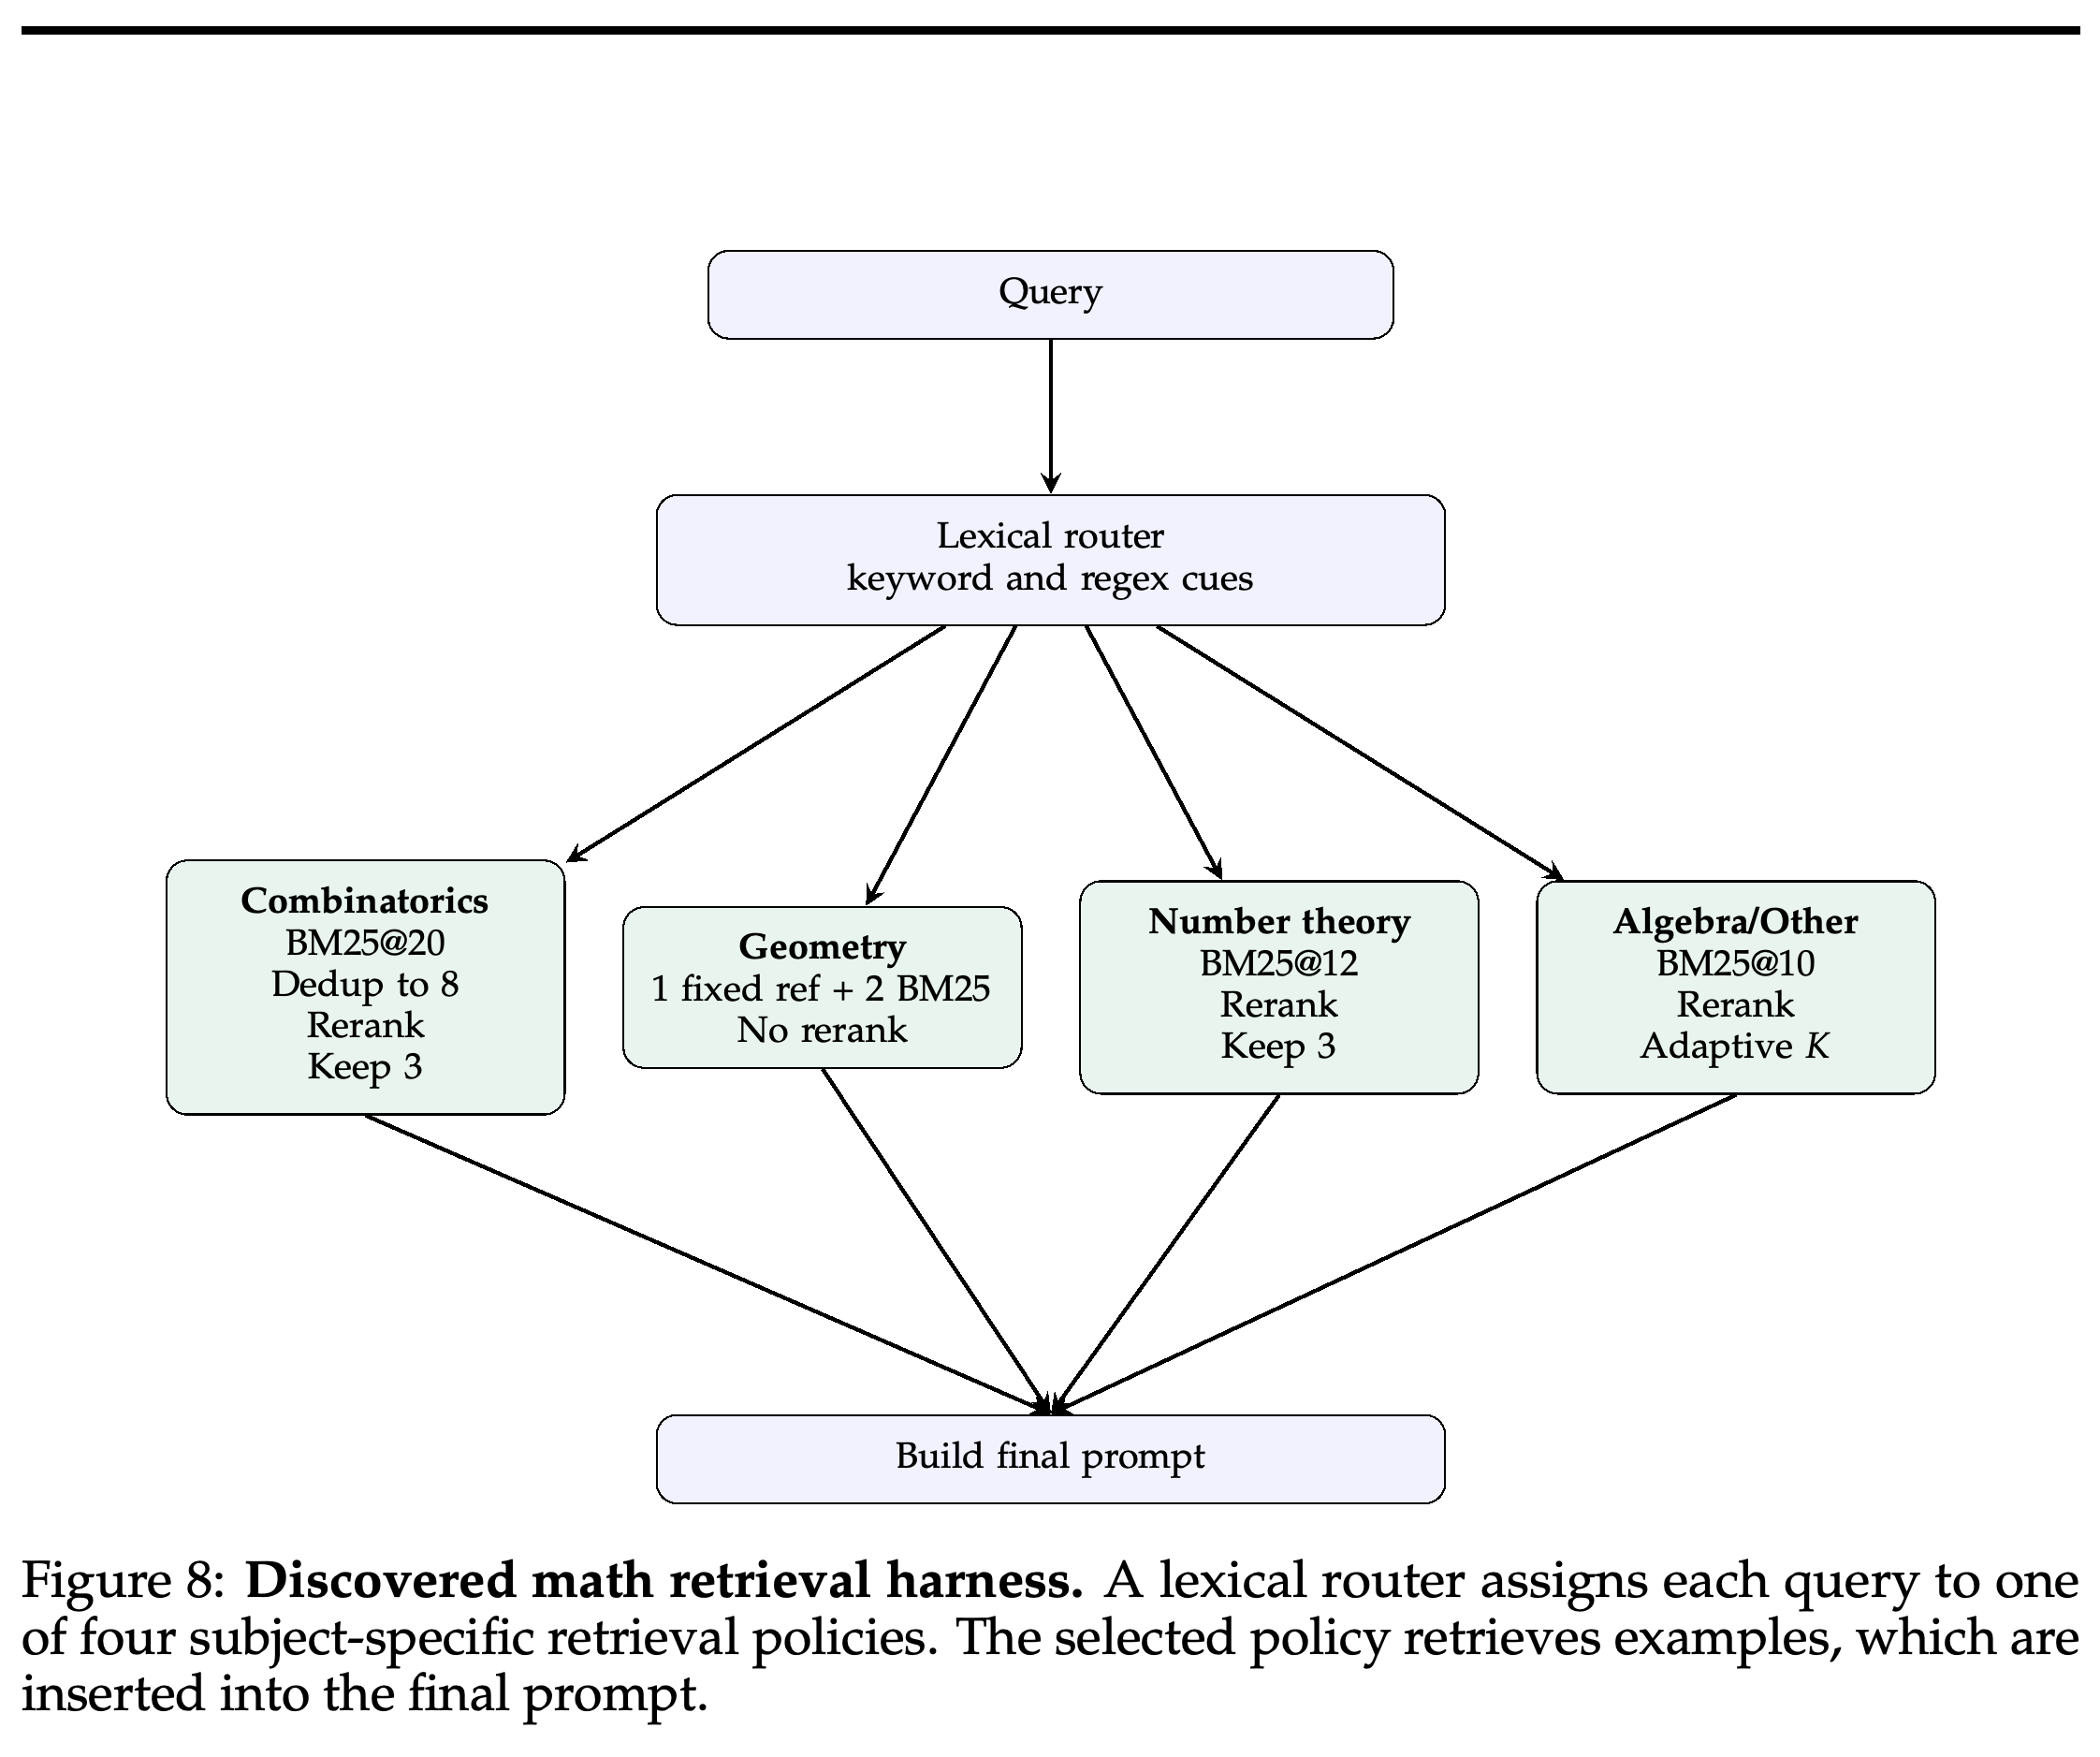
발견한 수학 하네스는 Figure 8에 제시된 경로 4개의 BM25 프로그램이다. 간단한 키워드와 정규식 조건이 조합론, 기하, 정수론, 기본 대수/기타 경로 중 정확히 1개를 선택한다. 선택된 경로만 최종 프롬프트에 예제를 제공한다.
- 조합론은 후보 20개를 검색하고 중복을 제거해 8개로 줄인 뒤, 어휘 점수와 난이도로 재정렬하여 3개를 남긴다. 기하는 어려운 NuminaMath 참고 문제 1개와 재정렬하지 않은 BM25 이웃 2개를 결합한다.
- 정수론은 후보 12개를 검색하고, 어휘 점수, 난이도, 기법을 초반에 명시한 경우의 가산점으로 재정렬하여 3개를 남긴다. 기본 경로는 후보 10개를 검색하고 점수의 집중도에 따라 예제 수를 조정한다.
- 선택된 프로그램은 성공한 탐색 계보 2개를 통합한다. 검색은 풀이가 비어 있지 않고 4,000문자보다 짧은 항목으로 제한하며, 삽입하는 풀이는 3,000문자에서 잘라낸다.
라우팅은 앙상블이 아니라 이산적인 선택이다. 정확히 1개의 주제별 정책이 최종 컨텍스트를 제공한다. 중복 제거, 재정렬, 예제 수는 경로마다 다르며, 탐색으로 선택한 실행 프로그램의 일부를 이룬다.
4.3 Evaluating Agentic Coding Harnesses on TerminalBench-2
TerminalBench-2는 어려운 자율 터미널 과제 89개로 구성된다. 탐색은 Terminus 2와 Terminus-KIRA에서 시작하지만, 탐색과 최종 평가에 같은 과제 89개를 사용한다. 저자들은 이를 별도 평가셋에 대한 일반화 실험이 아니라 벤치마크 탐색으로 규정한다.
- 수동 점검과 정규식 감사로 진화한 하네스에 과제별 문자열 누출이 있는지 확인한다.
- 이 감사는 눈에 보이는 하드코딩을 다루며, 모든 형태의 벤치마크별 적응이나 선택 편향을 검증하지는 않는다.
- 부록은 Claude Opus 4.6 search run (10-iteration)을 분석한다. 이 실행의 기준선 점수를 최종 리더보드 비교와 혼동해서는 안 된다.
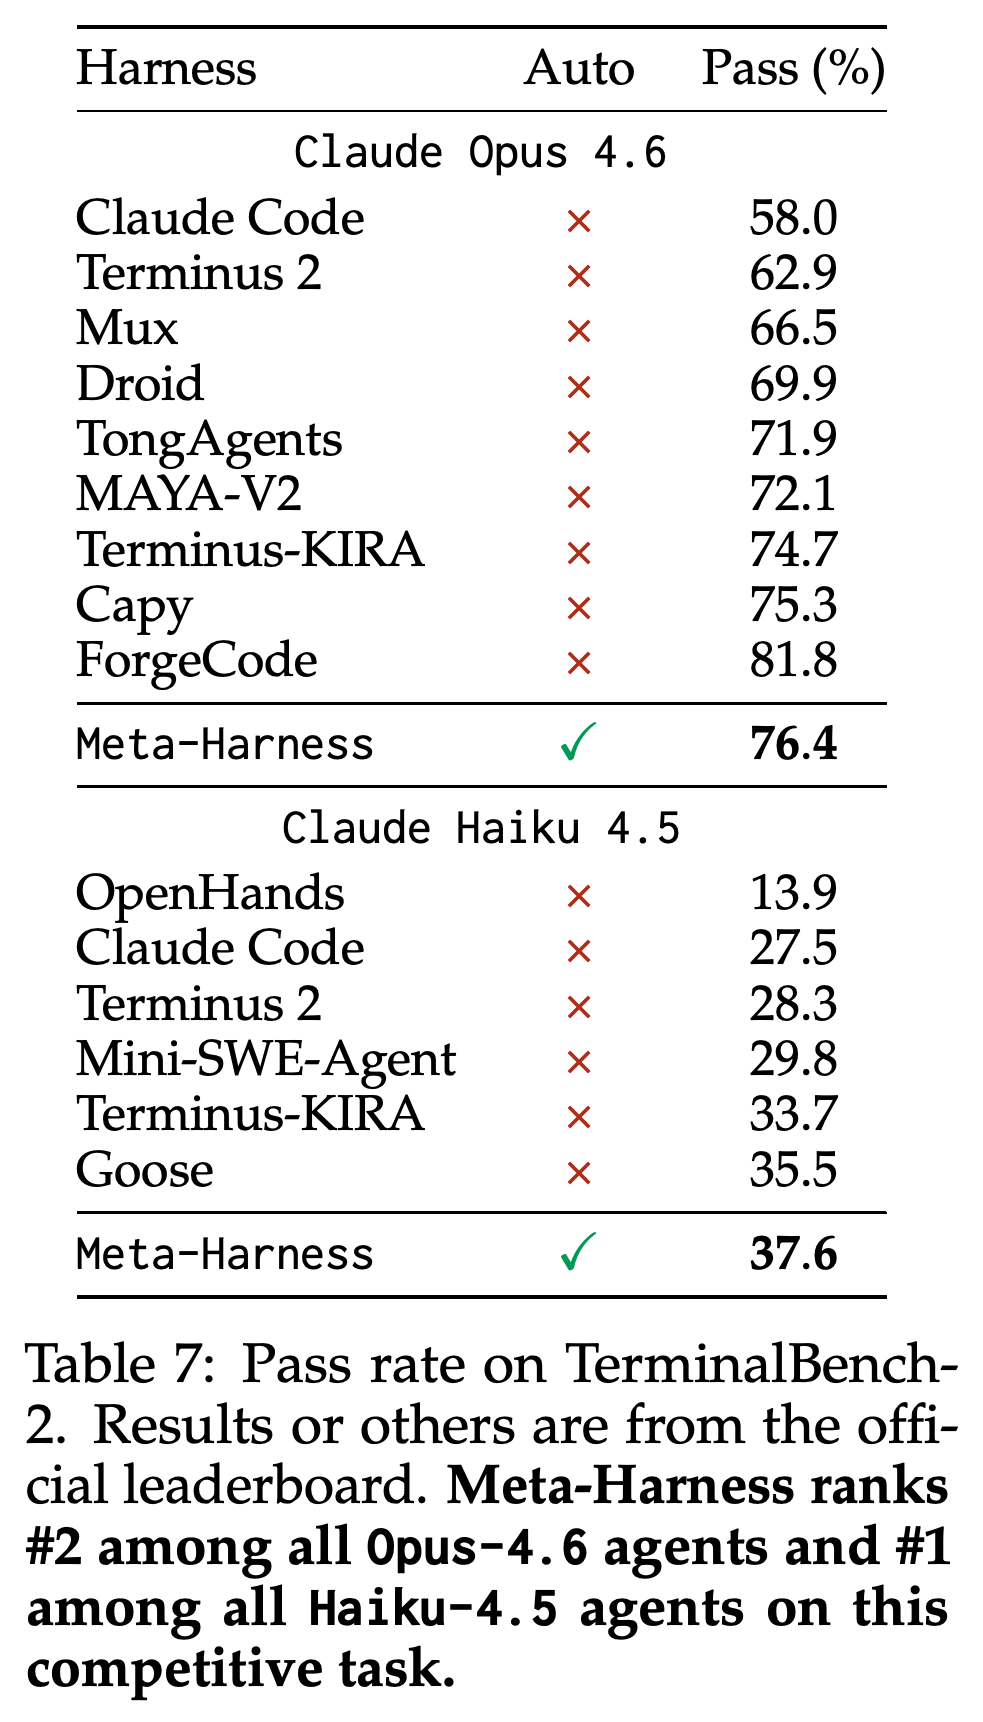
Table 7에서 Claude Opus 4.6을 사용하는 Meta-Harness의 통과율은 76.4%이며, Terminus-KIRA는 74.7%다. 보고된 ForgeCode의 81.8%에 이어 2위다. Claude Haiku 4.5에서 Meta-Harness는 37.6%를 달성하여 Goose의 35.5%보다 2.1포인트 높으며, 보고된 Haiku 4.5 에이전트 중 1위다.
- 비교 대상의 결과는 동일한 조건으로 재실행한 평가가 아니라 공식 리더보드에서 가져온다. “Meta-Harness Surpasses Hand-Engineered Agents on TerminalBench-2”는 보고된 모델별 비교를 구체적으로 가리킨다.
- 저자들은 ForgeCode의 공개 코드만으로는 해당 점수를 재현하지 못했다고 보고한다. 그렇다고 기재된 리더보드 결과가 무효가 되는 것은 아니다.
- 논문은 이 통과율 차이에 대한 신뢰구간을 보고하지 않는다.
Meta-Harness는 나열된 Opus 4.6 에이전트 중 2위, Haiku 4.5 에이전트 중 1위다. 비교 대상의 값은 공식 리더보드에서 가져온다. 발견한 하네스는 최종 채점에 사용한 것과 같은 벤치마크에서 최적화했다.
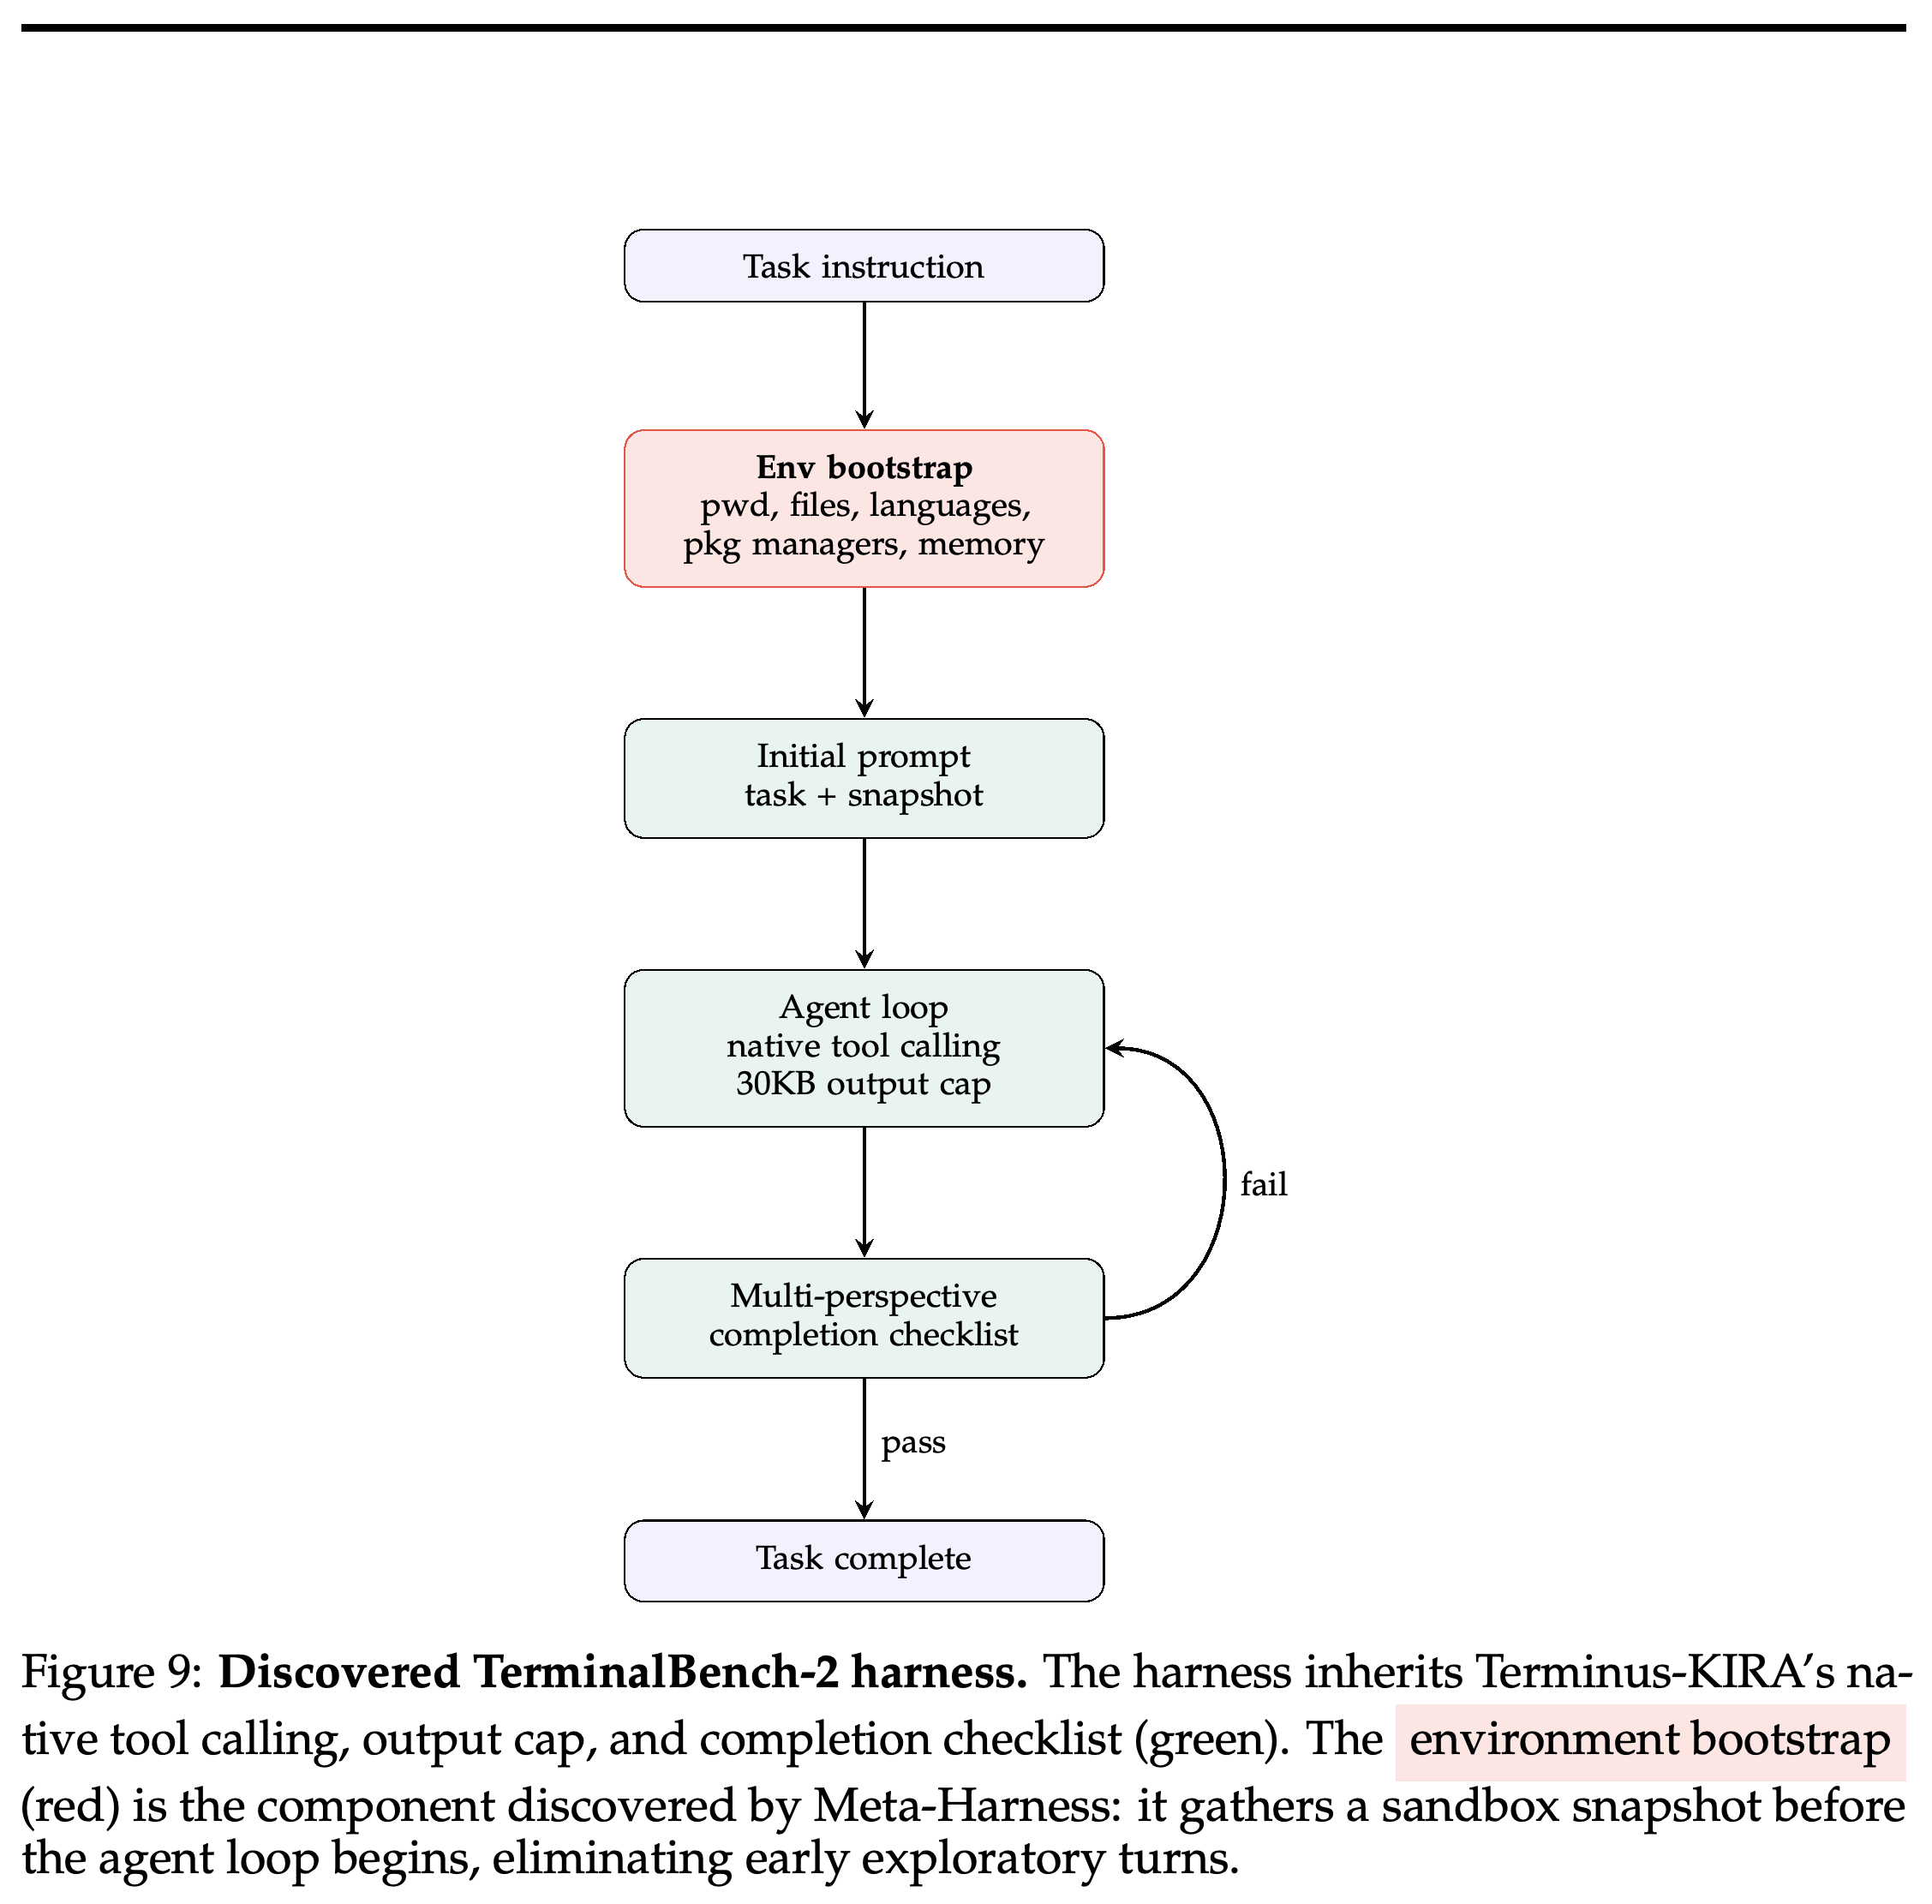
제안 에이전트는 프롬프트와 완료 흐름을 수정할 때 성능이 반복해서 하락하자 환경 부트스트래핑을 선택한다. 복합 셸 명령이 첫 모델 호출 전에 샌드박스 스냅샷을 수집하고 초기 프롬프트에 덧붙인다. Figure 9는 이 새 구성 요소를 Terminus-KIRA에서 이어받은 native tool calling, 출력 상한 30KB, 다중 관점 완료 체크리스트와 구분한다.
- 스냅샷에는 작업 디렉터리, 최대 20개의 /app 항목, 언어 버전, 패키지 관리자, 가용 메모리가 포함된다. 15초 타임아웃과 오류를 전파하지 않는 실패 처리로 특이한 환경에 대응한다.
- 구현에는 약 80줄이 추가된다. 논문은 과제 89개 중 7개에서 개선을 보고하며, protein-assembly와 path-tracing의 개선이 가장 크다. 저자들은 이를 필요한 도구가 명확하지 않은 과제와 연관 짓는다.
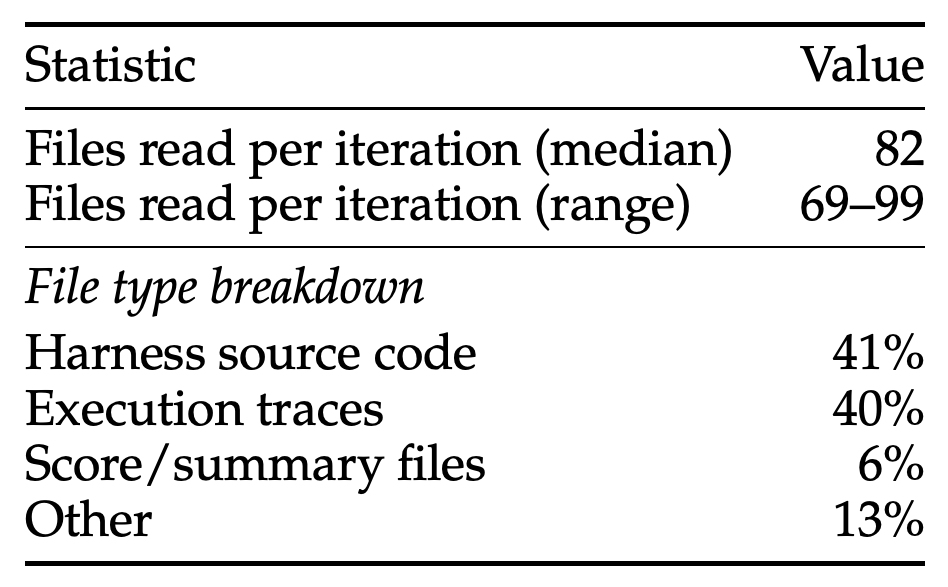
- Table 8에 따르면 반복당 읽은 파일 수의 중앙값은 82개이며, 읽기의 41%는 하네스 소스, 40%는 실행 추적에 해당한다. 파일 수는 과거 산출물의 활용을 보여 주지만, 각 읽기의 인과적 기여를 측정하지는 않는다.
소스 코드와 실행 추적 읽기의 비중이 거의 같아, 구현과 관찰된 동작을 모두 활용했음을 보여 준다. 이 통계는 폭넓은 산출물 접근을 입증하지만, 어떤 읽기가 개선을 일으켰는지는 밝히지 않는다.
발견한 환경 스냅샷은 기존 에이전트 루프 전에 삽입되며, 기존 도구 사용과 완료 처리 구조를 유지한다. 이러한 추가형 설계는 성능을 반복해서 떨어뜨린 프롬프트와 제어 흐름 수정에서 제안 에이전트가 방향을 전환한 결과다.
5 Discussion
논의는 코드 탐색 자체보다 진단에 필요한 경험에 선택적으로 접근하는 점을 강조한다. OOD 분류 성능과 탐색에 사용하지 않은 수학 모델로의 전이는 재사용 가능한 하네스 전략을 뒷받침한다. 또한 읽기 쉬운 코드는 명시적인 하드코딩을 점검하기 쉽게 한다.
- 저자들은 탐색 실행이 몇 시간 안에 완료된다고 설명하지만, 평가 비용, 제안 에이전트의 토큰 사용량, 실행 간 변동성을 포괄적으로 집계하지는 않는다.
- 3개 도메인 모두 Opus-4.6을 사용하는 Claude Code를 제안 에이전트로 사용한다. 더 약하거나 다른 제안 에이전트에서도 인터페이스의 이점이 유지되는지는 남은 문제다.
- 하네스와 모델 가중치를 함께 진화시키는 방법은 향후 연구로 제안하며, 이 논문에서 평가하지는 않는다.
부록
- A Qualitative Proposer Behavior와 A.1 File Access Statistics는 제안 에이전트의 파일 접근을 분석한다. 분석한 10-iteration TerminalBench-2 run 자료에서 제안 에이전트가 반복당 읽은 파일 수의 중앙값은 82개 파일이며, 범위는 69–99개다. 파일 유형별 읽기 비중은 하네스 코드 41%, 실행 추적 40%, 점수/요약 6%, 기타 13%다. 이는 가장 최근 후보 외의 자료에도 접근했음을 보여 준다.
- A.2 Qualitative Behavior: Causal Reasoning Over Prior Failures는 실패 진단 과정을 설명한다. 반복 1–2는 구조적 수정과 정리 목적의 프롬프트 수정을 함께 적용하면서, 해당 실행의 기준선 64.4%에서 58.9%와 57.8%로 하락한다. 반복 3은 공통된 프롬프트 변경을 찾아내고 수정을 분리해 시험하여 63.3%에 도달한다. 반복 4–6에서도 완료 로직, 프롬프트 표현, 대기 동작을 바꿀 때 성능이 하락한다. 반복 7은 환경 부트스트래핑을 추가하는 방향으로 전환하여 해당 실행의 최고 후보가 되고, 반복 8은 이전 수정과의 조합을 시도한다. 반복 9의 후보가 평가 전에 오류로 중단된 뒤, 반복 10은 다른 실행에서 얻은 교훈을 참조한다. 부록의 Summary는 이 과정을 진단과 가설 수정으로 해석한다. 이는 정성적 설명이며, 통제된 인과 연구가 아니다.
- B Discovered Harnesses와 B.1 Text Classification Harness는 보통 100–1000줄인 실행 프로그램의 전체 코드 대신, 핵심 절차를 추상화해 제시한다. Overview는 예측에 따라 지지 및 반박 예제를 검색하고 짧은 호출 2회를 사용하는 Meta-Harness (Draft Verification)와, 레이블 프라이밍, 클래스별 예제, 질의 중심 대조 쌍을 큰 프롬프트 1개에 결합하는 Meta-Harness (Label-Primed Query)를 대비한다. 후자는 주 실험에 선택된 시스템이다. Table 9는 Error-Annotated, CoT Replay, Cluster Coverage, Cascade Retrieval, RRF + Contrastive, Relevance + Contrastive 변형을 포함한 더 넓은 frontier를 제시한다.
- B.2 Math Retrieval Harness의 Overview는 어휘 기반 라우터와 주제별 BM25 정책을 설명한다. 라우터는 정책 1개를 선택하며, 경로별로 후보 수, 중복 제거, 난이도 재정렬, 예제 예산을 다르게 적용한다. 수학용 토크나이저는 LaTeX 토큰을 보존하고, 기하의 어려운 참고 문제 인덱스는 난이도가 6보다 큰 NuminaMath 문제를 사용한다. 최종 프로그램은 서로 다른 탐색 계보의 기하 전략과 조합론 전략을 자율적으로 결합한다.
- B.3 TerminalBench-2 Harness의 Per-task analysis는 환경 부트스트래핑의 과제별 효과를 설명한다. 환경 부트스트래핑은 기존 에이전트 루프나 완료 체크리스트를 바꾸지 않고 샌드박스 스냅샷을 추가한다. 부록은 필요한 도구가 불확실한 과제에서 초기 탐색 2–4턴을 피하는 데 그 가치가 있다고 설명한다. 또한 과제 7개에서 개선을 보고하며, 특히 protein-assembly와 path-tracing을 강조한다. 이는 관찰된 변화에 대한 과제 수준의 해석이며, 보편적인 턴 절약을 독립적으로 측정하여 보장한 결과는 아니다.
- C Dataset Details와 C.1 OOD Text Classification Datasets는 데이터셋 9개인 SciCite, FiNER-139, Amazon Reviews, Financial PhraseBank, GoEmotions, Banking77, AG News, SciTail, TweetEval (Hate)를 설명한다. 각각 인용 의도 3분류, 금융 수치 개체 유형 139개, 평점 5분류, 금융 감성 3분류, 중립을 포함한 감정 레이블 28개, 은행 업무 의도 77개, 뉴스 주제 4분류, 과학적 함의, 혐오 발언 이진 탐지를 다룬다.
- C.2 Math Retrieval Corpus의 Table 10은 OpenMathReasoning 281,743문제, DeepMath-103K 103,021문제, NuminaMath-1.5 129,520문제, PolyMath 11,083문제, Omni-MATH 4,289문제, FineProofs-SFT 4,275문제, AIME 1983–2024 933문제, Putnam-AXIOM 492문제를 제시하며, 총 535,356문제다. 필터링에는 NuminaMath의 대회 출처 선택, OpenMathReasoning의 문제당 풀이 1개를 남기는 중복 제거와 평가 벤치마크 계열에 속하는 문제 제거, 코퍼스 전체의 정확한 접두사 일치 및 임계값 0.8의 fuzzy Jaccard 오염 제거가 포함된다. OpenMathReasoning과 DeepMath 풀이는 5,000문자에서 잘라낸다.
- C.3 Math IMO-level Test Set의 Table 11은 층화 추출한 IMO-AnswerBench 부분집합 100문제, IMO-ProofBench 전체 60문제, ArXivMath December 2025와 January 2026의 17문제와 23문제를 명시한다. 전체 평가셋은 답안형, 증명형, 연구형 문제를 섞어 구성한다. 다만 PDF는 여기서 문제 수의 구성만 제시하며, 벤치마크별 Base와 Meta-Harness의 성능 비교는 제공하지 않는다.
- D Practical Implementation Tips에서 저자들은 짧은 3–5회 반복 실행으로 도메인 스킬을 개선하고, 어렵고 후보 간 차이를 잘 드러내는 탐색 예제를 선택하며, 기계가 읽을 수 있는 산출물을 기록할 것을 권한다. 필요하면 이력 탐색용 CLI를 제공하고, 비용이 큰 평가 전에 인터페이스를 검증하며, 제안 에이전트 외부에서 후보를 채점하도록 권한다. 이는 통제된 실험 결과가 아니라 개발 경험에서 얻은 교훈이다. 이 조언은 실용적인 탐색셋 예시로 수학 문제 88개를 언급하지만, Section 4.2는 250개를 보고한다. PDF는 이 수량 차이를 해명하지 않는다.
- E Extended Related Work는 AlphaEvolve / OpenEvolve를 구조화된 프로그램 데이터베이스, 스칼라 점수, 부모/변이 메커니즘을 기준으로 Meta-Harness와 대비한다. GEPA는 전체 후보군을 적응적으로 살펴보는 방식 대신 후보 수준의 성찰적 피드백을 사용한다는 점에서 대비한다. 프롬프트 오케스트레이션 프레임워크인 LMQL, LangChain, DSPy는 LLM 프로그램을 명세하고 구성하는 데 도움을 준다. 반면 Meta-Harness는 검색, 메모리, 오케스트레이션 정책의 실행 구현을 최적화한다. 이는 논문이 자신의 위치를 설명하는 구분이며, 다른 시스템이 더 풍부한 이력에 맞게 확장될 수 없다는 증거는 아니다.
짧은 생각
가장 명확한 기여는 피드백 인터페이스다. 분류 절제 실험은 원시 실행 추적을 보존하고 제안 에이전트가 살펴볼 대상을 정하게 하는 방식을 뒷받침한다. 발견한 정책은 구체적이고 해석 가능하지만, 평가의 설득력은 도메인마다 다르다. 탐색에 사용하지 않은 데이터셋과 모델은 전이의 근거를 제공하는 반면, TerminalBench-2는 별도 평가셋에 대한 일반화보다 벤치마크에 특화된 개선을 보여 준다. 후속 연구에서는 제안 에이전트를 비교하고, 탐색을 반복하여 불확실성을 추정하며, 평가 횟수의 효율성과 총 계산 비용을 구분할 필요가 있다. 수학에서는 모든 평가 모델이 검색 없음보다 개선되지만, k=5인 dense retrieval 대비 평균 우위는 0.7포인트에 그친다. 코딩 리더보드의 개선에는 신뢰구간이 보고되지 않는다. 결과는 시험한 설정에서 실행 하네스를 탐색할 때 완전한 진단 이력에 선택적으로 접근하는 방식을 뒷받침한다. 비구조화된 외부 루프가 보편적으로 우월하다는 근거는 아니다.