Generalized Out-of-Distribution Detection - A Survey 논문 설명
18 Aug 2022 | Out-of-Distribution Detection Survey목차
- 요약
- 1 Introduction
- 2 Generalized OOD Detection
- 3 OOD Detection: Methodology
- 4 Methodologies from Other Sub-tasks
- 5 Benchmarks and Experiments
- 6 Challenges and Future Directions
- 7 Conclusion
- 짧은 생각
Generalized Out-of-Distribution Detection: A Survey는 anomaly detection, novelty detection, open set recognition, OOD detection, outlier detection의 문제 정의와 방법을 비교한다. 각 분야에서 어떤 데이터를 정상으로 정의하며 무엇을 검출하는지 정리한 논문이다.
- 논문: Generalized Out-of-Distribution Detection: A Survey
- 저자: Jingkang Yang, Kaiyang Zhou, Yixuan Li, Ziwei Liu
- 소속: S-Lab, Nanyang Technological University; University of Wisconsin-Madison
- 최초 공개: 2021년 10월 21일. 이 글의 원래 작성 시점에 해당하는 v2는 2022년 8월 3일 공개되었다.
- 설명 기준: arXiv v3 PDF, 2024년 1월 23일 개정판
- 관련 구현: OpenOOD
아래 방법 분류와 실험 결과는 v3 개정판을 기준으로 한다. OpenOOD의 온라인 leaderboard는 이후 릴리스에 따라 갱신된다.
요약
- 알려진 클래스를 분류하도록 학습한 모델은 새로운 클래스의 입력에도 높은 softmax 값을 부여할 수 있다. OOD 검출은 이런 입력을 찾아 거부하는 문제를 다룬다.
- 논문은 다섯 연구 분야를 검출할 분포 변화, ID 클래스 수, ID 분류 필요 여부, 학습·테스트 분리 여부라는 네 기준으로 연결한다.
- 주류 의미적 OOD 검출에서는 학습에 없던 클래스를 거부하되, 이미 알려진 클래스의 분류 성능은 유지해야 한다. 단순한 촬영 환경 변화까지 무조건 거부할지는 응용 목적에 따라 결정한다.
- 주요 방법은 분류기 기반, 밀도 기반, 거리 기반, 재구성 기반으로 나뉜다. 추가 outlier 데이터 사용 여부와 재학습 필요 여부도 중요한 비교 조건이다.
- OpenOOD를 이용한 공통 조건의 비교에서는 데이터 증강 방법인 PixMix가 CIFAR-10 near-OOD AUROC 93.1%를 기록했다. 추가 데이터나 재학습의 이점은 ID 데이터와 near/far-OOD 구성에 따라 달랐다.
1 Introduction
음식 분류기에 고양이 사진을 넣어도 일반적인 softmax 분류기는 기존 음식 클래스 중 하나에 확률을 배분한다. 모델이 선택할 수 있는 출력이 닫혀 있기 때문이다. 실제 서비스에서는 이런 입력을 기존 클래스에 억지로 배정하지 않고 거부하거나 별도 처리해야 한다.
논문은 학습 데이터가 정의하는 분포를 in-distribution(ID), 그 범위 밖의 분포를 out-of-distribution(OOD)으로 부른다. 처음 보는 테스트 이미지도 학습 데이터와 같은 ID 분포에 속할 수 있다. OOD의 정의에는 허용할 입력의 범위와 거부할 분포 변화가 필요하다.
서베이의 기여는 공통 문제 정의, OOD 방법론 정리, 동일한 실험 조건에서의 비교, 그리고 남은 연구 문제의 정리이다.
2 Generalized OOD Detection
입력을 $X$, 의미적 클래스를 $Y$라 두고 데이터 분포를 $P(X,Y)$로 표현한다. 논문은 특히 다음 두 종류의 변화를 구분한다.
| 구분 | 변하는 것 | 예시 | 검출 여부 |
|---|---|---|---|
| Covariate shift | 입력의 모양·환경이 바뀌지만 다루는 클래스 집합은 유지된다. | 같은 개를 사진 대신 스케치로 보거나 다른 조명에서 촬영한다. | 일반화해야 할 수도 있고, 검사 조건에 따라 거부해야 할 수도 있다. |
| Semantic shift | 학습에서 다루지 않은 의미적 클래스가 등장한다. | 개·고양이·물고기를 배운 모델에 학습 클래스에 없는 새(bird)의 사진을 넣는다. | 의미적 OOD 검출에서는 거부 대상이다. |
이 서베이의 semantic shift 설정에서는 ID와 OOD 클래스가 겹치지 않는다. 알려진 클래스의 등장 비율만 달라지는 경우는 이 설정에서 거부할 대상에 해당하지 않는다.
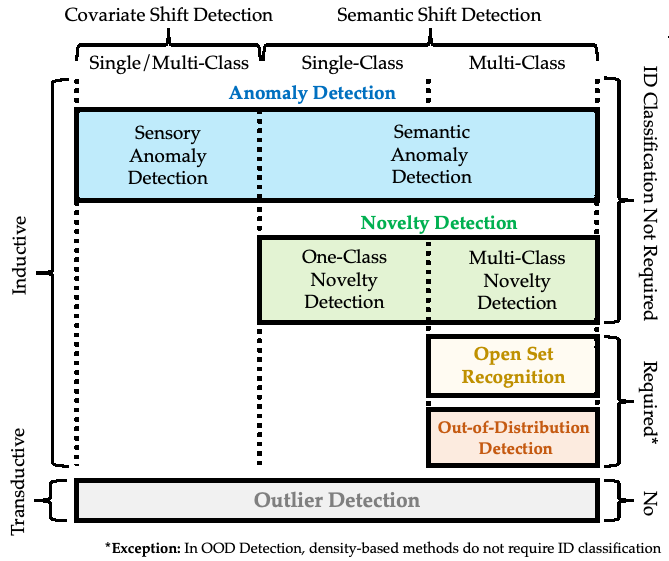
논문의 네 기준을 적용하면 다음과 같이 정리할 수 있다.
| 문제 | 정상으로 정의하는 대상 | 검출 대상 | ID 내부 분류 | 관측 방식 |
|---|---|---|---|---|
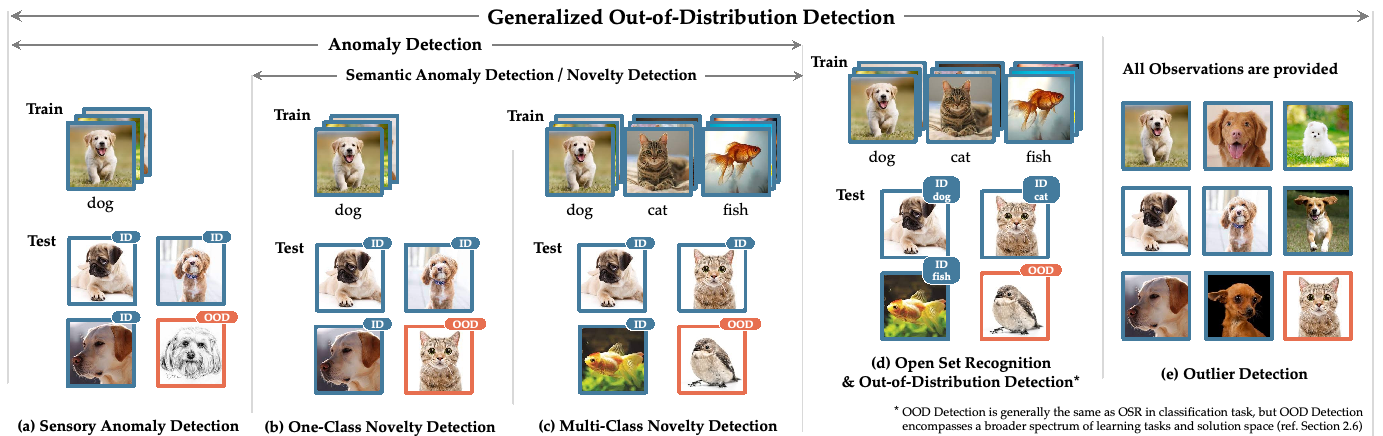
| Anomaly Detection(AD) | 미리 정한 정상 상태 또는 의미적 범주 | 외관·상태 이상 또는 새로운 의미적 범주 | 필수 아님 | 학습 후 새 샘플을 검사한다. |
| Novelty Detection(ND) | 하나 또는 여러 알려진 클래스 | 새로운 클래스 | 필수 아님 | 학습 후 새 샘플을 검사한다. |
| Open Set Recognition(OSR) | 라벨이 있는 여러 알려진 클래스 | 알려지지 않은 클래스 | 필요함 | 학습 후 새 샘플을 검사한다. |
| OOD Detection | 응용에서 정의한 ID 분포 | 주로 ID와 의미적으로 다른 입력 | 분류 문제에서는 성능을 유지해야 한다. | 학습 후 새 샘플을 검사한다. |
| Outlier Detection(OD) | 주어진 관측 집합의 다수 분포 | 집합의 나머지 관측과 크게 다른 점 | 필수 아님 | 분석할 관측 전체가 주어진다. |
마지막 행의 OD는 분석할 관측 집합 전체에서 이상점을 찾는 transductive 설정이다. 위 표는 이 서베이에서 사용하는 용어 정의를 따른다.
2.1 Anomaly Detection
AD에서는 정상의 정의가 우선이다. 제조 부품의 외관 검사라면 같은 종류의 부품에 생긴 균열이나 얼룩이 이상일 수 있다. 반면 특정 동물만 수집하는 서비스에서는 다른 동물 종이 이상이다.
논문은 전자를 sensory anomaly, 후자를 semantic anomaly로 구분한다. AD의 출력은 정상·이상 판정이며, 정상 데이터의 하위 군집을 각각 분류할 필요는 없다.
2.2 Novelty Detection
ND는 학습 중 알려진 클래스에 속하지 않는 테스트 샘플을 찾는다. 정상 클래스가 하나이면 one-class ND, 여러 개이면 multi-class ND이다.
여러 ID 클래스가 있더라도 결과가 “알려진 것인가, 새로운 것인가”의 이진 판별이면 ND로 볼 수 있다. 알려진 클래스 가운데 무엇인지를 정확히 맞히는 요구는 별도로 추가해야 한다.
2.3 Open Set Recognition
OSR은 알려진 클래스의 정확한 분류와 알려지지 않은 클래스의 검출을 동시에 요구한다. 예를 들어 개·고양이·물고기를 학습했다면 개는 개로 분류하면서 새는 unknown으로 처리해야 한다.
전통적인 OSR 벤치마크는 하나의 데이터셋을 클래스 단위로 나누어 일부를 known, 나머지를 unknown으로 사용한다. 논문은 전통적인 OSR 설정이 추가 외부 데이터를 사용하는 방법에 제약을 둔다는 점도 설명한다.
2.4 Out-of-Distribution Detection
분류 문제의 OOD detection은 OSR과 같은 목표를 가질 수 있다. 다만 OOD 연구는 서로 다른 데이터셋에서 ID/OOD를 구성하는 경우가 많고, 추가 outlier 데이터나 더 넓은 학습 문제를 다루기도 한다.
CIFAR-10을 ID로 정했다면 다른 데이터셋에 있는 개·고양이 사진도 ID 클래스와 겹친다. 의미적 OOD 평가를 구성할 때는 이런 클래스 중복을 제거한다.
또한 의료나 특정 장비 조건처럼 적용 범위를 엄격하게 제한한 환경에서는 입력 도메인의 변화 자체를 거부 대상으로 삼을 수 있다. 검출기의 목적을 정할 때 이 정책을 함께 명시해야 한다.
2.5 Outlier Detection
OD는 이미 주어진 데이터 전체에서 다수와 다른 관측을 찾는다. 오염된 데이터셋의 정제나 비정상 기록의 탐색이 대표적인 예이다.
OD는 검사 대상의 분포를 직접 참조할 수 있다. 별도의 정상 학습 데이터만으로 미래 입력을 판별하는 설정과 이용 가능한 정보가 다르므로, 평가 결과에는 이 관측 조건을 명시한다.
2.6 Related Topics
Domain adaptation과 domain generalization은 클래스 집합이 유지되는 환경 변화에서도 잘 예측하는 것을 목표로 한다. OOD detection이 의미적으로 새로운 입력을 거부하는 것과 함께 달성할 수 있는 목표이다.
Novelty discovery는 새로운 샘플들을 찾아 클래스나 군집으로 정리하는 데 관심을 둔다. Open-world recognition은 unknown 검출에 새로운 클래스의 점진적 학습까지 더한다. 검출 후 무엇을 할지까지 포함하는 문제이다.
서베이는 예측 집합과 불확실성을 다루는 conformal prediction도 관련 분야로 소개한다. 그 보장이 성립하는 분포 가정과 OOD 평가에서 허용하는 분포 변화를 함께 검토해야 한다.
3 OOD Detection: Methodology
검출기는 보통 입력마다 점수를 계산하고 임계값으로 ID/OOD를 나눈다. 아래에서는 값이 클수록 ID에 가깝다는 점수 $s(x)$를 사용한다.
\[g_{\tau}(x)= \begin{cases} \mathrm{ID}, & s(x)\geq\tau,\\ \mathrm{OOD}, & s(x)<\tau. \end{cases}\]실제 구현에서는 값이 클수록 이상하다는 점수를 사용하기도 하므로 부호와 양성 클래스의 정의를 반드시 확인해야 한다.
3.1 Classification-based Methods
분류기 출력이나 특징을 사용하므로 이미 학습된 모델에 검출 기능을 붙이기 좋다. 하지만 사후 점수만 바꾸는 방법과 모델을 재학습하는 방법은 비용과 이용 정보가 다르다.
| 계열 | 대표 방법 | 핵심 아이디어 | 비교할 조건 |
|---|---|---|---|
| Output-based, post-hoc | MSP, ODIN, Energy, ReAct, DICE, ASH | softmax·logit·activation에서 ID/OOD 구분 점수를 얻는다. | 재학습, activation 통계, 입력 gradient의 필요 여부를 확인한다. |
| Output-based, training | confidence branch, LogitNorm | 학습 목적이나 출력 구조를 바꿔 과도한 확신을 줄인다. | ID 분류 정확도와 검출 성능을 함께 측정한다. |
| Outlier Exposure | OE, MixOE, VOS | 실제 또는 생성한 이상 사례를 학습에 사용한다. | 외부 데이터의 종류와 평가 OOD와의 중복을 확인한다. |
| Gradient-based | GradNorm | gradient 크기 등의 정보를 점수로 사용한다. | backward 연산의 추론 비용을 포함한다. |
| Bayesian/ensemble | MC Dropout, Deep Ensemble | 모델 불확실성 또는 여러 예측의 차이를 이용한다. | 반복 추론 횟수, 모델 수, 메모리를 함께 비교한다. |
| Foundation model | MCM, LoCoOp, CLIPN | 사전학습된 시각·언어 표현과 텍스트 클래스 정보를 이용한다. | zero-shot, prompt tuning, 별도 학습의 조건을 구분한다. |
MSP(Maximum Softmax Probability)는 다음 점수이다.
\[s_{\mathrm{MSP}}(x)=\max_c p_{\theta}(y=c\mid x)\]입력이 알려진 클래스와 전혀 달라도 softmax는 기존 클래스 사이에 확률을 배분한다. 그 최댓값인 MSP를 입력이 ID에 속할 확률로 해석할 수는 없다.
ODIN은 temperature scaling과 입력 perturbation으로 ID/OOD 점수 차이를 키운다. 논문은 이를 ID 예측 확률을 보정하는 calibration과 구분한다.
Energy는 logit 전체의 크기 정보를 활용하는 대안이다. Energy 원 논문에서 $f_c(x)$를 클래스별 logit, $T$를 temperature라고 하면 다음과 같이 쓴다.
\[E(x)=-T\log\sum_c\exp(f_c(x)/T)\]이 표기에서는 에너지가 낮을수록 ID로 보는 방향이다. 앞서 정의한 ID 점수로 사용할 때는 $s(x)=-E(x)$로 맞출 수 있다. 수치 계산에는 안정적인 log-sum-exp 구현을 사용해야 한다.
Outlier Exposure(OE)는 알려진 외부 outlier에 대해 높은 불확실성이나 평평한 예측 분포를 유도한다. 학습용 outlier와 테스트 OOD를 분리하여, 학습에서 보지 못한 입력에 대한 검출 성능을 측정한다.
3.2 Density-based Methods
ID 데이터의 확률밀도 $p_{\theta}(x)$를 추정하고 밀도가 낮은 입력을 OOD로 보는 접근이다. 생성 모델이나 flow, 클래스 조건부 분포를 사용할 수 있다.
생성 모델이 단순한 배경이나 입력의 저수준 통계를 선호하면 의미적으로 다른 이미지에 더 높은 likelihood를 줄 수도 있다. 서베이는 likelihood ratio, 입력 복잡도 보정, 표현 공간에서의 밀도 추정 등을 개선 방향으로 정리한다.
3.3 Distance-based Methods
테스트 샘플의 특징이 ID의 클래스 중심이나 이웃에서 멀면 OOD로 간주한다. Mahalanobis 기반 방법은 특징의 방향별 분산과 상관관계를 고려한다.
클래스 $c$의 특징 평균을 $\mu_c$, 공유 공분산을 $\Sigma$, 입력 특징을 $h(x)$라 두면 핵심 거리는 다음과 같다.
\[d(x)=\min_c (h(x)-\mu_c)^\top\Sigma^{-1}(h(x)-\mu_c)\]거리가 작을수록 ID에 가깝다. 실제 방법은 여러 층의 점수 결합이나 추가 전처리를 사용하기도 한다. 공분산 추정에 필요한 데이터와 수치 안정성도 구현 조건이다.
KNN 방식은 특징 공간에서 가까운 ID 이웃까지의 거리를 이용하며, 특정 확률분포를 가정하지 않아도 된다. 반면 특징을 저장하고 검색하는 비용이 생긴다. 평균 중심에서의 거리와 개별 이웃에서의 거리는 데이터의 군집 구조에 따라 다르게 작동할 수 있다.
3.4 Reconstruction-based Methods
ID만 학습한 autoencoder가 정상 입력을 더 잘 복원할 것이라는 가정에서 출발한다. 입력과 복원 결과의 차이를 이상 점수로 사용할 수 있다.
일반적인 예시는 $r(x)=\lVert x-\hat{x}\rVert^2$이며, 이때 값이 클수록 이상하다는 방향이다. 그러나 OOD도 잘 복원하는 모델이 있을 수 있고, 픽셀 오차가 의미적 차이를 잘 반영하지 못할 수도 있다. 서베이는 특징 공간 재구성, 마스킹과 조건부 재구성 등의 접근을 함께 다룬다.
3.5 Theoretical Analysis
검출해야 할 OOD 분포를 아무 제약 없이 허용하면 모든 경우에 성공하는 검출기를 기대하기 어렵다. 이론 연구는 ID/OOD의 중첩, 가능한 분포 집합, 가설 공간 등의 가정 아래 학습 가능성과 오류 경계를 분석한다.
벤치마크의 AUROC는 그 평가에 사용한 ID/OOD 분포에서 측정한 결과이다. 이론적 오류 경계와 대조하려면 평가 분포가 해당 분석의 가정을 만족하는지 확인해야 한다.
3.6 Discussion
분류기 기반 방법은 별도 생성 모델 없이 시작할 수 있고, 거리 기반 방법은 표현 공간의 구조를 직접 사용한다. 밀도·재구성 기반 방법은 정상 분포를 모델링하지만 저수준 입력 통계와 의미의 차이를 주의해야 한다.
검출기 선택에는 재학습 가능 여부, 추가 데이터, ID 라벨, 특징 저장 공간, 반복 추론 비용도 영향을 준다.
4 Methodologies from Other Sub-tasks
다른 분야의 방법도 공통된 표현이나 점수를 활용하므로 OOD detection에 참고할 수 있다. 다만 원래 풀던 문제와 새 평가가 같은지는 확인해야 한다.
4.1 Open Set Recognition
OSR에서는 known 클래스 근처의 인식 영역을 제한하고 멀리 떨어진 open space에서 과도하게 클래스를 부여하지 않는 것이 중요하다. OpenMax는 클래스별 extreme value theory 모델로 출력 점수를 보정하는 대표적인 접근이다.
클래스별 prototype, 생성한 unknown, 학습 클래스 일부를 가상의 unknown으로 취급하는 방법도 쓰인다. 이때 unknown 거부만 높이고 known 분류가 나빠지지 않았는지 함께 검증한다.
4.2 Anomaly Detection & Novelty Detection
정상 데이터의 재구성, 정상 특징의 밀도, 이웃까지의 거리, one-class 경계 학습이 공통적으로 사용된다. DeepSVDD는 정상 특징을 작은 영역으로 모으는 대표적인 one-class 접근이다.
산업 결함처럼 미세한 외관 차이를 찾는 방법은 의미적으로 새로운 클래스를 찾는 데에도 일부 도움이 될 수 있다. 그러나 픽셀 손상 검출에 강한 방법이 near-OOD 의미 구분에도 강하다고 단정할 수는 없다.
4.3 Outlier Detection
OD는 전체 관측의 다수 구조와 다른 점을 찾으므로 이웃 거리, 밀도 차이, 재구성, outlier score 학습을 이용할 수 있다. 데이터 정제에서 유용하지만, 검사할 데이터 전체를 이용할 수 있다는 조건을 미래 입력에 대한 검출 성능과 혼동하지 않아야 한다.
5 Benchmarks and Experiments
서베이는 OpenOOD를 이용하여 여러 분야의 방법을 공통 조건에서 비교한다. 다음은 논문에 사용된 평가셋과 학습 설정이다.
5.1 Benchmarks and Metrics
CIFAR-10 또는 CIFAR-100을 ID로 삼고 다른 데이터셋을 OOD로 구성한다.
| ID | Near-OOD | Far-OOD |
|---|---|---|
| CIFAR-10 | CIFAR-100, 클래스 중복을 정리한 TinyImageNet | MNIST, SVHN, Texture, 클래스 중복을 정리한 Places365 |
| CIFAR-100 | CIFAR-10, 클래스 중복을 정리한 TinyImageNet | MNIST, SVHN, Texture, 클래스 중복을 정리한 Places365 |
Near-OOD는 ID와 시각적 조건이 비슷하지만 의미가 다른 경우이고, far-OOD는 입력 도메인의 차이까지 두드러진 경우이다. Far-OOD만 측정하면 모델이 의미 대신 배경·질감·해상도 차이를 이용해도 높은 점수를 얻을 수 있다.
논문은 CIFAR-10 설정의 TinyImageNet에서 1,207장, CIFAR-100 설정에서는 2,502장을 ID 클래스와 의미가 겹친다는 이유로 제거했다.
이 실험의 주요 지표는 AUROC이다. OOD 문헌에서는 AUPR, FPR@95TPR도 사용한다.
- AUROC는 임계값을 바꿨을 때의 순위 구분 능력을 평가한다. 높을수록 좋다.
- AUPR는 어느 쪽을 양성으로 삼는지와 테스트의 클래스 비율에 영향을 받는다. AUPR-In과 AUPR-Out을 구분해야 한다.
- FPR@95TPR는 양성 검출률 95%에서 음성을 양성으로 잘못 받아들이는 비율이다. 낮을수록 좋으며, ID를 양성으로 정했는지 OOD를 양성으로 정했는지 반드시 명시해야 한다.
- ID 분류 정확도는 OOD 검출 지표와 별도로 보고해야 한다.
5.2 Experimental Setup
공정한 비교를 위해 ResNet-18 backbone과 공통 설정을 사용한다. 학습이 필요한 방법에는 SGD, learning rate 0.1, momentum 0.9, weight decay 0.0005, 100 epochs를 적용한다.
같은 검출기라도 backbone이나 사전학습 데이터가 달라지면 결과가 달라질 수 있다. Post-hoc 방법, 학습이 필요한 방법, 추가 데이터가 필요한 방법을 구분한 상태에서 비교해야 한다.
5.3 Experimental Results and Findings
아래 그림은 논문에 실린 CIFAR-10/100 비교이다. 각 방법의 두 막대는 near-OOD와 far-OOD AUROC를 나타낸다.
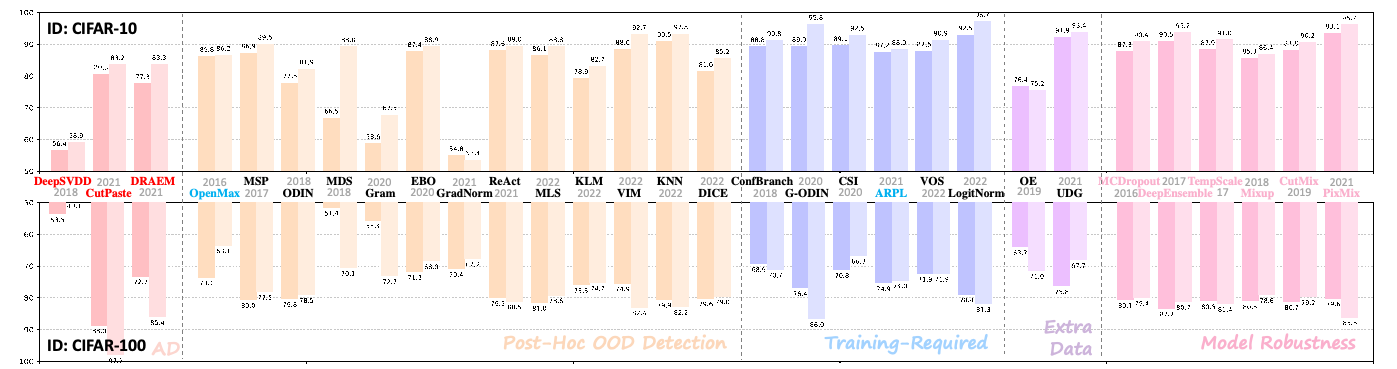
- 이 설정에서 PixMix는 CIFAR-10 near-OOD AUROC 93.1%를 기록했다. 강건성 향상을 위한 데이터 증강이 OOD 검출에도 효과를 보였다.
- 재학습이 필요한 방법과 post-hoc 방법의 우열은 평가 조건에 따라 달랐다.
- 추가 데이터를 사용한 UDG와 사용하지 않은 KNN의 비교에서는 UDG의 이점이 주로 CIFAR-10 near-OOD에 나타났다. 외부 outlier의 효과를 비교할 때는 사용한 데이터와 평가 조건을 명시해야 한다.
- 일부 AD 방법은 외관 차이가 큰 far-OOD에서 높은 성능을 보였다. 의미가 비슷한 near-OOD에서는 검출이 더 어려웠다.
5.4 Exclusion of Covariate-Shift Detection
이 실험은 순수한 covariate shift 검출을 별도 목표로 포함하지 않는다. 중심 목표는 semantic shift를 구분하는 것이다.
개정판은 covariate-shifted ID도 올바르게 받아들이면서 semantic OOD를 거부하는 full-spectrum OOD detection을 논의한다. 이 설정은 ID의 환경 변화에 대한 일반화와 새로운 클래스의 검출을 함께 평가한다.
6 Challenges and Future Directions
서베이는 검출 목표의 정의, 외부 outlier의 확보, ID 분류 성능 유지, 대규모 환경의 평가를 후속 과제로 정리한다.
6.1 Challenges
- 평가 정의: 어떤 변화를 검출하고 어떤 변화에 일반화할지 먼저 정해야 한다.
- Outlier-free 학습: 미래에 만날 unknown을 대표하는 외부 데이터가 없는 상황에서도 동작해야 한다.
- 분류와 검출의 균형: ID 정확도와 unknown 거부 능력을 함께 높이는 방법이 필요하다.
- 현실적 평가: CIFAR에서의 순위가 큰 의미 공간과 실제 환경에서도 유지되는지 확인해야 한다.
추가로 실무에서 임계값을 정할 때는 검증셋을 사용하고, 최종 테스트 OOD에 맞춰 점수 함수나 임계값을 고르지 않아야 한다. 이는 이 논문의 공정한 비교 원칙을 적용한 평가 절차이다.
6.2 Future Directions
서로 분리되어 발전한 AD·ND·OSR·OOD 방법을 함께 비교하고, 일반화와 검출을 결합하는 것이 주요 방향이다. 오염된 라벨 데이터나 open-set semi-supervised 학습의 unknown을 유용한 신호로 활용할 가능성도 있다.
개정판은 다중 라벨 분류, 객체 검출, 분할, 시계열, 3D 센서 데이터로의 확장과 foundation model을 이용한 OOD 검출을 다룬다. CLIP 계열에서는 목표 클래스를 표현하는 텍스트와 prompt tuning 등의 적응 방법이 연구 대상이다.
7 Conclusion
Generalized OOD는 분포 변화의 종류, 정상 클래스 구성, ID 분류 요구, 관측 가능한 데이터를 기준으로 다섯 분야의 문제 정의를 정리한다. 이 기준에 따라 각 방법이 사용한 정보와 기대하는 출력을 비교하고, 평가 목적에 맞는 벤치마크를 구성할 수 있다.
짧은 생각
TinyImageNet에서 ID와 의미가 겹치는 이미지를 제거한 절차가 눈에 들어온다. 다른 데이터셋에서 가져온 개 사진도 ID에 개 클래스가 있다면 정상 입력이다. 이를 OOD로 남겨 두면 해당 이미지를 ID로 받아들인 검출기가 오답 처리된다. 새 점수 함수를 비교하기 전에, 중복을 제거하기 전후의 near-OOD AUROC와 오분류 사례가 얼마나 달라지는지 확인하고 싶다.
Full-spectrum 설정은 그 다음에 확인할 조건이다. 조명이 달라진 개 사진은 받아들이고 새로운 동물 종은 거부해야 한다면, 입력 변화에 민감한 검출기가 오히려 정상 샘플을 더 많이 거부할 수 있다. 같은 검출기에 환경이 바뀐 ID와 semantic OOD를 함께 제시했을 때도 기존 near/far-OOD 평가의 순위가 유지되는지가 궁금하다.