


Trust The Typical 요약 설명
04 Feb 2026 | Paper Review Out-of-Distribution Detection LLM Safety Unsupervised Learning목차
- 요약
- 1 Introduction
- 2 Related Works
- 3 Methodology
- 4 Results
- Evaluation Setup
- RQ1: How does T3 compare against specialized safety models and traditional OOD methods on diverse harm detection benchmarks?
- RQ2: Can T3, trained only on safe data, generalize to detect novel, unseen adversarial and jailbreaking attacks?
- RQ3: How effectively does T3 mitigate the common problem of overrefusal on benign-but-challenging prompts? How is the cold-start performance with limited ID data?
- RQ4: Does T3’s performance generalize across different languages and specialized domains without retraining?
- RQ5: Can T3 be integrated into a high-performance inference engine for practical, real-time deployment with minimal latency?
- 5 Discussion
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Trust The Typical 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 4일(Arxiv), ICLR 2026
- Ganguly, Debargha, Sankar, Sreehari, Zhang, Biyao, Singh, Vikash, Gupta, Kanan, Kavuru, Harshini, Luo, Alan, Chen, Weicong, Morningstar, Warren, Machiraju, Raghu, et al.
- Case Western Reserve University, University of Pittsburgh, The Ohio State University, Google Research
- 논문 링크
요약
- Trust The Typical은 선별한 안전한 텍스트 분포에서 벗어나는 입력을 탐지하는 가드레일 프레임워크 T3를 제안한다. 3개 임베딩 모델의 이웃 통계를 결합하고 안전한 예시만으로 GMM이나 One-Class SVM을 학습하여 Forte를 텍스트에 적용한다.
- T3+OCSVM은 OffensEval에서 AUROC 0.9940과 FPR@95 0.0201을, PolyGuard HR에서 AUROC 0.9982와 FPR@95 0.0039를 달성한다. 다만 모든 평가에서 우세하지는 않다. CivilComments에서는 Perspective API가 더 우수하고, 여러 적대적 벤치마크에서는 안전성 전문 모델이 앞서며, OR-Bench에서는 LlamaGuard3-1B의 FPR@95가 더 낮다.
- NVIDIA H200에서 vLLM과 OPT-125M을 사용한 배포 실험은 프롬프트 500개에서 생성 오버헤드 1.5%, 프롬프트 5,000개에서 6.0%를 보고한다. 여기에는 약 10초의 T3 초기화 시간이 포함되지 않는다. HH-RLHF의 chosen 응답과 rejected 응답을 구분하는 설정에서는 T3 성능이 무작위 수준에 가깝다. 이는 관련 표현이 겹치면 전형성만으로 안전성을 신뢰성 있게 구분하기 어렵다는 점을 보여준다.
1 Introduction
서론은 지도학습 기반 안전 필터가 관측된 유해 콘텐츠와 공격 패턴에 의존한다는 점에서 T3의 필요성을 설명한다. T3는 탐지기를 학습할 때 유해한 예시를 사용하지 않고, 입력이 선별한 허용 가능한 사용 분포에 부합하는지를 판단한다. 지도학습에 대해서는 이 글을 참조하라.
- 저자들은 이 접근법을 정보이론의 전형 집합과 의미 표현 공간에서 무해한 상호작용이 집중되는 현상에 연결한다.
- 적대적 입력은 전형적인 언어에서 벗어날 수밖에 없다는 주장은 접근법의 출발점이 되는 가설이다. 유해한 의도와 무해한 의도를 기하학적으로 분리할 수 있다는 보장은 아니다.
2 Related Works
논문은 우도 기반 OOD 탐지, 표현 기반 탐지, 합성 이상치 노출 기법과 비교하며 T3의 위치를 설명한다. T3는 사전학습된 임베딩 표현을 유지하고, 이중 모델의 우도를 평가하는 방식을 피하며, 예상 공격의 예시를 생성할 필요도 없다.
- 관련 연구 논의는 고차원 공간에서 높은 우도가 반드시 전형성을 뜻하지는 않으며, 과제별 파인튜닝이 OOD 탐지에 유용한 기하 구조를 훼손할 수 있다는 점을 강조한다.
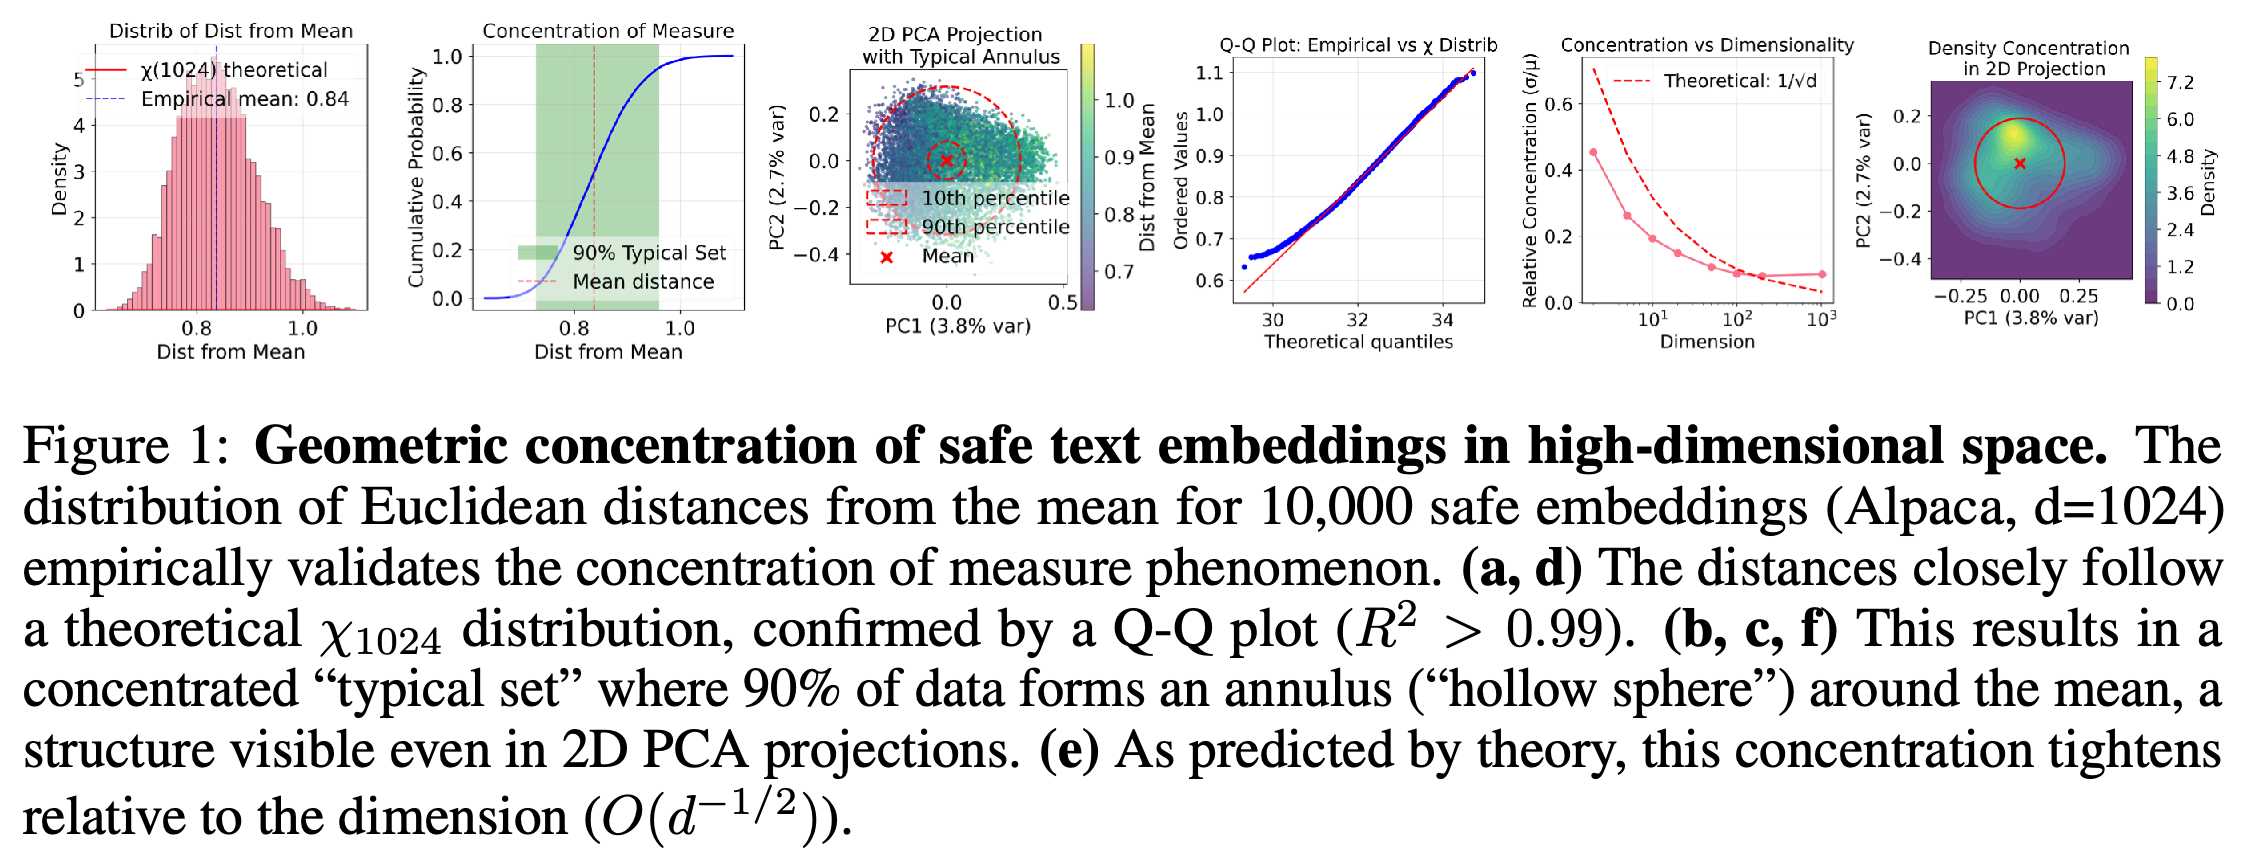
- Figure 1은 d=1024인 Alpaca 임베딩 10,000개를 분석한다. 캡션은 데이터의 90%를 포함하는 전형적인 환형 영역과 R² > 0.99인 Q-Q 적합도를 보고한다.
- 거리 집중 현상은 전형성을 연구할 근거가 되지만, PCA 투영이 안전한 콘텐츠와 유해한 콘텐츠 사이의 결정 경계를 입증하지는 않는다.
거리 히스토그램과 Q-Q 플롯은 안전성을 평균과의 근접성으로 보는 대신, 집중된 전형 영역을 연구할 근거를 제공한다. PCA 패널은 설명을 위한 투영이다. 이 투영이나 차원에 따른 추세가 유해 콘텐츠와의 분리를 입증하지는 않는다.
3 Methodology
T3는 각 텍스트 임베딩을 안전한 참조 이웃과의 관계로 표현한 뒤, 이 압축된 표현으로 탐지기를 학습한다. 원래 임베딩 공간에서 직접 밀도를 추정하는 대신, 여러 의미적 관점과 점별 Precision, Recall, Density, Coverage를 결합한다.
Problem Formulation:
안전한 참조 코퍼스 X와 테스트 집합 Y가 주어지면, T3는 참조 분포에 부합하지 않는 테스트 점을 식별한다. Qwen3-Embedding-0.6B, BGE-M3, E5-Large-v2는 각각 L2-normalized 임베딩을 생성하여 인코더별 크기 차이의 영향을 줄인다.
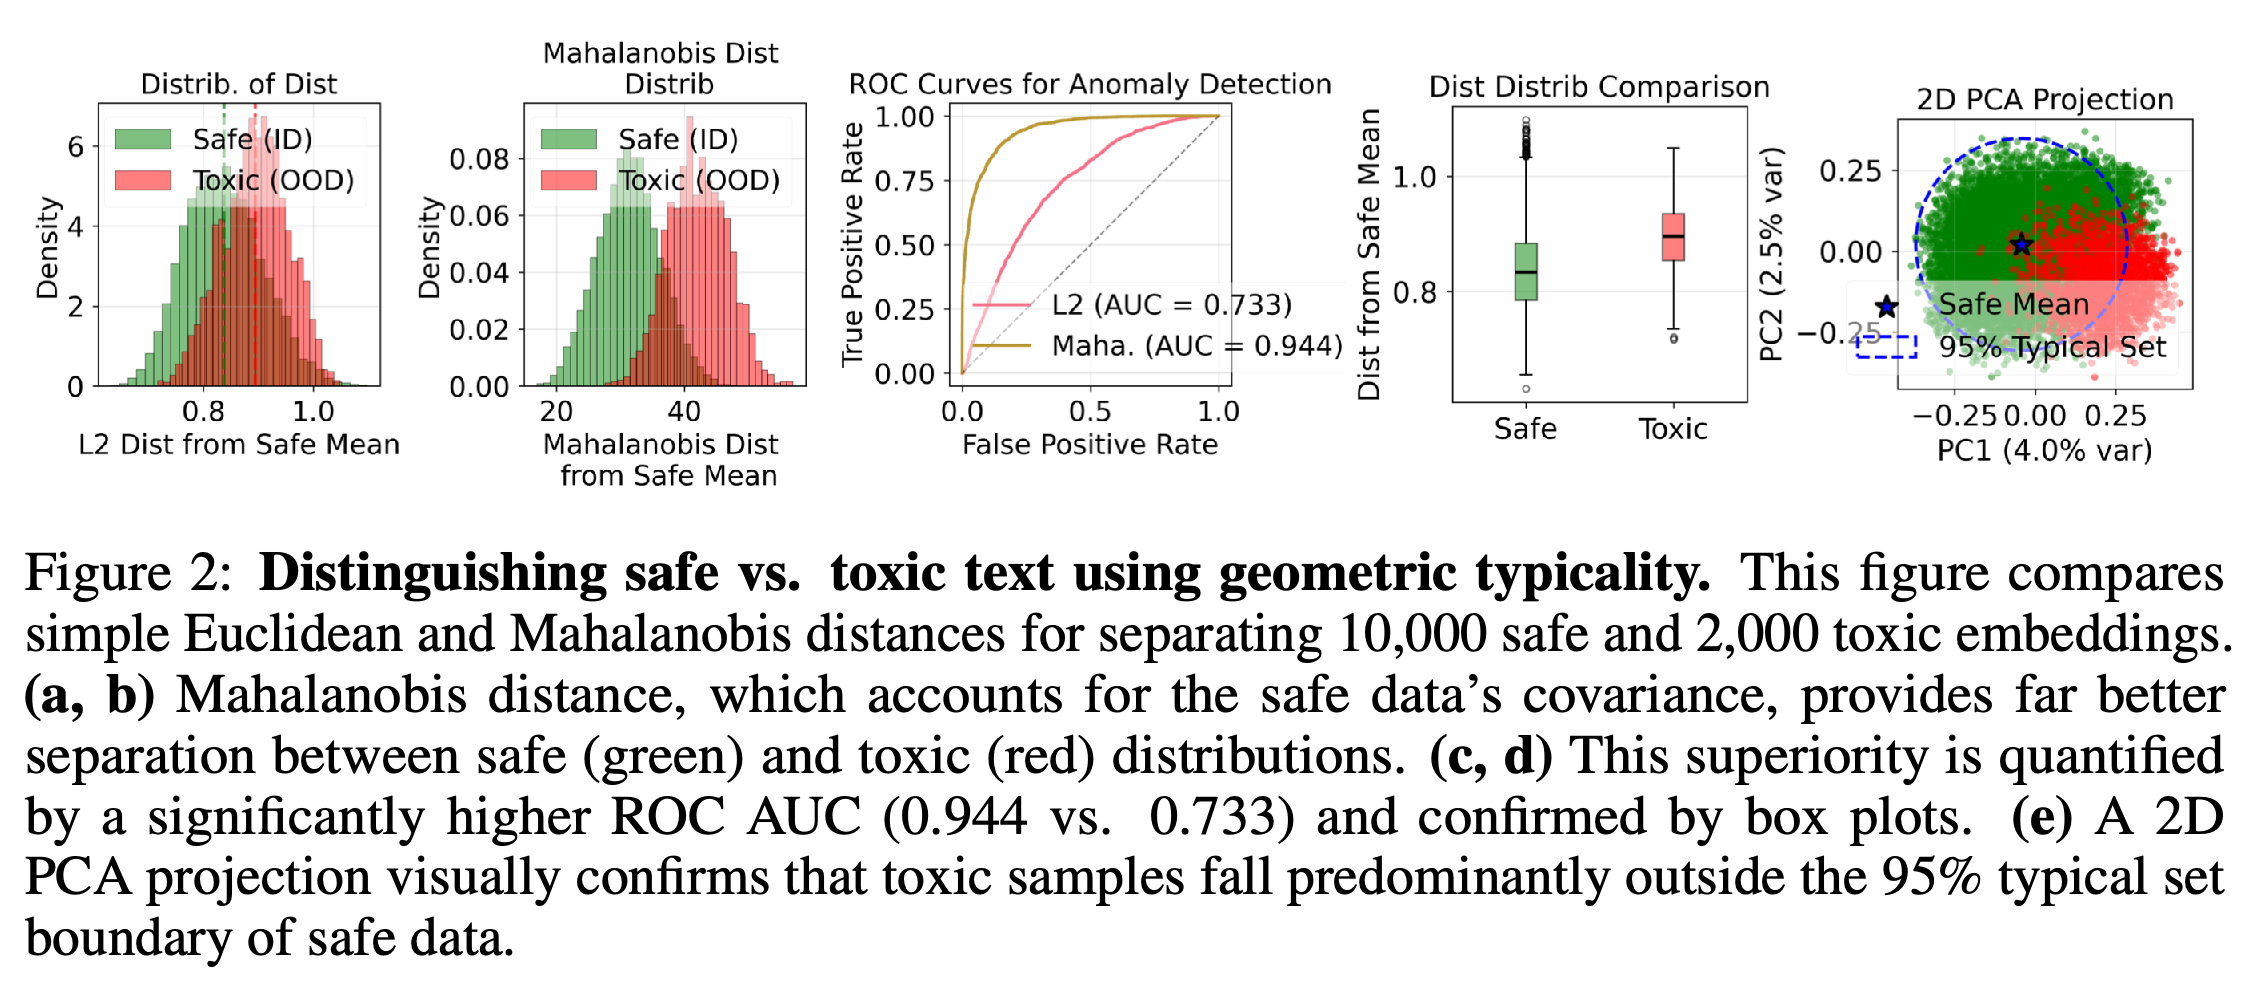
- Figure 2는 안전한 임베딩 10,000개와 독성 임베딩 2,000개를 비교한다. Mahalanobis 거리의 ROC AUC는 0.944이며, 안전한 임베딩의 평균으로부터 계산한 Euclidean 거리의 0.733보다 높다.
- 문제 정의에서는 적대적 프롬프트, 독성 콘텐츠, 주제에서 벗어난 질의를 모두 OOD로 묶는다. 따라서 의도한 사용에서 벗어나는 입력을 탐지하는 범위는 유해성 탐지보다 넓다.
이 예시에서는 공분산을 고려하면 분리 성능이 좋아진다. Mahalanobis의 ROC AUC는 0.944로, Euclidean 거리의 0.733보다 높다. 이는 더 풍부한 기하학적 특성을 사용할 근거가 되지만, 전체 T3 탐지기를 평가한 결과는 아니다.
Precision은 테스트 점이 참조 k-최근접 이웃 구 중 어느 하나에라도 포함되는지를 나타낸다. Density는 해당 점을 포함하는 참조 구의 수를 km으로 정규화한다. Recall은 테스트 점의 이웃에 포함된 참조 점의 비율을 측정하고, Coverage는 그 이웃에 참조 점이 하나라도 있는지를 나타낸다.
- Recall과 Coverage는 Y 내부에서 구성한 이웃을 사용하므로, 입력 프롬프트 하나만이 아니라 테스트 집합에 따라서도 값이 달라진다.
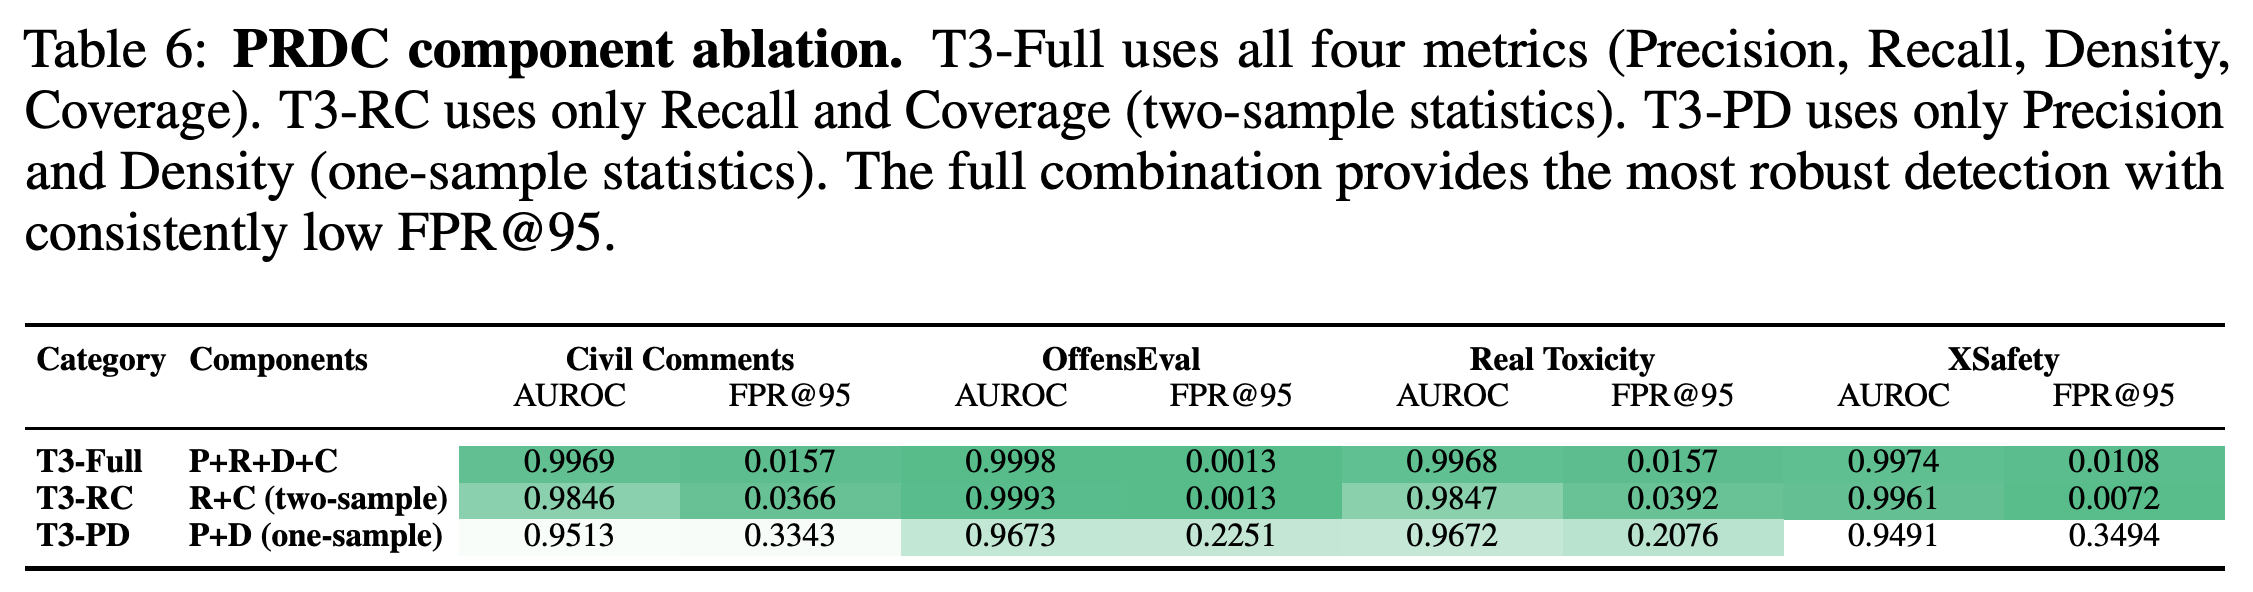
- Table 6에서 CivilComments의 FPR@95는 Precision+Density의 0.3343에서 Recall+Coverage의 0.0366으로, 4개 지표를 모두 사용할 때는 0.0157로 낮아진다.
- 전체 조합이 모든 항목에서 가장 좋지는 않다. XSafety의 FPR@95는 Recall+Coverage에서 0.0072이며, 4개 지표를 모두 사용할 때의 0.0108보다 낮다.
Recall과 Coverage는 Precision과 Density만 사용할 때보다 오탐을 크게 줄인다. 전체 표현이 대체로 가장 좋지만, XSafety의 FPR@95는 Recall+Coverage가 더 낮다. 또한 이 절제 실험의 값은 본문의 벤치마크 결과와 상당히 다르다.
Theorem 3.1은 귀무가설하의 기댓값 E[Recall]=k/n과 E[Density]=1/m, 상한 E[Coverage] ≤ 1−(1−k/n)^m, 그리고 Precision의 점근적 극한 1을 제시한다. 부록의 대칭성 논증은 연속 분포를 가정한다. Precision의 극한을 다루는 논증은 추가로 콤팩트 지지집합, 지지집합에서 유계이며 양의 하한을 갖는 밀도, 측도가 0인 경계를 가정한다. 귀무가설에 대해서는 이 글을 참조하라.
- 명시된 지지집합의 정규성 조건하에서, 유해 분포가 안전한 지지집합 밖에 확률 질량 α를 할당하면 Precision의 점근적 기댓값은 1−α라고 보고한다.
- 지지집합이 같은 밀도 변화에서는 보고된 Coverage의 극한이 r(y)=p_safe(y)/p_harmful(y)에 의존한다. 이 결과는 연속이고 양수이며 유계인 밀도와 유한한 양의 극한 표본 수 비율 λ를 가정한다.
- 이러한 기댓값 수준의 논증은 운영 임곗값을 제공하지 않으며, 모든 유해 프롬프트를 신뢰성 있게 분류할 수 있음을 입증하지도 않는다. 국소 섭동의 격차 식에는 부호 오류도 있으며, Brief Thoughts에서 이를 다룬다.
각 인코더의 4개 특성을 이어 붙여 R^(4K)의 표현 T(y)를 구성하며, 3개 인코더를 사용하면 특성은 12개가 된다. T3는 Bayesian Information Criterion으로 성분 수를 선택하는 GMM이나 RBF 커널 OCSVM을 학습한다. 논문은 이상 점수를 sigmoid로 정규화한다고 설명한다.
- 원문은 두 접근법의 점수를 모두 음의 로그우도라고 부르지만, OCSVM은 적합된 확률밀도가 아니라 결정 점수를 제공한다.
- GMM과 OCSVM 가운데 어느 하나도 모든 벤치마크에서 일관되게 우세하지 않다.
- 고전적인 최근접 이웃 기반 2개 표본 검정과의 비교에서는 참조 구조의 비대칭적 재사용을 강조한다. 동시에 집합 내부에서 구성하는 PRDC 이웃이 표본을 합쳐 구성하는 이웃 검정과 다르다는 점도 인정한다.
Implementation Details.
자기 유사성 편향을 줄이기 위해 참조 예시를 같은 크기의 2개 집합으로 무작위 분할하고, 임베딩은 PyTorch 형식으로 캐시한다. 구현은 정규화된 벡터 사이의 L2 거리를 사용하며, ∥x−y∥₂²=2(1−cos(x,y)) 관계를 활용한다.
- GMM 성분 수의 탐색 그리드는 {1, 2, 4, 8, 16, 32, 64}이며, 표본 수에 따라 제한한다.
- OCSVM의 ν 탐색 그리드는 {0.01, 0.05, 0.1, 0.2, 0.5}이다. 방법론에서는 검증 정확도로 값을 선택한다고 설명하지만, 이 부분에서는 검증 절차를 구체적으로 밝히지 않는다.
4 Results
평가는 유해성 탐지, 미관측 공격, 과도한 거부와 표본 효율성, 도메인 및 언어 전이, 서빙 지연 시간을 다룬다. 독성 탐지와 도메인 분리 결과는 대체로 적대적 프롬프트와 무해하지만 판단하기 까다로운 프롬프트에서의 결과보다 좋다.
Evaluation Setup
본문은 Alpaca, Dolly, OpenAssistant에서 같은 비율로 추출한 약 40K개의 안전한 예시를 사용하며, T3 학습에는 유해한 예시를 사용하지 않는다고 설명한다. 평가는 독성과 혐오 발언, 적대적 벤치마크, PolyGuard 도메인, 다국어 데이터셋, OR-Bench를 포함한다.
- 안전성 기준 모델에는 LlamaGuard, WildGuard, MD-Judge, DuoGuard, PolyGuard가 포함된다. 상용 서비스와의 비교에는 Perspective API와 OpenAI Omni Moderation이 포함된다.
- 표현 기반 기준 방법은 텍스트 임베딩에 맞게 수정한다. 추가 실험에서는 더 큰 임베딩 백본과 텍스트용 Energy, kNN, Mahalanobis 탐지기를 평가한다.
- 부록은 과제별 ID 코퍼스를 명시한다. 독성과 도메인 실험은 Anthropic/hh-rlhf가 포함된 4개 출처의 혼합 데이터를 사용하고, 다국어 실험은 OpenAssistant/oasst2 프롬프트 30,000개를 사용하며, OR-Bench는 자체 안전 학습 분할을 사용한다.
보고하는 지표는 AUROC, AUPRC, F1, FPR@95TPR이다. FPR@95는 유해한 예시의 95%를 탐지하는 ROC 운영점에서 안전한 예시를 잘못 탐지하는 비율을 측정한다. OR-Bench를 제외하면 안전한 평가 예시는 일반적으로 각 유해 벤치마크에 맞춘 무해한 예시가 아니라 별도로 분리해 둔 참조 코퍼스에서 가져온다.
- 논문은 T3의 밀도 추정기를 학습할 때 OOD 라벨과 테스트 데이터를 사용하지 않는다고 명시한다.
- 원문은 벤치마크별로 임곗값을 조정하지 않는다고 설명하지만, FPR@95 평가 절차는 각 평가 ROC 곡선에서 운영점을 선택한다. 따라서 이 통계만으로는 고정된 배포 임곗값 1개가 모든 벤치마크에서 유해 입력 재현율 95%를 달성한다고 볼 수 없다.
- 벤치마크별 유해 텍스트와 범용 안전 코퍼스를 분리하는 결과에는 유해성뿐 아니라 출처나 도메인의 차이도 반영될 수 있다.
RQ1: How does T3 compare against specialized safety models and traditional OOD methods on diverse harm detection benchmarks?
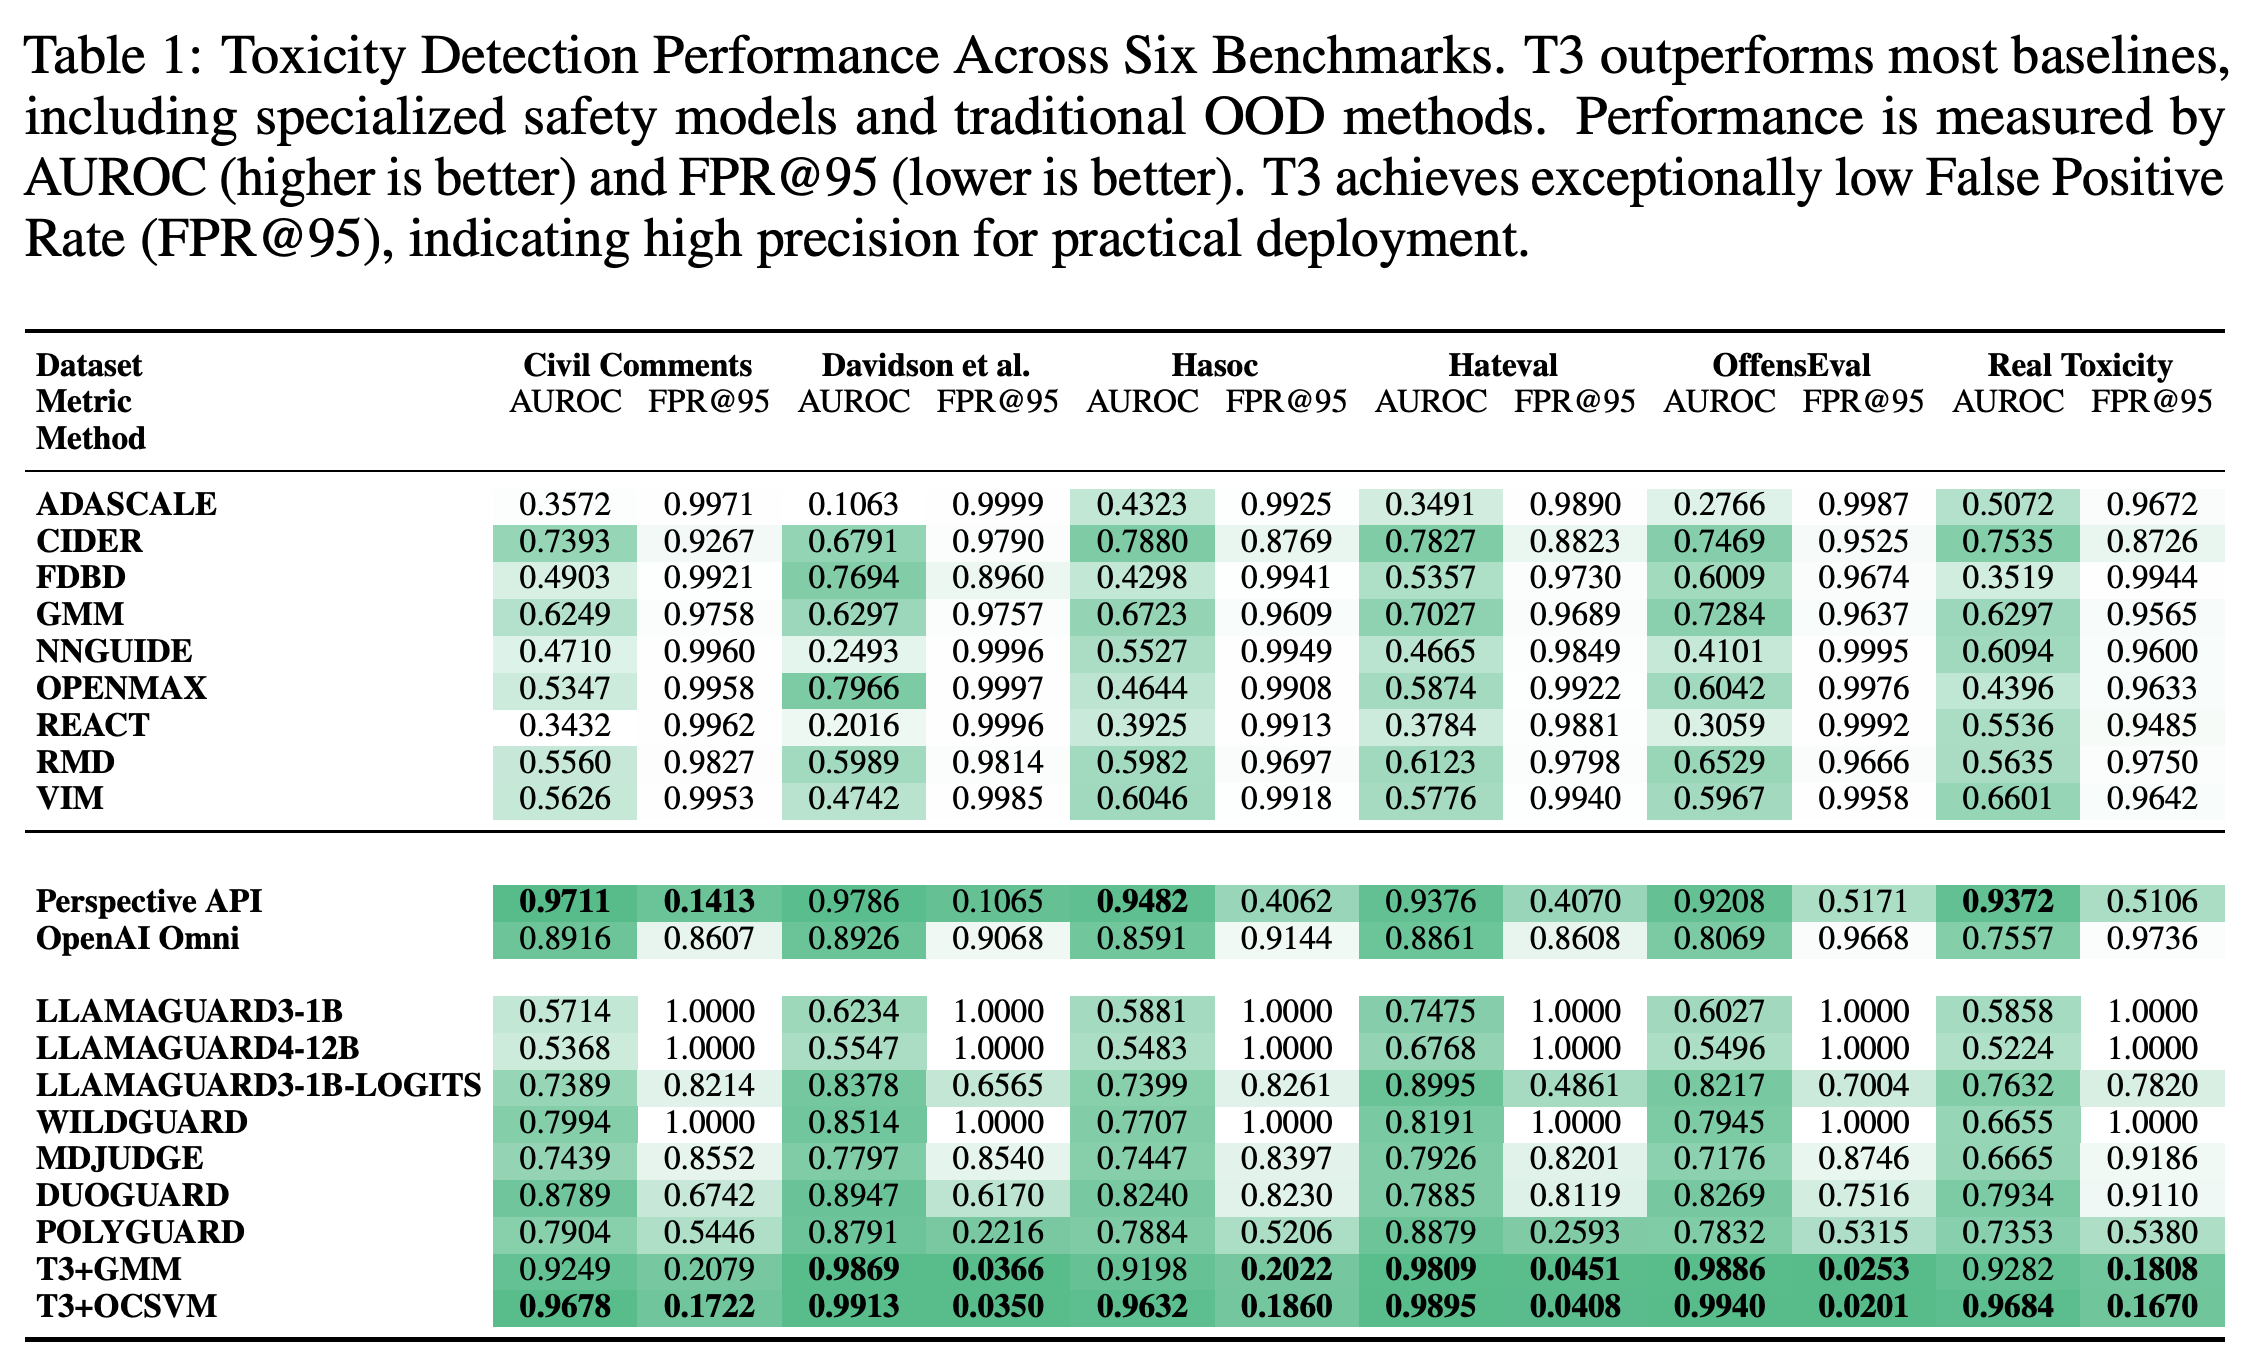
Table 1에서는 독성 벤치마크 6개 중 5개에서 T3+OCSVM이 우세하다. AUROC/FPR@95는 Davidson에서 0.9913/0.0350, HatEval에서 0.9895/0.0408, OffensEval에서 0.9940/0.0201이다.
- CivilComments에서는 Perspective API가 더 우수하다. AUROC는 0.9711, FPR@95는 0.1413으로, T3+OCSVM의 0.9678과 0.1722보다 좋다.
- 본문이 서술한 OffensEval의 약 37배 개선은 DuoGuard의 FPR@95 0.7516을 기준으로 한다. Perspective API는 0.5171, PolyGuard는 0.5315이므로, DuoGuard는 표에 나열된 기준 모델 중 해당 지표가 가장 좋은 모델이 아니다.
- LlamaGuard3-1B의 연속 logit 변형은 이산 점수 방식보다 개선되지만, Table 1에서는 여전히 T3보다 뒤처진다. 이는 ROC 기반 비교에서 점수 추출 방식이 중요하다는 점을 보여준다.
T3+OCSVM은 OffensEval의 FPR@95 0.0201을 포함하여 5개 데이터셋에서 나열된 AUROC와 FPR@95 결과가 가장 좋다. CivilComments에서는 Perspective API가 앞선다. Perspective API의 OffensEval 결과는 DuoGuard를 가장 좋은 기준 모델로 지목한 본문 서술과도 모순된다.
RQ2: Can T3, trained only on safe data, generalize to detect novel, unseen adversarial and jailbreaking attacks?
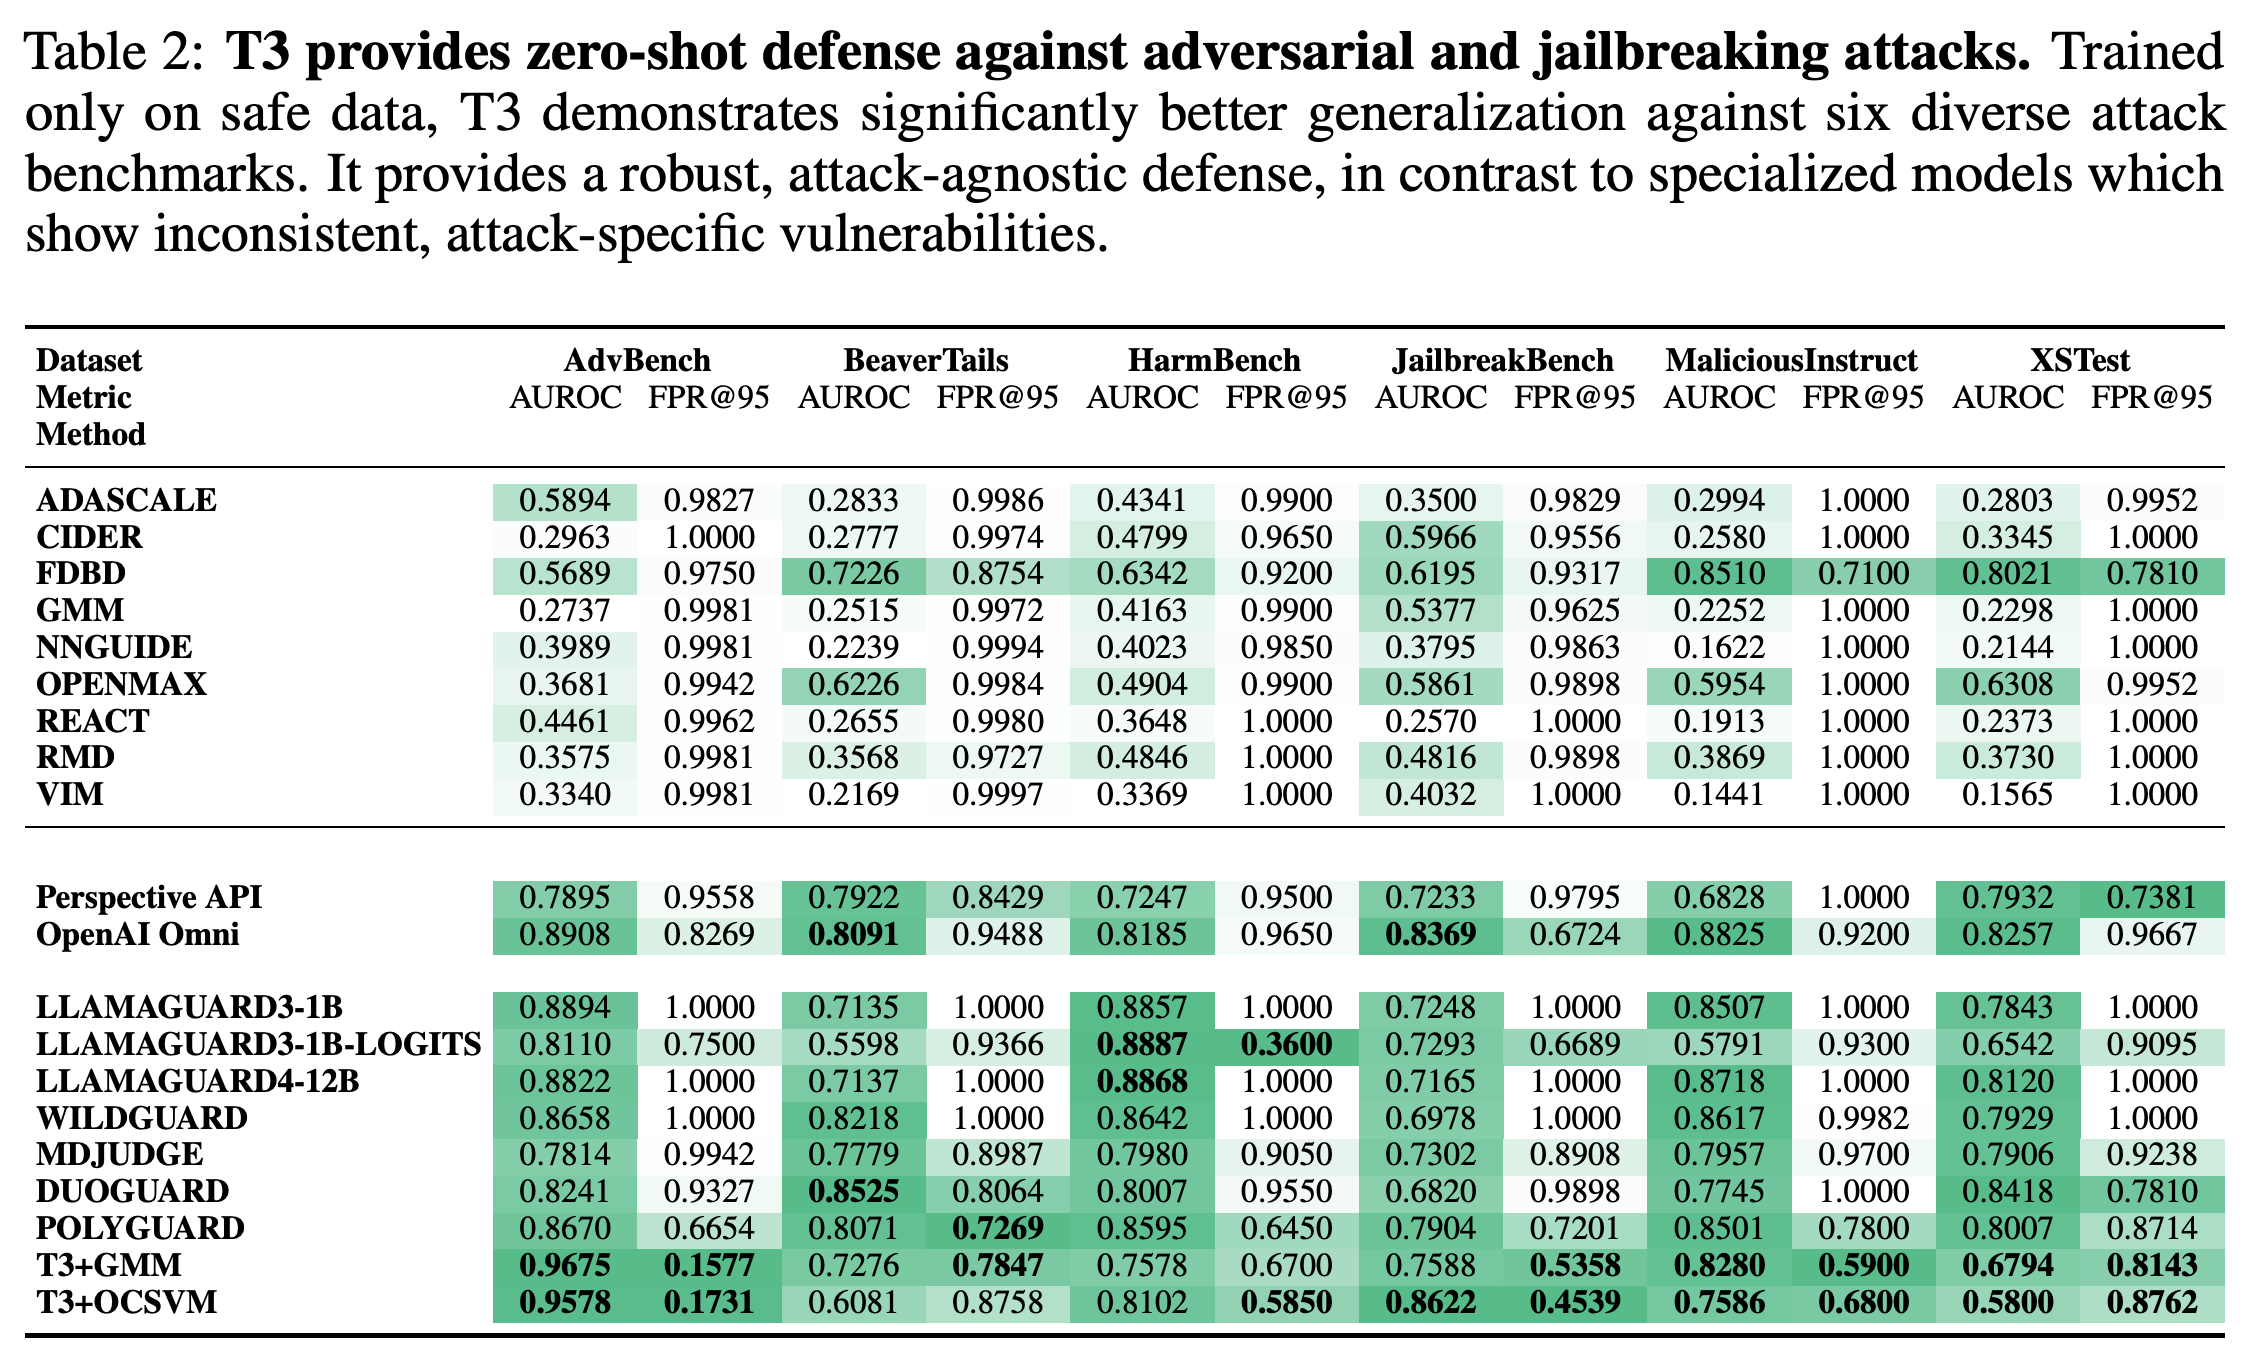
Table 2가 제시하는 미관측 공격 일반화 결과는 일관되지 않다. AdvBench에서는 T3+GMM이 AUROC 0.9675와 FPR@95 0.1577로 나열된 방법 가운데 가장 좋다. JailbreakBench에서는 T3+OCSVM이 각각 0.8622와 0.4539로 앞선다.
- HarmBench에서는 LlamaGuard3-1B-LOGITS가 AUROC 0.8887과 FPR@95 0.3600을 달성하여, T3+OCSVM의 0.8102와 0.5850보다 우수하다.
- BeaverTails에서는 DuoGuard의 AUROC 0.8525가 T3의 두 변형보다 높고, PolyGuard의 FPR@95 0.7269는 두 변형보다 낮다.
- XSTest는 T3에 여전히 어려운 과제다. AUROC는 GMM에서 0.6794, OCSVM에서 0.5800이다. 이 결과는 공격 탐지 성능이 항상 우수하다는 주장을 뒷받침하지 않는다.
AdvBench와 JailbreakBench에서는 T3가 우세하지만, HarmBench, BeaverTails, XSTest에는 중요한 예외가 있다. 여러 T3 오탐률이 여전히 높으므로, 적대적 공격 전반에 대해 오탐이 낮은 방어 수단이라는 주장은 제한적으로 해석해야 한다.
RQ3: How effectively does T3 mitigate the common problem of overrefusal on benign-but-challenging prompts? How is the cold-start performance with limited ID data?
OR-Bench에서 T3+OCSVM의 AUROC는 0.9342로 나열된 방법 가운데 가장 높고, T3+GMM의 FPR@95는 0.2217이다. 그러나 LlamaGuard3-1B의 FPR@95는 0.1483으로 더 낮다. 따라서 이 표는 과도한 거부와 관련된 모든 지표에서 T3가 가장 좋다는 점을 입증하지 않는다.
- 부록은 OR-Bench 하위 집합에서 안전한 학습 프롬프트 3,500개, 안전한 테스트 프롬프트 1,500개, 독성 프롬프트 600개를 사용한다고 명시한다.
- GPT-OSS-20B의 안전성 분석을 앞에 붙이면 두 변형 모두 성능이 저하된다. GMM의 AUROC는 0.9108에서 0.8594로, OCSVM의 AUROC는 0.9342에서 0.8581로 낮아진다.
- 이 실험은 안전한 프롬프트에 대한 탐지기의 오탐을 측정하며, 통합된 어시스턴트의 거부 행동이 어떻게 바뀌는지를 측정하지 않는다. LlamaGuard의 좋은 결과만으로는 원문이 제기한 데이터셋별 과적합을 입증할 수 없다.
T3+OCSVM은 AUROC 0.9342로 가장 높고, LlamaGuard3-1B는 FPR@95 0.1483으로 가장 낮다. 증강한 두 변형 모두 기본 버전보다 성능이 나빠진다. 이는 안전성 분석을 앞에 붙이는 방식이 반드시 탐지를 개선하지는 않는다는 점을 보여준다.
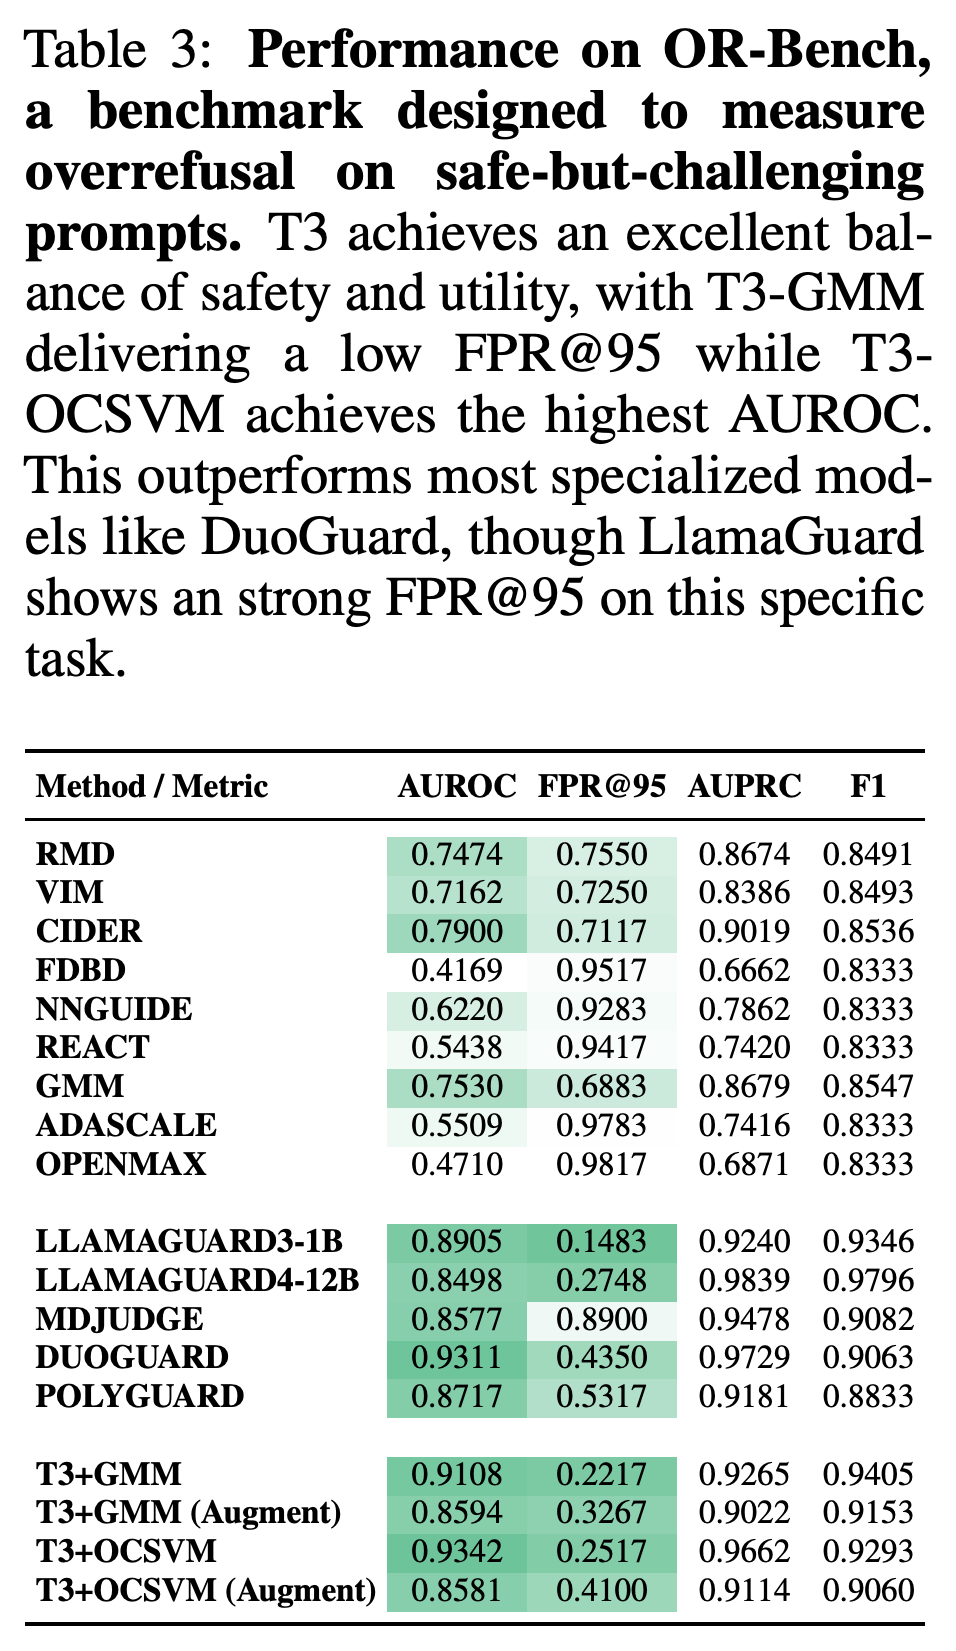
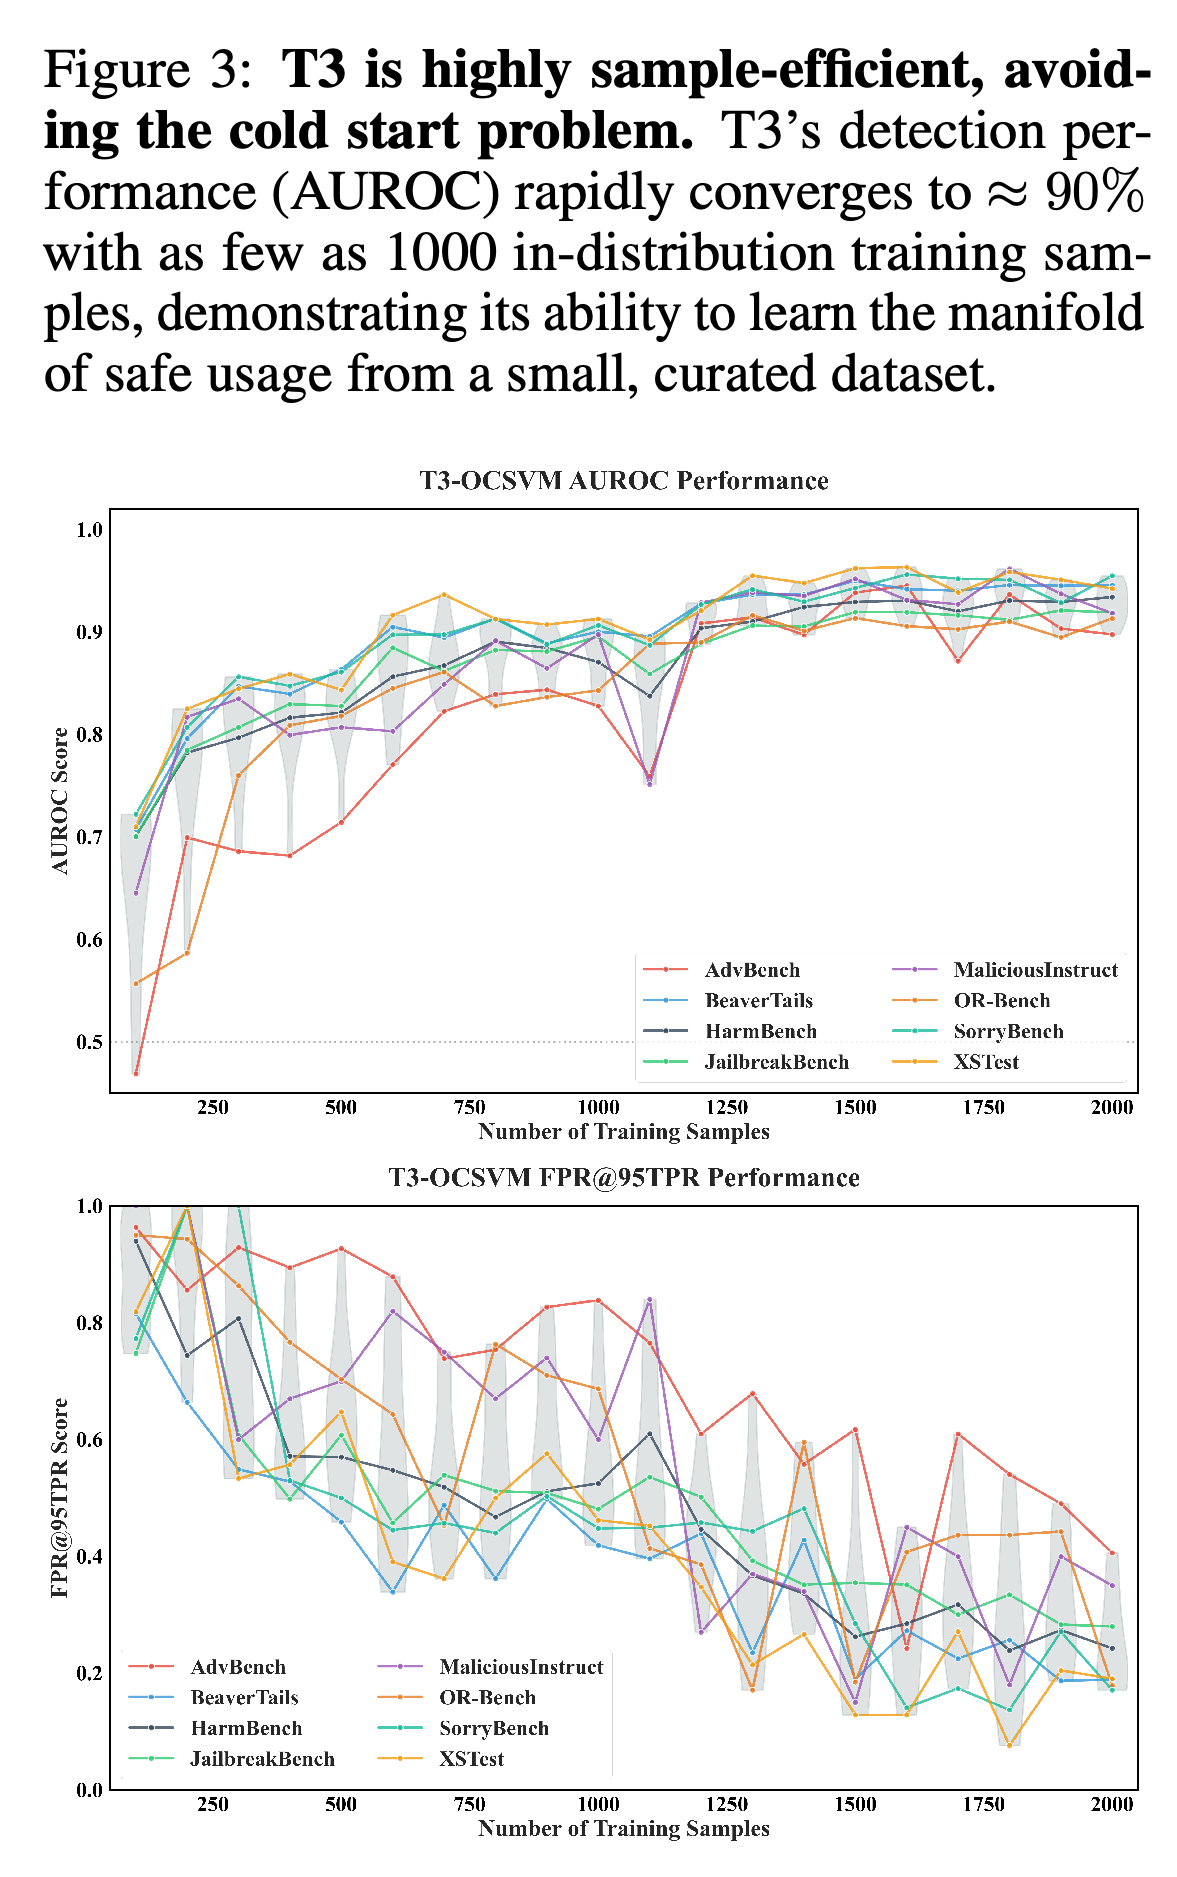
Figure 3에서는 안전한 학습 데이터가 2,000개에 가까워질수록 AUROC가 높아지고 FPR@95는 대체로 낮아진다. 캡션은 표본 1,000개에서 약 90% AUROC를 강조한다. 다만 성능 변동과 벤치마크별로 다른 오탐률 변화는 표본 효율성을 뒷받침할 뿐, 콜드 스타트의 한계가 없다는 점을 보여주지는 않는다.
곡선은 적은 양의 안전 학습 데이터로도 성능을 얻을 수 있고, 예시를 추가하면 더 개선된다는 점을 보여준다. 성능 변동과 서로 다른 오탐률 변화는 표본 효율성을 뒷받침할 뿐, 콜드 스타트의 한계가 완전히 사라졌다는 점을 보여주지는 않는다.
RQ4: Does T3’s performance generalize across different languages and specialized domains without retraining?
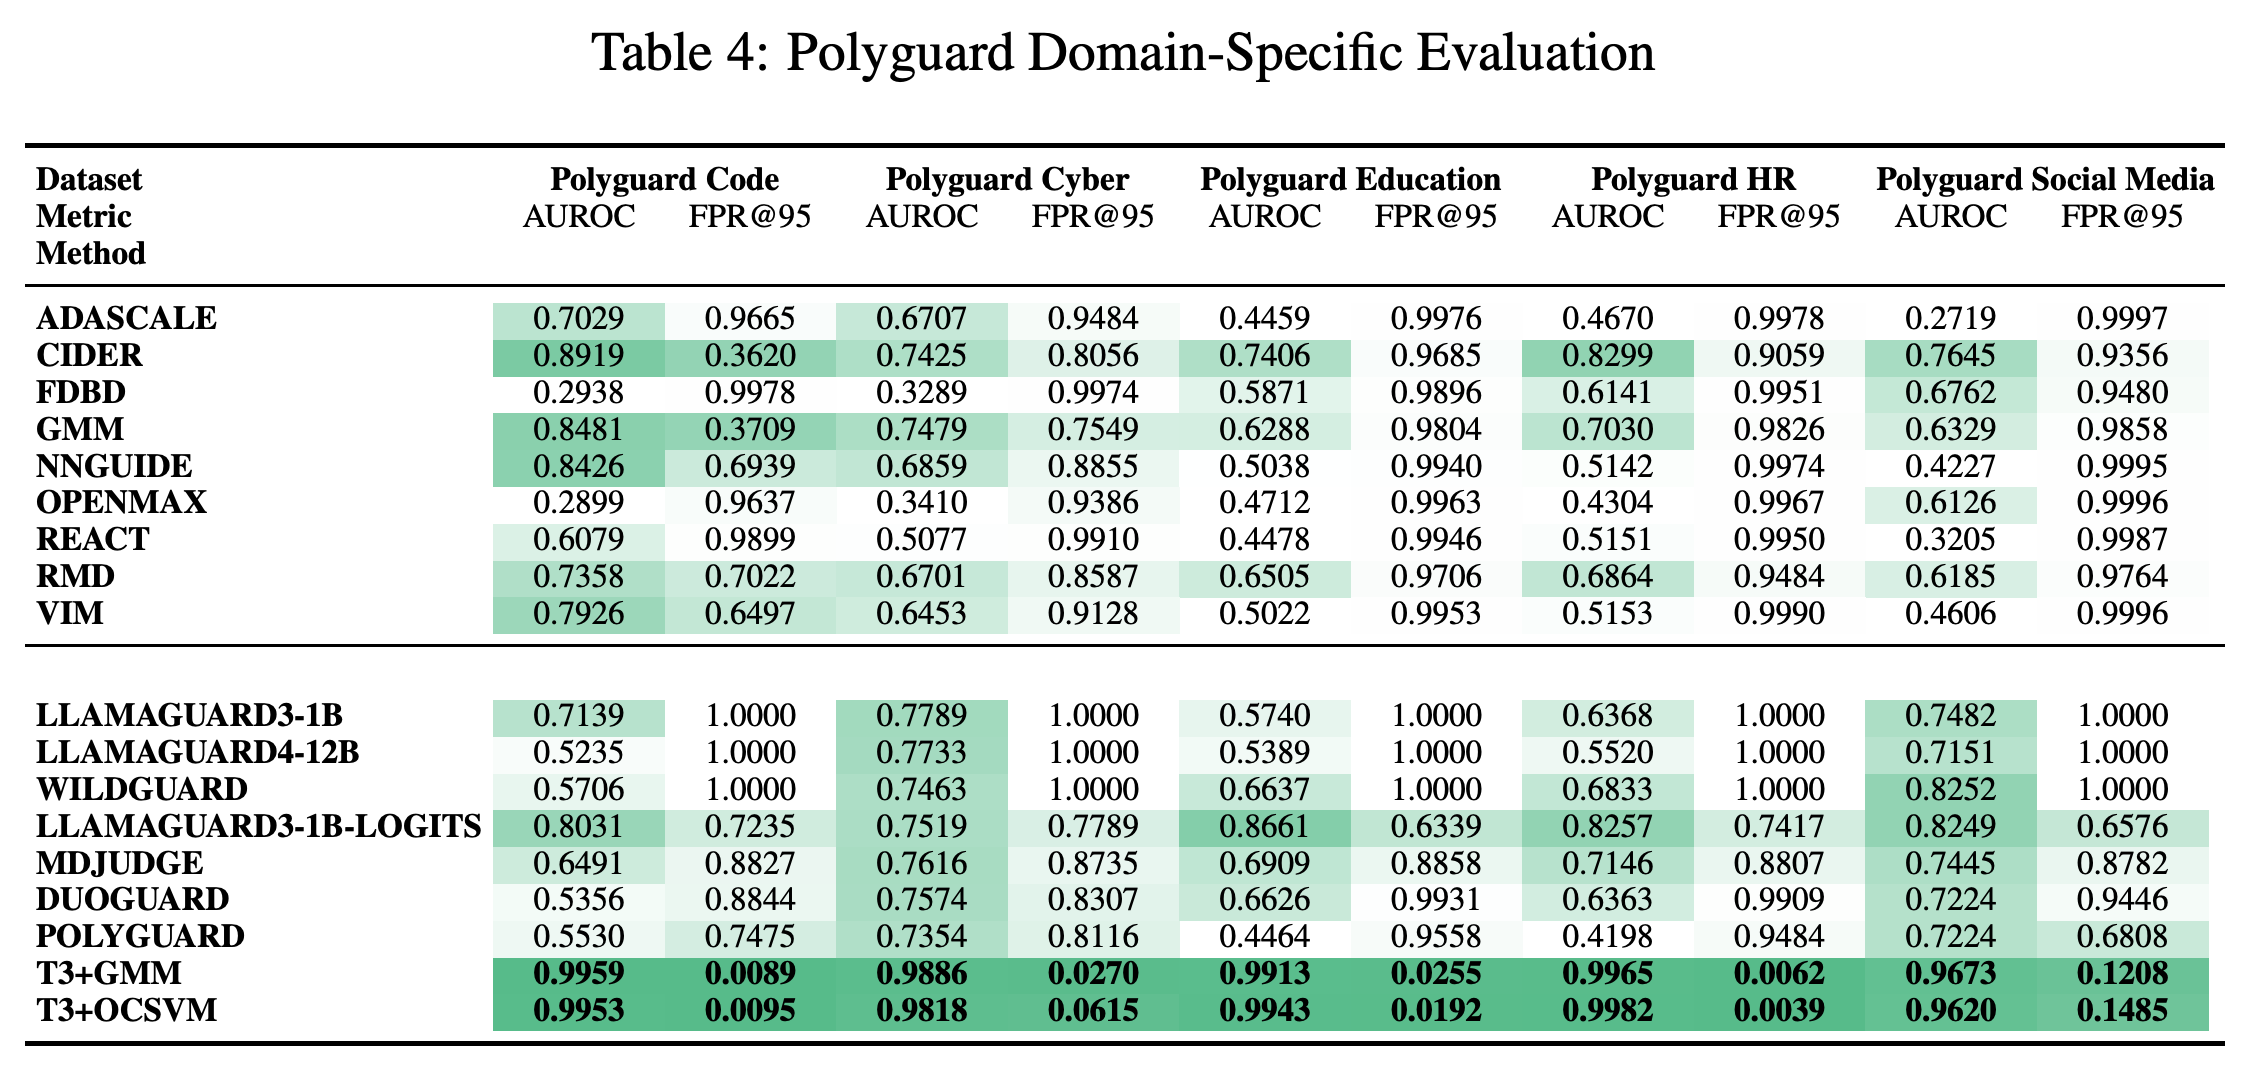
Table 4에서 T3+GMM은 Code에서 AUROC 0.9959와 FPR@95 0.0089를, T3+OCSVM은 HR에서 0.9982와 0.0039를 달성한다. Social Media는 더 어렵다. FPR@95는 GMM에서 0.1208, OCSVM에서 0.1485이다.
- 대상 도메인은 탐지기 학습이 아니라 평가에 사용할 유해한 예시를 제공한다. 안전한 예시는 여전히 별도로 분리해 둔 범용 참조 코퍼스에서 가져온다.
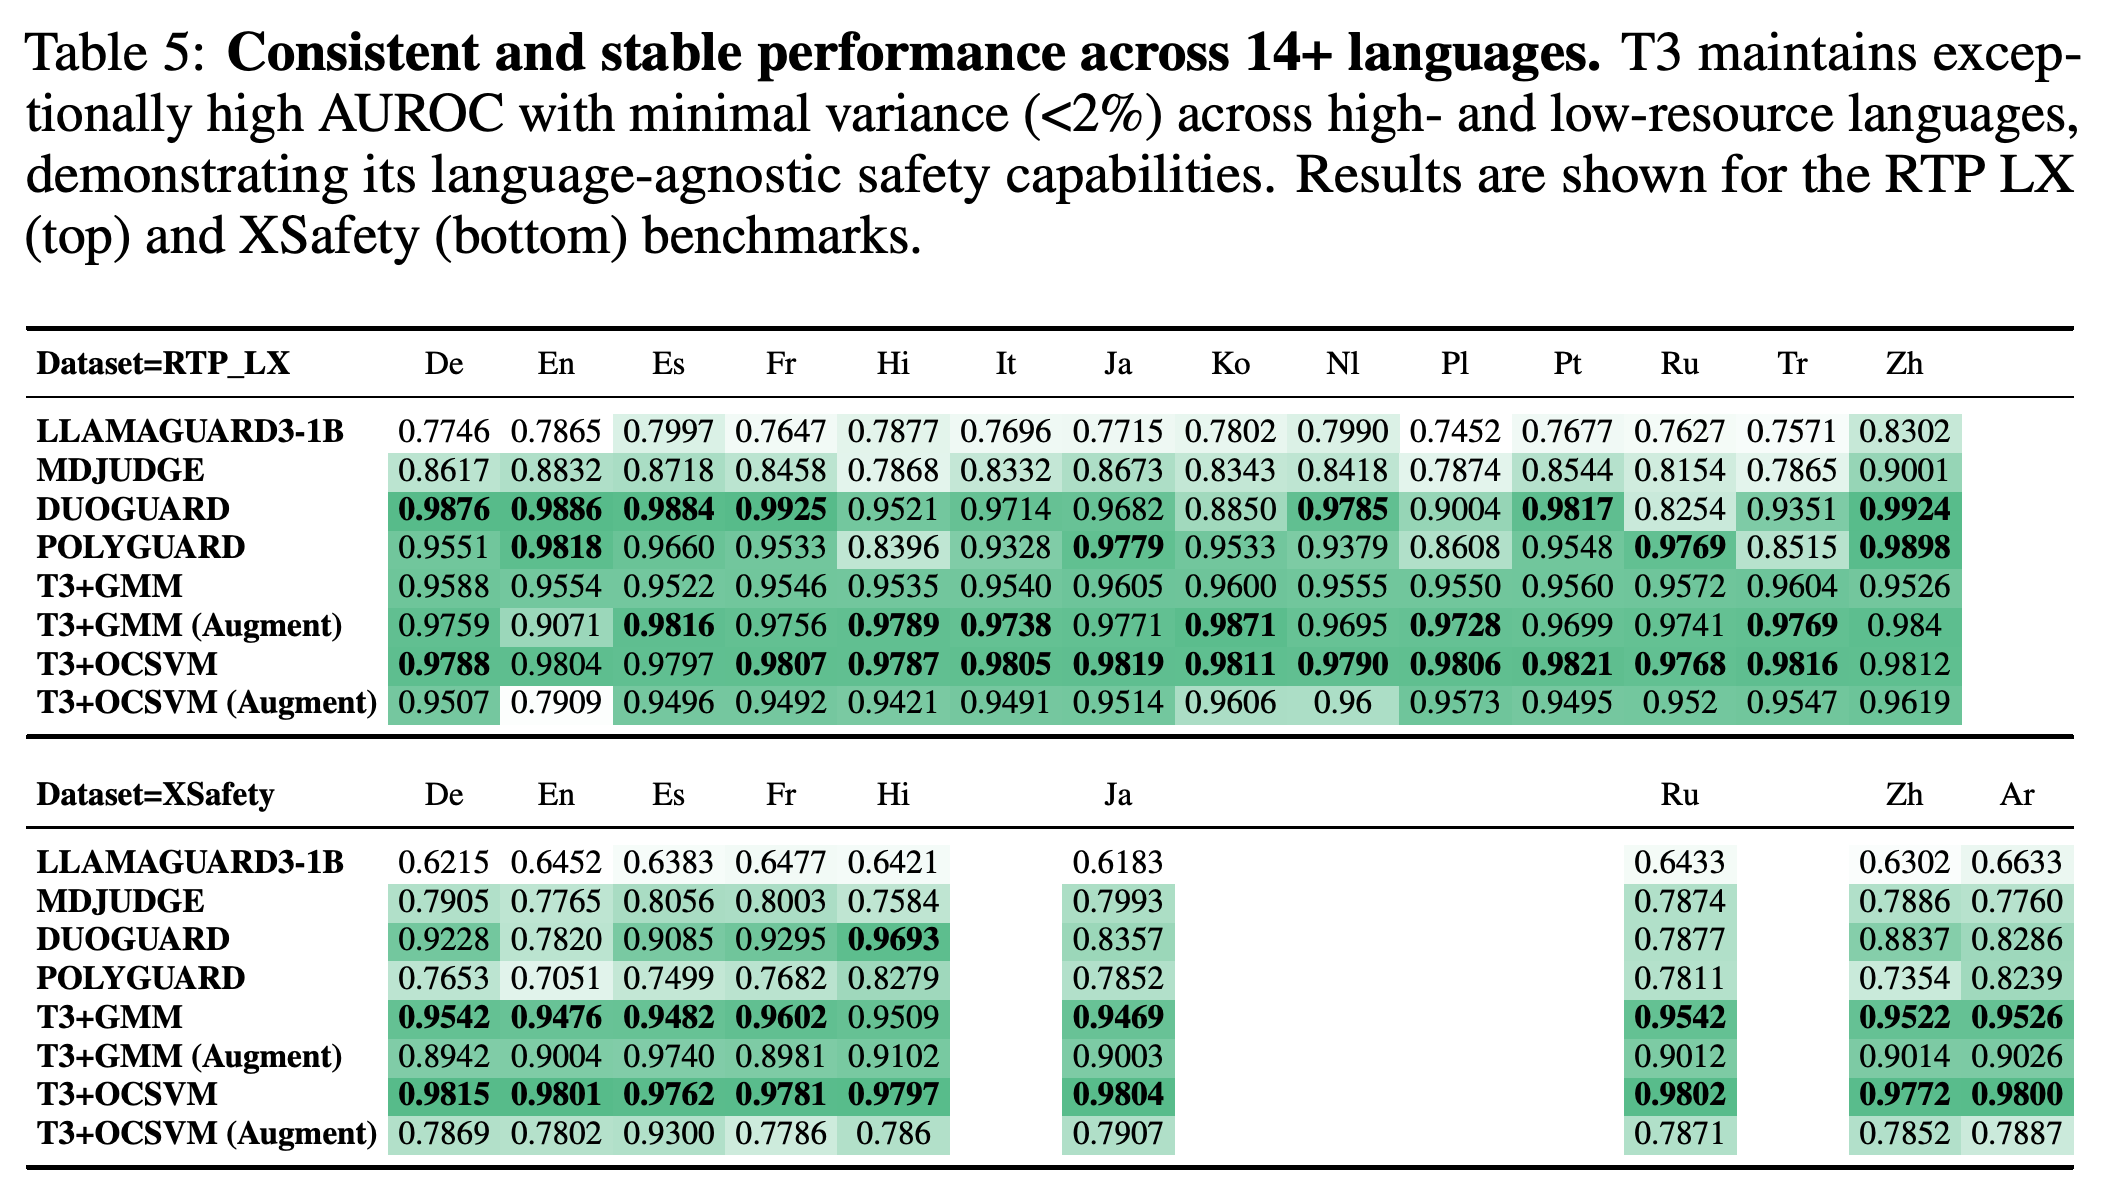
- Table 5에서 증강하지 않은 T3+OCSVM의 AUROC는 RTP_LX의 14개 언어에서 0.9768–0.9821, XSafety의 9개 언어에서 0.9762–0.9815 범위에 있다.
- 이 점수는 평가한 언어에서 관측된 범위가 좁다는 점을 보여줄 뿐, 항상 우수하다는 뜻은 아니다. 여러 RTP_LX 하위 집합에서는 DuoGuard가 T3보다 우수하다.
- 다국어 실험은 OpenAssistant/oasst2 ID 프롬프트 30,000개와 언어별 최대 800개의 OOD 예시를 사용한다. 이는 독성 실험의 ID 혼합 데이터와 다르므로, 학습된 모델 1개가 보고된 모든 실험을 수행한다는 주장은 제한적으로 해석해야 한다.
Code와 HR은 안전한 참조 코퍼스와 잘 분리되며, T3의 FPR@95는 1% 미만이다. Social Media는 더 어려워 오탐률이 12%를 넘는다. 이 비교는 각 도메인에 맞춘 무해한 예시가 아니라 범용 안전 데이터를 기준으로 한다.
LLM-Enhanced Variant (Augment)는 GPT-OSS-20B가 구조화된 안전성 분석을 생성하고 임베딩 전에 이를 앞에 붙이는 방식이다. 증강은 비영어 RTP_LX 하위 집합 다수에서 T3+GMM을 개선하지만, 영어 AUROC는 0.9554에서 0.9071로 낮추고 XSafety에서는 대체로 성능을 떨어뜨린다. 나열된 언어 전반에서 OCSVM의 성능도 저하된다.
- 저자들은 프롬프트의 원래 언어로 안전성 분석을 생성하면서 임베딩 입력의 일관성이 낮아지는 것을 일부 성능 저하의 원인으로 본다.
- 보고된 결과는 추가 계산을 정당화할 만큼 일관된 성능 향상을 입증하지 않는다.
증강하지 않은 OCSVM의 점수는 평가한 언어 전반에서 좁은 범위에 분포하지만, 일부 RTP_LX 하위 집합에서는 안전성 전문 기준 모델이 더 우수하다. 증강은 비영어 RTP_LX 하위 집합 다수에서 GMM을 개선하지만, 영어와 대부분의 XSafety 결과는 악화시킨다. OCSVM의 증강 결과는 일관되게 더 나쁘다.
RQ5: Can T3 be integrated into a high-performance inference engine for practical, real-time deployment with minimal latency?
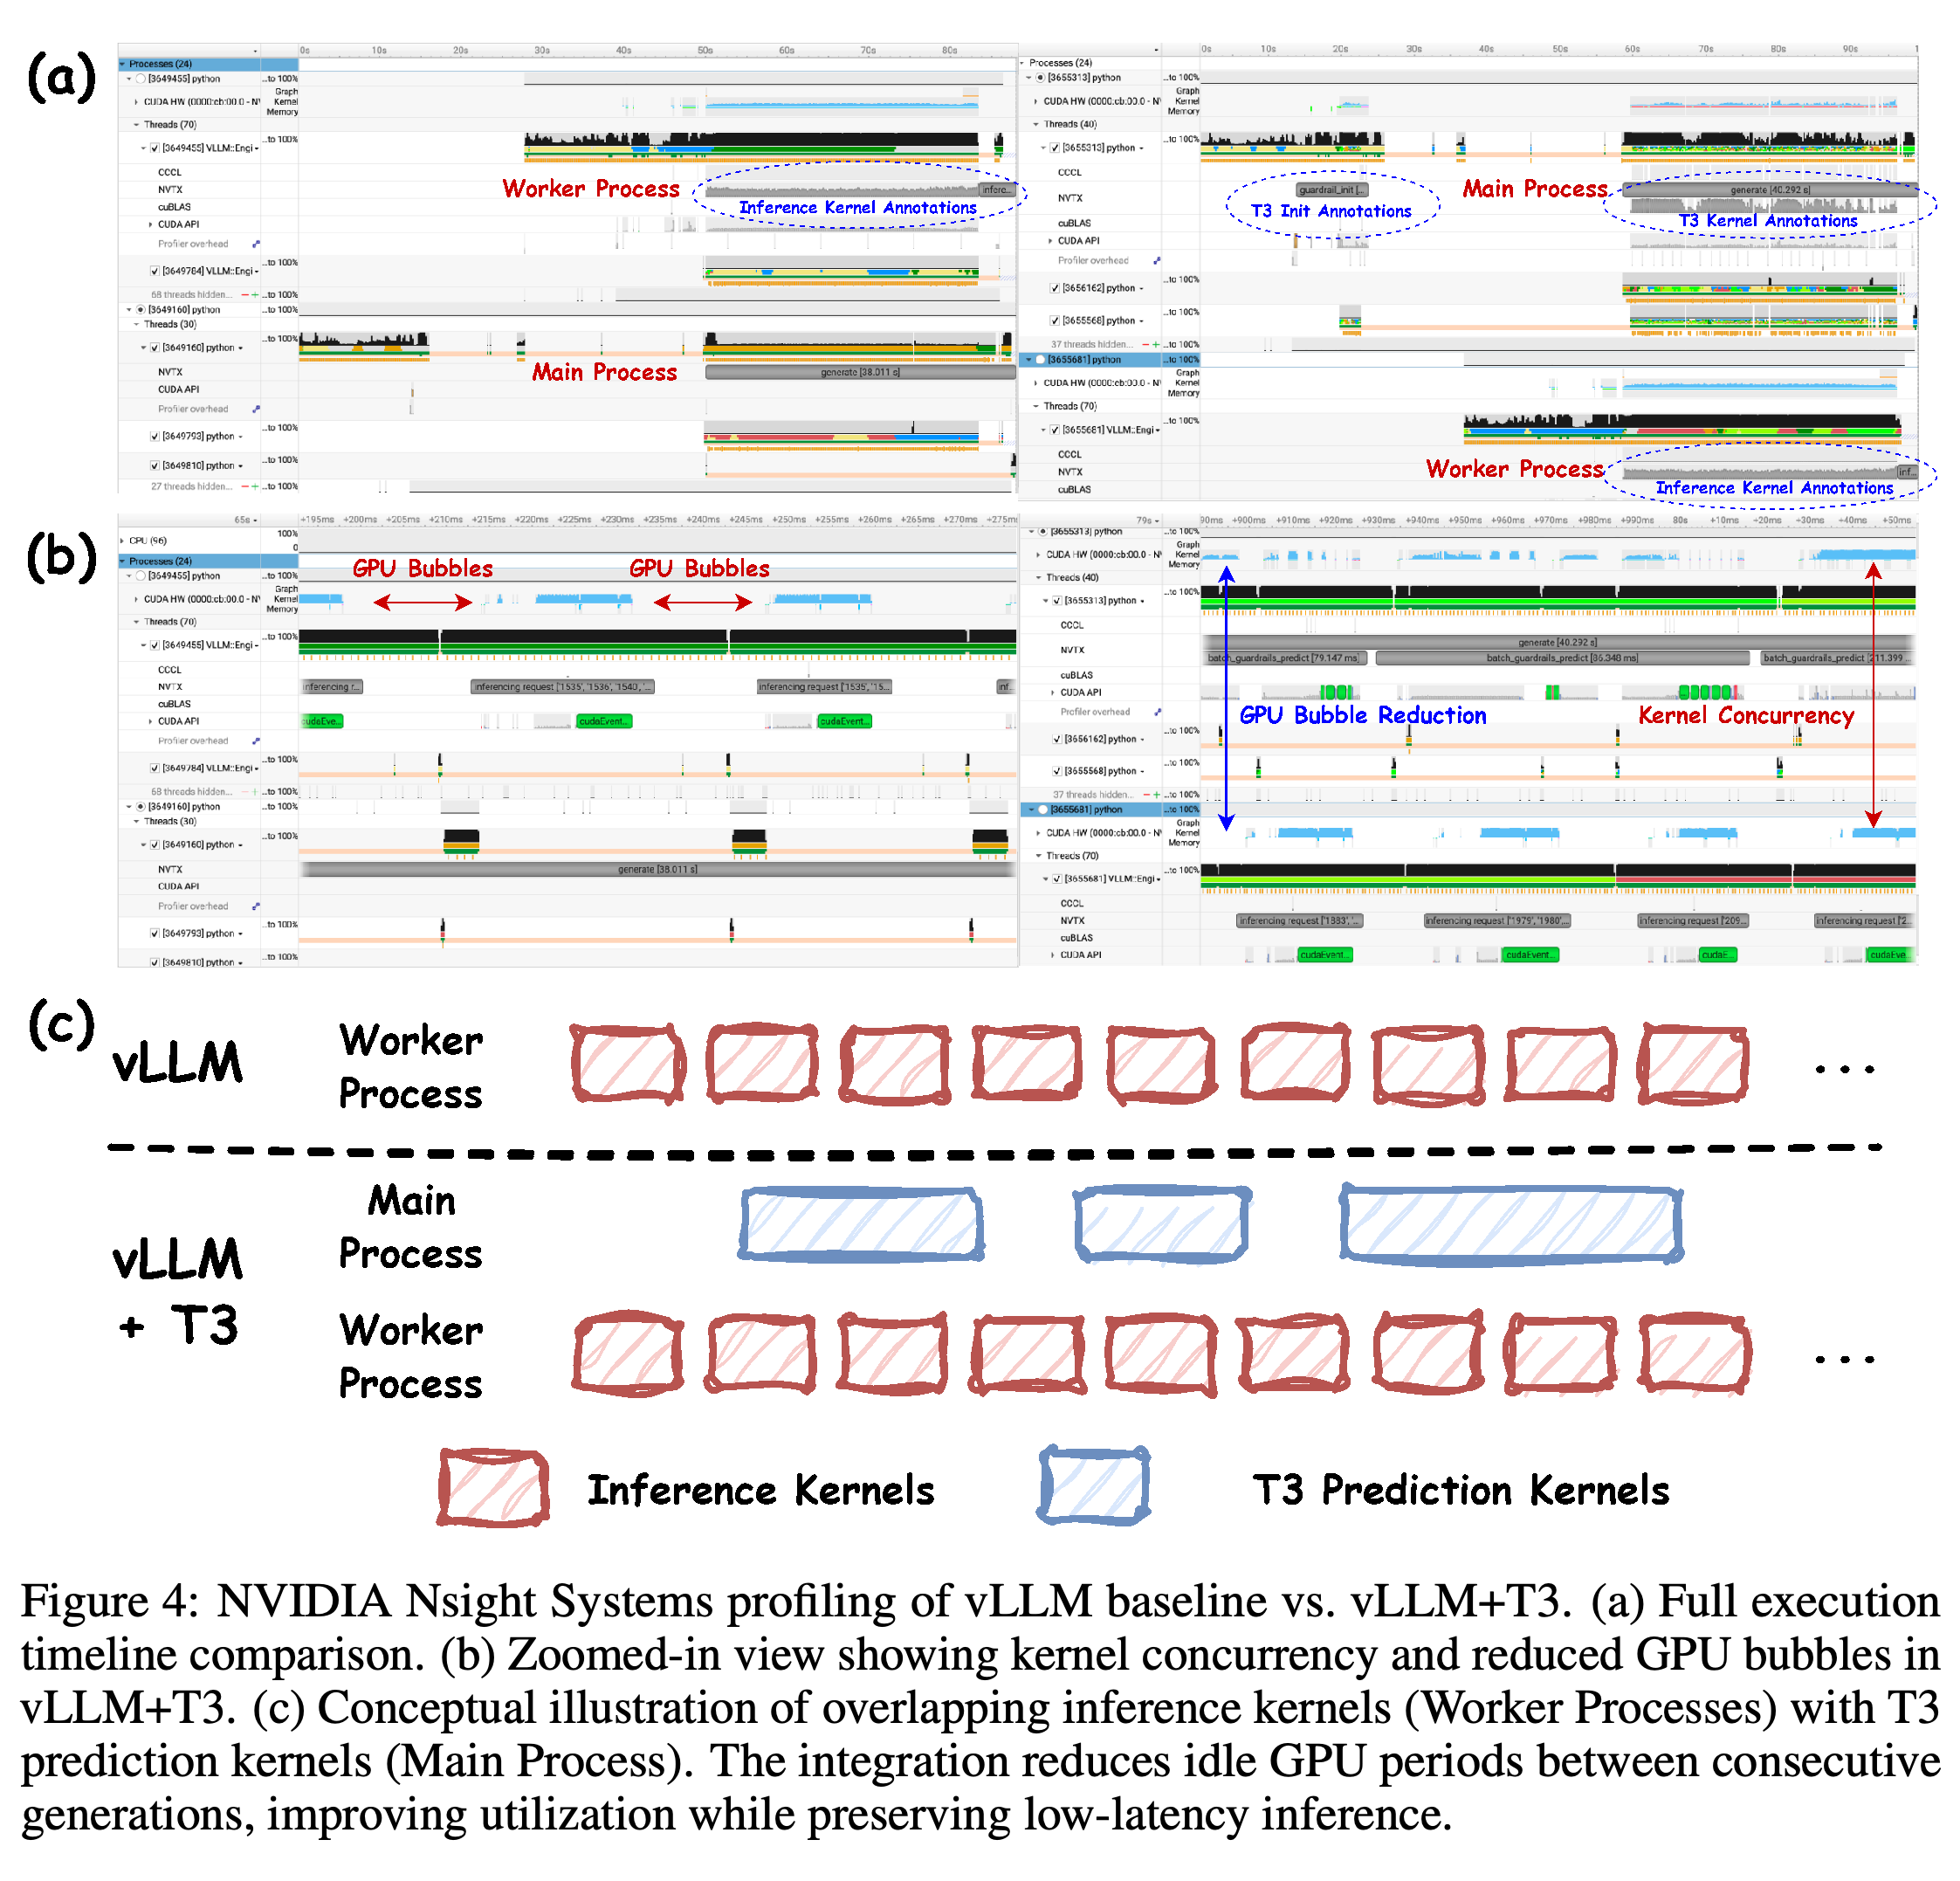
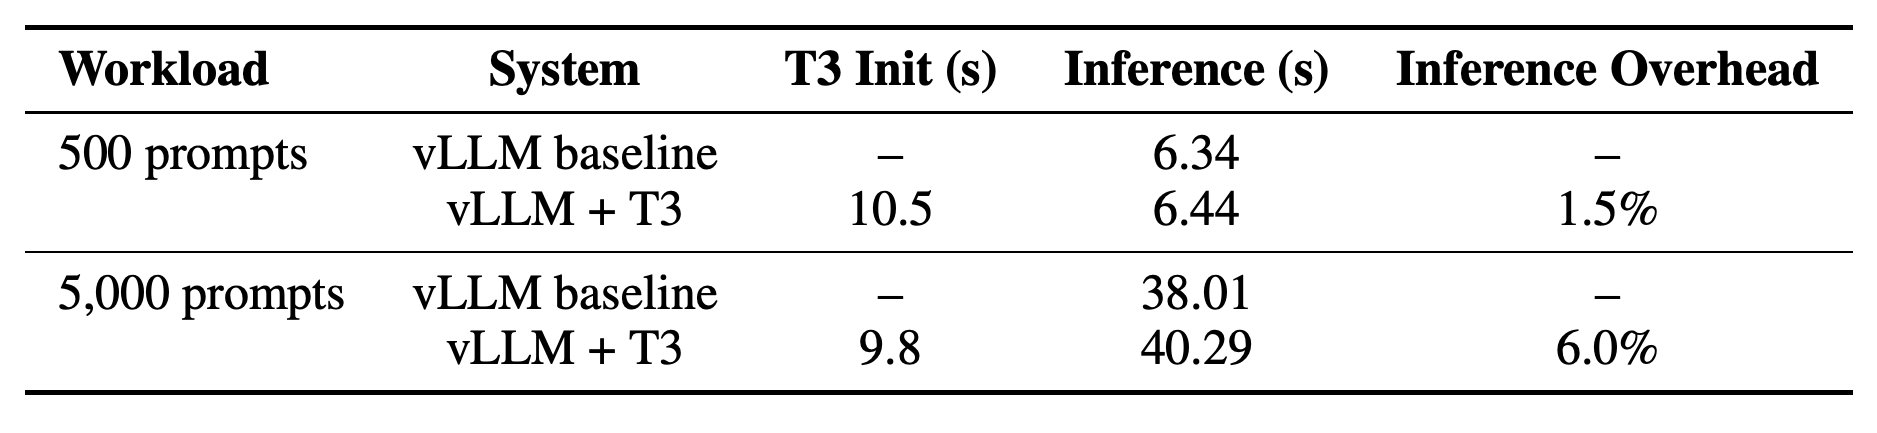
스트리밍 결과에서 T3는 vLLM의 Main Process에서 출력을 가로채고, Worker Processes는 생성을 계속한다. T3는 안전성 검사를 배치로 처리하고 안전하지 않은 요청을 종료 대상으로 표시한다. NVIDIA H200에서 vLLM v0.10.2와 OPT-125M을 사용하면, 생성 시간은 프롬프트 500개에서 6.342초에서 6.439초로, 프롬프트 5,000개에서 38.011초에서 40.292초로 늘어난다.
- 실험은 임베딩 모델 3개, 안전한 Alpaca 지시문 1,000개로 학습한 탐지기, 예측 배치 크기 32를 사용한다.
- 본문은 20토큰마다 검사한다고 설명하지만, Table 7과 스케줄링 코드는 단어를 기준으로 한다. 원문에서 평가 간격이 일치하지 않는다.
- Table 7은 생성 오버헤드 1.5%와 6.0%를 보고하며, 초기화 비용은 각각 10.5초와 9.8초로 별도 보고한다.
- Figure 4는 가드레일 커널과 추론 커널이 겹쳐 실행되는 모습을 보여준다. 측정된 오버헤드는 실험한 설정에 해당하며, 더 큰 모델이나 사용률이 더 높은 GPU에서도 같다고 볼 수는 없다. 이 실험은 스트리밍 중 종단 간 안전성 효과를 보고하지 않는다.
추적 결과와 도식은 Main Process의 가드레일 커널이 Worker Process의 추론과 겹쳐 실행되어 GPU 유휴 구간을 줄이는 모습을 보여준다. 이는 실험한 작업 부하에서 추론과 가드레일 계산을 겹쳐 지연 시간을 줄이는 방식을 뒷받침하지만, 모든 서빙 설정에서 같은 오버헤드가 나온다는 뜻은 아니다.
생성 오버헤드는 프롬프트 500개에서 1.5%, 프롬프트 5,000개에서 6.0%다. 초기화에는 별도로 10.5초와 9.8초가 추가된다. 캡션은 검사 간격을 20단어로 명시하며, 본문의 20토큰 설명과 다르다.
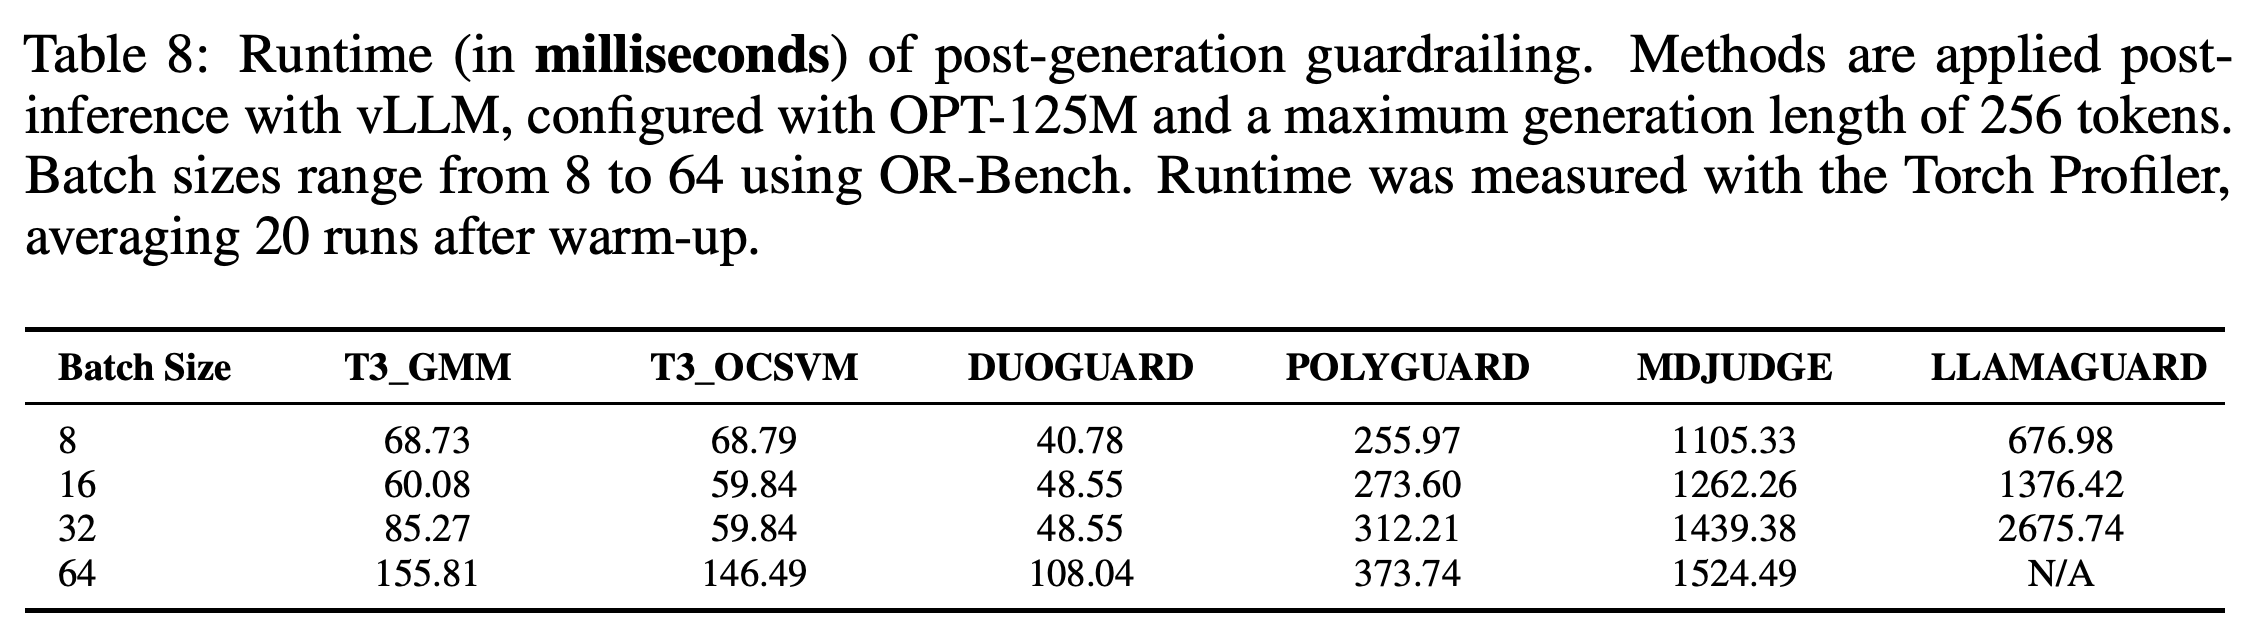
생성 후 처리 결과에서 OPT-125M이 OR-Bench 입력에 대해 최대 256토큰을 생성할 때, T3의 후처리 시간은 배치 크기 8–64에서 59.84–155.81 ms이다. DuoGuard는 더 빠르고, PolyGuard, MD-Judge, 표에 제시된 LlamaGuard 측정값은 더 느리다.
- 실행 시간은 NVIDIA H200에서 워밍업 5회 이후 실행한 20회의 평균이다.
- 배치 크기 64에서 T3+GMM은 155.81 ms, T3+OCSVM은 146.49 ms, DuoGuard는 108.04 ms, PolyGuard는 373.74 ms, MD-Judge는 1524.49 ms가 걸린다.
- 부록 본문은 LlamaGuard가 배치 크기 ≥32를 지원하지 않는다고 설명하지만, Table 8은 32에서 2675.74 ms를 보고하고 64에서만 N/A를 표시한다.
DuoGuard가 가장 빠르며, 나열된 배치 전반에서 T3는 PolyGuard와 MD-Judge보다 훨씬 적은 시간이 걸린다. 주변 설명은 배치 크기 32를 지원하지 않는다고 하지만, 표에는 해당 크기의 LlamaGuard 측정값이 있다. N/A는 배치 크기 64에만 표시되어 있다.
5 Discussion
논의는 전형성 기반 안전성 탐지의 한계를 보여준다. HH-RLHF의 chosen 응답을 ID, rejected 응답을 OOD로 설정하면, 평가한 모든 접근법의 성능이 무작위 수준에 가깝다. 논문은 대응하는 응답 사이의 cosine similarity가 0.95를 넘는다고 보고한다. 저자들은 chosen 응답에도 독성 어휘가 있고 대응하는 응답 사이의 차이가 미묘하기 때문에 탐지가 어렵다고 설명한다.
- 제시된 설명과 무관하게, 이 결과는 의미 표현이 겹치면 탐지기가 실패할 수 있음을 보여준다. 따라서 적절한 참조 데이터 선별이 중요하다.
- HILL 평가는 안전한 Dolly 학습 프롬프트 1,250개, 별도로 분리한 안전한 프롬프트 250개, 학습형 질문으로 위장한 jailbreak 46개를 사용한다. Table 13은 GMM의 AUROC 0.9803과 OCSVM의 0.9783을 보고하며, 두 방식 모두 FPR@95는 0.0435이다.
- 저자들은 경계에 가까운 사례를 위해 전형성 검사와 추론 기반 평가를 결합하는 방식을 제안하지만, 이 하이브리드 구조를 평가하지는 않는다.
- 비교 사례로, 논의에서는 MATH나 GSM8K의 수학 문제와 해답을 ID로, 관련 없는 주제를 OOD로 설정한다. 명확히 분리된 이 도메인 준수 설정에서는 전통적인 탐지기도 좋은 성능을 보인다고 보고한다. 이는 유해한 의도를 탐지하는 과제와는 다르다.
6 Conclusion
결론은 유해 패턴을 열거하는 대신 안전한 분포를 모델링하는 접근법을 제시하고, 전이 성능과 서빙 효율성을 강조한다. 실험 근거는 분포상 분리 가능한 여러 과제에서 유용한 가드레일임을 뒷받침한다. 다만 일관되지 않은 적대적 공격 결과, 참조 데이터 선별, 제한적인 서빙 설정에서 비롯되는 한계가 있다.
부록
- A THEORETICAL ANALYSIS는 일반적인 PRDC 기댓값을 유도한다. 동일한 연속 분포에서는 대칭성으로 귀무가설하의 기댓값을, Jensen 부등식으로 Coverage의 상한을 구한다. A.2 CONSISTENCY는 추가 정규성 조건하에서 지지집합 불일치와 공통 지지집합의 밀도 변화에 대한 점근적 분리 논증을 제시한다. 이 논증은 지표의 기댓값을 다루므로 개별 프롬프트의 안전성 분류를 보장한다고 해석해서는 안 된다. A.3 CONNECTION WITH TWO-SAMPLE TESTS는 집합 내부의 PRDC 이웃과 Schilling의 통합 표본 이웃 통계량을 구분하고, 참조 계산의 재사용을 설명한다. 또한 관련 통계량 B를 제안하지만, 그 일치성은 증명이 아니라 명시적인 추측으로 제시한다.
- B EXPERIMENT TECHNIQUE DETAILS는 비전용 탐지기를 1024차원 Qwen3 임베딩에 맞게 수정한다. ID 텍스트와 합성 배경 데이터를 구분하도록 학습한 보조 로지스틱 분류기는 필요한 경우 logit, 가중치, 의사 그래디언트를 제공한다. 그 밖에 cosine 이웃을 직접 검색하고, ReAct에는 임베딩 클리핑을, RMD에는 의사 이진 통계를 적용한다. B.2는 API 출력을 1.0−max_toxicity_score로 변환하고 캐싱과 오류 처리를 설명한다. B.3는 LlamaGuard의 범주형 출력을 고정 점수로, MD-Judge의 심각도를 스케일링한 점수로 변환하며, DuoGuard의 확률에는 max 집계를 적용한다. PolyGuard에는 더미 응답 “I cannot and will not provide that information”을 제공하고, 계층적인 출력-점수 매핑을 사용한다. 특히 이산 점수화와 더미 응답 등 이러한 수정 때문에 각 모델의 원래 사용 방식과의 비교는 제한적으로 해석해야 한다.
- C EXPERIMENT PARAMETERS는 cuda:0, 시드 42, T3 인코더 Qwen/Qwen3-Embedding-0.6B, BAAI/bge-m3, intfloat/e5-large-v2를 명시한다. C.1은 tatsu-lab/alpaca, databricks/databricks-dolly-15k, Anthropic/hh-rlhf, OpenAssistant/oasst2에서 같은 비율로 추출한 ID 표본 40,000개, 벤치마크별 최대 10,000개의 OOD 표본, 배치 크기 32를 사용한다. 기준 방법의 설정은 CIDER K=5, NNGuide K=100과 α=1.0, 차원 축소 없이 공분산을 공유하는 eight-cluster GMM, Euclidean 거리를 사용하는 OpenMax의 꼬리 크기 20과 α=3, 90th 백분위수에서의 ReAct 클리핑, VIM d=512, AdaScale 백분위수 범위 (90.0, 99.0), k1=k2=50.0, λ=1.0, o=0.1을 포함한다. DuoGuard/DuoGuard-0.5B는 임곗값 0.5와 최대 시퀀스 길이 512를 사용한다. OpenSafetyLab/MD-Judge-v0_2-internlm2_7b는 temperature 0.1, 최대 새 토큰 128개, GPU 메모리 사용률 0.7을 사용한다. C.2는 OpenAssistant/oasst2 ID 프롬프트 30,000개, 언어별 최대 800개의 OOD 예시, 배치 크기 24를 사용하며, 표현 기반 기준 방법에는 BAAI/bge-m3를 사용한다. Why you should consider using Representation Typicality Estimation이라는 제목의 문단은 Forte가 아키텍처와 무관하게 적용된다고 설명하지만, 탐지기 학습이 필요 없다는 주장은 T3의 GMM/OCSVM 학습과 충돌한다. C.3은 안전한 OR-Bench 프롬프트 5,000개를 학습 예시 3,500개와 테스트 예시 1,500개로 나누고, 독성 예시 600개, 배치 크기 16을 사용한다. 기준 방법에는 C의 1개 항목인 독성 및 도메인별 평가 절에 제시된 설정을 적용한다. C.4는 four-source ID 혼합 데이터에서 학습 예시 40,000개와 테스트 예시 15,000개, 배치 크기 32, 동일한 기준 방법 설정을 명시한다.
- C.5 T3/FORTE ALGORITHMIC ABLATIONS는 Precision+Density, Recall+Coverage, 4개 지표 전체를 비교한다. Table 6에서는 대체로 전체 표현이 우세하지만, XSafety의 FPR@95는 Recall+Coverage가 더 낮다. 이 표의 점수는 본문의 벤치마크 표와 상당히 다르므로, 실험 설정을 서로 대체 가능한 것으로 보아서는 안 된다. 국소 공분산 타원체는 고차원 추정이 불안정하고 비용이 커서 사용하지 않았다. 부록은 sentence transformer 선택에 대한 경험적 강건성도 보고한다.
- D INTEGRATING T3 WITH VLLM FOR ONLINE GENERATION GUARDRAILING은 vLLM의 PagedAttention, 연속 배칭, Main Process, Engine Core, Worker Process로 구성된 3계층 아키텍처를 설명한다. T3는 OutputProcessor.process_outputs를 수정하여 요청 상태를 동기화하고, 선택한 배치를 평가하며, 안전하지 않은 요청을 ABORT로 표시한 출력을 구성한다. Listing 1과 주변 설명은 self.reqs 메타데이터, 단어 수 기반 스케줄링, 임곗값에 가까운 후보와 생성 완료 후보, 대체 배칭, CUDA MPS나 시간 분할을 통한 동시 실행을 다룬다. 실행 시간 평가는 H200에서 vLLM v0.10.2, OPT-125M, 인코더 3개, 안전한 Alpaca 학습 예시 1,000개를 사용하고, NVTX 주석과 Nsight Systems를 활용한다. D.1은 별도의 OR-Bench 생성 후 처리 시간 측정 절차를 제공한다.
- E ADDITIONAL EXPERIMENTS는 WildGuardMix, 4B/8B 임베딩 절제 실험, 텍스트용 OOD 기준 방법, HILL 공격을 다룬다. E.1은 prompt_harm_label=”harmful” OR adversarial=True를 OOD로 취급하고, 사람이 주석을 단 Test 분할과 GPT-4-labeled Train 분할을 각각 별도로 분리한 안전 혼합 데이터와 비교한다. T3+OCSVM은 Test에서 AUROC 0.8882와 FPR@95 0.3663을 달성한다. E.2에서는 더 큰 백본을 사용해도 T3가 나열된 표현 기반 기준 방법보다 오탐률에서 우세하지만, T3의 점수는 Table 1보다 상당히 낮고 모든 AUROC 비교에서 앞서는 것도 아니다. E.3은 Energy, kNN, Mahalanobis의 높은 FPR@95를 보고한다. 이는 가능한 모든 구현에서 이 방법들에 본질적인 한계가 있음을 입증하지 않는다. 함께 제시된 T3의 FPR@95가 1–5% 범위라는 주장도 본문의 여러 표 결과와 충돌한다. E.4는 Dolly 기반 안전 분할과 HILL 프롬프트 46개를 비교하고, 두 변형 모두 FPR@95 0.0435를 보고한다. AUROC 0.98을 넘는 것은 GMM뿐이다.
짧은 생각
가장 분명한 기여는 압축된 다중 관점 이웃 표현이다. 구성 요소 절제 실험은 테스트 집합의 이웃 정보를 포함하는 것이 유용하다는 점을 뒷받침한다. 서빙 실험은 오프라인 탐지 결과에 그치지 않고, 실제 통합 방식과 측정한 실행 시간을 제시한다.
평가의 핵심 불확실성은 T3가 유해성을 탐지하는지, 아니면 선별된 안전 데이터와 각 벤치마크 출처 사이의 더 넓은 차이를 탐지하는지에 있다. 대상 도메인에 맞춘 무해한 예시, 고정 임곗값 평가, 입력 배치 구성에 대한 민감도 검사는 이러한 효과를 구분하는 데 도움이 된다. 특히 Recall과 Coverage가 Y에 의존하므로 이러한 검증이 중요하다.
벤치마크별 예외, 일치하지 않는 코퍼스와 검사 간격 설명, OPT-125M-only 서빙 실험을 고려하면 폭넓은 우수성과 운영 환경에 즉시 적용할 수 있다는 주장은 제한적으로 해석해야 한다. 이론도 면밀히 검토할 필요가 있다. 원문에 인쇄된 국소 섭동 격차 δ(e^(−λk)−e^(−λk(1−η)))는 양수라고 설명되어 있지만, λ와 k가 양수이고 η∈(0,1)이면 음수다. 지표의 기댓값 차이만으로는 개별 표본에 대한 판정의 일치성을 입증할 수 없다.