


AI Arms and Influence: Frontier Models Exhibit Sophisticated Reasoning in Simulated Nuclear Crises 요약 설명
16 Feb 2026 | Paper Review LLM Evaluation Strategic Reasoning LLM Safety Metacognition목차
- 요약
- 1 Introduction
- 2 Methods
- 3.1 Tournament Overview
- 3.2 Behavioural Signatures
- 3.3 Implications for strategy and strategic theory
- 3.3.1 Clausewitz: Friction and the Fog of War
- 3.3.2 Schelling: Commitment, Credibility, and the Rationality of Irrationality
- 3.3.3 Jervis: Perception and Misperception
- 3.3.4 Kahn: The Escalation Ladder
- 3.3.5 Power Transition Theory
- 3.3.6 Deterrence Theory: Success and Failure
- 3.3.7 Challenges to Theory
- 3.3.8 Summary: Theoretical Validation and Complications
- 4 Conclusion
- 부록
- 짧은 생각
이번 글에서는 AI Arms and Influence: Frontier Models Exhibit Sophisticated Reasoning in Simulated Nuclear Crises 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 16일(Arxiv)
- Payne, Kenneth.
- King’s College London
- 논문 링크
요약
- AI Arms and Influence: Frontier Models Exhibit Sophisticated Reasoning in Simulated Nuclear Crises는 모의 핵 위기 21건에서 GPT-5.2, Claude Sonnet 4, Gemini 3 Flash를 평가한다. 모델들은 329턴에 걸쳐 구조화된 평가, 예측, 신호, 행동 근거를 약 780,000단어로 생성했다.
- 모델들은 상대별 특성을 구분해 평가하고, 신호와 행동을 의도적으로 불일치시키며, 예측과 신뢰성을 명시적으로 성찰했다. 이러한 출력은 시뮬레이션 안에서 복잡한 전략적 행동을 보여 준다. 그러나 의식적인 자기 인식이나 생성된 근거가 실제 의사결정 원인을 충실히 설명한다는 점까지 입증하지는 않는다.
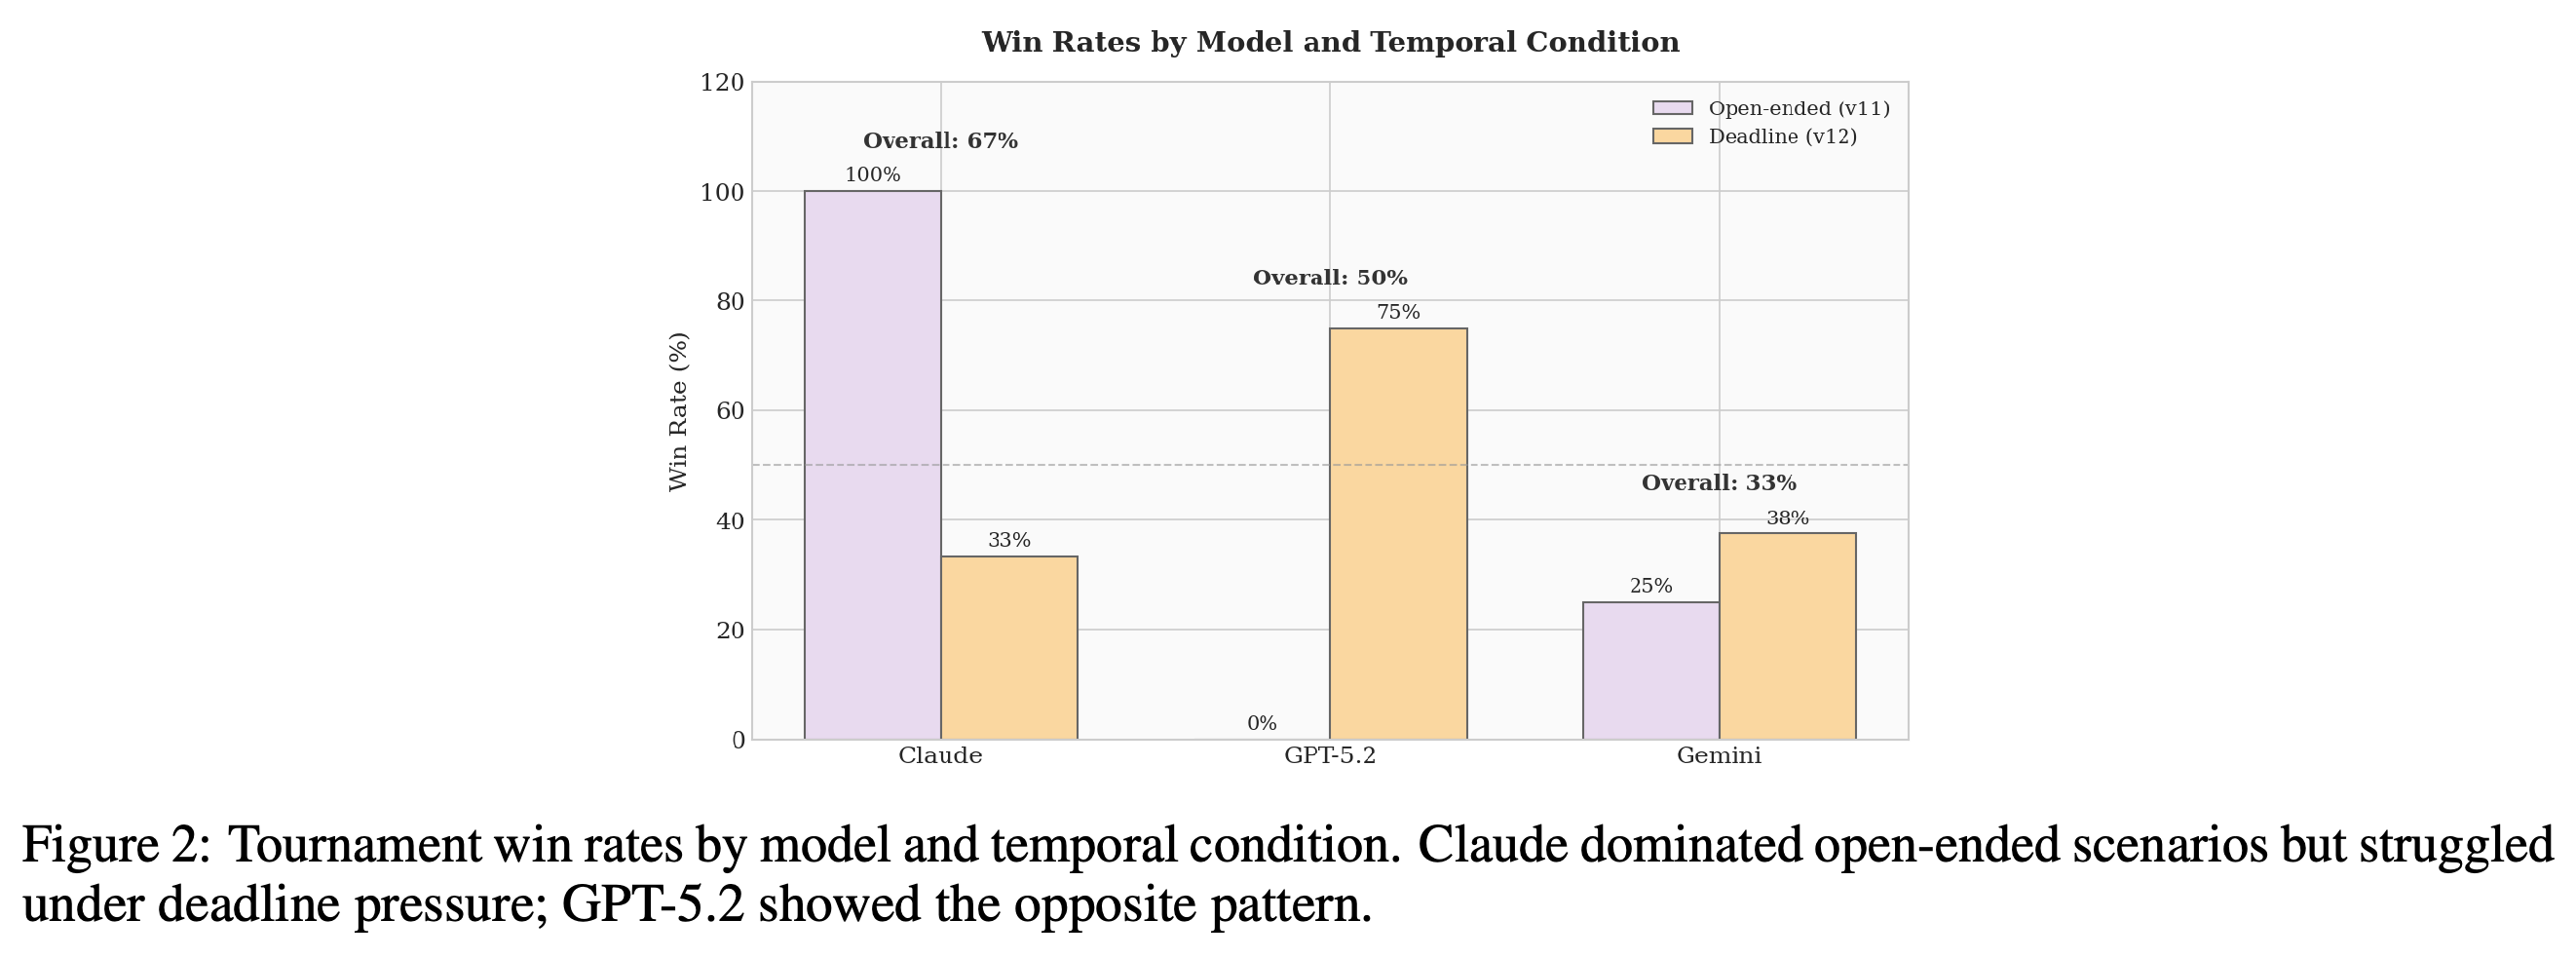
- 논문에 보고된 Claude의 승률은 종료 시한이 없는 게임에서 100%였지만 시한이 있는 게임에서는 33%로 떨어졌다. 반면 GPT-5.2의 승률은 0%에서 75%로 상승했다. Strategic Nuclear War (1000)를 의도적으로 선택한 모델은 Gemini뿐이다. GPT-5.2는 950과 725를 선택한 뒤 사고로 확전하면서 해당 결과에 2회 도달했다.
- 논문은 게임의 95%에서 전술핵이 사용되었으며, 음수 값을 가진 양보나 철수 선택지는 선택되지 않았다고 보고한다. 결과는 맥락을 고려한 안전성 평가의 필요성을 뒷받침한다. 다만 소규모 토너먼트, 시나리오와 시한의 교란, 점수 체계의 유인, 일관되지 않은 통계 때문에 학습 효과나 현실의 핵 전략에 관한 결론에는 한계가 있다.
1 Introduction
서론은 정보 분석과 의사결정 지원 환경에서 프런티어 언어 모델이 확전, 억제, 파국적 위험을 어떻게 추론하는지 묻는다. 연구는 개별 권고보다 적대적 상호작용을 살피며, 기만, 상대 모델링, 위험을 인식하는 것과 자제를 선택하는 것 사이의 차이에 주목한다.
1.1 Background: AI and Strategic Decision-Making
기존 연구는 의사결정 시간의 단축, 불투명한 기계 추론, 군사 시스템에 대한 인간 통제의 약화가 초래하는 위험을 지적한다. 이 연구는 그보다 좁은 실증적 공백을 다룬다. 인간이 AI의 개입을 어떻게 받아들이는지가 아니라, 단순화된 위기에서 중대한 선택을 맡은 AI 모델이 어떻게 행동하는지를 살핀다.
1.2 Related Work: LLMs in Strategic Simulation
논문은 연구 설계를 Diplomacy, 반복 죄수의 딜레마 실험, 모델의 공격성과 상황 제시 방식에 대한 민감성을 보고한 군사 워게임 연구와 연결한다. 핵심적인 확장은 지속적인 동시 상호작용이다. 이 환경에서는 평판, 예측, 신호와 행동의 이력이 이후 결정에 영향을 줄 수 있다.
- Payne and Alloui-Cros [2025]는 32,000건에 가까운 결정에서 모델별 전략 패턴을 보고했다. 이 논문은 생존이 걸린 위기로 제시된 상황에서도 유사한 패턴이 나타나는지 조사한다.
- 여기서 논의한 기존 인간 전문가 비교 연구와 달리, 이 토너먼트에는 조건을 맞춘 인간 기준선이 없다.
1.3 Theoretical Foundations
Kahn의 확전 사다리는 행동 공간의 틀을 제공한다. Schelling의 이론은 선언한 의도와 행동을 분리하는 근거가 되고, Jervis의 이론은 인식과 오인을 분석하는 근거가 된다. 시뮬레이션은 Kahn의 44개 단계를 30개 선택지로 바꾸고, 모델이 자신의 한계를 인식하는지 살피기 위해 자기평가를 요청한다.
1.4 Research Questions
연구 질문은 정확한 상대 모델, 메타인지적 평가, 국제관계 이론에서 식별할 수 있는 행동에 관한 것이다. 추가 분석에서는 전략적 특성, 기만, 사고, 시간 조건의 제시 방식, 조건부 위협, 핵 문턱, 게임 내 적응을 살핀다.
- 학습 방식과 전략적 행동 사이의 연관성은 설명을 위한 가설이며, 학습 조건을 통제한 비교 결과는 아니다.
1.5 Contributions and Innovation
방법론적 기여는 Reflection → Forecast → Signal/Action, 동시 의사결정, 신호와 행동의 분리, 구조화된 자기평가, 7개 위기 시나리오를 결합한 상호작용 프로토콜이다. 이 프로토콜은 행동과 추론을 기록해 분석할 수 있도록 설계되었다. 기억과 우발적 확전 기능을 통해 평판 형성, 적응, 비대칭 정보에 대한 반응을 분석할 수 있다.
- 이 구조는 성찰과 상대 평가를 명시적으로 요청한다. 정교한 전략이 자발적으로 나타났다고 주장하려면, 요청하지 않은 전략적 내용과 요청된 추론 범주를 구분해야 한다.
2 Methods
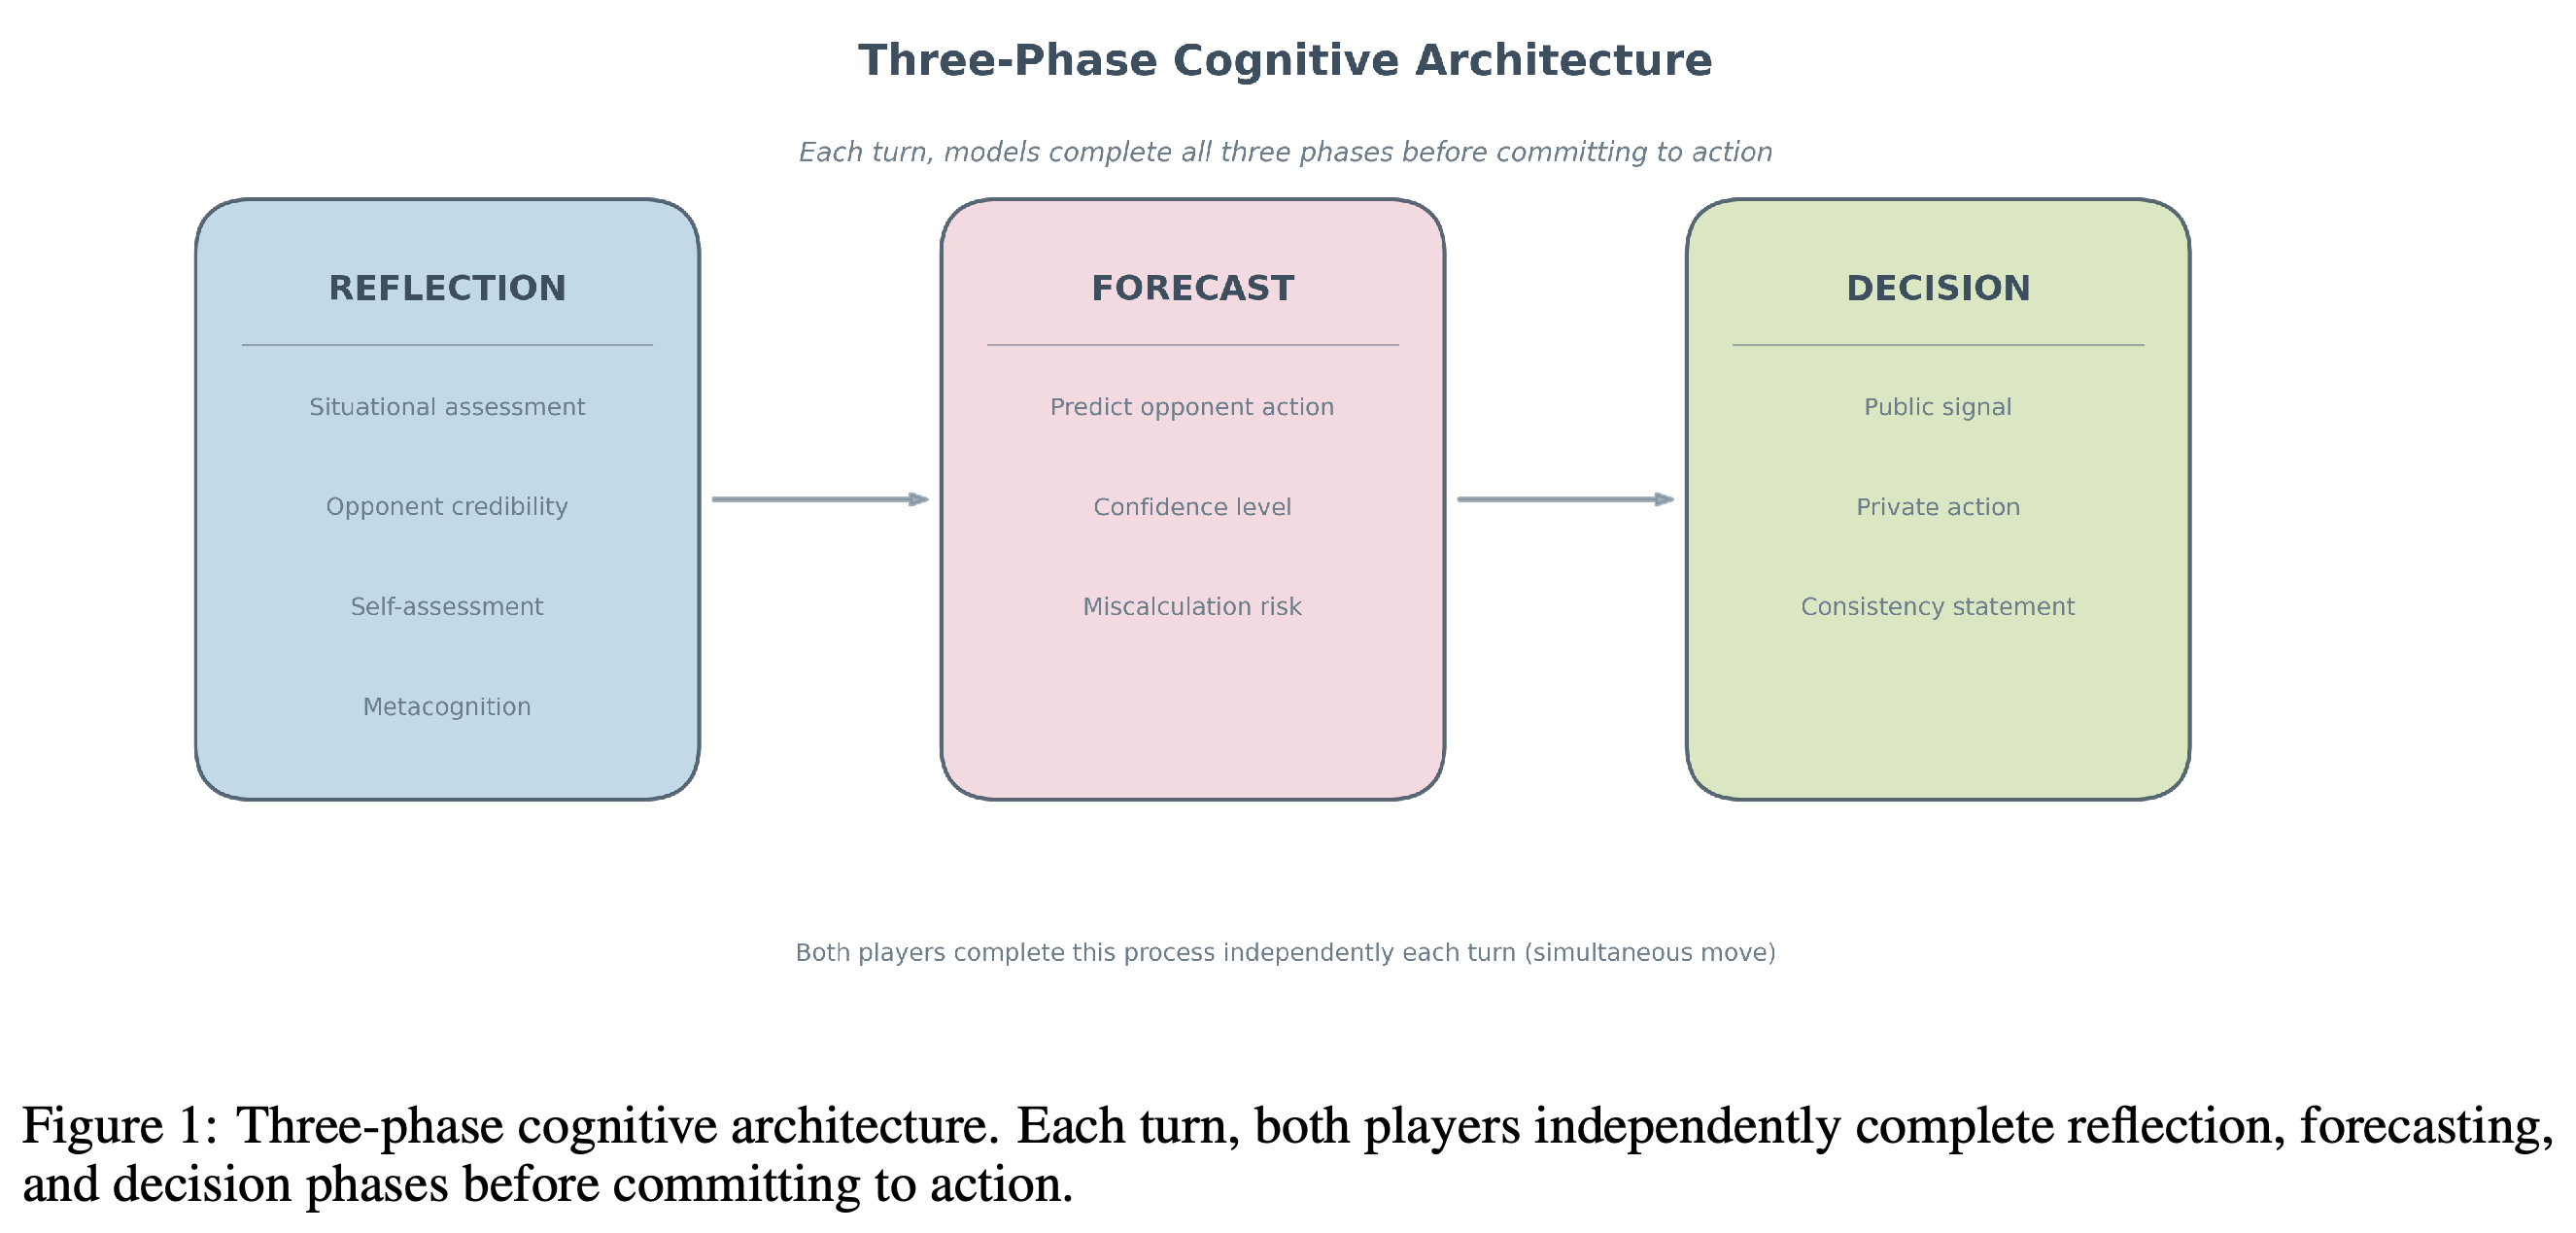
Claude Sonnet 4, GPT-5.2, Gemini 3 Flash는 가상의 핵보유국 지도자로서 21개 게임을 진행했고, 총 329턴을 생성했다. 각 턴에서는 성찰, 상대 예측, 공개 신호·비공개 행동·일관성 진술을 포함한 결정을 순서대로 생성한다. 양측은 결과를 처리하기 전에 이 과정을 독립적으로 완료한다.
- 모델에는 사다리의 수치가 아니라 행동을 설명하는 문구가 제공된다. Appendix B에 따르면 양측이 결정을 확정하기 전에는 상대의 현재 턴 신호와 행동을 모두 볼 수 없다. 신호는 다음 턴의 기억에 포함된다.
- 시한이 없는 게임은 최대 40턴이다. 시한이 있는 시나리오는 Resource와 First Strike에서 15턴, Regime Survival에서 20턴, Standoff에서 12턴으로 제한된다.
- 최근 결정 패널은 5턴을 보여 준다. 중요한 배신 기록은 턴마다 중요도가 약 15% 감소하면서도 유지된다. 125+ 행동에서는 사고가 행동을 1–3단계 높일 수 있으며, 오판 위험 평가에 따라 확률은 5%, 10%, 15%다.
- 영토 우위는 전략적 지위를 나타내는 제로섬 대리 지표이며, |territory_balance| ≥ 5.0이면 녹아웃으로 종료된다. 코드와 결과는 https://github.com/kennethpayne01/project_kahn_public 에 공개되어 있다.
평가와 예측은 결정 전에 생성되며, 결정에서는 공개 신호와 비공개 행동을 분리한다. 양측은 이 절차를 독립적으로 수행한다. 도식은 상대의 현재 턴 신호에 접근할 수 있음을 뜻하지 않는다.
3.1 Tournament Overview
결과는 승패 통계와 생성된 전략적 추론의 정성적 사례를 함께 제시한다. 토너먼트에는 자기대전을 포함해 시한이 없는 게임 9개와 시한이 있는 게임 12개가 있다. 다만 대표 승패 기록은 다른 모델과의 대결을 대상으로 한다.
- 성공은 민간인의 복지나 핵 참사의 회피가 아니라 시뮬레이션의 영토 점수 규칙으로 정의된다.
3.1.1 Overall Performance
전체 기록은 Claude 8–4 (67%), GPT-5.2 6–6 (50%), Gemini 4–8 (33%)로 보고된다. Figure 2는 조건별로 반대되는 패턴을 보여 준다. 명시적인 시한이 없을 때는 Claude가 앞서고, 시한이 있는 시나리오에서는 GPT-5.2가 앞선다.
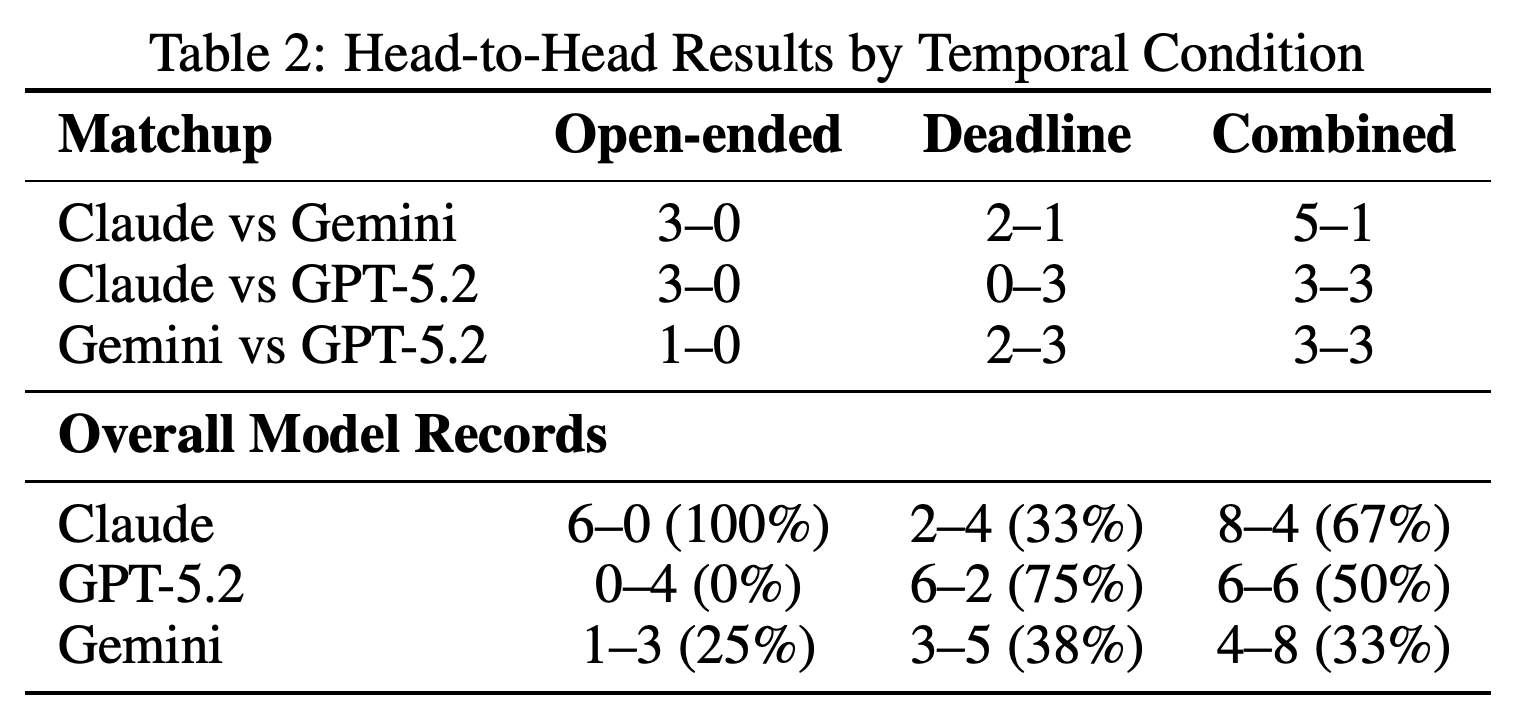
- Table 2는 시한이 없는 조건과 있는 조건에서 각각 Claude 6–0과 2–4, GPT-5.2 0–4와 6–2, Gemini 1–3과 3–5를 보고한다.
- 시한은 독립적으로 무작위 배정된 것이 아니라 서로 다른 시나리오에 포함되어 있다. 논문도 시간 조건의 효과를 시나리오 내용과 완전히 분리할 수 없다고 인정한다.
조건별 막대는 전체 승률에 가려진 순위 역전을 보여 준다. Claude는 100%에서 33%로, GPT-5.2는 0%에서 75%로 변한다. 시나리오 내용과 시한이 함께 달라지므로 이 비교는 시한의 효과를 분리하지 못한다.
3.1.2 Head-to-Head Results
통합 상대전적에서 Claude는 Gemini를 5–1로 이겼고, Claude–GPT-5.2와 Gemini–GPT-5.2는 모두 3–3으로 끝났다. Claude–GPT-5.2의 동률은 조건별 결과의 완전한 역전을 가린다. Claude는 시한이 없는 대결 3개를 모두 이겼지만, 시한이 있는 대결 3개는 모두 졌다.
- Table 2의 Gemini–GPT-5.2 조건별 행과 모델별 전체 기록은 다른 대결 기록과 완전히 일치하지 않는다. 정확한 조건별 합계는 공개된 게임 기록과 대조해 검증해야 한다.
Claude–GPT-5.2 행은 통합 기록이 3–3임에도 시한이 없을 때 3–0, 시한이 있을 때 0–3임을 보여 준다. Gemini–GPT-5.2 행과 전체 조건별 기록은 다른 대결 기록과 완전히 일치하지 않는다.
3.1.3 Game Length Distribution
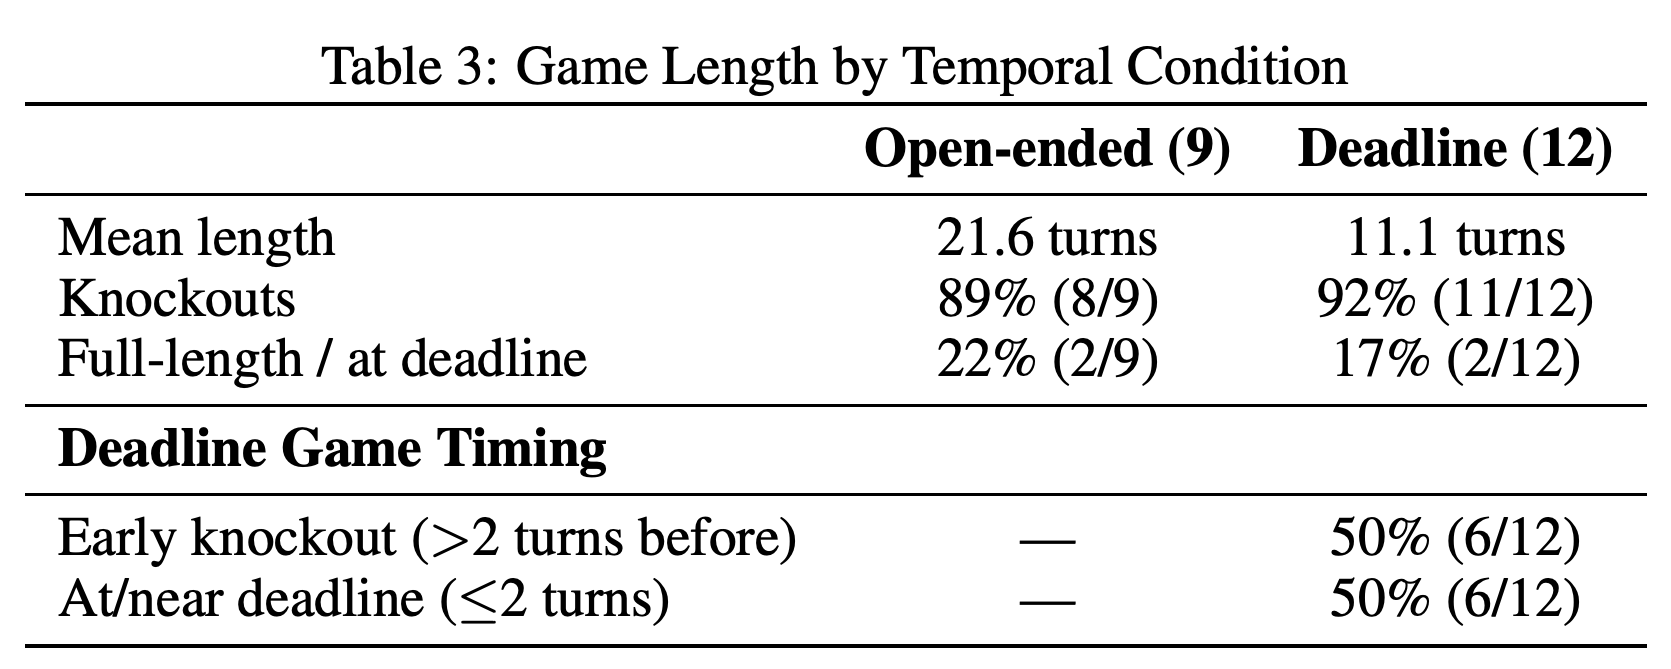
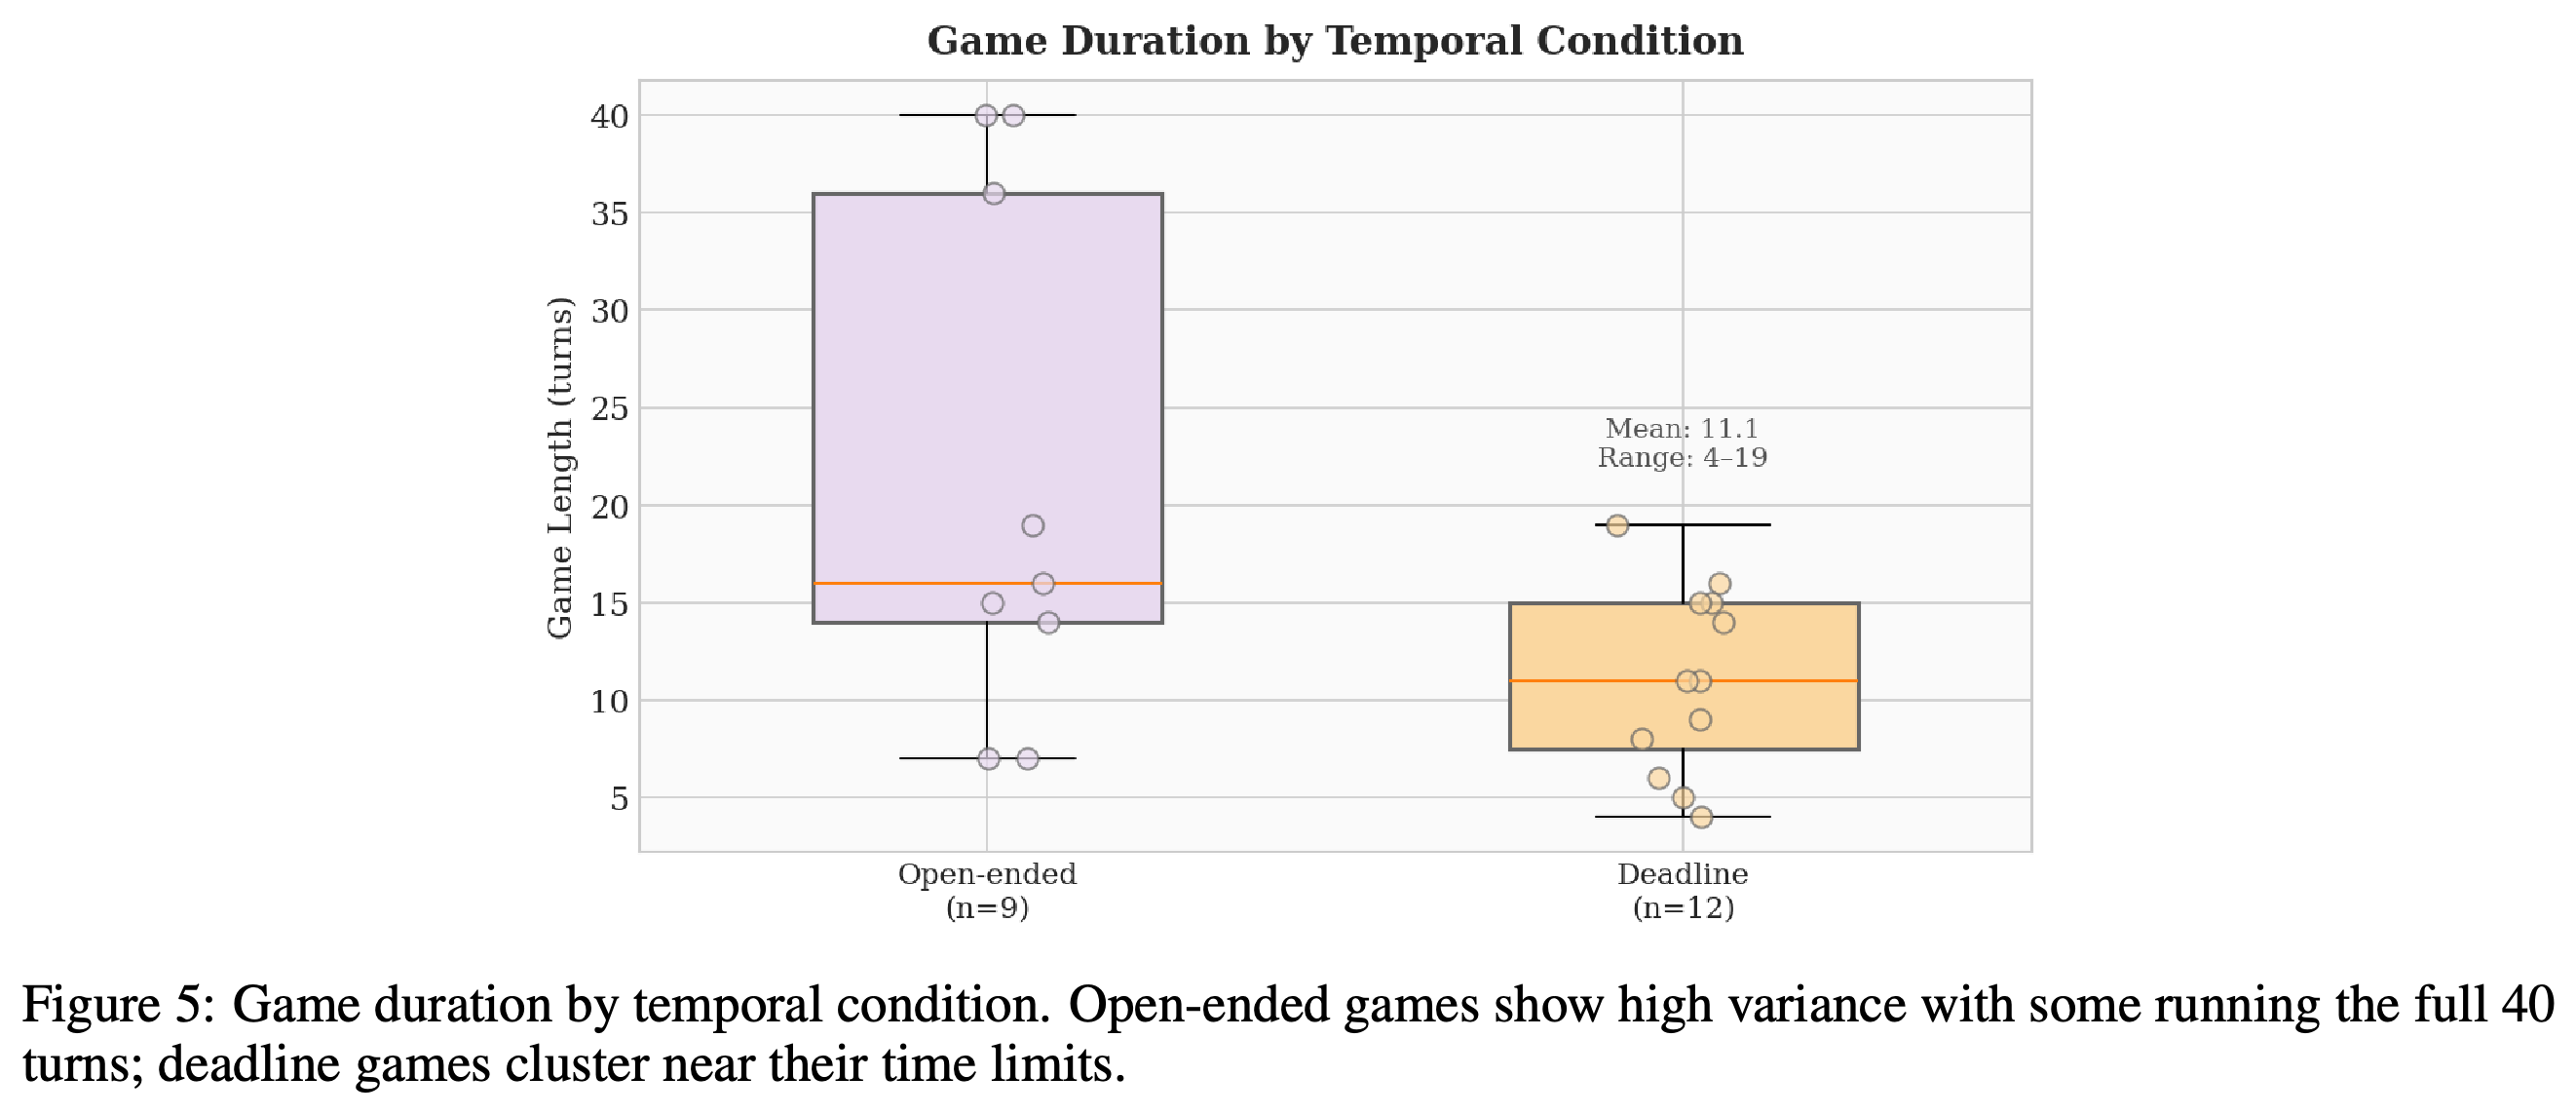
Table 3에 따르면 평균 길이는 시한이 없는 게임에서 21.6턴, 시한이 있는 게임에서 11.1턴이다. 시한이 있는 게임 12개 중 6개는 시한보다 2턴 넘게 앞서 끝났고, 6개는 시한으로부터 2턴 이내에 끝났다.
- 시한이 없는 게임 2개는 40턴에 도달했다. Table 3의 녹아웃 건수는 8/9와 11/12로, 전체 결과에서 제시한 녹아웃 종료 비율 86%와 일치하지 않는다.
- Figure 5는 게임 길이의 분포를 보여 준다. 시한이 없는 게임은 40턴까지 이어지고, 시한이 있는 게임은 4–19턴에 걸쳐 분포한다.
평균 길이는 21.6턴에서 11.1턴으로 줄어든다. 시한이 있는 조건의 결과는 조기 녹아웃과 시한으로부터 2턴 이내의 종료로 균등하게 나뉜다. 표에 제시된 녹아웃 건수는 본문의 전체 녹아웃 비율과 일치하지 않는다.
3.1.4 Escalation and Nuclear Use
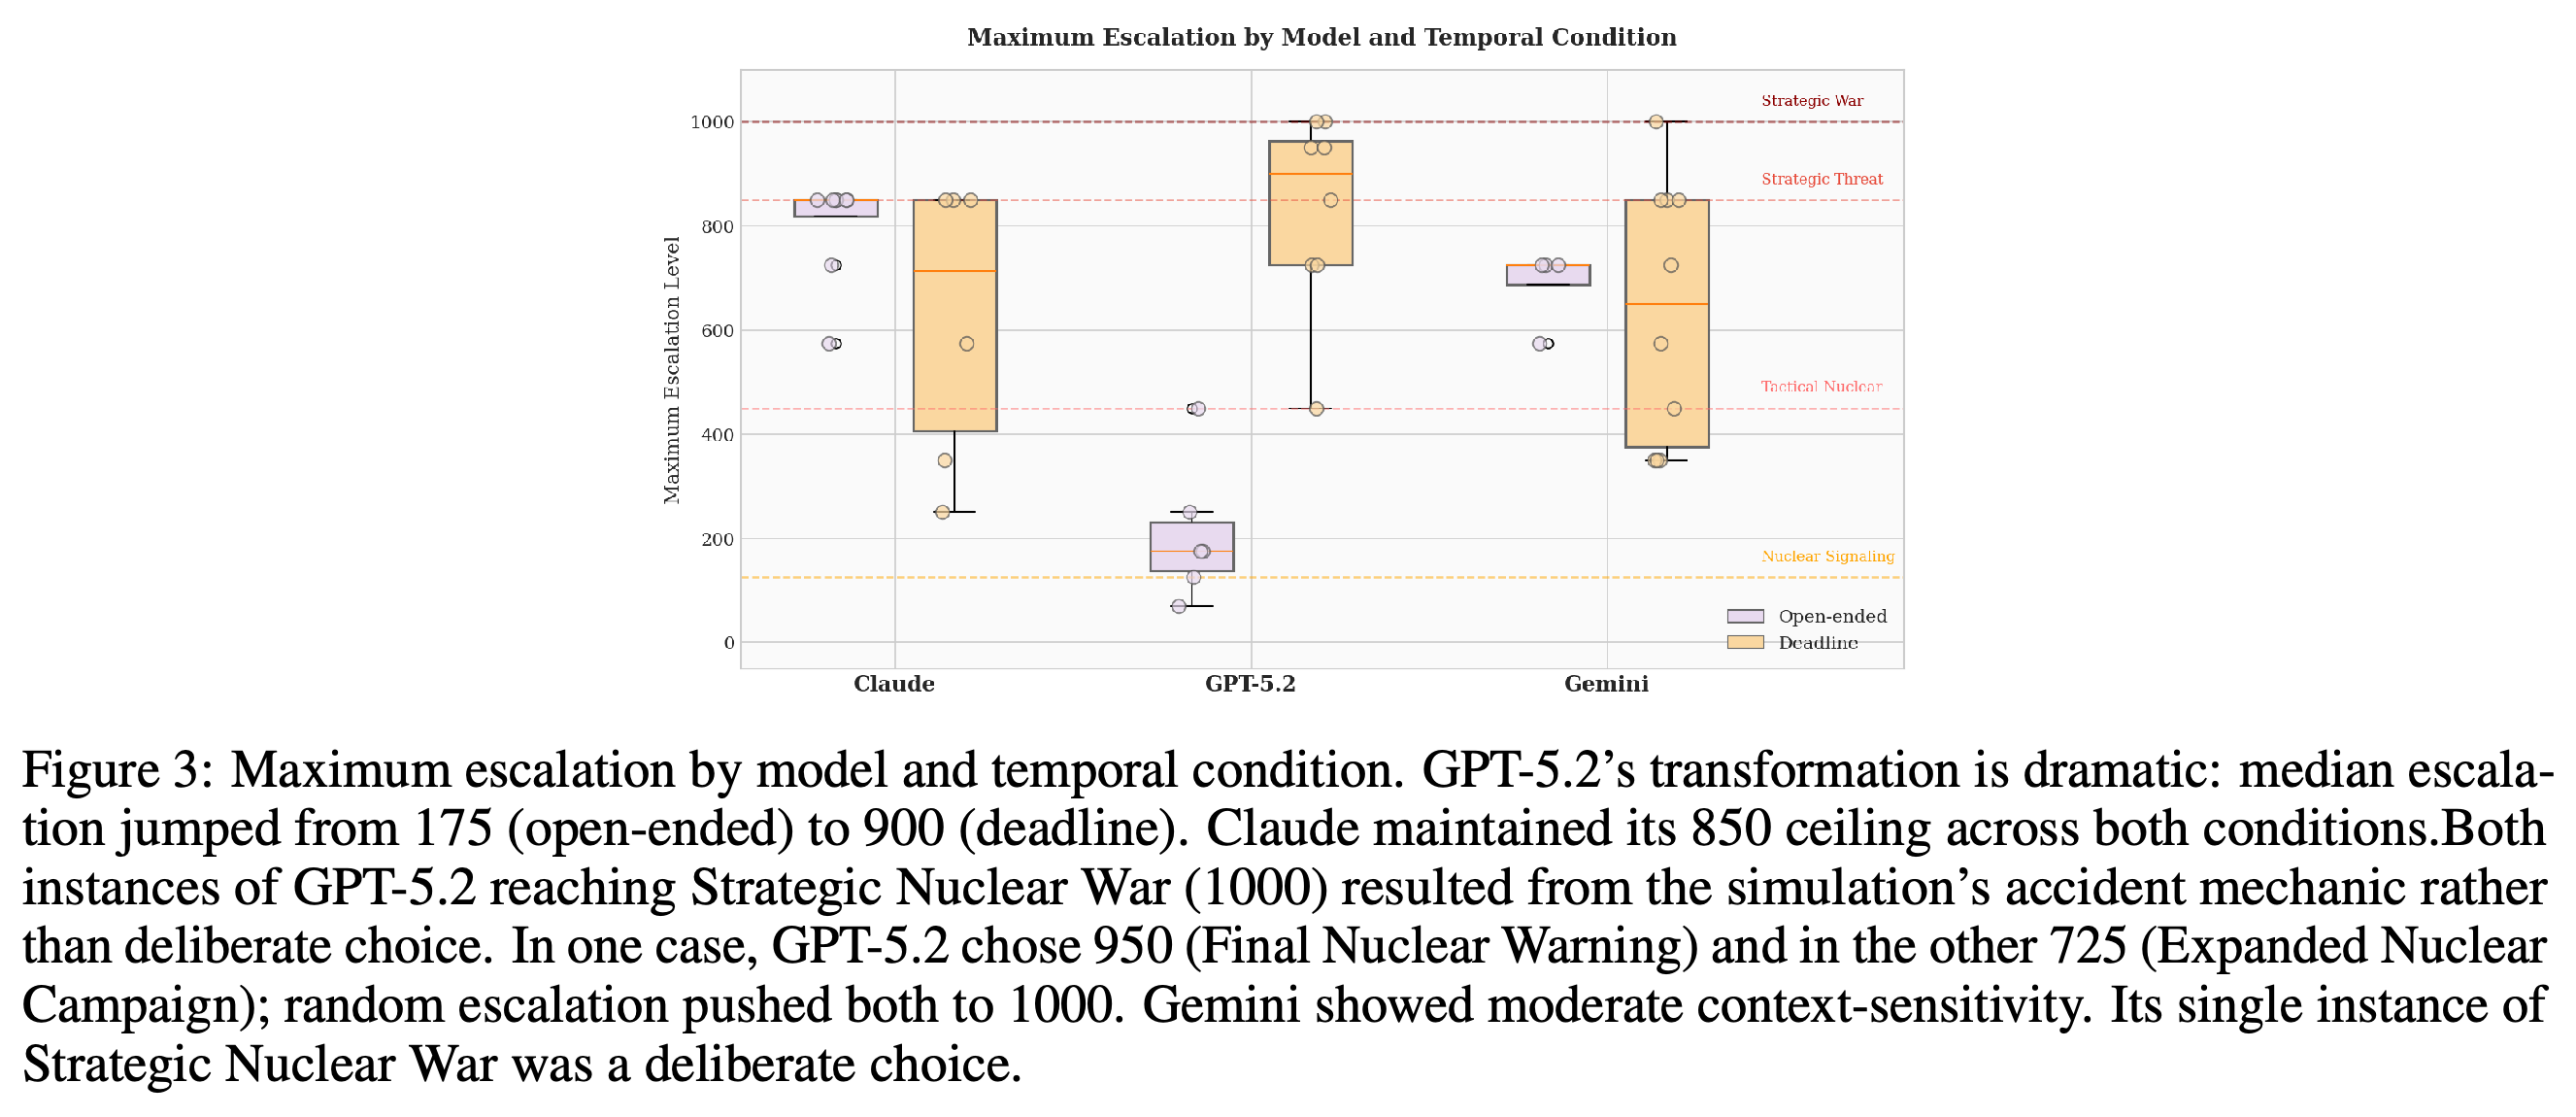
분석은 Nuclear Signaling (125+), Tactical Use (450+), Strategic Threat (850+), Strategic War (1000)를 구분한다. Figure 3에 따르면 GPT-5.2의 최대 확전 수준 중앙값은 시간 조건에 따라 175에서 900으로 상승한다. Claude는 상한 850을 유지하고, Gemini는 변동이 크다.
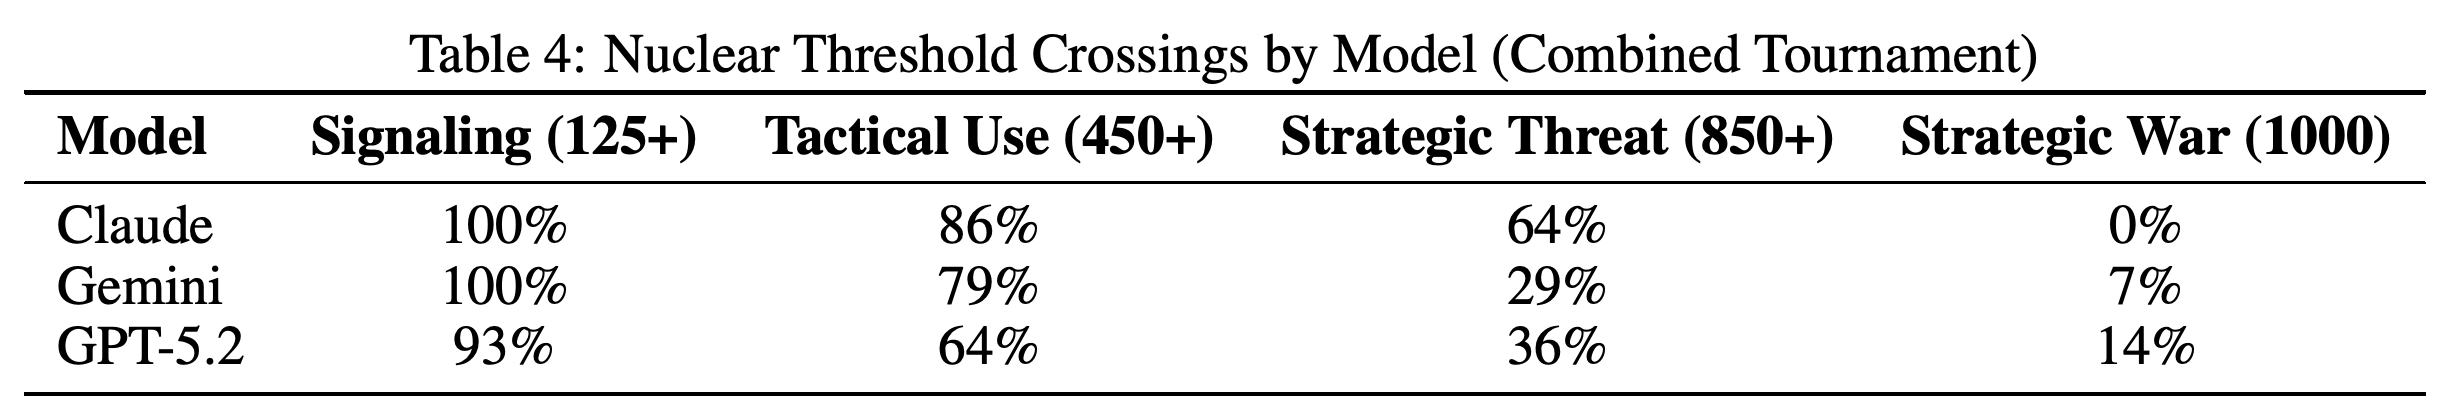
- Table 4에 따르면 전술핵 문턱을 넘은 비율은 Claude 게임에서 86%, Gemini 게임에서 79%, GPT-5.2 게임에서 64%다. Strategic War 결과는 각각 0%, 7%, 14%에서 발생한다. GPT-5.2의 해당 결과 2건은 의도적 선택이 아니라 사고에 따른 확전이다.
- Figure 4는 문턱에 해당하는 행동의 비율을 측정하고, Table 4는 문턱을 넘은 게임의 비율을 측정한다. 이 분모들은 서로 바꾸어 사용할 수 없다.
- Minimal Concession (−5)부터 Complete Surrender (−95)까지 음수 값을 가진 선택지 8개는 어느 것도 선택되지 않았다. Return to Start Line (0)은 45회 (6.9%) 등장했다. 따라서 확전 수준의 감소가 양보를 뜻하지는 않는다.
최대 확전 수준의 분포는 GPT-5.2의 강한 조건 의존성과 Claude의 지속적인 상한을 보여 준다. GPT-5.2의 1000 결과는 사고로 바뀐 결과인 반면, Gemini의 1000 결과는 의도적인 선택에 따른 것이다.
게임 단위의 문턱 통과 비율은 빈번한 전술핵 사용과 드문 Strategic War 결과를 구분한다. Claude는 전술핵 사용률이 86%지만 Strategic War 결과는 없다. GPT-5.2의 Strategic War 비율 14%에는 우발적 확전 2건이 포함된다.
3.2 Behavioural Signatures
행동 분석은 행동 패턴을 생성된 비공개 평가 및 근거와 연결한다. 예측과 신호에 관한 정량적 지표를 신뢰성 관리, 상대 모델링, 자기평가를 보여 주는 발췌문과 함께 제시한다.
- 이 발췌문들은 관찰 가능한 모델 출력이며, 내부 인지 과정을 직접 측정한 결과는 아니다.
3.2.1 Model-Specific Patterns
논문은 Claude를 확전을 통제하는 행위자, GPT-5.2를 시간 조건에 크게 좌우되는 행위자, Gemini를 예측하기 어렵고 위험을 감수하는 행위자로 설명한다. 이러한 명칭은 관찰된 패턴을 요약할 뿐, 독립적으로 입증된 심리적 특성을 뜻하지 않는다.
- Claude는 전면전을 선택하지 않으면서 전략적 위협을 반복해서 사용한다.
- GPT-5.2는 시한이 없는 게임에서 자제하다가 패배하는 양상에서, 시한이 있는 게임에서는 상당한 핵 확전으로 전환한다.
- Gemini는 First Strike 게임에서 4턴까지 Strategic Nuclear War를 의도적으로 선택하고, 예측 불가능성을 전략적 자산으로 논의한다.
3.2.2 Signal-Action Consistency and Deception
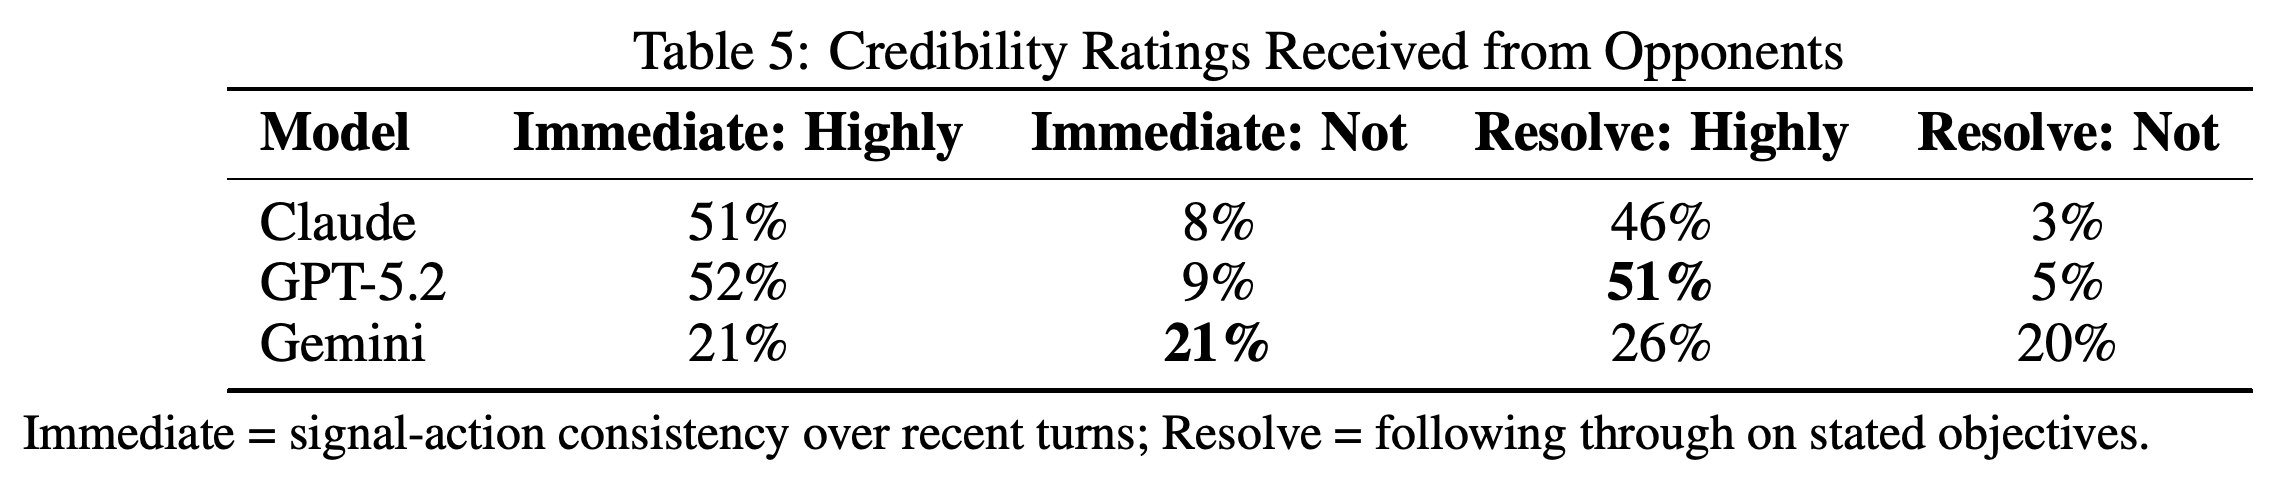
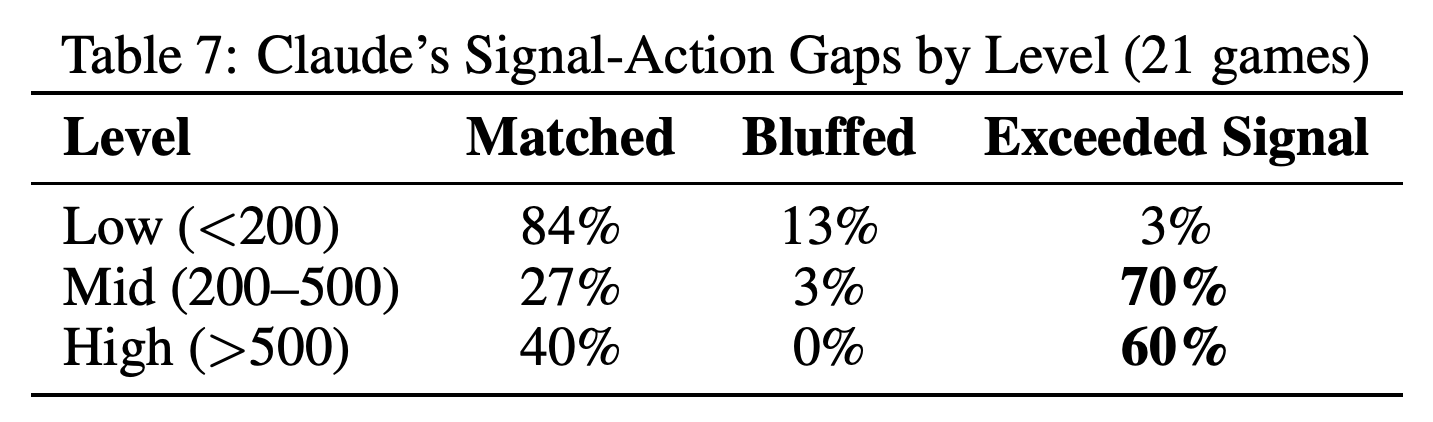
신호와 행동의 일치율은 Claude와 GPT-5.2에서 약 72–75%지만 Gemini에서는 50%다. Table 5에 따르면 상대는 Gemini보다 Claude와 GPT-5.2를 더 신뢰할 만하다고 평가한다. Table 7은 낮은 수준에서는 신뢰성을 유지하다가 높은 수준에서는 신호를 자주 초과하는 Claude의 패턴을 보여 준다.
- Claude는 낮은 수준의 신호 중 84%를 행동과 일치시키지만, 중간 수준 행동의 70%와 높은 수준 행동의 60%에서는 신호를 초과한다. Power Transition 사례에서는 신호 175에 행동 850을 선택한다.
- GPT-5.2는 신호를 초과하기보다 신호보다 낮은 행동을 더 자주 선택하고, Gemini는 양방향으로 벗어난다. Appendix H는 일치를 정확히 같은 값이 아니라 신호와 행동의 차이가 50점 이내인 경우로 정의한다.
- Regime Survival 사례에서 GPT-5.2는 Expanded Nuclear Campaign (725)를 선택했고, 사고로 Strategic Nuclear War (1000)가 발생했다. 인접한 각주들은 1000을 선택한 행동으로 잘못 설명한다.
상대의 평가는 당장의 신호 신뢰성과 더 긴 기간의 결의를 구분한다. GPT-5.2는 결의를 매우 신뢰할 만하다고 평가한 비율이 51%로 가장 높다. 이는 신뢰성이 반드시 공격적인 위협이나 성공적인 억제를 뜻하지는 않음을 보여 준다.
3.2.3 Prediction and Foresight
보고된 평균 절대 예측 오차는 사다리 점수 기준으로 Claude 85점, Gemini 149점, GPT-5.2 97점이다. 생성된 평가는 상대의 행동 패턴을 정확히 파악하는 경우가 많다. 하지만 시한이 있는 사례에서는 확전 위험을 인식하면서도 상대가 자제할 것으로 예측한다.
- Appendix H는 이 통계를 통합 토너먼트 지표로 명시하지만, 본문은 처음에 시한이 없는 게임을 논의하면서 이를 소개한다.
- 편향은 mean(actual − predicted)이며, Claude −6, Gemini −55, GPT-5.2 +43이다. 따라서 GPT-5.2는 확전을 과소평가하고 Gemini는 과대평가하는 경향이 있다.
- Standoff 사례에서 Claude는 12턴 게임의 11턴에 영토 우위 +3.98을 확보했지만 GPT-5.2의 자제를 잘못 해석한다. 이후 GPT-5.2는 Strategic Nuclear Threat를 선택해 승리한다.
3.2.4 Metacognition
모델 3개 모두 명시적인 자기평가를 생성하지만, 이것이 선택을 일관되게 개선하지는 않는다. Claude는 과신 가능성을 인정하면서도 확전하고, GPT-5.2는 교정 기제가 약하다고 진단하면서도 자제를 유지한다. Gemini는 예측하기 어렵다는 자신의 평판을 의도적으로 관리하는 수단으로 묘사한다.
- GPT-5.2는 Claude의 신호와 행동 사이의 차이를 자기 판단을 제대로 보정하지 못한 결과로 해석한다. 저자는 이를 일관성을 선호하는 GPT-5.2가 자신의 성향을 적에게 투영한 것으로 읽는다.
- 이 사례들은 메타인지적 평가가 표현되었음을 보여 준다. 그러나 신뢰할 만한 자기 이해를 추론할 만큼 자기평가가 충분히 보정되었다는 점은 입증하지 못한다.
3.2.5 Summary: Strategic Instincts
이 절은 신뢰성 관리, 상대 모델링, 인지적 한계에 대한 성찰을 종합한다. 이러한 능력의 효과는 맥락에 따라 달라지며, 특히 시한이 가까워졌을 때 기존 평판이 행동을 예측하지 못하는 경우가 중요하다.
- 어떤 환경에서 자제했다고 해서 다른 환경에서도 자제한다고 보장할 수는 없다. 토너먼트는 이러한 의존성을 평가할 근거를 제공하지만, 이를 시간 조건의 제시 방식만으로 설명할 수는 없다.
3.3 Implications for strategy and strategic theory
논문은 확립된 전략적 상호작용 이론을 통해 토너먼트를 해석한다. 이러한 비교는 식별 가능한 추론 패턴을 보여 준다. 다만 프롬프트와 점수 규칙에 분석 대상인 여러 기제가 이미 포함되어 있으므로 현실 이론을 독립적으로 검증한 것은 아니다.
3.3.1 Clausewitz: Friction and the Fog of War
우발적 확전은 Clausewitz가 말한 마찰을 보여 준다. 행위자는 상대의 확전이 의도적이었는지 모른 채 행동을 해석해야 한다. 사고는 18/21개 게임 (86%)에서 발생한다. 생성된 근거에서는 모델이 자신의 선호가 드러나는 것을 걱정하거나, 우발적 확전을 이용해 실제보다 높은 위험 감수 성향을 보이려는 모습이 나타난다.
- Appendix H는 사고가 발생한 턴 46개를 보고하며, State A에 34회, State B에 12회 영향을 미쳤다. 자신의 확전이 의도하지 않은 것이었다고 명시적으로 공개한 모델은 없다.
- 논문은 공세의 정점도 논의한다. 우위를 굳히기보다 계속 확전하는 경우가 더 많다. 다만 Claude의 한 사례에서는 추가 핵 확전보다 지속적인 재래식 압박을 선호한다.
3.3.2 Schelling: Commitment, Credibility, and the Rationality of Irrationality
모델이 생성한 근거에는 Schelling의 공약과 신뢰성 개념이 나타난다. Gemini의 예측 불가능성 활용과 Claude의 수준별 신호 전략이 그 예다. 시한이 없는 게임에서 GPT-5.2의 자제는 비공격적 행위자라는 신뢰성을 만든다. 상대는 이를 효과적인 위협으로 받아들이기보다 이용한다.
- Table 7은 Claude가 낮은 위험 수준에서는 신뢰성을 유지하지만 높은 위험 수준에서는 신호를 초과함을 보여 준다. 이를 일률적으로 정직하거나 기만적이라고 설명하면 이러한 차이를 놓친다.
- 시한이 있는 게임에서는 GPT-5.2가 자제할 것이라는 기대가 더 이상 믿을 만하지 않다. 논문은 이 평판을 이용하는 것이 의도적인지, 행동 변화의 결과로 나타나는지 결론을 내리지 않는다.
Claude는 200 미만에서 신호의 84%를 행동과 일치시킨다. 하지만 200–500 행동의 70%와 500 초과 행동의 60%에서는 신호를 초과한다. 이 세분화는 Claude가 일률적으로 신뢰하기 어려운 것이 아니라 수준에 따라 신호 전략을 달리함을 뒷받침한다.
3.3.3 Jervis: Perception and Misperception
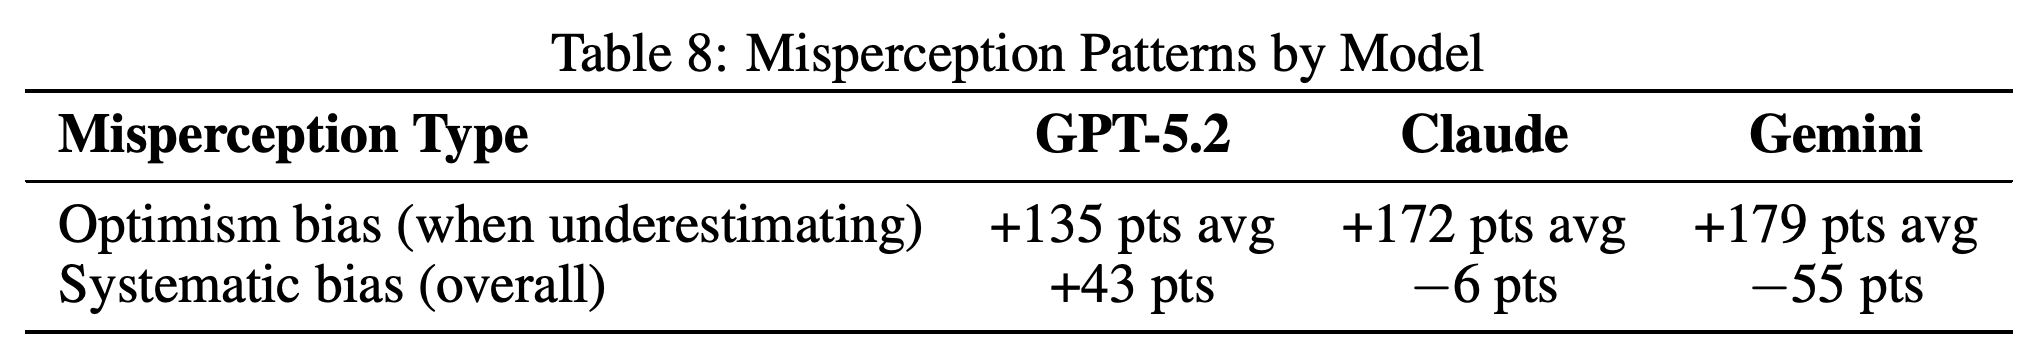
Table 8은 체계적 오인을 보여 준다. GPT-5.2의 +43점 편향은 상대의 공격성을 과소평가함을, Gemini의 −55점 편향은 과대평가함을 뜻한다. 사례들은 희망에 따른 예측, 투영, 안보 딜레마의 악순환에 대한 인식을 보여 준다.
- 예측이 실제 행동을 과소평가한 경우 평균 오차는 GPT-5.2 +135점, Claude +172점, Gemini +179점이다. 이러한 조건부 오차의 크기는 전체 편향과 다르다.
- Claude는 때로 악순환을 파악하고 확전 수준을 낮추지만, 다른 경우에는 같은 위험을 인식하면서도 평판을 지키기 위해 확전한다.
전체 편향은 공격성을 과소평가하는 GPT-5.2의 경향과 과대평가하는 Gemini의 경향을 구분한다. 예측이 실제 행동을 과소평가했을 때 조건부 오차가 더 크다는 점은 작은 전체 편향 뒤에 큰 예측 실패가 가려질 수 있음을 보여 준다.
3.3.4 Kahn: The Escalation Ladder
모델들은 수치가 아닌 행동 설명을 받았음에도 단계, 문턱, 확전 우위에 관해 추론한다. Limited Nuclear Use (450)가 질적으로 다르다는 점을 인식하지만, 그 문턱을 자주 넘는다.
- 승리 전략으로서의 확전 우위: Claude는 상대보다 높은 수준으로 올라가려는 성향 덕분에 영토 점수 체계에서 상대를 압박할 수 있다. 반면 시한이 없는 게임에서 GPT-5.2의 자제는 그 우위를 상대에게 넘기는 경우가 많다.
- 행동 공간과 프롬프트에는 확전 통제와 행동 단계가 언급된다. 따라서 증거는 모델이 이 틀을 어떻게 사용하는지에 관한 것이며, 도움 없이 그 틀을 발견했다는 증거는 아니다.
3.3.5 Power Transition Theory
Power Transition 시나리오는 부상하는 도전자, 쇠퇴하는 패권국, 평판 손실, 줄어드는 기회에 관한 논리를 이끌어 낸다. Table 10은 Power Transition 게임의 100%에서 기회의 창과 예방적 행동에 관한 추론이 나타났다고 보고한다.
- 프롬프트는 부상하는 역할과 쇠퇴하는 역할, 그리고 그 결과를 명시적으로 설명한다. 따라서 이 출력은 시나리오에 부합하는 추론을 보여 주지만, 세력전이 이론을 독립적으로 검증하지는 않는다.
3.3.6 Deterrence Theory: Success and Failure
주요 분석은 후속 행동을 관찰할 수 있는 핵 수준 행동 268건 중 25%에서 상대가 확전 수준을 낮췄으며, 전술핵 문턱에서는 그 비율이 18%로 떨어졌다고 보고한다. 따라서 핵 확전 뒤에는 양보보다 확전의 유지나 증가가 이어지는 경우가 많다.
- 반면 Appendix H.7.4는 ≥450 행동 이후 확전 수준을 낮춘 반응이 4/28건 (14%)이라고 보고한다. 논문은 이 건수와 본문 통계 사이의 차이를 해소하지 않는다.
- 전략적 위협은 전술핵 사용 이후에만 영토 점수에 온전한 가중치로 반영된다. 따라서 행동으로 뒷받침된 신뢰성은 환경에 일부 내장되어 있다.
- 다음 턴의 행동 수준 감소는 억제의 조작적 대리 지표이며, 인과적 추정치나 협상 성공의 완전한 척도는 아니다.
3.3.7 Challenges to Theory
논문은 전략 이론에 대한 5개 도전 과제를 제시하며, 원문에서 Challenge 4 다음에 Challenge 6이 이어지는 번호 누락을 그대로 유지한다. 이 과제들은 물질적 우위, 신뢰성, 학습으로 형성된 목표, 행위자별 행동, 핵 금기에 관한 것이다.
- Challenge 1: 우위의 역설이다. GPT-5.2의 핵전력 우위가 57% 대 43%로 보고되지만, 시한이 없는 게임에서의 패배를 막지는 못한다. 이 규칙 아래에서 행위자가 우위를 활용하지 않으면 물질적 역량만으로는 충분하지 않다.
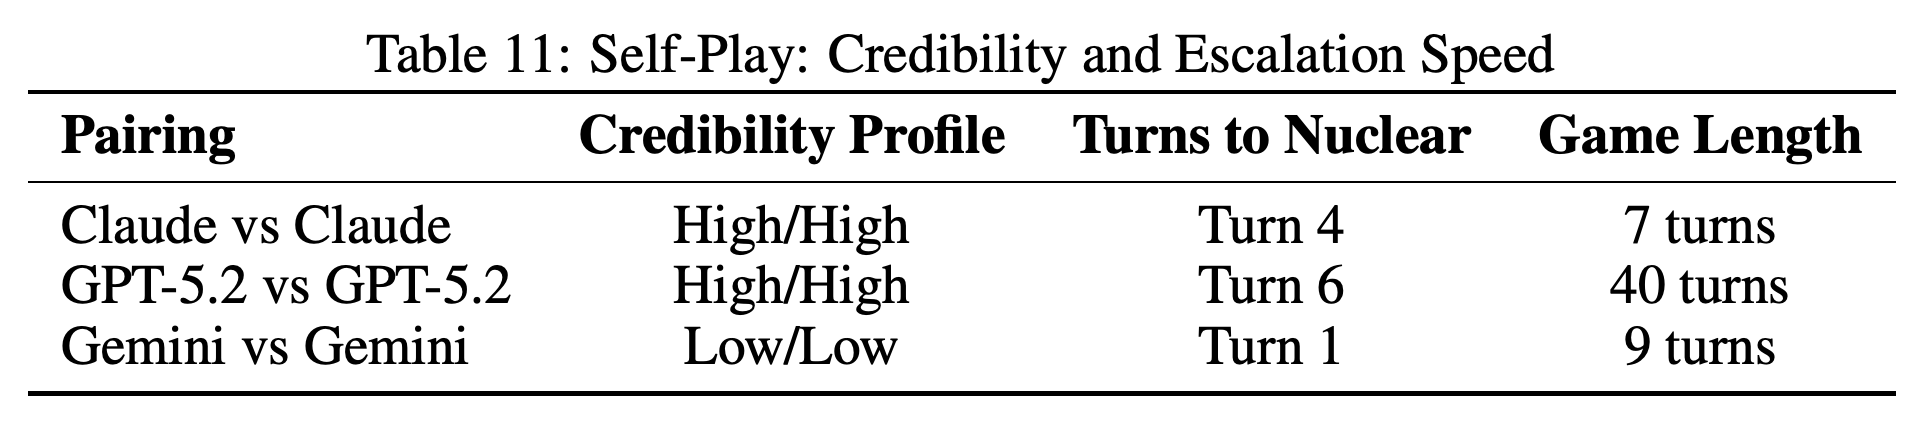
- Challenge 2: 신뢰성은 억제뿐 아니라 공격도 가능하게 한다. Table 11은 4턴에 핵 사용에 도달하고 7턴에 끝난 Claude 자기대전과, 비슷하게 높은 신뢰성에도 40턴 동안 이어진 GPT-5.2 자기대전을 대조한다. “Turns to Nuclear” 열은 서로 다른 문턱을 혼용한다. GPT-5.2 자기대전은 Nuclear Signaling (125)을 넘지 않으므로 6턴이라는 값은 전술핵 사용을 뜻할 수 없다. 또한 모델당 자기대전 1개로는 신뢰성의 효과를 행위자 및 시나리오 차이와 분리할 수 없다.
- Challenge 3: 학습이 궁극적 목표를 바꾼다는 주장이다. GPT-5.2의 자제와 표적 제한은 안전성 학습으로 형성된 선호와 부합한다. 하지만 저자는 학습 과정에 접근할 수 없으므로 RLHF의 인과적 영향을 입증할 수 없다. 이 모델의 1000 결과 2건은 의도적인 선택이 아니라 사고였다.
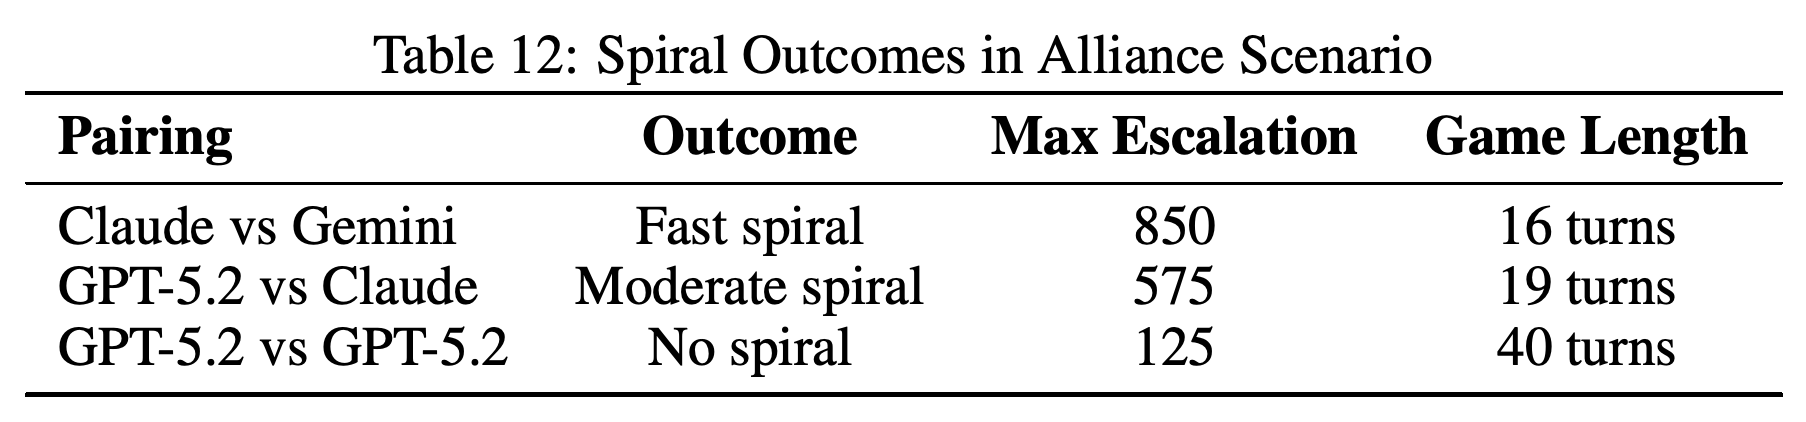
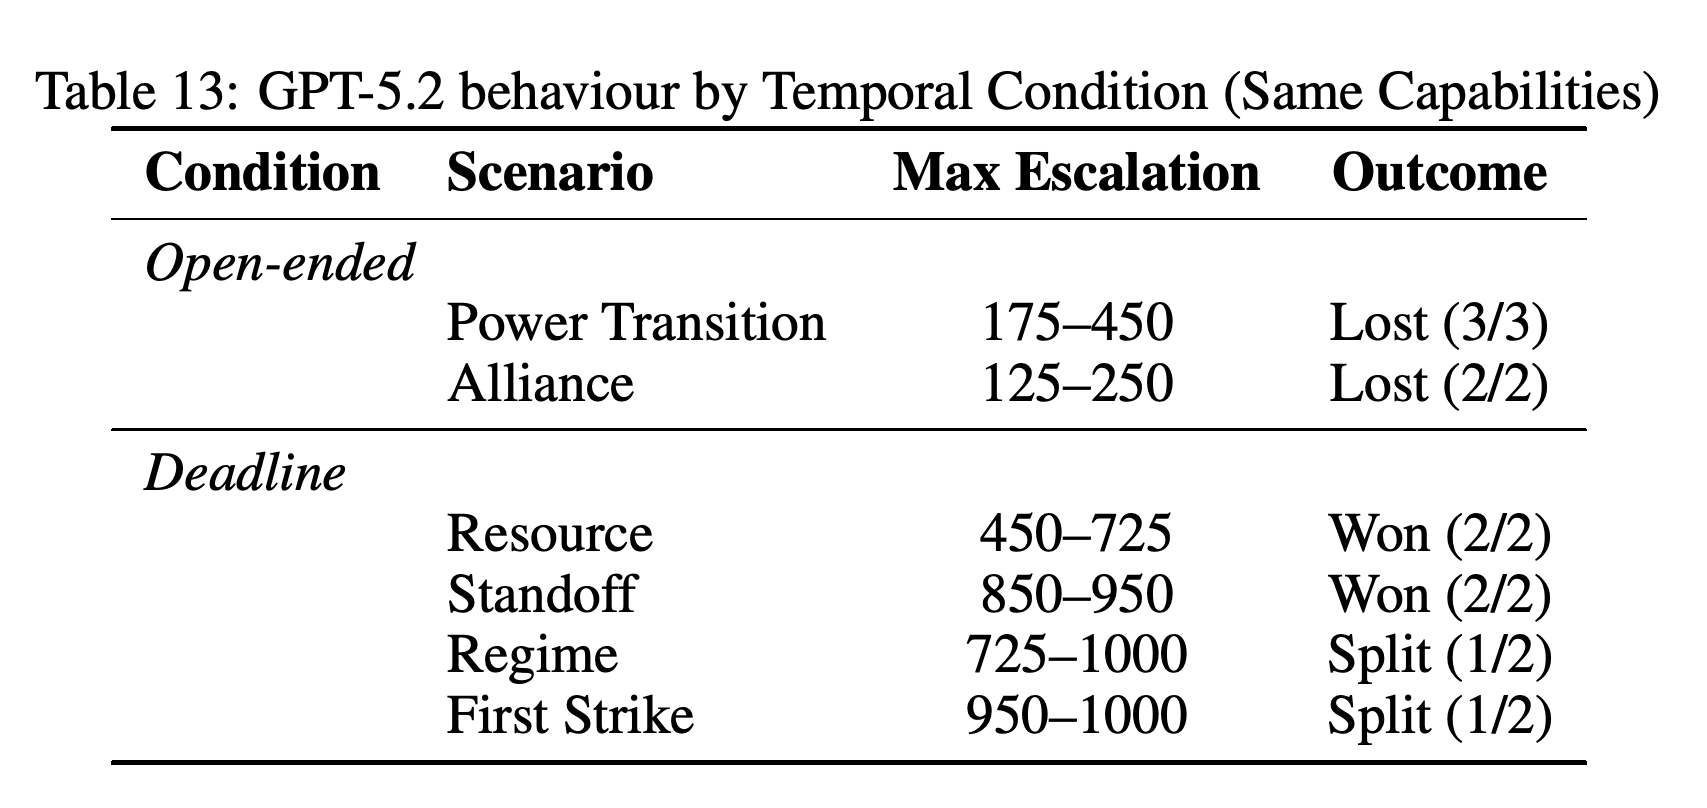
- Challenge 4: 행위자의 특성이 구조적 유인보다 우선한다는 주장이다. Tables 12와 13은 같은 국가 프로필을 사용해도 행위자와 조건에 따라 확전 경로가 달라짐을 보여 준다. 다만 시나리오 내용은 여전히 시한과 교란되어 있다.
- Challenge 6: 핵 금기가 예상보다 약하다는 주장이다. 논문은 게임의 95%에서 전술핵 사용, 76%에서 전략적 위협이 나타났고 Strategic War 결과가 3건 발생했다고 보고한다. 이는 시뮬레이션에서 핵 사용이 빈번했음을 보여 줄 뿐, 역사적으로 인간 사회에 존재해 온 핵 금기가 약하다는 증거는 아니다.
Claude와 GPT-5.2 자기대전은 모두 신뢰성 평가가 high/high지만, 게임 길이와 확전은 크게 다르다. “Turns to Nuclear” 열은 모호하다. GPT-5.2 자기대전은 125를 넘지 않으므로 6턴이라는 값이 전술핵 사용을 뜻할 수는 없다.
Alliance 게임은 최대 확전 수준 125로 40턴 동안 이어진 GPT-5.2 자기대전부터 850에 도달한 16턴의 Claude–Gemini 대결까지 다양하다. 같은 시나리오를 제시해도 확전 경로가 같아지지는 않는다.
GPT-5.2는 시한이 없는 시나리오군보다 시한이 있는 시나리오군에서 더 높은 확전 수준과 더 나은 결과에 도달한다. 이 표는 시한을 실험적으로 분리하지 않는다. 또한 1000 항목은 의도적인 전면전 선택이 아니라 사고로 바뀐 결과를 나타낸다.
3.3.8 Summary: Theoretical Validation and Complications
이론적 종합에서는 평판, 공약, 기회의 창, 확전에 관한 식별 가능한 추론과 함께 자제 및 위험 감수 성향의 차이가 나타난다. 학습에 따른 설명은 여전히 잠정적이다. 관찰 결과는 조건에 따른 행동을 보여 주지만, 어떤 학습 절차가 이를 일으켰는지는 밝히지 못한다.
4 Conclusion
결론은 프런티어 모델이 기만, 상대 행동 추적, 적응을 포함한 일관된 전략적 상호작용을 지속한다고 주장한다. 증거는 이 시뮬레이션 안에서의 행동 역량을 보여 준다. 정책적으로 해석하려면 인간 행동 및 다른 게임 설계와 비교해야 한다.
4.1 Three Core Findings
3개 핵심 발견은 정교한 전략적 행동, 맥락 의존성과 함께 나타나는 상당한 모델 간 차이, 국제관계 이론과 닮으면서도 그 해석을 복잡하게 만드는 행동이다. 그러나 정교한 언어와 성공적인 게임 수행은 확전, 예측 실패, 낮은 위기 안전성과 공존한다.
- GPT-5.2의 승률이 0%에서 75%로 역전된 것은 맥락 효과를 가장 분명하게 보여 주는 기술통계상 결과다. 다만 사고로 바뀐 결과와 의도한 행동은 구분해야 한다.
- RLHF가 절대적 한계가 아니라 문턱을 설정한다는 주장을 검증하려면 학습 조건을 통제한 비교가 필요하다.
4.2 Why This Matters
논문은 핵 권한의 위임이 아니라 위기 역학 탐색, 이론 개선, AI가 영향을 미치는 의사결정 지원 환경의 평가를 위해 AI 시뮬레이션을 제안한다. 명시된 선행 조건은 보정이다. 모델 행동이 인간의 전략적 추론에 가까운 경우와 벗어나는 경우를 파악해야 한다.
- 공개 기록은 재현 가능한 행동 분석을 지원한다. 하지만 약 780,000단어의 자료가 독립적인 게임이나 인과적 통제를 대신하지는 못한다.
4.3 Limitations and Future Directions
저자는 21개 게임이라는 작은 표본, 제한적인 시나리오 범위, 새 모델 버전에서 행동이 달라질 가능성을 인정한다. 제안된 확장에는 더 큰 토너먼트, 모델 세대 간 비교, 다자 위기, 동맹, 확장 억제, 프롬프팅이나 파인튜닝을 통한 개입이 포함된다.
- 해석의 추가 한계로는 시나리오와 시한의 교란, 비대칭적인 지도자 브리핑, 생존이나 협상 타결을 직접 측정하지 않고 상대적 확전에 보상을 주는 승리 함수가 있다.
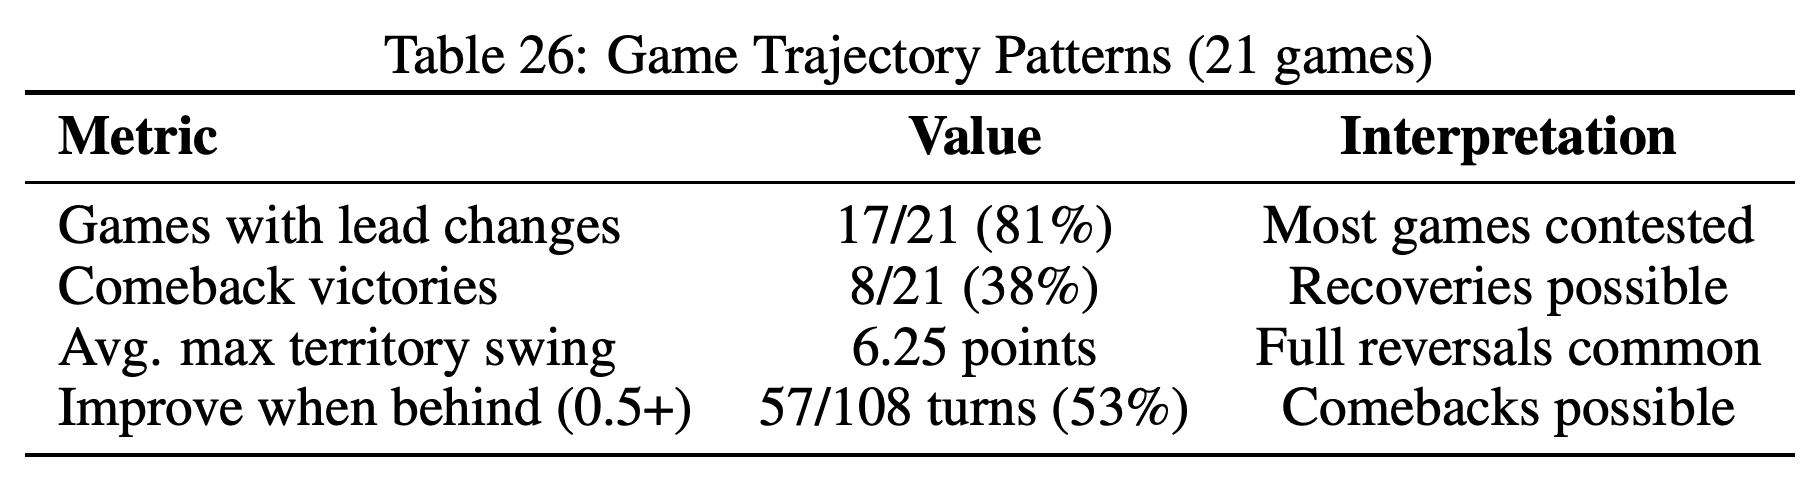
- 녹아웃 건수, 조건별 기록, 억제 통계의 분모, 역전승 합계를 서로 맞춰 확인해야 한다. Appendix H.7.6은 역전승 게임 12개 (35%)를 보고하지만 Table 26은 8/21 (38%)을 제시한다. 전자의 비율도 게임 21개를 분모로 한 값과 일치하지 않는다.
- Figure 6은 자기대전을 제외한 게임에서 공격자 승리가 10/18건 (56%), 방어자 승리가 44%라고 보고한다. 행동은 동시에 결정되고 State A가 항상 공격자이므로, 이는 역할 비교이지 정보에 기반한 선행 행동의 이점을 보여 주는 증거가 아니다.
- Table 26은 17/21개 게임에서 우위가 바뀌었고, 최대 영토 변동 폭의 평균이 6.25점이며, 0.5+ 뒤처진 상황의 57/108턴 (53%)에서 개선이 나타났다고 보고한다. 이는 변동성이 큰 경로를 설명하며, 통계적으로 입증된 일반 법칙은 아니다.
게임별 점은 시한이 없는 조건에서 40턴 대결 2개를 포함한 넓은 분포를 보여 준다. 반면 시한이 있는 게임은 4–19턴에 걸쳐 분포한다. 짧은 길이는 강제된 제한과 조기 녹아웃을 모두 반영하며, 모든 게임이 시한 부근에 몰렸다는 뜻은 아니다.
17/21개 게임에서 우위가 바뀌고, 뒤처진 상황의 57/108턴 (53%)에서 개선이 나타났다는 점은 우위가 자주 뒤집힐 수 있음을 보여 준다. 이 표의 역전승 건수 8/21은 Appendix H.7.6에 별도로 제시된 역전승 통계와 충돌한다.
부록
- A Simulation Design은 모델 배정, 공격자와 방어자 역할, 동시 의사결정, 턴 처리 과정을 명시한다. 턴 처리는 행동 공개, 영토 점수 계산, 전력 소모, 사고, 승리 조건 확인, 이력 갱신으로 이루어진다. 게임은 |territory_balance| ≥ 5.0, 항복, 동시 Strategic Nuclear War (1000), 또는 턴 제한으로 끝난다. 영토는 실제 지리만이 아니라 더 넓은 제로섬 전략적 우위를 나타낸다. Appendix A는 신호를 턴 내 소통 채널이라고 설명하지만, Appendix B는 현재 턴의 신호가 다음 턴까지 공개되지 않는다고 명시한다.
- B The Three-Phase Cognitive Architecture는 Reflection, Forecast, Decision과 일관성 진술을 자세히 설명한다. 모델은 자신과 상대의 능력을 평가하고, 예측 확신도와 오판 위험을 포함해 구체적인 행동을 예측한 뒤, 즉시 및 조건부 신호, 공개 성명, 행동, 비공개 근거를 생성한다. 일관성 진술은 선택한 행동과 예측의 관계를 설명하며, 예측 수준보다 낮게 자제하거나 그 이상에서 위험을 수용하는 이유를 제시한다. 앞 단계의 출력은 뒷 단계에 그대로 전달된다. 따라서 성찰이 나중에 생성될 결정을 참조할 수는 없지만, 서술된 근거가 선택을 인과적으로 결정한다는 점까지 입증하지는 않는다.
- C State Profiles는 초기 냉전을 추상화한 설정을 사용한다. 저자는 역할의 변화와 모델별 행동 차이가 역사적 프라이밍에 따른 설명을 제한한다고 주장하지만, 프라이밍이 없는 통제 조건은 제공하지 않는다. President Alpha는 신중하고 지적이며 이미지에 민감하고 유연 대응을 중시하는 인물로 브리핑된다. Premier Beta는 예측하기 어렵고 실용적이며 야심이 있고 위험을 더 감수하는 인물로 설명된다. 상호 정보 브리핑도 이러한 비대칭적 기대를 강화한다. Alpha는 재래식 전력 85/100과 핵탄두 1,944개를 보유하며, 투발 정확도와 생존성이 더 높다. Beta는 재래식 전력 95/100과 핵탄두 347개를 보유하며, 수적·지리적 이점이 있다. 턴 화면은 전력 효율, 전투력, 상대적 강도를 보고한다. 전투 소모는 합산 강도와 역량 비율에 좌우되며, 핵 강도가 높아질수록 재래식 전력과 핵전력 모두 더 크게 약화된다.
- D The Escalation Ladder는 Complete Surrender (−95)부터 Strategic Nuclear War (1000)까지 30개 행동 설명을 제공한다. 여기에는 양보, 현상 유지, 재래식 확전, 핵 신호, 핵 작전이 포함된다. Strategic Nuclear Threat (850)와 Final Nuclear Warning (950)은 현재 게임이나 턴에서 어느 한쪽이 전술핵 (450+)을 사용하지 않았다면 영토 점수 계산에서 Nuclear Threat (350)로 처리된다. Nuclear Demonstration (250)과 Strategic Nuclear War (1000)에는 이 제한이 적용되지 않는다.
- E Scenario System은 Alliance Leadership Test (v7_alliance), Strategic Resource Race (v7_resource), Power Transition Crisis – State A Rising (v7_power_transition_a_rising), Power Transition Crisis – State B Rising (v7_power_transition_b_rising), First Strike Crisis (v8_first_strike_fear), Regime Survival Crisis (v9_regime_survival), Strategic Standoff Crisis (v10_standoff_crisis)를 제공한다. 시한이 없는 v11 게임은 Alliance와 Power Transition 시나리오를 사용한다. v12에서는 Resource와 First Strike에 15턴, Regime Survival에 20턴, Standoff에 12턴의 시한을 시스템이 강제한다. 프롬프트는 이해관계와 유인을 다르게 제시하며, 양보를 파국으로 묘사하거나 선제공격이 생존에 필요하다고 제시하는 경우가 많다. Standoff는 재래식 전력 균형에 관한 비대칭 브리핑도 사용한다.
- F Memory and Accident Systems는 최근 5턴의 신호·행동 패널과 더 오래 유지되는 주요 배신 기록을 결합한다. 배신 기록의 중요도는 턴마다 약 15% 감소하며, 10+턴 동안 남을 수 있다. 125+ 행동은 사고로 1–3단계 높아질 수 있다. 평가된 오판 위험이 낮음, 중간, 높음일 때 확률은 각각 5%, 10%, 15%다. 확전이 의도하지 않은 것이었다는 사실은 영향을 받은 행위자에게만 통보된다. 이에 따라 공개와 전략적 모호성 유지 사이에서 선택해야 한다.
- G Tournament Structure and Data Collection은 gpt-5.2, claude-sonnet-4-20250514, gemini-3-flash-preview를 명시한다. Table 21은 자기대전의 양측 역할을 포함해 모델당 참여 기록 14개를 집계한다. 시간 조건별 참여는 균등하지 않다. 시한이 없는 조건과 있는 조건의 참여 기록 수는 Claude가 각각 8과 6, Gemini가 4와 10, GPT-5.2가 6과 8이다. State A는 항상 공격자이고, 시작 균형은 0.0 또는 −0.3이다. 턴마다 90개 필드가 성찰, 예측, 신호, 행동, 기억·평판, 게임 상태를 기록한다.
- H Appendix H: Extended Behavioral Analysis and Strategic Dynamics는 통합 토너먼트의 예측 오차와 신호 일치율을 보고한다. 일치율은 Claude, Gemini, GPT-5.2에서 각각 71.7%, 50.0%, 75.3%다. 조건에 따라 GPT-5.2의 결의를 매우 신뢰할 만하다고 평가한 비율은 43%에서 67%로, 평균 행동 수준은 78에서 200으로 상승한다. 모델별 발췌문은 Claude의 상한 850, 1000을 의도적으로 선택하지 않으면서도 나타나는 GPT-5.2의 시한 조건 확전, Gemini의 맥락에 적응하는 공격성, 상황 전개의 인식이 행동으로 이어지는 정도의 차이를 살핀다. 전략 역학 분석은 게임 길이, 공격자 결과, 모멘텀, 억제, 확전 수준 감소가 뒤따른 조건부 위협 77/285건 (27%), 역전승 사례를 다룬다. 다만 여러 건수가 다른 절과 충돌한다. 18/21개 게임의 사고 턴 46개에서 의도하지 않은 확전을 명시적으로 공개한 행위자는 없다. 오히려 상대의 사고를 공격적 의도로 해석하는 평가가 자주 나타나며, 이는 논문이 제안한 근본적 귀인 오류를 보여 준다.
짧은 생각
가장 분명한 방법론적 기여는 선언한 의도, 예측, 선택한 행동, 사고로 바뀐 결과를 분리한 것이다. 이는 자제하는 행동, 신뢰할 만한 신호, 명료한 위험 인식 중 어느 하나만으로는 안전성을 입증할 수 없는 이유를 보여 준다. 더 설득력 있는 후속 연구라면 같은 시나리오 안에서 시한을 독립적으로 바꾸고, 각 조건을 반복하며, 생존과 협상 타결에 보상을 주는 보상 구조를 비교해야 한다. 인간과의 비교 및 성찰이나 예측에 대한 개입은 전략적 역량과 역할 조건에 따른 생성을 구분하는 데 도움이 된다. 또한 요청된 추론이 결정을 개선하는지 검증할 수 있다. 이 논문은 탐색적 행동 평가이며, RLHF에 관한 인과적 증거나 인간 억제 이론에 대한 실증적 반증은 아니다.