


PTXBench: Benchmark and Adapt LLMs for GPU Kernel Optimization with Architecture-specific PTX 요약 설명
18 Aug 2026 | Paper Review GPU Kernel Optimization PTX LLM Evaluation Supervised Fine-Tuning목차
- 요약
- 1 Introduction
- 2 PTXBench
- 3 Adapting LLMs to Architecture-Specific PTX Programming
- 4 Benchmark Results
- 5 Adaptation Results
- 6 Related Work
- 7 Limitations
- 8 Conclusion
- 부록
- 짧은 생각
이번 글에서는 PTXBench: Benchmark and Adapt LLMs for GPU Kernel Optimization with Architecture-specific PTX 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 18일(Arxiv)
- Zhang, Genghan, Dong, Yixin, Fan, Chengze, Zeng, Zhichen, Yuan, Yueming, Zhu, Shaowei, Olukotun, Kunle.
- Stanford University, Carnegie Mellon University, RadixArk, Independent Researcher
- 논문 링크
- Github
- Project Page
요약
- PTXBench는 LLM이 인라인 아키텍처별 PTX를 포함한 CUDA 커널을 생성하여 기능적으로 정확하고, 요청된 명령어 패밀리를 동적으로 실행하며, cuBLAS, cuDNN 또는 FlashInfer 대비 지연 시간을 개선할 수 있는지 평가한다. NVIDIA H100 및 B200 GPU에서 GEMM과 attention 워크로드를 다룬다.
- 결과는 유효한 PTX 생성, 런타임 명령어 실행, 경쟁력 있는 성능을 구분한다. repair-conditioned LoRA SFT는 여러 작업에서 Qwen3.6-27B를 개선하지만, 전이 성능은 여전히 고르지 않으며 데이터 범위, 균형, reasoning teacher에 좌우된다.
1 Introduction
논문은 이식 가능한 CUDA와 고수준 커널 언어가 즉시 노출하지 않을 수 있는 GPU 메커니즘을 활용하는 수단으로 직접 PTX 프로그래밍을 제시한다. PTXBench는 종단 간 커널 벤치마크와 달리 대상 GPU와 명령어 패밀리를 고정하고, 생성 소스에서 cuDNN 및 cuBLAS 헤더를 금지하며, 요청된 저수준 메커니즘이 실제로 실행되는지 검증한다.
2 PTXBench
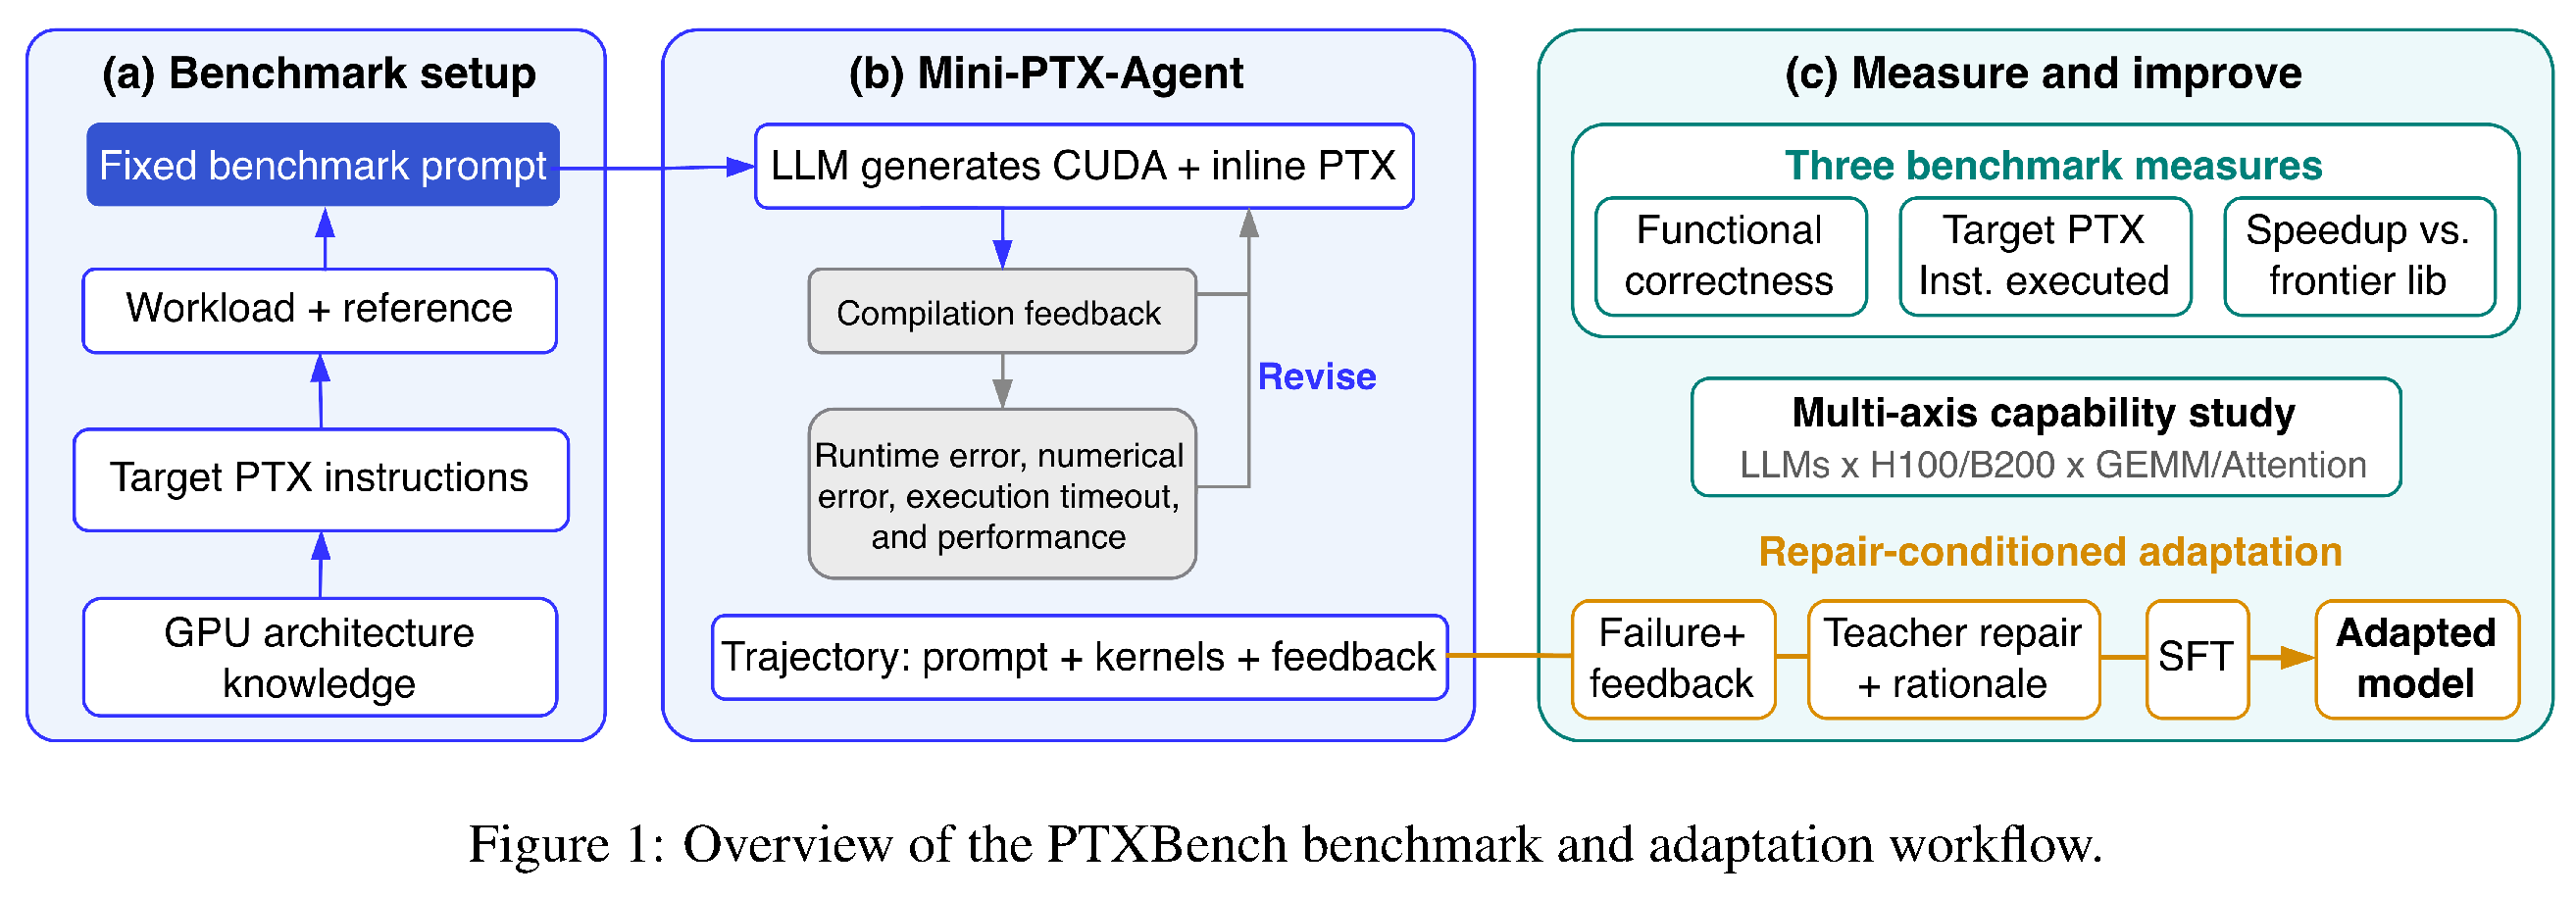
PTXBench는 고정된 워크로드와 frontier-library 참조 구현을 대상 아키텍처 및 필수 PTX 명령어 패밀리와 결합한다. FlashInfer-Trace로 워크로드, 해법, 검사를 표현하고, MiniPTXAgent로 CUDA–PTX 커널을 생성, 실행, 반복 수정한다.
이 workflow는 통제된 역량 평가와 적응을 분리한다. 고정된 아키텍처 지식과 필수 명령어 패밀리가 multi-turn CUDA–PTX agent에 입력되고, 컴파일 및 런타임 피드백이 수정을 지원한다. 성공적인 repair trajectory는 SFT용 repair-and-rationale supervision을 제공할 수 있다.
2.1 Benchmark Tasks and Controlled Context
모든 trajectory는 동일한 아키텍처별 지식 패키지를 받는다. 이 패키지에는 아키텍처 파라미터, PTX 명령어용 CUDA wrapper, 레이아웃, 동기화 및 메모리 일관성 계약, 그리고 정립된 연산자의 경우 전문가가 검증한 스케줄링 원칙이 포함된다. 이 패키지는 20k–30k tokens이므로, 벤치마크는 검색을 모델 역량으로 간주하지 않고 문서 검색 조건을 통제한다.
2.2 Multi-turn Evaluation Protocol
MiniPTXAgent는 nvcc로 후보를 컴파일한 뒤, 컴파일에 성공한 후보를 격리된 profiling service로 보내 메모리 안전성 검사, 기능 평가, 진단, 시간 측정을 수행한다. 대상 명령어 정확성은 수치적 정확성과 동적 실행을 모두 요구한다. 정적 SASS 검사는 적격 패밀리를 식별하고, Nsight Compute는 평가 워크로드에서 predicate-enabled thread count가 양수임을 보고해야 한다.
3 Adapting LLMs to Architecture-Specific PTX Programming
Fixit은 적응 전 모델이 생성한 실패 사례로부터 SFT 예제를 구성한다. 실패한 커널과 실행 피드백이 주어지면 repair teacher가 정확성 필터를 통과한 수정을 제공하고 reasoning teacher가 근거를 생성한다. student는 원래 문제, 실패 커널, 피드백을 조건으로 하며, 근거와 수정된 커널을 supervision으로 받는다.
4 Benchmark Results
벤치마크는 turn-level 기능 정확성, 대상 명령어 정확성, 정확한 커널 중 최고 speedup, 선택한 명령어를 실행하는 정확한 커널 중 최고 speedup을 보고한다. 결과는 세 개의 prompt variant와 각 variant의 여덟 턴 trajectory를 평균한 값이며(N = 32), GEMM에는 cuBLAS v13.1.0, 대부분의 attention 작업에는 cuDNN v9.20.0, GQA에는 FlashInfer v0.6.14를 사용한다.
4.1 Evaluation Metrics and Baselines
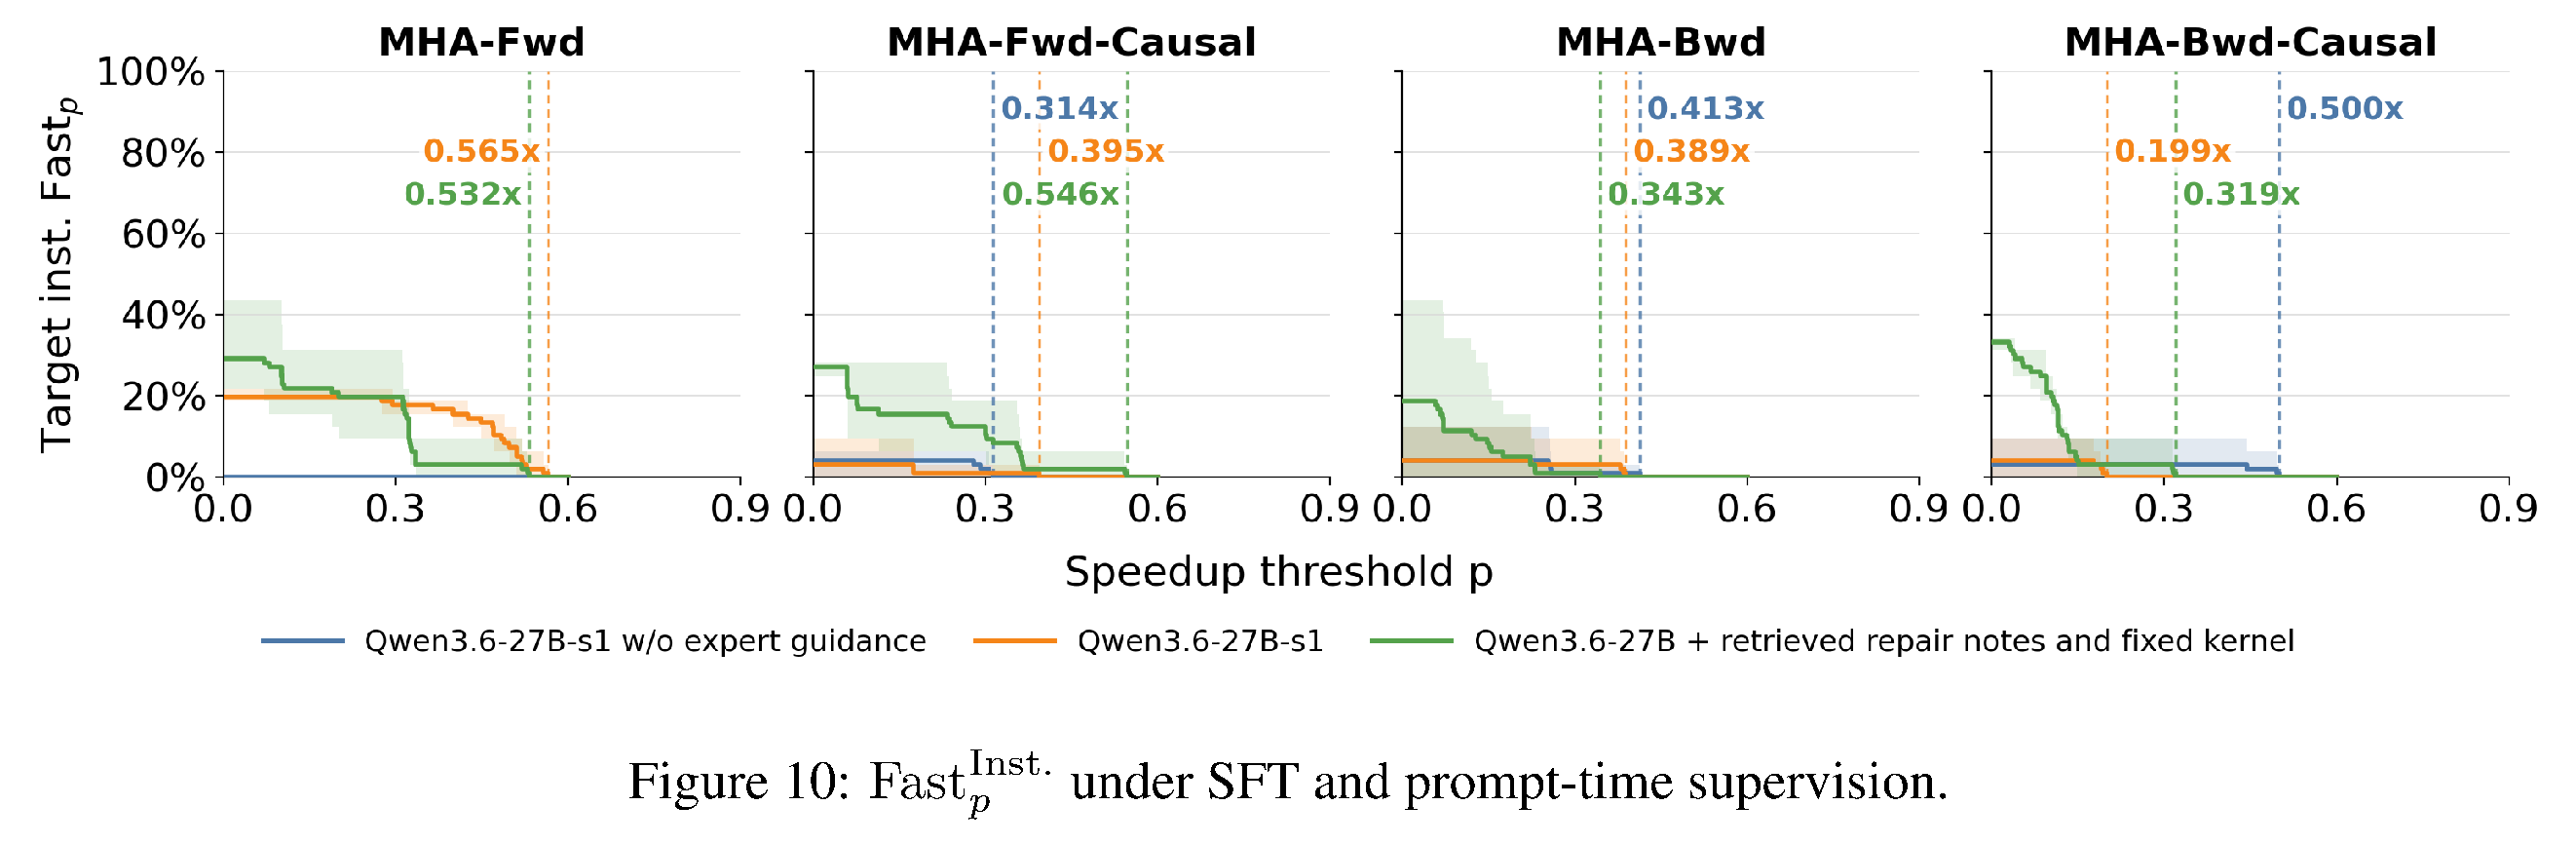
Fast_p는 모든 turn 중 임계값 p보다 빠른 정확한 커널을 생성한 비율이며, FastInst._p는 여기에 선택된 대상 명령어의 런타임 실행 조건을 추가한다. 기능 검사는 출력 shape와 dtype을 확인하고 atol=rtol=1e-2로 torch.allclose를 사용한다. 지연 시간은 10회 warmup 후 50회 측정 반복의 중앙값이다.
4.2 Architecture-Specific PTX Capability Remains Uneven
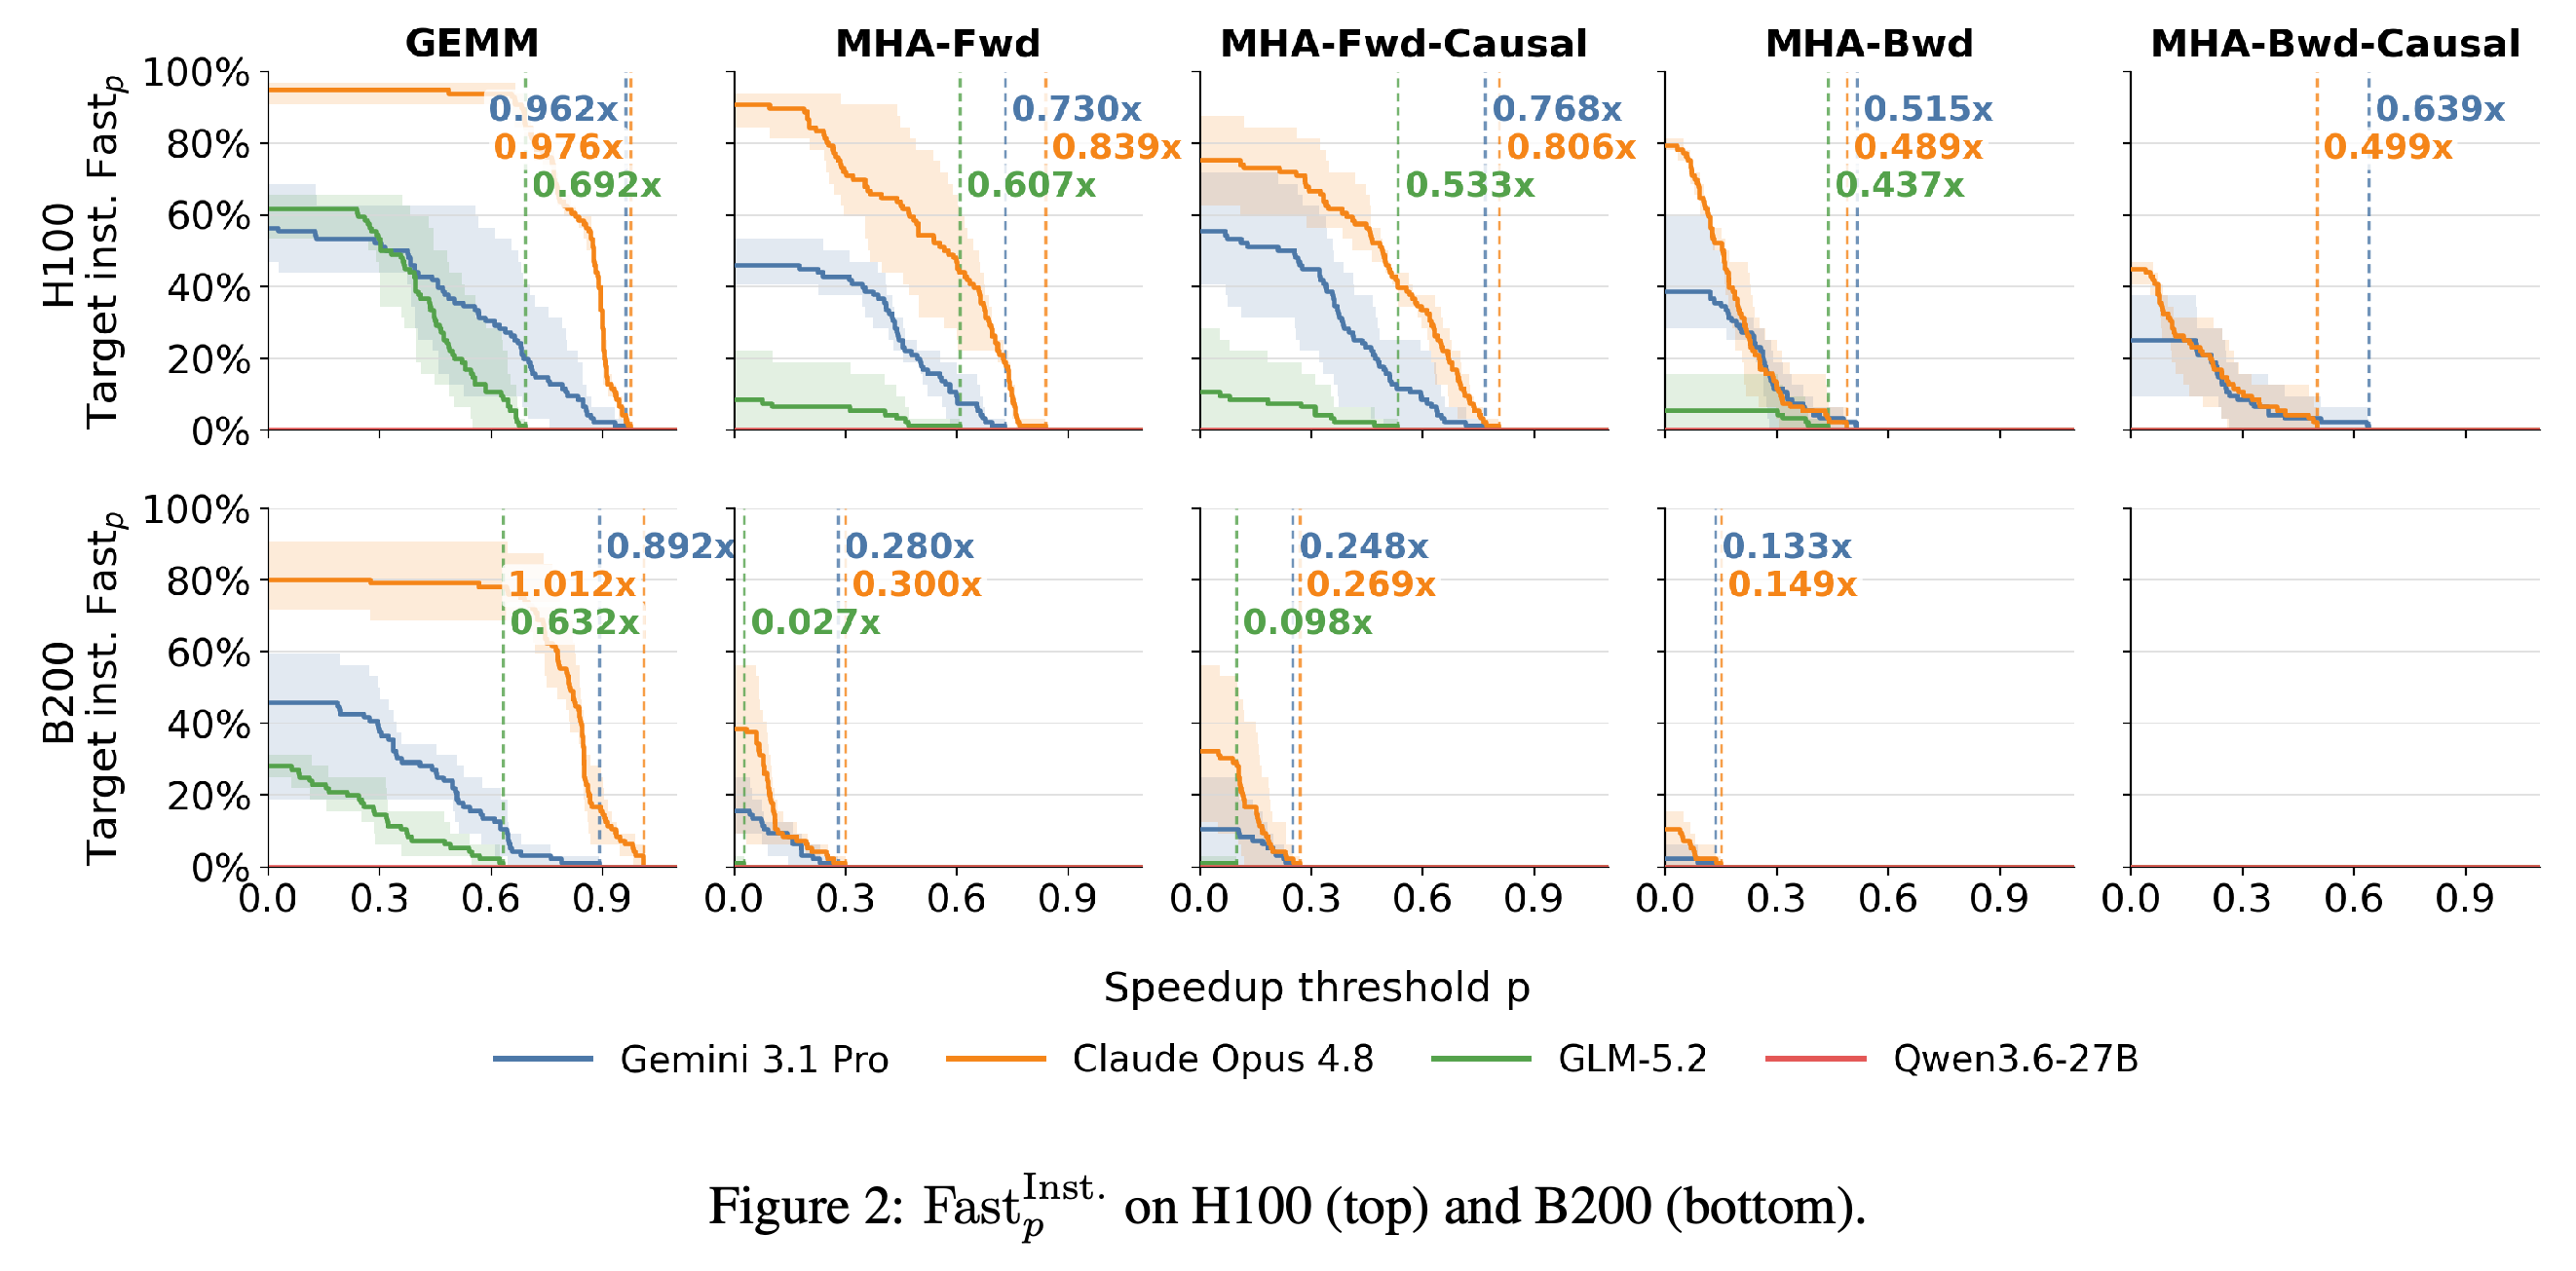
역량은 워크로드와 아키텍처에 크게 의존한다. Claude Opus 4.8은 대상 명령어 실행 조건에서 B200 GEMM에서 cuBLAS 대비 1.012×에 도달하지만, 평가한 어떤 모델도 frontier library와 일관되게 대등하지 않다. B200에서 Claude의 대상 명령어 최고 speedup은 MHA-Fwd에서 0.300×, causal MHA-Fwd에서 0.269×, MHA-Bwd에서 0.149×이며, 적격한 causal-backward 결과는 없다.
대상 명령어 FastInst._p 곡선은 성능 조건을 만족하는 성공이 GEMM과 forward attention에서 backward attention으로 갈수록 감소하며, 특히 B200에서 그러함을 보여 준다. Claude Opus 4.8은 표시된 B200 GEMM 최고 성능 1.012×를 기록하지만, 적격 attention 커널은 여전히 드물고 frontier baseline보다 느리다.
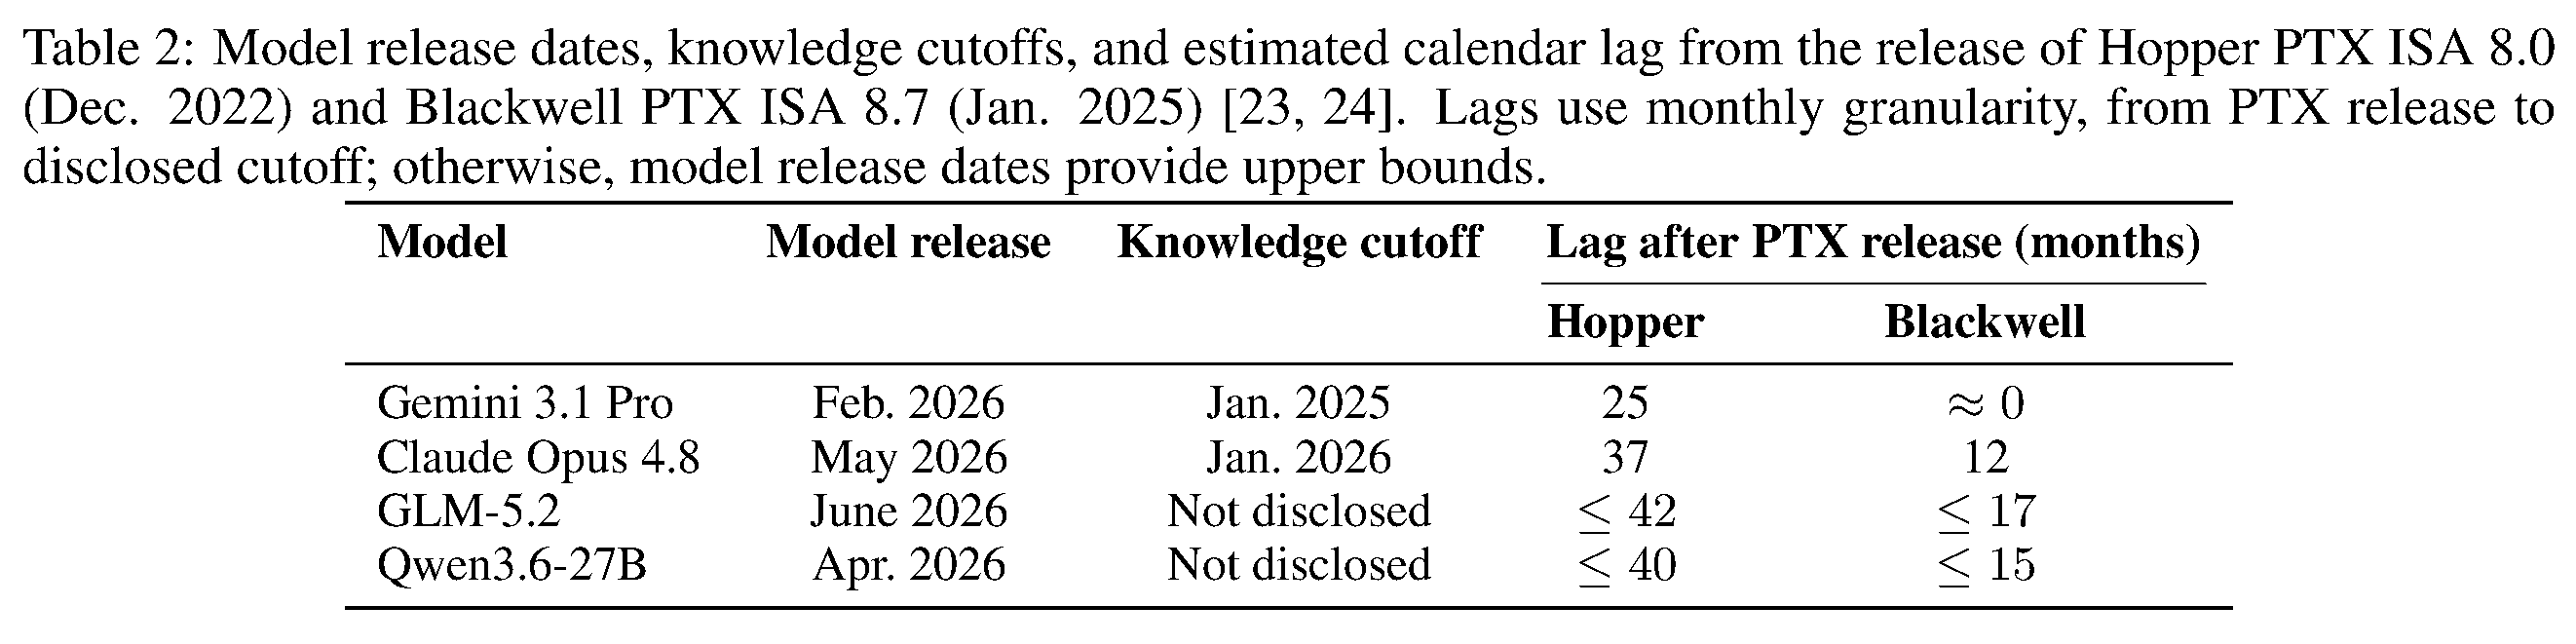
표는 Hopper PTX ISA 8.0 및 Blackwell PTX ISA 8.7과 비교한 평가 모델의 출시일과 공개된 knowledge cutoff를 맥락화한다. 이 날짜는 Blackwell별 지식 가용성이 직접 PTX 역량에 영향을 줄 가능성을 뒷받침하지만 인과관계를 확립하지는 않는다.
4.3 High-Level Kernel Languages Remain Valuable on New Architectures
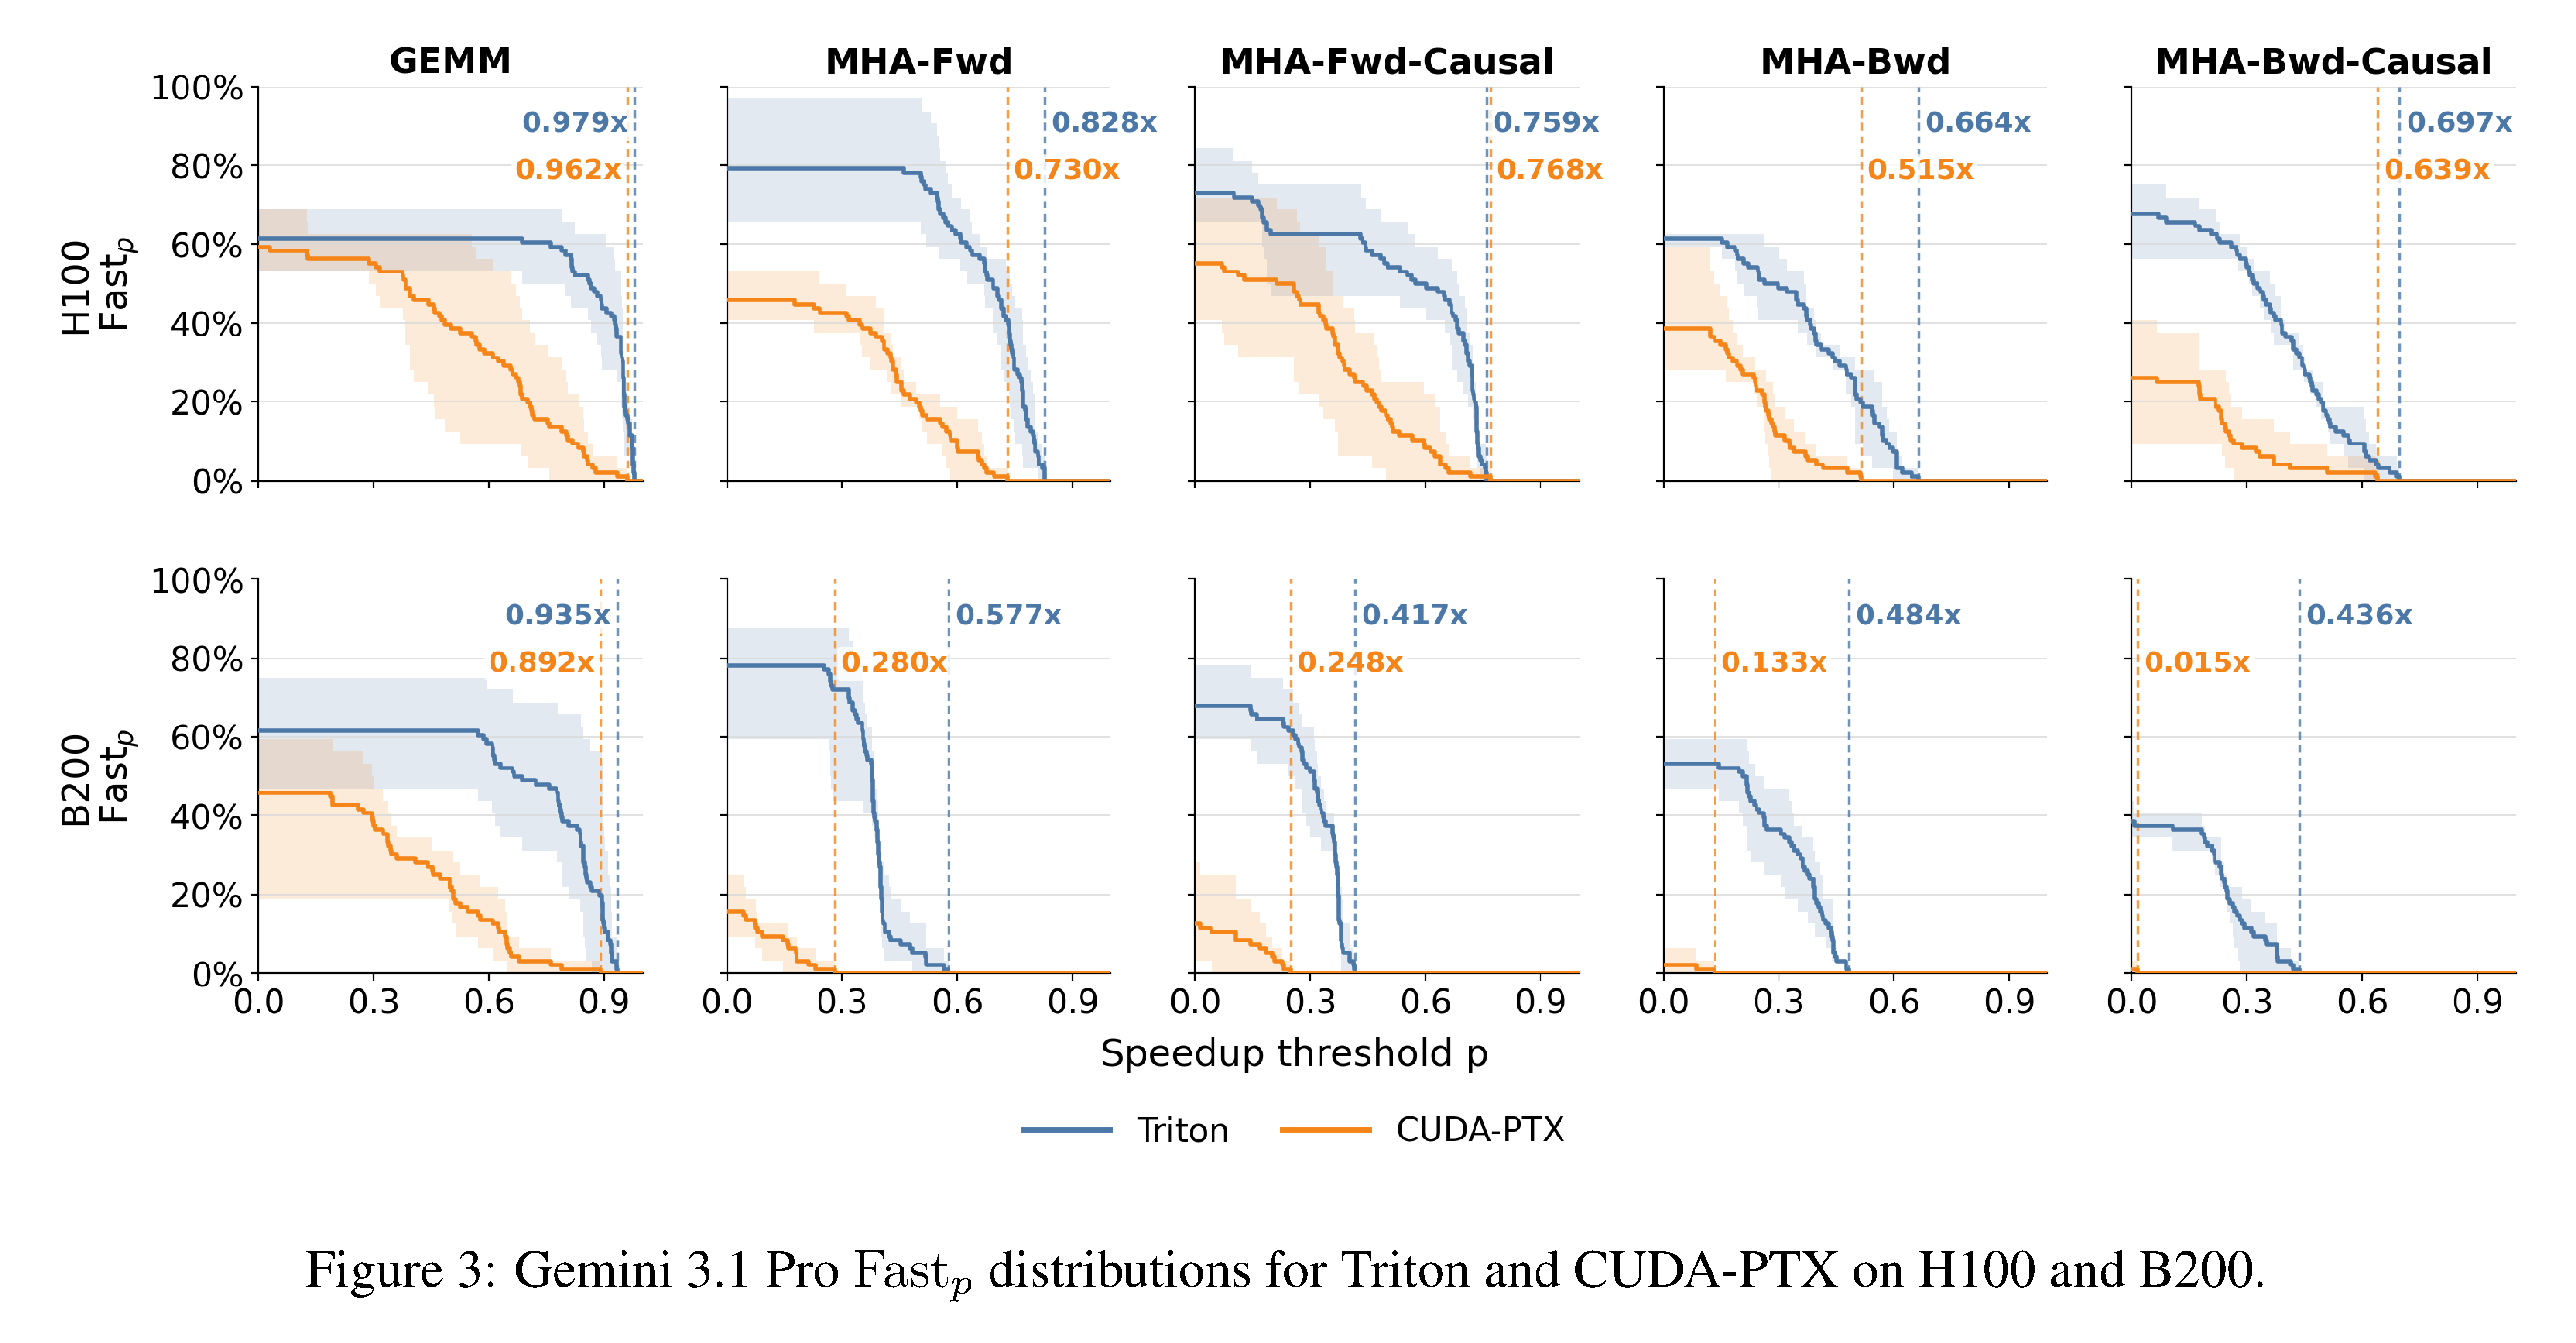
Gemini 3.1 Pro에서 직접 CUDA–PTX와 Triton은 Hopper에서 비교적 근접하며, causal MHA-forward 최고 성능은 각각 0.768×와 0.759×이다. B200 attention에서는 Triton이 크게 우세하다. backward 최고 성능은 Triton이 0.484×와 0.436×인 반면 CUDA–PTX는 0.133×와 0.015×이다. 저자들은 Blackwell의 더 높은 저수준 조율 복잡도와 부족한 아키텍처별 코드가 이 격차에 기여할 수 있다고 제시한다.
Gemini 3.1 Pro에서 Triton은 CUDA–PTX보다 B200 attention의 Fast_p 분포가 훨씬 높으며, 특히 backward attention에서 그렇다. 이 비교는 Hopper에서 직접 PTX가 때때로 우위를 보이더라도, 새 아키텍처에서 고수준 커널 언어가 여전히 유용하다는 논문의 결론을 뒷받침한다.
4.4 Explicit Architecture Knowledge Improves Target Instruction Execution
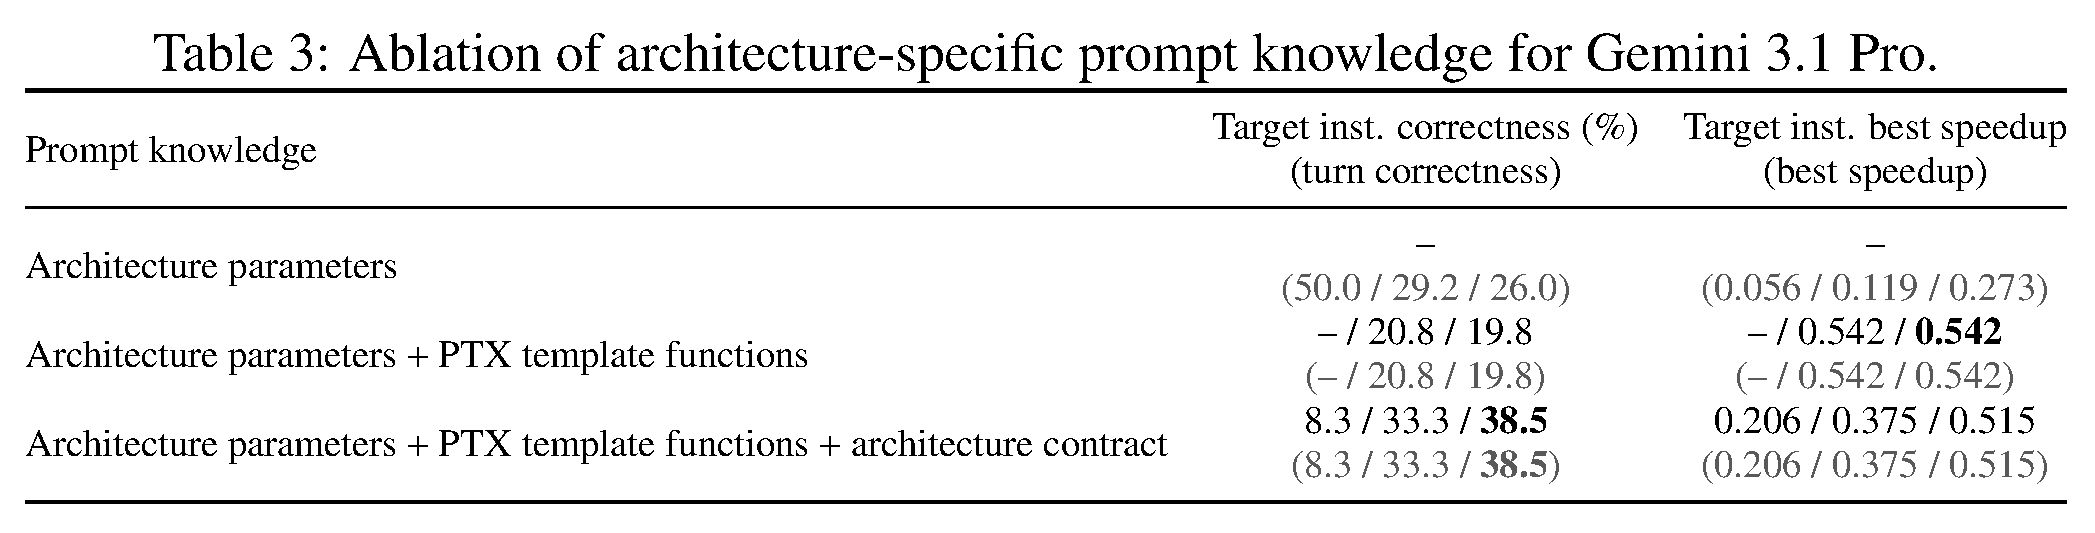
명시적인 prompt 지식은 대상 명령어 사용을 크게 개선한다. 8 turns에서 Gemini 3.1 Pro에 아키텍처 파라미터만 제공하면 제한 없는 정확성은 26.0%이지만 대상 명령어 성공은 없다. PTX template functions를 추가하면 대상 명령어 정확성은 19.8%가 되고, 아키텍처 계약까지 추가하면 38.5%로 상승하지만 최고 speedup은 나오지 않는다.
PTX template functions를 추가하면 Gemini 3.1 Pro는 대상 명령어 성공이 없는 상태에서 8 turns 기준 19.8%에 도달하고, 아키텍처 계약을 추가하면 38.5%로 상승한다. 최고 speedup 열은 더 완전한 prompt 지식이 최고 성능을 단조롭게 높이기보다 신뢰할 수 있는 명령어 조건 정확성을 가장 분명히 개선함을 보여 준다.
5 Adaptation Results
적응 연구는 긴 PTX prompt와 kernel trace를 수용할 수 있는 262K-token context를 가진 Qwen3.6-27B에 LoRA SFT를 적용한다. supervision 형식, 작업 범위와 균형, reasoning teacher, held-out 워크로드로의 전이, 가중치 업데이트에 대한 추론 시점 대안을 변화시켜 평가한다.
5.1 Training Format and Data Recipe Results
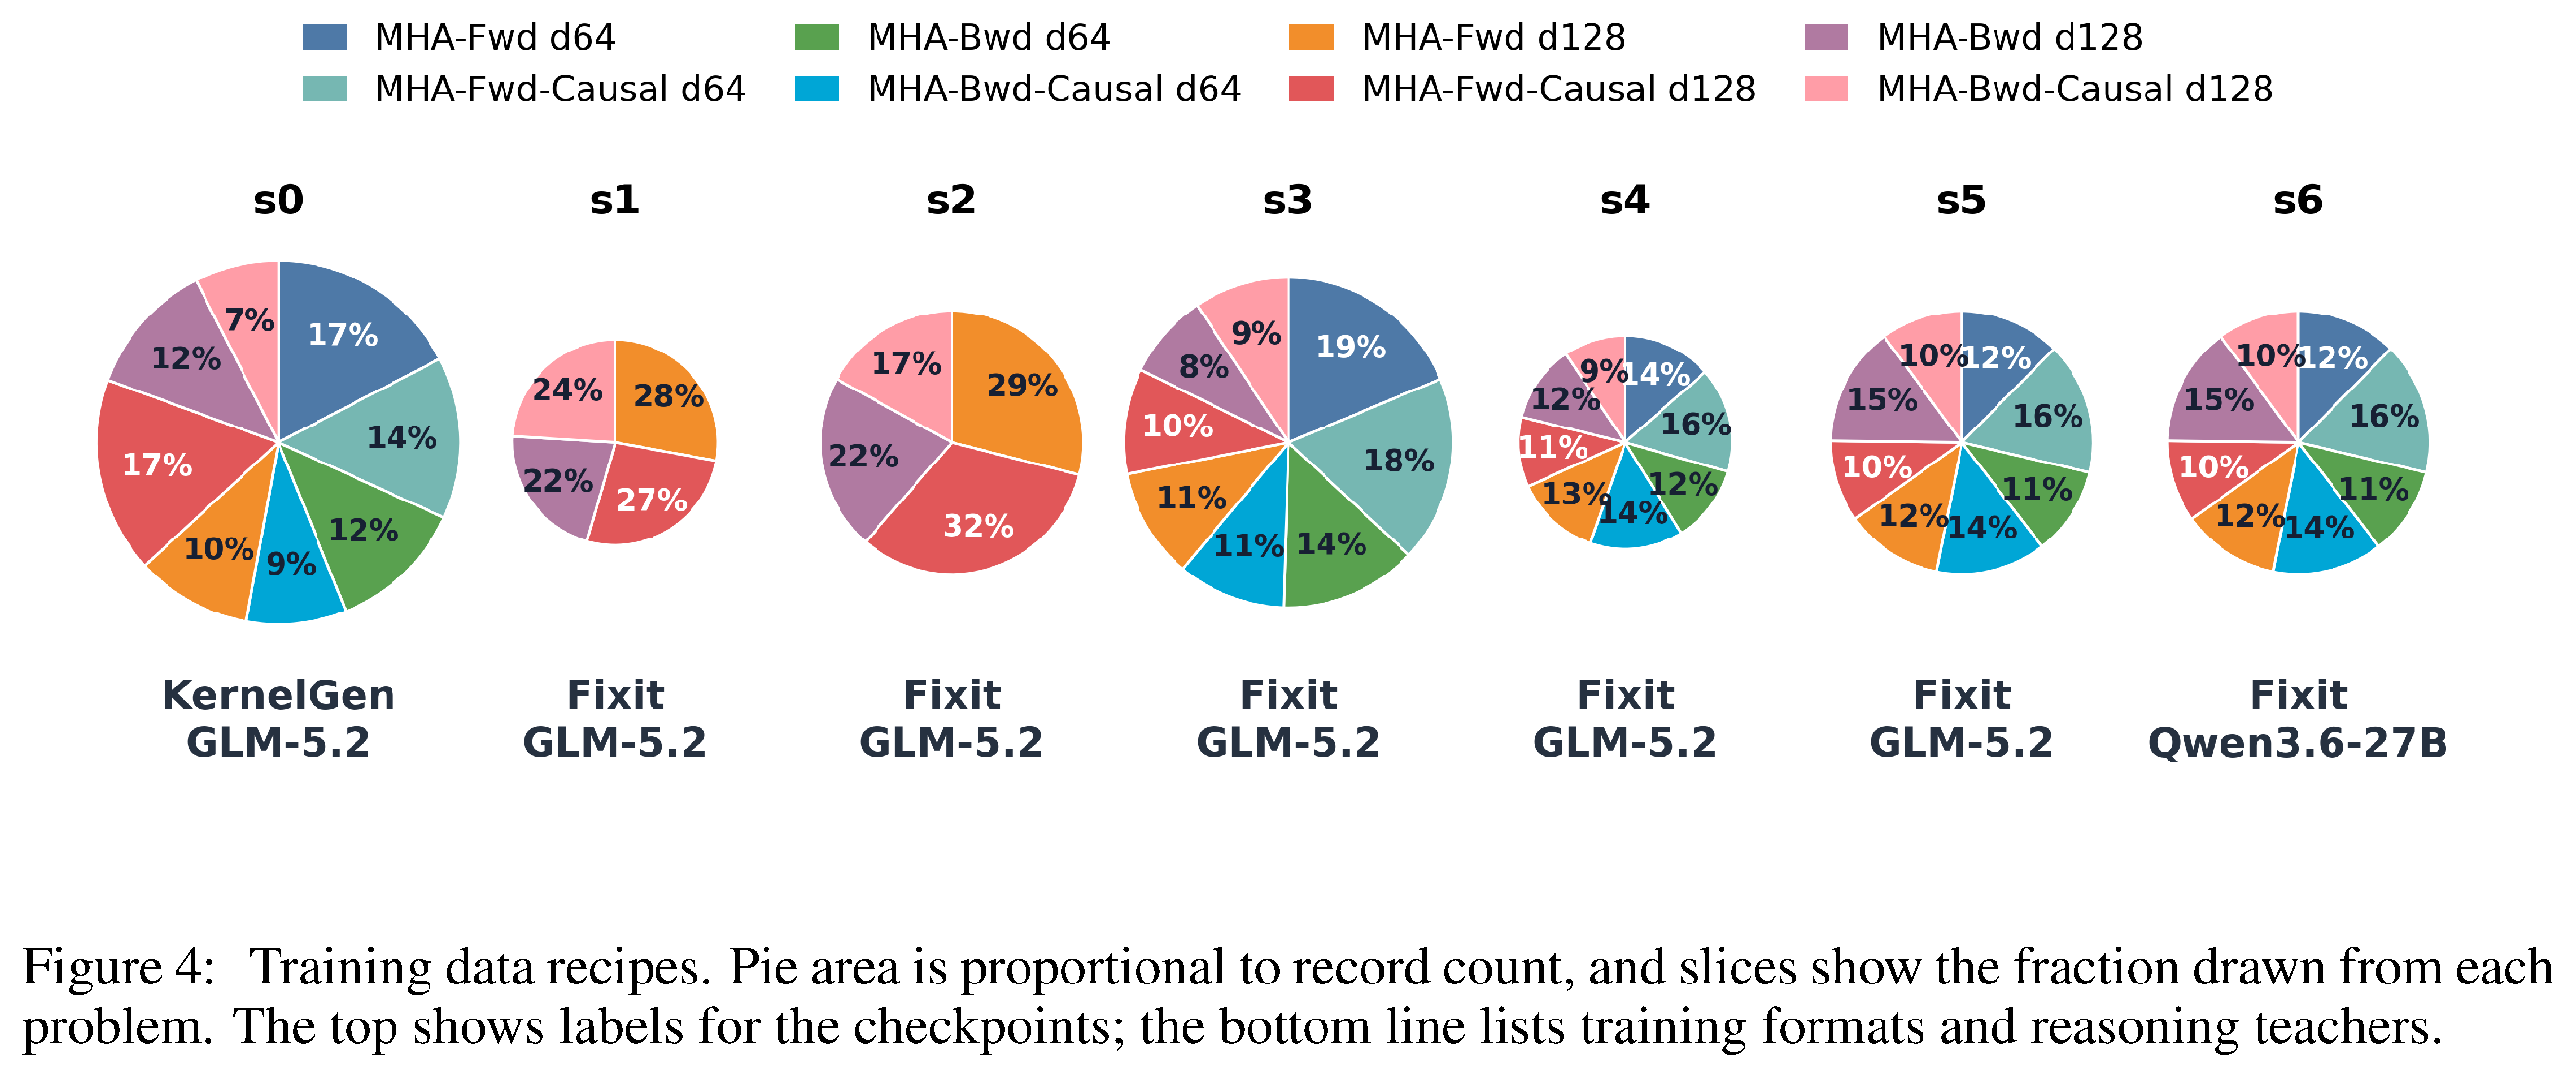
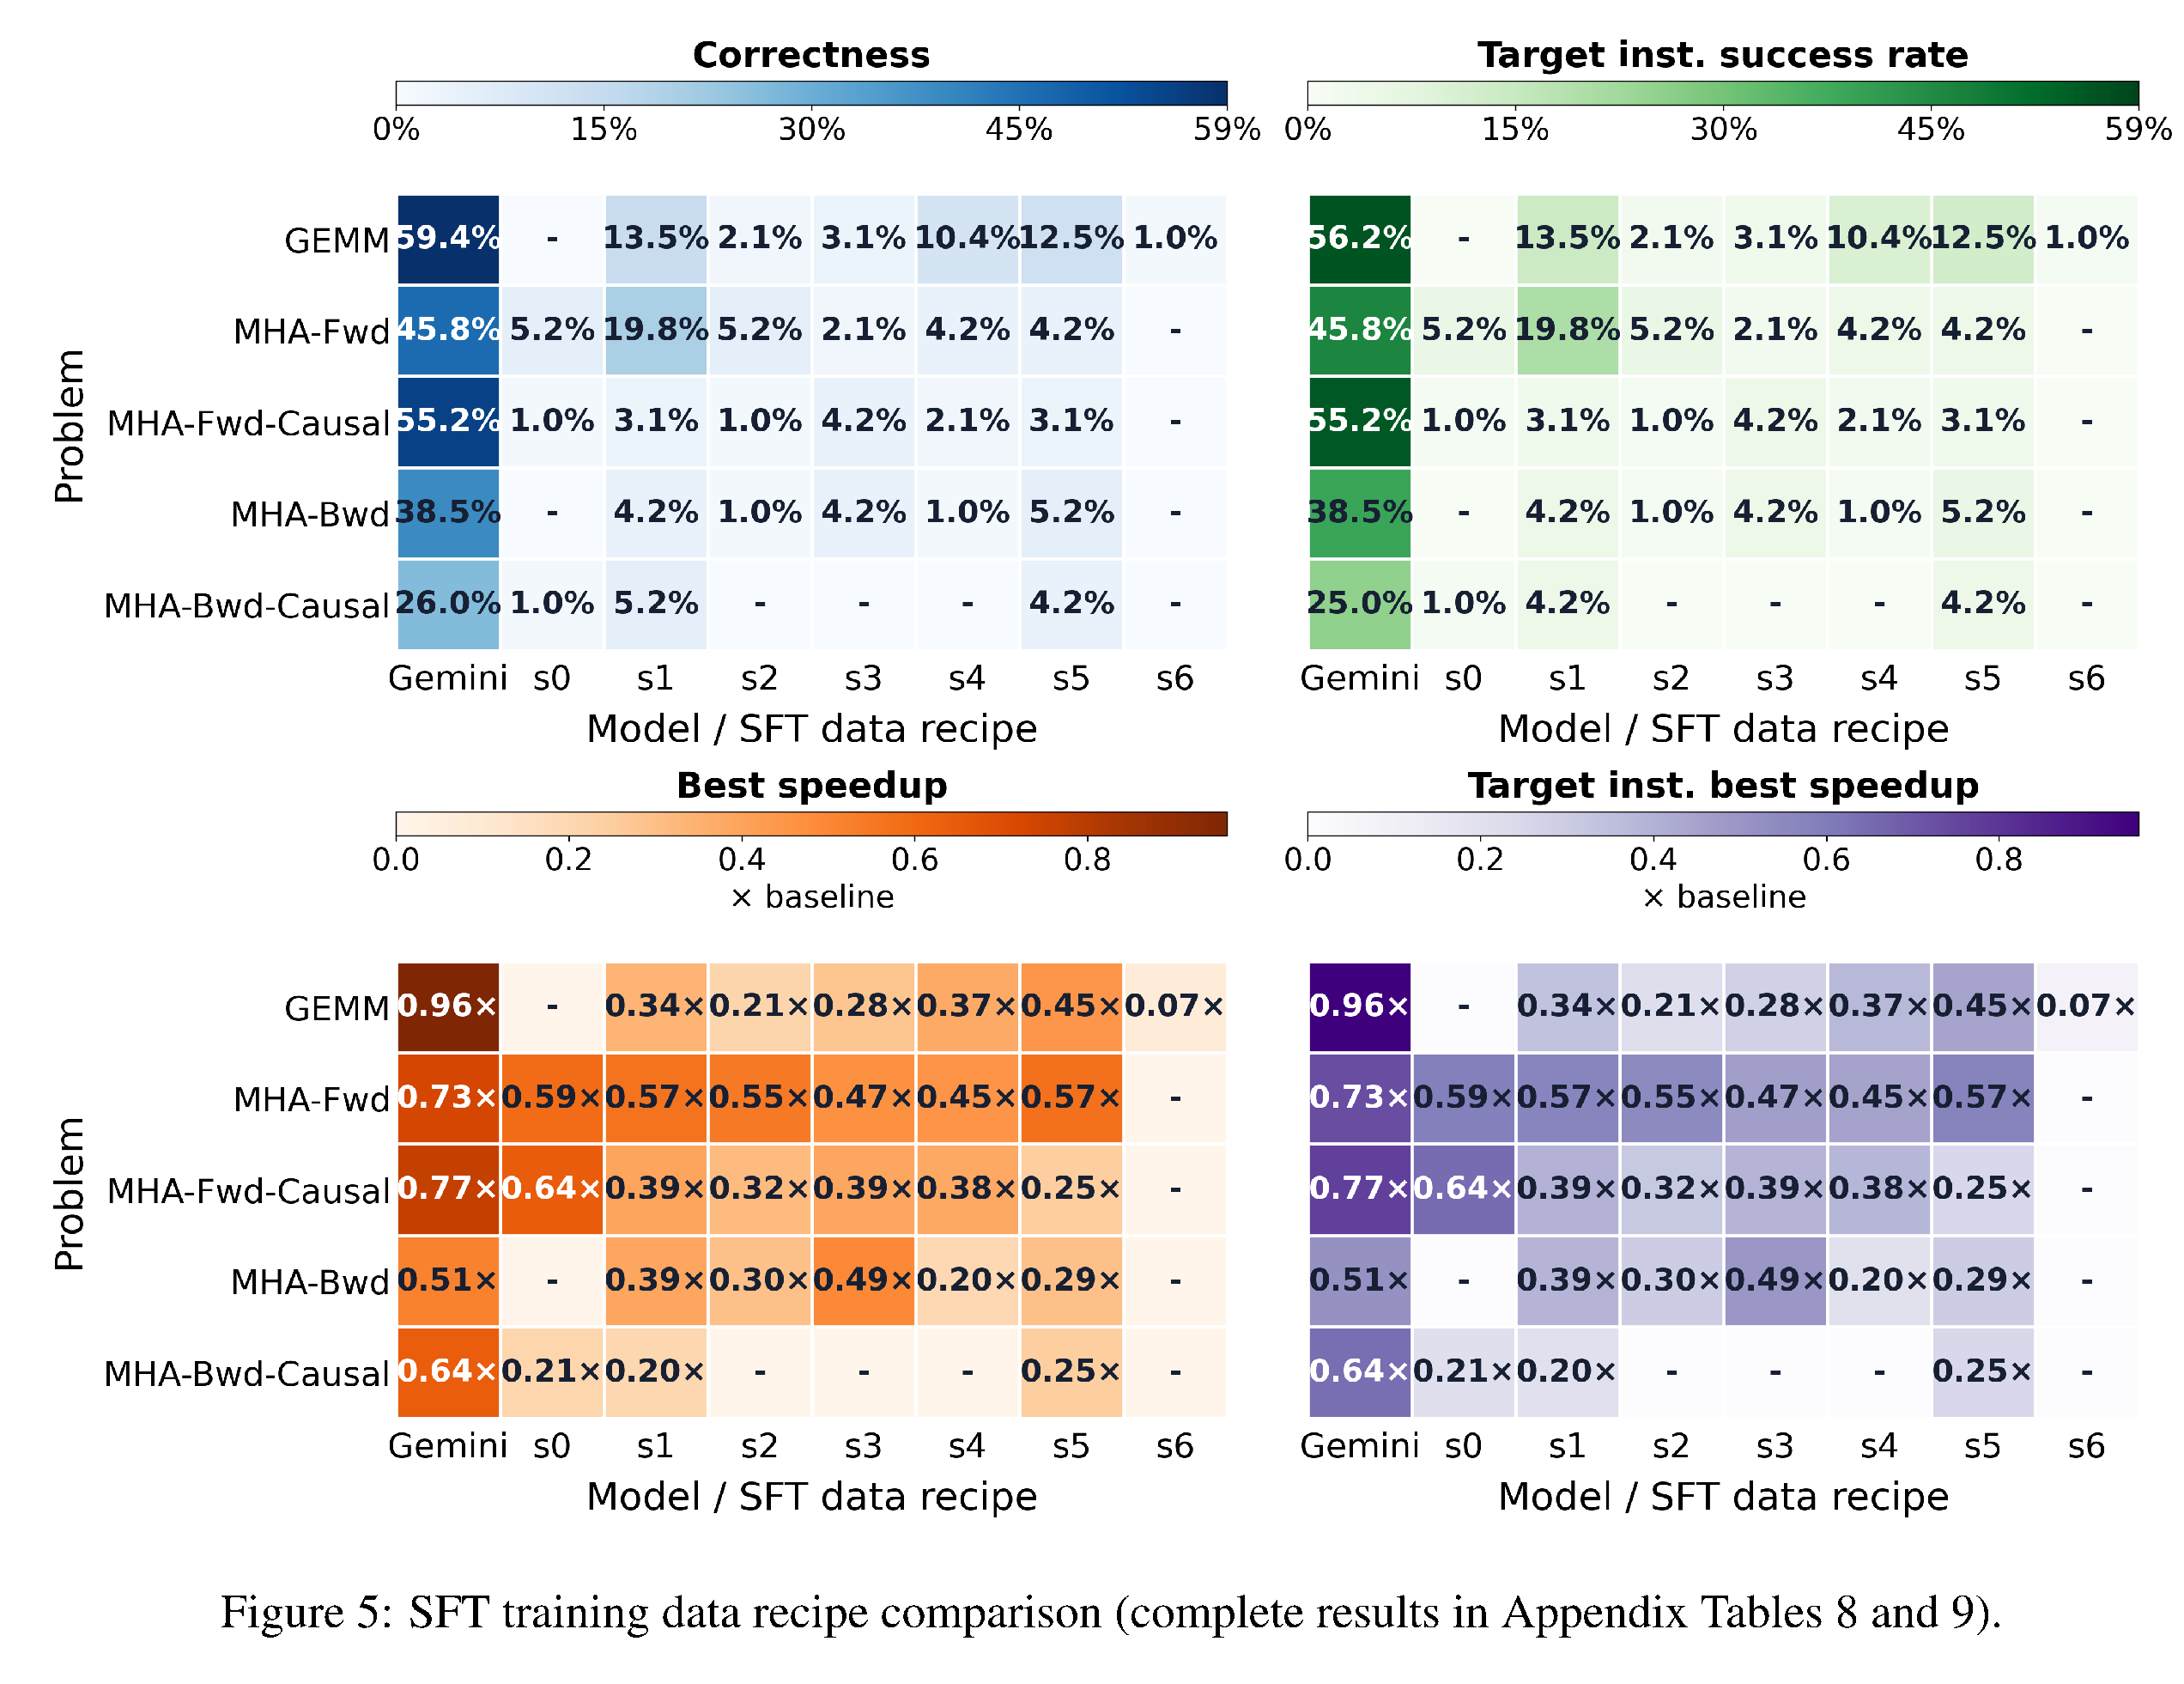
Fixit은 direct-solution KernelGen supervision을 일관되게 능가하지는 않는다. 유사한 범위와 record 수에서 s3 Fixit recipe는 GEMM, causal MHA-Fwd, MHA-Bwd의 여덟 턴 정확성을 개선하지만, MHA-Fwd와 causal MHA-Bwd에서는 s0보다 낮다. Fixit recipe 사이에서는 균형 잡힌 범위가 record 수 자체보다 중요하다. s1과 s5는 모든 평가 문제를 해결하는 반면, s5와 같은 예제에 Qwen3.6-27B를 reasoning synthesizer로 사용한 s6는 GEMM만 해결한다.
pie chart는 워크로드 혼합, record 수, supervision template, reasoning synthesizer가 다른 7개의 SFT recipe를 비교한다. 서로 다른 구성은 KernelGen과 Fixit을 비교하고, 작업 분포를 단순 record 수와 분리하는 기반을 제공한다.
heatmap은 Gemini와 Qwen adaptation recipe에서 정확성, 대상 명령어 성공, 최고 speedup, 적격 최고 speedup을 여러 kernel-generation 문제에 걸쳐 비교한다. KernelGen과 Fixit의 혼합된 결과, 균형 잡힌 s1과 s5의 더 넓은 작업 범위, 그리고 모든 워크로드와 측정 지표에서 최고인 단일 recipe가 없음을 보여 준다.
5.2 Effects and Generalization of Fixit SFT
head dimension 128 attention tasks로 학습한 선택된 s1 모델은 GEMM, 모든 d64 MHA 작업, d96 forward tasks 2개로 전이되지만, 정확한 d96 backward 또는 GQA 커널은 생성하지 못한다. 모든 테스트한 Hopper 워크로드에서 turn-level Triton 정확성은 낮아지지만, causal MHA-Fwd의 최고 Triton speedup은 0.238×에서 0.632×로, causal MHA-Bwd에서는 0.043×에서 0.331×로 상승한다.
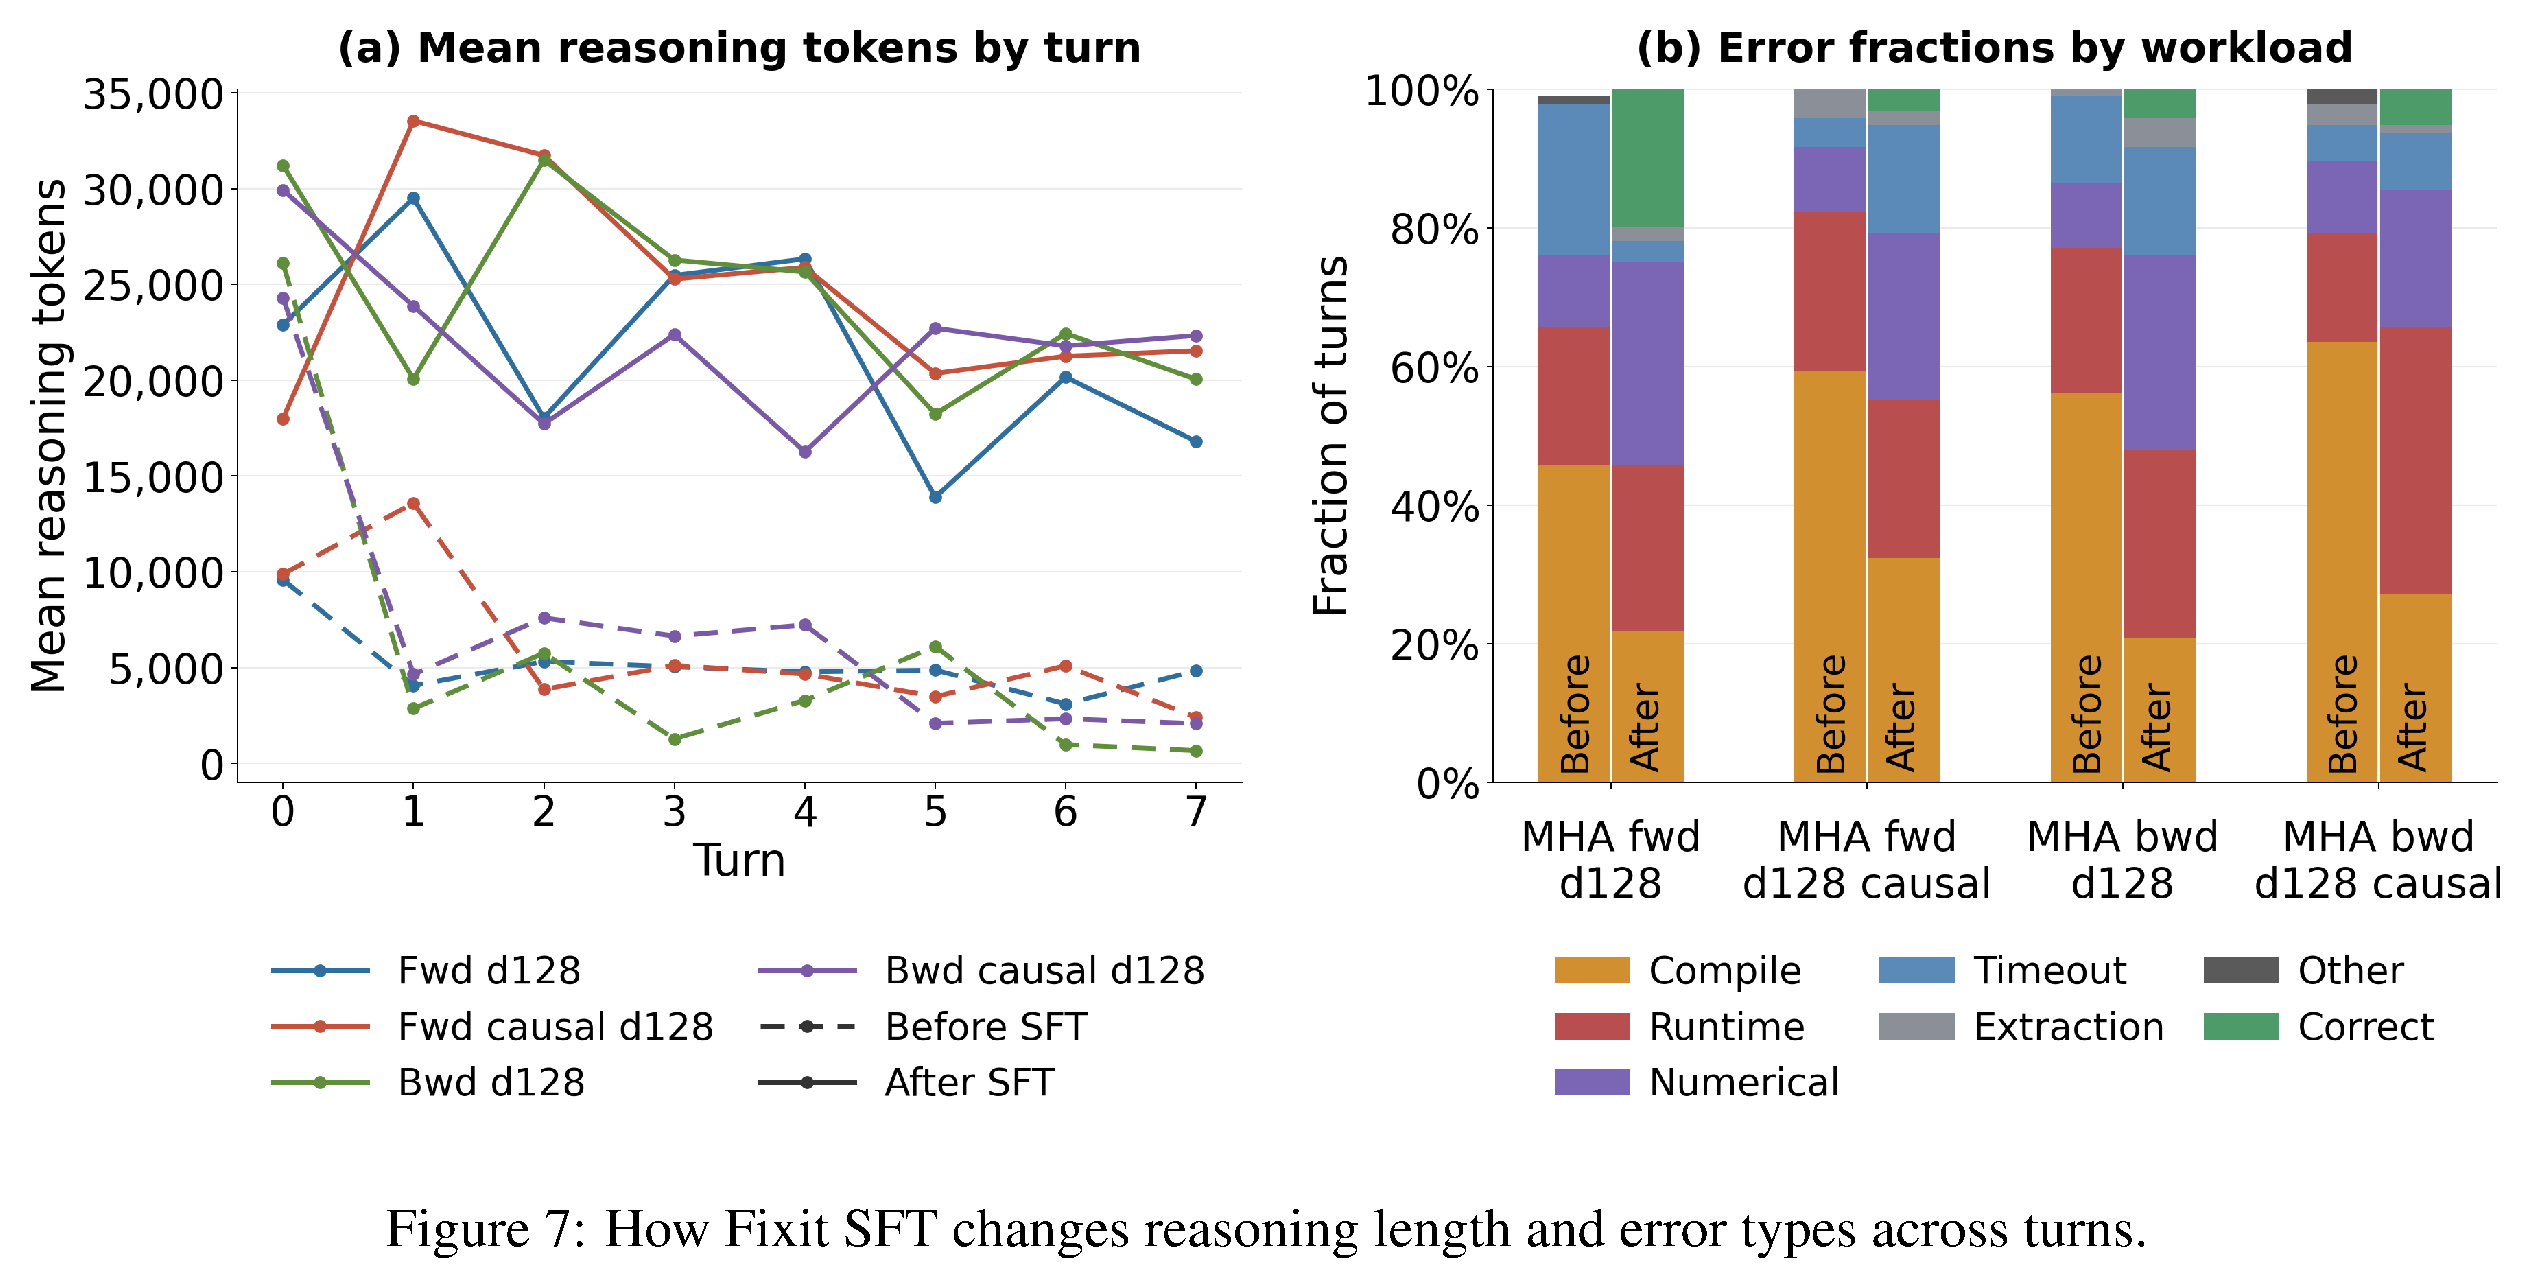
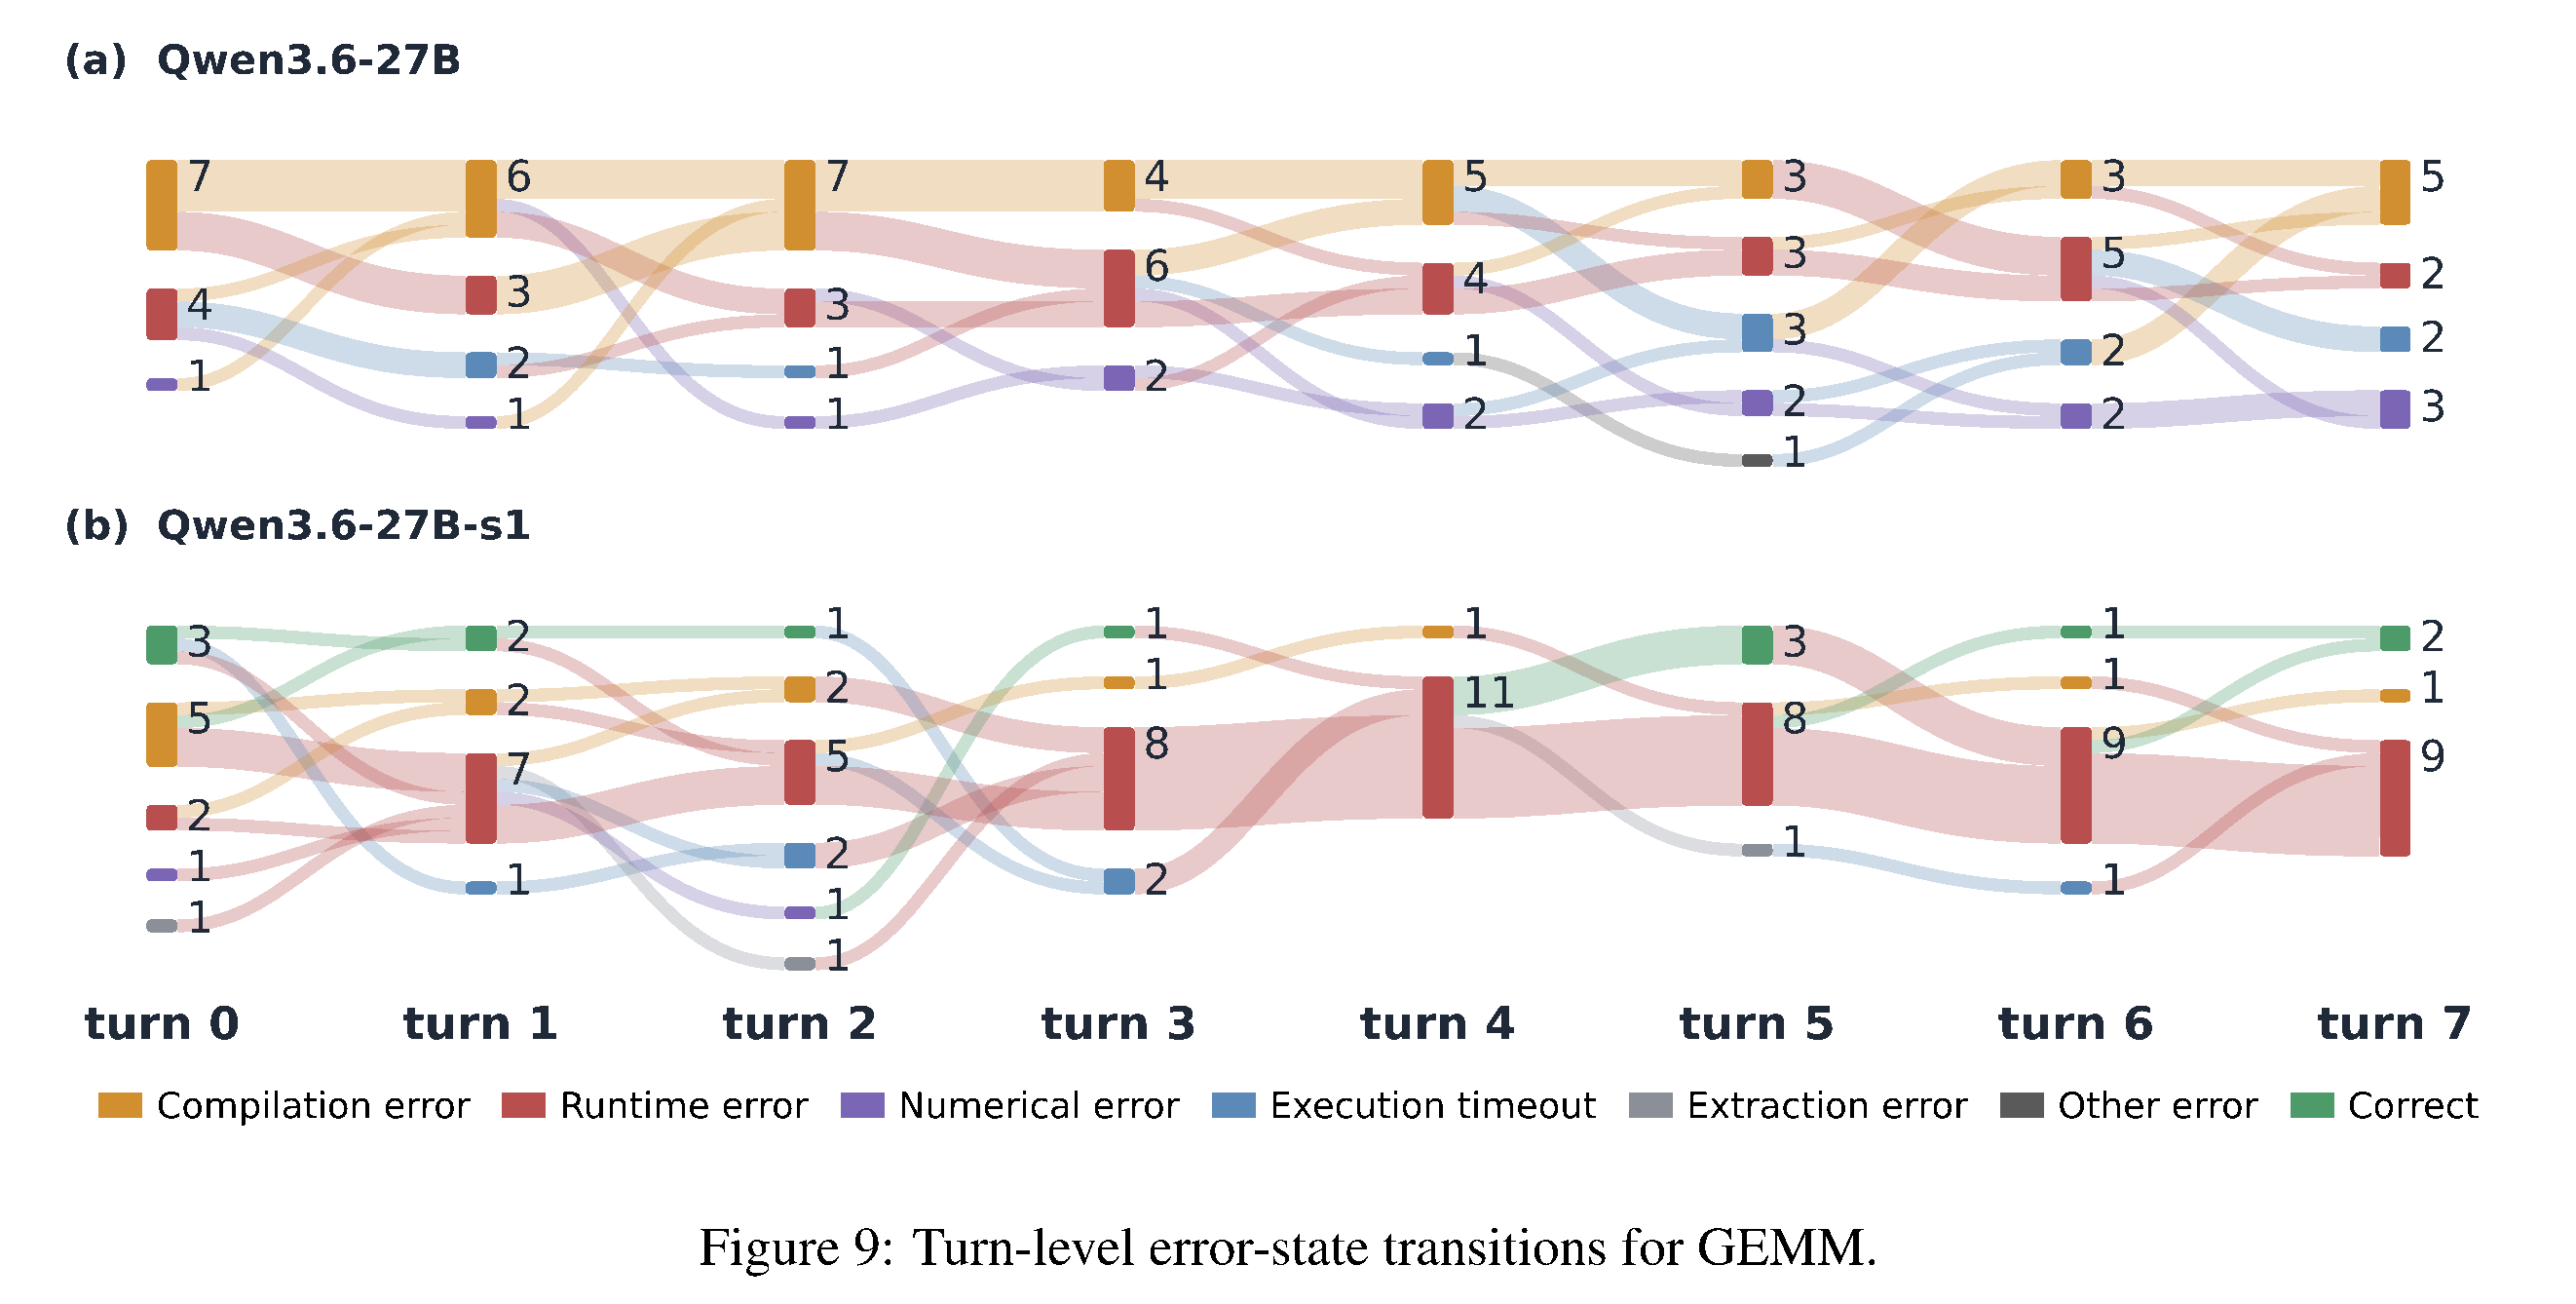
Fixit SFT 후 평균 reasoning 길이는 turn 전반에서 증가하고, 오류 분포는 컴파일 실패에서 런타임 및 수치 오류로 이동한다. 따라서 적응된 모델은 실행 가능한 후보를 더 자주 생성하지만, 실행 유효성과 수치적 정확성은 여전히 중요한 병목이다.
turn-level trajectory는 base Qwen3.6-27B가 컴파일 오류에 계속 지배되어 정확한 GEMM 커널에 도달하지 못하는 반면, s1은 turn 0과 이후 turn에서 정확한 커널을 생성함을 보여 준다. 남은 s1 실패는 런타임 및 수치 상태로 이동한다.
5.3 SFT Versus In-context Supervision
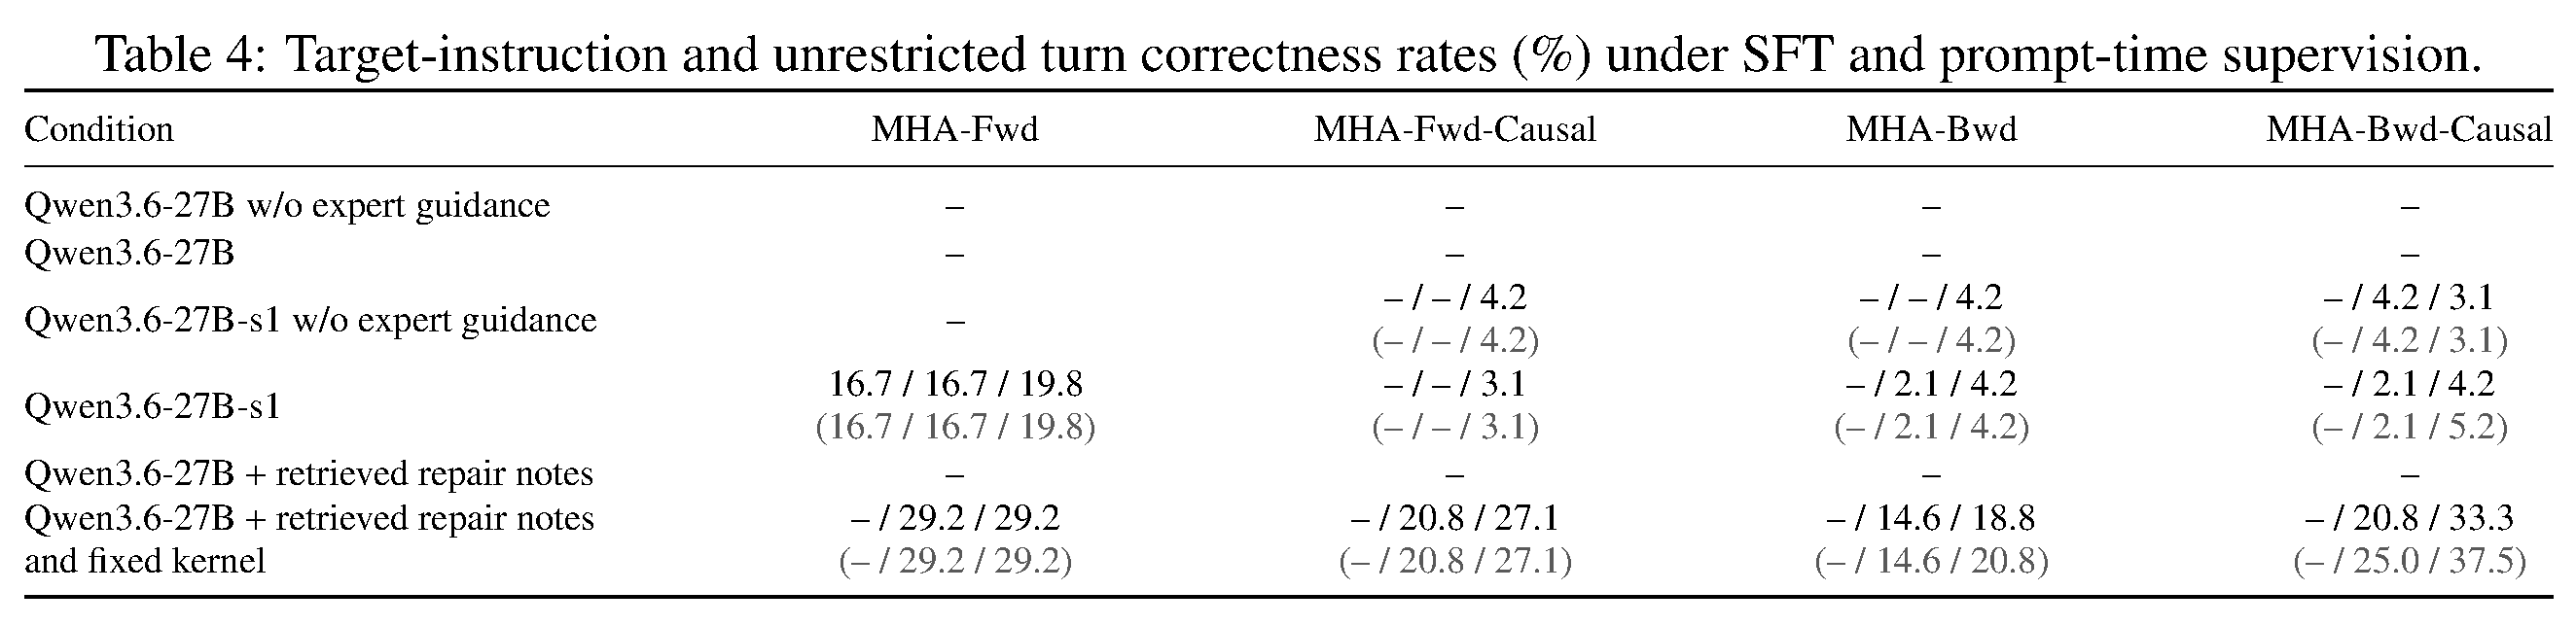
prompt 시점 안내만으로는 base Qwen3.6-27B가 정확한 MHA 커널을 생성하지 못하지만, s1은 전문가 안내 없이도 일부 정확한 MHA 커널을 생성한다. 검색된 repair note만으로도 정확한 커널은 생성되지 않는다. 수정된 커널을 포함할 때에만 retrieval이 효과적이며, 이는 prompt에 near-solution을 넣는 solution-bearing 조건이다.
base model과 repair note를 추가한 base model 모두 정확한 MHA 커널을 생성하지 못한다. S1은 여러 조건에서 0이 아닌 대상 명령어 정확성을 달성하며, note와 fixed kernel을 함께 검색하면 prompt에 solution-bearing 정보가 들어가므로 base model도 개선된다.
곡선은 전문가 안내가 없는 s1, 안내가 있는 s1, fixed kernel을 포함하는 repair retrieval의 명령어 조건 speedup을 비교한다. SFT는 solution-bearing retrieval 없이도 일부 역량을 제공하지만, 수정된 커널을 포함하면 base model이 정확한 출력을 만들 기회가 훨씬 커진다.
6 Related Work
기존 커널 생성 벤치마크는 주로 기능 정확성과 전체 속도를 평가하며, 고수준 DSL, 일반 CUDA 또는 library 사용을 허용하는 경우가 많다. PTXBench는 대신 지정된 아키텍처를 위한 from-scratch CUDA–PTX 생성을 분리하여 평가하고, 필요한 명령어 패밀리가 런타임에 실행되는지 검증한다.
7 Limitations
적응 결과는 소규모 LoRA dataset과 1개의 27B base model을 사용하므로, repair conditioning, 데이터 균형, teacher 품질의 효과가 산업 규모 post-training이나 다른 모델 계열로 그대로 전이되지 않을 수 있다. PTXBench도 GPU 연산자 및 하드웨어 전체 범위가 아니라 H100과 B200에서 BF16 GEMM 및 attention으로 제한된다.
8 Conclusion
저자들은 PTXBench를 아키텍처별 GPU-kernel 역량을 측정하고 표적 적응 데이터를 수집하기 위한 감사 가능한 환경으로 제시한다. 현재 모델은 때때로 forward 워크로드를 해결하고 요청된 명령어를 실행하지만, backward attention에는 여전히 약하며 frontier library 대비 성능도 일관되지 않는다. Fixit의 도움도 일관적이라기보다 선택적이다.
부록
- 부록은 NVIDIA H100 80 GB 및 B200 평가, sm 90a와 sm 100a를 대상으로 하는 nvcc -O3 컴파일, trajectory당 8개 모델 호출, 1.2× speedup 또는 context 소진 시 조기 종료를 명시한다. 또한 동적 SASS 및 Nsight Compute 측정, 주요 BF16 워크로드 shape, 5 epochs의 LoRA rank 32 학습, H100용 22,314 tokens 및 B200용 28,815 tokens의 총 prompt, profiling-service throughput 측정, 수정된 FlashAttention-3 pseudocode, 보충 결과를 문서화한다.
짧은 생각
벤치마크의 핵심 설계 선택은 수치적 정확성과 동적 명령어 실행을 분리하는 것이며, 이를 통해 dead-code 또는 실행되지 않은 명령어 주장으로는 아키텍처별 성공을 인정받지 못한다. 결과는 명령어 실행이 성능의 대리 지표가 아님도 보여 준다. 적격 커널은 library baseline보다 훨씬 느린 경우가 많고, 적응 증거는 신뢰할 수 있는 repair-SFT 전이의 광범위한 주장보다 데이터 품질과 범위의 중요성을 더 분명히 뒷받침한다.