


Echoverse: Deep, Evolving Environments for Training Computer-Use Agents at Scale 요약 설명
30 Jul 2026 | Paper Review Computer-Use Agents Synthetic Environments Reinforcement Learning Supervised Fine-Tuning목차
- 요약
- 4 Echoverse: the factory and the co-evolution loop
- 5 The environment suite
- 6 Supervised experiments
- 7 Reinforcement learning on the worlds
- 부록
- 짧은 생각
이번 글에서는 Echoverse: Deep, Evolving Environments for Training Computer-Use Agents at Scale 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 30일(Arxiv)
- Pandya, Yash, Gupta, Sahil, Harne, Sarthak, Yadav, Archana, Chourasia, Kavyansh, Mozannar, Hussein, Vineet, Vibhav, Abdali, Sara, Rosset, Corby, Lara, Yash, et al.
- Microsoft Research
- 논문 링크
요약
- Echoverse는 컴퓨터 사용 에이전트를 학습하기 위해 상태를 유지하고 재설정할 수 있는 합성 애플리케이션을 구축하며, 작업 결과는 스크린샷이 아니라 애플리케이션 데이터베이스 상태를 기준으로 검사한다. 목표 워크플로에 대한 깊이는 행동 충실도, 일관된 상태, 워크플로 의존성, 권위 있는 검증, 도메인 가치로 정의한다. 검증된 21,009개 궤적으로 학습한 9B 모델은 14개 평가 분할 전체에서 36.5%에서 67.1%로 향상된다.
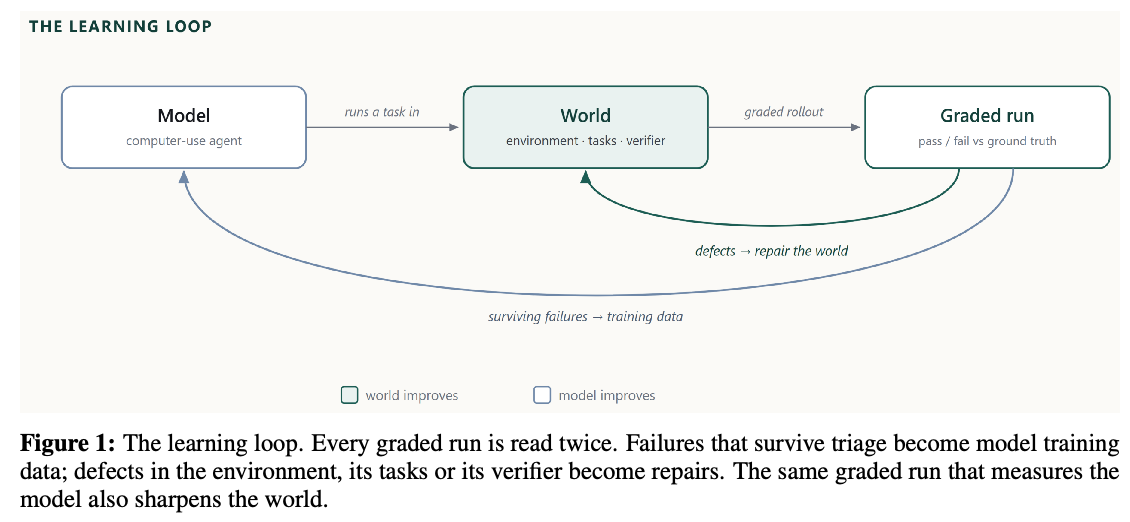
이 도식은 공진화 메커니즘을 보여 준다. 하나의 롤아웃은 채점 결과와 2개의 후속 경로를 낳는데, 하나는 월드 결함 수정이고 다른 하나는 검증된 에이전트 실패를 학습 데이터로 활용하는 경로다.
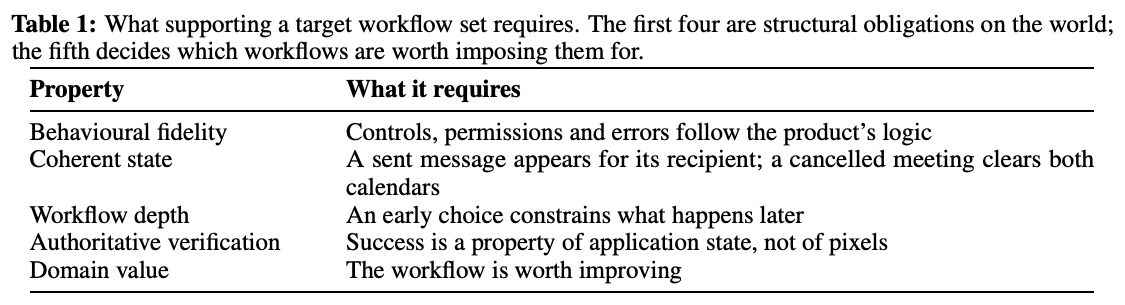
이 표는 깊이를 워크플로 완결성으로 조작화한다. 4개 구조적 요구사항과, 워크플로가 구축할 만큼 충분한 도메인 가치를 지니는지에 관한 선택을 구분한다.
4 Echoverse: the factory and the co-evolution loop
팩토리는 전체 도메인 월드와 좁은 역량 월드를 모두 생성한다. 빌더, 검증기, 분류기, 계층별 수정기가 애플리케이션과 작업 코퍼스를 구축한다. 채점된 각 롤아웃은 환경, 작업, 검증기 결함을 검사한 뒤, 유효한 모델 실패만 학습 신호로 보존한다.
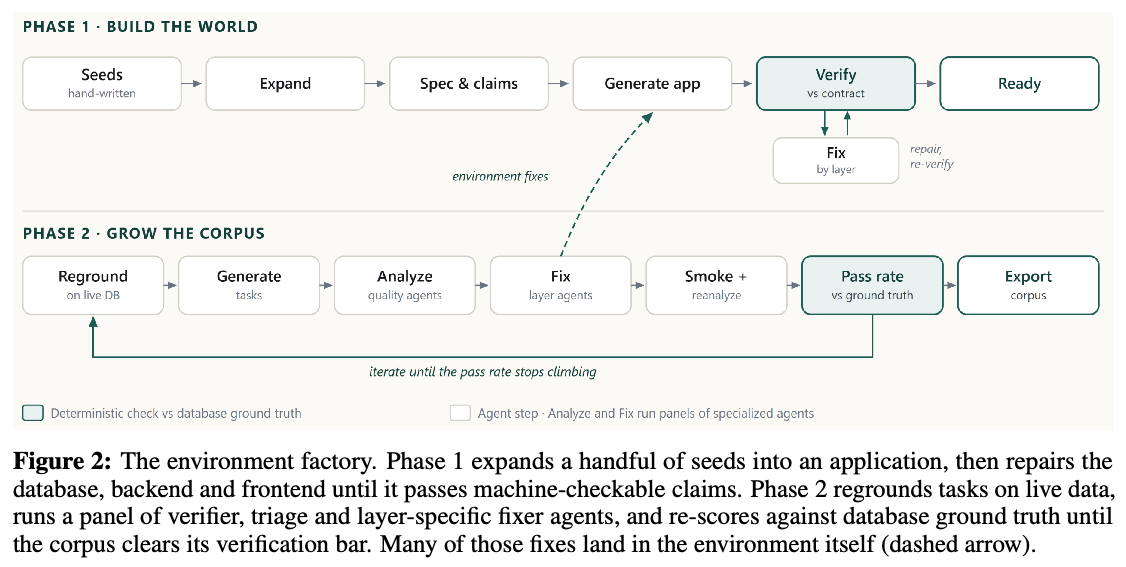
팩토리는 연결된 수정 루프로 구성된다. 1단계에서는 애플리케이션 주장이 데이터베이스, 백엔드, 프런트엔드 수정을 이끌고, 2단계에서는 다시 설정한 작업 검증이 작업 및 환경 수준 수정을 이끈다.
4.2 Phase 1: building the environment
1단계에서는 수작업 시드를 명세와 기계적으로 검사 가능한 주장으로 확장한 뒤, React 인터페이스 아래에 FastAPI와 SQLite 백엔드를 생성한다. 검증 에이전트는 실행 중인 애플리케이션과 데이터베이스를 통해 라우트, 상태, 동작을 점검한다. 주장의 최소 95%가 통과하고 미해결 하드 블로커가 없을 때만 월드를 다음 단계로 진행한다.
4.3 Phase 2: growing the corpus
2단계에서는 라이브 데이터베이스에 존재하는 엔터티를 기준으로 목표를 다시 설정하고, 그럴듯함, 난이도, 실행 가능성을 검사한다. 화이트박스 검증 에이전트는 Playwright, 소스 검사, 데이터베이스 쿼리를 사용해 불가능한 작업과 어려운 작업을 구분한다. 남은 코퍼스는 최소 95%가 검증을 통과할 때까지 재채점하며, 내보내는 모든 작업에는 데이터베이스에 근거한 검사가 포함된다.
4.6 One rollout, two signals
실패한 롤아웃이 항상 에이전트 약점의 증거는 아니다. 도달할 수 없는 목표, 잘못된 애플리케이션 동작, 부정확한 검증기를 드러낼 수도 있다. Echoverse는 실패를 분류 단계로 전달하고 원인 귀속이 불명확하면 수정을 우선하며, 통과율을 높이기 위한 목표 완화는 퇴행으로 간주한다. 공통 근본 원인을 수정하면 여러 작업을 한 번에 복구할 수 있다.
5 The environment suite
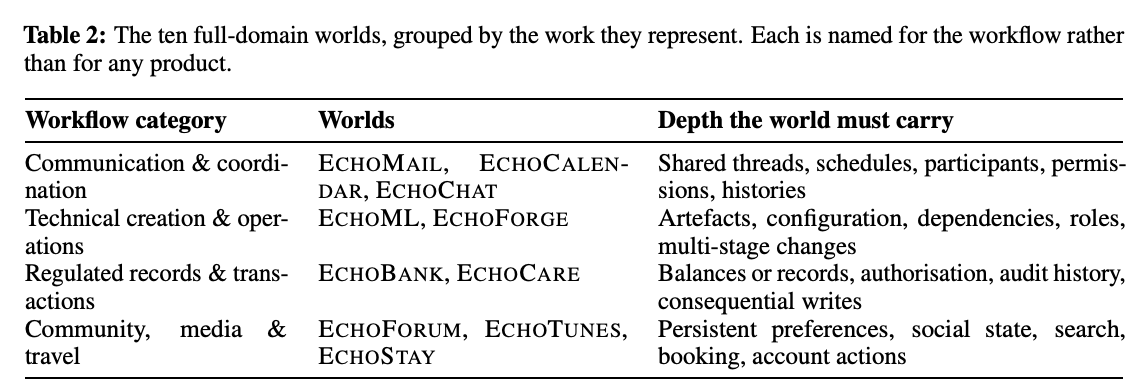
이 스위트는 통신, 기술 운영, 규제 기록 및 거래, 커뮤니티, 미디어, 여행을 아우르는 10개 심층 도메인과 2개 역량 월드로 구성된다. 학습에는 12개 월드를 모두 사용한다. 각 역량 월드에는 in-distribution 분할과 held-out 분할이 있으므로, 평가는 14개 분할의 비가중 성능 평균으로 계산한다.
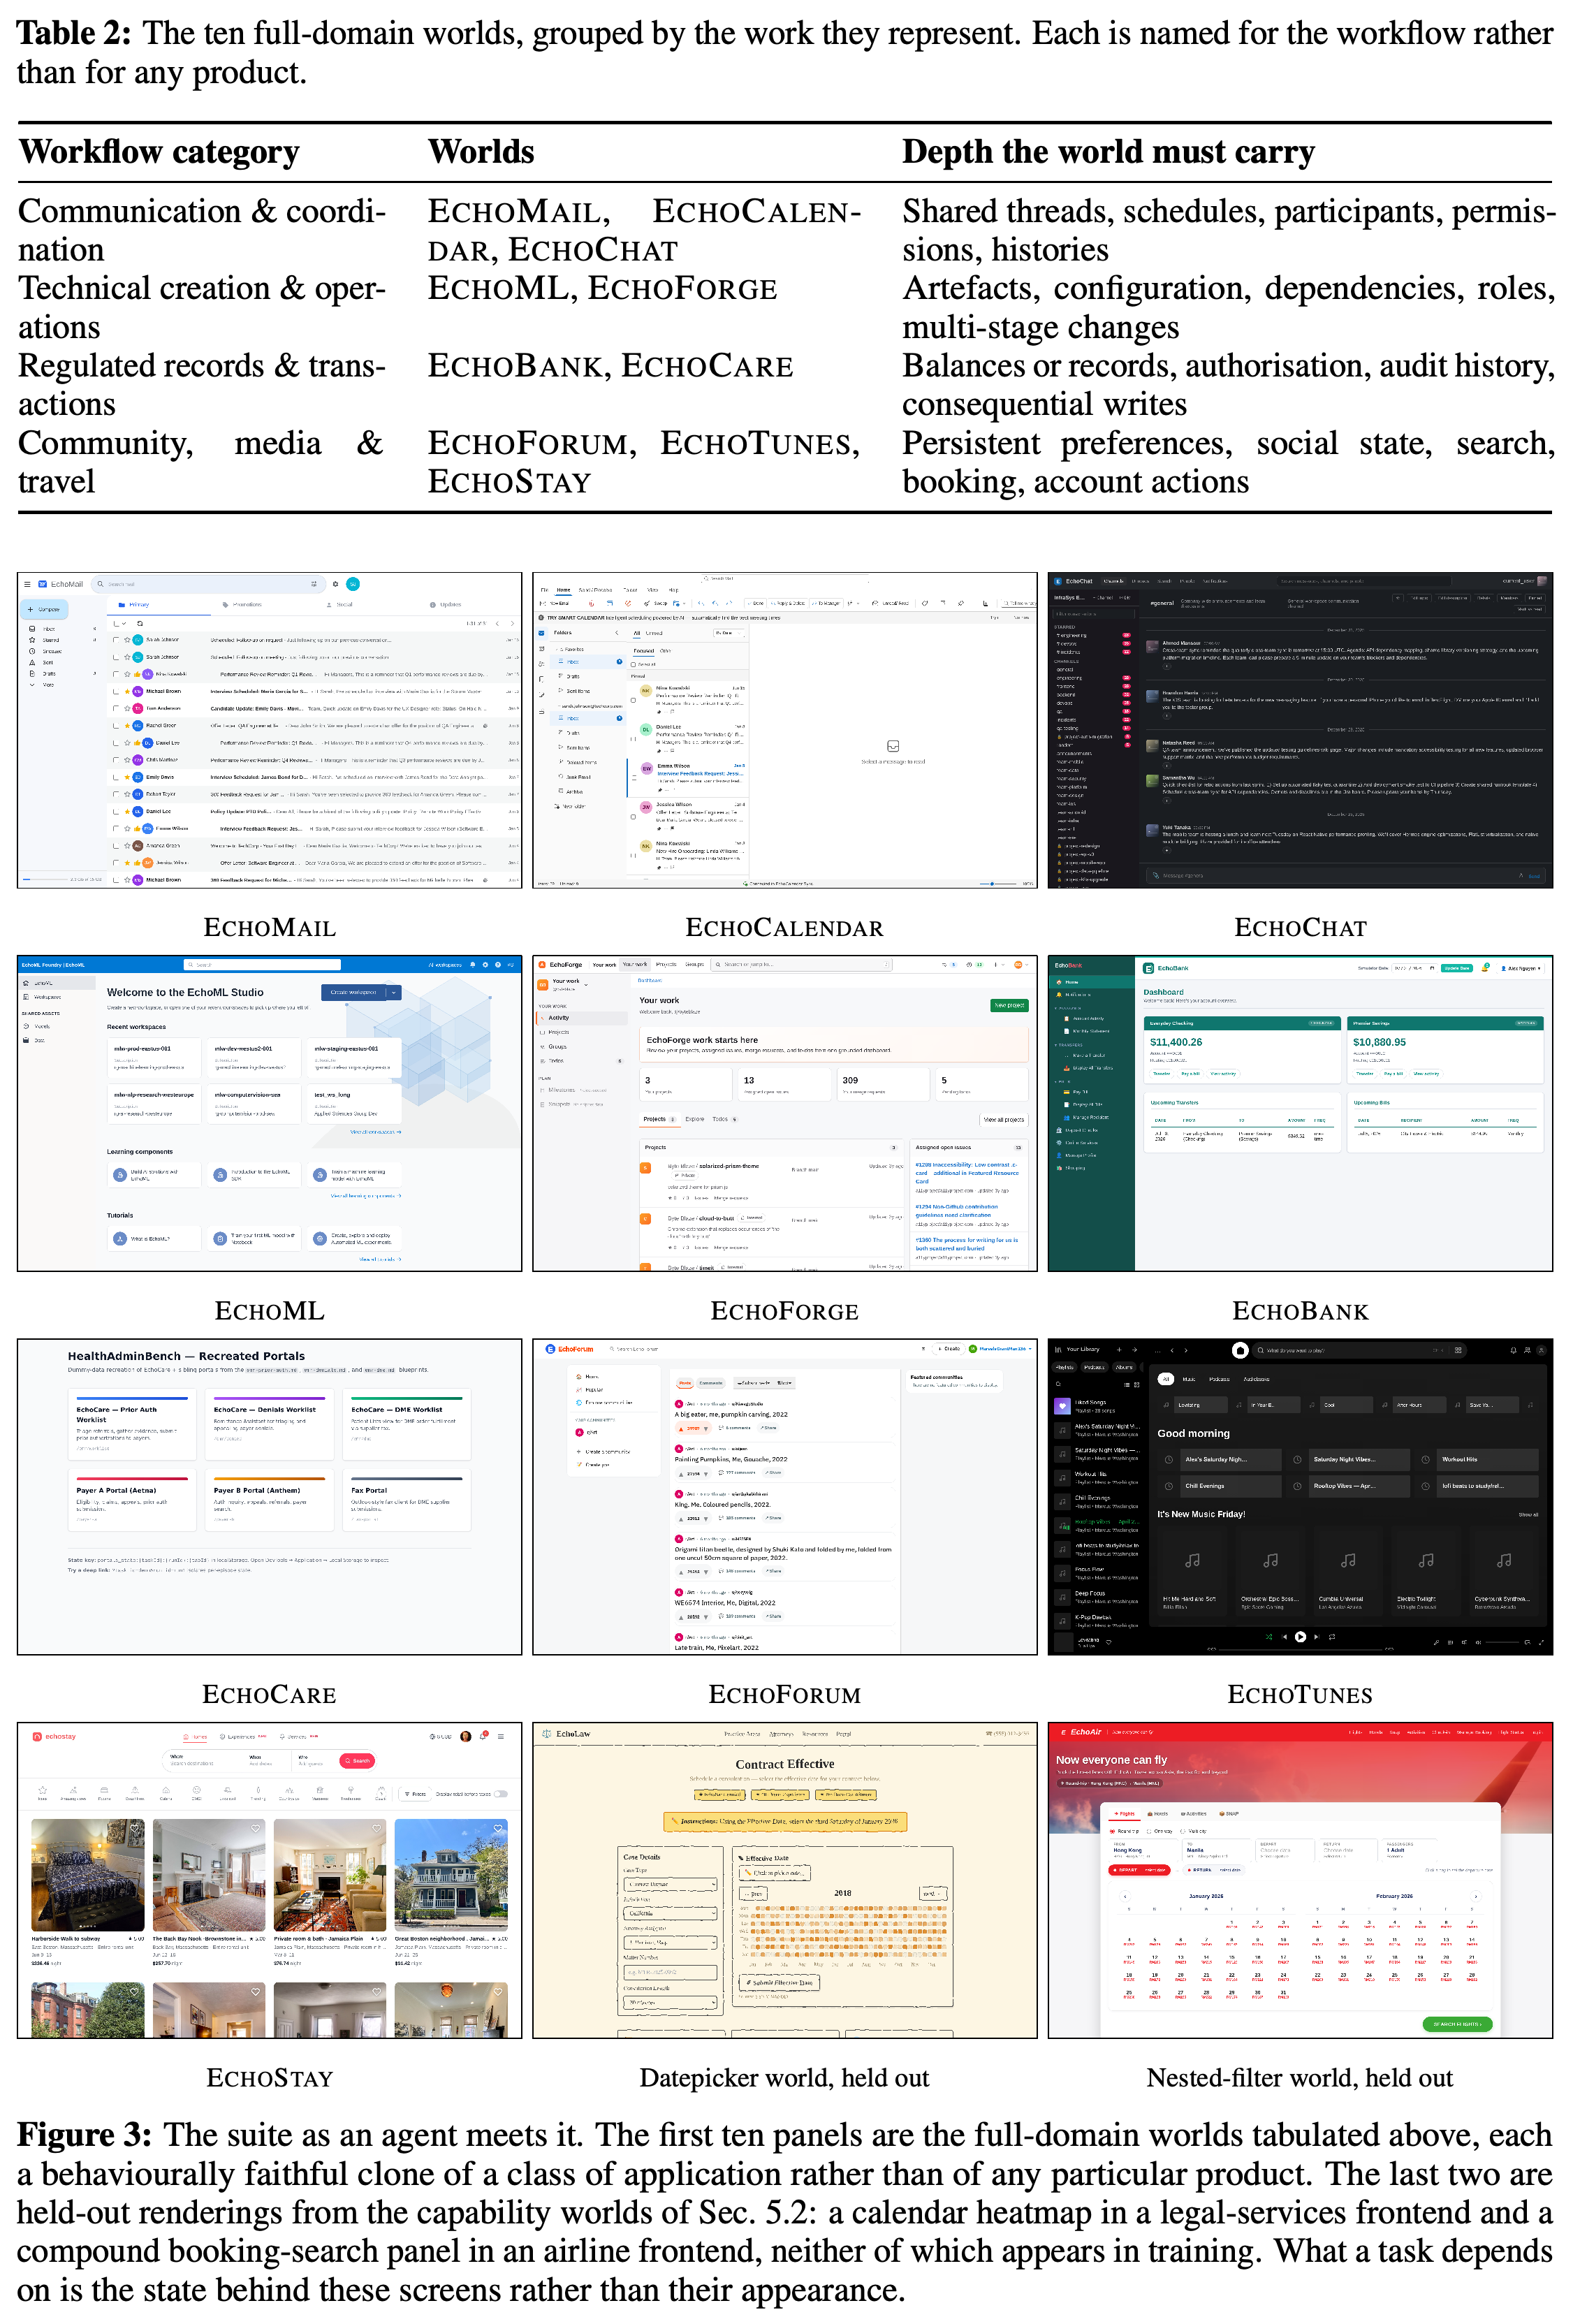
이 표는 각 전체 도메인 월드를 지속적인 다중 행위자 상태 및 워크플로 의존성과 연결한다. 이러한 요소는 목표 워크플로를 피상적인 인터페이스 복제와 구분한다.
패널은 10개 전체 도메인 월드와 2개 held-out 역량 렌더링의 시각적 다양성을 보여 준다. 작업의 정답 여부는 특정 제품과의 시각적 유사성이 아니라 인터페이스 뒤의 상태로 결정한다.
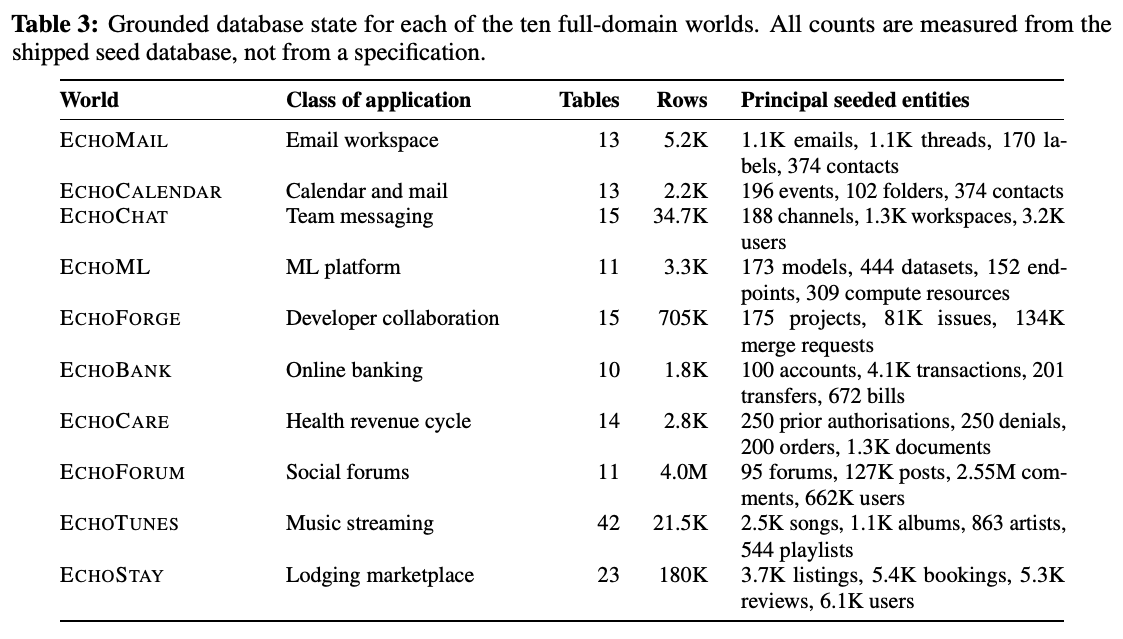
데이터베이스 규모는 월드마다 크게 다르다. ECHOBANK의 1.8K행부터 ECHOFORUM의 4.0M행까지 분포하며, 희소한 자리표시자가 아닌 조밀하게 시드된 상태를 문서화한다.
5.2 Two capability worlds
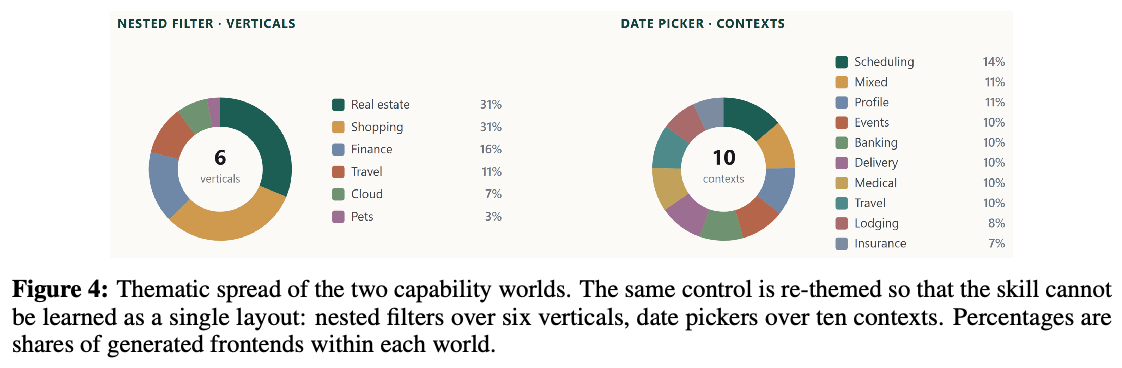
역량 월드는 또 다른 완전한 애플리케이션을 재현하는 대신 datepicker 및 nested-filter 상호작용 기술을 분리한다. datepicker 월드는 100개 프런트엔드에서 6개 위젯 유형으로 학습하고, 80개 프런트엔드에서 10개 특이 위젯을 held-out으로 둔다. nested-filter 월드는 200개 프런트엔드에서 20개 위젯 패밀리로 학습하고, 100개 프런트엔드에서 9개 복합 패널 패밀리를 held-out으로 둔다.
도넛 차트는 각 역량 월드가 동일한 control을 여러 수직 도메인과 맥락에 분산한다는 점을 보여 준다. 이는 하나의 주제별 레이아웃에 대한 의존성을 줄인다.
6 Supervised experiments
지도 학습 실험은 브라우저 행동에 정렬된 Qwen3.5-9B 기본 정책, 전체 코퍼스로 미세 조정한 동일한 9B 모델, 통과한 시연을 생성한 GPT-5.4를 비교한다. 롤아웃은 100개 행동으로 제한한다. 합성 작업은 데이터베이스에 근거한 채점을 사용하고, held-out WebVoyager와 Online-Mind2Web은 hosted 및 datacentre 브라우저 조건에서 공개된 평가기를 사용한다. 지도 학습에 대해서는 이 글을 참조하라.
6.2 Deep worlds transfer; shallow worlds set the model back
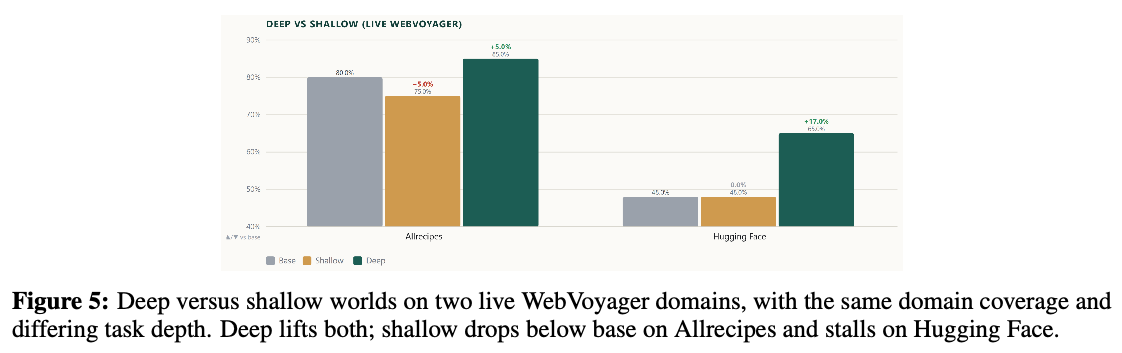
일치 도메인 live-WebVoyager 절제 실험에서 얕은 학습은 Allrecipes 정확도를 80.0%에서 75.0%로 낮추고 Hugging Face는 48.0%에 머문다. 반면 심층 학습은 각각 85.0%와 65.0%에 도달한다. 이 비교는 규모가 비슷하지만 동일하지는 않은 코퍼스를 가진 2개 도메인만 다루므로, 일반적인 정량 추정이 아니라 워크플로를 보존하는 깊이에 관한 방향성 주장만 뒷받침한다.
같은 2개 목표 도메인에서 심층 월드 학습만 두 live-WebVoyager 도메인을 모두 개선한다. 얕은 월드 학습은 Allrecipes 성능을 후퇴시키고 Hugging Face는 개선하지 못한다.
6.3 The full scorecard: base, our model and a frontier reference
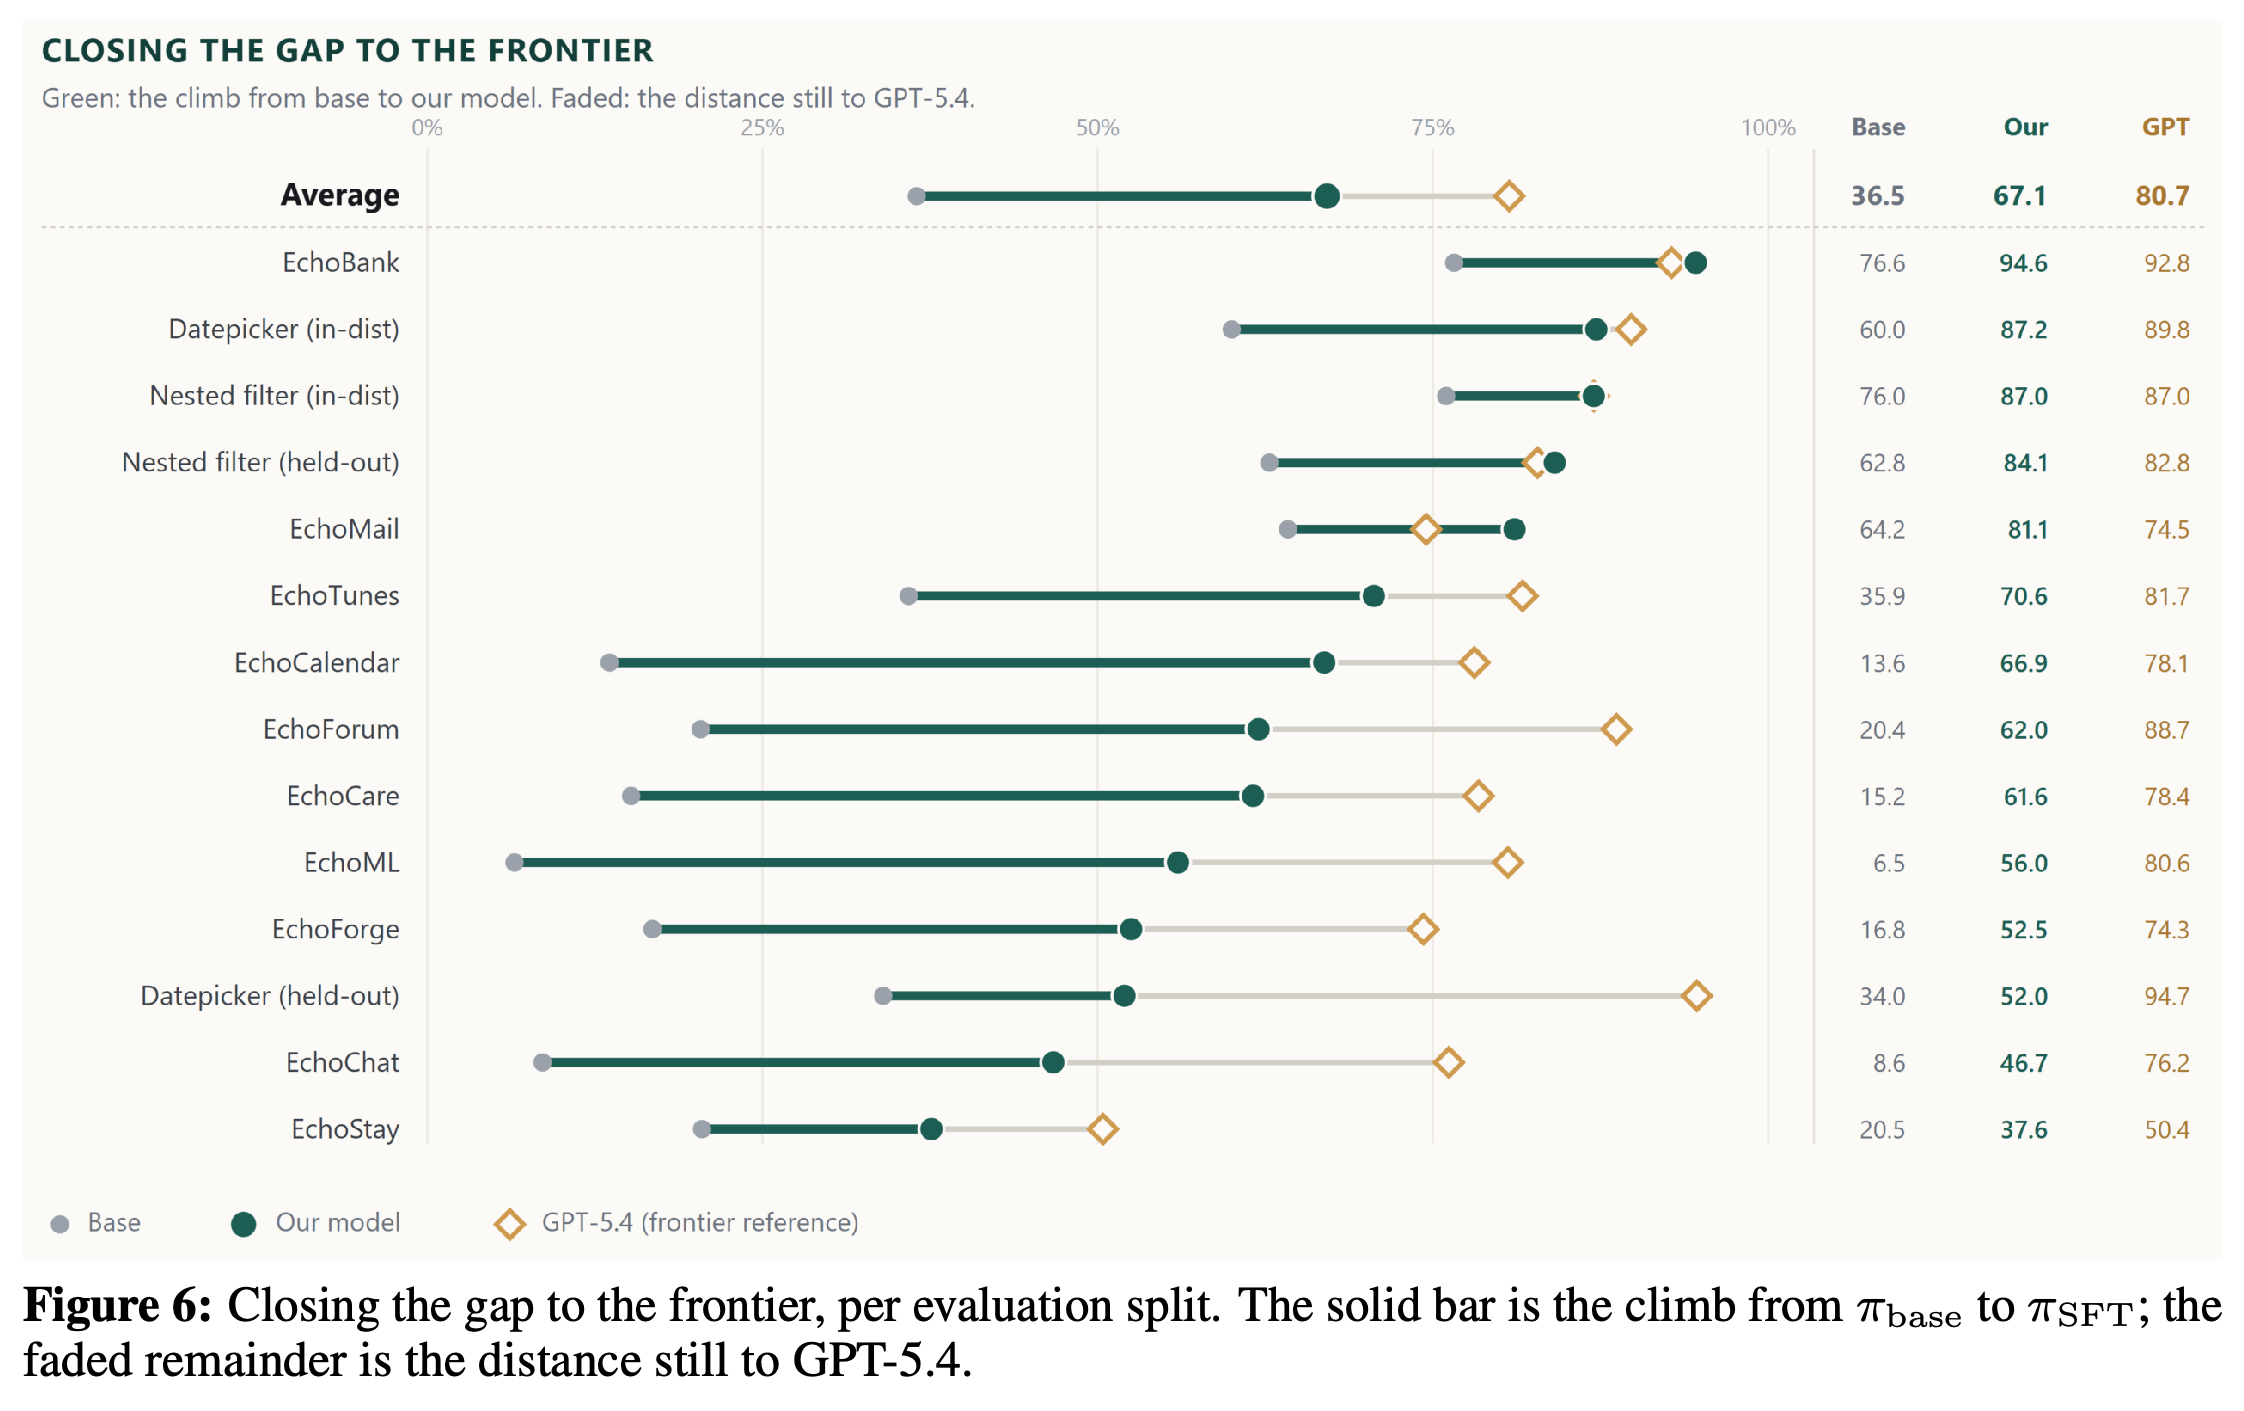
14개 데이터베이스에 근거한 분할 전체에서 완전한 지도 학습 모델은 평균 성공률을 36.5%에서 67.1%로 높이며, GPT-5.4는 80.7%를 기록한다. 9B 모델은 ECHOBANK, ECHOMAIL, 그리고 2개 nested-filter 분할에서 프런티어 참조 모델과 같거나 더 높은 성능을 보인다. 그러나 held-out datepicker, ECHOCHAT, ECHOSTAY 및 여러 다른 도메인에서는 여전히 크게 뒤처진다.
이 차트는 각 분할에서 기본 정책에서 지도 학습 모델로의 개선분과 GPT-5.4까지 남은 거리를 분해한다. 큰 향상과 함께 여전히 해결되지 않은 어려운 분할을 보여 준다.
6.4 Precision about one skill
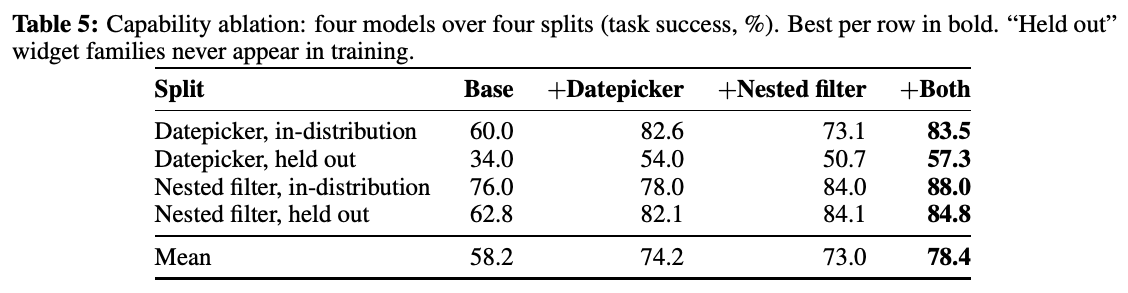
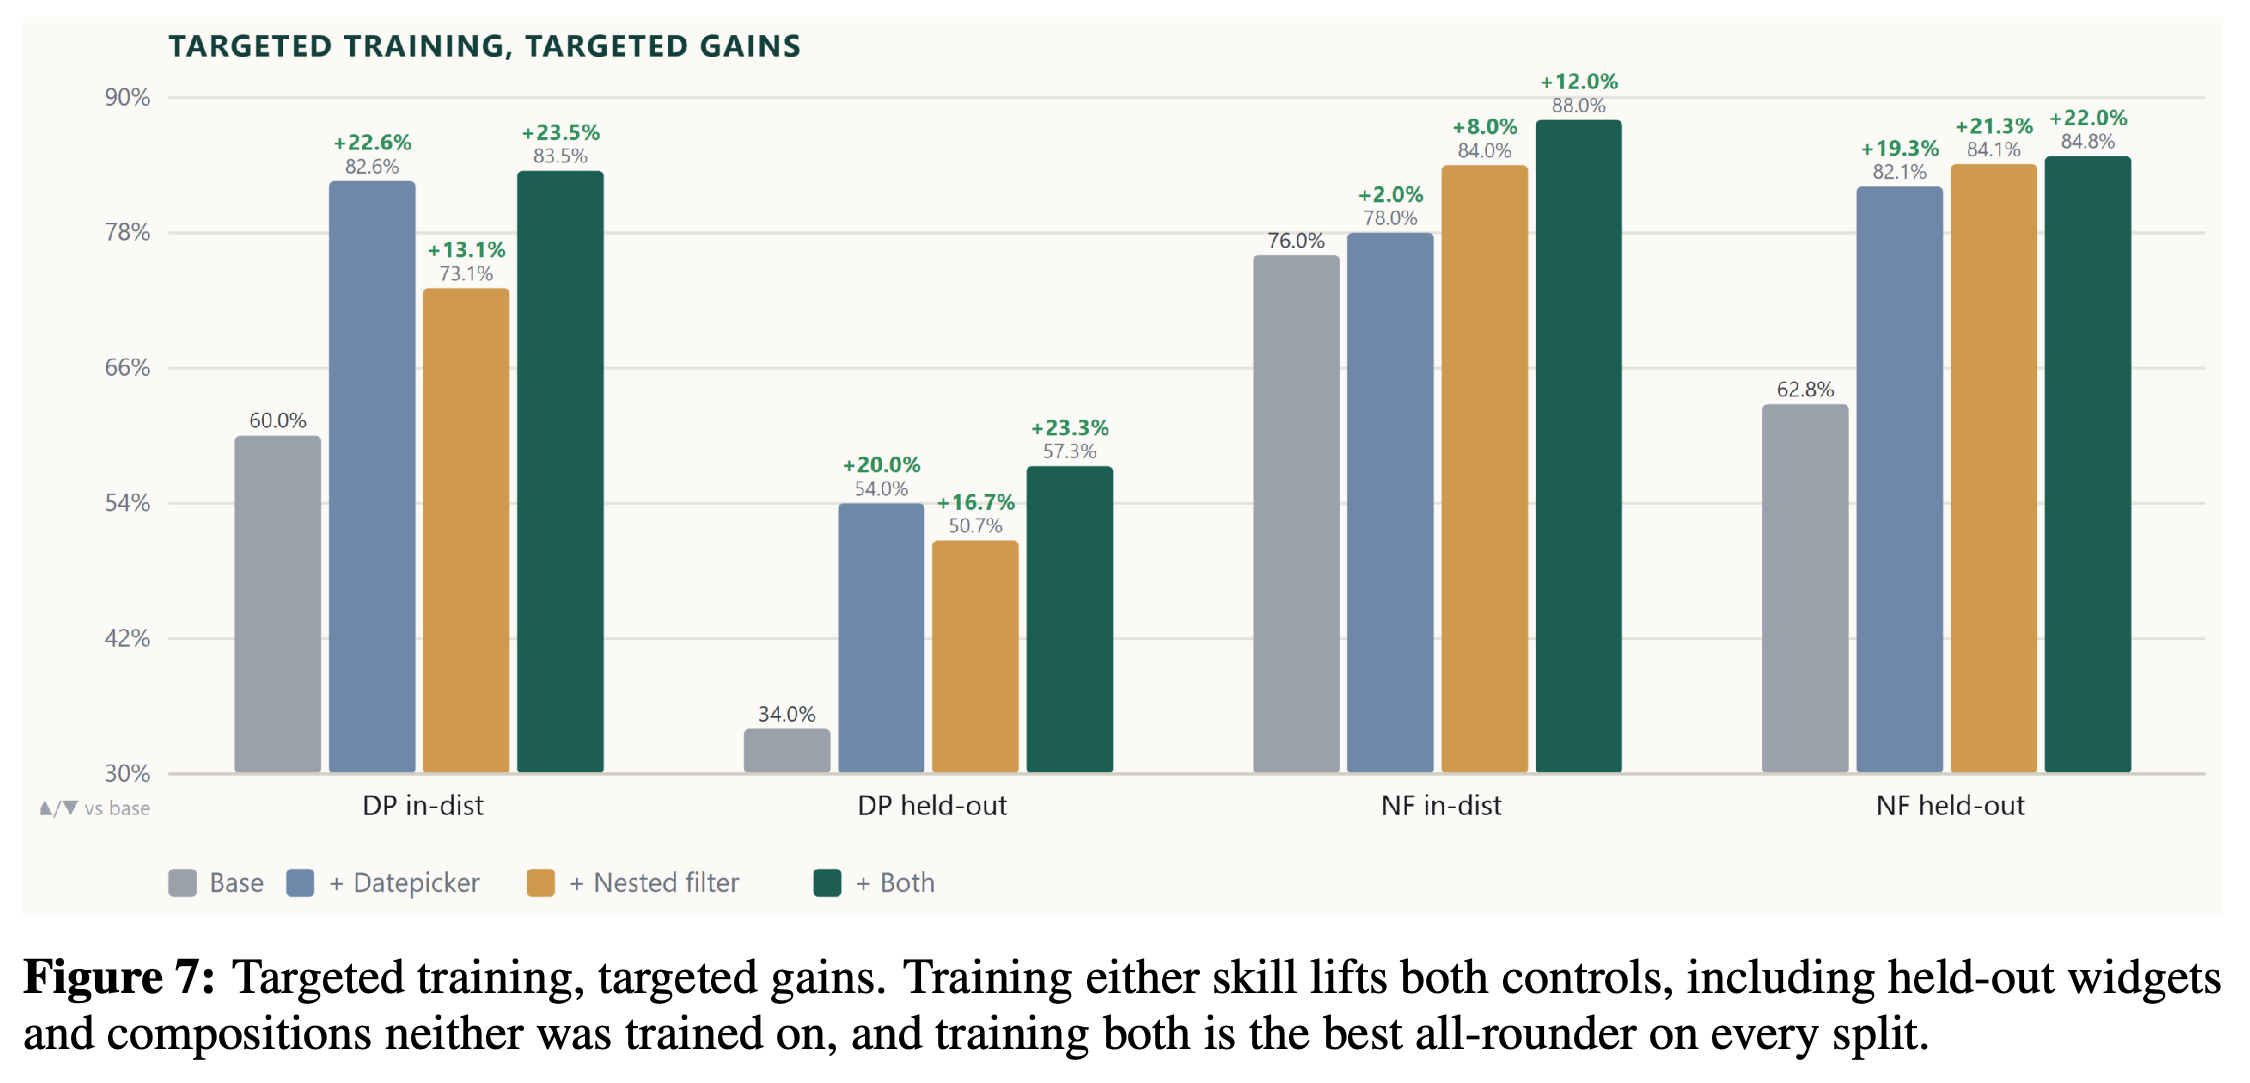
목표 역량 학습은 학습한 레이아웃을 넘어 일반화한다. 공동 학습한 역량 모델은 held-out datepicker 성공률을 34.0%에서 57.3%로, held-out nested-filter 성공률을 62.8%에서 84.8%로 높인다. 어느 한 control만 학습해도 다른 control의 성능이 개선되지만, 공동 학습은 보고된 모든 역량 분할에서 가장 강하며 capability-only 절제 실험에서 Online-Mind2Web을 29.5%에서 34.3%로 높인다.
이 절제 실험은 목표 기술 학습을 분리한다. 2개 단일 기술 모델은 각 control 간에 어느 정도 전이하지만, 공동 학습은 모든 in-distribution 및 held-out 역량 분할에서 최고 점수를 달성한다.
그룹 막대는 목표 역량 학습이 학습에 사용한 레이아웃뿐 아니라 보지 못한 위젯 패밀리와 조합에서도 성능을 향상함을 보여 준다.
6.6 What scaling buys, and what it does not
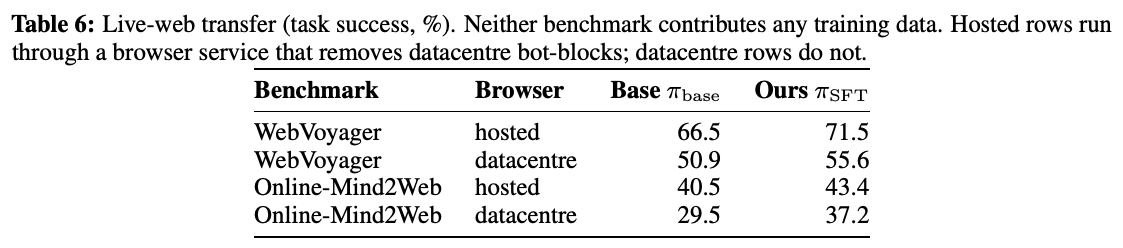
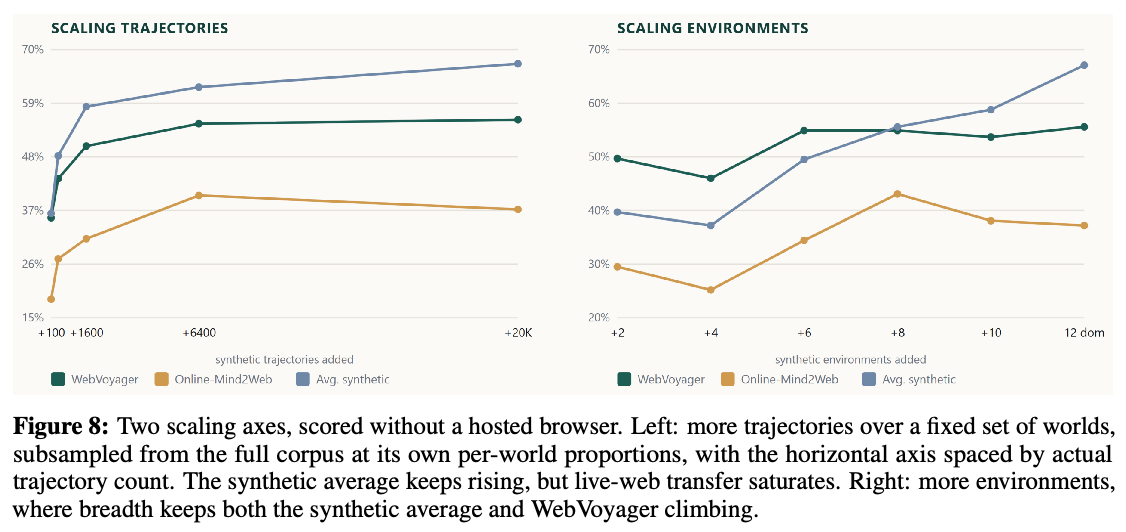
held-out 라이브 웹 벤치마크에서 완전한 지도 학습 모델은 hosted 브라우징에서 WebVoyager를 66.5%에서 71.5%로, datacentre 브라우징에서 50.9%에서 55.6%로 향상한다. Online-Mind2Web은 hosted에서 40.5%에서 43.4%로, datacentre에서 29.5%에서 37.2%로 상승한다. 월드 구성을 고정한 상태에서 궤적을 6,400개에서 20,000개로 늘려도 라이브 웹 전이가 실질적으로 개선되지는 않지만, 보고된 스윕에서는 서로 다른 환경을 추가하면 계속 도움이 된다.
이 표는 hosted와 datacentre 브라우징을 구분해 held-out 라이브 웹 성능 향상을 보여 준다. 동시에 인프라와 봇 차단이 절대 점수에 영향을 미친다는 점도 드러낸다.
왼쪽 패널은 고정된 월드에서 궤적 수가 늘면 in-domain 합성 성능은 상승하지만 라이브 웹 전이는 포화됨을 보여 준다. 오른쪽 패널은 스윕에서 환경을 추가하면 폭 의존적 전이가 계속 개선됨을 보여 준다.
6.7 The model is not the only thing that learns
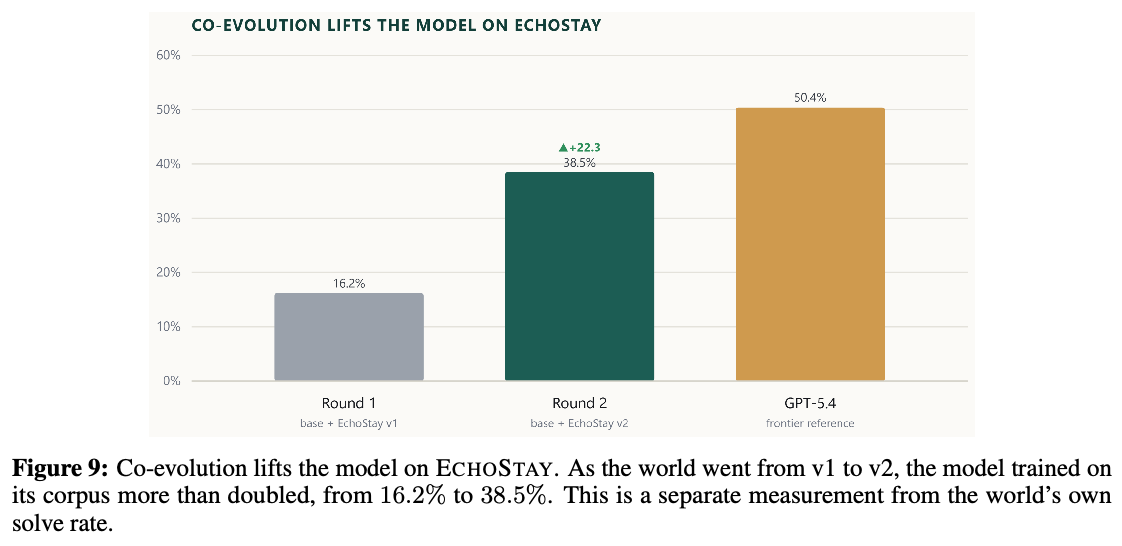
공진화는 단일 요인을 분리하지 않고 결합된 환경, 코퍼스, 검증기를 수정한다. ECHOSTAY에서는 투숙객 수 control을 수정해 완료 가능한 예약 비율이 48%에서 78%로 상승했고, 수정된 라운드 뒤에 학습한 모델은 16.2%에서 38.5%로 향상됐다. 저자들은 수정으로 제시하고 데이터베이스에 근거를 둘 수 있는 작업 자체가 달라지므로 환경만의 절제 실험은 잘 정의되지 않는다고 지적한다.
이 그림은 완전한 ECHOSTAY 공진화 라운드의 결과를 측정한다. 월드를 수정하고 코퍼스를 다시 생성하면 학습한 모델의 점수가 22.3 points 상승하지만, 그 향상을 개별 수정 하나에 귀속하지는 않는다.
7 Reinforcement learning on the worlds
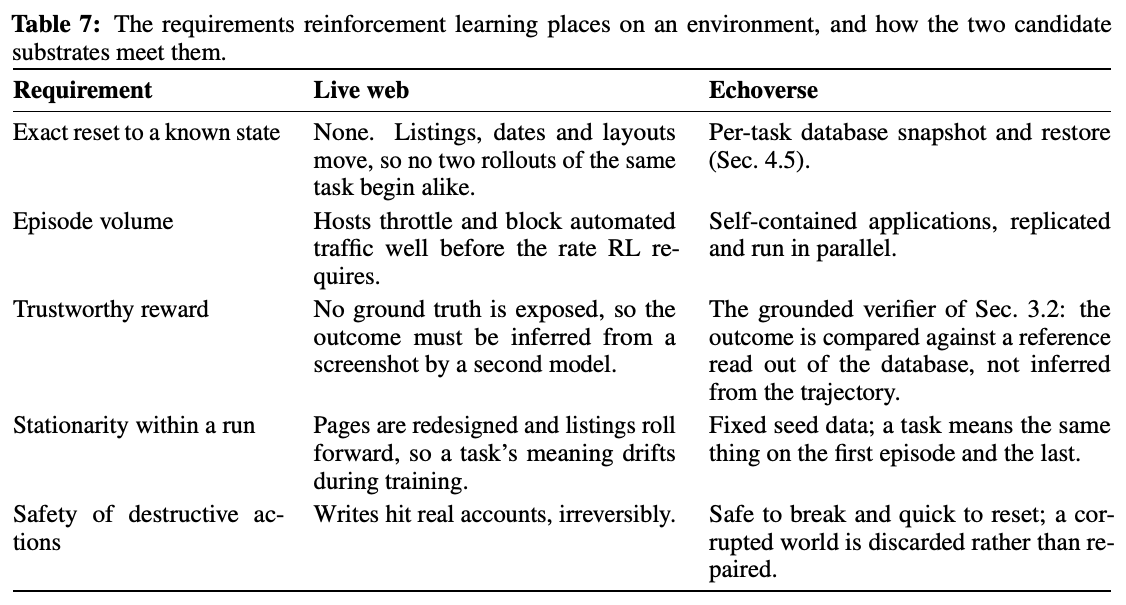
논문은 성공한 GPT-5.4 궤적을 모방하는 것만으로는 학생 모델 자신의 오류로부터 회복하거나 안정적으로 멈추는 법을 가르칠 수 없다고 주장한다. Echoverse는 라이브 웹에 없는 RL 조건을 제공한다. 조건은 정확한 작업별 데이터베이스 재설정, 병렬 에피소드 처리량, 데이터베이스에 근거한 결과, 정상성, 파괴적 행동에 대한 안전성이다.
이 비교는 저자들이 RL에 통제된 합성 월드를 사용하는 이유를 명확히 한다. 라이브 웹에는 정확한 재설정, 대량의 안전한 상호작용, 정상적인 작업, 직접 근거를 둔 보상이 부족하다.
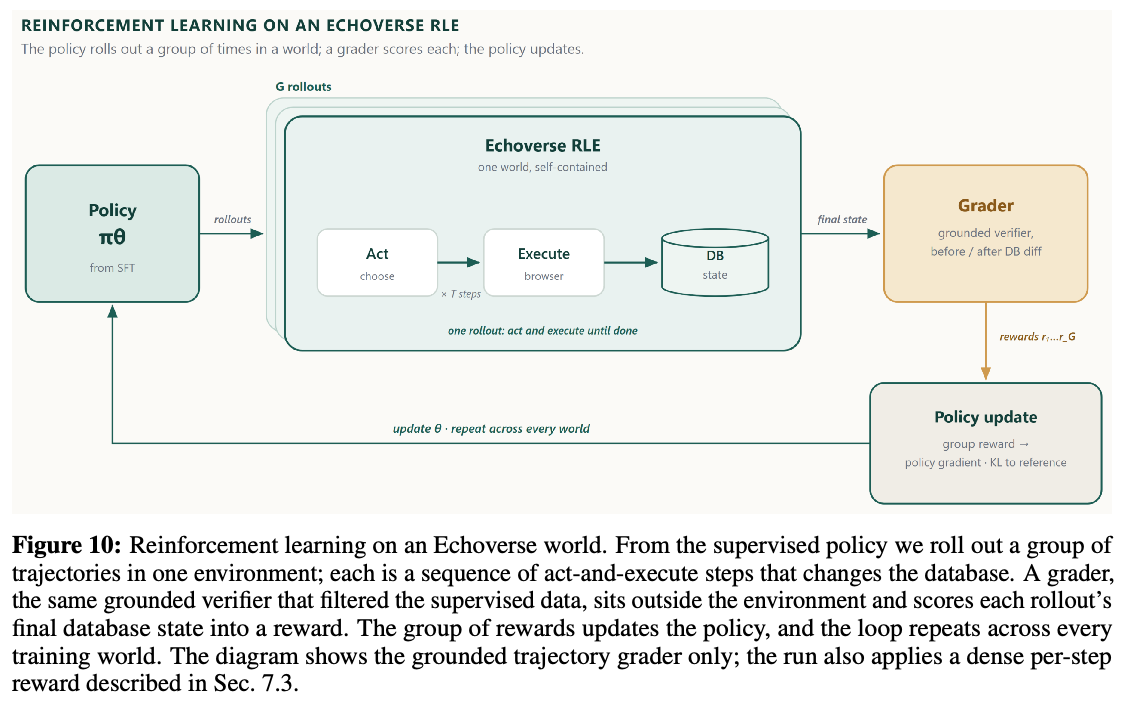
이 도식은 그룹화된 정책 롤아웃, 데이터베이스에 근거한 최종 상태 채점, 정책 업데이트를 보여 준다. 이는 종단 보상 채널을 묘사하며, 본문은 더 조밀한 단계별 학습 신호를 별도로 명시한다.
7.3 Method
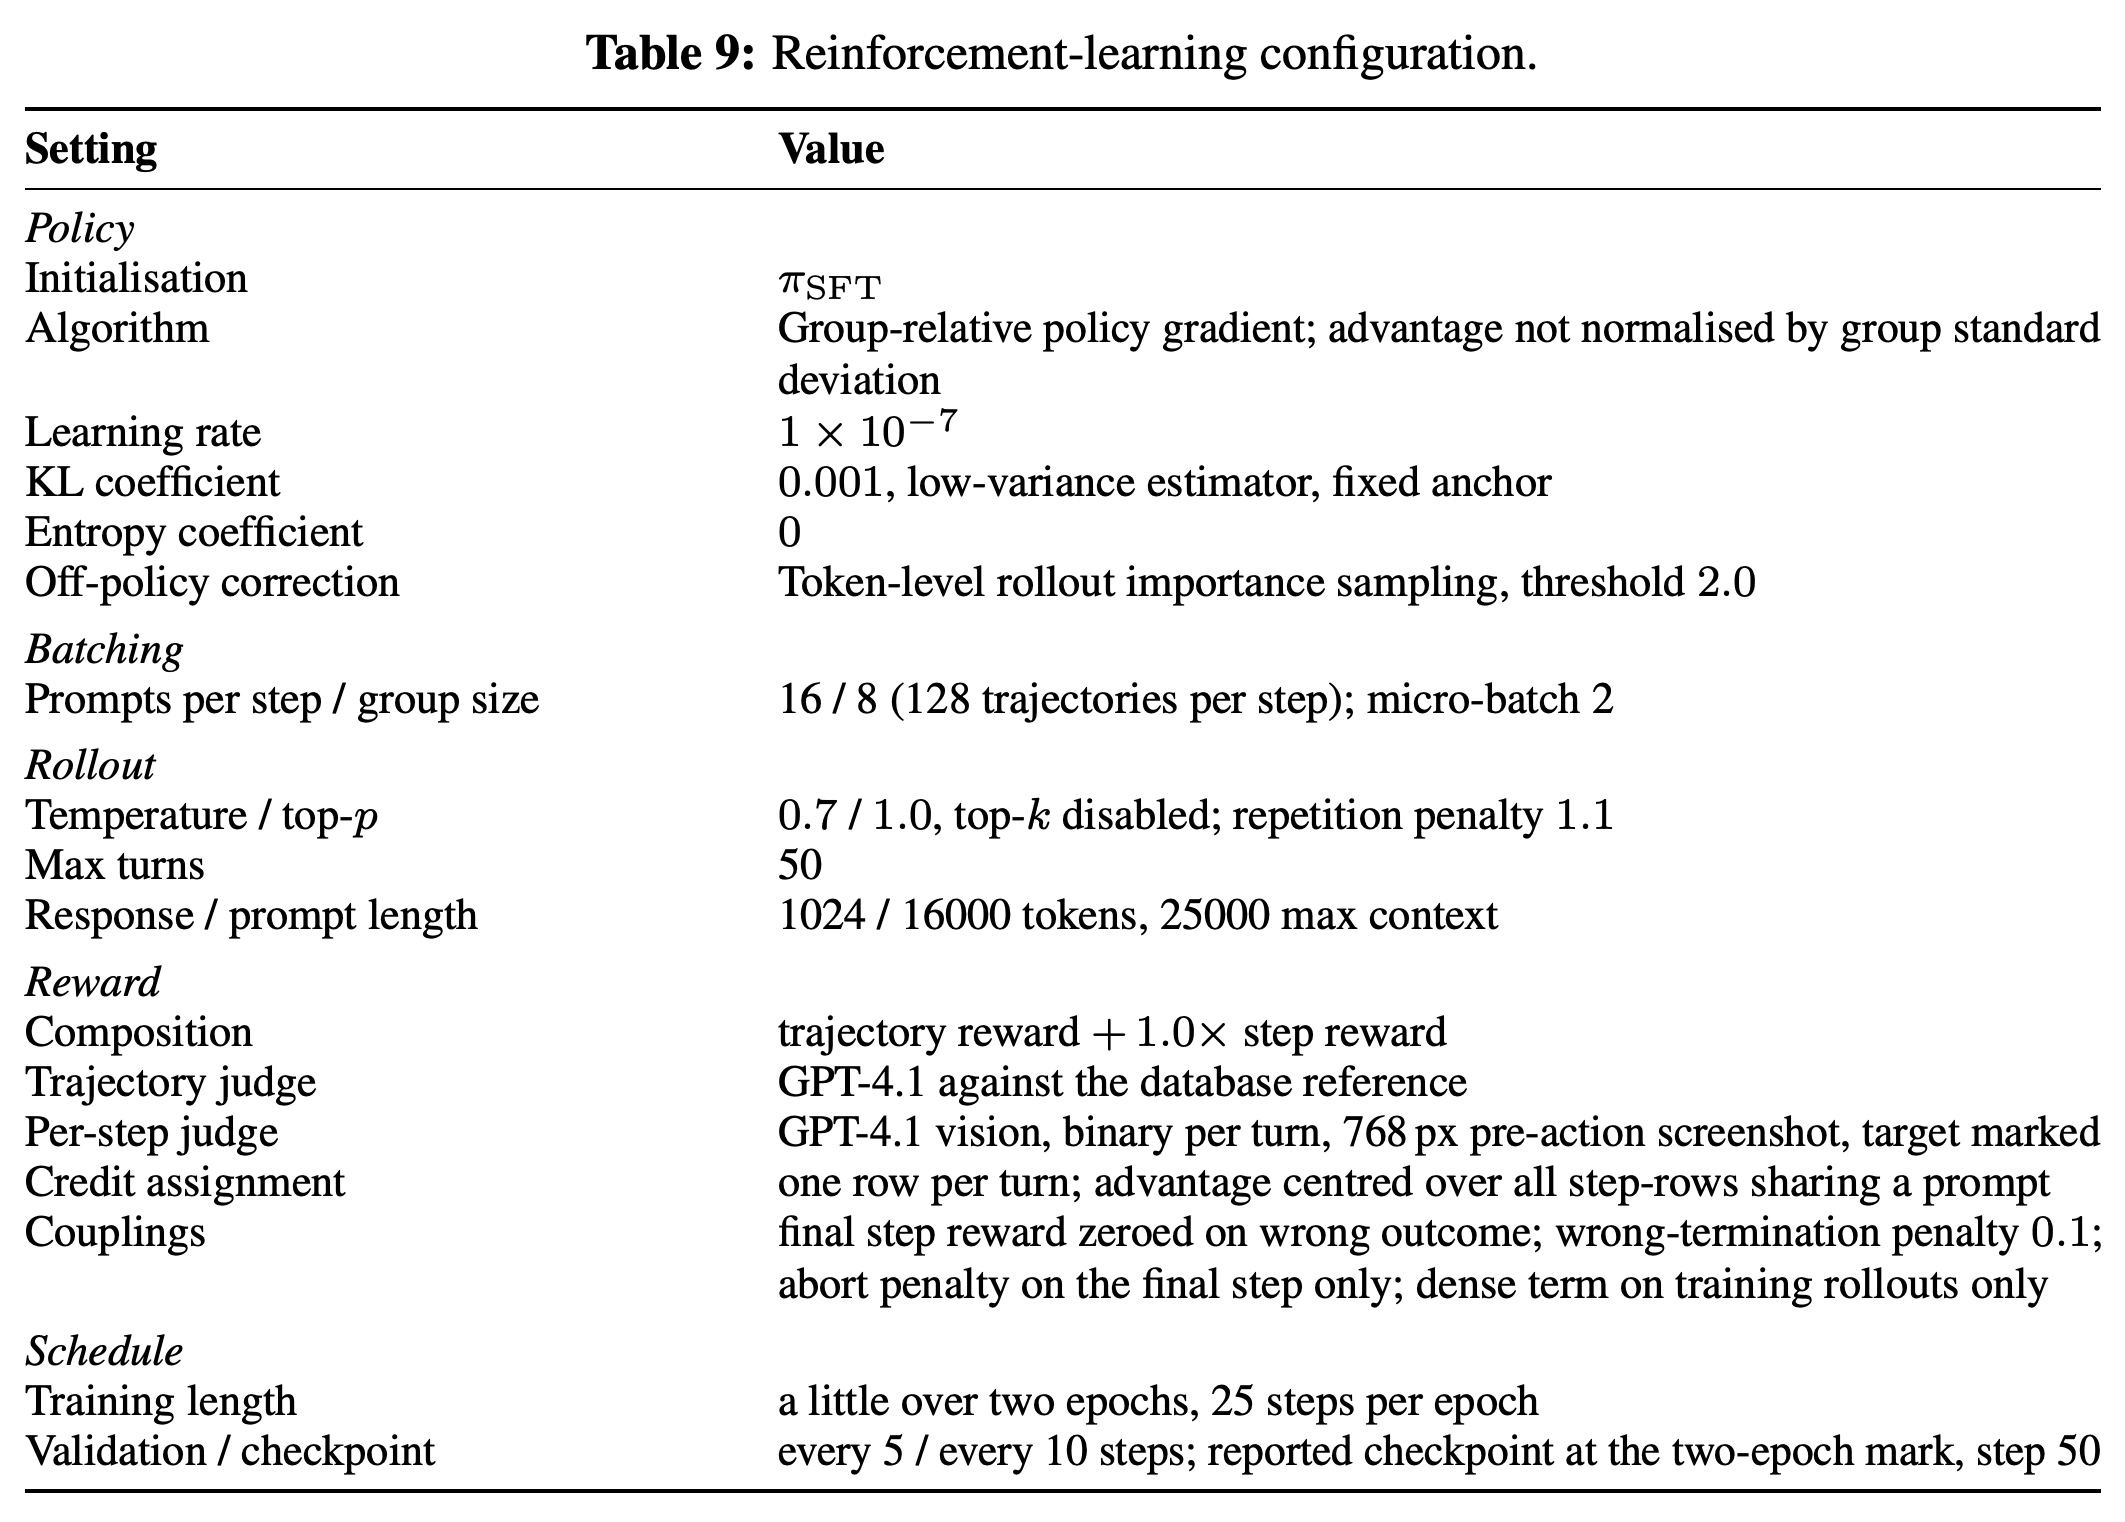
저자들은 πSFT에서 시작해 고정 참조 KL 패널티를 둔 group-relative policy gradient를 사용한다. 각 턴은 λ = 1인 Rrow = Rtraj + λ Rstep 보상을 받는다. Rtraj는 최종 데이터베이스 결과와 데이터베이스 참조를 비교하는 GPT-4.1 평가이며, Rstep ∈ {0, 1}은 표시된 행동이 작업을 명백히 진전시켰는지를 판단하는 GPT-4.1-vision 평가다. advantage는 표준편차 정규화 없이 같은 프롬프트를 공유하는 모든 step row에서 중심화한다.
7.5 Results
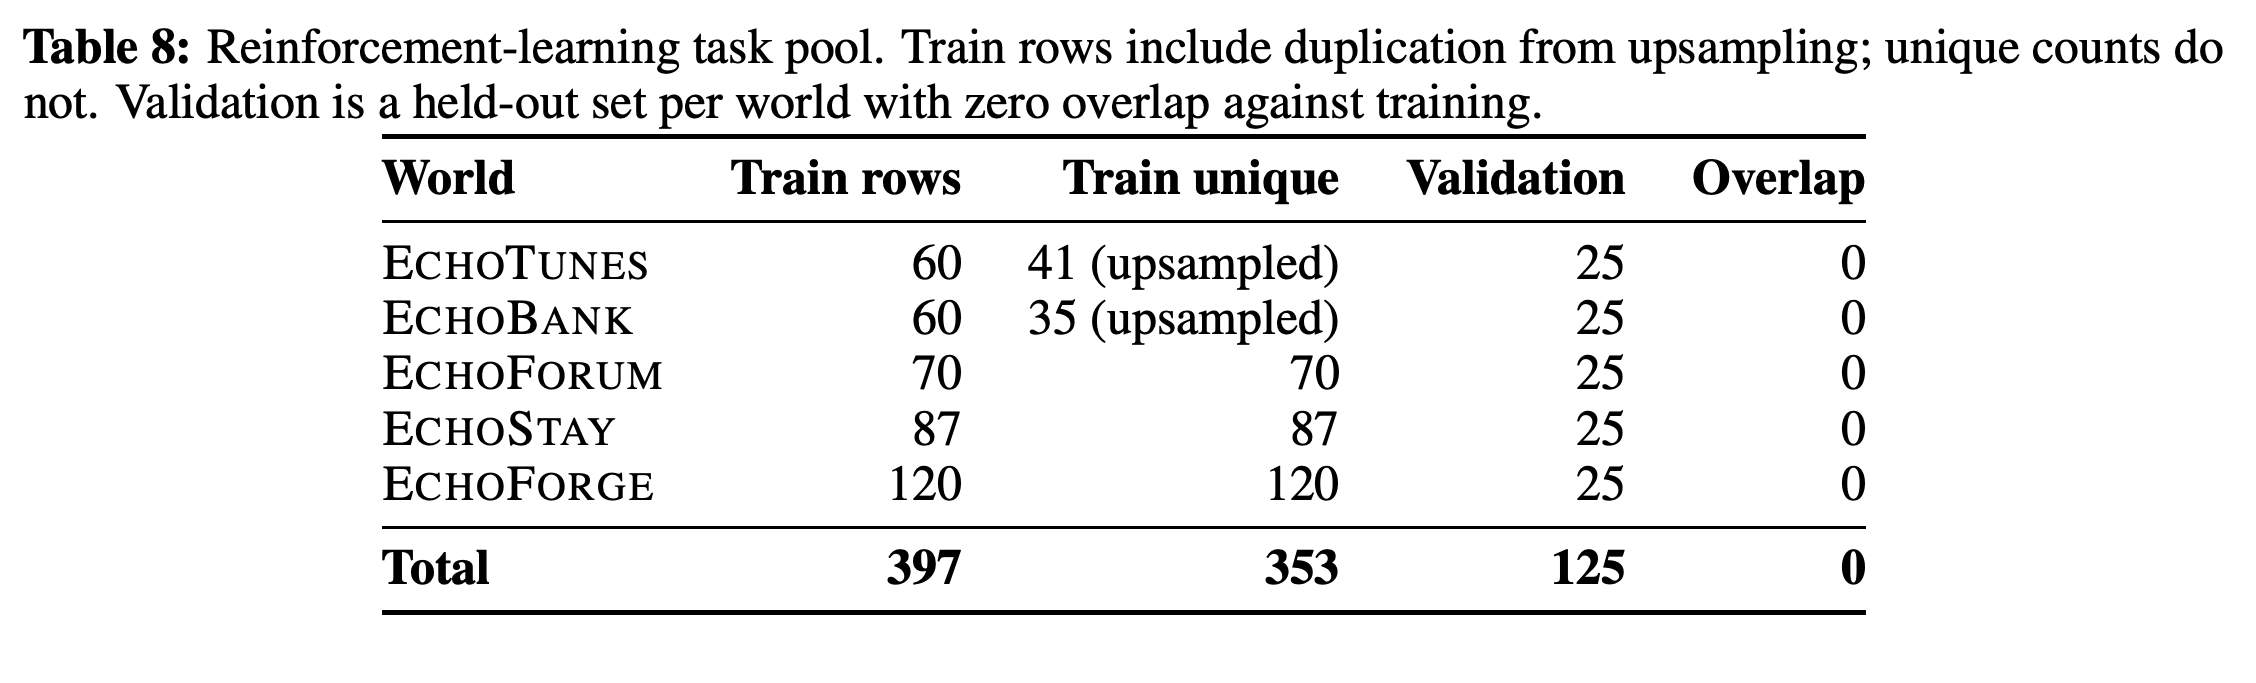
RL은 5개 월드에서 학습하며, 초기 정책 롤아웃 4회에서 0회 또는 4회 해결된 작업을 제외하도록 표본화한 353개 고유 필터링 작업과 분리된 검증 작업 125개를 사용한다. 2 epoch를 조금 넘긴 뒤 step 50에서 held-out grounded judged score는 58.8%에서 68.0%로 상승한다. 더 조밀한 단계별 보상은 학습 중에만 사용하며, 보고된 검증 지표에는 포함되지 않는다.
작업 풀 표는 업샘플링과 학습-검증 간 0개 중복을 포함한 5개 월드 RL 혼합을 기록한다. 따라서 68.0% 결과가 월드별로 분리된 검증 작업에서 평가됐음을 보여 준다.
이 설정은 group size 8, 1 × 10⁻⁷ 학습률, 50-turn rollouts, 궤적과 단계 보상을 결합한 설계를 포함하는 32-GPU group-relative policy-gradient 실행을 명시한다.
부록
- 부록은 명명 규칙, 21,009-trajectory supervised corpus, 읽기 및 쓰기 작업용 검증기 프롬프트, 역량 위젯 카탈로그를 문서화한다. 공개물은 시드 데이터와 데이터베이스에 근거한 검증기를 포함해 ECHOSTAY, ECHOFORGE, 두 역량 월드의 환경 코드와 평가 작업을 https://aka.ms/echoverse에서 제공한다.
짧은 생각
논문의 핵심 증거는 얕은 합성 월드가 라이브 사이트 성능을 낮출 수 있는 반면, 더 깊고 워크플로를 보존하는 월드는 성능을 개선한다는 통제 비교다. 결론은 생성된 환경, 데이터베이스에서 파생한 참조와 관찰 결과의 LLM 기반 의미 비교, 5개 월드 RL 실험이라는 제약을 받는다. 따라서 이 연구는 모든 컴퓨터 사용 환경에서 보편적 우위를 입증하기보다 유망한 환경 설계 접근법을 제시한다.