


Synthetic Sandbox for Training Machine Learning Engineering Agents 요약 설명
06 Apr 2026 | Paper Review Agent Learning Synthetic Environments Reinforcement Learning목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Preliminaries
- 4 SandMLE
- 5 Experiments
- 6 Analysis
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Synthetic Sandbox for Training Machine Learning Engineering Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 6일(Arxiv)
- Zhou, Yuhang, Zhang, Lizhu, Wu, Yifan, Liu, Jiayi, Fan, Xiangjun, Zhao, Zhuokai, Yan, Hong.
- Meta AI
- 논문 링크
요약
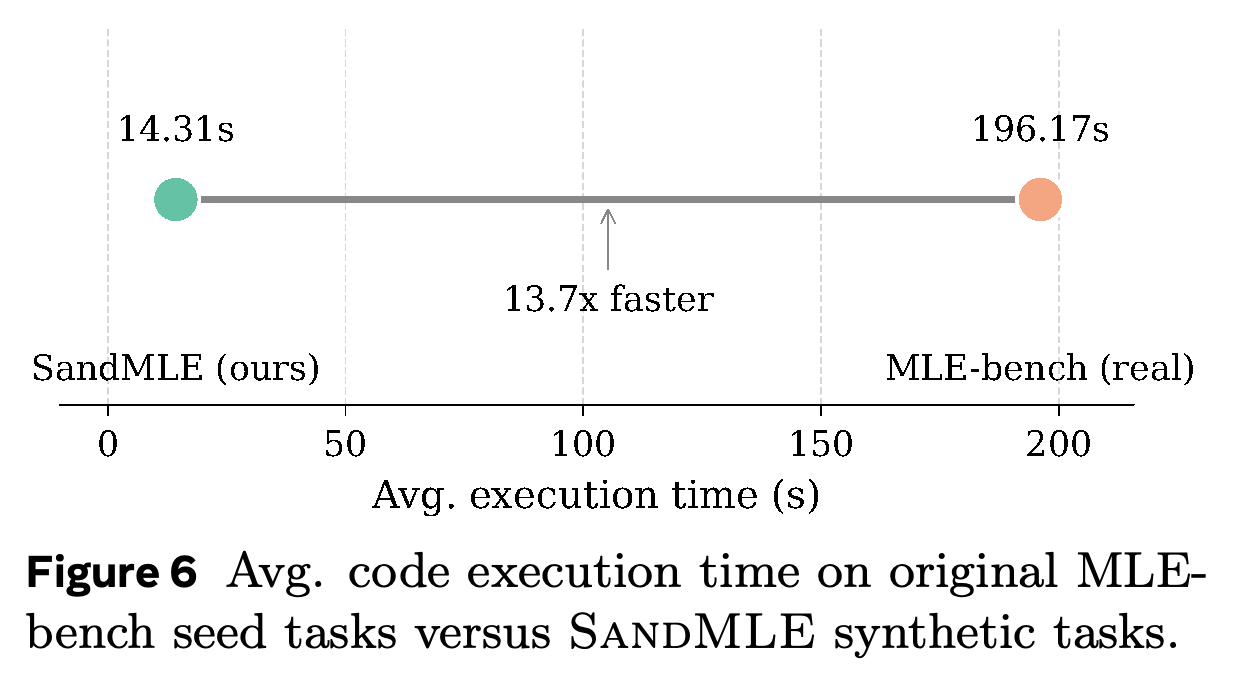
- Synthetic Sandbox for Training Machine Learning Engineering Agents는 궤적 단위 온폴리시 강화학습으로 MLE 에이전트를 훈련하는 프레임워크 SandMLE를 소개한다. 절차적으로 생성하는 과제는 표본 수 50–200개를 목표로 한다. 측정한 평균 코드 실행 시간은 원본 시드 과제의 196.17초에서 합성 과제의 14.31초로 줄어든다.
- 4개의 전문 에이전트가 과제 명세, 합성 데이터, 결정론적 평가기, 그리고 이들과 일치하는 설명을 생성한다. 실행 검사와 임곗값 순서 검증을 거쳐 궤적 단위 GRPO에 사용할 훈련 과제 848개와 검증 과제 64개를 확보한다. 보상은 추론 형식 준수, 유효한 제출물 생성, 점차 높아지는 성능 목표 달성에 부여한다.
- 학습에서 보지 않은 MLE-Bench-Lite 과제 22개에서 순수 SandMLE는 Qwen3-8B, Qwen3-14B, Qwen3-30B-A3B에 대해 각각 22.7%, 22.7%, 27.3%의 Any Medal 비율을 달성한다. 다른 스캐폴드와 MLE-Dojo 과제 62개에서도 전이를 확인하지만, 개선 폭은 스캐폴드와 지표에 따라 다르다. 어떤 생성 구성 요소가 전이를 가능하게 하는지는 실험으로 분리해 확인하지 않는다.
1 Introduction
MLE 에이전트는 접근법을 제안하고, 코드를 작성하고, 훈련 파이프라인을 실행한 뒤, 피드백을 확인하며 해법을 반복해서 수정한다. 소프트웨어 엔지니어링의 단위 테스트와 달리, 이러한 행동에는 대규모 데이터셋을 이용한 훈련과 추론이 필요할 수 있다. 논문은 실행 지연 시간을 궤적 단위 온폴리시 RL의 핵심 장애물로 지목한다.
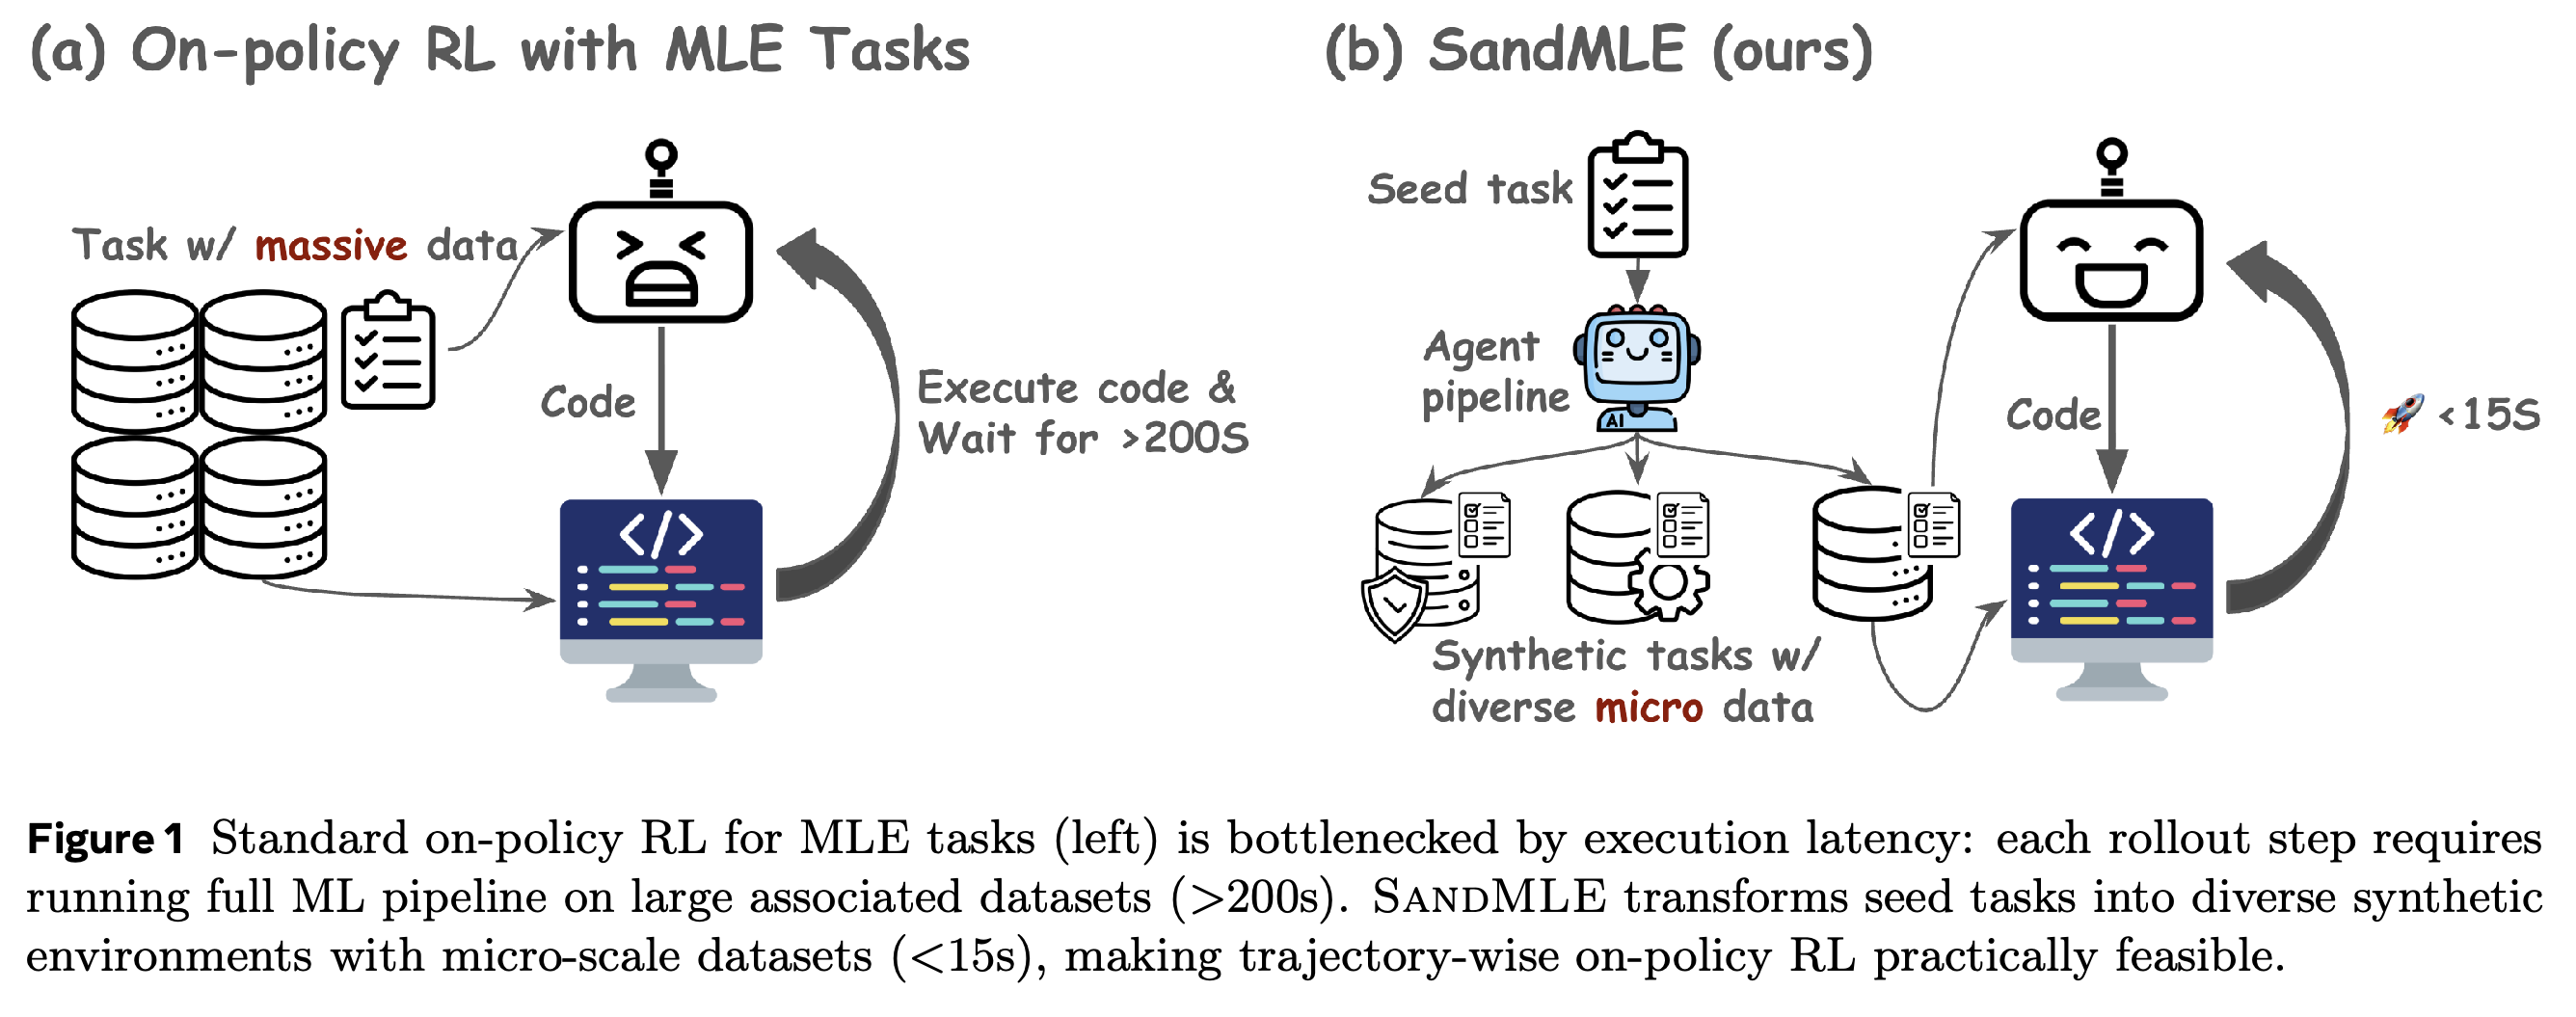
- Figure 1은 실제 데이터와 합성 소규모 데이터를 사용하는 상호작용 과정을 비교한다. >200s와 <15s 표시는 제안한 지연 시간 차이를 요약하며, 뒤에서 보고하는 측정 평균은 196.17초와 14.31초다.
- 주요 기여는 합성 샌드박스 생성, 단계별 성능 목표 보상을 사용하는 궤적 단위 RL, 그리고 훈련에 사용한 ReAct 이외의 스캐폴드에서 수행한 평가다.
- SandMLE는 추론 시점의 스캐폴드 설계에만 의존하지 않고 기반 모델의 정책을 갱신한다.
이 도식은 반복적인 코드 실행과 피드백을 병목으로 지목하고, SandMLE가 합성 과제 구성으로 이를 줄이는 방식을 보여준다. >200s와 <15s 표시는 의도한 지연 시간 차이를 요약하며, 뒤에서 제시하는 측정 평균과는 구분된다.
2 Related Work
관련 연구에서는 추론 시점의 MLE 스캐폴드와 실행에 기반한 정책 훈련을 구분한다. SandMLE는 MLE에 궤적 단위 RL을 적용할 때 제약이 되는 환경 비용을 다룬다.
2.1 Machine Learning Engineering (MLE) for Agents
MLE-bench는 Kaggle에서 가져온 과제와 메달 기반 평가를 제공하며, MLE-Dojo와 MLE-Smith는 사용 가능한 과제 모음을 확장한다. AIDE, AIRA, ML-Master, R&D Agent, FM Agent는 추론 시점의 탐색과 개선 과정을 강화한다. 논문은 이들의 성능이 스캐폴드 설계에 의존한다는 점을 강조한다.
- 프레임워크 간 비교 결과에서도 이러한 의존성이 나타난다. MLE-Dojo에서 Qwen3-14B-Base의 HumanRank Score는 MLE-Agent를 사용하면 9.62, AIDE를 사용하면 37.73이다.
- SandMLE는 모델 가중치를 훈련한 뒤, 학습한 정책이 RL 롤아웃에서 사용하지 않은 스캐폴드로 전이되는지 평가한다.
2.2 Reinforcement Learning for MLE Agents
소프트웨어 엔지니어링과 웹 검색 분야의 기존 궤적 단위 RL은 실행 피드백으로 학습하지만, MLE에는 반복적인 모델 훈련과 평가 비용이 추가된다. 저자들은 현재 정책으로 수집하는 SandMLE 롤아웃을 SFT, 오프라인 보상, 이전 정책 상태에서 궤적을 수집할 수 있는 비동기 훈련과 대비한다.
- 저자들은 비동기 실행으로 환경 지연 시간을 가리는 대신 지연 시간 자체를 줄이고자 한다.
- 실험은 조건을 맞춘 비동기 MLE RL 기준선이 아니라 Base 및 Seed-SFT 모델과 비교한다. 따라서 정책 지연을 없애는 효과를 직접 측정하지는 않는다.
3 Preliminaries
예비 지식에서는 MLE를 실행 가능한 환경과의 유한 단계 상호작용으로 정식화하고 GRPO를 소개한다. 환경 호출 비용이 높고 궤적이 끝난 뒤에야 보상이 결정된다는 점이 환경 및 보상 설계의 동기가 된다.
3.1 MLE as a Sequential Decision Process
MLE 과제는 초기 명세, 사용 가능한 도구, 실행 환경을 나타내는 (I, T, E)로 표현한다. 각 단계에서 정책은 명세, 도구, 이전 행동–관측 쌍을 조건으로 행동을 생성하고, 실행 결과, 오류, 지표를 받는다. 완성한 제출물은 비공개 테스트 데이터로 평가한다.
- 실행 지연 시간이 병목이 된다. 롤아웃의 각 행동은 전처리, 훈련, 추론을 호출할 수 있으므로, 온폴리시 궤적 수집 중 환경을 반복해서 호출하면 비용이 커진다.
- 상호작용은 지정된 제출 행동을 수행하거나 최대 단계 수 Tmax에 도달하면 종료된다. 기존의 실제 MLE 평가에서는 과제 1개에 최대 24시간을 허용하기도 한다.
3.2 Reinforcement Learning from Verifiable Rewards (RLVR)
GRPO는 입력마다 후보 N개를 샘플링하고 (\hat{A}_i = \frac{r_i-\mu_r}{\sigma_r})로 그룹 내 보상을 정규화한다. 클리핑된 확률비 목적함수는 별도의 크리틱 없이 상대적으로 더 나은 후보를 선호하도록 한다. 일반적인 정식화에는 참조 정책에 대한 KL 페널티가 포함되지만, SandMLE 구현에서는 이를 비활성화한다.
- 다중 턴의 궤적 단위 에이전트 과제에 GRPO를 적용할 때는 각 후보가 단일 응답이 아니라 완전한 행동–관측 궤적이다. 정책 그래디언트는 모델이 생성한 행동 토큰에만 적용한다.
- 논문은 훈련 예제당 환경 실행 비용을 O(N · Tmax · cexec)로 표현한다. cexec를 줄이면 수집 비용이 낮아진다. 단계별 성능 임곗값은 완료된 궤적들의 성능을 구분해, 희소한 성능 피드백을 보완한다.
- 어드밴티지는 궤적 단위로 계산한다. 학습 가능한 가치 함수나 턴별 어드밴티지 추정기는 도입하지 않는다.
4 SandMLE
SandMLE는 대회 데이터셋의 표본 수만 줄이는 대신 과제, 데이터, 평가기를 함께 구성한다. 저자들은 기존 과제의 표본 수를 줄이면 고정된 평가 데이터와 리더보드 기준선이 어긋날 수 있으며, 서로 다른 훈련 과제의 수는 늘어나지 않는다고 주장한다.
- 합성 환경을 구성하면 비공개 규칙, 데이터 규모, 기준선 임곗값, 제출 형식을 함께 설계할 수 있다.
- 실제 과제 평가는 이러한 소규모 환경에서 학습한 행동이 처음 접하는 대회에서도 유용한지 확인한다.
4.1 Synthetic Environment Generation
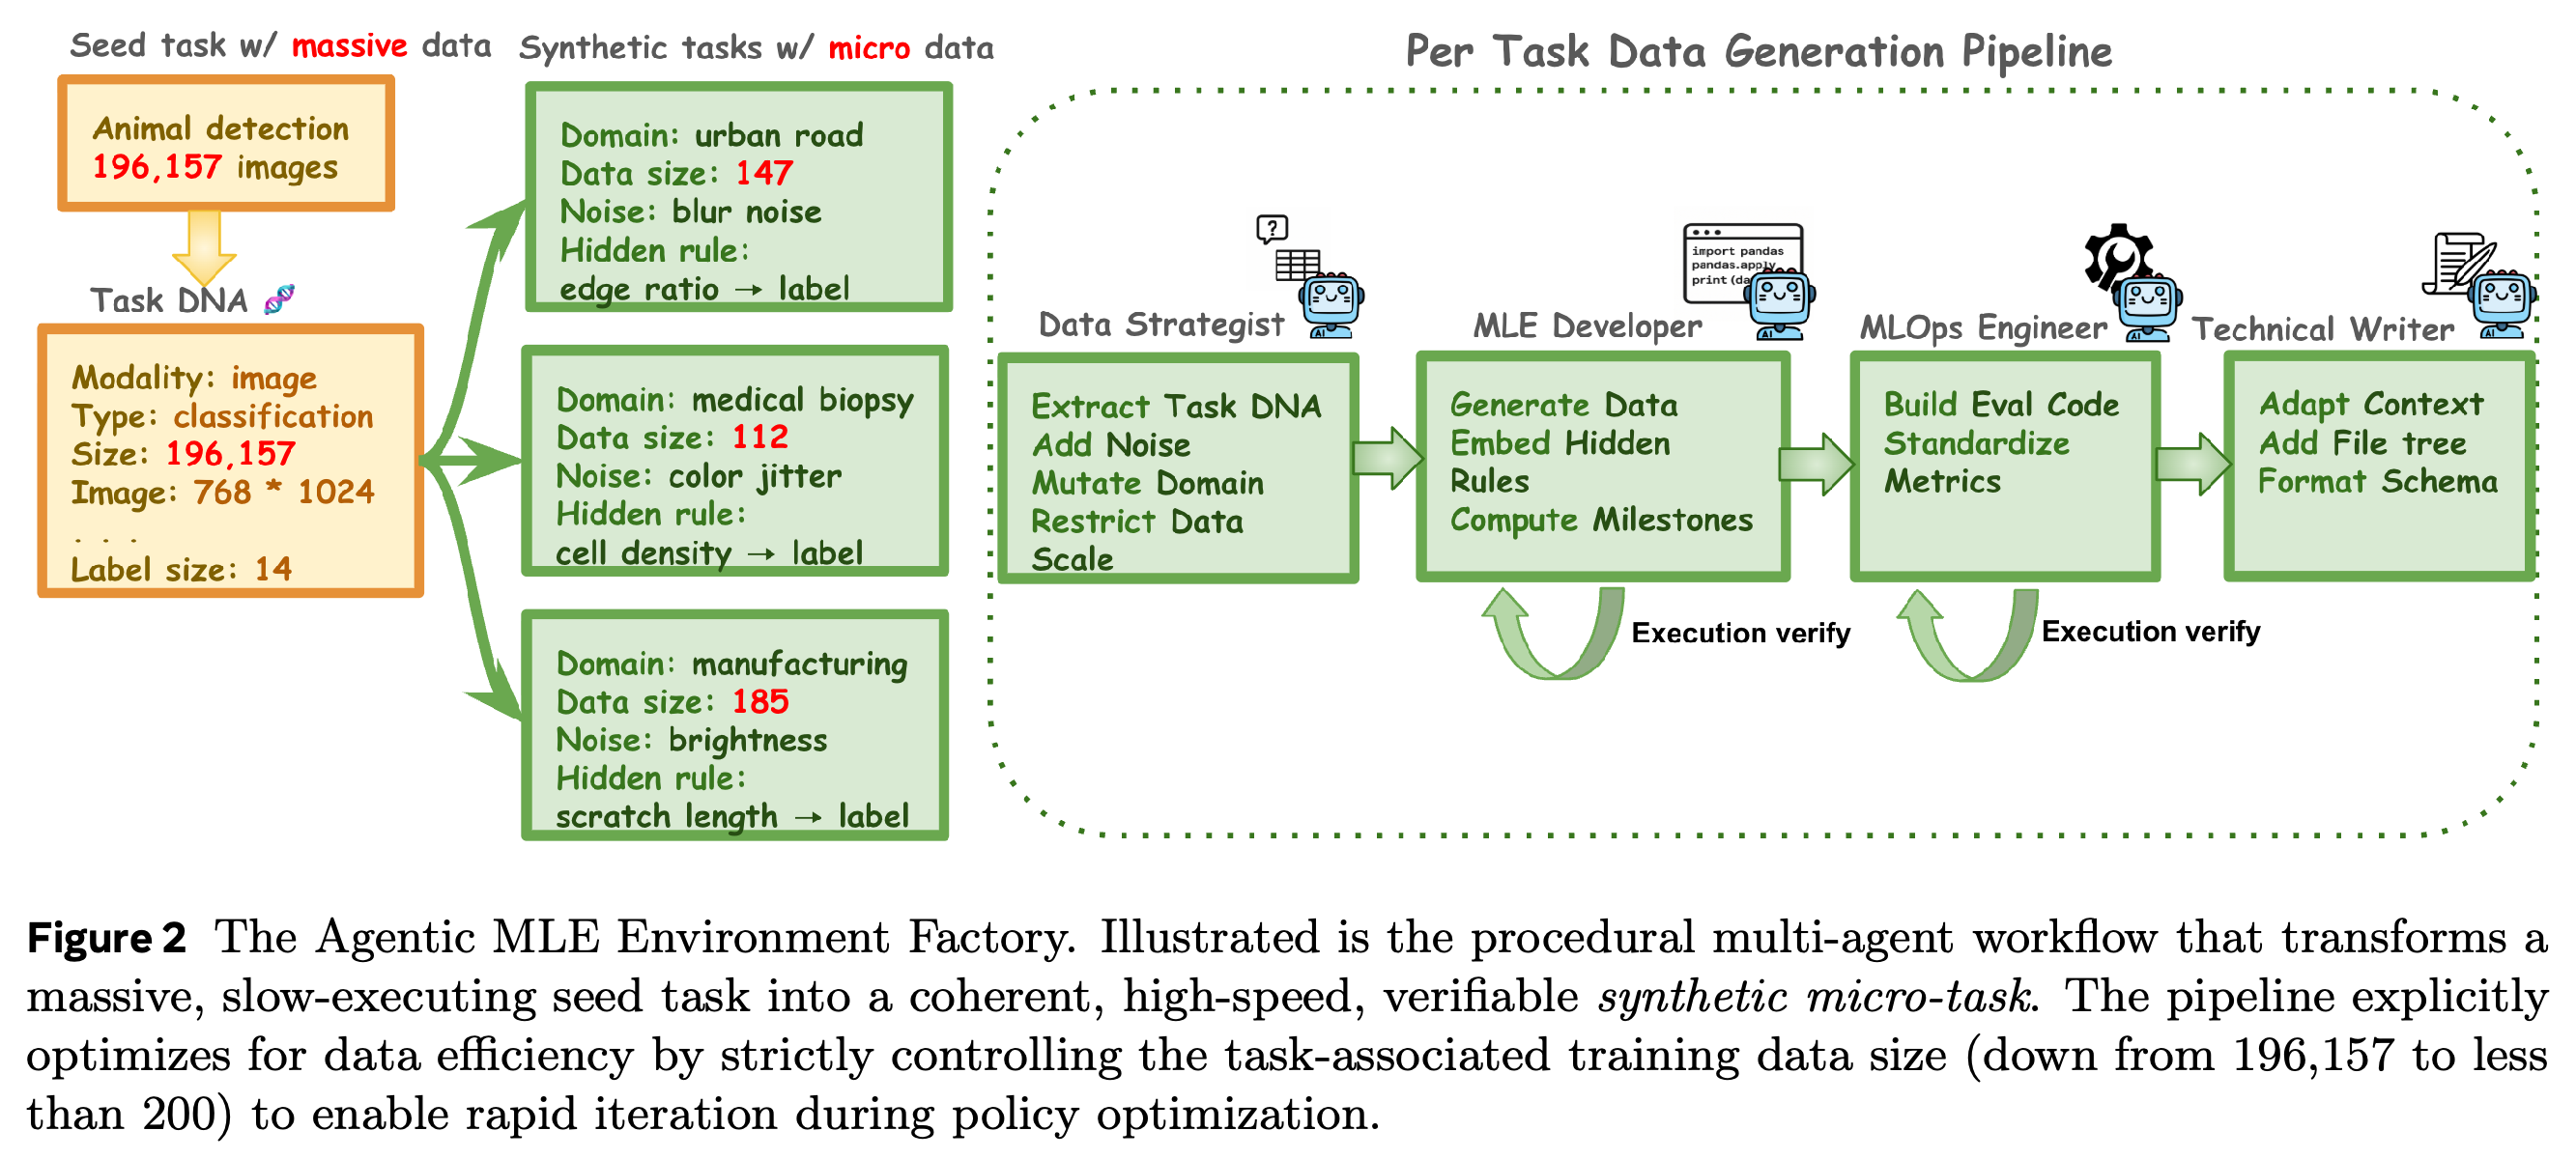
환경 생성기는 시드 과제를 확장하고 명세를 작성한 뒤, 에이전트를 통해 데이터를 생성하고, 평가 환경을 설정하고, 과제 설명을 작성한다. Figure 2는 이 과정을 조율하는 워크플로와 생성 데이터 및 평가기 스크립트를 실행 결과에 따라 수정하는 반복 과정을 보여준다.
- Data Strategist는 시드 과제를 확장하고 명세를 작성한다. 구조적 Task DNA를 추출해 다른 응용 도메인으로 옮기고, 모달리티에 맞는 노이즈를 주입한 뒤, 비공개 규칙 (H:\ l=f(z)+\epsilon)를 포함한 명세를 작성한다. 표본 수는 50–200개를 목표로 하며, 복잡도가 점차 높아지는 기준선 방법을 제안한다.
- ML Developer는 합성 데이터를 생성한다. 독립 실행형 Python 스크립트가 데이터 파일과 훈련/테스트 분할을 생성하고, 비공개 라벨 규칙을 구현하며, 기준선 방법을 평가해 단계별 성능 임곗값을 정하고, 더미 제출 예제를 만든다. 실행에 실패하면 디버깅을 위해 실행 결과를 에이전트에 돌려준다.
- MLOps Engineer는 평가 환경을 설정한다. 평가기는 지표, 최적화 방향, 임곗값을 고정하고, 예측을 비공개 라벨과 대응시켜 점수를 계산한다. 더미 제출물로 테스트하고 실행에 실패하면 수정한다.
- Technical Writer는 과제 설명을 작성한다. markdown 설명의 시나리오, 데이터 형식, 평가 지표, 제출 형식을 생성된 파일과 일치시킨다. 공개 파일 목록에서는 비공개 정답을 제외한다.
이미지 196,157개로 이루어진 시드를 Task DNA로 추상화한 뒤, 표본 수가 147개, 112개, 185개인 예제로 확장한다. 역할 4개로 구성한 워크플로가 데이터, 비공개 규칙, 단계별 성능 임곗값, 평가 코드, 문서를 조율한다. 개발자와 평가기 단계에는 실행 검증을 반복하는 과정이 포함된다.
4.2 Environment Sanity Verification
환경 건전성 검증은 단계별 성능 임곗값이 지표의 최적화 방향에 따라 엄격한 순서를 이루지 않는 과제를 제외한다. 가장 강한 임곗값을 s1, 가장 약한 임곗값을 sk로 두면, 낮을수록 좋은 과제는 s1 < s2 < ··· < sk와 s1 < ssample을 만족해야 한다. 높을수록 좋은 과제에는 반대 부등식을 적용한다.
- ssample과의 비교는 가장 강한 임곗값이 더미 제출물의 점수보다 나아야 한다는 조건이다.
- 이 검사는 임곗값의 일관성을 확인할 뿐, 과제의 해결 가능성, 편법의 부재, 실제 과제와의 난이도 동등성을 포괄적으로 보장하지는 않는다.
4.3 Trajectory-Level GRPO
MLE 과제에 온폴리시 RL을 적용할 때 ReAct 롤아웃은 단계별 실행 시간 제한과 최대 궤적 길이 안에서 추론 또는 코드 행동 생성과 환경 피드백을 번갈아 수행한다. 최종 제출, 단계 수 제한 도달, 또는 종료 오류가 발생하면 궤적을 끝낸다.
- 궤적 보상은 r = wformat · rformat + wexecute · Iexecute + Σ_i wsi · Isi다. 형식 항은 <think>…</think> 태그를 사용하는 단계의 비율를 측정하며, 나머지 항은 유효한 출력 생성과 최종 점수의 임곗값 달성 여부를 나타낸다.
- 가중치의 합은 1.0이며, 최고 성능 단계에 도달해야만 보상을 주는 대신 부분 점수를 제공한다. 조밀한 보상이라고 부르지만, 실행 및 성능 지시자는 매 턴에 별도의 성능 보상을 주는 것이 아니라 최종 환경 상태를 평가한다.
- 역전파에는 선택적 마스킹을 적용한다. 손실은 생성한 추론 및 행동 토큰에 적용하고, 관측이나 프롬프트에는 적용하지 않는다. 코드 실행이 시간 제한을 초과한 궤적은 전체를 마스킹한다.
5 Experiments
실험은 합성 환경의 실행 효율, 실제 과제 성능, 테스트 시점 스케일링, 훈련 양상을 측정한다. 이어지는 분석에서는 다른 스캐폴드로의 전이를 평가하고 단계별 성능 목표 보상을 희소 보상과 비교한다.
5.1 Experimental Setup
MLE-bench의 Medium, Hard, Dev 분할에서 가져온 질문 60개를 생성 파이프라인의 시드로 사용해 합성 훈련 과제 848개와 별도로 분리한 합성 검증 과제 64개를 만든다. 실제 과제 평가는 MLE-Bench-Lite의 학습에서 보지 않은 Easy 분할 질문 22개와 추가 MLE-Dojo 과제 62개를 사용한다.
- MLE-Bench-Lite는 Valid Submission, Above Median, Bronze, Silver, Gold, Any Medal을 보고하며, 주 지표는 Any Medal이다. MLE-Dojo는 제출 유효성과 HumanRank Score를 보고한다.
- 훈련에는 ReAct를 사용한다. 평가에는 MLE-Bench-Lite에서 ReAct, AIRA, AIDE를 사용하고, MLE-Dojo에서 MLE-Agent와 AIDE를 사용한다.
- 모델은 Qwen3-8B, Qwen3-14B, Qwen3-30B-A3B-2507이다. Base는 원본 체크포인트이며, Seed-SFT는 시드 60개에서 수집한 Claude-4.5-Sonnet 궤적으로 학습한다. SandMLE는 Base에서 GRPO를 적용하고, SFT-SandMLE는 Seed-SFT에서 GRPO를 적용한다.
- 보상 가중치는 wformat = 0.1, wexecute = 0.3, wsmedian = 0.1, wsbronze = 0.2, wssilver = 0.2, wsgold = 0.1이다. 훈련 제한은 Tmax = 20과 τmax = 90초다.
- Appendix A.2는 RLLM, 그룹 크기 n = 4, 롤아웃 temperature 1.0, 학습률 1 × 10⁻⁶, 배치 크기 16, 클리핑 비율 0.28, KL 페널티 미사용을 명시한다. 각 과제에 NVIDIA H200 GPU 1개를 할당하며, 평가 시 생성 temperature는 0.0이다.
5.2 Statistics of Synthetic Training Data
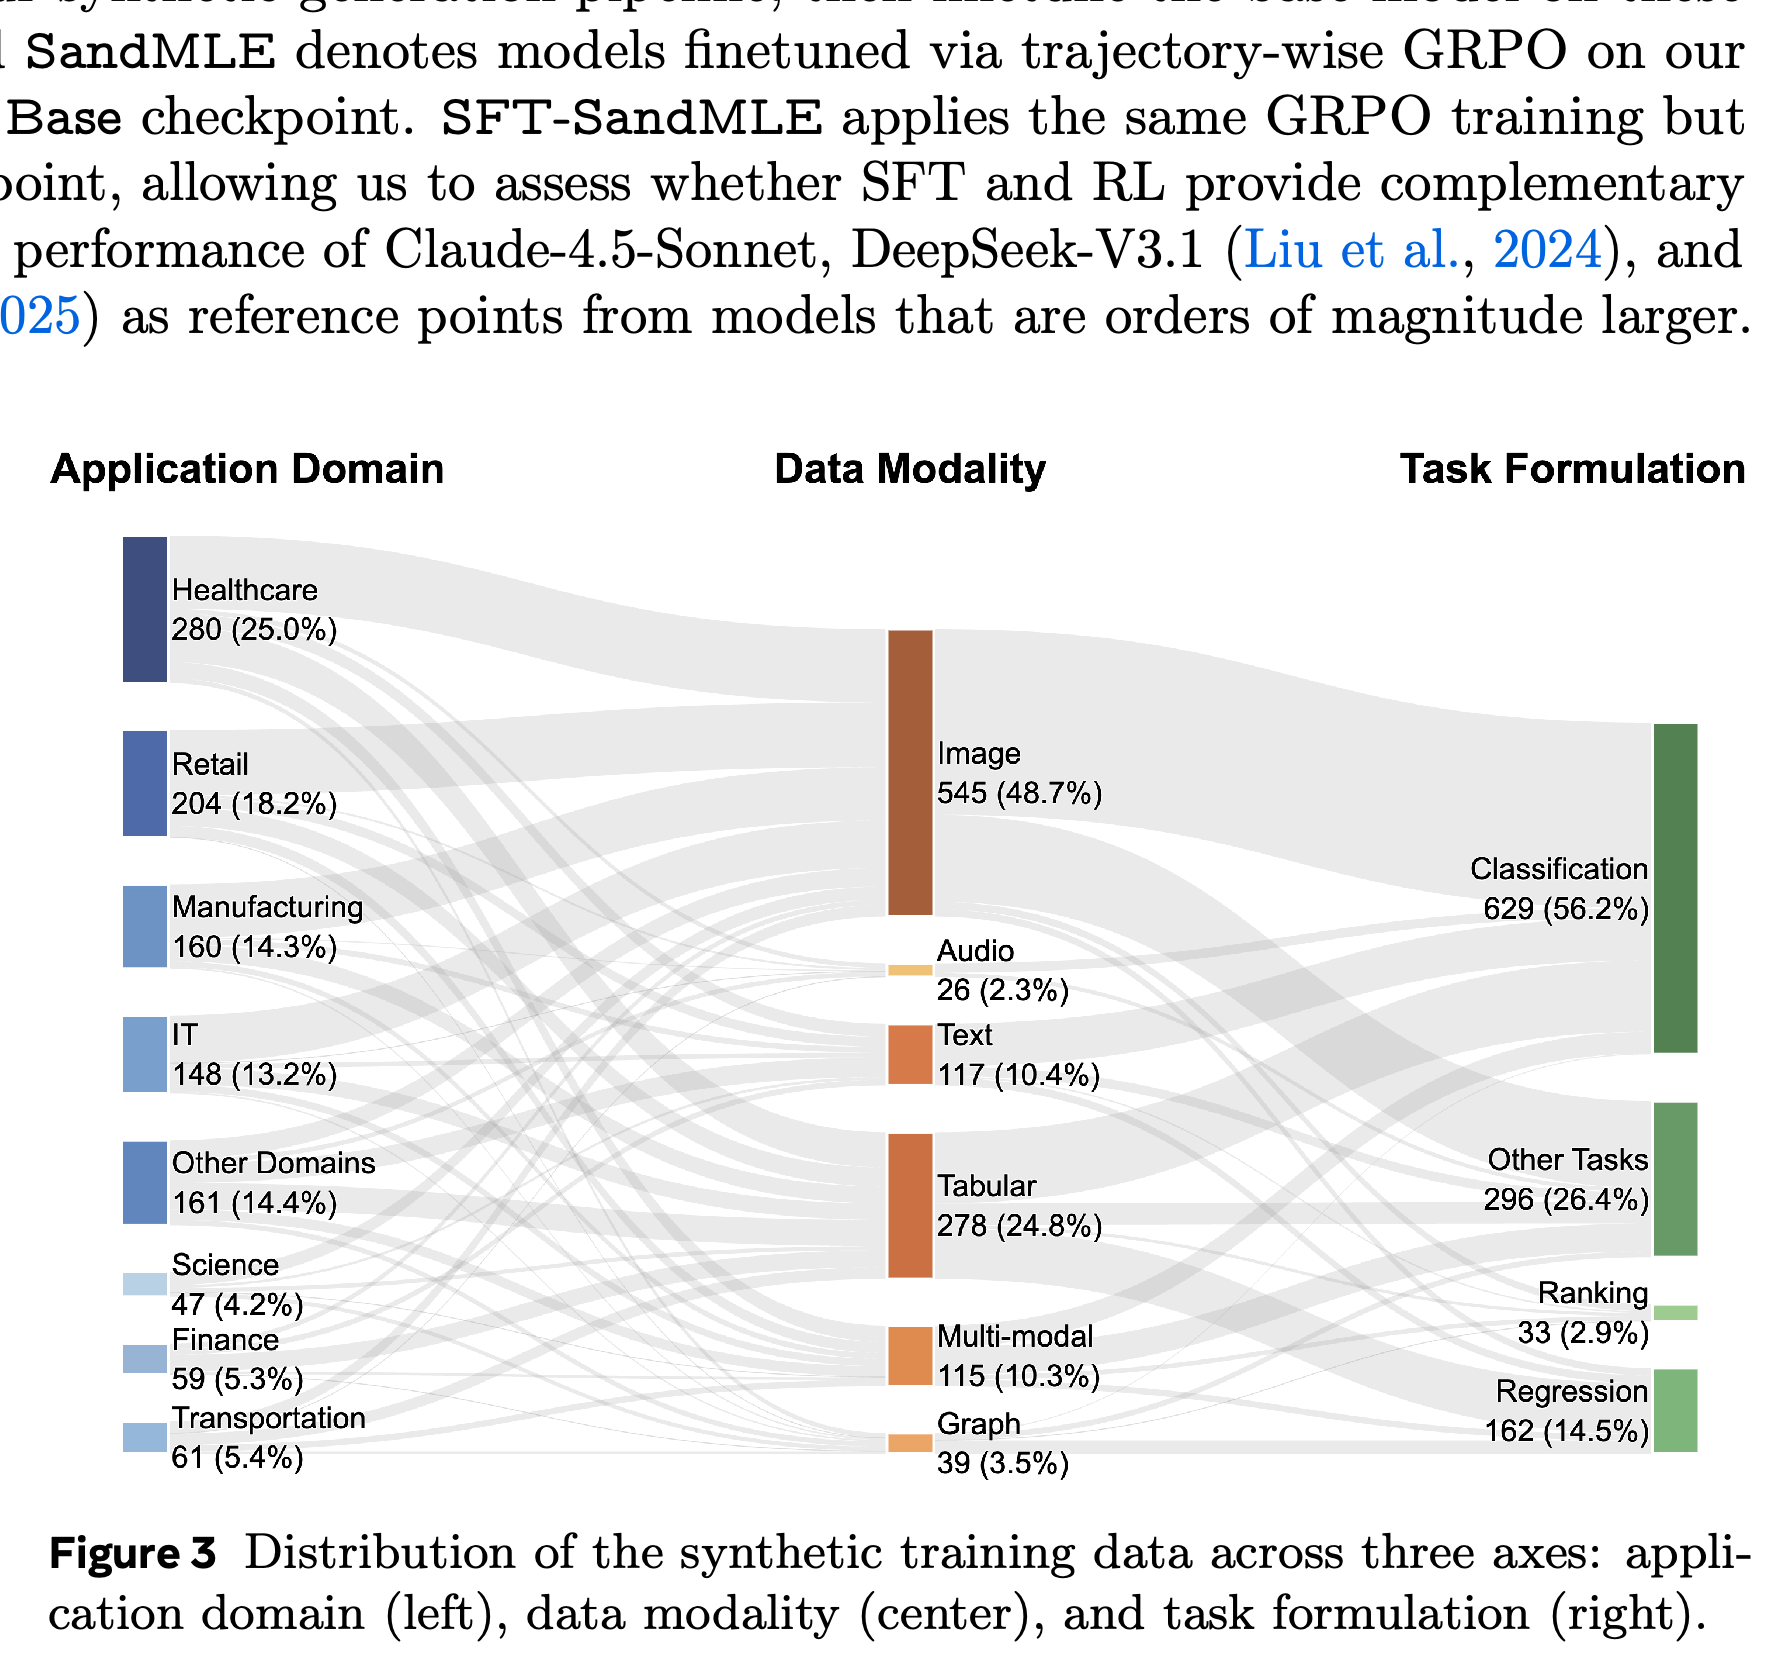
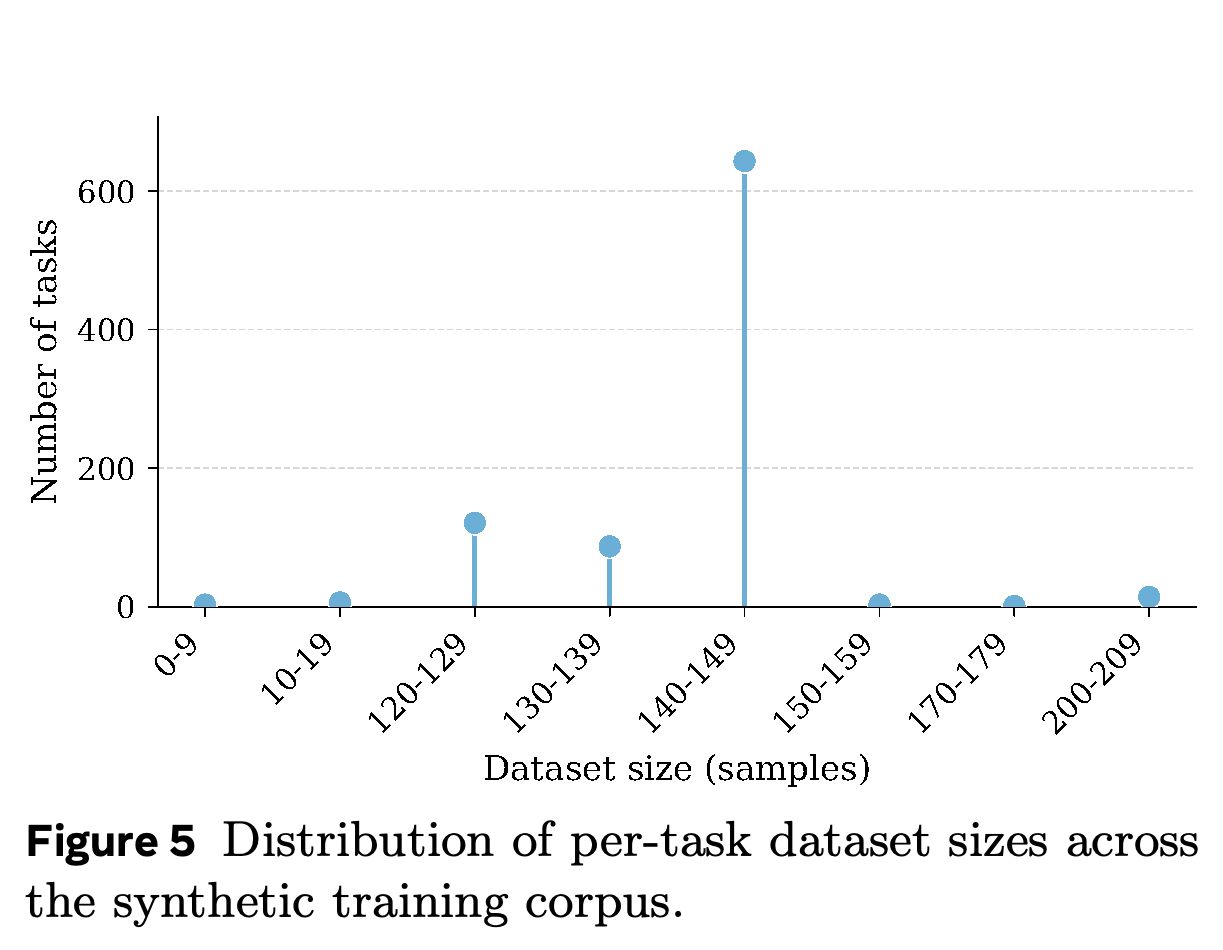
생성한 과제는 여러 응용 도메인, 모달리티, 문제 유형을 포함하며, 이미지와 분류가 가장 큰 비중을 차지한다. Figures 3–6은 구성 비율, 모델 간 쌍별 성능, 데이터셋 크기, 실행 지연 시간을 보고한다.
- 도메인별로 의료는 25.0%, 소매는 18.2%, 제조는 14.3%, IT는 13.2%를 차지한다. 모달리티별 비율은 이미지 48.7%, 정형 데이터 24.8%, 텍스트 10.4%, 멀티모달 10.3%, 그래프 3.5%, 오디오 2.3%다. 문제 유형별 비율은 분류 56.2%, 회귀 14.5%, 랭킹 2.9%, 기타 과제 26.4%다.
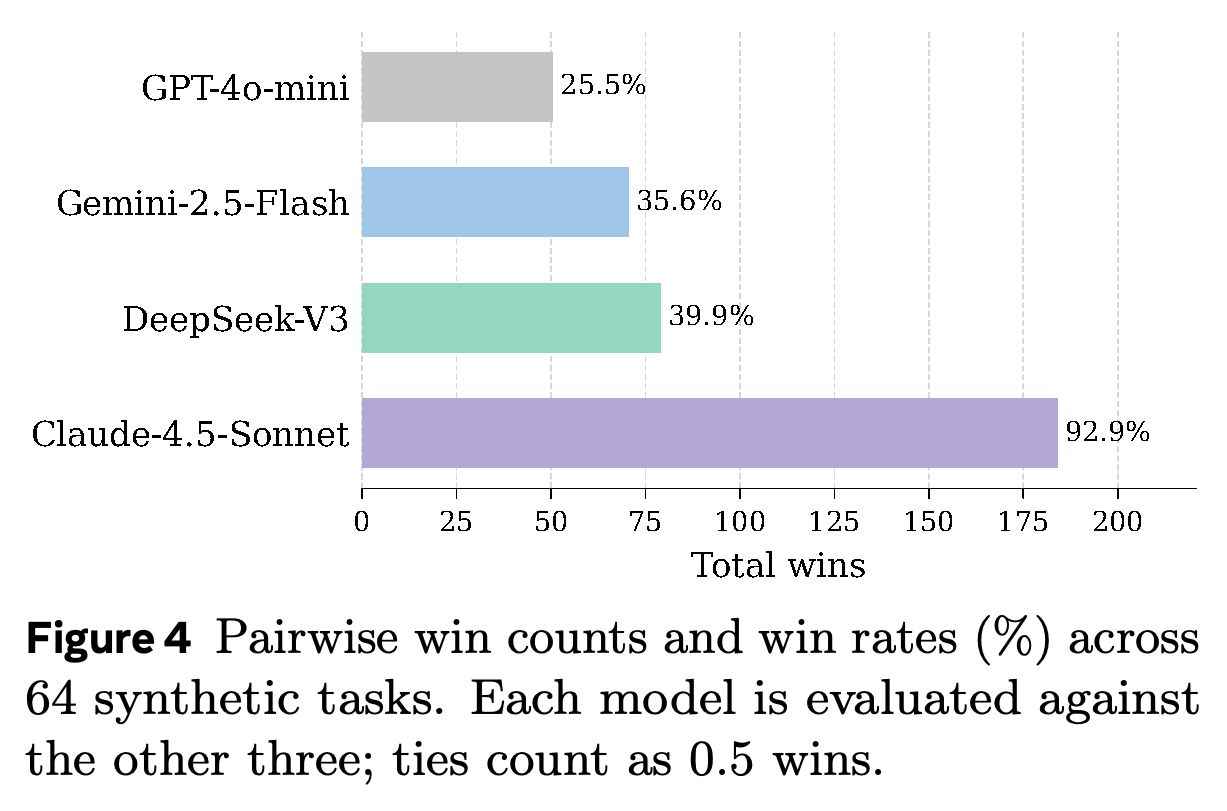
- 무작위로 샘플링한 합성 과제 64개에서 각 모델을 나머지 모델 3개와 비교하며, 승리는 1, 동률은 0.5로 계산한다. 승률은 Claude-4.5-Sonnet 92.9%, DeepSeek-V3 39.9%, Gemini-2.5-Flash 35.6%, GPT-4o-mini 25.5%다.
- 이 결과는 과제가 평가한 모델들의 성능을 구분한다는 점을 보여준다. 합성 과제의 난이도를 실제 대회 난이도에 맞춰 독립적으로 보정한 결과는 아니다.
- 대부분의 과제는 표본 120–150개를 포함하며, 원본 시드 과제는 평균 약 4.09백만 개의 표본을 포함한다. Gemini-2.5-Flash-generated 구현의 평균 실행 시간은 196.17초에서 14.31초로 줄며, 보고된 속도 향상은 13.7×다.
- Figure 3의 모달리티별 과제 수를 합하면 1119개로, 최종 과제 모음 912개보다 많다. 이는 Appendix C의 데이터 생성 후 과제 수와 일치하지만, PDF는 그림이 어느 필터링 단계를 나타내는지 명시하지 않는다. 따라서 그림의 비율이 최종 훈련 분할 848개의 구성을 나타낸다고 가정해서는 안 된다.
도메인과 모달리티, 문제 유형 사이의 연결은 여러 도메인에 걸친 다양성과 함께 이미지 및 분류의 높은 비중을 보여준다. 모달리티별 과제 수의 합은 1119개로, 최종 과제 모음 912개가 아니라 중간 생성 단계의 과제 수와 일치한다. PDF는 그림이 어느 필터링 단계를 나타내는지 명시하지 않는다.
합성 과제 64개에서 수행한 쌍별 비교의 승률은 Claude-4.5-Sonnet, DeepSeek-V3, Gemini-2.5-Flash, GPT-4o-mini에 대해 각각 92.9%, 39.9%, 35.6%, 25.5%다. 이 순위는 해당 모델들의 성능을 구분한다는 점을 보여주며, 실제 대회 난이도에 대한 직접적인 보정 결과는 아니다.
표본 수 140–149개 구간이 가장 큰 비중을 차지하며, 이는 대부분의 과제가 표본 120–150개를 포함한다는 본문 설명과 부합한다. 명목상 설계 범위보다 작은 0–9개 및 10–19개 구간에도 소수의 과제가 있다. 200–209개 구간은 설계 범위를 넘어서는 값을 포함하지만, 이 구간의 과제가 실제로 표본 200개를 초과하는지는 확인할 수 없다.
Gemini-2.5-Flash-generated 구현의 평균 실행 시간은 원본 시드 과제에서 196.17초, 합성 과제에서 14.31초이며, 보고된 속도 향상은 13.7×다. 이 측정은 코드 실행에 관한 것으로, 환경 생성, 모델 추론, 최적화를 포함한 전체 훈련 비용을 측정한 것은 아니다.
5.3 Main Results
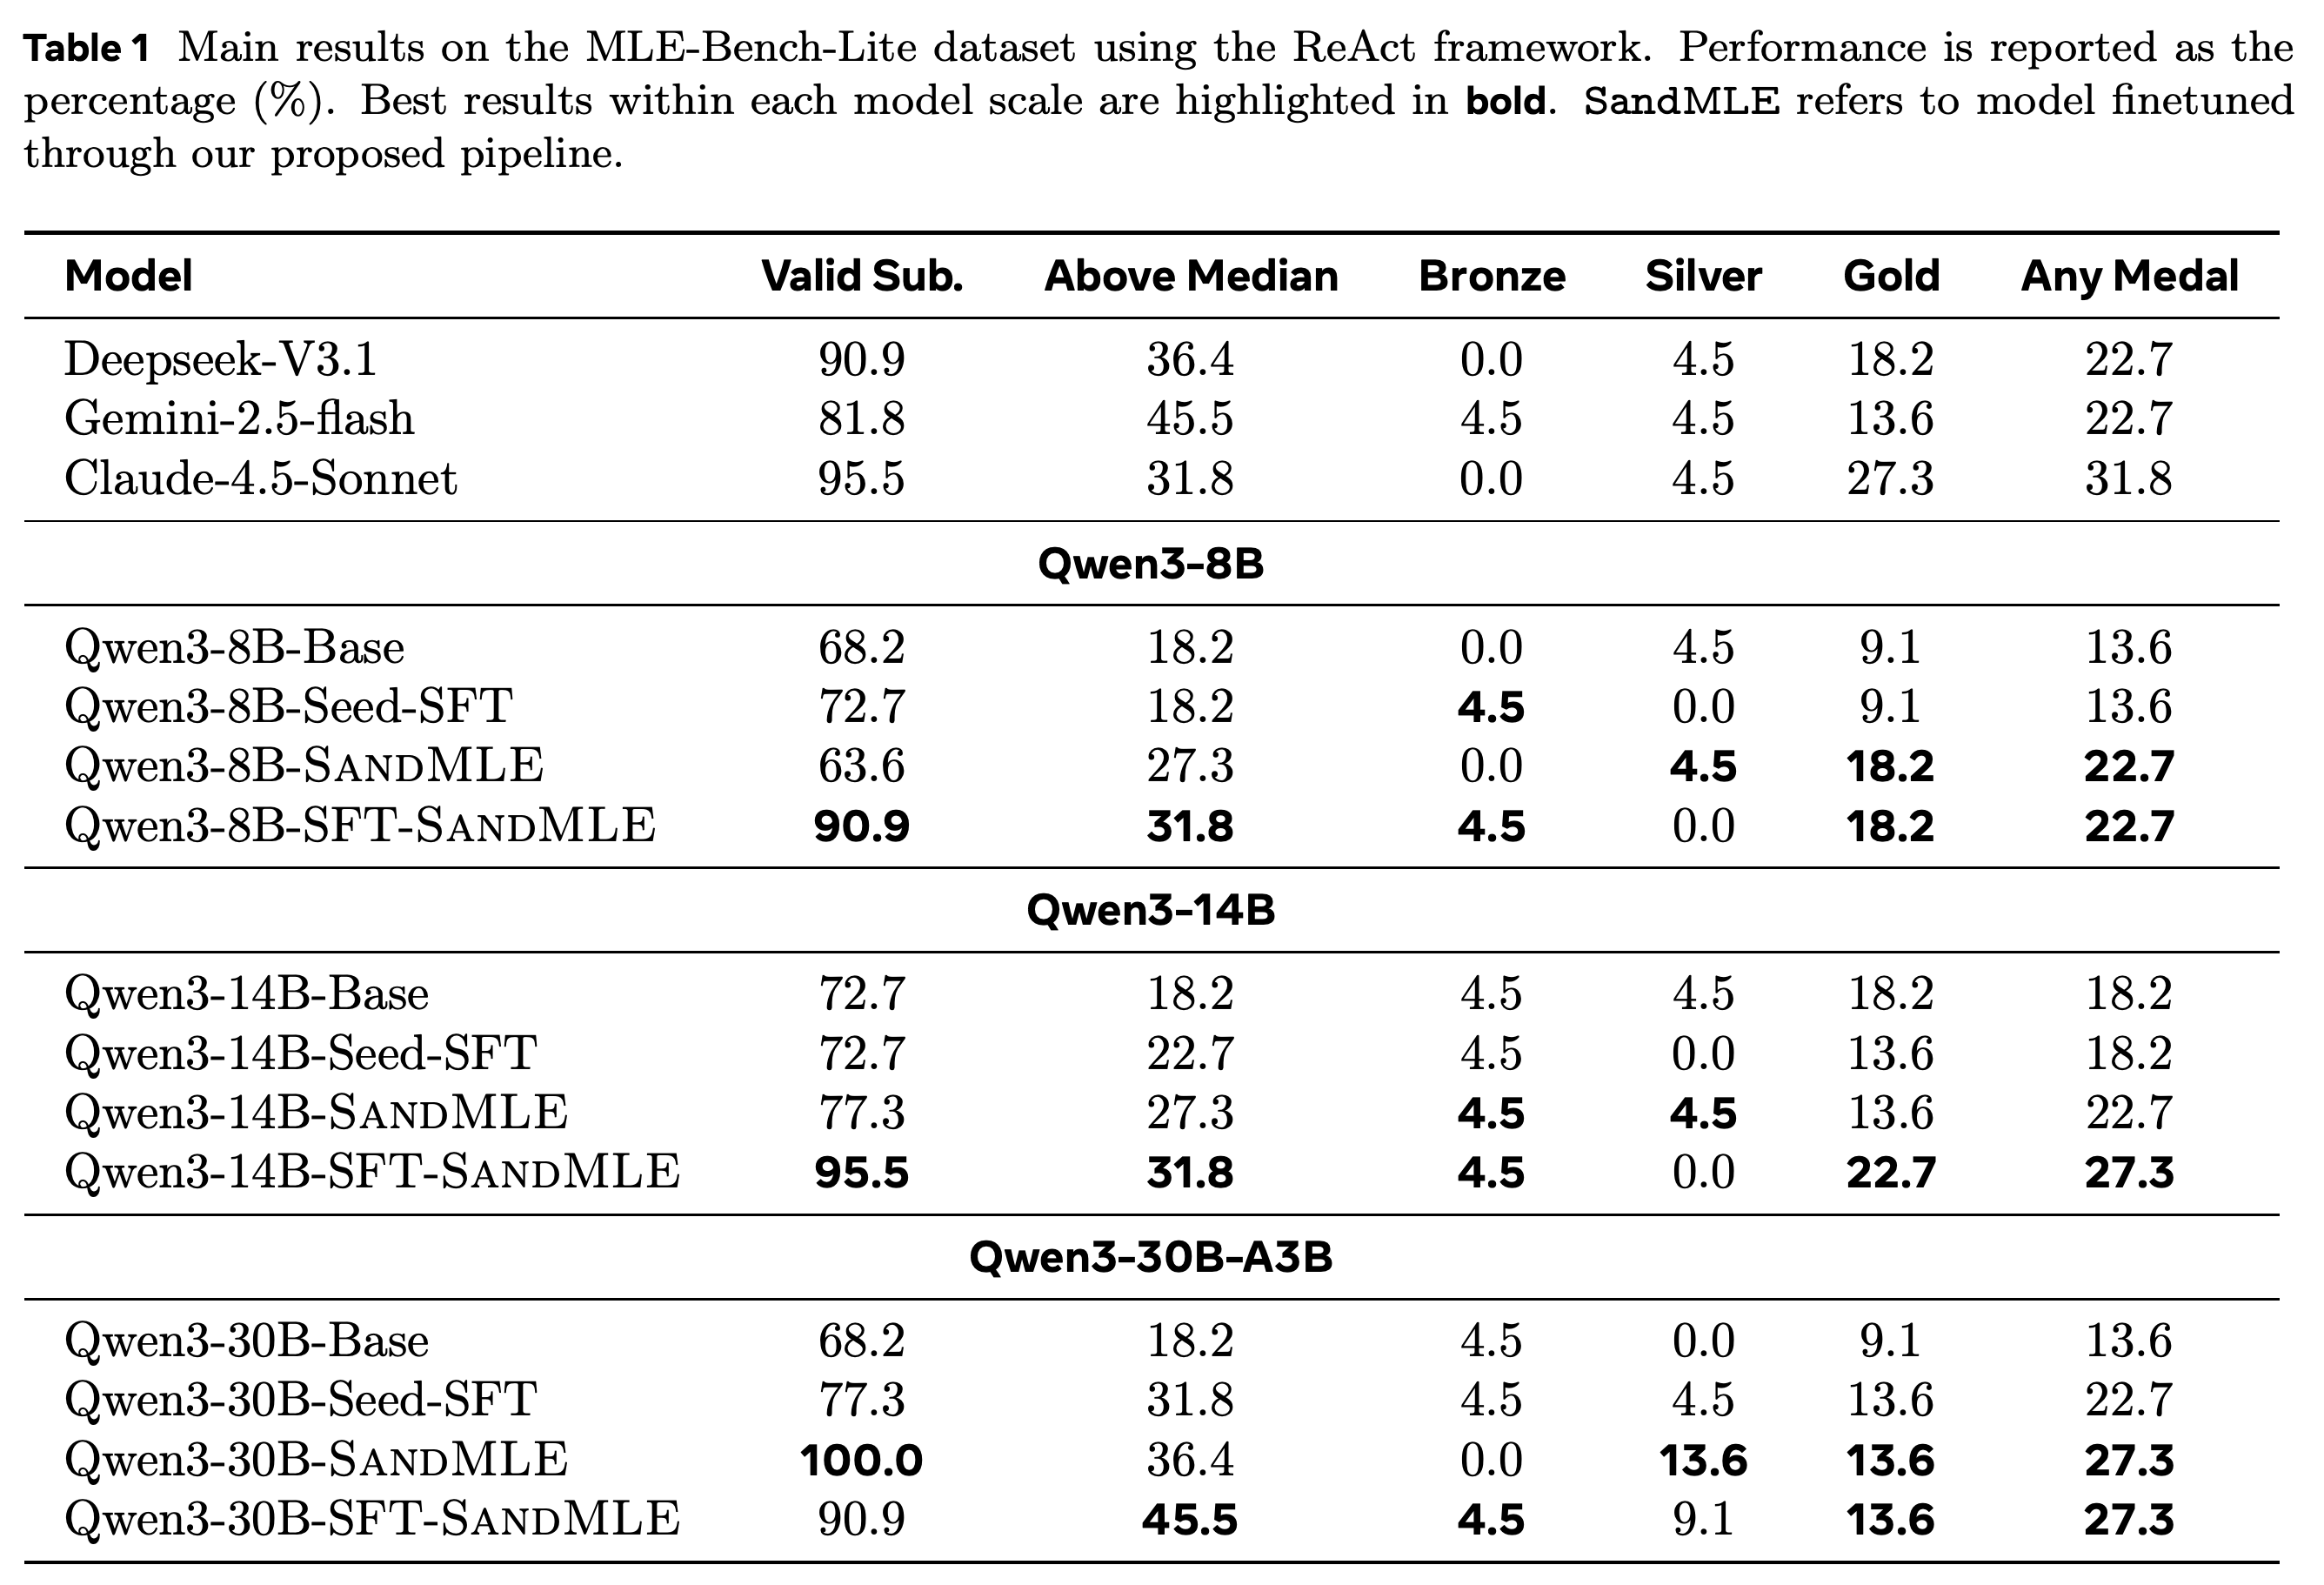
Table 1에서 순수 SandMLE의 Any Medal 비율은 8B, 14B, 30B에서 각각 22.7%, 22.7%, 27.3%이며, Base는 13.6%, 18.2%, 13.6%다. 논문은 Base 대비 상대 개선율을 66.9%, 24.7%, 100.7%로, Seed-SFT 대비 상대 개선율 범위를 20.3%–66.9%로 보고한다.
- 표에 제시된 Seed-SFT의 Any Medal 비율은 13.6%, 18.2%, 22.7%다. 30B 결과는 해당 Seed-SFT 비율이 13.6%에 머문다는 본문 설명과 모순된다. 표는 30B에서 SFT가 Base보다 상당히 개선된 결과를 뒷받침한다.
- SFT와 RL을 결합한 결과를 순수 SandMLE와 비교하면 SFT-SandMLE는 8B의 Valid Submission을 63.6%에서 90.9%로 높이지만 메달 비율 22.7%는 바꾸지 않는다. 14B에서는 제출 유효성이 77.3%에서 95.5%로, 메달 비율이 22.7%에서 27.3%로 높아진다. 30B에서는 제출 유효성이 100.0%에서 90.9%로 낮아지고 메달 비율은 27.3%로 유지된다.
- 순수 SandMLE의 제출 유효성은 63.6%, 77.3%, 100.0%로 높아지고, Above Median은 8B의 27.3%에서 30B의 36.4%로 높아진다. 이는 평가한 모델 계열 안에서 관찰한 추세이지, 보편적인 스케일링 법칙의 근거는 아니다.
- 8B SandMLE의 메달 비율은 Deepseek-V3.1과 Gemini-2.5-flash의 참조 결과인 22.7%와 같다. Claude-4.5-Sonnet은 31.8%로, Table 1에서 평가한 모든 SandMLE 변형을 웃돈다.
- Qwen3-14B-Base 행은 Bronze 4.5%, Silver 4.5%, Gold 18.2%를 보고하지만 Any Medal은 18.2%다. 대부분의 행과 달리 이 값들의 합은 Any Medal과 일치하지 않는다. PDF는 등급별 집계 방식을 설명하거나 이 행의 불일치를 해명하지 않는다.
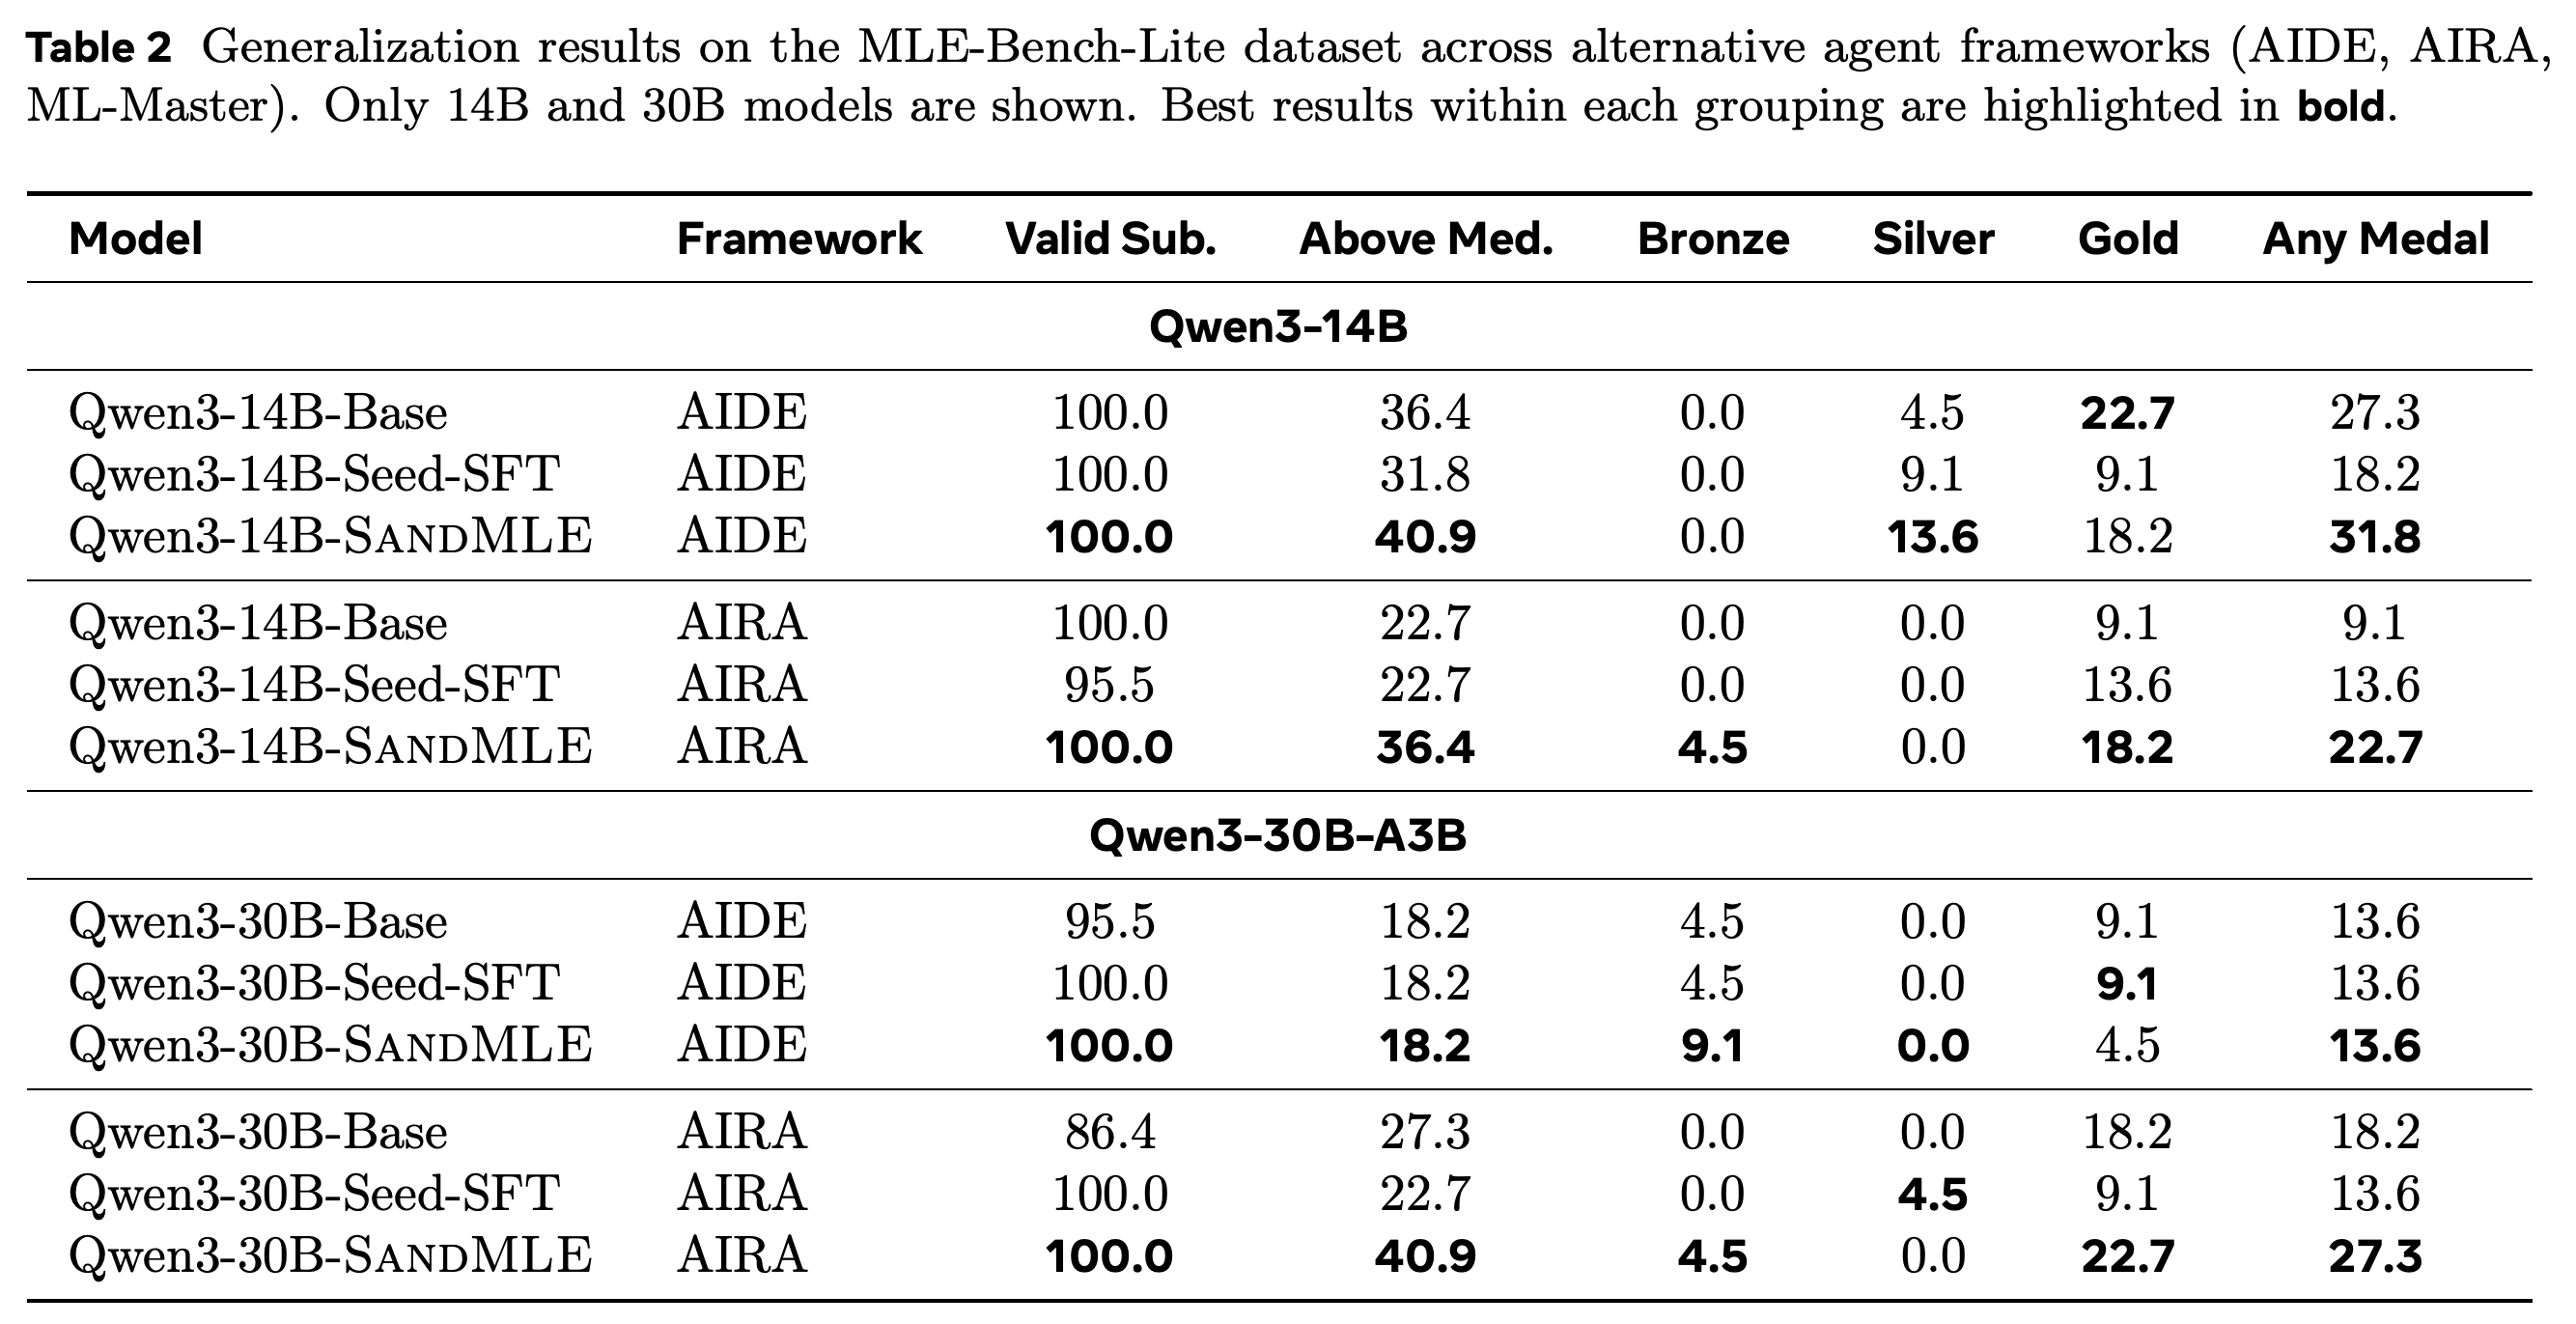
- Tables 2와 3은 다른 스캐폴드로 평가를 확장한다. Section 6.1은 개선된 경우와 주 지표가 변하지 않은 경우를 모두 다룬다.
합성 RL은 모델 규모 3개 모두에서 Base보다 Any Medal 비율을 높이지만, SFT 초기화가 제출 유효성에 미치는 효과는 규모에 따라 다르다. 표는 본문에 서술된 30B Seed-SFT 메달 비율과 모순된다. 14B Base의 메달 항목도 대부분의 행과 달리 합계가 Any Medal과 일치하지 않는다.
5.4 Test-Time Scaling of SandMLE Models
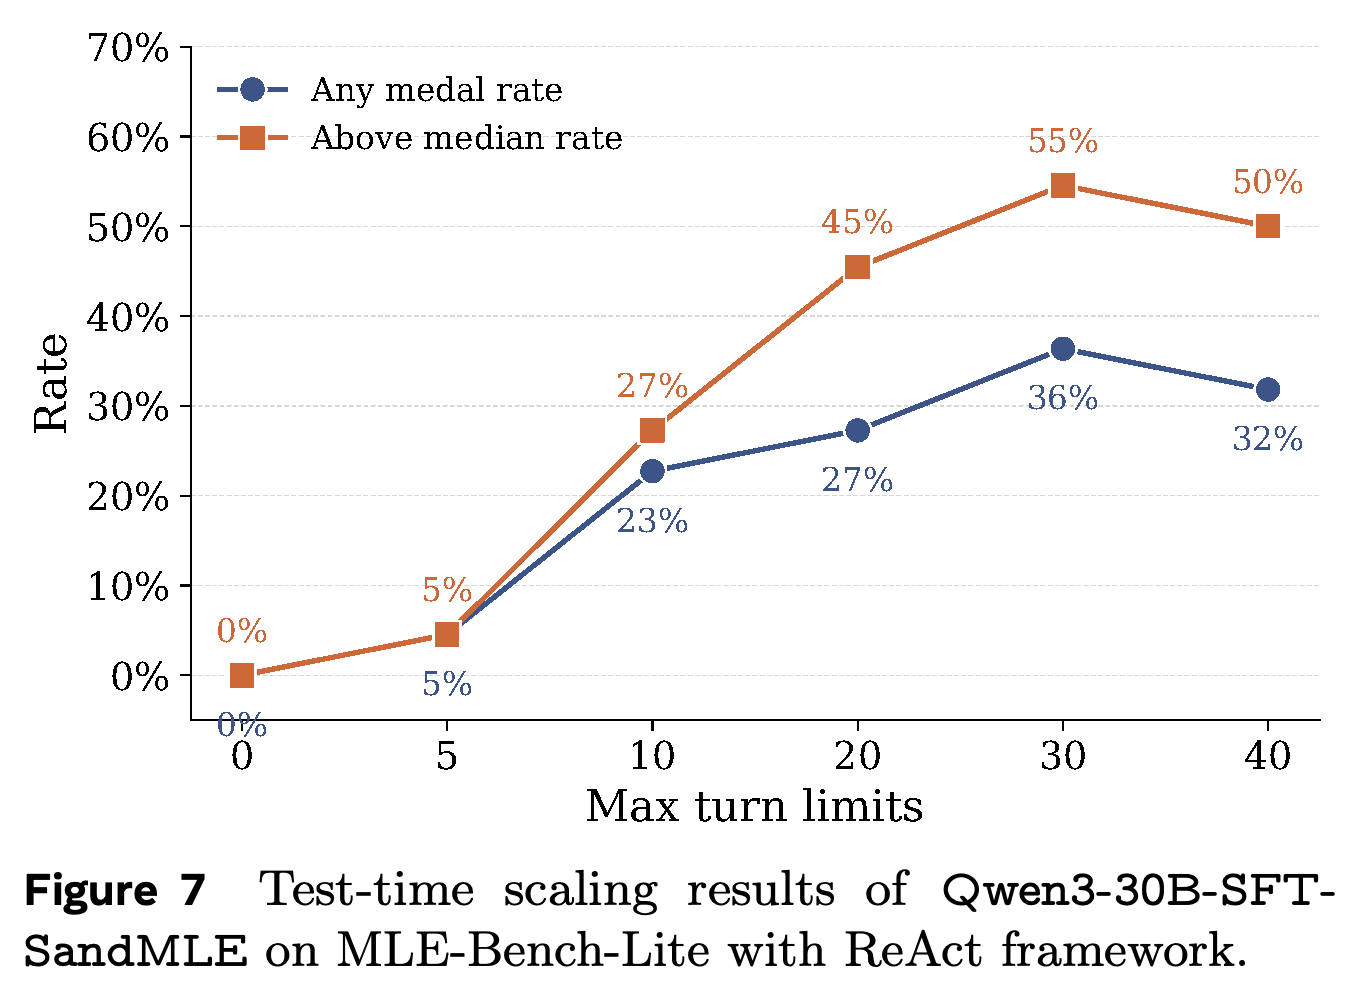
ReAct를 사용하는 Qwen3-30B-SFT-SandMLE에서 과제당 최대 연산 예산은 24 GPU시간으로 유지하고 허용 턴 수를 바꾼다. Figure 7에서 Any Medal과 Above Median은 30턴에서 각각 그래프상 최댓값인 36%와 55%에 도달한 뒤, 40턴에서 32%와 50%로 낮아진다.
- 턴 제한이 0, 5, 10, 20, 30, 40일 때 그래프의 Any Medal 비율은 0%, 5%, 23%, 27%, 36%, 32%이며, Above Median 비율은 0%, 5%, 27%, 45%, 55%, 50%다.
- 컨텍스트 용량에 도달하면 실패한 실행을 포함한 오래된 메시지를 제거한다. 저자들은 이러한 제거 전략에도 불구하고 컨텍스트 손실과 반복적인 루프 때문에 30턴 이후 성능이 낮아진다고 설명한다.
- 실험은 30턴까지 추가 반복의 이점을 보여주지만, 그 이후 성능 하락에서 컨텍스트 손실과 다른 가능한 원인을 분리하지는 않는다.
최대 예산을 24 GPU시간으로 고정한 실험에서 그래프의 지표는 30턴까지 개선되며, 이때 Any Medal은 36%, Above Median은 55%에 도달한다. 두 지표 모두 40턴에서 낮아진다. 저자들은 이를 컨텍스트 용량 초과와 실행 이력 손실로 설명하지만, 이 설명을 확인하는 통제 실험은 수행하지 않는다.
5.5 Training Dynamics
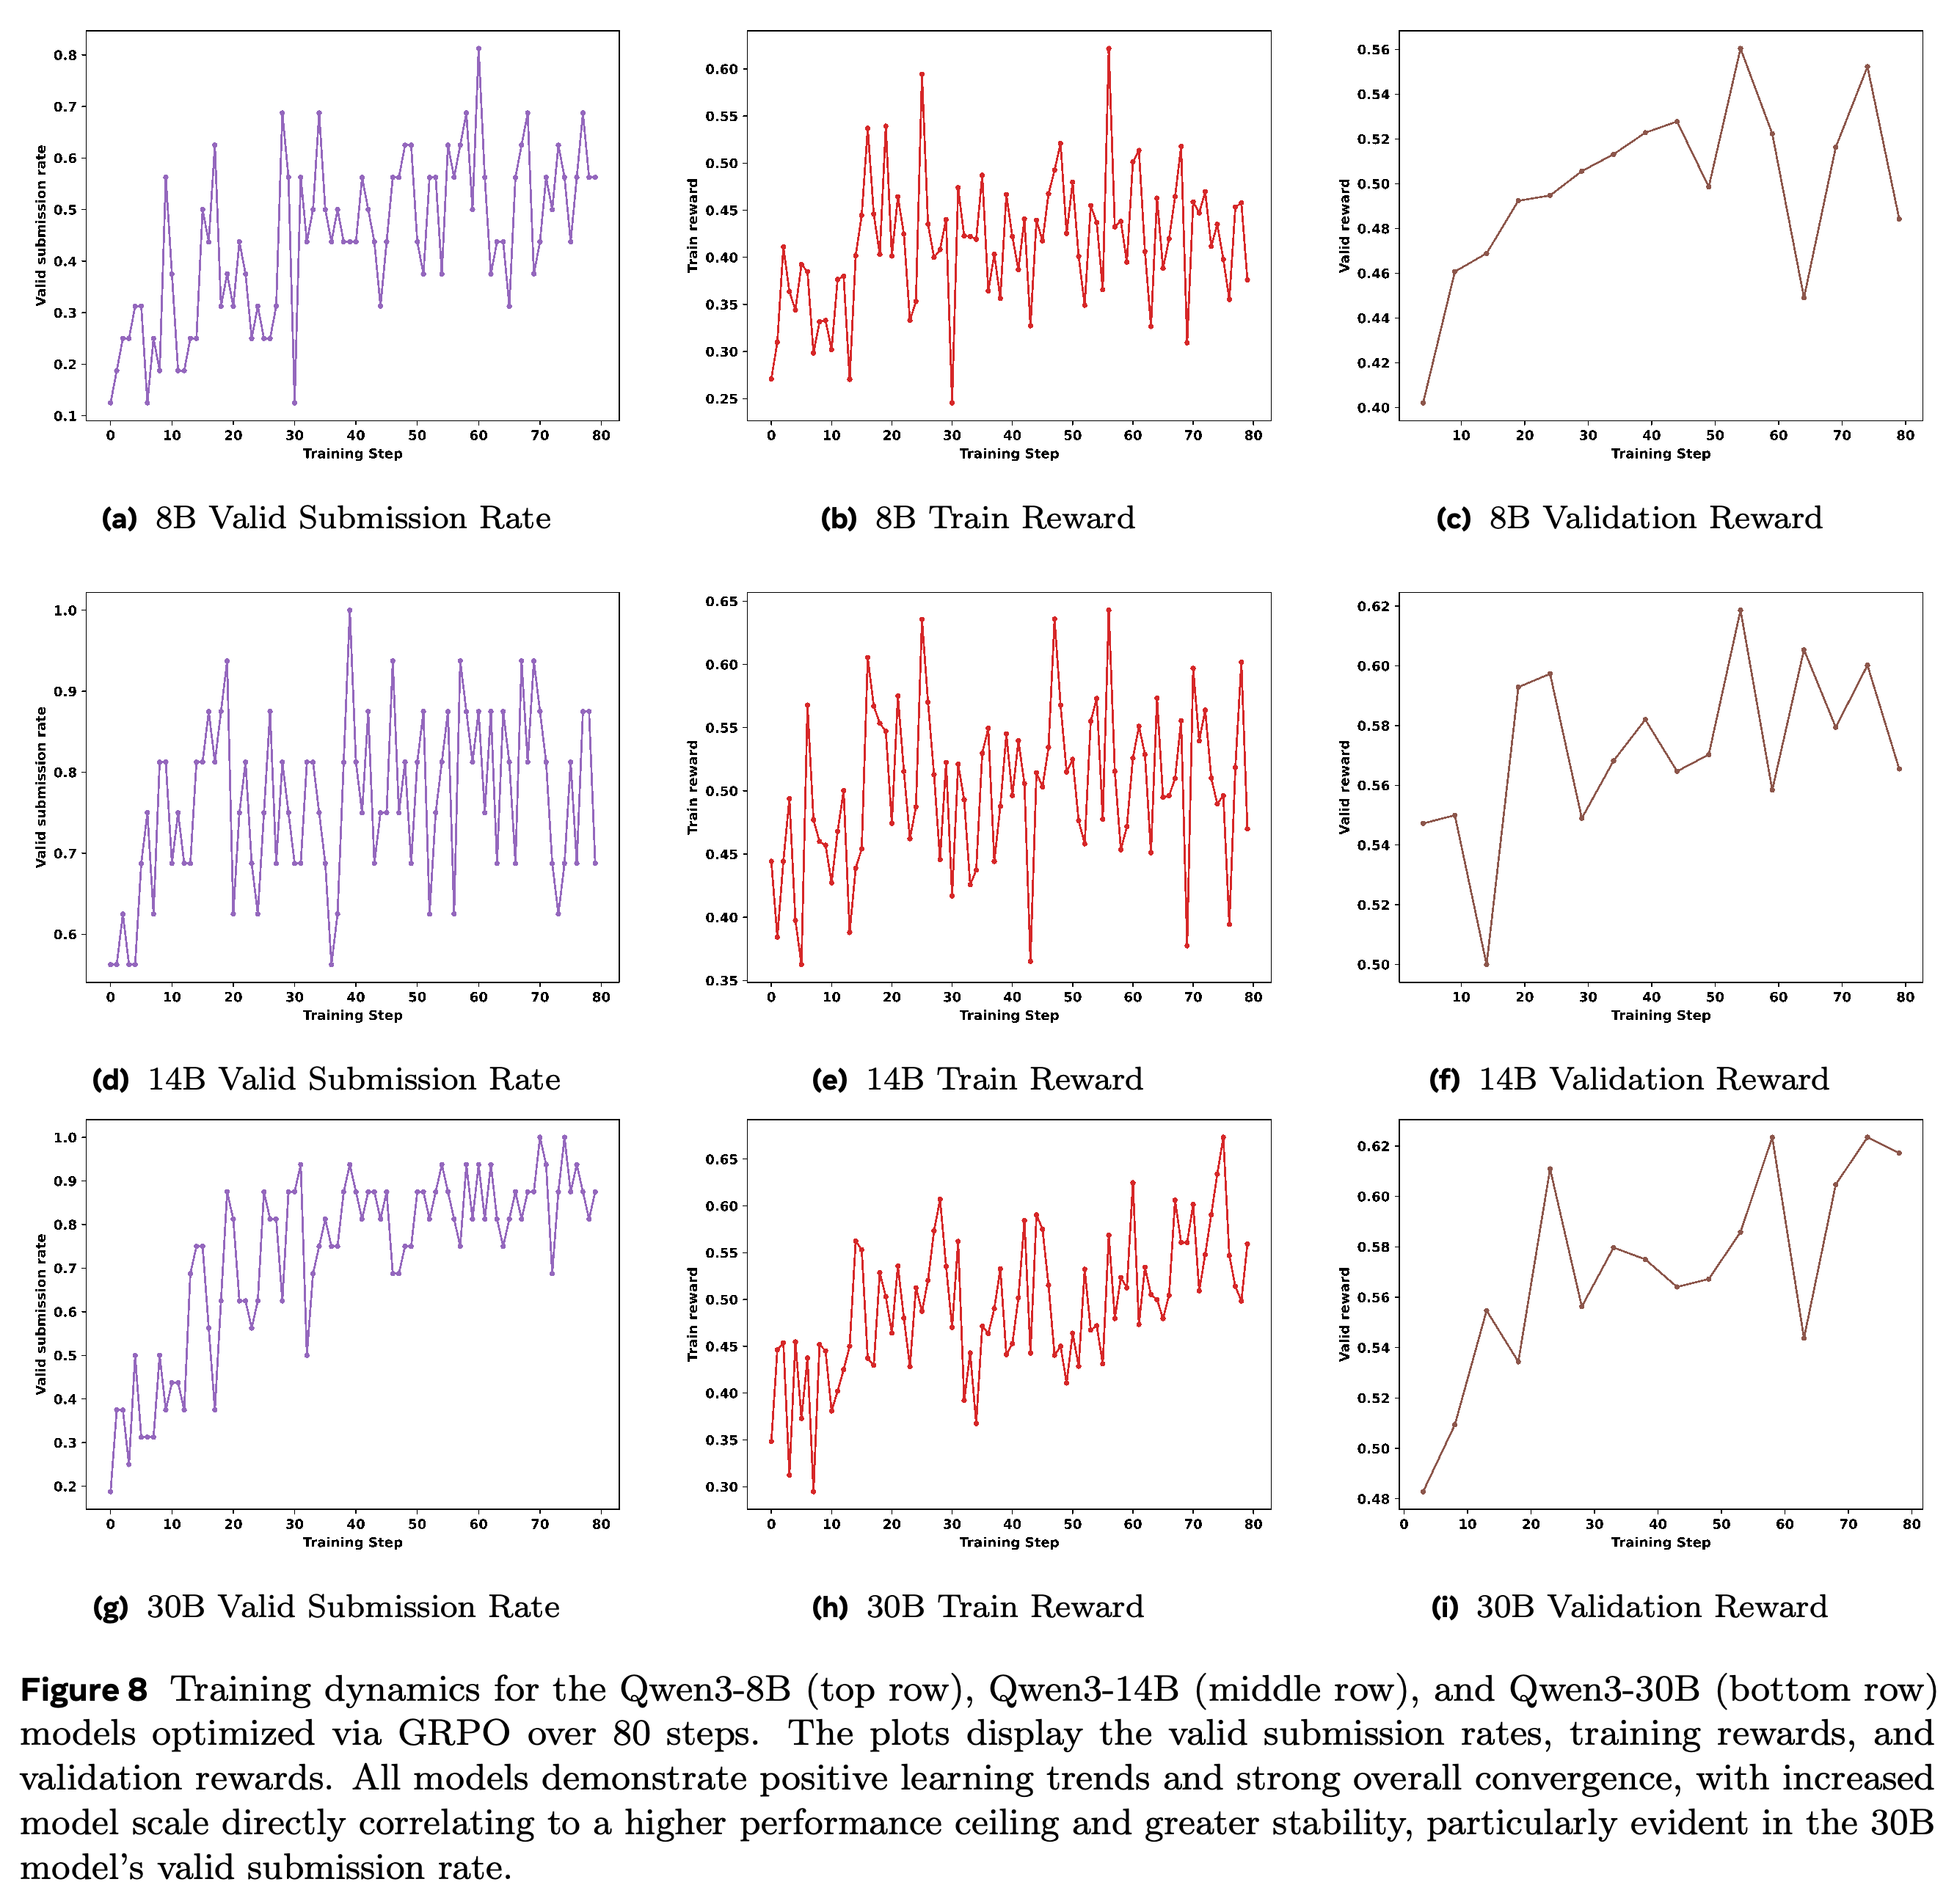
모델 규모 3개 모두에서 훈련 및 검증 보상은 대체로 개선되지만, 개별 곡선의 변동은 상당하다. Figure 8은 훈련 후반에 30B 모델이 작은 모델들보다 유효한 제출물을 더 안정적으로 생성한다는 점을 보여준다.
- Appendix B.1은 훈련 보상의 정점을 30B에서 약 0.67, 14B에서 약 0.62로 설명하며, 8B의 제출 비율은 약 0.1–0.8 사이에서 변동한다고 서술한다. 그래프의 14B 훈련 곡선은 약 0.65까지 도달하므로, 부록의 정점 설명은 근삿값이다.
- 이 곡선은 합성 환경에서의 학습을 측정한 것이며, 훈련 전반에 걸친 실제 과제 일반화를 측정한 것은 아니다.
- Appendix A.2는 훈련 단계 수를 100으로 명시하지만, Figure 8과 Appendix B.1은 80단계 곡선을 설명한다. PDF는 이 차이를 해명하지 않는다.
9개 패널은 80단계에 걸쳐 보상이 대체로 개선되지만 변동이 상당하며, 수렴이 일관되게 매끄럽지는 않다는 점을 보여준다. 훈련 후반의 제출 유효성은 30B가 작은 모델들보다 더 안정적이다. 그래프의 기간은 Appendix A.2에 제시된 100단계 설정과 다르다.
6 Analysis
분석에서는 ReAct 훈련에서 다른 에이전트 구조로의 전이를 평가하고, 단계별 성과 보상을 희소 보상 대안과 비교한다. 데이터셋 크기, 도메인 변형, 비공개 규칙의 복잡도, 개별 생성 역할에 대한 제거 실험은 수행하지 않는다.
6.1 Framework Generalization
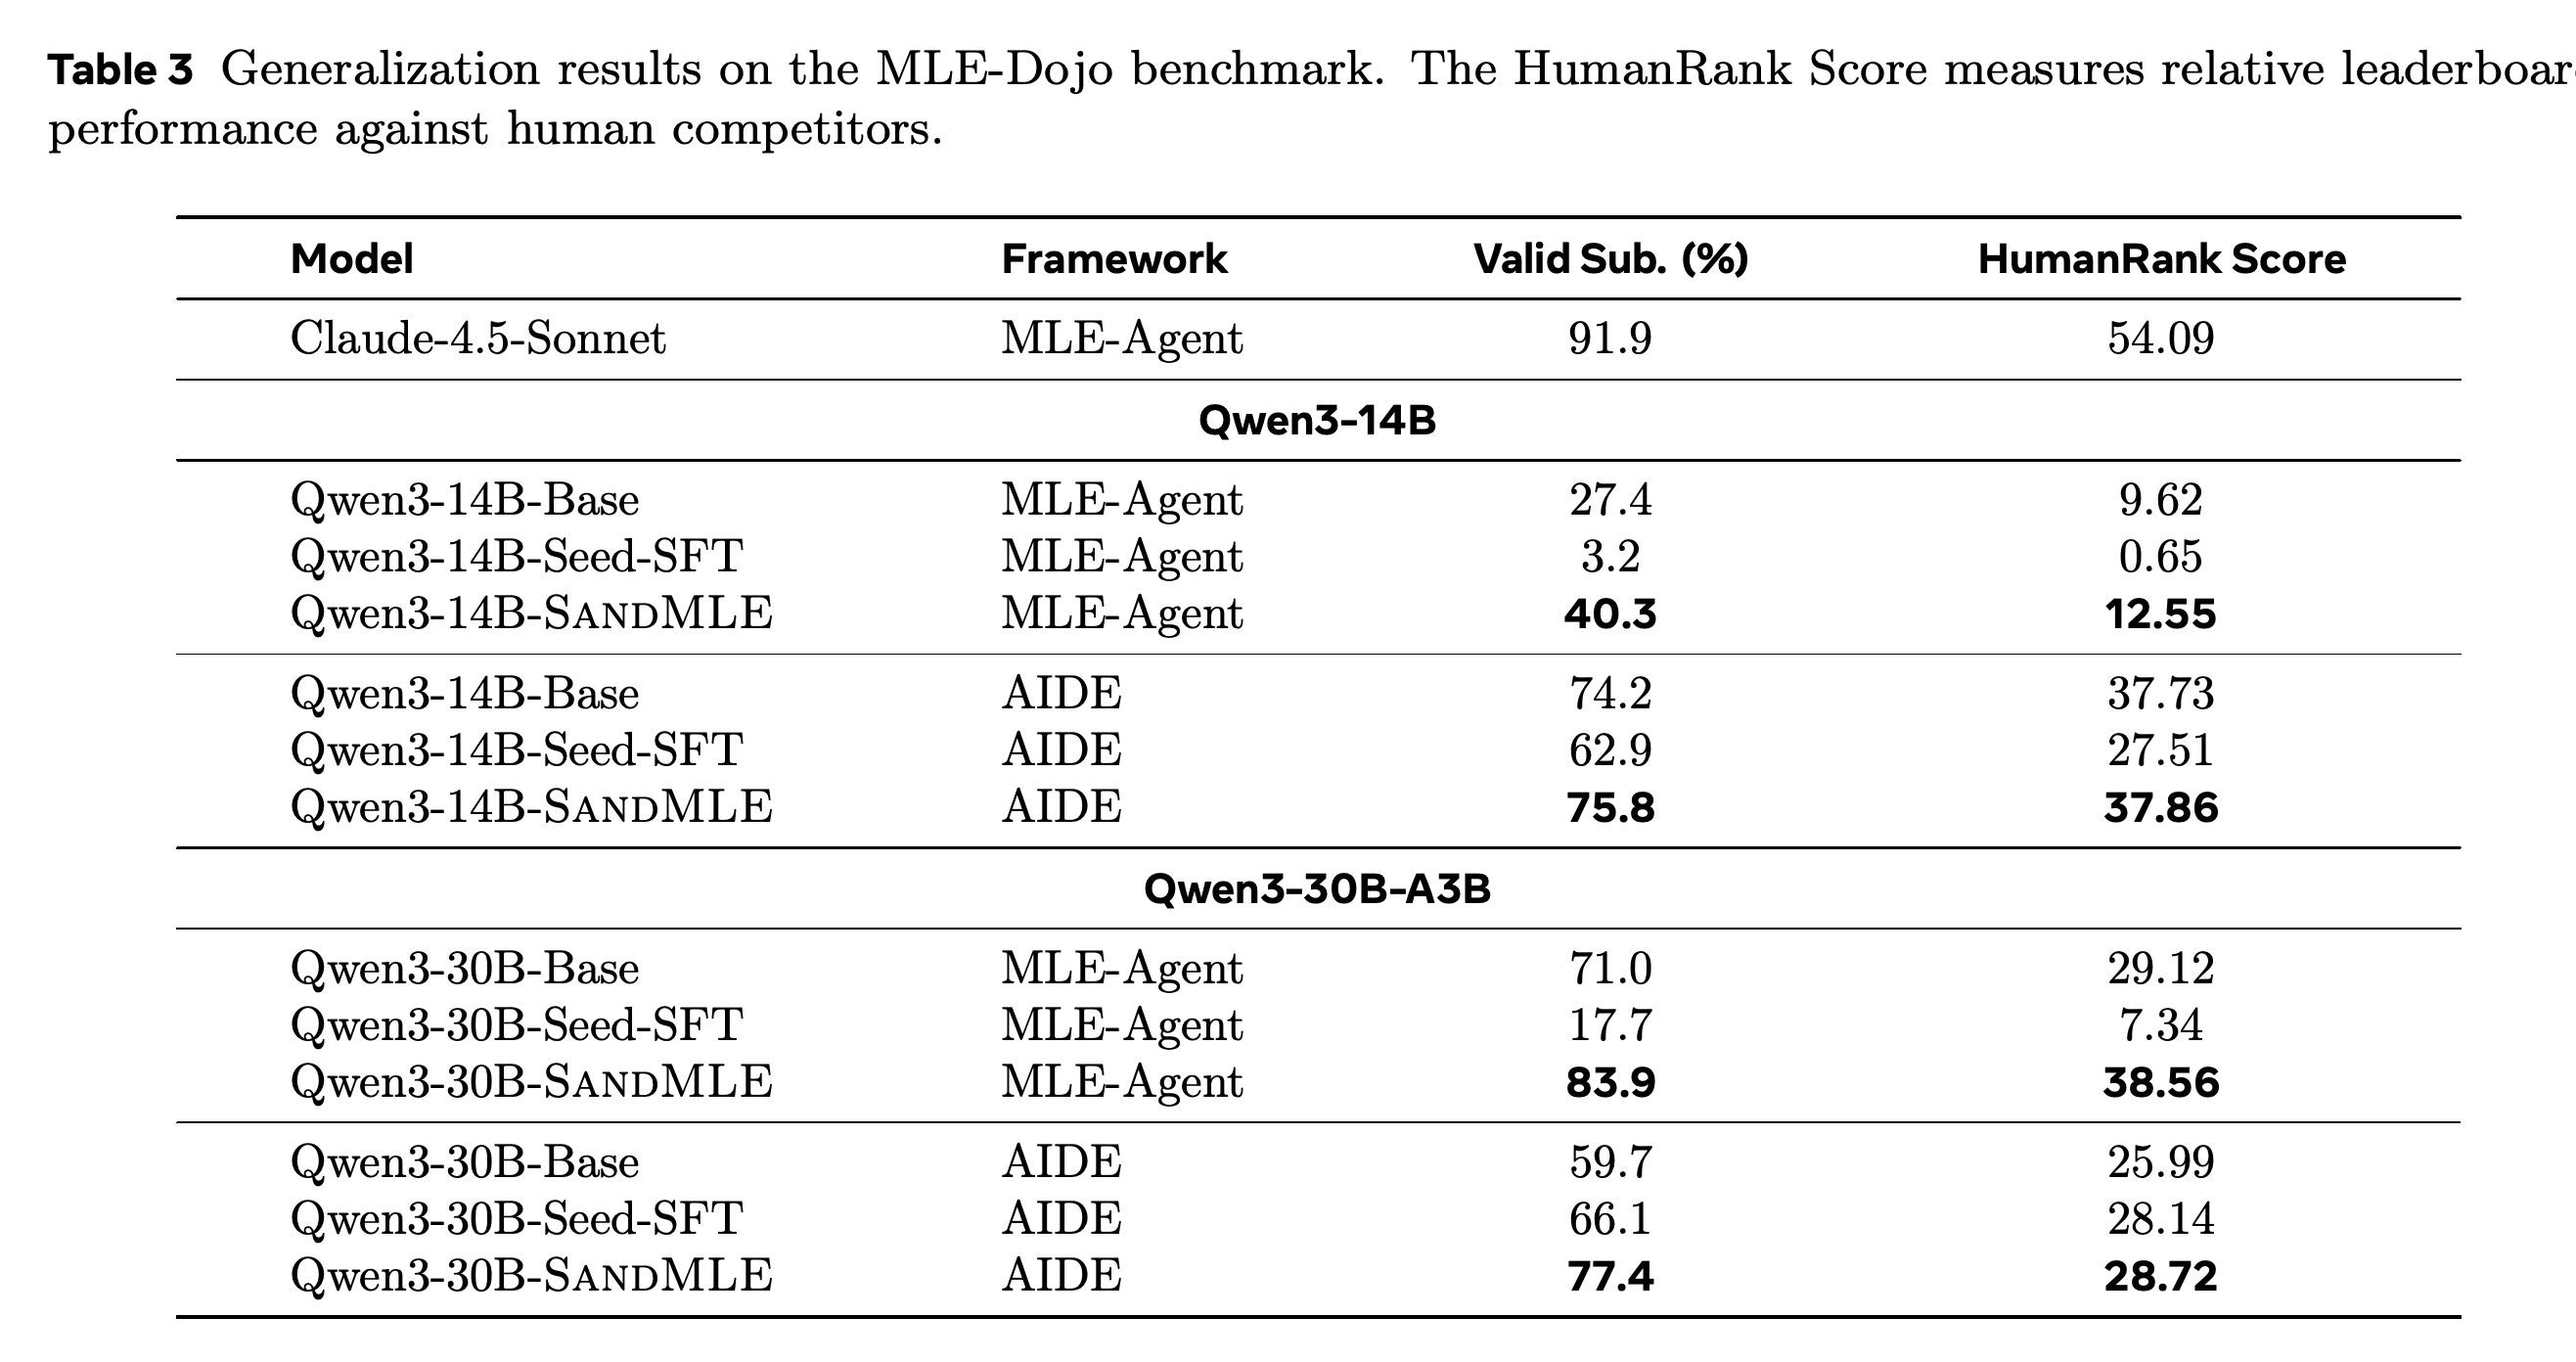
SandMLE는 MLE-Bench-Lite에서 AIDE와 AIRA로, MLE-Dojo에서 MLE-Agent와 AIDE로 전이된다. Tables 2와 3은 여러 설정에서 개선을 보여주지만, 모든 스캐폴드–벤치마크 조합에서 주 지표가 개선된다는 더 강한 주장을 뒷받침하지는 않는다.
- MLE-Bench-Lite에서 14B의 Any Medal은 AIDE를 사용하면 27.3%에서 31.8%로, AIRA를 사용하면 9.1%에서 22.7%로 높아진다. 30B에서는 AIRA가 18.2%에서 27.3%로 개선되지만, AIDE는 Base, Seed-SFT, SandMLE 모두 13.6%에 머문다.
- MLE-Dojo에서 MLE-Agent를 사용하면 14B의 HumanRank는 9.62에서 12.55로, Valid Submission은 27.4%에서 40.3%로 높아진다. 30B에서는 HumanRank가 29.12에서 38.56으로, 제출 유효성이 71.0%에서 83.9%로 높아진다. 이는 보고된 HumanRank 상대 개선율 약 32.4%에 해당한다.
- MLE-Dojo에서 AIDE를 사용하면 14B의 HumanRank는 37.73에서 37.86으로, 30B의 HumanRank는 25.99에서 28.72로 변한다. 따라서 절대 성능은 여전히 스캐폴드에 크게 의존한다.
- Seed-SFT는 MLE-Agent에서 취약하다. 제출 유효성은 14B에서 3.2%, 30B에서 17.7%로, 각각의 Base 비율보다 낮다. SandMLE는 이 특정 SFT 기준선보다 더 잘 전이된다.
- Table 2의 캡션에는 ML-Master가 나열되어 있지만, 표시된 행에는 AIDE와 AIRA만 있다. ML-Master 결과는 제공하지 않는다.
SandMLE는 AIDE와 AIRA에서 14B의 메달 비율을 개선하고, AIRA에서 30B의 메달 비율을 개선한다. 30B AIDE의 Any Medal 비율은 변형 3개 모두 13.6%에 머물러, 주 지표가 일관되게 개선되는 것은 아님을 보여준다. 원문 캡션에 ML-Master가 포함되어 있지만 해당 행은 없다.
30B MLE-Agent의 HumanRank는 29.12에서 38.56으로 높아지고, 제출 유효성은 71.0%에서 83.9%로 높아진다. AIDE의 HumanRank 개선 폭은 더 작으며, 특히 14B에서 작다. 이는 전이가 스캐폴드 선택에 대한 민감성을 없애지는 못한다는 점을 보여준다.
6.2 Effectiveness of Milestone-Based Rewards
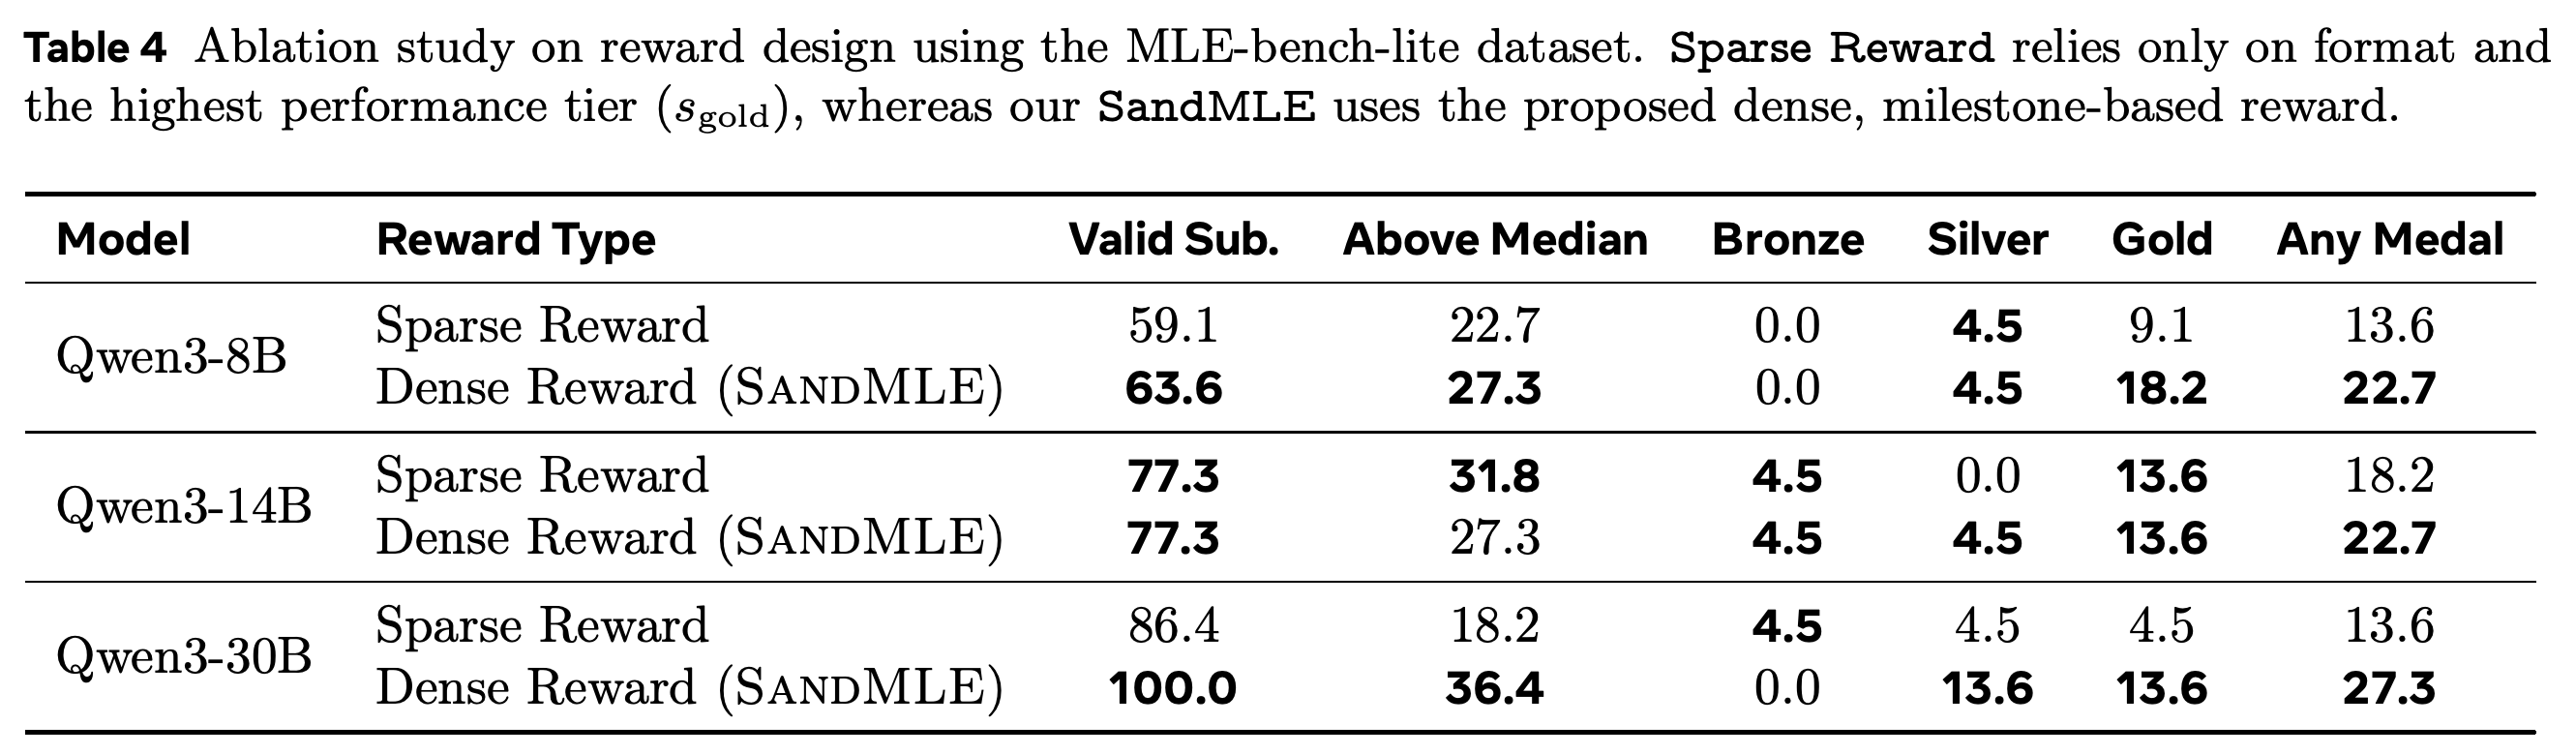
보상 제거 실험은 전체 단계별 성능 목표 보상과 r = 0.1 · rformat + 0.9 · Isgold로 정의한 Sparse Reward를 비교한다. Table 4에서 단계별 성능 목표 보상의 Any Medal 비율은 평가한 모든 규모에서 더 높다. 8B에서는 22.7% 대 13.6%, 14B에서는 22.7% 대 18.2%, 30B에서는 27.3% 대 13.6%다.
- 30B에서는 단계별 성능 목표 보상이 Valid Submission도 86.4%에서 100.0%로, Above Median도 18.2%에서 36.4%로 높인다. 이 결과는 실행과 중간 성능에 부분 점수를 주는 방식이 유용하다는 설명과 부합한다.
- 개선은 모든 지표에서 일관되지는 않는다. 14B 변형 모두 제출 유효성이 77.3%이며, Above Median은 Sparse Reward가 31.8%로 27.3%보다 높다.
- 이 제거 실험은 실행 및 중간 등급 보상을 동시에 없애고 Gold 가중치를 높인다. 전체 보상 정의를 이 대안과 비교한 것이지, 각 항의 개별 인과적 기여나 필요성을 평가한 것은 아니다.
단계별 성능 목표 보상은 모든 모델 규모에서 형식과 Gold만 사용하는 대안보다 Any Medal이 높다. 30B의 메달 비율은 13.6%에서 27.3%로 높아진다. 다만 14B의 Above Median은 희소 보상에서 더 높으며, 이 비교는 개별 보상 항의 효과를 분리하지 않는다.
7 Conclusion
논문은 합성 소규모 환경이 전이에 유용한 과제 구조를 유지하면서 MLE 에이전트의 궤적 단위 온폴리시 RL을 실용적으로 만든다고 결론짓는다. 측정한 실행 시간 감소, 실제 과제의 메달 비율 개선, 학습에서 보지 않은 스캐폴드에서의 결과는 전체 파이프라인을 뒷받침한다. 다만 합성 환경과 실제 데이터 훈련 환경이 동등하다는 점을 입증하지는 않는다.
부록
- A Supplementary Implementation Details의 A.1 Metric Definition Details는 MLE-bench-lite의 유효한 제출물, 인간 참가자 성능 중앙값 초과, 메달 임곗값, Any Medal을 정의한다. MLE-Dojo에서는 제출물 N개 중 순위가 p인 제출물에 (s=1-\frac{p}{N})을 부여한다. HumanRank는 공개 및 비공개 리더보드에서 독립적으로 계산한 순위 점수를 평균한다.
- A.2 Hyperparameter Setup은 훈련 단계 수를 100으로 명시하고, 단일 실행 시간 제한을 RL 중 90초에서 최종 MLE-bench 평가 시 4시간으로 늘린다. AIDE와 AIRA는 NVIDIA H200 GPU 1개, 실제 경과 시간 상한 24시간, 실행 제한 4시간, 유예 기간 5분을 사용한다. MLE-Agent 평가는 상호작용 15단계와 12시간을 허용하며, 전체 상호작용 이력을 유지한다. 최대 입력 길이는 50,000토큰이고, 라운드별 출력 상한은 8,192토큰이다.
- B Supplementary Results와 B.1 Training Dynamics는 Figure 8의 80단계 곡선을 설명한다. 보상이 증가하고 모델 규모가 클수록 제출 신뢰성이 높아진다고 보고하지만, 검증 보상은 변동하며 문서에 제시된 곡선 길이는 구현 설정의 100단계와 다르다.
- C Supplementary Analysis of the Generated Synthetic Dataset는 신뢰성을 기준으로 한 필터링 과정을 기록한다. 초기 과제 1200개는 최대 5회 시도하는 데이터 생성 검증 후 1119개, 최대 3회 시도하는 평가기 생성 후 1106개, 최종 건전성 검사 후 912개가 된다. C.2 Qualitative Analysis는 iwildcam-2019-fgvc6에서 파생한 Urban Road Surface Damage Classification Under Motion Blur를 분석한다. Task Derivation and Mutation Strategy는 롱테일 이미지 분류 구조를 도로 손상으로 옮긴다. Data Generation and Hidden Rules는 Perlin-noise 텍스처, 1–5프레임의 시간적 시퀀스, 점차 강해지는 모션 블러, 결정론적 손상 라벨 규칙을 사용해 해상도 1024×768의 합성 RGB 이미지 147개를 생성한다.
- Evaluation and Alignment는 클래스 불균형을 다루기 위해 Macro-F1을 사용하고, 임곗값 예제로 Gold = 0.68과 Silver = 0.55를 제시한다. 이 구성은 지표와 임곗값을 생성 데이터에 맞춰 연결한다. 다만 우승하려면 블러 제거, 주파수 영역 특징, 시퀀스 집계가 필요하다는 주장은 해법 간 비교 연구로 뒷받침되지 않는다.
- D Prompt Details는 반복 실행과 점수 계산을 위한 D.1 React framework 템플릿과 생성 역할 4개를 위한 D.2 SandMLE Method 템플릿을 제공한다. 생성 템플릿은 구조 추출 및 변형, generate_task_env.py, threshold.json, sample_submission.csv, 비공개 answer.csv, evaluator.py, 그리고 이들과 일치하는 description.md를 명시한다. 이 템플릿은 구현 선택을 기록한 것이며, 추가 성능 근거를 제공하지는 않는다.
짧은 생각
SandMLE의 유용한 기여는 환경 구성 요소를 함께 재설계한다는 점이다. 데이터셋만 따로 축소하지 않고 데이터 생성, 평가, 보상 임곗값을 함께 다시 구성한다. 측정한 13.7배의 실행 속도 향상과 실제 대회로의 전이는 합성 검증 보상 개선을 넘어서는 근거를 제공한다.
실험은 개별 설계에 대한 설명보다 전체 파이프라인을 더 강하게 뒷받침한다. 주 벤치마크가 22개 과제로 구성된다는 점, 불확실성 추정치를 보고하지 않는다는 점, Seed-SFT와 합성 RL이 접하는 과제가 서로 다르다는 점은 인과적 기여를 판단하는 데 제약이 된다. 같은 데이터로 수행하는 SFT, 생성 구성 요소별 제거 실험, 반복 평가는 온폴리시 학습, 과제 다양성, 보상 설계의 기여를 구분하는 데 도움이 된다.