


EnvHarness: Awakening Static Worlds for Agent Learning 요약 설명
20 Aug 2026 | Paper Review Agent Learning Environment Scaling Reinforcement Learning Self-Evolving Agents목차
- 요약
- 1. Introduction
- 2. EnvHarness
- 3. EnvHarness for Agent Learning
- 4. Experiments
- 5. Analysis
- 6. Related Work
- 7. Conclusion
- 부록
- 짧은 생각
이번 글에서는 EnvHarness: Awakening Static Worlds for Agent Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 20일(Arxiv)
- Huang, Chengsong, Wang, Zifeng, Han, Rujun, Yan, Jun, Chen, Yanfei, CuiZhu, Zoey, Jiang, Ke, Xia, Peng, Yu, Han, Zhuang, Yufan, et al.
- Washington University in St. Louis, Google Cloud AI Research, Google Cloud, University of North Carolina at Chapel Hill
- 논문 링크
- Github
- Project Page
요약
- EnvHarness는 LLM agent의 환경 구축을 wrapping 문제로 다룬다. 플러그인 component가 기본 구현을 수정하거나 verifier를 교체하지 않고 표준 interface를 통해 정적인 환경을 재구성한다. EnvRigger는 rollout으로 black-box policy를 진단하고, 표적 wrapper를 작성한 뒤 새 rollout에서 검증한다. 4개 domain의 5개 benchmark에서 held-out 성능이 최대 9.0-point 개선되고 실행 단계가 9.8% 감소했다고 보고한다.
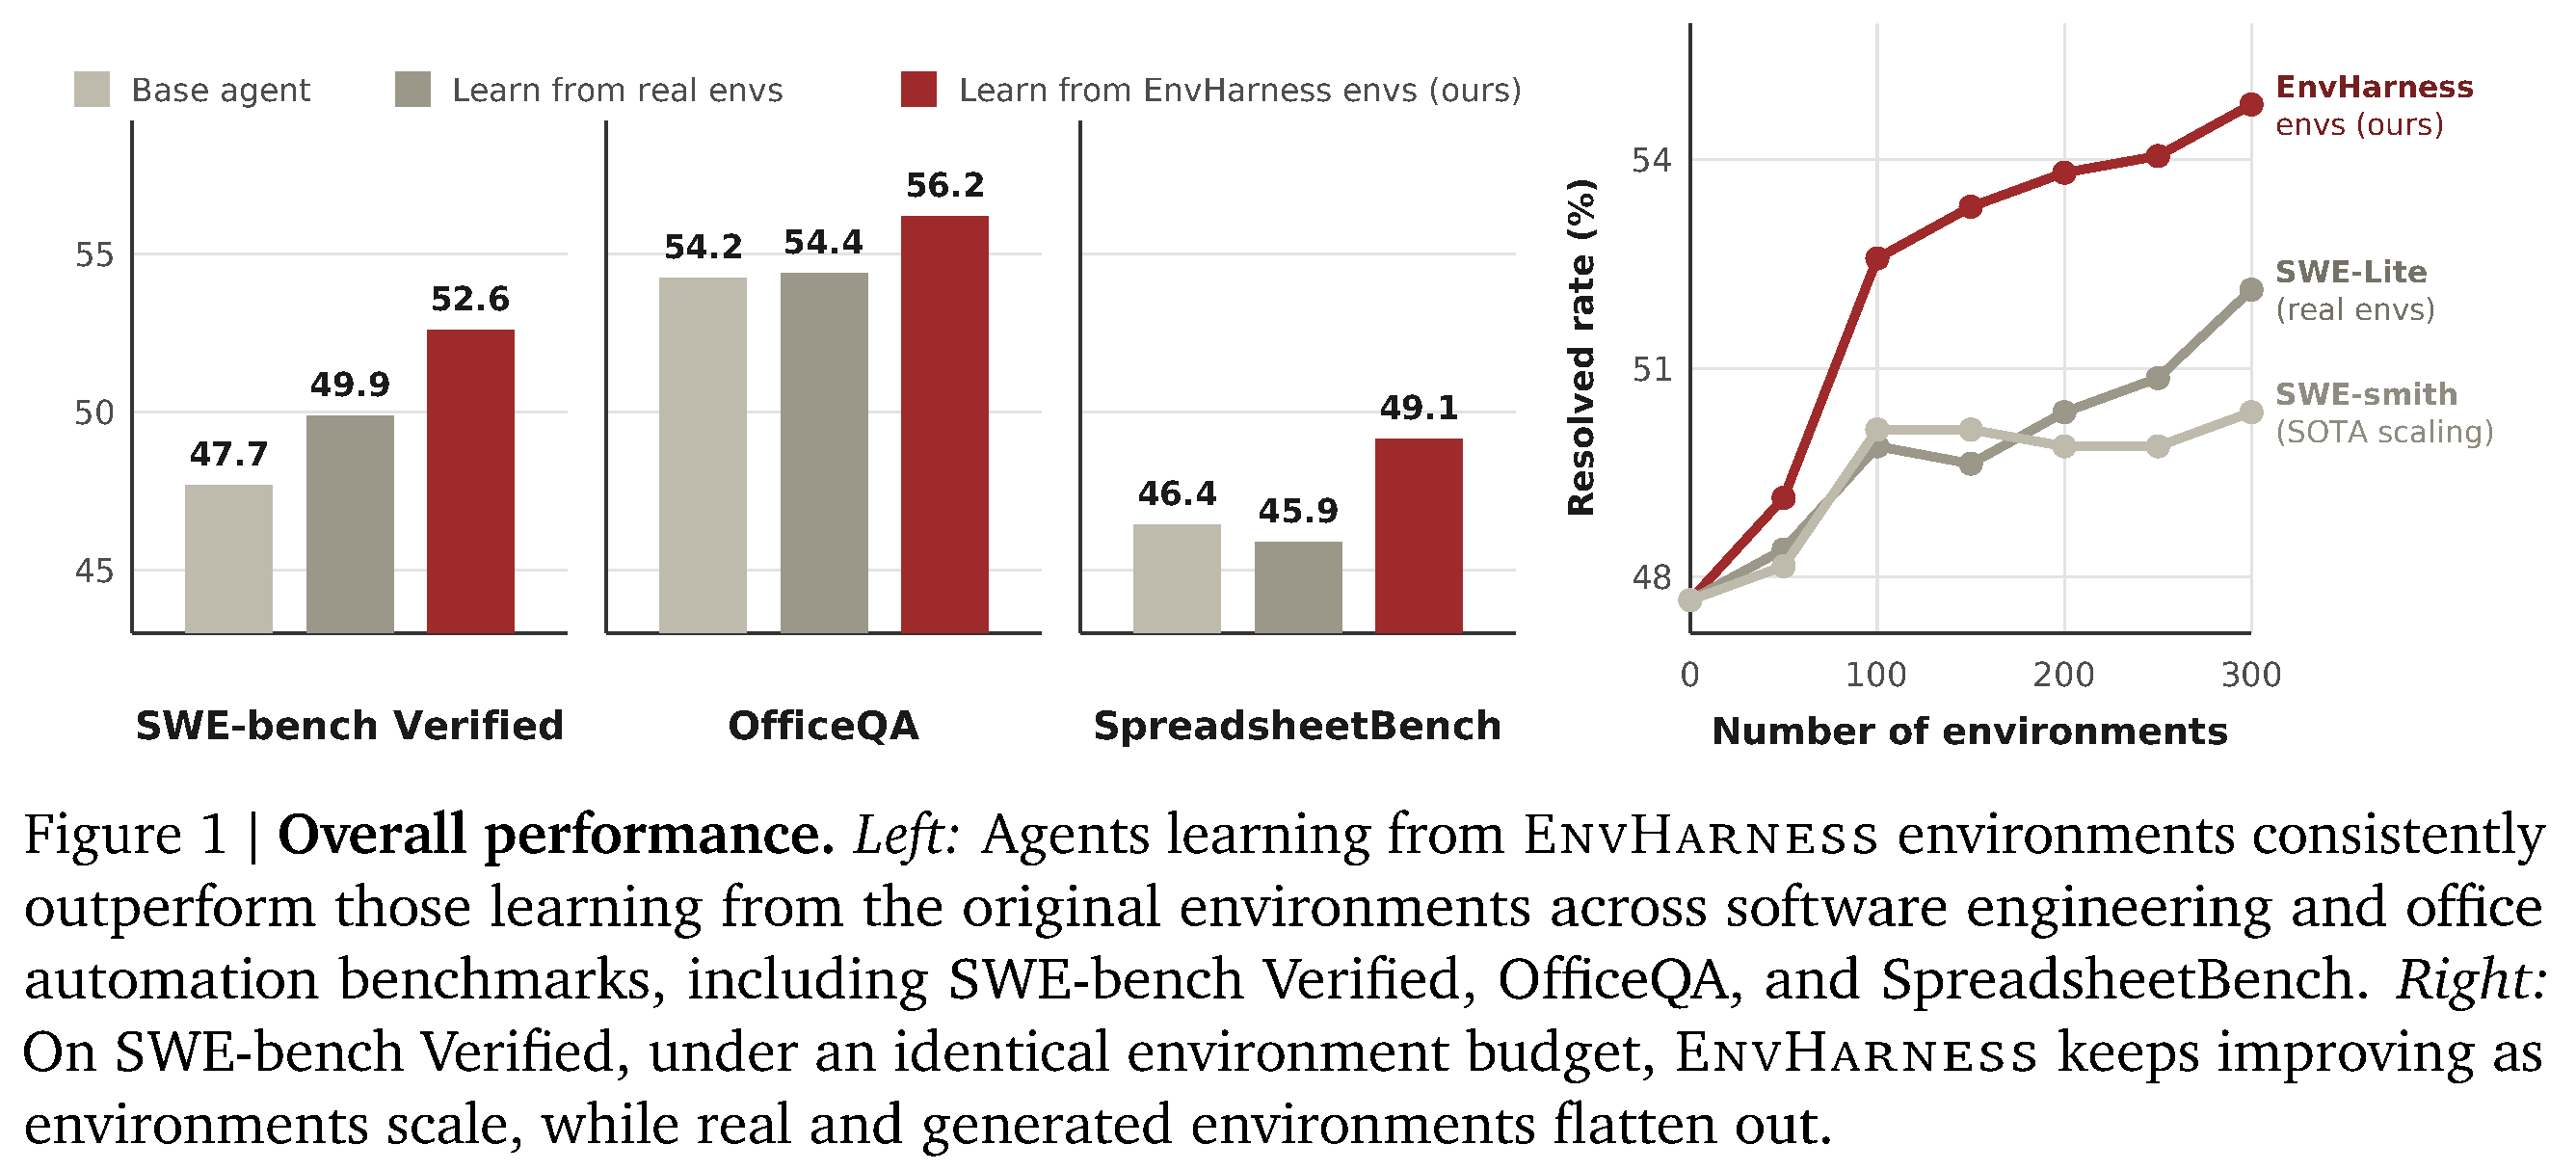
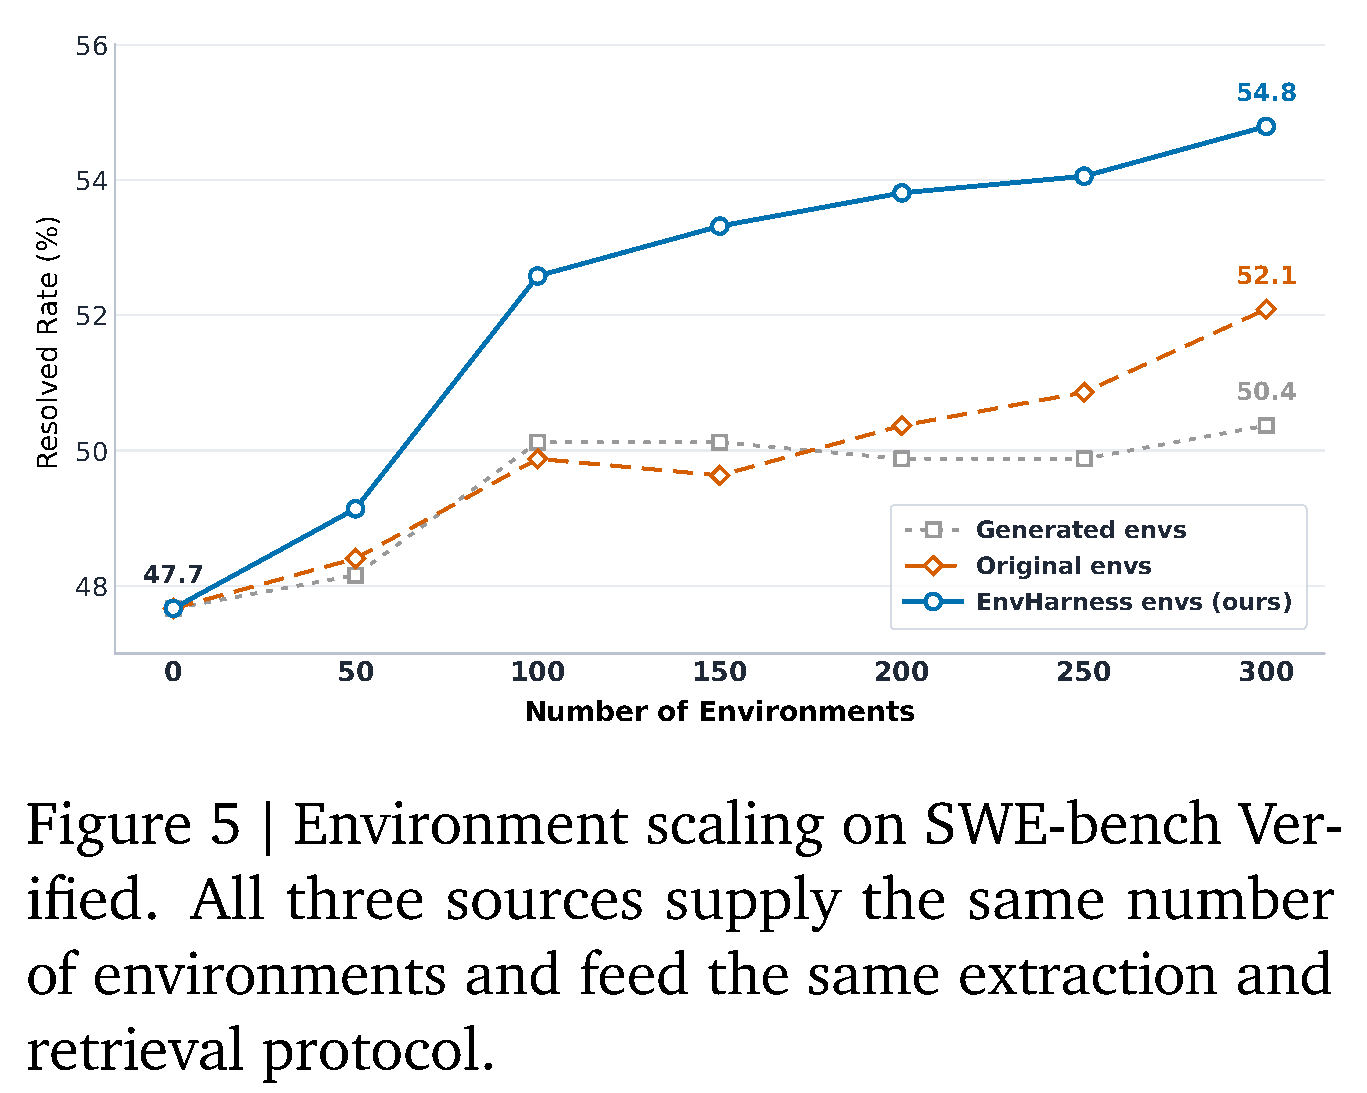
왼쪽 막대는 SWE-bench Verified, OfficeQA, SpreadsheetBench에서 base agent, 원래 환경으로 학습한 agent, EnvHarness 환경으로 학습한 agent를 비교하며, EnvHarness 조건이 3개 그룹 모두에서 가장 높다. 오른쪽 plot은 300개 환경까지 resolved rate가 증가하는 모습을 보이는 반면, 원래 환경과 생성 환경 curve는 더 낮은 값에서 평탄해진다.
1. Introduction
논문은 개선되는 agent에 대해 수작업 환경이 정적이라고 주장한다. 즉, 현재 약점을 겨냥하지 못하고 task가 쉬워진 뒤에는 유용한 학습 신호를 계속 제공하지 못한다. 기존 환경 생성 pipeline은 domain별로 특화되어 검증하기 어렵다고 보며, EnvHarness는 원래 task와 verifier를 유지한 채 외부에서 reset/step 상호작용을 매개한다.
2. EnvHarness
EnvHarness는 simulator backend를 수정하지 않고 정보 흐름을 바꾸는 기존 환경 주변의 programmable layer다. 플러그인 wrapper는 agent를 위한 표준 환경 interface를 보존하면서 초기 상태, 상호작용 제약, observation, episode 구성을 바꿀 수 있다.
2.1. The EnvHarness Paradigm
논문은 환경을 E = (S, A, O, T, R, s0)로 모델링하고, component를 E′ = w(E)를 생성하는 환경 비종속 변환 w로 정의한다. wrapper는 interface 경계에서 노출되는 상태, action, observation, transition 동작을 바꿀 수 있지만, 원래 evaluator는 여전히 episode를 평가할 수 있다.
2.2. Three EnvHarness Components
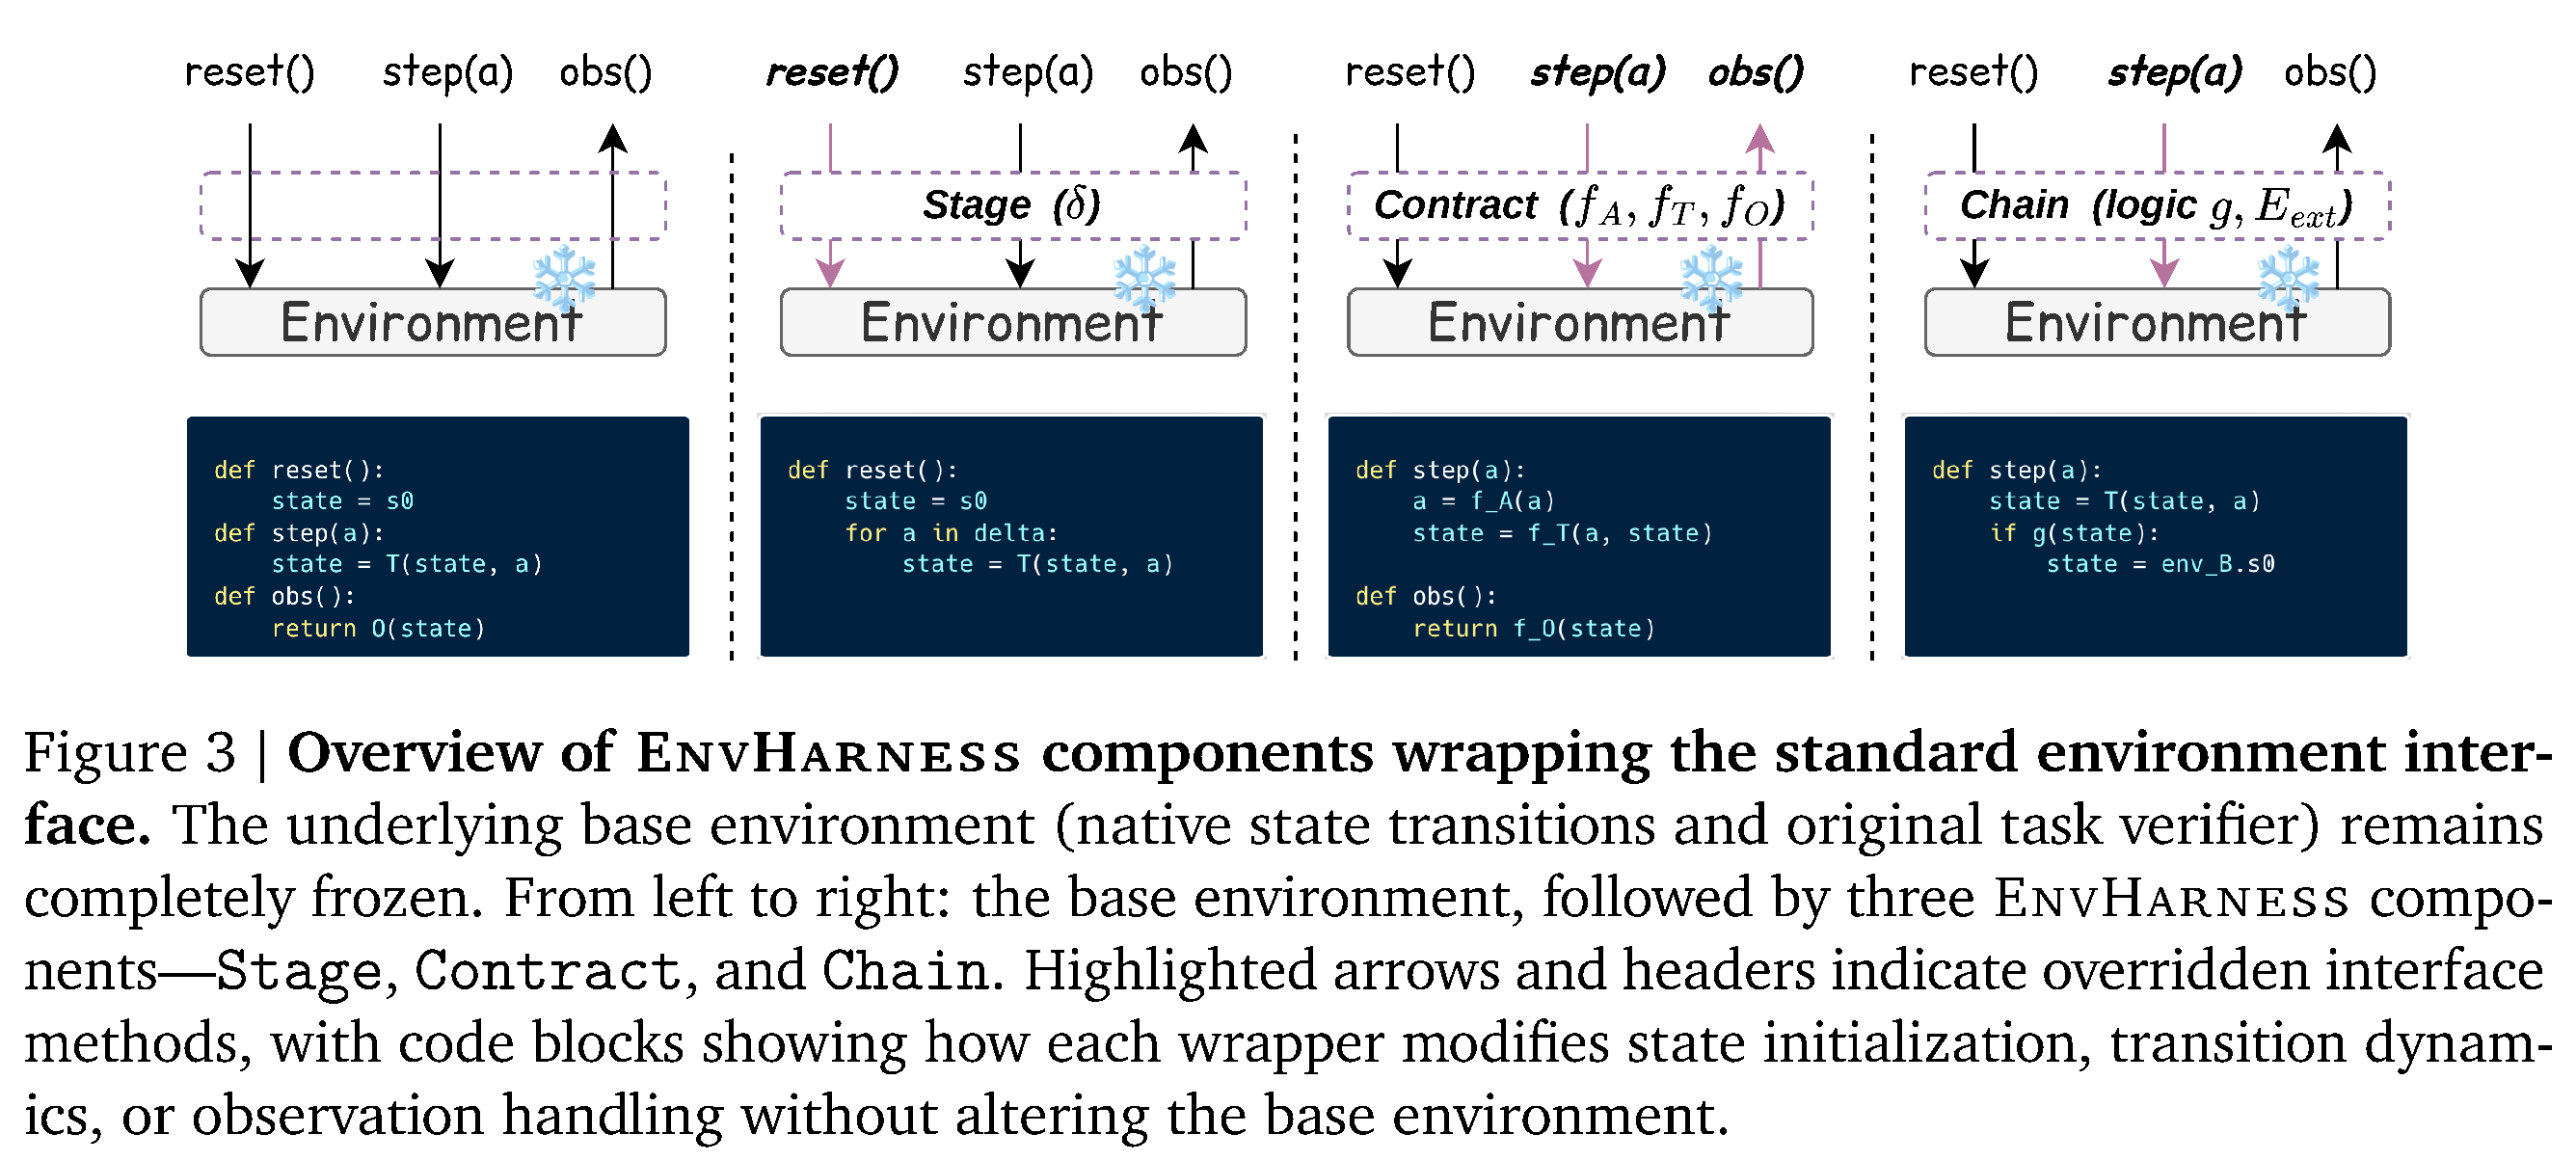
Stage는 reset 뒤 유효한 환경 action을 재생해 episode의 초기 상태를 바꾼다. Contract는 map (fA, fT, fO)을 통해 action, transition, observation을 재작성하고, Chain은 환경을 결합해 composite episode를 만든다. component 합성은 non-commutative하므로 wrapper 순서가 최종 초기화와 상호작용 제약을 결정한다.
이 그림은 표준 interface의 개입 지점마다 wrapper를 배치한다. Stage는 reset에서 파생된 초기화를 수정하고, Contract는 step 시점의 action, transition, observation 처리를 가로채며, Chain은 episode 수준의 구성을 바꾼다. Native state transition과 원래 verifier는 frozen base environment에 남아 있음을 강조한다.
3. EnvHarness for Agent Learning
Agent 학습에서 이 framework는 target policy의 구체적 약점을 드러내는 task- 및 policy-conditioned wrapped environment를 찾는다. 개별 component는 policy-agnostic transformation이지만, component의 선택과 parameterization은 base task 및 관찰된 policy 행동에 따라 결정된다.
3.1. Problem Setup
Base environment E, task t, target policy π가 주어지면, 목표는 교정적 학습 신호를 제공하는 wrapper를 합성해 E′ = H(E, t; π)를 생성하는 것이다. 이 방법은 π를 black box로 다루며, model weight가 아니라 output과 trajectory를 사용해 행동상 취약점을 식별한다.
3.2. EnvRigger
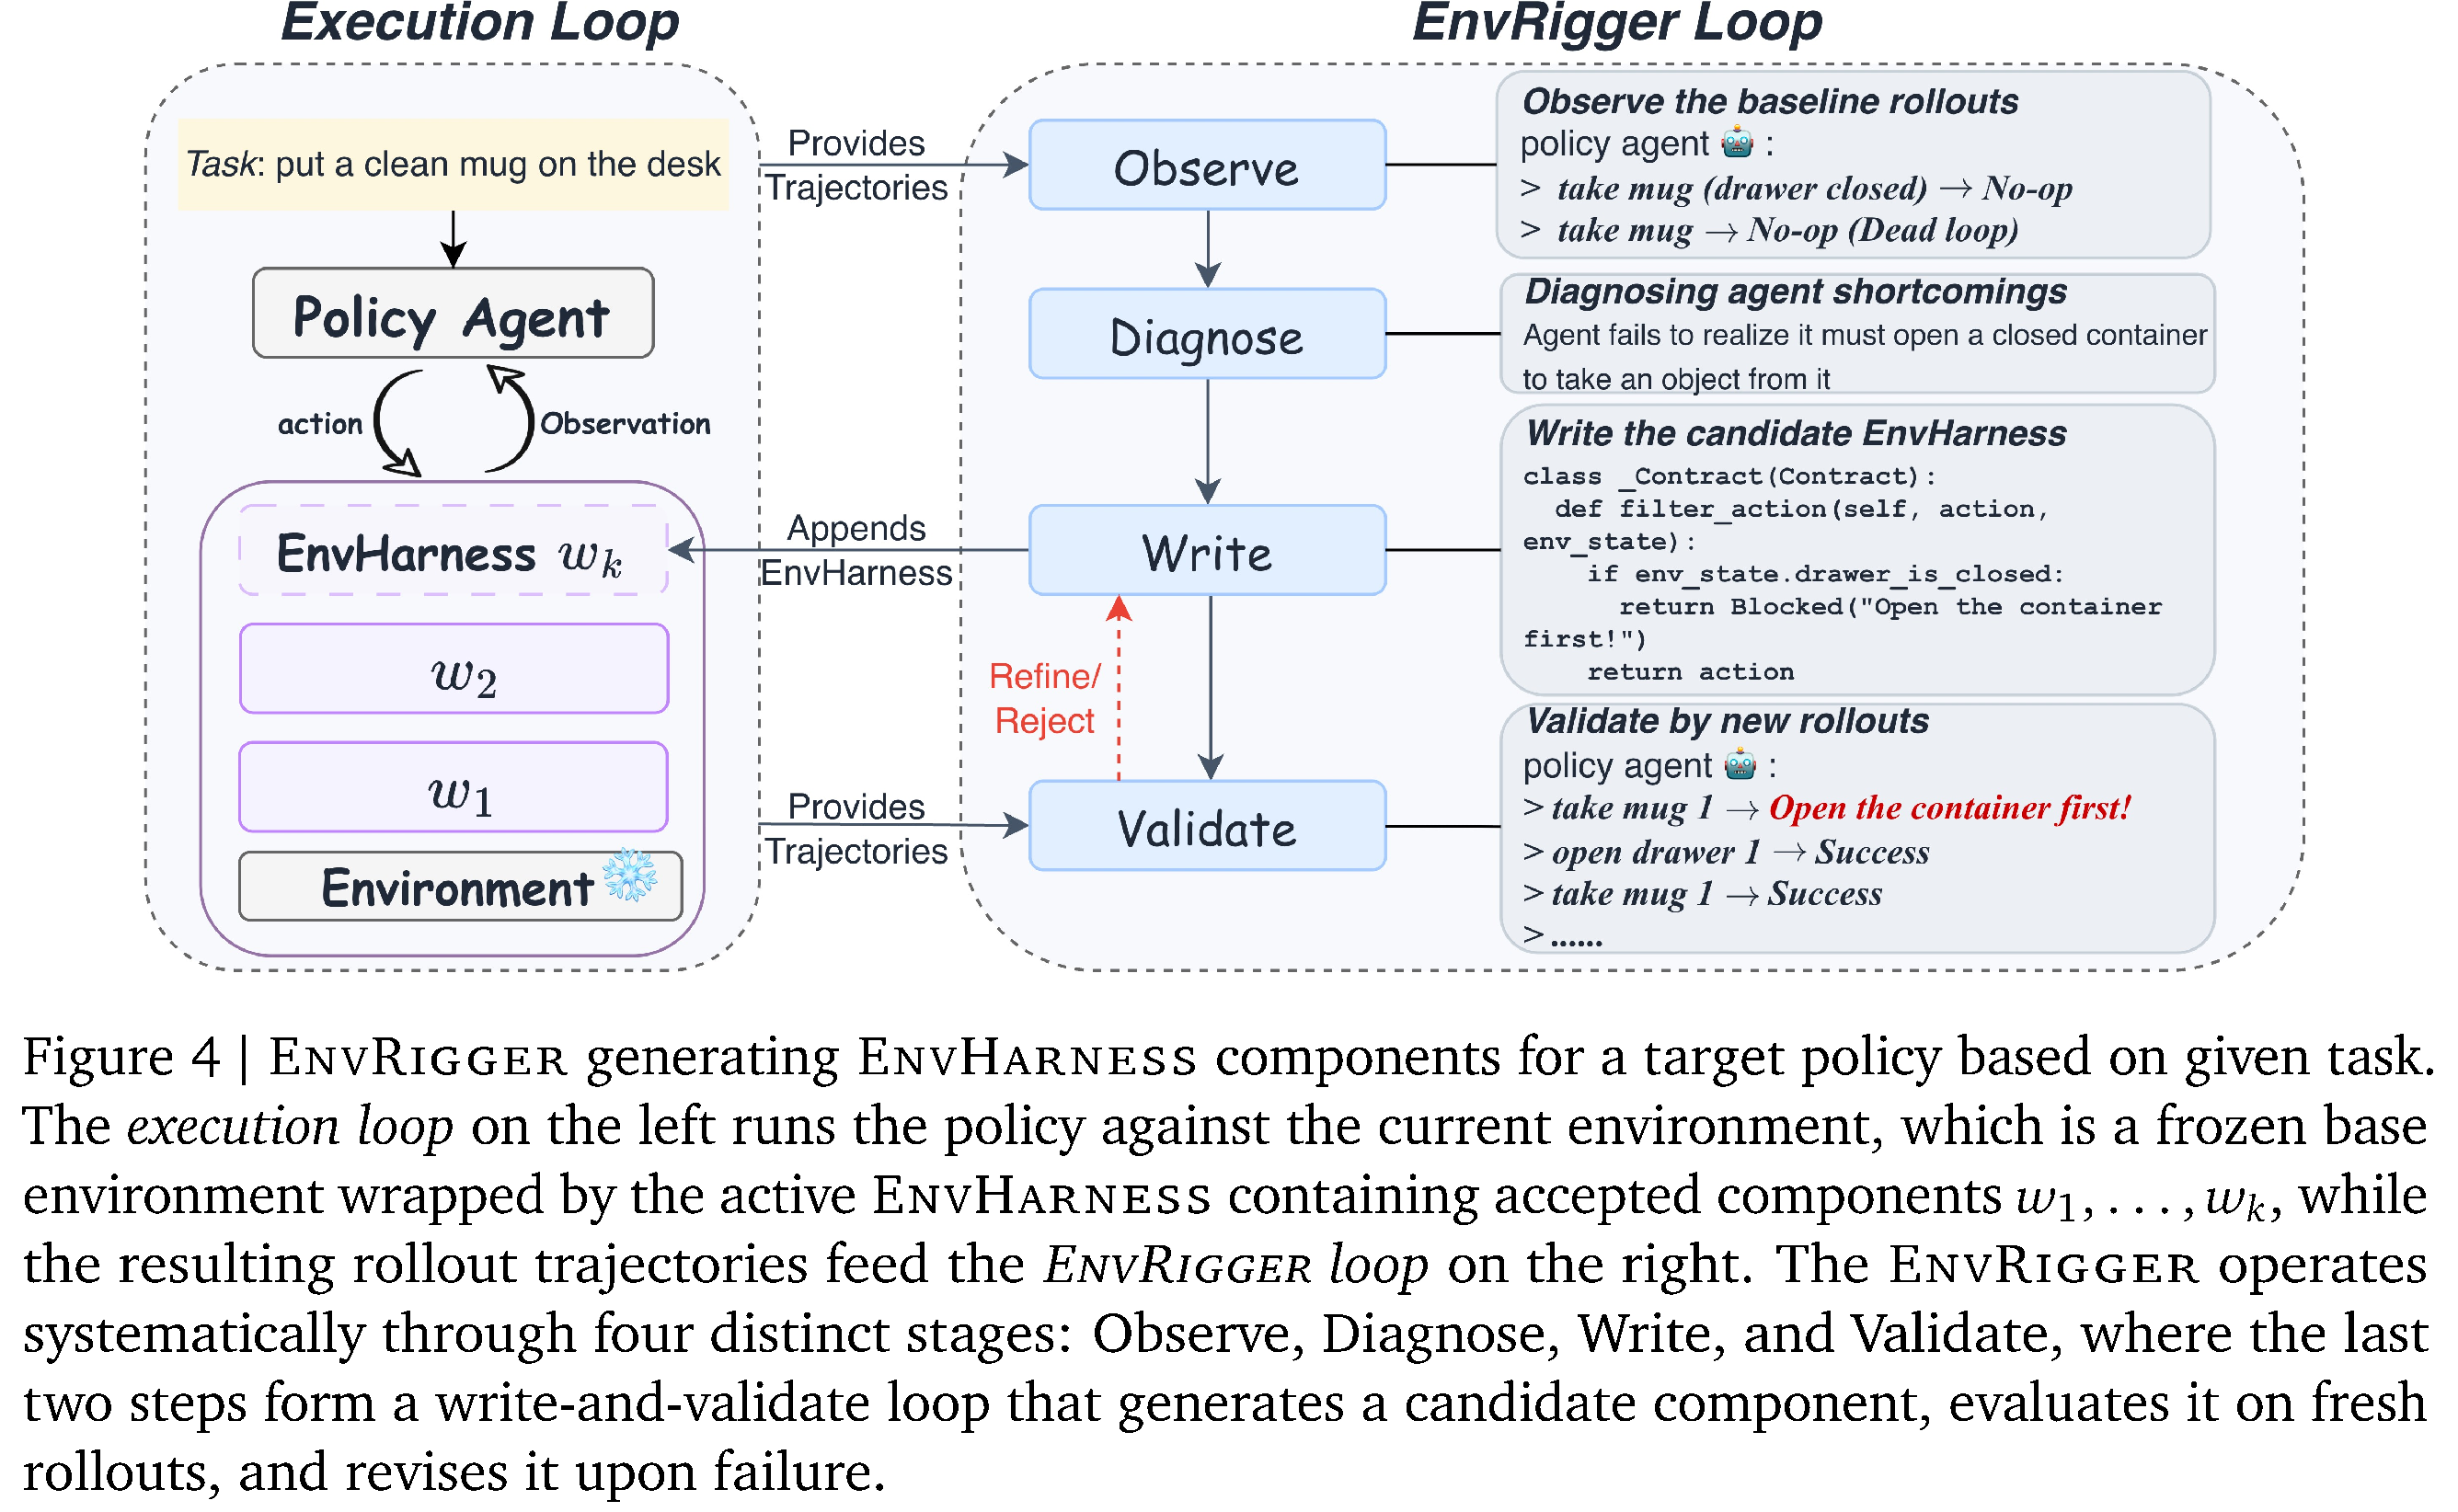
EnvRigger는 4단계로 구성된다. 먼저 policy rollout을 Observe하고, 체계적 실패를 Diagnose하며, 1개 이상의 후보 component를 Write한 뒤 새 rollout으로 후보를 Validate한다. 후보는 채택되거나, 너무 자명하거나 풀 수 없는 경우 거부되며, 학습 신호의 규모가 부적절하면 수정된다. 구현은 instance마다 baseline rollout 5개, validation rollout 5개, 최대 5회의 write–validate round를 사용한다.
이 workflow는 현재 wrapping된 환경에서의 target-policy 실행과 EnvRigger의 Observe, Diagnose, Write, Validate loop를 분리한다. 새 rollout 증거에 따라 후보 component를 채택, 거부, 수정하며, 채택된 component는 활성 wrapper stack에 추가된다.
4. Experiments
주요 skill 기반 실험은 ALFWorld, WebArena, SWE-bench Verified, OfficeQA, SpreadsheetBench를 대상으로 하며, 학습 episode와 평가 episode를 분리한다. EnvRigger와 policy는 benchmark마다 같은 backbone을 사용한다. ALFWorld와 WebArena에는 Gemini-3.1-Flash-Lite를, 나머지에는 Gemini-3.5-Flash를 사용한다. skill은 ReasoningBank를 따라 추출하며, Chain은 자동 pipeline에서 제외하고 별도로 분석한다.
4.1. Experimental Setup
Baseline은 No Skills, Original Envs에서 추출한 skills, 그리고 적용 가능한 경우 benchmark별 생성 방법인 GenEnv, VeriEnv, SWE-smith다. 저자들은 seed instance, 환경 수, skill-extraction pipeline, policy model을 고정한다. 학습에는 ALFWorld task 100개, sub-domain마다 WebArena task 20개, SWE-bench Lite task 100개, OfficeQA task 50개, SpreadsheetBench task 100개를 사용하고, 이후 held-out 원래 task에서 평가한다.
4.2. Main Results
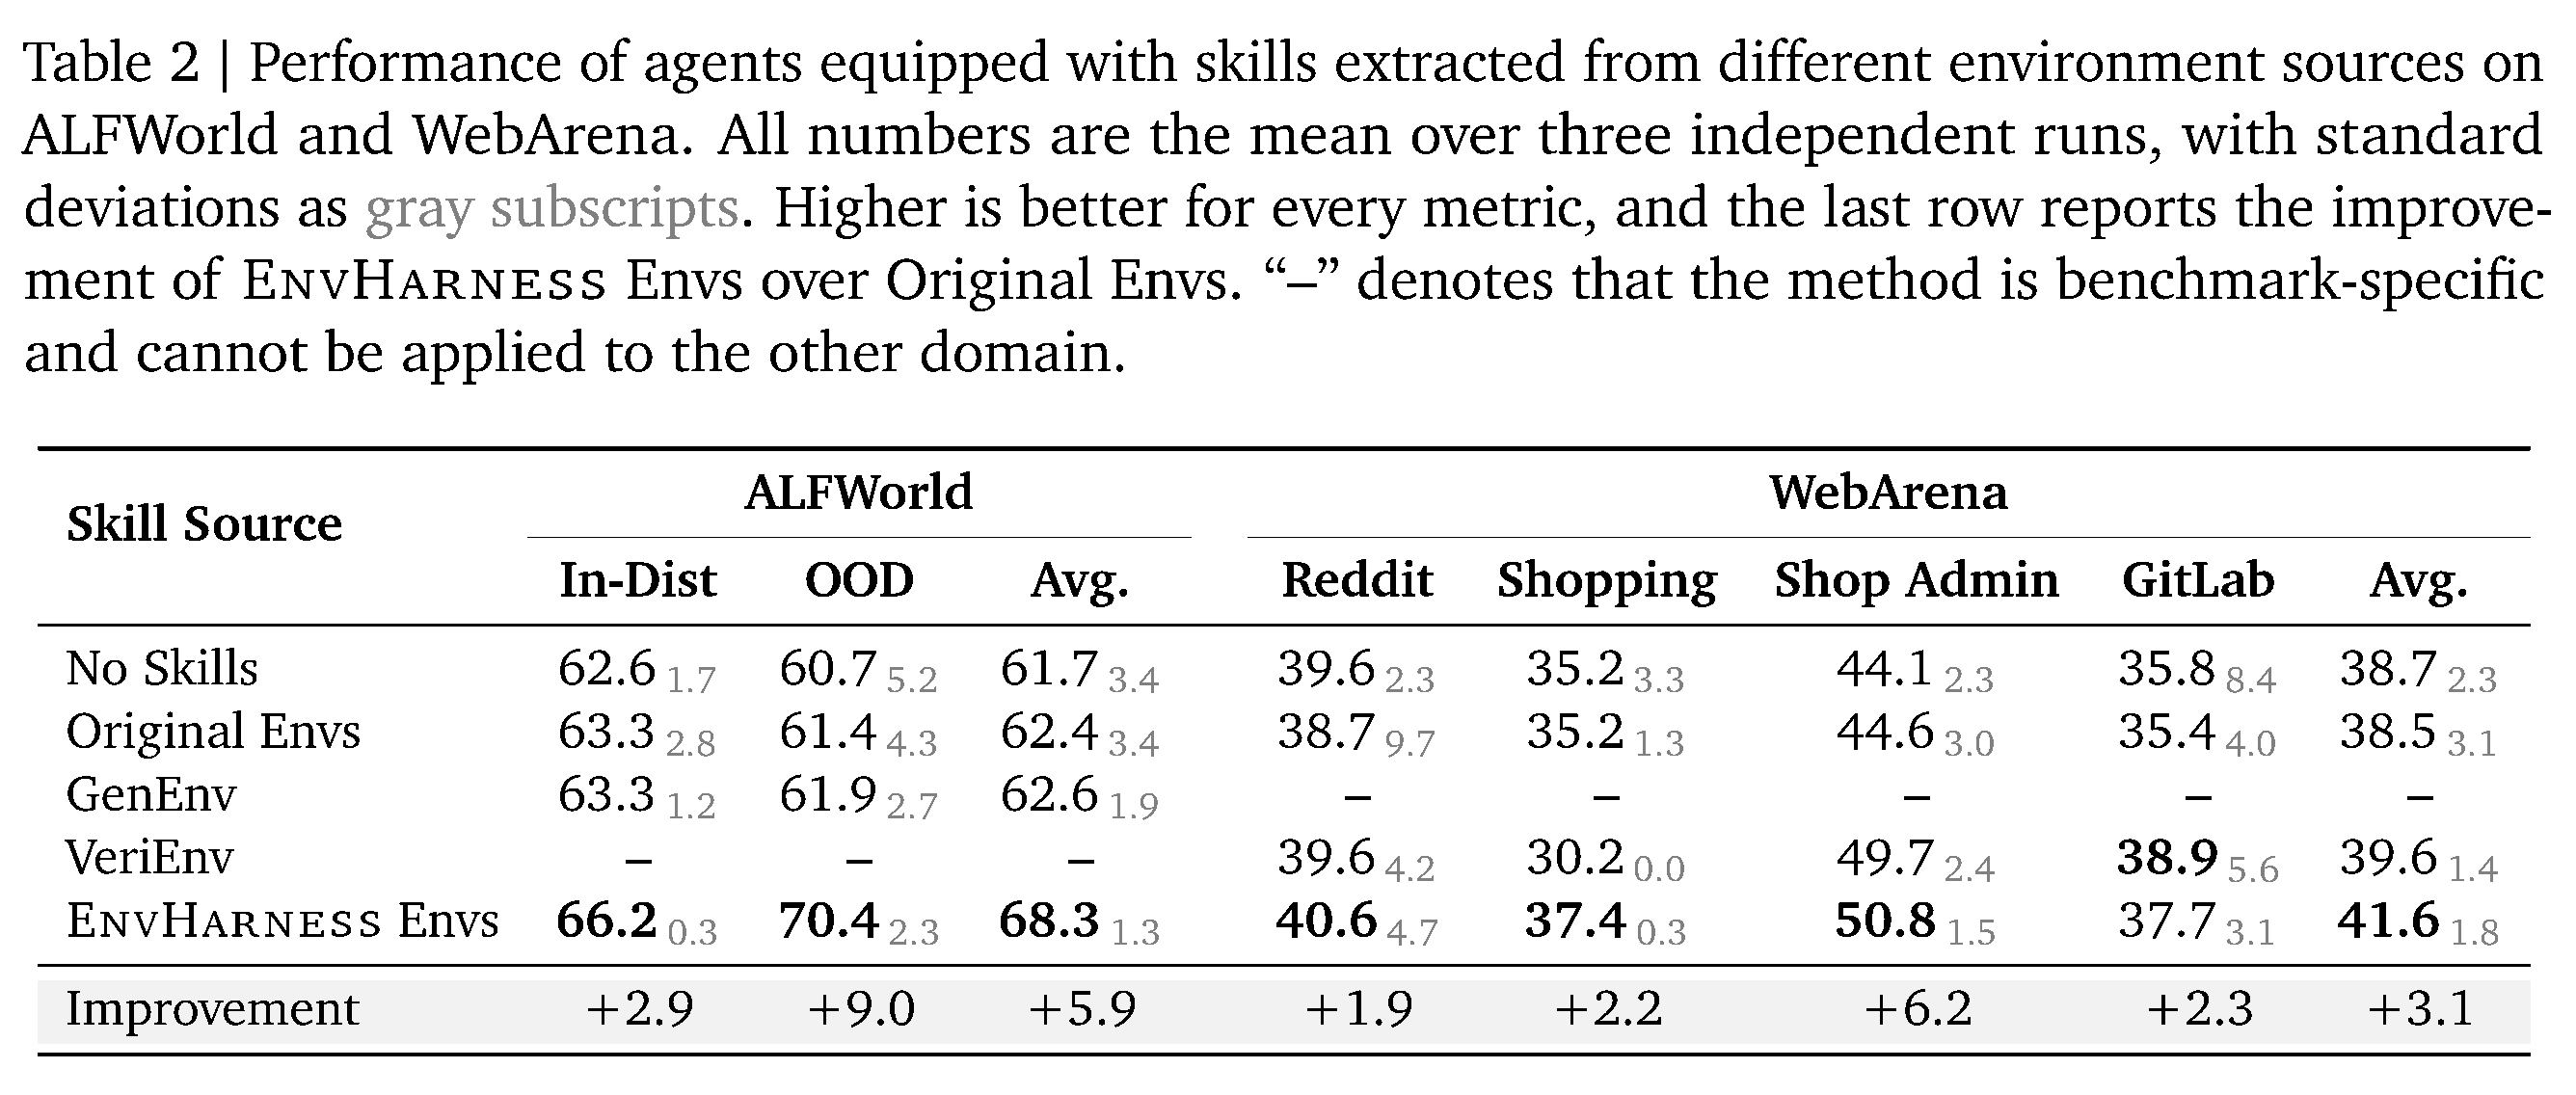
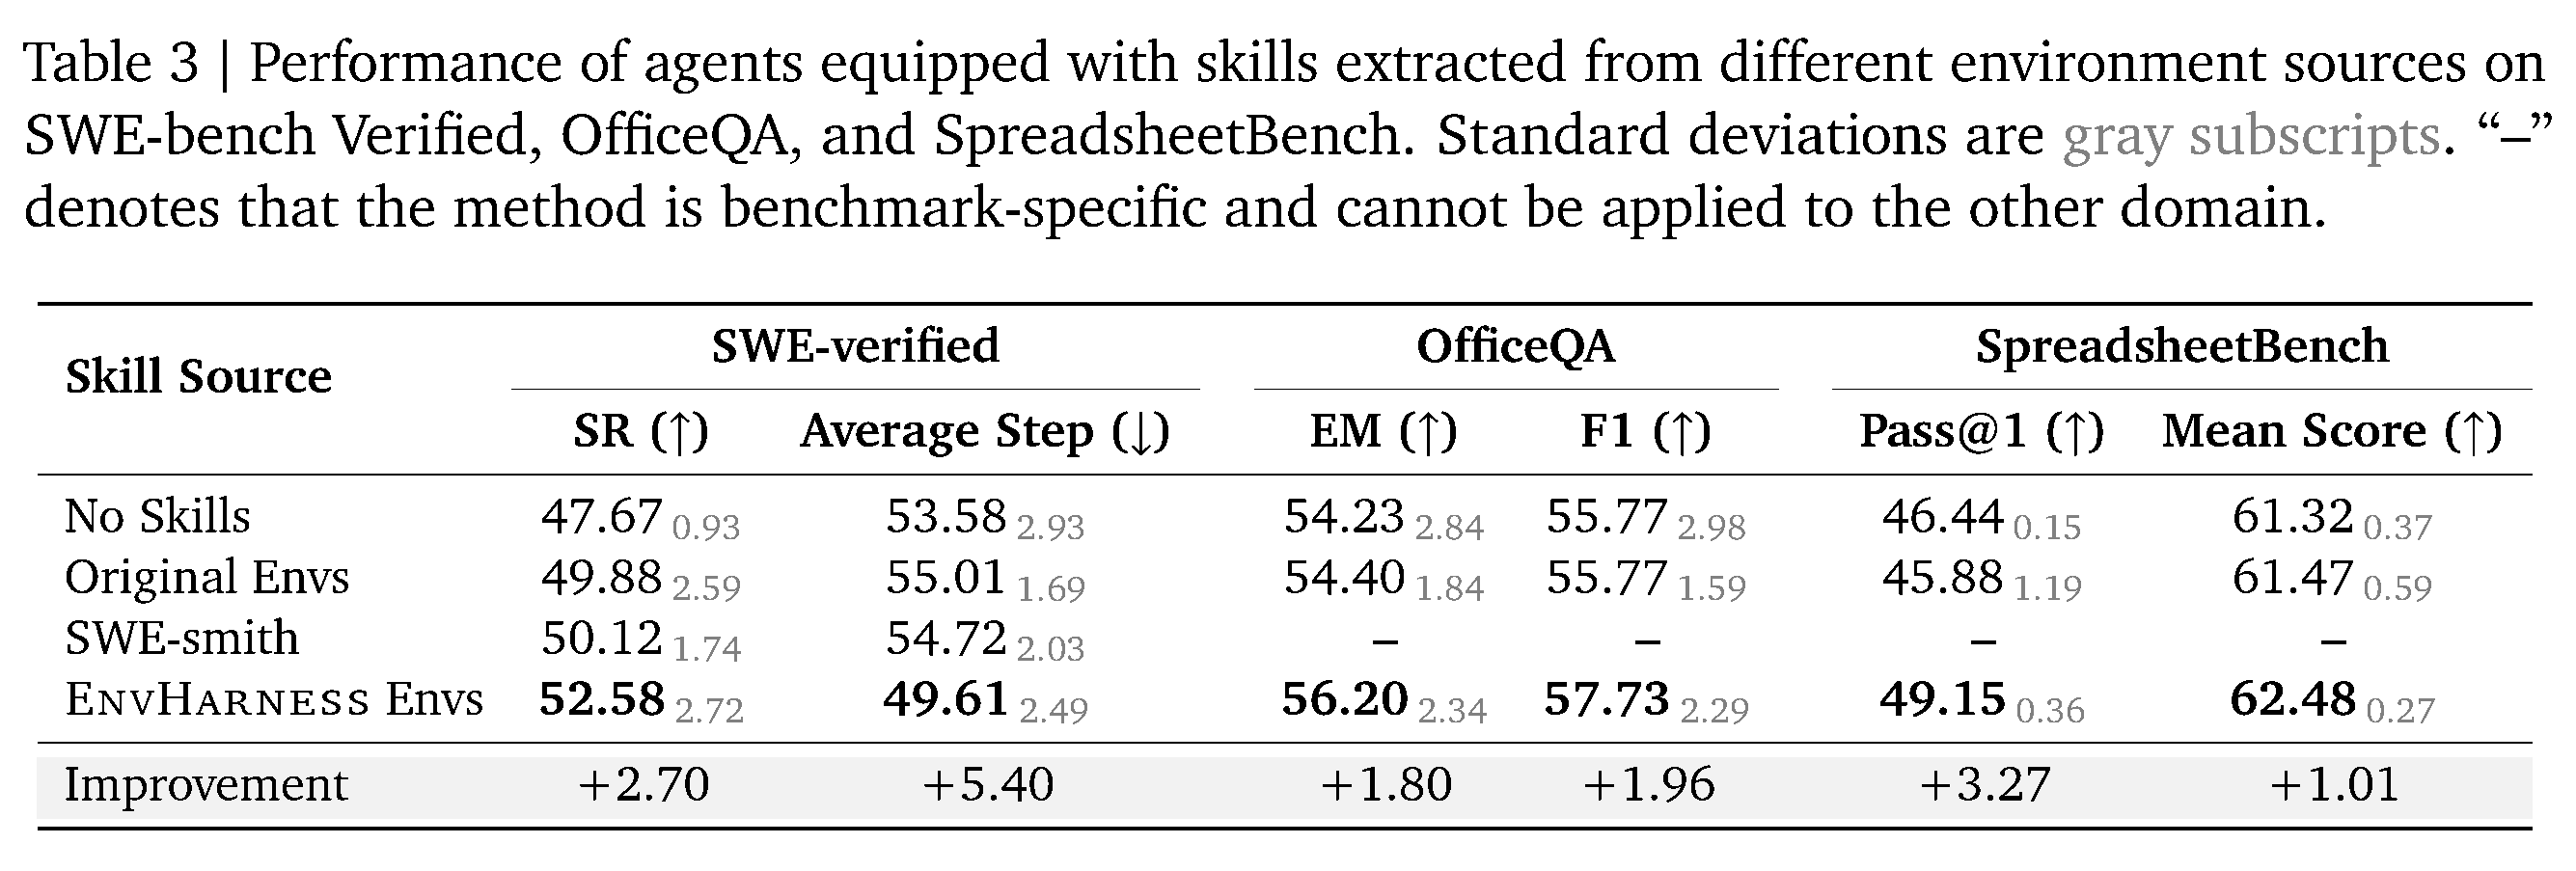
EnvHarness에서 추출한 skills는 보고된 모든 benchmark에서 Original Envs를 능가한다. 가장 큰 차이는 ALFWorld OOD에서 +9.0 points다. SWE-bench Verified에서는 success rate가 49.88 대비 52.58이고, 평균 단계 수는 55.01 대비 49.61이다. OfficeQA와 SpreadsheetBench도 표시된 metric에서 개선된다. Table 2는 독립 실행 3회의 평균을 보고하며, Table 2와 3에는 standard deviation도 제시한다.
ALFWorld에서 EnvHarness는 Original Envs의 62.4 대비 평균 성능 68.3을 달성하며, OOD에서는 61.4 대비 70.4를 기록한다. WebArena에서는 Original Envs의 38.5 및 VeriEnv의 39.6 대비 평균 41.6을 기록하며, 표시된 가장 큰 향상은 Shop Admin에서 나타난다.
EnvHarness는 SWE-bench Verified에서 success rate 52.58, 평균 단계 수 49.61을 기록하며, Original Envs는 각각 49.88과 55.01을 기록한다. 또한 표시된 OfficeQA와 SpreadsheetBench metric에서 가장 높은 값을 보이지만, SpreadsheetBench Pass@1에서는 Original Envs가 No Skills보다 약간 낮다.
5. Analysis
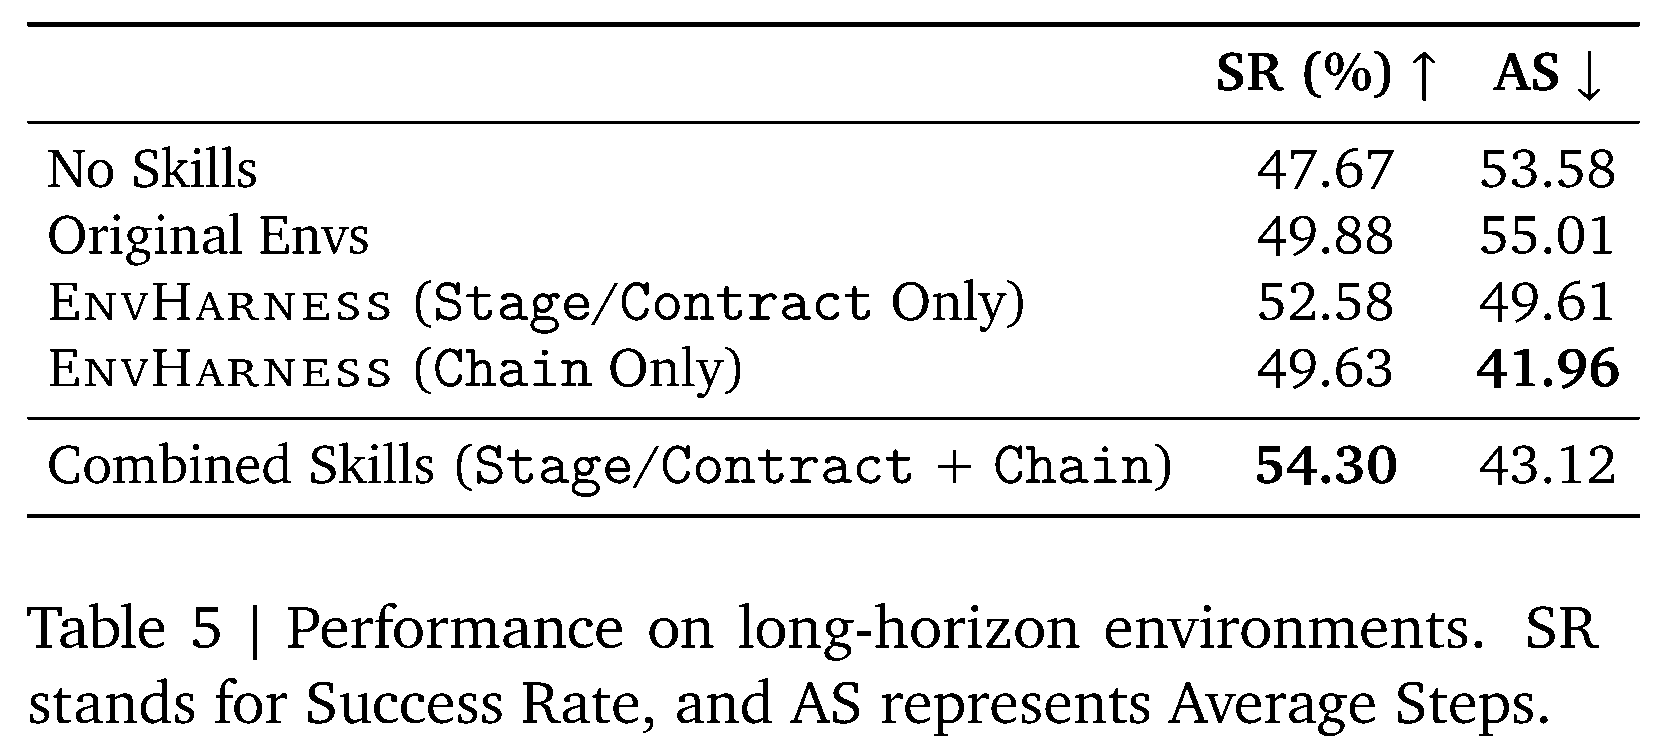
RL에서 EnvHarness 환경으로 GRPO 학습한 Qwen3-8B-base는 ALFWorld in-distribution success를 81.4에서 87.9로, WebShop score/success rate를 75.6/66.0에서 79.2/67.4로 높인다. 반면 ALFWorld OOD success는 89.6에서 88.8로 감소한다. 장기 horizon SWE-bench 분석에서 Chain-only skills는 평균 단계를 41.96으로 낮추지만 success rate는 49.63이다. Chain을 Stage/Contract skills와 결합하면 success rate는 54.30, 평균 단계 수는 43.12가 된다.
RL 비교는 EnvHarness로 학습한 policy가 ALFWorld in-distribution success와 WebShop의 2개 metric에서 원래 환경으로 학습한 policy를 능가함을 보인다. 예외로 ALFWorld OOD success는 0.8-point 감소하므로, 보고된 향상은 모든 outcome에서 일관되지는 않다.
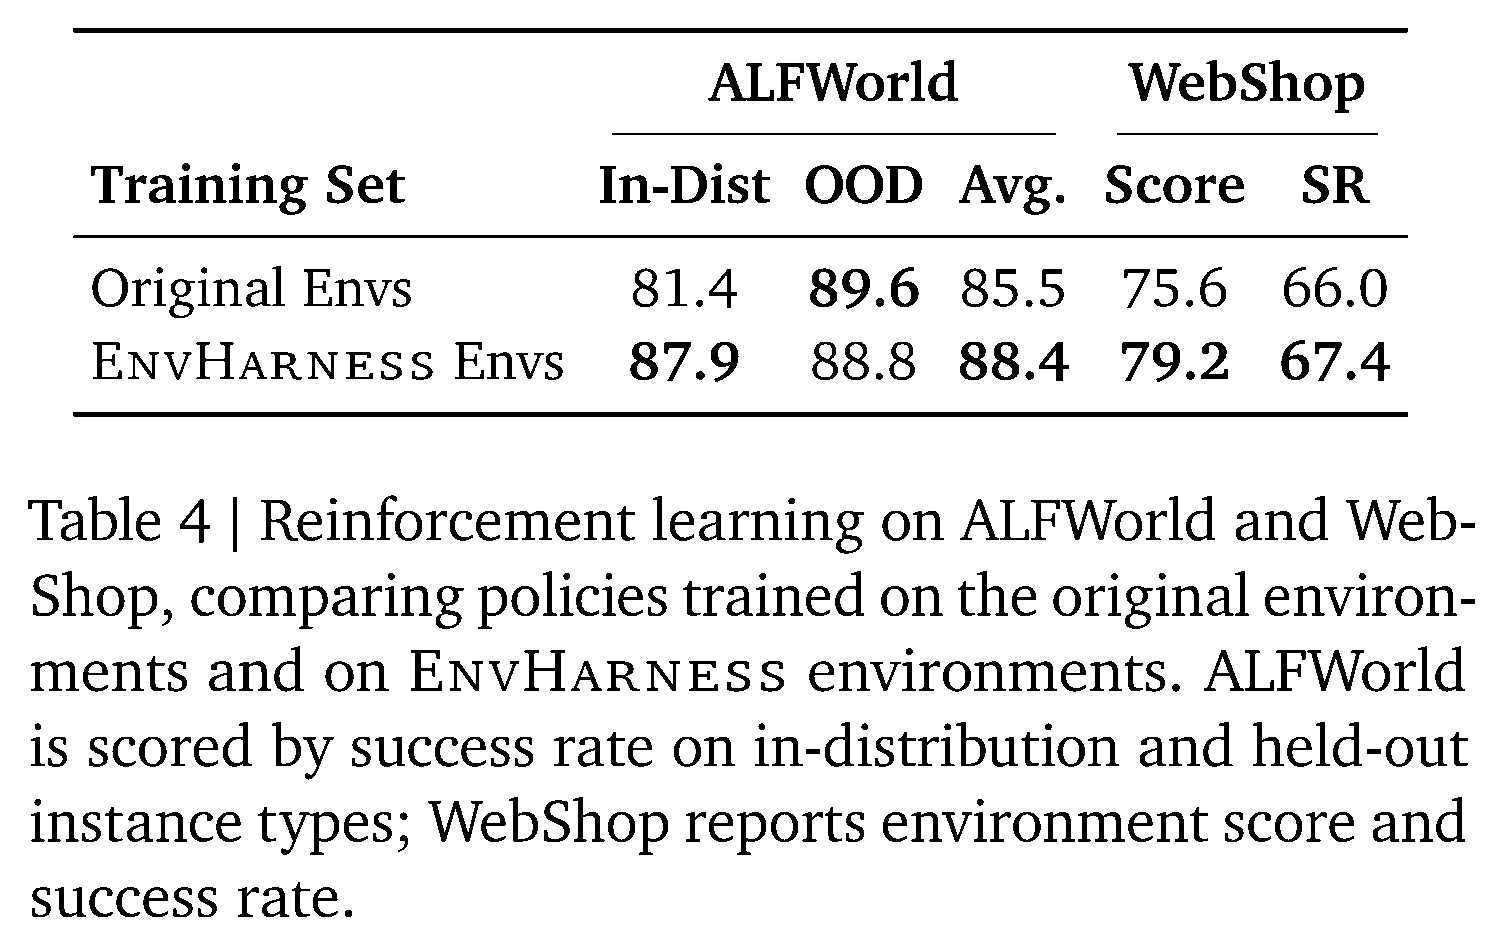
Chain-only skills는 No Skills의 평균 단계 수 53.58을 41.96으로 낮추지만, success rate 49.63은 Original Envs의 49.88보다 낮다. Chain을 Stage/Contract skills와 결합하면 가장 높은 표시 success rate인 54.30을 달성하며, 평균 단계 수는 43.12다.
동일한 환경 수와 공유된 추출 및 retrieval protocol에서 EnvHarness의 resolved rate는 300개 환경에서 47.67에서 54.79로 상승한다. 원래 환경은 52.13, 생성 환경은 50.37에 도달하며, 이는 반복적인 policy-conditioned 환경 구축의 scaling 근거로 제시된다.
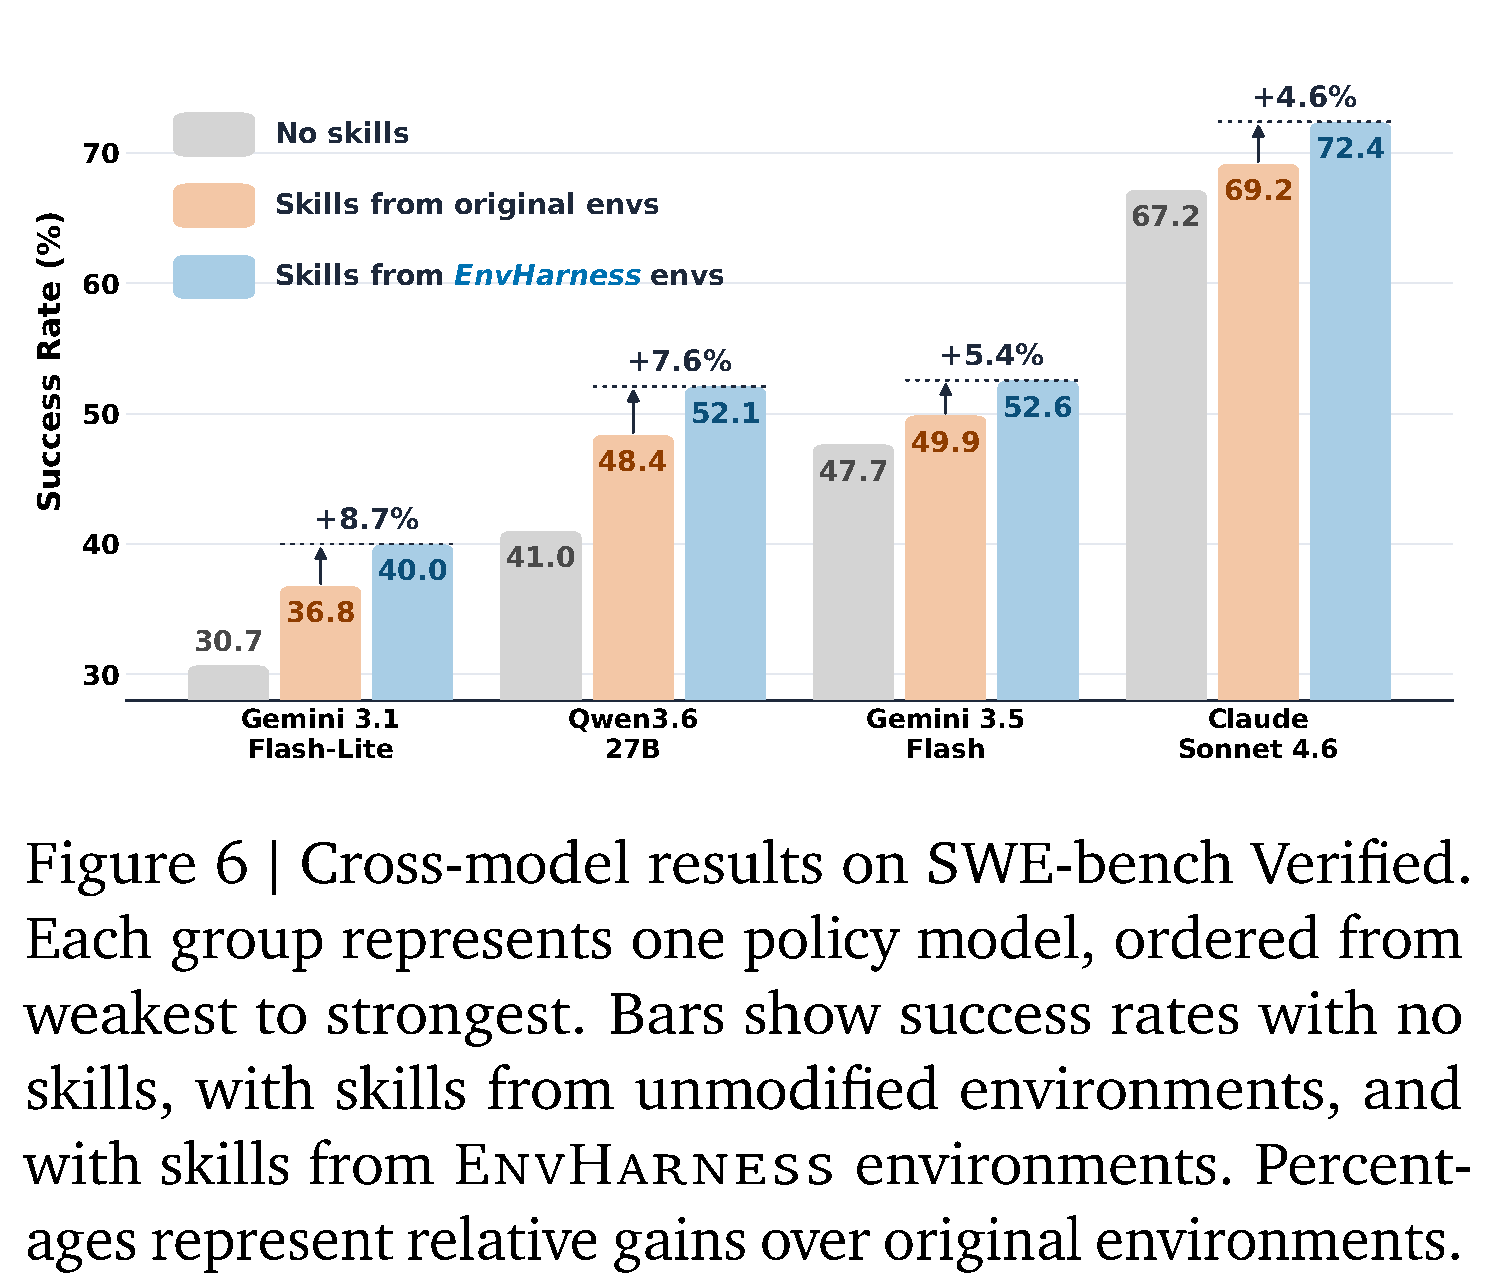
Gemini 3.1 Flash-Lite, Qwen3.6 27B, Gemini 3.5 Flash, Claude Sonnet 4.6 전반에서 EnvHarness skill bank는 모든 그룹에서 가장 높은 success-rate 막대를 보인다. Original Envs 대비 절대 우위는 2.7에서 3.7 points 범위다.
6. Related Work
Related work는 EnvHarness가 새 simulator, tool, task, verifier를 구축하는 대신 기존 환경의 interface 수준에서 적응한다는 점을 강조하며 simulator 및 programmatic environment-synthesis system과 구분한다. 또한 rollout 기반 진단에 따라 고정된 policy에 제시되는 환경을 적응시킨다는 점에서 self-evolving-agent 연구와 대조한다.
6.1. Environment Scaling
Environment-scaling 방법은 feedback을 모사하거나, 실행 가능한 환경을 합성하거나, 새 task instance를 생성하거나, curriculum을 설계할 수 있다. EnvHarness는 대신 benchmark 전반에서 공통 wrapper interface를 사용하고, 진단된 policy 약점에 따라 customization을 조건화하며, wrapping된 환경의 task와 verifier를 유지한다.
6.2. Self-Evolving Agent
기존 self-evolving-agent 방법은 prompt, reflection, skill, memory, workflow, harness, model weight, reward, 또는 self-proposed task를 갱신한다. EnvHarness는 진단 중 target policy를 black-box object로 다루면서 학습 환경을 적응시키는 것을 기여로 제시한다. harness에 대해서는 이 글을 참조하라.
7. Conclusion
결론은 base environment code를 수정하지 않고 난이도를 조정하고, skill을 분리하며, horizon을 확장하는 reset/step wrapper로 Stage, Contract, Chain을 제시한다. 핵심 실용적 주장은 상속된 verification을 EnvRigger의 rollout-driven component synthesis와 결합할 수 있다는 것이다.
부록
- Appendix는 EnvRigger prompt, ActionableEnv protocol, 이질적 runtime을 위한 Bridges, decorator 기반 component stack, Chain 구현, benchmark split, baseline, hyperparameter, 보충 분석을 명시한다. 반복 설계 loop는 비용이 클 수 있으며, Stage와 Chain은 reset 가능한 Gym-style interface를 요구한다고 설명한다. 구현된 Chain 실험은 serial composition을 사용하며, 의미적으로 근거 있는 branching이나 공유 intermediate state에는 composite verifier가 필요하다. Leave-one-out ALFWorld transfer는 평균 3.1 points 개선되지만 heat task에서는 8.7 points 악화된다.
짧은 생각
통제 비교는 각 benchmark 안에서 policy model, 추출 절차, seed instance, 환경 수를 공유하며, scaling 실험은 고정된 budget 아래 반복적인 policy-conditioned 환경 구축을 평가한다. 다만 근거는 reset 가능한, 주로 text-based 환경과 작은 rollout 기반 validation sample에 국한되며, wrapper가 synthetic constraint를 만들 수 있다. 보고된 leave-one-out 분석에서 수정하지 않은 task로의 transfer는 평균적으로 양수지만 균일하지는 않다.