


AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing 요약 설명
08 Sep 2026 | Paper Review Speech Generation Speech Editing Flow Matching Reinforcement LearningContents
- 요약
- 1 Introduction
- 2 Data Construction
- 3 Model Design
- 4 Model Training
- 5 Model Acceleration
- 6 Model Inference
- 7 Performance
- 8 Conclusion
- Contribution
- 부록
- 짧은 생각
이번 글에서는 AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 8일(Arxiv)
- Ma, Ziyang, Niu, Zhikang, Tu, Wenming, Wang, Tianrui, Yan, Ruiqi, Liu, Junxi, Huo, Yanru, Huang, Nickk, Liu, Yang, Xie, Qicong, et al.
- 논문 링크
- Github
- Project Page
요약
- AuK는 자연어 지시와 선택적 오디오 문맥을 목표 파형으로 변환하는 오픈소스 기반 모델이며, 음성 생성, 편집, 개선, 분리를 통합한다. 학습 말뭉치는 약 3.03 billion개의 지시-오디오 인스턴스와 1.95 million시간의 유효 지도 데이터를 포함하며, 증류 모델 AuK-Flash는 CFG 없이 4단계로 실행되어 조건을 맞춘 비교에서 4.5× wall-clock 속도 향상을 보인다.
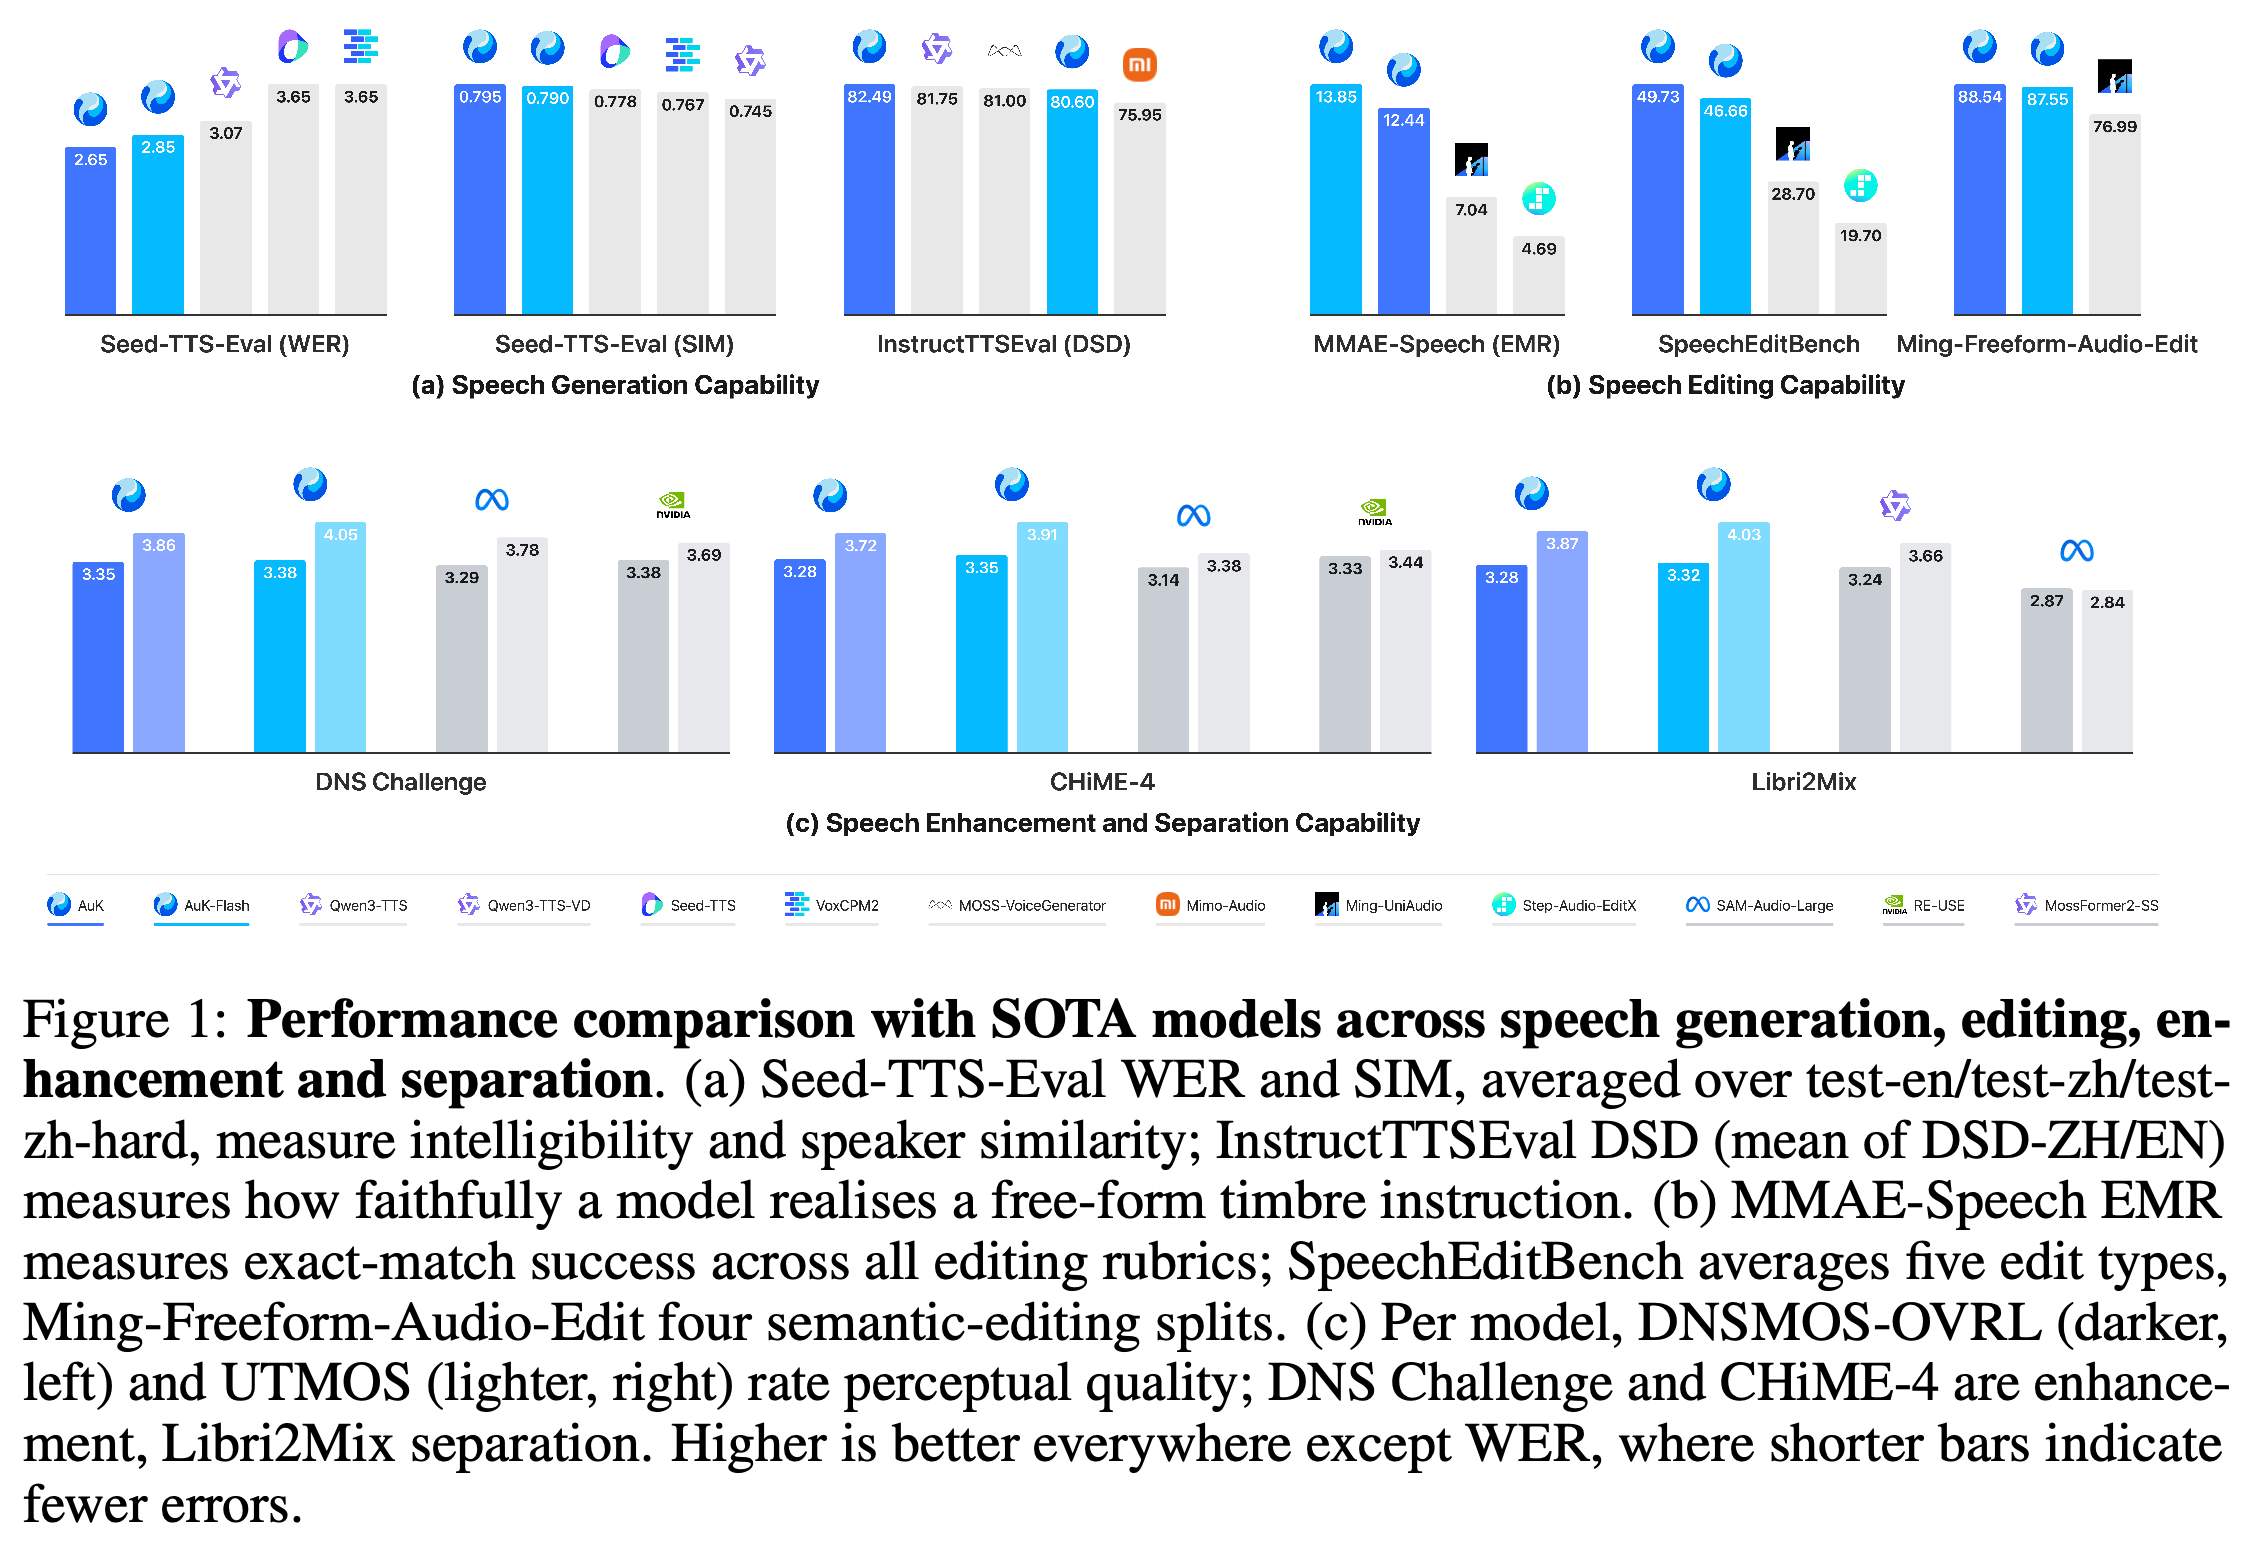
개요는 AuK, AuK-Flash, 기존 시스템을 선택한 generation, editing, enhancement, separation 지표에서 비교한다. 전체 모델과 증류 모델은 모든 작업에서 동일한 성능을 보이기보다 작업별로 강점이 다름을 보여준다.
1 Introduction
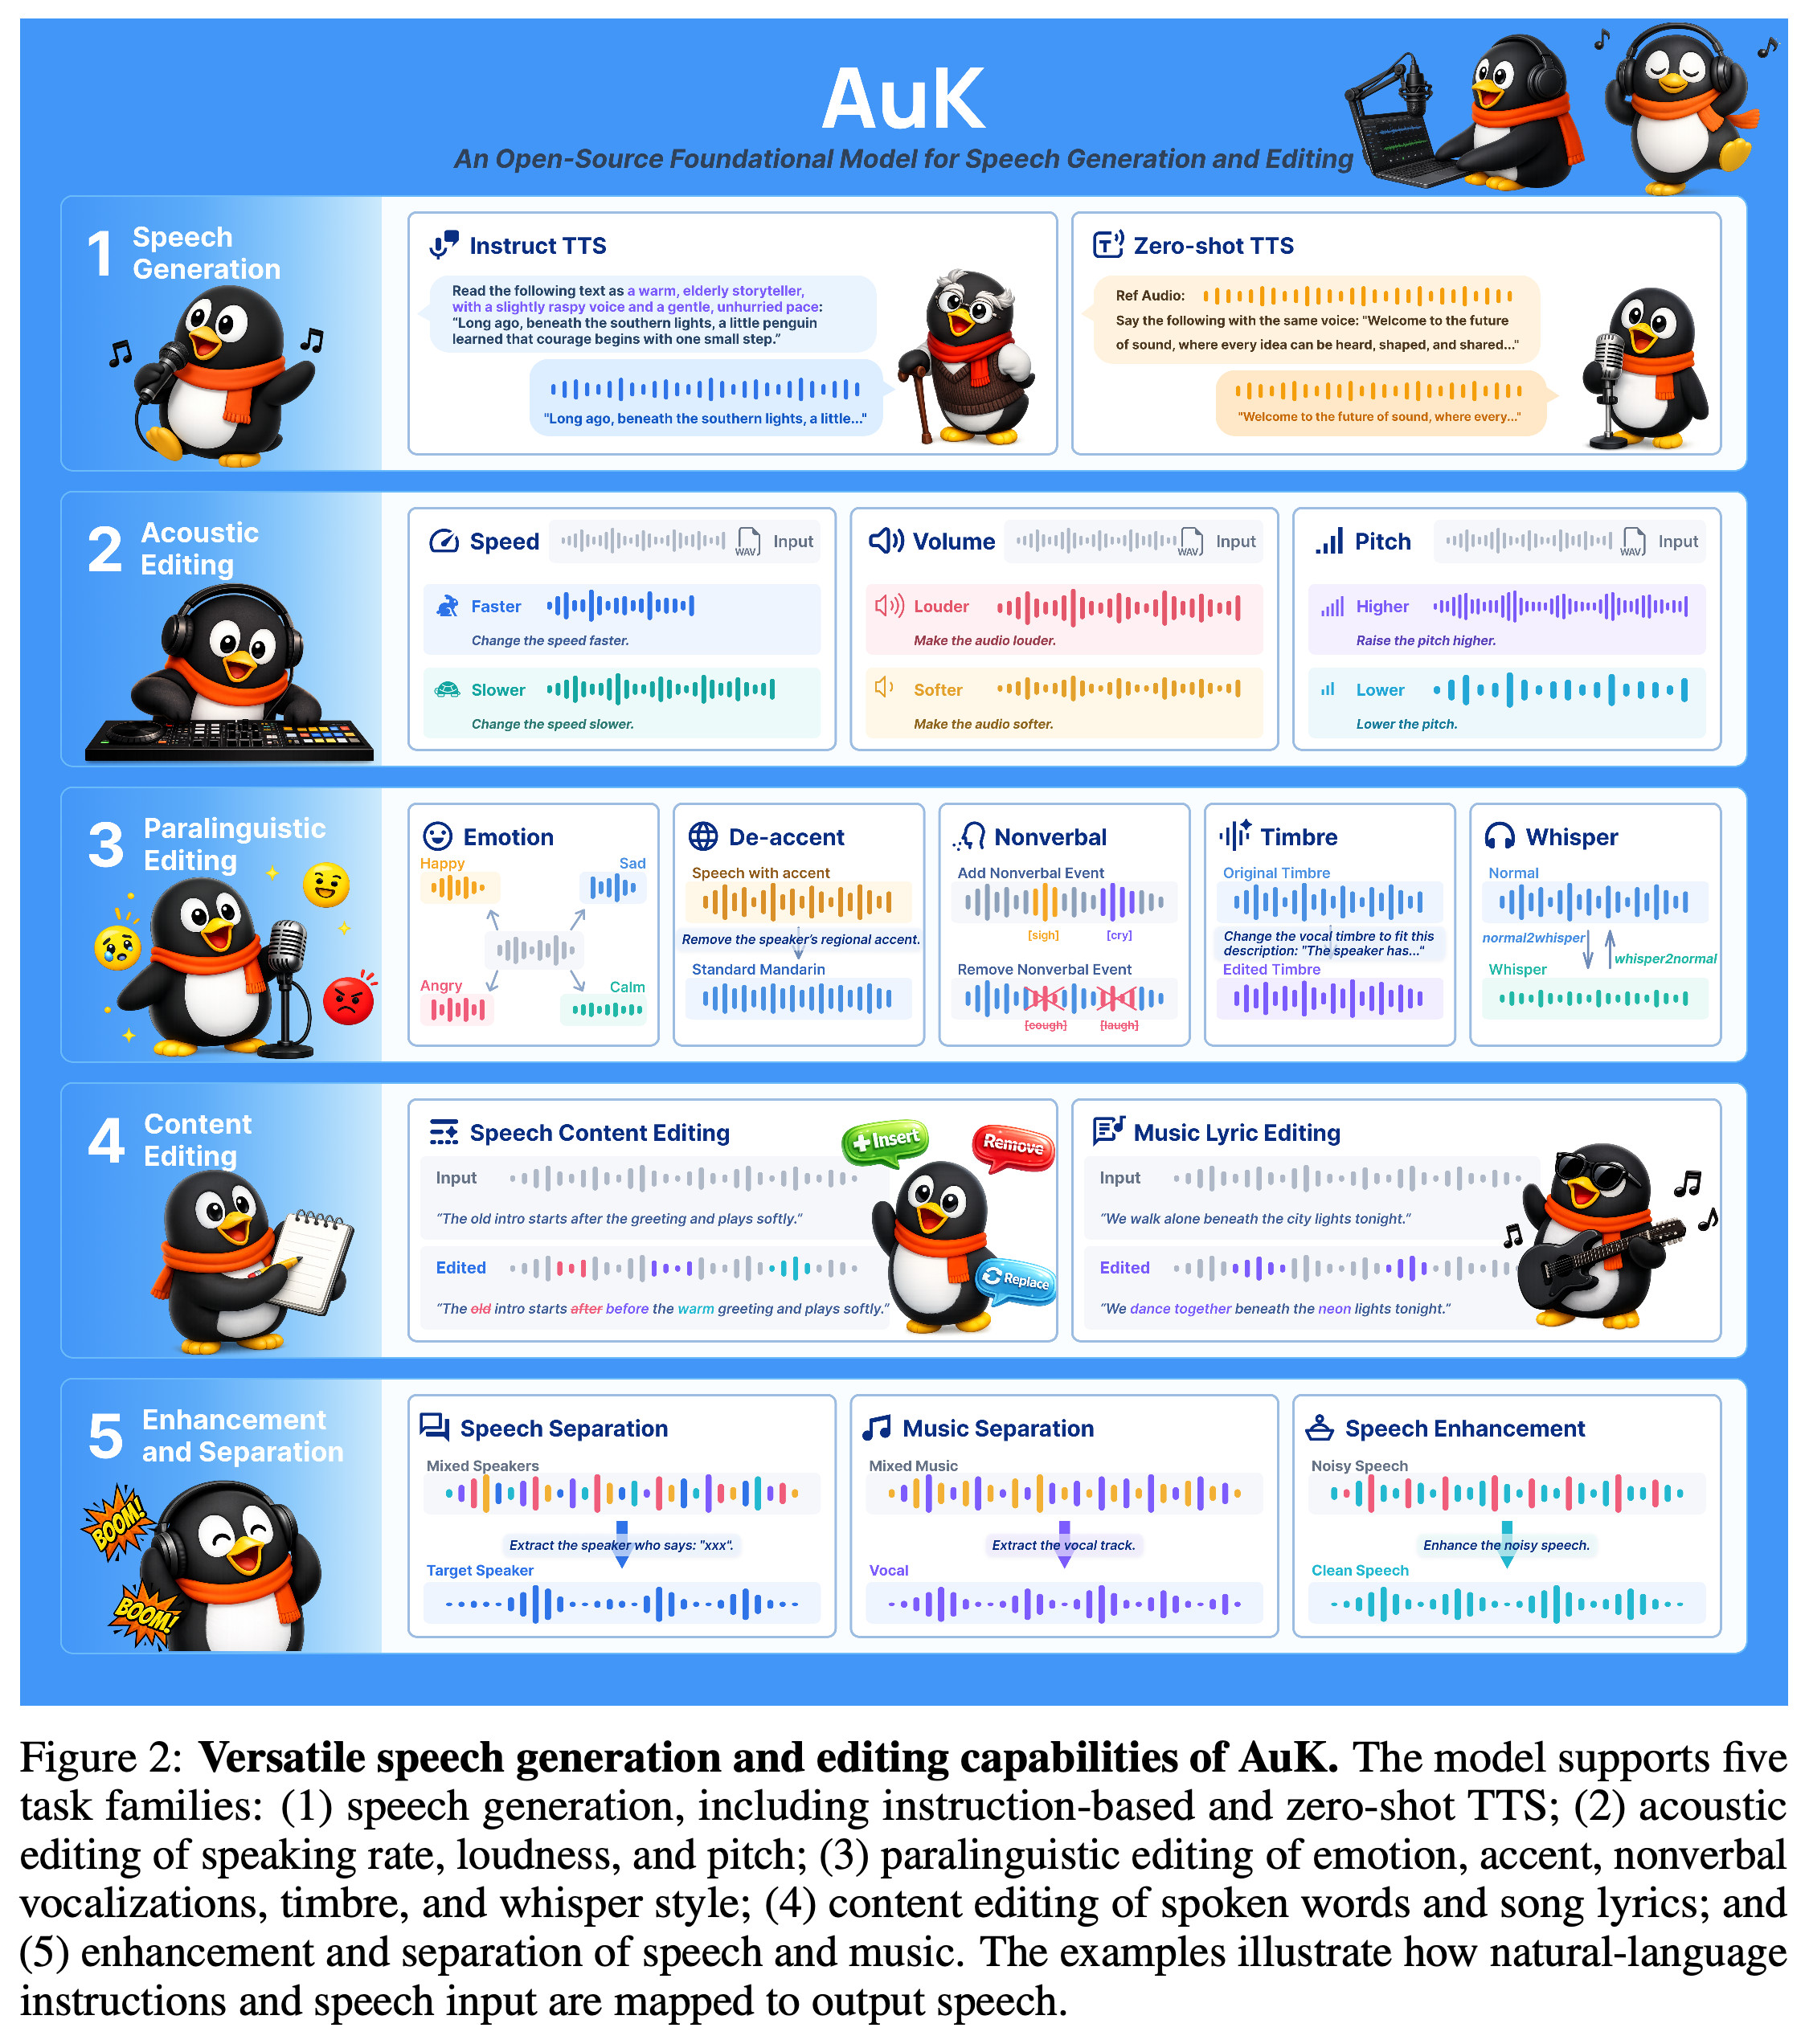
논문은 실제 음성 요청을 합성, 국소 편집, 속성 보존, 복원, 소스 선택의 조합으로 본다. 통합 모델은 이질적인 목적과 주관적인 편집 품질을 다루면서 텍스트 전용 입력과 오디오 조건부 입력을 모두 지원해야 한다.
그림은 자연어 지시와 선택적 음성 입력이 출력 오디오로 변환되는 공통 인터페이스를 보여준다. 모델이 다루는 5개 작업군을 정의한다.
2 Data Construction
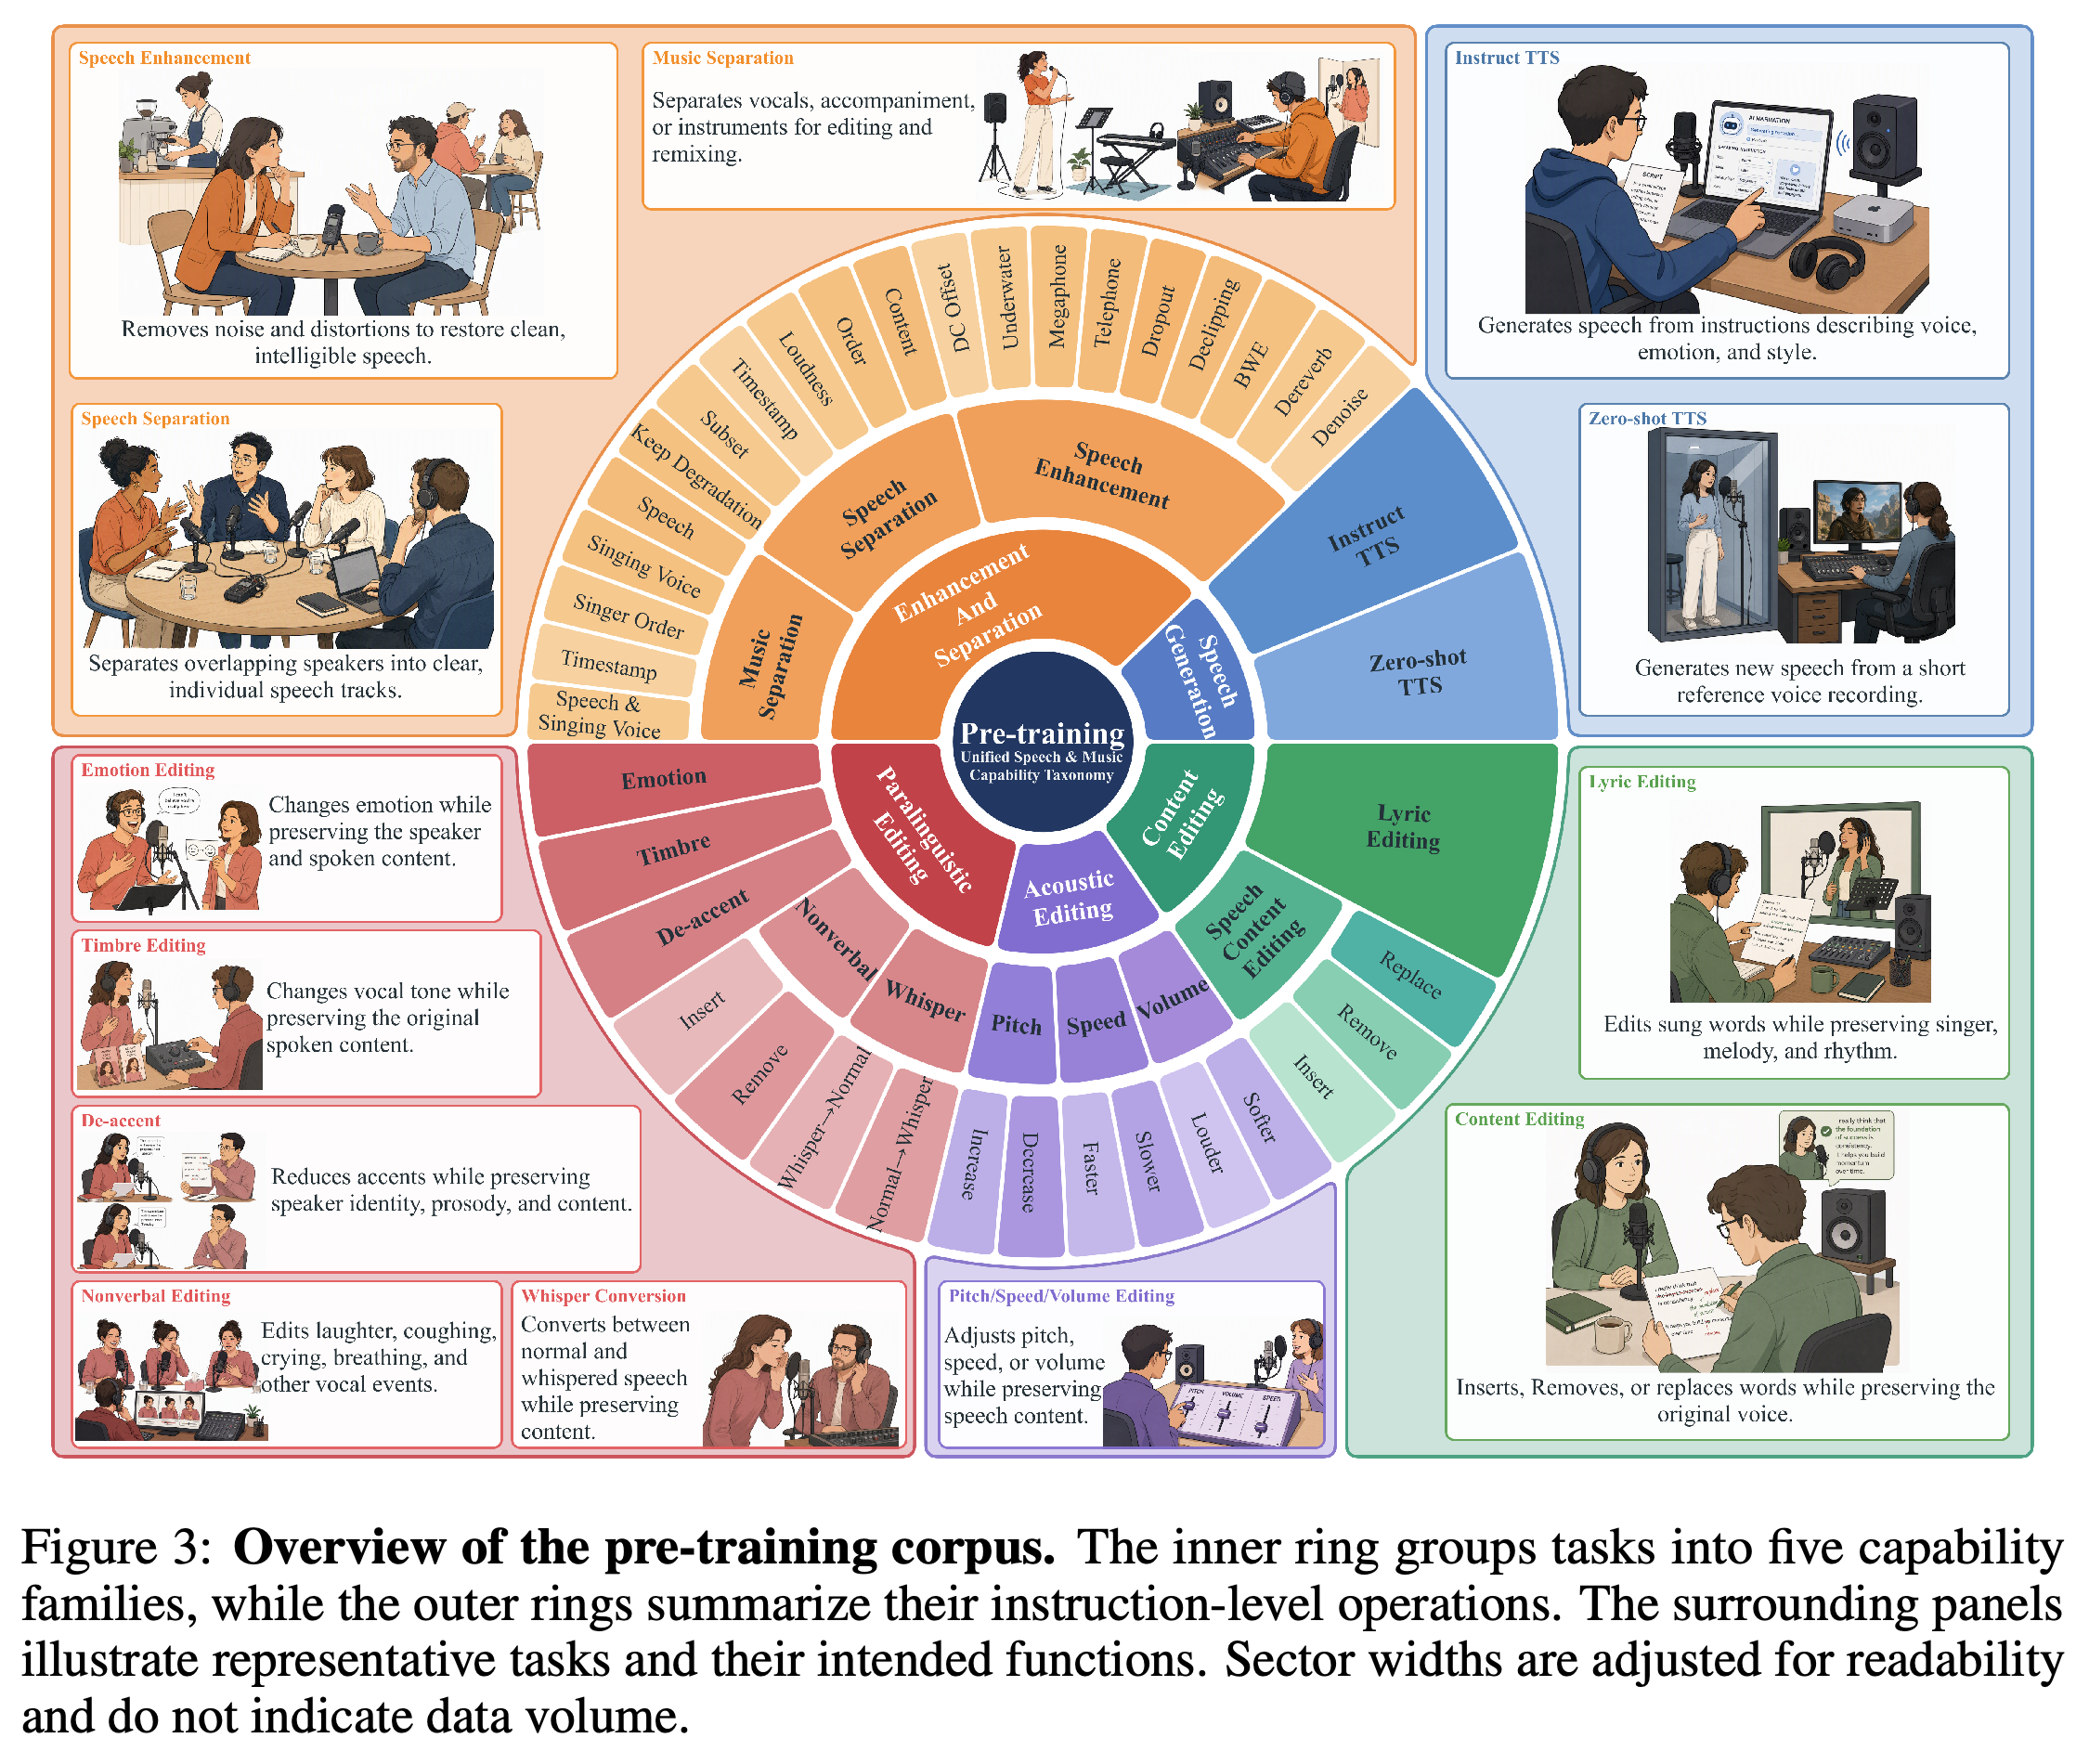
사전학습은 음성 생성, 음향 편집, 준언어적 편집, 내용 편집, 개선 및 분리에 걸쳐 공통된 지시-선택적 입력 오디오-목표 파형 인터페이스를 사용한다. 이 구성은 공유 backbone이 생성과 참조 조건부 변환을 함께 학습하도록 설계됐다.
Speech Generation
전사 없이 수행하는 zero-shot TTS에서는 같은 화자의 서로 다른 발화로 양방향 prompt-target 쌍을 만들고, prompt 전사 없이 prompt 오디오와 목표 텍스트를 제공한다. Instruct TTS는 Qwen3-Omni-generated 자유 형식 설명과 구조화된 음성 속성을 참조 오디오 없이 사용한다.
Acoustic Editing
음향 편집 지도 데이터는 내용과 화자 정체성을 보존하면서 발화 속도, 음량, 피치를 변경한다. 목표 데이터는 0.5×, 0.75×, 1.25×, 1.5×, 2.0×의 속도 배율, ±5, ±10, ±15 dB의 음량 오프셋, ±1, ±2, ±3 semitones의 피치 이동을 사용한다.
2.3 Paralinguistic Editing
준언어적 데이터는 감정, 음색, 탈억양, 비언어적 발성, 속삭임 변환을 다룬다. 데이터 구성에는 8개 감정 범주, 13개 중국어 방언 또는 지역 억양 범주, 정규화된 39개 비언어 이벤트 유형이 포함된다.
Content Editing
내용 편집 쌍은 발화 음성과 가사에서 삽입, 삭제, 대체를 지원한다. 단어 수준 정렬로 국소 마스킹 구간을 찾고 ASR 기반 품질 관리로 word error rate가 낮은 합성 샘플을 유지하며, 가사 대체에서는 중국어 글자 수 또는 영어 단어 수를 보존한다.
Enhancement and Separation
개선 및 분리 데이터에는 노이즈, 잔향, 채널 열화, 다화자 또는 음악 혼합을 적용한다. 목표는 언제나 완전히 깨끗한 음성을 복원하는 대신, 지시에서 지정한 오염 또는 소스만 제거할 수 있다.
방사형 배치는 말뭉치 분류 체계와 대표적인 지시 수준 작업을 요약한다. 각 구역의 너비는 데이터 규모를 나타내지 않는다고 명시한다.
3 Model Design
AuK는 고정된 multimodal language model, audio VAE, FLUX-style rectified-flow Transformer를 결합한다. 의미 특징은 지시와 오디오 문맥을 인코딩하고, VAE latent는 음향 조건과 파형 재구성에 사용된다. Transformer에 대해서는 이 글을 참조하라.
Overall Architecture
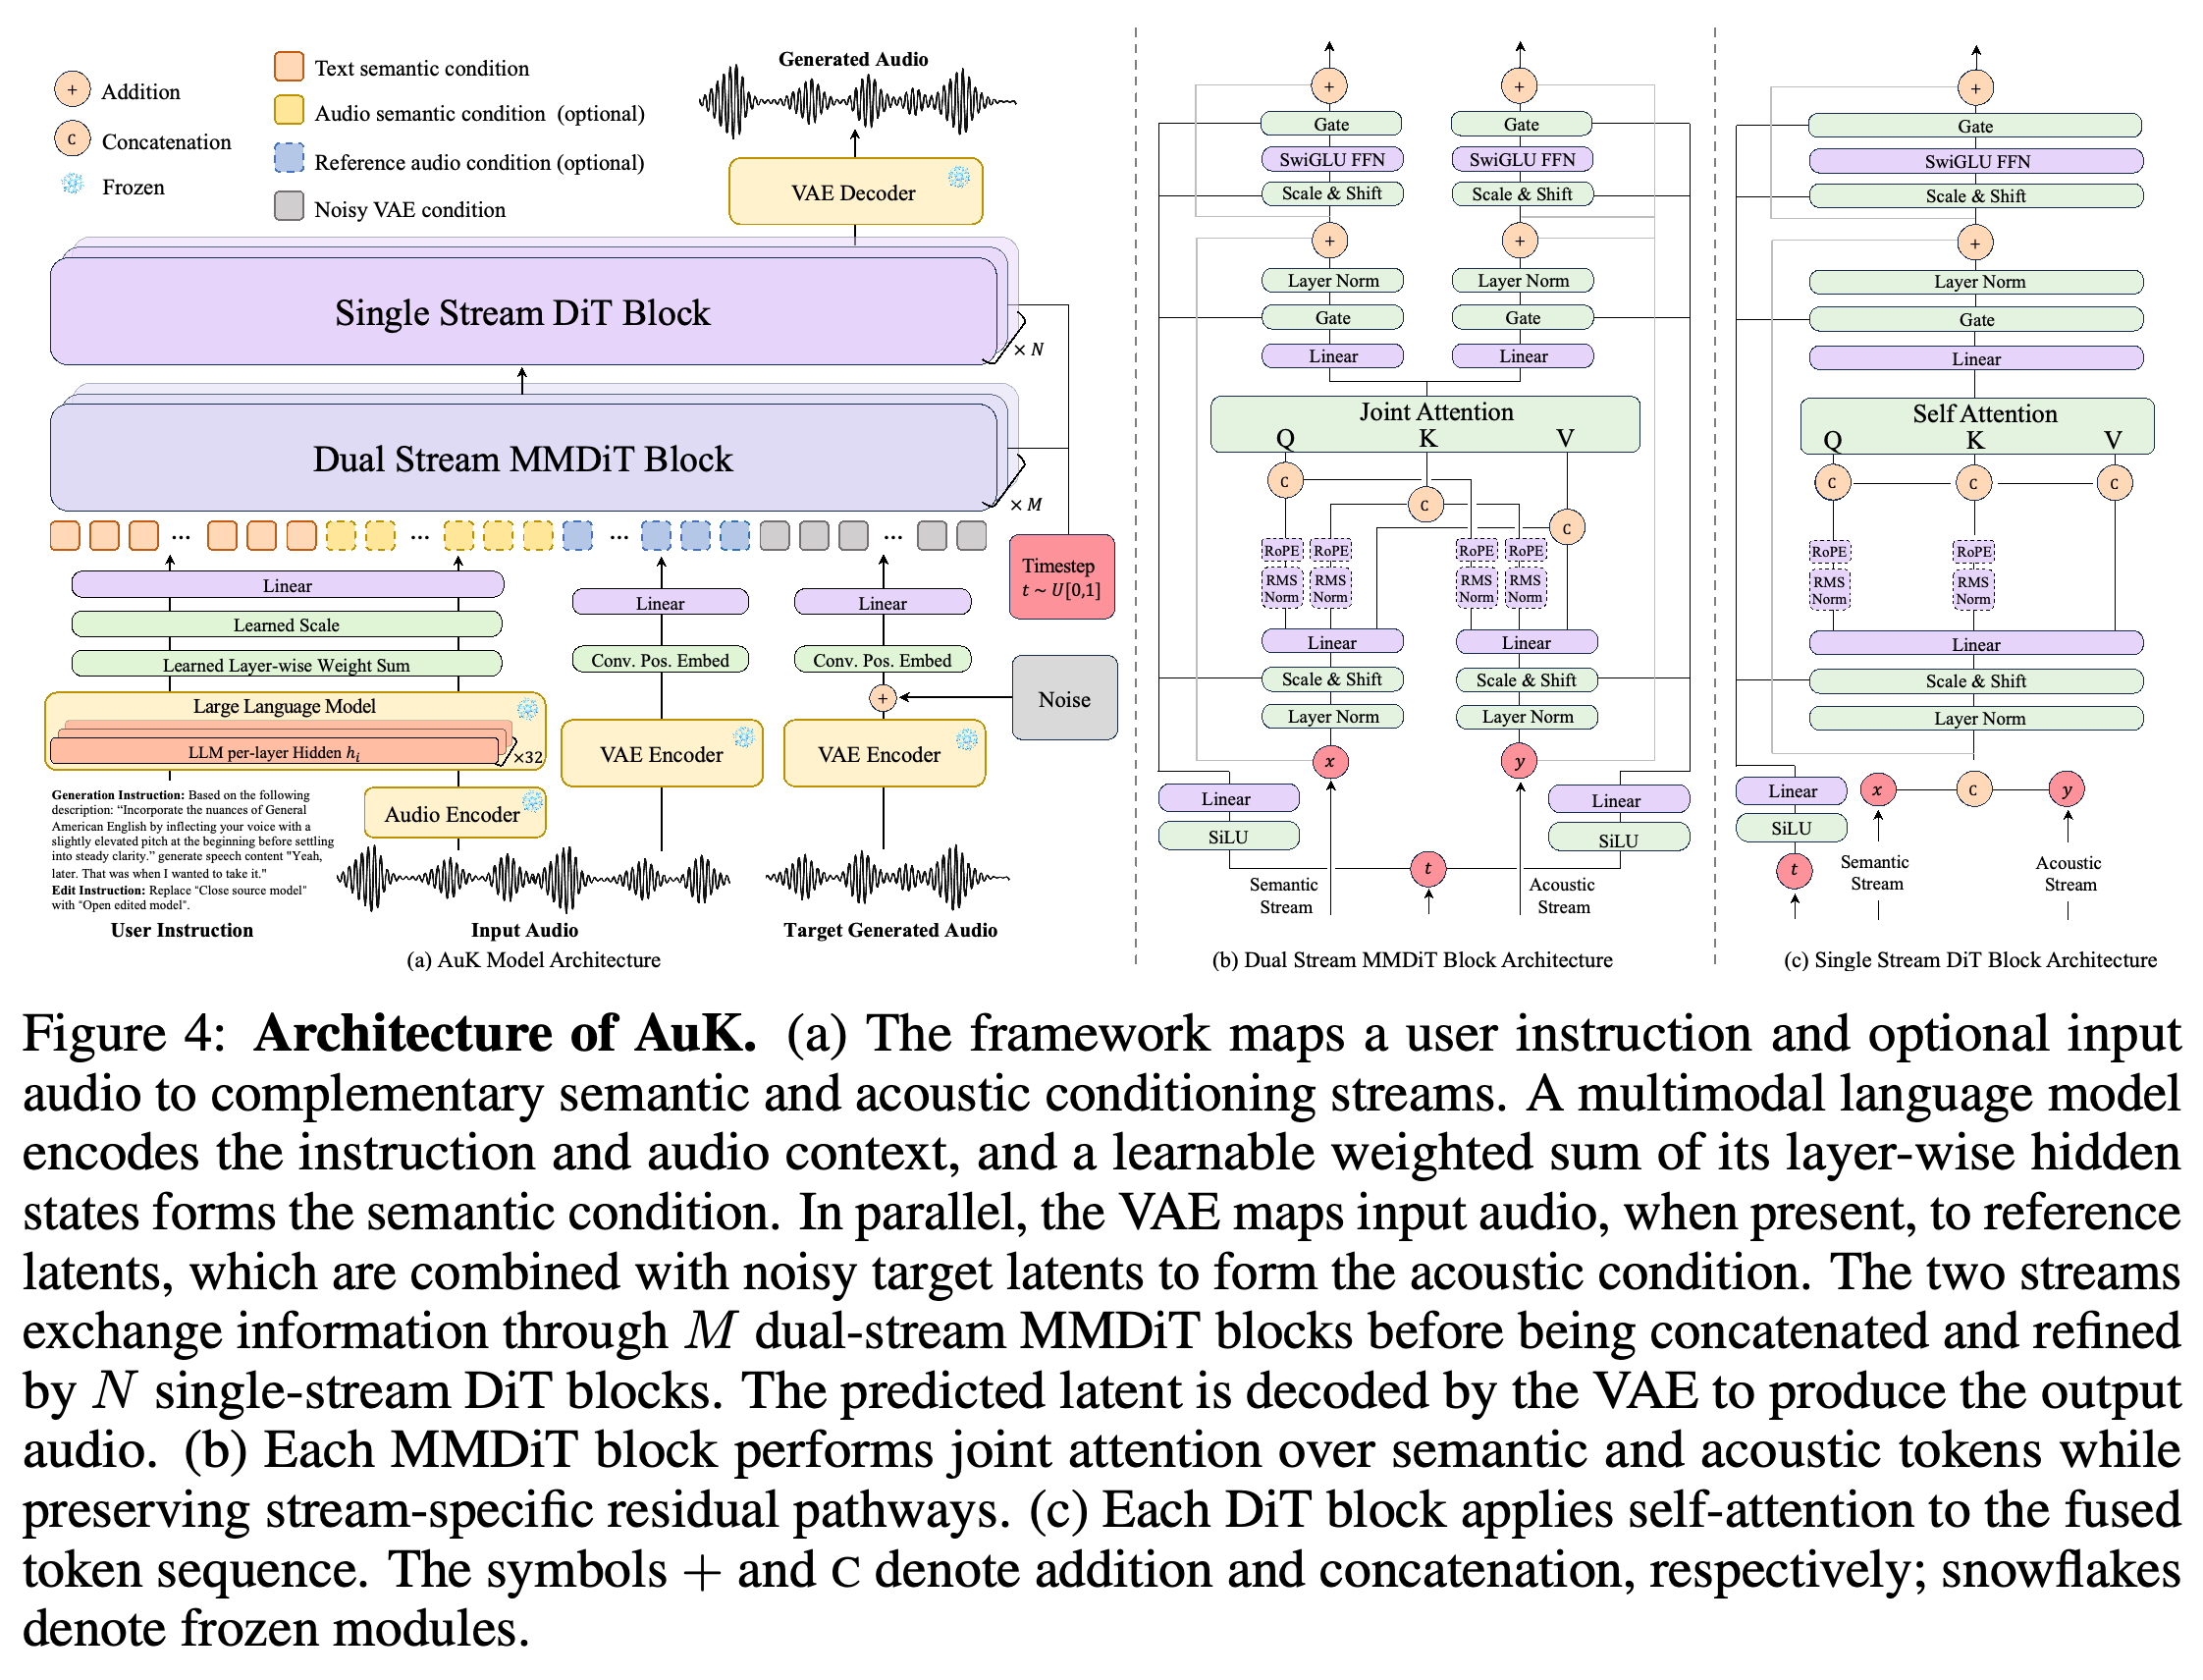
참조 오디오가 있으면 MLLM audio encoder와 VAE가 모두 이를 인코딩하며, 텍스트 전용 작업에서는 해당 분기를 생략한다. dual-stream MMDiT block은 semantic stream과 acoustic stream 사이에서 정보를 교환한 뒤, single-stream DiT block이 이들을 연결한 표현을 정제한다.
3.2 MLLM Semantic Condition
Qwen2.5-Omni는 지시와 참조 오디오가 있을 경우 이를 인코딩해 semantic condition을 제공한다. AuK는 고정된 MLLM layer 하나를 선택하는 대신 layer-normalized hidden state의 제약 없는 가중합을 학습한다.
3.3 VAE Acoustic Condition and Reconstruction
AuK-VAE는 24 kHz 오디오를 50 Hz에서 64-dimensional latent로 매핑하고 causal decoder로 파형을 생성한다. normalizing flow는 VAE 학습 중 posterior를 정규화하지만, 생성 시 음향 조건이나 재구성에는 사용하지 않는다.
Transformer Backbone
약 1.5-billion-parameter backbone은 30개 layer로 구성되며, 10개 dual-stream MMDiT block 뒤에 20개 single-stream DiT block이 이어진다. hidden dimension은 1536이고 attention head는 24개이며, 최종 DiT stack은 목표 latent 위치에서 rectified-flow velocity를 예측한다. attention에 대해서는 이 글을 참조하라.
도식은 MLLM의 semantic condition, 선택적 VAE 참조 오디오 condition, dual-stream MMDiT fusion, single-stream DiT refinement, VAE decoding을 보여준다. 같은 architecture가 텍스트 전용 생성과 오디오 조건부 편집을 모두 지원하는 방식을 설명한다.
4 Model Training
학습은 VAE 학습, 생성 전용 warm-up 이후의 생성-편집 공동 사전학습, 2개 post-training 단계로 구성된다. 통합 사전학습과 post-training 동안 MLLM encoder와 VAE는 고정한다.
VAE Training
AuK-VAE는 음성, 음악, 일반 오디오 약 3 million시간으로 1.24 million update 동안 학습하며, 인스턴스 비율은 6:3:1이다. 목적함수는 multi-scale log-mel 재구성, adversarial 및 feature-matching loss, KL regularization을 결합하고 λmel = 15, λadv = 1, λfeat = 2, λKL = 5를 사용한다.
4.2 Unified Pre-Training
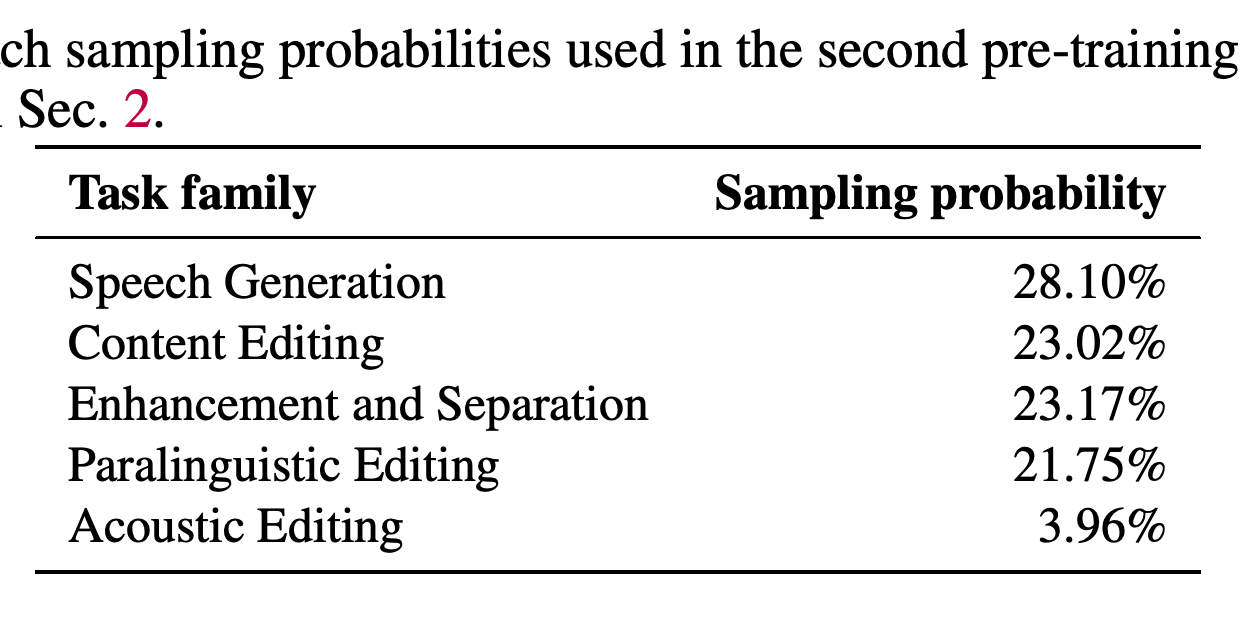
통합 사전학습은 생성 전용 50k update 후 5개 작업군 전체를 대상으로 600k joint update를 수행한다. 두 번째 단계의 sampling probability는 생성 28.10%, 내용 편집 23.02%, 개선 및 분리 23.17%, 준언어적 편집 21.75%, 음향 편집 3.96%다.
표는 두 번째 joint training 단계의 고정된 task mixture를 정의한다. 음향 편집은 나머지 4개 작업군보다 sampling probability가 현저히 낮다.
4.3 Post-Training
post-training은 개방형 편집 정렬과 음성 생성 최적화를 분리한다. 저자들은 충분히 광범위한 선호 데이터셋이나 즉시 사용할 reward model을 찾지 못했기 때문에 편집에는 human preference optimization을 사용하고, 생성에는 자동 콘텐츠, 화자 유사도, 스타일 일관성 보상을 사용한다.
Editing Preference Optimization
annotator는 지시마다 10개 또는 20개의 편집 후보를 failure, partial completion, success로 평가한다. 필터링 후 선호 데이터는 정보가 있는 818개 그룹과 평가된 9,080개 후보를 포함하며, label-smoothed ordinal listwise objective를 104 optimizer update 동안 학습한다.
4.3.2 Generation Reinforcement Learning
생성 RL은 10,000개 zero-shot prompt와 5,000개 instruction-following prompt에서 Flow-GRPO를 사용하며, G = 16개 후보와 500 optimizer update를 적용한다. 화자 보상은 tolerant recognition error Ei = 0인 후보들 사이에서만 표준화하여, 높은 유사도가 잘못된 내용을 상쇄하지 못하게 한다.
5 Model Acceleration
AuK-Flash는 consistency initialization 뒤 task-routed Decoupled DMD로 생성한다. 균일한 DMD가 다화자 및 보컬 분리를 저하시켰기 때문에, 분리 예제에는 supervised clean-latent regression을 사용하고 DMD 및 fake-score update에서 제외한다.
6 Model Inference
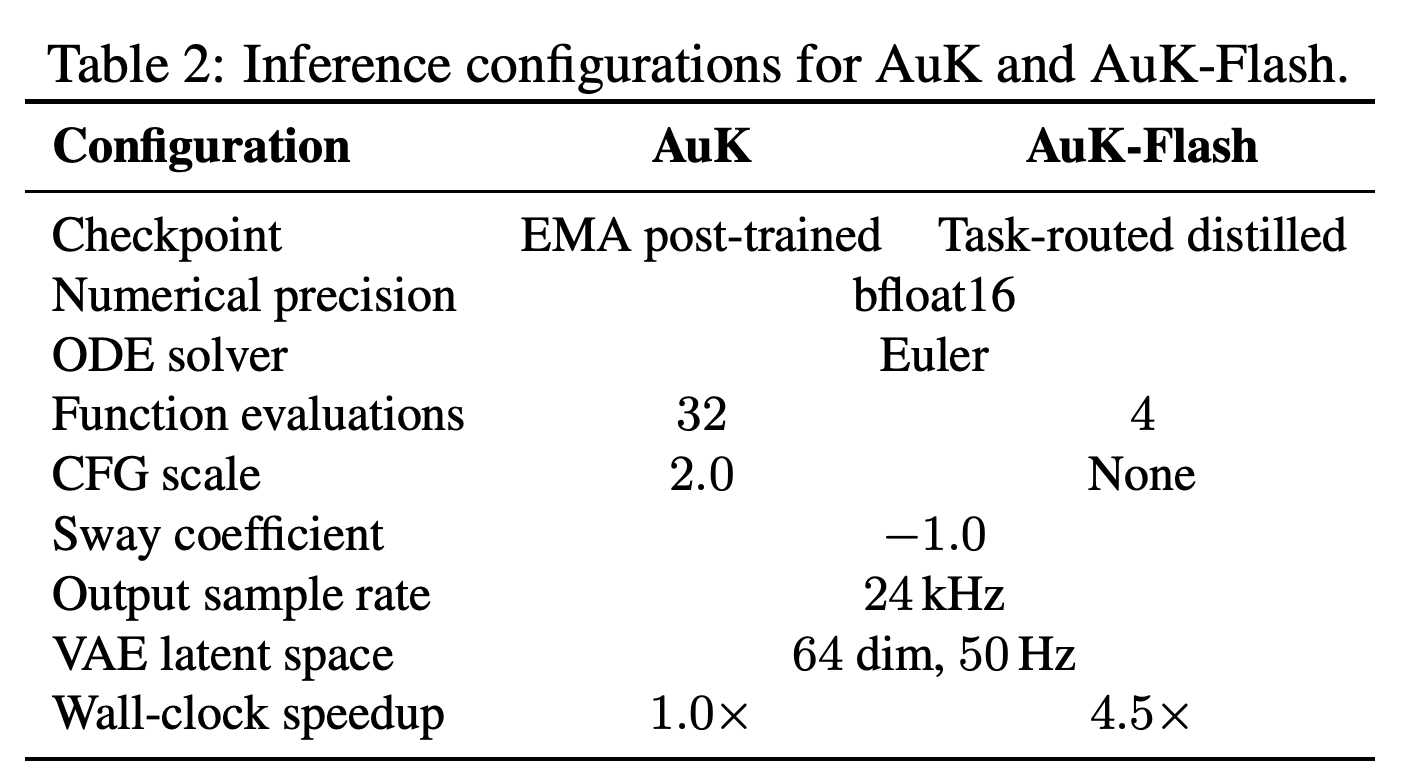
추론은 VAE latent 공간에서 조건부 flow sampling 전에 선택적으로 Prompt Enhancer를 적용한다. 전체 AuK는 32 Euler function evaluation과 CFG scale 2.0을 사용하고, AuK-Flash는 CFG 없이 4 evaluation을 사용한다.
Prompt Enhancer
Prompt Enhancer는 작업을 식별하고, 인수를 추출·검증하며, 요청을 지원되는 template에 맞게 다시 쓰고, 선택적 오디오를 준비하며, 길이를 추정한다. 발화 속도, 음량, 피치의 연속적 설명을 학습에서 지원한 이산값으로 매핑하고 지원하지 않는 요청은 거부한다.
Inference Strategy and Configuration
입력 오디오는 mono로 변환하고 24 kHz로 resample한 뒤 semantic 및 acoustic context로 인코딩하며, 텍스트 전용 생성은 지시만 사용한다. 4.5× Flash 속도 향상은 동일한 hardware, 출력 길이, batch size에서 32-NFE, CFG-2.0 AuK와 비교해 측정한다.
표는 전체 AuK와 Flash의 계산상 차이를 분리해 보여준다. Flash는 동일한 latent representation과 decoder를 사용하면서 32회 대신 4회 평가하고 CFG를 사용하지 않으며, 제시된 속도 향상은 이 sampler configuration에 해당한다.
7 Performance
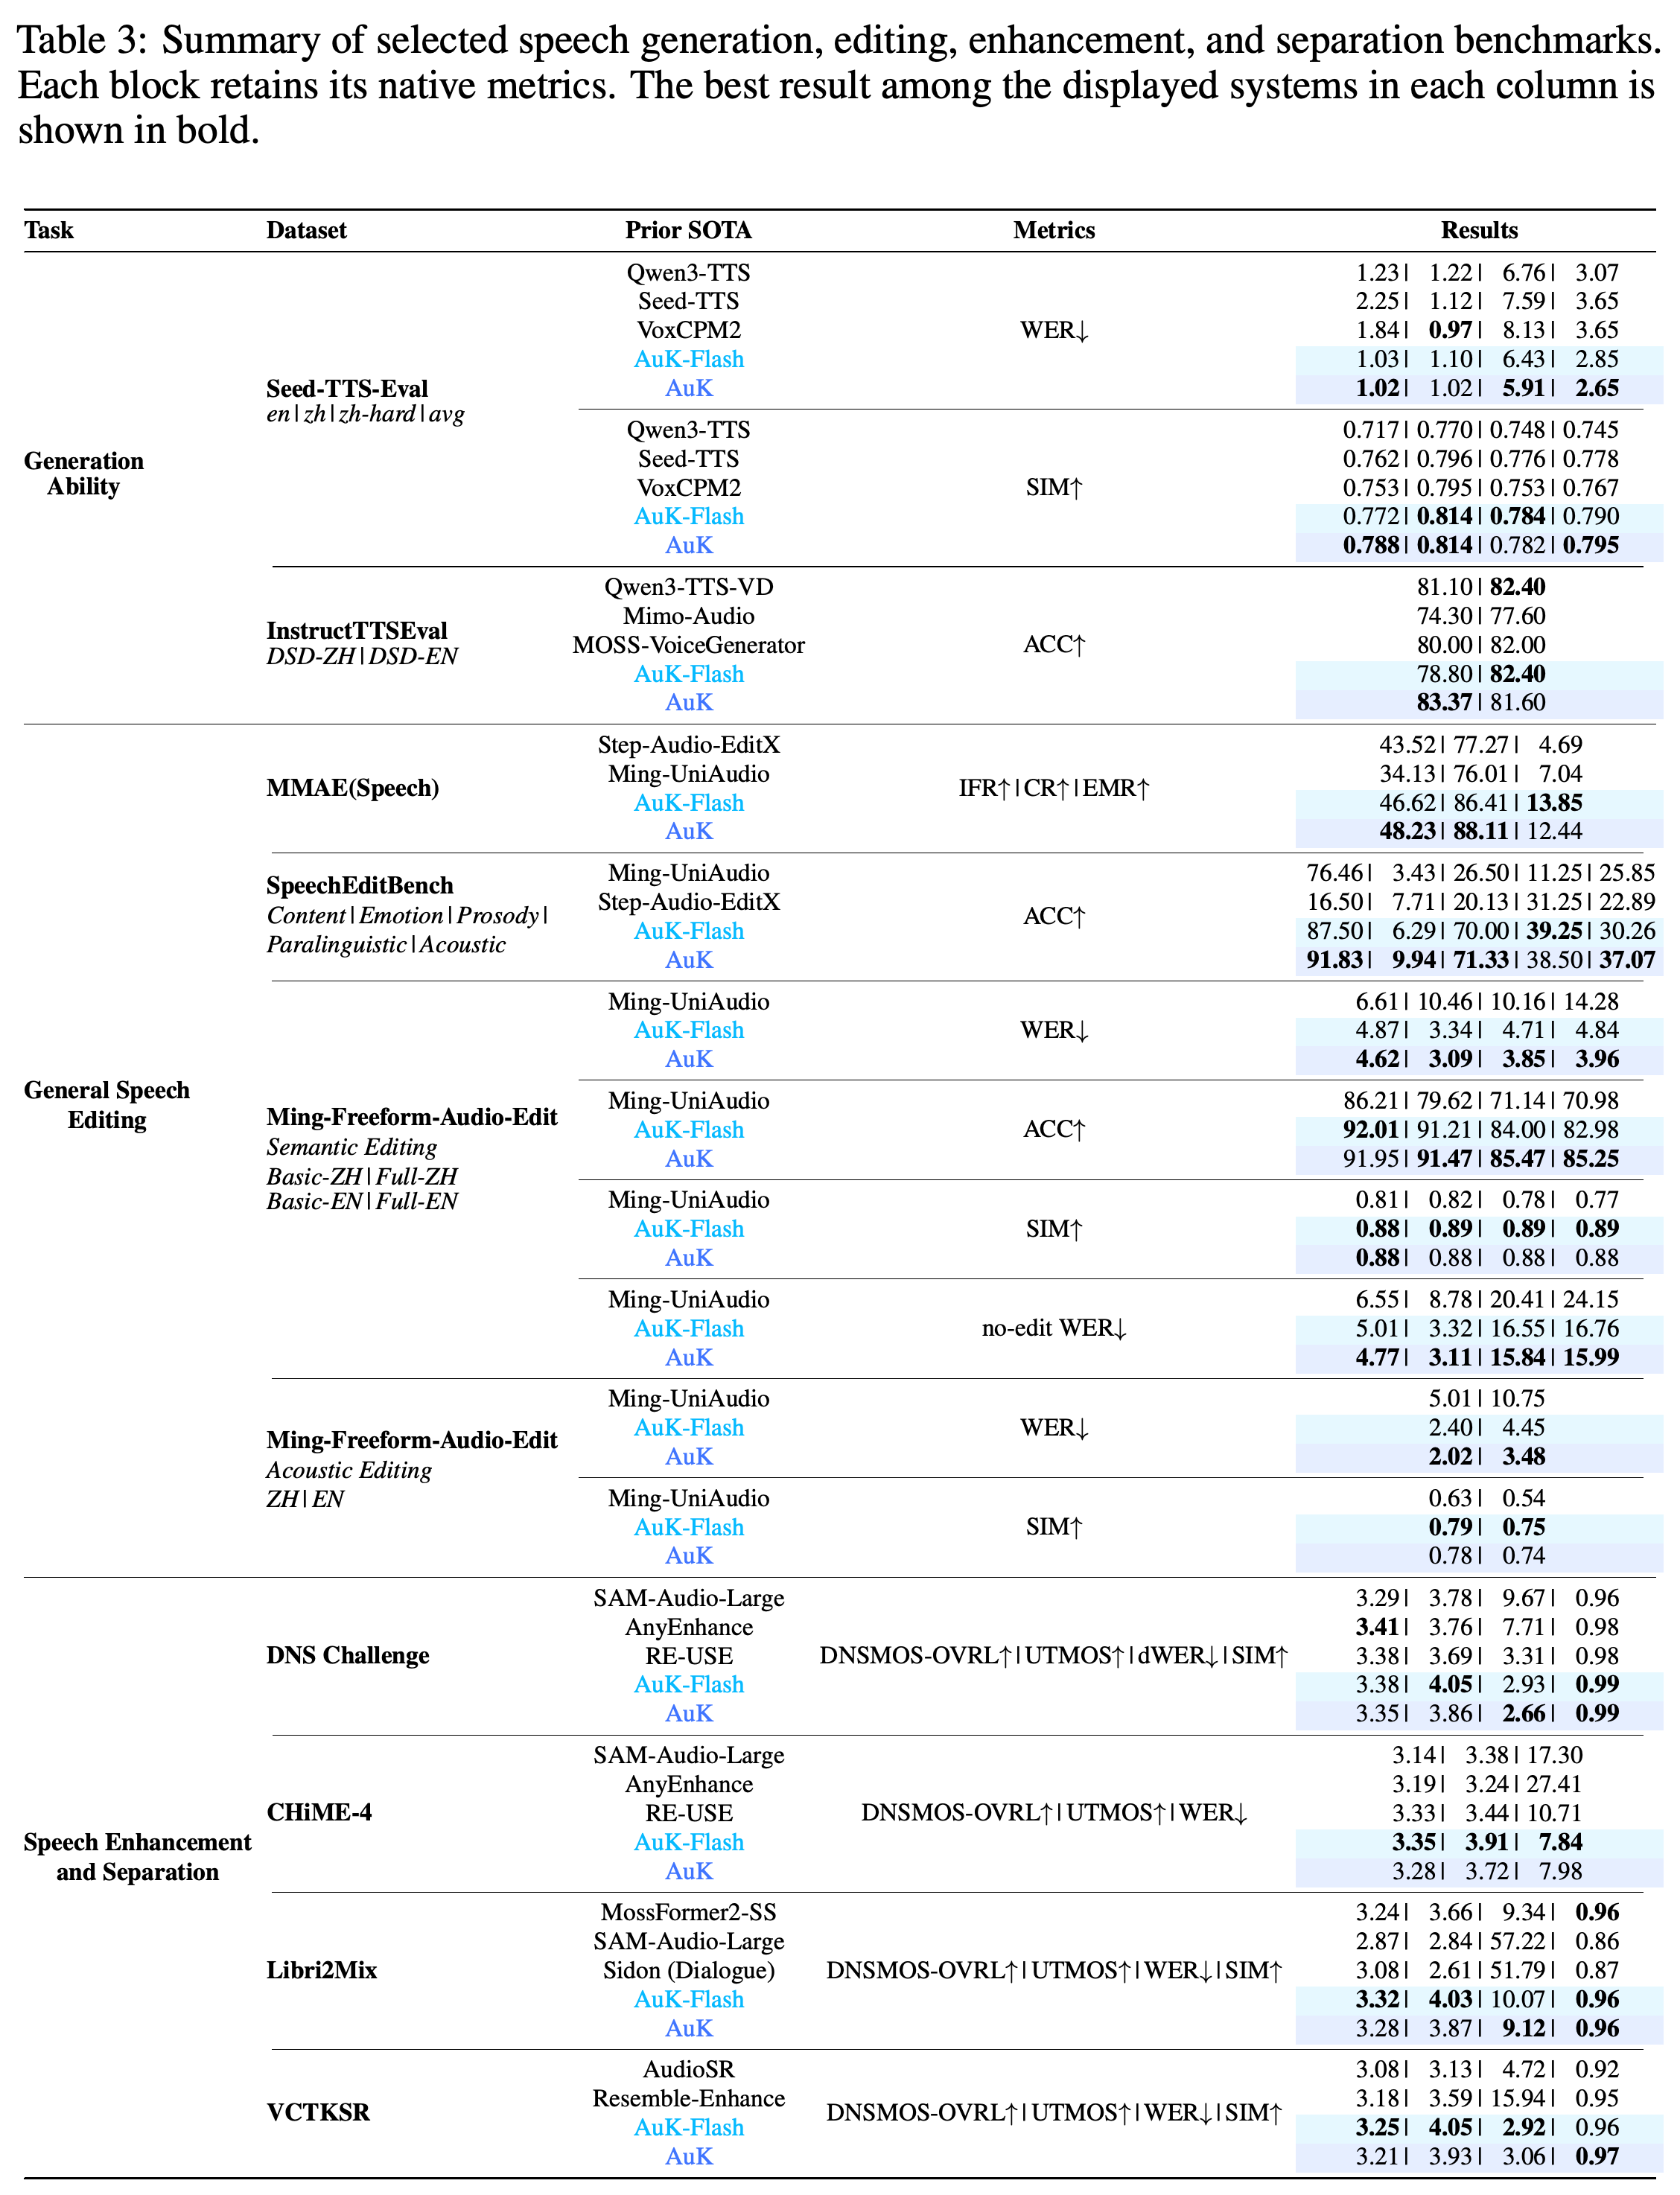
평가는 VAE 재구성, zero-shot 및 instruction-controlled generation, instruction-guided editing, 개선, 분리, super-resolution을 포함한다. 보고된 결과는 전체 모델의 언어적 정확도 및 편집 충실도 강점과 여러 지각 지표에서 Flash의 장점을 구분한다.
이 표는 주요 cross-task 비교 결과다. 전체 모델은 generation과 editing에서 강한 결과를 보이는 반면 Flash는 선택된 all-rubric 또는 지각 품질 지표에서 장점을 보인다.
VAE Reconstruction Results
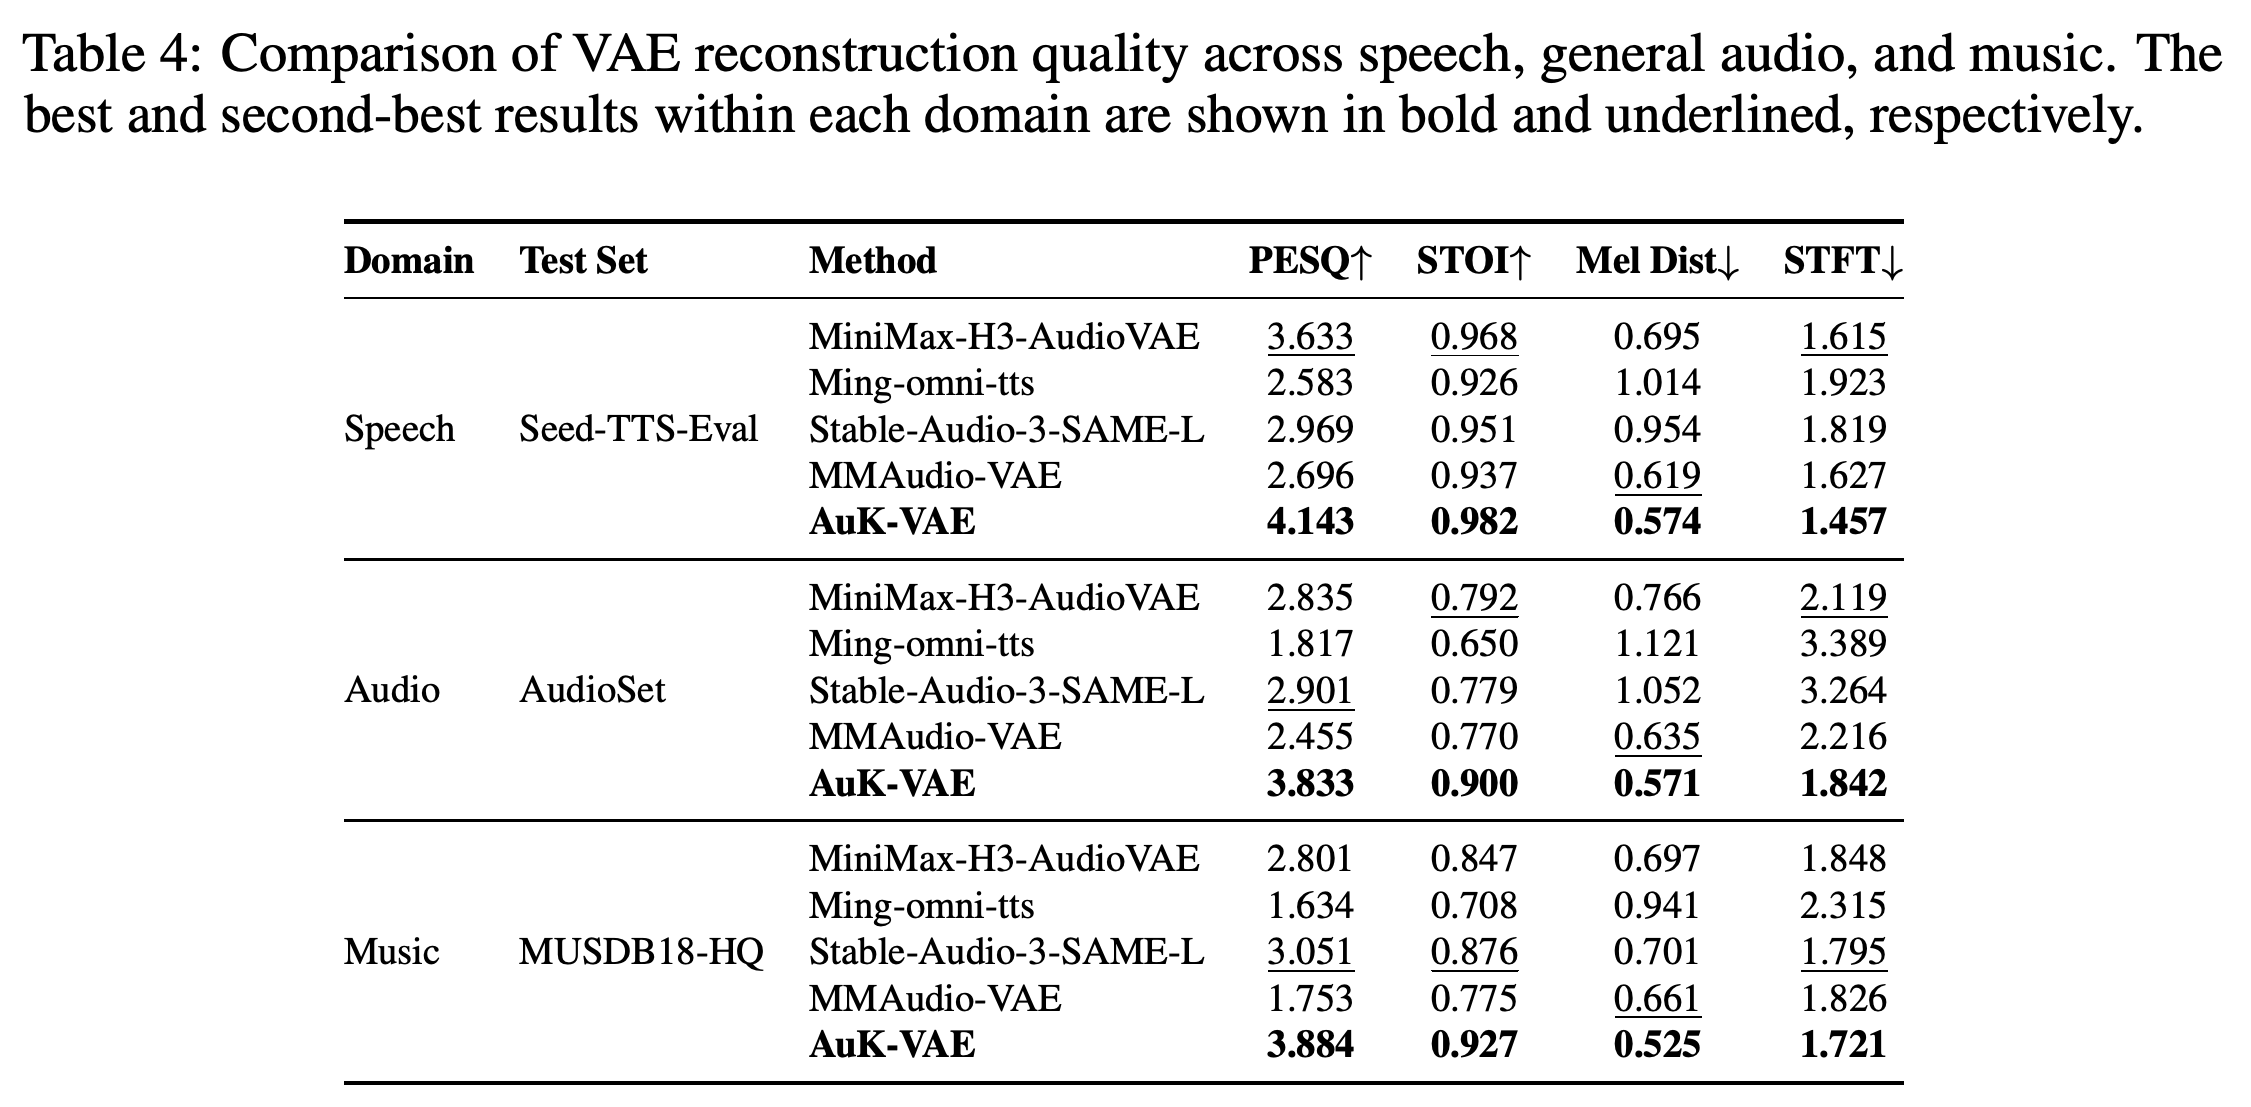
Seed-TTS-Eval 음성, AudioSet 일반 오디오, MUSDB18-HQ 음악에서 AuK-VAE는 PESQ, STOI, Mel Dist, STFT 최고 성능을 보고한다. 음성 재구성에서는 PESQ 4.143, STOI 0.982, Mel Dist 0.574, STFT 1.457을 기록한다.
재구성 비교는 생성에 사용하는 VAE 기반 표현을 평가한다. AuK-VAE는 음성, 일반 오디오, 음악에서 4개 지표 모두 최고 성능으로 보고된다.
7.2 Generation Ability
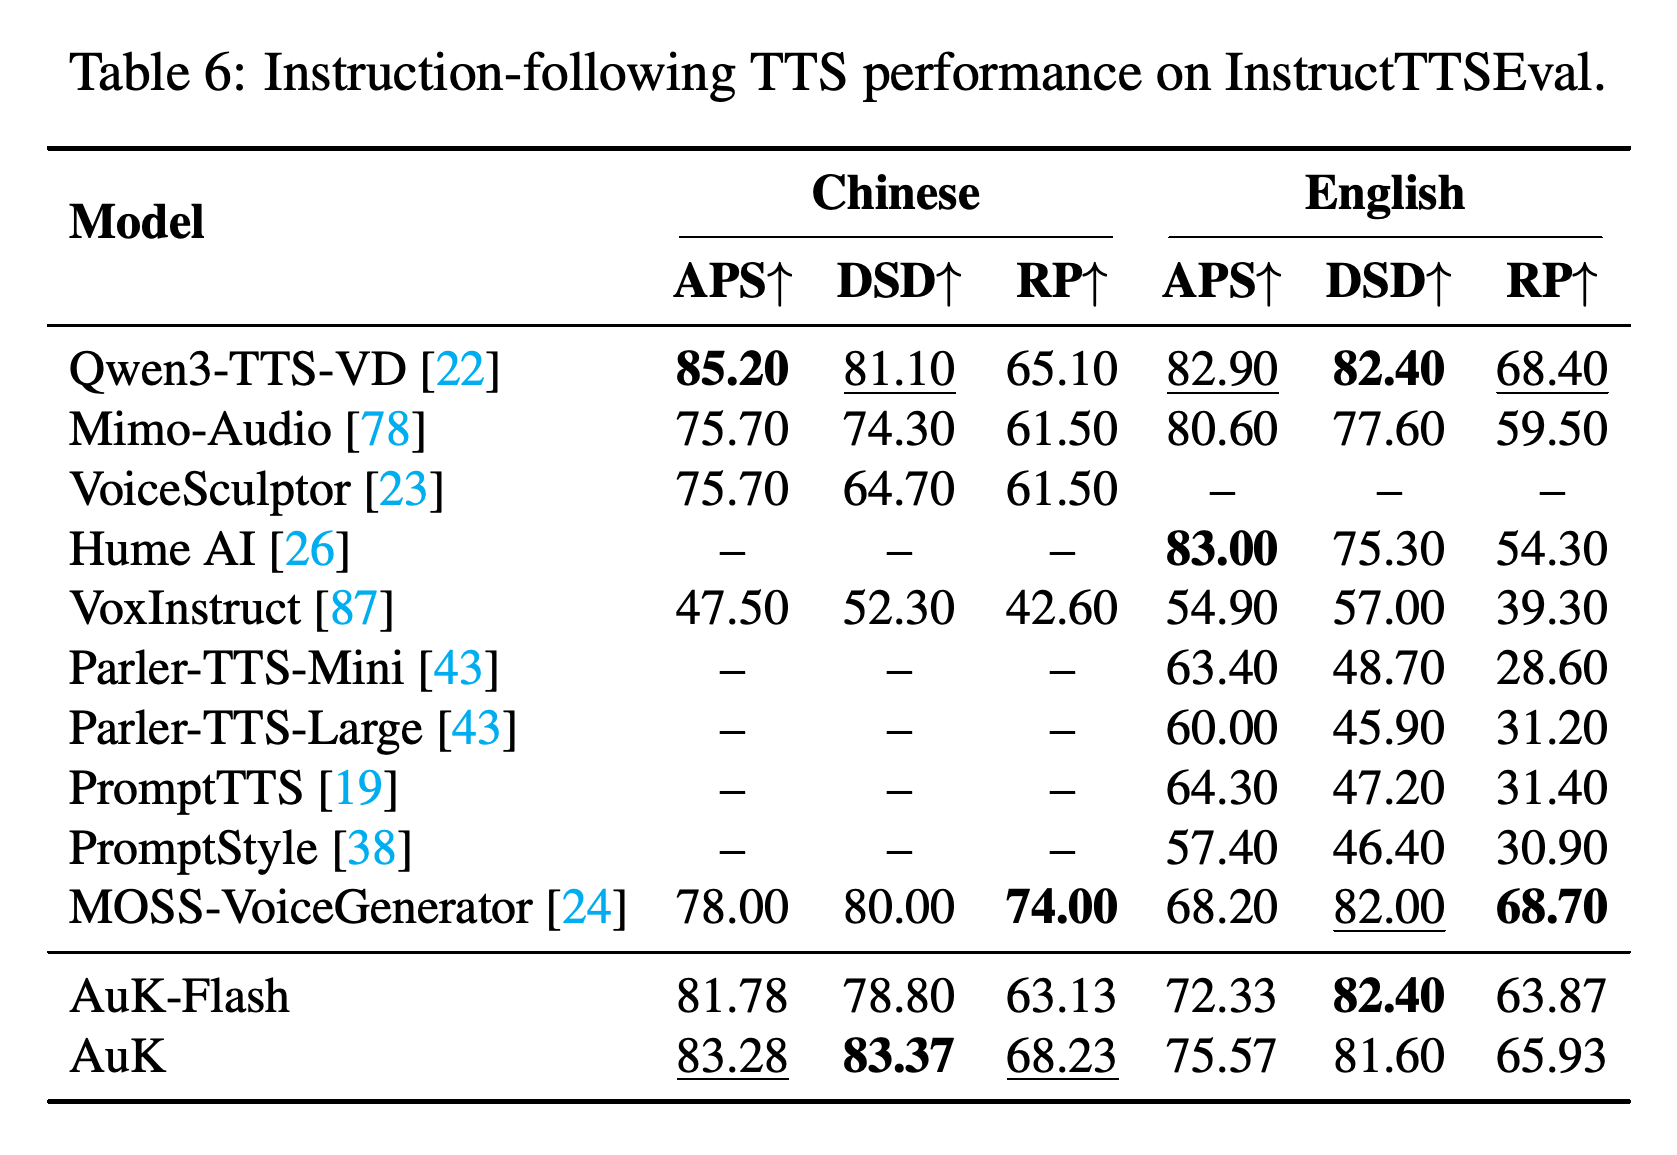
Seed-TTS-Eval에서 AuK는 평균 recognition error 2.65%와 SIM 0.795를 보고하며, Qwen3-TTS는 3.07%와 0.745를 기록한다. AuK-Flash는 2.85%와 0.790을 기록하고, InstructTTSEval에서 AuK는 Chinese DSD 83.37%, Flash는 English DSD 82.40%를 달성해 요약 비교에서 Qwen3-TTS-VD와 동률이다.
7.3 Editing Ability
편집 평가는 지시 이행과 보존을 operation-level semantic 및 acoustic test와 결합한다. 평가는 평균 지표와 모든 rubric 성공을 구분하고, 내용 보존을 지각 품질 및 화자 보존 지표와 분리한다.
7.3.1 General Speech Editing
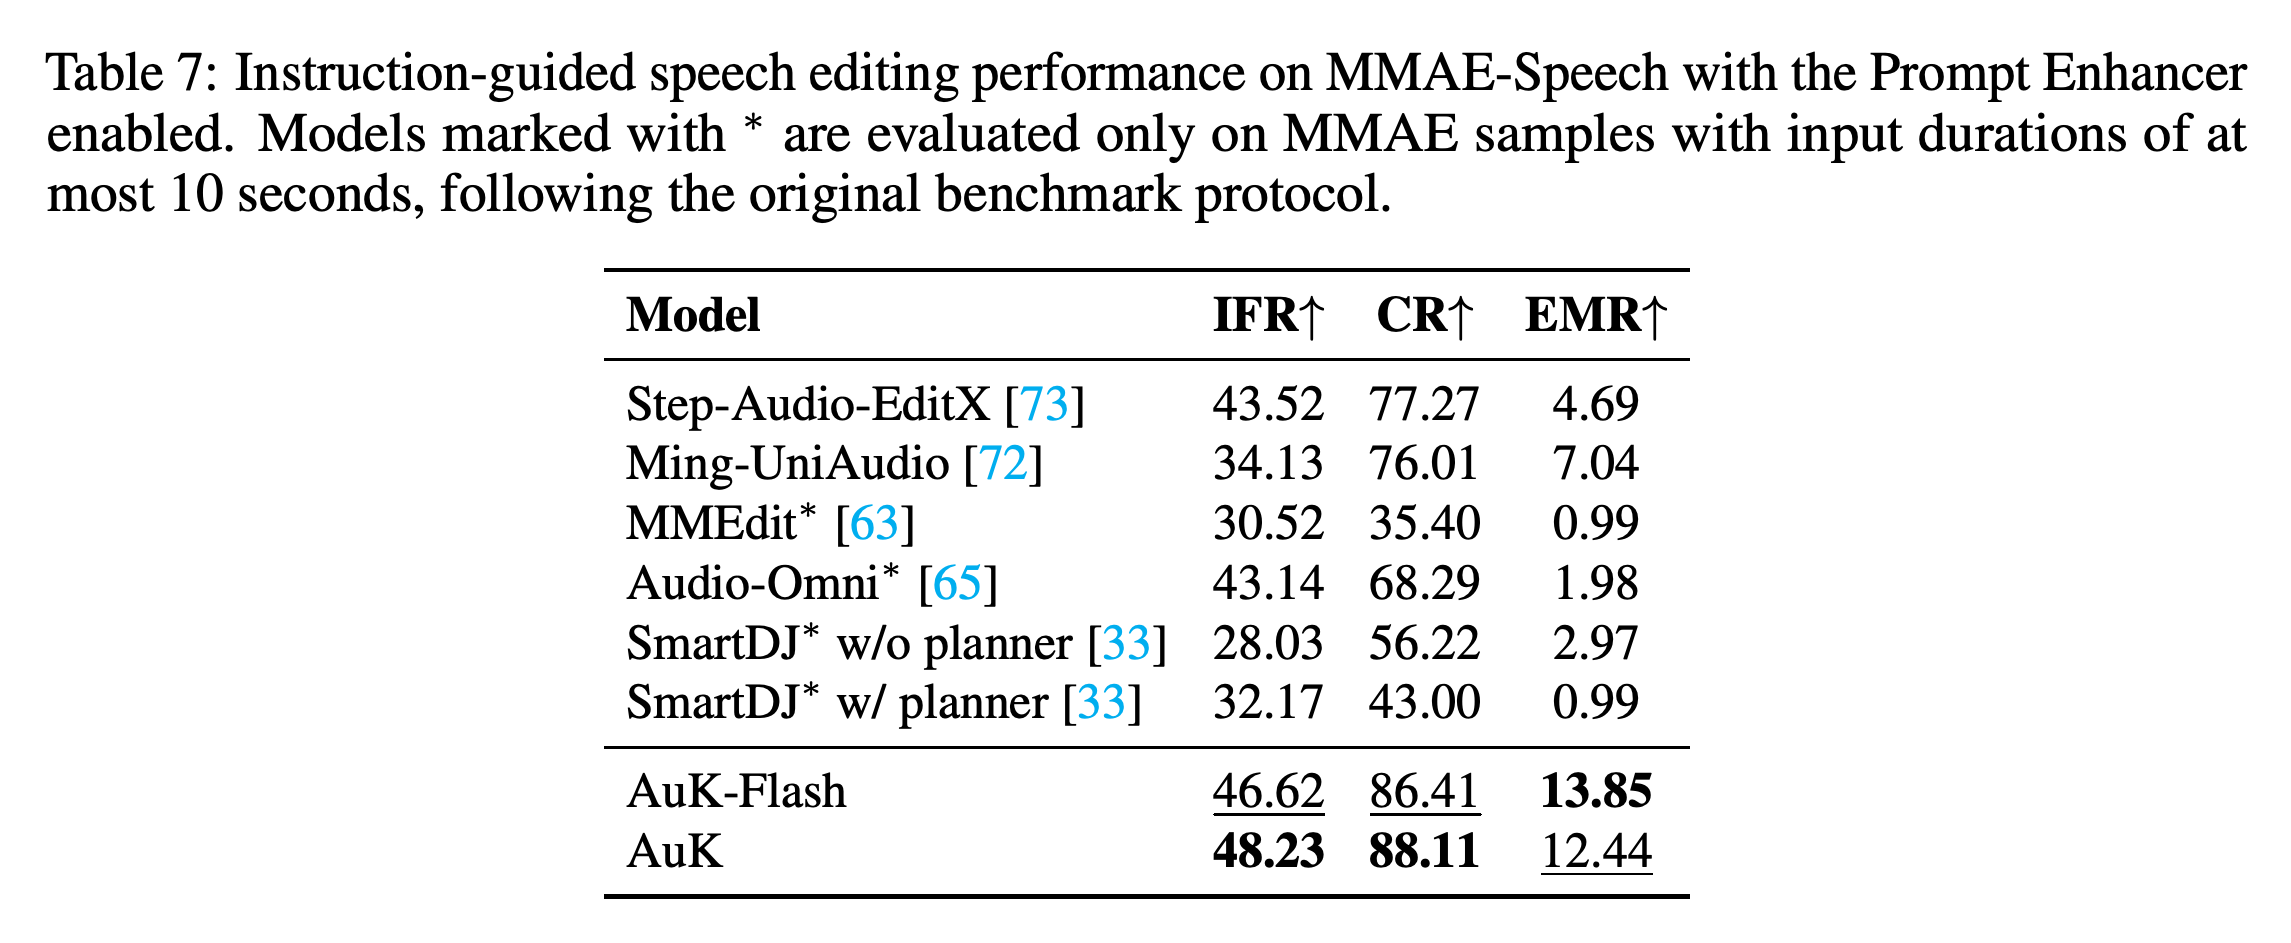
MMAE-Speech에서 AuK는 IFR 48.23%, CR 88.11%를 달성하고 AuK-Flash는 최고 EMR 13.85%를 달성한다. SpeechEditBench에서 AuK는 제시된 dedicated model 중 content, emotion, prosody, acoustic editing을 이끌고, Flash는 paralinguistic editing에서 39.25%로 선두다.
Speech Enhancement and Separation
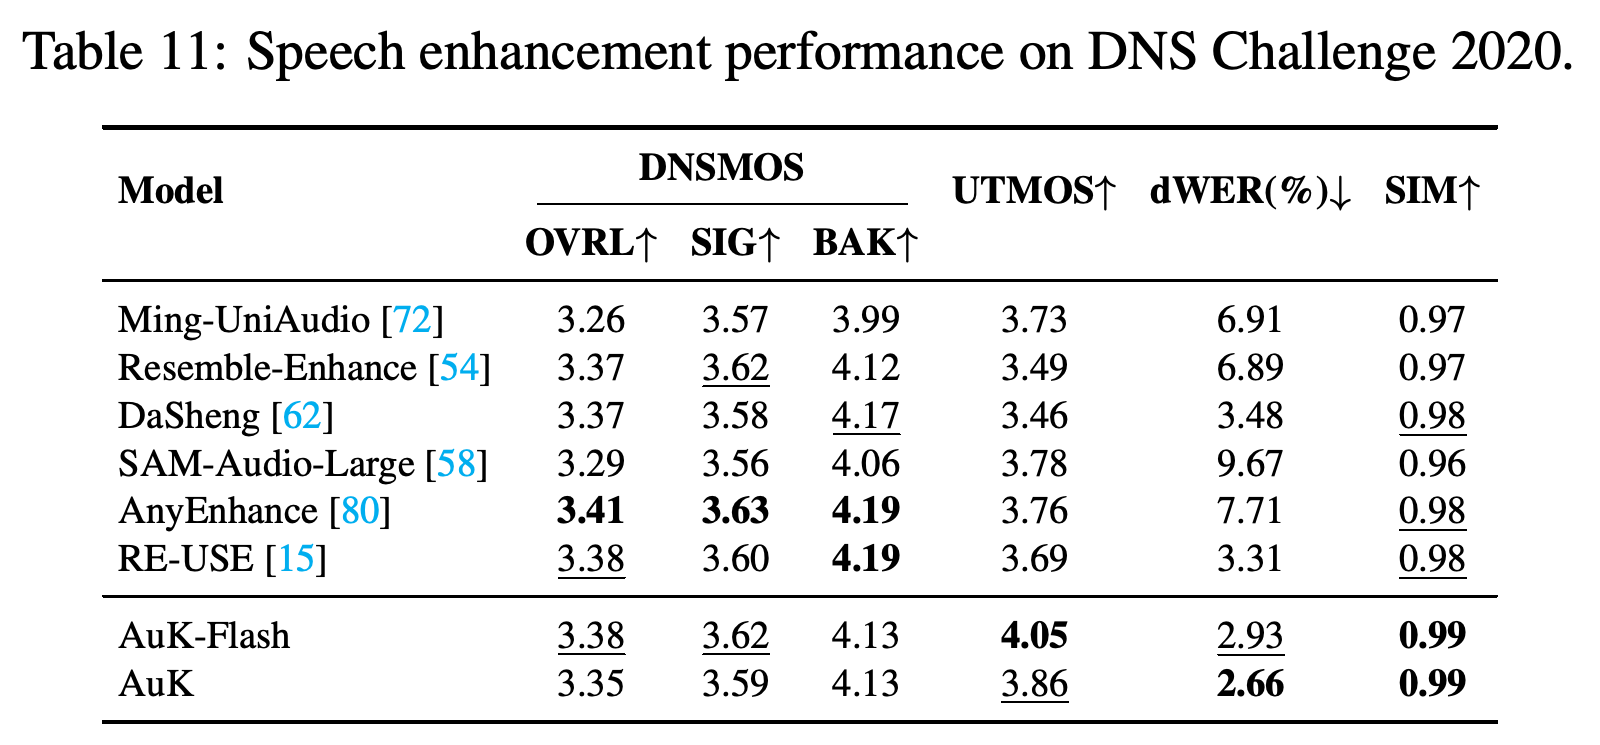
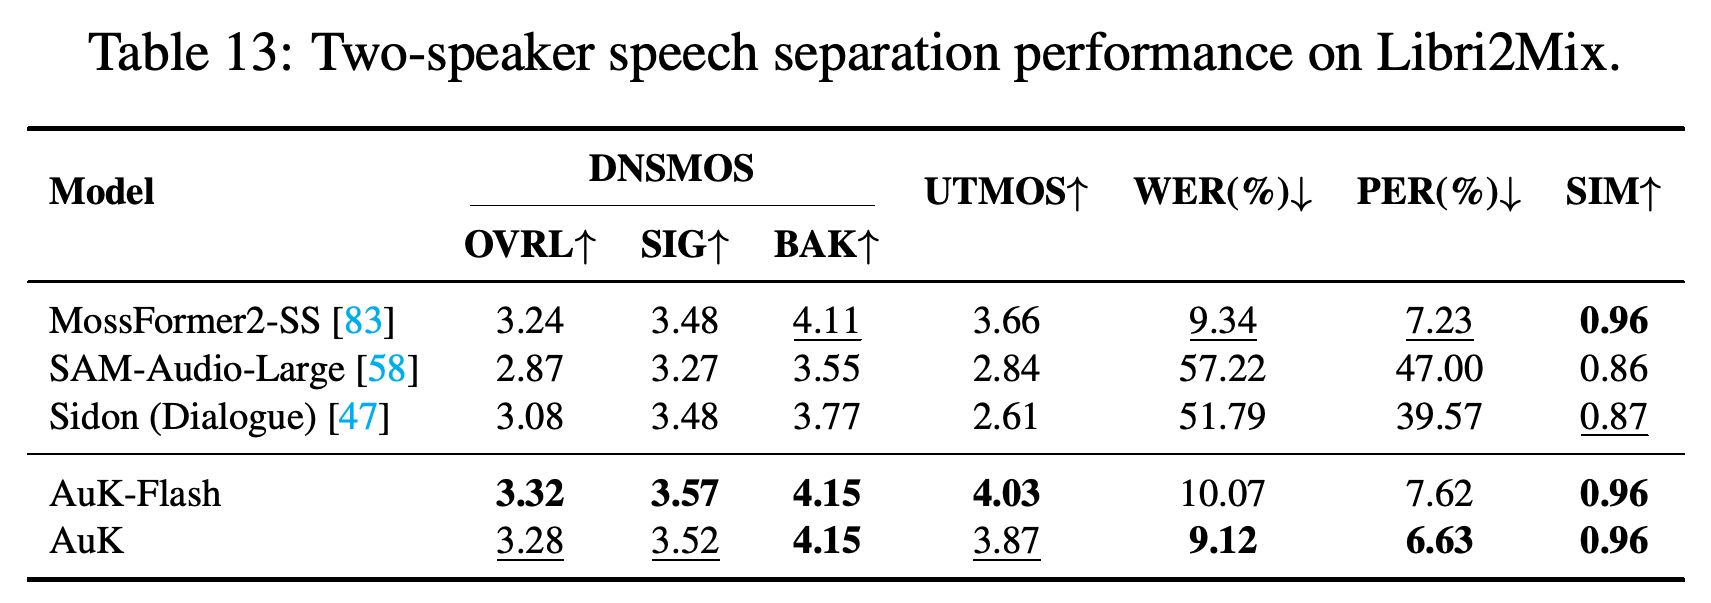
DNS Challenge에서 전체 AuK는 최저 dWER 2.66%를 기록하고 두 변형 모두 SIM 0.99에 도달하며, Flash는 최고 UTMOS 4.05를 기록한다. Libri2Mix에서 AuK는 더 낮은 WER/PER 9.12%/6.63%를 보이고, Flash는 더 높은 OVRL/UTMOS 3.32/4.03을 보인다.
Discovery
서로 다른 발화의 prompt-target pairing은 화자 불변 특성을 강조하고 전사 없는 voice cloning을 가능하게 하도록 제안됐다. 저자들은 whisper editing에서 텍스트 기반 whisper generation으로의 전이와 중국어 de-accenting 지도에서 일부 영어 억양으로의 전이를 정성적으로 관찰했지만, 이 관찰이 포괄적 평가는 아니라고 명시한다.
8 Conclusion
논문은 공유 MLLM–VAE–rectified-flow architecture, 5개 작업군 지도, 상호보완적 post-training, task-routed distillation이 폭넓은 음성 인터페이스를 지원한다고 결론짓는다. 제약 없는 자유 형식 요청을 신뢰성 있게 처리하려면 여전히 명시적 task routing과 prompt enhancement가 유용하다는 한계도 인정한다.
Contribution
보고서는 Ziyang Ma, Zhikang Niu, Wenming Tu, Tianrui Wang, Ruiqi Yan, Junxi Liu, Yanru Huo를 core contributor로 열거한다. Xie Chen은 corresponding author로 명시된다.
표는 Chinese와 English의 instruction-following TTS를 APS, DSD, role-playing 지표로 나눈다. 전체 AuK의 Chinese score와 Flash의 English DSD 동률을 구분해 뒷받침한다.
MMAE-Speech 표는 instruction following 및 preservation과 정확한 all-rubric success를 구분한다. AuK는 IFR과 CR에서 선두이고 Flash는 EMR에서 선두다.
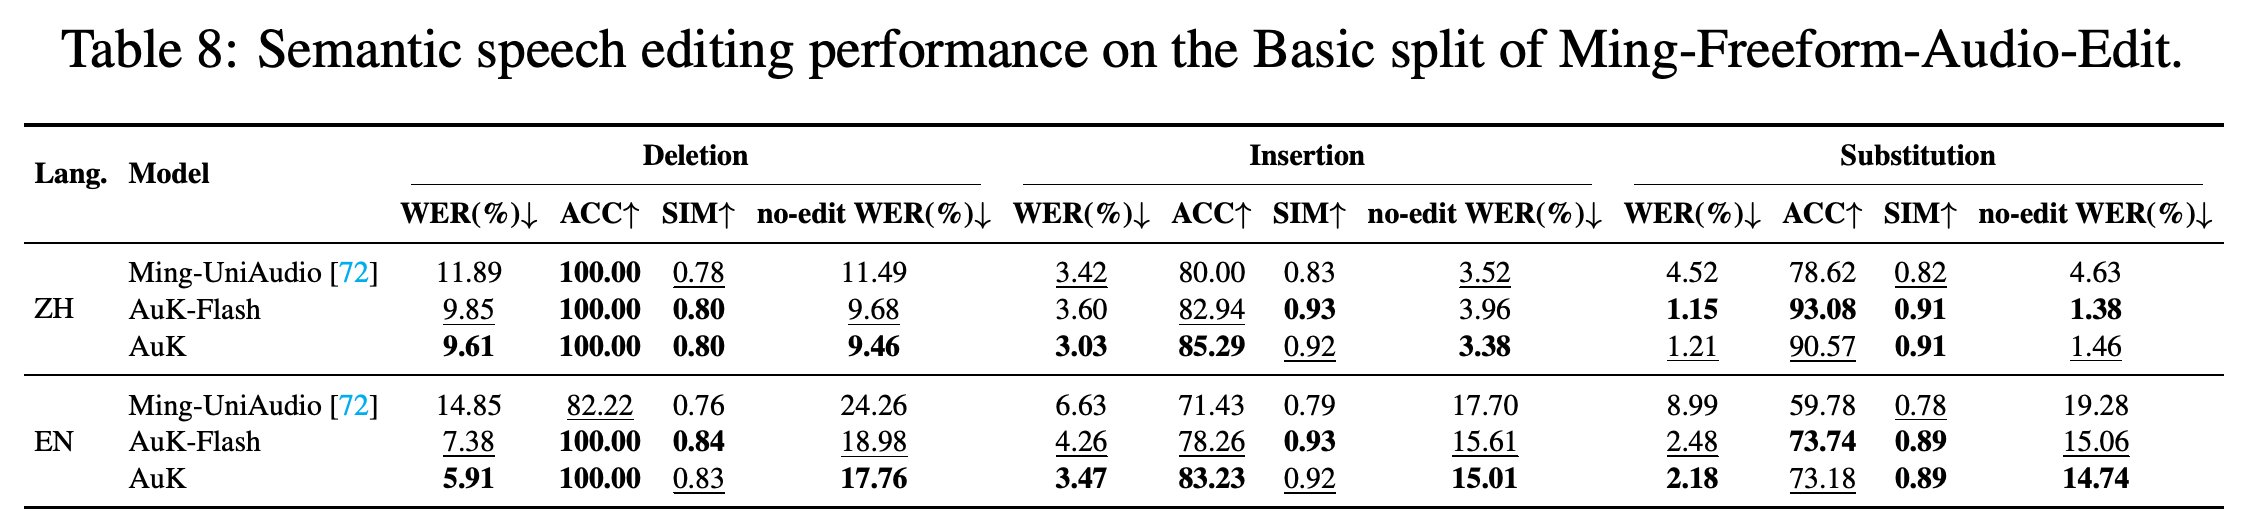
Basic split은 Chinese와 English의 semantic editing을 deletion, insertion, substitution으로 분해한다. 편집하지 않은 경우의 WER도 보존성 점검 지표로 포함한다.
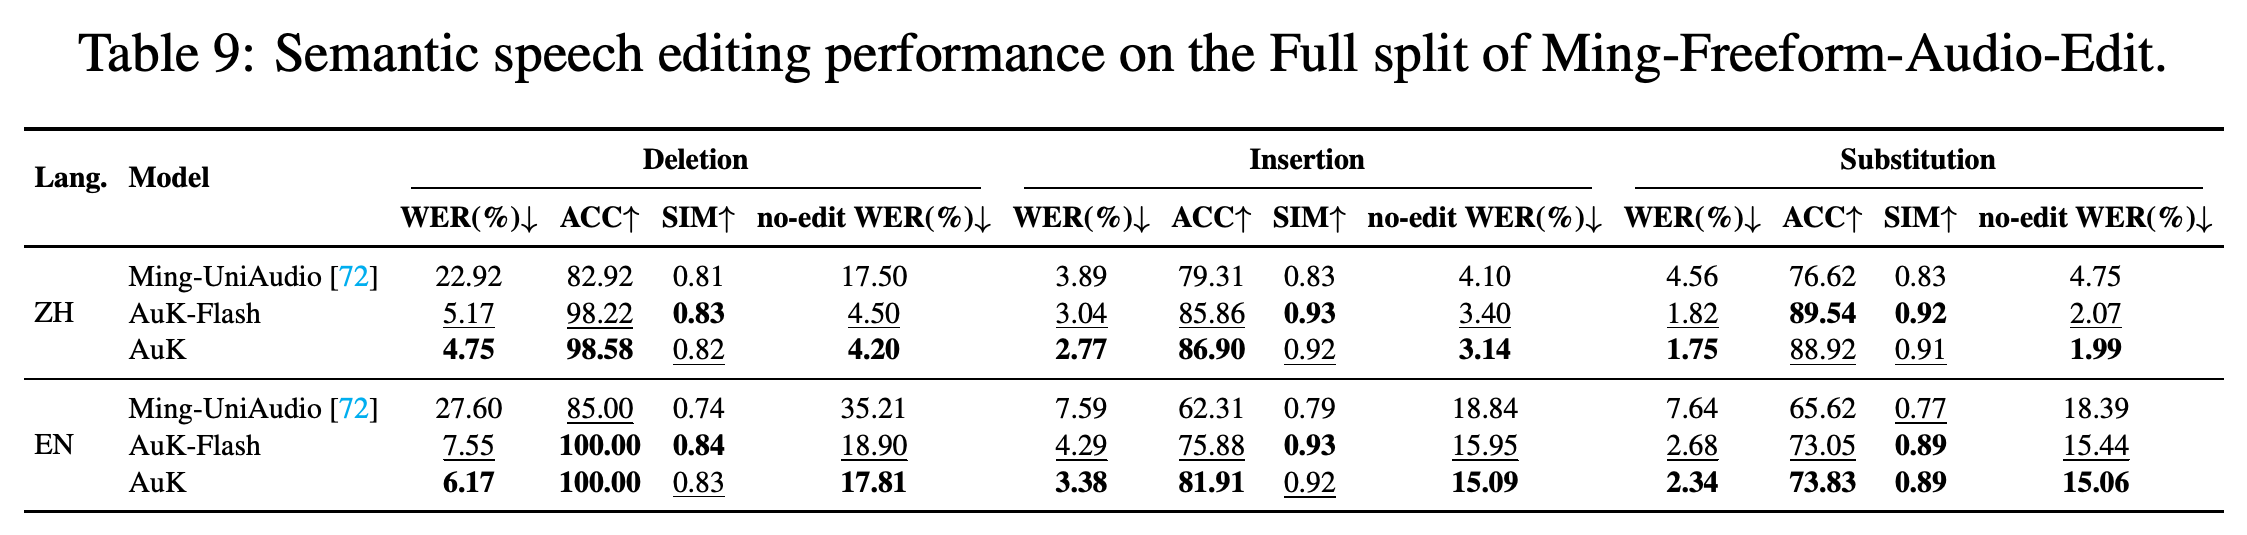
Full split은 더 어려운 semantic editing 비교를 제공한다. AuK 두 변형은 Ming-UniAudio 대비 평균 WER를 크게 낮추지만, 두 변형의 차이는 작업별로 다르다.
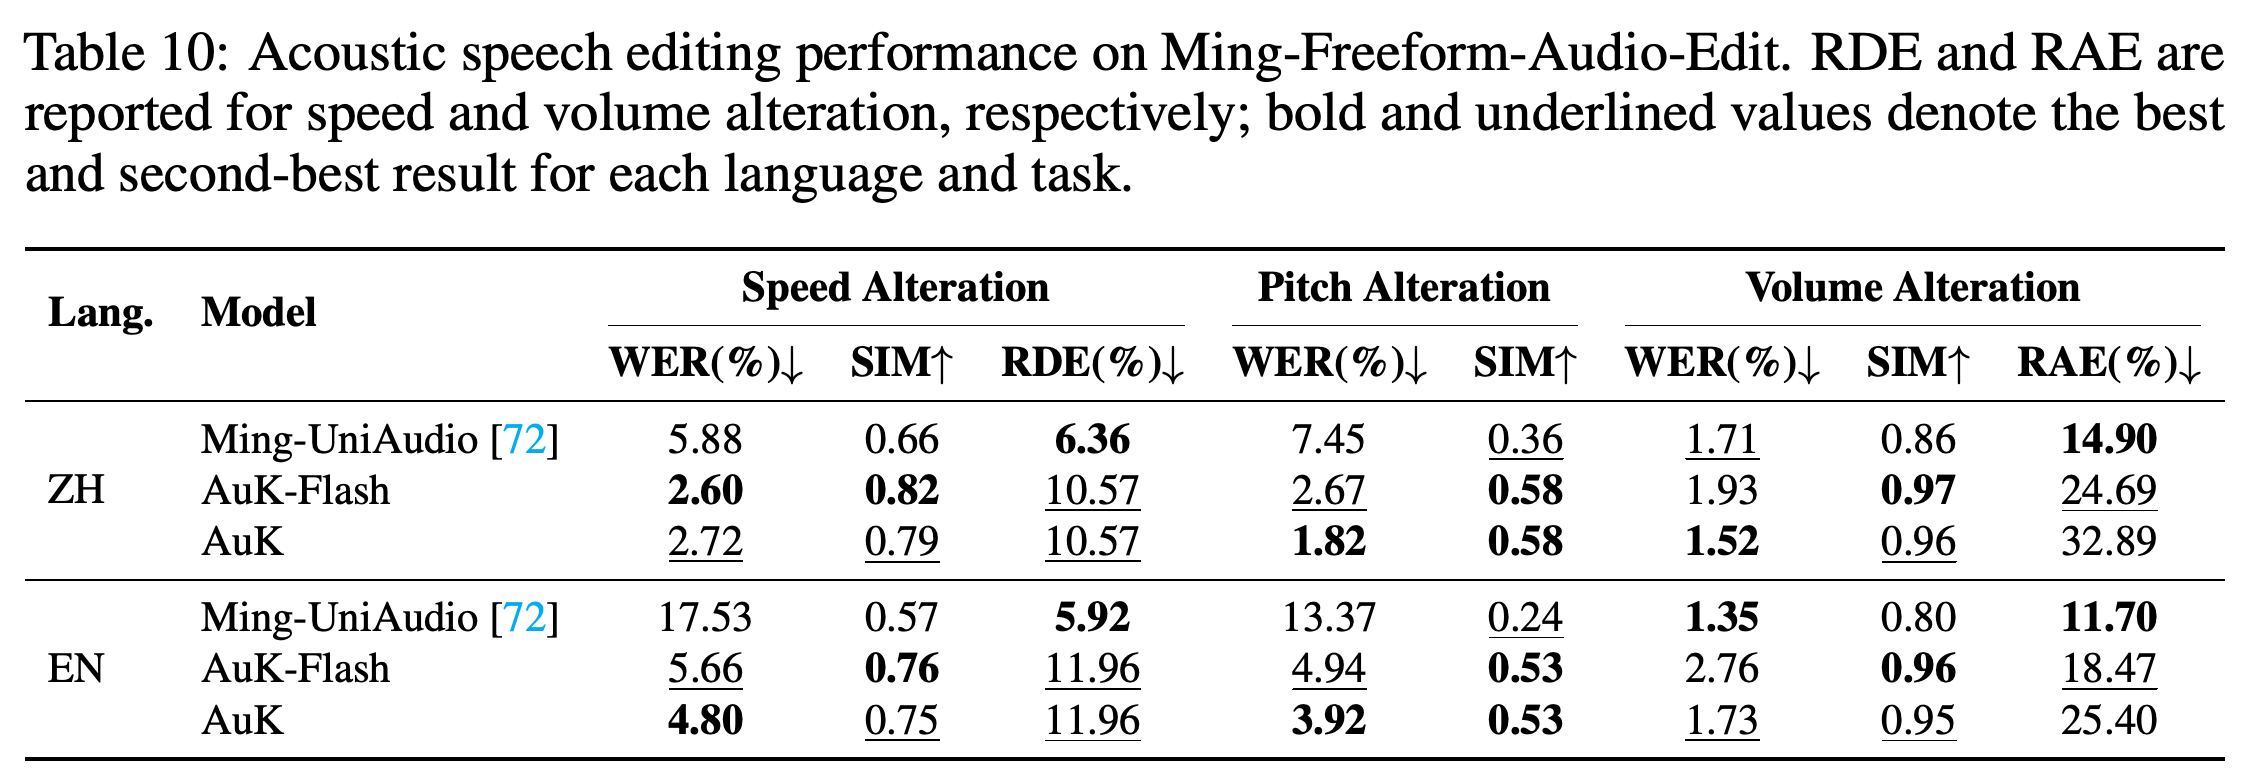
음향 편집 표는 발화 속도, 피치, 음량 제어와 함께 intelligibility, similarity, control-error 지표를 평가한다. 두 변형은 작업마다 WER와 화자 유사도에서 trade-off를 보인다.
DNS Challenge 2020에서 전체 AuK는 최저 dWER를 기록하고 두 변형은 SIM 0.99에 도달하며, Flash는 최고 UTMOS를 기록한다. 지각 지표와 recognition-oriented 지표는 서로 다른 변형을 선택한다.
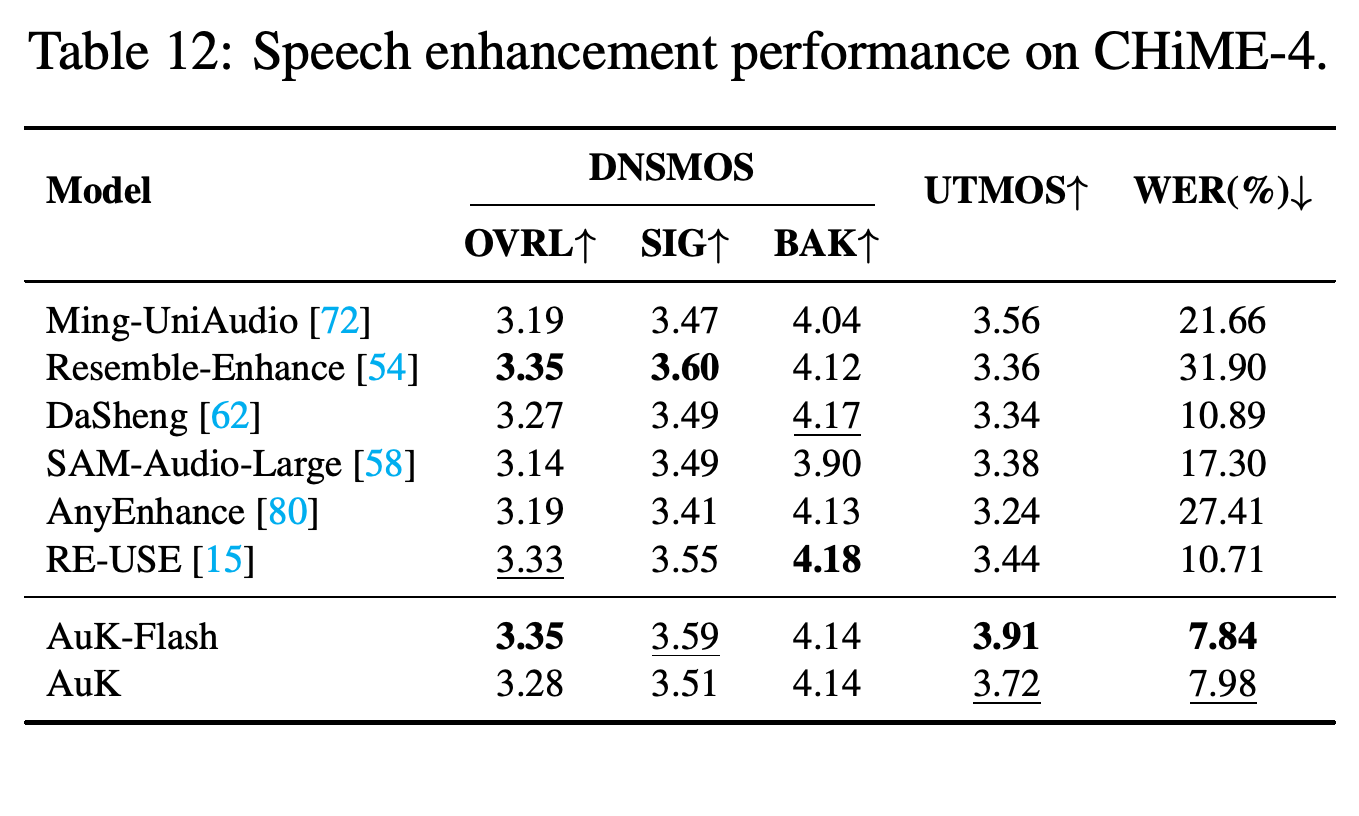
CHiME-4 비교에서 Flash는 표시된 WER와 UTMOS 최고 성능을 기록한다. 전체 표에서 OVRL 3.35는 최고 결과와 동률이다.
2화자 분리에서 전체 AuK는 더 낮은 WER와 PER를 보이고 Flash는 더 높은 OVRL과 UTMOS를 보인다. 두 변형 모두 최고 SIM 0.96과 동률이다.
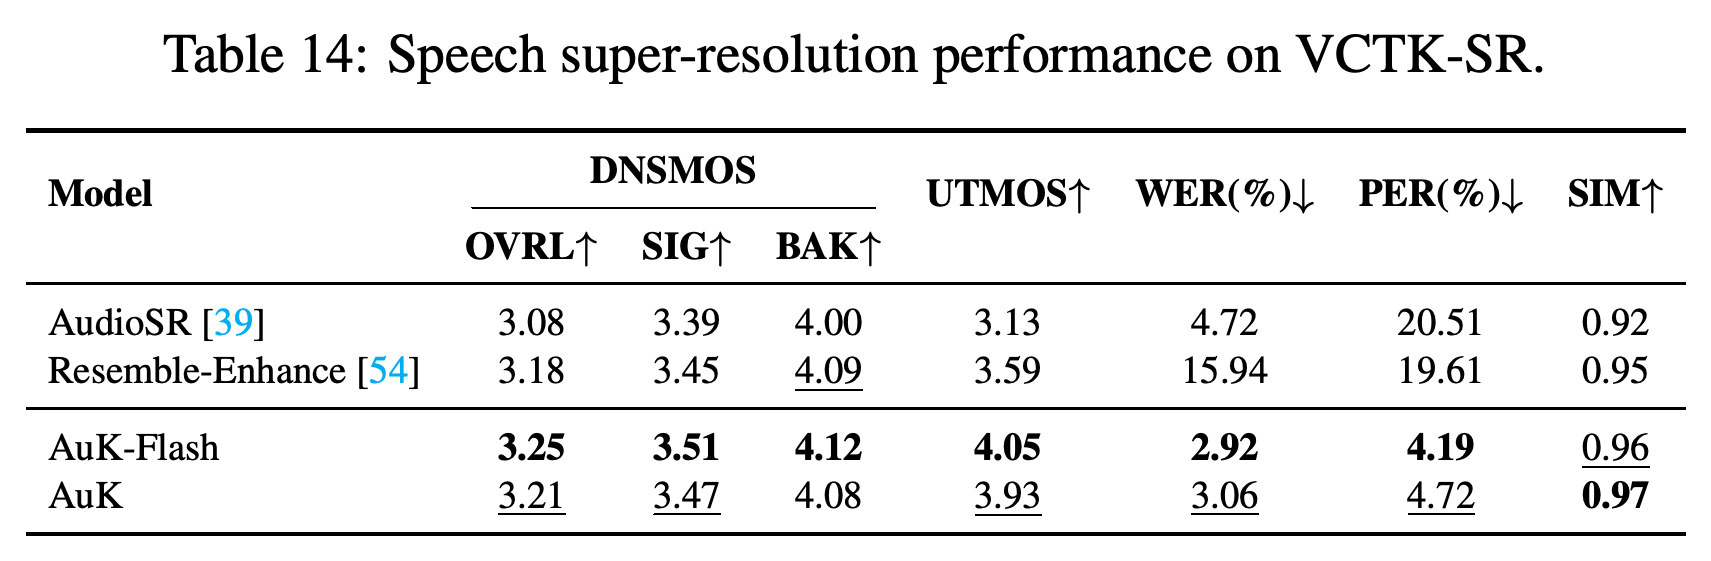
super-resolution 결과에서 Flash는 OVRL, UTMOS, WER, PER를 포함한 7개 보고 지표 중 6개에서 선두이며, 전체 AuK는 최고 SIM을 기록한다. 점수는 training range 밖의 2-kHz 조건을 포함한 8개 열화 subset 평균이다.
부록
- appendix는 더 폭넓은 generation baseline과 operation-level editing, 개선, 분리, super-resolution 결과로 benchmark 근거를 확장한다. MMAE-Speech가 Prompt Enhancer를 사용한다고 명시하며 deletion, insertion, substitution, speed, pitch, volume, DNS Challenge, CHiME-4, Libri2Mix, VCTK-SR의 상세 결과를 제공한다.
짧은 생각
이 보고서는 전체 모델과 증류 모델의 명시적인 trade-off를 포함해 generation, editing, enhancement, separation, super-resolution에 걸친 이례적으로 폭넓은 정량 평가를 제공한다. 주요 실용적 한계는 견고한 자유 형식 사용성이 여전히 외부 Prompt Enhancer와 task routing에 의존한다는 점이다.