


SPADE: Self-Play in Adaptive Synthetic Executable Environments 요약 설명
19 Aug 2026 | Paper Review Self-Play Unsupervised Environment Design Reinforcement Learning Tool Use목차
- 요약
- 4 SPADE: Self-Play in Adaptive Synthetic Executable Environments
- 5 Experimental Setup
- 6 Experimental Results
- 7 Ablations
- 8 Scaling Results
- 9 Discussion
- 부록
- 짧은 생각
이번 글에서는 SPADE: Self-Play in Adaptive Synthetic Executable Environments 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 19일(Arxiv)
- Liu, Bo, Yu, Simon, Jiang, Yiding, Qu, Ao, Zhao, Andrew, Liu, Zichen, Kim, Junsu, Zhou, Zijian, Kim, Seungone, Ren, Tongzheng, et al.
- University of Washington, Stanford University, Northeastern University, Carnegie Mellon University, Massachusetts Institute of Technology, National University of Singapore, Seoul National University, Stevens Institute of Technology, University of Chicago
- 논문 링크
요약
- SPADE는 하나의 LLM이 2개의 프롬프트된 역할을 수행하도록 학습한다. Environment Designer는 실행 가능한 Gym 스타일 Python 환경을 작성하고, Reasoning Agent는 이를 푼다. 제안한 적응형 커리큘럼은 코퍼스 기반 정보, 환경 메모리, 힌트 기반 regret 신호를 결합하며, 게임 기반 추론과 다단계 도구 사용에서 평가한다.
4 SPADE: Self-Play in Adaptive Synthetic Executable Environments
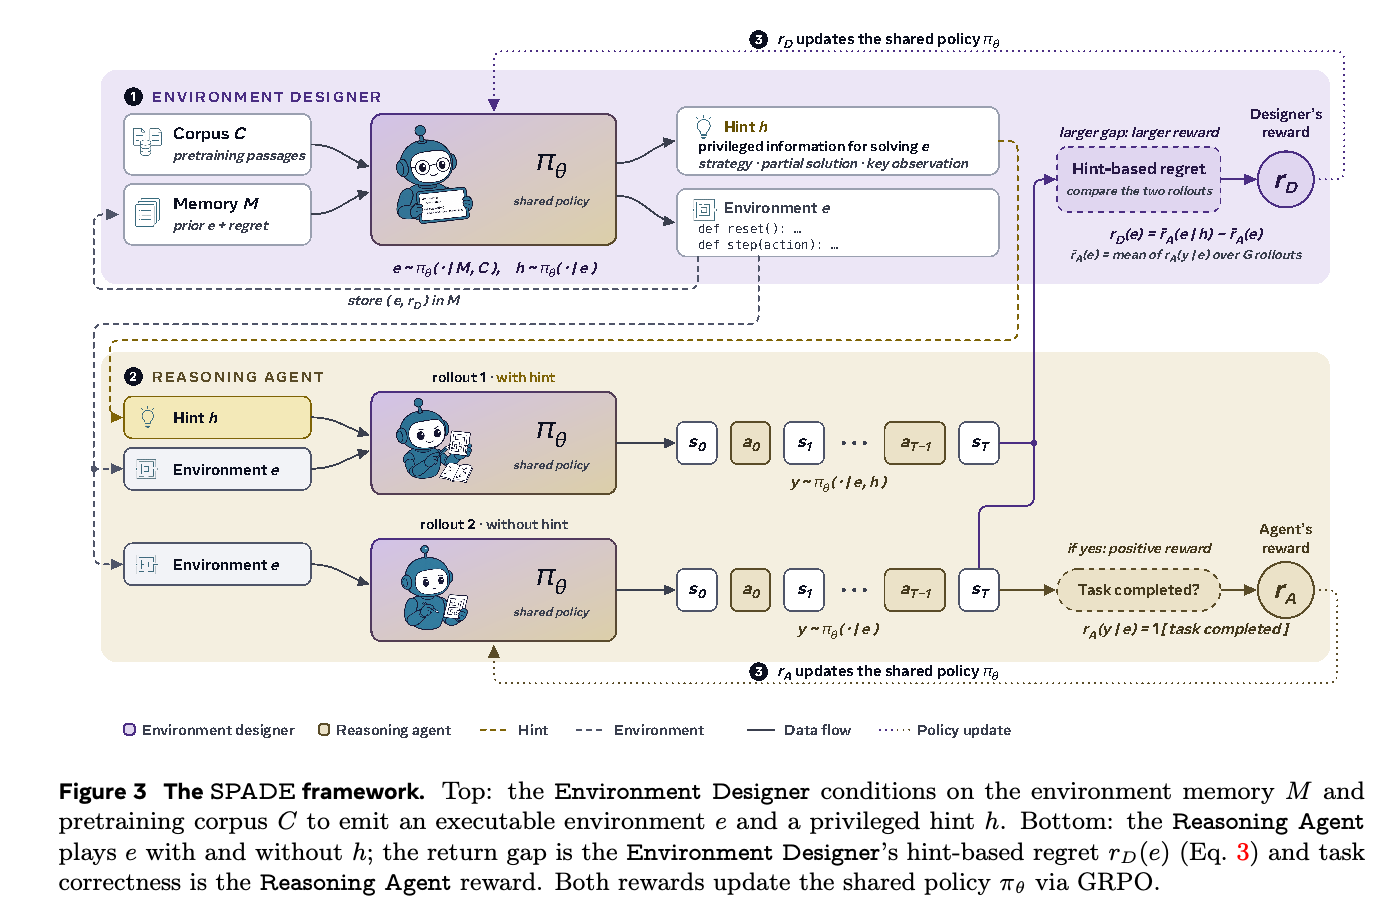
이 프레임워크는 환경 생성 및 검증과 힌트가 있는 Agent rollout 및 없는 Agent rollout을 번갈아 수행한 뒤, 공유 파라미터에 공동 GRPO 업데이트를 적용한다. 생성한 코드는 reset()/step() 인터페이스를 통해 상태 전이, 보상, 검증을 구현하며, 답 중심 과제와 상태를 유지하는 다중 턴 과제를 모두 다룬다. 상태를 유지하는 다중 턴 과제에 대해서는 이 글을 참조하라.
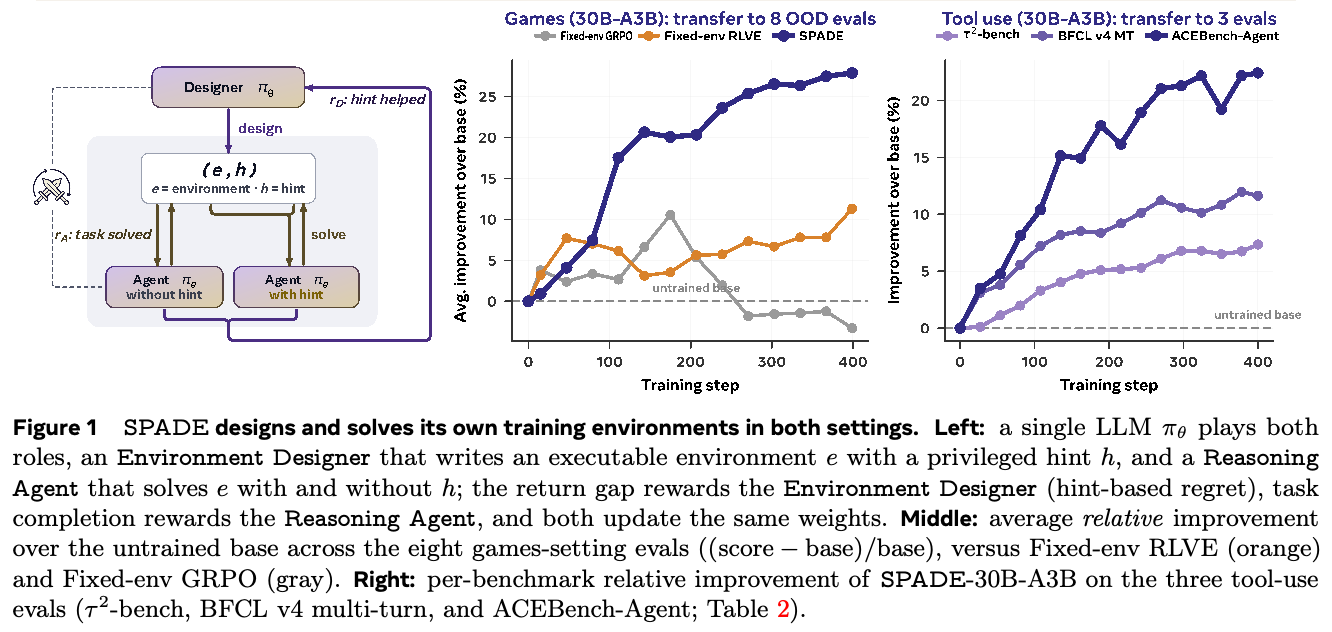
개요는 공유 정책의 이중 역할 loop를 보고한 전이 곡선과 연결한다. 30B-A3B 게임 곡선은 고정 환경 baseline을 넘으며, 도구 사용 향상은 3개 benchmark에서 서로 다르다.
4.1 Dual-Role Self-Play and Code-as-Environment
역할별 프롬프트는 동일한 정책 πθ에서 Designer 또는 Agent 동작을 선택한다. 후보 환경은 문법 및 실행 검사를 통과해야 하며, 학습에는 역할별 advantage 정규화, 절단 importance sampling을 적용한 지연된 Designer 업데이트, 비대칭 clipping, 그리고 Agent 승률을 0.4–0.6 범위로 유도하는 난이도 anchor를 사용한다.
4.2 Hint-Based Regret Reward
Designer 보상은 privileged hint가 있을 때와 없을 때의 평균 Agent return 차이로 정의한다. rD(e) = r̄A(e | h) − r̄A(e). 큰 차이는 힌트가 있으면 풀 수 있지만 보조 없이 정책이 아직 익히지 못한 과제를 가리킨다. 학습은 raw regret의 최솟값을 0으로 제한하고 난이도 anchor와 결합한다.
이 도식은 코퍼스 구절과 메모리가 환경 생성 조건으로 사용되고, Designer regret와 Agent task reward가 모두 GRPO를 통해 동일한 정책을 업데이트함을 명시한다.
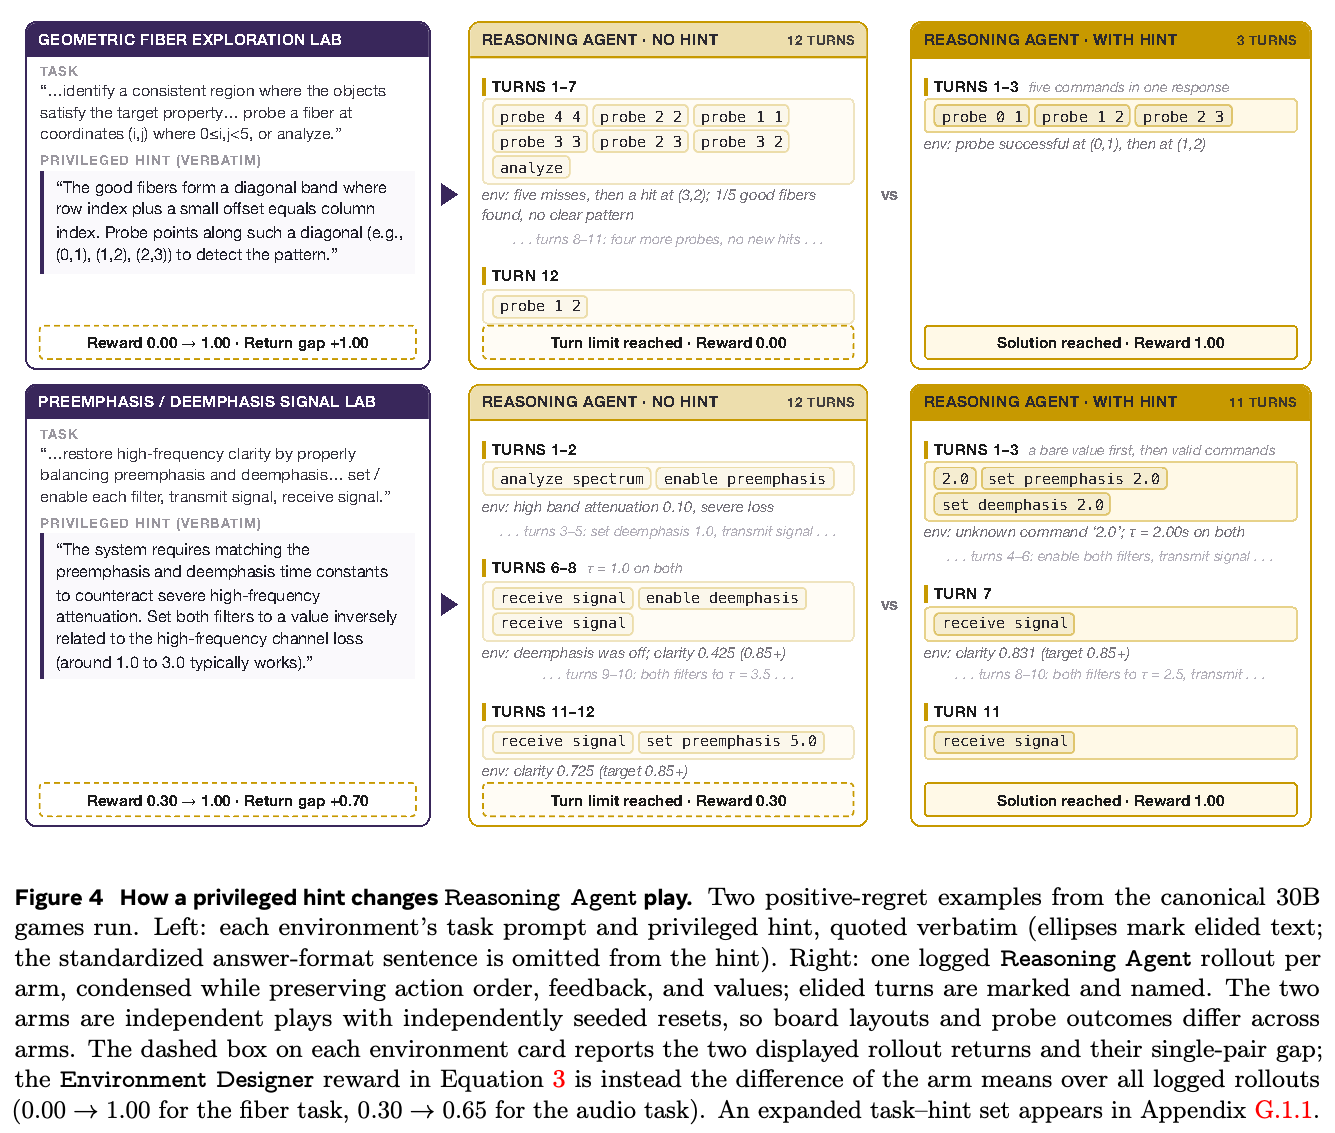
기록한 예시는 positive regret의 행동적 근거를 보여준다. 힌트는 생산적인 탐색 패턴이나 parameter 범위를 제안하며, 힌트가 없는 플레이가 실패하거나 부분 성공에 그친 상황에서 성공한 힌트 기반 trajectory와 연관된다.
4.3 Environment Design
새 문서는 주제별 소재를 제공하고, 이전 환경·skill label·regret score를 담은 메모리 버퍼는 frontier 지향 seed를 제공한다. 게임에는 DCLM과 MegaScience의 수학 문서 10k개와 과학 문서 5k개를 사용하며, 도구 사용에는 Nemotron pretraining-code 문서 15k개를 사용한다.
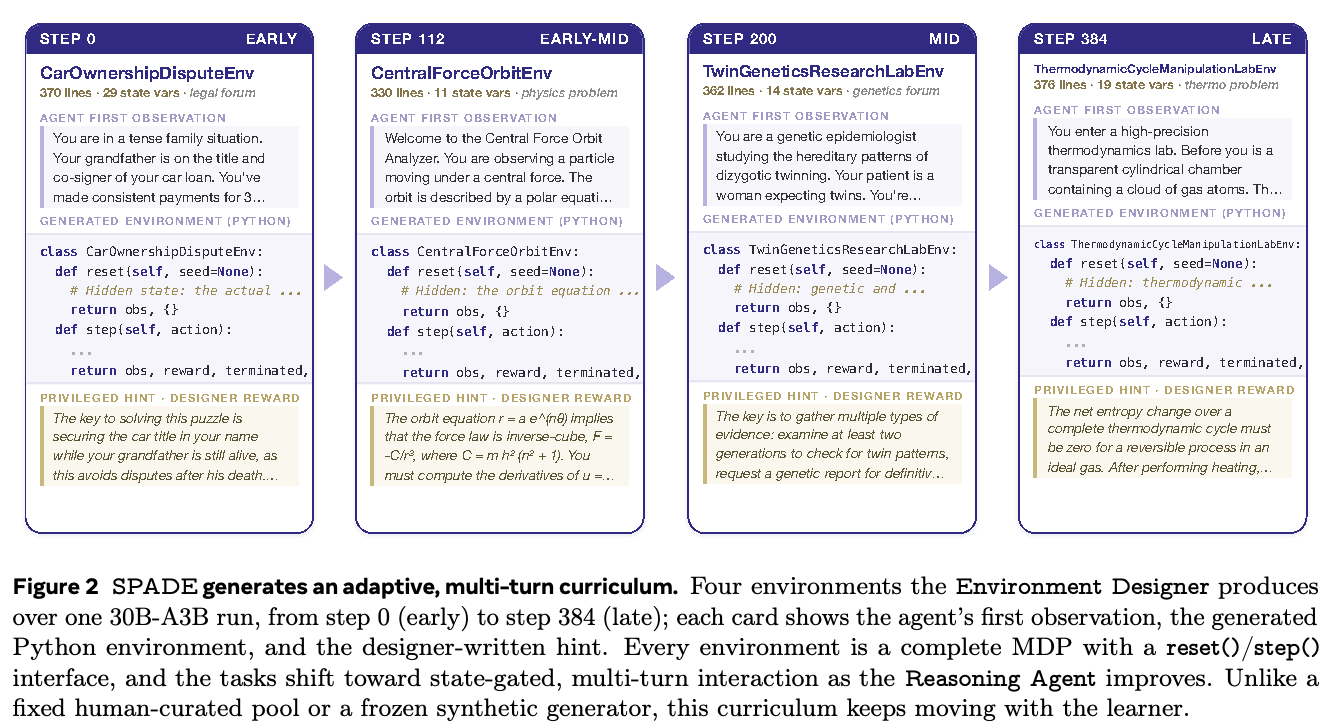
1회 30B-A3B run의 4개 checkpoint는 car-ownership 환경에서 상태 제약 상호작용을 갖춘 thermodynamics laboratory 환경으로 발전하는 저자들의 커리큘럼 변화를 보여준다.
5 Experimental Setup
저자들은 Qwen3-4B-Instruct-2507, Qwen3-8B, Qwen3-30B-A3B-Instruct-2507을 GRPO로 24개 환경의 400 rollout 동안 학습한다. 보고한 모든 평가 benchmark는 학습에서 제외한다.
5.1 SPADE Training Recipe
공통 설정은 24-environment rollout batch, group size G=16, learning rate 1 × 10⁻⁶, 지연된 Environment Designer 업데이트를 사용한다. Agent는 환경마다 힌트 없는 플레이를 16 × k회, 힌트 있는 플레이를 16회 수행하며, 게임에서는 k=4, 도구 사용에서는 k=8을 사용한다. RL backbone은 slime이다.
5.2 Domain: Games
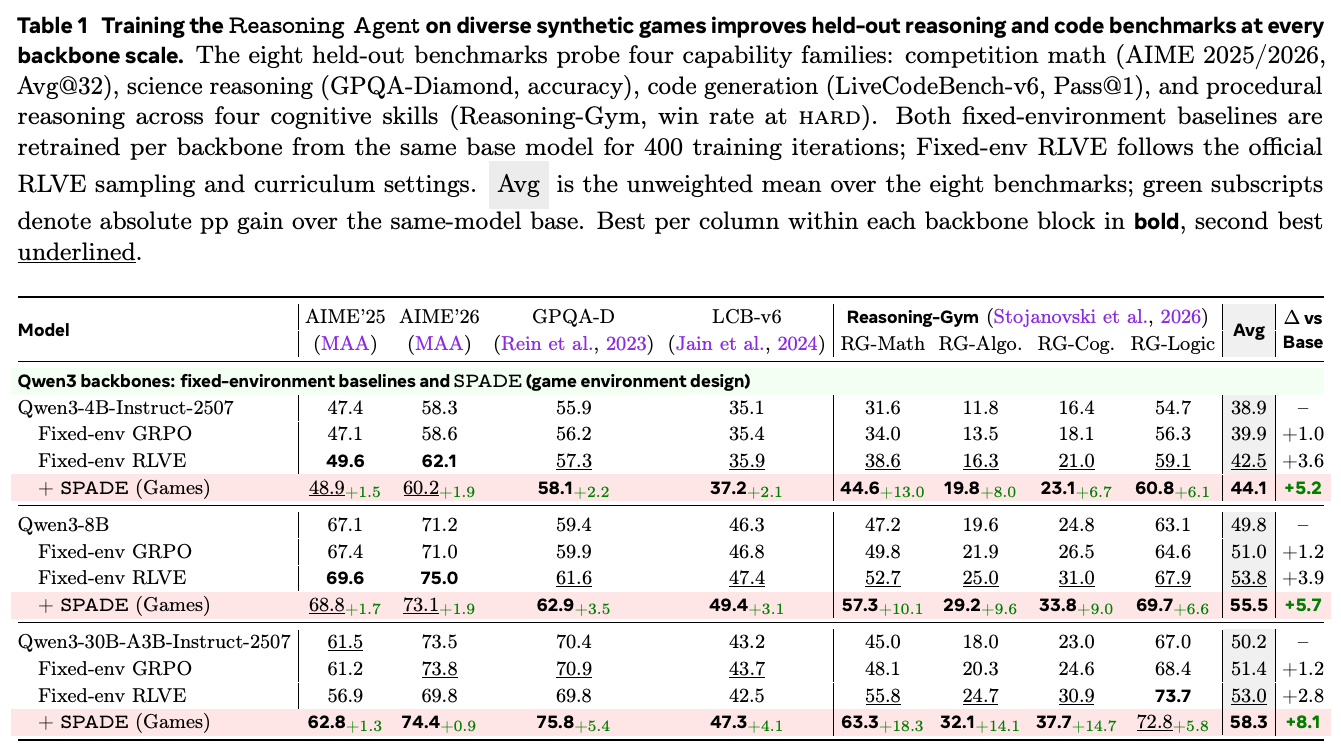
게임에서 각 rollout은 Mathematical Reasoning, Logical Deduction, Spatial Reasoning, Pattern Recognition, Optimization, Causal Inference 중 순환하는 3개 skill에 걸친 독립적인 Python 환경 24개를 포함한다. Fixed-env GRPO와 Fixed-env RLVE는 같은 400-iteration 예산으로 재학습하며, 평가는 AIME 2025/2026, GPQA-Diamond, LiveCodeBench-v6, 그리고 난도가 높은 Reasoning-Gym category 4개를 다룬다.
5.3 Domain: Tool Use
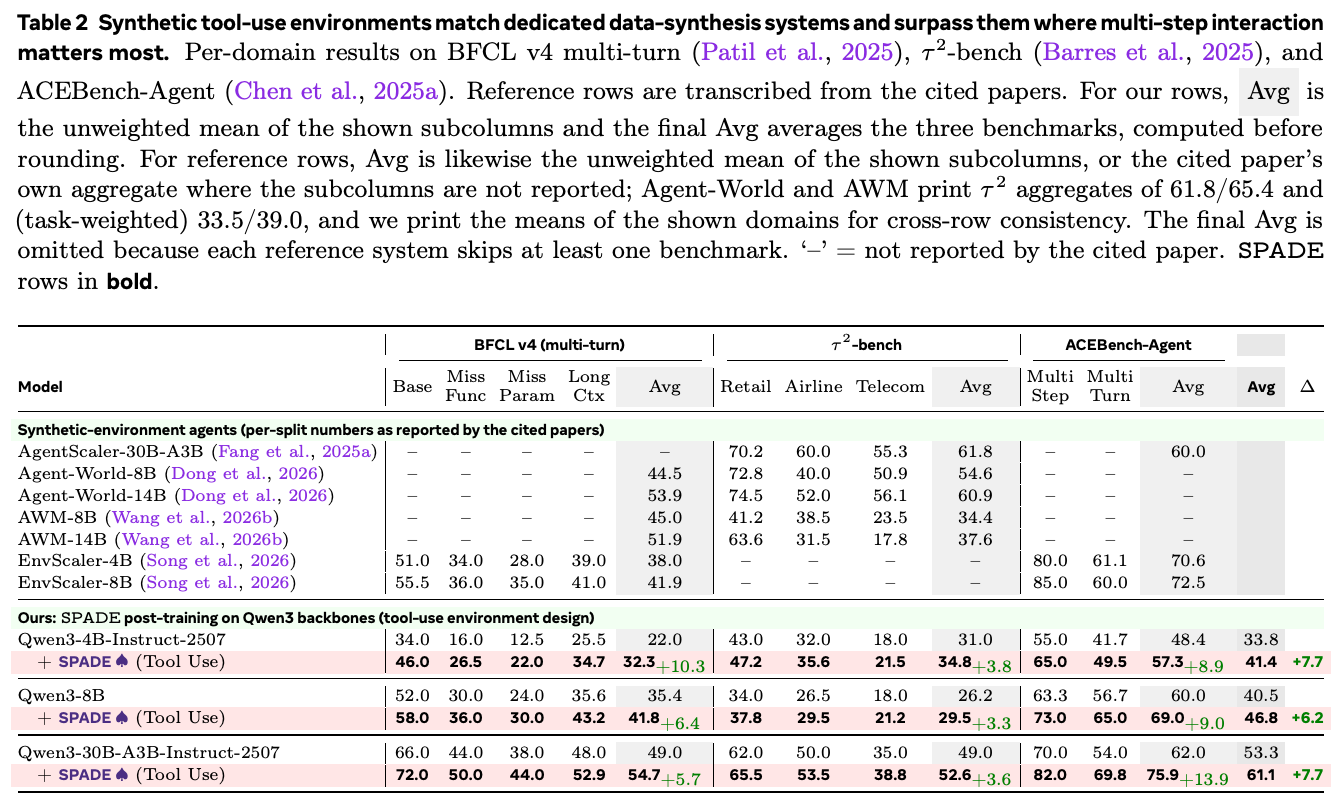
도구 사용에서 Designer는 모의 OpenAI function-calling tool, 변경 가능한 backend state, 상태 기반 기준을 갖춘 순차적 사용자 지시 3~5개를 생성한다. 도구 환경은 결정론적 reset 검사와 LLM solvability screen을 통과해야 한다. 평가는 BFCL v4 multi-turn, τ²-bench, ACEBench-Agent를 사용하며, 인용한 비교 행은 서로 다른 모델, 예산, harness, 그리고 경우에 따라 benchmark variant를 사용한다.
6 Experimental Results
실험은 적응형 합성 환경에서 학습한 결과가 보류된 추론, 코드, agent-interaction 과제로 전이되는지를 검증하고, 생성한 커리큘럼과 Agent 행동을 분석한다. 근거로 benchmark table, learning curve, 구성 요소 ablation, 다양성 측정, 정성적 trace를 제시한다.
6.1 Quantitative Analysis
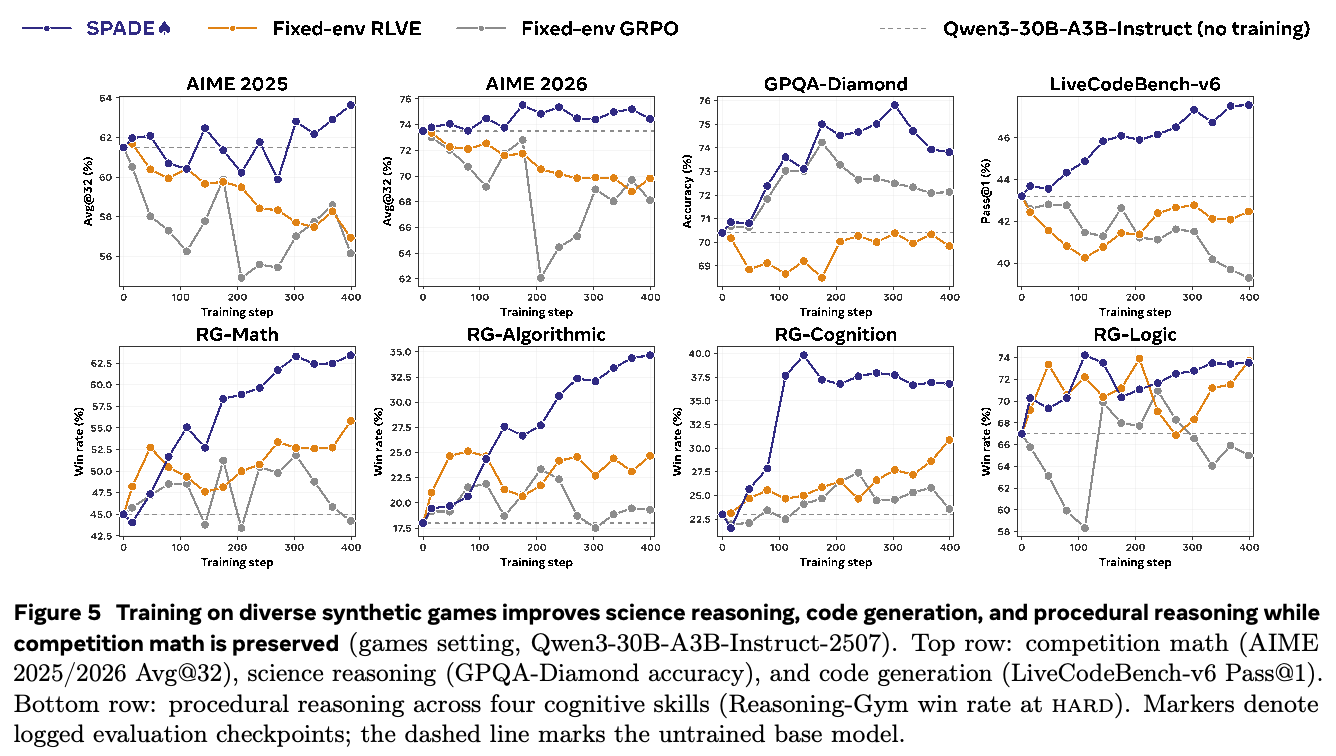
게임의 30B-A3B에서 SPADE는 suite average 58.3을 달성하며, 학습하지 않은 base의 50.2와 가장 강한 고정 환경 baseline인 Fixed-env RLVE의 53.0을 앞선다. 도구 사용의 30B-A3B에서는 각 대응 base 대비 BFCL v4 multi-turn을 +5.7, τ²-bench를 +3.6, ACEBench-Agent를 +13.9 개선한다.
3개 Qwen3 backbone에서 SPADE가 가장 높은 suite average를 기록한다. 4B에서는 44.1, 8B에서는 55.5, 30B-A3B에서는 58.3이다. 30B-A3B에서 base 대비 가장 큰 향상은 Reasoning-Gym Math의 +18.3, Algorithmic의 +14.1, Cognition의 +14.7이다.
Checkpoint plot은 SPADE가 competition-math 성능을 유지하면서 procedural reasoning, GPQA-Diamond, LiveCodeBench-v6에서 고정 환경 baseline과 가장 뚜렷하게 격차를 벌림을 보여준다.
SPADE는 표시한 모든 도구 사용 benchmark에서 대응하는 Qwen3 base보다 향상된다. 30B-A3B에서는 BFCL v4 multi-turn에서 54.7, ACEBench-Agent에서 75.9에 도달한다. Table과 appendix는 인용한 reference-system 행이 protocol-matched하지 않다고 명시적으로 주의한다.
6.2 Qualitative Analysis
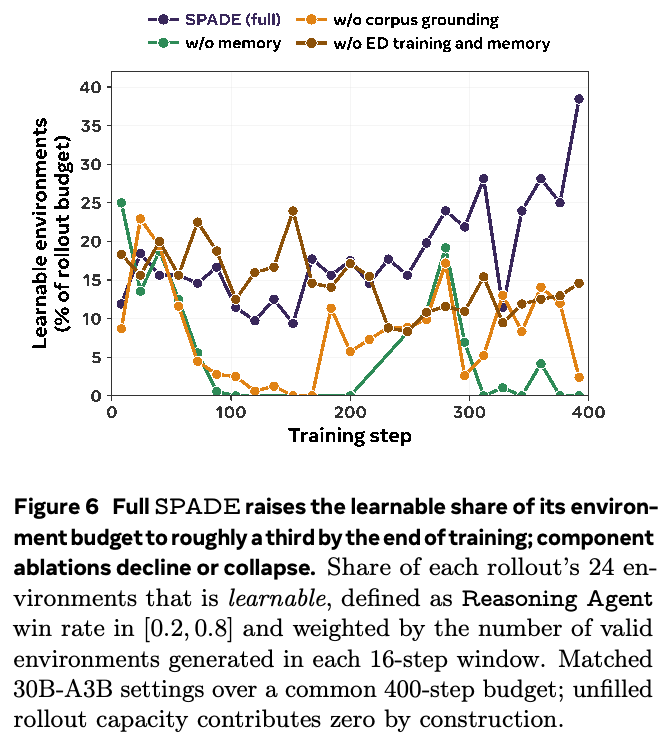
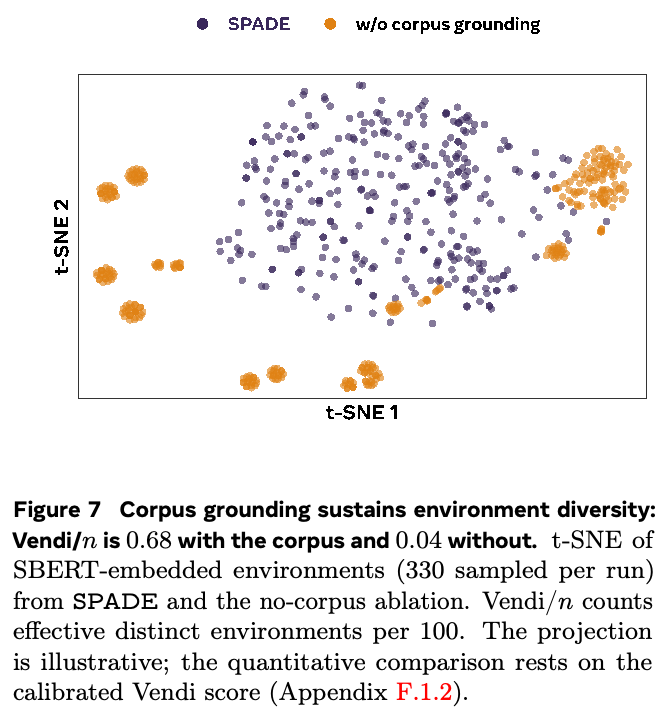
전체 30B games run에서 Agent 승률이 [0.2, 0.8]에 속하는 환경 비중은 학습 후반에 약 3분의 1에 이른다. 코퍼스 기반 정보는 보고한 다양성 증가와 연관되며, Vendi/n은 코퍼스 사용 시 0.68, 미사용 시 0.04이다. Trajectory 예시는 Agent가 긴 사전 유도에서 해법을 확정하기 전 탐색과 증거 수집으로 이동하는 모습을 보인다.
완전한 구성은 학습 후기의 학습 가능한 환경 비중을 높이는 반면, 코퍼스·메모리·Designer 학습을 제거한 ablation은 하락하거나 붕괴한다. 이 그림은 보류 과제 성능이 아니라 제공한 학습 환경을 측정한다.
t-SNE plot은 예시적이지만, 보고한 정량 Vendi/n 차이는 크다. 코퍼스 기반 정보 사용 시 0.68, 미사용 시 0.04이다. 이는 외부 문서가 생성 붕괴를 피하는 데 연관된다는 논문의 해석을 뒷받침한다.
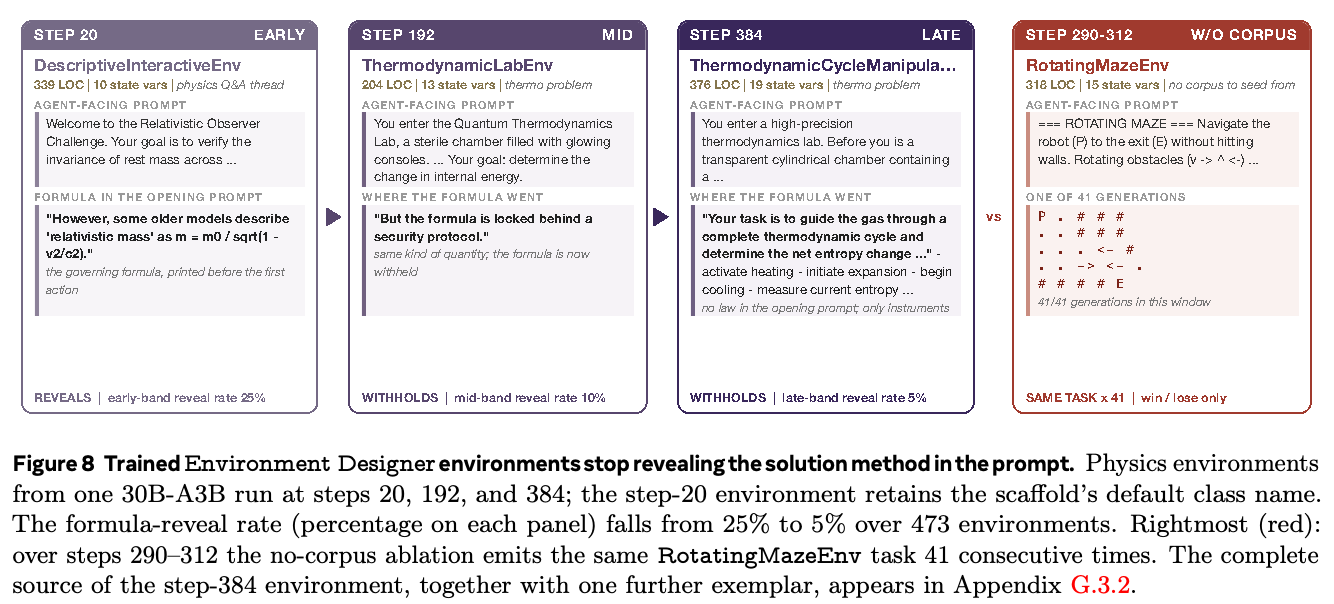
예시와 formula-reveal 통계는 후기 physics 환경이 다중 턴 구조를 유지하면서 해법 방법을 덜 자주 노출함을 보인다. 코퍼스 미사용 조건은 step 290–312에서 RotatingMazeEnv를 41회 반복한다.
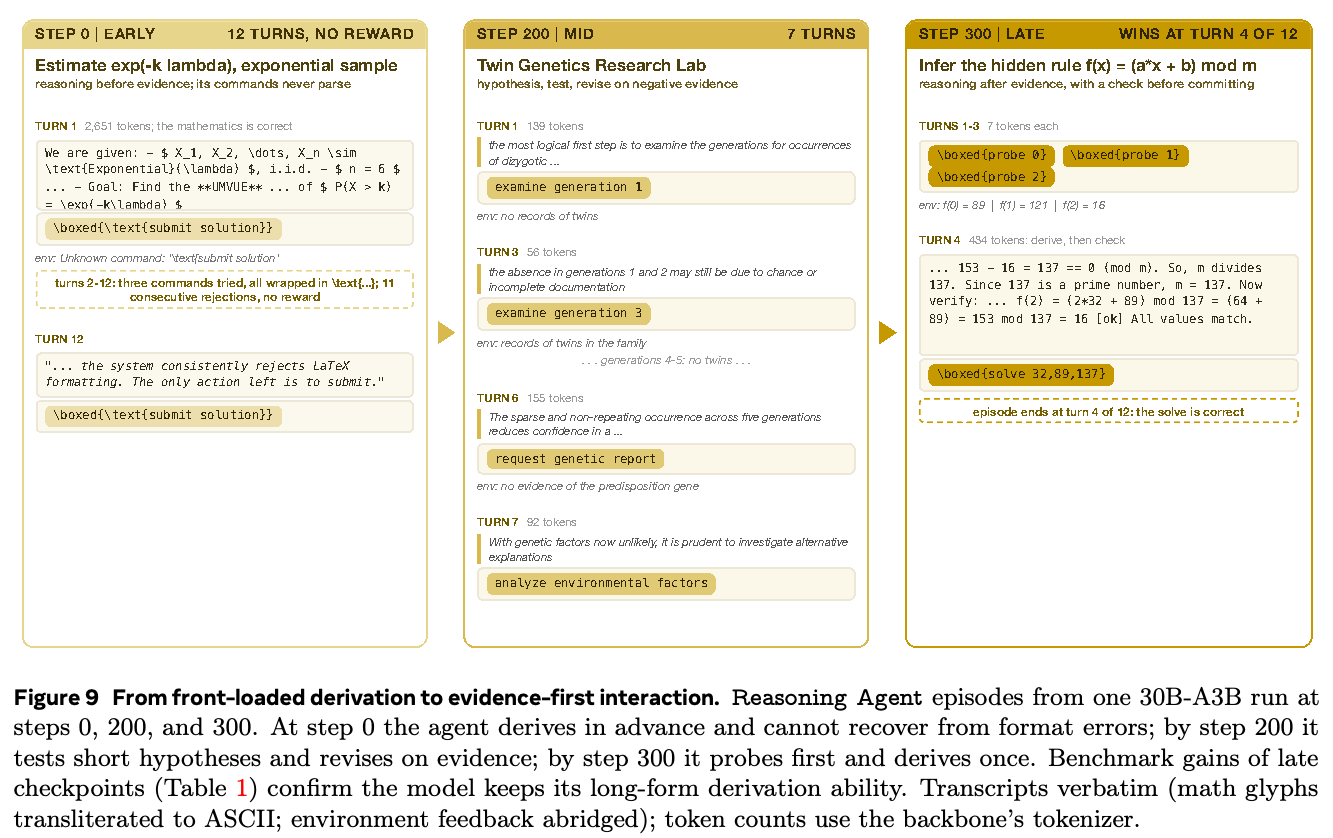
선택한 trace는 반복되는 파싱 불가능한 장문 답변에서 짧은 가설 검증을 거쳐, 숨은 규칙을 유도하기 전에 탐색하고 turn 4에 푸는 방식으로 변하는 정성적 변화를 묘사한다.
7 Ablations
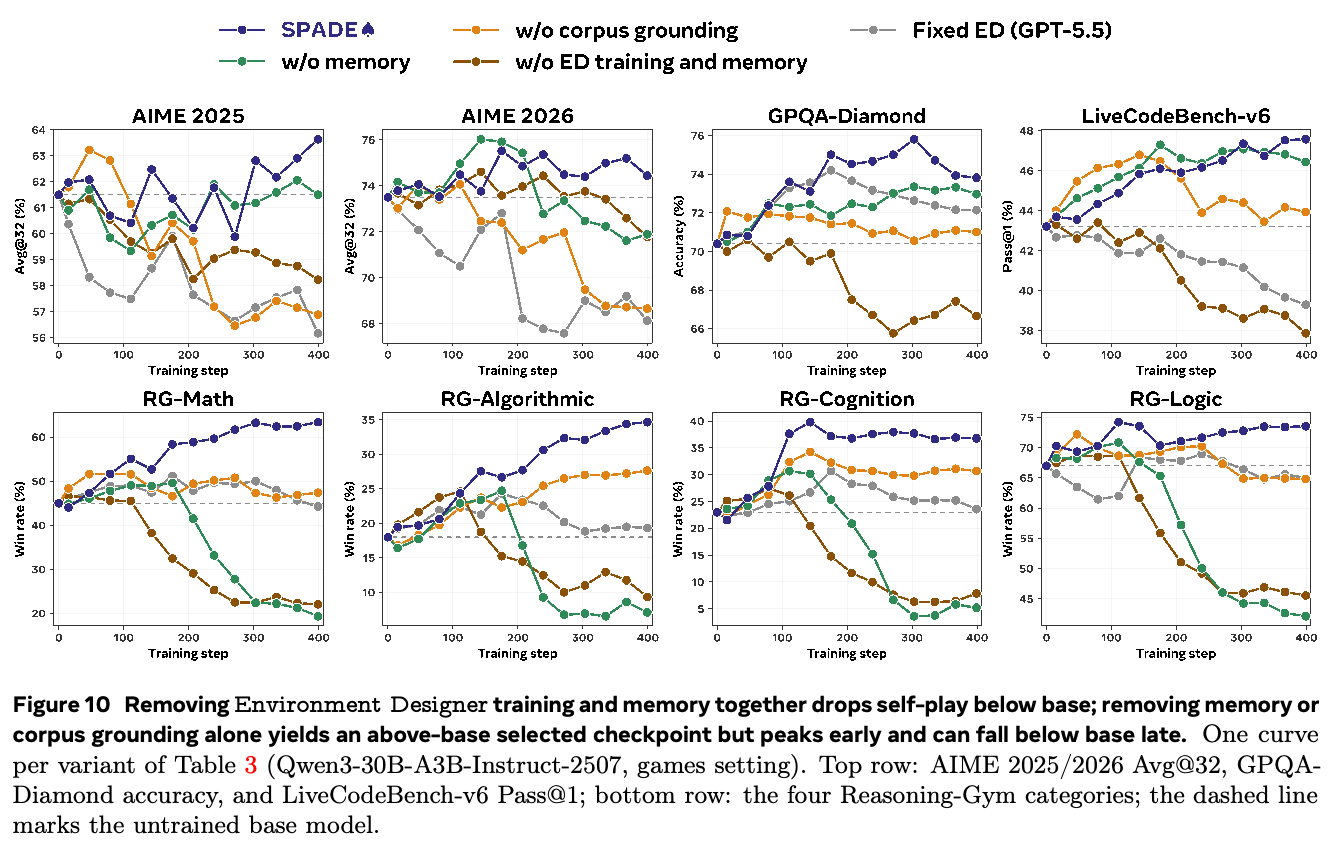
Ablation은 온라인 Designer 적응과 이를 학습하는 데 쓰는 보상을 평가한다. Qwen3-30B-A3B 게임에서 완전한 구성은 선택한 suite average 중 가장 높은 값을 달성한다. 메모리, 코퍼스 기반 정보, Designer 학습을 제거하면 선택한 결과가 낮아지며, 일부 부분 구성은 이르게 정점을 찍은 뒤 하락한다.
7.1 Ablation: Environment Designer Adaptation
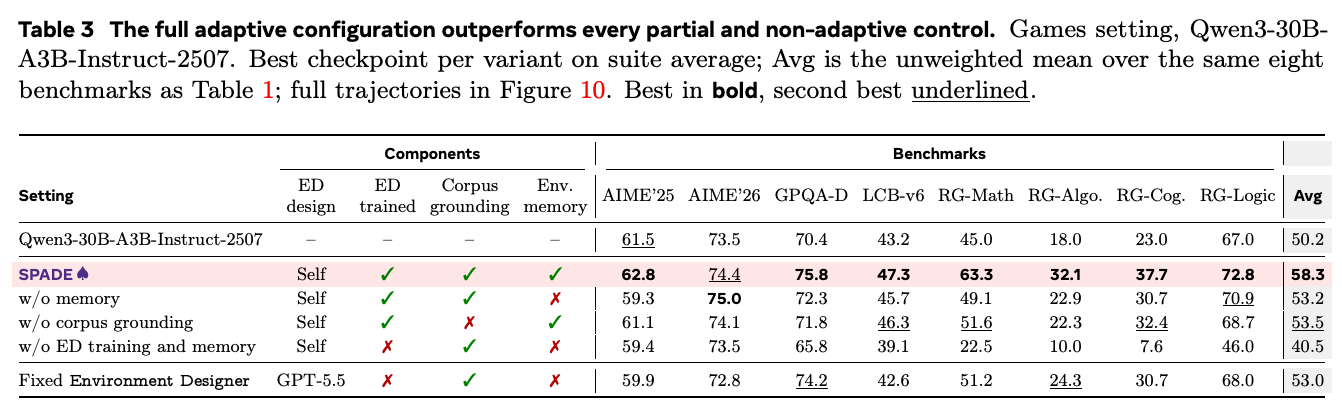
Environment Designer 학습과 메모리를 모두 제거하면 suite average는 40.5가 되어, 학습하지 않은 base의 50.2보다 낮다. 반면 정적인 코퍼스 기반 GPT-5.5-generated pool은 53.0에 도달한다. 이 대조군은 완전한 적응형 구성을 지지하지만 여러 요인을 함께 바꾸므로 단일 인과 구성 요소를 분리하지는 못한다.
완전한 설정은 58.3을 기록하며, 메모리 제외 시 53.2, 코퍼스 기반 정보 제외 시 53.5, Designer 학습과 메모리 제외 시 40.5, 고정 GPT-5.5 환경 pool 사용 시 53.0이다. 이 best-checkpoint 비교는 적응 ablation을 뒷받침하지만 모든 요인을 독립적으로 조작하지는 않는다.
완전한 SPADE 구성은 실행 후반에도 가장 강하며, 메모리 없음 및 코퍼스 없음 variant는 step 111 부근에서 정점을 찍은 뒤 여러 procedural metric에서 하락한다. 이 그림은 Table 3의 선택 checkpoint 값에 대한 trajectory 맥락을 제공한다.
7.2 Ablation: Environment Designer Reward
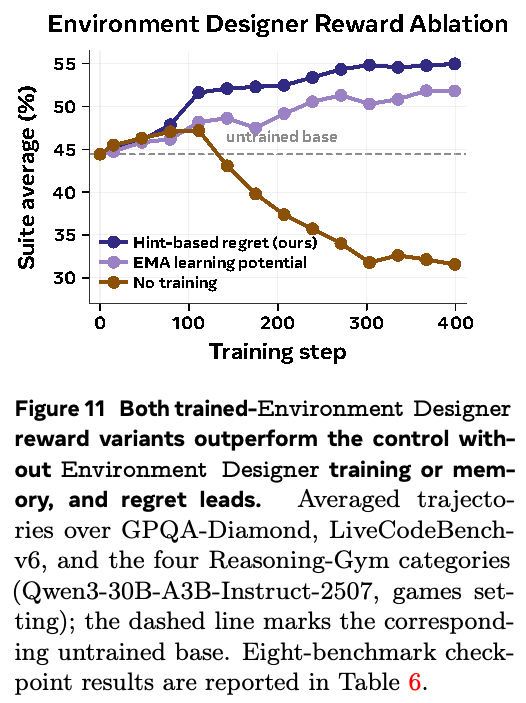
힌트 기반 regret를 EMA 기반 learning potential로 대체하면 여덟 개 benchmark suite에서 58.3 대신 55.9를 얻는다. 논문은 EMA 신호가 실행 중인 skill 평균에서의 부호 없는 편차이므로 이미 숙달한 환경과 난해한 환경을 모두 높게 평가할 수 있고, 정보성이 생기기 전 이력이 필요하다는 점으로 차이를 설명한다.
힌트 기반 regret는 가장 강한 trajectory average를 만들며, 약 50 step 뒤 EMA learning potential과 차이를 벌린다. 학습한 Designer를 쓰는 두 variant는 모두 Designer 학습과 메모리가 없는 대조군을 앞선다.
8 Scaling Results
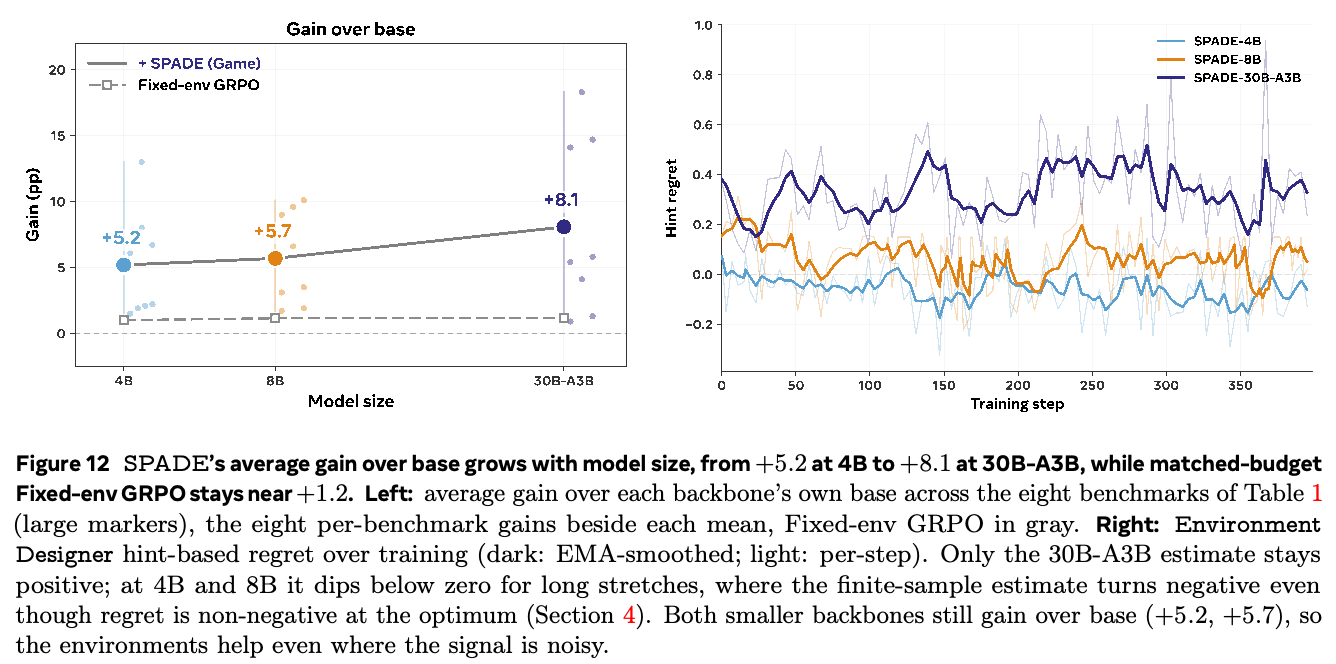
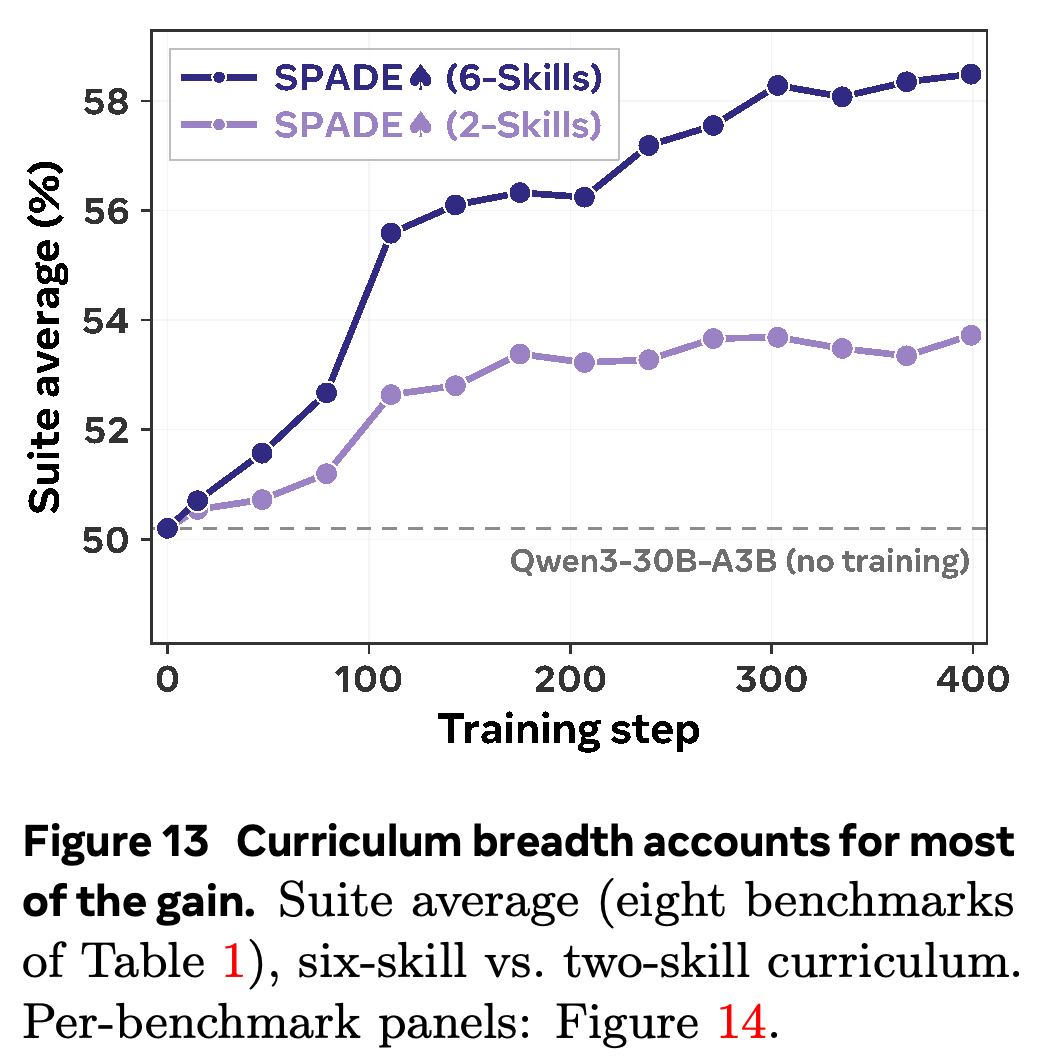
Base 대비 평균 게임 성능 향상은 4B에서 +5.2, 8B에서 +5.7, 30B-A3B에서 +8.1로 증가하며, Fixed-env GRPO는 +1.2 부근에 머문다. 6개 skill 커리큘럼은 2개 skill variant의 53.7보다 높은 58.3에 도달하며, 더 넓은 커리큘럼 범위가 보고한 전이에 실질적으로 기여함을 시사한다.
왼쪽 panel은 모델 규모에 따라 커지는 성능 향상을 요약한다. 오른쪽 panel은 유한 표본 신호의 한계를 보여준다. 4B와 8B의 2개 모델은 모두 base보다 향상되지만, 추정 hint regret는 긴 구간에서 음수이다.
제한된 2개 skill 커리큘럼은 학습하지 않은 base보다 향상되지만, 6개 skill 커리큘럼의 58.3 대신 53.7에 도달한다. 이 비교는 커리큘럼 폭이 suite 수준 성능 향상에 중요한 기여 요인임을 보여준다.
9 Discussion
보고한 결과는 시험한 Qwen3 설정에서 적응형 실행 환경 생성을 post-training 메커니즘으로 사용할 수 있음을 뒷받침한다. 저자들은 환경 복잡도가 여전히 모델 규모와 context에 제한되고, GRPO가 사람이 설계한 방식이며, 힌트 기반 regret에 실용적인 최적 커리큘럼 보장이 없고, 고정 benchmark가 개방형 능력 성장을 입증하지 못한다고 지적한다.
부록
- Appendix는 이상화한 expected-regret game을 정식화한다. 건전한 생성, 명시된 힌트, internalizability 가정 아래 모든 순수 Nash equilibrium은 모든 유효 환경에서 0의 hint regret와 힌트 없는 최적성을 갖는다. 또한 프롬프트, hyperparameter, 재현성 세부 사항, 확장 ablation, 다양성 분석, 생성 환경 예시를 제공한다. raw game-code executability는 출력된 상태에서 84.9%, Markdown fence를 제거한 뒤 90.3%로 보고하며, pipeline sanitizer가 남은 실패를 복구한다.
짧은 생각
SPADE의 운영상 기여는 합성 환경을 정적 dataset으로 취급하지 않고 환경 생성기를 온라인으로 학습한다는 점이다. 통제한 비교는 일관된 향상을 보이지만, 생성 예시와 명시한 검증 한계는 환경 품질, 보상 명세, protocol-matched 외부 비교가 독립 검증의 중요한 대상임을 보여준다.