


AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing 요약 설명
08 Sep 2026 | Paper Review Speech Generation Speech Editing Flow Matching Reinforcement Learning목차
이번 글에서는 AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 8일(Arxiv)
- Ma, Ziyang, Niu, Zhikang, Tu, Wenming, Wang, Tianrui, Yan, Ruiqi, Liu, Junxi, Huo, Yanru, Huang, Nickk, Liu, Yang, Xie, Qicong, et al.
- 논문 링크
- Github
- Project Page
요약
- AuK는 자연어 지시와 선택적 오디오 문맥을 목표 파형으로 변환하는 오픈소스 기반 모델이다. zero-shot 및 지시 제어 TTS, 음향 및 준언어적 편집, 콘텐츠 편집, 향상 또는 분리를 통합한다. 약 3.03 billion개의 지시-오디오 인스턴스로 학습하며, 1.95 million 시간의 유효 지도 신호를 사용한다. AuK-Flash는 CFG 없이 4회의 샘플링 단계를 사용하며, 동일 조건에서 4.5×의 wall-clock 속도 향상을 제공한다고 보고한다.
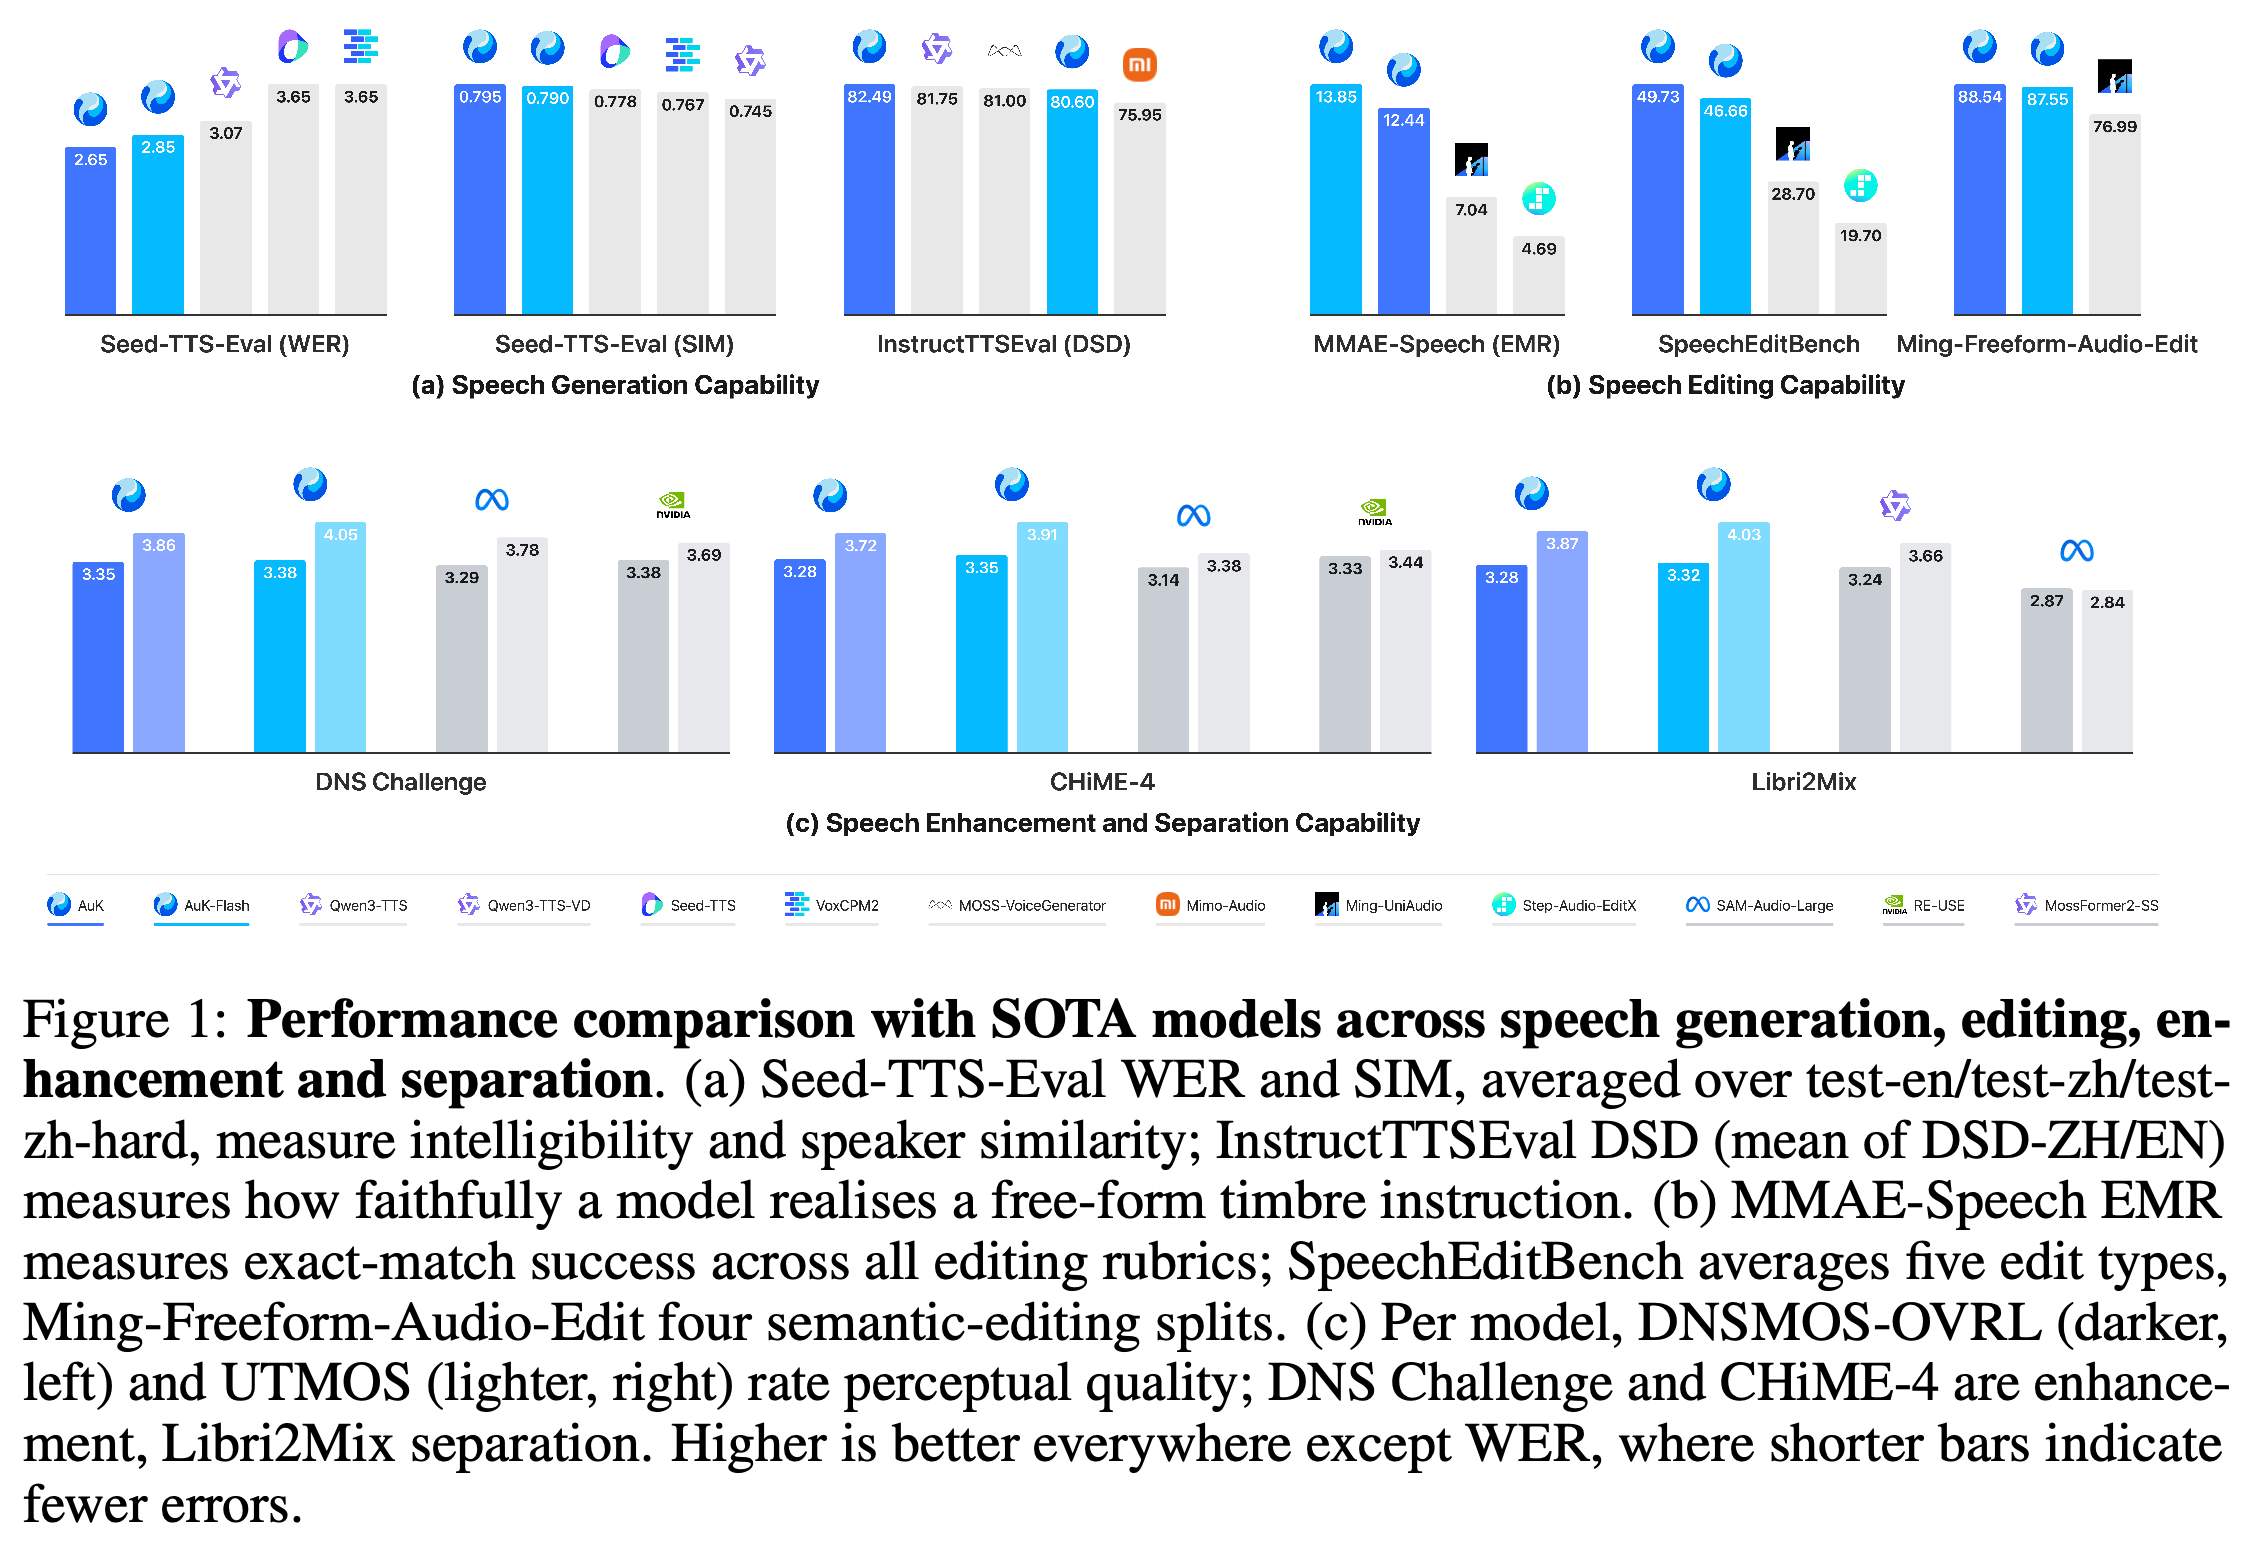
이 개요는 AuK와 AuK-Flash를 생성, 편집, 향상, 분리 전반의 작업별 및 통합 baseline과 비교한다. full model은 recognition 및 지시 정확성을 강조하는 반면, Flash는 현저히 적은 샘플링 단계를 사용하면서도 흔히 강한 perceptual-quality estimate를 보인다는 보고된 경향을 보여 준다.
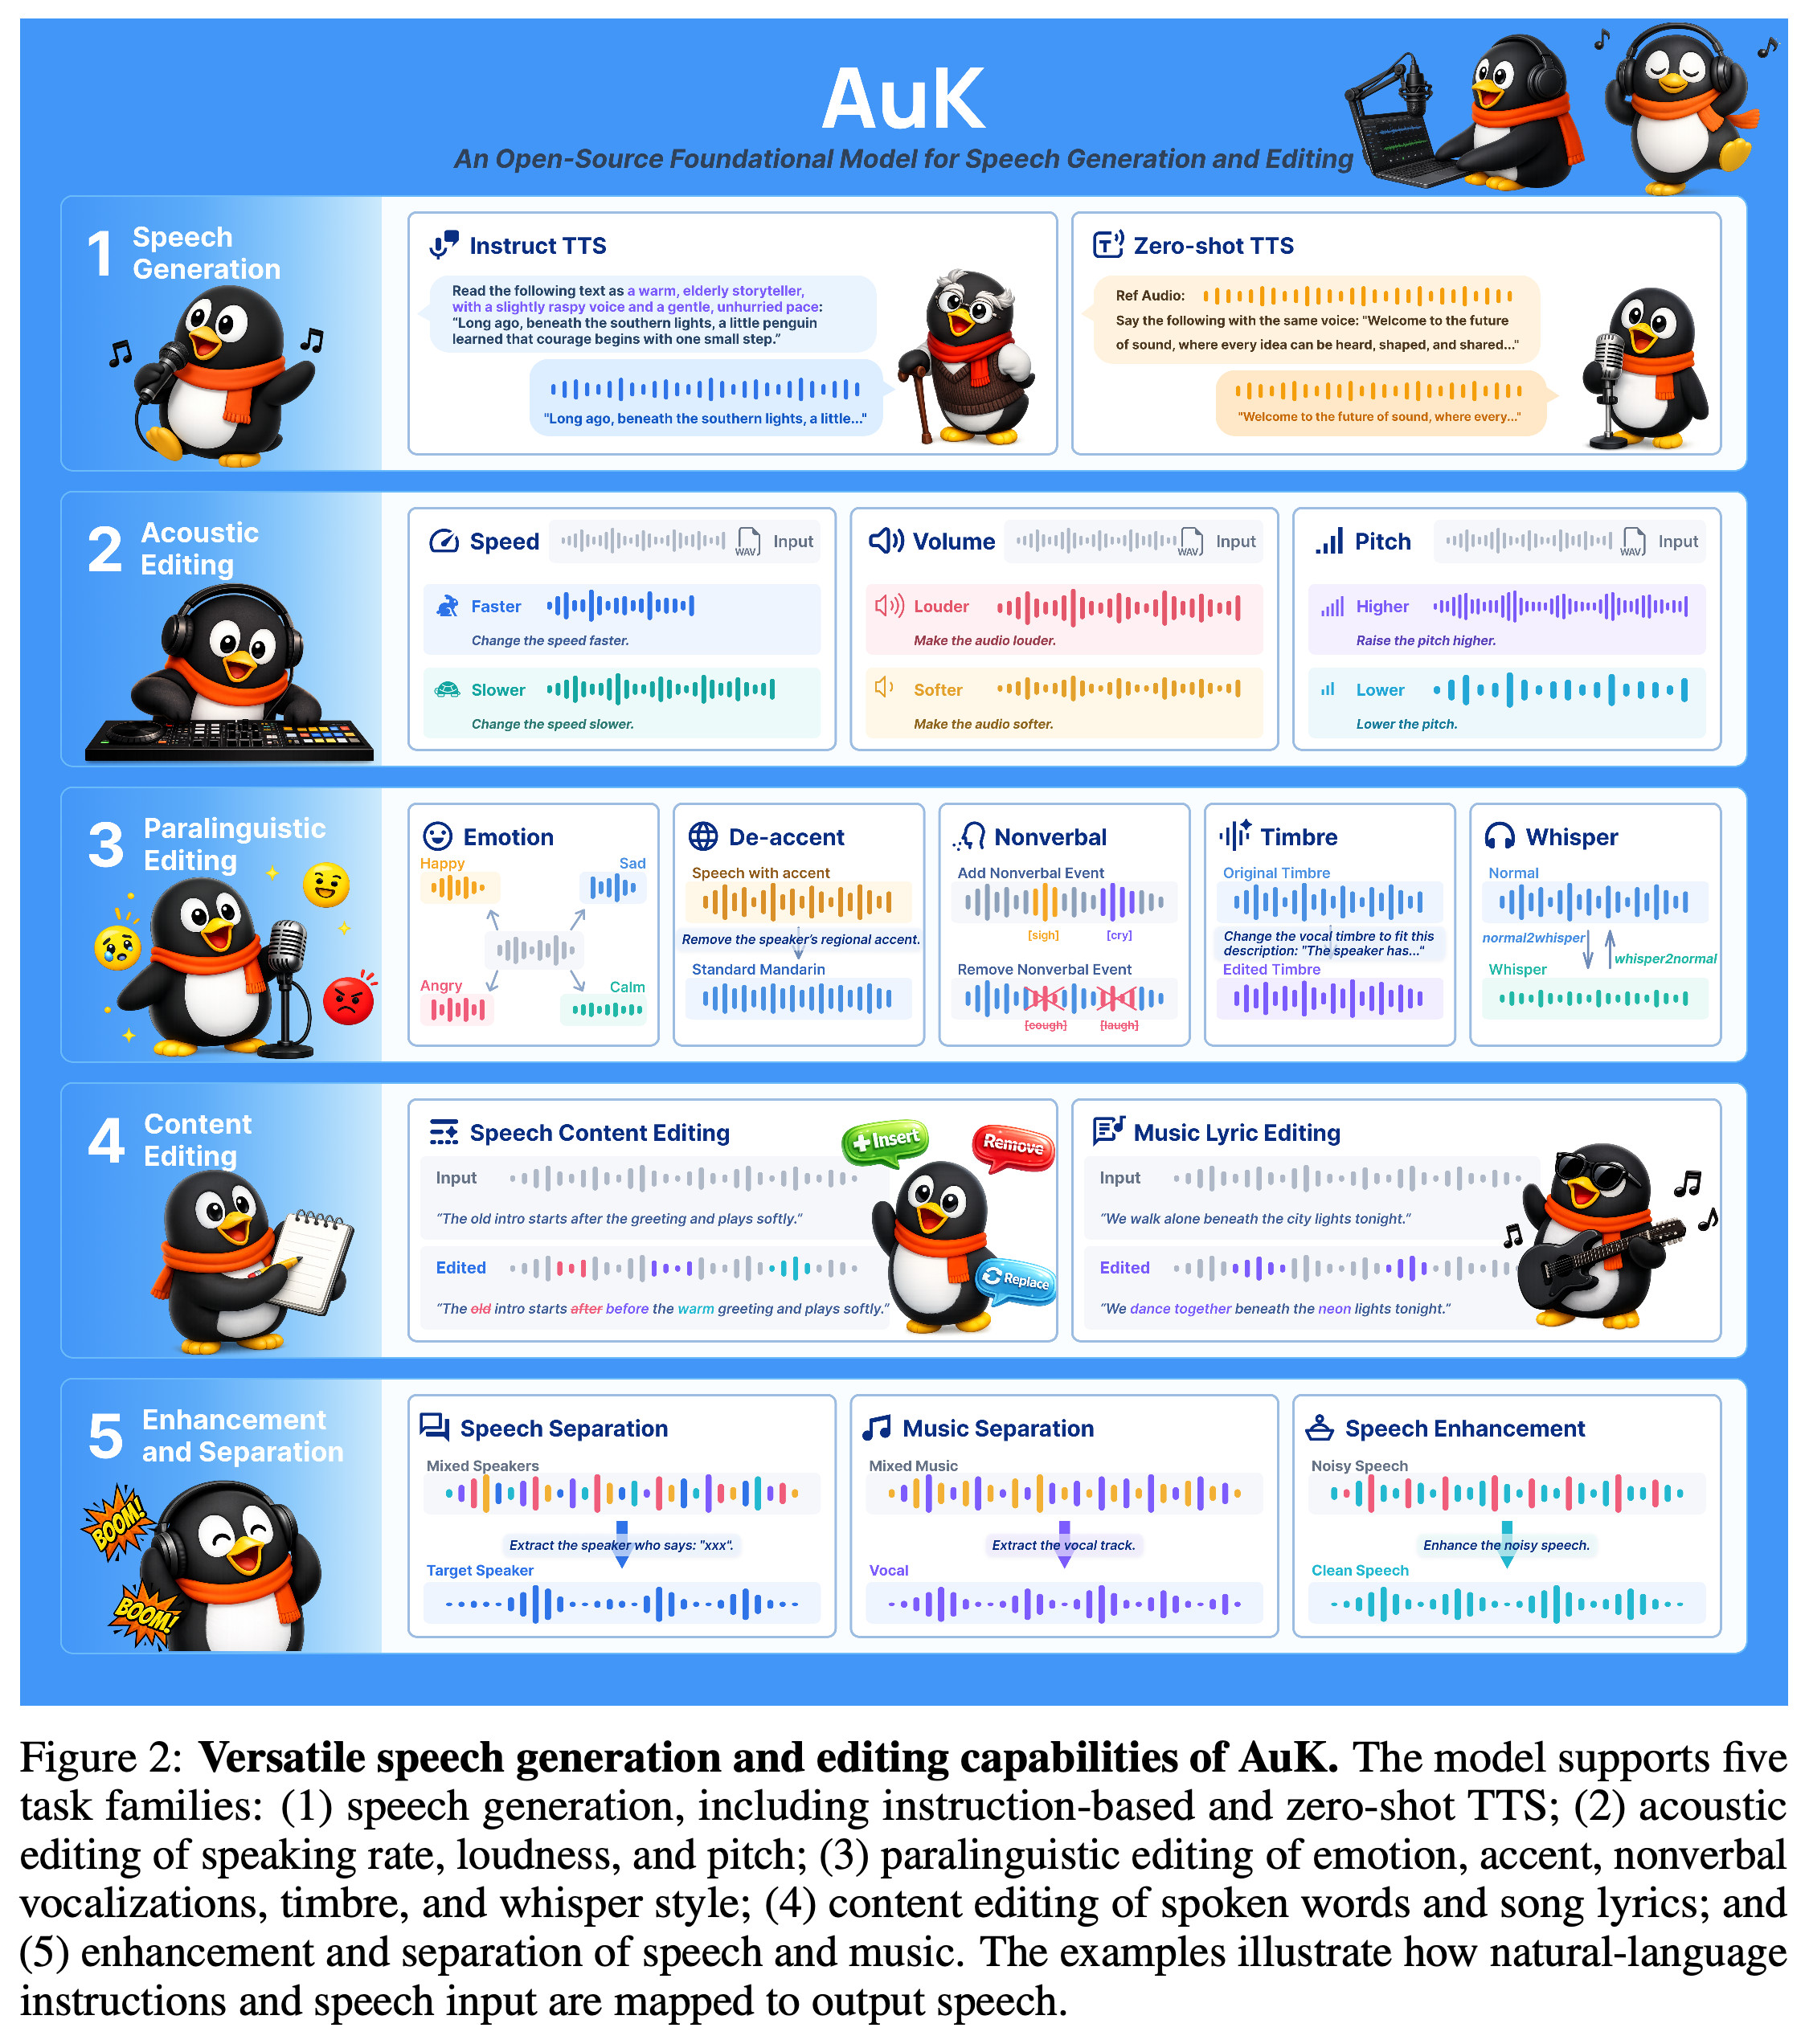
이 도식은 공통된 지시와 오디오 인터페이스를 사용해 시스템을 5개 능력군으로 구성한다. 텍스트에서 합성하거나, 국소적으로 편집하거나, 음성 전달 방식을 변환하거나, 혼합물에서 추출하고 복원할 수 있는 출력을 나타낸다.
2 Data Construction
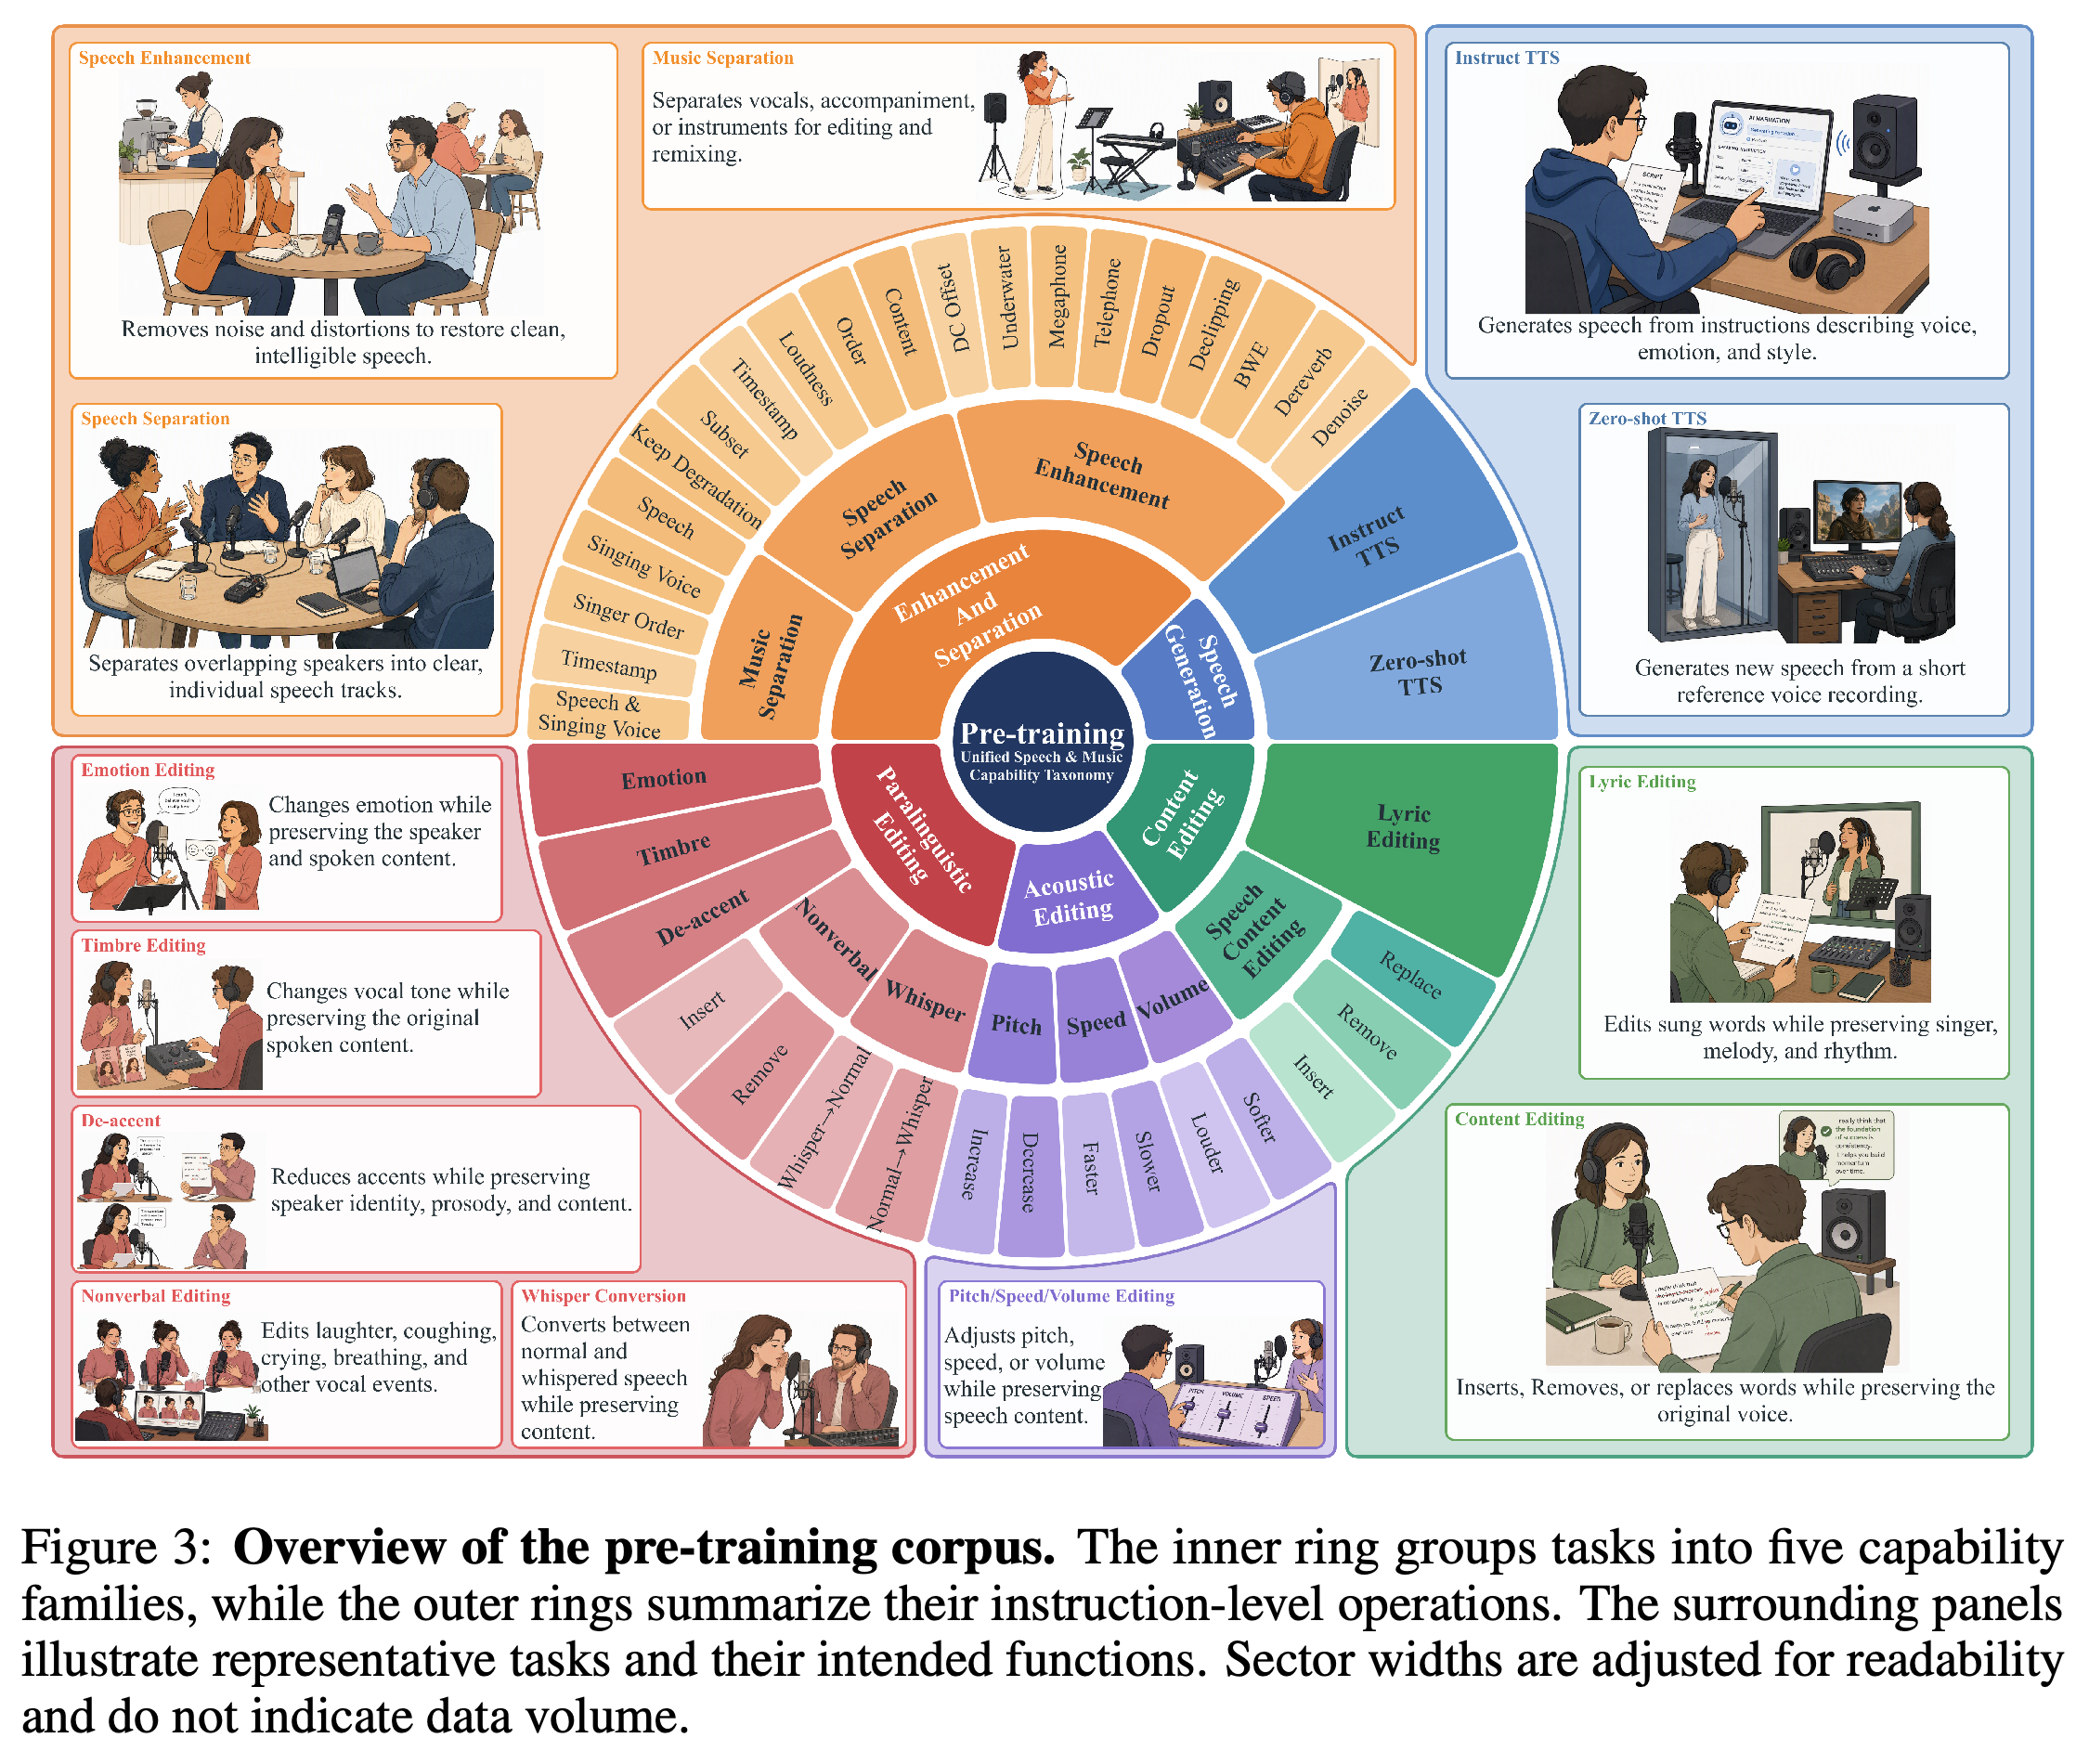
사전학습 코퍼스는 모든 예제를 지시, 선택적 입력 오디오, 목표 파형으로 표현하며, 음성 생성, 음향 편집, 준언어적 편집, 콘텐츠 편집, 향상 및 분리의 5개 작업군을 포괄한다. 이 공통 인터페이스는 새 음성 합성, 편집 중 비대상 속성 보존, 음향 장면에서 요청한 구성 요소 선택을 위한 지도 신호를 제공한다.
코퍼스 지도는 5개 학습 작업군을 생성, 국소 콘텐츠 편집, 음성 스타일 편집, source selection을 포함한 대표 작업과 연결한다. 각 영역의 너비는 명시적으로 정량적이지 않으므로, 데이터 비율이 아니라 작업 범위를 전달한다.
2.1 Speech Generation
음성 생성은 전사문이 없는 zero-shot TTS와 서술형 Instruct TTS를 결합한다. 각 화자에 대해 서로 다른 발화를 양방향으로 짝지어, 프롬프트 전사문 없이도 프롬프트 오디오와 목표 텍스트를 사용할 수 있게 한다. Instruct TTS는 참조 오디오 없이 Qwen3-Omni-generated 캡션과 구조화된 음성 속성을 사용한다.
2.2 Acoustic Editing
음향 편집 지도 신호는 콘텐츠, 화자 정체성, 비대상 속성을 보존하도록 설계한 결정론적 변환을 사용한다. 목표 데이터는 0.5×, 0.75×, 1.25×, 1.5×, 2.0×의 발화 속도 배율, ±5, ±10, ±15 dB의 음량 오프셋, ±1, ±2, ±3 semitone의 피치 이동을 사용한다.
2.3 Paralinguistic Editing
준언어적 편집은 감정, 음색, 억양 제거, 비언어적 발성, 속삭임 스타일 변환을 다룬다. 짝을 이룬 목표 데이터는 기존 음성 시스템, 정렬된 녹음, 필터링한 재구성 결과로 만들며, 언어적 콘텐츠와 해당하는 경우 화자 특성을 유지한 채 발화 방식을 바꾼다.
2.4 Content Editing
음성 콘텐츠 편집에서는 LLM이 삽입, 삭제, 치환 전사문을 만들고, 단어 수준 정렬이 infilling을 위한 국소 마스크 영역을 정의한다. 가사 편집은 중국어 글자 수 또는 영어 단어 수를 보존한 뒤, 완전한 목표 가사와 원래 멜로디를 조건으로 보컬을 합성한다.
2.5 Enhancement and Separation
향상 및 분리 데이터에는 잡음, 잔향, 채널 열화, 대화 혼합물, 음악 혼합물이 포함된다. 선택적 목표는 항상 깨끗한 음성을 생성하는 대신 지시가 지정한 구성 요소만 제거할 수 있으므로, 관련 없는 장면 속성을 보존해야 한다.
3 Model Design
AuK는 Qwen2.5-Omni 의미 인코더, 오디오 VAE, FLUX 스타일 rectified-flow Transformer로 구성된다. 의미 인코더는 텍스트만 처리하거나 텍스트와 참조 오디오를 함께 처리한다. VAE는 참조 latent를 제공하고 파형을 재구성하며, backbone은 목표 latent velocity를 예측한다.
3.1 Overall Architecture
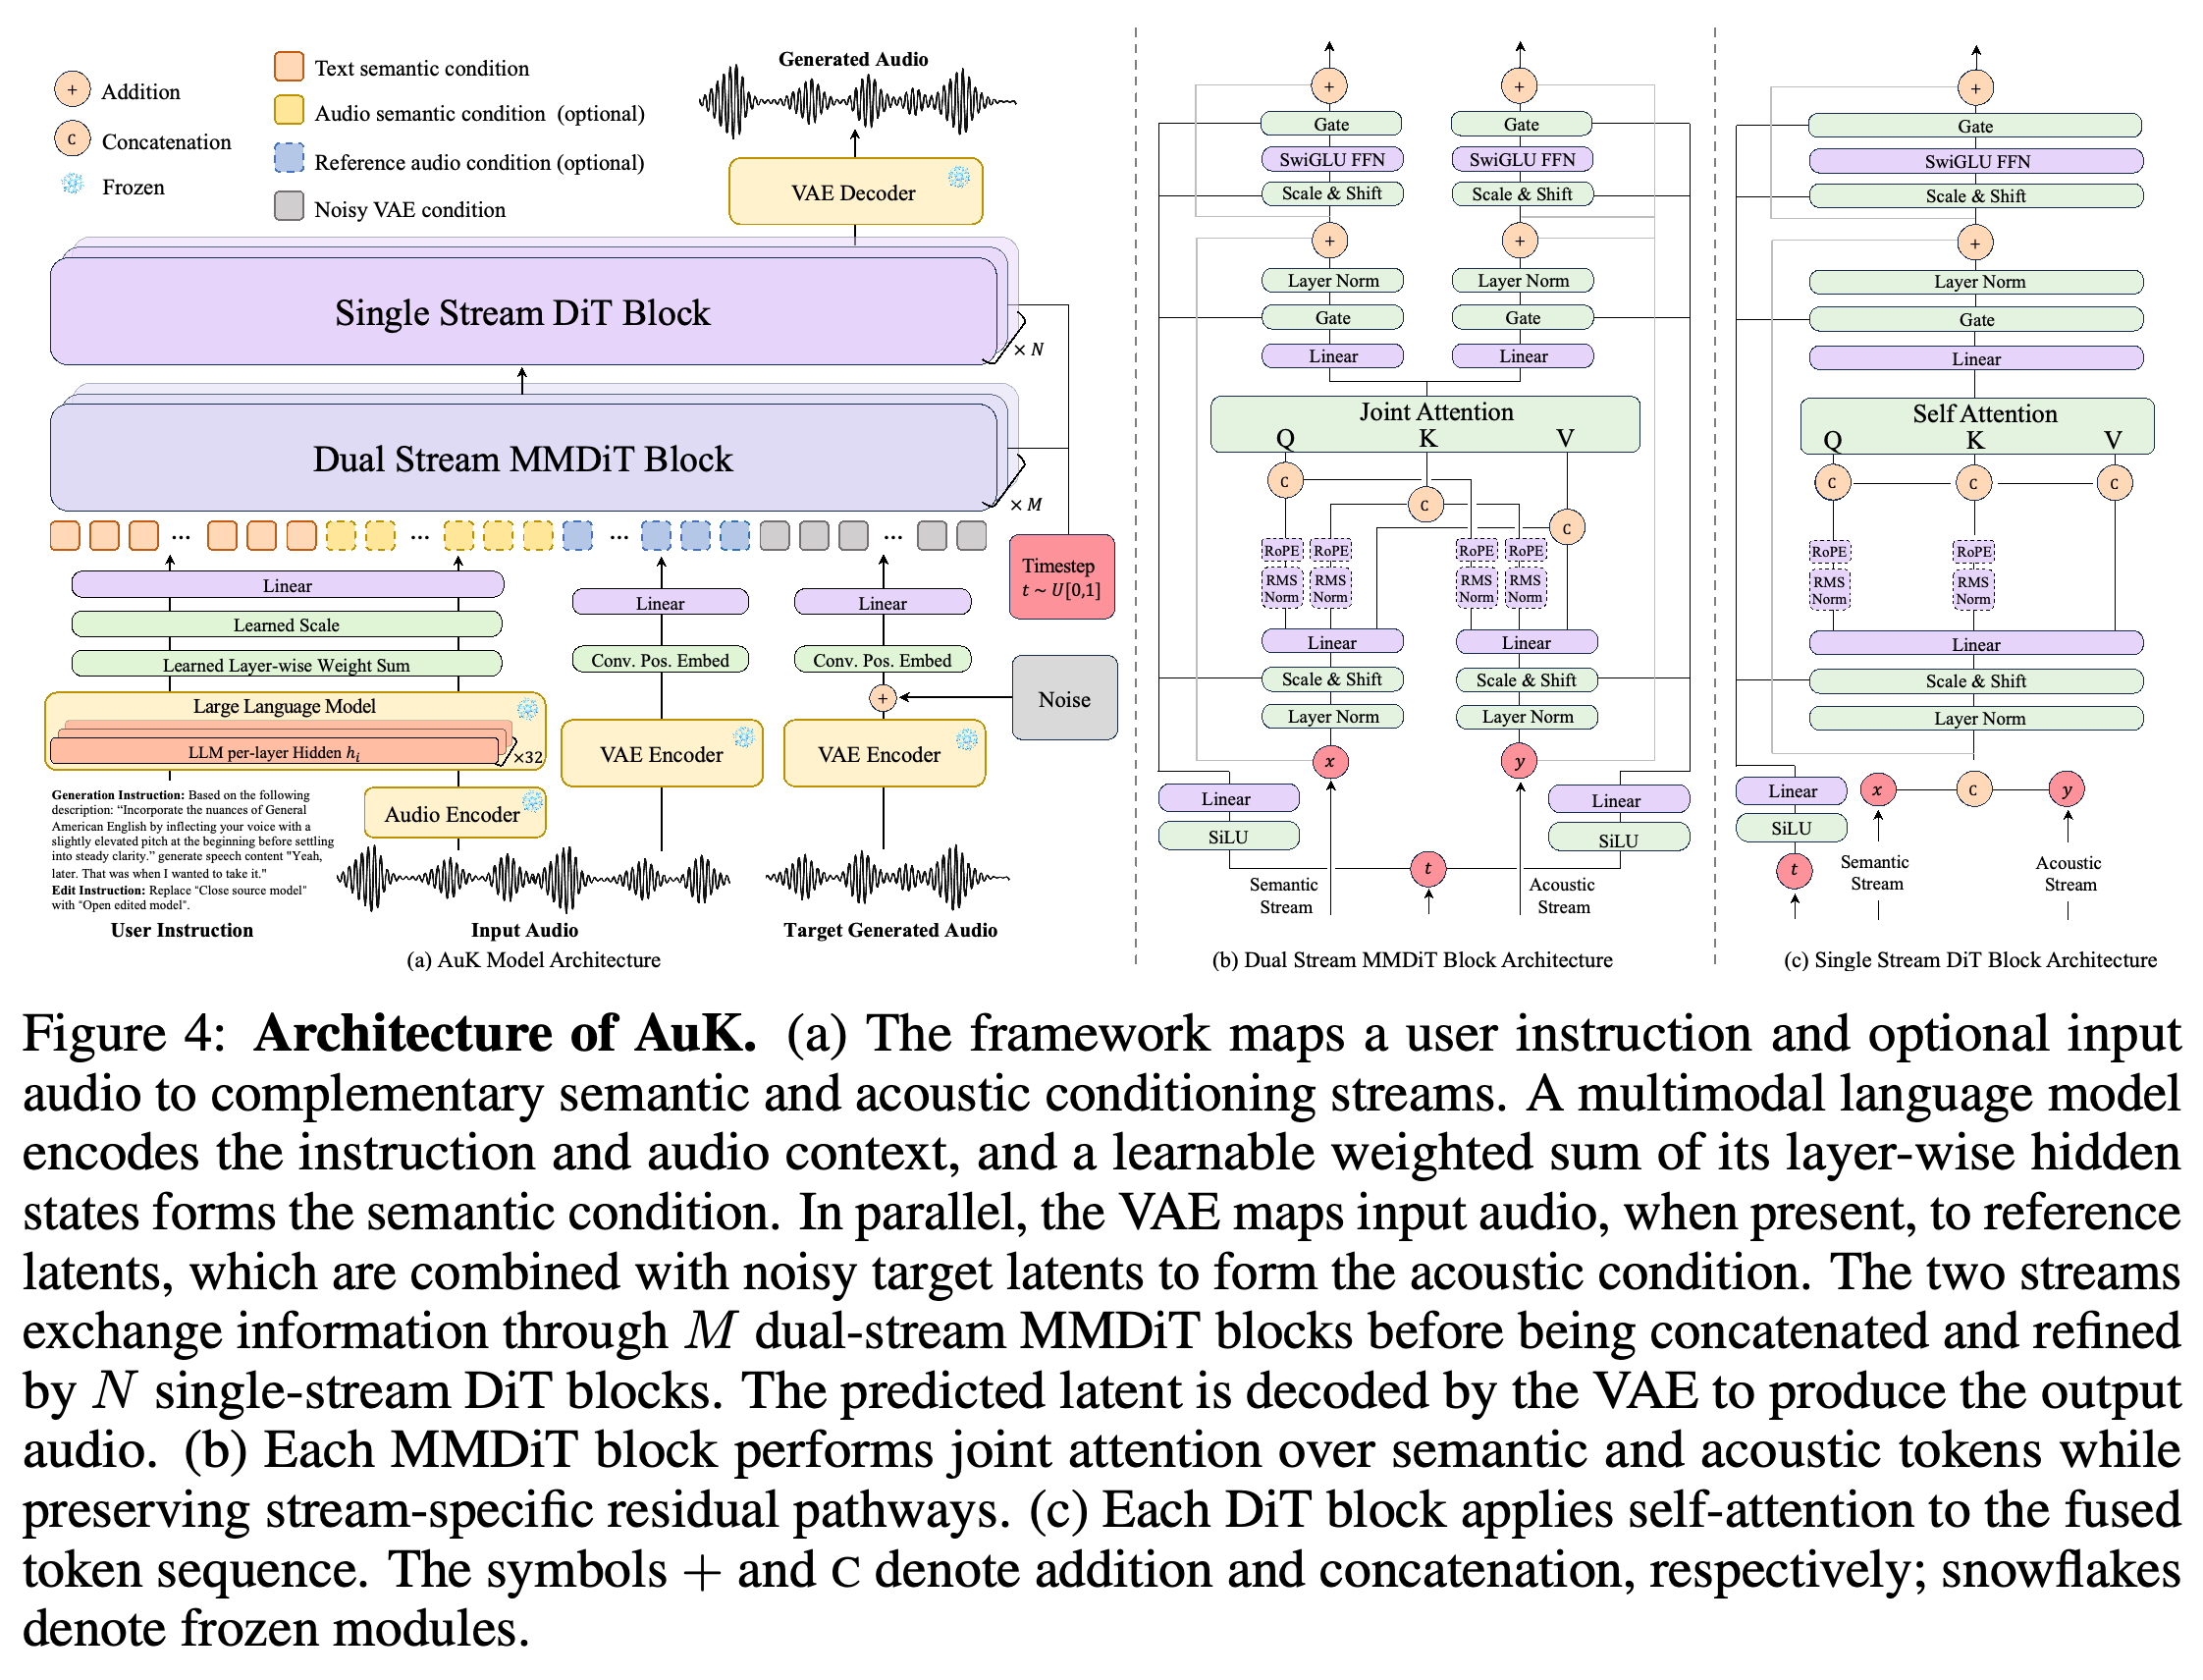
backbone은 의미 스트림과 음향 스트림 사이에서 정보를 교환하면서 서로 다른 잔차 경로를 유지하는 dual-stream MMDiT block으로 시작한다. 이후 스트림을 연결하여 single-stream DiT로 정제한다. 참조 조건 작업은 MLLM 오디오 인코더와 VAE에 같은 오디오를 제공하지만, 텍스트 전용 작업은 참조 분기를 생략한다.
이 구조는 지시와 선택적 참조 오디오가 의미 및 음향 조건을 만드는 과정을 추적한다. 이 조건은 dual-stream MMDiT layer에서 상호작용한 뒤, 융합된 DiT 처리와 VAE decoding을 거친다. 생성 backbone과 고정된 MLLM 및 VAE module을 구분한다.
4 Model Training
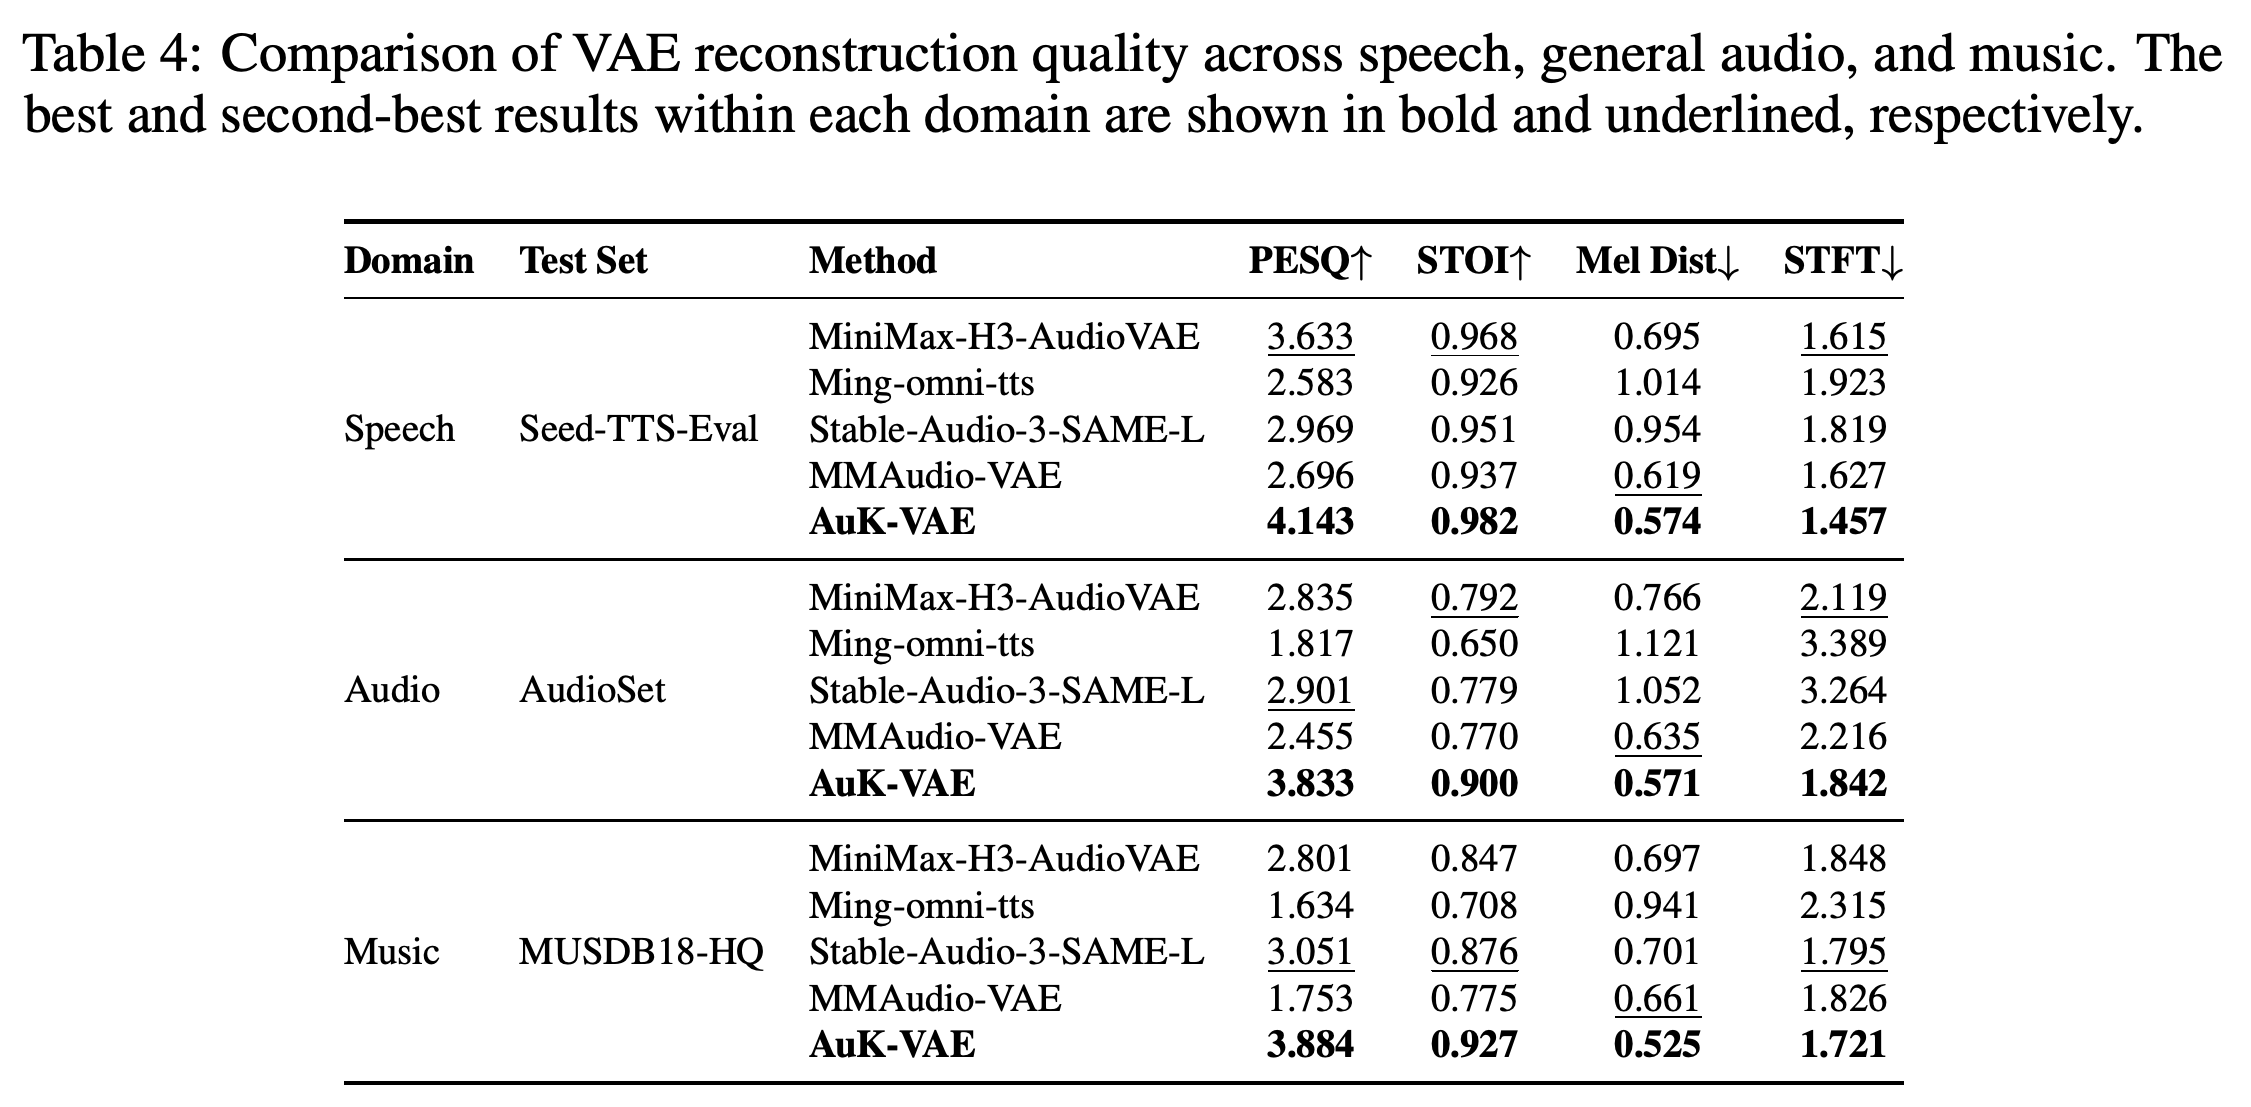
AuK-VAE는 24 kHz 오디오를 50 Hz에서 64-dimensional latent로 인코딩하고, 파형 재구성을 위해 causal decoder를 사용한다. speech, music, general audio 약 3 million 시간 분량으로 1.24 million update 동안 학습한다. multi-scale log-mel 재구성, adversarial 및 feature-matching loss, KL regularization을 사용한다.
4.2 Unified Pre-Training
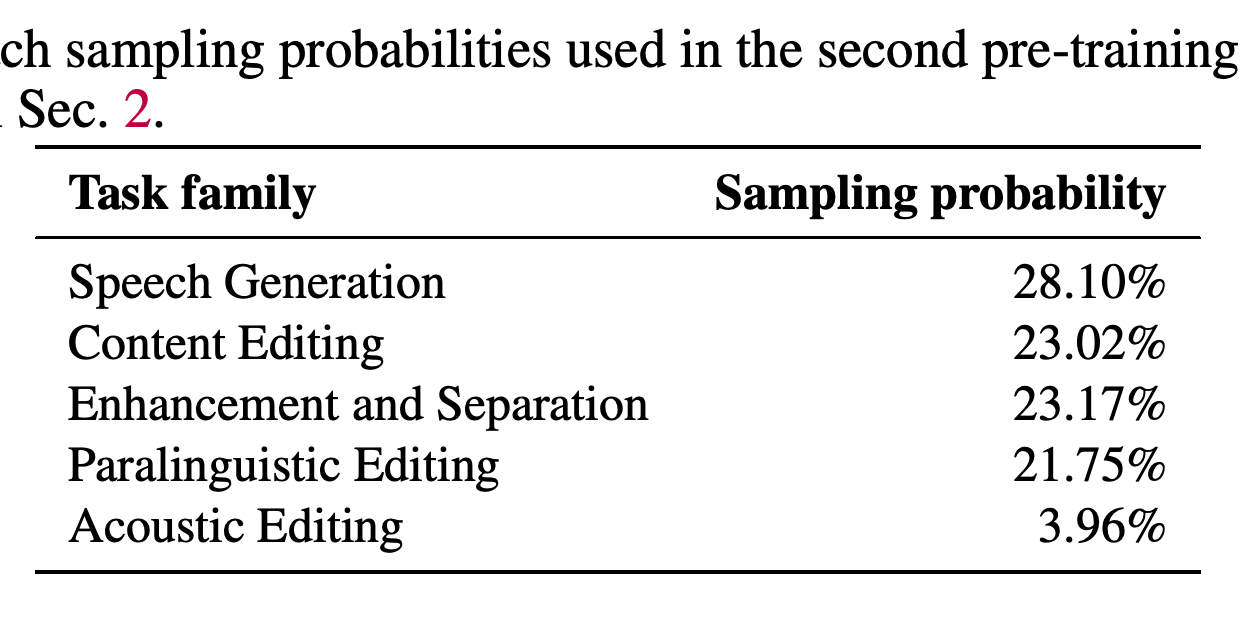
통합 사전학습은 MLLM과 VAE를 고정하고, 약 1.5 billion parameter Transformer를 생성 전용으로 50k update 동안 warm-up한 뒤 모든 작업군을 함께 600k update 동안 학습한다. masked rectified-flow MSE, hierarchical condition dropout, 잘라낸 zero-shot 참조 오디오, 고정 혼합 비율을 사용한다. 이 비율은 speech generation 28.10%, enhancement and separation 23.17%, content editing 23.02%가 주도한다.
이 table은 2번째 사전학습 단계에서 사용한 고정 sampling mixture를 제시한다. acoustic editing의 확률은 3.96%로 가장 작고, 나머지 각 작업군은 batch의 약 5분의 1에서 4분의 1을 조금 넘는 비율을 차지한다.
4.3 Post-Training
후속 학습은 완료 품질에 관한 ordinal listwise 피드백을 사용해, 9,080개 후보로 구성된 유의미한 인간 평가 편집 그룹 818개에 flow-based preference optimization을 먼저 적용한다. 이어 생성에 Flow-GRPO를 적용한다. zero-shot TTS는 콘텐츠 정확성과 화자 유사도에 보상하며, instruction TTS는 균형 잡힌 positive 및 negative sample 30,000개로 학습한 style-consistency reward model을 사용한다.
5 Model Acceleration
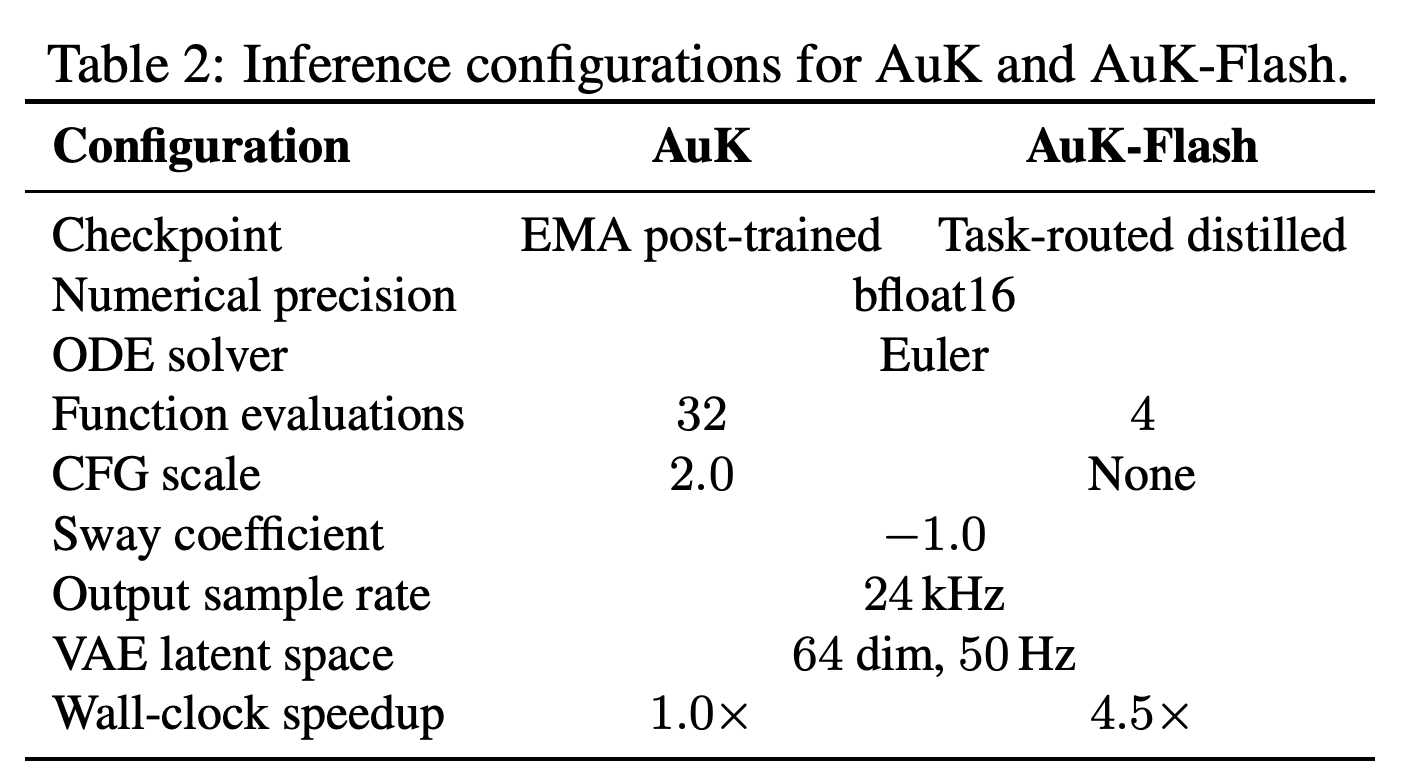
AuK-Flash는 consistency initialization과 작업별 경로 설정을 적용한 Decoupled DMD를 통해 후속 학습된 teacher에서 distillation한다. 저자들은 DMD에서 분리 성능 저하를 관찰한 뒤, DMD에서 분리 예제를 제외하고 supervised clean-latent regression을 대신 사용한다. student는 classifier-free guidance 없이 4회의 function evaluation을 사용하며, AuK는 CFG scale 2.0과 32회의 evaluation을 사용한다.
이 configuration은 AuK-Flash가 AuK와 같은 latent representation, decoder, prompt enhancement, audio preparation을 유지하면서 Euler evaluation을 32에서 4로 줄이고 CFG를 제거함을 보여 준다. 4.5× 속도 향상은 동일한 hardware, output duration, batch size 조건에서 보고했다.
7 Performance
추론에서는 Prompt Enhancer를 사용할 수 있다. 이 모듈은 자유 형식 요청을 작업별 학습 형식에 맞게 라우팅하고 재작성하며, parameter를 검증하고 입력 오디오를 준비하며 길이를 추정한다. 보고서는 이런 작업 라우팅과 프롬프트 재작성 없이는 임의의 자유 형식 편집 지시를 아직 안정적으로 처리하지 못한다고 밝힌다. 정규화된 지원 지시는 enhancer를 우회할 수 있다.
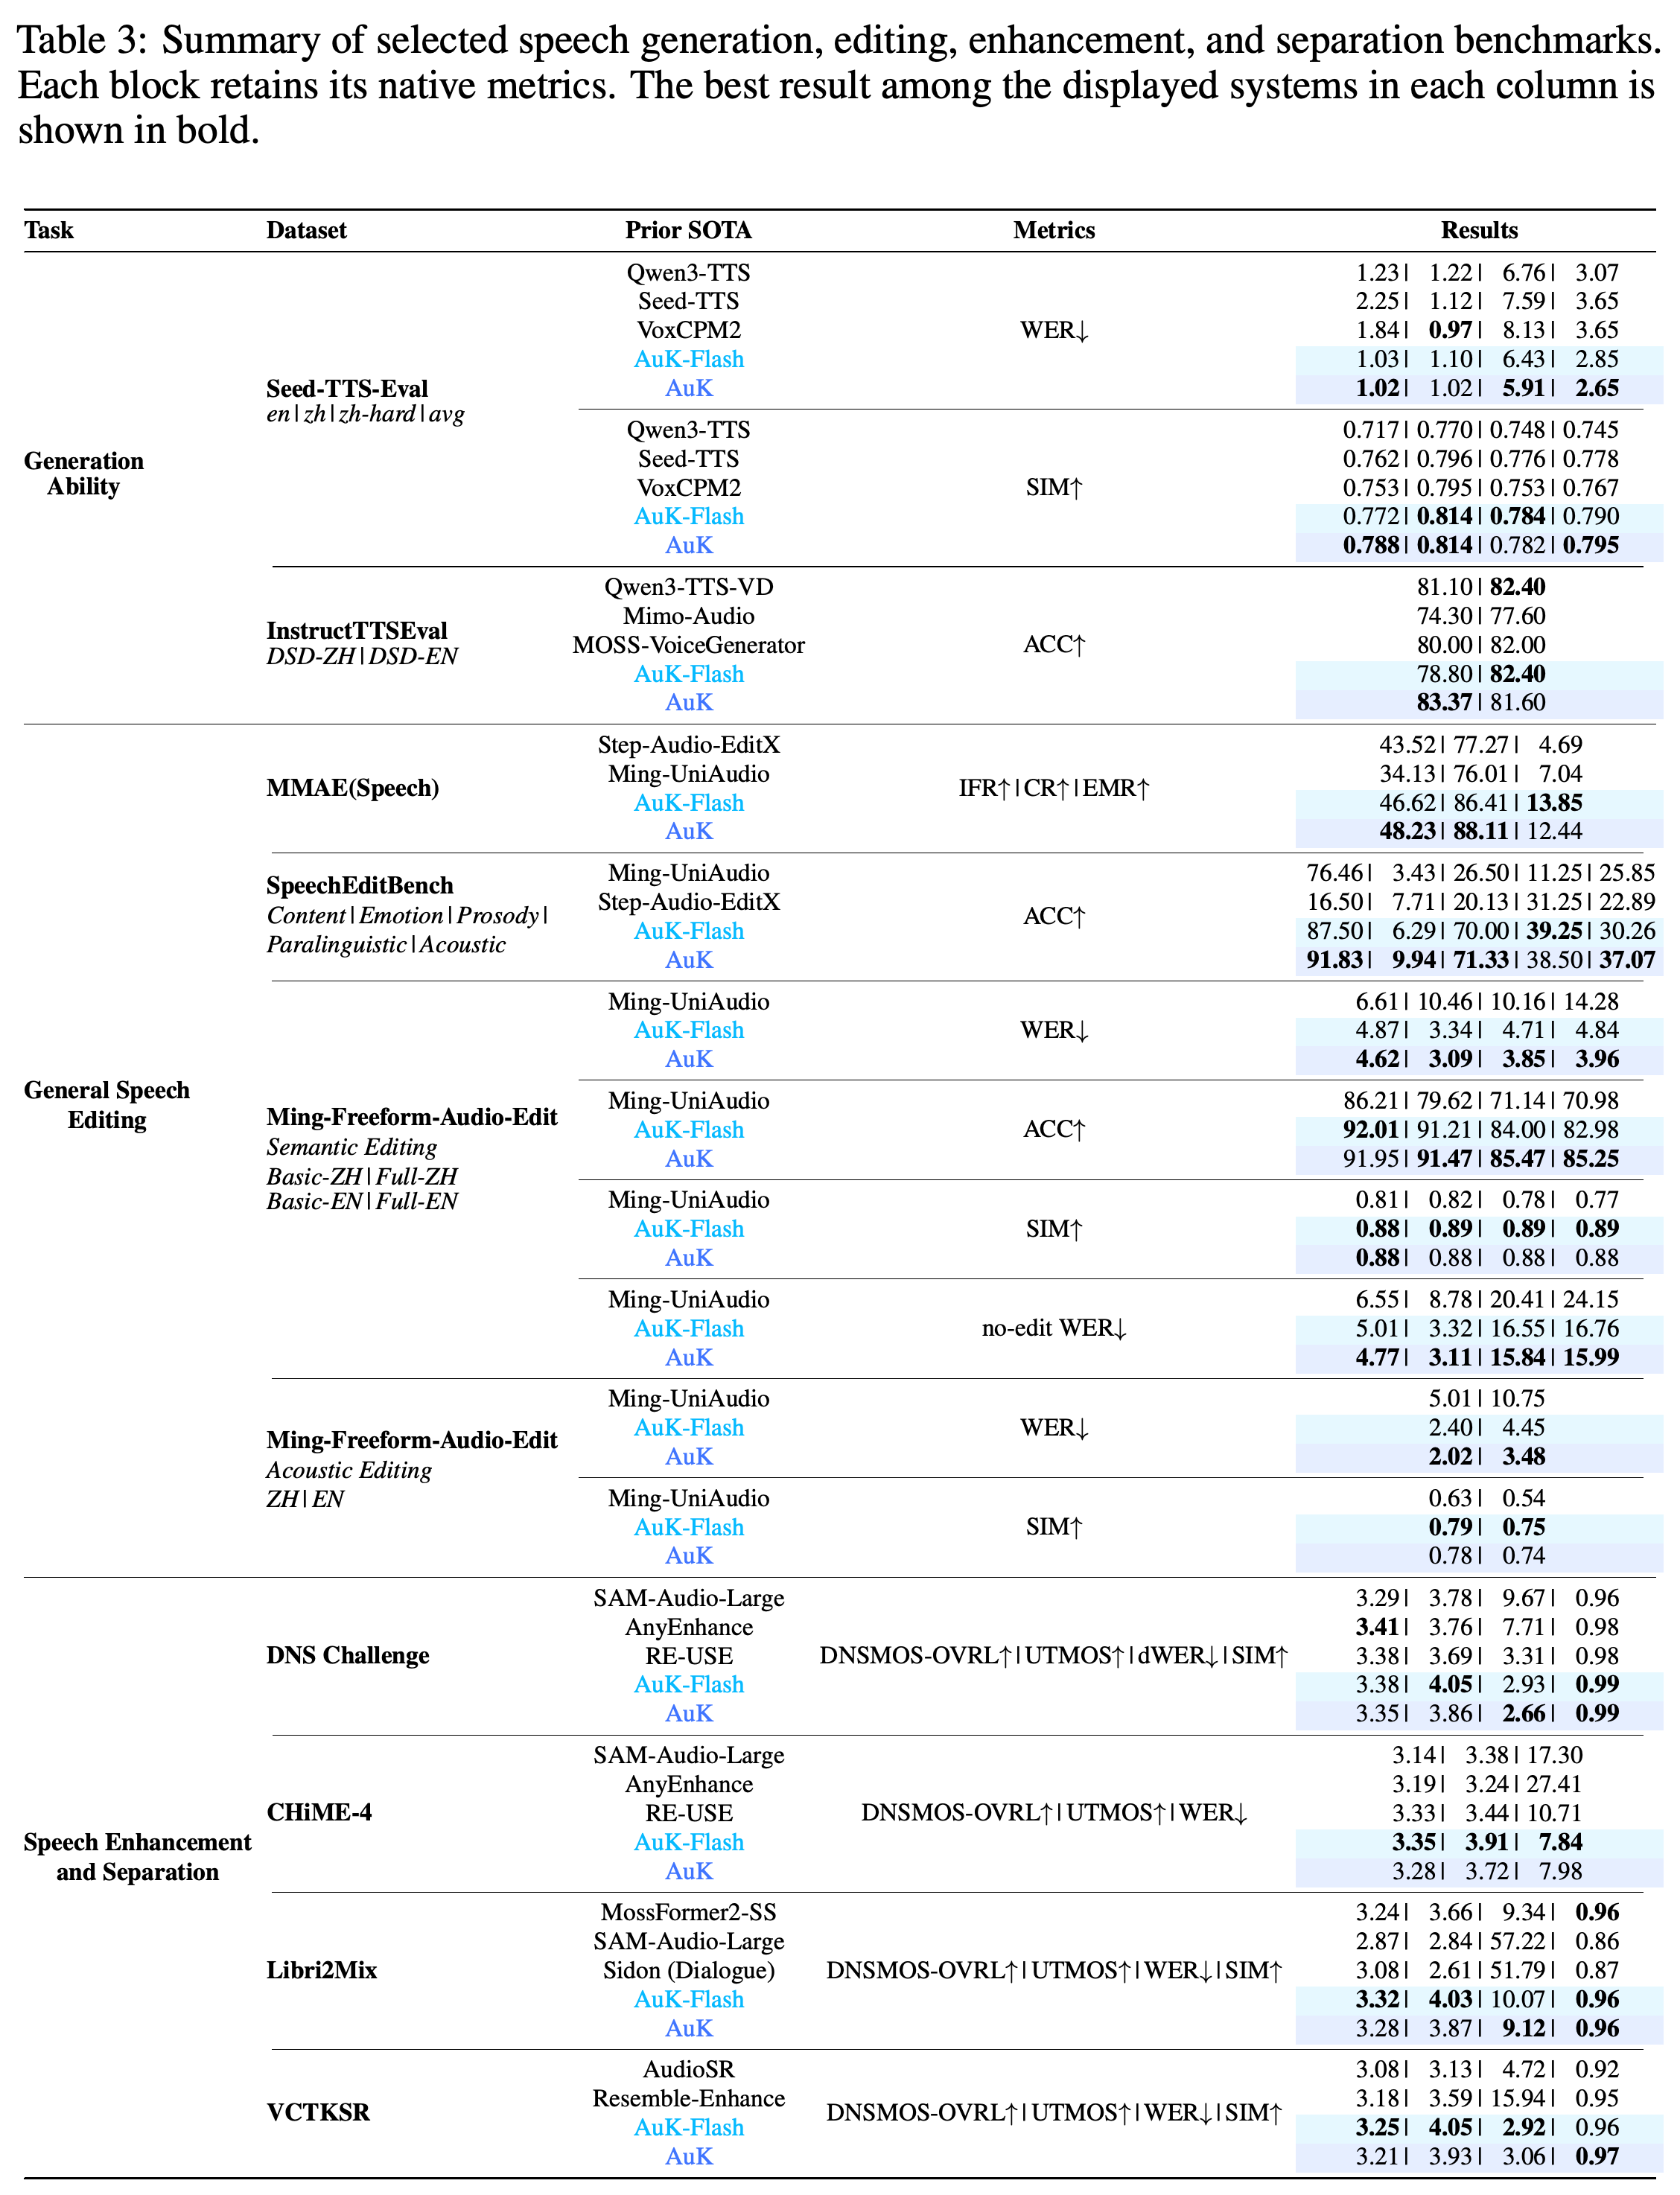
이 종합 table은 이질적인 native metric 전반의 수치 비교를 제공한다. 어느 variant도 모든 기준을 지배하지는 않는다. AuK는 흔히 recognition error와 edit fidelity를 개선하는 반면, Flash는 자주 더 높은 UTMOS score 또는 최고 MMAE-Speech exact-match 결과를 얻는다.
이 VAE 비교는 나열한 speech, general-audio, music 평가 전반에서 AuK-VAE가 표시된 PESQ, STOI, mel-distance, STFT-distance 최고값을 보고함을 보여 준다. 이 재구성 결과는 latent-space fidelity를 뒷받침하지만, downstream editing quality를 독립적으로 입증하지는 않는다.
7.2 Generation Ability
Seed-TTS-Eval에서 AuK는 표시된 평균 recognition error가 가장 낮은 2.65%이고 speaker similarity가 가장 높은 0.795라고 보고한다. AuK-Flash는 각각 2.85%와 0.790을 기록한다. InstructTTSEval에서 AuK는 표시된 Chinese DSD accuracy가 가장 높은 83.37%에 도달하며, AuK-Flash는 표시된 English DSD score 최고값인 82.40%와 동률을 이룬다.
7.3 Editing Ability
MMAE-Speech에서 AuK는 표시된 instruction-following rate 48.23%와 consistency rate 88.11%로 가장 높고, Flash는 exact-match rate 13.85%로 가장 높다. AuK는 Full-split semantic-editing WER를 Ming-UniAudio 대비 중국어에서 10.46%에서 3.09%로, 영어에서 14.28%에서 3.96%로 낮춘다. 복원 benchmark에서는 full model이 흔히 더 강한 recognition preservation을 보이는 반면, Flash는 흔히 더 높은 예측 perceptual-quality score를 달성한다.
부록
- appendix는 zero-shot 및 instruction-following TTS, operation-level semantic 및 acoustic editing, enhancement, separation, super-resolution에 관한 확장 benchmark table을 제공한다. MMAE-Speech는 Prompt Enhancer를 사용하며, 생성 결과는 benchmark별 template와 duration estimation을 사용한 3회 실행의 평균이라고 명시한다.
짧은 생각
이 보고서는 폭넓은 지시 조건 음성 작업을 preference optimization, 생성 reinforcement learning, 작업 인지 distillation과 결합한다. 제시한 근거는 benchmark별로 한정된다. 제한 없는 자유 형식 사용은 Prompt Enhancer 의존성과 다른 음성 모델의 출력을 사용하는 여러 데이터 파이프라인 때문에 여전히 제한적으로 해석해야 한다.