


PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost 요약 설명
22 Mar 2026 | Paper Review Agent Learning Reinforcement Learning Tool Use목차
- 요약
- 1. Introduction
- 2. Preliminaries and Motivating Observations
- 3. PivotRL
- 4. Experiments
- 5. Related Works
- 6. Conclusion
- 부록
- 짧은 생각
이번 글에서는 PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 22일(Arxiv)
- Yi, Junkeun, Mosk-Aoyama, Damon, Huang, Baihe, Gala, Ritu, Wang, Charles, Devare, Sugam Dipak, Bhardwaj, Khushi, Gupta, Abhibha, Kuchaiev, Oleksii, Jiao, Jiantao, et al.
- NVIDIA, UC Berkeley
- 논문 링크
요약
- PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost는 전문가 시연을 여러 턴에 걸친 에이전트 과제를 위한 국소 on-policy 강화학습 에피소드로 변환한다. 성공과 실패가 함께 나타나는 중간 assistant 턴을 선택하고, 시연된 응답을 정확히 재현하도록 요구하는 대신 국소적으로 허용되는 행동에 보상을 준다.
- 별도로 학습한 4개 에이전트 도메인에서 PivotRL은 Qwen3-30B-A3B-Thinking-2507 대비 평균 in-domain 정확도를 +14.11 %p 높였다. 같은 데이터를 사용한 SFT의 개선 폭은 +9.94다. 8개 OOD 벤치마크에서 평균 변화는 각각 +0.21과 −9.83이다. 다만 SWE-Bench Verified 점수는 32.67로, SFT의 37.40보다 낮다.
- SWE-Bench Verified 정확도를 32.67%로 맞추면 PivotRL은 약 133K rollout 턴을 사용하고, end-to-end RL은 약 542K를 사용한다. 같은 수의 연산 노드에서 PivotRL의 누적 rollout 시간은 약 5.5× 짧다. 이론은 이상적인 상태별 업데이트를 설명하고, 실험은 보고된 조건에서 OOD 성능 유지와 rollout 효율을 보여준다. 역량 보존이나 전체 학습 비용 절감을 일반적으로 보장하는 결과는 아니다.
1. Introduction
이 논문은 도구, 코드 저장소, 터미널, 검색 환경과 상호작용하는 에이전트의 post-training에서 비용과 일반화 사이의 상충 관계를 다룬다. SFT는 고정된 시연을 효율적으로 재사용하지만 학습 도메인 밖의 역량을 저하시킬 수 있다. End-to-end RL은 on-policy 상호작용을 활용하지만 비용이 큰 멀티턴 궤적을 반복해서 생성한다.
- 시연을 바로 국소 RL로 변환하면 2가지 약점이 생긴다. 무작위로 선택한 턴에서는 그룹 내 보상이 모두 같은 경우가 많고, 정확히 일치해야 보상을 주면 유효한 대안 행동도 거부한다.
- PivotRL은 오프라인 pivot 선택과 도메인별 국소 검증기로 이 문제를 해결한다. 전문가 상호작용 이력을 조건으로 사용하면서 새로운 assistant 응답은 on-policy로 샘플링한다.
2. Preliminaries and Motivating Observations
배경 설명에서는 턴 단위 행동 복제, end-to-end GRPO, 전문가 궤적의 상태에서 시작하는 국소 RL을 구분한다. PivotRL은 환경의 초기 상태부터 완전한 on-policy 궤적을 생성하지 않고도 학습 상태 분포와 보상 출처를 바꾼다.
Turn-level agentic training.
행동은 개별 토큰이 아니라 모델 호출 경계에서 생성한 assistant 응답 전체다. 상태에는 그전에 이루어진 상호작용 이력 전체가 포함된다. SFT는 시연된 행동의 가능도를 최대화한다. 반면 end-to-end RL은 궤적을 샘플링하고, 기준 정책에 대한 KL 정규화를 포함한 clipped GRPO 목적함수에서 그룹 정규화 보상을 사용한다.
- Equation (1)은 보상에서 그룹 평균을 빼고, 그룹 표준편차에 수치 안정화 항을 더한 값으로 나눈다.
- 보상이 모두 같으면 정규화된 advantage가 0이 되어 보상에 따른 업데이트 신호가 사라진다. 별도의 KL 항은 여전히 업데이트에 기여할 수 있다.
Local RL from expert trajectories.
단순한 국소 RL은 전문가 궤적의 중간 상태를 샘플링하고 on-policy 행동을 생성한 뒤, 그 행동이 시연된 후속 응답과 정확히 일치할 때만 보상을 준다. τ²-Bench에서 이 기준선의 점수는 57.34로, 같은 데이터를 사용한 SFT의 58.44보다 낮다. 이처럼 제한적인 보상 할당에서는 on-policy 샘플링만으로 정확도가 개선되지 않는다.
Motivating observations.
방법의 동기를 제시하는 실험에서는 τ²-Bench와 SWE-Bench에서 무작위로 샘플링한 턴의 71%가 그룹 정규화 학습 신호 0을 만든다고 보고한다. 해당 턴에서 샘플링한 행동이 모두 성공하거나 모두 실패하기 때문이다. 정확한 일치 조건은 또 다른 병목을 만든다. 국소적으로 허용되는 도구 호출, 셸 명령, 검색 단계도 텍스트가 다르면 거부한다.
- 누락률은 기능 검증기가 행동을 수락했다는 조건 아래 엄격한 일치 검사가 그 행동을 거부할 확률이다. 논문은 수치 추정치를 보고하지 않는다.
- 이 관찰은 성공과 실패가 섞인 턴에 rollout 예산을 배정하고, 시연된 문자열 1개만이 아니라 더 넓은 범위의 행동에 보상을 주는 방법의 근거가 된다.
3. PivotRL
PivotRL은 단순한 국소 RL 기준선에 오프라인 assistant 턴 필터링과 검증기 기반 국소 보상을 도입한다. 전문가 궤적의 앞부분 이력을 재사용하고, 짧은 국소 후속 응답을 생성한 뒤 GRPO 방식의 목적함수를 최적화한다.
3.1. Method
오프라인 턴 선택에서는 추출한 모든 assistant 턴을 pivot 후보로 삼는다. 고정된 기준 정책이 후보마다 K개의 국소 rollout을 생성한다. 검증기 보상으로 보상 평균과 분산을 추정하고, σ̂²(s) > 0과 μ̂(s) < λdiff를 만족하는 후보를 남긴다.
- 분산이 양수여야 한다는 조건은 관측된 결과가 모두 성공이거나 모두 실패인 턴을 제거한다.
- 보상 평균이 낮아야 한다는 조건은 어렵지만 일부 행동으로는 해결할 수 있는 상태에 집중한다. RL 전에 후보를 선택하며, 학습 중에 선택된 집합을 동적으로 갱신하지 않는다.
- PDF는 λdiff를 기호로 명시하지만 수치나 전체 profiling 예산은 제시하지 않는다.
검증기 기반 국소 보상에서는 검증기가 국소적으로 허용되는 행동 집합 M(s)를 정의하고, 보상으로 rfunc(s, a) = 1[a ∈ M(s)]를 사용한다. 시연과의 정확한 일치 대신 정규화된 문자열·스키마 검사, 과제별 동등성 규칙, 경량 LLM judge로 수락 여부를 판단할 수 있다.
- 국소 검증기의 수락이 의미적 동등성이나 전체 과제의 성공을 입증하는 것은 아니다. SWE-Bench 학습에서는 검증기가 도구 호출 이름만 확인하며, 인자나 결과 패치는 확인하지 않는다.
- 터미널 명령 검증은 출력 스키마 검증, 정규화된 문자열 유사도, 명령과 그 즉각적인 효과에 대한 동등성 기반 LLM-as-judge 평가를 결합한다.
Algorithm 1은 남겨 둔 pivot에서 미니배치를 샘플링하고, 국소 on-policy 행동 그룹을 생성한 뒤 평가에 필요한 짧은 rollout을 실행하여 그룹 정규화 advantage를 계산한다. Equation (7)은 기준 정책에 대한 KL 정규화와 함께 clipped importance-weighted GRPO 업데이트를 적용한다.
- importance ratio는 현재 정책과 각 샘플 행동을 생성한 정책을 비교한다.
- 저장된 전문가 이력을 조건으로 사용하면 온라인에서 궤적의 앞부분 전체를 다시 생성하지 않아도 된다. 다만 시연 수집과 오프라인 pivot profiling은 여전히 필요하다.
3.2. Theoretical analysis for PivotRL
Proposition 3.1은 이진 보상이 모두 같으면 그룹 정규화 advantage가 0이 된다는 점을 보인다. Theorem 3.2는 보상 분산과 이상적인 상태별 업데이트의 관계를 설명한다. 지수 틸팅으로 정의한 KL 정규화 정책 경로에서 모집단 GRPO 점수는 보상 표준편차를 β²로 나눈 값과 같다.
- 상태별 보상 목적함수의 자연 그래디언트에 대한 Fisher norm은 보상 표준편차와 같다.
- 따라서 β가 고정되어 있으면 보상 분산이 클수록 이 경로에서 자연 그래디언트 norm과 모집단 GRPO 점수가 커진다.
- 분산이 양수일 때는 보상 정규화로 점수를 정의한다. 증명은 분산이 없는 경우(0 case)를 별도로 다루며, 이때 자연 그래디언트는 사라진다. 이는 파라미터를 공유하는 언어 모델에서 유한 표본과 clipping을 사용하는 전체 최적화 과정을 분석한 결과가 아니다.
Theorem 3.3은 고정된 상태 분포와 β > 0인 KL 정규화 아래에서 이진 기능 보상을 분석한다. 기준 정책이 허용 가능한 행동에 확률 질량 ρ(s)를 부여하면, 상태별 최적 정책은 해당 행동에 qβ(s) = ρ(s)e^(1/β) / [(1 − ρ(s)) + ρ(s)e^(1/β)]의 질량을 부여한다. 이때 허용 집합과 그 여집합 내부에서는 기준 정책의 조건부 분포를 보존한다.
- 0 < ρ(s) < 1이면 허용 가능한 행동의 확률 질량이 엄격히 증가한다. 모든 행동이 허용 가능하면 최적 정책은 기준 정책과 같다.
- 허용 가능한 행동의 확률 질량이 qβ(s)인 분포 중에서는 블록별 재조정으로 얻은 최적 정책이 기준 정책에 대한 KL divergence를 유일하게 최소화한다. 이 모집단 결과는 고정된 분포가 포괄하는 상태에서 d에 대해 거의 확실하게 성립한다.
- 확률 비율은 각 블록 내부에서 보존되며, 허용 가능한 행동과 허용되지 않는 행동 사이에서는 보존되지 않는다.
이 분석은 유한한 행동 공간, 비어 있지 않은 허용 집합, 모든 행동에 양의 확률을 부여하는 기준 정책을 가정한다. OOD 성능 유지와 연결하려면 허용 집합 밖의 행동이 과제와 무관하다는 추가 가정도 필요하다. 같은 상태 안에서 이러한 행동의 순서를 보존한다고 해서 보지 못한 상태나 공유 신경망 파라미터 업데이트에서도 역량이 보존된다고 증명할 수는 없다.
4. Experiments
실험에서는 대화형 도구 사용, 소프트웨어 엔지니어링, 터미널 제어, 웹 탐색을 위해 4개 모델을 별도로 학습하고, 각각 τ²-Bench, SWE-Bench Verified, Terminal-Bench, BrowseComp로 평가한다. 모두 Qwen3-30B-A3B-Thinking-2507에서 시작하며, 최적화에는 Nemo-RL을, 환경 rollout에는 Nemo-Gym을 사용한다. 각 SFT–PivotRL 비교는 기반 모델, 프롬프트, 전문가 궤적을 공유한다.
- OOD 평가는 IFBench, AIME25, MATH500, LiveCodeBench, Scicode, MMLU-Pro, MMLU-ProX, WMT24++를 포함한다.
- 단일 도메인 비교에서는 시연 데이터를 통제하지만, SFT와 전체 연산량을 같게 맞춘 비교는 아니다.
- 논문은 성능 점수와 차이를 퍼센트포인트 단위로 보고한다고 명시한다.
4.1. In-Domain and OOD Accuracy
Table 1에서 PivotRL은 4개 in-domain 벤치마크 중 3개에서 같은 데이터를 사용한 SFT보다 높은 성능을 보인다. τ²-Bench는 63.81 대 58.44, Terminal-Bench는 20.00 대 13.75, BrowseComp는 11.30 대 1.50이다. SWE-Bench Verified는 예외로, 32.67 대 37.40이다. 따라서 SFT 대비 평균 +4.17의 우위가 모든 도메인에서의 개선을 뜻하지는 않는다.
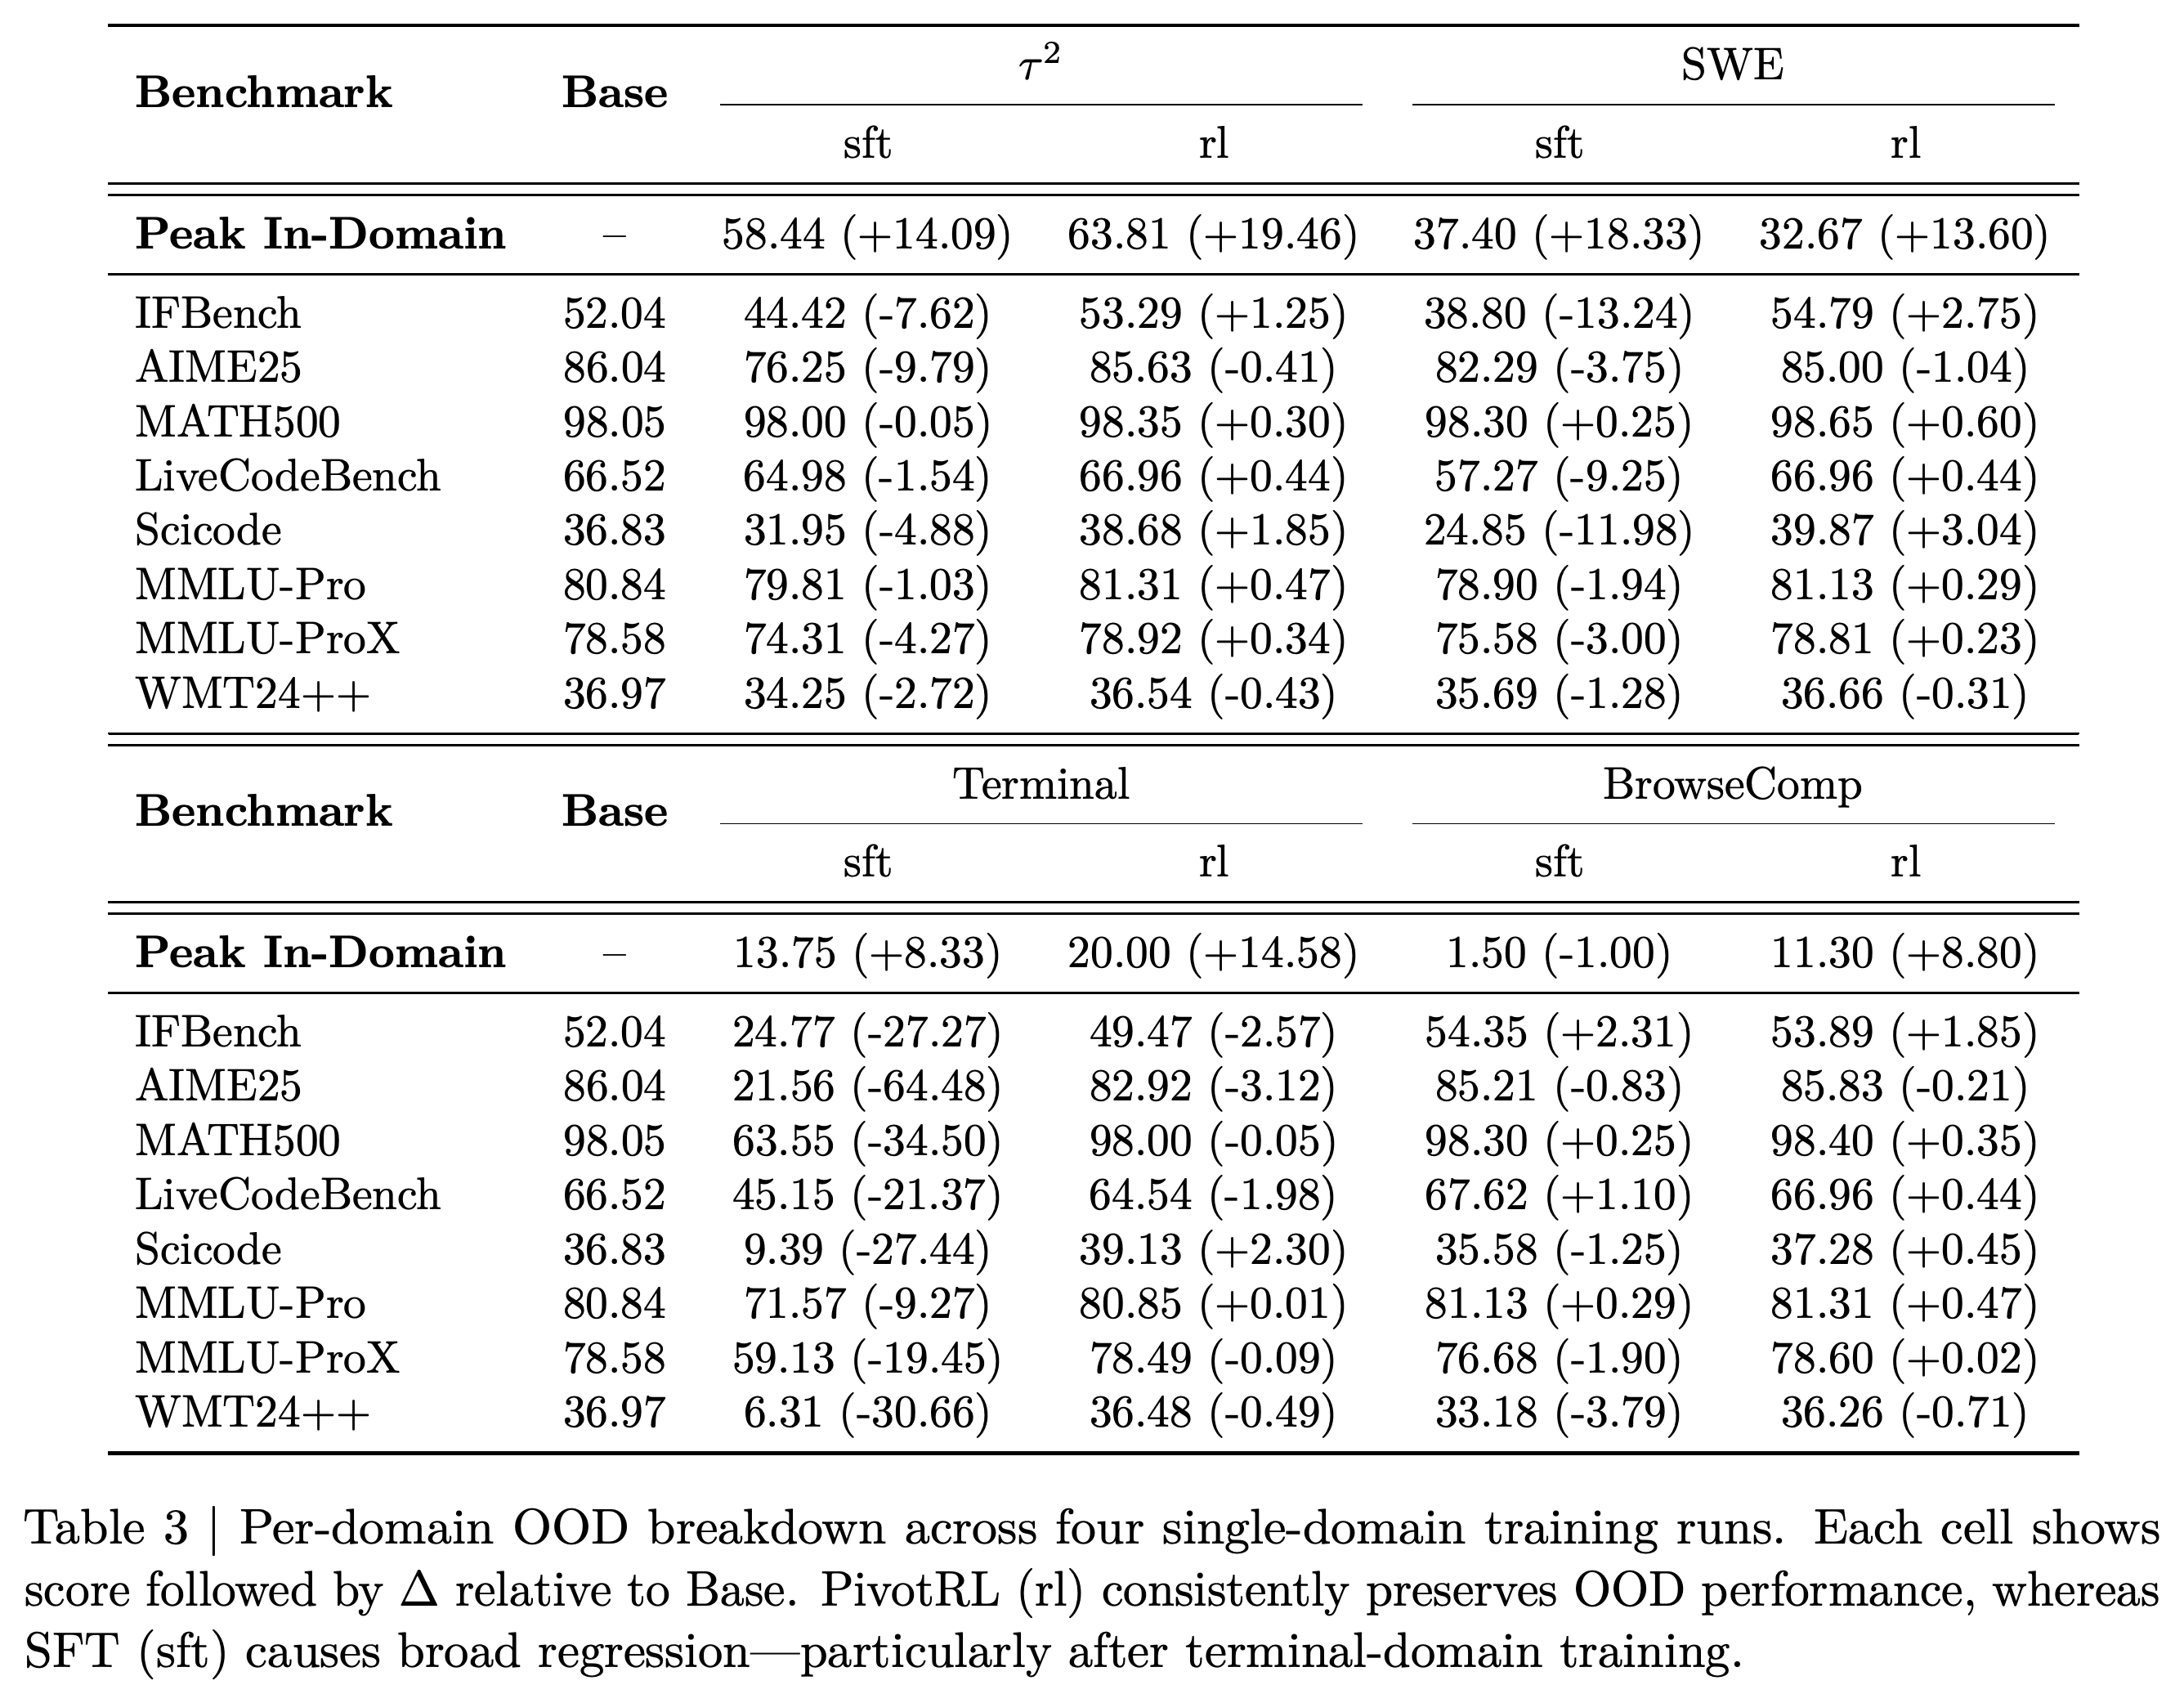
Tables 2 and 3은 평가한 OOD 벤치마크에서 역량이 얼마나 유지되는지 정량화한다. 4개 학습 실행과 8개 벤치마크에 걸쳐 평균을 내면 Base 대비 변화는 PivotRL이 +0.21, SFT가 −9.83이다. PivotRL의 개별 성능 하락 중 가장 큰 값은 터미널 도메인 학습 후 AIME25에서 나타난 −3.12다.
- 터미널 도메인의 SFT에서 가장 큰 성능 하락이 나타난다. AIME25는 86.04에서 21.56으로, MATH500은 98.05에서 63.55로, WMT24++는 36.97에서 6.31로 떨어진다.
- 이에 대응하는 PivotRL 점수는 82.92, 98.00, 36.48이다. 전체 평균에서 확인한 성능 유지 결과가 특히 불리한 이 학습 도메인에서도 나타난다.
- SFT 대비 OOD 우위 +10.04는 Table 2에서 도출되며 결론과도 일치한다. 서론의 SFT 변화 −9.48은 표에 제시된 −9.83과 일치하지 않는다.
4개 학습 실행과 8개 벤치마크에 걸쳐 OOD 변화의 평균을 내면 SFT는 −9.83, PivotRL은 +0.21이다. PivotRL의 작은 양수·음수 변화는 모든 벤치마크에서의 개선이 아니라 Base에 가까운 성능 유지를 나타낸다.
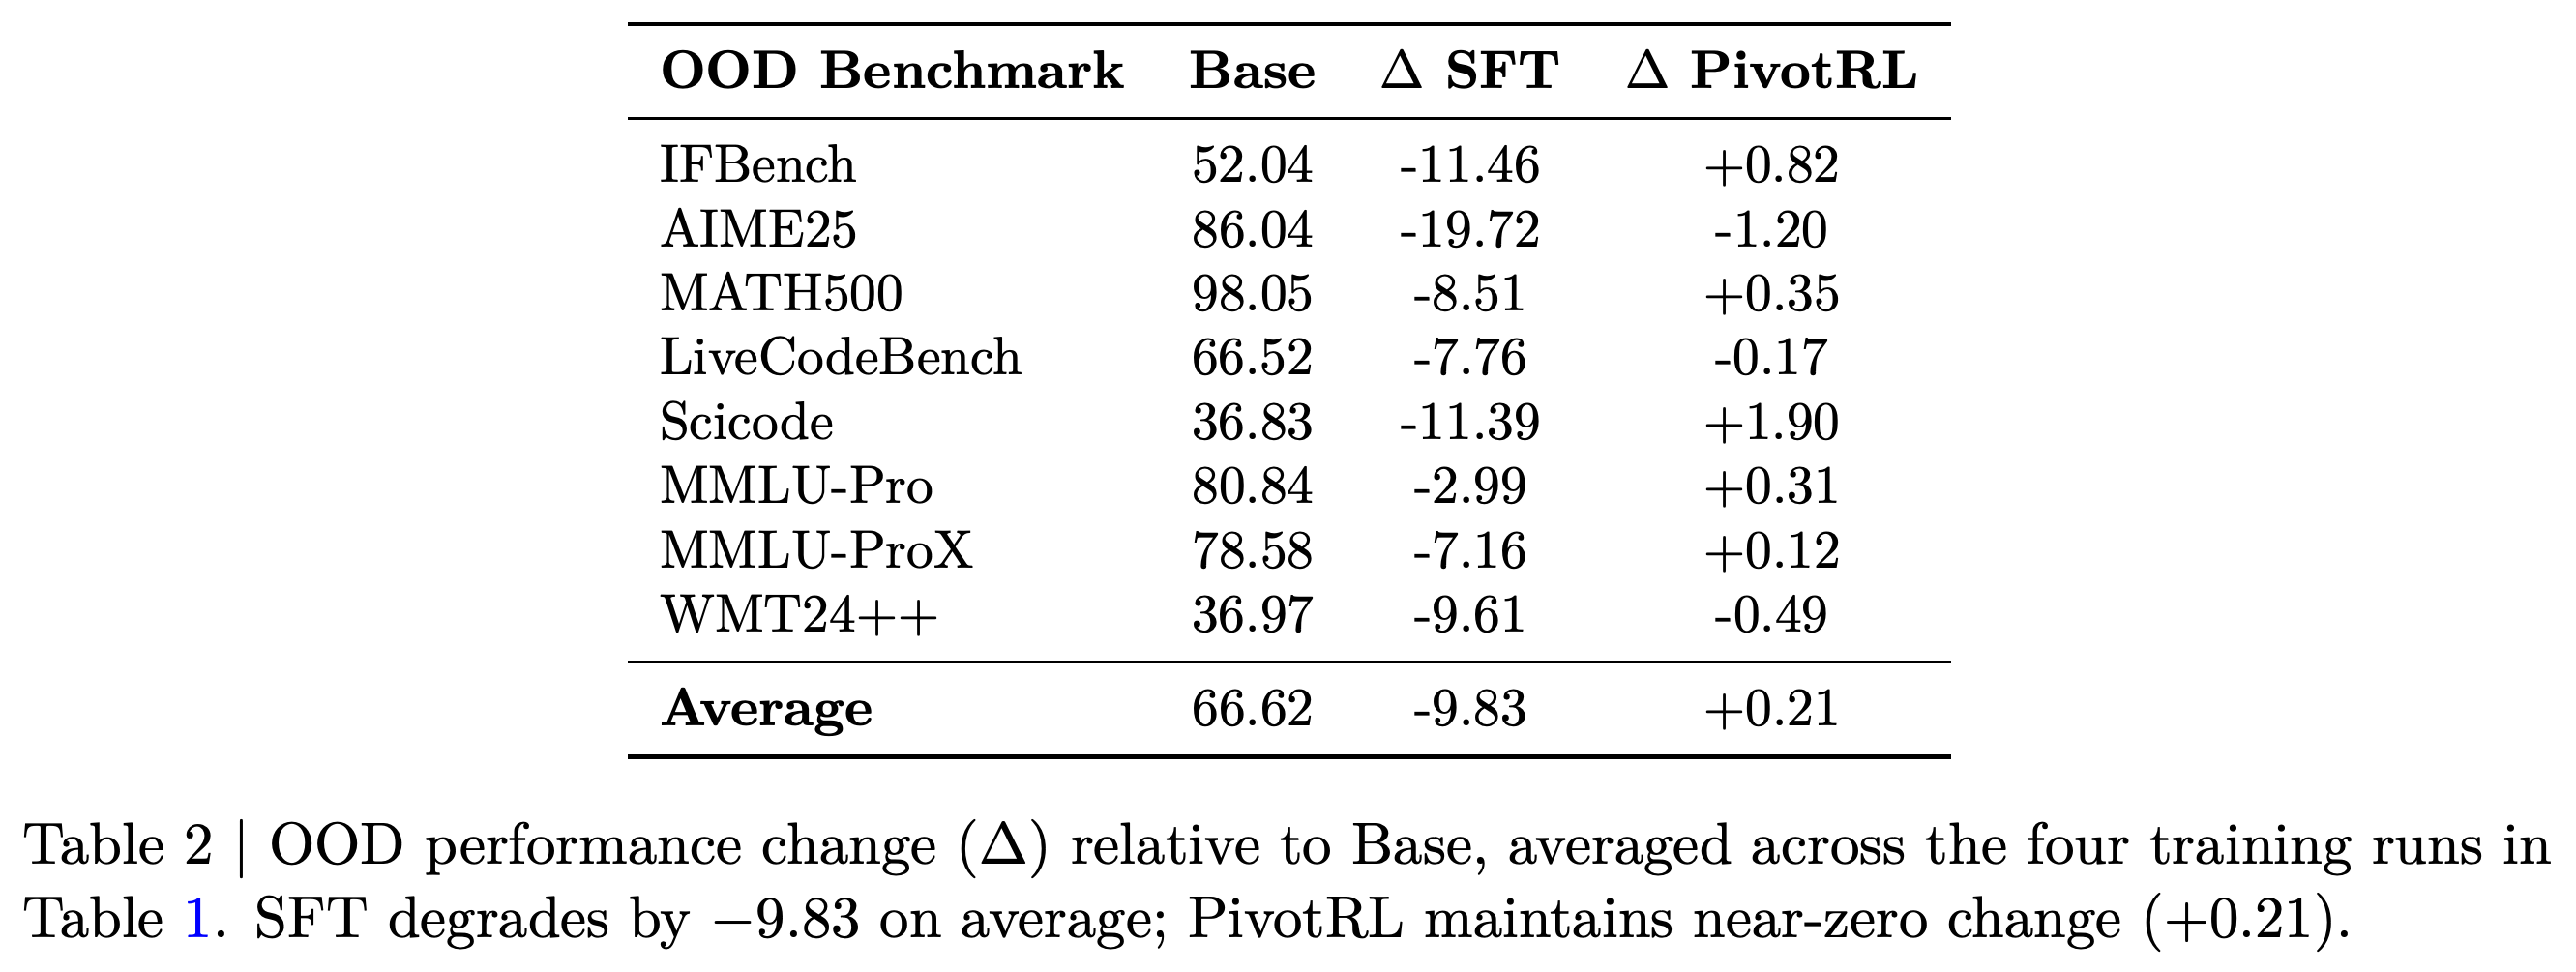
도메인별 결과에서 가장 큰 OOD 성능 하락은 터미널 도메인의 SFT에서 발생하며, AIME25 하락 폭은 64.48 퍼센트포인트다. PivotRL은 4개 학습 도메인 모두에서 이와 비슷한 수준의 하락을 피하지만, 일부 개별 점수는 소폭 감소한다.
4.2. Comparison to End-to-End RL on SWE-Bench
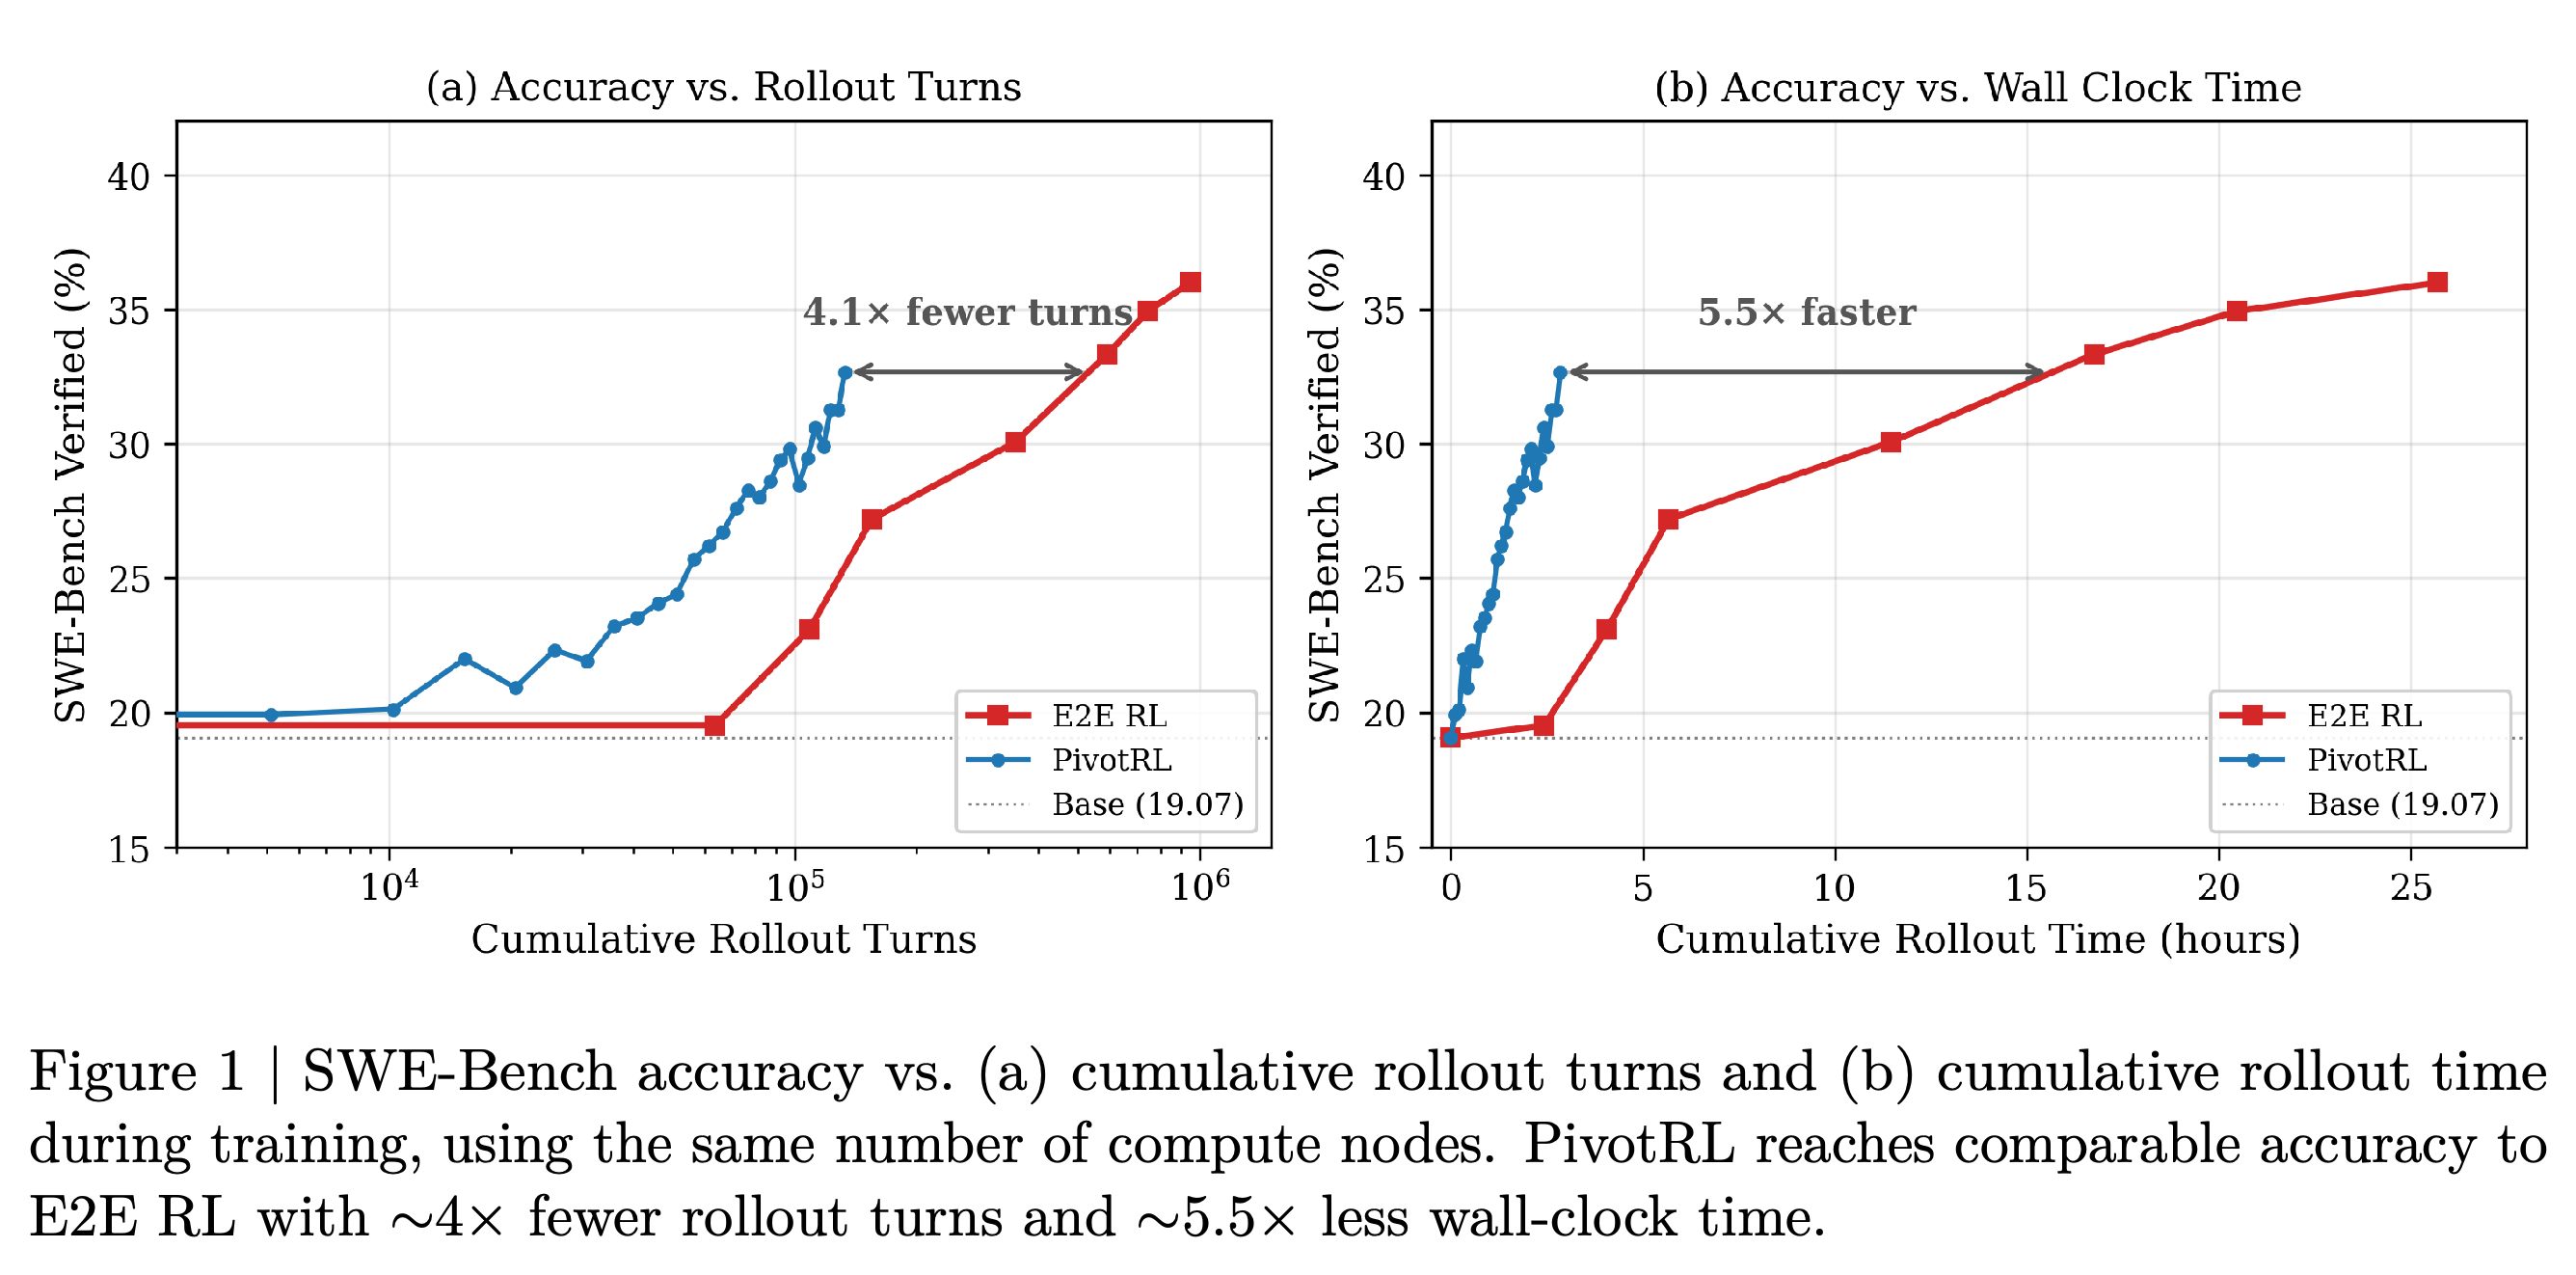
Figure 1은 같은 기반 모델, OpenHands 평가 도구, 연산 노드 수를 사용하여 SWE-Bench의 rollout 효율을 비교한다. 정확도 32.67%에서 PivotRL은 약 133K rollout 턴으로 step 130에 도달하고, end-to-end RL은 약 542K 턴으로 약 step 72에 도달한다. PivotRL은 약 4× 적은 턴과 약 5.5× 짧은 누적 rollout 시간을 사용한다.
- PivotRL의 배치 크기는 1024로, 64 prompts × 16 generations로 구성하며 샘플마다 1턴을 사용한다.
- End-to-end RL의 배치 크기는 512로, 16 prompts × 32 generations로 구성하며 궤적마다 12–25턴을 사용한다.
- 이는 정확도를 맞춘 rollout 비교다. Figure 1에서 end-to-end RL은 이후 더 높은 정확도에 도달한다. 보고된 절감량에는 시연 생성과 오프라인 profiling 비용의 완전한 집계가 포함되지 않는다.
정확도를 약 32.67%로 맞추면 PivotRL은 같은 연산 노드 수에서 약 4× 적은 rollout 턴과 5.5× 짧은 누적 rollout 시간으로 목표에 도달한다. End-to-end RL은 이후 더 높은 정확도에 도달하므로, 이 그림은 더 높은 최종 정확도가 아니라 공통 목표에서의 효율을 보여준다.
4.3. Ablation Study
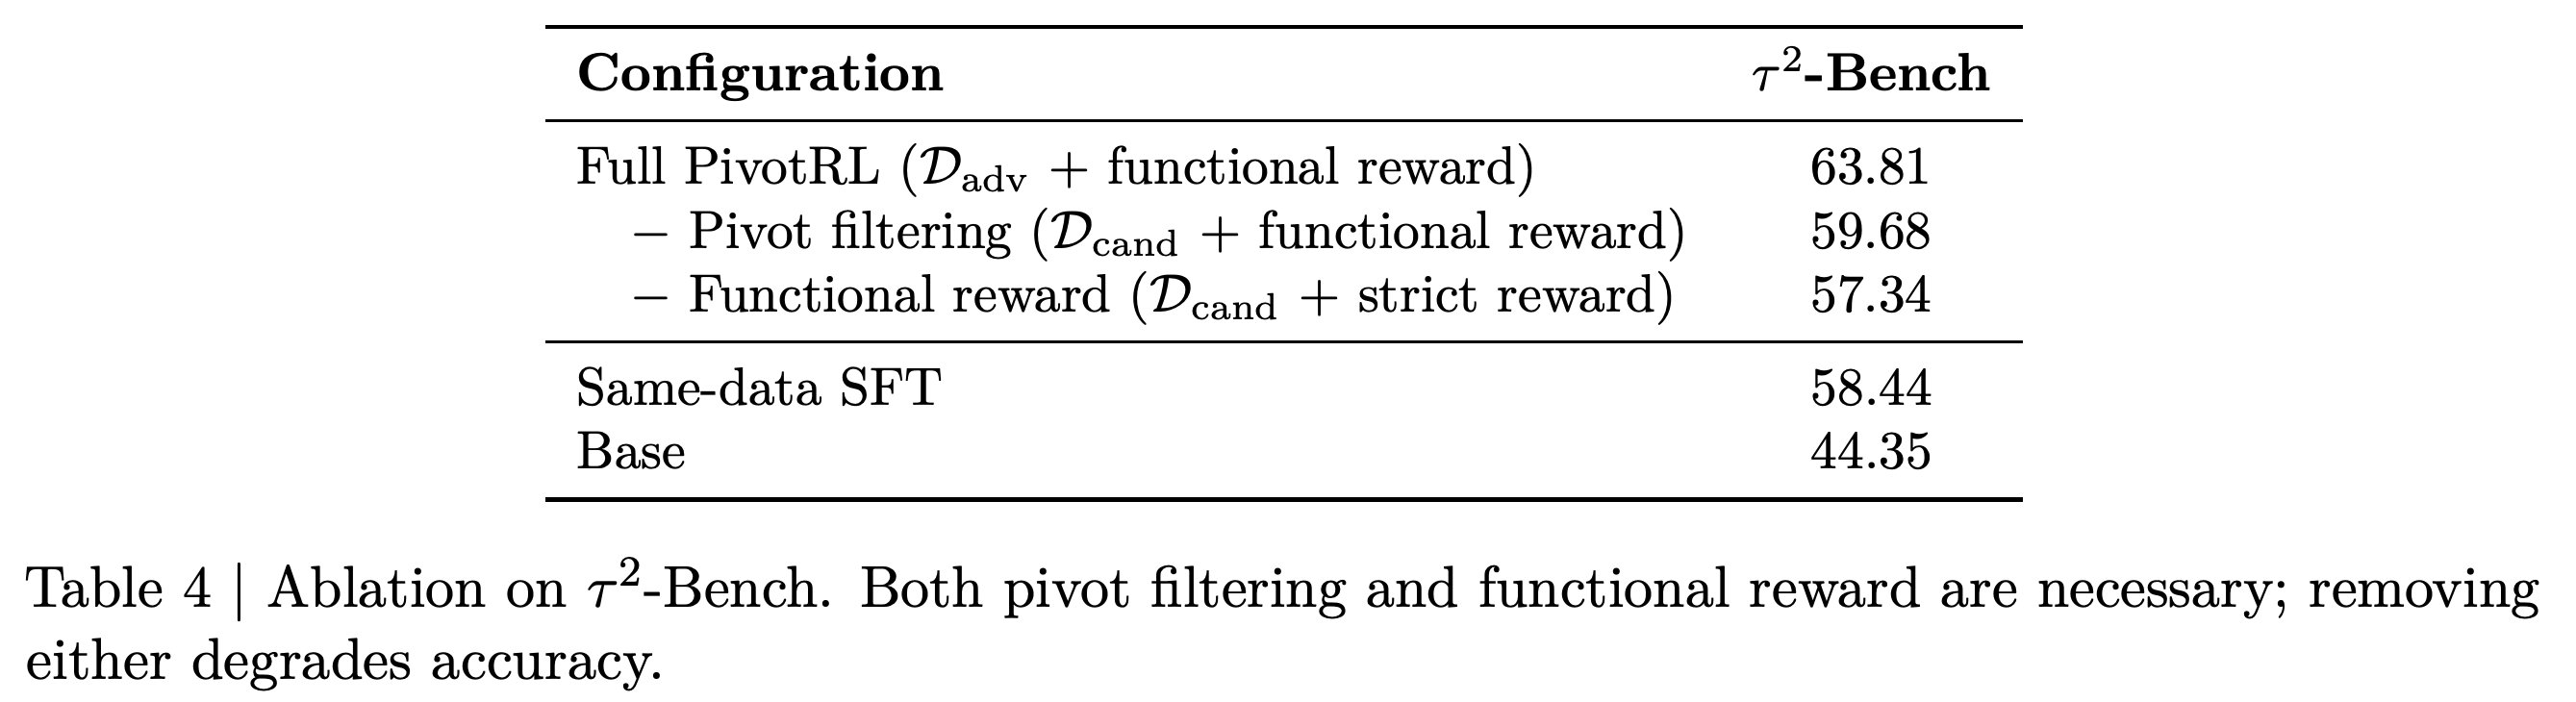
Table 4에서 전체 PivotRL은 τ²-Bench 점수 63.81을 기록하고, 기능 보상을 유지하되 필터링을 제거하면 59.68을 기록한다. 필터링 없이 엄격한 일치 보상을 사용하는 구성은 57.34로, 같은 데이터를 사용한 SFT의 58.44보다 낮다.
- 기능 보상을 사용하는 구성끼리 비교하면 pivot 필터링의 효과를 분리해 확인할 수 있다.
- 논문은 구성 요소를 하나씩 제거한다고 설명하지만, 엄격한 일치 보상 행에서는 필터링된 Dadv가 아니라 필터링하지 않은 Dcand를 사용한다. 따라서 63.81과 57.34를 비교하면 선택 방식과 보상이 모두 달라진다. 59.68과 57.34를 비교하는 편이 필터링 없이 기능 보상과 엄격한 일치 보상의 차이를 더 직접적으로 검증한다.
필터링과 기능 보상을 사용하는 학습은 63.81을 기록하며, 필터링을 제거하면 59.68, 필터링 없이 엄격한 일치 보상을 사용하면 57.34를 기록한다. 엄격한 일치 보상 행에서는 필터링도 제거하므로, 전체 PivotRL과의 비교로 보상 설계의 효과만 분리할 수는 없다.
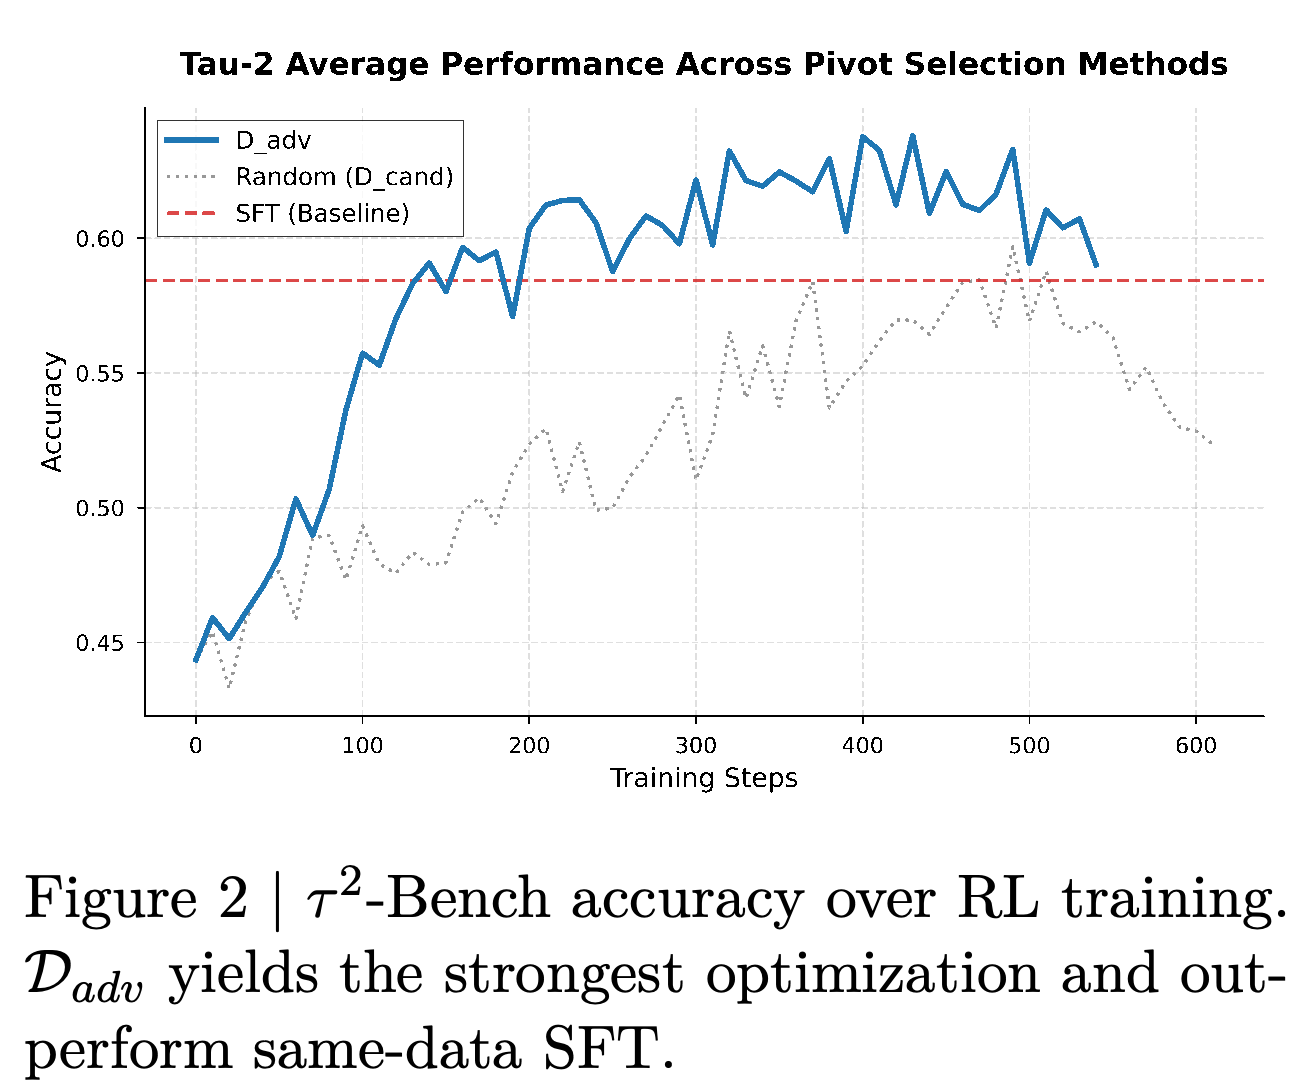
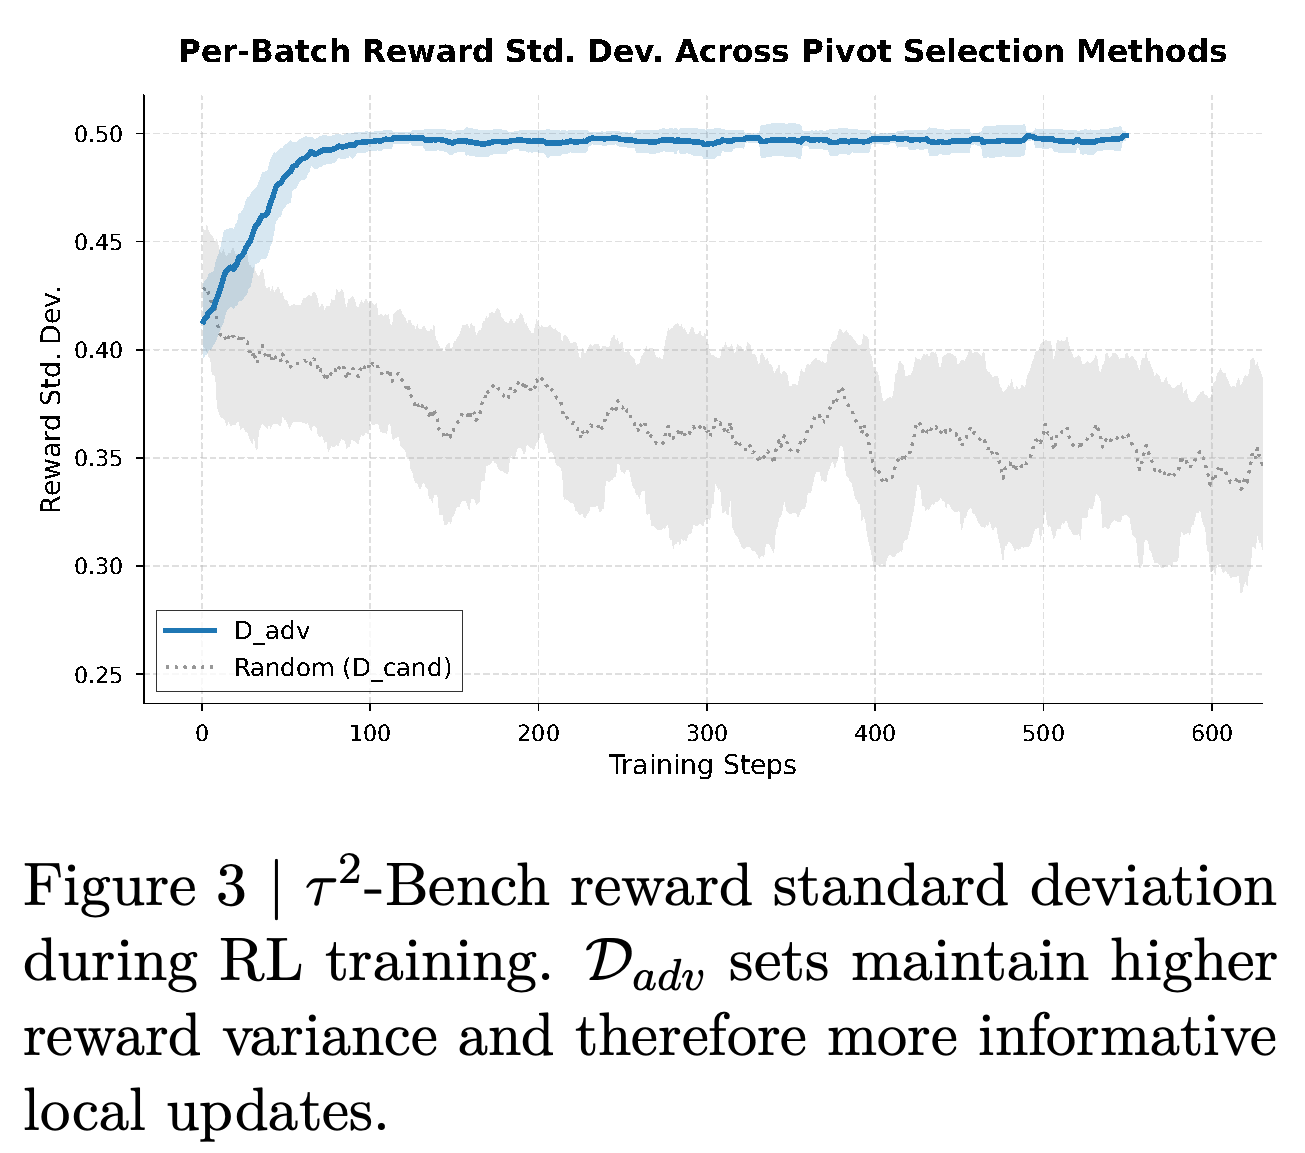
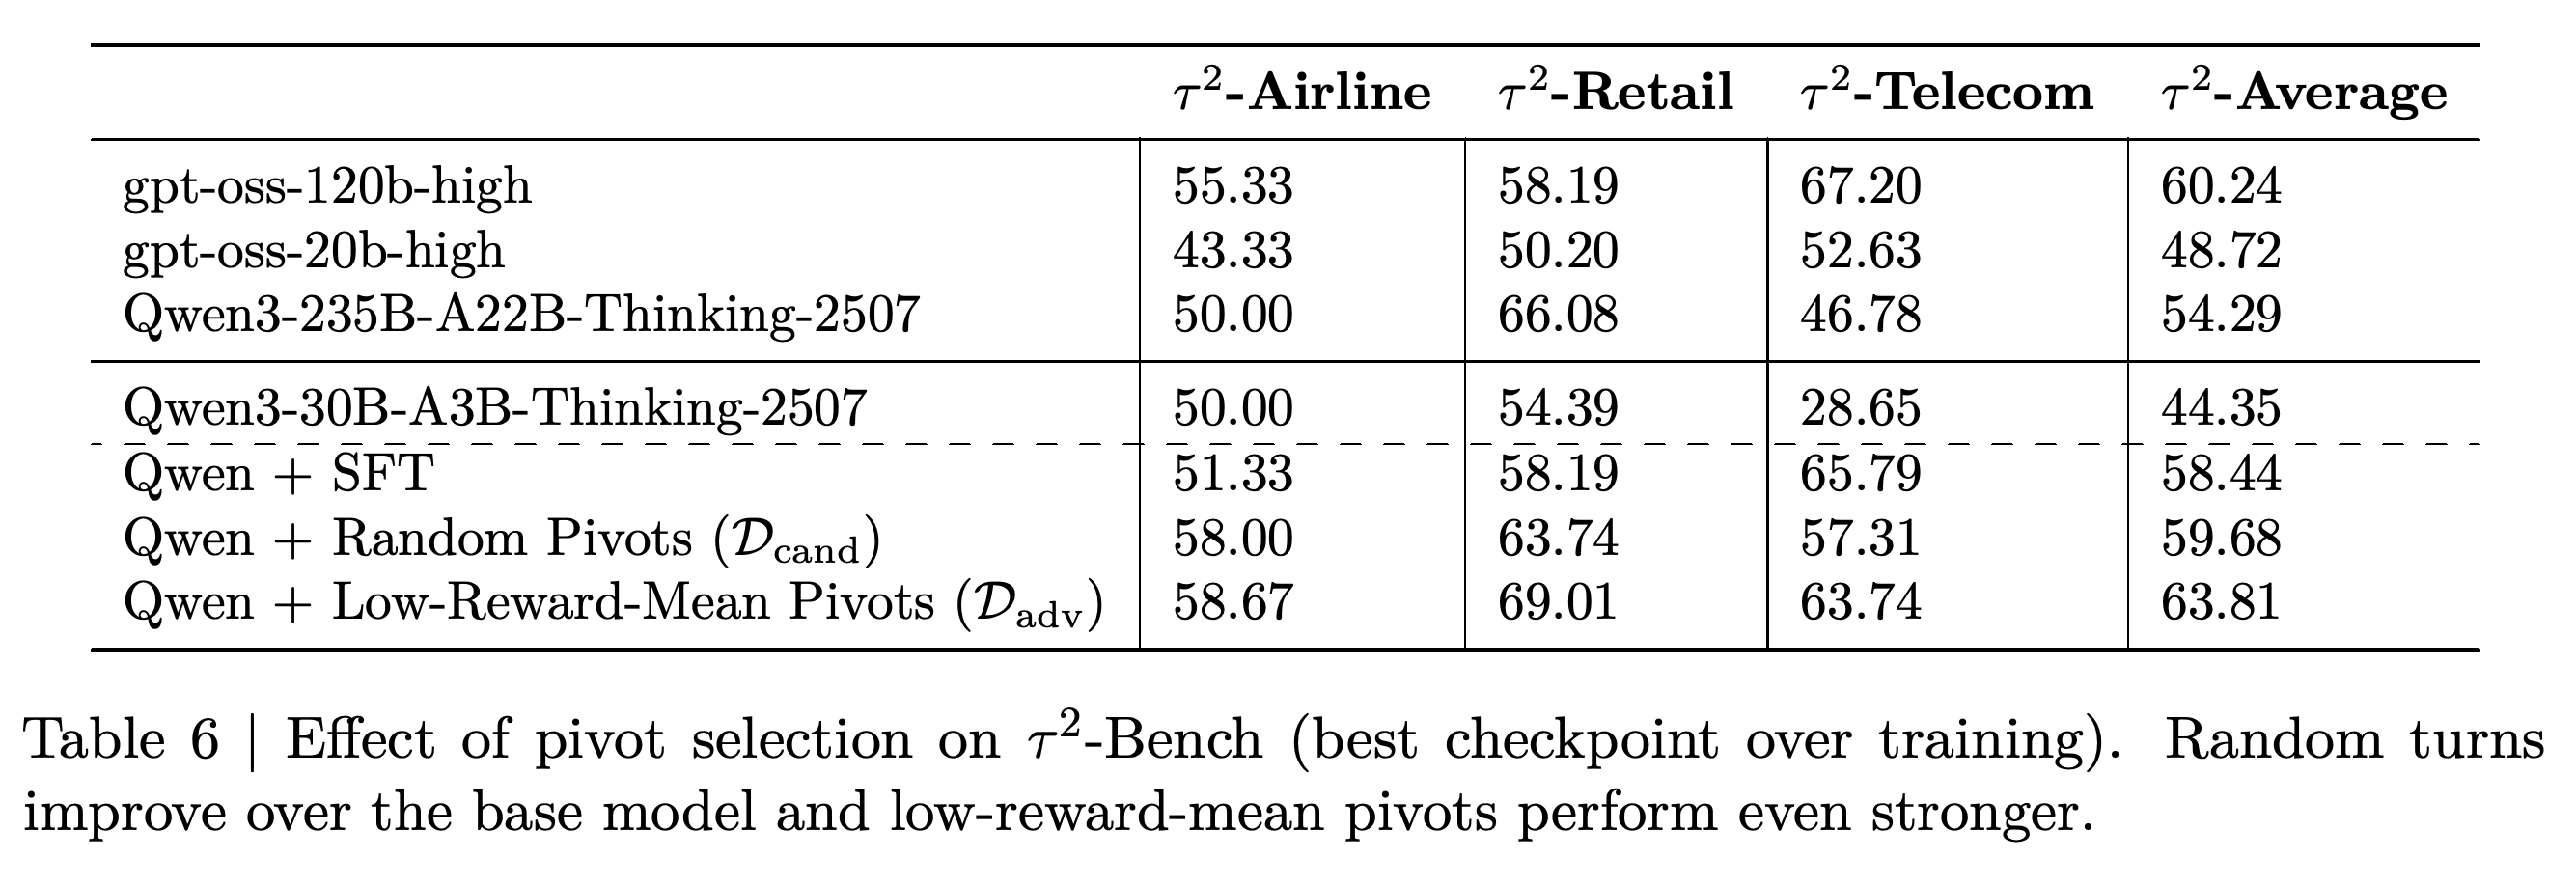
Figures 2 and 3에서는 무작위 후보 샘플링보다 필터링된 pivot을 사용할 때 검증 정확도와 배치별 보상 표준편차가 더 높다. Appendix Table 6에서 최적 체크포인트의 평균 점수는 무작위 후보가 59.68, 보상 평균이 낮은 pivot이 63.81이며, SFT는 58.44다.
- 개선은 τ²-Bench의 모든 하위 도메인에서 나타나지는 않는다. 필터링된 pivot은 Telecom에서 63.74로 SFT의 65.79보다 낮지만, Airline과 Retail에서는 성능을 개선한다.
- 무작위 샘플링의 보상 표준편차는 감소하지만 그래프에서는 여전히 0이 아닌 값으로 보인다. 그래프는 필터링이 더 유익한 샘플링을 제공한다는 해석을 뒷받침한다. 무작위 샘플링의 신호가 완전히 사라진다거나 분산만으로 정확도 개선이 발생한다는 증거는 아니다.
초기 상승 이후 필터링된 pivot의 곡선은 대체로 무작위 후보 학습과 SFT 기준선보다 높다. 체크포인트별 변동은 보고된 최적 체크포인트 점수가 학습 내내 유지되지는 않음을 보여준다.
필터링된 pivot은 보상 표준편차를 0.50에 가깝게 유지한다. 반면 무작위 샘플링은 더 낮고 감소하는 값을 보이지만 여전히 0이 아니다. 이는 필터링이 성공과 실패가 섞인 샘플링을 더 잘 유지한다는 주장을 뒷받침하며, 무작위 샘플링이 모든 학습 신호를 잃는다는 뜻은 아니다.
필터링된 pivot은 표에 제시된 τ²-Bench 평균 중 가장 높은 63.81을 달성하며, Airline과 Retail에서 SFT와 무작위 후보보다 높은 성능을 보인다. Telecom은 여전히 SFT보다 낮으므로, 평균 개선이 모든 하위 도메인에서 동일하게 나타나지는 않는다.
4.4. Integration into Large-Scale Post-Training
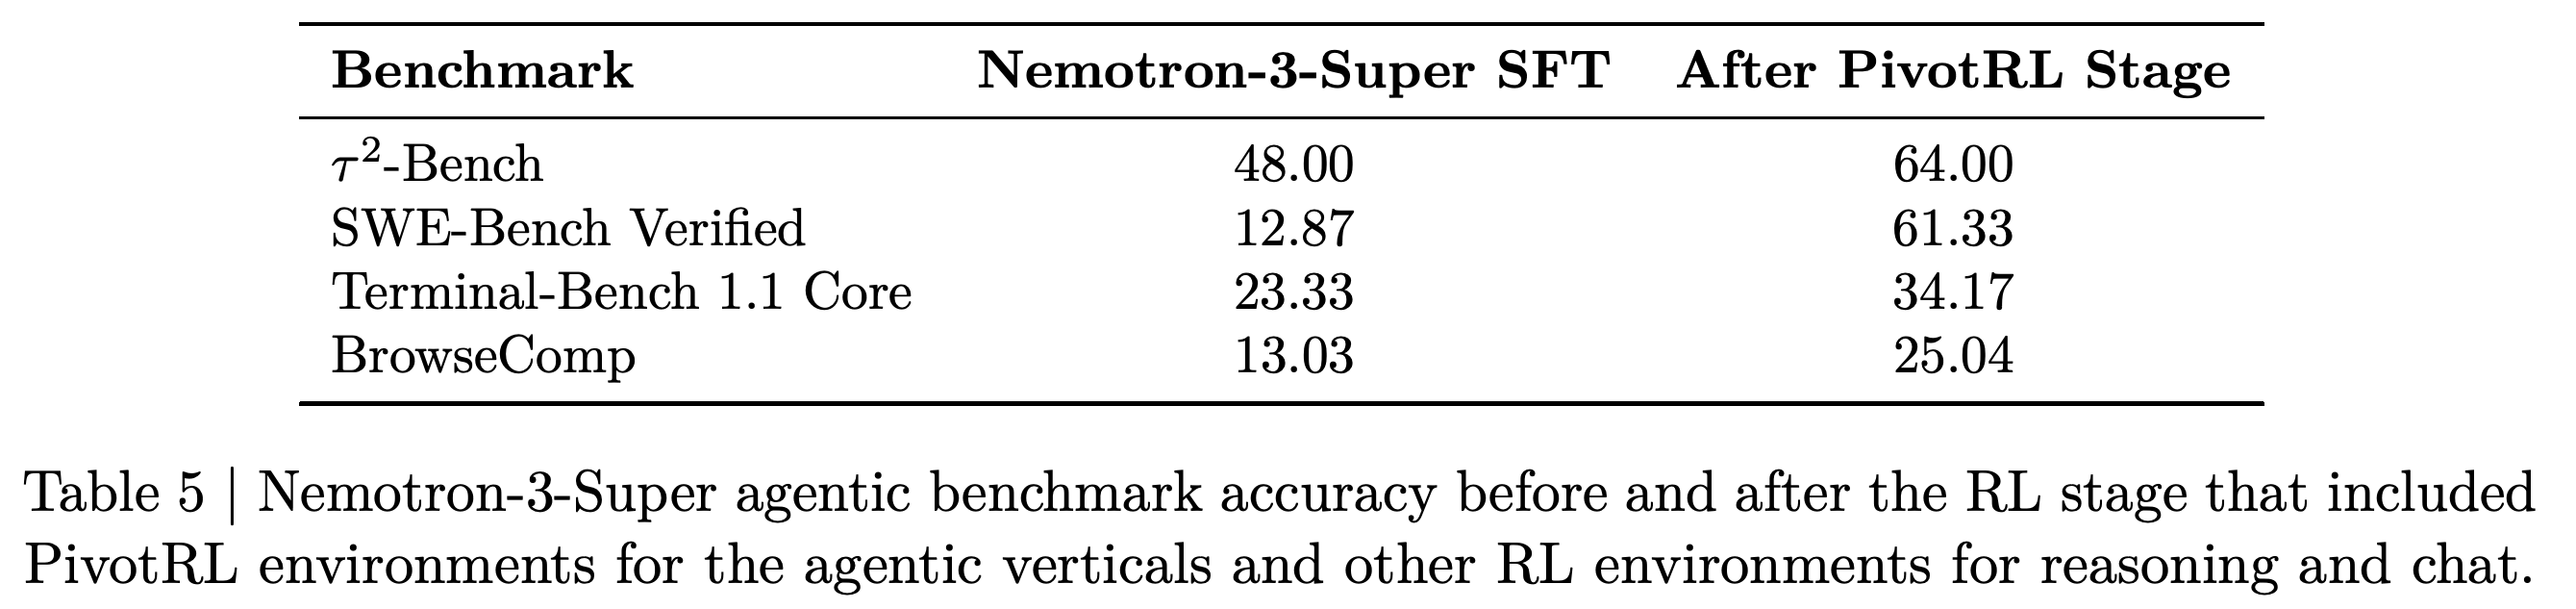
PivotRL은 Nemotron-3-Super post-training 파이프라인에서 에이전트 환경에 사용되며, 추론과 채팅을 위한 다른 RL 환경과 함께 적용된다. Table 5는 SFT 체크포인트에서 후속 혼합 RL 단계로 넘어갈 때의 변화를 보고한다. τ²-Bench는 48.00에서 64.00으로, SWE-Bench Verified는 12.87에서 61.33으로, Terminal-Bench 1.1 Core는 23.33에서 34.17로, BrowseComp는 13.03에서 25.04로 증가한다.
- 이 결과는 더 큰 post-training 학습 구성에 통합한 사례를 보여준다.
- 해당 단계에는 다른 RL 환경도 포함되므로, 이 표는 전체 체크포인트 개선에서 PivotRL의 기여만을 분리하지 못한다.
Nemotron-3-Super의 RL 단계 이후 4개 에이전트 점수가 모두 증가하며, SWE-Bench Verified는 12.87에서 61.33으로 오른다. 이 단계는 PivotRL 에이전트 환경과 추론·채팅 환경을 결합하므로, 결과는 PivotRL만의 효과가 아니라 파이프라인 통합 사례를 보여준다.
5. Related Works
관련 연구에서는 에이전트 정책 최적화와 검증 가능한 보상을, 오프라인 시연을 온라인 학습에 재사용하는 방법들과 연결한다. PivotRL은 선택한 assistant 턴 상태와 국소 검증기에 따른 보상 할당을 결합한다.
5.1. Agentic LLMs and Training Recipes
에이전트 LLM은 언어와 환경에 기반한 행동을 번갈아 수행하며, RL은 탐색과 멀티턴 보상 할당을 지원한다. PivotRL은 검증 가능한 보상을 사용하는 RL과 on-policy 학습을 활용한다. 별도의 보상 모델을 학습하지 않고 지도학습용 궤적을 턴 단위로 보상을 부여할 수 있는 상태로 변환한다.
- 검증이 프로그램 방식으로만 이루어지는 것은 아니다. 이 방법은 LLM judge를 허용하며, Terminal-Bench 구현에서도 이를 사용한다.
5.2. Adapting Behavior Cloning into RL
논문은 제안 방법을 SFT의 catastrophic forgetting, 과제의 길이에 따라 달라지는 모방학습 오류, 시연을 활용하는 RL과 연결한다. 기존 방법은 전문가 시연과 RL 업데이트를 혼합하거나, 궤적의 앞부분을 재사용하거나, SFT 토큰을 rollout 보상으로 변환한다. PivotRL은 선택한 assistant 상태와 기능 보상을 통해 이러한 SFT-to-RL 연결을 멀티턴 도구 사용에 적용한다.
6. Conclusion
결론에서는 PivotRL의 개선을 on-policy rollout과 검증기 기반 보상이 더 넓은 행동 범위를 다루기 때문이라고 설명한다. 평가 결과는 같은 데이터를 사용한 SFT 대비 평균 +4.17의 in-domain 우위와 +10.04의 OOD 성능 유지 우위를 뒷받침한다. 또한 SWE-Bench 정확도를 맞추면 end-to-end RL보다 rollout 비용이 낮다.
- 확장 방향으로 process reward model과 dynamic sampling 같은 온라인 보상 profiling을 제안한다.
- 결론은 비프로그램 방식의 검증도 제안하지만, Appendix A.2에서 이미 Terminal-Bench의 LLM-as-judge 평가를 설명한다.
부록
- A. Experiment Details와 A.1. Terminology Conventions는 추출한 pivot 후보와 오프라인 필터링을 거쳐 학습에 사용하는 pivot을 구분한다. 행동은 모델 호출 경계에서 생성한 assistant 응답 전체이며, 벤치마크에 따라 자연어만 포함한 턴도 포함한다. OOD 변화는 학습 도메인 밖의 벤치마크에서 Base 대비 측정한다. 무작위 집합은 모든 후보를 사용한다. 보상 평균이 낮은 집합은 성공과 실패가 섞여 있어야 하며, 시연 행동의 보상과 기준 정책의 평균 사이에 차이가 있어야 한다.
- A.2. Domain-Specific Training Details의 τ²-Bench 설명에 따르면, 4개 도메인 모두 RL 전에 후보를 추출하고 profiling과 필터링을 수행한다. 대화형 도구 사용 데이터셋에는 838개 도메인에 걸친 281,774개 궤적이 포함된다. 이 궤적은 ToolAce, Kimi-K2, DeepSeek-V3.2와 유사한 합성 파이프라인으로 생성한다. Assistant 턴은 언어, 도구 호출, 또는 둘 모두를 포함할 수 있다. 환경과 데이터는 Nemo-Gym과 Nemotron-Post-Training-v3를 통해 공개한다.
- Terminal-Bench에서 과제를 해결한 궤적은 Qwen/Qwen3-Coder-480B-A35B-Instruct와 moonshotai/Kimi-K2-Instruct가 Terminus-1과 Terminus-2를 사용하여 생성한다. Bash 명령 후보를 필터링하고 중복을 제거하여 약 20,000개 샘플을 얻는다. 국소적으로 서로 대체 가능한지는 스키마 검증, 정규화된 문자열 유사도, 동등성 기반 LLM 평가로 판단한다.
- SWE-Bench Verified의 내부 궤적은 SWE-Gym과 R2E-Gym 과제에서 MiniMaxAI/MiniMax-M2.5와 함께 OpenHands, OpenCode, Codex를 사용하여 생성한다. 오류가 아닌 도구 호출 후보를 Dadv로 필터링하여 87,718개 샘플을 얻는다. 평가는 OpenHands로 mean@3을 사용한다. 반면 학습 검증기는 도구 호출 이름만 비교하고, 인자나 패치 품질은 평가하지 않는다. 최종 과제 성공 여부는 전체 SWE-Bench 평가 도구로 판단한다.
- BrowseComp의 웹 탐색 궤적은 멀티홉 질의응답 데이터셋에서 온라인 검색 엔진과 DeepSeek-V3.2를 사용하여 생성하며, 13,215개 샘플을 얻는다. 행동에는 검색 질의 전송, 결과 열기, 근거 수집이 포함된다. 부록은 이 도메인의 국소 검증기를 다른 도메인만큼 자세히 명시하지 않는다.
- A.3. Detailed Ablation Analyses와 A.3.1. Effect of Turn Selection Strategy on τ²-Bench는 필터링하지 않은 무작위 후보와 Equation (5)로 정의한, 성공과 실패가 섞이고 보상 평균이 낮은 pivot을 비교한다. Table 6은 학습 중 최적 체크포인트를 보고한다. 평균 정확도는 SFT가 58.44, 무작위 후보가 59.68, 필터링된 pivot이 63.81이다.
- B. Omitted Proofs의 B.1. Proof of Theorem 3.2는 자연 그래디언트를 평균을 뺀 보상으로 유도하고, 그 Fisher norm의 제곱이 보상 분산과 같음을 보인다. 이어서 지수 틸팅으로 정의한 KL 경로를 미분하여 모집단 GRPO 점수를 얻는다. B.2. Proof of Theorem 3.3은 KL을 조건부 분포 항과 Bernoulli 확률 질량 항으로 분해한다. 엄격한 볼록성으로 허용 가능한 행동의 최적 확률 질량을 결정하며, 블록별 재조정은 블록 내부의 확률 비율을 보존한다. 증명은 허용 가능한 행동이 전혀 없는 경우와 모든 행동이 허용 가능한 경우의 경계 조건도 다룬다.
짧은 생각
핵심 기여는 같은 데이터를 사용하는 비교를 통해, 선택된 상태에서의 국소 on-policy 학습이 에이전트 기술을 습득하면서 이 실험에서 SFT가 저하시키는 역량을 유지할 수 있음을 보인 점이다. 정확도를 맞춘 SWE-Bench 비교는 구체적인 rollout 효율 개선을 제시한다. 다만 해당 도메인에서 PivotRL의 점수가 SFT보다 낮다는 점은 성능 유지와 효율이 반드시 in-domain 정확도를 최대화하지는 않음을 보여준다.
주요 한계는 세밀하지 않은 국소 보상 할당, 고정된 전문가 상태 범위, 불충분한 재현성 및 비용 보고다. 도구 이름만 확인하는 코딩 보상은 행동의 의미적 동등성을 입증하지 못하며, 상태별 이론도 신경망 모델의 OOD 성능 유지를 보장하지 않는다. PDF는 반복 실행의 불확실성, 전체 최적화 하이퍼파라미터, 오프라인 profiling을 포함한 end-to-end 비용 집계를 보고하지 않는다.