


Metacognition in LLMs: Foundations, Progress, and Opportunities 요약 설명
13 Jul 2026 | Paper Review Metacognition LLM Evaluation Confidence Calibration Self-Reflection목차
- 요약
- 2 What is Metacognition?
- 4 Do LLMs Have Metacognition?
- 5 Giving LLMs Metacognitive Abilities
- 6 Metacognitive Methods to Improve Capabilities of LLMs
- 7 Applications of LLM Metacognition
- 8 Reflections & Discussion
- 9 Future Directions
- 짧은 생각
이번 글에서는 Metacognition in LLMs: Foundations, Progress, and Opportunities 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 13일(Arxiv)
- Liu, Gabrielle Kaili-May, Gani, Areeb, Lu, Jacqueline, Thomas, Jordan, Steyvers, Mark, Cohan, Arman.
- Yale University, University of California, Irvine
- 논문 링크
요약
- 이 서베이는 LLM이 자신의 처리 과정을 언제, 어떻게 점검하고 조절하는지, 이러한 능력이 과제 수행과 신뢰성, 인간과 AI의 상호작용에 도움이 되는지를 검토한다. 새로운 실험을 보고하기보다 측정 방법, 관찰된 행동, 구현 방식, 응용, 미해결 질문에 관한 연구를 정리한다.
- 핵심 구분은 불확실성, 지식, 수행 수준, 진행 상황을 평가하는 모니터링과 그 평가를 바탕으로 계획을 세우거나 전략을 바꾸고, 노력을 배분하거나 도움을 구하는 제어다. 검토한 연구들은 과제에 따라 이러한 행동이 나타난다는 근거를 제시하지만, 과신과 불안정한 자기 평가, 자신이 파악한 정보를 행동에 반영하지 못하는 사례도 보고한다.
그림 중앙에서는 언어 모델을 모니터와 제어 구성 요소 사이에 배치한다. 모니터링은 처리 과정을 평가하고 제어는 이후 행동을 조절한다. 주변의 가지는 측정, 연구 결과, 구현, 능력 개선, 응용에 관한 검토 대상 연구를 분류한다. 이 도식은 검증된 아키텍처가 아니라 연구 분류 체계다.
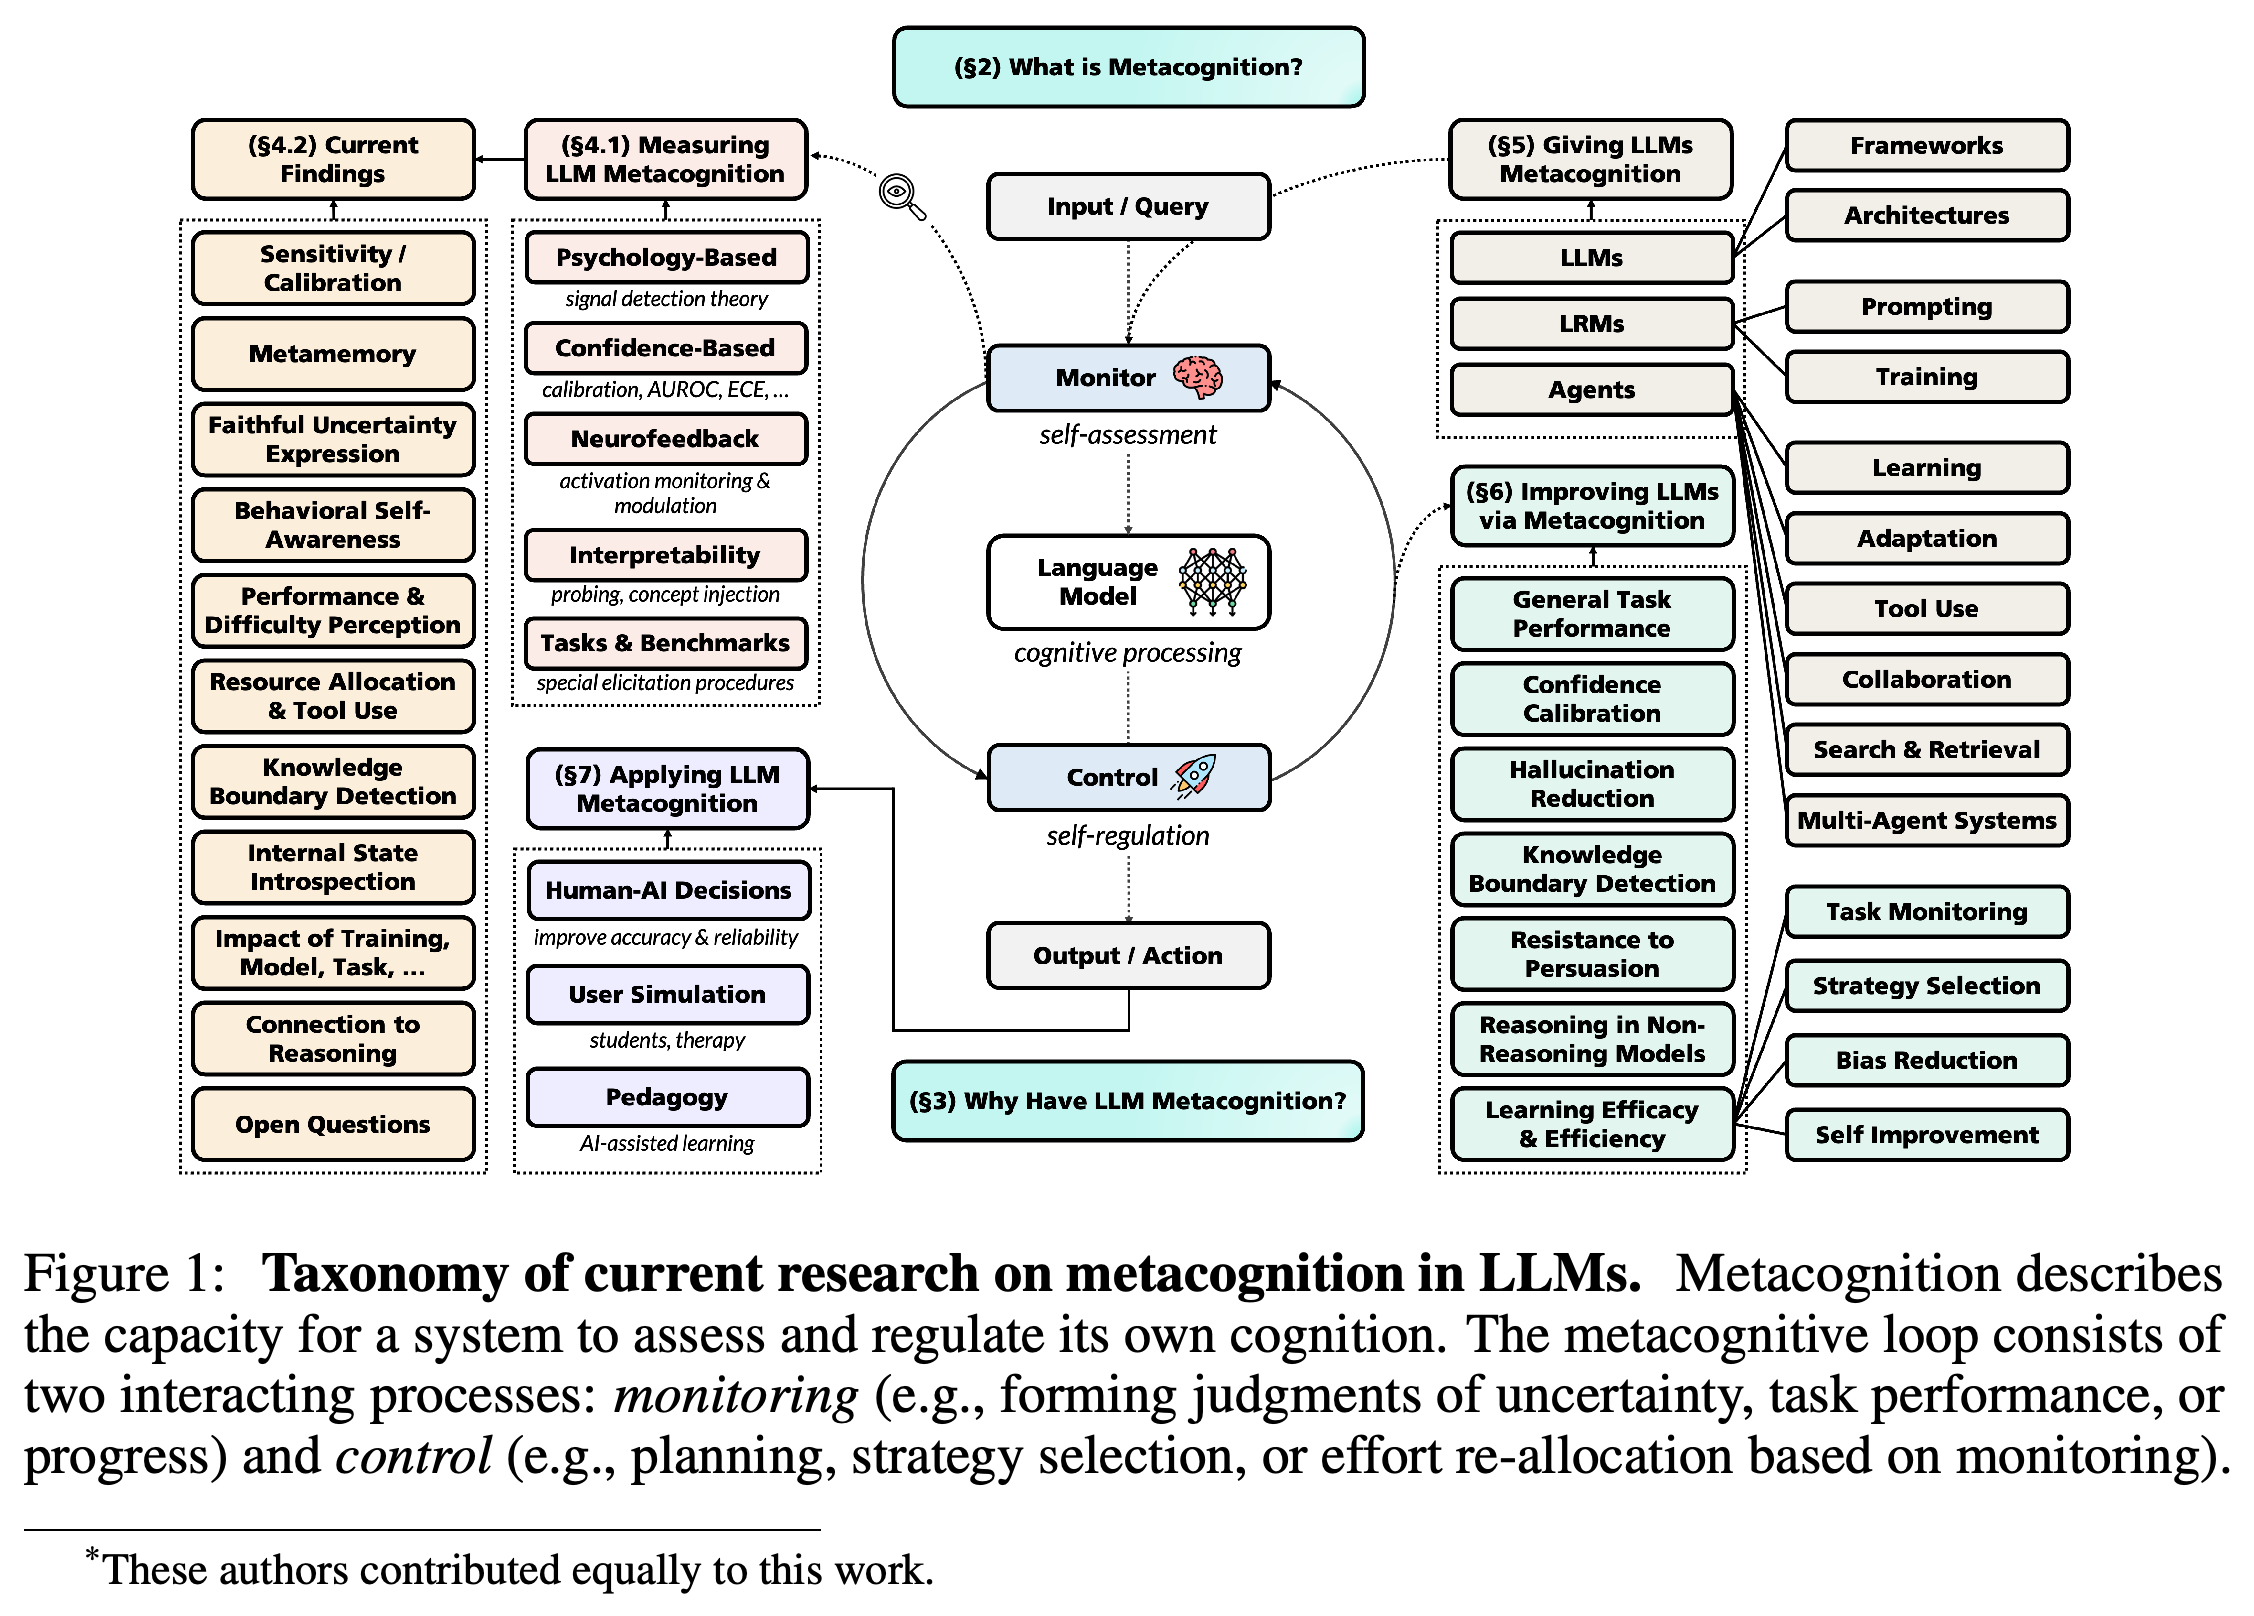
- 이 리뷰는 확신도 보정과 메타인지 민감도를 구분하고, 모니터링 결과가 실제 제어에 반영되는지 묻는다. 과제와 모델, 확신도를 끌어내는 방식이 연구마다 달라 결과를 비교하기는 어렵다. 저자들은 https://github.com/yale-nlp/LLM-Metacognition 에 논문 목록을 정리해 두었다.
2 What is Metacognition?
인간의 메타인지 이론에서는 자신의 능력을 점검한 결과가 이후 행동의 제어로 이어진다. 이 리뷰는 메타인지 지식, 조절, 경험을 구분한다. 민감도는 확신도가 정답과 오답을 얼마나 잘 구별하는지를 뜻하며, 보정은 확신도가 정답 확률과 얼마나 일치하는지를 뜻한다.
LLM의 메타인지에 대해서는 합의된 조작적 정의가 없다. 이 서베이는 심리학에 기반한 모니터링과 제어뿐 아니라 성찰이나 출력 수정처럼 더 느슨하게 쓰이는 용례도 다루되, 이를 동등하게 취급하지는 않는다. 기대되는 이점으로는 과제 수행과 학습의 향상, 도움을 구하거나 답변을 보류해야 할 때를 알아차리는 능력이 있다.
4 Do LLMs Have Metacognition?
연구 동기에는 불확실성을 신뢰성 있게 전달하고, 인간과 AI의 협업을 돕고, 환각을 줄이며, 해석 가능성을 높이는 일이 포함된다. 다만 이는 조건부로 기대할 수 있는 효과다. 인용된 연구들은 확신도가 높은 환각과 추론 과정이 최종 답변과 어긋나는 사례도 보고하므로, 성찰하는 듯한 문장이나 자신감 있는 설명만으로 신뢰할 만한 자기 모니터링을 입증할 수는 없다.
4.1 Measuring Metacognition in LLMs
심리학에서 착안한 평가에는 신호탐지이론을 사용해 메타인지 민감도인 type 2 민감도를 과제 자체의 type 1 민감도 및 응답 편향과 분리하는 방식이 있다. 이 리뷰는 meta-d′, d′, M-ratio, M-diff와 정보이론 기반 대안을 살펴본다. 개방형 생성에서는 확신도를 표현하도록 유도하고 정답 여부를 판정해야 하므로, 이러한 지표 중 상당수는 측정이 덜 직접적이다.
다른 접근법은 신경 피드백과 유사한 환경에서 내부 활성화에 대한 모니터링이나 제어를 시험하고, 모델의 내재적 확신도와 추론 단계의 품질을 비교하거나, 모델 내부 표현을 탐침하거나, 과제별 행동을 살펴본다. CogEdit, MetaMedQA, ObjexMT, AwareXtend는 서로 다른 대상을 평가하지만, 형식의 제약과 일반적인 과제 수행 능력에 대한 의존성 때문에 통일된 측정 기준이 되기는 어렵다.
4.2 Current Findings on Metacognition in LLMs
검토한 연구들은 대체로 메타인지 민감도가 낮거나 중간 수준이며 확신도 보정은 과제에 따라 달라진다고 보고하지만, 개별 과제의 결과는 일치하지 않는다. 토론 연구에서는 확신도가 계속 높아지거나 서로 양립할 수 없는 높은 확신이 나타난다. 학습 판단 연구에서는 미래의 기억 수행을 잘 예측하지 못하며, 불확실성 전달 연구에서는 표현된 불확실성과 모델 내부의 불확실성이 어긋난다고 보고한다.
일부 연구에서는 모델이 자신의 답변을 미리 예상하거나, 일부 활성화 방향을 보고하거나 조절하고, 학습된 행동을 설명하거나, 훈련 후 자기 지식을 개선할 수 있다고 보고한다. 이러한 결과는 과제와 응답을 유도하는 조건에 좌우된다. 추론 능력이 좋아져도 자기 평가가 개선되는 것은 아니며, 난도를 예측하는 정보가 있어도 그에 맞는 행동으로 반드시 이어지지는 않는다.
측정 방식을 바꾸면 관찰되는 결과도 달라진다. 인용된 한 연구에서는 0–100 척도로 표현한 확신도 응답의 75% 초과가 3개 값에 몰린다. 다른 연구에서는 토큰 로그 확률로 구한 M-ratio가 약 0.85–1.05인 반면, 별도의 연구와 환경에서 자기 평정으로 구한 값은 약 0.62–0.92로 보고된다. 모델 계열, 사후 훈련, temperature, 과제 영역도 비교를 어렵게 만든다. 한편 메타인지 효율은 기존의 확신도 보정 점수가 비슷한 모델도 구분할 수 있다.
5 Giving LLMs Metacognitive Abilities
이 리뷰는 LLM, 추론 모델, 에이전트에 메타인지 기능을 부여하려는 시도를 프레임워크, 아키텍처, 프롬프팅, 훈련 전략으로 분류한다. 구현 연구의 상당 부분은 추론에 집중되어 있으며, 개별 방법의 실증 근거와 다른 용례를 다루는 범위는 고르지 않다.
5.1 Implementations of Metacognition in LLMs
Monitor-Generate-Verify (MGV)는 생성 전에 모니터링을, 생성 후에 검증을 배치한다. Pangu Embedded는 이중 과정 이론에서 착안한 추론에 미세 조정, 강화학습, 메타인지 프롬프트를 결합한다. 아키텍처 사례로는 State Stream Transformer (SST), SAGE-nano, 2계층 Metacognitive Introspective Reward Architecture (MIRA)가 있으며, 각각 별도의 인용 연구에서 제시되었다.
5.2 Metacognition for Reasoning Models
대형 추론 모델을 위한 추론 시점의 접근법은 전략을 선택하거나 기존 추론 템플릿을 재사용하고, 추가로 추론할 가치가 있는지 평가하거나, 불필요하게 이어지는 숙고를 끝낸다. 인용된 한 조기 종료 방법은 해당 평가에서 정확도 손실을 최소화하면서 추론 길이를 거의 35% 줄였다. 훈련 기반 접근법은 자기 비평을 거친 추론 기록, 예측된 생성 통계, 정답 여부 신호, 추가 연산의 가치 추정치를 활용한다.
5.3 Metacognition for LLM Agents
에이전트 연구에서는 학습 진행 상황, 오류 수정, 다중 에이전트 조정, 협업, 기억 추상화, 탐색·검색·도구 사용에 관한 결정에 모니터링과 제어를 적용한다. 인용된 사례로는 인간 전문가에게 언제 도움을 요청할지 결정하는 방법, 적절한 추상화 수준에서 재사용 가능한 기억을 저장하도록 별도 모델을 DPO로 훈련하는 방법, 기존 지식만으로 충분한지 판단한 뒤 추가 근거를 검색하는 방법이 있다.
6 Metacognitive Methods to Improve Capabilities of LLMs
이 서베이는 목표 과제의 성능을 높이는 방법과 학습 효율을 높이는 방법을 구분한다. 두 부류 모두 수행 수준이나 진행 상황을 평가해 수정, 자원 배분, 전략 선택에 반영하지만, 보고된 효과는 구체적인 방법과 과제에 따라 달라진다.
6.1 Improving Task Performance
과제 중심 방법은 일반적인 문제 해결, 확신도, 환각, 지식의 경계, 해석 가능성, 비추론 모델의 추론, 검색을 다룬다. 이 리뷰는 답변 정확도에 맞춰 확신도를 보정하는 방식과, 표현된 불확실성을 모델 내부의 불확실성에 맞추는 ‘faithful calibration’을 구분한다. 메타인지 피드백을 활용한 강화학습(RLMF)은 후자의 사례로 인용된다.
다른 사례에서는 성찰을 활용해 추론 전략을 선택하고, 검색이 필요한지 결정하며, 편향을 찾아내거나 도구 사용을 안내한다. 효과가 일률적인 것은 아니다. 인용된 설득 연구에서는 모델이 스스로 확신도를 보고하도록 하면 기존 믿음이 약해지는 영향에 더 취약해질 수 있다고 보고한다. 이는 각 개입이 의도한 결과를 실제로 내는지 평가해야 함을 보여준다.
6.2 Improving Learning Efficacy
학습 중심 사례에서는 일관성을 빠르게 확인하는 모니터와 경험을 바탕으로 더 느리게 판단하는 모니터를 사용해 불안정한 탐색 경로를 찾아 수정하고, 자기 비평 신호로 오류 수정을 훈련하며, 메타인지 민감도를 기준으로 전문가 모델 중 하나를 선택한다. 사고의 기억과 자기 개선을 활용하는 프레임워크는 반복적으로 성능을 높일 가능성을 제시하지만, 이 서베이가 일반적인 자율적 자기 개선을 입증하는 것은 아니다.
7 Applications of LLM Metacognition
이 리뷰는 응용 분야를 인간과 AI의 의사결정, 사용자 시뮬레이션, 교육이라는 3개 영역으로 나눈다. 각 영역의 결과는 모델의 모니터링뿐 아니라 사람이나 후속 시스템이 그 신호를 어떻게 사용하는지에도 달려 있다.
Human-AI Decision-Making
협력적 의사결정에 관한 이론 및 실증 연구는 AI의 예측 정확도와 메타인지 민감도를 구분한다. 확신도가 정답과 오답을 더 잘 구별하면 AI의 전체 정확도가 낮더라도 공동 의사결정이 개선될 수 있다. AI의 도움은 사용자가 답변을 평가하는 부담을 늘리고, 일부 환경에서는 적극적인 비판적 검토를 줄일 수도 있다.
User Simulation
시뮬레이션된 학생은 실제 초보자가 생각을 말로 풀어내는 경우보다 더 일관되고 자신 있게 추론할 수 있다. Cognitive Echo는 실제 학습 상호작용을 활용해 시뮬레이션된 추론이 학생의 추론을 더 잘 나타내도록 한다. 한편 MindVoyager는 상담 회기가 진행됨에 따라 시뮬레이션된 내담자의 개방성과 메타인지를 변화시켜 LLM 상담사 평가를 지원한다.
Pedagogy
교육을 위한 설계에는 성찰을 유도하는 질문, 교육적 보상, 학습자가 자신의 사고를 밖으로 표현하도록 요청하는 ‘Cognitive Mirror’가 있다. 참여도와 효과는 불확실하다. 이 리뷰에서 인용한 공학 실습 연구에서는 학생의 23%만이 메타인지 과제에 LLM을 사용했다. 다른 연구에서는 3개 교육 환경에서 챗봇 참여도가 낮았으며, 참여도와 학습 성과 사이의 연관성도 관찰되지 않았다.
8 Reflections & Discussion
저자들은 과신, 자신의 지식과 수행 수준에 대한 부정확한 판단, 불안정한 자기 성찰, 모니터링 결과를 제어로 옮기지 못하는 문제를 근거로 LLM의 메타인지가 아직 견고하지 않다고 결론짓는다. 겉으로 드러난 성찰을 메타인지와 동일시하지 말라고 경고하며, 프롬프트와 자기 보고의 역할, 범용 방법과 과제별 방법 중 무엇을 택할지에 관한 질문을 미해결 과제로 제시한다.
What are risks of LLM metacognition?
자기 모니터링이 개선되면 정직한 모델은 문제가 될 만한 성향을 공개할 수 있지만, 부정직한 모델은 자신의 행동을 파악하는 능력을 이용해 평가 중에 역량을 숨길 수도 있다. 저자들은 자율적인 계획과 학습에 대한 감독 문제를 제기하고, 사용자가 모델의 자기 지식과 오도하는 출력을 알아차릴 자신의 능력을 모두 잘못 판단할 수 있다고 경고한다. 윤리 성명에는 이 서베이가 실험을 수행하지 않았고, 민감한 데이터셋을 사용하지 않았으며, 주석 작업자를 고용하지 않았다고 명시되어 있다.
9 Future Directions
우선 과제로는 과제, 모델, 확신도를 끌어내는 방식, temperature, 영역을 달리해도 비교하기 쉬운 평가 체계를 마련하고, 관찰된 행동의 기제를 조사하며, 개선된 모니터링이 실제로 유용한 제어로 이어지는지 검증하는 일이 있다. 저자들은 창의성, 자기 개선, 마음 이론, LLM이 자신의 메타인지적 판단의 품질까지 평가할 수 있는지에 관한 연구도 제안한다.
결론에서는 관찰된 행동이 메타인지인지, 학습된 패턴을 모방한 결과인지, 또 배포와 감독에 무엇을 시사하는지 열린 질문으로 남긴다. 저자들은 관련 연구나 동시에 진행된 연구를 놓쳤을 수 있으며, 확신도에 관한 논의가 메타인지에 초점을 맞추었을 뿐 보정 연구 전반을 포괄적으로 조사한 것은 아니라고 인정한다.
짧은 생각
이 서베이에서는 과제 수행 능력, 자기 평가의 품질, 그 평가에 따른 행동을 구분하는 관점이 유용하다. 어느 한 측면에 관한 근거만으로 다른 측면까지 입증할 수는 없다. 이 논문은 공통 실험을 수행하기보다 다양한 연구를 종합하므로, 제시한 분류 체계는 모델 전반의 순위를 매기는 데보다 연구를 비교하는 데 직접적으로 도움이 된다.