


Shaping capabilities with token-level data filtering 요약 설명
29 Jan 2026 | Paper Review Token-Level Data Filtering LLM Safety LLM Pretraining Weak Supervision목차
- 요약
- 1. Introduction
- 2. Motivation and related work
- 3. Setting and approach
- 4. Token-level data filtering works and scales
- 5. How to train your classifier
- 6. How bad are bad labels?
- 7. Wrapping up
- 부록
- 짧은 생각
이번 글에서는 Shaping capabilities with token-level data filtering 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 29일(Arxiv), Preprint
- Rathi, Neil, Radford, Alec.
- Anthropic, Stanford, Independent
- 논문 링크
- Github
요약
- Shaping capabilities with token-level data filtering은 사전학습 단계의 개입으로 유용한 능력을 유지하면서 원치 않는 능력을 억제할 수 있는지 연구한다. 의학을 망각 대상 영역의 대용으로 삼고, 생물학과 일반 비의학 과제를 유지 대상 영역으로 삼아 문서 필터링, 토큰 손실 마스킹, 토큰 제거를 비교한다.
- 파라미터 수가 61M에서 1.8B인 Transformer를 대상으로 한 손실 비교에서, 토큰 필터링은 문서 필터링보다 망각과 유지 사이의 절충이 더 우수하다. 1.8B 파라미터 모델에서 토큰 제거는 의학 텍스트에 대해 손실을 맞춘 유효 연산량 기준으로 7000×를 넘는 둔화 효과를 보인다. 또한 기준 모델의 의학 손실을 회복하려면 RMU보다 13× 많은 적대적 미세조정 토큰이 필요하다. 이들은 서로 다른 측정값이므로 적대적 공격 비용의 추정치로 혼용할 수 없다.
- 분류기 파이프라인은 sparse autoencoder 특징으로 잡음이 있는 토큰 레이블을 생성하고, 이를 양방향 언어 모델 표현을 사용하는 저비용 프로브로 증류한다. 토큰 제거는 학습에 사용하지 않은 의학 질문의 거절률도 높인다. 다만 이 실험만으로 의학 대용 영역, 실험한 규모, 공격 설정을 넘어선 보편적 능력 제거나 배포 안전성이 입증되지는 않는다.
1. Introduction
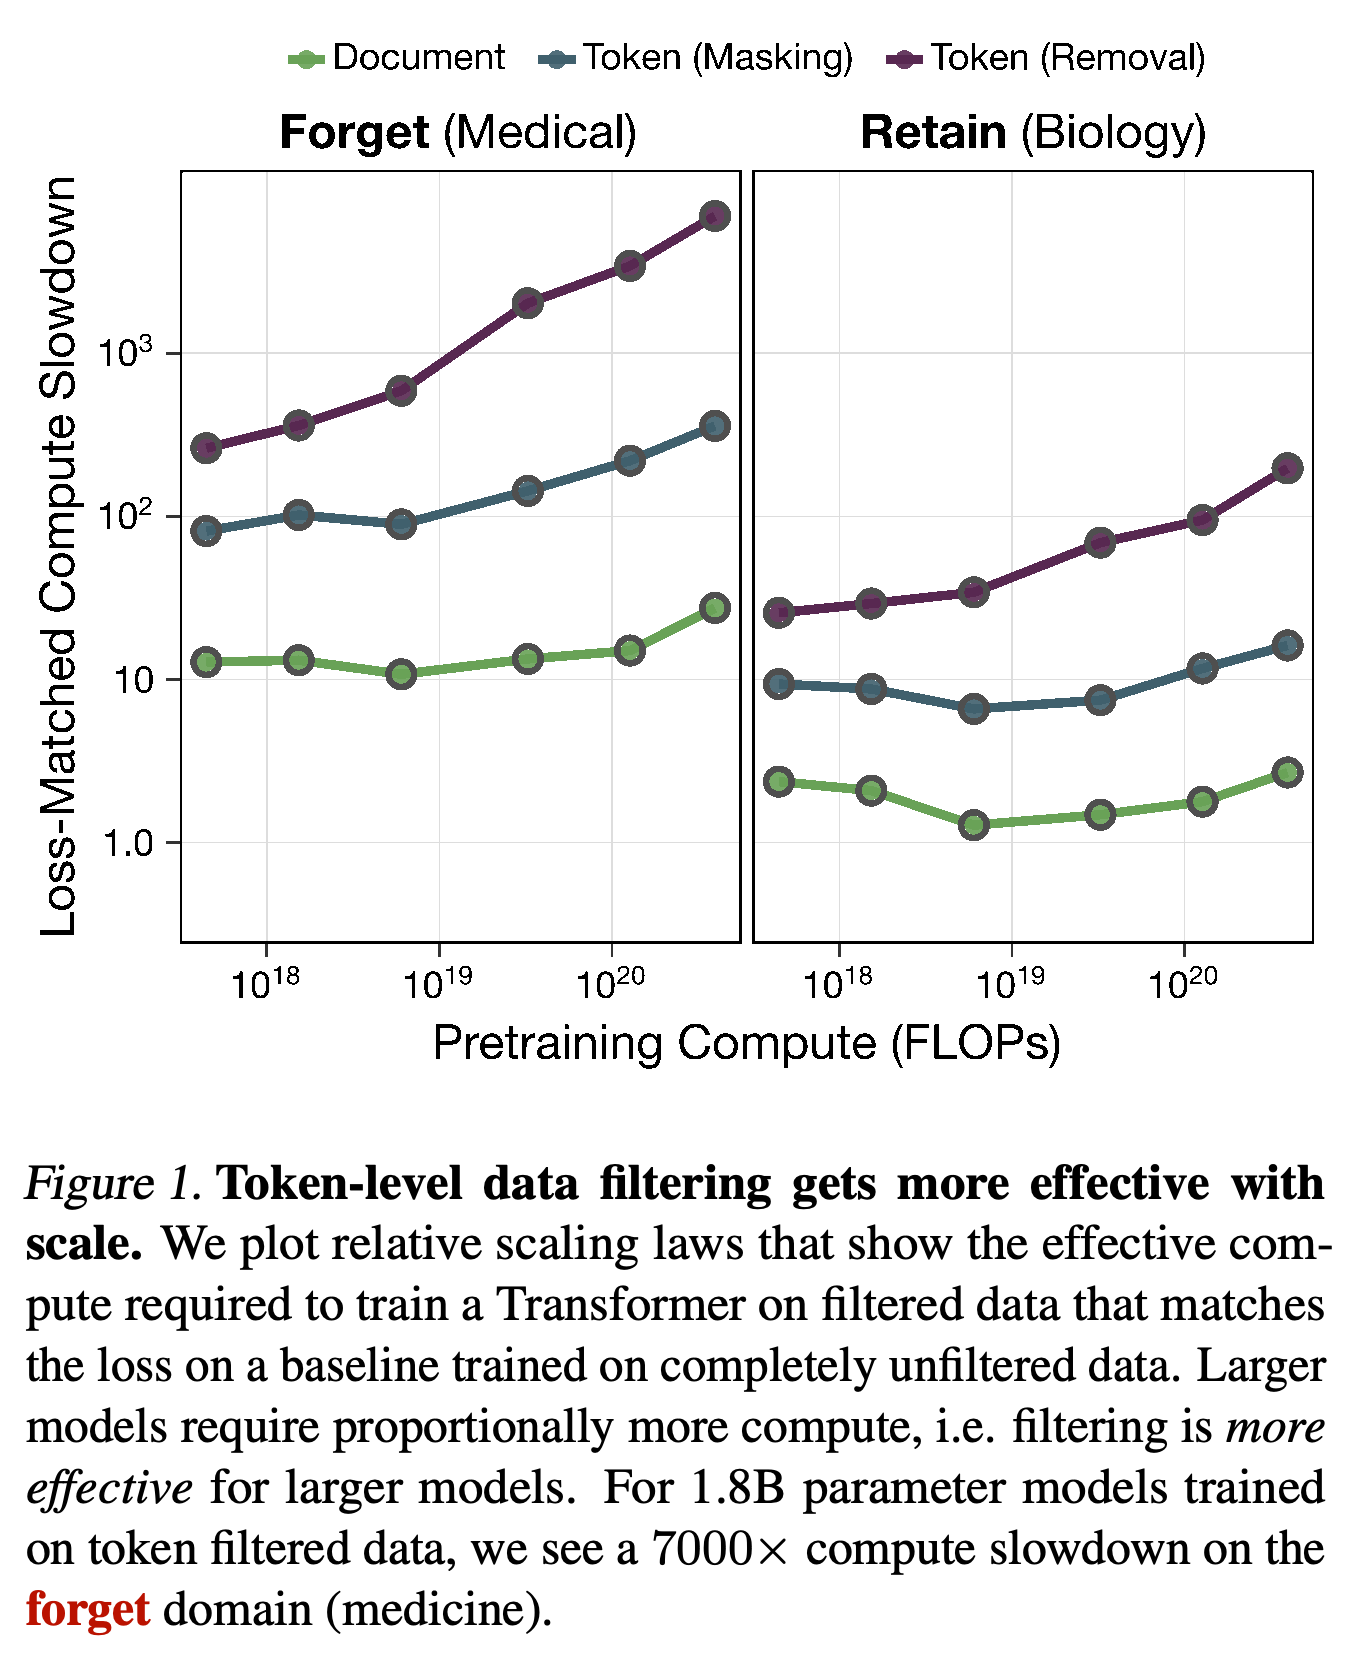
능력 조정은 유용한 능력을 크게 훼손하지 않으면서 원치 않는 능력을 줄이는 것을 목표로 한다. 논문은 사후 안전장치를 적용해도 사전학습 모델에 남아 있는 능력을 여전히 활용할 수 있다는 점을 들어 사전학습 중 필터링의 필요성을 설명한다. Figure 1은 규모가 커질수록 관찰된 의학 능력 억제가 강해지는 양상을 요약한다.
- 대체로 무해한 문서에서도 짧은 구간이 특정 능력을 학습시킬 수 있다. 따라서 문서 단위로만 데이터를 선택하기보다 토큰 단위 선택을 고려할 필요가 있다.
- 실험은 능력 억제, 재학습에 대한 견고성, 거절 학습, 분류기 비용, 불완전한 지도 신호를 각각 살펴본다.
- 원문은 저장소 식별자 neilrathi/token-filtering을 제공한다.
사전학습 연산량이 늘어나면 의학 손실을 맞춘 둔화 효과는 문서 필터링보다 토큰 제거에서 훨씬 빠르게 커진다. 생물학 패널에서도 유지 비용이 나타난다. 따라서 의학 결과는 부수적 손상 없이 능력을 억제한 결과가 아니라, 특정 영역의 유효 연산량 비교로 해석해야 한다.
2. Motivation and related work
관련 연구는 사후 행동 안전장치, machine unlearning, 사전학습 단계의 개입을 구분한다. 이미 습득한 능력은 제거하기 어렵고, 문서 필터링은 무해한 내용을 버리거나 대부분 무해한 문서 안의 유용한 정보 구간을 놓칠 수 있다. 이것이 더 세밀한 필터링을 시도하는 이유다.
- 기존 문서 필터링 연구는 CBRN 관련 능력의 억제를 보고했지만, 문서 단위가 최적이라는 점까지 입증하지는 않았다.
- 토큰 단위 데이터 기여도 분석은 같은 문서 안에서도 토큰마다 후속 생성에 미치는 영향이 크게 다를 수 있음을 보여준다.
- 논문은 외부 콘텐츠 분류기에만 의존하지 않고 모델 표현을 활용하는 대안으로 gradient routing과 unlearning을 적용한 모델로부터의 증류를 논의한다.
3. Setting and approach
목표는 유지 집합에서 기준 모델에 가까운 성능을 확보하면서 망각 집합의 성능을 최대한 낮추는 것이다. 사용 가능한 학습 예산으로는 실제 위험 능력을 유의미하게 평가할 만큼 강한 모델을 만들 수 없으므로, 의학을 대용 영역으로 사용한다.
- 사전학습 코퍼스에 레이블을 붙이고, 망각 관련 내용을 필터링한 뒤, 여러 연산량 예산으로 모델을 학습한다. 이후 텍스트 손실, 객관식 정확도, 자유 응답 품질을 평가한다.
- 생물학은 의학과 밀접한 유지 대상 영역이므로, 의학 분류 경계 부근에서 발생하는 부수적 손상을 드러낸다.
3.1. Data and data filtering
초기 실험에서 기본 FineWeb으로 학습한 모델은 1.8B 파라미터 규모에서도 생의학 벤치마크 성능이 낮았으므로, 모델을 FineWeb-Edu로 사전학습한다. 별도 명시가 없으면 분류기 임계값은 학습에 사용하지 않은 FineWeb-Edu 부분집합에서 F1을 최대화하도록 정한다.
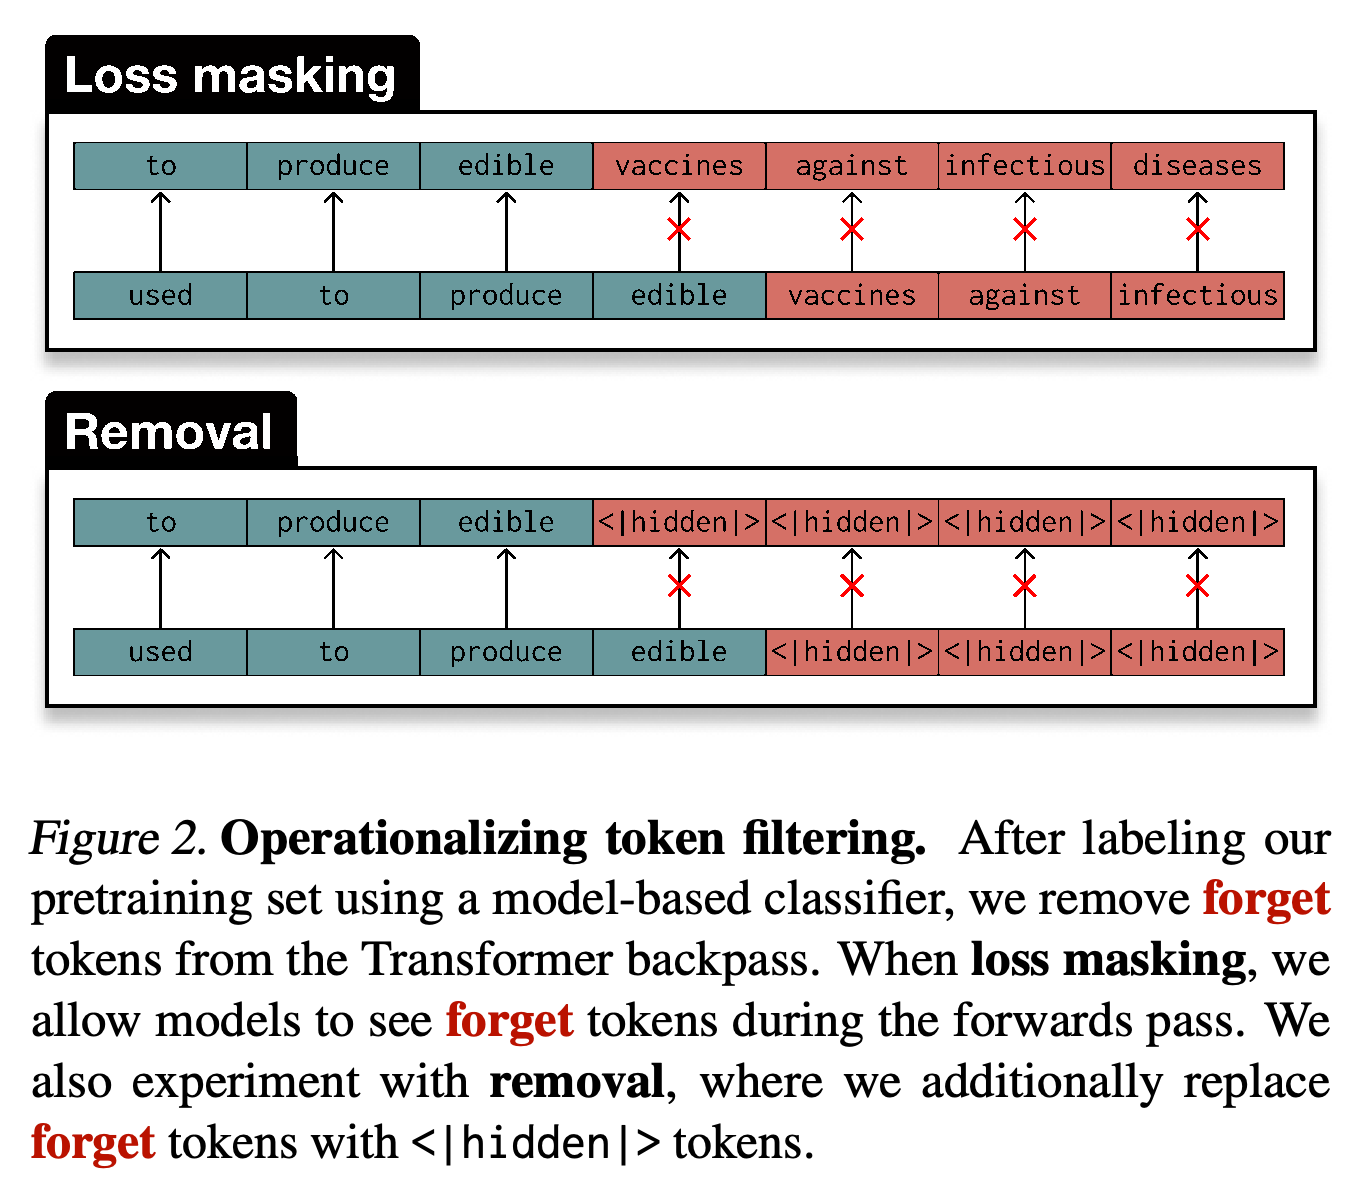
- 손실 마스킹은 망각 대상 토큰의 손실을 제외하지만, 순전파의 문맥에는 해당 토큰을 그대로 남긴다.
- 토큰 제거는 분류기가 망각 대상으로 식별한 토큰을 <|hidden|>으로 바꾸고 해당 손실을 마스킹한다. 토큰의 정체를 숨기지만 문맥의 일관성도 훼손한다.
- Figure 2는 타깃 손실을 억제하는 것과 입력 내용을 제거하는 것을 구분한다. 어느 방법도 능력과 관련된 모든 정보를 식별했다고 보장하지는 않는다.
두 방식 모두 분류기가 식별한 의학 타깃 위치의 학습 손실을 억제한다. 토큰 제거만 이후 입력 문맥에서 해당 토큰의 정체를 숨긴다. 이 차이는 마스킹과 제거가 서로 다른 표현과 억제 효과를 낼 수 있는 이유를 설명한다.
3.2. Model training
저자들은 AdamW와 µP 학습률 전이를 사용해, 파라미터 수가 61M에서 1.8B인 변형 GPT-2 계열 Transformer를 연산량 최적 설정으로 학습한다. 521M 이하 모델에는 2×NVIDIA H200을 사용하고, 1B와 1.8B 모델에는 8×NVIDIA H200을 사용한다.
- 주요 객관식 평가와 대화 평가는 1.8B 모델을 사용한다. 더 작은 비필터링 기준 모델은 성능이 너무 낮아 유의미한 억제 신호를 얻기 어려웠다.
- 제한된 연산량 예산에서 객관식 정확도를 충분히 끌어내기 위해 맞춤형 지시 학습 데이터 혼합을 사용한다. 대화 학습에는 smol-smoltalk를 사용한다.
- 이 평가는 필터링이 직접 수정하는 학습 목표와 밀접하게 연결된 텍스트 손실 평가를 보완한다.
3.3. Evaluation
텍스트 손실 평가는 의학 분야의 PubMed 논문, 생물학 분야의 bioRxiv 논문, 일반 비의학 분야의 arXiv와 PhilPapers 논문을 사용한다. Claude Sonnet 4로 잘못된 영역에 배정된 문서를 제거하고, 토큰 레이블링 파이프라인으로 관련 없는 토큰을 제외한다.
- 의학 객관식 시험은 MedMCQA, MedQA-USMLE, MMLU Medicine이다. 유지 영역 시험은 MMLU의 생물학, 비생의학 STEM, 비STEM 부분집합을 사용한다.
- 대화 학습을 거친 모델은 HealthSearchQA 질문에 답한다. Claude Sonnet 4가 Appendix E에 수록된 정의에 따라 정확성, 관련성, 문장 유창성을 평가한다.
- 자유 응답 평가의 대조 데이터는 의학 내용을 걸러낸 Alpaca다. AlpacaEval이나 그 평가 도구를 사용한 것은 아니다.
4. Token-level data filtering works and scales
결과에서는 망각과 유지 사이의 프런티어, 사전학습 규모별 억제 효과, 적대적 미세조정을 통한 회복, 거절 학습을 통한 제어를 평가한다. 이 시험은 영역 성능 저하, 재학습에 대한 저항성, 선택적 거절 행동을 구분한다.
4.1. Token filtering Pareto dominates document filtering
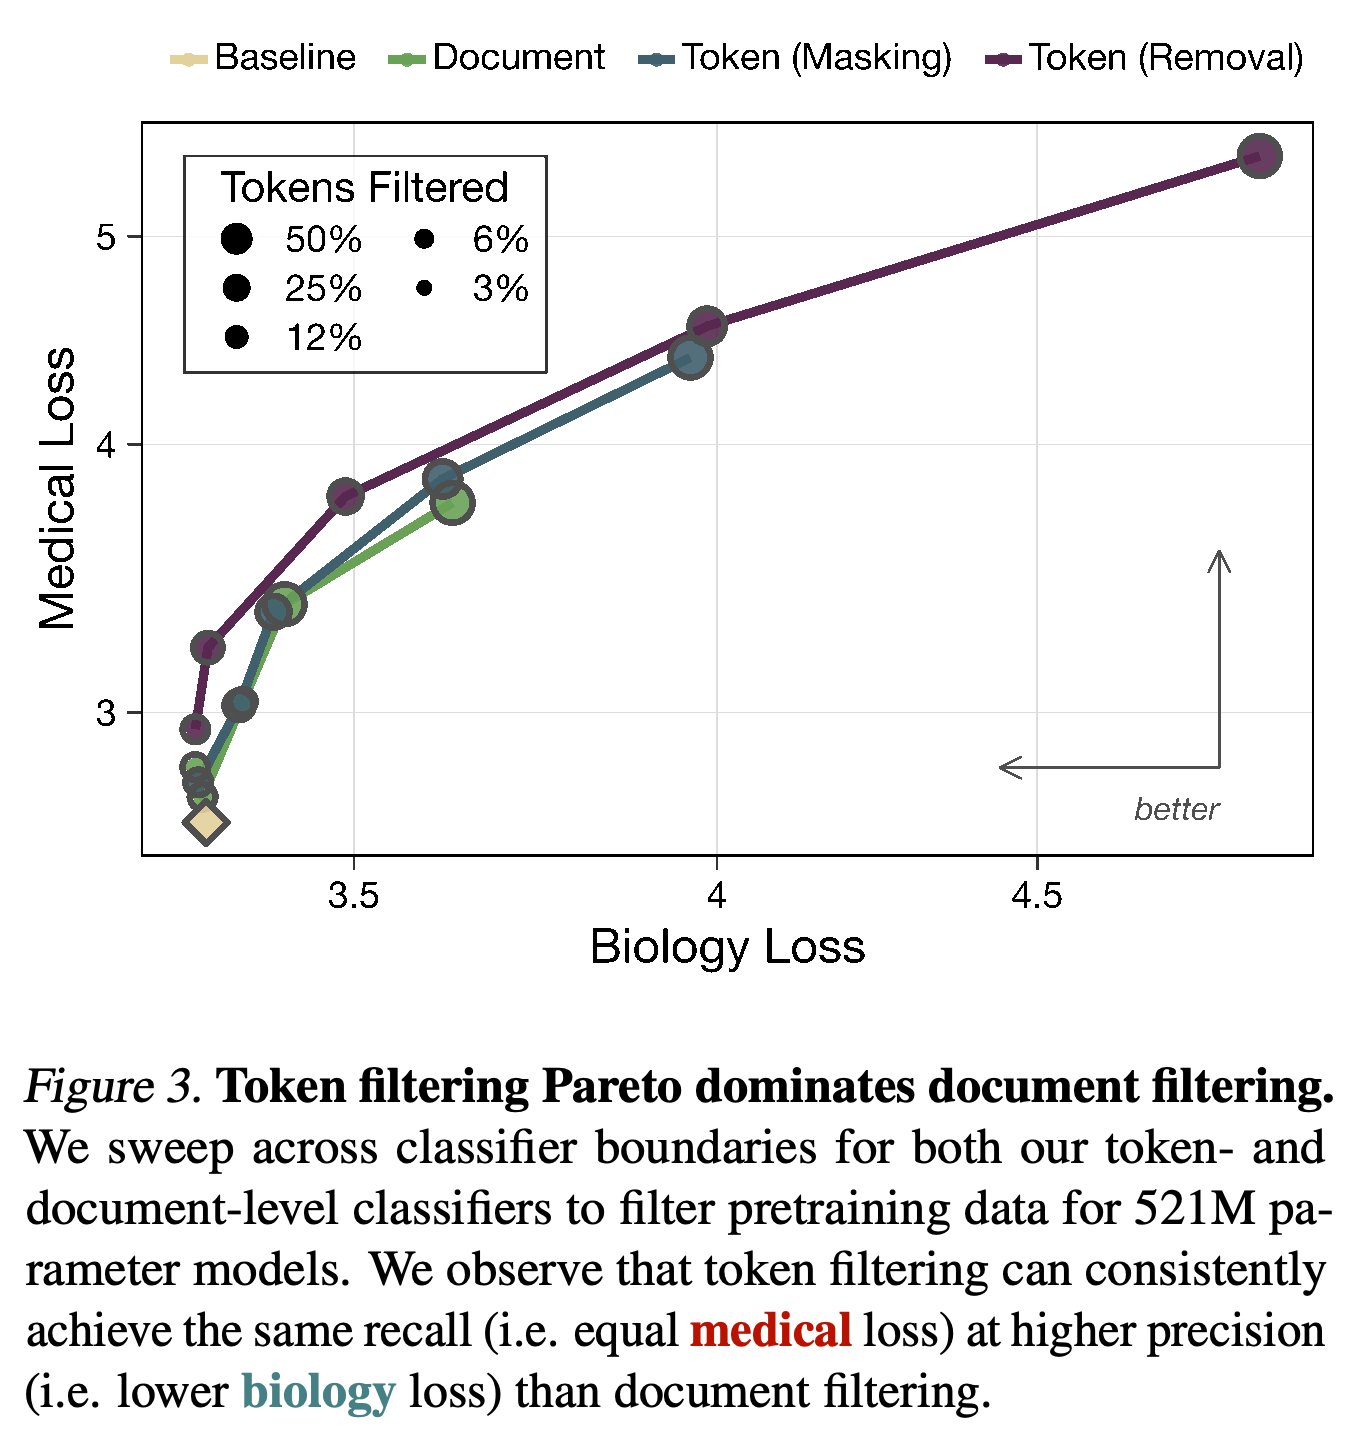
521M-parameter 모델에서 분류기 임계값을 바꾸어 사전학습 토큰의 3%, 6%, 12%, 25%, 50%를 필터링한다. Figure 3에서 토큰 필터링은 같은 의학 손실일 때 문서 필터링보다 생물학 손실이 낮다. 이는 이 실험에서 파레토 개선이 이루어졌음을 뒷받침한다.
- 의학 손실이 높을수록 억제가 강하고, 생물학 손실이 낮을수록 유지가 잘된 것이다.
- 이 비교는 분류기의 정밀도와 재현율을 직접 측정하는 것이 아니라, 후속 모델의 손실 간 절충을 측정한다.
521M-parameter 모델의 임계값 탐색에서 토큰 필터링은 문서 필터링보다 의학과 생물학 손실 사이의 절충이 더 우수하다. 마커 크기는 필터링 비율을 나타낸다. 단순히 더 적은 문서를 제거한다는 뜻이 아니라, 같은 의학 손실을 더 낮은 생물학 손실로 달성할 수 있다는 뜻이다.
4.2. Filtering works, and filtering scales
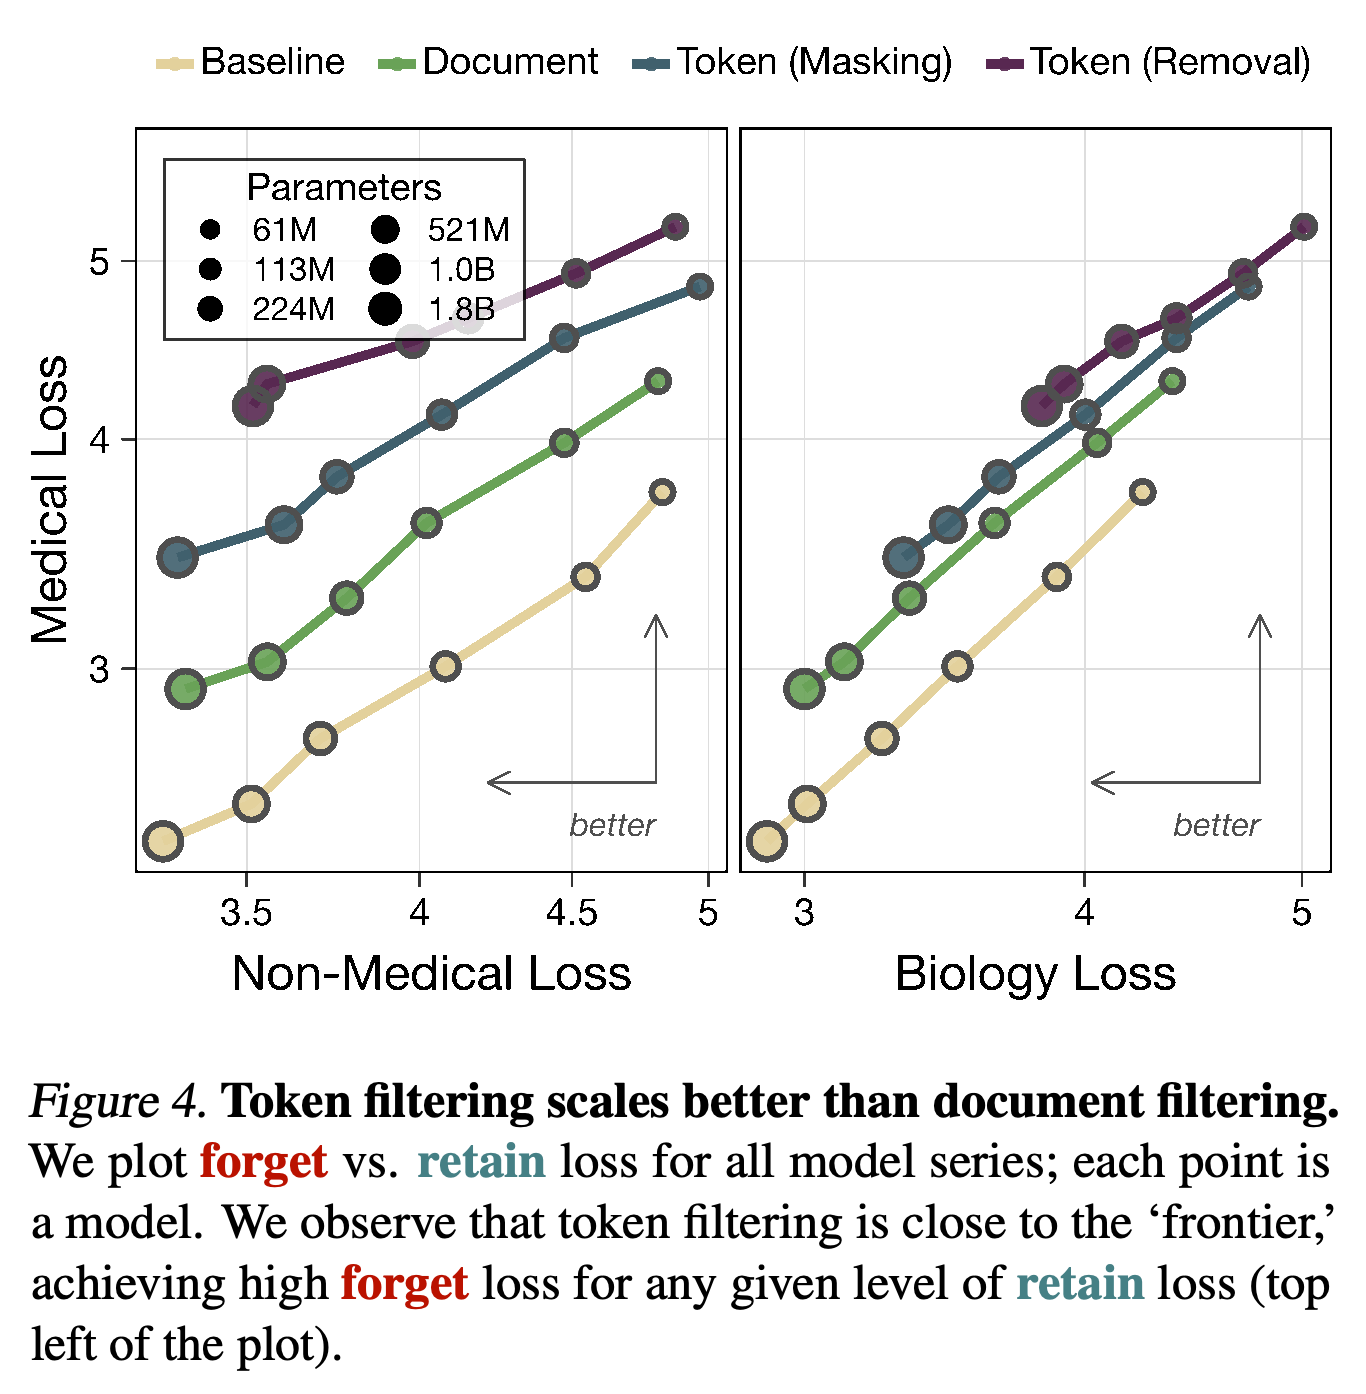
Figure 4는 모델 크기별 망각과 유지 손실의 프런티어를 보여준다. 토큰 필터링은 대체로 같은 유지 손실에서 더 높은 의학 손실을 달성한다. 비필터링 모델의 연산량과 손실 관계로 추정하면, 가장 큰 토큰 제거 모델의 의학 둔화 효과는 7000×를 넘고 문서 필터링은 약 30×다.
- 이는 손실을 맞춘 유효 연산량 추정치다. 실제 실행 시간이 느려지는 정도를 측정한 것도, 공격자에게 7000× 많은 연산량이 필요하다고 보장한 것도 아니다.
- 실험한 규모 범위에서는 기준 모델 대비 억제 효과가 강해진다. 다만 토큰 제거는 생물학 텍스트 손실도 상당히 높인다.
- 논문은 로그-로그 선형 보간을 설명한다. Figure 19는 가장 큰 토큰 제거 모델을 비교할 때 기준 모델의 관계를 실제 측정한 연산량 범위 아래로 확장한다.
각 점은 모델 크기를 나타내며, 규모에 따라 망각과 유지 사이의 절충이 어떻게 달라지는지 보여준다. 토큰 제거는 의학 손실을 가장 높이지만, 생물학 손실에서도 부수적 손상이 드러난다. 따라서 비의학 패널과 생물학 패널은 따로 해석해야 한다.
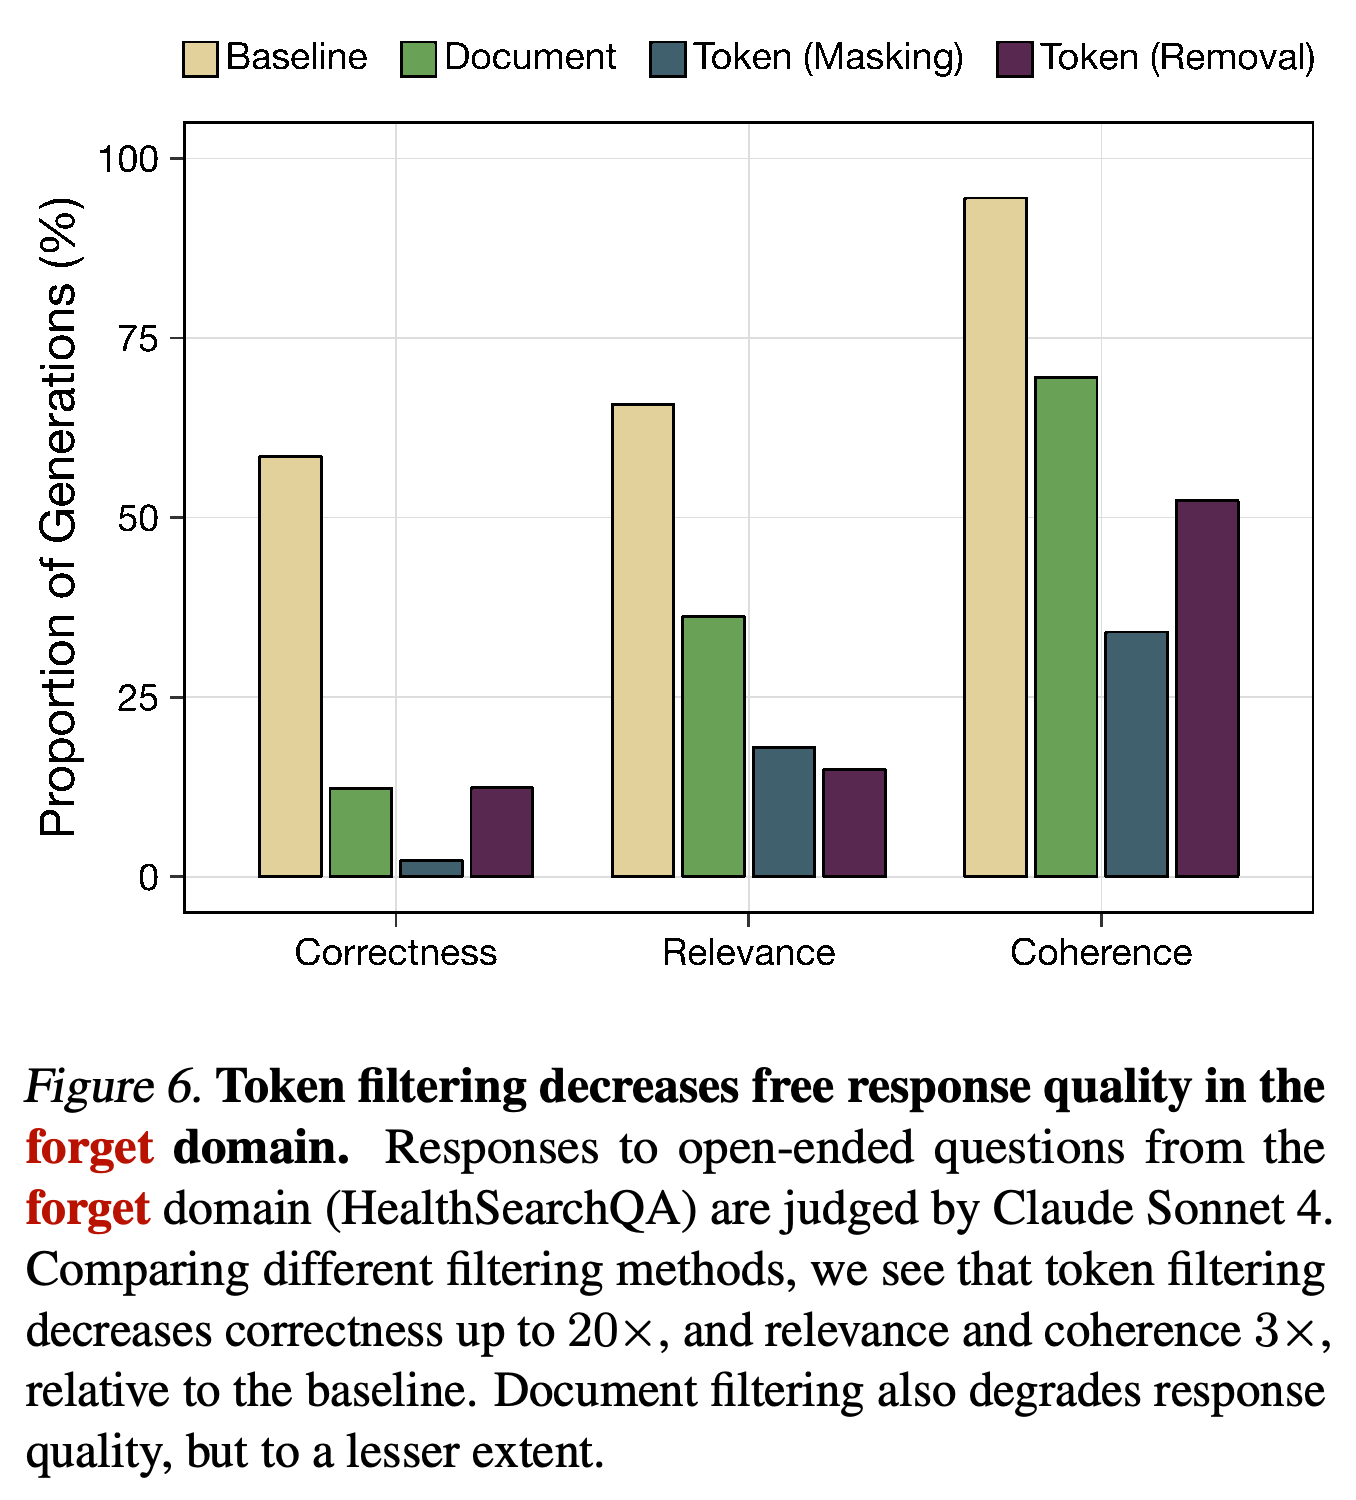
필터링한 모델에 instruction tuning을 적용하면 MedMCQA와 MedQA-USMLE 성능은 무작위 추측 수준에 가까워지지만, 유지 영역의 객관식 점수는 전반적으로 비슷하게 유지된다. 토큰 필터링은 HealthSearchQA 응답의 품질도 낮춘다. 응답은 반복적이거나 질문과 무관해지며, 유창하지만 사실과 다른 내용을 담기도 한다.
- Figure 5는 특히 토큰 제거에서 생물학과 비STEM 정확도가 낮아짐을 보여준다. 따라서 유지 성능이 전혀 변하지 않는 것은 아니다.
- 본문은 문장 유창성과 관련성이 4× 낮고 정확성이 10× 낮다고 보고한다. Figure 6의 캡션은 정확성이 최대 20× 낮고 관련성과 문장 유창성이 3× 낮다고 보고한다. 이 원문 진술들을 하나의 수치로 합쳐서는 안 된다.
- Alpaca 대조 평가에서 자유 응답 성능은 약간 저하되지만 대체로 비슷하다. 다만 부록의 해당 결과는 1개의 무작위 시드를 사용한다.
필터링한 모델은 MedMCQA와 MedQA-USMLE에서 무작위 추측 기준선인 25%에 가까워지지만, MMLU Medicine에서는 더 많은 잔여 성능을 유지한다. 유지 영역 점수는 전반적으로 비슷하지만, 막대그래프는 특히 토큰 제거에서 생물학과 비STEM 성능이 낮아짐을 보여준다.
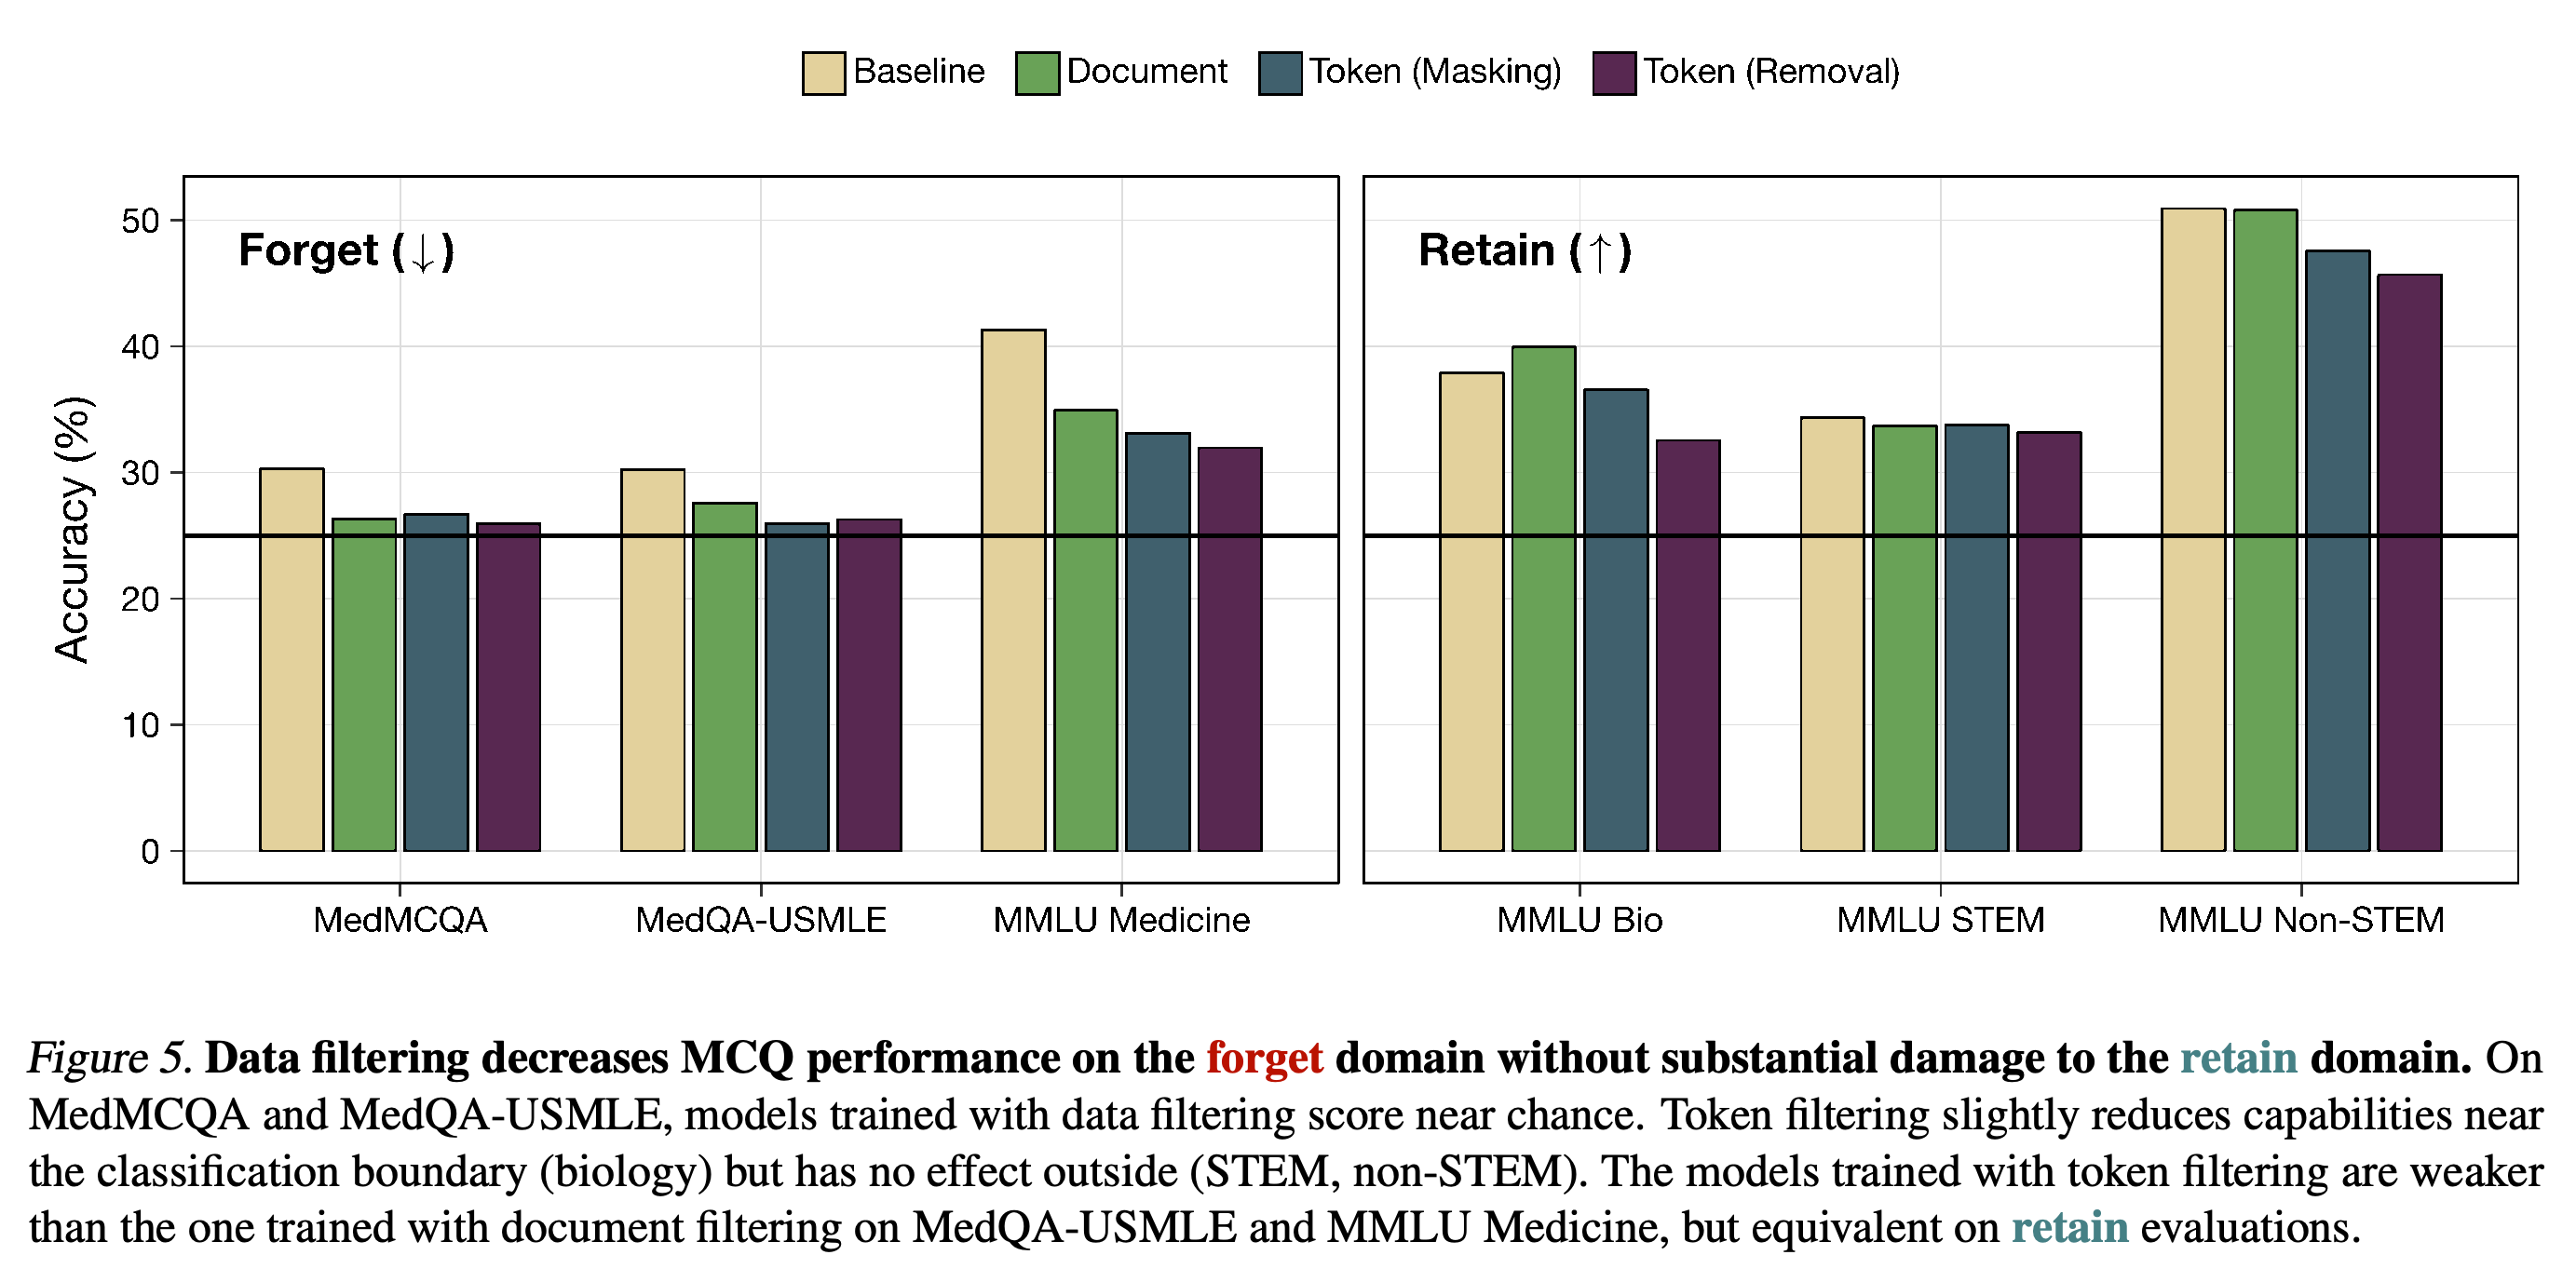
손실 마스킹에서는 사실적으로 정확하다고 판정된 응답이 특히 적다. 토큰 제거는 의학적 정확성을 회복하지 않으면서도 유창성을 더 많이 보존한다. 평가 기준은 사실적 정확성, 관련성을 보이려는 시도, 언어적 유창성을 구분한다. 캡션의 배수 표현은 본문 요약과 다르다.
4.3. Filtering is more robust than unlearning
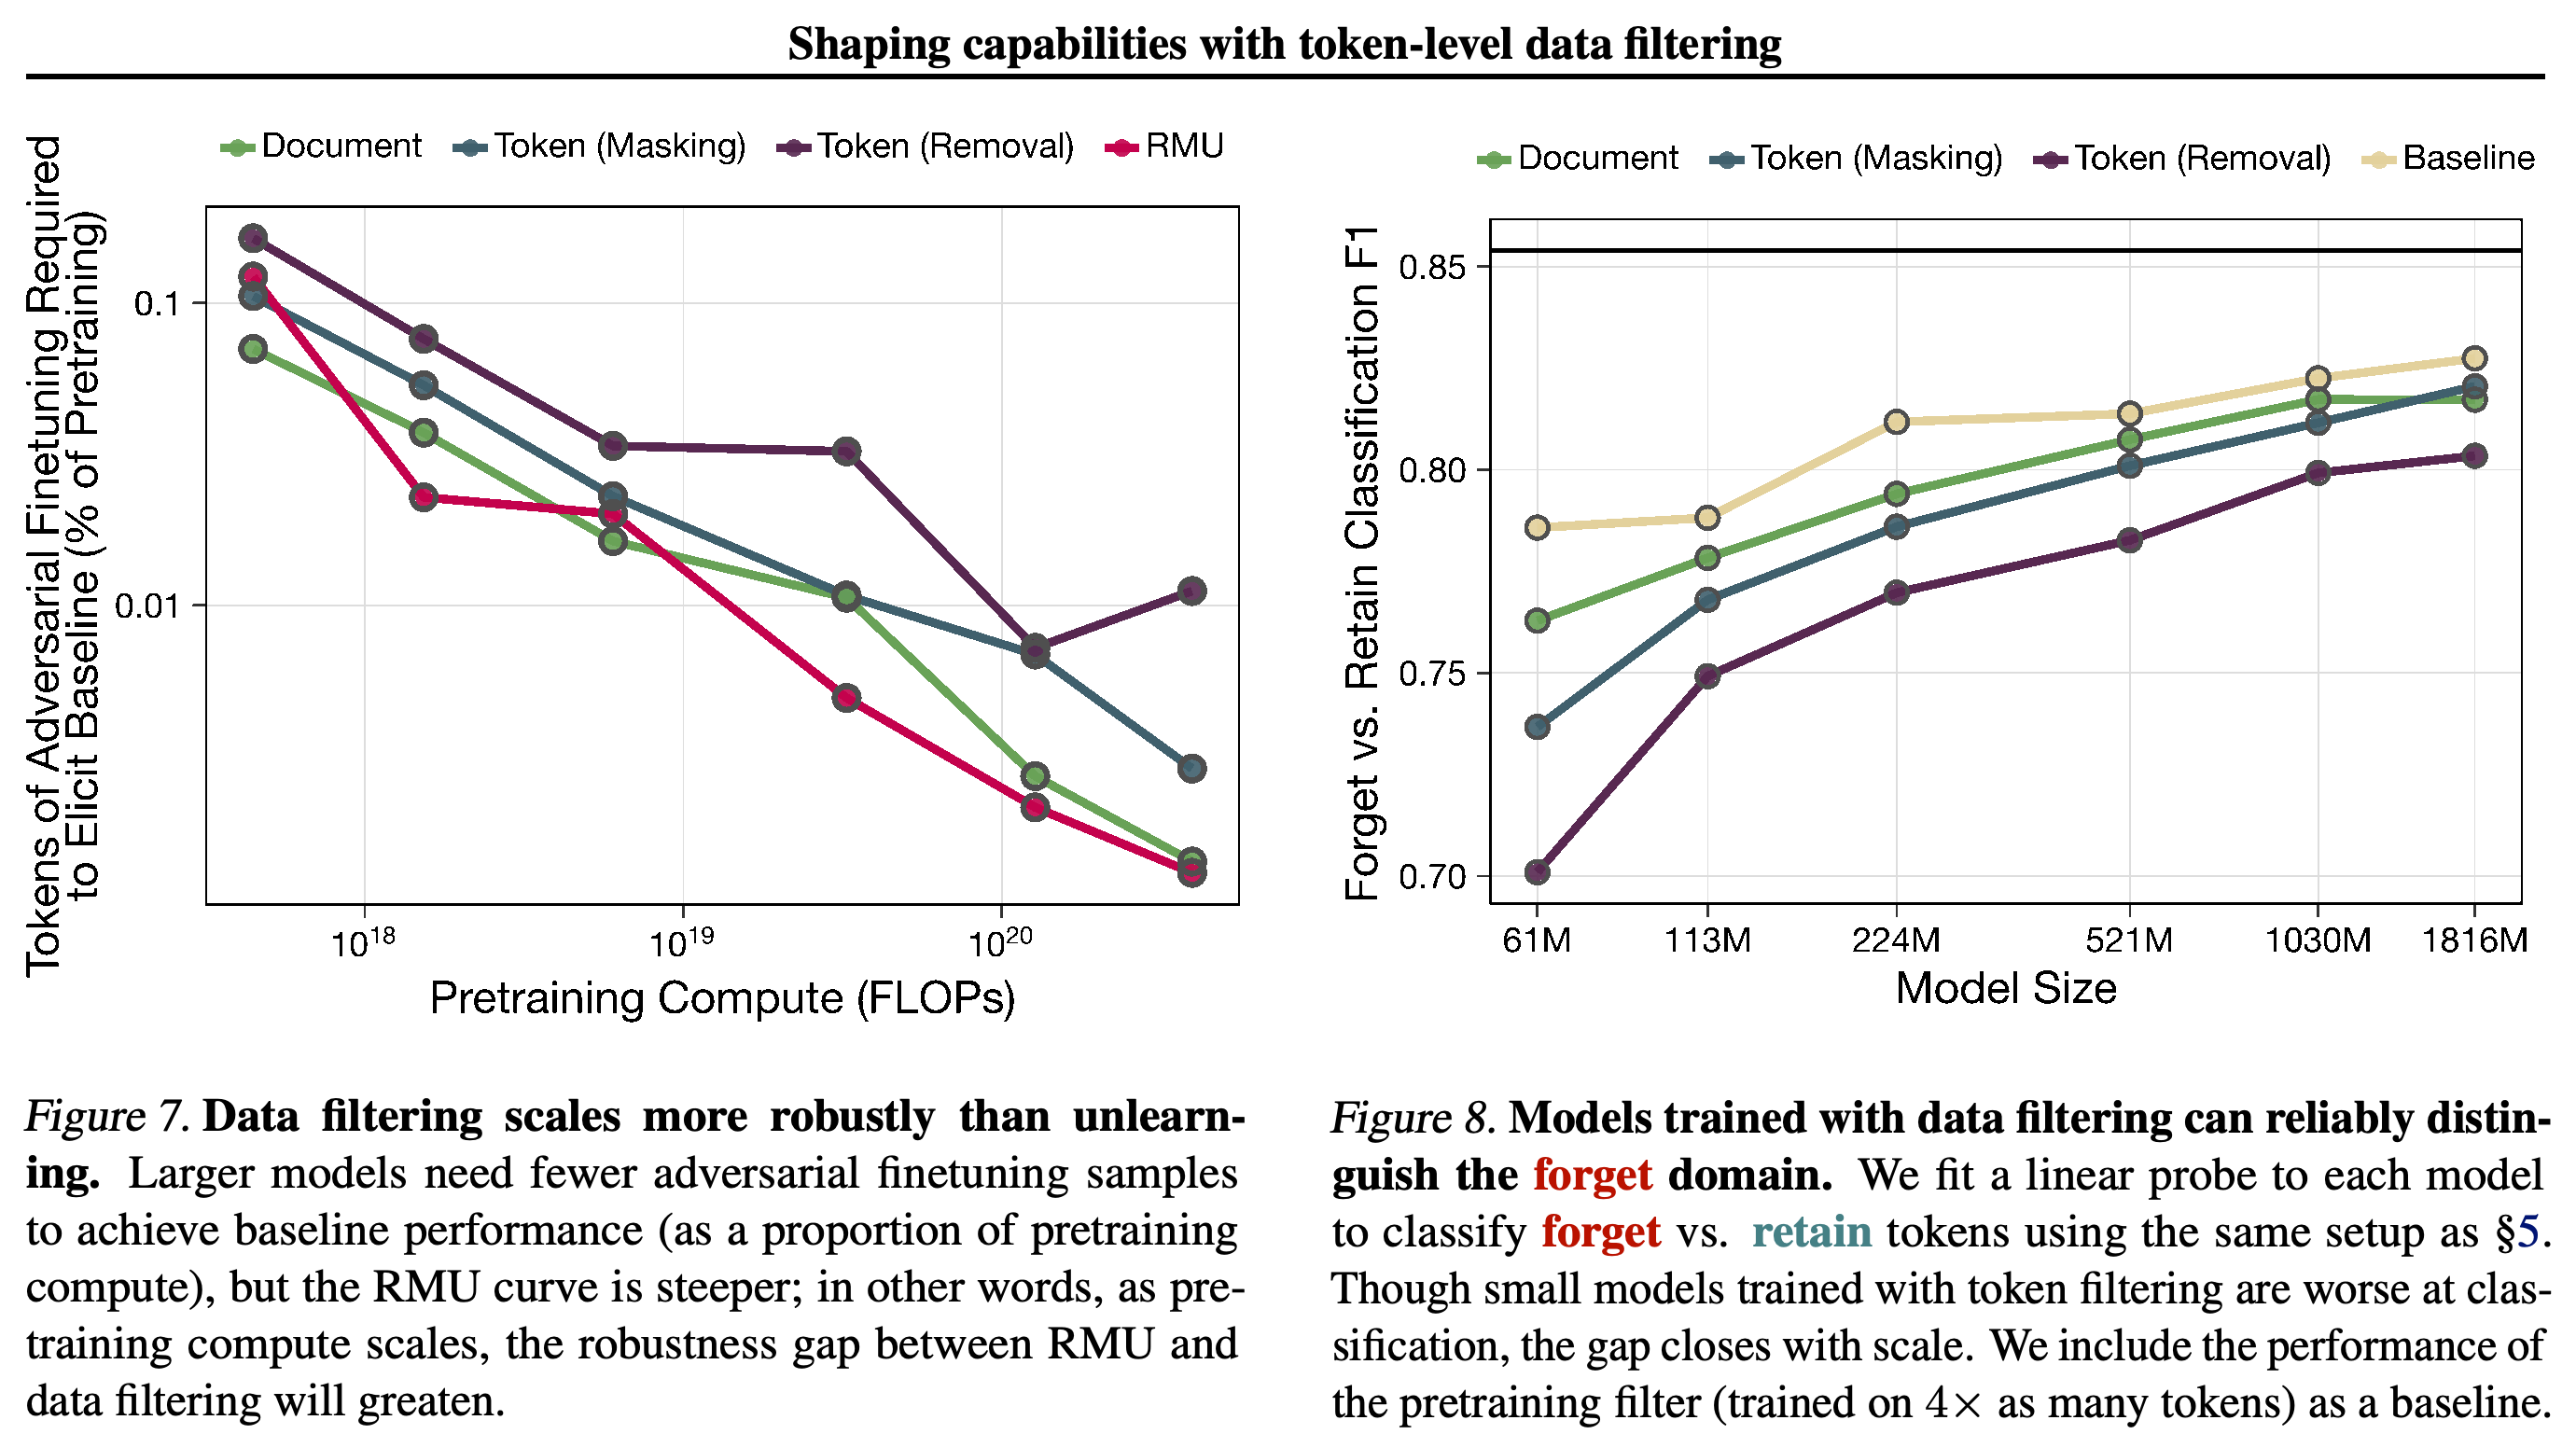
견고성 실험에서는 공격자에게 모델 가중치 접근을 허용하고, 의학 손실이 비필터링 기준 모델과 같아질 때까지 Common Pile의 PubMed 텍스트로 미세조정한다. 1.8B 파라미터에서 토큰 제거는 RMU보다 13× 많은 회복 토큰이 필요하다. 토큰 손실 마스킹은 3×, 문서 필터링은 1.5×가 필요하다.
- RMU는 PubMed를 망각 집합으로, Project Gutenberg를 유지 집합으로 사용한다. 유지 표현을 보존하면서 망각 표현을 무작위 벡터 쪽으로 이동시킨다.
- 미세조정 하이퍼파라미터는 공통 학습률을 강제하는 대신, 가장 적은 단계로 기준 손실을 회복하도록 선택한다.
- Figure 7에서 사전학습 토큰 대비 회복 토큰의 요구량은 규모가 커질수록 대체로 감소하며, RMU에서는 더 가파르게 감소한다. 이 비교에서는 필터링이 더 견고하지만, 재학습이 불가능하거나 모든 unlearning 방법보다 우수하다는 뜻은 아니다.
회복 토큰 수를 사전학습 토큰 수로 정규화하며, 모델이 커질수록 요구량은 대체로 감소한다. 가장 큰 규모에서는 토큰 제거의 요구량이 가장 높다. RMU는 사전학습 규모 대비 되돌리기가 더 쉬워진다. 이 곡선은 회복이 불가능하다는 뜻이 아니다.
4.4. Token-level filtering makes alignment easier
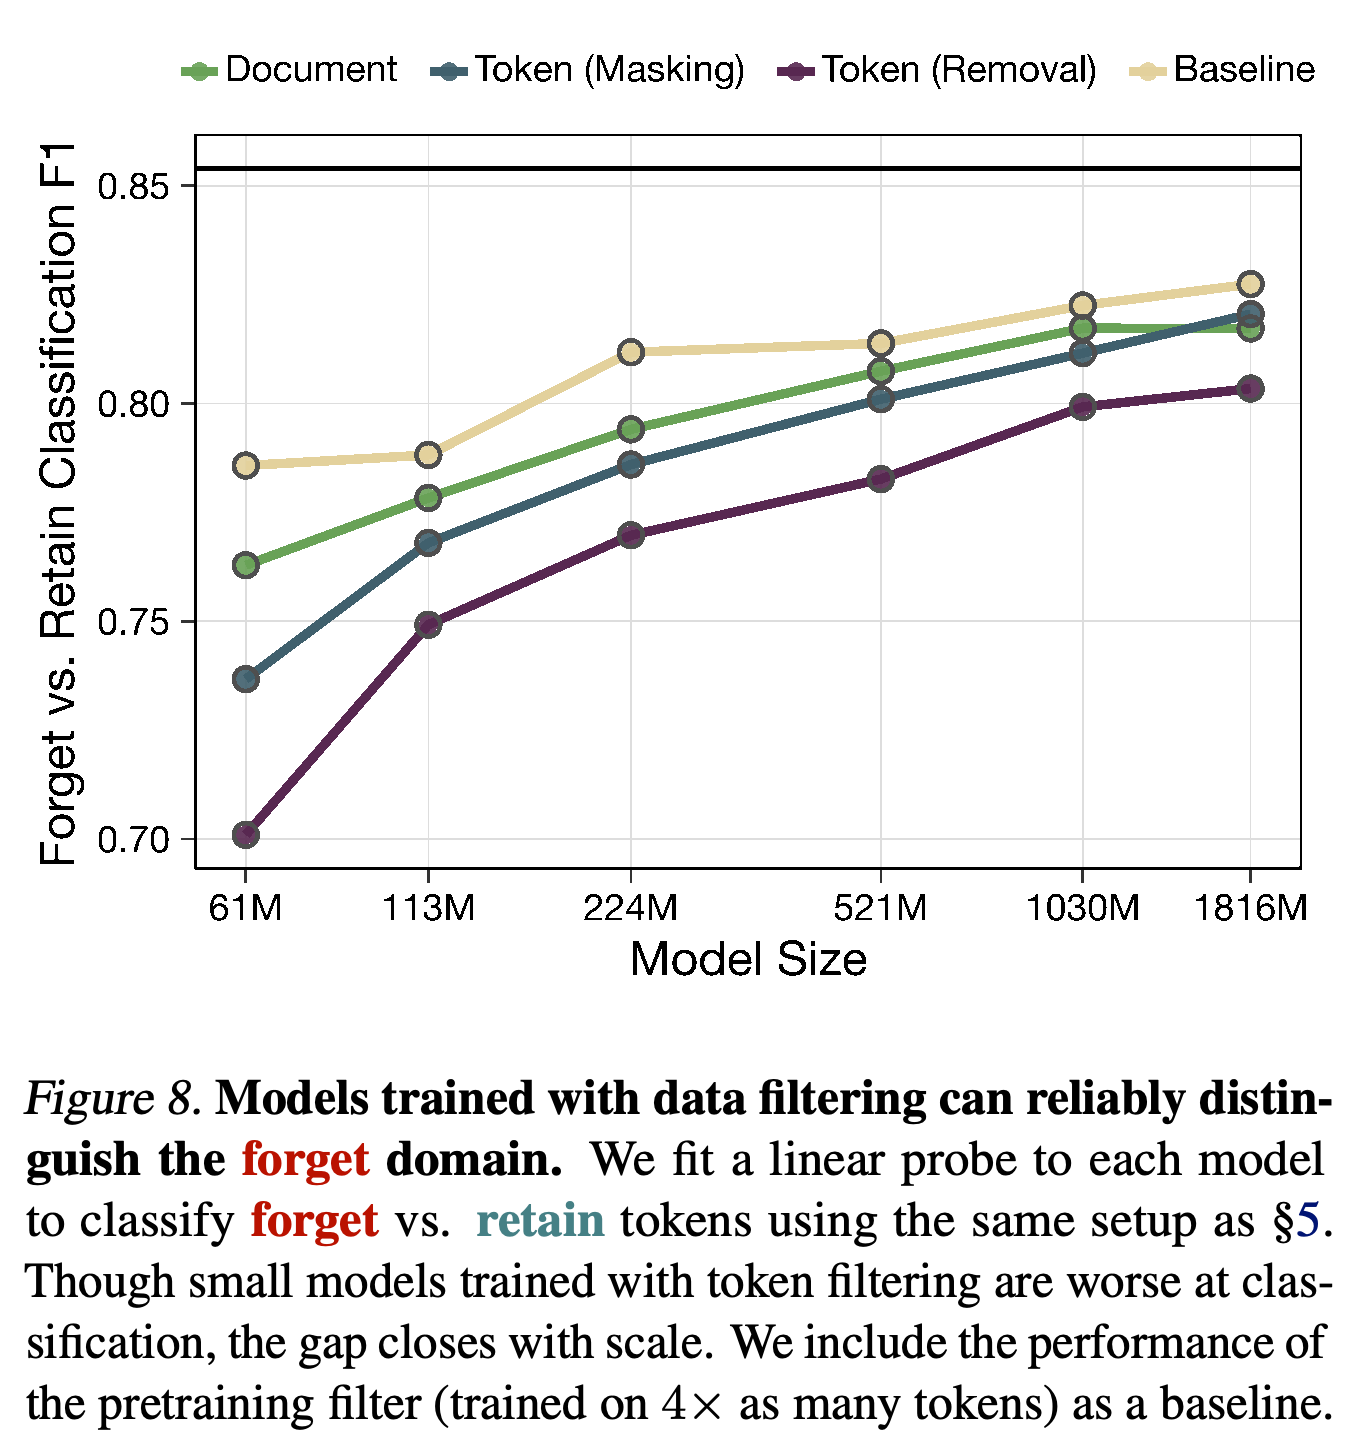
2.05M 토큰 부분집합으로 학습한 선형 프로브를 사용해, 필터링한 모델이 여전히 의학 토큰과 비의학 토큰을 구분하는지 시험한다. Figure 8에서 비필터링 모델과의 분류 성능 격차는 규모가 커질수록 줄어든다. 별도로 학습한 사전학습 필터도 추가 기준으로 제시한다.
- 영역을 인식할 수 있다고 해서 의학 질문에 답하는 능력이 보존되었다는 뜻은 아니다.
- 별도의 medRxiv 실험에서 토큰 필터링은 신경학과 감염병 사이의 구분을 약화시킨다. 반면 각 하위 영역과 비의학 내용 사이의 구분은 강하게 유지된다.
- 저자들은 이 양상이 망각 영역 내부의 세부 구분을 보존하기보다, 학습한 내용과 학습하지 않은 내용을 구분한다는 해석에 부합한다고 본다.
필터링한 표현은 의학과 비의학을 구분하는 데 여전히 유용하며, 비필터링 모델군과의 격차는 규모가 커질수록 줄어든다. 수평 기준선은 분류 토큰을 4× 많이 사용해 학습한 사전학습 필터다. 비필터링 모델군에 속한 또 다른 점이 아니다.
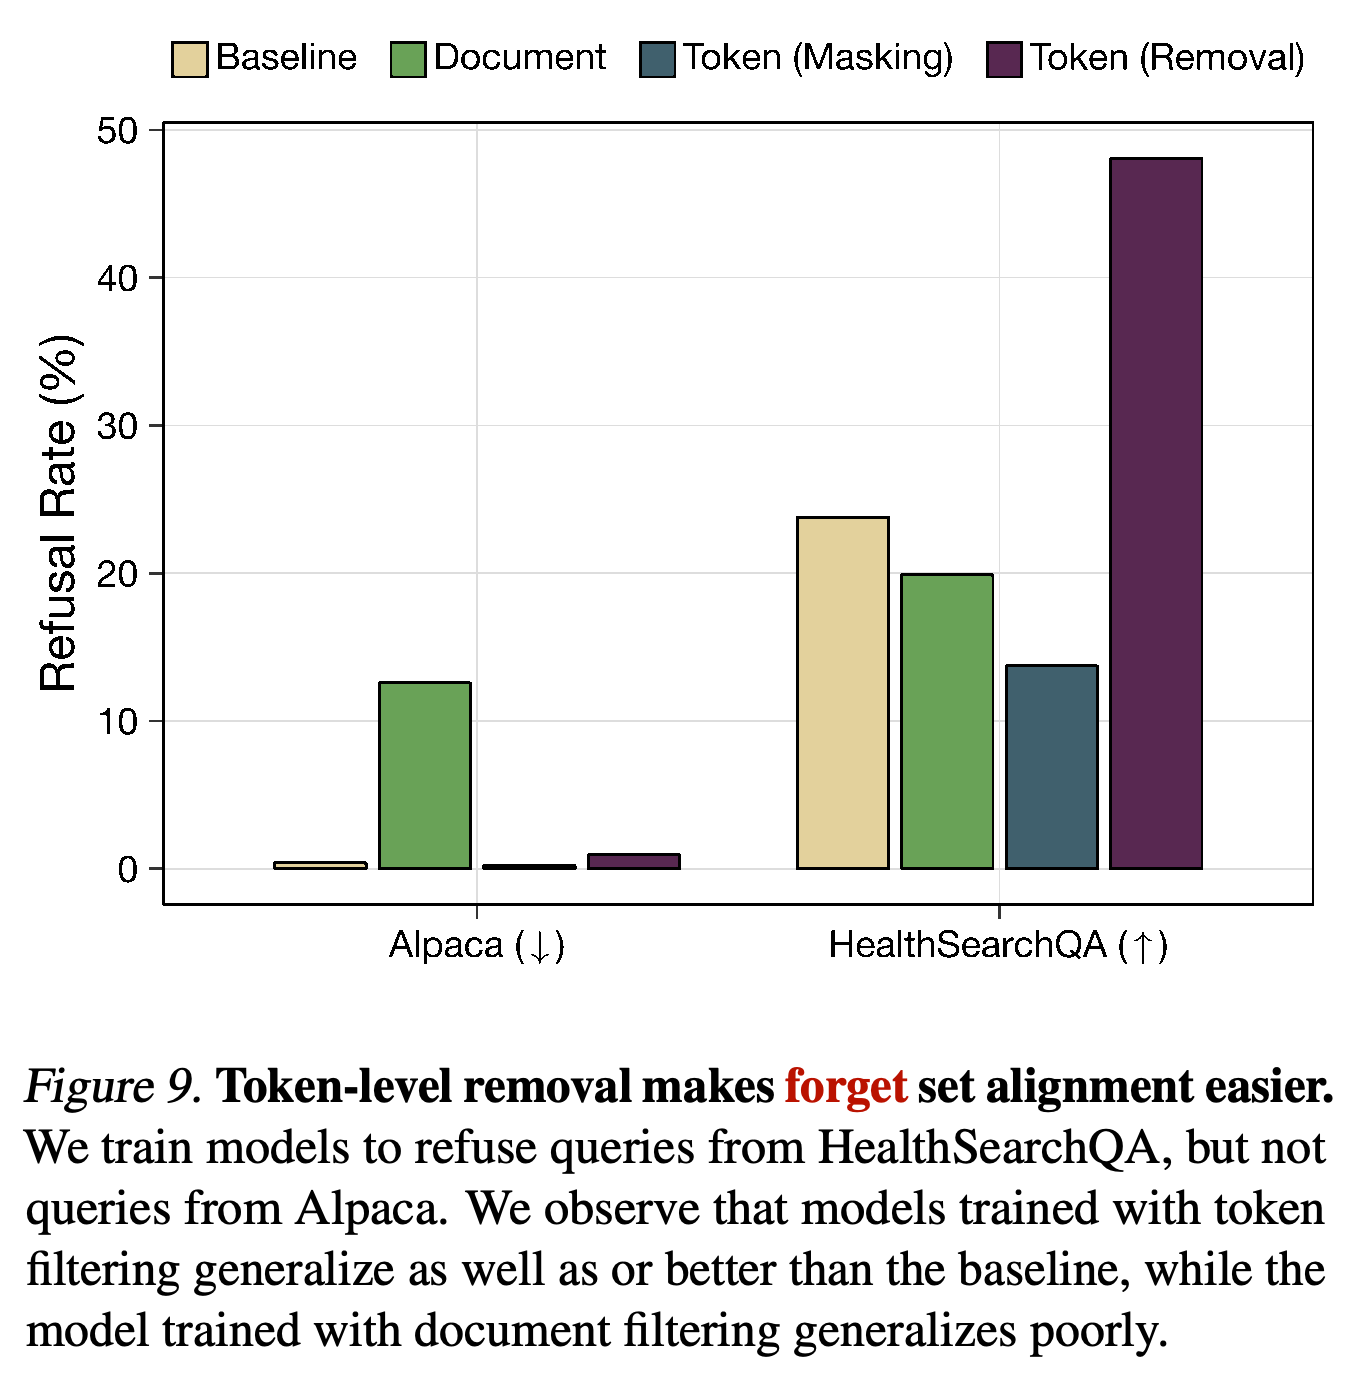
이미 대화 학습을 거친 1.8B 모델을 미세조정해 HealthSearchQA에는 한 문장으로 거절하고, Alpaca에는 일반적인 답변을 생성하도록 한다. 이후 학습에 사용하지 않은 예제를 세 개의 무작위 시드로 평가한다. 토큰 제거는 Alpaca 거절률을 눈에 띄게 높이지 않으면서 기준 모델 대비 의학 거절률을 약 두 배로 높인다. 반면 문서 필터링은 무해한 질문도 거절한다.
- 손실 마스킹은 기준 모델보다 의학 질문을 약간 덜 거절하며, Alpaca 거절률은 낮게 유지한다.
- Figure 9는 모든 토큰 필터링 방식이 아니라, 특히 토큰 제거에서 선택적 거절이 개선됨을 뒷받침한다.
- 거절률은 여전히 모든 대상 질문을 거절하는 수준에 크게 못 미친다. 이 실험은 광범위한 jailbreak 저항성 평가가 아니다.
토큰 제거는 Alpaca 거절률을 낮게 유지하면서 학습에 사용하지 않은 의학 질문의 거절률을 높인다. 문서 필터링은 선택성이 더 낮은 정책을 만든다. 손실 마스킹은 기준 모델보다 의학 거절률을 높이지 못한다. 따라서 이 시험의 정렬 이점은 토큰 제거 방식으로 제한된다.
5. How to train your classifier
분류기는 토큰이 망각 영역과 관련된 지식을 담는지 예측한다. 관련성을 그 토큰이 원치 않는 능력을 가르치는지 판단하는 대용 지표로 사용한다. 논문은 관련성과 인과적 영향을 명확히 구분한다. 능력을 높이는 데이터가 분류기를 통과할 수 있고, 분류기가 식별한 내용이 반드시 그 능력을 높이는 것도 아니다.
5.1. Sourcing ground-truth labels
토큰 주석은 폭이 16k인 Gemma 2 9B의 layer-31 SAE로 생성한다. Claude 3.5 Haiku가 Neuronpedia API를 통해 잠재 특징을 설명하고, Claude Sonnet 4가 의학 관련 설명을 식별한다. 임베딩 점수가 0.9 미만인 특징을 제외하면 의학 잠재 특징 600개가 남는다.
- 의학 잠재 특징 중 적어도 2개에서 활성값이 평균보다 4SD 이상 높으면 토큰에 의학 레이블을 붙인다. 이후 적어도 1개의 의학 잠재 특징에서 활성값이 양수인 인접 토큰을 수렴할 때까지 반복해서 추가한다.
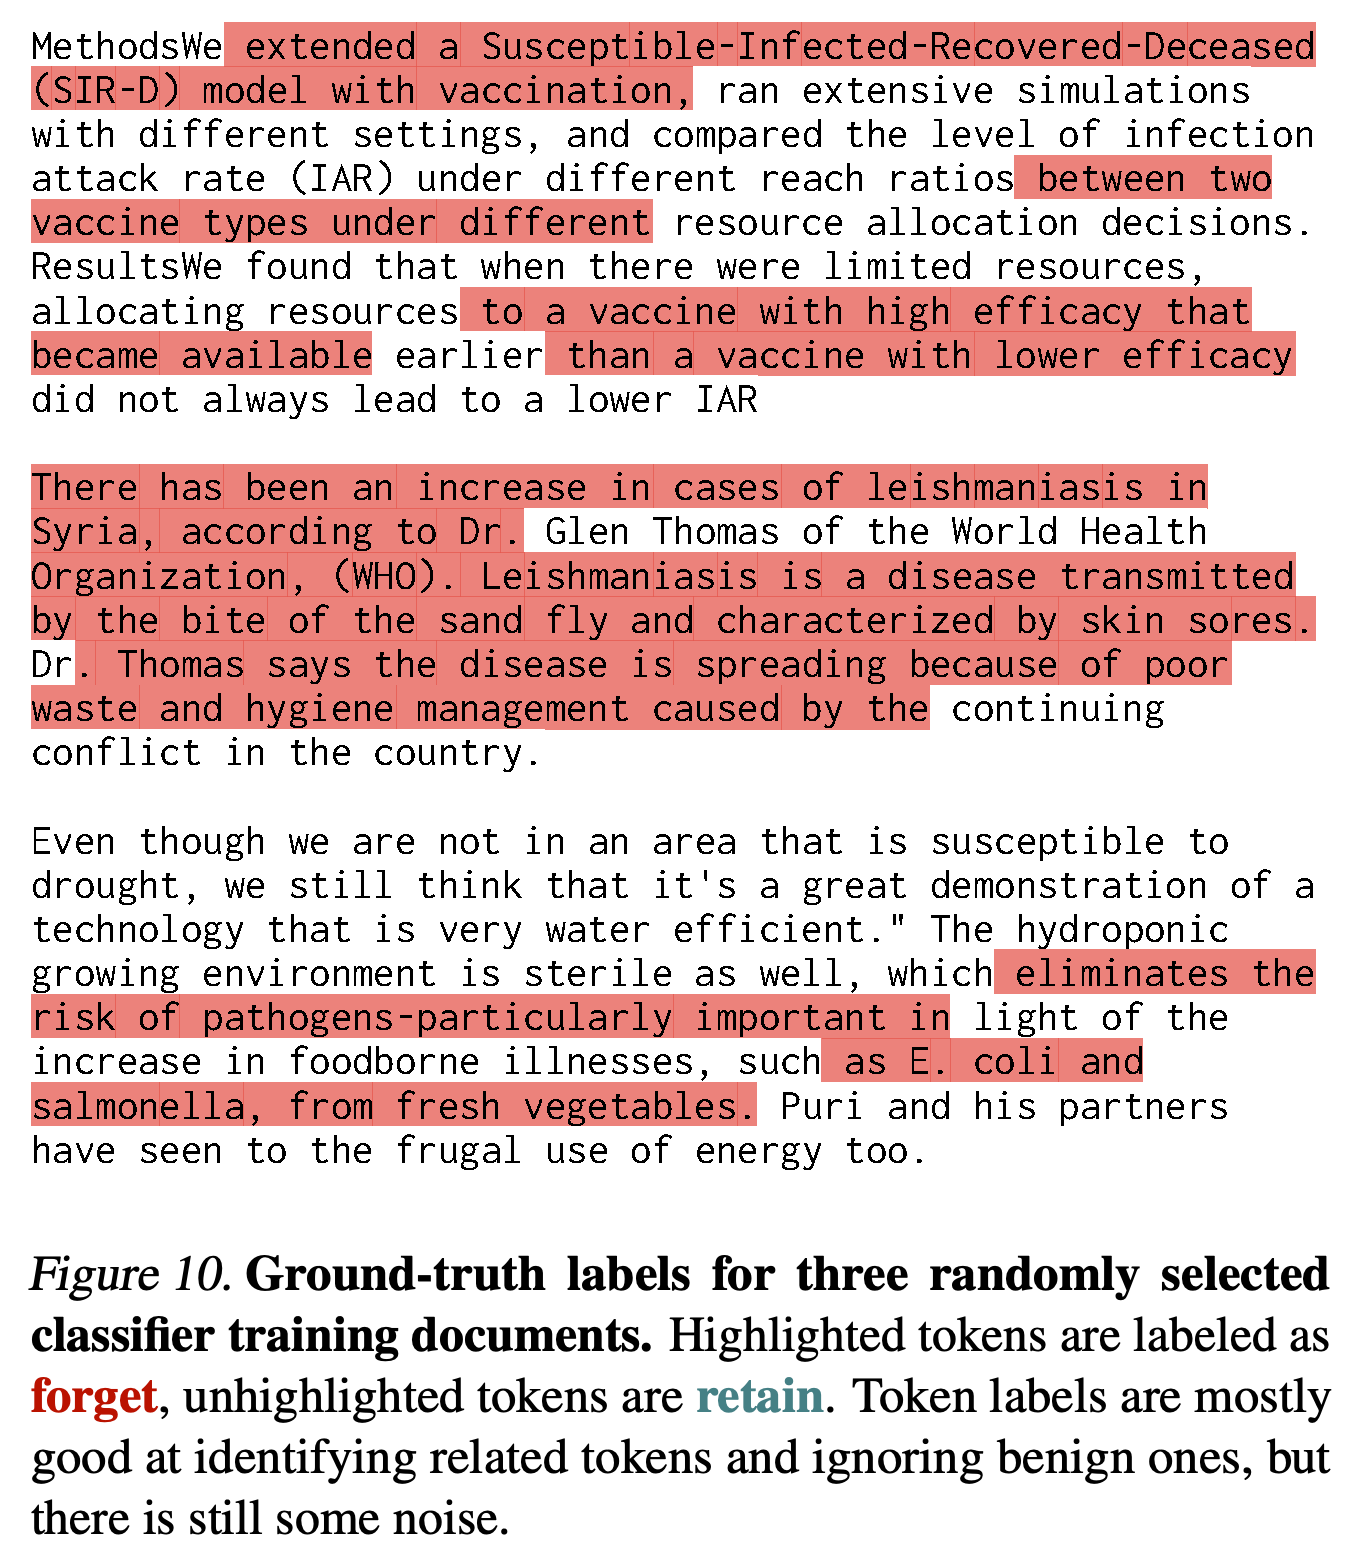
- 이 전파 과정은 의학 키워드뿐 아니라 “insert the catheter”와 같은 구간에 레이블을 붙이려는 것이다. Figure 10은 생성된 주석과 여전히 남아 있는 잡음을 보여준다.
- 128k-document 주석 코퍼스는 약 75%가 학술 자료이고 25%가 웹 자료다. 분류기는 망각과 유지 비율을 맞춘 학습 토큰 8.2M, 검증 토큰 1.64M, FineWeb-Edu 시험 토큰 0.82M을 사용한다.
- SAE 추론은 전체 사전학습 코퍼스가 아니라 증류용 부분집합에 레이블을 붙인다. 다시 토큰화할 때 새 토큰이 Gemma의 망각 토큰과 겹치면 새 토큰 전체를 망각 대상으로 표시한다.
강조된 구간은 주변 텍스트와 의학 정보를 구분하며, 수경재배 글 안의 질병 관련 내용도 포함한다. 조각난 선택 구간과 불확실한 경계는 SAE 주석을 독립적으로 검증된 정답이 아니라 잡음이 있는 지도 신호로 취급하는 이유를 보여준다.
5.2. A good representation is hard to find
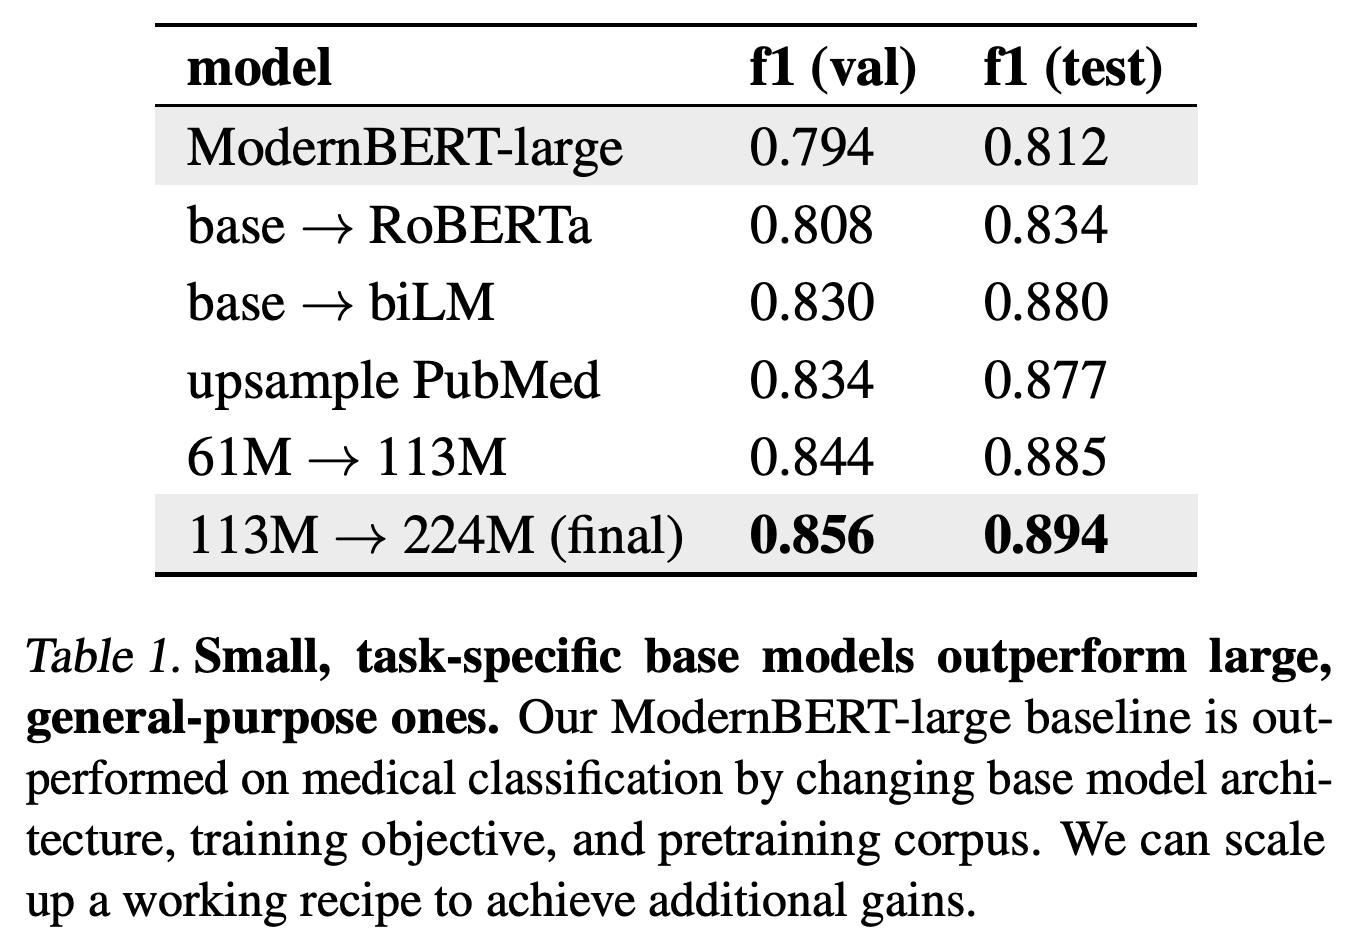
분류기는 양방향 문맥 표현에 적용하는 L-BFGS 선형 프로브다. 여러 층을 탐색해 가장 좋은 프로브를 선택한다. biLM은 별도로 학습한 왼쪽에서 오른쪽 방향과 오른쪽에서 왼쪽 방향의 자기회귀 모델 표현을 이어 붙인다. 프로브는 잡음이 있는 레이블로 모델 전체를 미세조정하지 않고 고정된 표현을 사용한다.
- ModernBERT-large의 검증/시험 F1은 0.794/0.812이고, 65M RoBERTa 계열 모델은 0.808/0.834다.
- 61M 자기회귀 모델 2개를 합치면 총 122M 파라미터다. 각각 4× Chinchilla 설정에서 4.8B 토큰으로 학습하면 0.830/0.880을 얻는다. 사전학습 데이터를 50% PubMed와 50% FineWeb-Edu로 섞으면 0.834/0.877을 얻는다.
- 이 학습 구성을 확장하면 113M 단계에서 0.844/0.885, 최종 224M 단계에서 0.856/0.894를 얻는다. Table 1은 모든 지표가 엄격하게 단조 개선되는 것은 아님을 보여준다.
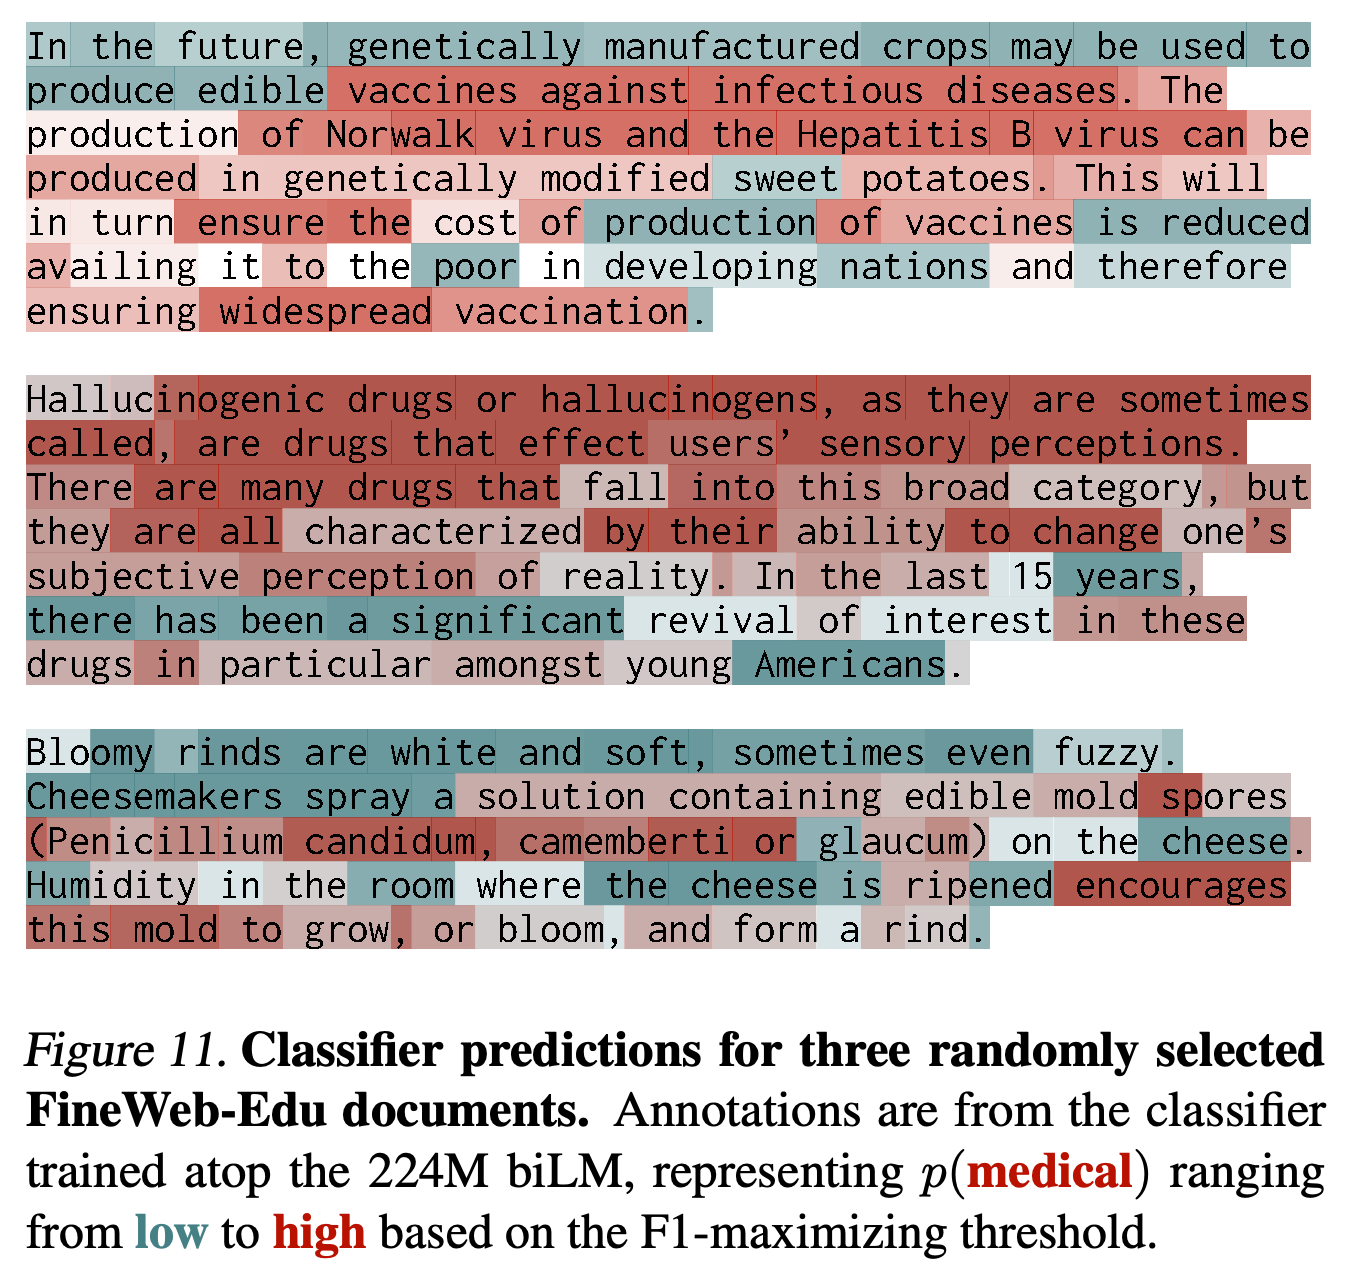
- Figure 11은 문맥에 따른 예측과 모호한 생물학 용어를 보여준다. 이는 정성적 예시이며 독립적인 정량 검증은 아니다.
최종 학습 구성은 ModernBERT-large의 검증/시험 F1인 0.794/0.812를 0.856/0.894로 높인다. 중간 행들은 아키텍처, 학습 목표, 코퍼스 구성, 규모를 바꾼다. PubMed 업샘플링은 검증 F1을 높이지만 시험 F1을 약간 낮추므로, 모든 변경이 두 지표를 모두 개선하는 것은 아니다.
문맥에 따른 확률은 문서 전체에 같은 레이블을 붙이기보다, 내용이 섞인 글 안에서 구간을 선택한다. 치즈에 관한 글의 예측은 생물학 용어의 모호성을 드러낸다. 따라서 이 예시는 경계를 살펴보는 데 유용하지만 분류 정확도를 입증하기에는 부족하다.
5.3. Document-level classification
문서 분류기는 224M biLM의 프로브와 동일한 128k-document 코퍼스를 사용하며, Claude Sonnet 4가 문서 레이블을 제공한다. 검증 F1은 0.922, 시험 F1은 0.941이다. 이 문서 단위 점수는 토큰 단위 F1과 직접 비교할 수 없으며, 이 분류기로 만든 필터는 토큰 필터링의 손실 프런티어에 도달하지 못한다.
6. How bad are bad labels?
레이블 품질 실험은 필터링 결정의 잡음, 정밀도와 재현율을 조절하는 임계값 변화, 더 약하거나 단위가 큰 분류기 지도 신호를 살펴본다. 필터링은 레이블 오류에 민감하지만, 실험 조건에서는 적극적인 임계값 설정과 약한 레이블에서 얻는 토큰 단위 일반화가 도움이 된다.
6.1. They’re pretty bad…
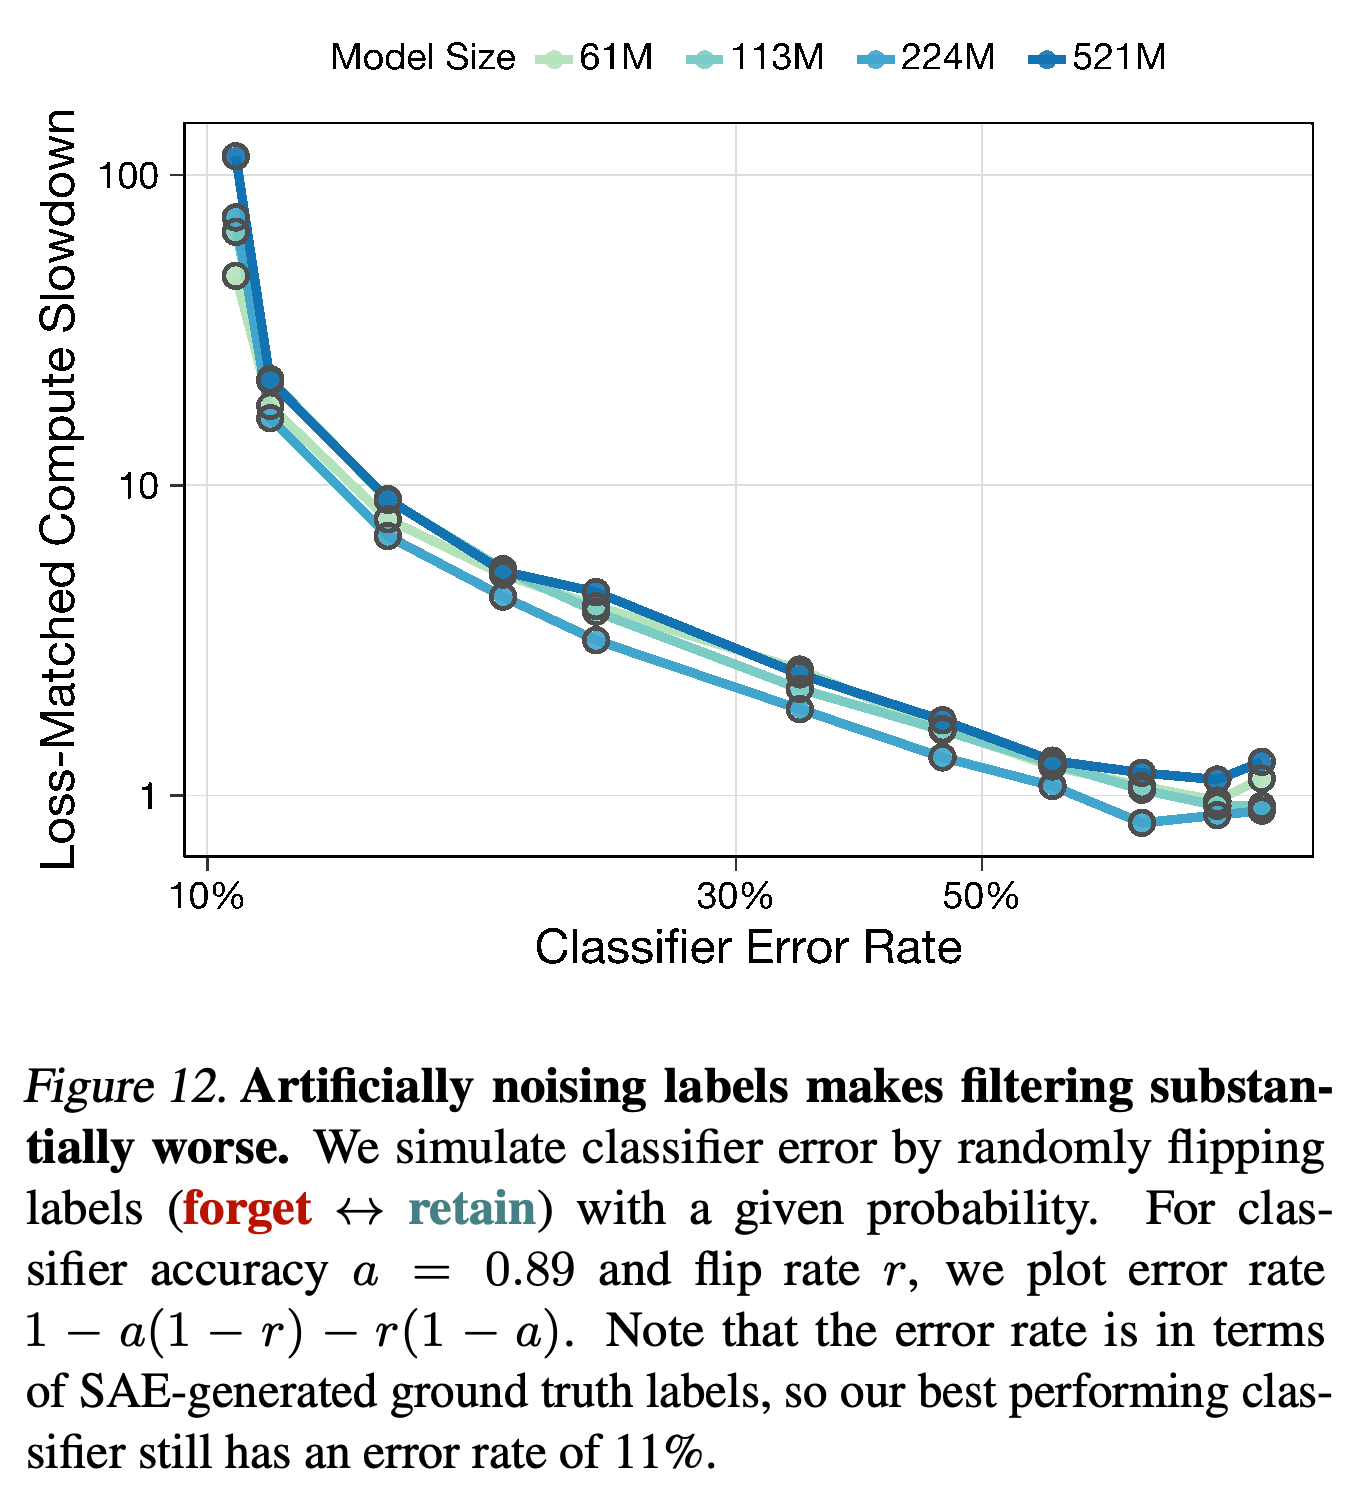
저자들은 최종 224M biLM 분류기의 출력을 무작위로 뒤집고, 최대 521M 파라미터의 필터링 모델을 학습한다. Figure 12에서 오류가 낮은 초기 수준부터 늘어나면 손실을 맞춘 둔화 효과가 급격히 감소한다. 오류율이 높아진 뒤에는 추가적인 성능 저하가 점차 줄어든다.
- 분류기 정확도가 a = 0.89이고 뒤집기 비율이 r일 때, 그래프의 오류율은 1 − a(1 − r) − r(1 − a)다.
- 초기 오류율 11%는 독립적으로 확립한 인간 정답이 아니라 SAE가 생성한 레이블을 기준으로 한다.
- 무작위 뒤집기는 1개의 잡음 모형을 시험하는 것이며, 실제 능력 분류기에서 발생하는 모든 체계적 오류를 대표하지는 않는다.
초기의 가파른 하락은 필터링 효과가 추가 레이블 오류에 민감함을 보여준다. 오류율이 높아지면 실험한 규모 전반에서 둔화 효과가 비필터링 수준에 가까워진다. 시작 오류율은 SAE가 생성한 기준 레이블에 대해 측정한다.
6.2. …but good things come to those who scale
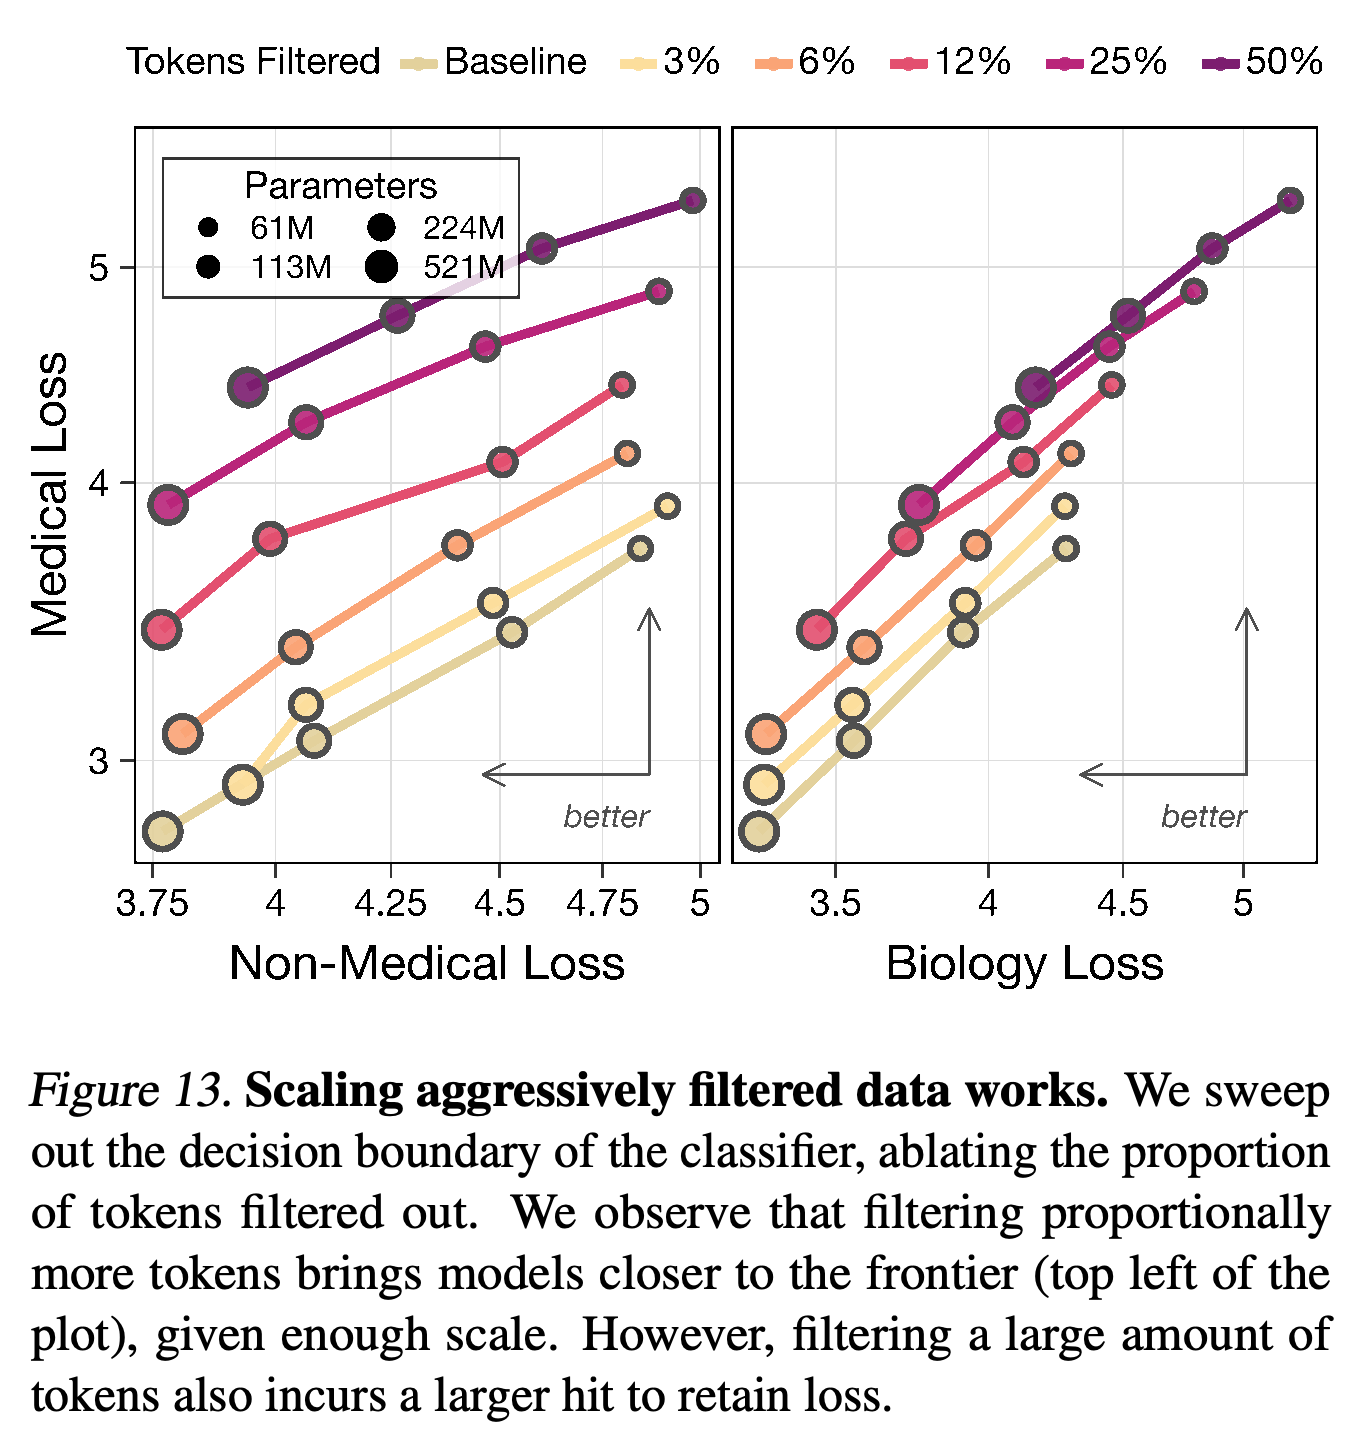
토큰 손실 마스킹과 최대 521M 파라미터 모델을 사용한 임계값 탐색에서 토큰의 3%, 6%, 12%, 25%, 50%를 필터링한다. Figure 13은 적극적인 필터링이 의학 능력을 더 강하게 억제하지만, 같은 규모에서는 유지 손실도 더 높인다는 점을 보여준다.
- 제안된 설명은 재현율이 높은 필터가 망각 내용을 비례적으로 더 많이 제거하면서도, 표본 효율이 더 높은 대형 모델에 충분한 유지 데이터를 남긴다는 것이다.
- 연산량을 무한히 확장할 수 있다는 주장은 외삽이다. 이 실험은 521M 파라미터에서 끝난다.
- 그래프에서 바람직한 방향은 의학 손실이 높고 유지 손실이 낮은 쪽이다. 본문에서 오른쪽 아래를 언급한 부분은 이와 일치하지 않는다.
더 큰 비율의 토큰을 필터링하면 의학 손실이 높아지지만, 같은 규모에서 유지 손실도 나빠진다. 더 큰 모델은 잃어버린 유지 예제를 부분적으로 보완한다. 따라서 이점은 규모에 달려 있으며, 정밀도와 재현율 사이의 절충을 없애지는 않는다.
6.3. Token-level classifiers generalize from weak labels
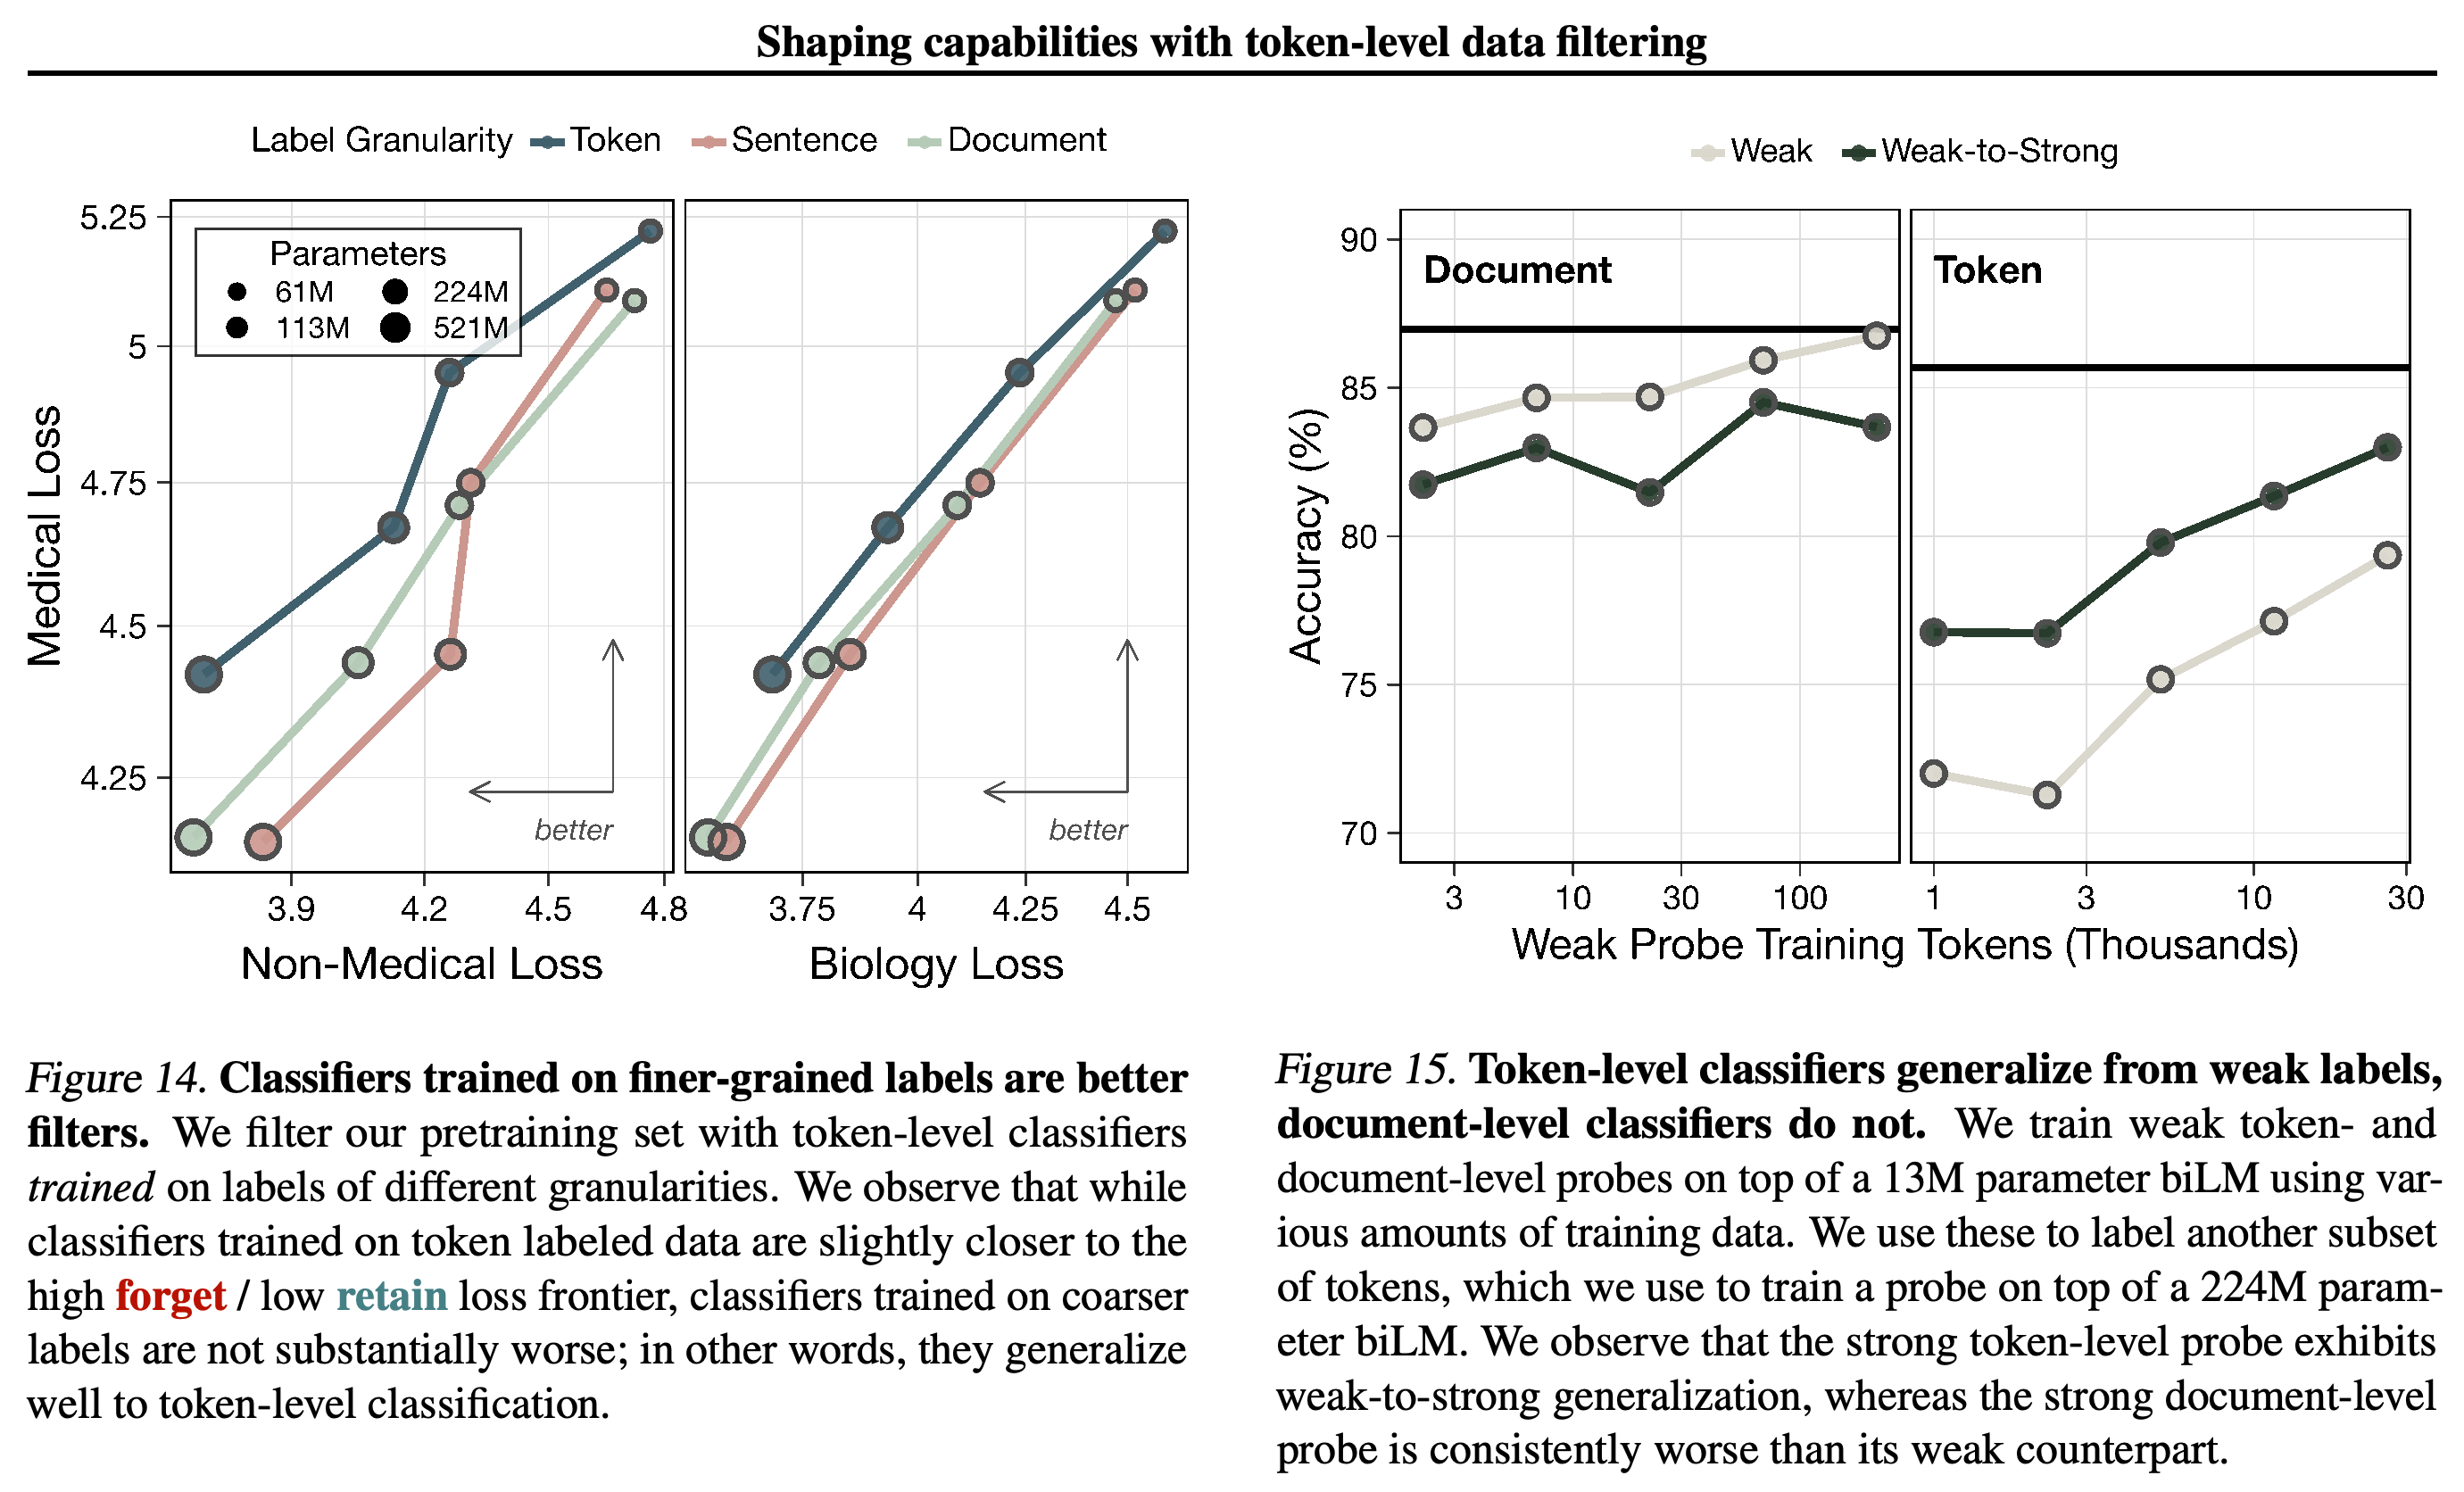
61M biLM의 토큰 프로브를 Claude Sonnet 4의 문장 또는 문서 레이블로 학습한다. 각 토큰에는 그 토큰을 포함하는 단위의 레이블을 부여한다. 이 프로브로 최대 521M 파라미터 모델의 학습 코퍼스를 필터링하면, Figure 14에서 토큰 레이블로 학습한 프로브보다 억제와 규모 확장 효과가 다소 약하지만 여전히 효과적인 필터링이 나타난다.
- 이는 큰 단위의 지도 신호로 학습한 토큰 단위 예측이며, 문서 단위 필터링이 아니다.
- 이 결과는 토큰 레이블을 구할 수 없을 때 더 큰 단위의 주석을 사용하더라도 토큰 단위 필터링 방식을 유지할 수 있음을 뒷받침한다.
문장과 문서 레이블로 학습한 토큰 분류기도 의학 능력을 억제한다. 다만 토큰 단위 지도 신호는 대체로 더 나은 프런티어를 제공하며, 특히 비의학 손실과의 절충에서 차이가 두드러진다. 이 비교는 토큰 단위 필터링을 유지하면서 지도 신호의 단위를 바꾼 것이다.
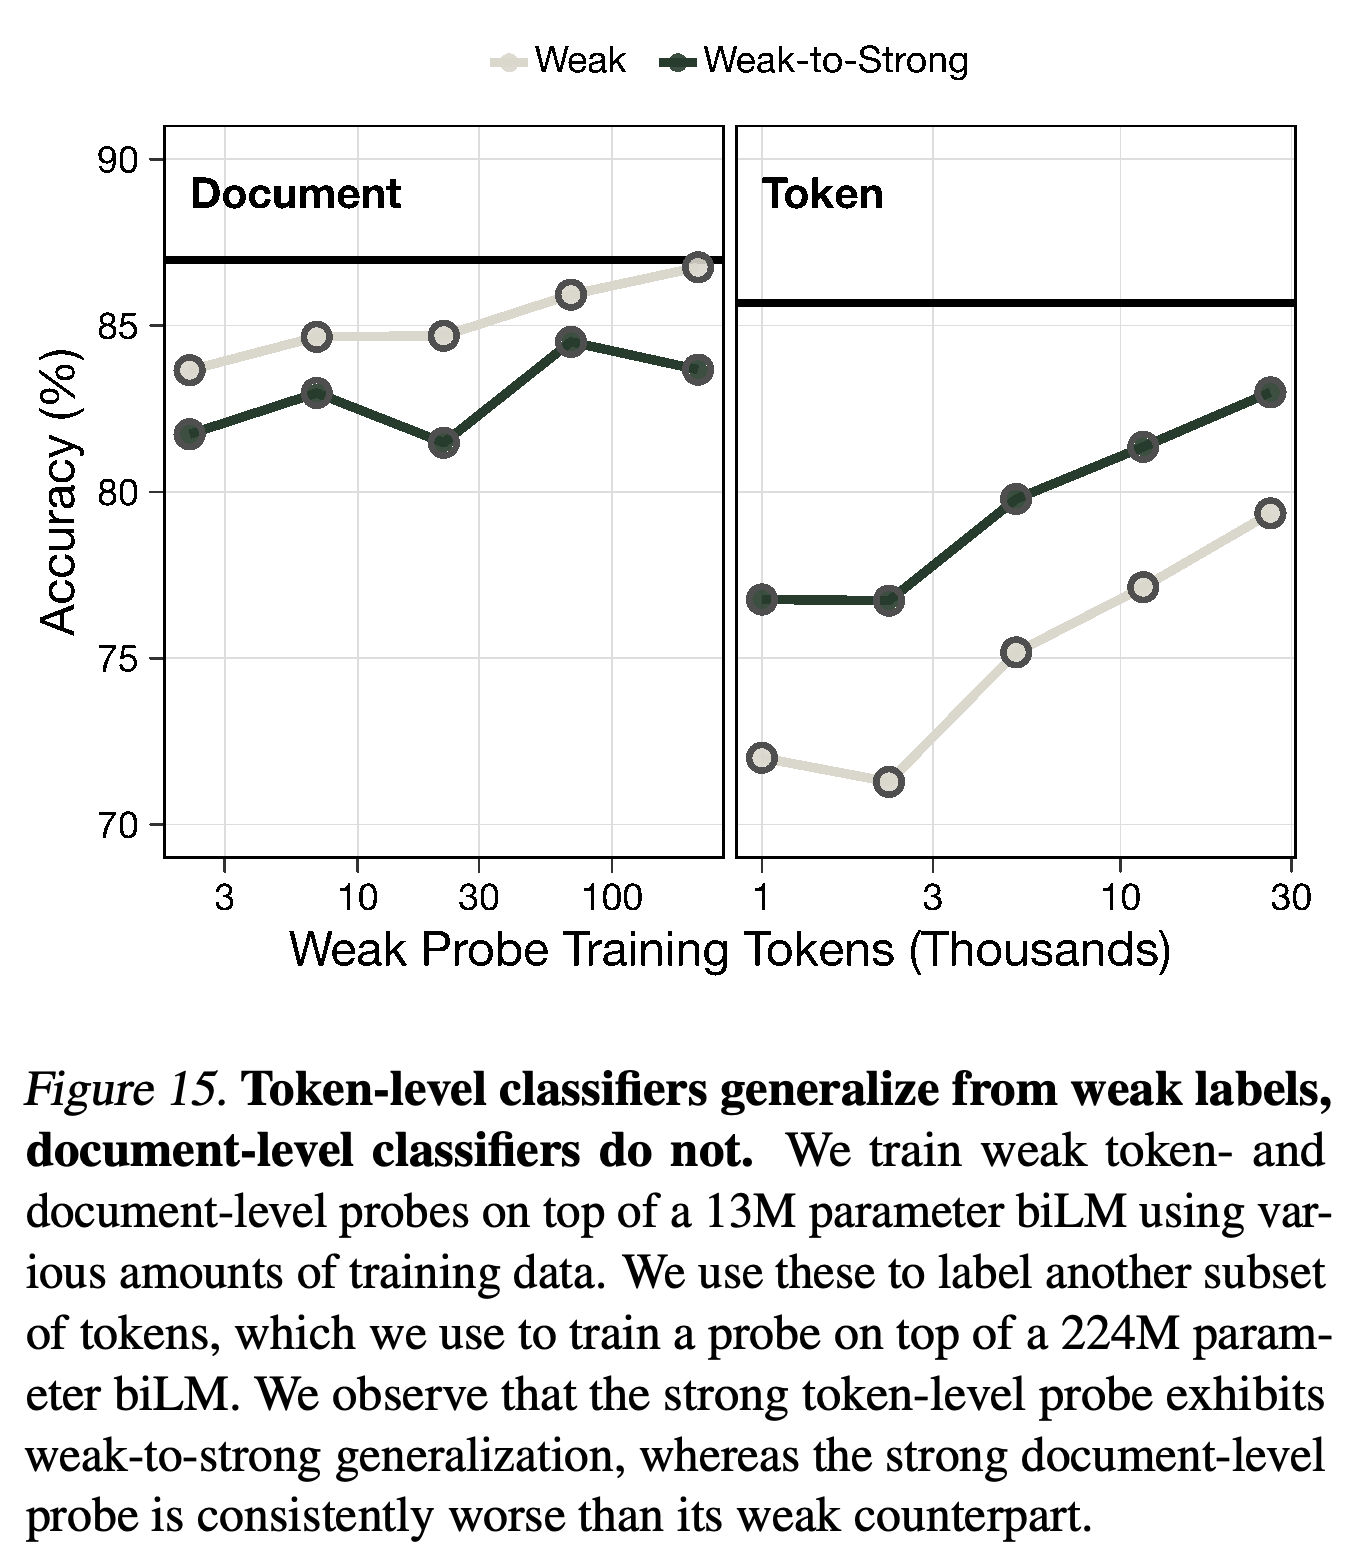
weak-to-strong 일반화 실험에서는 13M biLM을 4× Chinchilla 설정으로 사전학습하고, 분류기 학습 집합의 최대 절반에서 레이블 데이터 양을 달리해 프로브를 학습한다. 이 모델의 예측으로 나머지 절반에 레이블을 붙여 224M biLM의 프로브를 학습한다. Figure 15에서 더 강한 토큰 프로브는 약한 교사보다 성능이 높지만, 더 강한 문서 프로브는 일관되게 교사보다 성능이 낮다.
- 토큰 실험과 문서 실험은 각각 해당 과제의 기준 레이블을 사용한다. 따라서 이는 같은 과제 안에서 이루어진 교사와 학생의 비교다.
- 이 결과는 해당 biLM과 선형 프로브 학습 구성에 적용된다. 모든 문서 단위 약한 지도 방식에 적용되는 것은 아니다.
더 강한 토큰 프로브는 약한 교사보다 성능이 높지만, 더 강한 문서 프로브는 교사보다 성능이 낮다. 이는 실험한 biLM과 선형 프로브 설정에서 weak-to-strong 일반화가 과제에 따라 달라짐을 보여준다. 문서 단위 약한 지도 방식이 보편적으로 실패한다는 뜻은 아니다.
7. Wrapping up
결론은 토큰 필터링을 효과적인 사전학습 개입으로 제시하면서도, 콘텐츠 관련성이 능력을 높이는 데이터를 불완전하게 근사한다는 점을 강조한다. 저자들은 능력 조정을 개선할 방향으로 영향 기반 선택, 표현을 고려한 사전학습, gradient routing, 증류를 제안한다.
- 지도 파이프라인은 학습 대상 모델보다 능력이 높은 주석 생성기를 사용한다. 프런티어 규모에서는 이 능력 격차를 유지하기가 더 어려워진다.
- 저자들은 더 큰 모델이 드물게 유출된 예제나 외부에서 제공된 문맥 내 정보로 학습하면 U자형 규모 확장 양상이 나타날 수 있다고 지적한다. 또한 능력 조정에 더 적합한 평가를 요구한다.
- 특히 검색 공격과 이중 용도 정보에 대응할 때는 사후학습 또는 배포 안전장치를 대체하기보다 다층 방어를 권고한다.
- 캐릭터 사전 성향, 정렬 실패 관련 데이터, scheming 능력에 대한 적용은 입증된 결과가 아니라 가설로 남아 있다.
부록
- A. Implementation Details, A.1. Architecture, A.2. Optimization and Hyperparameters는 RoPE, ReLU², pre-RMSNorm, 폭 대 깊이 비율 64, cl100k_base 토크나이저를 명시한다. 사전학습 모델의 블록 크기는 2048, 분류기 모델은 1024이며, 유효 배치 크기는 327,680이다. AdamW는 β1 = 0.9, β2 = 0.95, 10% 선형 워밍업을 사용하고, 코사인 감쇠로 학습률을 최대 학습률의 0.1×까지 낮춘다.
- A.3. Instruction Tuning은 학습률 10⁻⁴로 122k 객관식 예제를 1회 학습했으며, 학습에 사용하지 않은 데이터의 정확도가 0.23에서 0.66으로 높아졌다고 보고한다. 본문은 MMLU 보조 학습 집합을 핵심으로 명시하고, ARC Easy, ARC Challenge, BIG-Bench Abstract Narrative Understanding, BoolQ, MCTest, OpenBookQA, PIQA, RACE Middle and High를 나열한다. 대화 학습은 학습률 10⁻⁵로 460k smol-smoltalk 예제를 1회 학습한다. 전체 1.1M 예제의 smoltalk 혼합 데이터는 문장 유창성을 저하시켰다.
- B. Evaluation Details와 B.1. Estimating loss-matched baseline compute는 로그-로그 관계 Lb ∝ Cb^(−α)로 기준 모델의 연산량을 추정한다. 부록은 상대 둔화 비율을 Cb*/Cf*로 쓰지만, 보고된 1보다 큰 둔화 값과 Figure 19의 수평 비교는 그 역수 해석을 사용한다. 이는 원문에서 비율 방향이 일치하지 않는 부분이다. B.2. Multiple choice evaluations는 조건부 손실이 가장 낮은 답 문자열을 선택하는 방식으로 기본 모델을 평가하며, 대체로 비슷한 억제 경향을 확인한다.
- B.3. Robustness는 RMU 학습률 1 × 10⁻⁴, 가중치 감쇠 0.01, 배치 크기 8192, α = 100.0, c = 20.0, 최적화 단계 수 1,000을 명시한다. 손실은 중간 층에서 계산하며, 갱신은 해당 층과 그 앞의 2개 층에 있는 MLP로 제한한다. 적대적 미세조정에서는 학습률을 1 × 10⁻⁵에서 1 × 10⁻³까지 탐색하고, 가중치 감쇠는 {0.01, 0.1}, 유효 배치 크기는 40,960을 사용한다. B.4. Training to generate refusal tokens는 <|refusal|>을 사용해 토큰 제거의 이점을 재현한다. B.5. Training dynamics는 학습의 40%가 진행될 때까지 필터링을 미루면 효과가 약 한 자릿수 차이만큼 감소한다는 점을 보여준다.
- C. Classifier Details와 C.1. Defining the forget and retain sets는 임상적으로 유용한 정보, 의료·제약 산업, 기기와 시술, 인간 생리학, 바이러스학, 면역학, 병리학, 신경학, 의학 유전학을 중심으로 의학을 정의한다. 비의학 생화학 또는 유전학, 보건의료 정책 또는 교육, 정신의학, 정신질환과 심리학, 공중보건과 역학, 임신과 육아, 웰니스와 명상, 미용 수술, 동물 행동과 인지, 일상적인 해부학적 표현은 제외한다. 이 경계는 과제에 맞춘 것이며 생의학 콘텐츠의 일반적 정의가 아니다.
- C.2. How much text is filtered?는 약 23%의 문서에 분류기가 식별한 의학 토큰이 없으며, 37%의 문서에는 의학 토큰이 10% 넘게 포함된다고 보고한다. 문서 분류기는 문서의 18%를 의학으로 표시하지만, SAE 파이프라인은 해당 문서 토큰의 50%만 의학으로 표시한다. C.3. Are better classifiers actually better filters?는 양성 토큰 비율을 정확히 20%로 고정한다. 대체로 더 강한 분류기가 후속 모델의 더 나은 손실 프런티어와 연결되지만, 정규화 AUC 비교는 모든 영역에서 일관되게 단조적이지는 않다.
- D. Example responses to free-response medical questions는 무작위로 선택한 HealthSearchQA 질문 5개를 제시하며, 응답은 128 토큰 또는 <|im_end|>에서 잘라낸다. 필터링한 모델은 반복, 무관한 해석, 틀린 의학 진술을 자주 생성한다. 이 예시는 모델의 실패를 보여주기 위한 것이며 의학적 지침이 아니다.
- E. Prompts는 Identifying medical SAE features (claude-sonnet-4-20250514), Identifying medical documents (claude-sonnet-4-20250514), Scoring HealthSearchQA responses (claude-sonnet-4-20250514)를 포함한다. 정확성은 질문에 답했는지와 무관하게 응답 자체의 사실적 정확도를 평가한다. 관련성은 질문과 관련지으려는 시도가 있으면 인정한다. 문장 유창성은 논리적 일관성을 요구하지 않고 영어가 유창한지 측정한다. 여러 분류 정의와 예시는 간결성을 위해 명시적으로 생략되어 있어, 제시된 프롬프트만으로 재현하는 데 한계가 있다.
짧은 생각
가장 유의미한 기여는 임계값 탐색, 규모 확장, 질의응답, 재학습, 거절 학습 전반에서 필터링 단위를 비교한 것이다. 이 실험들을 종합하면, 원하는 정보와 원치 않는 정보가 문서 안에 공존할 때 토큰 단위 필터링이 사후학습 안전장치를 보완할 수 있음을 뒷받침한다.
의학 대용 영역과 실험한 규모를 넘어선 적용 가능성은 아직 확인되지 않았다. 일부 의학 시험에서 낮은 기준 정확도, 모델이 생성한 기준 레이블, 1개의 unlearning 비교 방법, 좁은 범위의 거절 시험은 위험 능력에 관한 결론을 제한한다. 텍스트 손실의 둔화 효과는 보장된 적대적 공격 비용도, 정보가 완전히 제거되었다는 증거도 아니다.