


On Surprising Effectiveness of Masking Updates in Adaptive Optimizers 요약 설명
17 Feb 2026 | Paper Review Adaptive Optimization Update Masking LLM Pretraining목차
- 요약
- 1. Introduction
- 2. Update Masking as a Regularization
- 3. Momentum-Aligned Update Masking
- 4. Experiments
- 5. Discussion
- 6. Literature Review
- 7. Conclusion
- Impact Statement
- 부록
- 짧은 생각
이번 글에서는 On Surprising Effectiveness of Masking Updates in Adaptive Optimizers 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 17일(Arxiv)
- Joo, Taejong, Xia, Wenhan, Kim, Cheolmin, Zhang, Ming, Ie, Eugene.
- Northwestern University, Google
- 논문 링크
요약
- On Surprising Effectiveness of Masking Updates in Adaptive Optimizers는 dense 역전파를 유지하면서 파라미터 업데이트를 무작위로 건너뛰면 LLM 사전 학습을 개선할 수 있는지 살펴본다. SkipUpdate는 파라미터 블록 전체를 독립적으로 마스킹하고, 옵티마이저 상태는 dense하게 업데이트한다. 마스킹을 통과한 업데이트는 기댓값을 보존하도록 재조정한다.
- 국소 2차 분석에서는 업데이트 후 손실의 기댓값에 블록별 곡률 항이 추가됨을 확인한다. Momentum-aligned gradient masking(Magma)은 확률적 마스킹과 코사인 유사도 기반의 평활화된 감쇠를 결합한다. 현재 gradient가 누적 모멘텀과 더 잘 일치하는 블록에는 더 큰 업데이트 배율을 적용한다.
- C4에서 RMSProp+Magma는 60M, 130M, 350M, 1B Llama 2 모델의 검증 perplexity로 각각 28.55, 21.66, 16.16, 13.19를 얻는다. 1B 결과는 Adam의 16.35와 Muon의 14.52보다 각각 19%, 9%를 초과하는 개선을 보인다. 통제 실험에서는 논문이 heavy-tailed noise라고 부르는 조건과 이질적 이차함수에서 효과를 보인다. 다만 CIFAR-10의 ResNet-50에서는 개선을 보고하지 않는다.
1. Introduction
Dense 역전파를 사용하면 모든 파라미터에 적응적 업데이트를 동시에 적용하기 편리하다. 그러나 이것이 매 iteration마다 모든 파라미터를 업데이트해야 한다는 근거는 아니다. 논문은 RMSProp 기반 방법인 SkipUpdate로 이 가정을 시험한다. SkipUpdate는 파라미터 블록 업데이트의 절반을 버리면서도 모멘트 추정치는 계속 dense하게 업데이트한다.
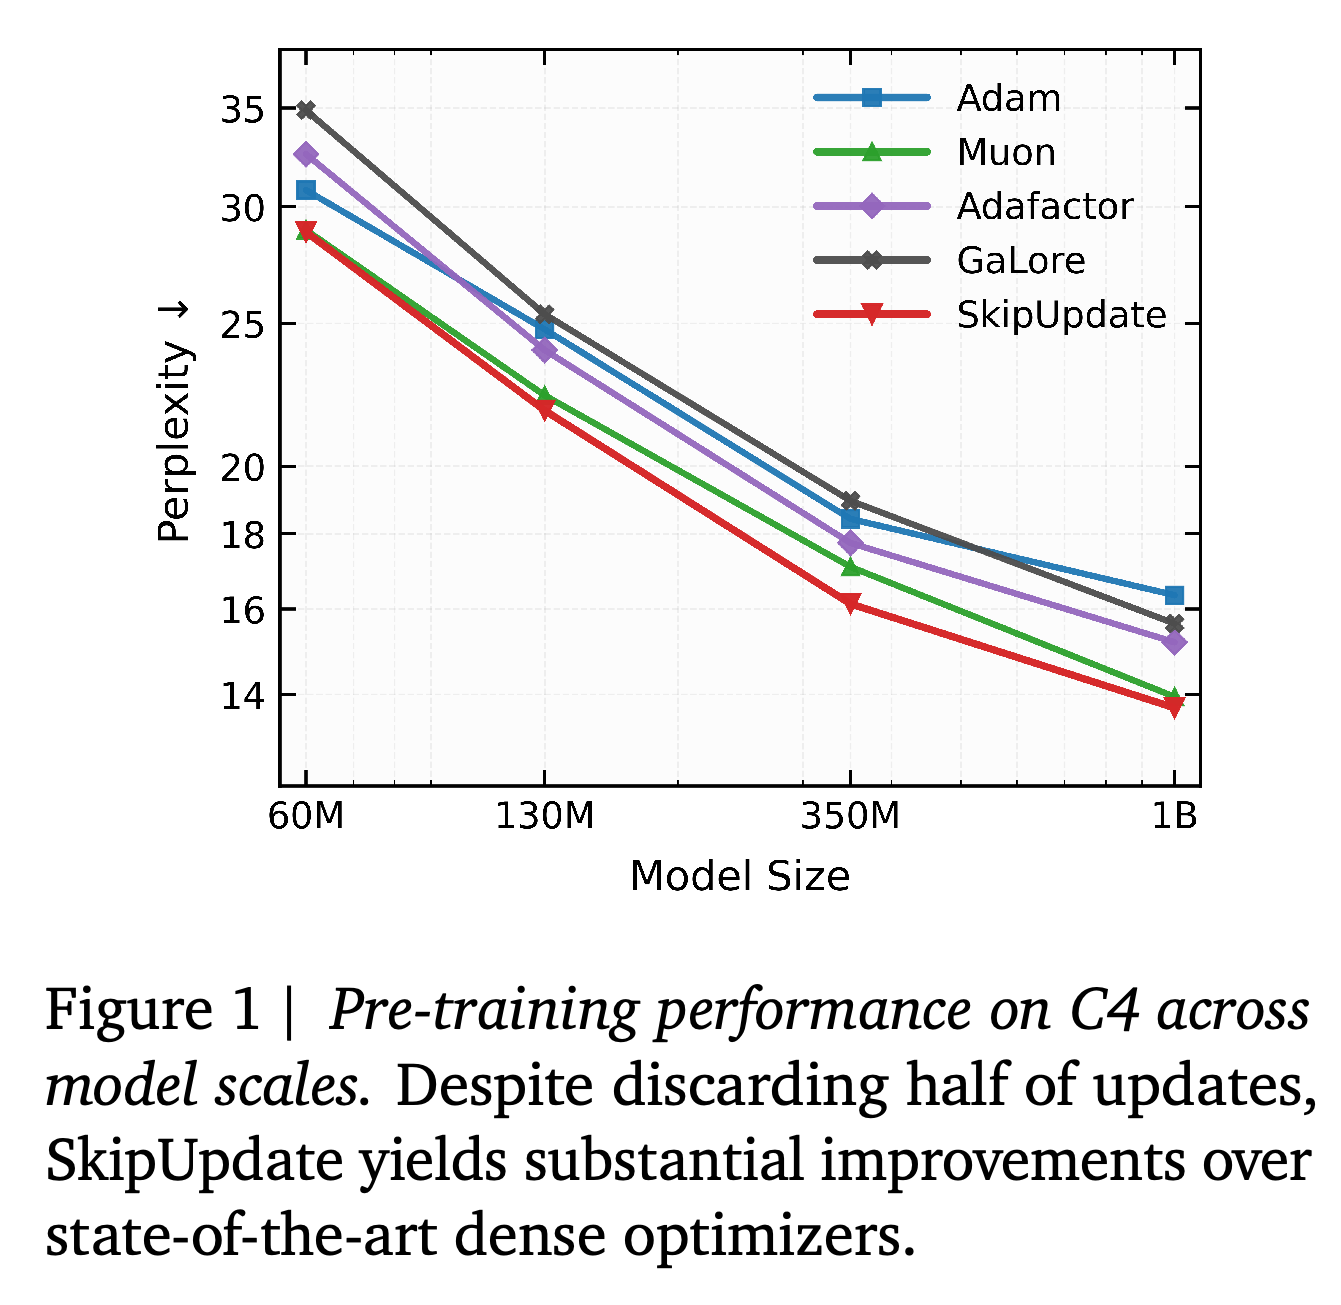
- Figure 1에서 SkipUpdate는 60M–1B 모델 크기 전반에 걸쳐 그래프에 제시된 dense baseline보다 낮은 C4 검증 perplexity를 보인다.
- 파라미터 업데이트를 건너뛰어도 역전파 비용이 줄거나 dense 옵티마이저 상태가 없어지지는 않는다. 이 실험은 sparse gradient 계산이 아니라 최적화 성능을 다룬다.
- 저자들은 마스킹 noise를 기하학적 정규화로 해석한다. 또한 모멘텀과 gradient의 일치도를 활용해 Magma에 블록별 적응적 감쇠를 도입한다.
SkipUpdate 곡선은 4개 모델 크기 모두에서 그래프의 Adam, Muon, Adafactor, GaLore 곡선보다 낮다. 1B에서는 Muon과의 차이가 작다. 이는 파라미터 블록 업데이트의 절반을 버려도 검증 perplexity가 개선될 수 있다는 연구의 출발점을 보여준다. 학습 속도를 측정하거나 개선 메커니즘을 규명하지는 않는다.
2. Update Masking as a Regularization
SkipUpdate는 생존 확률 p인 독립 Bernoulli 마스크를 적용하고, 마스킹된 블록 업데이트 Δ̃ₜ⁽ᵇ⁾ = mₜ⁽ᵇ⁾Δₜ⁽ᵇ⁾/p를 사용한다. Proposition 1은 파라미터와 기본 업데이트가 주어진 조건에서 업데이트 후 손실의 기댓값을 dense 업데이트의 손실과 블록별 곡률 항의 합으로 나타낸다. 이 표현에는 3차 나머지 항이 포함된다.
- 추가 항은 블록별 (Δₜ⁽ᵇ⁾)ᵀHᵦᵦ(θₜ)Δₜ⁽ᵇ⁾의 합에 (1−p)/(2p)를 곱한 값이다. 독립 마스킹은 블록 간 2차 항을 보존하지만 블록 내부 항은 증폭한다.
- 곡률이 양수인 방향에서는 이 항이 곡률이 큰 방향의 업데이트에 따른 손실의 기댓값을 높인다. 저자들은 기존에 보고된 transformer Hessian의 블록 구조를 근거로 이를 암묵적 기하학적 정규화로 해석한다.
- 이 결과에는 유효한 국소 Taylor 전개와 나머지 항의 상한이 필요하다. 실제 학습 알고리즘이 곡률 항을 최소화하거나, 더 평탄한 최솟값에 도달하거나, 일반화 성능을 개선한다는 점까지 입증하지는 않는다.
이 방법은 모멘트 추정치를 업데이트하는 gradient가 아니라 파라미터 업데이트를 마스킹한다. 마스킹 단위에 따라 2차 항에 남는 Hessian 상호작용이 달라진다. 원소별 마스킹은 대각 곡률 항을 추가하지만, 블록별 마스킹은 블록 내부 상호작용을 유지한다.
- 130M Llama 사전 학습에서 균일 마스킹의 perplexity는 열별 21.78, 원소별 21.73, 블록별 21.81이다. RMSProp의 값은 22.64이다.
- 저자들은 측정된 차이가 작고 블록 전체를 건너뛰면 연산을 생략할 수 있다는 이유로 블록별 마스킹을 채택한다.
- Dense와 sparse 상태 업데이트를 비교한 ablation에서는 sparse 모멘텀 업데이트가 불안정하게 나타난다. 메모리를 절약하는 부분공간 방법과 달리 SkipUpdate는 dense 보조 상태를 유지한다.
3. Momentum-Aligned Update Masking
Magma는 각 블록의 현재 gradient와 1차 모멘트 추정치 사이의 코사인 유사도로 스케일에 불변인 일치도 점수를 계산한다. Algorithm 1은 s̃ₜ⁽ᵇ⁾ = sigmoid(cossim(μₜ⁽ᵇ⁾, gₜ⁽ᵇ⁾)/τ)를 사용하고, sₜ⁽ᵇ⁾ = 0.9sₜ₋₁⁽ᵇ⁾ + 0.1s̃ₜ⁽ᵇ⁾로 평활화한다. 이후 기본 옵티마이저 업데이트에 이 점수와 독립 Bernoulli(0.5) 마스크를 곱한다.
- 기본 마스크는 여전히 균일하게 샘플링한다. 일치도는 생존 확률이 아니라 업데이트 크기를 조절한다.
- p = 0.5에서 2배 계수를 쓰는 SkipUpdate와 달리 Magma의 감쇠는 편향을 도입한다. 저자들은 일치도에 따라 생존 확률을 정하고 확률의 역수로 재조정하는 비편향 대안들을 시험했으나 학습이 불안정했다고 보고한다.
- Cautious Optimizer, MGUP, RPROP도 gradient 일관성을 사용하지만 Magma의 구조화된 확률적 마스킹 규칙을 구현하지는 않는다.
- 이 wrapper에는 추가 역전파나 명시적 곡률 계산이 필요하지 않다. 다만 일치도 계산과 점수 평활화에는 여전히 연산과 상태가 필요하다. PDF에는 오버헤드가 0이라는 주장을 뒷받침할 실제 실행 시간이나 메모리 측정값이 없다.
4. Experiments
실험은 언어 모델 사전 학습과 통제된 최적화 benchmark를 함께 사용한다. C4의 Llama 2 실험은 여러 모델 크기를 시험하고, OpenWebText의 Nano MoE 실험은 sparse expert routing과의 호환성을 시험한다. 단순화한 회귀와 이차함수 과제는 noise와 곡률의 영향을 살펴본다.
4.1. Pre-Training Llama
C4 benchmark는 Zhao et al. (2024)을 따라 60M, 130M, 350M, 1B 파라미터의 Llama 2 모델을 학습한다. 배치 크기는 512이고 최대 시퀀스 길이는 256이다. 학습률 탐색 grid는 {1e-4, 5e-4, 1e-3, 5e-3, 1e-2}이다. 각 실행은 10% warm-up 이후 cosine decay를 적용해 학습률을 최댓값의 10%까지 낮춘다.
- 4개 모델 크기의 학습은 각각 10K, 20K, 60K, 100K iteration 동안 진행한다. 보고된 perplexity는 탐색한 학습률 중 가장 좋은 실행에서 얻은 최종 평가 결과이다.
- Magma는 τ = 2를 사용하며 attention과 MLP layer에만 적용한다.
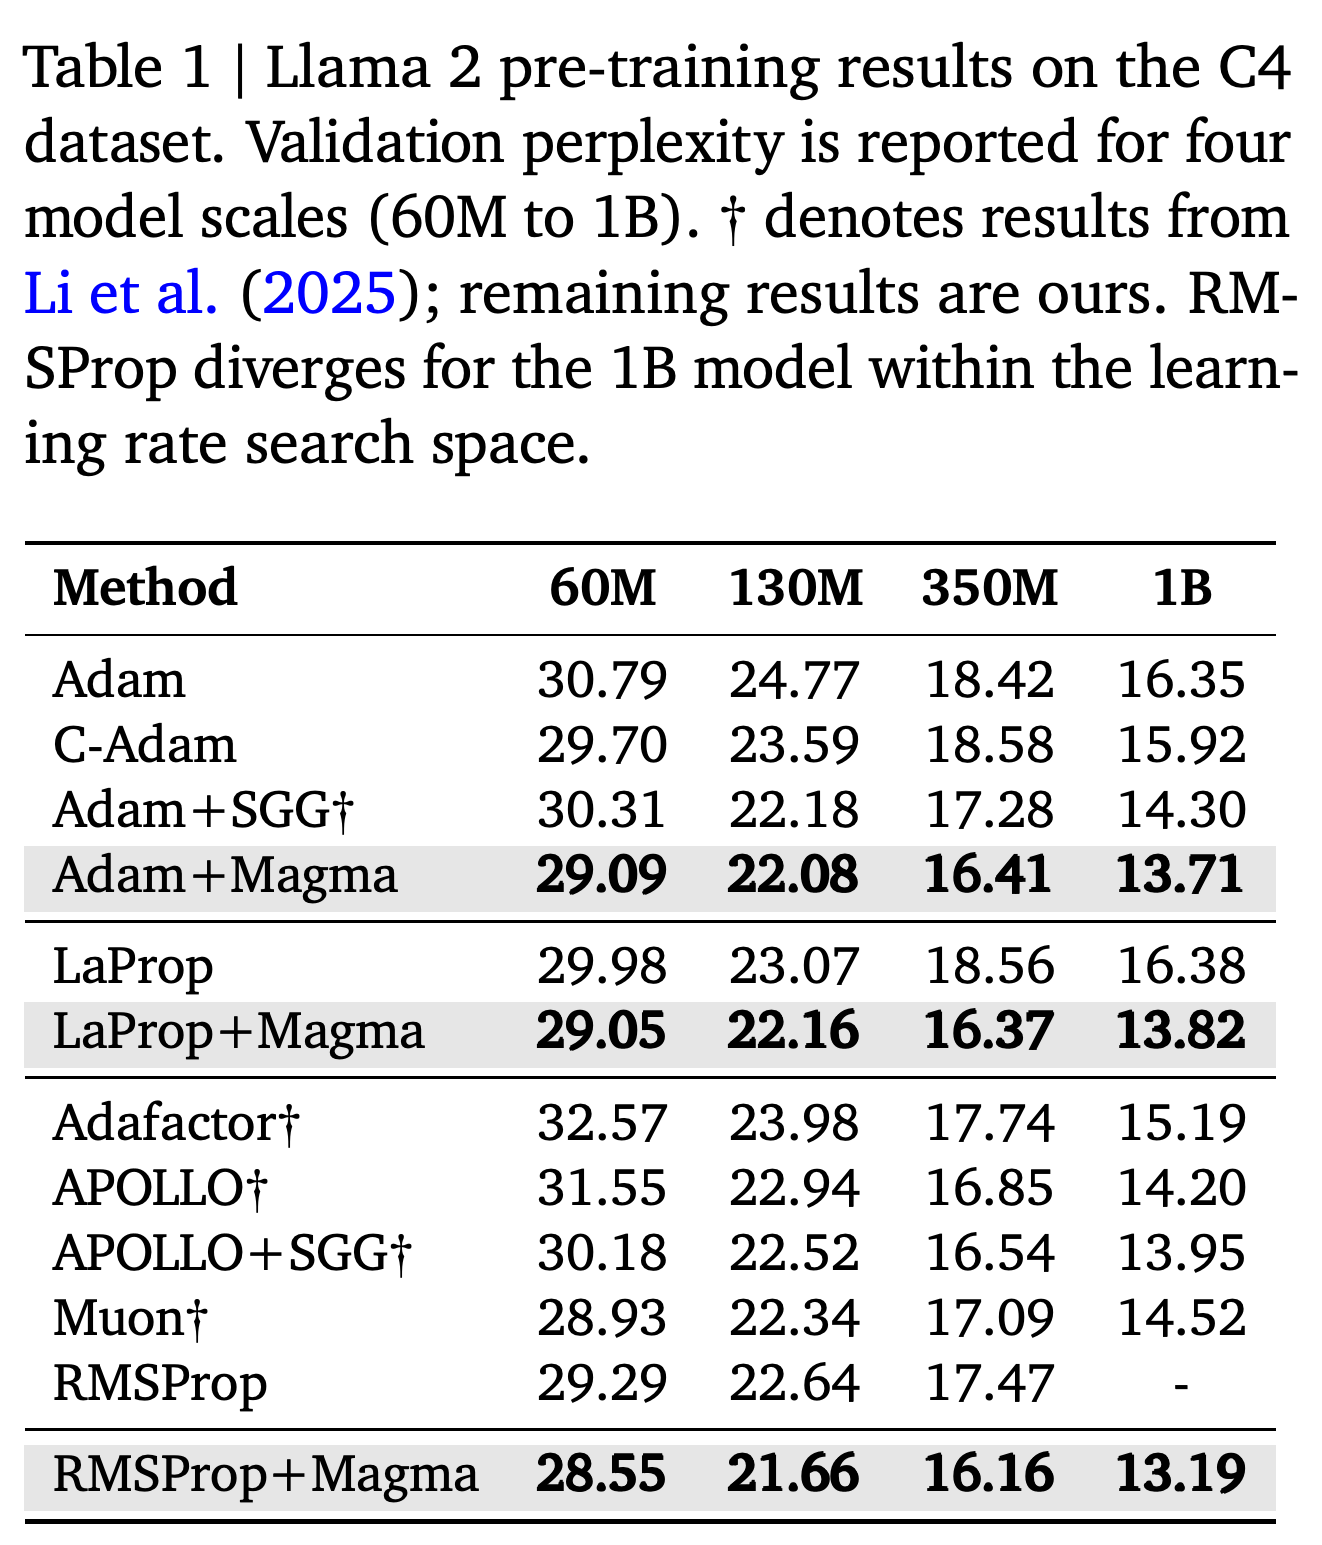
- Table 1은 저자들의 결과와 Li et al. (2025)에서 가져와 표시한 결과를 구분한다. 모든 비교가 새로 실행한 실험은 아니다.
Table 1에서 Adam, LaProp, RMSProp에 Magma를 추가하면 baseline 결과가 보고된 모든 모델 크기에서 성능이 개선된다. RMSProp+Magma는 모든 열에서 가장 낮은 perplexity를 얻으며, 1B에서는 13.19에 도달한다. Magma를 적용하지 않은 RMSProp는 탐색한 학습률 grid 안에서 1B 학습이 발산한다.
- Adam의 perplexity는 4개 모델 크기에서 30.79, 24.77, 18.42, 16.35에서 29.09, 22.08, 16.41, 13.71로 개선된다.
- LaProp+Magma는 29.05, 22.16, 16.37, 13.82를 기록한다. LaProp의 값은 29.98, 23.07, 18.56, 16.38이다.
- 1B에서 표는 Adam+SGG 14.30, APOLLO+SGG 13.95, Muon 14.52, C-Adam 15.92를 보고한다.
- Table 1은 1B Adam+Magma의 값을 13.71로 제시하지만, 주변 본문은 13.81로 제시한다. 이 리뷰는 표의 값을 사용한다. SOAP은 비교 본문에 언급되지만 Table 1에는 해당 행이 없다.
RMSProp+Magma는 모든 모델 크기 열에서 가장 낮은 perplexity를 기록한다. 1B에서는 13.19를 얻으며, Magma를 적용하지 않은 RMSProp는 탐색 grid 안에서 발산한다. Adam과 LaProp도 보고된 모든 크기에서 Magma를 적용하면 개선된다. 표는 저자들의 실행 결과와 Li et al. (2025)에서 가져와 표시한 결과를 함께 제시한다. 1B Adam+Magma의 표 값 13.71은 본문의 13.81과 일치하지 않는다.
4.2. Pre-Training Nano MoE
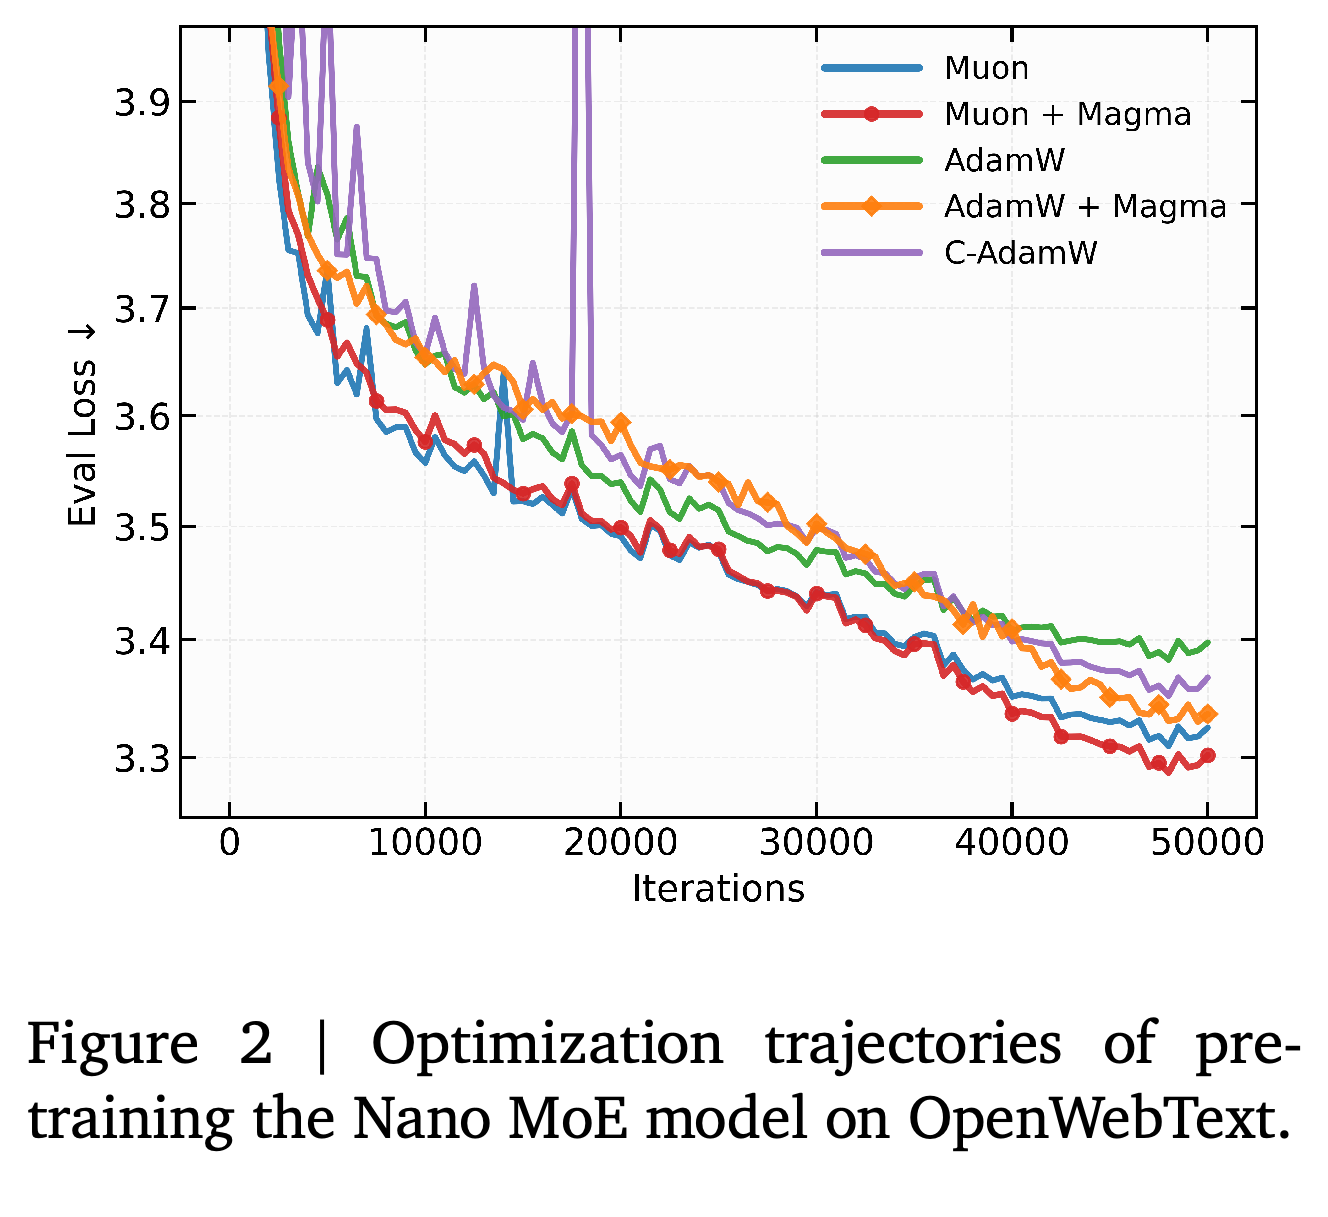
Nano MoE 사전 학습은 OpenWebText에서 124M-parameter GPT2-style transformer를 사용한다. 각 MoE layer에는 expert 8개를 두고 top-2 routing을 적용하며, dense layer와 MoE layer를 번갈아 배치한다. Figure 2에서는 AdamW나 Muon에 Magma를 추가하면 최종 평가 손실이 낮아진다. 그래프의 최종 시점에서는 Muon+Magma가 가장 좋은 값을 얻는다.
- 학습은 Wolfe (2024)를 따라 8xA100 GPU에서 50K iteration 동안 진행한다. 배치 크기는 12, gradient accumulation은 40, 시퀀스 길이는 1024, 최소 학습률은 5e-6, weight decay는 0.1, gradient clipping norm은 1.0이다.
- AdamW+Magma는 학습 중간에는 더 느리게 개선되지만 최종 손실은 AdamW와 C-AdamW보다 낮다. 이 이름들은 그림의 범례를 따른다. 함께 제시된 본문에서는 Adam과 C-Adam이라는 이름을 사용한다.
- Muon 결과는 행렬 기반 preconditioning과의 호환성을 보여준다. 다만 preconditioning과 마스킹이 독립적인 메커니즘으로 작동한다는 점을 입증하지는 않는다.
Muon+Magma는 Nano MoE를 50K iteration 학습한 뒤 가장 낮은 평가 손실을 얻는다. AdamW+Magma는 초기에는 AdamW보다 느리게 개선되지만 최종 손실은 더 낮다. 따라서 학습 내내 우위를 보이는 것은 아니다. C-AdamW는 눈에 띄는 손실 급증을 보이며, 최종 손실도 Magma를 적용한 변형들보다 높다.
4.3. Magma under Heavy-Tailed Gradient Noises
Noise benchmark는 Ahn et al. (2024)을 따라 단순화한 linear transformer를 학습한다. 모델은 무작위 선형 회귀 과제를 나타내는 시퀀스에서 마지막 label을 예측한다. 차원 d = 5와 문맥 길이 n = 20에서 Gaussian 공변량을, 단위 구면 공변량에 독립 변수 √Γ₀.₁,₁₀을 곱한 조건과 비교한다. 여기서 Γ는 shape 0.1, scale 10인 Gamma 분포를 뜻한다.
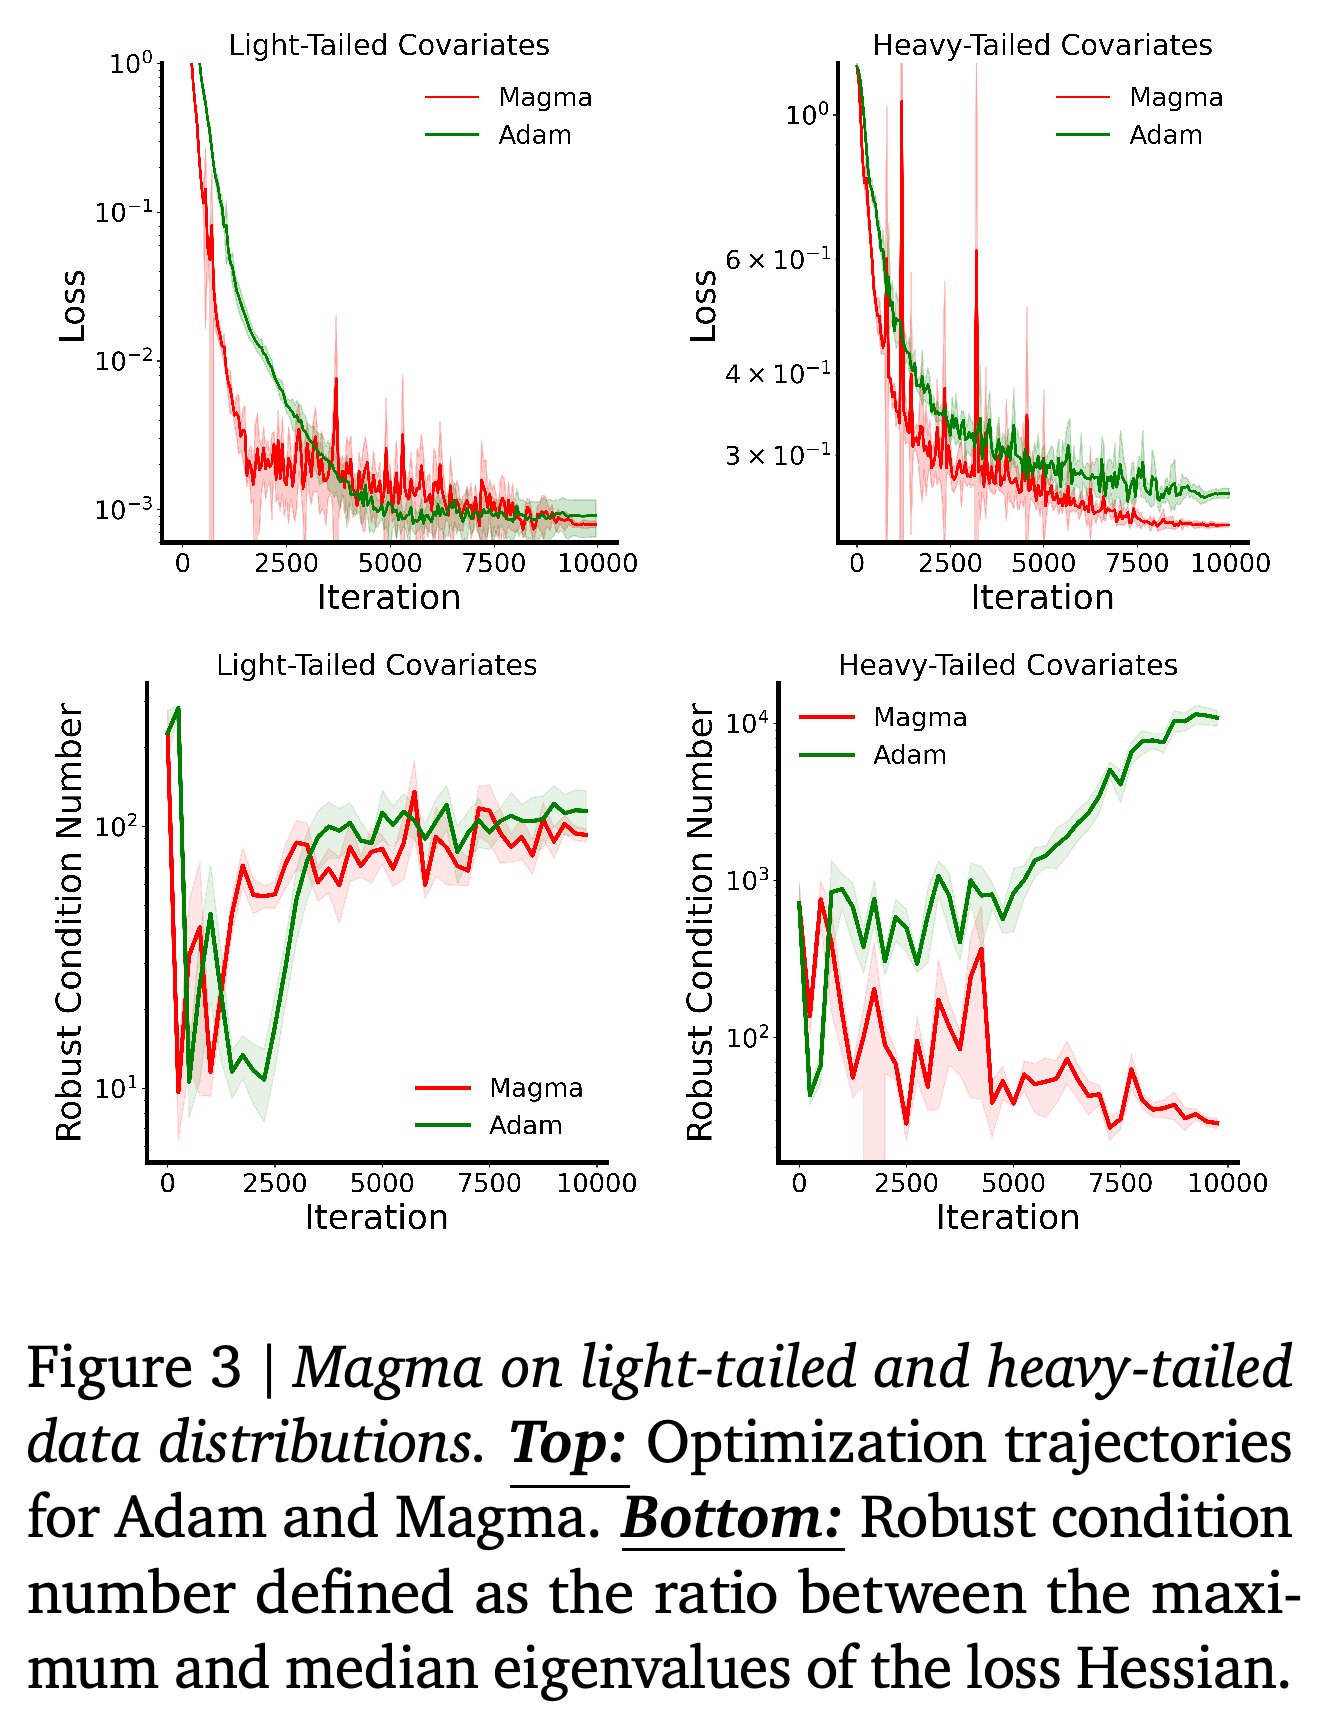
- Figure 3에서 Gaussian 공변량 조건의 Adam과 Magma는 최종 손실이 비슷하다. 반면 논문이 heavy-tailed라고 부르는 조건에서는 Magma의 손실이 더 낮다.
- 이 명칭을 공변량이 수학적으로 heavy-tailed라는 근거로 받아들여서는 안 된다. 명시된 Gamma 기반 반지름 분포는 light-tailed이다. 그럼에도 이 실험은 변동성이 큰 별도의 공변량 분포와 그에 따른 최적화 양상을 시험한다.
- 강건 조건수는 Hessian의 최대 고윳값을 고윳값의 중앙값으로 나눈 값이다. 후자의 조건에서 Magma의 학습 경로를 따라 이 값이 훨씬 작다는 결과는 낮은 손실과 학습 중 방문한 영역의 더 나은 조건수 사이의 연관성을 보여준다. 다만 마스킹과 감쇠 각각의 기여를 분리하지는 않는다.
Gaussian 공변량 패널에서는 학습 후반의 손실과 조건수가 대체로 비슷하다. Heavy-tailed로 표시한 패널에서는 Magma가 더 낮은 손실을 얻고, 강건 Hessian 조건수도 상승하는 Adam의 학습 경로보다 훨씬 낮게 유지된다. 함께 제시된 진단값은 최적화 개선과 학습 중 방문한 영역의 더 나은 조건수 사이의 연관성을 보여준다. 다만 마스킹과 감쇠의 인과적 기여를 분리하거나 수학적 꼬리 분류를 검증하지는 않는다.
4.4. Magma on Heterogeneous Quadratics
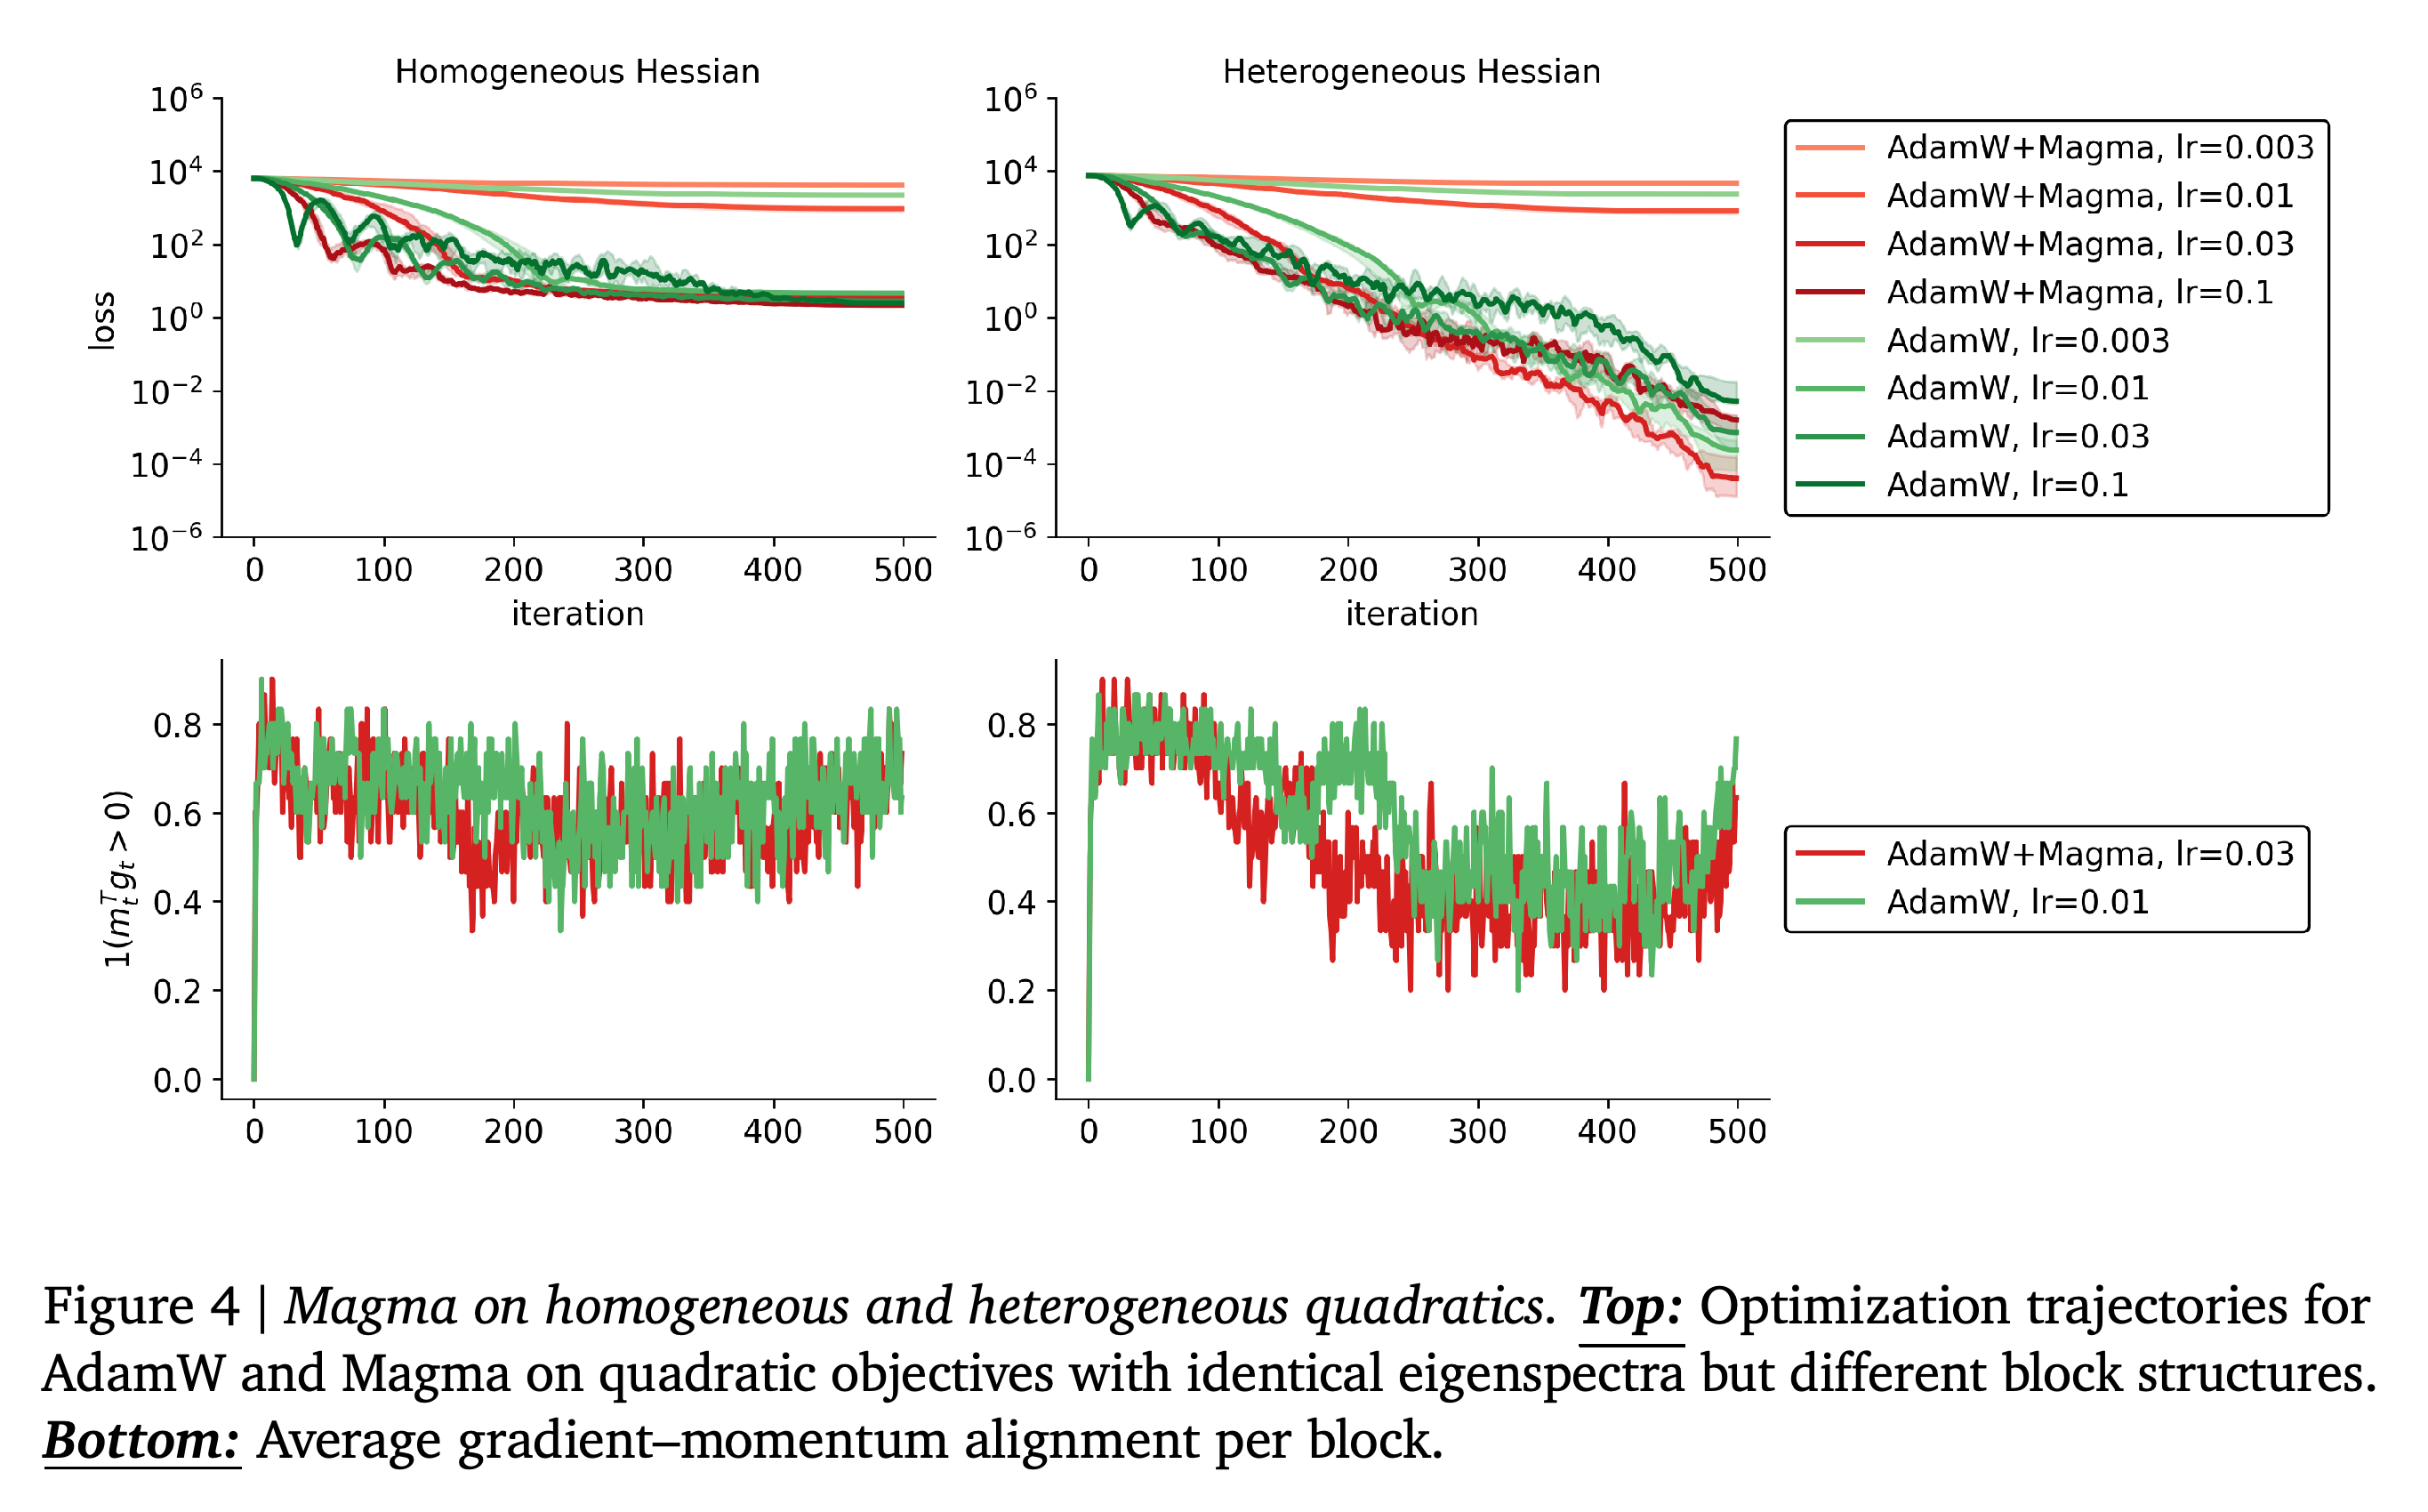
이차함수 benchmark는 ℝ⁹의 파라미터 블록 3개에서 Hessian 고유 스펙트럼을 고정하고 블록별 배치만 바꾼다. 2개 목적함수 모두 고윳값 {1, 2, 3, 99, 100, 101, 4998, 4999, 5000}을 사용하고, 각 3 × 3 블록 내부에 독립적인 무작위 회전을 적용한다. 확률적 gradient는 X = H¹ᐟ²에서 행을 부분 샘플링해 생성한다.
- 동질적 블록은 비슷한 스케일인 {1, 2, 3}, {99, 100, 101}, {4998, 4999, 5000}을 묶는다. 이질적 블록은 {1, 99, 4998}, {2, 100, 4999}, {3, 101, 5000}처럼 서로 다른 스케일을 섞는다.
- Figure 4에서 동질적 목적함수의 최선 실행들은 비슷한 최종 성능을 보인다. 이질적 목적함수에서는 AdamW+Magma가 더 낮은 손실로 더 빠르게 수렴한다.
- 그래프에 표시된 학습률은 0.003, 0.01, 0.03, 0.1이다. 일부 Magma 설정은 거의 개선되지 않으므로, 이 그림이 모든 학습률에서 우위를 보여주는 것은 아니다.
Figure 4의 아래 패널에서는 Magma가 이질적 이차함수를 더 잘 최적화하면서도 gradient와 모멘텀의 일치도를 크게 높이지는 않는다. 이 진단값은 감쇠에 쓰는 코사인 유사도 점수가 아니라 내적이 양수인지를 나타내는 지시함수의 평균이다. 저자들은 이를 일치도 통계를 바꾸는 것보다 실제 적용되는 업데이트를 조절하는 일이 더 중요하다는 근거로 해석한다.
- 논문은 설정을 튜닝해 CIFAR-10의 ResNet-50을 100 epoch 학습한 뒤에도 AdamW 대비 개선이 없었다고 보고한다. 테스트 정확도는 94.46% 대 93.82%이다.
- 이 부정적 결과는 입증된 효과가 특정 조건에 한정됨을 보여준다. 아키텍처 간 차이를 곡률만으로 설명할 수 있다는 근거는 아니다.
- 9차원 이차함수 구성은 블록 기하 구조의 영향을 분리하지만, transformer 학습을 정성적으로 추상화한 설정에 머문다.
고유 스펙트럼을 고정했을 때 동질적 이차함수에서는 성능이 가장 좋은 실행들의 최종 손실이 비슷하다. 이질적 이차함수에서는 AdamW+Magma가 더 낮은 손실에 도달한다. 학습률이 낮은 일부 Magma 실행은 거의 개선되지 않는다. 아래 패널은 선택한 학습률에서 gradient와 모멘텀의 내적이 양수인 빈도를 비교하며, Magma를 적용해도 크게 증가하지 않음을 보여준다. 이 패널은 감쇠에 쓰는 코사인 유사도 점수를 표시하지 않는다.
5. Discussion
수렴 논의는 실제 적응적 옵티마이저 wrapper가 아니라 학습률이 일정한 SGD를 다룬다. 명시된 블록별 smoothness와 확률적 gradient의 2차 모멘트 가정 아래에서 Lemma 4는 손실 감소량의 한계를 제안한다. Lemma 5는 유효 하강 계수와 noise 결합 계수를 도입하고, Theorem 6은 gradient 제곱 노름의 평균에 대한 상한을 제시한다.
- 유효 블록 smoothness는 L̃ₜ⁽ᵇ⁾ = ρₜ⁽ᵇ⁾L⁽ᵇ⁾/p이다. 여기서 ρ는 감쇠가 2차 모멘트를 줄이는 정도를 나타낸다.
- 제시된 정리는 학습률 제한 아래에서 1/T로 감소하는 최적화 항, noise와 하강의 결합 항, 곡률로 가중한 noise 항을 포함한다.
- 감쇠는 불안정성을 유발하는 2차 모멘트뿐 아니라 유용한 하강도 줄일 수 있다. 제안된 유리한 조건에서는 곡률 가중 noise나 smoothness 제약을 지배하는 블록을 감쇠해야 한다.
- 증명에는 보완이 필요하다. A.2는 좌표별 smoothness만으로 도출되지 않는 여러 블록의 동시 smoothness 상한을 주장한다. A.3는 실제 gradient와의 일치도를 사용해 평활화된 모멘텀 일치도로 계산한 감쇠의 한계를 도출한다.
이 분석은 실제 wrapper에 대해 검증된 보장을 제공하기보다 안정성을 설명하는 가설을 제안한다. 분석의 마스킹 연산자는 확률의 역수로 재조정하는 단계를 포함한다. 반면 Algorithm 1의 Magma 업데이트는 기본 업데이트에 감쇠된 Bernoulli 마스크를 직접 곱한다.
- 증명의 공백을 제외하더라도 SGD 분석은 RMSProp+Magma나 Muon+Magma에 대한 완전한 수렴 보장이 아니다.
- 확률적 gradient 가정은 2차 모멘트가 유계임을 요구하므로, 분산이 무한한 임의의 heavy-tailed noise를 포괄하지 않는다.
- Figure A3의 더 넓은 유효 학습률 범위는 실험적 근거이다. 이 분석은 모멘텀 일치도가 LLM 학습에서 곡률이 큰 블록을 신뢰성 있게 식별한다는 점을 입증하지 않는다.
6. Literature Review
관련 연구 검토는 Magma를 업데이트 안정화, 기하 구조를 고려한 최적화, 확률적 정규화와 연결한다. Magma는 명시적 곡률 행렬이나 추가 adversarial gradient를 계산하지 않고, 구조화된 무작위 마스크와 일치도 기반 감쇠로 파라미터 업데이트를 교란한다.
- Cautious Optimizer는 gradient와 모멘텀의 부호가 일치하지 않으면 업데이트를 마스킹한다. 다른 안정화 접근에는 모멘텀 초기화를 동반한 gradient clipping, 초기화 방식 변경, 아키텍처 수정이 있다.
- 곡률을 고려한 preconditioner는 2차 구조를 근사하고, SAM 같은 sharpness-aware 방법은 추가 gradient 평가를 사용한다. Magma는 이런 계산을 피한다. 다만 국소 곡률에 대한 해석만으로 평탄한 해를 찾는 동등한 목적함수를 갖는다고 볼 수는 없다.
- 관련 연구 검토는 meta-learning과 federated learning의 gradient masking, Gaussian noise 주입, Dropout, noisy embedding도 다룬다. Magma는 hidden activation이나 token 표현이 아니라 옵티마이저 업데이트에 교란을 가한다.
7. Conclusion
결론은 dense gradient를 사용할 수 있다는 이유만으로 dense 파라미터 업데이트가 최적이라고 볼 수는 없다고 주장한다. 입증된 기여는 보고된 Llama와 Nano MoE 사전 학습 지표를 개선하는 옵티마이저 wrapper이다. 논문은 이와 함께 국소 곡률 전개와 통제된 최적화 실험을 제시한다.
Impact Statement
Impact Statement는 이 연구가 머신러닝 발전을 목표로 하며, 저자들이 별도로 논의해야 할 사회적 영향을 식별하지 못했다고 밝힌다. 배포 위험이나 자원 사용의 영향에 대한 별도 평가는 포함하지 않는다.
부록
- A. Proofs of Claims는 A.1. Proof of Proposition 1, A.2. Proof of Lemma 4, A.3. Proof of Lemma 5, A.4. Proof of Theorem 6을 포함한다. A.1은 Taylor 전개와 독립 마스크의 모멘트를 사용한다. A.2는 다중 블록 smoothness 상한을 주장하고, A.3는 실제 gradient와의 일치도 사건을 분해한다. A.4는 제안된 하강 부등식을 망원합으로 정리한다. 뒤의 결과들에는 추가 정당화가 필요하다. 좌표별 smoothness만으로는 A.2의 상한이 성립하지 않으며, A.3는 실제로 쓰는 평활화된 감쇠 점수에 대해 일치도 기반 하한을 정당화하지 않는다.
- B. Experimental Details는 4개 benchmark 설정을 기록한다. B.1. C4 Pre-Training Benchmark Setup은 배치 크기 512, 시퀀스 길이 256, 학습률 탐색 grid {1e-4, 5e-4, 1e-3, 5e-3, 1e-2}, 10% warm-up, 최댓값의 10%까지 낮추는 cosine decay를 명시한다. 60M/130M/350M/1B 모델은 각각 10K/20K/60K/100K iteration 동안 학습한다. 결과 선택에는 탐색한 학습률 중 가장 좋은 실행의 최종 평가 perplexity를 사용한다.
- B.2. Nano MoE Pre-Training Benchmark Setup은 Wolfe (2024)를 따른다. 124M GPT2-style 모델에 expert 8개, top-2 routing, MoE stride 2, 보조 load-balancing loss, Switch Transformer-style 초기화를 사용한다고 명시한다. 50K-iteration 학습은 8xA100 GPU에서 배치 크기 12, accumulation 40, 시퀀스 길이 1024, 최소 학습률 5e-6, weight decay 0.1, gradient clipping norm 1.0을 사용한다.
- B.3. Heterogeneous Quadratic Benchmark Setup은 고윳값 {1, 2, 3, 99, 100, 101, 4998, 4999, 5000}과 3 × 3 Hessian 블록 3개를 고정하고, 스케일에 따라 묶는 방식을 바꾼다. 블록별 독립 무작위 회전과 X = H¹ᐟ²의 행 부분 샘플링으로 확률적 이차함수 benchmark를 구성해 동질적 곡률과 이질적 곡률을 비교한다.
- B.4. Heavy-Tailed Gradient Noise Benchmark Setup은 시퀀스마다 별도의 잠재 회귀 벡터 w를 N(0, I_d)에서 샘플링하고, 마지막 label의 평균 제곱 예측 오차를 최소화한다. d = 5와 n = 20으로 설정하고 N(0, I_d) 공변량을 단위 구면 샘플에 √Γ₀.₁,₁₀을 곱한 조건과 비교한다. 후자는 논문이 heavy-tailed라고 부르는 조건이지만, 명시된 공변량 분포는 수학적으로 heavy-tailed가 아니다.
- C. Ablation Studies는 주로 C4에서 130M Llama 모델과 RMSProp+Magma를 사용한다. C.1. Masking Component는 baseline 22.64, attention만 마스킹한 경우 21.92, attention+MLP 마스킹 21.65, 모든 구성 요소를 마스킹한 경우 21.94의 perplexity를 보고한다. 이 실험에서는 전체 마스킹보다 attention+MLP에 한정한 설정이 더 좋다.
- C.2. Masking Granularity는 원소, 행, 열, 블록 마스크를 여러 샘플링·감쇠 조합으로 비교한다. 균일 샘플링은 21.73, 21.76, 21.78, 21.81을 기록하고, 감쇠만 적용하면 21.97, 21.95, 21.91, 21.92를 기록한다. 균일 샘플링+감쇠는 21.58, 21.62, 21.61, 21.65를 기록한다. 일치도 기반 샘플링은 21.77, 21.78, 21.75, 21.78이며, 일치도 기반 샘플링+감쇠는 21.63, 21.60, 21.61, 21.65이다. 일치도 기반 샘플링은 균일 샘플링보다 일관된 우위를 보이지 않는다.
- C.3. Sampling Ratio and Damping Temperature는 p ∈ {0.25, 0.5, 0.75}와 τ ∈ {0.5, 1.0, 2.0, 4.0}을 시험한다. Figure A1에서 p = 0.5는 시험한 모든 온도에서 다른 생존 확률보다 성능이 좋고, 온도에 대한 민감도는 비교적 작다. 저자들은 τ = 2.0을 채택하지만, p = 0.5 그래프에서 이 값이 가장 낮은 perplexity를 얻는 것은 아니다.
- C.4. Sparse vs. Dense Momentum Update는 학습률 0.001에서 20,000 iteration 동안 4개 설정을 비교한다. Figure A2에서 dense 모멘텀 업데이트는 감쇠 유무와 관계없이 비슷하게 잘 수렴한다. 감쇠 없는 sparse 업데이트는 매우 불안정하고, 감쇠를 적용하면 부분적으로 안정화된다. 그래도 감쇠를 적용한 sparse 변형의 최종 학습 perplexity는 dense 변형들보다 높다.
- C.5. Sensitivity to Learning Rate는 Adam+Magma가 최대 0.05의 학습률에서도 효과를 유지한다고 보고한다. 반면 Adam과 C-Adam의 유리한 범위는 더 좁으며, 본문은 이를 약 0.001–0.003으로 설명한다. Figure A3는 시험한 지점에서 더 넓은 유효 학습률 범위를 뒷받침한다. 모든 과제에서 학습률 튜닝이 불필요해졌다는 근거는 아니다.
짧은 생각
가장 강한 근거는 모델 크기 전반에서 일관된 C4 개선, Nano MoE에서 성공적인 Muon 조합, 샘플링·감쇠·dense 상태 업데이트를 구분한 ablation이다. 이 결과들은 이미 계산한 업데이트 일부를 버리더라도 옵티마이저 수정 방법으로 업데이트 마스킹을 시험할 가치가 있음을 보여준다.
메커니즘에 대한 근거는 실험 결과보다 약하다. 업데이트 후 손실의 기댓값에 양의 곡률 항이 생긴다는 사실만으로 평탄한 최솟값을 선택한다고 입증할 수는 없다. 수렴 증명에도 가정과 실제 감쇠 규칙 사이의 공백이 있다. PDF는 C4 결과의 불확실성 추정치, 1B를 넘는 규모, 측정된 실제 실행 시간 오버헤드를 보고하지 않으며, CNN에서는 부정적 결과를 제시한다. 13.71/13.81의 보고 불일치와 Gamma 기반 benchmark의 heavy-tailed 명칭도 수치 및 강건성 주장을 해석할 때 주의할 부분이다.