


UniPool: Learning Expert-to-Layer Ownership from Brief Global Access 요약 설명
07 May 2026 | Paper Review Mixture-of-Experts Expert Routing LLM Pretraining목차
- 요약
- 1 Introduction
- 2 Related WORK
- 3 Motivating Observation: Substitutable Experts Under Fixed OWNERSHIP
- 4 Method
- 5 Experiments
- 6 Conclusion
- AI Use Statement
- Reproducibility Statement
- 부록
- 짧은 생각
이번 글에서는 UniPool: Learning Expert-to-Layer Ownership from Brief Global Access 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 7일(Arxiv)
- Huang, Minbin, Shi, Han, Zheng, Chuanyang, Wu, Yimeng, Chen, Guoxuan, Yu, Xintong, Yin, Yichun, Cheng, Hong.
- The Chinese University of Hong Kong, Huawei Technologies, The University of Hong Kong
- 논문 링크
- Github
요약
- UniPool: Learning Expert-to-Layer Ownership from Brief Global Access는 초기 학습에서 레이어별 라우팅 선호가 형성된 뒤에 MoE 전문가의 소속 레이어를 결정해야 하는지 연구한다. UNIPOOLlock은 모든 레이어에 전역 전문가 풀을 잠시 개방하고, 균형 잡힌 상호 배타적 배정을 학습한 뒤 레이어 전용 전문가 실행으로 학습을 이어간다.
- 전문가 FFN 저장량과 라우팅된 전문가 FLOPs를 맞춘 비교에서 UNIPOOLlock은 182M부터 1.5B까지 5개 dense-equivalent 규모의 테스트 손실을 0.0244–0.0367 줄인다. 1.5B에서는 약 60B 토큰 학습 후 손실이 1.6320에서 1.6073으로 감소한다. 182M과 469M의 4개 설정에서 측정한 잠금 후 스텝 시간 오버헤드는 −0.7%부터 +2.8%까지다.
- 조건을 맞춘 182M 대조 실험에서는 초기 전역 접근과 그 과정에서 얻은 배정이 모두 성능에 기여한다. 초기화 시점부터 무작위로 소속을 정하면 손실이 1.9319이고, 전역 접근 후 무작위로 잠그면 1.9173이며, 학습한 배정으로 잠그면 1.9040이다. 다만 잠금 일정은 1개만 시험했고, 더 큰 규모에서는 단일 시드 결과만 있으며, 다운스트림 평가는 zero-shot으로 한정된다.
1 Introduction
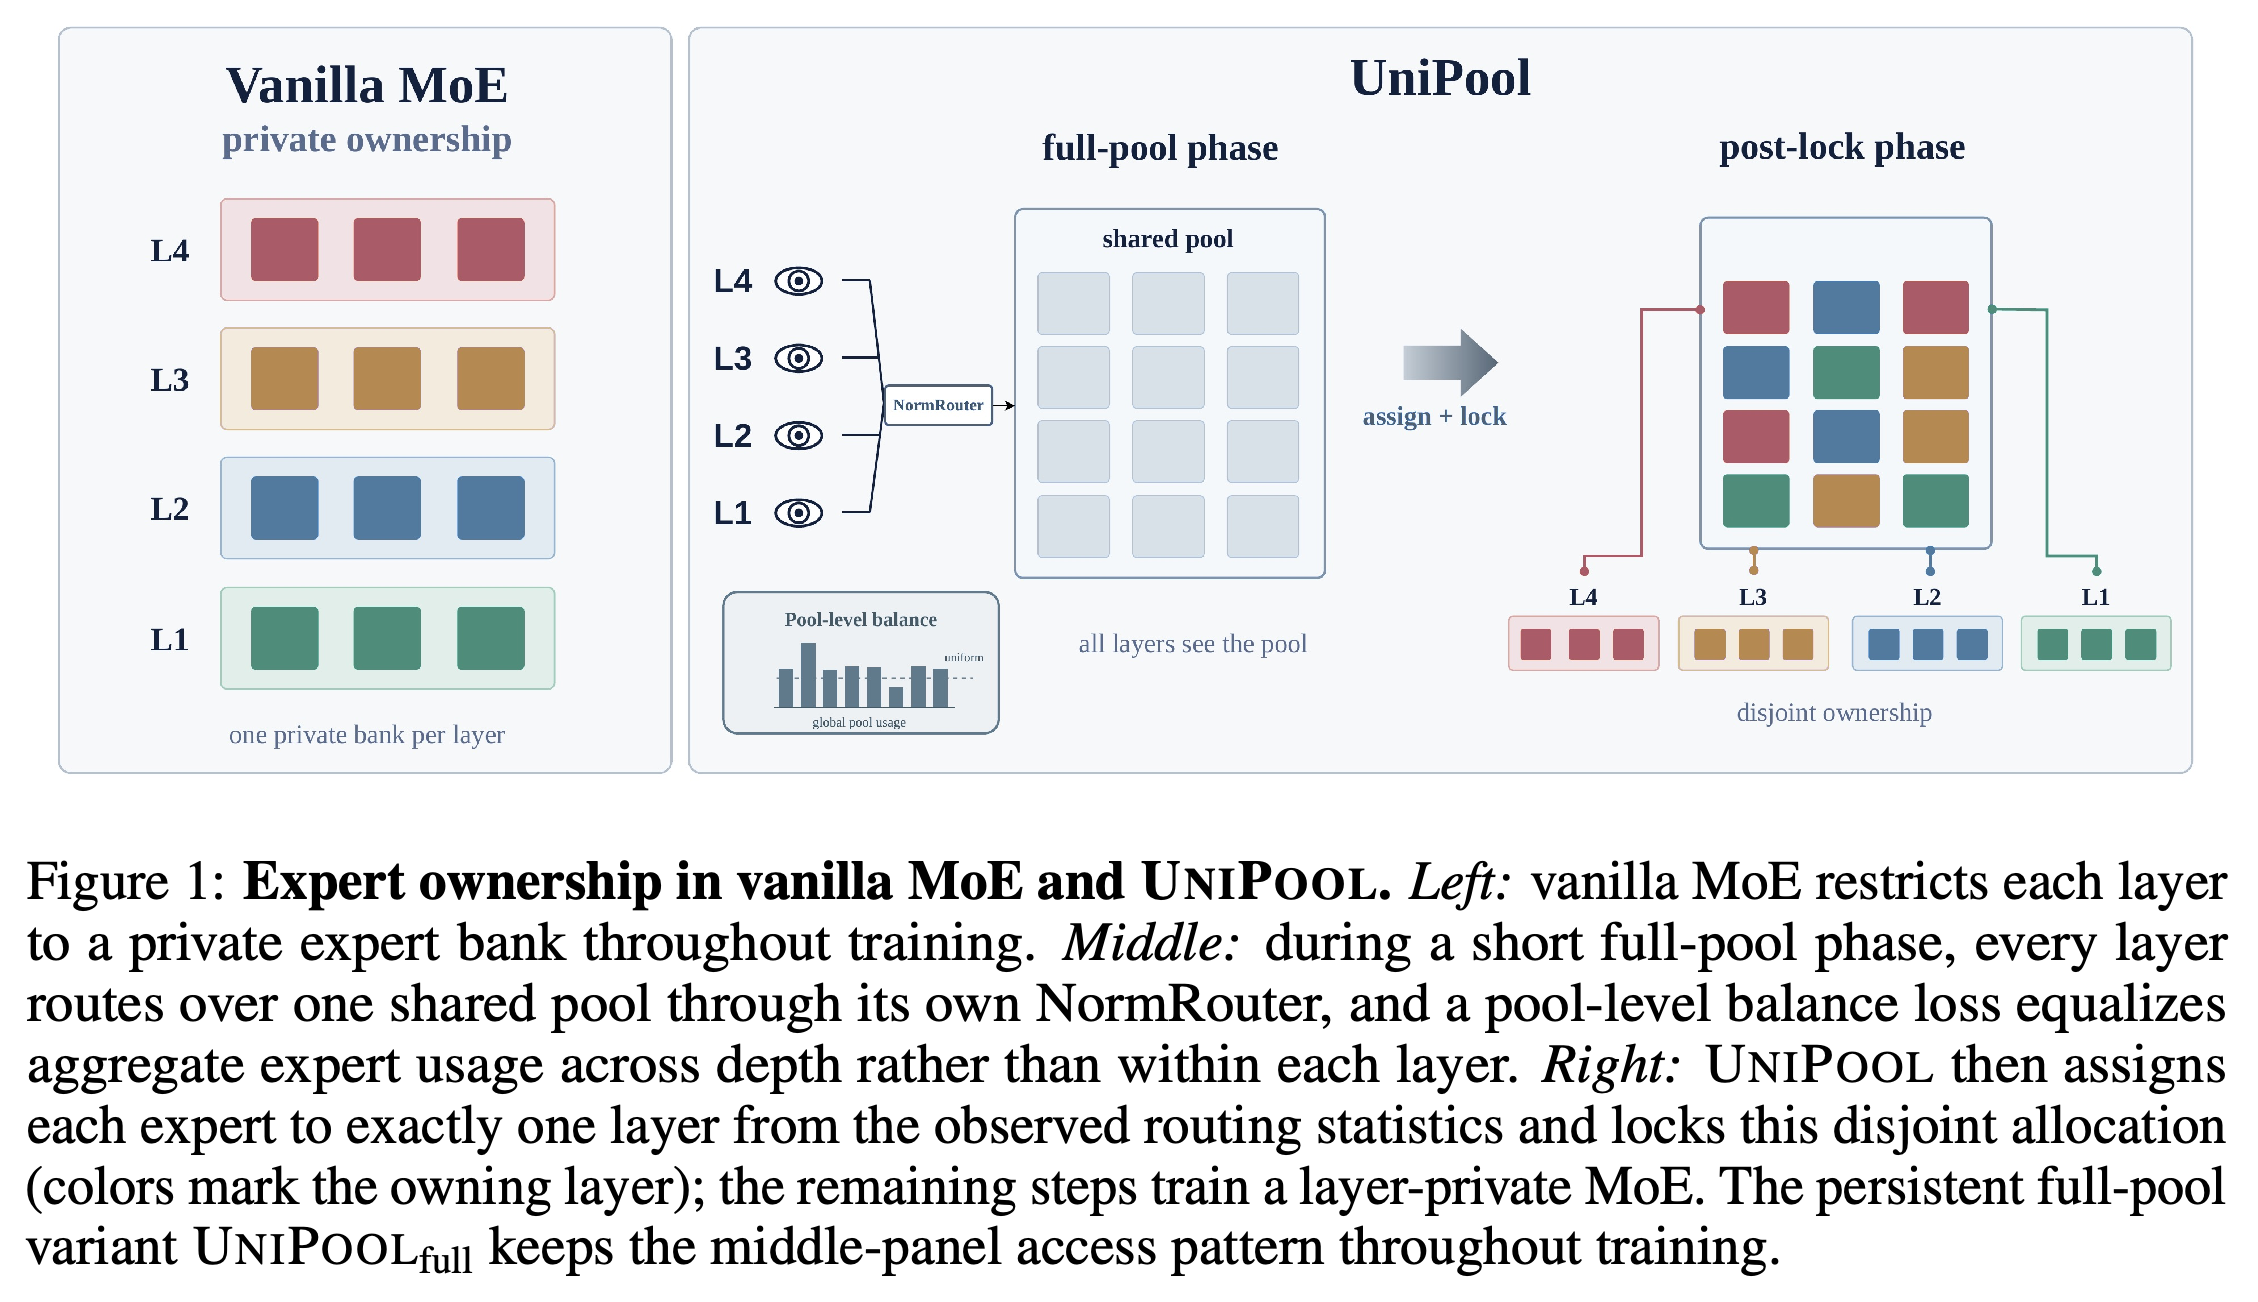
표준 MoEs는 학습 전에 각 전문가를 특정 레이어에 전용으로 배정한다. 이 시점에는 전문가들이 배정 관점에서 서로 교환 가능하며, 배정에 데이터가 반영되지 않는다. UNIPOOL은 초기 전역 경쟁을 통해 소속을 학습한 뒤 레이어 간 공유를 제거해 레이어 전용 실행으로 전환한다.
- 연구 동기는 레이어 내 전문가의 유사성과 가지치기 내성에 관한 기존 보고와 논문의 라우팅 무작위화 실험에서 나온다.
- UNIPOOLfull은 품질과 파라미터 효율을 비교하기 위한 기준으로, 학습 내내 전역 접근을 유지한다. 주된 방법은 UNIPOOLlock이다.
- Figure 1은 일시적인 전역 접근 구조와 최종 상호 배타적 소속 구조를 구분해 보여준다.
전역 공유는 UNIPOOLlock의 최종 실행 아키텍처가 아니라 일시적인 소속 학습 수단이다. 잠금 후 풀에서 색으로 표시된 각 전문가는 1개 레이어에 속한다. 따라서 전역 파라미터 컨테이너를 유지한다고 해서 레이어 간 실행도 계속되는 것은 아니다.
2 Related WORK
논문은 소속 학습을 희소 라우팅, 부하 균형 대안, 사전에 정한 레이어 간 공유, MoE 초기화나 활성화 패턴 변경과 구분한다. UNIPOOL은 전문가 활성화의 희소성을 고정한 채 각 전문가가 어느 레이어에 속하는지를 바꾼다.
- Switch 방식의 균형 조정은 레이어 전용 전문가 집합 안에서 작동한다. UNIPOOL은 공유 풀 전체의 사용량을 합산해 균형을 맞춘다.
- ReXMoE, MoUE, Universal Transformers 및 관련 방법은 공유 패턴을 미리 정한다. 반면 UNIPOOL은 배정을 학습한 뒤 공유를 제거한다.
- Upcycling은 초기화를 바꾸고, EvoMoE와 dense-training/sparse-inference 방법은 활성화 패턴을 바꾼다. 이 방법들은 짧은 전역 접근으로 상호 배타적인 전문가-레이어 배정을 학습하지 않는다.
3 Motivating Observation: Substitutable Experts Under Fixed OWNERSHIP
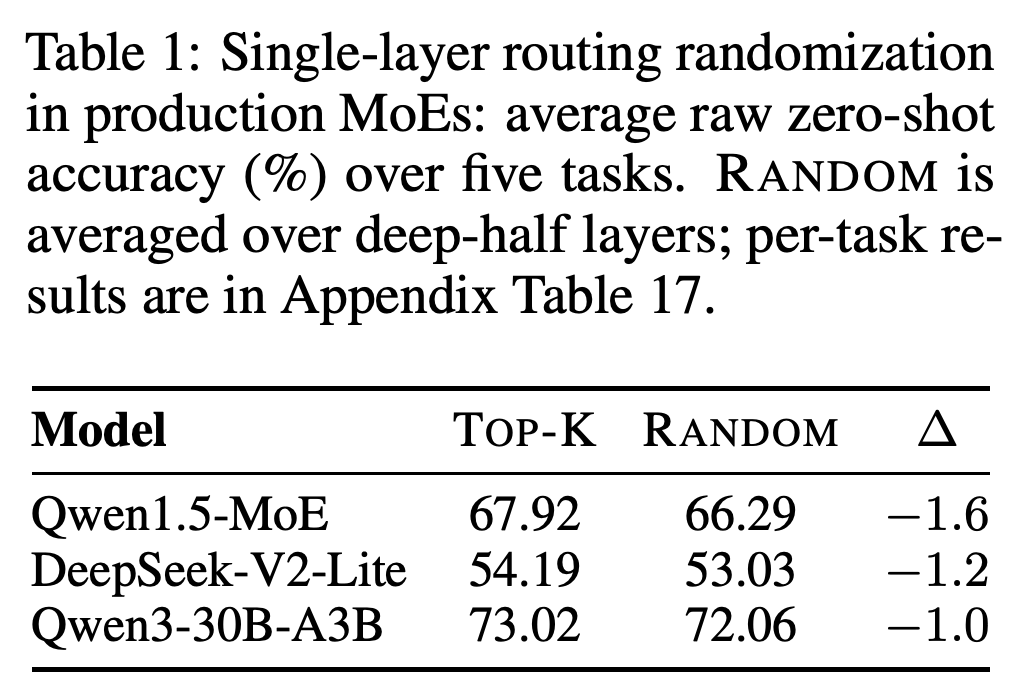
연구의 출발점이 된 실험은 후반부 MoE 레이어 1개의 학습된 라우터를 균등 무작위 배정으로 대체한다. 후반부 레이어마다 이 개입을 반복하고 5개 태스크의 다운스트림 정확도를 평균한다. Qwen1.5-MoE, DeepSeek-V2-Lite, Qwen3-30B-A3B에서 하락 폭은 1.0–1.6점에 그친다. 이는 해당 개입에서 어떤 전문가를 선택하는지에 대한 민감도가 낮음을 보여준다.
- Table 1의 raw zero-shot 정확도는 각각 67.92에서 66.29, 54.19에서 53.03, 73.02에서 72.06으로 변한다.
- 이 관찰은 소속 배정에 관한 가설의 출발점이지만, 고정된 소속이 중복성을 유발한다는 사실을 입증하지는 않는다.
- 이후 대조 실험은 동일한 전문가 예산에서 배정의 품질을 검증하고, 조건을 맞춘 진단 실험은 학습된 UNIPOOL 모델을 살펴본다.
후반부 레이어 1개의 라우터를 차례로 대체하면 공개된 실용 모델 3개 모두에서 평균 raw accuracy가 소폭 감소한다. 이는 연구의 출발점이 된 민감도 관찰을 확인하지만, 고정된 소속이 중복성의 원인이라는 인과적 설명은 아니다.
4 Method
UNIPOOL은 전역 풀 라우팅, 풀 수준 보조 손실, NormRouter를 소속 잠금과 결합한다. UNIPOOLlock은 초기 소속 학습 단계에서 전역 접근을 사용하고, UNIPOOLfull은 학습 내내 전역 접근을 유지한다.
4.1 Global EXPERT POOL
각 레이어는 자체 라우터를 유지하되 공통 풀에서 전문가를 선택한다. 라우팅된 FFN은 (\operatorname{FFN}l(x)=\sum{i\in\operatorname{Top-}k_{V_l}(r_l(x))}g_{l,i}(x)e_i(x))로 표현하며, V_l은 해당 레이어가 접근할 수 있는 전문가 집합이다. 전역 접근에서는 모든 전문가를 개방하고, 잠금 후에는 학습한 배정으로 접근 범위를 제한한다.
- 레이어가 L개이고 레이어마다 전용 전문가가 E개일 때, 예산을 맞춘 비교에서는 M = EL개의 전역 전문가를 사용한다.
- 두 아키텍처 모두 레이어와 토큰마다 동일한 k개의 전문가 FFN을 활성화한다. 축소 풀 실험에서는 M < EL을 사용한다.
- 깊이에 따라 은닉 상태 분포가 다르므로 레이어별 라우터를 유지한다.
4.2 POOL-Level AUXILIARY LOSS
한 레이어가 사용하지 않는 전문가를 다른 레이어가 활용할 수 있는 상황에서는 레이어별 균형 조정이 깊이별 선호를 억제할 수 있다. UNIPOOL은 대신 L_pool = α_pool M ∑_{i=1}^{M} f_i P_i를 최소화하며, 디스패치 비율과 평균 라우팅 점수를 레이어 전체에서 평균한다.
- 이 목적함수는 각 레이어가 모든 전문가에 트래픽을 균등하게 분배하도록 강제하지 않으면서, 풀 전체에서 사용되지 않는 전문가를 줄인다.
- 손실을 레이어별 항으로 분해할 수 있으므로 각 레이어가 자신의 기여분을 독립적으로 계산할 수 있다.
- 활성화 체크포인팅에서 레이어 간 텐서 의존성을 피하기 위해 이전 마이크로배치의 합산 디스패치 비율을 사용한다.
4.3 Normrouter
이 방법은 NormRouter (Zheng et al., 2026)를 사용하며, z = W_l h일 때 s_i = σc max(0, z_i/(∥z∥₂ + ϵ))로 전문가 점수를 계산한다. L2 정규화는 레이어별 로짓 크기 차이를 제거하고, ReLU는 음수 후보의 점수를 없앤다. σ는 1로 초기화하는 학습 가능한 스칼라이며, c는 초기에 선택된 점수의 크기를 보정한다.
- 보조 목적함수는 softmax 확률의 평균이 아니라 점수의 평균을 사용한다.
- 잠금 후에도 라우터는 M개 로짓을 모두 계산하고 전체 풀에 대해 정규화한다. 바뀌는 것은 전문가 접근 범위뿐이다.
- 전체 풀 정규화를 유지하면 잠금 전환 과정에서도 점수 보정을 유지할 수 있다.
4.4 Learning OWNERSHIP and Locking It
소속 학습 단계에서는 K_tar = E로 두고 L_card = (λ_card/L) ∑_{l=1}^{L}(H(p_l) − log K_tar)²를 사용해 각 레이어의 유효 전문가 수가 E에 가까워지도록 유도한다. 1K 스텝에서 별도로 분리한 3% 검증 분할의 라우팅 횟수를 사용해 배정을 결정한다. 이 배정은 전문가의 독점 소속과 레이어별 전문가 수 제약 아래에서 유지되는 라우팅 질량을 최대화한다.
- M = EL이고 각 레이어에 최소 E개의 전문가가 배정되므로, 모든 레이어는 정확히 E개를 받고 모든 전문가는 소속 레이어가 1개다.
- 배정 밖의 점수는 1K–2K 스텝 동안 cosine 일정으로 감쇠시키고, 2K 스텝에서 접근 범위를 영구적으로 잠근다.
- 1.5B에서도 같은 일정을 사용한다. 60K-step 학습에서는 마지막 96.7%를 레이어 전용 전문가 실행으로 진행한다.
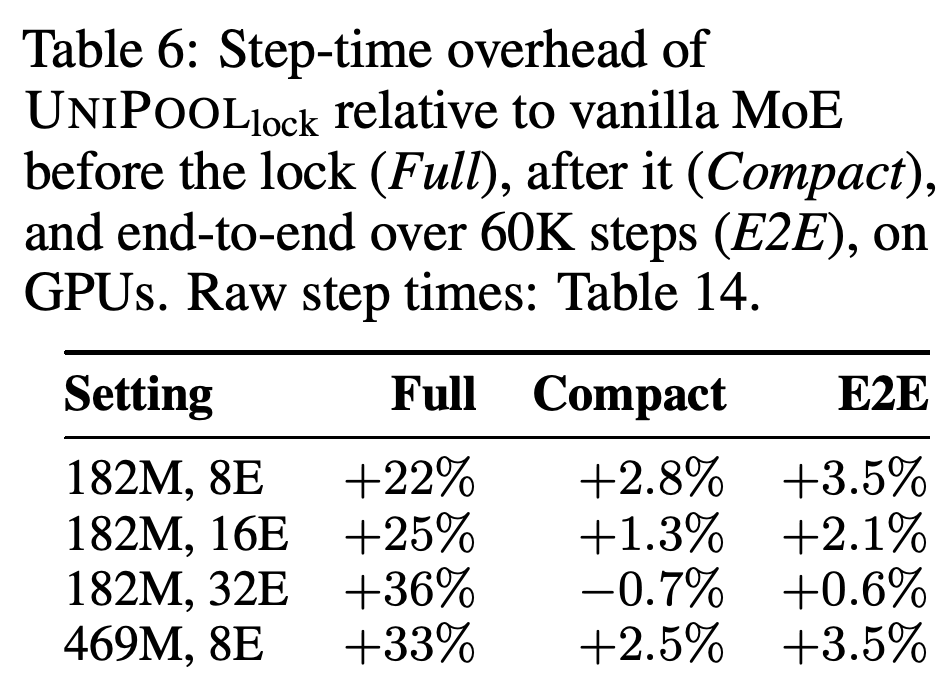
전역 접근은 같은 라우팅 연산을 더 많고 작은 grouped GEMM으로 나눈다. 보고된 측정에서 전체 풀 스텝은 22%–36% 더 느리다. 잠금 후에는 compact dispatch가 각 레이어의 선택된 전역 인덱스를 E개의 로컬 전문가 그룹으로 모아, vanilla와 같은 형태의 토큰 순열, 메타데이터, grouped GEMM 실행을 복원한다.
- 디스패처가 여전히 M개의 전문가 열과 그룹을 생성한다면 접근 마스크만으로는 충분하지 않다.
- 압축된 그룹은 전문가 파라미터를 복사하지 않고 원래 파라미터를 참조한다.
- 잠금 후에도 전역 점수 계산과 풀 통계 계산을 유지하므로 잔여 오버헤드가 발생한다.
5 Experiments
실험은 손실, zero-shot 다운스트림 정확도, 학습 처리량, 소속 대조 실험, 축소 풀, 구성 요소 ablation, 라우팅 민감도를 평가한다. 각 아키텍처 비교에서 전문가 FFN 저장량과 라우팅된 전문가 FLOPs를 맞춘다. 다만 더 넓은 UNIPOOL 라우터는 파라미터와 점수 계산 오버헤드를 추가한다.
5.1 Setup
LLaMA 방식의 백본을 Pile에서 182M, 469M, 650M, 830M, 1.5B의 dense-equivalent 활성 파라미터 규모로 학습한다. 앞의 네 규모는 60K 스텝, 전역 배치 512, 시퀀스 길이 1,024, 약 30B 토큰을 사용한다. 1.5B 모델은 36개 레이어, 너비 1,600, 전역 배치 1,024, 57,220 steps, 약 60B 토큰을 사용한다.
- 학습에는 AdamW, cosine 학습률 감소, bf16, Megatron-LM을 사용한다.
- 기본 예산은 레이어당 전문가 8개와 top-1 라우팅이다. UNIPOOL은 M = 8L개의 전문가를 사용한다.
- 182M 백본의 추가 16E/top-2 및 32E/top-4 설정은 전문가의 전체 너비를 유지한다. 이에 따라 vanilla MoE의 활성 파라미터는 약 268M과 438M이다.
- 보고된 4개 규모 설정에서 더 넓은 라우터는 저장 파라미터를 0.10%–0.37%, 활성 파라미터를 최대 2.2% 추가한다.
182M에서 vanilla MoE와 UNIPOOLfull은 시드 3개의 평균을 보고하며 테스트 손실 표준편차는 0.0023이다. UNIPOOLlock은 같은 학습 설정을 사용한 시드 2개의 결과인 1.9017과 1.9040을 평균한다. 다른 규모는 시드 1개를 사용하며, 저자들은 약 0.005 미만의 손실 차이를 동률로 취급한다.
- 최종 손실은 소속 결정에 사용한 3% 검증 분할과 겹치지 않는 별도 테스트 분할에서 측정한다.
- 더 큰 규모에서는 반복 실험이 제한적이므로, 잠금 방식과 지속적인 전체 풀 방식 사이의 작은 차이에 대해서는 결론을 내리기 어렵다.
5.2 Main Results
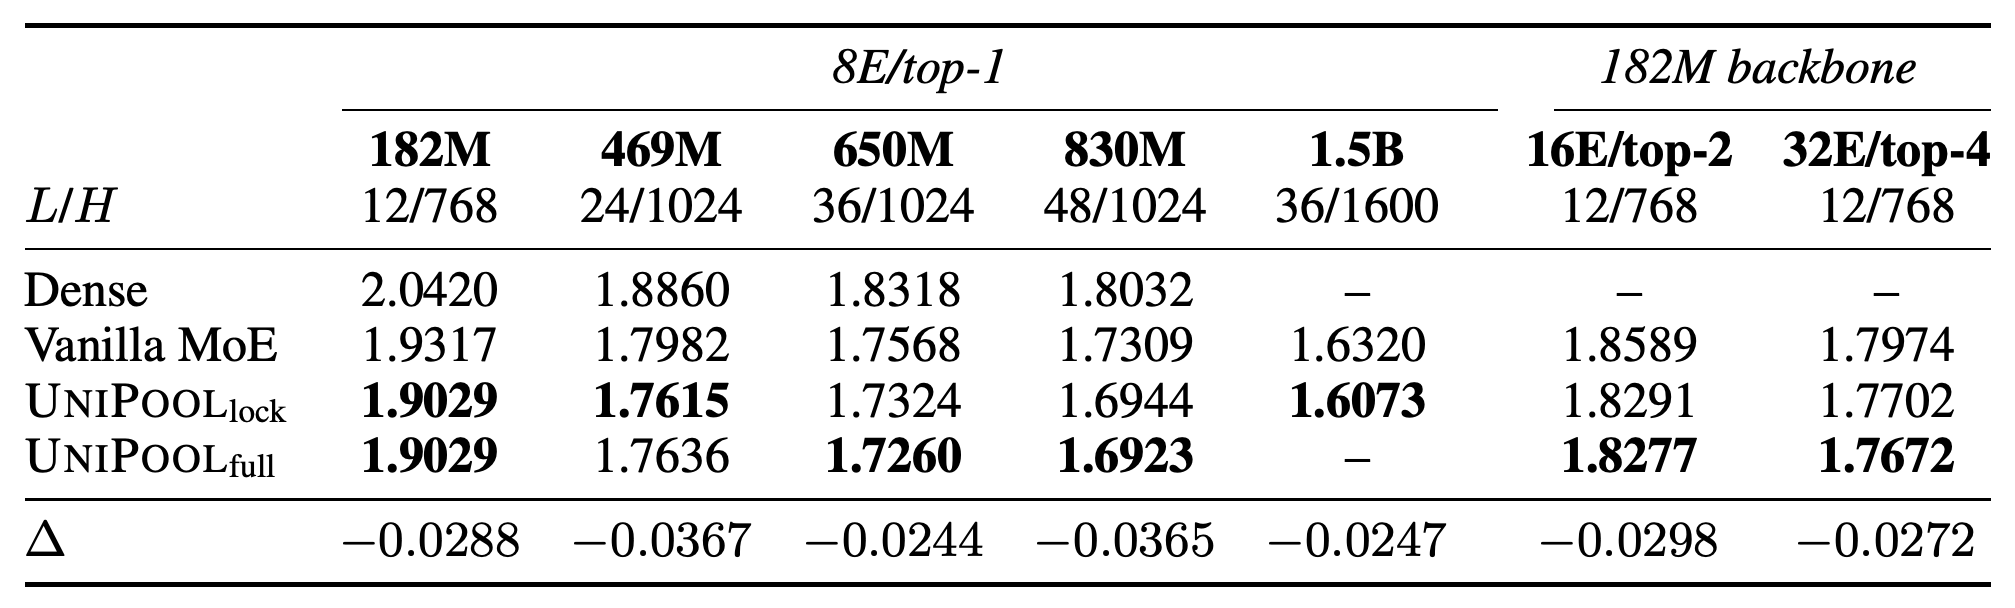
UNIPOOLlock은 기본 5개 규모 모두에서 vanilla MoE보다 테스트 손실이 낮다. 182M부터 1.5B까지 감소 폭은 각각 0.0288, 0.0367, 0.0244, 0.0365, 0.0247이다. 16E/top-2와 32E/top-4 예산에서도 손실을 각각 0.0298과 0.0272 줄인다.
- 두 방식을 모두 평가한 6개 설정에서 잠금 방식의 손실에서 지속적인 전체 풀 방식의 손실을 뺀 값은 −0.0021부터 +0.0064까지다.
- 1.5B에서는 UNIPOOLfull을 학습하지 않는다.
- dense 기준 모델과 조건을 맞춘 기본 4개 규모에서 모든 MoE 방식은 dense 모델보다 손실이 낮다.
잠금 모델의 모든 열은 조건을 맞춘 vanilla 기준보다 개선되며, 여기에는 1.5B run과 더 많은 전문가를 활성화하는 예산도 포함된다. 잠금 방식과 지속적인 전체 풀 방식의 손실은 가깝지만, 650M의 차이 0.0064는 논문의 대략적인 동률 기준인 0.005를 넘는다.
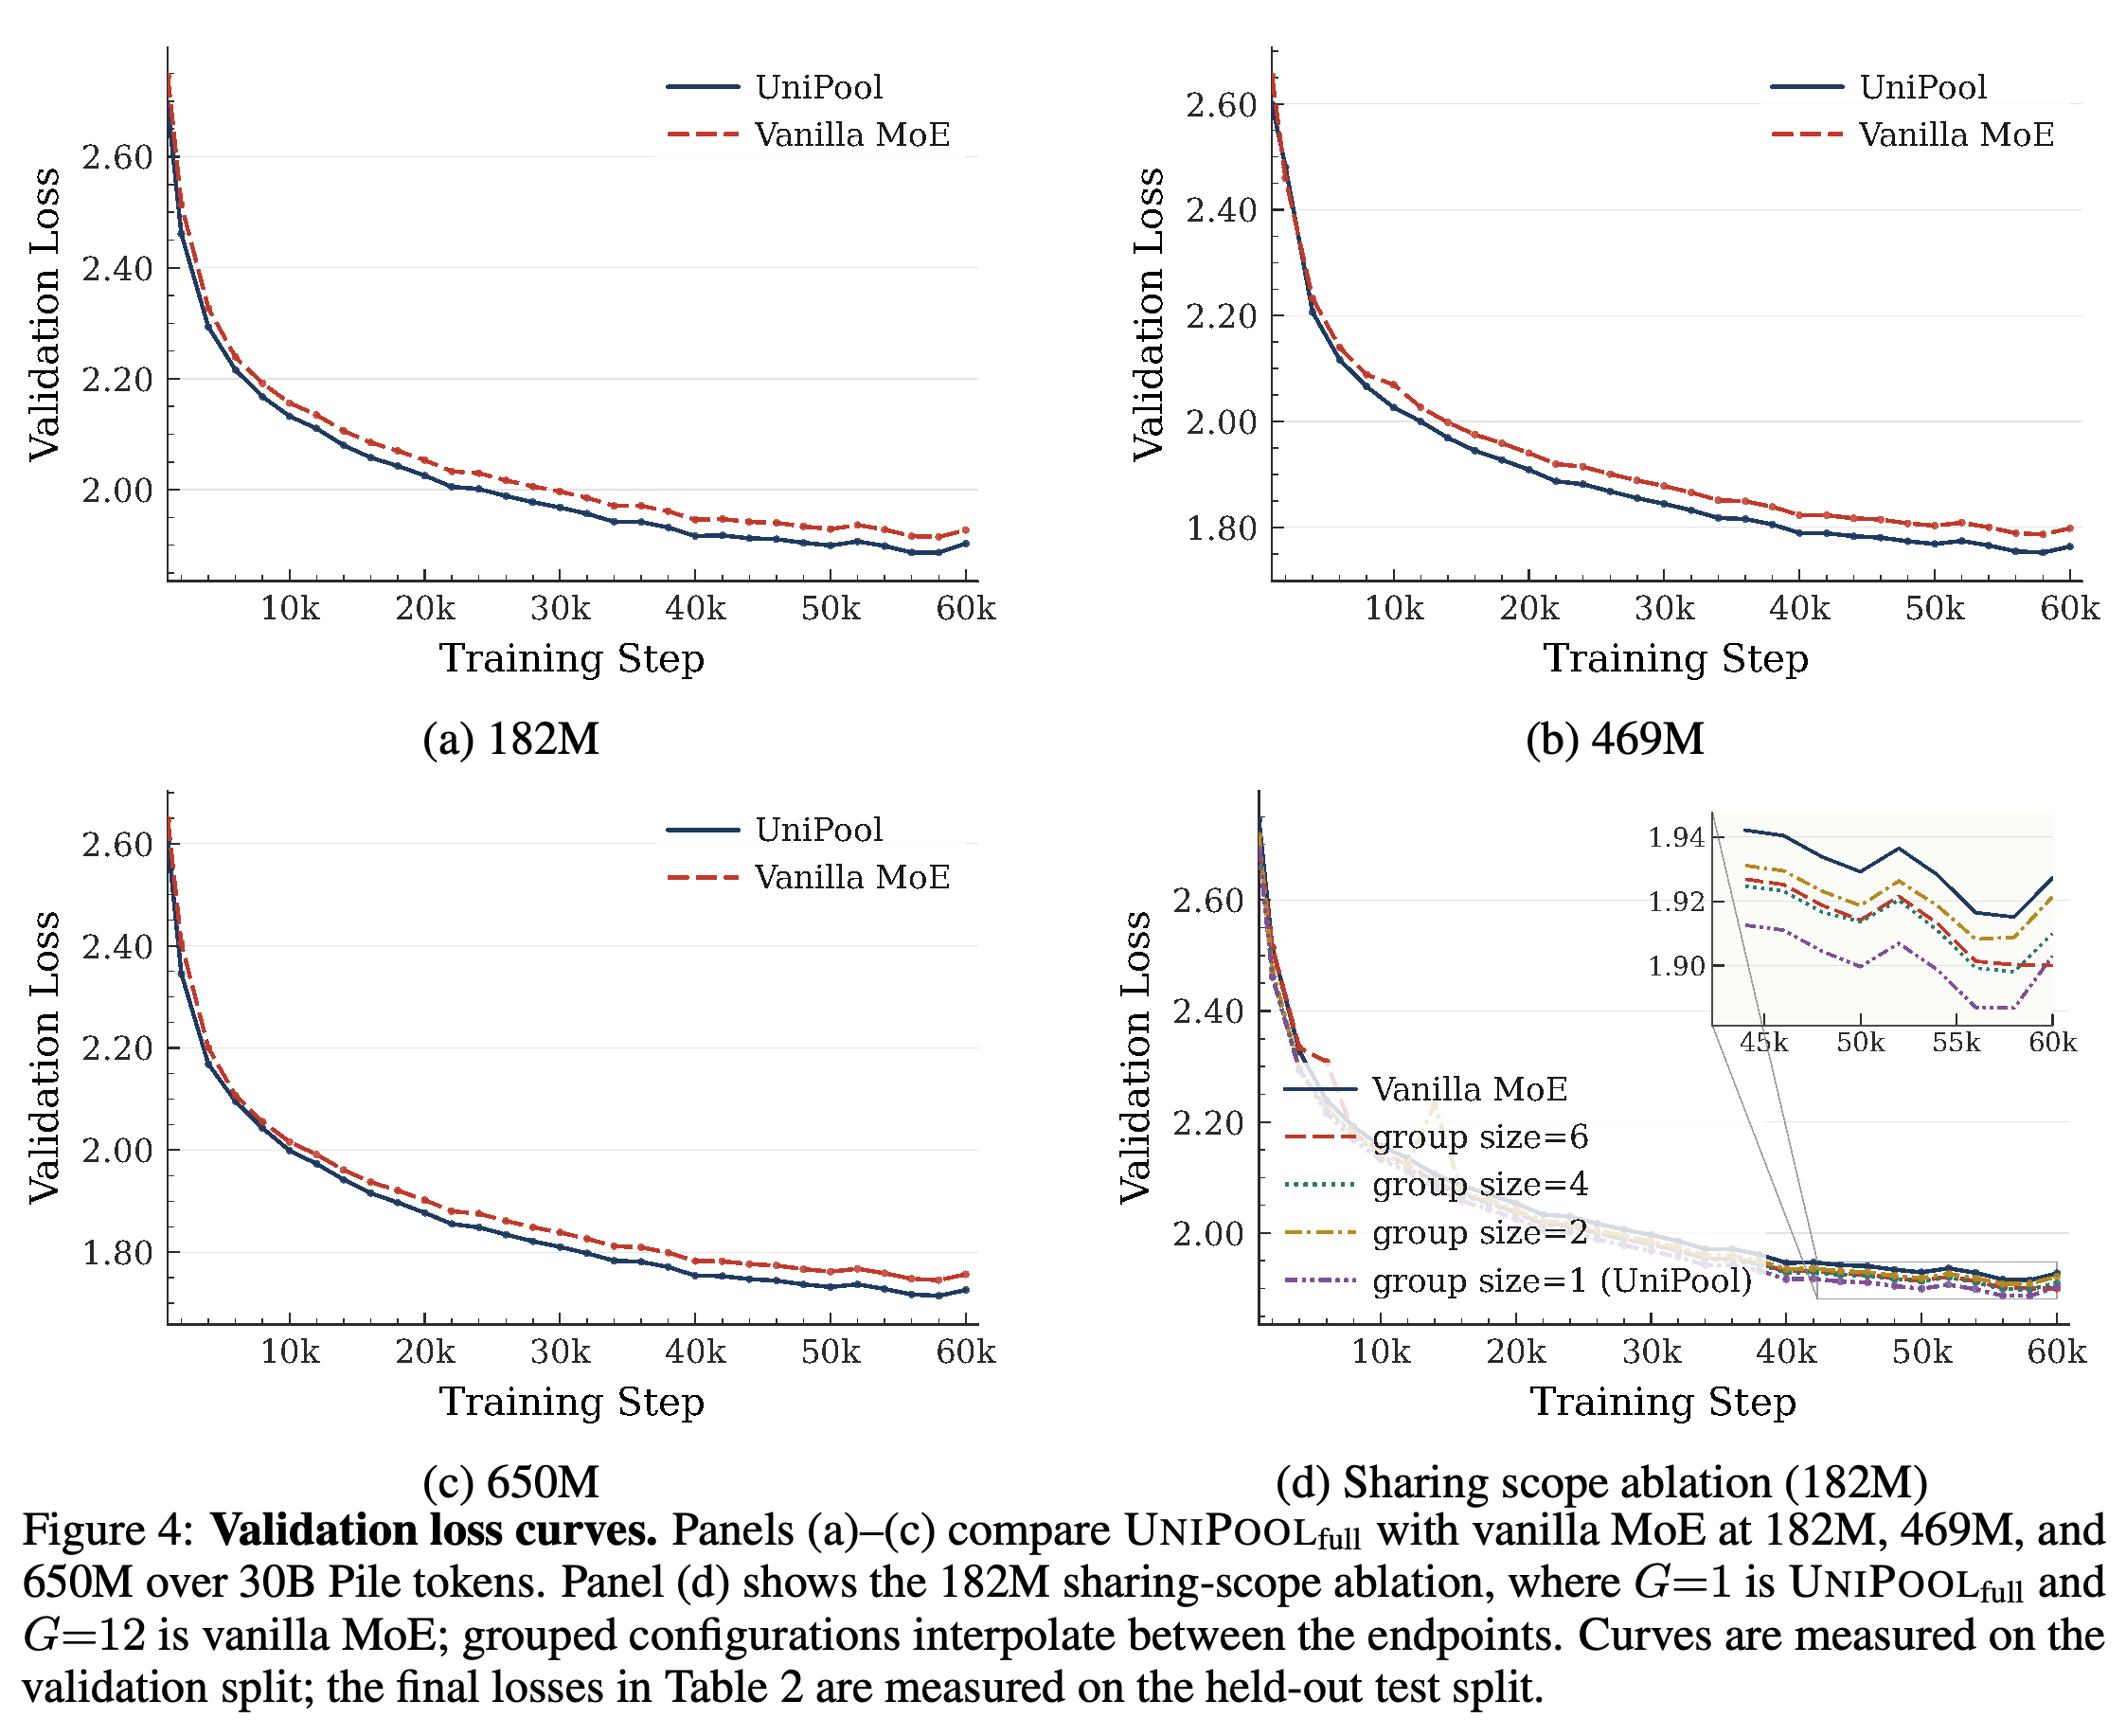
검증 곡선은 182M, 469M, 650M에서 UNIPOOLfull의 우위가 warmup 이후에도 유지됨을 보여준다. 공유 범위별 곡선도 대체로 최종 시점의 순위를 유지하므로, 보고된 이점이 마지막 체크포인트에만 한정되지는 않는다.
- Figure 4는 검증 손실을 나타내지만, 핵심 최종 수치 비교는 별도 테스트 분할의 손실을 보고한다.
- 이 곡선은 지속적인 전체 풀 학습에 관한 것으로, UNIPOOLlock의 학습 곡선을 직접 비교한 결과는 아니다.
지속적인 전체 풀 곡선은 3개 규모에서 warmup 이후에도 vanilla보다 낮게 유지된다. 이는 이점이 최종 시점에만 한정되지 않음을 보여준다. 공유 범위 패널은 대체로 최종 순위를 재현하며, 모든 곡선은 최종 테스트 손실이 아니라 검증 손실을 측정한다.
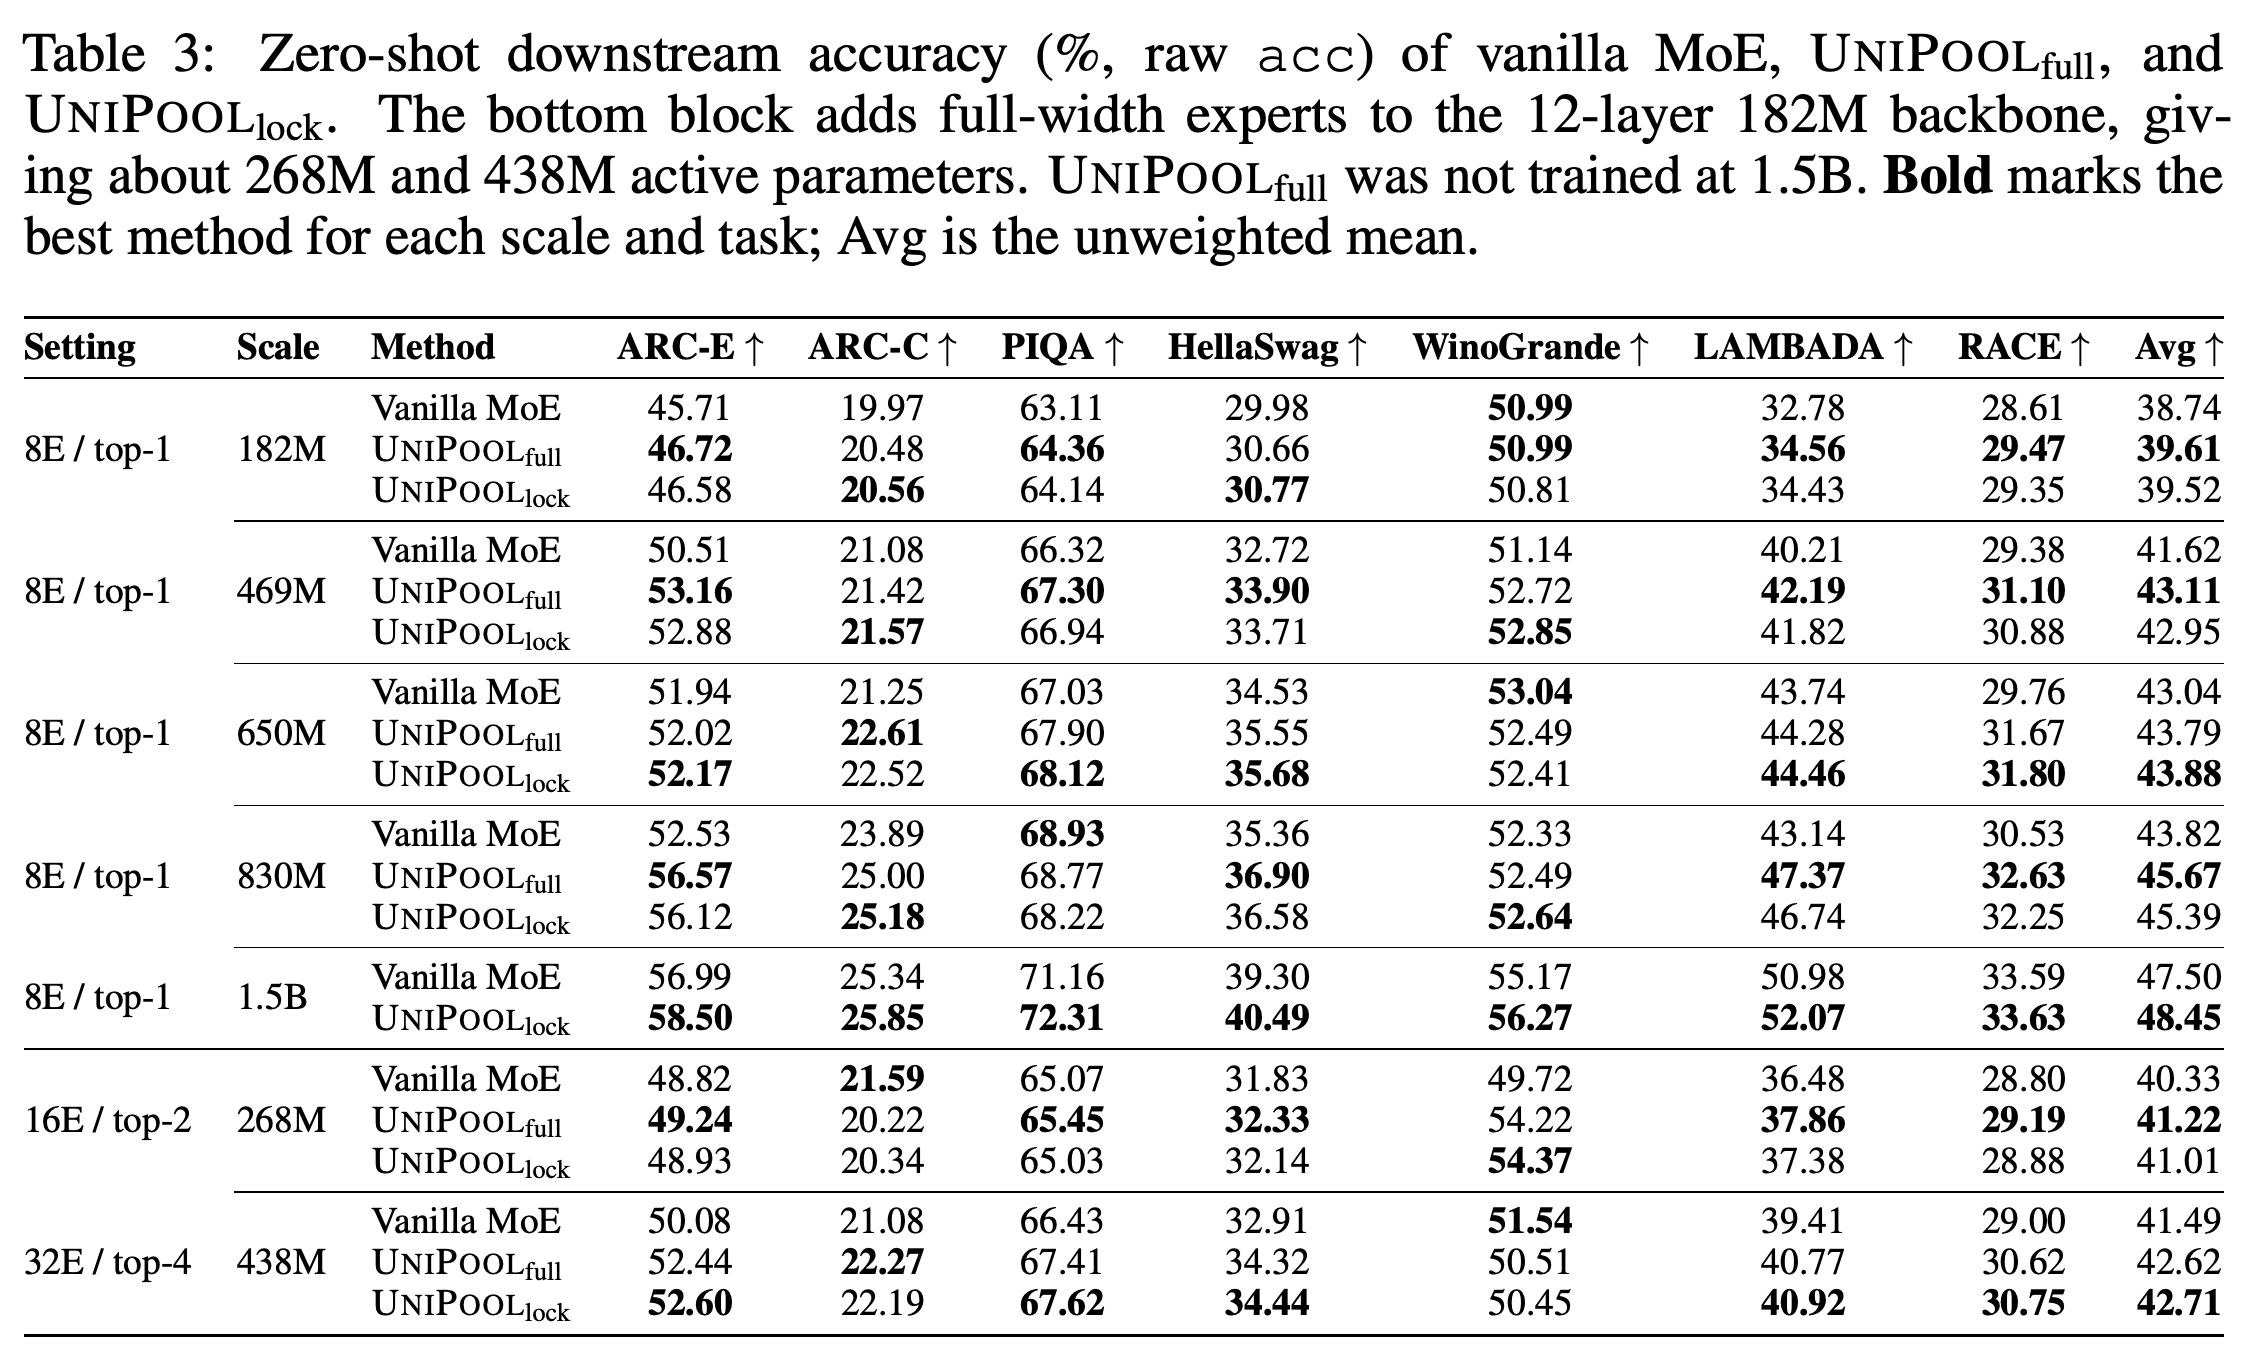
Zero-shot 평가는 ARC-Easy, ARC-Challenge, PIQA, HellaSwag, WinoGrande, LAMBADA, RACE에서 raw accuracy를 사용한다. UNIPOOLlock은 7개 설정에서 비가중 평균을 0.68–1.57점 높이고, 규모–태스크 조합 49개 중 43개에서 우세하다.
- 두 방식을 모두 평가한 모든 설정에서 UNIPOOLfull과의 평균 정확도 차이는 0.3점 이내다.
- 1.5B에서는 평균 정확도가 47.50에서 48.45로 오르며 7개 태스크가 모두 개선된다.
- 더 작은 규모의 모든 설정에서 개별 태스크가 일관되게 개선되지는 않는다.
손실 개선과 함께 평균 다운스트림 성능도 개선되지만, 개별 태스크 결과에서는 더 작은 규모의 예외가 나타난다. 1.5B locked model은 7 tasks 모두에서 개선을 보이고 평균을 47.50에서 48.45로 높인다.
측정한 4개 설정에서 전체 풀 실행은 스텝 시간을 22%–36% 늘린다. 반면 잠금 후 압축 실행의 스텝 시간 오버헤드는 vanilla 대비 −0.7%부터 +2.8%까지다. 전체 풀 스텝 2K와 압축 스텝 58K를 가중 합산하면 전체 학습 오버헤드는 +0.6%부터 +3.5%까지다.
- 측정에는 GPU 8개를 사용하며, 182M의 8E, 16E, 32E 설정과 469M의 8E 설정을 포함한다.
- 이 측정만으로는 650M, 830M 또는 1.5B에서 사용한 EP = 8 설정에서도 같은 오버헤드가 나온다고 할 수 없다.
전역 접근 단계는 2K 스텝만 차지하므로, 압축 실행은 측정한 4개 설정에서 가중 합산한 전체 학습 오버헤드를 +0.6%–+3.5%로 제한한다. 이 측정은 해당 설정의 실행 비용이 vanilla에 가깝다는 근거이며, 시험한 모든 규모의 처리량을 보장하지는 않는다.
5.3 Where Does the Gain Come From?
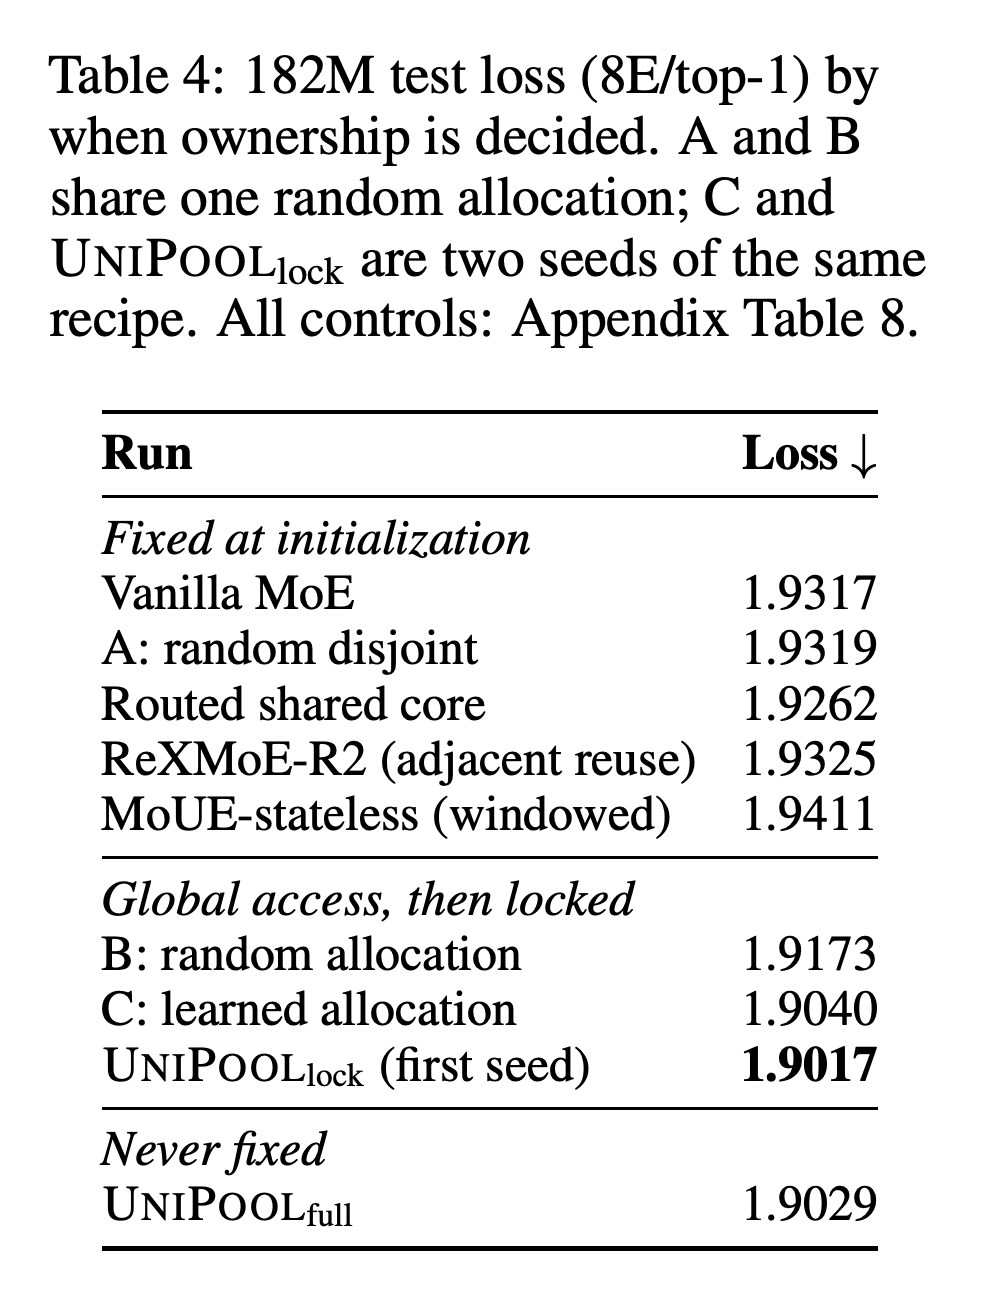
대조군 A는 초기화 시점에 균형 잡힌 상호 배타적 무작위 배정을 고정하되, UNIPOOL의 라우터와 손실을 유지한다. 손실은 1.9319로 vanilla의 1.9317과 비슷하다. 이는 초기 전역 접근 없이 이 구성만 사용해서는 개선을 설명할 수 없음을 보여준다.
- 사전에 정한 routed shared-core, adjacent-reuse, windowed-universal 변형의 182M 손실은 1.9262부터 1.9411까지다.
- Routed shared core는 182M에서 손실을 0.0055, 469M에서 0.0167 줄인다. 이는 각 규모의 지속적인 전체 풀 방식이 얻은 개선 폭의 절반보다 작다.
- 이 비교는 원래 공유 방법을 제한 없이 재현한 것이 아니라 파라미터 수를 맞춘 변형을 사용한다.
대조군 B와 C는 초기 전역 접근 일정이 같지만, 각각 무작위 소속과 학습한 소속을 잠근다. B의 손실은 1.9173이고 C는 1.9040이다. 따라서 학습한 배정을 유지하면 무작위 잠금 후에도 남는 이점에 더해 0.0133의 추가 개선을 얻는다.
- A에 비해 전역 접근 후 무작위 잠금은 손실을 0.0146 줄이고, 학습한 배정으로 잠그면 0.0279 줄인다.
- C와 손실이 1.9017인 다른 UNIPOOLlock 시드는 같은 학습 설정을 사용한다. 평균은 1.9029로, 보고된 정밀도에서 지속적인 전체 풀 결과와 같다.
- B–C 비교는 전역 학습을 거친 조건에서 배정의 가치를 확인한다. 그러나 이 단계가 전문가 가중치를 어떻게 바꾸는지는 별도로 분리하지 못하며, 조건을 맞춘 warm-start 대조군도 없다.
결과의 순위는 초기 무작위 배정, 초기 전역 접근, 학습한 배정의 잠금을 구분한다. 전역 접근 후 무작위로 잠그면 초기화 시점에 잠그는 것보다 개선되지만, 학습한 소속을 사용하면 지속적인 전체 풀의 이점을 훨씬 더 많이 회복한다.
지속적인 전문가 재사용은 크지 않으며 깊이에 따라 달라진다. UNIPOOLfull에서 토큰이 접근하는 서로 다른 전문가 수를 레이어 수로 나눈 비율은 12개, 24개, 36개 레이어에서 각각 94.1%, 89.5%, 83.4%다. 독립적인 균등 라우팅의 예상 비율은 각각 94.5%, 94.2%, 94.2%이므로, 우연 수준을 넘는 재사용은 더 깊은 설정에서 뚜렷하다.
- Vanilla MoE와 잠금 후 UNIPOOLlock은 소속이 상호 배타적이므로 레이어마다 반드시 서로 다른 전문가 텐서에 접근한다.
- 지속적인 재사용이 제한적이라는 결과는 잠금 방식과 전체 풀 학습 사이의 작은 품질 차이와 부합하지만, 그 차이를 확정적으로 설명하지는 못한다.
5.4 What the Full POOL Reveals
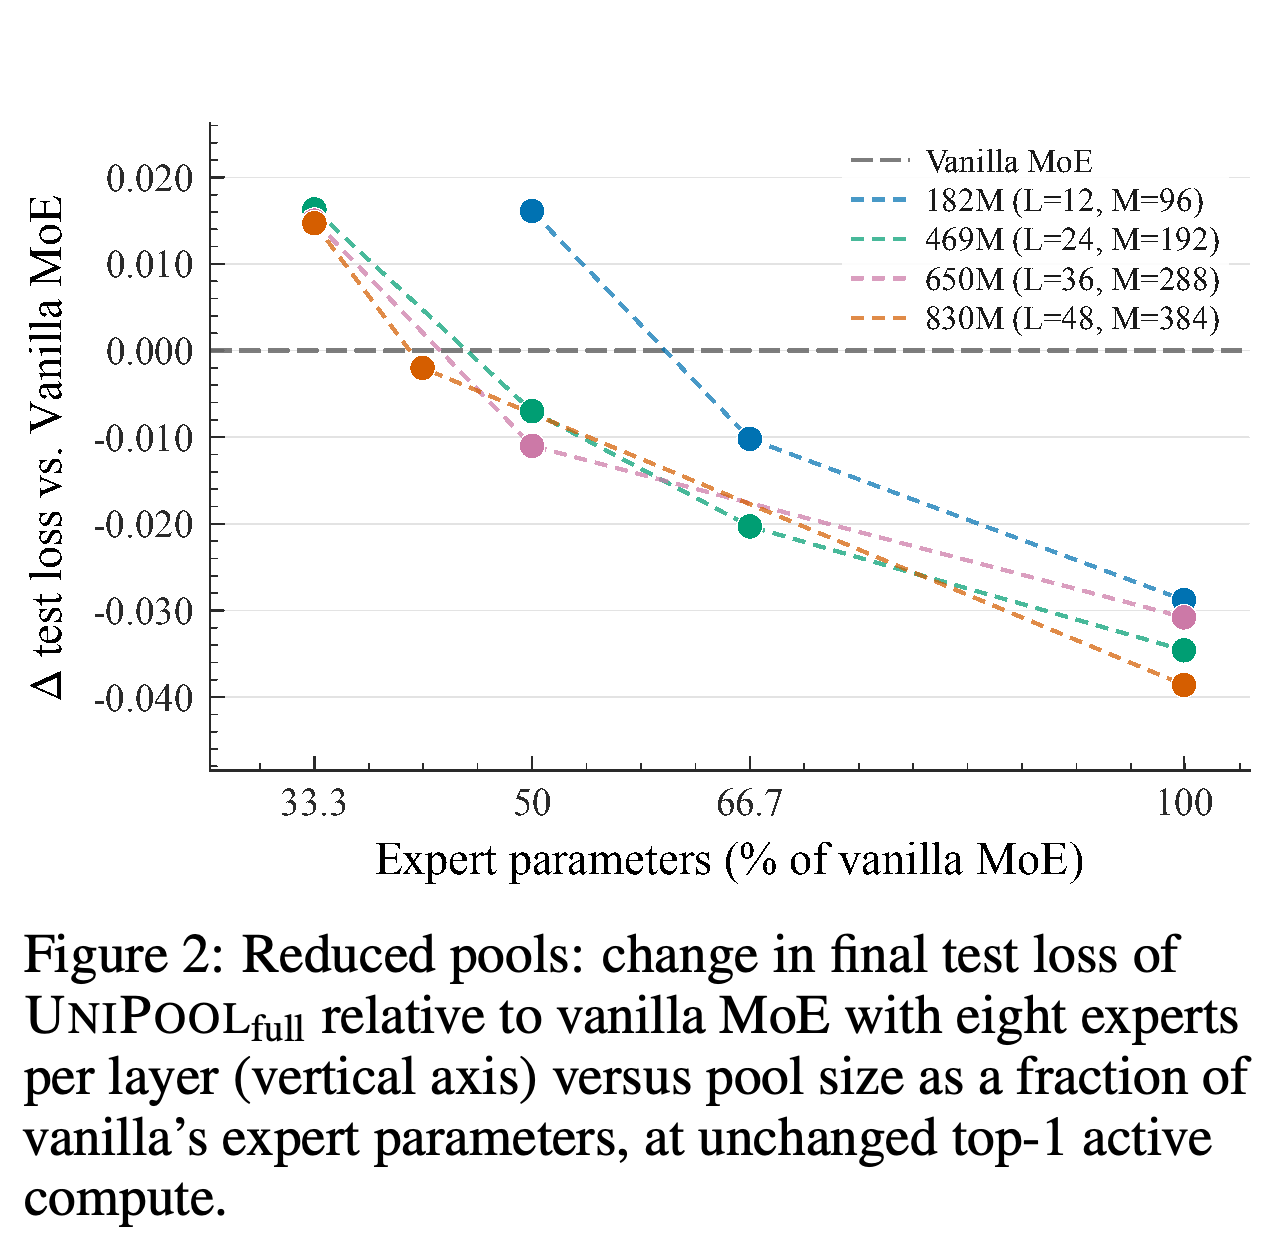
축소 풀 실험은 top-1 전문가 연산량을 고정한 채 UNIPOOLfull의 전문가 저장량을 줄인다. 182M에서는 66.7% 풀이 vanilla보다 우수하고, 469M과 650M에서는 50% 풀이 각각 0.007과 0.011만큼 손실을 줄인다. 830M에서는 41.7% 풀이 vanilla와 0.002 이내의 손실 차이를 보인다.
- 182M에서 50% 공유 풀의 손실은 1.9479이며, 레이어당 전용 전문가 4개를 둔 파라미터 수 일치 기준 모델은 1.9664다.
- 경쟁력을 유지하는 최소 비율은 여러 요소를 함께 확대한 설정에서 감소한다. 이 연구는 깊이만을 유일한 원인으로 분리하지 않는다.
- 이 파라미터 효율 결과는 UNIPOOLfull에 해당하며, 예산을 줄인 UNIPOOLlock의 결과는 아니다.
0 아래의 점은 top-1 전문가 연산량을 유지하면서 축소 공유 풀이 전체 예산의 전용 기준 모델보다 우수함을 뜻한다. 여러 요소를 함께 확대한 설정에서는 경쟁력을 유지하는 저장 비율이 더 작아지지만, 깊이의 효과를 다른 모델 변경과 분리하지는 않는다.
전체 풀의 이점은 전체 너비의 전문가 수를 늘리거나 레이어마다 전문가 연산을 2회 순환 실행해도 유지된다. 반복 실행 설정에서 UNIPOOLfull은 182M의 손실을 1.9077에서 1.8727로, 469M의 손실을 1.7768에서 1.7389로 줄인다.
- Attention은 레이어당 1회 실행하고, 정규화·라우터·전문가 경로는 파라미터를 공유하며 2회 실행한다.
- 2 step 에서는 갱신된 은닉 상태에서 라우팅을 다시 계산한다.
- 각 반복 실행 비교에서 실제 전문가 저장량과 토큰당 전문가 연산량을 맞춘다.
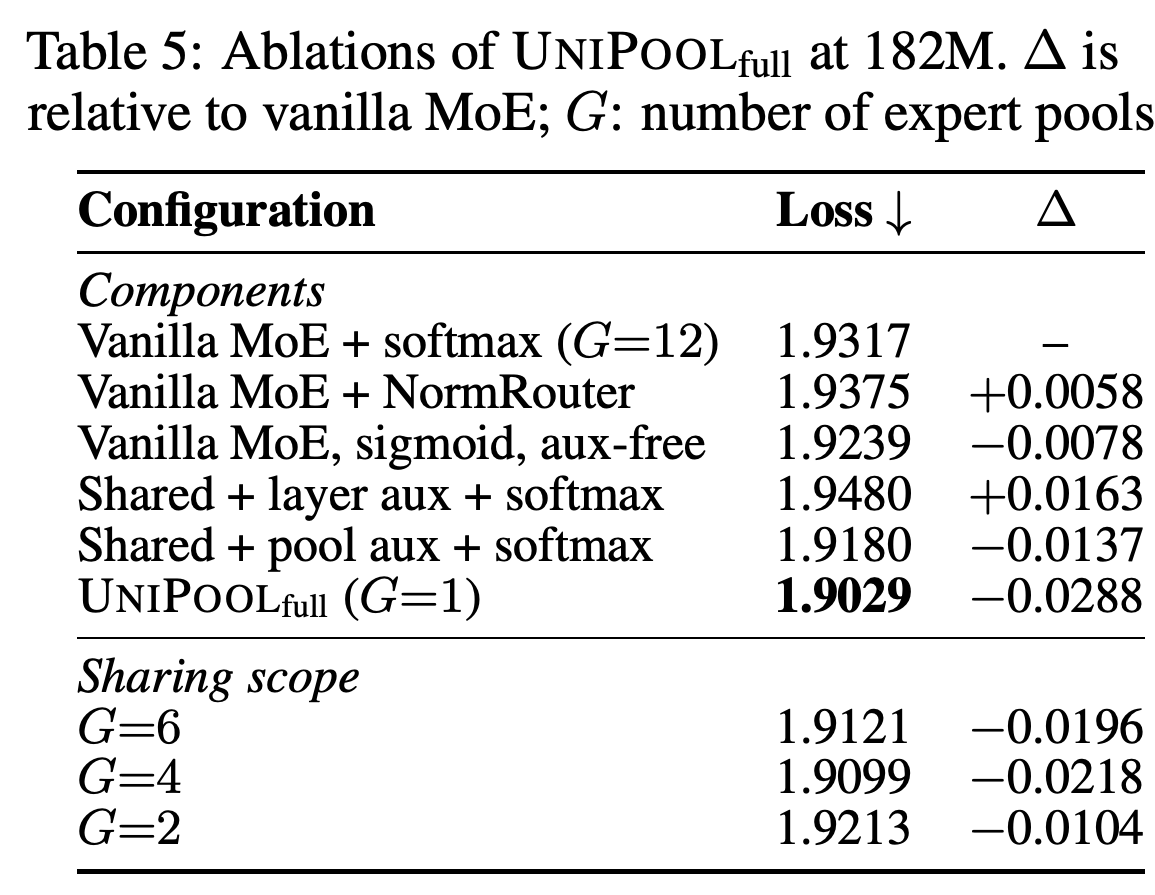
구성 요소 ablation은 공유 풀의 성능이 균형 조정과 점수 보정에 달려 있음을 보여준다. 공유 전문가에 레이어별 균형 조정과 softmax를 사용하면 손실이 1.9480이다. 풀 손실을 사용하면 1.9180으로 개선되고, NormRouter를 추가하면 1.9029에 도달한다.
- Figure 3은 소수 전문가에 집중된 합산 사용량과, UNIPOOLfull에서 더 넓게 분산된 합산 사용량 및 레이어별 선호를 대비한다.
- NormRouter만 사용하면 전용 전문가 집합의 손실이 1.9375로 악화된다. 이는 이 실험에서 NormRouter의 이점이 공유 후보 집합에 의존함을 보여준다.
- UNIPOOLfull은 손실이 1.9239인 전용 전문가·sigmoid 라우팅·보조 손실 없는 기준 모델보다도 우수하다.
- 중간 공유 범위인 G = 6, 4, 2는 vanilla보다 우수하지만, 전역 풀인 G = 1이 가장 좋다. 중간 G 값 사이에서는 개선이 단조롭지 않다.
공유만으로는 충분하지 않다. 풀 균형 조정은 공유 softmax 모델을 개선하고, NormRouter는 공유 설정에서 추가 개선을 제공하지만 전용 전문가 집합에서는 그렇지 않다. 중간 풀 개수는 모두 vanilla보다 우수하나, 손실이 단조롭게 변하지는 않는다.
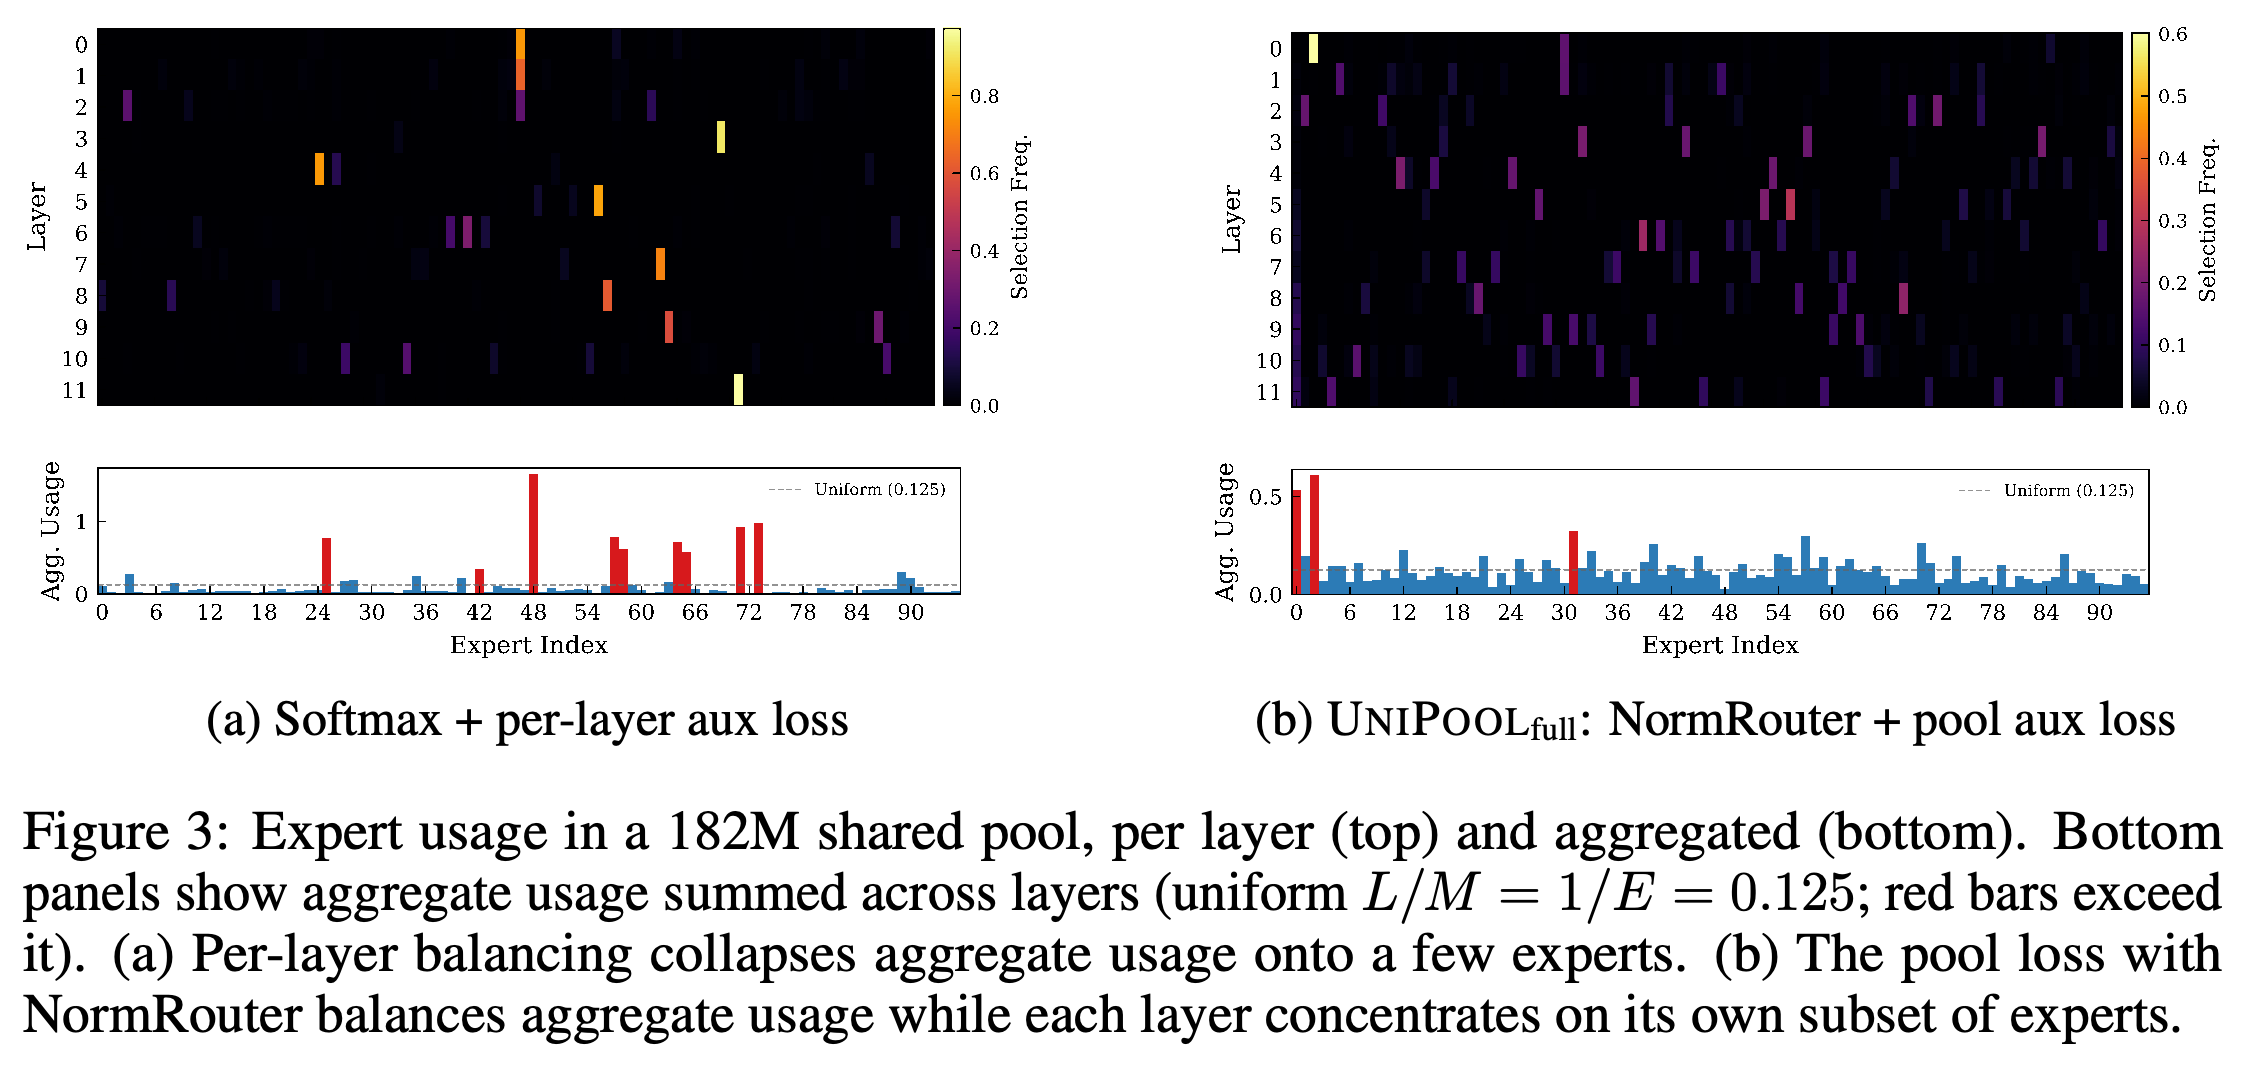
왼쪽 합산 히스토그램에서는 소수 전문가의 사용량이 크게 치솟는다. 오른쪽에서는 레이어별 선호 차이를 유지하면서 사용량이 더 넓게 분산된다. 오른쪽에도 일부 사용량 집중은 남아 있다. 이 비교는 풀 손실과 NormRouter를 결합한 설정을 보여주며, 어느 구성 요소의 효과도 따로 분리하지 않는다.
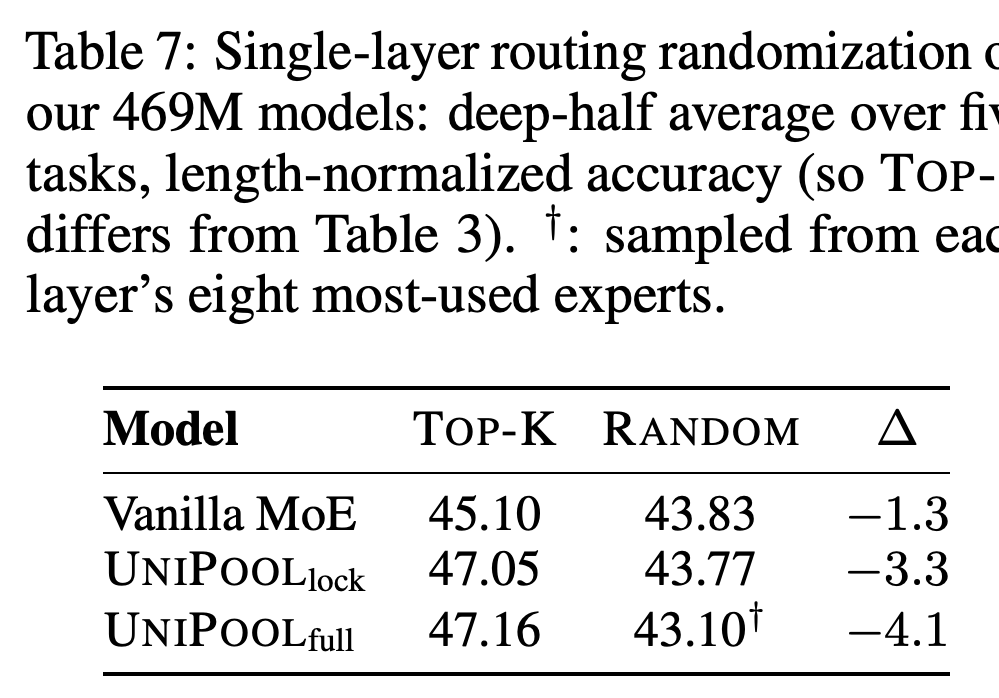
469M에서 전문가 선택 집합을 8개로 맞추고 후반부 레이어 1개의 라우팅을 무작위화하면, 5개 태스크 평균 정확도는 vanilla에서 1.3점, UNIPOOLlock에서 3.3점, UNIPOOLfull에서 4.1점 감소한다. 더 큰 하락 폭은 전역 경쟁 후 전문가가 더 뚜렷하게 분화했다는 해석과 부합한다.
- UNIPOOLlock은 배정된 전문가 8개에서 표본을 뽑고, UNIPOOLfull은 각 레이어가 가장 많이 사용한 전문가 8개에서 표본을 뽑는다.
- 이 평가는 4개 태스크에 길이 정규화 정확도를, WinoGrande에 raw accuracy를 사용하므로 Table 3의 평균과 직접 비교할 수 없다.
- 개입 중 선택된 게이트를 다시 정규화하므로, 이 실험은 소속의 인과성을 검증하는 실험이 아니라 민감도 검사다.
레이어마다 무작위화 후보를 8개로 두면, 잠금 모델은 전용 전문가 집합의 크기가 vanilla와 같아도 전문가 대체에 더 민감하다. 게이트를 다시 정규화하므로, 더 큰 정확도 하락은 전문화와 부합하는 라우팅 민감도의 근거이지 소속의 인과성을 검증하는 결과는 아니다.
6 Conclusion
논문은 짧은 전역 접근으로 전문가 배정을 학습할 수 있으며, 공유를 제거한 뒤에도 그 이점이 유지된다고 결론 내린다. 근거는 5개 규모의 손실 개선, 두 방식을 모두 시험한 설정에서 지속적인 전체 풀 기준에 가까운 손실, 측정한 설정에서 vanilla에 가까운 잠금 후 스텝 시간이다.
- 축소 풀은 지속적인 전역 접근의 파라미터 효율을 별도로 보여준다.
- 다른 잠금 일정이나 다운스트림 후속 학습 절차에 대한 강건성은 실험으로 확인하지 않는다.
AI Use Statement
저자들은 생성형 AI를 원고 문장 편집과 LaTeX 형식 변환에 사용했으며, 실험 결과를 생성하거나 실증 데이터를 바꾸는 데는 사용하지 않았다고 보고한다. AI의 도움을 받은 내용을 실제 실험 및 원자료와 대조해 검토했고, 최종 원고에 책임을 진다고 명시한다.
Reproducibility Statement
재현성 설명은 실험 설정, 모델 및 하이퍼파라미터 부록, 소속 잠금 구현, 대조 실험, 공유 기준 모델, 평가 절차, 풀 손실 유도, NormRouter 초기화를 안내한다. 논문은 코드 URL https://github.com/Centaurus-Alpha/UniPool도 제공한다.
부록
- A ALTERNATIVE EXPERT-SHARING BASELINES는 예산을 맞춘 routed shared-core, ReXMoE-R2, MoUE-stateless, DeepSeekMoE 방식의 대조군을 명시한다. 추가 대조군은 단일 시드 1234를 사용한다. MoUE 변형은 경로 상태를 사용하는 Universal Router를 생략한다. DeepSeekMoE 방식의 대조군은 16E/top-2 예산에서 라우팅 전문가 16개를 라우팅 전문가 15개와 항상 활성화되는 레이어 전용 전문가 1개로 대체한다. 이 비교는 전역 배치 크기를 맞추지만, 대조군과 vanilla 기준 모델의 마이크로배치 크기는 다르다.
- B LIMITATIONS AND FUTURE WORK는 배정 시점, 잠금 시점, 감쇠 일정, 전문가 수 제약 계수에 대한 ablation이 없다고 밝힌다. 축소 풀과 순환 실행은 UNIPOOLfull에서만 평가한다. 축소 예산과 잠금을 결합하려면 레이어별 배정을 더 작게 하거나 비균등하게 해야 하며, few-shot 평가와 후속 학습 이후 평가는 아직 수행하지 않았다.
- C MODEL AND MOE CONFIGURATIONS는 30B 토큰으로 학습한 백본 4개를 정리한다. L/H 값은 12/768, 24/1024, 36/1024, 48/1024이며, 전역 풀의 전문가 수는 96, 192, 288, 384개다. 모두 시퀀스 길이 1024, SwiGLU, FFN 중간 크기 4 × H를 사용한다. UNIPOOLfull과 UNIPOOLlock의 라우터 파라미터 수는 같다.
- D LOOPED-EXPERT COMPATIBILITY DETAILS는 레이어마다 전문가를 2회 순환 갱신하며 잔차 스케일 1/R과 R = 2를 사용하도록 정의한다. Attention은 순환 바깥에 둔다. 두 전문가 단계는 정규화, 라우터, 전문가 파라미터를 재사용하되 top-1 선택을 다시 계산한다. 따라서 비교하는 두 아키텍처 모두 토큰당 2L회의 전문가 평가를 수행한다.
- E ADDITIONAL TRAINING CURVES는 Figure 4의 검증 손실 곡선을 설명한다. UNIPOOLfull은 182M, 469M, 650M에서 warmup 이후에도 vanilla보다 낮은 손실을 유지한다. 공유 범위별 곡선은 대체로 전역 공유와 전용 방식 사이에 놓이며, 학습 대부분에서 전역 공유의 손실이 가장 낮다.
- F HYPERPARAMETER DETAILS는 RMSNorm, SwiGLU, base 1M인 RoPE, KV 헤드 네 개, 입력과 출력에서 공유하지 않는 임베딩을 보고한다. 30B 토큰으로 학습한 네 규모는 학습률 5 × 10⁻⁴, 최소 학습률 5 × 10⁻⁵, warmup 1%, 그래디언트 클리핑 1.0, bf16, 초기화 표준편차 0.01을 사용한다. 1.5B runs에서는 EP = 8을 사용하며, vanilla MoE의 활성 파라미터는 약 1.49B이고 저장 파라미터는 약 9.23B다.
- G OWNERSHIP LOCK AND COMPACT DISPATCH DETAILS는 first 1K steps 동안 λ_card를 5 × 10⁻³까지 높이고, 학습 내내 풀 손실을 유지한다. 압축 실행은 접근 가능한 전역 인덱스를 정렬하고 마스크 밖 배정을 허용하지 않으며, 파라미터를 복사하지 않고 원래 파라미터를 참조한다. 단계별 중앙값 처리량 측정에는 GPU 8개, dropless grouped GEMM, bfloat16, EP = TP = PP = 1을 사용한다.
- H OWNERSHIP CONTROLS는 비교 아키텍처를 12개 레이어, 전문가 96개, top-1 라우팅으로 고정하고, 잠금 후 레이어마다 상호 배타적인 전문가 8개를 둔다. 이 제약은 182M UNIPOOLlock 모델의 최종 배정 전문가 수와 일치한다.
- H.1 MATCHED CONTROLS FOR EARLY EXPERT ACCESS는 A–C에서 아키텍처, NormRouter, 전체 풀 정규화, 보조 계수, 시드, 배치 크기, 시퀀스 길이, 학습률, 학습 일정을 동일하게 유지한다. A와 B는 같은 무작위 배정을 사용한다. C는 검증 라우팅 횟수로 소속을 선택하며, 최종 NLL은 B보다 0.0133 개선된다.
- I DISTINCT-EXPERT ACCOUNTING은 관측한 서로 다른 전문가 접근 수를 독립 균등 라우팅의 기댓값 (M\left[1-\left(1-\frac{1}{M}\right)^L\right])과 비교한다. 36개 레이어에서 전체 풀은 토큰당 서로 다른 전문가 30.03개에 접근하며, 기댓값은 33.90개다. 12개 레이어에서 전체 풀의 재사용은 우연 수준에 가깝고, 축소 풀은 우연 수준보다 더 많은 서로 다른 전문가에 접근한다.
- J ADDITIONAL ROUTING-RANDOMIZATION DETAILS는 공개된 실용 모델의 태스크별 결과와 UNIPOOLfull의 조건을 맞춘 top-8 평가 절차를 제시한다. 후반부 레이어마다 전문가 선택을 무작위화하고, 선택된 게이트를 다시 정규화하며, 결과를 레이어 전체에서 평균한다. UNIPOOLlock은 태스크별 점수가 아니라 5-task 평균만 보고한다.
- K POOL AUXILIARY LOSS: DETAILED DERIVATION은 전체 평균 점수를 레이어별 평균 점수의 평균으로 표현하면 독립적인 레이어별 풀 손실 항을 얻는다는 사실을 보인다. 디스패치 비율은 그래디언트 없이 누적하며 마이크로배치 1개만큼 늦춰 사용한다. 라우팅 점수에는 목적함수를 통해 그래디언트가 전달되지만, 이 손실 경로에서 전문가 FFN 파라미터로 직접 전달되는 그래디언트는 없다.
- L NORMROUTER: MONTE CARLO INITIALIZATION DETAILS는 Gaussian 로짓, L2 정규화, ReLU, 가장 큰 k개 성분을 사용해 c를 보정한다. Algorithm 1은 초기화 시 (N=10^5)개의 표본을 사용해 선택된 성분의 L2 노름 역수의 기댓값을 추정한다.
짧은 생각
소속 대조 실험은 라우팅 민감도 실험보다 배정 품질에 관한 직접적인 근거를 제공한다. 전역 접근 후 무작위로 잠가도 이점의 일부가 유지되고, 학습한 배정으로 잠그면 같은 최종 전문가 수에서 손실이 0.0133 더 줄어든다. 이는 공유 단계를 거친 조건에서 데이터에 기반한 배정의 가치를 뒷받침한다.
실용적으로 중요한 결과는 측정된 오버헤드가 낮은 전용 실행으로 전환해도 손실 개선이 유지된다는 점이다. 주요 미해결 과제는 잠금 일정에 대한 민감도, 더 큰 규모의 반복 실험, 더 큰 전문가 병렬 설정의 처리량이다. 축소 풀 효율은 여전히 UNIPOOLfull의 별도 결과다.