


ERNIE 5.0 Technical Report 요약 설명
04 Feb 2026 | Paper Review Autoregressive Language Models Mixture-of-Experts Elastic Training Reinforcement Learning목차
- 요약
- 1 Introduction
- 2 Architecture
- 3 Pre-Training
- 4 Post-Training
- 5 Infrastructures
- 6 Evaluations
- 7 Conclusion
- 8 Contributors
- 부록
- 짧은 생각
이번 글에서는 ERNIE 5.0 Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 4일(Arxiv)
- Wang, Haifeng, Wu, Hua, Wu, Tian, Sun, Yu, Liu, Jing, Yu, Dianhai, Ma, Yanjun, He, Jingzhou, He, Zhongjun, Hong, Dou, et al.
- Baidu
- 논문 링크
요약
- ERNIE 5.0 Technical Report는 텍스트, 이미지, 비디오, 오디오의 이해와 생성을 위한 조 단위 파라미터 기반 모델을 설명한다. 공유 자기회귀 백본은 Next-Group-of-Tokens Prediction과 모달리티에 구애받지 않는 전문가 라우팅을 사용하며, 활성화 비율은 3% 미만이다.
- Elastic training은 사전 학습 중 모델 깊이, 전문가 풀 너비, 라우팅 top-k를 바꾸어 다양한 배포 구성을 지원한다. 실험용 ERNIE 5.0-Exp 모델군에서는 라우팅 top-k를 25%로 줄이면 디코딩 속도가 15% 넘게 개선된다고 보고한다. 여러 탄력성 설정을 함께 적용한 변형 모델은 활성화 파라미터의 53.7%와 전체 파라미터의 35.8%를 사용하며, 추가 중간 학습과 사후 학습을 거친 뒤 전체 모델의 75.55에 비해 75.17을 기록한다.
- 사후 학습은 지도 미세 조정과 통합 멀티모달 강화학습을 결합하며, 순서를 보존하는 rollout 스케줄링, 혼합 단위 중요도 샘플링, 양성 샘플 마스킹, 적응형 추론 힌트를 활용한다. 사실 지식, 다중 지시 이행, 일부 시각 지각 과제와 오디오 과제에서 강점을 보이지만, 어려운 추론과 일부 비디오 이해 벤치마크에서는 격차가 더 크다. 고해상도 시각 생성에는 별도로 학습한 diffusion refiner도 사용한다.
1 Introduction
이 보고서는 사전 학습된 언어 모델에 연결한 생성기에 주로 의존하지 않고 멀티모달 이해와 비텍스트 생성을 통합하는 방법을 다룬다. ERNIE 5.0은 처음부터 여러 모달리티로 백본을 공동 학습하고, 공유 전문가 풀로 토큰을 라우팅하며, 배포 유연성을 사전 학습에 반영한다.
- 서론은 late-fusion 시스템의 “ability seesaw”를 설명한다. 멀티모달 통합을 강화하면 언어 성능이 저하될 수 있다는 문제다. 처음부터 공동 학습하는 방식을 해결책으로 제안하지만, 평가에서는 조건을 맞춘 late-fusion 대조군과 비교해 이 효과를 분리하지 않는다.
- 멀티모달 RL 안정화와 조 단위 파라미터 규모의 초희소 MoE를 학습하기 위한 분산 인프라도 기여에 포함된다.
2 Architecture
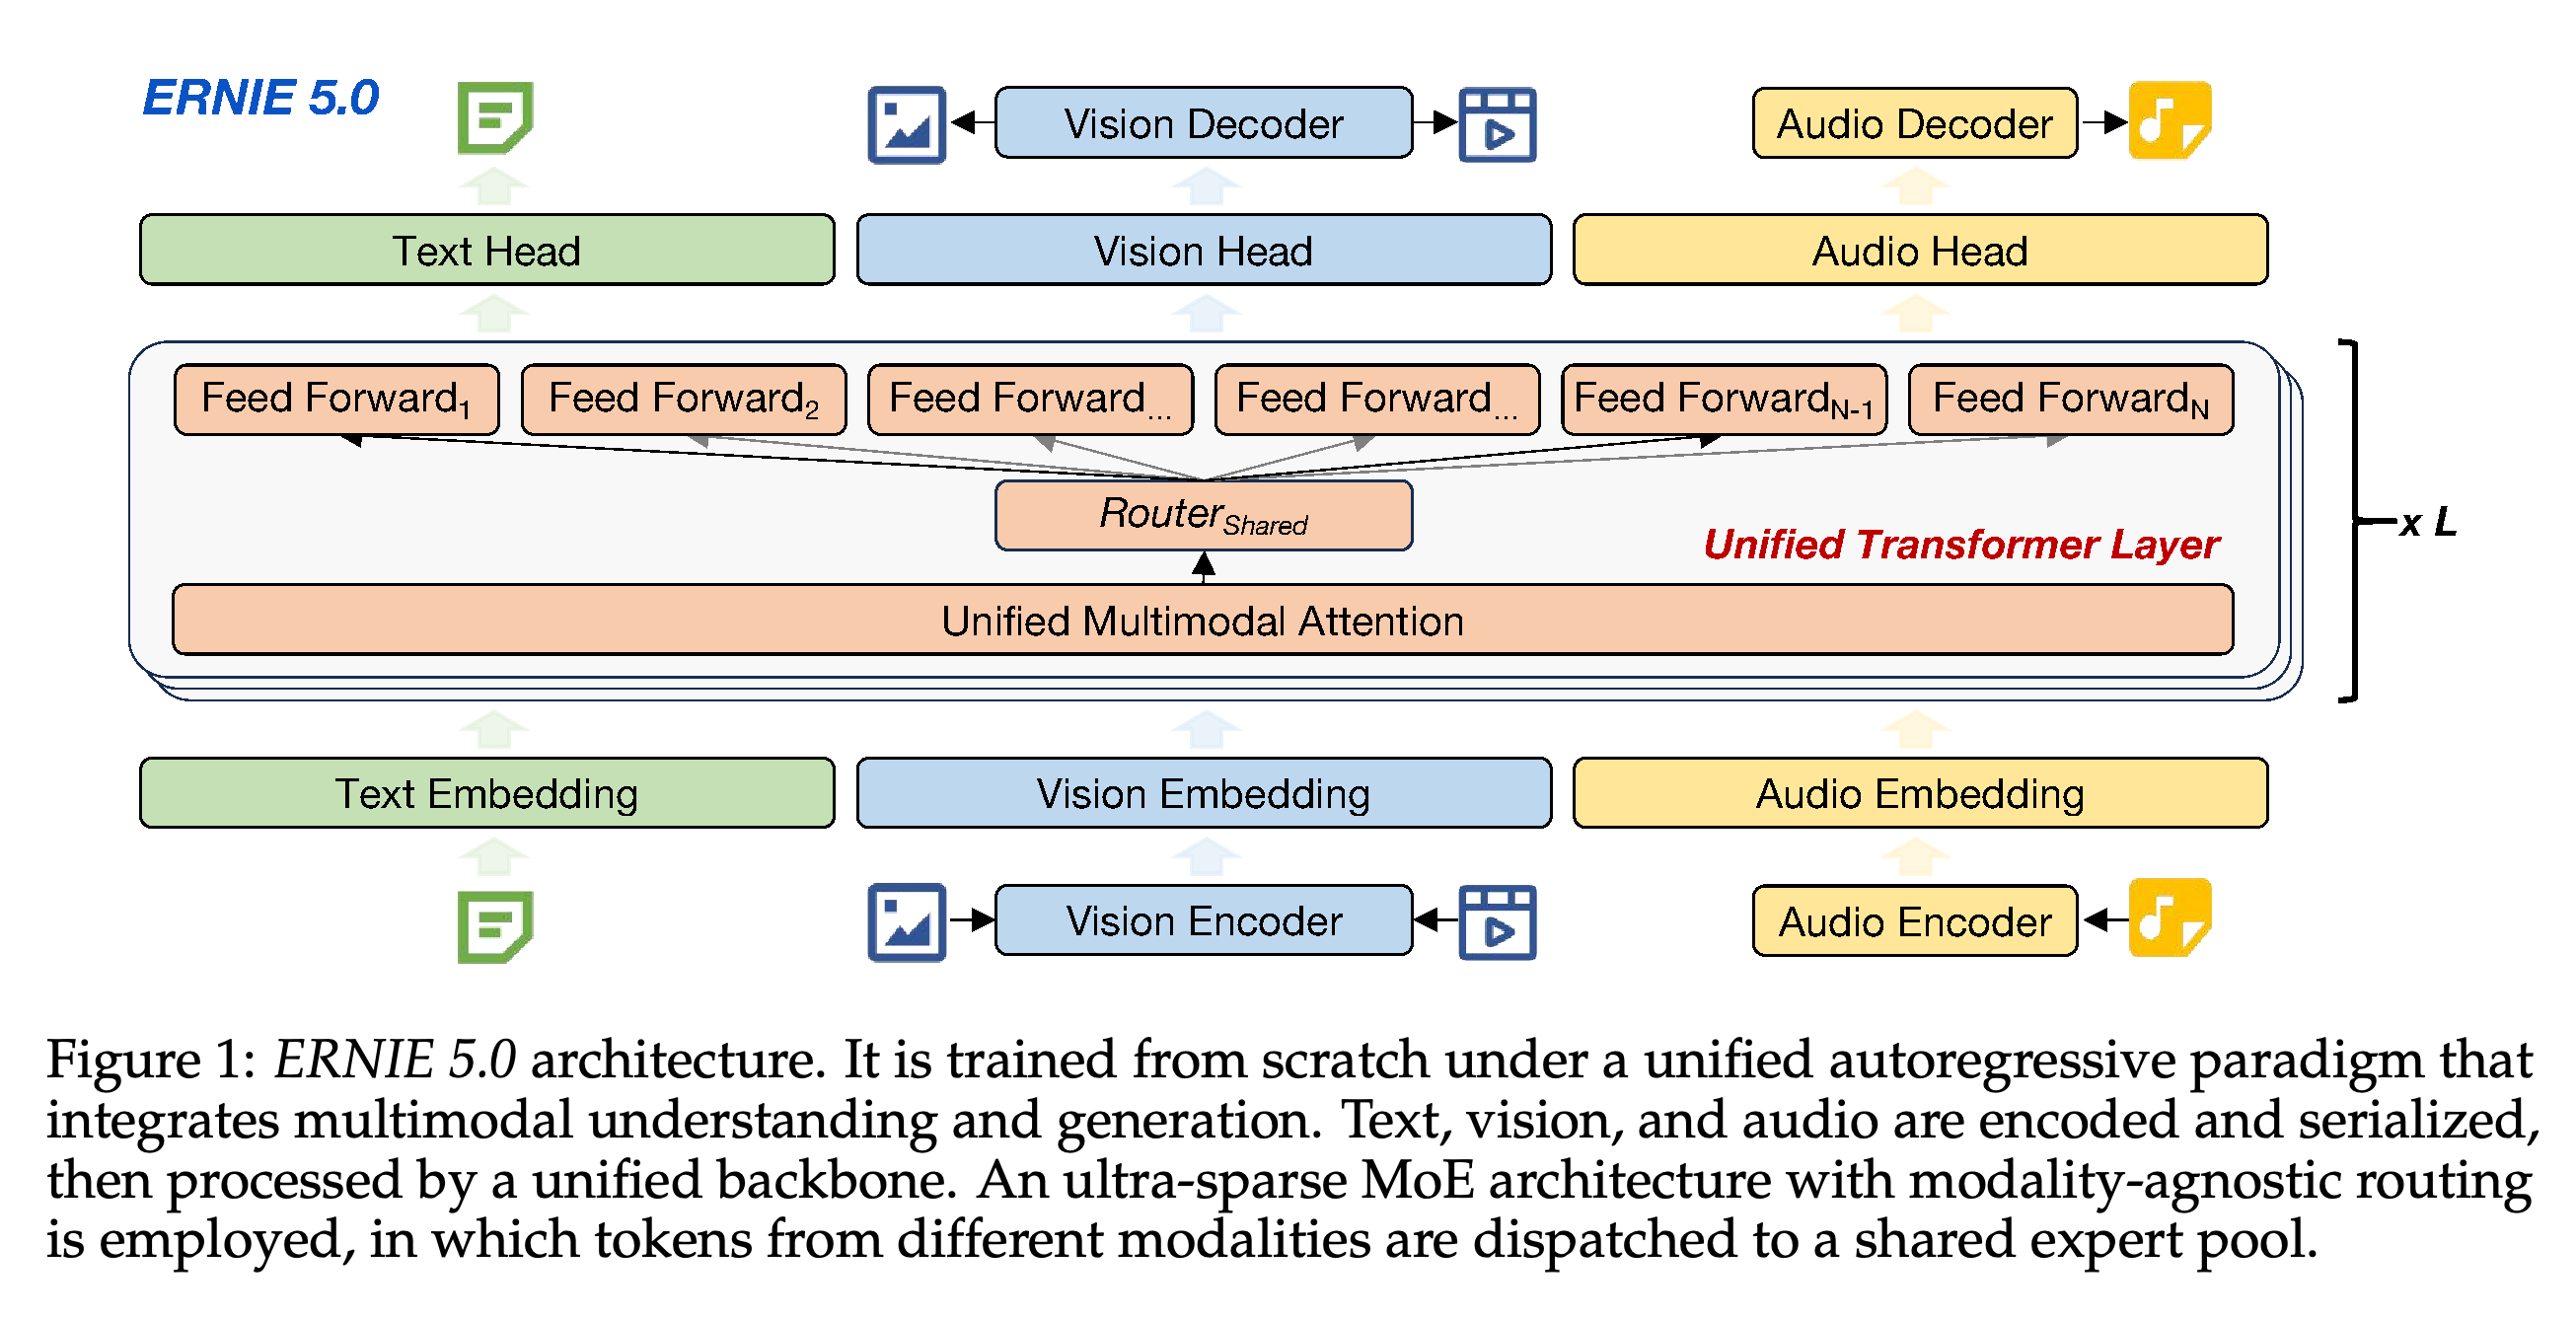
Figure 1은 텍스트, 시각, 오디오 입출력 인터페이스를 갖춘 공유 transformer 백본을 중심으로 ERNIE 5.0의 구조를 보여준다. 토큰화, 임베딩, 출력 헤드는 모달리티별로 유지하고, 시퀀스 모델링, 멀티모달 어텐션, 전문가 라우팅은 Next-Group-of-Tokens Prediction을 사용하는 공유 백본 안에서 수행한다.
공유 라우터와 전문가 풀은 통합 transformer 레이어 안에 있으며, 임베딩, 인코더, 디코더, 출력 헤드는 모달리티별로 유지한다. 이 도식은 백본 수준의 통합과 특화된 입출력 구성 요소의 제거를 구분한다.
2.1 Unified Autoregressive Backbone with Ultra-Sparse Mixture-of-Experts
백본은 서로 다른 유형의 입력을 공유 시퀀스로 직렬화하고, 명시적인 모달리티 식별자가 아니라 토큰 표현에 따라 라우팅한다. 텍스트에는 Multi-Token Prediction (MTP)을 결합한 Next-Token Prediction을, 시각에는 Next-Frame-and-Scale Prediction (NFSP)을, 오디오에는 Next-Codec Prediction (NCP)을 사용한다.
- 초희소 세분화 MoE의 활성화 비율은 3% 미만이며, 보조 손실이 없는 부하 균형 기법으로 전문가 활용을 안정화한다.
- 입출력 인터페이스는 모달리티마다 필요한 표현을 수용한다. 이해에는 추상적 의미가 중요하고, 생성에는 세밀한 지각 정보도 필요하다.
- 보고서는 조 단위 파라미터 규모와 활성화 비율의 상한을 공개하지만, 정확한 레이어 수와 전문가 수를 포함한 실제 서비스용 백본의 전체 사양은 공개하지 않는다.
2.2 Visual Modeling
2.2.1 Vision Tokenization은 이미지를 단일 프레임 비디오로 취급하고, 사전 학습된 causal 2D 다중 스케일 이미지 토크나이저를 확장해 causal 3D 합성곱 토크나이저를 구성한다. 적대적 지도 신호와 의미 정규화로 복원 및 표현 품질을 높인다. 백본 학습 중에는 저비트 토크나이저에서 고비트 토크나이저로 점진적으로 전환해 더 세밀한 이산 표현을 도입한다.
- 비트 단위 양자화는 시각 잠재 표현을 bit-code 그룹으로 나타낸다. 전환 일정은 큰 어휘 집합에서 발생하는 초기 불안정성을 줄이기 위한 것이지만, 정확한 비트 수와 전환 시점은 공개하지 않는다.
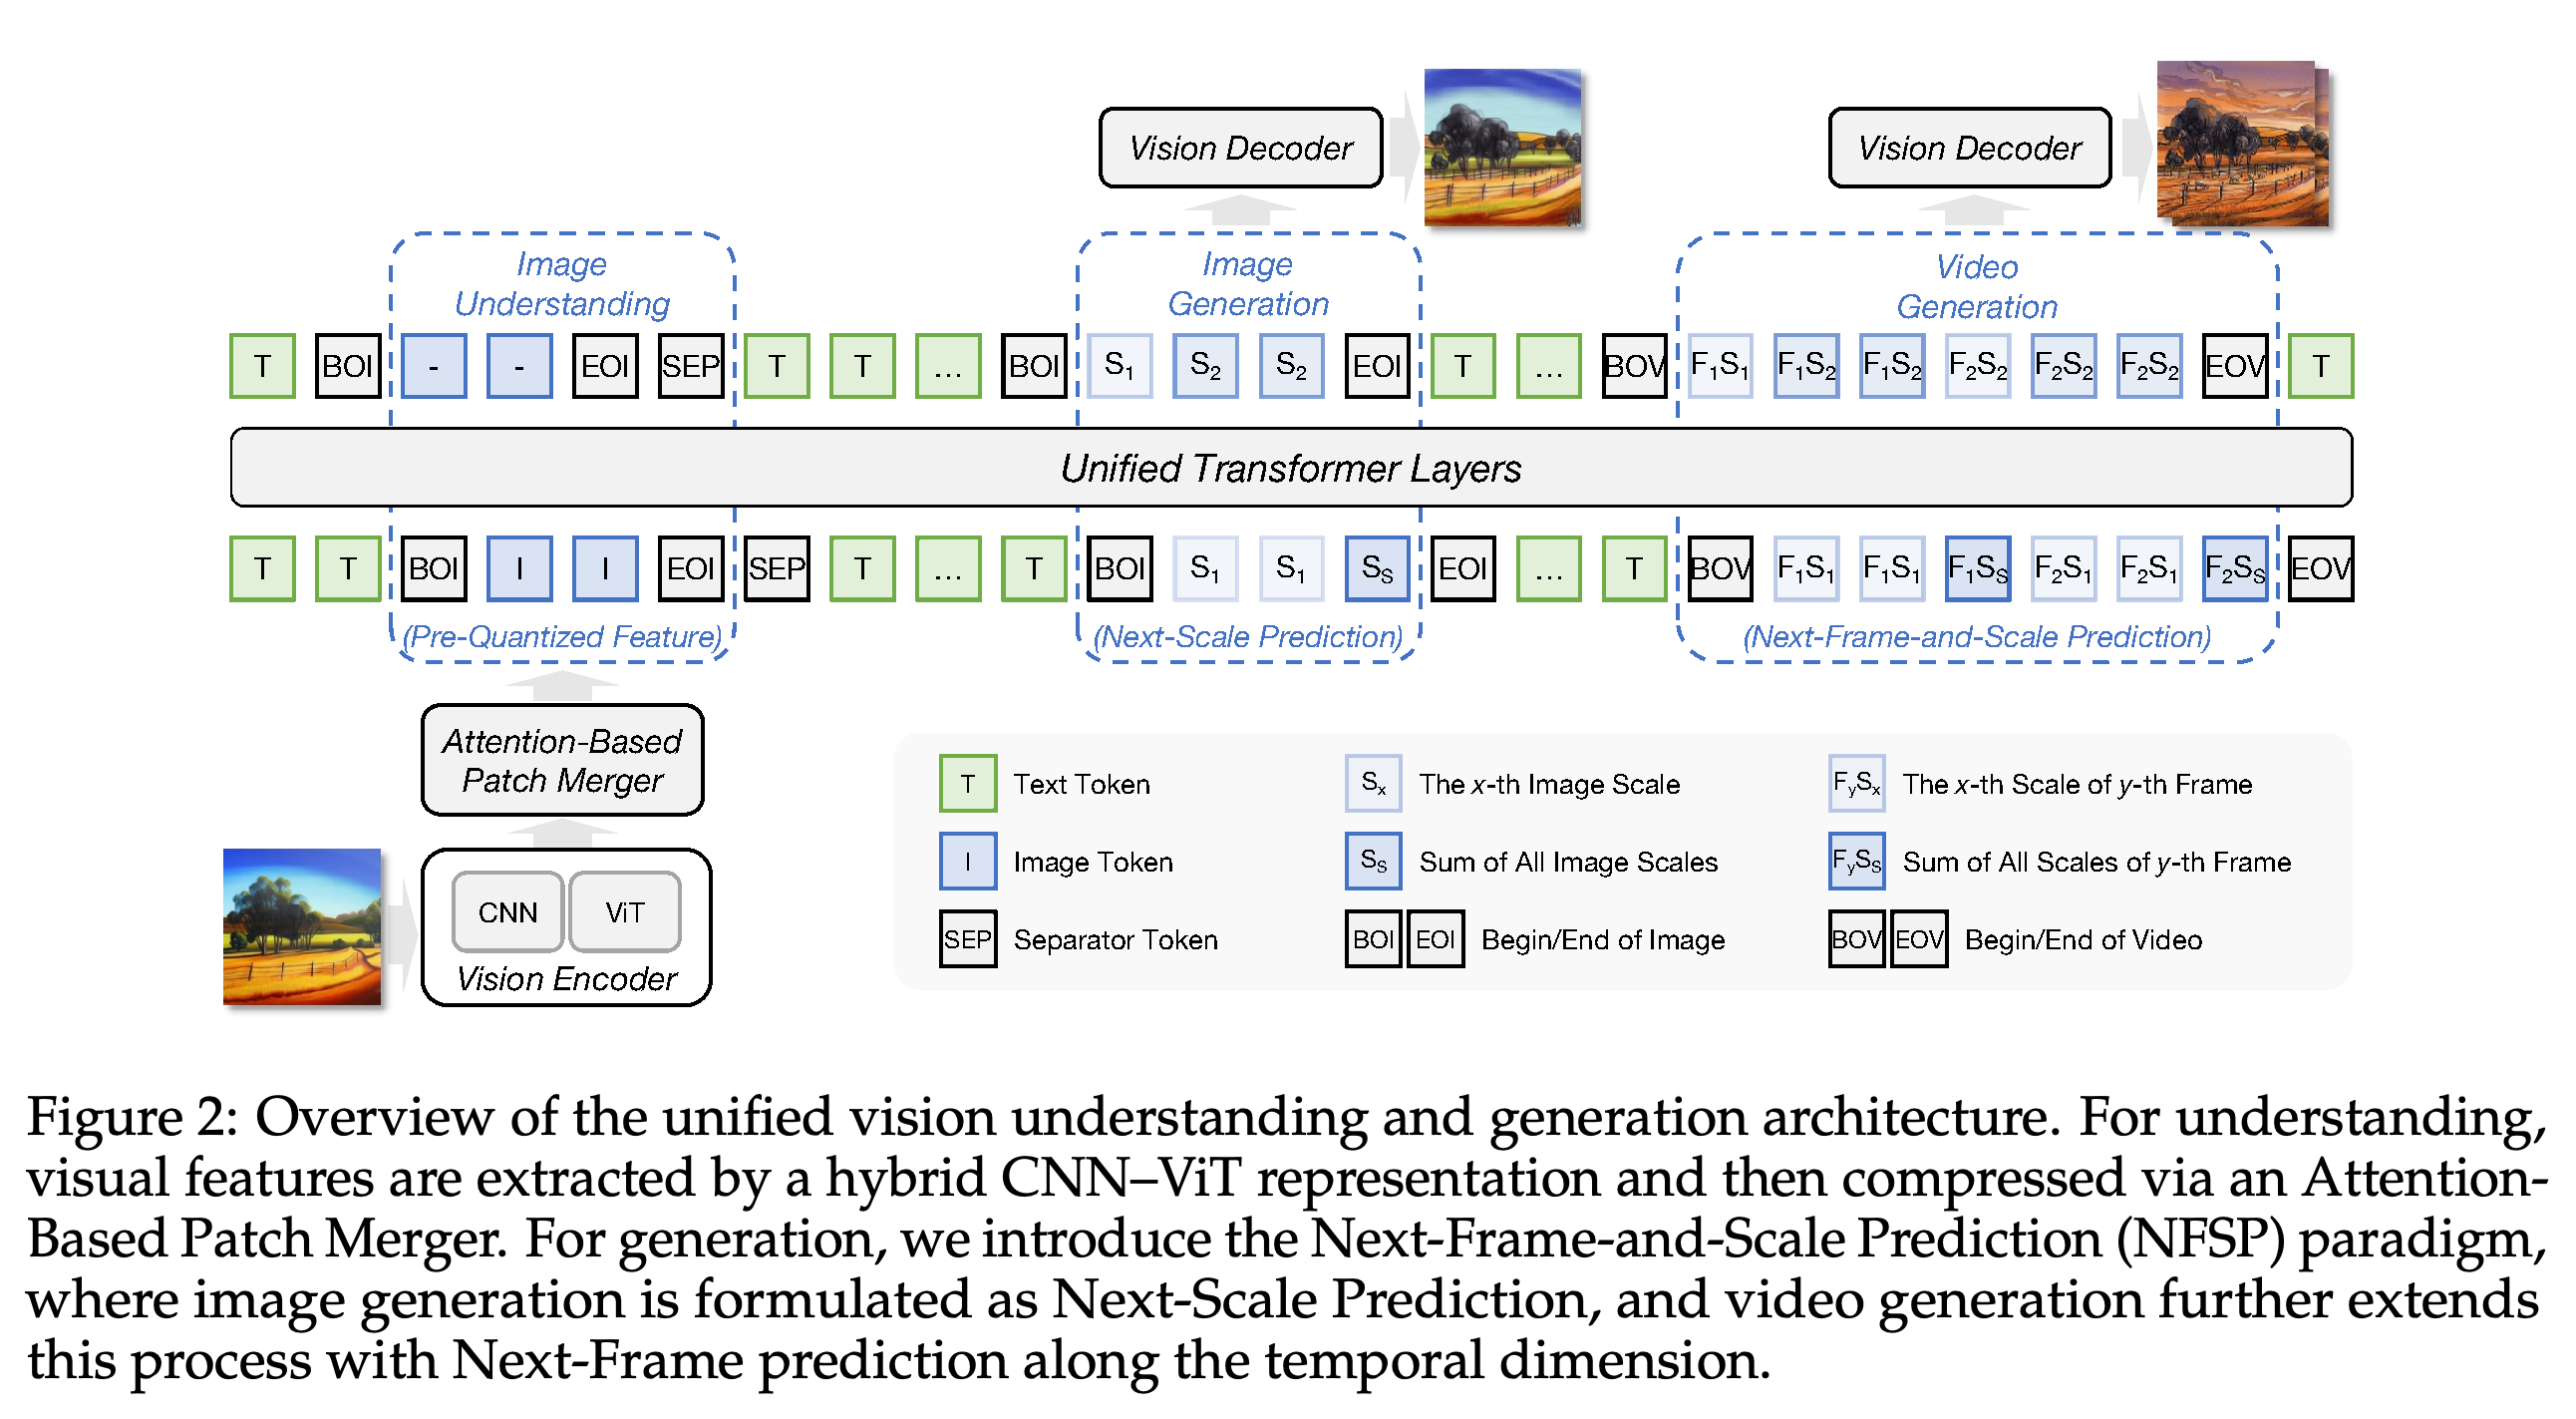
2.2.2 Visual Understanding with Dual-Path Hybrid Representation은 양자화 전 CNN 지각 특징과 ViT 의미 특징을 결합해 저차원 양자화 특징을 사용할 때 생기는 압축을 피한다. Figure 2에서 Attention-based Patch Merger는 CNN 특징을 ViT 특징 공간에 투영하고, 2개 경로의 특징을 패치 차원으로 연결한 뒤 self-attention을 적용한다. 이어서 평균 풀링을 수행하고 결과를 백본의 임베딩 공간에 투영한다. self-attention에 대해서는 이 글을 참조하라.
- 이미지 이해에서는 인접 패치를 K = 4개씩 묶고, 비디오 이해에서는 이웃한 4개 프레임에 걸친 패치를 K = 16개씩 묶는다.
- 저자들은 CNN만 사용한 방식, ViT만 사용한 방식, 단순 MLP 융합보다 특히 문서와 차트에서 개선된다고 보고하지만, 이 PDF에는 융합 방식의 정량적 ablation 표가 없다.
2.2.3 Visual Generation with Next-Frame-and-Scale Prediction은 각 프레임을 거친 공간 스케일에서 세밀한 스케일 순으로 생성한 뒤, 후속 프레임을 예측한다. 각 스케일 안에서는 병렬로 예측하며, 국소 양방향 어텐션을 사용하고 이전 스케일과 과거 프레임에는 인과적으로 접근한다.
- Unified Spatiotemporal Rotary Positional Embedding (Uni-RoPE)은 시각 토큰에 시간 및 공간 좌표를 부여한다. 텍스트와 오디오는 시퀀스 인덱스에 따라 각 축에 같은 좌표를 사용하고, 다중 스케일 시각 좌표는 중심을 정렬한다.
- 과거 토큰의 비트를 무작위로 뒤집어 누적 오류를 교정하도록 학습한다. 초기 스케일 손실의 가중치 조정, 윈도 기반 시간 어텐션, 과거 프레임의 무작위 마스킹도 시각 생성을 지원한다.
- 별도로 학습한 단계형 diffusion refiner가 저해상도 자기회귀 출력을 개선한다. 따라서 공유 백본은 자기회귀 방식이지만, 전체 고해상도 시각 생성 파이프라인이 자기회귀 방식만으로 구성되지는 않는다.
이해에는 양자화 전 CNN–ViT 특징을 병합해 사용하고, 생성에는 이산 다중 스케일 토큰을 사용한다. 서로 다른 표현이 공통 백본에 입력되며, 비디오 생성은 공간의 다음 스케일 예측을 프레임 차원으로 확장한다.
2.3 Audio Modeling
2.3.1 Audio Tokenization은 12.5 Hz에서 Residual Vector Quantization (RVQ)을 사용하며, 첫 번째 코드에는 의미 정보를, 후속 코드에는 잔차 음향 세부 정보를 할당한다. 첫 번째 코드 표현은 평균 풀링한 Whisper 인코더 출력에 정렬하고, 잔차 코드는 음색과 운율 같은 특성을 보존한다.
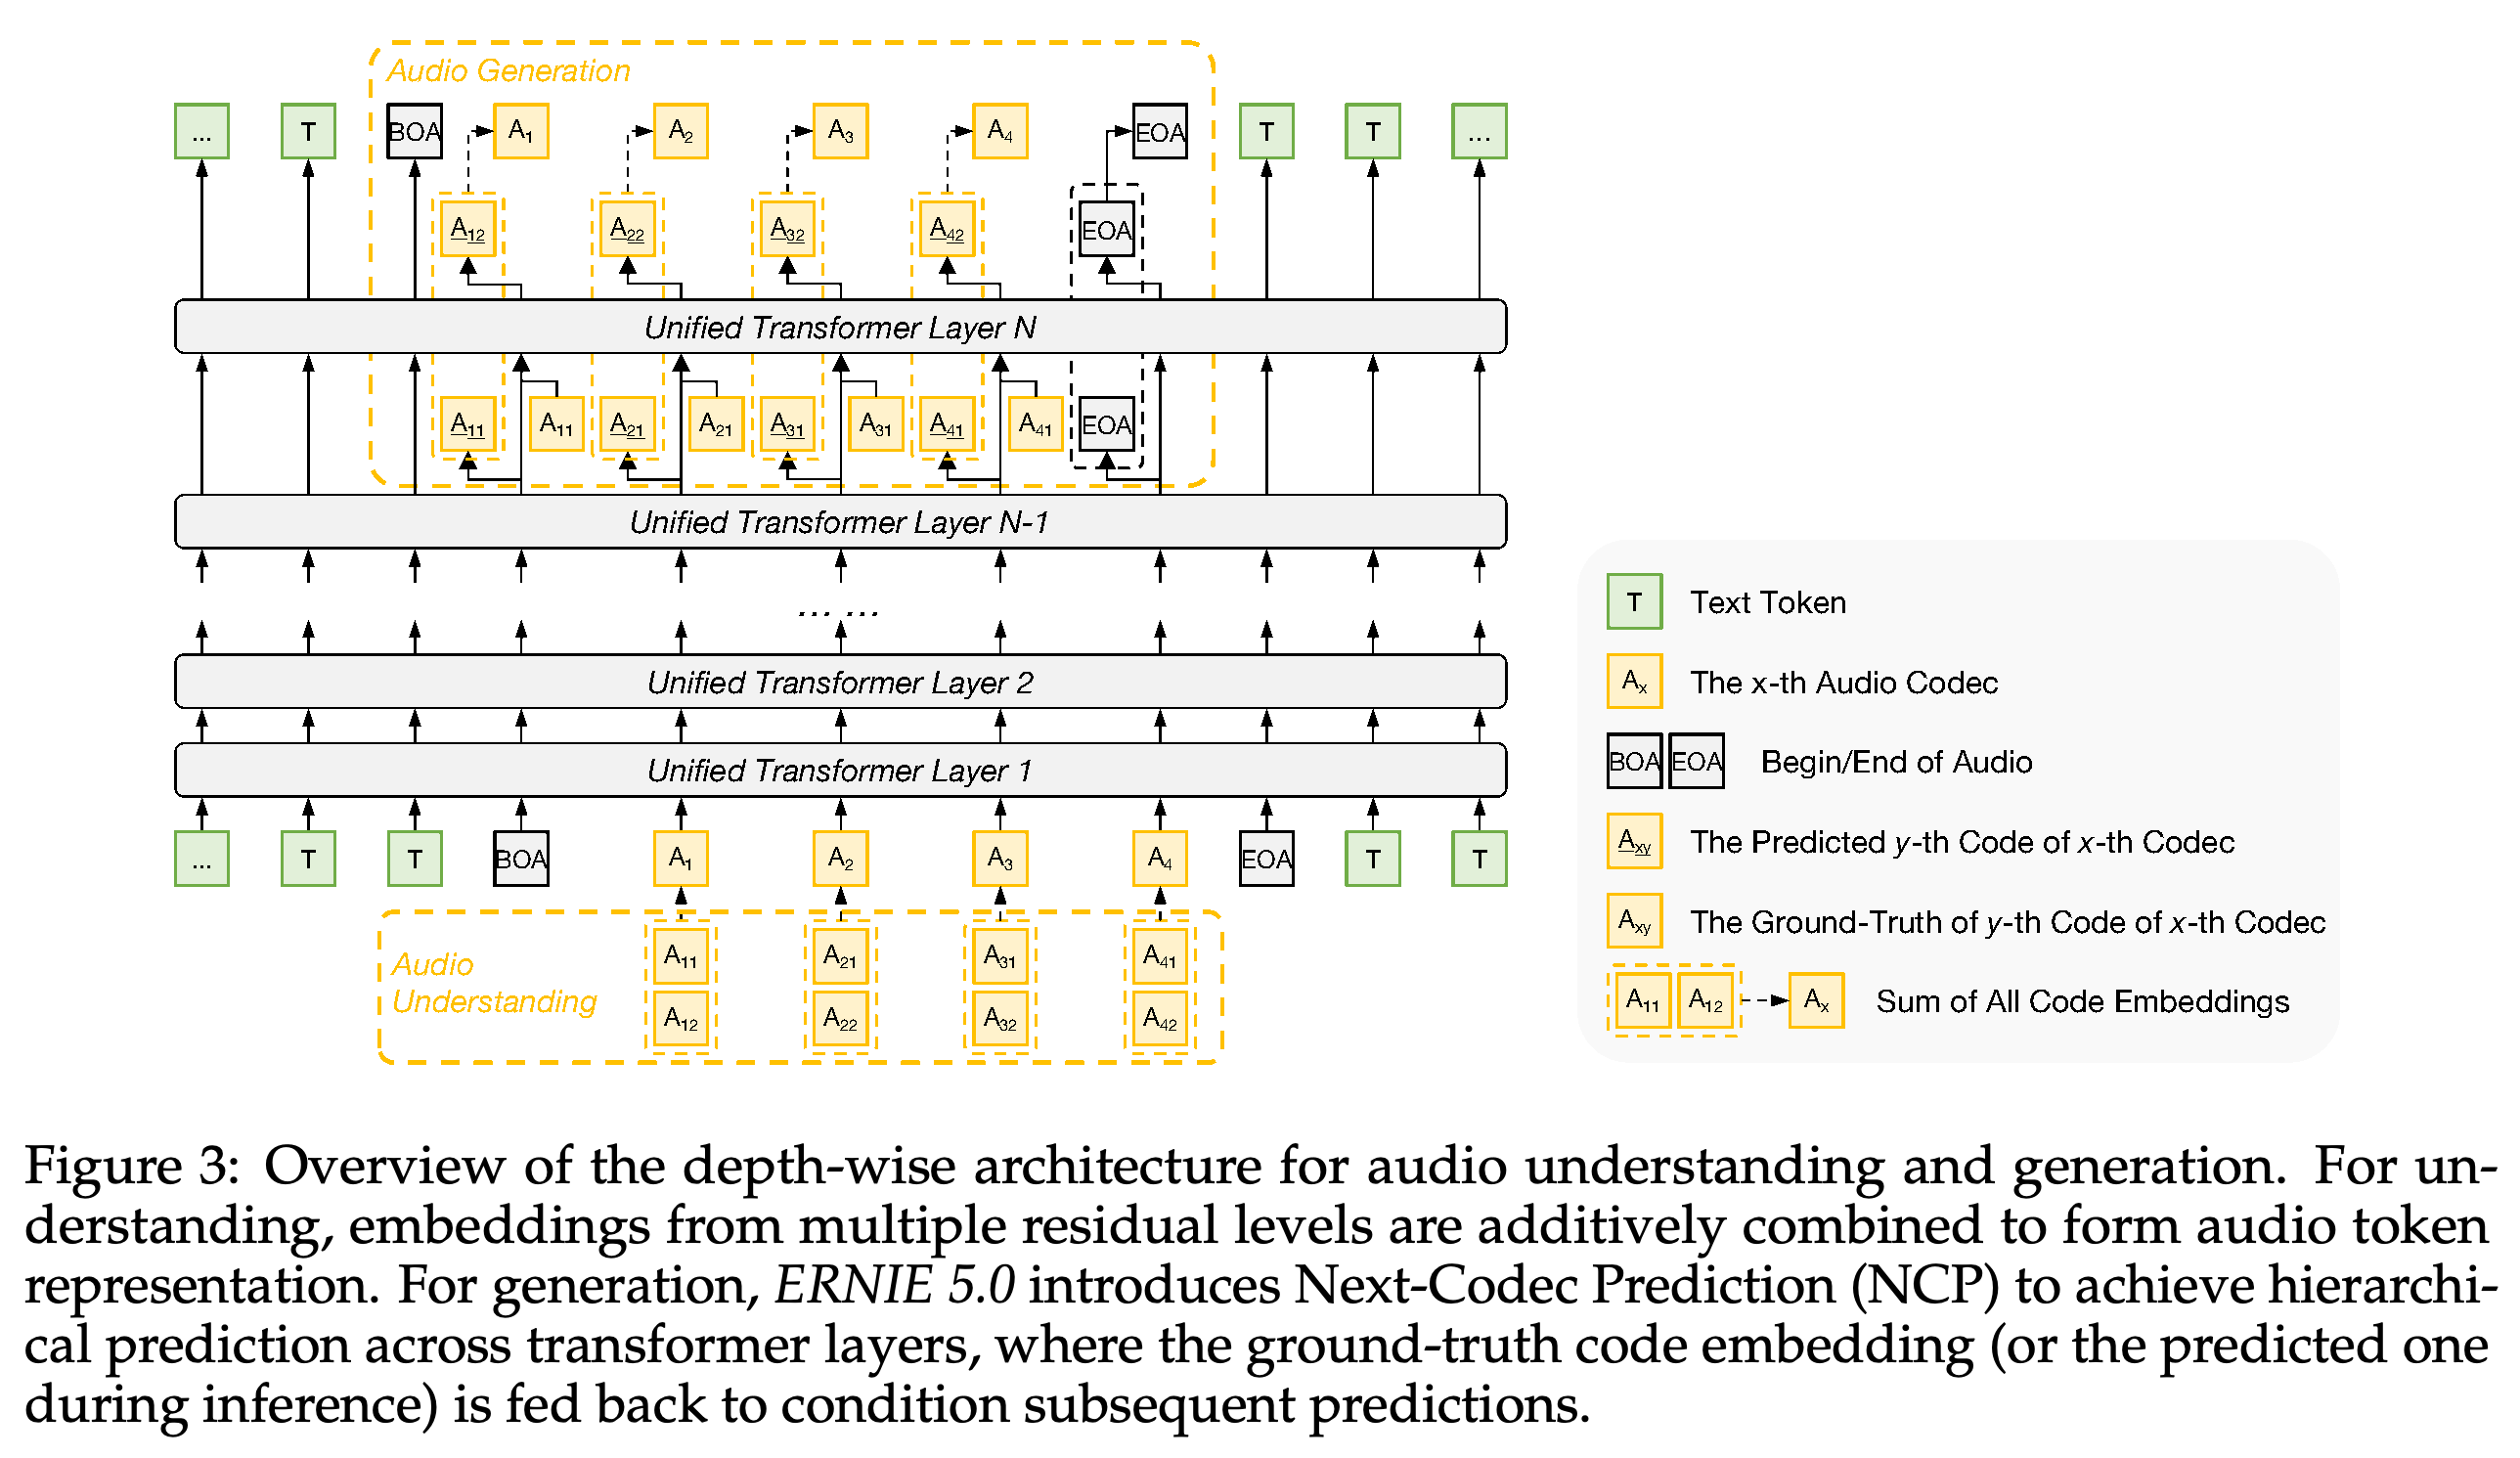
- 2.3.2 Audio Understanding and Generation with Next-Codec Prediction은 이해 과제에서 모든 코드를 더 긴 시간 시퀀스로 펼치지 않고, 단계별 코드 임베딩을 합산한다.
- 생성 과제에서는 상위 transformer 레이어의 헤드가 깊이 방향으로 의미 코드와 잔차 코드를 차례로 예측한다. 각 코드 임베딩은 은닉 상태에 다시 더한다. 학습에서는 teacher forcing으로 정답 코드를 피드백하고, 추론에서는 예측 코드를 사용한다.
- Figure 3은 깊이 방향 구조를 보여준다. 화자 임베딩으로 음성의 음색을 조건화하고, 오디오 디코더가 완성된 코드 계층을 파형으로 변환한다.
이해에서는 입력에서 코드 임베딩을 합산하지만, 생성에서는 상위 transformer 레이어를 따라 코드를 차례로 예측한다. 예측 단계 간 피드백으로 모든 코드북을 펼쳐 시간 시퀀스를 늘리는 방식을 피한다.
3 Pre-Training
사전 학습은 모달리티 간 표현을 공동으로 학습하고, 문맥 길이를 점진적으로 늘리며, 탄력적인 하위 네트워크군을 최적화한다. 이 절은 데이터 범주와 일부 최적화 설정을 제시하지만, 정확한 코퍼스 크기, 모달리티 비율, 총 학습 연산량을 포함한 전체 학습 절차는 제공하지 않는다.
3.1 Pre-Training Data
Text Data에는 다국어 웹 크롤링 데이터, 선별된 코퍼스, 책, 과학 출판물, 코드 저장소, 구조화된 지식이 포함된다. Multimodal Data에는 image–text, video–text, audio–text와 교차 배치된 시퀀스가 포함되며, 표준화된 데이터 플랫폼에서 입력 및 출력 모달리티에 따라 구성한다.
- 다시 학습한 텍스트 토크나이저는 UTF-16BE 바이트 수준 fallback과 BPE dropout을 사용한다. 공백 경계가 없는 언어에서는 분해 가능한 긴 무공백 구절을 토크나이저 어휘에서 제거해 희소성을 줄인다.
- 보고서는 휴리스틱 및 모델 기반 필터링, 중복 제거, 벤치마크 오염 제거를 설명한다. 코퍼스가 수조 개의 텍스트 토큰과 멀티모달 사례로 구성된다고 설명하지만, 모달리티별 정확한 수량이나 오염 제거 결과는 제시하지 않는다.
3.2 Training Recipe
Stage 1: 8K Pre-Training은 최대 문맥 길이 8K 토큰을 사용한다. 2,000-step 선형 warmup으로 학습률을 1 × 10⁻⁴까지 높인 뒤, 해당 단계의 나머지 기간에는 일정하게 유지한다. 전역 배치는 14M 토큰에서 56M 토큰으로 늘리고, RoPE base는 처음부터 1,000,000으로 설정한다.
- Stage 2: 32K&128K Mid-Training은 전역 배치를 유지하면서 문맥을 32K 토큰, 이어서 128K 토큰으로 확장하고, cosine annealing으로 학습률을 1 × 10⁻⁴에서 1 × 10⁻⁵로 낮춘다.
- 보조 손실이 없는 부하 균형 기법의 bias 갱신 속도는 1 × 10⁻⁴에서 1 × 10⁻⁵로 낮추고, MTP 손실 가중치는 0.3에서 0.1로 낮춘다.
- 사후확률 기반 가중치는 모달리티별 자기회귀 손실을 공통 구간으로 재조정해 최적화 불균형을 줄인다.
3.3 Once-For-All with Elastic Training
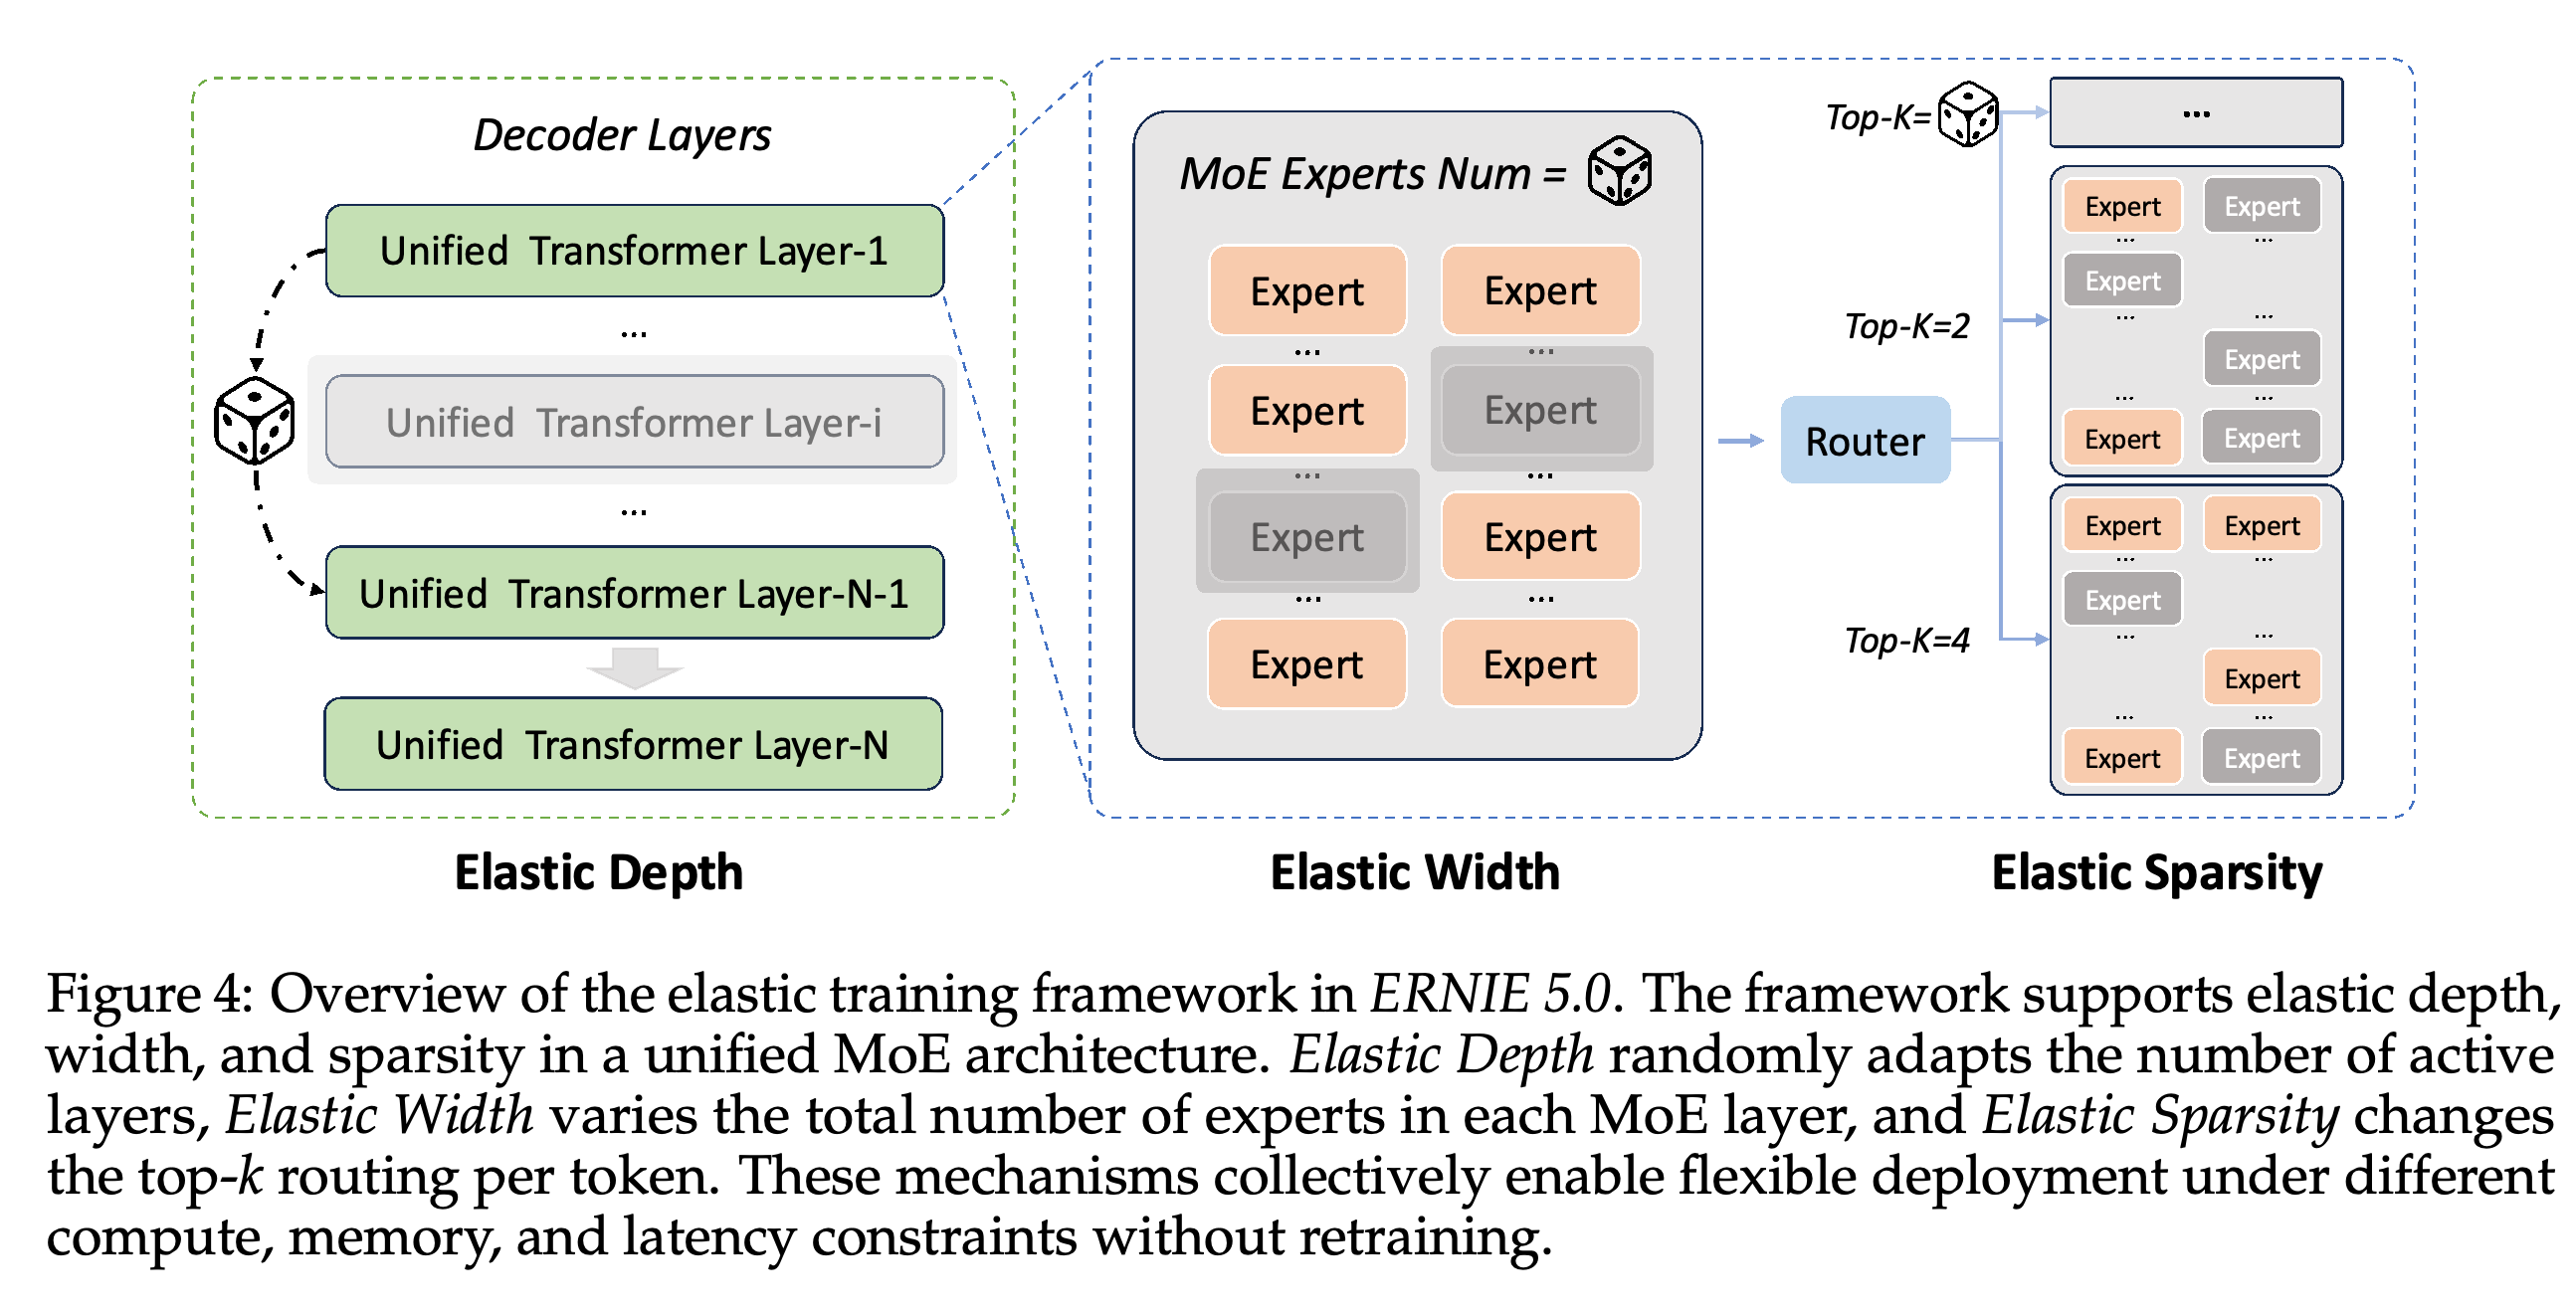
Once-For-All with Elastic Training은 레이어와 전문가의 부분집합을 선택하고 토큰당 활성화 전문가 수를 바꾸는 소형 구성을 포함한 super-network를 최적화한다. Figure 4는 활성 레이어를 바꾸는 Elastic Depth, 사용 가능한 전문가 풀을 바꾸는 Elastic Width, 저장된 모델 크기를 줄이지 않고 라우팅 top-k를 바꾸는 Elastic Sparsity를 구분한다.
- Elastic Depth는 75% 확률로 전체 모델을 사용하고, 25% 확률로 깊이를 줄인 하위 네트워크를 사용한다.
- Elastic Width는 80% 확률로 모든 전문가를 유지하고, 20% 확률로 라우팅을 무작위로 뽑은 전문가 부분집합에 제한한다.
- Elastic Sparsity는 80% 확률로 기본 라우팅 구성을 유지하고, 20% 확률로 더 작은 top-k를 뽑는다. 은닉 차원의 탄력성은 구현하지 않았다. 추출한 하위 네트워크는 중간 학습이나 미세 조정의 시작점으로 사용할 수 있다.
레이어 제거와 전문가 풀 제한은 배포 모델에 저장하는 파라미터를 줄일 수 있다. 반면 top-k를 낮추면 주로 활성화되는 연산량이 줄어든다. 3가지 제어 방식은 서로 다른 배포 제약을 다룬다.
4 Post-Training
사후 학습에서는 지도 미세 조정(SFT) 이후 통합 멀티모달 강화학습(UM-RL)을 수행한다. SFT는 지시 이행과 긴 추론 능력을 학습하고, 다단계 RL은 확장된 통합 검증기 시스템으로 추론, 에이전트, 지시 이행 과제를 결합한다.
- 주요 과제는 rollout 비용, 희소 전문가 라우팅으로 증폭되는 학습과 추론 간 수치 불일치, 희소 보상을 받는 이질적인 과제다.
- 보고서는 이어지는 안정화 기법을 설명하지만, 검증기의 전체 사양이나 모든 구성 요소의 개별 정량적 ablation은 공개하지 않는다.
4.1 Enhancing Rollout Efficiency with Unbiased Replay Buffer
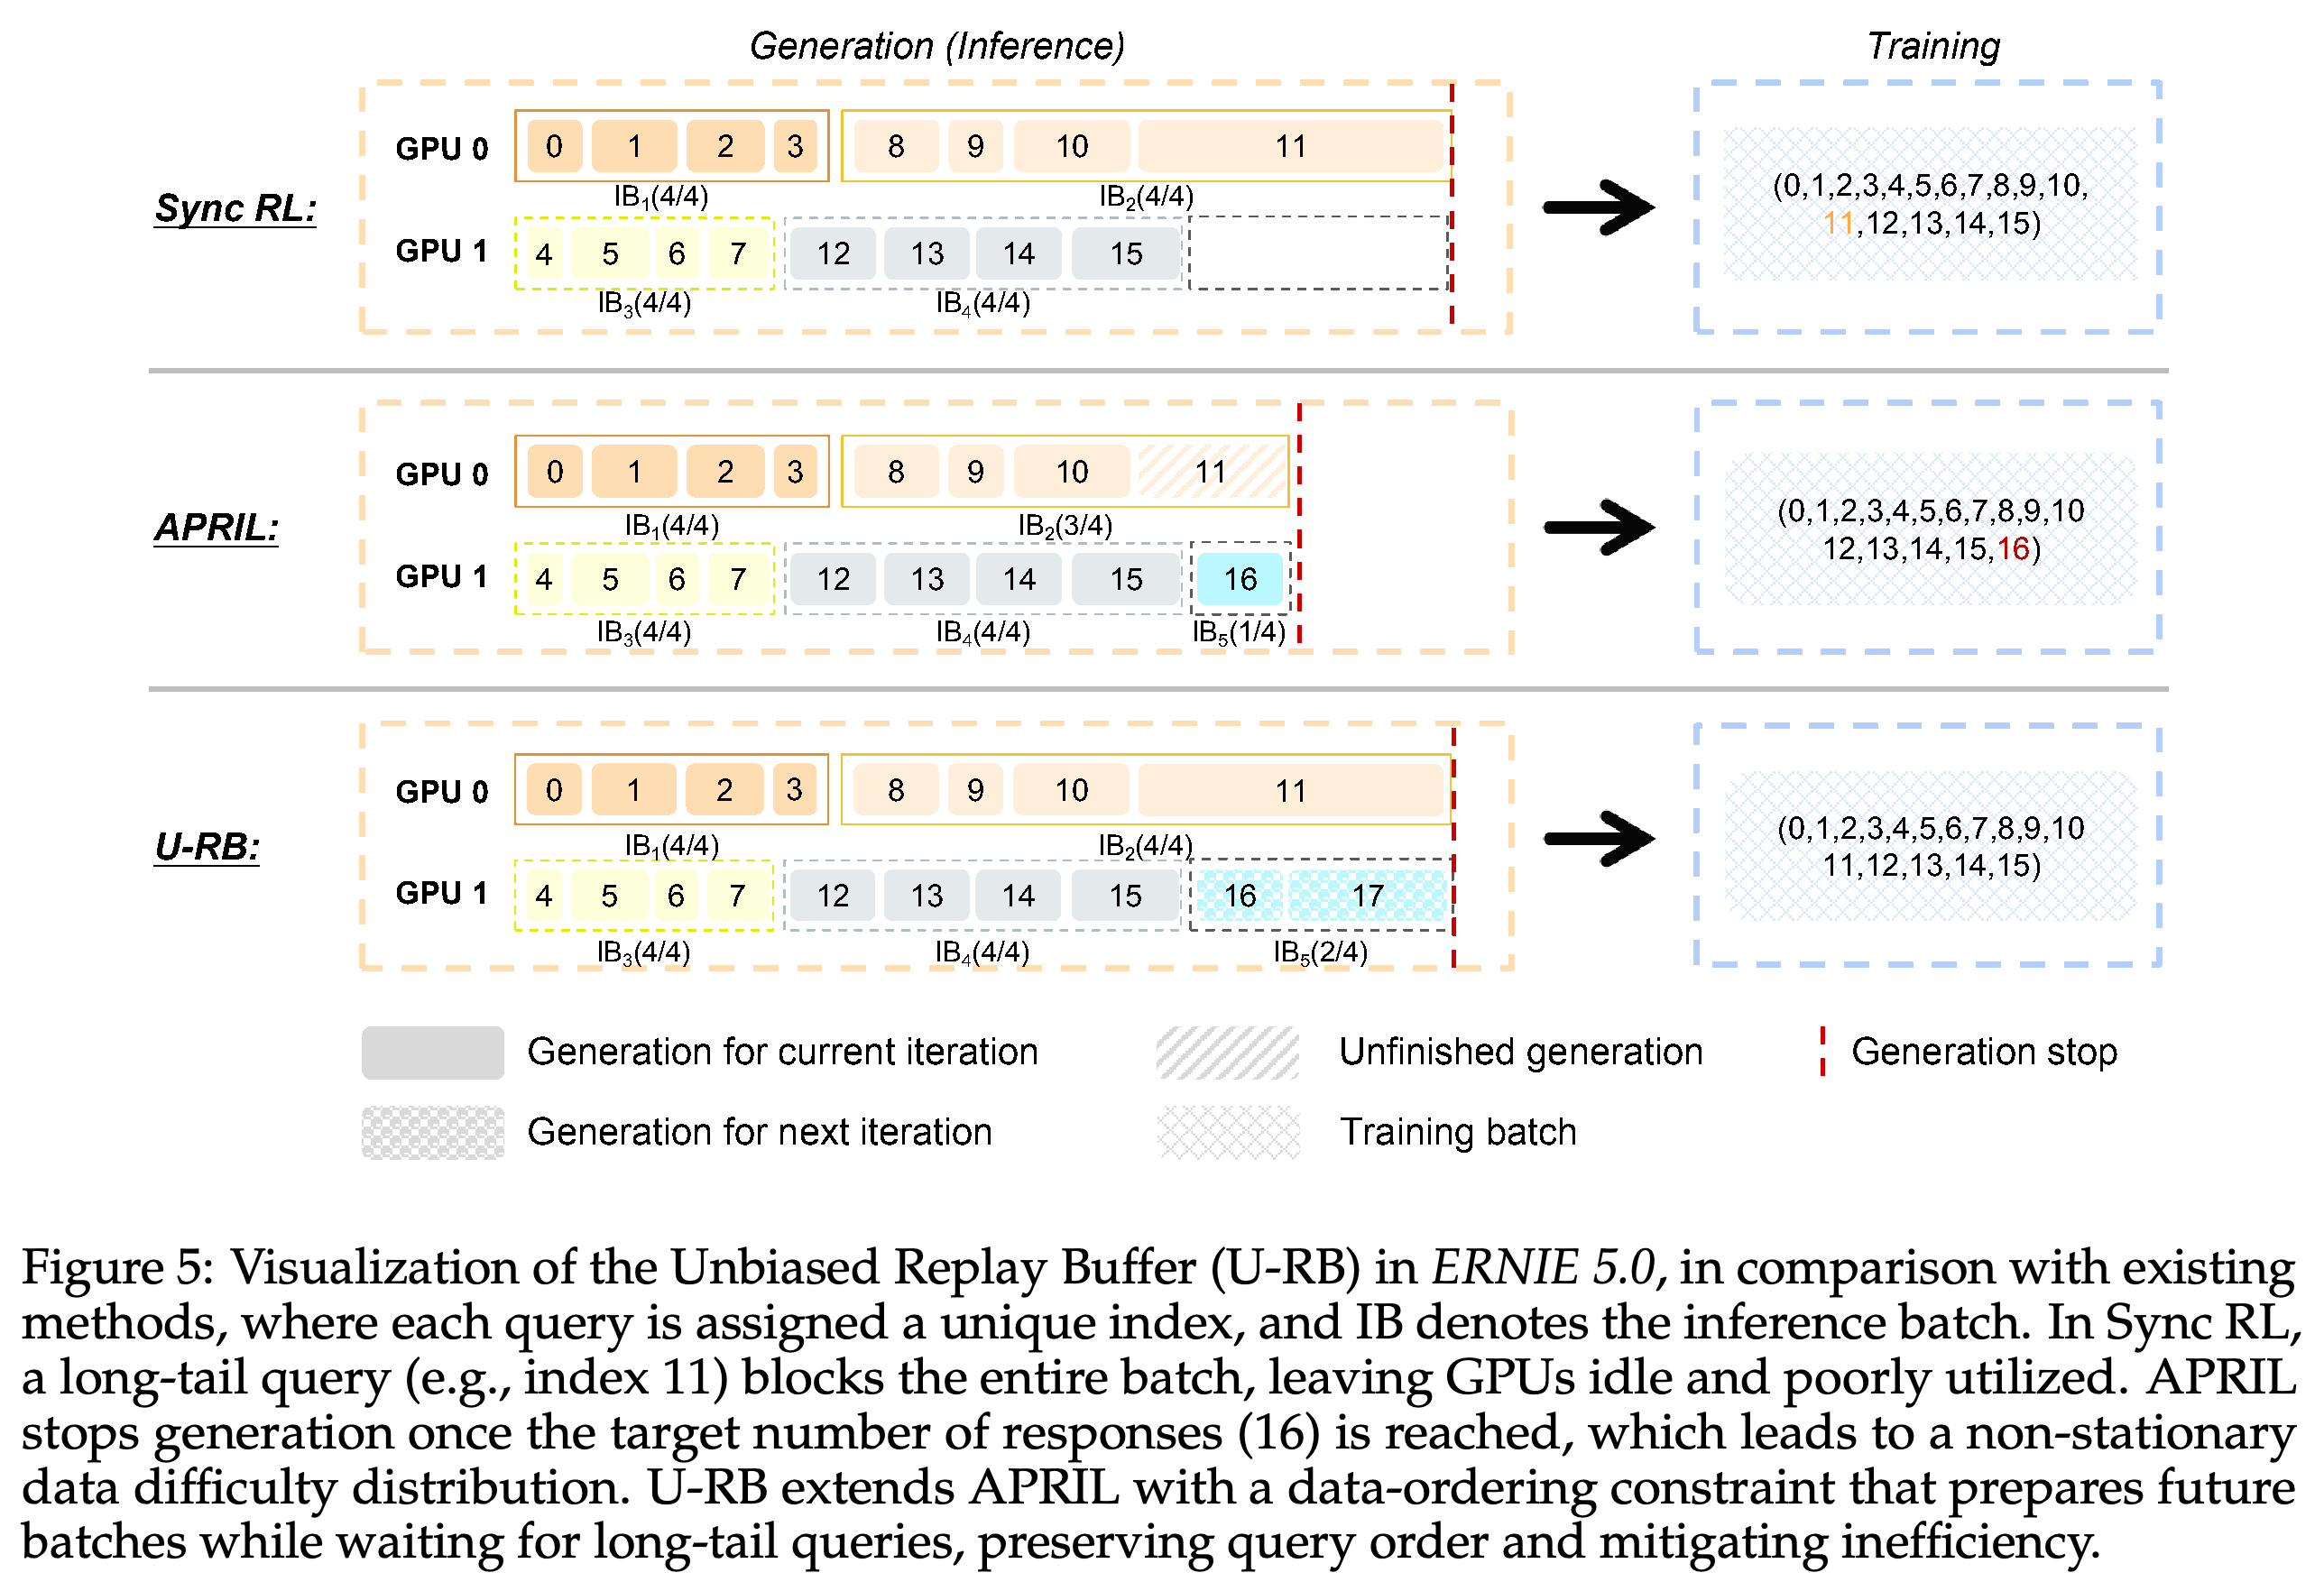
보고서는 rollout 생성이 RL 학습 시간의 90%를 넘게 차지한다고 설명한다. U-RB: Unbiased Replay Buffer Generation은 여유 추론 용량으로 향후 그룹을 처리하되, 각 학습 반복에서는 원래 할당된 쿼리 그룹을 사용하도록 한다. 이를 통해 짧은 응답이 해당 그룹의 미완료 응답을 대체하지 못하게 한다.
- 추론 풀 용량은 학습 배치 크기와 버퍼 크기의 곱이며, 학습 풀은 학습 배치 1개를 담는다.
- 각 반복은 할당된 그룹에서 가장 긴 rollout이 [EOS]에 도달할 때까지 기다린 뒤, 해당 그룹의 궤적을 최적화에 전달한다. 궤적은 이전 추론 실행에서 이어서 생성할 수 있다.
- Figure 5는 이 순서 제약을 동기식 대기 및 APRIL의 완료 개수 기반 중단 규칙과 비교한다. 여기서 “Unbiased”는 쿼리 수용과 완료 순서의 편향에 관한 표현이며, 재개된 모든 궤적이 현재 정책에서 샘플링된다는 보장이 입증된 것은 아니다.
U-RB는 긴 쿼리 11을 현재 학습 그룹에 유지하면서, 여유 용량으로 이후 반복에 사용할 쿼리 16과 17을 시작한다. 반면 APRIL은 쿼리 11보다 쿼리 16을 먼저 수용한다. 이는 순서 제약이 줄이려는 완료 순서 편향을 보여준다. 이 그림은 처리량 측정이 아니라 스케줄링 예시다.
4.2 Stabilizing Training with Mitigated Entropy Collapse
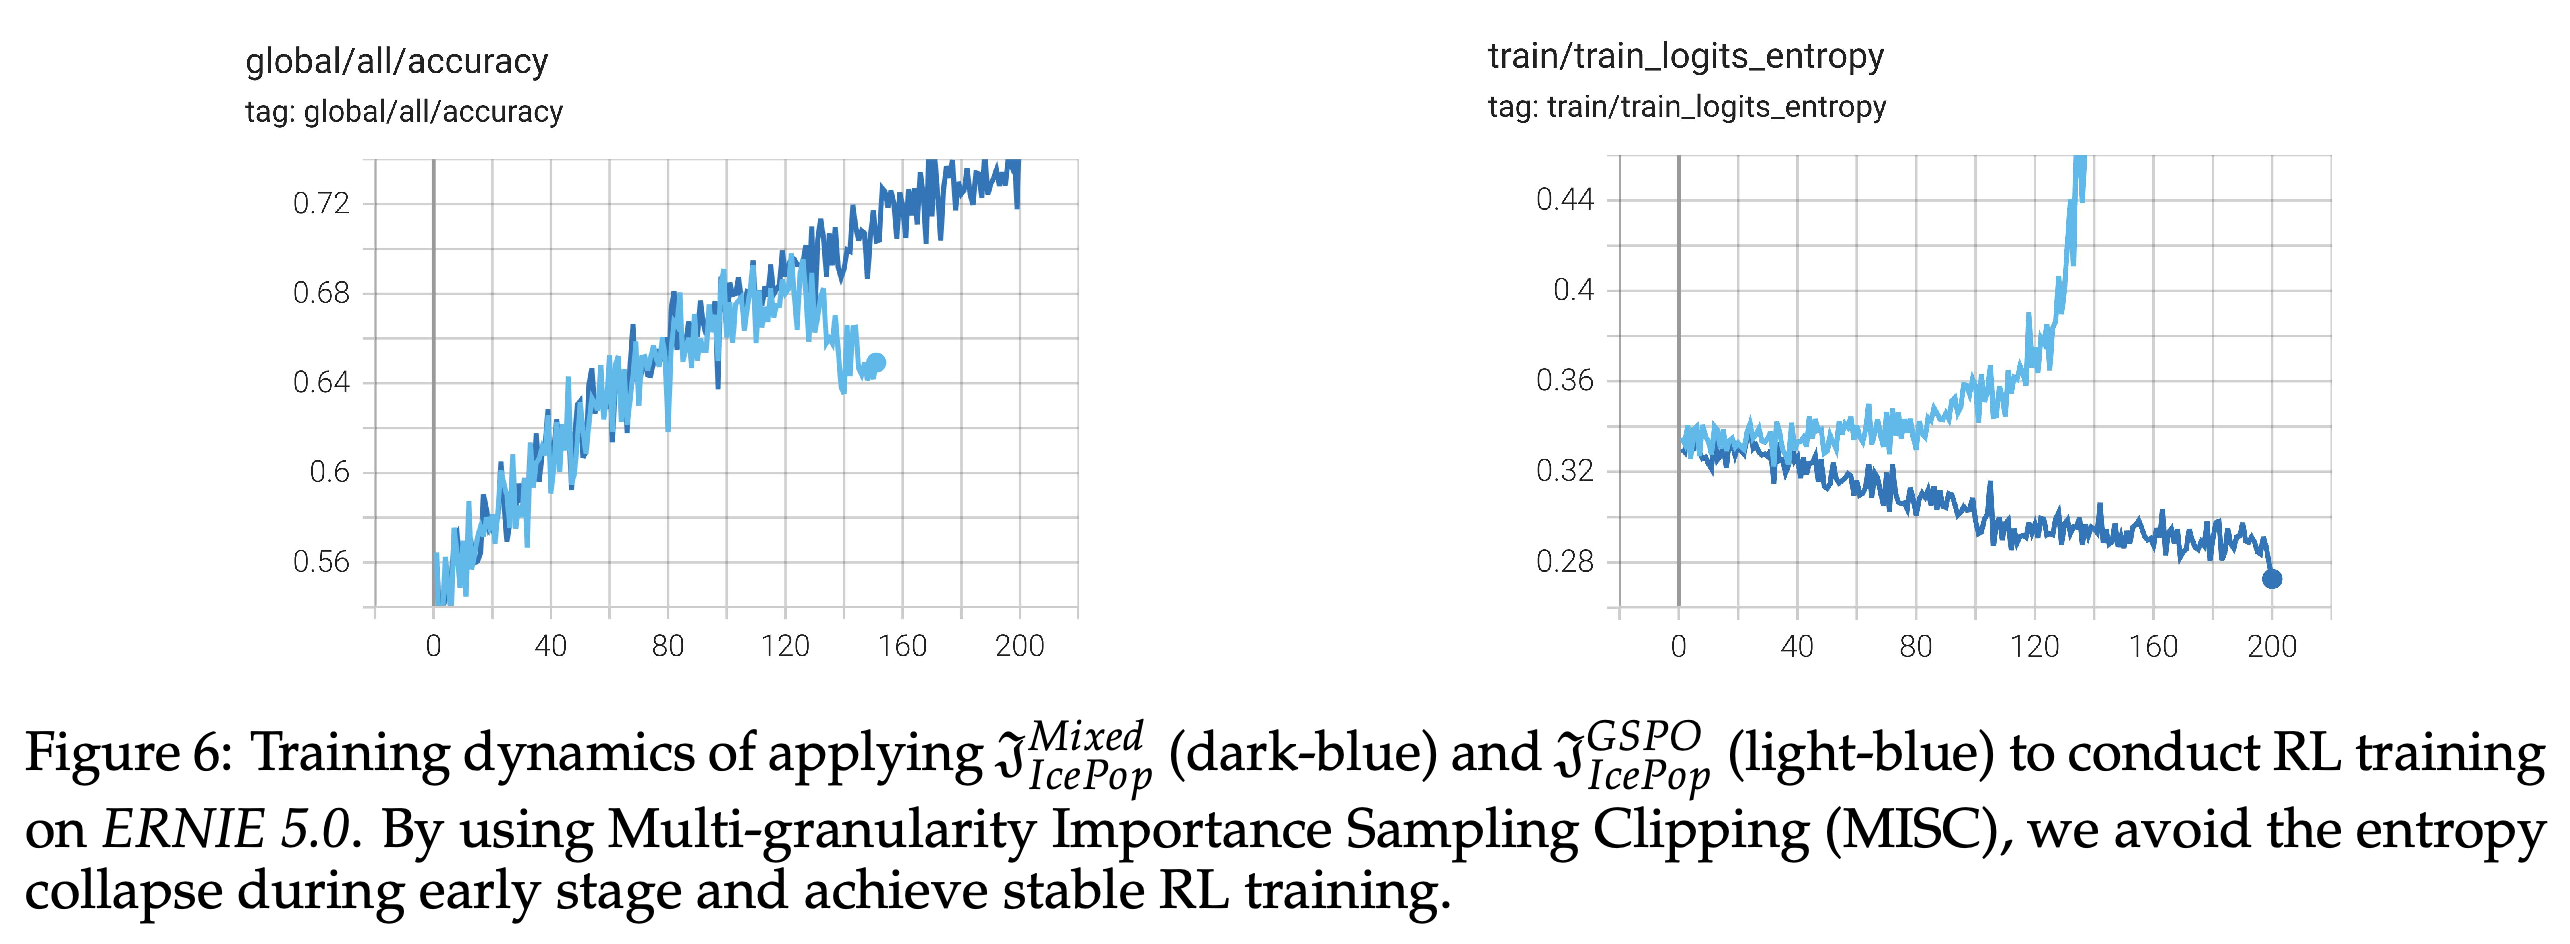
MISC: Multi-granularity Importance Sampling Clipping은 토큰 수준의 학습·추론 보정과 길이로 정규화한 시퀀스 수준 정책 중요도 비율을 결합한다. Figure 6에서는 엔트로피가 점진적으로 감소하면서 정확도가 계속 개선된다. 반면 시퀀스 수준의 IcePop-calibrated GSPO를 직접 적용하면 엔트로피가 급증하고 정확도가 하락한다.
- 보고서는 학습·추론 불일치 상황에서 시퀀스 수준 절단이 저엔트로피 응답을 다수 제거하기 때문에 비교 방식이 불안정해진다고 설명한다. 보고서에서 사용하는 “entropy collapse”는 엔트로피의 급격한 감소뿐 아니라 급격한 증가도 포함한다.
- WPSM: Well-learned Positive Sample Mask는 쿼리 성공률을 추적하고, 평균 정확도가 τ를 넘으면서 응답 엔트로피가 η보다 낮으면 응답 가중치를 줄인다. 마스킹 강도 α ∈ [0, 1]이 감소 폭을 조절한다.
- WPSM은 더 어려운 쿼리에 기울기 업데이트를 집중하기 위한 기법이다. PDF는 임계값이나 WPSM만의 정량적 ablation을 제공하지 않는다.
혼합 단위 방식으로 학습하면 엔트로피가 점진적으로 감소하면서 정확도가 계속 개선된다. 시퀀스 수준 비교 방식에서는 엔트로피가 급격히 증가하고 정확도가 하락한다. 보고된 실행의 안정화를 뒷받침하지만, 여러 seed나 과제에 대한 일반성을 입증하지는 않는다.
4.3 Boosting Sample Efficiency with Hint-based Learning
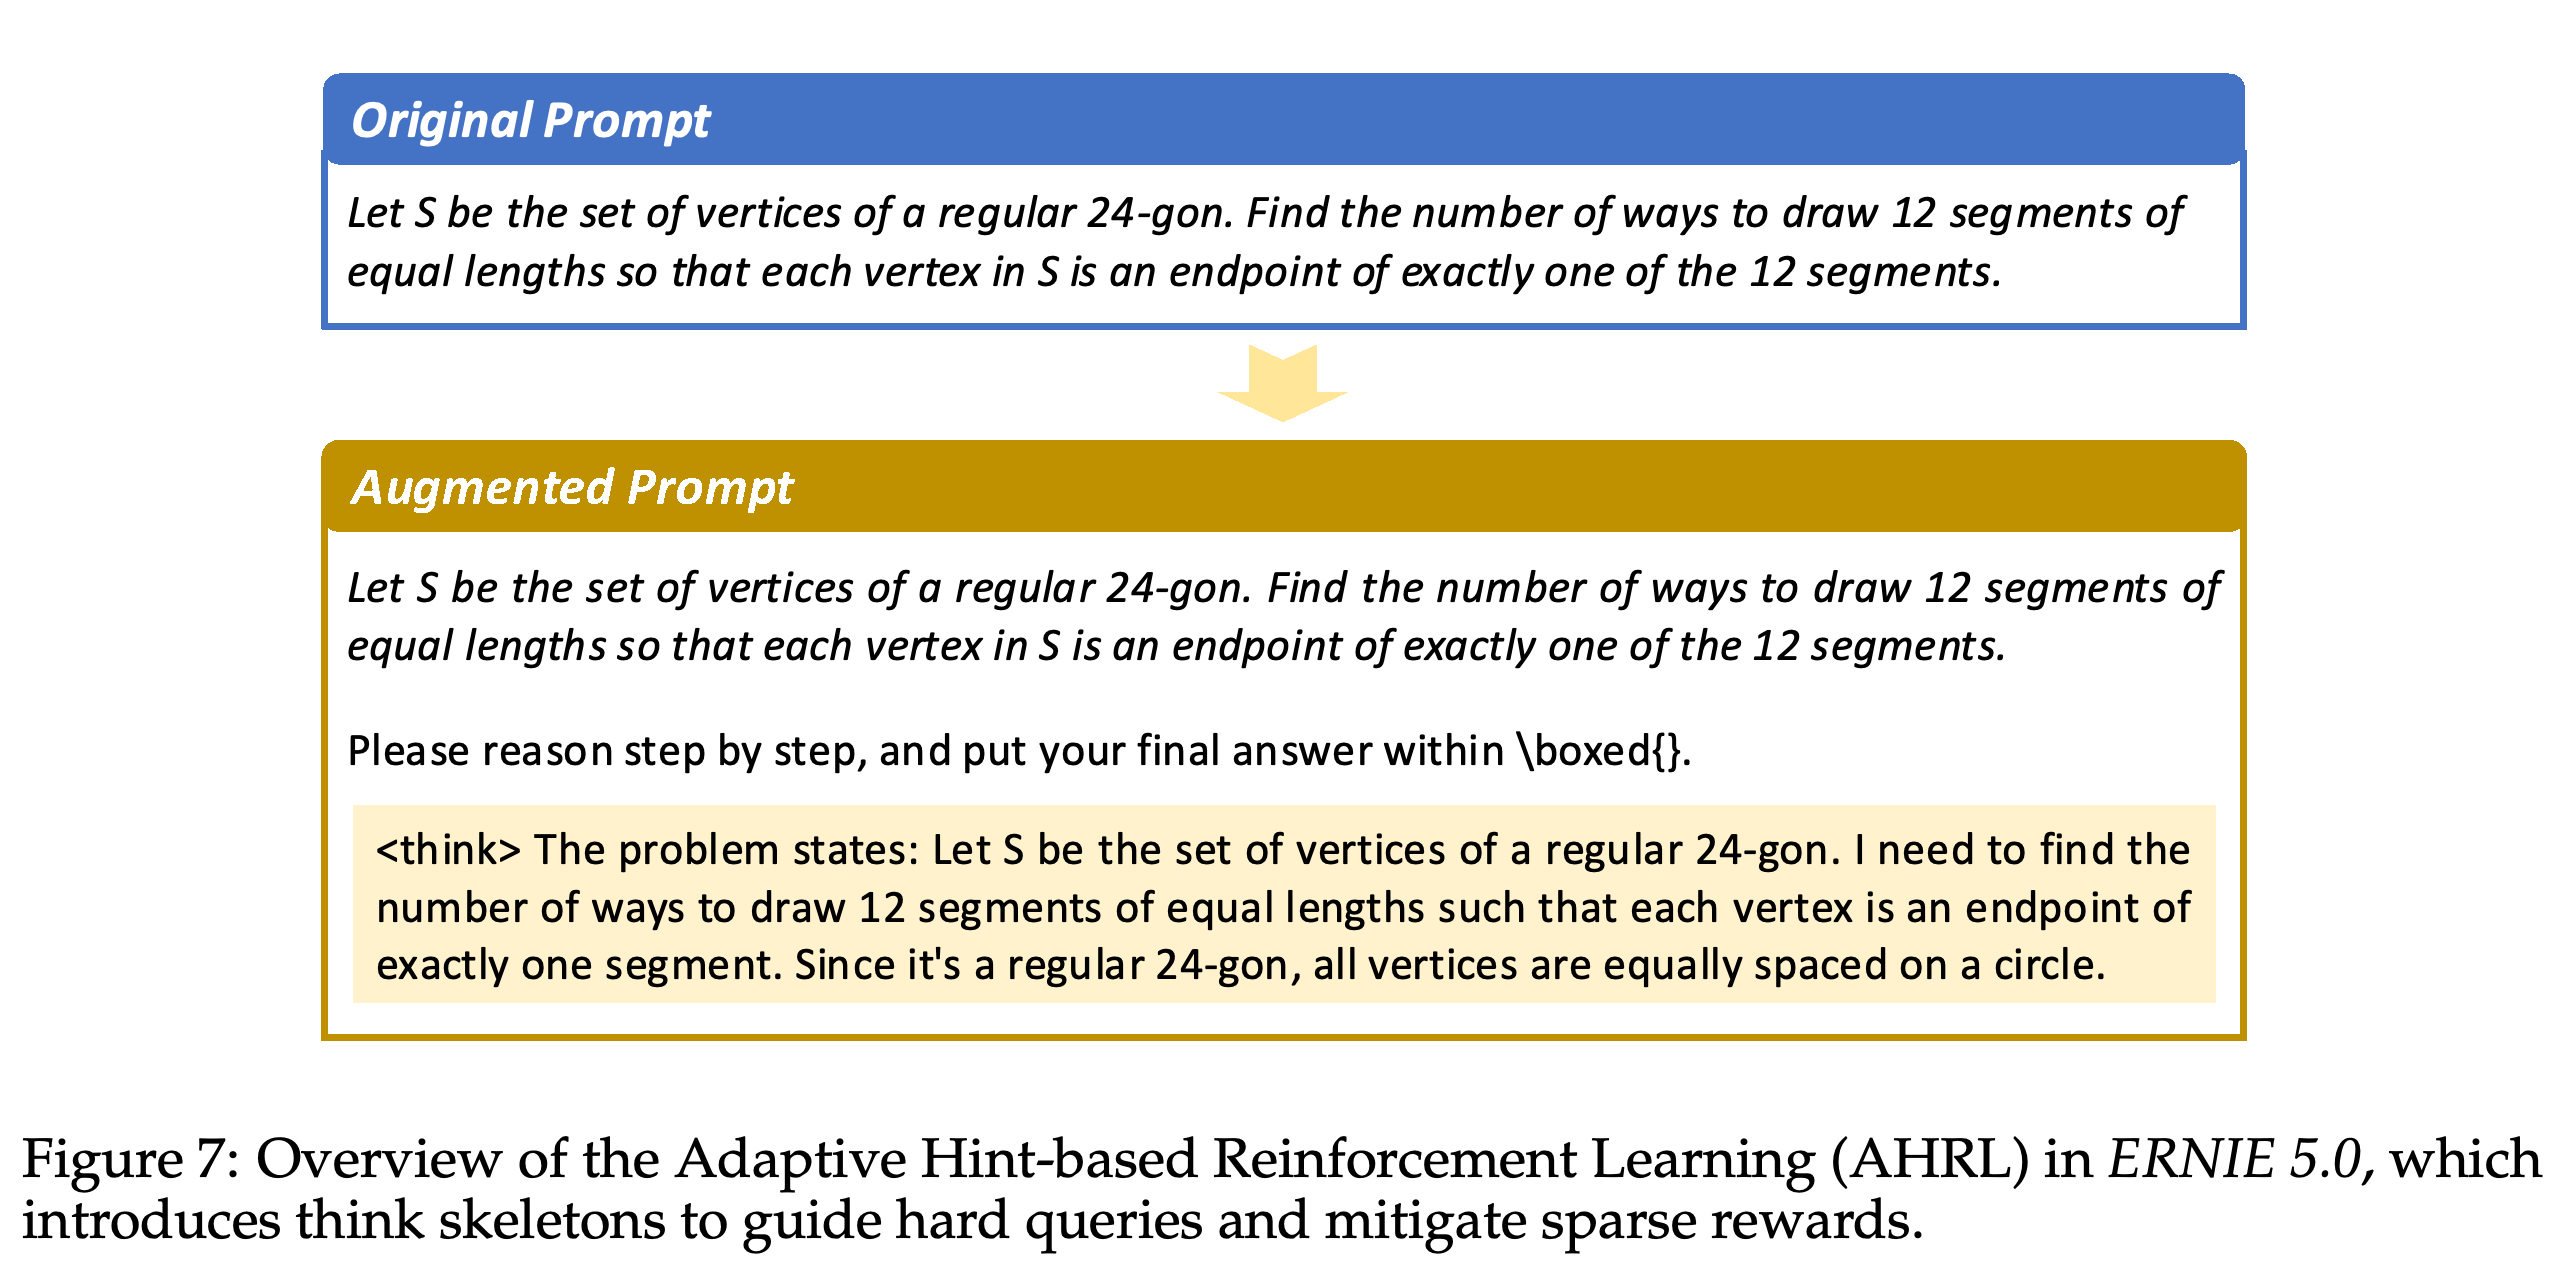
AHRL: Adaptive Hint-based Reinforcement Learning은 모든 rollout이 보상 0을 받아 그룹 상대 최적화에 유용한 학습 신호가 없는 어려운 쿼리를 다룬다. 쿼리에 부분적인 추론 개요를 덧붙이고, 공개하는 비율을 점진적으로 줄인다. Figure 7의 정24각형 문제가 이 방식을 보여준다.
- 힌트 감소 일정은 phint(xᵗ) = pinitial · exp(−γ · t · passinitialˣ)이다. 여기서 t는 학습 반복, γ는 감쇠율, passinitialˣ는 해당 쿼리에 대한 SFT 모델의 pass@k다.
- 초기 성공률이 낮은 쿼리일수록 힌트가 더 천천히 줄어든다. 보고서는 이 메커니즘을 설명하지만, 샘플 효율의 정량적 개선이나 최종 무힌트 성능에 대한 기여를 분리한 평가는 제시하지 않는다.
정24각형 예시는 최종 답이 아니라 추론 개요의 시작 부분을 덧붙인다. AHRL이 어려운 쿼리의 탐색 조건을 어떻게 바꾸는지 보여주지만, 학습 개선을 정량화하지는 않는다.
5 Infrastructures
인프라는 PaddlePaddle을 기반으로 구축했으며 ERNIE 4.5 training system을 확장한다. 보고서가 제시하는 네 가지 과제는 MoE 메모리와 통신, 이질적인 토크나이저 작업량, 샘플에 따라 달라지는 어텐션 패턴, 일관된 연산을 유지하는 확장 가능한 RL이다.
- Tremendous Memory Pressure and Communication Overhead는 큰 전문가 파라미터와 노드 간 토큰 전달 문제를 다루며, 하이브리드 병렬화와 세밀한 메모리 제어가 필요한 이유를 설명한다.
- Multimodal Training with Multiple Tokenizers는 각 구성 요소가 적절한 병렬화 전략을 사용하도록 토크나이저를 백본에서 분리한다. Flexible Attention Patterns across Modalities는 FlashMask로 텍스트와 오디오의 causal 처리 및 시각의 국소 양방향 어텐션을 함께 지원한다.
- Scalable RL under Throughput and Consistent Constraints는 분리 실행으로 학습, rollout, 환경 상호작용을 조율하면서 수치 불일치, 완료 순서 편향, 이질적인 자원 활용 문제를 다룬다.
5.1 Hybrid Parallelism for Training at Scale
최종 구성은 4-way tensor parallelism, 가상 단계를 포함한 12-way pipeline parallelism, 64-way expert parallelism, ZeRO-1 data parallelism, 긴 문맥 학습을 위한 context parallelism을 결합한다. DeepEP가 노드 간 통신을 처리하며, 라우팅 때문에 간헐적으로 메모리 부족이 발생해도 학습 중 토큰을 버리지 않는다.
- FP8 혼합 정밀도 학습과 FP8 활성값 저장으로 최대 메모리 요구량을 줄인다.
- 메모리가 부족하면 동적 적응형 활성값 offloading을 실행하고, 하위 배치 연산으로 대규모 메모리 할당 요청을 줄인다.
- 자동 메모리 조각 모음은 CUDA virtual memory management (VMM)를 사용한다. 보고서는 이러한 조치가 학습을 가능하게 한다고 설명하지만, 개별 오버헤드는 정량화하지 않는다.
5.2 Disaggregation Architecture for Multimodal Training
토크나이저와 백본을 분리하는 구조는 모달리티별 토크나이저를 전용 연산 노드에 배치하고, data parallelism을 사용하는 독립적인 수평 확장 서비스로 운영한다. 백본은 원격 호출로 인코딩된 표현을 가져오므로, 토크나이저와 다른 병렬화 전략을 사용할 수 있다.
- 이 분리는 가변 시퀀스 길이와 모달리티별 인코딩 비용에서 발생하는 부하 불균형을 줄이기 위한 것이다. 토크나이저를 백본과 같은 노드에 배치한 구성과 조건을 맞춘 처리량 비교는 제공하지 않는다.
5.3 FlashMask for Flexible Multimodal Attention
FlashMask는 전역 causal 어텐션 안에 국소 양방향 시각 영역을 지원하며, 샘플마다 다른 마스크를 사용할 수 있다. 보고서는 FlexAttention 대비 연산자 수준 속도가 최대 200% 개선되고, 전체 학습 속도는 20% 넘게 개선된다고 주장한다.
- context parallelism과 커널 수준에서 통합하면 Megatron-LM 방식보다 성능이 80% 개선된다고 보고한다.
- PDF는 이 비교에 사용한 하드웨어, 입력 형태의 분포, 상세 측정 절차를 명시하지 않는다.
5.4 Scalable and Disaggregated RL Infrastructure
분리형 RL 인프라는 중앙 제어기로 학습, 추론, 환경 상호작용, 보상 평가를 비동기적으로 조율한다. 통합 FP8 스택은 학습과 rollout에 동일한 연산자를 사용하고, Rollout Router Replay와 함께 수치 및 라우팅 불일치를 줄인다.
- 순서를 보존하는 replay buffer는 Section 4.1에서 설명한 쿼리 수용 제약을 구현한다.
- 탄력적 CPU 풀링은 클러스터의 유휴 CPU 용량을 가상화해 환경 상호작용과 검증에 사용한다. 경과 시간과 비용 효율의 이점은 정성적으로 설명하며, 인프라 ablation으로 측정하지 않는다.
6 Evaluations
평가는 내부 ERNIE-Eval 프레임워크로 언어, 시각, 오디오 과제를 다룬 뒤, 라우팅 분석과 elastic training 실험을 수행한다. 코드 평가는 LiveCodeBench와 SandboxFusion을 사용해 실행 결과를 평가한다.
- 결과는 신뢰구간이 없는 점 추정치다. 언어 기반 모델 비교에서는 few-shot 설정을 명시하지만, 모든 사후 학습 비교 모델의 프롬프트와 샘플링 절차를 같은 수준으로 상세하게 제공하지는 않는다.
6.1 Evaluation on Language Benchmarks
Language Benchmarks는 사실 지식, 일반 시험형 과제, STEM, 코딩, 다국어 이해, 추론, 지시 이행, 에이전트를 다룬다. Evaluation of Pre-trained Models의 Table 1에서 ERNIE 5.0-Base는 보고된 대부분의 항목에서 앞선다. PreciseWikiQA10-shot은 74.48, ChineseSimpleQA10-shot은 90.09, MMLU-Pro5-shot은 75.58, HumanEval+0-shot은 80.86, MMMLU5-shot은 78.94를 기록한다.
- C-Eval, CMMLU, MBPP+에서는 Kimi K2-Base가 더 높다. LiveCodeBench v6는 2408부터 2505까지를 다루며, 기반 모델 비교에 1-shot 설정을 사용한다.
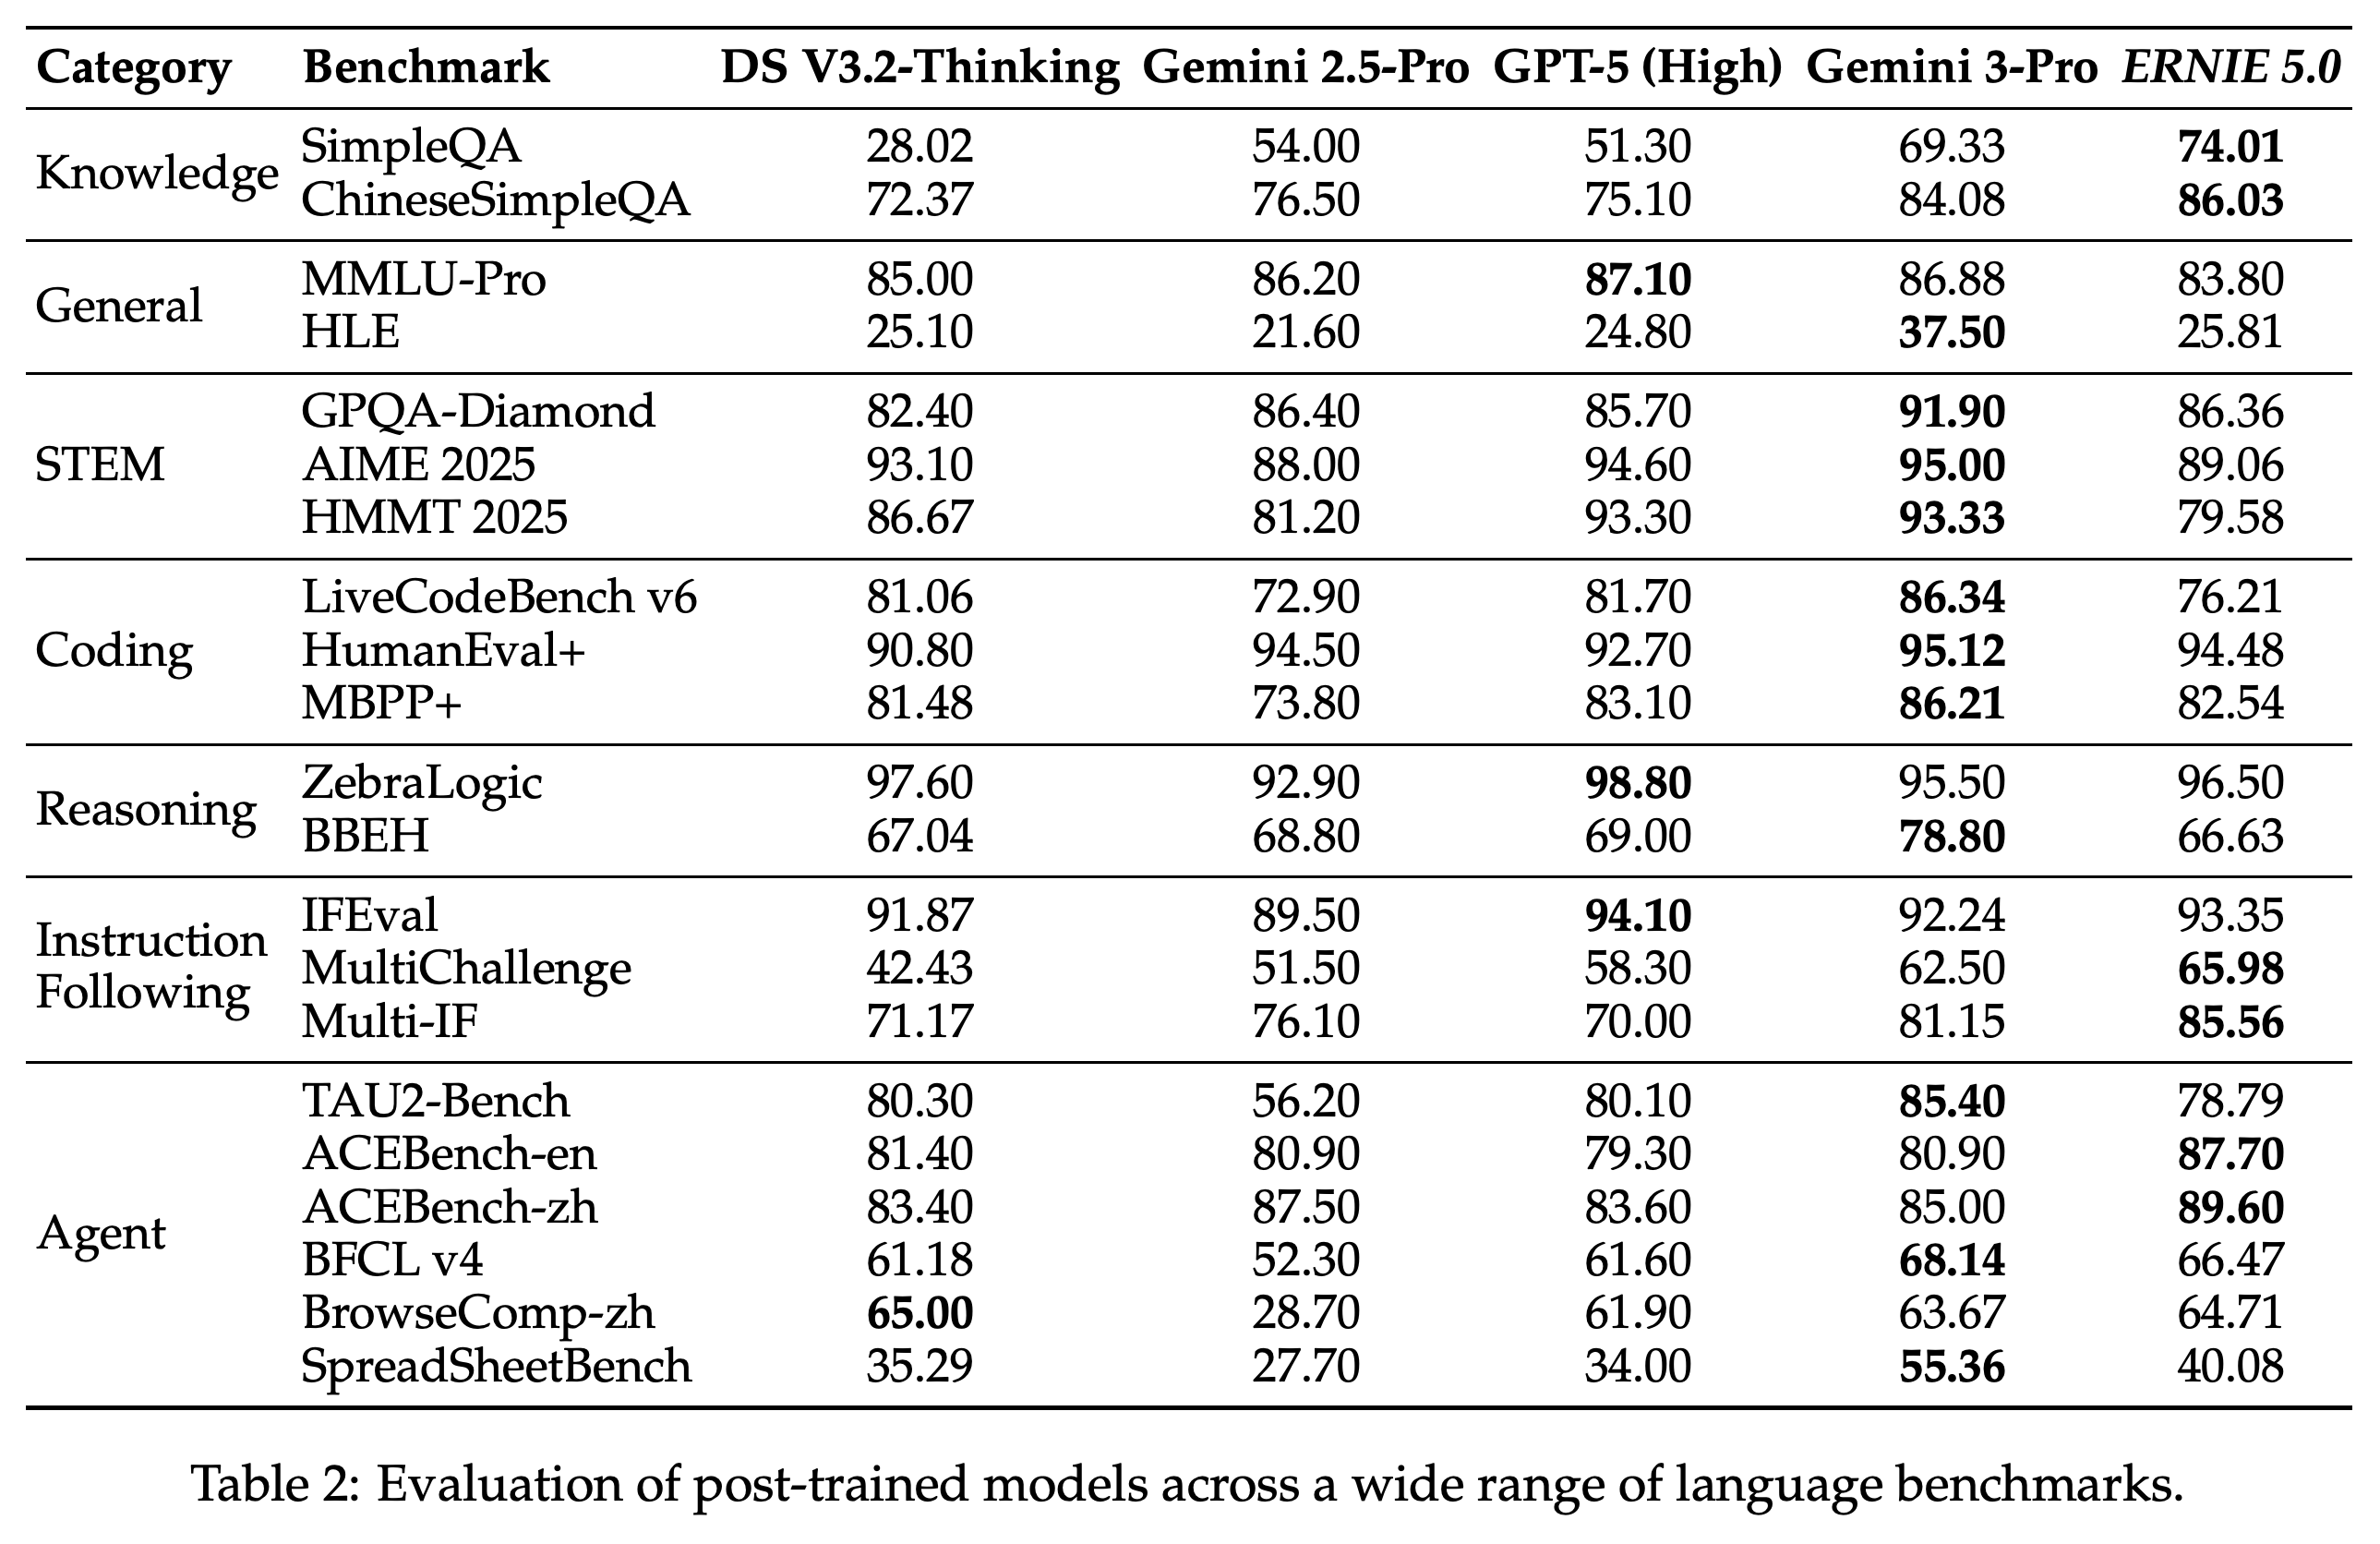
- Evaluation of Post-trained Models의 Table 2에서는 SimpleQA (74.01), ChineseSimpleQA (86.03), MultiChallenge (65.98), Multi-IF (85.56), ACEBench-en (87.70), ACEBench-zh (89.60)에서 표에 제시된 최고 점수를 기록한다.
- 어려운 추론에서는 여전히 약점을 보인다. ERNIE 5.0의 HLE, HMMT 2025, LiveCodeBench v6 점수는 각각 25.81, 79.58, 76.21로, Gemini 3-Pro의 37.50, 93.33, 86.34보다 낮다. BrowseComp-zh 점수 64.71도 DS V3.2-Thinking의 65.00보다 낮으므로, 해당 과제에서 선두라는 보고서의 주장에는 단서가 필요하다.
사실 QA와 다중 지시 이행에서는 앞서지만, HLE, HMMT 2025, LiveCodeBench v6 점수는 Gemini 3-Pro보다 낮다. 에이전트 성능도 과제에 따라 다르다. ERNIE는 ACEBench에서는 앞서지만, TAU2-Bench, BrowseComp-zh, SpreadSheetBench에서는 앞서지 않는다.
6.2 Evaluation on Vision Benchmarks
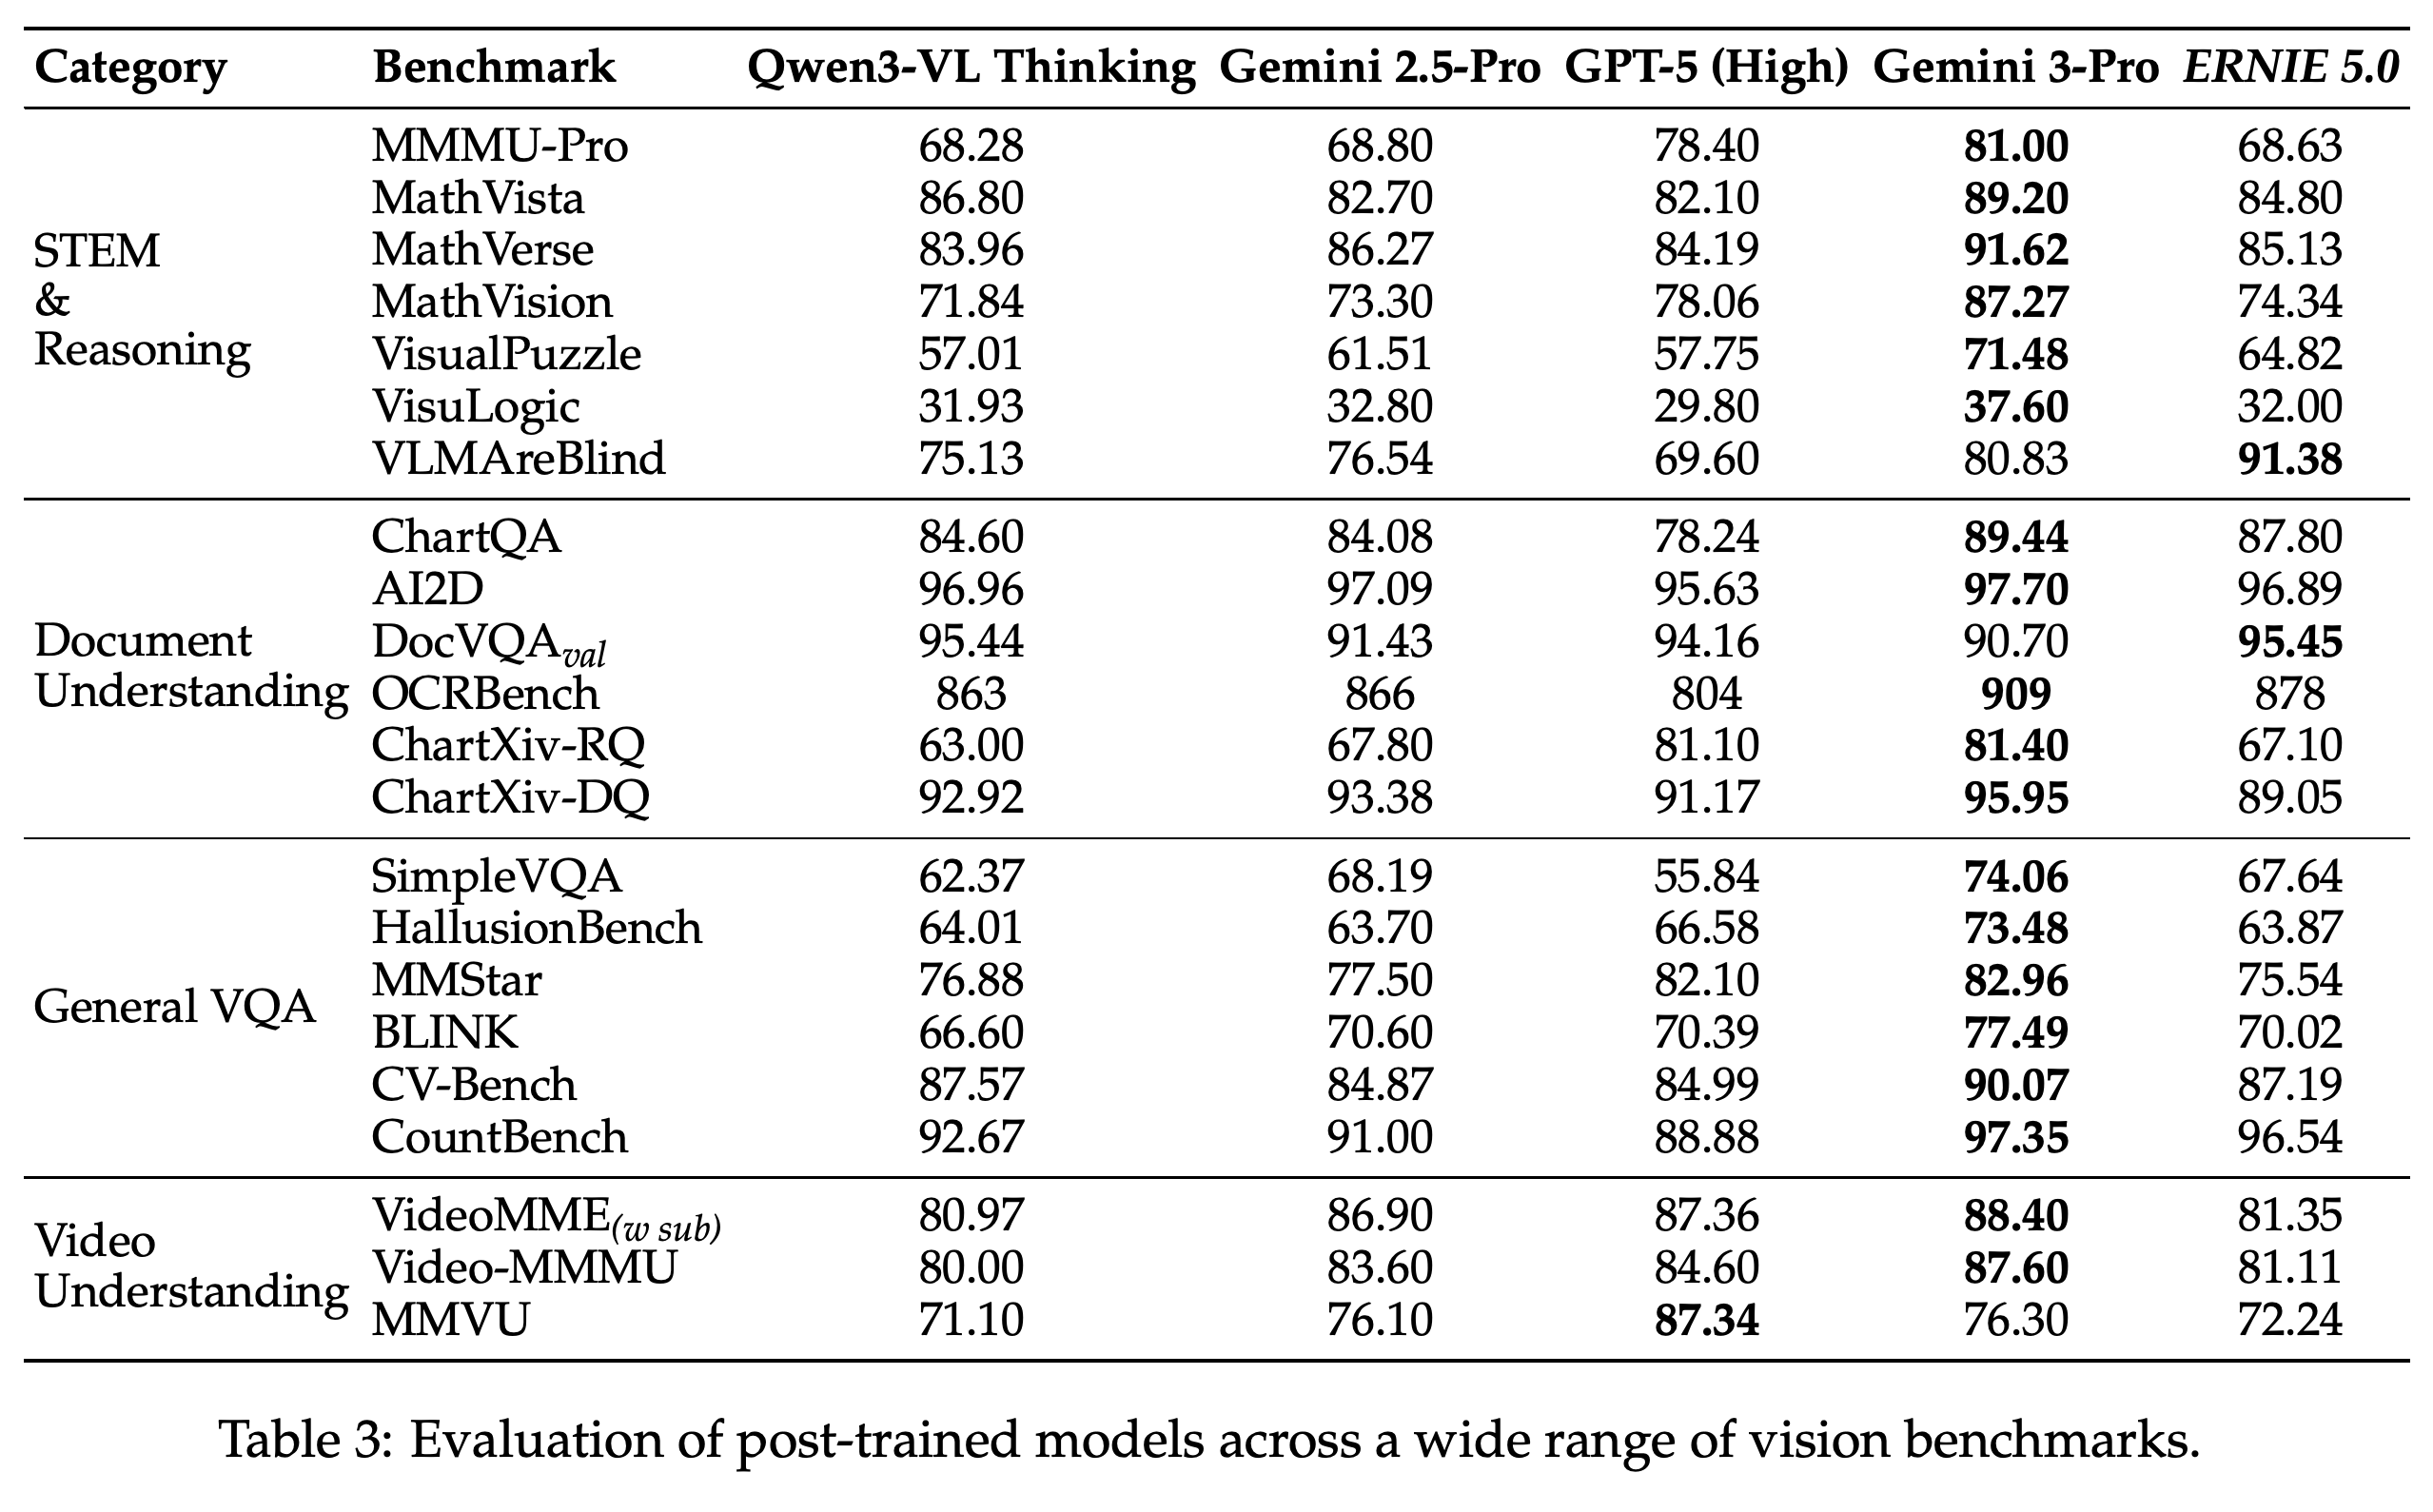
Visual Understanding & Generation Benchmarks는 시각 STEM과 추론, 문서, 일반 VQA, 비디오 이해, 이미지 및 비디오 생성을 다룬다. Evaluation of Visual Understanding의 Table 3에서는 VLMAreBlind (91.38)와 DocVQAval (95.45)에서 강점을 보인다. 그러나 MMMU-Pro에서는 ERNIE 5.0이 68.63으로 Gemini 3-Pro의 81.00보다 낮고, VideoMME(w sub)에서도 81.35로 88.40보다 낮다.
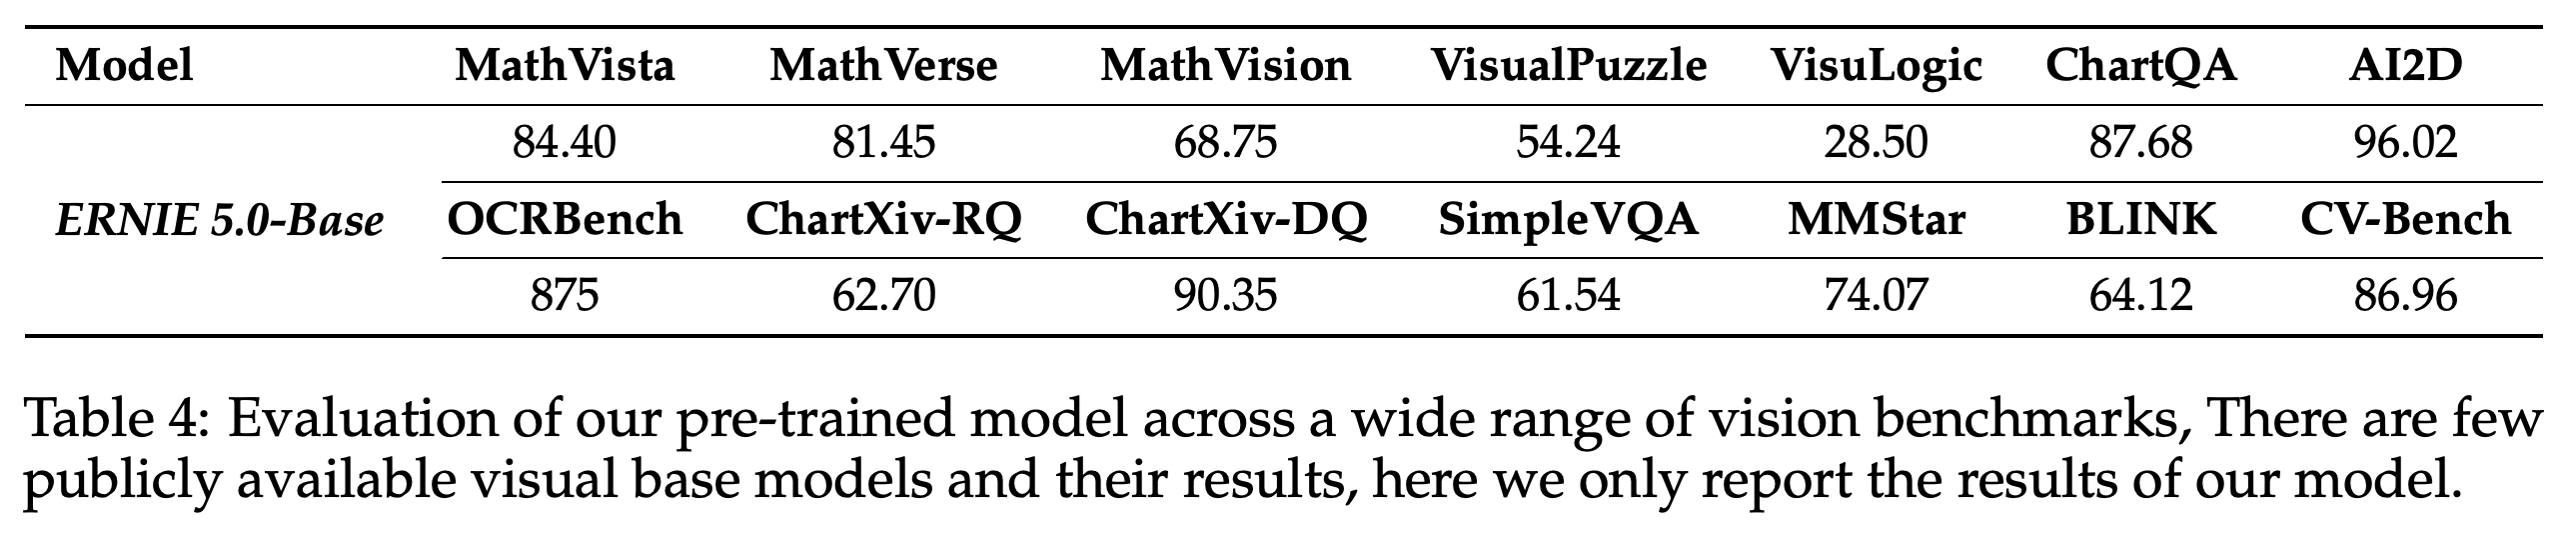
- Table 4는 비교 가능한 공개 시각 기반 모델 결과가 드물어 ERNIE 5.0-Base만 보고한다. MathVista 84.40, ChartQA 87.68, OCRBench 875를 기록한다. 사후 학습은 여러 과제를 개선하지만 모든 과제를 개선하지는 않으며, ChartXiv-DQ는 90.35에서 89.05로 하락한다.
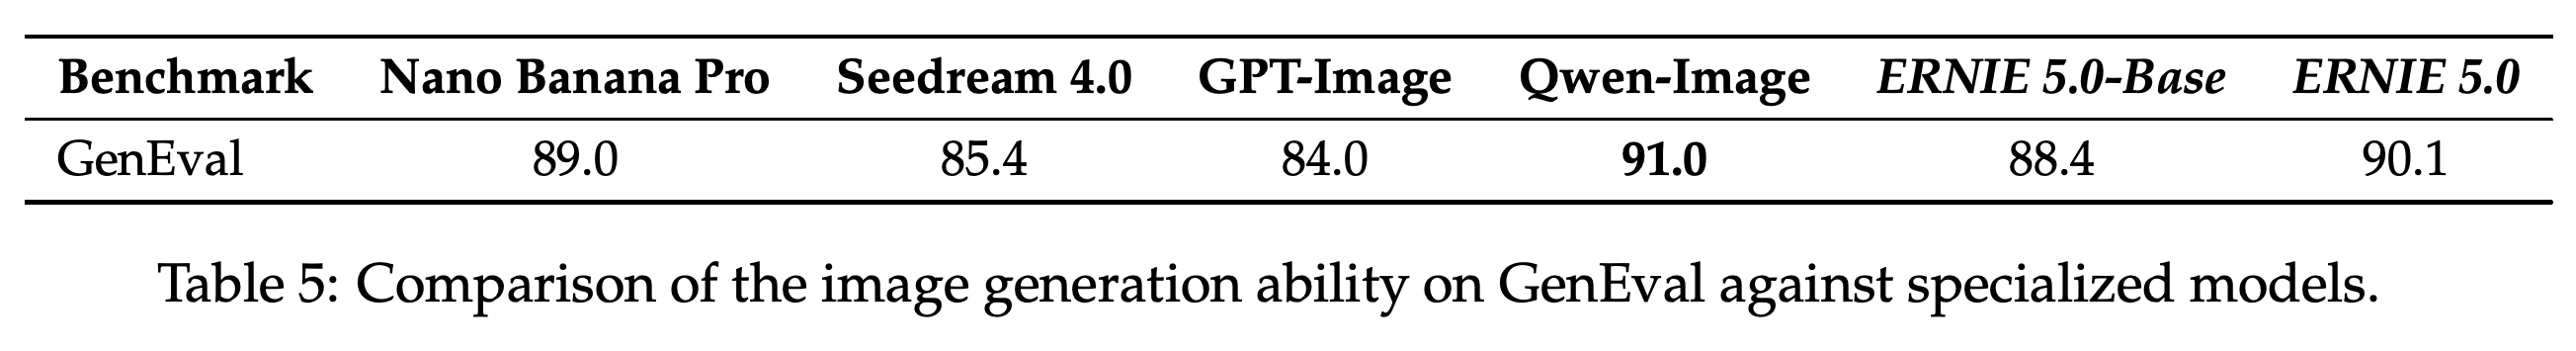
- Evaluation of Visual Generation의 Table 5에서는 GenEval이 기반 모델의 88.4에서 사후 학습 후 90.1로 오른다. 비교 모델인 Qwen-Image는 91.0, Nano Banana Pro는 89.0을 기록한다.
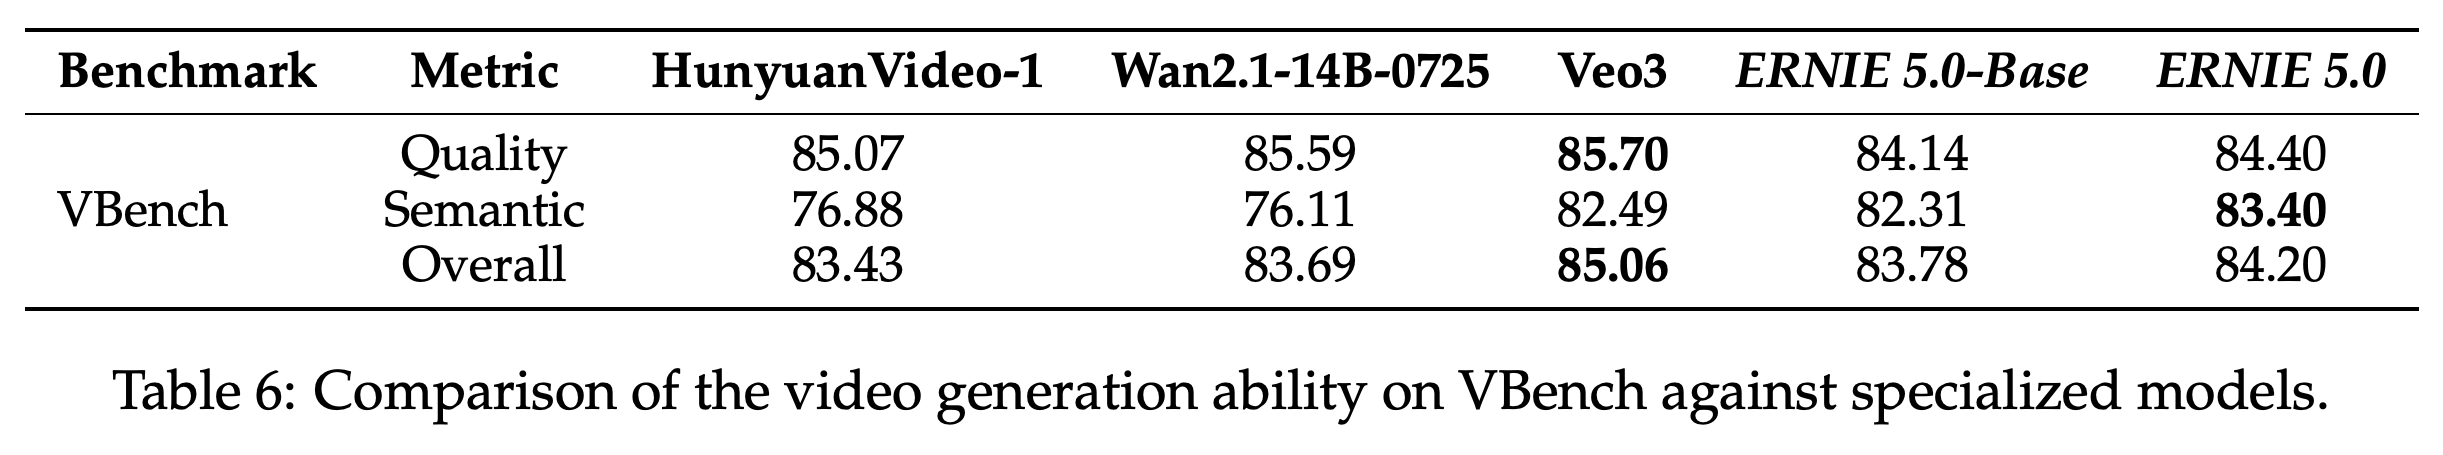
- Table 6의 VBench 점수는 Quality 84.40, Semantic 83.40, Overall 84.20이다. ERNIE 5.0은 표에 제시된 모델 중 Semantic에서 앞서고, Veo3는 Quality (85.70)와 Overall (85.06)에서 앞선다. 이 결과가 모든 미적 품질이나 시간적 품질 차원에서의 우위를 입증하지는 않는다.
VLMAreBlind와 DocVQAval은 ERNIE 5.0이 두드러진 성능을 보이는 항목이다. 반면 MMMU-Pro와 여러 비디오 이해 벤치마크에서는 더 강한 비교 모델과 격차가 있다. 이 결과가 시각 추론 전반의 선두를 입증하지는 않는다.
기반 모델은 지시 튜닝 전에도 시각 이해를 수행한다. 표에는 ERNIE 5.0-Base만 있으므로, 다른 시각 기반 모델 아키텍처보다 우수하다는 근거로 사용할 수는 없다.
사후 학습 후 GenEval은 88.4에서 90.1로 개선되어 ERNIE 5.0이 Nano Banana Pro의 89.0보다 높지만, Qwen-Image의 91.0보다 낮다. 이 비교는 포괄적인 미적 품질이 아니라 객체 중심의 텍스트·이미지 정렬을 평가한다.
ERNIE 5.0은 표에 제시된 최고 Semantic 점수인 83.40을 기록하고, Veo3는 Quality와 Overall에서 앞선다. 따라서 의미 정렬은 상대적인 강점이지만, 모든 차원에서 비디오 품질이 우수하다는 뜻은 아니다.
6.3 Evaluation on Audio Benchmarks
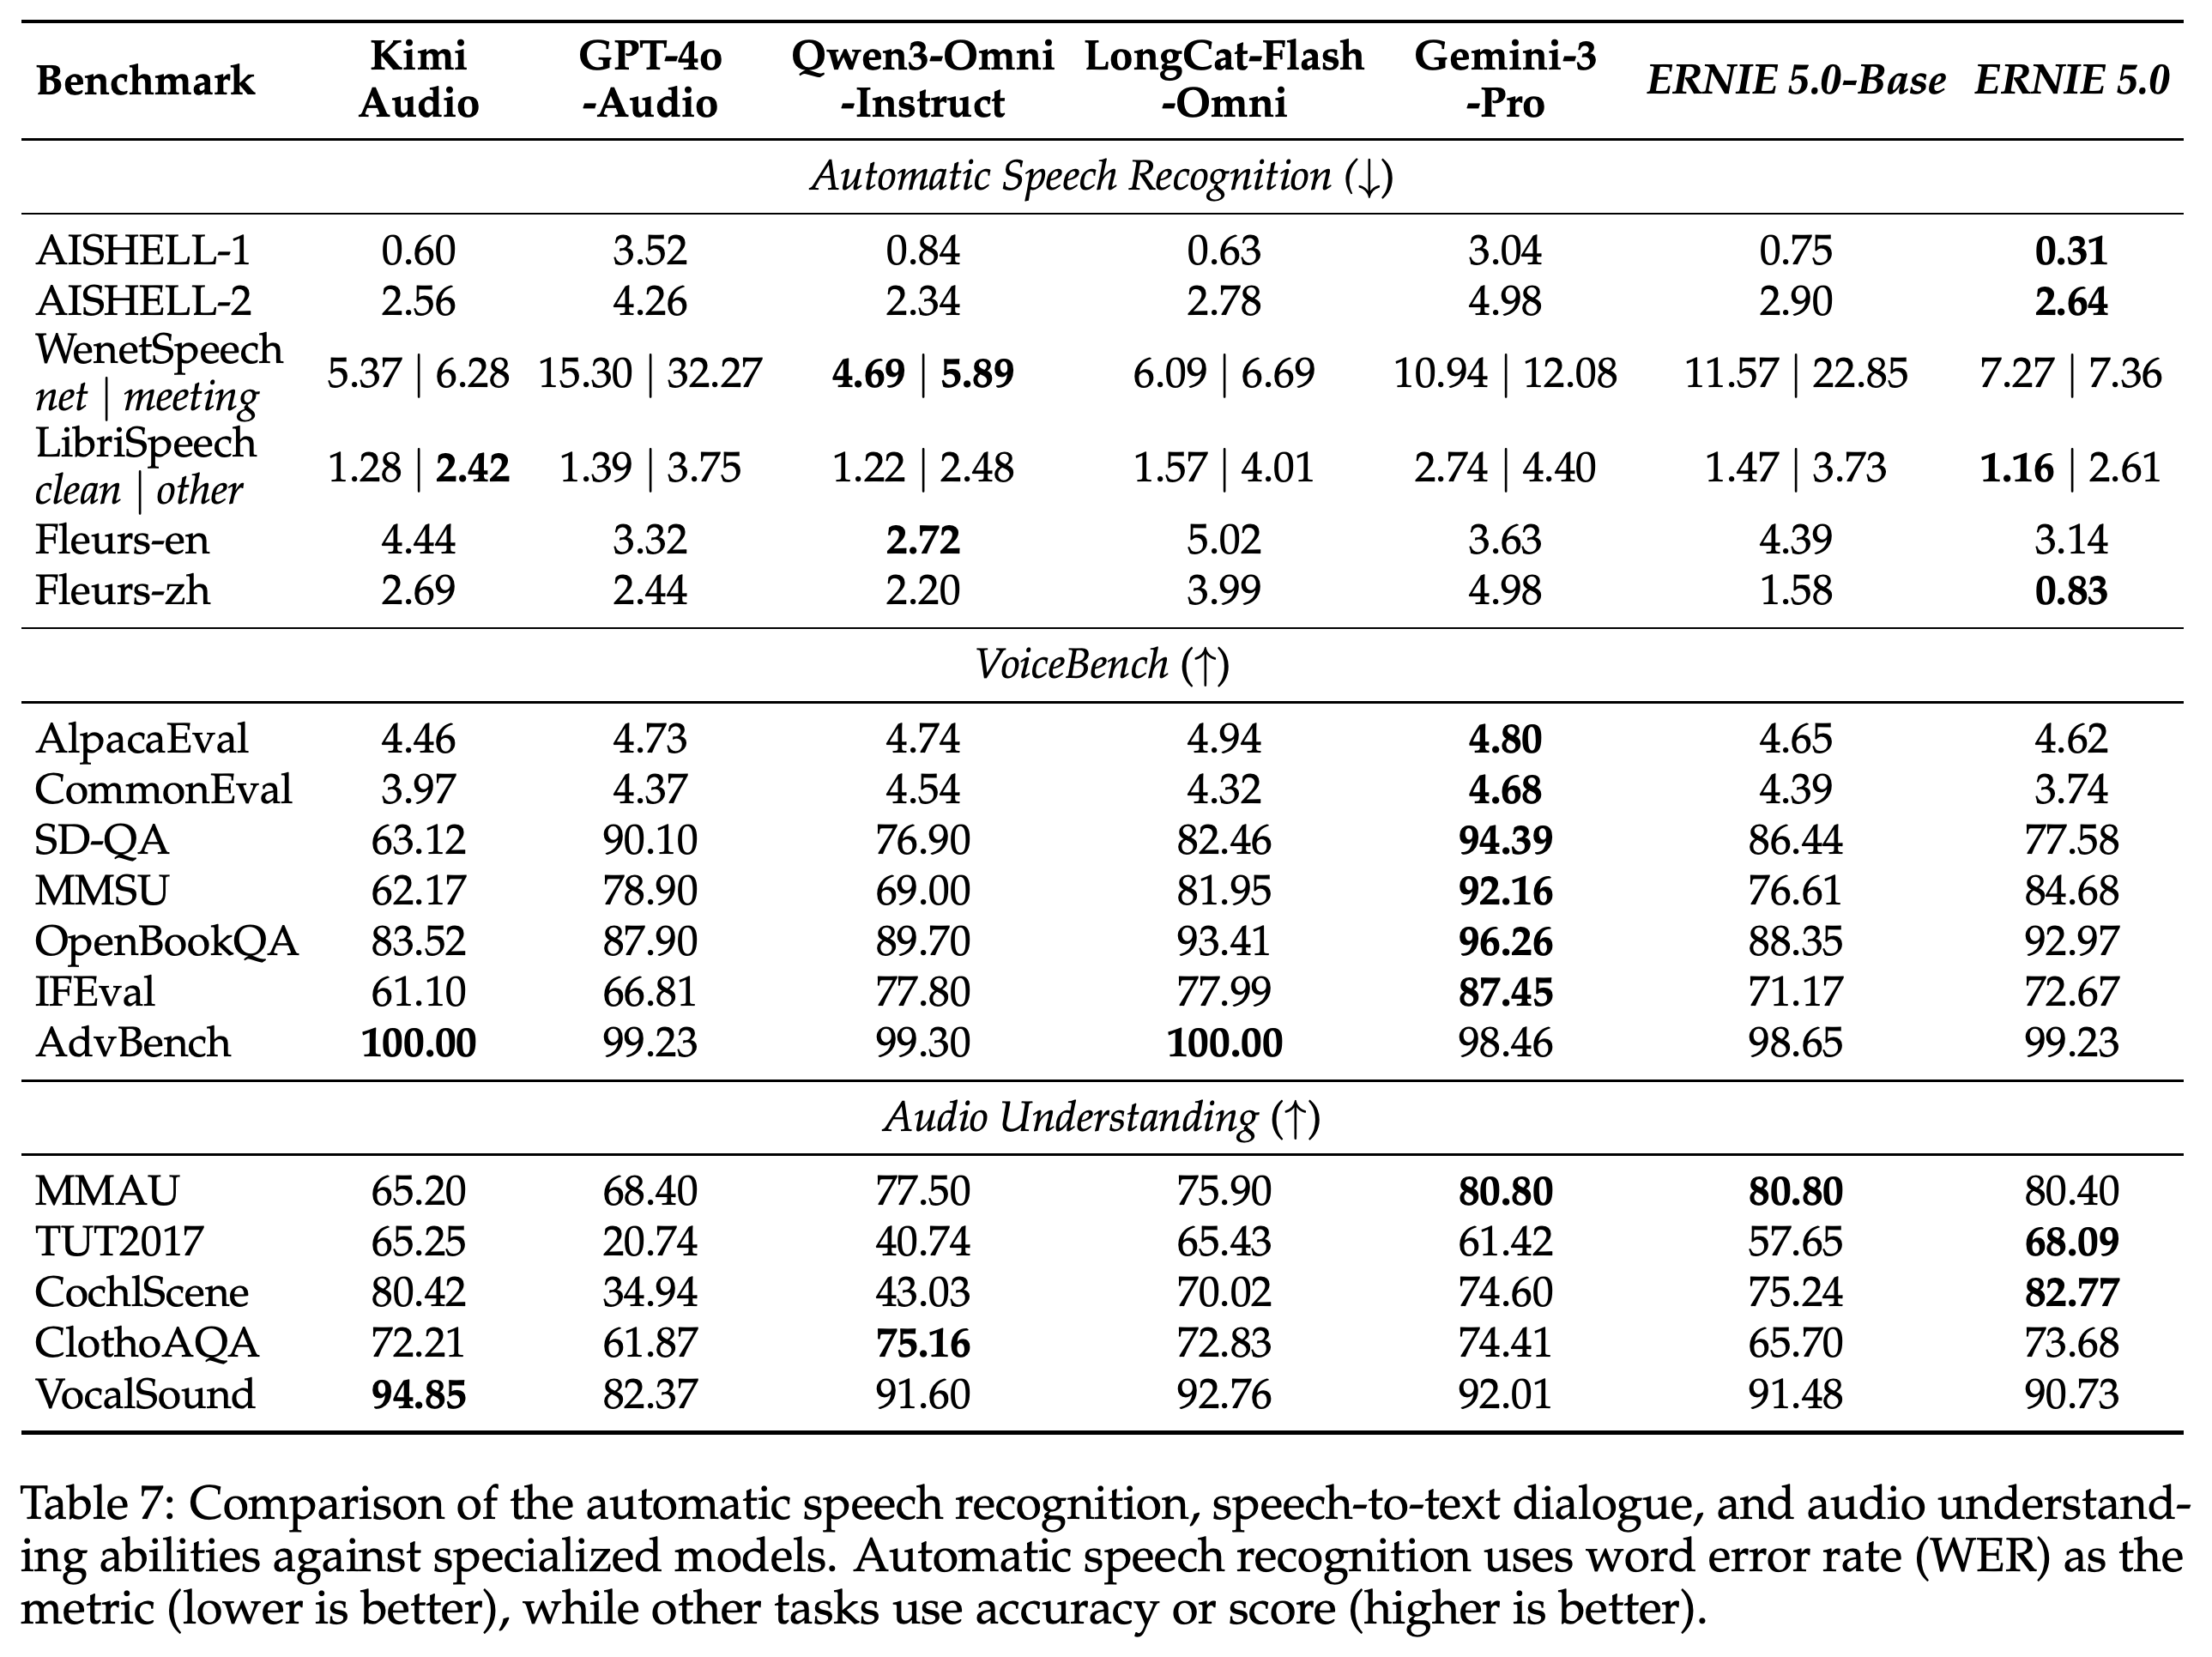
Audio Understanding & Generation Benchmarks는 ASR, VoiceBench 음성 기반 상호작용, 일반 오디오 이해, SEED-TTS 음성 생성을 다룬다. Evaluation of Audio Understanding의 Table 7에서는 ASR WER이 AISHELL-1에서 0.31, LibriSpeech clean에서 1.16, Fleurs-zh에서 0.83이다. TUT2017 (68.09)과 CochlScene (82.77)에서는 표에 제시된 최고 점수를 기록한다.
- 성능은 고르지 않다. WenetSpeech에서는 Qwen3-Omni-Instruct가 더 강하며, ERNIE 5.0의 VoiceBench CommonEval과 SD-QA 점수는 기반 모델의 4.39와 86.44에서 3.74와 77.58로 하락한다. MMAU도 80.80에서 80.40으로 낮아진다.
- Evaluation of Audio Generation의 Table 8에서 SEED-TTS test-zh | test-en WER은 사후 학습 후 1.35 | 1.54이며, 기반 모델은 3.41 | 2.44다.
- CosyVoice 3는 0.71 | 1.45, Qwen3-Omni는 1.07 | 1.39를 기록한다. SEED-TTS WER은 내용 일관성을 측정하며, 음성의 자연스러움, 운율 품질, 화자 유사성을 측정하지 않는다.
ERNIE는 일부 ASR과 음향 장면 항목에서 앞서지만, 여러 VoiceBench 점수는 사후 학습 후 낮아진다. 지표의 방향을 구분해 해석해야 한다. ASR WER은 낮을수록 좋고, 대화 및 이해 점수는 높을수록 좋다.
6.4 Discussion
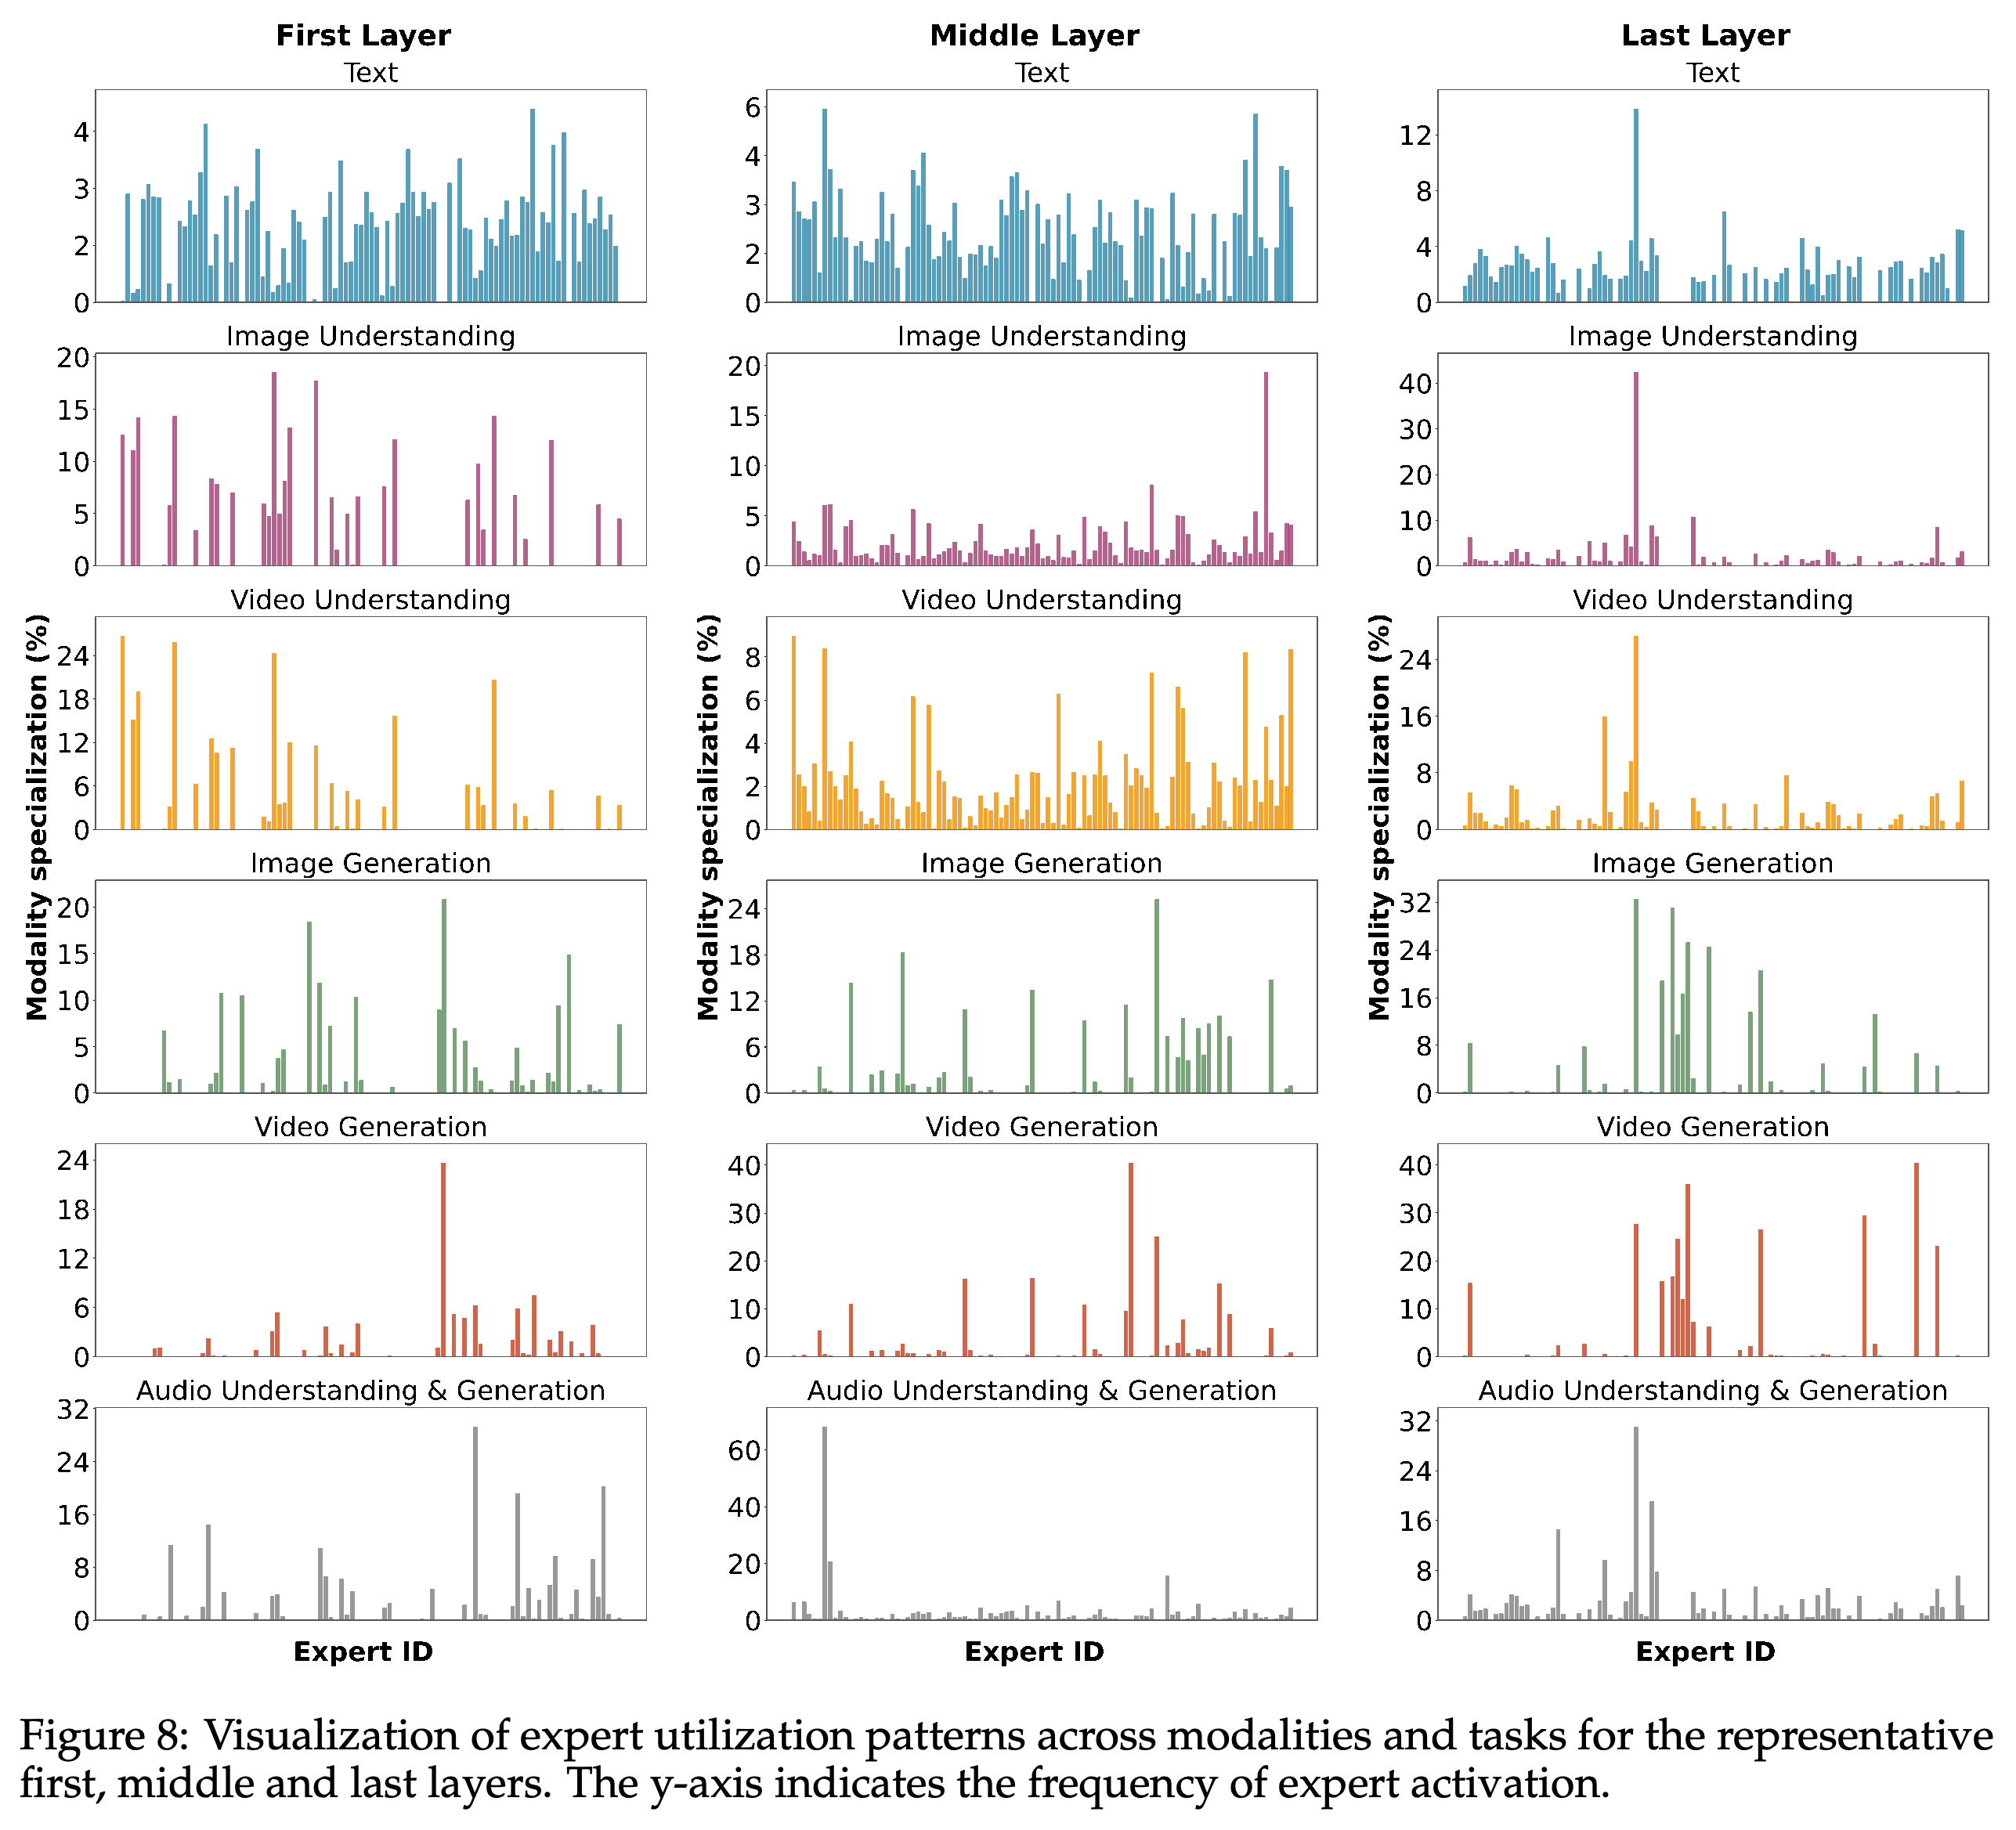
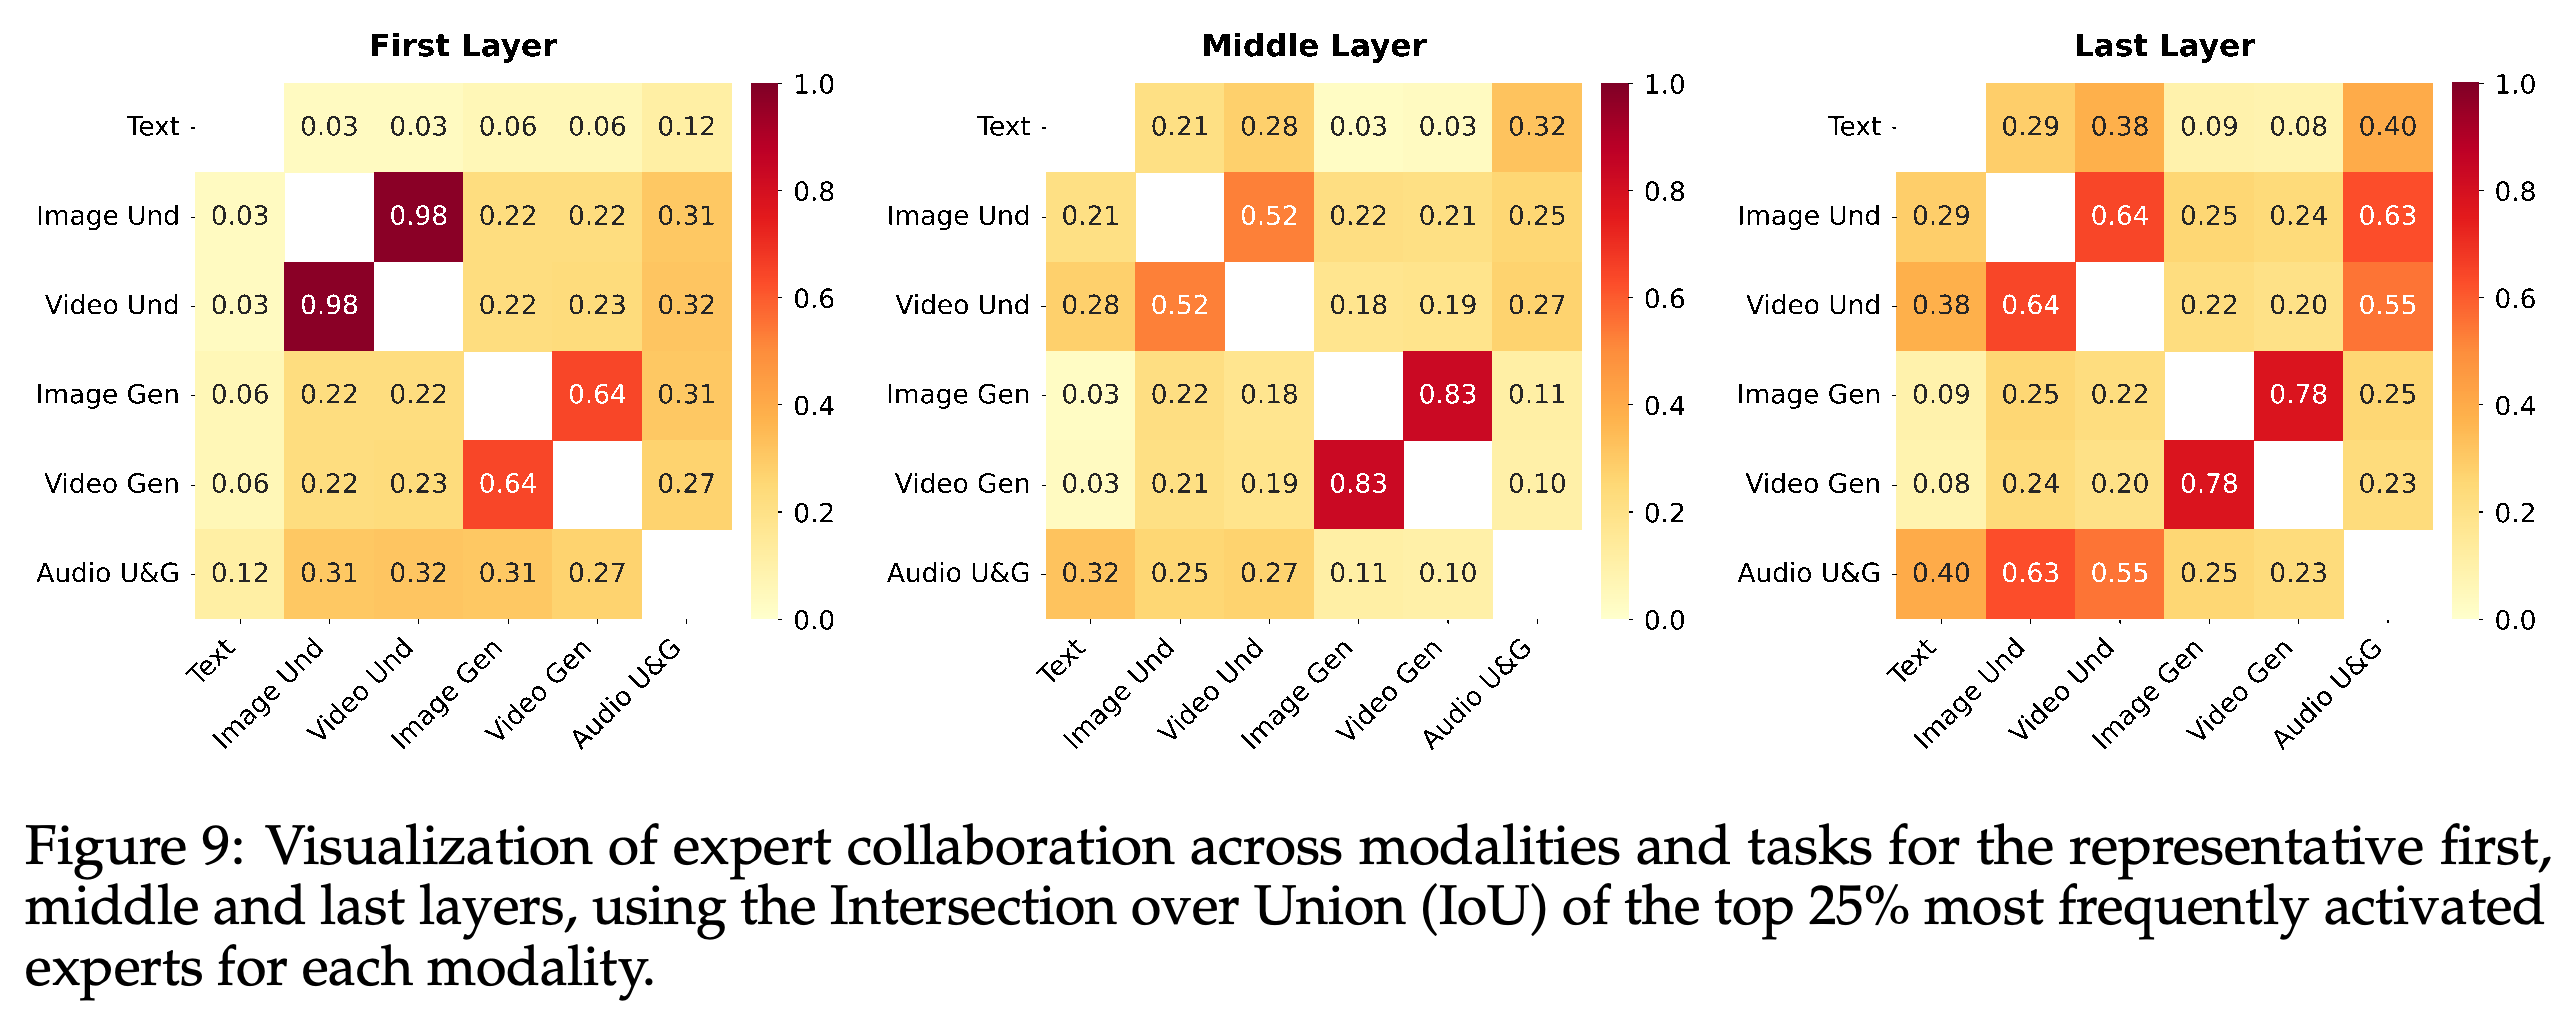
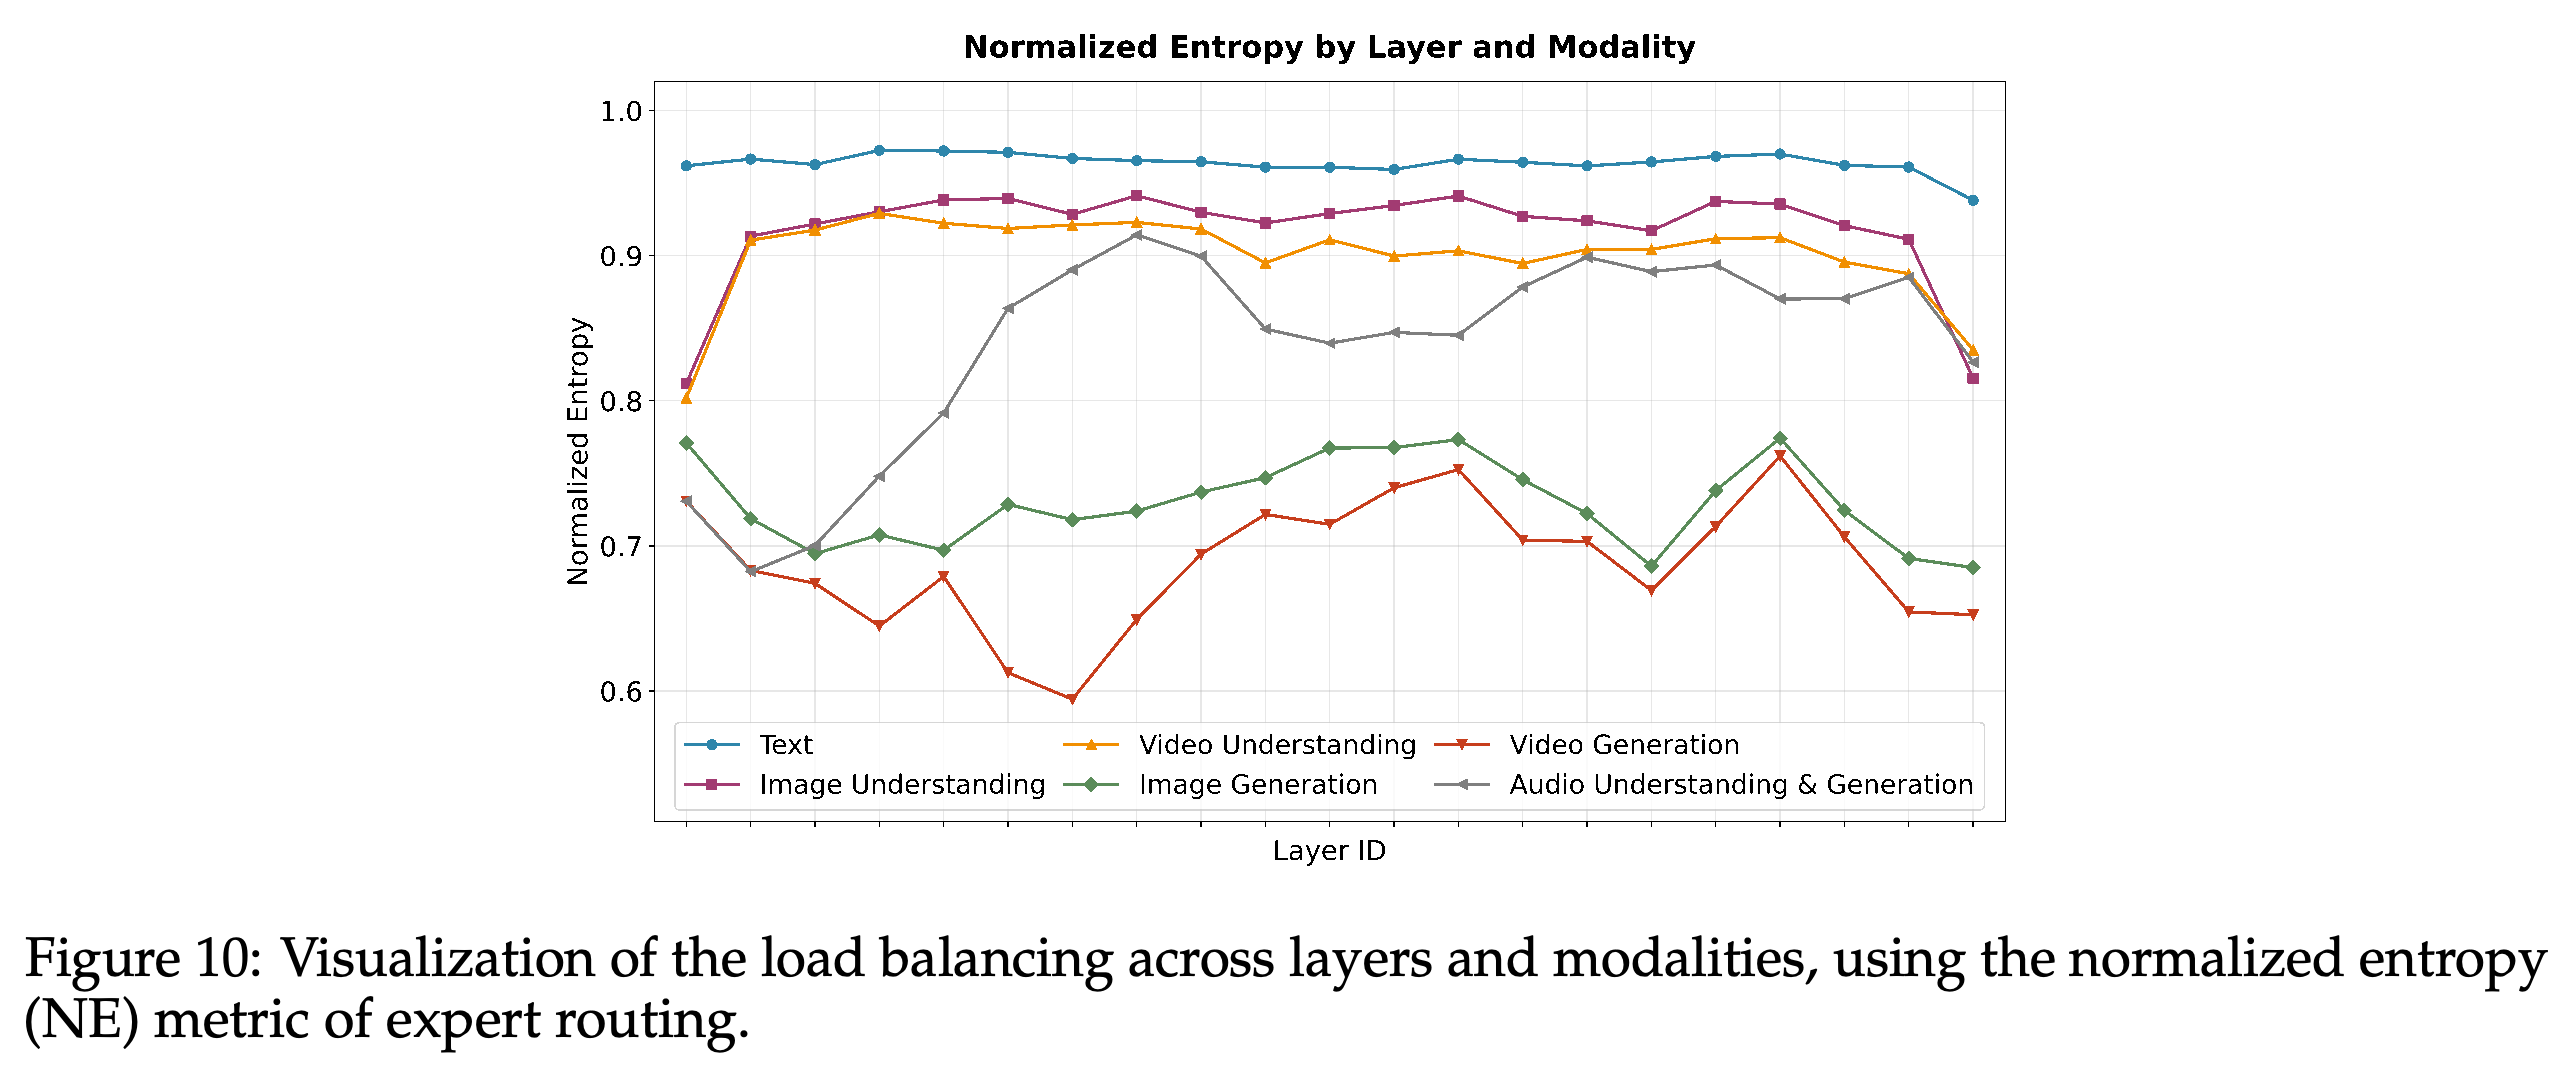
6.4.1 Modality-Agnostic Expert Routing은 명시적인 모달리티별 라우팅 규칙 없이 전문가 활용, 협업, 부하 균형을 분석한다. Figure 8에서는 시각 생성과 오디오 과제의 전문가 활성화가 텍스트보다 집중되어 있다. Figure 9에서는 이미지·비디오 이해 내부와 이미지·비디오 생성 내부의 중첩이 이해와 생성 사이의 중첩보다 더 크다.
- Perspective of Expert Utilization and Specialization에서는 공유 라우팅에서도 전문화가 나타난다. 다만 활성화 빈도는 사용 패턴을 보여줄 뿐, 전문가의 기능을 독립적으로 입증하지는 않는다.
- Perspective of Cross-Modality Expert Collaboration에서는 활성화 빈도 상위 25% 전문가의 텍스트·오디오 간 IoU가 첫 레이어의 0.12에서 마지막 레이어의 0.40으로 증가한다. 이미지·비디오 이해의 중첩은 대표적인 첫 레이어, 중간 레이어, 마지막 레이어에서 각각 0.98, 0.52, 0.64다.
- Perspective of Load Balancing의 Figure 10은 정규화 엔트로피 NE = −Σᵢ₌₁ᴺ pᵢ log(pᵢ) / log N을 사용한다. N은 전문가 수이고 pᵢ는 라우팅 비율이다. 텍스트는 비교적 균일하고, 시각 생성은 더 집중되며, 시각 이해는 중간 레이어에서 더 균형적이다. 이러한 관찰은 모달리티별로 분할한 라우팅 대비 인과적 이점을 분리해 보여주지 않는다.
대표 레이어에서 텍스트 활성화는 더 넓게 분산되고, 시각 생성과 오디오는 더 뚜렷한 정점을 보인다. 따라서 모달리티에 구애받지 않는 라우팅은 균일한 전문가 공유를 요구하지 않고 과제별 집중을 허용한다.
활성화 빈도 상위 25% 전문가 집합의 중첩은 이미지·비디오 이해 내부와 이미지·비디오 생성 내부에서 높지만, 이 과제군 사이에서는 낮다. 텍스트·오디오 중첩은 깊이에 따라 증가한다. 중첩만으로 의미 통합이나 인과적인 성능 이점을 입증할 수는 없다.
텍스트는 깊이 전반에서 높은 라우팅 엔트로피를 유지하고, 시각 생성은 훨씬 더 집중된다. 시각 이해는 중간 레이어에서 비교적 균형적이다. 이는 전체 부하 균형이 과제별 차이를 가릴 수 있는 이유를 보여준다.
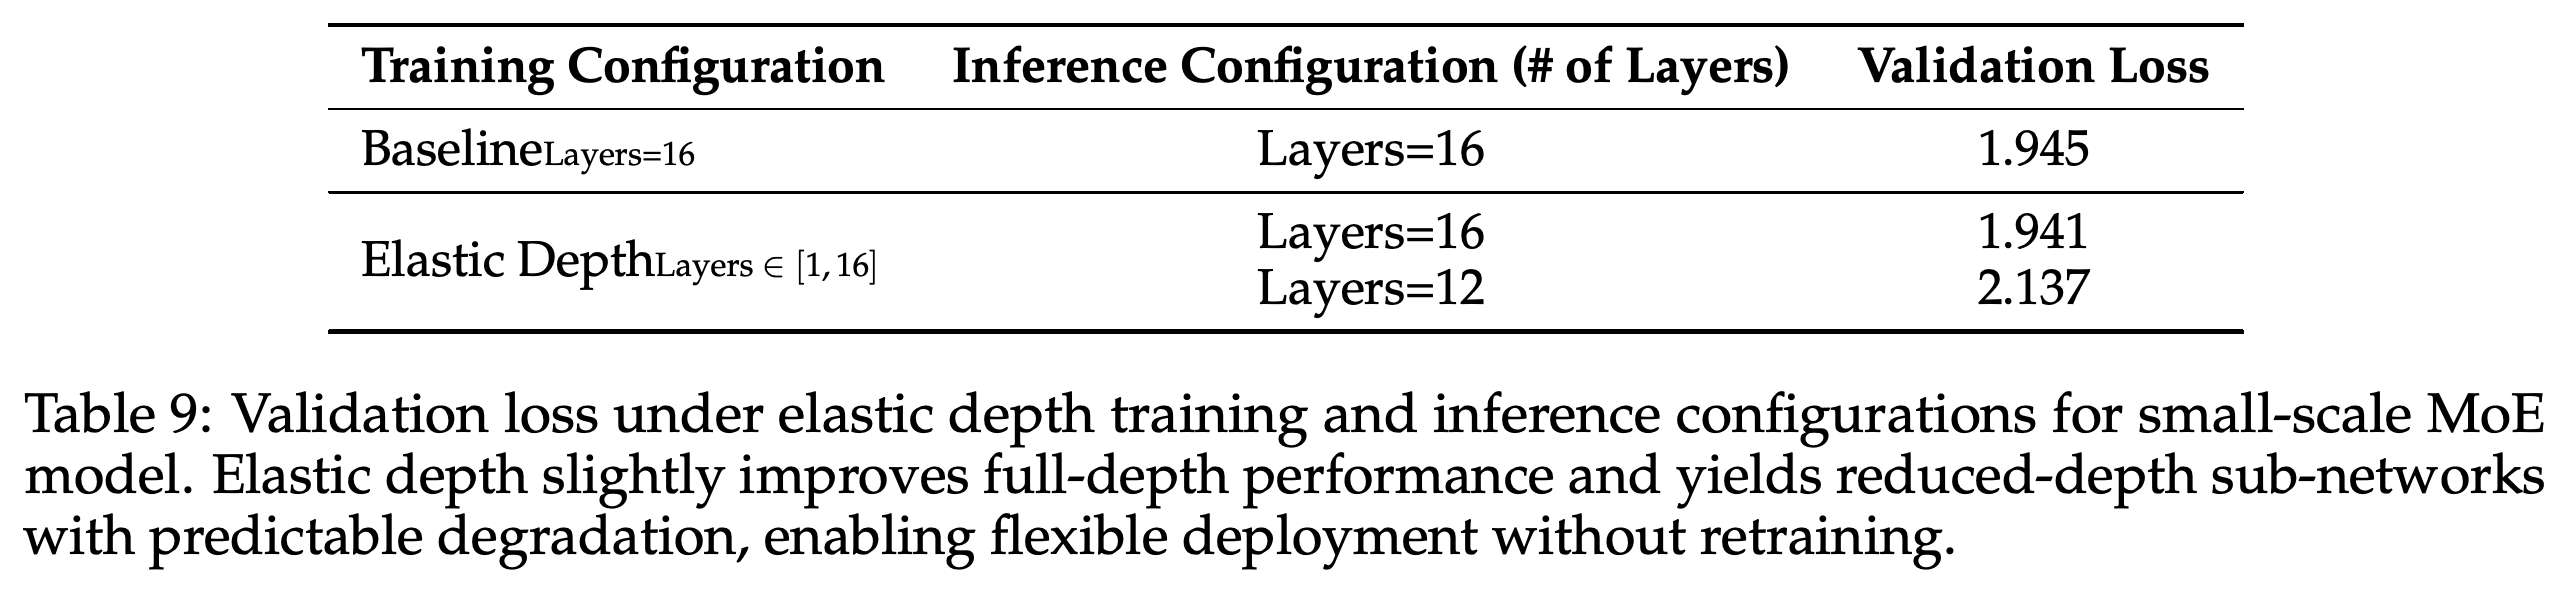
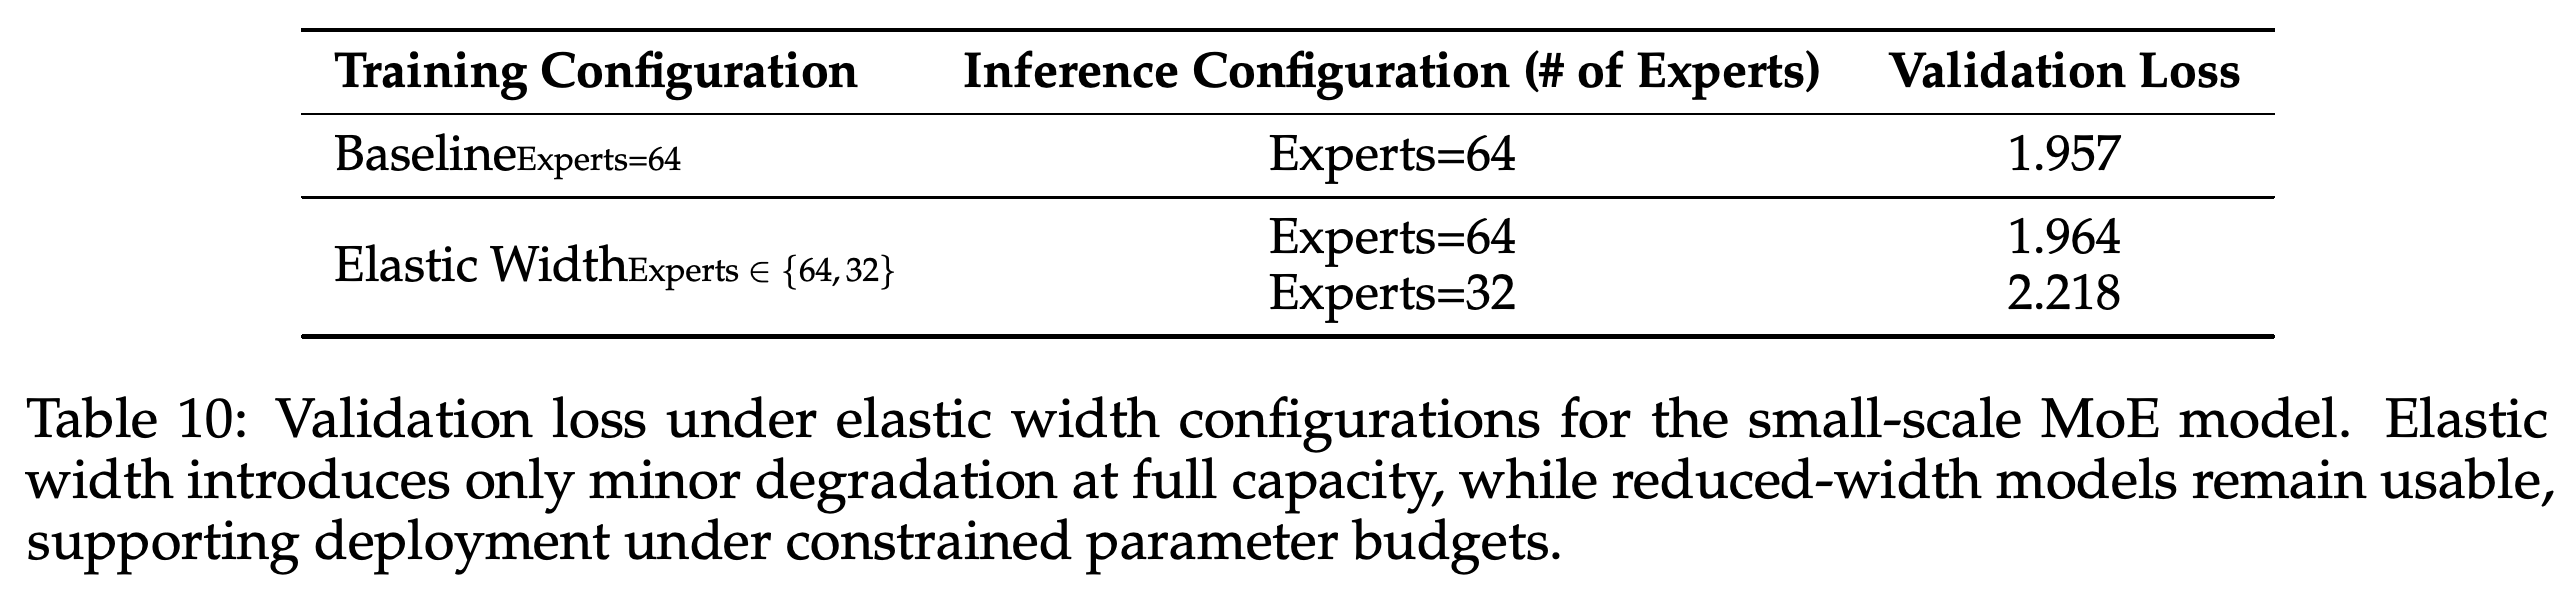
6.4.2 Elastic Training: Controlled-Scale Experiments는 전문가 64개, 활성화 파라미터 454M, 전체 파라미터 3.2B, 기본 top-k = 8인 MoE를 250B 토큰으로 학습한다. Tables 9–11은 학습에 사용하지 않은 검증 데이터의 손실을 사용해 깊이, 너비, 희소성의 탄력성을 각각 시험한다.
- Table 9에서 16-layer 기준 모델의 손실은 1.945다. Elastic Depth의 손실은 16개 레이어에서 1.941, 12개 레이어에서 2.137이다. 통제 실험은 전체 깊이 80% / 축소 깊이 20% 혼합을 명시한다. 구성이 일관된다고 설명하지만, Section 3.3의 75% / 25% 학습 설정과 다르다.
- Table 10에서 64-expert 기준 모델의 손실은 1.957이다. Elastic Width는 전문가 64개에서 1.964, 전문가 32개에서 2.218을 기록한다.
- Table 11에서 기준 모델의 top-k = 8 손실은 1.945다. Elastic Sparsity는 top-k = 8, 4, 2, 1에서 각각 1.969, 1.971, 2.003, 2.175를 기록한다. 이 표들은 축소 비용을 정량화하지만, 축소한 탄력적 구성을 같은 정도로 축소한 비탄력적 체크포인트와 비교하지 않는다.
Elastic Depth는 전체 깊이 손실을 기준 모델의 1.945에서 1.941로 바꾸지만, 12개 레이어를 사용하면 손실이 2.137로 오른다. 깊이를 줄인 구성에는 측정 가능한 손실 증가가 있다. 전체 깊이에서의 작은 개선에는 불확실성 추정치가 제시되지 않는다.
전문가 64개를 모두 사용하는 탄력적 구성의 손실은 1.964로 기준 모델의 1.957에 가깝지만, 전문가 32개로 제한하면 2.218로 오른다. 이는 저장된 전문가 풀을 줄일 때의 용량 비용을 측정한다.
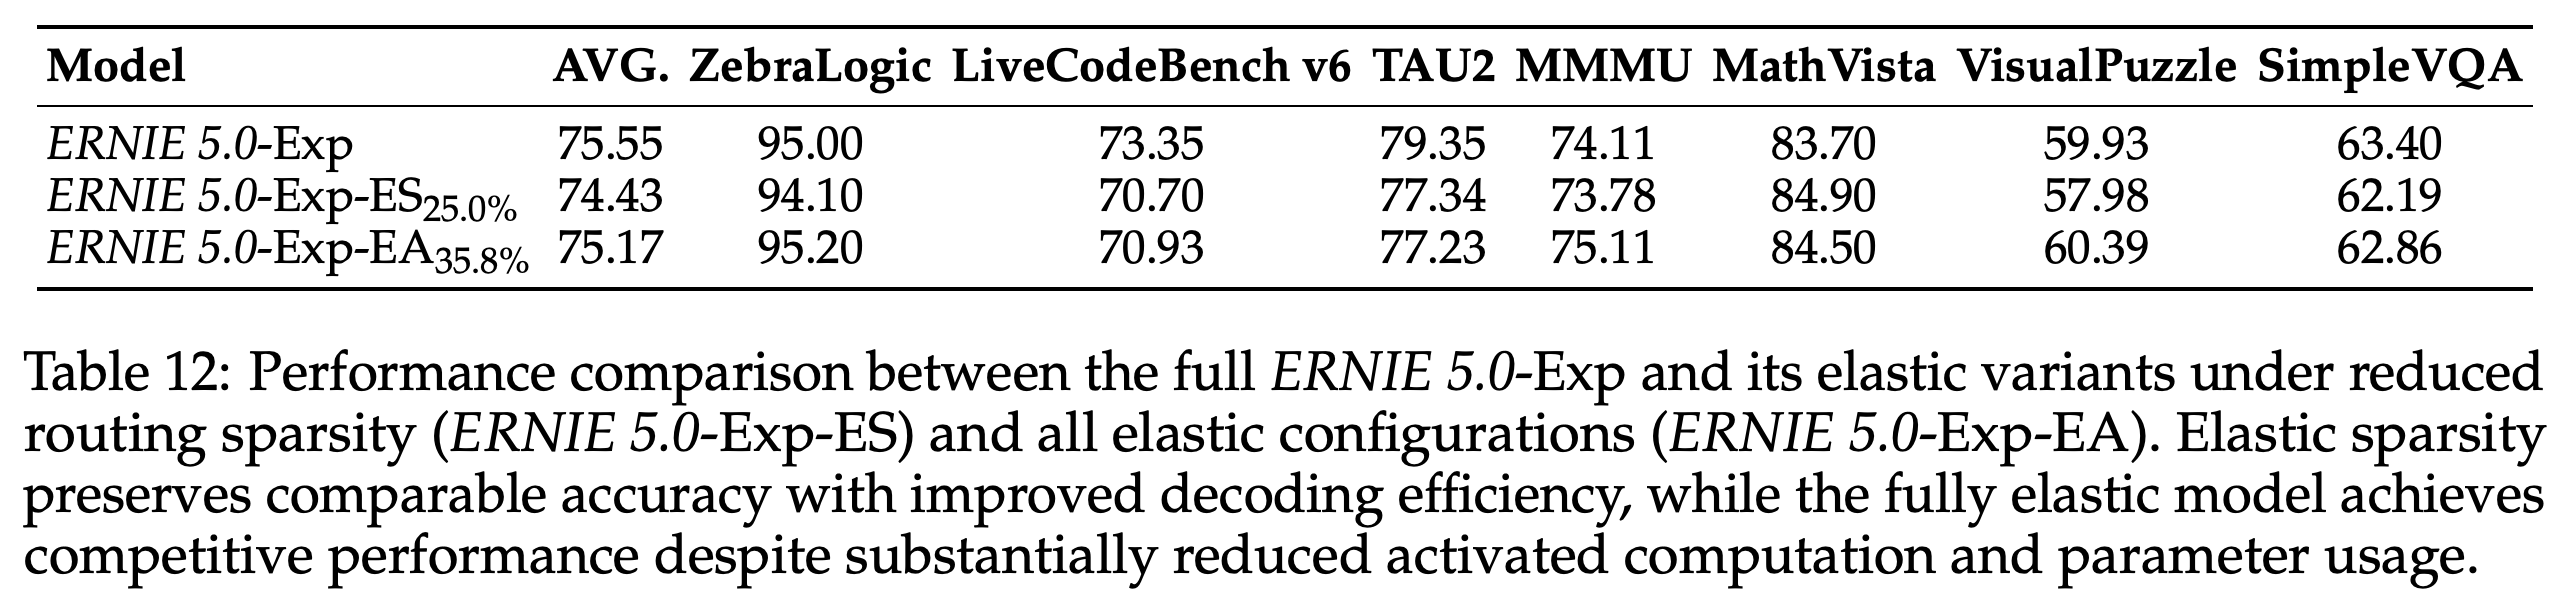
Scaling to ERNIE 5.0은 주요 벤치마크 모델이 아니라 실험용 ERNIE 5.0-Exp 모델군을 평가한다. Table 12에서 ERNIE 5.0-Exp의 평균은 75.55이고, ERNIE 5.0-Exp-ES25.0%는 74.43이다. 후자는 라우팅 top-k를 25%로 줄인 모델이며, 디코딩 속도가 15% 넘게 개선된다고 보고한다.
- ERNIE 5.0-Exp-EA35.8%는 활성화 파라미터의 53.7%와 전체 파라미터의 35.8%를 사용한다. 7개 벤치마크 평균은 75.17이다. ZebraLogic과 VisualPuzzle은 각각 95.20과 60.39로, 전체 실험 모델의 95.00과 59.93보다 높다.
- 여러 탄력성 설정을 함께 적용한 소형 모델은 ERNIE 5.0-Exp-Base에서 추출한 뒤, 전체 모델과 동일한 데이터 및 전략으로 중간 학습과 사후 학습을 거친다. 따라서 추가 학습 없이 추론 시점에만 축소한 결과가 아니다.
- 대규모 비교는 일부 텍스트 및 시각 이해 과제를 다루며, 오디오나 이미지·비디오 생성은 다루지 않는다. 디코딩 속도 주장에는 하드웨어와 작업 부하별 세부 결과가 없다.
여러 탄력성 설정을 함께 적용한 변형 모델은 전체 실험 모델의 7개 과제 평균에 거의 근접하지만, 추론 시점에만 희소성을 바꾼 모델은 정확도가 더 많이 하락한다. 소형 모델은 중간 학습과 사후 학습도 거치므로, 각 행은 추론 구성뿐 아니라 적응 절차도 다르다.
7 Conclusion
결론은 처음부터 공동 학습한 멀티모달 자기회귀 모델링, 공유 초희소 라우팅, 탄력적 사전 학습, 확장 가능한 RL을 핵심 기여로 제시한다. 결과는 폭넓은 멀티모달 능력과 배포 절충 관계를 보여준다. 다만 최초의 통합 1조 규모 구현이라는 표현은 독립적으로 입증된 사실이 아니라 저자들이 단서를 붙여 제시한 우선권 주장이다.
8 Contributors
보고서의 저자는 ERNIE Team, Baidu이며, 27–28페이지에 Haifeng Wang, Hua Wu, Tian Wu, Yu Sun, Jing Liu, Dianhai Yu, Yanjun Ma를 시작으로 개별 기여자를 나열한다. 목록은 개인별 기술적 역할을 배정하거나 추가 소속 기관을 제시하지 않는다.
부록
- 제공된 36페이지 PDF에는 별도 부록이 없다. 기여자 목록 뒤의 29–36페이지는 References이며, 추가 부록 실험이나 구현 세부 사항은 없다.
짧은 생각
Elastic training의 근거는 특히 구체적이다. 통제된 검증 손실 측정과 대규모 실험 비교가 레이어, 전문가 용량, 라우팅 top-k를 줄이는 비용을 보여준다. 통합 아키텍처도 기술적으로 실질적인 내용을 담고 있다. 다만 모달리티 간 간섭을 피하고 공유 라우팅으로 능력을 개선한다는 이점은 조건을 맞춘 아키텍처 대조군으로 분리해 검증하지 않는다. “Unified”는 공유 자기회귀 백본과 예측 프레임워크를 가장 직접적으로 가리키며, 전체 시스템에서 모달리티별 인터페이스나 diffusion을 제거했다는 뜻은 아니다. 표는 사실 QA, 다중 지시 이행, 일부 지각 과제, VBench 의미 정렬에서 강점을 뒷받침한다. 반면 어려운 추론, 여러 VoiceBench 과제, 일부 비디오 이해 평가에서는 여전히 약점을 보인다. 실제 서비스용 아키텍처, 코퍼스 혼합 비율, 총 학습 연산량이 공개되지 않았고, 평가 절차가 불완전하며, 여러 RL 및 시스템 기법의 개별 ablation이 없어 재현성에 한계가 있다.