Linformer(Self-Attention with Linear Complexity) 요약 설명
18 Aug 2022 | Paper Review Attention Mechanisms목차
- 요약
- Introduction
- Backgrounds and Related works
- Self-Attention is Low Rank
- Model
- Experiments
- Conclusion
- 부록
- 짧은 생각
Linformer: Self-Attention with Linear Complexity는 key와 value를 시퀀스 축으로 압축하여 self-attention의 계산량과 메모리 사용량을 줄이는 논문입니다.
- 공개: 2020년 6월, arXiv preprint. 아래 설명은 v3를 기준으로 합니다.
- 저자: Sinong Wang, Belinda Z. Li, Madian Khabsa, Han Fang, Hao Ma
- 소속: Facebook AI, Seattle
- 논문 정보, 원문 PDF
- 비공식 PyTorch 구현
요약
- 일반적인 self-attention은 길이 $n$인 입력에서 $n\times n$ attention 행렬을 계산합니다. Linformer는 key와 value의 길이를 $k$로 줄이고 $n\times k$ attention을 계산합니다.
- 시퀀스 길이 축을 압축하므로 한 head에서 key/value의 크기는 $n\times d$에서 $k\times d$로 바뀝니다. 각 토큰의 feature 차원 $d$와 최종 출력 크기 $n\times d$는 유지합니다.
- 논문은 사전 학습한 RoBERTa의 attention에 특이값이 집중되는 현상을 관찰하고, 낮은 rank를 이용한 attention 출력 근사를 이론적으로 분석합니다. 이를 매번 SVD로 구현하지 않고 학습 가능한 선형 투영으로 계산합니다.
- 동일한 corpus와 학습 update 수를 사용한 비교에서, $n=512$, $k=256$이고 모든 층이 투영을 공유하는 Linformer는 네 가지 자연어 이해 과제의 평균 개발 세트 점수 92.30을 기록했습니다. 비교한 RoBERTa-base는 92.25였습니다.
- 투영 길이 $k$를 고정하면 attention의 시간·공간 복잡도는 입력 길이 $n$에 대해 선형으로 증가합니다. V100 GPU에서 무작위 입력으로 측정한 $n=4096$, $k=256$ 설정은 기본 Transformer보다 추론 속도가 3.2배 빨랐고, 메모리에 들어가는 최대 batch size는 13배였습니다.
Introduction
Transformer의 self-attention은 멀리 떨어진 토큰 사이의 관계를 직접 계산할 수 있습니다. 그러나 입력 길이가 두 배가 되면 attention score의 원소 수는 네 배가 됩니다. Linformer는 이 이차적인 증가를 줄여 학습과 추론 양쪽의 비용을 낮추고자 합니다.
Sparse attention은 참조할 위치를 제한하고, Reformer는 hashing으로 비슷한 토큰을 묶습니다. Linformer는 전체 위치의 정보를 짧은 key/value 표현으로 섞은 뒤 모든 query가 이 압축 표현에 attention을 적용합니다. 따라서 원래 위치 사이의 연결을 일부만 남기는 방식과 계산 구조가 다릅니다.
Backgrounds and Related works
Transformer and Self-Attention
입력의 embedding 차원을 $d_m$, head 수를 $h$, 각 head의 차원을 $d$라고 하겠습니다. 입력 $X\in\mathbb{R}^{n\times d_m}$에 대해 한 head의 query, key, value를 다음과 같이 씁니다.
\[Q=XW^Q,\qquad K=XW^K,\qquad V=XW^V\in\mathbb{R}^{n\times d}.\]각 가중치 $W^Q,W^K,W^V$의 크기는 $d_m\times d$이며, 해당 head의 출력은 다음과 같습니다.
\[P=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt d}\right), \qquad H=PV.\]$P\in\mathbb{R}^{n\times n}$의 각 행은 한 query가 모든 key에 배분한 가중치입니다. Softmax는 각 query의 key 축에 적용합니다. $QK^\top$와 $PV$의 계산량은 각각 $O(n^2d)$이며, 명시적으로 저장하는 attention 행렬에는 $O(n^2)$ 공간이 필요합니다. 여러 head의 출력을 이어 붙인 후 출력 투영을 적용하는 부분은 일반적인 multi-head attention과 같습니다.
Related works
Mixed precision과 양자화는 수치 표현의 비용을, knowledge distillation은 모델 크기를 줄입니다. Gradient checkpointing은 중간 활성값을 다시 계산하여 메모리를 절약합니다. 이 방법들은 $n\times n$ attention의 구조 자체를 바꾸지는 않으므로, Linformer의 시퀀스 압축과 함께 사용할 수 있는 별개의 선택입니다.
Self-Attention is Low Rank
논문은 RoBERTa-base와 RoBERTa-large에서 얻은 attention 행렬을 SVD로 분석했습니다. Wiki103과 IMDB의 문장 10,000개를 이용한 분석에서 큰 특이값 일부에 정보가 집중되었고, 특히 상위 층에서 그 경향이 강했습니다. 이는 관찰한 attention이 낮은 rank로 잘 근사될 가능성을 뒷받침합니다.
이때 다음 세 가지를 구분해야 합니다.
- Softmax 이전 행렬 $QK^\top$의 rank는 $d$ 이하입니다. 그러나 원소별 비선형 연산과 정규화가 들어간 $P$의 rank가 자동으로 $d$ 이하가 되는 것은 아닙니다.
- 논문의 첫 번째 정리는 random projection과 Johnson–Lindenstrauss lemma를 이용하여, value의 열벡터에 대한 attention 출력을 낮은 rank의 행렬로 근사할 수 있음을 분석합니다. 고정한 오차 수준에서 제시하는 rank 규모는 $\Theta(\log n)$입니다.
- 정리가 다루는 대상은 attention 출력의 근사 오차입니다. 실제 모델에 사용할 $k$는 학습한 투영으로 얻은 과제 성능을 기준으로 선택합니다.
원래 $P$를 만든 다음 상위 $k$개 특이값만 남길 수도 있지만, 이 방법은 이미 큰 행렬을 계산한 뒤 SVD를 수행해야 합니다. Linformer는 이 계산을 피하려고 key와 value를 먼저 압축합니다.
Model
한 head의 시퀀스 투영을 $E,F\in\mathbb{R}^{k\times n}$으로 정의하면 다음처럼 계산할 수 있습니다. 원문 일부 문장에는 투영 차원이 반대로 적혀 있으나, 아래에서는 원문의 도식과 행렬 곱에 맞춰 $k\times n$ 표기를 사용합니다.
\[\widetilde K=EK\in\mathbb{R}^{k\times d},\qquad \widetilde V=FV\in\mathbb{R}^{k\times d},\] \[\overline P=\operatorname{softmax}\left(\frac{Q\widetilde K^\top}{\sqrt d}\right) \in\mathbb{R}^{n\times k},\qquad H=\overline P\widetilde V\in\mathbb{R}^{n\times d}.\]$E$의 각 행은 원래 $n$개 위치의 key를 하나의 압축 key로 결합하는 가중치입니다. Query는 압축하지 않으므로 입력 위치마다 출력이 하나씩 남습니다. 예를 들어 $n=4096$, $d=64$, $k=256$이면 key/value는 $256\times64$, attention은 $4096\times256$, 출력은 $4096\times64$가 됩니다.
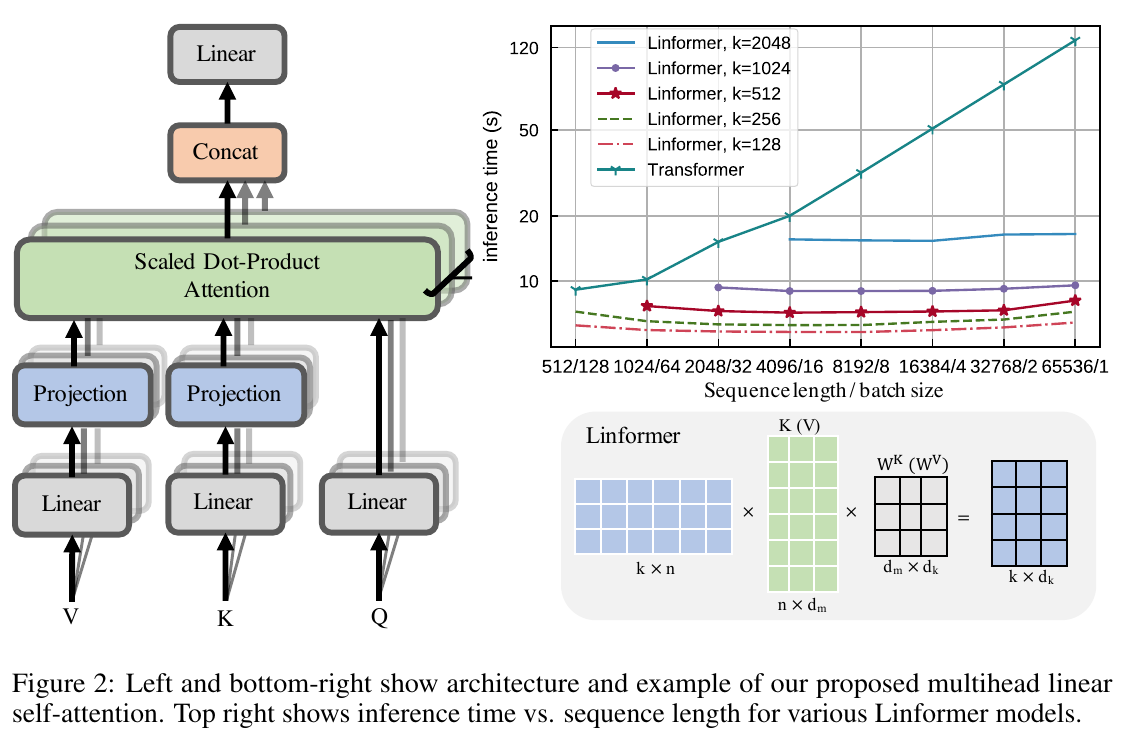
시퀀스 투영, 압축된 attention score, value 가중합의 계산량은 각각 $O(nkd)$ 수준입니다. Attention 행렬의 저장 공간은 $O(nk)$입니다. 따라서 $k$와 head 차원을 고정하면 길이 $n$에 대해 선형으로 증가합니다. 다만 feed-forward network와 feature 투영 비용은 여전히 존재하므로 attention 원소 수의 감소율이 모델 전체 속도 향상률과 같지는 않습니다.
길이 축에 적용하는 투영 행렬은 입력 길이에 맞춰야 하므로, 구현에서는 최대 길이와 짧은 입력의 padding 처리 방식을 정해야 합니다. 또한 $EK,FV$가 전체 시퀀스를 섞으면 미래 토큰의 정보도 압축 표현에 포함될 수 있습니다. 따라서 causal decoder에 적용하려면 이 정보가 이전 위치의 출력에 전달되지 않도록 별도의 제약이 필요합니다. 원문의 성능 실험은 양방향 MLM과 자연어 이해 과제를 다룹니다.
논문의 두 번째 정리는 선형 투영을 이용한 출력 근사를 분석하고, head 차원과 오차에 의존하면서 시퀀스 길이에 의존하지 않는 투영 크기를 선택할 가능성을 제시합니다. 실제 학습에서는 이론의 random projection을 그대로 고정하는 대신 학습 가능한 투영을 사용하며, 적절한 $k$는 실험으로 선택합니다.
Additional Efficiency Techniques
투영은 head와 층 사이에서 공유할 수 있습니다.
| 공유 방식 | 공유하는 범위 | 12층 모델의 서로 다른 투영 행렬 수 |
|---|---|---|
| Headwise sharing | 한 층의 모든 head가 $E,F$를 각각 공유합니다. | 24 |
| Key-value sharing | 한 층에서 모든 head와 key/value가 하나의 행렬을 공유합니다. | 12 |
| Layerwise sharing | 모든 층, head, key/value가 하나의 행렬을 공유합니다. | 1 |
논문은 상위 층에 더 작은 $k$를 배정하는 방법과 pooling 또는 convolution을 이용하는 압축도 논의합니다. 핵심 비교 실험에서는 학습한 선형 투영과 위 공유 방식을 평가했습니다.
Experiments
Pretraining Perplexities
BookCorpus와 English Wikipedia를 합친 약 33억 단어로 masked language modeling을 학습했습니다. 실험은 64대의 Tesla V100에서 250,000 update를 수행하는 설정을 사용했습니다.
- $n=512$에서는 $k=128$, $n=1024$에서는 $k=256$만으로도 기본 Transformer에 가까운 validation perplexity를 얻었습니다. $k$가 커질수록 대체로 성능이 좋아졌습니다.
- $n=512$에서 layerwise sharing을 사용한 모델은 투영을 더 세분하여 사용하는 모델과 비슷한 perplexity를 보였습니다.
- $k=256$을 고정하고 $n$을 512, 1024, 2048, 4096으로 바꾼 MLM 실험에서도 최종 perplexity가 비슷했습니다.
Downstream Results
SST-2와 IMDB는 감성 분류, QNLI는 문장 쌍의 추론, QQP는 질문 쌍의 유사성 판단 과제입니다. 아래는 원문의 개발 세트 결과입니다. 비교 모델의 사전 학습 corpus, objective, 최대 update 수를 맞췄으므로, 더 큰 corpus로 학습한 다른 RoBERTa 결과와 구분해야 합니다.
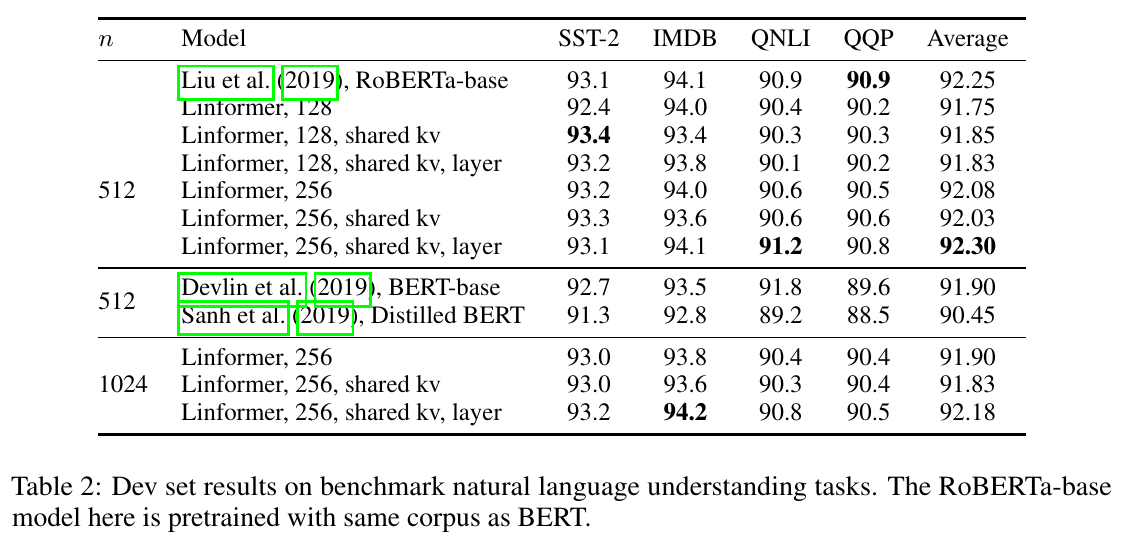
$n=512$, $k=256$, layerwise sharing 모델은 SST-2 93.1, IMDB 94.1, QNLI 91.2, QQP 90.8을 기록했습니다. 네 점수의 평균은 92.30으로 RoBERTa-base의 92.25와 비슷했습니다. $k=128$이며 공유하지 않은 모델의 평균은 91.75였으므로, 더 강하게 압축할 때는 정확도 손실이 생길 수 있습니다.
Inference-time Efficiency Results
16 GB Tesla V100 한 대에서 무작위 입력에 대해 전체 forward pass를 실행했습니다. 속도와 함께 메모리에 들어가는 최대 batch size를 비교했으며, 표의 memory saving은 이 최대 batch size의 비율로 산정했습니다. 고정 batch의 실제 peak memory가 그 비율만큼 감소했다는 의미는 아닙니다.
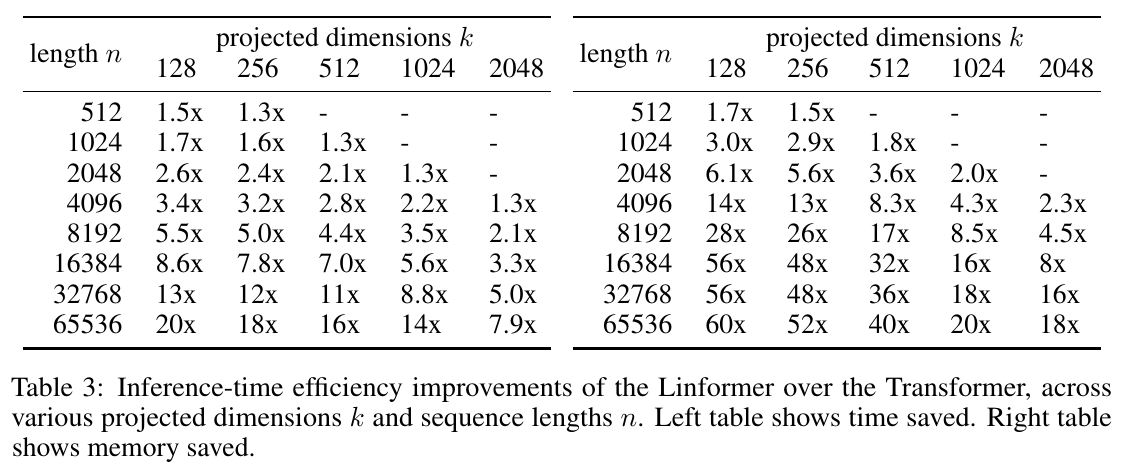
- $n=512$, $k=128$에서는 속도가 1.5배, 최대 batch size가 1.7배였습니다.
- $n=4096$, $k=256$에서는 속도가 3.2배, 최대 batch size가 13배였습니다.
- $n=65536$, $k=256$에서는 속도가 18배, 최대 batch size가 52배였습니다. 이 장문 효율 실험은 무작위 입력으로 측정했으므로, 65,536-token 과제에서 정확도까지 검증한 결과는 아닙니다.
Conclusion
Linformer는 attention의 길이 축에 학습 가능한 저차원 투영을 적용하여, $k$를 고정했을 때 attention의 시간·공간 복잡도를 시퀀스 길이에 대해 선형으로 줄입니다. 논문은 MLM과 네 가지 자연어 이해 과제에서 성능을 비교하고, 별도 추론 실험으로 긴 시퀀스에서의 효율 개선을 확인했습니다.
부록
부록 A는 Johnson–Lindenstrauss lemma를 이용하여 attention 출력을 낮은 rank의 행렬로 근사하는 첫 번째 정리의 증명을 제시합니다. 부록 B는 key와 value에 선형 투영을 적용하는 두 번째 정리의 증명을 다루며, 투영 크기와 근사 오차 및 head 차원의 관계를 분석합니다.
짧은 생각
모든 층과 head가 투영 하나를 공유한 모델은 $n=512$, $k=256$ 비교에서 가장 높은 평균 개발 세트 점수를 기록했습니다. 적어도 이 네 과제에서는 각 층에 별도의 시퀀스 투영을 학습하는 자유도가 성능 개선으로 이어지지 않았습니다. 각 공유 방식에서 $k$를 줄였을 때 평균 점수가 낮아지는 표의 경향까지 보면, 이 설정에서는 투영 행렬의 수보다 압축 후 남기는 길이를 먼저 조정할 근거가 있습니다.
다만 길이가 다른 입력에서 MLM perplexity가 비슷했다는 결과만으로, 정답에 필요한 정보가 멀리 떨어진 과제에서도 같은 $k$로 충분한지는 알 수 없습니다. 정답 단서의 위치와 거리를 바꾸는 문서 질의응답에서 $k$를 고정한 채 공유·비공유 모델을 비교하면 두 효과를 구분할 수 있습니다. 두 모델이 함께 낮아지면 압축 길이를, 공유 모델만 낮아지면 층별 투영의 필요성을 먼저 검토할 수 있을 것입니다.