


Attention Residuals 요약 설명
16 Mar 2026 | Paper Review Attention Mechanisms Residual Connections Language Models목차
- 요약
- 1 Introduction
- 2 Motivation
- 3 Attention Residuals: A Unified View of Time and Depth
- 4 Infrastructure Design
- 5 Experiments
- 6 Discussions
- 7 Related Work
- Conclusion
- 부록
- 짧은 생각
이번 글에서는 Attention Residuals 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 16일(Arxiv)
- Kimi Team, Chen, Guangyu, Zhang, Yu, Su, Jianlin, Xu, Weixin, Pan, Siyuan, Wang, Yaoyu, Wang, Yucheng, Chen, Guanduo, Yin, Bohong, et al.
- 논문 링크
- Github
요약
- Attention Residuals (AttnRes)는 고정된 잔차 덧셈을 이전 층 출력에 대한 softmax 가중 검색으로 대체한다. 층마다 학습하는 pseudo-query가 입력에 따라 달라지는 key를 통해 토큰별 가중치를 생성한다. 이를 통해 각 층은 깊이 방향으로 자신에게 필요한 출력의 혼합을 선택한다.
- Block AttnRes는 여러 층의 출력을 합산한 블록 표현으로 압축하여, 이력 저장 공간과 파이프라인 단계 간 표현 전송량을 O(Ld)에서 O(Nd)로 줄인다. 논문은 단계 간 캐싱과 2단계 추론을 적용했을 때 파이프라인 병렬 학습의 오버헤드가 4% 미만이며, 일반적인 워크로드에서 추론 지연 시간의 오버헤드가 2% 미만이라고 보고한다.
- 5개 모델 크기를 비교한 스케일링 실험에서 검증 손실이 일관되게 낮아졌다. 피팅한 곡선을 기준으로 Block AttnRes는 1.25×의 연산량 이점을 보였다. 총 파라미터 48B / 활성 파라미터 3B인 Kimi Linear 모델을 1.4T 토큰으로 학습한 결과, 보고된 벤치마크 15개 중 14개에서 성능이 향상되었고 나머지 1개에서는 동률을 기록했다. GPQA-Diamond는 36.9 → 44.4, HumanEval은 59.1 → 62.2로 향상되었다. 평가는 연구에 사용한 아키텍처 계열에 한정되며, 반복 실행에 따른 불확실성 추정치는 제공하지 않는다.
1 Introduction
표준 잔차 연결은 기울기가 직접 전달되는 경로를 제공하며, 깊이 방향으로 고정된 집계 규칙을 사용한다. 점화식을 전개하면 임베딩과 모든 이전 출력에 동일한 가중치를 적용한 합이 된다. 서론은 이 집계를 PreNorm에서 각 층의 상대적 기여가 희석되는 문제와 연결한다. 덧셈 점화식을 다시 수정하는 대신 깊이 방향으로 내용에 따라 출력을 검색하는 방법을 제안한다.
- 주요 기여는 Full 및 Block AttnRes, 잔차 메커니즘에 대한 구조화된 행렬 해석, 인프라 최적화, 그리고 스케일링·절제·다운스트림 평가다.
- 소스 저장소는 https://github.com/MoonshotAI/Attention-Residuals 이다.
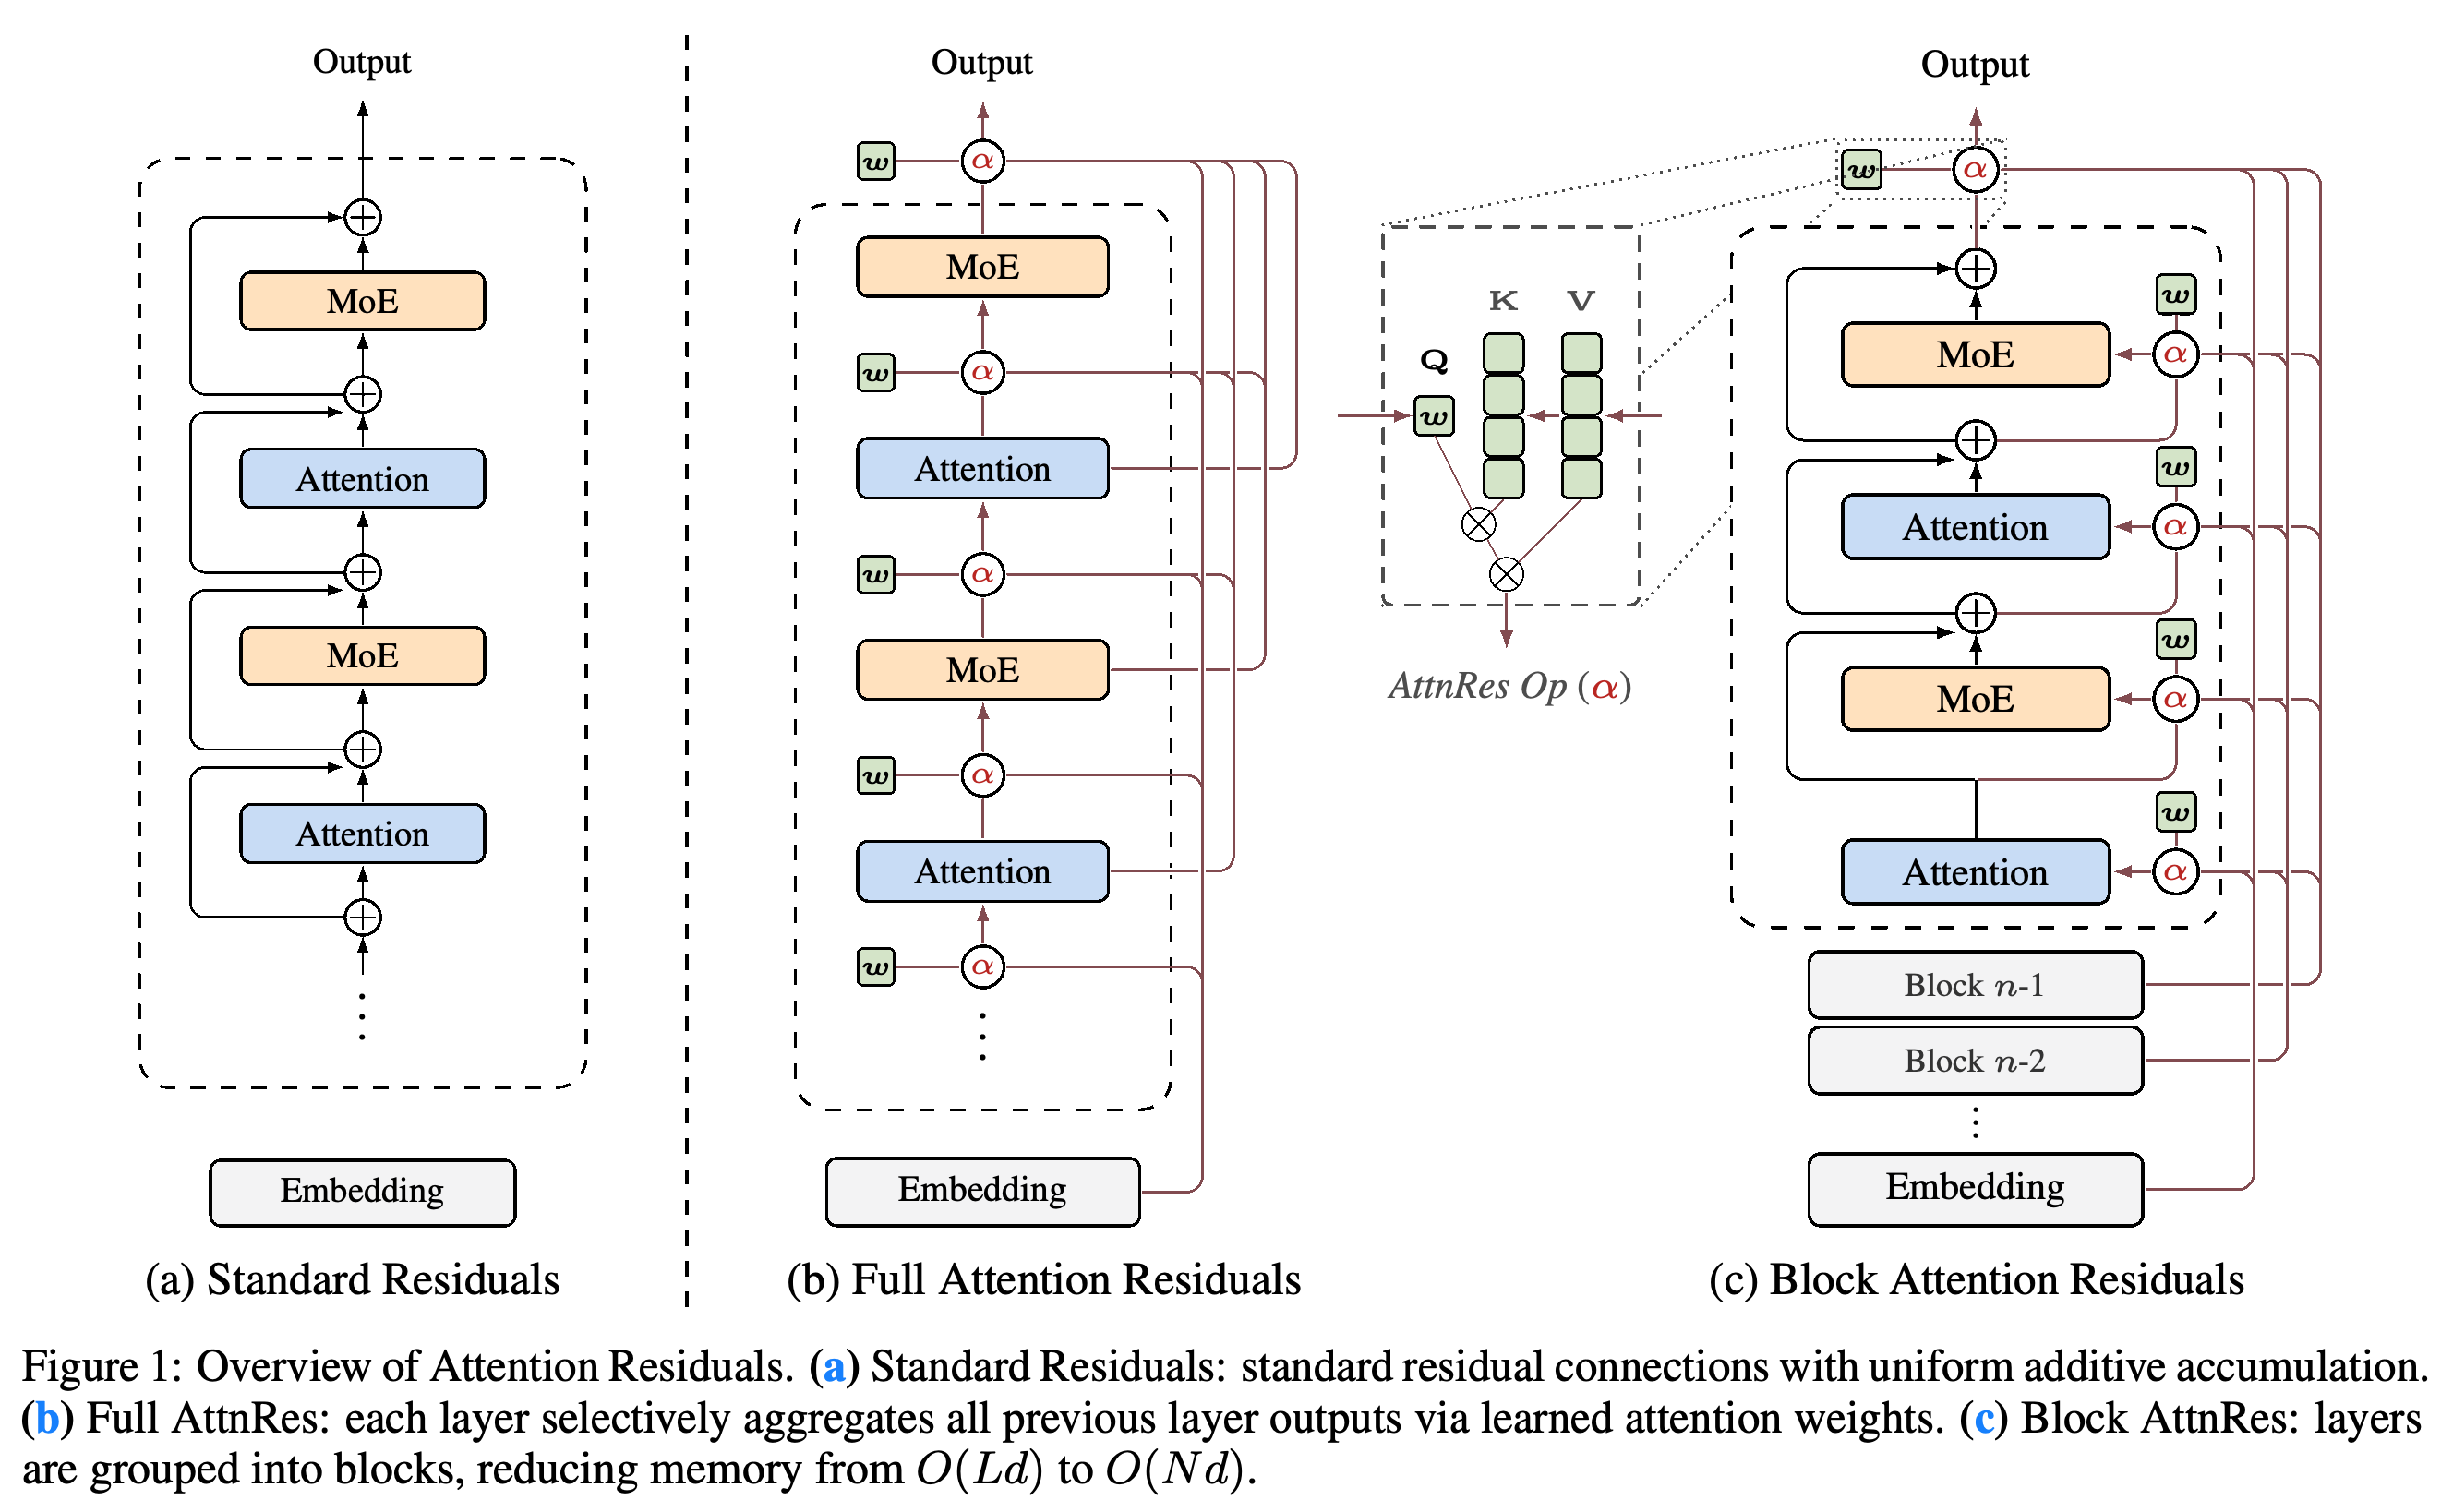
그림은 집계 방식의 차이를 보여준다. 표준 잔차 연결은 출력을 단일 스트림으로 합치고, Full AttnRes는 독립적으로 선택할 수 있는 이전 출력을 보관하며, Block AttnRes는 합산된 그룹을 선택한다. 저장 공간 감소는 학습된 깊이 방향 가중치를 제거해서가 아니라 소스의 단위를 더 크게 묶어서 얻는다.
2 Motivation
입력 배치의 형태는 B × T × d로 표기하며, B는 배치 크기, T는 시퀀스 길이, d는 은닉 차원이다. 단일 토큰에서 h_l은 층 l에 입력되는 상태, h_1은 임베딩, f_l은 층의 변환이다. 각 attention 또는 MLP 하위층을 개별 층으로 세므로, Transformer 블록에는 이러한 층이 2개 포함된다.
2.1 Training Deep Networks via Residuals
Residual Learning은 h_l = h_{l−1} + f_{l−1}(h_{l−1})를 사용하며, 이를 전개하면 임베딩과 모든 이전 층 출력의 합이 된다. 역전파에서 I + ∂f_j/∂h_j 인자들의 곱을 전개하면 항등 항이 유지되어 기울기가 직접 전달되는 경로를 제공한다. Highway 네트워크는 원소별 게이트로 갱신을 일반화하지만, 여전히 집계된 단일 상태를 전달한다.
- Generalizing Residuals는 h_l = α_l h_{l−1} + β_l f_{l−1}(h_{l−1})로 표현한다. 표준 잔차 연결은 2개 계수를 모두 1로 설정하며, Highway는 α_l = 1 − g_l과 β_l = g_l을 사용한다. 벡터 게이트에는 원소별 곱셈을 적용한다.
- Limitations는 단일 상태 집계의 한계로 3가지를 지적한다. 개별 이전 출력을 선택적으로 참조할 수 없고, 집계 중 잃어버린 정보를 복구할 수 없으며, 누적 상태에 영향을 주려면 뒤쪽 층의 출력이 점점 더 커져야 한다.
3 Attention Residuals: A Unified View of Time and Depth
The Duality of Time and Depth는 층을 따라 이루어지는 잔차 누적을 토큰을 따라 이루어지는 RNN 점화식과 비교한다. AttnRes는 압축된 상태를 전달하는 인터페이스를 (h_l = \alpha_{0\to l}h_1 + \sum_{i=1}^{l-1}\alpha_{i\to l}f_i(h_i))로 대체하며, 소스 가중치의 합은 1이다. 저자들은 일반적인 깊이가 L < 1000이므로 깊이에 대해 이차 복잡도를 갖는 attention도 계산상 가능하다고 주장한다.
3.1 Full Attention Residuals
Full AttnRes는 q_l = w_l과 k_i = v_i를 사용한다. 임베딩은 v_0 = h_1로, 이전 층 출력은 v_i = f_i(h_i)로 설정한다. α_{i→l} = exp(w_l^T RMSNorm(k_i)) / Σ_{j=0}^{l−1} exp(w_l^T RMSNorm(k_j))를 계산하고, 정규화하지 않은 value로 다음 입력을 구성한다. Key 정규화는 소스의 크기가 선택을 직접 지배하지 않도록 한다.
- Pseudo-query는 학습 가능한 d차원 파라미터다. 다만 key가 토큰별 층 출력이므로 가중치는 입력에 따라 달라진다.
- 토큰당 연산량은 O(L²d)이며, 이력 저장 공간은 O(Ld)다. 일반적인 학습에서는 역전파를 위해 이 출력들이 이미 존재하지만, 활성값 재계산과 파이프라인 병렬화에서는 추가 보관 및 전송 비용이 발생한다.
- 블록 단위 최적화는 층을 순차 실행하기 전에 고정된 query들을 이미 확보한 이력에 대해 일괄 계산하고, 블록 내부 의존성은 별도로 처리한다. 이를 통해 블록 내 층들에 나누어 계산한 평균 층당 I/O를 O((S + N)d)로 줄인다. 다만 Full AttnRes의 O(Ld) 단계 간 표현 전송을 없애지는 않는다.
3.2 Block Attention Residuals
Block AttnRes는 L개 층을 N개 블록으로 나누고, 완료된 블록 n을 b_n = Σ_{j∈B_n} f_j(h_j)로 표현한다. 각 층은 임베딩 b_0와 완료된 블록의 합을 참조하며, 해당 블록의 첫 층 이후에는 계속 갱신되는 블록 내부 부분합도 참조한다. 최종 출력은 임베딩을 소스로 유지하면서 완료된 블록들을 집계한다.
- Intra-Block Accumulation은 attention 가중 입력이 아니라 변환 출력을 합산한다. 균일한 블록에 대한 유도는 S = L/N을 가정하며, 마지막 블록의 층 수가 부족하면 마지막 부분합을 그 블록의 표현으로 사용한다. RMSNorm은 완료된 블록과 부분합에서 얻은 key를 모두 정규화한다.
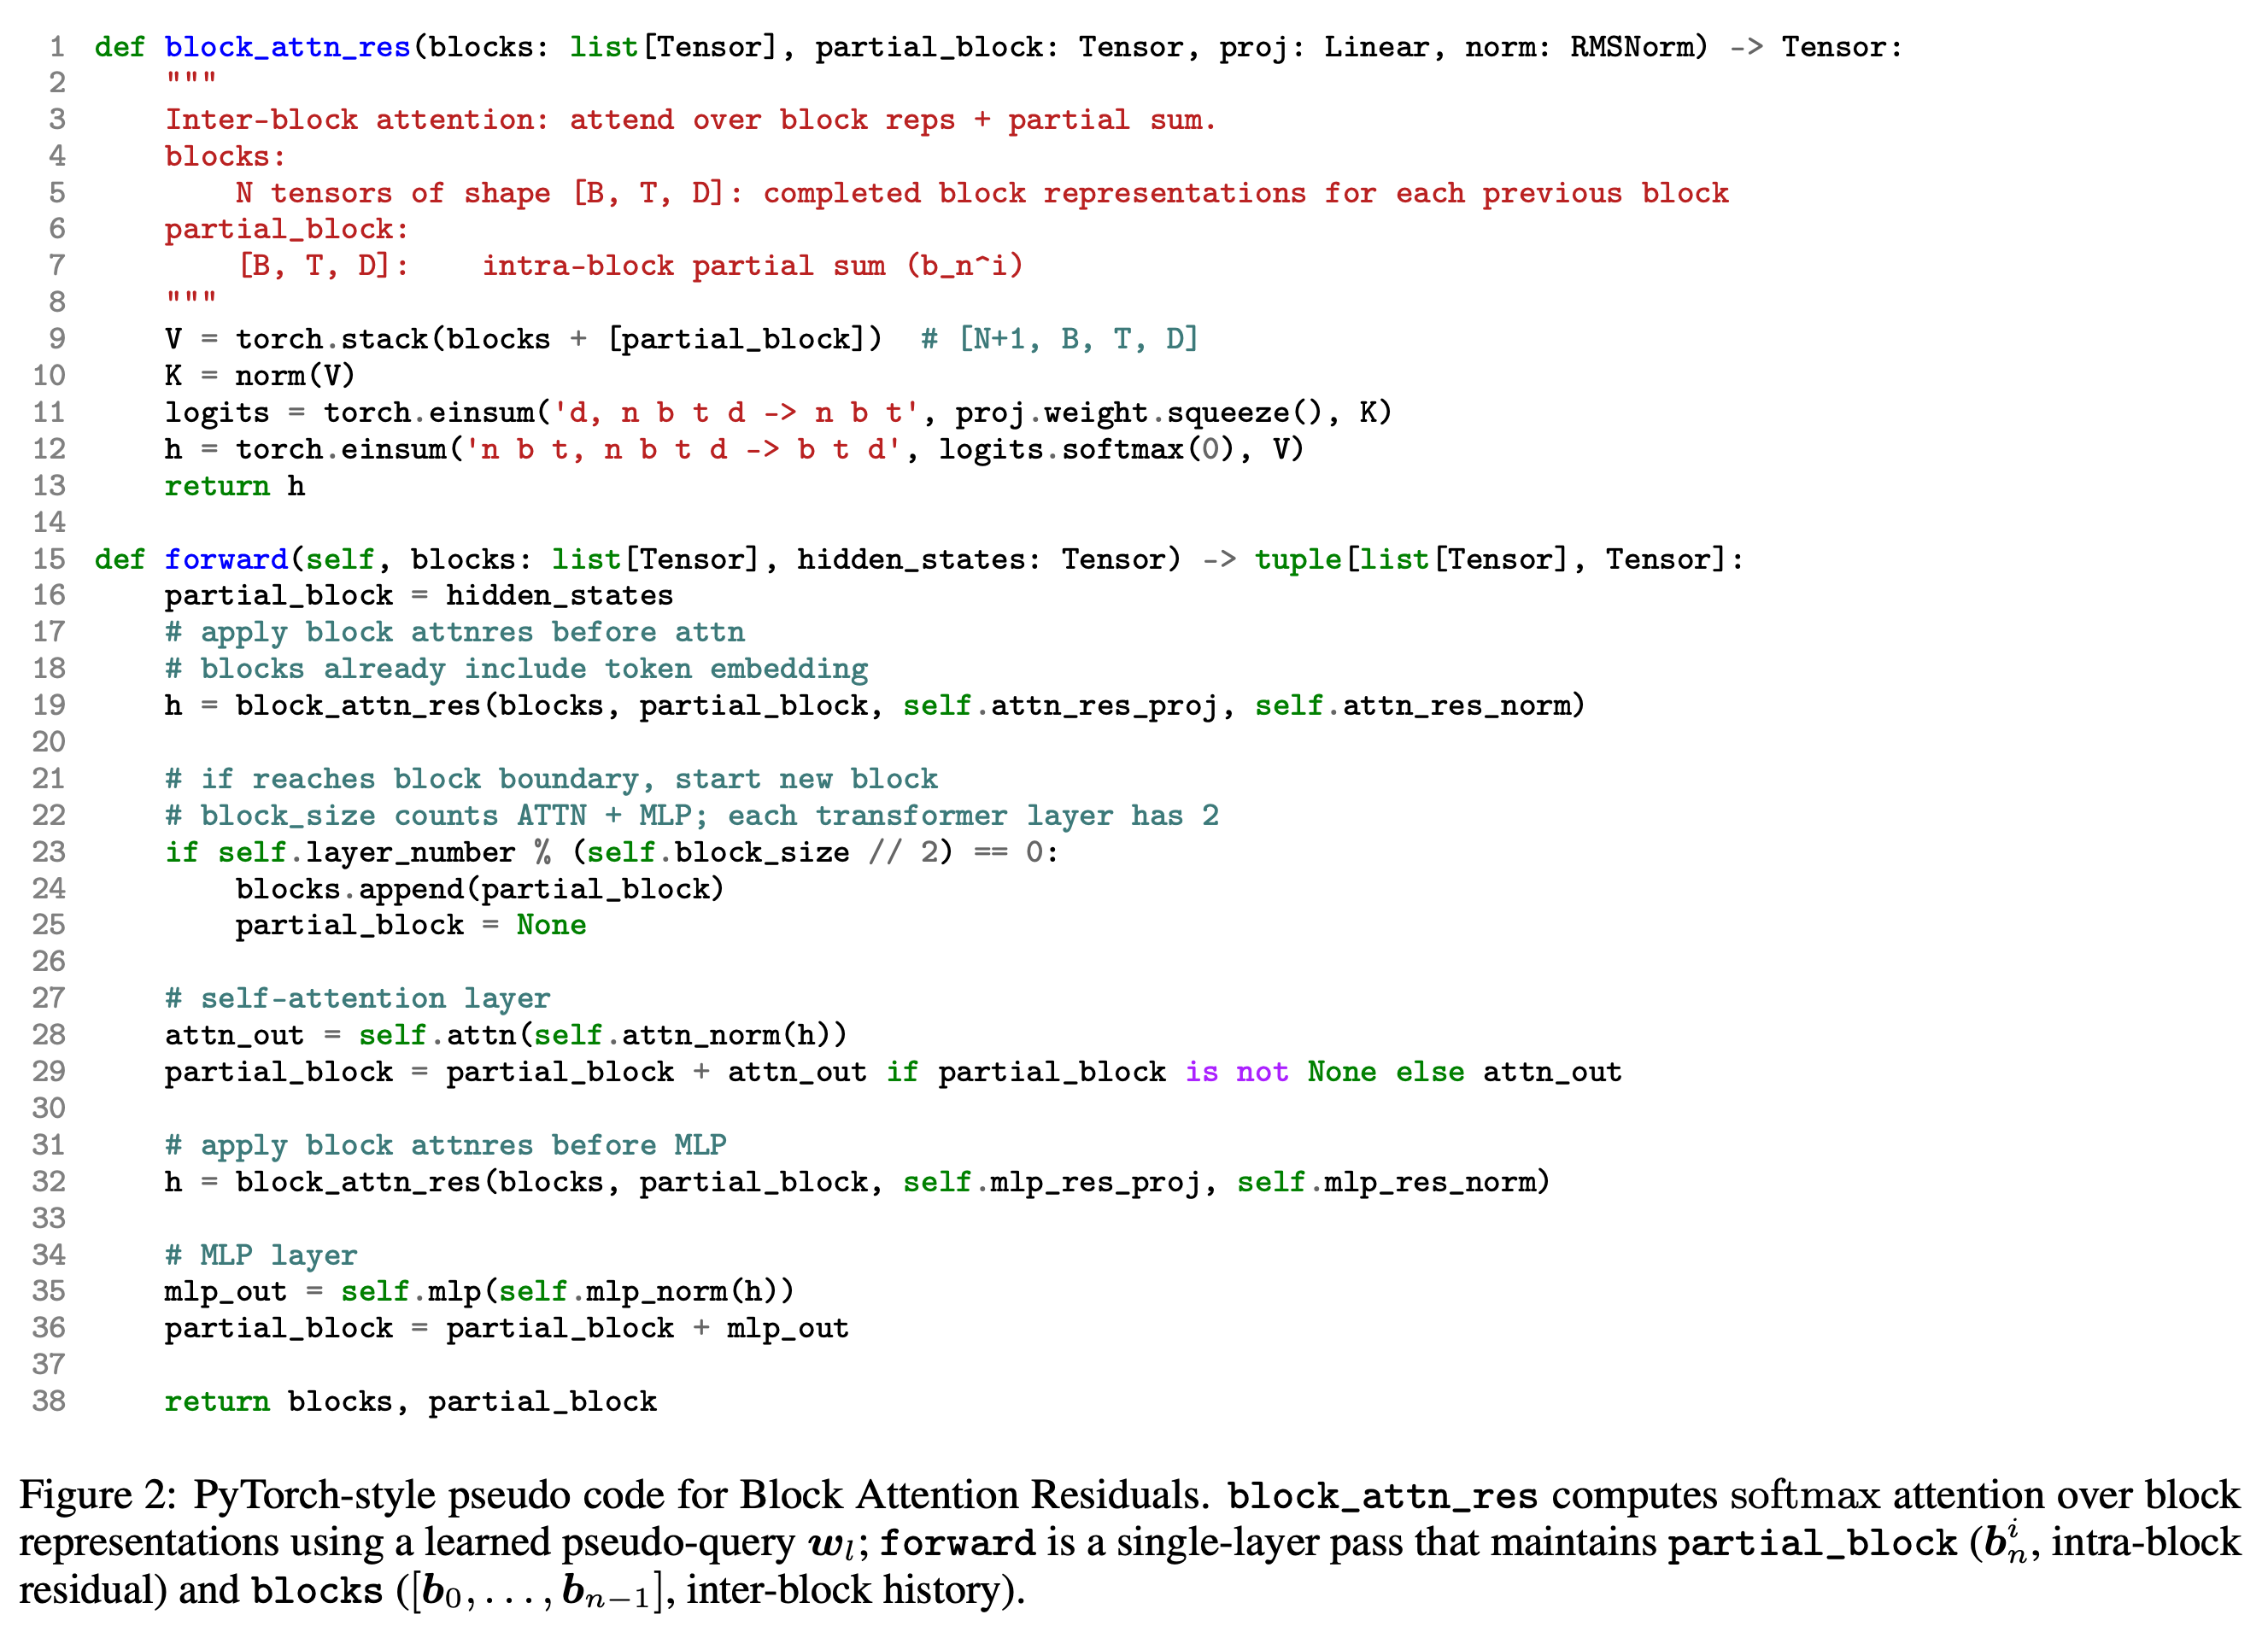
- Inter-Block Attention은 먼 이력을 보존하지만, 완료된 블록 내부의 개별 출력을 선택할 수는 없다. Figure 2는 attention과 MLP 앞에 별도의 AttnRes 연산이 있음을 보여준다.
- 보관하는 표현의 저장 공간은 O(Nd)다. Section 3.2는 연산량을 O(N²)로 기술하지만, Related Work는 L개 층의 집계에 대해 O(LN)을 제시한다. 후자는 각 층이 블록 소스들을 참조하는 연산을 반영한다. N = L이면 Full AttnRes가 되지만, N = 1은 임베딩과 부분합에 별도의 가중치를 유지하므로 원래의 비정규화 잔차 덧셈을 재현하지 않는다.
- 스케일링 실험에서는 약 8개 블록으로 성능 향상의 대부분을 얻는다. 블록 수를 고정하면 추론 중 사용하는 깊이 이력 캐시의 크기도 제한할 수 있다.
의사코드는 key를 정규화하고, 깊이 소스 전체에 softmax를 계산하여 정규화하지 않은 value를 혼합한다. Attention과 MLP 앞에서 각각 호출하므로 하위층마다 다른 혼합을 사용할 수 있다. partial_block은 변환 출력을 누적하고 블록 경계에서 완료된 이력에 추가된다.
4 Infrastructure Design
Infrastructure Design은 파이프라인 단계 간 중복 전송, 추론 중 반복되는 이력 읽기, 긴 컨텍스트 prefill 중 표현 저장 문제를 다룬다. 해결책으로 단계 간 캐싱, 블록 간 attention의 일괄 계산 후 블록 내부 결과의 순차 병합, 시퀀스 분할 prefill을 제안한다.
4.1 Training
학습에서는 각 물리적 파이프라인 rank가 앞서 받은 블록 표현을 캐싱하여, 뒤쪽 가상 단계에서는 새로 추가된 이력만 전송한다. 물리적 단계 P개, 가상 단계 V개, 청크 C = PV개와 논문의 단순화 가정에 따른 평균 블록 생성량 N_p를 사용하면, Comm_naïve = C(C−1)N_p d/2와 Comm_cached = P(P−1)N_p d/2 + (V−1)P²N_p d가 된다.
- 캐싱이 없으면 단계가 전환될 때마다 점점 늘어나는 이력을 다시 전송한다. 단계 간 캐싱은 전환당 최대 전송 비용의 복잡도를 O(C)에서 O(P)로 줄여 V× 개선하며, 역전파 통신에도 적용된다.
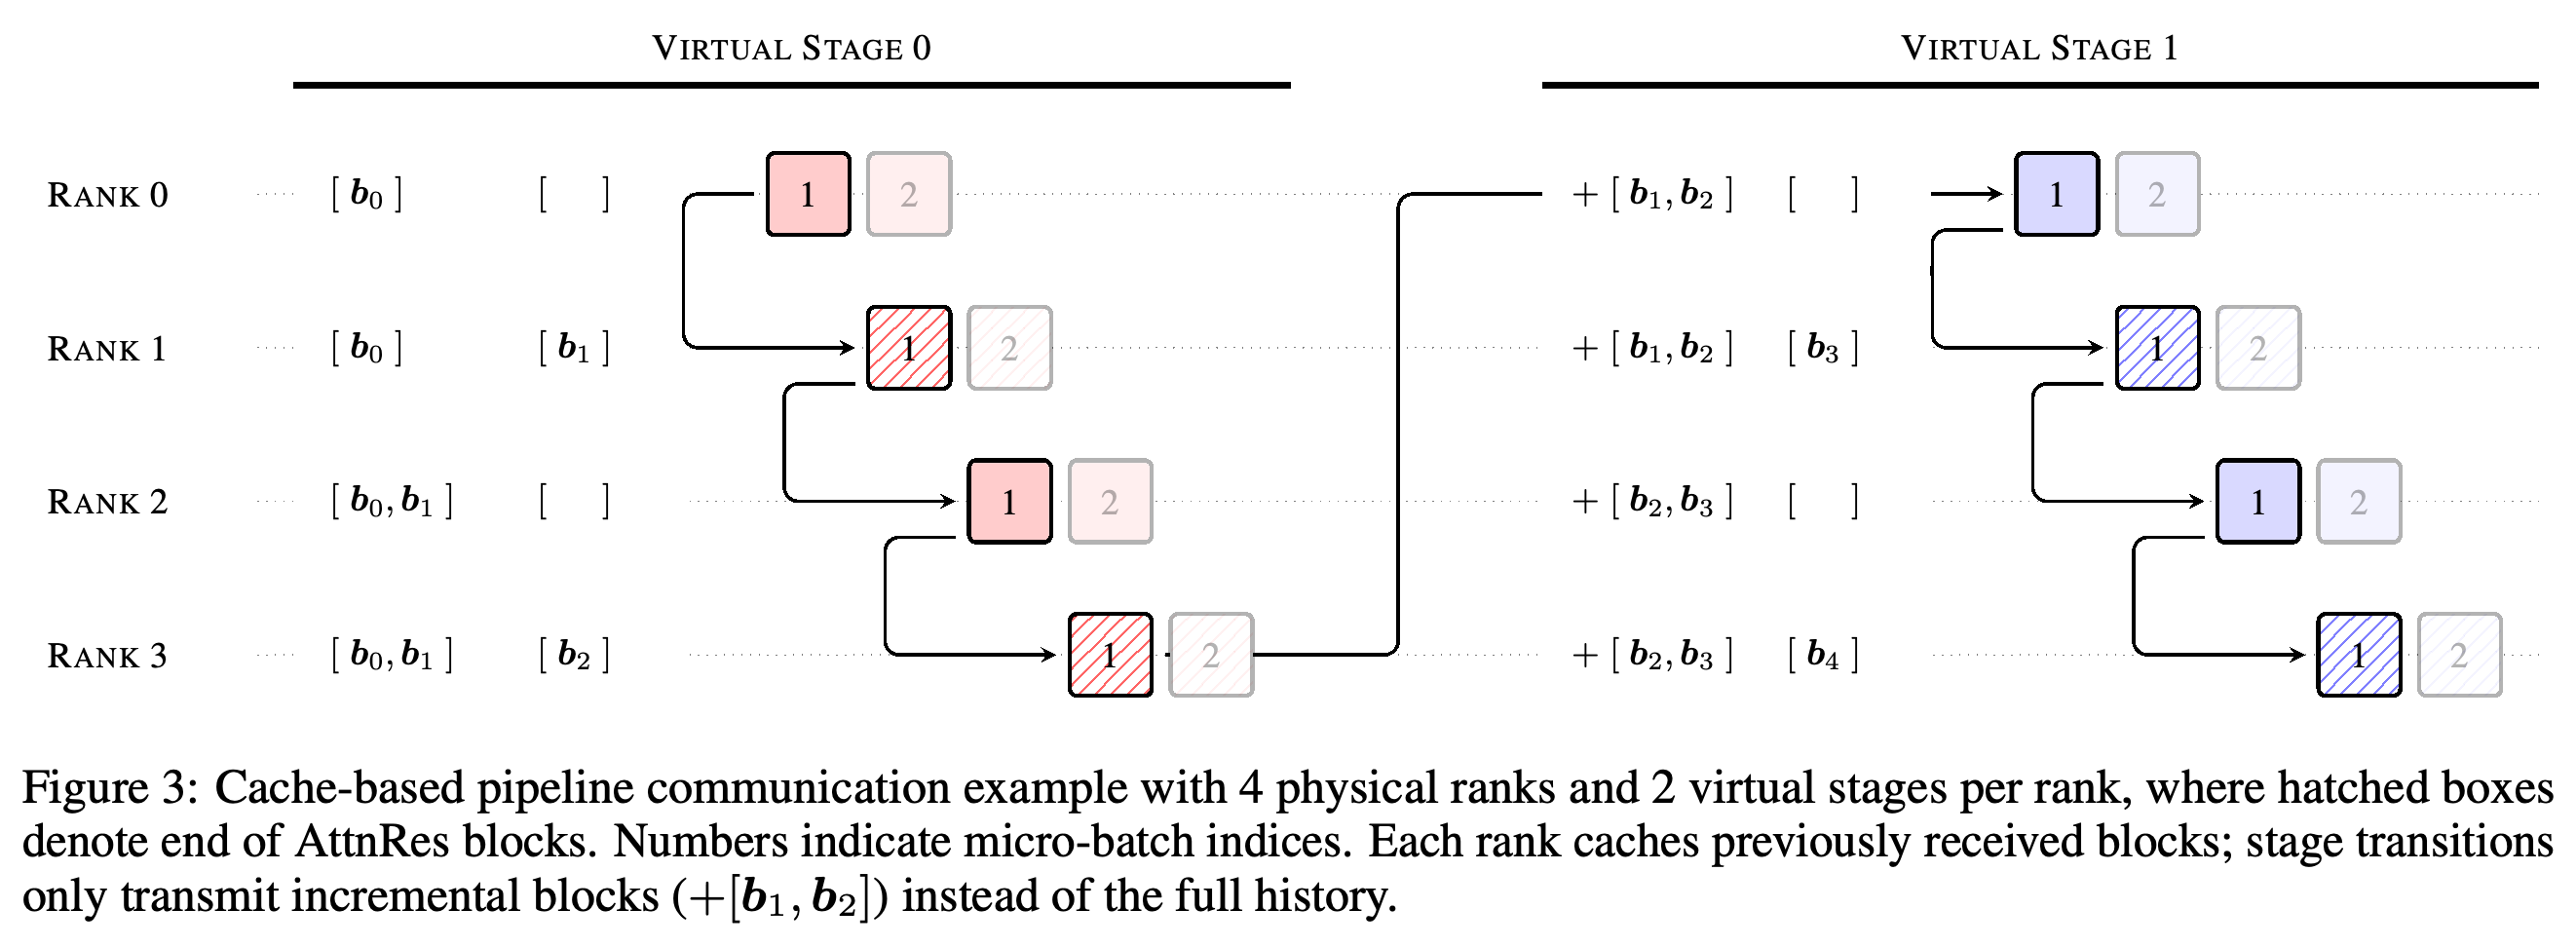
- P = 4, V = 2 예시는 두 번째 가상 단계에서 중복 블록 전송 6건을 제거한다. 블록 경계가 물리적 단계 경계와 일치할 필요는 없다.
- 각 블록은 가상 단계 전체에서 1회만 저장된다. 활성값 체크포인팅은 블록 간 attention의 중간값을 제거하면서, 대체된 은닉 상태와 같은 크기의 입력을 유지한다. 논문은 파이프라인 병렬화가 없을 때 학습 오버헤드가 미미하며, 파이프라인 병렬화를 적용했을 때 측정한 전체 오버헤드는 4% 미만이라고 보고한다.
두 번째 가상 단계는 각 rank에 이미 캐싱된 이력을 재사용하고 새로 추가된 블록만 전송한다. 물리적 rank 4개와 가상 단계 2개를 사용하는 예시는 중복 블록 전송 6건을 제거한다. 빗금으로 표시된 경계는 AttnRes 블록이 물리적 단계에 걸쳐 배치될 수 있음도 보여준다.
4.2 Inference
추론은 pseudo-query가 은닉 상태와 독립적이라는 점을 활용한다. 1단계는 블록의 S개 query를 완료된 이력에 대해 일괄 계산한다. 2단계는 각 층에서 갱신되는 블록 내부 소스를 순차 처리하고, 정확한 online-softmax 병합으로 2개 결과를 결합한다.
- Algorithm 1은 attention의 분자와 정규화 통계를 유지한다. 2개 단계의 값을 공통 최댓값에 맞춰 재조정한 뒤 결합된 분자를 결합된 정규화 항으로 나눈다. 이는 근사가 아니라 2개 소스 집합 전체에 softmax를 적용한 것과 동등하다.
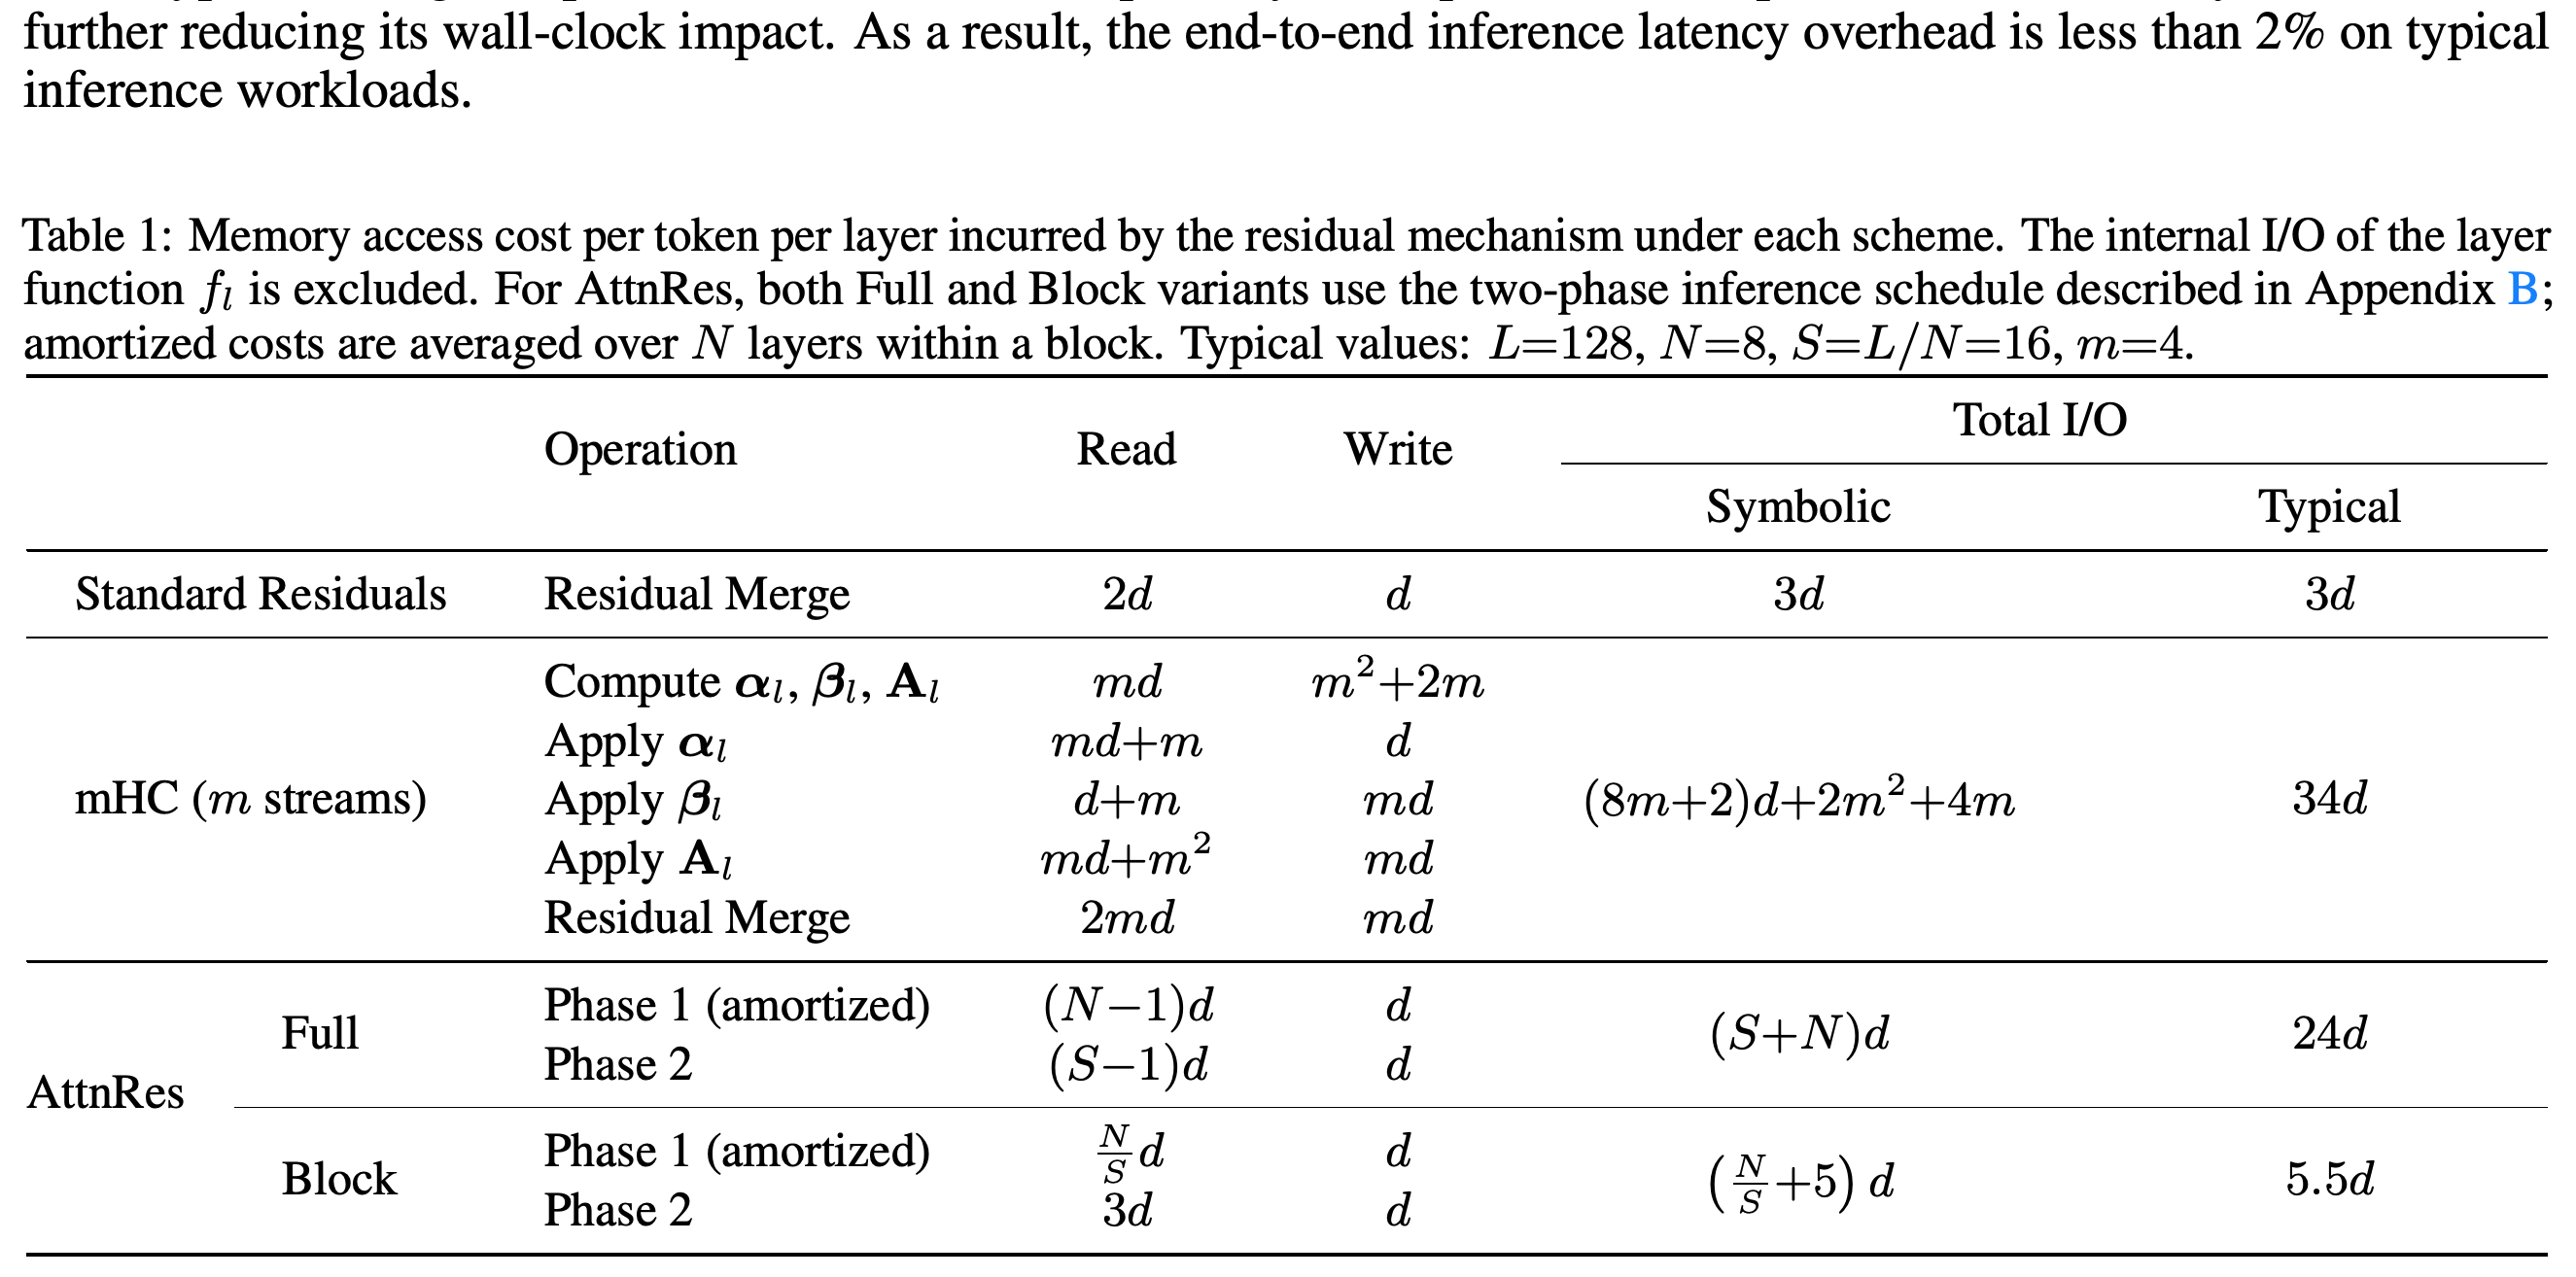
- Block AttnRes의 평균 층당 읽기는 (N/S + 3)d이고 쓰기는 2d다. L = 128, N = 8, S = 16에서 잔차 총 I/O는 5.5d이며, 표준 잔차 연결은 3d, Full AttnRes는 24d, m = 4인 mHC는 34d다. 이 추정치는 층 내부 변환을 제외한다.
- 메모리 효율적인 prefill은 N × T × d 표현을 텐서 병렬 장치에 분할하고, reduce-scatter/all-gather 경로 안에서 로컬 병합을 수행한다. 논문의 128K-token, 8개 블록 예시에서 장치당 메모리는 15 GB에서 약 1.9 GB로 감소하며, 16K 청크 prefill을 사용하면 0.3 GB 미만으로 줄어든다.
- 논문이 보고한 추론 지연 시간의 오버헤드는 일반적인 워크로드에서 2% 미만이다. 하드웨어와 워크로드별로 지연 시간을 상세히 비교한 결과는 제공하지 않는다.
L = 128, N = 8, S = 16, m = 4에서 Block AttnRes의 토큰당·층당 잔차 I/O는 5.5d이며, 표준 잔차 연결은 3d, Full AttnRes는 24d, mHC는 34d다. 이 평균 전송량 추정치는 층 함수를 제외하며, 전체 지연 시간도 같은 비율로 달라진다는 뜻은 아니다.
5 Experiments
Architecture Details는 잔차 집계 외에는 Kimi Linear MoE 아키텍처를 그대로 유지한다. Kimi Delta Attention (KDA)과 Multi-Head Latent Attention (MLA)을 3:1 비율로 배치하고, 각각 뒤에 MoE feed-forward 층을 둔다. AttnRes는 하위층마다 RMSNorm 1개와 pseudo-query 벡터 1개를 추가하며, 이들이 전체 파라미터에서 차지하는 비중은 미미하다.
- 모든 pseudo-query를 0으로 초기화하여, 초기에는 소스 가중치가 균일하고 동일 가중 평균을 사용한다. 저자들은 실험에서 학습 불안정을 피하려면 이 초기화가 필요했다고 설명한다.
5.1 Scaling Laws
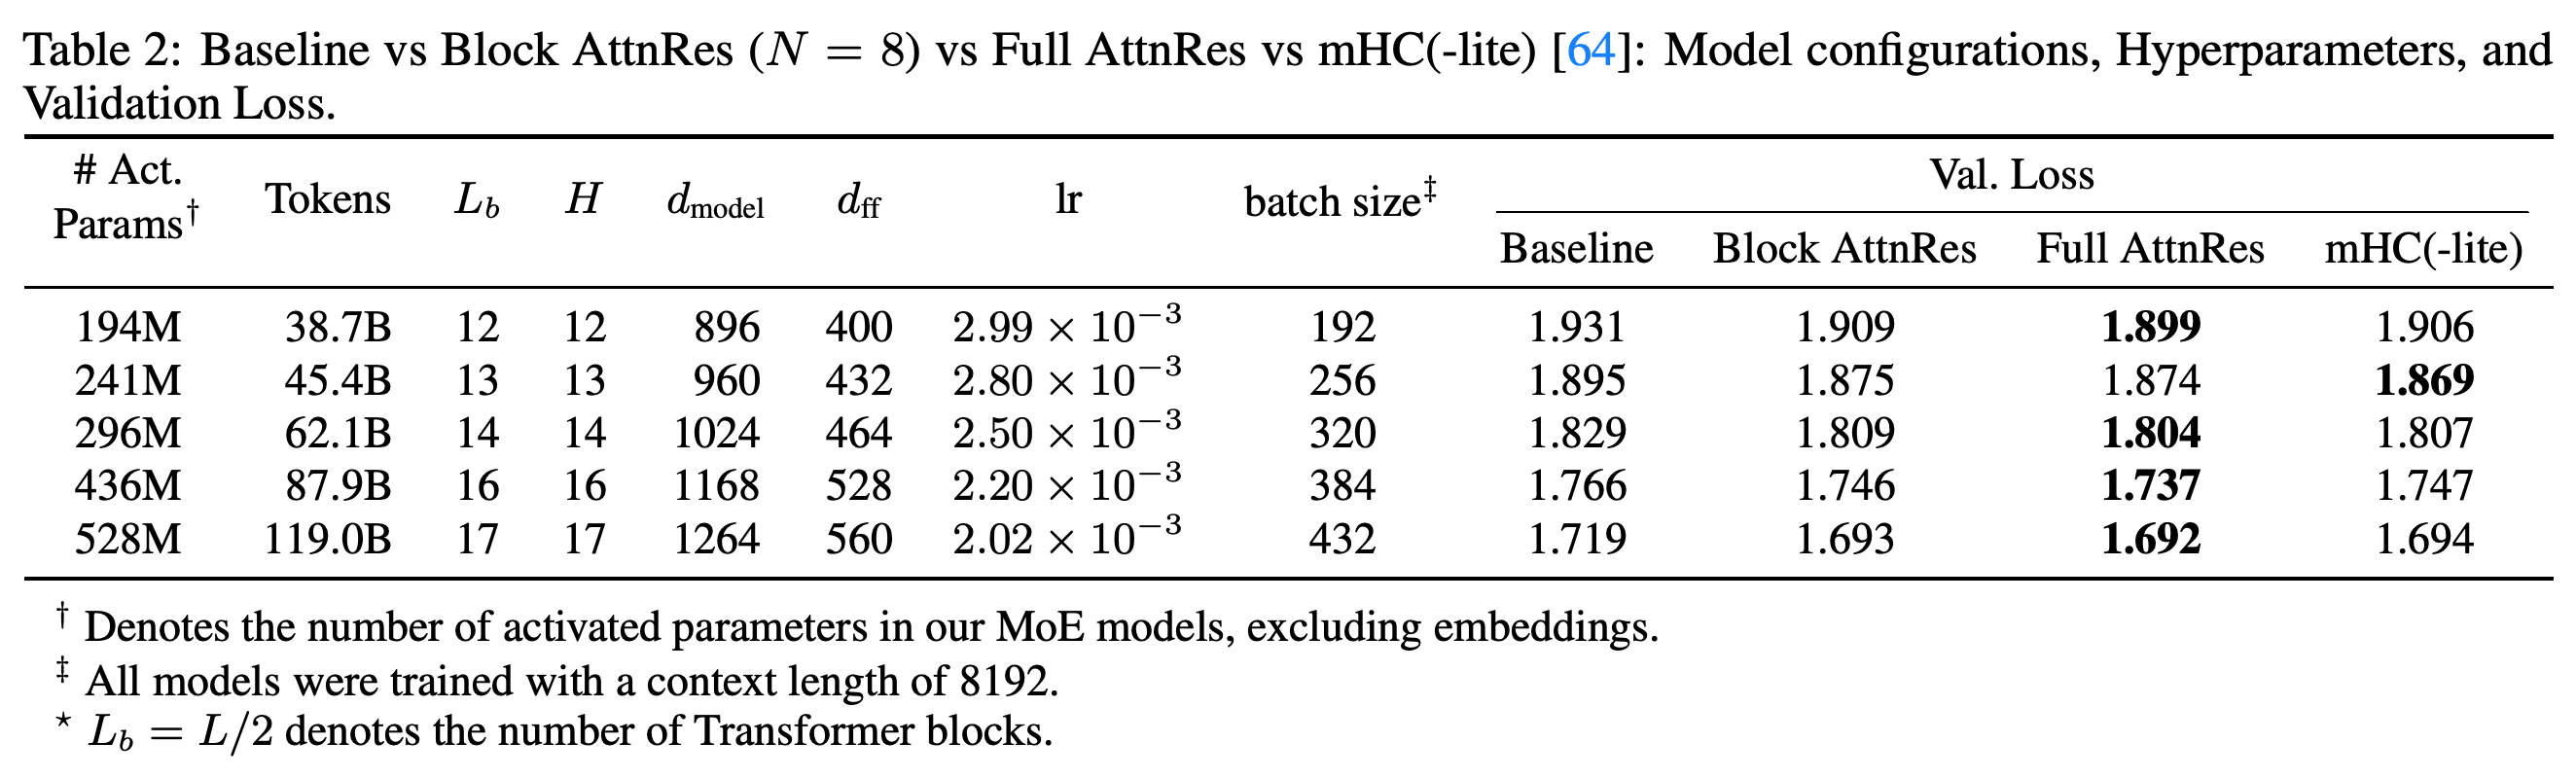
Scaling Laws는 임베딩을 제외한 활성 파라미터가 194M, 241M, 296M, 436M, 528M인 5개 MoE 크기에서 PreNorm, Full AttnRes, 약 8개 블록을 사용하는 Block AttnRes를 비교한다. 모두 8192 토큰 컨텍스트와 cosine 학습률 스케줄을 사용한다. 같은 크기의 모델에는 기준 모델을 위해 선택한 동일한 하이퍼파라미터를 적용한다.
- 학습 토큰 수는 각각 38.7B, 45.4B, 62.1B, 87.9B, 119.0B다. 대응하는 Baseline / Block / Full 검증 손실은 1.931 / 1.909 / 1.899, 1.895 / 1.875 / 1.874, 1.829 / 1.809 / 1.804, 1.766 / 1.746 / 1.737, 1.719 / 1.693 / 1.692다.
- 피팅한 곡선은 Baseline의 ℒ = 1.891 × C^(−0.057), Block AttnRes의 ℒ = 1.870 × C^(−0.058), Full AttnRes의 ℒ = 1.865 × C^(−0.057)이며, C의 단위는 PFLOP/s-days다.
- 5.6 PFLOP/s-days에서 논문은 피팅한 곡선의 손실 비교를 Block 1.692 versus Baseline 1.714로 제시하고, 1.25×의 연산량 이점이 있다고 설명한다. 이 곡선 기반 비교는 Table 2에서 실제 측정한 가장 큰 모델의 행과 구별된다.
- 실제 측정한 가장 큰 모델에서 Full–Block 차이는 0.001이다. Table 2의 mHC(-lite) 참조 결과는 241M 행에서 손실이 가장 낮으므로, Full AttnRes가 모든 크기에서 이를 능가하지는 않는다.
측정한 5개 크기 모두에서 두 AttnRes 변형의 검증 손실이 PreNorm보다 낮으며, 활성 파라미터 528M에서 Full–Block 차이는 0.001이다. mHC(-lite) 참조 결과는 241M 행에서 손실이 가장 낮으므로, 주변 본문이 제시하는 포괄적인 우월성 주장은 제한해서 해석해야 한다.
5.2 Main Results
학습 설정은 Transformer 블록 27개, 즉 attention/MLP 층 54개를 사용한다. 라우팅 expert 256개 중 8개와 공유 expert 1개를 사용하여 총 파라미터 48B / 활성 파라미터 3B가 된다. Block AttnRes는 블록당 6개 층을 묶어 완료된 블록 9개와 임베딩을 구성하며, 최종 깊이 방향 소스는 10개다.
- 동일하게 맞춘 학습 설정은 4096 토큰 컨텍스트, Muon optimizer, WSD (Warmup–Stable–Decay) 학습률 스케줄, 전역 배치 크기 8M 토큰을 사용한다.
- 학습은 사전학습 토큰 1T 이후 Moonlight annealing 설정에 따라 약 400B의 고품질 중간 학습 토큰을 사용하는 과정으로 구성된다. 후속 컨텍스트 확장 학습에서는 32K 토큰에 도달한다.
- 혼합 KDA/MLA 아키텍처는 위치 인코딩이 없는 MLA (NoPE)를 사용하므로, 보고된 컨텍스트 확장에는 YaRN이나 attention-temperature 재조정이 필요하지 않다.
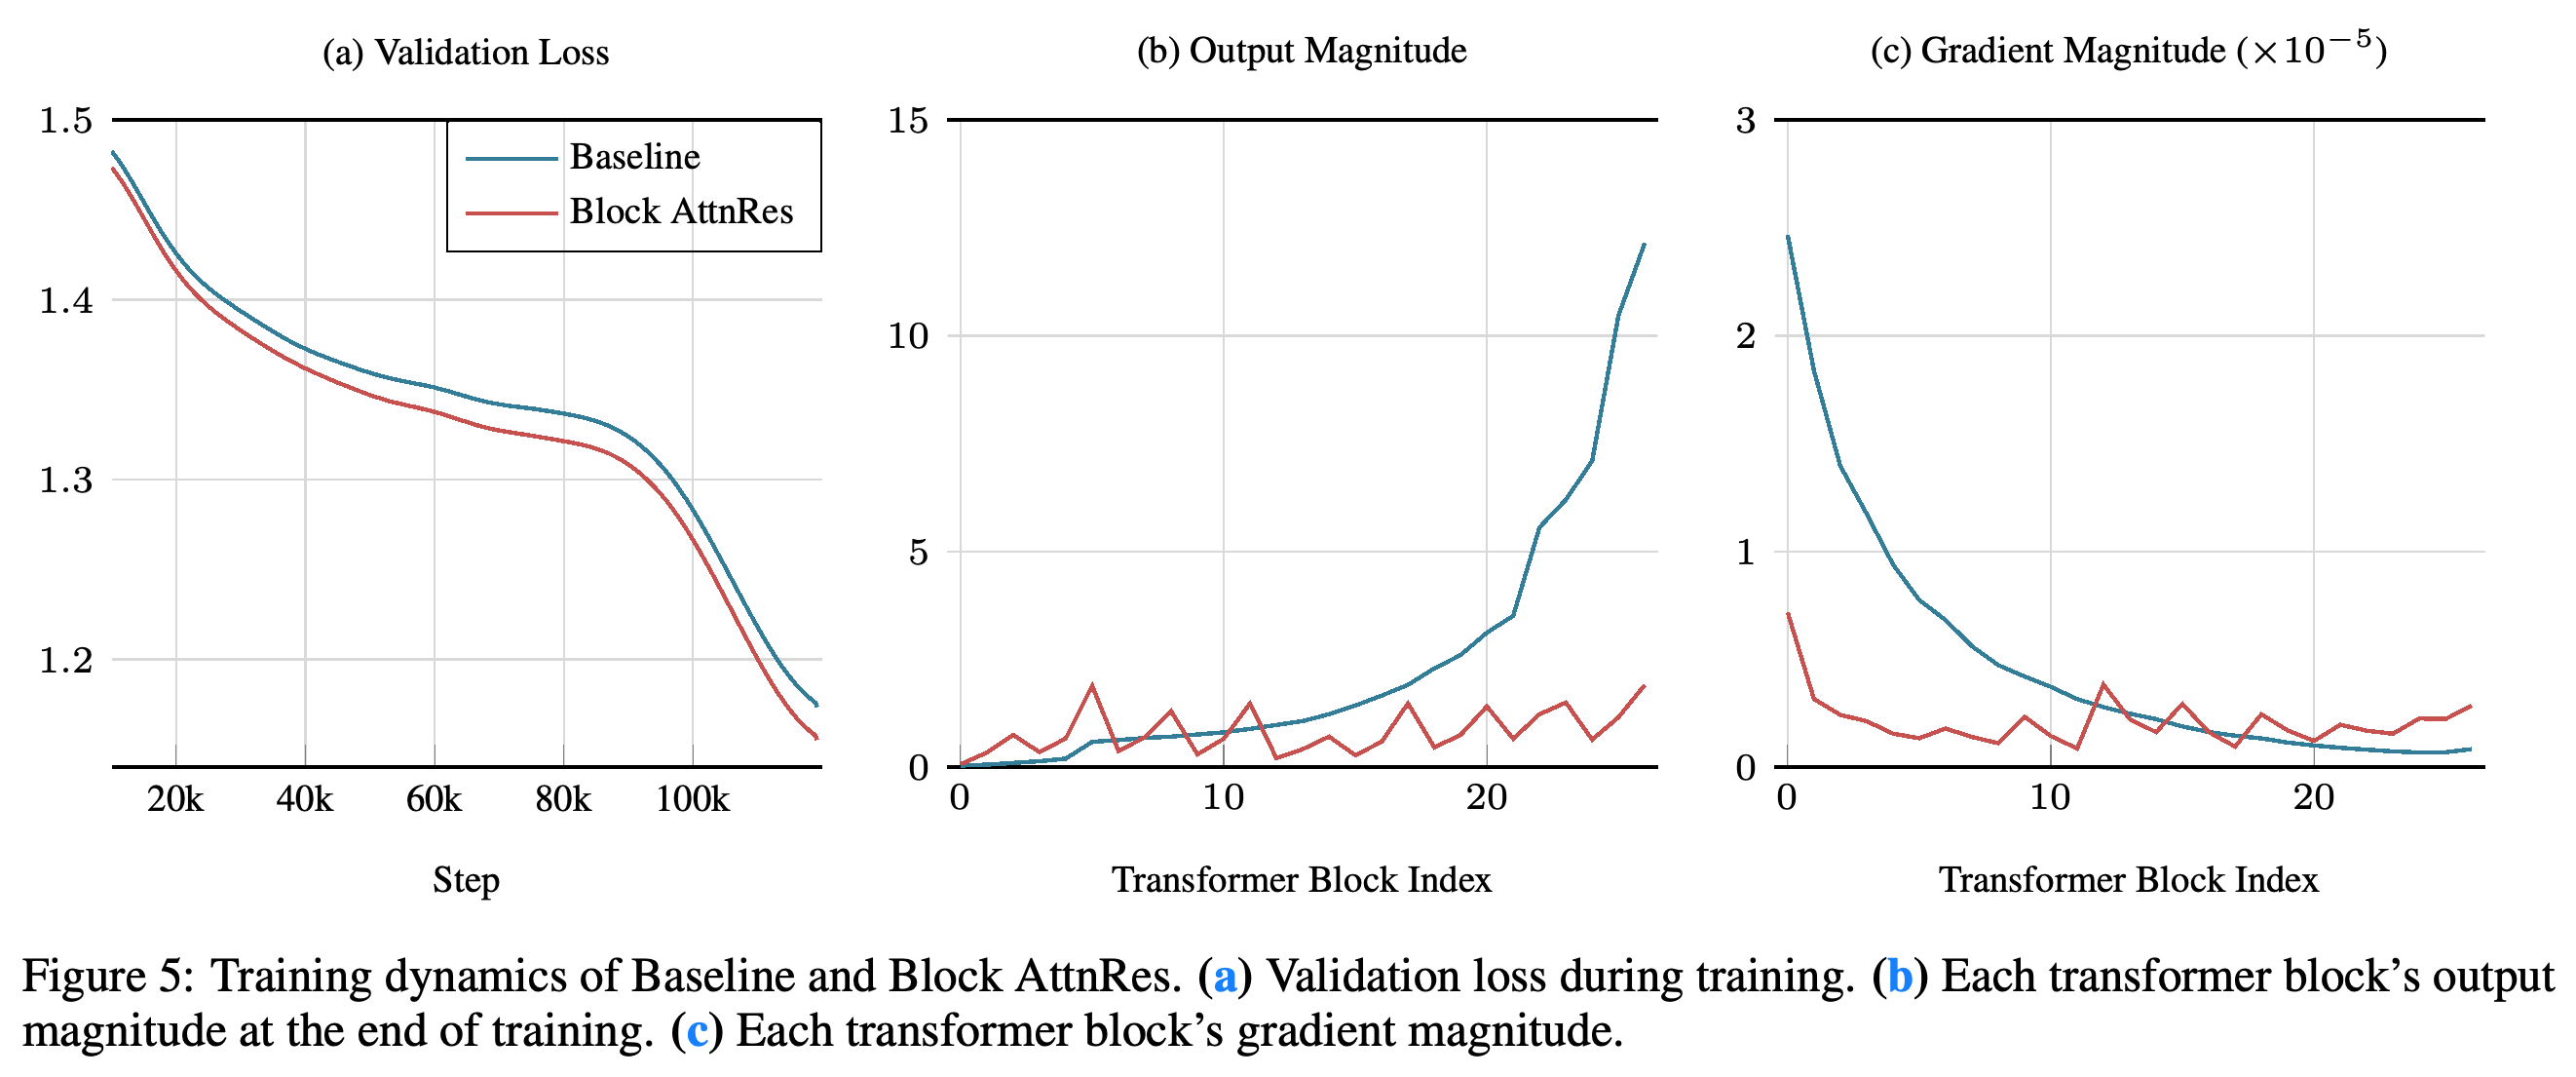
1T-token 학습 구간의 학습 양상을 보면 Block AttnRes의 검증 손실은 학습 전반에서 더 낮으며, decay 구간에서는 차이가 더 커진다. Figure 5는 출력 크기가 제한된 범위에서 주기적으로 변하고, 기울기가 깊이 전반에 더 고르게 분포함을 보여준다. 반면 기준 모델의 출력은 뒤쪽 블록에서 급격히 커지고, 기울기는 앞쪽 블록에서 가장 크다.
- 저자들은 이 주기적인 크기 패턴을 블록 내부로 제한된 누적과 블록 경계에서의 선택적 집계로 해석한다.
- 이 측정 결과는 연구한 모델에서 PreNorm의 기여 희석이 완화됨을 뒷받침하지만, 일반적인 안정성 보장을 입증하지는 않는다.
손실 패널은 1T-token 학습 구간 전반에서 Block AttnRes가 유리함을 보여준다. 출력 크기는 낮은 수준에서 주기적인 패턴을 유지하며, 기울기 분포는 기준 모델보다 평탄하다. 이 관찰은 해당 모델에서 기여 희석이 완화됨을 뒷받침하지만, 일반적인 안정성 보장을 뜻하지는 않는다.
다운스트림 성능은 Kimi Linear 평가 프로토콜에 따라 동일한 설정으로 학습한 모델들을 비교한다. Block AttnRes는 보고된 벤치마크 14개에서 성능이 향상되었고 MMLU-Pro에서는 동률을 기록했다. 제시된 결과 중 GPQA-Diamond의 향상 폭이 가장 크다. 깊이 방향 검색과 조합적 추론 사이의 연관성은 아직 가설이다.
- 일반 벤치마크의 Baseline → AttnRes 결과는 MMLU 73.5 → 74.6, MMLU-Pro 52.2 → 52.2, GPQA-Diamond 36.9 → 44.4, BBH 76.3 → 78.0, ARC-Challenge 64.6 → 65.7, HellaSwag 83.2 → 83.4, TriviaQA 69.9 → 71.8이다.
- Math & Code 결과는 GSM8K 81.7 → 82.4, MGSM 64.9 → 66.1, Math 53.5 → 57.1, CMath 84.7 → 85.1, HumanEval 59.1 → 62.2, MBPP 72.0 → 73.9다.
- 중국어 결과는 CMMLU 82.0 → 82.9와 C-Eval 79.6 → 82.5다. 이 차이에 대한 신뢰구간이나 반복 실행 변동성은 보고하지 않는다.
5.3 Ablation Study
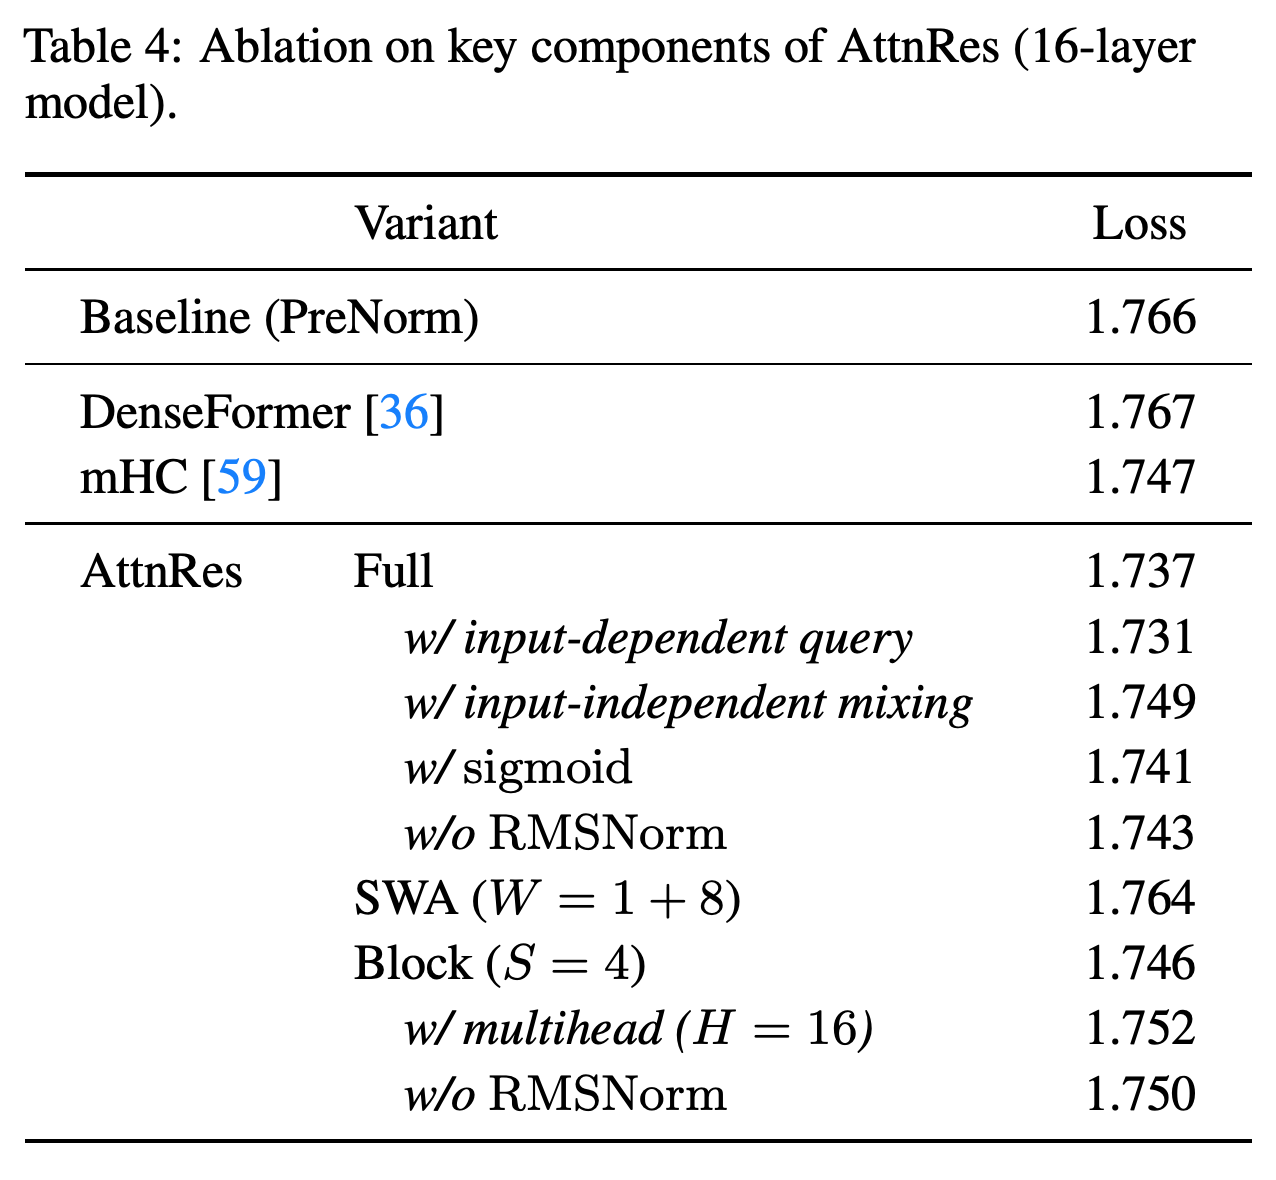
기존 방법과의 비교는 Table 2의 16-head 설정에서 동일한 하이퍼파라미터와 연산 예산을 사용한다. 검증 손실은 PreNorm 1.766, DenseFormer 1.767, mHC 1.747, Full AttnRes 1.737, S = 4인 Block AttnRes 1.746이다. 이 설정에서는 내용에 따라 층 간 출력을 집계하는 방식이 유리하지만, Block AttnRes와 mHC의 차이는 0.001에 불과하다.
- 층 간 참조는 짧은 윈도우를 넘어설 때 효과가 있다. 임베딩과 최근 출력 8개를 집계하는 sliding-window 방식은 손실이 1.764에 그친다.
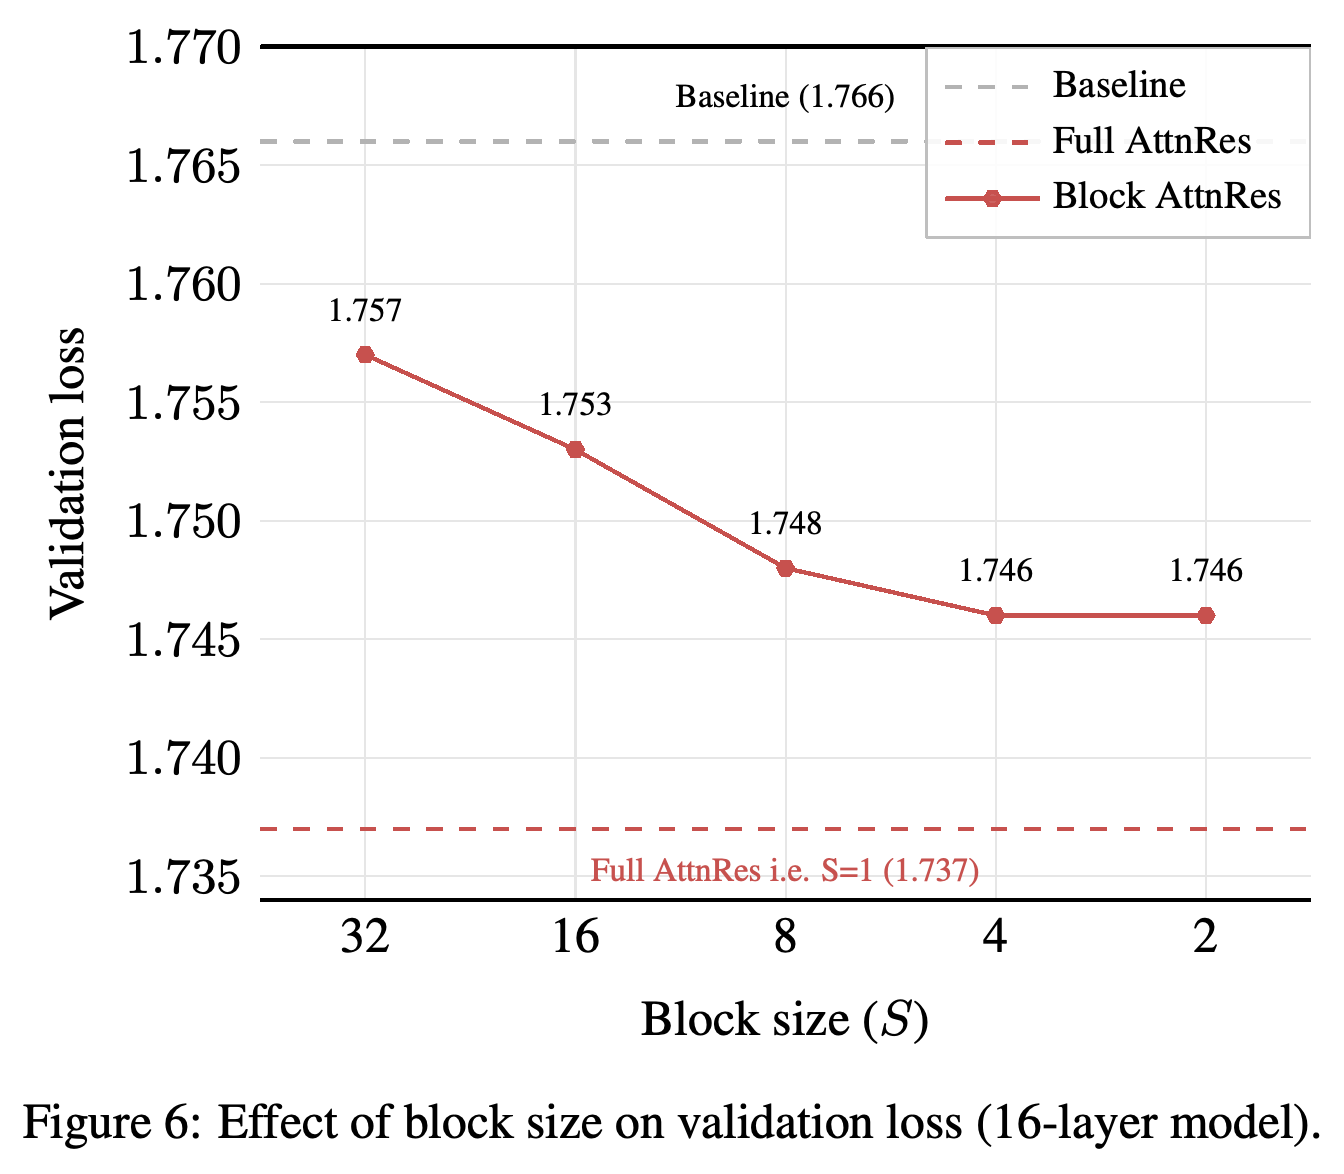
- Figure 6에서 S = 32, 16, 8, 4, 2의 손실은 각각 1.757, 1.753, 1.748, 1.746, 1.746이며, S = 1인 Full AttnRes는 1.737을 기록한다. 큰 블록도 일부 이점을 유지하지만, 세밀한 참조가 여전히 더 좋다.
- Table 4와 Figure 6은 이를 16층 모델이라고 부르지만, Table 2와 Figure 8은 attention 층 16개와 MLP 층 16개를 포함한 Transformer 블록 16개로 설명한다. 따라서 캡션은 논문의 하위층 기준 표기와 다른 층 수 계산 방식을 사용한다.
Full AttnRes는 PreNorm의 1.766보다 낮은 1.737을 기록하며, 정적 혼합, sigmoid 가중치, RMSNorm 제거는 각각 손실을 높인다. 입력에 따라 달라지는 query는 1.731을 기록하지만 투영 및 순차 접근 비용을 추가한다. Block multihead 집계 역시 단일 혼합을 사용하는 Block 설계보다 성능이 낮다.
블록 크기를 32에서 4로 줄이면 손실이 1.757에서 1.746으로 낮아지며, 크기 2에서는 추가 향상이 측정되지 않았다. 크기 1인 Full AttnRes는 여전히 더 낮은 1.737을 기록한다. 이는 저장 공간과 통신 측면에서 유리한 절충에도 불구하고 블록 압축에 따른 손실이 남아 있음을 보여준다.
구성 요소 절제 실험은 softmax 경쟁, 정규화된 key, 내용에 따라 달라지는 가중치가 유리함을 보여준다. 입력에 따라 달라지는 query를 사용하면 Full AttnRes 손실이 1.731로 더 낮아진다. 다만 d × d 투영과 순차적인 query 생성이 파라미터 및 디코딩 중 메모리 접근 비용을 추가하므로, 저자들은 고정된 학습 query를 유지한다.
- 입력과 무관한 학습 혼합은 Full 손실을 1.749로 높이며, sigmoid 가중치는 1.741, key RMSNorm 제거는 1.743을 기록한다.
- Block AttnRes에서 H = 16인 multihead 깊이 집계는 1.746 대신 1.752를 기록하며, RMSNorm을 제거하면 1.750을 기록한다.
- Multihead 결과는 이 실험에서 전체 표현을 혼합하는 방식만으로 충분하다는 해석과 일치하지만, 채널별 특화가 일반적으로 도움이 되지 않는다는 점을 입증하지는 않는다.
5.4 Analysis
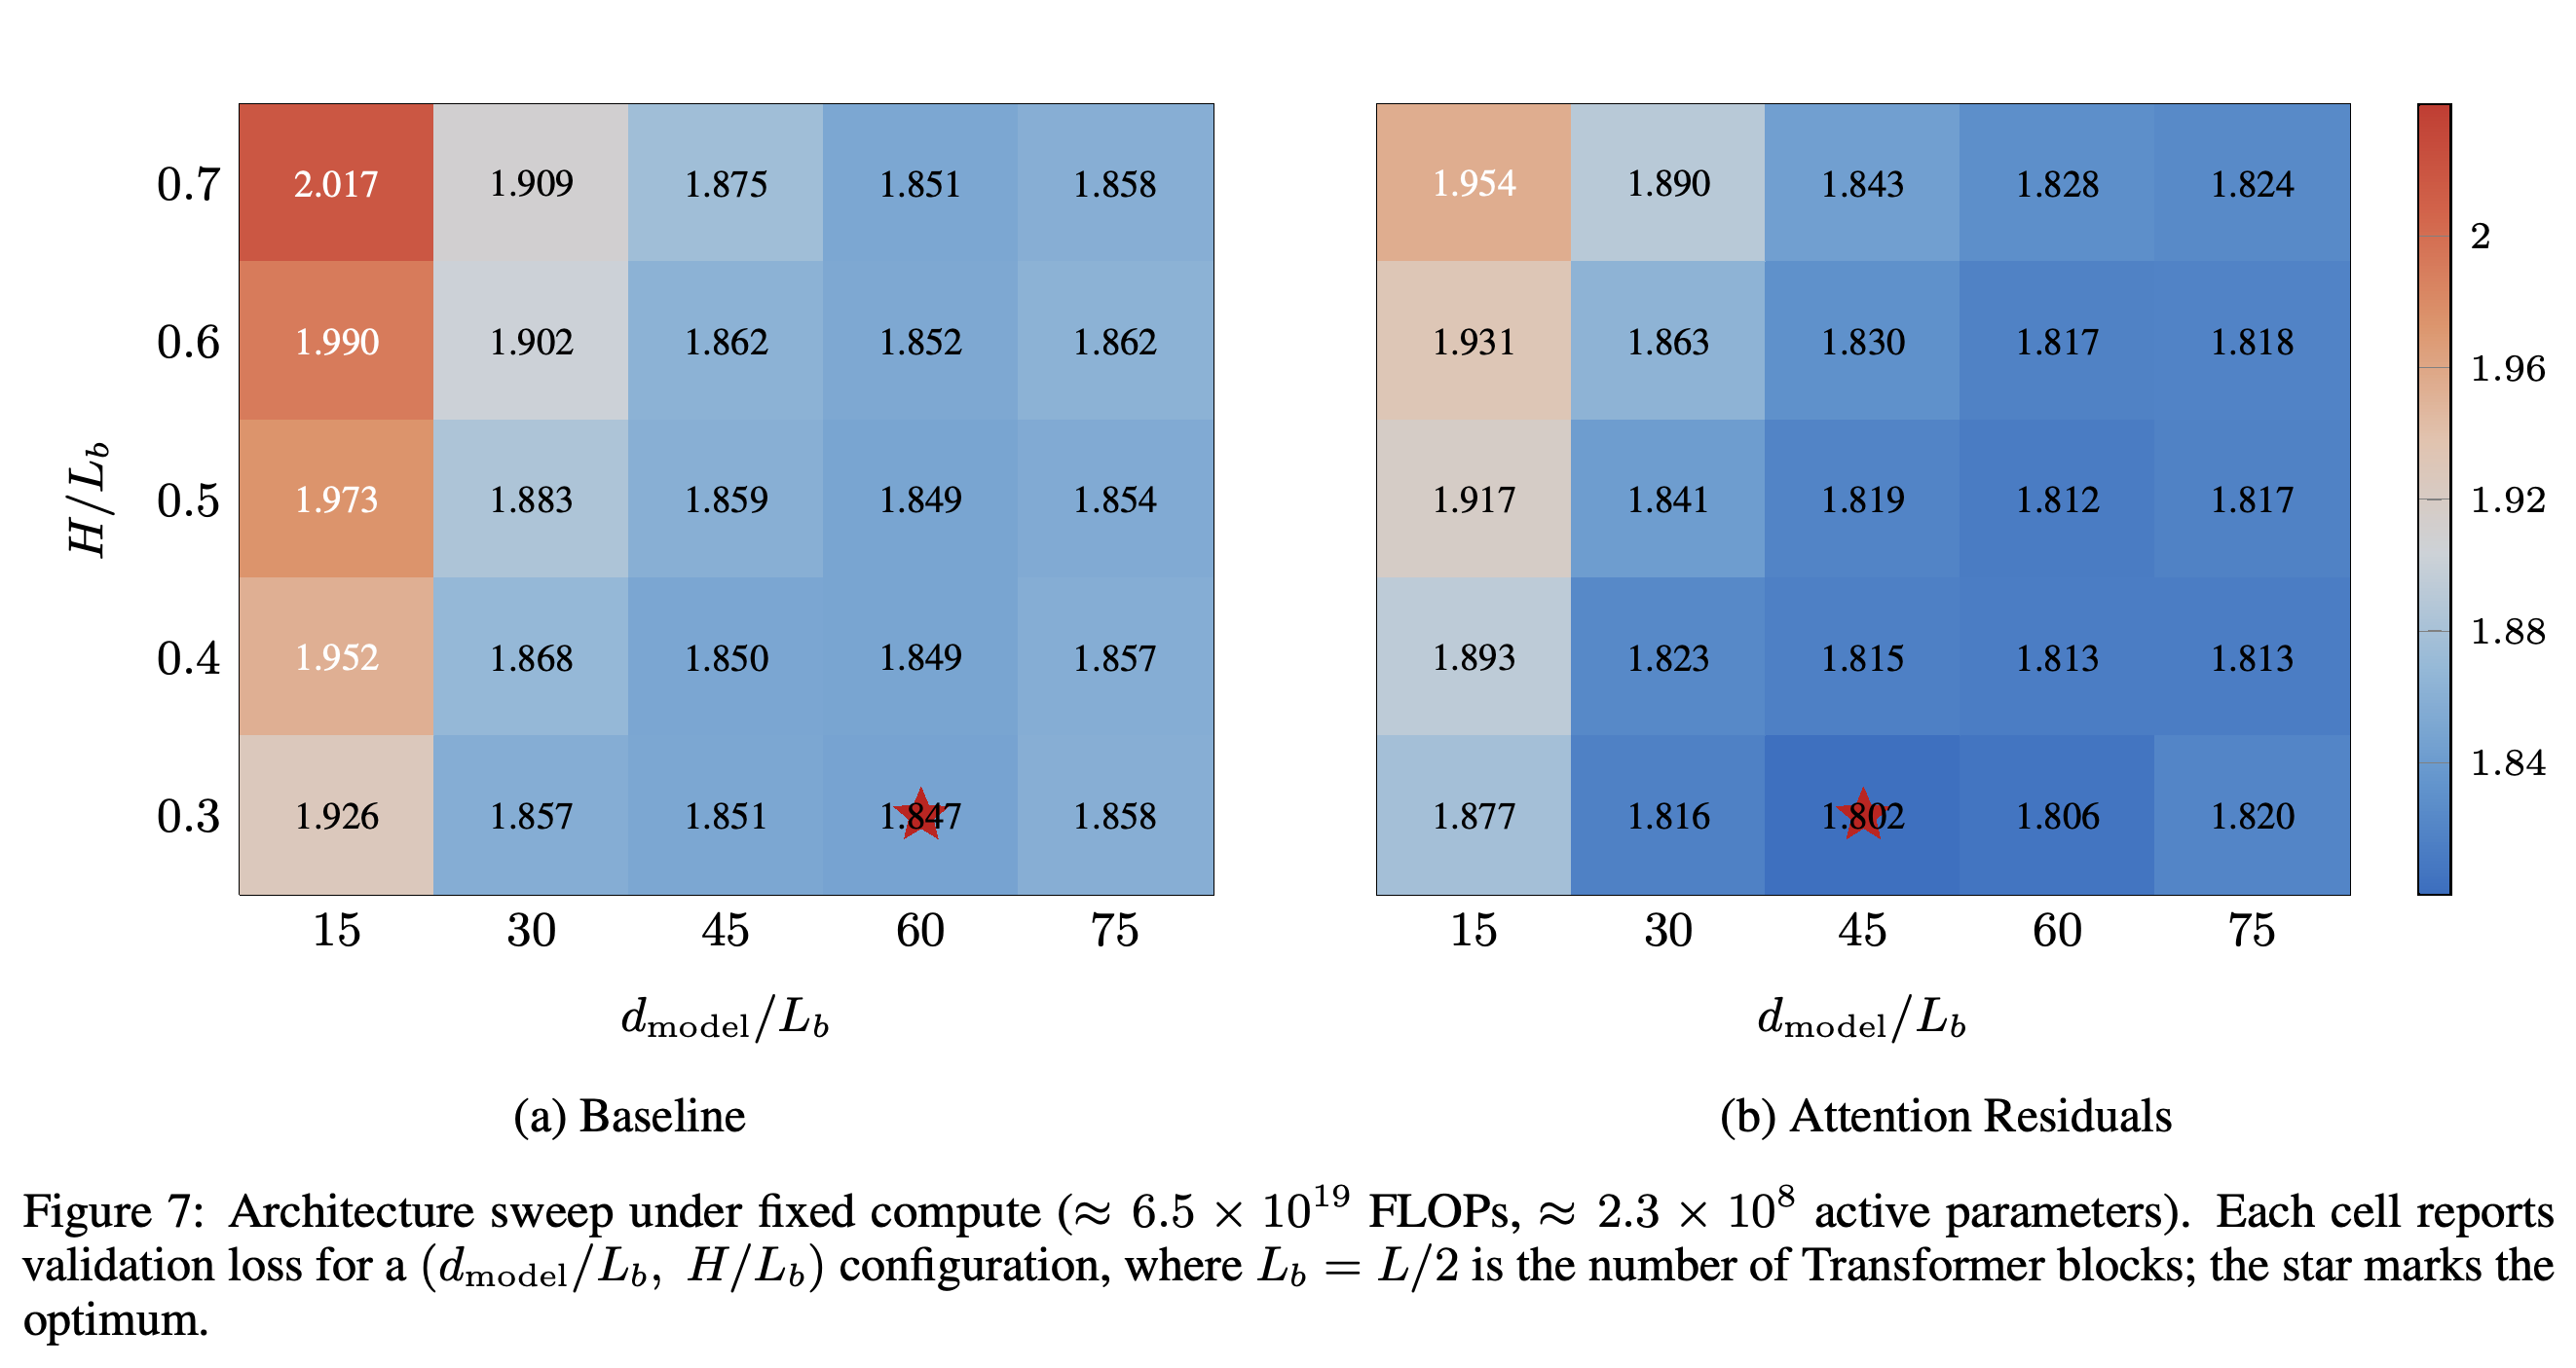
5.4.1 Optimal Architecture는 약 6.5 × 10^19 FLOPs와 활성 파라미터 2.3 × 10^8의 예산에서 d_ff/d_model ≈ 0.45인 설정 25개를 연구한다. 격자는 d_model/L_b ∈ {15, 30, 45, 60, 75}와 H/L_b ∈ {0.3, 0.4, 0.5, 0.6, 0.7}을 포함하며, L_b = L/2다.
- AttnRes는 모든 격자 셀에서 손실을 0.019–0.063 낮춘다. 두 최적점 모두 H/L_b ≈ 0.3이지만, 기준 모델의 최적점은 d_model/L_b ≈ 60에서 손실 1.847이며, AttnRes는 ≈ 45에서 1.802다.
- 고정된 파라미터 예산에서 폭 대 깊이 비율이 낮아졌다는 것은 더 깊고 좁은 구성을 선호함을 뜻한다. 저자들은 순차적인 깊이가 커지면 추론 지연 시간이 늘어날 수 있다고 지적한다. 따라서 이 분석은 배포 설정에 대한 권고가 아니다.
AttnRes는 고정 예산 아키텍처 격자의 모든 셀에서 손실을 낮춘다. Head 대 깊이 비율 0.3을 유지하면서 최적 폭 대 깊이 비율이 기준 모델의 60에서 45로 이동하므로, 더 깊고 좁은 구성을 선호함을 보여준다. 이 손실 탐색은 추가적인 순차 깊이에 따른 지연 시간 비용을 측정하지 않는다.
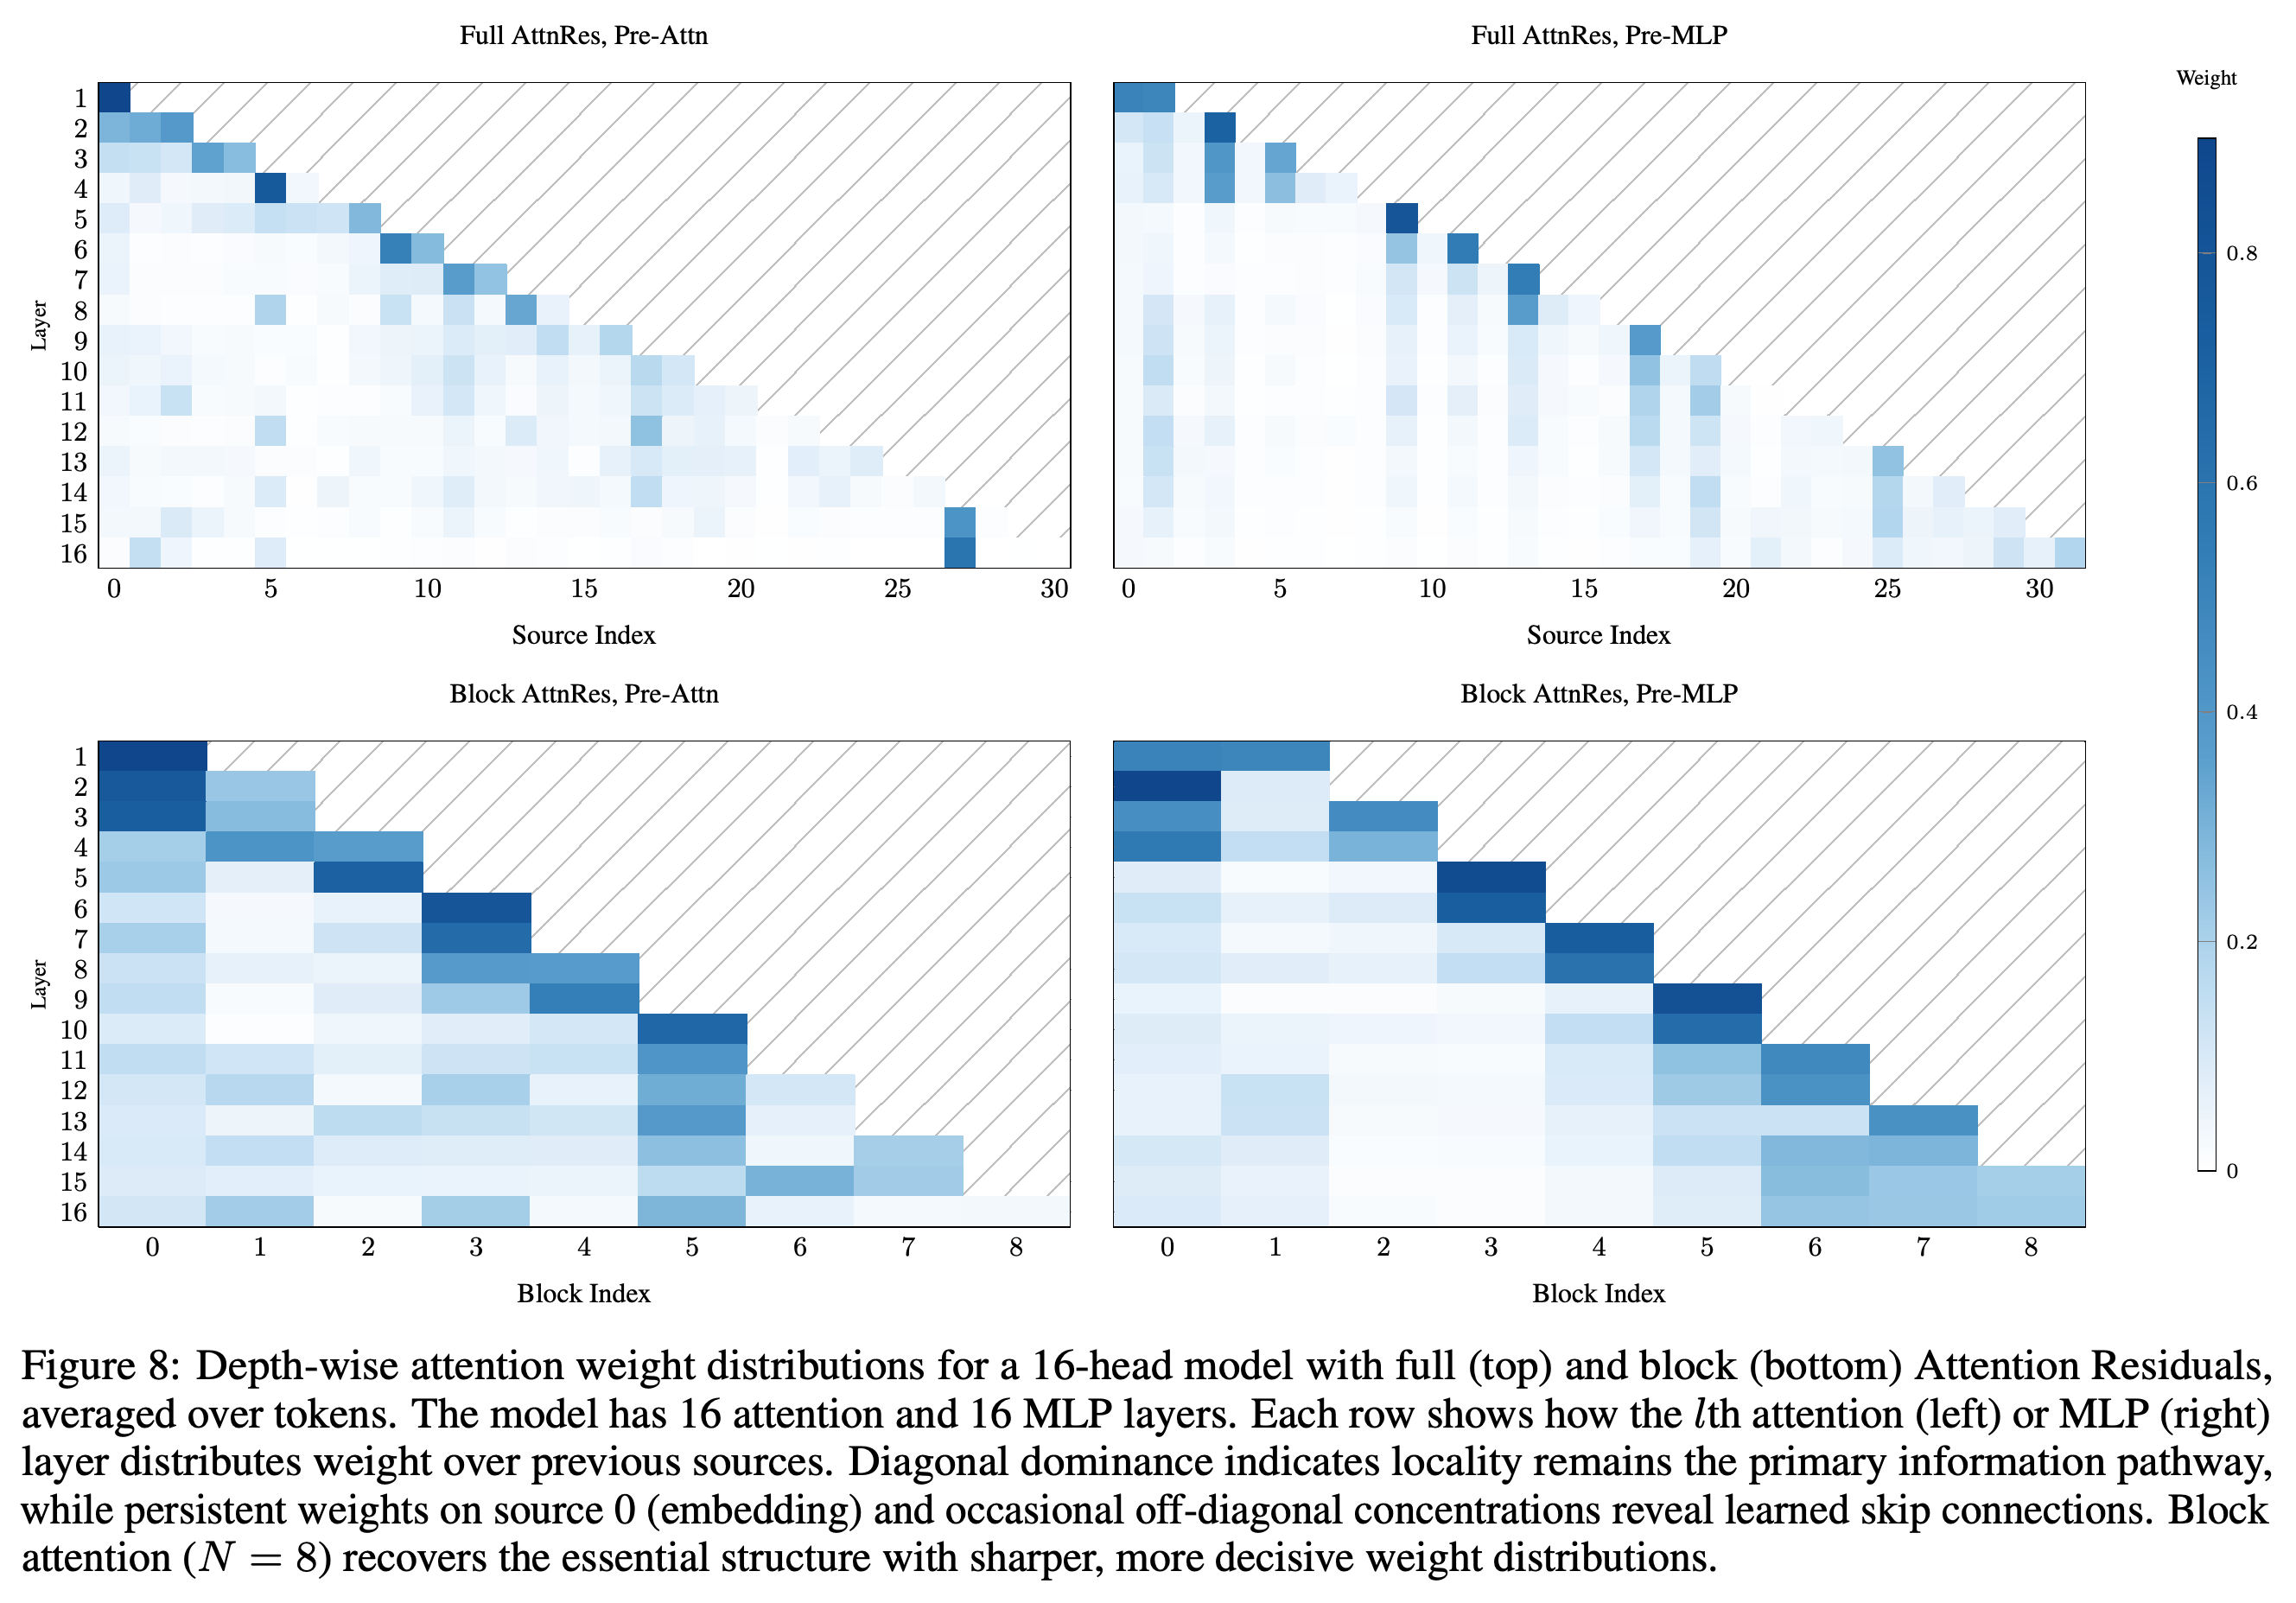
5.4.2 Analyzing Learned AttnRes Patterns는 attention 층 16개와 MLP 층 16개를 가진 모델의 토큰 평균 가중치를 분석하며, Full과 N = 8인 Block AttnRes를 비교한다. 두 방식 모두 강한 국소 경로를 유지하면서 임베딩에는 지속적인 가중치를, 먼 소스에는 선택적인 가중치를 부여한다.
- 대각선 우세는 국소성을 유지함을 보여주며, 대각선 밖에 집중된 가중치는 학습된 skip connection을 나타낸다.
- 층별 특화는 attention 전에는 더 넓은 소스 혼합으로, MLP 전에는 최근 소스에 더 집중된 의존으로 나타난다. 특히 attention 전에는 임베딩 가중치가 뚜렷하다.
- Block AttnRes는 더 집중된 분포로 이러한 정성적 패턴을 유지한다. 다만 히트맵은 토큰 평균이므로 토큰별 라우팅의 변동 정도를 보여주지 않으며, 저자들이 제안한 암묵적 정규화 효과를 입증하지도 않는다.
대각선에 집중된 가중치는 가까운 소스가 여전히 중요함을 보여주며, 임베딩 가중치와 대각선 밖의 피크는 먼 깊이 소스를 지속적이고 선택적으로 참조함을 보여준다. Attention 전에는 MLP 전보다 더 넓은 소스를 혼합하고, Block AttnRes도 이러한 패턴을 유지한다. 토큰 평균은 개별 라우팅 결정을 드러내지 않는다.
6 Discussions
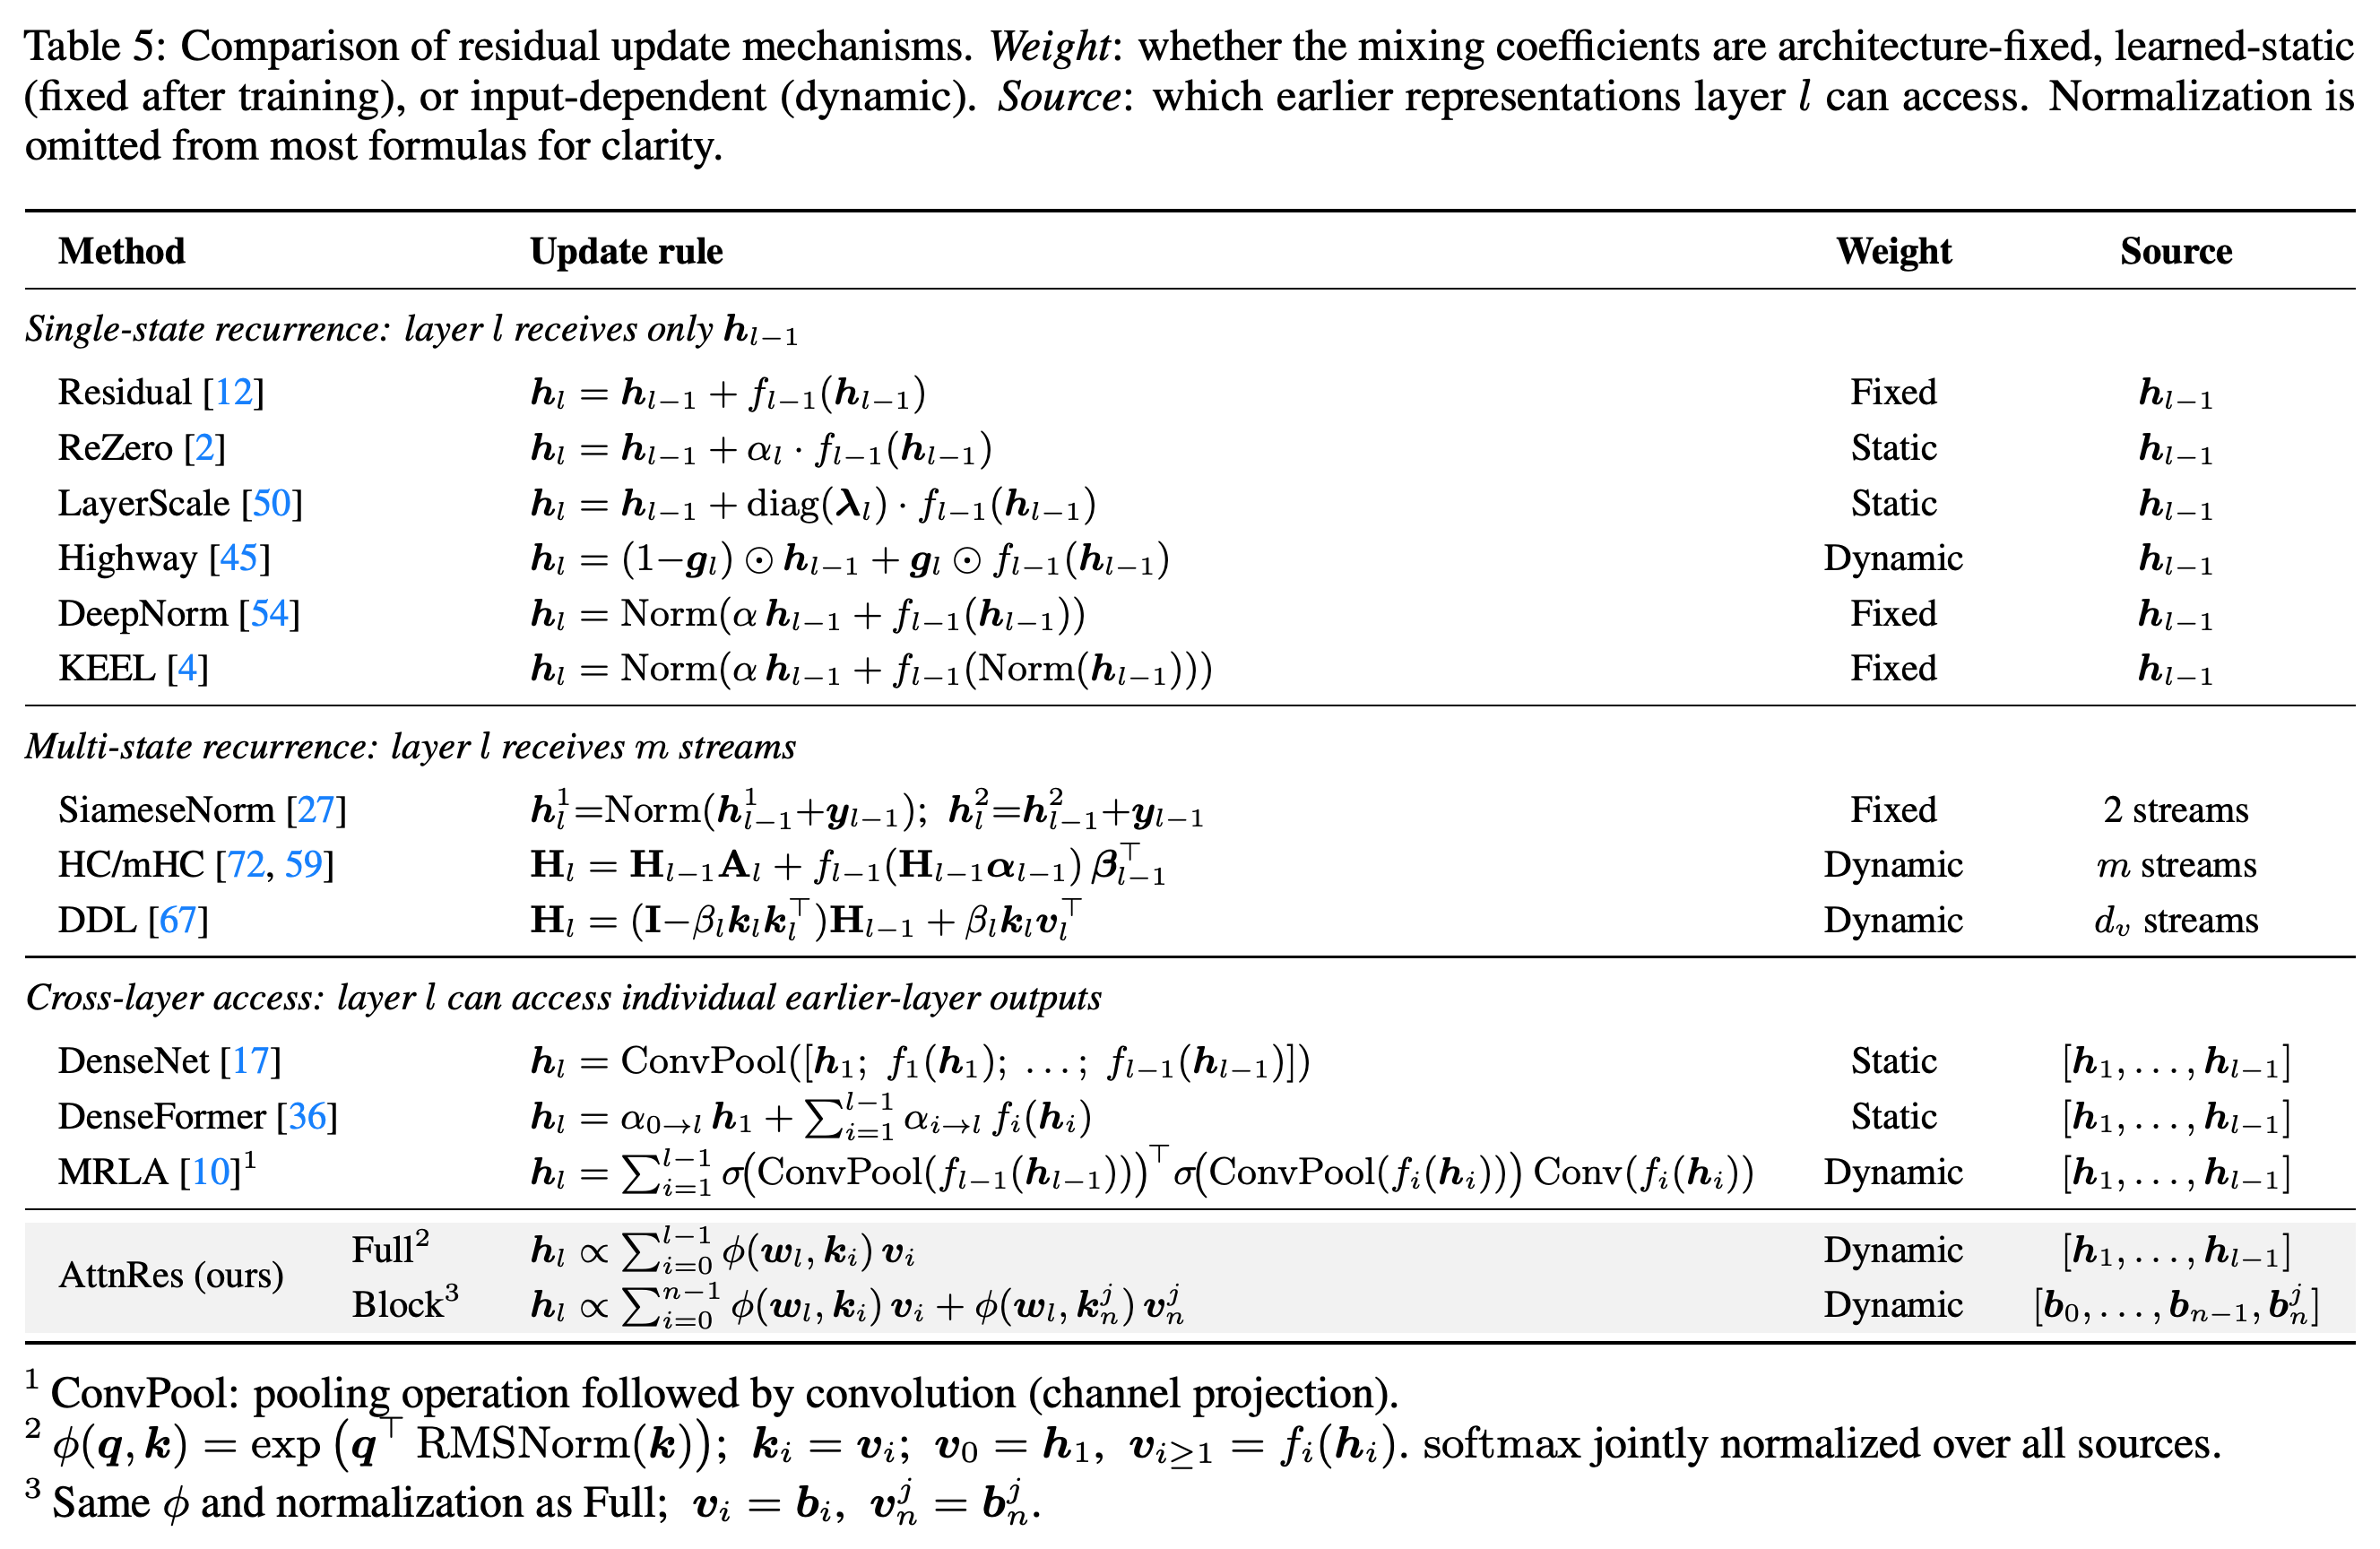
Discussions는 시퀀스–깊이 이중성과 구조화된 깊이 혼합 행렬로 잔차 메커니즘을 정리한다. Table 5는 고정 가중치, 학습된 정적 가중치, 입력에 따라 달라지는 가중치를 구별한다. 또한 단일 상태 점화식, 다중 상태 점화식, 보관한 이전 출력의 참조를 구분한다.
6.1 Sequence-Depth Duality
Sequence-Depth Duality는 시퀀스의 순환 갱신을 깊이 방향의 순환 갱신과 연결한다. Test-Time Training은 W_t = W_{t−1} − η∇ℓ(W_{t−1}; x_t)로 표현되며, 선형인 경우 덧셈 형태의 linear attention인 S_t = S_{t−1} + k_t v_t^T가 된다. 표준 잔차 연결도 층 방향으로 이 덧셈 형태를 공유한다.
- 논문은 시퀀스 게이트를 Highway 네트워크와, delta-rule 모델을 DDL과, MRLA를 gated linear attention과 연결한다. 반면 AttnRes는 깊이 방향의 직접적인 softmax attention을 통해 이전 출력을 참조하게 한다.
- 이는 구조적 유사성에 대한 설명이지, AttnRes가 Test-Time Training을 수행하거나 층 변환 사이의 순차 의존성을 제거한다는 주장이 아니다.
표는 동적 가중치와 직접적인 층 간 참조를 구별한다. Highway와 HC/mHC는 입력에 따라 갱신이 달라지지만 전달 상태를 대상으로 연산하는 반면, AttnRes는 보관한 이전 소스를 선택한다. DenseFormer의 학습된 정적 층 간 가중치는 소스 참조와 내용 의존성이 서로 다른 설계 선택임을 보여준다.
6.2 Residual Connections as Structured Matrices
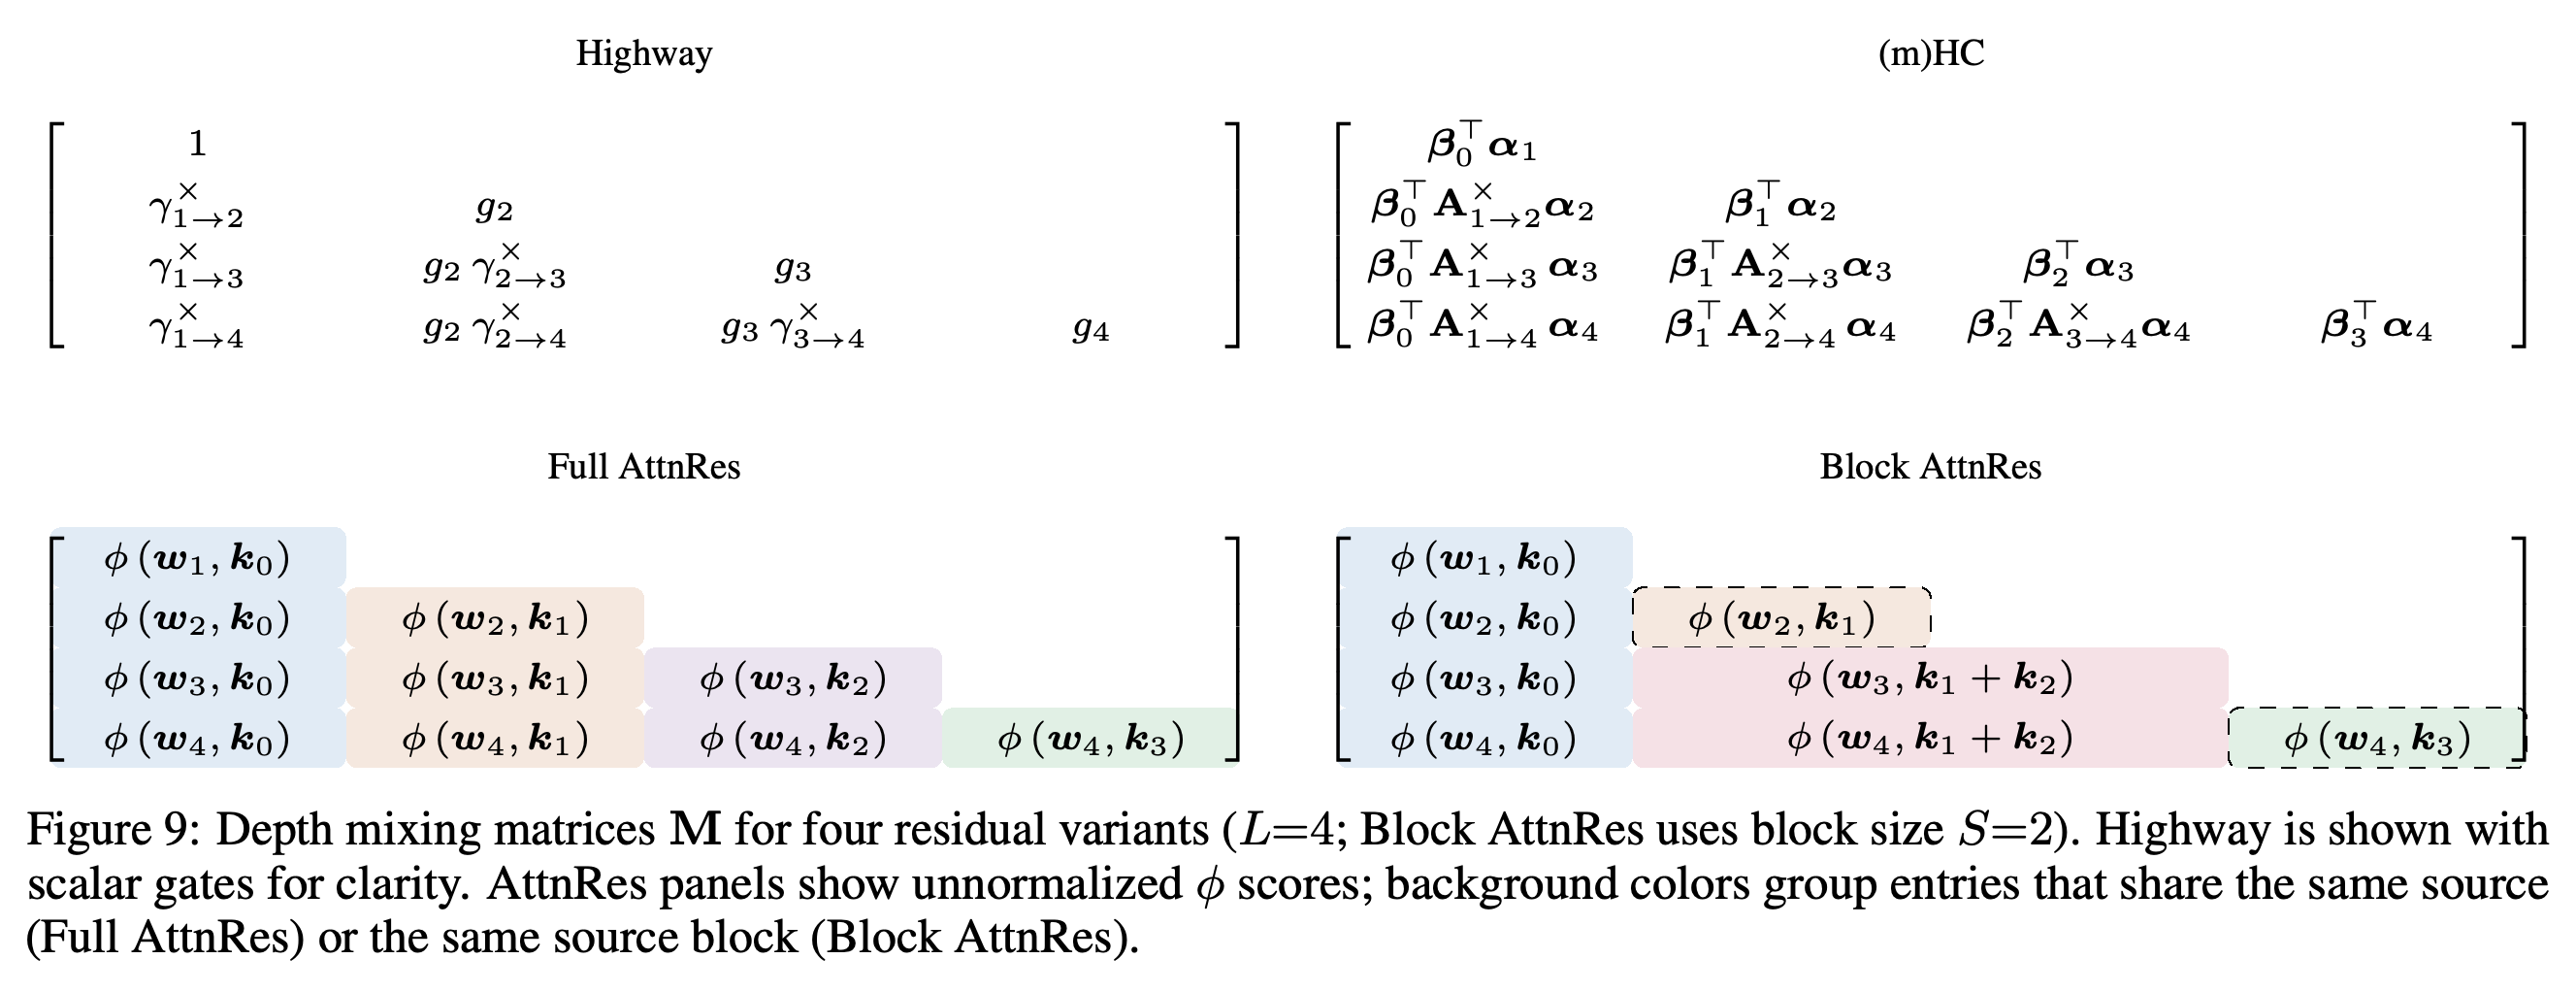
Residual Connections as Structured Matrices는 h_l = Σ_{i=0}^{l−1} M_{i→l}v_i로 표현하고 깊이 혼합 행렬 M의 구조를 비교한다. 표준 잔차 연결은 하삼각 부분의 원소가 모두 단위값인 행렬을 만든다. 스칼라 게이트를 사용하는 Highway는 1-semiseparable이고 m-stream HC/mHC는 m-semiseparable이다. 이 semiseparable rank는 점화식의 구조를 설명하는 값이며, 전체 삼각 행렬의 일반적인 rank가 아니다.
- Highway의 소스 가중치는 write gate와 이후 carry gate들의 곱으로 분해된다. 가중치 합이 1이라는 성질은 이 점화식을 softmax-free stick-breaking attention과 연결한다.
- HC/mHC를 전개하면 M_{i→l} = β_i^T A^×_{i+1→l} α_l이 되며, 소스 층과 수신 층 사이의 누적 전이 곱이 포함된다. mHC는 전이 행렬을 이중 확률 행렬로 제한한다.
- Full AttnRes는 정규화된 softmax 가중치를 직접 계산한다. Block AttnRes는 완료된 각 블록 내부 출력들의 가중치를 공유하고 현재 부분합을 소스로 추가한다. 논문은 유효 rank가 N과 N + S 사이에 있다고 설명하지만, 이 경계에 대한 별도의 유도는 제공하지 않는다.
Highway와 HC/mHC의 가중치는 중간 점화 연산자들의 곱을 포함하지만, Full AttnRes는 이전 소스의 점수를 직접 계산한다. Block AttnRes는 완료된 소스 그룹 내에서 점수를 공유하므로, 블록 내부 선택 능력이 사라지는 점이 명확하게 드러난다. 표시된 AttnRes 점수는 정규화되지 않은 값이다.
Practicality는 행렬 관점으로 지속적으로 높은 가중치를 받는 소스를 식별하고, 분해 가능한 attention kernel을 순환 구현과 연결한다. Prior Residuals as Depth-Wise Linear Attention은 HC/mHC의 α_l을 query, β_i를 key, 누적 전이를 깊이 방향의 상대적 위치 연산자로 해석한다. 다중 스트림은 순환 상태를 d에서 d × m으로 확장한다.
- 논문은 이러한 행렬 상태 기반 linear-attention 메커니즘을 AttnRes의 깊이 방향 softmax attention과 대비한다. 이 해석은 설계 사이의 관계를 설명하지만, 표현력이나 배포 비용이 동등하다는 뜻은 아니다.
- 인수분해 가능한 kernel ϕ(q, k) = φ(q)^Tφ(k)는 순환 집계를 가능하게 한다. 반면 선택한 지수 kernel은 내용에 따라 소스를 선택하는 정규화된 검색을 구현한다.
7 Related Work
Related Work는 정규화 및 잔차 스케일링, 다중 상태 점화식, 층 간 연결을 구별한다. AttnRes는 이전 출력에 대한 softmax 정규화 및 입력 의존 선택, 층마다 단일 d차원 pseudo-query, 분산 학습과 추론 최적화로 뒷받침되는 블록 압축을 결합한다.
- Normalization, Scaling, and Depth Stability는 PreNorm의 항등 기울기 경로와 크기 증가를 PostNorm의 잔차 경로상 반복 정규화와 대비하고, 스케일링·혼합·게이트 기반 대안을 논의한다.
- Multi-State Recurrence에는 HC/mHC, DDL, SiameseNorm이 포함된다. 이들은 독립적으로 선택할 수 있는 이전 출력을 보관하는 대신 전달 상태를 확장하거나 안정화한다.
- Cross-Layer Connectivity에는 DenseNet, ELMo, DenseFormer, ANCRe의 정적 집계, MUDDFormer와 MRLA의 동적 집계, Value Residual Learning, LAuReL, Dreamer의 특정 대상 참조가 포함된다.
Conclusion
Conclusion은 학습된 깊이 방향 attention을 핵심 변화로, Block AttnRes를 실용적인 대규모 변형으로 제시한다. 시험한 스케일링 설정에서는 약 8개 블록으로 성능 향상의 대부분을 얻는다. Full AttnRes는 더 세밀한 선택을 유지하는 대신 이전 층 출력을 보관하고 전송하는 비용을 부담한다.
- 대규모에서의 실용성은 적은 추가 파라미터 수만이 아니라 단계 간 캐싱과 2단계 계산에 달려 있다. 더 세밀한 블록 구성은 여전히 아키텍처상 절충이며, 48B 규모에서 실험으로 입증된 개선은 아니다.
부록
- A Contributions는 기여의 중요도에 따라 기여자를 나열하며, 프로젝트 리더는 마지막에 등장한다. Guangyu Chen, Yu Zhang, Jianlin Su는 동등 기여자로 표시되어 있다. 이 부록은 추가 실험 증거가 아니라 기여자 정보를 제공한다.
- B Optimized Inference I/O for Full Attention Residuals는 층별 소스를 압축하지 않고, 스케줄링만을 위해 실행을 S = L/N개 층으로 이루어진 N개 블록으로 나눈다. Phase 1: Batched Inter-block Attention의 총 읽기는 dL(N−1), 쓰기는 Ld다. Phase 2: Sequential Intra-block Attention은 읽기 NS(S−1)d와 쓰기 Ld를 추가한다. 그 결과 평균 층당 비용은 읽기 (S + N − 2)d, 쓰기 2d이며, (\text{Total I/O per layer}=(S+N)d)가 된다.
짧은 생각
통제된 손실 비교, 구성 요소 절제 실험, 대형 모델의 다운스트림 결과는 AttnRes에 대해 상호 보완적인 근거를 제공한다. 정적 혼합과 짧은 윈도우 참조는 Full AttnRes보다 성능이 낮지만, Block AttnRes는 이점의 상당 부분을 유지한다. 이러한 비교는 시퀀스–깊이 유사성만으로 설명하는 것보다 내용에 따라 먼 깊이 이력을 참조하는 방식의 효과를 더 직접적으로 뒷받침한다.
일반화 가능성은 아직 확인되지 않았다. 실험은 Kimi Linear 아키텍처 계열을 사용하며, 반복 실행에 따른 불확실성이나 상세한 지연 시간 벤치마크 표를 제공하지 않는다. 1.25× 이점은 피팅한 곡선에 기반한 학습 연산량 비교이지, 실제 측정한 실행 시간 단축이 아니다. 토큰 평균 라우팅 그림은 정성적 해석을 뒷받침하지만, 추론 능력 향상의 메커니즘을 입증하지는 않는다.