Tapered Language Models 요약 설명
22 Jun 2026 | Paper Review Language Models Depth-Aware Capacity Allocation MLP Width Tapering목차
- 요약
- 1. Introduction
- 2. Tapered Language Models
- 3. Experiments
- 4. Layer-wise Novelty
- 5. Related Work
- 6. Limitations
- 7. Discussion and Conclusion
- 부록
- 짧은 생각
이번 글에서는 Tapered Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 22일(Arxiv)
- Bayat, Reza, Behrouz, Ali, Courville, Aaron.
- Mila, Cornell University, Université de Montréal, CIFAR AI Chair
- 논문 링크
요약
- Tapered Language Models는 언어 모델의 모든 층에 같은 양의 파라미터를 배분해야 하는지 검증한다. 제안한 방법은 MLP 중간 차원의 평균 너비를 유지하면서 깊이가 증가할수록 너비를 단조 감소시킨다. 총 파라미터 수와 학습 및 추론 FLOPs는 그대로 유지한다.
- 440M Transformer에서 15개 설정을 탐색한 결과, 기준 MLP 너비에 대한 배율이 1.50에서 0.50 times로 감소하는 cosine taper를 선택했다. 이 설정은 분포 내 검증 perplexity를 16.28에서 14.44로 낮췄다. 설정을 바꾸지 않고 760M과 1.3B 규모의 네 아키텍처에 적용했을 때, 평균 상식 추론 정확도와 LAMBADA perplexity는 각각 여덟 비교 모두에서 개선됐고 WikiText perplexity는 일곱 비교에서 개선됐다.
- 사전 학습된 GPT-2를 측정한 결과, 뒤쪽 층의 MLP 업데이트는 입력 residual stream과 더 잘 정렬됐다. 이 관찰은 앞쪽 층에 더 많은 용량을 배분하는 근거가 된다. 다만 논문은 인과적 메커니즘, 아키텍처와 규모 전반에 걸친 최적 배분 형태, 실제 실행 시간 절감, 다른 아키텍처 차원에 대한 적용 가능성을 입증하지는 않는다.
1. Introduction
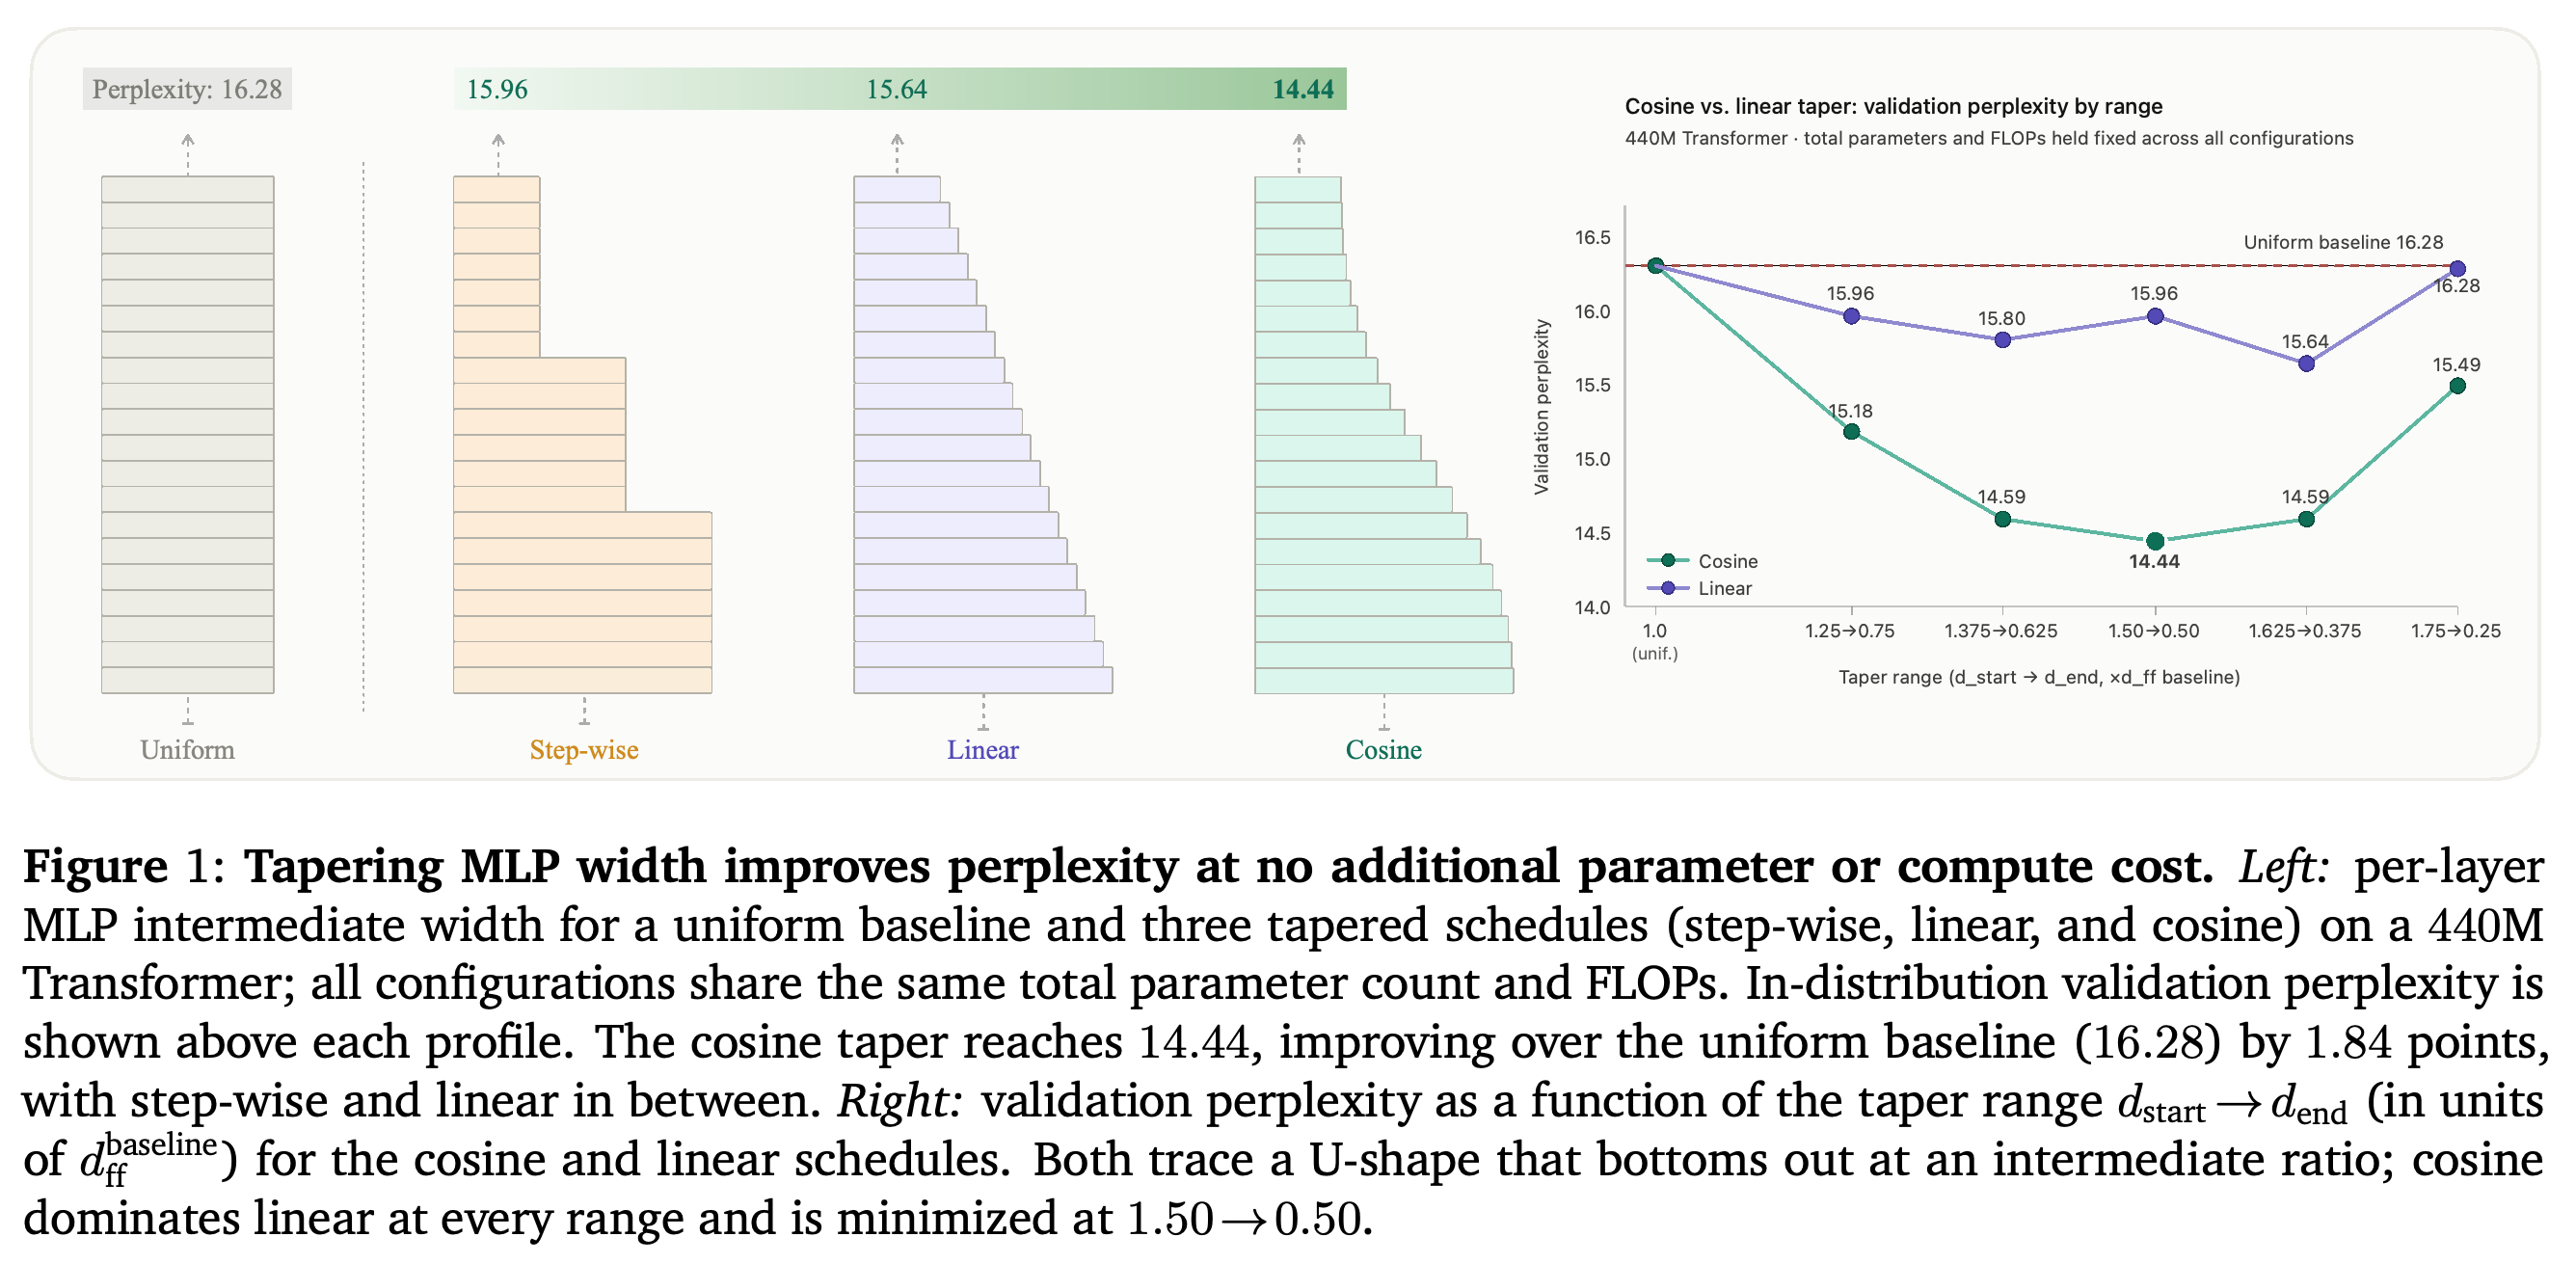
Transformer, 순환형 언어 모델, 메모리 기반 언어 모델은 보통 각 층에 token-mixing 모듈과 MLP를 함께 두고 깊이 전체에 용량을 균등하게 배분한다. 이 논문은 early exit, layer skipping, 중복성 분석, 해석 가능성 연구에서 층의 기여도가 깊이에 따라 다르다는 근거를 바탕으로 이 기본 설계에 의문을 제기한다. Figure 1은 모델 크기나 FLOP 예산을 늘리지 않고도 너비를 부드럽게 재배분하면 perplexity를 개선할 수 있음을 보여준다.
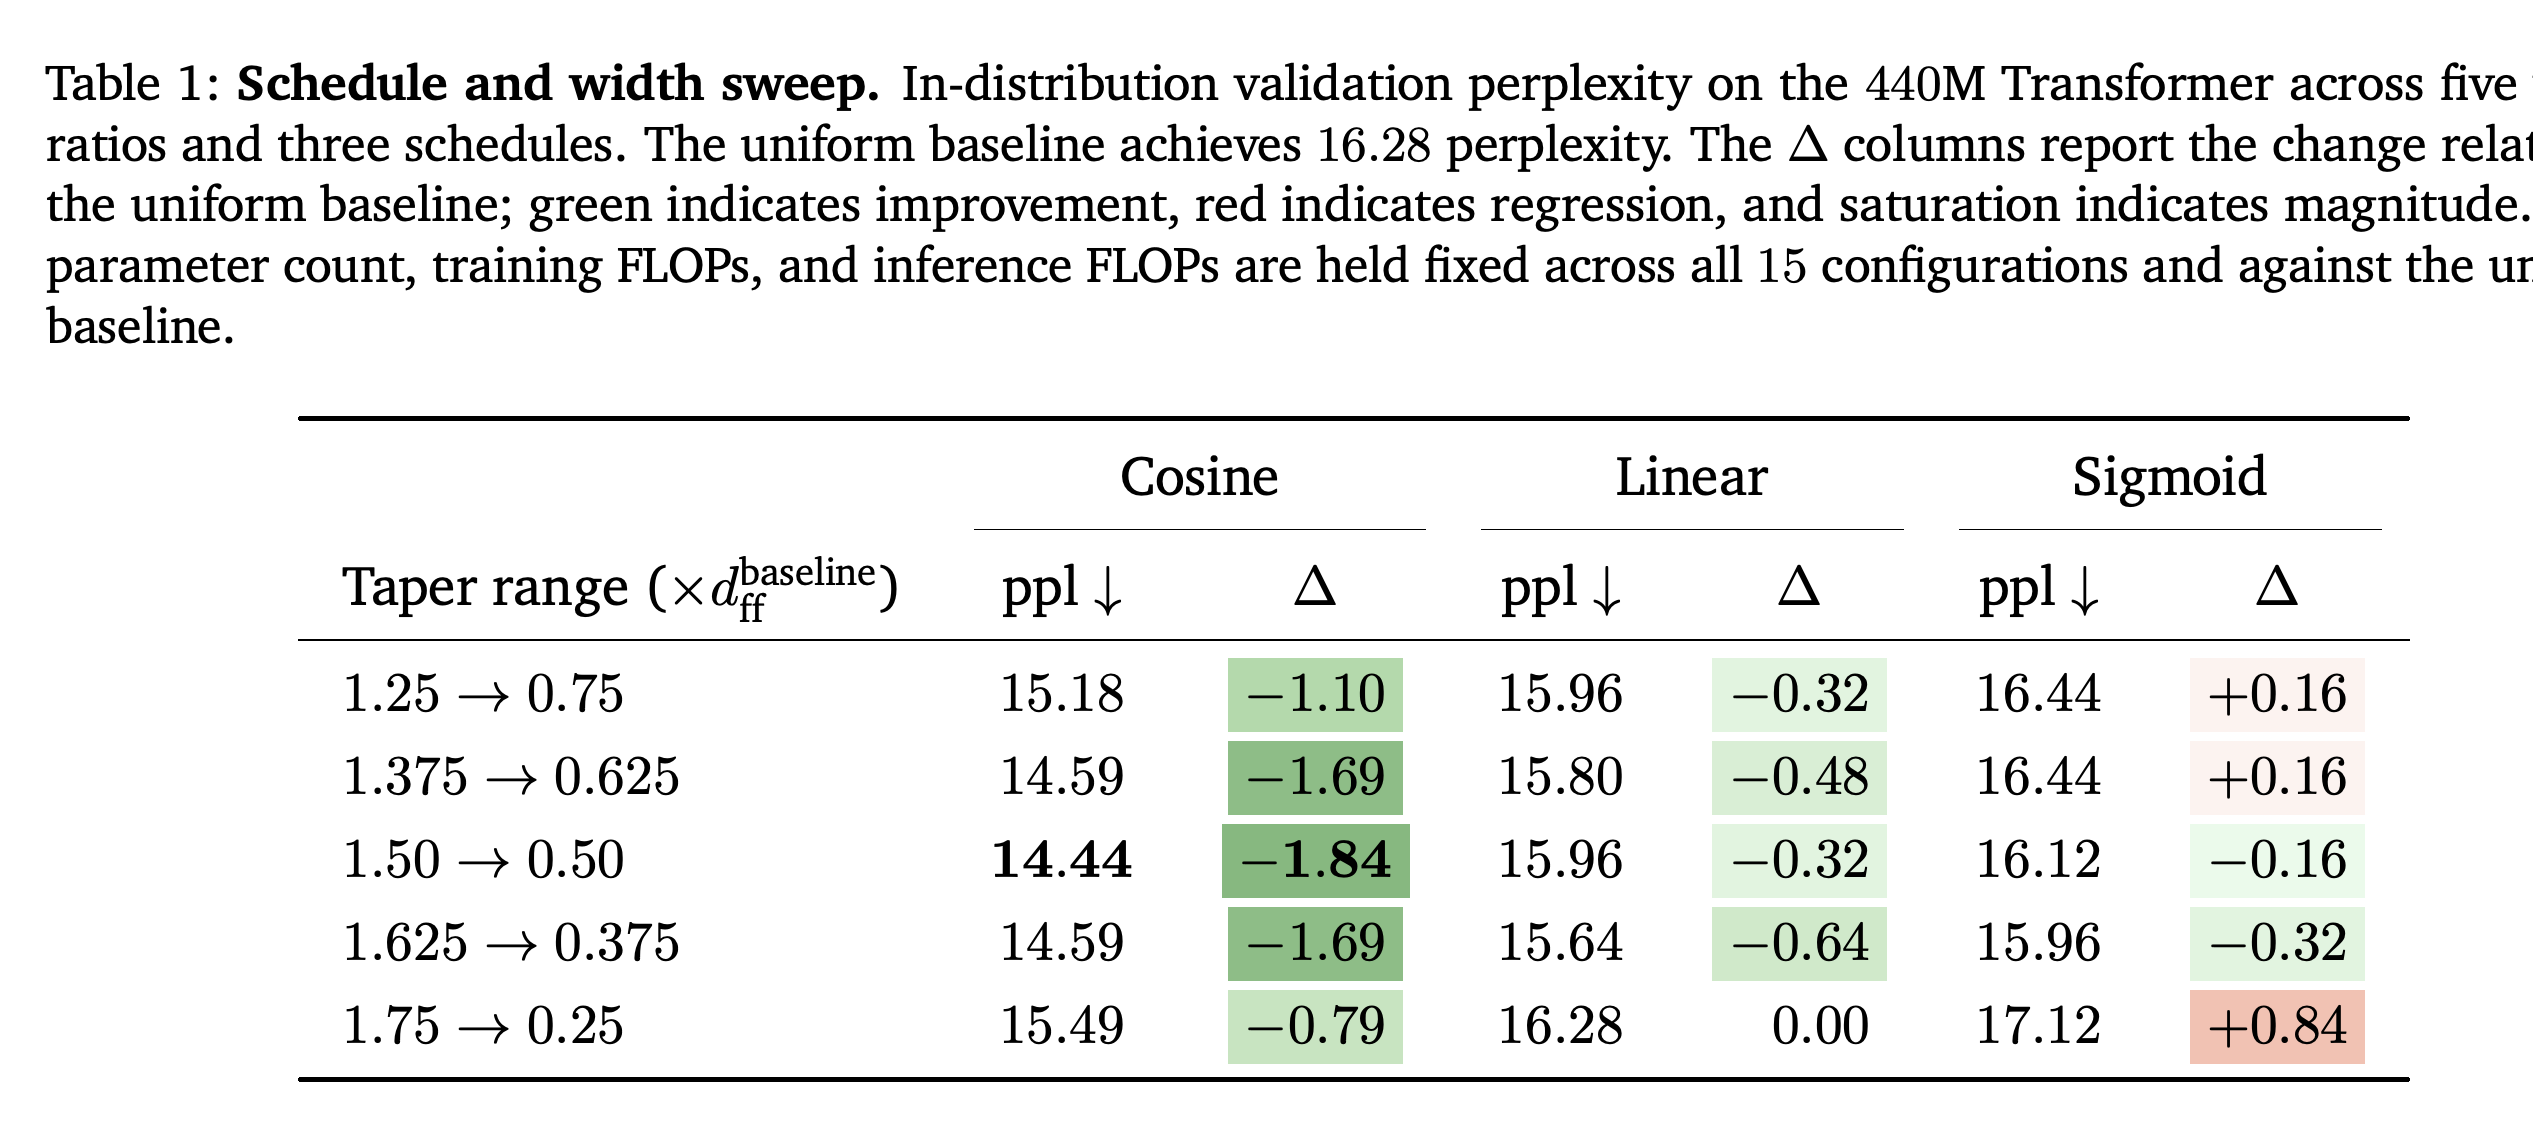
왼쪽 패널은 예산이 같은 너비 배분 형태를 비교한다. Perplexity는 uniform에서 16.28, step-wise에서 15.96, linear에서 15.64, cosine에서 14.44이다. 오른쪽 패널에서는 실험한 모든 범위에서 cosine이 linear보다 좋으며, 1.50→0.50에서 최솟값을 기록한다. 왼쪽의 linear 형태가 표시된 cosine 최적 설정과 같은 시작·끝 너비를 사용한다고 가정해서는 안 된다. Table 1에서 1.50→0.50의 linear perplexity는 15.96이다.
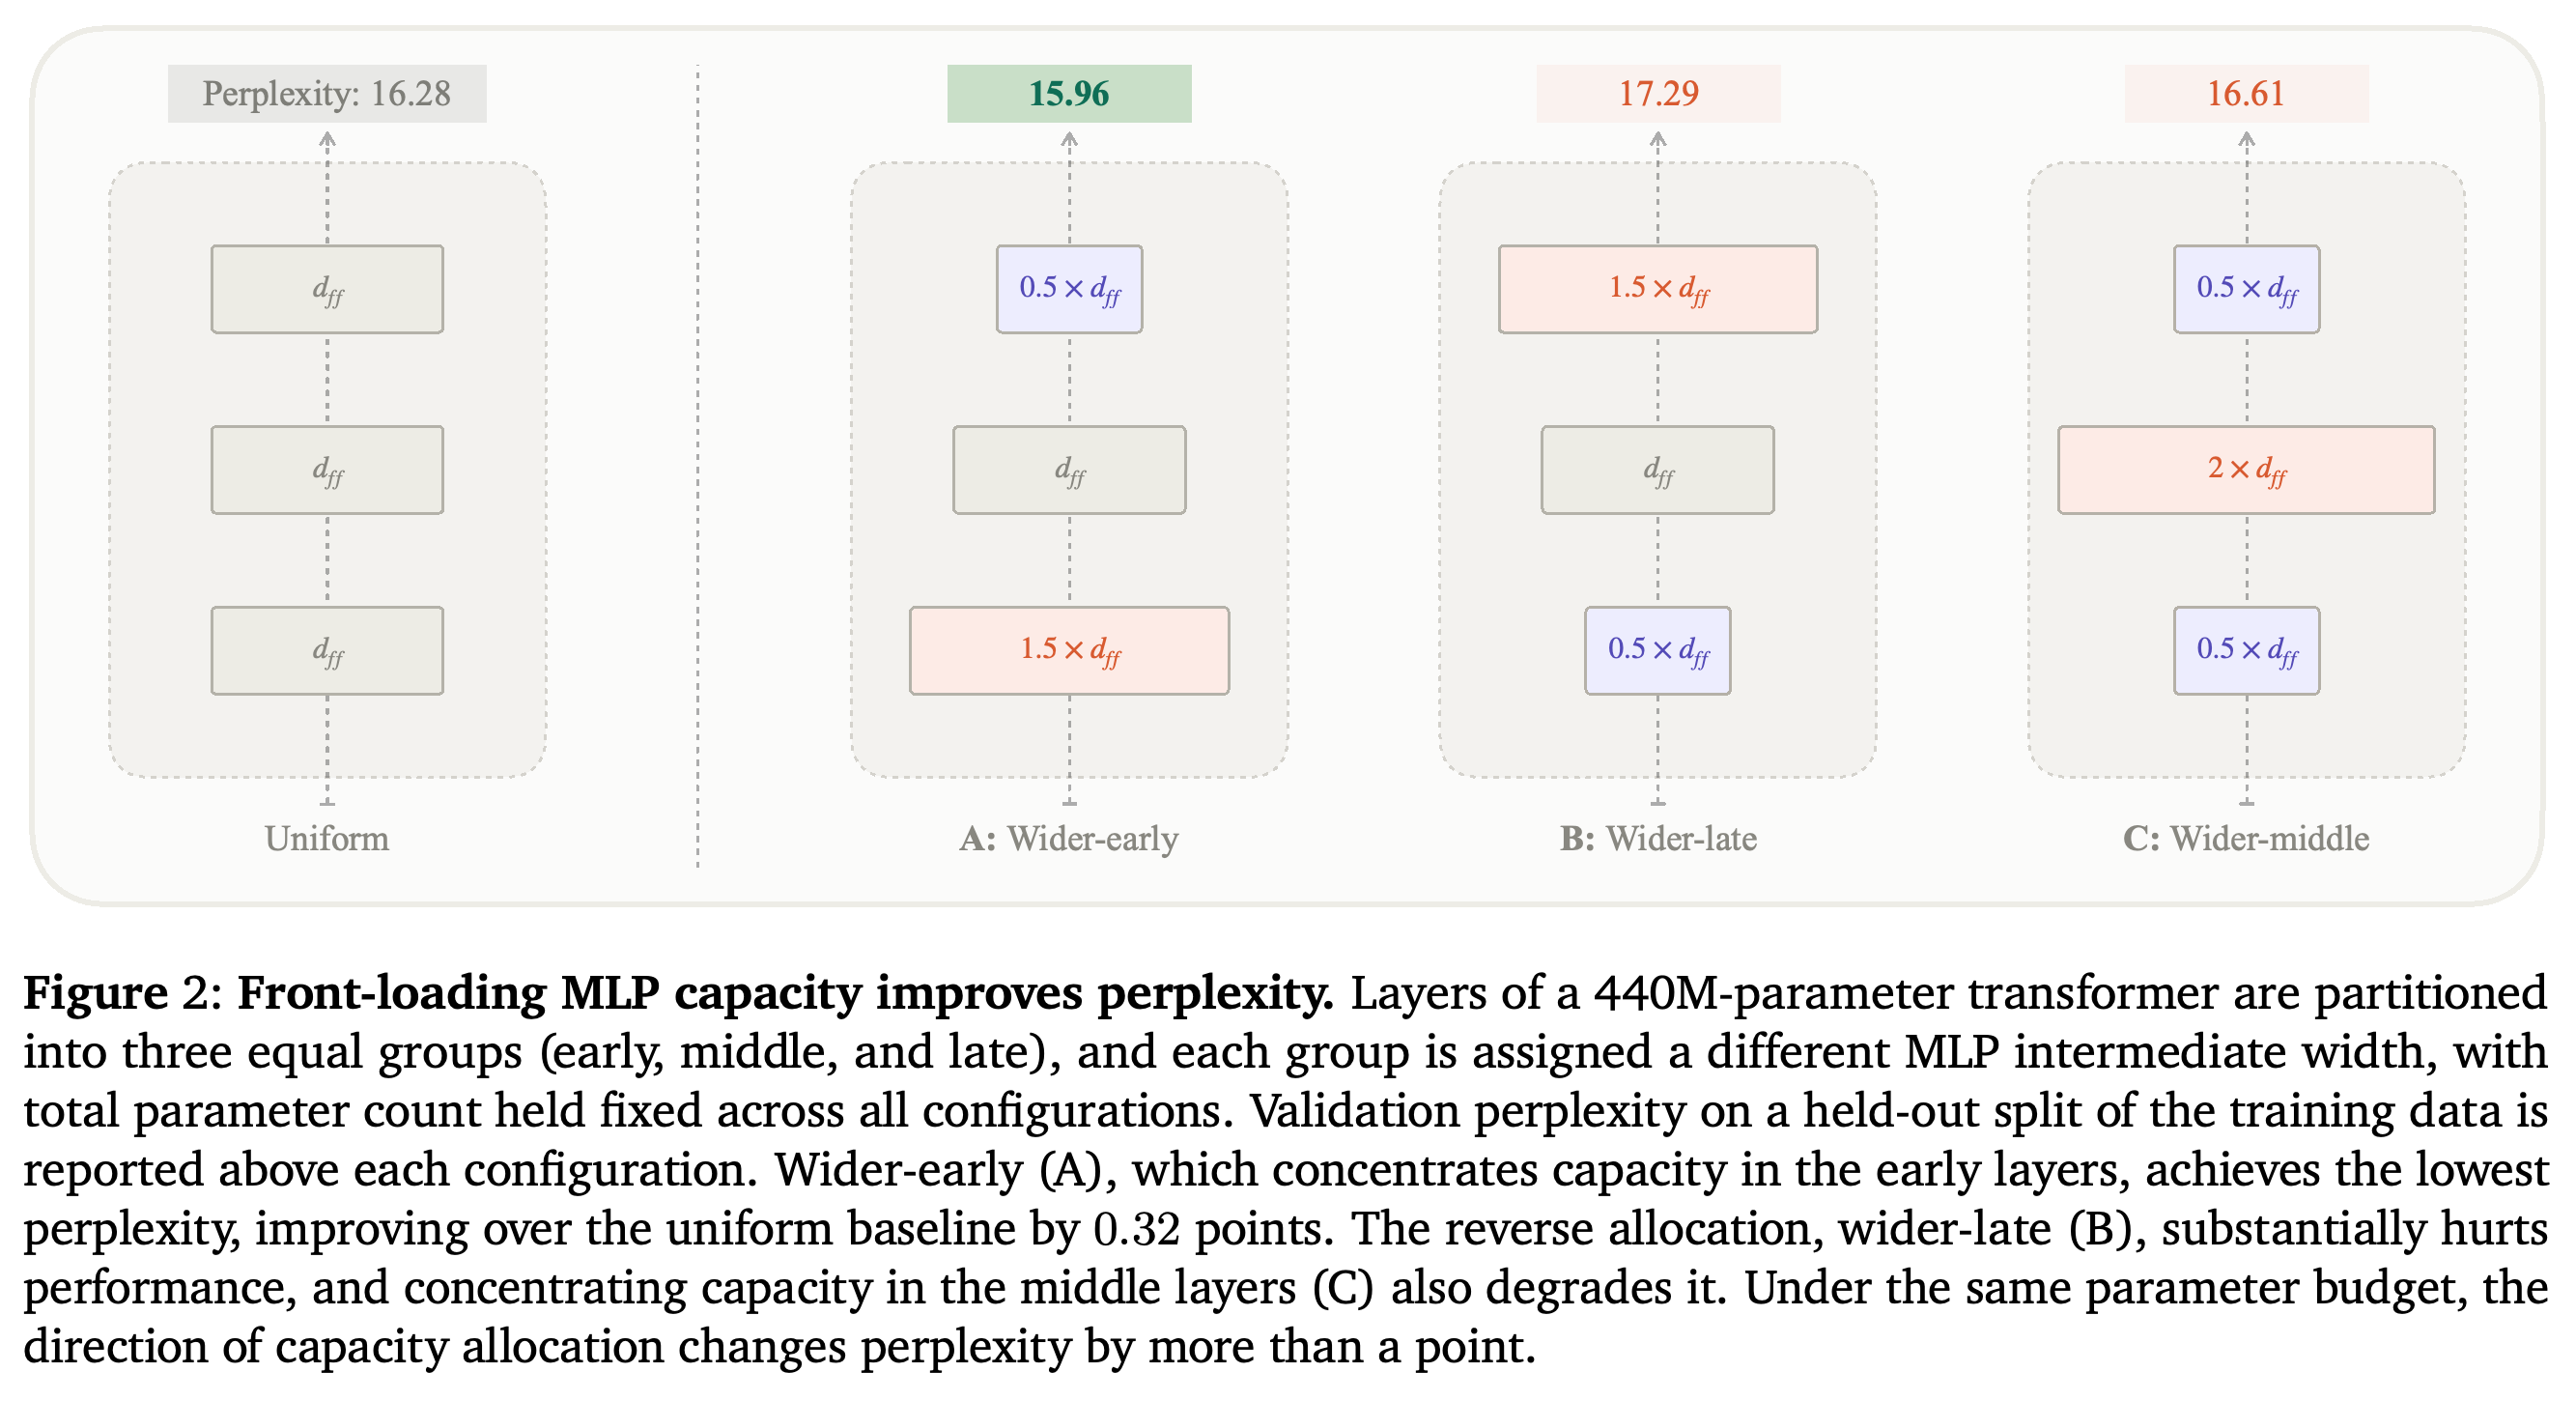
출발점이 되는 실험에서는 440M Transformer의 층을 앞쪽, 중간, 뒤쪽의 크기가 같은 3개 그룹으로 나눈다. 총 파라미터 수를 고정했을 때 uniform 배분의 perplexity는 16.28, wider-early는 15.96, wider-late는 17.29, wider-middle은 16.61이다.
- 앞쪽에서 뒤쪽 순서로 wider-early의 너비 배율은 1.5, 1, 0.5이고, wider-late는 0.5, 1, 1.5이며, wider-middle은 0.5, 2, 0.5이다.
- wider-early와 wider-late의 결과가 반대라는 점은 비균등 배분 자체보다 배분 방향이 영향을 준다는 근거가 된다. 이 실험은 해당 효과를 실험한 Transformer에서 확인한 것이며, 모든 모델 계열에서 확인한 것은 아니다.
총 파라미터 수를 유지하면서 앞쪽 층으로 용량을 옮기면 perplexity가 15.96으로 낮아지지만, 반대 방향으로 옮기면 17.29로 높아진다. 중간에 용량을 집중한 배분도 16.28 uniform baseline보다 나쁜 16.61을 기록한다. 이 실험은 해당 모델에서 배분 방향의 효과를 분리해 보여준다.
2. Tapered Language Models
Tapered Language Models (TLMs)는 3개 그룹을 사용한 실험을 확장해, 파라미터 수에 영향을 주는 차원을 층이 깊어질수록 단조 감소시키는 고정 아키텍처 배분을 제안한다. 실험에서는 이 원칙을 MLP 중간 차원의 너비에만 적용한다. 검토한 아키텍처에서 MLP 파라미터 수는 이 너비에 선형으로 비례한다.
- Attention head 수, key-value 차원, 순환 상태 크기, 메모리 슬롯 수, Mixture-of-Experts의 expert 수도 후보 차원으로 제안하지만, 이 논문에서는 이들을 tapering하는 실험을 하지 않는다.
2.1. Background
논문은 블록 수가 L이고 residual 차원이 d인 decoder-only 모델의 각 블록을 (z_l = h_l + \mathcal{M}l(h_l)), 이어서 (h{l+1} = z_l + \mathcal{F}_l(z_l))로 표현한다. 간결한 표현을 위해 layer normalization은 생략한다. Token mixer M은 아키텍처에 따라 달라지지만, MLP F에는 용량을 조절하는 중간 차원 d_ff가 있다.
- 층별 MLP 파라미터 수는 vanilla FFN에서 2 d d_ff이고 SwiGLU에서 3 d d_ff이다. 둘 다 d_ff에 선형으로 비례하므로 residual 차원을 바꾸지 않고도 예산을 유지하며 용량을 재배분할 수 있다.
- 일반적인 균등 너비는 표준 FFN에서 4d이고 gated 변형에서 (8/3)d이다.
2.2. Tapering
층 인덱스 l ∈ {0, 1, …, L − 1}에 대해 tapering은 인접한 층 사이에 d_C(l + 1) ≤ d_C(l)을 요구하며, (1/L) ∑_{l=0}^{L−1} d_C(l) = d_C^baseline도 만족해야 한다. 첫 번째 조건은 앞쪽에서 뒤쪽으로 용량이 감소하도록 배분 방향을 정하고, 두 번째 조건은 해당 구성 요소의 평균 차원을 유지한다.
- 실험에서 적용한 MLP 너비 조정은 평균 너비를 유지하면 파라미터 수도 유지한다. Projection의 크기가 너비에 선형으로 비례하기 때문이다. 다만 일반적인 정식화만으로는 제안된 모든 구성 요소에서 차원과 비용의 관계가 같다고 볼 수 없다.
2.3. Tapering MLP Width
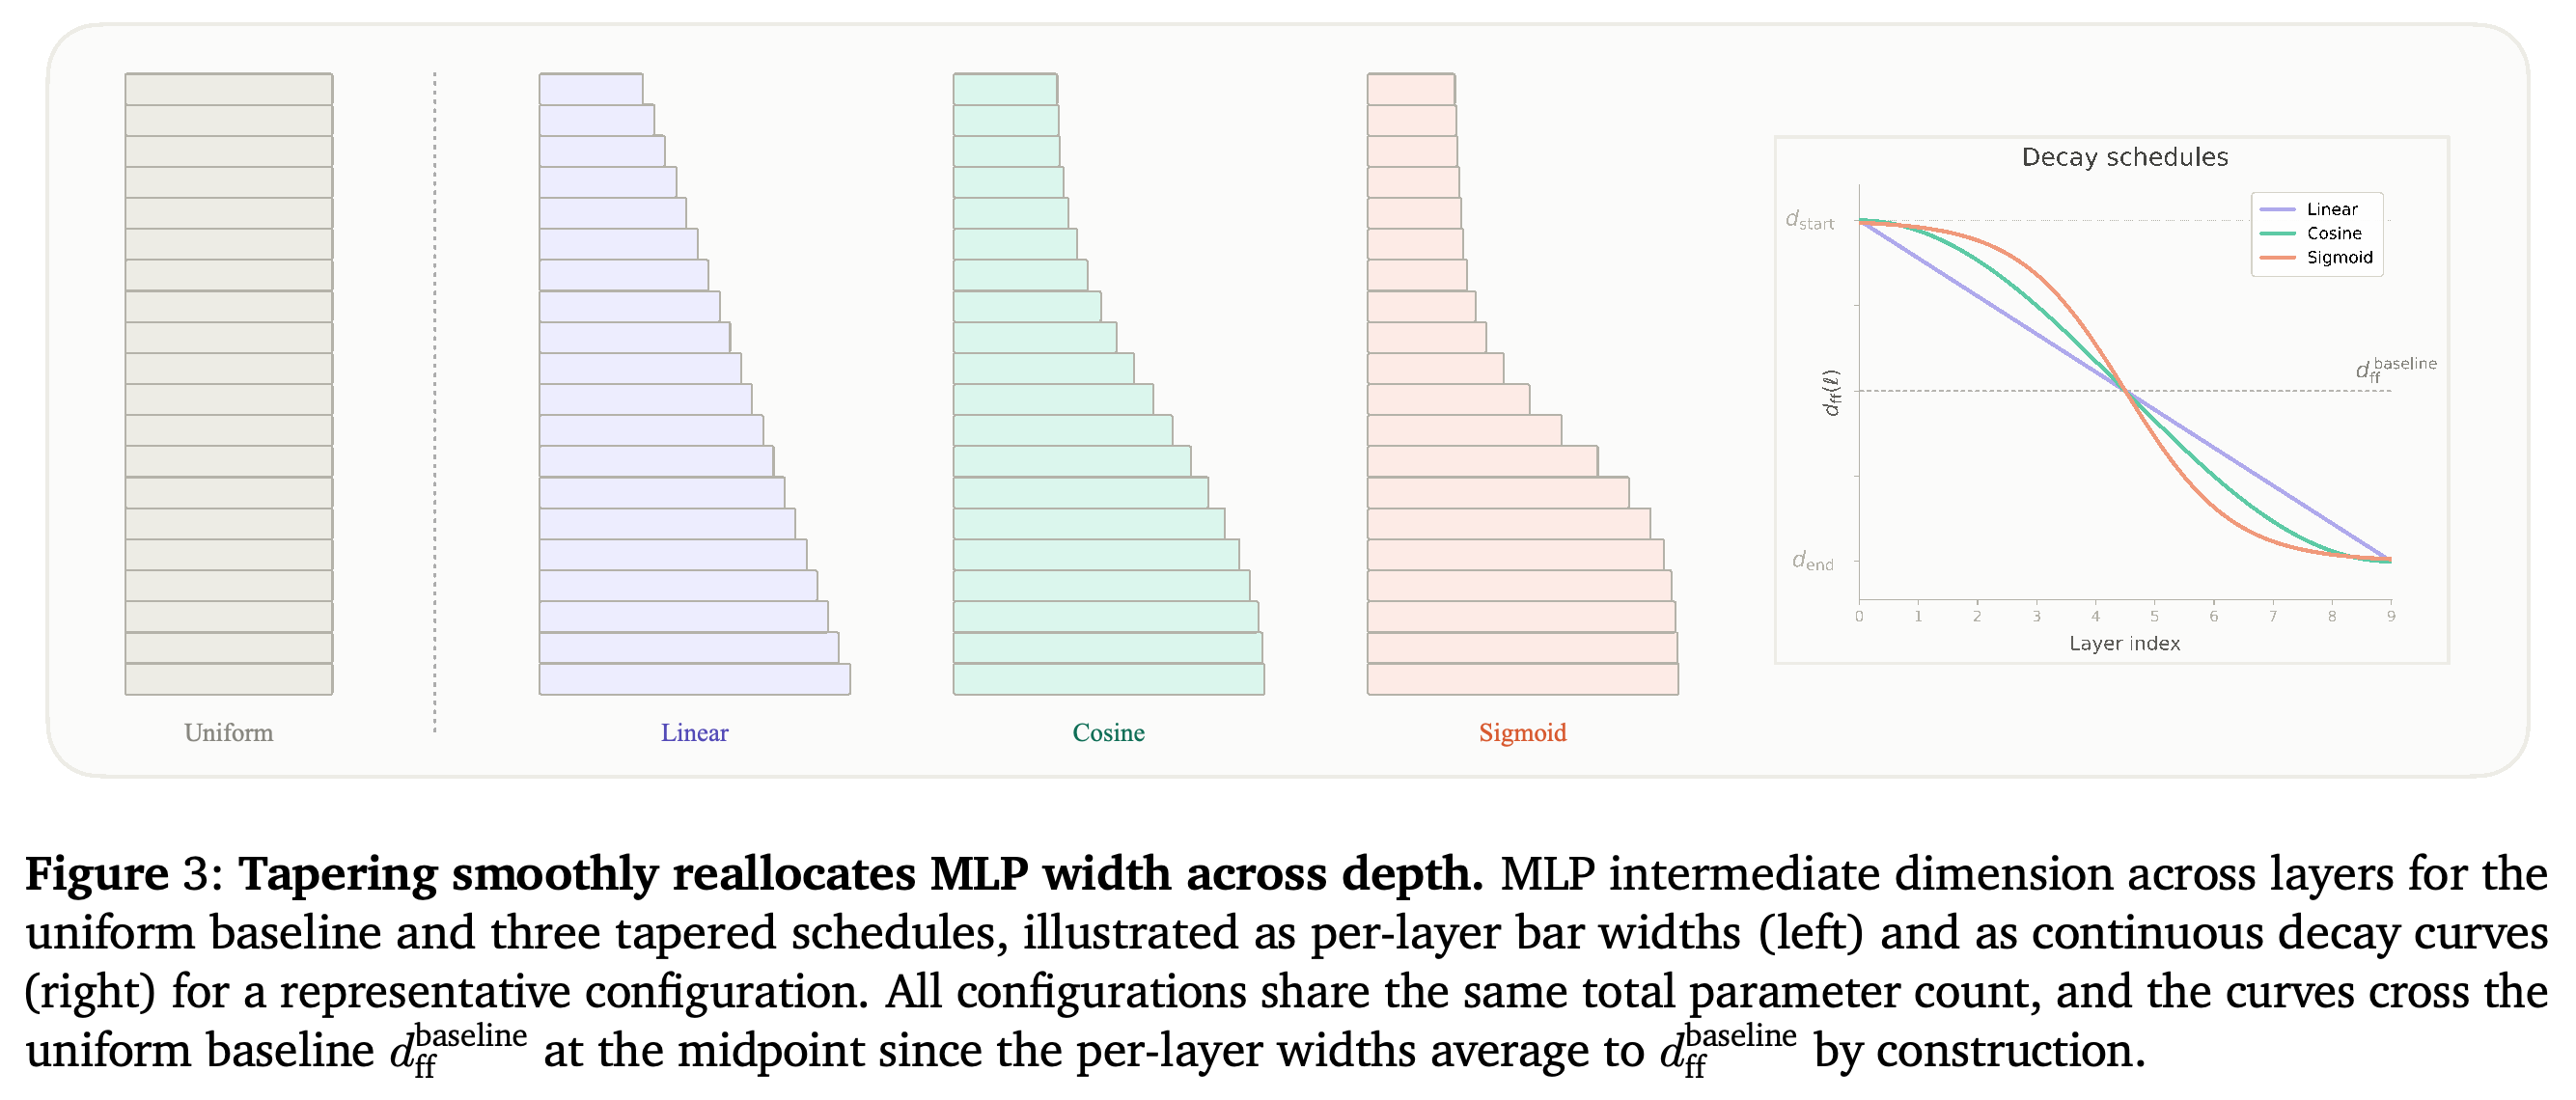
논문은 d_start > d_end로 설정한 linear, cosine, sigmoid 스케줄을 비교한다. Linear는 일정한 속도로 너비를 줄이고, cosine은 양 끝에서 천천히 변하며 중간 지점에서 가장 빠르게 변한다. Sigmoid는 중간 부근에 변화를 집중시키며, 모든 실험에서 k = 10을 사용한다.
- Linear는 d_ff(l) = d_start − (d_start − d_end) l/(L − 1)이다.
- Cosine은 d_ff(l) = d_end + ((d_start − d_end)/2)(1 + cos(πl/(L − 1)))이다.
- Sigmoid는 d_ff(l) = d_end + (d_start − d_end)/(1 + exp(k(l/(L − 1) − 0.5)))이다.
파라미터 수를 유지하려면 (1/L) ∑_{l=0}^{L−1} d_ff(l) = d_ff^baseline을 만족해야 한다. MLP 파라미터 수와 projection FLOPs는 중간 차원의 너비에 선형으로 비례하므로, 이 제약을 적용하면 총 파라미터 및 FLOP 예산을 늘리지 않고 용량을 재배분할 수 있다.
- 너비는 가장 가까운 16의 배수로 반올림한다. 첫 층과 마지막 층의 너비를 d_start와 d_end로 고정하고, 내부 층의 너비를 16 단위로 조정해 단조 순서를 유지하면서 예산을 정확히 맞춘다.
- Residual 차원, attention head 수, key-value 차원은 기준 모델과 동일하게 유지한다. FLOPs가 같다고 실제 지연 시간이나 처리량까지 같다는 뜻은 아니다.
이 그림은 성능 결과가 아니라 3개 연속 스케줄의 형태를 보여준다. Linear는 너비를 일정하게 줄이고, sigmoid는 넓은 2개 평탄 구간 사이에 급격한 중간 전환을 둔다. Cosine은 양 끝에 평탄 구간을 두면서 더 완만하게 전환한다. 평균 너비가 같다는 점은 MLP 예산을 바꾸지 않고 아키텍처를 변경할 수 있음을 보여준다.
3. Experiments
실험은 설정 선택과 전이 평가를 분리한다. 440M Transformer에서 스케줄과 너비를 탐색한 뒤, 선택한 설정을 변경하지 않고 760M과 1.3B 규모의 4개 아키텍처에서 평가한다.
- 각 uniform–tapered 비교에서는 총 파라미터 수, 학습 FLOPs, 추론 FLOPs, 학습 하이퍼파라미터를 고정한다. 층별 MLP 중간 차원만 바꾼다.
3.1. Setup
4개 backbone은 표준 softmax self-attention을 사용하는 Transformer, 출력 gating을 적용하는 Gated Attention, 여러 주기로 작동하는 자체 수정 메모리를 사용하는 Hope-attention, 테스트 시점에 기억하는 법을 학습하는 신경망 장기 메모리 모듈을 사용하는 Titans이다. 이 구성은 같은 MLP 배분 방식이 서로 다른 token mixer에도 전이되는지 검증한다.
학습에는 보고된 어휘 크기가 32K인 Llama 3 tokenizer와 길이가 4K 토큰인 시퀀스를 사용한다. 440M, 760M, 1.3B 모델의 학습 토큰 수는 각각 30B, 50B, 100B이다.
- Optimizer는 cosine annealing을 적용한 AdamW이며, 최대 학습률은 4 × 10⁻⁴, weight decay는 0.1, 전역 배치 크기는 0.5M 토큰이다.
- PDF는 학습에 가속기 하드웨어를 사용한다고 밝히지만, 가속기 모델이나 사전 학습 코퍼스는 명시하지 않는다.
스케줄 선택에는 학습 데이터에서 별도로 분리한 검증 데이터의 분포 내 perplexity를 사용한다. 본 평가에서는 WikiText와 LAMBADA의 분포 외 perplexity와 함께 LAMBADA, PIQA, HellaSwag, WinoGrande, ARC-easy, ARC-challenge, SIQA, BoolQ의 정확도를 측정한다.
- Table 2는 HellaSwag과 ARC-challenge 열을 acc_n으로 표기해 다른 정확도 열과 구분한다. Avg.는 보고된 8개 과제 점수의 평균이다.
3.2. Schedule and Width Sweep
440M Transformer 탐색은 세 스케줄과 기준 너비에 대한 다섯 시작→끝 배율 범위인 1.25→0.75, 1.375→0.625, 1.50→0.50, 1.625→0.375, 1.75→0.25 times를 조합한다. Cosine은 모든 범위에서 perplexity가 가장 낮다. Linear는 네 범위에서 sigmoid보다 좋고, 1.625→0.375에서는 둘 다 15.96으로 같다.
- 범위 순서대로 cosine의 perplexity는 15.18, 14.59, 14.44, 14.59, 15.49이다. 최솟값은 16.28 uniform baseline보다 1.84포인트 낮지만, 재배분을 더 강하게 하면 개선 폭이 줄어든다.
- 실험한 cosine 중 가장 나쁜 결과인 15.49도 linear의 최선 결과인 15.64보다 좋다. Sigmoid는 uniform 배분보다 나빠질 수 있으며, 1.75→0.25에서 17.12를 기록한다.
- 선택한 cosine 범위 1.50→0.50은 특정 조건에서 선택한 기본 설정이지, 전역 최적값으로 입증된 것은 아니다. 양 끝의 평탄한 구간과 중간의 완만한 변화가 효과를 낸다는 저자들의 설명도 이 탐색에서 독립적으로 검증하지는 않는다.
15개 설정 모두 파라미터 수와 FLOPs를 유지하므로, 순위는 더 큰 예산이 아니라 실험한 배분 방식의 차이를 반영한다. Cosine은 모든 범위에서 가장 좋고, 1.50→0.50에서 14.44를 기록한다. Linear의 최선 결과는 1.625→0.375에서 15.64이다. 이 범위에서 sigmoid는 15.96이므로 linear와 동률이 아니다. 가장 강하게 재배분한 범위에서 sigmoid가 기록한 17.12는 앞쪽에 용량을 집중하는 단조 배분만으로 개선을 보장할 수 없음을 보여준다.
3.3. Language Modeling and Commonsense Reasoning
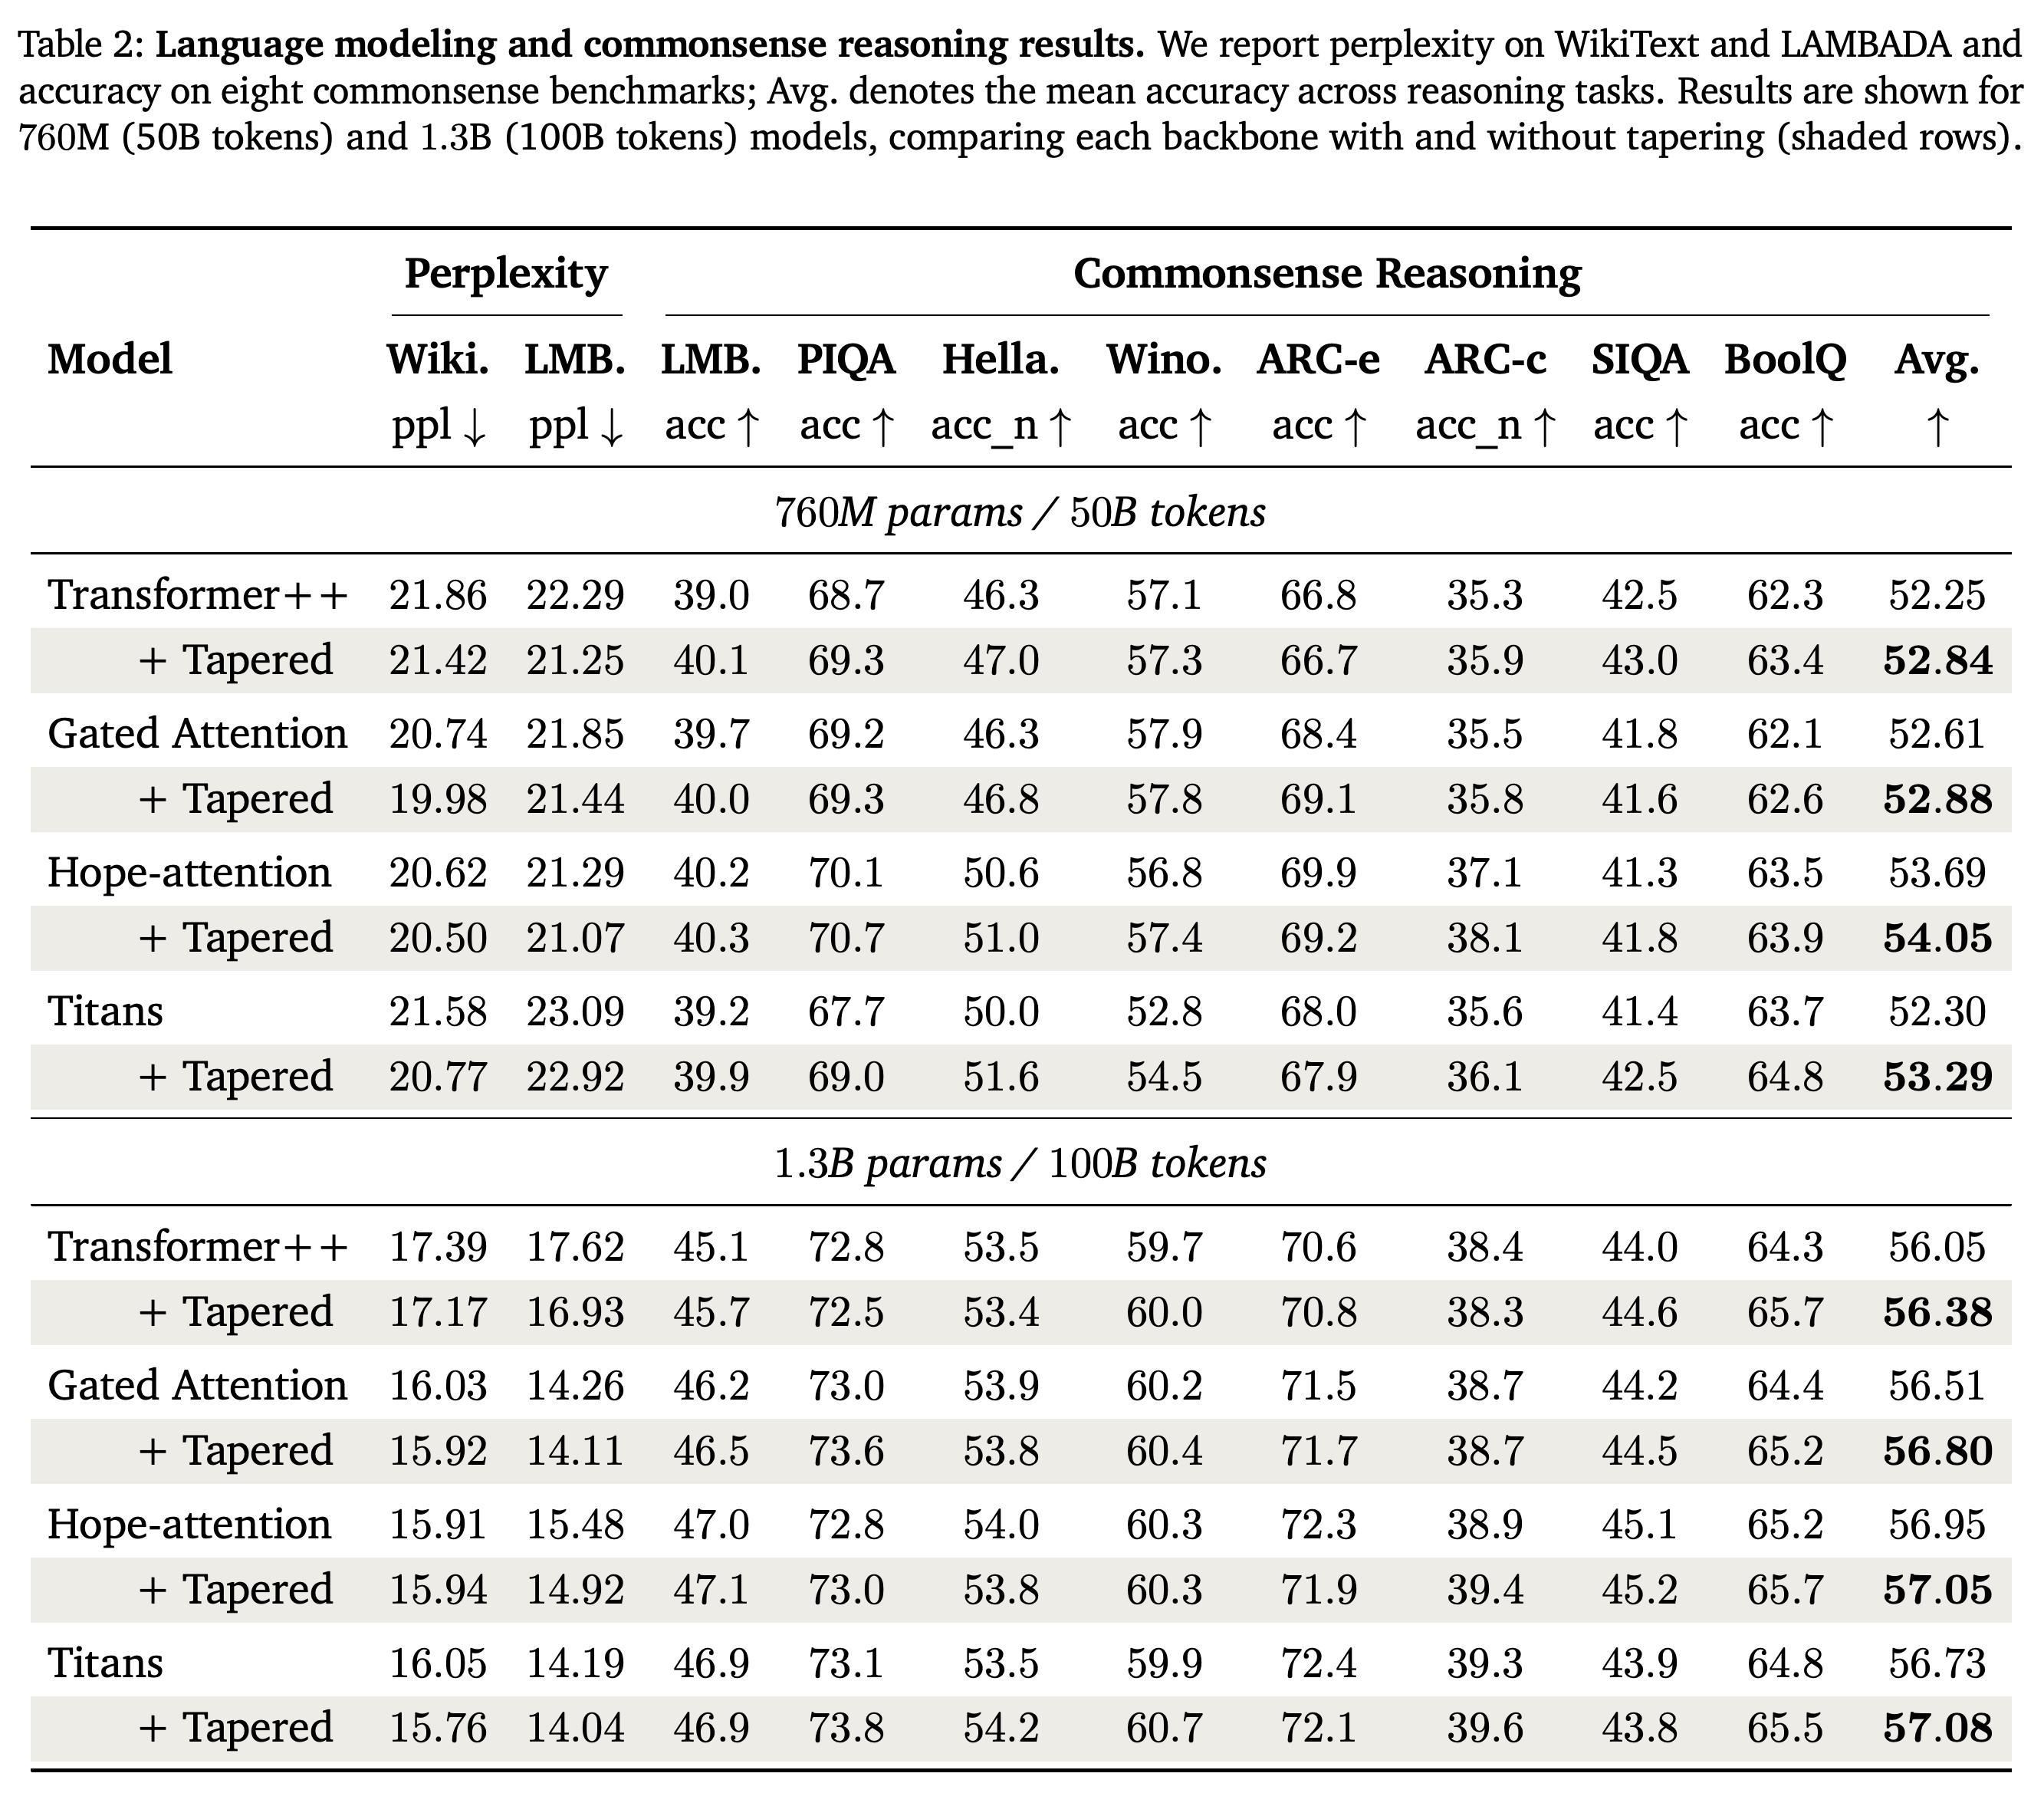
선택한 cosine taper를 고정한 Table 2에서는 더 큰 2개 규모 모두에서 모든 backbone의 평균 상식 추론 정확도가 높아진다. LAMBADA perplexity는 8개 비교 모두에서 감소한다. WikiText perplexity는 7개 비교에서 감소하지만, 1.3B Hope-attention에서는 15.91에서 15.94로 소폭 증가한다.
- 760M에서 Avg.는 Transformer++의 경우 52.25에서 52.84로, Gated Attention은 52.61에서 52.88로, Hope-attention은 53.69에서 54.05로, Titans는 52.30에서 53.29로 변한다.
- 1.3B에서 Avg.는 Transformer++의 경우 56.05에서 56.38로, Gated Attention은 56.51에서 56.80으로, Hope-attention은 56.95에서 57.05로, Titans는 56.73에서 57.08로 변한다.
- 개별 과제 점수가 모두 개선되는 것은 아니다. 예를 들어 1.3B Transformer++의 PIQA는 72.8에서 72.5로 감소하고, 1.3B Hope-attention의 ARC-easy는 72.3에서 71.9로 감소한다. 일관된 결과는 모든 benchmark가 아니라 과제 평균에 관한 것이다.
모든 tapered 모델은 대응하는 기준 모델보다 과제 평균 점수가 높고, 모든 LAMBADA perplexity 비교에서도 개선된다. 다만 개별 지표까지 모두 개선되는 것은 아니다. 1.3B Hope-attention의 WikiText perplexity는 약간 나빠지고, 일부 과제의 정확도도 감소한다. 이 표는 실험한 아키텍처 전반에서 종합 성능 개선이 일관되게 전이된다는 근거이지, 모든 평가에서 개선된다는 근거는 아니다.
4. Layer-wise Novelty
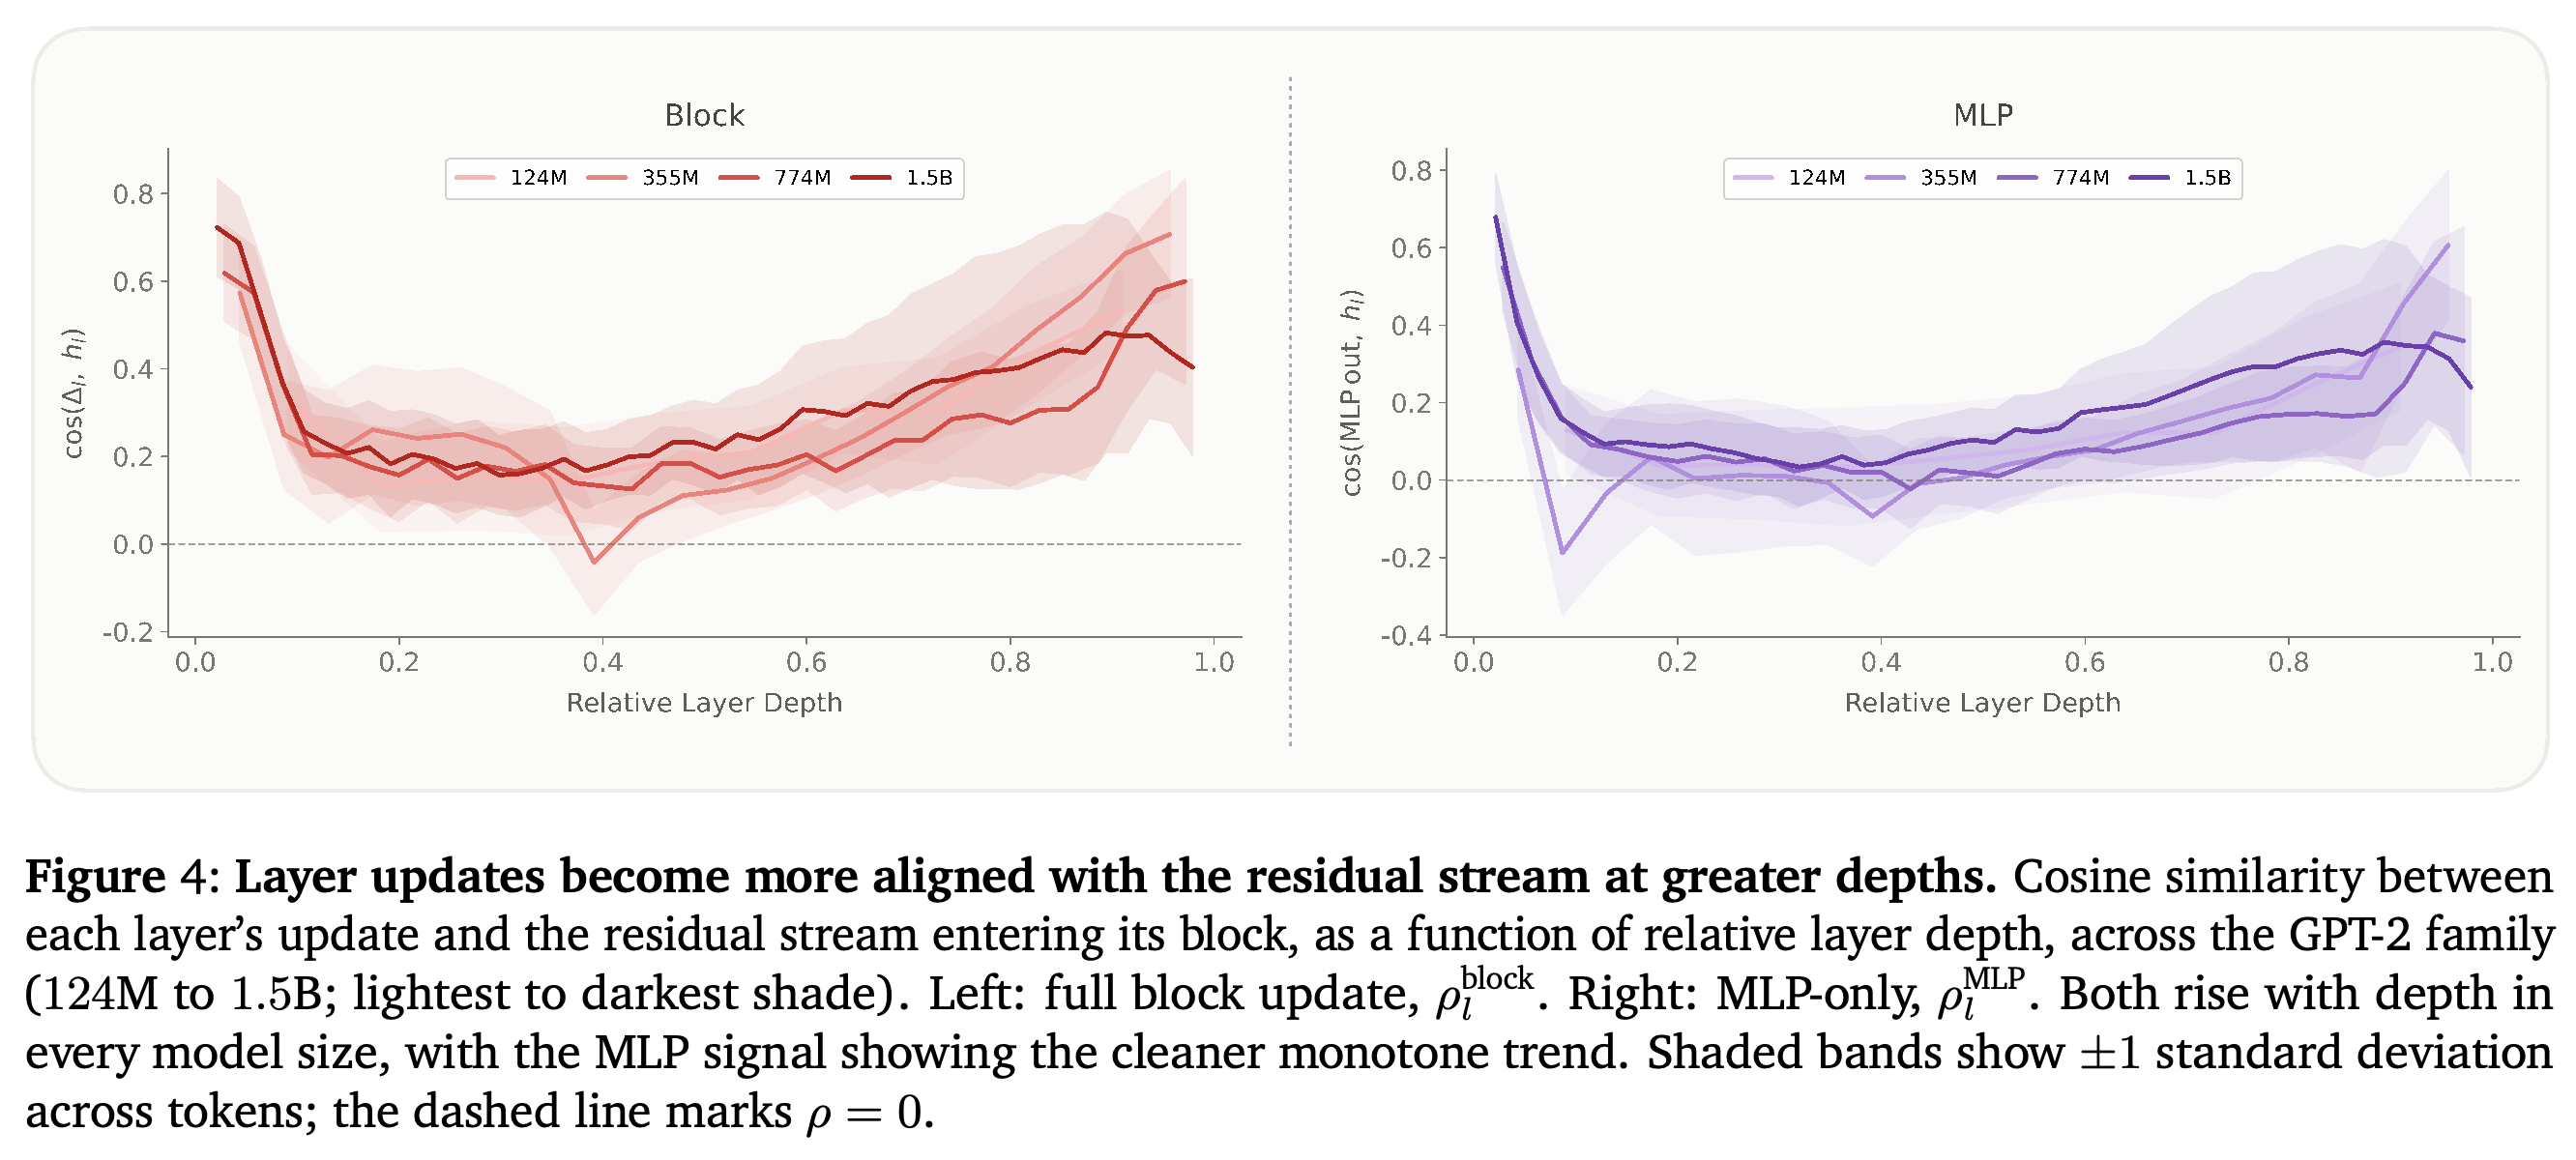
층별 새로움은 토큰별 값을 평균한 2개 cosine similarity, ρ_l^block = cos(h_{l+1} − h_l, h_l)과 ρ_l^MLP = cos(F_l(z_l), h_l)로 평가한다. 첫 번째 지표는 전체 블록 업데이트가 입력 residual과 얼마나 정렬되는지 측정하고, 두 번째 지표는 MLP의 기여만 분리해 측정한다.
- 값이 0에 가까우면 업데이트가 기준 residual과 직교하고, 양수이면 이미 존재하는 방향과 정렬됨을 뜻한다. 논문은 정렬도가 높아지는 현상을 새로움이 줄어드는 것으로 해석한다. 다만 이 지표는 방향을 나타내는 대리 지표이며 정보량을 직접 측정하지는 않는다.
- MLP 출력은 z_l에 더해지지만, 두 지표 모두 h_l을 기준으로 사용한다. 논문은 정규화하지 않은 기준을 공유하고 정규화된 MLP 입력에서 생기는 방향 왜곡을 피하기 위한 선택이라고 설명한다.
분석에는 WikiText-2의 2048개 토큰과 파라미터 규모가 124M에서 1.5B인 사전 학습된 GPT-2 checkpoint를 사용한다. 첫 층과 마지막 층은 경계에 해당하는 사례로 제외한다. 블록과 MLP의 정렬도는 모두 앞쪽에서 중간에 이르는 층에서 낮아지고, 각 모델의 후반부에서는 대체로 증가한다.
- 층 인덱스와의 Pearson 상관계수는 모든 측정에서 양수이다. MLP 지표는 r = 0.49에서 r = 0.71이고, 블록 지표는 r = 0.27에서 r = 0.71이다.
- 이 측정은 업데이트 방향이 깊이에 따라 달라진다는 근거가 된다. 다만 사용하지 않는 hidden 차원을 직접 측정하거나 정렬된 업데이트가 불필요하다고 입증하지는 않는다. 또한 분석 대상은 실험에서 tapering한 4개 backbone이 아니라 GPT-2이다.
GPT-2 checkpoint 전반에서 전체 블록과 MLP의 업데이트 지표는 초기에 비교적 높은 정렬도를 보인 뒤 앞쪽에서 중간에 이르는 층에서 낮아지고, 뒤쪽 층에서는 대체로 높아진다. MLP 패널은 깊이에 따른 패턴을 더 뚜렷하게 보여준다. 이는 앞쪽에 더 많은 너비를 배분하는 논거와 부합하지만, 인과적 설명을 입증하지는 않는다. 음영은 토큰별 표준편차를 나타내며, 아키텍처 성능 개선의 불확실성 추정치는 아니다.
5. Related Work
논문은 고정된 MLP tapering을 토큰별 연산 라우팅, sequence pooling, layer dropping, 탄력적인 중첩 블록, 학습 후 pruning과 구분한다. 가장 가까운 비교 대상은 층 사이에서 FFN 용량을 재배분하는 기존 방법이다. 이들 중 일부는 attention 차원도 함께 바꾸거나 FFN을 완전히 제거한다.
- 방법론적 차이는 파라미터 및 FLOP 예산을 동일하게 유지하고 모든 층을 활성화한 채 MLP 너비만 바꾼다는 점이다. 따라서 너비 재배분 효과를 실효 깊이의 변화나 여러 아키텍처 차원의 동시 변경 효과와 구분할 수 있다.
- 기존 연구가 모두 앞쪽 배분을 지지하는 것은 아니다. 논의에서는 주요 결과가 중간 배치를 지지하는 연구를 언급하며, 선호하는 배치가 규모에 따라 달라진다고 설명한다. 따라서 tapering 방향을 해석할 때는 통제된 실험 조건이 중요하다.
- Early exit, 중복성, FFN 해석 가능성 연구는 층의 중요도가 균일하지 않다는 연구 동기를 제공하지만, 논문의 고정 예산 아키텍처 실험을 대신하지는 않는다.
6. Limitations
논문이 명시한 한계는 스케줄과 시작·끝 너비를 440M Transformer에서만 탐색했다는 점이다. 선택한 설정을 변경 없이 전이한 결과는 전이 가능성의 근거가 되지만, 더 큰 모델이나 다른 아키텍처에서도 최적이라는 뜻은 아니다.
- 적합한 배분 형태는 깊이, hidden 차원, MLP가 차지하는 파라미터 비율, token-mixing 아키텍처, 학습 예산에 따라 달라질 수 있다.
- 평가의 추가 한계는 PDF가 benchmark 비교에서 seed를 바꿔 반복했을 때의 변동성이나 신뢰구간을 보고하지 않는다는 점이다. 따라서 보고된 결과만으로는 작은 평균 점수 변화의 통계적 신뢰성을 판단할 수 없다.
- 메커니즘 분석은 짧은 WikiText-2 sample과 별도의 사전 학습 모델 계열을 사용한다. 측정된 정렬도와 tapering으로 얻은 개선 사이의 인과관계를 검증하지는 않는다.
7. Discussion and Conclusion
MLP 너비에 고정된 cosine 배분을 적용하면 총 파라미터 수나 FLOPs를 늘리지 않고도 실험한 backbone과 예산 전반에서 종합 평가 결과가 개선된다. 그룹 단위 배분 실험, 스케줄 탐색, 전이 평가는 이러한 조건에서 깊이 전체에 MLP 용량을 균등하게 배분하는 설계를 재검토할 근거가 된다.
- 다른 차원을 tapering하거나 이 원칙을 vision transformer, diffusion transformer, multimodal 모델에 적용하는 것은 제안된 확장 방향이며, 검증된 결과는 아니다.
- 전체 실험은 3개 파라미터 규모를 다루지만, 4개 아키텍처 전체의 언어 모델링 및 추론 비교는 760M과 1.3B에서만 수행한다.
부록
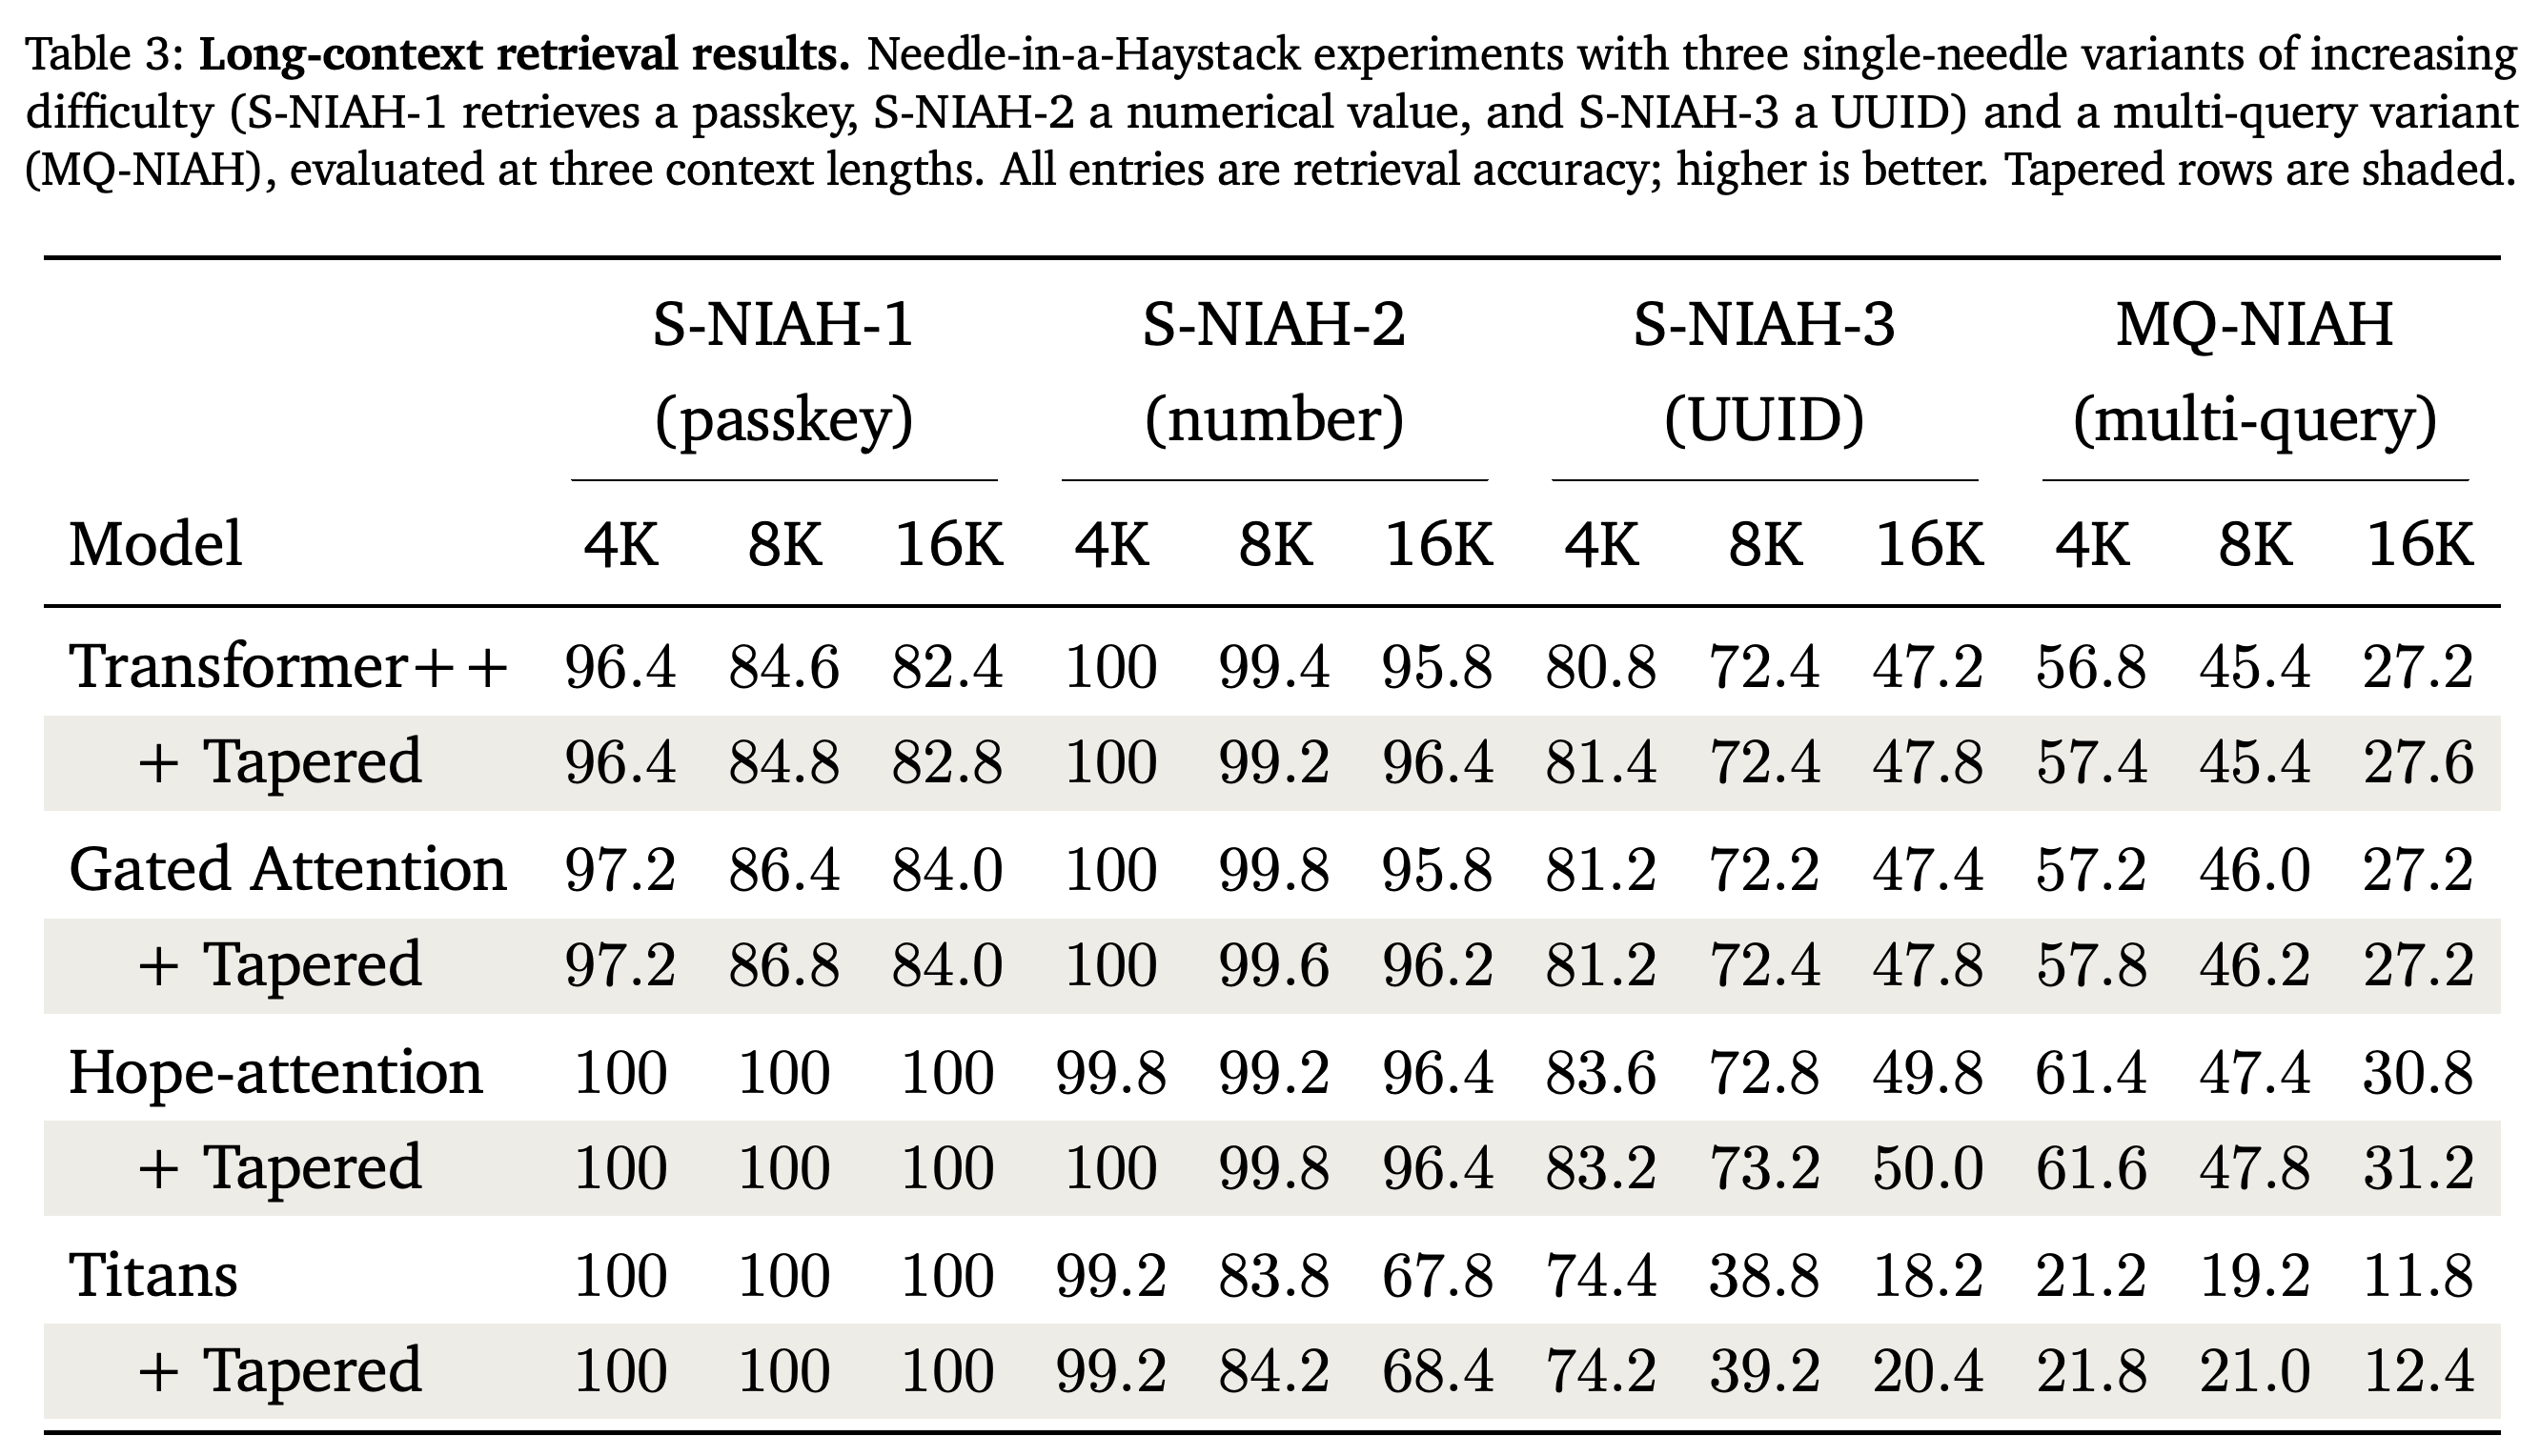
- A. Long-Context Retrieval on Needle-in-a-Haystack에서는 passkey를 찾는 S-NIAH-1, 수치를 찾는 S-NIAH-2, UUID를 찾는 S-NIAH-3, 여러 질의에 답하는 MQ-NIAH를 각각 4K, 8K, 16K context 길이에서 평가한다. Table 3에서는 검색 정확도가 대체로 유지되거나 소폭 개선된다. 예를 들어 16K에서 Titans의 S-NIAH-3은 18.2에서 20.4로 상승한다. 다만 부록은 tapered 모델이 표 전체에서 기준 모델과 같거나 더 좋다고 주장하면서 몇몇 하락을 간과한다. 여기에는 8K에서 Transformer++의 S-NIAH-2가 99.4에서 99.2로 하락한 결과와 4K에서 Hope-attention의 S-NIAH-3이 83.6에서 83.2로 하락한 결과가 포함된다. 부록은 평가한 파라미터 규모를 명시하지 않는다.
짧은 생각
핵심 기여는 다른 조건을 통제한 채 MLP 용량의 배분 위치가 미치는 효과를 분리했다는 점이다. 배분 방향 실험과 설정을 바꾸지 않은 4개 backbone의 전이 결과는 고정된 파라미터 및 FLOP 예산에서 균등 너비가 항상 최선은 아니라는 근거가 된다.
제시한 근거가 뒤쪽 층은 추가 용량을 활용할 수 없다는 점까지 입증하지는 않는다. Cosine 정렬도는 방향을 나타내는 대리 지표이며, 본문의 주요 표에는 작은 개선과 개별 지표의 하락도 포함된다. Table 3도 모든 셀의 개선보다는 검색 성능이 전반적으로 유지된다는 근거가 된다. 더 넓은 스케줄 탐색, seed를 바꾼 반복 평가, 실제 실행 시간 비교가 있다면 최적성, 신뢰성, 실제 비용을 더 명확히 판단할 수 있다.
Tapering 이후 검색 정확도는 대부분 유지되거나 소폭 높아진다. 여기에는 16K에서 Titans의 UUID 검색이 18.2에서 20.4로 상승한 결과가 포함된다. 다만 표에는 작은 하락도 있다. 예를 들어 8K에서 Gated Attention의 수치 검색은 99.8에서 99.6으로 감소하고, 4K에서 Titans의 UUID 검색은 74.4에서 74.2로 감소한다. 이 결과들은 모든 tapered 결과가 기준 모델과 같거나 더 좋다는 부록의 주장에 예외가 있음을 보여준다.