


mHC: Manifold-Constrained Hyper-Connections 요약 설명
31 Dec 2025 | Paper Review Residual Connections Hyper-Connections LLM Pretraining목차
- 요약
- 1. Introduction
- 2. Related Works
- 3. Preliminary
- 4. Method
- 5. Experiments
- 6. Conclusion and Outlook
- 부록
- 짧은 생각
이번 글에서는 mHC: Manifold-Constrained Hyper-Connections 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 31일(Arxiv)
- Xie, Zhenda, Wei, Yixuan, Cao, Huanqi, Zhao, Chenggang, Deng, Chengqi, Li, Jiashi, Dai, Damai, Gao, Huazuo, Chang, Jiang, Yu, Kuai, et al.
- DeepSeek-AI
- 논문 링크
요약
- mHC: Manifold-Constrained Hyper-Connections는 Hyper-Connections(HC)의 불안정성과 메모리 접근 오버헤드를 다룬다. HC는 residual stream을 확장하고 병렬 stream 사이의 상호작용을 학습한다. 논문은 제약 없는 residual 혼합 행렬의 곱을 대규모 언어 모델 사전학습에서 신호가 증폭되는 원인 중 하나로 지적한다.
- mHC는 Sinkhorn-Knopp 정규화로 이중 확률 residual mapping을 근사한다. 정확한 이중 확률성을 만족하면 stream 사이에서 정보를 교환하면서도 stream 평균을 보존한다. 혼합 정밀도 연산을 융합한 커널, 선택적 재계산, 확장된 DualPipe 스케줄로 확장된 stream의 비용을 줄인다. 저자들은 확장률 n = 4인 내부 대규모 학습에서 추가 학습 시간이 6.7%였다고 보고한다.
- 27B 모델에서 mHC는 표준 residual 기준 모델보다 최종 학습 손실을 0.021 낮추고, downstream benchmark 8개 모두에서 성능을 높였으며, HC보다 7개에서 앞섰다. 측정된 합성 역전파 이득은 HC의 3000에 가까운 값 대신 약 1.6에 도달한다. 다만 유한한 Sinkhorn-Knopp 반복은 근사 오차를 남기며, 공개된 스케일링 실험은 3B, 9B, 27B 모델만 다룬다.
1. Introduction
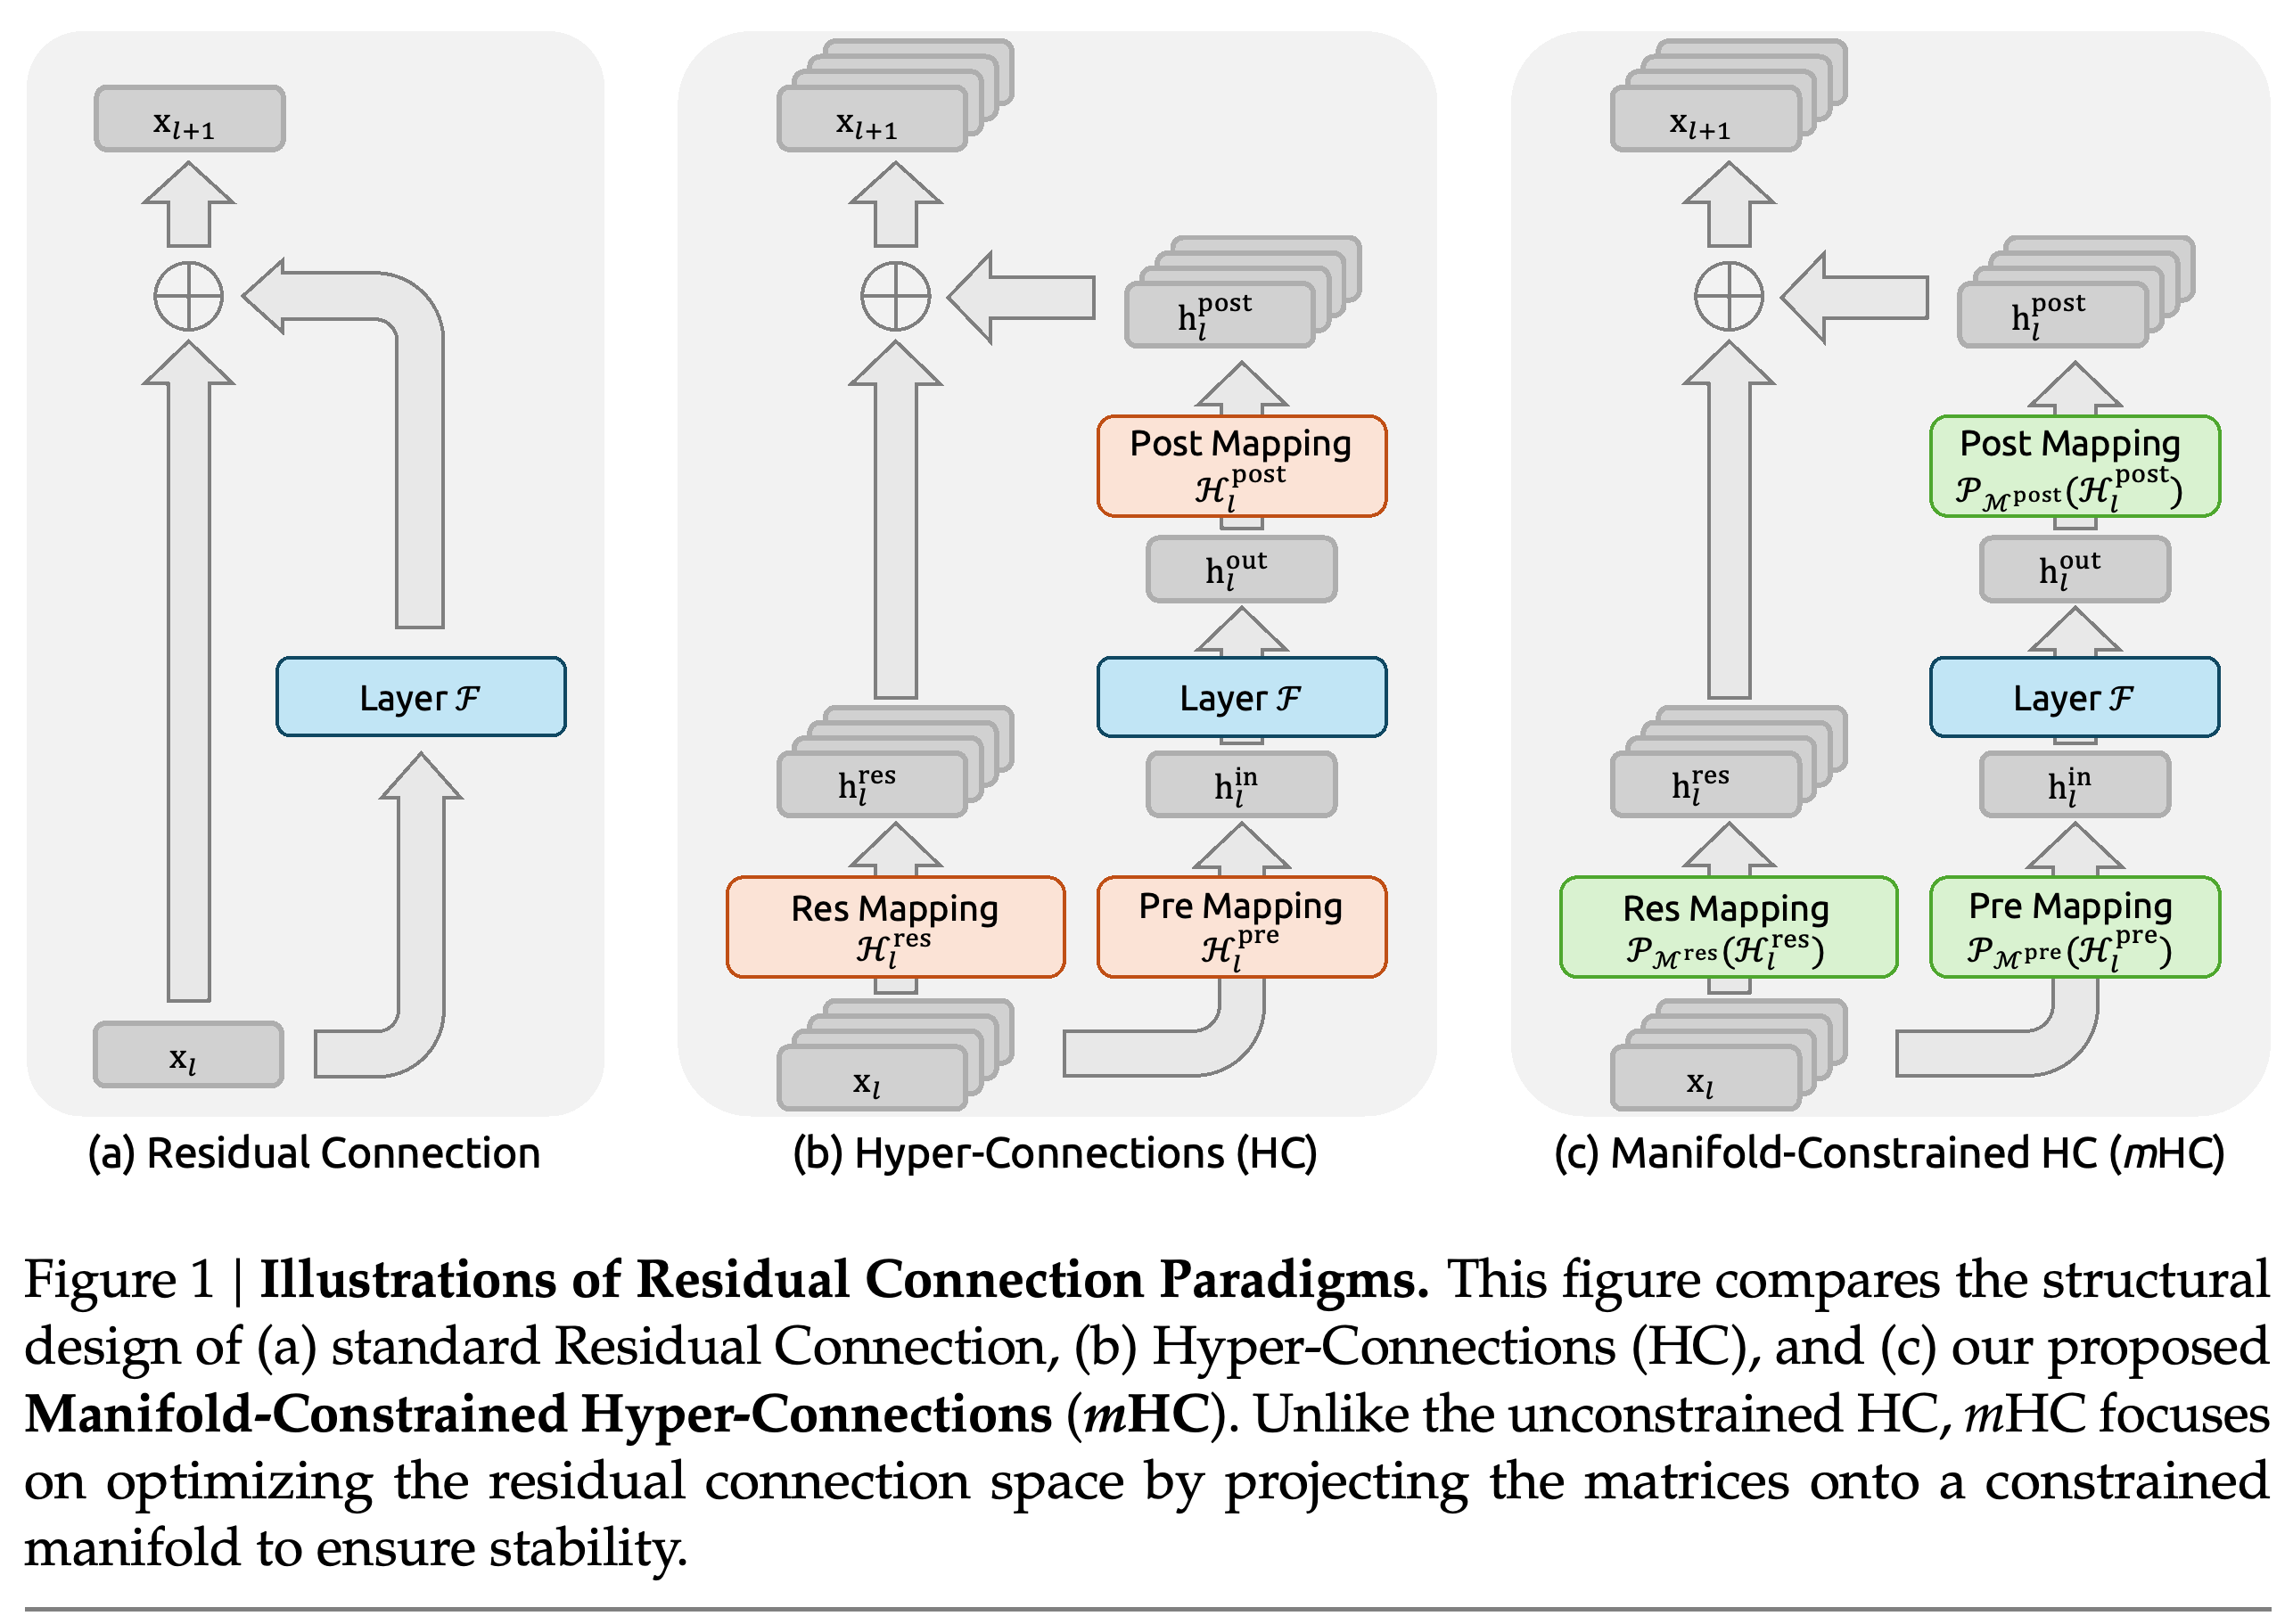
표준 residual connection은 변하지 않는 덧셈 경로로 표현을 전달하며, 전파 규칙은 (x_{l+1}=x_l+\mathcal{F}(x_l,W_l))이다. 반면 HC는 residual 상태를 C에서 n × C로 넓히고 학습 가능한 pre-mapping, post-mapping, residual mapping을 도입한다. Figure 1은 mHC가 이 다중 stream 구조를 유지하면서 매핑에 제약을 가해, 층간 전파 안정성과 넓어진 상태의 하드웨어 비용을 다룬다는 점을 보여준다.
- pre-mapping은 n개 stream을 F의 C차원 입력으로 집계하고, post-mapping은 F의 출력을 stream들에 다시 분배한다. residual mapping은 stream들을 직접 혼합한다.
- HC는 여러 층에 걸쳐 변하지 않는 residual 경로 대신 학습된 residual 행렬의 곱을 사용한다. 제약 없는 행렬 곱은 신호를 증폭하거나 감쇠할 수 있지만, 정확한 이중 확률 행렬의 곱은 stream 평균을 보존한다.
3개 도식은 구조의 변화를 구분해 보여준다. HC는 residual 상태를 넓히고 학습 가능한 집계, 재분배, 혼합 연산을 추가한다. mHC는 비용이 큰 층 함수의 입력 차원을 늘리지 않고 이 연산들에 제약을 가한다. 변화의 대상은 attention이나 FFN 연산의 대체가 아니라 residual 연결 방식이다.
2. Related Works
관련 연구는 블록 내부의 연산을 정하는 micro-design과 블록 사이에서 표현을 전달하고 라우팅하고 병합하는 방식을 정하는 macro-design으로 나누어 설명한다. mHC는 attention이나 feed-forward 연산 자체보다 macro-design을 주로 바꾼다.
2.1. Micro Design
micro-design 검토에서는 convolutional block에서 attention과 Feed-Forward Networks(FFNs)로 이어지는 변화를 살펴본다. 효율성을 높이는 attention 변형으로 Multi-Query Attention(MQA), Grouped-Query Attention(GQA), Multi-Head Latent Attention(MLA)을 다룬다. 또한 활성 연산량을 비례해서 늘리지 않고 파라미터 용량을 확장하는 방법으로 Mixture-of-Experts(MoE)를 설명한다.
2.2. Macro Design
macro-design 검토에서는 ResNet, DenseNet, FractalNet, Deep Layer Aggregation을 최근의 residual 용량 확장 시도와 연결한다. HC는 연결 강도를 학습하고, Residual Matrix Transformer는 외적 메모리 행렬에 특징을 저장하며, MUDDFormer는 다중 경로의 동적 dense connection을 사용한다. 논문은 mHC를 stream 혼합에 제약을 가하고 메모리 트래픽을 명시적으로 다루는 HC 확장으로 제시한다.
3. Preliminary
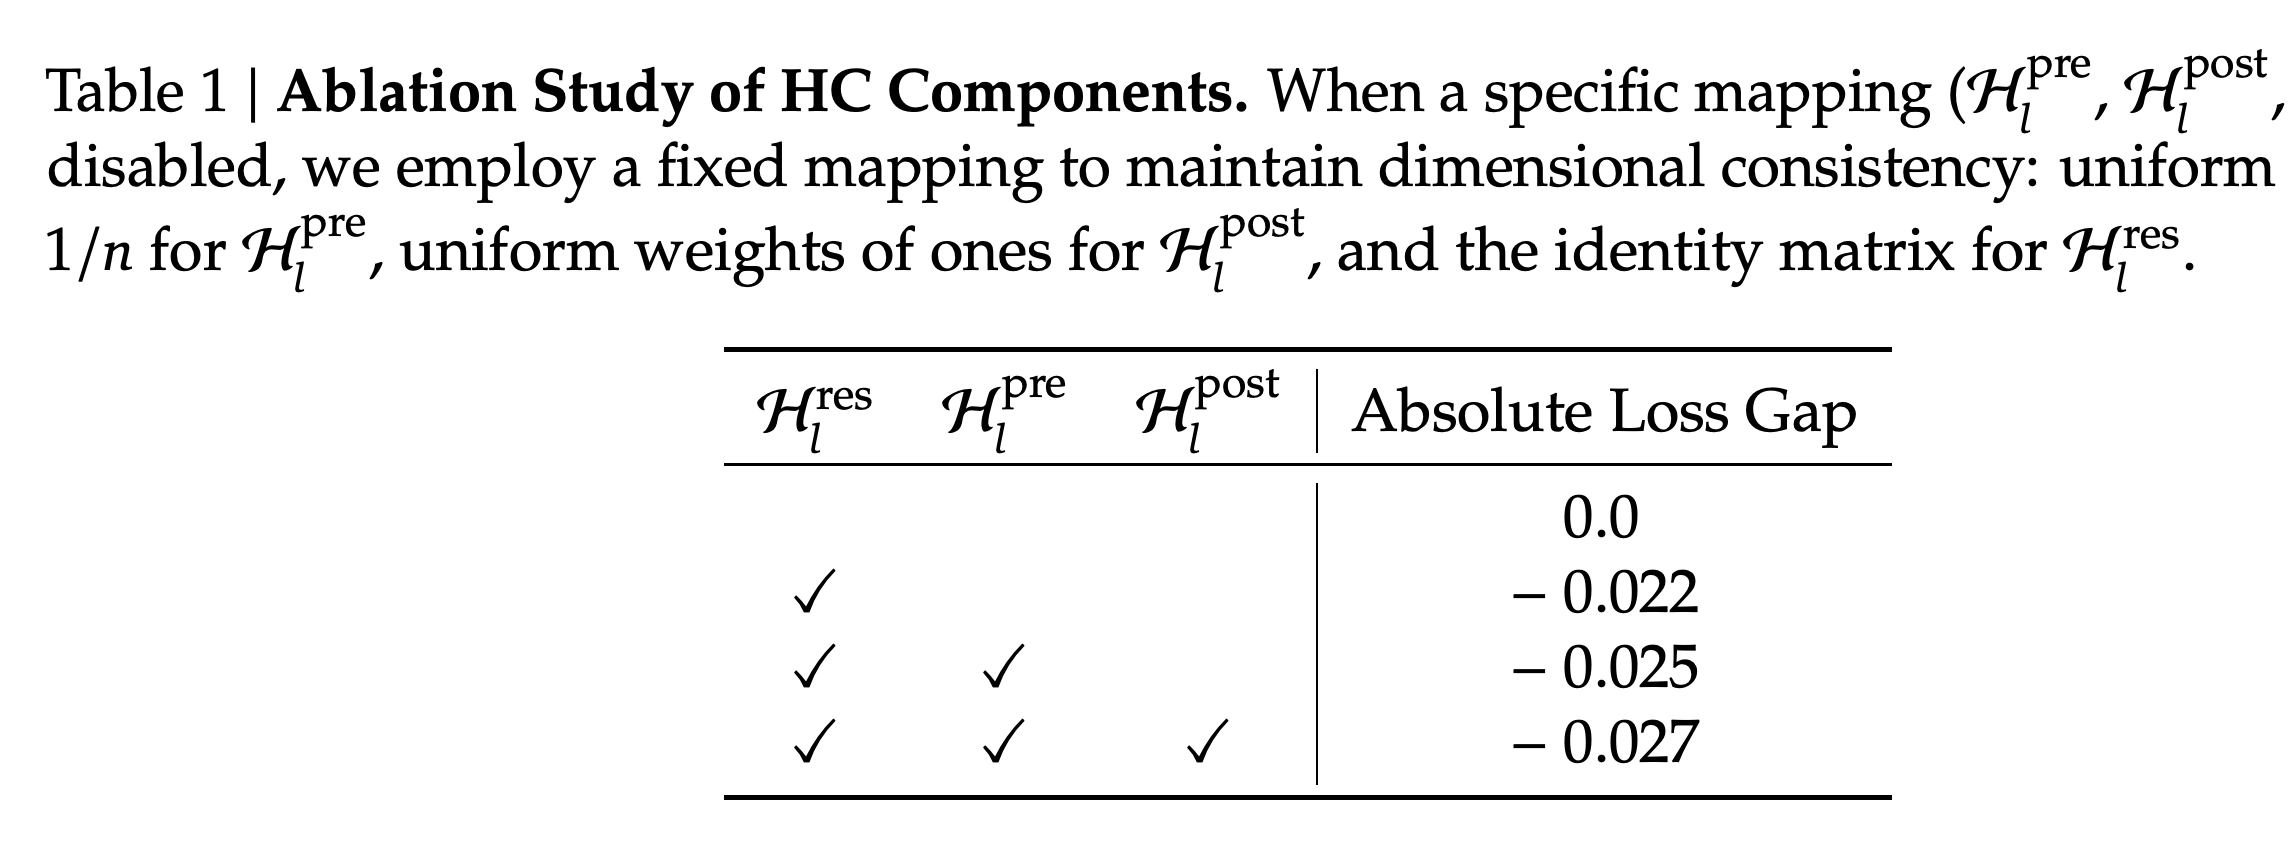
HC는 residual 상태를 n × C 행렬로 표현하고, 입력에 따라 달라지는 동적 계수와 전역 정적 계수를 함께 학습한다. 전파 규칙은 x_{l+1} = H_l^{res}x_l + (H_l^{post})^T F(H_l^{pre}x_l, W_l)이다. Table 1의 구성 요소 제거 실험에서는 residual stream 혼합을 학습하는 것이 측정된 손실 개선의 대부분을 차지한다.
- 원래 HC는 RMSNorm으로 정규화한 특징, 선형 투영, tanh, 작은 값으로 초기화한 학습 가능한 게이트로 동적 계수를 구한 뒤, 학습 가능한 정적 편향을 더한다.
- 구성 요소 제거 실험의 손실 차이는 모든 매핑을 고정하면 0.0, residual mapping만 학습하면 −0.022, pre-mapping도 학습하면 −0.025, 3개 매핑을 모두 학습하면 −0.027이다.
- 학습을 비활성화한 매핑은 균일한 pre-weight 1/n, post-weight 1, 항등 residual 행렬을 사용한다. 이 고정 매핑은 차원 일관성을 유지하면서 학습 가능한 매핑의 기여를 분리한다.
residual 혼합만 학습해도 손실 차이가 −0.022이며, 모든 매핑을 학습할 때는 −0.027이다. 이후 pre-mapping과 post-mapping을 추가해서 얻는 개선은 더 작다. 이는 혼합을 항등행렬로 대체하기보다 효과적인 stream 혼합을 유지하는 데 집중한 논문의 방향을 뒷받침한다.
3.1. Numerical Instability
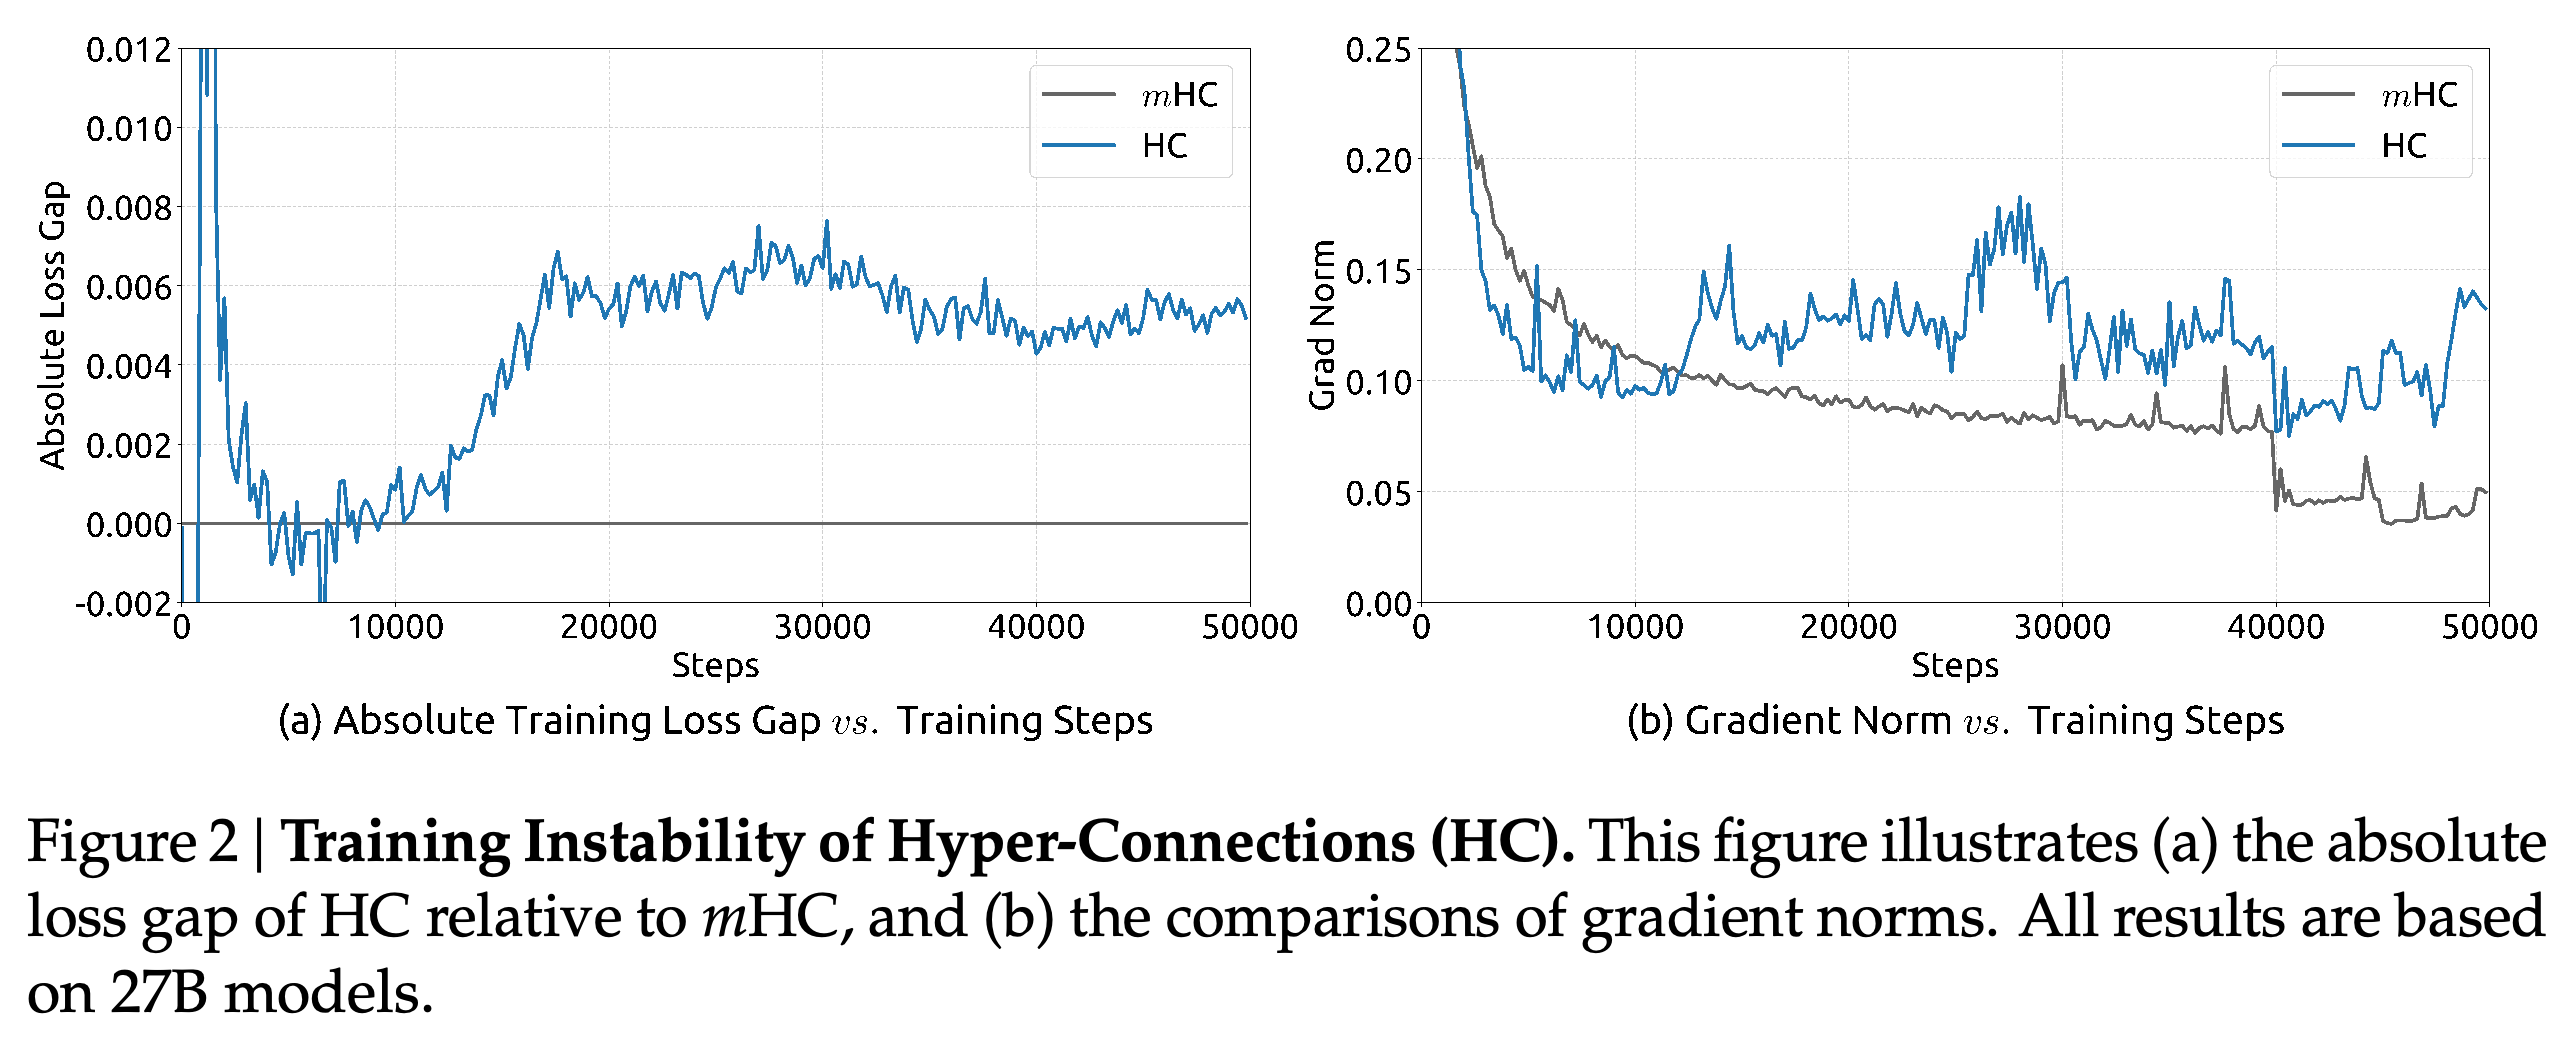
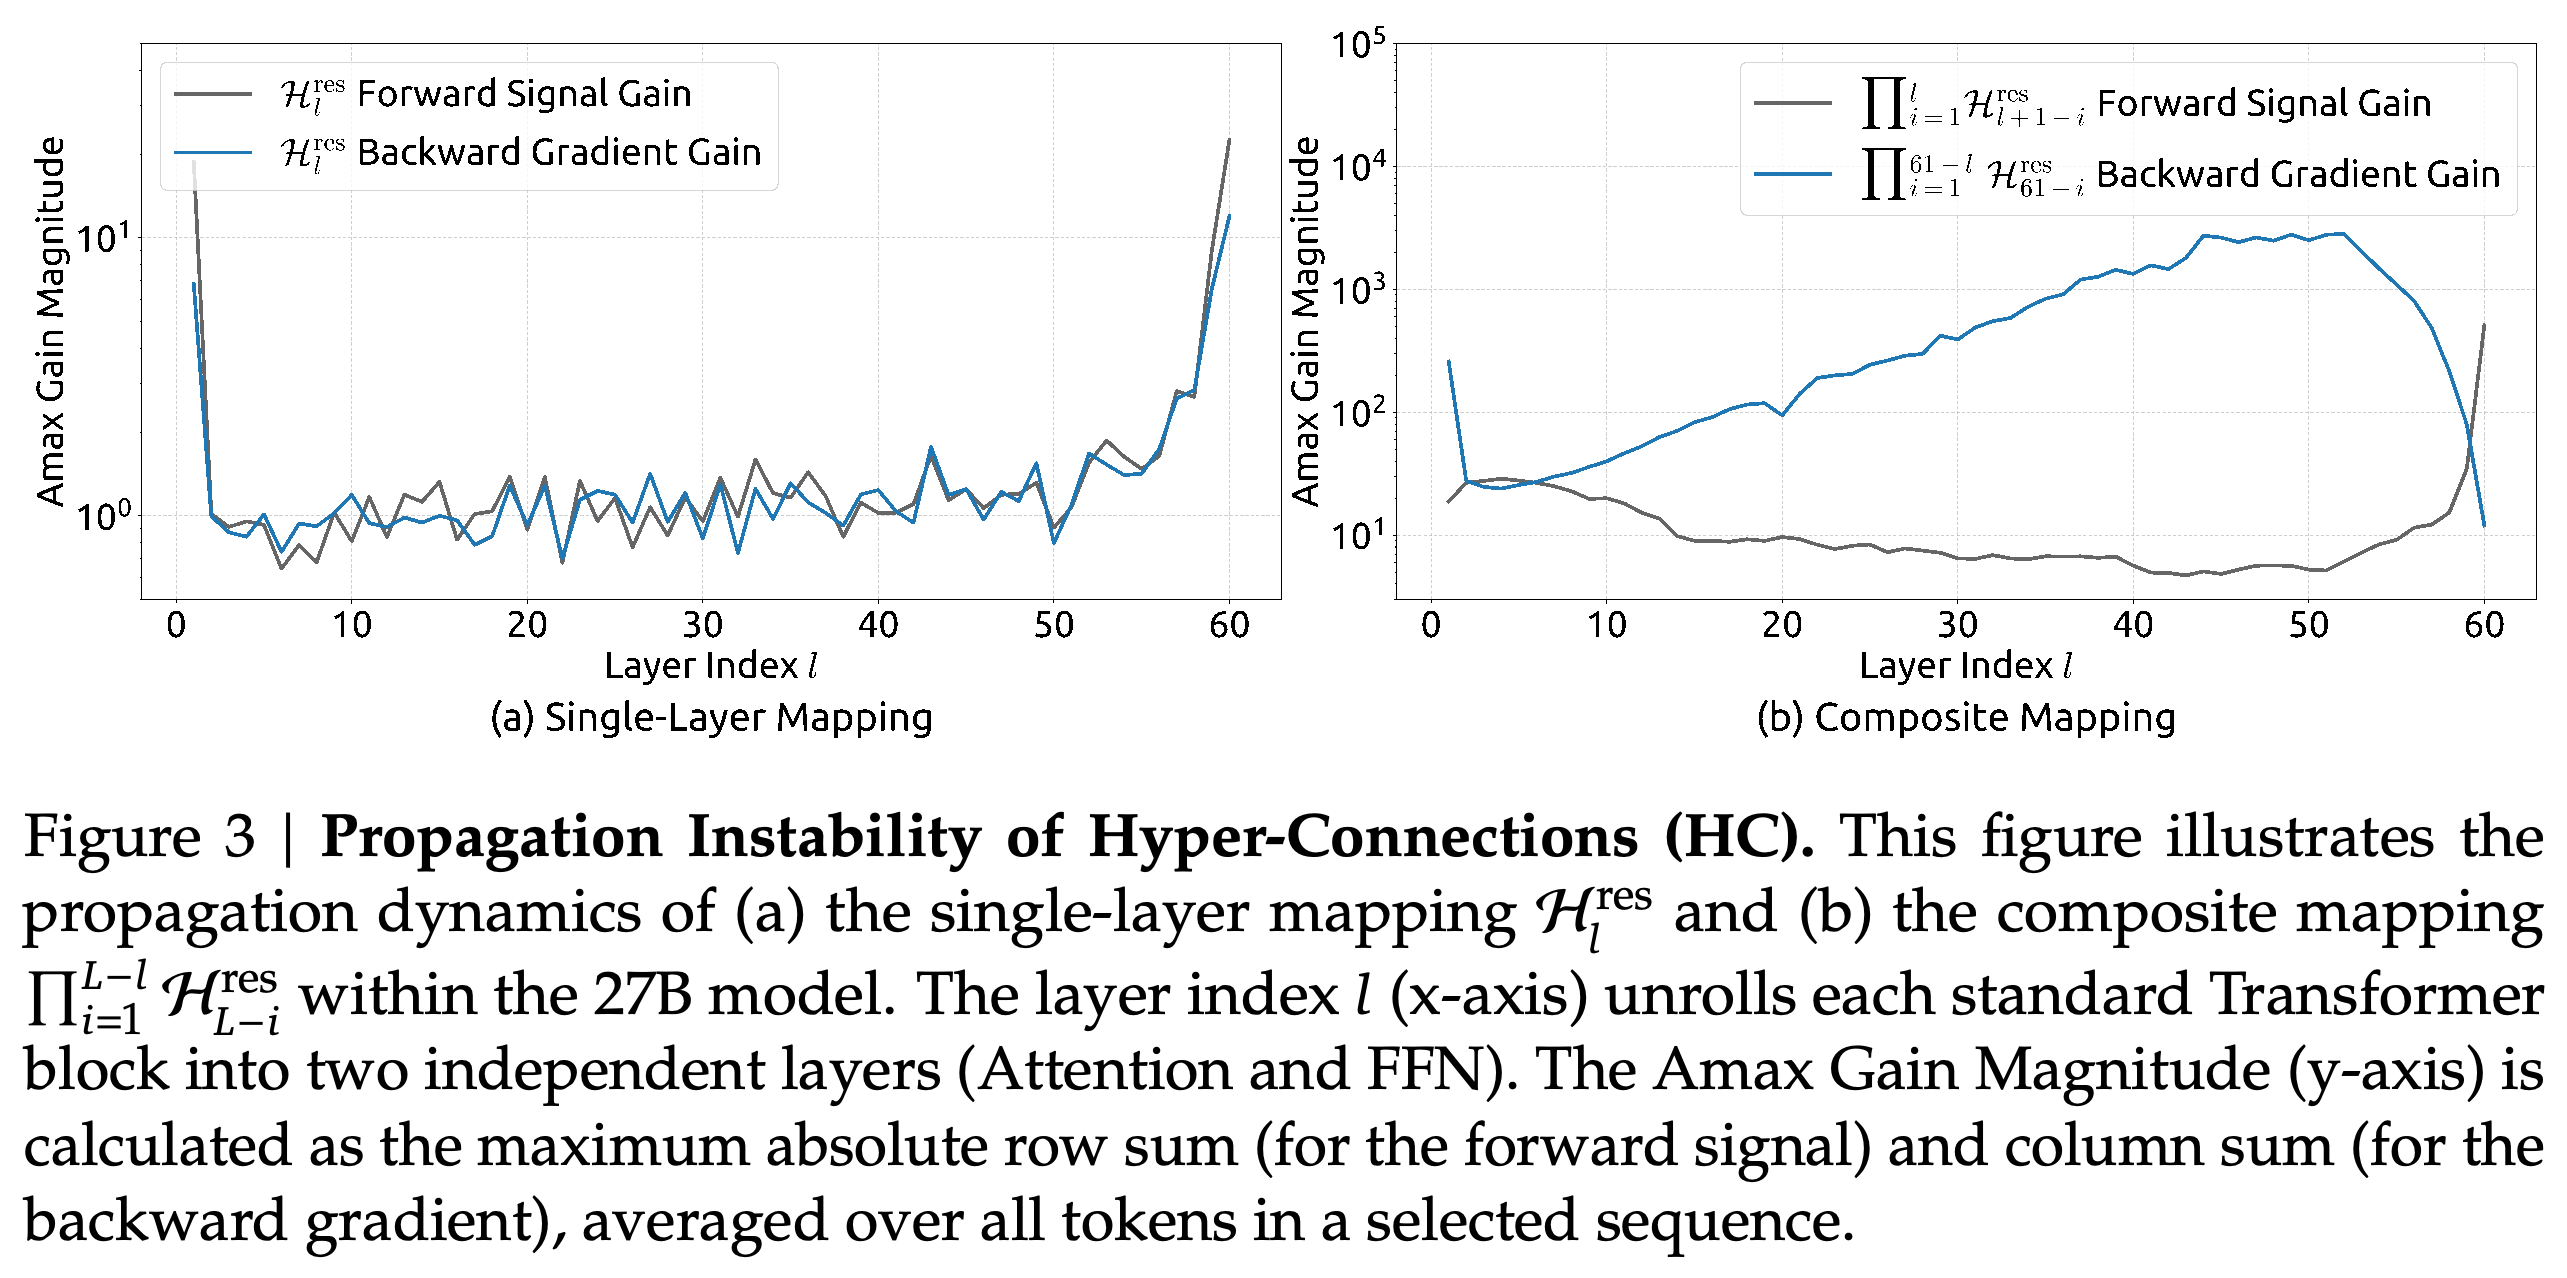
Figure 2에서 27B HC 학습은 약 12k step에 손실이 급증하고 gradient norm도 불안정해진다. Figure 3은 이 현상을 누적된 residual mapping과 연결한다. 개별 매핑의 이득은 다수가 1에 가깝지만, 합성 역방향 Amax Gain Magnitude는 약 3000까지 상승한다.
- 순방향 Amax Gain Magnitude는 residual mapping의 각 행 합에 절댓값을 취한 뒤 그중 최댓값을 구한다. 역방향 이득은 열 합을 사용한다. 각 원소의 절댓값을 합하는 것이 아니라 부호를 포함해 합한 뒤 절댓값을 취하며, 그래프의 측정값은 선택한 시퀀스의 토큰에 걸쳐 평균한 값이다.
- 층 축에서는 attention과 FFN을 별도의 residual layer로 취급하므로, 30개 블록으로 구성된 27B 모델에는 residual layer가 60개 있다.
- 이 측정값은 residual 혼합 경로의 증폭을 진단한다. 부호가 있는 HC 행렬에서는 일반적인 유도 노름의 상한이 아니며, 전체 네트워크 Jacobian을 측정하지도 않는다.
HC는 초기 과도 구간이 지난 뒤 mHC와 비슷한 손실을 보이다가 약 12k step부터 지속적인 양의 손실 차이를 보이며, gradient norm의 변동도 커진다. 이 곡선은 학습 실행의 완전한 발산이 아니라 학습 악화를 보여준다.
개별 HC residual mapping의 이득은 다수가 1에 가깝지만, 이들을 합성하면 역방향 이득이 약 3000에 도달한다. 이는 논문이 제안한 누적 메커니즘을 뒷받침한다. 다만 부호를 포함한 행 합·열 합 진단을 원소의 절댓값 합에 기반한 유도 노름과 혼동해서는 안 된다.
3.2. System Overhead
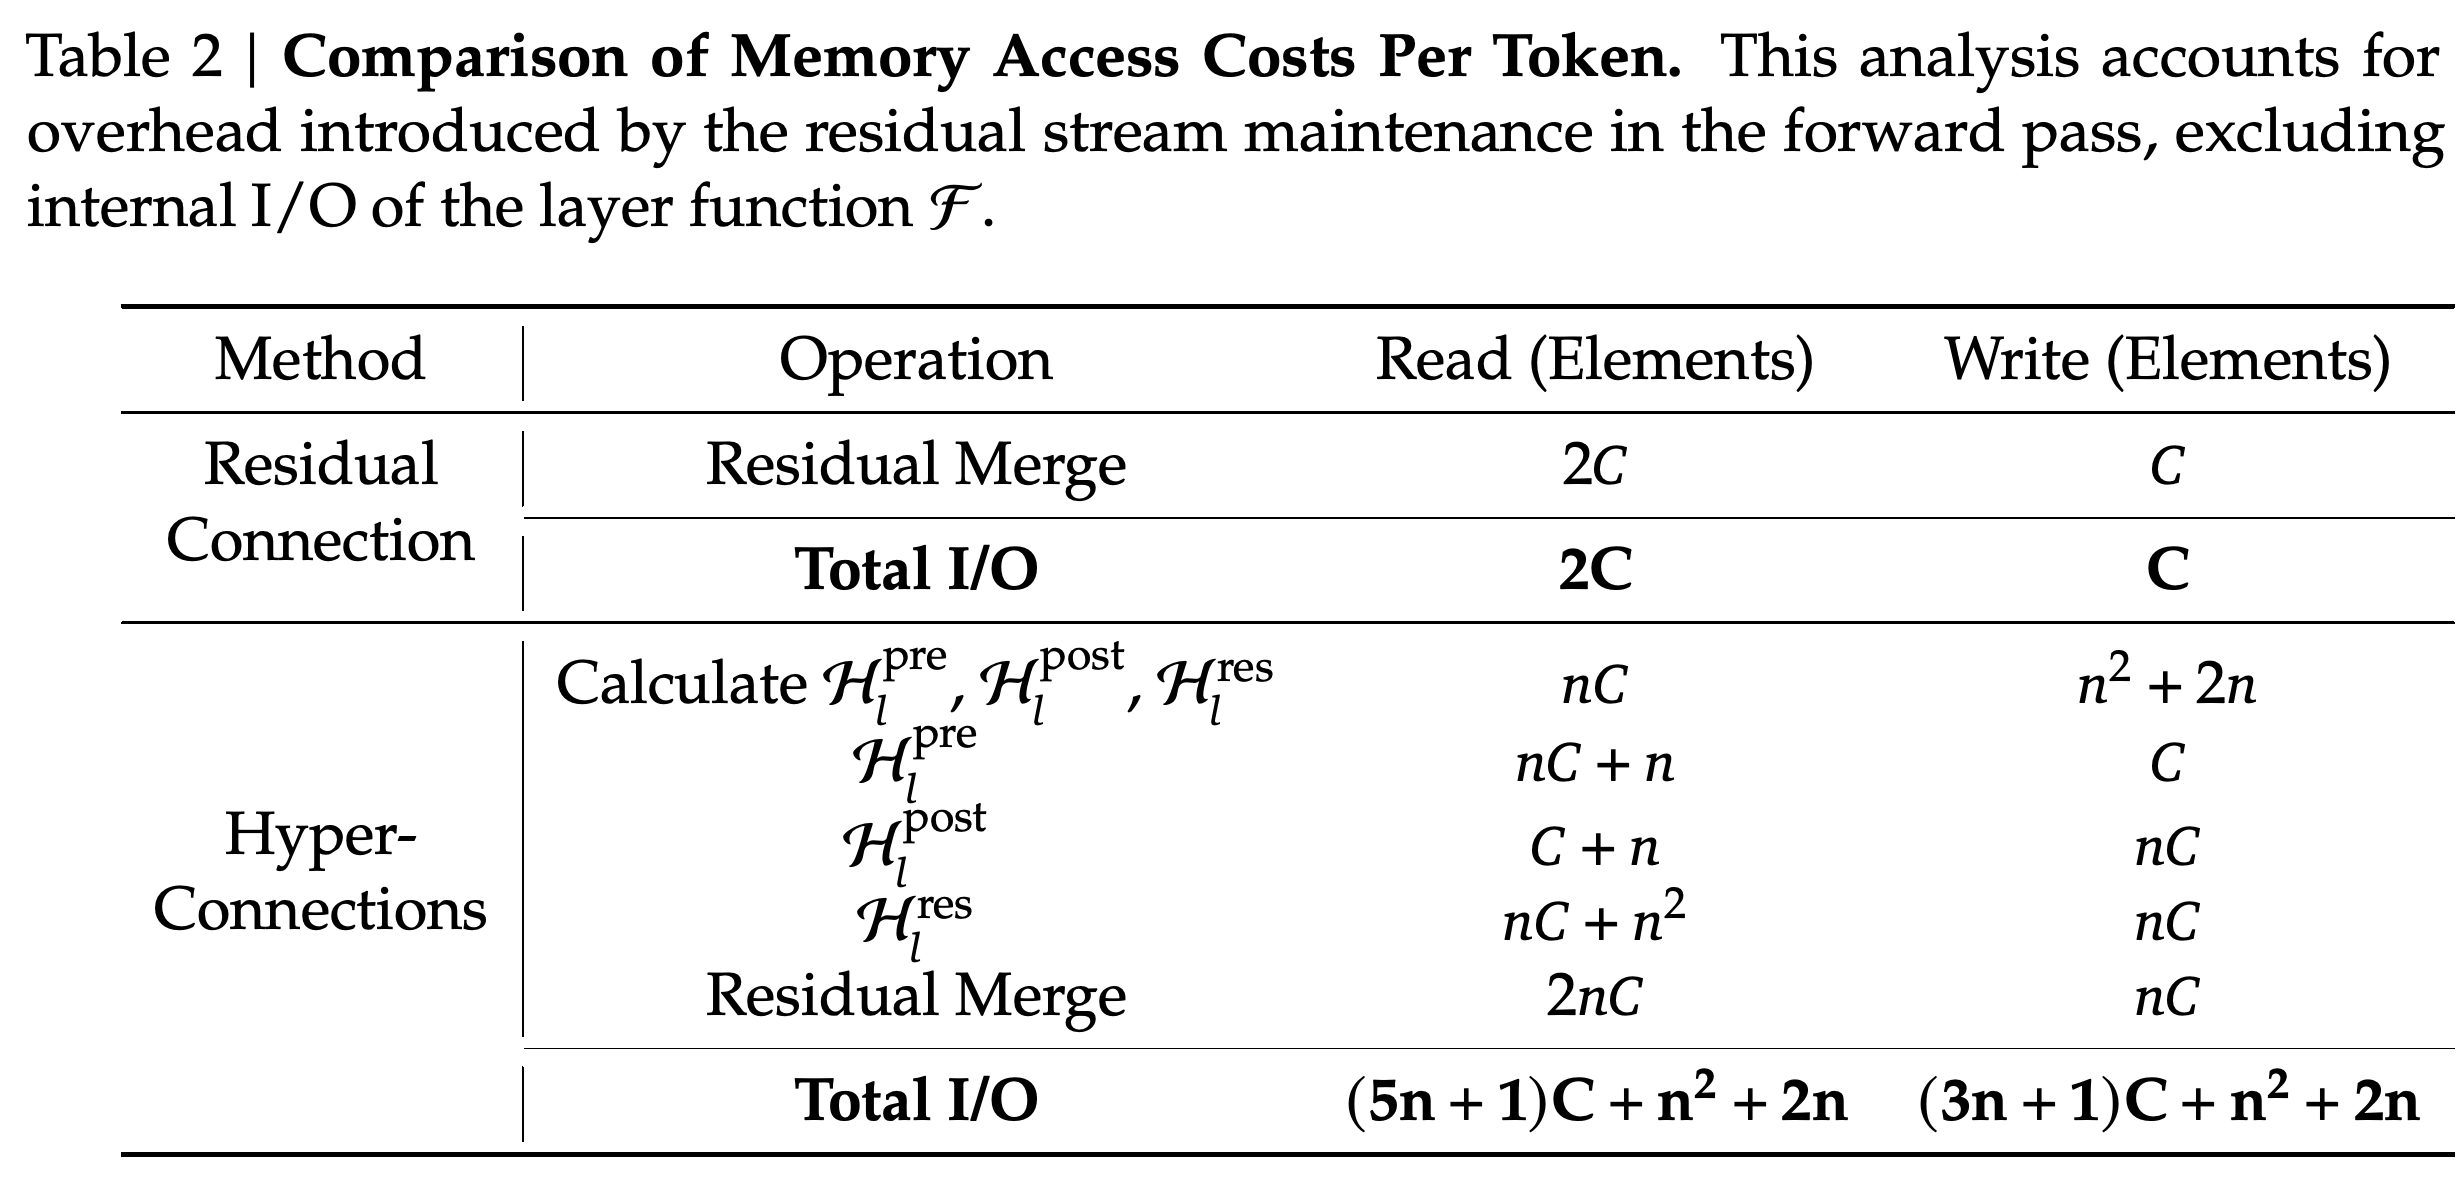
HC에서 추가 FLOPs가 적다고 실행 시간 오버헤드도 적은 것은 아니다. Table 2는 확장된 stream을 유지할 때 순방향 메모리 트래픽이 대략 n에 비례해 증가한다는 점을 보여준다. 학습 가능한 매핑은 역전파를 위해 추가 활성값도 필요로 하며, pipeline parallelism에서는 n배 넓어진 residual 상태를 통신한다.
- F 내부의 I/O를 제외하면, 표준 residual merge는 토큰당 2C개 원소를 읽고 C개 원소를 쓴다.
- 융합하지 않은 HC는 토큰당 (5n + 1)C + n² + 2n개 원소를 읽고 (3n + 1)C + n² + 2n개 원소를 쓴다.
- 이로 인해 발생하는 대역폭 수요, 활성값 메모리, pipeline 통신 비용을 줄이기 위해 연산 융합, 재계산, 통신과 연산의 중첩을 도입한다.
이 계산은 FLOP 기반 비교로 포착하지 못하는 대역폭 비용을 드러낸다. 표준 residual 유지 연산은 토큰당 2C개 원소를 읽고 C개 원소를 쓴다. 반면 융합하지 않은 HC는 계수 계산, 집계, 재분배, 혼합, 병합을 위해 확장된 상태에 반복해서 접근한다.
4. Method
제안 방법은 제약을 가한 residual stream 매핑과 인프라 최적화를 결합한다. residual 행렬을 항등행렬로 고정하지 않고도 여러 층에 걸친 혼합을 제어한다. 항등행렬로 고정하면 stream 사이의 정보 교환이 사라진다.
4.1. Manifold-Constrained Hyper-Connections
mHC는 residual mapping을 Birkhoff polytope로 제한한다. 제약 조건은 H_l^{res}1_n = 1_n, 1_n^T H_l^{res} = 1_n^T, H_l^{res} ≥ 0이다. 따라서 각 출력 stream은 입력 stream들의 볼록 결합이며, 제약을 정확히 만족하면 stream 평균이 보존된다.
- 정확한 이중 확률 행렬의 spectral norm은 최대 1이므로, residual 혼합 연산은 비팽창적이다. 이는 노름의 상한이지 모든 입력 벡터의 노름을 보존한다는 뜻은 아니다.
- 이중 확률 행렬은 곱셈에 대해 닫혀 있으므로, 정확한 residual mapping을 여러 층에 걸쳐 합성해도 보존 성질을 유지한다.
- Birkhoff polytope는 순열 행렬들의 볼록 껍질이므로, 이 매핑을 stream 순열의 혼합으로 해석할 수 있다. n = 1에서는 residual mapping이 스칼라 1로 줄어든다.
- mHC는 부호가 있는 집계와 재분배에서 발생하는 상쇄를 막기 위해 pre-mapping과 post-mapping 계수도 음이 아닌 값으로 제한한다.
4.2. Parameterization and Manifold Projection
mHC는 RMSNorm과 동적 계수 예측 전에 전체 n × C residual 상태를 평탄화해, 각 매핑이 모든 stream에 의존할 수 있도록 한다. pre-mapping logits에는 sigmoid를, post-mapping logits에는 sigmoid 출력의 2배를, residual logits에는 Sinkhorn-Knopp 정규화를 적용한다.
- 동적 투영의 차원은 pre-mapping과 post-mapping에서 nC × n이고, residual mapping에서 nC × n²이다. 이후 학습 가능한 게이트와 정적 편향을 적용한다.
- Sinkhorn-Knopp는 M^(0) = exp(H̃_l^{res})에서 시작해 (M^{(t)}=\mathcal{T}_r\left(\mathcal{T}_c\left(M^{(t-1)}\right)\right))를 반복한다. T_c와 T_r은 각각 열과 행을 정규화한다.
- 극한에서 정확한 이중 확률성을 얻으려면 반복이 수렴해야 한다. 실험에서는 정규화 정확도와 계산 비용을 절충해 t_max = 20을 사용한다.
4.3. Efficient Infrastructure Design
4.3.1. Kernel Fusion은 계수 계산과 매핑 적용을 결합해 대역폭 비용과 커널 실행 오버헤드를 줄인다. 구현에서는 RMS norm으로 나누는 연산을 투영 뒤로 옮기고, RMSNorm 가중치를 투영 파라미터에 흡수하며, 계수 계산에 혼합 정밀도를 사용한다.
- 입력 상태는 bfloat16, 통합 투영은 tfloat32, 게이트·편향·출력 계수는 float32를 사용한다. 투영과 norm 계산은 융합 커널을 공유하고, 작은 계수 변환에는 별도 커널을 사용한다.
- Sinkhorn-Knopp 반복은 1개 커널 안에서 실행한다. 사용자 정의 역방향 커널은 정규화 중간 결과를 온칩에서 재계산한다.
- post-mapping, residual 혼합, residual merge를 융합하면 해당 적용 커널의 읽기는 (3n + 1)C에서 (n + 1)C로, 쓰기는 3nC에서 nC로 줄어든다.
- Eq. (14)–(15)에 해당하는 투영 및 norm 커널을 제외한 대부분의 커널은 TileLang으로 구현한다.
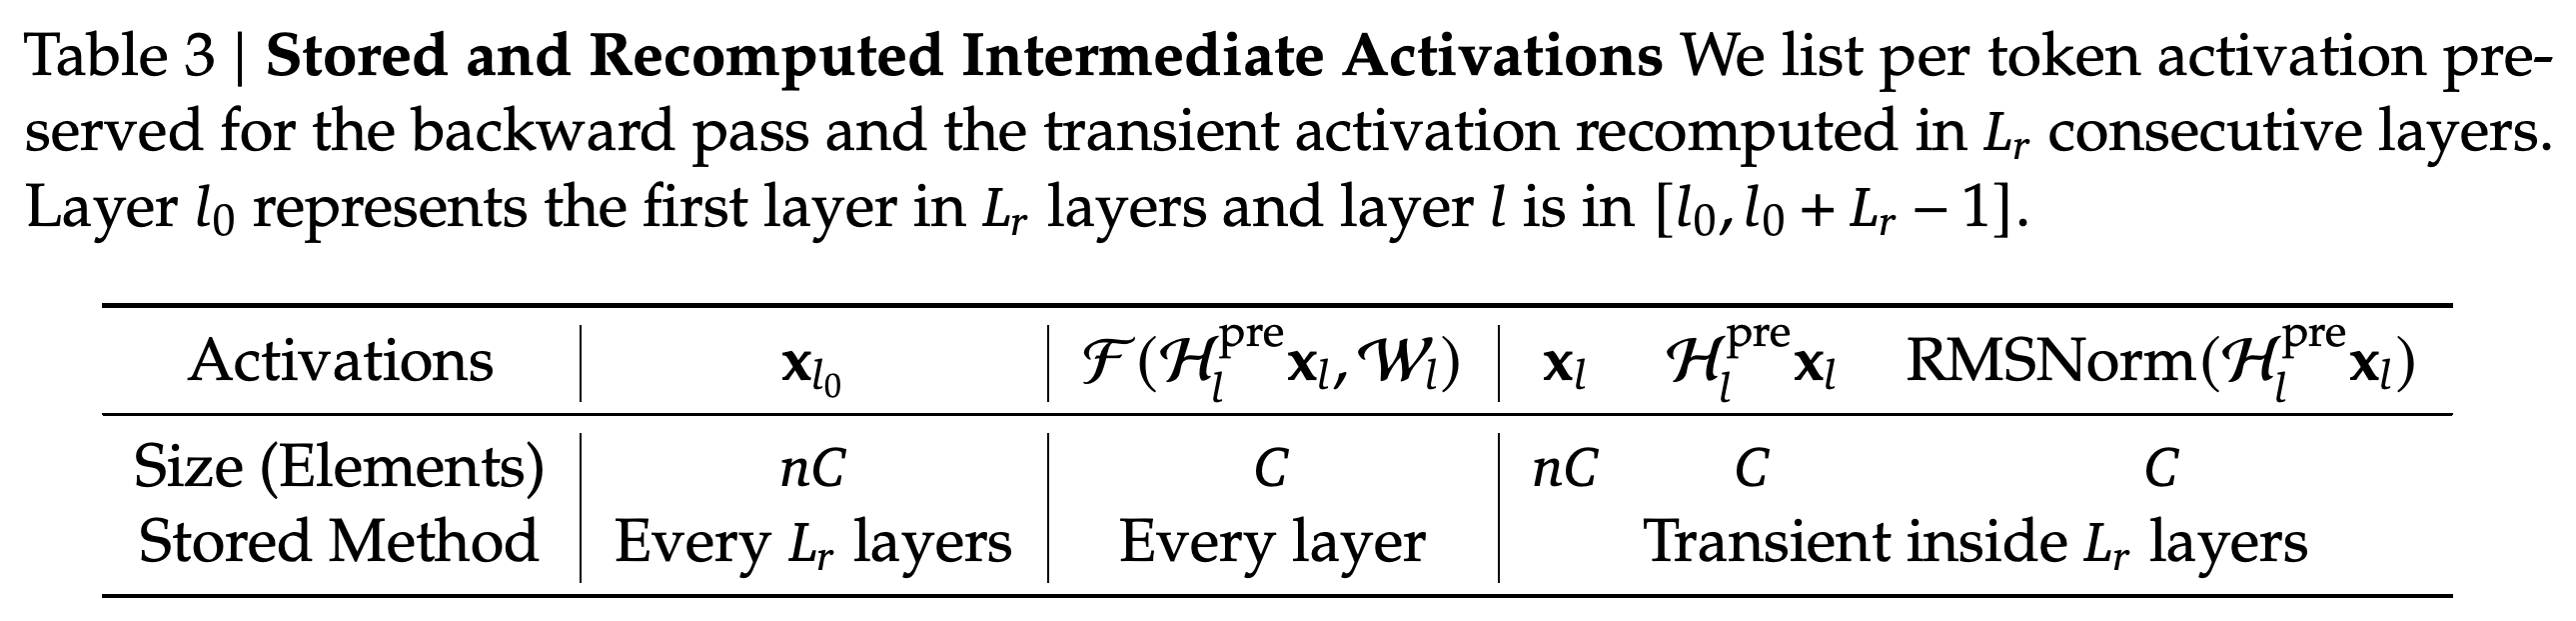
4.3.2. Recomputing은 순방향 계산이 끝나면 mHC 중간 활성값을 버리고, 역전파 때 비용이 큰 층 함수 F를 다시 실행하지 않고 이를 복원한다. Table 3은 계속 저장하는 블록 입력과 층 출력을 일시적으로 재구성하는 상태와 구분한다.
- L_r개 residual layer로 이루어진 각 블록에서는 nC개 원소를 가진 초기 residual 상태를 저장한다. 각 층에서는 C개 원소로 이루어진 F 출력도 저장한다.
- 블록 크기에 따른 메모리 목적함수는 nC⌈L/L_r⌉ + (n + 2)CL_r이며, 근사 최적값은 L_r* ≈ √(nL/(n + 2))이다.
- 재계산 블록은 pipeline stage 경계를 넘을 수 없다. 이론적 최적값이 대체로 stage 깊이에 가까우므로, 구현에서는 재계산 블록을 stage에 맞춘다.
이 저장 방식은 넓어진 residual 입력을 재계산 블록당 1회 저장하고, 층 함수 출력을 각 층에서 저장한다. residual 상태, pre-mapping을 적용한 입력, 정규화된 입력은 일시적으로 재구성한다. 따라서 메모리 최적값은 checkpoint 저장 빈도와 현재 재계산 중인 블록 크기 사이의 균형으로 정해진다.
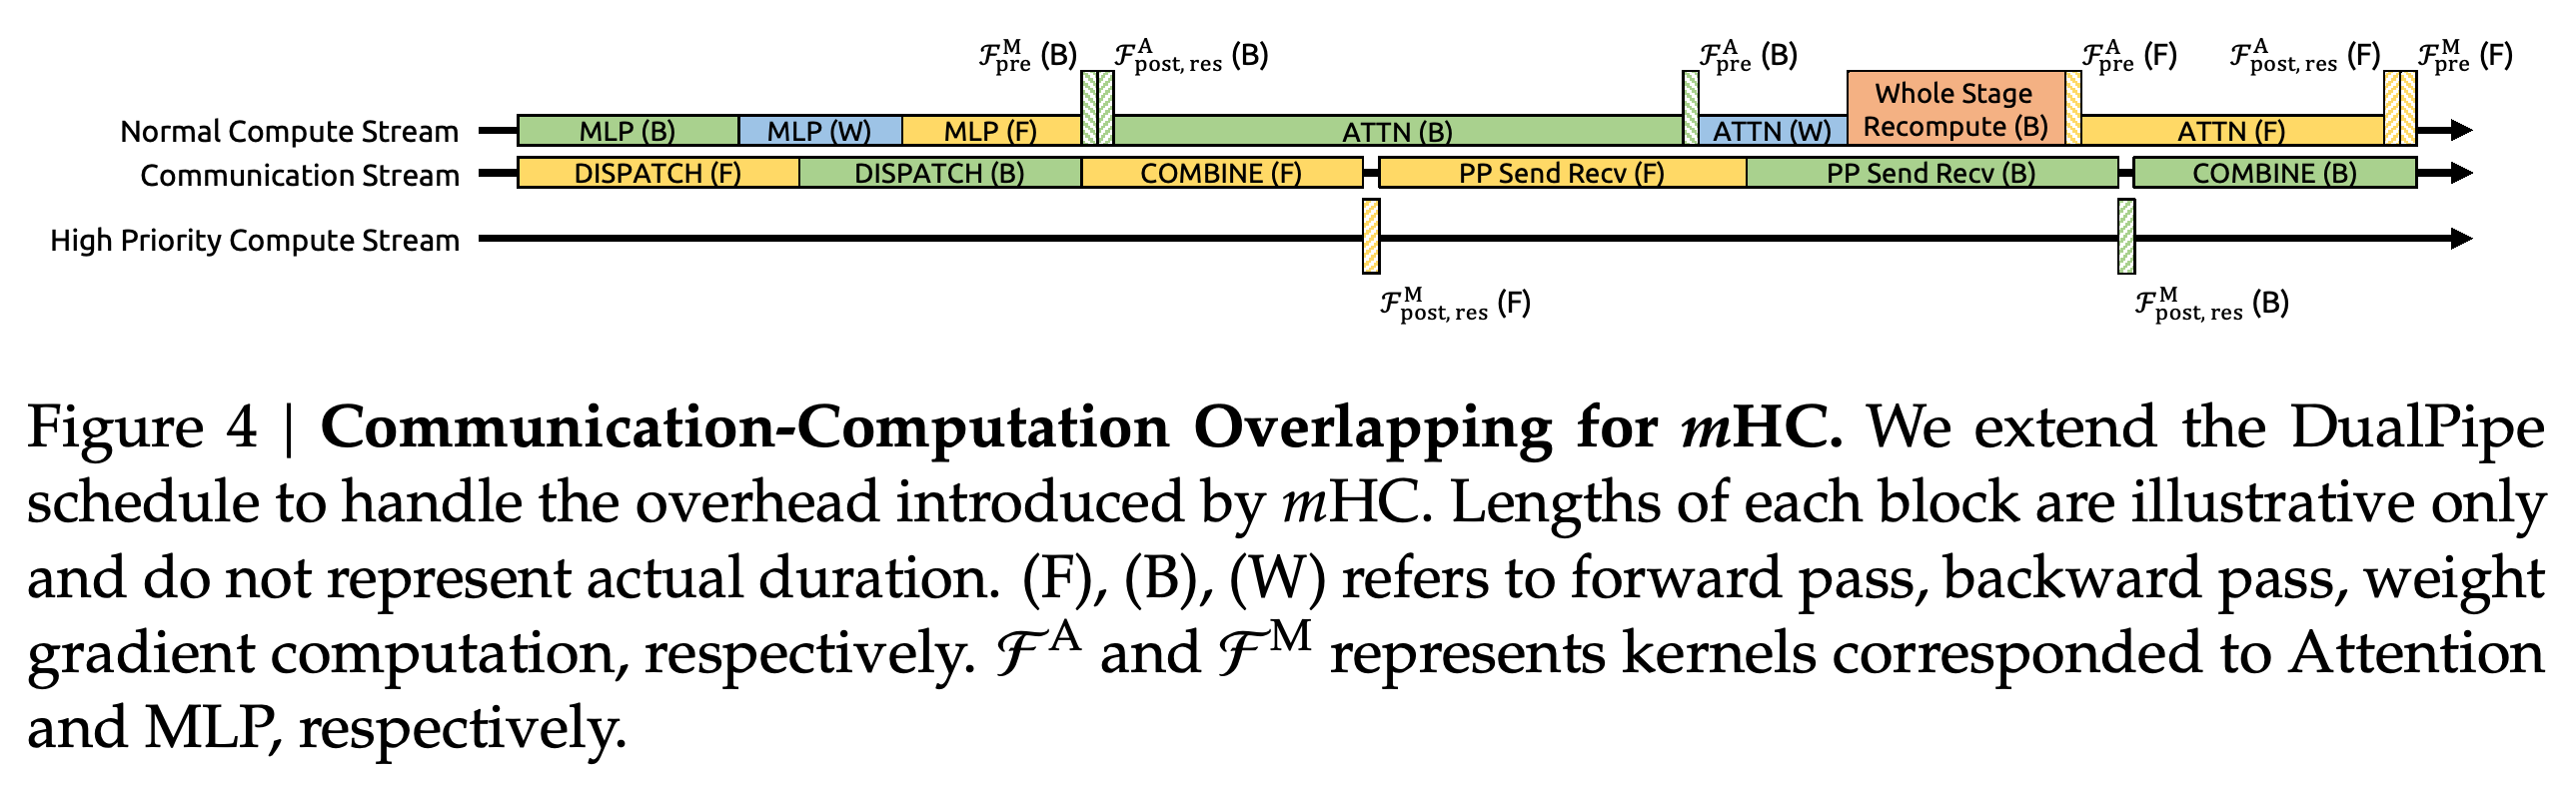
4.3.3. Overlapping Communication in DualPipe는 pipeline 스케줄을 확장해 넓어진 상태의 통신과 stage 단위 재계산을 다른 작업과 중첩한다. Figure 4는 일반 연산, 통신, 높은 우선순위 연산 stream의 조율을 보여준다. 블록 길이는 측정 시간이 아니라 개략적인 표현이다.
- FFN post-mapping과 residual merge 커널은 높은 우선순위 stream에서 실행해, pipeline 통신이 긴 연산 뒤에서 막히지 않도록 한다.
- 오래 실행되는 attention 연산은 persistent kernel을 사용하지 않아, 중첩 작업을 더 유연하게 스케줄링할 수 있다.
- 각 stage의 초기 residual 상태가 이미 로컬에 캐시되어 있으므로 재계산은 pipeline 통신과 독립적으로 진행할 수 있다. 저자들은 이 인프라 설계를 함께 적용했을 때 n = 4에서 추가 학습 시간이 6.7%였다고 보고한다.
이 스케줄은 통신에 중요한 짧은 FFN 매핑 커널을 높은 우선순위 stream에 배치하면서, 다른 연산과 pipeline 전송, stage 재계산을 중첩한다. 스케줄링 전략을 설명하지만, 블록 길이가 예시이므로 지연 시간 절감량을 정량화하지는 않는다.
5. Experiments
실험은 수렴, downstream benchmark 성능, 스케일링 양상, residual 전파 진단을 통해 언어 모델 사전학습을 평가한다. 주요 비교 대상은 표준 residual 기준 모델, HC, mHC이다.
5.1. Experimental Setup
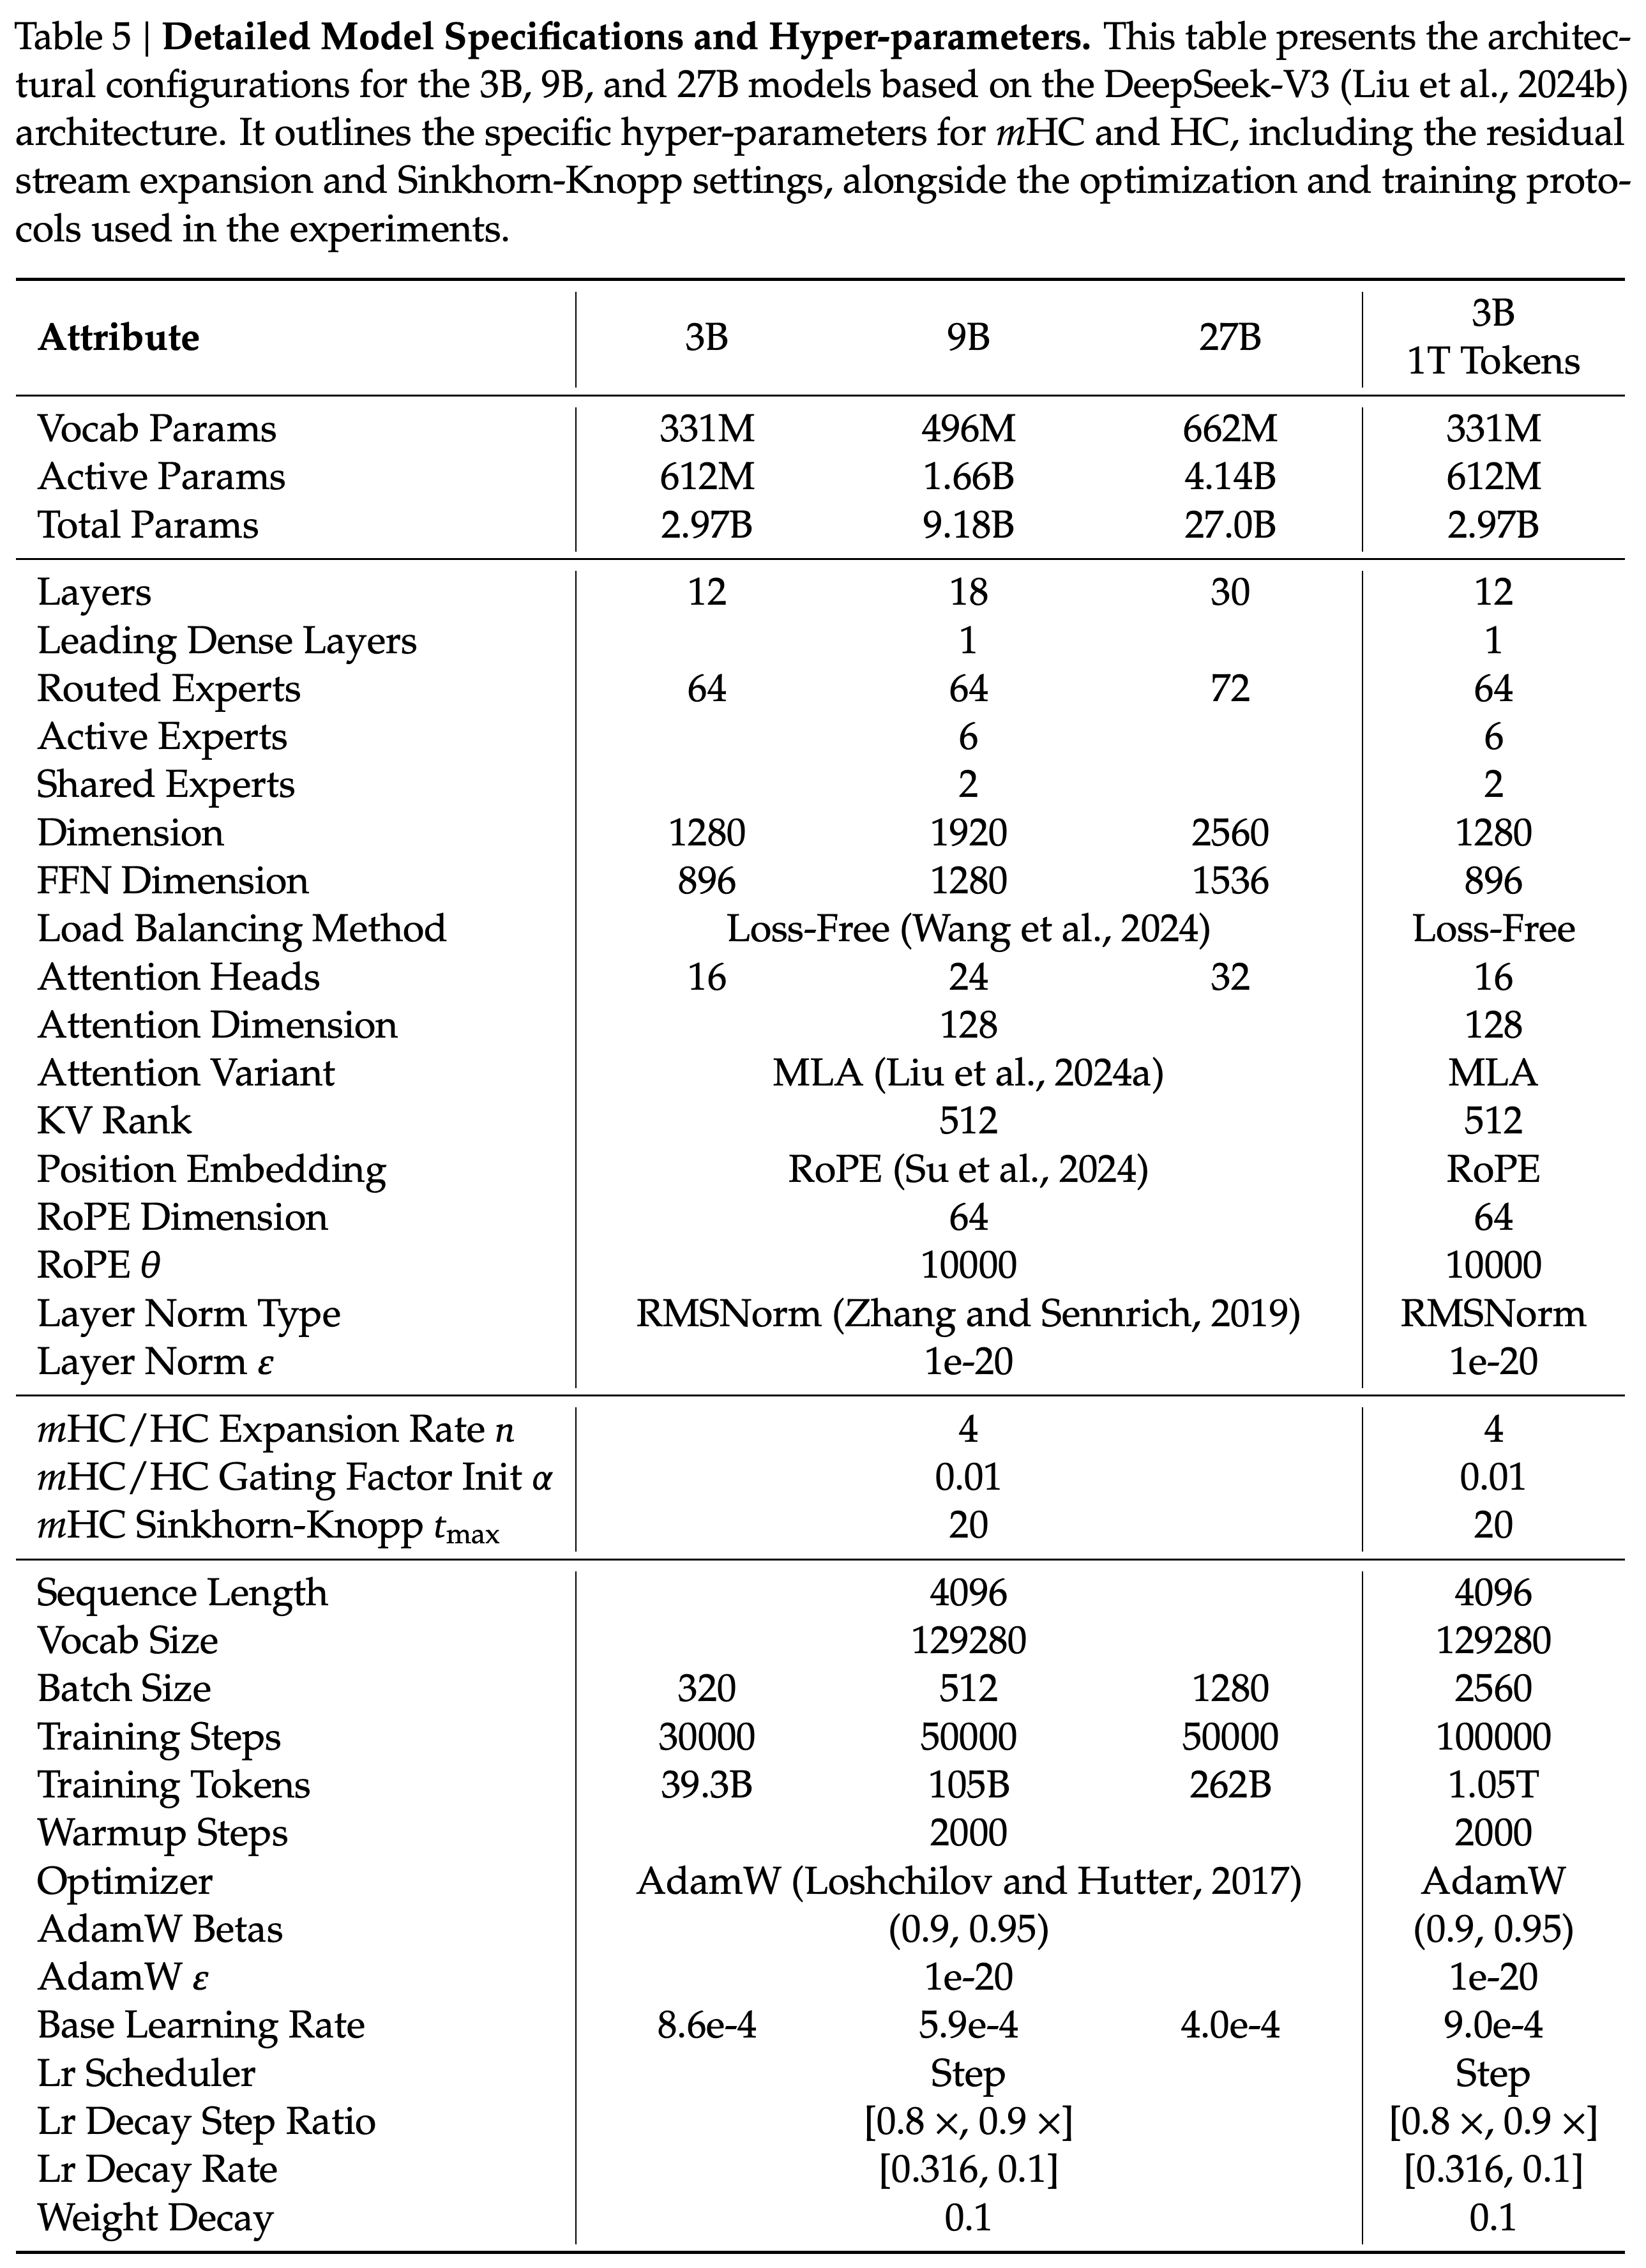
모델은 DeepSeek-V3에서 영감을 받은 MoE 구조를 사용하며, HC와 mHC 모두 n = 4로 설정한다. 연산량 스케일링 실험은 모델 규모에 비례하는 데이터셋으로 학습한 3B, 9B, 27B 모델을 사용한다. 별도의 3B 학습은 1 trillion tokens로 설명된 코퍼스에서 토큰 스케일링을 살펴보며, Table 5에는 학습 토큰이 1.05T로 기재되어 있다.
- 명목상 3B, 9B, 27B 모델의 총 파라미터는 각각 2.97B, 9.18B, 27.0B이지만, 활성 파라미터는 612M, 1.66B, 4.14B이다.
- 학습 예산은 각각 30000, 50000, 50000 step에 걸친 39.3B, 105B, 262B tokens이다. 모든 구성의 sequence length는 4096이다.
- Table 5는 구조와 최적화 설정을 명시하며, Transformer 블록 수 12, 18, 30과 Sinkhorn-Knopp 반복 횟수 20을 포함한다.
명세는 MoE의 총 파라미터와 활성 파라미터를 구분하고, 모델 규모에 비례하는 데이터로 수행한 스케일링 학습과 확장된 3B 학습을 분리한다. sequence length 4096, 확장률 4, 정규화 반복 횟수 20을 명시하며, 명목상 1T-token 학습이 실제로는 1.05T training tokens를 처리한다는 점도 보여준다.
5.2. Main Results
Figure 5의 27B 모델 비교에서 mHC는 HC에서 관찰된 지속적인 손실 악화를 피하며, 최종 손실이 기준 모델보다 0.021 낮다. gradient norm의 변화도 HC보다 안정적이며, 학습 후반에는 기준 모델의 양상에 가까워진다.
다중 stream 방법들은 모두 표준 기준 모델보다 손실을 개선하지만, mHC는 학습 후반에 더 큰 개선을 유지하며 HC의 지속적인 gradient 변동을 피한다. mHC의 최종 손실 차이는 기준 모델 대비 −0.021이다.
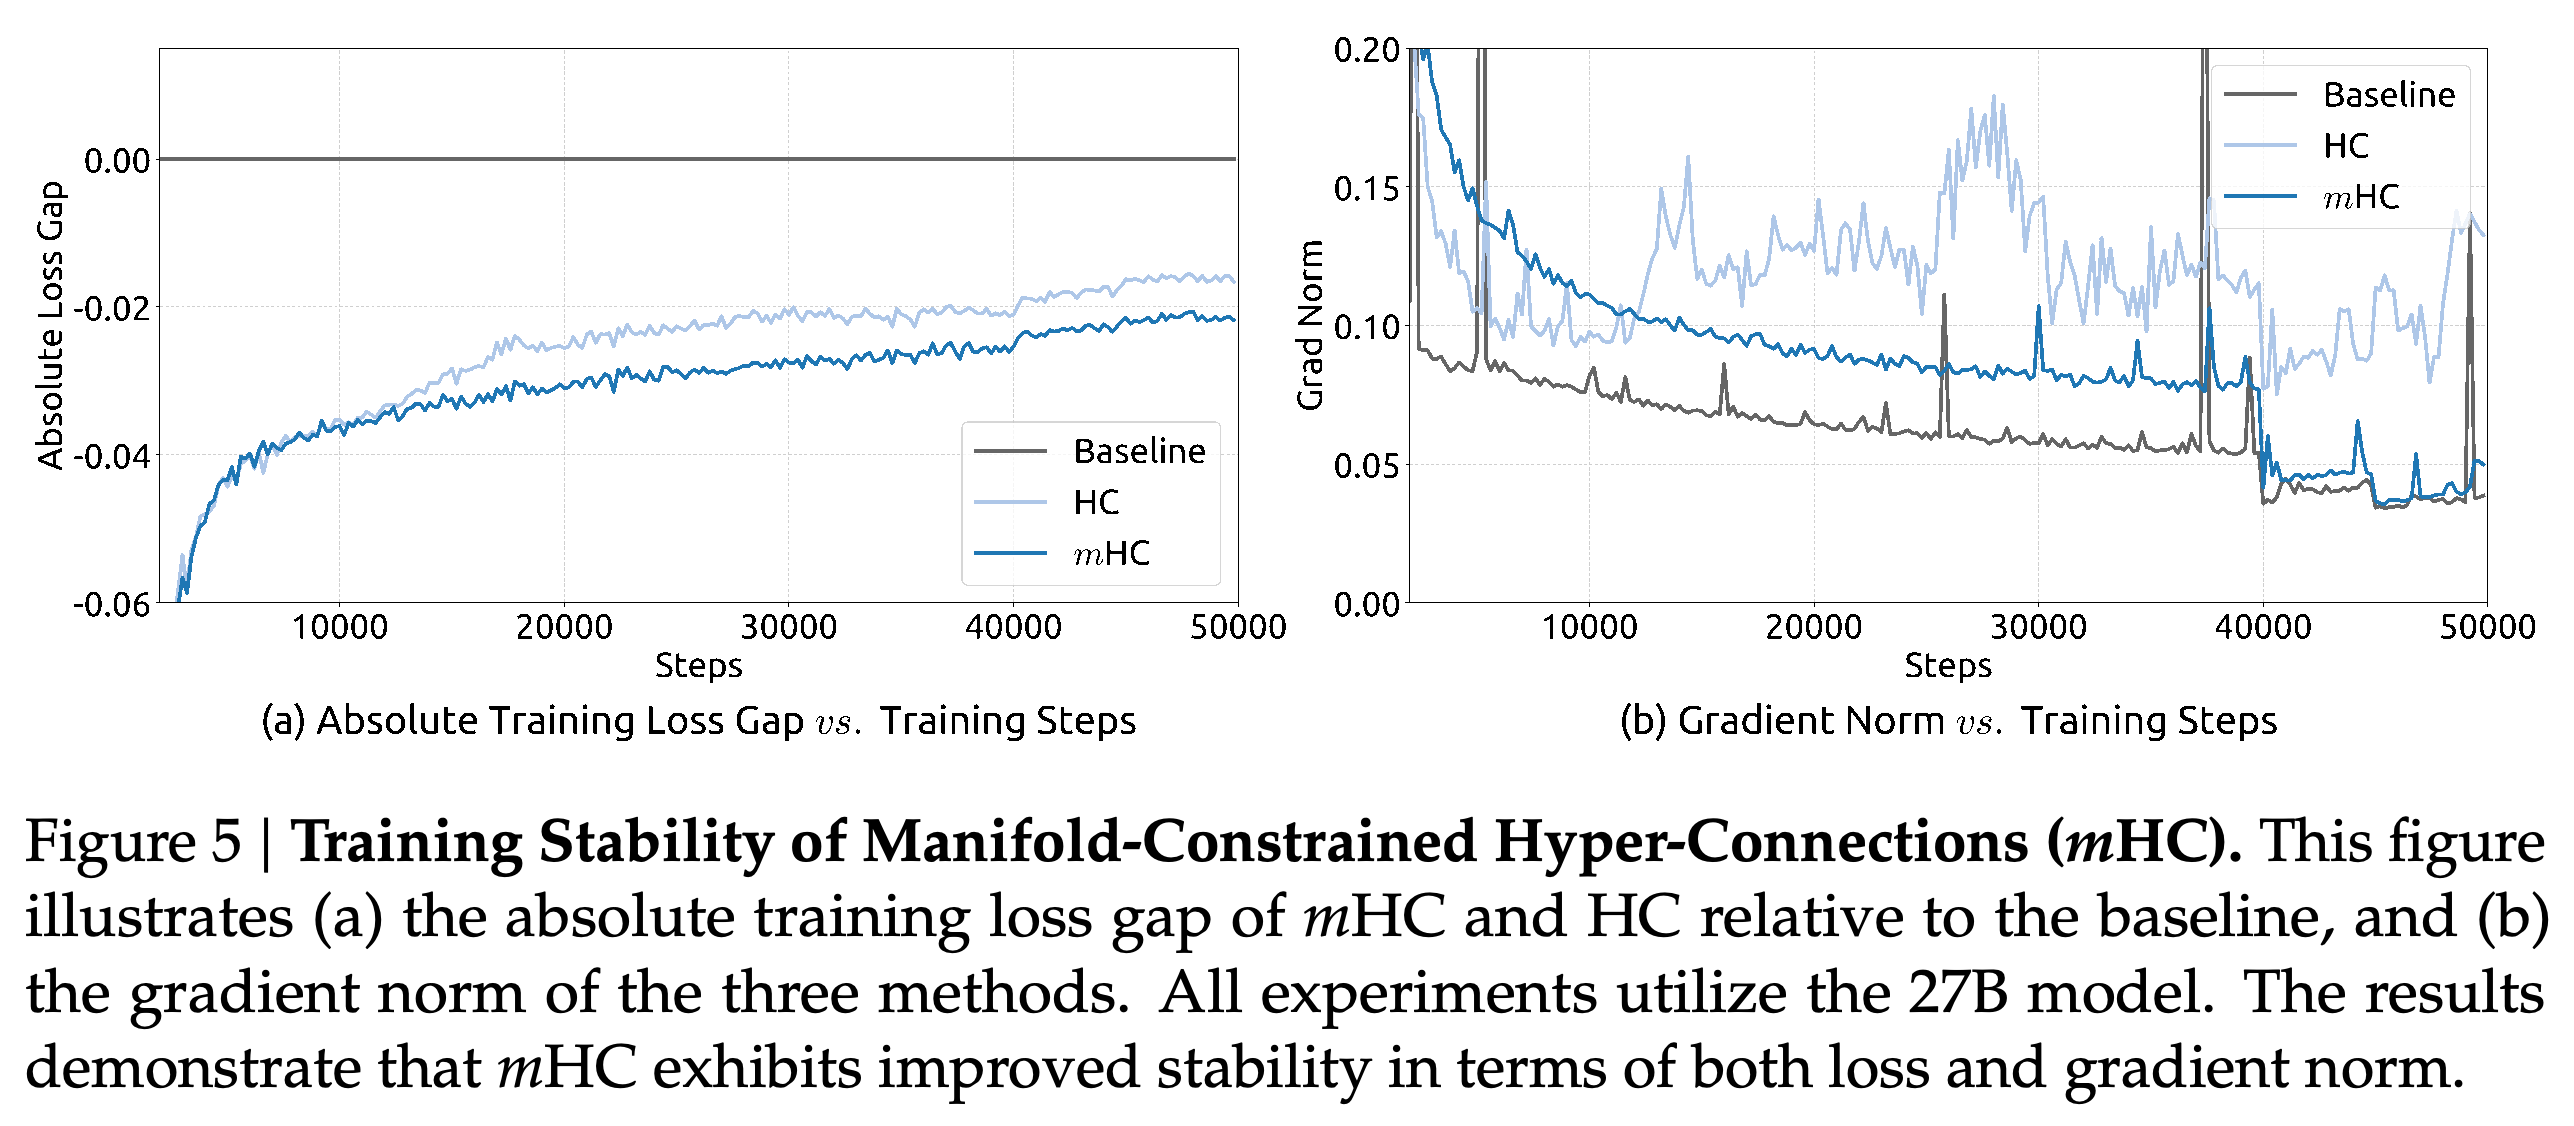
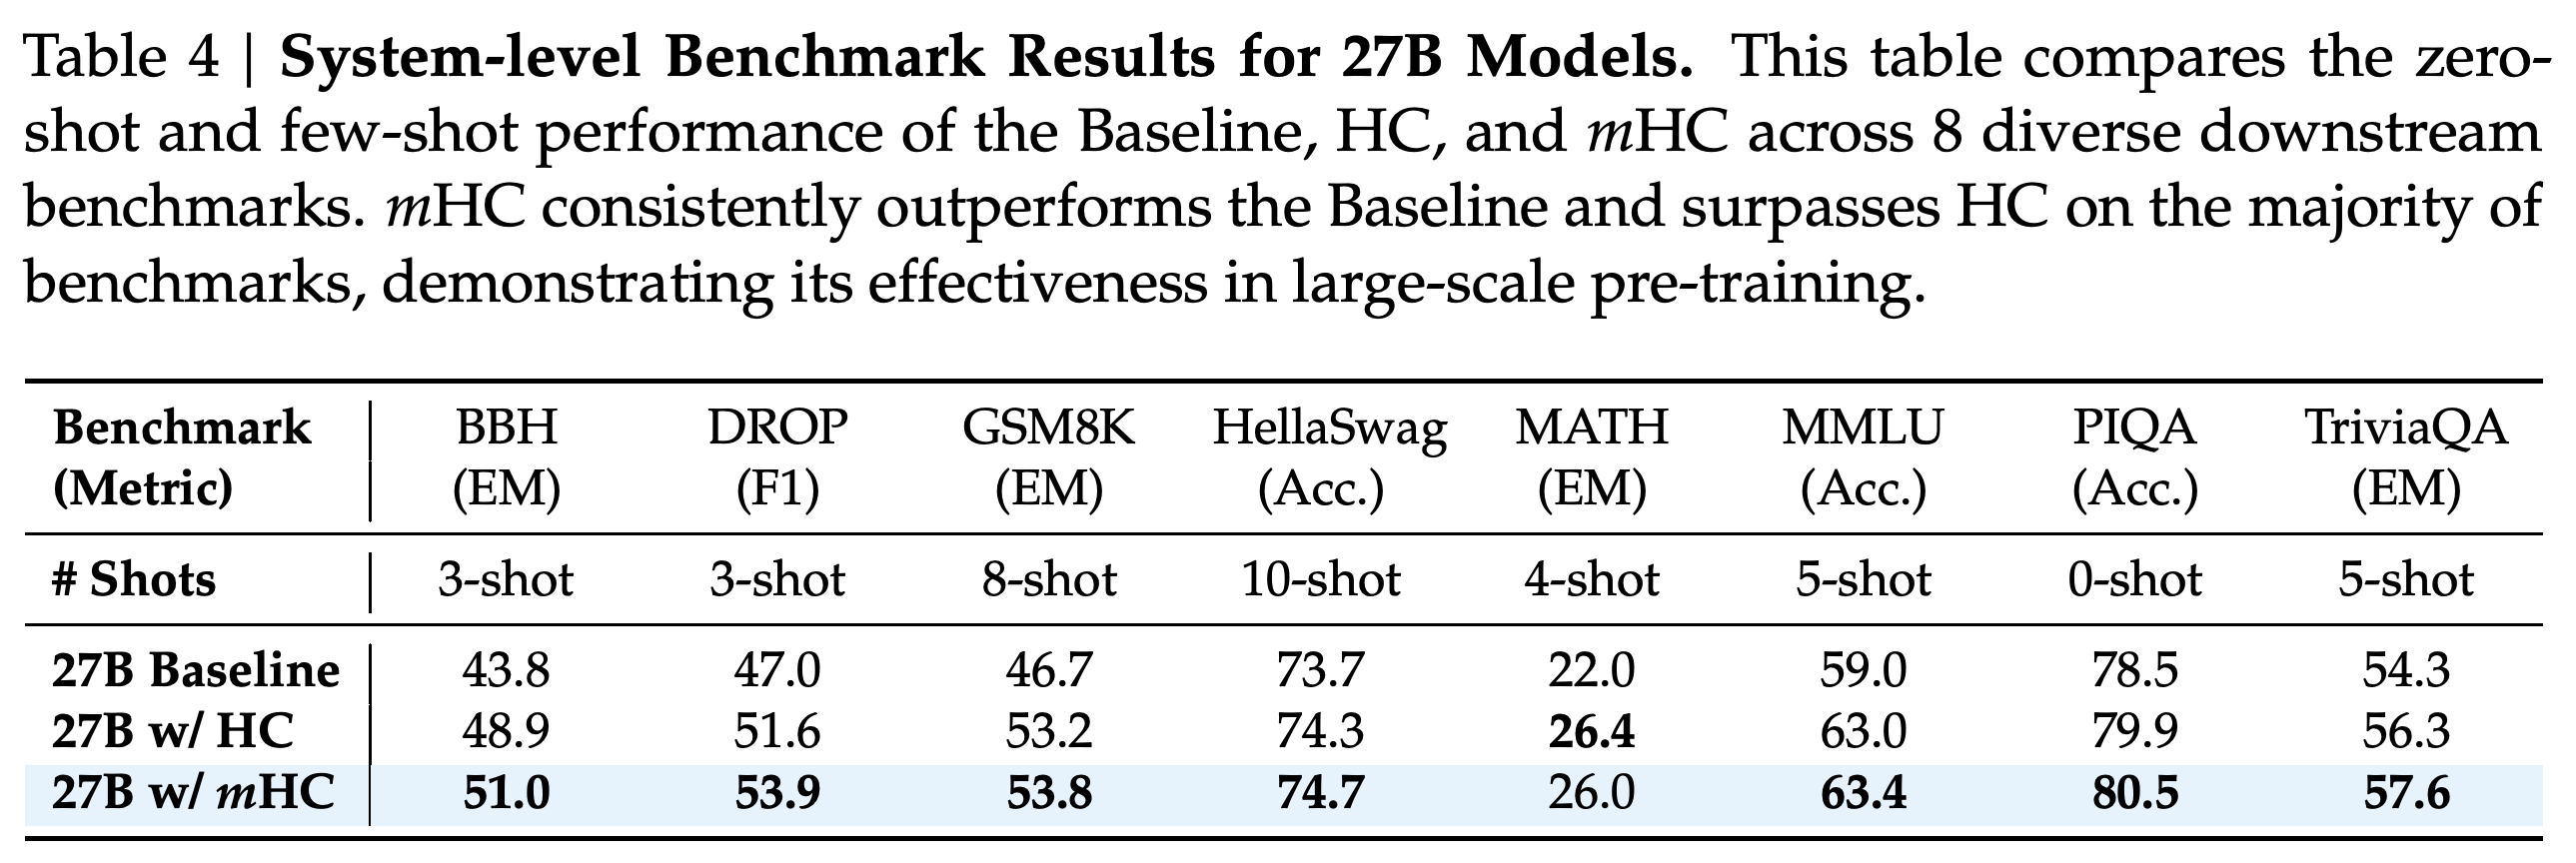
Table 4에서 mHC는 평가한 downstream benchmark 모두에서 기준 모델보다 앞서고, HC보다 8개 중 7개에서 앞선다. HC 대비 BBH는 48.9에서 51.0으로, DROP은 51.6에서 53.9로 오른다. 예외인 MATH는 26.4에서 26.0으로 낮아지지만, 기준 모델의 22.0보다는 높다.
- 평가에는 BBH 3-shot EM, DROP 3-shot F1, GSM8K 8-shot EM, HellaSwag 10-shot accuracy, MATH 4-shot EM, MMLU 5-shot accuracy, PIQA 0-shot accuracy, TriviaQA 5-shot EM을 사용한다.
- 이 benchmark 순서대로 기준 모델의 점수는 43.8, 47.0, 46.7, 73.7, 22.0, 59.0, 78.5, 54.3이고, HC의 점수는 48.9, 51.6, 53.2, 74.3, 26.4, 63.0, 79.9, 56.3이다.
- mHC의 점수는 51.0, 53.9, 53.8, 74.7, 26.0, 63.4, 80.5, 57.6이다. 보고된 점수 척도에서 BBH와 DROP의 차이는 각각 2.1 percentage points와 2.3 percentage points이다.
mHC는 모든 benchmark에서 기준 모델보다 앞서고, 대부분의 benchmark에서 HC보다 앞선다. HC-to-mHC 개선 폭은 BBH와 DROP에서 각각 2.1과 2.3 percentage points로 가장 크다. MATH는 HC보다 항상 우수하지는 않다는 명시적인 예외이다.
5.3. Scaling Experiments
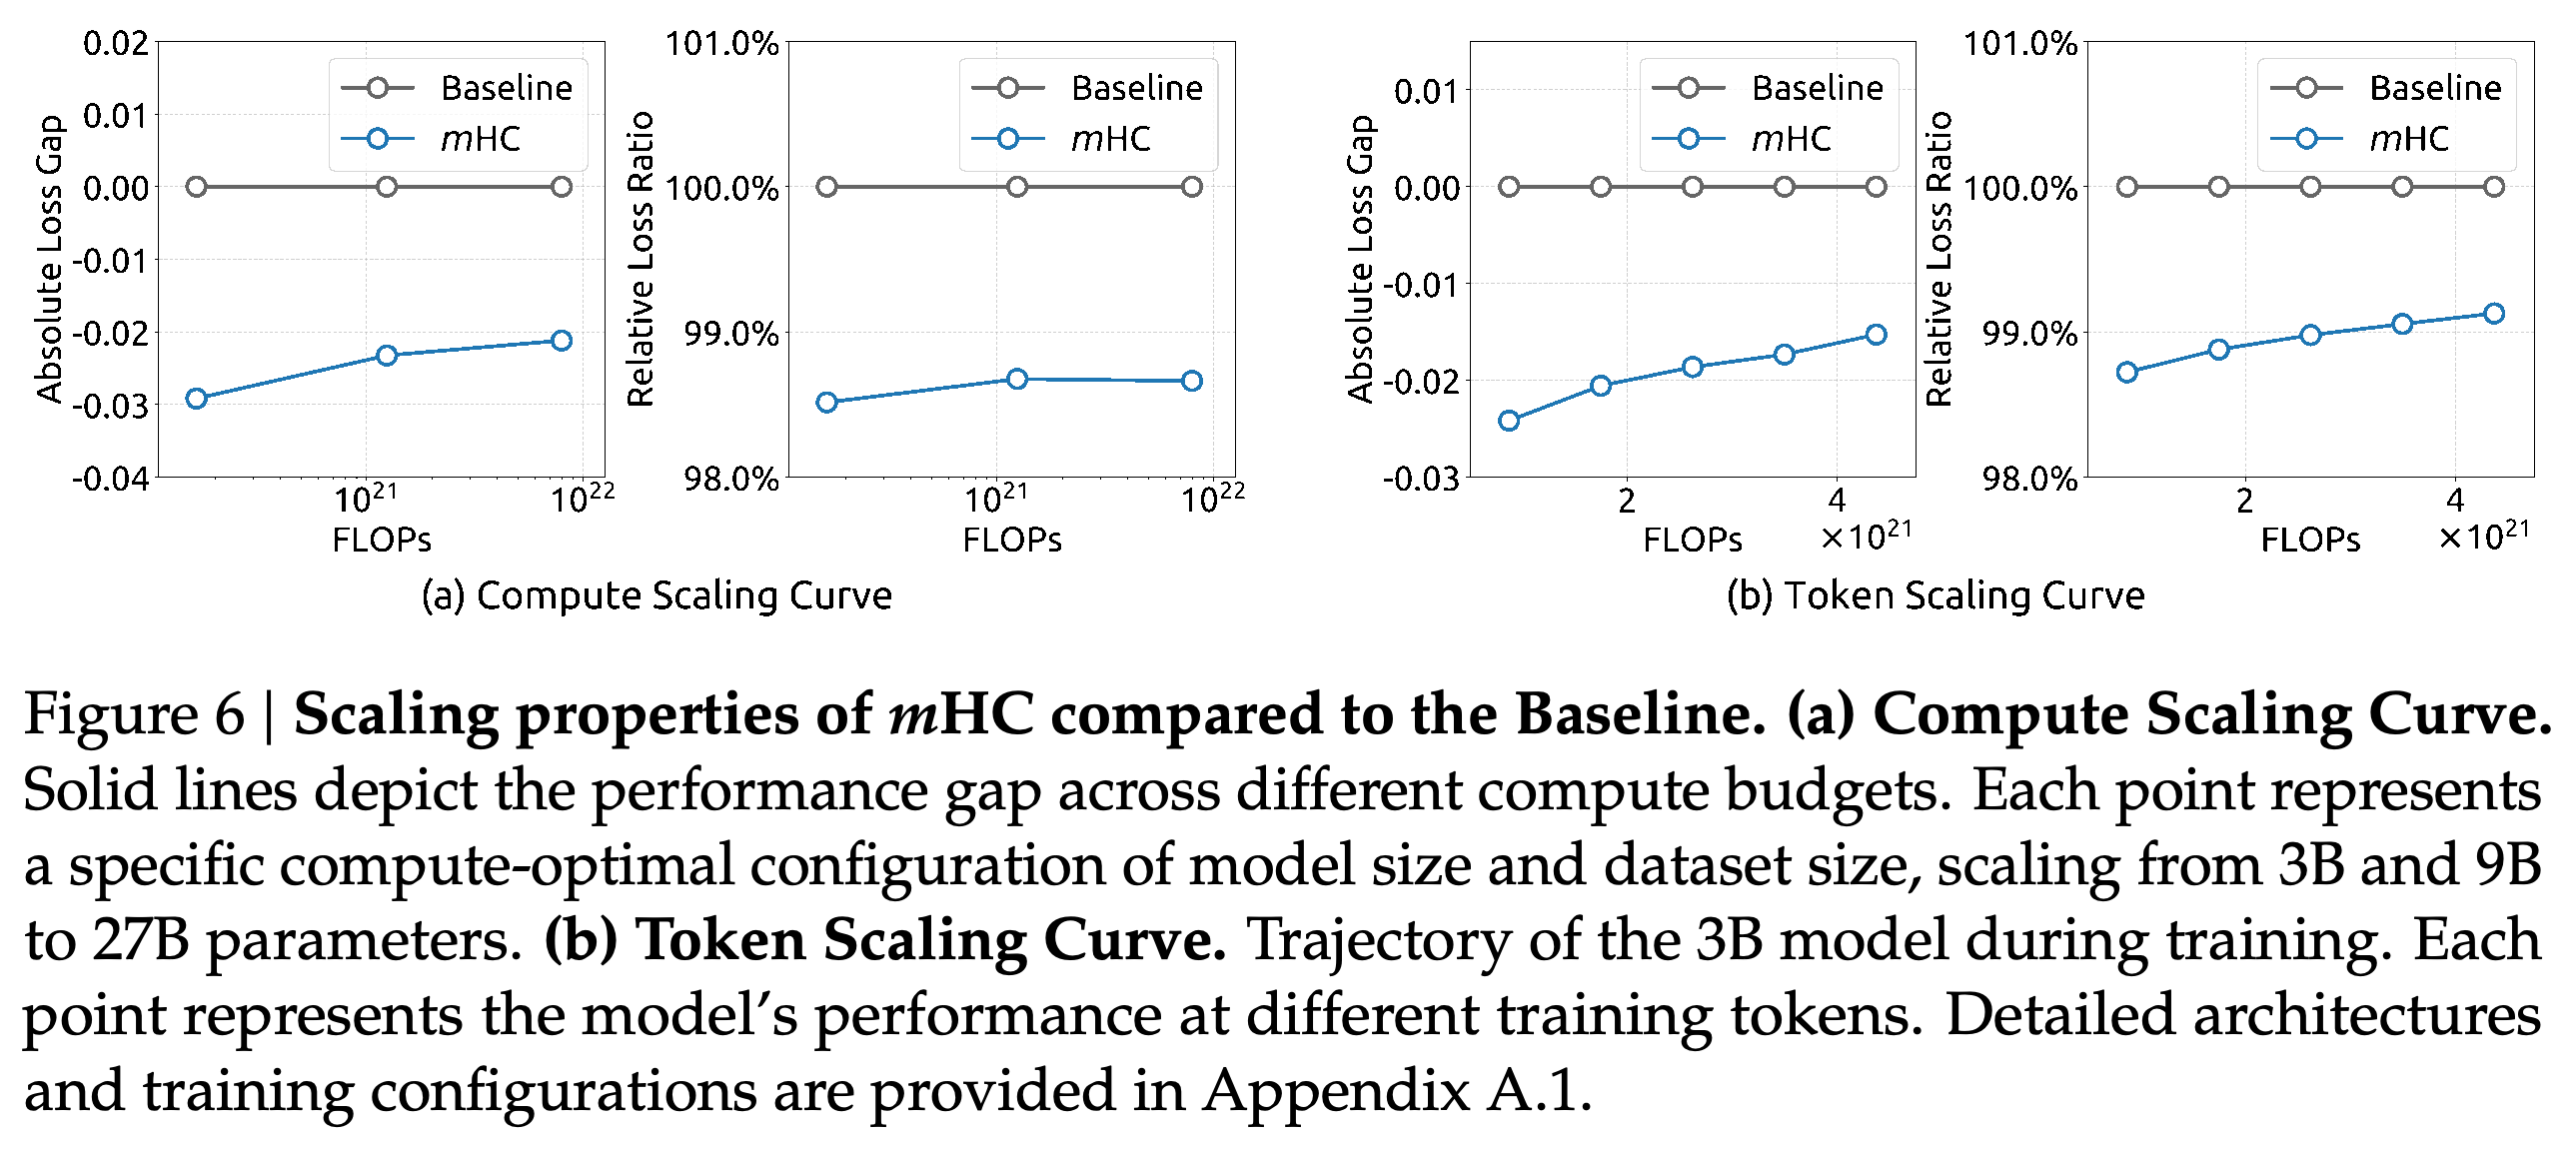
Figure 6에서 mHC는 3B, 9B, 27B 연산량 스케일링 구성 전반에 걸쳐 기준 모델보다 낮은 손실을 유지하지만, 예산이 커지면 이점이 다소 줄어든다. 별도의 3B 토큰 스케일링에서도 학습이 진행되는 동안 이점이 유지되지만 차이는 좁아진다.
- 연산량 스케일링은 모델 크기와 학습 데이터 크기라는 2개 변수를 함께 바꾸고, 토큰 스케일링은 1회 3B 학습 안에서 checkpoint들을 추적한다.
- 그래프는 절대 손실 차이와 상대 손실 비율을 모두 보고한다. 이는 시험한 예산 안에서 이점이 지속됨을 뒷받침하지만, 더 큰 규모로 제한 없이 외삽할 근거는 아니다.
- 저자들은 내부 대규모 학습도 언급하지만, PDF에는 해당 모델 구성이나 상세 결과를 제공하지 않는다.
절대 손실 차이와 상대 손실 비율 모두에서 모델 크기를 늘릴 때와 확장된 3B 학습 안에서 mHC의 이점이 지속된다. 측정 구간에서는 차이가 좁아지므로, 규모에 따라 이점이 커진다기보다 이점이 유지된다는 근거이다.
5.4. Stability Analysis
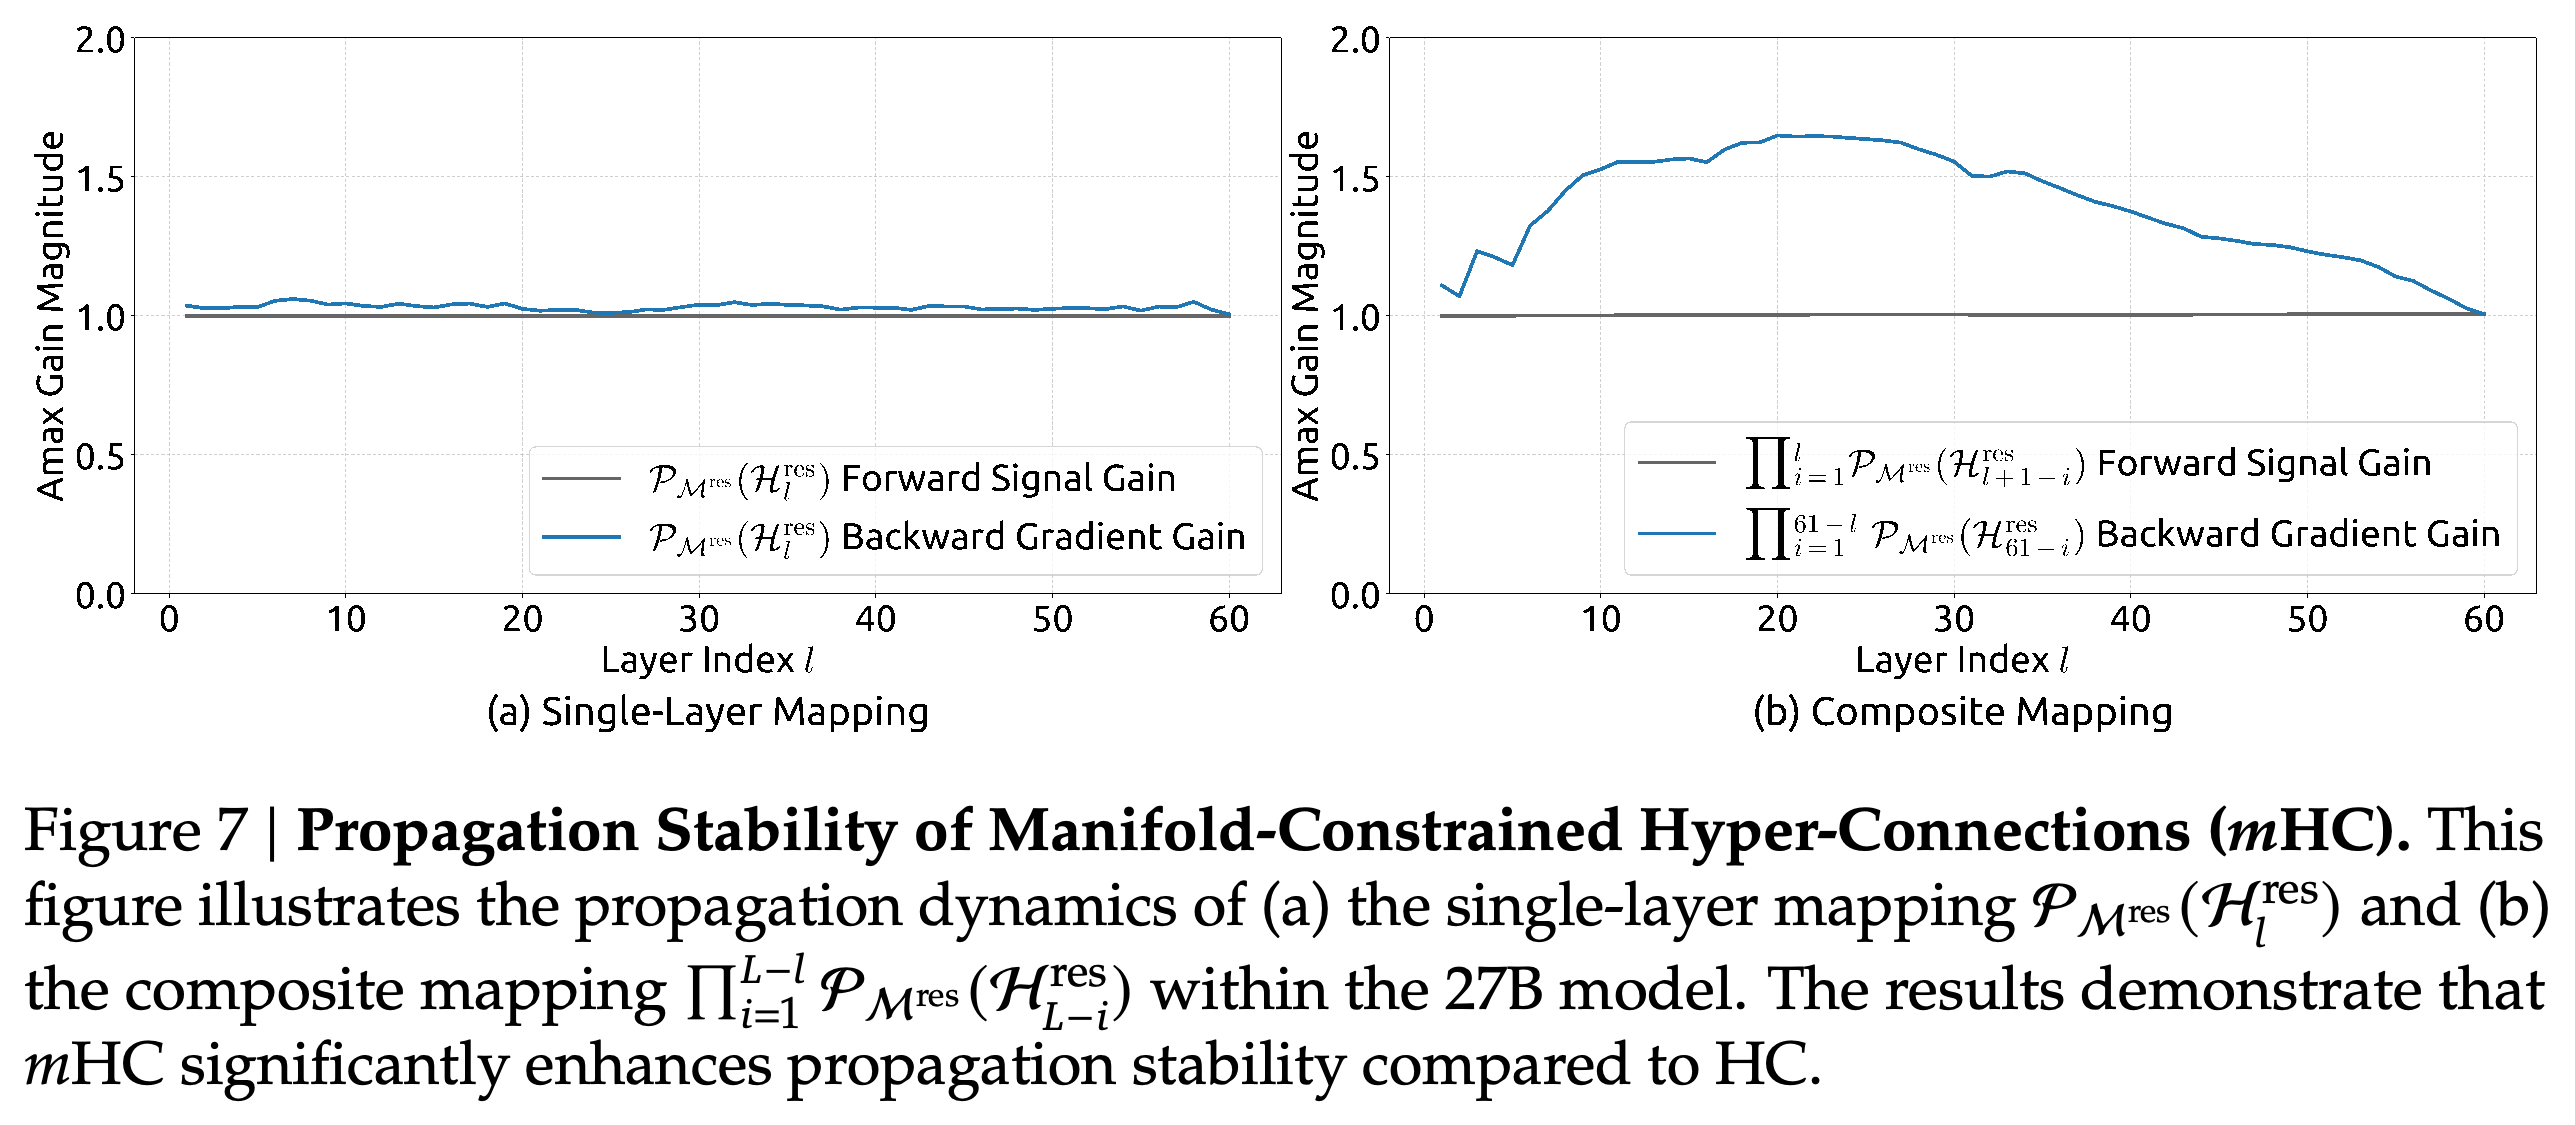
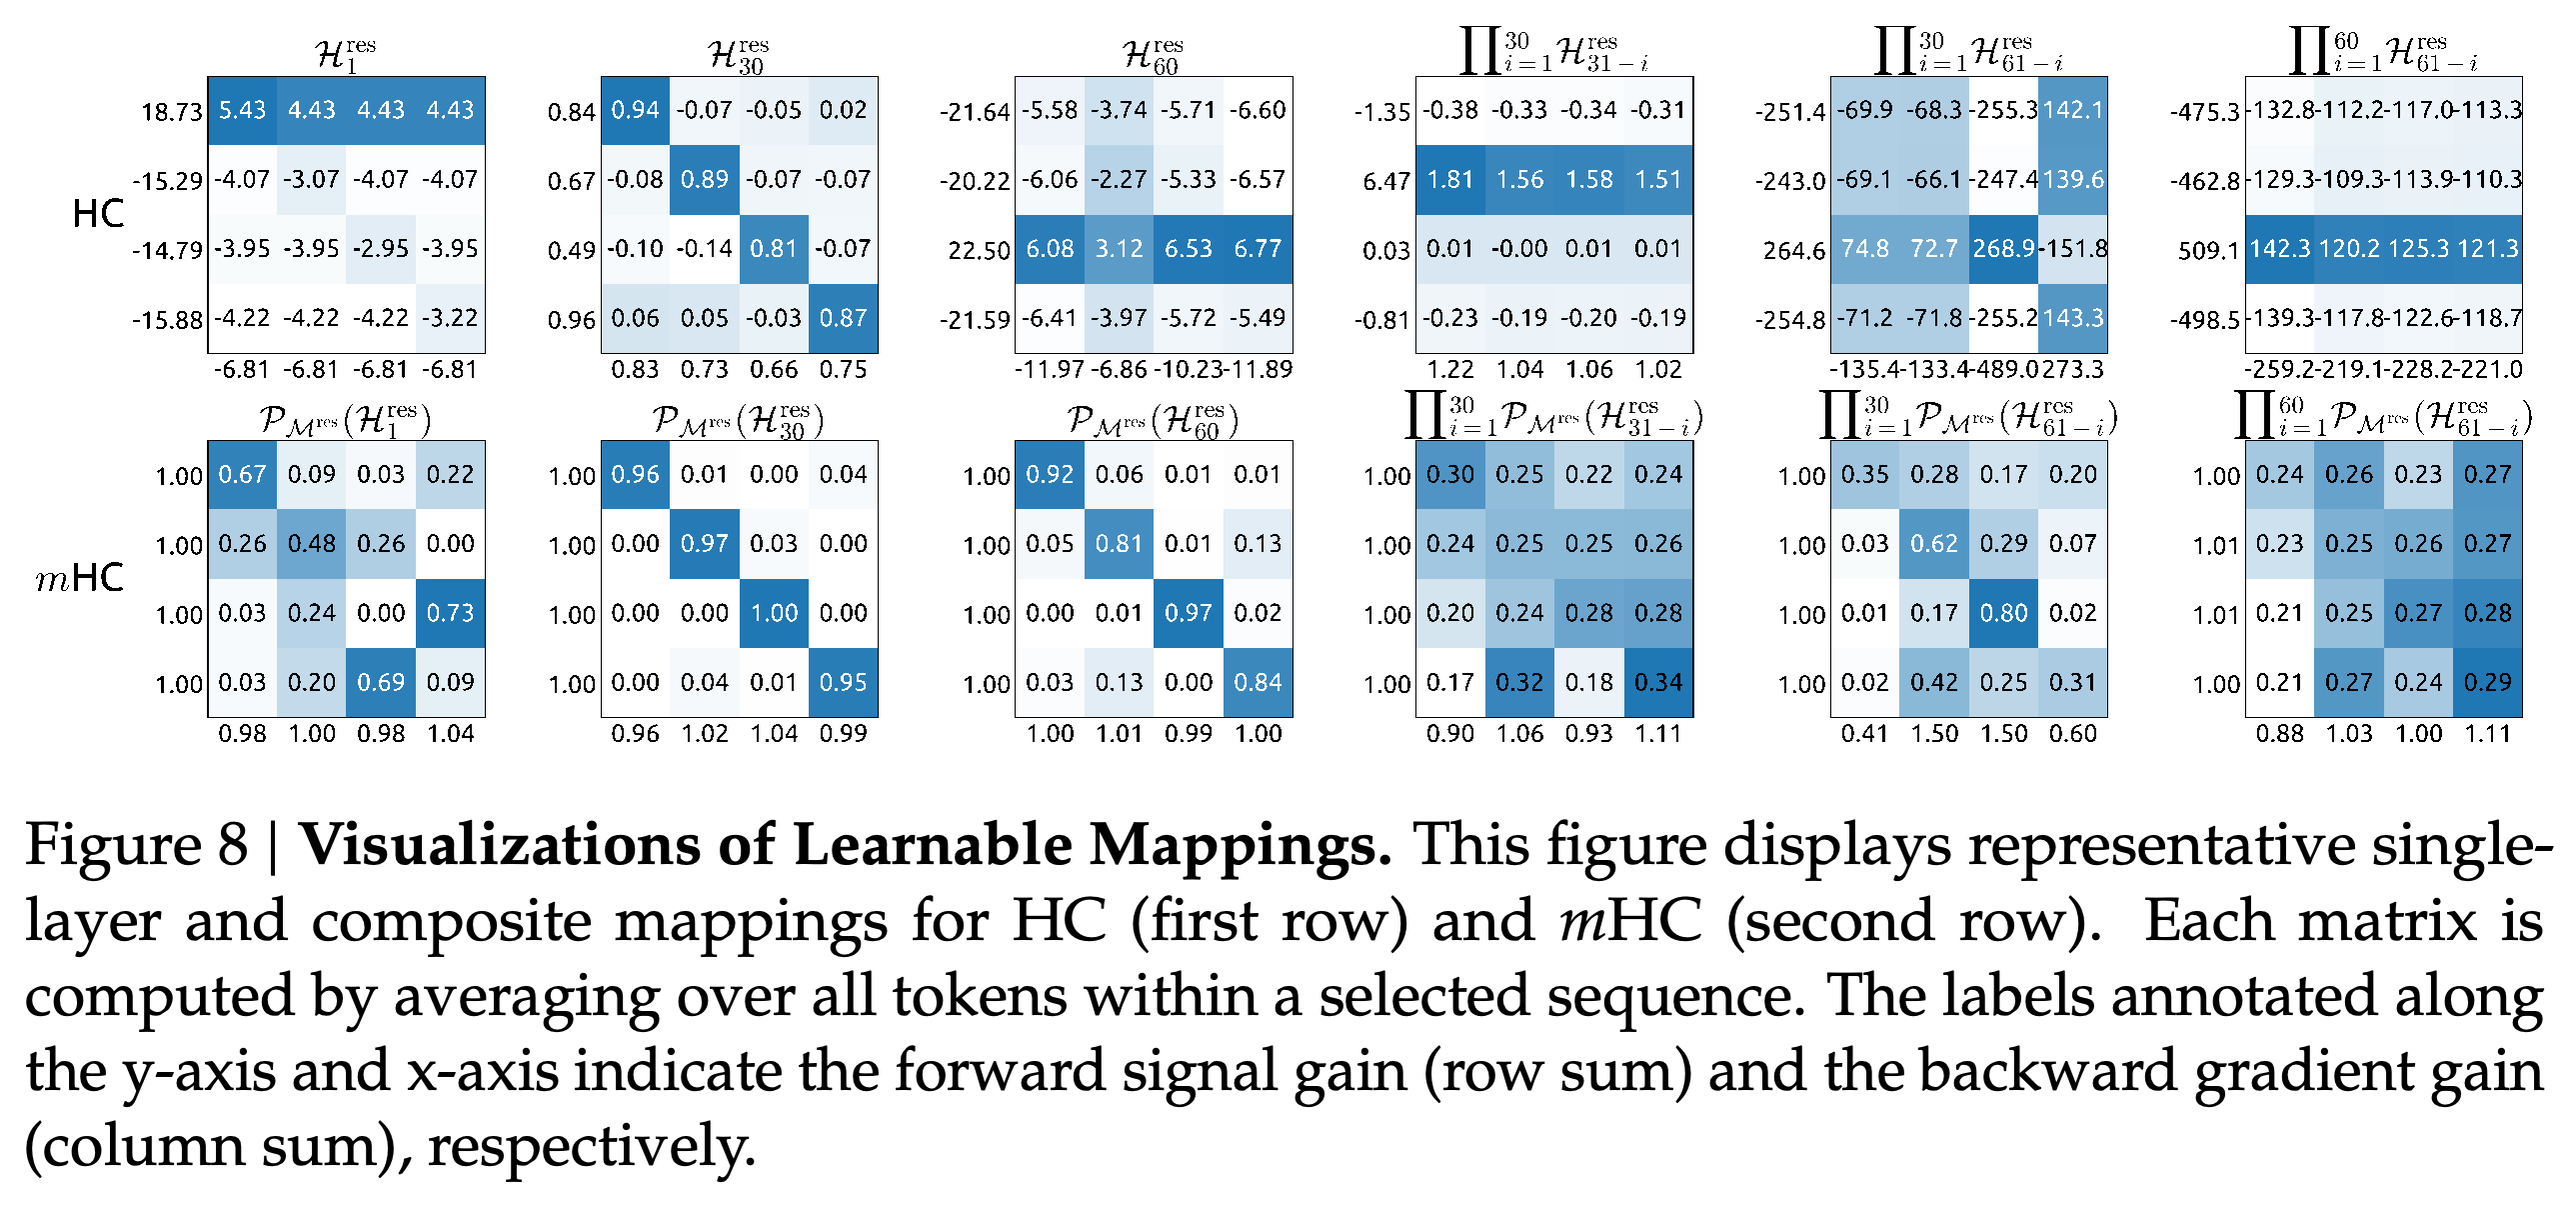
Figure 7에서 순방향 residual 이득은 1에 가깝고, 단일 층의 역방향 이득에는 유한한 20회 Sinkhorn-Knopp 근사와 관련된 작은 편차가 나타난다. 매핑을 합성하면 역방향 이득은 약 1.6에 도달하며, HC의 3000에 가까운 값보다 작다. Figure 8의 대표 행렬에서 HC는 부호가 있는 큰 계수를 보이고, mHC는 음이 아닌 계수와 훨씬 작은 행 합·열 합 편차를 보인다.
- 마지막 행 정규화 연산은 행 합을 1에 가깝게 유지하지만, 열 합에는 근사 오차가 남을 수 있다. 이 오차는 합성 과정에서 누적될 수 있다.
- 이 residual 경로 진단에서는 이득이 약 3 orders of magnitude만큼 감소했다고 보고한다.
- 행렬 시각화와 이득 곡선은 선택한 시퀀스를 사용하므로, 모든 모델 입력에 대한 최악의 경우 상한을 입증하기보다 작동 원리를 보여준다.
단일 층 이득은 1에 가깝게 유지되며, 합성 역방향 이득의 최댓값은 HC의 3000에 가까운 값 대신 약 1.6이다. 정확히 1에서 벗어나는 모습은 유한 반복 정규화의 오차를 드러낸다. 실제 매핑은 완벽한 이중 확률 행렬이 아니다.
HC의 대표 합성 행렬에는 여러 경로에 걸쳐 큰 양수와 음수 원소가 있다. mHC의 행렬은 음이 아닌 값을 유지하며, 전체 깊이에 걸친 예시에서는 계수가 균일 분포에 가깝고 행 합도 1에 가깝다. 이 관찰만으로 행렬의 조건수나 가역성이 보존된다고 할 수는 없다.
6. Conclusion and Outlook
결론에서는 mHC의 이점을 제어된 다중 stream 혼합에서 찾는다. 이 방식은 HC의 표현 유연성을 유지하면서 전파 불안정성을 줄인다. 넓어진 residual 상태의 학습 오버헤드를 제한하는 구현도 실용적인 기여에 포함된다. 다른 기하학적 제약은 실험으로 입증한 결과가 아니라 향후 연구로 제안한다.
부록
- A.1. Detailed Model Specifications and Hyper-parameters. Table 5에서 3B, 9B, 27B 구성의 모델 너비는 각각 1280, 1920, 2560이고, FFN 차원은 896, 1280, 1536이다. routed expert는 64, 64, 72개이며, 활성 expert 6개, 공유 expert 2개, 선두 dense layer 1개를 사용한다. 또한 KV rank 512인 MLA와 loss-free load balancing을 사용한다. 공통 설정은 RoPE 차원 64, RoPE θ = 10000, RMSNorm ε = 1e-20, vocabulary size 129280, residual 확장률 4, 게이트 초기값 0.01, Sinkhorn-Knopp 반복 횟수 20이다.
- 3B, 9B, 27B, 확장 학습 3B 순서로 4개 구성의 batch size는 320, 512, 1280, 2560이고, 학습 step은 30000, 50000, 50000, 100000이며, 기본 learning rate는 8.6e-4, 5.9e-4, 4.0e-4, 9.0e-4이다. AdamW는 betas (0.9, 0.95), ε = 1e-20, weight decay 0.1, warmup 2000 step을 사용한다. step scheduler의 decay step ratios는 [0.8 ×, 0.9 ×]이고 decay rates는 [0.316, 0.1]이다.
짧은 생각
전파 진단과 학습 결과는 서로 보완하는 근거를 제공한다. 제약을 가한 행렬은 측정된 residual 이득을 줄이고, 27B 학습은 더 안정적으로 유지되며, downstream 성능도 대체로 개선된다. 시스템 분석은 적은 추가 FLOPs와 상당한 메모리 트래픽·통신 비용을 구분한다는 점에서 유용하다.
“restore the identity mapping property”라는 표현은 정확한 제약을 만족하는 residual 혼합 경로의 보존성과 비팽창성을 뜻하며, 모든 표현에 대한 항등 변환을 뜻하지 않는다. 정확한 이중 확률 혼합도 stream 사이의 차이를 축소할 수 있으며, 이 분석은 입력 의존적 매핑과 전체 비선형 네트워크의 전역 안정성을 입증하지 않는다. 또한 PDF에는 여러 seed에 대한 불확실성 추정, 확장률과 반복 횟수를 바꾸는 실험, 보고된 6.7% 오버헤드가 다른 환경에서도 유지되는지 평가하는 데 필요한 하드웨어별 시간 분석이 없다.