


Beyond Language Modeling: An Exploration of Multimodal Pretraining 요약 설명
03 Mar 2026 | Paper Review Multimodal Pretraining Representation Autoencoders Mixture-of-Experts Scaling Laws목차
- 요약
- 1 Introduction
- 2 Experiment Setup
- 3 Visual Representations for Unified Multimodal Pretraining
- 4 Understanding the Impact of Data
- 5 Towards World Modeling in Unified Multimodal Models
- 6 Unified Multimodal Architecture Design
- 7 Scaling Laws for Unified Multimodal Models
- 8 Related Work
- 9 Discussion
- 부록
- 짧은 생각
이번 글에서는 Beyond Language Modeling: An Exploration of Multimodal Pretraining 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 3일(Arxiv)
- Tong, Shengbang, Fan, David, Nguyen, John, Brown, Ellis, Zhou, Gaoyue, Qian, Shengyi, Zheng, Boyang, Vallaeys, Théophane, Han, Junlin, Fergus, Rob, et al.
- FAIR, Meta, New York University
- 논문 링크
- Project Page
요약
- Beyond Language Modeling: An Exploration of Multimodal Pretraining은 시각 표현, 데이터 혼합, 아키텍처, 연산량 배분이 통합 비전-언어 모델에 미치는 영향을 연구한다. 통제 실험에서는 동결된 사전학습 시각 인코더와 사전학습 디코더를 유지하면서, 언어에는 Transfusion 방식의 다음 토큰 예측을, 시각 생성에는 flow matching을 적용해 Transformer 백본을 처음부터 학습한다.
- SigLIP 2 기반의 단일 Representation Autoencoder(RAE)는 실험한 VAE 대안보다 시각 이해와 생성을 더 효과적으로 지원한다. 여러 통제 비교에서 다양한 데이터로 사전학습하면 과제별 데이터를 늘리는 것보다 후속 VQA와 내비게이션 성능이 좋아진다. 다만 멀티모달 혼합은 분포 밖 언어 성능을 소폭 저하시킨다.
- 세분화된 Mixture-of-Experts(MoE) 라우팅은 활성 파라미터 수를 대략 고정한 상태에서 언어와 시각 성능을 모두 높이며, 모달리티에 따라 다른 전문가 사용 패턴을 학습한다. IsoFLOP 적합 결과에서 시각의 학습 데이터 스케일링 지수는 언어보다 높다. MoE는 적합된 지수 차이를 0.10에서 0.05로 줄이지만 없애지는 못한다.
1 Introduction
이 연구는 통합 멀티모달 사전학습으로 얻은 능력과 사전학습 언어 백본에서 물려받은 능력을 구분하고자 한다. 저자들은 Transformer를 무작위로 초기화하고 시각 표현, 데이터, 월드 모델링, 아키텍처, 스케일링의 5개 축을 조사한다.
- 시각 관측에는 텍스트로 완전히 표현되지 않는 공간·시간 정보가 담겨 있고, 고품질 텍스트 자원은 유한하다는 점이 연구 동기다.
- 실험은 후속 학습을 모두 거친 어시스턴트가 아니라 사전학습 과정에서 나타나는 변화를 살펴본다. 프로젝트 페이지는 https://beyond-llms.github.io/이다.
2 Experiment Setup
각 ablation 실험군 안에서 연산 예산과 학습 하이퍼파라미터를 통제한다. 별도 명시가 없으면 instruction tuning 없이 사전학습 직후 평가하며, VQA에는 이후 지도 미세조정을 적용한다.
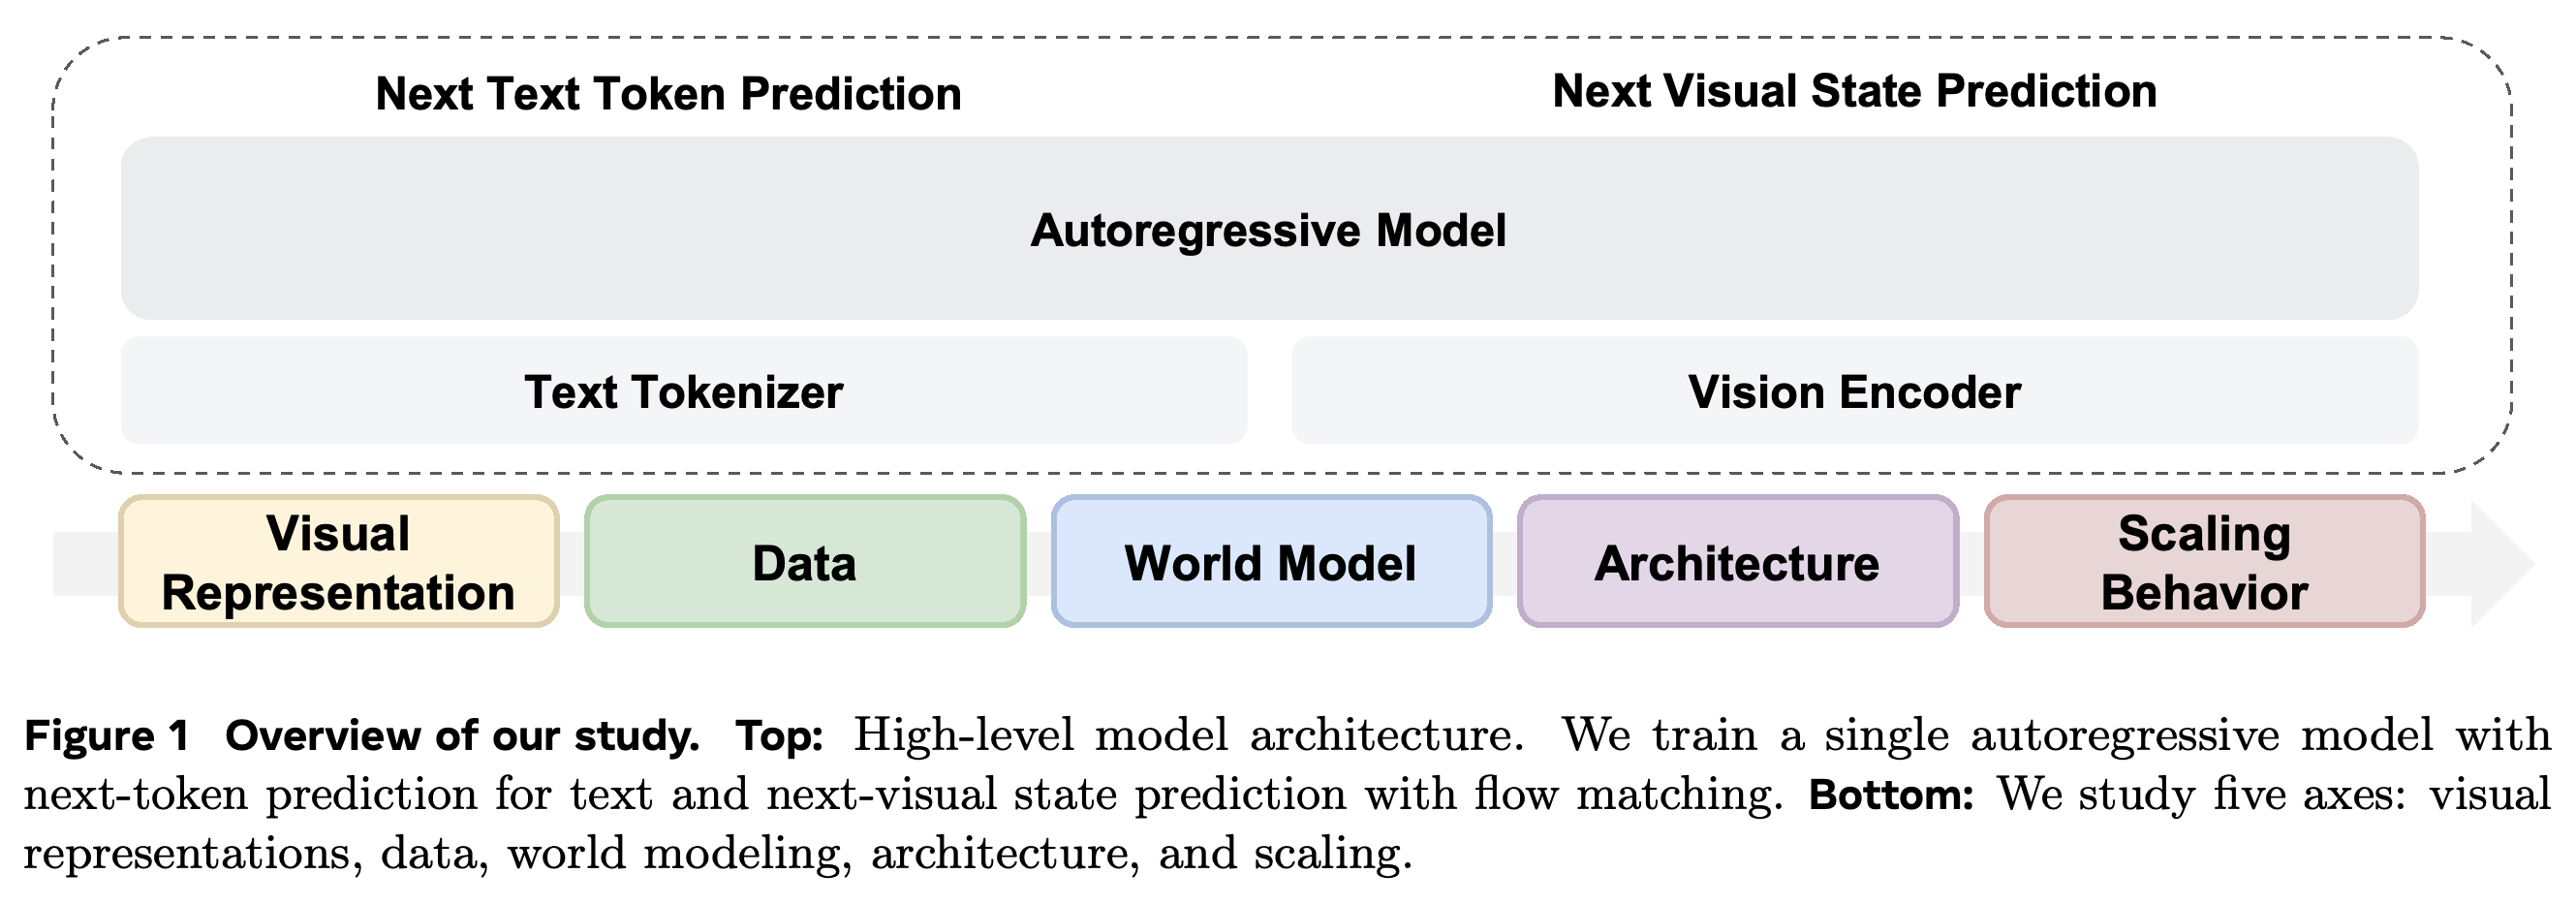
- Figure 1은 공유 순차 모델과 5개 실험 축을 요약한다.
- 57B-token MoE 스윕, 약 1T-token 표현 연구, 200B-token 내비게이션 혼합 연구는 서로 다른 학습 조건을 사용하므로 하나의 통제 실험처럼 비교해서는 안 된다.
이 도식은 토큰화와 공유 순차 백본을 분리하고, 하나의 프레임워크 안에서 표현, 데이터, 아키텍처, 스케일링을 바꾸는 방식을 보여준다. 텍스트 예측과 시각 상태 예측은 같은 모델 안에서 서로 다른 목적함수를 사용한다.
2.1 Training and Inference
언어 학습은 자기회귀 교차 엔트로피 L_LM = −Σ_i log p_θ(x_i | x_<i)를 최소화한다. 시각 학습은 Gaussian noise ε와 프레임별 timestep t ∼ U[0, 1]을 샘플링하고, z_t = (1 − t)ε + tz_0를 구성한 뒤 L_flow = E[||v_θ(z_t, t, context) − (z_0 − ε)||²₂]를 최소화한다. 공동 목적함수는 L = λ_LM L_LM + λ_flow L_flow이며, 기본 가중치는 λ_LM = 1.0과 λ_flow = 3.0이다.
- 이미지나 프레임 안의 모든 토큰은 1개의 noise timestep을 공유하며, 프레임 간에는 이를 독립적으로 샘플링한다. 고차원 표현에는 더 많은 노이즈가 있는 입력 쪽으로 noise schedule을 이동한다. 후속 실험에서는 노이즈가 없는 잠재 표현을 직접 예측하는 x-pred도 시험한다.
- FlexAttention은 텍스트에 causal attention을, 시각 입력에 블록 단위 causal attention을 구현한다. 프레임 안의 패치는 서로 양방향으로 attention을 수행하지만, 텍스트와 다른 프레임에는 인과적 순서에 따라 접근한다.
- 시각 추론은 25-step Euler sampler에 이어 사전학습 디코더를 사용한다. 학습 중 10%의 경우에는 조건을 제거하며, 이미지 생성 평가에서는 classifier-free guidance scale을 3.0으로 고정한다.
2.2 Model and Tokenization
기본 decoder-only Transformer는 선형 시각 입력·출력 투영과 공유 attention 블록 안의 별도 텍스트·시각 FFN을 사용한다. 총 파라미터는 2.3B이지만 토큰당 1.5B만 활성화한다. 공유 FFN 기준 모델은 총 파라미터와 활성 파라미터가 모두 1.5B이다.
- 텍스트는 LLaMA-3 BPE로 토큰화한다. 동결된 시각 인코더는 이미지와 개별 비디오 프레임을 연속 잠재 토큰으로 변환하며, 기본 인코더는 SigLIP 2 So400M이다.
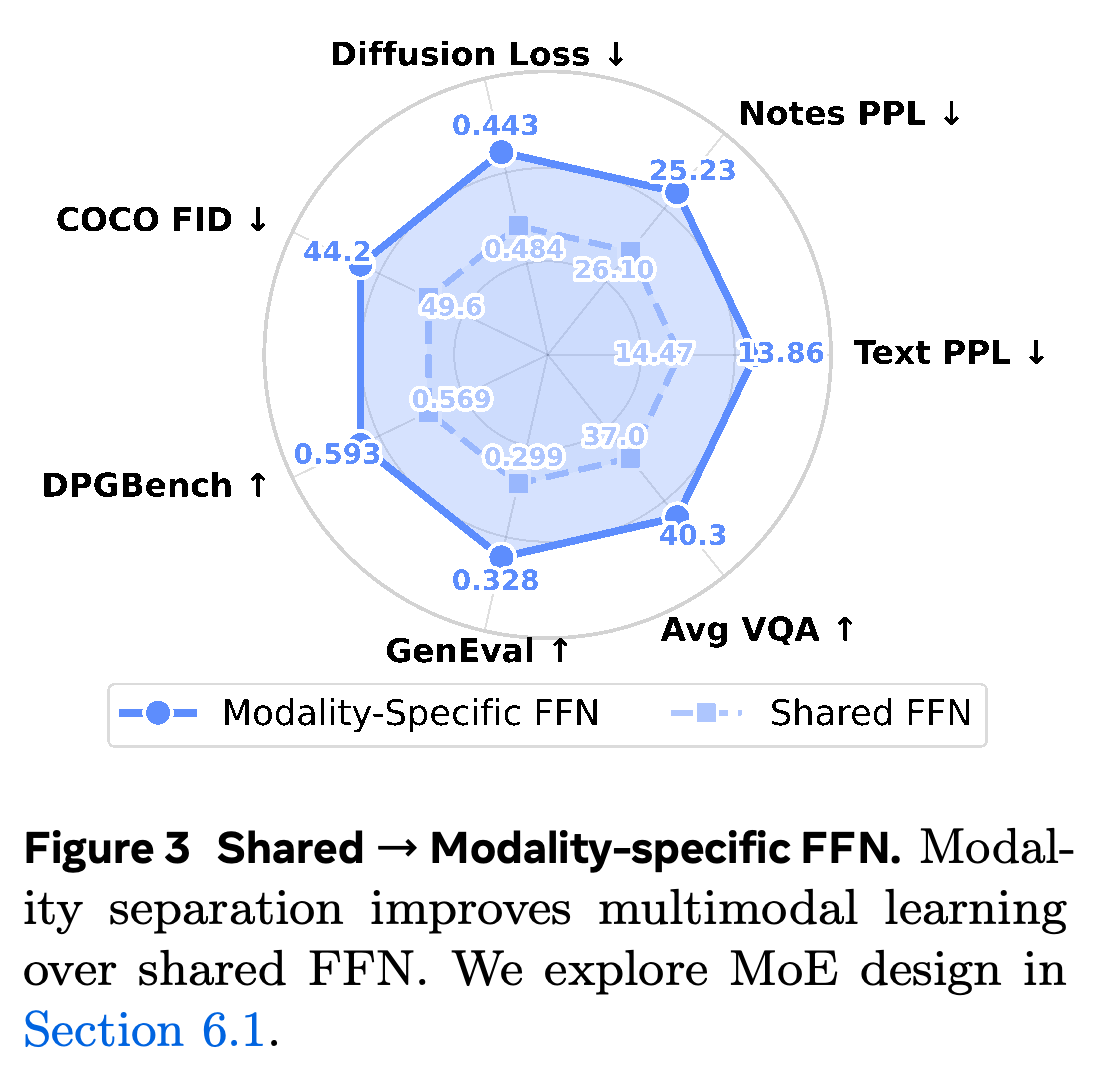
- Figure 3에서 모달리티별 FFN은 보고된 모든 지표를 개선한다. DCLM PPL은 14.47에서 13.86으로 낮아지고, 평균 VQA 정확도는 37.0%에서 40.3%로 높아진다.
- 본문에서는 224×224 프레임을 명시한다. Appendix E.4와 Table 4는 224×224 RAE·원시 픽셀 입력과 256×256 VAE 입력을 구분한다. VAE의 잠재 격자는 시각 토큰 256개를 유지하도록 재배열한다.
모달리티별 FFN은 언어 perplexity, diffusion loss, 생성 지표, VQA를 함께 개선한다. 이 비교는 총 용량을 늘리되 토큰마다 해당 모달리티의 FFN 1개만 활성화한다.
2.3 Data Sources
학습에는 DCLM 웹 텍스트, 1 FPS로 샘플링한 원시 비디오, MetaCLIP과 사내 Shutterstock 이미지-텍스트 쌍, 행동 조건부 시각 궤적을 함께 사용한다. 내비게이션 예시와 텍스트 주석이 있는 비디오는 같은 I + T → I 예측 형식을 사용한다.
- 비디오 출처에는 YouTube-Temporal 1B, SomethingSomething V2, Kinetics가 포함된다.
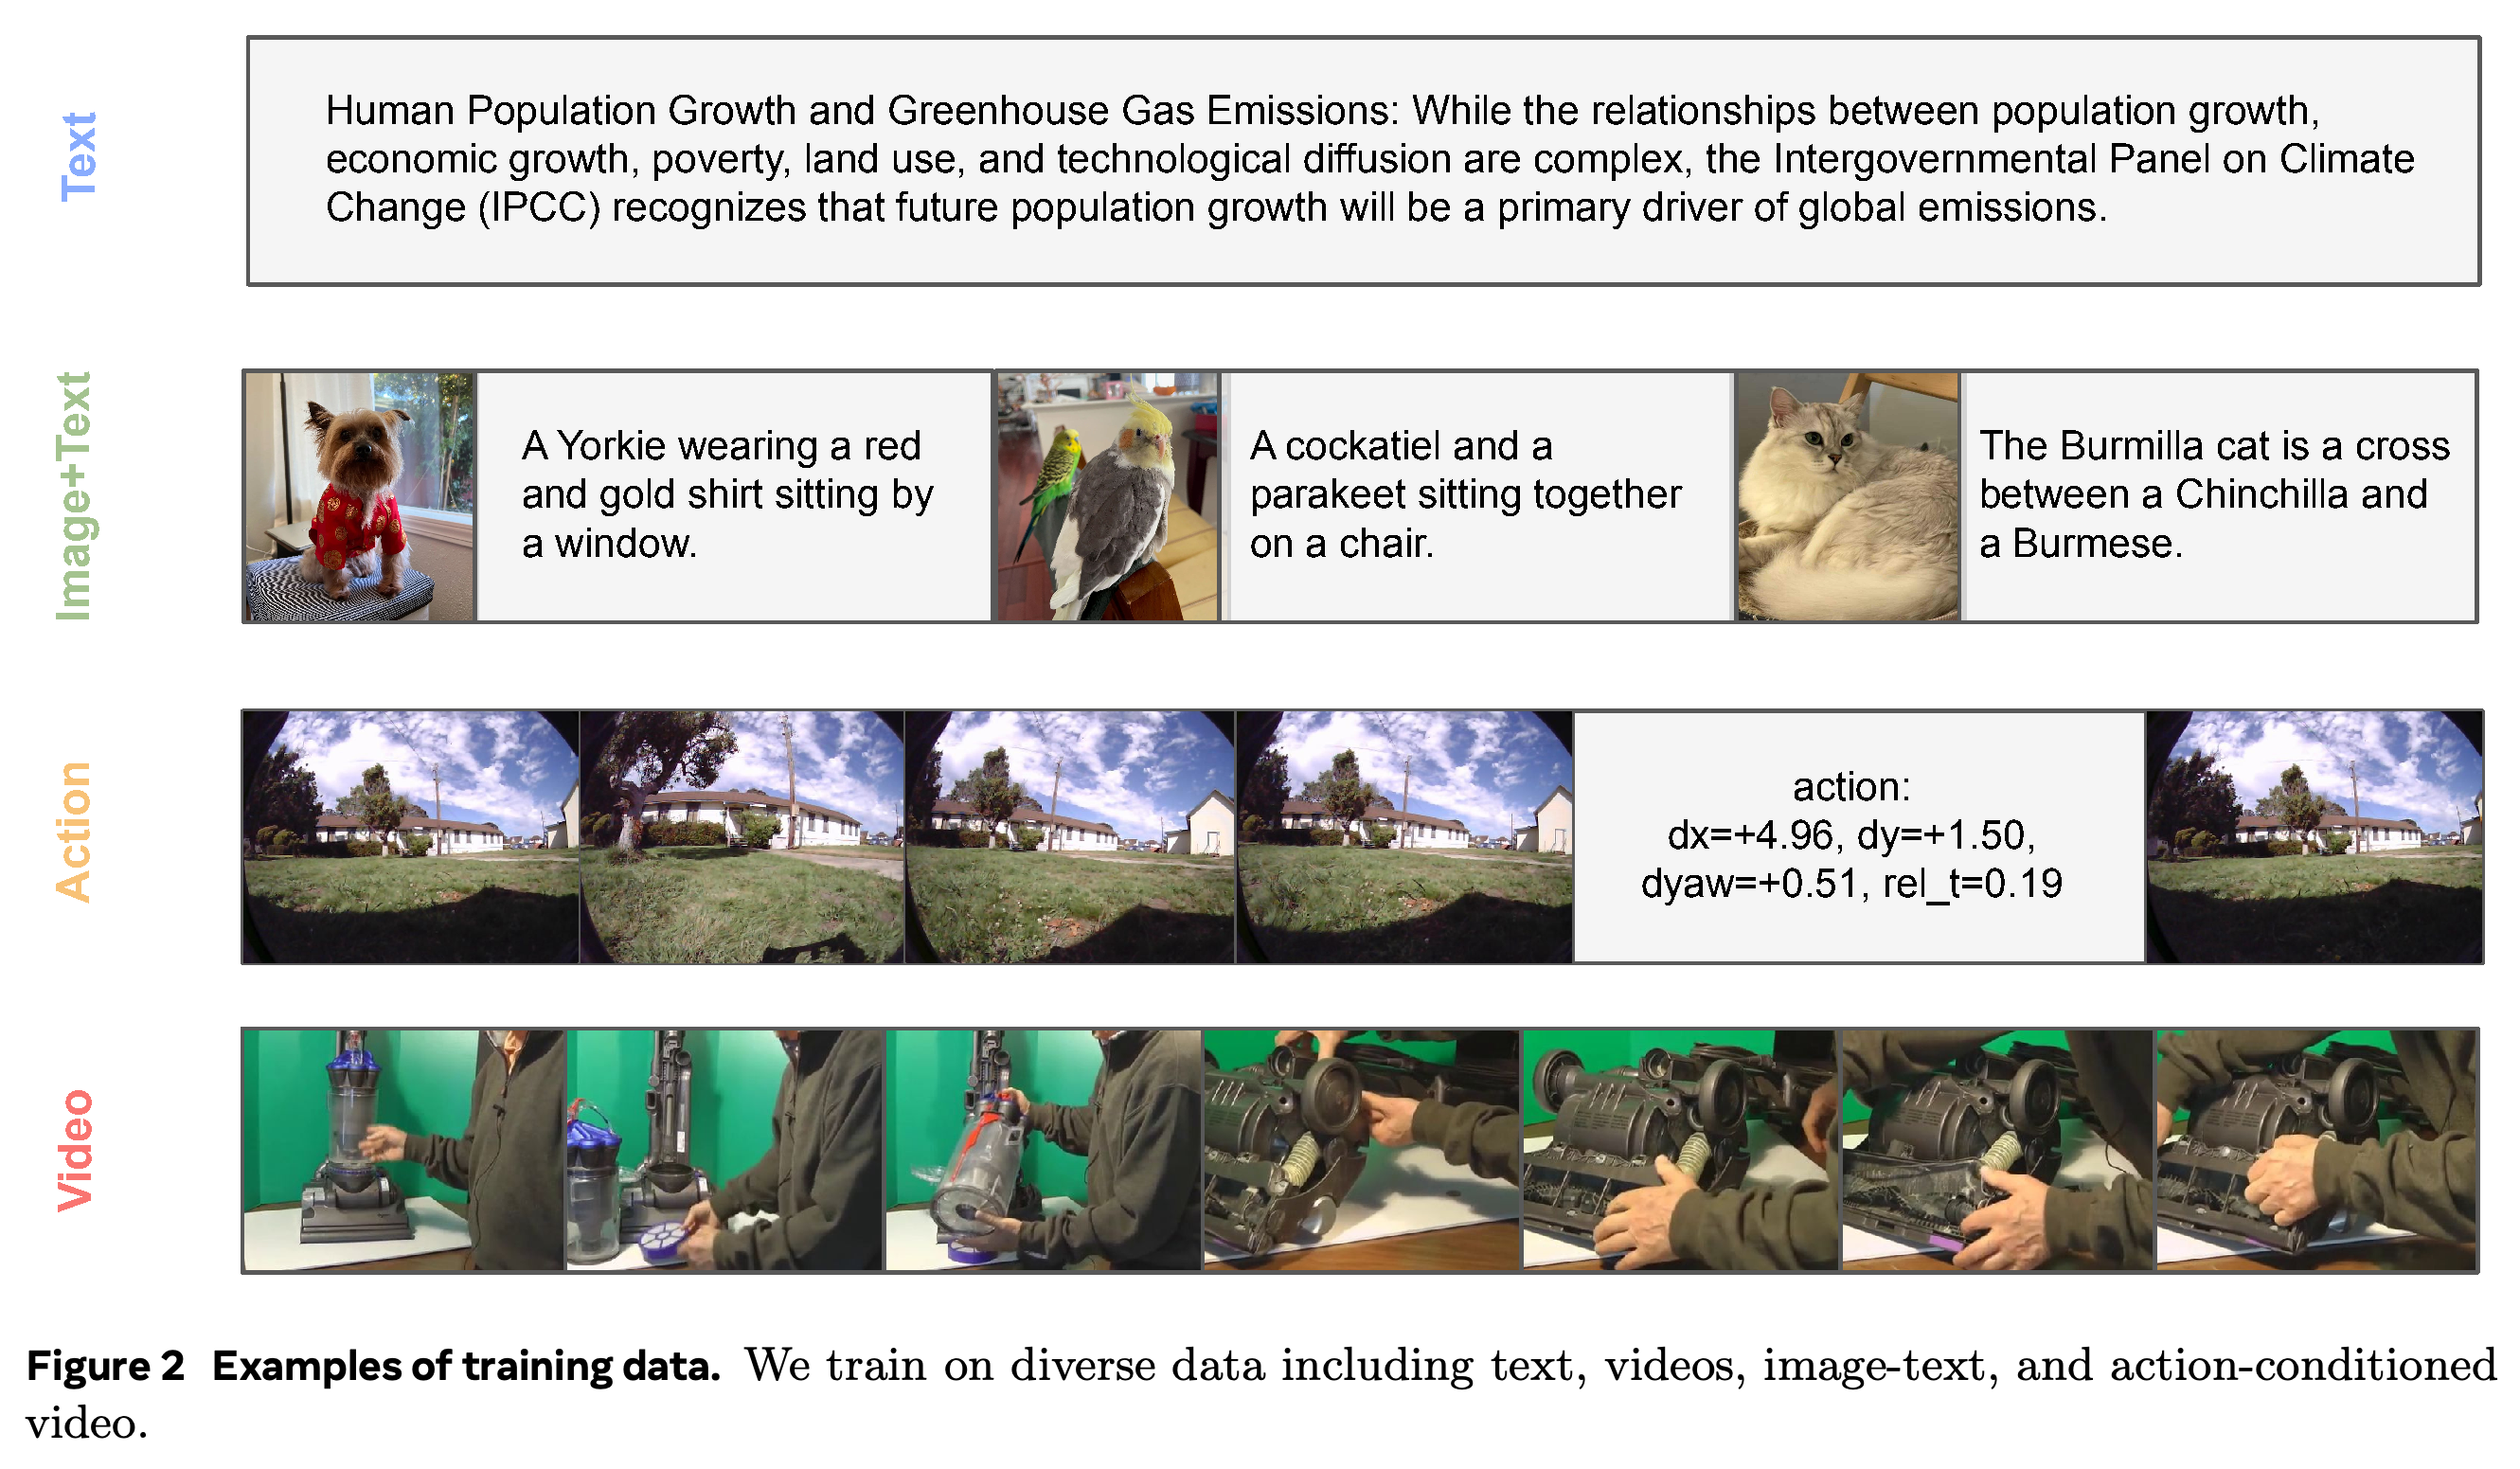
- Figure 2는 텍스트, 이미지-텍스트 쌍, 프레임 시퀀스, 수치형 행동 문자열을 통합 학습 프레임워크에 넣는 방식을 보여준다.
내비게이션 행동은 시각 문맥과 목표 프레임 사이에 일반 텍스트로 들어간다. 원시 비디오는 모든 시퀀스에 캡션을 붙이지 않고도 시간적 예측 예시를 제공한다.
2.4 Evaluation
언어 평가는 학습에서 제외한 DCLM과 분포 차이가 더 큰 사내 Notes 코퍼스의 perplexity를 측정한다. 시각 평가는 학습에서 제외한 CC12M의 diffusion loss, DPGBench와 GenEval 생성 점수, 16개 Cambrian 벤치마크의 평균 VQA 정확도를 사용한다.
- 보고된 모든 VQA 결과는 시각 인코더를 동결한 채 Cambrian-7M에서 1 epoch 미세조정을 거친 결과다.
- 텍스트 전용 기준 모델은 먼저 Cambrian-Alignment에서 vision-adapter alignment를 수행한 뒤 같은 VQA 미세조정 절차를 따른다. 따라서 VQA는 zero-shot 사전학습 정확도가 아니라 적응 이후 성능을 측정한다.
3 Visual Representations for Unified Multimodal Pretraining
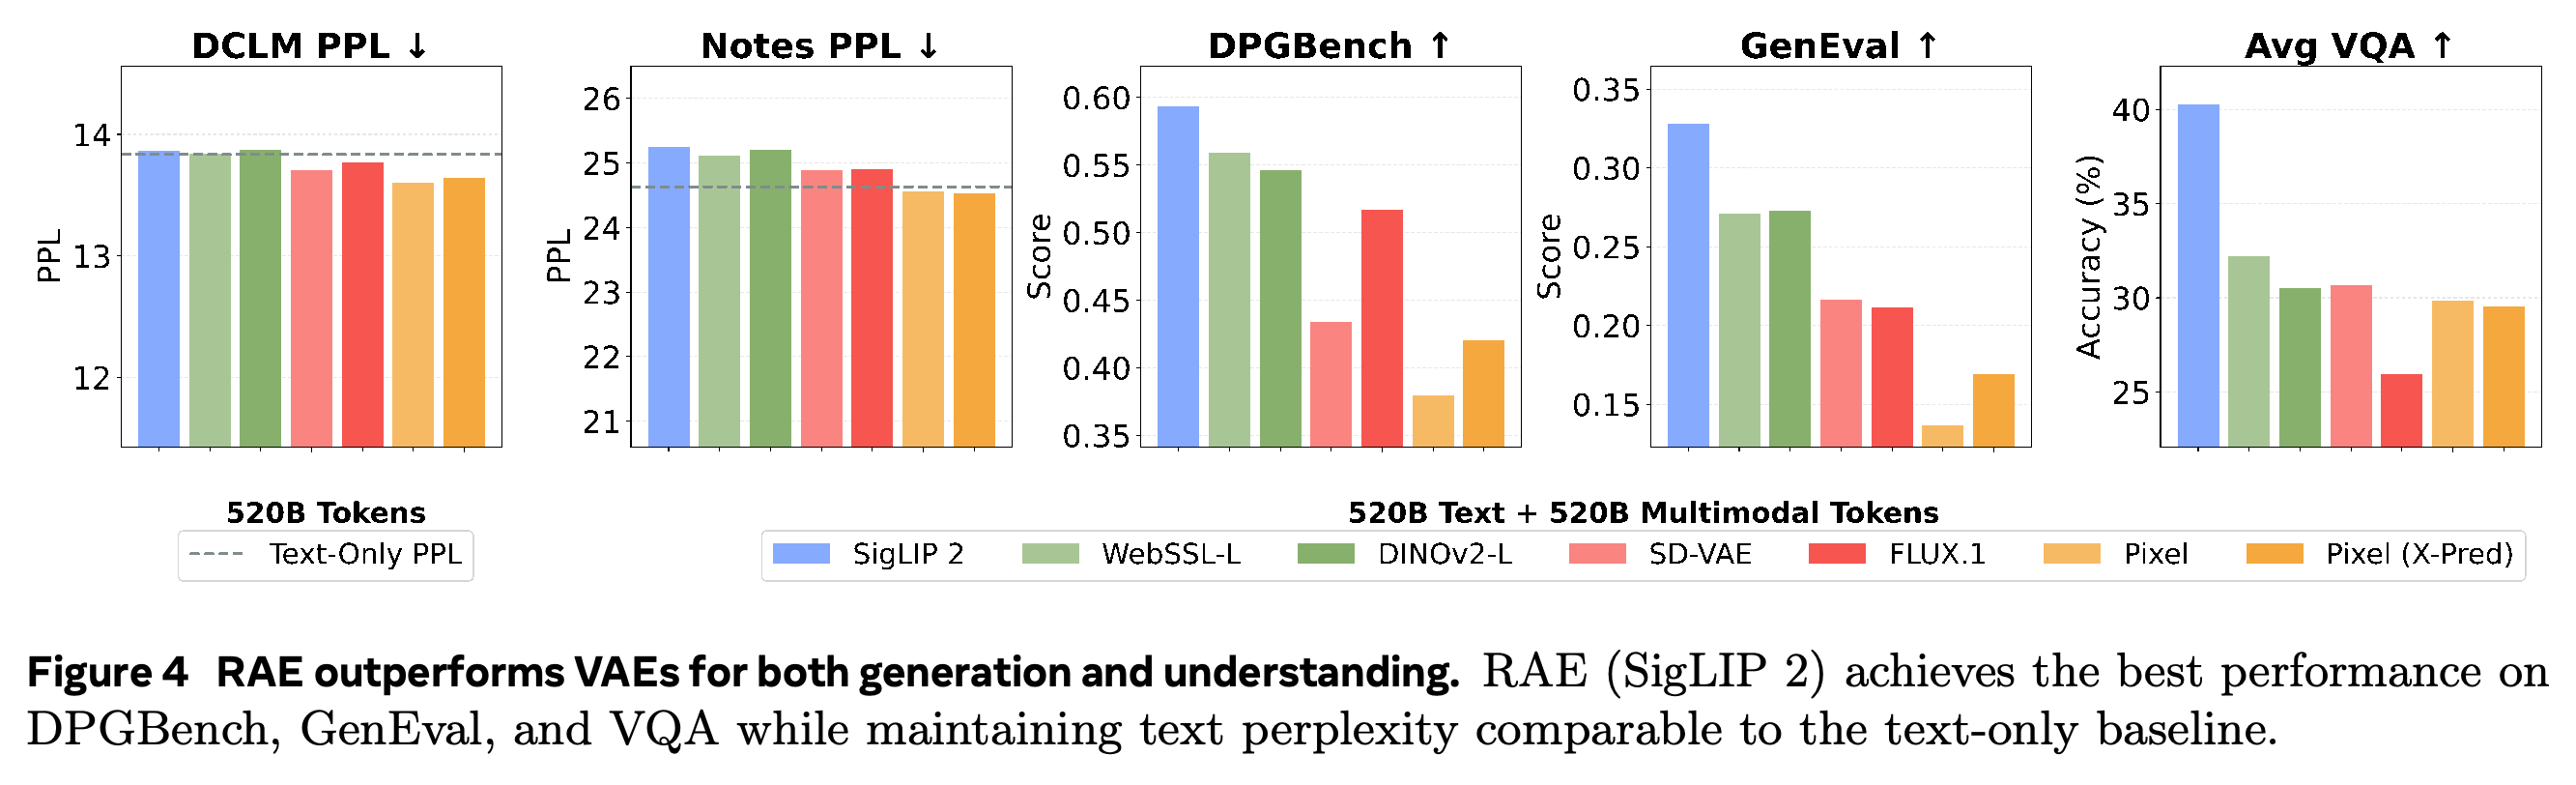
표현 ablation 실험은 SD-VAE와 FLUX.1, RAE 디코더를 사용하는 의미 인코더 SigLIP 2 So400m·DINOv2-L·WebSSL-L, 원시 14×14 RGB 패치를 비교한다. Figure 4에서 SigLIP 2는 언어 perplexity를 텍스트 전용 기준 모델에 가깝게 유지하면서 생성과 이해를 종합한 성능이 가장 좋다.
- 멀티모달 실험은 520B text + 520B multimodal tokens를 사용하지만, 언어 전용 비교 모델은 520B text tokens를 사용한다. 텍스트 노출량은 같지만 총 학습 연산량이 같다는 뜻은 아니다.
- 실험한 의미 잠재 공간은 이해와 생성에 별도 인코더를 두지 않고 2개 과제를 모두 지원한다.
- 원시 픽셀은 실험한 표현 중 텍스트 perplexity가 가장 낮고, VQA에서도 일부 대안에 견줄 만하다. 그러나 생성에서는 의미 인코더보다 뒤처진다. 추가 스케일링으로 이 격차를 줄이는 방안은 향후 연구로 제안했을 뿐 입증하지는 않았다.
SigLIP 2는 실험한 인코더 중 생성과 이해를 종합한 결과가 가장 좋으며, 언어 perplexity 차이는 작다. 언어 전용 비교 모델은 텍스트 노출량이 같지만 총 학습 토큰 수는 더 적다.
4 Understanding the Impact of Data
데이터 연구는 시각 공동 학습이 언어를 방해하는지, 이미지 캡션 분포가 언어 성능 저하를 설명하는지, 다양한 데이터가 후속 능력을 개선하는지라는 3개 질문을 구분한다. 통합 시퀀스 형식 덕분에 아키텍처를 바꾸지 않고 이를 비교할 수 있다.
4.1 Pretraining Data Composition
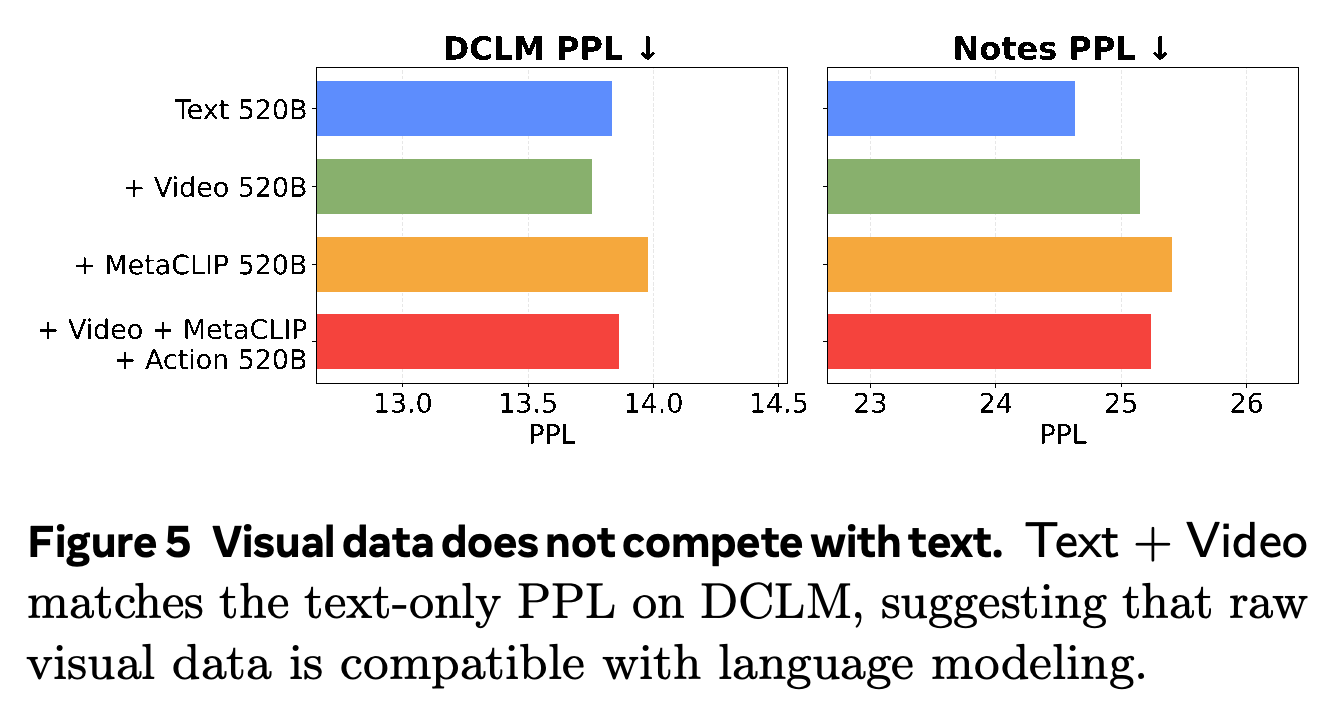
저자들은 각각 520B text + 520B multimodal tokens를 사용하는 Text + Video, Text + MetaCLIP, Text + Video + MetaCLIP + Action을 520B-token 텍스트 전용 기준 모델과 비교한다. Text + Video는 멀티모달 혼합 중 언어 perplexity가 가장 좋고, 텍스트 전용 모델보다 DCLM perplexity도 소폭 개선한다. 반면 모든 멀티모달 혼합에서 Notes perplexity는 나빠진다.
- Figure 5는 원시 비디오와 분포 내 언어 모델링이 양립할 수 있음을 보여주지만, 분포 밖 일반화 성능은 저하됨을 함께 보여준다.
- Text + MetaCLIP은 실험한 혼합 중 perplexity가 가장 나쁘며, 이를 계기로 캡션 분포를 분석한다.
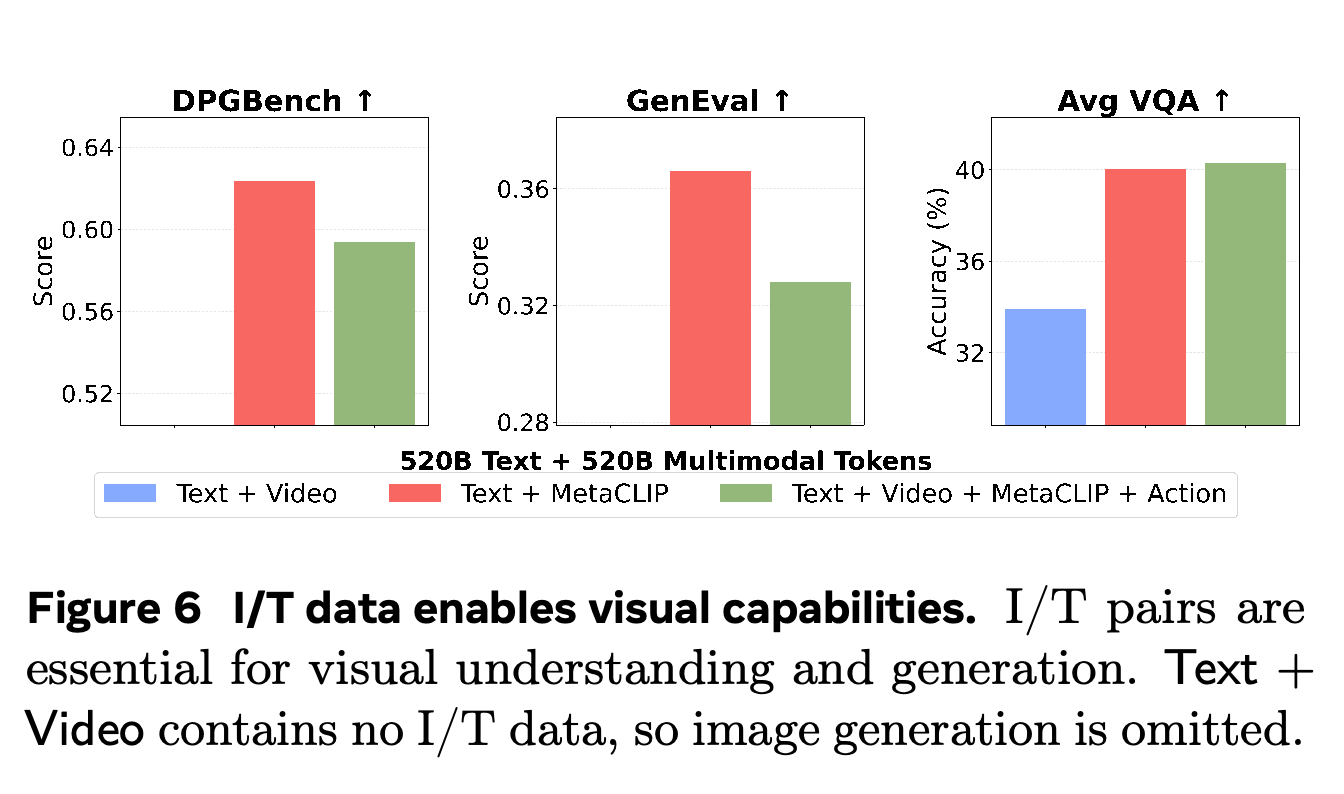
- Figure 6에서 이미지-텍스트 쌍은 텍스트 조건부 시각 생성을 지원하고 이해를 개선한다. 모든 데이터를 포함한 다양한 혼합은 평균 VQA 정확도가 가장 높다. Text + Video는 이미지-텍스트 쌍이 없으므로 생성 결과를 보고하지 않는다.
Text + Video는 DCLM perplexity를 소폭 개선하지만, Notes perplexity는 여전히 텍스트 전용 기준 모델보다 나쁘다. 이 결과는 분포 내 언어 모델링과의 양립 가능성과 분포 밖 일반화 성능의 보존을 구분한다.
모든 데이터를 포함한 다양한 혼합은 VQA 결과가 가장 좋지만, 이미지-텍스트만 공동 학습한 경우에는 생성 점수가 더 높다. 따라서 목표 능력에 따라 혼합을 선택해야 한다.
4.2 Image-Text Distribution
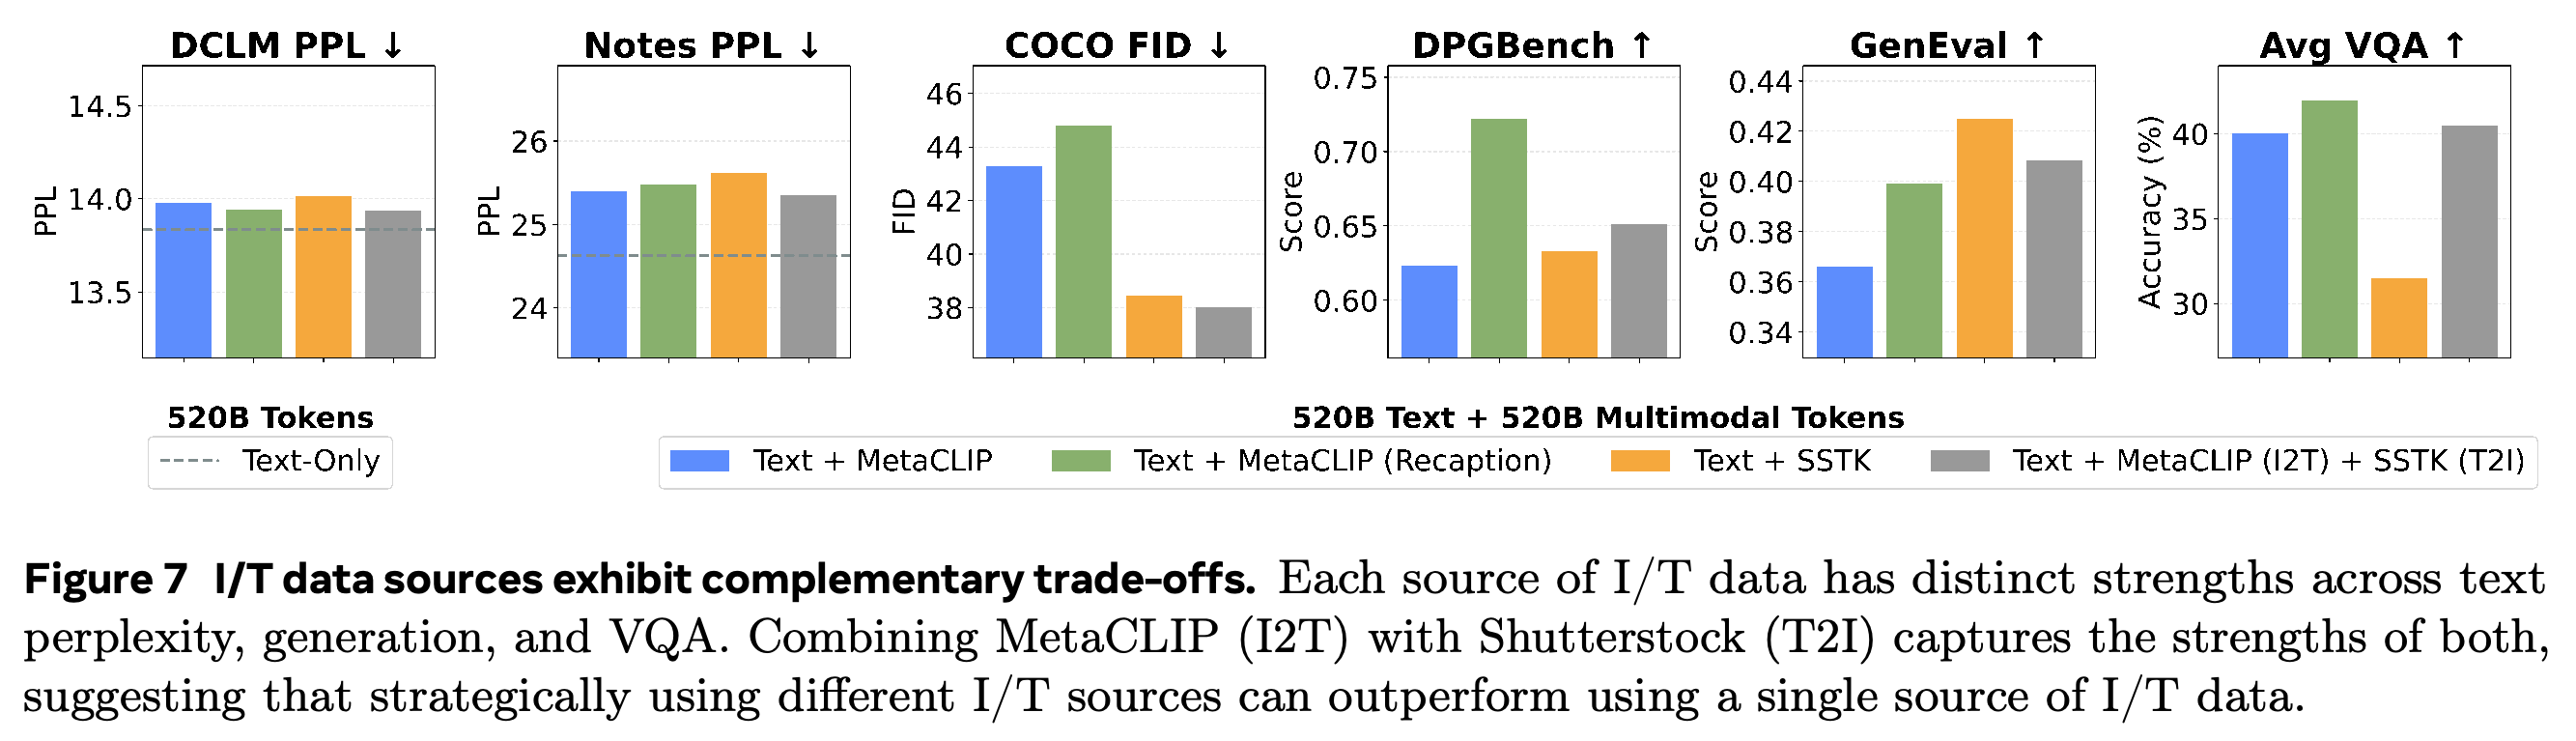
이미지 캡션 분포는 DCLM과 다르다. Table 1에서 중심점 간 cosine distance는 MetaCLIP이 0.196, MetaCLIP (Recap)이 0.286, SSTK가 0.215다. Figure 7은 지표별 상충 관계를 보여준다. 캡션 재작성은 VQA와 DPGBench를 개선하지만, Shutterstock은 기본 MetaCLIP보다 FID와 GenEval 결과가 좋다.
- 이미지에서 텍스트를 생성할 때 MetaCLIP을, 텍스트에서 이미지를 생성할 때 SSTK를 사용하면 각 출처의 유용한 특성을 결합할 수 있다. 다만 모든 단일 출처 결과보다 좋은 것은 아니다.
- 거리는 데이터셋마다 100K개 샘플을 최대 2000자로 잘라 Qwen3-Embedding-8B로 임베딩한 뒤 계산한다.
- 중심점 거리 분석은 분포 변화 가설을 뒷받침하지만 상관관계 분석이다. 캡션 스타일, 이미지 내용, 그 밖의 데이터셋 차이를 독립적으로 분리하지 못한다. 거리 순위도 그래프의 Notes perplexity 순위와 정확히 일치하지 않는다.
캡션 재작성은 VQA와 DPGBench 점수가 가장 높고, Shutterstock은 기본 MetaCLIP보다 FID와 GenEval을 개선한다. 목적별로 MetaCLIP I2T와 SSTK T2I를 결합하면 각 출처의 유용한 특성을 활용할 수 있지만, 모든 단일 출처 결과를 넘지는 못한다.
4.3 Synergy in Multimodal Pretraining
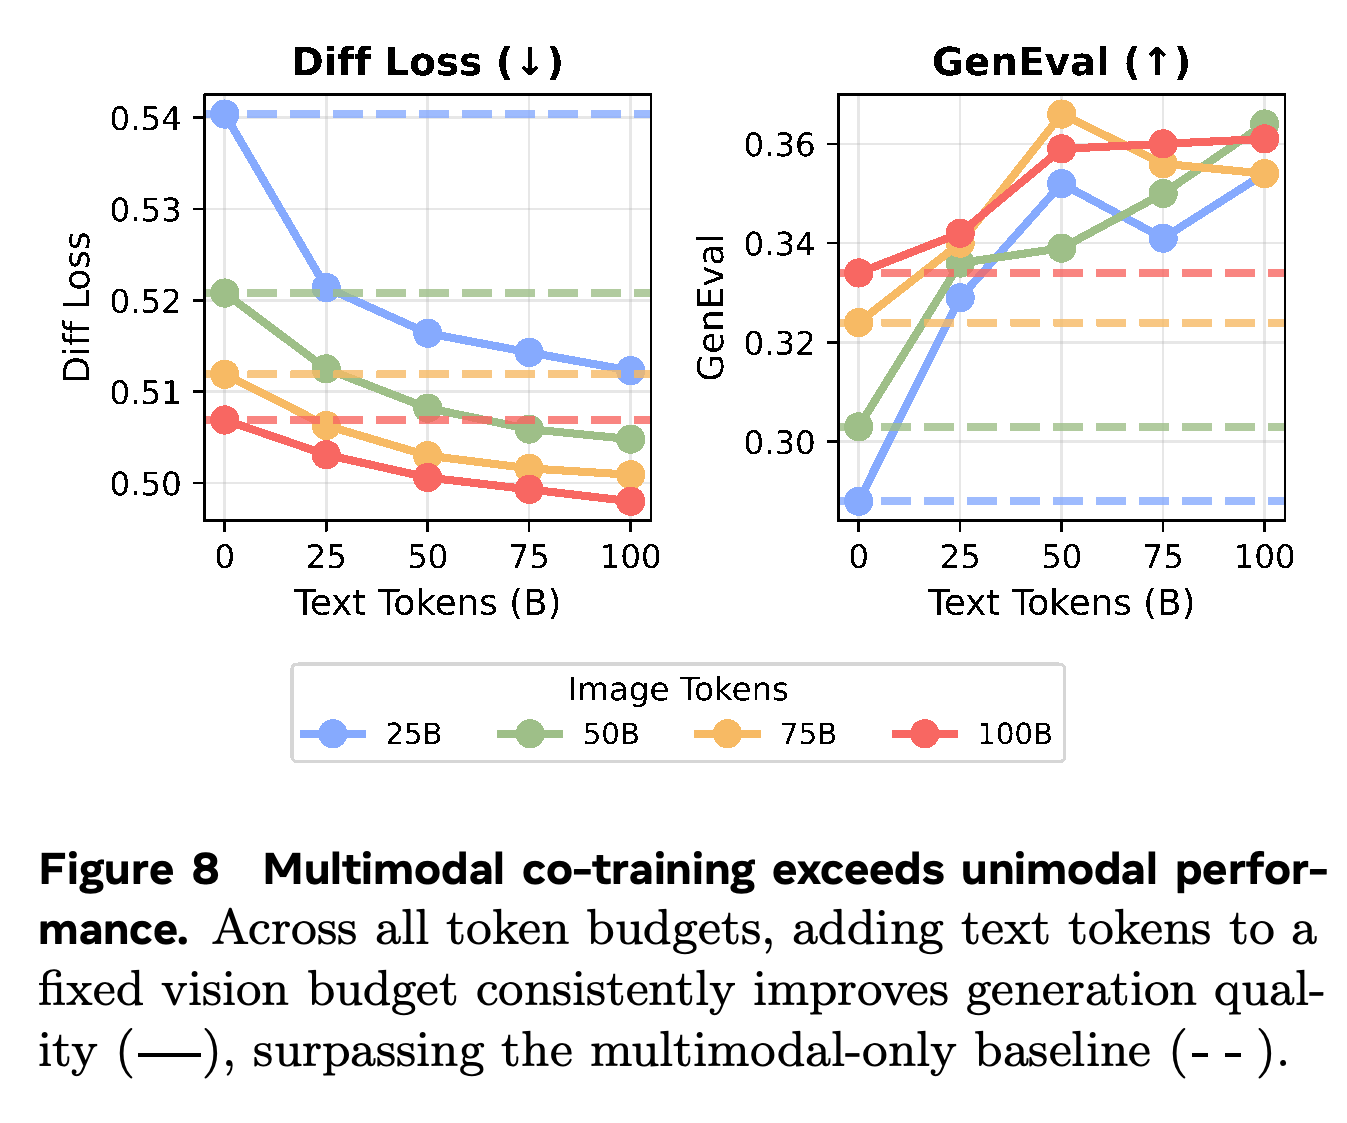
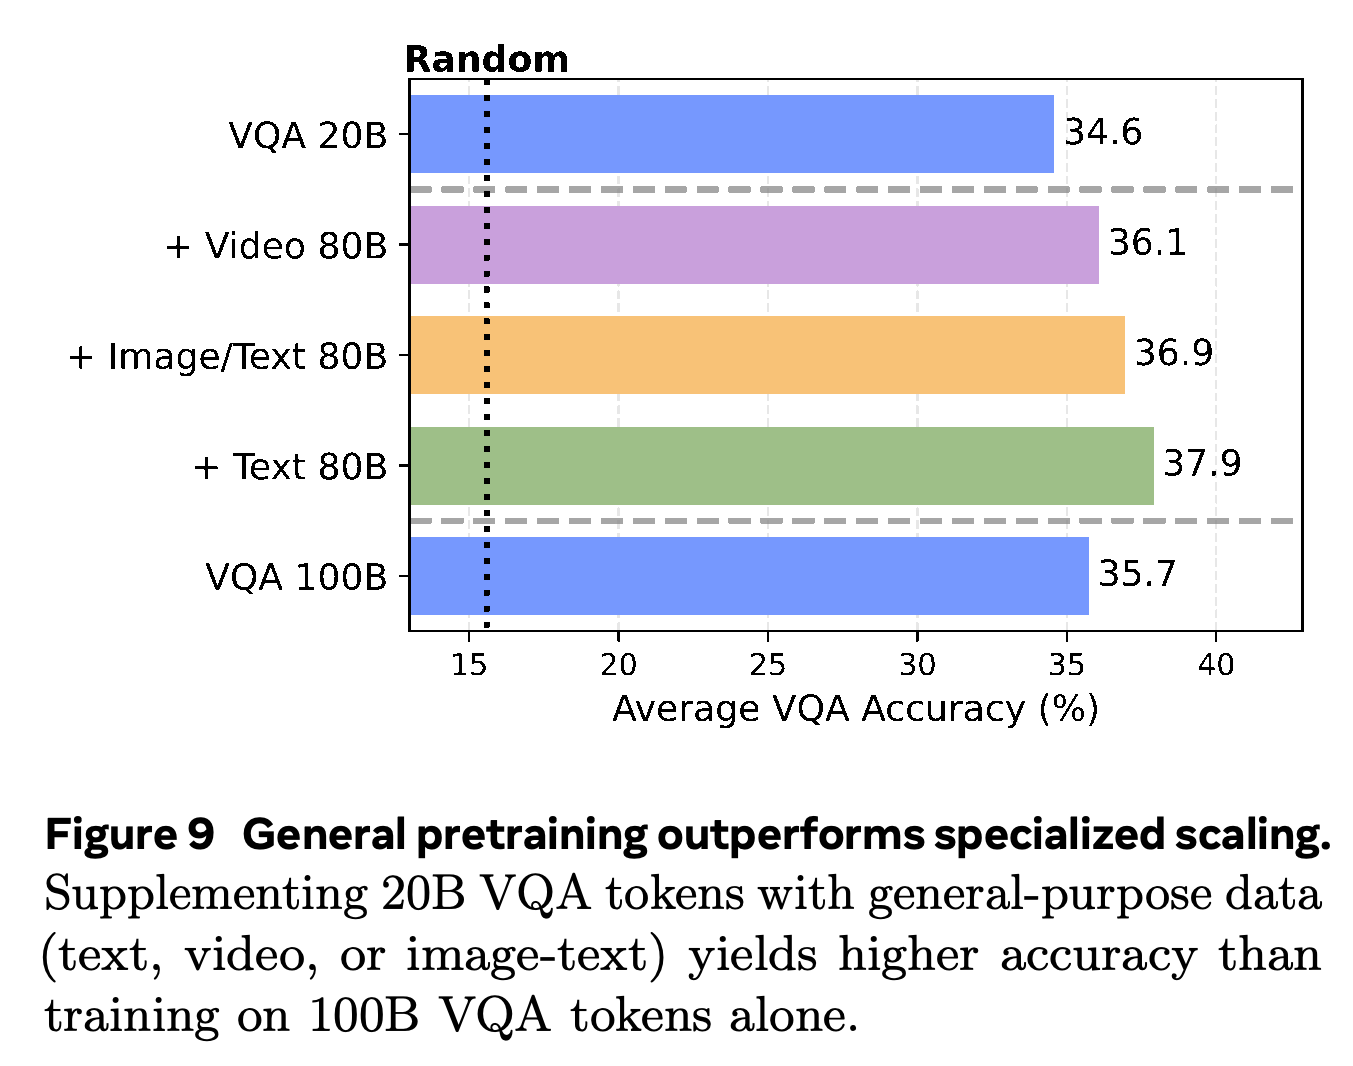
텍스트와 이미지 토큰 예산을 {0, 25, 50, 75, 100}B로 조합한 격자 실험에서, 시각 예산을 고정하고 텍스트를 추가하면 텍스트를 추가하지 않은 기준 모델보다 diffusion loss가 낮아지고 텍스트 조건부 생성이 좋아진다. 후속 VQA 연구에서는 20B VQA tokens에 80B의 비디오, 이미지-텍스트, 텍스트 토큰을 각각 추가해 정확도 36.1%, 36.9%, 37.9%를 얻는다. 모두 100B VQA 전용 기준 모델의 35.7%를 넘는다.
- 20B VQA 전용 기준 모델은 34.6%를 달성한다. 혼합 실험은 VQA 데이터를 5배 적게 사용하면서도 낮은 예산의 기준 모델과 총 토큰 수가 같은 특화 기준 모델보다 좋은 성능을 얻는다.
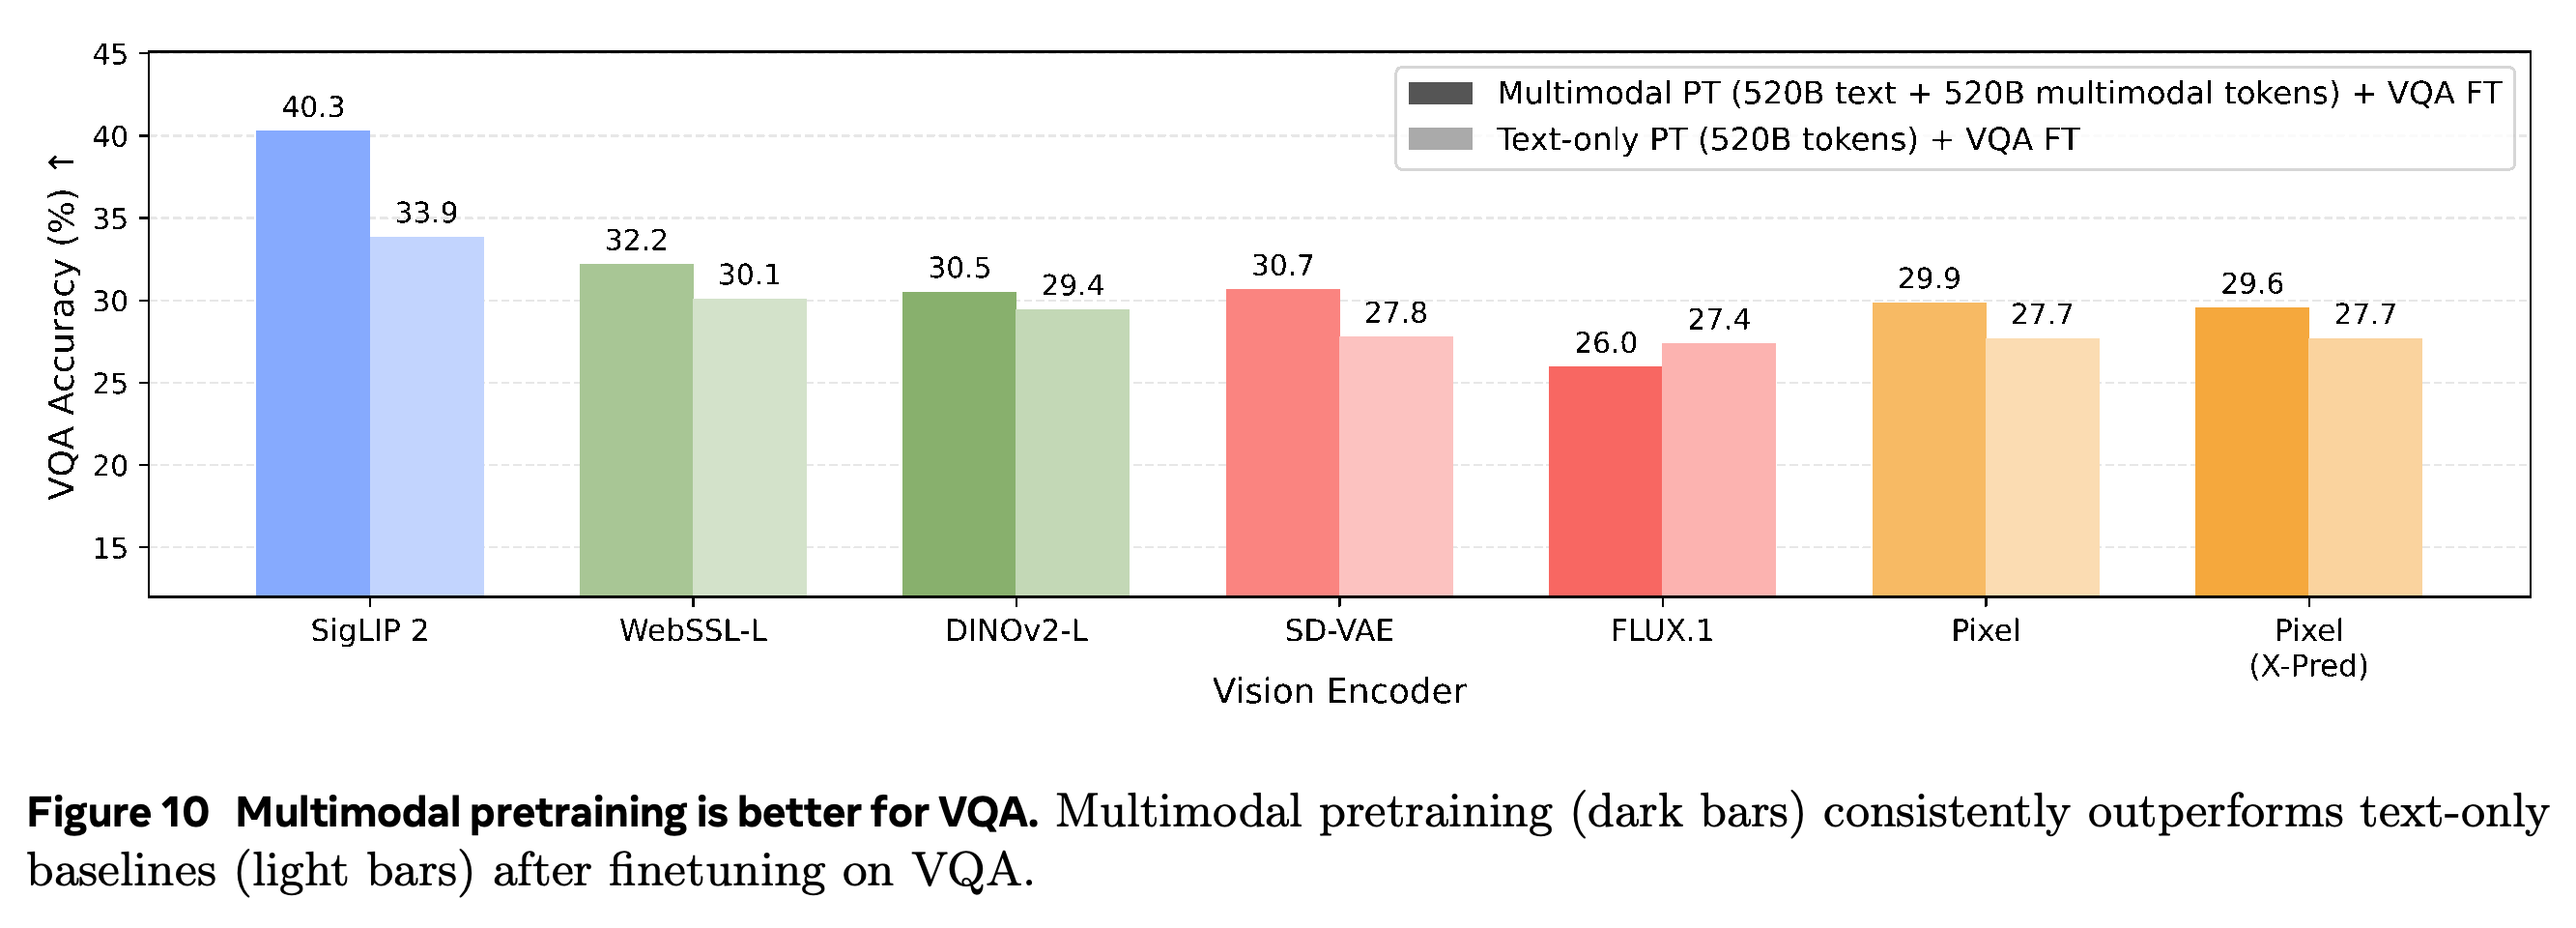
- Figure 10은 520B text + 520B multimodal 사전학습 후 VQA 미세조정을 수행하는 비교로 확장한다. SigLIP 2는 40.3%를 달성하며, 텍스트 전용 사전학습 후에는 33.9%를 달성한다.
- 모든 인코더에서 개선되지는 않는다. FLUX.1은 멀티모달 사전학습 후 26.0%, 텍스트 전용 사전학습 후 27.4%를 달성한다. 이는 일관된 개선을 주장하는 그림 캡션과 다르다.
각 이미지 토큰 예산을 고정한 상태에서 텍스트를 추가하면, 텍스트를 추가하지 않은 비교 모델보다 diffusion loss가 낮아지고 GenEval이 좋아진다. 다만 GenEval이 매 증가 단계에서 단조롭게 개선되지는 않으며, 텍스트 추가는 총 학습 노출량도 늘린다.
혼합한 100B-token 실험은 VQA 토큰을 20B만 사용하면서도 100B VQA 전용 모델보다 좋다. 텍스트 추가가 37.9%로 가장 좋으며, 특화 데이터 스케일링은 35.7%를 얻는다.
SigLIP 2는 멀티모달 사전학습의 이점을 크게 얻으며, VQA 미세조정 후 정확도는 40.3% 대 33.9%다. FLUX.1은 26.0% 대 27.4%로, 일관된 개선을 주장하는 캡션의 예외다.
5 Towards World Modeling in Unified Multimodal Models
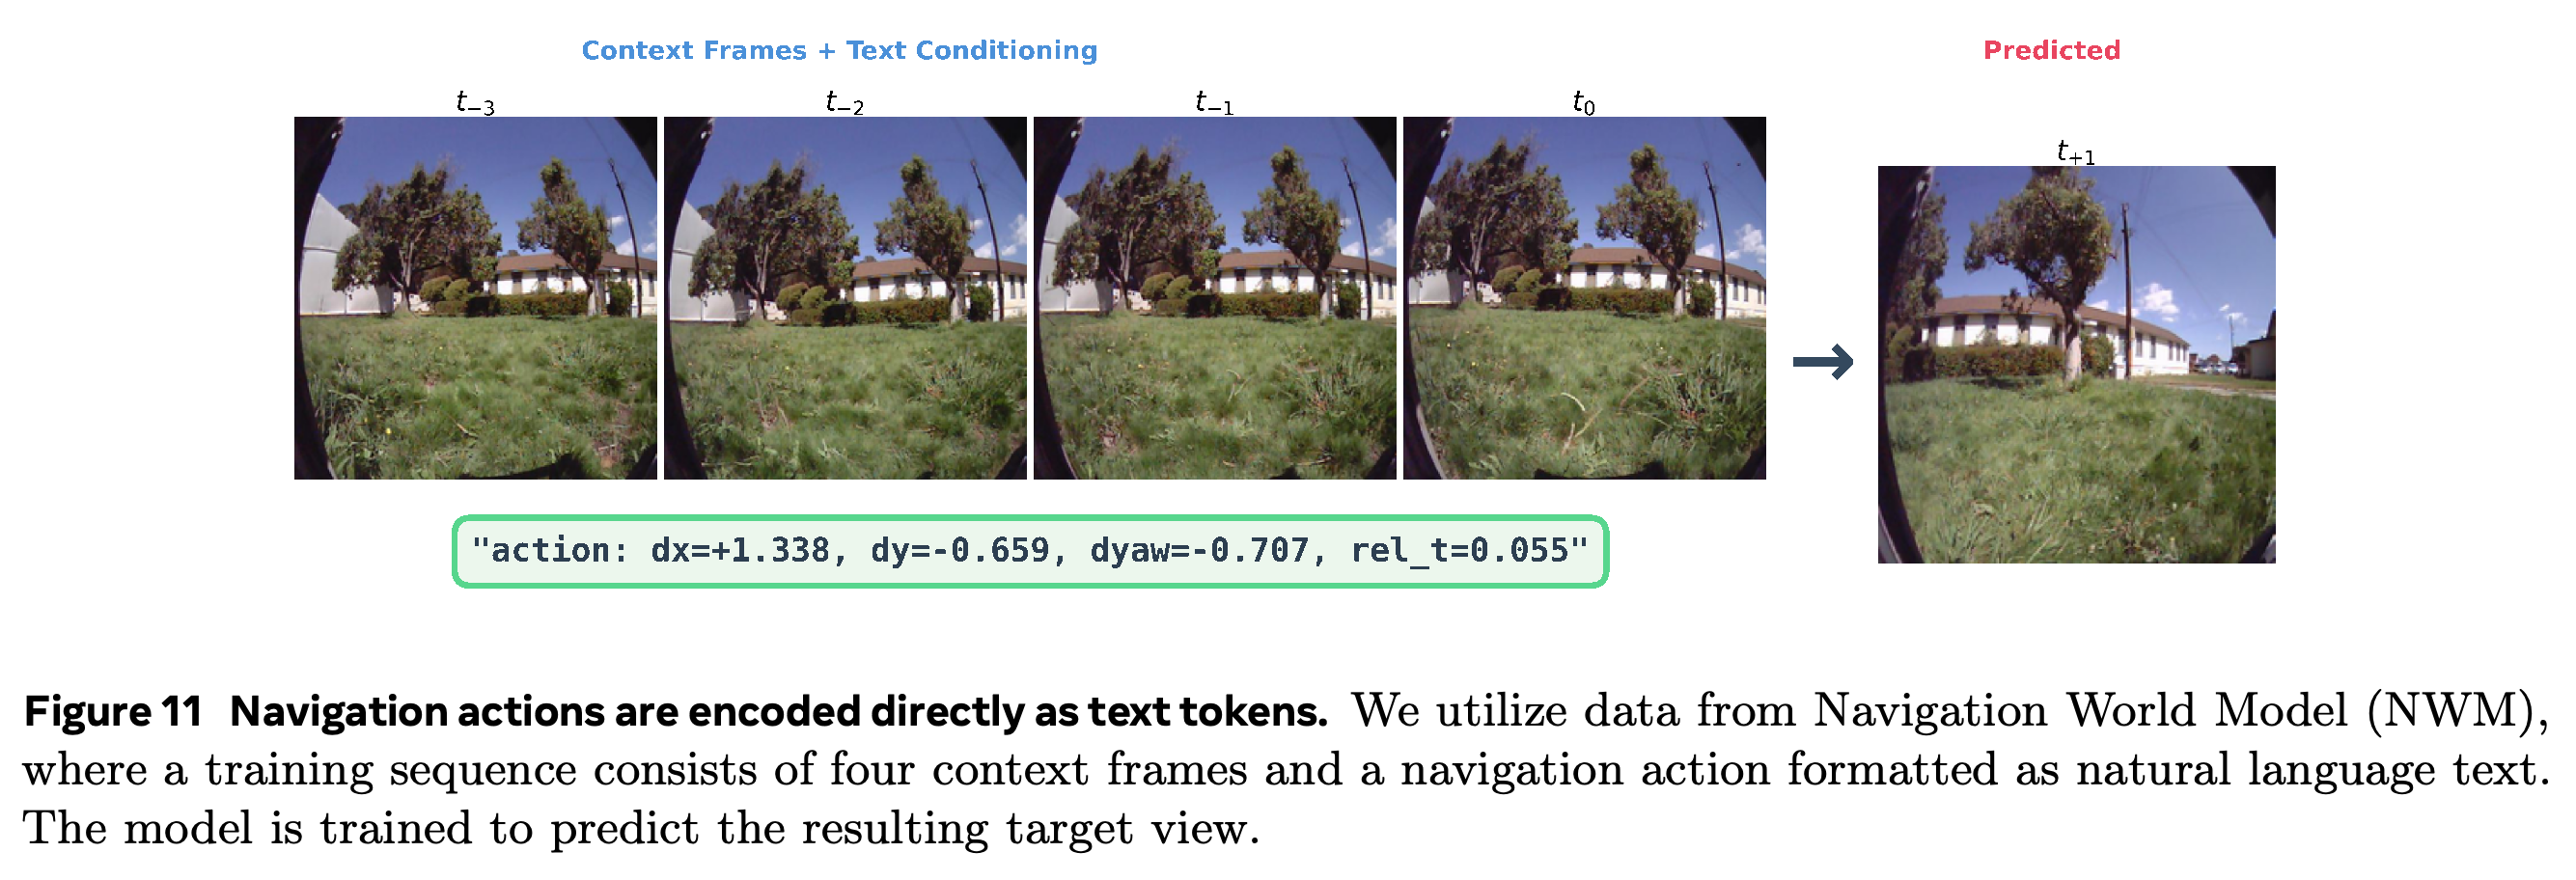
월드 모델링은 Navigation World Model(NWM) 설정에서 State_t + Action → State_t+1로 정의한다. NWM의 전용 연속 행동 표현과 달리, 이 모델은 이동과 회전 변화량을 수치형 텍스트 문자열로 인코딩한다. 따라서 행동 전용 adapter 없이 내비게이션을 또 하나의 I + T → I 과제로 처리한다.
- Figure 11은 4개 문맥 프레임 뒤에 행동 문자열과 예측한 목표 시점 영상이 이어지는 예시를 보여준다.
4개 문맥 시점 영상과 문자열 “action: dx=+1.338, dy=-0.659, dyaw=-0.707, rel_t=0.055”을 조건으로 목표 시점 영상을 예측한다. 이 예시는 전용 행동 adapter 없이 수치형 행동을 시퀀스에 넣는 방식을 보여준다.
5.1 NWM Data and Protocol
내비게이션 학습은 SCAND와 RECON을 포함한 로봇의 자기중심 시점 데이터셋을 사용하며, 샘플마다 4개 문맥 프레임, 행동, 목표 프레임을 포함한다. 평가는 Cross-Entropy Method(CEM) 계획을 사용한다. 8-step horizon에 걸친 N = 120개 후보 행동 시퀀스를 생성하고, 예측한 마지막 프레임과 목표 이미지 사이의 LPIPS 거리를 최소화한다.
- Appendix F.1은 2초에 해당하는 8-step horizon, 상위 K = 5개 궤적 선택, 해당 행동들의 평균 계산, 평가 인스턴스당 3회 반복을 명시한다.
- Absolute trajectory error(ATE)와 relative pose error(RPE)는 정답 궤적을 기준으로 측정한다. 이 절차는 예측한 시각 상태를 통한 계획을 평가하며, 실제 배치된 로봇을 자유로운 자연어로 제어하는 능력을 평가하지는 않는다.
5.2 World Modeling Emerges from Multimodal Pretraining
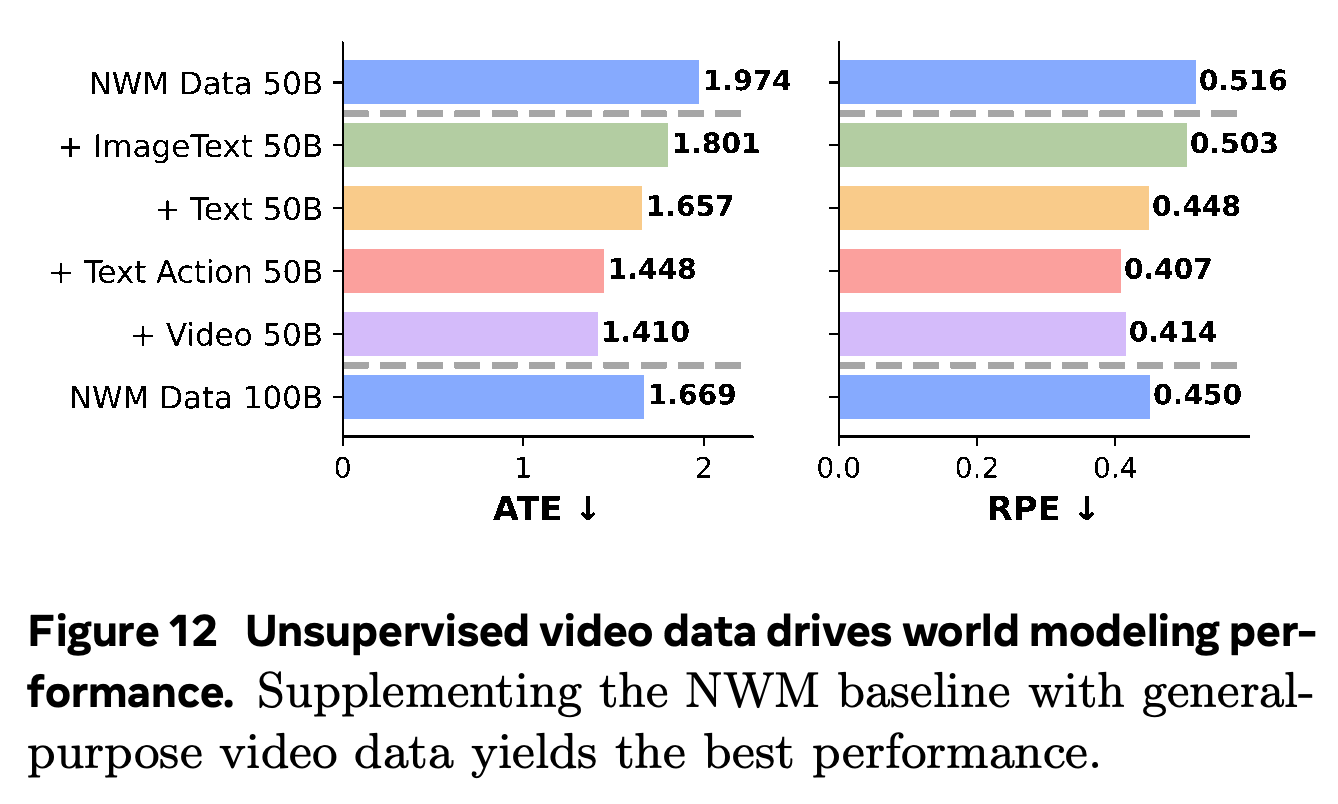
50B NWM tokens에 50B 원시 비디오 토큰을 추가하면 ATE 1.410과 RPE 0.414를 얻는다. 50B NWM 전용 모델은 1.974와 0.516, 100B NWM 전용 모델은 1.669와 0.450을 얻는다. 텍스트-행동 비디오는 가장 좋은 RPE인 0.407을 달성하며, 원시 비디오는 가장 좋은 ATE를 달성한다.
- 실험한 모든 추가 데이터는 50B NWM 전용 모델보다 좋은 성능을 얻지만, 모두 100B NWM 전용 모델보다 좋은 것은 아니다. 이미지-텍스트를 추가하면 ATE 1.801과 RPE 0.503을 얻는다.
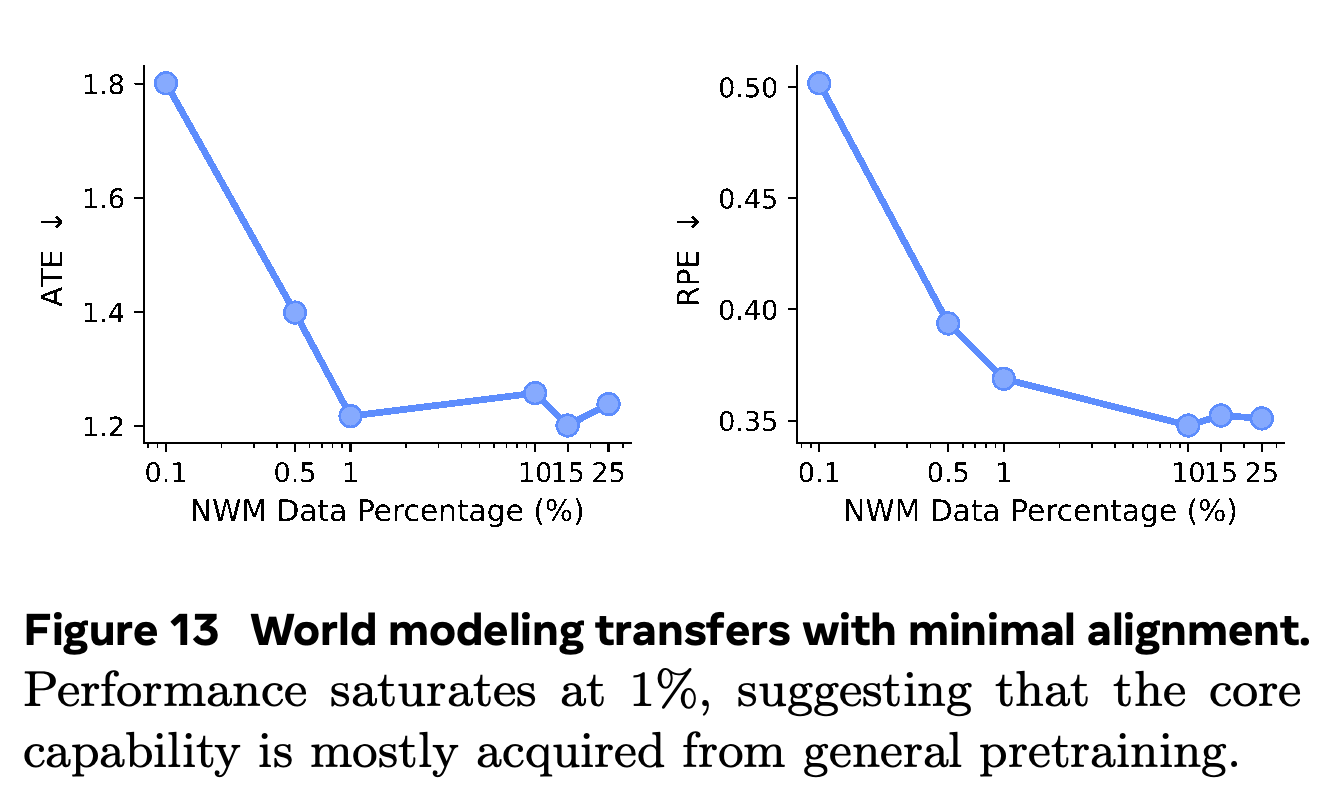
- 200B-token 학습 예산을 고정하고 NWM 데이터 비중을 0.1%에서 25%까지 바꾸면, 약 1%의 도메인 내 데이터로도 경쟁력 있는 성능을 얻으며 이후 개선은 제한적이다.
- 비율 실험은 일반 사전학습에서 데이터 효율적으로 전이할 수 있음을 보여준다. 그러나 가장 작은 조건에도 내비게이션 데이터가 포함되므로, 도메인 정렬 없이 계획할 수 있음을 입증하지는 않는다.
원시 비디오는 가장 낮은 ATE인 1.410을, 텍스트-행동 추가는 가장 낮은 RPE인 0.407을 얻는다. 이미지-텍스트 추가는 50B NWM 전용 모델보다 좋지만, ATE와 RPE 모두 100B NWM 전용 모델보다 나쁘다.
고정된 200B-token 예산에서 내비게이션 데이터 비중을 가장 작은 수준에서 약 1%까지 늘릴 때 가장 큰 개선이 나타난다. 더 높은 비율의 추가 개선은 제한적이지만, 내비게이션 데이터가 0인 조건은 제시하지 않는다.
5.3 Qualitative Rollouts with Free-form Language as Actions
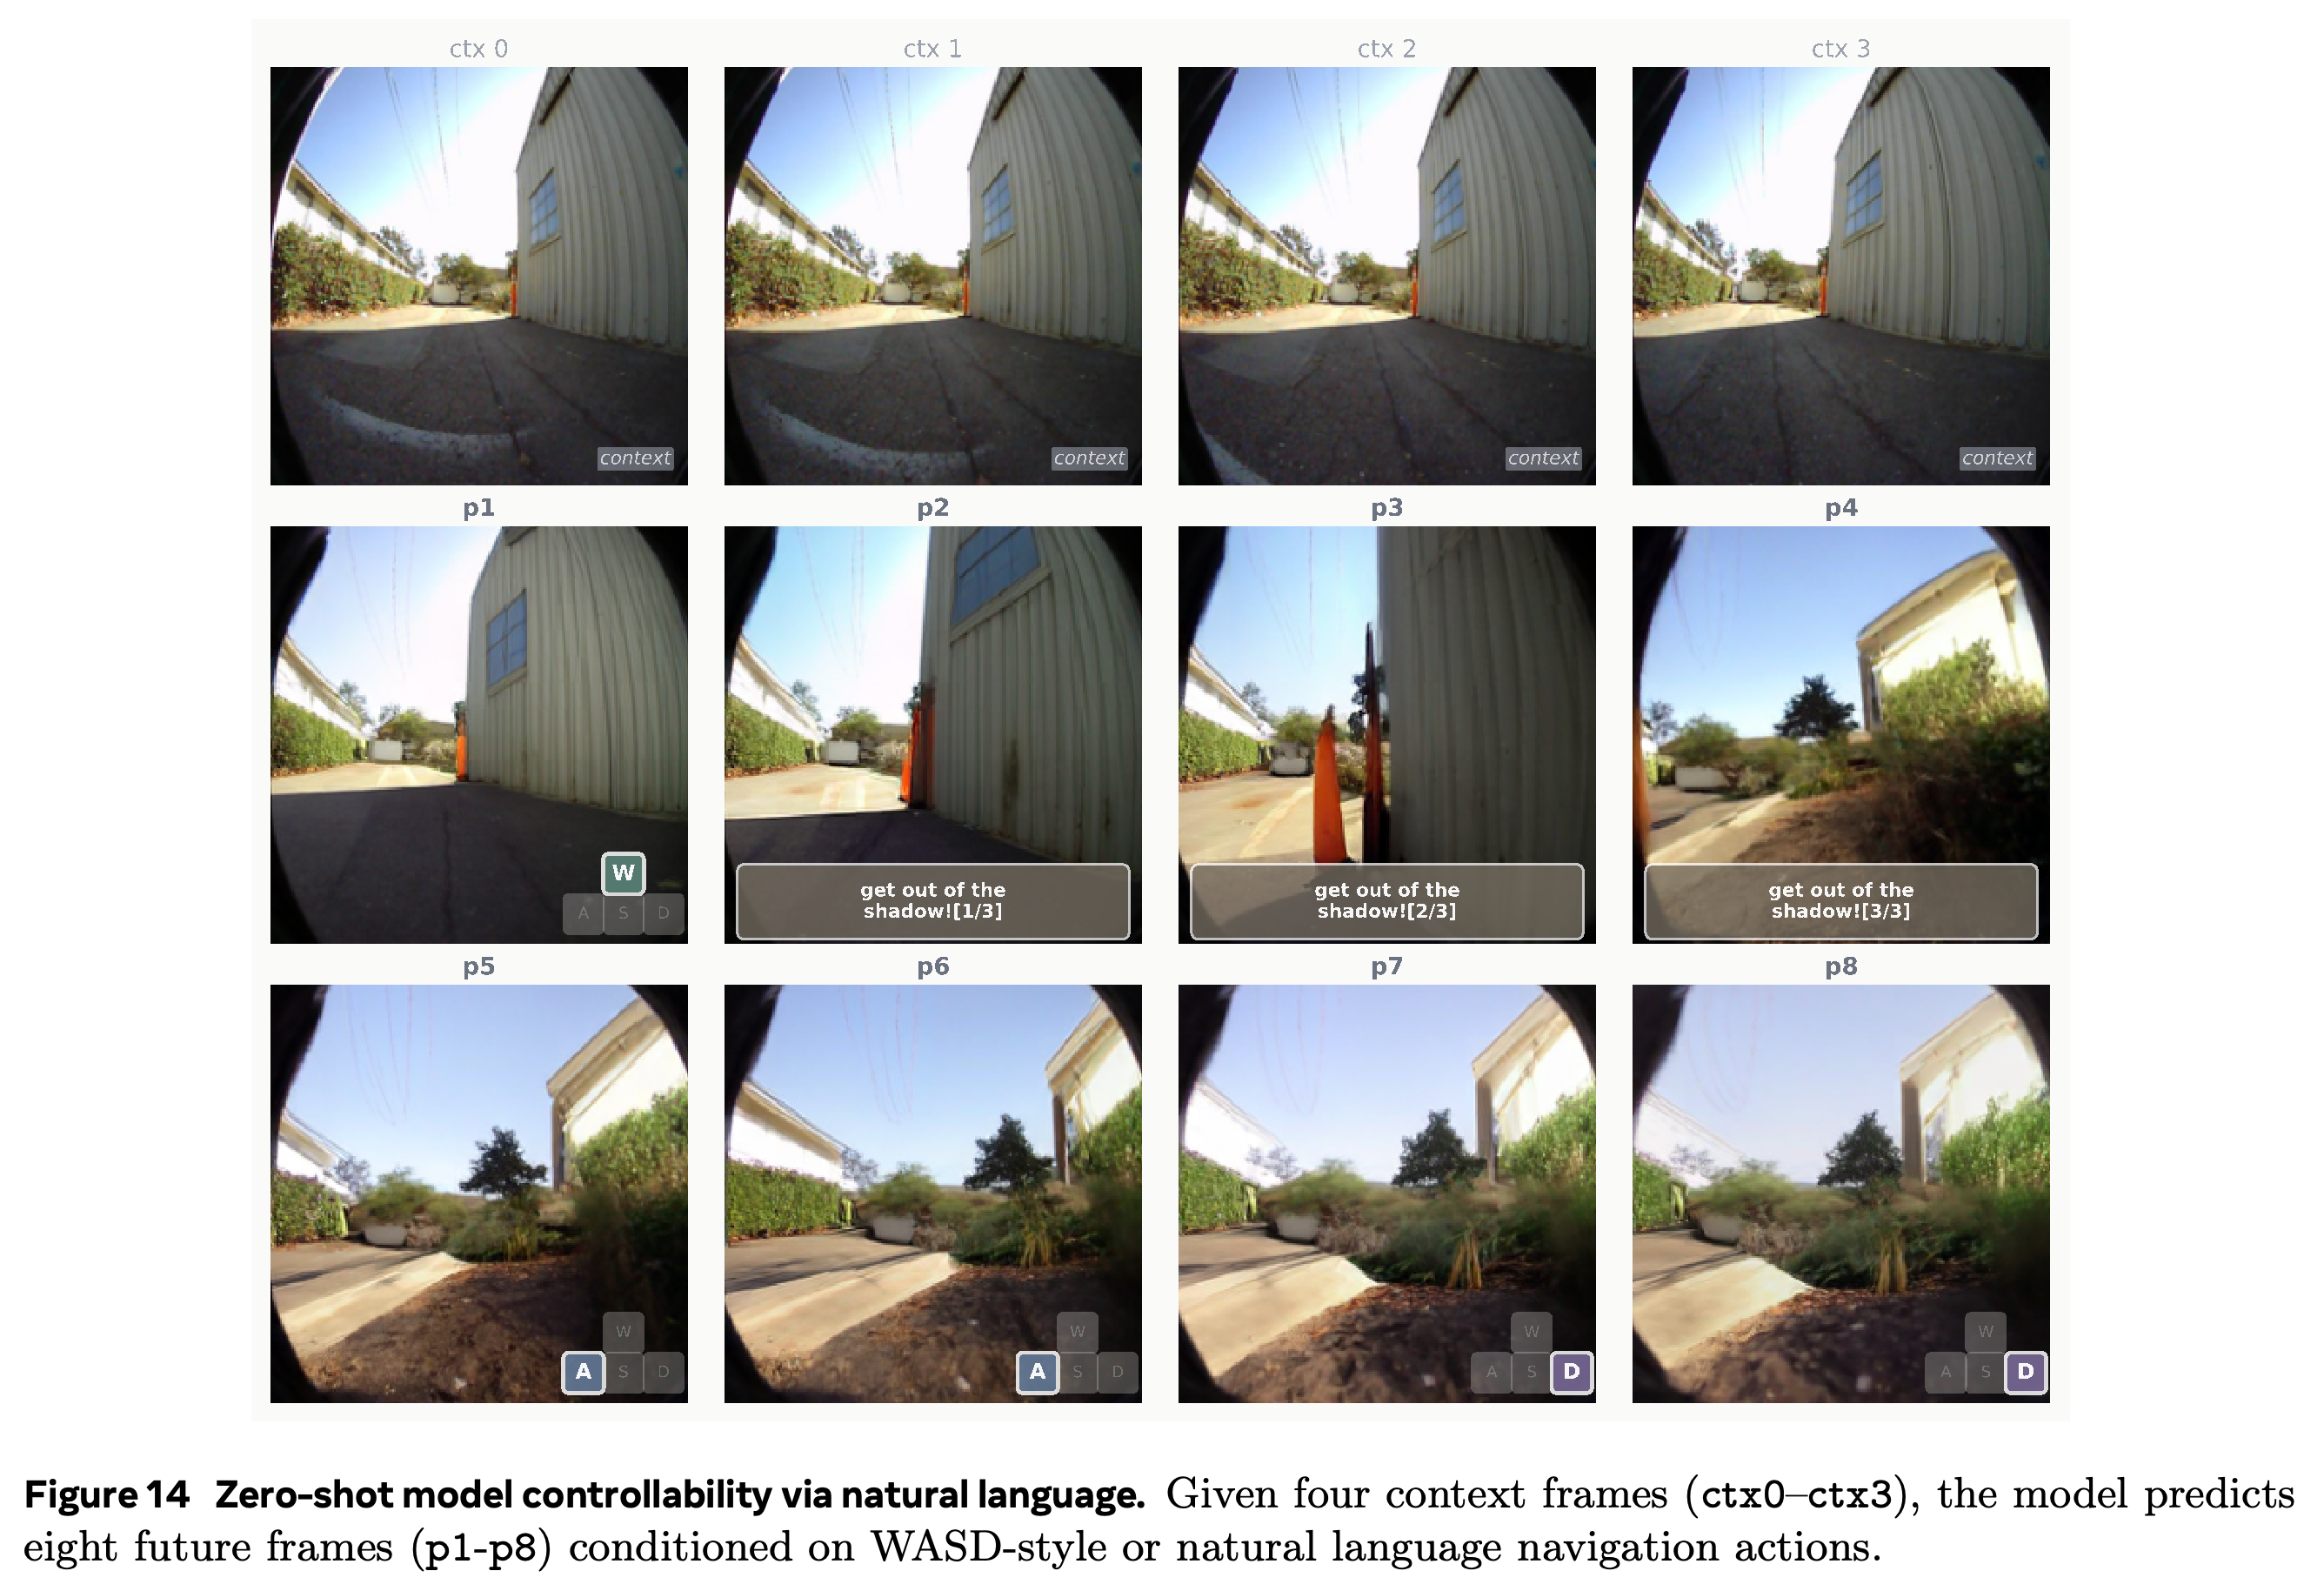
Figure 14는 4개 문맥 프레임에서 시작해 사전 정의된 WASD 행동과 자유 형식 명령 “get out of the shadow!”를 모두 사용하는 자기회귀 rollout을 보여준다. 생성된 시점 영상은 요청한 움직임과 정성적으로 일치하며, 수치형 행동 형식을 넘어 언어 조건부 시각 상태 전환이 가능함을 보여준다.
- 로봇 중심 좌표계에서 정의한 행동은 W = (+0.5, 0, 0), S = (−0.5, 0, 0), A = (+0.2, 0, +0.5), D = (+0.2, 0, −0.5)이다.
- 자유 형식 언어 제어는 정성적으로 예시를 제시할 뿐, 정량적 명령 수행 벤치마크로 평가하지 않는다. 선택된 rollout만으로 일반적인 물리적 충실도나 명령 수행 신뢰성을 입증할 수는 없다.
이 rollout은 수치형 WASD 제어와 “get out of the shadow!”를 함께 사용하며 더 밝은 시점으로 이동한다. 언어 조건부 제어를 보여주지만, 명령 집합 전반의 성공률을 측정하지는 않는다.
6 Unified Multimodal Architecture Design
고정된 모달리티별 FFN은 공유 FFN보다 좋지만, 설계상 텍스트와 시각에 용량을 동일하게 배분한다. 반면 MoE는 총 모델 용량과 토큰당 활성 연산량을 분리하면서 토큰에 따른 용량 배분을 학습한다.
- 아키텍처 연구는 전문가 세분화 수준, 희소성, 예측 대상, 공유 전문가, 학습 과정에서 나타나는 라우팅 패턴, 앞선 실험에서 선호된 시각 표현과의 조합을 시험한다.
6.1 Exploring MoEs for Unified Multimodal Models
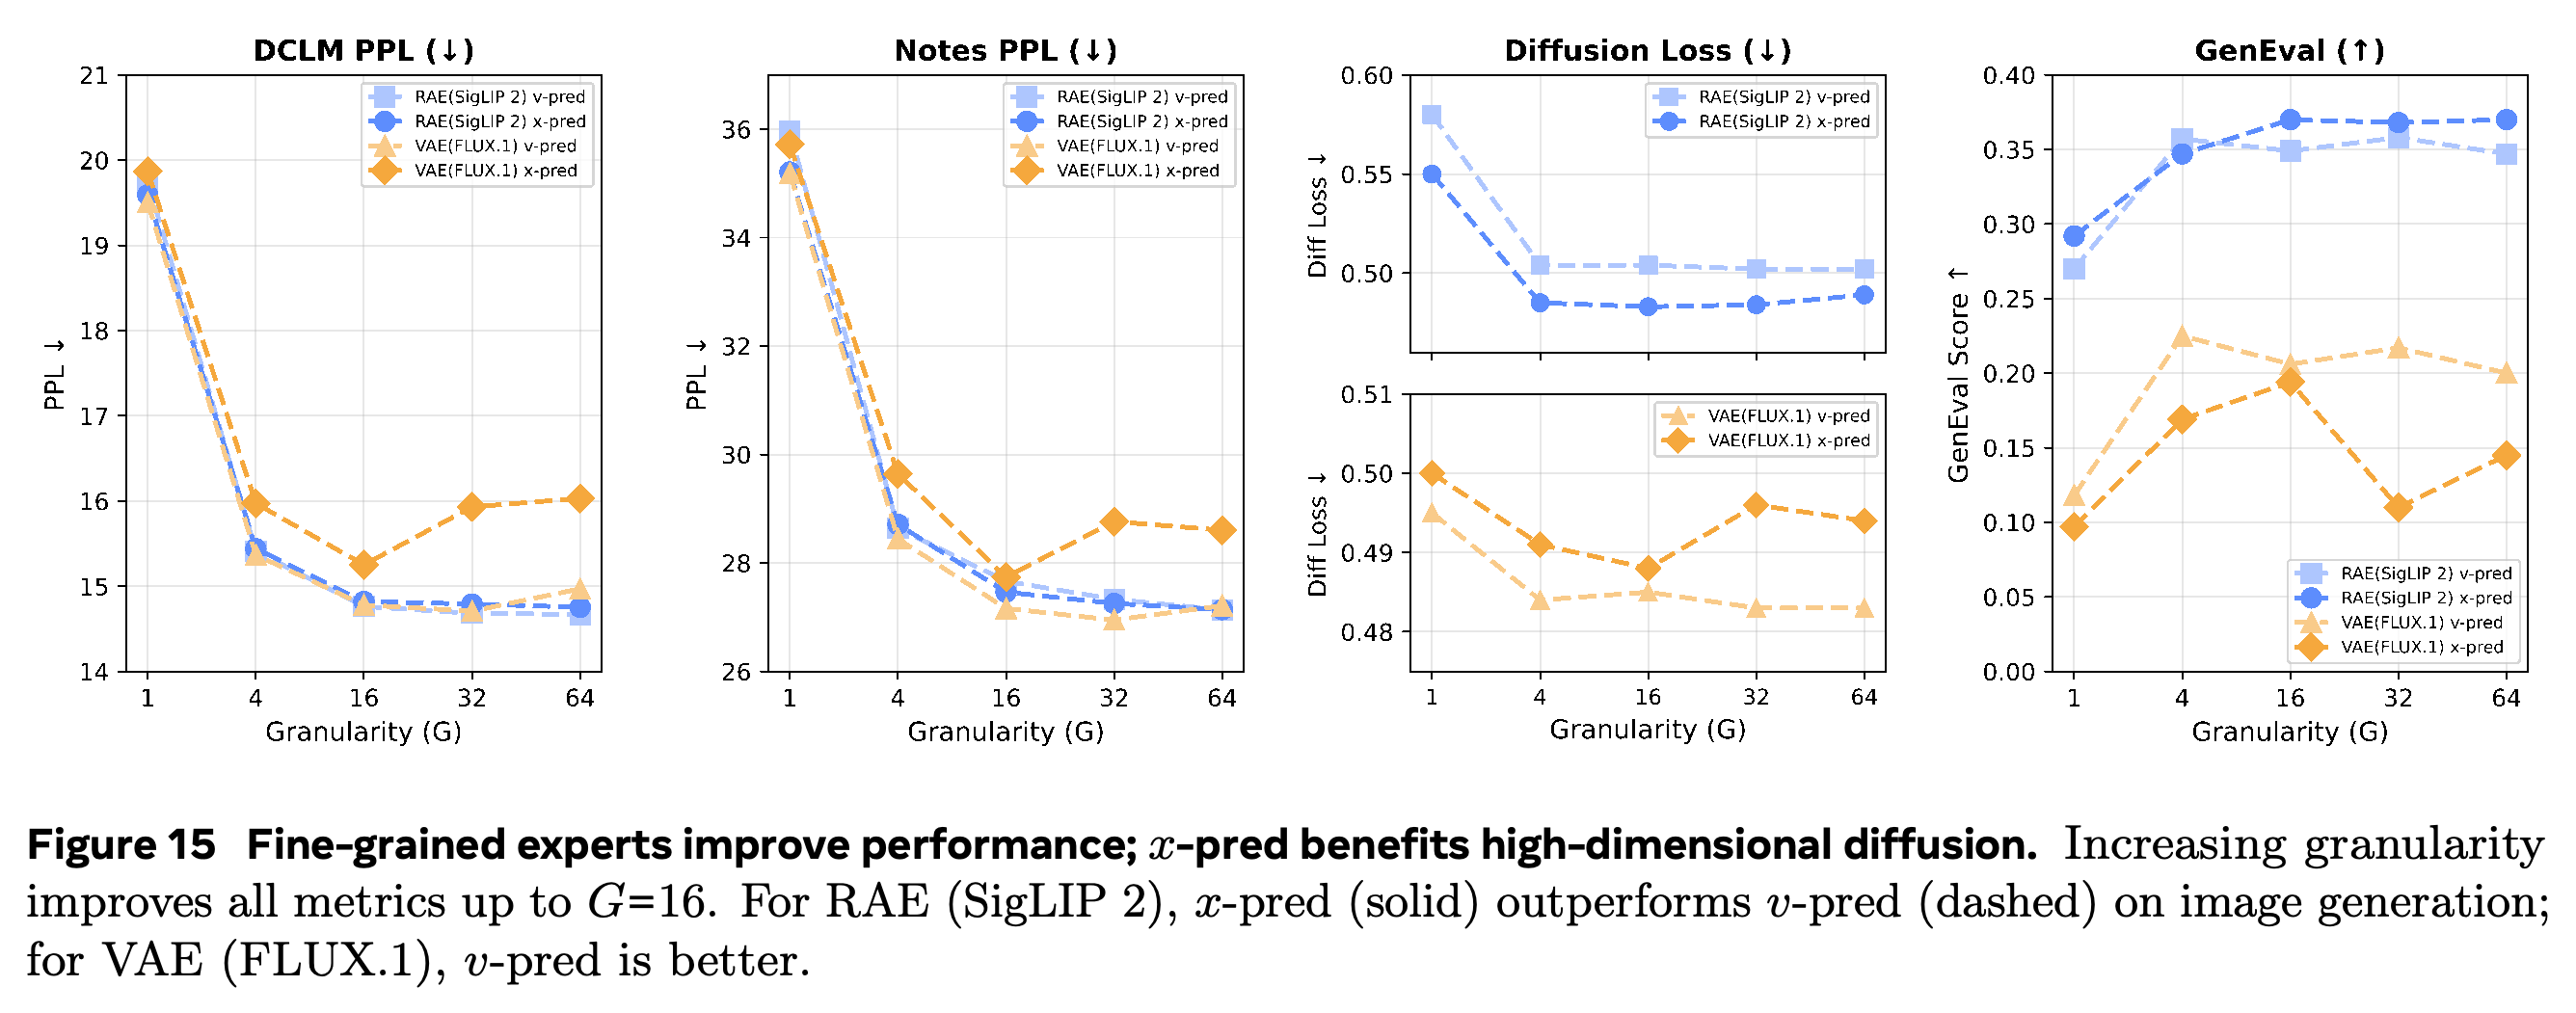
기본 MoE 스윕은 DCLM 텍스트와 Shutterstock 이미지 데이터를 50/50으로 혼합해 57B tokens 동안 학습한다. 전문가 세분화 수준은 G = 4d_model/d_expert이다. 활성 연산량을 대략 고정한 채 G ∈ {1, 4, 16, 32, 64}를 탐색하면 더 세분화된 라우팅에서 상당한 개선을 얻는다. 저자들은 시각이 G = 4 부근에서, 언어가 G = 16 부근에서 포화되어 시각이 더 일찍 포화한다고 보고하며, 후속 실험에는 G = 16을 채택한다.
- 세분화 스윕은 총 파라미터 약 13.5B와 활성 파라미터 약 1.5B를 사용한다. G = 1은 큰 전문가와 Top-1 라우팅을 사용한다. G = 64 구현에서는 TorchTitan 제약 때문에 전문가 1024개 대신 1008개를 사용한다.
- SigLIP 2를 사용하는 RAE는 생성에서 v-pred보다 x-pred가 유리하다. FLUX.1에는 v-pred가 더 적합하며, 세분화 수준이 높을 때 x-pred는 언어 perplexity를 악화시킨다.
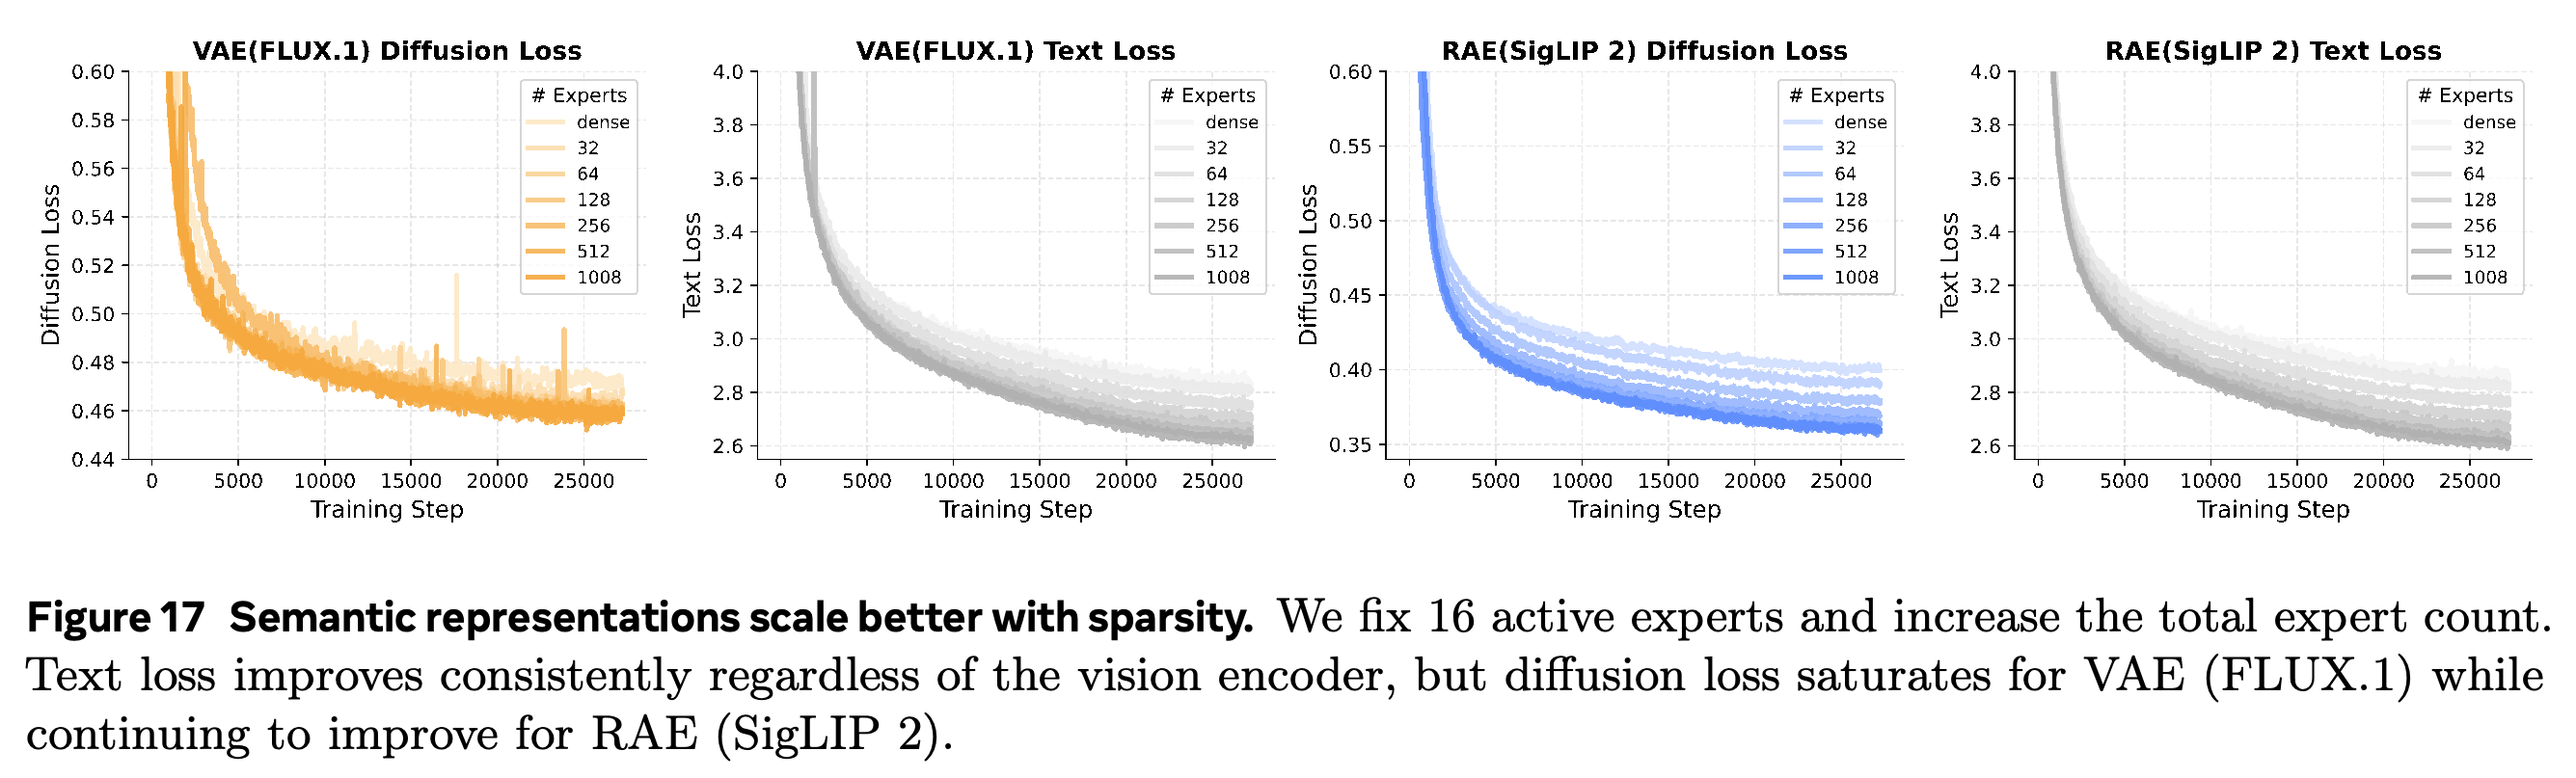
- G = 16에서 희소성 스윕은 차원 512인 활성 전문가 16개를 유지하면서 전체 풀을 32개에서 1008개로 늘린다. 양쪽 표현 모두 언어 loss가 개선되지만, VAE의 diffusion loss 개선은 포화되고 RAE의 개선은 계속된다.
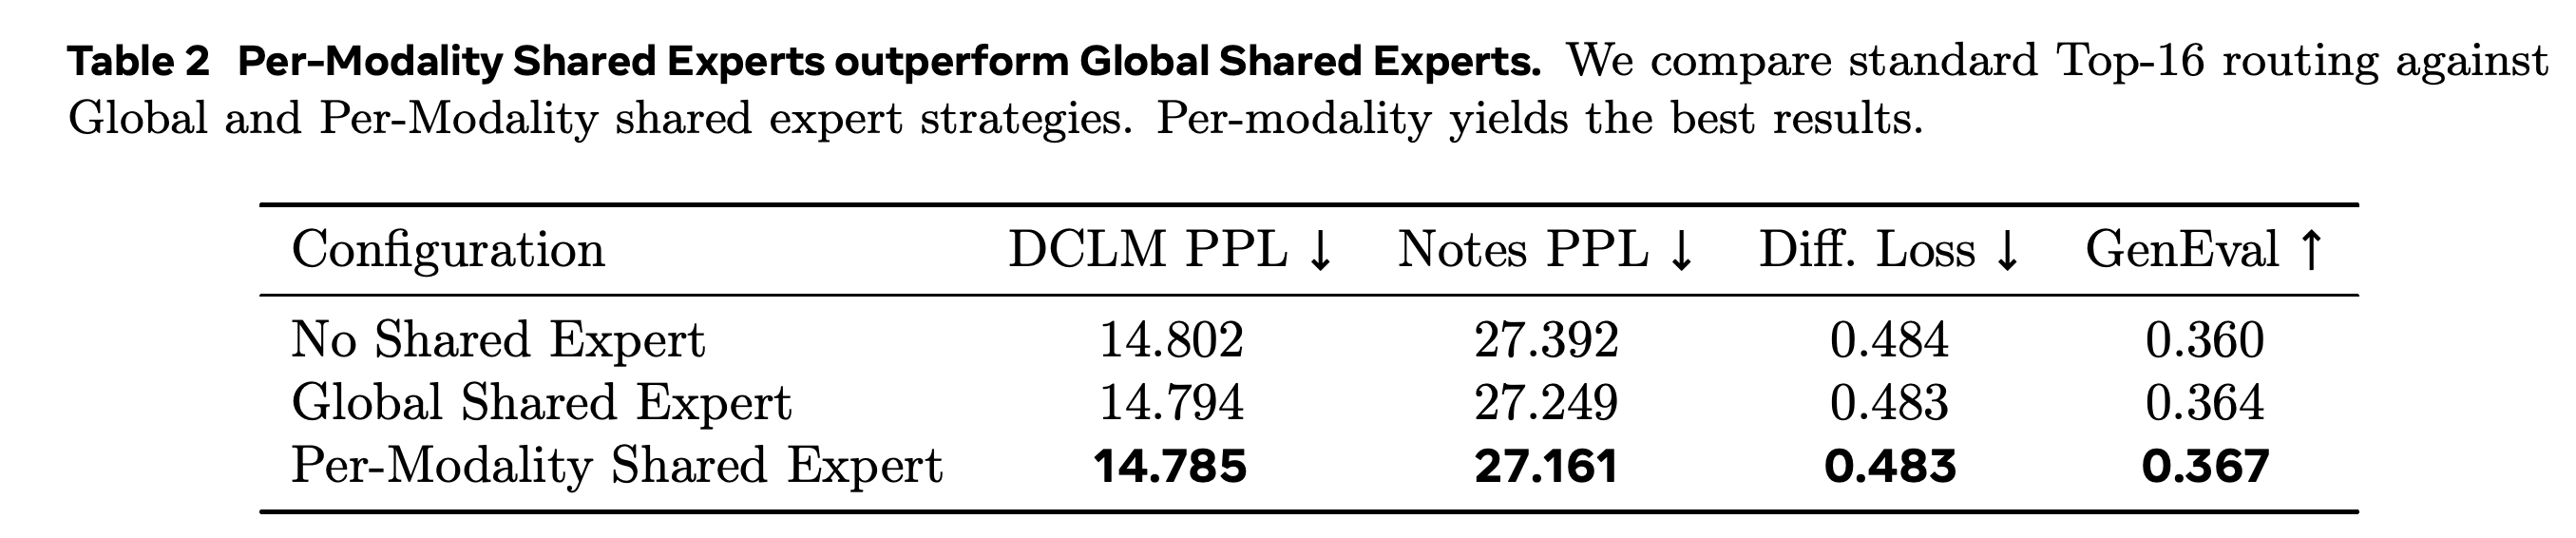
- Table 2는 총 전문가 256개와 활성 전문가 16개 조건에서 공유 전문가 없음, 전역 공유 전문가 1개, 모달리티별 공유 전문가를 비교한다. 모달리티별 공유는 DCLM PPL 14.785, Notes PPL 27.161, diffusion loss 0.483, GenEval 0.367을 얻는다. 표준 라우팅과의 차이는 작으며 불확실성 추정치는 보고하지 않는다.
전문가를 더 세분화하면 언어 성능이 크게 개선되다가 개선 폭이 줄어든다. SigLIP 2는 생성에 x-pred가 유리하지만, FLUX.1의 x-pred는 높은 세분화 수준에서 언어 perplexity를 악화시킨다. 포화 지점은 모달리티와 지표에 따라 다르다.
활성 전문가 16개를 유지하면서 전문가 풀을 늘리면 perplexity와 diffusion loss가 낮아진다. 생성 개선은 RAE에서 가장 크지만, GenEval이 전문가 수를 늘리는 모든 단계에서 단조롭게 높아지지는 않는다.
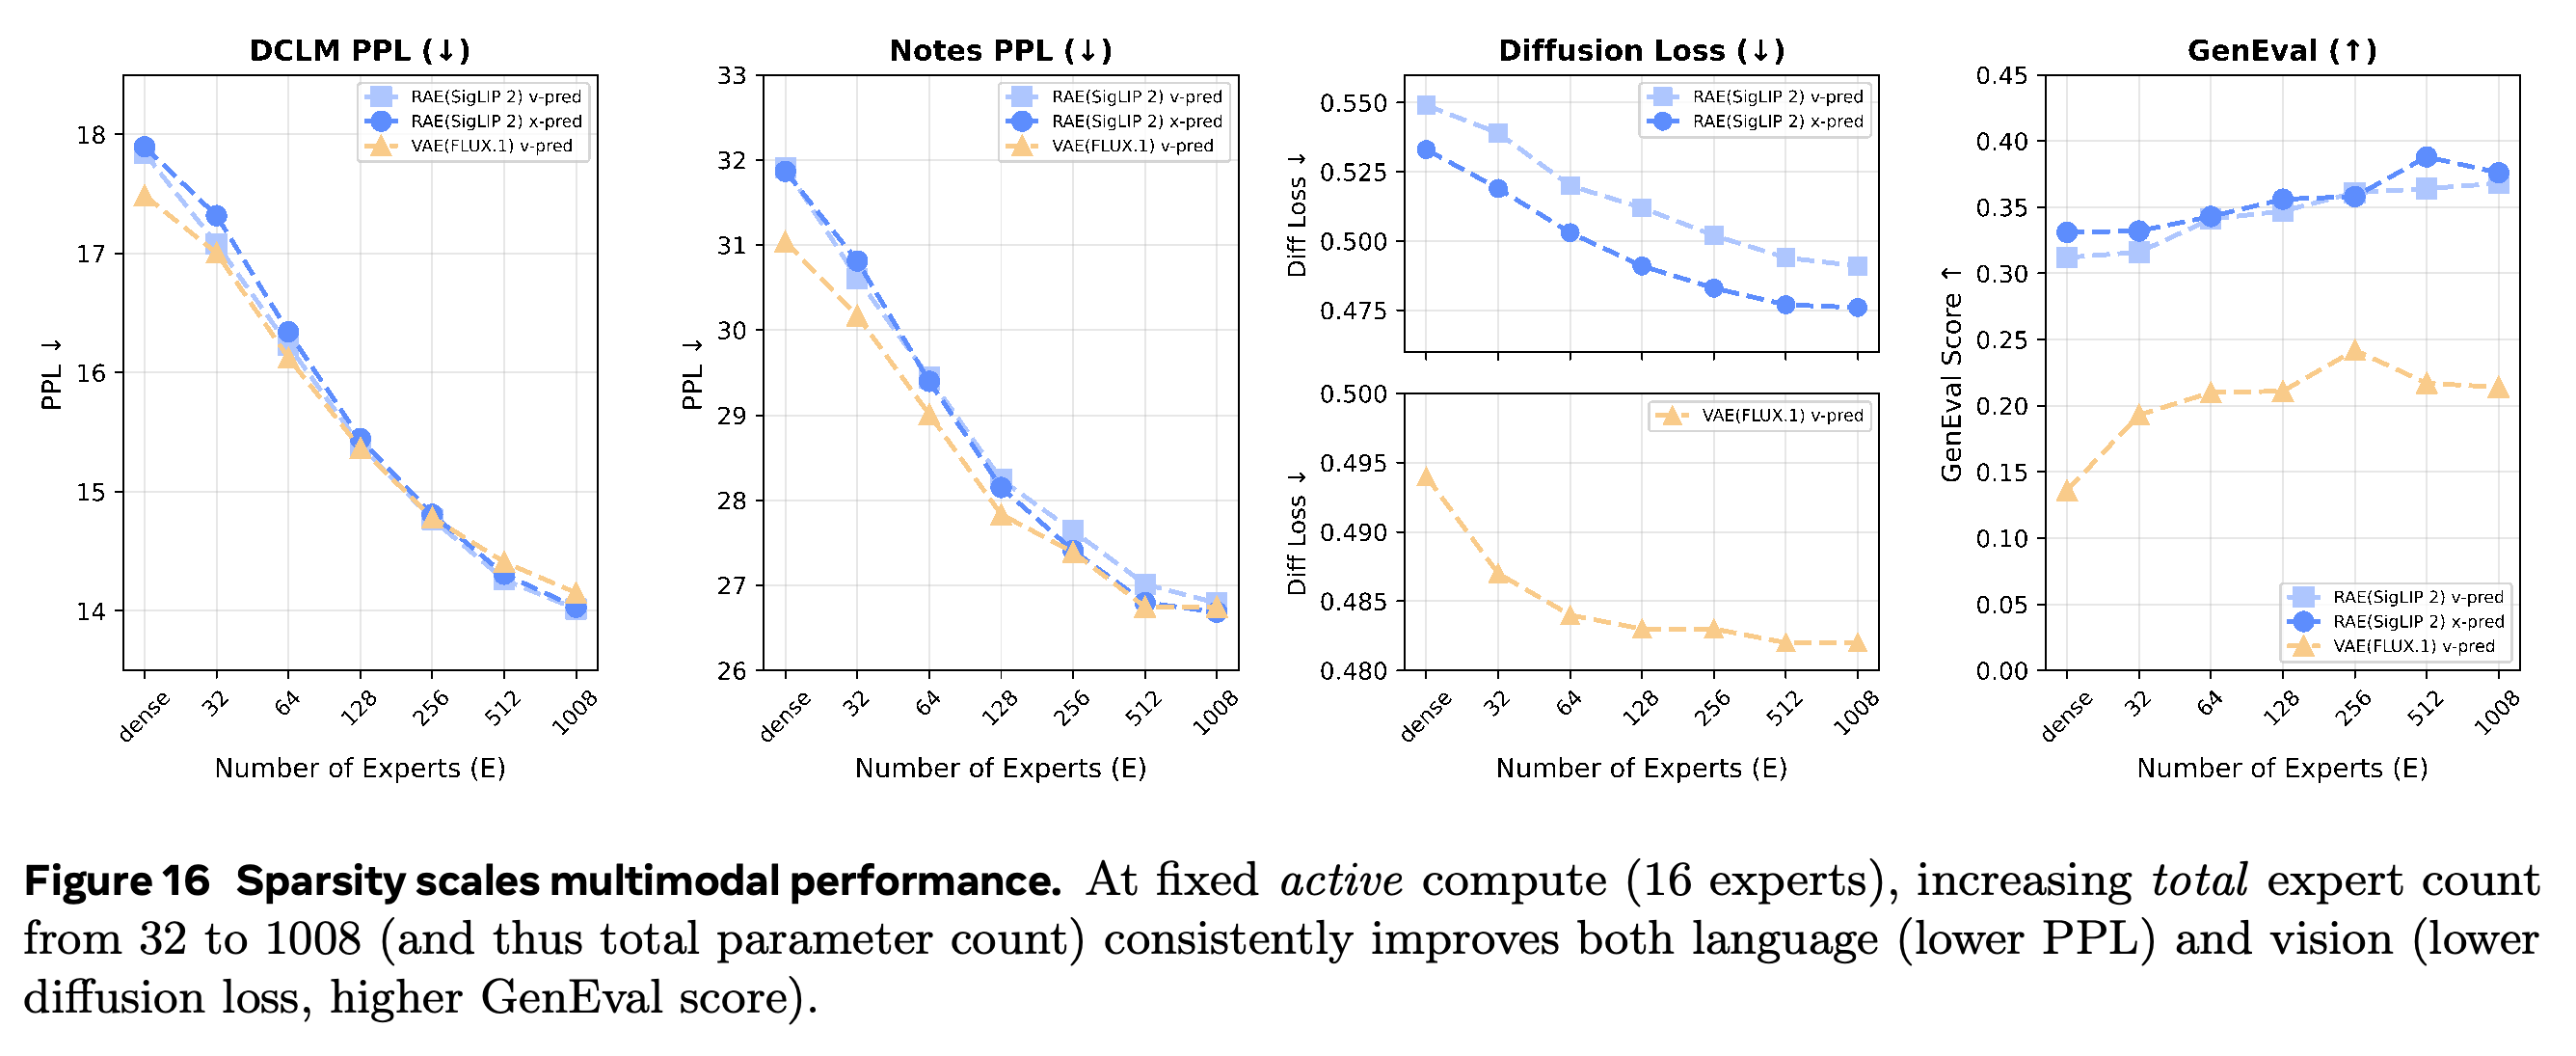
양쪽 인코더 모두 전문가가 많을수록 언어 loss 곡선이 개선된다. FLUX.1 diffusion 곡선은 비슷한 loss로 수렴하지만, SigLIP 2는 전문가 수에 따른 차이를 더 크게 유지한다. 이는 희소 용량의 이점이 표현에 따라 다름을 보여준다.
모달리티별 공유 전문가는 보고된 perplexity와 GenEval이 가장 좋고, diffusion loss는 전역 공유와 같은 0.483이다. 차이는 작으며, 표에는 불확실성 추정치가 없다.
6.2 Emergent Expert Specialization
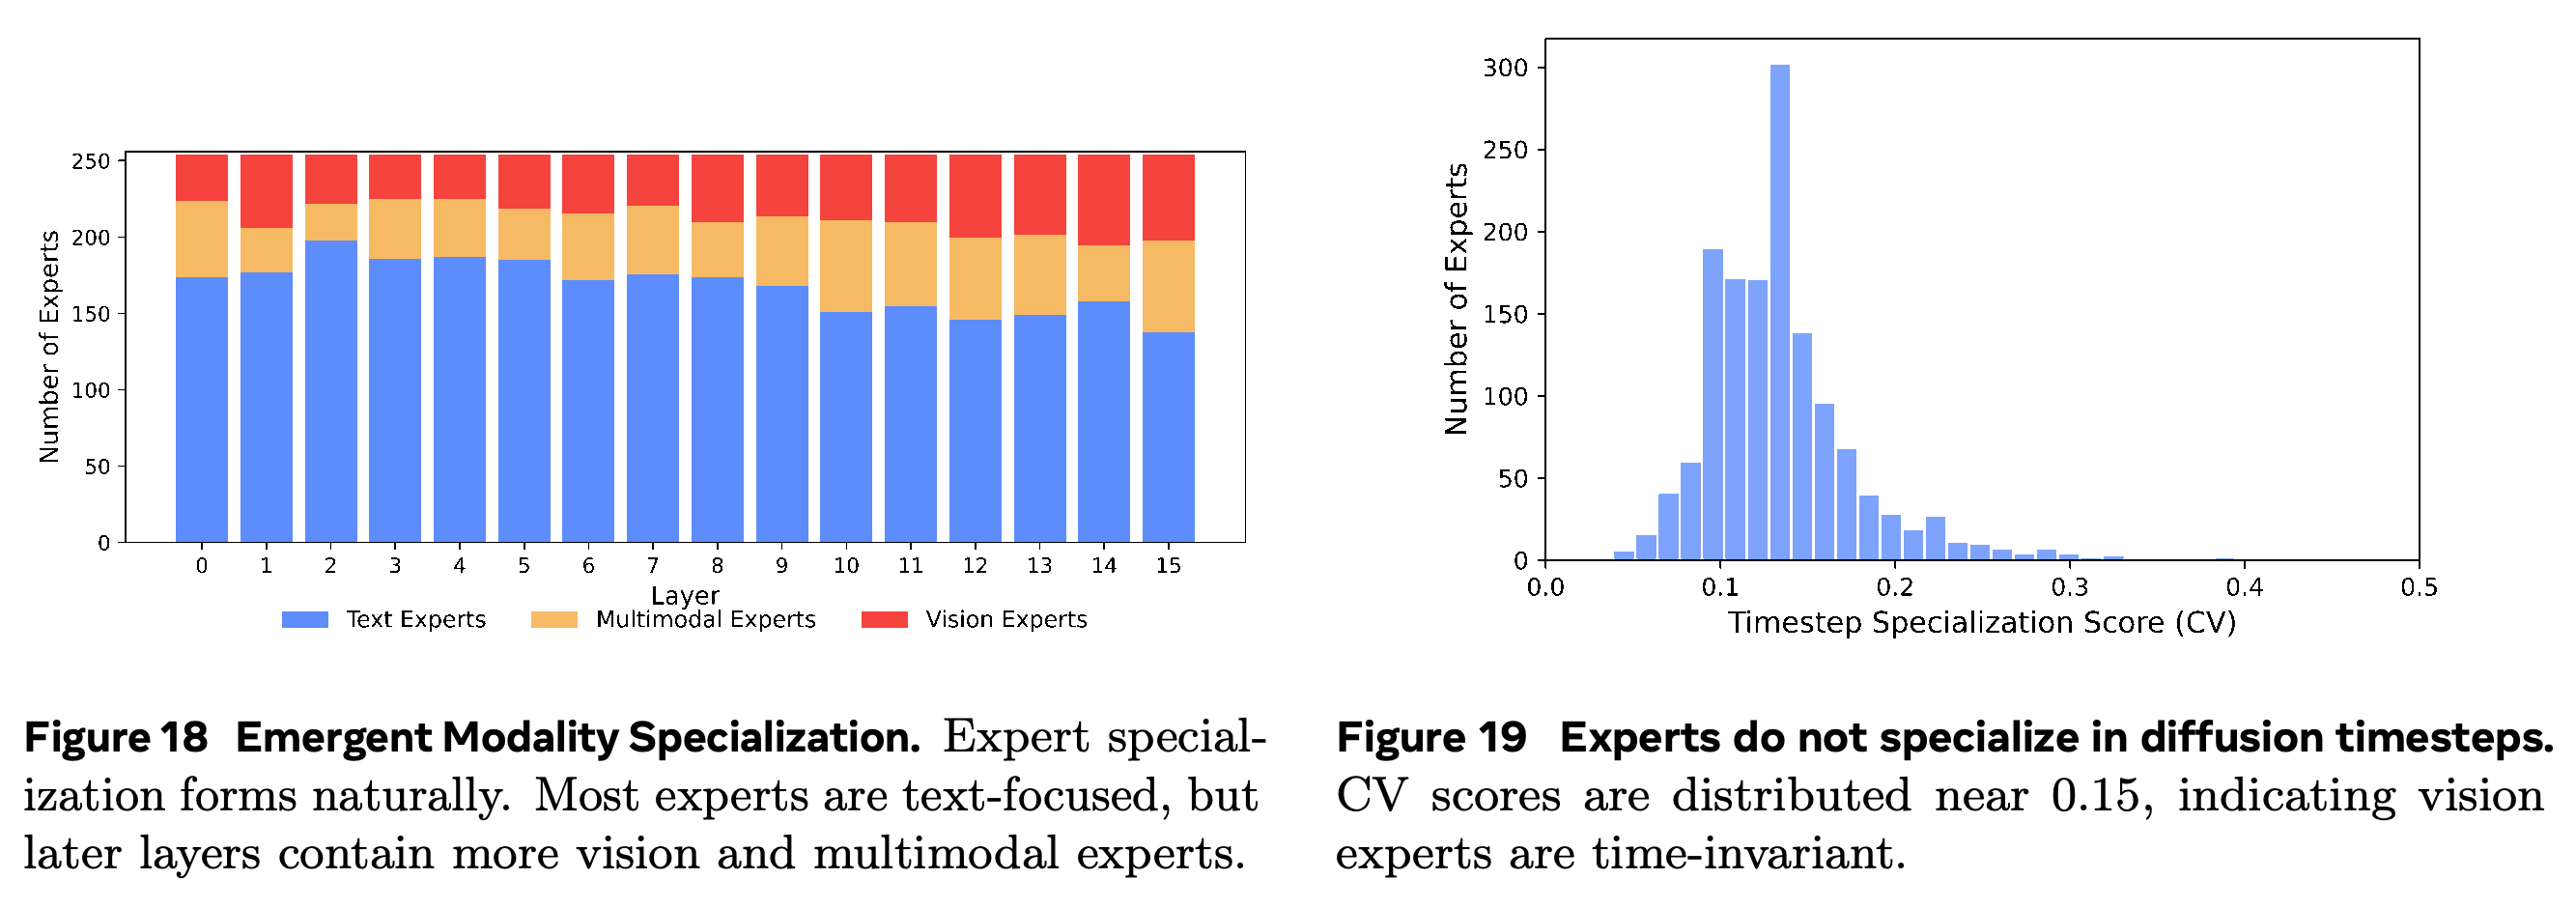
라우팅 분석은 혼합 토큰 1T로 학습한 SigLIP 2, x-pred MoE를 살펴본다. 이 모델은 총 파라미터 약 13.5B, 활성 파라미터 1.5B, G = 16, 전문가 256개를 사용한다. 텍스트를 선호하는 전문가가 우세하며, 후반 층에는 시각 전문가와 멀티모달 전문가가 더 많다.
- 정규화한 선택률 차이로 전문가를 분류한다. 점수가 0.5보다 높으면 텍스트 선호, −0.5보다 낮으면 시각 선호, 그 사이면 멀티모달 사용을 뜻한다.
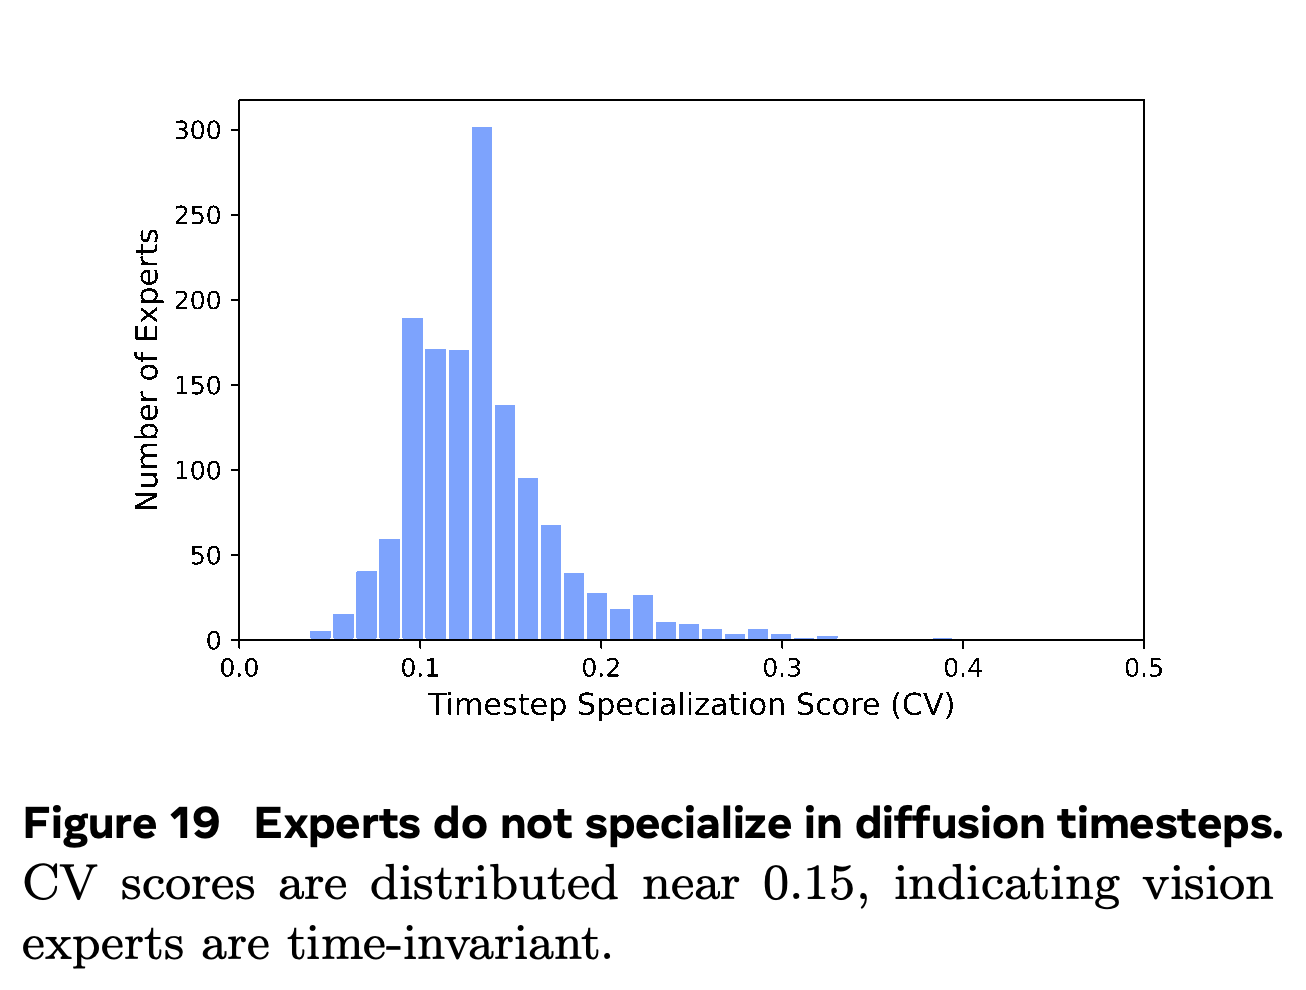
- diffusion timestep을 나눈 10개 구간에서 전문가 선택률의 변동계수 점수는 0.15 부근에 모인다. 이는 엄격한 시간 불변성이 아니라 timestep에 따른 전문화가 제한적임을 시사한다.
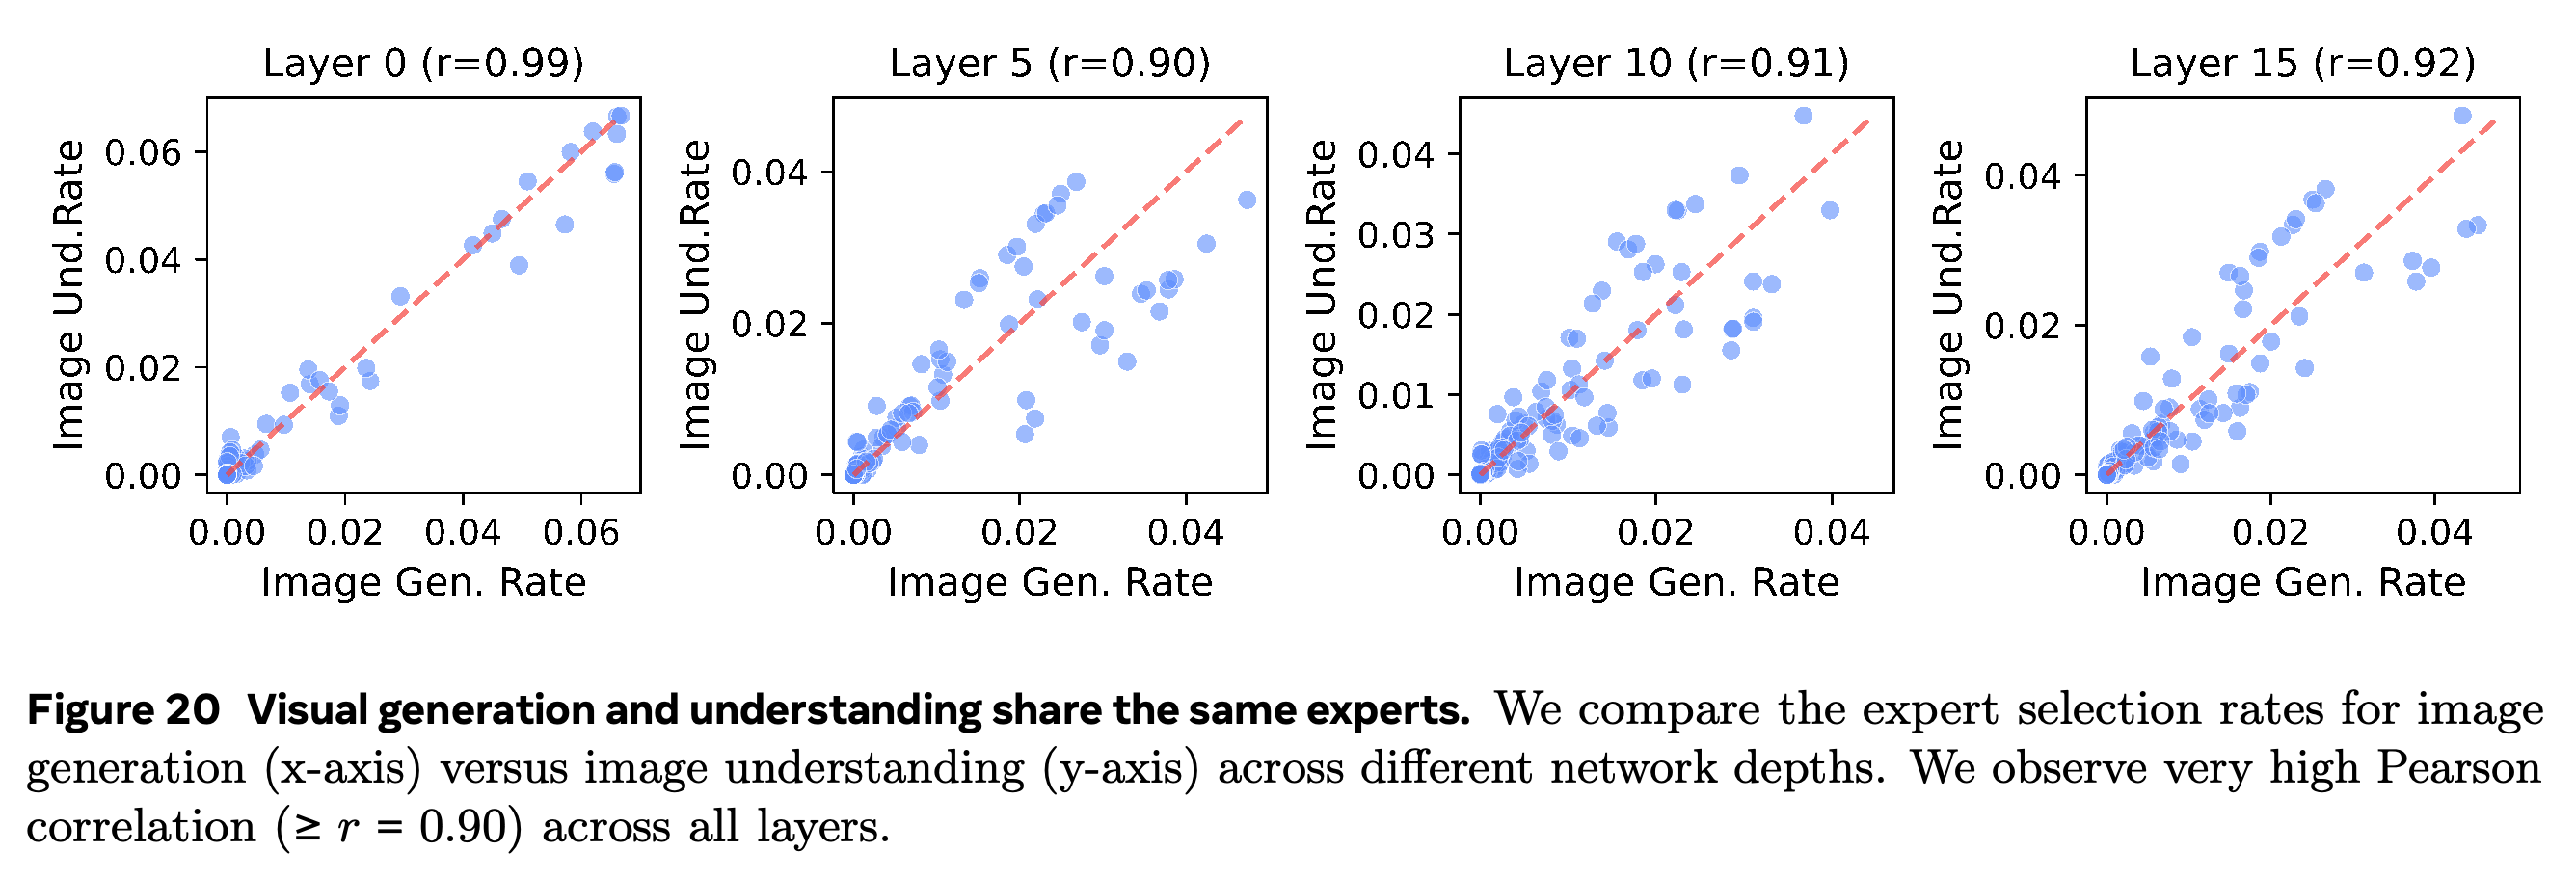
- 생성과 이해의 전문가 선택률은 여러 깊이에서 높은 상관관계를 보인다. Figure 20에서 층 0, 5, 10, 15의 상관계수는 각각 r = 0.99, 0.90, 0.91, 0.92다. 이는 라우팅 패턴을 공유한다는 뜻이며, 모든 전문가가 동일한 인과적 기능을 수행한다는 뜻은 아니다.
표시된 모든 층에서 텍스트를 선호하는 전문가가 가장 큰 범주다. 후반 층은 시각과 멀티모달 사용에 더 큰 비중을 배분한다. 이는 고정된 균등 분할이 아니라 깊이에 따른 라우팅을 보여준다.
대부분의 timestep 전문화 점수는 변동계수 0.15 부근에 모인다. 노이즈 수준에 따른 라우팅 변화는 비교적 작지만, 0이 아닌 점수만으로 정확한 시간 불변성을 입증할 수는 없다.
생성과 이해의 선택률은 대각선 근처에 모이며, 표시된 층의 상관계수는 0.90에서 0.99 사이다. 이는 과제 간에 시각 전문가를 상당히 재사용함을 보여준다.
6.3 Stacking Design Choices
하이퍼파라미터, 데이터, 토큰 수, FLOPs를 맞춘 조건에서 설계를 차례로 바꾸면 Transfusion 기준 모델이 개선된다. 모달리티별 FFN을 적용하면 PPL은 15.93에서 15.13으로, DPG는 0.45에서 0.47로 바뀐다. 이어 SigLIP 2는 PPL 15.06과 DPG 0.57, MoE는 PPL 12.49와 DPG 0.63을 달성한다.
- 단일 SigLIP 2 인코더는 실험한 SigLIP 2/SD-VAE 이중 인코더 구성보다 좋다. 처음부터 학습하는 이 설정에서는 MoE가 학습한 분리 방식도 dense와 Mixture of Transformers(MoT) 대안보다 좋다.
- Figure 21에서 MoE + SigLIP 2를 x-pred로 바꾸면 DPG는 0.65로 개선되지만 PPL은 12.69로 높아진다. 따라서 언어와 생성 사이에 작은 상충 관계가 남는다.
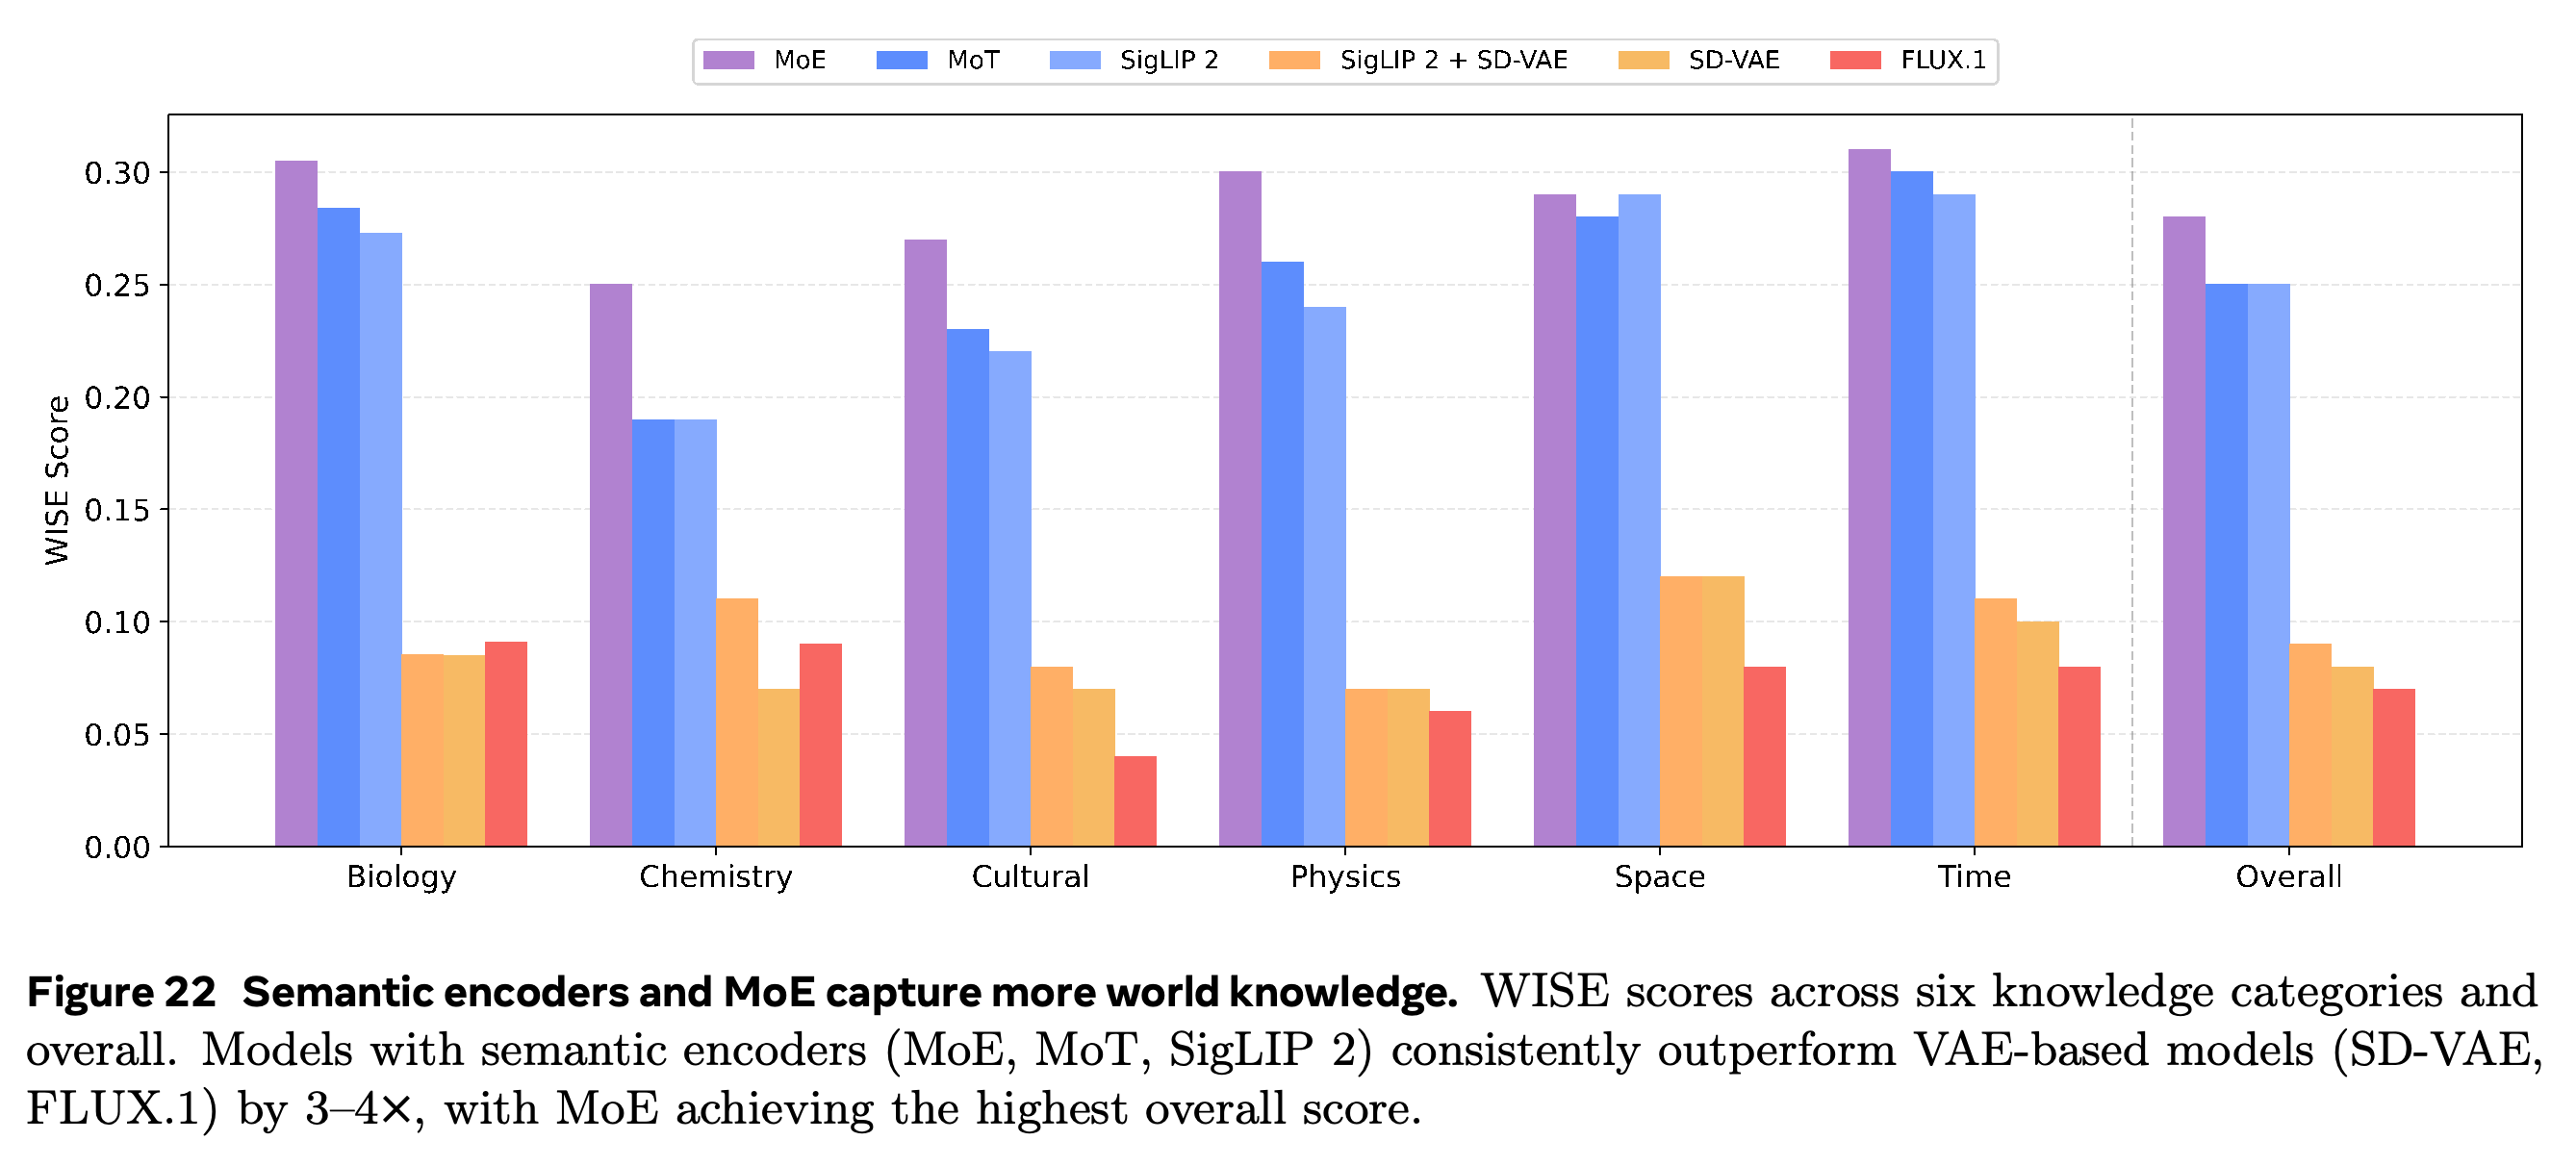
- WISE에서는 의미 인코더 구성이 VAE 기반 구성보다 상당히 좋다. 저자들은 그 차이를 약 3–4배로 요약하며, MoE가 종합 점수에서 가장 높다. 범주별 비율은 다르므로 균일한 배수의 개선이나 물리적 이해의 종합적 척도로 해석해서는 안 된다.
의미 인코더 모델은 표시된 WISE 범주 전반에서 VAE 기반 구성보다 좋으며, 범주별 비율은 다르다. 지식을 활용한 생성의 종합 점수는 MoE가 가장 높다.
7 Scaling Laws for Unified Multimodal Models
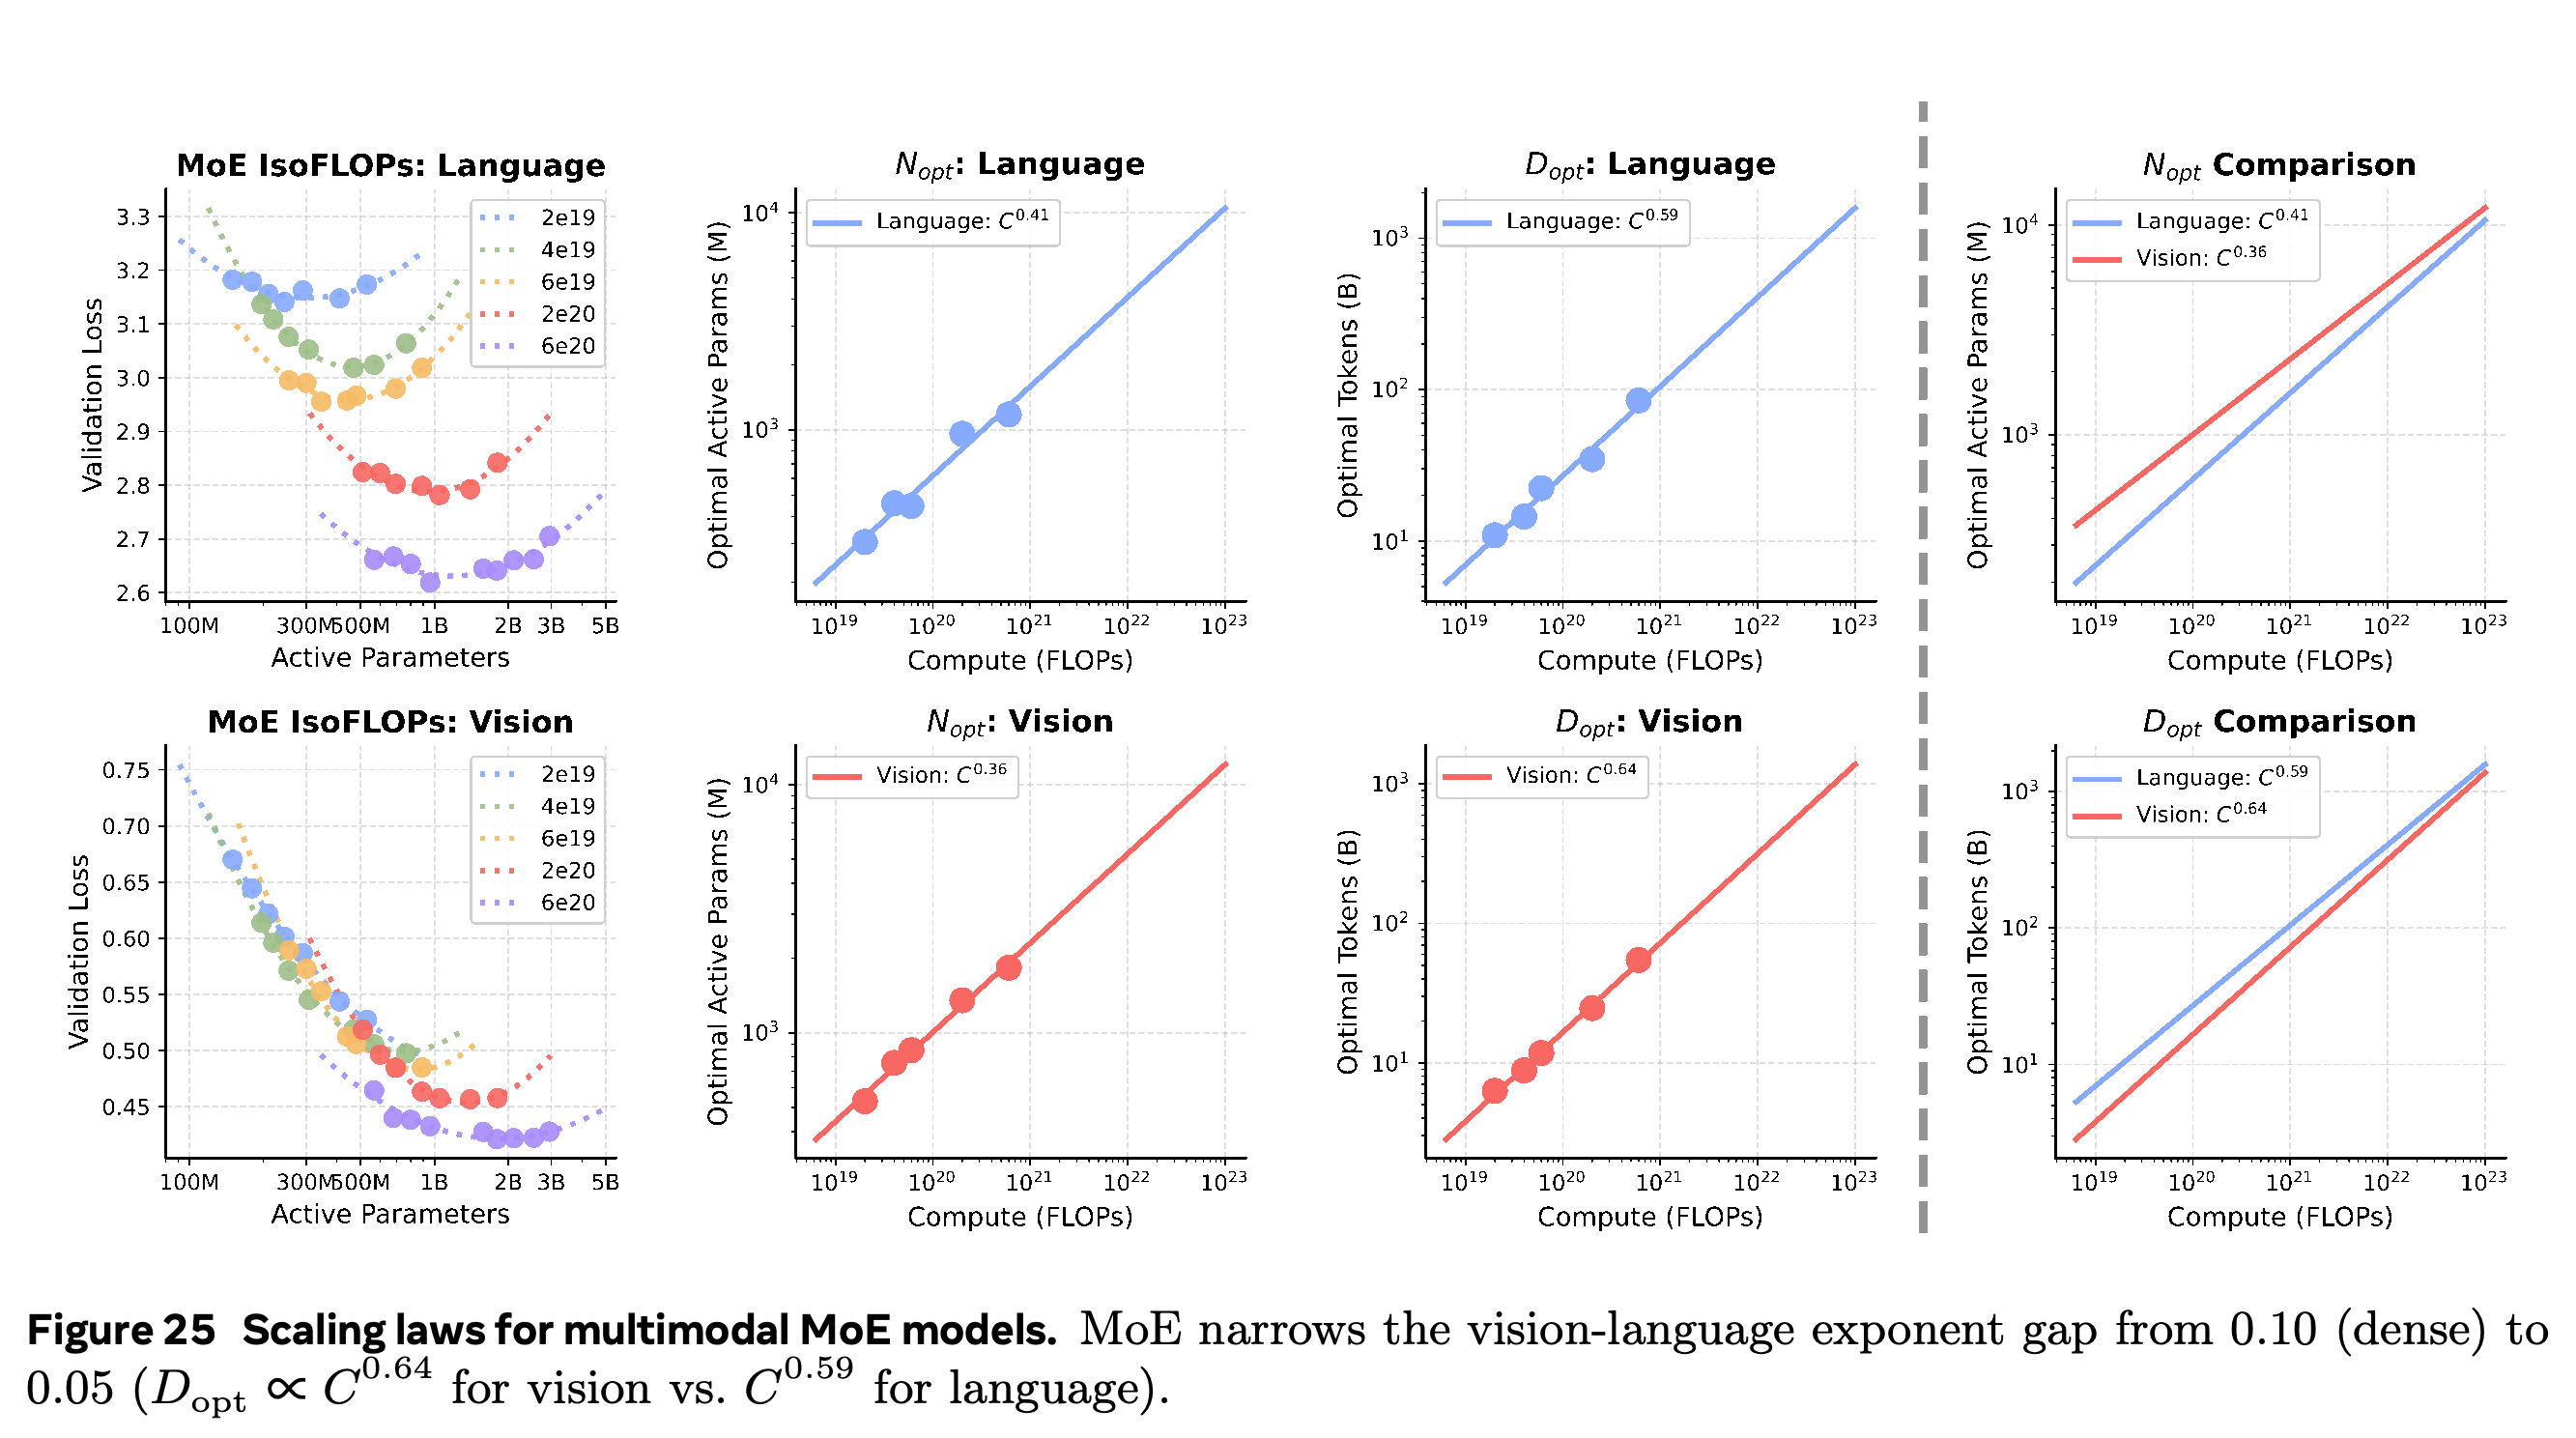
IsoFLOP 분석은 연산량 C를 고정하고 모델 크기 N과 토큰 수 D를 탐색한다. dense 모델에는 6ND ≈ C를 사용하고 MoE에는 활성 파라미터를 사용한다. 로그 파라미터 공간의 포물선 적합으로 loss를 최소화하는 모델 크기를 추정한 뒤, a + b = 1인 N_opt ∝ C^a와 D_opt ∝ C^b를 거듭제곱 법칙으로 적합한다.
- Dense 적합은 6×10^18, 6×10^19, 3×10^20, 6×10^20, 10^21 FLOPs의 연산 예산을 사용한다. 언어는 a ≈ 0.47과 b ≈ 0.53, 시각은 a ≈ 0.37과 b ≈ 0.63을 얻는다.
- 이 적합 결과에서 시각은 언어보다 데이터 집약적이다. 논문은 상대적 데이터 수요 증가를 O(N^0.57)로 외삽한다. 이는 1B 대비 100B 파라미터에서 14배, 1T 파라미터에서 51배에 해당한다.
- 100B- 및 1T-parameter 추정치는 적합된 추세를 외삽한 값이며, 해당 크기로 학습한 모델의 측정값이 아니다.
각 loss의 최솟값은 2개 모달리티에 서로 다른 파라미터·데이터 배분이 필요함을 시사한다. Dense 언어 적합은 거의 균형 잡힌 스케일링을 선호하지만, 시각의 데이터 지수는 0.63으로 언어의 0.53보다 높다. 연장된 적합선은 외삽이다.
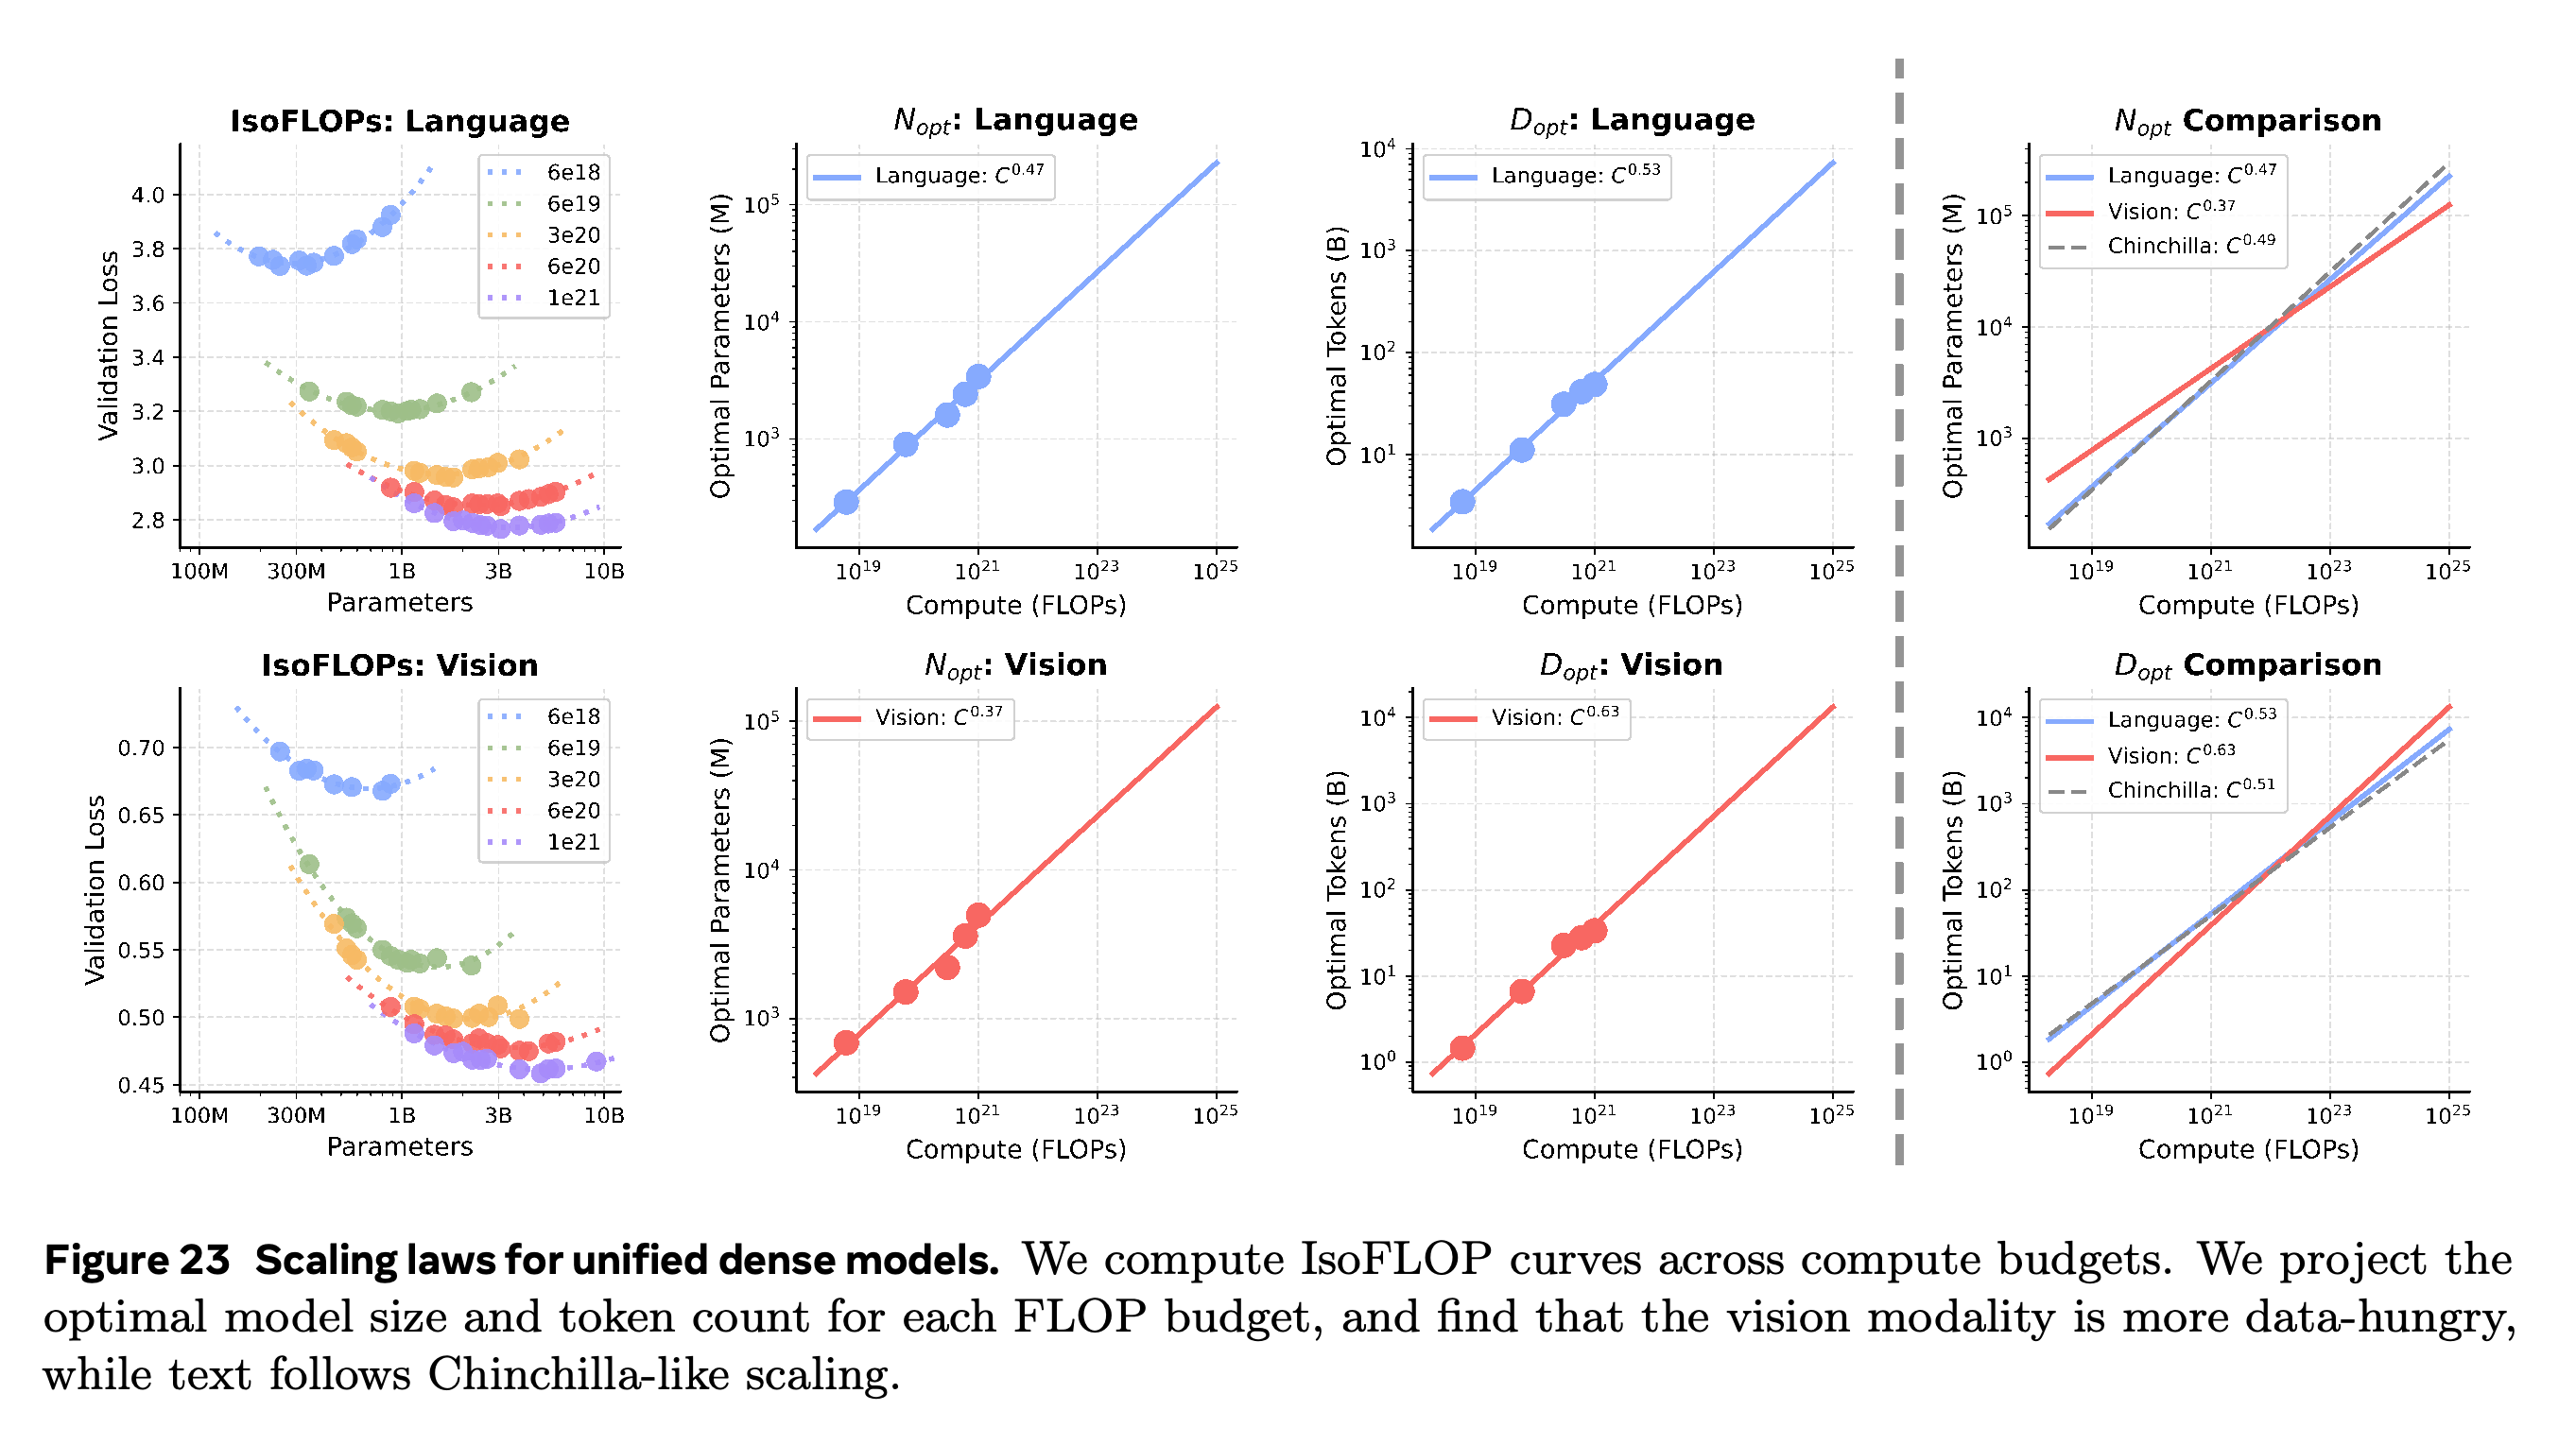
희소성 비율이 16일 때 MoE 적합은 언어에서 a ≈ 0.41, b ≈ 0.59, 시각에서 a ≈ 0.36, b ≈ 0.64를 얻는다. 언어가 더 데이터 집약적인 학습 조건으로 이동하고 시각의 적합 지수는 거의 바뀌지 않으면서 지수 차이가 0.10에서 0.05개로 줄어든다.
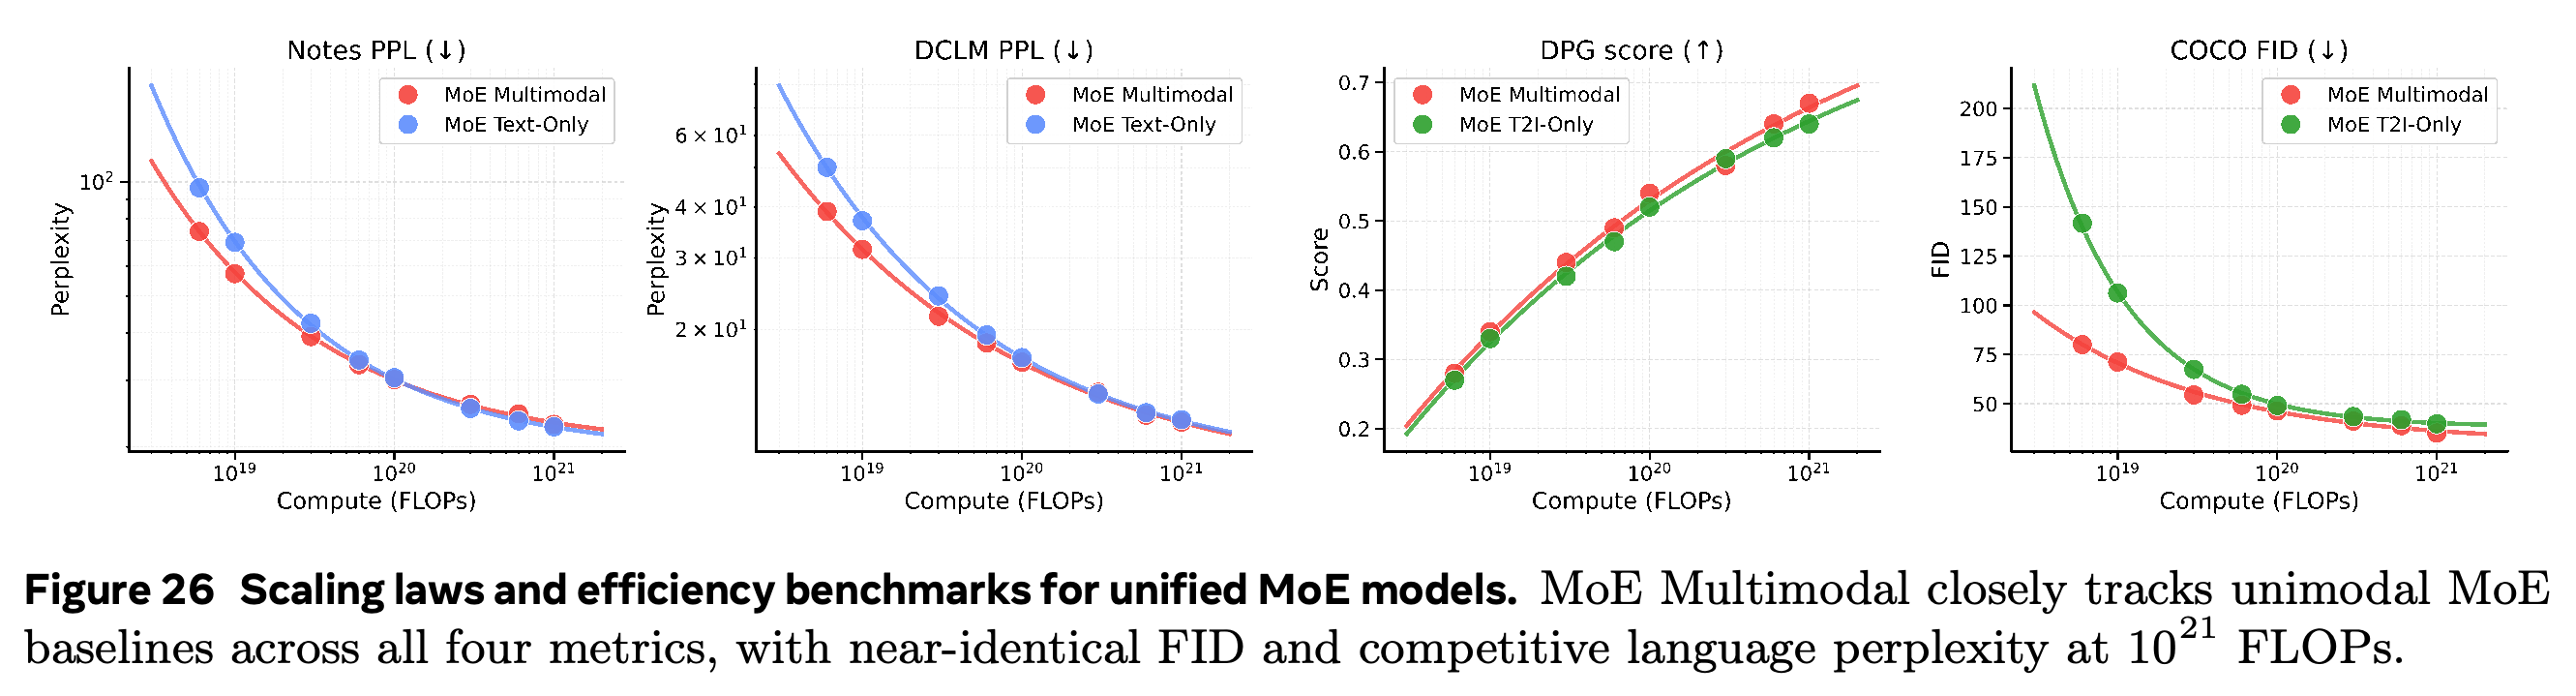
- 효율 곡선은 L(C) = A·C^(−α) + E로 적합하며, E는 로그 공간 MSE를 최소화하도록 격자 탐색으로 선택한다.
- 10^21 FLOPs에서 dense 멀티모달 학습은 텍스트 전용 모델 대비 Notes PPL 23.7 대 23.8, DCLM PPL 13.3 대 13.6을 달성한다. 생성은 T2I-only 모델 대비 DPG 0.622 대 0.598, FID 39.3 대 41.5를 달성한다.
- 10^21 FLOPs에서 멀티모달 MoE는 MoE 텍스트 전용 모델 대비 DCLM PPL 12.3 대 12.0, MoE T2I-only 모델 대비 FID 39.2 대 39.8을 달성한다. 이는 같은 연산량에서 단일 모달리티에 가까운 성능을 뒷받침하지만, 모든 지표에서 더 좋다는 뜻은 아니다.
- 활성 FLOPs를 고정해도 메모리 요구량이나 실제 실행 시간이 같아지는 것은 아니다. Appendix A는 전문가 간 불균등한 토큰 분배를 하드웨어 활용률의 병목으로 지적한다.
같은 연산량에서 dense 멀티모달 언어 곡선은 텍스트 전용 곡선에 가깝게 유지되며, 생성은 대체로 T2I-only보다 좋아진다. 보고된 10^21-FLOP 결과는 공동 학습 효율을 뒷받침하며, 이를 해석하는 데 모든 예산에서 균일한 개선을 전제할 필요는 없다.
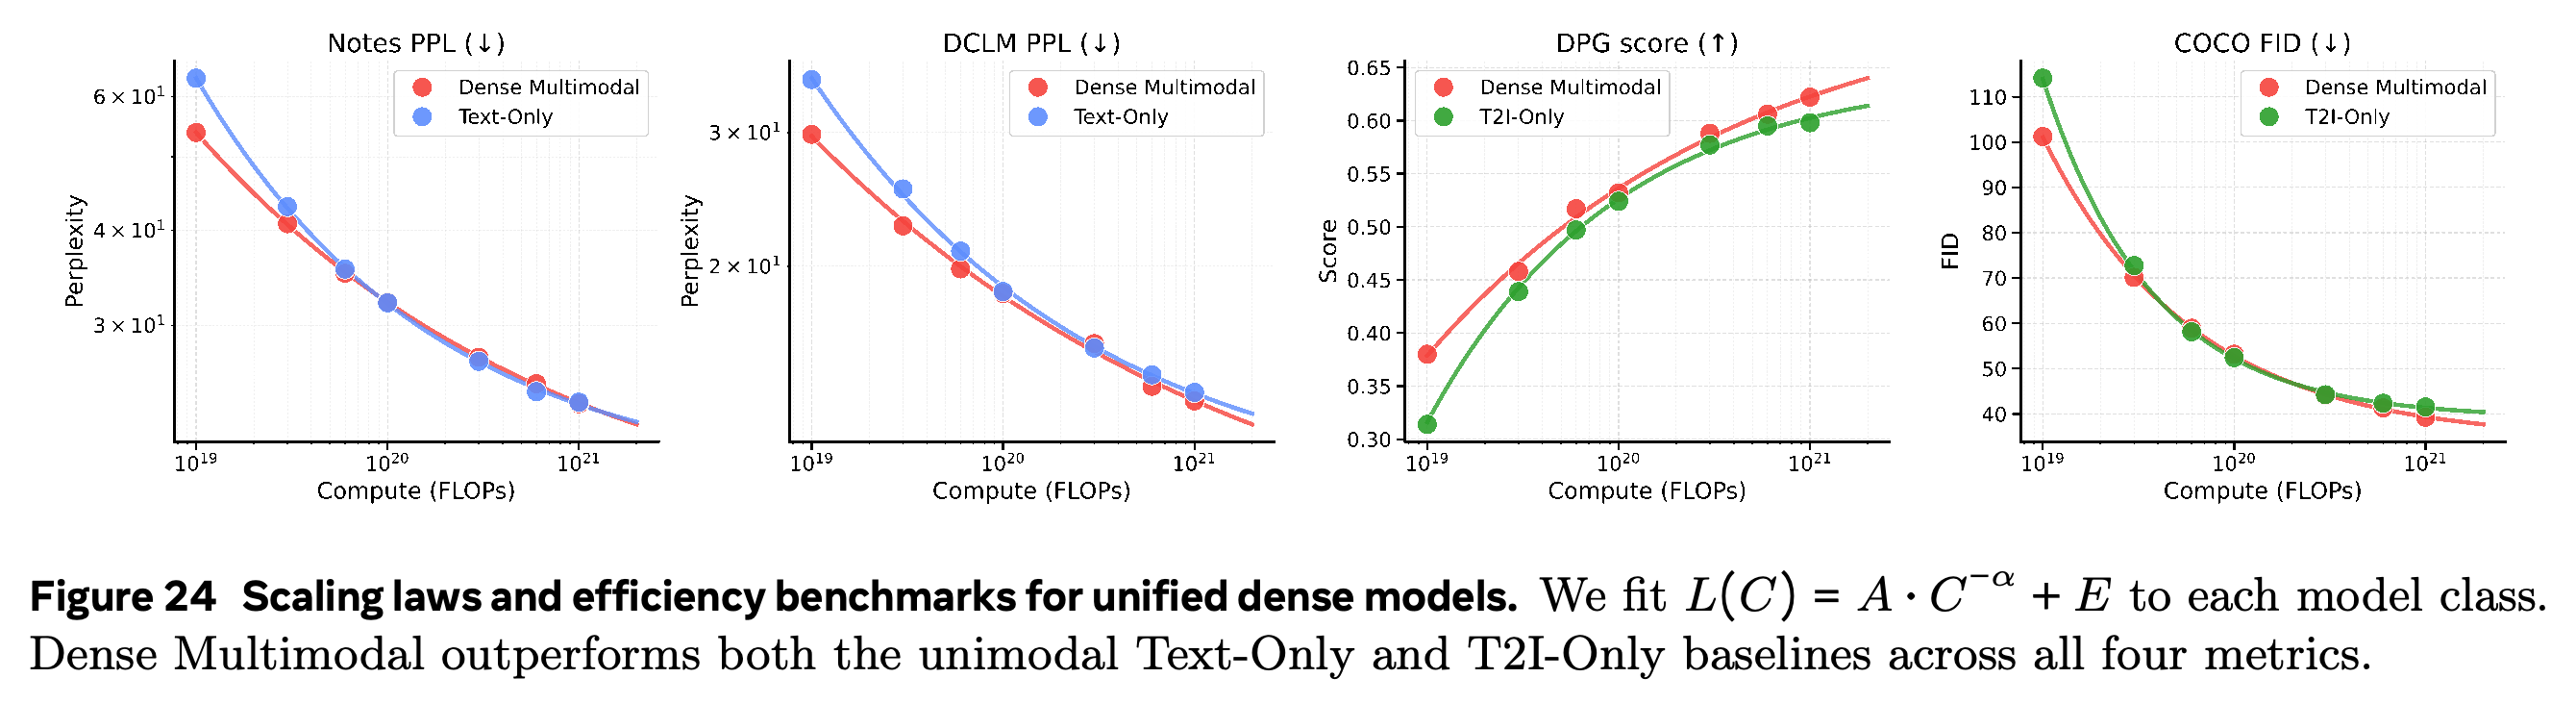
MoE는 적합된 언어 토큰 지수를 0.59로 바꾸어 시각의 0.64에 더 가깝게 만든다. 남은 차이 0.05는 연산 최적 스케일링이 같아진 것이 아니라 부분적으로 정렬되었음을 보여준다.
통합 MoE 곡선은 단일 모달리티 비교 곡선을 가깝게 따른다. 10^21 FLOPs에서 멀티모달 DCLM PPL은 12.3 대 12.0으로 조금 나쁘지만, FID는 39.2 대 39.8로 조금 좋다.
8 Related Work
논문은 네이티브 멀티모달 사전학습과 사전학습 언어 모델의 적응을 구분하고, 이해 전용 모델과 텍스트·이미지를 모두 생성하는 모델을 구분한다. 기여는 새로운 통합 모델링 목적함수가 아니라 Transfusion 설계 공간을 통제해 연구한 데 있다.
- 아키텍처 비교는 공유 Transformer, 모달리티별 FFN, 더 깊은 MoT 분리, 학습된 MoE 라우팅을 연결한다.
- 표현 연구는 의미 잠재 공간이 diffusion을 지원한다는 기존 연구를 확장한다. 내비게이션 실험은 일반 멀티모달 사전학습과 행동 조건부 월드 모델링을 연결한다.
- 스케일링 분석은 Chinchilla 방식의 파라미터·데이터 상충 관계를 1개 생성 모델 안의 별도 언어·시각 loss로 확장한다.
9 Discussion
논의에서는 캡션 분포 변화와 경직된 용량 배분을 모달리티 경쟁의 잠재적 원인으로 제시한다. 실험한 사전학습 조건에서는 단일 의미 표현, 다양한 데이터, 학습된 희소 라우팅이 유리하지만, 언어 성능 저하의 원인을 완전히 분리하지는 못한다.
- 저자들은 의미 인코더가 세밀한 복원 정보를 잃을 수 있고, 멀티모달 학습이 분포 밖 텍스트 일반화를 소폭 악화시킬 수 있으며, MoE 설계 탐색이 충분하지 않음을 인정한다.
- 내비게이션 계획과 선택된 언어 조건부 rollout은 시각 상태 예측으로의 전이를 보여준다. 물리적 추론과 미래 네이티브 멀티모달 시스템에 관한 더 넓은 주장은 직접적인 실험 결과가 아니라 해석에 해당한다.
부록
- A Limitations and Future Work: 부록은 방법론, 추가 분석, 구현 세부 사항, 월드 모델 예시, 데이터 문서로 본 실험을 보충한다. 이 연구는 interleaved 학습 데이터를 제외하고 강화학습 후속 학습을 조사하지 않는다. 불균등한 전문가 부하는 하드웨어 활용률의 한계로 남으므로, 희소 활성 연산의 이점과 실제 시스템 효율을 구분해야 한다.
- B Extended Methodology: Unified Multimodal Mechanics: 각 이미지나 비디오 프레임을 <BOI>와 <EOI>로 감싸고, 블록 간에는 causal attention을, 프레임 안에서는 bidirectional attention을 사용한다. 학습 중 이미지 뒤의 텍스트는 노이즈가 있는 시각 잠재 표현을 조건으로 사용하며, 모달리티별 출력 head는 한 번의 forward-backward pass에서 2개 loss를 계산한다. 추론 중 <BOI>를 샘플링하면 텍스트 생성을 중단하고 노이즈가 있는 시각 토큰을 삽입한다. 이어 25-step denoising을 수행하고 <EOI>를 붙인 뒤 자기회귀 텍스트 생성을 재개한다.
- C Shared vs. Modality-Specific FFNs: 약 1T-token 비교는 활성 연산량을 일정하게 유지하면서 별도 시각·언어 FFN으로 총 파라미터 수를 늘린다. 이는 기본 용량 분리 설계를 뒷받침하지만, 총 파라미터 수가 같은 모델끼리의 비교는 아니다.
- D Additional Results and Exploration: D.1 Layer-wise Performance는 SigLIP 2의 ImageNet 정확도가 층 0의 12.8%에서 층 26의 86.3%로 높아지는 반면, 복원 PSNR은 29.6 dB에서 20.9 dB로 낮아진다고 보고한다. 학습된 Transformer는 인코더의 의미적 품질을 대체로 유지한다. D.2 Loss Centering은 EMA로 구한 공유 loss 중심과 적응형 모달리티별 가중치를 사용한다. SigLIP 2의 DPG는 0.570에서 0.612로 높아지지만 PPL도 15.06에서 15.36으로 높아진다. D.3 Text Performance on Data Composition Studies는 텍스트 예산을 고정하고 시각 데이터를 추가할 때 DCLM이 소폭 개선되고 Notes는 소폭 악화됨을 보여준다.
- E Implementation Details: E.1과 E.2는 선형 투영, 기본 loss 가중치 1.0과 3.0, 시퀀스 길이 4096, GPU 128개, GPU당 batch size 4, AdamW 최대 LR 3×10^−4, warmup 1000 steps, 최대 LR의 5%까지 줄이는 cosine decay를 명시한다. E.3은 자기회귀 텍스트 추론, 25-step Euler 시각 샘플링, CFG 3.0, 사전학습 디코더를 명시한다. E.4는 모든 인코더를 시각 토큰 256개로 표준화하며, VAE 격자에는 PixelUnshuffle(2)와 PixelShuffle(2)를 사용한다. E.5는 DCLM/SSTK 토큰 예산 격자를 문서화한다. E.6은 최대 LR 1×10^−5로 1-epoch VQA 미세조정을 수행한다. E.7은 NVIDIA H200 GPU 64개에서 수행한 MoE 스윕을 설명하며, 총 파라미터는 2.30B에서 51.46B로, 활성 파라미터는 1.50B에서 1.53B로 늘어난다. E.8은 1T-token 모델의 정규화된 라우팅 점수와 생성·이해 상관관계를 문서화한다.
- F World Modeling: F.1 Implementation Details는 CEM 계획, RECON 평가, WASD 변위 튜플, H100 GPU 128개에서 수행한 200B-token 데이터 비율 연구를 명시한다. 기본 혼합은 텍스트에 25%, 비디오에 25%를 배분하고, 나머지 멀티모달 배분 안에서 내비게이션 데이터 비중을 바꾼다. F.2 More Navigation Examples는 언어 조건부 rollout과 같은 문맥에서 시작하는 반사실적 궤적을 제시한다. 자연어 행동 수행을 정량적으로 평가하지는 않지만 정성적 근거를 확장한다.
- G Data: G.1 Data Sources는 데이터셋과 지도 형식을 열거한다. G.2 MetaCLIP Recaption은 vLLM을 통해 Qwen2.5-VL-32B-Instruct를 사용하며, 8-way tensor parallelism, temperature 0.6, top-p 0.95, 최대 생성 토큰 128개를 적용한다. Recaptioning Prompt는 구체적이고 정보 밀도가 높은 1–2문장 캡션을 요청한다. G.3 Video Action Annotations는 모델이 생성하고 자체 검증한 약 12M개 주석을 설명하며, 각 주석에는 1–4개 문맥 프레임과 1–4개 결과 프레임이 포함된다. G.4 Cosine Distance Computation은 Qwen3-Embedding-8B로 100K-sample을 최대 2000자로 잘라 수행한 중심점 분석을 문서화한다.
짧은 생각
가장 큰 기여는 표현, 데이터, 라우팅의 효과를 통제해 분리한 데 있으며, 같은 연산량의 단일 모달리티 비교가 이를 뒷받침한다. 결과는 RAE 방식의 의미 잠재 표현과 세분화된 MoE가 유리함을 보여준다. 다만 사전학습 시각 구성요소, 소폭의 OOD 언어 성능 손실, 표현별 예외, 제한적인 내비게이션 평가를 전제로 해석해야 한다. 스케일링 결과는 배분 불일치가 줄었음을 정량화하지만 지수 차이 0.05가 남는다. 대형 모델의 데이터 수요 추정치는 여전히 외삽이다. 1% 내비게이션 결과는 실험한 혼합 안에서 데이터 효율적인 정렬이 가능함을 보여주며, 도메인 데이터 없이 능력을 습득했다는 뜻은 아니다. 일반적인 물리적 이해를 입증하려면 궤적 오차와 선택된 rollout 이상의 근거가 필요하다.