


Scaling Embeddings Outperforms Scaling Experts in Language Models 요약 설명
29 Jan 2026 | Paper Review N-gram Embeddings Mixture-of-Experts Scaling Laws목차
- 요약
- 1 Introduction
- 2 N-gram Embedding Layer
- 3 Comparative Analysis of Expert and Embedding Scaling
- 4 Efficient Inference
- 5 Integration with Per-Layer Embedding
- 6 LongCat-Flash-Lite
- 7 Conclusions
- 부록
- 짧은 생각
이번 글에서는 Scaling Embeddings Outperforms Scaling Experts in Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 29일(Arxiv)
- Liu, Hong, Zhang, Jiaqi, Wang, Chao, Hu, Xing, Lyu, Linkun, Sun, Jiaqi, Yang, Xurui, Wang, Bo, Li, Fengcun, Qian, Yulei, et al.
- Meituan LongCat Team
- 논문 링크
요약
- 이 논문은 희소 파라미터 용량을 MoE expert 추가 대신 N-gram Embedding에 배분해야 하는 조건을 연구한다. 파라미터 수를 맞춘 실험에서는 expert 확장의 이득이 감소하는 구간에서 임베딩이 유리하다. 다만 희소성이 낮거나 임베딩에 지나치게 많은 파라미터를 배분하면 이러한 이점이 나타나지 않는다.
- 활성 파라미터가 280M, 790M, 1.3B인 모델의 학습 토큰 수를 300B로 설정하고 중국어와 영어 검증 손실을 평가한다. 모델 폭이 커질수록 임베딩의 이점이 커지고, 깊이가 커지면 줄어든다. 어휘 크기, 여러 해시 sub-table, Embedding Amplification도 결과에 영향을 준다.
- LongCat-Flash-Lite는 이 결과를 68.5B-parameter 모델에 적용한다. N-gram Embedding 파라미터는 31.4B이며, 토큰당 활성 파라미터는 2.9B–4.5B다. 1.3T 토큰 시점에서 파라미터 수가 같은 expert-only baseline보다 base model 벤치마크 11개 중 9개에서 높은 성능을 보인다. Chat model은 보고된 agentic 비교에서는 앞서지만, 일반 분야와 수학 비교에서는 앞서지 못한다.
1 Introduction
MoE 확장은 전체 용량과 토큰당 연산량을 분리하지만, expert 수를 늘릴수록 성능 이득이 줄고 통신 오버헤드와 메모리 대역폭 부담이 커진다. 이 보고서는 임베딩을 또 다른 희소 확장 방식으로 검토하며, 용량 배분, 아키텍처 제약, 대안적인 임베딩 구조, 디코딩 효율을 분석한다.
- 임베딩 조회의 인덱싱 복잡도는 테이블 크기에 대해 O(1)이다. 다만 전체 N-gram Embedding 분기에는 해싱, 투영, 통신도 필요하다.
- 주된 기여는 N-gram Embedding 자체의 도입이 아니라, 기존 N-gram Embedding 설계를 활용한 확장 방식 비교와 시스템 연구에 있다.
2 N-gram Embedding Layer
N-gram Embedding은 각 토큰에서 끝나는 국소 시퀀스를 해싱한 표현으로 해당 토큰의 표현을 보강한다. Figure 1은 최종 Over-Encoding 설계를 보여준다. 각 n-gram 차수에는 어휘 크기가 서로 다른 K개의 sub-table이 있으며, 그 출력을 모델의 은닉 차원으로 투영한 뒤 기본 임베딩과 평균한다.
- Equation (1)은 e_i = (1/N)(E_0(t_i) + ∑_{n=2}^{N} E_n(H_n(t_{i−n+1}, …, t_i)))이며, j ≤ 0이면 t_j = 0으로 둔다.
- Equation (2)는 다항식 rolling hash를 사용하며, H_n(t_{i−n+1}, …, t_i) = (∑_{j=0}^{n−1} t_{i−j} V_0^j) % V_n으로 계산한다.
- Equation (3)은 e_i = (E_0(t_i) + ∑_{n=2}^{N}∑_{k=1}^{K} W_{n,k}E_{n,k}(H_{n,k}(t_{i−n+1}, …, t_i)))/((N−1)K+1)이다. 각 sub-table의 폭은 D/((N−1)K)이며, 제시된 크기 설계에서는 N과 K가 바뀌어도 임베딩 파라미터 예산이 유지된다.
3 Comparative Analysis of Expert and Embedding Scaling
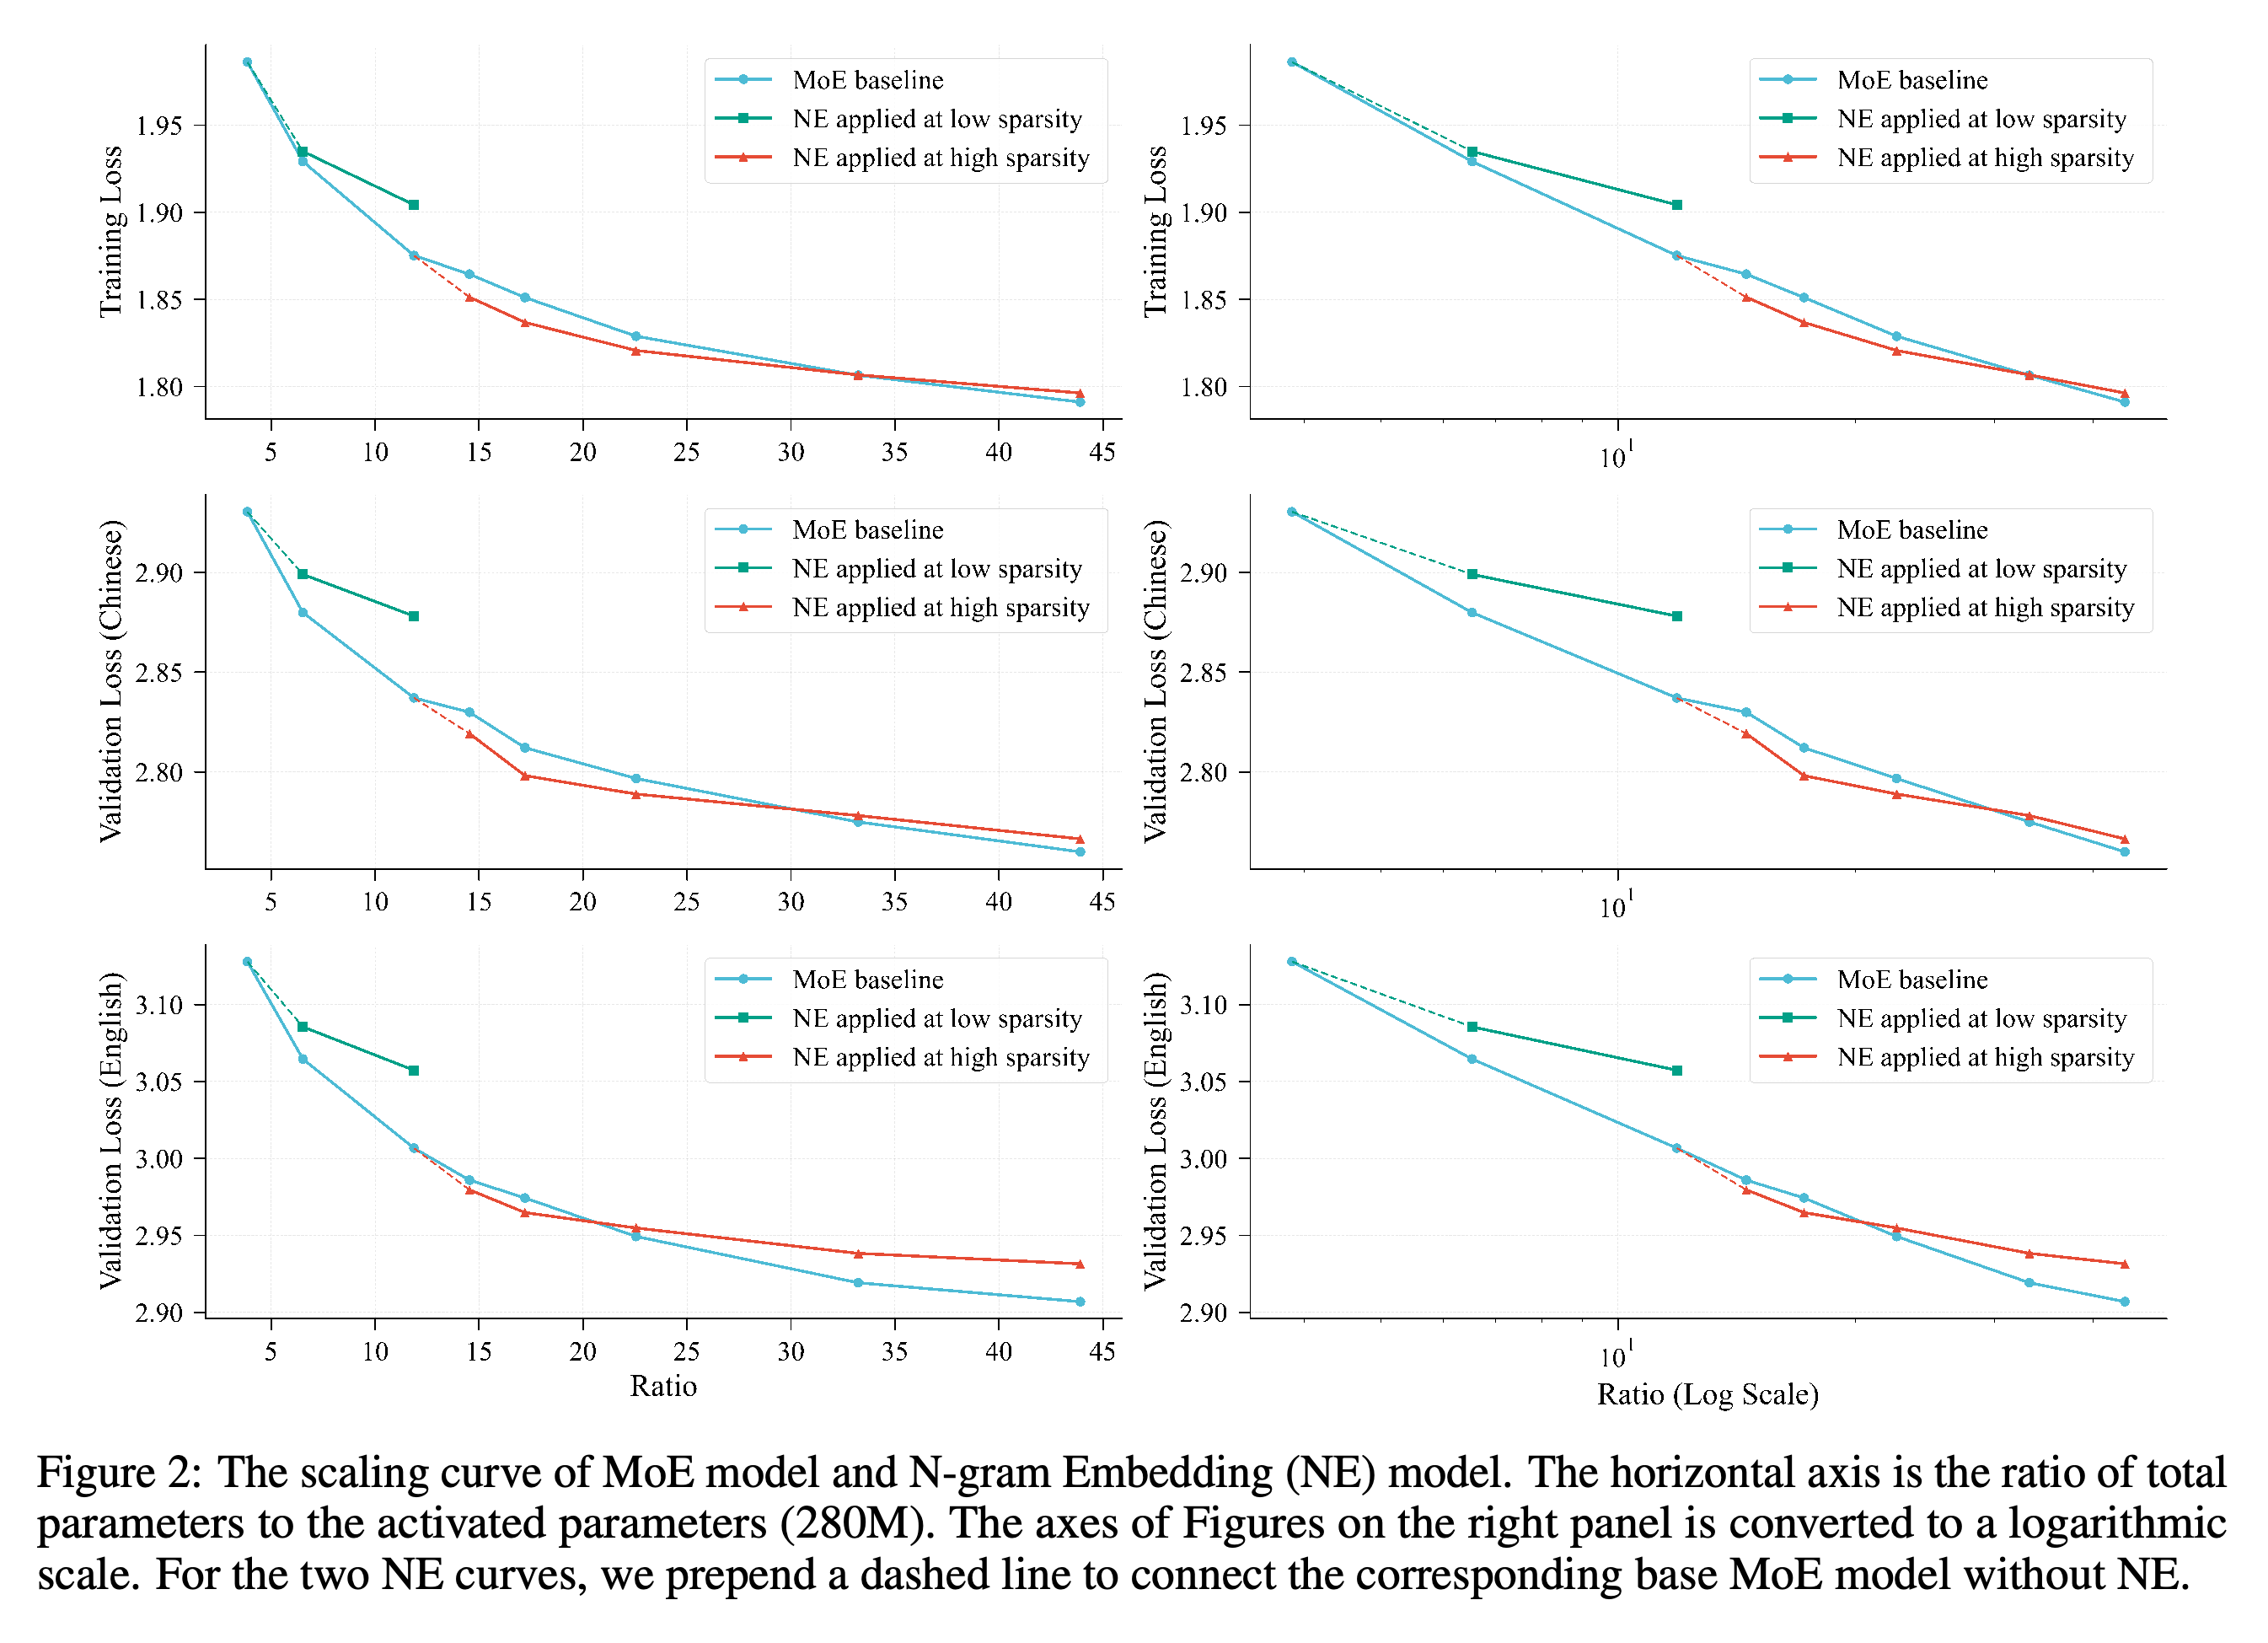
확장 실험에서는 Longcat-Flash 아키텍처에 N-gram Embedding을 통합하고, 활성 파라미터가 280M, 790M, 1.3B인 모델을 처음부터 학습한다. 기본 MoE의 희소성은 35%에서 98%까지다. 임베딩을 추가한 각 설정은 총 파라미터 수가 같은 expert 확장 baseline과 비교한다.
- 모든 설정을 300B 토큰으로 학습하고, 학습 손실과 중국어 및 영어 검증 손실을 각각 비교한다.
- 가로축의 확장 변수는 총 파라미터 수를 활성 파라미터 수로 나눈 비율이며, 희소성의 대리 지표로 사용한다.
3.1 Optimal Timing for N-gram Embedding Integration
Figure 2에서는 희소성이 낮은 기본 모델에 임베딩을 추가하는 방법이 expert를 추가하는 방법보다 효과가 낮다. 기본 MoE의 활성 파라미터 대비 총 파라미터 비율이 이미 높으면, 임베딩 확장이 초기에 손실을 더 효율적으로 낮춘다. 따라서 저자들은 expert 수가 경험적으로 확인한 “sweet spot”을 넘은 뒤 임베딩을 도입할 것을 권장한다.
- Expert-only 곡선은 비율을 로그로 표시한 축에서 대략 선형이다. 이는 같은 크기의 손실 감소를 얻으려면 추가하는 파라미터의 절대량이 점점 커져야 함을 나타낸다.
- 여기서 “Timing”은 학습 도중 개입하는 시점이 아니라, 임베딩 용량을 도입할 아키텍처의 희소성 구간을 뜻한다.
활성 파라미터 280M에서 낮은 희소성으로 시작한 임베딩 곡선은 expert 확장보다 계속 나쁘다. 더 높은 희소성의 기본 모델에서 시작하면 초기에는 손실이 더 낮지만, 임베딩 배분이 커지면 이점이 사라진다. 영어 검증의 교차점은 학습 및 중국어 검증의 교차점보다 이르므로, 본문에서 언급한 비율 20 근처의 교차점은 지표 3개에 공통으로 적용되지 않는다.
3.2 Integration Strategy
3.2.1 Parameter Budgeting for N-gram Embeddings: 임베딩의 비중을 늘리면 결국 파라미터 수가 같은 MoE에 대한 이점이 줄어든다. 저자들은 Figure 2를 근거로 총 파라미터의 50% 이하를 N-gram Embedding에 배분할 것을 권장한다.
- 본문은 교차점을 20을 약간 넘는 비율 및 기본 MoE 비율 12와 연결한다. 그러나 Figure 2에서 학습 손실, 중국어 검증 손실, 영어 검증 손실의 교차점은 서로 다르므로, 제시된 비율을 공통으로 측정된 임계값으로 해석해서는 안 된다.
- 50% 한도는 경험적인 예산 배분 지침이며 보편적인 최적값이 아니다. 이후의 모델 폭 실험에서는 유리한 구간이 아키텍처와 평가 언어에 따라 달라진다.
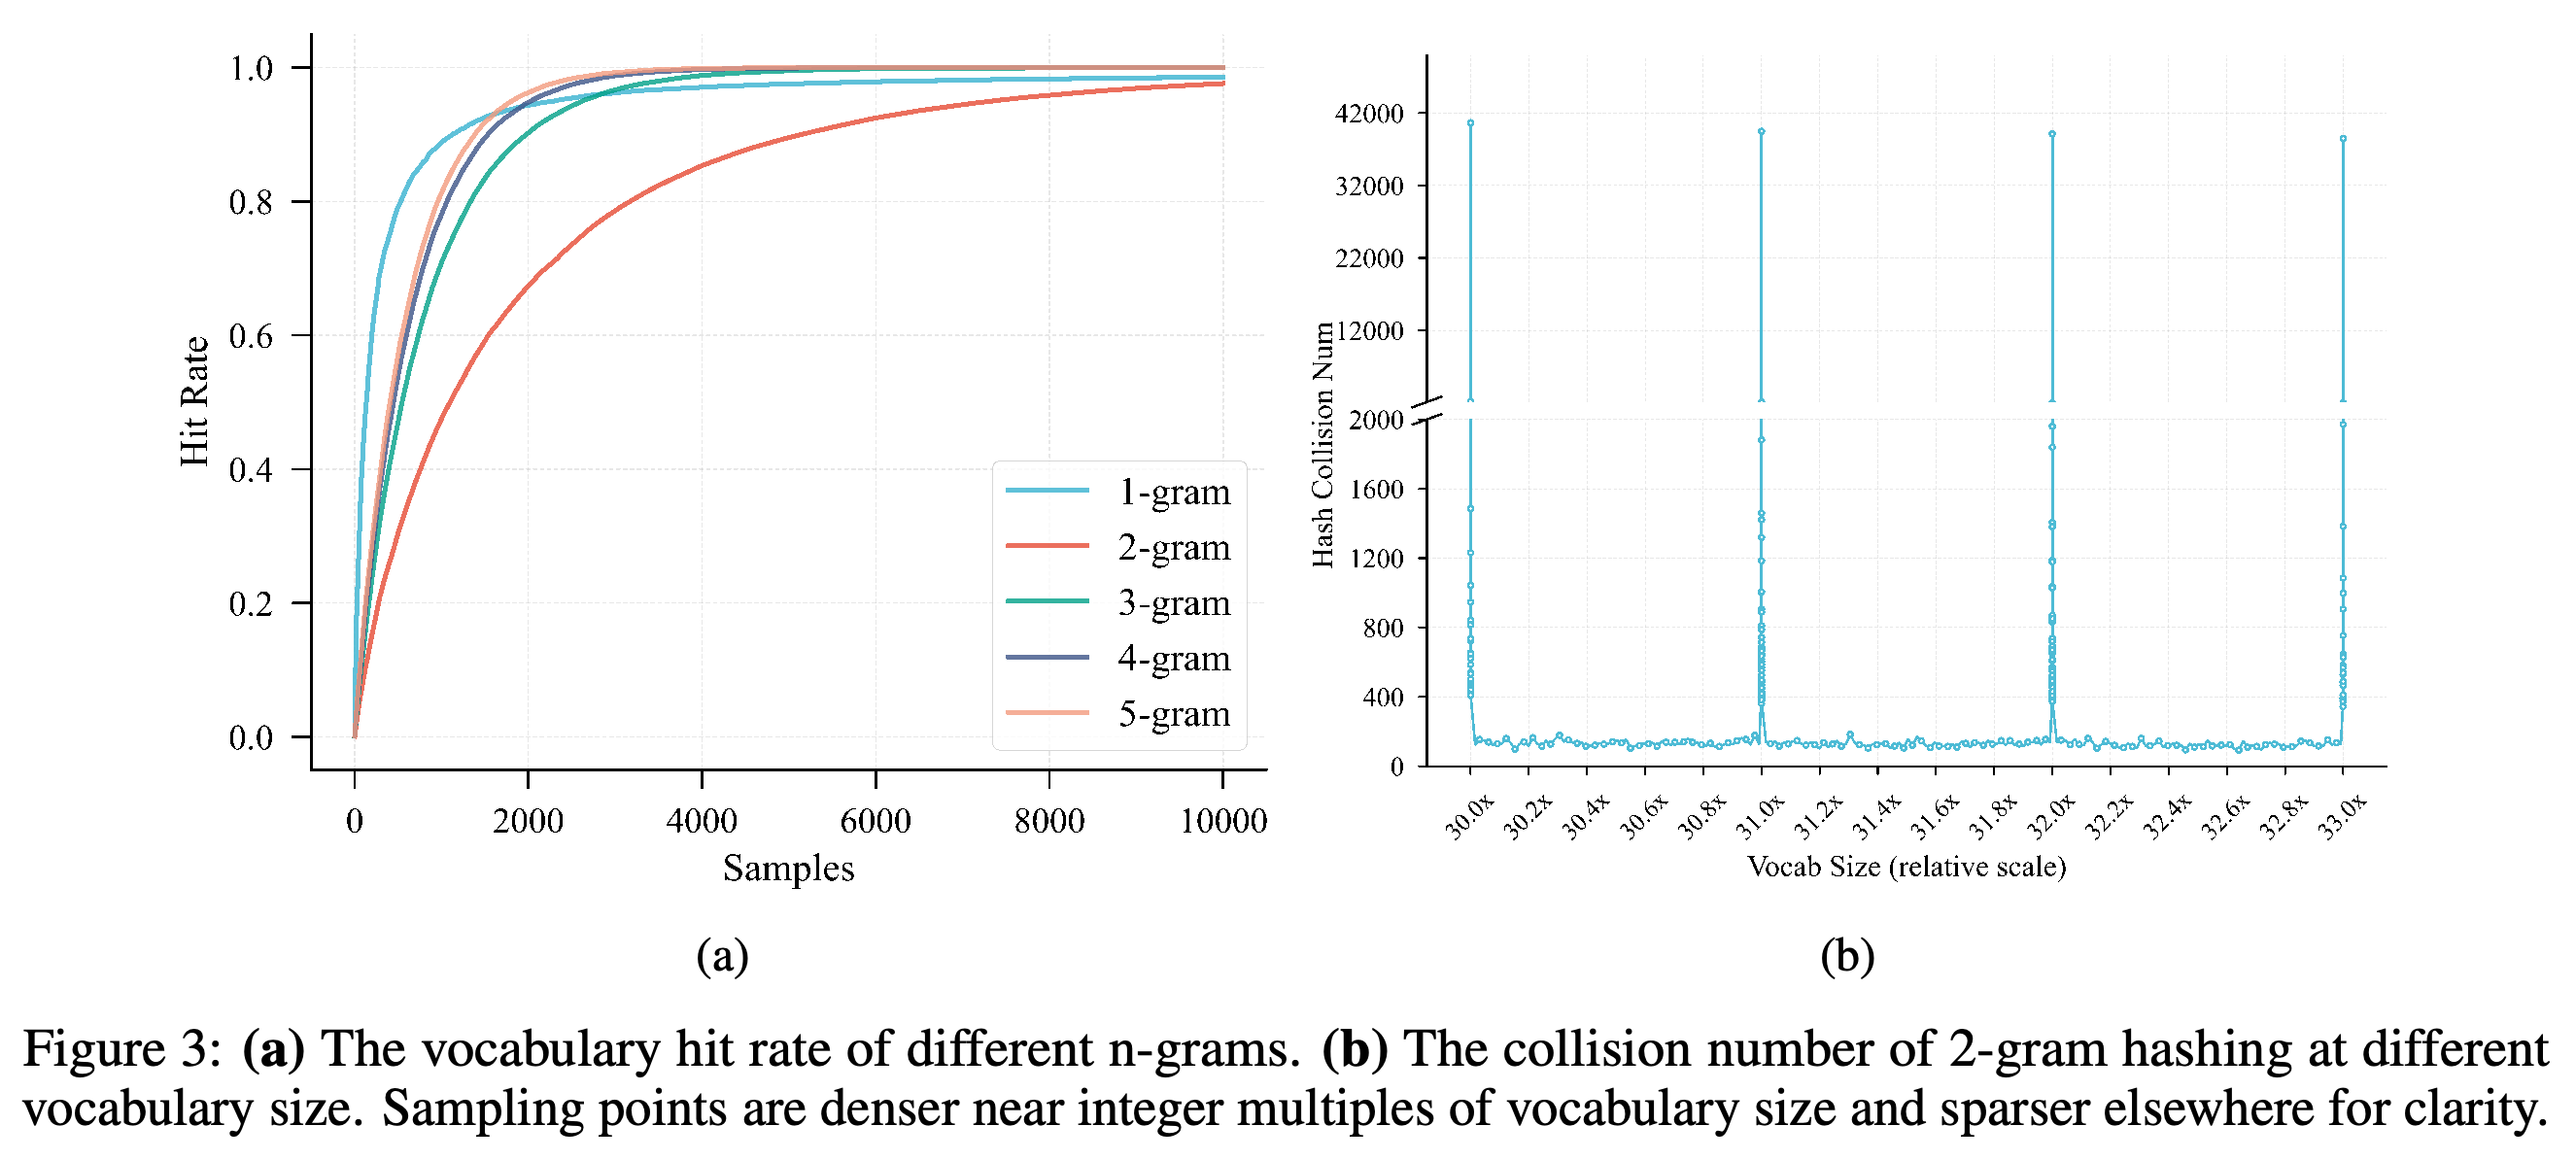
3.2.2 Mitigating Hash Collisions via Vocabulary Sizing: 기본 어휘 크기가 128k일 때, hit-rate 분석은 기본 어휘 크기의 30×인 n-gram 테이블을 사용한다. 충돌 수는 학습 시퀀스 100개를 대상으로 테이블 크기를 30×에서 33×까지 바꾸며 측정한다. Figure 3에서는 기본 어휘 크기의 정수배 근처에서 2-gram 충돌 수가 급격히 증가한다.
- 고차 테이블은 2-gram 테이블보다 전체 엔트리 사용률에 더 빠르게 접근한다. 다만 엔트리 사용률이 높다는 사실만으로 개별 n-gram이 충돌 없이 표현된다고 볼 수는 없다.
- 저자들은 기본 어휘 크기의 정수배에서 충분히 벗어난 테이블 크기를 권장한다. 테이블 크기를 소수로 선택하는 것만으로는 관측된 급증 현상이 사라지지 않는다고 설명한다.
Hit-rate 패널에서 2-gram은 고차 해시보다 엔트리 사용률이 더 느리게 증가한다. 충돌 패널에는 기본 어휘 크기 128k의 정수배 근처에서 좁고 급격한 증가가 나타난다. 이는 큰 어휘 크기나 소수 크기에만 의존하기보다 테이블 크기를 신중히 선택해야 함을 뒷받침한다.
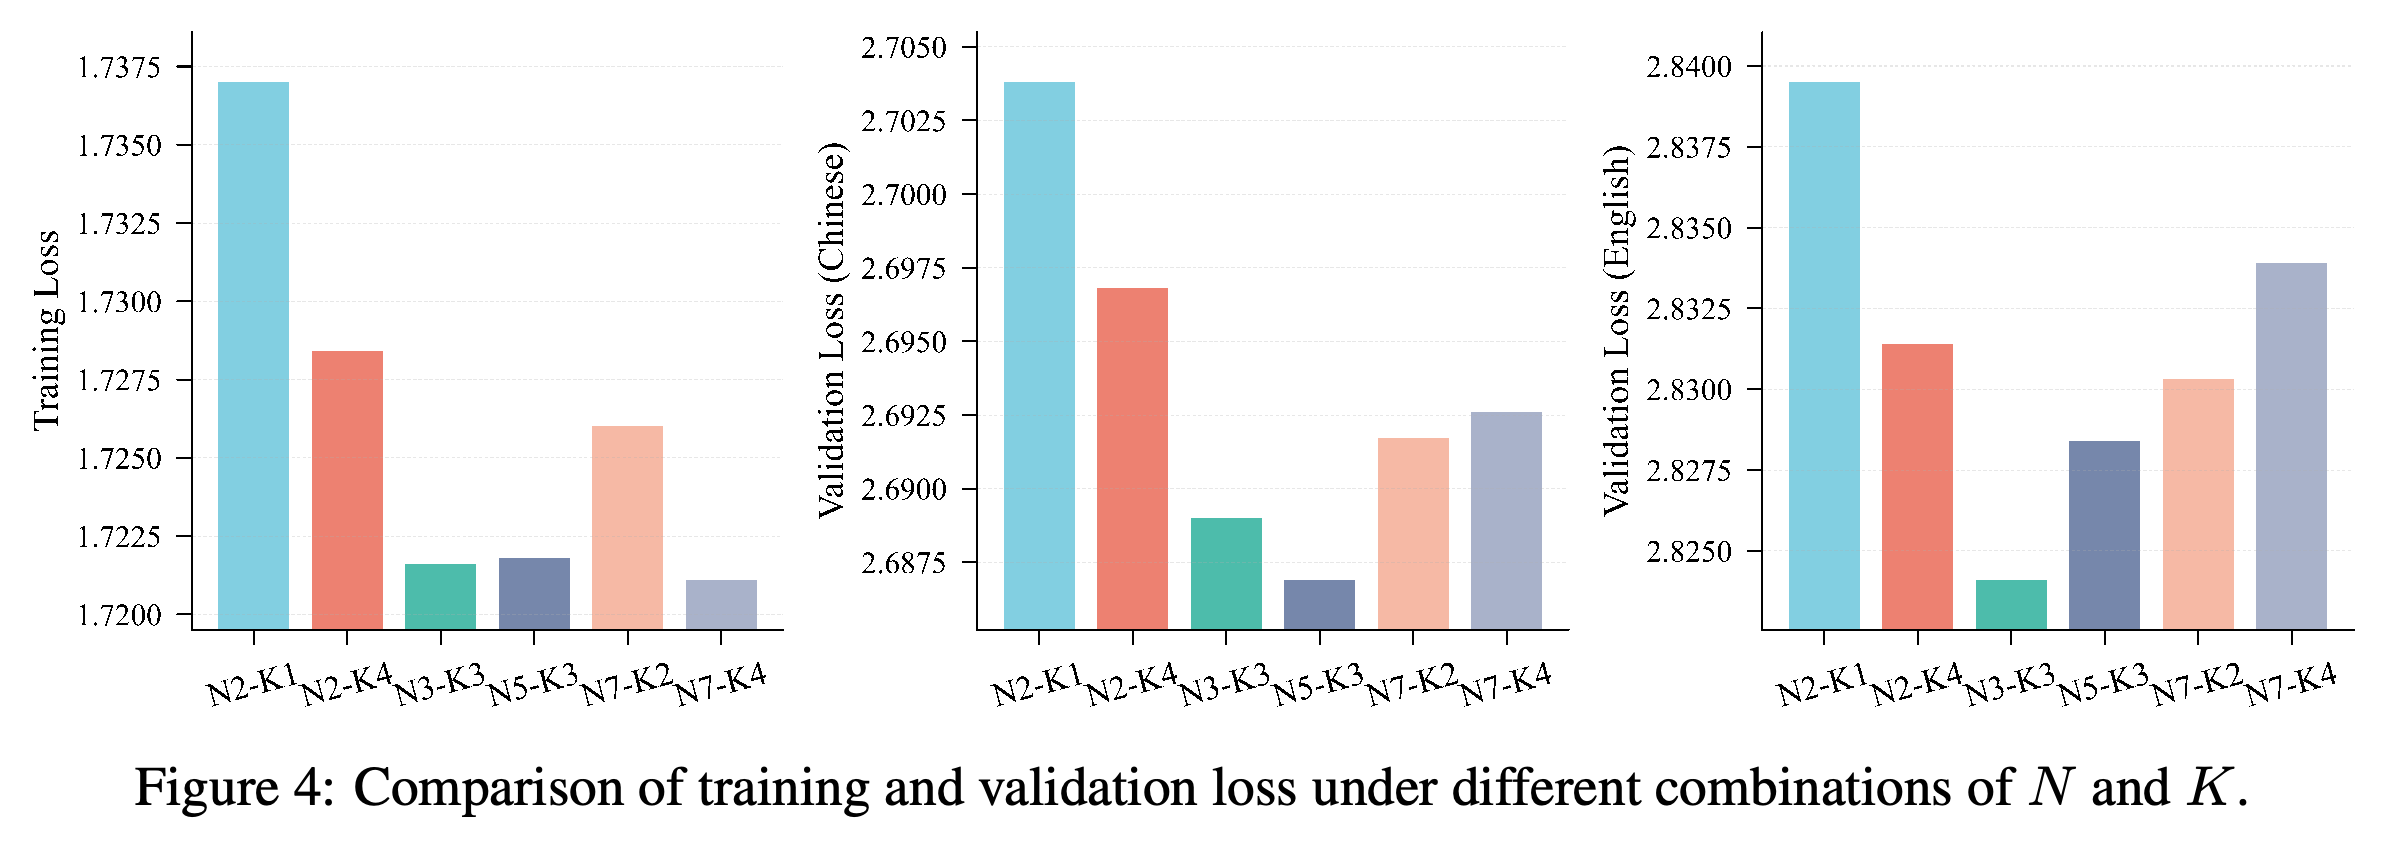
3.2.3 Sensitivity Analysis of Hyperparameters: Figure 4의 활성 파라미터 790M ablation에서는 최대 n-gram 차수 N과 sub-table 수 K를 바꾼다. N = 2 및 K = 1의 성능이 가장 낮다. 실험한 N ≥ 3 및 K ≥ 2 설정들은 성능 차이가 비교적 작으며, N이 3에서 5인 경우가 대체로 최적에 가깝다.
- 차수가 높아지면 더 많은 국소 문맥을 제공하지만 개별 n-gram의 출현 빈도는 낮아진다. 해시 sub-table을 추가하면 충돌로 인한 모호성이 줄지만, 추가에 따른 이득은 점차 감소한다.
- N이 크면 해싱에서 수치 오버플로를 피하도록 거듭제곱 전에 모듈러 연산을 수행할 것을 권장한다.
N2-K1은 실험한 설정 중 손실 지표 3개 모두에서 가장 낮은 성능을 보인다. 표현력이 더 높은 설정들은 대체로 비슷한 결과를 보이고, 최적 설정도 지표마다 다르다. 따라서 n-gram 차수나 sub-table 수를 무조건 최대화할 근거는 부족하다.
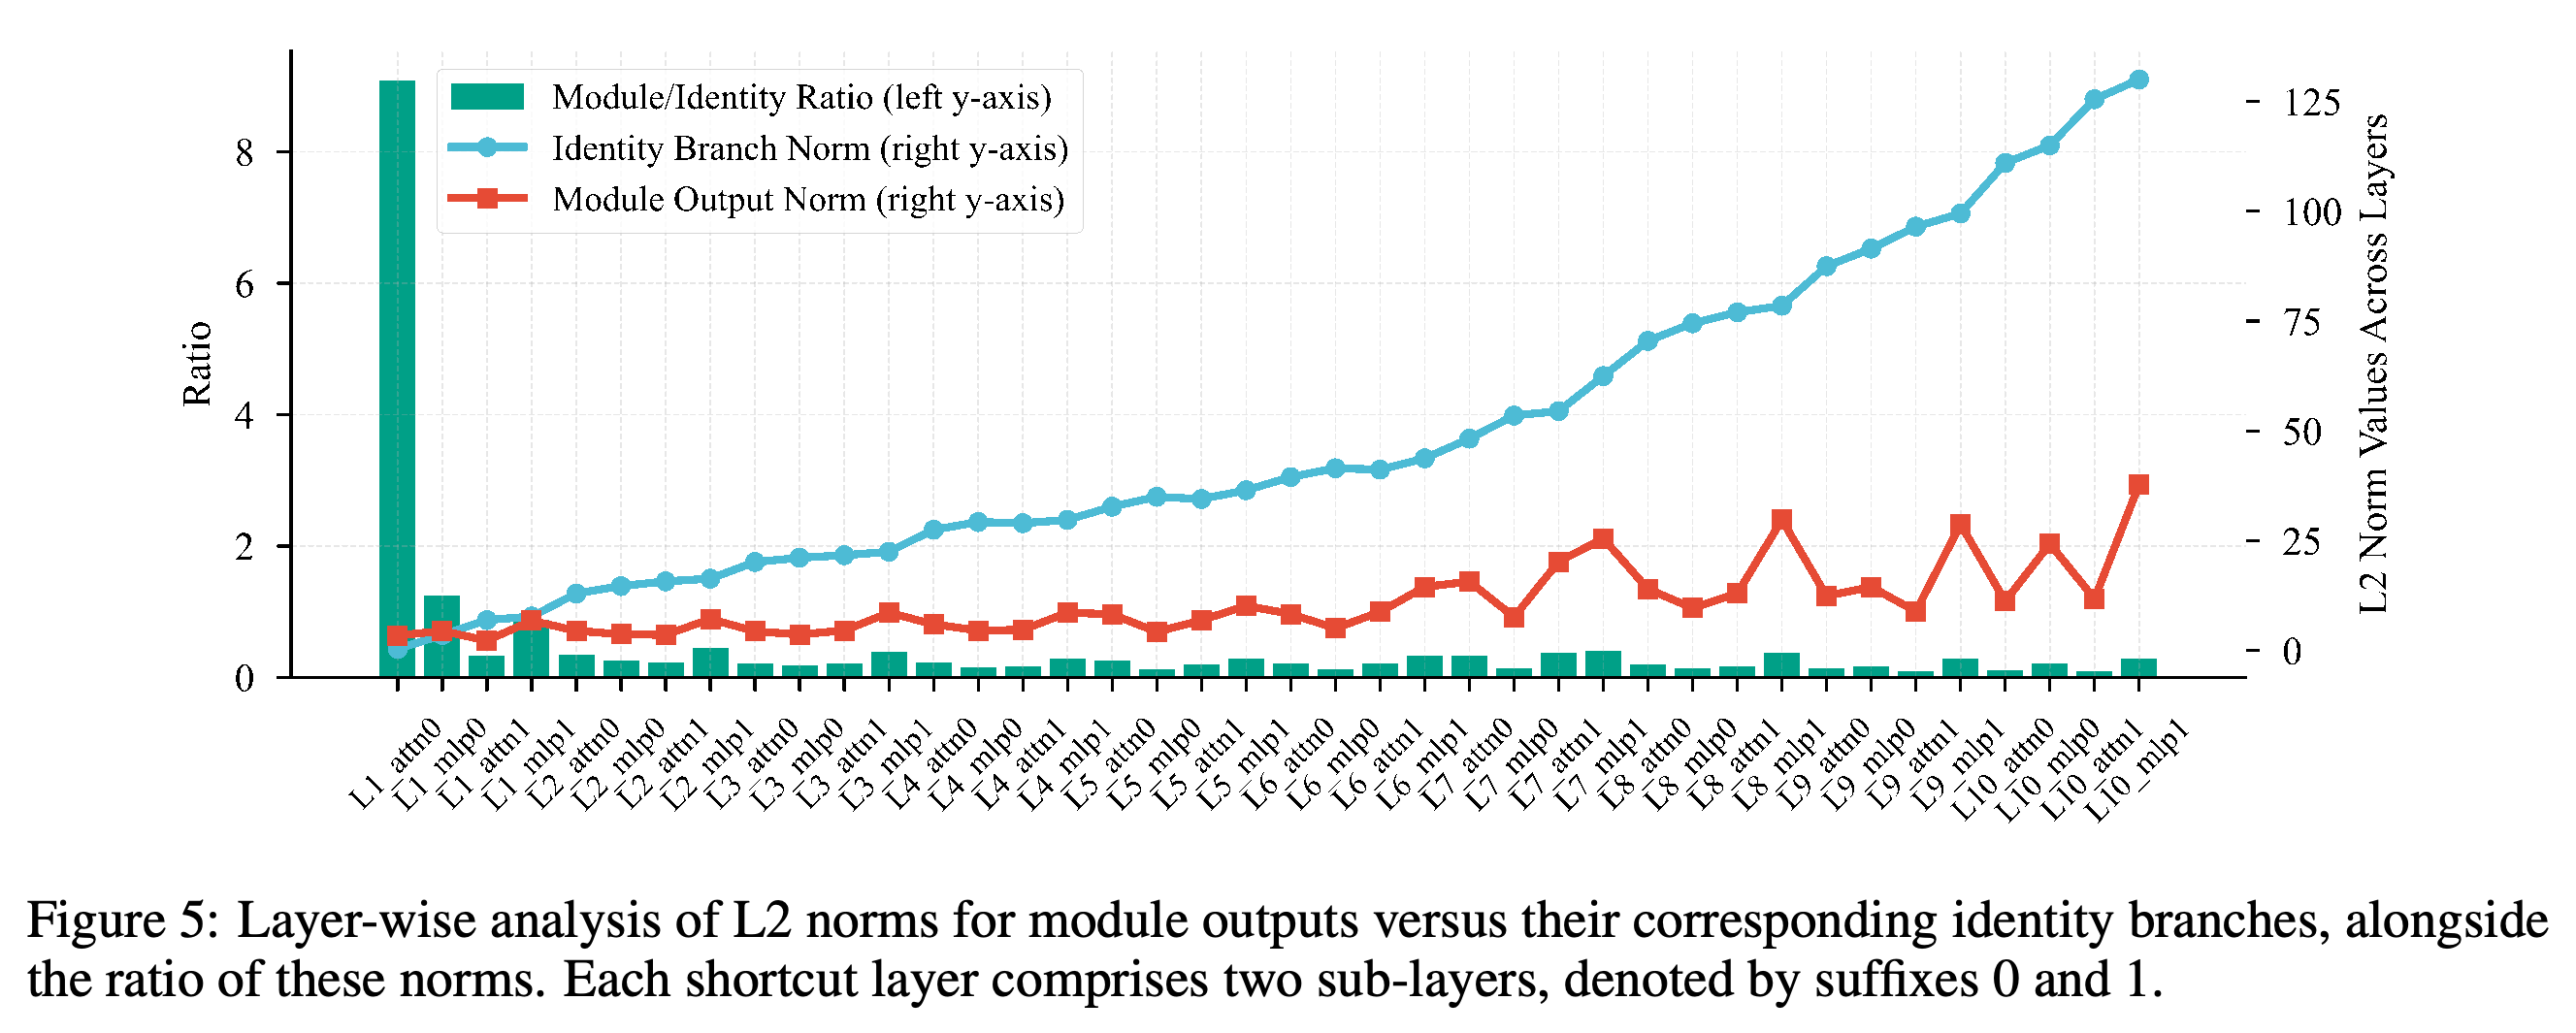
3.2.4 Embedding Amplification for Effective Training: 별도 조정 없이 300B 토큰을 학습한 설정에서, Figure 5의 첫 attention 출력 norm은 identity 분기 norm의 약 10×다. 이는 attention이 임베딩 신호를 압도할 가능성을 시사한다. 임베딩 출력에 일반적으로 (\sqrt{D})를 곱하거나 LayerNorm을 적용하면, 조정하지 않은 설정보다 학습 손실과 중국어 및 영어 검증 손실이 모두 0.02 낮아진다고 보고한다.
- 저자들은 이 방법들을 Embedding Amplification이라고 부르며, residual stream에서 임베딩의 기여를 유지하는 효과로 해석한다.
- 이 실험에서는 학습 안정성에 유의미한 영향이 없었다고 보고한다. 측정된 이점은 모델 손실 감소다.
첫 attention 모듈의 출력 norm은 입력 identity 분기의 norm보다 훨씬 크며, 이후 layer로 갈수록 identity 분기의 norm이 커진다. 이 진단은 입력 임베딩 신호를 증폭할 필요성을 제시하지만, norm 불균형만으로 제안한 메커니즘이 입증되지는 않는다.
3.3 Scaling Properties across Model Width and Depth
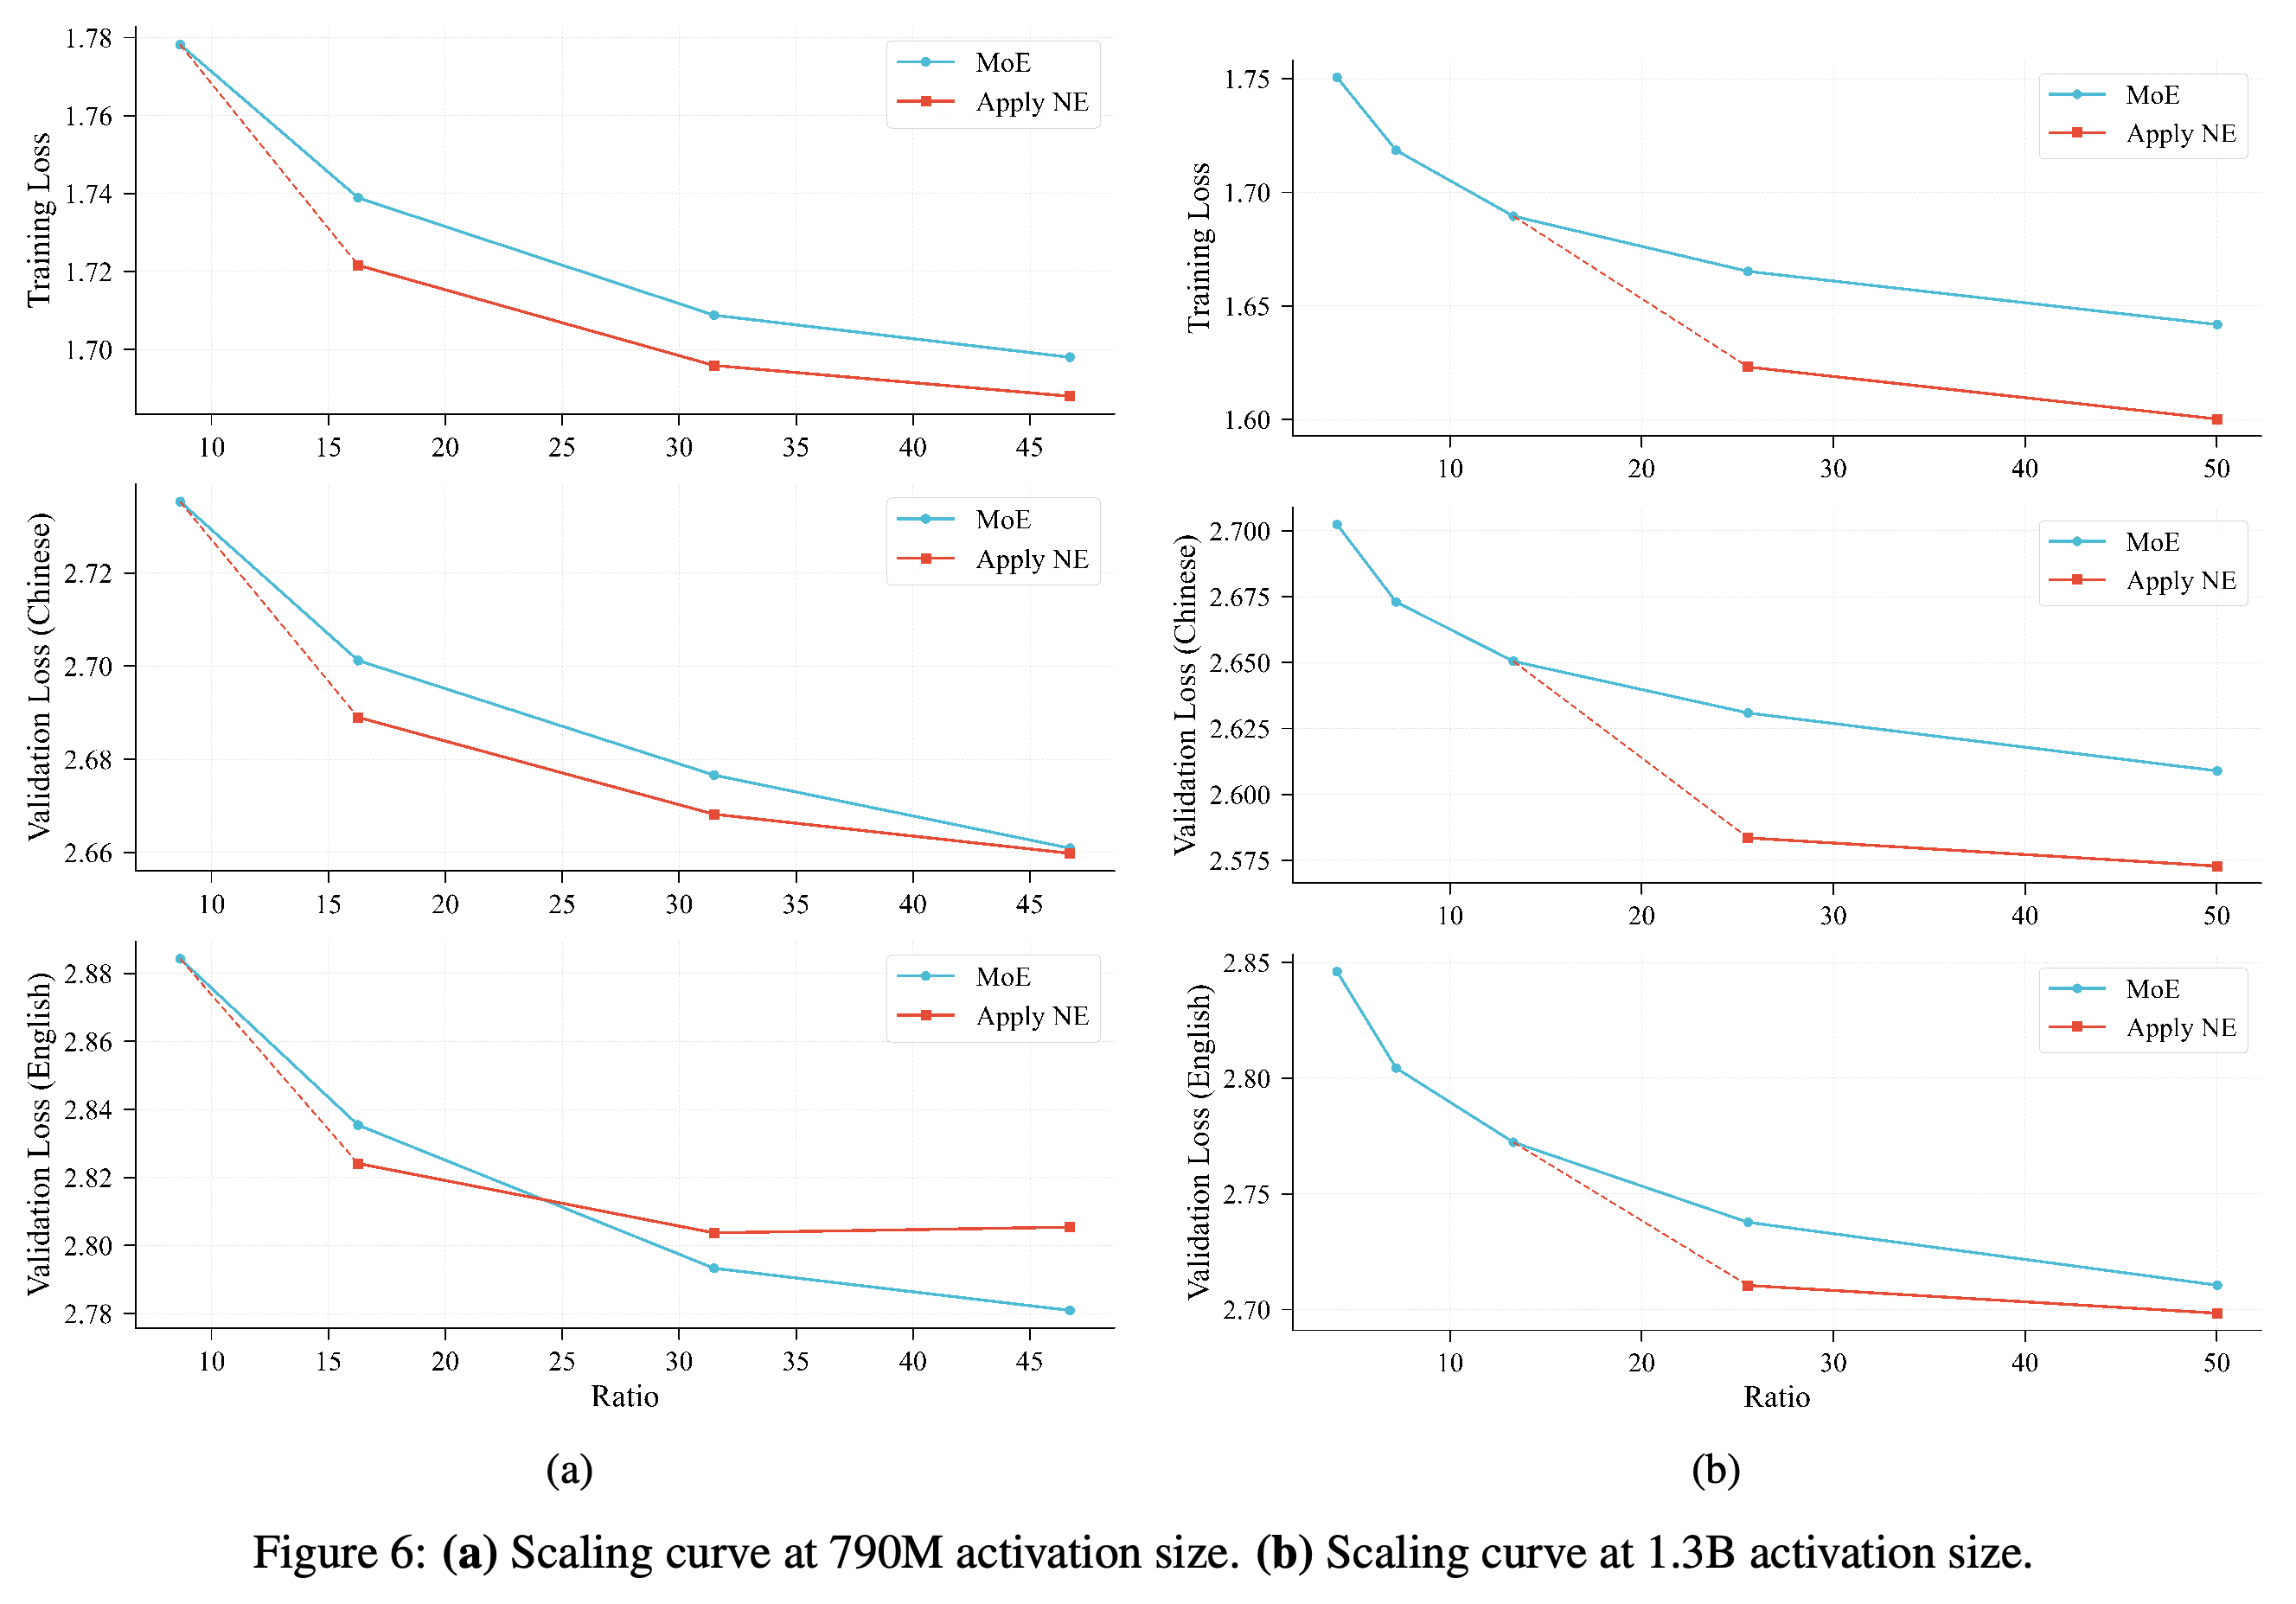
3.3.1 Enhanced Advantage in Wider Models: 깊이를 shortcut layer 10개로 고정하고 은닉 크기와 모듈 차원을 늘려 활성 파라미터 790M 및 1.3B에 도달한다. Figure 6에서는 폭이 큰 모델이 더 넓은 활성 파라미터 대비 총 파라미터 비율 구간에서 임베딩의 이점을 유지한다. 1.3B 설정에서는 실험 범위 내에 교차점이 관측되지 않는다.
- 활성 파라미터 280M에서는 비율 30을 넘으면 임베딩의 성능이 더 낮다. 790M에서는 해당 비율에서의 열세가 영어 검증에만 나타난다.
- 활성 파라미터 1.3B에서는 활성 파라미터 대비 총 파라미터 비율이 50이어도 N-gram Embedding이 손실 지표 3개 모두에서 더 좋다.
활성 파라미터 790M에서는 학습 손실이 더 낮게 유지되어도 비율이 커지면 영어 검증의 이점이 역전된다. 1.3B에서는 비율 50까지 표시된 모든 지표에서 임베딩 설정의 손실이 expert baseline보다 낮다. 이는 교차점이 관측되지 않은 채 유리한 구간이 더 넓어졌음을 보여준다.
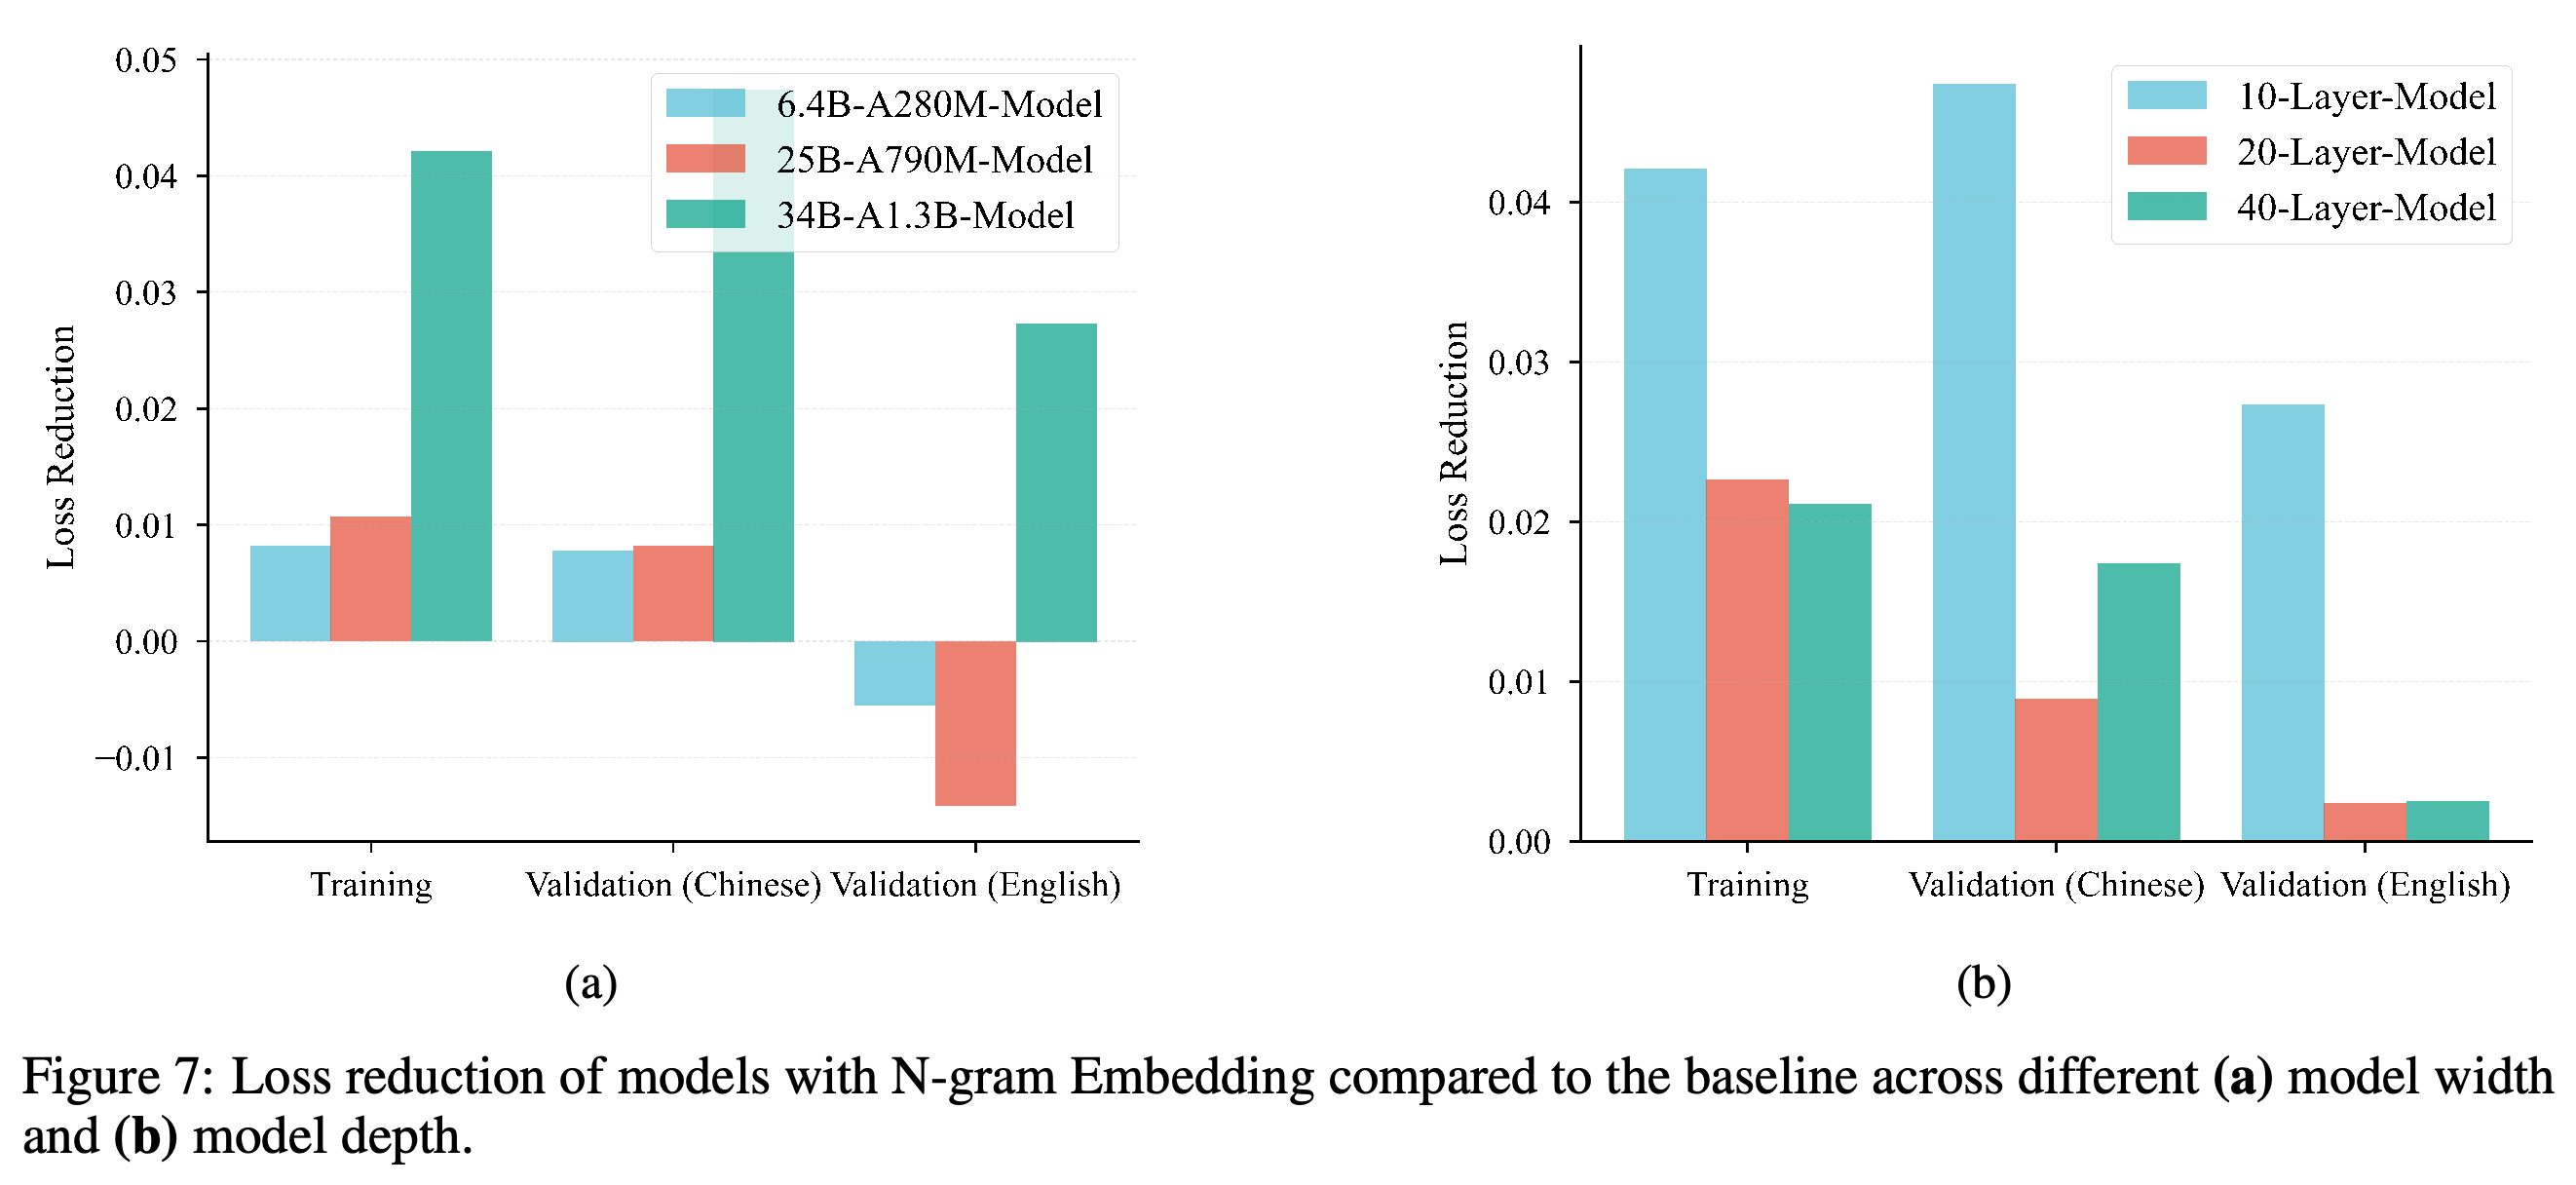
3.3.2 Diminishing Returns in Deeper Models: 활성 파라미터 1.3B 설정을 기반으로 아키텍처를 20개와 40개 layer로 확장하고, N-gram Embedding은 총 파라미터의 약 50%로 유지한다. Figure 7에서는 10개 layer 모델보다 손실 개선 폭이 크게 줄며, 특히 영어 검증에서 차이가 크다.
- 저자들은 깊은 pre-normalized residual network를 거치면서 입력 임베딩 신호가 약해지기 때문이라고 해석한다. Norm 분석은 이 해석과 일치하지만, 그 자체로 인과관계를 입증하지는 않는다.
- 20개에서 40개 layer로 늘릴 때 모든 검증 지표에서 이점이 단조롭게 감소하지는 않는다. 다만 더 깊은 설정들은 모두 10개 layer 설정보다 이득이 훨씬 작다.
폭 비교에서는 가장 넓은 설정의 이득이 더 크다. 선택된 더 작은 설정들에서는 영어 검증 성능이 악화되지만, 가장 넓은 설정에서는 개선된다. 깊이 비교에서는 20개와 40개 layer의 개선 폭이 10개 layer보다 훨씬 작으며, 특히 영어 검증에서 차이가 크다. 20개에서 40개 layer 사이의 검증 이득은 모든 지표에서 단조롭게 변하지 않는다.
4 Efficient Inference
추론 분석은 아키텍처의 희소성과 실제 서빙 효율을 구분한다. 용량을 expert에서 임베딩으로 옮기면 expert 가중치 접근량이 줄지만, 실제 이점을 얻으려면 유효 배치 크기가 충분히 커야 하고 추가 임베딩 조회 오버헤드를 제어해야 한다.
4.1 Reduction of MoE Activation Parameters
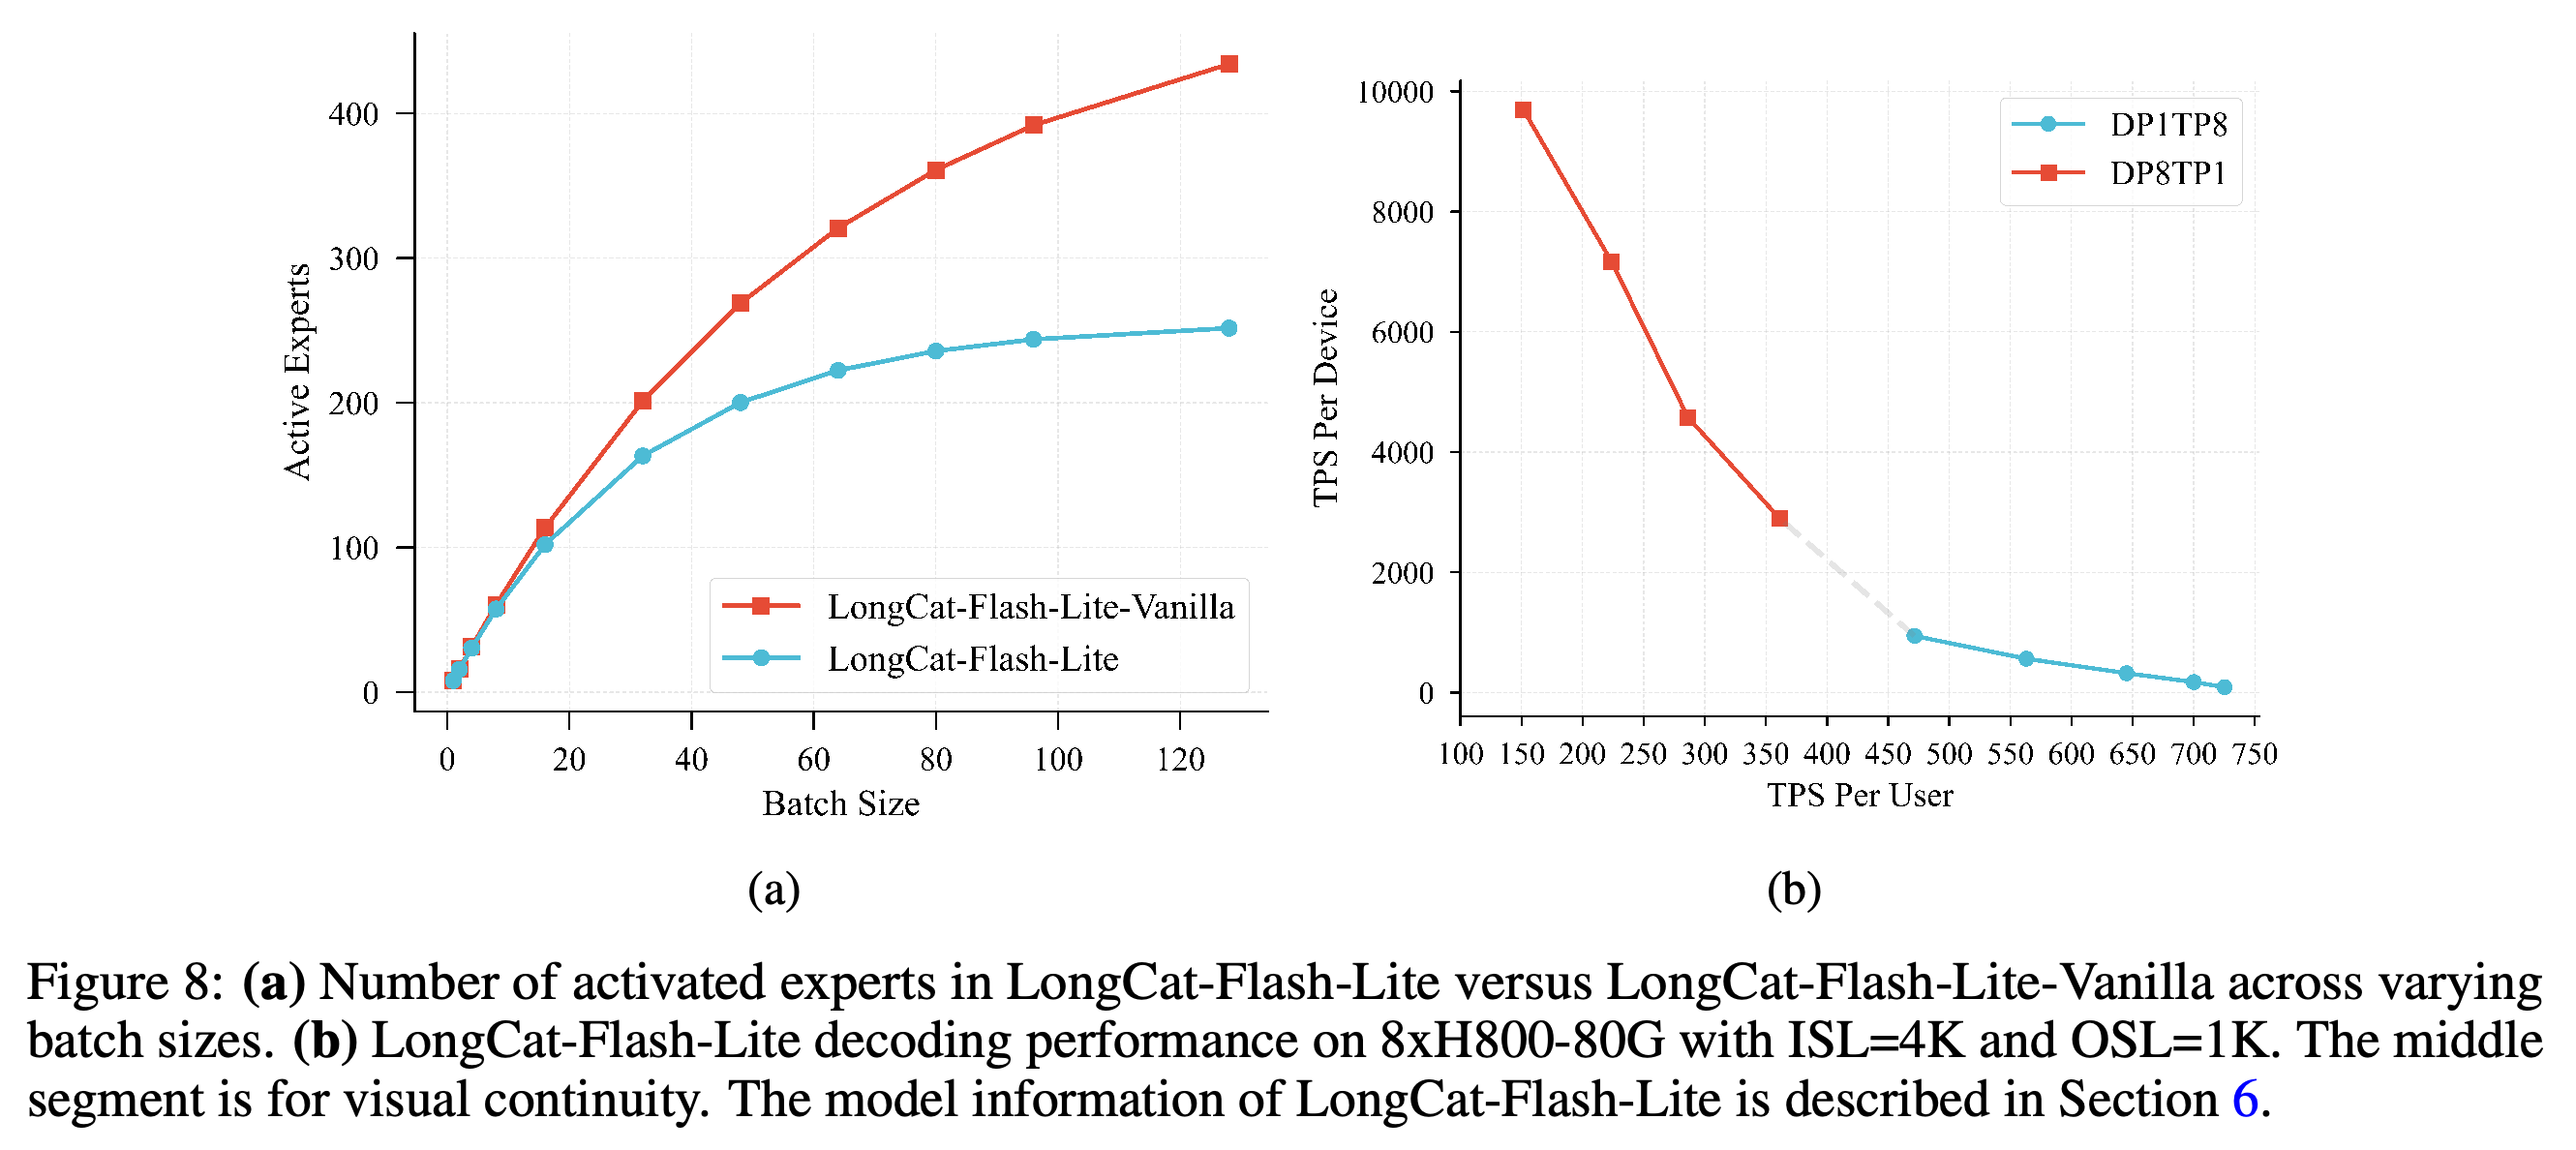
Figure 8a에서는 배치 크기가 커질수록 LongCat-Flash-Lite가 LongCat-Flash-Lite-Vanilla보다 적은 종류의 expert를 활성화한다. 이에 따라 디코딩 배치 전체에서 접근하는 expert 파라미터 수가 줄어든다. Multi-step speculative decoding은 유효 배치 크기를 늘리며, 하드웨어 활용률을 높이는 데 사용된다.
- 작은 배치에서는 차이가 작고 큰 배치에서는 차이가 커지므로, 서빙 이점은 워크로드에 따라 달라진다.
- 임베딩 조회 작업량은 전체 임베딩 테이블을 스캔하는 양이 아니라 토큰과 선택된 엔트리에 따라 달라진다. 다만 이 분기는 여전히 오버헤드를 추가하며, 다음 절에서 이를 다룬다.
4.2 Optimized Embedding Lookup
N-gram Cache는 맞춤형 CUDA 커널로 장치 내 n-gram ID를 관리하며, KV cache에서 착안한 방식으로 동적 추론 스케줄링과 동기화한다. 보고서는 draft model에 일반 임베딩을 사용하고 drafting 중 n-gram 임베딩을 캐싱하여 검증 단계의 중복 작업을 피하는 방법도 제안한다.
- 이 방법들은 표준 임베딩 layer보다 추가되는 I/O, 투영, 통신, 스케줄링 복잡성을 다룬다.
- Figure 8b는 ISL=4K, OSL=1K인 8xH800-80G에서 DP1TP8과 DP8TP1을 사용한 통합 시스템의 디코딩 절충 관계를 보고한다. Expert-only 서빙 baseline이나 각 최적화의 개별 이득은 제공하지 않는다.
배치 크기가 커질수록 활성화되는 expert 종류 수의 차이가 커진다. 이는 큰 배치에서 임베딩 기반 모델의 expert 가중치 접근량이 더 적음을 나타낸다. 서빙 패널은 병렬화 구성 2개에서 사용자당 속도와 장치당 처리량 사이의 절충 관계를 보여준다. 가운데 연결 구간은 시각적 연속성을 위한 표시일 뿐이며, Vanilla 서빙 곡선은 제공하지 않는다.
4.3 Rethinking N-gram Embedding Optimization: The Role of Speculative Decoding
저자들은 speculative decoding에 국소 n-gram 정보를 활용하는 탐색적 방안 2개를 제시한다. 임베딩 출력으로 저비용 draft predictor를 구성하는 방법과, target model의 전체 검증 전에 가능성이 낮은 draft token을 조기 거부하는 방법이다. 이 보고서는 어느 방안에도 구현 시스템 평가나 측정된 가속 결과를 제시하지 않는다.
- N-gram Embedding 기반 drafting은 앞선 N−1개 토큰의 단거리 문맥을 인코딩한 임베딩에 가벼운 선형 투영을 적용하는 방안을 검토한다.
- 조기 거부는 의미적 일관성이나 신뢰도를 확인하는 방법으로 제안된다. 토큰 수락 동작과 디코딩 정확성에 미치는 영향은 평가하지 않는다.
5 Integration with Per-Layer Embedding
보고서는 입력 단계의 N-gram Embedding을 네트워크 layer 내부에 임베딩 용량을 배치하는 Per-Layer Embedding (PLE)과 비교한다. 또한 Per-Layer N-gram Embedding (PLNE)을 도입하여 문맥 기반 조회 용량을 여러 layer에 분산하면 확장 효과가 개선되는지 검토한다.
5.1 Per-Layer Embedding
PLE는 SwiGLU의 up-projection 출력을 layer별 토큰 임베딩으로 대체한다. Equation (4)는 FFN^(l)(x_i) = W_d^(l)(SiLU(W_g^(l)x_i^(l)) ⊙ E_0^(l)(t_i))이며, down-projection과 gate-projection은 학습 가능한 변환으로 유지한다.
- 저자들은 실험한 임베딩 주입 방법 중 이 대체 방식이 가장 효율적이라고 설명한다.
- Layer별 임베딩 테이블은 Equation (1)에서 정의한 기본 테이블과 형태가 같다.
5.2 Per-Layer N-gram Embedding
PLNE는 PLE의 토큰 임베딩을 Equation (3)으로 계산한 layer별 N-gram Embedding 출력으로 대체한다. Equation (5)는 FFN^(l)(x_i) = W_d^(l)(SiLU(W_g^(l)x_i^(l)) ⊙ e_i^(l))이며, 임베딩을 주입하는 각 layer마다 독립적인 임베딩 테이블과 투영 행렬을 사용한다.
5.3 Empirical Comparison
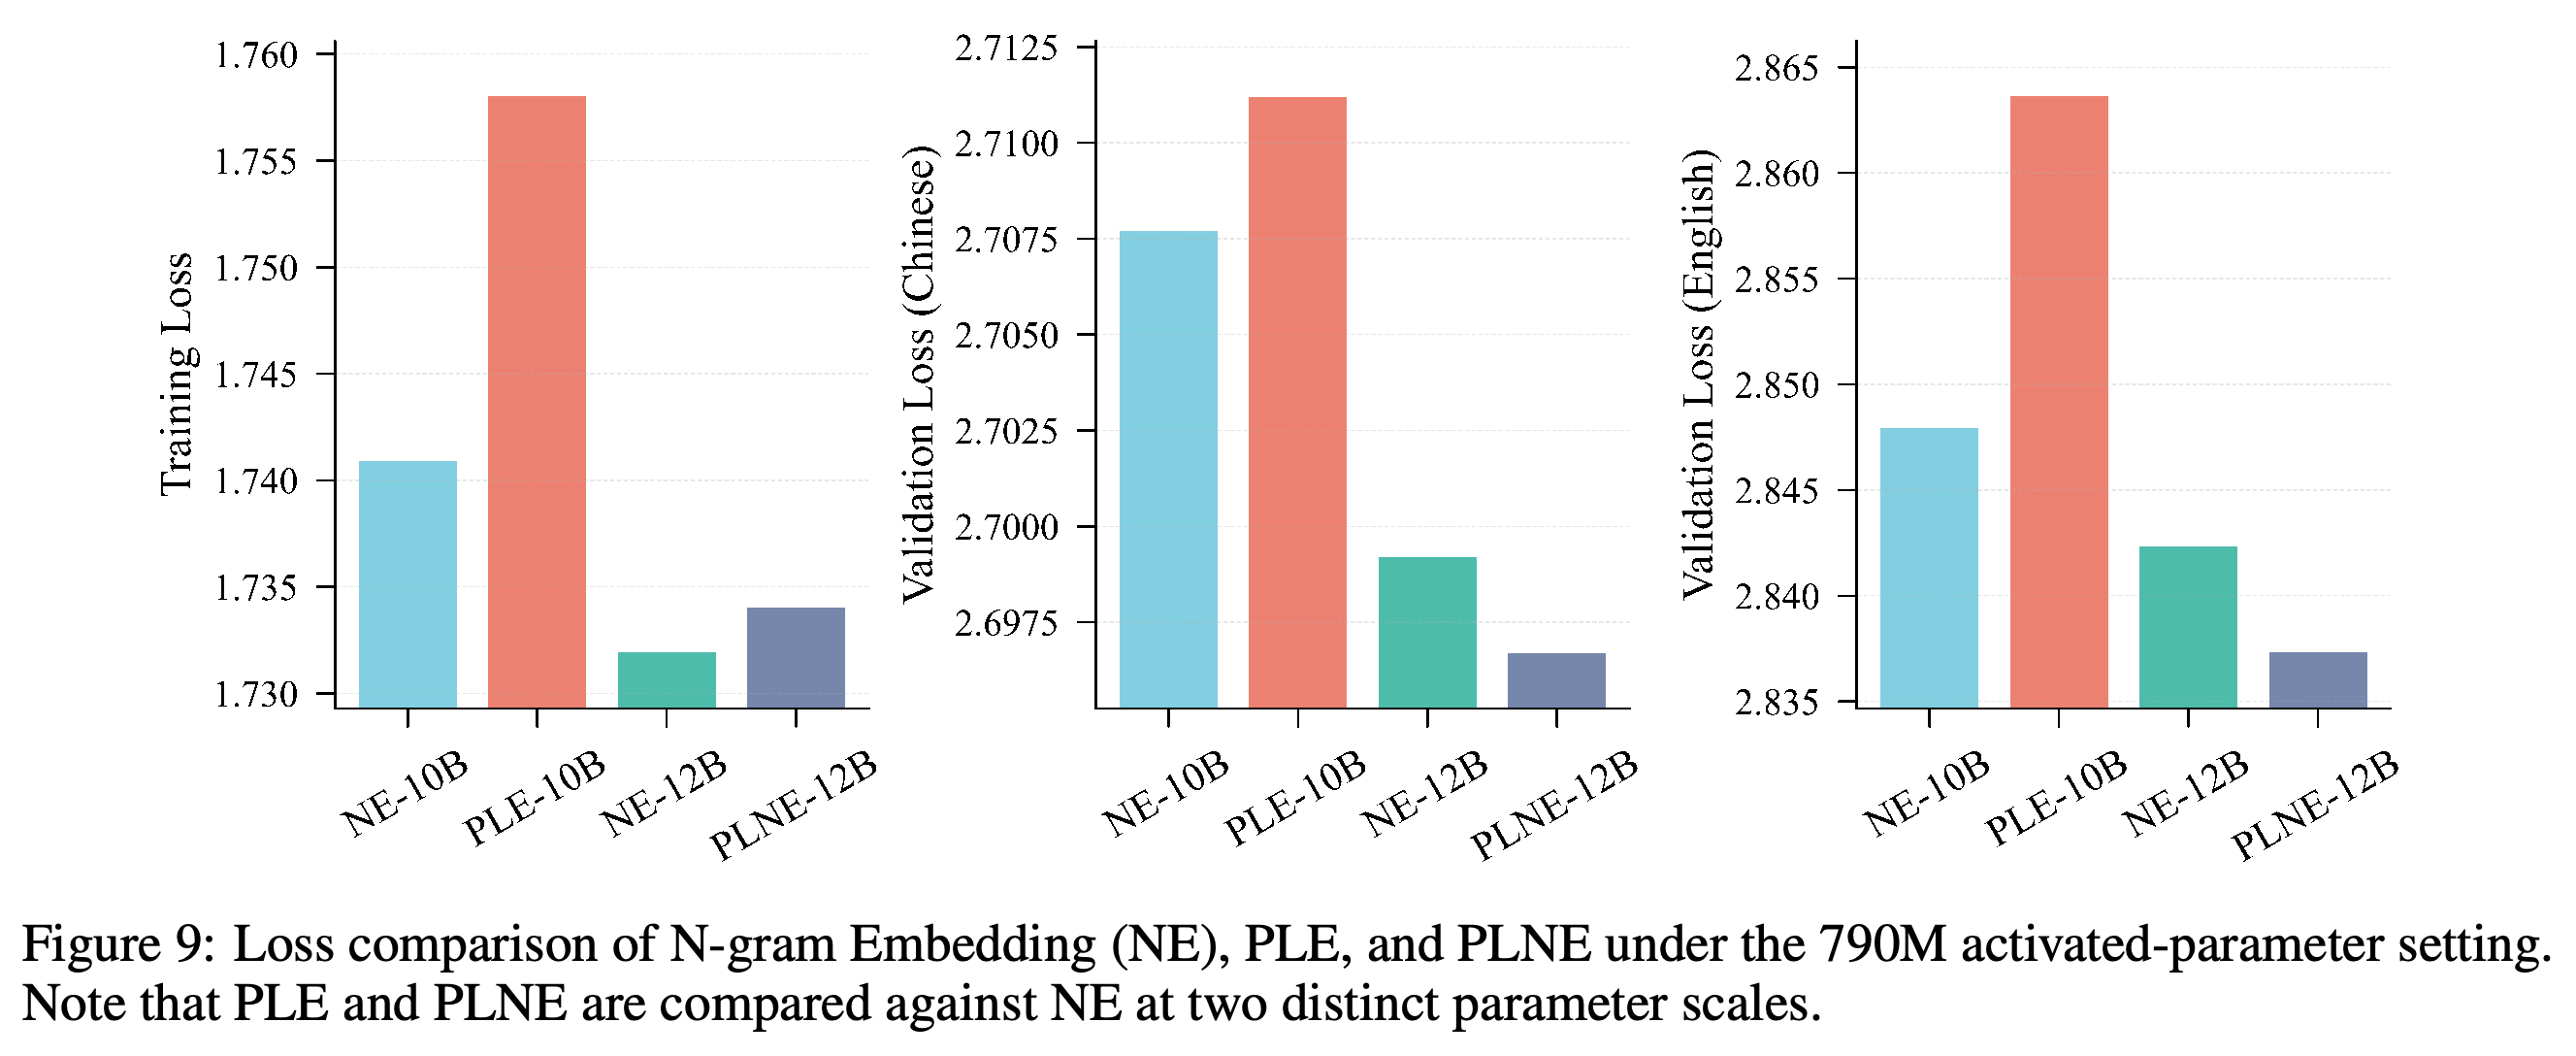
Figure 9는 총 파라미터 10B에서 PLE와 NE를, 12B에서 PLNE와 NE를 비교한다. 모든 설정의 활성 파라미터는 790M이다. PLE는 손실 지표 3개 모두에서 더 나쁘다. PLNE는 대응하는 NE보다 검증 손실이 약간 낮지만 학습 손실은 약간 높다.
- Per-layer 방법들은 모두 각 shortcut layer의 dense-sub-layer MLP에만 임베딩을 주입한다. 저자들은 layer 배치가 비교를 교란하지 않도록 PLE와 PLNE 사이의 파라미터 수를 직접 맞추지 않는다.
- 폭과 깊이를 늘린 후속 실험에서도 PLNE의 일관된 이점은 나타나지 않는다. Layer별 투영 행렬이 추가되면 활성 파라미터가 늘어나므로, 저자들은 LongCat-Flash-Lite에 PLNE를 사용하지 않는다.
- 임베딩 파라미터를 layer별로 어떻게 배분하는 것이 최적인지는 아직 해결되지 않았다.
PLE-10B는 지표 3개 모두에서 NE-10B보다 손실이 높다. PLNE-12B는 NE-12B보다 중국어와 영어 검증 손실이 약간 낮지만 학습 손실은 약간 높다. 따라서 그 이점은 모든 지표의 개선으로 해석할 수 없다.
6 LongCat-Flash-Lite
LongCat-Flash-Lite는 이 연구의 아키텍처 권고를 대규모로 적용한 모델이다. 처음부터 pre-training, mid-training, supervised finetuning을 거쳐 학습하며, https://huggingface.co/meituan-longcat/LongCat-Flash-Lite 에 공개되어 있다.
6.1 Model Information
Architecture: LongCat-Flash-Lite는 shortcut layer 14개, 총 파라미터 68.5B, N-gram Embedding 파라미터 31.4B로 구성된다. N-gram Embedding은 전체의 46%를 차지한다. 각 shortcut layer의 MoE에는 FFN expert 256개와 zero-expert 128개가 있다. 각 토큰은 expert 12개를 선택하며, 문맥에 따라 2.9B–4.5B 파라미터를 활성화한다.
Training Data: 모델은 시퀀스 길이 8k에서 pre-training 토큰 11T를 학습한다. 이어 시퀀스 길이를 128k로 확장하여 mid-training 토큰 1.5T를 학습하고, 이후 SFT를 수행한다. 시퀀스 길이 32k 단계에서 YARN을 도입하여 최대 256k 토큰을 지원한다.
- N-gram Embedding이 없는 baseline인 LongCat-Flash-Lite-Vanilla는 총 파라미터 수를 유지하면서 N-gram Embedding 파라미터 예산을 추가 expert로 전환한다.
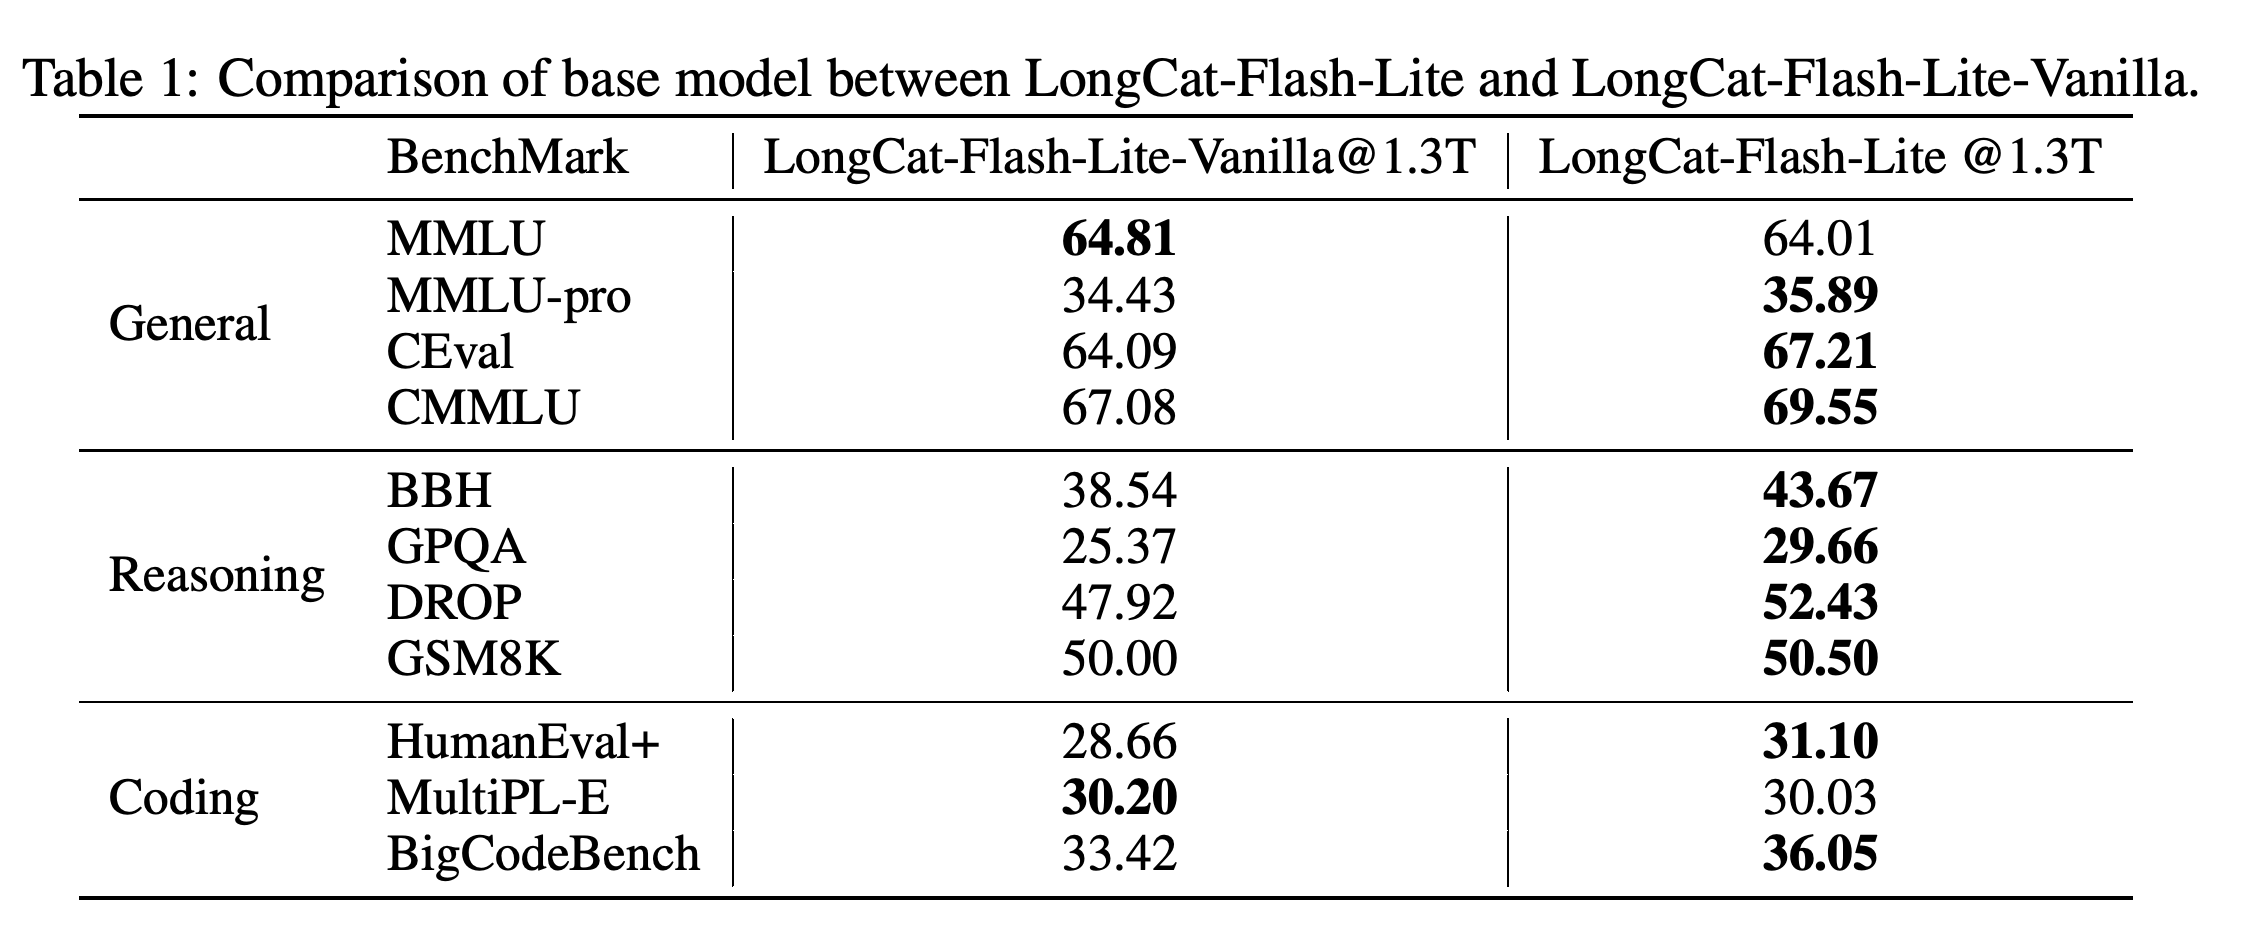
- 2개 모델은 동일한 학습 전략과 데이터 구성을 사용한다. 따라서 base model 비교는 독립적으로 학습한 외부 chat model과의 비교보다 파라미터 배분 효과를 더 잘 보여준다.
6.2 Base Model Evaluation
Table 1의 1.3T 토큰 체크포인트에서 LongCat-Flash-Lite는 벤치마크 11개 중 9개에서 Vanilla보다 높은 성능을 보인다. BBH는 38.54에서 43.67로, GPQA는 25.37에서 29.66으로, DROP은 47.92에서 52.43으로, BigCodeBench는 33.42에서 36.05로 개선된다. MMLU는 64.81에서 64.01로, MultiPL-E는 30.20에서 30.03으로 하락한다.
- 나머지 개선 결과는 MMLU-pro 34.43→35.89, CEval 64.09→67.21, CMMLU 67.08→69.55, GSM8K 50.00→50.50, HumanEval+ 28.66→31.10이다.
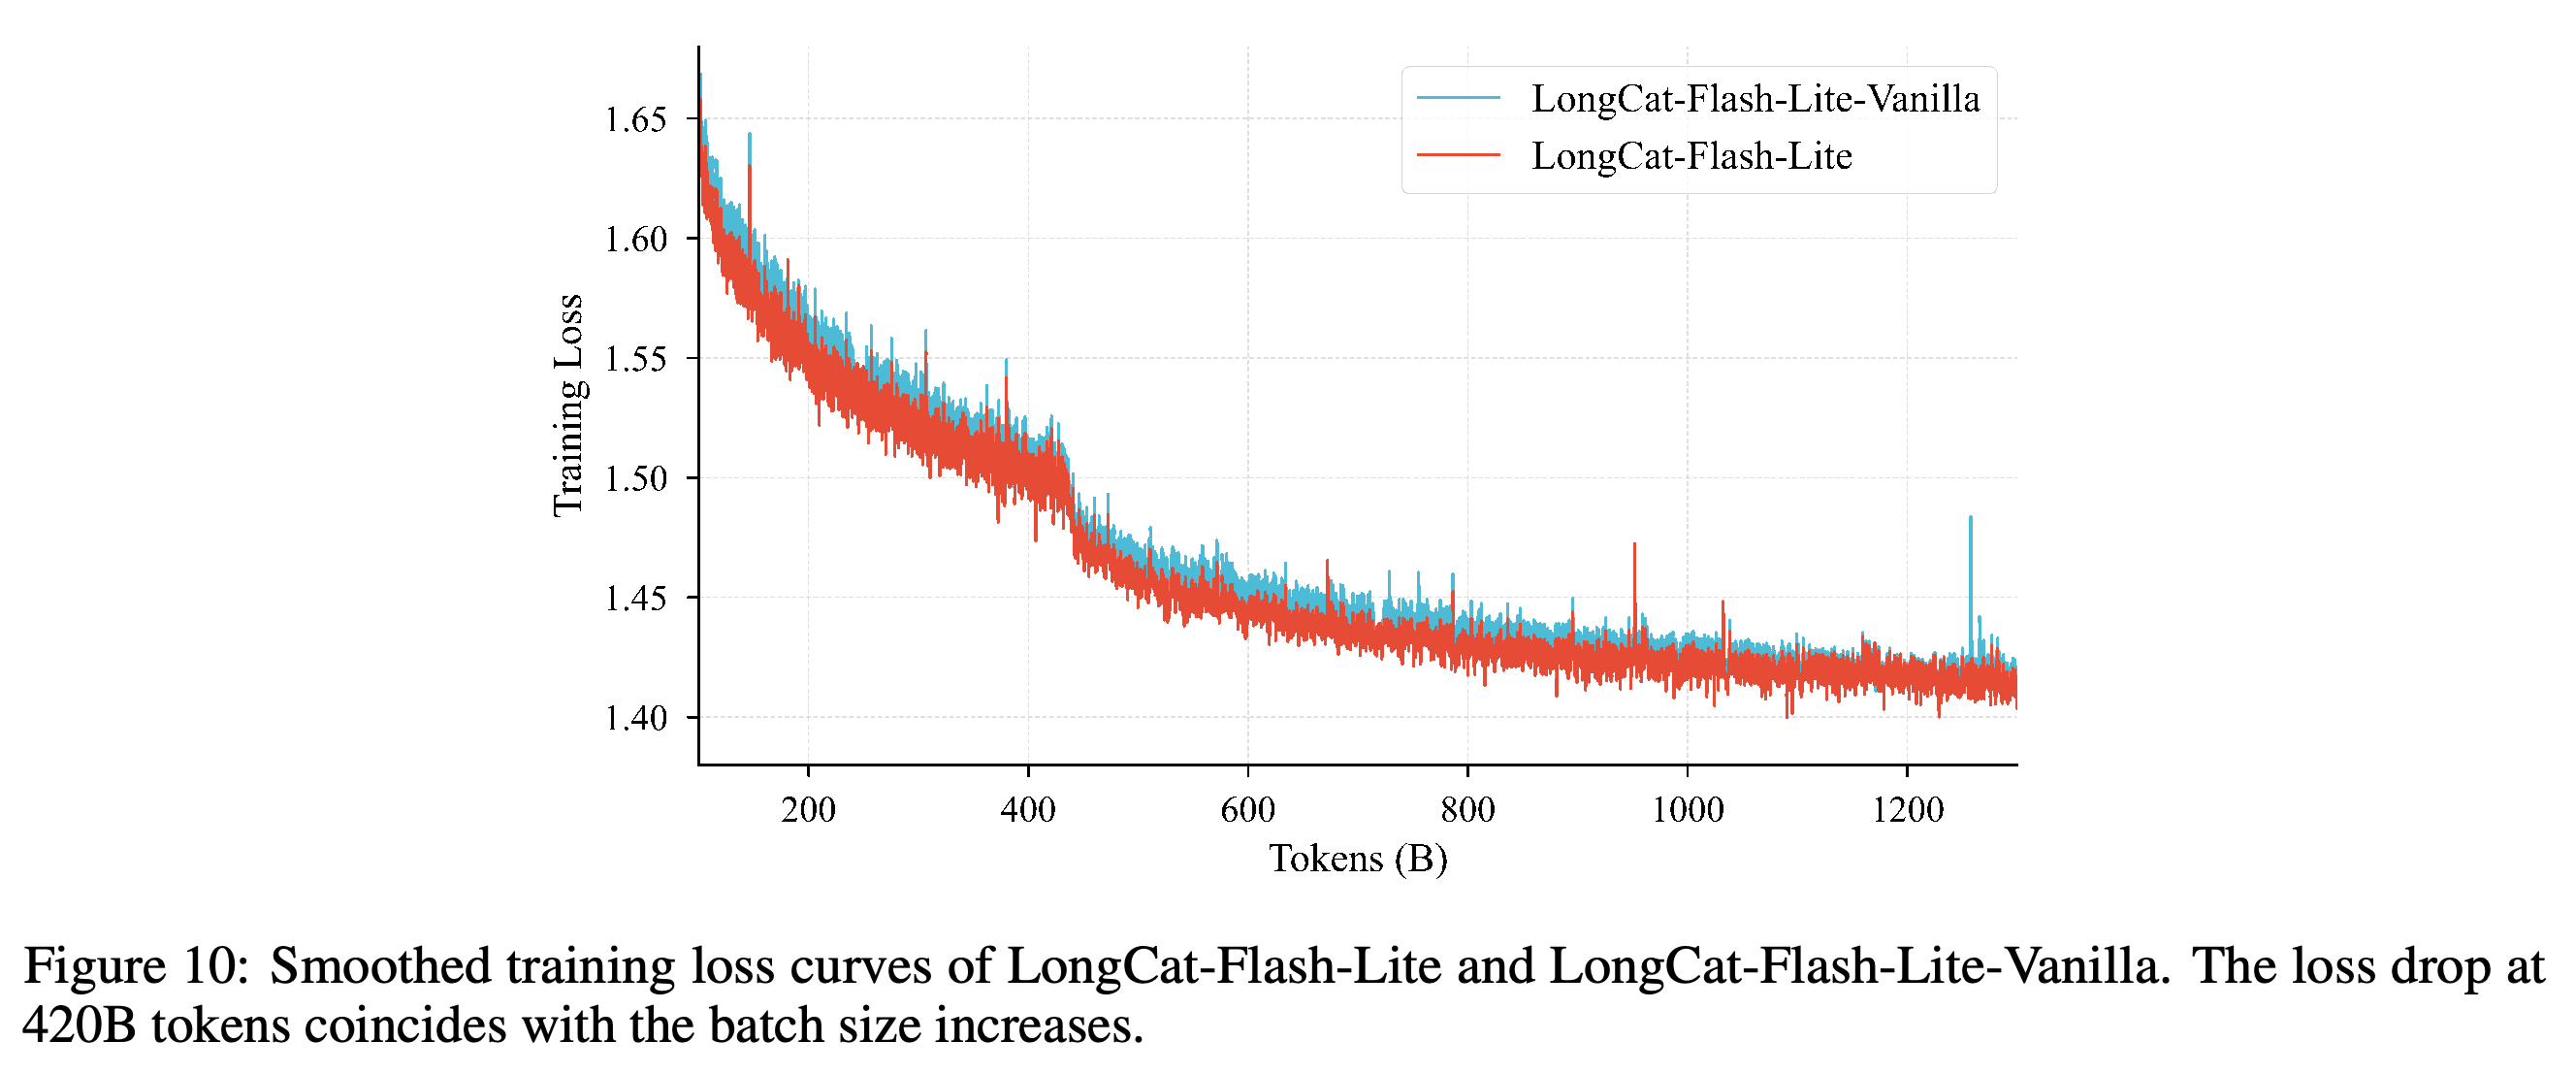
- Figure 10에서는 약 1.3T 토큰까지 표시된 구간에서 학습 손실이 더 낮게 유지된다. 420B 토큰에서 공통으로 나타나는 하락은 배치 크기 증가와 시점이 일치한다.
- 이 벤치마크 결과는 최종 11T-token pre-training 종료 시점이 아니라 중간 base model 체크포인트에서 얻은 결과다.
학습량을 1.3T 토큰으로 맞춘 비교에서 LongCat-Flash-Lite는 벤치마크 9개에서 더 높은 성능을 보인다. BBH, GPQA, DROP의 절대 개선 폭은 GSM8K보다 크다. MMLU와 MultiPL-E에서는 Vanilla가 더 높으므로, 이 표는 광범위한 downstream 개선을 뒷받침하지만 모든 task의 개선을 뜻하지는 않는다.
임베딩 기반 모델은 표시된 구간에서 더 낮은 학습 손실을 유지한다. 곡선들은 배치 크기가 증가하는 420B 토큰 근처에서 함께 하락한다. 따라서 이 불연속적인 변화는 임베딩에만 적용한 개입의 효과로 해석해서는 안 된다.
6.3 Chat Model Evaluation
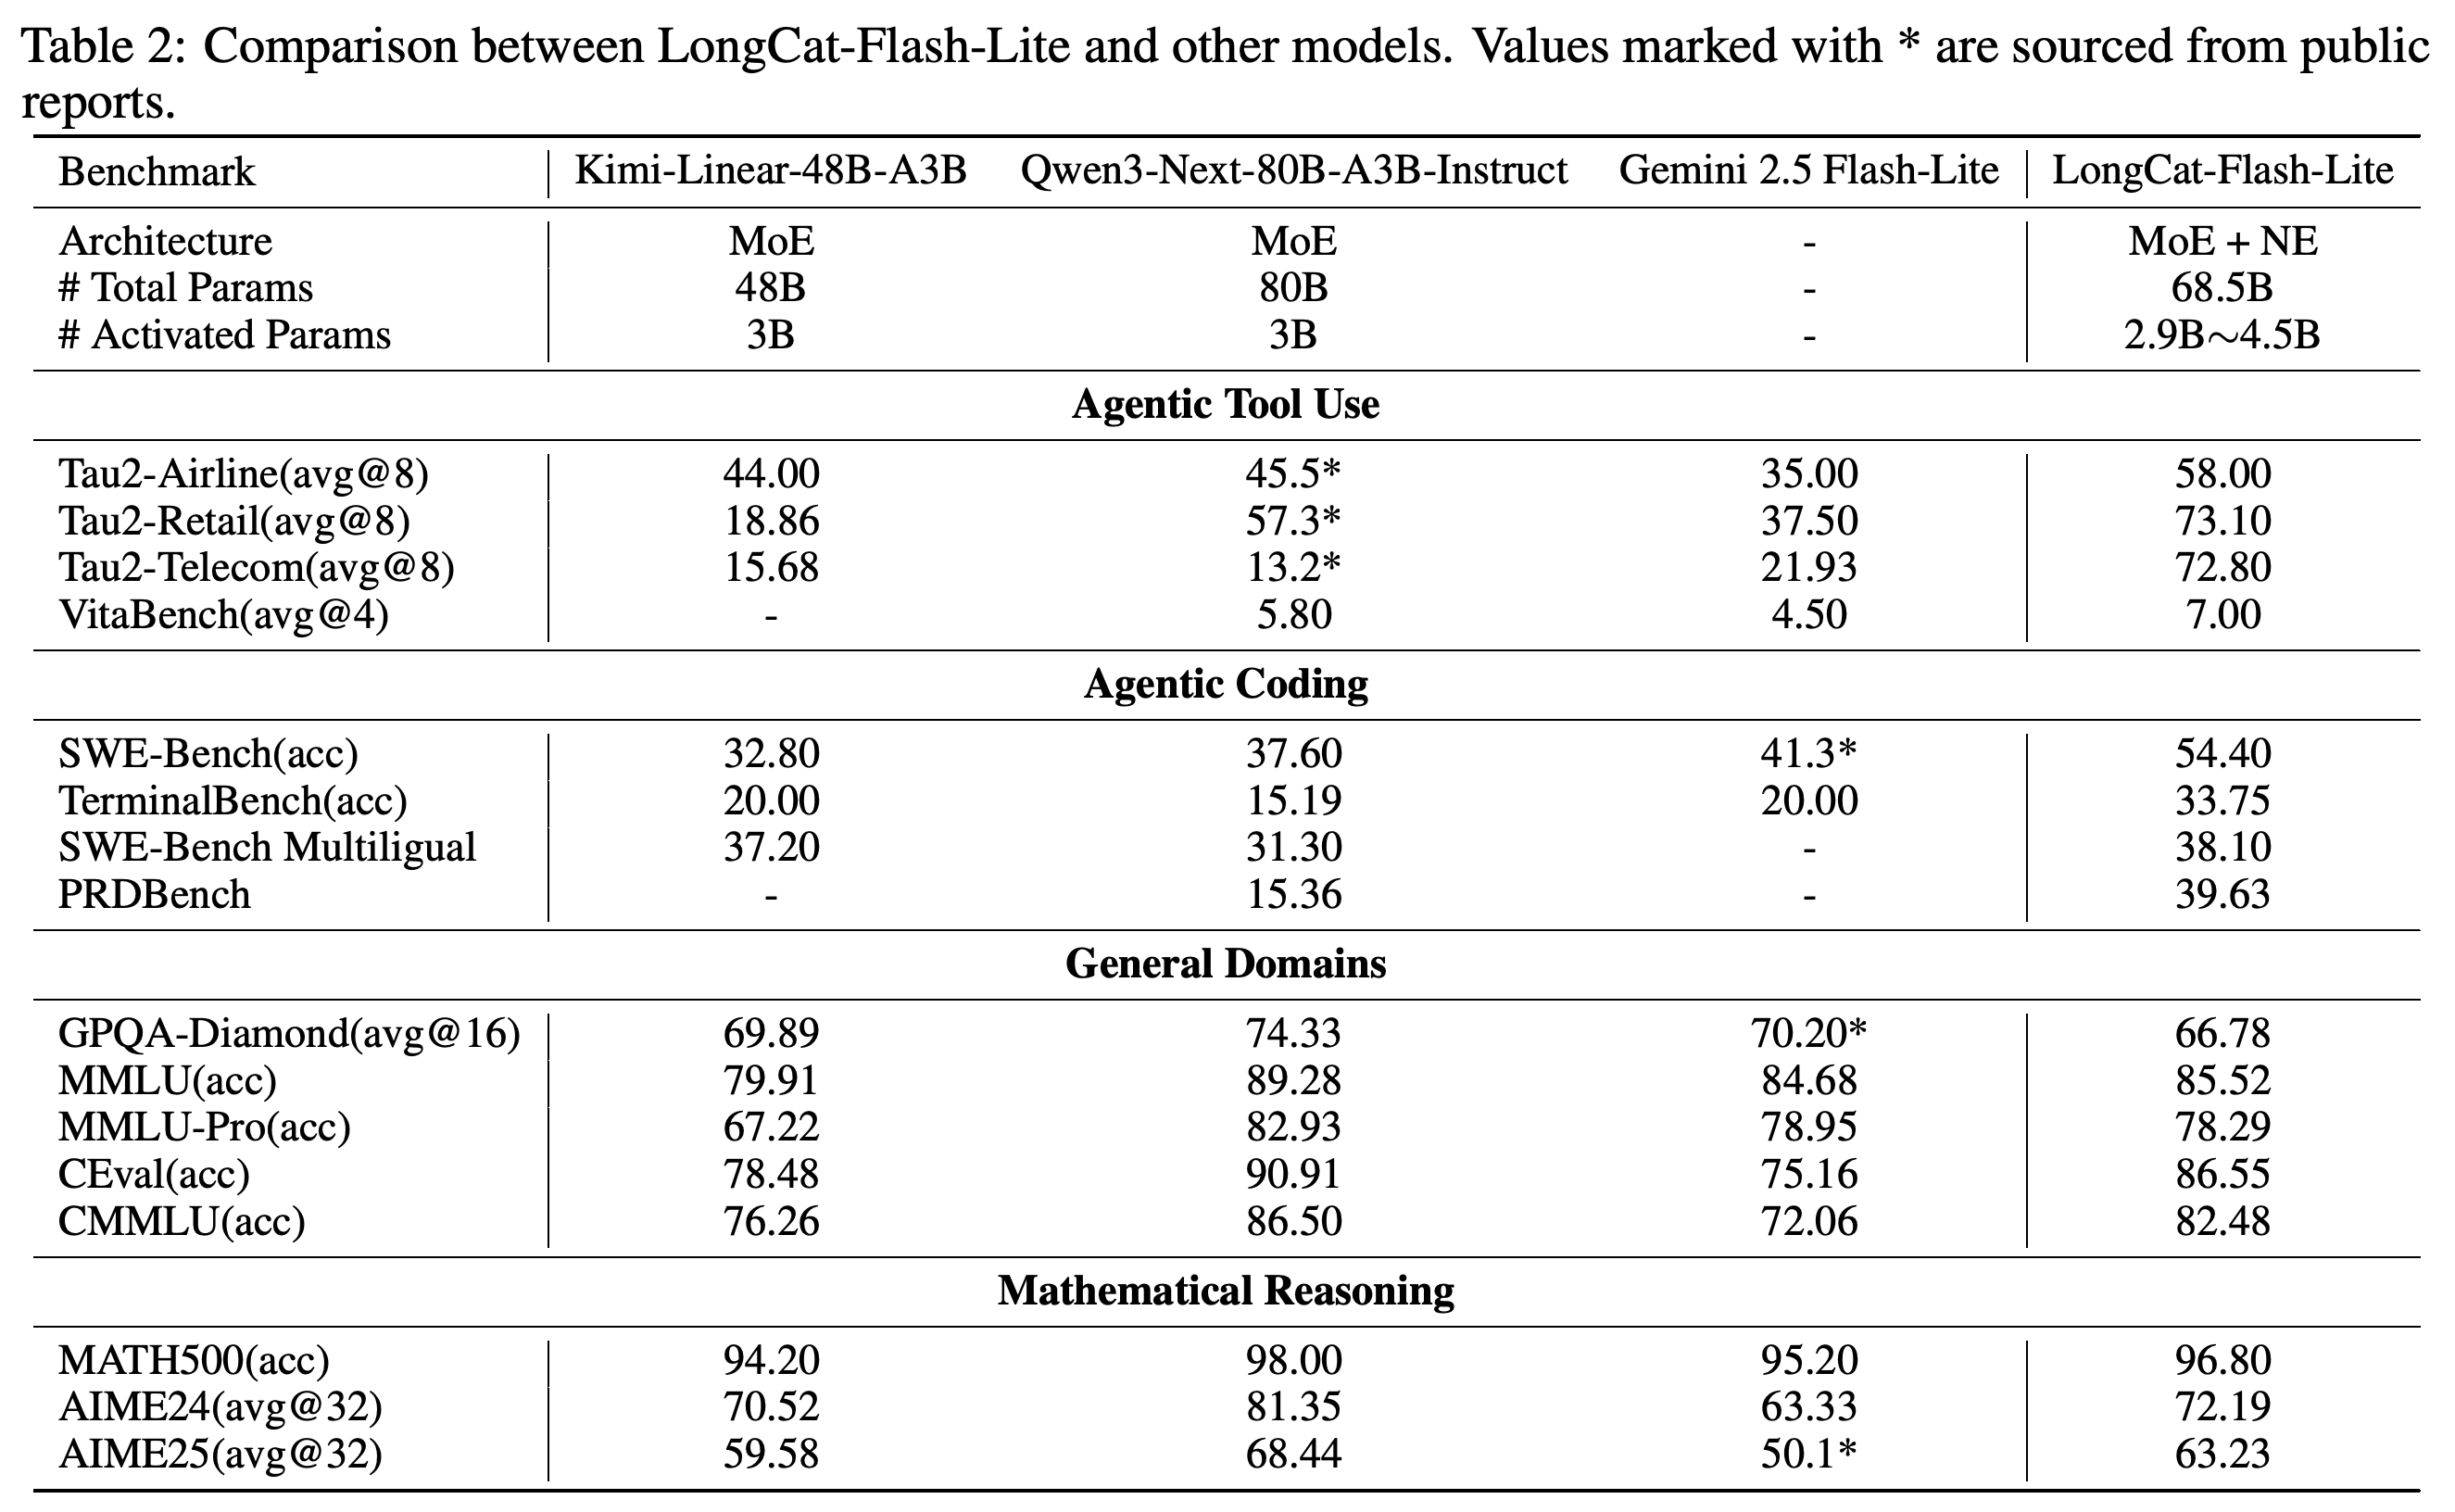
Table 2는 chat model을 Kimi-Linear-48B-A3B, Qwen3-Next-80B-A3B-Instruct, Gemini 2.5 Flash-Lite Preview 09-2025와 비교한다. LongCat-Flash-Lite는 보고된 agentic tool-use 결과에서 앞선다. 점수는 Tau2-Airline(avg@8) 58.00, Tau2-Retail(avg@8) 73.10, Tau2-Telecom(avg@8) 72.80, VitaBench(avg@4) 7.00이다.
- 저자들은 원본의 노이즈를 지적하며, τ²-Bench 평가에 https://github.com/AGI-Eval-Official/tau2-bench-revised 의 수정 데이터셋을 사용한다.
- Agentic coding 점수는 SWE-Bench(acc) 54.40, TerminalBench(acc) 33.75, SWE-Bench Multiligual 38.10, PRDBench 39.63이며, 해당 행에 제공된 모든 비교 점수보다 높다.
- 일부 비교값은 공개 보고서에서 가져왔으며 Table 2에서 *로 표시한다. 따라서 모두 동일한 통제 조건에서 재평가한 결과는 아니다.
Chat 평가 결과는 agentic task 외의 영역에서 일관된 우위를 보이지 않는다. LongCat-Flash-Lite의 GPQA-Diamond(avg@16) 점수는 66.78로 비교 모델 3개 모두보다 낮다. 보고된 모든 일반 분야 및 수학 벤치마크에서도 Qwen3-Next-80B-A3B-Instruct보다 낮다.
- 다른 일반 분야 점수는 MMLU(acc) 85.52, MMLU-Pro(acc) 78.29, CEval(acc) 86.55, CMMLU(acc) 82.48이다.
- 수학 점수는 MATH500(acc) 96.80, AIME24(avg@32) 72.19, AIME25(avg@32) 63.23이다. Kimi-Linear-48B-A3B와 Gemini 2.5 Flash-Lite보다 높지만 Qwen3-Next-80B-A3B-Instruct보다 낮다.
- Vanilla chat model과의 비교는 보고하지 않는다. 따라서 외부 모델과의 agentic 비교 결과만으로는 임베딩 확장의 기여를 학습 데이터와 post-training의 효과에서 분리할 수 없다.
LongCat-Flash-Lite는 비교 점수가 제공된 모든 agentic 행에서 앞서지만, 보고된 모든 일반 분야와 수학 행에서는 Qwen3-Next-80B-A3B-Instruct가 앞선다. LongCat-Flash-Lite의 GPQA-Diamond 점수는 모델 4개 중 가장 낮다. *로 표시한 공개 보고서 값과 누락된 값 때문에 비교 조건이 균일하지 않다.
6.4 Fast Inference with Optimized Kernels
배포에서는 Eagle3에 3-step speculative decoding 전략, wide EP (Expert Parallel), SBO (Single Batch Overlap)를 결합한다. Kernel Optimization은 통신과 연산자 융합, 양자화 모델의 기존 연산자에 통합한 활성값 양자화, 라우팅과 zero-expert 선택의 통합, 최적화한 attention-combine 커널로 launch 오버헤드를 줄인다.
- 융합 예시는 AllReduce + Residual Add + RMSNorm, AllGather + Q-Norm + KV-Norm, ReduceScatter + RMSNorm + Hidden State Combine이다.
- 최적화한 splitkv-and-combine 구현은 combine-kernel 지연 시간을 50% 줄인다. 이는 구성 요소 수준의 결과이며 end-to-end 50% 가속을 뜻하지 않는다.
- PDL (Programmatic Dependent Launch)은 의존 관계가 있는 커널을 일찍 실행하여 실행 구간을 겹치게 한다. Figure 8b는 통합 서빙 결과를 제시하지만 Eagle3, 캐싱, 융합, PDL을 분리한 ablation은 제공하지 않는다.
7 Conclusions
보고서는 특정 희소성과 아키텍처 조건에서 임베딩 확장이 expert 확장보다 손실과 용량 사이의 절충 관계를 개선할 수 있다고 결론짓는다. LongCat-Flash-Lite는 이 배분 전략을 더 큰 규모에서 보여준다. N-gram Cache와 최적화한 커널은 임베딩 분기가 추가하는 서빙 오버헤드를 다룬다.
부록
- 제공된 18페이지 PDF에는 부록이 없다. 결론과 감사의 글 다음에 나오는 16–18페이지는 참고문헌이며, 추가 실험이나 구현 부록은 제공하지 않는다.
짧은 생각
가장 강한 근거는 통제된 파라미터 배분 비교다. 소규모 연구에서는 총 파라미터와 학습 토큰 수를 맞췄고, 이어 1.3T 토큰에서 동일한 데이터를 사용한 Vanilla와 비교했다. 폭, 깊이, 해싱, 증폭 실험까지 함께 보면, 이 결과는 임베딩 확장이 언제나 expert 확장보다 우수하다는 무조건적 주장보다 조건부 설계 지침을 뒷받침한다. 약 50%의 임베딩 예산 권고는 아키텍처에 따라 달라지는 교차점과 중국어 및 영어 검증의 상이한 결과를 함께 고려해야 한다. Figure 9는 per-layer 방법에 관한 주장의 범위를 좁힌다. PLNE의 작은 검증 이득은 학습 손실에는 나타나지 않으며, 추가 확장에서도 일관되게 유지되지 않는다.
Chat model의 강점과 end-to-end 추론 이득의 원인을 판단할 근거는 상대적으로 부족하다. 보고서에는 Vanilla chat 비교, expert-only 서빙 성능 곡선, 시스템 구성 요소별 ablation이 없다. 확장 실험과 벤치마크 결과의 불확실성 구간이나 여러 seed에서의 변동성도 보고하지 않는다. 서빙 성능 곡선은 8xH800-80G, ISL=4K, OSL=1K 조건에 한정된다. 따라서 다른 하드웨어, 문맥 길이, 배치 분포에서도 같은 이점이 있다고 입증하지는 않는다. 임베딩 기반 drafting과 조기 거부는 연구 제안으로 남아 있으며, 입증된 가속 효과에 포함해서는 안 된다.