


Ministral 3 요약 설명
13 Jan 2026 | Paper Review Knowledge Distillation Model Pruning LLM Pretraining Reinforcement Learning목차
- 요약
- 1 Introduction
- 2 Model Architecture
- 3 Training Recipe
- 4 Results
- 5 Discussions
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Ministral 3 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 13일(Arxiv)
- Liu, Alexander H., Khandelwal, Kartik, Subramanian, Sandeep, Jouault, Victor, Rastogi, Abhinav, Sadé, Adrien, Jeffares, Alan, Jiang, Albert, Cahill, Alexandre, Gavaudan, Alexandre, et al.
- 논문 링크
- Project Page
요약
- Ministral 3는 3B, 8B, 14B 파라미터 규모의 Base, Instruct, Reasoning으로 구성된 9개의 오픈 웨이트 밀집 모델을 소개한다. 모든 모델이 이미지 이해를 지원하며 Apache 2.0으로 공개된다. 서론에 명시된 최대 컨텍스트 길이는 256k 토큰이며, Reasoning 모델은 128k 토큰이다.
- Cascade Distillation은 사전학습된 Mistral Small 3.1 부모 모델을 점차 작은 모델로 가지치기하고, 로짓 증류로 성능을 회복한다. 논문에서 보고한 자식 모델의 학습량은 1조~3조 토큰이지만, 이 비교에는 부모 모델의 최초 학습 비용이 포함되지 않는다.
- 14B 모델이 기준 모델과의 비교에서 가장 좋은 결과를 보인다. Base는 24B 부모 모델의 능력을 상당 부분 유지하고, Reasoning은 보고된 6개 추론 벤치마크 모두에서 Qwen 3 14B를 앞선다. 더 작은 모델의 결과는 엇갈리며, 교사 모델 비교 실험은 사전학습에서 더 뛰어난 교사가 반드시 더 좋은 학생을 만드는 것은 아니라는 점을 보여준다.
1 Introduction
이 논문은 연산량과 메모리가 제한된 환경에서 사용할 고성능 소형 모델을, 규모마다 처음부터 독립적으로 사전학습하지 않고 만드는 방법을 다룬다. Ministral 3는 24B Mistral Small 3.1 모델의 지식과 가중치를 재사용해 점차 작은 모델을 만든다.
- 서론은 자식 모델의 학습량인 1조~3조 토큰을 Qwen3의 36조 토큰, Llama3의 15조 토큰과 비교한다. 이는 보고된 학습 토큰 수의 비교이며, 전체 연산량을 동일한 조건에서 측정한 결과는 아니다.
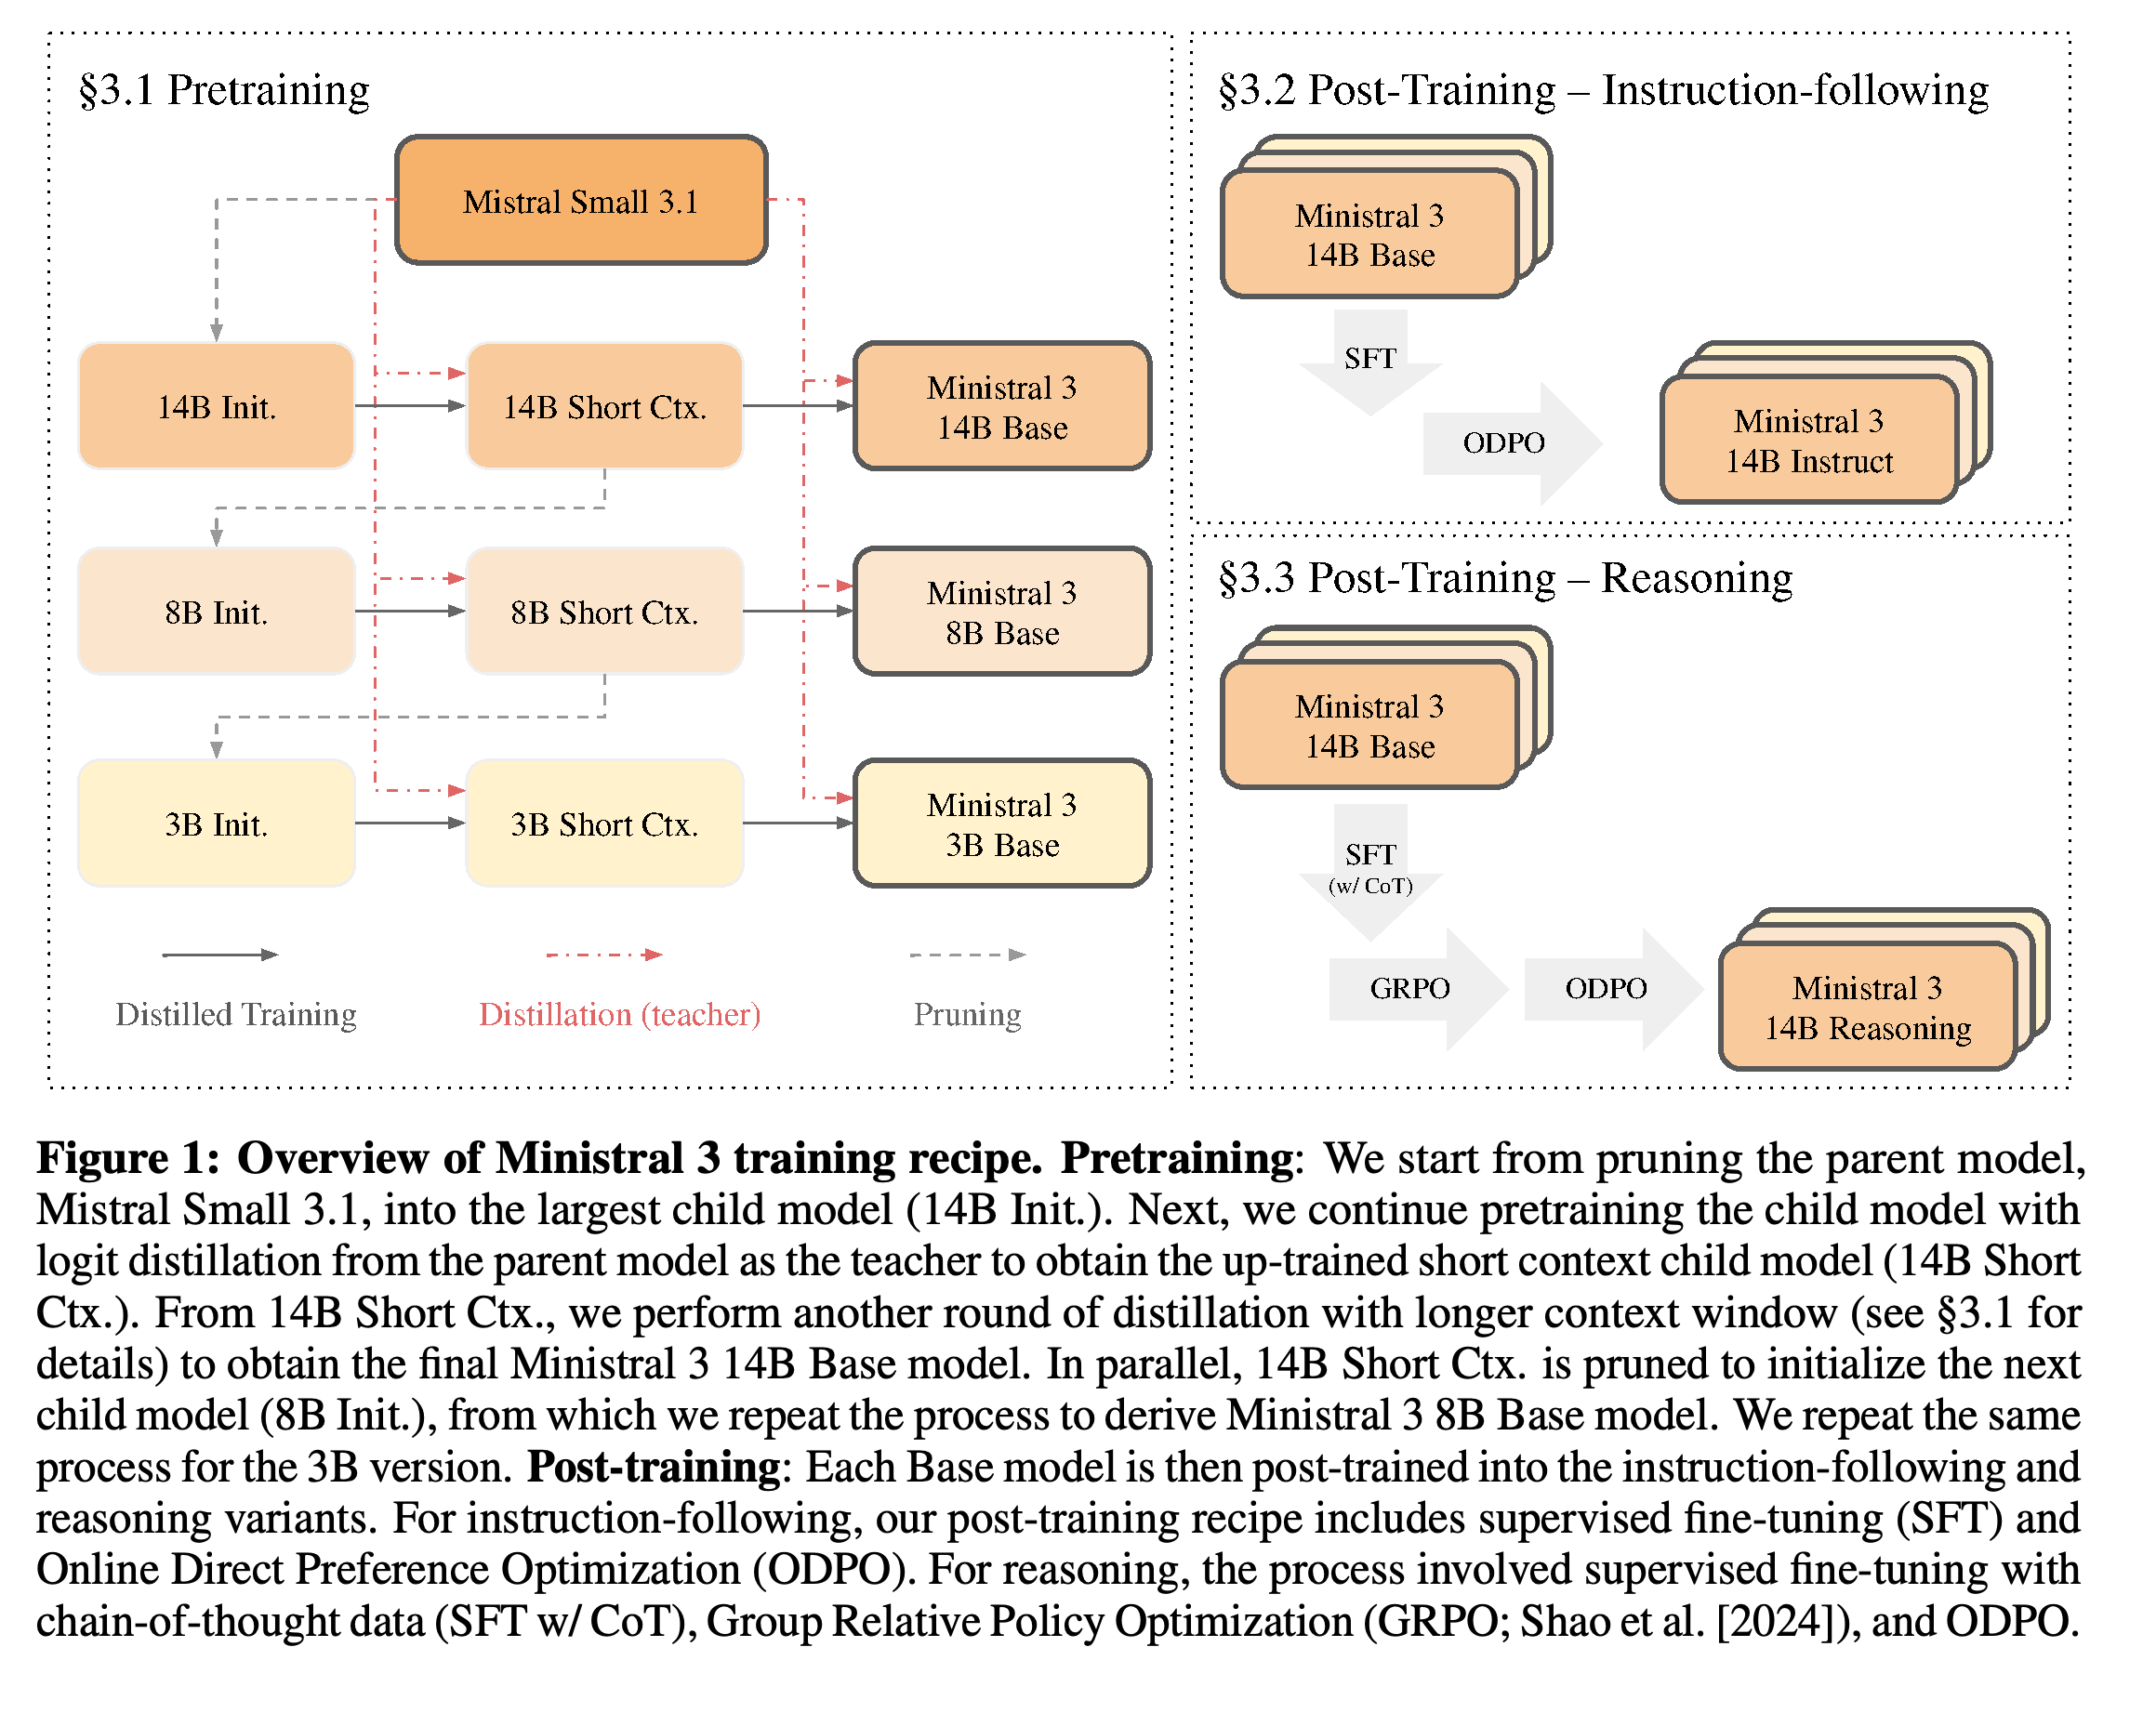
- Figure 1은 순차적인 사전학습 캐스케이드와 별도의 지시 수행 및 추론 후속 학습 분기를 구분한다.
- 공개 자료는 https://mistral.ai/news/mistral-3 및 https://huggingface.co/collections/mistralai/ministral-3 에서 확인할 수 있다.
이 도식은 2가지 재사용 방식을 구분한다. 짧은 컨텍스트 자식 체크포인트는 다음의 더 작은 모델을 초기화하고, Mistral Small 3.1은 사전학습 전체에서 교사 로짓을 제공한다. Instruct와 Reasoning은 하나의 후속 학습 파이프라인에서 이어지는 단계가 아니라 Base에서 나뉘는 별도 분기다.
2 Model Architecture
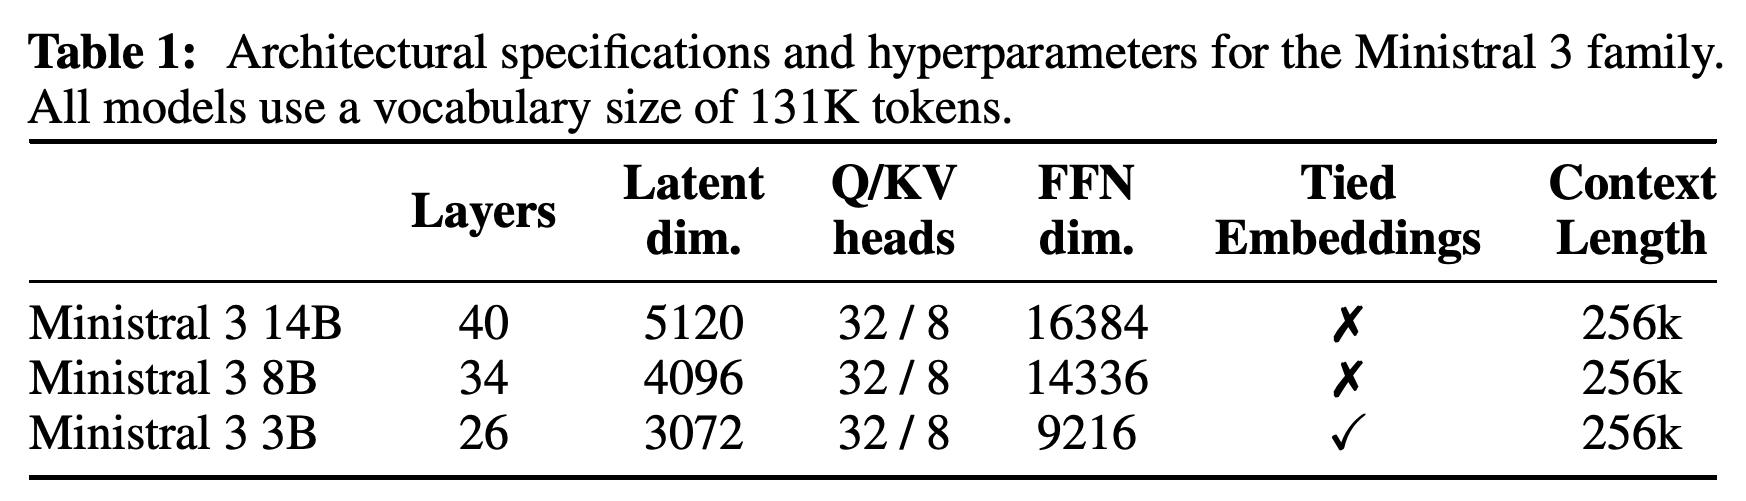
모델은 Grouped Query Attention, 쿼리 헤드 32개, 키-값 헤드 8개, RoPE, SwiGLU, RMSNorm, 131K-token 어휘를 사용하는 디코더 전용 Transformer다. Table 1은 깊이와 너비를 모두 줄이는 구조를 보여준다. 입력과 출력 임베딩을 공유하는 모델은 3B뿐이다.
- 14B, 8B, 3B 순서로 레이어 수는 40, 34, 26개이고, 잠재 차원은 5120, 4096, 3072이며, FFN 차원은 16384, 14336, 9216이다.
- 긴 컨텍스트로 확장할 때는 YaRN과 위치 기반 softmax 온도 조정을 사용한다. Table 1에는 아키텍처의 컨텍스트 길이가 256k로 기재되어 있지만, 서론은 공개된 Reasoning 모델의 컨텍스트를 별도로 128k로 제한한다.
- 모든 모델은 Mistral Small 3.1 Base에서 410M-parameter ViT를 물려받아 고정하며, Pixtral에 기술된 아키텍처를 사용한다. 기존의 비전-언어 투영은 제거하고 모델마다 새로운 투영을 학습한다.
명세는 쿼리 헤드 32개와 키-값 헤드 8개를 유지하면서 깊이, 잠재 차원, FFN 너비를 줄이는 구조를 보여준다. 3B 모델은 임베딩을 공유한다는 점이 다르며, 이를 통해 131K-token 어휘에 할당되는 파라미터 수를 제한한다.
3 Training Recipe
학습은 가지치기와 증류를 활용한 지속 사전학습으로 멀티모달 Base 체크포인트를 만드는 데서 시작한다. 이후 각 Base 체크포인트에서 2개의 별도 후속 학습 파이프라인을 시작한다. Instruct에는 SFT 이후 ODPO를 적용하고, Reasoning에는 추론 SFT 이후 GRPO와 ODPO를 적용한다.
3.1 Pretraining
Cascade Distillation은 Mistral Small 3.1에서 14B, 8B, 3B로 이어지는 ‘가지치기-증류-반복’ 순서를 따른다. Algorithm 1은 짧은 컨텍스트 체크포인트를 다음 가지치기의 시작점으로 보존한다. 별도의 긴 컨텍스트 학습 분기에서는 각 규모의 최종 Base 모델을 만든다.
- 캐스케이드 전체에서 로짓 교사는 Mistral Small 3.1로 유지된다. 점차 작아지는 체크포인트는 초기화 가중치를 제공할 뿐, 원래 교사를 대체하지 않는다.
- 저자들은 이 과정을 중간에 가지치기를 수행하는 지속 사전학습으로 설명한다. 캐스케이드 전체에서 혼합된 학습 데이터를 반복 없이 사용한다.
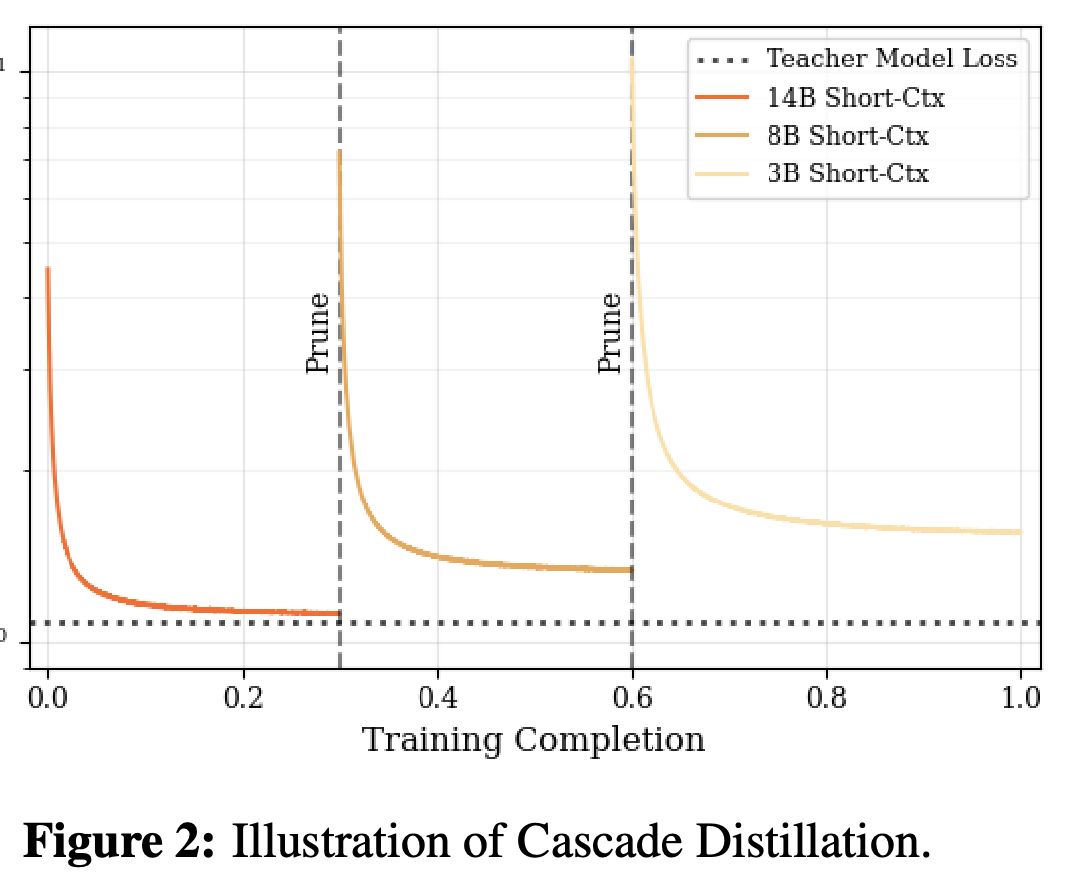
- Figure 2는 가지치기 직후 교차 엔트로피 손실이 급증하고, 지속 학습 과정에서 회복되는 모습을 보여준다. 캐스케이드를 설명하는 그림이며, 처음부터 학습하는 방법 대비 이점을 정량화하지는 않는다.
가지치기마다 손실이 급증한 뒤 증류 학습 중 회복된다. 더 작은 체크포인트의 손실은 교사의 손실보다 높은 수준에 머무르므로, 교사 수준의 교차 엔트로피까지 완전히 회복하지는 못함을 보여준다. 이 그래프는 독립적인 사전학습 대비 절감량을 정량화하지 않는다.
Algorithm 2는 대규모 보정 배치에서 얻은 활성값을 사용해 레이어, 은닉 차원, 피드포워드 차원을 가지치기한다. 활성값 기반 기준으로 선택한 구성 요소를 유지하면서 더 큰 체크포인트를 목표 아키텍처에 맞춘다.
- 레이어 선택에는 활성값 노름의 비율을 중요도의 대리 지표로 사용한다. 주변 본문은 출력 대비 입력 노름의 비율로 설명하지만, Algorithm 2는 명시적으로 (output_norm / input_norm).mean()을 계산하고 점수가 높은 레이어를 유지한다.
- 은닉 차원을 가지치기할 때는 여러 레이어의 어텐션 정규화 입력과 피드포워드 정규화 입력을 연결한 뒤 PCA를 적용한다. 차원을 줄이기 전에 네트워크 전체에서 공유하는 회전을 구한다.
- 피드포워드 가지치기는 게이트 활성값 silu(layer.ffn.w1.output_x) * layer.ffn.w3.output_x의 절댓값 평균으로 점수를 계산하고, 점수가 가장 높은 차원을 유지한다.
가지치기 이후 각 자식 모델은 텍스트 전용 데이터와 텍스트·이미지가 번갈아 등장하는 데이터를 사용해 forward KL 로짓 증류로 학습한다. 저자들은 이 목적 함수만 사용하는 방법이 증류 손실과 다음 토큰 예측 손실의 가중 조합을 조정하는 방법보다 우수하다고 보고한다. 다만 손실 목적 함수 비교 실험의 수치는 제시하지 않는다.
- 짧은 컨텍스트 단계는 16,384 토큰의 컨텍스트 윈도우를 사용하며, 이 단계의 결과로 다음 자식 모델을 초기화한다.
- 긴 컨텍스트 단계에서는 YaRN과 위치 기반 온도 조정으로 윈도우를 16,384 토큰에서 262,144 토큰으로 확장한다.
3.2 Post-Training: Ministral Instruct
3.2.1 Supervised Fine-tuning은 선별한 텍스트 전용 및 멀티모달 지시 데이터, fp8 양자화, Mistral Medium 3의 로짓 증류 손실을 사용한다. 저자들은 사전학습과 달리 이 단계에서는 더 강력한 교사가 도움이 된다고 보고한다. 비전 인코더는 고정하고 어댑터는 학습한다.
3.2.2 Online Direct Preference Optimization 단계는 현재 정책에서 T=0.7로 응답 2개를 샘플링하고, 텍스트 기반 Pairwise Reward Model(PWRM)로 순위를 매긴다. 확정적인 승자·패자 레이블 대신 PWRM이 예측한 선호 확률로 가중한 양방향 DPO 손실을 사용한다.
- PWRM은 후보 응답이 쌍으로 포함된 대화 기록을 사용해 SFT로 학습한다. 온도를 조정해 선호 확률을 보정하고, β-rescaling으로 DPO 손실을 안정화한다.
- 무한 반복이 나타나는 응답은 자동으로 패자로 처리해 이러한 생성 오류를 억제한다.
- 생성 중에는 도구 실행을 허용한다. 저자들은 도구 사용 성능이 향상되고 SFT나 오프라인 선호 최적화보다 선호 정렬이 좋아진다고 보고하지만, 이를 뒷받침하는 수치 비교 실험은 제시하지 않는다.
3.3 Post-Training: Ministral Reasoning
3.3.1 Reasoning Supervised Fine-Tuning은 Instruct ODPO 체크포인트가 아니라 긴 컨텍스트 사전학습 체크포인트에서 시작한다. 수학, 코딩, 대화, 지시 수행, 다국어 작업, 도구 사용, 시각적 추론에 걸쳐 짧고 긴 chain-of-thought 샘플을 혼합한다.
- 긴 추론 과정 앞에는 추론 전용 시스템 프롬프트를 붙인다. 필터링을 통해 형식이 부적절하거나 반복이 과도하거나 원치 않는 언어 전환이 나타나는 샘플을 제거한다.
- 3B에서는 일반 SFT가 불안정하고 반복적이며 지나치게 장황한 출력과 무한 생성을 유발했다. 저자들은 Magistral Small 1.2의 로짓 증류가 장황함을 줄이고 이후 RL을 안정화했다고 보고한다.
3.3.2 Reinforcement Learning은 GRPO를 2단계로 적용한다. 수학, 코드, 시각적 추론에 대한 STEM RL 이후, 더 폭넓은 대화와 지시 수행 프롬프트에 대한 General RL을 수행한다. General RL은 개별 채점 기준을 사용하며, LLM 평가자가 충족된 휴리스틱의 비율을 보상으로 부여한다.
- STEM 질문-답변 쌍은 공개 및 비공개 출처에서 수집한다. 유효하지 않거나 불완전하거나 너무 쉽거나 너무 어려운 문제는 필터링한다. 자세한 학습 방법은 Rastogi et al. [2025]를 참조하도록 한다.
- 저자들은 General RL이 STEM 성능을 유지하고 때로는 향상하면서 대화와 지시 수행을 개선한다고 보고하지만, 단계별 수치 표는 제공하지 않는다.
- RL 생성 결과 중 상당수가 최대 길이에 도달해 잘렸기 때문에 최대 생성 길이를 32K에서 80K로 늘린다. 저자들은 어려운 추론 과정을 끝까지 생성할 수 있을 때 성능이 추가로 향상된다고 보고한다.
3.3.3 Online Direct Preference Optimization은 GRPO 이후 최종 선호 정렬 단계를 추가한다. Instruct ODPO 설정을 따르되, 보상 모델이 생성 응답을 평가하기 전에 thinking chunks를 제거한다.
- 이 단계는 제거된 추론 과정을 직접 평가하기보다 대화와 지시 수행 행동을 대상으로 한다.
- 모델 규모에 따른 결과는 Section 5.3과 Figure 6에서 살펴본다.
4 Results
평가는 일반 지식과 추론, 수학과 코딩, 다국어 지식, 멀티모달 이해, 후속 학습 이후의 행동을 다룬다. 외부 기준 모델은 저자들의 평가 파이프라인으로 다시 평가하며, Table 2는 모든 모델에 동일한 설정을 사용했다고 명시한다.
- Base 평가에는 MMLU, MMLU-Redux, ARC-Challenge, RACE High, TriviaQA, NaturalQS, AGIEval, MATH, GPQA Diamond, MBPP, MMMU, MathVista가 포함된다.
- 후속 학습 평가에는 Arena Hard, WildBench, MM MTBench, AIME 2024/2025, HMMT 2025, PhyBench, LiveCodeBench가 포함된다.
- MM MTBench는 https://huggingface.co/datasets/mistralai/MM-MT-Bench 에서 확인할 수 있다. 보고서는 모든 벤치마크에 대해 완전히 재현 가능한 평가 설정을 제공하지는 않는다.
4.1 Pretraining Results
Table 2의 Base 결과는 경쟁력이 있지만 벤치마크에 따라 달라진다. Ministral 3 14B는 TriviaQA에서 74.9 대 70.3, MATH에서 67.6 대 62.0으로 Qwen 3 14B를 앞선다. 반면 MMLU-Redux, AGIEval, Multilingual MMLU에서는 점수가 낮다.
- 8B에서 Ministral과 Qwen의 점수는 MMLU-Redux에서 79.3 대 79.4, TriviaQA에서 68.1 대 63.9, MATH에서 62.6 대 57.6이다. 또한 제시된 5개 지표 중 4개에서 Gemma 3 12B를 앞서지만, TriviaQA에서는 뒤진다.
- 3B에서 Ministral은 TriviaQA에서 59.2 대 53.0, MATH에서 60.1 대 40.5로 Qwen 3 4B를 앞서지만, 나머지 3개 지표에서는 뒤진다.
- 본문은 Ministral 3 14B가 모든 벤치마크에서 Gemma 3 12B보다 우수하다고 주장하지만, Table 2의 TriviaQA 점수는 74.9 대 78.8로 이 주장과 모순된다.
제시된 각 규모에서 MATH와 TriviaQA 점수는 Qwen보다 높지만, 모든 벤치마크에서 일괄적으로 우수하지는 않다. TriviaQA에서 Gemma 3 12B는 78.8, Ministral 3 14B는 74.9로, 주변 본문의 모든 벤치마크에서 우수하다는 주장과 모순된다.
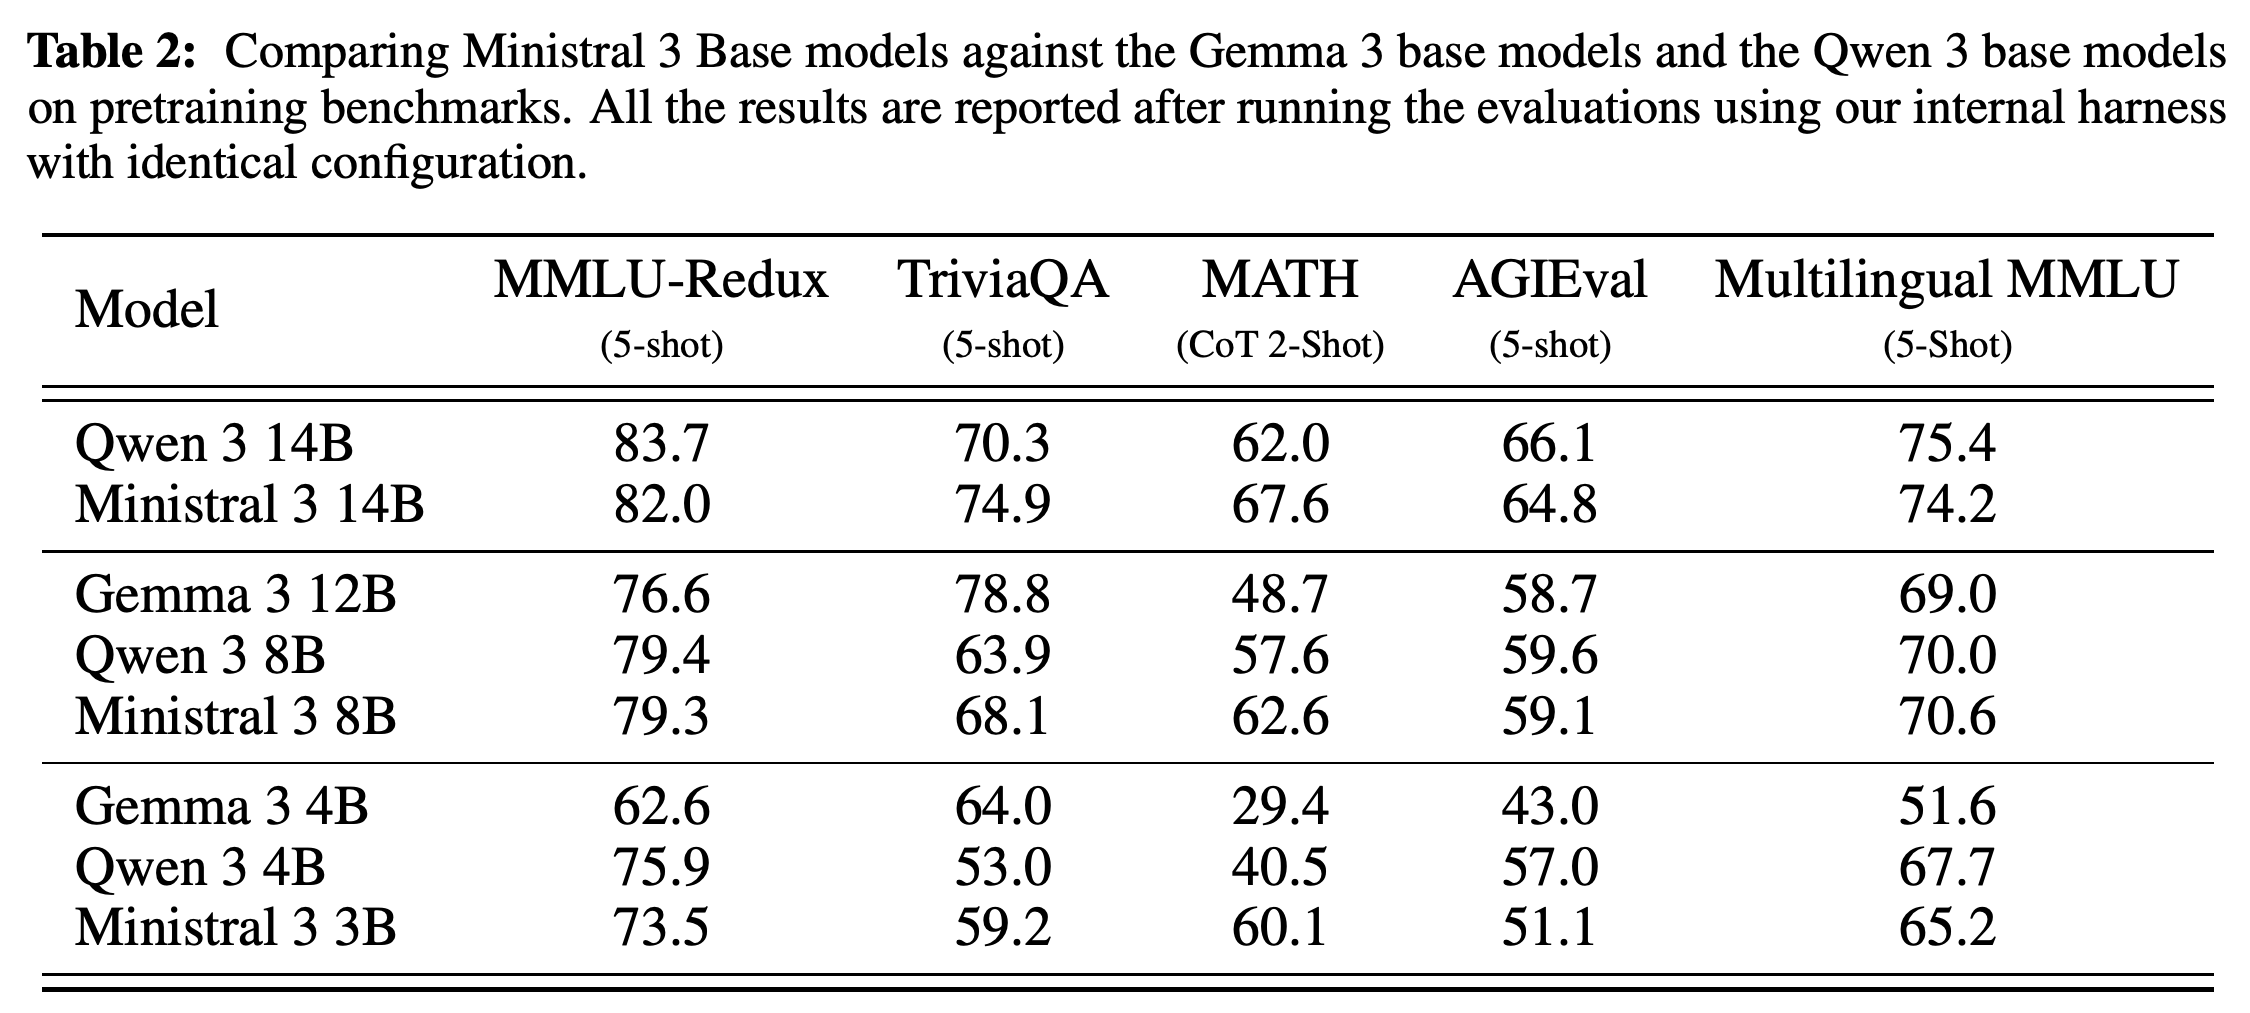
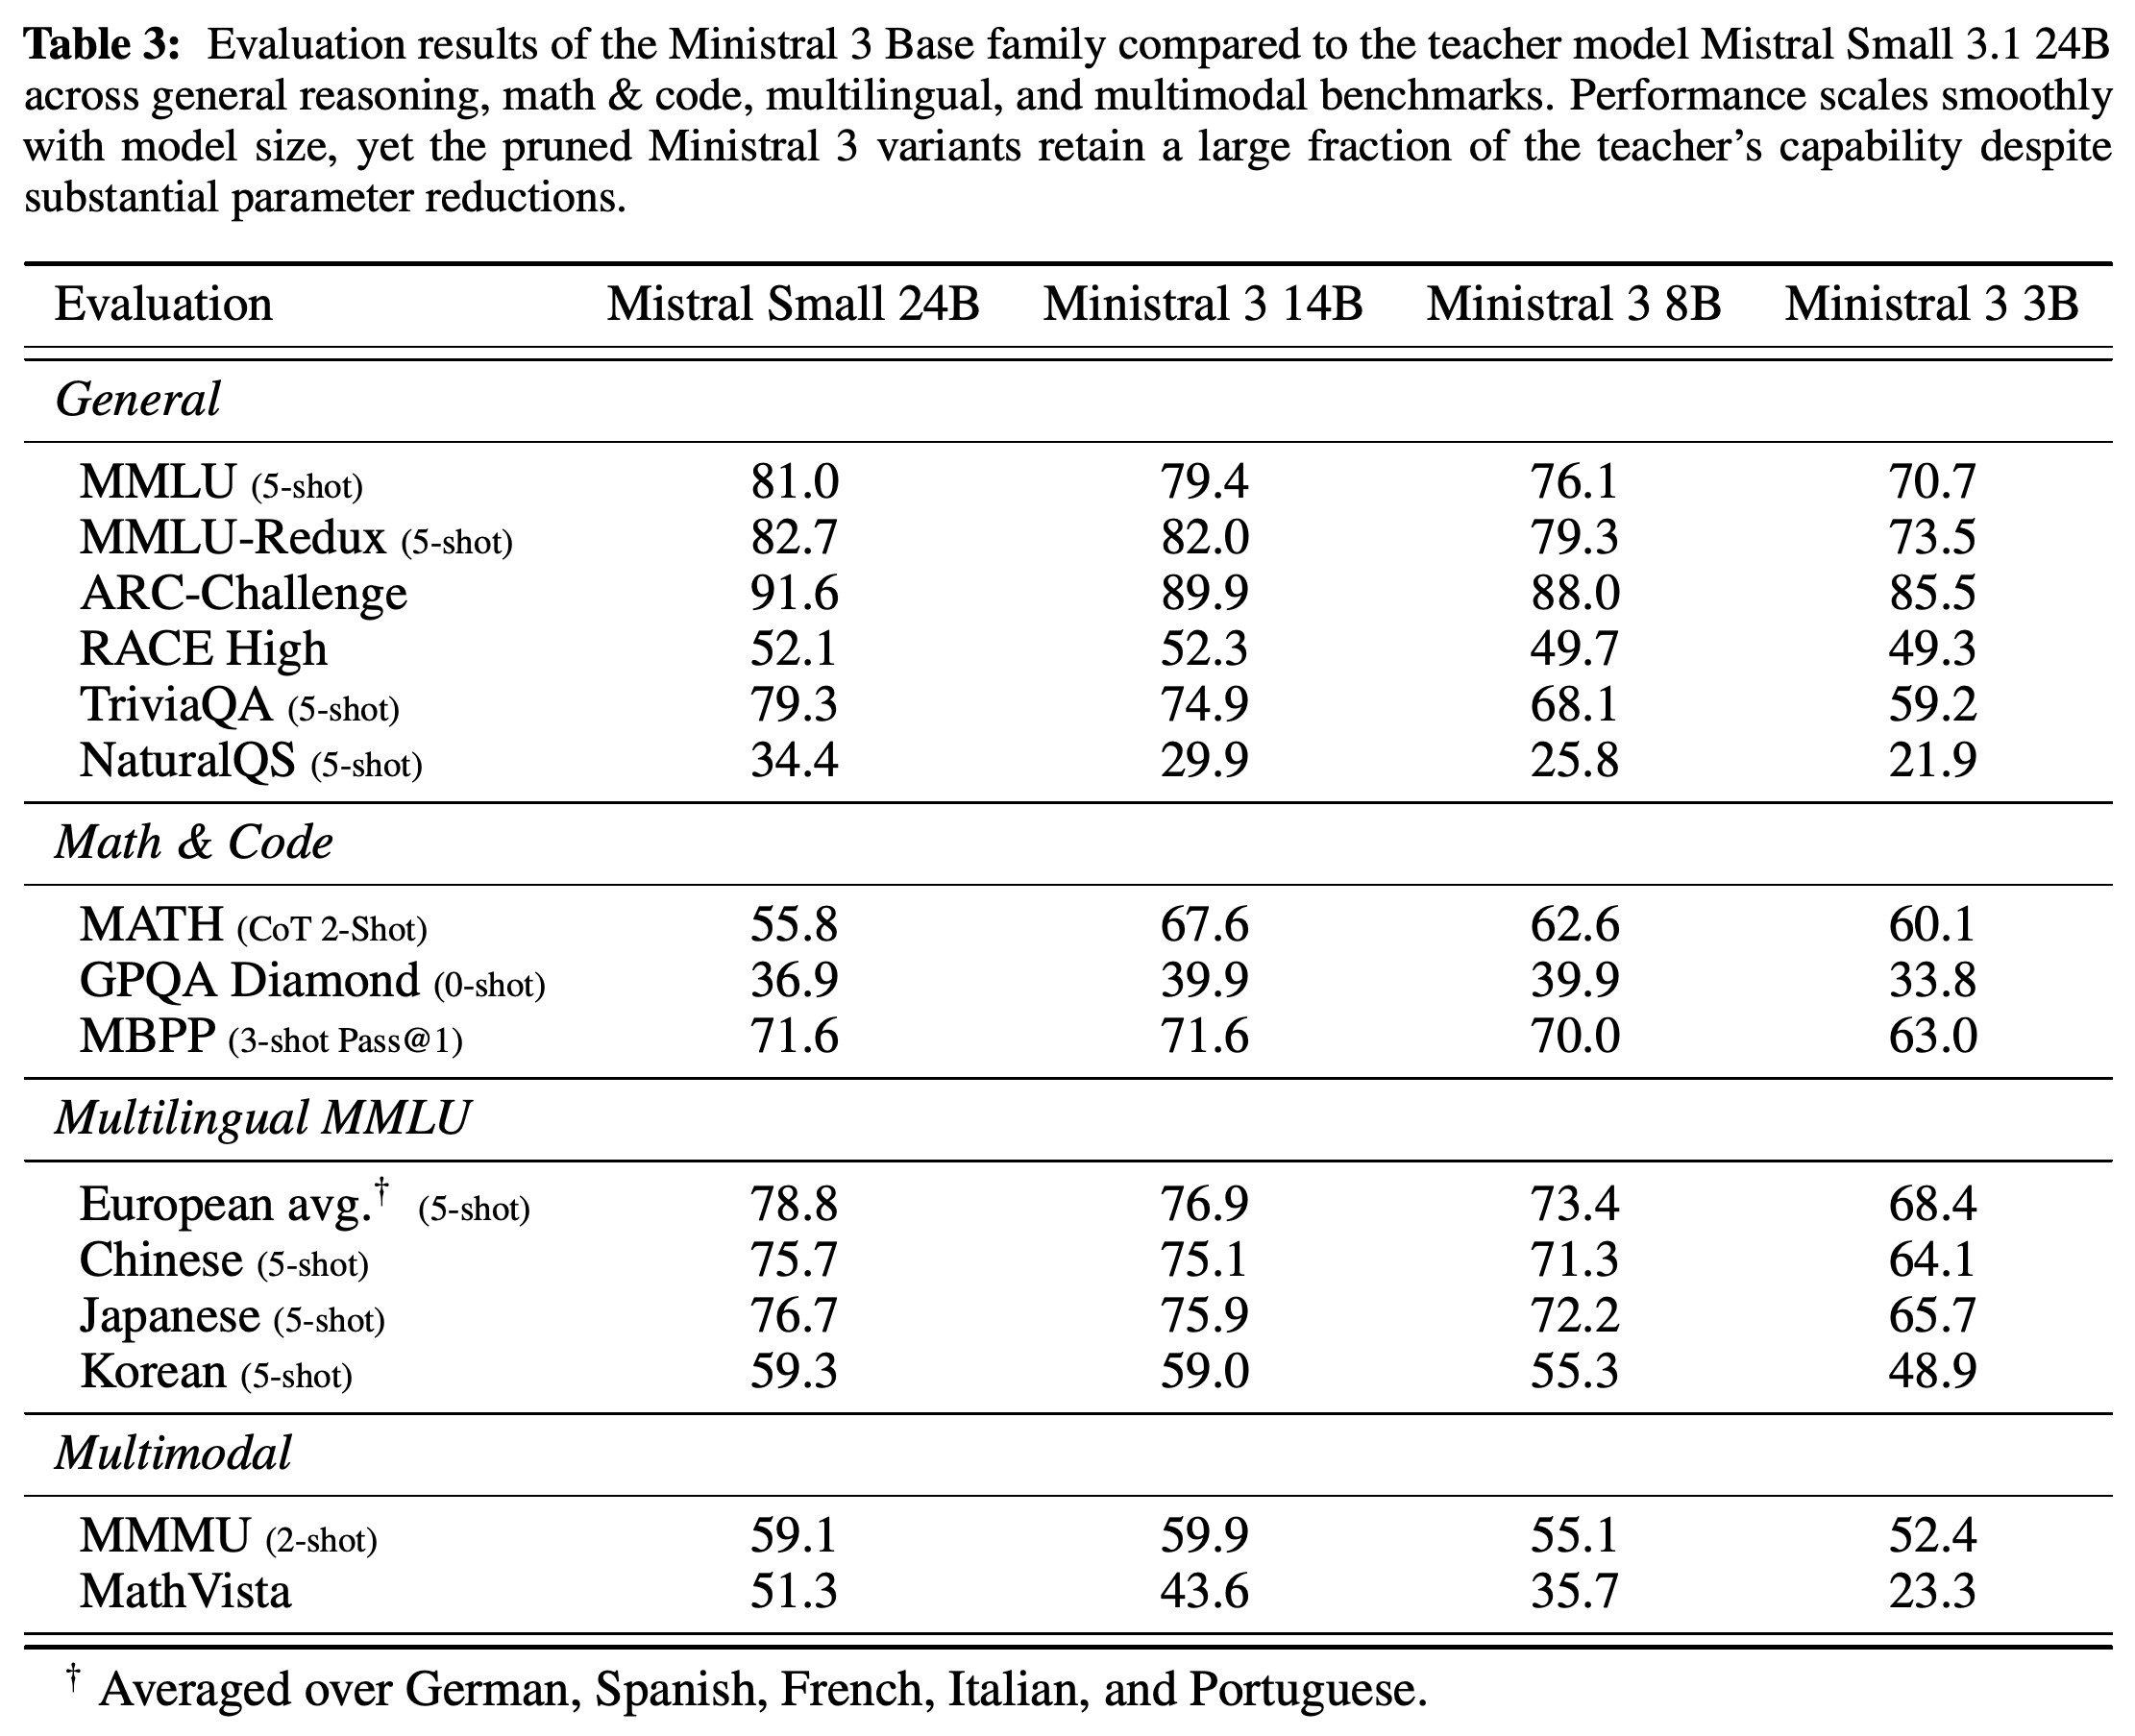
Table 3은 자식 모델을 24B 부모 모델과 직접 비교하며, 능력을 상당 부분 유지하면서도 일부 작업에서는 성능이 하락함을 보여준다. Ministral 3 14B는 MMLU-Redux에서 82.0 대 82.7로 부모 모델에 근접하고, MBPP에서는 71.6으로 동일하며, MATH에서는 67.6 대 55.8로 앞선다.
- 자식 모델 3개 모두 부모 모델의 MATH 점수를 앞선다. 14B, 8B, 3B의 점수는 각각 67.6, 62.6, 60.1이다. 다만 3B의 GPQA Diamond는 부모 모델의 36.9에서 33.8로 하락하므로 추론 능력이 전반적으로 더 좋다는 뜻은 아니다.
- 모델이 작아질수록 지식 검색 성능은 하락한다. NaturalQS는 부모 모델의 34.4에서 29.9, 25.8, 21.9로 낮아진다.
- 멀티모달 결과는 고르지 않다. MMMU에서 14B 모델은 부모 모델의 59.1보다 높은 59.9를 기록하지만, MathVista는 부모 모델의 51.3에서 자식 모델 3개 규모에 걸쳐 43.6, 35.7, 23.3으로 하락한다.
자식 모델은 부모 모델의 성능을 상당 부분 유지하며 모두 MATH 점수를 앞선다. 하지만 규모가 작아질수록 NaturalQS와 MathVista에서 뚜렷한 하락이 나타난다. 14B 모델은 MMMU에서 59.9 대 59.1로 부모를 앞서지만, MathVista에서는 43.6 대 51.3으로 뒤진다. 멀티모달 능력의 유지 정도가 작업에 따라 다름을 보여준다.
4.2 Post-training Results
Table 4는 14B Instruct의 우수한 성능과 더 작은 모델에서 엇갈리는 비교 결과를 보여준다. Ministral 3 14B는 Arena Hard에서 55.1 대 42.7, WildBench에서 68.5 대 65.1, MATH (maj@1)에서 90.40 대 87.00으로 Qwen3 14B (Non-Thinking)를 앞선다.
- Qwen3-VL-8B-Instruct와 비교하면 Ministral 3 8B는 WildBench와 MM MTBench에서 조금 높지만, Arena Hard에서는 50.9 대 52.8, MATH에서는 87.60 대 94.60으로 낮다.
- Ministral 3 3B는 제시된 4개 지표 모두에서 Qwen3-VL-2B-Instruct를 앞선다. 하지만 Qwen3-VL-4B-Instruct와 비교하면 3개 지표에서 뒤지고, WildBench에서는 56.8로 동일하다.
- 주변 본문은 비전 기능을 갖춘 Qwen3-VL 기준 모델을 강조하지만, 14B 행에는 Qwen3 14B (Non-Thinking)가 기재되어 있으며 MM MTBench 결과가 없다.
14B Instruct 모델은 제시된 Qwen3 non-thinking 기준 모델과 비교할 수 있는 모든 공통 지표에서 앞선다. 8B의 Qwen3-VL 비교 결과는 엇갈린다. 3B는 제시된 2B 기준 모델을 앞서지만, 4B 기준 모델에는 3개 지표에서 뒤지고 WildBench에서는 동일하다.
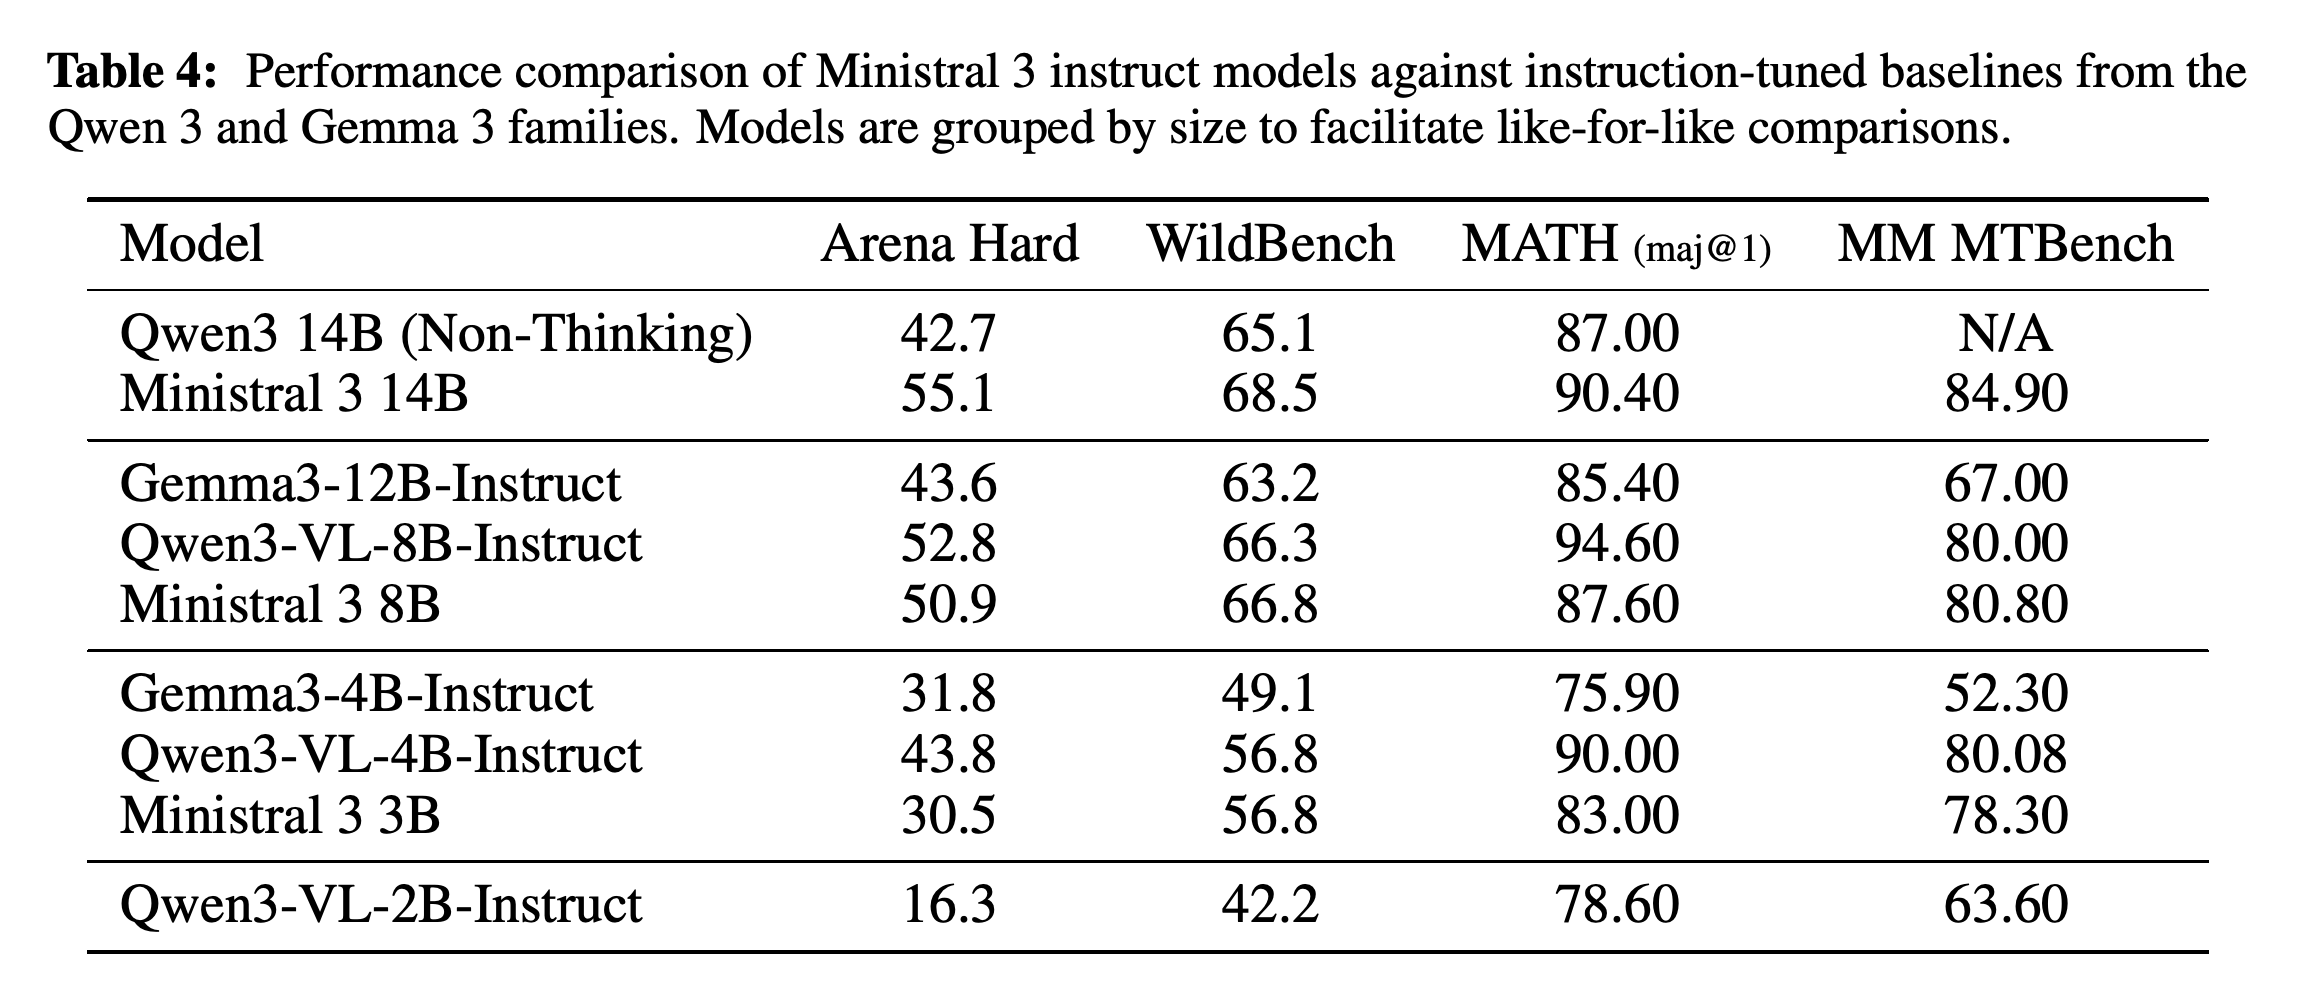
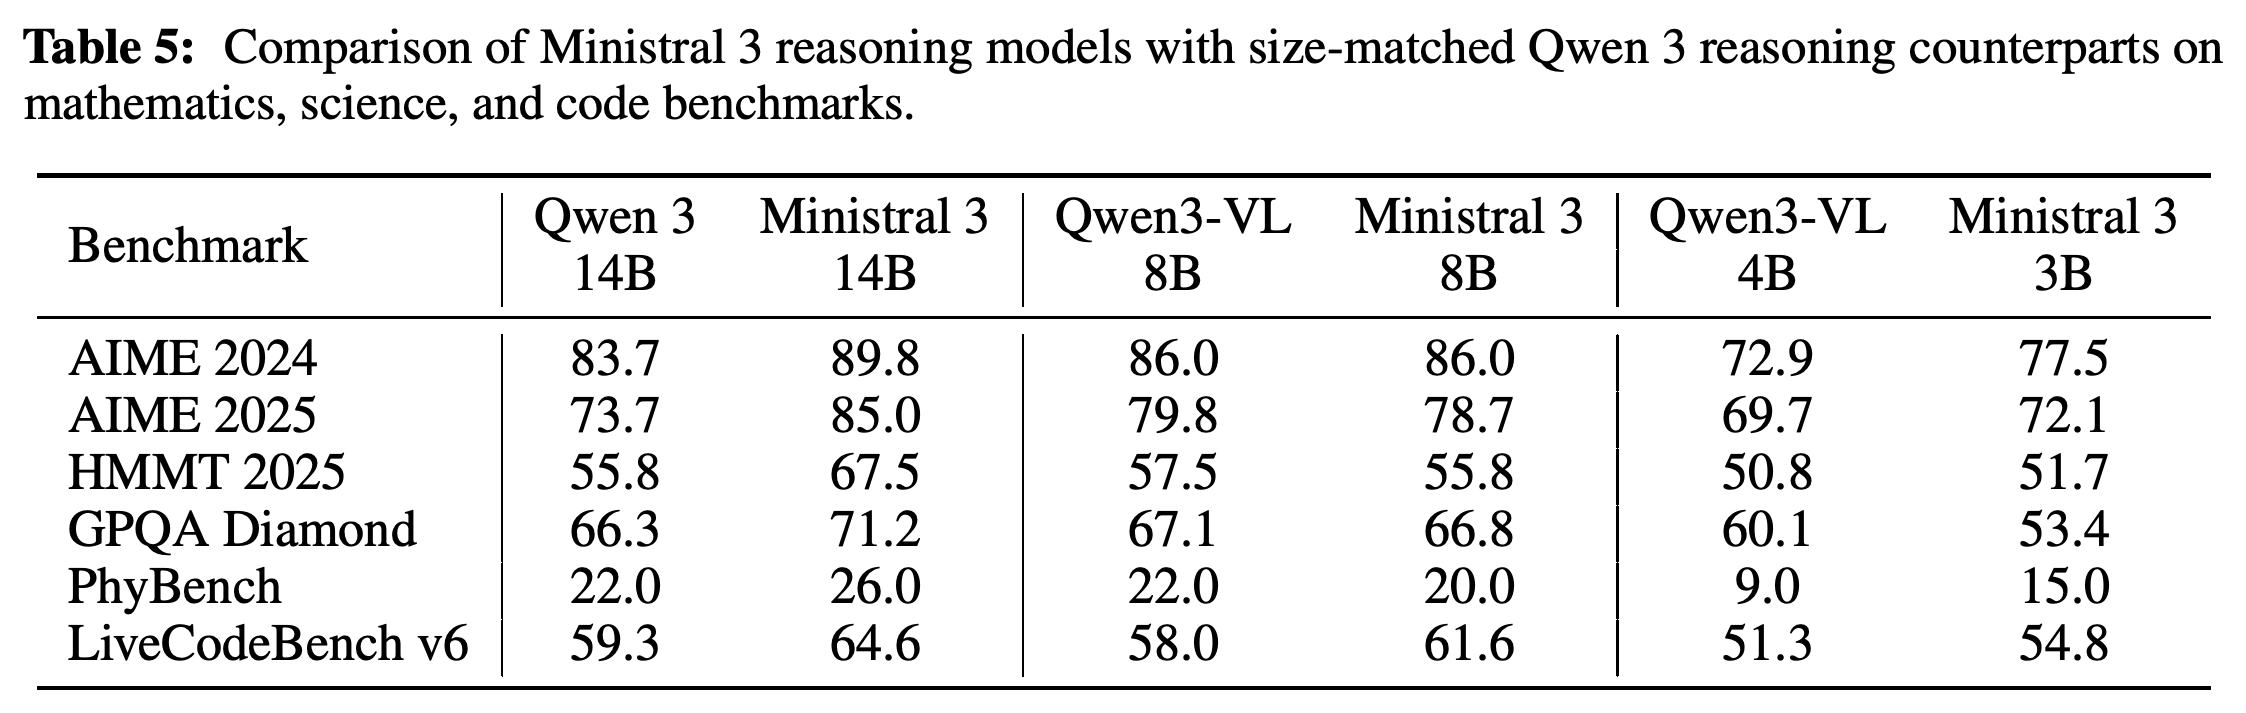
Table 5에서 Ministral 3 14B Reasoning은 보고된 6개 벤치마크 모두에서 Qwen 3 14B를 앞선다. AIME 2025는 85.0 대 73.7이고, LiveCodeBench v6는 64.6 대 59.3이다. 보고서는 추론 평가에 pass@16을 사용하되 LiveCodeBench에는 pass@5를 사용한다고 명시한다.
- 8B에서 Ministral은 AIME 2024에서 86.0으로 Qwen3-VL과 동일하고, LiveCodeBench v6에서는 61.6 대 58.0으로 앞서지만, 나머지 4개 벤치마크에서는 뒤진다.
- Ministral 3 3B는 AIME 2025의 72.1 대 69.7을 포함해 6개 벤치마크 중 5개에서 Qwen3-VL 4B를 앞선다. 하지만 GPQA Diamond에서는 53.4 대 60.1로 상당히 낮다.
- 이 비교들은 동일한 평가 파이프라인을 사용하지만, 3B–4B 비교는 파라미터 수가 정확히 일치하지 않는다. 명시된 다중 샘플 평가는 단일 생성 정확도로 제시해서는 안 된다.
14B Reasoning 모델은 6개 지표 모두에서 대응하는 Qwen 3 모델을 앞선다. 8B 모델은 AIME 2024에서 동일하고 코딩에서 앞서며, 나머지 4개 벤치마크에서는 뒤진다. 3B는 5개 지표에서 4B 기준 모델을 앞서지만 GPQA Diamond에서는 뒤진다. 논문은 pass@16으로 평가하되 LiveCodeBench에는 pass@5를 사용한다고 명시한다.
5 Discussions
논의에서는 교사 선택, 응답의 장황함, 추론 RL 이후의 선호 정렬을 살펴본다. 그래프로 제시한 비교 실험과 정성적인 학습 관찰을 함께 다루지만, 보고된 개선 중 일부에는 수치 결과나 자세한 실험 설정이 없다.
5.1 Choice of Teacher Model for Distillation
Figure 3에서 14B 학생은 더 크고 강력한 Mistral Medium 3보다 Mistral Small 3.1의 증류로 사전학습했을 때 성능이 좋다. 저자들은 이를 교사와 학생의 역량 격차와 연관 지으며, FLOP을 맞춘 비교가 아니라는 점을 언급한다.
- 그래프는 MMLU REDUX, HellaSwag, TriviaQA, MATH, AGI-EVAL, Winogrande를 비교하며, 모든 경우에 Small 3.1 교사가 더 높은 점수의 학생을 만든다.
- 후속 학습에서는 결과가 다르다. 논의에서는 더 뛰어난 Mistral Medium 3.1이 도움이 된다고 보고한다. Section 3.2는 Instruct SFT의 교사를 Mistral Medium 3로 명시하므로, 보고서는 정확한 Medium 체크포인트를 일관되게 명시하지 않는다.
- 이 결과는 학습 단계마다 교사 선택을 별도로 검증할 필요성을 뒷받침한다. 더 큰 교사가 사전학습에서 일반적으로 더 낮은 학생 성능을 낸다는 결론을 입증하지는 않는다.
그래프의 모든 벤치마크에서 Mistral Small 3.1은 Mistral Medium 3보다 점수가 높은 14B 학생을 만든다. 이는 관찰된 교사 선택 결과를 뒷받침한다. 다만 FLOP을 맞추지 않은 설정이므로 원인을 분리해 규명하거나 교사 효율에 관한 일반적인 법칙을 입증하지는 않는다.
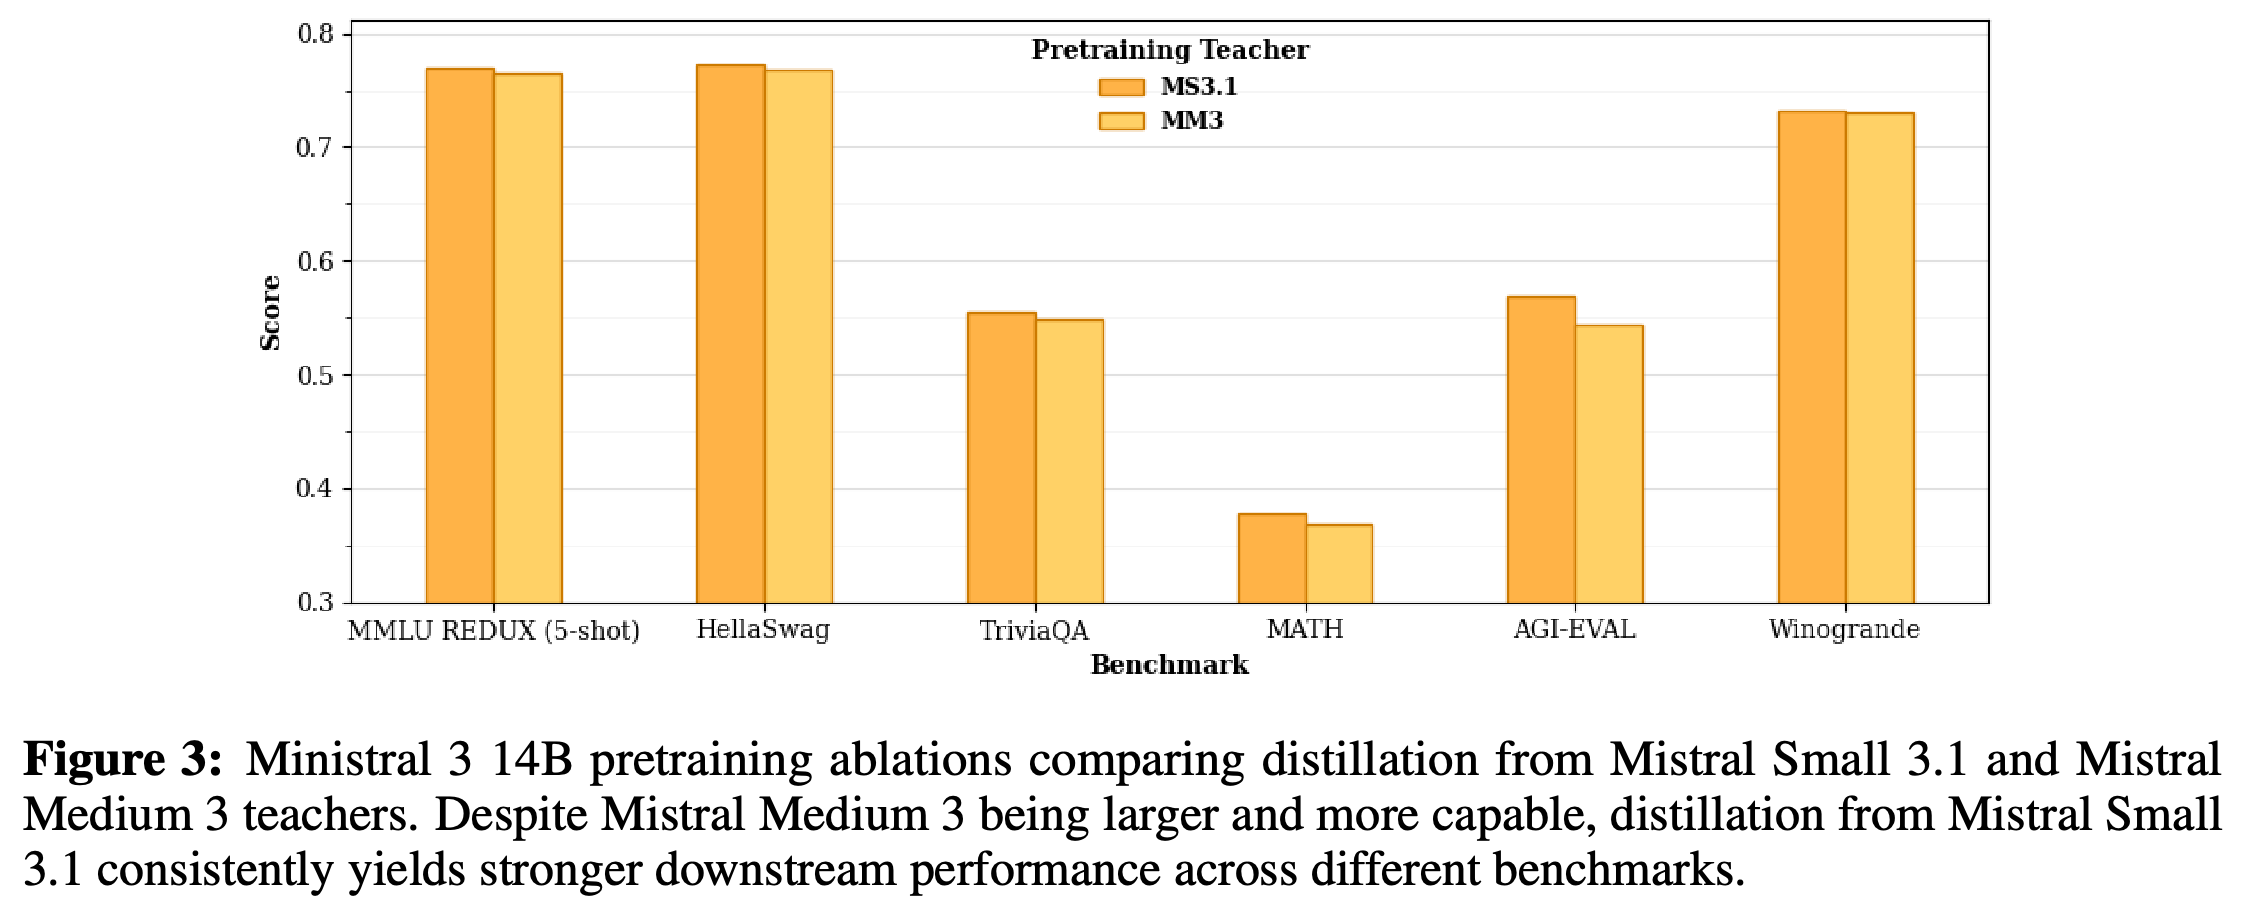
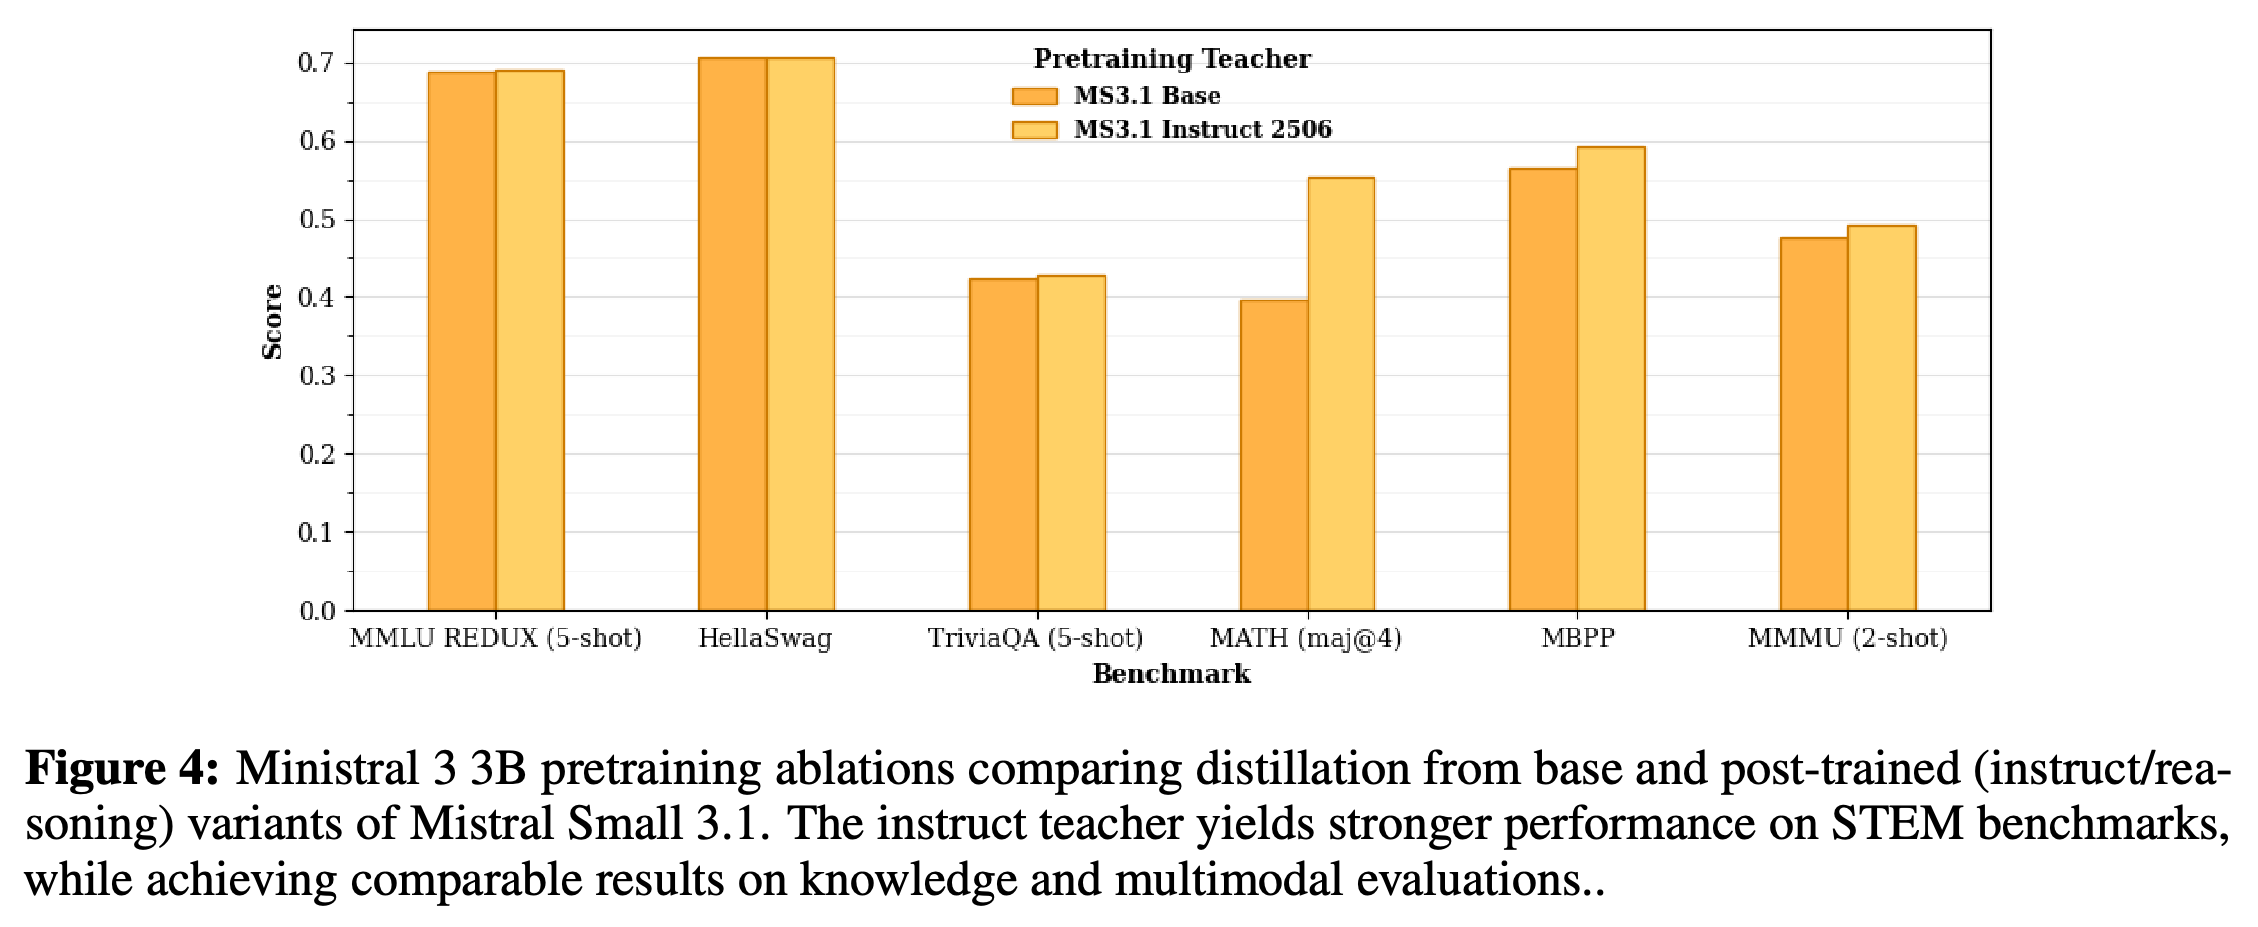
Figure 4에서 후속 학습된 Mistral Small 3.1 교사로 3B 학생을 증류하면 Base 교사 대비 MATH와 MBPP가 개선된다. 지식 및 멀티모달 지표의 변화는 훨씬 작다. 그래프 범례는 구체적으로 MS3.1 Base와 MS3.1 Instruct 2506을 비교한다.
- 가장 눈에 띄는 차이는 MATH (maj@4)에서 나타난다. MMLU REDUX, HellaSwag, TriviaQA는 비슷한 수준을 유지하고, MMMU는 소폭 개선된다.
- 저자들은 학생 SFT 과정에서 내부 Mistral Medium 3 SFT 교사와 선호 튜닝된 교사도 비교한다. 선호 튜닝된 교사가 일관되게 더 좋으며, 학생 자체의 선호 튜닝 이후에도 이점이 유지된다고 보고한다.
- 선호 튜닝된 교사 비교에 대해서는 수치 표, 불확실성 추정치, 자세한 설정을 제공하지 않는다.
Instruct 2506 교사의 가장 뚜렷한 이점은 MATH (maj@4)에서 나타나며, MBPP도 개선되고 MMMU는 소폭 상승한다. 지식 점수는 거의 변하지 않아, 이점이 모든 능력에 고르게 나타나기보다 일부에 집중됨을 보여준다.
5.2 Model Verbosity.
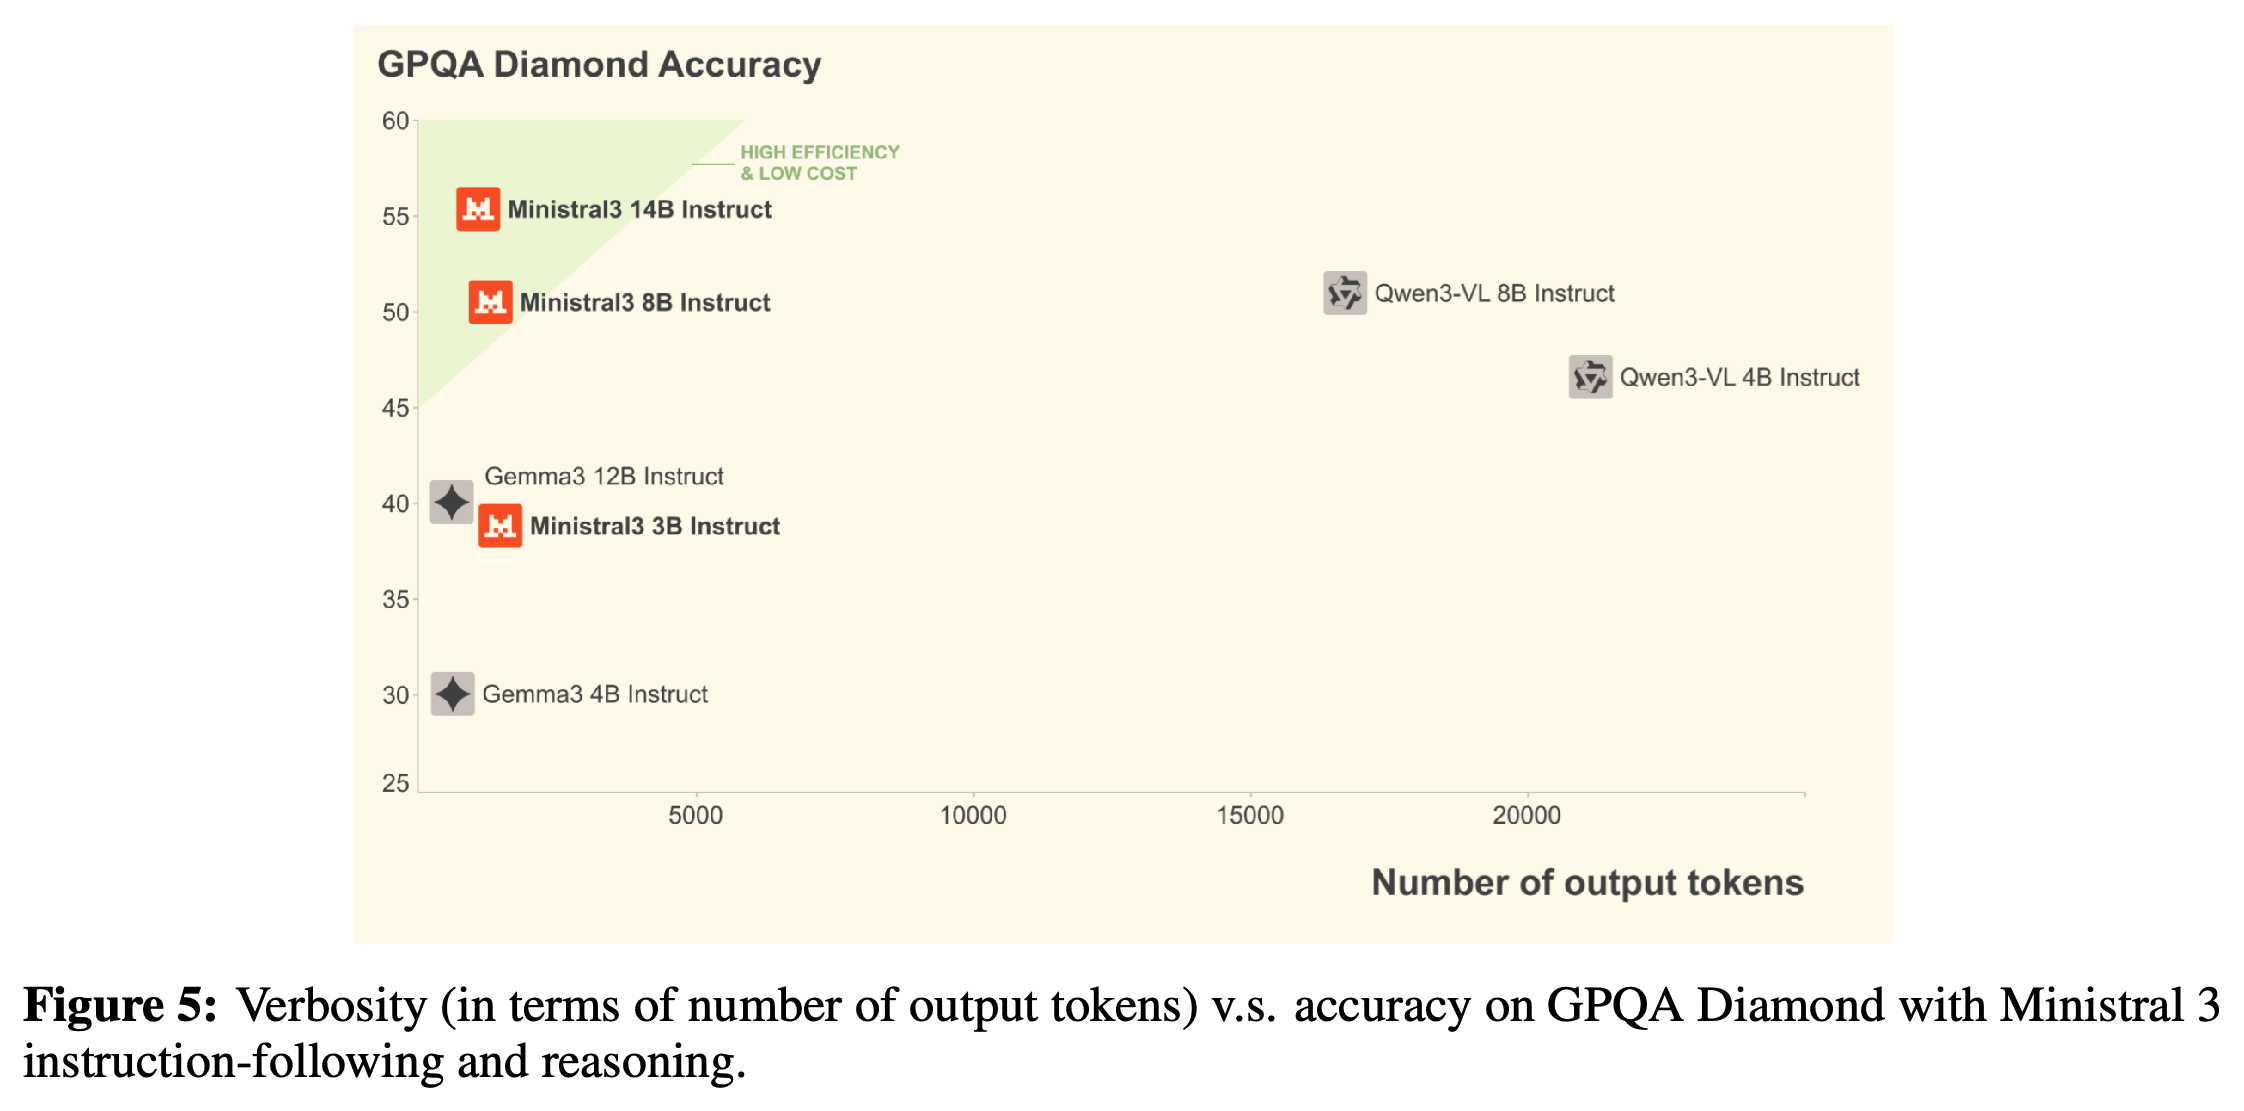
Figure 5는 출력 토큰 수에 따른 GPQA Diamond 정확도를 나타낸다. Ministral Instruct 모델은 그래프에 제시된 Qwen3-VL Instruct 기준 모델보다 훨씬 짧은 응답을 생성한다. 저자들은 추론 RL의 차이가 이 행동에 영향을 줄 수 있다고 설명하지만, 통제된 비교 실험으로 이 설명을 검증하지는 않는다.
- 저자들은 Instruct SFT에서 긴 CoT 과정의 비중을 늘리면 STEM 벤치마크 성능이 향상되지만, 과도한 재검토, 내부 독백, 이전 추론으로 되돌아가는 행동도 발생한다고 보고한다.
- 상자 안의 예시는 수학 답변에서 반복적으로 재검토하는 모습을 보여준다. 이는 대화 스타일에 대한 정성적 우려를 뒷받침하지만, 해당 행동의 빈도를 측정한 결과는 아니다.
- 캡션은 지시 수행과 추론을 언급하지만, Figure 5에서 보이는 점의 레이블은 Instruct 모델을 가리킨다.
Ministral Instruct의 점들은 Qwen3-VL Instruct의 점들보다 훨씬 왼쪽에 있어 GPQA Diamond 응답이 더 짧음을 나타낸다. Ministral 14B는 그래프에서 가장 높은 정확도와 비교적 적은 출력 토큰 수를 함께 보인다. 다만 특정 작업에 대한 이 그래프는 지연 시간이나 에너지 사용량을 직접 측정하지 않는다.
5.3 ODPO for Ministral 3 Reasoning.
Figure 6은 GRPO로 학습한 14B 및 8B Reasoning 체크포인트에 ODPO를 적용하면 ArenaHard, EQBench, WildBench가 개선됨을 보여준다. 3B 모델은 공개 벤치마크에서 변화가 훨씬 작지만, 내부 인간 평가에서는 ODPO 체크포인트가 더 좋은 평가를 받아 공개 모델로 선택되었다.
- 보상 모델은 thinking chunks를 제거한 뒤 응답을 평가하므로, 선호 피드백은 사용자에게 보이는 답변에 집중된다.
- 저자들은 3B Base 모델이 14B 및 8B 모델보다 미세조정 하이퍼파라미터에 더 민감하다고 보고한다.
- 보고서는 내부 인간 평가 절차를 설명하거나 보고된 개선을 정량화하지 않아, 3B 공개 모델 선택을 독립적으로 평가하기 어렵다.
6 Conclusion
논문은 반복적인 가지치기와 증류로 기존의 더 큰 체크포인트에서 소형 멀티모달 Base, Instruct, Reasoning 모델군을 만들 수 있다고 결론짓는다. Apache 2.0 오픈 웨이트를 제공하지만, 결론의 256K 컨텍스트에 대한 일반적인 설명은 서론에 명시된 Reasoning 모델의 128k 제한과 함께 읽어야 한다.
부록
- 제공된 PDF에는 부록이 없다. 결론과 기여자 목록 이후의 12–14페이지는 참고문헌이며, 추가 구현 세부 사항이나 실험 표는 없다.
짧은 생각
이 학습 방법의 유용한 특징은 초기화 가중치의 상속과 교사 선택을 분리한다는 점이다. 작은 모델은 순차적으로 가중치를 물려받지만, 사전학습 교사는 원래 부모 모델로 유지된다. 교사 비교 실험과 추론 SFT 및 ODPO에서 나타난 3B의 다른 행동은 모델 규모마다 압축과 후속 학습 방식을 평가할 필요성을 보여준다.
벤치마크 결과는 정확한 연산 효율 우위보다 소형 모델의 경쟁력, 특히 14B의 경쟁력을 더 분명하게 뒷받침한다. 보고서는 측정된 학습 FLOPs, 실제 소요 시간이나 메모리 비교, 정확한 모델별 토큰 예산, 전체 학습 데이터 구성, 신뢰구간을 제공하지 않는다. 또한 명시된 최대 컨텍스트 길이에서 긴 컨텍스트의 품질을 평가하지 않는다. 1조~3조 토큰의 학습량은 이미 사전학습된 부모 모델을 활용하므로, 모델군을 만드는 데 필요한 전체 연산량을 나타내지 않는다. Table 2의 TriviaQA 예외와 엇갈리는 8B 후속 학습 결과를 고려하면, 비슷한 규모의 기준 모델보다 일괄적으로 우수하다는 주장은 범위를 좁혀야 한다. 추론 RL 중 생성 한도를 80K로 늘린 점도 파라미터 효율과 추론 토큰 효율을 구분할 필요성을 보여준다. 이 한도는 일반적인 응답 길이를 측정한 값이 아니다.