


Video models are zero-shot learners and reasoners 요약 설명
24 Sep 2025 | Paper Review Zero-Shot Learning Video Generation Visual Reasoning목차
이번 글에서는 Video models are zero-shot learners and reasoners 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 24일(Arxiv)
- Wiedemer, Thaddäus, Li, Yuxuan, Vicol, Paul, Gu, Shixiang Shane, Matarese, Nick, Swersky, Kevin, Kim, Been, Jaini, Priyank, Geirhos, Robert.
- Google DeepMind
- 논문 링크
- Project Page
요약
- 이 논문은 영상 생성용으로 학습한 모델이 태스크별 학습이나 적응 없이 지시만으로 시각 태스크를 해결할 수 있는지 묻고, 이 설정을 zero-shot learning이라고 부른다. 동일한 이미지와 텍스트 태스크 설정에서 최대 10회 시도했을 때 Veo 3는 5×5 미로의 78%를 해결하며 Veo 2는 14%를 해결한다. 다만 미로가 커지면 성능이 떨어진다.
- 연구에서는 정성 평가 태스크 62개와 정량 평가 태스크 7개에 걸쳐 영상 18,384개를 생성했다고 보고한다. 모델의 능력을 시각 정보를 이해하는 perception, 시각 세계와 그 속성을 표현하는 modeling, 그 세계를 바꾸는 manipulation, 공간과 시간에 걸쳐 변화를 조율하는 reasoning으로 분류한다.
- 공개된 Veo 모델에 초기 이미지와 텍스트 지시를 입력하면 모델이 720p, 24 FPS로 8s 영상을 생성한다. FPS는 초당 프레임 수를 뜻한다. 저자들은 생성된 영상 프레임에 태스크와 관련된 변화를 순차적으로 표현하며 시각 문제를 푸는 방식을 chain-of-frames(CoF)라고 부른다.
- 10회 시도에서 최적 프레임과 최대 점수를 선택하면 Veo 3는 주석으로 표시된 경계와의 일치도를 측정하는 edge detection에서 0.77, 주석으로 표시된 객체 마스크와의 겹침을 측정하는 segmentation에서 0.74를 기록한다. 태스크 전용 edge detection 참조 모델은 0.90을 기록한다. 시각 추론 성능도 고르지 않다. 최적 프레임을 선택하면 대칭 완성 성능은 높지만 반사와 회전 analogy는 무작위 선택 기준인 0.33 chance baseline보다 낮다.
- 이 결과는 신중하게 선택한 프롬프트에서 모델이 보이는 능력을 입증한다. 다만 활용할 수 있는 출력을 얻으려면 반복 샘플링, 출력 선택, 원치 않는 움직임 제어가 필요하다. 영상 생성 전에 지시를 수정하는 언어 모델 기반 prompt rewriter 때문에 성과를 생성기 자체에 귀속하기 어렵고, 올바른 중간 프레임이 마지막 프레임까지 유지되지 않는 경우도 있다.
1. Introduction
이 논문은 프롬프트로 여러 언어 태스크를 수행하는 생성 모델인 대규모 언어 모델(LLMs)과의 유사성에 주목하고 영상 생성도 범용 비전을 구현하는 경로가 될 수 있는지 묻는다. 여기서 zero-shot learning은 특정 태스크에 맞춰 모델을 갱신하는 fine-tuning이나 태스크별 출력 모듈인 추가 inference head를 사용하는 대신 태스크 지시를 제공하는 방식이다.
- 실증적 기여는 새로운 아키텍처를 학습한 것이 아니라 기존 생성 시스템을 조사한 데 있다.
- 저자들은 다양한 태스크를 수행하는 능력과 전문 모델 수준의 성능을 구분한다. 서론에서도 태스크 전용 모델이 0-shot video model보다 우수하다고 인정한다.
- 프로젝트 페이지는 https://video-zero-shot.github.io/이며, 제공된 논문은 arXiv:2509.20328v2다.
2. Methods
저자들은 Google Cloud의 Vertex AI API를 통해 Veo 2와 Veo 3에 첫 프레임으로 사용할 입력 이미지와 태스크를 설명하는 텍스트를 전달한다. API는 영상 생성에 사용하는 프로그래밍 인터페이스다. 출력 영상은 화면 비율 16:9, 해상도 720p, 24 FPS, 길이 8s이며, Methods에는 veo-3.0-generate-preview와 veo-2.0-generate-001이 명시되어 있다.
- API에는 LLM 기반 prompt rewriter가 포함된다[30]. 저자들은 rewriter와 생성기를 1 black-box system으로 평가하며 Sudoku 같은 일부 문제의 해답은 rewriter에서 나왔을 가능성을 인정한다.
- 저자들은 독립적으로 사용한 Gemini 2.5 Pro가 입력 이미지만으로 robot navigation, maze solving, visual symmetry를 안정적으로 해결하지 못했다고 보고한다. 이 비교는 성과 귀속 문제를 살펴보지만 결합된 시스템 안에서 생성기의 기여를 분리하지는 못한다.
- Veo는 영상 생성 leaderboard에서 높은 성능을 보여 선택되었다[31]. Veo 2와 Veo 3의 비교는 공개된 모델 세대 사이의 차이를 측정하지만 어떤 학습 또는 아키텍처 변화가 차이를 만들었는지는 밝히지 않는다.
3. Qualitative results: Sparks of visual intelligence?
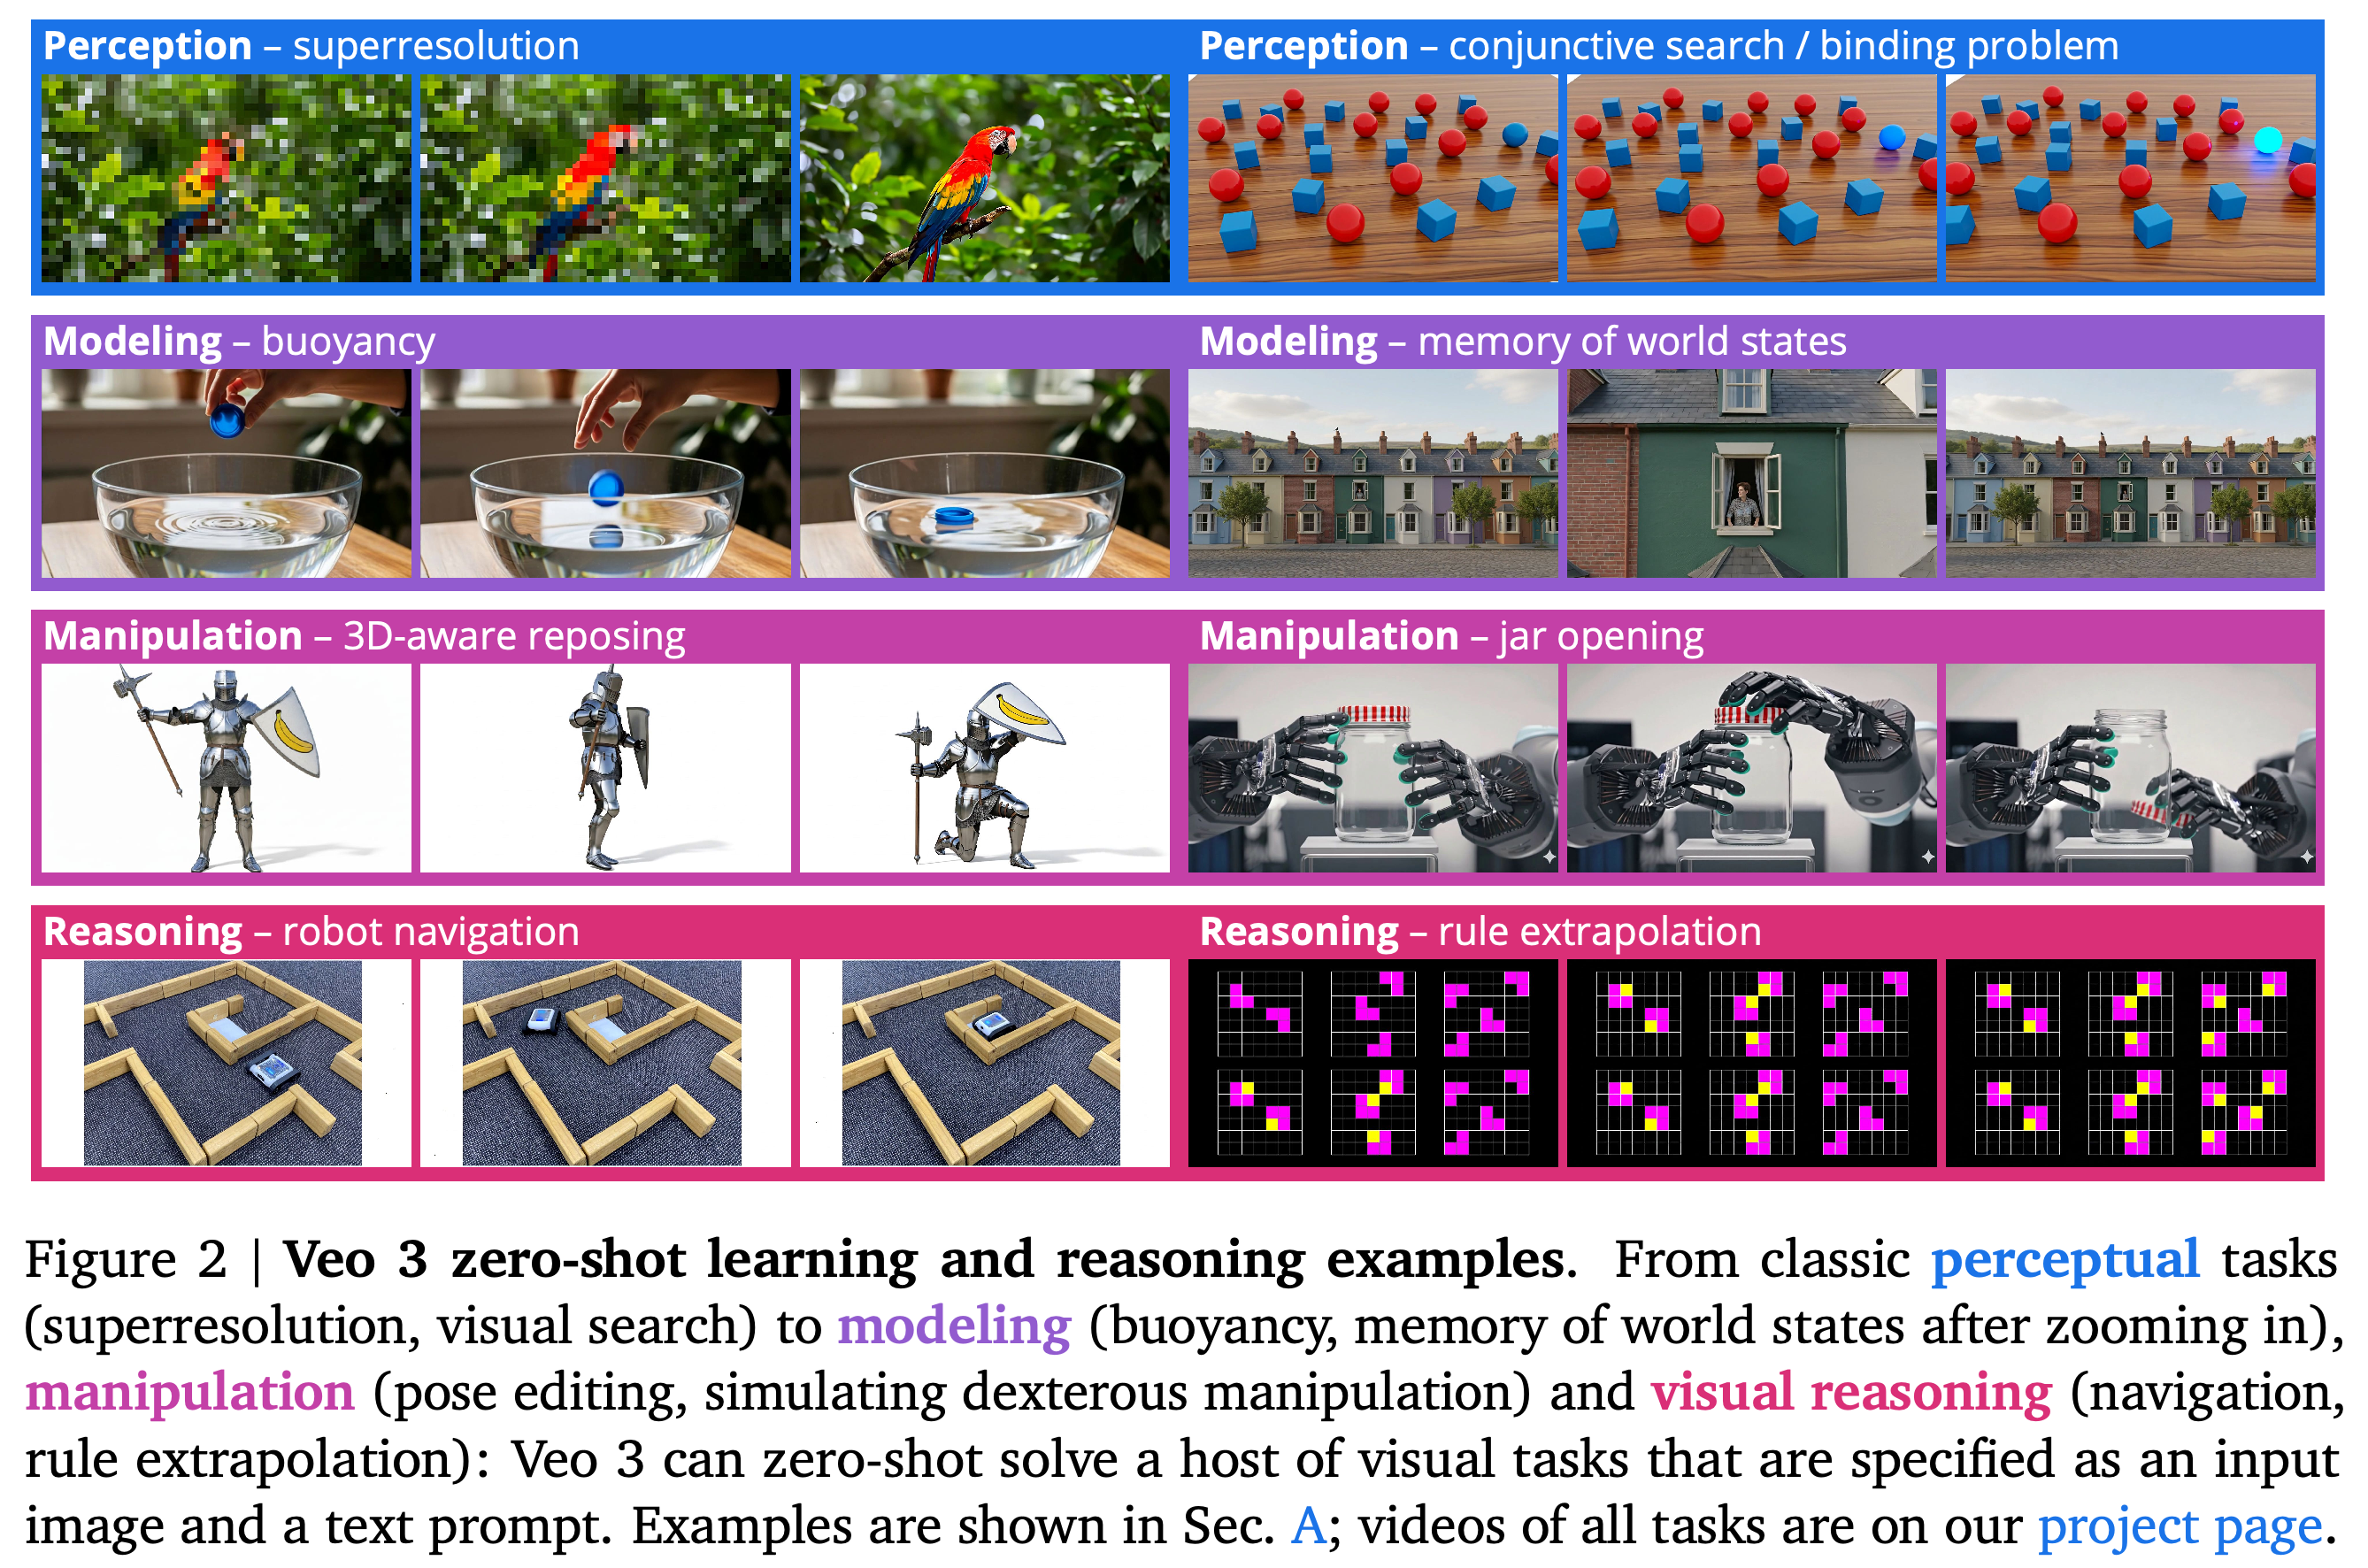
정성 평가 태스크 62개마다 Veo 3 영상을 12개씩 생성하고 저자들이 태스크 해결 비율을 판정한다. Figure 1과 Figure 2는 평가 범위와 사례를 요약한다. 적은 표본으로 구한 성공률은 가능한 능력과 대략적인 신뢰도를 보여준다.
- Perception에는 서로 다른 객체를 분리하는 segmentation, 지정된 이미지 위치를 찾는 keypoint localization, 이미지 세부 정보를 늘리는 super-resolution, restoration, 여러 속성을 조합해 객체를 선택하는 conjunctive search가 포함된다. 저자들은 이 태스크들을 위한 학습을 하지 않았다는 주장에 denoising을 명시적으로 예외로 둔다. 이미지 노이즈를 제거하는 denoising은 diffusion 모델의 표준 학습 목적이기 때문이다.
- Modeling 사례는 가연성, 강체와 변형 가능한 물체, 중력, 물체가 뜨거나 가라앉는지를 다루는 부력, 광학 효과, 범주 구분, 문자 패턴, 카메라 이동 중 장면 상태 유지 등을 다룬다.
- Manipulation에는 누락된 이미지 영역을 채우는 inpainting, 원본 이미지 바깥의 내용을 생성하는 outpainting, 새로운 시점, 자세 변경, 손과 물체의 상호작용 시뮬레이션이 포함된다. 물체로 할 수 있는 행동을 뜻하는 object affordance는 망치를 자연스럽게 잡는 태스크로 평가하며 실제 로봇 실험은 수행하지 않는다.
- Reasoning 사례에는 노드 사이의 연결을 따라가는 graph traversal, sequence completion, tool use, 미로, navigation, 예시에서 추론한 규칙을 적용하는 rule extrapolation이 포함된다. CoF는 프레임별 태스크 수행을 해석하는 개념이며 논문은 통제된 비교를 통해 이를 인과적 추론 메커니즘으로 입증하지 않는다.
태스크 62개에 걸친 분포는 폭넓지만 고르지 않은 능력을 보여준다. Restoration과 manipulation 태스크 중 다수는 저자 판정 성공률이 높지만 여러 reasoning 태스크는 드물게 성공한다. 각 막대는 생성 결과 12개만을 바탕으로 하므로, 이 그래프는 신뢰도를 탐색적으로 추정한 결과다.
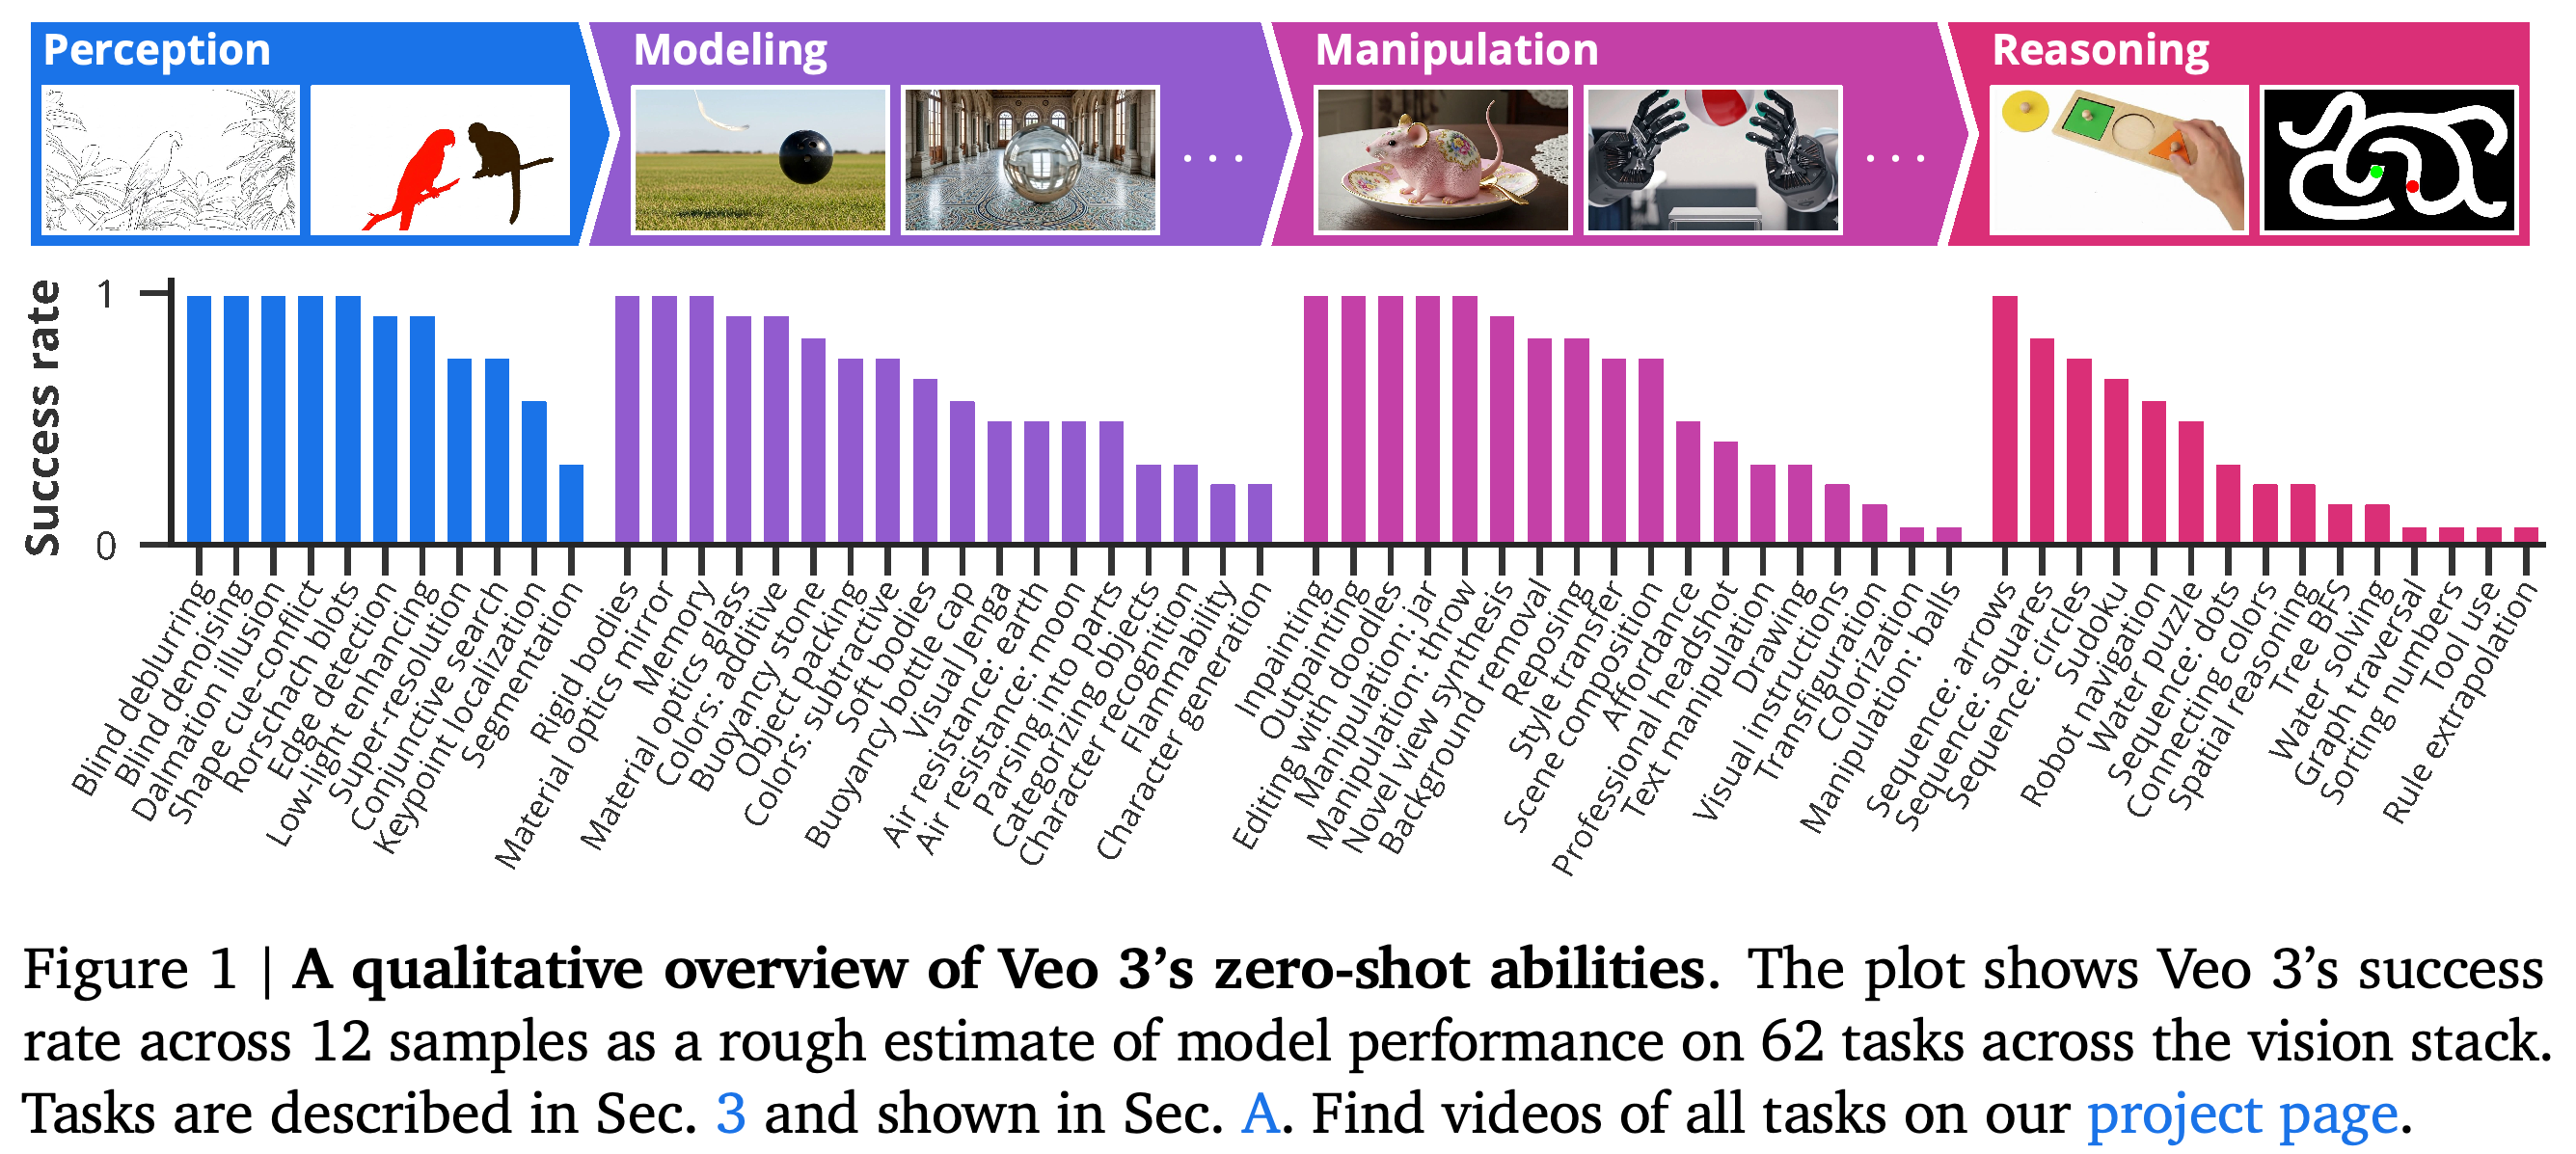
이 시퀀스들은 이미지 세부 정보 개선부터 장면 내 이동이나 시각 규칙 완성까지, 논문이 제안한 능력의 위계를 보여준다. 선별된 성공 시퀀스는 가능한 결과를 보여주지만 그 결과가 얼마나 자주 나오는지는 입증하지 않는다.
4. Quantitative results
정량 평가 태스크 7개는 perception, manipulation, reasoning을 평가한다. 이 연구에서는 물리적 modeling을 정량 평가하지 않는다. 비교가 가능한 경우에는 Veo 2, Veo 3, 참조 모델로 사용하는 이미지 편집 모델 Nano Banana를 비교한다[54].
- 최적 프레임 평가는 생성된 영상 전체에서 점수가 가장 높은 프레임을 선택해 성능 상한을 측정한다. 마지막 프레임 평가는 미리 정한 출력 위치를 사용하며 올바른 해답을 만든 뒤에도 생성이 계속될 때 발생하는 성능 저하를 드러낸다.
- 성공 여부가 이진값인 태스크에서 pass@k는 k회 시도 중 적어도 한 번 성공했는지를 측정한다. Edge detection과 segmentation에서는 대신 k회 시도 중 최대 지표 값을 표시한다. 최적 시도나 프레임을 선택할 때는 실제 배포 환경에서 자동으로 얻을 수 없는 평가 정보를 사용한다.
- 대부분의 실험에서는 고정된 프롬프트로 입력마다 출력 10개를 생성한다. Visual analogy의 여러 시도 결과를 집계하는 방식은 예외다. 정답 여부를 알고 성공한 시도를 고르는 대신, 가장 자주 판정된 답을 선택하는 다수결을 사용한다.
4.1. Perception: Edge detection
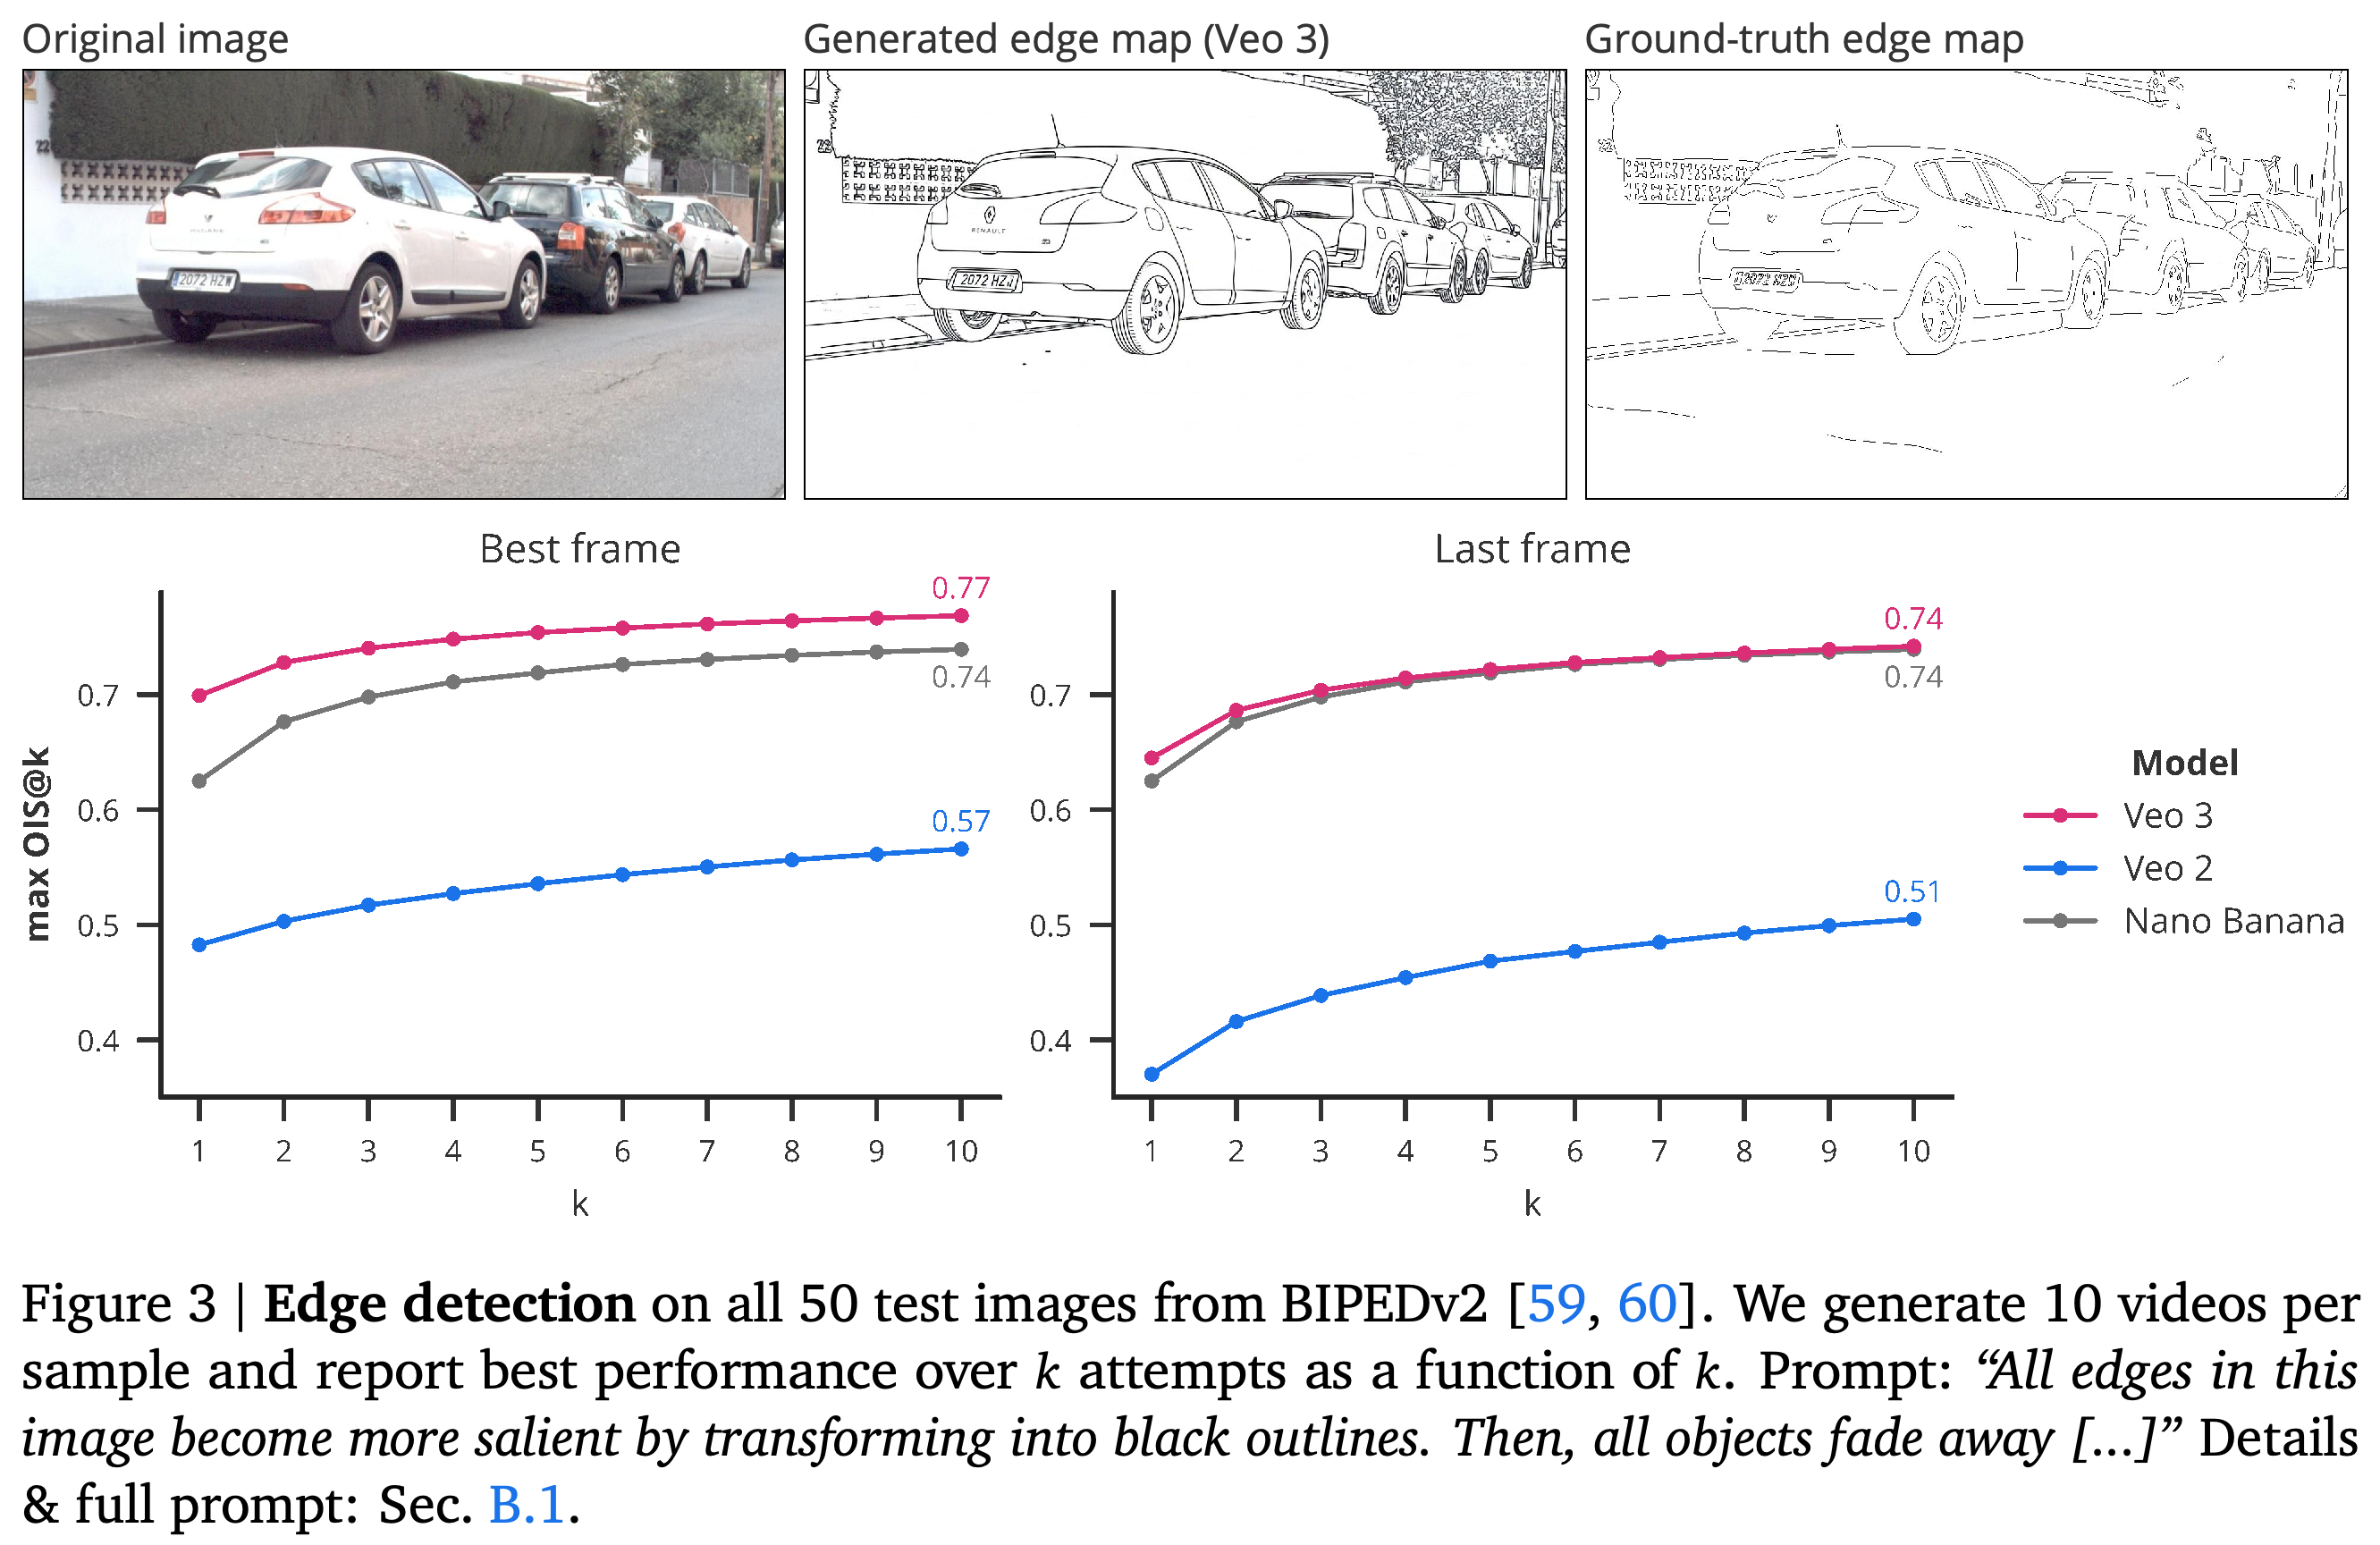
Edge detection 데이터셋 BIPEDv2의 테스트 이미지 50개 전체에서 Veo 3는 10회 시도 기준 최적 프레임 OIS 0.77을 기록한다[59, 60]. Veo 2는 0.57, Nano Banana는 0.74를 기록한다. 논문에서 optimal image scale이라고 부르는 OIS는 임계값별 F1-score의 최댓값이다. F1은 예측한 경계 중 주석과 일치하는 비율인 precision과 주석으로 표시된 경계 중 검출한 비율인 recall을 결합한다.
- 10회 시도 기준 마지막 프레임 점수는 Veo 3가 0.74, Veo 2가 0.51, Nano Banana가 0.74다. 태스크 전용 참조 모델의 점수는 0.90이다[60].
- 평가 과정에서는 국소 최댓값이 아닌 경계 응답을 억제하고 경계 맵에 임계값을 적용한 뒤 가늘게 만든다. 균등 간격의 임계값 16개를 시험하며 이미지 대각선 길이의 0.75%, 약 11픽셀 이내에서 경계 위치 차이를 허용한다.
- 저자들은 측정된 false positive 중 일부가 주석에서 빠진 나뭇잎, 반사, 타이어 세부 구조에 해당함을 보여준다. 채점 사례에는 실제로 놓친 경계도 있으므로, 주석 범위만으로 모든 오류를 설명할 수는 없다.
10 attempts에서 Veo 3는 최적 프레임 OIS 0.77을 기록하며 Veo 2는 0.57, Nano Banana는 0.74를 기록한다. 이 모델의 마지막 프레임 점수는 0.74로, segmentation이나 symmetry보다 시간 경과에 따른 감소가 작다.
4.2. Perception: Segmentation
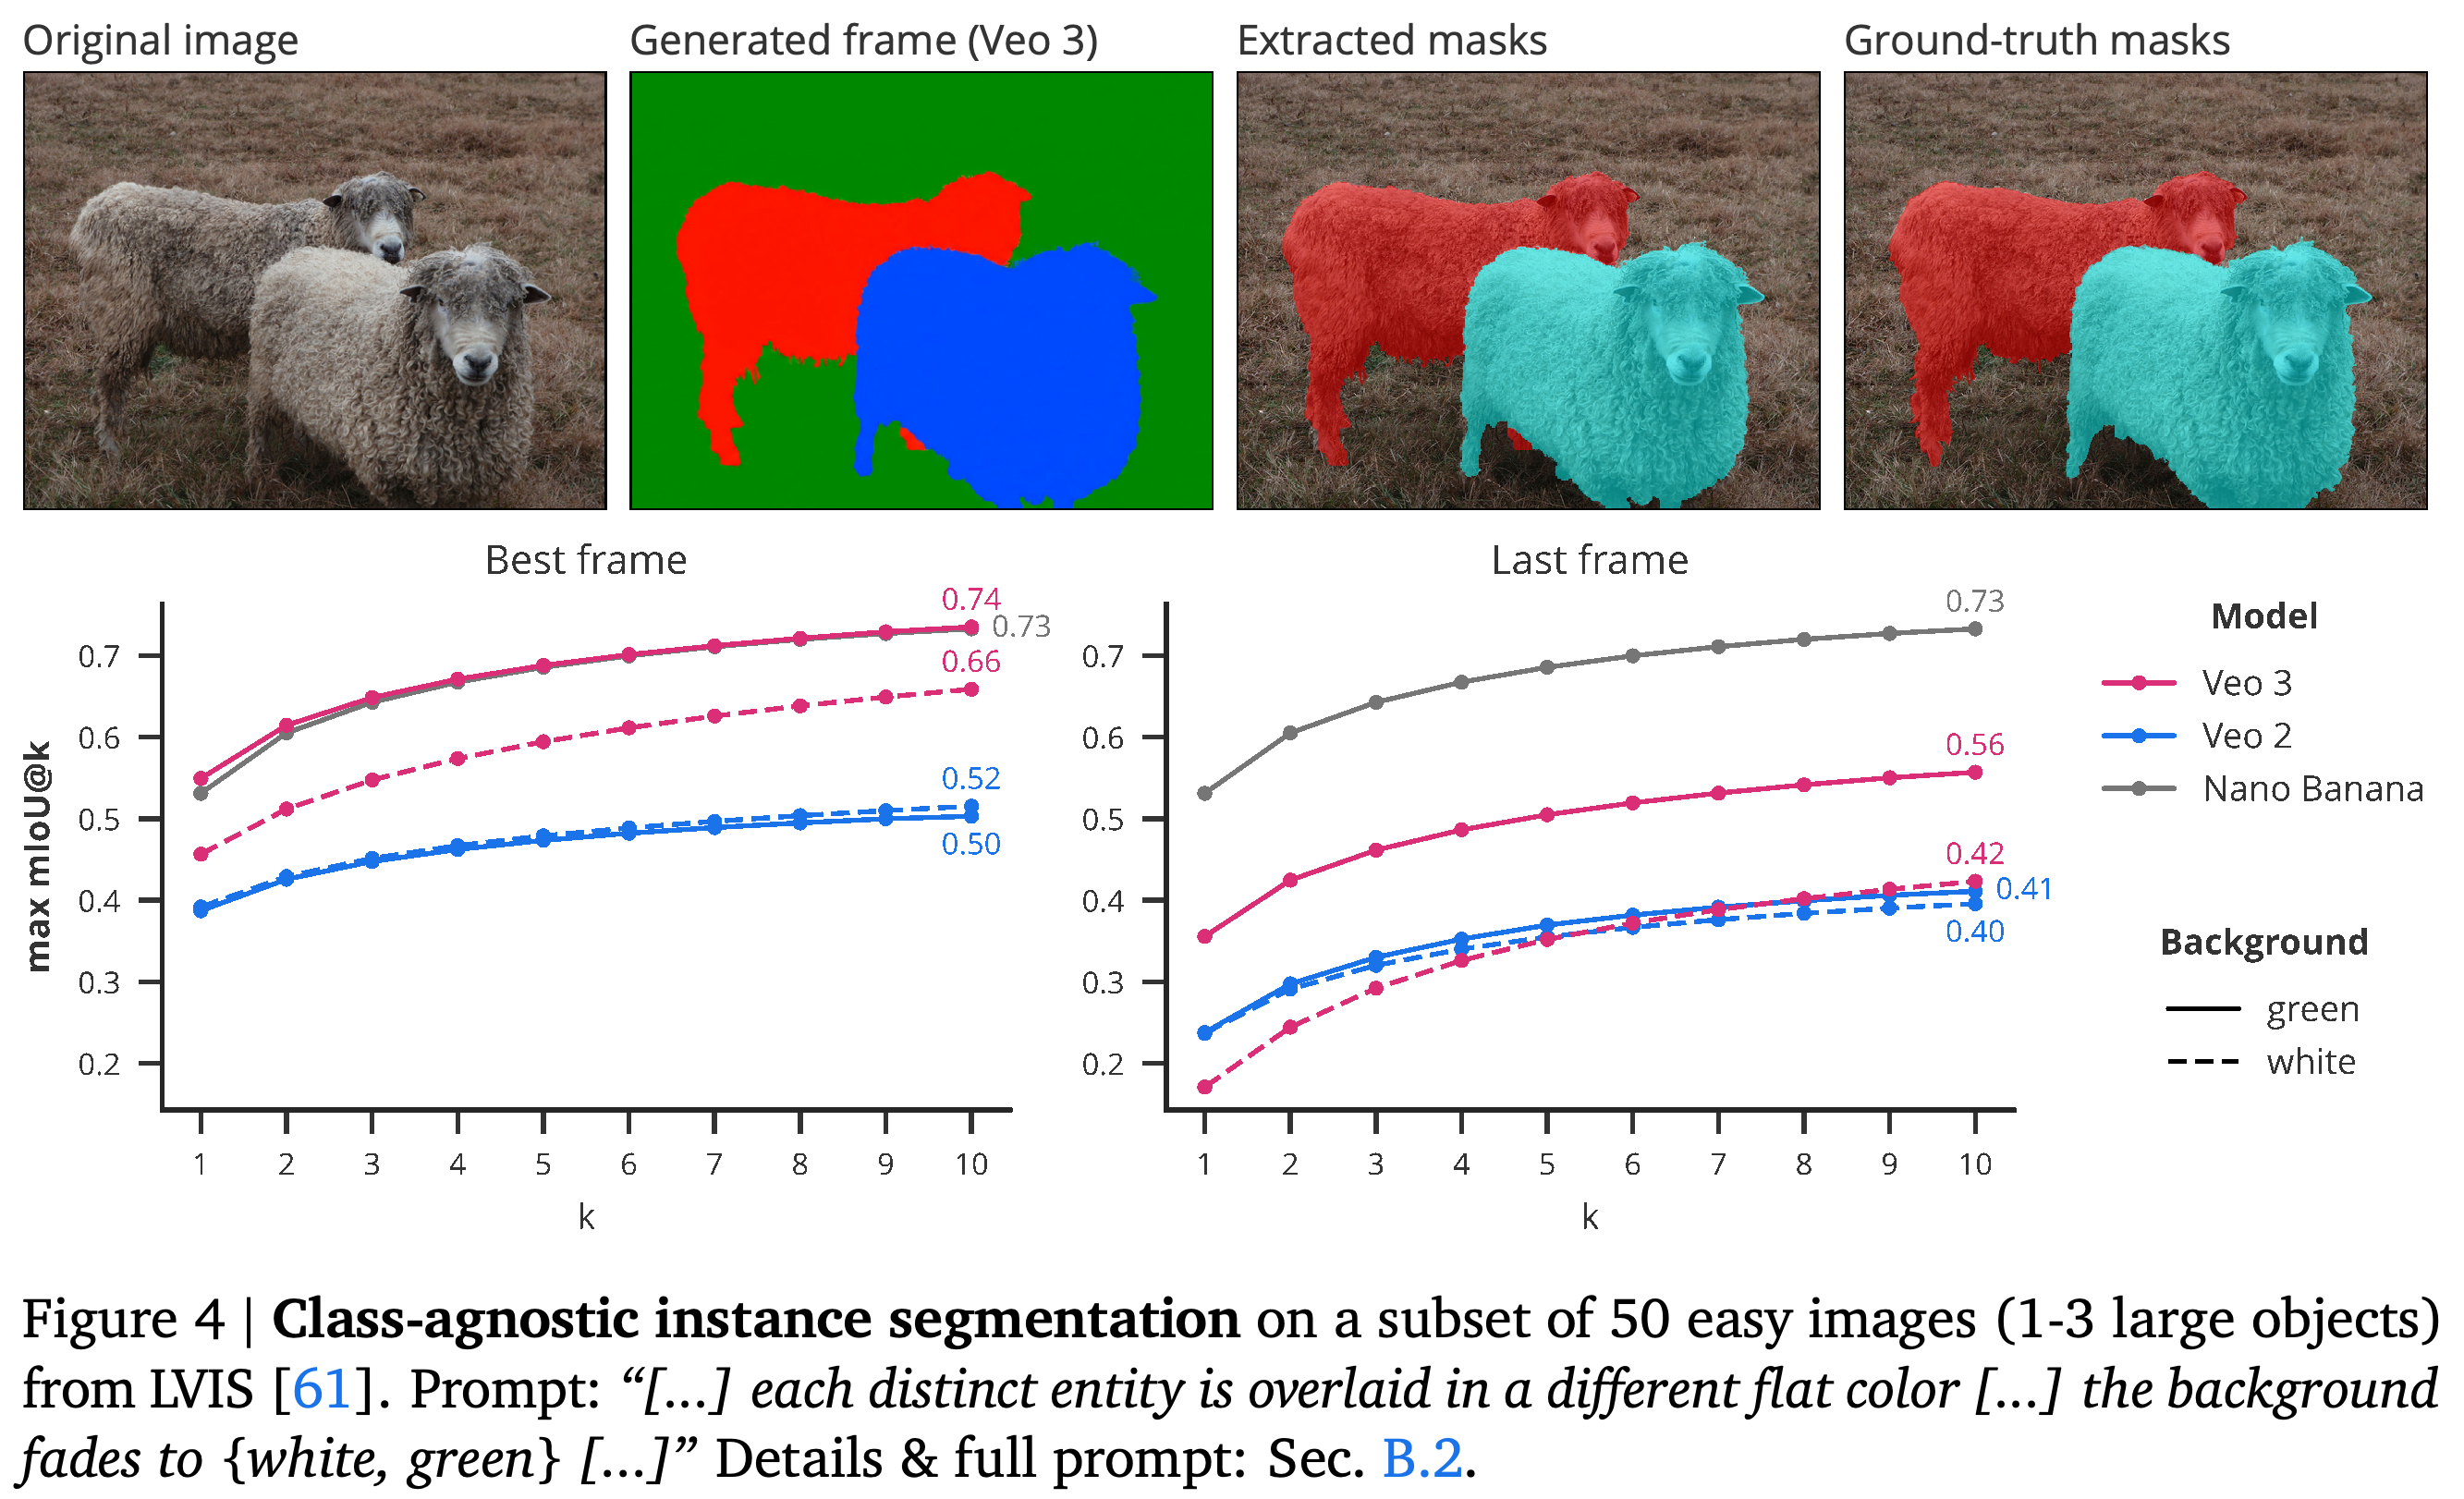
Segmentation 실험은 객체 인스턴스에 주석을 단 데이터셋 LVIS에서 무작위로 선택한 이미지 50개를 사용한다[61]. 각 이미지는 크기가 각각 5000픽셀 이상인 객체를 1개부터 3개까지 포함한다. 모델은 클래스, 위치, 인스턴스 수를 받지 않고 모든 객체의 경계를 구분해야 한다. 성능은 마스크 교집합과 합집합의 비율을 평균한 mean Intersection over Union(mIoU)으로 측정한다.
- 녹색 배경 프롬프트에서 Veo 3는 10회 시도 기준 최적 프레임 mIoU 0.74를 기록하며 Veo 2는 0.50, Nano Banana는 0.73을 기록한다. 흰색 배경 프롬프트에서는 Veo 3의 점수가 0.66으로 낮아진다. 이를 그린 스크린의 사용 빈도로 설명하는 것은 가설이다.
- Veo 3의 마지막 프레임 점수는 녹색 배경에서 0.56, 흰색 배경에서 0.42이며, Nano Banana는 0.73이다. 따라서 최적 프레임 점수가 비슷하다고 해서 최종 출력 성능도 비슷한 것은 아니다.
- 색상 차이로 마스크를 추출하고 각 정답 마스크를 겹침이 가장 큰 예측 마스크와 대응시킨다. 이 점수는 의도적으로 쉬운 이미지 부분집합과 이러한 대응 절차에 한정된다.
녹색 배경 프롬프트에서 Veo 3의 최적 프레임 mIoU 상한은 0.74지만, 마지막 프레임 점수는 0.56으로 떨어진다. Nano Banana는 0.73을 기록한다. 흰색 배경 조건은 Veo 3의 성능을 더 낮추며, 프롬프트 의존성과 중간 마스크를 보존하지 못하는 문제를 드러낸다.
4.3. Manipulation: Object extraction
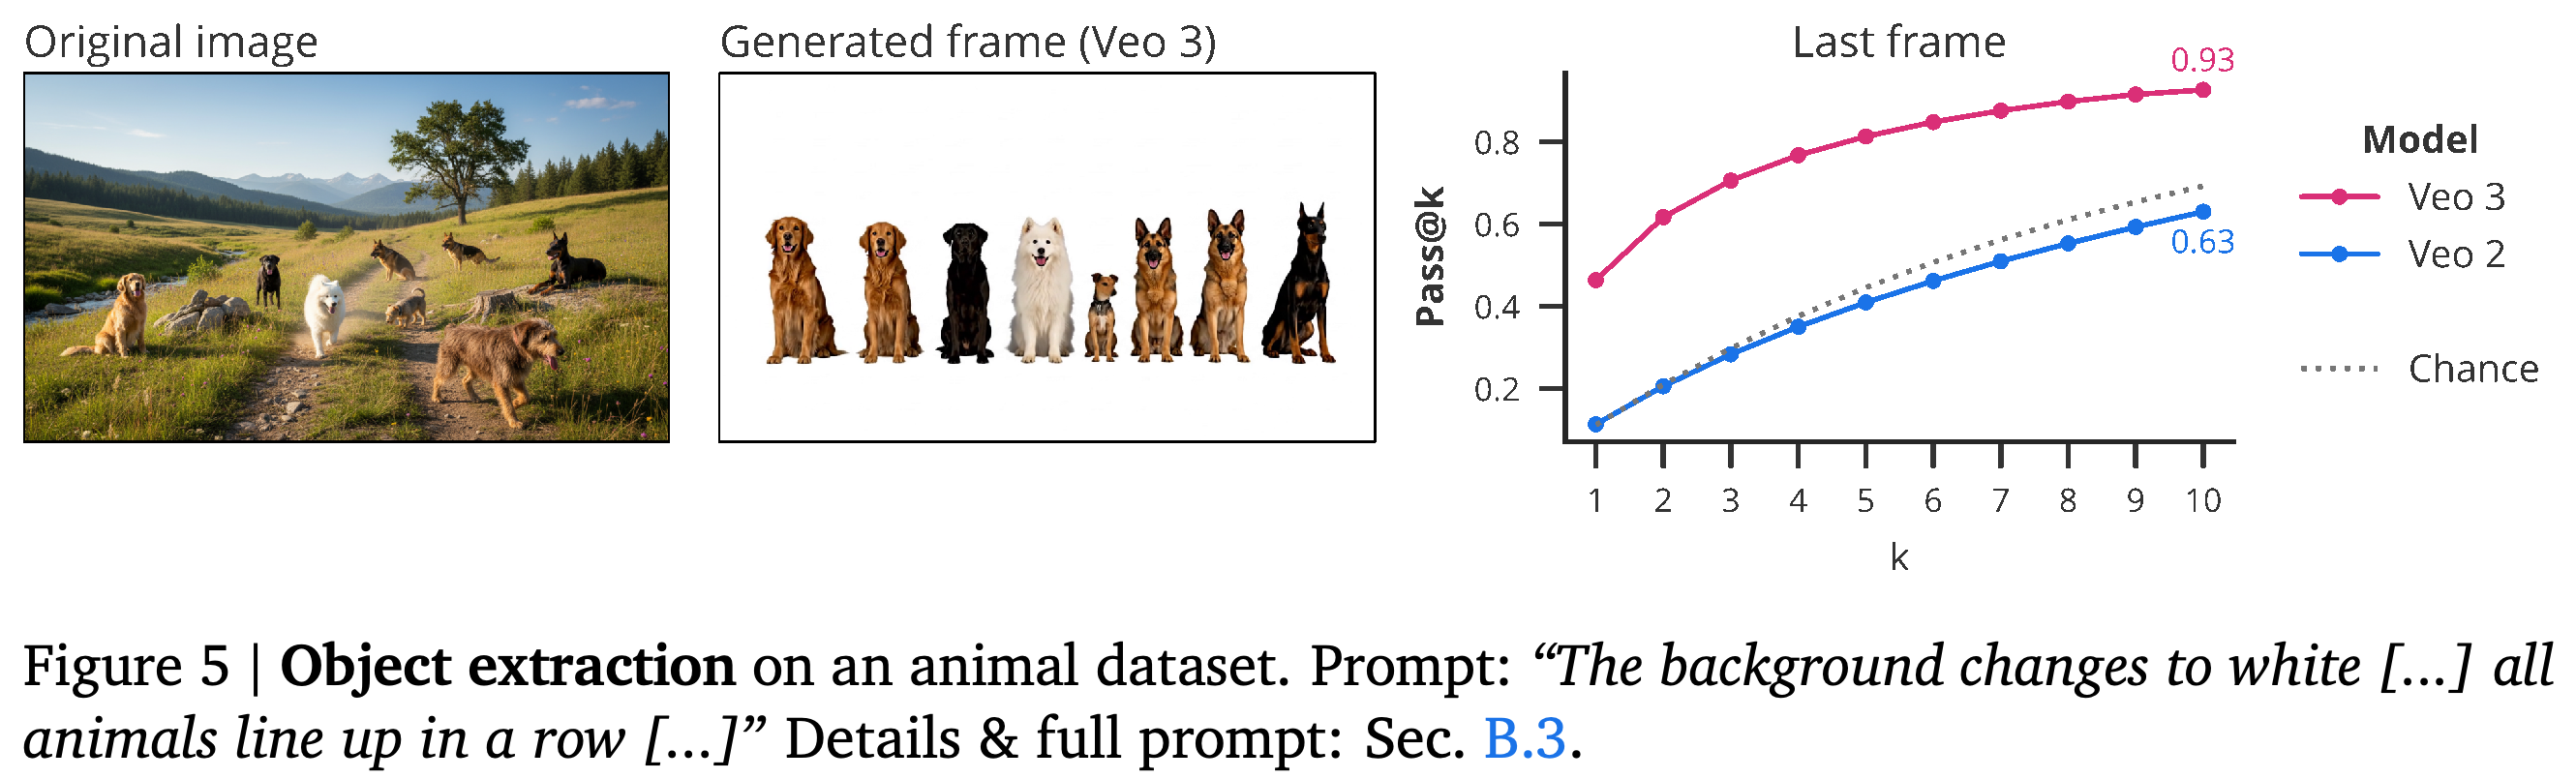
Veo는 장면에 있는 모든 동물을 추출해 흰색 배경에 서로 떨어뜨려 배치해야 한다. 자체 데이터셋은 Nano Banana로 생성하고 수작업으로 확인한 이미지 54개로 구성되며, 동물 수가 1마리부터 9마리까지인 경우마다 정확히 6개씩 포함한다.
- 평가기는 마지막 프레임에 임계값을 적용하고 서로 이어진 전경 영역인 connected component를 세어 추출된 동물 수를 추정한다.
- Veo 3는 pass@10에서 93%를 기록하고 Veo 2는 63%를 기록한다. 후자의 점수는 1부터 9까지의 개수를 반복해서 무작위로 추측하는 기준선과 비슷하다.
- 이 지표는 동물 수를 확인하지만 모든 동물의 정체성, 외형, 추출 경계를 검증하지 않는다. 저자들은 완벽한 모델이라면 이 단순한 태스크에서 100%를 달성해야 한다고 인정한다.
Veo 3의 마지막 프레임 동물 수 정확도는 10회 시도에서 0.93까지 높아진다. Veo 2는 0.63으로 반복 추측 기준선과 비슷하다. 평가기는 추출 결과의 시각적 충실도를 완전히 확인하는 대신 재배치 후 동물 수를 확인한다.
4.4. Manipulation: Image editing
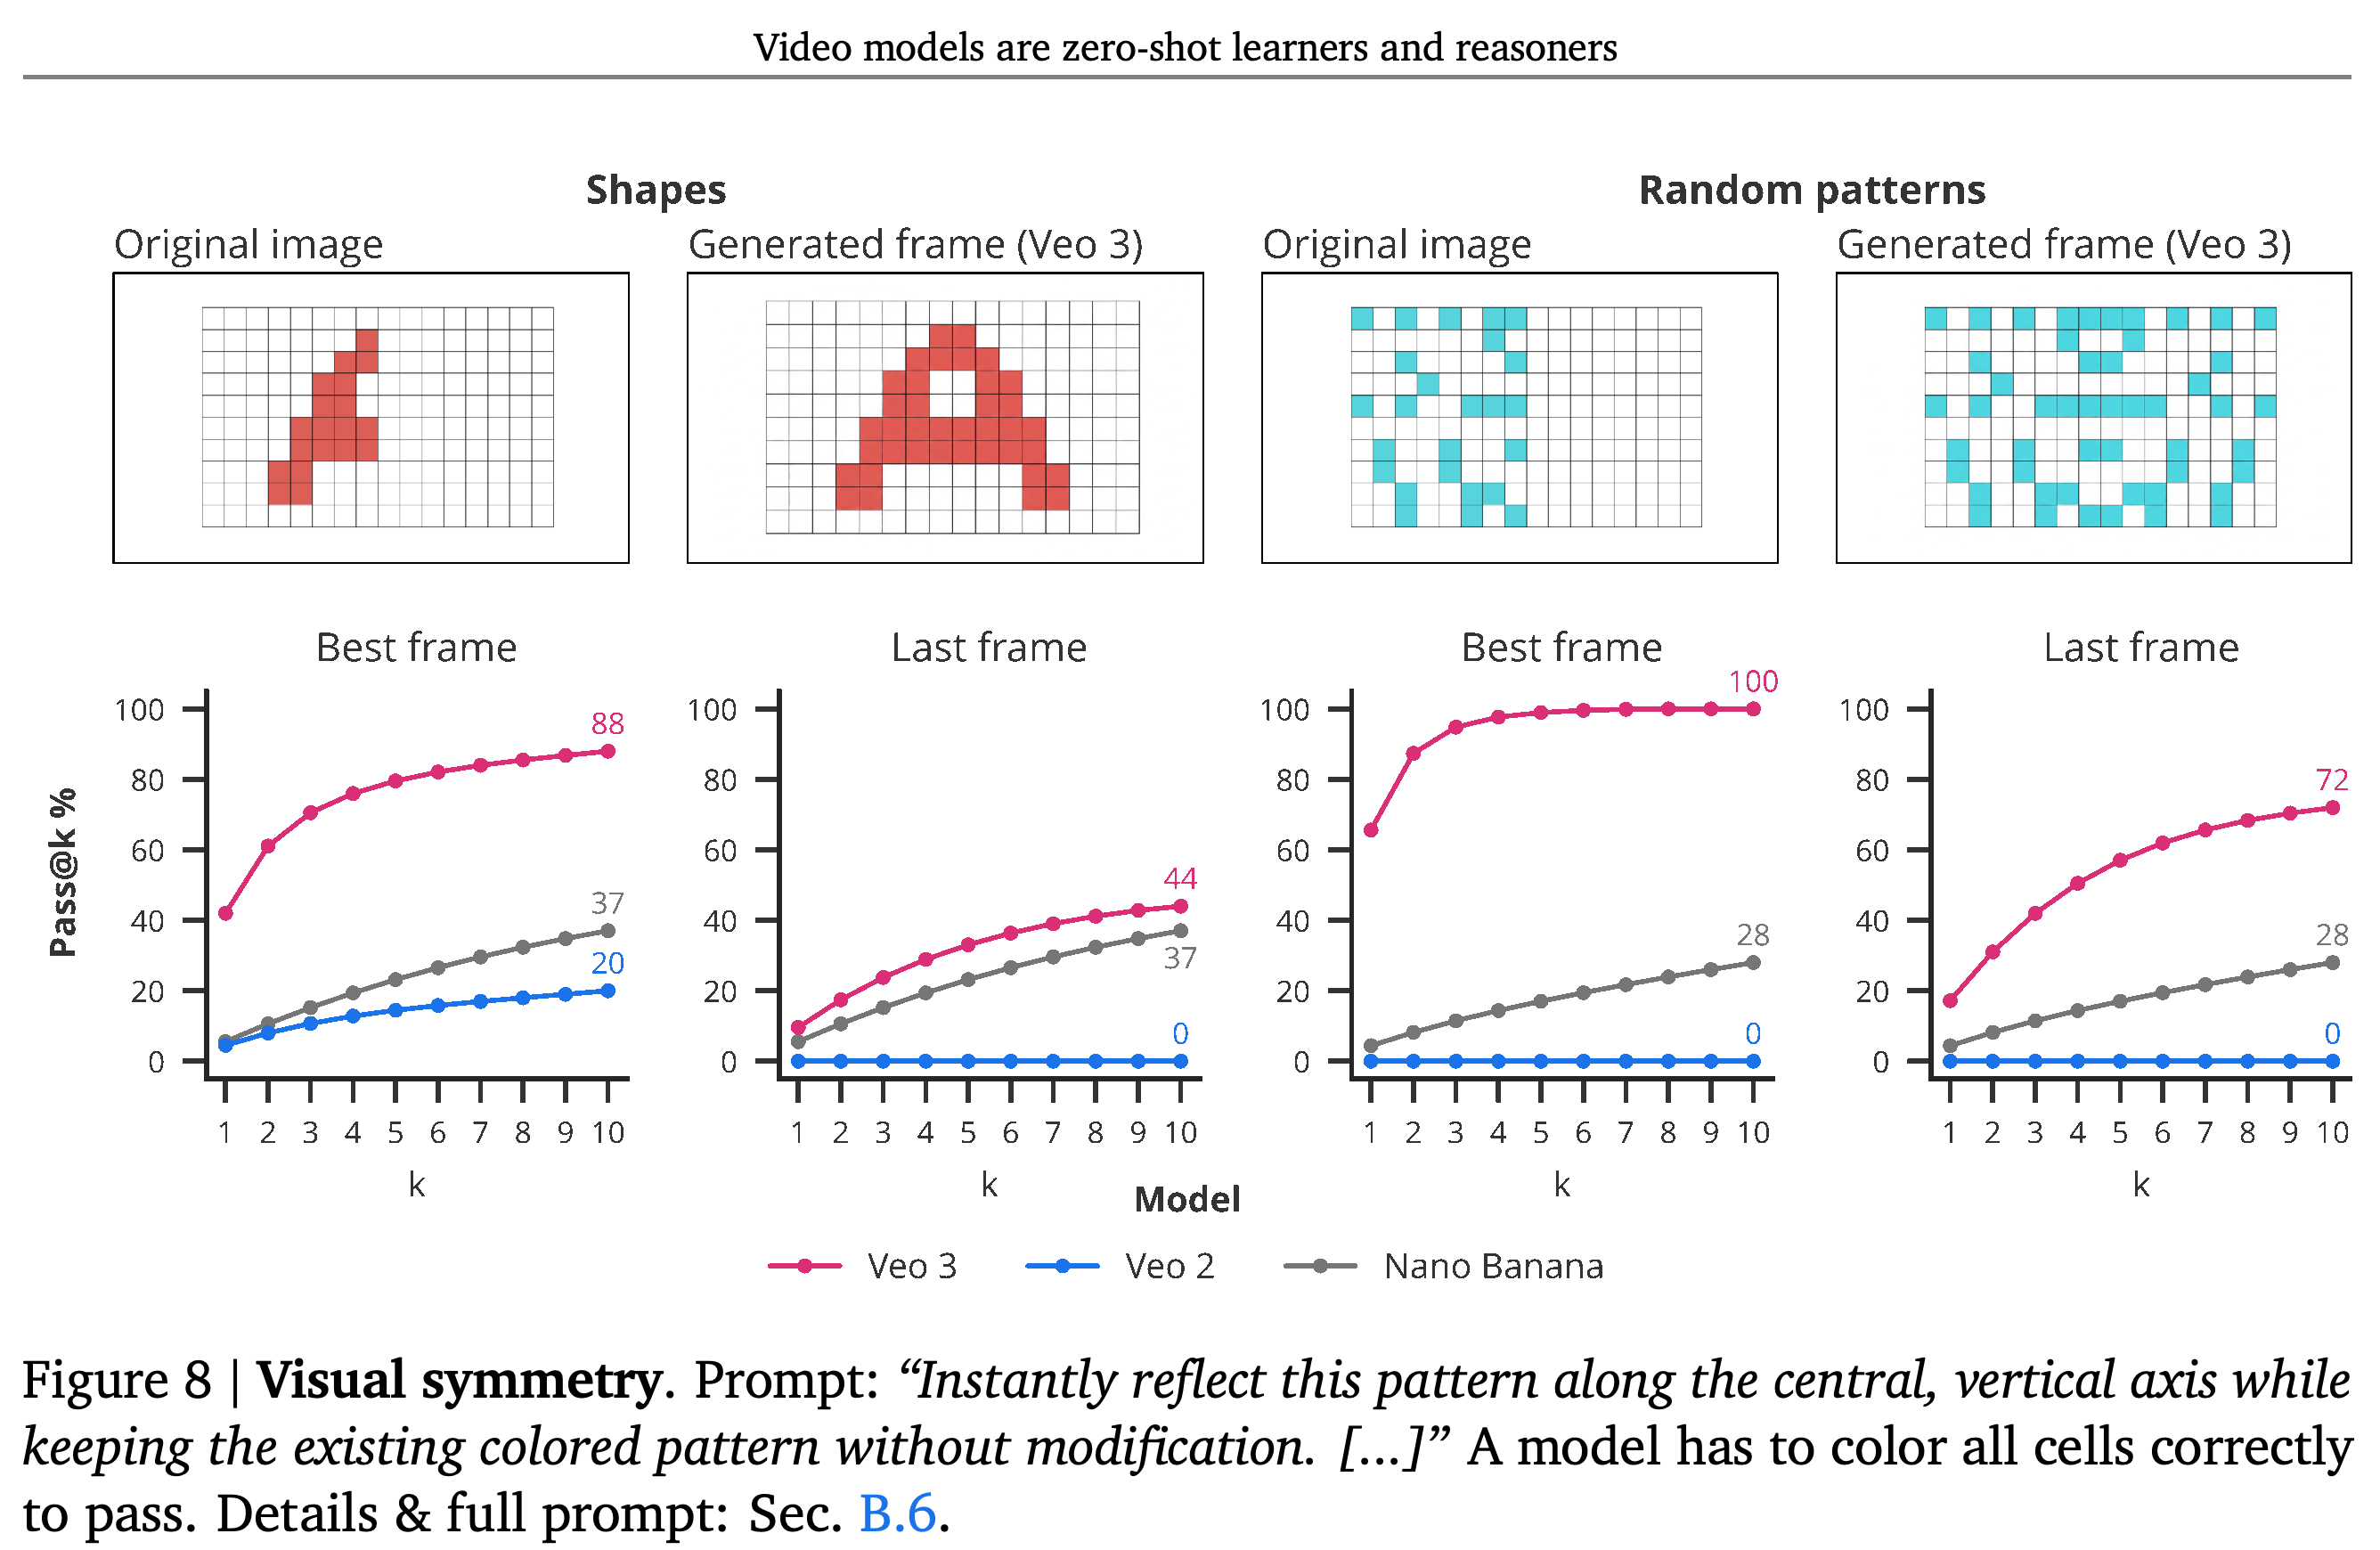
사람 평가자 3명이 지시 기반 이미지 편집 데이터셋 Emu-edit의 테스트 이미지에서 무작위로 선택한 30개에 대한 편집 결과를 평가한다[62]. 요청한 편집이 올바른지를 나타내는 fidelity와, 올바른 편집 외에 의도하지 않은 변경이 없는지를 나타내는 precision을 구분한다.
- Figure 6에서 Veo 3는 fidelity 100%, precision 60%를 기록하며 Veo 2는 각각 20%와 10%를 기록한다.
- Fidelity와 precision의 차이는 실제 사용에서 발생할 수 있는 실패 양상을 보여준다. 올바른 편집과 함께 원치 않는 카메라 움직임, 사람의 움직임, 기타 장면 변화가 발생할 수 있다.
- Appendix B.4에서는 이미지마다 샘플 2개를 생성하고 첫 번째 샘플을 사람이 평가했다고 설명한다. 따라서 보고된 사람 평가 결과는 best-of-10 결과가 아니다.
Veo 3의 fidelity 100%와 precision 60%는 요청한 편집에 성공해도 무관한 장면 변화가 남을 수 있음을 보여준다. Veo 2의 해당 점수는 20%와 10%다. 이 사람 평가는 best-of-10 선택 대신 처음 생성된 샘플을 사용한다.
4.5. Reasoning: Maze solving
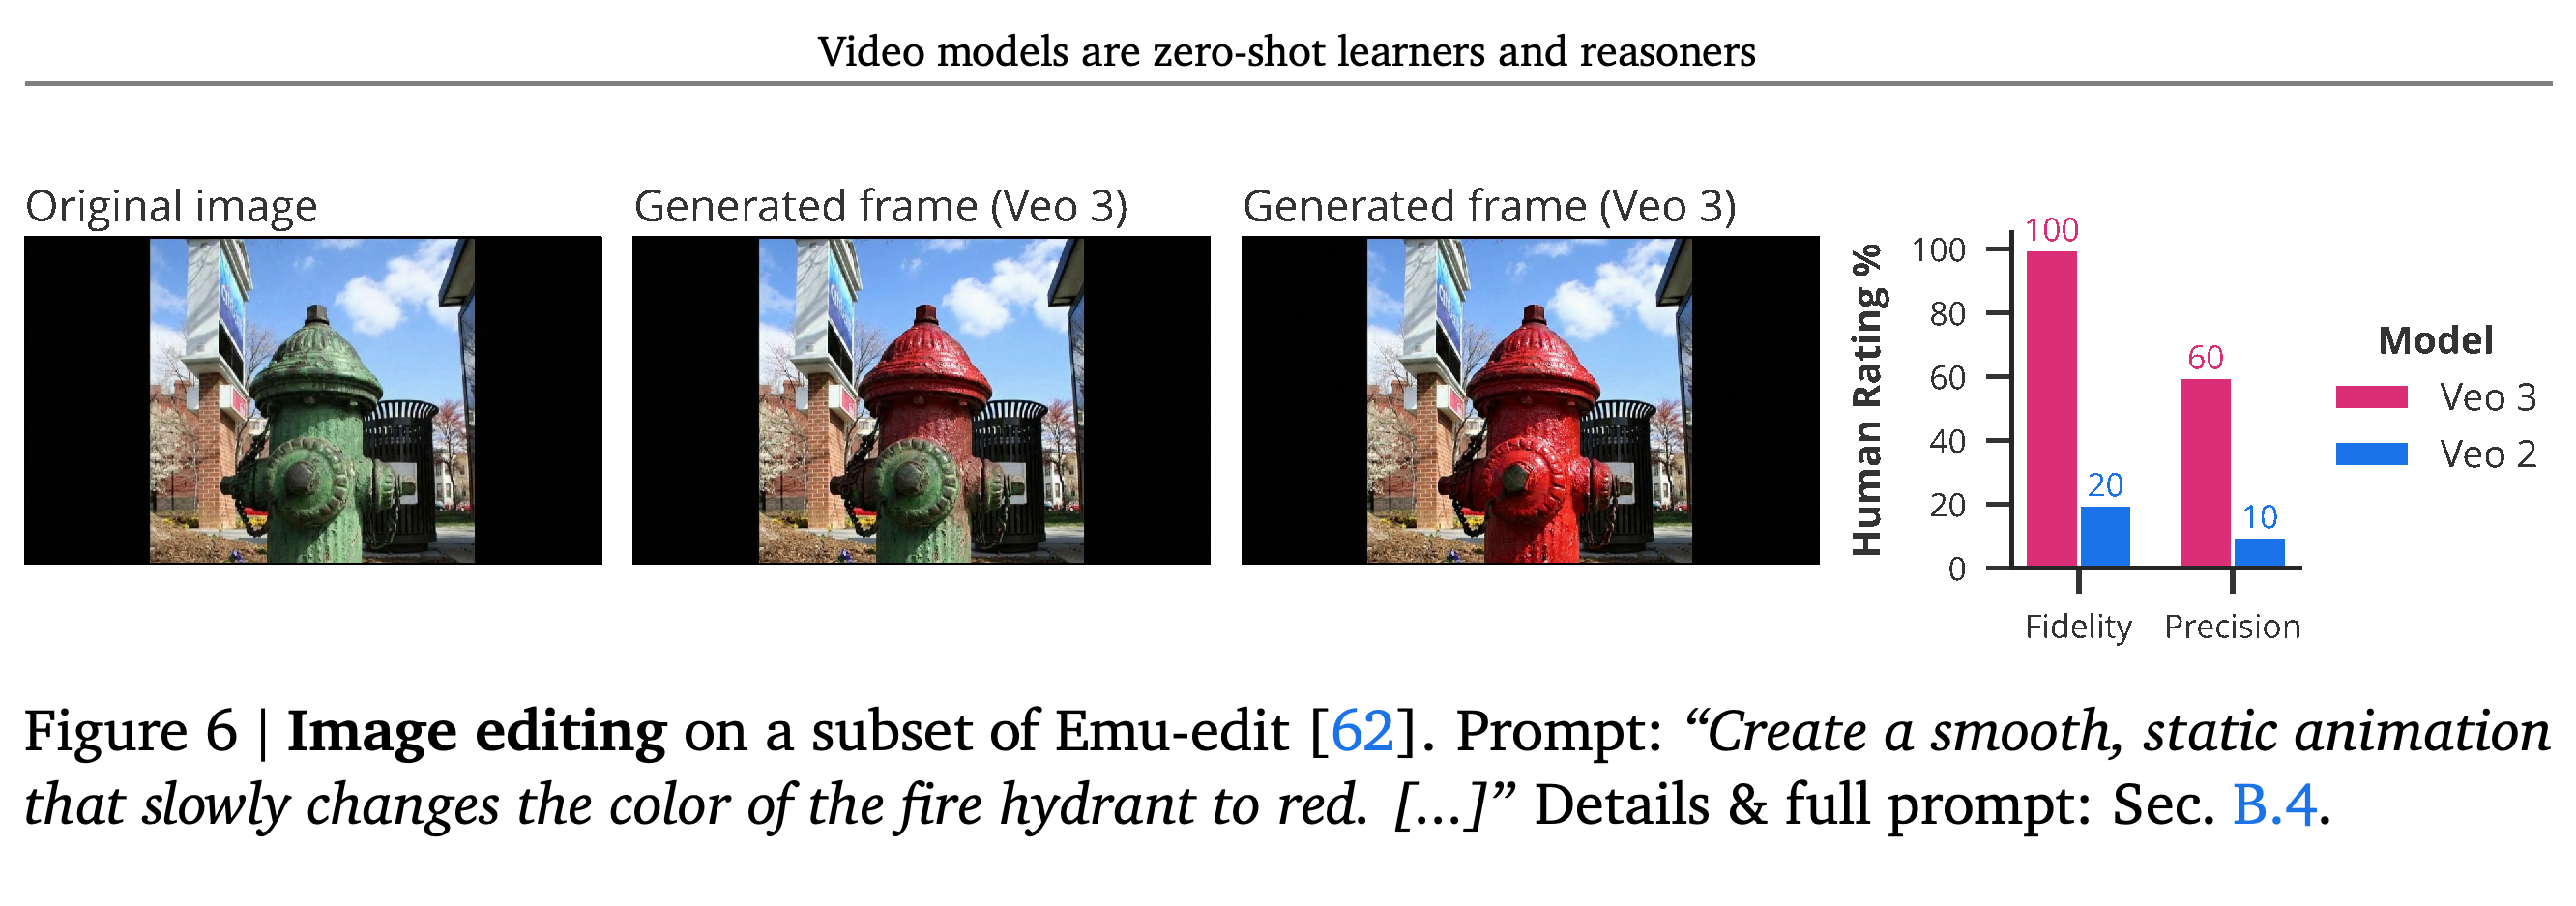
빨간 원은 검은 벽을 가로지르거나 목표 위치를 바꾸지 않고 흰색 미로 경로를 따라 녹색 목표에 도달해야 한다. 프레임별 검증에서 전체 이동 경로를 확인하므로, 마지막 프레임에서 원을 목표에 놓는 것만으로는 충분하지 않다.
- pass@10에서 Veo 3는 5×5, 7×7, 9×9 격자에 대해 각각 78%, 38%, 12%를 기록하며 Veo 2는 14%, 2%, 2%를 기록한다. 격자 크기가 커지면 성능이 급격히 떨어진다.
- 불규칙 미로에서는 Veo 3가 75%를 기록하고 Veo 2와 Nano Banana는 모두 0%를 기록한다. Nano Banana는 직사각형 미로의 3가지 크기에서 각각 74%, 40%, 22%를 기록한다.
- Gemini 2.5 Pro에는 image-to-text를 뜻하는 I2T 조건으로 이미지를 입력하거나, text-to-text를 뜻하는 T2T 조건으로 ASCII 문자 격자 표현을 입력한다. 텍스트 입력 점수는 92%, 72%, 8%이며, 상대적인 순위가 미로 크기와 입력 표현에 따라 달라짐을 보여준다.
- Appendix B.5는 크기별 무작위 직사각형 미로 50개와 손으로 그린 미로 10개를 뒤집고 회전해 만든 불규칙 샘플 40개를 설명한다. Table 1은 split마다 이미지 50개가 있는 2 × 4개 미로 split을 기재하므로, 전체 미로 수의 집계는 불명확하다.
Veo 3는 모든 미로 크기에서 Veo 2보다 우수하지만 pass@10은 5×5 격자의 78%에서 9×9 격자의 12%로 떨어진다. 불규칙 미로에서는 이 모델이 75%, Nano Banana가 0%를 기록한다. 텍스트로 표현한 작은 격자에서 Gemini가 더 높은 성능을 보인다는 점은 입력 표현에 따라 비교 결과가 달라짐을 보여준다.
4.6. Reasoning: Visual symmetry solving
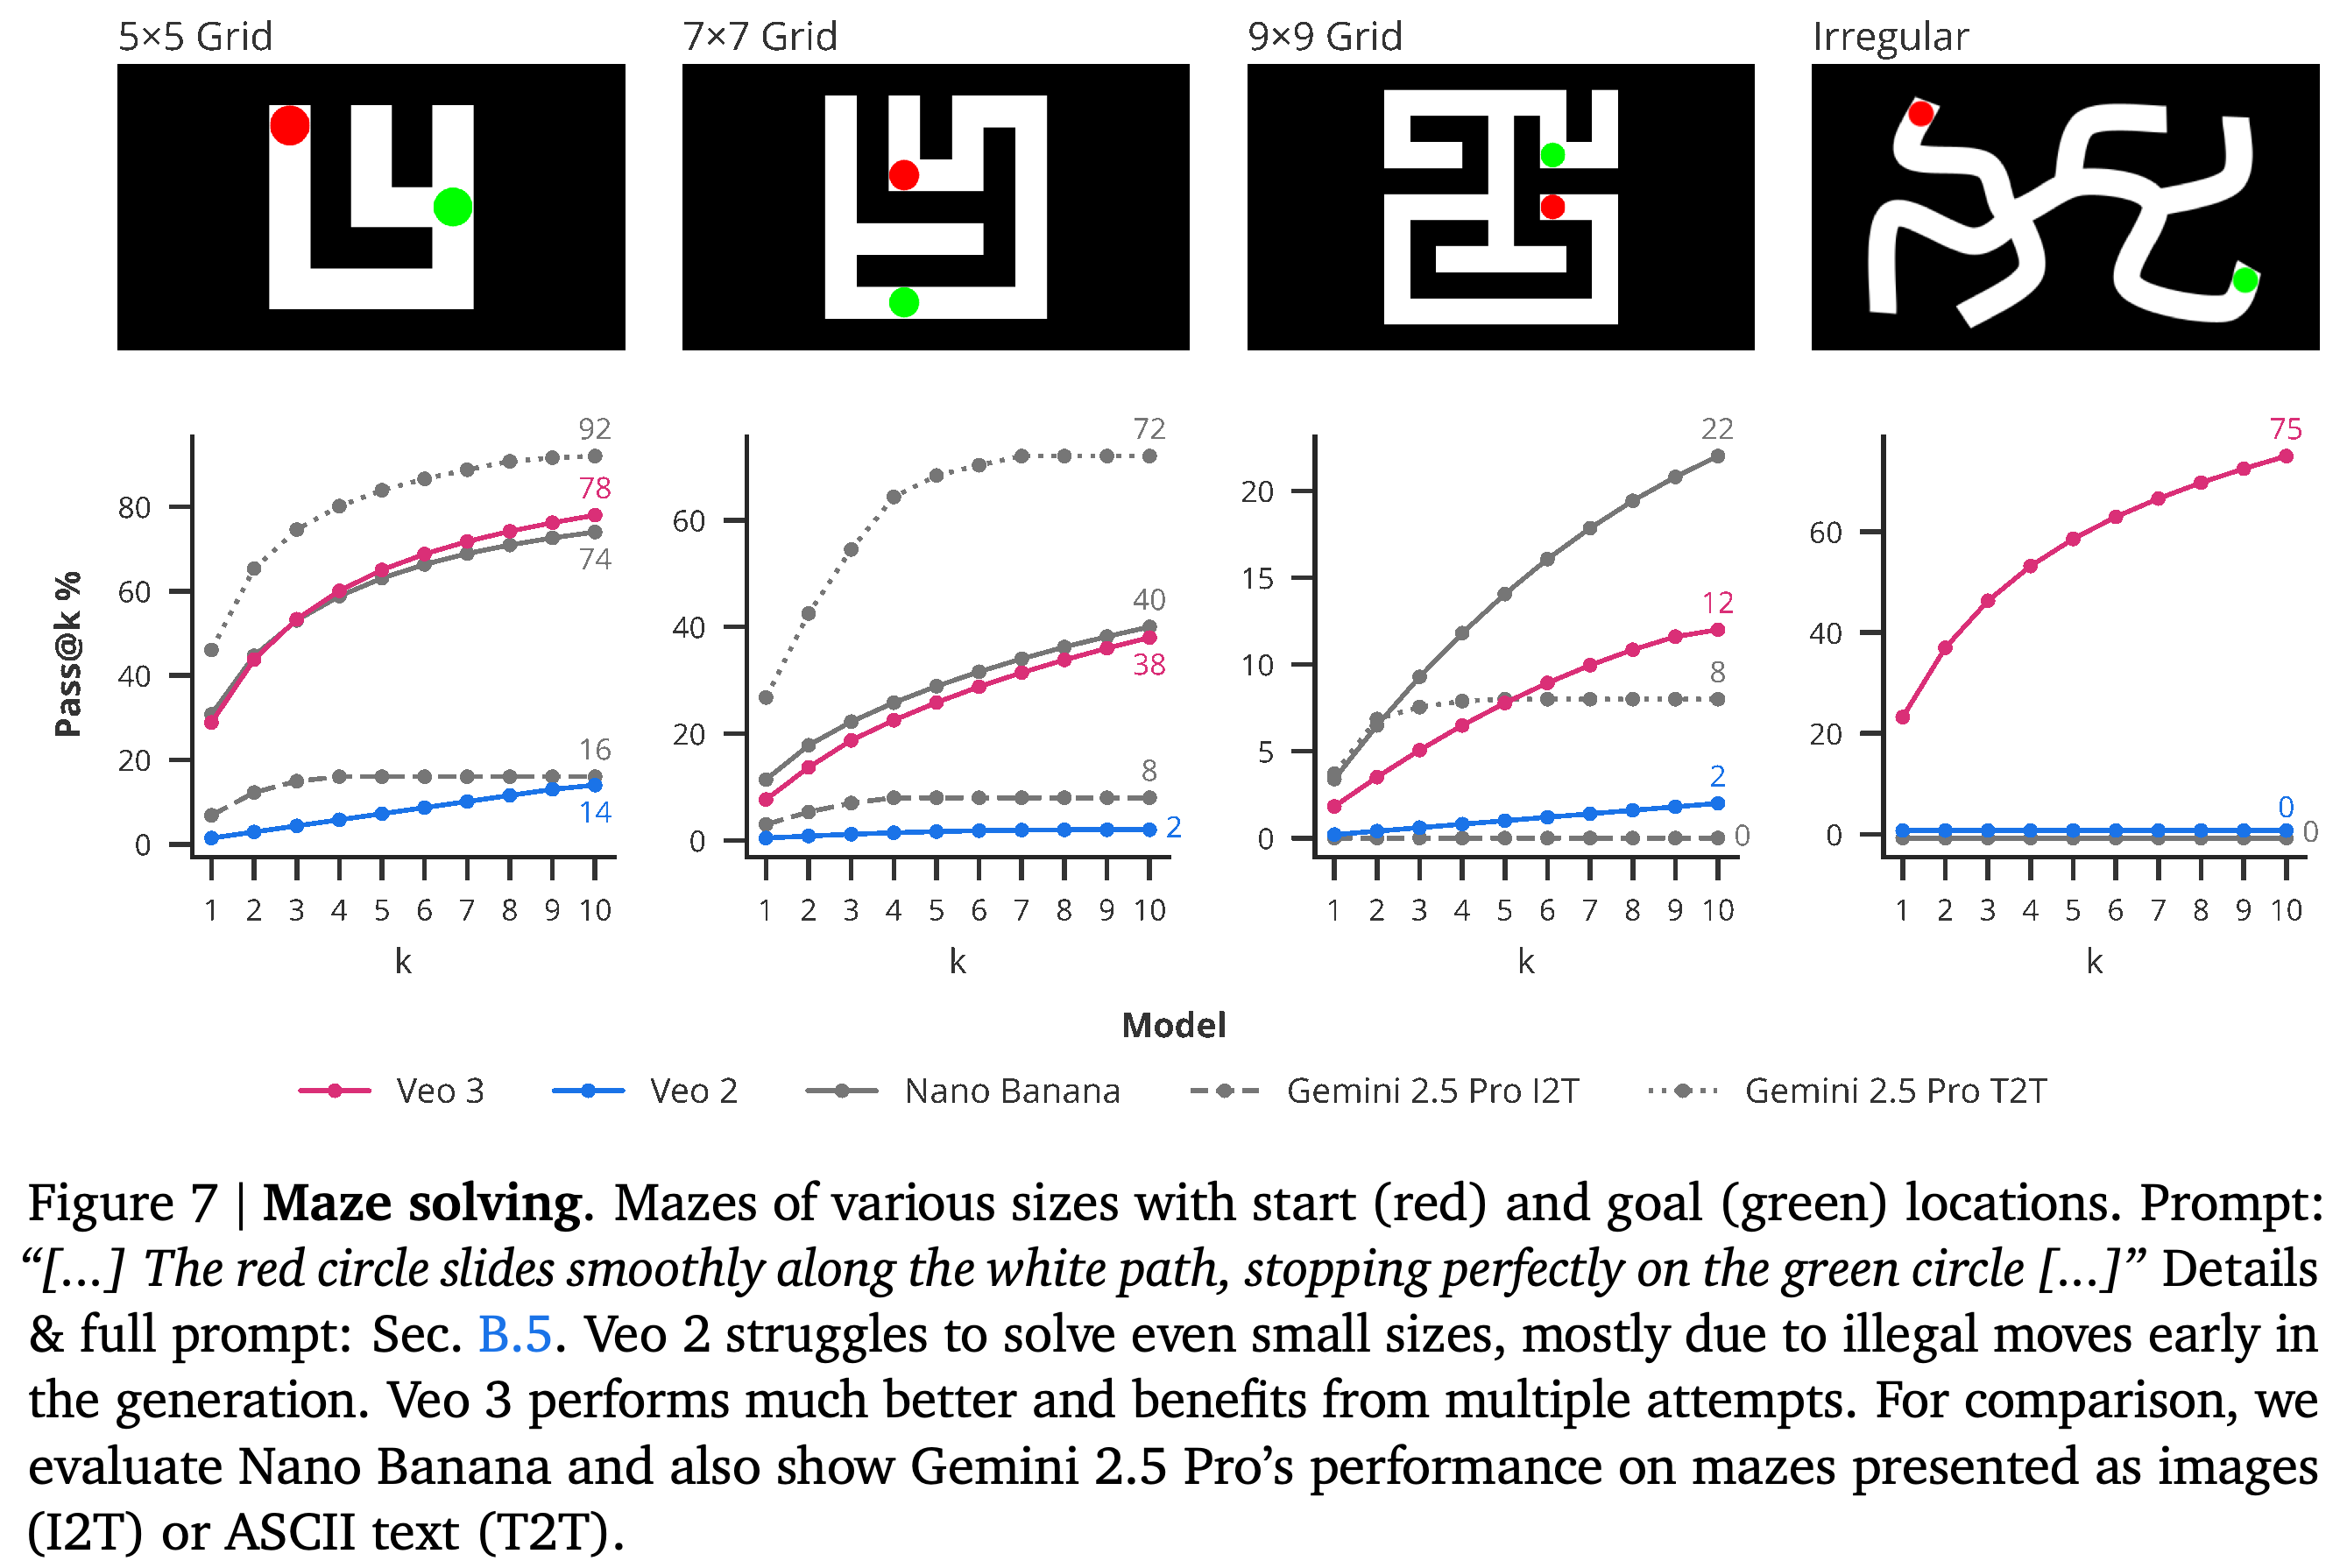
Visual symmetry 태스크에서는 기존 셀을 유지하면서 10×16 격자의 왼쪽 절반을 중앙 수직축에 대해 반사해 오른쪽 절반을 완성해야 한다. 합성 데이터 split 2개는 알아볼 수 있는 도형 25개와 무작위 패턴 25개로 구성되며, 잘못 칠한 셀이 0개여야 성공으로 판정한다.
- 최적 프레임 pass@10에서 Veo 3는 도형 88%, 무작위 패턴 100%를 기록한다. Veo 2는 각각 20%, 0%이고, Nano Banana는 37%, 28%다.
- Veo 3의 마지막 프레임 점수는 각각 44%, 72%로 떨어진다. 올바른 중간 해답이 생성 종료까지 유지되지 않는 경우가 많다.
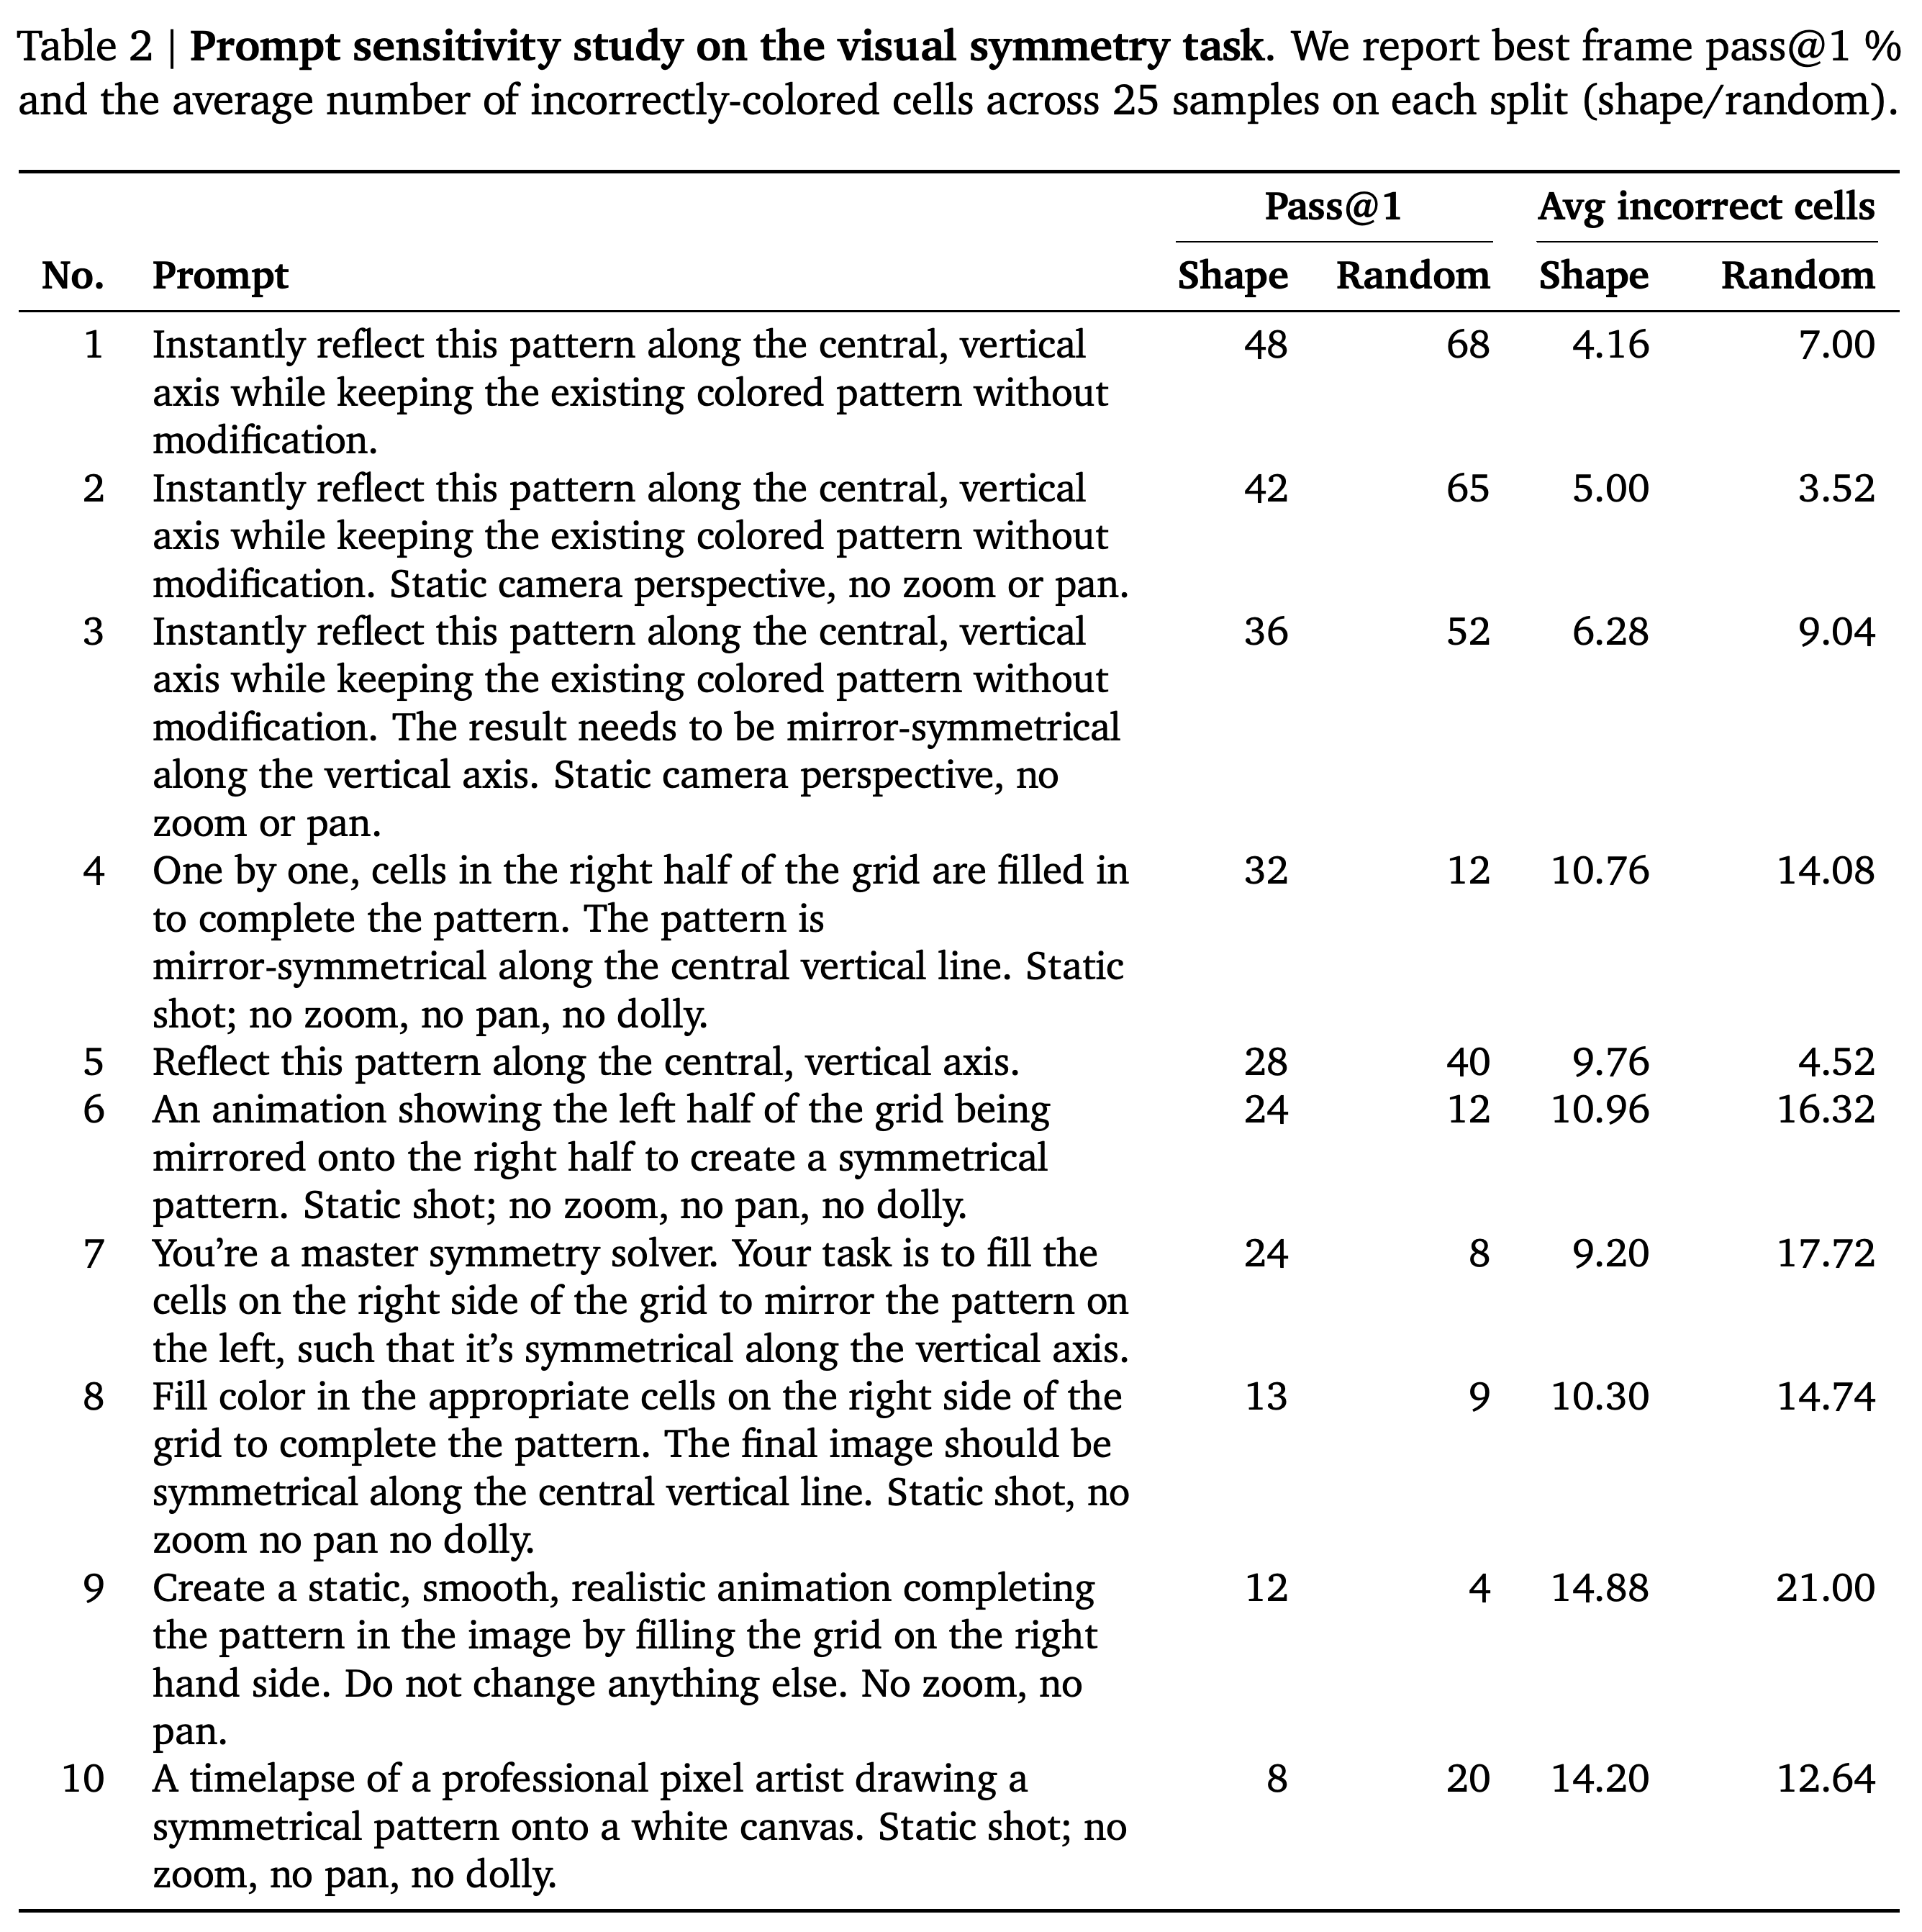
- Table 2는 프롬프트 변형 10개를 시험하며 최적 프레임 pass@1이 도형에서 8%부터 48%, 무작위 패턴에서 4%부터 68%까지 달라진다고 보고한다. 차이는 각각 40%p와 64%p다.
- 셀의 정답 여부는 지각적 색 공간인 CIELAB에서 평균 색상 차이를 구하고 임계값 15.0을 적용해 판정한다.
Veo 3의 최적 프레임 pass@10은 도형에서 88%, 무작위 패턴에서 100%지만, 마지막 프레임 결과는 44%와 72%로 떨어진다. 이 그래프는 정확한 해답을 만드는 능력과 생성 종료까지 해답을 유지하는 능력을 구분한다.
4.7. Reasoning: Visual analogy completion
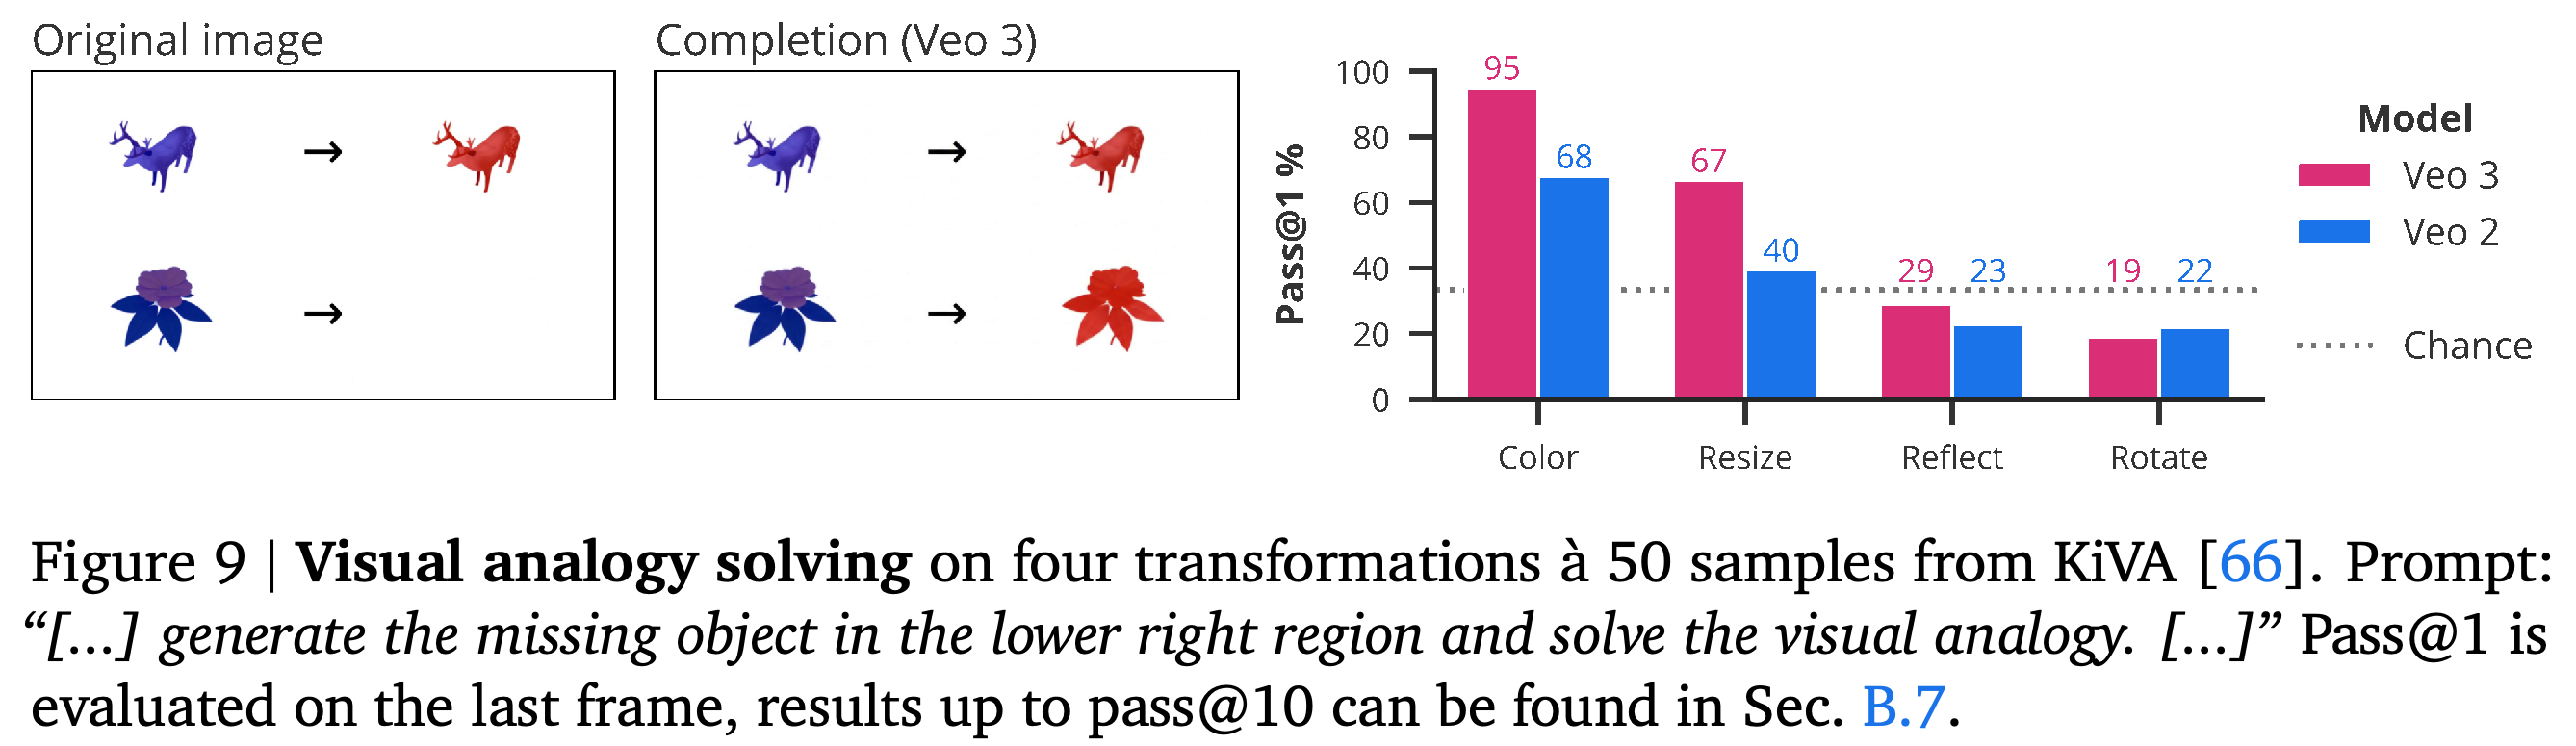
Visual analogy completion은 참조 객체 쌍이 보여주는 변환을 적용해 2×2 배치에서 비어 있는 사분면을 채우는 태스크다. 연구에서는 Kid-inspired Visual Analogies 벤치마크 KiVA에서 color, resize, reflect, rotate 변환을 각각 샘플 50개로 평가한다[66].
- Veo 3의 마지막 프레임 pass@1 점수는 순서대로 95%, 67%, 29%, 19%이며, Veo 2는 68%, 40%, 23%, 22%다. 두 모델 모두 반사와 회전에서 무작위 선택 기준인 0.33 chance baseline보다 낮다.
- 자동 이미지 비교 평가기인 Gemini 2.5 Pro autorater는 생성된 객체를 후보 답 3개 중 하나에 대응시킨다. 평가기는 조건별 정보를 받으며 조건마다 샘플 25개를 사용한 예비 평가에서 저자 판정과의 일치도가 88%를 넘었다.
- 객체가 나타나지 않거나 객체 종류가 틀리면 평가 과정에서 선택지 3개 중 하나를 무작위로 배정한다. 따라서 유효하지 않은 생성 결과는 기댓값 기준으로 무작위 선택 수준의 점수에 기여한다.
- Figure 61에서 10회 시도의 다수결을 적용하면 Veo 3는 98%, 68%, 22%, 14%를 기록한다. 다수결은 반사와 회전의 오류를 강화하며 이는 변환이 잘못된 축을 사용하는 경우가 많다는 저자들의 관찰과 일치한다.
Veo 3는 color와 resize analogy에서 pass@1 95%와 67%를 기록한다. 반사와 회전은 29%와 19%로 무작위 선택 기준인 0.33 chance baseline보다 낮아, 일반적인 변환 추론 능력에 관한 주장을 제한한다.
5. Discussion
저자들은 폭넓은 태스크 수행 범위와 Veo 2에서 Veo 3로의 성능 향상을 영상 생성이 범용 비전 모델을 뒷받침할 수 있다는 근거로 해석한다. 태스크 표현과 프롬프트를 바꾸면 성공 여부가 달라질 수 있으므로, 특정 이미지와 텍스트 프롬프트에서 측정한 성능을 모델 능력의 하한으로 설명한다.
- 관찰된 성능과 내재된 능력의 구분[69, 70]이 시험하지 않은 프롬프트나 태스크에서의 성공을 입증하지는 않는다. 기록된 실패와 프롬프트 민감성도 실험 결과의 일부다.
- 논문은 영상 생성 비용이 전문 모델의 추론 비용보다 높다고 인정하며 LLM 추론 가격의 하락을 유사 사례로 인용한다[71]. 그러나 영상 비용의 변화 추이나 측정된 비용 대비 성능 비교는 제공하지 않는다.
- 반복하거나 개선한 출력에 더 많은 연산을 투입하는 inference-time scaling[72–75]과 자동 검증을 활용한 post-training을 개선 방안으로 제안한다. 연구에서는 반복 샘플링을 시험하지만 이러한 post-training 개입은 시험하지 않는다.
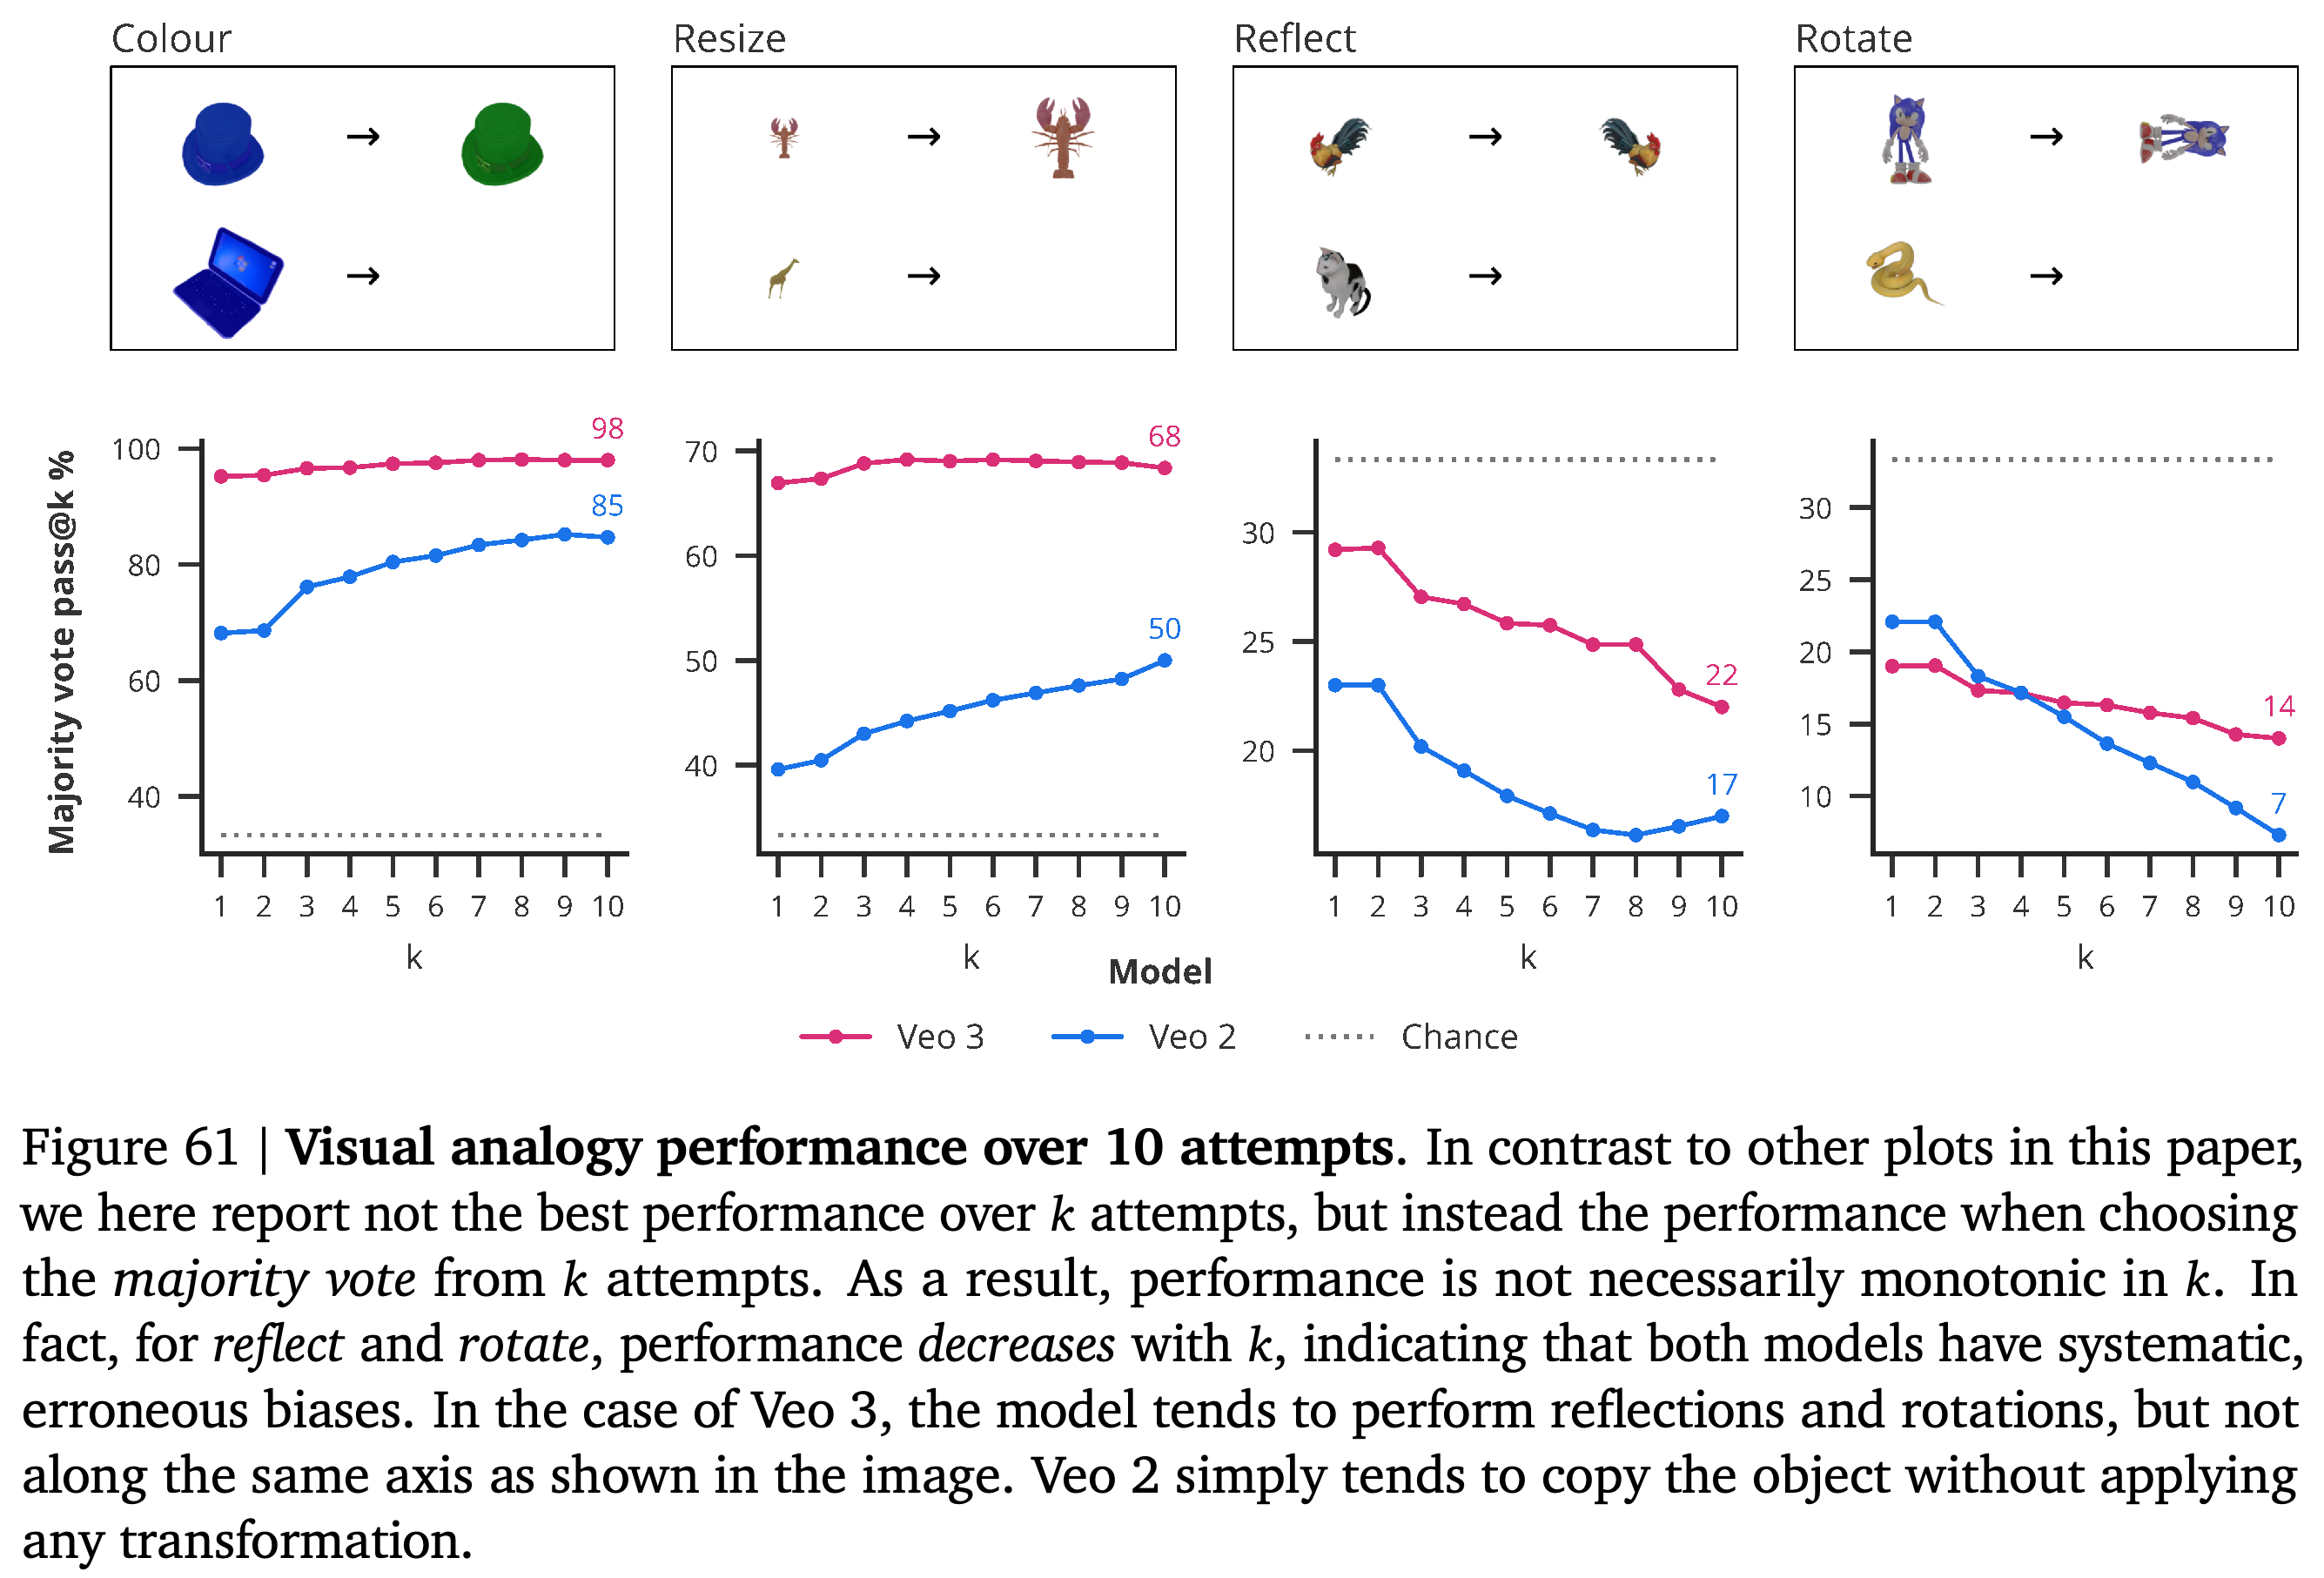
- Table 1은 정량 연구 영상 17,640개와 정성 평가 영상 744개를 보고하며 이를 합하면 명시된 총계인 18,384개가 된다. Table 2와 Figure 61은 반복 샘플링의 이점에 조건이 있음을 보여준다. 프롬프트가 성능에 큰 영향을 미치며, 다수결은 체계적인 오류를 악화시킬 수 있다.
보고된 정량 연구 영상 17,640개와 정성 평가 영상 744개를 합하면 논문에서 제시한 총계인 18,384개가 된다. 세부 내역은 샘플링 규모를 기록하지만 미로와 편집 영상 수는 관련 부록 설명과 완전히 일치하지 않는다.
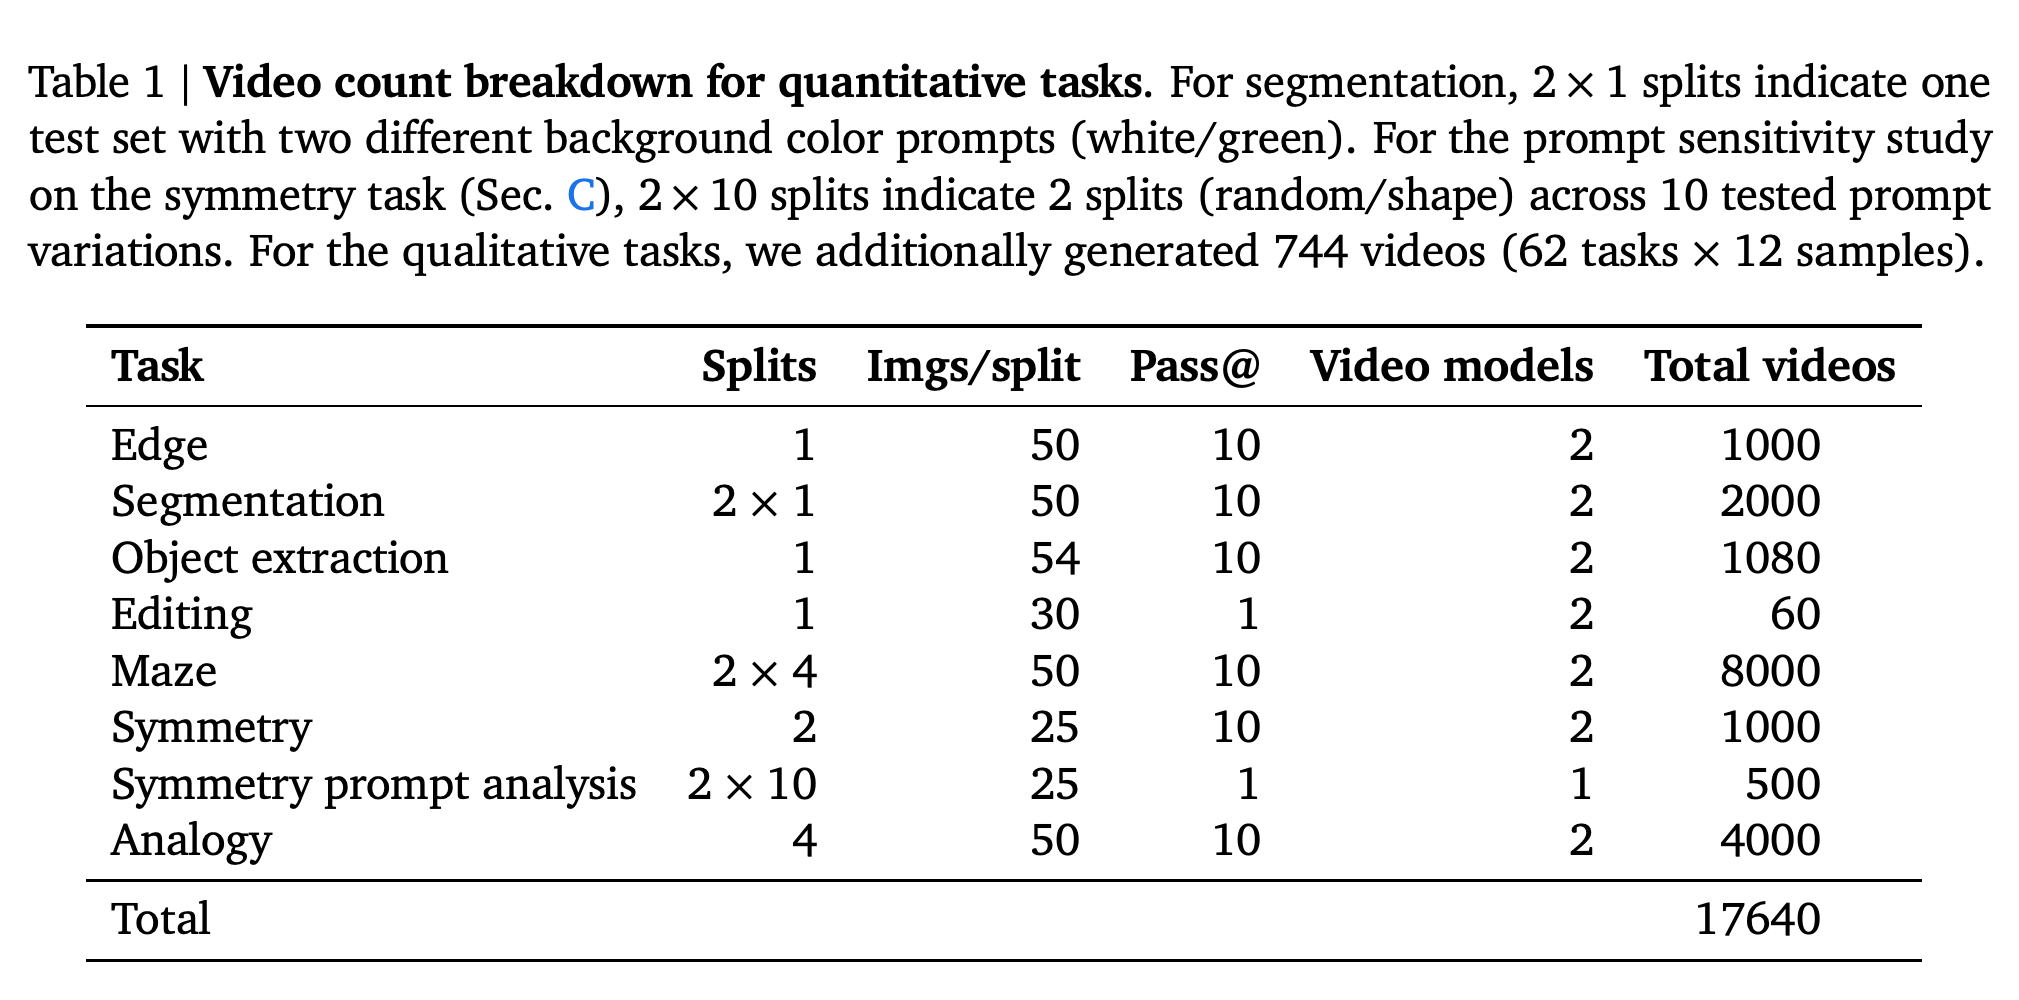
10회 시도에 다수결을 적용하면 Veo 3의 color 정확도는 98%로 높아지지만 반사와 회전은 22%와 14%로 낮아진다. 다수결이 반복되는 잘못된 변환을 강화할 수 있으므로, 반복 샘플링이 선택된 답을 항상 개선하지는 않는다.
프롬프트 10개에서 최적 프레임 pass@1은 도형의 경우 8%부터 48%, 무작위 패턴의 경우 4%부터 68%까지 달라진다. 문구가 측정 성능에 큰 영향을 미치며, 카메라 제어 지시를 추가해도 성공률이나 셀 오류가 일관되게 개선되지는 않는다.
Author contributions
논문은 Thaddäus Wiedemer, Priyank Jaini, Robert Geirhos를 연구 책임자로 기재하고 프로젝트 아이디어를 Robert Geirhos에게 귀속한다. Yuxuan Li와 Paul Vicol은 핵심 기여자, Shixiang Shane Gu는 부분 기여자이며 Nick Matarese는 Figure 38에 기여했다. Kevin Swersky와 Been Kim은 자문을 맡았다.
부록
- A. Qualitative results: Perception, Modeling, Manipulation, Reasoning은 이미지 시퀀스, 태스크 프롬프트, 저자가 판정한 성공률을 제공한다. A.1. Perception은 edge detection, segmentation, keypoint localization, restoration, 속성 기반 검색, 모호한 이미지 해석을 기록한다. 잉크 얼룩 패턴을 객체로 해석하는 Rorschach 사례는 태스크 정답 여부가 정의되지 않으며 지시 준수에 대해서만 1.0을 보고한다.
- A.2. Modeling은 재료 속성, 강체와 변형 가능한 물체, 낙하 물체, 부력, 객체 제거와 수납, 광학, 색 혼합, 범주, 문자 구조, 장면 기억을 다룬다. 보고된 성공률은 크게 다르다. 재료 속성은 0.25, 병뚜껑 부력은 0.58, 돌의 부력은 0.83, 카메라 확대 후 원래 장면으로 돌아가기는 1.0이다.
- A.3. Manipulation에는 배경 제거, 스타일 변경, 흑백 이미지에 색을 넣는 colorization, 누락 영역 완성, 장면 구성, 새로운 시점, 자세 변경, 손동작 시뮬레이션이 포함된다. Inpainting과 낙서 기반 편집은 모두 1.0을 기록한다. Colorization과 한 손에서 공 2개를 굴리는 Baoding balls 회전은 각각 0.08을 기록한다. 이 성공률은 정성 평가 태스크마다 생성한 영상 12개에서 구한 값이다.
- A.4. Reasoning은 graph traversal, 트리를 점진적으로 채우며 너비 우선 탐색을 표현하는 Tree BFS, 시퀀스 완성, 색 맞추기, 도형 끼워 맞추기, 숫자 정렬, tool use, Sudoku, 물 퍼즐, 미로, robot navigation, rule extrapolation을 다룬다. 도구로 호두를 꺼내는 태스크는 0.92를 기록하지만 유리를 관통하지 않고 꺼내도록 요구하면 성공률이 0.08로 낮아진다. 겉으로는 태스크를 완료했더라도 물리적 제약을 위반했을 수 있음을 보여준다.
- B. Quantitative results: experimental details는 본문의 정량 평가 하위 절 7개에 대응하는 B.1–B.7에서 데이터셋, 프롬프트, 샘플링, 평가기를 명시한다. B.1은 임계값을 적용한 경계를 정제한다. B.2는 표준편차 2인 scipy.ndimage.gaussian_filter1d를 사용해 색조 차이에서 마스크를 추출한다. B.3은 scipy.ndimage.label로 임계값을 적용한 연결 영역의 개수를 세고, B.4는 사람 평가를 사용한다. B.5는 미로의 전체 경로, B.6은 모든 대칭 셀을 확인하며 B.7은 analogy 출력을 선택지 3개와 비교한다.
- 부록은 Veo 2를 veo-2.0-generate-preview-001로 기재하지만 Methods는 veo-2.0-generate-001로 기재한다. Veo 3는 일관되게 veo-3.0-generate-preview로 표기한다. 참조 모델은 Nano Banana의 gemini-2.5-flash-image-preview와 Gemini 2.5 Pro의 gemini-2.5-pro다. Table 1은 편집 영상 60개를 기록하지만 B.4는 이미지마다 샘플 2개를 생성하고 첫 번째 샘플만 평가했다고 설명하므로 생성 수의 집계 기준이 불명확하다.
- C. Prompting best practices는 모호함을 없애고, 유지해야 할 요소를 명시하며 카메라와 변화 속도를 제어하도록 권장한다. 또한 해결된 장면을 유지하려는 목적으로 태스크와 무관한 움직이는 요소인 motion outlet을 제공하도록 권장한다. 해답 추출을 위한 시각적 완료 표시와 현실적인 태스크 표현도 제안한다. Table 2는 프롬프트 민감성을 직접 측정하며 나머지 권장 사항은 저자들의 실험 관찰을 요약한다.
- D. Failure cases는 거리와 표면 방향을 나타내는 depth map과 surface-normal map의 부정확성, 움직임 주석을 따르지 못하는 실패, 불가능한 밧줄 움직임, 잘못된 경로 탐색과 단어 찾기, 존재하지 않는 그래프 간선과 텍스트 생성, 잘못 탐지한 이미지 차이, 틀린 시각 퍼즐, 물리적으로 부자연스러운 상호작용을 기록한다. Tiling puzzle에서는 조각 형태가 훼손되고 골프공은 크기가 맞지 않는 작은 꽃병 입구를 통과한다. 빨래 접기는 물리 법칙을 위반하며 소파 이동 계획은 강체의 회전과 평행 이동을 유지하는 대신 객체 자체를 바꾼다.
- E. LLM use는 태스크 아이디어 구상, 관련 연구 제안, 코딩, 사람이 쓴 글의 윤문에 Gemini 2.5 Flash와 Gemini 2.5 Pro의 도움을 받았다고 공개한다. F. Image sources는 생성된 입력, 저자의 그림과 수정본, 벤치마크 이미지, 외부 이미지를 구분한다. 정성 평가 장면 중 상당수는 Gemini로 생성했으므로, 정성 평가 근거가 자연 사진만으로 구성된 것은 아니다.
짧은 생각
이 논문은 기존 영상 생성 시스템이 프롬프트로 지정한 다양한 시각 태스크의 해답을 생성할 수 있음을 보여준다. 미로의 전체 경로 검증과 대칭 셀의 정확한 검사는 그럴듯해 보이는 시연을 선별하는 것보다 태스크 수행 능력에 대한 구체적인 근거를 제공한다. 최적 프레임과 마지막 프레임의 성능 차이는 기술적 장애물을 드러낸다. 출력 추출과 생성 중단이 올바른 중간 해답을 보존해야 한다. Prompt rewriter, 쉬운 segmentation 부분집합, 생성된 정성 평가 입력, 불완전한 analogy autorater는 일반성과 성과 귀속에 관한 결론을 제한한다. 전문 비전 모델의 대체 가능성은 여전히 가설이다. 전문 모델 수준의 정확도, 운영 신뢰도, 비용을 함께 입증하지는 못했다.